このプロトコルでは、実世界の中医学外来診療記録から監査可能な集約出力を生成するために、匿名化、用語の標準化、ソース検証、および再現可能な可視化を統合しています。
方法論記事
和建脾方を用いた実臨床における中医学症例記録のソース監査付きマイニングおよび可視化
* These authors contributed equally
この記事について
サマリー
要約
実世界の中医学(TCM)外来記録には、診断、証要素、症状の記述、および個別化された処方に関する縦断的な情報が含まれていますが、その半構造化された形式が再現性のある分析を困難にしています。本記事では、匿名化された症例記録を、追跡可能な集計表および出版可能な可視化データに変換するための、ソース監査済みプロトコルを提示します。このワークフローでは、適格基準と分析単位を定義し、元の用語と正規化された用語とのマッピングを保持し、報告されたすべての分子と分母を検証し、バージョン管理されたソーステーブルから図を再生成します。2015年1月から2024年6月までの記録に適用した結果、本プロトコルにより396名の患者から555件の適格な処方受診が特定されました。最終的なデータセットには、324個の正規化された生薬ラベルと9,339件の生薬使用例が含まれていました。このワークフローにより、西洋医学と中医学の並行的な疾患スペクトラム、明示的な証要素スペクトラムと共起行列、生薬頻度および本草学プロファイル、病歴由来の37項目の症状スペクトラム、15件の有向相関ルール、階層的クラスタリング、および診断層別生薬使用ヒートマップが生成されました。474件の受診(85.41%)において、あらかじめ指定された病歴キーワードが少なくとも1つ検出されました。施設の方針で許可される場合は、人間が監督する人工知能(AI)オプションを用いて、用語のチェック、ファイル間の整合性確認、およびキャプションと図の整合化を支援させることができます。AIの使用はすべて個別の監査記録に文書化される必要があり、ソースデータのレビューに代わるものであってはなりません。ガバナンス、正規化、計算、臨床的解釈、および視覚的出力を単一の再現可能なワークフローに統合することで、本手法は分散した臨床文書を検証可能な研究リソースへと変換します。このプロトコルは、他の専門的診療データセット、多施設共同の用語プロジェクト、および前向き臨床データプラットフォームに適応させることが可能です。
概要
実臨床における中医学(TCM)の外来診療記録には、叙述的な症状、並行する診断システム、証の記述、および個別化された処方を通じて、縦断的な臨床推論が保存されています。初期の知識発見に関する研究では、症例記録は複雑な経験的データであり、そのパターンを信頼性高く研究するためには専用の情報学的手法が必要であることが認められました1。その後の研究により、同義的な症状表現、きめ細かなエンティティ、および局所的に記録された診断用語は、元の文言を消去することなく正規化されなければならないことが示されています2,3,4,5,6。また、電子健康記録(EHR)データは、臨床的コンテキストとデータの系統が可視化されていれば、計算機による処方研究や再利用可能な分析ツールの活用を支援することが可能です7,8。したがって、生薬名、加工形態、性質、味、および経絡の割り当てを標準化するためには、権威ある本草書のリファレンスが必要となります9,10。報告レベルでは、RECORDおよびSTROBE声明において、データソース、適格性基準、変数、および分析上の決定に関する透明性のある記述が求められており、一方でFAIR原則は、追跡可能で再利用可能な研究オブジェクトを強調しています11,12,13。これらの検討事項は、記録に繰り返しの受診、欠損フィールド、重複する用語、および自由記述テキストが含まれている場合に特に重要となります。適合性評価では、完全性、適合性、妥当性、およびソース間の一致に対処しなければなりません14,15。また、自由記述テキストの匿名化には、明示的な手順と人間によるレビューが必要です。なぜなら、自動化された手法では、有用な臨床内容は保持できる一方で、潜在的なプライバシーリスクが残る可能性があるためです16,17,18。
ガバナンスと用語が定義された後、頻度プロファイリング、相関ルールマイニング、および階層的クラスタリングを用いることで、処方構造に関する相補的な視点を得ることができる。19,20,21ネットワークおよびサイエンスマッピングの手法は、協調的な視覚的表現によって、単一のランキングリストでは捉えきれない関係性をいかに明らかにできるかをさらに実証している。22,23,24,25うつ病を合併した関節リウマチ、潰瘍性大腸炎におけるヤヌスキナーゼ阻害薬、および線維筋痛症を合併した関節リウマチに関する最近の研究は、バージョン固定された検索基準、共起ネットワーク、クラスタリング、時系列解釈、および分析上の限界に関する明示的な記述の有用性を例証している。26,27,28本研究では、これらの転用可能な設計原則を、文献計量学ではなく臨床記録のマイニングに適応させる。元の記録において、「和胃健脾方(Hegan Jianpi Formula)」は、姚耐礼(Nai-li Yao)教授の診療に関連する経験方である。29,30関連する出版物では、彼のより広範な肝脾調和および脾胃の臨床的アプローチについて記述されています。29,30本メソッド論文において、処方名はソースレコードのコンテキストを特定するためのみに用いられ、固定された組成、用量、治療適応、または有効性の主張を規定するものではありません。計算ワークフローには、決定論的ルールおよび汎用的な統計的手法が使用されています。再現可能な計算実践には、さらに、入力データの保存、パラメータの文書化、スクリプトによる変換、およびレビュー可能な出力データの保持が必要です。31,32人間が監督する人工知能(AI)オプションは、その使用が文書化されている場合に限り、用語のチェック、ファイル間の整合性レビュー、および視覚的な品質管理を支援することができます。臨床的専門知識、プライバシー保護策、および責任ある人間による意思決定が、引き続き最優先されなければなりません。補足表1)33,34本手法の全体的な目的は、匿名化された中医学(TCM)の症例記録を、疾患、証、症状、生薬の使用、関連性、クラスタリング、および診断によって層別化された、ソース監査済みの出力チェーンに変換することである。具体例として、396人の患者による555件の適格な処方訪問データを用い、患者レベルの記録、正確な処方詳細、投与量比、または処方指示を開示することなく、ガバナンス、正規化、計算、臨床的解釈、および視覚的な公開をどのように統合できるかを示す。
プロトコル
匿名化された臨床記録を用いた本レトロスペクティブ解析は、中国中医科学院広安門病院の医学倫理委員会によって審査および承認されました(承認番号:2026-108-KY、2026年7月13日)。また、同委員会によりインフォームドコンセントの必要性は免除されました。
1. 倫理、ガバナンス、およびデータセキュリティの確立
- データ保管責任者、ソースデータ分析担当者、臨床用語レビュー担当者、定量的レビュー担当者、および集計データの公開を承認する権限を持つ研究者を指名する。各役割をプロジェクトログに記録する。
- 許可されたソースシステム、研究期間、フィールド、保存場所、アクセス権限、バックアップ手順、保存期間、および連携キーの制限を規定したデータ管理計画を策定する。
- あらかじめ規定された分析に必要な最小限の変数のみをエクスポートする。これには、ローカル患者識別子、来院日、許可されている場合は年齢または生年月日、性別、西洋医学的診断名、TCM(中医学)疾患名、匿名化された既往歴テキスト、舌診テキスト、脈診テキスト、証(しょう)のテキスト、および処方生薬フィールドを含める。
- 管理された施設内環境において、氏名、国民識別番号、電話番号、詳細な住所、保険識別子、連絡先情報、およびその他の直接的な識別子を削除する。各診療録番号をプロジェクト固有の患者識別子に置き換える。
- 自由形式テキストフィールドをスキャンして残存する識別子を確認し、検出されたすべての項目をマスキングする。連携キーは分析データセットとは別に保存し、作業用、共同研究用、および提出用フォルダからは除外する。
- 最初に匿名化してエクスポートしたデータを、読み取り専用のソーススナップショットとして保存する。ファイル名、作成日、行数、列数、ファイルサイズ、およびチェックサムをソースマニフェストに記録する。
- ソースファイル、作業ファイル、辞書、集計表、図、スクリプト、および監査記録用に個別のディレクトリを作成する。
- 公開または共有する資料は、集計表、承認済みの匿名化辞書、スクリプト、および出版用図表に限定する。個人を特定できる記録、または再特定が可能な記録を、公開生成AIシステム、未承認のクラウドサービス、または公開リポジトリにアップロードしてはならない。
注:施設の方針により人間が監視するAI支援が許可されている場合は、匿名化されたテキスト抜粋または集計表のみを提供すること。目的、レビュー済みの出力、承認された修正、レビュー担当者、および日付を監査ログに記録する。
2. レコード識別ルールと分析単位の定義
- 施設、外来設定、責任臨床チーム、電子カルテシステム、およびスクリーニング前の抽出期間を定義する。実例では、2015年1月から2024年6月までの記録を使用する。
- 解析結果を確認する前に、コホート同定ルールを制限付きのバージョン管理ファイルに保存する。受理された用語のバリエーションと、すべての選択基準および除外基準を記録し、原稿内では機密となる策定上の詳細は開示しない。
- 生薬名の正規化後、処方受診レベルでバージョン固定された記録同定ルールを適用する。ソースファイル、辞書、コホートルール、および解析パラメータを単一のリリーセットとして確定させる。
- バージョン固定されたコンポーネントが変更された場合は、常に新しいバージョンを作成し、すべての依存出力を再生成する。疾患分布、生薬頻度、相関ルール、またはクラスターを確認した後に、コホート同定ルールを変更してはならない。
- バージョン固定された研究期間内にあり、有効なプロジェクト患者識別子にマッピングされ、解釈可能な処方記録を含み、かつ制限付き記録同定ルールを満たす外来受診を組み入れる。
- 完全な重複エクスポート、研究期間外の記録、解釈可能な処方がない記録、およびバージョン固定された同定ルールを満たさない行を除外する。除外された各行に、主要な除外理由を1つ割り当てる。
- 重複したエクスポートと、真正な再診を区別する。システムまたはエクスポート上の完全な重複のみを削除し、真正な再診は保持する。
- 安定した患者識別子および処方受診識別子を割り当てる。ソースバージョン、ルールバージョン、スクリーニングステータス、選択または除外理由、患者識別子、受診識別子、およびレビューアーステータスを含むコホートマニフェストを作成する。
- 年齢や性別などの固定的な人口統計学的要約には、ユニークな患者1人につき1つの記録を使用する。疾患、証、既往歴キーワード、舌診、脈診、生薬、相関ルール、およびクラスター解析には、処方受診を解析単位として使用する。
- コホートの適格性と変数の利用可能性を分離する。変数固有のフィールドが欠落していても、それ以外に適格な受診は保持し、各解析における評価可能な分母を報告する。
- 記述解析の前にコホートマニフェストを凍結する。適格な処方受診数とユニーク患者数を記録し、適格性の判定が変更された場合はすべての依存出力を再生成する。
3. 用語の標準化と監査証跡の保存
- 生薬、西洋医学的診断名、中医学的疾患名、証の構成要素、既往歴キーワード、舌診用語、脈診用語、および薬材属性について、個別にバージョン管理された辞書を作成する。
- 各辞書には、元の用語、正規化後の用語、用語カテゴリー、ソースフィールド、ルール、参照元、辞書バージョン、査読者、査読日、およびコメントを含める。正規化後も、すべての元の用語を保持する。
- 権威ある命名法の参照文献9,10を用いて、中薬材(CMM)名を正規化する。臨床的に意味のある炮製形式は保持しつつ、誤植やシステムの略称を修正する。
- 炒製、酢製、蜜製、姜製、酒製、炭化、および生などの炮製修飾語を、個別のラベルとして保持する。
- 表記上または臨床的に異なる生薬は、区別して保持する。白芍と白朮を統合したり、ソースの確認なしに曖昧な略語から生薬を推論したりしてはならない。
- 利用可能な場合は、元の用量と単位を個別のフィールドに保持する。受診レベルの生薬存在変数を作成する場合にのみ、用量のテキストを除去する。
- 出現頻度を、累積投与量または治療強度として解釈してはならない。
- 西洋医学的疾患名と中医学的疾患名を独立して正規化する。診断システムと主診断ステータスを保持し、両方が明記されていない限り、中医学的疾患ラベルを西洋医学的診断名に変換してはならない。
- 読者の理解を助けるために必要な場合は、最初に使用する際に翻字した中医学的疾患ラベルを定義する。元のソースラベルは保持する。
- バージョン固定のデリミタを用いて、多値の明示的な証のテキストを分割し、ソース表現を正規化された証の構成要素にマッピングする。受診ごとの各正規化要素について重複を排除する。
- 明示的な証のテキストは、継承された指標列やスコアから導出された指標列とは別に保持する。
- 元の舌診、脈診、構造化された症状、および匿名化された既往歴フィールドを、個別のデータ製品として保持する。既往歴キーワードの一致を、臨床医が入力した構造化された症状と同等に扱ってはならない。
- 曖昧なマッピングや多対一のマッピングについては、1人の査読者に提案させ、2人目の臨床査読者に検証させる。不確実なマッピングは、ソースの確認により解決されるまで、公開される解析から除外する。
- 正規化ラベルの空白、一対多のマッピング、多対一のマッピング、辞書の重複エントリ、未査読の用語、および炮製ラベルの誤消失がないかを確認する。集計表を生成する前に、辞書バージョンを固定する。
4. ソースフィールドを検証し、レポート出力項目をロックする
- 原稿の各主張、表、および図のパネルごとに1行を割り当てたエビデンス台帳を作成する。解析単位、ソースフィールド、ソースバージョン、辞書バージョン、スクリプトバージョン、分子、分母、出力ファイル、レビュー担当者、および承認済み文言を記録する。
- バージョン固定されたファイルから、適格訪問数およびユニーク患者数、人口統計学的サマリー、疾患数、明示的な症候群数、履歴キーワード数、統合ハーブ頻度、およびハーブ使用合計数を直接再計算する。
- 再計算した各値を、対応する原稿、スプレッドシート、または図の値と比較する。不一致が確認された場合は、原稿を修正し、依存する出力を再生成する。
- 各不一致をソースフィールドレベルで解決する。影響を受ける結果を公開する前に、理由、修正内容、レビュー担当者、および日付をエビデンス台帳に記録する。
- 各集計表に、対応する記述を再現するために必要な正規化ラベル、分子、分母、パーセント定義、解析単位、およびソース識別子が含まれていることを確認する。
- 各パーセンテージに使用される分母を確認する。固定的な人口統計学的特性にはユニーク患者を使用し、動的な臨床変数および処方変数には処方訪問数を使用する。
- 図のラベル、値、順序、およびパネル定義を、バージョン固定された集計表と比較する。プロット値を手動で編集するのではなく、表の修正後に各図を再生成する。
- 臨床レビュー担当者に用語マッピングの検証を依頼する。定量レビュー担当者に件数、率、ルール指標、およびヒートマップの分母の検証を依頼する。
- 原稿の組み立て前に、エビデンス台帳、集計表、および図のソースを単一のバージョン識別子で固定する。
5. 記述的スペクトルおよび共起出力の作成
- ユニークな患者1人につき1行のデータから、患者レベルの年齢および性別のサマリーを作成する。不明なカテゴリーは保持し、明示的に報告すること。
- 処方回(処方受診)レベルで、西洋医学と中医学(TCM)の疾患スペクトラムを個別に作成する。元の診断システムを維持し、共通の受診回数を分母として正規化された主要ラベルを算出すること。
- 明示的に正規化された証(しょう)のテキストフィールドから、証-要素スペクトラムを作成する。バージョン固定のデリミタを用いて用語を分割し、1回の受診内での各用語の重複を排除して、受診レベルの頻度を算出すること。
- 同一の受診内トークンセットから、証の共起行列を構築する。ノードのサイズを受診頻度で、エッジの幅またはヒートマップの強度をペアごとの共起回数でエンコードすること。
- 症状情報が主に記述形式である場合は、正確な既往歴キーワード辞書を事前に指定する。匿名化された既往歴フィールドのみをスキャンし、1回の受診内につき各概念を最大1回までカウントすること。
- 少なくとも1つの既往歴キーワードを含む適格な受診の割合を算出し、すべてのキーワード数をランク付けする。完全なテーブルとプロットしたサブセットをエクスポートすること。
- 正規化された処方データから、統合生薬頻度を作成する。正規化された各生薬ラベルを1回の受診につき最大1回までカウントし、臨床的に意味のある加工形態は別のラベルとして保持すること。
- バージョン固定の本草学辞書から、四気、五味、および帰経のプロファイルを作成する。四気については、属性コードが付与された各生薬の出現に対して単一値のカテゴリーとして扱うこと。
- 五味と帰経はマルチラベル属性として扱う。属性コードが付与された分母を明記し、個別の分析単位を維持すること。
- 最終的な図を作成する前に、記述ドメインごとにマシンリーダブルな集計テーブルを1つずつエクスポートすること。
6. アソシエーションルール分析および階層的クラスター分析の実施
- バージョン固定済みの正規化処方テーブルから、バイナリ形式の「処方訪問×生薬」マトリクスを作成する。適格な訪問を1行とし、正規化された生薬ラベルを1列とする。
- 単一生薬の有向アソシエーションルールについて、サポート、信頼度、およびリフト値を算出する19。信頼度は前件に依存するため、各ルールの方向性を保持する。
- あらかじめ設定した閾値(サポート ≥ 0.30、信頼度 ≥ 0.70、リフト > 1.0)を適用する。保持された各ルールを、共起回数および3つの指標とともにエクスポートする。
- 保持されたルールセット全体を、有向二部ルールネットワークおよび順序付きルール強度プロファイルとして描画する。ネットワークのエッジ幅をサポートで、エッジの色をリフトでエンコードする。
- 順序付きプロファイルにおいて、点のサイズをサポートでエンコードし、信頼度を注釈として記載する。
- 両方のルール表示に同一の保持ルールセットが含まれており、ルールの方向性が保持されていることを検証する。公開前に、不一致がある場合はエクスポートしたルールテーブルと照合して修正する。
- 階層的クラスタリングのため、出現頻度の高い上位20件の生薬存在変数を選択する。ペアごとのJaccard距離を算出し、平均連結法を適用する。
- デンドログラムに正規化生薬名をラベル付けする。枝の近接性は、訪問レベルでの出現パターンの類似性としてのみ解釈する。
- 図の生成前に、バイナリマトリクスの仕様、ルールテーブル、ネットワークエッジリスト、クラスタリングの入力順序、距離行列、および連結行列をエクスポートする。
- 定量的なレビュー担当者に、ルール指標の1つを手計算で再現してもらう。すべてのネットワークエッジをルールテーブルと照合する。
- コホート、用語辞書、または生薬存在マトリクスが変更された場合は、ルールおよびクラスタリングのワークフロー全体を再実行する。
- 例題については、各患者についてソース順で最も早い記録のみを保持することで、決定論的な「1患者1訪問」感度分析を行う。得られた12個のルールを、訪問レベル分析による15個のルールと比較する。
- この変化を、患者レベルの検証ではなく、記述的な堅牢性の結果として報告する。Supplementary File 1に提供されている決定論的な再計算を用いる。
7. 診断別に層別化したパターンの作成および臨床解釈フレームワークの構築
- 診断別の生薬分布を確認する前に、臨床的に関連のある主要な西洋医学的診断層を選択する。
- 各診断層において、1回の受診につき正規化された各生薬ラベルを最大1回までカウントする。有病率は、ラベルを含む受診数をその層の適格受診総数で除して算出する。
- 診断層全体で、同一の表示生薬セットと固定された0%~100%のカラースケールを使用する。正確な解釈を維持するため、セルの値を表示する。
- 表示される各セルの分子と分母を、独立した集計表に報告する。
- 記述的なヒートマップを完成させた後、別途臨床解釈パネルを作成する。算出結果と専門家による解釈は、視覚的に明確に区別して保持する。
- キューレイヤーには、バージョン固定された履歴キーワードテーブルまたは明示的な正規化症候テキストに遡ることができる用語のみを記載する。
- 2名の臨床レビュー担当者に、選択したキューの簡潔な文脈的解釈について合意を得る。レビュー担当者と最終的な文言をエビデンス台帳に記録する。
- 各文脈的解釈を、変数選択、前向き検証、または仮説生成などの研究用途に紐付ける。
- 解釈レイヤーには、非方向性の破線コネクタを使用する。用量、固定組成、および治療推奨に関する内容は除外する。
- ヒートマップと解釈パネルを合わせて確認する。算出された有病率、専門的な文脈、および今後の研究用途が明確に分離されていることを確認する。
8. 再現性パッケージの構築と検証
- ソースマニフェスト、コホートマニフェスト、ディクショナリのバージョン、エビデンスレジャー、解析スクリプト、集計表、図のソース、および最終的な図を、それぞれ別個のディレクトリにエクスポートする。
- 各ファイルに、固定の図番号または表番号およびバージョン日付を用いて名前を付ける。最新の正本バージョンを1つ保持し、更新前の出力物は別途アーカイブする。
- 各図を1つのマルチパネル画像ファイルとして作成する。レビュー用に、高解像度のPDFと300 dpiのPNGをエクスポートする。
- 図の説明文(レジェンド)は原稿内に配置し、画像ファイルの外に保持する。各パネル、解析単位、分母、および視覚的エンコーディングについて記述する。
- 各表について、独立したXLSXファイルを1つずつ作成する。
- 独立したレビュー担当者に、原稿内の数値と集計表の数値、およびパーセンテージとその分子・分母を照合してもらう。
- ルールの境界線をルール表と照合し、ヒートマップのセルをソースマトリックスと照合する。
- ファイル名の整合性、必須セクション、図の寸法、表の数、引用文献数、テンプレートの残骸、および制限用語について、自動チェックを実行する。
- 臨床著者のチームに、用語、解釈、知的財産の境界、著者詳細、資金提供の順序、倫理規定の文言、および最終的な図のセットを確認してもらう。
- 患者レベルのファイル、リンケージキー、制限のないフリーテキスト、内部連絡書、および一時的なレビュー用成果物を、提出パッケージから削除する。
- リリースパッケージを凍結し、そのバージョン、日付、チェックサム、原稿バージョン、および著者の承認ステータスを記録する。その後の修正ごとに、新しいバージョンと変更履歴(チェンジログ)を作成する。
結果
本プロトコルを適切に適用した結果、匿名化されたソーススナップショット、コホートマニフェスト、用語辞書、集計表、スクリプト、および最終的な図を結ぶ追跡可能なチェーンを構築することができた。バージョン固定されたスクリーニング手順により、396名のユニーク患者から555件の適格な処方受診を特定した。図1に、本手法の調整された3つの段階であるガバナンス、用語の正規化、および臨床レビューを伴う分析をまとめている。AI支援レビューのための集計データのみの境界設定を含む、対応する透明性と監査に関するドキュメントは、付録表1に記載している。
最終的なコホートは、396人の固有患者による555件の適格な処方受診で構成されました(図2および表1)。動的な臨床変数および処方変数については、実際の再診データが保持され、一方で年齢と性は患者レベルで重複排除した後に要約されました。患者の年齢範囲は13歳から94歳で、平均は47.11歳、標準偏差は14.88歳でした。コホートには、女性患者228人(57.58%)、男性患者167人(42.17%)、および性別不明の患者1人(0.25%)が含まれていました。このように解析単位を分けることで、人口統計学的分母を過大評価させることなく、縦断的な受診記録を保持しました。
西洋医学および中医学における疾患スペクトラムを以下にまとめる。 図3欧米での診断は、胃腸疾患、肝胆道および膵臓疾患に集中していた。階層的グループ化により、271件の受診が胃腸疾患に、222件が肝胆道または膵臓疾患に、62件がその他の系に割り当てられた。図3A)。主な個別の診断名は、慢性胃炎が133件(23.96%)、脂肪肝が77件(13.87%)、肝硬変が46件(8.29%)であり、次いで慢性萎縮性胃炎、腹痛、慢性B型肝炎、消化不良、逆流性食道炎、慢性表在性胃炎、慢性膵炎であった(図3C および 表 2).
対応する中医学(TCM)の病名スペクトラムでは、同一の受診例を並行的な診断体系に従って分類した。脾胃病または腸病の病名は280件、肝胆病は223件、気血津液失調は26件、心胸頭病は12件、経絡・肢体病は5件、婦科病は4件、その他のカテゴリーは5件であった(図3B)。心下痞(Wei pi:心窩部の膨満感または不快感を示す、維持された中医学的疾患ラベル)が163回の受診(29.37%)で記録された。積証(Ji disease:蓄積型のソース中医学ラベル)、肝濁(Gan zhuo:直訳すると肝臓の固定。維持された古典的な中医学的疾患ラベル)、痺証(Bi disease:妨害疾患)、および消渴(Xiao ke:消耗性口渇)は、ソース中医学ラベルとして維持され、現代の生物医学的診断には変換されなかった。脂肪肝疾患に関する現代中国のコンセンサスで使用されている中医学的疾患ラベルである肝脾(Gan pi)が、77回の受診(13.87%)で記録された。35西洋医学および伝統中国医学(TCM)の情報源フィールドは独立したままであり、互いに代替されることはなかった(図3D および 表3)。「泄瀉(xie xie:緩便または水様便)」と「腹瀉(fu xie:下痢)」は、もともと別々の中医学の疾患ラベルであり、それぞれ6回と2回記録されていたが、いずれも現代生物医学的な診断とは同一視されていなかった。これら2つのスペクトラムを並べて表示することで、各診断システムの論理を維持しつつ、ソース記録の臨床的な幅広さを実証した。
明示的な正規化症候群テキストフィールドには、555件の適格な受診行が含まれていた。受診内での重複排除後、主要な要素は脾(362件、65.23%)、肝(304件、54.77%)、気虚(295件、53.15%)、胃(171件、30.81%)、湿(151件、27.21%)、および気滞(109件、19.64%)であった(図4Aおよび表4)。それ以外には、熱、水停、血、血瘀、経絡、腎、心、および陰虚が含まれていた。1回の受診で複数の症候群要素が発生し得るため、パーセンテージは排他的ではない。
ネットワークおよびカウント行列は、同一の受診レベルのトークンセットから生成された(図 4B,C)。頻繁な共記録は脾、肝、気虚を中心に集中しており、さらに胃、湿、気滞、熱、および水停への接続が認められた。頻度プロット、ネットワーク、ヒートマップに同一のバージョン固定行列を用いることで、これら3つのパネルすべてが異なる詳細レベルで同一の根拠に基づいていることが保証された。回収された監査では、555行のうち完全な症候群テキスト/指標の一致は0件であり、テキスト-指標間の平均ジャカード類似度は0.1806であった。そのため、指標列は実質的な報告から除外された。保持された資料には、クリーニング前の分布ベクトルを再構築可能なデータが含まれていなかったため、バージョン間の分布安定性は推定されなかった。代わりに、患者1人につき1回の受診に限定した感度分析を行い、再診による影響を検討した。ソース監査およびデータ品質の結果は、付録表 2にまとめられている。
用語の正規化および臨床的に意味のある加工形態の保持を行った後、555件の受診において、統合された324種類の生薬名と9,339件の生薬使用例が認められた。白芍が531件(95.68%)に記録され、次いで茯苓が520件(93.69%)、当帰が510件(91.89%)、赤芍が467件(84.14%)、炒白朮が361件(65.05%)であった。 図5A および 表5)。上位36個のラベルのランク-頻度曲線は、急峻な高頻度セグメントと、それに続く次第に広がるテール部分を示しており(図5B)、共通の背景成分と個別処方の成分を簡潔に表現している。生薬の命名法の根拠となる、ソースから正規化名へのマッピング、処理修飾子、標準CMM名称、ソース種、およびエビデンスの境界は、〜に記録されている。 付録表3.
補助的な本草辞典には、特性コードが付与された生薬の使用事例が 9,115 件含まれていた。主な四気カテゴリーは、温(2,588 件, 28.39%)、微寒(2,339 件, 25.66%)、平(2,330 件, 25.56%)、寒(1,221 件, 13.40%)であった(Figure 5C)。化合物ソースの味覚用語を正規化した結果、主な五味カテゴリーは苦(4,488 件, 49.24%)、甘(4,377 件, 48.02%)、辛(2,893 件, 31.74%)であった(Figure 5D)。帰経コードでは、脾(5,541 件, 60.79%)、肝(4,801 件, 52.67%)、肺(3,358 件, 36.84%)、胃(2,988 件, 32.78%)、心(2,702 件, 29.64%)が上位を占めた(Figure 5E)。Figure 5F には、個別の受診レベルおよび特性コード付きの分析単位と、それらの再現性の関連性が記録されている。これらのパネルを総合すると、処理固有の用語を統合することなく、処方頻度と標準化された本草記述子をどのように要約できるかが示されている。
事前に規定された病歴辞書には37の正確な症状概念が含まれていた。適格な受診555回のうち、474回(85.41%)において少なくとも1つの概念が検出された。主な項目は、喉の乾燥が178回(32.07%)、倦怠感が151回(27.21%)、睡眠不足が139回(25.05%)、腹部膨満感が115回(20.72%)、酸逆流が100回(18.02%)、苦味感(苦味)が99回(17.84%)、胸やけが90回(16.22%)、しゃっくりが87回(15.68%)、げっぷが87回(15.68%)、および軟便が77回(13.87%; Figure 6A,B および Table 6)であった。
完全なランク周波数曲線は全37項目の分布を示しており、一方で累積線は各ランクにおけるすべてのキーワード検出の集中度をまとめたものである(図 6C)。図 6Dは、スペクトルを生成するために用いられた再現可能なシーケンスを記録している:辞書の固定、匿名化された履歴テキストのスキャン、各受診内でのコンセプトの重複排除、そして集計数と率のエクスポートである。
アソシエーションルールマイニングには、バージョン固定された555行の処方訪問×生薬存在行列を使用した。15個の有向単一生薬ルールが、サポート値 ≥ 0.30、信頼度 ≥ 0.70、およびリフト値 > 1.0 を満たした(図 7A,B および 表 7)。保持されたサポート値は 0.3009 から 0.7892、信頼度は 0.7302 から 0.9748、リフト値は 1.0010 から 1.1226 の範囲であった。
最も頻繁に併記された有向ペアはChi Shao > Fu Lingであり、438件の受診に基づき、支持度 0.7892、信頼度 0.9379、リフト値 1.0010を示しました。逆方向のルールは支持度が同様で、信頼度は 0.8423であり、この結果はルールの方向性を保持する必要があることを示しています。閾値感度分析では、支持度 ≥ 0.25 または ≥ 0.35、信頼度 ≥ 0.65 または ≥ 0.75、あるいはリフト値 > 1.02 または > 1.05 の条件下で、それぞれ 18、11、21、14、7、4 個のルールが保持されました。患者1人につき1回の受診とする分析では、同じペアが316件の受診で出現し、支持度 0.7980、信頼度 0.9489、リフト値 0.9994であったため、リフト値 > 1.0 の基準では保持されませんでした。閾値の摂動および再診感度の結果はSupplementary Table 4に、決定論的な再計算結果はSupplementary File 1に記載されています。したがって、受診レベルでの高い支持度は、患者レベルでの検証として解釈すべきではありません。
最大のリフト値は、甘草 > 炒白朮 (1.1226) および甘草 > 赤芍薬 (1.1200) で観察されました。図 7A では、保持された全 15 個のルールを有向二部ネットワークに統合しており、エッジの幅で支持度を、エッジの色でリフトをコード化しています。図 7B では、同じルールをリフト順にランク付けし、各点の大きさで支持度をスケールさせ、信頼度を注釈として付記しています。したがって、これら 2 つのパネルは、同じ視覚的表現を重複させるのではなく、ネットワークトポロジーとルール強度の定量的評価を区別して示しています。
出現頻度の高い上位20個の薬草変数の階層的クラスター分析には、ジャカード距離と平均連結法を用いました(図 7C)。デンドログラムは、訪問レベルの存在パターンの類似性を包括的に示しており、これはアソシエーションルールによって得られる局所的な方向性情報を補完するものです。これらのパネルを合わせることで、補完的な分析視点を、単一のバージョン固定バイナリ行列に整合させることができることを示しています。
診断別に層別化した有病率は、脂肪肝(77例)、肝硬変(46例)、および慢性胃炎(133例;図 8Aおよび表 8)について算出した。白芍、茯苓、および当帰は、3つの層すべてにおいて高い有病率を示した。肝硬変の症例では、丹参(95.65%)、酢制莪朮(86.96%)、酢制鼈甲(84.78%)、および生黄耆(60.87%)の記載が顕著であった。脂肪肝の症例では、他の層よりも茵蔲蒿(41.56%)および沢瀉(31.17%)の有病率が高く、一方で慢性胃炎の症例では、黄連(44.36%)、木香(34.59%)、および柴胡(36.09%)が繰り返し認められた。したがって、このヒートマップは、主要な臨床的コンテキストにおける集約的な処方パターンの簡潔な記述的比較を提供している。
図 8Bでは、計算と解釈を分離しています。検証済みの履歴の手がかりが、簡潔な専門家のコンテキストに紐付けられ、さらに「症候群要素のコンテキスト化」、「診断層別化パターンの比較」、「前向き検証のための変数の選択」、「フォローアップ質問の生成」といった研究利用へと繋がっています。この最終パネルは、計算された有病率とは明確に区別しつつ、臨床的な専門知識がいかに分析結果を充実させることができるかを示しています。
図 8C では、ソースで検証済みまたは再解析されたコンポーネントを、注意またはさらなる確認が必要な要素と区別することで、再現性とリリース境界をまとめています。この最終的な監査レイヤーにより、未解決または再構成不可能な分析産物が、検証済み出力として提示されるのを防ぎます。
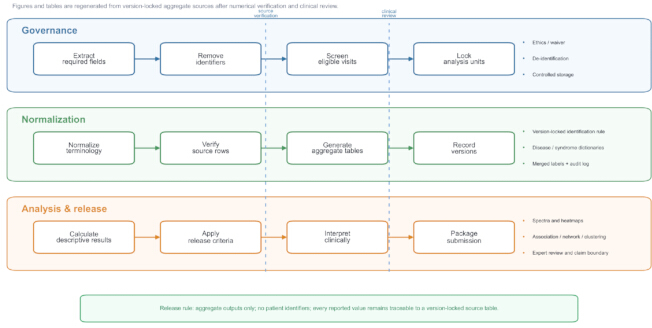
図1ソース監査済みケースレコードマイニングワークフロー。 ガバナンス、用語の正規化、集計分析、臨床レビュー、およびリリースパッケージングが、ワークフローの連続したステージとして示されている。青、緑、オレンジの帯でワークフローのドメインを区別し、垂直の破線は監査ゲートを示す。矢印はワークフローの順序を示しており、生物学的な因果関係を意味するものではない。リリースルールでは、集計済みの出力のみをリリースし、患者識別子は除外し、報告されるすべての値がバージョン固定されたソーステーブルまで追跡可能であることが規定されている。エラーバーは適用されない。 この図の拡大版を表示するには、ここをクリックしてください。
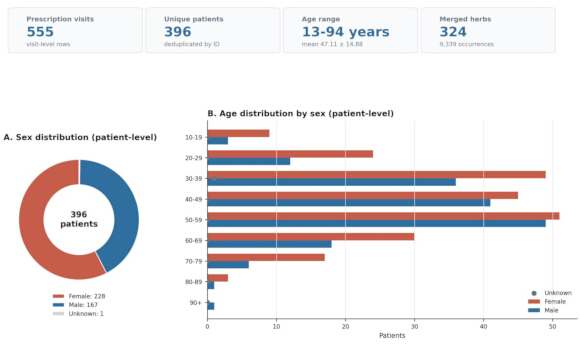
図2: データセットのプロファイルおよび患者レベルの人口統計学的特性。 サマリーボックスには、処方訪問回数555回、ユニーク患者数396名、患者レベルの年齢範囲13~94歳(平均年齢 47.11 ± 14.88 歳)、および9,339件の生薬使用例に相当する統合済み生薬ラベル数324件が示されている。(A)ユニーク患者396名における患者レベルの性別分布(女性、男性、不明のカテゴリーを含む)。(B)同一の患者396名における性別ごとの患者レベルの年齢分布。サマリーボックスでは、必要に応じて表示されている訪問レベルまたは患者レベルの分母が使用されている。色は性別カテゴリーおよびサマリー要素を区別するためのものであり、統計的な意味は持たない。こちらのリンクをクリックして、この図の拡大版を表示してください。
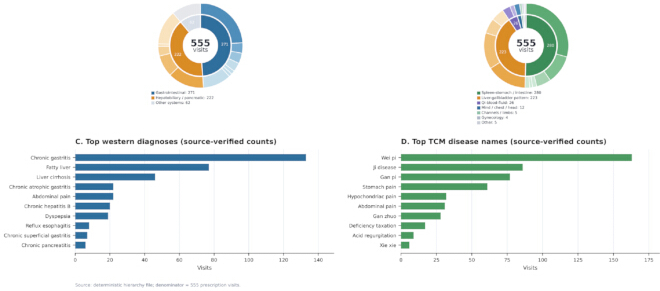
図3処方箋受診から回収された疾患スペクトラム。 (A) 階層的な西洋疾患グループおよび (B) 555件の適格な処方訪問から得られた階層的な中医学(TCM)疾患グループ。 (C) 主要な正規化された西洋医学的診断および (D) 同一の受診レベルの分母から得られた、主要な正規化TCM疾患名。リングセグメントとバーは受診回数を表し、色は診断システムまたはカテゴリーを区別するものであり、治療効果を表すものではない。保持されたTCMソースラベルの定義は、以下に記載されている。 表3胃痞(心窩部の膨満感または不快感)、積病(中医学における積滞型の疾患ラベル)、肝痞(脂肪肝疾患に用いられる中医学の疾患ラベル)、肝濁(直訳では肝の固定。古典的な中医学の疾患ラベルとして保持)、痺病(阻害疾患)、消渇(衰弱に伴う渇き)、泄泄(緩便または水様便)、および腹泄(下痢)。これらの注釈は、元のラベルを現代の生物医学的診断に変換するものではない。 こちらの図の拡大版を表示するには、ここをクリックしてください。
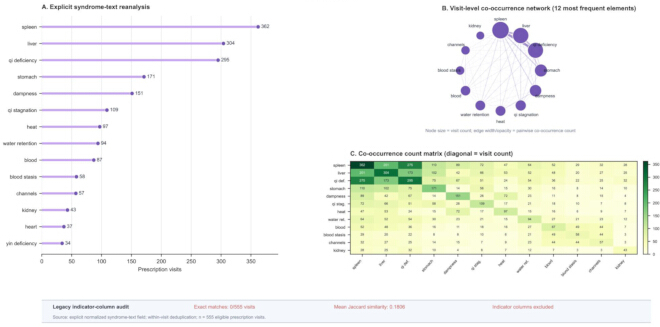
図4: 明示的な症候群テキストのスぺクトラムと共起構造。 (A) 555件の適格な処方受診を分母とした、受診内での重複排除後の正規化された14の症候群要素の受診レベル頻度。 (B) 最も頻度の高い12の症候群要素の共起ネットワーク。ノードの大きさは受診頻度を、エッジの幅と不透明度はペアごとの共起回数を表す。 (C) 対応する対称共起回数行列。対角線上のセルは個々の受診頻度を、非対角線上のセルはペアごとの共起回数を表す。監査ストリップでは、555行にわたって症候群テキスト/指標の完全一致が0件であり、テキストと指標の平均Jaccard類似度は0.1806であったため、従来の指標列は実質的な報告から除外された。行列において、Qi def.は気虚を、Qi stag.は気滞を、Water ret.は水停を表す。カラーパレットは記述的なものである。エラーバーは適用されない。 この図の拡大版を表示するには、ここをクリックしてください。
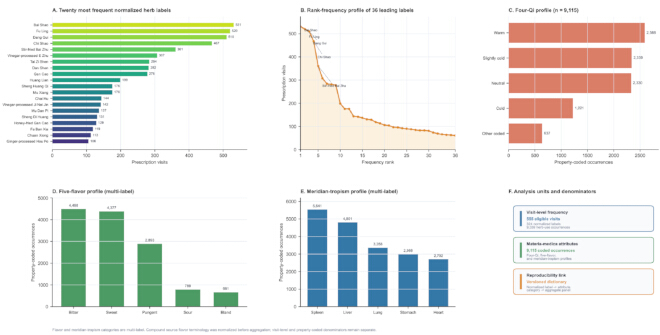
図 5: 高頻度の生薬および正規化された本草学的属性プロファイル。 (A) 適格な処方訪問555件における、正規化された生薬ラベルの出現頻度上位20項目。 (B) 主要な正規化生薬ラベル36項目の順位-頻度プロファイル。 (C) 9,115件の属性コード化された生薬使用例に基づく四気分布。四気は各コード化例に対して単一の値を持つ。 (D) 五味および (E) 帰経の分布。これらは同一の属性コード化分母に基づいており、いずれもマルチラベル属性であるため、カテゴリー数は排他的ではない。 (F) 訪問レベルおよび属性コード化された分析単位と、それらの再現性のリンク。棒の長さは件数を表し、色はパネルを区別している。エラーバーは適用されていない。 こちらをクリックして、この図の拡大版を表示してください。
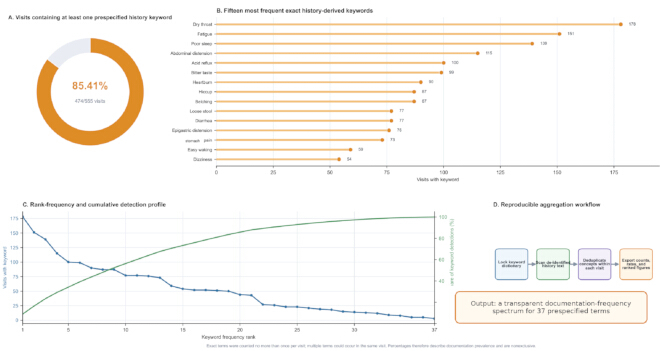
図 6: 病歴由来の症状キーワードスペクトラムおよび再現可能な集計ワークフロー。 (A) 事前に定義した病歴キーワードを少なくとも1つ含む、適格な処方受診555件の割合。474件(85.41%)に少なくとも1つのキーワードが含まれていた。 (B) 出現頻度の高い上位15個の病歴由来の症状概念。 (C) 全37項目のランク・頻度分布およびキーワード検出の累積シェア。 (D) 事前定義辞書から集計出力に至る、バージョン固定済みのワークフロー。各概念は1回の受診につき最大1回までカウントされ、同一の受診内に複数の概念が存在し得た。オレンジ色のバーはキーワード数を表し、ワークフローの色は処理段階を区別している。エラーバーは適用されない。 この図の拡大版を表示するには、ここをクリックしてください。
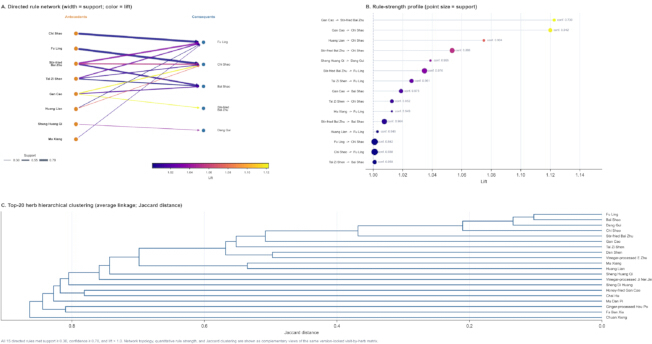
図 7: 有向生薬アソシエーションルールと階層的クラスタリング。 (A>) サポート ≥ 0.30、信頼度 ≥ 0.70、リフト > 1.0 という事前規定の閾値を満たした計 15 個の単一生薬アソシエーションルールの有向二部ネットワーク。エッジの幅はサポートを、エッジの色はリフトを表す。(B>) リフト順に並べた上記 15 個のルールのルール強度プロファイル。点の大きさはサポートを表し、隣接するラベルは信頼度(conf.)を示す。(C>) Jaccard 距離を用いた、出現頻度の高い上位 20 個の生薬変数の平均連結法による階層的クラスタリング。すべてのパネルにおいて、分析単位として処方回数を用いており、有効性、相乗効果、または推奨される固定組み合わせではなく、共記録パターンを記述している。エラーバーは適用されない。 この図の拡大版を表示するには、ここをクリックしてください。
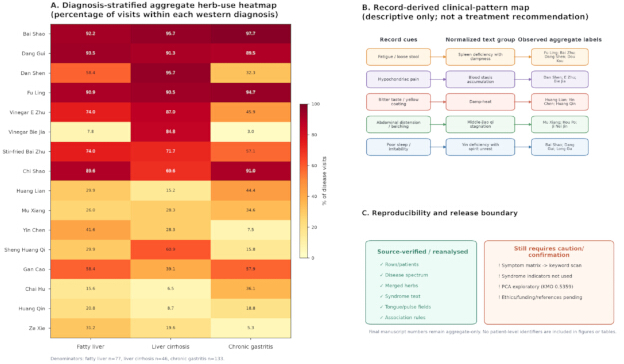
図8診断別層別化集約漢方パターン、臨床パターンマップ、および放出境界。 (A) 脂肪肝(n = 77)、肝硬変(n = 46)、および慢性胃炎(n = 133)における、正規化された16種類の生薬ラベルの受診レベルでの有病率を示す診断層別ヒートマップ。各セルは、0%から100%の固定カラースケールを用い、対応する西洋医学的診断層内における適格な受診の割合を示している。(B)検証済みの記録上の手がかりを、正規化されたテキストグループおよび観察された集計生薬ラベルに結びつけた、記録由来の臨床パターンマップ。点線の無方向性コネクターにより、この記述的な解釈レイヤーと計算された有病率が区別されている。本パネルは治療推奨を構成するものではない。(C)再現性とリリース境界により、ソースで検証済みまたは再解析済みのコンポーネントと、注意または確認を要する項目とを区別します。 こちらの図の拡大版を表示するには、ここをクリックしてください。
| 指標 | 値 | 単位/分母 | ステータス |
| 処方箋受取のための受診 | 555 | 555件の処方箋受診 | 復元されたXLSXファイルにより確認済み |
| ユニーク患者数 | 396 | 396名の固有患者 | 復旧したXLSXファイルより確認済み |
| 患者レベルの年齢範囲 | 13-94 | 年 | 検証済み |
| 患者レベルの年齢 平均値 ± 標準偏差 | 47.11 +/- 14.88 | 年 | 検証済み |
| 来院レベルの年齢平均値 +/- 標準偏差 | 48.22 +/- 15.82 | 年 | 検証済み |
| 患者レベルの性別 | 女性 228名、男性 167名、不明 1名 | 396名の患者 | 検証済み |
| 来院レベルの性別 | 女性 327名、男性 227名、不明 1名 | 555回の閲覧 | 検証済み |
| 混合生薬 | 324 | 重複を除去した統合名称 | 検証済み |
| 統合された生薬使用事例 | 9339 | 555件の処方箋受診 | 検証済み |
表1:データセットのプロファイル。 患者レベルの人口統計学的特性および処方・受診レベルの変数は、それぞれの分母を用いて報告されている。正規化された生薬の合計数も提供されている。
| 疾患名 | 数 | 受診率 (%) |
| 慢性胃炎 | 133 | 24 |
| 脂肪肝 | 77 | 13.9 |
| 肝硬変 | 46 | 8.3 |
| 慢性萎縮性胃炎 | 22 | 4 |
| 腹痛 | 22 | 4 |
| 慢性B型肝炎 | 20 | 3.6 |
| 消化不良 | 19 | 3.4 |
| 逆流性食道炎 | 8 | 1.4 |
| 慢性表在性胃炎 | 7 | 1.3 |
| 慢性膵炎 | 6 | 1.1 |
| 潰瘍性大腸炎 | 6 | 1.1 |
| 胆嚢ポリープ | 6 | 1.1 |
| 胆嚢摘出後症候群 | 6 | 1.1 |
| 腸機能不全 | 6 | 1.1 |
| 胆石 | 6 | 1.1 |
| 慢性肝炎 | 5 | 0.9 |
| 倦怠感 | 5 | 0.9 |
| 胃腸機能不全(元のラベル不明) | 5 | 0.9 |
| 慢性胃炎(元のラベル不明) | 5 | 0.9 |
| 自己免疫性肝硬変 | 4 | 0.7 |
表2:主要な正規化欧米診断名。 555件の適格な処方訪問において記録された、主要な正規化欧米診断名の件数および割合。割合の分母には適格な処方訪問数を使用している。
| TCM疾患名 | カウント | 訪問率 |
| 胃痞(心窩部膨満感または不快感) | 163 | 29.4 |
| ジー病(蓄積型) | 86 | 15.5 |
| 肝痞(脂肪肝疾患に用いられる中医学の病名) | 77 | 13.9 |
| 腹痛 | 61 | 11 |
| 心下痛 | 32 | 5.8 |
| 腹痛 | 31 | 5.6 |
| 肝著(Gan zhuo:直訳すると「肝の固定」。伝統的な中医学の疾患ラベルとして保持されている) | 28 | 5 |
| 不足税額課税 | 17 | 3.1 |
| 胃酸逆流 | 9 | 1.6 |
| 下痢(ゆるい便または水様便) | 6 | 1.1 |
| 不眠症 | 4 | 0.7 |
| 赤痢 | 4 | 0.7 |
| 頭痛 | 4 | 0.7 |
| 痺証(ししょう) | 4 | 0.7 |
| 月経異常 | 3 | 0.5 |
| 胸部閉塞 | 3 | 0.5 |
| 発汗異常症 | 3 | 0.5 |
| 便秘 | 3 | 0.5 |
| 腹瀉(下痢) | 2 | 0.4 |
| 消渴(しょうかつ) | 2 | 0.4 |
表3:主要な正規化済みTCM疾患名。 555件の適格な処方訪問にわたり記録された、主要な正規化済みTCM疾患名の件数および割合。割合の分母には適格な処方訪問数を用いている。保持されたソースラベルおよび解説注釈は、現代の生物医学的診断との同等性を意味するものではない。
| 順位 | 症候群要素 | 処方訪問 | 適格訪問 | 訪問率 |
| 1 | 脾臓 | 362 | 555 | 65.23% |
| 2 | 肝臓 | 304 | 555 | 54.77% |
| 3 | 気虚 | 295 | 555 | 53.15% |
| 4 | 胃 | 171 | 555 | 30.81% |
| 5 | 湿気 | 151 | 555 | 27.21% |
| 6 | 気滞 | 109 | 555 | 19.64% |
| 7 | 熱 | 97 | 555 | 17.48% |
| 8 | 水分保持 | 94 | 555 | 16.94% |
| 9 | 血液 | 87 | 555 | 15.68% |
| 10 | 血瘀 | 58 | 555 | 10.45% |
| 11 | チャネル | 57 | 555 | 10.27% |
| 12 | 腎臓 | 43 | 555 | 7.75% |
| 13 | 心臓 | 37 | 555 | 6.67% |
| 14 | 陰虚 | 34 | 555 | 6.13% |
表4:主要な正規化症候群要素。症候群要素は、明示的な正規化症候群テキストから抽出され、処方ごとの受診内で重複が排除された。件数は、適格な処方受診555件を分母として算出している。1回の受診で複数の症候群要素が発生し得るため、パーセンテージは非排他的である。
| 統合された生薬名 | 回数 | 処方率 (%) |
| 白芍 | 531 | 95.7 |
| 茯苓 | 520 | 93.7 |
| 当帰 | 510 | 91.9 |
| 赤芍 | 467 | 84.1 |
| 炒白朮 | 361 | 65 |
| 醋制莪朮 | 307 | 55.3 |
| 太子参 | 284 | 51.2 |
| 丹参 | 282 | 50.8 |
| 甘草 | 278 | 50.1 |
| 黄連 | 199 | 35.9 |
| 生黄耆 | 176 | 31.7 |
| 木香 | 176 | 31.7 |
| 柴胡 | 144 | 25.9 |
| 醋制鶏内金 | 142 | 25.6 |
| 牡丹皮 | 137 | 24.7 |
| 生地黄 | 131 | 23.6 |
| 蜜炙甘草 | 129 | 23.2 |
| 法半夏 | 119 | 21.4 |
| 川芎 | 113 | 20.4 |
| 姜制厚朴 | 106 | 19.1 |
| 茵陳 | 104 | 18.7 |
| 生白朮 | 97 | 17.5 |
| 豆蔻 | 96 | 17.3 |
| 生龍骨 | 92 | 16.6 |
| 浙貝母 | 90 | 16.2 |
| 黄芩 | 88 | 15.9 |
| 党参 | 85 | 15.3 |
| 醋制鱉甲 | 83 | 15 |
| 桂枝 | 83 | 15 |
| 生牡蠣 | 81 | 14.6 |
| 膠記者 | 74 | 13.3 |
| 合歓花 | 69 | 12.4 |
| 酒制黄精 | 66 | 11.9 |
| 陳皮 | 64 | 11.5 |
| 沢瀉 | 63 | 11.4 |
| 金銭草 | 61 | 11 |
表5:処方回数に基づいた主要な標準化生薬ラベル。 各標準化生薬ラベルは、1回の処方につき最大1回までカウントされた。カウント数およびパーセンテージは、適格な処方回数555回を分母として算出されており、臨床的に意味のある加工形態は個別のラベルとして保持されている。
| 順位 | 既往歴由来キーワード | 処方回数 | 対象回数 | 訪問率 |
| 1 | 口の渇き | 178 | 555 | 32.07% |
| 2 | 倦怠感 | 151 | 555 | 27.21% |
| 3 | 睡眠不足 | 139 | 555 | 25.05% |
| 4 | 腹部膨満感 | 115 | 555 | 20.72% |
| 5 | 胃酸逆流 | 100 | 555 | 18.02% |
| 6 | 苦味 | 99 | 555 | 17.84% |
| 7 | 胸やけ | 90 | 555 | 16.22% |
| 8 | しゃっくり | 87 | 555 | 15.68% |
| 9 | げっぷ | 87 | 555 | 15.68% |
| 10 | 軟便 | 77 | 555 | 13.87% |
| 11 | 下痢 | 77 | 555 | 13.87% |
| 12 | 心下膨満感 | 76 | 555 | 13.69% |
| 13 | 胃痛 | 73 | 555 | 13.15% |
| 14 | 中途覚醒 | 59 | 555 | 10.63% |
| 15 | めまい | 54 | 555 | 9.73% |
| 16 | 嘔吐 | 52 | 555 | 9.37% |
| 17 | 吐き気 | 52 | 555 | 9.37% |
| 18 | 鈍痛 | 51 | 555 | 9.19% |
| 19 | 張裂けるような痛み | 50 | 555 | 9.01% |
| 20 | 食欲不振 | 44 | 555 | 7.93% |
| 21 | 腹痛 | 43 | 555 | 7.75% |
| 22 | 胸部圧迫感 | 27 | 555 | 4.86% |
| 23 | 苛立たしさ | 26 | 555 | 4.68% |
| 24 | 頭痛 | 23 | 555 | 4.14% |
| 25 | 腸鳴 | 23 | 555 | 4.14% |
| 26 | 心下不快感 | 21 | 555 | 3.78% |
| 27 | 動悸 | 19 | 555 | 3.42% |
| 28 | 尿の黄染 | 18 | 555 | 3.24% |
| 29 | 異物感 | 15 | 555 | 2.70% |
| 30 | 刺痛 | 14 | 555 | 2.52% |
| 31 | 便秘 | 13 | 555 | 2.34% |
| 32 | 眠気 | 12 | 555 | 2.16% |
| 33 | 咽喉異物感 | 9 | 555 | 1.62% |
| 34 | 多汗 | 8 | 555 | 1.44% |
| 35 | 肋下痛 | 5 | 555 | 0.90% |
| 36 | 後重感 | 5 | 555 | 0.90% |
| 37 | 便の乾燥 | 3 | 555 | 0.54% |
表6:病歴由来の主要な症状キーワード。 匿名化された病歴テキストから検出された正確な症状概念。各概念は1回の処方受診につき最大1回までカウントされ、同一の受診内で複数の概念が出現する場合がある。カウント数およびパーセンテージは、適格な処方受診555件を分母として算出している。
| 前件 | 後件 | 共起回数 | 支持度 | 信頼度 | リフト値 |
| Chi Shao | Fu Ling | 438 | 0.7892 | 0.9379 | 1.0010 |
| Fu Ling | Chi Shao | 438 | 0.7892 | 0.8423 | 1.0010 |
| Stir-fried Bai Zhu | Fu Ling | 350 | 0.6306 | 0.9695 | 1.0348 |
| Stir-fried Bai Zhu | Bai Shao | 348 | 0.6270 | 0.9640 | 1.0076 |
| Stir-fried Bai Zhu | Chi Shao | 320 | 0.5766 | 0.8864 | 1.0535 |
| Tai Zi Shen | Fu Ling | 273 | 0.4919 | 0.9613 | 1.0260 |
| Tai Zi Shen | Bai Shao | 272 | 0.4901 | 0.9577 | 1.0010 |
| Gan Cao | Bai Shao | 271 | 0.4883 | 0.9748 | 1.0189 |
| Gan Cao | Chi Shao | 262 | 0.4721 | 0.9424 | 1.1200 |
| Tai Zi Shen | Chi Shao | 242 | 0.4360 | 0.8521 | 1.0127 |
| Gan Cao | Stir-fried Bai Zhu | 203 | 0.3658 | 0.7302 | 1.1226 |
| Huang Lian | Fu Ling | 187 | 0.3369 | 0.9397 | 1.0029 |
| Huang Lian | Chi Shao | 180 | 0.3243 | 0.9045 | 1.0750 |
| Sheng Huang Qi | Dang Gui | 168 | 0.3027 | 0.9545 | 1.0388 |
| Mu Xiang | Fu Ling | 167 | 0.3009 | 0.9489 | 1.0127 |
表7:規定の閾値を満たした有向ハーブ関連ルール。 ルールは、support ≥ 0.30、confidence ≥ 0.70、およびlift > 1.0を用いて、555件のバイナリ処方-受診行から生成された。Supportの分母には555件の処方受診数を使用しており、confidenceは方向性を持つため、ルールの方向性は維持されている。
| ハーブラベル | 脂肪肝(名詞) | 脂肪肝(正常) | 脂肪肝 (%) | 肝硬変 (n) | 肝硬変 (N) | 肝硬変 (%) | 慢性胃炎 (n) | 慢性胃炎 (N) | 慢性胃炎 (%) |
| 白芍 | 71 | 77 | 92.21% | 44 | 46 | 95.65% | 130 | 133 | 97.74% |
| 当帰 | 72 | 77 | 93.51% | 42 | 46 | 91.30% | 119 | 133 | 89.47% |
| 丹参 | 45 | 77 | 58.44% | 44 | 46 | 95.65% | 43 | 133 | 32.33% |
| 茯苓 | 70 | 77 | 90.91% | 43 | 46 | 93.48% | 126 | 133 | 94.74% |
| 酢制麻黄 | 57 | 77 | 74.03% | 40 | 46 | 86.96% | 61 | 133 | 45.86% |
| 酢制鼈甲(すせいべっこう) | 6 | 77 | 7.79% | 39 | 46 | 84.78% | 4 | 133 | 3.01% |
| 炒白朮(ちょうびゃくじゅつ) | 57 | 77 | 74.03% | 33 | 46 | 71.74% | 76 | 133 | 57.14% |
| Chi Shao | 69 | 77 | 89.61% | 32 | 46 | 69.57% | 121 | 133 | 90.98% |
| 黄連 | 23 | 77 | 29.87% | 7 | 46 | 15.22% | 59 | 133 | 44.36% |
| ムキョウ | 20 | 77 | 25.97% | 13 | 46 | 28.26% | 46 | 133 | 34.59% |
| 陰陳 | 32 | 77 | 41.56% | 13 | 46 | 28.26% | 10 | 133 | 7.52% |
| 生黄耆 | 23 | 77 | 29.87% | 28 | 46 | 60.87% | 21 | 133 | 15.79% |
| 甘草 | 45 | 77 | 58.44% | 18 | 46 | 39.13% | 77 | 133 | 57.89% |
| 柴胡 | 12 | 77 | 15.58% | 3 | 46 | 6.52% | 48 | 133 | 36.09% |
| 黄芩 | 16 | 77 | 20.78% | 4 | 46 | 8.70% | 25 | 133 | 18.80% |
| ゼ・シェ | 24 | 77 | 31.17% | 9 | 46 | 19.57% | 7 | 133 | 5.26% |
表8:診断別生薬使用率。脂肪肝(n = 77)、肝硬変(n = 46)、および慢性胃炎(n = 133)における、正規化された16種類の生薬ラベルの分子、分母、および受診レベルの使用率。各生薬ラベルは、対象となる処方受診1回につき最大1回までカウントされた。
補足表1:AI支援による透明性および監査記録。2026年8月21日に実施された修正段階の一貫性レビューと、元の解析記録を区別するための文書。本表には、ツール/モデル/バージョン、入力範囲、目的、特定された四至(Four-Qi)の基数不一致、人間による修正、使用制限、レビュー担当者情報、処理結果、およびプロンプトテンプレートが記録されている。AIシステムに生の患者レベルの行は提供されていない。 こちらのリンクからファイルをダウンロードしてください。
付録表2:ソース監査データ品質結果。 ソース臨床フィールドおよびレガシー解析構造について、回収フィールドの完全性、監査所見、解析上の処置、およびリリース状態を報告する。本表では、調整不能なレガシー症候群指標の除外、以前のハーブ総数の修正、バージョン間安定性推定のためのクリーニング前分布ベクトルの再構築不能、および再構築できなかった数量について記録している。 こちらのリンクからファイルをダウンロードしてください。
補足表3:生薬名称のマッピング。 管理された生薬の表示ラベルを、加工修飾子、標準的な中薬材(CMM)名称、出典用語、植物・動物・鉱物由来、参照バージョン、エビデンスロケーター、およびエビデンス境界に関連付けている。臨床的に意味がある場合は、加工固有のラベルを保持している。 こちらをクリックしてファイルをダウンロードしてください。
補足表4:閾値および再診感度分析。アソシエーションルールの閾値変動、患者1人につき1回の受診とするルールセットの比較、Chi Shao > Fu Ling 感度指標、および190ペアのクラスタリング入力距離の比較について報告する。 こちらをクリックしてファイルをダウンロードしてください。
補足ファイル1:決定論的閾値および再訪感度のスクリプト バージョン固定されたソースデータセットから、集計しきい値および再訪感度メトリクスを再現するために使用される決定論的スクリプト。本ファイルに患者レベルのデータは含まれていない。 こちらのファイルをダウンロードするには、ここをクリックしてください。
ディスカッション
本プロトコルの中心的な貢献は、匿名化された中医学(TCM)の症例記録から集計された研究図表に至るまで、完全かつ検証可能な経路を提示したことです。最も重要なステップは、分析結果を確認する前にコホート抽出ルールを確定させること、ユニークな患者と処方訪問を区別すること、オリジナル用語から正規化用語へのすべてのマッピングを保存すること、そして可視化の前に各分子と分母を検証することです。これらの管理策により、データクリーニングは目に見えない予備的な作業から、メソッドの文書化された構成要素へと変わります。また、これによりワークフローがRECORD、STROBE、FAIR、および確立されたEHRデータ品質フレームワーク11,12,13,14,15に準拠することになります。結果が公開可能と判断されるのは、そのソースフィールド、分析単位、辞書バージョン、計算ルール、分母、表、図、および査読者の決定がエビデンスレジャー(証跡簿)で追跡できる場合に限られます。
本手法が革新的である理由は、ガバナンス、用語エンジニアリング、計算、可視化、および臨床レビューが、個別のタスクとしてではなく統合して扱われている点にあります。単一の明示的な症候群行列から、出現頻度スペクトル、共起ネットワーク、およびヒートマップが生成されます。また、単一の処方・受診別生薬行列が、頻度要約、有向アソシエーションルール、および階層的クラスタリングをサポートしています19,20,21。単一の診断層別化テーブルにより、正確なパーセンテージと最終的なヒートマップの両方がサポートされます。分析ワークフローには、スクリプト化された再現可能なオープンソースツールが使用されており36,37,38,39,40、上流の辞書やコホート決定に対する修正を、すべての依存出力に伝播させることが可能です。また、以前の臨床データウェアハウスの研究においても、ソースにリンクした前処理と構造化データの再利用の重要性が示されています41,42。このアーキテクチャにより、手動の転記が削減され、グラフィカルなエンコーディングとソーステーブル間の整合性が維持され、監査、教育、および他の研究チームへの移行が容易になります。
最近の3つのデータベースマイニング研究では、解析単位が臨床訪問ではなく論文となっているものの、有用な設計原理が示されています。関節リウマチとうつ病に関する研究では、定義済みの検索戦略に、国、機関、著者、ジャーナル、キーワード、およびタイムライン解析を組み合わせています26。潰瘍性大腸炎とJanusキナーゼ阻害薬に関する研究では、調整された共著関係、共引用、クラスタリング、およびバースト解析を用いて、持続的なテーマと新興の研究フロンティアを区別しています27。関節リウマチと線維筋痛症に関する研究では、2つのエビデンス層の区別を維持しつつ、バイオインフォマティクスを用いてビブリオメトリクスマッピングを拡張しています28。本プロトコルでは、調整されているが互換性のない解析的視点という同様の原理を適用しています。婦人科、呼吸器内科、リウマチ科、またはその他の専門分野へ移行する場合、ルールセットを再利用する前に、専門分野特有のフィールド、用語辞書、包含および除外ルール、アウトカム、および臨床レビュー手順を再構築する必要があります。疾患スペクトラム、症候群ネットワーク、症状キーワード、相関ルール、クラスタリング、および診断層別パターンはすべてバージョン固定されたソースから得られますが、それぞれが異なる問いに対応し、独自の分母と解釈境界を保持しています。
人間が監督するAIは、承認済みの匿名化された抜粋または集計資料に限定して使用される場合、追加の品質管理レイヤーを提供できます。このワークフローにおいて、AIはファイル間での用語の比較、キャプションと表の間の不整合のフラグ立て、図の境界外にまで及んでいるラベルの特定、表示されている各ネットワークノードに有効なエッジがあるかの検証、およびより明確な表現の提案を行うことができます。AIは、コホートの適格性の判定、用語マッピングの考案、治療効果の推論、またはソースデータのレビューに代わる操作を行うことはありません。この責任分担は、医療AIは責任所在を曖昧にするのではなく、人間の判断を増強すべきであるというより広範な見解と一致しています33。また、これは、透明性のある人的要因、エラー処理、および責任ある評価を強調するDECIDE-AIの指針を反映したものです34。したがって、AIの支援を利用した場合は常に、各プロンプトの目的、レビューされた出力、承認された修正内容、レビュー担当者、および日付を監査ログに保持する必要があります。
出力結果が臨床的に妥当に見えるものの、ソース照合に失敗した場合には、トラブルシューティングが特に重要となる。このような場合、不一致の原因が、適格性の判定、重複削除、用語マッピング、項目の選択、分母の選択、または図表の組み立てのいずれにあるかまで追跡できるまで、後続の解釈は保留すべきである。その後、修正した上で、すべての依存出力結果を再生成する必要がある。提示した例は、単一施設で後方視的に収集された専門外来のデータセットであり、再診などの繰り返し受診は互いに独立していない。患者1人につき1回の受診とする感度分析では、上位20種類の生薬の構成を維持しつつ、保持されるルールセットを15から12へと削減した。これら20の共通変数間の全190組の非順序対において、ピアソン相関係数は0.9944、スピアマンの相関係数(rho)は0.9836であり、ジャカード距離の平均絶対変化量は0.0146、最大変化量は0.0528であった(補足表4したがって、訪問レベルでの高いサポートは、患者レベルでの妥当性が確認されたものと解釈すべきではありません。履歴キーワードのスペクトラムは、検証済みの症状尺度ではなく、文字通りの記録を反映したものです。薬物学的な要約は、投与量による重み付けではなく、出現頻度による重み付けがなされています。アソシエーションルールは、因果関係ではなく、同時記録について記述したものです。診断別に層別化したヒートマップは記述的なものであり、比較有効性、疾患特異性、または治療の必要性を立証するものではありません。
本プロトコルは、熟練した臨床経験の継承、専門外来コホートの記述、多施設間での用語の標準化、ドキュメンテーションの質的なレビュー、前向きレジストリのための変数選択、およびプライバシーに配慮した共同研究用集計データセットの作成などの研究に適用可能です。今後の課題として、前向きで構造化された症状収集、患者クラスターモデル、明示的な投与量変数、事前に規定された比較仮説、外部検証、バージョン管理された用語サービス、プライバシー保護計算、およびインタラクティブなエビデンス・レジャーの導入が考えられます。バージョン固定のルールと人間による検証の下で運用されれば、自然言語処理やAI支援によるレビューによって、反復的なキュレーションをさらに削減できる可能性があります。より広範には、本プロトコルにより、分散した臨床経験を、点検、再現、検証、および拡張が可能な、透明性の高い研究対象へと変換することが可能になります。本手法は頻度を有効性に変換するものではなく、むしろ文書化されていない分析上の決定を可視化されたエビデンスへと変換し、より厳格な臨床上の問いと、より持続可能なリアルワールドにおけるTCM研究の基盤を提供するものです。
開示事項
著者は、競合する利害がないことを宣言します。
謝辞
原稿の校閲において、集計レベルでのファイル間の整合性チェックおよび表現の提案を目的として、OpenAI Codex (gpt-5.6-luna および gpt-5.6-sol) が限定的に使用されました。AIシステムに患者レベルの記録は提供されていません。AIによる出力内容はすべて、2026年8月21日にTian Xiaによって元の資料と照らし合わせて独立して検証されました。著者は最終的な内容を確認し、承認しており、本原稿に対して全責任を負います。本プロジェクトは、中国国家重点研究開発計画の中薬近代化重点特別プロジェクト(No. 2025YFC3512800)、中国国家科学技術重大プロジェクト(プロジェクトNo. 2026ZD0554100、サブプロジェクトNo. 2026ZD0554101)、中央高水準中医学病院臨床研究・成果変換能力向上プロジェクトの著名な中医学専門家による学術経験継承特別プロジェクト(No. HLCMHPP2023016)、および新疆ウイグル自治区自然科学基金(No. 2025D01C213)の支援を受けて実施されました。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| 集計再解析スプレッドシート | 著者作成のローカルファイル | 該当なし | 集計数、表、および図の作成に使用。 |
| 匿名化済み外来症例記録エクスポート | 施設内の電子カルテシステム | 該当なし | 管理された施設内環境でのみ使用。患者レベルの記録は提出資料に含まれない。 |
| lxml | lxml project | 6.1.1 | 改訂段階の再生成において、名前空間を保持したシリアライズに使用されたソフトウェアバージョン。歴史的なオリジナル解析時のバージョンではない。 |
| Matplotlib | Matplotlib project (matplotlib.org) | 3.11.1 | 改訂段階の再生成環境および図3のSVGメタデータで確認されたバージョン。歴史的なオリジナル解析時のバージョンではない。 |
| NetworkX | NetworkX project | PyPI package: networkx | パッケージ識別子を記録。継承された環境において、改訂段階の正確なバージョンは検証されていない。 |
| NumPy | NumPy project | 2.3.5 | 改訂後の集計出力を再生成するために使用されたソフトウェアバージョン。歴史的なオリジナル解析時のバージョンではない。 |
| openpyxl | openpyxl project | 3.1.5 | 改訂後の集計XLSX出力を書き出すために使用されたソフトウェアバージョン。歴史的なオリジナル解析時のバージョンではない。 |
| pandas | pandas project | 3.0.1 | 改訂後の集計出力を再生成するために使用されたソフトウェアバージョン。歴史的なオリジナル解析時のバージョンではない。 |
| PyMuPDF | PyMuPDF project | 1.28.2 | 改訂後の図の出力を再生成するために、改訂段階で使用されたソフトウェアバージョン。歴史的なオリジナル解析時のバージョンではない。 |
| Python | Python Software Foundation | 3.13.15 | 改訂後の集計出力を再生成するために使用されたソフトウェアバージョン。歴史的なオリジナル解析時のバージョンではない。 |
| SciPy | SciPy project | PyPI package: scipy | パッケージ識別子を記録。継承された環境において、改訂段階の正確なバージョンは検証されていない。 |
参考文献
- Wang YH, et al. Study on knowledge discovery in traditional Chinese medical case records [in Chinese]. Zhong Xi Yi Jie He Xue Bao. 2007;5(4):368-372.
- Wang Y, et al. Automatic symptom name normalization in clinical records of traditional Chinese medicine. BMC Bioinformatics. 2010;11:40.
- Zhou L, et al. Natural language processing algorithms for normalizing expressions of synonymous symptoms in traditional Chinese medicine. Evid Based Complement Alternat Med. 2021;2021:6676607.
- Chu X, et al. Quantitative knowledge presentation models of traditional Chinese medicine (TCM): a review. Artif Intell Med. 2020;103:101810.
- Zhang T, et al. Constructing fine-grained entity recognition corpora based on clinical records of traditional Chinese medicine. BMC Med Inform Decis Mak. 2020;20:64.
- Wang Q, et al. A study of entity-linking methods for normalizing Chinese diagnosis and procedure terms to ICD codes. J Biomed Inform. 2020;105:103418.
- Zhang H, et al. Transformer- and generative adversarial network-based inpatient traditional Chinese medicine prescription recommendation: development study. JMIR Med Inform. 2022;10(5):e35239.
- Dan W, et al. SinoMedminer: an R package and Shiny application for mining and visualizing traditional Chinese medicine herbal formulas. Chin Med. 2025;20:80.
- Chinese Pharmacopoeia Commission. Pharmacopoeia of the People's Republic of China. 2025 ed. China Medical Science and Technology Press; Beijing; 2025.
- Editorial Committee of Zhonghua Bencao, State Administration of Traditional Chinese Medicine. Zhonghua Bencao. 10 vols. Shanghai Scientific and Technical Publishers; Shanghai; 1999. ISBN: 7532351068. Available from: National Diet Library record
- Benchimol EI, et al. The REporting of studies Conducted using Observational Routinely-collected health Data (RECORD) statement. PLoS Med. 2015;12(10):e1001885.
- von Elm E, et al. The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: guidelines for reporting observational studies. Lancet. 2007;370(9596):1453-1457.
- Wilkinson MD, et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.
- Weiskopf NG, Weng C. Methods and dimensions of electronic health record data quality assessment: enabling reuse for clinical research. J Am Med Inform Assoc. 2013;20(1):144-151.
- Kahn MG, et al. A harmonized data quality assessment terminology and framework for the secondary use of electronic health record data. EGEMS (Wash DC). 2016;4(1):18.
- Kovačević A, Bašaragin B, Milošević N, Nenadić G. De-identification of clinical free text using natural language processing: a systematic review of current approaches. Artif Intell Med. 2024;151:102845.
- Meystre SM, et al. Text de-identification for privacy protection: a study of its impact on clinical text information content. J Biomed Inform. 2014;50:142-150.
- Neamatullah I, et al. Automated de-identification of free-text medical records. BMC Med Inform Decis Mak. 2008;8:32.
- Agrawal R, Srikant R. Fast algorithms for mining association rules in large databases. Presented at: 20th International Conference on Very Large Data Bases; Santiago, Chile; 1994. p. 487-499.
- Hahsler M, Grün B, Hornik K. arules: a computational environment for mining association rules and frequent item sets. J Stat Softw. 2005;14(15):1-25.
- Murtagh F, Contreras P. Algorithms for hierarchical clustering: an overview. WIREs Data Min Knowl Discov. 2012;2(1):86-97.
- van Eck NJ, Waltman L. Software survey: VOSviewer, a computer program for bibliometric mapping. Scientometrics. 2010;84(2):523-538.
- Chen C. CiteSpace II: detecting and visualizing emerging trends and transient patterns in scientific literature. J Am Soc Inf Sci Technol. 2006;57(3):359-377.
- Aria M, Cuccurullo C. bibliometrix: an R-tool for comprehensive science mapping analysis. J Informetr. 2017;11(4):959-975.
- Donthu N, et al. How to conduct a bibliometric analysis: an overview and guidelines. J Bus Res. 2021;133:285-296.
- Zhao Y, Chen GY, Fang M. Research trends of rheumatoid arthritis and depression from 2019 to 2023: a bibliometric analysis. J Multidiscip Healthc. 2024;17:4465-4474.
- Wang Y, et al. Research trends and hotspots in JAK inhibitors for ulcerative colitis: a bibliometric analysis from 2015 to 2024. J Multidiscip Healthc. 2025;18:6755-6771.
- Chen G, Yan Z, Wang Y, Tao Q. Rheumatoid arthritis and fibromyalgia syndrome: a bibliometric and bioinformatics perspective on comorbidity research. J Multidiscip Healthc. 2025;18:6811-6827.
- Wang SL, et al. Yao Naili's experience in applying the harmonizing liver and spleen method. Journal of Traditional Chinese Medicine. 2008;49(7):596-597.
- Wang L, et al. Analysis of Professor Naili Yao's experience in treating spleen-stomach diseases [in Chinese]. Lishizhen Med Mater Med Res. 2022;33(6):1436-1438.
- Sandve GK, Nekrutenko A, Taylor J, Hovig E. Ten simple rules for reproducible computational research. PLoS Comput Biol. 2013;9(10):e1003285.
- Munafò MR, et al. A manifesto for reproducible science. Nat Hum Behav. 2017;1:0021.
- Topol EJ. High-performance medicine: the convergence of human and artificial intelligence. Nat Med. 2019;25(1):44-56.
- Vasey B, et al. Reporting guideline for the early-stage clinical evaluation of decision support systems driven by artificial intelligence: DECIDE-AI. Nat Med. 2022;28(5):924-933.
- Branch of Gastrointestinal Diseases, China Association of Chinese Medicine. Expert consensus on traditional Chinese medicine diagnosis and treatment of Gan pi (2023). Chinese Journal of Integrative Digestive Diseases. 2024;32(9):741-747.
- McKinney W. Data structures for statistical computing in Python [conference paper]. Presented at: 9th Python in Science Conference; Austin, TX; 2010. p. 56-61. doi:10.25080/Majora-92bf1922-00a.
- Harris CR, et al. Array programming with NumPy. Nature. 2020;585(7825):357-362.
- Virtanen P, et al. SciPy 1.0: fundamental algorithms for scientific computing in Python. Nat Methods. 2020;17(3):261-272.
- Hunter JD. Matplotlib: a 2D graphics environment. Comput Sci Eng. 2007;9(3):90-95.
- Hagberg AA, Schult DA, Swart PJ. Exploring network structure, dynamics, and function using NetworkX. Presented at: 7th Python in Science Conference; Pasadena, CA; 2008. p. 11-15. doi:10.25080/TCWV9851.
- Zhou X, et al. Development of traditional Chinese medicine clinical data warehouse for medical knowledge discovery and decision support. Artif Intell Med. 2010;48(2-3):139-152.
- Liu B, et al. Data processing and analysis in real-world traditional Chinese medicine clinical data: challenges and approaches. Stat Med. 2012;31(7):653-660.