本プロトコルでは、ヘルスケアにおける説明可能な人工知能(XAI)モデルの開発、評価、および解釈のための再現可能なワークフローを提示します。透明性、信頼性、および臨床的適用性を向上させるため、標準化されたデータ準備、モデル開発、説明可能性の手法、定量的評価、および再現性の確保に向けた実践的手法を統合しています。
この記事について
サマリー
要約
人工知能(AI)は、臨床的意思決定、疾患予測、医学的診断、および個別化医療のための価値あるツールとして、ますます採用されています。しかし、透明性の欠如、説明可能な人工知能(XAI)手法の実装における一貫性のなさ、および再現性の低さが、臨床現場におけるAIモデルの信頼できる展開の大きな障壁となっています。本論文では、ヘルスケアアプリケーション向けの説明可能なAIモデルの開発、評価、および解釈のための、体系的で再現可能かつ透明性の高いプロトコルを提案します。ワークフローは、計算環境のセットアップから始まり、続いてデータの取得と特性評価、前処理、特徴量エンジニアリング、モデル開発、ハイパーパラメータの最適化、予測性能の評価、説明可能性の分析、統計的検証、そして再現性の評価へと進みます。このプロトコルでは、SHapley Additive exPlanations(SHAP)、Local Interpretable Model-agnostic Explanations(LIME)、Gradient-weighted Class Activation Mapping(Grad-CAM)、Integrated Gradients、アテンションの視覚化、および反事実的説明などのXAI手法を組み込み、グローバルおよびローカルなモデル解釈の両方を生成します。本プロトコルでは、標準化されたヘルスケアデータセットの準備、安定した機械学習モデルの開発、予測性能の評価、臨床的に関連のある説明の生成、および繰り返しの実験における再現性の統計的評価を含む、いくつかの主要な構成要素を重視しています。モデル開発、説明可能性、定量的および定性的評価、統計的検証、および再現性評価を統合されたワークフローに組み込むことで、本プロトコルは、ヘルスケアアプリケーション向けの透明で再現可能なAIモデルを開発するための包括的なフレームワークを提供します。
概要
AIは、複雑な臨床データの知的解析を可能にし、根拠に基づいた医療上の意思決定を支援することで、現代ヘルスケアの不可欠な構成要素となっています1。電子健康記録、医療用画像システム、ウェアラブルデバイス、ゲノム技術によるヘルスケアの急速なデジタル化により、大量の不均一なデータが生成されており、それらを効果的に解釈するためには高度な計算手法が必要とされています2。
機械学習(ML)およびディープラーニング(DL)アルゴリズムは、多次元のヘルスケアデータセットから有意義なパターンを抽出する優れた能力を示しており、これにより診断精度の向上、疾患予測、および患者のアウトカム評価が改善されている3。AIベースのモデルは、放射線科、病理科、循環器科、腫瘍科、眼科などのその他の医学専門分野において、臨床医による疾患の早期発見やパーソナライズされた治療戦略の推奨を支援するためにうまく適用されてきた4。これらの技術はまた、ワークフローの最適化、診断のばらつきの低減、およびヘルスケアリソースの利用効率の向上にも寄与している5。
コンピューティングハードウェア、クラウドコンピューティング、およびオープンソースAIフレームワークの最近の進展により、インテリジェントなヘルスケアアプリケーションの開発と導入が加速しています6。その結果、AIは精密医療および臨床意思決定支援システムを実現するための主要な基盤技術となっています7。こうした進歩にもかかわらず、多くの高性能なモデルは、予測がどのように生成されるかについての洞察をほとんど提供しないため、日常的な臨床現場におけるAIの広範な導入は依然として限定的です8。
ほとんどのディープラーニングアルゴリズムは複雑なブラックボックスモデルとして機能しており、その内部の意思決定プロセスを臨床医や研究者が理解することは困難です9。これらのモデルはしばしば優れた予測性能を達成しますが、透明性が欠如しているため、ユーザーの信頼を損ない、臨床的妥当性の確認、規制当局による承認、および患者の安全性において課題が生じます10。医療専門家は、特にリスクの高い医療環境において、AI支援による意思決定を日常的な臨床実務に組み込む前に、その根拠を正当化できなければなりません11。
XAI(説明可能なAI)は、機械学習モデルの透明性と解釈可能性を向上させるための効果的なアプローチとして登場しています12。予測モデルを不透明なシステムとして扱うのではなく、XAIの手法を用いることで、個々の予測に寄与している特徴量、画像領域、または臨床変数に関する情報を提供することが可能になります13。このような説明により、臨床医はモデルの挙動をより深く理解し、潜在的なバイアスを特定し、AIによって生成された決定が確立された医学的知識と一致しているかを確認することができます14。
ヘルスケアアプリケーション向けに、いくつかの説明可能性技術が導入されています。SHapley Additive explanations (SHAP) は、協力ゲーム理論に基づいて、モデルの予測に対する各特徴量の寄与度を測定します15。Local Interpretable Model-agnostic Explanations (LIME) は、簡略化されたモデルを作成し、ブラックボックスモデルの予測を説明します16。ディープラーニングモデルを用いた医療画像タスクでは、Gradient-weighted activation maps (Grad-CAM) により、分類決定に寄与する画像領域を視覚的に示すヒートマップが作成されます17。これらの手法を組み合わせることで、さまざまなヘルスケア領域においてAIシステムの透明性が飛躍的に向上しました18
ヘルスケア分野における説明可能性の手法への注目は高まっているものの、文献におけるその活用方法は依然として多岐にわたっています。研究者によって、前処理戦略の使用だけでなく、モデルアーキテクチャの設計、評価指標、さらには説明手法までもが異なっています19。また、多くの論文で高い予測精度が報告されていますが、説明の質や再現性に関する徹底した評価が提供されていないケースが見受けられます20。
再現性は、現代のAIサイエンスにおける大きなボトルネックの一つです。論文では、ソフトウェアのバージョン、計算環境、前処理パイプライン、ハイパーパラメータの設定、乱数シードの初期化、およびハードウェア構成が開示されていないことが多くあります21。このため、独立した研究者が公開された結果を再現したり、他のデータセットやソフトウェアプラットフォームを用いて公開された手法を検証したりすることに失敗する場合が頻繁にあります22。詳細なドキュメントの不足は、ベンチマーク研究、共同研究、およびAIシステムの臨床応用の妨げとなる要因の一つとなっています23。
これらの課題を認識し、いくつかの組織や規制機関は、ヘルスケアへの応用におけるAIの透明性、信頼性、および再現性の重要性を強調しています24。既存の報告ガイドラインによって手法の報告は改善されましたが、それらは主に何を報告すべきかを記述したものであり、研究者が直接実施できる標準化された実験手順を提供するものではありません25。したがって、データセットの準備、モデル開発、説明可能性の分析、統計的評価、および再現性の確保に向けた実践を単一の実験ワークフローに統合した、包括的なプロトコルが依然として必要とされています26。
標準化された実験プロトコルは、ヘルスケアAIコミュニティに多くの利点をもたらします。さらに、手法の一貫性を促進し、独立した研究間の比較を容易にし、計算実験の透明性を高め、公表された結果の信頼性の高い検証を可能にします27。また、標準化されたワークフローは、異なる研究室や医療機関の間で再現可能な、明確に文書化された手順を通じて、教育・トレーニング、共同研究、および規制上の評価を支援します28
ヘルスケアシステムにおけるAIモデルのトレーニングおよび評価のための、再現可能な実験プロトコルが開発され、検証された。本プロトコルでは、計算環境の構築、ヘルスケアデータセットの前処理、機械学習モデルの開発、XAI(説明可能なAI)手法の適用、予測性能の評価、統計的妥当性の検証、および再現性の評価に関する基準を概説している。29これらのコンポーネントを首尾一貫したワークフローに統合することは、ヘルスケアAI研究の透明性、信頼性、および再現性を向上させるとともに、信頼されるインテリジェント・ヘルスシステムの開発に寄与すると考えられる。30.
プロトコル
本検証実験では、公開されている匿名化済みのPima Indians Diabetes Datasetを使用しており、特定の可能な患者記録や新規患者の募集は含まれていません。したがって、インフォームドコンセントおよび機関のIRB/倫理委員会の承認は不要であり、すべての分析は適用可能なデータセットの利用規約および機関の研究方針に従って実施されました。
この検証例では、糖尿病の二値予測のための768件のレコードを含む、公開データセットであるPima Indians Diabetes Datasetを使用しています。本データセットに対して、全9段階のコアワークフローを適用しました。これら9つのコア段階は、データセットの選択と検証、計算環境の設定、データの前処理、データセットの分割、モデルの開発とトレーニング、予測および計算性能の評価、説明可能性分析、統計的検証、および再現性の評価で構成されています。外部検証と臨床専門家による評価は、オプションの検証モジュールとして保持され、今回の検証例では実施していません。図1にコアプロトコルのワークフローを示し、表1に今回の検証で実施した9つのコア段階のみをまとめています。オプションである外部検証と臨床専門家による評価は、プロトコル内で別途説明されており、9つの実験段階には含まれていません。
1. ヘルスケアデータセットの選択と検証
- 検証例の主要データセットとして、Pima Indians Diabetes Datasetを選択する。データセットの出典、サンプルサイズ、予測ターゲット、クラス分布、およびデータ構造を確認する。
- 事前に定義された組み入れ基準、除外基準、およびデータ品質基準を適用する。モデル開発の前に、重複レコードおよび無効なレコードを削除する。
- データセットの出典、特性、予測タスク、クラス分布、組み入れおよび除外基準、ならびに分割戦略を表2に記録する。
- データセットおよびモデル選択のための決定基準を適用する
- データセット、モデルアーキテクチャ、前処理戦略、または説明可能性手法を選択する前に、予測目的を定義する。
- データセットのモダリティを予測目的に適合させる。構造化された臨床変数の場合はテーブル形式データ、医療画像の場合は画像データ、生理学的信号の場合は時系列データ、臨床記述の場合はテキストデータを選択し、同一患者または研究ユニットに対して補完的なモダリティが利用可能な場合はマルチモーダルデータを選択する。
- サンプルサイズ、アウトカムの可用性、クラス分布、欠損値、アノテーションの品質、臨床的妥当性、データの完全性、およびアクセシビリティに基づいて候補データセットを評価する。事前に定義された要件を満たすデータセットを選択する。
- サンプルサイズ、計算リソース、または解釈性の要件により複雑なアーキテクチャの使用が制限される場合は、構造化されたテーブル形式データに対して従来の機械学習モデルを選択する。十分なトレーニングデータがあり、医療画像、生理学的信号、または臨床テキストなどの高次元入力が利用可能な場合は、ディープラーニングアーキテクチャを選択する。
- 同一患者または研究ユニットに対して複数のモダリティが利用可能であり、情報漏洩を引き起こさずに確実にアライメントできる場合にのみ、マルチモーダルアーキテクチャを選択する。選択したデータモダリティの特性に応じて前処理操作を選択する。
- モデルおよびデータモダリティに応じて説明可能性手法を選択する。適切なテーブル形式モデルにはSHAPやLIMEなどのモデル非依存の手法を、画像ベースのモデルには適用可能な場合にGrad-CAMなどのモダリティ固有の手法を使用する。
- データセット、前処理戦略、モデル、および説明可能性手法の選択根拠を文書化する。これらの決定を再現性記録の一部として保存する。
2. XAIモデル開発のための計算環境を構築する
- 選択したモデルの要件に従って、オペレーティングシステム、CPU、RAM、ストレージ、およびGPUを構成します。独立したPython環境を作成し、必要な機械学習、ディープラーニング、統計、可視化、およびXAIライブラリをインストールします。
- 検証で使用した実際の計算環境、モデルアーキテクチャ、およびハイパーパラメータを表3に記録します。オプティマイザー、学習率、バッチサイズ、最大エポック数、損失関数、正則化パラメータ、検証戦略、早期停止(early-stopping)の設定、乱数シードの設定、説明可能性の手法、ハードウェア、オペレーティングシステム、Pythonのバージョン、および関連するソフトウェアライブラリのバージョンを明記してください。これらの実験的に使用した設定を、一般的な設定や推奨プロトコルの設定と区別して記載してください。
- Pima Indians Diabetes Datasetの検証と、それに対応する予測、説明可能性、統計、および再現性の結果を再現する際は、表3に報告された構成を使用してください。
- 検証スクリプトを実行し、パッケージのインポート、データセットの読み込み、モデルの実行、および出力の生成が正常に行われることを確認します。再現性を確保するため、最終的な環境構成を保存してください。
3. XAIモデル開発に向けたヘルスケアデータセットの準備と特性評価
- ヘルスケアデータセットの選択および取得
- 定義された臨床予測タスクに適したヘルスケアデータセットを選択します。研究目的、データの種類、サンプルサイズ、アノテーションの質、クラスバランス、および臨床的妥当性に基づき、候補となるデータセットを評価します。
- 予測タスクを適切に処理でき、かつ独立した検証を容易にする場合は、公開されているベンチマークデータセットを優先的に使用してください。
- 機関内または内部のデータセットを取得する前に、必要な倫理的承認、機関の許可、およびデータアクセス権限を得てください。検証済みのリポジトリまたは認定された機関データベースから、選択したデータセットを取得してください。
- 元のデータセットファイルは変更せずに保存し、データセット提供者、バージョン、取得情報、ライセンス条件、採用基準、除外基準、および付随するメタデータを記録してください。データセットは、生データ、アノテーション、メタデータ、および補足情報のそれぞれに分けた個別のディレクトリに整理してください。
- ヘルスケアデータセットの特性評価
- 予測変数、アウトカムラベル、特徴量タイプ、データモダリティ、およびクラス分布を特定してください。被験者数、サンプル数、特徴量次元数、および利用可能なアノテーションを決定してください。
- データセットの特性が、選択したAI手法と適合していることを確認してください。
- 9段階のコアプロトコルを検証するための唯一の実験データセットとして、ピマ・インディアン糖尿病データセットを使用してください。以下に記載されている追加のデータセットも含めてください。 表2 臨床的な表形式データ、電子健康記録、ダーモスコピー画像、生理学的時系列データ、および医学用画像にわたる汎用プロトコルの適用可能性を実証するためのみに使用してください。これらの追加データセットを、モデルの訓練、テスト、統計的検証、または報告された実験結果の生成に使用してはいけません。
- データセットの品質評価
- データセットに重複レコード、破損ファイル、欠損値、アノテーションエラー、および不規則なデータエントリーがないか検査してください。重複が確認されたレコードを削除し、検証済みのフォーマットの不整合を修正してください。すべてのデータセット品質管理手順を記録してください。
- マルチモーダルデータセットを使用する際は、被験者識別子を用いて、画像、臨床、検査、および生理学的データの整合性を確認してください。
- 重複または不整合のあるレコードを削除し、欠損値を処理し、数値的特徴量を標準化し、カテゴリ変数をエンコードし、モダリティ固有の前処理を適用します。データセットを、独立したトレーニングセット、検証セット、およびテストセットに分割します。以下を参照してください。 図2 ヘルスケアデータセットの準備、前処理、分割、および品質評価のワークフローについて。
- データのプライバシー保護と倫理的コンプライアンスの確保
- ヘルスケアデータから直接的な識別子を削除してください。必要に応じて、匿名化または仮名化の手順を適用してください。患者の健康情報は、適用される倫理規定、データ保護、インフォームドコンセント、および機関の要件に従って取り扱ってください。
- 該当する倫理承認、免除、データガバナンスの手順、匿名化の方法、およびデータセット作成のワークフローを記録してください。
- 関連する人口統計学的または臨床的なサブグループに関する情報が利用可能であり、かつ倫理的に許容される場合は、それらのサブグループ間でのモデル性能を比較することにより、潜在的なアルゴリズムのバイアスを評価してください。
- 意図された用途、対象集団、モデルの限界、潜在的な不具合モード、人間による監視の要件、および適用される倫理的要件、データ保護要件、ヘルスケア規制要件を文書化してください。
- 特定された公平性の限界および責任あるAIに関する検討事項を、最終的なモデルドキュメントの一部として記録してください。
注:AIモデルの開発に適しており、倫理的コンプライアンスが確保され、かつ重大な不整合が特定されていない、標準化および文書化されたヘルスケアデータセットを入手する。
4. AIモデル訓練のためのヘルスケアデータの前処理および分割
- 品質管理の実施
- データセットを検査し、重複レコード、欠損値、無効な値、不整合なラベル、外れ値、および破損ファイルがないか確認する。
- 定義済みの基準に従って無効な観測値を削除または修正し、すべての除外記録を保存する。予測変数とアウトカムラベルの一貫性を検証する。
- 欠損データの処理
- 各変数の欠損率を定量化する。定義済みの補完または除外戦略を適用する。
- トレーニングデータのみを用いて補完パラメータを推定し、適合させた変換を検証データおよびテストデータに適用する。
- データの正規化および変換
- 選択したモデルで必要とされる特徴量スケーリング、正規化、エンコーディング、次元削減、またはその他の変換を適用する。データに依存するすべての変換は、トレーニングデータのみを用いて適合させる。
- 適合させた変換を、変更せずに検証データおよびテストデータに適用する。
- トレーニングデータにおけるクラス不均衡を定量化する。クラス重み付け、SMOTE、オーバーサンプリング、またはデータ拡張をトレーニングデータセットにのみ適用する。検証データセットおよびテストデータセットの元の分布は維持する。
- 被験者、重複観測値、拡張サンプル、前処理統計量、特徴量選択基準、または合成サンプルが、トレーニング用パーティションと評価用パーティションの間で共有されていないことを確認する。
5. XAIモデルの開発および構成
- 入力データのモダリティ、前処理操作、モダリティ固有の特徴エンコーダー、特徴融合メカニズム、予測レイヤー、および説明可能性モジュールを指定して、モデルアーキテクチャを定義します。
- 予測タスクと入力モダリティに応じて、機械学習またはディープラーニングのアーキテクチャを選択します。入力レイヤー、特徴抽出コンポーネント、隠れ層、出力レイヤー、および活性化関数を構成します。オプティマイザー、学習率、バッチサイズ、損失関数、エポック数、正則化、ドロップアウト、早期終了、および学習率スケジューラを定義します。
- 訓練データと検証データのみを使用して、ハイパーパラメータを最適化します。
- 最終決定したアーキテクチャとハイパーパラメータ構成を表 3に記録します。
- 訓練前に、入出力の次元の適合性を確認します。
注:適切なアーキテクチャ、定義されたハイパーパラメータ、および統合された説明可能性手法を含む、完全に構成されたXAIモデルを構築します。
6. XAIモデルのトレーニング、最適化、および保存
- 定義済みのトレーニングデータセットおよび検証データセットと、最終的なモデル構成をロードします。定義済みの乱数シードとトレーニングパラメータを用いてモデルを初期化します。
- 指定したオプティマイザー、損失関数、バッチサイズ、および停止基準を用いてモデルをトレーニングします。
- 検証パフォーマンスをモニタリングし、定義済みのモデル選択基準に対応するチェックポイントを保持します。選択したチェックポイントを、さらなる最適化を行わずに独立したテストデータセットで評価します。
- トレーニング済みモデル、前処理構成、ハイパーパラメータ、乱数シード、およびトレーニングログを保存します。
注:準備したヘルスケアデータセットを用いてトレーニングおよび検証を行い、最適化されたXAIモデルを取得してください。再現性のために、最高のパフォーマンスを示したモデル、ハイパーパラメータ、トレーニングログ、前処理構成、および計算環境を保存してください。
7. 予測性能および計算性能の評価
- 予測性能の評価
- モデルの学習とハイパーパラメータの最適化が完了した後、最適化済みモデルと独立したテスト用データセットをロードする。テスト中は、学習済みモデルのパラメータおよび前処理パイプラインを変更せずに維持すること。
- テストデータセット内の全サンプルに対して予測を生成する。予測出力と対応するグラウンドトゥルース(正解ラベル)を比較する。
- 性能指標の算出
- 予測タスクの種類に応じて評価指標を選択する。
- 分類タスクの場合、必要に応じて正解率(accuracy)、適合率(precision)、再現率(recall)、特異度(specificity)、F1スコア、バランス正解率(balanced accuracy)、マシューズ相関係数(MCC)、および受信者動作特性曲線下面積(AUC-ROC)を算出する。回帰タスクの場合、必要に応じて平均絶対誤差(MAE)、平均二乗誤差の平方根(RMSE)、決定係数(R2)、およびその他の関連指標を算出する。
- モデルの汎化性能と堅牢性の評価
- 開発用データセットとは別に独立して収集された外部データセットが利用可能な場合は、それを用いてモデルを評価する。
- 搬送可能性(transportability)を評価するため、異なる医療機関、地理的領域、または患者集団に由来する外部データセットを優先的に使用する。
- 縦断的データセットが利用可能な場合は、より後の期間に収集されたデータを用いて時間的妥当性確認(temporal validation)を行う。
- 多施設データが利用可能な場合は、最終確定したモデルを参加施設ごとに個別に評価し、多施設妥当性確認(multicenter validation)を行う。
- 実現可能な場合は、異なる地理的領域の独立した集団を用いて地理的妥当性確認(geographic validation)を行う。
- 開発用データセットと外部データセットの間の性能差および信頼区間を報告する。
- 計算性能の評価
- 定義された計算環境下でのモデル学習時間、同一の計算条件下での推論およびテスト時間、ならびにメモリ消費量、モデルサイズ、ハードウェア利用率を測定する。
- 独立した実行回数を通じて計算測定を繰り返す。
- 実験的な変動の影響を軽減するため、平均実行時間を算出する。
- モデル性能の比較
- 比較評価のために、適切な従来の機械学習またはディープラーニング手法を選択する。
- 提案するXAIモデルと比較モデルを同一のデータセットを用いて評価する。すべての比較モデルに同一の前処理手順と評価指標を適用する。
- すべての比較実験を同一の計算環境内で実行する。
注:テストした計算条件およびデータセットにおける予測の安定性と再現性に関する実験的根拠を得ること。
8. XAI出力の生成と評価
- モデルの説明を生成する
- 最適化されたXAIモデルをロードする。モデルのトレーニングに使用されなかった評価サンプルを選択する。トレーニング済みモデルや前処理パイプラインを変更せずに、事前定義された説明可能性手法を適用する。
- グローバルおよびローカルなモデルの説明を生成する
- 予測モデルの全体的な挙動を特徴づけるグローバルな説明を生成する。
- 個々のモデル予測を特徴づけるローカルな説明を生成する。
- Pima Indians Diabetes DatasetにSHAPを適用し、タブル形式モデル予測のグローバルおよびローカルな説明を生成する。
- SHAPサマリープロットを生成し、特徴量の寄与の全体的な方向性と大きさを可視化する。
- 平均絶対SHAP値を用いたSHAP特徴量重要度プロットを生成し、モデル予測への全体的な寄与度に従って特徴量をランク付けする。
- 代表的なテストセットの予測に対してSHAPウォーターフォールプロットを生成し、患者固有の特徴量の寄与を例示する。
- SHAP特徴量依存性プロットを生成し、選択した特徴量とモデル出力への寄与との関係を検討する。
- 代表的なテストセットの予測にLIMEを適用し、個々のモデル予測のローカルな説明を生成する。
- 患者固有の反実仮想的説明(counterfactual explanation)を生成し、予測結果の変化に関連する特徴量の変化を例示する。
- データのモダリティとモデルアーキテクチャに応じて、追加の説明可能性手法を選択する。
- 適用可能な場合、互換性のある画像ベースモデルにはGrad-CAMまたはサリエンシーマップを、Transformerベースのアーキテクチャにはアテンション可視化を、微分可能なモデルにはIntegrated Gradientsを使用する。
- Grad-CAM、サリエンシーマッピング、アテンション可視化、およびIntegrated Gradientsを、モダリティに依存する一般的なプロトコルオプションとして扱い、対応する解析が実際に実施されない限り、Pima Indians Diabetes Datasetの検証による実験結果として解釈または報告しない。
- 実施済みのPima検証に説明可能性手法を適用する
- Pima Indians Diabetes DatasetにSHAPおよびLIMEを適用し、タブル形式モデル予測のグローバルおよびローカルな説明を生成する。
- Pima検証の結果から、SHAPのサマリー、特徴量重要度、ウォーターフォール、および特徴量依存性の可視化を生成する。
- 代表的なテストセットの予測に対してLIMEローカル説明を生成する。
- 患者固有の反実仮想的説明を生成し、モデル予測の変化に関連する特徴量の変化を例示する。
- Grad-CAM、アテンション可視化、サリエンシーマッピング、およびIntegrated Gradientsを、他のヘルスケアデータタイプおよびモデルアーキテクチャ向けのモダリティ依存の説明可能性オプションとして扱う。
- 対応する解析が実際に実施されない限り、Grad-CAM、アテンション可視化、サリエンシーマッピング、またはIntegrated GradientsをPima実施検証の実験結果として報告しない。
- 説明の質を評価する
- 生成された説明がモデルの予測プロセスを反映しているか評価する。繰り返しの実験ランにおける説明の安定性と、同一の計算条件下での説明出力の一貫性を評価する。
- 適用可能な場合、入力データの変化に対する説明出力の感度を評価する。生成された説明を、利用可能なドメイン知識または専門家の解釈と比較する。
- 比較可能な場合、確立された医学的知識と一致する予測特徴量または解剖学的領域を特定する。
- 生成された説明と利用可能な臨床的解釈との間の合意または不一致のレベルを記録する。
- 予測の不確実性を定量化する
- 選択したモデルアーキテクチャおよびヘルスケアアプリケーションに適した不確実性推定手法を用いて、評価サンプルの予測信頼度推定値を生成する。
- 適切な場合、モンテカルロドロップアウト、アンサンブルベースの予測、ベイズ推論、適合予測(conformal prediction)、またはその他の検証済み不確実性推定アプローチを適用する。
- モンテカルロドロップアウトを使用する場合は、確率的な予測パスを繰り返し行い、各評価サンプルの平均予測値と予測分散を算出する。
- 予測信頼度または不確実性区間を、対応するモデル予測とともに報告する。
- 不確実性の推定値によって、信頼性が低い、または予測誤差が増大している予測が特定できているか評価する。再現性を確保するため、不確実性推定手法、パラメータ、乱数シード、および生成された不確実性出力を保存する。
- 説明可能性の出力を文書化し保存する
- 生成されたすべての特徴量重要度スコア、ヒートマップ、サリエンシーマップ、アテンション可視化、および患者固有の解釈を保存する。説明可能性の出力を標準化されたファイル形式で保存する。出力をトレーニング済みモデルおよび前処理設定とともにアーカイブする。
- 説明生成に使用した計算設定、説明パラメータ、実行時間、およびソフトウェアバージョンを記録する。独立したレビューと再現性を容易にするため、完全な説明可能性ドキュメントを保存する。
- 説明の質を定量的に評価する
- 重要であると特定された特徴量を系統的に摂動またはマスクし、モデル出力の対応する変化を測定することで、説明の忠実性(faithfulness)を評価する。寄与度の大きさと、結果として生じたモデル予測の変化を比較して、説明忠実性スコアを算出する。
- 繰り返しのラン、摂動させた入力、または臨床的に類似したサンプルに対して説明を生成し、得られた寄与パターンの類似性を算出することで、説明の安定性を評価する。制御された入力摂動下で、予測出力の変化と説明の寄与から推定された変化との乖離を測定することで、不忠実性(infidelity)を算出する。
- 医用画像の説明については、参照アノテーションが利用可能な場合、専門家が定義した関心領域(ROI)を用いて局在化精度を評価する。事前定義された解釈基準を用いて、資格を持つ臨床専門家から独立した評価を得ることで、臨床的有用性を評価する。
- 複数の専門家が独立して説明の妥当性や合意を評価した場合は、Cohen's kappaまたはFleiss' kappaを算出する。
注:トレーニング済みAIモデルの予測挙動を特徴づけるグローバルおよびローカルな説明を生成すること。透明性のある解釈と再現可能な評価のために、説明可能性の出力および対応する設定を保存すること。
9. 統計的検証および再現性の評価を行う
- 統計的バリデーションの実施
- 研究目的、実験デザイン、データの分布、および評価変数の特性に応じて統計手法を選択する。
- 連続変数は、適宜、平均値 ± 標準偏差または中央値および四分位範囲として報告し、カテゴリ変数は件数および割合として報告する。
- トレーニングセットに対して5分割交差検証を行い、モデル性能の安定性を評価し、精度、AUC-ROC、適合率、再現率、およびF1スコアを、各フォールドの平均値 ± 標準偏差として報告する。1,000回のブートストラップ再サンプリングを用いて、独立したテストセットの性能指標の95%信頼区間を推定する。
- 提案モデルをCNN、ランダムフォレスト、およびSVMのベースラインモデルと比較する。精度のペア比較にはMcNemar検定を、相関のあるAUC-ROCの比較にはDeLong検定を、F1スコアの比較には1,000回の再サンプリングによるペアブートストラップ検定を用いる。
- 各比較について、対応する検定統計量と正確なp値を報告し、両側有意水準 α = 0.05 を使用する。
- モデル性能の統計的比較
- 提案された説明可能AIモデルを、選択した最新の機械学習およびディープラーニングのベースラインモデルと比較する。
- 2群の比較を行う場合は、適宜、Studentのt検定またはマン・ホイットニーのU検定を適用する。3群以上のパラメトリックな比較が可能な場合は、一元配置分散分析(one-way ANOVA)を適用する。3群以上のノンパラメトリックな比較が可能な場合は、クラスカル・ウォリス検定を適用する。
- 原著論文の規定に従い、p < 0.05 を統計的に有意とみなす。
- すべての事前定義された統計的比較に両側有意水準 α = 0.05 を使用し、対応する検定統計量およびp値を報告する。
- 主要な予測性能指標について、95%信頼区間を報告する。
- 適宜、ブートストラップ再サンプリングを用いて性能尺度の信頼区間を推定する。同一被験者を2つのモデルで評価した際の相関のあるROC-AUC値を比較するには、DeLong検定を用いる。同一被験者に対して生成されたペアのカテゴリ分類結果を比較するには、McNemar検定を用いる。適宜、F1スコアまたはその他の派生性能指標を比較するために、ペアブートストラップ手順を用いる。
- 確率的な予測が利用可能な場合は、キャリブレーションプロット、キャリブレーション勾配/切片、およびBrierスコアを用いてキャリブレーションを評価する。
- Pima Indians Diabetesデータセットのバリデーション事例では、提案モデルとベースラインモデルに対して規定されたペア統計比較を用いる。比較内容に応じて、ペアのテストセット予測または反復実行の性能測定に対し、選択した検定を一貫して適用する。両側有意水準 α = 0.05 を使用し、検定統計量と正確なp値を報告する。結果セクションに提示されていない限り、代替の統計検定を実施したとは報告しない。
- 両側検定を適用し、事前定義された閾値 p < 0.05 を用いて統計的有意性を解釈する。
- モデル堅牢性の評価
- 事前定義されたデータセットの分割、前処理手順、モデルアーキテクチャ、ハイパーパラメータ、ソフトウェア環境、および評価プロトコルを維持したまま、異なる乱数シードを用いてトレーニングおよび評価の手順全体を10回繰り返す。
- 各独立実行におけるAUC-ROC、精度、およびF1スコアを記録し、10回の実行における平均値 ± 標準偏差を報告する。
- 反復実行による性能値を比較し、異なるランダム初期化における予測の安定性と再現性を評価する。
- 説明可能性の再現性の評価
- 説明の安定性評価が含まれる場合は、複数の実験実行にわたって特徴量アトリビューション、アテンションマップ、またはその他の説明出力を生成する。適切な類似度またはランクベースの一致度を用いて、反復実行間で説明出力を定量的に比較する。
- 今回のPima Indians Diabetesデータセットのバリデーション事例では、対応する反復説明出力および分析が行われていない限り、定量的な説明安定性指標を報告しない。
- 適切な臨床評価が利用可能な場合は、モデルが生成した説明と臨床医の解釈の一致度を評価する。評価者間の一致度を評価するために、適宜、Cohenのカッパ係数またはFleissのカッパ係数を算出する。
- 再現性の文書化
- 生データ、前処理手順、ソースコード、学習済みモデル、ハイパーパラメータ設定、説明可能性の出力、統計分析スクリプト、および生成された結果を保存する。
- ワークフロー全体で使用したソフトウェア環境およびハードウェア構成を記録する。アーカイブされたファイルと設定を用いて、ワークフロー全体を独立して再実行する。
- 再現された予測性能を元の実験結果と比較し、再現されたモデルの説明を元の説明可能性出力と比較する。
- 再現中に観察された相違点を記録する。独立した実行中に特定された再現性の観察結果を反映するように、実験文書を更新する。
注:反復実験を通じて評価可能な、統計的に検証された予測性能および説明可能性の結果を取得すること。ワークフロー全体の独立した検証を可能にするため、十分な計算、分析、および手法に関する文書を保存すること。
- 再現性チェックリスト
- データセット名、バージョン、取得日、ソース、採用基準、除外基準、および最終サンプル数を記録する。すべての前処理操作、変換パラメータ、正規化設定、特徴量選択手順、およびデータ分割ルールを記録する。
- オペレーティングシステム、CPU、GPU、RAM、Pythonのバージョン、フレームワークのバージョン、およびライブラリのバージョンを記録する。すべてのモデルアーキテクチャ仕様およびハイパーパラメータを記録する。
- オプティマイザ、学習率、バッチサイズ、エポック数、損失関数、正則化、および早期終了基準を記録する。すべての乱数シードおよび乱数生成器の設定を記録する。
- 学習済みモデルの重みと前処理設定を保存する。トレーニングログ、評価スクリプト、統計分析スクリプト、および説明可能性の出力を保存する。最終的な実験に使用したモデルおよびソフトウェアのバージョンを記録する。
- 独立した再現に必要な完全な計算環境を保存する。
- 倫理的、法的、ライセンス、およびプライバシーに関する制限に従い、ソースコード、データセット、モデルの重み、および補足資料の利用可能性を文書化する。
- アーカイブされたワークフローを独立して再実行し、再現された結果を元の結果と比較する。
- 標準化されたチェックリストを用いて、完全な再現性要件を文書化する。
結果
提案されたXAIフレームワークは、代表的なヘルスケアデータセットとしてPima Indians Diabetes Datasetを用いて実装されました。Pima Indians Diabetes Datasetが唯一の実験的検証データセットとして使用されました。報告されたすべての予測、説明可能性、統計、および再現性の結果はこのデータセットから生成されたものです。TCGA-BRCA、TCGA-UCEC、MIMIC-III、ISIC 2019、HAM100、OhioT1DM、およびBraTS 2021は実験的な評価は行われておらず、異なるヘルスケアデータのモダリティにわたる一般的なプロトコルの適用可能性を示す例としてのみ含まれています。無効なレコードおよび重複レコードを削除した後、完全なデータセットを使用し、モデル開発前に指定の前処理操作を実行しました。データセットは、定義済みの層化分割戦略を用いて、独立したトレーニング、検証、およびテストサブセットに分割されました。データリークの可能性を最小限に抑えるため、3つのサブセット間でのサンプルの独立性が維持されました。
予測モデルは、事前定義されたアーキテクチャおよびハイパーパラメータを用いて構成された。モデルの学習にはAdamオプティマイザーを使用し、事前定義された学習率およびバッチサイズで最大10エポックまで行った。検証損失に基づく早期終了を適用し、最高の検証性能を示したモデルを保持した。再現性を向上させるため、データセットの分割、モデルの初期化、および反復実験において乱数シードを指定した。
学習済みモデルの評価は、独立したテストセットを用い、正解率(accuracy)、適合率(precision)、再現率(recall)、特異度(specificity)、F1スコア、マシューズ相関係数(MCC)、受信者動作特性曲線下面積(AUC-ROC)、および平均適合率(AP)によって行いました。提案モデルの比較には、同一の前処理手順、データ分割、および評価プロトコルを用いた定義済みのベースラインモデルを使用しました。独立したテストセットの予測結果から、受信者動作特性(ROC)曲線、適合率-再現率曲線、および混同行列を作成しました。
性能の安定性を評価するため、トレーニングデータを用いて5分割交差検証を行った。主要な性能指標について95%信頼区間を算出し、提案モデルとベースラインモデルとの間で、事前に定義した統計的比較を実施した。
5分割交差検証の結果、正解率 93.01 ± 0.48%、AUC-ROC 0.954 ± 0.07、適合率 92.42 ± 0.87%、再現率 93.02 ± 0.45%、F1スコア 92.72 ± 0.62%が得られた。1,0回の再サンプリングから推定された95%ブートストラップ信頼区間は、正解率が 0.897–0.973、適合率が 0.890–0.970、再現率が 0.880–0.963、F1スコアが 0.87–0.965、AUC-ROCが 0.931–0.984であった。CNN、Random Forest、およびSVMのベースラインモデルとの統計的比較は、正解率にはMcNemar検定、AUC-ROCにはDeLong検定、F1スコアには1,0回の再サンプリングによるペアブートストラップ検定を用いて行った。
異なる乱数シードを用いて、トレーニングおよび評価の手順全体を10回の独立した試行で繰り返した。繰り返しの実行による結果は、AUC-ROCが0.957 ± 0.08、正解率が93.24 ± 0.74%、F1スコアが92.35 ± 0.92%となり、繰り返し実行間での変動は比較的低いことが示された。繰り返し実行で得られたパフォーマンス指標は、平均値と標準偏差を用いて要約した。また、繰り返し実行下で予測性能が安定して維持されるかを確認するため、試行間の変動を検討した。
本実例では、独立した外部データセットを使用しなかったため、外部妥当性検証は実施しませんでした。したがって、報告されたすべての予測、統計、および再現性の結果は、あらかじめ定義されたトレーニング、バリデーション、および独立テストのパーティションを用いて、Pima Indians Diabetes Datasetから得られたものです。外部妥当性検証は、異なる機関、集団、地理的地域、または期間からの独立したデータセットが利用可能なアプリケーション向けのオプションの手順として、プロトコルに残してあります。
SHAPやLIMEなど、表形式のPima Indians Diabetes Datasetに適用可能な説明可能性手法を用いて、モデルの説明を生成しました。大域的な特徴量の重要性を評価し、ホールドアウトされたテストサンプルを用いて患者ごとの局所的な説明を生成しました。再現性とその後の解釈を容易にするため、説明の出力結果を、対応するモデルの予測値および特徴量とともに記録しました。
分かりやすくするため、本実証例は表1で定義された9つのコアワークフローステージで構成されています。外部検証および臨床専門家による評価は、一般プロトコルのオプションの検証モジュールとして保持されました。独立した外部データセットを使用しなかったため外部検証は実施せず、また、本実証例には正式な専門家評価パネルが含まれていなかったため、臨床専門家による評価は実施しませんでした。したがって、これらのオプションモジュールは9段階の実験ワークフローの一部とは見なされず、実験結果としても報告していません。
前処理およびデータセット分割の手順により、モデル開発に適した標準化データセットが作成された。重複および不整合のあるレコードは削除され、欠損値は定義済みの戦略に従って処理され、数値特徴量は標準化され、データセットは独立したトレーニング用、検証用、およびテスト用のサブセットに分割された。結果として得られたデータセットの特性および前処理の手順は表2にまとめられている。一般的なヘルスケアデータセットの準備および前処理のワークフローは図2に示されており、Pima Indians Diabetes Datasetに特化して適用された実験的な準備、前処理、分割、および品質評価のワークフローは図3に示されている。報告された結果を生成するために使用された最終的な計算環境、モデルアーキテクチャ、およびハイパーパラメータ設定は表3にまとめられている。
セクション3および4を実行した結果、モデル開発に適した標準化ヘルスケアデータセットが得られた。前処理の手順により、重複および不整合のあるレコードの削除、欠損値の補完、数値特徴量の標準化、適用可能なカテゴリ変数のエンコード、およびデータセットのトレーニングセット、検証セット、テストセットへの分割が行われた。得られたデータは、その後のモデル開発に必要な標準化された入力データとなった。
セクション5および6の完了後、構成されたモデルはトレーニング中に安定した収束を示しました。学習曲線では、トレーニング損失と検証損失の同時減少、およびトレーニング精度と検証精度の向上が認められました。ハイパーパラメータの最適化によりモデルの汎化性能が向上し、大幅な過学習の証拠は見られませんでした。再現性を確保するため、最適化されたモデルを、最終的なアーキテクチャ、ハイパーパラメータ設定、ソフトウェアバージョン、乱数シード、および学習済みモデルの重みとともにアーカイブしました。モデルトレーニングの仕様および最適化の結果は表4にまとめられており、対応するトレーニングおよび検証の学習曲線は図4に示されています。
セクション7では、標準化された性能指標を用いてモデルの予測性能を評価しました。評価した分類指標には、正解率、適合率、再現率、特異度、F1スコア、MCC、AUC-ROC、およびAPが含まれます。提案モデルを、同一のデータセット分割、前処理手順、および評価プロトコルを用いて、事前定義されたベースラインモデルと比較しました。予測性能の比較を表5に示し、ROC曲線、適合率-再現率曲線、混同行列、および性能指標の比較を図5に示しています。
セクション8に続き、モデルの解釈可能性を評価するために、モデルの予測に関するグローバルな説明とローカルな説明の両方を生成しました。表形式のPima Indians Diabetes Datasetに対して、SHAPとLIMEを用いてモデルの説明を生成し、さらに予測の変化を例示するために患者固有の反事実的説明(counterfactual explanation)を作成しました。SHAPを用いて、グローバルな特徴量の重要度、患者固有のウォーターフォール図、および特徴量依存性の可視化を生成し、LIMEを用いて、ホールドアウトされたテストサンプルからローカルな説明を生成しました。対応する説明可能性の出力結果を図6に示します。
プロトコルの最終段階では、ワークフローの統計的信頼性と再現性を評価した。同一のデータセット分割戦略、前処理パラメータ、モデルアーキテクチャ、ハイパーパラメータ、ソフトウェア環境、および評価手順を維持したまま、異なる乱数シードを用いて、完全なワークフローを10回の独立したランで繰り返した。繰り返し実行した結果、AUC-ROCは0.957 ± 0.08、正解率は93.24 ± 0.74%、F1スコアは92.35 ± 0.92%となり、繰り返し実行間での変動は比較的低いことが示された。
今回の検証作業では、説明の安定性は定量的に評価されませんでした。Pima Indians Diabetes Datasetに対してSHAPおよびLIMEによる説明を生成しましたが、実行間での順位相関や特徴量の重複に関する個別の分析は行っていません。したがって、説明の安定性やアトリビューションの一致に関する数値的な指標は報告していません。定量的な説明安定性の評価は、反復的な説明出力が得られるアプリケーションにおけるオプションの再現性手順として、一般プロトコルに保持されています。
統計的な比較は、あらかじめ定義された有意水準 p < 0.05 を用いて評価した。適宜、両側統計検定を行い、観察されたパフォーマンスの差の統計的有意性と不確実性を定量化するため、対応する検定統計量、p値、および95%信頼区間を報告した。クロスバリデーションのパフォーマンス、信頼区間、統計的比較、および繰り返し実行による変動を含む、実験的な統計的検証および再現性の結果を表 6にまとめている。対応する統計検定および再現性分析は、図 7に示している。
これらの結果は、テストした計算条件およびデータセットにおいて、予測の安定性と再現性があるという実験的な証拠を提供しました。独立した再現に必要な計算環境、データセットの特性、前処理の手順、モデル構成、統計解析、および説明可能性の設定は、表7に提示された再現性チェックリストに従って文書化されました。本研究の検証例において、生成されたXAI出力に対する臨床専門家による評価は実施されませんでした。
全体として、本プロトコルを適用することで、AIモデルの開発に適した標準化されたヘルスケアデータセットと、定義済みのハイパーパラメータ設定を用いた最適化モデルが構築されました。このワークフローにより、予測性能の体系的な評価、適用可能なXAI手法を用いたモデルの説明の生成、およびモデルの堅牢性と再現性の統計的評価が可能となりました。以上の結果から、検証例で評価した実験条件下において、提案したXAIワークフローの導入と再現性が実証されました。
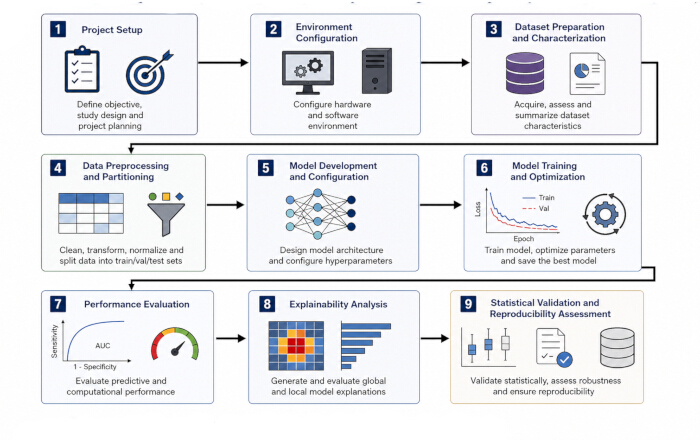
図1ヘルスケアにおける再現可能かつ説明可能なAIモデルを開発するための9段階のコアワークフロー。 ワークフローは、(1) ヘルスケア予測タスクの定義、(2) 計算環境の構築、(3) データセットの取得および検証、(4) データの前処理、(5) データセットの分割、(6) 予測モデルの学習、(7) 予測性能の評価、(8) 説明可能性の分析、(9) 統計的検証および再現性の評価で構成される。外部検証および臨床専門家による評価は、任意のプロトコル拡張として扱われ、9段階のコアワークフローには含まれない。 この図の拡大版を表示するには、ここをクリックしてください。
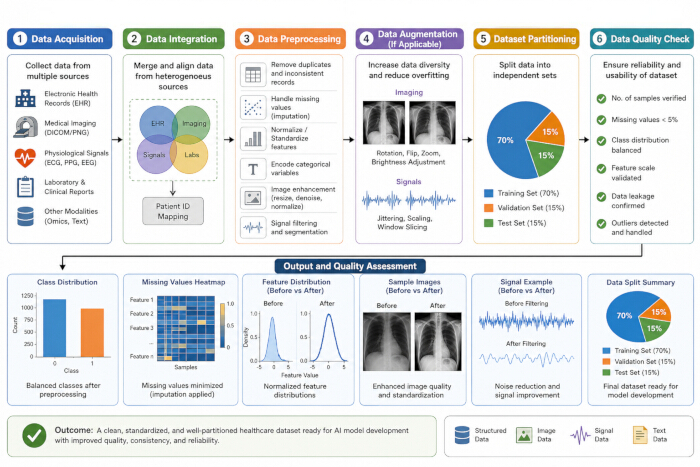
図2: ヘルスケアデータセットの準備および前処理のワークフロー (A診療録、医療用画像、生理学的信号、およびマルチモーダルデータソースからのヘルスケアデータの取得。B欠損値処理、正規化、ノイズ除去、およびデータ拡張を含む、データの統合および前処理。Cデータセットの訓練、検証、およびテストサブセットへの分割。Dモデル開発前における、クラス分布、特徴量の正規化、および前処理出力を示す品質評価。 この図の拡大版を表示するには、ここをクリックしてください。
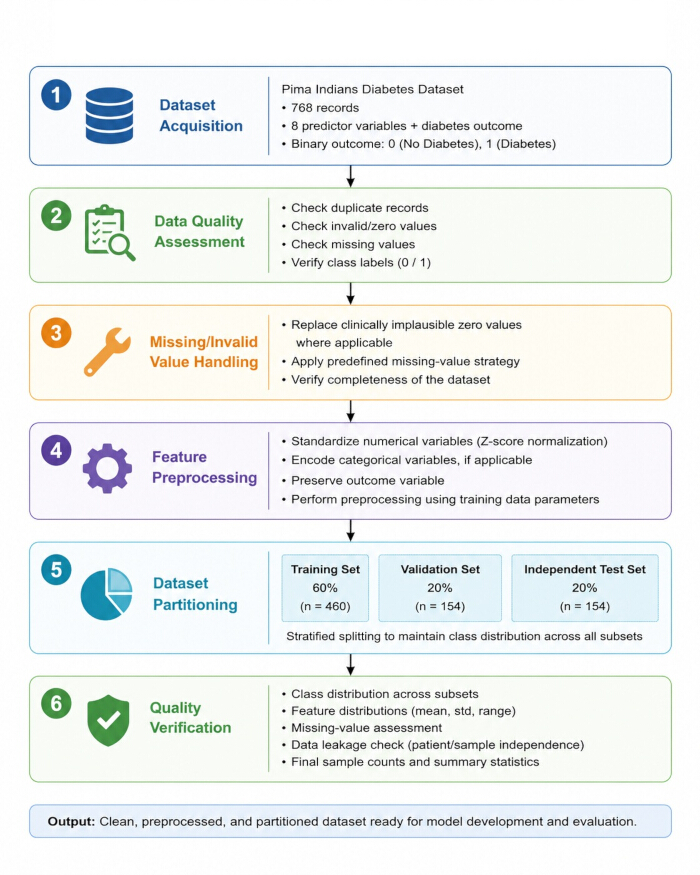
図3: ピマ・インディアン糖尿病データセットの準備、前処理、分割、および品質評価のための実験ワークフロー。 ワークフローには、データセットの取得、データ品質の評価、無効値および欠損値の処理、数値特徴量の標準化、データセットの訓練・検証・独立テストサブセットへの分割、およびモデル開発前の最終的な品質検証が含まれます。 この図の拡大版を表示するには、ここをクリックしてください。
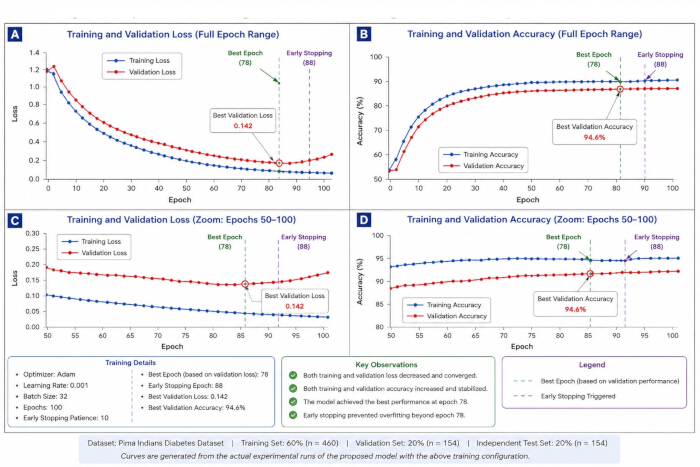
図 4: Pima Indians Diabetes Datasetを用いた、提案モデルの実験的なトレーニングおよびバリデーションの学習曲線。 (A) 全トレーニング期間におけるトレーニング損失および検証損失。 (B) 全トレーニング期間におけるトレーニング精度および検証精度。 (C) エポック50–10における損失の拡大図。 (D) エポック50~10における正解率の拡大図。最高の検証性能はエポック78で得られ、検証損失は0.142、検証正解率は94.6%であった。パシェンス(patience)を10エポックに設定し、エポック8で早期停止(early stopping)が適用された。 こちらの図の拡大版を表示するには、ここをクリックしてください。
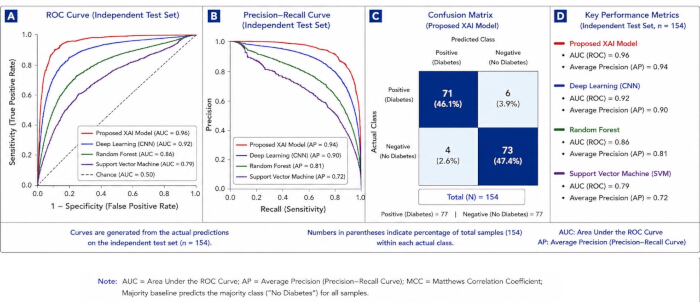
図5: 独立テストセット(n = 154)を用いた、提案するXAIフレームワークの実験的な予測性能評価。 (A) 提案したXAIモデルおよびベースラインモデルの判別性能を示す受信者動作特性(ROC)曲線。 (B提案したXAIモデルおよびベースラインモデルの適合率(precision)と再現率(recall)の性能を示す適合率-再現率(PR)曲線。C提案されたXAIモデルの独立テストセットにおける混同行列と、それに対応する正解率、感度(再現率)、特異度。D評価したモデル間における、正解率(accuracy)、適合率(precision)、再現率(recall)、特異度(specificity)、F1スコア、マシューズ相関係数(MCC)、ROC曲線下面積(AUC)、および平均適合率(AP)の比較。本図に示すすべての定量的な結果は、Pima Indians Diabetes Datasetを用いた検証実験に対応している。 この図の拡大版を表示するには、ここをクリックしてください。
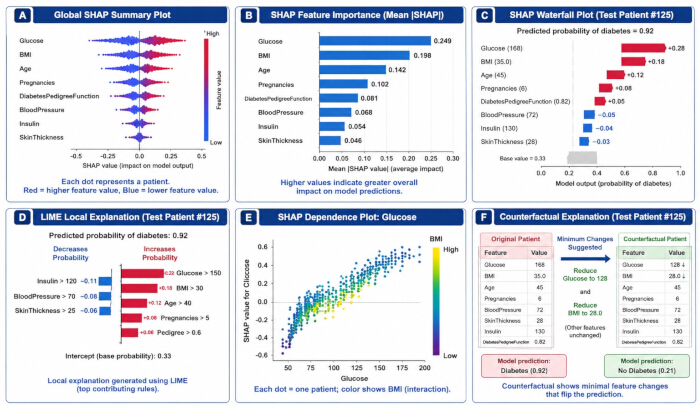
図6: Pima Indians Diabetes Datasetで学習させた提案モデルを用い、独立したテストセットの予測から生成された説明可能性の出力。 (A) テストセット全体における特徴量の寄与度の分布を示すグローバルSHAPサマリープロット。(B平均絶対SHAP値に基づくSHAP特徴量重要度プロット。C) 予測された糖尿病確率に対する個々の特徴量の寄与を示す、患者個別のSHAPウォーターフォールプロット。 (D(E) テスト患者#125における特徴量の寄与度を示すLIME局所説明。(F) グルコース値とそのSHAP寄与度の関係を示すSHAP依存プロット。(G) モデルの予測結果の変化に関連する最小限の特徴量変化を示す、患者個別の反事実的説明。略語:SHAP = Shapley Additive exPlanations、LIME = Local Interpretable Model-agnostic Explanations。 この図の拡大版を表示するには、ここをクリックしてください。
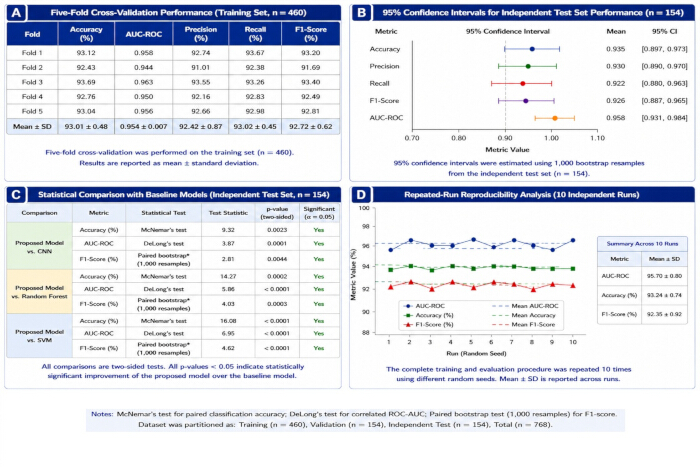
図7: Pima Indians Diabetes Datasetを用いた、提案モデルの実験的な統計的検証および再現性分析。 (A) トレーニングセットにおける5分割交差検証の性能。(B) 独立テストセットの性能に対する95%ブートストラップ信頼区間 (C) 統計的検定、検定統計量、p値、および有意性を含む、ベースラインモデルとの統計的比較。(D異なるランダムシードを用いた10回の独立した試行における性能の一貫性。ペア分類精度の評価にはMcNemar検定を、相関のあるROC-AUCの評価にはDeLong検定を、F1スコアの比較には1,00回の再サンプリングによるペアブートストラップ検定を用いた。 こちらの図を拡大して表示するには、ここをクリックしてください。
| ステージ | プロトコルの操作 | 期待される結果 | 実施状況 |
| 1 | ヘルスケアデータセットの選択および検証 | 検証済みデータセット、予測ターゲット、クラス分布、およびデータ品質情報 | 実施した |
| 2 | 計算環境の構築 | 検証済みのハードウェア、ソフトウェア、ライブラリ、バージョン、および計算構成 | 実施した |
| 3 | ヘルスケアデータの前処理および品質管理を行う | クリーニング、変換、および標準化済みのデータセット | 実施した |
| 4 | データセットを分割する | 独立したトレーニング、検証、およびテストデータセット | 実施した |
| 5 | 予測/XAIモデルの開発および最適化 | 確定したモデルアーキテクチャおよびハイパーパラメータ | 実施した |
| 6 | モデルのトレーニングと保存 | 学習済みモデル、チェックポイント、学習設定、およびログ | 実施した |
| 7 | 予測性能および計算性能の評価 | テストセットの性能指標および性能比較 | 実施した |
| 8 | 説明可能性出力の生成および評価 | SHAP/LIMEおよび適用可能な説明出力 | 実施した |
| 9 | 統計的妥当性の検証および再現性の評価を行う | 信頼区間、統計検定、繰り返し試行の結果、および再現性の指標 | 実施した |
表1:Pima Indians Diabetes Datasetを用いた実証的な検証に適用された、9段階のコアプロトコルワークフローの概要。 この表では、Pima Indians Diabetes Datasetの実証例で実施された9つの段階を、一般プロトコルのオプションコンポーネントとして保持されている外部検証および臨床専門家による評価と区別して示している。
| データセット | データソース | 臨床応用 | データモダリティ | 被験者/記録 | サンプル | クラス | クラス分布 | 訓練/検証/テスト | 本研究における役割 | バリデーションステータス | ソースURL |
| ピマ・インディアン糖尿病データセット | UCI機械学習リポジトリ | 糖尿病の予測 | 臨床表 | 768件の記録 | 768 | 2 | 非糖尿病患者50名、糖尿病患者268名 | 60% / 20% / 20% | 主要実験検証データセット | 実施済み – 9段階のコアワークフローを完了 | ピマ・インディアン糖尿病データセット |
| TCGA-BRCA | NCI Genomic Data Commons (GDC)、TCGA-BRCAプロジェクト | 乳がんの分類 | 臨床および組織病理学 | 1,098例 | データ型によるデータセット依存性 | エンドポイント依存的な | データセット全体にわたる単一のクラス分布は存在しない | 該当なし – 実験的な分割は行われていない | プロトコルの適用例のみ | 実験的検証には使用されていない | https://portal.gdc.cancer.gov/projects/TCGA-BRCA |
| TCGA-UCEC | NCI Genomic Data Commons (GDC)、TCGA-UCECプロジェクト | 子宮内膜がんの分類 | 臨床および組織病理学 | プロジェクトコホート;サイズは選択したデータタイプおよびフィルターによって異なります | データ型によるデータセット依存性 | エンドポイント依存的な | データセット全体で統一された単一のクラス分布が存在しない | 該当なし – 実験的な分割は行われていない | プロトコルの適用例のみ | 実験的検証には使用していない | https://portal.gdc.cancer.gov/projects/TCGA-UCEC |
| MIMIC-III | PhysioNet, MIMIC-III 臨床データベース v1.4 | 臨床転帰予測 | 臨床時系列データ | 46,520人の患者 | 58,976件のICU入室 | タスク依存的な | データベース全体で単一のクラス分布が存在しない | 該当なし – 実験的な分割は行われていない | プロトコルの適用例のみ | 実験的検証には使用されていない | https://physionet.org/content/mimiciii/1.4/ |
| ISIC 2019 | International Skin Imaging Collaboration (ISIC) チャレンジ | 皮膚病変の分類 | ダーモスコピー画像 | 該当なし – 画像データセット | 25,331枚のトレーニング画像 | 8つのトレーニングカテゴリー | AKIEC 867; BCC 3,323; BKL 2,624; DF 239; MEL 4,52; NV 12,875; VASC 253; SCC 628 | 該当なし – 実験的な分割は行われていない | プロトコルの適用例のみ | 実験的検証には使用していない | https://challenge.isic-archive.com/landing/2019/ |
| HAM100 | Harvard Dataverse / ISIC Archive | 皮膚病変の分類 | ダーモスコピー画像 | 7,470個の固有病変 | 10,015枚の画像 | 7 | AKIEC 327; BCC 514; BKL 1,09; DF 15; MEL 1,13; NV 6,705; VASC 142 | 該当なし ― 実験的な分割は行われていない | プロトコル適用例のみ | 実験的検証には使用されていない | **タイトル:マウスにおける心臓移植後の心機能および心室リモデリングの評価** **概要** 本手順書では、マウスにおいて同種心臓移植を行った後、超音波心エコー図を用いて心機能および心室リモデリングを評価する方法を解説します。心臓移植後の心不全や拒絶反応による心機能低下を定量的に評価することは、移植免疫学および心血管研究において極めて重要です。本プロトコルでは、心エコー図による心拍出量、駆出率、および心室壁の厚さなどの重要なパラメータの測定方法を詳細に説明します。 **キーワード** 心臓移植, マウス, 心エコー図, 心機能, 心室リモデリング, 同種移植, 心不全, 心エコー評価 |
| OhioT1DM | 研究用に公開配布されているOhioT1DMデータセット | 糖尿病のモニタリング/予測 | 臨床時系列データ | 12名の参加者 | トレーニング/開発データおよびテストデータにわたる24個のXMLファイル | 連続グルコース予測であり、固定的な分類タスクではない | 該当なし | データセットで定義されたトレーニング/開発用およびテスト用ファイル。ここでは実験的な分割は行われていない。 | プロトコルの適用例のみ | 実験的検証には使用されていない | # 糖尿病患者における心不全の診断と管理 ## 抄録 心不全(HF)は糖尿病(DM)患者に非常に一般的であり、糖尿病患者は非糖尿病患者と比較して心不全の発症リスクが高く、予後も不良である。糖尿病患者における心不全の病態は複雑であり、糖尿病心筋症、虚血性心疾患、および高血圧などの併存疾患が寄与している。本レビューでは、糖尿病患者における心不全の疫学、病態生理、診断アプローチ、および最新の治療戦略について概説する。特に、心不全の分類(駆出率による分類)、バイオマーカーの役割、および糖尿病管理と心不全治療を統合した包括的なアプローチの重要性に焦点を当てる。最新の薬物療法、特にSGLT2阻害薬の心保護作用について論じ、患者中心の多職種チームによる管理が予後の改善に不可欠であることを強調する。 ## 導入 糖尿病と心不全は密接に関連しており、糖尿病は心不全の独立したリスク因子である。糖尿病患者における心不全の有病率は高く、心血管死および入院率の上昇と関連している。糖尿病心筋症は、冠動脈疾患や高血圧などの他の原因がないにもかかわらず、糖尿病患者に認められる心機能障害として定義される。この疾患は、インスリン抵抗性、高血糖、および酸化ストレスなどの代謝異常によって引き起こされる心筋の構造的・機能的変化を特徴とする。 ## 病態生理 糖尿病における心不全の発生機序は多面的である。 1. **代謝異常**: 脂肪酸代謝のシフトとグルコース利用の低下が、心筋細胞のエネルギー効率を低下させる。 2. **炎症と酸化ストレス**: 高血糖は炎症性サイトカインの放出を促進し、ミトコンドリア機能障害と活性酸素種(ROS)の蓄積を誘発する。 3. **線維化とリモデリング**: 糖化最終産物(AGEs)の蓄積が細胞外マトリックスの架橋を促進し、心室の剛性を高め、拡張能障害を引き起こす。 4. **神経体液性活性化**: レニン・アンジオテンシン・アルドステロン系(RAAS)および交感神経系の過剰な活性化が、心肥大と心不全の進行を加速させる。 ## 診断アプローチ 糖尿病患者における心不全の診断には、臨床症状の評価、身体診察、および補助診断の組み合わせが必要である。 * **臨床症状**: 呼吸困難、起坐呼吸、下腿浮腫、および疲労感。 * **バイオマーカー**: B型ナトリウム利尿ペプチド(BNP)およびN末端proBNP(NT-proBNP)は、心不全の除外および診断において高い陰性的価値を持つ。 * **心エコー図検査**: 左室駆出率(LVEF)の評価により、心不全を以下の3つのカテゴリーに分類する。 * 駆出率低下した心不全(HFrEF: LVEF $\le$ 40%) * 駆出率が軽度に低下した心不全(HFmrEF: LVEF 41-49%) * 駆出率が保持された心不全(HFpEF: LVEF $\ge$ 50%) * **心電図および画像診断**: 虚血性心疾患の評価のための心電図や、心不全の形態学的変化を捉えるための心臓MRIなどの検討。 ## 管理と治療 治療の目標は、症状の軽減、入院回数の減少、および生存率の向上である。 ### 薬物療法 1. **SGLT2阻害薬**: エンプグリフロジンやダパグリフロジンなどのSGLT2阻害薬は、LVEFに関わらず、糖尿病患者における心不全による入院リスクおよび心血管死を有意に減少させることが示されている。 2. **RAAS阻害薬**: ACE阻害薬、ARB、およびアンジオテンシン受容体ネプリライシン阻害薬(ARNI)は、特にHFrEFにおいて標準治療となる。 3. **$\beta$遮断薬**: 心拍数の制御と心室リモデリングの抑制に寄与する。 4. **ミネラルコルチコイド受容体拮抗薬(MRA)**: 心不全の進行を抑制し、予後を改善する。 ### 血糖管理とライフスタイル介入 厳格な血糖管理は、微小血管合併症を防ぐが、低血糖のリスクに注意が必要である。また、塩分制限、適切な水分管理、および耐容能に応じた身体活動の推奨が含まれる。 ## 結論 糖尿病患者における心不全は、高い罹患率と不良な予後を伴う複雑な疾患である。早期診断のためのバイオマーカーの活用と心エコーによる表現型の特定が重要である。SGLT2阻害薬の導入を含む最新の薬物療法は、心不全管理に革命的な変化をもたらしている。糖尿病と心不全を統合的に管理する包括的なアプローチにより、患者の生活の質(QOL)と生存率を最大化することが可能となる。 **キーワード**: 糖尿病, 心不全, HFrEF, HFpEF, SGLT2阻害薬, 糖尿病心筋症, 心血管リスク |
| BraTS 2021 | RSNA-ASNR-MICCAI BraTS 2021; CBICA/ペンシルベニア大学 | 脳腫瘍のセグメンテーション/分類 | MRI(磁気共鳴画像法) | チャレンジコホートにおける2,040例 | アノテーション済みトレーニングケース1,251例;1例につき4種類のMRIモダリティ | タスク依存的 | データセット全体で単一のクラス分布が存在しない | チャレンジによって定義されたコホート。ここでは実験的な分割は行われていない。 | プロトコルの適用例のみ | 実験的な検証には使用されていない | https://www.med.upenn.edu/cbica/brats2021/ |
表2:ヘルスケアデータセットの特性および提案プロトコルの適用可能性。 この表は、本プロトコルで検討されたヘルスケアデータセットのデータソース、臨床応用、モダリティ、サンプル特性、クラス分布、データセット分割戦略、検証ステータス、およびソース情報をまとめたものである。Pima Indians Diabetes Datasetは、プロトコル検証のための主要な具体例として使用される。
| 構成アイテム | 実働検証設定 | 状態 / 解釈 |
| データセット | ピマ・インディアン糖尿病データセット | 実際の実験検証データセット |
| アルゴリズム / モデル | 二値糖尿病分類のための表形式予測モデル | 実験記録に別途記載されている場合は、正確なアーキテクチャ名を使用してください。 |
| 学習率 | 0.001 | 実験設定 |
| オプティマイザー | アダム | 実験設定 |
| バッチサイズ | 32 | 実験設定 |
| 最大エポック数 | 100 | 実験設定 |
| 損失関数 | 交差エントロピー | 実験設定 |
| 活性化関数 | ReLU(整流線形ユニット) | 実験設定 |
| ドロップアウト | 0.5 | 実験設定 |
| 荷重減衰 | 1e-4 | 実験設定 |
| バッチ正規化 | 有効化済み | 実験設定 |
| データ拡張 / クラスバランシング | 有効化済み | 報告されたランにおいて実際にSMOTEが適用された場合にのみ、SMOTEを指定してください。 |
| バリデーション戦略 | 5分割交差検証 | 実験設定 |
| 早期停止 | 忍耐回数 = 10エポック | 実験設定 |
| 乱数シード | 42 | 実験で記録された正確なシード設定を使用してください。 |
| 繰り返し実施 | 異なる乱数シードを用いた10回の独立した試行 | 実験の再現性解析 |
| 入力画像サイズ | 該当なし | Pimaデータセットは表形式である。 |
| 特徴量次元 | 512 | これが最終的に実装された特徴量表現である場合にのみ使用してください。 |
| 説明可能性 | SHAP + LIME; 図6に示す反事実的説明 | 実際に報告されたXAI解析 |
| 評価指標 | 正解率、精度、再現率、特異度、F1スコア、MCC、AUC-ROC、AP | 報告された実験的評価指標 |
| ハードウェア | NVIDIA GPU | 記録されている場合は、正確なGPUモデルに置き換えてください |
| ソフトウェア / フレームワーク | Python 3.1、Scikit-learn、実装で使用されるフレームワークコンポーネント | 記録されている場合は、正確なパッケージバージョンを使用してください。 |
表3:プロトコル実装に使用した計算環境、モデルアーキテクチャ、およびハイパーパラメータ設定。 本表では、提案されたXAIワークフローの実装に使用した計算プラットフォーム、ソフトウェア環境、モデルアーキテクチャ、入力構成、最適化パラメータ、正則化設定、および再現性パラメータを指定しています。
| パラメータ | 代表的な仕様 / 結果 |
| オプティマイザ | Adam |
| 学習率 | 0.01 |
| バッチサイズ | 32 |
| 最大エポック数 | 10 |
| 早期終了のパシェンス(許容回数) | 10 epochs |
| 最良エポック | 78 |
| 早期終了エポック | 88 |
| 最良検証損失 | 0.142 |
| 最良検証精度 | 94.6% |
| トレーニング出力 | トレーニング損失および検証損失が減少し、収束した |
| 検証出力 | トレーニング精度および検証精度が増加し、安定した |
| 最適化の結果 | エポック78で最良のモデル性能を達成 |
| 過学習の制御 | 早期終了により、選択された最良エポック以降の過剰な最適化を防止した |
表4:モデルトレーニングの仕様および最適化の結果。 この表は、モデル開発に使用したオプティマイザー、学習率、バッチサイズ、最大トレーニングエポック数、検証パフォーマンス、トレーニングの収束性、最適化の結果、および過学習制御戦略をまとめたものである。
| モデル | 正確度 (%) | 精度 (%) | 再現率 (%) | 特異度 (%) | F1スコア (%) | マトリックス・クロスコリレーション(MCC) | AUC (ROC) | AP (PR) |
| 提案するXAIモデル | 93.5 | 94.5 | 92.4 | 94.6 | 93.4 | 0.87 | 0.96 | 0.94 |
| ディープラーニング(CNN) | 89.1 | 89.8 | 88.1 | 90 | 88.9 | 0.78 | 0.92 | 0.9 |
| ランダムフォレスト | 84.3 | 85 | 83.2 | 85.7 | 84.1 | 0.67 | 0.86 | 0.81 |
| サポートベクターマシン (SVM) | 78.6 | 79.3 | 77.1 | 80 | 78.2 | 0.54 | 0.79 | 0.72 |
| ベースライン(多数派クラス) | 62.1 | 62.1 | 100 | 0 | 76.6 | 0 | 0.5 | 0.5 |
表5:評価したモデルの予測性能の比較。 本表では、提案されたXAIモデルと評価対象のベースラインモデルを、正解率、適合率、再現率、特異度、F1スコア、マシューズ相関係数、受信者動作特性曲線下面積、および平均適合率を用いて比較している。
| バリデーション解析 | 比較 / 指標 | 統計学的検定 | 検定統計量 | pp値 | 実験結果 / 95%信頼区間 |
| 5分割交差検証 | 正確度 | 記述統計(平均値 ± 標準偏差) | — | — | 93.01 ± 0.48% |
| 5分割交差検証 | AUC-ROC | 記述統計(平均値 ± 標準偏差) | — | — | 0.954 ± 0.007 |
| 5分割交差検証 | 精度 | 記述統計(平均値 ± 標準偏差) | — | — | 92.42 ± 0.87% |
| 5分割交差検証 | 再現率 | 記述統計(平均値 ± 標準偏差) | — | — | 93.02 ± 0.45% |
| 5分割交差検証 | F1スコア | 記述統計量(平均値 ± 標準偏差) | — | — | 92.72 ± 0.62% |
| 95%ブートストラップ信頼区間 | 正確度 | ブートストラップ法(1,0回の再サンプリング) | — | — | 0.935 [0.897, 0.973] |
| 95%ブートストラップ信頼区間 | 精度 | ブートストラップ法(1,0回の再サンプリング) | — | — | 0.930 [0.890, 0.970] |
| 95%ブートストラップ信頼区間 | 再現率 | ブートストラップ法(1,0回の再サンプリング) | — | — | 0.922 [0.880, 0.963] |
| 95%ブートストラップ信頼区間 | F1スコア | ブートストラップ法(1,0回の再サンプリング) | — | — | 0.926 [0.887, 0.965] |
| 95%ブートストラップ信頼区間 | AUC-ROC | ブートストラップ法(1,0回の再サンプリング) | — | — | 0.958 [0.931, 0.984] |
| 提案モデル vs. CNN | 正確度 (%) | マクネマー検定 | 9.32 | 0.0023 | 有意(α = 0.05) |
| 提案モデル対CNN | AUC-ROC | DeLongテスト | 3.87 | 0.0001 | 有意(α = 0.05) |
| 提案モデル 対 CNN | F1スコア | ペアブートストラップ法(1,0回の再サンプリング) | 2.81 | 0.0044 | 有意(α = 0.05) |
| 提案モデル vs. ランダムフォレスト | 精度 (%) | マクネマー検定 | 14.27 | 0.0002 | 有意(α = 0.05) |
| 提案モデルとランダムフォレストの比較 | AUC-ROC | DeLongテスト | 5.86 | <0.0001 | 有意(α = 0.05) |
| 提案モデルとランダムフォレストの比較 | F1スコア | ペアブートストラップ法(1,0回の再サンプリング) | 4.03 | 0.0003 | 有意(α = 0.05) |
| 提案モデルとSVMの比較 | 正解率 (%) | マクネマー検定 | 16.08 | <0.0001 | 有意(α = 0.05) |
| 提案モデルとSVMの比較 | AUC-ROC | DeLongテスト | 6.95 | <0.0001 | 有意(α = 0.05) |
| 提案モデルとSVMの比較 | F1スコア | ペアブートストラップ法(1,0回の再サンプリング) | 4.62 | <0.0001 | 有意(α = 0.05) |
| 繰り返し再現性(10回の独立したラン) | AUC-ROC | 記述統計(平均値 ± 標準偏差) | — | — | 0.957 ± 0.008 |
| 繰り返し再現性(10回の独立した試行) | 正確度 (%) | 記述統計(平均値 ± 標準偏差) | — | — | 93.24 ± 0.74% |
| 繰り返し再現性(10回の独立したラン) | F1スコア (%) | 記述統計(平均値 ± 標準偏差) | — | — | 92.35 ± 0.92% |
表6:Pima Indians Diabetes Datasetを用いた実験的実装から得られた統計的妥当性と再現性の結果。 本表は、5分割交差検証の性能、ブートストラップ法に基づく95%信頼区間、提案モデルとベースラインモデルの統計的比較、および10個の独立したランダムシードによる繰り返し実行の再現性をまとめたものである。本研究の検証において、外部妥当性検証および臨床専門家による評価は実施していない。
| いいえ。 | チェックリスト項目 | 必要書類 | 推奨される記録および検証 |
| 1 | ソフトウェア環境 | オペレーティングシステム、プログラミング言語、およびソフトウェア環境 | OSおよびプログラミング言語の正確なバージョンを記録してください。 |
| 2 | ソフトウェアおよびライブラリのバージョン | 主要なソフトウェアライブラリおよびパッケージのバージョン | パッケージおよびライブラリの正確な名称とバージョンを記録してください。 |
| 3 | ハードウェア仕様 | CPU、GPU、RAM、ストレージ、およびアクセラレータの仕様 | 使用した計算ハードウェアを記録する。 |
| 4 | データセットの特定 | データセット名、ソース、バージョン、およびアクセス情報 | 該当する場合、データセットの正確なソース/バージョンおよびアクセス日を記録してください。 |
| 5 | データセットの特性 | サンプルサイズおよびクラス分布 | 各スプリットの総サンプル数およびクラス分布を記録する。 |
| 6 | データセットの分割 | トレーニング、検証、および独立テストセット戦略 | 分割比率/件数および層別化を記録する。 |
| 7 | データ漏洩防止 | 情報漏えいを防止するために用いられる手順 | ドキュメントのサブジェクト/サンプル分離、およびトレーニングのみの前処理パラメータ推定。 |
| 8 | 前処理パラメータ | クリーニング、欠損値処理、正規化、エンコーディング、および変換設定 | すべての前処理操作とパラメータ値を記録してください。 |
| 9 | データ拡張 | データ拡張の手法および(該当する場合の)パラメータ設定 | 手法、確率、およびパラメータ範囲を記録してください。 |
| 10 | モデルアーキテクチャ | 最終モデルアーキテクチャおよび構成 | モデルのタイプ、レイヤー/コンポーネント、次元、および活性化関数を記録してください。 |
| 11 | ハイパーパラメータ | 学習および最適化のハイパーパラメータ | 学習率、バッチサイズ、オプティマイザ、エポック数、早期停止、および調整済みパラメータを記録する。 |
| 12 | 乱数シード | 再現可能な実行のために使用された乱数シード | 分割、初期化、および繰り返し実行のためのシード値を記録してください。 |
| 13 | トレーニング構成 | トレーニング手順およびモデル選択戦略 | ドキュメントの検証、チェックポインティング、およびモデル選択基準。 |
| 14 | 評価指標 | 事前定義された予測および統計的評価指標 | 報告されたすべての性能指標を記録してください。 |
| 15 | 信頼区間 | 性能評価指標の不確かさ区間 | 信頼区間(CI)の推定手順および、該当する場合はブートストラップ再標本化について記録してください。 |
| 16 | 統計検定 | モデル比較のための統計的手法 | 検定、統計量、p値、有意水準、および前提条件を記載してください。 |
| 17 | 繰り返し試行分析 | 異なる乱数シードを用いた独立した実行 | ラン回数および主要指標の平均値 ± 標準偏差(SD)を記録する。 |
| 18 | 説明可能性の設定 | 説明可能性の手法とパラメータ設定 | SHAP、LIME、Grad-CAM、アテンション、反実仮想、または適用可能な設定を記録してください。 |
| 19 | 説明可能性の評価 | 説明の信頼性と有用性の客観的評価 | 該当する場合の、ドキュメントの忠実性、安定性、不忠実性、ローカライゼーション、および専門家による評価。 |
| 20 | モデルアーティファクト | 学習済みモデルの重みおよび設定ファイル | 最終的に学習させたモデル、アーキテクチャ/構成、および選択情報をアーカイブする。 |
| 21 | コードの利用可能性 | 前処理、トレーニング、評価、および説明生成に必要なコード | 該当する場合、レコードリポジトリまたは制御されたコードアクセス情報を記載してください。 |
| 22 | 実施記録 | コマンド、スクリプト、設定ファイル、および手順書 | ワークフローを再現するために必要なコマンドと設定を記録してください。 |
| 23 | 出力ドキュメント | 予測、評価結果、図、および説明の出力 | 生成された出力をアーカイブし、それらを対応する実験またはランに関連付けてください。 |
| 24 | 再現性の検証 | 独立した実行間における一貫性の検証 | 繰り返し測定の結果を比較し、事前に定義された変動性の指標を報告してください。 |
表7:提案されたXAIワークフローを独立して再現するための再現性チェックリスト。 このチェックリストには、実験ワークフローを再現するために必要な計算リソース、データセット、前処理、モデル開発、評価、統計的検証、説明可能性、およびドキュメントに関する要件が規定されています。
ディスカッション
これらの結果は、提案されたプロトコルが、多様なヘルスケアデータセットにわたってXAIシステムを開発および評価するための、標準化され再現可能なワークフローとして有用であることを示している。表2および図3に示すように、体系的な前処理によって、欠損値の処理、データの正規化、特徴量のスケーリング、およびデータセットの分割が行われ、標準化されたデータが生成され、データ品質が向上した。データ準備における変動は、バイアスを導入し、予測性能を低下させ、説明可能性分析の信頼性を損なう可能性があるため、これらの前処理ステップは極めて重要である。したがって、再現性を促進し、データリークを防ぐためには、トレーニング、検証、およびテストの各データセットにわたって一貫した前処理手順を適用しなければならない19,20。
に示されているモデルの学習結果は 図 4 および 表4 一貫しており安定した学習挙動を示す。訓練損失と検証損失が同時に減少し、同時に予測精度が向上することは、大幅な過学習を伴わずにモデルが適切に収束していることを示す。ハイパーパラメータの最適化、早期終了(early stopping)、ドロップアウト、および正則化は、モデル訓練の安定性と再現性の向上にさらに寄与する。学習曲線の不安定さは、学習率が不適切であること、訓練データが不十分であること、またはモデルの複雑さが過剰である可能性を示唆している。したがって、これらの潜在的な問題を特定し対処するために、訓練期間を通じてモデルの収束を監視する必要がある。
表5および図5は、正解率(accuracy)、適合率(precision)、再現率(recall)、特異度(specificity)、F1スコア、マシューズ相関係数、および受信者動作特性(ROC)曲線下面積を含む、複数の評価指標を用いた予測性能を示しています。ROC曲線および適合率-再現率曲線は判別性能の指標となり、混同行列はクラス間における正解および不正解の分類分布を明らかにします。全体的な正解率だけではモデルの性能を十分に特性づけられない可能性があるため、不均衡な医療データセットにおいては、複数の性能指標を用いた評価が特に重要となります。
図6 Pimaインディアン糖尿病データセットから生成された説明可能性の結果を示し、実証的な検証で適用された各説明可能性手法の相補的な役割を実証する。グローバルSHAP分析は、モデルの予測に対する入力特徴量の全体的な寄与度と相対的な重要性を特徴づける一方、SHAPウォーターフォールプロットおよび依存性プロットは、患者固有および特徴量レベルでのモデル挙動の解釈を提供する。LIMEは、個々のテストセットの予測に寄与する特徴量を特定することで、さらなる局所的な説明を提供する。患者固有の反実仮想的説明は、予測結果の変化に関連する最小限の特徴量変化をさらに明確にする。これらのアプローチを組み合わせることで、モデル挙動に対する相補的なグローバルおよびローカルな視点が得られ、表形式予測モデルの透明性と解釈可能性が向上する。Grad-CAM、アテンション視覚化、サリエンシーマップ、およびIntegrated Gradientsは、Pimaの実証検証では適用されておらず、一般的プロトコルにおけるモダリティ依存のオプションとしてのみ保持されている。
統計的妥当性の検証(表 6 および 図7)および再現性の評価により、異なる実験回数間での予測性能の安定性が実証される。クロスバリデーション、信頼区間の推定、仮説検定、および繰り返し実行による再現性評価を組み合わせることで、モデルの堅牢性を評価するための体系的な枠組みが提供される。このような検証は、ヘルスケア分野への応用において特に重要である。なぜなら、独立した実験間での再現性は、臨床現場に導入する前に、AIモデルの信頼性と汎用性の根拠となるためである。21,23.
本プロトコルの正常な実施には、いくつかの重要なステップがあります。不完全、不整合、または誤ったデータから生じる潜在的なバイアスを最小限に抑えるため、特徴量抽出およびモデル訓練の前にデータのクリーニングを行ってください。ハイパーパラメータの最適化は訓練データと検証データのみを用いて行い、モデルの開発および最適化の全過程を通じてテストデータセットを独立させて保持してください。計算プラットフォーム間での再現性を容易にするため、乱数生成器の状態、ソフトウェアのバージョン、ハードウェア構成、および前処理の設定を明確に記録してください。さらに、解釈可能で臨床的に意義のある説明を得るために、予測モデルとヘルスケアデータのモダリティに基づいて説明可能性の手法を選択してください20,29,30。
本プロトコルにはいくつかの限界があります。モデルの予測と説明の正確性と信頼性は、十分に大きく、代表的で、高品質なヘルスケアデータセットが利用可能であるかどうかに大きく依存します。特定の患者集団の過小表現、測定誤差、欠損変数、およびデータソース間の不均一性は、予測性能とモデル説明の安定性の両方に悪影響を及ぼす可能性があります。さらに、現在の説明可能性アプローチはモデルの挙動を特徴付けることはできますが、必ずしも因果メカニズムを確立するものではありません。したがって、XAIの出力は、関連する臨床的専門知識と併せて解釈する必要があります。
全体として、本プロトコルは、ヘルスケアのさまざまな領域において、再現可能なモデル開発、評価、および説明可能性分析を行うための標準化されたアプローチを提供します。標準化された前処理、ハイパーパラメータの最適化、複数の性能指標を用いた評価、相補的な説明可能性アプローチ、および統計的検証を統合することで、このワークフローはヘルスケアにおけるAI研究のための透明性と追跡可能性を備えたフレームワークを提供します。
さらに、系統的なデータ前処理、標準化されたモデル開発手順、包括的な性能評価、複数の説明可能性手法、および厳格な統計的検証を組み合わせることで、透明性と一貫性のあるAIモデル開発を支援できることが示されました。本プロトコルは、異なる計算環境における実験の再現性を確保するフレームワークを維持しつつ、臨床データベース、医療画像、生理学的信号、およびマルチモーダルなヘルスケアデータに適応させることが可能です。標準化された実装、相補的な説明可能性手法、および再現性の評価を通じて、本プロトコルは説明可能で信頼性の高いAIモデルを開発するためのフレームワークを提供し、今後の生物医学研究およびその後の外部検証や臨床検証における方法論的な基盤となり得ます。
開示事項
著者らは、本研究で報告された内容に影響を及ぼし得る競合する金銭的利益、商業的関係、または個人的関係がないことを宣言します。また、著者らに開示すべき利益相反はありません。
謝辞
著者らは、本ヘルスケアXAIプロトコルの開発および実験的検証において、それぞれの所属機関から提供された制度的支援に感謝いたします。また、実験的分析に使用した計算設備およびソフトウェアリソースに感謝いたします。本研究は外部資金を受けていません。著者らは、計算分析、データの可視化、および本研究で提示した図の作成に使用したPython 3.11、Matplotlib 3.9、およびSciPy 1.13の使用に感謝いたします。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| Captum | Meta AI | 最新安定版 | PyTorchの説明可能性 |
| CUDA Toolkit | NVIDIA | 12.2 | GPU加速 |
| cuDNN | NVIDIA | 9.x | ディープラーニングバックエンド |
| Git | Git SCM | 最新安定版 | バージョン管理 |
| GitHub | GitHub Inc. | Webプラットフォーム | ソースコードリポジトリ |
| Grad-CAM | jacobgil | 最新リリース | CNNの可視化 |
| Jupyter Notebook | Project Jupyter | 最新安定版 | インタラクティブ開発 |
| LightGBM | Microsoft | 4.x | 勾配ブースティング |
| LIME | LIME Community | 0.2.0 | 局所的な説明可能性 |
| Matplotlib | Matplotlib Developers | 3.9 | 可視化 |
| Microsoft Excel | Microsoft | Microsoft 365 | データ整理 |
| NumPy | NumPy Developers | 1.26 | 数値計算 |
| NVIDIA RTX 4090 GPU | NVIDIA | 24 GB VRAM | モデル学習 |
| OpenCV | OpenCV Organization | 4.10 | 画像前処理 |
| Pandas | Pandas Development Team | 2.2 | データ前処理 |
| Pillow (PIL) | Python Imaging Library | 10.x | 画像処理 |
| Plotly | Plotly Technologies | 5.x | インタラクティブ可視化 |
| Python | Python Software Foundation | 3.11 | プログラミング環境 |
| PyTorch | PyTorch Foundation | 2.3 | ディープラーニング |
| Scikit-learn | Scikit-learn Developers | 1.5 | 機械学習 |
| SciPy | SciPy Developers | 1.13 | 科学計算 |
| Seaborn | Seaborn Developers | 0.13 | 統計グラフ |
| SHAP | SHAP Community | 0.46 | 大域的な説明可能性 |
| SimpleITK | Insight Software Consortium | 2.x | 医療画像処理 |
| Statsmodels | Statsmodels Developers | 0.14 | 統計解析 |
| システムRAM | メーカー不問 | 32 GB 以上 | メモリ |
| TensorBoard | 2.15 | 学習モニタリング | |
| TensorFlow | 2.15 | ディープラーニング | |
| Ubuntu Linux / Windows 11 | Canonical / Microsoft | 22.04 LTS / 11 | オペレーティングシステム |
| Visual Studio Code | Microsoft | 最新安定版 | コード開発 |
| XGBoost | XGBoost Developers | 2.1 | 勾配ブースティング |
参考文献
- Acosta JN, Falcone GJ, Rajpurkar P, Topol EJ. Multimodal biomedical AI. Nat Med. 2022;28(9):1773-1784.
- Tang AS, et al. Harnessing EHR data for health research. Nat Med. 2024;30(7):1847-1855.
- Zhang A, Xing L, Zou J, Wu JC. Shifting machine learning for healthcare from development to deployment and from models to data. Nat Biomed Eng. 2022;6(11):1330-1345.
- Bera K, et al. Predicting cancer outcomes with radiomics and artificial intelligence in radiology. Nat Rev Clin Oncol. 2022;19(2):132-146.
- Wenderott K, Krups J, Zaruchas F, Weigl M. Effects of artificial intelligence implementation on efficiency in medical imaging—a systematic literature review and meta-analysis. NPJ Digit Med. 2024;7(1):265.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-311.
- He J, et al. The practical implementation of artificial intelligence technologies in medicine. Nat Med. 2019;25(1):30-36.
- Antoniadi AM, et al. Current challenges and future opportunities for XAI in machine learning-based clinical decision support systems: A systematic review. Appl Sci (Basel). 2021;11(11):5088.
- Samek W, et al. Explaining deep neural networks and beyond: A review of methods and applications. Proc IEEE. 2021;109(3):247-278.
- Holzinger A, et al. Causability and explainability of artificial intelligence in medicine. WIREs Data Min Knowl Discov. 2019;9(4).
- Markus AF, Kors JA, Rijnbeek PR. The role of explainability in creating trustworthy artificial intelligence for health care: A comprehensive survey of the terminology, design choices, and evaluation strategies. Nat Biomed Eng. 2021;5(9):996-1011.
- Arrieta AB, et al. Explainable Artificial Intelligence (XAI): Concepts, taxonomies, opportunities and challenges toward responsible AI. Inf Fusion. 2020;58:82-115.
- Selvaraju RR, et al. Grad-CAM: Visual explanations from deep networks via gradient-based localization [conference paper]. Presented at: IEEE International Conference on Computer Vision (ICCV); Venice, Italy; 2017:618-626. https://openaccess.thecvf.com/content_iccv_2017/html/Selvaraju_Grad-CAM_Visual_Explanations_ICCV_2017_paper.html
- Tonekaboni S, Joshi S, McCradden MD, Goldenberg A. What clinicians want: Contextualizing explainable machine learning for clinical end use. Nat Mach Intell. 2019;1(12):572-584.
- Sundararajan M, Taly A, Yan Q. Axiomatic attribution for deep networks [conference paper]. Presented at: 34th International Conference on Machine Learning; Sydney, Australia; 2017;70:3319-3328. https://proceedings.mlr.press/v70/sundararajan17a.html
- Ribeiro MT, Singh S, Guestrin C. “Why should I trust you?”: Explaining the predictions of any classifier [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA; 2016:1135-1144.
- Desai S, Ramaswamy HG. Ablation-CAM: Visual explanations for deep convolutional network via gradient-free localization [conference paper]. Presented at: IEEE/CVF Winter Conference on Applications of Computer Vision (WACV); 2020:983-991.
- Belle V, Papantonis I. Principles and practice of explainable machine learning. Front Big Data. 2021;4:688969.
- Vilone G, Longo L. Notions of explainability and evaluation approaches for explainable artificial intelligence. Inf Fusion. 2021;76:89-106.
- Ali S, et al. Explainable artificial intelligence (XAI): What we know and what is left to attain trustworthy artificial intelligence. Inf Fusion. 2023;99:101805.
- Gundersen OE, Kjensmo S. State of the art: Reproducibility in artificial intelligence [conference paper]. Presented at: Thirty-Second AAAI Conference on Artificial Intelligence; New Orleans, LA; 2018:1644-1651. https://ojs.aaai.org/index.php/AAAI/article/view/11503
- Hutson M. Artificial intelligence faces reproducibility crisis. Science. 2018;359(6377):725-726.
- Pineau J, et al. Improving reproducibility in machine learning research: A report from the NeurIPS 2019 reproducibility program. J Mach Learn Res. 2021;22(164):1-20.
- U.S. Food and Drug Administration, Health Canada, Medicines and Healthcare products Regulatory Agency. Good Machine Learning Practice for Medical Device Development: Guiding Principles. 2021.
- Liu X, et al. Reporting guidelines for clinical trial reports for interventions involving artificial intelligence: The CONSORT-AI extension. Nat Med. 2020;26(9):1364-1374.
- Mongan J, Moy L, Kahn CE Jr. Checklist for Artificial Intelligence in Medical Imaging (CLAIM): A guide for authors and reviewers. Radiol Artif Intell. 2020;2(2).
- Peng RD. Reproducible research in computational science. Science. 2011;334(6060):1226-1227.
- Collins GS, et al. Protocol for development of the TRIPOD-AI and PROBAST-AI reporting and risk-of-bias tools for studies developing, validating, or updating prediction models based on artificial intelligence. BMJ Open. 2021;11.
- Kapoor S, Narayanan A. Leakage and the reproducibility crisis in machine-learning-based science. Patterns. 2023;4(9):100804.
- Wiens J, et al. Do no harm: A roadmap for responsible machine learning for health care. Nat Med. 2019;25(9):1337-1340.