このワークフローでは、バルクおよびシングルセルトランスクリプトミクスを患者組織の予備アッセイと統合し、糖尿病性足潰瘍におけるMMP1を優先的に特定しました。MMP1は線維芽細胞中心の発現パターンと高い組織存在量を示し、マトリックスリモデリングとの関連性が支持されましたが、因果関係および臨床的有用性は未解決のままです。
研究記事
統合的バルクおよびシングルセル・トランスクリプトミクスと組織検証による糖尿病性足潰瘍におけるMMP1の優先順位付け
* These authors contributed equally
この記事について
サマリー
要約
糖尿病性足潰瘍(DFU)において再現性のあるトランスクリプトーム変化をもたらす細胞源は、まだ十分に定義されていません。本研究では、変動発現解析、加重遺伝子共発現ネットワーク解析(WGCNA)、糖尿病性末梢神経障害(DPN)遺伝子スクリーニング、探索的な機械学習による特徴量選択、2つの外部バルクトランスクリプトームデータセット、シングルセル解析、中医学(TCM)ネットワーク解析、および患者組織を用いた定量的PCR(qPCR)とウェスタンブロッティングを統合して解析しました。GSE199939(DFUサンプル10例、コントロールサンプル11例)において、3,691個の変動発現遺伝子が同定され、WGCNAのブルーモジュールがDFUと強い相関を示しました(r = 0.97, p = 5 × 10-13)。変動発現遺伝子、ブルーモジュールのハブ遺伝子、および1,062個のDPN関連遺伝子の積集合から、77個の候補遺伝子が抽出されました。CCL7、CHEK1、MKI67、MMP1、MMP13、およびTRPV2は、少なくとも2つの特徴量選択手法によって支持されましたが、サポートベクターマシン再帰的特徴消去における完全な分離は、発見コホートへの過学習の懸念を抱かせました。MMP1は、発見コホートにおいて最大の発現変化を示しました(log2 fold change = 9.854; adjusted p = 1.24 × 10⁻²⁹)。統合されたGSE68183/GSE80178マトリックスにおいて、MMP1の補正後p値は0.0159であり、受信者動作特性曲線下面積(AUC)は0.981でした。GSE134431では、MMP1の発現は非潰瘍性の糖尿病性足皮膚よりもDFUで名目的に高い値を示しました(p = 0.0225; adjusted p = 0.135; AUC = 0.808)。24サンプルから得られた69,944個の細胞の解析により、線維芽細胞でMMP1の平均発現量が最も高く、サンプルレベルではDFUの線維芽細胞、角質細胞、および内皮細胞で発現が高いことが示されました。患者組織のアッセイでは、4組のペアにおいてMMP1 mRNA量が高く(ΔCqによるペアテスト, p = 3.04 × 10⁻⁵)、3組のペアにおいてタンパク質量が高いことが示されました(paired p = 0.0107)。統計的な再現性は不完全でした。これらの知見は、線維芽細胞を中心としたマトリックスリモデリングとの関連を示唆していますが、カウントベースの発見解析におけるTPM(transcripts per million)入力、不完全なシングルセル前処理記録、および組織アッセイコホートの小規模さによる制限があります。因果関係および臨床的有用性はまだ確立されていません。
概要
糖尿病性足潰瘍は、ニューロパチー、反復的な機械的負荷、末梢動脈疾患、感染への感受性、および組織修復能の低下が複合的に作用して発生する、糖尿病の深刻かつ再発しやすい合併症である。近年の推定では、世界中で毎年数百万人もの人々が影響を受けており、治癒には時間を要することが多く、再発、入院、下肢切断、および死亡という重大なリスクを伴う1。したがって、予防および管理には、局所の創傷ケアだけでなく、保護感覚の消失の特定、足底圧の軽減、感染症および虚血の治療、ならびに全身的なリスク要因への対処が必要となる1,2。糖尿病性末梢ニューロパチーは特に重要であり、進行性の感覚機能障害により圧迫、外傷、および組織崩壊への認識が低下する一方で、運動および自律神経の異常が足のバイオメカニクスや皮膚の完全性をさらに変化させる可能性がある2,3。組織レベルでは、ニューロパチーによる損傷が、神経炎症、微小血管機能不全、代謝ストレス、および修復不全と共存している可能性があり、標準的なケアを行っても損傷が持続する創傷環境が形成される1,3。
皮膚の治癒を成功させるには、炎症、再上皮化、血管新生、線維芽細胞の活性化、細胞外マトリックス(ECM)の沈着、およびその後のマトリックス再構築が協調的に行われる必要があります。糖尿病においては、これらのプロセスが時間的に乱れることがあります。例えば、炎症シグナルが活性化したままになったり、角化細胞の遊走が妨げられたり、内皮細胞の応答が不十分になったり、線維芽細胞が異常なマトリックスを産生または構築したりすることがあります。線維芽細胞は、マトリックスタンパク質の合成、コラーゲン構造の調節、免疫細胞や上皮細胞との相互作用、および創傷収縮への寄与を行うため、修復のストローマ段階において中心的な役割を担っています。患者由来のDFU線維芽細胞を用いた研究では、ECM関連の転写およびマトリックス構築に持続的な異常があることが示されており、線維芽細胞の状態が慢性創傷の生物学における重要な要素であるという見解を支持しています4。マトリックスメタロプロテアーゼ(MMP)は、ECM基質を切断することで細胞遊走、組織代謝、および再構築を可能にすることにより、このプロセスに関与します。しかし、その影響は部位、タイミング、基質の可用性、および組織メタロプロテアーゼ抑制因子(TIMP)による調節に依存します5。したがって、タンパク質分解とマトリックス置換の不均衡は修復不全と一致する可能性がありますが、単一のMMPの発現増加だけでは、それが有害な役割を果たすか有益な役割を果たすかを決定づけるものではありません。線維状コラーゲンの代謝に関与できる間質性コラーゲナーゼであるマトリックスメタロプロテアーゼ1(MMP1)は、DFU組織において変化していることが報告されており、先行する臨床研究ではMMP/TIMPプロファイルと創傷の状態または治癒軌跡との関連が示されています6,7。これらの観察結果は、DFUにおけるMMP1のさらなる研究を支持するものです。
トランスクリプトーム解析は、糖尿病性足潰瘍(DFU)に関連する分子プログラムを特定するための体系的なアプローチを提供しますが、いくつかの方法論的な制限が解釈を困難にしています。バルク組織のデータセットでは、角化細胞、線維芽細胞、内皮細胞、免疫細胞、およびその他のコンパートメント全体のシグナルが平均化されるため、候補遺伝子が特定の細胞型における発現変化を反映しているのか、細胞組成の変化を反映しているのか、あるいはその両方であるのかを判断することが困難です。また、プラットフォーム、標準化戦略、組織サンプリング部位、潰瘍の重症度、感染状態、疾患ステージ、および参照組織の違いによって、データセット間の比較可能性が低下することがあります。重要な点として、潰瘍化していない糖尿病患者の足部皮膚は、臨床的に関連のある糖尿病組織の比較対象となりますが、健康な皮膚と互換性があるわけではありません。シングルセルRNAシーケンシングは、不均一な細胞集団とその転写状態を解明することで、細胞ソースの問題を部分的に解決できます。DFUに関する過去のシングルセルおよび空間トランスクリプトーム研究では、異なる線維芽細胞集団が特定され、線維芽細胞のプログラムが創傷の状況や治癒状態に応じて異なることが示されました8。これらの知見は、バルクのトランスクリプトームデータを補完するために、細胞解像度での解析を用いることの有用性を支持しています。
特徴量選択の手法は、高次元の発現データから候補を優先順位付けするのに役立つ可能性がありますが、小規模サンプルによる生物医学研究は、楽観的な推定や不安定な遺伝子選択の影響を特に受けやすくなります。測定変数の数が生物学的サンプルの数を大幅に上回る場合、汎用性のある予測情報が限られているときであっても、見かけ上の完全な分離が起こる可能性があります。特徴量選択、チューニング、および性能評価に同じ観察データを再利用すると、AUCがさらに膨張するため、予測性能を評価するには、入れ子状交差検証(nested cross-validation)、ロック済みモデル、および真に独立したテストコホートが不可欠となります9,10。公開されているコホートは小規模で不均一であることが多いため、これらの懸念はDFUの研究において重要です。なお、中医学の成分-標的-生薬データベースは、仮説生成のためだけにのみ使用されました。
本研究では、バルクトランスクリプトミクス、WGCNA、DPN関連遺伝子のスクリーニング、機械学習による特徴量選択、外部データセットによる評価、シングルセル解析、TCMネットワーク解析、および患者組織による検証を統合しました。探索コホートで特定された候補遺伝子を、追加のトランスクリプトームデータセットを用いて評価し、最有力候補をシングルセルデータを用いて特定の細胞型に局在させました。次に、qPCRおよびウェスタンブロッティングにより、患者組織におけるMMP1のmRNAおよびタンパク質レベルを検討しました。このフレームワークは、再現性のあるDFU関連候補を特定し、その細胞学的および生物学的背景を明らかにすることを目的として設計されました。
プロトコル
Study design and data sources
The study, including the collection and use of patient tissue specimens for qPCR and western blot validation, was reviewed and approved by the Ethics Committee of Wuhan Fourth Hospital (approval No. KY2024-161-01). All procedures involving human tissue were conducted in accordance with the approved protocol and applicable ethical principles. The transcriptomic component of the study used publicly available, de-identified datasets. Written informed consent was obtained from all participants whose tissue specimens were used for the experimental validation. The publicly available transcriptomic datasets were analyzed in de-identified form, and consent procedures for the original data-generating studies were handled by the respective institutions.
This study integrated bulk transcriptomics, network analysis, feature selection, single-cell analysis, TCM network prediction, and patient-tissue validation. The discovery cohort was Gene Expression Omnibus (GEO) dataset GSE199939 (10 DFU and 11 control samples). External bulk-transcriptomic assessment included a merged GSE68183/GSE80178 matrix (9 DFU and 6 control samples) and GSE134431 (13 DFU and 8 non-ulcerated diabetic foot skin [DFS] samples). Single-cell analysis used a preprocessed, SingleR-annotated Seurat object derived from GSE165816, comprising 69,944 cells from 24 samples (14 DFU and 10 controls). Tissue assessment included four matched DFU–periwound patient pairs for qPCR and three matched pairs for western blotting, based on recovered assay records and author-confirmed pairing. All materials and equipment used in this study are listed in the Table of Materials.
Construction of the DPN-related gene set
DPN-related genes were retrieved from the National Center for Biotechnology Information (NCBI) Gene database using rentrez. Search terms included “diabetic peripheral neuropathy”, “diabetic neuropathy”, “diabetic polyneuropathy”, “painful diabetic neuropathy”, and “diabetic sensorimotor polyneuropathy”, restricted to Homo sapiens. Returned identifiers were mapped to official gene symbols, converted to uppercase, cleaned, and deduplicated. The database-derived genes were combined with a literature-curated DPN gene list and deduplicated, yielding 1,062 DPN-related genes. The complete search strings and identifier-cleaning code are included in the accompanying scripts; they also include diabetic neuropathies, diabetes combined with distal symmetric/symmetrical polyneuropathy or peripheral neuropathy, and the Diabetic Neuropathies MeSH term. The literature-derived component still requires citation-level provenance.
Discovery-cohort preprocessing and differential-expression analysis
The GSE199939 expression matrix was aligned to the phenotype table by sample identifier. Duplicate gene identifiers were made unique. The archived discovery analysis rounded the expression values and fitted a negative-binomial model using DESeq2 (version 1.48.2), with group as the design factor and DFU versus control as the contrast. Genes with missing adjusted p values were excluded. Multiple testing was controlled using the Benjamini–Hochberg (BH) procedure. The archived differentially expressed gene (DEG) list used an absolute log2 fold change greater than 1 and BH-adjusted p < 0.05. Comparison with the public GEO source confirmed that the input was TPM, rather than raw read counts. Rounding TPM does not meet the raw-count requirement of DESeq2. The original estimates are retained, but the validity of the discovery statistics and dependent WGCNA and feature-selection results remains unresolved pending appropriate reanalysis. The source comparison is documented in the supplementary archive.
For visualization, the DESeq2 variance-stabilizing transformation (VST) was applied with blind = FALSE. Principal component analysis (PCA) was performed on the VST expression matrix. The heatmap used row-wise z scores for the 50 genes with the smallest adjusted p values. The PCA implementation centered and scaled gene-wise transformed values using prcomp with scale. = TRUE.
Weighted gene co-expression network analysis
For WGCNA, genes with counts greater than 5 in at least three GSE199939 samples were retained. Size factors were estimated with DESeq2, VST was applied with blind = TRUE, and the 5,000 genes with the largest across-sample variance were selected. Sample and gene quality was assessed using goodSamplesGenes, and average-linkage hierarchical clustering was used for sample-level quality assessment.
A signed network was constructed with WGCNA (version 1.74). Candidate powers of 1–10 and 12–30 in increments of 2 were evaluated using pickSoftThreshold; a scale-free topology fit target of 0.85 was used, and the selected soft-thresholding power was 18. Modules were identified with blockwiseModules using a signed adjacency and signed topological overlap matrix, Pearson correlation, minimum module size of 30, merge cut height of 0.25, reassignment threshold of 1 × 10⁻⁶, pamRespectsDendro = FALSE, and maximum block size of 10,000.
Module eigengenes were correlated with a binary DFU trait. Non-gray modules with |r| > 0.5 and p < 0.05 were considered DFU-associated. For each associated module, gene significance (GS) was defined as the Pearson correlation between gene expression and DFU status, and module membership (MM) as the Pearson correlation between gene expression and the corresponding module eigengene. Hub genes were defined by |MM| > 0.8 and |GS| > 0.5. The blue module, which showed the strongest positive association with DFU, was carried forward. Its hub genes were intersected with the DEGs and the DPN-related gene set. The reported hub threshold therefore uses the absolute values of both MM and GS, regardless of correlation sign.
Machine-learning-based feature prioritization
The 77 genes shared by the DEG, blue-module hub-gene, and DPN-related gene sets were evaluated in GSE199939. Duplicate gene symbols were collapsed by their mean expression. The candidate-gene matrix was log2-transformed as when the maximum value exceeded 50, zero-variance features were removed, and retained features were standardized. A random seed of 123 was used. The implemented sequence was cohort-wide candidate screening, duplicate-symbol collapsing, conditional log transformation, zero-variance filtering, full-cohort centering and scaling, and algorithm-specific feature selection. DEG and WGCNA screening used the full discovery cohort before algorithm-level cross-validation. The reported workflow therefore does not establish leakage-free nested validation, and its internal AUCs cannot be used as unbiased estimates of predictive performance.
Three feature-selection procedures were applied. First, least absolute shrinkage and selection operator (LASSO) logistic regression was fitted with glmnet (version 5.0), binomial family, alpha = 1, classification error as the cross-validation measure, no additional standardization, and five-fold cross-validation constrained by the smaller class size. Features at lambda.1se were selected; lambda.min was used only if lambda.1se selected no gene. Second, a random forest with 1,000 trees was fitted using randomForest (version 4.7-1.2); genes with a mean decrease in Gini at least as large as the mean importance across candidate genes were retained. Third, linear support vector machine recursive feature elimination (SVM-RFE) was implemented with e1071 (version 1.7-17), ranking features by the squared linear weight on the full cohort before evaluating progressively smaller feature subsets by leave-one-out cross-validation (LOOCV) AUC. The ranking was not recomputed within each training fold. Linear SVM fitting used scale = FALSE and probability = TRUE without an explicit cost-tuning grid. LASSO penalty selection used its internal cross-validation without a separate outer evaluation loop, and random-forest importance was calculated from the full cohort.
No gene was selected by all three methods; therefore, genes supported by at least two methods were retained. SVM-RFE produced an AUC of 1.00 across all evaluated subset sizes, and the smallest tied subset was selected. Because this complete separation raised concerns about overfitting and optimistic assessment in the small discovery cohort, the SVM-RFE AUC was not interpreted as an estimate of clinical performance. No locked multigene model was tested in an external cohort; external receiver operating characteristic (ROC) analyses assessed individual candidate-gene expression. Inspection of the analysis script confirmed that preprocessing and SVM feature ranking were not confined to training folds. The same LOOCV results were used to choose the subset size, without an outer evaluation loop. Consequently, this workflow contains information leakage and supports exploratory feature prioritization only.
Functional enrichment analysis
Gene Ontology (GO) and Kyoto Encyclopedia of Genes and Genomes (KEGG) over-representation analyses were performed on the six-gene panel. Gene symbols were mapped to Entrez identifiers with org.Hs.eg.db (version 3.21.0). GO analysis was performed with clusterProfiler (version 4.16.0) across biological process, cellular component, and molecular function ontologies. KEGG enrichment used the human organism code (hsa). Significant terms were defined as nominal p < 0.05 and BH-adjusted p < 0.05. Because only six genes were included, enrichment analysis was used primarily for functional annotation. The KEGG script used local KEGG.db annotations with enrichKEGG(use_internal_data = TRUE); the annotation release must be documented. The GO and KEGG scripts did not supply a custom universe, so the annotation databases defined the default backgrounds.
External bulk-transcriptomic assessment
For the merged GSE68183/GSE80178 matrix, gene symbols were standardized and duplicate symbols were collapsed by mean expression across matching rows. The six candidate genes were aligned to the phenotype file. Because the available files did not fully document the upstream merging and batch-correction procedure, this dataset was analyzed as provided and interpreted cautiously. Consequently, neither the removal of batch effects nor the independence of the group signal from study effects can be established from the supplied processing record. This matrix provides exploratory cross-dataset support rather than definitive replication.
For GSE134431, the six candidate genes were extracted from the reads per kilobase per million mapped reads (RPKM) matrix and transformed as log2(RPKM + 1). DFS was used as the reference group and DFU as the comparison group. DFS represents non-ulcerated diabetic foot skin. The originally submitted Figure 4C plotted raw RPKM; the revised panel uses the stated log2(RPKM + 1) scale. Two-sided Wilcoxon tests with the normal approximation and continuity correction and automatically oriented ROC analyses were verified on both scales and gave identical p values and AUCs because the transformation is strictly monotonic.
Within each bulk validation dataset, between-group expression differences were tested using two-sided Wilcoxon rank-sum tests, and BH correction was applied across the six genes. ROC curves were calculated with pROC (version 1.19.0.1), using direction selected automatically by the package. AUCs and corresponding 95% confidence intervals (CIs) were calculated to compare discriminatory patterns across datasets. Automatically selecting ROC direction from each assessment dataset may give optimistic discrimination; these single-gene AUCs are descriptive and do not validate a prespecified clinical prediction model.
Single-cell localization and sample-level analysis
Single-cell analysis used the saved Seurat object biofsci_SingleR_annotated_MMP1_analyzed.rds from GSE165816, containing 22,889 genes and 69,944 cells in the RNA assay. The RNA assay retained a non-negative integer counts layer and a data layer generated by LogNormalize with a scale factor of 10,000 followed by log1p transformation; the latter was not TPM. The object contained 2,000 variable genes selected using the vst method (loess.span = 0.3; 20 equal-width bins), scaled expression for all retained genes (centering and scaling enabled; scale.max = 10), and 50 principal components calculated from the variable features with seed 42. The saved command history used Harmony dimensions 1–20 for nearest-neighbor construction and uniform manifold approximation and projection (UMAP). Neighbor settings included k = 20, Annoy with 50 trees and Euclidean distance, and a shared nearest-neighbor (SNN) pruning threshold of 1/15. Clustering used resolution 0.8, algorithm 1, n.start = 10, n.iter = 10, and random.seed = 0. UMAP used the uwot implementation, 30 neighbors, two output dimensions, a cosine distance metric, min.dist = 0.3, spread = 1, learning.rate = 1, and seed 42. The object retained a Harmony reduction, but the original quality-control cutoffs, complete RunHarmony call including the batch covariates, and SingleR reference and annotation settings for this analyzed object could not be recovered. Cell-type labels, group labels, and sample identifiers were stored in SingleR_label, Group, and orig.ident, respectively. Ten annotated cell types were retained: B cells, CD8+ T cells, endothelial cells, epithelial cells, fibroblasts, hematopoietic stem cells, keratinocytes, macrophages, monocytes, and neurons.
MMP1 expression was summarized by cell type. Cells with normalized MMP1 expression greater than zero were classified as MMP1-positive. For sample-level analysis, mean normalized expression was calculated for each sample-cell-type combination. DFU and control samples were compared within each cell type using two-sided Wilcoxon rank-sum tests followed by BH correction across all tested cell types. The GEO sample accession, rather than the individual cell, was the unit used in these reported comparisons. The 24 accessions were not treated as proof of 24 independent donors. The saved object did not contain a verified donor identifier, and repeated tissue sampling within donors was not modeled; the sample-level tests are consequently interpreted as exploratory. These summaries average normalized expression within sample and cell type; they are not count-summed pseudobulk differential-expression models.
Ten functional gene sets were scored with Seurat AddModuleScore. Spearman correlations between per-cell MMP1 expression and module scores were calculated and BH-corrected. For exploratory MMP1-high analysis, the three cell types with the highest mean MMP1 expression among cell types containing at least 50 cells were selected. A global cutoff was defined as the median expression among MMP1-positive cells when more than 10 positive cells were available; the script otherwise used the overall 75th percentile. Cells above this cutoff were assigned to the MMP1-high group and the remaining cells to the MMP1-low group. FindMarkers used a Wilcoxon test, logfc.threshold = 0.25, and min.pct = 0.1. Upregulated genes with adjusted p < 0.05 were subjected to GO biological-process enrichment. Because the groups were defined by MMP1 expression, this analysis was used to describe pathways associated with the MMP1-high state. Per-cell correlations, their adjusted p values, and MMP1-high versus MMP1-low enrichment are descriptive because within-sample dependence was not modeled. Individual cells were not interpreted as independent biological replicates.
TCM ingredient-target-herb prediction
The six prioritized genes were matched to column 4 of the local Comparative Toxicogenomics Database (CTD) chemical-gene interaction table. Records were restricted to Homo sapiens in column 7. Ingredient names were trimmed and normalized to lowercase for matching, and duplicate ingredient-target and herb-ingredient mappings were removed. Ingredients were linked to herbs using the herb-ingredient reference table. Database enrichment used nominal p < 0.05 and adjusted p < 0.05. Duplicate herb-ingredient-target records were removed before coverage-based summarization. Herb enrichment used clusterProfiler::enricher with the herb-ingredient mapping as TERM2GENE, minGSSize = 1, maxGSSize = 500, pvalueCutoff = 1, and qvalueCutoff = 1 before applying the nominal and BH-adjusted significance thresholds. These database links may describe changes in expression or activity and do not establish direct binding or a uniform direction of effect.
Herbs were ranked using the following coverage score:
S = 3R + 5L +2T + 3C + 2I + N (1)
Here, R is the MMP1 record count, L is the number of MMP1-linked ingredients, T is the number of covered targets, C is the core-ingredient count, I is the matrix-axis indicator, and N is the total number of ingredients.
Core ingredients were quercetin, luteolin, and berberine. The matrix-axis indicator was set to 1 when an herb covered both MMP1 and MMP13 and to 0 otherwise. Candidate herbs were required to contain at least one MMP1-linked record and either at least two MMP1-linked ingredients or at least four targets plus one core ingredient. The score was used to summarize database coverage and was not treated as a pharmacologic efficacy measure. The coefficients define a custom, heuristic coverage rule that emphasizes MMP1-linked records and ingredients, broader target coverage, the three designated ingredients, and joint MMP1/MMP13 coverage. They were not fitted to clinical outcomes or experimentally validated, and alternative weights could change herb rankings.
Patient tissue collection and preliminary qPCR and western blot assessment
Patients with clinically diagnosed diabetic foot ulcers who underwent clinically indicated debridement or surgery at Wuhan Fourth Hospital were eligible when foot tissue was available and written informed consent had been obtained. Exclusion criteria were malignancy at the sampling site, a non-diabetic cause of the ulcer, or insufficient tissue quantity or quality for the planned assays. DFU tissue and non-ulcerated tissue surrounding the wound were obtained from the same patient under the approved study protocol. The latter served as a matched periwound comparator; it was not healthy non-diabetic skin. The qPCR assessment comprised four matched pairs (four DFU specimens and four corresponding periwound specimens), and western blotting comprised three matched pairs. Matching was confirmed by the authors for each assay; cross-assay identity was not used in the statistical comparisons. Each patient was the biological unit, and technical PCR wells were repeated measurements within a specimen. These preliminary assays were intended to assess tissue-level expression of MMP1 and were not designed to establish diagnostic performance, causality, or generalizability across DFU phenotypes.
For qPCR validation, total RNA was extracted from patient-derived tissue specimens using a total RNA extraction reagent according to the manufacturer's instructions. RNA concentration and purity were assessed spectrophotometrically, and samples with an A260/A280 ratio of 1.8–2.1 were used for subsequent analyses. Total RNA (1 µg) was reverse transcribed using a Moloney murine leukemia virus (M-MLV) reverse-transcription kit in a final reaction volume of 20 µL. The available instrument project identifies a real-time PCR system. Quantitative PCR was reported using 2x SYBR Green PCR master mix in a 20 µL reaction containing 10 µL of 2x SYBR Green master mix, 0.4 µL each of the forward and reverse primers, 2 µL of complementary DNA (cDNA), and 7.2 µL of nuclease-free water. The amplification program consisted of an initial denaturation at 95 °C for 30 s, followed by 40 cycles of 95 °C for 5 s and 60 °C for 30 s. A melting-curve analysis was performed to verify amplification specificity. MMP1 transcript abundance was measured with β-actin (ACTB) as the reference gene. Primer sequences are listed in Table 1. For the revised paired analysis, the five technical wells per target within each specimen were averaged before ΔCq calculation, and relative MMP1 expression was calculated using the 2-ΔΔCq method, with the non-ulcerated periwound tissue group used as the calibrator. The recovered sample pairs were NC–DFU, NC1–DFU1, NC2–DFU2, and NC3–DFU3, confirmed by the authors as four patient-matched pairs. The previous qPCR plot used five technical-well values from only NC and DFU; the revised plot shows one specimen-level value after averaging technical wells for each of the four pairs. Paired inference used ΔCq = mean Cq(MMP1) − mean Cq(ACTB), rather than well-level fold-change values. The archived instrument project also differs from the reported reaction volume and cycling program, and its correspondence to the plotted experiment remains unresolved.
For western blot (WB) validation, tissue specimens were homogenized in ice-cold radioimmunoprecipitation assay buffer supplemented with protease inhibitors. Lysates were incubated on ice for 30 min and centrifuged at 12,000 x g for 15 min at 4 °C. The supernatants were collected, and protein concentrations were determined using a bicinchoninic acid assay. Equal amounts of protein (20 µg per lane) were separated on 4%–20% gradient sodium dodecyl sulfate-polyacrylamide gels and transferred onto 0.22 µm polyvinylidene difluoride membranes. Membranes were blocked with 5% nonfat milk in Tris-buffered saline containing 0.1% Tween-20 for 1 h at room temperature and incubated overnight at 4 °C with an MMP1 polyclonal antibody (1:1,000) and a cofilin polyclonal antibody (1:6,000). After three washes with Tris-buffered saline containing 0.1% Tween-20, membranes were incubated with horseradish peroxidase-conjugated goat anti-rabbit immunoglobulin G (IgG) (1:5,000) for 1 h at room temperature. Protein bands were visualized using an enhanced chemiluminescent substrate and imaged with a chemiluminescence imaging system using the associated operating software (version 1.2.0), as recorded in the image metadata. Bands were quantified using ImageJ software. Cofilin was used as the loading control, and MMP1 protein abundance was normalized to cofilin for between-group comparison.
Statistical analysis and software
All tests were two-sided unless otherwise stated. BH-adjusted p < 0.05 was used as the primary multiple-testing threshold. Exact sample sizes varied by dataset and, for the single-cell sample-level analysis, by the presence of a given cell type in each sample. Continuous expression summaries are shown as individual observations with boxplots displaying the median and interquartile range; whiskers extend to 1.5 times the interquartile range. For western blotting, the six recovered MMP1-to-cofilin ratios were analyzed using a two-sided paired t-test on three author-confirmed patient pairs (df = 2; p = 0.0107). For qPCR, five ACTB and five MMP1 Cq values were averaged separately within each specimen before ΔCq calculation. A two-sided paired t-test compared DFU and matched periwound ΔCq values across four author-confirmed patient pairs (df = 3; p = 3.04 × 10⁻⁵). The mean periwound ΔCq was used as the common calibrator for the relative-expression display. The geometric mean within-patient fold change and its 95% CI were obtained by back-transforming the mean paired ΔCq difference and its t-based CI. Individual biological observations are shown with lines joining matched tissues; technical wells do not increase the biological sample size. Tissue-assay p values are nominal and exploratory. With three or four patients, normality of paired differences cannot be assessed reliably, and the assays remain preliminary. Bioinformatic analyses and figure generation were performed in R 4.5.2 on Windows 11. Core package versions included DESeq2 1.48.2, WGCNA 1.74, glmnet 5.0, randomForest 4.7-1.2, e1071 1.7-17, pROC 1.19.0.1, clusterProfiler 4.16.0, Seurat 5.5.0, SingleR 2.10.0, rentrez 1.2.4, and ggplot2 4.0.3. A consolidated software, database, and parameter inventory is provided in Supplementary Table 1.
結果
探索的トランスクリプトーム解析により、DFUに関連する広範な発現プログラムを特定
GSE199939を探索コホートとして使用し、10例のDFUサンプルと11例のコントロールサンプルを含めました(図1A)。VST正規化後の発現データの主成分分析では、明確なグループ間の分離が認められ、主成分1および2はそれぞれ全分散の34.8%および15.1%を説明しました(図1B)。
|log2 fold change| > 1 および BH補正後 p < 0.05 を基準とした発現変動解析により、3,691個のDEGが同定され、そのうち1,247個の遺伝子がDFUで発現上昇し、2,444個の遺伝子がDFUで発現低下していた(図 1C)。上位50個のDEGは、強いグループ構造を持つ発現パターンを示した(図 1D)。その後選択された6つの遺伝子のうち、MMP1が発見コホートにおいて最大の変動を示した(log2 fold change = 9.854; 補正後 p = 1.24 × 10⁻²⁹)。
DFUに関連する共発現モジュールが、DEGおよびDPN関連遺伝子と収束する
VST変換後の遺伝子のうち、変動の大きい上位5,000個に対してWGCNAを実施した。スケールフリートポロジーの適合性とコネクティビティのバランスを考慮し、符号付きネットワーク(signed network)に対してソフトしきい値(soft-thresholding power)として18を選択した(図 2A)。階層的クラスタリングおよび動的モジュール検出により、複数の共発現モジュールが同定された(図 2B)。DFUと最も強い正の相関を示したのはブルーモジュールであった(Pearson r = 0.97, p = 5 × 10-13; 図 2C)。対応するサンプルのクラスタリングおよびモジュールサイズの品質管理サマリーは、付録図 1A,Bに示している。
ブルーモジュール内では、ハブ基準である|MM| > 0.8および|GS| > 0.5を満たす遺伝子が689個認められた(図2D)。3,691個のDEG、689個のブルーモジュールハブ遺伝子、および1,062個のDPN関連遺伝子の積集合を取った結果、77個の共通候補遺伝子が抽出された(図2E)。ブルーモジュールハブネットワークの簡略化されたビューおよび上位のハブ統計量は、付録図2A,Bに示されている。
マルチメソッドによる特徴量選択で6つの遺伝子が優先されたが、探索コホートへの過学習が認められた
重複する77個の遺伝子を、LASSO、ランダムフォレスト、およびSVM-RFEを用いて解析した。LASSOでは、選択したペナルティにおいて7つの遺伝子が保持された。 MMP1, MMP13, TRPV2, CCL7, AURKA, MKI67、および CHEK1 (図3A)。ランダムフォレストによるフィルタリングにより、重要度が平均以上の41遺伝子が保持され、そのうち、最終的なパネルの5つのメンバーが最も高いランクの特徴量に含まれていた(図3B)。SVM-RFEは、評価したすべてのネストされたサブセットにおいて1.00のAUCを示した。最小サイズタイルールに基づき、 CHEK1 単一遺伝子サブセットとして選択された(図3C)、これにより、探索コホートにおける過学習および楽観的な評価に関する懸念が生じている。対応する探索コホートの発現量、ヒートマップ、およびROC曲線は、以下に示されている。 付随図 3A–C.
3つの方法すべてで選択された遺伝子はありませんでした。少なくとも2つの方法で支持された遺伝子を保持した結果、CCL7、CHEK1、MKI67、MMP1、MMP13、およびTRPV2が抽出されました(図 3D)。これら6つの遺伝子のGOアノテーションでは、細胞外マトリックスの分解、コラーゲンの異化および代謝プロセス、凝縮染色体、およびメタロエンドペプチダーゼ関連機能が強調されました(すべてBH補正後 p < 0.05;図 3E)。KEGG解析により、インターロイキン-17 (IL-17) シグナリング(CCL7/MMP1/MMP13;補正後 p = 1.81 × 10⁻⁴)およびリラキシンシグナリング(MMP1/MMP13;補正後 p = 0.0175;図 3F)が同定されました。これらの濃縮解析の結果を用いて、6つの遺伝子パネルが示す生物学的機能を特徴付けました。
データセット間の評価により、MMP1に対する不均一な支持が示された
統合されたGSE68183/GSE80178マトリックス(DFU 9例およびコントロール6例)において、6つの遺伝子にわたるBH補正後、CCL7、MMP1、およびMMP13が群間で有意に異なっていました(補正後p = 0.0168、0.0159、および0.0431;Figure 4A)。CHEK1、MKI67、およびTRPV2は、補正後の有意水準に達しませんでした(補正後p = 0.259、0.680、および0.259)。単一遺伝子のROC解析の結果、AUCはCCL7で0.944(95% CI, 0.825–1.000)、CHEK1で0.704(0.403–1.000)、MKI67で0.574(0.243–0.905)、MMP1で0.981(0.930–1.000)、MMP13で0.870(0.686–1.000)、およびTRPV2で0.722(0.447–0.997)となりました(Figure 4B)。上流の統合およびバッチ補正の手順が十分に文書化されていないため、これらのROC値は探索的なものと考えられました。
GSE134431(13例のDFUおよび8例の非潰瘍性DFSサンプル)において、公称有意水準でのWilcoxon検定の結果、MMP1の発現はDFSよりもDFUで高く、有意であったが(p = 0.0225)、この関連性はBH補正後には有意ではなくなった(補正後 p = 0.135;Figure 4C)。他の5つの遺伝子では、群間に有意な差は見られなかった。MMP1は記述的なAUCにおいても最高値を示し、AUCは0.808(95% CI, 0.589–1.000)であったのに対し、他の候補遺伝子のAUCは0.529から0.635の範囲であった(Figure 4D)。全体として、MMP1は6つの候補の中で最も一貫した記述的パターンを示したが、統計的な再現性は不完全であった。
単一細胞解析により、MMP1が主に線維芽細胞に局在することが判明した
シングルセルデータセットには、24サンプル(DFU群 14例、対照群 10例)から得られた69,944個の細胞が含まれており、注釈付きの10種類の細胞型で構成されていた(図 5A)。UMAPによる特徴量の可視化では、MMP1の発現はアトラス全体に均一に分布しているのではなく、限定的な細胞領域に局在していた(図 5B)。全体として、3,799個の細胞(5.43%)で、正規化後のMMP1発現量が0より大きかった。線維芽細胞は、正規化後平均発現量が最も高く(0.181)、MMP1陽性細胞の割合も全体で最大であった(7.88%; 図 5C)。
サンプルレベルにおいて、平均MMP1発現量は、ケラチノサイト、線維芽細胞、および血管内皮細胞のいずれにおいても、対照群サンプルよりDFUサンプルで高くなっていました。テストしたすべての細胞型にわたるBH補正後、これらの各比較における調整済みp値は0.0214でした(ケラチノサイト:対照群9サンプル、DFU群14サンプル;線維芽細胞:10サンプルおよび14サンプル;血管内皮細胞:10サンプルおよび14サンプル;Figure 5D)。MMP1陽性画分は、線維芽細胞では5.86%から9.29%へ、ケラチノサイトでは0.026%から6.68%へ、そして血管内皮細胞では0.29%から2.67%へと増加しました(Figure 5E)。
細胞ごとのモジュールスコアの相関は緩やかであった。最大の正の相関は、細胞老化/老化関連分泌表現型(SASP)モジュールスコアで観察され(Spearman rho = 0.274)、次いで細胞外マトリックスリモデリング(rho = 0.240)、フェロトーシス(rho = 0.197)、線維芽細胞活性化(rho = 0.170)の順であった(Figure 5F)。MMP1高発現およびMMP1低発現の線維芽細胞を比較したところ、細胞外マトリックス組織化、細胞外構造組織化、コラーゲン線維組織化、糖タンパク質プロセシング、およびタンパク質折り畳みに関する用語の濃縮が認められた(Figure 5G)。これらの記述的な知見は、MMP1高発現の線維芽細胞状態がマトリックスリモデリング関連プロセスに結びついていることを示した。追加のグループレベルUMAP、全細胞型サンプルサマリー、および機能スコアのコンテクストは、Supplementary Figure 4A–Cに記載されている。個々の細胞の関連性は、ドナー独立的な根拠としては扱われなかった。
ネットワークカバレッジにより、MMP1に関連する成分および候補生薬を優先的に抽出する
フィルタリング後の生薬-成分-標的の関係テーブルには、99種類の生薬、14種類の成分、および6つの候補標的のうち5つを結びつける561件の一意なレコードが含まれていた。最も頻度の高い標的はMMP1で156件であり、次いでCHEK1(120件)、MMP13(102件)、MKI67(100件)、TRPV2(83件)であった(図 6A)。成分の中では、ケルセチンとルテオリンが生薬へのカバー範囲が最も広く、それぞれ83種類および62種類の生薬と結びついていた。ベルベリンは10種類の生薬と結びついていた。これら3つの成分は、優先順位付けルールのコア成分として使用された(図 6B)。
カバレッジスコアにより、管黄博(Guanhuangbo)、麻黄(Mahuang)、牛膝(Niuxi)が共同で最高位となりました(スコアはいずれも38;図 6C)。これらはすべて、利用可能な5つのターゲットをすべてカバーしており、2つのMMP1関連成分を含んでいました。成分-ターゲットマトリックスでは、ケルセチンがターゲットパネル全体で最も広いカバレッジを提供し、ルテオリンとベルベリンがさらなるMMP1中心のコネクティビティを提供していることが示されました(図 6D)。フォーカスネットワークにより、主要な生薬と代表的な成分、および5つの利用可能なターゲットが結びつけられました(図 6E)。これらの結果から、さらなる評価のためにデータベースカバレッジの高い生薬-成分-ターゲットの組み合わせが特定されました。補助的な生薬-ターゲットおよびコア成分のカバレッジマトリックスを付随図 5A,Bに示します。
予備的なペア組織アッセイにより、MMP1 mRNAおよびタンパク質の量が高いことが示された
ウェスタンブロット法による評価の結果、DFU(糖尿病性足潰瘍)検体におけるMMP1の含有量は、対応する潰瘍周囲の非潰瘍部位の検体よりも高いことが示された(図7A,B)。3組のペアにおけるDFU(糖尿病性足潰瘍)部位と潰瘍周囲部位とのMMP1/コフィリン比の平均差は0.3553(95% CI: 0.1959–0.5147、両側対応)であった。 翻訳対象のテキストが提供されていません。翻訳する英文をご提示ください。-試験、 t(2) = 9.592, p = 0.0107)。各患者のペア測定値を以下に示します。 図7B標本1個あたりの遺伝子につき5つのテクニカルウェルを平均化した結果、qPCRにより、より高い標準化された MMP1 4つのDFU検体のそれぞれにおいて、対応する創周囲検体よりもmRNA量が多く(図7C)。患者内におけるDFUから周傷部を減じた値の平均は ΔCq差は−2.6035(95% CI:−2.8024〜−2.4046;両側対応)であった。 t-試験、 t(3) = −41.663, p = 3.04 × 10⁻⁵)、これは幾何平均で6.08倍の増加(95% CI, 5.30–6.98)に相当する。これらの小サンプルによる観察結果は予備的なものであり、機能的な効果を立証するものではない。
ディスカバリーデータセットおよび外部バルクデータセット全体を通じて、優先的に選定された6つの遺伝子のうち、MMP1は統計的な再現性は不完全であったものの、最も一貫した記述パターンを示しました。シングルセル解析の要約では、線維芽細胞において平均発現量が最も高く、3名の患者からのペアWB測定および4名の患者からのペアqPCR測定において、MMP1の量が高いことが示されました。これらの観察結果は、MMP1がさらなる調査対象となるDFU関連候補であることを支持しています。計算解析から組織評価に至る全体のワークフローは、補足図6にまとめられています。
データの可用性:
公開トランスクリプトームデータセットは、NCBI Gene Expression Omnibusのアクセッション番号GSE199939、GSE68183、GSE80178、GSE134431、およびGSE165816から入手可能です。利用可能な解析および図作成スクリプト、処理済みの発現および結果テーブル、定量的図のソーステーブル、統計出力テーブル、元のqPCRワークブックおよびインストゥルメントプロジェクト、および提供された未トリミングのウェスタンブロット画像は、Supplementary File 1に含まれています。また、このアーカイブには、復元されたシングルセルオブジェクトから抽出された細胞メタデータとコマンド履歴、マトリクス形式の検証レポート、およびファイルマニフェストが含まれています。Supplementary File 1には履歴ソースファイルが保持されており、改訂済みのペアアッセイソーステーブル、統計出力、図作成コード、および修正されたパラメータインベントリを含むR2_Updatesフォルダが含まれています。解析済みの完全なSeurat RDSはアーカイブドキュメントで特定されていますが、この補足ZIPファイルには組み込まれていません。バルク統合の完全な履歴、元のシングルセルフィルタリングおよびアノテーション設定、ならびに元のブロットのバックグラウンド減算およびレーンから定量までの詳細は完全には利用できず、これらの制限についてはプロトコルおよび考察で説明しています。ローカルで復元されたRDSは、公開リポジトリには登録されていません。
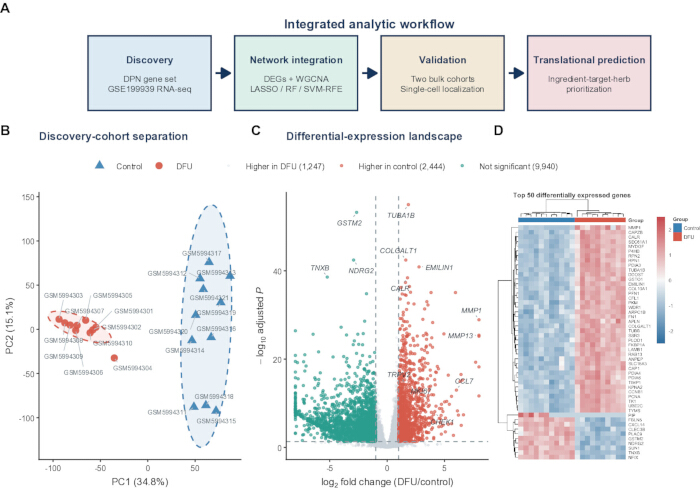
図 1: ディスカバリー・トランスクリプトーム解析によりDFU関連の発現プログラムを特定。 (A) 計算ワークフローの概要。DPN遺伝子セットの構築とGSE199939ディスカバリー解析、ネットワークおよび機械学習の統合、バルクおよびシングルセル評価、ならびにTCM成分-ターゲット-生薬の予測で構成される。 (B) DFUサンプル10検体および対照サンプル11検体から得られた、分散安定化後のGSE199939発現プロファイルの主成分分析。楕円は90%グループ領域を示し、パーセンテージは各成分によって説明される分散を示す。 (C) DFU対対照のDESeq2差分的発現解析結果のボルケーノプロット。赤色の点はDFUで、青緑色の点は対照で、それぞれアップレギュレートされた遺伝子を示す(|log2 fold change| > 1 かつ BH補正後 p < 0.05)。灰色の点は両方の閾値を満たさなかったものである。 (D) 補正後 p 値が最小である50遺伝子の行方向 z スコアヒートマップ。列は生物学的サンプルであり、アノテーションバーはグループを示す。DEGs: 差分的発現遺伝子、DFU: 糖尿病性足潰瘍、DPN: 糖尿病性末梢神経障害、VST: 分散安定化変換。最終的な実験的評価については、プロトコルおよび図 7に記載されている。qPCR: 定量的PCR、TCM: 中医学(伝統中国医学)、RF: ランダムフォレスト、LASSO: 最小絶対収縮選択演算子、SVM-RFE: サポートベクターマシン再帰的特徴消去。 この図の拡大版を表示するには、ここをクリックしてください。
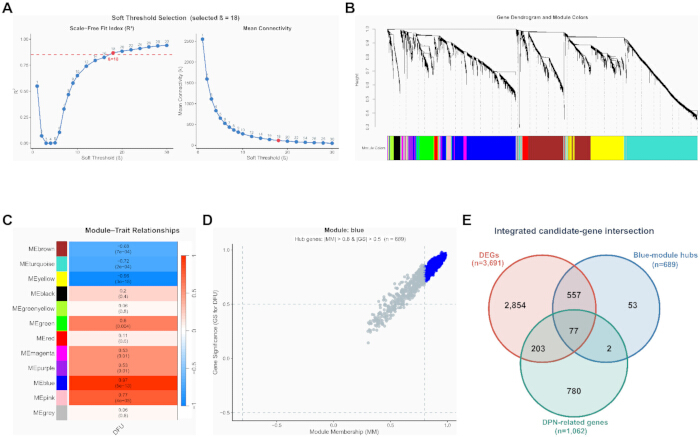
図2: WGCNAと既知のDPN知見から導き出された77個の候補遺伝子。 (A) 変動の大きい上位5,000個のVST変換済み遺伝子に対する、符号付きネットワークのソフトしきい値評価。選択されたパワーはbeta = 18であり、破線は目標とするスケールフリー・トポロジー適合度0.85を示す。 (B) 動的モジュール色割り当てを伴う平均連結法による遺伝子デンドログラム。 (C) モジュール固有遺伝子(eigengene)とバイナリDFU形質の間のピアソン相関。各セルは相関係数と対応する両側p値を示し、色は方向と大きさを表す。 (D) ブルーモジュールにおけるDFUに対する遺伝子有意性とモジュールメンバーシップ。青色の点は|module membership| > 0.8 かつ |gene significance| > 0.5 を満たすものであり、n = 689個のハブ遺伝子である。 (E) 3,691個のDEG、689個のブルーモジュールハブ遺伝子、および1,062個のDPN関連遺伝子の3セットの共通部分により、77個の共通候補が得られた。DFU: 糖尿病性足潰瘍、DPN: 糖尿病性末梢神経障害、GS: 遺伝子有意性、MM: モジュールメンバーシップ、WGCNA: 加重遺伝子共発現ネットワーク解析。発見コホートには21サンプル(DFU 10例、コントロール 11例)が含まれていた。図2Dの注釈では、元の選択コードで検証された絶対値基準に合わせ、|MM| > 0.8 および |GS| > 0.5 を使用している。こちらのリンクをクリックして、この図の拡大版を表示してください。
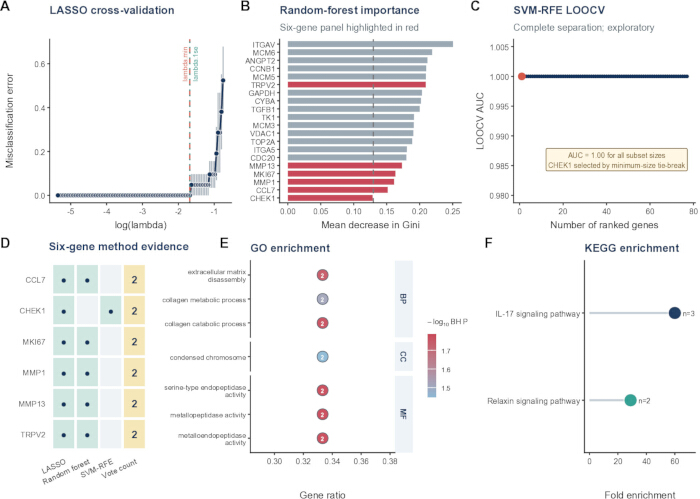
図 3: 多角的手法による特徴量優先順位付けにより6遺伝子パネルを抽出。 (A) 二項LASSO回帰の5分割交差検証曲線。垂直の破線はlambda.minおよびlambda.1seを示す。選択された非ゼロ特徴量は、そのペナルティで特徴量が抽出されなかった場合を除き、lambda.1seにおいて決定された。 (B) 1,000本の決定木モデルによる、上位20位までの遺伝子のランダムフォレストにおけるGini不純度減少量の平均。赤色のバーは最終的な6遺伝子パネルの構成要素を示す。破線は、全候補セットにおける保持しきい値として使用された重要度の平均を示す。 (C) 入れ子状の特徴量サブセットにおける線形SVM-RFE LOOCV AUC。すべてのサブセットサイズでAUC = 1.00となり、最小サイズタイルールによってCHEK1が選択された。これは探索コホートにおける過学習を示唆している。 (D) CCL7, CHEK1, MKI67, MMP1, MMP13, およびTRPV2の手法サポートマトリクス。ドットはLASSO、ランダムフォレスト、またはSVM-RFEによる選択を示す。右端の列はサポートした手法の数を示す。 (E) 6つの遺伝子において濃縮された選択Gene Ontology用語。点の位置は遺伝子比率を、点のラベルはマッピングされた遺伝子数を、色は-log10 BH補正p値を示し、サイドストリップはオントロジーを示す。 (F) マッピングされた遺伝子において濃縮されたKEGGパスウェイ。点の位置は濃縮倍率を、点のサイズのラベルはマッピングされた遺伝子数を示し、色はパスウェイを区別する。濃縮の条件は、名目上のp < 0.05およびBH補正p < 0.05とした。AUC: 受信者動作特性曲線下面積、BH: Benjamini-Hochberg、BP: 生物学的プロセス、CC: 細胞成分、KEGG: 京都遺伝子・ゲノム百科事典、LOOCV: 1個抜き交差検証、MF: 分子機能、SVM-RFE: サポートベクターマシン再帰的特徴消去、LASSO: least absolute shrinkage and selection operator。パネルA–Dでは、21の探索サンプル(DFU 10例および対照群 11例)を使用している。パネルAにおいて、エラーバーは交差検証誤差の標準誤差を示す。こちらのリンクをクリックして、この図の拡大版を表示してください。
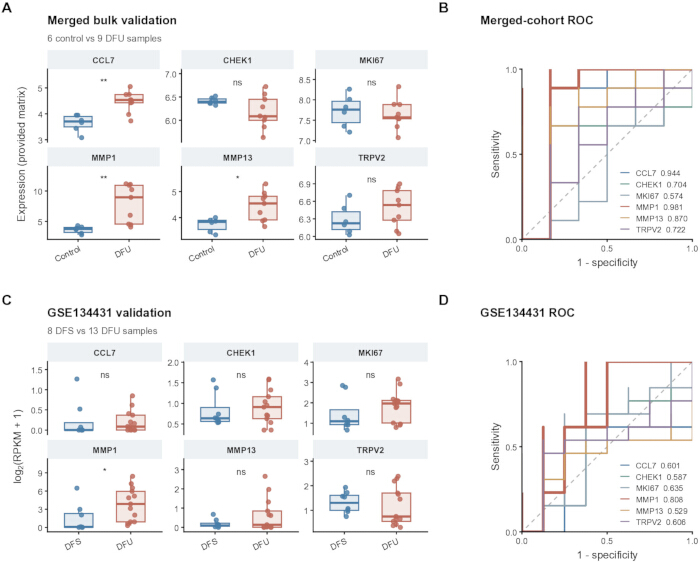
図 4: 6遺伝子パネルのデータセット間バルクトランスクリプトーム評価。 (A>) 統合されたGSE68183/GSE80178マトリックス(コントロール6検体、DFUサンプル9検体)における6遺伝子の発現。 (B>) 対応する単一遺伝子のROC曲線およびAUC値。95%信頼区間はソースデータテーブルに記載されている。上流の統合およびバッチ補正の文書化が不十分であったため、これらの結果は探索的なものとして解釈した。 (C>) GSE134431(非潰瘍性DFS 8検体、DFUサンプル13検体)におけるlog2(RPKM + 1)発現。 (D>) 対応する単一遺伝子のROC曲線およびAUC値。 (A>) および (C>) において、ボックスは中央値と四分位範囲を示し、ひげは四分位範囲の1.5倍まで延び、点は生物学的サンプルを表す。アスタリスクは両側ウィルコクソン順位和検定による名目上の有意性を示す(*p < 0.05, **p < 0.01)。6遺伝子全体でのBH調整済みp値は本文およびソースデータテーブルに記載されている。ROCの方向はpROCによって自動的に選択された。AUC: 受信者動作特性曲線下面積、DFS: 非潰瘍性糖尿病性足部皮膚、DFU: 糖尿病性足部潰瘍、RPKM: reads per kilobase per million mapped reads、ROC: 受信者動作特性。 ここをクリックして、この図の拡大版を表示してください。
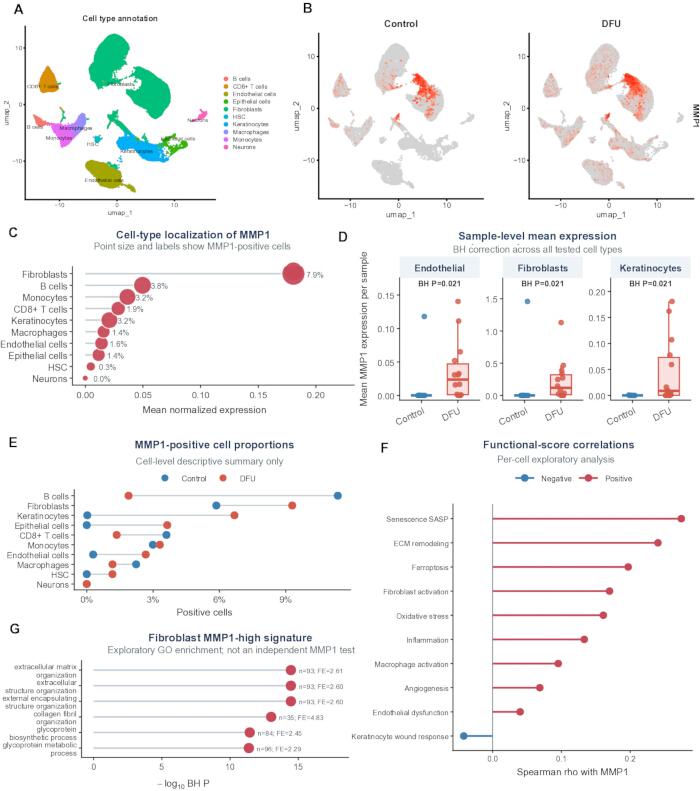
図5単一細胞局在の関連性 MMP1 線維芽細胞およびマトリックス再構築シグナルへの。 (A) 24サンプル(コントロール10例およびDFUサンプル14例)から得られた69,944個の細胞のUMAP。SingleRで導出された10種類の細胞型アノテーションに基づいて色分けしている。 (B正規化されたデータを示すUMAP特徴量プロット MMP1 対照細胞およびDFU細胞における発現。(C) 平均正規化値の細胞型別サマリー MMP1 発現;点の大きさとラベルは全体を的に示す MMP1-正の画分(正規化された発現量として定義) > 0. (D) サンプルレベルの平均値 MMP1 血管内皮細胞、線維芽細胞、および角化細胞における発現。ボックスは中央値および四分位範囲を、点は生物学的サンプルを示す。全解析細胞タイプにおいて、両側ウィルコクソン順位和検定を行い、B-H法による補正を適用した。利用可能なサンプル数は、血管内皮細胞および線維芽細胞でコントロール群10例、DFU群14例であり、角化細胞ではコントロール群9例、DFU群14例であった。E) MMP1グループおよび細胞型別の陽性細胞分画。F) 細胞ごとのSpearman相関(以下) MMP1 発現および機能モジュールスコア。 (G) ~において発現が上昇した遺伝子におけるGO生物学的プロセス濃縮解析 MMP1高濃度対 MMP1-低密度の線維芽細胞。BH:ベンジャミーニ・ホッホベルグ法;DFU:糖尿病性足潰瘍;ECM:細胞外マトリックス;GO:ジーンオントロジー;HSC:造血幹細胞;UMAP:一様多様体近似および投影。パネルFおよびGにおける細胞ごとの相関および発現条件付き濃縮解析は探索的な記述であり、ドナーを考慮した確認的推論は行われていない。サンプルレベルの独立性については、ドナー識別子の検証が必要である。 この図の拡大版を表示するには、ここをクリックしてください。
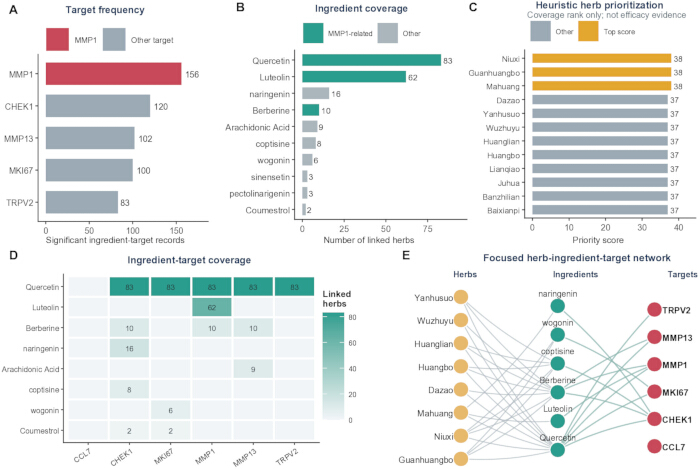
図6MMP1を中心とした、カバレッジに基づく中薬成分-標的-生薬の予測 (A) 利用可能な各候補ターゲットにおける、フィルタリング後のデータベースの生薬成分-ターゲット記録数。 (B) 最頻出成分における関連生薬数。ティール色はMMP1に関連する成分を示す。 (C) カバレッジスコアによってランク付けされた主要な生薬。金色のバーは、同率で上位3位となるスコアを示している。 (D) 代表的な高カバレッジ成分の成分-標的マトリクス。セルの値はリンクされた生薬の数を示し、空のセルはフィルタリング後のリレーションテーブルに記録がないことを示す。(E) 代表的な高ランクの生薬、成分、および候補ターゲットを接続したフォーカスネットワーク。ノードの色はエンティティの種類を示し、灰色の生薬-成分間のエッジは含有を、ティール色の成分-ターゲット間のエッジはデータベースのリンクを示す。フィルタリング後の関係テーブルには、適格なリンクを持つ561件の一意なレコード、99種類の生薬、14種類の成分、および5つのターゲットが含まれている。CCL7は、6番目の候補ノードとして独立して表示されている。TCM:伝統中国医学。 この図の拡大版を表示するには、ここをクリックしてください。
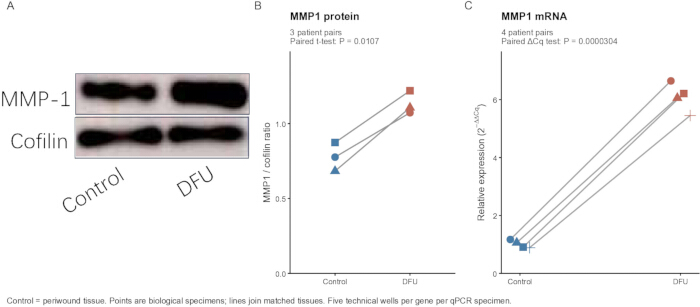
図7DFUにおけるMMP1発現の患者組織を用いた予備的なqPCRおよびウェスタンブロット評価。 (A) 非潰瘍性の創周囲組織および糖尿病性足潰瘍(DFU)組織におけるMMP1タンパク質の存在量を示す、既提供の代表的なウェスタンブロット。ローディングコントロールとしてコフィリンを使用。 (B)元のプロッティングプロジェクトから回収したMMP1対コフィリン比。シンボルは3組の患者ペアからの個々の生物学的測定値を示し、線は対応する創周囲および糖尿病性足潰瘍(DFU)検体を結んでいる。両側対応 t-テストの結果、得られた t(2) = 9.592であり、 p = 0.0107. (C相対的 MMP1 著者によって確認された、整合する4組の患者ペア(NC–DFU、NC1–DFU1、NC2–DFU2、およびNC3–DFU3)におけるmRNA存在量。5つのテクニカル ACTB ウェルおよび5つのテクニカルレプリケート MMP1 各検体につき、ウェルの値を個別に平均化した後、 ΔCq値の算出。相対発現量は2^-ΔΔCq法により算出した。−ΔΔ定量サイクル(Cq) 平均周創領域を用いた手法 Δ共通キャリブレーターとしてのCq。各シンボルは1つの生物学的検体を表し、線は対応する組織を繋いでいる。両側ペアド t-検体レベルで使用した試験 ΔCq値(t(3) = −41.663; p = 3.04 × 10⁻⁵)、テクニカルウェルの倍率変化ではありません。有意性を示すアスタリスクは使用していません。テクニカルウェルは生物学的反復ではありません。コントロールは、潰瘍化していない創周囲組織を示します。Cq:定量サイクル。組織アッセイ p 値は名目上のものであり、探索的です。 こちらの図の拡大版を表示するには、ここをクリックしてください。
| 遺伝子 | RefSeqアクセッション番号 | フォワードプライマー 5'から3'方向 | リバースプライマー 5'から3'方向 |
| MMP1 | NM_002421 | ATGAAGCAGCCCAGATGTGGAG | TGGTCCACATCTGCTCTTGGCA |
| ACTB | NM_001101.5 | CACCATTGGCAATGAGCGGTTC | AGGTCTTTGCGGATGTCCACGT |
表 1: MMP1の定量的PCR検証に用いたプライマー配列。ヒトMMP1(NM_002421)およびACTB(NM_001101.5)のフォワードおよびリバースオリゴヌクレオチド配列(5′–3′)とNCBI RefSeq転写物アクセッション番号を示す。ACTB(β-actin)をMMP1の相対発現量の参照遺伝子として使用した。
補足図 1: WGCNAの品質管理サマリー。 (A) 最も変動の大きい5,000個の分散安定化遺伝子に基づいた、GSE199939サンプルの平均連結階層的クラスタリング。サンプルラベルはグループごとに色分けされており、破線の水平線は視覚的な外れ値評価に使用されたデンドログラム高さの95パーセンタイルガイドである。 (B) 各WGCNAモジュールに割り当てられた遺伝子数。ティール色のバーはDFUとの関連基準を満たした8つの非グレーモジュールを示し、グレーのバーはその他のモジュールを示す。DFU:糖尿病性足潰瘍、VST:分散安定化変換、WGCNA:加重遺伝子共発現ネットワーク解析。 こちらをクリックしてファイルをダウンロードしてください。
付随図2ブルーモジュールの共発現サポート。 (A) 上位25位のブルーモジュールハブ遺伝子の簡略化された共発現ネットワーク。| の値を持つペアごとの相関において、r| > 0.70。表示されているネットワークは、各遺伝子の最も強い2つのリンクの和集合を含んでいます。ノードの大きさはこの表示されたスパース化ネットワーク内での次数を示し、ノードの塗りつぶしはDFUに対する遺伝子有意性を示しています。(B) 上位15個のハブ遺伝子における遺伝子有意性とブルーモジュールメンバーシップ。エッジのサブセットは可読性のために選択されており、条件を満たすすべての相関を示しているわけではない。DFU:糖尿病性足潰瘍、GS:遺伝子有意性、MM:モジュールメンバーシップ。 こちらのファイルをダウンロードするには、ここをクリックしてください。
補完図 3: 内部探索コホートにおける機械学習の表示。 (A) GSE199939探索コホートにおけるCCL7、CHEK1、MKI67、MMP1、MMP13、およびTRPV2のスケーリングされた発現量。ボックスは中央値と四分位範囲を示し、点は生物学的サンプルを表す。 (B) 同一の6つの遺伝子に関するサンプルレベルの行zスコアヒートマップ。短縮サンプルラベルは、ソースデータキー内のGEO識別子に対応している。 (C) フィッティングされた多遺伝子探索コホートモデルのROC曲線。同一の21サンプルでモデルのフィッティングと評価を行ったためAUCが1.00となり、探索コホートにおける過学習(オーバーフィッティング)が示された。AUC:受信者動作特性曲線下面積、ROC:受信者動作特性。探索コホートには21サンプル(DFU 10例、対照群 11例)が含まれていた。 こちらをクリックしてファイルをダウンロードしてください。
補足図 4: 単一細胞発現コンテキスト。 (A) コントロール群およびDFU群で色分けした69,944細胞のUMAP。(B) 全10種類の細胞型アノテーションにおける生物学的サンプルレベルの平均MMP1発現。点はサンプルを示し、x軸は表示のために平方根変換を用いている。(C) アノテーション済み各細胞型の細胞間で要約し、各モジュール内で標準化した機能モジュールスコアのヒートマップ。DFU: 糖尿病性足潰瘍、UMAP: 一様多様体近似および投影。 こちらをクリックしてファイルをダウンロードしてください。
補足図 5: TCMカバレッジマトリックスの支持データ。 (A) MMP1に関連するカバレッジを持つ上位18種類の生薬、およびフィルタリング後の関係テーブルに示される5つの候補ターゲットのデータベースにおける生薬-ターゲットレコード数。(B) 同じ生薬と、コア成分であるquercetin、luteolin、およびberberineとを関連付けるデータベースレコード数。セルの値は重複排除後のユニークなデータベースレコード数を示す。TCM: 伝統中国医学。 こちらをクリックしてファイルをダウンロードしてください。
補足図6計算および組織評価ワークフロー。 この概略図は、ディスカバリー入力、DEG/WGCNAの交差抽出、探索的特徴量選択、外部バルク解析による評価、シングルセルコンテキスト、TCMへの拡張、およびマッチング組織発現評価をまとめたものである。qPCRでは4組のマッチング患者ペアを、ウェスタンブロッティングでは3組のマッチング患者ペアを用いた。候補数および報告された計算結果は、元の解析から維持している。カウントベースのディスカバリーワークフローにおけるTPM入力、不完全な元のシングルセル前処理記録、および小規模な組織アッセイコホートが制限事項として残っている。この概略図は、ディスカバリー解析が再検証されたことを意味するものではない。 こちらをクリックしてファイルをダウンロードしてください。
付録表 1: 解析ソフトウェア、データベース、パラメーター、および制限事項の目録。 このワークブックには、解析ステップ、ツールまたはデータベース、報告されたバージョン、入力、主要パラメーター、出力、および不足情報または制限事項を含む26の解析ステップが記録されています。内容は、ディスカバリー・トランスクリプトミクス、WGCNA、遺伝子スクリーニングと特徴選択、エンリッチメント、外部バルクおよびシングルセル解析、TCMネットワーク解析、および組織アッセイの報告を網羅しています。本表は利用可能な手法情報を記録したものであり、それ自体で独立した再現性を確立するものではありません。 こちらをクリックしてファイルをダウンロードしてください。
補足ファイル 1データ、解析コード、図のソース、およびアッセイのソースアーカイブ。 本アーカイブには、利用可能な解析および図作成スクリプト、処理済みの発現データおよび結果テーブル、定量図および統計ソースデータ、元のqPCRワークブックおよびインストルメントプロジェクト、提供済みの未カットのウェスタンブロット画像、抽出されたシングルセルメタデータおよびコマンド履歴、マトリックス型検証レポート、ならびにファイルマニフェストが含まれています。履歴ファイルは保存されており、R2_Updatesフォルダーには、修正済みのペアアッセイ解析、更新された図のソース、および改訂されたパラメータインベントリが格納されています。 こちらをクリックしてファイルをダウンロードしてください。
ディスカッション
この統合的なワークフローでは、バルクトランスクリプトーム解析、WGCNA、DPN関連遺伝子スクリーニング、および探索的特徴量選択からMMP1を優先的に抽出し、次にその細胞内コンテクストと組織発現を検討しました。少なくとも2つの選択手法で支持された遺伝子は6つあり、その中でMMP1が発見コホートにおいて最大の発現変動を示しました。外部エビデンスは不均一であり、統合されたGSE68183/GSE80178マトリックスではMMP1は有意なままでしたが、GSE134431における関連性は名目的(p = 0.0225)であり、BH補正後には有意ではありませんでした(補正後p = 0.135)。GSE134431におけるAUC 0.808は記述的な値であり、特にROCの方向が評価データセット内で選択されたことによるものです。したがって、「最も一貫している」という表現は、6つの候補間で観察されたパターンを指すものであり、完全な統計的再現性や検証済みの診断バイオマーカーであることを意味するものではありません。
候補パネルは、コラーゲン代謝回転、ECM分解、メタロエンドペプチダーゼ活性、およびIL-17およびリラキシンシグナリングに関連付けられました。これらのアノテーションは慢性創傷の生物学と整合していますが、関与している遺伝子はわずかです。先行するヒト研究では、糖尿病性潰瘍においてMMPおよび阻害剤のプロファイルが変化していることが報告されており6、また前向きなDFU研究では、MMP1と組織メタロプロテアーゼ阻害剤1(TIMP1)の比率が高いことが治癒と関連しているとされています7。したがって、MMP1の発現増加が一様に有害な影響を示すとは限らず、その関連性は修復段階、基質の利用可能性、および阻害剤のバランスに依存する可能性があります。MMP13、CCL7、およびIL-17に関する実験的観察は追加的な背景情報を提供しますが11,12,13,14、それらの機能がヒトのDFUにおいても同等であると想定することはできません。
単一細胞サマリーにより、平均MMP1発現が最も高いのは線維芽細胞であることが特定され、サンプルレベルではDFU線維芽細胞、角化細胞、および内皮細胞においてより高い発現が認められた。このパターンは、DFU由来線維芽細胞における細胞外マトリックス(ECM)構築の変化4、単一細胞および空間解析研究における線維芽細胞状態の不均一性8、およびマクロファージに関連した治癒線維芽細胞プログラム15に関する報告と一致している。しかし、サンプル識別子はドナーレベルでの検証が必要であり、細胞レベルのモジュールスコア相関および発現条件付き濃縮は、ドナー内依存性がモデル化されていないため、記述的な解析に留まっている。また、上皮細胞および内皮細胞集団からの寄与は、線維芽細胞のみで完結する自律的なメカニズムを否定する根拠となる。空間トランスクリプトーム解析、RNA in situ ハイブリダイゼーション、または免疫染色は、相補的な局在化情報の提供に有用であると考えられる16
本手法の価値は、候補となる遺伝子を優先順位付けするために、発現変動、共発現、既存の遺伝子知見、細胞レベルの要約、および独立したアッセイモダリティを組み合わせた点にあります。発見コホートにおける予測精度に価値があるわけではありません。コホート全体のスクリーニングがアルゴリズムレベルの交差検証に先行しており、SVM-RFEのAUCが一律に1.00であることは、リーク、過学習、および楽観的な評価の懸念を生じさせます。したがって、このパネルは特徴量の優先順位付けの結果として扱うべきです。予測能を評価するには、前処理、選択、チューニングを完全にネストさせ、その後に固定された独立したテストを行う必要があります9,10。発見時の入力データは、カウントベースのモデルに使用されていたにもかかわらずTPMであることが確認されました。そのため、得られた発見統計量およびその後の選択結果は、適切な再解析が行われるまで未検証のままとなります。統合されたバルクマトリックスには、完全な前処理履歴が不足しています。復元されたSeuratオブジェクトにより、正規化、可変特徴量選択、PCA、近傍、クラスタリング、およびUMAPの設定は提供されていますが、元のフィルタリング、完全なHarmonyの実行内容、およびアノテーションのリファレンスについては、ドキュメント化が不十分なままです。ソースデータからの調和的な再処理、文書化されたバッチ効果の評価、およびドナーを考慮したpseudobulk解析または混合モデル解析が、さらなる評価のための代替アプローチとなります。
患者組織のアッセイにより、MMP1の含有量が高いという予備的な直交的根拠が得られた。比較対象は同一患者の潰瘍のない創周囲組織であるため、この対比は健康な皮膚との比較ではなく、糖尿病組織内における潰瘍に関連した局所的な差を反映している。3組のマッチングした患者ペアから回収されたWB測定値と、著者が確認した4組のマッチングしたペアからのqPCR測定値をペア検定を用いて解析し、個々の生物学的観察結果を表示した。qPCRについては、各検体内のテクニカルウェルの平均値を算出し、ΔCqを用いて推論した。テクニカルウェルによって生物学的サンプルサイズが増大することはない。ペア観察における一貫した傾向は、予備的な発現比較を支持するものであるが、小規模なコホートであるため、一般化を確立したり、分布の仮定を確実に評価したりすることはできない。バルク組織の含有量だけでは、細胞レベルのタンパク質局在、酵素活性、または治癒への因果効果を立証することはできない。より大規模で臨床的に特徴付けられたコホートが必要である。その他の限界としては、臨床共変量の不備、比較組織の相違、文献由来のDPN遺伝子セットの不完全なドキュメント化、および元のブロットにおけるバックグラウンド除去記録の不備が挙げられる。健康な組織、研究で定義された対照組織、および潰瘍のない糖尿病足皮膚を、相互に代替可能なものとして扱うべきではない。
TCMネットワークは、仮説を生成するための拡張ツールである。そのカスタムウェイトは、ターゲットへの結合能や有効性ではなく、データベースのカバー率を要約したものであり、ランキングはデータベースの内容やウェイトの選択によって変動する可能性がある。また、Quercetinおよびberberineは、全身曝露量が変動的であるか、あるいは限定的である17,18。したがって、候補となる成分や生薬には、直接的なターゲット、線量反応、薬物動態、毒性、および機能性の試験が必要である。今後の研究では、十分に文書化された独立したコホートに、初代線維芽細胞または多細胞創傷モデルにおける空間的局在およびMMP1摂動を組み合わせるべきである。本知見は、線維芽細胞中心のマトリックスリモデリングの文脈において、MMP1がDFU関連の候補であることを支持するものであるが、因果関係や臨床的有用性を立証するものではない。
開示事項
著者らは、利益相反がないことを宣言します。
謝辞
本研究は、武漢市衛生健康委員会が管理する武漢市医療科学研究プロジェクト(指導プロジェクト、助成金番号 WX23Z77)の支援を受けて実施されました。
著者らは、本研究のために組織検体を提供してくださった参加者の方々と、NCBI Gene Expression Omnibusに公開データセットを生成および登録した研究者の方々に感謝いたします。
材料
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| 0.2 mL薄壁透明PCR 8連チューブストリップ | Axygen / Corning | PCR-0208-C | URL: https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Tubes/p/PCR-0208-C |
| 1,000-μL 滅菌済みフィルターピペットチップ | Axygen / Corning | TF-1000-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/SEA/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-1000-R-S |
| 1.5 mL滅菌済みマイクロ遠心チューブ、DNase/RNaseフリー | Solarbio Life Sciences | YA0430 | 商品名:アッセイキット(ヒト P-Selectin ELISA) 概要: 本キットは、ヒト血清、血漿、または細胞培養上清中の P-selectin(P-セレクチン)を定量するためのサンドイッチELISAキットです。 原理: 本アッセイでは、P-selectin 特異的な抗体を用いて抗原を捕捉し、検出用の抗体と酵素標識抗体を反応させることで、P-selectin の量を測定します。 特性: ・高感度で正確な定量が可能 ・迅速な操作手順 ・再現性に優れた結果を提供 キット構成: ・抗P-selectin キャプチャー抗体被覆プレート ・P-selectin 標準品 ・検出用抗体 ・HRP標識二次抗体 ・TWEAK緩衝液 ・洗浄バッファー ・基質溶液 ・停止液 保存条件: 2~8℃で保存してください。 用途: ・P-selectin の定量分析 ・炎症反応や血小板活性化の研究 ・血管内皮細胞の機能解析 |
| 10-μL 滅菌済みフィルター付きピペットチップ | Axygen / Corning | TF-300-L-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Aerosol-Barrier-Tips/p/TF-300-L-R-S 液体ハンドリング / ピペットチップおよびアクセサリ / ピペットチップ / Axygen® エアロゾルバリアチップ / TF-300-L-R-S |
| 2× SYBR Green PCR マスターミックス | Solarbio Life Sciences | SR1110 | 製品名:D-Glucose Oxidase (D-グルコース酸化酵素) カタログ番号:G-1011 特長: D-グルコース酸化酵素(D-Glucose Oxidase)は、β-D-グルコースを基質として、酸素および水を用いてD-グルコノ-1,5-ラクトンと過酸化水素を生成する酵素です。本製品は、多くの生物学的および産業的プロセスにおけるグルコースの検出や定量分析に広く利用されています。 成分: D-Glucose Oxidase 由来:*Aspergillus niger* 活性: 1ユニット(U)は、25℃、pH 5.5のリン酸緩衝液中において、1分間に1μmolのグルコースを酸化する酵素量と定義されます。 保存条件: -20℃で保存してください。 用途: ・グルコース測定キットの構成成分 ・バイオセンサーの開発 ・食品および飲料中の糖分分析 ・臨床診断における血糖値測定の研究 |
| 20× Tris緩衝生理食塩水 | Solarbio Life Sciences | T1080 | URL: https://www.solarbio.com/goodsInfo?id=1309 |
| 200-μL 滅菌済みフィルター付きピペットチップ | Axygen / Corning | TF-200-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-200-R-S |
| ACTB qPCRプライマーペア | Solarbio Life Sciences(カスタムオリゴヌクレオチド合成) | カスタム | RefSeq NM_001101.5; F: CACCATTGGCAATGAGCGGTTC; R: AGGTCTTTGCGGATGTCCACGT; URL: https://www.solarbio.com/ |
| Amersham Imager 600 | GE Healthcare Bio-Sciences AB、スウェーデン、ウプサラ | Amersham Imager 600 | 提供された22枚すべてのTIFFファイルに記録されたモデル。操作ソフトウェア Ver.1.2.0。URL: https://cdn.cytivalifesciences.com/api/public/content/digi-17089-original |
| ビシンコニン酸タンパク質アッセイキット | Solarbio Life Sciences | PC0020 | URL: https://www.solarbio.com/goodsInfo?id=64504 |
| clusterProfiler | Bioconductor | https://bioconductor.org/packages/clusterProfiler/ | バージョン 4.16.0 |
| Cofilinポリクローナル抗体(ウサギ抗Cofilin抗体) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., 中国、武漢) | 10960-1-AP | 本研究で使用したWB希釈倍率:1:6,000、URL:https://www.ptgcn.com/、RRID:AB_2291830 |
| 比較毒性ゲノミクスデータベース | 共通技術文書 | https://ctdbase.org/ | 成分-標的リソース |
| DESeq2 | Bioconductor | https://bioconductor.org/packages/DESeq2/ | バージョン 1.48.2 |
| DNase/RNaseフリー水 | Solarbio Life Sciences | R1600 | URL: https://www.solarbio.com/goods.php?id=1085 |
| e1071 | CRAN / e1071 著者 | https://cran.r-project.org/package=e1071 | バージョン 1.7-17 |
| ECL Plus 化学発光基質 | Solarbio Life Sciences | PE0010 | **produkct name: 2',3'-O-Methylcytidine (2',3'-O-Me-cytidine)** **CAS番号:** 134221-22-6 **分子式:** $\text{C}_{10}\text{H}_{15}\text{N}_{3}\text{O}_{5}$ **分子量:** 257.24 **特性:** 本製品は、リボースの2'位および3'位のヒドロキシ基がメチル化されたシチジン誘導体であり、RNAの化学修飾や核酸研究における重要な構成成分です。 **品質規格:** * **外観:** 白色粉末 * **純度 (HPLC):** $\ge 98\%$ **溶解性:** 水またはDMSOに溶解させて使用してください。 **保存条件:** $-20\text{°C}$で保存してください。 **注意点:** 本製品は研究用であり、医薬品や診断薬として使用することはできません。取り扱いには適切な個人用保護具を着用し、安全データシート(SDS)に従ってください。 |
| Gene Expression Omnibus: GSE134431 | 国立生物工学情報センター | GSE134431 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE134431 |
| Gene Expression Omnibus: GSE165816 | 国立生物工学情報センター | GSE165816 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE165816 |
| Gene Expression Omnibus: GSE199939 | 国立生物工学情報センター | GSE199939 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE199939 |
| Gene Expression Omnibus: GSE68183 | 国立生物工学情報センター | GSE68183 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE68183 |
| Gene Expression Omnibus: GSE80178 | 国立生物工学情報センター | GSE80178 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE80178 |
| ジーンオントロジー | ジーンオントロジーコンソーシアム | https://geneontology.org/ | GO(グルタチオン-S-トランスフェラーゼ) |
| ggplot2 | ggplot2開発者 | https://ggplot2.tidyverse.org/ | バージョン 4.0.3 |
| glmnet | CRAN / glmnet 著者 | https://cran.r-project.org/package=glmnet | バージョン 5.0 |
| 生薬成分参照表 | 原稿内に記載なし | 報告なし | 記載なし:正確なデータベース/ファイル名、バージョン/日付、および公開アクセスURL |
| HRP標識ヤギ抗ウサギIgG (H+L) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd.、中国、武漢) | SA00001-2 | 本研究で使用したWB希釈倍率:1:5,000、URL:https://www.ptgcn.com/products/HRP-conjugated-Goat-Anti-Rabbit-IgG-H-L-SA00001-2.htm、RRID:AB_2722564 |
| ヒト糖尿病性足潰瘍組織検体 | 武漢第四医院、中国、武漢 | 翻訳するソーステキストが提供されていません。翻訳が必要なテキストをご入力ください。 | 患者対照DFU検体;qPCR n=4検体;WB n=3検体;承認済みプロトコル KY2024-161-01 |
| ヒト非潰瘍性創周囲組織検体 | 武漢第四医院、中国、武漢 | 提供されたソーステキストがありません。翻訳するテキストを入力してください。 | 患者一致の創周囲対照試料;qPCR n=4検体;WB n=3検体;承認済みプロトコル KY2024-161-01 |
| ImageJ | 米国国立衛生研究所 | https://imagej.net/ij/ | バージョン未記載 |
| 京都遺伝子ゲノム百科事典 | KEGG | https://www.genome.jp/kegg/ | ヒト生物種コード hsa |
| 文献キュレーション済みDPN遺伝子リスト | 文献由来のコンポーネント。遺伝子レベルのソーステーブルが完全に文書化されていない。 | 報告されていない | 遺伝子レベルの由来が十分に文書化されていない |
| 微量分光光度計(UV-vis) | 原稿に製造メーカーおよびモデルの記載なし | 報告されていない | 記載なし:正確な製造業者、モデル、および製品URL。報告されている用途:RNA濃度およびA260/A280の評価 |
| MMP1ポリクローナル抗体(ウサギ抗MMP1抗体) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., 中国、武漢) | 10371-2-AP | 本研究で使用したWB希釈倍率:1:1,000、URL:https://www.ptgcn.com/Products/MMP1-Antibody-10371-2-AP.htm、RRID:AB_2297741 |
| MMP1 qPCRプライマーペア | Solarbio Life Sciences(カスタムオリゴヌクレオチド合成) | カスタム | RefSeq NM_002421; 正方向プライマー: ATGAAGCAGCCCAGATGTGGAG; 逆方向プライマー: TGGTCCACATCTGCTCTTGGCA; URL: https://www.solarbio.com/ |
| NCBI Gene | 国立生物工学情報センター | https://www.ncbi.nlm.nih.gov/gene/ | ヒト遺伝子データベース |
| 脱脂粉乳、ブロッキング剤 | Solarbio Life Sciences | D8340 | URL: https://www.solarbio.com/goodsInfo?id=1488 |
| org.Hs.eg.db | Bioconductor | https://bioconductor.org/packages/org.Hs.eg.db/ | バージョン 3.21.0 |
| 調製済みSDS-PAGEゲル、4%–20%勾配 | Solarbio Life Sciences | PG42010-S | URL: https://www.solarbio.com/goodsInfo?id=12646 |
| pROC | CRAN / pROC 著者 | pROC パッケージ ROC曲線の分析および評価のためのRパッケージ pROCパッケージは、ROC(受信者動作特性)曲線の分析および評価を行うための包括的なツールを提供します。このパッケージを用いることで、バイナリ分類器の性能を視覚化し、定量的に評価することが可能です。 主な機能: - ROC曲線の作成と描画 - AUC(曲線下面積)の算出および信頼区間の推定 - 最適なカットオフ値(閾値)の決定 - 複数のROC曲線の比較(統計的検定) - 感度(Sensitivity)および特異度(Specificity)の算出 pROCは、感度と特異度のバランスを最適化するための多様な手法を実装しており、臨床診断試験や機械学習モデルの評価において広く利用されています。 | バージョン 1.19.0.1 |
| プロテアーゼ阻害剤混合物, 100× | Solarbio Life Sciences | P6730 | URL: https://www.solarbio.com/goodsInfo?id=25748 |
| タンパク質転写システム | 原稿内にメーカー/モデルの記載なし | 報告されていない | 記載なし:詳細な製造メーカー、モデル、製品URL。報告されている用途:0.22- への移送μm PVDF膜 |
| PVDFメンブレン、 0.22 μm | Solarbio Life Sciences | YA1690 | URL: https://www.solarbio.com/goodsInfo?id=228106 |
| R | R Foundation for Statistical Computing | https://www.r-project.org/ | バージョン 4.5.2 |
| ランダムフォレスト | CRAN / randomForest 著者 | https://cran.r-project.org/package=randomForest | バージョン 4.7-1.2 |
| リアルタイムPCR装置 | Roche Diagnostics | LightCycler 96 | ソフトウェアのバージョンは未確認。プロジェクトの容量およびサイクル数は報告されているプロトコルと異なっており、正確な実験との関連性は引き続き確認が必要である。 |
| 冷却マイクロ遠心機 | 原稿に製造者およびモデルの記載なし | 報告なし | 記載なし:正確な製造メーカー、モデル、製品URL。報告された使用数:12,000 × 15分間、~で遠心分離する 4 °C |
| 戻ってください | CRAN / rentrez 著者 | https://cran.r-project.org/package=rentrez | バージョン 1.2.4 |
| RIPA溶解バッファー(高強度) | Solarbio Life Sciences | R0010 | URL: https://www.solarbio.com/goodsInfo?id=1163 |
| SDS-PAGE電気泳動システム | 原稿に製造元およびモデルの記載なし | 報告されていない | 記載なし:正確な製造者、モデル、製品URL。報告されている用途:4%でのタンパク質分離–20% グラジエントゲル |
| Seurat | Satija Lab / Seurat開発者 | https://satijalab.org/seurat/ | バージョン 5.5.0 |
| SingleR | Bioconductor | https://bioconductor.org/packages/SingleR/ | バージョン 2.10.0 |
| 組織ホモジナイザー | 原稿にメーカーおよびモデルの記載なし | 報告されていない | 記載なし:正確な製造業者、モデル、および製品URL。報告されている用途:氷冷溶解バッファー中での組織ホモジナイズ |
| TriQuick Reagent 全量RNA抽出試薬 | Solarbio Life Sciences | R1100 | URL: https://www.solarbio.com/goodsInfo?id=1083 |
| Tween-20 | Solarbio Life Sciences | T8220 | URL: https://www.solarbio.com/goodsInfo?id=102 |
| 0.2 mL PCRチューブストリップ用超透明フラットキャップ | Axygen / Corning | PCR-2CP-RT-C | URL: https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Caps/p/PCR-2CP-RT-C |
| ユニバーサルRT-PCRキット (M-MLV) | Solarbio Life Sciences | RP1100 | URL: https://www.solarbio.com/goodsInfo?id=992 製品名:L-乳酸(L-Lactic Acid) 製品番号:L-001 特性: L-乳酸は、多くの生物に共通して見られる重要な代謝中間体であり、乳酸菌による糖の分解過程で生成されます。また、ヒトの骨格筋において、激しい運動時の無酸素的な糖解糖系の最終産物としても知られています。 用途: ・各種生化学的分析および研究用 ・培地成分として ・pH調節剤として ・乳酸誘導体合成の原料として 保存条件: 室温で保存してください。 品質規格: 純度:≥99%(HPLC) |
| 加重遺伝子共発現ネットワーク解析 (WGCNA) | CRAN / WGCNA 著者 | WGCNA: 加重遺伝子共発現ネットワーク解析 (Weighted Gene Co-expression Network Analysis) | バージョン 1.74 |
| ウィンドウ | Microsoft | Windows 11 - Microsoft | Windows 11 |
参考文献
- Armstrong DG, Tan TW, Boulton AJM, Bus SA. Diabetic foot ulcers: a review. JAMA. 2023;330(1):62–75.
- Bus SA et al. Guidelines on the prevention of foot ulcers in persons with diabetes (IWGDF 2023 update). Diabetes Metab Res Rev. 2024;40(3):e3651.
- Sloan G, Selvarajah D, Tesfaye S. Pathogenesis, diagnosis and clinical management of diabetic sensorimotor peripheral neuropathy. Nat Rev Endocrinol. 2021;17(7):400–20.
- Maione AG et al. Altered ECM deposition by diabetic foot ulcer-derived fibroblasts implicates fibronectin in chronic wound repair. Wound Repair Regen. 2016;24(4):630–43.
- Caley MP, Martins VLC, O'Toole EA. Metalloproteinases and wound healing. Adv Wound Care (New Rochelle). 2015;4(4):225–34.
- Lobmann R et al. Expression of matrix-metalloproteinases and their inhibitors in the wounds of diabetic and non-diabetic patients. Diabetologia. 2002;45(7):1011–6.
- Muller M et al. Matrix metalloproteinases and diabetic foot ulcers: the ratio of MMP-1 to TIMP-1 is a predictor of wound healing. Diabet Med. 2008;25(4):419–26.
- Theocharidis G et al. Single cell transcriptomic landscape of diabetic foot ulcers. Nat Commun. 2022;13(1):181.
- Vabalas A, Gowen E, Poliakoff E, Casson AJ. Machine learning algorithm validation with a limited sample size. PLoS One. 2019;14(11):e0224365.
- Lewis MJ et al. nestedcv: an R package for fast implementation of nested cross-validation with embedded feature selection designed for transcriptomics and high-dimensional data. Bioinform Adv. 2023;3(1):vbad048.
- Hattori N et al. MMP-13 plays a role in keratinocyte migration, angiogenesis, and contraction in mouse skin wound healing. Am J Pathol. 2009;175(2):533–46.
- Pang J, Maienschein-Cline M, Koh TJ. Monocyte/macrophage heterogeneity during skin wound healing in mice. J Immunol. 2022;209(10):1999–2011.
- Finley PJ et al. Diabetic wounds exhibit decreased Ym1 and arginase expression with increased expression of IL-17 and IL-20. Adv Wound Care (New Rochelle). 2016;5(11):486–94.
- Moon JY et al. IL-17A is increased in diabetic wounds and impairs keratinocyte function via histone demethylase JMJD3. Nat Commun. 2026;17(1):780.
- Xiao Y et al. Macrophages regulate healing-associated fibroblasts in diabetic wound. Mol Biol Rep. 2024;51(1):203.
- Theocharidis G et al. Integrated skin transcriptomics and serum multiplex assays reveal novel mechanisms of wound healing in diabetic foot ulcers. Diabetes. 2020;69(10):2157–69.
- Almeida AF et al. Bioavailability of quercetin in humans with a focus on interindividual variation. Compr Rev Food Sci Food Saf. 2018;17(3):714–31.
- Khoshandam A, Imenshahidi M, Hosseinzadeh H. Pharmacokinetic of berberine, the main constituent of Berberis vulgaris L.: a comprehensive review. Phytother Res. 2022;36(11):4063–79.