이 연구는 L1-L2-영어와 L1-L2 포르투갈어를 비교하여 외국어 억양의 영향이 메트릭과 운율-음향 매개변수, 음성 라인업에서 대상 음성 선택을 얼마나 설명하는지 확인하는 것을 목표로 했습니다.
이 콘텐츠를 보려면 JoVE 구독이 필요합니다. 로그인하거나 오늘 무료 평가판을 시작하세요.
이 논문에서
요약
초록
본 연구는 외국어 억양의 영어와 외국어 억양의 브라질 포르투갈어의 운율-음향 특징과 지각적 상관관계를 모두 조사하고, 화자의 외국어 억양과 원어민 억양이 청취자의 인식과 어떤 상관관계가 있는지 확인하는 것을 목표로 합니다. 방법론에서는 L2 브라질 포르투갈어를 구사하는 미국인 그룹과 L2 영어를 구사하는 브라질 사용자 그룹과 함께 음성 생성 절차를 수행했으며, 두 언어에 대한 음성 라인업을 수행하는 음성 인식 절차를 수행했습니다. 음성 생성 통계 분석을 위해 Generalized Additive Model을 실행하여 반대 부류의 공변량(들)의 평활화 효과에 대해 제어되는 기능의 각 클래스(미터법 또는 운율-음향학)에 대한 언어 그룹의 효과를 평가했습니다. 음성 인식 통계 분석을 위해 Kruskal-Wallis 테스트와 사후 Dunn's 테스트를 실행하여 청취자가 판단한 점수에 대한 라인업의 목소리가 미치는 영향을 평가했습니다. 그럼에도 불구하고 우리는 코사인과 유클리드 거리를 기반으로 음향(음성) 유사성 테스트를 수행했습니다. 결과는 f0, 지속 시간 및 음성 품질의 가변성 측면에서 언어 그룹 간에 상당한 음향적 차이를 보여주었습니다. 라인업의 경우, 결과는 f0, 강도 및 음성 품질의 운율적 특징이 청취자의 인지된 판단과 상관관계가 있음을 나타냈습니다.
서론
억양은 모국어(L1)와 외국어(L2) 모두에서 의사 소통과 유창함의 두드러지고 역동적인 측면입니다1. 외국어 악센트는 대상 언어의 L2 음성 기능을 나타내며 화자의 L2 경험, 말하기 스타일, 입력 품질, 설명 등에 따라 시간이 지남에 따라 변경될 수 있습니다. 외국어 악센트는 외국어 화자가 생성한 L2 음성과 대상 언어의 현지 또는 참조 악센트 간의 (스칼라) 차이 정도2,3,4,5.
이 연구는 외국어 억양의 영어와 외국어 억양의 브라질 포르투갈어(BP)의 운율-음향 특징과 지각적 상관관계를 조사하고, 화자의 외국어 및 원어민 억양이 청취자의 인식과 어느 정도 상관관계가 있는지 확인하는 것을 목표로 합니다. 법의학 분야의 선행 연구에서는 외국어 억양 식별에서 모음과 자음의 견고성이 개인에 대한 장기 분석(The Lo Case6) 또는 화자의 높은 ID 정확도(The Lindbergh Case7)를 참조하여 안정적임을 입증했습니다. 그러나 지속 시간, 기본 주파수(f0, 즉, 피치의 음향 상관 관계), 강도 및 음성 품질(VQ)을 기반으로 하는 운율 음향 기능에 대한 탐색이 점점 더 주목을 받고 있습니다8,9. 따라서 이 연구에서 운율-음향 기능에 대한 선택은 법의학 음성학 분야에서 유망한 길을 나타냅니다8,10,11,12,13.
본 연구는 법의학 사례에서 음성 위장의 한 형태로 외국어 억양에 관한 연구14,15, 화자 인식을 위한 음성 라인업 준비16,17. 예를 들어, 말하기 속도는 독일어, 이탈리아어, 일본어 및 브라질어 영어 사용자를 식별하는 데 중요한 역할을 했습니다18,19,20,21,22. 말하기 속도 외에도, 장기 스펙트럼 및 f0 기능은 뇌와 인지 기반이 기억력, 주의력 및 감정의 결핍을 겪기 때문에 장기 스펙트럼 및 f0 기능은 긴 말하기 회전 동안 화자의 음성 수행에 반영되기 때문에 대상 언어에 익숙한 L2 능숙한 사용자에게 도전23. 법의학 분야에서 외국어 억양에 대한 견해는 실제로 외국어 억양처럼 들리는 것에 대한 정의는 극단적이지 않은 정도의 외국어 억양이 있는 말투를 갖는 것보다 듣는 사람의 낯설음에 크게 좌우된다는 것입니다24.
지각 영역에서 1990년대 중반부터 범죄자 인식을 위해 사용된 일반적인 포렌식 도구는 범죄 현장에서 범인을 식별하는 데 사용되는 시각적 인식과 유사한 Voice Lineup(청각 인식)입니다16,25. 음성 라인업에서 용의자의 목소리는 목격자가 식별할 수 있도록 나이, 성별, 지리적 위치, 방언 및 문화적 지위와 같은 사회 언어학적 측면에서 유사한 호일 목소리와 함께 제시됩니다. 음성 라인업의 성공 또는 실패는 음성 샘플의 수와 샘플 지속 시간에 따라 달라집니다.25,26. 또한 실제 샘플의 경우 오디오 품질이 음성 인식의 정확도에 지속적으로 영향을 미치는 것으로 간주됩니다. 오디오 품질이 좋지 않으면 voice27의 고유한 특성이 왜곡될 수 있습니다. 음성 유사성의 경우 f0을 기반으로 하는 미세한 음성 세부 정보는 음성 인식 중에 청취자를 혼동할 수 있습니다28,29. 이러한 음향 기능은 f0를 넘어 확장되며 지속 시간 요소와 강도 및 VQ30의 스펙트럼 기능을 포함합니다. 여러 운율 기능에 대한 이러한 보기는 정확한 화자 식별을 보장하기 위해 포렌식 음성 비교의 맥락에서 매우 중요합니다9,14,15,29,31.
요약하면, 법의학 음성학의 연구는 지난 수십 년 동안 외국어 억양 식별과 관련하여 약간의 변화를 보여주었습니다. 한편으로는, 외국어 억양은 화자를 식별하는 과정에 영향을 미치지 않는 것 같습니다32,33 (특히 화자가 대상 외국어 억양에 익숙하지 않은 경우34). 반면에 반대 방향의 결과가 있습니다12,34,35.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
프로토콜
이 연구는 인간 연구 윤리 위원회의 승인을 받았습니다. 또한, 본 연구에 참여한 모든 참가자로부터 자신의 데이터를 사용하고 게시하기 위해 정보에 입각한 동의를 얻었습니다.
1. 음성 제작
참고: 그룹 1: The American English (from the U.S.A.) Speakers (AmE-S)와 Group 2: The Brazilian Speakers (Bra-S)가 제작한 'L1 BP-L2 English'에 대한 읽기 과제에서 음성을 수집했습니다. 음성 생성을 위한 순서도는 그림 1을 참조하십시오.

그림 1: 음성 생성을 위한 회로도 순서도. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
- 참가자
- 참가자 수, 언어(L1 영어, L2 BP; L1 BP, L2 영어), 성별(여성 또는 남성), 연령(평균, 표준 편차), 그룹 특성(전문가 또는 학부생) 및 각 그룹의 L2 숙련도 수준(고급 또는 고급).
참고: 본 연구에서 AmE-S와 Bra-S는 모두 L2에 능숙한 것으로 간주되었습니다(두 그룹 모두 B2-C136으로 자격이 부여됨). AmE-S는 절차가 진행될 당시 브라질에서 2년 동안 살았다. 브라-S는 시술이 진행될 당시 미국에서 2년 이상 살았다. 해외에 사는 동안 두 그룹 모두 하루에 ~4-5시간, 일주일에 최소 6일 동안 공부와 업무 목적으로 L2를 사용하곤 했습니다. - 참가자들을 편안하고 조용한 방에 배정하고 각 그룹에 대한 읽기 자료를 제시합니다.
- 참가자 수, 언어(L1 영어, L2 BP; L1 BP, L2 영어), 성별(여성 또는 남성), 연령(평균, 표준 편차), 그룹 특성(전문가 또는 학부생) 및 각 그룹의 L2 숙련도 수준(고급 또는 고급).
- 데이터 수집
참고: 음성 데이터는 읽기 작업에서 L1-English 및 L2-BP로 수집해야 합니다. L1-BP 및 L2-English. 필요하다면 참가자들이 성구를 미리 읽게 한다.- 기록 절차
- 적절한 음향 조건이 있는 조용한 장소에서 음성 데이터를 녹음합니다.
- 디지털 음성 녹음기(재료 표 참조)37 및 단방향 전자기 절연 카디오이드 마이크(재료 표 참조)38을 사용합니다.
- 오디오 데이터를 '.wav' 형식으로 녹음합니다.
- 샘플링 속도를 48kHz로 설정하고 양자화 속도를 16비트로 설정합니다.
참고: 1.2.1.3 및 1.2.1.4 단계에서 설명한 샘플링 및 양자화 속도에 대한 오디오 형식과 구성은 나중에 음향 분석에 사용되는 스펙트럼 기능을 보존하기 위해 고품질 및 노이즈 감소를 보장하기 위해 적용됩니다.
- 기록 절차
- 음향 분석
참고: 음향 분석 절차를 강제 정렬, 재정렬 및 음향 특징 추출의 세 단계로 나눕니다.- 언어 전사를 작성하십시오 ( '.txt' 파일)을 사용합니다.
- '.txt'/'.wav' 파일 쌍에 동일한 이름(예: 'my_file.wav'/ 'my_file. txt').
참고: 섹션 1.3.7에 설명된 절차의 성능을 향상시키려면 '.txt/.wav' 파일 태그의 처음 세 문자는 언어, 방언 또는 억양을 나타내고 네 번째에서 여섯 번째 문자는 성별을 나타내는 것이 좋습니다(예: E nglish L1 Fem의 경우 EL1FEM 에일). 7번째 문자부터 사용자는 화자 번호를 표시해야 합니다(예: 첫 번째 화자의 경우 001). 결과적으로 첫 번째 '.txt/.wav' 쌍은 EL1FEM001입니다. - 각 L1-L2 언어에 대한 폴더를 만듭니다.
참고: L1-L2 영어용 폴더와 L1-L2 BP용 폴더. - 동일한 언어의 모든 파일 쌍이 동일한 폴더에 있음을 인증합니다.
- 강제 정렬을 수행합니다.
- https://clarin.phonetik.uni-muenchen.de/BASWebServices/interface/Pipeline 에서 MAUS(Munich Automatic Segmentation) 강제 정렬기(웹MAUS)39의 웹 인터페이스에 액세스합니다.
- 의 각 쌍을 끌어다 놓습니다. wav / . txt 파일을 파일의 파선 사각형으로 이동합니다(또는 사각형 내부를 클릭하여 그림 2A).
- 업로드 버튼을 클릭하여 파일을 정렬기에 업로드합니다(그림 2A)의 빨간색 화살표 참조).
- 서비스 옵션 메뉴에서 다음 옵션을 선택합니다(그림 2B).파이프라인 이름의 경우 G2P-MAUS-PHO2SYL; L1-L2 영어 데이터인 경우 영어(미국)(언어의 경우); 이탈리아어(IT)(언어용)(L1-L2 BP 데이터인 경우).
참고: webMAUS는 BP 강제 정렬을 위한 사전 훈련된 음향 모델을 제공하지 않기 때문에 BP 데이터에 대해 'Italian'을 선택했습니다. 음성 문헌에 따르면 이탈리아어 음운론은 BP40과 마찬가지로 다소 유사한 대칭 7모음 목록과 자음 음향 유사성41,42 .
- 'Output format(출력 형식)' 및 'Keep everything(모두 유지)'에 대한 기본 옵션을 유지합니다.
- 사용 약관에 동의하려면 실행 옵션 상자를 선택합니다(그림 2C).
- 웹 서비스 실행 버튼을 클릭하여 aligner.
에서 업로드된 파일을 실행합니다. 참고: 각 오디오 파일에 대해 MAUS 강제 정렬기는 Praat TextGrid 객체(1.3.1단계에서 설명한 '.txt' 파일에서 추출한 언어 전사를 기반으로 단어, 음운 음절 및 전화의 주석을 포함하는 Praat의 사전 서식이 지정된 .txt'' 파일)를 반환합니다. - ZIP 파일로 다운로드 버튼을 클릭하여 TextGrid 파일을 압축 파일(그림 2C).
로 다운로드합니다. 참고: 압축된 TextGrid 파일이 오디오 파일과 동일한 폴더에 다운로드되었는지 확인하십시오. - 나중에 음성 분석 소프트웨어인 43에서 재정렬하기 위해 TextGrid 파일을 추출합니다.
- 재정렬을 수행합니다.
- https://github.com/leonidasjr/VVunitAlignerCode_webMAUS/blob/main/VVunitAligner.praat 에서 Praat VVUnitAligner44에 대한 스크립트에 액세스하고 다운로드합니다.
- 동일한 언어와 VVUnitAligner 스크립트의 모든 파일 쌍이 동일한 폴더에 있음을 인증합니다.
참고: L1-L2 영어 파일 및 VVunitAligner용 폴더, L1-L2 BP 파일 및 VVunitAligner용 폴더. - 음성 분석 소프트웨어를 엽니다.
- Praat | Praat 스크립트를 열어 개체 창에서 스크립트를 호출합니다.
- 실행 버튼을 한 번 클릭합니다.
참고: 스크립트 사용을 위한 설정이 포함된 음성 음절 정렬이라는 형식이 화면에 나타납니다(그림 3A). - 언어 버튼을 클릭하여 '영어(미국)', '포르투갈어(브라질)', '프랑스어(프랑스)' 또는 '스페인어(스페인)' 언어 중에서 선택합니다.
- 청크 세그멘테이션 버튼을 클릭하여 '자동', '강제(수동)' 또는 '없음' 세그멘테이션 절차 중에서 선택합니다.
- 새 TextGrid 파일을 자동으로 저장하려면 TextGrid 파일 저장 옵션을 선택합니다.
- Ok (확인) | 1.3.5.7 단계에서 음성 단위 재정렬을 위한 실행 버튼 .
참고: 각 오디오 파일에 대해 VVUnitAligner는 섹션 1.3.7(그림 3B)에 대한 새 TextGrid 파일을 생성합니다.
- 음향 특징의 자동 추출을 수행합니다.
- 운율-음향 기능을 자동으로 추출하기 위해 https://github.com/leonidasjr/SpeechRhythmCode/blob/main/SpeechRhythmExtractor.praat 에서 SpeechRhythmExtractor45 스크립트에 액세스하고 다운로드합니다.
- 새 폴더를 만들고 SpeechRhythmExtractor를 모든 언어의 모든 오디오 / TextGrid 파일 쌍과 함께 넣으십시오.
- 음성 분석 소프트웨어를 엽니다.
- Praat | Praat 스크립트를 열어 개체 창에서 스크립트를 호출합니다.
- 실행 단추를 한 번만 클릭합니다.
참고: 스크립트 설정이 포함된 양식이 화면에 나타납니다. 출력 '.txt' 파일 이름 상자에서 그에 따라 파일 이름을 바꾸거나 기본 이름을 그대로 둡니다. - 음성 품질 매개 변수 옵션을 확인하여 음성 품질에 대한 출력 파일 VQ를 저장합니다(그림 3C).
참고: 이 두 번째 출력 파일(출력 파일 VQ)에는 1차 및 2차 고조파(H1-H2)와 Cepstral Prominence Peak(CPP)9 간의 차이 매개변수가 포함되어 있습니다. - '언어', '방언' 또는 '악센트' 레이블(그림 3C) 중에서 선택하려면 언어 대상 옵션을 선택합니다.
- 단위 옵션을 선택하여 f0 기능을 Hz 또는 반음(그림 3C)으로 선택합니다.
- F0 임계값, 최소 및 최대 f0 임계값을 설정합니다(그림 3C).
참고: 연구에 특정 목적이 있거나 특정 오디오 기능이 미리 설정되어 있지 않은 경우 1.3.7.9단계의 매개변수를 기본값으로 두는 것이 좋습니다. - Ok (확인) | 음향 기능 .
의 자동 추출을 위해 실행합니다. 참고: SpeechRhythmExtractor 스크립트는 스피커에서 추출한 음향 기능이 포함된 탭으로 구분된 '.txt' 파일(출력 파일/출력 파일 VQ)을 반환합니다.
- 통계 분석
- 음향 기능이 포함된 스프레드시트를 R46 환경(또는 선택한 통계 소프트웨어/환경)에 업로드합니다.
- GAM(Generalized Additive Model) 비모수 통계량을 수행합니다.
- R에서 GAM을 수행합니다.
- 다음 명령을 입력하고 Enter 키를 누릅니다.
라이브러리(MGCV)
model = gam(분석에서 미터법/운율-음향 기능 ~ 언어 + s(선택한 미터법 기능, by = 언어) + 기타 미터법/운율-음향 기능, 데이터 = 데이터 프레임)
참고: 우리는 학계에서 음성학자(및 언어학자) 사이에서 인기가 높아지고 있기 때문에 R 프로그래밍 언어로 프로토콜의 테스트 통계를 수행하기로 결정했습니다. R은 음성 현장 조사 연구에서 주로 사용되었습니다47. 1.4.2.2 단계에는 의사 코드가 포함되어 있습니다. 연구 변수에 따라 코드를 작성합니다.

그림 2: MAUS 강제 정렬기를 사용한 음성 정렬의 스크린샷. (A) 점선 사각형은 'my_file.wav'/' my_file.txt' 파일을 드래그 앤 드롭하거나 내부를 클릭하여 폴더에서 해당 파일을 검색하기 위한 것입니다. 업로드 버튼은 빨간색 화살표로 표시됩니다. (B) 패널 A에서 업로드된 파일(파란색 화살표 참조), 사용할 파이프라인, 파일 쌍의 언어, 반환할 파일 형식 및 모든 파일을 보관하기 위한 'true/false' 버튼. (C) 사용 확인란 사용 약관(녹색 화살표 참조), 웹 서비스 실행 버튼 및 결과(다운로드할 TextGrid 파일). 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
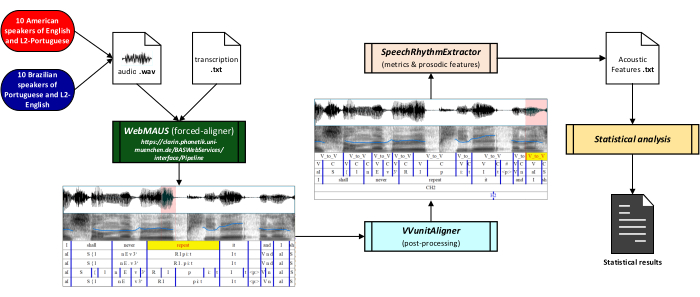
그림 3: 재정렬 절차의 스크린샷. (A) 재정렬 절차를 위한 입력 설정 양식. (B) 부분 파형, f0(파란색) 윤곽이 있는 광대역 스펙트로그램, 계층 1로 분할된(및 레이블링된) 6개 계층: 다음 모음 시작까지의 모음 시작 단위(V_to_V); 모음 시작 (V_to_V); Tier 2 : 모음 (V), 자음 (C) 및 일시 중지 (#)의 단위; Tier 3 : 음성 표현 V_to_V; Tier 4 : 텍스트의 일부 단어; 계층 5: 텍스트에서 음성의 일부 청크(CH); 티어 6: 여성 AmE-S가 생성한 각 음성 청크의 가장 높은(H) 톤과 가장 낮은(L) 톤을 포함하는 톤 계층입니다. (C) 음향 기능의 자동 추출을 위한 입력 설정. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
2. 음성 인식
참고: 미국 청취자를 대상으로 4개의 영어 음성 라인업을, 브라질 청취자를 대상으로 BP에서 4개의 음성 라인업을 수행했습니다. 음성 인식을 위한 순서도는 그림 4를 참조하십시오.
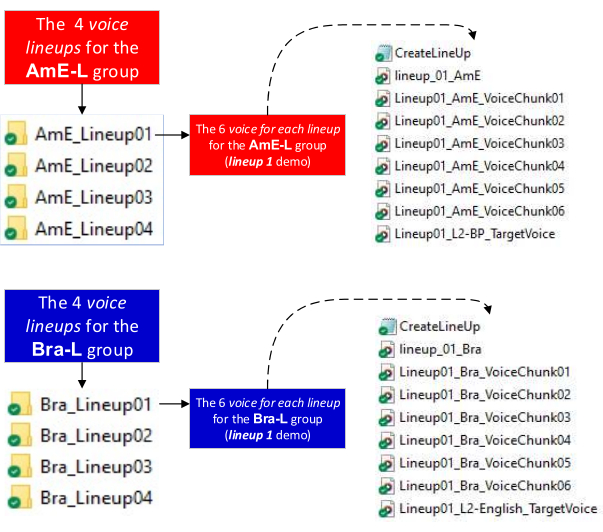
그림 4: 음성 인식을 위한 개략적인 순서도. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
- 참가자
- 음성 제작 프로토콜에 참여한 참가자 중에서 각 그룹에 대해 다른 참가자를 선택하십시오.
참고: 프로토콜의 이 부분에 대해 두 그룹의 참가자가 선택되었습니다: 그룹 1: The American English (미국에서) Listeners (AmE-L) 및 그룹 2 : Brazilian Listeners (Bra-L). 본 연구에서는 AmE-L과 Bra-L 모두 L2에 능숙한 것으로 간주되었습니다(두 그룹 모두 B2-C136 AmE-L은 절차가 수행될 당시 브라질에서 2년 동안 살았습니다. 브라-L은 시술이 진행될 당시 미국에서 2년 이상 살았다. 해외에 사는 동안, 두 그룹 모두 공부와 업무 목적(일주일에 최소 6일, 하루에 약 4-5시간)을 위해 L2를 사용하곤 했습니다. - 참가자 수, 언어(L1 영어, L2 BP; L1 BP, L2 영어), 성별(여성 또는 남성), 연령(평균, 표준 편차), 그룹 특성(전문가 또는 학부생) 및 각 그룹의 L2 숙련도 수준.
- 음성 제작 프로토콜에 참여한 참가자 중에서 각 그룹에 대해 다른 참가자를 선택하십시오.
- 음성 라인업
참고: 음성 라인업의 절차를 두 가지 다른 단계, 즉 음성 라인업 준비 및 실행으로 나눕니다.- 영어용 음성 라인업 4개, BP용 음성 라인업 4개를 준비합니다.
- 섹션 1: 음성 제작의 화자로부터 오디오 파일을 가져옵니다.
- 각 언어 요소의 오디오 파일이 별도의 폴더에 있음을 인증합니다.
- L1 영어 또는 L1 BP.
6개의 음성 청크를 무작위로 선택합니다. 참고: 라인업에 있는 6개의 음색은 1개의 대상 음성과 5개의 포일을 나타냅니다. - 2.2.1.3.
단계에 포함된 스피커 중 하나에서 L2 영어 또는 L2 BP의 음성 청크를 선택합니다. 참고: 2.2.1.4단계의 음성 청크는 참조 음성입니다. 청크의 길이는 약 20초여야 합니다.8. - https://github.com/pabarbosa/prosody-scripts-CreateLineUp 에서 Praat CreateLineup48에 대한 스크립트에 액세스하고 다운로드합니다.
- CreateLineup 스크립트(그림 5)를 실행하기 전에 L2 참조 음성, L1 포일 및 L1 대상 음성이 동일한 폴더에 있는지 인증합니다.
- 음성 분석 소프트웨어를 엽니다.
- 개체 창에서 Praat | Praat 스크립트를 열어 스크립트를 호출합니다.
- Run(실행) | run.
참고: 스크립트는 (L2 참조 음성) + (L1 대상 음성 및 무작위로 분포된 포일) (그림 5)의 순서로 파일을 반환합니다.
- 음성 라인업 실행
- 선택한 플랫폼(예: SurveyMonkey)에서 라인업을 호스팅할 수 있는 온라인 공간을 만듭니다. See the Table of Materials)에서 음성 라인업을 원격으로 지휘할 수 있습니다.
- 온라인 스페이스 링크에 접속합니다.
- CreateLineup 스크립트에서 반환된 파일을 플랫폼에 업로드합니다.
- 참가자보다 먼저 절차를 실행하여 모든 단계를 테스트합니다.
참고: 사전에 링크에 액세스하고 라인업을 실행하여 모든 것이 정상적으로 진행되고 있는지 확인하는 것이 좋습니다.
- 영어용 음성 라인업 4개, BP용 음성 라인업 4개를 준비합니다.
- 통계 분석
- 청취자의 판단 점수가 포함된 스프레드시트를 R 환경(또는 선택한 통계 소프트웨어/환경)에 업로드합니다.
- R에서 Kruskal-Wallis 검정을 수행합니다.
- 다음 명령을 입력하고 Enter 키를 누릅니다.
model = kruskal.test(판단 ~ 각 음성 라인업, 데이터 = 데이터 프레임)
- 사후 Dunn의 검정을 수행합니다.
- R에서 Dunn의 테스트를 수행합니다.
- 다음 명령을 입력하고 Enter 키를 누릅니다.
라이브러리(FSA)
model = dunnTest(판단 ~ 각 음성 라인업, 데이터 = 데이터, 방법 = "bonferroni")
참고: 2.3.1.2 및 2.3.2.2 단계의 코드는 의사 코드입니다(참고 1.4.2.2 참조).
- 청취자의 판단 점수가 포함된 스프레드시트를 R 환경(또는 선택한 통계 소프트웨어/환경)에 업로드합니다.
- 음향 유사성 분석
- 타겟과 포일 사이에 유의미하지 않은 차이를 나타낸 라인업(2.2.1.3단계 참고 참조)을 선택합니다.
- 1.3.1 - 1.3.7.5 단계 및 1.3.7.8 - 1.3.7.10 단계를 반복합니다.
- https://github.com/leonidasjr/AcousticSimilarity/blob/main/AcousticSmilarity_cosine_euclidean.py.
에서 Python49, AcousticSimilarity_cosine_euclidean50에 대한 스크립트 액세스 및 다운로드 참고: 스크립트는 세 개의 행렬('.txt' 및 '.csv')을 반환합니다: 하나는 코사인 유사성51,52, 하나는 유클리드 거리52,53, 다른 하나는 변환된 유클리드 거리 값, 그리고 대상 음성과 각 포일 간의 쌍별 비교입니다. - 스크립트가 라인업 데이터 집합의 동일한 폴더에 다운로드되었는지 확인합니다.
- Open file... 버튼을 클릭하여 스크립트를 호출합니다.
- Run(실행) | 버튼을 디버깅하지 않고 실행.
참고: 두 번째 실행 단추는 실행 또는 디버깅 없이 실행 또는 스크립트 실행으로 태그가 지정될 수 있습니다. 그들은 모두 동일한 명령을 실행합니다. 단순히 사용되는 Python 환경에 따라 다릅니다. - 음향 기능을 기반으로 음성 유사성 테스트를 수행합니다.
참고: 코사인 유사성(또는 코사인 거리)은 인공 지능(AI), 특히 자동 음성 인식(ASR) 시스템의 기계 학습에 적용되는 기술입니다. 0과 1 사이의 유사성을 나타내는 척도입니다. 코사인 유사성이 1에 가까우면 두 목소리가 비슷할 가능성이 매우 높다는 것을 의미합니다. 코사인 유사도가 0에 가까우면 음성이 서로 다를 가능성이 높다는 것을 의미합니다52. 종종 유클리드 유사성이라고 하는 유클리드 거리는 AI, 기계 학습 및 ASR에서도 널리 사용됩니다. 유클리드 space53에서 두 점 사이의 직선 거리를 나타냅니다. 즉, 점이 가까울수록(거리 값이 짧을수록) 음성이 더 유사합니다. 두 기법의 보고된 결과를 보다 명확하게 이해하기 위해 유클리드 거리 원시 점수를 0(음성 유사성 감소)에서 1(음성 유사성 증가)54 값으로 변환했습니다.

그림 5: 음성 인식을 위한 디렉토리 설정. 라인업 폴더. 각 폴더에는 6개의 L1 음성, L2 대상 음성, "CreateLineup" 스크립트 및 음성 라인업 오디오 파일(스크립트 실행 후 반환됨)이 포함되어 있습니다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
결과
언어 생성 결과
이 섹션에서는 통계적으로 유의미한 운율-음향 특성과 리듬 지표의 성능을 설명했습니다. 이러한 운율 특성에는 지속 시간과 관련된 발화 속도, 조음 속도, 휴지 속도 및 음성 품질과 관련된 쉬머(shimmer)가 포함되었습니다. 리듬 지표로는 음절 지속 시간의 표준 편차(SD), 자음의 SD, 모음 또는 자음 지속 시간의 SD, 그리고 음절 지속 시간의 변동 계수가 사용되었습니다(보충 표 S1 참조).
The 말하기 속도 (그림 6A) L1-L2 영어의 경우 L1-L2 브라질 포르투갈어(BP)보다 더 빠르게 감소하지만, 두 제2언어(L2) 모두에서 그 속도는 더 낮습니다. 이 말하기 속도 세 가지 지표, 즉 음절 지속 시간의 표준 편차(SD)와 관련이 있습니다.SD-S<...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
토론
현재 프로토콜은 (법의학) 음성학 분야에서 참신함을 제시합니다. 생산(음향 분석)과 지각(판단 분석)의 두 단계로 나뉩니다. 생산 분석 단계는 통계 외에 데이터 준비 및 강제 정렬, 재정렬 및 운율-음향 특징의 자동 추출로 구성됩니다. 이 프로토콜은 주로 수동 세분화를 기반으로 하는 기존 프로토콜보다 더 빠르고 효율적인 방식으로 데이터 수집 단계를 데이터 분석에 연결합니다.
그러나 프로토콜 단계 1.3.6 - 1.3.6.9에 표시된 재정렬 프로세스는 기본적으로 프로토콜 단계 1.3.1 - 1.3.4에서 생성된 전화 및 워드 유닛에서 작동합니다. 재정렬 프로세스의 참신함은 음절 계층, 단어를 기반으로 자동 또는 수동으로 생성할 수 있는 음성 청크 계층, f0 측정값을 계산하는 데 매우 유용할 수 있는 톤 계층의 세 가지 새로운 텍스트 계층을 포함하는 새로운 TextGrid를 생성한다는 것입니다. 이 프로토콜에 대해 제안된 재정렬 지침은 이전에 L2 음성 리듬 연구
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
공개 사항
저자는 선언할 이해 상충이 없습니다.
감사의 글
이 연구는 National Council for Scientific and Technological Development - CNPq, 제1저자에 대한 보조금 번호 307010/2022-8, 두 번째 저자에 대한 보조금 번호 302194/2019-3의 지원을 받았습니다. 저자들은 본 연구에 참여한 분들의 아낌없는 협력과 귀중한 기여
에 진심으로 감사의 뜻을 표한다.액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| CreateLineup | 개인 컬렉션 | # | 스크립트 for praat for voice 라인업 준비 |
| Dell I3 (솔리드 스테이트 드라이브 - SSD 포함) | Dell | # | 노트북 컴퓨터 |
| Praat | Paul Boersma & David Weenink | # | 음성 분석을 위한 소프트웨어 |
| Python 3 | Python Software Foundation | # | 인터프리터, 고수준, 범용 프로그래밍 언어 |
| R | 통계 컴퓨팅을 위한 R 프로젝트 | # | 통계 컴퓨팅을 위한 프로그래밍 언어 |
| Shure Beta SM7B | Shure | # | 마이크 |
| SpeechRhythmExtractor | 개인 소장품 | # | 음향 기능 자동 추출을 위한 스크립트 |
| SurveyMonkey | SurveyMonkey Inc. | # | 사용자 정의 가능한 무료 설문 조사와 데이터 분석, 표본 선택, 편향 제거 및 데이터 표현을 포함하는 백엔드 프로그램 제품군을 조합합니다. |
| Tascam DR-100 MKII | Tascam | # | 디지털 음성 녹음기 |
| 뮌헨 자동 세분화 시스템 MAUS | 뮌헨 대학교 | # | 오디오(.wav) 및 언어 정보(.txt) 파일의 강제 정렬기 |
| VVUnitAligner | 개인 컬렉션 | # | 음성 단위의 자동 재정렬 및 사후 처리를 위한 스크립트 |
참고문헌
- Moyer, A. Foreign Accent: The Phenomenon of Non-native Speech. , Cambridge University Press. (2013).
- Munro, M., Derwing, T. Foreign accent, comprehensibility and intelligibility, redux. J Second Lang Pronunciation. 6 (3), 283-309 (2020).
- Levis, J. Intelligibility, Oral Communication, and the Teaching of Pronunciation. , Cambridge University Press. (2018).
- Munro, M. Applying Phonetics: Speech Science in Everyday Life. , Wiley-Blackwell. (2022).
- Gut, U. Speaker Classification. Muller, C. , Springer-Verlag. 75-87 (2007).
- Rogers, H. Foreign accent in voice discrimination: a case study. Forensic Linguistics. 5 (2), 203-208 (1998).
- Solan, L., Tiersma, P. Hearing Voices: Speaker Identification in Court. Hastings Law Journal. 54, 373-436 (2003).
- Alcaraz, J. The long-term average spectrum in forensic phonetics: From collation to discrimination of speakers. Estudios de Fonética Experimental / Journal o Experimental Phonetics. 32, 87-110 (2023).
- Silva, L. Jr, Barbosa, P. A. Voice disguise and foreign accent: Prosodic aspects of English produced by Brazilian Portuguese speakers. Estudios de Fonética Experimental / Journal o Experimental Phonetics. 32, 195-226 (2023).
- Munro, M., Derwing, T. Modeling perceptions of the accentedness and comprehensibility of L2 speech. Studies in Second Language Acquisition. 23 (4), 451-468 (2001).
- Keating, P., Esposito, C. Linguistic Voice Quality. Working Papers in Phonetics. , 85-91 (2007).
- Niebuhr, O., Skarnitzl, R., Tylečková, L. The acoustic fingerprint of a charismatic voice -Initial evidence from correlations between long-term spectral features and listener ratings. Proceedings of Speech Prosody. , 359-363 (2018).
- Segundo San, E. International survey on voice quality: Forensic practitioners versus voice therapists. Estudios de Fonética Experimental. 29, 8-34 (2021).
- Farrús, M. Fusing prosodic and acoustic information for speaker recognition. International Journal of Speech, Language and the Law. 16 (1), 169(2009).
- Farrús, M. Voice disguise in automatic speaker recognition. ACM Computing Surveys. 51 (4), 1-2 (2018).
- Nolan, F. A recent voice parade. The International Journal of Speech, Language and the Law. 10 (2), 277-291 (2003).
- McDougall, K. Ear-catching versus eye-catching? Some developments and current challenges in earwitness identification evidence. Speaker Individuality in Phonetics and Speech Sciences. Bernardasci, C., Dipino, D., Garassino, D., Negrinelli, S., Pellegrino, E., Schmid, S. , Officinaventuno. 33-56 (2021).
- Gut, U. Rhythm in L2 speech. Speech and Language Technology. 14 (15), 83-94 (2012).
- Urbani, M. Pitch Range in L1/L2 English. An Analysis of F0 using LTD and Linguistic Measures. Coop. , Libraria Editrice Università di Padova. (2012).
- Gonzales, A., Ishihara, S., Tsurutani, C. Perception modeling of native and foreign-accented Japanese speech based on prosodic features of pitch accent. J Acoust Soc Am. 133 (5), 3572(2013).
- Silva, L. Jr, Barbosa, P. A. Speech rhythm of English as L2: an investigation of prosodic variables on the production of Brazilian Portuguese speakers. J Speech Sci. 8 (2), 37-57 (2019).
- Foreign accent and L2 speech rhythm of English a pilot study based on metric and prosodic parameters. Silva, L. Jr, Barbosa, P. A. Proceedings of the II Brazilian Conference on Prosody (Anais II Congresso Brasileiro de Prosódia), 1, 41-50 (2023).
- Costa, A. El cerebro bilingüe: La neurociencia del lenguaje. , Penguin Randon House. (2017).
- Eriksson, A. Tutorial on forensic speech science: Part I. Forensic Phonetics. , (2005).
- Harvey, M., Giroux, M., Price, H. Lineup size influences voice identification accuracy. Applied Cognitive Psychology. 37 (5), 42-89 (2023).
- Pautz, N., et al. Identifying unfamiliar voices: Examining the system variables of sample duration and parade size. Q J Exp Psychol (Hove). 76 (12), 2804-2822 (2023).
- McDougall, K., Nolan, F., Hudson, T. Telephone transmission and earwitnesses: Performance on voice parades controlled for voice similarity. Phonetica. 72 (4), 257-272 (2015).
- Nolan, F., McDougall, K., Hudson, T. Some acoustic correlates of perceived (dis) similarity between same-accent voices. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2011). , 1506-1509 (2011).
- Sheoran, S., Mahna, D. Voice identification and speech recognition: an arena of voice acoustics. Eur Chem Bull. 12 (5), 50-60 (2023).
- Hudson, T., McDougall, K., Hughes, V. Forensic phonetics. The Cambridge Handbook of Phonetics. Knight, R. -A., Setter, J. , Cambridge University Press. 631-656 (2021).
- Eriksson, A. The disguised voice: Imitating accents or speech styles and impersonating individuals. Language and identities. Llamas, C., Watt, D. , Edinburgh University Press. 86-96 (2010).
- Köster, O., Schiller, N. Different influences of the native language of a listener on speaker recognition. Forensic Linguistics. 4 (1), 18-27 (1997).
- The influence of native-language background on speaker recognition. Köster, O., Schiller, N., Künzel, H. Proceedings of the International Congress of Phonetic Sciences (ICPhS 1995), , 306-309 (1995).
- Thompson, C. P. A language effect in voice identification. Applied Cognitive Psychology. 1, 121-131 (1987).
- San Segundo, E., Univaso, P., Gurlekian, J. Sistema multiparamétrico para la comparación forense de hablantes. Estudios de Fonética Experimental. 28, 13-45 (2019).
- Council of Europe. Common European Framework of Reference for Languages: Learning, Teaching, Assessment. , Press Syndicate of the University of Cambridge. (2001).
- How to use Tascam DR-100 MKII: Getting started. , https://www.youtube.com/watch?v=O2E72uV9fWc (2018).
- Getting the most from your Shure SM58 microphone. , https://www.youtube.com/watch?v=wweNufW7EXA (2020).
- Kisler, T., Reichel, U. D., Schiel, F. Multilingual processing of speech via web services. Computer Speech & Language. 45, https://clarin.phonetik.uni-muenchen.de/BASWebServices/interface/WebMAUSBasic 326-347 (2017).
- Escudero, P., Boersma, P., Rauber, A., Bion, R. A cross-dialect acoustic description of vowels: Brazilian and European Portuguese. J Acoust Soc Am. 126 (3), 1379-1393 (2009).
- Post-aspiration in standard Italian: some first cross-regional acoustic evidence. Stevens, M., Hajek, J. Proceedings 11th Conference of the International Speech Communication Association (INTERSPEECH 2010), , 1557-1560 (2011).
- Barbosa, P., Madureira, S. Manual de Fonética Acústica Experimental: aplicações a dados do português. , Cortez. (2015).
- Boersma, P., Weenink, D. Praat: Doing phonetics by computer. (Version 6.1.38) [Computer program]. , https://www.praat.org/ (1992-2021).
- Silva, L. Jr VVUnitAligner. [Computer program]. , https://github.com/leonidasjr/VVunitAlignerCode_webMAUS (2022).
- Silva, L. Jr, Barbosa, P. A. SpeechRhythmExtractor [Computer program]. , https://github.com/leonidasjr/VowelCode (2019-2023).
- R Core Team. A language and environment for statistical computing. R Foundation for Statistical Computing. , https://www.R-project.org/ (2023).
- Pigoli, D., Hadjipantelis, P. Z., Coleman, J. Z., Aston, J. The statistical analysis of acoustic phonetic data. Journal of the Royal Statistical Society. 67 (5), 1103-1145 (2018).
- Barbosa, P. A. CreateLineup [Computer program]. , https://github.com/pabarbosa/prosody-scripts-CreateLineUp (2021).
- Van Rossum, G., Drake, F. L. Python 3 Reference Manual. , CreateSpace. (2009).
- Silva, L. Jr AcousticSimilarity_cosine_euclidean. [Computer program]. , https://github.com/leonidasjr/AcousticSimilarity/blob/main/AcousticSmilarity_cosine_euclidean.py (2024).
- Automatic assessment of voice similarity within and across speaker groups with different accents. Gerlach, L., McDougall, K., Kelly, F., Alexander, A. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023), , 3785-3789 (2023).
- Gahman, N., Elangovan, V. A comparison of document similarity algorithms. International Journal of Artificial Intelligence and Applications. 14 (2), 41-50 (2023).
- San Segundo, E., Tsanas, A., Gómez-Vilda, P. Euclidean distances as measures of speaker similarity including identical twin pairs: A forensic investigation using source and Filter voice characteristics. Forensic Science International. 270, 25-38 (2017).
- Speaker's voice characteristics and similarity measurement using Euclidean distances. Singh, M. K., Singh, N., Singh, A. K. Proceedings of the International Conference on Signal Processing and Communication (ICSC 2019), , 317-322 (2019).
- Darling-White, M., Banks, W. Speech rate varies with sentence length in typically developing children. J Speech Lang Hear Res. 64 (6), 2385-2391 (2021).
- Barbosa, P. A. Incursões em torno do ritmo da Fala. , Pontes Editores. (2006).
- Golestani, N., Pallier, C. Anatomical correlates of foreign speech sound production. Cereb Cortex. 17 (4), 929-934 (2007).
- Trouvain, J., Fauth, C., Möbius, B. Breath and non-breath pauses in fluent and disfluent phases of German and French L1 and L2 read speech. Proceedings of Speech Prosody. , 31-35 (2016).
- Waaning, J. The Lombard effect: the effects of noise exposure and being instructed to speak clearly on speech acoustic parameters. [Master's thesis]. , Radboud University. (2021).
- Villegas, J., Perkins, J., Wilson, I. Effects of task and language nativeness on the Lombard effect and on its onset and offset timing. J Acoust Soc Am. 149 (3), 1855(2021).
- Differences between native and non-native Lombard speech in terms of pitch range. Proceedings of the 23rd International Congress on Acoustics(ICA 2019). Marcoux, K., Ernestus, M. , 5713-5720 (2019).
- Marcoux, K., Ernestus, M. Pitch in native and non-native Lombard speech. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2019). , 2605-2609 (2019).
- Marcoux, K., Ernestus, M. Acoustic characteristics of non-native Lombard speech in the DELNN corpus. Journal of Phonetics. 102, 1-25 (2024).
- Gil, J., San Segundo, E. La cualidad de voz en fonética judicial [Voice quality in judicial phonetics]. Lingüística Forense: la Lingüística en el ámbito legal y policial. Garayzábal, M., Jiménez, M., Reigosa, M. , Euphonía Ediciones. 154-199 (2014).
- Gil, J., San Segundo, E. El disimulo de la cualidad de voz en fonética judicial: Estudio perceptivo de la hiponasalidad [Voice quality disguise in judicial phonetics: A perceptual study of hyponasality. Panorama de la fonética española actual. Penas-báñez, M. A. , Arco Libros. 321-366 (2013).
- Passeti, R., Madureira, S., Barbosa, P. What can voice line-ups tell us about voice similarity. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023). , 3765-3769 (2023).
- Nolan, F. The DyViS database: Style-controlled recordings of 100 homogeneous speakers for forensic phonetic research. International Journal of Speech Language and the Law. 16 (1), 31-57 (2009).
- Caroll, D. Psychology of Language. , Wadsworth. (1994).
- Ortega-Llebaria, M., Silva, L. Jr, Nagao, J. Macro- and micro-rhythm in L2 English: Exploration and Refinement of Measures. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023). , 1582-1586 (2023).
- Fernández-Trinidad, M. Hacia la aplicabilidad de la cualidad de la voz en fonética judicial. Loquens. 9 (1-2), 1-11 (2022).
- Brouwer, S. The role of foreign accent and short-term exposure in speech-in-speech recognition. Atten Percep Psychophys. 81, 2053-2062 (2019).
- Love, R., Wright, D. Specifying challenges in transcribing covert recordings: Implications for forensic transcription. Front Commun. 6, 1-14 (2021).
- Meer, P. Automatic alignment for New Englishes: Applying state-of-the-art aligners to Trinidadian English. J Acoust Soc Am. 147 (4), 2283-2294 (2020).
- Montreal Forced Aligner: trainable text-speech alignment using Kaldi. McAuliffe, M., Socolof, M., Mihuc, S., Wagner, M., Sonderegger, M. Proceedings 18th Conference of the International Speech Communication Association (INTERSPEECH 2017), , 498-502 (2017).
- Chodroff, E. Montreal Forced Aligner: MFA Tutorial. , https://zenodo.org/records/7591607 (2023).
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
재인쇄 및 허가
