이 연구는 관계 마케팅 요소가 중국 슈퍼리그 팬들의 스포츠 추천 시스템을 개선하는지 여부를 조사합니다. 만족, 신뢰, 헌신, 상호성을 통합하면 특히 드문드문 조건과 롱테일 조건에서 Top-N 추천의 정확도가 크게 향상됩니다. 결과는 헌신과 상호성은 반복적인 높은 참여 행동을 촉진하는 반면, 만족도와 신뢰는 주로 초기 참여를 지지한다는 것을 보여줍니다.
이 콘텐츠를 보려면 JoVE 구독이 필요합니다. 로그인하거나 오늘 무료 평가판을 시작하세요.
이 논문에서
요약
초록
팬 소비 행동을 이해하고 예측하는 것은 프로 스포츠에서 핵심적인 과제이지만, 대부분의 추천 시스템은 주로 과거 상호작용에 의존하고 팬 참여를 형성하는 관계 마케팅 요소에는 제한적으로 주의를 기울입니다. 이 격차를 해소하기 위해 본 연구는 MLP-PA(피라미드 어텐션을 가진 다층 지각론)를 개발하고, 만족도, 신뢰, 헌신, 상호성과 같은 팬들의 관계 상태를 통합함으로써 중국 슈퍼리그(CSL) 팬들 사이에서 다양한 소비 시나리오에서 추천 효과를 향상시킬 수 있는지 검토합니다. 티켓팅, 상품, 멤버십, 디지털 콘텐츠를 포함하는 다중 시나리오 데이터셋을 사용한 경험적 결과, MLP-PA가 생성한 추천 자료가 기존의 협업 필터링 방식보다 훨씬 높은 상위 N 순위 정확도를 달성하며, 특히 희소 및 롱테일 설정에서 두드러진 개선을 보였습니다. 분석은 또한 서로 다른 관계 요인들이 뚜렷한 소비 패턴과 연관되어 있음을 밝혔는데, 헌신과 상호성은 반복적이고 높은 참여 행동과 더 강하게 연관되어 있는 반면, 만족도와 신뢰는 주로 초기 및 단기 반응에 영향을 미친다. 이 결과들은 관계 마케팅 요소가 팬 소비 행동에서 실질적이고 차별화된 역할을 하며, 프로 축구에서 개인 맞춤형 참여 전략과 디지털 운영에 실질적인 인사이트를 제공함을 보여줍니다.
서론
최근 몇 년간 추천 시스템은 디지털 플랫폼의 핵심 구성 요소가 되어, 데이터 기반 개인화를 통해 사용자, 제품, 소비 맥락의 정렬을 가능하게 합니다. 추천 기술은 전자상거래나 온라인 미디어 분야에서 잘 확립되어 있지만, 프로 스포츠에서의 적용은 비교적미진척입니다. 중국 슈퍼리그(CSL)와 같은 리그에서는 팬 소비 행동이 매우 맥락에 민감하며, 경기 전, 경기 당일, 경기 후 단계에 걸쳐 진화하며, 구매 결정은 오프라인 관중, 감정적 애착, 사회적 정체성과 밀접하게 연관되어 있습니다. 하지만 대부분의 기존 스포츠 추천 연구는 주로 다른 도메인에서 협업 필터링이나 콘텐츠 기반 기법을 적용하여 클릭이나 구매와 같은 단기적 상호작용 신호에 집중합니다. 이러한 접근법들은 스포츠 마케팅 조사에서 장기적인 참여와 반복 소비를 형성하는 것으로 알려진 신뢰, 헌신, 상호성 등 팬과 클럽 간의 관계 역학을 대체로 간과합니다. 그 결과, 현재 모델들은 유사한 행동 이력이 서로 다른 관계 상태에서 왜 서로 다른 소비 결과를 초래할 수 있는지 설명하기 어렵습니다. 이 격차는 상호작용 빈도를 넘어 팬의사결정에서 관계 기반 메커니즘을 명확히 고려하는 추천자 프레임워크의 필요성을 강조합니다.
관계 마케팅 관점에서 만족도, 신뢰, 헌신, 상호성은 함께 관계를 구성하며, 경기 관중, 상품 구매, 회원 갱신, 입소문 홍보 등 주요 팬 성과를 이끄는 원동력으로 확고히 자리 잡고 있습니다. 반면, 대부분의 기존 스포츠 추천 시스템은 팬과 아이템 간의 상호작용을 대체로 동질적인 행동 신호로 모델링하며, 그 상호작용의 관계적 맥락에는 거의 신경 쓰지 않습니다. 이러한 단순화는 소비 단계와 참여 강도에 따라 서로 다른 관계 요인들이 어떻게 뚜렷한 영향을 미치는지 포착하는 능력을 제한하며, 상호작용 이력만을 기반으로 한 모델이 단기 반응과 지속적이고 높은 참여도를 가진 팬 행동을 구분하지 못하는 이유를 설명하는 데 도움을 줍니다.
공학적 관점에서 스포츠 추천 시스템은 비대칭적 암시적 피드백, 심각한 롱테일 희소성, 이기종적인 다중 터치 상호작용 맥락 등 추가적인 도전에 직면해있습니다. 전통적인 협업 필터링 접근법과 단일 경로 딥 모델은 이러한 환경에서 맥락 간 일반화가 제한적이며, 마케팅 운영에서의 의사결정 지원에 대한 해석 가능성을 거의 제공하지 않습니다.
방법론적으로, 이전 추천 시스템 연구들은 희소성, 이질성, 장기 최적화를 해결하기 위한 다양한 해결책을 제안해 왔습니다. 그래프 기반 및 주의 기반 모델은 이웃의 중요성을 재가중치하고 고차 상호작용을 포착함으로써 표현 학습과 순위 향상을 향상시켰습니다 8,9. 협업 신호와 딥러닝을 결합한 하이브리드 아키텍처는 대규모추천 작업에서 성과를 입증했습니다. 강화 학습 기반 접근법은 근시안적 정확성보다는 장기적인 목표에 최적화를 더욱 확장합니다11. 이러한 발전은 희소 피드백 하에서 복잡한 상호작용을 모델링하는 데 귀중한 방법론적 기반을 제공합니다.
그럼에도 불구하고, 대부분의 접근법은 관계 마케팅 구조에 구애받지 않고 만족도, 신뢰, 헌신, 상호성과 같은 변수를 추천 과정에 명시적으로 포함하지 않습니다. 이 한계는 특히 팬-클럽 관계가 진화하고 서로 다른 관계 차원이 행동 결과를 지배하는 프로 축구 맥락에서 두드러집니다(예: 첫 방문 구매 대 재방문 등)12, 13, 14, 15.
이 격차를 해소하기 위해 우리는 중국 슈퍼리그(CSL) 시나리오에 맞춘 관계 인식 추천자 프레임워크인 MLP-PA(다중 계층 Perceptron with Pyramid Attention)를 제안합니다. 다층 인식론(MLP) 백본을 가진 신경 협력 필터링(NCF) 아키텍처를 기반으로 한 제안된 모델은 만족도, 신뢰, 헌신, 상호성을 일류 관계 특성으로 간주하고 주의 기반 이전 채널에 주입합니다. 이후 후기 융합에는 피라미드 특징 주의 모듈을 사용하여 여러 규모에서 두드러진 상호작용 패턴을 선택적으로 증폭시키고, 팬, 아이템, 맥락적 표현을 통합합니다. MLP-PA는 비선형 상호작용 특징과 함께 관계 변수를 명시적으로 모델링함으로써 스포츠 추천에서 예측 정확도와 해석 가능성을 모두 향상시키는 것을 목표로 합니다.
자체 구축한 CSL 데이터셋에 대한 실증 평가에 따르면, 제안된 접근법은 Top-N 순위 지표 전반에서 UserCF, ItemCF, MF-BPR 등 고전적 기준선보다 꾸준히 우수한 성능을 보였습니다. 모델 변이에 대한 추가 분석은 관계 인식 주의를 통합함으로써 롱테일 희소성과 맥락적 이질성을 완화하는 데 도움이 된다는 것을 보여줍니다. 결과는 관계 요인의 차별화된 역할도 드러낸다. 헌신과 상호성은 반복적이고 높은 참여 행동과 더 강하게 연관되어 있는 반면, 만족과 신뢰는 주로 첫 경험과 단기 반응을 지원합니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
프로토콜
본 연구는 식별 해제된 팬-아이템 상호작용 로그와 익명화된 설문지 데이터를 연구 목적으로 수집하여 사용합니다. 개인 식별 정보가 접근, 저장 또는 처리되지 않았습니다. 기관 및 국가 지침에 따르면, 이 연구는 공식적인 윤리 위원회의 승인이나 개인의 사전 동의가 필요하지 않았습니다.
데이터셋 준비 및 실험 절차
1단계. 데이터 준비 및 전처리
데이터셋 준비와 실험 절차는 원시 행동 로그와 설문조사 응답을 모델 훈련 및 평가에 적합한 통합되고 재현 가능한 실험 데이터셋으로 변환하도록 설계되었습니다. 이 과정은 데이터 정제, 익명화, 특징 구축, 정규화, 상호작용 기록과 관계 관련 변수의 정렬에 중점을 둡니다. 원시 상호작용 로그는 먼저 불완전한 항목과 중복된 이벤트를 제거하여 데이터 일관성을 확인했습니다. 팬 식별자와 아이템 식별자는 사용자 프라이버시를 보호하기 위해 해싱을 통해 익명화되었습니다. 브라우징, 클릭, 구매, 출석 검증 등 다양한 상호작용 형태가 암묵적인 피드백 신호에 매핑되었으며, 관찰된 각 상호작용은 긍정적인 사례로 처리되었습니다. 관계 관련 변수들—만족도, 신뢰, 헌신도, 상호성—이 설문지 응답에서 수집되어 해당 팬 식별자와 연결되었습니다. 누락된 설문지 값은 그룹 수준 특성을 보존하기 위해 동일한 회원 계층 내에서 평균 보철법을 사용하여 해결하였습니다. 연속 특징은 변수 간 비교 가능성을 보장하기 위해 최소 최대 척도법을 사용하여 [0, 1]로 정규화되었습니다. 전처리 후, 최종 데이터셋은 익명화된 팬 ID, 항목 ID, 타임스탬프, 맥락 태그, 정규화된 관계 변수로 구성된 구조화된 파일에 저장되었으며, 모든 실험 환경에서 일관되게 사용되었습니다.
기대 결과:
이 과정의 결과로 출력물에는 깨끗한 상호작용 테이블, 팬 식별자와 정렬된 관계 변수 정규화 테이블, 최종 데이터셋 내 팬, 아이템, 상호작용 수를 상세히 설명한 통계 요약이 포함됩니다.
2단계. 훈련/검증/테스트 분할과 음의 샘플링
정보 유출을 방지하기 위해 사용자 수준에서 데이터를 시간 순서대로 분할합니다. 각 팬마다 가장 최근 상호작용은 테스트용, 두 번째로 최근 상호작용은 검증용, 나머지는 훈련용으로 할당됩니다. 음의 샘플은 문항 집합에서 상호작용하지 않는 항목을 균일하게 샘플링하여 생성됩니다. 각 양성 상호작용에 대해 훈련 중에 고정된 수의 음수 샘플(음의 샘플링 비율 = 1:5)이 추출됩니다. 동일한 후보 집합 구성이 모든 모델에 일관되게 적용됩니다.
기대 결과:
이 단계의 결과로 출력물에는 시간 순서대로 나누어진 훈련, 검증, 테스트 데이터셋과 지정된 표본 비율에 따라 구성된 미리 생성된 음의 표본 목록이 포함됩니다.
3단계. 소프트웨어 환경 및 구현
모든 실험은 파이썬으로 구현됩니다. 모델 훈련과 평가는 PyTorch(버전 ≥ 1.12)를 사용하여 수행됩니다. 베이지안 하이퍼파라미터 최적화는 Optuna(버전 ≥ 3.0)를 사용하여 수행됩니다. 학습 스크립트는 단일 NVIDIA GPU(≥ 8GB 메모리)가 장착된 워크스테이션에서 실행됩니다. 구성 파일은 재현성을 보장하기 위해 데이터셋 경로, 모델 매개변수, 최적화 설정을 지정합니다.
4단계. 모델 구성 및 매개변수 명세서
MLP-PA 모델은 임베딩 계층, 다층 지각론 백본, 관계-주의 채널, 피라미드 주의 융합 모듈로 구성됩니다. 주요 매개변수는 다음과 같이 설정됩니다: 임베딩 차원 = 32; MLP 숨겨진 층 = [64, 32]; 활성화 함수 = ReLU; 옵티마이저 = 학습률 0.001, 가중치 감쇠 1e-5. 피라미드 주의 모듈은 커널 크기 {1, 2, 4}이고 보폭이 커널 크기와 같음을 가진 세 가지 풀링 스케일을 사용합니다. 주의력 감소 비율은 4로 설정되어 있습니다. 과적합을 방지하기 위해 0.3의 드롭아웃이 적용됩니다. 10년 연속 에포크에서 검증 NDCG@10가 개선되지 않을 경우 조기 중단이 발동됩니다.
5단계. 훈련 및 하이퍼파라미터 최적화
이 모델은 쌍별 베이지안 개인 순위(BPR) 손실을 사용하여 학습됩니다. 교육 기간 동안 각 에포크가 끝날 때 검증 성과를 모니터링합니다. 학습률, 임베딩 크기, 중퇴율, 음의 샘플링 비율, 주의 관련 매개변수에 대한 베이지안 하이퍼파라미터 최적화 탐색. 최적화 목표는 검증 NDCG@10입니다. 각 후보 구성은 계산 비용을 줄이기 위해 조기 정지(early stopping)로 훈련됩니다.
기대 결과:
이 과정의 결과로 출력물에는 학습된 모델 체크포인트, 검증 성능 로그, 그리고 베이지안 최적화를 통해 식별된 최적 하이퍼파라미터 구성이 포함됩니다.
6단계. 평가 및 결과 생성
훈련 후에는 검증 NDCG@10 기반의 가장 성능이 좋은 모델이 테스트 세트에서 평가됩니다. 각 팬별로 Top-N 추천 목록이 생성되며, 성능은 HR@K와 NDCG@K을 통해 측정됩니다. 추가 분석, 즉 절제 연구와 위상 조건화 주의 프로파일링을 포함한 추가 분석도 동일한 평가 프로토콜을 사용하여 수행하여 비교 가능성을 보장합니다.
수료 기준
다음 출력이 얻어지면 프로토콜이 완전하다고 간주됩니다: 1) 최적화된 하이퍼파라미터를 갖춘 완전히 훈련된 MLP-PA 모델; 2) 모든 기준선 및 소작 모델에 대한 테스트 세트 HR@K 및 NDCG@K 결과; 3) 저장된 모델 체크포인트, 평가 지표, 재현 가능한 구성 파일. 이러한 출력물들은 제안된 추천 시스템 프로토콜의 독립적인 복제를 가능하게 합니다.
약속-신뢰 관계 마케팅 이론
헌신-신뢰 이론은 헌신과 신뢰를 관계의 질을 결정하는 핵심 요인으로 규정합니다. 거래 불확실성을 줄이고 장기적 지향성과 협력 의도를 촉진함으로써 이러한 요소들은 관계의 연속성과 가치 창출을 촉진합니다16. 신뢰는 팬들이 클럽의 역량, 진실성, 선의에 대한 믿음을 반영하여 인지된 위험과 정보 비대칭을 낮춥니다. 그 결과, 높은 신뢰는 개인화된 추천, 데이터 권한 부여, 결제 과정을 통한 마찰 없는 참여를 촉진하여, 클릭 투 구매 퍼널 내에서 초기 단계와 저의지 행동을 지원합니다. 반면 헌신은 팬들이 경쟁하는 대안이나 일시적인 불만족에도 불구하고 관계를 유지하기 위해 시간, 재정적 자원, 정서적 유대감을 투자하려는 의지를 포착합니다17. 헌신은 정체성 정렬, 매몰 비용, 헌신 투자와 밀접하게 연관되어 있기 때문에, 재구매, 회원 갱신, 경기장 내 관람, 입소문 옹호와 같은 고비용과 높은 참여 행동에 대해 보다 안정적인 설명력을제공합니다.
이러한 구분을 바탕으로 다음과 같은 가설들을 도출합니다.
H1(신뢰 → 지지 행동): 높은 신뢰는 의사결정 마찰과 인지된 위험을 줄여 클릭, 장바구니 추가 행동, 첫 구매 같은 얕은 행동 가능성을 높입니다.
H2(헌신의 상대적 우위): 네 가지 관계 차원 중 헌신은 재구매, 갱신, 오프라인 참석 등 고비용 및 장기적 행동에 대해 가장 강력한 한계 설명력을 보이며, 예측 성과에 대한 기여도는 만족도와 신뢰보다 높습니다.
사회 교환 이론
사회 교환 이론은 개인이 반복적인 상호작용에서 상호성과 공정성의 규범을 따른다고 강조한다19. 상호성으로 인식된다면 팬들은 클럽이 가치 양보, 감정적 반응, 자원 배분에서 주고받는 관계를 느낀다. 상호성이 진정성 있고 지속 가능하다고 인식될 때, 팬들은 소비와 관람을 통해 더 잘 되돌려 긍정적 피드백 루프를 형성합니다20. 만족도는 기대에 비해 누적된 경험의 함수입니다. 기대-확인 메커니즘을 통해 단기적인 준수와 긍정적인 입소문을 촉진하고, 신뢰와 헌신 발전에 비옥한 토양을 제공합니다21.
따라서 우리는 다음과 같이 도출합니다:
H3(만족도→ 지원 행동): 만족도가 높을수록 후회가 줄고 반응의 즉각성이 높아져 단기 구매와 참여가 증가합니다.
H4(상호성→ 전환 및 재구매): 반복 게임 프레임워크 내에서 상호성 신호는 "나는 이익→을 얻고 돌려준다"는 교환 강도를 증폭시켜, 특히 가격에 민감하거나 희소성 맥락에서 전환 및 재구매율을 크게 향상시킵니다.
두 이론을 종합하면, 네 차원은 영향 경로에서 명확한 맥락적 이질성을 보인다:
불확실성이나 높은 인지된 위험 인식이 있는 맥락—신제품, 동적 가격 책정, 고위험 승인/지불—에서는 신뢰가 더 강한 한계 효과를 발휘합니다(H1 지지).
장기적이고 정체성이 중요한 상황—시즌 패스, 연속 홈 경기, 회원 갱신—에서는 헌신이 지배적입니다(H2 지원).
주요 매칭 노드나 인센티브/희소성 부족—제한된 혜택, 승진—에서는 상호성이 전환과 재매입을 더 강력하게 끌어올립니다(H4 지원).
만족은 '기본 토양' 역할을 하여 거의 모든 맥락에서 단기 행동을 긍정적으로 이끌고(H3 지원), 경험의 질을 개선하여 신뢰와 헌신을 간접적으로 공고히 합니다. 구조 방정식 모델링을 통해 이 가설들을 검증하는 대신, 우리는 네 차원을 주의 계층에 주입하여 모델이 맥락화된 가중치를 학습하고 소작 실험으로 그 메커니즘을 확인하도록 합니다.
MLP
다층 지각론(MLP)은 우리 프레임워크에서 중추 표현 학습자 역할을 합니다.
(1) 입력 매핑 계층.
원래의 특징 벡터는 가중치 행렬 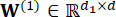 과 바이어스 b(1)에 의해 한 번 선형적으로 확장되어 다음과 같이 됩니다.
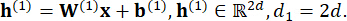 (1)
(2) 깊은 비선형성층.
선형, 활성화, 정규화 계층을 쌓습니다. 선형 사상은 완전 연결 아핀 변환을 사용합니다:
z = Wx + b, (2)
여기서 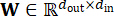 는 가중 행렬,
 는 바이어스 벡터, x 는 이전 층의 출력, z 는 선형 출력입니다. ReLU의 활성화 특성을 맞추고 훈련 중 구배를 안정적으로 유지하기 위해, 우리는 W에 대해 He를 초기화합니다:
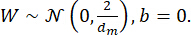 (3)
활성화 함수는 ReLU로, 특히 딥 아키텍처22에 적합합니다. x>0 시 ReLU의 미분은 일정하여 시그모이드 활성화와 관련된 소멸 기울기 문제를 효과적으로 완화하고 역전파와 수렴을 가속화합니다. ReLU는 계산적으로 단순하고(지수 함수가 없으며) 자연스럽게 희소(x<0에 대해 0을 출력함)하여 중복 신경 반응을 줄이고 일반화를 향상시킵니다. 정의는24입니다
σ(x) = max(0,x), (4)
선형 출력에 원소별로 적용하면 다음과 같이 얻습니다:
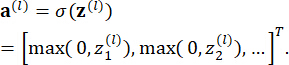 (5)
각 "선형 → 활성화" 연산 후에는 배치 정규화(BN)를 도입하여 구배를 안정화하고 수렴을 가속화합니다. BN은 각 미니 배치 내 특징을 동적으로 표준화하여 내부 공변량 이동을 완화하고 학습 안정성을 개선하며 학습률에 대한 민감도를 낮춥니다. BN은 노이즈 주입과 유사한 약간의 정규화 효과를 가지고 있어, 모델 용량을 저해하지 않으면서 과적합을 방지하는 데 도움을 줍니다.
현재 미니 배치 출력을 라고 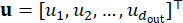 하자. j번째 특징에 대한 BN 변환은 다음과 같다.
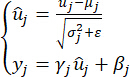 (6)
여기서 μ j와 σj2는 j번째 특징의 배치 평균과 분산이며, ε는 수치 안정성을 위한 작은 상수이며, γj, βj는 네트워크의 비선형 표현성을 복원하는 학습 가능한 스케일 및 시프트 매개변수이다.
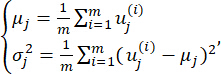 (7)
여기서 m은 미니 배치 크기이고, ε는 수치 안정성을 위한 작은 상수이며, γ j, βj는 정규화 후 네트워크의 비선형 표현도를 복원하는 데 사용되는 학습 가능한 스케일/시프트 매개변수입니다.
(3) 특징 압축 계층
딥 피처 추출 후, MLP 블록 끝에 특징 압축 계층을 추가하여 중복성을 억제하고 후속 모듈의 계산 부담을 줄이며 약간의 정규화를 제공합니다. 입력 벡터를 라고  하자. 압축된 출력은
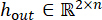 매개변수 인
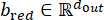 입니다
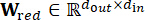 . 연산은 다음과 같습니다:
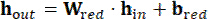 (8)
피라미드 주의(PA) 메커니즘
마지막 MLP 계층 출력을 라고  하자. 고차 비선형 상호작용에 대한 명시적 선택을 가능하게 하기 위해, 먼저 장/채널별로 행렬25로 재배열
 합니다:

 (9)
여기서 C는 채널 수이고 L 은 채널당 길이입니다.
(1) 다중 스케일 특징 구성.
특징 축 L을 따라 여러 축척을 가진 1차원 풀링을 적용하여26을 얻습니다
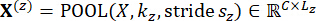 (10)
여기서 ks와 stride가 S차 스케일을 정의합니다.
(2) 스케일별 집중 채널.
각 척도별로 채널 설명자와 주의 가중치를27:
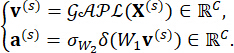 (11)
여기서 δ(⋅)는 ReLU, σ(⋅)는 시그모이드입니다.
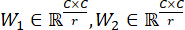 , r 은 환원비입니다.
채널별로 가중치를 적용하세요:
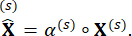 (12)
(3) 퓨전과 쓰기.
각 스케일을 GAPL로 통합된 1차원 공간으로 투영하고 융합합니다:
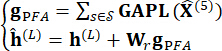 (13)
여기서 P는 융합 가중치이고 Wr은 잔차 쓰기에서 사용되는 학습 가능한 투영입니다.
최종 점수:
 (14)
여기서 ⊙는 원소별로 하다마르(Hadamard)곱을  , 벡터 연결(vector concatenation)을 나타낸다.
상위 N개 과제 형식화 및 학습 목표
(1) 문제 설정.
팬 세트는 F, 아이템 세트 I (티켓, 굿즈, 멤버십 혜택, 콘텐츠 포함)이라고 하자. 암묵적  피드백은 팬
 이 아이템
 (클릭, 구매, 출석/검증 등)과 상호작용했는지를 나타냅니다. 훈련 집합에서 양의 샘플은 다음과 같습니다.
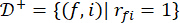 ,
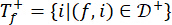 .
우리는 만족도, 신뢰, 헌신, 상호성의 네 가지 관계 마케팅 변수를 주의 층에 벡터 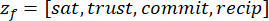 로 주입하여 맥락 인식 관계 표현
 을 얻고, 이는 팬/아이템 임베딩
 과 융합되어 점수
 를 산출합니다. 각 양의 쌍
 에 대해 우리는 에서
 고정된 비율로 여러 음수를 끌어 를 만듭니다
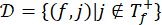 .
(2) 쌍별 목적.
상대적 순위를 직접 최적화하기 위해 우리는 BPR(베이지안 개인 순위) 손실28을 사용합니다:
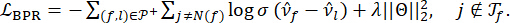 (15)
여기서 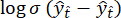 는 "양의 점수가 음의 점수를 초과할 가능성"을 표현하며;
 는 과적합을 제어하는 L2 정규화자이며;
 는 모든 학습 가능한 매개변수를 나타낸다.
(3) 추론과 순위.
테스트 시점에서 후보 집합은 입니다. 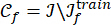 점수 를 계산하고 상위 N 목록29를 반환합니다:
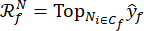 (16)
추천 알고리즘 설계
이 섹션에서는 데이터 전처리부터 모델 학습, 온라인 추론에 이르는 종단 간 파이프라인을 포함하는 이 연구에서 사용된 전체 권고 워크플로우를 설명합니다. 워크플로우는 원시 팬-아이템 상호작용 데이터와 관계 변수가 표현 학습과 주의력 기반 모델링을 통해 개인화된 순위 점수로 변환되는 과정을 설명합니다. 자세한 절차는 다음과 같습니다.
1단계: 데이터 준비 및 정규화.
CSL 팬-아이템 상호작용 로그는 암묵적인 피드백 신호로 변환됩니다. 누락된 값은 처리되며, 만족도, 신뢰, 헌신, 상호성의 네 가지 관계 변수가 정규화됩니다. 데이터는 훈련, 검증, 테스트 세트로 시간 순서대로 나뉘며, 각 긍정적 상호작용마다 여러 음의 샘플이 생성됩니다.
2단계: 관계-주의 인코딩.
네 가지 관계 변수는 주의 모듈에 입력되어 맥락 인식 중요도 가중치를 학습하여, 후속 모델링을 위한 간결한 팬 관계 표현을 생성합니다.
3단계: 상호작용 입력 구성.
팬과 아이템 임베딩은 학습되어 관계 표현과 연결되어 각 팬-아이템 상호작용의 완전한 특징 벡터를 형성합니다.
4단계: 표현 학습.
상호작용 특징은 MLP 분기를 통해 고차 비선형 패턴을 포착하고 융합된 잠재 표현을 생성합니다.
5단계: 피라미드 기능 주의.
MLP 출력 위에 다중 스케일 특징 피라미드가 구축됩니다. 채널별 주의와 교차 규모 융합이 적용되며, 잔류 연결을 통해 향상된 기능을 통합하여 두드러진 채널을 증폭하고 중복 채널을 억제합니다.
6단계: 점수 산출과 출력.
선형 분기는 향상된 비선형 표현과 연결되어 출력 계층에 입력되어 각 팬-항목 쌍의 선호도 점수를 계산합니다.
7단계: 훈련 및 최적화.
이 모델은 쌍별 순위 목표를 사용하여 최적화됩니다. 적응 최적화 장치는 무게 감소, 드롭아웃, 조기 정지와 함께 사용되어 일반화 개선과 과적합 완화를 돕습니다.
8단계: 베이지안 하이퍼파라미터 최적화.
검증 순위 지표는 임베딩 차원, 네트워크 깊이 및 폭, 학습률, 음의 샘플링 비율, 중도 탈락률, 피라미드 및 주의 관련 매개변수 등 주요 하이퍼파라미터를 자동으로 검색하는 목적으로 사용됩니다.
9단계: 추론과 순위 매기기.
온라인 추론 과정에서는 후보 항목 세트에 비해 각 팬의 선호도 점수를 계산하여 상위 N개 추천을 생성하며, 신선성, 다양성, 비즈니스 제약을 고려한 선택적 순위 후 전략을 적용합니다.
실험적 검증
데이터셋 및 특징 스키마
우리는 팬-아이템 암묵적 상호작용의 식별이 해제된 CSL 클럽 정보 시스템 로그와 동시대 관계 조사를 결합한 자체 구축 데이터셋을 기준으로 평가합니다. 데이터는 티켓, 상품, 멤버십, 콘텐츠 등 네 가지 비즈니스 도메인을 포함하며, 탐색, 클릭, 장바구니에 추가/즐겨찾기, 구매/티켓팅, 경기장 내 검증 이벤트, 타임스탬프, 터치포인트 채널, 컨텍스트 태그, 프로모션 플래그가 포함됩니다. 이 기간은 한 시즌 전체≥ 진행되며; 스케일은 팬, 아이템, 이벤트 정도로 깊이 모델링에 적합합니다.
특징 스키마 및 인코딩: Items-ItemID, ItemType, TeamTag, PriceBand (ID/카테고리 임베딩); 팬—FanID, 지역, 회원 등급, 임시 기간(FanID는 임베딩으로 학습; 기타 범주/수치 필드는 표준화됨); RQ 기능—만족, 신뢰, 헌신, 상호성은 [0,1]로 스케일링되어 주의 채널에 전달된 후 PA를 통해 MLP 표현과 융합; 컨텍스트—PhaseTag, Channel, PromoFlag, Hour, Weekday (임베딩으로 분류; 사인파 신/코스 인코딩을 가진 시간 특징).
하이퍼파라미터 최적화
MLP-PA의 주요 하이퍼파라미터는 사전 설정된 탐색 공간 내에서 베이지안 최적화를 통해 조정되며, 검증 세트의 NDCG@10을 주요 타깃으로 삼고(HR@10를 기준으로 삼음), 과적합을 완화하기 위해 조기 정지가 적용됩니다. 각 후보 구성은 여러 무작위 시드로 실행되어 평균화됩니다. 최종 배치 설정은 표 1에 보고되어 있습니다.
| 하이퍼파라미터 | 설명 | 탐색 범위 | 선택된 가치 |
| 임베딩 차원 | 팬/아이템 임베딩 크기 | {32, 64, 128} | 64 |
| MLP 숨겨진 계층 | MLP 계층 수 | {2, 3, 4} | 3 |
| MLP 숨겨진 유닛 | 숨겨진 층별 유닛 | {64, 128, 256} | 128 |
| 중도 탈락률 | 중도 탈락 확률 | [0.1, 0.5] | 0.3 |
| 학습 속도 | 초기 학습률 | [1e-4, 1e-2] | 1.00E-03 |
| 음의 표본 추출 비율 | 양성 표본당 음수 | {1, 3, 5, 10} | 5 |
표 1: MLP-PA 모델의 최종 하이퍼파라미터 설정
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
결과
수렴과 안정성
제안된 모델의 수렴 동작과 학습 안정성을 평가하기 위해, 피라미드 특징 주의 또는 관계 인식 주의가 없는 표준 MLP 기반 추천기(대조 모델)와 검증 성능을 비교합니다. 모든 모델은 공정한 비교를 위해 동일한 데이터 분할, 최적화 설정, 정지 기준 하에서 학습됩니다.
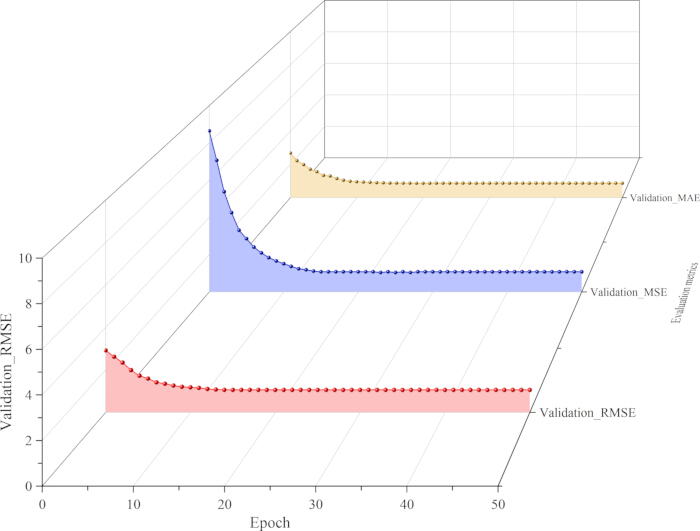
그림 1: 훈련 중 제안된 모델의 수렴과 안정성.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
토론
개념적 및 방법론적 기여
본 연구는 만족도, 신뢰, 헌신, 상호성이라는 관계 차원을 정적인 보조 특징이 아닌 관여 단계별로 영향력이 달라지는 맥락 민감 관계 신호로 재구성함으로써 개념적으로 기여합니다. 제안된 프레임워크는 행동 표상과 함께 관계 단서를 동적으로 재가중치하는 주의 기반 메커니즘을 통해 이 아이디어를 실현합니다. 이를 통해 기능 풍부화를 넘어 관계 마케팅 구조를 현대 추천 아키텍처에 내재화하는 원칙적인 방식을 도입합니다.
방법론적으로, 관계 인식 우선순위를 다중 규모 표현 학습 중추와 통합함으로써 해석 가능성과 예측 모델링이 공동으로 다룰 수 있음을 보여줍니다. 주의를 단순히 수행 능력 향상 요소로만 다루는 대신, 이 프레임워크는 주의를 관계적 메커니즘을 분석하고 해석할 수 있는 분석적 렌즈로 사용합니다. 이로 인해 이 모델은 ...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
공개 사항
저자는 이해 상충을 주장할 필요가 없습니다.
감사의 글
저자는 이 원고의 명확성과 품질을 향상시키는 데 도움을 준 건설적인 의견과 제안에 익명의 심사위원들에게 감사드립니다. 또한 이 연구에 사용된 데이터에 대한 접근 제공을 제공해 준 협력 기관의 지원에도 감사를 표합니다. 이 논문에 표현된 모든 의견, 연구 결과 및 결론은 저자의 것이며 반드시 관련 기관의 견해를 반영하지는 않습니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
재료
```html
```
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| Python | https://www.python.org | 3.9.10 | |
| 딥 러닝 프레임워크 | PyTorch | https://pytorch.org | >= 1.12 |
| 하이퍼파라미터 최적화 라이브러리 | Optuna | https://optuna.org | >= 3.0 |
| 하드웨어 | NVIDIA GPU | https://www.nvidia.com | 단일 GPU, >= 8 GB 메모리 |
| 데이터셋 | 자체 구축 CSL 팬 데이터셋 | N/A | 하나의 전체 시즌 이상; 딥 모델링에 충분한 규모 |
| 상호작용 데이터 | 팬–아이템 암시적 상호작용 로그 | N/A | 별도의 버전은 없음 |
| 설문 조사 데이터 | 관계 설문 조사 데이터 | N/A | 별도의 버전은 없음 |
| 데이터 전처리 방법 | 해시 기반 익명화 | N/A | 팬 및 아이템 식별자에 적용 |
| 데이터 전처리 방법 | 멤버십 등급 내 평균 대체 | N/A | 누락된 설문 조사 응답에 적용 |
| 데이터 전처리 방법 | 최소값–최대값 정규화 | N/A | 범위 [0, 1] |
| 데이터 분할 전략 | 시간순 사용자 수준 분할 | N/A | 가장 최근 = 테스트; 두 번째로 최근 = 검증; 나머지 = 학습 |
| 부정 샘플링 | 균일 부정 샘플링 | N/A | 양성:부정 비율 = 1:5 |
| 모델 백본 | MLP (다층 퍼셉트론) | https://pytorch.org/docs/stable/nn.html | 숨김 레이어 [128, 64, 32] (최적화됨) |
| 주의 모듈 | 관계 주의 채널 | N/A | 사용자 정의 모듈 |
| 융합 모듈 | 피라미드 주의 (PA) | N/A | 풀링 스케일 {1, 2, 4}, 스트라이드 = 커널 크기, 감소 비율 = 4 |
| 최적화기 | Adam | https://pytorch.org/docs/stable/generated/torch.optim.Adam.html | 학습률 0.001, 가중치 감소 1e-5 |
| 정규화 | 드롭아웃 | https://pytorch.org/docs/stable/generated/torch.nn.Dropout.html | 비율 0.3 |
참고문헌
- Wang, L., et al. Drug combination recommendation model for systemic lupus erythematosus and antiphospholipid syndrome. Pharmaceutics. 18 (8), 1224(2025).
- Hu, X., Yuan, Z., Ma, Z. A robot control knowledge recommendation model PKGAT based on multimodal knowledge graph. Int J Softw Eng Knowl Eng. 35 (8), (2025).
- Ji, S. An intelligent recommendation model for disclosure of electricity market entities based on association rule mining algorithm. Electr Eng. , In press (2025).
- Xie, F., et al. Differential weighting and flexible residual GCN-based contrastive learning for recommendation. Symmetry. 17 (8), 1320(2025).
- Duan, J., et al. A deep recommendation model based on semantic information and correlation between items. J Intell Inf Syst. , In press (2025).
- Malakhatka, E., et al. Optimal time recommendation model for home appliances: HSB Living Lab dishwasher study. Energy Effic. 18 (1), 3(2024).
- Yuan, Q., Cong, G., Ma, Z., Sun, A., Magnenat-Thalmann, N. Time-aware point-of-interest recommendation. Proc Int ACM SIGIR Conf Res Dev Inf Retr, 36, 363-372 (2013).
- Alaoui, E. D., et al. Comparative study of filtering methods for scientific research article recommendations. Big Data Cogn Comput. 8 (12), 190(2024).
- Li, X., Hu, G. Design and implementation of an electronic journal resource recommendation system integrating user profile and knowledge graph. Front Comput Intell Syst. 10 (2), 74-78 (2024).
- Sami, A., et al. A deep learning-based hybrid recommendation model for internet users. Sci Rep. 14 (1), 29390(2024).
- Zhonghua, W. Intelligent recommendation model of tourist places based on collaborative filtering and user preferences. Appl Artif Intell. 37 (1), (2023).
- Wang, Q., Esquivel, A. J. Personalized movie recommendation system based on DDPG: Application and analysis of reinforcement learning in user preferences. Front Soc Sci Technol. 5 (18), (2023).
- Miao, L., et al. Study on two-tier EV charging station recommendation strategy under multi-factor influence. J Artif Intell. 5, 181-193 (2023).
- Yunni, X., et al. A quasi-Newton matrix factorization-based model for recommendation. Int J Web Serv Res. 20 (1), 1-15 (2023).
- Mourad, J., et al. Personalized PV system recommendation for enhanced solar energy harvesting using deep learning and collaborative filtering. Sustain Energy Technol Assess. 60, 103456(2023).
- Pfajfar, G., et al. Value of corporate social responsibility for multiple stakeholders and social impact: A relationship marketing perspective. J Bus Res. 143, 46-61 (2022).
- Khan, R. U., et al. The impact of customer relationship management and company reputation on customer loyalty: The mediating role of customer satisfaction. J Relatsh Mark. 21 (1), 1-26 (2022).
- Sheth, J. New areas of research in marketing strategy, consumer behavior, and marketing analytics: The future is bright. J Mark Theory Pract. 29 (1), 3-12 (2021).
- Mishra, M., Mund, P. Fifty-two years of consumer research based on social exchange theory: A review and research agenda using topic modeling. Int J Consum Stud. 48 (4), e13074(2024).
- Cook, K. S., Hahn, M. Social exchange theory: Current status and future directions. Theor Sociol. 50, 179-205 (2021).
- Naseer, A., Jalal, A. Multimodal objects categorization by fusing GMM and multilayer perceptron. Proc 5th Int Conf Adv Comput Sci (ICACS), , 1-7 (2024).
- Hussain, K., et al. Analyzing LULC transformations using remote sensing data: Insights from a multilayer perceptron neural network approach. Ann GIS. 30, 1-28 (2024).
- Mfetoum, I. M., et al. A multilayer perceptron neural network approach for optimizing solar irradiance forecasting in Central Africa with meteorological insights. Sci Rep. 14 (1), 3572(2024).
- Yu, Y., et al. Multi-scale spatial pyramid attention mechanism for image recognition: An effective approach. Eng Appl Artif Intell. 133, 108261(2024).
- Liu, H., et al. A deep convolutional neural network for the automatic segmentation of glioblastoma brain tumor: Joint spatial pyramid module and attention mechanism network. Artif Intell Med. 148, 102776(2024).
- Liu, M., et al. Vehicle object counting network based on feature pyramid split attention mechanism. Vis Comput. 40 (2), 663-680 (2024).
- Alvarado, O., et al. A systematic review of interaction design strategies for group recommendation systems. Proc ACM Hum-Comput Interact, 6 (CSCW2), 1-51 (2022).
- Zhao, Y. Design of garment style recommendation system based on interactive genetic algorithm. Comput Intell Neurosci. 2022, 9132165(2022).
- Nazer, L. H., et al. Bias in artificial intelligence algorithms and recommendations for mitigation. PLOS Digit Health. 2 (6), e0000278(2023).
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.