본 연구는 염색체 서열이 이미 알려져 있거나 관심 없는 플라스미드의 나노포어 시퀀싱 워크플로우를 설명합니다. 초기 플라스미드 DNA 풍부화 단계는 최적의 플라스미드 서열 깊이를 보장하고 플로우 셀당 시퀀싱 가능한 샘플 수를 극대화합니다.
방법 논문
나노포어 시퀀싱 기반 워크플로우를 이용한 롱리드 플라스미드 시퀀싱 및 조립
* These authors contributed equally
이 논문에서
요약
초록
본 연구는 플라스미드 DNA 수율과 시퀀싱 정확도를 극대화하기 위해 설계된 나노포어 시퀀싱 워크플로우를 설명합니다. 연구자들은 플라스미드 DNA 추출, 빠른 바코딩 및 어댑터 연결을 통한 라이브러리 준비, 라이브러리를 플로우 셀에 적재하여 시퀀싱, 염기 호출(실시간 또는 사후 호출), Autocycler를 이용한 서열 조립 등 공정의 각 단계를 다룹니다. 저자들은 또한 컴퓨터 요구사항을 명시하는데, 이는 주로 베이스콜링이 실시간으로 이루어지는지에 따라 달라집니다. 저자들은 이 워크플로우를 사용해 10가지 임상 균주에서 정제한 플라스미드를 시퀀싱했습니다. 숙주-세포 균주 차이를 변수로 제거하기 위해, 저자들은 이 임상적 균주들을 공통 수용자 균주와 결합시키고 환합 균주를 시퀀싱했습니다. 이 실험들은 겔 이동성으로 추정된 플라스미드 크기와 일치하는 플라스미드 조립체를 생성했으며, 3분의 2의 경우에는 단독 연마 조립체와도 일치하거나 0.05% 쌍별 서열 동일성 내에 있는 경우도 있었습니다. 플라스미드 DNA 서열의 풍부화는 플라스미드 시퀀싱의 효율성을 극대화하여 최대 24개의 샘플을 최적의 커버리지로 병렬 시퀀싱할 수 있게 합니다. 이 프로토콜은 4에서 174 kb까지의 플라스미드에 적합하며, 정확도에 영향을 주지 않고 최대 72%의 염색체 오염을 견딜 수 있습니다. 이 프로토콜은 염색체 서열이 이미 알려져 있거나 관심 없는 상황, 예를 들어 플라스미드 서열 검증, WGS로 이미 얻은 플라스미드 서열의 정확도 향상, 또는 접합으로 포획된 플라스미드 시퀀싱 등에 이상적입니다. 이 연구를 설명하는 데 사용된 유기체는 대 장균으로, 재조합 유전자 발현과 접합을 통한 플라스미드 포획에 사용되는 숙주를 대표합니다.
서론
플라스미드는 박테리아에서 흔히 발견되는 자가 복제 DNA 조각입니다. 크기는 매우 다양하여 <800 bp에서 2.5 Mbp 사이이며, 일반적으로 이중분포를 따르며, 다중복제 비접합 플라스미드에 해당하는 작은 봉크와 저접합 접합 플라스미드에 해당하는 큰 봉크가 있습니다. 플라스미드는 미생물 생태계에서 중요한 역할을 하며, 숙주가 환경 문제에 적응하거나 새로운 생태적 지위를 확보하는 데 도움을 주는 유전자를 가지고 있습니다. 플라스미드는 또한 가속화된 진화의 플랫폼 역할을 하며, 유전적 가소성을 높이고 균주, 종, 속, 심지어 가족 간에 걸쳐 수평 유전자 전달을 매개합니다 3,4. 네트워크 및 비교 유전체 분석을 통해 환경 저항체가 임상적으로 중요한 항생제 내성 유전자(ARG)의 지속적인 저장소로서 역할을 하여, 생태계 환경 전반에 걸쳐 유지되고 확산되는 데 기여함을 확인했습니다5. 플라스미드와 그에 포함된 항생제 내성 및 병원성 유전자를 추적하는 것은 전파 경로를 식별하는 데 도움이 됩니다. 6. 따라서 플라스미드의 식별과 특성 분석은 다양한 공중보건, 임상 미생물학, 생명공학 응용 분야에서 매우 중요한 관심사입니다.
미지의 DNA 주형을 고처리량으로 시퀀싱할 수 있는 차세대 시퀀싱(NGS) 기술의 도입은 미생물 분리주의 유전체 특성 분석의 문을 열었습니다. 전체 유전체 시퀀싱(WGS)은 새로운 병원체, 약물 내성 균주, 백신 회피 변이의 출현, 확산 및 전파를 추적할 수 있게 합니다. 또한 임상 발병 시 전파 경로를 식별하는 데 점점 더 활용되고 있으며, 이는 향후 발병 예방을 위한 개입에 도움이 될 가능성이 있습니다. 7. 마지막으로, WGS는 ARG의 프로파일링을 가능하게 하여 치료 결정에 도움을 줄 수 있으나, ARG를 항생제 내성 표현형과 정성적 및 양적 연계하는 작업은 아직 진행 중입니다.
하지만 WGS가 대규모로 생산하는 단독(SR) 시퀀싱 데이터는 일반적으로 400–500 bp 범위에 속합니다. 이 크기는 대부분의 이동성 유전 요소(MGE)보다 짧아10을 분리할 수 없습니다. WGS 데이터에서 플라스미드 서열의 실리코 내 식별은 불완전한 범위와 플라스미드 간 및 박테리아 염색체와 다른 플라스미드 간의 서열 공유 때문에 더욱 복잡합니다10. 그 결과, 조립체는 종종 광범위하게 분해되고 불완전하여 그 하위 유전체 위치(염색체 또는 플라스미드)를10으로 귀속시키는 것이 불가능합니다.
롱리드(LR) 시퀀싱 기술은 더 많은 반복 과정에 걸쳐 매우 연속적인 조립체를 생성하여 완전한 플라스미드 조립체의 생산을 크게 용이하게 합니다. 본질적으로 두 가지 유형의 장독 단일 분자 기술이 존재합니다11,12. 이러한 접근법 중 하나인 나노포어 시퀀싱은 저렴한 비용, 빠른 처리 시간, 자원 제한 환경에 적합하다는 점으로 인해 미생물 유전체학에서 점점 인기를 얻고 있습니다13,14.
나노포어 시퀀싱 장치는 수천 개의 나노포어 배열을 포함하는 플로우셀을 사용합니다. DNA는 헬리케이스 활성을 가진 모터 단백질에 의해 열린 플로우 셀에 적재되며, 전류 차동에 의해 구동되는 나노 구멍을 통과합니다. 특정 단일 가닥의 뉴클레오타이드가 개별 나노기공을 통과할 때, 전류가 교란되어 각 기공에 연결된 전자 센서로 측정되는 특성 신호가 생성됩니다. 이 신호는 베이스콜링 알고리즘을 사용해 디코딩되고, 그 결과 데이터는 다양한 생물정보학 도구를 통해 하위 단계에서 수집 및 분석됩니다.
SR 시퀀싱 접근법과 비교할 때, 나노포어 시퀀싱은 낮은 읽기 품질(낮은 Q-점수)을 생성하고, 전기 신호 데이터 분석 중 동질중합체 서열에 삽입/결실을 발생시키는 경향이 있습니다(베이스콜링)15. 또한 자연 DNA에서 근처의 메틸화가 체계적인 염기 호출 오류를 일으킬 수 있다는 점도 관찰되었습니다16. 일반적으로 채택된 해결책은 조립 후 오류 수정을 위한 단판 데이터를 포함하는 것이었습니다. 하지만 이 과정('폴리싱'이라 불림)은 비용과 복잡성오버헤드를 증가시킵니다. 시퀀싱 커버리지를 늘리는 것도 정확도를 높일 수 있지만, 기술적으로 항상 가능한 것은 아닙니다.
2024년에는 옥스퍼드 나노포어 시퀀싱(ONT) R10.4.1 플로우 셀과 V14 화학이 G-균에 대해 고품질의 연속적인 조립체를 생성하는 반면, 단일 염기체 수준에서의 더 정밀한 분석도 SR 시퀀싱 데이터의 이점을 얻는 것으로 밝혀졌습니다18. 하지만 LR과 SR 시퀀싱 정확도 간의 격차는 점차 줄어들고 있습니다. 최근 다양한 개선 사항으로는 더 정밀한 데이터 샘플링 과정과 향상된 시퀀싱 속도, 천연 박테리아 DNA와 메틸화에 맞춘 새로운 염기호출자 도입(염기호출 정확도 향상)19, 그리고 위상 측정, 변이 호출, 별-대립유전자 호출에 관한 새로운 알고리즘 등 분석 도구의 업데이트가 포함됩니다. 또한 최신 Dorado 알고리즘 V.0.9.0 ONT (2025)는 원시 스퀴글 데이터의 리베이스 호출에 사용할 수 있다는 점에 유의하세요. 실제로 일부 WGS 연구에서는 이미 나노포어 시퀀싱을 통해 미생물 게놈이 생성되었으며, 이 품질은 단독 연마가 합의 서열을 크게 개선할 것으로 기대되지 않는다고 보고하고 있습니다20,21.
플라스미드는 특히 장내세균과(Enterobacteriaceae) 분리주에서 획득된 내성 유전자의 대부분을 포함하는 경우가 많습니다. 따라서 플라스미드 서열을 분해하면 AR 유전자의 맥락화가 가능하며, 이는 AMR 전파 추적에 핵심적인 역할을 합니다23,24. 나노포어 시퀀싱은 이미 blaKPC가 플라스미드를 보유한 미세진화를 조사하는 데 사용되었습니다. MinION 장치는 또한 병원 환경에서 임상 분리주에서 플라스미드의 실시간 벤치 상단 시퀀싱과 내성 유전자 검출에 사용되었습니다26. 그렇긴 하지만, 플라스미드 심문은 아직 일상적인 감염 통제 관행의 일부가 아닙니다.
LR 시퀀싱이 유전체서열 27에서 플라스미드를 구출하는 능력에서 SR 시퀀싱에 비해 크게 향상되었음에도 불구하고, 여전히 몇 가지 문제가 남아 있습니다. Flye28, Canu29 , Raven30 과 같은 롱리드 어셈블러는 고품질 염색체 조립체를 생산하지만 플라스미드 서열을 조립하는 데는 어려움을 겪습니다. 이는 부분적으로 플라스미드 DNA가 WGS 시퀀싱 데이터에서 과소대표되어 있어 범위 깊이가 부족하기 때문입니다31. 모듈형 구조, 풍부한 2차 구조, 반복 반복 현상으로 인해 플라스미드 DNA 서열의 고품질 조립은 염색체 DNA보다 더 높은 커버리지가 필요하다는 점에 유의하라(50배 읽기 깊이32).
플라스미드 서열로 DNA 샘플을 풍부하게 하는 것은 덮개 깊이를 높이는 효과적인 방법이지만, DNA 시퀀싱 전에 플라스미드 DNA를 분리하거나 풍부하게 하는 것은 임상 진단용으로 너무 비용이 많이 들거나 번거로울 수 있으며, 선택된 DNA 서열을 풍부하게 하여 편향을 초래할 수 있습니다. 2017년에는 임상 샘플에서 플라스미드 DNA의 완전한 조립을 시도하는 데 플라스미드 풍부 DNA를 사용하여ARGs 24 검출을 시도했습니다. 6종의 서로 다른 장관박테리아과에서 분리된 8종을 시퀀싱하여 개체군과 플라스미드 구조 다양성을 극대화하였습니다. 여러 조립기를 시도한 결과, Canu/Canu+Pilon이 다른 어셈블러보다 확실히 우수한 성능을 보였으며; 이 연구팀은 또한 메타 어셈블리 접근법을 시도하여 추가 플라스미드 구조의 해상도를 달성하여, 시퀀싱된 샘플 내 알려진 모든 플라스미드의 78%를 완전하게 조립하는 결과를 얻었습니다. 그러나 대규모 반복 구조의 존재와 (다소 적지만) DNA 추출 문제는 모든 단일 조직 플라스미드 조립체 검출에 상당한 어려움을 남겼다24.
최근에는 저점유 플라스미드 서열의 풍부화 보완적 접근법으로서 적응 샘플링이 박테리아 분리 샘플에서 염색체 서열을 거부하는 방식으로 연구되었으나, 이 방법은 알려진 참조 서열이 필요하다33.
여기서 저자들은 플라스미드 DNA 농축 샘플에 맞춘 ONT 시퀀싱 프로토콜을 설명합니다. 플라스미드 DNA의 표현성 증가와 최신 라이브러리 준비 프로토콜, 플로우 셀 기술, 서열 조립 도구를 결합하여, 이 워크플로우는 겔 이동성에서 추정된 크기와 일치하는 조립체를 생성했으며, 3분의 2의 경우에는 SR 시퀀싱 연마와 일치하거나 0.05% 쌍별 서열 동일성 내에 도달했습니다. 플라스미드 DNA 서열의 풍부화는 플라스미드 시퀀싱의 효율성을 극대화하여 최대 24개의 샘플을 최적의 커버리지로 병렬 시퀀싱할 수 있게 합니다. 이 프로토콜들은 표준 나노포어 WGS 접근법을 대체하려는 것이 아니라, 염색체 서열이 이미 알려져 있거나 관심 없는 상황에서 플라스미드 시퀀싱의 정확성과 효율성을 극대화하기 위한 것입니다.
워크플로우에는 플라스미드 DNA 추출, 바코딩을 이용한 라이브러리 준비, 모터 단백질과의 어댑터 연결, 플로우셀 점검, 라이브러리를 플로우셀에 적재하여 시퀀싱, 전기 신호 데이터 분석(실시간 또는 사후 분석), Autocycler34를 이용한 서열 조립, 그리고 다양한 후속 분석(그림 1)이 포함됩니다.
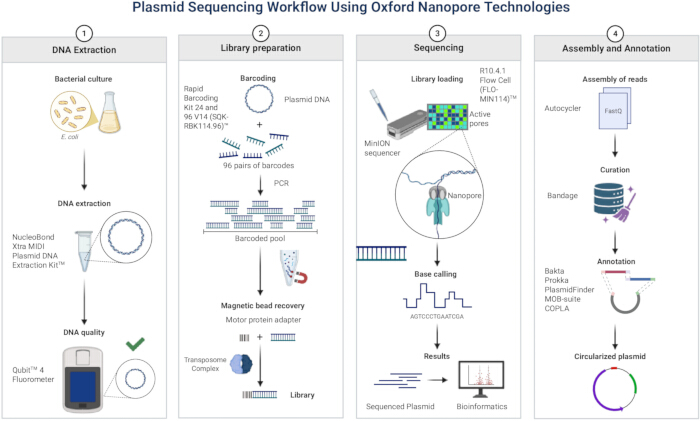
그림 1: 옥스퍼드 나노포어 테크놀로지를 이용한 플라스미드 시퀀싱 워크플로우. 1단계: DNA 추출; 2단계: 도서관 준비; 3단계: 시퀀싱; 4단계: 조립 및 주석 작성. BioRender로 제작되었습니다. 코르테스, G. (2026) https://BioRender.com/u3b15st. 이 그림의 더 큰 버전을 보시려면 여기를 클릭해 주세요.
프로토콜
1. 플라스미드 DNA 추출
참고: 이 프로토콜은 상용 플라스미드 DNA 추출 키트35를 사용하여 임상용 대장균과 해당 트랜스콘가간에서 플라스미드 DNA를 추출하는 데 사용되었습니다. 활용에 대한 자세한 프로토콜은36에서 확인할 수 있습니다. 이 프로토콜은 ~3 kb에서 ~200 kb까지 고복사 및 저 복사 플라스미드 모두에 적합합니다. 대형 플라스미드는 복사 수가 적어 세포당 1-2개 정도 DNA 생산량이 제한되므로 특별한 주의가 필요합니다. 이를 보상하기 위해 프로토콜은 세포 질량과 용해 및 중화 완충제의 부피를 증가시켜 컬럼 결합에 필요한 충분한 플라스미드 DNA를 확보할 것을 권장합니다. 이 프로토콜을 사용하면 최대 200 kb의 플라스미드도 여전히 복구할 수 있습니다; 하지만 메가 플라스미드(>200 kb)에는 적용 범위가 제한적입니다.
- 플라스미드 추출
- 1일차: 적절한 항생제를 보충한 Luria–Bertani(LB) 한천 플레이트에 스트릭 샘플을 부착하여 해당 플라스미드 내성 마커를 선택하고, 37°C에서 24시간 인큐베이션합니다.
참고: 최종 농도는 100 μg/mL로 LB에 100 mg/mL 100 mg/mL 육수액 1 μL을 첨가하여 배지에 첨가할 수 있습니다. - 2일차: 1일째부터 단일 분리된 콜로니에 적절한 항생제 배지를 투여하여 LB 3–5 mL를 접종합니다. 37°C에서 흔들며 ~8시간 또는 배양 온도가 OD₆₀₀₀ 1–2에 도달할 때까지 배양합니다.
참고: OD600 측정: 적절한 항생제가 포함된 신선한 LB 배지로 분광광도계를 빈 후 1mL를 깨끗한 큐벳에 옮기고 600nm에서 OD를 측정합니다. 측정값이 선형 범위를 초과하면 샘플을 희석하고 다시 측정합니다. - 400 mL의 LB에 적절한 항생제 배지를 보충하고, 400 μL 2일차 스타터 배양액을 접종합니다. 37°C에서 흔들며 8–12시간 또는 OD600 이 1–2에 도달할 때까지 배양하세요(앞서 설명한 대로).
참고: OD600 이 12시간 이내에 1–2에 도달하지 못하면 배양 부피를 400 mL 이상으로 늘리십시오. 플라스미드 손실 또는 재배열 위험을 줄이기 위해 배양 내 통과를 최대한 제한하고 모든 성장 단계에서 항생제 선택을 유지해야 합니다. 더 높은 DNA 수량을 원할 때만 배양 부피를 늘리세요. - 3일차: 배양물을 배양 부피에 맞는 원심분리기 병으로 옮깁니다. 4200 x g 에서 10분간 원심분리한 후, 제조사가 권장하는 시약 부피에 따라 다음 공식에 따라 펠릿을 재현탁합니다:
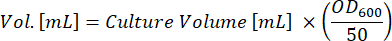
참고: 예시: 400 mL의 저복제 박테리아 배양(OD600 = 2)을 용해할 경우, 용해 완충제인 RES, LYS, NEU의 적절한 부피는 각각 16 mL입니다.
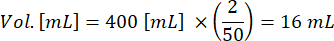
참고: 재현탁, 용해 또는 중화를 위한 시약 부피가 전체 배양 생체량(OD600 × Volume, 또는 ODV)에 적절히 맞지 않으면 용해가 불완전하고, 중화가 비효율적이며, 침전물 형성이 과도할 수 있습니다. 이로 인해 플라스미드 수율 감소, 순도 감소, 정제 컬럼 막힘 위험이 발생할 수 있습니다. 제조사의 공식(단계 1.1.4)을 사용하여 버퍼 부피를 비례적으로 조절하면 효율적인 용해, 완전한 중화, 고품질 플라스미드 DNA의 일관된 회수를 보장합니다. - 키트에서 지시한 대로 세포 용해, 적절한 완충제를 사용한 여과 습윤, 중화를 수행합니다.
참고: 침전물 부피가 많으면 필터 두 개를 쌓아 완충 양을 비례적으로 조절하세요. 상정액이 불투명한 상태일 경우 추가 원심분리 단계를 수행하세요. 중화 후에는 침전물이 많아 추가 원심분리 단계가 필요할 수 있습니다. 이는 대부분의 임상 대장균 샘플에서 해당되며, 이는 두꺼운 매트릭스38이 분비되는 배양37에서 바이오필름을 형성하는 경향이 있기 때문일 수 있습니다. 용해액에 과도한 침전물이 있으면 컬럼이 막히고, 배수 시간이 길어지며, 샘플이 단백질로 오염될 수 있습니다. 상정액이 맑으면 이러한 추가 절차가 필요하지 않을 수 있습니다. - 용해물을 4200 x g 에서 30분간 원심분리합니다. 상정액을 새 튜브로 옮기고 다시 30분간 원심분리기를 사용하세요. 이 회전 후에도 상정액이 불투명하면(그림 2), 4200 x g에서 추가 원심분리를 수행하세요.
참고: 원심분리 중 용해액을 50mL 배양관으로 옮기면 침전물이 제대로 펠릿으로 전달되지 않아 튜브 상단 근처에 갇힐 수 있어 상정액 제거가 용이해질 수 있습니다. 처리되는 양이 많아 단일 컬럼이 포화되어 추가 샘플을 수용하지 못할 수 있습니다. 여과 속도를 높이거나 DNA 수율을 극대화하기 위해 용해액을 두 개의 컬럼에 나누어 나눌 수 있습니다. - 키트 설명서에 따라 EQU, WASH, ELU 단계를 수행하세요.
- 이소프로판올을 사용해 DNA를 침전시킵니다.
참고: 펠릿이 보이지 않을 경우 -20 °C에서 ~10분 정도 배양하세요. 하지만 일반적으로 상정액은 조심스럽게 제거하는 것이 가장 좋으며, 눈에 보이지 않더라도 펠릿이 관 벽에 붙어 있을 것이라 믿습니다. - 지시에 따라 DNA를 에탄올로 세척하세요. 단백질 침전물이 계속되면 추가 세척을 수행하세요.
- DNA를 실온(~20 °C)에서 15–30분간 건조시킵니다.
- DNA를 100 μL 무핵효소 물에 재현탁; 이 작은 부피는 나노포어 라이브러리 준비에 대한 농도를 극대화하는 데 도움이 됩니다.
참고: 이 지점은 편리한 중간 지점입니다. 플라스미드 DNA는 –20°C에서 몇 달간 저장할 수 있습니다. 이 프로토콜에 사용된 추출 키트는 최적화된 완충 화학, 부드러운 용해 및 용해액 정화 단계를 통해 염색체(유전체) DNA 오염을 최소화하도록 설계되었으나, 상당한 염색체 DNA 오염을 배제할 수는 없으며, 저자들은 준비 과정에서 이를 발견했습니다(결과 참조).
- 1일차: 적절한 항생제를 보충한 Luria–Bertani(LB) 한천 플레이트에 스트릭 샘플을 부착하여 해당 플라스미드 내성 마커를 선택하고, 37°C에서 24시간 인큐베이션합니다.
- DNA 수율 및 품질 관리
형광 염료를 사용하여 DNA를 정량하고 품질을 평가하는데, 이는 UV 흡수 방식에 비해 낮은 DNA 농도에서도 더 높은 특이성과 민감도를 제공합니다. 이 프로토콜에서는 형광도계 장치를 사용하여 DNA, RNA 또는단백질 샘플을 정확하고 편리하게 정량합니다.- 형광광도 작업 흐름
- DNA 샘플을 실온으로 옮기세요. 표준 및 샘플을 위한 튜브를 준비하세요.
참고: 샘플 수를 기준으로 작업 용액에 포함할 적절한 염료와 버퍼 양을 계산하세요. 각 표준과 샘플에 대해, 버퍼 내 염료를 1:200 비율로 희석하여 200 μL의 작업 용액을 준비해야 합니다. 이 장치에는 이러한 계산에 사용할 수 있는 시약 계산기가 내장되어 있습니다. - 표 1에 따라 분석관을 준비하세요.
- 각 튜브를 몇 초간 소용돌이로 돌린 후 실온에서 2분간 배양합니다.
- 기준을 사용해 형광도계를 보정하세요. 샘플 튜브를 삽입하고 측정값을 기록하세요. 자세한 지침은 형광도계 매뉴얼39를 참조하십시오.
참고: 일반적인 플라스미드 Midi 제제의 경우 DNA 수확량은 플라스미드 크기, 복제 수, 성장 조건에 따라 100–400 mL 배양당 ~50에서 150 μg 사이로 예상됩니다. 일반적인 나노포어 리드 길이는 ~2 kb에서 20 kb 사이이며, 표준 플라스미드의 경우 중간 읽기 길이는 보통 5–10 kb 사이입니다. 연결 기반 키트는 더 큰 플라스미드에 대해 더 긴 리드(>20 kb 중앙값)를 생성할 수 있지만, 빠른 키트는 약간 짧은 리드 시간을 대가로 더 빠른 준비를 제공합니다.
- DNA 샘플을 실온으로 옮기세요. 표준 및 샘플을 위한 튜브를 준비하세요.
- 형광광도 작업 흐름
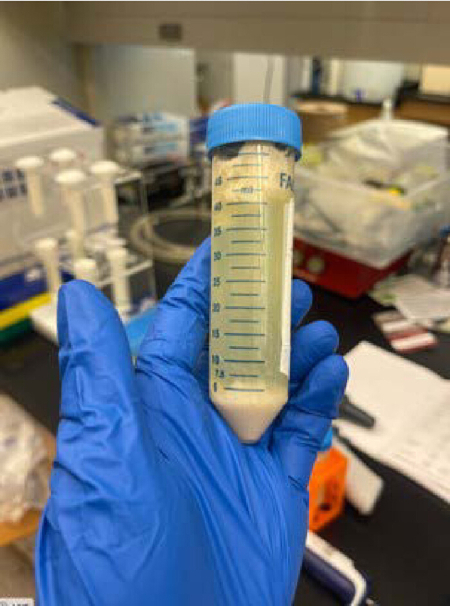
그림 2: 원심분리 한 단계 후 흐린 용해상 상액. 여과 컬럼이 막히지 않도록 상원액이 맑아질 때까지 연속 원심분리가 필요합니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭해 주세요.
| 표준 분석 튜브 | 사용자 샘플 분석관 | |
| 작업 용액 (염료 및 버퍼, 1:200) | 190 μL | 180–199 μL |
| 스탠다드 (키트 기준) | 10 μL | – |
| 사용자 샘플 | – | 1–20 μL |
| 각 분석관 내 총 부피 | 200 μL | 200 μL |
표 1: 형광광량계용 시약 부피 및 양. 단일 샘플에 대한 양이 표시되며; 분석할 샘플 수에 따라 풀을 준비할 수 있습니다.
2. 방법 2: 도서관 준비
참고: 고려사항 추출한 플라스미드의 시퀀싱을 위한 라이브러리 준비는 바코딩 키트40에 제공된 지침에 따라 수행되었습니다. 이 프로토콜은 전이효소 기반 방식을 사용하여 DNA를 동시에 단편화하고 바코드를 처리하여, 빠르고 효율적인 워크플로우를 제공하여 직접 작업하는 시간을 줄이고 도서관 준비를 단순화합니다.
- DNA 준비
- 1일차: 열 사이클러를 프로그래밍합니다: 30 °C에서 2분, 그 후 80 °C에서 2분.
- 상온에서 해동 키트 부품을 해동하고, 회전시키고, 표 2에 따라 혼합하세요.
참고: 원심분리기를 사용할 경우, 330 x g를 넘지 않는 느린 속도로 회전 내립니다. - 뉴클레아제가 없는 물에서 DNA 제제: 200 ng DNA를 0.2 mL PCR 튜브에 옮기고, 각 샘플에 적절한 양의 뉴클레아제 무첨가물을 추가하여 최종 부피를 10 μL로 만듭니다. 부드럽게 10–15회 피펫팅하여 혼합합니다. 다음 단계에서 피펫팅을 용이하게 하기 위해 330 x g 의 마이크로퓨지 또는 원심분리기에서 잠시 회전 종료하세요.
- 표 3에 설명된 대로 PCR 튜브에서 혼합물을 준비합니다.
- 피펫팅으로 섞은 후 잠시 돌려 내려.
- 1단계부터 열주기 프로그램을 사용하여 PCR 튜브를 인큐베이팅하세요. 튜브를 얼음 위에 올려 식히세요.
- 잠시 회전 내리세요.
- 네이티브 바코드 연결
- 깨끗한 1.5mL 에펜도르프 튜브에 담긴 바코드 샘플을 풀링합니다. 총 부피가 1000 μL를 넘지 않도록 하세요.
- 비즈를 소용돌이로 다시 현지하세요. 모인 바코드 샘플에 같은 양의 비즈를 넣고 튕겨서 섞으세요.
- 튜브를 Hula 믹서기에서 실온에서 10분간 인큐베이팅하세요.
- 80% 에탄올 2mL를 뉴클레아제가 없는 물에 담아 준비하세요.
- 자석에 튜브를 대고 샘플과 펠릿을 회전시키세요. 튜브를 자석에 고정한 채 피펫으로 상원액을 폐기물로 제거하세요.
참고: 적절한 강도와 크기의 자석, 네오디뮴 자석을 포함해서도 비싼 자석 랙을 사용하는 대신 효과적인 대안이 될 수 있습니다. 약 5–12파운드의 고정력과 0.3–1인치 직경의 자석은 표준 0.2–1.5 mL 튜브에 적합하며, 비드 기반 정화 단계에서 상정액을 깨끗이 제거할 수 있습니다. - 자석 위에 1mL 80% 에탄올로 비즈를 세척하세요. 에탄올을 제거하세요. 세척을 반복하세요.
참고: 튜브의 자석 대비 위치를 바꾸면 에탄올 제거가 더 쉬워질 수 있습니다. 펠릿이 우연히 손상되었을 경우, 완전한 비드 펠릿을 보장하기 위해 추가로 저속 회전 장치를 활용하세요. - 잠시 회전해서 튜브를 자석 위에 다시 올려놓으세요. 잔류 에탄올을 피펫으로 제거하세요. 30초간 건조하되, 펠릿이 갈라질 정도로 건조하지 마세요.
- 자석을 제거하고 용출 버퍼에 비즈를 다시 현탁하세요. 사용 중인 바코드 수에 따라 적절한 EB 부피는 표 4 를 참조하세요.
- 튜브를 실온에서 10분간 부화시키세요.
- 튜브를 자석에 다시 연결해 세출액이 깨끗해질 때까지 보관하세요.
- 형광도계에서 용출된 샘플 1 μL을 사용해 DNA 농도를 정량하여 라이브러리 준비가 성공적으로 수행되었는지, 실패한 라이브러리에 플로우 셀을 낭비하지 않도록 합니다.
- 어댑터 연결(Adapter ligation)
- DNA 라이브러리 11 μL을 새로운 튜브와 표지로 옮깁니다.
참고: 필요 시 향후 시퀀싱 실행을 위해 추가 DNA를 -20°C에 저장하세요. - 표 5에 따라 해동된 래피드 어댑터를 새 튜브에 희석한 후 피펫을 위아래로 움직여 혼합하세요.
- 11 μL DNA 라이브러리에 희석된 RA 1을 추가합니다.
- 튜브를 튕겨 섞고, 잠시 돌려서 튜브 바닥에 전체 부피가 쌓이도록 하세요.
- 벤치에서 5분간 부양하세요.
- DNA 라이브러리 11 μL을 새로운 튜브와 표지로 옮깁니다.
| 시약 | 상온에서 해동 | 스핀 다운 | 피펫팅으로 혼합 |
| 빠른 바코드 | 겨울왕국이 아니야 | ✓ | ✓ |
| 래피드 어댑터 | 겨울왕국이 아니야 | ✓ | ✓ |
| AMPure XP 비즈 | ✓ | ✓ | 사용 직전에 피펫팅 또는 소용돌이 처리로 혼합하세요 |
| 용출 버퍼 | ✓ | ✓ | ✓ |
| 어댑터 버퍼 | ✓ | ✓ | 소용돌이 혼합 |
표 2: 나노포어 라이브러리 준비를 위한 시약 부피 및 양. 각 시약에 대해 수행할 동작은 (✓)로 표시됩니다.
| 시약 | 볼륨/샘플 |
| 10 μL 템플릿 DNA (이전 단계에서 200 ng) | 10 μL |
| 1.5 μL 급속 바코드, 각 샘플마다 하나씩 | 1.5 μL |
| 총 부피 | 11.5 μL |
표 3: 빠른 바코딩을 위한 시약 및 부피. DNA 샘플당 부피가 표시되며; 풀링된 혼합물을 준비하고 DNA를 별도로 첨가할 수 있습니다.
| 1-24 바코드 | 48개의 바코드 | 72개의 바코드 | 96개의 바코드 | |
| 용출 버퍼 부피 | 15 μL | 30 μL | 45 μL | 60 μL |
표 4: 24개의 바코드당 사용되는 용출 버퍼 볼륨. 부피는 바코드 수에 따라 표시됩니다.
| 시약 | 볼륨 |
| 래피드 어댑터(RA) | 1.5 μL |
| 어댑터 버퍼 (ADB) | 3.5 μL |
| 총 부피 | 5μL |
표 5: 어댑터용 시약 및 양. 샘플 수에 따라 볼륨을 조절할 수 있습니다.
3. 플로우 셀 실행
참고: 중간 정도의 범위가 필요한 소수의 플라스미드를 시퀀싱할 때는 표준 출력 플로우 셀을 선택하세요. 나노포어는 활성 기공 수를 확인하기 위해 플로우 셀 검사를 수행할 것을 권장합니다; 나노포어 장치의 플로우셀은 보증 기준에 따라 최소 800개의 활성 기공을 가져야 합니다. 단일 MinION 플로우셀은 플라스미드 DNA로 풍부해진 여러 DNA 샘플의 시퀀싱에 충분한 출력을 제공하며(다중화에 관한 자세한 내용은 토론 섹션에서 참고), GRIDion이나 Promethean 플로우셀보다 더 낮은 비용과 더 큰 유연성을 제공합니다.
- 플로우셀의 프라이밍 및 부하
참고: 이 프로토콜 개발에는 2022년에 출시된 R10.4.1 플로우 셀이 사용되었습니다. 이 플로우 셀은 더 긴 기공과 이중 리더 헤드를 가지고 있어 동등분자 시퀀싱이 향상됩니다20,21. 이 시퀀싱 프로토콜과 바코딩 키트는 다른 플로우 셀과 호환되지 않습니다. 대규모 다중화, 높은 범위 확보, 또는 더 큰 플라스미드나 유전체를 다룰 때는 고출력 플로우 셀을 선택하세요. 비용, 처리량, 시열 질의 균형을 위해 샘플 수와 목표 깊이를 고려하세요.- 시퀀싱 버퍼(SB), 라이브러리 비드(LIB) 또는 라이브러리 용액(LIS), 소 혈청 알부민(BSA), 플로우셀 테더(FCT), 플로우셀 플러시(FCF) 등 시약을 냉장 보관에서 제거하세요. 상온에서 얼음 위에 해동하세요. 시약이 녹으면 소용돌이로 섞고, 빠르게 회전시키고, 얼음 위에 보관하세요.
- 표 6에 나열된 시약을 사용해 신선한 DNA 튜브를 혼합하여 플로우셀 프라이밍을 준비합니다. 반전과 피펫팅으로 혼합하세요.
- 장치의 뚜껑을 열고 플로우셀을 삽입하세요. 적절한 위치를 확인하기 위해 부드럽게 압력을 가하세요.
- 덮개를 밀어 프라이밍 포트를 노출하세요.
- 프라이밍 포트 안이나 인접한 공기 방울이 있는지 확인하세요. 기포를 제거하기 위해 20–30 μL의 액체를 끌어당깁니다.
참고: 20–30 μL 이상의 버퍼를 제거하지 마십시오. 기공은 항상 버퍼 안에 잠겨 있어야 합니다. 공기에 노출된 기공은 사용할 수 없게 될 수 있습니다. 버퍼가 가시 채널 전체에 걸쳐 연속적인지 확인하세요. - 프라이밍 혼합액 800 μL을 끌어올려 프라이밍 포트에 분배합니다. 기포 유입을 피하세요. 기기를 5분간 두세요.
- 리브를 위아래로 피펫팅하여 다시 현지하세요.
참고: 사용 직전에 즉시 재정지하세요. 리브가 빠르게 가라앉기 때문입니다. - 표 7에 표시된 대로 DNA 라이브러리와 적절한 부피의 라이브러리 비즈를 새 튜브에 섞습니다.
참고: 저자들이 사용하는 Rapid Barcoding 키트는 의도적인 크기 선택 없이 DNA 조각과 바코드를 부착하는 데 트랜스포효아제 기반 방식을 사용하므로, 읽기 길이는 주로 원래 입력 DNA를 반영합니다. 네이티브 바코드 키트와 같은 연결 기반 키트와 달리, Rapid Barcoding 키트는 별도의 단편 또는 긴 조각 버퍼를 포함하지 않습니다. 긴 DNA도 긴 리드를 생성할 수 있지만, 분포는 더 다양하고 일반적으로 롱 프래그먼트 버퍼를 사용하는 연결 기반 라이브러리보다 짧습니다. 버퍼가 없으면 작업 흐름이 단순화되고 직접 작업하는 시간이 줄어들지만, 라이브러리 크기 분포에 대한 제어가 적어 조립 품질에 영향을 줄 수 있습니다. 연결 기반 키트는 큰 조각을 선택적으로 농축하고 짧은 조각을 제거함으로써 일반적으로 더 높은 중앙값 읽기 길이와 특히 신생 조립체와 복잡한 게놈에서 조립 연속성이 개선됩니다. - 샘플 포트 커버를 조절해 포트를 드러내세요. 플로우셀 프라이밍 포트에 200 μL 프라이밍 혼합물을 주입합니다.
- 준비된 DNA 라이브러리를 부드럽게 섞은 후 로딩하세요.
- DNA 라이브러리 75 μL을 비즈와 함께 샘플 포트에 한 방울씩 분사하여 각 방울이 흡수될 때까지 기다립니다.
- 샘플 포트 커버를 다시 붙이고 프라이밍 포트를 닫으세요.
- 라이트 쉴드를 플로우 셀에 추가하세요. 라이트 쉴드의 앞쪽 가장자리를 클립과 맞추고, 나머지 부분을 내리면 플로우 셀을 덮으세요. 라이트 차폐막을 클립 아래에 넣으려 하지 마세요. 빛 차폐막은 덮개 주변에 위치해 플로우 셀 상단 전체를 빛으로부터 보호해야 합니다.
참고: 라이브러리가 로드된 즉시 플로우 셀에 라이트 차폐막을 설치하여 최적의 시퀀싱 출력을 원합니다. 라이브러리가 플로우 셀에서 제거될 때까지 이후 단계에서는 켜두세요. 라이트 차폐막은 장치에 단단히 고정되어 있지 않으며; 밀어내지 않도록 조심해서 다루세요. - 장치 뚜껑을 닫고 시퀀싱 실행을 시작하세요.
- 시퀀싱 실행-계산 요구사항 시작:
최소한: 8스레드 CPU, 16GB RAM, 1070 NVIDIA GPU, 500GB SSD
권장 사양: 16스레드 CPU, 32GB RAM, 2070 NVIDIA GPU, 1TB SSD
참고: 소프트웨어와 컴퓨터 모두 최신 상태인지, 새 파일을 수용할 수 있는 최소 500GB 이상의 여유 저장 공간이 있는지 확인하세요. 소프트웨어 업데이트나 기타 프로그램이 시퀀싱 실행에 방해가 될 수 있습니다. 소프트웨어를 윈도우 또는 우분투 운영체제에서 실행하세요.- 실행 시간 제한을 설정하세요: 다중화되는 플라스미드 수에 따라 실행 제한을 설정하세요. 기본 시간은 48시간이며, 최대 72시간까지 플레이할 수 있습니다. 자세한 설명은 매뉴얼을 참고하세요.
참고: 실행 시간은 플라스미드 수보다는 다중화와 플라스미드 크기에 따라 달라집니다. 다중화할 수 있는 샘플이나 플라스미드 수는 원하는 시퀀싱 깊이와 플로우 셀의 출력에 따라 달라집니다. 일반적인 플라스미드 시퀀싱의 경우, 표준 나노포어 플로우 셀당 20–24개의 샘플을 다중화하는 것이 보통 정확한 조립 및 변이 검출에 충분한 커버리지를 제공하며, 플라스미드 크기가 ~200 kb 미만이라고 가정할 때 가능합니다. 더 큰 플라스미드 수나 더 높은 커버리지 요구사항은 플로우셀당 샘플 수를 줄일 수 있습니다. 고출력 플로우 셀은 한 번에 최대 96개 이상의 샘플을 지원할 수 있어 고처리량 플라스미드 시퀀싱이나 매우 깊은 커버리지가 필요한 프로젝트에 적합합니다. 사용자는 바코드 수, 플라스미드 크기, 표적 깊이를 균형 있게 조절하여 각 플라스미드가 완전한 조립을 위해 적절한 리드를 받도록 해야 합니다. - 시퀀싱 중 디멀티플렉싱을 수행할 경우 바코드 트리밍을 활성화하세요.
참고: 바코드별로 측정 신호를 모니터링하며, 흐름 셀의 수명을 보존할 수 있을 만큼 충분한 커버리지가 확보되면 운영을 중단합니다. - 초정밀 기지 호출 모드를 선택하세요.
참고: 적응형 샘플링/바코드 밸런싱을 선택하지 마세요. 이 옵션은 읽기 출력을 크게 줄이고 기공을 더 빠르게 분해합니다. GPU가 없다면, 런이 끝난 후에는 베이스 콜을 미루는 것이 좋습니다. - 적절한 빠른 바코드 키트(24 또는 96)를 선택하세요.
- 장치가 수평인지 확인하고 기본 설정(최소 Q 점수 10)으로 시퀀싱 실행을 시작하세요.
참고: 이 지점은 편리한 중간 지점입니다. 이 장치는 밤새 작동할 수 있습니다. - 사후 베이스콜링(실시간 베이스콜링을 위한 용량이 부족하거나 정확도를 높이기 위해 향상된 분석 도구로 원시 데이터를 재분석할 때): 소프트웨어에서 완료된 시퀀싱 실행을 엽니다
참고: 다음 단계는 라이브 베이스콜링을 선택하지 않은 경우에만 적용됩니다. - 베이스콜링을 선택하고 초정확도(SUP) 모델을 선택하세요.
- 원시 FAST5/POD5 데이터를 선택하고 출력 디렉터리를 설정하세요.
- 베이스 콜 시작해.
- 실행 시간 제한을 설정하세요: 다중화되는 플라스미드 수에 따라 실행 제한을 설정하세요. 기본 시간은 48시간이며, 최대 72시간까지 플레이할 수 있습니다. 자세한 설명은 매뉴얼을 참고하세요.
| 시약 | 플로우 셀당 부피 |
| 플로우셀 플러시(FCF) | 1,170 μL |
| 소 혈청 알부민(BSA) 50 mg/mL | 5 μL |
| 플로우 셀 테더(FCT) | 30 μL |
| 최종 튜브 내 총 부피 | 1,205 μL |
표 6: 플로우셀 프라이머 및 로딩을 위한 시약 및 부피. 각 플로우 셀마다 시약의 부피가 표시됩니다.
| 시약 | 플로우 셀당 부피 |
| 시퀀싱 버퍼(SB) | 37.5 μL |
| 라이브러리 비즈(LIB) 또는 라이브러리 솔루션(LIS), | 25.5 μL |
| DNA 라이브러리 | 12 μL |
| 총 | 75 μL |
표 7: 도서관 로딩을 위한 시약 및 부적. DNA 도서관의 권은 표시되어 있으며; 라이브러리 비즈(입찰)는 사용 직전에 반드시 섞어야 합니다.
4. 방법 4: 오토사이클러 조립
참고: 리드를 컨티그로 조립하는 방법은 여러 가지가 있습니다. 각 어셈블러는 장점과 편향이 있습니다. 이 프로토콜은 여러 어셈블리를 하나의 어셈블리로 결합하는 Autocycler 사용을 권장합니다. 이 방법은 더 많은 노동 집약적이고, 단일 조립기로 시간을 절약할 수 있습니다. 적절한 소프트웨어를 다운로드하려면 터미널에 Conda를 설치해 주세요. 보조 명령어 문서에는 시스템 설정을 위한 환경 파일 링크가 포함되어 있습니다.
- 런 품질 평가: Minknow 소프트웨어나 런 보고서 .html 파일에서 런의 품질을 확인하여 품질 지표(수확량, Q-스코어, 길이, 분포)를 기록하세요. 선택적으로 NanoPlot을 사용하여 FASTQ 파일을 평가하여 각 바코드의 읽기 길이 분포, N50, 품질 점수 프로필을 확인할 수 있습니다. 시퀀싱 수율과 읽기 길이 분포가 예상 플라스미드 크기와 일치할 때만 진행하세요.
- 바코드 제거: 시퀀싱 실행 중에 바코드 트리밍이 활성화되었는지 확인하세요. 바코드가 제거되지 않았다면, Porechop(v0.2.4)을 사용해 FASTQ 파일을 트리밍하고, 후속 분석을 위해 바코드 어댑터 시퀀스가 성공적으로 제거되었는지 확인하세요.
- 트림 리드: Filtlong(v0.3.1)을 사용해 긴 리드를 트리밍하여 약 5–10%의 저품질 리드를 제거하면서 전체 수율의 ~90%를 유지합니다. 조립용으로 필터링된 FASTQ 파일을 생성하세요. 이후 조립체에서 키메라 연합체가 발생하면, 최소 읽기 길이 임계값을 ≥3,000 bp로 강제하여 필터링 엄격성을 높이고 필터링된 리드를 재생성합니다.
- 서브샘플 및 어셈블 리드 서브셋: 서브샘플은 권장 설정에 따라 Autocycler를 사용해 읽고, 각 리드 서브셋은 Raven(v1.8.3), Fye(v2.9.6), Canu(v2.3.0), miniasm(v0.3.0), Myloasm(v0.2.0), NECAT(v0.0.1), Plassembler(v1.8.1) 및 기타 선택된 어셈블리를 사용하여 조립합니다. 각 조립체의 연속 길이와 원형화 상태를 주목하세요. 원형화 현상을 보고하는 조립기(Raven, Flye, miniasm, Myloasm, Plassembler)는 플라스미드 재구성에 우선순위를 두어야 합니다. Canu 및 NECAT 조립체의 경우, 이전 조립체에서 원형 조직체에서 예상되는 플라스미드 크기를 기반으로 후보 플라스미드 조직을 식별합니다.
- 조립체 검사 및 큐레이션: Bandage(v0.9.0)를 사용해 각 조립 그래프 파일(.gfa)을 시각화하고, 원형성, 조립기 간 크기 일관성, 키메라 결합 증거 등을 평가합니다. 여러 어셈블러에서 지지가 부족한 선형 연합체를 제거하고, 일관된 크기 추정치를 가진 원형 연속체를 유지합니다. 많은 조립체에 키메라 조인이 포함되어 있다면 4.3단계로 돌아가 최소 읽기 길이 임계값(권장 ≥3,000 bp)을 증가시킵니다. 주요 플라스미드는 원형화되었지만 더 작고 지지되지 않는 조직체가 남아 있는 경우, 합의 생성 전에 소규모 조직체를 제거하세요. 합의 생성으로 진행하며, 수작업 선별 후 일괄 처리가 가능합니다.
- 합의 생성 및 최종 조립: 수동 큐레이션 후, 큐레이션된 어셈블리를 사용해 Autocycler 합의 생성을 진행하세요. 남은 Autocycler 명령을 실행하여 최종 합의 플라스미드 서열을 생성합니다. 상세한 명령줄 지침과 매개변수 설정은 보조 자료에 제공되어 있습니다.
- 폴리싱: 완전한 어셈블리가 생성되면, Medaka(v2.1.1)로 트리밍된 롱 리드를 사용해 어셈블리를 다듬어 합의 정확도를 크게 향상시킵니다.
참고: 추가 연마 라운드는 합의 정확성에 도움이 되지만, 오류를 유발할 수도 있습니다. 연마하기 전에 DNAapler 같은 프로그램을 사용해 새 모습을 회전시키는 것이 최선의 방법입니다; 명령어는 보조 명령 섹션에서 확인할 수 있습니다.
5. 방법 5: 주석
참고: 박테리아에 대한 효과적인 주석 도구가 많이 있습니다. 자세한 주석을 위해 다음 프로그램들이 권장됩니다.
- 박타는 현재 활발히 유지 관리되고 있으며 프로카41,42의 정신적 후계자로서 프로테오믹 분석에 매우 적합합니다.
- 리플리콘 타입, 플라스미드 이동성 타입, 결합 타입 등에는 MOB-suite가 신뢰할 만한6. MOB-suite는 매시 디스멀링을 통해 플라스미드 계통발생을 추론할 수 있으며, 삽입 서열(IS) 요소43을 식별할 수 있습니다.
- COPLA는 플라스미드 분류학에도 유용한 도구입니다. 플라스미드를 플라스미드 분류 단위로 분류하는 Copla의 독특한 접근법은44 분야에서 권장됩니다.
참고: 플라스미드 계통발생은 플라스미드 모듈 구조와 높은 재조합 빈도로 인해 서열 정렬이 어렵기 때문에 역사적으로 상당한 도전 과제가 있었습니다. COPLA는 평균 뉴클레오타이드 동일성(ANI)을 계산하여 이러한 문제를 해결합니다.
결과
임상 대장균 균주
임상 균주 플라스미드 시퀀싱에 ONT를 사용하는 방법을 설명하기 위해, 저자들은 워싱턴 대학교의 스티븐 살리판테 박사가 후원하는 10개 균주를 시퀀싱했습니다. 이 균주는 워싱턴 대학교 의료센터45에서 일상 임상 진료 중 얻은 312개의 혈액 또는 소변 유래 대장균(ExPEC) 컬렉션의 일부였습니다.
플라스미드 접합 및 겔 이동성 분석법을 통한 특성 분석
연구진은 또한 대 장균 LMB100을 수혜자로 사용한 결합 검사도 수행했습니다. 접합은 한 세포(기증자)에 존재하는 플라스미드가 다른 세포(수혜자라고 불림)로 전달되는 과정입니다46. 이 이식은 두 세포 간의 물리적 접촉이 필요하며, 일반적으로 수용 세포 내에 접합성 플라스미드가 존재함을 나타내는 마커를 사용하여 검출됩니다. 이를 통해 저자들은 숙주 균주 차이를 변수로 제거하고, 플라스미드 포획(특정 생태적 지위에서 플라스미드를 프로파일링하는 방법)로 얻은 플라스미드 서열 분석 프로토콜의 사용을 설명할 수 있었습니다. 모든 결합 분석은 트랜스콘커건트를 생성하여 기증자 내에 접합 플라스미드가 존재함을 확인했습니다. 저자들이 따랐던 프로토콜은36쪽에 설명되어 있습니다. 연구팀은 기증자와 수혜자 균주에 존재하는 플라스미드를 확인하고, 펄스장 겔 전기영동(PFGE)을 통해 그 이동성을 추정했습니다. 표 8 에는 대표적인 10가지 공여 균주 목록이 나와 있으며, 이들 중 플라스미드의 추정 크기는 세 번째 열에 나와 있습니다. PFGE 겔의 해상도 범위를 벗어난 플라스미드는 이 표에서 제외되지만, 연구진은 약 ~4kb 정도의 작은 플라스미드 여러 개를 조립할 수 있었습니다(사진에는 표시되지 않음).
| 기증자 계통 | 플라스미드 | 추정 PFGE 크기 | 조립 길이 | 평균 깊이 | bp 제로 깊이 | 보장 % | 입장 변경 | SR 이전 정확도 % |
| blood_08 _0081 | pblood_08_ 0081_1 | 170000 | 171829 | 100 | 99.941803 | 54 | 0.0314 | 99.9686 |
| blood_08 _0081 | pBlood_08_ 0081_2 | 82000 | 85576 | 46.9 | 0 | 100 | 2 | 99.9977 |
| blood_d-08 _0094 | pBlood_d-08 _0094 | 179000 | 173334 | 382.6 | 3121 | 98.19943 | 2,347 | 98.646 |
| blood_08 _1447 | pBlood_08 _1447 | 97000 | 99624 | 36.2 | 0 | 100 | 0 | 100 |
| blood_10 _0913 | pBlood_10 _0913_1 | 70000 | 71788 | 49 | 4 | 99.994428 | 188 | 99.7381 |
| blood_10 _0913 | pBlood_10 _0913_2 | 112000 | 118727 | 41.2 | 126 | 99.893874 | 276 | 99.7675 |
| blood_1 1_184 | pBlood_11 _184_1 | 150000 | 146583 | 65.1 | 287 | 99.804206 | 134 | 99.9086 |
| blood_11_184 | pBlood_11 _184_2 | 75000 | 74263 | 82.1 | 0 | 100 | 32 | 99.9569 |
| blood_2011 _0238 | pBlood_ 2011_0238 | 170000 | 167286 | 110.9 | 0 | 100 | 0 | 100 |
| upec_108 | pUPEC_108 | 130500 | 131039 | 103.9 | 0 | 100 | 0 | 100 |
| upec_134 | pUPEC_134 | 160500 | 157829 | 169 | 0 | 100 | 0 | 100 |
| upec_271 | pUPEC_271 | 145500 | 144519 | 86 | 33311 | 76.950436 | 1,557 | 98.9226 |
| upec_90 | pUPEC_90 | 70000 | 74624 | 139.8 | 0 | 100 | 6 | 99.992 |
표 8: 10개 기증 균주 패널의 플라스미드 크기 추정 및 시퀀싱 정확도 지표. PFGE 또는 조립된 ONT 공여 플라스미드 서열을 기반으로 한 플라스미드 크기 추정치가 나열되어 있습니다. ONT 단단과 SR-서열 연마 플라스미드 조립체의 쌍별 비교도 정확도의 지표로 제시됩니다. 지표로는 어셈블리 길이, 평균 깊이, 제로 깊이 영역, 커버리지 비율, 위치 변경, SR 이전 정확도 비율 등이 포함됩니다.
ONT 기반 플라스미드 시퀀싱 출력 지표
시퀀싱 런은 24시간으로 설정되었습니다. 총 24개의 샘플이 다중화되었습니다. 각 샘플의 기술 데이터, 품질 점수(Q), 길이, 커버리지 등은 표 9에 나와 있습니다. 나노기공 시퀀싱은 분석된 모든 샘플에 대해 충분한 읽기 출력과 품질을 제공했습니다. 모든 라이브러리를 통틀어 시퀀싱은 샘플당 평균 134,115개의 리드를 생성했으며, 평균 수율은 576.2 Mb에 해당합니다. 리드의 평균 길이는 8,797 bp, 평균 N50은 3,693 bp로, 플라스미드 조립에 충분한 리드 연속성을 제공했습니다. 평균 읽기 품질 점수는 Q16.0, 중앙값은 Q16.6이었고, 개별 런은 Q13.7에서 Q18.0 사이였습니다.
| 서열 변형 | 읽기 (kb) | 베이스 (Mb) | 평균 길이 | 최대 길이 | 최소 길이 | N50 | 중간 길이 | 평균 Q | 중앙값 Q | |
| Blood_08_0081 기증자 | 109.8 | 261 | 5713 | 508418 | 78 | 2377 | 1351 | 14.5 | 15 | |
| Blood_08_0094 기증자 | 89.3 | 229 | 4177 | 114948 | 81 | 2565 | 1065 | 13.7 | 14 | |
| Blood_08_1447 기증자 | 87.5 | 246 | 5041 | 135147 | 75 | 2816 | 1609 | 15.1 | 15.7 | |
| Bblood_10_0913 기증자 | 247.7 | 1026 | 9260 | 174231 | 70 | 4143 | 1661 | 15.5 | 16.1 | |
| Blood_11_154 기증자 | 51.5 | 110 | 4172 | 91148 | 73 | 2127 | 1387 | 16.1 | 16.5 | |
| Blood_2011_0238 기증자 | 16.8 | 42 | 6707 | 104848 | 62 | 2534 | 845 | 15.3 | 15.2 | |
| UPEC_108 기증자 | 50.6 | 77 | 1915 | 90234 | 67 | 1525 | 1103 | 15.8 | 16.2 | |
| UPEC_134 기증자 | 50 | 143 | 7110 | 158393 | 72 | 2865 | 1133 | 16 | 16.2 | |
| UPEC_217 기증자 | 64 | 236 | 7512 | 144275 | 78 | 3678 | 1895 | 17.4 | 17.9 | |
| UPEC_90 기증자 | 52.9 | 157 | 5666 | 95944 | 72 | 2969 | 1593 | 16.8 | 17.2 | |
| Blood_08_0081 LMB100 환합 전합체 | 53.5 | 119 | 5162 | 225856 | 1 | 2232 | 1009 | 16 | 16.8 | |
| Blood_08_0094 LMB100 환합부 | 160 | 442 | 7257 | 252176 | 1 | 2761 | 1083 | 17.3 | 18.2 | |
| Blood_08_1447 LMB100 전공부액 | 238 | 1029 | 10249 | 209221 | 1 | 4320 | 1857 | 17.7 | 18.7 | |
| Blood_10_0913 LMB100 환결합 | 792.3 | 4341 | 11508 | 474325 | 1 | 5479 | 2731 | 17.7 | 18.8 | |
| Blood_11_184 LMB100 환합부 | 42.5 | 281 | 17931 | 146626 | 87 | 6615 | 2448 | 16 | 16.7 | |
| Blood_2011_0238 LMB100 환합부 | 147.7 | 585 | 9000 | 344203 | 1 | 3962 | 1781 | 18 | 18.9 | |
| UPEC_108 LMB100 환합 전공액 | 173.4 | 778 | 10127 | 168756 | 80 | 4485 | 2079 | 15.3 | 16.1 | |
| UPEC_134 LMB100 환결합 | 105.4 | 667 | 17568 | 349230 | 71 | 6323 | 2232 | 15.5 | 16.3 | |
| UPEC_271 LMB100 환합 | 74.2 | 336 | 14521 | 342195 | 83 | 4520 | 1306 | 14.6 | 14.8 | |
| UPEC_90 LMB100 환결합 | 75.2 | 418 | 15348 | 225661 | 83 | 5561 | 2016 | 15.7 | 16.4 | |
표 9: 10개 기증 균주 패널에 대한 NanoQ 시퀀싱 출력 지표 보고서. 시퀀싱 출력 지표가 나열되어 있습니다. 여기에는 리드, 염기, 길이(평균, 중앙값, 최대값, 최소값), 길이, N50, 그리고 기증자 및 환합자로부터 얻은 Q(평균 및 중앙값) 값이 포함됩니다.
플라스미드 조립 및 정확도
플라스미드 서열은 Autocycler34를 사용해 조립되었습니다. 10개 샘플의 조립된 플라스미드 서열의 크기는 표 8 네 번째 열에 나와 있으며, 모든 경우에 PFGE 이동도를 기반으로 한 추정치(세 번째 열에 나열됨)와 일치하였습니다. 정확도는 Medaka 연마된 롱리드 어셈블리와 Medaka(v2.2.0) 및 폴리폴리시(v0.6.1) 어셈블리를 비교하여 평가되었습니다. 서열 동일성은 MUMmer(v3.2.4)의 dnadiff를 사용해 계산하였다(표 8). 분석된 모든 플라스미드(n = 12)를 통틀어 조립체의 평균 길이는 120.4 kb였고, 평균 시퀀싱 깊이는 109배로 지원되었으며, 플라스미드 서열에 걸쳐 평균 97.9%의 적용률을 보였습니다. 연마 이전에는 조립체의 평균 서열 동일성이 SR 연마 조립체에 비해 99.74%였습니다.
염색체 오염 추정
플라스미드 범위와 염색체 오염을 추정하기 위해 레딩을 조립된 플라스미드 서열과 대장균 LMB100 염색체 서열로 매핑하였다. Basecalled Nanopore 리드는 minimap2(v2.2.6)를 사용하여 정렬되었습니다. 결과된 정렬은 SAMtools(v1.1.7)를 사용하여 정렬된 BAM 파일을 생성하고 매핑 통계를 계산했습니다. 플라스미드 커버리지와 평균 깊이는 SAMtools 커버리지를 사용하여 추정하였습니다. 플라스미드 시퀀싱 깊이는 샘플마다 달랐으나, 정확한 조립에 필요한 최소 커버리지(50–70 x)를 훨씬 상회했습니다. 리드 중 일부는 염색체에 매핑되어 플라스미드 추출 중 숙주 DNA의 운반을 나타냅니다(표 10).
| 플라스미드 | 총 읽기 횟수 | 염색체 판독 | % 염색체 판독 | 평균 염색체 커버리지 | 평균 플라스미드 적용 범위 | P:C 비율 |
| pBlood_08_0081_2 | 53491 | 20116 | 37.61% | 5 | 1068 | 236 |
| pBlood_d-08_0094 | 160024 | 74827 | 46.76% | 37 | 1618 | 44 |
| pBlood_08_1447 | 238031 | 127967 | 53.76% | 62 | 7842 | 127 |
| pBlood_10_0913_1 | 792263 | 221610 | 27.97% | 87 | 7801 | 90 |
| pBlood_10_0913_2 | 792263 | 221610 | 27.97% | 87 | 7772 | 89 |
| pBlood_11_184_1 | 42494 | 15919 | 37.46% | 7 | 1637 | 250 |
| pBlood_11_184_2 | 42494 | 15919 | 37.46% | 7 | 2188 | 335 |
| pBlood_2011_0238 | 147680 | 80526 | 54.53% | 56 | 2965 | 53 |
| pUPEC_108 | 173409 | 107884 | 62.21% | 61 | 4008 | 65 |
| pUPEC_134 | 105418 | 68645 | 65.12% | 29 | 3640 | 127 |
| pUPEC_271 | 74232 | 53554 | 72.14% | 34 | 1202 | 35 |
| pUPEC_90 | 75193 | 30052 | 39.97% | 16 | 4488 | 278 |
표 10: 염색체 DNA 오염 추정치. 수용자 균주에서 정제된 플라스미드의 염색체 오염은 플라스미드 리드에 비해 LMB100 염색체 서열에 매핑되는 리드의 비율로 정량화되었습니다. 각 플라스미드에 대해 플라스미드 리드, 총 리드, 염색체 리드, 평균 염색체 커버리지, 평균 플라스미드 커버리지, P:C 비율이 나열되어 있습니다. pBlood_08_0081_1 불필요한 이유는 수혜자에서 회수할 수 없었기 때문이며, 이 추정은 수혜자의 균일한 염색체 배경 때문에 수행되었다는 점에 유의하세요.
염색체 오염은 조립된 LMB100 염색체 서열에 매핑된 리드의 비율과 플라스미드 리드 간의 비율로 정량화되었습니다. 염색체 오염률은 72.1%에서 28.0% 사이였으며, 평균 46.9%였습니다(표 10). 이 방법은 플라스미드와 염색체 모두에 대한 매핑 리드가 염색체 전용 것으로 간주되어 염색체 오염을 과대평가할 가능성이 있지만, 상당한 염색체 운반을 나타냅니다. 염색체 운반에도 불구하고, 조립 작업 흐름은 모든 샘플에서 PFGE 이동성에서 예측된 크기와 일치하는 완전한 플라스미드 서열을 성공적으로 재구성했습니다(표 8, 3, 4열).
대표적인 기증자-수혜자 결합 플라스미드 쌍
업펙 균주는 2011년부터 2013년 사이에 요로 샘플에서 분리되어 계통그룹 B2와 서열 유형 ST131로 분류되었습니다. PFGE 분석 결과 약 145 kb 크기의 플라스미드에 해당하는 밴드가 존재함을 확인했습니다 [그림 3A, (기증자)]. 단독 서열 분석을 통해 IncF 복제체의 존재가 확인되었습니다.
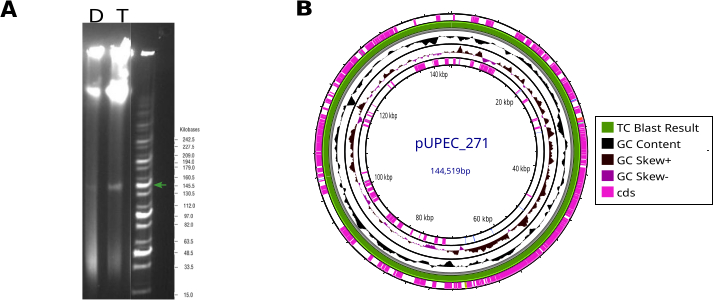
그림 3: pUPEC271의 특성 분석. (A)기증자와 환결합액의 PFGE. 공여자(D)와 환결합부(T)의 PFGE 밴드가 표시되어 있습니다; 초록색 화살표는 pUPEC271에 해당하는 플라스미드 밴드를 나타냅니다. PFGE에 사용되는 프로토콜은 연구36에서 설명되어 있습니다. (B)pUPEC271 지도. 트랜스콘가겐 이 기증자에게 강렬하게 맞춰졌고, 100% 동일한 컨센서스가 초록색 링으로 표시됩니다. 이 표현은 Proksee48을 사용하여 생성되었습니다. 가장 바깥쪽 고리는 CDS 위치를 나타내고, 두 안쪽 고리는 GC 함량과 왜도를, 가장 안쪽 고리는 tRNA 유전자의 위치를 나타냅니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭해 주세요.
저자들이 pUPEC271이라 명명한 이 플라스미드의 전이는 앞서36 에서 설명한 프로토콜을 사용한 PFGE 분석을 통해 추가로 확인되었습니다 [그림 3A, T(transconjugant)]. 기증자 upec271 균주(pUPEC271_donor)에서 정제한 플라스미드 DNA는 나노포어를 사용해 시퀀싱되었습니다. PFGE 겔에서 밴드 크기와 일치하여, pUPEC271_donor 서열은 144,519 bp 크기의 플라스미드를 발견했습니다(그림 3B). 이 플라스미드는 IncF형 레플리콘을 가지고 있었으며, 여섯 가지 뚜렷한 항생제 군에 대한 내성 유전자를 보유하고 있었습니다( 보충표 1 참조). 저자들은 또한 트랜스콘이어 인사 중 하나(pUPEC271_TC)에서 DNA를 정제하여 기증자의 DNA와 동일한 서열을 얻었습니다. 최종 조립체는 pUPEC271_donor과 비교되어 그림 3B에 표시되어 있습니다. 이 결과, 기증자에 존재하는 접합 플라스미드가 트랜스인커겐 균주로 이전되었음을 확인하였습니다. 기술 데이터는 표 9에 나와 있습니다.
균주 Blood_10_0913는 여러 플라스미드를 가진 균주의 예입니다. 이 샘플은 2008년부터 2013년 사이에 혈액에서 채취되었으며, 단기 시퀀싱 분석 결과 IncF와 IncY 두 개의 복제 물질이 발견되었습니다. 이 균주에 대한 PFGE 분석에서 각각 약 70kb와 110kb의 두 플라스미드가 확인되었습니다(그림 4A). 이는 나노포어 시퀀싱을 통해 확인되었으며, 각각 71,182 bp와 111,226 bp 크기의 두 조립체가 생성되었습니다. 저자들은 이 두 플라스미드를 pBlood_10_0913_1와 pBlood_10_0913_2로 명명했다(그림 4B). 그러나 조립체들은 접합 기계를 가진 플라스미드 단면에서 광범위한 서열 상동성(광범위한 상동성의 부분은 그림 4B에 강조됨)으로 인해 처음에는 원형화되지 못했다. 붕대47 을 사용해 생성된 실패한 조립 도면은 그림 4C에 나와 있습니다. 두 플라스미드의 완전한 조립은 짧은 리드(< 3000 bp) 서열의 공격적인 리드 컬링 후에야 가능했습니다.
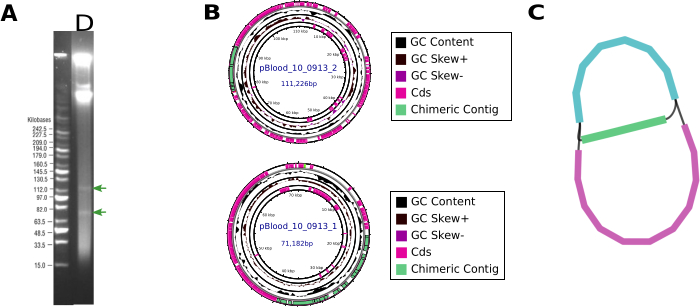
그림 4: Blood_10_0913 균주 플라스미드의 식별 및 조립. (A) PFGE. 초록색 화살표는 플라스미드 밴드를 나타냅니다. PFGE에 사용되는 프로토콜 은36 (B) 서열 조립에 설명되어 있습니다. pBlood_10_0913 샘플에 존재하는 두 개의 작은 플라스미드인 pBlood_10_0913_2와 pBlood_10_0913_2의 조립 과정. (C) 조립 실패. 두 개의 서로 다른 어셈블리 간에 공유 시퀀스가 존재하여 어셈블리 실패를 표현하는 방식. 이 표현은 Bandage47을 사용해 생성되었습니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭해 주세요.
보충표 1: pUPEC271이 운반하는 내성 유전자. pUPEC271과 관련된 플라스미드 크기, 레플리콘, 내성 유전자가 나타났습니다. 이 파일을 다운로드하려면 여기를 클릭해 주세요.
보조 지휘부. 이 파일을 다운로드하려면 여기를 클릭해 주세요.
토론
플라스미드의 식별 및 특성 분석은 공중보건, 임상 미생물학, 미생물 생태학에서 매우 중요한 과제로, 적응 유전자의 유지 및 확산을 생태 환경 전반에 촉진하고 가속화된 진화의 플랫폼 역할을 하기 때문입니다 1,5. NGS 기술의 도입으로 미생물 분리주와 집단 게놈의 고처리량 시퀀싱이 가능해졌으나, 완성된 플라스미드나 플라스미드 유래 컨티그의 조립 후 식별은 일반적으로 롱리드 서열이 필요한데, 이는 단독 시퀀싱 데이터가 리드 크기보다 큰 반복 영역을 해독하지 못하기 때문입니다. ONT는 전체 유전체 시퀀싱과 메타게노믹스를 넘어 플라스미드 서열 검증, 후생유전학적 변형의 검출 및 특성화, RNA 시퀀싱, 그리고 탠덤 유전자 배열의 내재적 불안정성 평가(12,49에서 검토됨)를 포함하는 매우 인기 있는 장기 독기 시퀀싱 접근법으로 자리 잡았습니다.
여기서 연구진은 염색체 서열이 이미 알려져 있거나 관심 없는 상황을 위해 설계된 플라스미드 ONT 시퀀싱 워크플로우를 제시합니다. 그 이유는 플라스미드 추출이 노동 집약적이고 비용이 많이 들며 시간이 많이 걸리기 때문입니다(숙주 집단을 배양 및 가공해야 하기 때문입니다). 그리고 나노포어 기술을 이용한 전체 유전체 시퀀싱만으로도 완전한 플라스미드 조립체를 얻으면서도 유전체적 맥락을 제공하는 데 충분하기 때문입니다. 프로토콜이 도움이 되는 예로는 플라스미드 유전공학맥락에서 플라스미드 서열 검증, WGS24에서 이미 얻은 플라스미드 서열의 정확도 향상, 임상 또는 환경 샘플에서 접합을 통해 포착된 플라스미드의 특성 규명 등이 있습니다.
임상 및 환경 샘플에서 DNA 추출은 일부 맞춤화가 필요할 수 있습니다. 여기서 저자들은 사용한 일부 임상 균주가 필터를 막는 바이오필름 매트릭스를 생성해 여러 번의 펠릿 부착 단계를 필요로 했고, 때로는 두 개의 필터를 추가해야 했다고 보고합니다. 또한, 접합 플라스미드를 시퀀싱하기 위해서는 다중 복제 플라스미드 시퀀싱에 비해 더 큰 배양 부피가 필요한데, 자연적으로 존재하는 중형 및 대형 플라스미드는 플라스미드 복제 번호2가 낮은 경향이 있기 때문입니다.
이 프로토콜은 4 kb에서 173 kb 크기의 플라스미드를 시퀀싱할 수 있게 했습니다. 이 범위는 제조사 사양(2에서 200kb 사이)에 정확히 부합합니다. 최근 NCBI에 침착된 23,000개의 플라스미드 서열을 조사한 연구에서는 출처에 따라 크기 차이가 크게 나타났으며, 인간기원의 플라스미드는 가장 작은 중간 크기(76 kb)를 가졌고, 토양과 식물 플라스미드는 각각 215 kb와 427 kb로 가장 컸습니다; 다른 모든 출처의 플라스미드는 중앙값이 79에서 147 kb 사이였으므로, 이 프로토콜은 대부분의 플라스미드를 포함할 수 있으며, 메가플라스미드52 와 토양 또는 식물 기원 플라스미드3을 제외하면 예외가 될 수 있습니다.
저자들은 플라스미드 DNA 농축 단계를 포함하여 플라스미드 DNA 조립체의 정확도를 높이고 있습니다. 대량의 염색체 DNA가 존재하면 시퀀싱 플로우 셀의 세포 구멍에 비표적 리드가 퍼져 플라스미드 DNA 깊이가 크게 감소합니다. 임상 샘플에서ARGs 24 검출을 위해 플라스미드 DNA 완전 조립을 시도하기 위해 플라스미드 DNA 농축 단계가 이미 시행되었습니다. 이 결과는 나노포어 단독 서열로 플라스미드 조립을 완료했을 때 효과가 크게 향상되었음을 보여주었습니다(벤치마크 대비 78% 완성). 이후50, 53, 54 등 다른 예시들도 있었습니다.
읽기 정확도를 높이기 위해 이 중 두 연구는 나노포어가 개발한 '의사쌍 리드에 대한 쌍 베이스콜링' 기법을 사용했습니다50,53. 이 방법은 동일한 DNA 분자의 센스 가닥과 안티센스 가닥에서 나오는 원시 전기 신호를 정렬하여 정확도가 약 100배 향상되는 것을 포함합니다. 의사쌍 리드에서의 쌍 염기호출은 같은 분자의 순방향 가닥과 역방향 가닥을 식별할 수 있는 전략이라면 다중화와 호환됩니다. 따라서 알려지지 않은 플라스미드 보체 샘플에서 정제되거나 플라스미드 혼합물이 포함된 플라스미드에는 사용할 수 없습니다. 유전체 내 플라스미드 수는 일반적으로 0에서 7 사이(특히 임상 분리주에서)로 범위를 가진다는 점에 유의하세요.
연구진은 샘플에서 높은 수준의 염색체 오염을 발견했습니다(표 10). 분석 대상 10개 샘플의 오염 수준은 리드 매핑에 따라 28%에서 72% 사이였습니다. 그러나 연구자들이 이 서열을 염색체 크기에 맞게 정규화했을 때, 플라스미드 서열이 염색체 서열보다 평균 144배 더 풍부하다는 사실이 밝혀졌습니다. 이 수치를 플라스미드 DNA 농축 수준으로 변환하려면 각 샘플 내 플라스미드 복사 수를 알아야 합니다.
MinION 플로우 셀은 일반적으로 ~30GB의 시퀀싱 출력을 생성하여, 이론적으로 한 번에 96개 이상의 플라스미드를 시퀀싱할 수 있습니다. 실제로 다중화는 96바코드 제한에 의해 제약받기 때문에, 플로우 셀당 실질적으로 96개의 플라스미드가 실질적인 상한선이 됩니다. 그러나 염색체 DNA 오염과 자연스러운 바코드 불균형은 샘플당 유효 읽기 깊이를 감소시킵니다. 각 샘플에 충분한 독독 깊이를 보장하기 위해 보다 보수적인 접근법은 플로우 셀당 약 24개의 플라스미드를 다중화하는 것입니다. 플라스미드 서열의 정확한 조립을 위한 권장 깊이는 50에서 70x32.56 사이입니다. 이 글에서 제시한 예시들에서, 저자들은 한 플로우 셀에서 21개의 다중화 샘플을 실행하여 평균 깊이(109x)를 얻었는데, 이는 플로우 셀별로 권장되는 샘플 최적값과 잘 일치합니다.
읽기 깊이가 과도할 경우, 통과/실패 읽기 파티션은 전체 읽기 품질 평가에 도움이 되지 않는다는 점에 유의하세요. 대신 길이 분포에서 도출된 지표는 데이터셋 품질을 더 명확하게 나타냅니다. 그 중 하나가 N50으로, 전체 염기의 50%를 차지하는 읽기 길이로 정의됩니다. 이 값은 품질 관리 단계에 매우 민감합니다. 예를 들어, Filtlong과 같은 도구로 저품질 또는 짧은 리드를 필터링하면 분포의 짧은 꼬리 부분의 상당 부분이 제거되어 N50이 부풀려집니다. 이 효과는 표 9에서 명확히 나타납니다.
저자들은 ONT의 Rapid Barcode 키트를 사용했는데, 이 키트는 트랜스포좀을 이용해 플라스미드 DNA를 분해하여 플라스미드의 제한 패턴에 대한 사전 지식이 필요하지 않습니다. 이전 연구에서는 소형 플라스미드(<20 kb)의 경우, 소플라스미드는 대부분의 DNA 추출 시 원형으로 남아 있어 어댑터 연결(adapter ligation 54)을 위한 자유 말단이 없기 때문에 효소 단절이 필요하다는 것을 발견했습니다. 그 연구는 PCR 증폭을 통해 추가 자유 말단을 생성하는 바코드를 사용하지 않았기 때문에, 이 경우에는 아마도 논쟁의 의미가 없을 것입니다. OnRamp는 일상적인 플라스미드 검증을 위한 고급 절차 중 하나로, 조립을 위해 전체 길이의 플라스미드 리드를 활용해 바코드 사용을 피하여 샘플 준비과정을 단순화합니다. 이 경우 저자들은 세 가지 이유로 바코드를 선호했습니다. 첫 번째는 플라스미드 길이와 상관없이 조립체를 만드는 것입니다. 두 번째는 염색체 DNA 오염을 견디는 것입니다. 세 번째는 앞서 언급한 대로 여러 샘플을 다중화할 수 있는 가능성을 열어준다는 점입니다.
이전 연구에서는 서로 다른 조립기의 집합이 개별 조립 플랫폼에 내재된 편향을 상쇄하여 최종 결과를 개선한다고 지적했다24. 이 메타분석은 저자들이 사용하는 어셈블리 프로그램인 Autocycler34에 통합된 기능입니다. 이전 버전인 트라이사이클러57에 비해 오토사이클러는 다소 더 자동화되어 있습니다; 읽기 중 여러 하위 집합을 사용하며, (앞서 언급했듯이) 여러 어셈블리를 사용해 더 정확한 합의 어셈블리를 만듭니다. 그러나 대부분의 조립자, 예를 들어 Flye28, Canu29, Raven30과 같은 최고의 조합기들조차도 광범위한 서열 상동성을 가진 플라스미드의 존재에 어려움을 겪거나, 잘못된 플라스미드 서열을 병합하거나, 단일 플라스미드의 여러 복제본을 생성하는 경우가 많으며, 작은 플라스미드58,59가 빠지는 경우가 많습니다(그림 4C 참조). 이럴 때 저품질 리드를 제거하고 짧은 리드를 제거하면 키메라 연결 문제를 해결할 수 있습니다.
시퀀싱 프로토콜의 전반적인 정확성을 확립하기 위해, 저자들은 ONT 전용 어셈블리와 롱리드와 숏리드를 결합해 다듬어진 어셈블리를 비교했는데, 이 어셈블리는 (PacBio 데이터를 제외하고) 현재 골드 스탠다드입니다. 저자들은 또한 플라스미드 수와 추정 크기를 보여주는 겔 데이터도 가지고 있었습니다(표 8, 세 번째 열). 연구진은 10개 샘플에서 발견된 13개의 플라스미드를 모두 성공적으로 조립했고, 조립된 서열과 일치하는 크기를 얻었습니다. 이는 매우 성공적인데, LR 서열 조립기는 구조적으로 복잡한 플라스미드를 조립하는 데 실패하는 경우가 많기 때문입니다. 더 세밀한 수준에서는 두 서열 집합 간의 쌍별 비교에서 정확도가 가변적임을 나타냈다(표 8). 플라스미드 조립체 중 다섯 개는 ONT 조립체에서 노출되지 않은 영역이 있었는데, 이는 ONT 전용 서열 조립 과정에서 추가된 서열 인공성 때문으로 추정됩니다. 나머지 7개 중 3개는 단일 염기체 다형성을 보였으며, 쌍별 차이는 0.0023%에서 0.05% 사이였고, 4개는 완벽한 일치를 보였다. 정확도 수준은 플라스미드 DNA 풍부도 수준이나 시퀀싱 깊이와 상관관계가 없으나, 한 샘플에 여러 플라스미드가 존재하면 상관관계가 있습니다. 이는 여러 플라스미드가 있을 경우 서열 복잡성이 증폭되기 때문일 수 있습니다(표 8). 요약하자면, 이 워크플로우는 플라스미드 서열 수율과 정확도를 최적화하도록 설계되었습니다. 플라스미드 서열을 조립할 수 있지만, 뉴클레오타이드 수준에서는 정확도가 변동적입니다. 이 프로토콜은 다양한 크기의 플라스미드를 시퀀싱할 수 있으며, 최소 72%의 염색체 DNA 오염을 견딜 수 있고, 플라스미드 크기와 플로우셀 상태에 따라 단일 플로우셀에 최소 24개의 플라스미드를 수용할 수 있습니다.
공개 사항
저자들은 공개할 것이 없습니다.
감사의 글
워싱턴 대학교의 스티브 살리판테가45년에 발표된 임상 대장균 균주를 아낌없이 공유해 주셔서 매우 감사드립니다. 이 연구는 UCSC에서 MC에 혁신 및 기업가 개발 이사직을 임명하기 위한 연구 지원 기금과, 캘리포니아 대학교 Alianza MX의 "멕시코 고부담 및 취약 인구 간 결핵 분리의 유전체 프로파일링: 전염 및 약물 내성에 대한 통찰"이라는 연구 지원 자금의 지원을 받았습니다.
재료
```html
```
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| 1.5 mL Eppendorf DNA LoBind tube | Sigma Aldrich | EP022431081 | 다른 브랜드로 교체 가능 |
| 1.5 mL tube racks | Thermo Fisher Scientific | 22-313630 | 다른 브랜드로 교체 가능 |
| 15 mL conical tubes | FALCON | 352096 | 다른 브랜드로 교체 가능 |
| 15 mL tube racks | Thermo Fisher Scientific | 8850 | 다른 브랜드로 교체 가능 |
| 2.0 mL microcentrifuge tubes | Fisherbrand | 05-408-138 | 다른 브랜드로 교체 가능 |
| 250 mL sterile flasks | PYREX | 5320 | 다른 브랜드로 교체 가능 |
| Carbenicillin | GOLD BIOTECHNOLOGY | C-103-50 | 다른 브랜드로 교체 가능 |
| Centrifuge | Eppendorf | 5424R-PR-R | 다른 브랜드로 교체 가능 |
| Centrifuge | Eppendorf | 5810R-P-R | 다른 브랜드로 교체 가능 |
| Centrifuge bottles | Sigma Aldrich | B1283-4EA | 다른 브랜드로 교체 가능 |
| Disposable Inoculating Loops: 1 μL | Fisherbrand | 22-363-595 | 다른 브랜드로 교체 가능 |
| Electronic Digital Scale | Denver Instrument | APX-2001 | 다른 브랜드로 교체 가능 |
| Ethanol | Fisher Scientific | 04-355-720 | 다른 브랜드로 교체 가능 |
| Ethanol-resistant markers | Sharpie | 37001; 37002; 37003 | 다른 브랜드로 교체 가능 |
| Flow cell (R10.4.1) | Oxford Nanopore Technologies | FLO-MIN114 | |
| Flow Cell Wash Kit | Oxford Nanopore Technologies | EXP-WSH004 | |
| Gloves | X-GEN | 44-100M | 모든 니트릴 장갑 브랜드 가능 |
| Ice bucket | Thermo Fisher Scientific | 432128 | 다른 브랜드로 교체 가능 |
| Isopropanol | Fisher Scientific | BP26184 | 다른 브랜드로 교체 가능 |
| MinION Sequencing Device | Oxford Nanopore Technologies | MIN-101B | |
| Native Barcoding Kit 96 V14 | Oxford Nanopore Technologies | SQK-NBD114.96 | |
| NucleoBond Xtra MIDI Plasmid DNA Extraction Kit | Takara | 740410.5 | |
| PCR tube racks | AXYGEN | R96PCRFSP | 다른 브랜드로 교체 가능 |
| PCR tubes: (0.2 mL) | AXYGEN | PCR-02-C | 다른 브랜드로 교체 가능 |
| Program autocycler v0.5.2 | Ryan Wick / University of Melbourne | ||
| Program bcftools v1.22 | Wellcome Sanger Institute (HTSlib / Samtools team) | ||
| Program bwa v0.7.19 | Heng Li, originally at the Broad Institute | ||
| Program canu v2.3 | University of California, Davis & Pacific Biosciences collaborators | ||
| Program flye v2.9.6 | University of California, San Diego (Pavel Pevzner lab) | ||
| Program medaka v2.1.1 | Oxford Nanopore Technologies | ||
| Program metamdbg v1.2 | INRIA | ||
| Program miniasm v0.3 | Heng Li | ||
| Program minimap2 v2.28 | Heng Li | ||
| Program minipolish v0.2.0 | Ryan Wick / University of Melbourne | ||
| Program porechop v0.2.4 | Ryan Wick / University of Melbourne | ||
| Program racon v1.5.0 | Genome Institute of Singapore | ||
| Program samtools v1.22.1 | Wellcome Sanger Institute (HTSlib / Samtools project) | ||
| Qubit® 4 Fluorometer | Invitrogen | Q33226 | |
| Qubit® Assay Tubes | Invitrogen | Q32856 | |
| Rapid Barcoding Kit 24 and 96 V14 | Oxford Nanopore Technologies | SQK-RBK114.96 | |
| Set of micropipettes that dispense between 1 – 10 μL (P10), 2 – 20 μL (P20), 20 – 200 μL (P200) and 200 – 1000 μL (P1000) | RAININ | 17008648; 17008650; 17008652; 17008653 | Micropipettes should be calibrated |
| Spectrophotometer | Thermo Scientific | 335905P | 다른 브랜드로 교체 가능 |
| Sterilized tips for 10 μL, 200 μL and 1000 μL | Eclipse | 1011-260-000-9; 1018-260-000; 1019-260-000-9 | |
| Thermal cycler C1000 Touch | Bio-Rad | 1851196 | 다른 브랜드로 교체 가능 |
| Water bath | Thermo Scientific | 51221052 | 다른 브랜드로 교체 가능 |
참고문헌
- Finks, S. S., Martiny, J. B. H. Plasmid-encoded traits vary across environments. mBio. 14 (1), e0319122(2023).
- Ramiro-Martinez, P., de Quinto, I., Lanza, V. F., Gama, J. A., Rodriguez-Beltran, J. Universal rules govern plasmid copy number. Nat Commun. 16 (1), 6022(2025).
- Redondo-Salvo, S., et al. Pathways for horizontal gene transfer in bacteria revealed by a global map of their plasmids. Nat Commun. 11 (1), 3602(2020).
- Rodriguez-Beltran, J., DelaFuente, J., Leon-Sampedro, R., MacLean, R. C., San Millan, A. Beyond horizontal gene transfer: the role of plasmids in bacterial evolution. Nat Rev Microbiol. 19 (6), 347-359 (2021).
- Castaneda-Barba, S., Top, E. M., Stalder, T. Plasmids, a molecular cornerstone of antimicrobial resistance in the one health era. Nat Rev Microbiol. 22 (1), 18-32 (2024).
- Robertson, J., Bessonov, K., Schonfeld, J., Nash, J. H. E. Universal whole-sequence-based plasmid typing and its utility to prediction of host range and epidemiological surveillance. Microb Genom. 6 (10), (2020).
- Conlan, S., et al. Single-molecule sequencing to track plasmid diversity of hospital-associated carbapenemase-producing Enterobacteriaceae. Sci Transl Med. 6 (254), 254ra126(2014).
- Zankari, E., et al. Identification of acquired antimicrobial resistance genes. J Antimicrob Chemother. 67 (11), 2640-2644 (2012).
- Eyre, D. W., et al. WGS to predict antibiotic MICs for Neisseria gonorrhoeae. J Antimicrob Chemother. 72 (7), 1937-1947 (2017).
- Arredondo-Alonso, S., Willems, R. J., van Schaik, W., Schurch, A. C. On the (im)possibility of reconstructing plasmids from whole-genome short-read sequencing data. Microb Genom. 3 (10), e000128(2017).
- Rhoads, A., Au, K. F. PacBio sequencing and its applications. Genomics Proteomics Bioinformatics. 13 (5), 278-289 (2015).
- Zhang, T., et al. Nanopore sequencing: flourishing in its teenage years. J Genet Genomics. 51 (12), 1361-1374 (2024).
- González, A., Fullaondo, A., Odriozola, A. Why are long-read sequencing methods revolutionizing microbiome analysis? Microorganisms. 13 (8), (2025).
- Wick, R. R., Holt, K. E. Polypolish: Short-read polishing of long-read bacterial genome assemblies. PLoS Comput Biol. 18 (1), e1009802(2022).
- Delahaye, C., Nicolas, J. Sequencing DNA with nanopores: Troubles and biases. PLoS One. 16 (10), e0257521(2021).
- Watson, M., Warr, A. Errors in long-read assemblies can critically affect protein prediction. Nat Biotechnol. 37 (2), 124-126 (2019).
- De Maio, N., et al. Comparison of long-read sequencing technologies in the hybrid assembly of complex bacterial genomes. Microb Genom. 5 (9), (2019).
- Lerminiaux, N., Fakharuddin, K., Mulvey, M. R., Mataseje, L. Do we still need Illumina sequencing data? Evaluating Oxford Nanopore Technologies R10.4.1 flow cells and the Rapid v14 library prep kit for Gram-negative bacteria whole genome assemblies. Can J Microbiol. 70 (5), 178-189 (2024).
- Dabernig-Heinz, J., et al. A multicenter study on accuracy and reproducibility of nanopore sequencing-based genotyping of bacterial pathogens. J Clin Microbiol. 62 (9), e0062824(2024).
- Sereika, M., et al. Oxford Nanopore R10.4 long-read sequencing enables the generation of near-finished bacterial genomes from pure cultures and metagenomes without short-read or reference polishing. Nat Methods. 19 (7), 823-826 (2022).
- Wick, R. R., Judd, L. M., Holt, K. E. Assembling the perfect bacterial genome using Oxford Nanopore and Illumina sequencing. PLoS Comput Biol. 19 (3), e1010905(2023).
- Paterson, D. L. Resistance in gram-negative bacteria: enterobacteriaceae. Am J Med. 119 (1), discussion S62-70 S20-S28 (2006).
- Peter, S., et al. Tracking of antibiotic resistance transfer and rapid plasmid evolution in a hospital setting by nanopore sequencing. mSphere. 5 (4), (2020).
- George, S., et al. Resolving plasmid structures in Enterobacteriaceae using the MinION nanopore sequencer: assessment of MinION and MinION/Illumina hybrid data assembly approaches. Microb Genom. 3 (8), e000118(2017).
- Dong, N., Yang, X., Zhang, R., Chan, E. W., Chen, S. Tracking microevolution events among ST11 carbapenemase-producing hypervirulent Klebsiella pneumoniae outbreak strains. Emerg Microbes Infect. 7 (1), 146(2018).
- Lemon, J. K., Khil, P. P., Frank, K. M., Dekker, J. P. Rapid nanopore sequencing of plasmids and resistance gene detection in clinical isolates. J Clin Microbiol. 55 (12), 3530-3543 (2017).
- Linde, J., et al. Comparison of Illumina and Oxford Nanopore Technology for genome analysis of Francisella tularensis, Bacillus anthracis, and Brucella suis. BMC Genomics. 24 (1), 258(2023).
- Bickhart, D. M., et al. Generating lineage-resolved, complete metagenome-assembled genomes from complex microbial communities. Nat Biotechnol. 40 (5), 711-719 (2022).
- Koren, S., et al. Canu: scalable and accurate long-read assembly via adaptive k-mer weighting and repeat separation. Genome Res. 27 (5), 722-736 (2017).
- Vaser, R., Sikic, M. Time-and memory-efficient genome assembly with Raven. Nat Comput Sci. 1 (5), 332-336 (2021).
- Lynch, M. D., Neufeld, J. D. Ecology and exploration of the rare biosphere. Nat Rev Microbiol. 13 (4), 217-229 (2015).
- Kruasuwan, W., et al. Comparative evaluation of commercial DNA isolation approaches for nanopore-only bacterial genome assembly and plasmid recovery. Sci Rep. 14 (1), 27672(2024).
- Ulrich, J. U., et al. Nanopore adaptive sampling effectively enriches bacterial plasmids. mSystems. 9 (3), e0094523(2024).
- Wick, R. R., Howden, B. P., Stinear, T. P. Autocycler: long-read consensus assembly for bacterial genomes. Bioinformatics. 41 (9), (2025).
- NucleoBond Xtra Plasmid DNA Purification User Manual. , Takara Bio USA. Available from: https://www.takarabio.com/documents/User%20Manual/NucleoBond%20Xtra%20Plasmid%20DNA%20Purification%20User%20Manual_Rev_15.pdf?srsltid=AfmBOorkdYVlr34yclNUgmBCn4imrn-gbvTafmkD2Yrnnch6fH-K_VwZ (2019).
- Mota-Bravo, L., et al. Detection of horizontal gene transfer mediated by natural conjugative plasmids in E. coli. J Vis Exp. (193), (2023).
- Hancock, V., Witso, I. L., Klemm, P. Biofilm formation as a function of adhesin, growth medium, substratum, and strain type. Int J Med Microbiol. 301 (7), 570-576 (2011).
- Hung, C., et al. Escherichia coli biofilms have an organized and complex extracellular matrix structure. mBio. 4 (5), e00645-e00713 (2013).
- Qubit 4 assays quick reference (Pub. No. MAN0017210 C.0). , Thermo Fisher Scientific. (2025).
- Rapid barcoding sequencing kit 96 v14. , Oxford Nanopore Technologies. Available from: https://store.nanoporetech.com/us/rapid-barcoding-sequencing-kit-96-v14.html (2026).
- Schwengers, O., et al. Bakta: rapid and standardized annotation of bacterial genomes via alignment-free sequence identification. Microb Genom. 7 (11), (2021).
- Seemann, T. Prokka: rapid prokaryotic genome annotation. Bioinformatics. 30 (14), 2068-2069 (2014).
- Singh, H., et al. Integrons: the hidden architects of bacterial adaptation, evolution, and the challenges of antimicrobial resistance. Antonie Van Leeuwenhoek. 118 (7), 90(2025).
- Redondo-Salvo, S., et al. COPLA, a taxonomic classifier of plasmids. BMC Bioinformatics. 22 (1), 390(2021).
- Salipante, S. J., et al. Large-scale genomic sequencing of extraintestinal pathogenic Escherichia coli strains. Genome Res. 25 (1), 119-128 (2015).
- Couturier, A., et al. Real-time visualisation of the intracellular dynamics of conjugative plasmid transfer. Nat Commun. 14 (1), 294(2023).
- Wick, R. R., Schultz, M. B., Zobel, J., Holt, K. E. Bandage: interactive visualization of de novo genome assemblies. Bioinformatics. 31 (20), 3350-3352 (2015).
- Grant, J. R., et al. Proksee: in-depth characterization and visualization of bacterial genomes. Nucleic Acids Res. 51 (W1), W484-W492 (2023).
- MacKenzie, M., Argyropoulos, C. An Introduction to nanopore sequencing: past, present, and future considerations. Micromachines (Basel). 14 (2), (2023).
- Emiliani, F. E., Hsu, I., McKenna, A. Multiplexed assembly and annotation of synthetic biology constructs using long-read nanopore sequencing. ACS Synth Biol. 11 (7), 2238-2246 (2022).
- Brown, S. D., Dreolini, L., Wilson, J. F., Balasundaram, M., Holt, R. A. Complete sequence verification of plasmid DNA using the Oxford Nanopore Technologies' MinION device. BMC Bioinformatics. 24 (1), 116(2023).
- Hall, J. P. J., Botelho, J., Cazares, A., Baltrus, D. A. What makes a megaplasmid? Philos Trans R Soc Lond B Biol Sci. 377 (1842), 20200472(2022).
- Brown Kav, A., Benhar, I., Mizrahi, I. A method for purifying high-quality and high-yield plasmid DNA for metagenomic and deep sequencing approaches. J Microbiol Methods. 95 (2), 272-279 (2013).
- Mumm, C., et al. Multiplexed long-read plasmid validation and analysis using OnRamp. Genome Res. 33 (5), 741-749 (2023).
- Balbuena-Alonso, M. G., et al. Genomic analysis of plasmid content in food isolates of E. coli strongly supports its role as a reservoir for the horizontal transfer of virulence and antibiotic resistance genes. Plasmid. 123-124, 102650(2022).
- Zhao, W., et al. Oxford nanopore long-read sequencing enables the generation of complete bacterial and plasmid genomes without short-read sequencing. Front Microbiol. 14, 1179966(2023).
- Wick, R. R., et al. Trycycler: consensus long-read assemblies for bacterial genomes. Genome Biol. 22 (1), 266(2021).
- Johnson, J., Soehnlen, M., Blankenship, H. M. Long read genome assemblers struggle with small plasmids. Microb Genom. 9 (5), (2023).
- Boostrom, I., Portal, E. A. R., Spiller, O. B., Walsh, T. R., Sands, K. Comparing long-read assemblers to explore the potential of a sustainable low-cost, low-infrastructure approach to sequence antimicrobial resistant bacteria with Oxford Nanopore sequencing. Front Microbiol. 13, 796465(2022).
재인쇄 및 허가
