실험적 뇌말라리아(ECM)는 신경염증과 혈액-뇌 장벽 기능 장애를 일으킵니다. GSE162535를 사용하여 이 재현 가능한 R 기반 RNA-seq 워크플로우는 대조(CB), ECM(MB), ARTESUNATE 처리(AB) 뇌를 비교하여 QC, PCA, DESeq2 분석을 수행합니다. ECM 유발 전사 변화를 규명하고, 아르테산산 매개 염증 및 신경혈관 경로 조절을 평가합니다.
이 콘텐츠를 보려면 JoVE 구독이 필요합니다. 로그인하거나 오늘 무료 평가판을 시작하세요.
방법 논문
DESeq2를 이용한 실험적 뇌말라리아 뇌 조직에서 아르테산산 관련 전사체 이동을 정량화하는 계산 프로토콜
* These authors contributed equally
이 논문에서
요약
초록
RNA 시퀀싱(RNA-seq)은 질병 관련 전사 프로그램을 정의하는 데 널리 사용되지만, 실험군 간 재현 가능한 비교를 보장하고 생물학적으로 해석 가능한 결과를 촉진하기 위해서는 일관된 종단 간 워크플로우가 필요합니다. 여기서는 실험적 뇌말라리아(ECM)에서 뇌 전사체 변화를 평가하고 아르테산산 치료 후 공공 데이터셋 GSE162535을 활용한 완전한 RNA-seq 분석 프로토콜을 제시합니다. 이 워크플로우는 HTSeq 계수 매트릭스에서 시작하여 대조 뇌(CB), ECM 뇌(MB), 아르테산산 처리 ECM 뇌(AB) 세 그룹을 분석합니다. 원시 카운트를 가져오고 포맷한 후, 프로토콜은 CB를 기준 수준으로 하는 DESeq2 데이터셋을 구성하고, 저수 유전자를 필터링하며, 라이브러리 크기 시각화, 주성분 분석, 샘플 거리 클러스터링을 통해 품질 관리를 수행합니다. 이후 세 가지 주요 대조(MB 대 CB, AB vs MB, AB vs CB)에 대해 차별 발현을 계산하며, log² 변화 축소를 적용하여 안정적인 효과 규모 추정을 수행합니다. 프로토콜은 완전하고 유의미한 차별 발현 표를 내보내고, 화산 플롯과 MA 플롯을 생성하며, 가장 변이가 큰 유전자와 대조별 상위 차별 발현 유전자의 히트맵을 생성합니다. 기전적 해석을 지원하기 위해 워크플로우에는 표적 면역 마커 추출(예: 사이토카인, 케모카인, 미소아교세포 활성화 마커, BBB/내피 유전자)이 포함되며, 유전자 온톨로지 및 KEGG 풍부화 분석을 수행하여 유전적 상향 및 하향 유전자 집합에 대해 수행합니다. 이 프로토콜은 ECM 관련 신경염증 전사 프로그램을 특성화하고 아르테산염 관련 신호 조절을 정량화하는 재현 가능한 템플릿을 제공합니다.
서론
뇌말라리아(CM)는 Plasmodium falciparum 감염의 생명을 위협하는 신경학적 합병증으로, 사례 관리의 발전에도 불구하고 말라리아 사망률의 주요 원인으로 남아 있습니다. CM은 급성 뇌병증, 미세혈관 기능 장애, 내피 활성화, 혈액-뇌 장벽(BBB) 장애가 특징이며, 혼수상태에 이를 수 있는 하류 신경염증과 생존자 중 지속적인 신경인지 후유증1. CM의 병인기는 다인자이며, 숙주 염증 반응이 신경혈관 경계에서 기생충 및 숙주 유래 인자와 상호작용하여 임상 평가 지표만으로 인과기전을 추론하기 어렵습니다.
특히 C57BL/6 마우스에서 발생한 실험적 뇌말라리아(ECM) 모델은 통제된 환경에서 뇌 특이적 면역병리학, BBB 손상, 신경염증 신호 전달을 탐구할 수 있는 다루기 쉬운 플랫폼을 제공합니다 2,3. 이 모델들은 질병 단계에 걸친 세포 및 분자 반응 지도화와 부조적 개입 실험에 사용되었습니다 2,3. 그러나 ECM 병리생물학은 복잡하고 매우 역동적이기 때문에, 표적 분석은 여러 면역 및 신경혈관 프로그램에서 발생하는 조정된 경로 수준의 변화를 놓칠 수 있습니다.
아르테수네이트는 중증 말라리아에 권장되는 1차 경정구 치료제이며, 주요 근거 기준에서 퀴닌에 비해 상당한 생존 이점을 입증했습니다. 기생충 제거가 아르테산염 효능의 핵심이지만, 신경학적 결과는 기생충 감소와 염증 및 신경혈관 경로의 2차 조절을 모두 반영하는 것으로 보인다 1,4. 따라서 아르테미시닌 치료가 ECM 중 뇌 전사 프로그램을 어떻게 재구성하는지 이해하면 임상 효능 데이터를 보완하는 기전적 통찰을 제공하고 보조 신경보호 전략의 후보 경로를 식별할 수 있습니다.
RNA 시퀀싱(RNA-seq)은 질병 및 치료 상태에서 전사 반응을 편향 없이 전사하는 전사 전사 프로파일링을 가능하게 하여 차별 발현 분석과 후속 기능 해석을 지원합니다. NCBI 유전자 발현 옴니버스(GEO)와 같은 공개 저장소는 재현 가능한 재분석에 적합한 엄선된 데이터셋을 제공하며, 여기에는 대조 뇌(CB), ECM 뇌(MB), 아르테산염 처리 ECM 뇌(AB)에서 나온 뇌 RNA-seq가 포함된 GSE162535이 포함됩니다5. 이러한 데이터셋에서 재현 가능한 발견을 지원하기 위해서는 개수 기반 차별 발현을 위한 견고한 통계적 틀이 필요하며, 생물학적 경로와 과정의 관점에서 유전자 수준의 변화를 해석하는 풍부화 도구가 필요합니다.
본 연구는 대조군(CB), 실험적 뇌말라리아(MB), 아르테산염 처리군(AB) 그룹에 대한 뇌 조직 간 재현 가능한 종단 간 RNA-seq 분석 워크플로우를 제시합니다. 이 글의 새로움은 표준화된 DESeq2 기반 파이프라인에 있으며, 미리 정의된 생물학적 관련 대조(MB 대 CB, AB 대 MB, AB 대 CB), 엄격한 품질 관리 결과물(라이브러리 크기 평가, 주성분 분석, 샘플 거리 히트맵), 그리고 clusterProfiler 6,7을 이용한 유전자 온톨로지(GO) 및 KEGG 경로 풍부화를 통한 통합 하위 해석에 있습니다. 또한, 이 워크플로우는 구조화된 면역 패널 기반 해석을 구현하여 신경염증, 면역, 신경혈관 전사 반응의 체계적인 특성화를 가능하게 합니다. 통계적 엄밀성, 투명성, 출판 준비가 된 결과물을 결합함으로써, 이 프로토콜은 전임상 말라리아 연구에서 ECM 관련 전사체 조절 이상을 분석하고 치료 주도 조절을 평가하는 견고하고 재사용 가능한 틀을 제공합니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
프로토콜
이 연구는 공개된 RNA-seq 데이터를 활용하여 새로운 인간 또는 동물 실험을 포함하지 않았습니다. 따라서 윤리적 승인과 사전 동의는 필요하지 않았습니다(자료표).
1. 컴퓨팅 환경과 폴더 구조를 준비합니다
- 하드웨어 및 운영체제 설정
- 다운로드 및 출력 시 최소 8GB RAM(권장 16GB)과 ≥10GB 여유 디스크 공간이 있는 워크스테이션이나 노트북을 사용하세요.
- Windows 또는 macOS, Linux 중 R 패키지를 설치하고 작업 디렉터리에 파일을 쓰는 권한 있는 상태로 사용하세요.
- 필수 소프트웨어 설치
- R 설치(버전 4.2 이상). RStudio Desktop(권장)을 설치하면 워크플로우를 인터랙티브하게 실행하고 프로젝트 디렉터리를 관리하세요.
- 프로젝트 디렉터리와 출력 폴더를 생성하세요
- 분석을 위한 새 폴더(예: GSE162535_RNAseq_DESeq2)를 만드세요. 이 폴더를 R 작업 디렉터리로 설정하세요.
- 출력 폴더는 정확히 다음과 같이 생성하세요:
- 결과를 만들어내세요/. 결과를 만들어내고, 결과/표/를 만드세요.
- 필요한 R 패키지 설치
- CRAN 패키지를 설치하세요: tidyverse, pheatmap, 그리고 RColorBrewer. Bioconductor 패키지를 설치하세요: DESeq2, apeglm(선택 사항), clusterProfiler, org. Mm.eg.db.
- 스크립트 시작 시 필요한 패키지를 불러오세요: DESeq2, tidyverse, pheatmap, RColorBrewer, clusterProfiler, org. Mm.eg.db, 그리고 ggplot2. set.seed(123)를 실행하여 재현성을 위해 시드를 설정하세요.
- 데이터 무결성 및 개인정보 보호 장치를 적용하세요
- 다운로드 파일은 프로젝트 디렉터리에만 저장하세요. 환경에 민감하거나 금지된 데이터가 있다면 프로젝트 디렉터리 접근을 제한하세요. 워크플로우 마지막에 sessionInfo()를 결과/sessionInfo.txt로 내보내서 소프트웨어 버전을 기록하세요.
참고: 이 프로토콜은 공개된 RNA-seq 카운트 데이터를 실리코 내에서 분석하며 생물 표본을 다루지 않습니다.
- 다운로드 파일은 프로젝트 디렉터리에만 저장하세요. 환경에 민감하거나 금지된 데이터가 있다면 프로젝트 디렉터리 접근을 제한하세요. 워크플로우 마지막에 sessionInfo()를 결과/sessionInfo.txt로 내보내서 소프트웨어 버전을 기록하세요.
2. RNA-seq 계수 행렬을 얻고 실험 그룹을 정의한다
- GEO 데이터셋 파일을 다운로드하세요GSE162535
- GEO에서 GSE162535용 HTSeq count 파일을 다운로드하여 프로젝트 디렉터리에 GSE162535_All.HTSeq.counts.txt.gz 상태로 저장하세요. gzfile()와 read.delim()을 사용하여 파일이 오류 없이 열리는지 확인하여 파일 무결성을 확인하세요.
- HTSeq를 R에 적재하세요
- read.delim(gzfile(...), header = TRUE, check.names = FALSE, quote = "", comment.char = """"를 사용하여 압축된 카운트 테이블을 가져오세요. str(), head(), colnames()를 사용하여 가져온 객체를 검사하여 다음을 확인하세요:
- 첫 번째 열에는 유전자 식별자(예: AccID)가 포함되어 있습니다. 나머지 열에는 샘플 수준 카운트가 포함되어 있습니다.
- read.delim(gzfile(...), header = TRUE, check.names = FALSE, quote = "", comment.char = """"를 사용하여 압축된 카운트 테이블을 가져오세요. str(), head(), colnames()를 사용하여 가져온 객체를 검사하여 다음을 확인하세요:
- 데이터 유형을 표준화하고 중복된 유전자 식별자를 해소합니다
- 샘플 열을 유전자 식별자 열(AccID)을 제외한 모든 열로 정의합니다. 모든 샘플 열을 정수 개수로 강제하세요. 동일한 AccID를 공유하는 행 간 개수를 합산하여 중복된 유전자 식별자를 축소합니다.
- 접힌 테이블을 표준 데이터 프레임으로 변환하세요. 행 이름을 유전자 식별자로 설정하고 개수 행렬에서 식별자 열을 제거하세요.
- 카운트 행렬 구조를 검증하세요
- 카운트 매트릭스에 12개의 샘플 컬럼이 있는지 확인하세요. 샘플 열명이 AB_1..AB_4, CB_1..CB_4, MB_1.MB_4 형식을 따르는지 확인하세요.
- 카운트 행렬에 12열이 없으면 실행을 중지합니다.
- 샘플 메타데이터 생성 및 검증
- 다음 열을 포함하는 샘플 메타데이터 테이블(colData)을 생성하세요:
- 샘플: 카운트 행렬의 열 이름에 대응하는 고유 샘플 식별자입니다. 그룹: 각 샘플에 부여된 생물학적 상태.
- 유전자 발현 옴니버스(GEO)에서 데이터셋 GSE162535에 해당하는 샘플 주석을 검색하세요.
- GEO 입력 정보와 실험 상태를 설명하는 샘플 주석 필드를 사용하여 각 샘플 정체성을 검증합니다. 카운트 매트릭스 내 각 샘플 식별자를 검증된 GEO 주석에 매핑합니다.
- 검증된 각 샘플은 다음 그룹 중 하나에 할당합니다: 대조군(CB), 실험적 뇌말라리아뇌(MB), 또는 아르테산염 치료 실험적 뇌말라리아뇌(AB).
- 메타데이터 테이블을 샘플 순서가 카운트 매트릭스의 열 순서와 일치하도록 배열합니다.
- 메타데이터 테이블의 샘플 식별자를 카운트 매트릭스와 비교하여 1:1 대응 여부를 확인하세요. 그룹 변수를 인코딩하여 CB, MB, AB로 레벨을 정렬합니다.
- CB를 기준 수준으로 설정하여 대조 뇌 그룹을 후속 차별 발현 분석의 기준선으로 정의합니다.
- 메타데이터 테이블의 행 이름을 샘플 식별자와 동일하게 설정합니다.
참고:그룹 라벨은 카운트 행렬 내 샘플의 순서만으로 부여되지 않았습니다. 샘플 식별은 GEO 메타데이터와 입력 정보를 사용하여 독립적으로 검증된 후 표현 매트릭스와 정렬하여 재현성을 높이고 샘플 오분류 위험을 줄였습니다.
- 다음 열을 포함하는 샘플 메타데이터 테이블(colData)을 생성하세요:
3. DESeq2 데이터셋을 구성하고 기본 품질 관리를 수행합니다
- 카운트 행렬을 소독하세요
- 카운트 행렬의 누락된 값을 0으로 대체합니다. 열별 is.na() 요약을 사용하여 누락 값이 없음을 확인하세요.
- DESeq2 데이터셋을 생성하세요
- DESeqDataSetFromMatrix()를 사용하여 다음을 사용하여 DESeqDataSet을 생성합니다: countData = counts; colData = sample_info; 디자인 = ~ 그룹.
- 필터 저수 유전자
- 모든 샘플에서 총 수가 <10인 유전자는 dds <- dds[rowSums(counts(dds)) >= 10, ]를 사용해 제거합니다. 객체 요약을 출력하여 보유한 유전자 수를 기록하세요.
- 라이브러리 크기 평가하기
- 라이브러리 크기를 필터링된 카운트 행렬의 컬럼 합으로 계산합니다. 라이브러리 크기의 막대 표시를 생성해서 결과/그림/library_sizes.pdf로 저장하세요.
- 라이브러리 크기 플롯을 점검하여 연구 설계와 일치하지 않는 극단적인 시퀀싱 깊이를 가진 샘플이 없는지 확인하세요.
4. DESeq2를 실행하고 시각화용 변환 객체를 생성합니다
- DESeq2 모델 적합
- dds <- DESeq(dds)를 사용하여 차분식 모델링을 실행하세요. 모든 후속 결과 추출에 적합한 DDS 객체를 유지합니다.
- 변환된 표현식 행렬 생성
- rld <- rlog(dds, blind = FALSE)를 사용하여 정규화된 로그 변환을 계산합니다. 분산 안정화 변환을 vsd <- vst(dds, blind = FALSE)로 계산합니다. PCA, 클러스터링, 히트맵에는 rld와 vsd를 사용하세요.
참고: 그룹 의존적 분산 구조를 보존하기 위해 blind = FALSE를 사용하세요.
- rld <- rlog(dds, blind = FALSE)를 사용하여 정규화된 로그 변환을 계산합니다. 분산 안정화 변환을 vsd <- vst(dds, blind = FALSE)로 계산합니다. PCA, 클러스터링, 히트맵에는 rld와 vsd를 사용하세요.
5. PCA 및 샘플 간 거리 클러스터링을 이용한 전역 품질 관리 수행
- 주성분 분석(PCA) 생성
- plotPCA(rld, intgroup = "group", returnData = TRUE)를 사용하여 PCA를 계산합니다. PC1과 PC2에 대한 설명된 분산 비율을 추출합니다. ggplot2를 사용해 PC1과 PC2를 그래프 표시하고, 샘플 이름으로 점을, 그룹별로 색칠하세요.
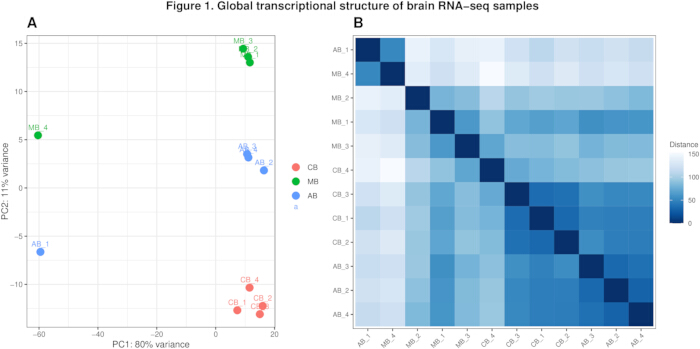
- PCA 플롯을 결과/그림/PCA_samples.pdf로 저장하세요. 생물학적 복제가 집단별로 이루어지며, 어떤 샘플도 예외로 분리되지 않는다는 것을 확인하세요.
- 샘플 거리 히트맵 생성
- dist(t(assay(vsd)))를 사용하여 쌍별 표본 거리를 계산합니다. 거리 객체를 시각화를 위해 행렬로 변환하세요. 각 샘플에 대한 그룹 인자를 포함하는 열 주석 표를 만드세요.
- pheatmap()으로 거리 행렬을 그려서 결과/fig/sample_distance_heatmap.pdf로 저장하세요. 샘플이 주로 그룹별로 집단화된다는 것을 확인해 주세요.
6. 세 가지 주요 대조에 대한 미분식 계산
- 대조를 정의하세요
- 질병 효과를 ECM 대 대조군으로 정의하세요: MB 대 CB. ECM 내 치료 효과를 아르테산염 처리 대 ECM: AB 대 MB로 정의합니다. 치료와 기저선을 아르테산트 치료 대 대조군으로 정의하세요: AB 대 CB.
- 로그2 접수-변형 수축을 포함한 DESeq2 결과를 추출합니다
- 결과(dds, contrast = c("그룹", 그룹A, 그룹B)를 사용하여 각 조영제에 대해 원시 결과를 추출합니다. lfcShrink(dds, contrast = c("그룹", 그룹A, 그룹B), res=res, type = "normal"을 사용하여 log2 접힘 변화를 수축합니다.
- 결과를 데이터 프레임으로 변환하고 유전자 식별자를 gene_id이라는 열로 저장하세요. 안정적인 보고를 위해 명목 p-값 순으로 결과를 정렬합니다.
- 각 전체 결과 표를 results/table/에 저장하세요:
- DESeq2_MB_vs_CB_all_genes.csv, DESeq2_AB_vs_MB_all_genes.csv, DESeq2_AB_vs_CB_all_genes.csv
참고: 패키지 구성으로 인해 축소가 실패하면, 로컬 설치에서 지원하는 대체 축소 유형으로 재실행하세요.
- DESeq2_MB_vs_CB_all_genes.csv, DESeq2_AB_vs_MB_all_genes.csv, DESeq2_AB_vs_CB_all_genes.csv
- 유의성 임계값을 정의하고 유의미한 유전자 집합을 내보내세요
- 조정 p-값(FDR) <0.05와 절대 log² 변화 ≥ 1을 사용하여 차별발현 유전자(DEG)를 정의합니다. 각 조영제를 필터링하여 조정된 p-값이 빠진 유전자를 제외하세요.
- 중요한 DEG 테이블을 결과/테이블/DESeq2_MB_vs_CB_sig.csv, 결과/테이블/DESeq2_AB_vs_MB_sig.csv, 결과/테이블/DESeq2_AB_vs_CB_sig.csv 내보내기
- 대조별로 DEG 카운트를 요약하세요
- 대조제당 유의자 수를 계산합니다. 요약 테이블을 결과/표/DE_summary_counts.csv로 저장하세요.
7. 각 대조별로 화산 플롯을 생성합니다.
- 화산 플롯 함수를 만드세요.
- 각 유전자에 대해 -log10(조정된 p-값)을 계산합니다. 각 유전자를 임계값으로 분류하세요: FDR < 0.05 및 |log2FC| ≥ 1.
- ggplot2를 사용해 log2FC(x축)와 -log10(FDR)(y축)을 그래프로 표시하세요. log2FC = ±1 그리고 -log10(0.05)에 점선 임계값선을 추가합니다.
- 수출 화산 플롯
- 각 그래프를 results/fig/: volcano_MB_vs_CB.pdf, volcano_AB_vs_MB.pdf, volcano_AB_vs_CB.pdf에 PDF로 저장하세요.
참고: 대비 전반에 걸쳐 일관된 축 제한을 사용하여 도형 간 시각적 비교를 지원하세요.
- 각 그래프를 results/fig/: volcano_MB_vs_CB.pdf, volcano_AB_vs_MB.pdf, volcano_AB_vs_CB.pdf에 PDF로 저장하세요.
8. 각 대조에 대해 MA 플롯 생성
- MA 플롯을 단일 PDF로 내보내세요.
- results/fig/MA_plots.pdf라는 PDF 기기를 열어보세요. plotMA는 plotMA()를 사용하여 각 원시 DESeq2 결과 객체에 대해 플롯 프로트를 만듭니다. 각 플롯에 대조 이름으로 라벨을 붙이세요. PDF 기기를 닫아.
9. 전역 변동성 및 대조 특이적 DE 유전자에 대한 발현 열맵 생성.
- 모든 샘플에서 상위 변이 유전자를 표시하세요.
- vsd 분석법 행렬에서 샘플 간 행별 분산을 계산합니다. 가장 변이가 큰 유전자 상위 100개를 선택하세요. 각 유전자를 샘플 간에 걸쳐 평균 중심 배치하세요.
- 표본 그룹 주석을 포함한 pheatmap()을 사용하여 히트맵을 생성합니다. 수치를 결과/그림/heatmap_top100_variable_genes.pdf로 저장하세요.
- 각 대조균에 대해 상위 차별발현 유전자를 그래프로 표시하세요.
- 각 조조제별로 조정된 p-값으로 상위 50개 유전자를 선택합니다. 유전자에 의해 VSD 발현 행렬과 평균 중심을 추출합니다. 각 콘트라스트별로 히트맵을 생성하고 다음 이름으로 저장하세요:
- 결과/그림/heatmap_top50_MB_vs_CB.pdf, 결과/그림/heatmap_top50_AB_vs_MB.pdf, 결과/그림/heatmap_top50_AB_vs_CB.pdf
참고: 행 라벨이 활성화되어 있다면 PDF 너비와 높이를 증가시키세요.
10. 표적 면역 지표 분석을 수행한다.
- 대조균 전반에 걸쳐 선택된 면역 유전자를 요약합니다.
- 면역 표지 집합을 정의하세요: Il6, Il1b, Il10, Tnf, Ifng, Il21, 그리고 Icam1. 각 조영 결과 표에서 log2FC, p-값, 조정 p-값을 추출합니다.
- 세 가지 대조 요약을 유전자 식별자별로 합치세요. 병합된 테이블을 결과/테이블/immune_genes_summary.csv로 저장하세요.
- 면역 지표 히트맵(rlog)을 생성하세요.
- 변형된 분석 매트릭스에 존재하는 면역 유전자를 식별합니다. 현재 면역 유전자에 대한 rlog 발현 기질을 추출합니다.
- 유전자에 의한 평균 중심 발현. 히트맵을 생성해서 결과/fig/heatmap_immune_genes.pdf에 저장하세요.
11. 기능 범주별 확장 면역 패널 분석 수행
- 면역 패널을 정의하세요.
- 면역 마커 패널을 다음과 같은 범주별로 정의하며, 여기에는 다음과 같은 유형이 포함됩니다: 염증성 사이토카인 및 인터페론 반응 유전자, 항염증 및 조절 유전자, 케모카인, 미세아교세포 활성화 마커, 성상교세포 마커, BBB 및 내피 활성화 마커, T 세포 마커 및 피로 마커, 단핵구/대식세포 마커, 보체 경로 유전자, 산화 스트레스 및 세포 사사 유전자.
- 각 조영제마다 면역 패널 DE 결과를 추출하세요.
- 유전자 기호에서 면역 범주로 매핑 테이블을 만드세요. 각 조영제 결과 표에서 면역 패널 유전자를 필터링하세요. 각 필터링된 결과 테이블에 카테고리 매핑을 연결하세요.
- 세 가지 조영구 특이적 면역 표를 하나의 표로 연결하세요. 합쳐진 테이블을 결과/테이블/immune_panels_DE_all_contrasts.csv로 저장하세요. 기밀 면역 패널 발현 열맵을 생성하세요.
- rld 분석기 매트릭스에 존재하는 면역 패널 유전자를 확인한다. 그림 내 패널 분류를 보존하기 위해 행 이름에 카테고리 라벨을 붙이세요. rlog 히트맵을 샘플 그룹 주석으로 표시하세요.
- 출력을 저장하세요.
- 저장된 이름: 결과/그림/heatmap_immune_panels_all.pdf, 결과/그림/heatmap_immune_panels_all.png
12. 면역 오버레이 화산 플롯 생성
- 면역 오버레이 화산 플롯을 만드세요.
- 면역 패널에 연결하여 각 조영 결과 표에 유전자를 면역성 또는 비면역성 또는 비면역으로 표시하세요. 비면역 유전자는 모두 회색 배경 포인트로 표시하세요. 전경에 면역 범주별로 색칠된 면역 유전자를 표시하세요. log2FC = ±1과 -log10(0.05)에 임계값 라인을 추가합니다.
- 면역 오버레이 화산 플롯을 내보내세요.
- MB와 CB 면역 오버레이 화산 플롯을 저장하세요:
- 결과/도표/volcano_MB_vs_CB_immune_overlay.pdf
- 결과/그림/volcano_MB_vs_CB_immune_overlay.png
- AB와 MB 면역 오버레이 화산 플롯을 저장하세요:
- 결과/도표/volcano_AB_vs_MB_immune_overlay.pdf
- 결과/그림/volcano_AB_vs_MB_immune_overlay.png
참고: 선별된 면역 유전자 패널이 미리 정의되어 기능 범주로 분류되었으며; 주석이 포함된 유전자 심볼의 전체 목록은 보충 표 S1에 제공되어 있습니다. 이 표는 투명성과 재현성을 보장하여 연구 전반에 걸쳐 패널 기반 분석의 직접 재사용과 검증을 가능하게 합니다.
- MB와 CB 면역 오버레이 화산 플롯을 저장하세요:
13. 기능 농축 분석 수행 (GO 및 KEGG)
- 풍부화를 위한 유전자 집합을 정의하세요
- 각 조영제(MB 대 CB, AB 대 MB)에 대해, 조정된 p-값 임계값 < 0.05와 절대 log₂ 폴드 변화 임계값 ≥ 1을 사용하여 유의미하게 차별발현된 유전자(DEG)를 추출합니다.
- DEG를 상향 조절 유전자(log₂FC > 0)와 하향 조절 유전자(log₂FC < 0)로 분리합니다.
- 배경(우주) 유전자 집합을 정의하세요
- DESeq2 데이터셋에서 카운트 필터링 후 유지된 모든 유전자를 배경 우주로 사용하세요. 필터링된 DESeq2 객체에서 유전자 심볼을 추출합니다. org를 이용한 bitr() 함수를 사용해 배경 유전자 기호를 Entrez 식별자로 변환하세요. Mm.eg.db.
참고: 일관된 배경 유전자 세트의 사용은 편향 없는 풍부 효과를 보장합니다.
- DESeq2 데이터셋에서 카운트 필터링 후 유지된 모든 유전자를 배경 우주로 사용하세요. 필터링된 DESeq2 객체에서 유전자 심볼을 추출합니다. org를 이용한 bitr() 함수를 사용해 배경 유전자 기호를 Entrez 식별자로 변환하세요. Mm.eg.db.
- 풍부분을 위한 유전자 식별자 지도
- bitr()를 사용하여 각 DEG 집합의 유전자 심볼을 Entrez 식별자로 변환합니다. REMAIN은 KEGG 농축을 위해 성공적으로 지도화된 유전자만 사용했습니다. 유전자 세트에 대한 풍부도 분석은 유전자 세트가 성공적으로 매핑되지 않았다면 건너뛰세요.
참고: 유전자 온톨로지(GO) 풍부화는 유전자 심볼을 사용하는 반면, KEGG 과도화는 Entrez 식별자를 필요로 합니다.
- bitr()를 사용하여 각 DEG 집합의 유전자 심볼을 Entrez 식별자로 변환합니다. REMAIN은 KEGG 농축을 위해 성공적으로 지도화된 유전자만 사용했습니다. 유전자 세트에 대한 풍부도 분석은 유전자 세트가 성공적으로 매핑되지 않았다면 건너뛰세요.
- 유전자 온톨로지(GO) 풍부화 수행 (생물학적 과정)
- enrichGO()를 사용해 GO 엔richment를 실행하고, OrgDb = org를 사용합니다. Mm.eg.db. KeyType = "SYMBOL" 및 온톨로지 (ont) = "BP"를 설정하세요. 유니버스를 DESeq2 데이터셋의 모든 필터링된 유전자 심볼로 지정합니다.
- 다중 테스트 보정을 위해 pAdjustMethod = "BH"를 사용하세요. pvalueCutoff = 0.05, qvalueCutoff = 0.05의 유의성 임계치를 적용합니다. 유전자 집합 크기를 minGSSize = 10, maxGSSize = 500으로 제한하세요.
- GO 풍부화 결과를 results/tables/ 디렉터리로 내보내세요. 상위 강화된 GO 항들의 막대 표시를 생성하고 결과/fig/에 저장하세요.
- KEGG 경로 농축 수행
- enrichKEGG()를 사용하여 유기체 = "mmu"로 KEGG 농축을 실행합니다. DEG 집합의 엔트레즈 식별자를 입력 유전자로 제공합니다. 맵에 표시된 Entrez 배경을 우주로 사용하세요.
- pAdjustMethod = "BH"를 적용합니다. pvalueCutoff = 0.05, qvalueCutoff = 0.05의 유의성 임계값을 사용하세요. 유전자 집합 크기를 minGSSize = 10, maxGSSize = 500으로 제한하세요.
- KEGG 풍부 테이블을 결과/테이블/로 내보내세요. 풍부해진 KEGG 경로의 바플롯을 생성하고 결과/fig/로 저장하세요.
참고: 유전자 지도 작성이 불충분할 경우 KEGG 농축이 결과를 반환하지 않을 수 있습니다; 이러한 경우는 워크플로우를 중단하지 않고 처리됩니다.
14. 면역 농축 분석 수행 (선택 모듈)
- 면역 특이적 유전자 집합 구성
- 엄선된 기능 범주를 기반으로 면역 패널 유전자를 정의합니다. DEG 리스트와 면역 패널 유전자를 교차시킵니다. 각 조영제별로 면역 특이적 DEG를 상향 조절과 하향 조절 세트로 나누었습니다.
- 면역 특이적 유전자 집합에 대한 농축을 수행하세요.
- 13조에 설명된 동일한 GO 및 KEGG 농축 절차를 적용하십시오. 동일한 배경 우주와 매개변수 설정을 사용하세요. "immune"이라는 라벨이 포함된 파일명으로 저장 출력을 저장하여 전역 농도 결과와 구분하세요.
15. 풍부 도트 플롯 생성 (선택 모듈)
- 농축 결과를 적재하세요.
- results/tables/ 디렉터리에서 GO 또는 KEGG 풍부 테이블을 가져오세요.
- 풍부도 지표를 변환하세요.
- GeneRatio 값을 분수 형식(x/y)에서 숫자 비율로 변환하세요. 시각화를 위해 −log₁₀(조정된 p-값)를 계산합니다.
- 점표를 생성하세요.
- 유전자 비율은 x축에, 풍부한 용어 설명은 y축에 배치합니다. 유전자 수에 따른 점 크기 스케일, 그리고 조정된 p값으로 −log₁₀로 색상을 표시합니다.
- 조정된 p-값 순위를 기준으로 상위 풍부 용어를 선택하세요. dot plot을 results/fig/ 디렉터리에 PDF와 PNG 파일로 저장하세요.
16. 세션 정보 저장 및 실행 완료
- 세션 정보 내보내기.
- sessionInfo() 출력을 결과로 저장하거나 sessionInfo.txt 문서에 저장하세요. R 버전과 패키지 버전입니다.
- 완료 확인
- 워크플로우가 생성되었는지 확인하세요: 결과/fig/의 수치, results/tables/의 표.
- 세 가지 주요 대비 출력이 존재하며 비어 있지 않은지 확인하세요: DESeq2_MB_vs_CB_all_genes.csv, DESeq2_AB_vs_MB_all_genes.csv, DESeq2_AB_vs_CB_all_genes.csv
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
결과
데이터 품질 평가 및 전사 체체 구조
12개의 뇌 샘플(CB, MB, AB; n=그룹당 4개)에서 RNA-seq 데이터가 표준화된 워크플로우를 사용해 처리되었습니다. 저수 유전자(총 ≥10개 유전자)를 필터링한 후, 데이터셋은 후속 분석을 위해 보존되었습니다. rlog 변환 카운트의 주성분 분석(PCA)은 실험 그룹별로 샘플이 분리되어 복제체가 그룹 내에서 일관되게 군집화되는 것을 보여주었습니다(그림 1A–B).
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
토론
본 연구는 미리 정의된 생물학적 대조를 넘어 대량 RNA-seq 데이터를 분석하기 위한 재현 가능한 DESeq2 기반 워크플로우를 제시합니다. 프로토콜은 표준화된 전처리, 검증된 메타데이터 할당, 정규화, 차별 발현 검사, 구조화된 하위 출력 기능을 통합하여 일관되고 투명한 전사체 결과를 생성할 수 있게 합니다. 분석 단계와 매개변수를 명시적으로 정의함으로써, 워크플로우는연구 6, 7, 11 간의 재현성과 비교 가능성을 향상시키도록 설계되었습니다.
워크플로우의 견고한 성능을 보장하기 위해서는 여러 단계가 매우 중요합니다. 첫째, 샘플 메타데이터를 유전자 발현 옴니버스(GEO) 주석과 비교해 검증함으로써 그룹 할당이 카운트 행렬 순서만으로만 추론되지 않도록...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
공개 사항
저자들은 상충하는 이해관계가 없습니다.
감사의 글
저자들은 아무런 인정도 하지 않았다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
재료
```html
```
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| clusterProfiler (R 패키지) | Bioconductor | RRID:SCR_016884 | 기능 강화 분석(GO 및 KEGG 경로) |
| DESeq2 (R 패키지) | Bioconductor | RRID:SCR_015687 | 카운트 기반 RNA-seq 데이터의 차등 발현 분석 |
| ggplot2 (R 패키지) | CRAN | RRID:SCR_014601 | PCA 플롯, 화산 플롯 및 요약 그림 시각화 |
| GitHub (선택 사항) | GitHub Inc. | RRID:SCR_002630 | 재현 가능한 스크립트의 버전 관리 및 공유 |
| HTSeq-count RNA-seq 데이터세트(GSE162535) | NCBI 유전자 발현 오미버스(GEO) | RRID:SCR_005012 | 분석을 위한 입력으로 사용되는 벌크 RNA-seq 카운트 매트릭스 |
| matrixStats (R 패키지) | CRAN | RRID:SCR_016361 | 행/열 통계(예: 분산)의 효율적인 계산 |
| openxlsx (R 패키지) | CRAN | RRID:SCR_019215 | 결과 테이블의 Excel 형식 내보내기 |
| 운영 체제 | Microsoft / Apple / Linux | N/A | Windows 10+, macOS 또는 Linux 지원 |
| org.Mm.eg.db (R 패키지) | Bioconductor | RRID:SCR_002815 | 유전자 ID 매핑을 위한 마우스 유전자 주석 데이터베이스 |
| PDF 뷰어 | 어느 것이든 | N/A | 출력 그림(PCA, 히트맵, 화산 플롯) 보기 |
| 개인용 컴퓨터 또는 워크스테이션 | 어느 것이든 | N/A | RNA-seq 분석을 위한 최소 16 GB RAM 권장 |
| pheatmap (R 패키지) | CRAN | RRID:SCR_016418 | 유전자 발현 및 클러스터링의 히트맵 시각화 |
| R 통계 소프트웨어(버전 ≥ 4.2) | R 통계 컴퓨팅 재단 | RRID:SCR_001905 | 모든 RNA-seq 분석의 핵심 컴퓨팅 환경 |
| RColorBrewer (R 패키지) | CRAN | RRID:SCR_015742 | 히트맵 및 플롯의 색상 팔레트 |
| RStudio Desktop | Posit 소프트웨어 | RRID:SCR_000432 | 스크립팅 및 재현성을 위한 통합 개발 환경(IDE) |
| 샘플 메타데이터 파일(CSV 형식) | 생성됨 / GEO 주석 | N/A | 샘플을 CB, MB 및 AB 그룹에 연결하는 큐레이트된 샘플 주석 |
| stringr (R 패키지) | CRAN | RRID:SCR_019195 | 강화 시각화 및 포맷팅을 위한 문자열 처리 |
| tibble (R 패키지) | CRAN | RRID:SCR_019186 | 데이터 프레임 처리 및 깔끔한 데이터 구조 |
| tidyverse (R 패키지 제품군) | CRAN | RRID:SCR_019186 | 데이터 조작, 변환 및 시각화 |
참고문헌
- Storm J, Craig AG. Pathogenesis of cerebral malaria—inflammation and cytoadherence. Front Cell Infect Microbiol. 2014;4:100.
- Hinduja S, Kunieda M. Modelling of ECM and EDM processes. CIRP Annals. 2013 Jan 1;62(2):775–97.
- Soares SMA, Gualberto ACM, da Costa AC, Gonçalves DA, Gameiro J. A high-fat diet protects C57BL/6 mice from Plasmodium berghei ANKA infection in an experimental malaria study. Front Trop Dis. 2023;4:1188902.
- Manzoni G, Try R, Guintran JO, Christiansen-Jucht C, Jacoby E, Sovannaroth S, Zhang Z, Banouvong V, Shortus MS, Reyburn R, Chanthavisouk C. Progress towards malaria elimination in the Greater Mekong Subregion: perspectives from the World Health Organization. Malaria Journal. 2024 Mar 1;23(1):64.
- Wang Q, Tang Y, Pan Z, Yuan Y, Zou Y, Zhang H, et al. RNA-seq-based transcriptome analysis of the anti-inflammatory effect of artesunate in early treatment of a mouse cerebral malaria model. Mol Omics. 2022;18(8):716–30.
- Love MI, Huber W, Anders S. Moderated estimation of fold change and dispersion for RNA-seq data with DESeq2. Genome Biol. 2014;15(12):550.
- Anders S, Huber W. Differential expression analysis for sequence count data. Genome Biol. 2010;11(10):R106.
- Robinson MD, McCarthy DJ, Smyth GK. edgeR: a Bioconductor package for differential expression analysis of digital gene expression data. bioinformatics. 2010 Jan 1;26(1):139-40.
- McCarthy DJ, Chen Y, Smyth GK. Differential expression analysis of multifactor RNA-Seq experiments with respect to biological variation. Nucleic Acids Res. 2012;40(10):4288–97.
- Conesa A, Madrigal P, Tarazona S, Gomez-Cabrero D, Cervera A, McPherson A, et al. A survey of best practices for RNA-seq data analysis. Genome Biol. 2016;17:13.
- Yu G, Wang LG, Han Y, He QY. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284–7.
- Hänzelmann S, Castelo R, Guinney J. GSVA: gene set variation analysis for microarray and RNA-seq data. BMC Bioinformatics. 2013 Jan 16;14(1):7.
- Shen-Orr SS, Gaujoux R. Computational deconvolution: extracting cell type–specific information from heterogeneous samples. Curr Opin Immunol. 2013;25(5):571–8.
- Subramanian A, Tamayo P, Mootha VK, Mukherjee S, Ebert BL, Gillette MA, et al. Gene set enrichment analysis: a knowledge-based approach for interpreting genome-wide expression profiles. Proc Natl Acad Sci U S A. 2005;102(43):15545–50.
- Stark R, Grzelak M, Hadfield J. RNA sequencing: the teenage years. Nat Rev Genet. 2019;20(11):631–56.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
재인쇄 및 허가
이 논문이 게재되었습니다
동영상 곧 제공