본 논문은 고정밀도 및 고정확도의 데이터와 재현 가능한 결과를 얻기 위해 하드웨어 및 디스플레이 선택, 실험실 설정, 피험자 관리, 보정 및 검증, 온라인 품질 관리, 그리고 전처리(이벤트 검출 및 드리프트 보정)를 포함하여 인간의 읽기 실험에서 고정밀 안구 추적 데이터를 수집하기 위한 단계별 프로토콜을 제시합니다.
이 논문에서
요약
초록
안구 추적(Eye tracking)은 읽기 과정 중의 주의력과 언어 처리 과정을 연구하기 위한 핵심적인 방법론적 접근 방식입니다. 결과의 타당성과 재현성은 데이터 품질, 명확한 방법론, 그리고 일관된 전처리에 달려 있습니다. 본 논문은 읽기 연구에서 고품질의 안구 추적 데이터를 수집하기 위한 포괄적인 단계별 프로토콜을 제시합니다. 프로토콜은 실험실 환경 준비 및 장비 설정으로 시작하여, 안구 추적 하드웨어와 소프트웨어의 선택 및 구성, 그리고 자극 준비와 실험 설계 순으로 진행됩니다. 피험자 관리, 고지된 동의, 그리고 언어적 및 심리 측정적 특성의 문서화가 수행됩니다. 이후 보정(Calibration) 및 검증(Validation) 절차가 진행되며, 데이터 수집 과정 동안 피험자의 편안함과 데이터 품질을 온라인으로 면밀히 모니터링합니다. 전처리 파이프라인에는 표준 형식의 로우 데이터 내보내기, 데이터 정제, 그리고 명확하게 정의된 파라미터를 이용한 고정(fixation) 및 사카드(saccade) 탐지(속도 기반 및 분산 기반 알고리즘 적용), 신호 손실 및 노이즈 제어를 위한 시각적 검사, 다행 텍스트를 위한 수직 드리프트 보정, 그리고 표준 읽기 측정치(고정 시간, 사카드 지표, 단어 건너뛰기 및 회귀율)의 추출이 포함됩니다. 프로토콜 전반에 걸쳐 연구 질문과 하드웨어 사양 간의 일치, 정기적인 점검을 통한 드리프트 관리, 그리고 모든 중요한 파라미터와 결정 사항에 대한 상세한 보고가 특히 강조됩니다. 성공적인 데이터 수집은 일반적으로 설정된 범위 내의 안정적인 검증 정확도, 낮은 데이터 손실률, 그리고 단어 길이, 빈도 및 예측 가능성과 관련된 잘 알려진 효과를 재현하는 해석 가능한 고정 시간 및 사카드 행동 분포로 나타납니다. 본 프로토콜은 데스크톱 안구 추적기, 일반적인 소프트웨어 환경, 그리고 머리 고정 및 비고정 배치 모두와 호환되며, 조명 조건, 안경 반사, 피험자의 자세 변화와 같은 실질적인 문제들을 다룹니다. 본 연구는 방법론적 지침을 통합된 워크플로우로 정리한 명확하고 실용적인 프로토콜을 제시합니다. 이는 읽기 연구에서 신뢰할 수 있는 안구 추적 데이터 수집을 지원하고, 재현성과 메타 분석을 촉진하며, 실험실 및 연구 그룹 간의 일관성을 높여 궁극적으로 읽기 연구의 과학적 신뢰성을 강화하는 것을 목표로 합니다.
서론
시선 추적은 읽기 과정 중의 주의력과 언어 처리 과정을 연구하는 핵심 방법으로, 고정과 도약 안구 운동은 자극에 대한 시각적 및 인지적 자원의 순간적인 할당 상태를 나타냅니다. 고전 및 현대의 리뷰 논문들은 안구 운동과 지각 범위, 미리보기 이점, 안구 운동 제어 모델과 같은 이론적 개념 사이의 견고한 연관성을 기록하고 있습니다1,2. 이러한 연관성을 조사하는 신뢰할 수 있는 연구를 수행하기 위해서는 장비 선택, 실험 설계, 보정 및 검증, 그리고 전처리 과정에서의 방법론적 엄격함이 필수적입니다. 그렇지 않으면 데이터 품질 저하로 인해 추정치에 편향이 생기고 재현성이 훼손될 수 있습니다3.
지난 10년 동안 여러 입문서와 모범 사례 논문들이 해당 분야의 방법론적 지식을 통합해 왔습니다. 최근의 기초 시리즈는 이론과 측정치를 연결하고, 조작화 및 알고리즘 변동성을 논의하며, 특정 연구 질문에 적합한 시선 추적기 선택을 위한 지침을 제공합니다4,5,6,7,8. 상호 보완적인 가이드라인은 하드웨어 선택, 정확도 및 정밀도 확보, 측정치 정의, 결과 보고에 관한 모범 사례를 제시하며, 타당도 저해 요인을 줄이기 위한 권장 사항을 포함하고 있습니다9. 읽기 연구를 위한 입문 자료 또한 실험 설계, 일반적인 측정치 및 분석 파이프라인에 대한 접근하기 쉬운 개요를 제공합니다10,1. 응용 언어학과 읽기 분야의 영역별 리뷰 논문들은 측정치와 추적기의 선택 과정을 요약하고 과제 의존적 제약 사항을 강조하고 있습니다12,13,14,15,16,17.
본 논문은 해당 지침을 읽기 연구에서의 고정밀 시선 추적 데이터 수집을 위한 단계별 프로토콜로 변환하여 제시합니다. 광범위하고 이론적인 최적 실무 지침을 제공하거나 특정 분석 기법에만 좁게 집중하는 기존 자료들과 달리, 본 프로토콜은 이러한 개념들을 종단적이고 실행 가능한 워크플로우로 구체화하였습니다. 본 프로토콜의 목적은 구체적이고 순차적인 지침을 제공함으로써 일상적인 실험실 실무를 용이하게 하는 것입니다. 적용 가능성 측면에서, 본 프로토콜은 머리 고정 장치(턱 또는 이마 받침대)가 포함된 고주파 데스크톱 기반 시선 추적기(예: 50-200 Hz)를 사용하는 엄격하게 제어된 실험실 읽기 실험에 최적화되어 있습니다. 따라서 정밀한 단어 수준의 고정이나 세밀한 사카드 지표를 분석하는 연구와 같이 엄격한 데이터 품질 제약, 높은 공간 정확도 및 정밀도가 요구되는 연구에 가장 적합합니다.
독서 연구를 포함하여 헤드프리(head-free) 또는 자연스러운 설정의 사용이 인기를 얻고 있으나, 본 논문에서는 범위를 실험실 연구로 한정합니다. 여기서는 하드웨어 및 소프트웨어 선택, 실험실 설정, 자극 준비, 피험자 관리, 캘리브레이션 및 검증, 온라인 품질 관리, 그리고 전처리(이벤트 검출 및 드리프트 보정 포함)를 다룹니다. 본 프로토콜을 따름으로써 연구자들은 현재의 표준과 일치하는 데이터 품질을 기록하고 달성할 수 있으며, 이를 통해 독서 관련 연구 결과의 투명성, 신뢰성 및 재현성을 향상시킬 수 있습니다.
프로토콜
COST CA2131 데이터 수집에 대한 윤리 승인은 폴란드 야기에워 대학교 철학부 연구윤리위원회로부터 프로토콜 번호 21.0042.18_2024로 부여받았습니다. 모든 참여자로부터 고지된 동의를 얻었습니다.
1. 실험실 환경 준비 및 장비 설정
- 실험 환경 준비
- 조명 및 환경 소음 조건을 확인합니다. 실험실 환경의 창문은 갑작스러운 동공 확장 변화를 일으키거나 시선 추적 카메라와 모니터에 빛 반사를 유발할 수 있습니다. 가능하다면 창문이 없는 방에서 데이터를 수집하거나 암막 커튼을 사용하여 햇빛을 차단하십시오. 인공 조명을 사용하고 반사 광원은 제거합니다. 모니터에 반사가 나타나지 않는지 확인하고, 반사가 없을 때까지 블라인드나 각도를 조정하십시오. 방이 조용하게 유지되도록 하고 방해 요소가 없도록 조치합니다(예: 안내 표지판 설치, 문 잠금). 외부 신호를 사용하여 방해를 방지하십시오(예: 문 밖에 “실험 진행 중입니다. 노크를 하거나 입실하지 마십시오.”라는 표지판 부착).
- 물리적 인체공학적 조건을 확인합니다. 회전하지 않는 안정적인 의자를 사용하십시오. 자세를 유지하고 의자 회전으로 인한 캘리브레이션 손실을 방지하기 위해 (조절이 가능한 경우) 테이블 높이를 조정하십시오.
- 사회적 실재감을 배제합니다. 동일한 공간에 실험자가 있으면 참가자가 주의를 분산될 수 있습니다. 사회적 실재감 효과를 최소화하기 위해 제어실을 참가자 방과 분리하거나 시야 밖으로 유지하십시오.
- 공기 환기를 확인합니다. 실험 세션 전후로 환기를 실시하십시오. 참가자가 일정 시간 동안 정지 상태를 유지해야 하므로 실내 온도를 확인하십시오.
- 시선 추적 장비 선택
- 연구 목표와 측정 항목 간의 호환성을 확인합니다. 특정 연구의 목표, 즉 대상 측정 항목(종속 변수)은 시선 추적 장비의 성능과 일치해야 합니다. 기관에서 보유한 장비의 가용성에 따라 의도한 연구 범위에 제한이 생길 수 있습니다. 시선 추적 시스템의 세 가지 주요 구성 특성(샘플링 속도, 정밀도, 정확도)과 연구 요구 사항 충족 가능성을 확인하십시오. 핵심은 시선 추적 장비의 성능이 연구 목표와 호환되는지 확인하는 것입니다.
참고: 샘플링 속도(Sampling rate) = 샘플링 속도는 Hz로 표시되며, 일정 기간 동안 시선 추적기가 수집하는 샘플의 크기를 나타냅니다. 60 Hz 시선 추적기는 16 ms마다 샘플을 수집하고, 50 Hz 시선 추적기는 1 ms마다 샘플을 수집합니다. 이는 측정 유형에 영향을 미치는데, 저주파 시선 추적기는 16-ms 기간 동안 시작된 사카드(saccade)를 고정(fixation)으로 포함하거나 그 반대의 경우가 발생할 수 있기 때문입니다. 샘플링이 데이터 정확도와 혼동되는 경우가 있으나, 이 둘은 서로 다른 특성입니다.
정밀도(Precision) = 시간이 지남에 따라 시선 추적기가 데이터를 일관되게 수집할 수 있는 정도입니다.
정확도(Accuracy) = 시선 추적기가 검출한 시선 지점과 실제 시선 지점 사이의 오차 양입니다.
예를 들어, 단어의 글자상 시선 위치로 설명되는 단어의 고정 착지 지점을 연구하는 경우에는, 읽기 중 회귀적 사카드(regressive saccades)의 비율(전진적 사카드와 비교하여)에만 집중하는 연구보다 훨씬 높은 샘플링 속도(≥50-20 Hz), 정밀도 및 정확도가 필요합니다. - 안구 운동 기록 방법론을 결정합니다. 샘플링 속도, 정밀도 및 정확도가 높은 데스크톱 시선 추적기를 사용하십시오. 턱 받침대(chinrest)나 이마 받침대(forehead rest)를 사용하여 머리를 고정하십시오. 헤드프리 시선 추적(원격 시선 추적)을 사용하는 경우, 얼굴 추적 성능을 향상시키기 위해 가능하다면 참가자의 이마에 스티커를 부착하십시오. 또한, 추적기 제조사가 권장하지 않는 한 반사성 스티커의 사용은 피하십시오.
참고: 웨어러블 시선 추적 장비는 데스크톱 시선 추적기에 비해 샘플링 속도, 정밀도 및 정확도가 상대적으로 낮고 안구 운동 데이터 분석에 어려움이 있어 읽기 연구에서 드물게 사용되었습니다. 그러나 지난 10년 동안 데이터 품질 향상과 자동화된 분석 파이프라인의 도입으로 헤드프리 또는 자연스러운 설정이 인기를 얻고 있으며, 이에 따라 읽기 중 안구 운동 연구 범위가 자연스러운 환경 및 VR 환경 내 읽기로 확장되고 있습니다.
- 연구 목표와 측정 항목 간의 호환성을 확인합니다. 특정 연구의 목표, 즉 대상 측정 항목(종속 변수)은 시선 추적 장비의 성능과 일치해야 합니다. 기관에서 보유한 장비의 가용성에 따라 의도한 연구 범위에 제한이 생길 수 있습니다. 시선 추적 시스템의 세 가지 주요 구성 특성(샘플링 속도, 정밀도, 정확도)과 연구 요구 사항 충족 가능성을 확인하십시오. 핵심은 시선 추적 장비의 성능이 연구 목표와 호환되는지 확인하는 것입니다.
- 하드웨어 및 소프트웨어 설정
- 하드웨어를 설정합니다. 참가자의 얼굴, 모니터 및 시선 추적기 사이의 거리를 측정합니다. 제조사 권장 사항(예: ~60–70 cm) 및 필수 구성 기하학적 구조에 따라 시청 거리를 설정하십시오. 모든 텍스트가 중심 시야와 추적기의 유효 범위 내에 유지되도록 가급적 평면 21–27인치 LCD 모니터(예: 60 cm 거리에서 24인치, 시야각 ~48° x 28°)를 사용하십시오. 모니터 기울기와 회전, 그리고 시선 벡터와 화면상의 해당 위치 간의 정렬을 확인하십시오. 모니터 크기와 재생률을 목표 값으로 설정합니다. 화면 해상도를 지정된 값으로 설정하십시오. 지정된 거리에서 흰색 배경의 모니터 휘도를 측정하십시오. 휘도 값을 세션 보고서에 기록합니다.
- 필요한 경우, 특히 시선 Contingent 과제 및 검증된 타이밍이 중요한 경우 고주사율(120 Hz 이상, 예: 14–240 Hz) LCD 모니터를 권장합니다. 가변 재생률 기술(G-Sync/FreeSync)을 비활성화하십시오. 시선 추적기를 여러 연구자가 서로 다른 실험에 사용하는 경우, 각 데이터 수집 중에 변경된 사항을 기록하는 것이 중요합니다. 각 데이터 수집이 끝나면 설정을 세션 시작 시의 원래 상태 또는 실험실 프로토콜에 정의된 상태로 되돌려야 합니다.
- 소프트웨어를 설정합니다. 대부분의 시선 추적기 제조사는 오픈 소스 소프트웨어와의 호환성 및 통합을 위해 관련 소프트웨어, 소프트웨어 개발 키트(SDK) 및/또는 라이브러리를 제공합니다.
참고: 최근 특정 설정들은 여전히 맞춤형 솔루션이 필요한 기술적 과제로 남아 있습니다. 예를 들어, EEG 및 fNIRS와 같은 보완적 측정 방법과 시선 추적기의 시간 동기화를 위해서는 시선 추적기 클록과 자극 제시 클록 간의 적절한 타임 락킹(time-locking) 수준을 보장하거나 화면 재생 비동기화를 해결하기 위한 특수 하드웨어 및/또는 소프트웨어 솔루션이 필요합니다. 따라서 대부분의 제조사 도구는 자극 제시 및 안구 운동 기록과 같은 연구자의 기본 요구 사항을 충족하는 실험 설계 환경을 제공합니다. 현재 사용 가능한 소프트웨어 패키지 목록은 재료 표(Table of Materials)에 제시되어 있습니다.
- 하드웨어를 설정합니다. 참가자의 얼굴, 모니터 및 시선 추적기 사이의 거리를 측정합니다. 제조사 권장 사항(예: ~60–70 cm) 및 필수 구성 기하학적 구조에 따라 시청 거리를 설정하십시오. 모든 텍스트가 중심 시야와 추적기의 유효 범위 내에 유지되도록 가급적 평면 21–27인치 LCD 모니터(예: 60 cm 거리에서 24인치, 시야각 ~48° x 28°)를 사용하십시오. 모니터 기울기와 회전, 그리고 시선 벡터와 화면상의 해당 위치 간의 정렬을 확인하십시오. 모니터 크기와 재생률을 목표 값으로 설정합니다. 화면 해상도를 지정된 값으로 설정하십시오. 지정된 거리에서 흰색 배경의 모니터 휘도를 측정하십시오. 휘도 값을 세션 보고서에 기록합니다.
2. 실험 설계 및 예비 실험
- 자극 준비
- 읽기 자료를 준비하십시오. 읽기 자료는 보통 연구 목적에 따라 문장 또는 단락 형태로 제시됩니다. 이 방법이 연구 목적과 부합한다면, 텍스트를 직접 작성하기보다 기존 자료에서 읽기 자료를 발췌하는 것을 고려하십시오.
- 텍스트 재사용을 위한 라이선스 조건을 확인하십시오. 모든 텍스트의 라이선스 조건을 확인하십시오. 출판된 실험 자료가 오픈 소스여서 이를 사용하고자 하는 누구에게나 공개적으로 제공된다면 허가가 필요하지 않습니다. 그렇지 않은 경우에는 사용 전 필요한 허가를 받으십시오. 자극물을 실험에 사용할 수 있는지와 이를 보충 자료로 공유할 수 있는지 확인하는 것이 중요합니다.
- 형식화된 자극물을 준비하십시오. 텍스트 자극물을 형식화하려면 적절한 글꼴 속성(글꼴 종류, 크기, 글자, 단어 및 줄 간격)을 사용해야 합니다. 관련 문헌에서 사용된 설정을 고려하여, 적절한 글꼴 크기와 간격을 갖춘 고정폭 글꼴(monospace font)을 사용하십시오.
참고: 단어 기반의 관심 영역(Area of Interest, AOI)을 사용하는 읽기 실험에서는 Courier New와 같은 고정폭 글꼴을 사용하는 것이 권장됩니다. 이러한 글꼴은 라틴 알파벳 내의 서로 다른 알파벳, 숫자 및 기호에 대해 동일한 픽셀 크기를 제공하기 때문입니다. 연구자는 글꼴과 인터페이스의 호환성, 그리고 비라틴 문자의 자극 제시나 우측에서 좌측으로 읽는 방향과 같은 자극의 특정 특성을 확인해야 하며, 실험 소프트웨어 도구가 자동 IA(Interest Area) 또는 AOI(Area of Interest) 지정 방법을 제공하는지 확인해야 합니다.
- 실험 절차 설계
- 지침서 작성
참고: 지침은 독서 중 안구 운동에 상당한 영향을 미치므로 매우 중요합니다. 최소한의 형태일지라도 과제 지침을 사용하는 것이 필수적입니다. 명시적인 지침이 부족할 경우, 참가자의 시선 행동에 영향을 주는 의도치 않은 결과가 발생할 수 있습니다. 예를 들어, 어떤 참가자는 세심하게 읽어야 한다는 잠재적 가정을 가질 수 있는 반면, 다른 참가자는 이해를 위한 자연스러운 독서가 아닌 훑어읽기를 수행할 수 있습니다.- 표준화된 지침을 화면에 제시하고, 지침 제시 시작 시간과 지속 시간을 기록하며, 녹화 중에는 구두 지시를 피하십시오. 일반적인 관행은 참가자에게 내용을 이해하며 읽도록 요청하는 것입니다. 참가자가 일상적인 환경에서 읽는 것처럼 읽어야 하는 경우에는, 자연스럽게 읽어야 한다는 점, 즉 눈을 깜빡이거나 다시 읽는 것을 피할 필요가 없음을 안내하십시오. 또한, 이해도 질문과 같은 추가 과제가 있는 경우(이는 참가자가 내용을 이해하며 읽고 있음을 보장하는 데 중요합니다) 이를 참가자에게 알리십시오. 지침은 과제뿐만 아니라 실험 단계(예: 훈련 단계 vs. 본 과제)에 따라 달라질 수 있습니다. 이를 설명하기 위해, 훈련 단계에서 사용된 지침의 예시를 아래에 제공합니다.18.
이제 교육 세션을 시작하겠습니다. 이를 위해 표시된 4개의 키(A, B, C, D)가 필요합니다. 세부 지침은 곧 화면에 표시될 것입니다. 교육이 끝나면 1~2분 동안 수행 능력을 평가합니다. 교육 수행 결과가 미흡할 경우 교육의 마지막 부분이 반복됩니다. 수행 결과가 충분할 경우 저는 다시 방으로 돌아가겠습니다. 준비가 되면 스페이스 바를 누르십시오. - 독서 연구를 위해 설계된 실험의 훈련 세션에 이러한 지침을 사용할지 여부는 연구자의 판단에 따릅니다. 그럼에도 불구하고, 실험 세션에서는 해당 지침을 사용하십시오. 일반 관련성 지침 조건(텍스트 내 질문 유무 모두 포함)에서 사용되는 실험 단계 지침의 예시는 다음과 같습니다.19.
귀하는 일련의 짧은 설명문을 읽게 됩니다. 텍스트를 주의 깊게 읽고 최대한 많은 내용을 이해하시기 바랍니다. 독해 후에는 텍스트의 주요 아이디어에 대해 구두 요약을 요청받게 되며, 이를 통해 귀하가 읽은 내용을 얼마나 잘 이해했는지 확인하게 됩니다.
문장 읽기 과제를 활용하는 실험에 대한 또 다른 예시 지침이 아래에 제시되어 있습니다.20.
독해 연구에 참여해 주셔서 감사합니다. 본 연구에서 귀하는 약 10개의 문장을 접하게 됩니다. 이 문장들은 다양한 출처에서 무작위로 선정되었으며, 무작위 순서로 제시될 것입니다. 책을 읽을 때와 마찬가지로, 본인의 자연스러운 읽기 속도에 맞추어 의미를 파악하며 마음속으로 읽어 주십시오. 일부 문장 뒤에는 이해도 확인 질문이 제시될 수 있습니다. 해당 질문에 답변해 주시기 바랍니다. 정답을 모르실 경우 해당 질문은 건너뛰십시오. 세션 중간에 휴식 시간이 있을 예정입니다. 불편함을 느끼신다면 언제든지 휴식을 요청하거나 세션에서 나가실 수 있습니다. 문의 사항이 있으시면 실험자에게 알려주십시오. 모든 내용을 확인하셨다면, 버튼을 눌러 절차를 시작해 주십시오.
- 표준화된 지침을 화면에 제시하고, 지침 제시 시작 시간과 지속 시간을 기록하며, 녹화 중에는 구두 지시를 피하십시오. 일반적인 관행은 참가자에게 내용을 이해하며 읽도록 요청하는 것입니다. 참가자가 일상적인 환경에서 읽는 것처럼 읽어야 하는 경우에는, 자연스럽게 읽어야 한다는 점, 즉 눈을 깜빡이거나 다시 읽는 것을 피할 필요가 없음을 안내하십시오. 또한, 이해도 질문과 같은 추가 과제가 있는 경우(이는 참가자가 내용을 이해하며 읽고 있음을 보장하는 데 중요합니다) 이를 참가자에게 알리십시오. 지침은 과제뿐만 아니라 실험 단계(예: 훈련 단계 vs. 본 과제)에 따라 달라질 수 있습니다. 이를 설명하기 위해, 훈련 단계에서 사용된 지침의 예시를 아래에 제공합니다.18.
- 시행 및 블록을 설계하십시오. 블록 단위의 시행 제시와 블록 내 및 블록 간 시행 순서의 무작위화를 고려하여 실험 흐름을 설계하십시오. 각 시행 전에는 고정 십자 표식(50-80ms)을 사용하여 참가자의 초기 시선이 디스플레이의 동일한 위치에 고정되고 텍스트의 어느 부분과도 겹치지 않도록 하십시오.
동공 크기가 종속 변수인 시선 추적 실험을 설계할 때는, 동공 크기가 고정-사카드(fixation-saccade) 시퀀스와 같은 일시적인 반응이 아니므로 이에 맞추어 실험 흐름을 조정해야 합니다. 구체적으로, 동공 크기를 종속 변수로 사용하는 경우, 자극 제시 전과 이후의 시행(trial) 전에 동공 크기가 안정화될 수 있도록 적절한 지속 시간의 사전 기저선 윈도우(pre-onset baseline window)와 검은 화면 구간을 도입해야 합니다. 연구자는 기록된 동공 데이터가 종속 변수로서 적절히 해석될 수 있도록 동공 측정법(pupillometry) 가이드라인에 관한 최신 연구들을 확인해야 합니다.21,22. - 블록 사이에 휴식 시간을 설계하십시오. 데이터 품질을 보장하고 피로도를 줄이기 위해 실험 블록 사이에 드리프트 보정(drift-correction) 화면과 선택적 짧은 휴식 시간을 도입하십시오. 미리 지정된 횟수의 시행 후에 또는 정확도가 눈에 띄게 저하될 때 드리프트 확인 단계를 삽입하십시오(실험 도중 보정/검증을 강제 실행할 수 있는 단축키가 있는지 확인하십시오). 드리프트가 발생한 경우 다시 검증하십시오. >1° 시야각(x 및 y 좌표의 평균).
- 대상 독립 변수를 식별하십시오. 읽기 연구에서 단어 빈도 및 단어의 문장 내 예측 가능성과 같은 텍스트의 특정 속성은 주요 대상 독립 변수를 구성합니다. 연구 목적에 따라 실험의 독립 변수를 나열하십시오. 통계 분석 시, 독립 변수 지표는 값의 정규화가 필요할 수 있습니다. 자극제의 속성을 바탕으로 각 변수의 관련성을 평가하십시오.
- 텍스트 줄 시작 부분의 단어들은 분석에서 제외하십시오. 해당 단어들에 대한 고정(fixation)은 대개 정확하지 않은데, 이는 텍스트나 문장에서의 첫 번째 시도적 고정이거나 줄 바꿈 후의 첫 번째 고정(리턴 스윕(return-sweep)이라 함)을 반영할 수 있기 때문이며, 이들은 어떤 경우에도 정확하지 않고 보통 교정 고정(corrective fixations)이 뒤따릅니다. 또한 각 줄의 마지막 단어도 제외하십시오. 이러한 단어들은 (뒤따르는 단어들로 인한) 시각적 밀집도(visual crowding)의 영향이 적으며, 줄 끝 단어에 대한 고정은 종종 시행의 종료나 다음 텍스트 줄로 가기 위한 리턴 스윕의 프로그래밍을 반영하기 때문입니다.
참고: 관사와 같은 기능어가 많은 언어에서는 첫 번째 고정(first fixation) 지속 시간이 덜 중요할 수 있습니다(분석 영역에는 관사와 명사가 모두 포함되어야 하지만, 첫 번째 고정은 관사의 처리만을 반영할 수 있으므로 그 중요성이 낮아질 수 있습니다).
- 텍스트 줄 시작 부분의 단어들은 분석에서 제외하십시오. 해당 단어들에 대한 고정(fixation)은 대개 정확하지 않은데, 이는 텍스트나 문장에서의 첫 번째 시도적 고정이거나 줄 바꿈 후의 첫 번째 고정(리턴 스윕(return-sweep)이라 함)을 반영할 수 있기 때문이며, 이들은 어떤 경우에도 정확하지 않고 보통 교정 고정(corrective fixations)이 뒤따릅니다. 또한 각 줄의 마지막 단어도 제외하십시오. 이러한 단어들은 (뒤따르는 단어들로 인한) 시각적 밀집도(visual crowding)의 영향이 적으며, 줄 끝 단어에 대한 고정은 종종 시행의 종료나 다음 텍스트 줄로 가기 위한 리턴 스윕의 프로그래밍을 반영하기 때문입니다.
- 대상 종속 변수를 식별하십시오. 읽기 연구에서 첫 고정 시간(first fixation duration), 단일 고정 시간(single fixation duration), 응시 시간(gaze duration), 회귀 백분율(regression percentage), 단어 건너뛰기 확률(word skipping probability)과 같은 일련의 안구 운동 지표는 연구 목적과 관련된 주요 대상 종속 변수를 구성합니다. 분석할 안구 운동 지표를 지정하십시오. 이러한 지표를 통계 분석의 핵심 근거로 사용하십시오.
참고: 참가자가 키보드로 입력해야 하는 과제는 턱받침(chinrest)에서 벗어나야 할 가능성이 있어 보정(calibration) 상태가 소실될 수 있으므로 피하십시오. 대신, 참가자가 마우스를 사용하여 응답을 선택하도록 합니다. 안구 운동 기록 중 참가자의 구두 피드백이 필요한 경우에는 턱받침 대신 이마받침(forehead rest)을 사용하고, 참가자가 이마받침에 머문 상태에서 구두로 응답하거나 단일 키 응답을 하도록 요청하십시오.
- 지침서 작성
- 실험 절차의 구현
- 자극 제시 소프트웨어를 선택하십시오. 적절한 자극 제시 소프트웨어를 사용하여 실험을 설정합니다. 텍스트를 제시하고 안구 운동을 기록하기 위해 제조사 제공 도구와 범용 실험 설계 도구를 모두 사용할 수 있습니다. 소프트웨어를 선택할 때는 사용 가능한 하드웨어 통합 기능(예: 해당 안구 추적기에 대한 기본 지원), 요구되는 타이밍 정확도의 수준, 그리고 스크립팅 방식과 GUI 기반 설계 방식 중 선호하는 수준을 고려하십시오. 플랫폼에 관계없이, 분석 단계에서 고정과 단사(saccade)를 해당 텍스트 요소와 정렬할 수 있도록 소프트웨어는 자극 이벤트(예: 단어 시작, 문장 시작)와 안구 추적 데이터 스트림 간의 신뢰할 수 있는 동기화를 지원해야 합니다. 외부 소프트웨어를 사용하는 경우, 특히 데이터 시각화 및 데이터 내보내기 측면에서 안구 추적기 소프트웨어와 외부 소프트웨어 간의 호환성을 확인하십시오.
참고: 소프트웨어 예시: Experiment Builder(SR Research, EyeLink 시스템용)는 드리프트 체크(drift check), 보정 루틴 및 기록 컴퓨터로 전송되는 이벤트 메시지에 대한 내장 지원 기능을 갖춘 그래픽 인터페이스를 제공합니다. PsychoPy 및 OpenSesame와 같은 오픈 소스 플랫폼도 유사한 기능을 제공하며 하드웨어에 구애받지 않는 특성을 가집니다. 이러한 플랫폼에서는 그래픽 인터페이스나 스크립팅(예: PsychoPy의 경우 Python)을 통해 시행(trial)을 설계하고, 자극 제시 타이밍을 제어하며, 단어나 텍스트 라인 주변에 관심 영역(Region of Interest, 관심 영역 IA 또는 관심 영역 AOI라고도 함)을 정의할 수 있습니다. 때로는 경력이 짧은 연구자들에게 데이터 시각화 및 데이터 내보내기 연결 과정이 간단하지 않을 수 있으며, 따라서 제조사 제공 소프트웨어를 사용하는 것이 더 쉬울 수 있습니다. 결과적으로, 시선 추적기를 선택할 때 중요한 고려 사항은 각 제조사 또는 개발자 커뮤니티에서 제공하는 지원 수준입니다. - 실험을 시범 운영하십시오. 구현된 실험 절차를 테스트하고 기록된 데이터를 확인하여 실험이 예상대로 진행되는지 확인하십시오. 사전 정의된 성공 기준을 모니터링함으로써 실험이 예상대로 수행되는지 확인하기 위해 실험실 환경에서 예비 연구를 실시하십시오. 기록된 데이터를 확인하여 연구에 필요한 모든 항목이 등록되고 있는지 확인하십시오.
- 자극 제시 소프트웨어를 선택하십시오. 적절한 자극 제시 소프트웨어를 사용하여 실험을 설정합니다. 텍스트를 제시하고 안구 운동을 기록하기 위해 제조사 제공 도구와 범용 실험 설계 도구를 모두 사용할 수 있습니다. 소프트웨어를 선택할 때는 사용 가능한 하드웨어 통합 기능(예: 해당 안구 추적기에 대한 기본 지원), 요구되는 타이밍 정확도의 수준, 그리고 스크립팅 방식과 GUI 기반 설계 방식 중 선호하는 수준을 고려하십시오. 플랫폼에 관계없이, 분석 단계에서 고정과 단사(saccade)를 해당 텍스트 요소와 정렬할 수 있도록 소프트웨어는 자극 이벤트(예: 단어 시작, 문장 시작)와 안구 추적 데이터 스트림 간의 신뢰할 수 있는 동기화를 지원해야 합니다. 외부 소프트웨어를 사용하는 경우, 특히 데이터 시각화 및 데이터 내보내기 측면에서 안구 추적기 소프트웨어와 외부 소프트웨어 간의 호환성을 확인하십시오.
3. 참가자 모집 및 안내
- 참가자 선정
- 시력 조건 요구사항을 결정합니다. 정상 시력이거나 교정 시력이 정상인 참가자를 모집합니다. 제조사 지침에 따라 반사가 최소화된(눈부심 방지, 모니터 각도 조절 등) 안경 및 콘택트렌즈 착용은 허용 가능합니다. 공변량 확인을 위해 교정 유형(안경, 콘택트렌즈)을 기록합니다.
참고: 일반적으로 (더 이상 흔하지 않지만) 하드 콘택트렌즈는 추적이 매우 어렵습니다. 콘택트렌즈 자체가 문제는 아니지만, 때때로 렌즈와 각막 사이에 공기 방울이 형성되어 추적을 방해하는 반사가 발생할 수 있습니다. 광택이 있는 테의 안경 또한 추적을 방해할 수 있습니다. 광택이 있는 안경테의 경우, 시선 추적 소프트웨어에서 시야(field-of-view) 감지 범위를 줄이십시오. - 연령, 독해 능력, 언어 배경, 주로 사용하는 손과 같은 특정 개인적 특성과 난독증, 이중 언어 사용 또는 읽기 장애와 같이 안구 운동 데이터에 영향을 줄 수 있는 일반적인 제외 및 포함 기준을 바탕으로 참가자를 스크리닝합니다. 따라서 연구 목표에 따라 독자가 실험에 적합한 참가자가 되기 위한 조건, 즉 포함 및 제외 기준을 구체화하십시오(토론 섹션 참조).
- 시각 장애 조건을 확인합니다. 참가자가 백내장(수술 후 포함), 녹내장 또는 황반변성과 같이 교정 불가능한 시각 장애가 없는지 확인합니다.
- 신경학적 조건을 확인합니다. 참가자가 안구 운동 기록 시 불편함을 느낄 만한 질환이 없는지 확인합니다. 대부분의 시선 추적기는 안구에 안전한 것으로 간주되는 근적외선(near-IR) LED/레이저 또는 인증된 NIR LED/VCSEL 조명을 사용합니다. 장치의 안구 안전 인증(예: Class 1 IEC 60825-1, IEC/EN 62471 또는 이와 유사한 인증)을 확인하십시오. 참가자에게 장비의 안전 규정(제조사에서 발행한 CE 인증서, 일반적으로 EU 적합성 선언서로 알려져 있으며 제품이 모든 필수 유럽 보건, 안전 및 환경 규정을 준수함을 증명하는 문서 등)에 대해 안내합니다.
- 시력 조건 요구사항을 결정합니다. 정상 시력이거나 교정 시력이 정상인 참가자를 모집합니다. 제조사 지침에 따라 반사가 최소화된(눈부심 방지, 모니터 각도 조절 등) 안경 및 콘택트렌즈 착용은 허용 가능합니다. 공변량 확인을 위해 교정 유형(안경, 콘택트렌즈)을 기록합니다.
- 위생 관리
- 개인 간 거리와 관련된 주의 사항을 준수합니다. 실험 프로토콜 진행 시 개인 간 거리 단축이 필요할 수 있으므로, 필요한 경우 일회용 장갑과 마스크를 착용하십시오.
- 장비를 소독합니다. 현재 기관 지침에 따라 알코올 솜을 사용하여 턱 받침대 및 기타 액세서리를 소독합니다. 장비에 손상을 줄 수 있는 화학 물질을 사용하지 않도록 주의하십시오. 제조사 사양을 확인하십시오. 특히 턱 받침대, 머리 받침대, 마우스 또는 참가자가 접촉하게 될 장비의 다른 부분의 경우, 참가자가 보는 앞에서 세척을 진행하면 참가자가 더 편안함을 느낄 수 있습니다.
- 참가자 안내
- 실험실 환경에 대해 안내합니다. 실험자가 참가자에게 실험실 환경과 시선 추적 장비를 소개하는 구두 안내 세션을 설계합니다.
- 실험에 대해 안내합니다. 실험 배경(연구 목적 및 예상 소요 시간; 이는 파일럿 테스트 중에 확인해야 함), 보상 또는 지급 절차, 실험에 대한 참가자의 기여도, 그리고 장기적으로 연구 결과에 대해 확인할 수 있는 권리를 명확하게 설명합니다. 기록 세션 중 주의 사항과 금지 사항을 안내합니다. 데이터의 고품질 기록을 위해 (머리 고정 장치가 없는 경우) 기록 중에 머리를 너무 많이 움직이지 않도록 하거나 턱 받침대에서 떨어지지 않도록 요청하십시오(그 외의 경우, 참가자는 언제든지 사유를 밝히지 않고 실험을 중단하고 세션을 종료할 수 있습니다).
- 고지된 동의를 얻습니다. 세션 시작 전 참가자에게 윤리 승인서와 동의 서류를 제공하고 설명합니다. 성인의 경우, 연구 목적, 진행 과정, 자발적 참여 옵션, 데이터 개인정보 보호 및 철회 권리를 포함한 권리를 이해했는지 확인한 후 서면 동의서를 받습니다. 미성년자가 참여하는 경우, 부모 또는 법정 대리인의 서면 동의와 미성년자 본인의 동의를 얻습니다. 모든 필수 동의서 및 승낙서가 작성된 후에만 보정(calibration)과 기록을 진행하십시오. 고지된 동의 절차는 성인과 미성년 참가자 간에 상당히 다릅니다. 따라서 연구자는 해당 지역 기관의 가이드라인을 따라야 합니다.
참고: 실험 중 일시 중지나 휴식이 발생한 경우, 보정 상태의 재검증이 필요하며, 재검증에 실패하면 재보정이 필요합니다.
4. 보정 및 검증 수행
- 참가자 배치 및 장비 조정
- 참가자 배치. 참가자에게 편안하게 앉도록 요청한다. 머리 위치를 일정하게 유지할 수 있도록 의자/테이블 및 턱받침을 조정한다. 보정, 검증 및 기록 단계 동안 이 머리 위치를 유지해야 함을 참가자에게 알린다.
- 장비 조정. 참가자의 동공이 명확하게 보이고 감지될 수 있도록 아이트래커 카메라를 정렬하여 시선 추적 장비를 조정한다. 일부 시선 추적 시스템은 이 정렬을 자동으로 수행하지만, 일부 시스템은 카메라 초점을 수동으로 조정해야 할 수도 있다.
참고: 실험자는 참가자가 이러한 단계로 인해 부담을 느끼지 않도록 실제 데이터 수집을 시작하기 전에 장비 조정 및 보정 연습을 수행해야 한다.
- 보정 실행
- 참가자 안내. 보정 절차(예: 일련의 타겟 마커가 표시될 것이며, 참가자가 약 1분 정도 이를 따라가야 한다는 점 등)에 대해 참가자에게 안내한다.
참고: 조정 시 사용하는 용어에 주의를 기울이는 것이 권장된다. 예를 들어, 실험자는 이 절차가 참가자를 아이트래커에 맞추는 것이 아니라, 참가자에 맞게 아이트래커를 보정하는 것임을 강조한다. 또한, 시선 추적 장비로 비디오/영상이 기록되지 않음을 확실히 하는 것이 중요하다. 참가자의 눈이 보이지만, 좌표로 변환된 눈의 위치만 기록된다. - 보정 절차 실행. 참가자에게 타겟 마커를 추적하고 머리 위치를 일정하게 유지하도록 지시한다. 예를 들어, 보정 절차가 끝난 후 뒤로 기대지 않도록 한다. 보정 기호의 중심에 시선을 고정하고 기호가 움직일 때까지 눈을 움직이지 않도록 지시한다. 참가자들은 특히 검증 단계에서 기호의 움직임을 예측하는 경향이 있으며, 이는 오차를 증가시키고 불필요한 보정 단계를 유발할 수 있다. 이 설명을 지침이나 보정/검증 과정 설명에 포함시킨다.
참고: 제조사마다 보정 과정에 서로 다른 유형의 기호(점, 아동 친화적 기호, 정적 또는 축소되는 기호 등)와 서로 다른 보정 설정(즉, 보정 포인트의 수)을 제공한다. 이러한 다양한 보정 설정에 따른 보정 차이를 확인하고 특정 연구의 필요에 가장 적합한 설정을 선택하는 것이 중요하다. 예를 들어, 자극이 화면 전체를 사용하는 경우(예: 여러 단락이 있는 텍스트), 모서리를 포함하여 상단부터 하단까지 양호한 보정이 보장되는 보정 설정이 필요하다. 그러나 자극이 화면 중앙에 제시되는 문장인 경우, 더 적은 수의 포인트로 구성된 보정 설정으로도 충분할 수 있다. 또한, 후자의 경우 전자에 비해 수평 또는 x-좌표의 보정 정확도가 더 중요하며, 전자는 수직 및 수평 좌표 모두에서 우수한 정확도가 필요하다. - 보정 절차 종료. 보정 절차를 완료한 후 참가자에게 검증 절차에 대해 안내한다.
참고: 보정 실패가 지속되는 경우, 아이트래커의 카메라 정렬, 조명 조건 및 참가자 배치를 확인한다. 성인 참가자의 경우, 반사성 메이크업, 안경 또는 콘택트렌즈가 추적을 방해할 수 있다. 참가자를 안심시키고, 짧은 휴식을 제공하거나 필요에 따라 보정을 반복한다. 문제가 지속되면 시선 추적 시스템을 재시작하는 것을 고려한다. 시스템 재시작 후에도 문제가 지속되고 구성 파라미터를 확인한 뒤에도 보정 실패의 원인을 찾지 못한 경우, 시선 추적 기술이 충분히 발달하지 않았으며 이는 참가자의 문제가 아니라 기술적 상태와 관련된 문제임을 참가자에게 알린다.
- 참가자 안내. 보정 절차(예: 일련의 타겟 마커가 표시될 것이며, 참가자가 약 1분 정도 이를 따라가야 한다는 점 등)에 대해 참가자에게 안내한다.
- 검증 수행
- 검증 절차 실행. 보정 직후에 검증 절차를 실행한다.
- 오차 확인. 평균 시선 위치 오차를 확인하고 이것이 허용 범위 내에 있는지 확인한다. 일반적으로 1도 미만(<1°)의 시각적 각도가 권장되며, 이는 약 4글자에 해당한다(즉, 0.5도는 약 2글자에 해당함). 오차가 이 범위를 벗어나면 재보정을 수행한다. 예를 들어, 평균 오차가 ≤0.5–1.0°이고 최대/포인트별 오차가 ≤1.5–2.0°인 경우 보정을 승인하고, 그렇지 않으면 재보정한다. 재검증 주기(예: 각 블록 또는 중단 후)를 지정한다. 제조사 SR Research의 보정 품질 평가 기준을 예로 들면, 평균 오차 <1° 및 최대 오차 <1.5°인 경우 대부분의 작업에서 허용 가능한 것으로, 평균 오차 <1°-1.5° 및 최대 오차 <1.5°-2°인 경우 보통으로, 이 값보다 큰 경우 불량으로 간주한다.
- 참가자 안내. 참가자에게 최대한 비슷한 자세를 유지하도록 지시하고 기록 세션의 시작을 알린다.
5. 데이터 수집
- 데이터 수집 절차 수행
- 기록 세션 시작. 기록 세션을 시작하고, 구두 지시를 제공하는 등 참가자가 과제를 수행하는 동안 방해가 되지 않도록 주의하십시오.
- 참가자 모니터링. 데이터 기록 중 참가자의 편안함 상태를 모니터링하십시오. 참가자가 무리나 피로감 없이 안정적인 자세를 유지하는지 확인하십시오. 주의 산만, 안구 건조 또는 턱 받침대/이마 받침대로 인한 불편함의 징후가 있는지 관찰하십시오.
- 데이터 기록 모니터링. 기록 중 데이터 품질을 모니터링하십시오. 평균 검증 오차 또는 온라인 정확도가 1°(또는 미리 지정된 정확도 임계값)를 초과하거나, 참가자의 자세가 바뀐 경우 재교정을 수행하십시오.
- 로그 작성. 실험 후 점검을 위해 실험 중 관찰된 모든 이상 징후(예: 비정상적으로 긴 교정 절차 또는 기록 중 의도치 않은 중단)를 기록하여 세션 로그를 작성하십시오. 이때 세션 로그 스키마를 사용하여 이벤트 발생 시간, 중단 횟수, 재교정 횟수 및 해당 오차, 드리프트 확인 및 조명 변경 사항을 모니터링하십시오.
- 세션 종료
- 데이터 저장. 실험 세션이 끝나면 원시 시선 데이터를 저장하십시오. 세션 라벨링에는 체계적인 방법(예: 실험 날짜와 참가자 번호를 조합하여 2025년 7월 18일의 참가자 01번인 경우 25071801 또는 250718-P01로 표기; 참가자의 개인 식별 정보 사용은 피하십시오)을 사용하는 것이 좋습니다.
- 종료 및 인사. 참가자에게 감사를 표하고 실험에 대해 궁금한 점에 답변하십시오. 이후 장비를 소독하십시오(단계 3.2.2 참조).
- 데이터 확인. 데이터와 로그를 확인하여 세션이 올바르게 완료되었는지 확인하십시오.
6. 데이터 전처리 및 품질 확인
- 원시 데이터의 내보내기, 정리 및 정제
- 데이터 내보내기. 원시 시선 데이터를 표준 형식(예: .csv, .tsv, .edf)으로 내보내고 세션 ID를 표준화하십시오(예: 25071801 또는 250718-P01, 5.2.1 참조).
- 데이터 정제. 제조업체 소프트웨어에서 제공하는 내장 도구를 사용하거나 장치 또는 샘플링 속도에 맞춰 조정된 사용자 정의 스크립트를 사용하여, 눈깜빡임 감지 및 누락 데이터 감지 알고리즘을 적용함으로써 원시 데이터를 정제하십시오.
참고: 정제 루틴을 실행하는 동안 원시 데이터의 백업본을 생성하십시오.
- 안구 운동 이벤트 감지
- 안구 운동 이벤트 감지 알고리즘 선택. 고정(fixation) 감지 절차를 선택하여 실행하고, 필요에 따라 알고리즘 파라미터를 조정하십시오. 고정 식별을 위한 대표적인 알고리즘으로는 주로 속도 기반 알고리즘(예: I-VT 속도 임계값 식별)과 분산 기반 알고리즘(예: I-DT 분산 임계값 식별) 등이 있습니다23. 각 알고리즘은 고유한 파라미터를 가집니다.
참고: 제조업체 소프트웨어는 일반적으로 기본값으로 특정 알고리즘과 흔히 사용되는 특정 파라미터 세트를 가정합니다. 적절한 알고리즘과 파라미터를 선택하고, 이를 분산/속도 임계값, 이 값보다 짧은 고정을 제거하기 위한 최소 고정 지속 시간 임계값(예: 60 ms 또는 10 ms), 이 값보다 긴 고정을 제거하기 위한 최대 고정 지속 시간 임계값(예: 10 ms), 사용된 평활화 윈도우(smoothing window) 및 인접 고정의 병합 규칙 등과 같이 연구 방법론 설명에 보고하는 것은 연구자의 책임입니다23. - 부적절한 고정 식별. 디스플레이 영역 밖의 고정을 제거하거나 표시하십시오. 미리 정의된 최소 임계값보다 짧거나 최대 임계값보다 긴 고정을 제거하거나 표시하십시오.
- 데이터 시각적 검토. 사용 가능한 시각화 도구를 사용하여 데이터를 시각적으로 검토함으로써 데이터의 유효성을 확인하십시오. 신호 손실, 과도한 노이즈, 샘플 누락 또는 정렬되지 않은 고정이 있는지 확인하십시오. 각 기록 세션 후, 시선 추적 소프트웨어에서 제공하는 시각화 도구(예: 시선 플롯, 스캔패스, 시계열 트레이스)를 사용하여 데이터를 시각적으로 검토하십시오. 이 단계는 전처리 및 분석으로 넘어가기 전 데이터가 충분한 품질을 갖추었는지 확인하는 데 도움이 됩니다.
- 특히, 시선 패턴에서 긴 공백이 있거나 자극물 내에 시선 샘플이 기록되지 않은 영역이 있는지 확인하여 신호 손실 및 추적 문제를 점검하십시오. 빈번하거나 장기간의 추적 손실은 해당 세션을 제외하거나 반복해야 함을 나타낼 수 있습니다.
- 과도한 노이즈를 확인하려면, 원시 x/y 위치 트레이스에서 자극 레이아웃과 일치하지 않는 갑작스러운 도약이나 오류 샘플이 있는지 검토하십시오. 과도한 노이즈는 잘못된 캘리브레이션, 불안정한 머리 위치 또는 하드웨어 문제를 나타낼 수 있습니다.
- 누락되었거나 불규칙한 샘플을 찾아내려면, 샘플링 속도가 예상치(예: 50 Hz)와 거의 일치하는지, 그리고 일반적인 눈깜빡임 외에 예상치 못한 누락 샘플 군집이 있는지 확인하십시오.
- 정렬되지 않은 고정을 찾아내려면, 제시된 자극물 위에 고정을 겹쳐 놓고 의도한 줄과 단어 위에 위치하는지 확인하십시오. 체계적인 오프셋(예: 고정이 지속적으로 텍스트 밖에 위치함)은 캘리브레이션 드리프트 또는 시선 좌표와 화면 좌표 간의 잘못된 매핑을 나타낼 수 있습니다. 기록된 시선 패턴은 텍스트 구조(예: 왼쪽에서 오른쪽으로의 진행, 줄 단위 진행)를 대략적으로 따라야 하며, 고정은 단어에 집중되고 그 사이에는 비교적 매끄러운 사카드(saccade)가 나타나야 합니다. 이러한 패턴에서 체계적으로 벗어나거나 사용 가능한 데이터가 빈번하게 손실되는 경우, 영향을 받은 데이터를 이후 분석에서 제외해야 할 수도 있습니다.
- 드리프트 보정 수행. 필요한 경우 수직 드리프트 오류 보정을 수행하십시오. 여러 줄로 된 텍스트의 경우 행별 수직 드리프트 보정을 적용하십시오. 검증된 방법의 적용 가능성을 확인하십시오21.
참고: 그림 1은 프로토콜 섹션에 설명된 시선 추적 실험 설정 및 데이터 분석 파이프라인 설계에 포함된 단계들을 묘사합니다. 다음 섹션에서는 기록된 세션의 대표적인 결과물을 제시합니다.
- 안구 운동 이벤트 감지 알고리즘 선택. 고정(fixation) 감지 절차를 선택하여 실행하고, 필요에 따라 알고리즘 파라미터를 조정하십시오. 고정 식별을 위한 대표적인 알고리즘으로는 주로 속도 기반 알고리즘(예: I-VT 속도 임계값 식별)과 분산 기반 알고리즘(예: I-DT 분산 임계값 식별) 등이 있습니다23. 각 알고리즘은 고유한 파라미터를 가집니다.
결과
데이터 품질 및 검증
성공적인 세션은 일반적으로 타겟 전반에 걸쳐 평균 오차 ≤0.5–1.0° 및 최대/지점별 오차 <1.0–1.5°의 검증 정확도를 나타내며, 평균값과 지점별 값을 모두 보고해야 합니다. 지점별 오차의 히스토그램과 세션당 평균 ± SD 및 최대 오차를 요약한 표를 제공하십시오. 이러한 기준은 일반적인 관행 및 공급업체 권장 사항과 일치하며, 이 임계값을 초과하는 세션은 연구 규칙에 따라 부분적으로 또는 완전히 제외해야 합니다. 그림 2는 세 차례의 보정 시도가 포함된 9지점 보정에 대한 보정 정확도의 지점별 오차 히스토그램 예시를 보여줍니다.
정밀도 및 데이터 손실
정밀도(예: 고정 시 시료 간 분산의 RMS(Root Mean Square))와 데이터 손실(시행/세션당 누락된 시료의 %)을 보고하십시오. 성공적인 시행에서는 일반적으로 고정 시 분산이 낮고 데이터 손실이 적게 나타납니다(예: 안구 추적 장비 및 설정에 따라 <5–10%). 데이터 손실 백분율의 분포와 이상치를 확인하기 위한 시행별 정밀도 대 손실 산점도를 제공하십시오. 정의 및 최소 보고 항목에 관한 최신 문헌을 확인하십시오3,4,5,6,7,8,9,10,11.
드리프트 거동 (보정 전/후)
성공적인 시험 실행에서는 작고 거의 일정한 수직 오프셋이 나타나며, 이는 자동 드리프트 보정 알고리즘21 또는 수동 보정을 통한 라인별 보정으로 상당히 감소합니다. 반면, 문제가 있는 실행에서는 비단조적이거나 큰 잔류 드리프트가 나타납니다. 보정 전/후의 수직 절대 오차 중앙값을 포함하십시오. 자동 드리프트 보정 방법의 적용 가능성을 확인하십시오.
일반적인 읽기 측정값의 분포
첫 고정 지속 시간(FFD), 단일 고정 지속 시간(SFD), 첫 통과 지속 시간(FP), 총/응시 지속 시간(GD), 통과 시간, 건너뛰기 확률 및 회귀 확률에 대한 요약 분포를 제공하십시오. 알파벳 텍스트를 읽는 숙련된 성인의 경우, 고정 지속 시간은 일반적으로 ~200–250 ms 부근에 집중되며(상당한 왜도 동반), 도약 안구 운동(saccade)은 평균적으로 ~7–9개의 문자를 포괄합니다. 이러한 범위를 크게 벗어나거나 매우 뚜렷한 이봉성 도약 분포가 나타나는 경우, 이것이 타이밍 오류가 아니라 과제 제약이나 처리 어려움으로 인해 예상되는 전진 및 후진 도약 안구 운동을 나타내는 것인지 확인해야 합니다. 측정값의 선택과 범위는 대상 집단, 특정 언어 및 맞춤법 체계에 따라 달라질 수 있습니다. 그림 3은 대표 세션에서 얻은 샘플 고정 지속 시간 분포 프로토콜을 보여줍니다.
정상성 확인(Sanity checks)
일반적으로 단어의 길이(긴 단어)가 증가하면 해당 단어의 건너뛰기 비율이 감소하고 응시 시간이 길어집니다. 반면, 기능어(예: 관사 또는 전치사)는 보통 건너뛰게 됩니다. 빈도가 높거나 언어적 맥락(텍스트 또는 문장 내)에 따라 예측 가능성이 높은 단어는 일반적으로 첫 고정 시간과 응시 시간이 짧고 건너뛰기 비율이 높게 나타납니다(빈도가 낮고 예측 가능성이 낮은 단어의 경우 그 반대로 예상됩니다). 데이터가 이러한 패턴 중 일부를 최소한 한 방향으로라도 재현하는지 확인하십시오. 큰 반전이 나타난다면 이는 드리프트 오류, 단어와 고정 위치의 불일치 또는 데이터 처리 오류를 나타낼 수 있습니다.
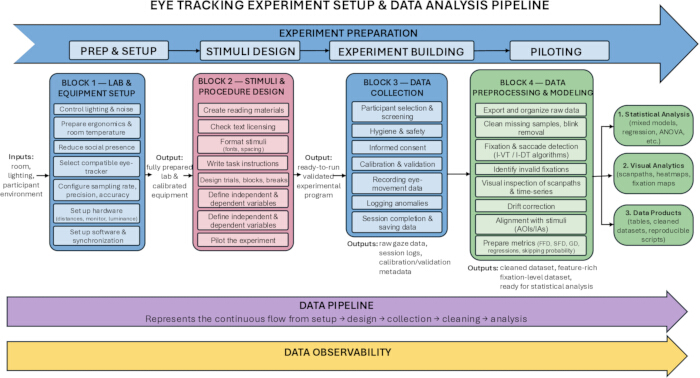
그림 1. 시선 추적 실험 설정 및 데이터 분석 파이프라인 설계에 포함된 단계들에 대한 묘사. 여기에서 이 그림의 더 큰 버전을 확인하십시오.
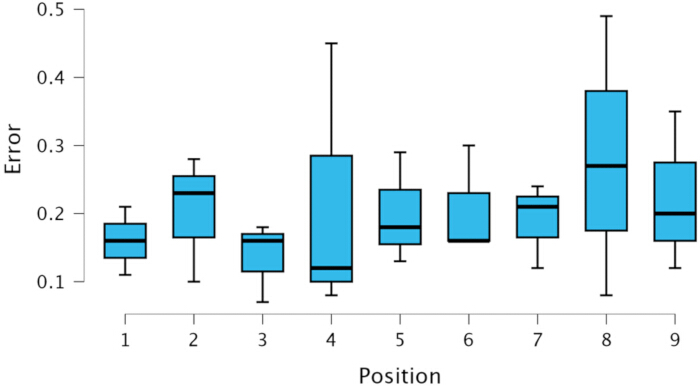
그림 2. 3회 보정 시도를 포함한 9지점 보정의 보정 정확도에 대한 지점별 오차 히스토그램. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
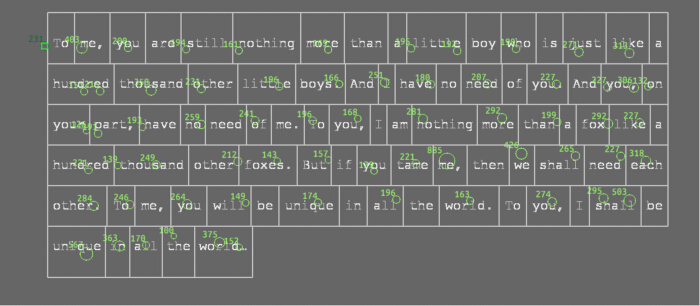
그림 3. 대표 세션의 고정 지속 시간 분포 프로토콜; 소설 어린 왕자의 발췌문을 읽고 있는 한 명의 참가자. 원의 위치와 크기는 각각 고정 위치와 지속 시간을 나타냅니다. 원 옆의 숫자는 ms 단위의 고정 지속 시간을 나타냅니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
토론
본 프로토콜은 읽기 연구에서 신뢰할 수 있는 시선 추적 데이터를 얻기 위해 필요한 주요 단계를 요약하여 제시합니다. 이러한 단계 중 상당수는 숙련된 연구자들에게 잘 알려져 있을 수 있으나, 종종 개별 방법론 논문, 공급업체 문서 및 비공식적인 실험실 관행에 흩어져 있는 경우가 많습니다. 실험실 준비부터 전처리까지의 과정을 단일 워크플로우로 구성함으로써, 읽기 시선 추적 연구를 처음 접하는 연구자들에게 실질적인 가이드를 제공하고자 합니다. 범용 시선 추적 가이드라인이나 주로 시선 이동 검출 알고리즘에 집중하는 리소스와 달리, 본 프로토콜은 높은 공간 해상도와 샘플링 빈도의 데이터 기록을 요구하는 읽기 연구의 특성에 맞춘 엔드-투-엔드 프레임워크를 제공합니다.
워크플로의 모든 단계에서 관통하는 핵심 주제는 환경 제어와 장비 설정을 시작으로 하는 선제적인 데이터 품질 관리의 중요성입니다. 모니터의 반사, 의자의 불안정성 또는 일관되지 않은 시청 거리와 같은 작은 문제들이 고정 위치나 정밀도에 계통 오차를 유발할 수 있습니다. 이러한 요인들을 조기에 해결하면 사후 교정의 필요성을 최소화하고 더욱 일관된 검증 정확도(평균 오차 ≤ 0.5–1°)를 확보할 수 있습니다.
또한 본 프로토콜은 연구 질문과 하드웨어 특성 간 정렬의 중요성을 강조합니다. 읽기 연구의 상당수는 고정(fixations), 도약 안구 운동 착륙 위치(saccade landing positions) 및 회귀(regressions)의 정밀한 공간적, 시간적 측정에 의존합니다1,2. 따라서 적절한 샘플링 속도, 정밀도 및 정확도를 갖춘 안구 추적기를 선택하는 것이 필수적이며, 특히 착륙 위치나 주변와 예견(parafoveal preview)과 같이 작은 공간적 오차에 민감한 측정 항목의 경우 더욱 그렇습니다. 구체적인 연구 제약 조건에 따라 이러한 방법들은 수정될 수 있습니다. 예를 들어, 턱 받침대를 견디지 못하는 신경다양성 인구 집단을 대상으로 연구할 때, 연구자는 원격 헤드프리(head-free) 추적기로 전환하고 더 큰 글꼴, 더 넓은 줄 간격 및 더 광범위한 관심 영역(Interest Areas)을 활용하여 공간적 정밀도의 손실을 보완할 수 있습니다. 헤드프리 시스템을 사용할 경우, 연구자는 증가된 움직임과 잠재적인 데이터 손실을 고려해야 합니다. 원격 추적기는 더 자연스러운 설정이 가능하다는 장점이 있지만, 대부분의 읽기 과제에서는 여전히 머리 고정이 더 선호됩니다.
실험 설계는 데이터의 품질과 해석 가능성 모두에 영향을 미치는 또 다른 핵심 요소입니다. 표준화된 화면 지침, 시행 무작위 배정 및 적절한 블록 구조는 세션 전반에 걸쳐 피험자의 안정적인 행동을 유지하는 데 도움이 됩니다. 특히 읽기 실험에서는 아주 작은 점진적 편차라도 텍스트 줄을 따라 누적될 수 있으므로, 정기적인 간격으로 드리프트 체크(drift check)를 포함하는 것이 매우 중요합니다. 또한 본 프로토콜은 언어 의존적 어휘 규범의 사용과 독립 변수 및 종속 변수의 투명한 보고를 지원하여, 연구 간의 재현과 비교를 용이하게 합니다.
데이터 수집 과정에서 정확도, 자세 및 참가자의 편안함을 지속적으로 모니터링하면 대규모 데이터 손실을 방지하는 데 도움이 됩니다. 흔히 발생하는 문제들에 대해서는 능동적인 문제 해결이 필요한 경우가 많습니다. 예를 들어, 화면 모서리에서 보정이 실패할 경우 모니터나 의자 높이를 조정함으로써 주변부 트래킹 손실 문제를 해결할 수 있습니다. 반사되는 안경이나 콘택트렌즈로 인한 문제는 주변 조명을 조절하거나 모니터 각도를 변경하여 해결할 수 있는 경우가 있습니다. 상세한 세션 로그를 작성하면 추후 문제 해결에 도움이 되며, 중단 사항, 재보정 및 예기치 않은 사건들을 기록함으로써 투명성을 강화할 수 있습니다. 최근 많은 발표 논문에서 정밀도와 데이터 손실률을 포함한 품질 지표의 명시적인 보고를 요구하고 있으므로 이는 점점 더 중요해지고 있습니다.
전처리 섹션에서는 이벤트 검출, 드리프트 보정 및 클리닝 루틴에서의 일관되고 잘 문서화된 선택을 강조합니다. 고정 분류 알고리즘과 임계값이 결과 측정치에 강한 영향을 미칠 수 있으므로, 연구자는 모든 파라미터 설정을 명시해야 하며 일반적인 기본값과 다를 경우 그 근거를 제시해야 합니다. 자동화된 도구를 적용하더라도 시각적 검토는 여전히 중요한 단계로 남습니다. 또한, 본 프로토콜은 연구 간의 더 신뢰할 수 있는 비교가 가능하도록 검증 정확도, 정밀도, 데이터 손실 및 드리프트 거동과 같은 표준 품질 지표를 보고할 것을 권장합니다.
또한, 이 프로토콜은 단어 길이, 빈도 또는 예측 가능성의 영향과 같이 읽기 행동에 대한 간단한 정밀도 검사(sanity checks)를 권장합니다. 이러한 전형적인 패턴을 재현함으로써 인지하지 못한 정렬 문제, 문제가 되는 표류(drift) 또는 전처리 오류에 대한 추가적인 안전장치를 마련할 수 있습니다. 이러한 검사는 전체 통계 분석을 대체하는 것은 아니지만, 데이터가 숙련된 읽기 과정에서 예상되는 대로 작동하는지에 대한 빠른 피드백을 제공합니다.
이미 언급된 실험 프로토콜의 세부 사항 외에도, 참가자들의 언어적 및 심리 측정적 특성을 기술하는 것이 중요합니다. 이에 대한 주요 근거는 실험 연구자들이 서로 다른 연구 간의 비교 가능성과 관련하여 직면하는 어려움 때문입니다. 이는 특히 오픈 사이언스 시대에 매우 중요한데, 공개적으로 이용 가능한 데이터셋을 원래 데이터를 수집하지 않은 연구자가 사용할 경우, 참가자들의 (사회)언어적 배경 차이로 인해 발생할 수 있는 잠재적인 특이성을 인지하지 못할 수 있기 때문입니다.
언어적 배경과 관련하여, 참여자의 모국어를 기록해야 하며, 결과에 영향을 미칠 수 있는 방언의 차이를 고려하기 위해 사용 중인 방언에 관한 정보를 수집해야 합니다. 오늘날의 일반적인 상황처럼 참여자가 두 개 이상의 언어를 사용하는 경우에는 제2언어 숙달도를 기록해야 합니다. 이중 언어 사용 또는 제2언어 처리 연구에서는 검증된 제2언어 배치 평가를 사용하여 제2언어 숙달도를 측정해야 합니다. 또한, 사회경제적 지위의 관련 측면(예: 참여자의 독서 습관)을 기록할 수 있습니다.
작업 기억 용량 및 인지적 유연성과 같은 참가자의 심리 측정적 특성을 평가하기 위한 테스트를 실시해야 합니다(특히 이중 언어 연구의 경우). 방법론적 관점에서 어떤 테스트를 선택할지, 그에 따른 인지적 요구도와 소요 시간, 그리고 실험 프로토콜 내에서 이러한 측정을 언제 수행할지(안구 추적 세션 전, 후 또는 별도의 세션에서 수행할지 여부)를 고려해야 합니다.
읽기 연구에서는 자극의 언어적 특성과 독자의 심리 측정적 특성(또는 참가자의 언어 행동과 관련된 기타 특징)을 모두 사용하여 언어 행동을 측정하고 설명한다는 점을 기억하는 것이 중요합니다1,12,17,20. 연구 간의 비교를 가능하게 하려면 데이터 해석과 관련될 수 있는 모든 요인이 포함되어야 합니다. 어떤 특성을 포함할지의 선택은 연구 목적에 따라 달라질 것입니다. 데이터는 비교 가능해야 합니다. 요약하자면, 잠재적 사용자가 데이터를 최대한 유연하게 사용할 수 있도록 충분히 상세하게 데이터를 수집하고 기술해야 합니다. 이러한 고려 사항이 프로토콜 자체의 일부는 아닐 수 있지만, 모든 개별 연구에 적용됩니다. 오늘날의 글로벌 과학 환경에서 이러한 세부 사항은 수집된 데이터의 향후 활용 가능성을 높여줍니다.
본 프로토콜에는 몇 가지 한계점이 있으며, 가장 눈에 띄는 것은 데이터 품질과 생태적 타당성 사이의 절충점입니다. 머리를 고정한 채 정적인 모니터를 읽는 방식은 자연스러운 읽기 행동을 완전히 포착하지 못하며, 엄격한 시각적 포함 기준은 표본의 대표성을 제한할 수 있습니다. 또한, 시선 추적기는 좌표 스케일링, 타임스탬프 정밀도 및 이벤트 분류 방식에서 상당한 차이를 보입니다. 본 프로토콜의 한계는 이러한 변동성이 연구실 간 또는 하드웨어 브랜드 간의 재현성에 어떤 영향을 미치는지 명확히 설명하지 않는다는 점입니다. 따라서 장치 간 검증을 위한 지침을 마련하고, 실험실 패러다임을 몰입형 가상현실(VR) 또는 증강현실(AR) 읽기 환경으로 조정하거나 인지 및 주의력 장애를 위한 디지털 바이오마커를 개발하는 것과 같은 현실적인 미래 응용 방안을 수립하는 것이 중요한 공백을 메우는 길이 될 것입니다.
종합적으로, 본 프로토콜은 기존의 방법론적 지침을 통합하여 읽기 과정에서 고품질의 시선 추적 데이터를 수집하기 위한 명확하고 투명한 워크플로우를 제공합니다. 연구자들은 제시된 단계들을 수행하고 관련 품질 지표를 보고함으로써 읽기 연구의 재현성과 신뢰성을 높일 수 있으며, 해당 분야 전반에 걸쳐 더 강력한 방법론적 일관성을 확립하는 데 기여할 수 있습니다.
감사의 글
연구비 지원: 본 프로젝트는 COST–European Cooperation in Science and Technology (CA2131–Enabling multilingual eye-tracking data collection for human and machine language processing research (MultiplEYE), https://www.cost.eu/actions/CA2131)24, 포르투갈 과학기술재단(Foundation for Science and Technology, Portugal)(연구비 번호: UID/214/2025, UI/BD/15450/2022), 그리고 야기엘로니안 대학교 전략 프로그램 우수성 이니셔티브 우선 연구 분야 DigiWorld (ID.UJ) 프로젝트 “Cognitive Aspects of Interaction and Communication in Natural and Artificial Agents”의 지원을 받아 수행되었습니다. 기술적 지원을 아끼지 않은 Anna Maria Wilkosz에게 감사드립니다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| 알코올 스왑 (70% isopropyl) | 세척 도구 | 현지 실험실 공급처 | |
| 높이 조절 가능 턱 받침대 | 머리 고정 장치 | 다양한 실험실 공급처 | |
| 동의서 및 디브리핑 자료 | 문서화 | 기관 승인 템플릿 | |
| 아이트래커 (예: SR Research EyeLink 10 Plus, Tobii Pro Fusion) | 시선 추적 하드웨어 | SR Research Ltd., Tobii AB | |
| 시선 추적 데이터 분석 소프트웨어 (Data Viewer, Tobii Pro Lab) | 안구 운동 데이터 분석 소프트웨어 | SR Research Ltd., Tobii AB | |
| 시선 추적 소프트웨어 (예: Experiment Builder, Tobii Pro Lab, PsychoPy) 및 해당 SDK | 자극 제시 소프트웨어 및 소프트웨어 개발 키트 | SR Research Ltd., Tobii AB, Open source | |
| 데이터 분석용 범용 소프트웨어 (lme4, ggplot2가 포함된 R, JASP, Pandas, NumPy, Matplotlib이 포함된 Python) | 데이터 전처리 및 분석 | Open source, https://www.python.org, https://www.r-project.org, https://www.jasp.org | |
| 실험 설계용 범용 소프트웨어 (PsychoPy) | 자극 제시 소프트웨어 | Open source, https://www.psychopy.org | |
| 기타 서드파티 소프트웨어 (예: E-Prime) | 자극 제시 소프트웨어 | Psychology Software Tools, Inc. | |
| 방음실 | 환경 제어 | 기관 시설 | |
| 표준 24인치 LCD 모니터 (또는 그 이하) | 디스플레이 장치 | ISO 준수 모든 제조업체 |
참고문헌
- Rayner, K. Eye movements in reading and information processing: 20 years of research. Psychol Bull. 124, 372-422 (1998).
- Rayner, K. Eye movements and attention in reading, scene perception, and visual search. Q J Exp Psychol. 62, 1457-1506 (2009).
- Carter, B. T., Luke, S. G. Best practices in eye tracking research. Behav Res Methods. 52, 278-295 (2020).
- Hessels, R. S., et al. The fundamentals of eye tracking part 1: The link between theory and research question. Behav Res Methods. 56, 16(2024).
- Hooge, I. T. C., et al. The fundamentals of eye tracking part 2: From research question to operationalization. Behav Res Methods. 57, 73(2025).
- Nyström, M., et al. The fundamentals of eye tracking part 3: How to choose an eye tracker. Behav Res Methods. 57, 67(2025).
- Niehorster, D. C., et al. The fundamentals of eye tracking part 4: Tools for conducting an eye tracking study. Behav Res Methods. 57, 46(2025).
- Hessels, R. S., et al. The fundamentals of eye tracking part 5: The importance of piloting. Behav Res Methods. 57, 216(2025).
- Dunn, M. J., et al. Minimal reporting guideline for research involving eye tracking (2023 edition). Behav Res Methods. 56, 4351-4357 (2024).
- Eskenazi, M. A. Best practices for cleaning eye movement data in reading research. Behav Res Methods. 56, 2083-2093 (2024).
- Schotter, E. R., Dillon, B. A beginner’s guide to eye tracking for psycholinguistic studies of reading. Behav Res Methods. 57, 68(2025).
- Conklin, K., Pellicer-Sánchez, A. Using eye tracking in applied linguistics and second language research. Second Lang Res. 32 (3), 453-468 (2016).
- Pellicer-Sánchez, A. Eye-tracking in vocabulary research: Introduction to the special issue. Res Methods Appl Linguist. 3 (1), 100095(2024).
- Hutton, S. B. Eye-tracking methodology. Eye movement research: An introduction to its scientific foundations and applications. , Springer International Publishing. 277-308 (2019).
- Pokhoday, M. Y., et al. Eye tracking methods in psycholinguistics and parallel EEG recording. Neurosci Behav Physi. 53, 220-229 (2023).
- Azman, H., Mihat, W., Soh, O. K. Analyzing stimuli presentations and exit-interview protocols to improve wearable eye-tracking data collection guidelines for reading research. IJCALLT. 11 (2), 51-65 (2021).
- Papadopoulos, T. C., et al. Eye-tracking in reading research: A systematic review of studies with children of varying reading ability. Eur Psychol. , (2026).
- Garlichs, A., Lustig, M., Gamer, M., Blank, H. Protocol to study how expectations guide predictive eye movements and information sampling in humans. STAR Protoc. 6 (2), 103737(2025).
- Moreno, J., León, J., Kaakinen, J. K., Hyönä, Relevance instructions combined with elaborative interrogation facilitate strategic reading: Evidence from eye movements. J Psicol Educ. 27 (1), 51-65 (2020).
- Acartürk, C. Eyes on Text: Eye movements in reading and language processing. , John Benjamins. (2025).
- Steinhauer, S. R., Bradley, M. M., Siegle, G. J., Roecklein, K. A., Dix, A. Publication guidelines and recommendations for pupillary measurement in psychophysiological studies. Psychophysiology. 59 (4), e14035(2022).
- Papesh, M. H., Goldinger, S. D. Modern pupillometry: Cognition, neuroscience, and practical applications. , Springer. (2024).
- Salvucci, D. D., Goldberg, J. H. Identifying fixations and saccades in eye-tracking protocols. Proc Symposium Eye Tracking Res Appl, , 71-78 (2000).
- Jakobi, D. N., et al. MultiplEYE: creating a multilingual eye-tracking-while-reading corpus. Proc Symposium Eye Tracking Res Appl, , ACM. 111(2025).