본 논문은 You Only Look Once 버전 11 (YOLOv11)과 합성곱 신경망(convolutional neural networks)을 통합한 생산 라인 안전 모니터링 방법을 제안합니다. 이 방법은 그래픽 처리 장치(graphics processing unit)에서 0.5 intersection-over-union 임계값에서의 평균 정밀도 평균(mAP@0.5) 0.91, mAP@0.5:0.95 0.82, 초당 120 프레임을 달성하여 평가된 베이스라인 모델들보다 우수한 성능을 보였습니다.
이 콘텐츠를 보려면 JoVE 구독이 필요합니다. 로그인하거나 오늘 무료 평가판을 시작하세요.
이 논문에서
요약
초록
Industry 4.0가 심화됨에 따라 생산 라인의 자동화 및 지능화 수준이 크게 향상되었으며, 이에 따라 모니터링의 실시간 성능, 정확도 및 안전성에 대한 요구사항이 높아졌습니다. 수동 점검이나 단순 임계값 기반 결정에 의존하는 기존 모니터링 시스템은 일반적으로 응답 시간이 느리고 오경보율이 높으며 지능 수준이 제한적이라는 단점이 있습니다. 따라서 본 논문에서는 You Only Look Once version 11 (YOLOv11)과 합성곱 신경망 (CNN)을 결합한 생산 라인 안전 모니터링 시스템을 제안합니다. 먼저, 획득한 이미지를 전처리하였습니다. 그 다음, YOLOv11을 사용하여 작업자, 장비 및 잠재적 위험 요소를 실시간으로 식별하였습니다. 이어서, 작고 가려진 대상에 대한 특징 추출 능력을 향상시키기 위해 다중 스케일 특징 융합 및 어텐션 메커니즘이 적용된 강화된 CNN 네트워크를 도입하였습니다. 마지막으로, 탐지 결과를 CNN 강화 특징과 융합하여 안전 상태를 평가하였습니다. 자체 구축한 생산 라인 안전 데이터셋을 사용하여 실험을 수행하였으며, 모멘텀 0.9인 확률적 경사 하강법 (SGD) 최적화 도구, 초기 학습률 0.01, 가중치 감쇠 0.0005, 코사인 어닐링 학습률 조정, 배치 크기 32 및 200 epoch 학습을 적용하였습니다. 평가 기준 알고리즘과의 비교를 위한 평가 지표로는 mAP@0.5 및 초당 프레임 수 (FPS)의 탐지 속도를 사용하였습니다. 결과적으로 제안된 시스템은 0.91의 mAP@0.5와 120 FPS의 탐지 속도를 달성하였습니다. 또한 음영 및 다양한 조명과 같은 복잡한 조건에서도 강건한 성능을 보여주어, 생산 라인 안전 모니터링에서의 효과와 실제 적용 가능성을 입증하였습니다.
서론
현대 산업 생산에서 안전은 생산 효율성과 인원 복지를 보장하는 초석입니다. 생산 라인 환경은 일반적으로 고속 기계 장비, 복잡한 기술 공정, 그리고 여러 과업이 포함된 협업 작업으로 구성됩니다. 아주 작은 잠재적 안전 위험 요소라도 심각한 생산 사고로 이어져 상당한 경제적 손실과 심지어 인명 피해를 초래할 수 있습니다. 따라서 산업 생산의 안전성을 향상시키기 위해 효율적이고 지능적인 실시간 안전 모니터링 시스템을 구축하는 것이 매우 중요합니다1,2.
전통적인 안전 모니터링 방법은 주로 수동 비디오 감시와 다양한 센서(적외선, 연기 및 진동 센서 등)3에 의존합니다. 수동 모니터링은 효율성이 떨어질 뿐만 아니라, 모니터링 인원의 피로로 인해 탐지 누락이 발생하기 쉽고, 지속적이고 포괄적인 커버리지를 제공할 수 없습니다. 센서는 일정 수준의 조기 경보 기능을 제공할 수 있지만, 탐지 범위가 제한적이고 환경적 간섭에 민감하여 오경보라는 두드러진 문제가 발생합니다4. 이에 따라 지능형 모니터링 시스템이 점점 더 연구의 중심이 되고 있습니다. 딥러닝 알고리즘을 사용하여 비디오 스트림을 실시간으로 분석하면 이상 이벤트, 불안전한 행동 및 잠재적 위험을 자동으로 식별할 수 있으며, 이를 통해 모니터링 시스템의 지능을 크게 향상시킬 수 있습니다4,5.
객체 탐지는 지능형 모니터링의 핵심 기술입니다. 1단계 객체 탐지기의 대표 주자인 You Only Look Once (YOLO) 시리즈 알고리즘은 상당한 강점을 보여줍니다. YOLOv1부터 YOLOv8에 이르기까지, 이 알고리즘 모음은 네트워크 아키텍처, 손실 함수 및 학습 방법론 등 여러 측면에서 지속적인 발전을 거듭해 왔습니다6,7. 특히 YOLOv11은 복잡한 배경과 밀집된 타겟에 직면했을 때도 높은 프레임 속도를 유지하면서 더 높은 탐지 정확도를 달성했습니다8.
하지만 일반적인 객체 검출 작업에서의 우수한 성능에도 불구하고, YOLOv11은 특정 생산 라인 안전 모니터링 시나리오에서 여전히 어려움에 직면해 있습니다9. 예를 들어, 작업자가 장비에 의해 부분적으로 가려지거나 안전 표지판이 작고 배경색과 매우 유사한 경우 YOLOv11의 검출 정확도가 감소할 수 있습니다. 이를 위해서는 모델이 더 강력한 특징 추출 및 의미론적 이해 능력을 갖추어야 합니다10.
합성곱 신경망(Convolutional neural networks, CNNs)은 이미지 특징 추출 분야에서 강력한 성능을 가지고 있습니다11. 더 깊고 복잡한 네트워크 구조를 설계함으로써, CNN은 더 풍부하고 추상적인 이미지 특징을 학습할 수 있습니다. CNN을 YOLOv11과 결합하면 YOLOv11의 빠른 탐지 능력과 CNN의 심층 특징 추출 기능을 활용할 수 있어, 더욱 견고하고 지능적인 안전 모니터링 시스템을 구축할 수 있습니다.
이를 바탕으로, 본 논문은 YOLOv11과 CNN을 이용한 생산 라인 안전 모니터링 시스템을 제안합니다. 본 연구의 혁신적인 측면은 다음과 같습니다: (1) YOLOv11과 개선된 CNN의 딥 퓨전 아키텍처를 제안함; (2) 주요 안전 특성의 인식 능력을 향상시키기 위해 다중 스케일 특징 퓨전 및 복합 어텐션 메커니즘을 도입함; (3) 자체 구축한 복잡한 장면 데이터셋을 통해 모델의 성능 우위를 검증함.
YOLO 시리즈 알고리즘의 발전
2015년 Redmon 등에 의해 처음 소개된 이후12, You Only Look Once (YOLO) 알고리즘은 상당한 관심을 끌었습니다. 영역 제안(region proposals)에 의존하는 2단계 검출기와 달리, YOLO는 객체 검출을 회귀 작업으로 처리합니다. 이미지 내 객체의 클래스와 위치를 직접 예측함으로써 YOLO는 검출 속도를 현저히 높였으며, 이를 통해 실시간 사용에 적합하게 되었습니다13.
이 시리즈의 선구적인 연구로서, YOLOv1은 최초로 엔드투엔드 대상 검출을 구현하였습니다.14YOLOv1은 입력 이미지를 그리드 구조로 분할하는 방식을 포함하며, 여기서 각 그리드 셀은 일반적으로 다음과 같이 배치됩니다. S × S 형식은 그 경계 내에 들어오는 객체를 검출하는 작업을 수행합니다.
구체적으로, YOLOv1의 출력은 텐서입니다. S × S × (B × 5 + C) 중에서, 각 바운딩 박스의 예측은 중심점 좌표(x,y), 너비 w, 높이 h, 그리고 신뢰도 c의 5개 요소로 구성됩니다. 계산 과정은 식 (1)에 나타나 있습니다:
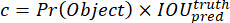 (1)
그중 Pr(Object)는 그리드 내에 타겟이 존재할 확률을 나타내며, IOU는 예측된 바운딩 박스와 실제 정답(ground-truth) 박스 사이의 교집합 영역을 합집합 영역으로 나눈 비율을 나타냅니다. 또한 각 그리드는 타겟이 존재할 때 해당 타겟이 i번째 클래스에 속할 확률을 나타내는 클래스 확률 세트 Pr 를 예측합니다. YOLOv1의 손실 함수는 좌표 예측 손실, 신뢰도 추정 손실, 카테고리 예측 손실의 세 가지 주요 구성 요소로 이루어져 있습니다15.
YOLOv2는 안정성과 정확도를 향상시키기 위해 Batch Normalization, 고해상도 분류기 및 다중 스케일 훈련 전략을 도입했습니다16. YOLOv3는 Darknet-53를 백본 네트워크로 사용하며, 타겟 검출을 강화하기 위해 Feature Pyramid Network (FPN) 개념에서 영감을 얻었습니다17.
YOLOv4는 YOLOv3를 기반으로 수많은 최적화를 수행하였으며, 모델 성능을 더욱 향상시키기 위해 Cross Stage Partial Network (CSPNet)18, Path Aggregation Network (PANet)19 및 Mosaic 데이터 증강과 같은 기술들을 도입하였습니다. YOLOv5는 더 사용하기 쉽고 효율적인 구현을 제공함으로써 공학적으로 상당한 기여를 하였습니다20.
최근 몇 년 동안 YOLO 시리즈는 YOLOv6, YOLOv7, YOLOv8와 같은 버전들이 잇따라 출시되며 계속해서 진화해 왔습니다. YOLOv7은 확장 효율적 레이어 집계 네트워크(Extended Efficient Layer Aggregation Network, E-ELAN) 구조와 모델 재매개변수화 기술을 도입함으로써 속도와 정확도 모두에서 새로운 돌파구를 마련했습니다. 이러한 향상은 특징 학습의 효율성을 높일 뿐만 아니라 네트워크의 추론 성능을 최적화하여, YOLOv7이 다양한 실시간 객체 탐지 작업에서 이전 버전들과 많은 주류 탐지기들을 능가할 수 있게 했습니다. YOLOv8은 네트워크 구조를 더욱 최적화하고, 앵커 프리(anchor-free) 설계를 채택하여 모델을 단순화하였으며, 일반화 능력을 향상시켰습니다21.
이 연구에 사용된 YOLOv11은 이전 버전들의 장점을 기반으로 복잡한 산업 현장에 최적화되었습니다. 주요 개선 사항으로는 특징 추출 네트워크, 더욱 효율적인 특징 융합 모듈 및 더 견고한 손실 함수 설계가 포함됩니다. 이러한 개선을 통해 YOLOv11은 생산 환경의 폐쇄물, 소형 타겟 및 복잡한 배경을 처리할 때 더 나은 성능을 발휘합니다. YOLOv11은 Ultralytics에서 출시한 YOLO 시리즈의 한 버전입니다. YOLOv8과 비교하여 C3K2 모듈과 특징 융합 경로를 개선하였으며, 적응형 앵커 박스 전략을 도입하여 산업 현장에서 더 강력한 검출 견고성을 제공합니다.
합성곱 신경망(CNN)의 기초 및 발전
합성곱 신경망(CNN)은 컴퓨터 비전 분야에서 딥러닝의 성공에 지대한 영향을 미친 핵심 모델입니다. CNN은 합성곱 연산을 통해 이미지의 지역적 특징을 추출하고, 이후 풀링 연산을 통해 특징의 차원을 축소함으로써 계층적인 이미지 추상화를 구현합니다22.
전형적인 CNN은 여러 개의 합성곱 층, 풀링 층 및 완전 연결 층으로 구성됩니다. 합성곱 층은 합성곱 커널을 사용하여 입력 이미지를 스캔하고, 국소 영역에 대해 내적을 계산하여 특징 맵을 생성합니다. 계산 과정은 식 (2)에 나타나 있습니다:
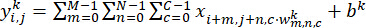 (2)
여기서 x는 입력 이미지, wk와 bk는 각각 컨볼루션 커널의 가중치와 편향이며,  은 위치 (i,j)에서의 출력 특성 맵 값입니다. 풀링 층은 일반적으로 Max Pooling 또는 Average Pooling을 사용합니다. 완전 연결 층은 특성을 추출하고 분류 확률을 예측하는 역할을 합니다.
이를 바탕으로, 본 논문에서는 YOLOv11을 위한 CNN 특징 강화 모듈을 설계하였으며, 이는 두 개의 병렬 브랜치로 구성됩니다. 하나는 3 × 3 및 5 × 5 컨볼루션 커널을 사용하여 다중 스케일 특징을 추출하는 다중 스케일 컨볼루션 브랜치이며, 다른 하나는 채널 주의 집중(Squeeze-and-Excitation) 및 공간 주의 집중 모듈을 순차적으로 연결하여 주요 타겟의 판별적 특징을 강화하는 주의 집중 브랜치입니다. 두 브랜치의 출력은 요소별 덧셈(element-wise addition)을 통해 융합되며, 이에 해당하는 특징 강화 손실 함수는 식 (3)에 나타나 있습니다.
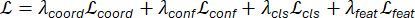 (3)
Lcoord는 바운딩 박스 좌표 회귀 손실이며, Lconf는 타겟 신뢰도 손실이고, Lcls는 카테고리 분류 손실입니다. Lfeat는 특징 강화 손실로, CNN 강화 모듈에 의해 추출된 소형 타겟 및 가려진 타겟의 판별적 특징을 제한하는 데 사용됩니다. λcoord, λconf, λcls, λfeat는 해당 손실 항의 가중치 계수입니다. 본 작업에서는 λfeat = 0.05로 설정하였으며, 나머지 가중치는 검출 작업 요구 사항에 따라 균형을 맞추었습니다.
VGGNet23 및 ResNet24와 같은 고전적인 CNN 구조는 이미지 분류 작업에서 큰 성공을 거두었습니다. 이러한 아키텍처 중에서 ResNet은 심층 네트워크 학습 시 발생하는 기울기 소실 문제를 효과적으로 완화하여, 더 깊고 복잡한 네트워크 구조를 구축하는 것을 용이하게 합니다.
객체 검출 작업에서 CNN은 일반적으로 특징 추출기(백본)로 사용됩니다. 예를 들어, YOLO 시리즈 알고리즘의 Darknet, cross-stage partial Darknet (CSPDarknet) 등은 모두 CNN을 기반으로 구축되었습니다25. 특징 추출 능력을 향상시키기 위해 연구자들은 수많은 개선된 CNN 구조를 제안해 왔습니다. 예를 들어, Inception 모듈은 다중 스케일 컨볼루션 커널을 통해 병렬로 특징을 추출합니다. DenseNet은 조밀한 연결(dense connections)을 통해 특징 재사용성을 높입니다. Squeeze-and-Excitation Network는 어텐션 메커니즘을 통해 특징 채널의 중요도를 적응적으로 조정합니다26.
본 연구에서는 YOLOv11의 특징 추출 능력을 향상시키기 위해 개선된 CNN 모듈을 설계하였습니다. 이 모듈은 다중 스케일 특징 융합과 어텐션 메커니즘을 결합하여 생산 라인 시나리오의 핵심 안전 정보를 더욱 효과적으로 포착합니다.
산업 안전 모니터링에서의 딥러닝 적용 현황
딥러닝은 산업 안전 모니터링 분야에서 상당한 주목을 받고 있습니다. CNN 기반 알고리즘은 작업자의 안전모 착용 여부 판별, 위험 구역으로의 무단 침입 감지, 그리고 오작동 장비의 상태 모니터링 등에 활용되고 있습니다27.
행동 인식 측면에서는 3D CNN과 순환 신경망을 사용하여 작업자의 작업 행동을 분석하고 잠재적으로 위험한 행동을 식별합니다. 예를 들어, 작업자의 자세 시퀀스를 분석함으로써 안전 작업 절차를 위반하고 있는지 여부를 판단할 수 있습니다28.
YOLO와 Faster R-CNN은 실시간 감시 비디오에서 인원 및 장비 검출을 위해 널리 사용됩니다. 예를 들어, 문헌에서는 YOLOv5 기반의 실시간 헬멧 검출 시스템이 제안되었으며, 이는 건설 현장 안전 관리의 지능화를 효과적으로 향상시켰습니다29.
기존 연구에서 어느 정도 진전이 있었음에도 불구하고, 몇 가지 과제가 남아 있습니다. 첫째, 산업 현장은 일반적으로 복잡한 조명, 가려짐 및 배경 간섭이 특징이며, 이는 알고리즘의 강건성에 엄격한 요구 사항을 부과합니다. 둘째, 실시간 성능이 핵심 요구 사항이며, 알고리즘은 정확도를 유지하면서 고속 추론을 달성해야 합니다. 마지막으로, 기존 연구는 주로 단일 작업 탐지에 집중되어 있으며, 다중 소스 정보 융합 및 종합적 분석에 대한 탐구가 부족한 실정입니다30.
본 연구에서 제안하는 YOLOv11 및 CNN 융합 모델은 특성 추출 및 융합 능력을 강화함으로써 앞서 언급한 문제들을 해결하고, 생산 라인의 안전 위험에 대한 포괄적인 실시간 모니터링을 달성하는 것을 목표로 합니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
프로토콜
YOLOv11 및 CNN 알고리즘
시스템 전체 아키텍처
본 논문에서 제안하는 생산 라인 안전 모니터링 시스템은 고정밀, 고속 실시간 안전 모니터링을 달성하기 위해 YOLOv11과 개선된 CNN을 결합한 하이브리드 아키텍처를 채택합니다. 그림 1에 나타난 바와 같이, 시스템은 주로 입력 전처리 모듈, YOLOv11 객체 검출 모듈, CNN 특징 강화 모듈 및 융합 결정 모듈로 구성됩니다. 입력 이미지는 먼저 전처리 모듈에 의해 정규화 및 증강되어 모델의 일반화 능력을 향상시킵니다. 이후 CSPDarknet 백본에 의해 특징이 추출되며, spatial pyramid pooling-fast (SPPF) 모듈을 통해 수용 영역(receptive field)이 확장됩니다. 업샘플링 후 다중 스케일 특징이 융합되며, 융합된 특징에 채널 어텐션과 공간 어텐션이 순차적으로 적용되어 주요 타겟의 판별적 표현력을 더욱 강화합니다. CNN 특징 강화 모듈은 YOLOv11 백본 네트워크의 C3, C4, C5 레이어 출력 뒤에 삽입되어 각각 80 × 80 × 256, 40 × 40 × 512, 20 × 20 × 1,024 크기의 다중 스케일 특징 맵을 전달받습니다. CNN 특징 강화 모듈은 작거나 가려진 타겟에 대한 특징 추출을 더욱 강화합니다. 마지막으로 융합 결정 모듈은 YOLOv11의 검출 결과와 CNN 강화 특징을 결합하고, 설계된 손실 함수를 통해 이를 공동 최적화하여 타겟의 정확한 위치, 카테고리 및 신뢰도 점수를 출력합니다.
YOLOv11 검출 프레임워크
YOLOv11은 YOLO 시리즈의 단일 단계 검출 프레임워크가 가진 강점을 활용하여 여러 가지 중요한 개선 사항을 도입했습니다. 해당 아키텍처는 백본 네트워크, 특징 융합 네트워크, 검출 헤드의 세 가지 주요 구성 요소로 나뉩니다. 백본 네트워크는 강화된 CSPDarknet 구조를 사용합니다. 특징 융합 네트워크는 특징 피라미드 네트워크와 경로 집계 네트워크에서 영감을 받아 다중 규모 특징을 효과적으로 병합하기 위해 교차 단계 로컬 연결과 깊이별 분리 컨볼루션을 통합하였습니다.
특징 강화 모듈
특징 강화 모듈은 주요 안전 특징에 대한 모델의 민감도를 향상시키는 것을 목표로 합니다. 이 모듈은 YOLOv11 백본 네트워크의 각 층에서 생성된 특징 맵을 처리하며, 업샘플링 및 다운샘플링 연산을 통해 서로 다른 스케일 간의 정보를 융합합니다. 구체적으로, 다중 스케일 분기는 공간적 스케일의 다양성을 포착하고, 어텐션 분기는 주요 채널과 위치 응답을 동적으로 강화합니다. 이 두 분기는 독립적으로 작동하지 않고 잔차 연결 및 특징 재보정을 통해 상호 보완적으로 융합됩니다. 각 스케일에서 강화 모듈에 의해 처리된 특징 맵은 1 × 1 컨볼루션을 통해 원래 특징 맵의 채널 수와 일치하도록 조정된 후, 요소별 덧셈을 통해 원래의 YOLOv11 특징 맵과 융합됩니다. 이렇게 융합된 특징 맵은 이후 다중 스케일 융합을 위해 특징 피라미드 네트워크(FPN)로 입력되어 계층적 안전 특징 표현을 형성합니다. 모듈 간의 원활한 통합을 보장하기 위해 엔드-투-엔드 공동 학습 전략이 채택되었으며, 손실 함수는 YOLOv11 검출 손실과 CNN 모듈 특징 강화 손실로 구성됩니다.
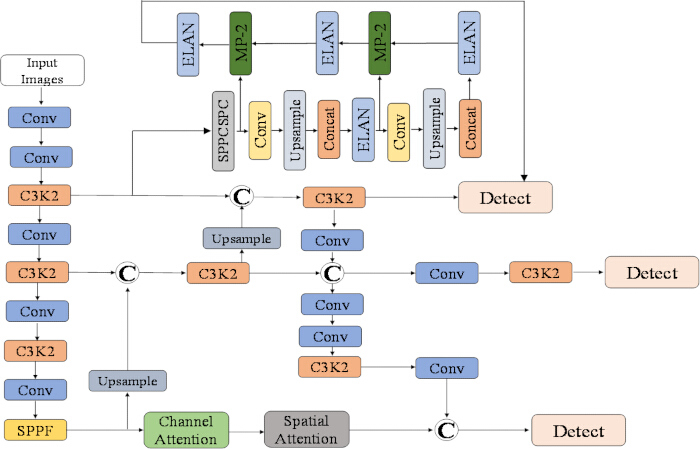
그림 1YOLOv11-CNN 알고리즘. 특징 강화 모듈은 주요 안전 특징에 대한 모델의 민감도를 증폭시키는 것을 목표로 합니다. 이 모듈은 YOLOv11 백본의 다양한 레이어에서 추출된 특징 맵을 처리하며, 업샘플링 및 다운샘플링 연산을 통해 서로 다른 스케일의 특징들을 융합합니다. 또한, 채널 및 공간 주의 집중 메커니즘을 통합합니다. YOLOv11과 CNN 모듈 간의 원활한 통합을 보장하기 위해 공동 학습 전략이 채택되었습니다. 학습 과정에서 두 모듈의 파라미터는 엔드투엔드로 최적화됩니다. 손실 함수는 YOLOv11의 검출 손실과 CNN 모듈의 특징 강화 손실을 결합하여 구성됩니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
결과
제안된 YOLOv11 및 CNN 융합 모델의 생산 라인 안전 모니터링 효율성을 검증하기 위해 다양한 안전 위험 시나리오를 포함하는 데이터셋을 구축하였다. 이 데이터셋은 12,000장의 생산 라인 장면 이미지로 구성되었으며, 고정 랜덤 시드 42를 사용하여 훈련, 검증 및 테스트 세트로 7:1.5:1.5 비율로 나누었다. 데이터셋은 표준 조명, 저조도, 부분 가림, 심한 가림, 모션 블러 및 복잡한 배경을 포함한 다양한 작업 조건을 포괄한다. 추론을 위한 신뢰도 임계값은 0.5로, 비최대 억제(NMS) 임계값은 0.45로 설정하였다. 모든 실험은 3회 반복 수행하였으며, 결과는 평균 ± 표준 편차로 보고하였다. 어노테이션 카테고리는 작업자, 안전모, 로봇 팔, 위험 구역, 도구 및 차량으로 설정하였으며 PASCAL Visual Object Classes (VOC) 형식을 사용하였다. IoU(intersection-over-union) 임계값은 0.5로 설정하였고, 2인 교차 검증을 통해 어노테이션 일관성을 확인하였다. 입력 이미지...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
토론
실험 결과, 제안된 YOLOv11–CNN 융합 모델이 생산 라인 안전 모니터링의 검출 정확도와 실시간 성능을 향상시키는 것으로 나타났습니다. YOLOv11의 효율적인 단일 단계 검출과 CNN 모듈의 특징 강화 기능을 활용하여, 시스템은 복잡한 조명 및 가려짐 조건에서도 작업자, 장비 및 위험 구역을 식별했습니다. 다중 스케일 특징 융합과 어텐션 메커니즘을 통해 핵심 안전 요소에 집중하는 능력이 강화되었으며, 이를 통해 조기 경보를 위한 해석 가능한 시각적 근거를 제공했습니다.
이 시스템은 실시간 모니터링을 통해 수동 검사에 대한 의존도를 낮추고 잠재적인 안전 위험에 대한 대응 시간을 단축할 수 있어, 자동차 제조 및 전자 제품 조립과 같은 환경의 생산 라인에서 실용적인 가치를 가집니다. 나사나 공구와 같은 작은 대상물, 그리고 로봇 팔이나 기타 장비에 의해 부분적으로 가려진 작업자 대상물의 경우, 다중 스케일 특징 융합 및 어텐션 메커니즘이 안전 관련 특징을 추출하고 강조하는 모...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
공개 사항
저자들은 선언할 이해상충이 없습니다.
감사의 글
본 연구는 타이저우 대학교 고위 인재 과학 연구 재단의 "지능형 제조를 위한 정밀 검측 핵심 기술 연구"(TZXY2020QDJJ006)의 지원을 일부 받아 수행되었습니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| COCO API | 해당 없음 | 타겟 검출 정확도 평가 및 통계 분석에 사용된 평가 도구. | |
| CUDA 11.4 | NVIDIA | 해당 없음 | PyTorch 1.12 프레임워크와 함께 사용된 병렬 컴퓨팅 플랫폼. |
| Edge TPU | 해당 없음 | 지연 시간 및 전력 소비 테스트에 사용된 배포 플랫폼; 보고된 지연 시간은 18 ms, 전력 소비는 15 W임. | |
| Jetson Xavier 엣지 컴퓨팅 장치 | NVIDIA | 처리량 테스트에 사용된 엣지 컴퓨팅 장치; 보고된 처리 속도는 70 FPS이며 99% 백분위수 지연 시간은 50 ms 이내임. | |
| NVIDIA Tesla V100 GPU | NVIDIA | 학습/평가 서버에 사용된 GPU. | |
| PyTorch 1.12 | 해당 없음 | 모델 학습 및 평가에 사용된 딥러닝 프레임워크. | |
| scikit-learn | 해당 없음 | 모델 평가에 사용된 평가/통계 분석 도구. | |
| 자체 구축 생산 라인 안전 데이터셋 | 해당 없음 | 해당 없음 | VOC 형식의 생산 라인 장면 이미지 12,000장으로 구성된 데이터셋으로, 표준 조명, 저조도, 부분 가려짐, 심한 가려짐, 모션 블러 및 복잡한 배경을 포함함; 어노테이션 카테고리는 작업자, 안전모, 로봇 팔, 위험 구역, 도구, 차량의 6가지임. |
| 학습 서버 | NVIDIA Tesla V100 GPU와 Ubuntu 20.04 운영체제가 탑재된 서버. | ||
| Ubuntu 20.04 운영체제 | 해당 없음 | 학습/평가 서버에서 사용된 운영체제. | |
| VOC 어노테이션 형식 | 해당 없음 | 해당 없음 | 자체 구축 생산 라인 안전 데이터셋에 사용된 어노테이션 형식. |
| YOLOv11 객체 검출 모델 | Ultralytics | 해당 없음 | 작업자, 장비 및 잠재적 위험 요소를 실시간으로 검출하는 데 사용된 객체 검출 모델. |
참고문헌
- Ramadan MNA, Ali MAH, Jaber H, Alkhedher M. Blockchain-secured IoT-federated learning for industrial air pollution monitoring: a mechanistic approach to exposure prediction and environmental safety. Ecotoxicol Environ Saf. 2025;300:118442.
- Ahn J, et al. SafeFac: video-based smart safety monitoring for preventing industrial work accidents. Expert Syst Appl. 2023;215:119397.
- Natha S, et al. A scalable and generalized deep ensemble model for road anomaly detection in surveillance videos. Comput Mater Contin. 2024;81(3):3707-3729.
- Diallo AR, Homri L, Dantan JY. Reducing false alarms in fault detection: a comparative analysis between conformal prediction and classical methods applied to PCA and autoencoders. J Process Control. 2025;152:103495.
- Cheng X, Han Y, Zhang W. Development of intelligent monitoring system for soil erosion in pipeline engineering based on deep learning. Comput Electr Eng. 2025;126:110432.
- Yan H, et al. A global feature fusion and adaptive optimization method to enhance detection accuracy and computational efficiency based on YOLOv8. Alexandria Eng J. 2025;129:538-552.
- Samma H, Al-Azani S, El-Ferik S. UAV-based real-time face detection using YOLOv7. Transp Res Procedia. 2025;84:331-338.
- Gong X, Yu J, Zhang H, Dong X. AED-YOLO11: a small object detection model based on YOLO11. Digit Signal Process. 2025;166:105411.
- Li R, Xiao K, Lin S, Wu Z. Enhancing aquatic ecosystem monitoring through fish jumping behavior analysis and YOLOv5: applications in freshwater fish identification. J Environ Manage. 2025;391:126413.
- Zhang D, Gao Q, Chen Z, Lin Z. Semantic feature refinement of YOLO for human mask detection in dense crowded. J Vis Commun Image Represent. 2025;107:104399.
- Choi MJ, Ku DG, Lee SJ. Integrated YOLO and CNN algorithms for evaluating degree of walkway breakage. KSCE J Civ Eng. 2022;26(8):3570-3577.
- Li Y, et al. Underwater acoustic intelligent spectrum sensing with multimodal data fusion: an Mul-YOLO approach. Future Gener Comput Syst. 2025;173:107880.
- Jiang D, et al. Real-time tracker of chicken for poultry based on attention mechanism-enhanced YOLO-Chicken algorithm. Comput Electron Agric. 2025;237:110640.
- Yang X, et al. Automated concrete bridge damage detection using an efficient Vision Transformer-enhanced anchor-free YOLO. Engineering. 2025;51:311-326.
- Fuertes D, et al. People detection with omnidirectional cameras using a spatial grid of deep learning foveatic classifiers. Digit Signal Process. 2022;126:103473.
- Deepak GD, Bhat SK. Maximizing YOLOv2 efficiency: a study on multiclass detection of indoor objects. Results Eng. 2025;26:105405.
- Zhang C, et al. Personnel target detection in infrared environment based on YOLOv3-tinier network and its FPGA implementation. Infrared Phys Technol. 2025;150:106015.
- Zhou Y. A YOLO-NL object detector for real-time detection. Expert Syst Appl. 2024;238:122256.
- Asadollahpour E, Rahmannejad R, Asghari A, Abdollahipour A. Back analysis of closure parameters of Panet equation and Burger's model of Babolak water tunnel conveyance. Int J Rock Mech Min Sci. 2014;68:159-166.
- Anguchamy KK, Palanisamy V. Real-time object detection using improvised YOLOv4 and feature mapping technique for autonomous driving. Expert Syst Appl. 2025;280:127452.
- Khan AT, Jensen SM, Khan AR. Advancing precision agriculture: a comparative analysis of YOLOv8 for multi-class weed detection in cotton cultivation. Artif Intell Agric. 2025;15(2):182-191.
- Raushan R, Singhal V, Jha RK. Damage detection in concrete structures with multi-feature backgrounds using the YOLO network family. Autom Constr. 2025;170:105887.
- Zarboubi M, Bellout A, Chabaa S, Dliou A. CustomBottleneck-VGGNet: advanced tomato leaf disease identification for sustainable agriculture. Comput Electron Agric. 2025;232:110066.
- Xie F, et al. Wine variety traceability by data fusion of near-infrared spectroscopy and mid-infrared spectroscopy combined with GAF and ResNet. Chemom Intell Lab Syst. 2025;264:105468.
- Huang J, et al. Estimation of the orientation of potatoes and detection bud eye position using potato orientation detection you only look once with fast and accurate features for the movement strategy of intelligent cutting robots. Eng Appl Artif Intell. 2025;142:109923.
- Huang Y, et al. Human intrusion detection with distributed fiber optic data based on Squeeze-Excitation and hierarchical connection enhancement network. Opt Fiber Technol. 2025;94:104297.
- Qi R, et al. Mechanical fault diagnosis of on-load tap changers using time-frequency vibration analysis and a lightweight YOLO model. Measurement. 2025;256:118441.
- Yan J, Wang Z. YOLO V3+VGG16-based automatic operations monitoring and analysis in a manufacturing workshop under Industry 4.0. J Manuf Syst. 2022;63:134-142.
- Nazli NANM, et al. A real-time system for detecting personal protective equipment compliance using deep learning model YOLOv5. Procedia Comput Sci. 2024;245:647-656.
- Xiao Y, et al. The prediction of kiwi quality attributes based on multi-source data fusion comprehensive analysis model using HSI and FHSI. J Food Compos Anal. 2025;144:107645.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.