본 연구는 인지 설계 원칙, 지각적 색상 모델링 및 딥러닝을 통합한 자동화된 사용자 인터페이스 프로토타이핑 프레임워크를 제시합니다. 이 시스템은 접근성, 레이아웃 명확성, 색상 조화 및 교차 화면 일관성을 개선하여 일관성 있고 사용자 중심적인 인터페이스 설계를 가능하게 합니다.
이 콘텐츠를 보려면 JoVE 구독이 필요합니다. 로그인하거나 오늘 무료 평가판을 시작하세요.
연구 논문
사용성과 레이아웃 명확성 향상을 위해 인지 및 시각적 디자인 원리를 통합한 자동 사용자 인터페이스 프로토타이핑 프레임워크
이 논문에서
요약
초록
효과적인 사용자 인터페이스(UI) 디자인은 시각적 매력, 인지적 사용성, 레이아웃 일관성 사이의 조화로운 균형을 필요로 합니다. 그러나 현재의 자동 UI 생성 방식은 주로 시각적 외관이나 컴포넌트 탐지에 집중하고 있으며, 인지 원칙, 색상 지능 및 구조적 추론을 통합한 통일된 프레임워크가 부족한 실정입니다. 또한, 기존 방법들은 제한적인 레이아웃 일반화, 낮은 해석력, 정적인 색상 선택, 그리고 화면 간의 일관성 없는 동작이라는 문제점을 가지고 있습니다. 이러한 맥락에서 본 연구는 Faster region-based convolutional neural network (Faster R-CNN) 기반의 컴포넌트 탐지와 CIECAM02 균일 색 공간 (CAM02-UCS) 기반의 지각적 색상 모델링을 통합하고, 인지 및 시각적 디자인 원칙을 강화한 자동 UI 프로토타이핑 프레임워크를 제안합니다. Faster R-CNN은 대규모 인터페이스 데이터셋에서 UI 컴포넌트를 식별하고 계층 구조를 추론하는 데 사용됩니다. 강화된 색상 생성 모듈은 브랜드 또는 참조 이미지를 분석하여 CAM02-UCS를 통해 지각적으로 균일하고 조화로우며 사용성을 준수하는 색상 테마를 보장합니다. 이러한 결과물은 게슈탈트 그룹화, 핏츠의 법칙(Fitts’ law) 및 힉의 법칙(Hick’s law), 주의 집중 기반 간격 조정, 시각적 계층 구조 모델링을 포함한 인지 디자인 규칙을 통해 추가로 최적화되어, 정교하고 작업 지향적인 UI 레이아웃을 자동으로 생성합니다. RICO, ENRICO 및 Guo의 UI Color 데이터셋을 대상으로 수행한 실험 결과, 제안된 시스템은 92.4%의 컴포넌트 탐지 정확도를 달성하였으며, 레이아웃 명확성과 읽기 순서 정확도를 18.7% 향상시켰고, 베이스라인 방법들과 비교해 디자이너로부터 24.5% 더 조화롭다는 평가를 받은 색상 팔레트를 생성했습니다. 사용자 평가에서도 인지 부하가 31% 감소하고 화면 간 디자인 일관성이 28% 증가한 것으로 나타났습니다. 이러한 결과는 딥러닝 기반의 구조적 이해를 지각 기반 색상 모델링 및 인지 디자인 원칙과 결합함으로써 매우 효율적이고 심미적으로 일관되며 사용자 친화적인 UI 프로토타입을 생성할 수 있음을 입증합니다. 본 프레임워크는 지능적이고 인간 중심적인 자동 UI 프로토타이핑을 위한 새로운 엔드-투-엔드(end-to-end) 접근 방식을 제시합니다.
서론
그래픽 사용자 인터페이스(GUI)는 인간과 컴퓨터 시스템 사이의 기본적인 통신 매체 역할을 하며, 사용성, 접근성 및 전반적인 사용자 경험(UX)에 상당한 영향을 미칩니다1,2. 현대의 소프트웨어 시스템은 사용자를 유치하고 유지하기 위해 직관적이고 시각적으로 매력적인 인터페이스에 의존합니다. 전통적인 UI 디자인은 그래픽 레이아웃을 생성한 후, 엔지니어가 이를 프런트엔드 코드로 변환하는 과정을 거칩니다. 하지만 운영 체제마다 플랫폼별 프로토콜이 다르기 때문에 반복적인 적응 과정이 필요하며, 이는 개발 복잡성과 노력의 증가로 이어집니다. 이에 따라 수동 작업을 줄이고 개발 효율성을 높이기 위한 자동화된 UI 코드 생성이 중요한 연구 방향으로 부상했습니다.
자동화된 UI 생성의 초기 접근 방식은 영역 탐지 및 분류를 위해 전통적인 이미지 처리 기술과 딥러닝 모델을 결합하였습니다3,4. 현재 GUI 코드 생성을 위한 주된 전략은 컴퓨터 비전 기술을 적용하여 UI 이미지를 분석하고 이를 구조화된 프런트엔드 표현형으로 변환하는 것입니다5,6,7. 이미지 처리 방식은 수작업으로 설계된 특징에 의존하는 반면, 딥러닝 접근 방식은 대규모 데이터셋에서 계층적 표현을 추출합니다. 이에 따라 연구자들은 견고성과 정확도를 향상시키기 위해 딥러닝과 도메인 특화 이미지 처리 기술을 결합한 하이브리드 접근 방식을 탐구해 왔습니다.
색상은 UI 디자인의 또 다른 중요한 요소이며, 사용자의 인지, 사용성 및 미적 호감도에 영향을 미칩니다1. 시각적 입력값의 색조와 맥락이 다양할 때 이미지 콘텐츠와 UI 색상 체계 간의 일관성을 유지하는 것은 어려운 과제가 됩니다8,9,10. 이에 따라 자동화된 색상 팔레트 생성 및 지각적 색상 모델링에 관한 상당한 연구가 진행되어 왔습니다. 기존의 색상 생성 방법에는 CIELAB 색 공간에 기반한 기술들이 포함됩니다11. 다른 접근 방식으로는 k-means와 같은 클러스터링 알고리즘을 사용하여 이미지에서 지배적인 색상을 추출하는 방법이 있습니다12. 그 결과, 최근 연구에서는 색상 모델링을 위해 데이터 기반의 머신러닝 접근 방식을 점점 더 많이 채택하고 있습니다.
이와 병행하여, 딥러닝 접근 방식은 UI 컴포넌트 검출 및 레이아웃 이해도를 크게 향상시켰습니다. 신경망은 모바일 인터페이스의 더 정확한 구조적 파싱을 가능하게 했습니다13. 하지만 이러한 방법들은 주로 검출 정확도에 집중하며, 인지적 사용성, 레이아웃 계층 구조 및 상호작용 효율성과 같은 더 높은 수준의 측면을 간과하는 경우가 많습니다. UI 레이아웃 합성을 위한 생성 모델 또한 제안되었으나14,15, 이러한 모델들은 화면 간 일관성을 유지하고 해석 가능한 디자인 결정을 제공하는 데 어려움을 겪고 있습니다16. 다른 접근 방식들은 시각적 유사성이나 렌더링 품질에 집중하지만, 컴포넌트 시맨틱, 색상 조화 및 사용성 제약을 결합한 통합된 프레임워크가 부족한 실정입니다17. 텍스트 인식 또한 UI 콘텐츠를 이해하는 데 중요합니다. 합성곱 재귀 신경망(CRNNs)과 같은 기술은 인터페이스 화면 내의 복잡한 텍스트 패턴을 정확하게 인식할 수 있게 합니다18,19,20.
스케치나 이미지로부터 UI 코드를 생성하기 위해 여러 시스템이 제안되었습니다. Sketch2Code는 객체 탐지를 사용하여 스케치를 코드 표현으로 변환하지만21,22, 이미지 품질에 민감합니다. REDRAW는 합성곱 신경망과 순환 신경망을 결합하여 구조화된 UI 표현을 생성하는 데이터 수집 및 모델 학습을 위한 자동화된 파이프라인을 제공합니다23,24. 이후의 연구에서는 생성된 UI 품질을 평가하기 위해 개선된 평가 지표가 도입되었습니다25. 보다 최근의 접근 방식으로는 오토인코더 방법이 없는 확산 레이아웃 트랜스포머, 트랜스포머 기반 GUI 배치 그래프를 이용한 GUI 레이아웃 생성, 대규모 언어 모델 기반 UI 레이아웃 생성과 같은 레이아웃 생성을 위한 확산 기반 및 트랜스포머 기반 모델이 포함됩니다26,27,28. 이러한 접근 방식들에 대한 비교 개요는 표 1에 제시되어 있습니다.
| 참고 문헌 및 핵심 방법(들) | 목적 | 장점 | 단점 |
| 자동화된 이미지 기반 사용자 인터페이스 색상 테마 생성: 주요 색상 추출 및 CAM02-UCS 지각적 색상 모델링¹ | 참조 이미지로부터 조화로움과 사용성을 최적화하여 UI 색상 테마를 자동으로 생성합니다. | 강력한 지각적 근거(CAM02-UCS); 조화와 사용성(대비 및 다양성)의 균형을 명시적으로 조절; 웹 기반 구현 및 디자이너 평가 포함. | 색상/테마에만 집중하며(레이아웃이나 컴포넌트 구조 제외), 엔드투엔드(end-to-end) 학습 기반의 UI 합성보다는 규칙/휴리스틱 기반의 방식입니다. |
| 디커플링된 확산 모델을 통한 레이아웃 생성의 통합 (LDGM)²⁵ | 그래픽 장면 및 사용자 인터페이스(UI)를 위한 통합적이고 유연한 레이아웃 생성. | 레이아웃 생성을 위한 최첨단 다양성과 제어 가능성을 제공하며, 조건부 생성 및 다양한 속성 유형을 지원합니다. | 확산 기반 출력물은 제약을 가하지 않을 경우 정렬 또는 세밀한 레이아웃 문제가 발생할 수 있으며, 모델 복잡도와 추론 비용이 더 높습니다. |
| 오토인코더 방법론을 제외한 확산 레이아웃 트랜스포머: 레이아웃 생성을 위한 트랜스포머와 확산 모델의 결합 (오토인코더 미사용)²⁶ | 레이아웃 생성 벤치마크의 충실도 및 정렬 개선 (FID, 정렬 및 중첩 지표). | 인접 객체 간의 의미적 상관관계를 더 잘 포착하며, FID 및 정렬 지표에서 우수한 성능을 보임. | UI 시맨틱보다는 레이아웃 기하학적 구조(위치, 크기, 범주)에 주로 초점을 맞춥니다. |
| GUI 배치 그래프(GUI-AGs)²⁷ 기반의 트랜스포머 모델을 이용한 GUI 레이아웃 생성 | 디자이너를 지원하기 위해 위치/그래프 제약 조건으로부터 GUI 레이아웃을 생성합니다. | 그래프 표현은 관계적 제약 조건을 포착하며, 트랜스포머는 제약 조건에 기반한 유연한 생성을 가능하게 합니다. | 설계자로부터 명시적인 제약 그래프(constraint graphs)가 필요할 수 있으며, 색상 및 사용성 지표에 대한 강조가 제한적임. |
| UI 문법 가이드 기반 LLM을 이용한 UI 레이아웃 생성: 대규모 언어 모델(LLM) + 계층적 UI 문법²⁸ | 레이아웃 생성을 위한 대규모 언어 모델(LLM)을 탐구하고, 문법 표현을 통해 설명 가능성과 제어 능력을 향상시킵니다. | 높은 수준의 제어 가능성과 설명 가능성; 거대언어모델(GPT 유형)의 인컨텍스트 학습(in-context learning)을 활용할 수 있음. | 제한적인 경험적 검증을 거친 초기 단계의 연구; 문법 설계 및 UI 전반의 견고성 |
표 1: 기존 UI 색상 모델링 및 레이아웃 생성 방법의 비교. 이 표는 색상 테마 생성, 확산 기반 레이아웃 생성, 트랜스포머 기반 방법 및 대규모 언어 모델 가이드 레이아웃 생성을 포함한 사용자 인터페이스 디자인의 대표적인 접근 방식들을 요약합니다. 각 방법에 대해 기반 기술, 목적, 장점 및 한계점이 제시되어 있으며, 지각 모델링, 레이아웃 생성 능력, 제어 가능성 및 사용성 고려 사항의 차이점을 강조합니다.
이러한 진보에도 불구하고 한 가지 핵심적인 한계가 남아 있는데, 그것은 구성 요소 탐지, 지각적 색상 모델링, 인지적 디자인 원칙 및 멀티스크린 레이아웃 일관성을 단일 엔드-투-엔드 프레임워크 내에서 공동으로 통합한 기존 시스템이 없다는 점입니다1. 현재의 접근 방식은 대개 탐지, 레이아웃 또는 색상과 같은 한두 가지 측면만을 최적화하며, 이들 간의 상호 의존성은 고려하지 않습니다. 이러한 단절은 통합된 인간 중심의 자동 UI 프로토타이핑 시스템 개발에 있어 중대한 연구 공백이 있음을 시사합니다. 특히 게슈탈트 법칙, 피츠의 법칙 및 힉의 법칙과 같은 인지적 디자인 원칙들은 계산 모델에 공식적으로 통합되기보다 개념적으로만 다뤄지는 경우가 많습니다.
이러한 한계를 해결하기 위해, 본 연구는 컴포넌트 탐지, 지각적 색상 모델링 및 인지적 디자인 원칙을 단일 시스템 내에 통합한 엔드 투 엔드(end-to-end) 자동 UI 프로토타이핑 프레임워크를 제안합니다. 이 프레임워크는 레이아웃 품질 개선, 인지 부하 감소, 색상 조화 향상 및 전반적인 사용성 증대를 위해 설계되었습니다. 이러한 개선 사항은 RICO, ENRICO 및 Guo의 UI 색상 데이터셋을 이용한 실험을 통해 검증되었으며, 이는 단일 자동 UI 프로토타이핑 파이프라인 내에 구조적, 지각적 및 인지적 측면을 결합하는 것의 효과성을 입증합니다. 딥러닝 기반의 컴포넌트 탐지, 지각적 색상 모델링 및 인지적 디자인 원칙을 통합 프레임워크 내에 통합하면 기존 방식에 비해 UI 프로토타입의 품질이 유의미하게 향상될 것이라는 가설을 세웠습니다. 구체적으로, H1은 이 프레임워크가 정렬, 그룹화 및 읽기 순서를 포함한 레이아웃 품질을 향상시킨다는 점을 제안합니다. H2는 이 프레임워크가 사용자의 인지 부하를 줄여준다는 가설을 세웁니다. H3는 지각적 색상 모델링이 색상 조절과 시각적 조화를 개선한다는 점을 시사합니다. H4는 UI 프로토타입의 전반적인 사용성과 심미적 품질이 향상됨을 명시합니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
프로토콜
본 연구는 공개적으로 이용 가능한 데이터셋을 사용하며, 인간 또는 동물 피험자를 포함하지 않습니다.
제안된 자동화된 UI 프로토타이핑 프레임워크는 딥러닝 기반의 구조적 이해, 지각적으로 균일한 색상 모델링 및 인지적 디자인 원칙을 통합하여 일관성 있고 사용자 중심적인 인터페이스 프로토타입을 생성합니다. 이 방법론은 먼저 RICO 및 ENRICO 데이터셋으로 학습된 Faster R-CNN 아키텍처를 통해 UI 구성 요소를 검출하고 이들의 계층적 관계를 추출함으로써 다양한 화면 레이아웃의 정확한 해석을 가능하게 합니다. 검출된 구성 요소는 이후 색상 지능 모듈에 의해 처리되며, 이 모듈은 브랜드 또는 이미지 기반의 색상 단서를 추출하고 CAM02-UCS를 사용하여 지각적 유사성을 모델링하며, 조화롭고 대비가 명확하며 접근성 표준을 준수하는 색상 팔레트를 생성합니다. 이어서 게슈탈트 그룹화 법칙, 피츠의 법칙, 힉의 법칙, 주의 기반 간격 및 시각적 계층 구조 제약 조건을 포함하는 인지적 디자인 원칙이 인지 최적화 엔진을 통해 적용되어 공간 구성과 구성 요소 정렬을 정밀하게 조정합니다. 마지막으로, 레이아웃 추론 레이어가 구조적, 지각적 및 인지적 제약 조건을 통합하여 사용성, 심미성 및 기능적 명확성의 균형을 맞춘 다중 화면 일관성 UI 프로토타입을 생성합니다. 이러한 통합 파이프라인은 지각적 일관성을 보장하고 인지 부하를 줄이며 인간 중심 디자인 원칙을 준수합니다. 제안된 방법의 전체 워크플로우는 그림 1에 나타나 있습니다.
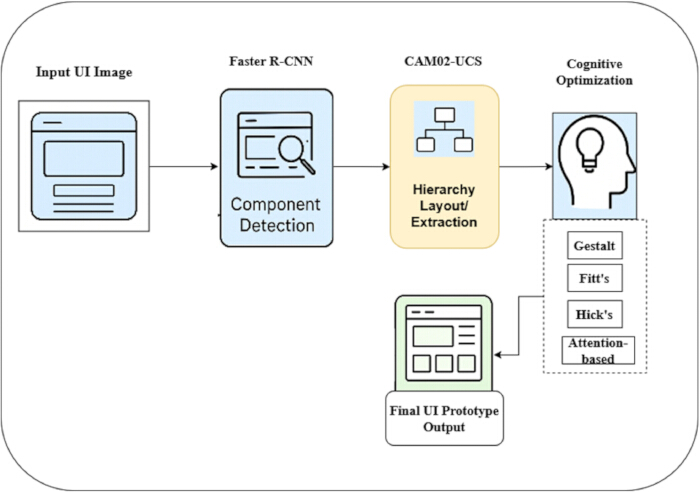
그림 1. 제안된 자동화된 사용자 인터페이스 프로토타이핑 프레임워크의 전체 아키텍처. 이 다이어그램은 입력 UI 이미지부터 시작되는 전체 파이프라인을 보여줍니다. 인터페이스 요소를 식별하기 위해 Faster R-CNN을 사용하여 컴포넌트 탐지를 수행합니다. 탐지된 컴포넌트는 계층 구조 및 레이아웃 추출을 위해 CAM02-UCS 기반의 지각 모델링을 통해 처리됩니다. 이후 게슈탈트 원리, 피츠의 법칙, 힉의 법칙 및 주의 집중 기반 조정을 사용하여 인지 최적화가 적용됩니다. 화살표는 모듈 간의 데이터 흐름을 나타내며, 최종적으로 UI 프로토타입 결과물이 출력됩니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
프레임워크 개요
그림 1은 가공되지 않은 UI 스크린샷을 인지적으로 정제된 프로토타입으로 변환하는 제안된 자동 UI 프로토타이핑 프레임워크의 엔드-투-엔드 워크플로우를 보여줍니다. 프로세스는 입력 UI 이미지에서 시작되며, 이는 Faster R-CNN 기반의 컴포넌트 검출 모듈로 전달됩니다. 이 모듈은 버튼, 아이콘, 텍스트 필드 및 컨테이너와 같은 인터페이스 요소를 식별하고, 이에 해당하는 바운딩 박스와 클래스 레이블을 출력합니다. 검출된 컴포넌트는 이후 계층 및 레이아웃 추출 단계에서 처리됩니다. 시스템은 공간적 관계와 구조적 패턴을 기반으로 사용자가 화면 구성을 자연스럽게 인식하는 방식을 반영하는 계층적 레이아웃 트리를 구축합니다. 이 표현은 UI 요소 간의 시각적 그룹화와 구조적 의존성을 포착합니다. 추출된 레이아웃은 인간 중심 설계 원칙을 적용하는 인지적 최적화를 통해 이어서 정제됩니다. 여기에는 시각적 클러스터링을 위한 게슈탈트 그룹화, 터치 타겟 크기 및 접근성 최적화를 위한 피츠의 법칙, 결정 복잡성을 줄이기 위한 힉의 법칙, 그리고 시각적 계층 구조 개선을 위한 주의 집중 기반 간격 조정이 포함됩니다. 그 결과, 레이아웃은 사용자 상호작용에 있어 더욱 직관적이고 가독성이 높으며 효율적으로 변합니다. 마지막으로, 최적화된 레이아웃은 지각적 색상 모델링과 결합되어 일관된 UI 프로토타입을 생성합니다. 결과적으로 생성된 인터페이스는 구조적으로 정확하고 시각적으로 조화로우며, 인간의 사용성 기대치에 부합하게 됩니다.
해당 프레임워크는 Ubuntu 22.04 환경에서 PyTorch 2.0을 사용하여 구현되었습니다. 실험은 NVIDIA RTX 4090 GPU (24 GB VRAM)가 장착된 시스템에서 수행되었습니다. Faster R-CNN 모델은 ImageNet 데이터셋으로 사전 학습된 ResNet-50 백본을 사용하였습니다. 학습은 학습률 0.001, 배치 크기 16, 최대 60 epoch 조건에서 확률적 경사 하강법(SGD) 옵티마이저를 사용하여 수행되었습니다. 과적합을 방지하기 위해 전체 데이터의 20%로 구성된 검증 세트를 사용하여 조기 종료(Early stopping)를 적용하였습니다. 학습은 최대 60 epoch까지 수행되었으나, 일반적으로 검증 손실에 기반한 조기 종료를 통해 그보다 이전에 수렴되었습니다. 모멘텀과 가중치 감쇠(weight decay)는 각각 0.9와 0.0005로 설정되었습니다. 데이터 증강에는 정규화, 랜덤 수평 뒤집기, 랜덤 크롭 및 리사이징이 포함되었습니다.
데이터셋 준비
제안된 자동화된 UI 프로토타이핑 프레임워크를 지원하기 위해 ENRICO29, RICO30, 그리고 Guo의 UI 컬러 데이터셋1이라는 세 가지 상호 보완적인 데이터셋이 활용되었습니다. RICO 데이터셋은 9,700개의 애플리케이션에서 수집된 66,261개의 Android UI 화면을 포함하고 있어, 컴포넌트 검출 및 계층적 레이아웃 추출을 위한 대규모 다양성을 제공합니다. ENRICO는 20가지 디자인 패턴으로 수동 분류된 1,464개의 고품질 UI 스크린샷을 포함하며, 이를 통해 구조적 추론 및 레이아웃 일관성 모델링에 대한 일반화 능력을 향상시켰습니다. Guo의 UI 컬러 데이터셋은 색상 테마가 주석 처리된 128개의 선별된 UI 이미지로 구성되며, 이는 지각적 색상 모델링 및 팔레트 평가에 사용됩니다. 다만, 상대적으로 작은 크기로 인해 레이아웃 특성에서 일부 변동성이 나타날 수 있습니다. 본 연구에서는 학습 및 평가를 위해 총 5,128개의 화면으로 구성된 통합 데이터셋을 준비하였습니다. 구체적으로, RICO의 이미지 약 4,000장은 컴포넌트 검출을 위한 Faster R-CNN 모델 학습에 사용되었고, ENRICO의 이미지 1,000장은 레이아웃 패턴 학습 및 구조적 일관성 모델링에 사용되었으며, Guo 데이터셋의 이미지 128장은 색상 평가 작업에 사용되었습니다. 모든 이미지는 480 × 800 픽셀의 해상도로 정규화되었으며, 동일한 sRGB 색 공간으로 변환되었고, 데이터셋 간의 호환성을 보장하기 위해 표준화된 바운딩 박스와 계층적 메타데이터로 재주석 처리되었습니다. 본 연구에 사용된 데이터셋의 개요는 표 2에 제시되어 있습니다. RICO 데이터셋은 UI 컴포넌트의 대규모 검출 및 구조적 분석을 지원하며, ENRICO는 레이아웃 패턴을 인식하고 화면 간 일관성을 강제하는 모델의 능력을 강화합니다. Guo의 UI 컬러 데이터셋은 규모는 작지만 지각적 색상 조화 및 대비 모델링을 평가하는 데 결정적인 역할을 합니다. 종합적으로, 이 데이터셋들은 제안된 자동화된 UI 프로토타이핑 프레임워크의 학습, 검증 및 평가를 위한 포괄적이고 균형 잡힌 기반을 제공합니다.
| 데이터셋 | 사용 가능한 총 이미지 수 | 연구에 사용된 이미지 수 | 제안된 프레임워크에서의 목적 |
| RICO Dataset30 | 66,261 | 4,000 | UI 컴포넌트 탐지, 구조적 레이아웃 추출 |
| ENRICO Dataset29 | 1,464 | 1,000 | 디자인 패턴 학습, 레이아웃 일관성 모델링 |
| Guo’s UI Color Dataset1 | 128 | 128 | 색상 테마 추출, 지각적 색상 평가 |
| 결합 총계 | 67,853 | 5,128 | 탐지, 레이아웃, 색상 모델링을 위한 종합 데이터셋 |
표 2: 제안된 프레임워크에 사용된 데이터셋 요약. 이 표는 RICO, ENRICO 및 Guo의 UI Color 데이터셋을 포함하여 훈련 및 평가에 활용된 데이터셋을 나타냅니다. 사용 가능한 전체 이미지 수, 본 연구에서 사용된 서브셋, 그리고 제안된 프레임워크 내의 컴포넌트 검출, 레이아웃 모델링 및 지각적 색상 분석에서 각 데이터셋의 구체적인 역할을 보고합니다.
RICO, ENRICO 및 Guo 데이터셋 전반의 UI 구성 요소, 레이아웃 구조 및 색상 분포의 다양성을 유지하기 위해 층화 추출 전략이 사용되었습니다. 데이터셋은 층화 추출을 통해 훈련(70%), 검증(15%) 및 테스트(15%) 하위 집합으로 분할되었습니다. 이미지는 평균(0.485, 0.456, 0.406)과 표준 편차(0.229, 0.224, 0.225)를 사용하여 정규화되었습니다. 데이터 증강에는 무작위 수평 뒤집기(확률 = 0.5)와 무작위 크롭(배율 범위: 0.8–1.0)이 포함되었으며, 이후 훈련 과정에서 224 × 224 픽셀로 크기를 조정하였습니다.
구성 요소 주석 및 전처리
RICO, ENRICO 및 Guo의 UI Color 데이터셋은 제안된 자동 UI 프로토타이핑 프레임워크의 세 가지 핵심 기능 구성 요소인 컴포넌트 검출, 레이아웃 모델링, 지각적 색상 최적화를 종합적으로 지원합니다. RICO 데이터셋은 66,000개 이상의 모바일 UI 화면으로 구성된 대규모 컬렉션으로, 주로 컴포넌트 검출 모듈을 학습시키는 데 사용됩니다. 이 데이터셋의 다양성을 통해 Faster R-CNN 모델은 광범위한 애플리케이션에 걸쳐 버튼, 이미지, 텍스트 필드와 같은 공통 UI 요소의 강건한 표현을 학습할 수 있습니다. 이를 통해 다양한 디자인 조건에서도 UI 컴포넌트를 정확하게 검출하고 위치를 특정할 수 있습니다. ENRICO 데이터셋은 구조적 관계와 레이아웃 패턴 학습을 위해 패턴 레이블이 지정된 고품질 UI 화면을 제공합니다. 이를 통해 시스템은 컴포넌트 간의 관계, 계층적 조직 및 공통 디자인 템플릿을 이해할 수 있습니다. 이 데이터셋은 레이아웃 구조를 모델링하고 다중 화면 일관성을 유지하는 데 결정적인 역할을 하며, 프레임워크가 확립된 디자인 관례에 부합하는 레이아웃을 생성할 수 있도록 합니다. 반면, Guo의 UI Color 데이터셋은 지각적 및 인지적 색상 모델링을 위해 특별히 사용됩니다. 구조적 측면에 집중하는 RICO 및 ENRICO와 달리, 이 데이터셋은 색상 테마가 주석으로 달린 엄선된 UI 이미지를 포함하고 있습니다. 이러한 주석은 색상 추출 및 조화 평가 모듈을 학습시키는 데 사용됩니다. 색상 관계를 CAM02-UCS와 같은 지각적 색 공간으로 매핑함으로써, 프레임워크는 대비, 접근성 및 심미적 일관성의 균형을 맞춘 색상 팔레트를 생성하는 방법을 학습합니다. 결과적으로 이 데이터셋들은 하나의 통합된 파이프라인을 형성합니다. RICO는 컴포넌트 검출을 지원하고, ENRICO는 레이아웃 패턴 이해와 구조적 일관성을 가능하게 하며, Guo의 데이터셋은 지각적 색상 최적화를 용이하게 합니다. 이러한 통합을 통해 생성된 UI 프로토타입이 구조적으로 정확하고 시각적으로 조화로우며 인지적으로 최적화됨을 보장합니다.
평균 [0.485, 0.456, 0.406] 및 표준 편차 [0.229, 0.224, 0.225]를 사용하여 정규화를 수행하였습니다. 모델의 일반화 성능을 향상시키기 위해 무작위 크롭(random cropping), 수평 뒤집기(horizontal flipping) 및 회전을 포함한 데이터 증강 기법을 적용하였습니다. 또한, 데이터셋 간의 일관성을 확보하기 위해 픽셀 값을 [0, 1] 범위로 스케일링하고 모든 이미지의 해상도를 480 × 800 픽셀로 조정하였습니다. 훈련 중 증강을 위해서는 224 × 224 픽셀로 조정된 이미지를 사용하였으며, 레이아웃 분석을 위해서는 원래 해상도인 480 × 800 픽셀을 유지하였습니다. 바운딩 박스는 사전 정의된 임계값을 사용하여 무관한 어노테이션을 필터링하도록 조정되었습니다. 데이터셋 전반의 균일성을 달성하기 위해 LabelImg 어노테이션 도구를 사용하여 모든 UI 요소를 수동으로 어노테이션하였습니다. 어노테이션 전, UI 요소를 버튼(button), 텍스트(text), 이미지(image), 아이콘(icon) 및 컨테이너(container)와 같은 카테고리로 분류하기 위한 사전 정의된 스키마를 수립하였습니다. 바운딩 박스 표현을 위해 통일된 좌표계를 적용하였으며, 요소 간의 공간적 관계와 레이아웃 트리 내의 부모-자식 연관성을 기반으로 계층 구조 정보를 구축하였습니다. 또한, RICO, ENRICO 및 Guo 데이터셋 전반에서 요소의 일관된 어노테이션, 겹치는 컴포넌트의 적절한 처리 및 최소 크기 임계값 적용을 보장하기 위한 가이드라인을 수립하였습니다.
부품 검출 학습 및 레이아웃 패턴 추출을 위한 상세한 수학적 공식은 보충 자료 1에 제공됩니다.
Faster R-CNN 모델은 모멘텀 0.9와 가중치 감쇠(weight decay) 0.0005의 SGD를 사용하여 학습되었습니다. 초기 학습률은 0.001로 설정되었으며, 검증 성능에 기반한 스텝 감쇠(step decay) 정책을 사용하여 조정되었습니다. 학습은 배치 크기 16으로 최대 60 epoch 동안 수행되었습니다. 과적합을 방지하기 위해 학습 데이터의 20%로 구성된 검증 세트를 사용하여 조기 종료(early stopping)를 적용하였습니다.
매핑 함수 f(.)는 검출된 UI 요소를 입력으로 받아 계층적 레이아웃 표현을 출력으로 생성합니다. 이 함수는 공간적 거리와 정렬 기준을 바탕으로 UI 요소 간의 인접 관계를 계산하고, 이러한 관계를 나타내는 인접 행렬을 구성합니다. 그 다음 DBSCAN과 같은 클러스터링 알고리즘을 적용하여 관련 컴포넌트들을 그룹화합니다. 마지막으로, 클러스터링된 요소들은 부모-자식 관계에 따라 계층 구조로 조직되어 구조화된 레이아웃 표현을 형성합니다.
색상 조화 모델링 및 통합 최적화 목표에 대한 상세 공식은 보조 파일 1에 제공되어 있습니다.
이 목적 함수는 구조적 탐지, 레이아웃 추론 및 지각적 색상 모델링의 통합을 수학적으로 공식화하여, 프레임워크의 모든 구성 요소가 일관성 있고 사용자 중심적인 UI 프로토타입을 생성하는 데 공동으로 기여하도록 보장합니다. 최적화는 프레임워크의 각 구성 요소에 대해 모듈식으로 수행됩니다. 구성 요소 탐지 모듈의 학습에는 SGD가 사용되며, 통합 목적 함수의 공동 최적화 과정에서는 Adam 옵티마이저가 사용됩니다. 결합된 목적 함수는 전체적인 시스템 성능을 안내하는 데 사용됩니다. 공동 최적화 단계에서 목적 함수는 학습률 0.001 및 배치 크기 16의 Adam 옵티마이저를 사용하여 최소화됩니다. 학습은 최대 60 epoch 동안 수행되며, 검증 손실의 변화가 5 epoch 연속으로 10−4 미만일 때 조기 종료가 적용됩니다.
Faster R-CNN을 이용한 구성 요소 검출
제안된 프레임워크는 버튼, 아이콘, 텍스트 필드, 이미지 및 컨테이너를 포함한 UI 구성 요소의 자동 검출을 위해 Faster R-CNN을 사용한다. Faster R-CNN은 높은 객체 검출 정확도와 효율적인 영역 제안 생성을 결합하고 있어, 요소들이 밀집된 복잡한 UI 레이아웃을 처리하는 데 필수적이므로 이 작업에 매우 적합하다. 이 모델은 각 UI 화면에서 컨볼루션 특징 맵을 추출하기 위해 ImageNet 데이터셋으로 사전 학습된 ResNet-50 백본을 활용한다. 학습 과정에서 일반적인 시각적 특징을 유지하기 위해 초기 층은 동결시켰으며, 상위 층(conv4_x 및 conv5_x)은 UI 특화 구성 요소 검출을 위해 미세 조정되었다. 이러한 특징 맵은 시각적 구조, 에지, 질감 및 구성 요소 경계를 포착한다. 검출 과정에서 영역 제안 네트워크(RPN)는 UI 구성 요소가 포함되었을 가능성이 높은 후보 영역(앵커)을 식별한다. 앵커는 다양한 크기의 UI 요소를 수용하기 위해 여러 스케일(128, 256, 512)과 종횡비(1:1, 1:2, 2:1)를 사용하여 정의된다. 학습 시, 그라운드 트루스(ground truth) 박스와의 교집합-합집합 비율(IoU)이 0.7보다 큰 앵커는 양성으로, IoU가 0.3보다 작은 앵커는 음성으로 라벨링하며, 중간 IoU 값을 가진 앵커는 무시한다. 각 앵커에는 구성 요소의 존재 여부를 나타내는 확률이 할당된다. 이후 비최대 억제(NMS)를 적용하여 중복되고 겹치는 제안 영역을 제거함으로써, 복잡한 인터페이스에서도 의미 있는 UI 요소를 효율적으로 로컬라이제이션할 수 있도록 한다. 후보 영역이 생성되면 각 제안 영역은 사전 정의된 구성 요소 범주로 분류되고 바운딩 박스 좌표가 정밀하게 조정된다. 관심 영역(ROI) Align 연산은 각 제안 영역에 대해 고정된 크기의 특징 표현을 추출하며, 이는 이후 분류 및 회귀를 위해 완전 연결 층에서 처리된다. 분류 분기(branch)는 클래스 확률을 출력하고, 회귀 분기는 정밀한 바운딩 박스 좌표를 예측한다. 전체 Faster R-CNN 모델은 RPN 손실과 최종 검출 손실을 결합한 공동 손실 함수를 최적화함으로써 엔드-투-엔드로 학습된다. 이를 통해 시스템은 UI 구성 요소를 정확하게 인식할 뿐만 아니라 다양한 인터페이스 구조 전반에서 정밀하게 로컬라이제이션할 수 있다. RPN 단계, ROI 분류, 바운딩 박스 정밀 조정 및 최종 최적화 목표를 포함한 Faster R-CNN 구성 요소 검출에 대한 상세한 설명은 다음에서 제공된다. 보충 파일 1.
알고리즘 S1은 상세한 컴포넌트 탐지 및 구조 추출 워크플로우를 제공합니다(보충 파일 1). 이는 원본 화면 이미지로부터 UI 컴포넌트를 자동으로 탐지하고 구조를 추출하는 전체 과정을 기술합니다. 입력 이미지는 먼저 전처리를 거친 후 CNN 백본을 통해 전달되어 심층 시각적 특징을 추출합니다. 이러한 특징들은 RPN에 의해 후보 바운딩 박스를 생성하는 데 사용되며, 이후 분류 및 회귀를 통해 정교화됩니다. NMS는 중복된 탐지 결과를 제거하여 정확한 위치를 확보합니다. 탐지 후에는 노이즈 기반의 밀도 기반 공간 클러스터링(DBSCAN)을 사용하여 공간적 근접성에 따라 컴포넌트들을 그룹화합니다. 이 클러스터링 단계는 컴포넌트 간의 부모-자식 관계와 논리적 그룹화를 캡처하는 계층적 UI 트리를 구축할 수 있게 합니다. 이러한 계층적 표현은 이후의 레이아웃 분석 및 UI 이해의 기초가 됩니다. 그림 2는 모바일 UI 화면에서 Faster R-CNN 컴포넌트 탐지 프로세스를 보여줍니다. 입력 인터페이스(왼쪽)에는 버튼 및 텍스트 블록과 같은 UI 요소가 포함되어 있으며, 이들은 자동으로 바운딩 박스 내에 둘러싸입니다. 이렇게 탐지된 영역은 레이블이 지정된 연결선으로 표시된 바와 같이 컴포넌트 카테고리(예: Button 및 Text)로 분류됩니다. Faster R-CNN 탐지 모듈(오른쪽)은 바운딩 박스 좌표를 정교화하고 시맨틱 레이블을 할당하며, 구조화된 컴포넌트 수준의 정보를 출력합니다. 이 단계는 UI 컴포넌트에 대해 정확하고 시맨틱적으로 의미 있는 표현을 제공함으로써 레이아웃 추출, 인지적 최적화 및 UI 프로토타입 생성을 포함한 후속 프로세스의 핵심 기반 역할을 합니다.
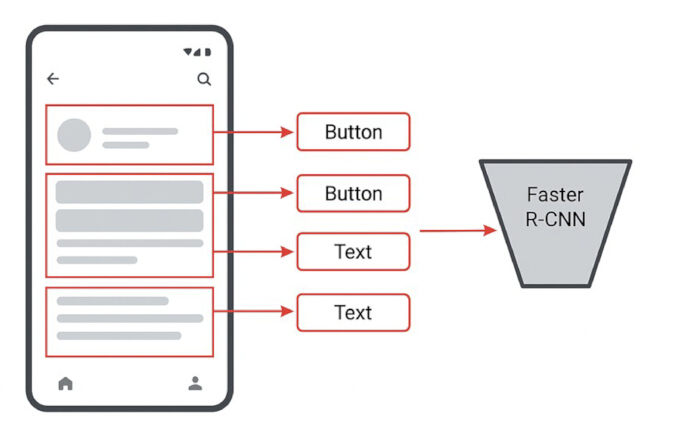
그림 2Faster R-CNN을 이용한 사용자 인터페이스 요소의 구성 요소 검출. 이 그림은 입력 인터페이스 스크린샷에서 UI 구성 요소를 검출하는 과정을 보여줍니다. 경계 상자(bounding box)를 사용하여 관심 영역을 식별하며, 버튼 및 텍스트 필드와 같은 요소들은 Faster R-CNN을 통해 분류됩니다. 화살표는 검출된 구성 요소가 해당 시맨틱 레이블로 매핑되는 과정을 나타냅니다. 이 그림의 확대 버전을 보시려면 여기를 클릭하십시오.
레이아웃 패턴 추출 및 계층적 모델링
Faster R-CNN을 이용한 컴포넌트 검출 이후, 각 UI 요소는 바운딩 박스로 표현됩니다. 하지만 이러한 바운딩 박스만으로는 요소들이 인터페이스 내에서 어떻게 구조적으로 조직되어 있는지, 예를 들어 어떤 요소가 헤더, 내비게이션 바 또는 그룹화된 콘텐츠 영역에 속하는지를 전달할 수 없습니다. 이러한 한계를 해결하기 위해, 검출된 컴포넌트들은 논리적 UI 트리로 변환되며, 여기서 각 컴포넌트는 노드로 처리되고 기능적 또는 시각적으로 관련된 컴포넌트들은 공통 부모 노드 아래로 그룹화됩니다. 의미 있는 레이아웃 그룹을 식별하기 위해 DBSCAN 또는 계층적 응집 클러스터링과 같은 클러스터링 기법이 적용됩니다. 이러한 방법들은 컴포넌트 간의 공간적 근접성과 정렬 패턴을 분석하여 UI 요소 사이의 관계를 검출합니다. 인간의 디자인 관행과 유사한 방식으로, 시스템은 헤더, 푸터, 그리드 및 콘텐츠 블록과 같은 일반적인 구조적 패턴을 인식하도록 학습합니다. 그룹화가 설정되면 정렬, 그리드 구성 및 읽기 순서를 포함한 추가적인 구조적 특성을 분석하여 종합적인 레이아웃 표현을 구축합니다. 예를 들어, 동일한 너비의 열로 정렬된 컴포넌트들은 카드 기반 레이아웃을 나타낼 수 있으며, 수직으로 쌓인 요소들은 폼 또는 피드 기반 인터페이스를 나타낼 수 있습니다. 클러스터링, 공간 추론 및 정렬 규칙을 통합함으로써, 본 프레임워크는 시각적 그룹화와 기능적 관계를 모두 포착하는 계층적 UI 트리를 구축합니다. 이러한 계층적 표현은 이후의 레이아웃 정밀화 및 멀티스크린 일관성 모델링의 기초가 되어, 시스템이 구조적이고 일관되며 사용자 중심적인 인터페이스 디자인을 생성할 수 있게 합니다.
공간 거리와 정렬 유사성에 대한 세부 공식은 보충 파일 1에 제공되어 있습니다.
레이아웃 그룹화를 위한 클러스터링 (DBSCAN)
레이아웃 그룹을 식별하기 위해 DBSCAN이 적용됩니다. DBSCAN은 두 가지 매개변수를 사용합니다: (1) ε = 인접한 구성 요소 간의 최대 거리 및 (2) = 클러스터를 형성하는 데 필요한 구성 요소의 최소 수. 본 분석에서 DBSCAN 매개변수는 정규화된 UI 해상도(480 × 800 pixels)를 기준으로 경험적으로 선택되었습니다. 인접한 UI 구성 요소 간의 공간적 근접성을 포착하기 위해 이웃 거리 매개변수는 ε = 50 pixels로 설정되었습니다. 무의미하거나 가짜 UI 구성 요소 그룹이 형성되는 것을 방지하기 위해 클러스터 형성에 필요한 최소 포인트 수는 MinPts = 3으로 설정되었습니다.
상세한 논리적 UI 트리 구축 공식은 보충 자료 1에 제공되어 있습니다.
CAM02-UCS를 이용한 지각적 색상 모델링
지각적 색상 모델링은 생성된 UI에 사용되는 색상이 조화롭고 가독성이 높으며 인지적으로 효율적이도록 보장합니다. 지배적인 색상은 클러스터링 기법을 사용하여 UI 이미지와 같은 입력 소스로부터 추출됩니다. 구체적으로, 대표 색상 팔레트를 얻기 위해 K-means++ 초기화를 포함한 K-means 클러스터링을 300회 반복 수행합니다. 그러나 RGB 색 공간은 인간의 시각적 지각을 정확하게 반영하지 못하며, 이는 수치적으로 유사한 색상이 지각적으로는 다르게 보일 수 있음을 의미합니다. 이러한 한계를 해결하기 위해 추출된 모든 색상은 지각적으로 균일한 CAM02-UCS로 변환됩니다. 이 공간에서는 동일한 거리가 동일한 지각적 색상 차이에 해당하므로, 색상 조화와 대비를 모델링하는 데 적합합니다. CAM02-UCS로 매핑되면 유클리드 거리를 사용하여 지각적 색상 차이를 계산하며, 이를 통해 시스템은 색상 간의 대비, 조화 및 변이 정도를 정량화할 수 있습니다. 가독성을 높이기 위해 너무 유사한 색상은 분리하고, 과도하게 대비되는 색상은 시각적 불편함을 피하기 위해 완화합니다. 생성된 팔레트는 WCAG AA 및 AAA와 같은 접근성 표준을 준수하여 전경과 배경 요소 사이에 충분한 대비가 확보되도록 합니다. 또한, 의도한 UI 테마에 따라 팔레트 관계를 보색, 유사색 또는 삼보색 체계로 제한하여 색상 조화를 강제합니다. 이를 통해 결과 색상 팔레트가 시각적으로 매력적일 뿐만 아니라 기능적으로 접근 가능하고 인지적으로 최적화되도록 합니다. 팔레트를 더욱 정교하게 만들기 위해 지각적 유사성, 대비, 조화 및 브랜드 일관성 제약 조건 하에서 최적화 프로세스가 적용됩니다. 기본 색상(예: 브랜드 아이덴티티에서 추출)을 선택하고, 시각적 계층 구조를 유지하기 위해 보조 색상의 휘도와 채도를 조정합니다. 규칙 기반 평가 메커니즘은 지각적 거리와 접근성 지표를 기반으로 후보 팔레트를 평가하여, 심미적 균형을 유지하면서 인지적 부담을 최소화합니다. 결과적으로 이 프레임워크는 전문가 수준의 일관성, 가독성 및 지각적 일관성을 갖춘 UI 색상 체계를 생성합니다.
CAM02-UCS 기반 지각적 색상 모델링을 위한 상세한 수학적 표현식은 보충 파일 1에 제공됩니다.
알고리즘 S2 (보충 파일 1) 조화로움과 접근성 제약 조건 하에서 CAM02-UCS 기반의 지각적 색상 추출 및 최적화 워크플로를 설명합니다. 우선, 입력 이미지에서 주도적 색상을 추출하고 이를 CAM02-UCS로 변환하여 색 차이가 인간의 지각과 일치하도록 합니다. 이후 색상 간의 지각적 거리를 계산하고, 명료함과 조화로움을 모두 유지하기 위해 이를 사전 정의된 범위 내로 제한합니다. 이어서 WCAG 가이드라인에 따라 휘도 대비비를 평가하여 접근성을 강제합니다. 최종 팔레트는 지각적 간격, 대비 요구 사항 및 색상 조화 제약 조건의 균형을 맞추는 결합 목적 함수를 최적화하여 도출합니다. 이를 통해 생성된 UI 색상 체계가 시각적으로 매력적일 뿐만 아니라 가독성이 높고, 접근 가능하며, 지각적으로 일관되도록 보장합니다.
인지 설계 최적화
인지적 디자인 최적화는 자동 생성된 UI 프로토타입이 시각적으로 일관될 뿐만 아니라 이해하기 쉽고 상호작용하기 편리하도록 보장합니다. 이 모듈은 게슈탈트 원칙, 피츠의 법칙(Fitts’ law), 힉의 법칙(Hick’s law)을 포함한 핵심 인지 디자인 원칙을 통합하여 UI 구성 요소의 배치, 그룹화 및 간격을 조정합니다. 인지적 디자인 최적화를 위한 상세한 수학적 공식은 보충 파일 1에 제공됩니다.
통합 인지 최적화 목표
통합 인지 최적화 목표에 대한 수학적 표현식은 보충 자료 1에 제공되어 있습니다. 시각적 그룹화, 상호작용 효율성 및 결정 복잡성의 중요도를 나타내는 계수는 각각 alpha, beta, gamma로 표시합니다. 본 연구에서는 검증 데이터셋을 사용하여 alpha, beta, gamma의 값을 경험적으로 결정하였습니다. 본 실험에서 계수는 α = 0.5, β = 0.3, γ = 0.2로 설정되었습니다. 이러한 구성은 시각적 그룹화, 상호작용 효율성 및 결정 단순성 사이의 효과적인 균형을 제공합니다.
멀티스크린 일관성 및 UI 생성
다중 화면 일관성 모델링은 애플리케이션 내의 서로 다른 화면들이 일관된 시각적 정체성, 구조적 레이아웃 및 상호작용 패턴을 공유하도록 보장합니다. 사용자가 여러 화면을 탐색함에 따라 요소 배치, 타이포그래피, 간격 및 시각적 계층 구조에 대한 기대치가 형성됩니다. 이러한 기대치를 충족하기 위해 시스템은 RICO 및 ENRICO 데이터셋에서 도출된 템플릿을 사용하여 화면 간 패턴을 분석합니다. 이 템플릿들은 홈-상세 레이아웃, 리스트-상세 패턴, 다단계 양식 및 대시보드 흐름과 같은 일반적인 UI 구조를 포착합니다. 구성 요소의 배치와 그룹화 동작을 비교함으로써, 시스템은 어떤 요소가 일관되게 유지되어야 하고 어떤 요소가 변할 수 있는지를 식별하는 화면 간 구조적 프로필을 구축합니다. 구조적 패턴이 식별되면, 프레임워크는 타이포그래피 스케일, 간격 비율, 그리드 레이아웃 및 내비게이션 앵커의 일관성을 강제합니다. 예를 들어, 헤더 바는 일정한 높이를 유지하고, 기본 버튼은 균일한 크기와 정렬을 유지하며, 콘텐츠 블록은 예측 가능한 시각적 순서를 따릅니다. 이는 각 화면을 전역적 구조적 제약 조건과 대조하여 평가하는 레이아웃 정규화 프로세스를 통해 달성됩니다. 일관되지 않은 패딩이나 정렬되지 않은 제목과 같이 화면이 학습된 템플릿에서 벗어난 경우, 시스템은 레이아웃을 자동으로 조정하여 일관성을 회복합니다. 이러한 보정은 원활한 UX를 보장하고 화면 간의 인지적 전환 비용을 줄이는 데 도움이 됩니다. 또한, 프레임워크는 상호작용 흐름의 일관성을 유지하기 위해 화면 간의 내비게이션 그래프를 분석합니다. 이전/다음 전환, 탭 내비게이션 및 다단계 워크플로우를 포함한 일반적인 내비게이션 패턴이 식별되고 적용됩니다. 각 전환은 사용자의 멘탈 모델과 일치하는지 검증되어 사용성을 향상시키고 혼란을 줄입니다. 결과적으로, 다중 화면 일관성 모델은 시각적 노이즈를 최소화하고 친숙함을 높이며 통합된 상호작용 경험을 촉진합니다.
멀티스크린 일관성 및 UI 생성을 위한 상세한 수학적 공식은 보충 파일 1에 제공됩니다.
마지막으로, 렌더링 엔진은 SVG 와이어프레임, HTML/CSS 프로토타입 또는 픽셀 기반 UI 모형과 같은 형식으로 시각적 결과물을 생성합니다. 이렇게 생성된 UI 화면은 올바른 읽기 순서, 조화로운 색상 관계, 정밀한 그리드 정렬 및 여러 화면에 걸쳐 일관된 시각적 계층 구조를 보여줍니다.
알고리즘 S3는 인지-시각적 레이아웃 최적화 및 멀티스크린 일관성 워크플로우를 제공합니다(보충 파일 1). 알고리즘 S3는 사용자 친화적인 UI 레이아웃을 생성하는 데 사용되는 통합 인지 및 구조 최적화 프로세스를 설명합니다. 이는 통합 최적화 프레임워크 내에서 지각적 그룹화(게슈탈트 원리), 상호작용 효율성(피츠의 법칙), 그리고 의사결정 단순성(힉의 법칙)을 결합합니다. 우선, 구성 요소 간의 공간적 관계를 평가하여 지각적 그룹화를 설정합니다. 이후 구성 요소의 크기와 배치를 조정하여 상호작용 효율성을 최적화하며, 사용자에게 제시되는 선택지의 수를 제한하여 의사결정 복잡성을 제어합니다. 또한, 이 알고리즘은 각 화면을 학습된 레이아웃 템플릿에 맞춰 정렬함으로써 멀티스크린 일관성을 강제하며, 타이포그래피, 간격 및 구조적 구성의 균일성을 보장합니다. 이어서 다목적 최적화 함수가 정렬, 간격 및 인지 비용의 균형을 맞추어 레이아웃을 정교화하며, 그 결과 시각적으로 일관되고 인지적으로 효율적인 인터페이스가 생성됩니다. 전반적으로, 이 알고리즘은 생성된 멀티스크린 레이아웃이 높은 수준의 시각적 일관성, 사용성 및 지각적 명확성을 유지하도록 보장합니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
결과
제안된 자동화 UI 프로토타이핑 프레임워크는 세 가지 출처인 4,000개의 RICO 이미지, 1,000개의 ENRICO 화면, 그리고 Guo의 UI Color Dataset에서 가져온 128개의 색상 주석 처리된 UI 샘플로 구성된 총 5,128개의 UI 화면 통합 데이터셋을 사용하여 평가되었습니다. 이 혼합 데이터셋은 컴포넌트 검출 정확도, 레이아웃 구조의 명확성, 다중 화면 일관성 및 지각적 색상 조화를 평가하기 위한 균형 잡힌 벤치마크를 제공합니다.
실험 결과, Faster R-CNN 기반의 탐지 모델은 92.4%의 컴포넌트 탐지 정확도를 달성하였으며, 다양한 모바일 UI 스타일 전반에 걸쳐 효과적으로 일반화됨을 보여주었습니다. 또한, ENRICO 패턴 어노테이션을 통합함으로써 레이아웃 추론 능력이 향상되었으며, 그 결과 레이아웃 명확성이 18.7% 증가하고 읽기 순서 보존 능력이 개선되었습니다. 색상 평가 실험에서는 CAM02-UCS 기반의 색상 모델링 모듈이 디자이너 평...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
토론
연구 결과, 사용성, 구조적 조직화 및 지각적 품질에서 통계적으로 유의미한 개선(p < 0.05)이 나타났으며, 이는 자동화된 UI 프로토타이핑에 인지 설계 원칙을 통합하는 것이 효과적임을 확인시켜 줍니다. 주로 시각적 탐지나 규칙 기반 휴리스틱에 의존하는 기존의 UI 생성 시스템과 달리, 제안된 프레임워크는 UI 재구성 프로세스 전반에 걸쳐 게슈탈트 그룹화, 계층 모델링, 간격 제약 및 지각적 가독성을 통합합니다. NASA-TLX, SUS 및 SET에서 관찰된 개선 사항은 인지 부하의 통계적으로 유의미한 감소(NASA-TLX, p.< 0.01)를 추가로 입증합니다. 이러한 결과는 자동화된 UI 생성이 단순히 시각적 재구성 정확도를 넘어 실제적인 사용성을 달성하기 위해 인간 중심 설계 지식을 통합해야 함을 시사합니다. 또한, 설정된 모든 가설(H1–H4)이 실험 결과에 의해 실증적으로 지지되었습니다.
레이아웃 개선 외에도, CAM02-UCS 기반의 ...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
공개 사항
저자들은 이해관계의 충돌이 없습니다.
감사의 글
저자들은 본 연구를 수행하는 동안 Wuhan College of Foreign Languages & Foreign Affairs, 계명대학교, 그리고 상하이 상업외국어대학교로부터 제공받은 학술적 및 기관적 지원에 감사드립니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| CPU (프로세서) | AMD Ryzen 9 7950X (16-core, 32-thread, 4.5–5.7 GHz) | Advanced Micro Devices (AMD), USA | Ryzen 9 7950X |
| CUDA Toolkit | 버전 11.8 | NVIDIA Corporation, USA | CUDA Toolkit 11.8 |
| cuDNN | 버전 8.9 | NVIDIA Corporation, USA | cuDNN v8.9 |
| Faster R-CNN | 객체 검출 모델 (Region Proposal Network 포함) | Meta AI Research / Detectron2 | Detectron2 framework |
| Matplotlib | 버전 3.7 | Matplotlib Development Team | v3.7.0 |
| NVIDIA RTX 4090 GPU | 24 GB GDDR6X 그래픽 카드 | NVIDIA Corporation, Santa Clara, CA, USA | RTX 4090 |
| NumPy | 버전 1.24 | NumPy Developers | v1.24.0 |
| OpenCV | 버전 4.8 | OpenCV Foundation | v4.8.0 |
| PyTorch | 버전 2.0 | PyTorch Foundation (Meta AI) | v2.0.0 |
| FPN 기반 ResNet-50 | Feature Pyramid Network 기반 백본 CNN | Microsoft Research / Detectron2 | ResNet-50-FPN |
| Scikit-learn | 버전 1.3 | Scikit-learn Developers | v1.3.0 |
| SciPy | 버전 1.10 | SciPy Community | v1.10.0 |
| 시스템 메모리 (RAM) | 64 GB DDR5 | Corsair / Kingston (또는 동등 제품) | DDR5 64GB Kit |
| Ubuntu 운영 체제 | 버전 22.04 LTS | Canonical Ltd., UK | Ubuntu 22.04 LTS |
참고문헌
- Weingerl P. Automated image-based user interface color theme generation. Appl Sci. 2024;14:2850.
- Feng Z, Fang J, Cai B, Zhang Y. Guis2Code: Computer vision tool to generate code automatically from graphical user interface sketches. In: Proc Int Conf Artif Neural Netw; 2021; p. 53–65.
- Chen C, Zhang X, Yang Y, Li Y. GalleryDC: Design search knowledge discovery through auto-created GUI component gallery. Proc ACM Hum Comput Interact. 2019;3:1–22.
- Chen J, et al. Object detection for graphical user interface: Old-fashioned deep learning combination. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1202–1214.
- Xie M, et al. UIED: Hybrid tool for GUI element detection. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1655–1659.
- Gijsenij A, et al. Determining key colors from a design perspective using dE-means color clustering. Color Res Appl. 2023;48:69–87.
- Yuan LP, et al. InfoColorizer: Interactive recommendation of color palettes for infographics. IEEE Trans Vis Comput Graph. 2022;28:4252–4266.
- Cao Y, et al. Influences of color salience and location of website links on user performance and affective experience. Int J Hum Comput Interact. 2021;37:547–559.
- Liu W, Cao Y, Proctor RW. App icon color and border shape influence visual search efficiency and user experience. Int J Ind Ergon. 2021;84:103160.
- Yamin PAR, Park J, Kim HK, Hussain M. Effects of button colour and background on augmented reality interfaces. Behav Inf Technol. 2023;43:663–676.
- Deng L, Zhang ZR, Zhou FY, Liu RY. Effects of app icon border form and interface background color saturation. Adv Multimed. 2022;2022:1166656.
- Weingerl P, Hladnik A, Javoršek D. Machine learning model for extracting image prominent colors. Color Res Appl. 2020;45:409–426.
- Huang K, et al. WovenProbe: Probing possibilities for on-skin systems. In: Proc ACM Des Interact Syst Conf; 2021; p. 1193–1207.
- Dewez D, Guillemot C, Bailly G, Isenberg T. Dual body representations during an isomorphic 3D manipulation. IEEE Trans Vis Comput Graph. 2022;28:2047–2057.
- Kim J, Kim C, Nam KY. ThinkWrite: Design interventions for online petition deliberation. In: Proc CHI Conf Hum Factors Comput Syst Ext Abstr; 2022.
- Gao L, Wang Y, Müller S, Hudson SE. DataLev: Mid-air data physicalisation using acoustic levitation. In: Proc CHI Conf Hum Factors Comput Syst; 2023; p. 1–14.
- Khorsandi PM, Ogata M, Rekimoto J, Inami M. FabriCar: In-car media interactions using e-textile sensors. In: Proc ACM Des Interact Syst Conf; 2023; p. 764–776.
- Zhang Z, Ding Y, Huang C. Automatic front-end code generation via multi-head attention. In: Proc Int Conf Comput Eng Appl; 2023; p. 869–872.
- Jain V, et al. Sketch2code: Transformation of sketches to UI using deep neural network [preprint]. arXiv:1910.08930; 2019.
- Chai Y, et al. Dynamic prototype network for few-shot malware detection. IEEE Trans Knowl Data Eng. 2023;35:4754–4766.
- Qiu J, et al. AI security in 5G networks: Adversarial examples. IEEE Veh Technol Mag. 2020;15:95–100.
- Qiu J, et al. Automatic concept extraction from big data in smart city. IEEE Trans Comput Soc Syst. 2020;7:225–233.
- Xie M. UI2CODE: Computer vision-based reverse engineering of UI design [Internet]. GitHub; 2021. Available from: https://github.com
- Wang C, Bochkovskiy A, Liao HYM. CSPNet: Backbone enhancing learning capability of CNNs. In: Proc IEEE Conf Comput Vis Pattern Recognit Workshops; 2020; p. 1571–1580.
- Hui M, et al. Unifying layout generation with decoupled diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18434–18443.
- Wang Y, et al. Dolfin: Diffusion layout transformers without autoencoder. In: Proc Eur Conf Comput Vis; 2024; p. 513–530.
- Sobolevsky A, et al. GuiLGet: GUI layout generation with transformer [preprint]. arXiv:2304.09012; 2023.
- Lu Y, et al. UI layout generation with LLMs guided by UI grammar [preprint]. arXiv:2310.15455; 2023.
- Leiva LA, Hota A, Oulasvirta A. ENRICO: A dataset for mobile UI design modeling. In: Proc Int Conf Hum Comput Interact Mobile Devices Serv; 2020.
- Li G, et al. Learning to denoise mobile UI layouts. In: Proc CHI Conf Hum Factors Comput Syst; 2022; p. 1–15.
- Beltramelli T. pix2code: Generating code from a GUI screenshot. In: Proc ACM SIGCHI Symp Eng Interact Comput Syst; 2018.
- Zheng G, et al. LayoutDiffusion: Controllable diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18424–18433.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.