이 프로토콜은 웹 기반 암 임상 진료 지침에서 콘텐츠를 검색하고 요약하여 사용자 질문에 대한 참고 기반 응답을 생성하는 가이드라인 기반 검색 증강 생성 챗봇의 개발 및 평가를 설명합니다.
이 콘텐츠를 보려면 JoVE 구독이 필요합니다. 로그인하거나 오늘 무료 평가판을 시작하세요.
이 논문에서
요약
초록
인터넷을 통한 의료 정보의 광범위한 보급은 환자들의 건강 관련 지식 접근성을 향상시켰으며; 하지만 부정확한 의료 정보에 대한 노출도 증가시켰습니다. 암 치료는 복잡한 정보를 포함하여 환자가 정확하고 근거 기반의 출처를 파악하기 어렵습니다. 대형 언어 모델은 자연어 상호작용을 가능하게 하지만 자주 환각을 발생시켜 의료 정보 전달에서의 적용이 제한적입니다. 검색 증강 생성(RAG)은 외부 참조 소스에 기반을 두고 응답을 완화할 잠재력을 가지고 있습니다. 본 연구는 공개된 웹 기반 암 임상 진료 지침을 사용하는 가이드라인 기반 RAG 챗봇의 개발 및 평가를 설명합니다. 이 시스템은 가이드라인의 목차 페이지에서 URL을 추출하고, 형태학적 분석과 용어 빈도-역 문서 빈도를 기반으로 한 코사인 유사성을 이용해 페이지 텍스트를 처리하며, 매우 관련성 높은 페이지에서 참조 정보를 생성합니다. 대형 언어 모델은 이러한 참조를 사용하여 가이드라인 내용에 제한된 응답을 생성합니다. JLCS 폐암 환자 및 가족 가이드북이 참고 지침으로 사용되었습니다. 질문 세트에는 가이드라인에서 다루는 범위 내 암 유형과 범위 외 암 유형이 모두 포함되어 반응 통제를 평가하였습니다. 의료 정보는 목차에서 성공적으로 추출되었으며, 추출된 URL의 98%가 참고 가능한 의료 내용을 포함하고 있었습니다. 범위 내 질문에 대해서는 챗봇이 가이드라인 내용을 요약하여 응답을 생성했으며, 정의된 테스트 조건 내에서 수동 검토 중 환각은 발견되지 않았습니다. 범위를 벗어난 질문에 대해서는 챗봇이 일관되게 답변을 거부하며 이용 가능한 정보가 불충분하다고 표시했습니다. 가이드라인의 웹 구조는 URL 수준에서 참조 콘텐츠의 효율적인 스크래핑과 조직을 가능하게 했습니다. 이 프로토콜은 웹 기반 임상 진료 지침을 기반으로 의료 정보를 전달하는 인공지능 시스템 구축에 실질적인 지침을 제공합니다.
서론
인터넷과 소셜 미디어의 광범위한 사용으로 환자들이 의료 정보를 더 쉽게 접근할 수 있게 되었습니다 1,2. 암 치료 정보는 종종 복잡하고 방대하기 때문에, 환자들이 정확하고 관련성 있으며 과학적 증거에 기반한 출처를 식별하기 특히 어렵습니다. 온라인 자료는 환자 이해를 돕는 데 도움이 되지만, 상당량의 잘못된의료 정보가 포함되어 있어환자의 치료 결정에 부정적인 영향을 미칠 수 있습니다. 암 관련 허위 정보가 환자 결과에 영향을 미칠 수 있기 때문에,5, 개별 사용자가 의료 정보를 검색, 요약, 해석할 수 있도록 돕는 인공지능(AI) 시스템에 대한 수요가 증가하고 있습니다. 6.
대형 언어 모델(LLM)은 사용자가 자연어 대화를 통해 정보를 접근할 수 있게 합니다7; 그러나 잘못된 정보(즉, 환각)의 생성은 의료 분야에서 여전히 심각한 문제로 남아 있습니다 8,9,10,11. 잘못된 정보의 주요 원인 중 하나는 챗봇 개발에 사용된 훈련 데이터의 품질과 정확성입니다. 또한, 모델 학습의 정적인 특성은 지식이 시간이 지남에 따라 구식이 될 수 있음을 의미하며, LLM이 현재적이고 맥락에 적합한 정보를 제공하는 능력을 제한합니다12,13. 이러한 한계는 챗봇 응답이 정확하고 관련성 있으며 최신 상태를 유지하도록 효과적인 지식 관리 전략의 중요성을 강조합니다. 특히, 임상 진료 지침과 같은 최신 근거 기반 자원에 쉽게 접근하고 참조할 수 있는 시스템은 권고와 치료 기준이 지속적으로 진화하는 의료 환경에서 바람직합니다. 이 문제를 해결하기 위해, 외부 지식원에서 정보를 통합하여 응답을 생성하는 검색 증강 생성(RAG)이 점점 더 주목받고 있습니다10, 13, 14, 15, 16, 17.
RAG가 의료 챗봇에 점점 더 많이 적용되고 있지만, 임상 실무 지침이 체계적으로참고 정보원으로 어떻게 통합되어야 하는지에 대한 관심은 제한적이었습니다. 많은 임상 실무 지침이 웹상에 공개되어 있습니다; 기존 웹 구조가 RAG 시스템18의 검색 프레임워크로 직접 활용될 수 있는지는 불분명합니다. 또한, 수작업으로 지식 기반 개발을 하지 않고 참고 정보를 구축하는 실용적인 방법도 잘 확립되지 않았습니다.
본 연구에서는 공개된 웹 기반 암 임상 진료 지침을 사용하는 지침 기반 RAG 챗봇을 개발 및 평가하여 의료 분야에서 가이드라인 참조 AI 시스템의 설계 원칙을 확립하고자 했으며, 이를 통해 가이드라인 기반 정보에 간단하고 시기적절하게 접근할 수 있게 되었습니다. 개념 증명으로서, 우리는 공개된 임상 실무 지침의 웹 구조를 활용하여 가이드라인 검색, 반응 생성, 반응 제한의 기술적 타당성을 평가하여, 지침 참조 RAG 시스템에 대한 재현 가능한 개발 프로토콜을 제안하는 것을 목표로 했습니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
프로토콜
이 연구는 연구 위험으로부터 보호가 필요한 인간 대상자가 아닙니다. 따라서 인간 대상 의학 연구에 대해 일본 윤리 지침에 따라 기관 심사 위원회의 심사를 요구하지 않는다19. 이 연구는 개인 예후 또는 진단을 위한 다변수 모델 투명 보고(TRIPOD)-LLM 가이드라인에 따라 보고되었습니다20.
가이드라인 기반 RAG 챗봇 프로토콜의 도식은 그림 1 을 참조하십시오.
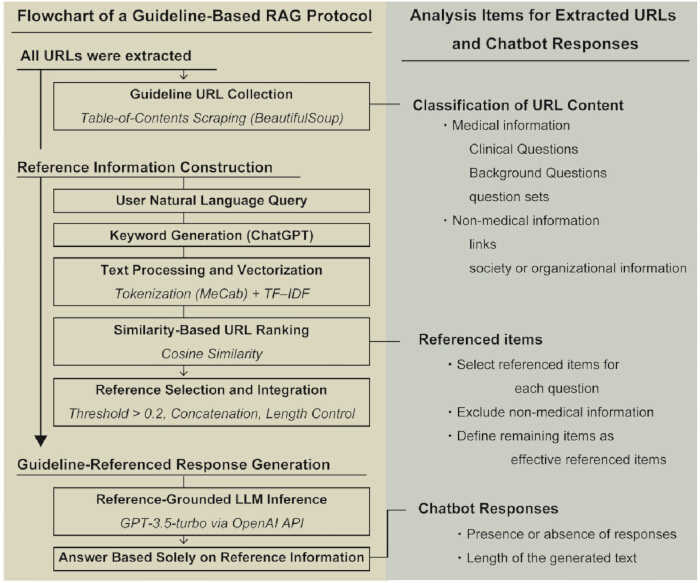
그림 1. 가이드라인 기반 검색 증강 생성(RAG) 챗봇 프로토콜의 워크플로우. 가이드라인 기반 RAG 챗봇 워크플로우의 도식적 개요. URL은 웹 기반 임상 실무 지침의 목차 페이지에서 추출하여 참고 정보를 구성하는 데 사용됩니다. 사용자 쿼리는 키워드로 변환되며, 웹페이지 내용은 토큰화, 용어 빈도-역문서 빈도 벡터화, 코사인 유사도 분석을 통해 관련 가이드라인 페이지를 식별합니다. 선택된 참고 정보는 통합되어 대규모 언어 모델에 제공되어 참고된 지침 내용만을 기반으로 응답을 생성합니다. 오른쪽 패널은 추출된 URL, 참고 문헌, 챗봇 응답에 사용된 평가 항목을 요약합니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭해 주세요.
1. 웹 기반 가이드라인을 기반으로 한 참고 정보 준비
- Python(버전 3.12) 프로그래밍 언어로 구현된 BeautifulSoup 4(HTML 파싱 라이브러리)를 사용해 대상 웹 기반 임상 진료 지침의 목차 페이지에서 모든 URL을 추출하세요.
참고: HTML 파싱 라이브러리(버전 4.12.3)와 요청(웹페이지 검색 라이브러리; 버전 2.32.3)을 사용하여 URL 추출 스크립트를 프로그래밍 언어로 구현하세요. PIP를 사용해 패키지를 설치하세요. URL 추출을 위한 전체 소스 코드는 보충 파일 1에 제공되어 있습니다. 소프트웨어 세부 사항은 재료표 를 참조하세요. - 추출된 모든 URL을 수동으로 검토하여 성공적인 접근성과 대상 임상 진료 지침과의 관련성을 확인하세요.
- 각 URL을 의료 정보와 비의료 정보를 포함하고 있는 것으로 분류하세요. URL 분류는 한 명의 저자(S.N.)에 의해 수행됩니다.
참고: 의료 정보는 임상 질문(CQ), 배경 질문, 문제 세트를 포함한 참조 가능한 지침 내용으로 정의되었습니다. 비의료 정보에는 링크, 학회 또는 조직 페이지, 그리고 참고용이 부적합한 기타 부가 콘텐츠가 포함되었습니다. - 검증된 URL을 Microsoft Excel 워크북(.xlsx 형식)에 컴파일하고, 각 행마다 하나의 URL을 기록하세요. 결과 URL 목록을 입력 데이터셋으로 저장하여 이후 텍스트 검색, 전처리, 유사성 분석을 수행합니다.
2. 사용자 쿼리를 통한 키워드 생성
- 자연어 쿼리를 ChatGPT(생성 사전 학습 변환기, 버전 40; 키워드 생성 모델)에 입력하세요.
- 모델에 사용자 쿼리에 대응하는 두 개의 키워드를 추출하도록 프롬프트를 보냅니다.
- 키워드 생성을 위해 일본어로 작성된 다음 프롬프트를 사용하세요:
""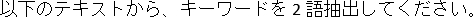
(영어 번역: "다음 텍스트에서 두 개의 키워드를 추출하라.") - 사용자의 자연어 쿼리를 이 명령어에 추가하고, 키워드 생성 모델에 제출하여 키워드 생성을 진행합니다.
- 모델 매개변수를 수동으로 수정하지 마세요. 키워드 생성 모델의 기본 설정을 사용하여 키워드 생성을 수행합니다.
- 각 사용자 쿼리마다 두 개의 키워드를 생성하세요. 추가 수정, 필터링, 수동 선택 없이 두 키워드를 유지하여 이후 유사도 계산에 활용하세요.
- 생성된 키워드를 Microsoft Excel 워크북(.xlsx 형식)에 저장하세요. 각 레코드에 대해 원본 사용자 쿼리와 그에 해당하는 생성된 키워드를 저장하여 이후 유사성 기반 검색에 활용합니다.
3. 텍스트 처리 및 유사도 계산
- 웹페이지 검색 라이브러리와 HTML 파싱 라이브러리를 사용하여 추출한 각 URL에서 전체 텍스트 내용을 검색하세요. BeautifulSoup get_text() 함수를 사용해 HTML 소스에서 텍스트 내용을 추출하세요.
- 추출된 웹페이지 텍스트와 생성된 키워드를 HTML 태그와 비일본어 문자를 제거하여 사전 처리하세요.
- MeCab(버전 0.996; 기본 사전과 함께 일본어 형태학 분석기. 명사만 유지하고 공간 구분된 텍스트 문자열로 연결하세요.
- 생성된 키워드를 하나의 텍스트 문자열로 결합하고, 웹페이지 텍스트에 적용되는 동일한 전처리 및 토큰화 절차를 적용합니다.
- scikit-learn 라이브러리(버전 1.6.1)의 TfidfVectorizer 구현을 사용해 처리된 웹페이지 텍스트와 키워드 텍스트에서 기본 매개변수 설정을 사용하여 용어 빈도–역문서 빈도(TF–IDF) 벡터를 생성할 수 있습니다.
참고: 모든 TfidfVectorizer 매개변수는 기본 값으로 유지되었으며, 사용자 지정 매개변수 설정은 적용되지 않았습니다. - 코사인 유사도 함수를 사용하여 각 웹페이지 벡터와 키워드 벡터 간의 코사인 유사도를 계산합니다.
- 코사인 유사도 점수에 따라 URL을 내림차순으로 순위 매기세요. 추가적인 동점 결정 기준을 적용하지 마십시오.
- 코사인 유사도 점수가 ≥0.2인 페이지를 후보 참고 자료로 선택하세요.
참고: 코사인 유사도 임계값(0.2)은 시스템 개발 중 경험적으로 선택되어 검색 회상을 우선시하고 잠재적으로 관련 있는 가이드라인 내용을 배제하지 않도록 했습니다. - 유사도 기준을 충족하는 모든 후보 페이지를 유지하세요.
4. 참고 정보의 구성
- 순위 목록 상단에서 선택한 페이지의 텍스트 내용을 순차적으로 추출합니다.
- 추출한 텍스트를 연결하여 하나의 참고 문서를 만듭니다.
- LLM에 제출하기 전에 참조 텍스트 내 줄바늘 문자와 연속된 공백 문자를 하나의 공백으로 교체하세요.
- LLM에 제공하기 전에 연결된 참조 텍스트를 처음 4,096자로 잘라내세요.
참고: 절단 제한은 토큰이 아닌 문자를 기준으로 했습니다. 4,096자 제한을 경험적으로 선택하여 프롬프트와 참조 정보가 GPT-3.5-터보-16k 응답 생성 모델의 입력 용량 내에 유지되도록 했습니다.
5. AI 기반 응답 생성
- 애플리케이션 프로그래밍 인터페이스(API)를 통해 생성된 참조 정보와 원래 사용자 쿼리를 응답 생성 모델에 제공합니다.
- 다음 프롬프트(전부 일본어로 작성됨)를 사용하여 AI에게 제공된 참고 정보만을 바탕으로 응답이 생성되도록 지시하세요:
"당신은 암 환자들에게 안내를 제공하는 의료 정보 보조원입니다. 다음 참고 정보만을 바탕으로 답변을 작성하며, 본인의 일반적인 지식이나 추론을 사용하지 마십시오. 답변은 약 500자 길이로 상세하고 이해하기 쉬워야 합니다. 참고 정보에 충분한 정보가 없으면 '텍스트에 정보가 부족하다'고 답하라. 추측이나 일반 지식을 사용하지 말고." - 참고 정보와 사용자 쿼리를 하나의 사용자 메시지 내에 함께 제공하세요. 입력을 "참고 정보: [참고 텍스트]" 다음에 "질문: [사용자 쿼리]"로 구조화하세요.
- 응답 생성 모델을 사용하여 다음 설정으로 응답을 생성하세요: temperature = 0.1, 최대 출력 길이 = 1,024 토큰, n = 1, stop = None.
- AI 생성 응답을 얻어 후속 평가를 받으세요.
참고: 참고 정보와 사용자 문의는 단일 사용자 메시지로 제출하세요. 응답 생성 명령어는 시스템 메시지로 별도로 제공하세요.
6. 참고 지침 및 질문 구성
- 가이드라인 기반 RAG 챗봇 시스템의 참고 정보로 온라인에서 무료로 제공되는 JLCS 폐암 환자 및 가족 가이드북(폐 가이드북)21을 선택하세요.
- 암 유형별로 평가 질문을 두 가지 범주로 만드세요: 가이드라인 범위 내에 있는 흉선 종양과 참조된 정보 범위를 벗어난 소아 교모세포종입니다.
- 각 암 유형별 진단과 치료를 다루는 네 가지 질문을 작성하세요:
"XX(예: 흉선 또는 소아 교모세포종) 종양에 대한 진단 방법은 무엇인가요?"
"XX 종양에 대한 병리학적 진단 접근법은 무엇인가요?"
"XX 종양에 대한 치료 옵션은 무엇인가요?"
"XX 종양에 대한 수술 치료 옵션은 무엇인가요?" - 참고된 웹 기반 가이드라인에 적용된 암 유형과 관련된 질문을 챗봇에 제출하세요. 예를 들어, 폐 가이드북을 참고 자료로 삼아 흉선종양 진단에 관한 질문을 제출하세요.
- 참고 지침 범위를 벗어난 질문을 챗봇에 제출하여 외부 정보나 관련 없는 정보를 사용하지 않는지 평가하세요. 예를 들어, Lung Guidebook을 참고 자료로 사용하여 소아 교모세포종에 관한 질문을 제출하세요.
- 각 질문을 독립적인 채팅 세션에서 평가하세요. 질문 사이에 대화 기록을 이어가지 마세요.
- AI 생성 응답을 기록하여 후속 평가를 수행하세요.
7. 반응 평가
- 생성된 모든 응답을 수동으로 검토하세요.
- 각 반응에 환각이 포함되어 있는지 평가하세요.
- 각 응답이 참고 지침에 포함된 정보에 의해 뒷받침되는지 평가하세요.
참고: 환각은 존재하지 않는 사건, 이름 또는 용어가 포함된 반응으로 정의되었으며, 이는 잠재적으로 의학적 피해를 줄 수 있습니다14. 모든 응답은 대학 병원에서 8년 경력을 가진 한 저자가 정확성과 환각 유무를 검토했으며, 암 환자에 대한 환자 지원 및 의료 소통도 포함하였습니다. 반응 분류에 관한 불확실성은 일본 국립암센터에서 20년 이상의 암 정보 서비스 경험을 가진 공동 저자와의 논의를 통해 해결되었습니다. - 추가 지식이나 근거 없는 추론 없이 모든 임상적으로 관련된 진술이 검색된 참고문헌 가이드라인에서 직접 확인할 수 있을 때만 응답을 지지한다고 간주하세요.
- 각 반응을 미리 정의된 결과 라벨로 분류하세요. 참고 지침에 의해 뒷받침되는 정보만 포함된 반응은 "환각 부재"로 분류합니다. 근거 없거나 조작된 정보가 포함된 답변은 '환각 존재'로 분류하세요.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
결과
목차 페이지를 통한 의료 콘텐츠 검색 가능
웹 스크래핑 아키텍처는 가이드라인의 목차 페이지에서 URL을 수집했습니다. 폐 가이드북에서 목차 페이지에서 106개의 URL이 추출되었으며, 이 중 104개(98%)는 의료 정보를 포함하고 있습니다(보충표 1). 가이드라인 내용 페이지를 기반으로 한 챗봇 응답의 효과는 표 1에 요약되어 있습니다. 챗봇은 질문이 지침 범위 내에 있을 때 네 가지 임상 키워드 모두에 대해 답변을 생성했습니다. "흉선 종양 진단"과 "병리학적 진단"에 대해서는 각 키워드별로 세 개의 관련 URL을 추출했으며, 추출된 모든 URL이 100% 효과로 간주되었습니다. "치료 방법"과 "외과적 치료"에 대해 각 키워드별로 15개의 URL을 추출했으며, 14개의 유효 문항(93%)을 포함했습니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
토론
본 연구에서는 웹 기반 임상 진료 가이드라인인 JLCS 폐암 환자 및 가족 가이드북을 참고 정보 출처로 사용하는 가이드라인 기반 RAG 챗봇의 유용성을 검토했습니다. 챗봇은 가이드라인의 웹 구조를 활용해 사용자 쿼리와의 유사성을 바탕으로 페이지를 검색하여 지침 내용에 기반한 응답을 생성했습니다. 이 접근법은 유사성 기반 검색과 가이드라인 참조 응답 생성이 신뢰할 수 있고 효율적인 의료 정보 전달을 지원할 수 있음을 입증했습니다. 최근 연구들은 LLM 기반 의료 챗봇의 잠재력과 한계, 특히 환각과 반응 신뢰성 측면에서 부각시켰습니다12, 13, 14. 이전 연구들이 일반 챗봇 프레임워크10, 12
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
공개 사항
저자들은 상충하는 이해관계가 없다고 선언한다.
감사의 글
저자들은 가이드라인 기반 검색-증강 생성 챗봇 개발에 있어 광범위한 기술 지원을 제공한 이노우에 켄이치 박사(쇼난 메모리얼 병원 유방 센터)에게 감사를 표합니다. 저자들은 또한 이 논문에서 다루는 주제에 대해 귀중한 조언을 제공해 준 야마키 치카코 박사와 일본 국립암센터 암 통제 연구소(도쿄, 일본 ) 연구팀 전원에게 감사를 표합니다. 또한 저자들은 영어 편집에 대해 Editage에 감사를 표합니다. 이 연구는 보건 및 노동과학 연구 보조금(R6–암 통제–23EA1026)의 지원을 받았습니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
재료
```html
```
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| Beautiful Soup 4 (버전 4.12.3) | Beautiful Soup 프로젝트 | N/A | URL 추출 및 HTML 파싱에 사용되는 Python 라이브러리 |
| ChatGPT 버전 4o | OpenAI | N/A | 키워드 생성에 사용됨 |
| GPT-3.5-turbo | OpenAI | N/A | 응답 생성에 사용됨 |
| 폐암 환자 및 가족을 위한 JLCS 가이드북 | Japan Lung Cancer Society | N/A | 참조 정보로 사용되는 웹 기반 임상 실무 지침 |
| MeCab (버전 0.996) | MeCab 프로젝트 | N/A | 일본어 형태소 분석기 |
| OpenAI API | OpenAI | N/A | AI 기반 응답 생성에 사용됨 |
| Python (버전 3.12) | Python Software Foundation | N/A | 프로그래밍 환경 |
| Requests (버전 2.32.3) | Requests 프로젝트 | N/A | 웹페이지 검색에 사용되는 Python 라이브러리 |
| scikit-learn (버전 1.6.1) | scikit-learn 개발자들 | N/A | TF–IDF 벡터화 및 코사인 유사도 계산에 사용됨 |
| urllib.parse | Python Software Foundation | N/A | URL 정규화 및 결합에 사용되는 Python 라이브러리 |
참고문헌
- Helft PR, Hlubocky F, Daugherty CK. American oncologists' views of internet use by cancer patients: a mail survey of American Society of Clinical Oncology members. J Clin Oncol. 2003;21(5):942-947.
- Chen X, Siu LL. Impact of the media and the internet on oncology: survey of cancer patients and oncologists in Canada. J Clin Oncol. 2001;19(23):4291-4297.
- Goto Y, et al. Differences in the quality of information on the internet about lung cancer between the United States and Japan. J Thorac Oncol. 2009;4(7):829-833.
- Ogasawara R, et al. Reliability of cancer treatment information on the internet: observational study. JMIR Cancer. 2018;4(2):e10031.
- Johnson SB, Park HS, Gross CP, Yu JB. Complementary medicine, refusal of conventional cancer therapy, and survival among patients with curable cancers. JAMA Oncol. 2018;4(10):1375-1381.
- Rajpurkar P, Chen E, Banerjee O, Topol EJ. AI in health and medicine. Nat Med. 2022;28(1):31-38.
- The Lancet Digital Health. ChatGPT: friend or foe? Lancet Digit Health. 2023;5(3):e102.
- Huang L, et al. A survey on hallucination in large language models: principles, taxonomy, challenges, and open questions. arXiv. 2023;2311.05232.
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):248.
- Yang R, et al. Retrieval-augmented generation for generative artificial intelligence in health care. npj Health Syst. 2025;2(2).
- Zakka C, et al. Almanac—retrieval-augmented language models for clinical medicine. NEJM AI. 2024;1(2):AIoa2300068.
- Chow JCL, Li K. Developing effective frameworks for large language model-based medical chatbots: insights from radiotherapy education with ChatGPT. JMIR Cancer. 2025;11:e66633.
- Chow JCL, Li K. Large language models in medical chatbots: opportunities, challenges, and the need to address AI risks. Information. 2025;16(7):549.
- Nishisako S, Higashi T, Wakao F. Reducing hallucinations and trade-offs in responses in generative AI chatbots for cancer information: development and evaluation study. JMIR Cancer. 2025;11:e70176.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-9474.
- Gao Y, et al. Retrieval-augmented generation for large language models: a survey. arXiv. 2023;2312.10997.
- Jeong M, Sohn J, Sung M, Kang JJB. Improving medical reasoning through retrieval and self-reflection with retrieval-augmented large language models. Bioinformatics. 2024;40:i119-i129.
- Lewis M, et al. Grounding large language models in clinical evidence: a retrieval-augmented generation system for querying UK NICE clinical guidelines. arXiv. 2025;2510.02967.
- Ministry of Education, Culture, Sports, Science and Technology; Ministry of Health, Labour and Welfare; Ministry of Economy, Trade and Industry. Ethical guidelines for medical and biological research involving human subjects [Article in Japanese]. Ministry of Health, Labour and Welfare.
- Gallifant J, et al. The TRIPOD-LLM reporting guideline for studies using large language models. Nat Med. 2025;31:60-69.
- The Japanese Lung Cancer Society. JLCS Guidebook for Lung Cancer Patients and Families. Available at: https://www.haigan.gr.jp/public/guidebook/2024/. Accessed January 21, 2026.
- Liu M, et al. Evaluating the effectiveness of advanced large language models in medical knowledge: a comparative study using Japanese national medical examination. Int J Med Inform. 2025;193:105673.
- Kudo T, Yamamoto K, Matsumoto Y. Applying conditional random fields to Japanese morphological analysis. In: Proceedings of the 2004 Conference on Empirical Methods in Natural Language Processing. 2004:230-237.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.