본 연구는 두 개의 데이터셋에서 감정 인식 정확도를 향상시키기 위해 트랜스포머 인코더, 얽힘 제거된 감정 표현, 그리고 시각적 매핑을 이용한 그래프 기반 교차 모달 어텐션을 활용하는 엔드 투 엔드 멀티모달 감정 분석 프레임워크를 제안합니다.
이 콘텐츠를 보려면 JoVE 구독이 필요합니다. 로그인하거나 오늘 무료 평가판을 시작하세요.
이 논문에서
요약
초록
기계가 인간의 정서적 상태를 이해하고 해석하며 이에 반응할 수 있게 함으로써, 다중 모달 정서 특성의 시각적 매핑은 지능형 인터페이스 설계에 있어 매우 중요합니다. 그럼에도 불구하고, 현재의 다중 모달 정서 감지 알고리즘은 주로 예측 성능에 집중하고 있어 해석 가능성, 상호작용 인식 또는 특징 수준의 교차 모달 상호작용에 대한 통찰력을 거의 제공하지 못하고 있습니다. 본 연구에서는 상호작용 중심의 시각화, 해석 가능한 표현 학습 및 정서 예측을 결합한 다중 모달 정서 측면의 시각적 매핑 프레임워크를 소개하였습니다. 수동으로 생성된 특징을 사용하는 대신, 트랜스포머 기반 인코더를 사용하여 텍스트, 오디오 및 시각 모달리티에서 고차원 정서 임베딩을 추출하였습니다. 강건성을 높이기 위해 얽힘 해제 표현 학습(disentangled representation learning) 기법을 사용하여 정서 특이적 정보와 모달리티 특이적 정보를 분리하였습니다. 또한, 모달리티 간의 미묘한 정서적 관계를 모사하기 위해 적응형 어텐션 가중치를 사용하는 그래프 기반 교차 모달 어텐션 네트워크를 구축하였습니다. 투명성을 높이기 위해 시간적 정서 궤적, 교차 모달 어텐션 분포 및 잠재 정서 임베딩을 묘사하는 다중 뷰 시각적 매핑 모듈을 개발하였습니다. 제안된 프레임워크를 평가하기 위해 Carnegie Mellon University Multimodal Opinion Sentiment and Emotion Intensity (CMU-MOSEI) 데이터셋과 Chinese Multimodal Sentiment Analysis Dataset (CH-SIMS)를 사용하였습니다. 실험 결과에 따르면, 제안된 프레임워크는 정확도, F1-score, 상관관계 및 평균 절대 오차 측면에서 대표적인 베이스라인 기법들을 일관되게 능가하는 동시에 개선된 특징 수준의 해석 가능성과 상호작용 인식 시각화를 제공하였습니다. 또한, 시각적 매핑 모듈은 다중 모달 정서 표현, 교차 모달 상호작용 및 시간적 정서 역동성의 정성적 해석을 용이하게 하여 상호작용 인식 시각화 및 분석을 지원하였습니다.
서론
인간의 감정을 정확하게 식별하고 이해하는 능력은 인간과 기계 사이의 상호작용을 개선하는 데 매우 중요해졌습니다. 감정 분석은 인간-컴퓨터 상호작용의 개선에 필수적일 뿐만 아니라, 사전 진단 의료 진단1, 교실 내 행동 분석2, 환자의 심리 추적3, 차량 내 피로 식별4, 그리고 스마트 홈 환경의 지능형 관리5를 포함한 여러 분야에 혁신을 가져올 잠재력을 가지고 있습니다. 최근 Affective Computing 및 딥러닝6의 발전으로 인해 인간 감정의 복잡성을 포착할 수 있는 실시간 시스템 구축에 대한 관심이 높아졌습니다.
현재의 많은 방법들은 주로 텍스트, 그래픽 또는 청각적 신호와 같은 단일 모달 데이터에 의존하고 있습니다7,8,9. 이러한 접근 방식들은 반어법이나 문맥 특유의 뉘앙스와 같은 정교한 신호를 감지하는 데 반복적으로 실패합니다. 이에 따라 이러한 제한 사항을 극복하기 위해 여러 소스로부터 상호 보완적인 데이터를 통합하는 다중 모달 감정 평가로 연구가 이동하였습니다10,11,12. 여러 모달리티를 병합하는 것의 이점은 early fusion-long short-term memory (EF-LSTM)13, light and FM deep neural networks (LF-DNN)14, tensor fusion networks (TFN), 그리고 low-rank multimodal fusion 접근 방식과 같은 베이스라인 모델들을 통해 입증되었습니다. 하지만 이러한 접근 방식의 대부분은 오프라인 특징 생성에 의존하므로, 동적인 실제 상황에는 적합하지 않습니다.
감정 상태를 수용하기 위해 지난 10년 동안 멀티모달 감정 식별 연구와 응용 분야가 성장해 왔습니다15. 오늘날 가장 도전적이고 중요한 연구 분야 중 하나는 다양한 데이터 소스를 사용하여 감정 상태를 지속적으로 모니터링하는 것입니다16. 멀티모달리티라는 개념은 이와 같이 다양한 지식 체계가 등장하면서 자연스럽게 나타났으며, 이는 감성 컴퓨팅, 인간-컴퓨터 상호작용(HCI), 학습, 비디오 게임, 소비자 서비스, 의료 서비스, 사용자 경험(UX) 평가 등과 같은 영역에서 감정 응용의 많은 발전을 이끌었습니다. 하지만 UX 평가에 감정 인식 기술을 적용하는 것이 항상 간단했던 것은 아닙니다.
단일 모달 방법보다 멀티모달 인식에 집중하는 주요 이유 중 하나는 단일 정보원에 의존할 때 발생하는 본질적인 단점 때문입니다. 단일 모달 감정 탐지 시스템은 데이터의 누락이나 불분명함으로 인해 정확도가 낮아질 수 있는 반면, MER 방식은 여러 데이터 소스를 통합함으로써 더욱 신뢰할 수 있으며 표현 상태에 대해 더 종합적이고 심도 있는 이해를 제공합니다17. 예를 들어, 특히 제스처가 복잡하거나 불분명할 때 얼굴 표정만으로는 감정을 정확하게 분류하기에 충분하지 않을 수 있습니다. 반면, 얼굴 표정을 언어나 신체적 신호와 같은 다른 형태의 의사소통 방식과 결합하면 감정 인식의 정확도를 높일 수 있습니다.
감정 인식에 관한 광범위한 연구가 여러 모달리티(modality)를 대상으로 수행되어 왔습니다. 초기 연구들은 그래픽, 음향 또는 텍스트 기반 입력과 같은 서로 다른 모달리티에서 구별되는 특징을 식별하는 데 집중했습니다. 하지만 다양한 모달리티를 통합함으로써 균형 잡힌 감정 정보를 제공할 수 있으며, 결과적으로 더 신뢰할 수 있고 정밀한 감정 검출이 가능하다는 점이 점점 더 분명해지고 있습니다. 본 섹션에서는 단일 모달리티 및 멀티모달 감정 분석의 주요 발전 사항을 검토하며, 특히 베이스라인 접근 방식과 그 한계점, 그리고 본 연구 방법의 근거에 초점을 맞춥니다.
감정 인식에 관한 초기 연구는 주로 단일 모달리티에 집중되었습니다. 시각적 영역에서는 획기적인 연구를 통해 전형적인 얼굴 움직임의 범주화가 이루어졌습니다20. 이후 시각적 움직임21 및 은닉 마르코프 모델(hidden Markov models)22과 같이 시간적 역동성을 포착하는 기술들이 발전하였으며, 얼굴 반응은 얼굴 움직임 부호화 시스템(Facial Action Coding System, FACS)23을 사용하여 행동 단위(action units)로 구분되었습니다. LSTM과 합성곱 신경망(CNN)은 원시 오디오 신호에서 유의미한 특징을 직접 추출하는 데 성공적으로 사용되어 왔으며, 오디오 기반 감정 식별 방법론은 전통적인 신호 처리에서 딥러닝으로 발전했습니다24. 텍스트 기반 감정 분석에서 문맥적 감성 신호를 추출하는 기능은 어텐션 메커니즘을 통합한 순환 신경망(RNN)과 최근의 트랜스포머 기반 모델에 의해 크게 향상되었습니다. 이러한 성과에도 불구하고, 단일 모달리티 기술은 다른 모드에서 발견되는 보완 정보가 부족하기 때문에 사람들이 경험하는 복잡성을 정확하게 표현하는 데 본질적으로 한계가 있습니다.
대화형 감성 식별 분야에서 더 장기적인 환경 데이터를 수집하기 위해 DialogXL 모델25과 같은 일부 attention mechanism 기반 모델들이 2021년에 제안되었습니다. Kim 등26은 ERC의 정확도를 높이기 위해 2021년에 EmoBERTa 모델을 도입했습니다. 이 모델은 화자 데이터를 사용하여 대화 내 화자의 특성과 화자 간의 상호작용 기능을 개선합니다. 2022년에 Li 등27은 CoG-BART 방법을 제시했습니다. 이 구조는 지도 대조 학습(supervised contrastive learning)을 사용하여 관련 데이터를 해석하는 모델의 능력을 향상시킵니다. 지도 학습에는 상당한 양의 레이블된 데이터가 필요하다는 점에 유의해야 합니다.
이러한 연구의 전형적인 예는 특징 상호작용 토큰과 대조 정렬을 사용하여 모달리티 간 일반화 성능을 향상시키는 Multimodal Interaction-Aware Representation (MIAR) 프레임워크28입니다. MIAR는 모달리티 정렬을 개선하고 여러 데이터셋에서 강력한 성능을 달성하지만, 시각적 매핑을 다루지 않고 주로 예측 정확도에 집중합니다. 마찬가지로, Cross-Attentional Audio-Visual Fusion 모델29은 정서가(valence) 및 각성도(arousal) 예측을 위해 세밀한 오디오-비주얼 상호작용을 효과적으로 포착하지만, 두 가지 모달리티로 제한되며 시각화 기능이 부족합니다. LSTM 네트워크 및 오토인코더 퓨전 기반의 시계열 모델링 접근 방식은 감정의 시간적 역동성을 성공적으로 포착하나, 모달리티 상호작용과 학습된 감정 표현에 대한 통찰력은 제한적입니다. 보다 최근에는 Transformer-based Multimodal Fusion Network (TMFN)30와 같은 트랜스포머 기반 방법들이 강화된 멀티모달 퓨전과 대조 학습을 통해 CMU-MOSI 및 CMU-MOSEI에서 강력한 성능을 입증했습니다. 그럼에도 불구하고, 이러한 접근 방식들은 여전히 주로 성능 중심적이며 설명 가능성, 특징 수준의 해석 및 상호작용 중심의 시각화에 대한 지원이 제한적입니다.
텍스트, 음향 및 시각 데이터의 통합을 강화하기 위해 여러 멀티모달 감정 인식 기술이 제안되어 왔습니다. EF-LSTM 및 LF-DNN과 같은 초기 퓨전 기술은 복잡한 교차 모달 상호작용을 포착하지는 못했지만, 감성 및 감정 분석에 멀티모달 정보를 활용하는 것의 이점을 입증했습니다. TFN은 CMU-MOSI 및 CMU-MOSEI와 같은 벤치마크 데이터셋에서 성능을 향상시키고 모달 간 상호작용의 명시적 모델링을 도입했으나, 제한적인 해석 가능성과 높은 계산 복잡성으로 인해 활용도에 한계가 있었습니다. 모달리티 정렬과 동적 특징 퓨전을 개선하기 위해 MIAR, 교차 주의 집중 퓨전 모델, TMFN 및 적응형 멀티모달 트랜스포머와 같은 최신 기술들은 트랜스포머 토폴로지와 주의 집중 메커니즘을 사용해 왔습니다. 이러한 방법들은 정확도, F1-score, 평균 절대 오차와 같은 일반적인 평가 지표에서 경쟁력 있는 결과를 얻었음에도 불구하고, 주로 예측 성능에 집중하여 특징 수준의 감정 표현 및 교차 모달 의존성에 대한 통찰력은 거의 제공하지 못했습니다. 또한, 잠재 감정 임베딩, 주의 집중 분포 및 시간적 감정 역학을 공개할 수 있는 시각화 기술을 구축하거나 모달 간 상호작용의 그래프 기반 모델링을 통합한 연구는 거의 없었습니다. 제안된 접근 방식은 이러한 단점을 극복하고 멀티모달 감정 인식 성능을 향상시키기 위해 다중 뷰 시각적 매핑, 그래프 기반 교차 모달 주의 집중 퓨전 및 얽힘 해제 표현 학습을 통합합니다.
이와 유사하게, Adaptive Multimodal Transformer32는 노이즈가 있거나 누락된 모달 정보를 적응적으로 완화하기 위해 교환 기반 융합(exchange-based fusion)을 제안하여 감정 분류 성능을 향상시켰습니다. 이러한 접근 방식은 모달 정보의 분포 차이를 효과적으로 해결할 수 있지만, 설계 자체가 감정 분석이라는 특정 작업에 국한되어 있어 학습된 감정 표현에 대한 통찰력은 제한적입니다. 또 다른 중요한 기여로는 CNN, 곱셈 LSTM(multiplicative LSTMs) 및 트랜스포머 기반 어텐션을 통합하여 실시간 멀티모달 감정 인식을 수행하는 Multimodal Fusion Model33이 있습니다. 이 모델은 비디오, 오디오 및 텍스트 모달리티에 대해 완전 융합(full fusion)을 수행하며 견고한 인식 성능을 보여줍니다. 그럼에도 불구하고, 다른 기존 모델들과 마찬가지로 주로 예측 정확도에 집중하고 있으며, 시각화 및 상호작용 중심의 해석 가능성을 위한 명시적인 특징이 부족합니다.
결론적으로, 현재의 최신 다중모드 감정 인식 접근 방식들은 교차 모드 상호작용을 포착하고 예측 정확도를 높이는 데 상당한 성과를 거두었으나, 대부분은 인식 중심의 작업에 치중되어 있습니다. 특성 수준의 해석 가능성, 이미지 공간에서의 감정 표현 시각화, 그리고 지능형 상호작용 설계를 위해 제안된 프레임워크를 통합하는 분야는 거의 주목받지 못했습니다. 본 연구에서는 이러한 과제들을 해결하기 위해 제안된 프레임워크를 소개합니다.
멀티모달 감정 인식의 주목할 만한 발전에도 불구하고28,29, 현재의 대다수 방법론은 학습된 감정 표현과 교차 모달 상호작용의 해석 가능성을 거의 제공하지 않은 채 주로 예측 성능을 개선하는 데 집중하고 있습니다. 텍스트, 음향 및 시각 모달리티 간의 복잡한 상호작용은 특히 모달리티 간의 불일치나 정보 부족이 발생할 때 현재의 퓨전 전략으로는 모델링하기 어려운 경우가 많습니다28,31. 트랜스포머 기반 설계와 어텐션 메커니즘이 표현 학습을 향상시켰으나, 감정 특이적 정보와 모달리티 특이적 정보의 명시적 분리가 부족하여 투명성과 해석 가능성이 종종 떨어집니다31,32,33. 또한, 모달 간 상호작용의 그래프 기반 모델링을 연구하거나 시간적 감정 역동성, 어텐션 분포 및 감정 임베딩을 공개할 수 있는 시각화 프레임워크를 구축한 연구는 소수에 불과합니다. 이러한 단점들은 상호작용 중심의 시각적 매핑과 강력한 교차 모달 학습을 결합한, 지능형 인간-기계 상호작용을 위한 해석 가능한 멀티모달 프레임워크의 필요성을 보여줍니다.
본 연구는 지능형 인터페이스 설계에서 다중 모달 감정 측면의 시각적 매핑을 위한 해석 가능한 프레임워크를 제시합니다. 이 시스템은 수동으로 생성된 특성 없이도 엔드-투-엔드 딥러닝을 사용하여 텍스트, 오디오 및 시각적 모달리티에서 고수준의 감정 표현을 추출합니다. 교차 모달 감정 상호작용은 감정 특이적 정보와 모달리티 특이적 정보를 분리하는 그래프 기반 어텐션 퓨전 메커니즘을 사용하여 모델링되며, 이를 통해 얽힘 해제된 표현 학습(disentangled representation learning)을 가능하게 하여 해석력과 강건성을 향상시킵니다. 또한, 시간적 감정 역학, 교차 모달 어텐션 패턴 및 감정 임베딩을 보여주기 위해 다중 뷰 시각화 모듈이 구축되었습니다. 제안된 프레임워크의 효능과 지능형 인간-기계 상호작용 시스템에서의 적합성은 벤치마크 다중 모달 감정 인식 데이터셋에 대한 검증을 통해 평가되었습니다.
본 연구는 기존의 예측 중심 접근 방식에서 벗어나, 현재의 멀티모달 감정 인식 시스템에서 나타나는 교차 모달 상호작용의 모델링 부족과 제한된 해석 가능성을 극복하기 위해 멀티모달 감정 측면의 시각적 매핑을 위한 독창적인 프레임워크를 제공합니다. 제안된 접근 방식은 단일 아키텍처 내에서 트랜스포머 기반의 멀티모달 표현 학습, 얽힘 해제된 감정 인지 특징 모델링, 그래프 기반 교차 모달 어텐션 퓨전 및 상호작용 중심 시각화를 결합합니다. 분류 성능에 주로 집중하는 기존 방식과 달리, 본 프레임워크는 감정 특이적 표현과 모달리티 특이적 표현을 명확히 분리하여 해석 가능성, 강건성 및 교차 모달 일관성을 향상시킵니다. 또한, 텍스트, 오디오 및 시각적 모달리티 간의 미세한 감정 상호의존성을 캡처하여 모달 간 상호작용의 적응적 모델링이 가능한 그래프 기반 어텐션 메커니즘을 제시합니다. 모델의 의사 결정 과정에 대한 직관적인 통찰력을 제공하기 위해 시간적 감정 궤적, 교차 모달 어텐션 패턴 및 잠재 감정 임베딩을 드러내어 투명성을 높이는 멀티뷰 시각적 매핑 모듈을 구축하였습니다. CH-SIMS 및 CMU-MOSEI 벤치마크 데이터셋에 대한 실험적 평가 결과, 멀티모달 감정 역동성의 시각화 및 해석 가능성이 향상되었을 뿐만 아니라 정확도, F1-score, 평균 절대 오차 및 상관관계 측면에서 경쟁력 있는 성능을 보여주었습니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
프로토콜
제안된 연구는 다중 모달 감정 특징의 시각적 매핑을 위한 해석 가능한 프레임워크를 제공함으로써 지능형 상호작용 설계를 개선하는 것을 목표로 한다. 본 연구에서는 공개적으로 이용 가능한 CH-SIMS 및 CMU-MOSEI 데이터베이스를 사용하였다. 두 데이터셋 모두 각각의 공식 출처에서 확보하였으며, 제작자가 제시한 사용 가이드라인, 연구 기준 및 라이선스 조건에 따라 활용되었다. 데이터셋 제공자가 승인된 참가자 동의 및 데이터 수집 프로토콜에 따라, 텍스트, 오디오 및 비디오 데이터를 포함한 데이터셋의 다중 모달 콘텐츠를 먼저 수집하고 주석을 달았다. 본 연구에서는 직접적인 인간 상호작용, 새로운 참가자의 모집, 또는 개인을 식별할 수 있는 정보의 수집이 전혀 이루어지지 않았다. 모든 분석은 공개적으로 이용 가능한 연구용 데이터셋을 사용하여 수행되었다. 따라서 본 연구의 2차 데이터 분석은 추가적인 윤리적 승인 또는 기관 생물윤리위원회(IRB) 심의를 요구하지 않았다. 본 연구는 공개 데이터셋의 사용, 윤리적 연구 절차 및 관련 데이터 사용 정책을 규제하는 적절한 기관 기준에 따라 수행되었다.
감정 또는 모달리티 특이적 특성을 활용하여 모달리티 간 감정 특성을 학습하고 이해도를 향상시키기 위해 그래프 기반의 교차 모달리티 어텐션 메커니즘이 사용되었다. 실시간 감정 인식 기반 상호작용 설계를 향상시키기 위해 다중 뷰 시각적 매핑 구성 요소가 활용되며, 감정 인식을 위한 그 효율성이 평가된다. 연구 결과는 제안된 방법이 실제 환경에서 감정을 인식하는 지능형 사용자 인터페이스의 해석 가능성과 효율성 모두를 향상시킨다는 것을 보여준다. 그림 1은 제안된 연구의 아키텍처 워크플로우를 나타낸다. 그림 1은 지능형 상호작용 시스템 맥락에서 다중 모달리티 감정 특징 학습을 위한 제안된 시각적 매핑 프레임워크의 전체 워크플로우를 보여준다. 이 워크플로우는 언어적, 음성적, 얼굴 표현 모달리티로부터 보완적인 감정 정보를 포착하는 텍스트, 오디오, 비디오의 세 가지 동기화된 입력 모달리티로 시작된다. 각 모달리티는 모달리티 특이적 트랜스포머 인코더에 의해 처리되어 원시 입력 데이터의 고수준 표현을 얻는다. 그런 다음 이러한 표현은 분리된 표현 학습 모듈에 입력되며, 여기서 감정 특이적 임베딩이 모달리티 특이적 특징으로부터 분리되어 이질적인 데이터 소스 간에 학습된 감정의 일관성을 보장한다. 각 모달리티로부터 추출된 감정 특이적 임베딩은 이후 그래프 기반의 교차 모달리티 어텐션 네트워크에 의해 집계되며, 이 네트워크는 모달리티 간 감정 의존성을 모델링하고 상호작용 맥락에 따라 각 모달리티에 동적 중요도 가중치를 할당한다. 마지막으로, 이 프레임워크는 감정 분류 출력과 상호작용 인사이트를 모두 제공하여 투명한 감정 인식 기반 의사결정 및 적응형 지능형 상호작용 설계를 촉진한다.
다중 모드 데이터 수집
CH-SIMS 및 CMU-MOSEI 데이터셋은 동기화된 비디오, 오디오 및 텍스트와 같은 다중 모달 정보를 수집한 기존의 공개 다중 모달 데이터셋 두 가지이다. CH-SIMS 데이터셋은 영화, 텔레비전 드라마 및 예능 프로그램의 여러 비디오 클립에서 유도된 2,281개의 비디오 세그먼트를 포함하여 중국인을 대상으로 한 다중 모달 검사를 포함한다. 이러한 비디오 세그먼트에 해당하는 오디오 및 텍스트를 추가함으로써 다중 모달 데이터를 이용한 감정의 다중 모달 분석 연구가 더욱 흥미롭고 실현 가능해진다. 그러나 의견, 감정 및 감정을 조사하기 위한 가장 큰 다중 모달 데이터셋 중 하나는 다양한 주제에 대해 1,000명 이상의 화자들에 의해 말해진 문구의 23,000개 이상의 비디오 클립에서 수집된 CMU-MOSEI 데이터셋이다. 이 데이터셋은 클래스 분포를 유지하면서 훈련(70%), 검증(15%) 및 테스트(15%) 하위 집합으로 무작위로 분할되었다.
텍스트 전사본, 오디오 신호 및 비디오 프레임은 세밀한 시간 수준에서 일치하도록 타임스탬프 정렬을 통해 획득된다. 프레임 수준의 통합을 통해 제안된 표현 학습 및 그래프 기반 융합 메커니즘이 시각적 표현, 음성 어조 및 언어적 내용에서 발생하는 감정 정보를 공동으로 모델링하고 활용할 수 있다. 이러한 형태의 다중 모달 획득 기술은 시각적 표현, 음성 어조 및 언어적 내용에서 발생하는 감정 정보를 공동으로 모델링하고 활용할 수 있게 하며, 지능형 상호작용 설계 및 이해 가능한 시각적 매핑에 필수적이다.
표 1은 제안된 방법에서 사용된 다중 모달 감정 데이터셋의 주요 구조를 보여준다. 발화된 단어, 음성 억양 및 얼굴 표정과 같은 더 넓은 범위의 관련 감정을 얻기 위해 CH-SIMS 및 CMU-MOSEI는 이러한 데이터셋으로부터 비디오, 오디오 및 텍스트 모달리티를 통합한다. 또한, CH-SIMS에는 제한된 수의 데이터 샘플만 존재하므로 중국 내 모달리티 간 상호작용 및 감정 변화를 철저히 조사할 수 있다. 반면, CMU-MOSEI 데이터셋은 다양한 언어, 주제 및 주석이 달린 감정 수준에 걸쳐 방대한 양의 데이터를 포함하고 있어 본 연구에서 다루는 표현 학습 및 관련 시각화 알고리즘의 내구성을 평가하는 데 더욱 중요하다. 또한 이전 연구에 비해 모델을 테스트할 때 정보 선택의 어려움을 줄여준다.
다중 모달 전처리 및 동기화
CH-SIMS 및 CMU-MOSEI 데이터셋의 타임스탬프 주석을 사용하여 텍스트, 청각 및 시각 모달리티를 동기화하여 일관된 다중 모달 표현 학습을 보장하였다. 각 화성(utterance)은 기본 분석 단위로 기능하였으며, 동일한 시간 간격 내의 일치하는 오디오 및 비디오 세그먼트와 연결되었다. 정렬은 화성 수준에서 수행되었다. 원고는 각 화성의 시작 및 종료 타임스탬프에 따라 세그먼트로 분할되었다. 동일한 시간 간격 내에 포함된 해당 비디오 프레임과 오디오 신호를 추출함으로써 원고-오디오-시각적 대응 관계를 설정하였다. 오디오 세그먼트는 음향 표현을 생성하기 위해 Wav2Vec 2.0을 사용하여 처리한 반면, 비디오 세그먼트의 시각 프레임은 미리 정의된 비율로 샘플링되고 Vision Transformer(ViT)를 사용하여 인코딩되었다. RoBERTa 인코더는 화성 원고로부터 텍스트 임베딩을 생성하는 데 사용되었다. 세 가지 모달리티가 서로 다른 길이의 특징 시퀀스를 생성하기 때문에, 모든 모달리티 특징을 단일 화성 경계에 정렬함으로써 시간 동기화를 달성하였다. 다양한 길이의 시퀀스를 정규화하기 위해 고정 길이 형식이 사용되었다. 더 긴 시퀀스는 허용된 최대 시퀀스 길이로 축소되었으며, 더 짧은 시퀀스는 0으로 패딩되었다. 훈련 중에는 어텐션 마스크를 사용하여 패딩된 요소를 유효한 특징 위치로부터 분리하였다. 모달리티 간 시퀀스 길이의 차이를 극복하기 위해 모달리티별 임베딩은 융합 전에 공통 잠재 공간으로 투영되었다. 이는 차원 일관성을 보장하고 그래프 기반 어텐션 메커니즘이 효과적인 교차 모달 상호작용 학습을 가능하게 하였다. 손상된 파일, 누락된 주석 또는 불완전한 모달리티 정보를 가진 샘플은 데이터 품질과 동기화 무결성을 유지하기 위해 연구에서 제외되었다.
트랜스포머 기반 특징 추출
딥러닝 방법을 사용하여 시각, 오디오, 텍스트와 같은 다중 모달리티의 정보로부터, 멀티모달 데이터 정렬 및 필요한 전처리 후에 종단 간 방식으로 고차원 감정 인식 특징 표현을 학습한다. 제안된 방법은 트랜스포머 인코더를 사용하여 원시 멀티모달 데이터로부터 본질적으로 구별력 있는 특징 표현을 학습함으로써 특징 엔지니어링의 필요성을 제거한다. 제안된 접근 방식에서 사용하는 데이터셋 간의 일관성을 확보하기 위해 각 모달리티에 대해 고정 크기의 임베딩을 학습한다. 예를 들어, 이미지, 오디오, 텍스트 모달리티를 포함한 각 개별 모달리티 전반에 걸쳐 768차원 특징 임베딩을 학습하여 통합된 특징 공간을 형성하며, 이는 전체 접근 방식 전반에서 특히 제안된 CH-SIMS 데이터셋 및 CMU-MOSEI 데이터셋 전반에 걸쳐 사용되는 특징 추출 접근 방식에서 다양한 크기의 데이터에 걸쳐 고차원 특징을 학습하는 데 활용된다.
시각 모달리티: 감정 인식 프레임 임베딩을 위한 비전 트랜스포머
감정과 관련된 공간적 표현을 얻기 위해 비디오 프레임에서 시각 정보를 추출하기 위해 비전 트랜스포머(ViT-Base) 모델을 사용하였다. 특징 추출 전에 각 비디오 구간의 프레임을 (224 × 224) 픽셀로 크기를 조정하고 정기적인 시간 간격으로 샘플링하였다. 16 × 16 픽셀의 패치 크기를 사용하여 ViT-Base 아키텍처는 12개의 트랜스포머 인코더 계층에 의해 처리되는 일련의 시각 토큰을 생성한다. 검색된 프레임 수준 표현은 사전 훈련된 ViT 모델을 시각적 백본으로 사용하여 768차원의 임베딩 공간으로 투영되었다. 프레임 수준 임베딩은 각 구간의 최종 시각 표현을 생성하기 위해 평균 풀링(mean pooling)을 사용하여 집계되었다. 훈련 중에는 일반화를 향상시키기 위해 이미지 정규화 및 무작위 자르기, 수평 뒤집기와 같은 일반적인 증강 방법을 사용하였다. 그런 다음 제안된 다중 모달 융합 프레임워크를 사용하여 이러한 시각 임베딩을 텍스트 및 청각 표현과 결합하였다.
감정의 시간적 동역학을 유지하기 위해 CH-SIMS 및 CMU-MOSEI 데이터셋의 영상 샘플을 시각적 모달리티에 대해 균일하게 샘플링한다. 각 영상의 프레임 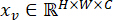 은 N개의 고정된 크기의 구간으로 나눌 수 있으며, 이후 이를 평탄화하고 차원이
 인 잠재 임베딩 공간으로 역변환한다. 위치 임베딩과 학습 가능한 그룹화 토큰을 더하여 시리즈를 생성한다.
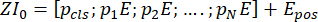 (1)
여기서  는 위치 인코딩을 나타내고,
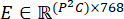 는 패치 임베딩 행렬이다.
임베딩된 패치 시퀀스를 처리하기 위해 피드포워드 네트워크와 멀티헤드 셀프어텐션으로 구성된 스택형 트랜스포머 인코더 층을 사용한다. 층 l에서의 변환은 다음과 같이 기술된다.
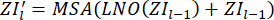 (2)
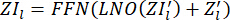 (3)
감정 인식 시각적 특징 벡터를 얻기 위해 클래스 토큰에 해당하는 출력을 특징 벡터  로 추출한다. 데이터셋 간의 언어 및 콘텐츠 차이에도 불구하고 일관된 시각적 감정 표현을 해결하기 위해 각 비디오 세그먼트의 프레임 수준 임베딩을 결합하여 얼굴 표정과 감정의 변화 과정을 포착한다.
조도 및 의미 음향 임베딩을 위한 Wav2Vec 2.0을 활용한 음성 모달리티 문맥화된 음성 임베딩은 사전 훈련된 Wav2Vec 2.0 인코더를 음향 백본으로 사용하여 생성하였다. 각 어구에 대한 고정 길이의 음향 특징 벡터는 평균 풀링(mean pooling)을 사용하여 출력된 은닉 표현들을 집계함으로써 얻었다. Wav2Vec 2.0 모델은 음성 신호로부터 음향 표현을 추출하여 문맥적 특성과 감정 관련 음성 특성을 포착하는 데 사용되었다. 특징 추출 전에 오디오 녹음본은 정규화되고 16 kHz로 리샘플링되었다. 텍스트 및 시각 모달리티 간의 동기화를 보장하기 위해, 각 화행 수준의 오디오 구간은 데이터셋 주석에서 제공된 타임스탬프 범위를 사용하여 분리하였다. 모델 훈련 중에 사전 훈련된 음향 인코더를 조정하여 작업 특화 적응을 향상시켰으며, 이를 통해 도출된 표현이 음성 신호의 감정적 요소를 더욱 정확하게 반영할 수 있도록 하였다. 이후 최종 오디오 임베딩을 사용하여 그래프 기반의 다중 모달리티 간 어텐션 융합 및 분리 가능한 표현 학습을 수행하였다.
오디오 모달리티에서 Wav2Vec-2.0은 CH-SIMS 및 CMU-MOSEI 데이터셋의 초기 음성 정보에서 유도된 음성 신호를 모델링하여 감정과 관련된 오디오 특징을 직접 추출하는 데 사용된다. 각 입력 음성 신호  에 대해 합성곱 특징 인코딩이 존재한다.
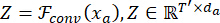 (4)
여기서 Z는 멜로디, 음조, 에너지와 같은 저수준 음성 특성을 의미한다. 트랜스포머 기반의 컨텍스트 네트워크는 장거리 시간적 의존성을 표현하는 데 앞서 언급한 구조에 유용하다.
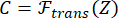 (5)
감정 표현에 필수적인 프로소디(p prosody) 및 의미 음향 데이터는 이러한 문맥적 음향 표현에 포함된다. 특정 길이의 오디오 임베딩은 시간적 풀링 과정을 수행함으로써 생성된다.
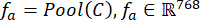 (6)
이 설계는 MFCC와 같은 음향 특성을 사용하지 않으며, 단순히 파형에서 표현을 추출함으로써 CMU-MOSEI의 영어 음성 데이터와 CH-SIMS의 중국어 음성 데이터를 활용하여 내구성을 달성한다.
문맥 기반 감정 임베딩을 위한 RoBERTa를 활용한 텍스트 모달리티
텍스트 모달리티의 경우, 두 데이터셋에서 얻은 음성 기록물에 대해 심층 양방향 트랜스포머인 RoBERTa를 적용하여 문맥적 의미와 정서적 의미를 생성한다. 트랜스포머 인코더 기반의 RoBERTa는 기록 데이터로부터 텍스트 표현을 추출하여 문맥적 의미 및 정서 정보를 포착하는 데 사용되었다. 영어로 구성된 CMU-MOSEI 데이터셋에는 사전 훈련된 RoBERTa 모델을 사용하였으며, 중국어 CH-SIMS 데이터셋에는 언어별 언어적 특성을 더 잘 반영하기 위해 중국어 RoBERTa 변형 모델을 사용하였다. 텍스트 전처리 과정에는 각 언어에 적합한 RoBERTa 토크나이저를 이용한 토큰화와 텍스트 정규화가 포함되었다. 일관된 배치 처리를 보장하기 위해 입력 시퀀스는 토큰 임베딩으로 변환되며, 사전에 정의된 최대 시퀀스 길이에 맞추어 패딩 또는 잘림 처리를 거쳤다. RoBERTa 입력 형식에 따라 특수 분류 토큰과 구분 토큰이 도입되었다. 트랜스포머 인코더가 생성한 문맥화된 토큰 표현들을 집계하여 최종 [CLS]에 해당하는 문장 표현을 사용함으로써 고정 길이의 텍스트 임베딩을 얻었다. 학습된 표현들을 정서 인식 과제에 적응시키기 위해 사전 훈련된 RoBERTa 인코더를 다중 모달 훈련을 통해 정제하였다. 이후 제안된 다중 모달 융합 프레임워크를 사용하여 텍스트 임베딩을 오디오 및 시각적 특성과 통합하였다.
토큰 임베딩과 위치 인코딩은 각각 토큰화된 입력에 대해 결합될 수 있으며, 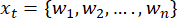 , 이를 통해 심층 양방향 변환 기법으로 알려진 입력 표현을 생성할 수 있다.
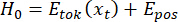 (7)
이 형태는 단어들 사이의 문맥적 의존성을 파악하기 위해 자기 주의(self-attention)를 사용하는 L 변환기(transformer)의 층들을 통해 표현된다:
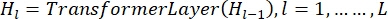 (8)
분류 토큰의 최종 은닉 상태를 사용하여 문맥적 감정 임베딩을 얻는다:
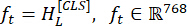 (9)
감정 관련 언어적 특성의 예인 감정 극성, 강한 감정 및 관련된 함의는 이 임베딩에 의해 표현될 것이다. RoBERTa는 언어에 독립적인 모델링을 보다 용이하게 한다. 이를 통해 시스템은 CMU-MOSEI 데이터셋의 영어 텍스트와 CH-SIMS 데이터셋의 중국어 텍스트 모두에 동일한 임베딩 크기를 사용할 수 있게 된다.
제안된 심층 특징 표현 학습 단계를 통해 시각적 fv, 청각적 fa, 텍스트 ft 모달리티 각각에 대한 768차원의 모달리티별 특징 벡터 세 개가 추출된다. 지능형 상호작용 설계에서 이러한 학습된 표현은 특징 수준의 시각적 매핑, 그래프 기반의 모달리티 간 융합 및 분리 가능한 표현 학습을 위한 기반 역할을 하는 통합된 다중 모달리티 특징 공간을 생성한다.
분리된 표현 학습
딥러닝 기반 특징 표현을 학습한 후, 시각, 청각 및 텍스트 모달리티에서 추출된 다중 모달 특징 벡터를 추가로 처리함으로써 정서의 분리된 설명을 도출할 수 있다. 이전 단계에서 사용된 청각, 시각 및 텍스트 모달리티의 모달리티별 특징 임베딩을 각각 fv, fa 및 ft로 나타낸다고 할 때,  및
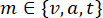 와 같이 표현할 수 있다. 이 단계의 목적은 각 모달리티의 이전 의미 정보를 고려한 후 정서 표현을 포함하는 두 개의 별개 잠재 표현으로 모든 모달리티 특징을 분해하는 것이다.
이것은 각 모달리티 특징 fm 을 두 개의 병렬 프로젝션 네트워크인 감정 인코더  과 모달리티 인코더
 에 입력함으로써 이루어지며, 이 두 인코딩이 생성된다.
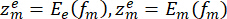 (10)
여기서  는 감정과 관련된 잠재 특성을 나타내며,
 는 특정 모달리티에 고유한 잠재 특성을 나타낸다. 이를 통해 감정 특이적 임베딩이 오디오, 시각, 텍스트를 포함한 다수의 입력에서 반복적으로 공간 간 소통을 할 수 있으며, 각 모달리티와 관련된 고유한 구조적 데이터를 유지할 수 있다.
독립성 제약 조건을 적용하여 재구성함으로써 효과적인 분리를 시행한다. 원래 모달리티 특징의 재구성은 다음과 같다.
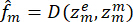 (11)
여기서  는 디코더 네트워크이다. 재구성 손실은 다음 데이터를 보존한다:
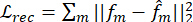 (12)
또한 감정과 모달리티 특이적 묘사 사이의 직교성 또는 비상관성은 종종 정보 중복을 제한한다:
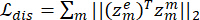 (13)
이러한 목표를 달성함으로써 모델은 신뢰할 수 있고 이해 가능하며 모달리티의 변동성에 강건한 감정 표현을 학습할 수 있다. 후속 그래프 기반의 다중 모달리티 융합 및 시각적 매핑 기능은 특히 지능형 상호작용 설계를 위해 해석 가능하고 구조화된 감정 표현에 크게 의존한다.
모달리티 간 감정 일관성
감정 일관성의 추가는 모달리티 간 융합의 효과성을 명확히 향상시킨다. 이는 모달리티별 감정 임베딩이 잠재 공간을 공유하므로 두 표현 간의 큰 차이를 융합 전략이 고려할 필요가 없기 때문이다. 두 감정의 통합된 표현은 다음과 같이 설명된다  . 감정별 표현이 일관될 경우 가중치 기반 융합은 더욱 안정적이며, 다양한 모달리티에서 발생하는 신호의 변동이 결과에 더 이상 영향을 미치지 않게 된다.
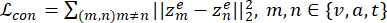 (14)
감정 정보의 의미적 정렬을 강제함으로써, 이 목적은 다양한 모달리티 간의 불일치를 최소화하고 감정 지각이 감정을 표현하는 데 사용된 모달리티에 관계없이 일관되도록 보장한다. 결과적으로 음성 신호, 얼굴 표현 및 언어적 내용에서 얻어진 감정 단서들을 투영함으로써 응집력 있고 정서적인 표현 공간이 생성된다.
교차 모달 퓨전에 미치는 영향
모달리티 간 감정 일관성이 도입될 때, 교차 모달 융합이 더욱 효과적으로 이루어진다. 감정 특이적 임베딩이 공통 잠재 공간에서 정렬되기 때문에, 융합 메커니즘은 더 이상 모달리티 간 상당한 표현 간격을 메우기 위해 노력할 필요가 없다. 융합된 감정 표현은 다음과 같이 정의된다.
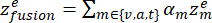 (15)
αm은 모달리티 m에 부여된 어텐션의 가중치를 나타낸다. 감정별 표현이 일관될 때 가중 퓨전은 더욱 안정적이고 이해하기 쉬워지며, 퓨전 결과는 상반된 모달리티 신호가 아니라 보완적인 감정 근거를 보여준다.
수학적으로, 감정 유형별 표현 방식들 간의  분산을 에 상대적으로 감소시키는 것은 다음과 동일하다:
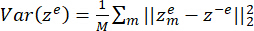 (16)
여기서  은 평균 감정 표현을 나타낸다. 분산이 줄어들면 입력 모달리티가 모달리티 잡음이 아닌 정확한 감정적 중요도에 따라 가중되어 네트워크 수렴성이 향상되고 주의 집중 평가의 정확도가 높아진다.
분리된 감정 시각화의 궁극적인 학습 목표는 파편화, 재구성 및 감정의 균일성을 결합하는 것이다.
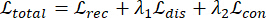 (17)
두 개의 하이퍼파라미터 λ1 및 λ2는 교차 모달 감정 신뢰성과 비연관성 간의 관계를 조절한다. 제안된 모델은 이를 달성하기 위해 모달리티 불변이며 해석 가능하고 융합 가능한 감정 표현을 획득하며, 지능형 인터페이스 설계에서 후속 그래프 기반 융합 및 특징 수준 표현을 위한 견고한 기반을 제공하는 데 중점을 둔다.
그래프 기반의 다중 모달 간 어텐션 융합
세분화된 감정적 관계를 모사하기 위해 그래프 기반의 교차 모달 어텐션 네트워크가 사용되었다. 모달리티 간 정보 흐름을 촉진하기 위해 각 모달리티별 임베딩(텍스트, 오디오, 시각 정보)을 그래프 노드로 표현한 완전 연결 다중 모달리티 그래프를 구성하였다. 모달리티 간 관계를 이용해 그래프 인접 행렬을 구성한 후, 학습 가능한 어텐션 방법을 통해 이를 개선하였다. 여러 어텐션 헤드의 출력을 연결 및 투영하여 공유 잠재 공간을 생성하였으며, 어텐션 가중 풀링을 사용해 노드 표현을 집계함으로써 통합된 다중 모달 감정 표현을 생성하였다. 이후 이 병합된 표현은 상호작용 인식 분석 및 감정 인식을 위한 예측 및 시각화 모듈에 입력되었다. 그래프 융합 모듈은 256의 은닉 표현 차원을 가지며, 각각 8개의 어텐션 헤드를 가진 두 개의 그래프 어텐션 레이어로 구성되었다. 연결된 노드 간 어텐션 계수를 계산하고 소프트맥스 함수를 사용하여 정규화함으로써 인접한 모달리티들의 상대적 중요도를 파악하였다. 각 그래프 어텐션 레이어 다음에는 레이어 정규화, 잔차 연결, 그리고 훈련 안정성을 높이고 과적합을 줄이기 위한 0.2의 드롭아웃률이 적용되었다. 여러 어텐션 헤드의 출력을 공통 잠재 공간으로 연결 및 투영한 후, 어텐션 가중 풀링을 통해 노드 표현을 단일 다중 모달 감정 임베딩으로 통합하였다. 이후 병합된 표현은 다중 뷰 시각적 매핑 및 감정 예측에 사용되었다.
다양한 교차 모달 상호작용은 멀티헤드 그래프 어텐션을 사용하여 포착되었다. 연결된 노드 간 어텐션 계수를 정규화하기 위해 각 노드에 대해 소프트맥스 함수가 사용되었다. 학습의 안정성을 높이고 과적합을 방지하기 위해, 그래프 융합 모듈의 쌓인 그래프 어텐션 계층 다음에 잔차 연결, 계층 정규화 및 드롭아웃 정규화를 적용하였다.
각각의 용어 는 시각, 음성, 텍스트 모달리티를 통해 수집된 특정 감정에 대응하는 표현을 개별적으로 나타내며, 각 구성 요소는 공유 잠재 공간  내에 존재한다. 모달리티 노드에 대한 모델은 그래프 표기법
 을 사용하며, 집합의 노드
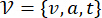 는 세 가지 모달리티 노드 자체에 해당하며, 다양한 모달리티 표현 간에 공유되는 감정적 의존성을 명시적으로 강화한다.
그래프의 각 노드에 감정별 특징 벡터를 할당한 후에는 다음과 같습니다:
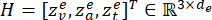 (18)
기존의 융합 방법이 사전에 결정되거나 고정된 융합 가중치를 사용하는 반면, 제안된 방법은 채널 간 및 감정 상황 간 중요도와 상호 의존성에 기반하여 적응형 엣지 가중치를 학습한다.
교차 모달 융합을 위해 그래프 어텐션 네트워크(GAT)가 사용된다. 각 노드 i와 그 인접 노드(즉, 노드 j)에 대해 어텐션 계수를 계산한다:
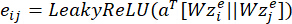 (19)
모드 j에서 양식 i로 전환할 때의 정서적 효과는 정규화된 가중치 αij로 측정된다.
다음으로, 각 모달리티 노드의 융합된 외관은 그 이웃 노드들의 가중 그룹화로 계산된다:
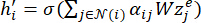 (20)
여기서 활성화 함수  는 비선형이다. 궁극적으로 각 노드의 업데이트된 특징들이 결합되어 전역 통합 감정 표현을 얻는다.
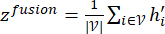 (21)
다양한 모달리티로부터 보완적인 정보를 포착하면서 복잡한 모달리티 간 관계를 유지하기 때문에 해석 가능한 감정 모델링 및 후속 시각적 매핑에 유용한 기법이다.
알고리즘 1(보조 자료 1)은 그래프 기반의 교차 모달 융합을 수행하기 위한 일반적인 절차를 제공한다. 처음에 시각적, 음성적, 텍스트 모달리티 각각에 연결된 감정 특이적 특성을 지닌 그래프가 생성된다. 그런 다음 감정적 의존성 조합을 나타내는 각 그래프 노드 쌍에 대한 어텐션 점수가 계산된다. 이후 어텐션 점수는 각 모달리티가 특정 감정 맥락에 기여하는 상대적 정도를 나타내도록 정규화되어 어텐션 가중치의 학습이 가능하게 한다. 마지막 단계에서 그래프 노드와 관련된 특징들을 통합함으로써 일반 감정 임베딩이 생성된다. 이와 같은 맥락에서, 특정 감정과 연결된 다중 모달 특징을 일반적으로 융합하는 본 알고리즘은 적응성, 해석 가능성 및 맥락 지능 측면에서 유망한 가능성을 보여준다.
그림 2는 다중 모달 감정 융합을 위한 제안된 교차 모달 어텐션 네트워크의 구조와 작동 방식을 보여준다. 텍스트, 청각 및 비디오 모달리티에 대해 독립적으로 도출된 감정 특이적 임베딩은 처음에 모달리티 수준의 어텐션 메커니즘을 통과하며, 이는 주어진 감정 맥락에서 언어적, 음성적 및 얼굴 정보의 상대적 중요도를 학습한다. 모달리티의 어텐션 가중 표현은 이후 통합된 감정 임베딩을 형성하기 위해 결합되며, 여기서 어텐션 행렬은 모달리티 간 의존성과 상호작용 강도를 포착한다. 네트워크가 학습한 어텐션 행렬은 모달리티의 기여도를 동적으로 조절하여, 노이즈가 많고 정보량이 적은 모달리티는 무시하면서 가장 강력한 지시적 모달리티에 집중할 수 있게 한다. 융합된 감정 표현을 통해 중립, 포옹, 걱정과 같은 감정 상태에 대한 정확한 감정 인식 및 미세 분석이 가능해진다.
시각적 매핑 모듈
시각적 매핑 섹션의 도움을 받아, 이 목적을 위해 특별히 제작된 이 섹션을 통해 지능형 상호작용 설계자는 그래프를 기반으로 크로스 모달 퓨전 과정 후에 이해 가능하고 쉽게 소비 가능한 시각적 형태로 정서 상태의 통합 표현을 변환할 수 있다.
잠재적인 감정 표현을 보다 쉽게 이해하기 위해 차원 축소 기법을 사용하여 학습된 다중 모달 감정 임베딩을 시각화하였다. 주성분 분석(PCA)을 사용하여 대부분의 분산을 유지하면서 특징 차원을 축소한 후, t-분포 확률적 근접 임베딩(t-SNE)을 통해 임베딩을 2차원 공간으로 투영하여 표시하였다. t-SNE에는 30의 퍼플렉시티 수치, 200의 학습률, 그리고 1,000회의 최적화 반복이 사용되었다. 이렇게 얻어진 투영을 통해 감정별 클러스터 및 모달리티 간 관계를 시각화하였다. 그래프 기반 어텐션 네트워크에서 얻은 정규화된 교차 모달 어텐션 가중치를 사용하여 어텐션 히트맵을 생성하였다. 이러한 히트맵은 감정 예측 과정에서 텍스트, 오디오, 시각 모달리티의 상대적 기여도를 나타낸다. 학습된 어텐션 계수는 엣지 가중치로 사용되어 교차 모달 상호작용 그래프를 생성하였으며, 이를 통해 융합 프레임워크 내에서의 모달 간 관계 및 정보 흐름을 시각적으로 검토할 수 있었다. 감정 궤적 플롯은 연속적인 화자 발화에 걸쳐 잠재 감정 임베딩의 변화를 추적함으로써 시간에 따른 감정 역학을 분석하기 위해 생성되었다. 이러한 궤적은 감정 상태와 모달리티 기여도가 시간이 지남에 따라 어떻게 변화하는지를 보여준다. 모든 시각화는 Matplotlib 및 Scikit-learn과 같은 파이썬 패키지를 사용하여 생성되었다. 해석 가능성, 클러스터 형성, 모달리티 기여도 및 시간적 감정 역학을 평가하기 위해 임베딩 시각화, 상호작용 그래프 및 어텐션 히트맵에 대한 정성적 분석을 수행하였다.
변수 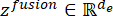 이 그래프 어텐션 네트워크 함수에 의해 융합된 정서 상태 표현을 나타내도록 하자. 정서 상태 플롯의 출력 수준 시각화와 달리, 이 모듈의 주요 목적은 정서 상태 표현과 어텐션 메커니즘의 대응하는 가중치를 이해하기 쉬운 시각적 형태로 변환하는 것이다.
αji를 학습한 후, 각 모달리티의 기여도를 시각적으로 검토하기 위해 어텐션 히트맵을 생성한다. 그런 다음 유입되는 어텐션 가중치를 합산하여 각 모달리티에 대한 복합 중요도 점수를 결정한다:
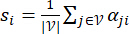 (22)
여기서 si 는 모달리티 I의 상대적 정서 기여도를 나타낸다. 주의 히트맵을 생성하는 데 도움을 주기 위해, 얻어진 값들을 정규화하고 색상 맵에 매핑하여 사용자가 다양한 시간 단계나 상호작용 상태에서 두드러진 모달리티를 쉽게 식별할 수 있도록 한다. 다양한 시각적, 청각적 또는 텍스트 입력 모달리티를 통해 이러한 인터페이스는 사용자가 시스템의 주의 메커니즘이 어떻게 작동하는지 이해하는 데 도움을 준다.
학습된 그래프는 인간 감정의 교차 모달 종속성을 나타내기 위해 특별히 "가중 상호작용 그래프"로 모델링된다. 각 모달리티는 그래프 내의 개별 노드로 표현되며, 인간 감정과 관련된 상호작용의 강도는 노드를 연결하는 엣지에 있는 αji 형태의 가중치로 표현된다. 위의 가중 그래프는 인간 감정 간 상호작용의 강도를 보여준다. i와 j의 정의는 다음과 같다.
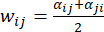 (23)
이 가중치 덕분에 그래프 시각화의 선 두께나 투명도가 적절하게 표시된다. 이를 통해 모달리티 간의 상호작용을 이해하기가 쉬워진다. 크로스모달 상호작용 그래프는 설계자가 융합 과정 중 정서 지표들이 어떻게 상호작용하는지 더 잘 이해할 수 있도록 도와준다.
각 시간 단계에서의 융합된 감정 임베딩  은 PCA 또는 t-SNE와 같은 차원 축소 알고리즘을 사용하여 저차원 공간으로 축소되어 시간에 따른 감정의 변화를 시각화할 수 있다:
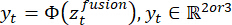 (24)
여기서 투영 함수는  로 표현된다. 감정 전이, 강도 및 상호작용에서의 안정성을 보여주는 2D/3D 감정 궤적의 출현은 시간에 따른 감정 상태의 변화를 직관적으로 묘사한 것으로 해석될 수 있다. 이러한 측면들은 지능형 상호작용, 의사결정 및 실시간 모니터링에 활용될 수 있다.
기존의 감정 시스템이 특정 클래스나 점수에 매핑하는 데 그치는 것과 달리, 본 시스템은 인간의 감정이 어떻게 형성되는지를 보여주는 데 중점을 둔다. 이 시스템은 중간 단계의 특징들(가중 요소, 모델 간 상호작용 및 해당 경로 포함)을 시각화함으로써 의사결정 과정을 드러낸다. 이를 통해 사용자는 각 요인(시각적, 음성적, 언어적)이 인간 감정에 대한 시스템의 반응 생성에 어떻게 영향을 미치는지 이해할 수 있다.
시각적 표현을 통해 감정을 이해하기 쉬운 형태로 매핑함으로써 딥러닝 방법을 이용한 감정 분석과 지능형 인터페이스 설계를 위한 통합 사이의 간극을 줄일 수 있다. 이렇게 수집된 데이터는 보다 정밀한 사용자 인터페이스를 개발하는 데 활용될 수 있다. 따라서 제안된 접근법은 인터랙션 디자이너가 보다 정확한 사용자 인터페이스를 설계할 수 있도록 중요한 정보를 제공할 수 있다. 즉, 감정 인식이 인터랙션 디자인의 매우 능동적인 부분이 되는 것이다. 감정 인식이 인터랙션 디자인에 능동적으로 반영될 때에만 정확도는 더욱 향상될 수 있다.
시각적 매핑 모듈은 서로 연결되어 있지만 서로 다른 여러 방식으로 설명 가능성을 제공한다. 특징 수준의 설명 가능성은 DNN이 생성한 감정의 기본 표현을 드러내어 감정과 관련된 각 특징을 설명하는 데 사용되는 의미를 이해할 수 있게 해준다. 모달리티 수준의 설명 가능성은 상호작용 그래프와 시각적 주의 히트맵의 데이터를 활용하여 시각, 오디오, 텍스트 모달리티 각각이 감정 표현 결정에 어떻게 기여하는지를 설명한다. 마지막으로, 감정 임베딩에서 비롯된 궤적을 통해 동적 상호작용 관점에서 각 시각 및 텍스트 모달리티가 시간에 따라 어떻게 변화하는지를 이해할 수 있다. 알고리즘 2를 참조하라(보조 자료 1).
제안된 시각적 매핑 알고리즘 2를 사용하여 융합된 다중 모달 감정 특징을 지능형 상호작용 설계를 위한 시각적으로 중요한 표현으로 매핑한다. 그래프 기반의 다중 모달 어텐션 가중치를 사용하여 각 시간 단계에서 입력되는 시각, 음성 및 텍스트 요소들 간의 차이를 정량화한다. 그런 다음 이러한 차이를 시각적 표현으로 매핑하여 히트맵 시각 요소를 사용해 감정에 영향을 주는 주요 요인들을 강조한다. 입력 요소들 간의 상호작용을 명확히 보여주고 다중 모달 입력 요소들에 의해 생성된 감정의 변화를 전달하기 위해, 쌍별 상호작용 강도를 계산하여 다중 모달 상호작용 가중치를 생성한다. 동시에, 시간에 걸쳐 수집된 융합 감정 요소들을 저차원 공간으로 매핑함으로써 연속적인 감정 요소의 변화를 나타내는 감정 변화의 시각적 표현을 생성한다.
감정 예측 및 상호작용 피드백
융합된 감정 표현의 결과는 로 표현되며, 이는 상호작용 피드백과 감정 예측 모두를 위한 함수로 사용된다. 또한, 감정 예측은 연속적인 감정 강도 인식을 위한 회귀 과제와 이산 감정 인식을 위한 분류 과제로 구성된 멀티태스크 모델로 설명된다. 다음의 소프트맥스 기반 분류 모델이 이산 감정 인식에 사용된다.
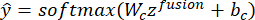 (25)
여기서  는 기대되는 감정 클래스 확률을 나타내며, Wc 및 bc는 학습 가능한 제약 조건이다. 분류 목적을 향상시키기 위해 교차 엔트로피 손실을 사용한다.
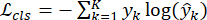 (26)
여기서 yk 는 정답 태그이고, K는 감정 클래스의 수이다. 감정 강도를 병렬적으로 추정하기 위해 회귀 브랜치를 사용하여 가치성(valence) 및 각성도(arousal)를 포함한 다양한 연속 정서 특성의 예측 값을 생성한다. 다음 정의를 제공한다:
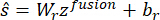 (27)
여기서 기대되는 감정 강도 점수는  로 표시된다. 회귀 과제를 향상시키기 위해 평균 제곱 오차 손실을 사용한다:
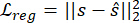 (28)
일반적으로 두 과제는 예측 목적에서 결합된다.
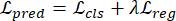 (29)
여기서 회귀 및 분류의 목적은 λ에 의해 균형을 이룬다. 이는 이러한 유형의 상호작용 인식 피드백을 가능하게 하기 위해 식별된 감정 상태에 기반하여 시각화 모듈을 동적으로 수정할 것을 제안한다. 주어진 시점 t에서의 상호작용 맥락은 ct로 표현된다. 시각화 모듈의 응답은 다음에 의해 제공된다.
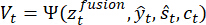 (30)
여기서 시각화 적응 함수는  로 표현된다. 이를 통해 예상되는 변화와 감정에 기반하여 모달리티 히트맵, 상호작용 그래프 및 감정 궤적을 실시간으로 조정할 수 있다. 이는 시스템이 감정 상태 예측에서 우수한 성능을 보일 뿐 아니라 피드백에 대한 상당한 지원을 제공함을 나타낸다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
결과
본 연구는 두 개의 벤치마크 데이터셋인 CH-SIMS와 CMU-MOSEI를 사용하여, 상호작용 인식 해석 가능성과 예측 성능 측면 모두에서 제안된 멀티모달 감정 특징의 시각적 매핑 프레임워크를 검증합니다. 실험 결과에 따르면, 제안된 접근 방식은 상관관계, 정확도, F1-스코어 및 평균 절대 오차(MAE)를 포함한 다양한 지표에서 기존의 멀티모달 감정 인식 기술보다 일관되게 우수한 성능을 보입니다. 얽힘 해제된 감정 표현, 그래프 기반 교차 모달 융합 메커니즘, 그리고 엔드투엔드 딥 표현 학습 전략은 모두 더 안정적이고 의미론적으로 정렬된 감정 모델링을 가능하게 함으로써 이러한 성능 향상에 기여합니다. 제안된 접근 방식은 시각적 매핑을 통해 정량적 이득을 넘어 더 풍부한 특징 수준의 통찰력을 제공하며, 모달리티의 기여도와 감정적 역동성을 더 쉽게 이해할 수 있게 합니다. 언어, 문화적 표현 및 데이터셋 크기의 차이에도 불구하고, 앞서 언급한 성능 향상이 두 데이터셋 모두에서 일관되게 관찰되어 제안된 프레임워크의 강력한 일반화 능...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
토론
실험 결과, CH-SIMS 및 CMU-MOSEI 데이터셋 전반에서 다중모달 감정 특성을 위한 제안된 시각적 매핑 프레임워크가 기존의 다중모달 감정 인식 기술보다 우수한 성능을 보였다. EF-LSTM 및 TFN과 같은 초기 및 후기 융합 모델과 비교했을 때, 제안된 기술은 더 높은 정확도와 F1 Score를 달성하여 다양한 감정 정보를 처리하는 데 있어 강건함을 입증했다. 이러한 방법론의 개선은 양식별 노이즈를 억제하고 시각, 오디오, 텍스트 양식 간의 감정 일관성을 보장하는 얽힘 해제된 감정 표현(disentangled emotion representation) 덕분인 것으로 분석된다36.
최근 Adaptive Multimodal Transformers37 및 MIAR38와 같은 트랜스포머 기반의 멀티모달 모델들이 교차 모달 의존성 모델링에서 인상적인 ...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
공개 사항
저자들은 이해관계의 충돌이 없습니다.
감사의 글
저자들은 말레이시아 페낭의 Universiti Sains Malaysia, School of Housing, Building and Planning과 중국 창샤의 Changsha University of Science & Technology, School of Design Art의 지원에 감사드립니다. 또한, 본 연구 전반에 걸쳐 학술 및 연구 지원을 제공해 준 중국 샤먼의 Fuzhou University, Xiamen Academy of Arts and Design에 감사의 뜻을 표합니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| Adam | PyTorch Optimizer 라이브러리 | https://pytorch-optimizers.readthedocs.io/en/latest/ (Learning Rate = 1 × 10⁻⁴) | 모델 학습 중 파라미터 최적화 |
| CH-SIMS | 원본 데이터셋 저장소 | 최신 공개 버전 | 중국어 멀티모달 감성/정서 분석을 위한 벤치마크 데이터셋 |
| CMU-MOSEI | CMU Multimodal SDK 저장소 | https://github.com/CMU-MultiComp-Lab/CMU-MultimodalSDK (최신 공개 버전) | 멀티모달 감성 및 정서 인식을 위한 벤치마크 데이터셋 |
| Disentangled Emotion Encoder | 커스텀 구현 | https://pytorch-geometric.readthedocs.io/en/latest/(Dual Encoder 아키텍처) | 정서 특이적 및 모달리티 특이적 잠재 표현의 분리 |
| Graph Attention Network (GAT) | PyTorch Geometric | Multi-head GAT (https://pytorch-geometric.readthedocs.io/en/latest/) | 교차 모달 정서 관계 모델링 및 적응형 특징 융합 |
| Graph-Based Cross-Modal Attention Layer | 커스텀 구현 | Multi-Head Attention 융합 | 모달리티 간의 세밀한 정서적 의존성 학습 |
| Matplotlib | Matplotlib 프로젝트 | 3.7+ | 플롯 생성 및 시각적 분석 |
| NetworkX | NetworkX 프로젝트 | 3.0+ | 교차 모달 상호작용 그래프 구축 및 시각화 |
| NVIDIA GPU | NVIDIA Corporation | CUDA 지원 GPU | 트랜스포머 및 그래프 신경망 학습 가속화 |
| Principal Component Analysis (PCA) | Scikit-learn | sklearn.decomposition.PCA | 고차원 정서 임베딩의 초기 차원 축소 |
| Python | Python Software Foundation | 3.8+ | 멀티모달 정서 분석 프레임워크 구현을 위한 핵심 프로그래밍 언어 |
| PyTorch | PyTorch Foundation | 2.0+ | 심층 신경망의 개발, 학습 및 최적화 |
| RoBERTa | Hugging Face Transformers | https://huggingface.co/docs/transformers/index (roberta-base, 768-dim 임베딩) | 문맥적 언어 및 의미론적 정서 표현 추출 |
| Seaborn | Seaborn 프로젝트 | 0.12+ | 어텐션 히트맵 및 통계적 시각화 생성 |
| t-distributed Stochastic Neighbor Embedding (t-SNE) | Scikit-learn | scikit-learn.org (Perplexity = 30, Iterations = 1000) | 잠재 정서 클러스터 및 궤적 시각화 |
| Ubuntu Linux | Canonical Ubuntu | 20.04 LTS 또는 이후 버전 | 실험 실행 환경 |
| Vision Transformer (ViT-Base) | Google Research Vision Transformer | ViT-Base/16, 768-dim 임베딩 | 비디오 프레임에서 정서 인지적 시각적 표현 추출 |
| Wav2Vec 2.0 | Meta AI Research | Base 모델, 768-dim 임베딩 | 문맥적 음향 및 음성 정서 특징 추출 |
참고문헌
- Zhu X, et al. EMVAS: End-to-end multimodal emotion visualization analysis system. Complex Intell Syst. 2025;11:1-15.
- Zhu X, et al. A client-server based recognition system: Non-contact single/multiple emotional and behavioral state assessment methods. Comput Methods Programs Biomed. 2025;260:108564.
- Lasri I, Riadsolh A, Elbelkacemi M. Facial emotion recognition of deaf and hard-of-hearing students for engagement detection using deep learning. Educ Inf Technol. 2023;28:4069-4092.
- Saibene A, Assale M, Giltri M. Expert systems: Definitions, advantages and issues in medical field applications. Expert Syst Appl. 2021;177:114900.
- Poria S, Cambria E, Bajpai R, Hussain A. A review of affective computing: From unimodal analysis to multimodal fusion. Inf Fusion. 2017;37:98-125.
- Chatterjee R, et al. Real-time speech emotion analysis for smart home assistants. IEEE Trans Consum Electron. 2021;67(1):68-76.
- Zhu X, Huang Y, Wang X, Wang R. Emotion recognition based on brain-like multimodal hierarchical perception. Multimed Tools Appl. 2024;83:56039-56057.
- Khan M, El Saddik A, Alotaibi FS, Pham NT. AAD-Net: Advanced end-to-end signal processing system for human emotion detection and recognition using attention-based deep echo state network. Knowl Based Syst. 2023;270:110525.
- Chaturvedi I, Chen Q, Cambria E, McConnell D. Landmark calibration for facial expressions and fish classification. Signal Image Video Process. 2022;16:377-384.
- Li D, Liu J, Yang Z, Sun L, Wang Z. Speech emotion recognition using recurrent neural networks with directional self-attention. Expert Syst Appl. 2021;173:114683.
- Zhu X, et al. A review of key technologies for emotion analysis using multimodal information. Cogn Comput. 2024;16:1504-1530.
- Wang R, et al. Multimodal emotion recognition using tensor decomposition fusion and self-supervised multitasking. Int J Multimed Inf Retr. 2024;13:39.
- Fan C, Lin J, Mao R, Cambria E. Fusing pairwise modalities for emotion recognition in conversations. Inf Fusion. 2024;106:102306.
- Williams J, Kleinegesse S, Comanescu R, Radu O. Recognizing emotions in video using multimodal DNN feature fusion. Proceedings of Grand Challenge and Workshop on Human Multimodal Language. Melbourne, Australia. 2018;10.18653/v1/W18-3302.
- Zhao Z, Wang Y, Wang Y. Multi-level fusion of Wav2Vec 2.0 and BERT for multimodal emotion recognition. arXiv. 2022;arXiv:2207.04697.
- Middya AI, Nag B, Roy S. Deep learning based multimodal emotion recognition using model-level fusion of audio-visual modalities. Knowl Based Syst. 2022;244:108580.
- Maithri M, et al. Automated emotion recognition: Current trends and future perspectives. Comput Methods Programs Biomed. 2022;215:106646.
- Wu Y, Mi Q, Gao T. A comprehensive review of multimodal emotion recognition: Techniques, challenges, and future directions. Biomimetics. 2025;10(4):418.
- Zheng S, Zhang X, Liu Y, Li Z. CMFF: A cross-modal multi-layer feature fusion network for multimodal sentiment analysis. Appl Soft Comput. 2025;184(Pt B):113868.
- Yan L, Shi Y, Wei M, Wu Y. Multi-feature fusing local directional ternary pattern for facial expressions signal recognition based on video communication system. Alex Eng J. 2023;63:307-320.
- Guo X, Zhang Y, Lu S, Lu Z. Facial expression recognition: A review. Multimed Tools Appl. 2024;83(8):23689-23735.
- Liu ZT, Han MT, Wu BH, Rehman A. Audio emotion recognition based on convolutional neural network with attention-based bidirectional long short-term memory network and multitask learning. Appl Acoust. 2023;202:109178.
- Mirsamadi S, Barsoum E, Zhang C. Automatic audio emotion recognition using recurrent neural networks with local attention. 2017 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), New Orleans, LA, USA. 2017; 10.1109/ICASSP.2017.7952552.
- Gu T, He Z, Zhao H, Li M, Ying D. Aspect-based sentiment analysis with multi-granularity information mining and sentiment hint. Expert Syst Appl. 2024;252:124104.
- Shen W, Chen J, Quan X, Xie Z. DialogXL: All-in-one XLNet for multi-party conversation emotion recognition. Proc AAAI Conf Artif Intell. 2021;35(15):13789-13797.
- Kim T, Vossen P. EmoBERTa: Speaker-aware emotion recognition in conversation with RoBERTa. arXiv. 2021;arXiv:2108.12009.
- Li S, Yan H, Qiu X. Contrast and generation make BART a good dialogue emotion recognizer. Proc AAAI Conf Artif Intell. 2022;36(10):11002-11010.
- Zhu J, Yu J. MIAR: Modality interaction and alignment representation fusion for multimodal emotion. arXiv. 2026;arXiv:2601.02414.
- Praveen RG, Granger E, Cardinal P. Cross attentional audio-visual fusion for dimensional emotion recognition. 2021 16th IEEE International Conference on Automatic Face and Gesture Recognition (FG 2021), Jodhpur, India. 2021;10.1109/FG52635.2021.9667055.
- Salas-Cáceres J, López M, Martínez A, Rodríguez P. Multimodal emotion recognition based on a fusion of audio-visual information with temporal dynamics. Multimed Tools Appl. 2025;84:27327-27343.
- Fu J, Zhang Y, Wang L, Chen H. TMFN: A text-based multimodal fusion network with multi-scale feature extraction and unsupervised contrastive learning for multimodal sentiment analysis. Complex Intell Syst. 2025;11:133.
- Tuerhong G, Fu F, Wushouer M. Adaptive multimodal transformer based on exchanging for multimodal sentiment analysis. Sci Rep. 2025;15:27265.
- Gupta C, Sharma R, Patel S, Verma A. A multimodal fusion model for real-time environment emotion recognition using audio-visual-textual features. J Big Data. 2025;12:256.
- Yu W, Li X, Zhang H, Wang Z, Liu Z. CH-SIMS: A Chinese multimodal sentiment analysis dataset with fine-grained annotation of modality. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics. 2020; 10.18653/v1/2020.acl-main.343.
- Zadeh A, et al. Multimodal language analysis in the wild: CMU-MOSEI dataset and interpretable dynamic fusion graph. Proceedings of the 56th Annual Meeting of the Association for Computational Linguistics, Melbourne, Australia. 2018; 10.18653/v1/P18-1208.
- Zadeh A, Chen M, Poria S, Cambria E, Morency LP. Tensor fusion network for multimodal sentiment analysis. arXiv. 2017;arXiv:1707.07250.
- Tsai YHH, Bai S, Yamada M, Morency LP, Salakhutdinov R. Multimodal transformer for unaligned multimodal language sequences. Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, Florence, Italy. 2019; 10.18653/v1/P19-1656.
- Moreno M, Rioseco P, Van Den Bosch H. Spectrum of the linearized Vlasov–Poisson equation around steady states from galactic dynamics. arXiv. 2023;arXiv:2305.05749.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.