이 프로토콜은 핀휠 컨볼루션, 이중 주의, 다중 스케일 융합을 통합하여 대장항문 폴립을 분할하는 U자형 딥러닝 네트워크를 구현합니다.
이 콘텐츠를 보려면 JoVE 구독이 필요합니다. 로그인하거나 오늘 무료 평가판을 시작하세요.
방법 논문
대장암 전암성 병변 진단을 위한 회전차 합성곱과 이중 주의를 기반으로 한 폴립 분할 네트워크
* These authors contributed equally
이 논문에서
요약
초록
대장 폴립의 정확한 분절은 대장암의 조기 예방과 진단에 매우 중요합니다. 그러나 폴립의 형태, 크기, 질감이 매우 이질적이며, 장 환경의 복잡성(주름, 반사, 대변 잔류물 등)으로 인해 기존 방법들은 경계 위치 파악과 소형 폴립 검출에 여전히 큰 어려움을 겪고 있습니다. 이러한 문제를 해결하기 위해 본 논문은 핀휠 컨볼루션과 이중 주의(PWD-Net)를 기반으로 한 폴립 분할 네트워크를 제안합니다. 제안된 네트워크는 U자형 인코더-디코더 아키텍처를 채택하며, 사전 학습된 ResNet을 인코더로 사용하여 다층 로컬 특징을 추출합니다. 구체적으로, 병목 계층에 핀휠 컨볼루션 모듈(PCM)이 도입되어 다중 각도 회전 컨볼루션 커널을 통해 폴립의 전역 기하학적 구조와 다방향 맥락 정보를 포착합니다. 채널 주의와 공간적 주의를 통합하는 이중 주의 메커니즘(DAM)은 배경 소음을 적응적으로 억제하고 폴립 영역 특징을 강화하도록 설계되었습니다. 또한, 다중 규모 특징 융합(MSF) 전략을 사용하여 깊은 의미 정보와 얕은 경계 세부사항을 결합하여 세분화 결과의 완전성과 정밀도를 모두 보장합니다. Kvasir-SEG 및 CVC-ClinicDB 데이터셋에서 수행된 실험 결과, PWD-Net은 각각 평균 Dice 계수 0.865와 0.944, IoU 점수 0.765와 0.892를 달성하여 기존 최첨단 방법을 크게 우수하게 달성했습니다. 제거 연구는 각 모듈의 효과를 검증하며, 교차 데이터셋 평가를 통해 모델의 강력한 일반화 능력을 확인한다. 이 연구는 임상 용종 분할에 대한 고정밀도이자 견고한 해결책을 제공하며, 대장암 전암성 병변의 조기 진단과 컴퓨터 지원 개입을 지원하는 데 큰 가치를 제공합니다.
서론
대장암은 전 세계적으로 가장 흔한 악성 종양 중 하나로, 발생률과 사망률이 꾸준히 높습니다. 연구에 따르면 대부분의 대장암은 선종성 용종에서 발생하며, 이 과정은 보통 10년에서 15년 정도 걸려 조기 발견과 개입을 위한 귀중한 시간 창을 제공합니다. 선종 발견률(ADR)을 1% 증가시키면 대장암 위험을 약 3% 감소시켜 환자 사망률을 유의미하게 낮출 수 있습니다. 대장내시경은 대장암 검진의 금본위로 여겨지며, 검사 중 용종을 직접 제거할 수 있어 암 발생률과 사망률을 효과적으로 줄입니다.
하지만 기존 대장내시경은 내시경 전문의의 경험과 기술 수준에 크게 좌우됩니다. 주관적 판단, 시각 피로, 산만함과 같은 요인들이 20%에서 30%의 실패율을 초래할 수 있으며, 이는 선별 효과에 직접적인 영향을 미칩니다. 따라서 대장 용종의 자동 분할을 위한 컴퓨터 지원 탐지(CAD) 시스템 개발은 ADR 개선과 진단 누락 감소에 매우 중요합니다. 최근 임상 조사들은 인공지능을 내시경 병변 평가 워크플로우에 통합하려는 관심을 더욱 부각시키며, 견고하고 재현 가능한 분할 방법의 필요성을 강화했습니다.
최근 몇 년간 딥러닝은 특히 합성곱신경망(CNN)에서 의료 영상 분석에서 눈에 띄는 진전을 이루었으며, 이는 이미지분할 작업에 대한 특징 추출과 표현에 강력한 능력을 보여줍니다. 고전적인 의료 영상 분할 모델인 U-Net은 대칭 인코더-디코더 아키텍처를 사용하며 연결을 건너뛰어 정확한 픽셀 수준 분할을 달성하여 이 분야의 벤치마크가 되었습니다5. U-Net을 기반으로 복잡한 의료 영상 분할 작업을 해결하기 위해 많은 개선된 아키텍처가 제안되었습니다. UNet++는 중첩 및 밀집 스킵 연결을 도입하여 인코더와 디코더 특징 맵 간의 의미적 간극을 줄입니다. ResUNet++는 잔류 블록, 압축 및 여기 모듈, 확장된 컨볼루션, 주의 메커니즘을 통합하여 폴립 분할7에서 강력한 성능을 달성합니다. U2-Net은 다중 스케일 특징 정보를 포착하기 위해 2단계 중첩된 U자형 구조를 채택합니다. 최근에는 병렬 인코딩 및 디코딩 경로를 활용해분할 정확도를 더욱 향상시키는 이중 인코더-디코더 기반의 딥 폴립 분할 네트워크가 제안되었습니다.
한편, 주의 메커니즘의 도입은 기능 향상과 노이즈 억제를 위한 새로운 해결책을 제공합니다. 주의 U-Net은 주의 게이트를 사용해 목표 영역에 집중하고 무관한 배경 정보를 억제합니다.10. 이중 주의 네트워크(DANet)는 채널 및 공간 차원 모두에서 특징을 적응적으로 가중치하여 중요한 특징의 인식을 향상시킵니다. 트리플 어텐션 네트워크(TANet)는 다중 스케일 특징의 적응형 선택을 통해 세분화 성능을 더욱 향상시킵니다12.
자연어 처리와 컴퓨터 비전13에서 트랜스포머 아키텍처의 성공에 힘입어, 연구자들은 의료 이미지 분할에 대한 적용을 탐구하기 시작했습니다. TransUNet은 장거리 의존성을 사실상 모델링하기 위해 인코더로 트랜스포머를 처음으로 사용한 회사였습니다. Swin-UNet은 순수 트랜스포머 아키텍처를 채택하여 시프트 윈도우 메커니즘을 통해 효율적인 글로벌 정보 집계를 달성합니다. UTNet은 CNN의 로컬 특징 추출 능력과 Transformers16의 글로벌 모델링 능력을 결합한 하이브리드 아키텍처를 제안합니다.
폴립 세분화 분야에서 Polyp-PVT는 피라미드 비전 Transformer를 활용해 다중 스케일 글로벌의미 정보를 포착하며, 다중 스케일 중첩 UNet은 Transformers18을 통합하여 맥락적 이해를 향상시킵니다. 최근 연구들은 또한 교차 영역 폴립 분할에 대한 부정적 상관 학습 전략(19), 곰퍼츠 증강 분할 강화20, 경계 안내를 포함하는 주의 기반 아키텍처(21)를 탐구했습니다. 이러한 접근법들이 분할 성능을 어느 정도 향상시키긴 하지만, 폴립 분할은 여전히 여러 도전 과제에 직면해 있습니다. 첫째, 폴립은 형태, 크기, 질감에서 매우 이질적이며, 5mm 미만의 미세한 폴립부터 30mm를 넘는 큰 폴립까지 다양하며, 형태는 원형, 타원형부터 매우 불규칙한 형태까지 다양합니다. 둘째, 장 환경은 복잡하고 변동적이며, 점막 주름, 반사, 배설물 잔여물, 음식물 찌꺼기가 심각한 배경 간섭을 일으킵니다. 셋째, 많은 폴립은 경계가 흐릿하거나, 주름에 의해 부분적으로 막히거나, 장액에 잠겨 있어 경계 위치를 정확히 파악하는 것이 매우 어렵습니다.
기존 방법들은 이러한 문제를 해결하는 데 여전히 명확한 한계를 제시하고 있습니다. 전통적인 CNN은 국소 질감과 가장자리 특징을 추출하는 데 효과적이며; 그러나 고정된 정사각형 컨볼루션 커널은 특히 고도로 불규칙한 폴립의 경우 다양한 기하학적 형태를 포착하는 데 적합하지 않으며, 다방향 기하학적 특징을 효과적으로 모델링할 수 없습니다. 트랜스포머 기반 방법은 전역 의존성을 모델링할 수 있지만, 세밀한 국소 세부사항과 경계 정보를 포착하는 데는 덜 효과적입니다. 더불어, 계산 복잡성이 높아 실시간 임상 응용에는 덜 적합하다24. 최근 폴립 분할 기법인 PraNet(역주의 모듈을 사용해 주요 영역25), 경계 유도 캐스케이드 주의 네트워크(경계 특징 추출을 향상시키는26), 교차 주의 메커니즘을 통해 인코더와 디코더 기능을 융합하는 CAFE-Net(27)과 같은 최근 폴립 분할 방법들도 작은 폴립을 다룰 때 특징 표현이 불충분하고 경계 위치가 부정확합니다28, 흐릿한 경계와 복잡한 배경들. 더욱이 대부분의 방법은 기하학적 형태를 소홀히 하고, 다방향 맥락 정보를 충분히 활용하지 못해 불규칙한 폴립의 최적이 아닌 분할을 초래합니다.
요약하자면, 현재의 CNN 기반 방법은 고정된 정사각형 컨볼루션 커널에 의존하기 때문에 다방향 기하학적 특징을 포착할 수 없습니다. 트랜스포머 기반 접근법은 전역 모델링을 제공하지만 국소 경계 정밀도를 희생하고 높은 계산 비용을 부과합니다. 한편, 기존의 주의력 강화 및 다중 규모 융합 전략은 폴립 분할에 특별히 맞춤화된 통합 프레임워크 내에서 공동으로 최적화되지 않았습니다29. 이러한 격차는 기하학적 특징 모델링, 적응적 노이즈 억제, 그리고 교차 규모 특징 통합을 동시에 다루는 방법 개발을 촉진합니다.
이러한 문제를 해결하기 위해 이 프로토콜은 핀휠 컨볼루션과 이중 주의(PWD-Net)를 기반으로 한 폴리프 세그멘테이션 네트워크를 제시합니다. 제안된 네트워크는 기하학적 특징 모델링, 다차원 주의력 향상, 다중 규모 특징 융합을 통합하여 복잡한 폴립의 정밀한 분할을 가능하게 합니다. 이 연구의 주요 기여는 다음과 같이 요약됩니다: 핀휠 구조에서 영감을 받은 핀휠 컨볼루션 모듈(PCM)은 0°, 45°, 90°, 135°, 180°, 225°, 270°, 315° 등 여러 각도에서 합성곱 연산을 통해 폴립의 다방향 기하학적 특징을 포착하는 새로운 회전 컨볼루션 커널 설계를 제안합니다. 이 모듈은 병목 단계에서 기존의 합성곱 층을 대체하여 다양한 가장자리 방향을 효과적으로 인식하고 불규칙한 폴립의 표현을 크게 향상시킵니다. 이중 주의 메커니즘(DAM)은 대장내시경 이미지에서 주름, 반사, 대변 잔여물과 같은 배경 잡음을 다룹니다. 채널 주의와 공간적 주의를 통합하는 이중 주의 모듈이 설계되었습니다. 스킵 연결에 내장된 이 모듈은 배경 간섭을 적응적으로 억제하고 폴립 영역의 특징 반응을 향상시키며, "무엇이 중요한지"(채널 차원)와 "어디"가 목표가 위치한지(공간 차원)를 동시에 식별하여 이후 융합에 정제된 특징만 포함되도록 보장합니다. 다중 규모 특징 융합 전략(MSF)은 디코더에 도입된 계층적 메커니즘을 통해 깊은 의미 정보와 얕은 경계 세부사항을 모두 보존합니다. DAM 강화 인코더 기능과 업샘플링 디코더 기능을 점진적으로 통합함으로써, 이 전략은 다운샘플링으로 인한 공간적 세부 손실을 효과적으로 보정하여 작은 폴립을 정확히 탐지하고 경계를 정밀하게 구분할 수 있게 합니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
프로토콜
이 연구는 공개된 익명화된 대장내시경 이미지 데이터셋(Kvasir-SEG)만을 사용합니다. 새로운 인간 대상 데이터는 수집되지 않았습니다. 식별 해제된 공개 데이터셋의 사후 분석에 대한 기관 검토 정책에서 확인된 바와 같이, 기관 윤리 승인과 환자 사전 동의는 필요하지 않았습니다.
1. 데이터 준비
- 공식 저장소에서 Kvasir-SEG 데이터셋을 다운로드하세요33 (https://datasets.simula.no/kvasir-seg/). 데이터셋에는 픽셀 단위의 지상 진실 마스크가 부착된 1,000개의 폴립 이미지가 포함되어 있습니다.
- 데이터셋을 학습(800장), 검증(100장), 테스트(100장) 세트로 무작위로 나누고, 고정된 무작위 시드(시드 = 42)를 사용해 8:1:1 비율로 나눕니다. 데이터 누수를 방지하기 위해 세 하위 집합 간에 이미지가 겹치지 않는지 확인하세요.
- 이미지는 쌍선형 보간, 마스크는 최근이웃 보간을 사용하여 모든 이미지와 해당 마스크를 352 x 352 픽셀로 크기 조정합니다.
- 픽셀 값을 255로 나누어 [0, 1]으로 정규화한 후, ImageNet의 채널별 평균 뺄셈(0.485, 0.456, 0.406)과 표준편차 정규화(0.229, 0.224, 0.225)를 적용합니다.
- 다음 증강 변환은 훈련 세트에만 적용하라(검증 세트나 테스트 세트에는 적용하지 않음): 무작위 수평 반전(확률 = 0.5); 무작위 수직 뒤집기(확률 = 0.5); 무작위 회전(범위: −30°에서 +30°, 확률 = 0.5); 무작위 다중 스케일 크기 조정 (스케일 인수: 0.75에서 1.25, 확률 = 0.5)
참고: 정렬을 유지하기 위해 이미지와 해당 마스크 모두에 동일한 공간 변환을 적용하세요. 훈련을 시작하기 전에 여러 증강 이미지-마스크 쌍을 육안으로 검사하여 증강 정확성을 확인하세요.
2. 전체 건축
참고: PWD-Net의 매크로 수준 인코더-디코더 백본은 그림 1 을, 피처 플로우 내 핵심 모듈의 통합 및 상호작용은 그림 2 를 참조하세요. 전체 아키텍처는 용종의 크기 변화와 대장내시경 이미지에서의 배경 간섭을 처리하기 위해 U자형 인코더-디코더 설계를 따릅니다.
- 백본 및 인코딩 경로 (그림 1)
- ImageNet에서 사전 학습된 ResNet-50(공식 PyTorch 모델 동물원에서 제공)을 백본 인코더30으로 사용하세요. 훈련 중에 모든 인코더 레이어를 미세 조정하세요.
- 입력된 대장내시경 이미지(352 x 352 픽셀로 크기 조정)를 5단계의 잔여 합성곱 블록을 거쳐 계층적 특징을 추출합니다. 특징 지도의 공간 해상도는 다섯 단계에 걸쳐 점진적으로 내려오며, 채널 크기도 그에 따라 증가합니다(64 → 128 → 256 → 512 → 1024).
- 병목 지점(가장 깊은 인코더 층)에서는 표준 합성곱 계층을 핀휠 합성곱 모듈(PCM, 섹션 3에서 설명)으로 대체하여 전 지구적 기하학적 형태와 다방향 맥락 정보를 저해상도로 포착합니다.
참고: 다섯 개의 인코더 단계는 표준 ResNet-50 계층 그룹인 conv1, layer1, layer2, layer3, layer4에 해당합니다. 사전 학습된 가중치는 강력한 저수준 및 중간 수준 특징 초기화를 제공하여 소규모 의료 데이터셋에서 수렴 시간을 단축합니다.
- 핵심 구성 요소 및 기능 상호작용 (그림 2 및 그림 3)
- 각 인코더 단계의 출력에 듀얼 어텐션 메커니즘(DAM, 4절에 설명됨)을 적용한 후 디코더에 스킵 연결을 통해 전송합니다. 이 단계는 장 주름과 반사에 의해 발생하는 배경 잡음을 적응적으로 억제하는 동시에 폴립 영역의 특징 반응을 증진시킵니다. 필터링된 특징만 해당 디코더 계층에 전달됩니다.
- 디코더에서는 이중 선형 업샘플링을 통해 점진적으로 공간 해상도를 복원합니다. 각 디코더 계층에서 이전 디코더 단계에서 업샘플링된 특징을 동일한 공간 해상도의 DAM 강화 인코더 특징과 연결합니다.
- 두 개의 연속된 합성곱 층(각 층에 배치 정규화와 ReLU 활성화 후)을 적용하여 다중 스케일 정보를 융합합니다. 이것이 5절에서 설명한 다중 규모 특징 융합(MSF) 전략을 구성합니다.
참고: 디코더는 깊은 층에서 얕은 층(5단계→ 1단계)으로 진행되며, 각 단계에서 깊은 의미 위치 정보와 얕은 경계 세부 정보가 효과적으로 통합되도록 보장합니다.
- 출력 생성
- 최종 디코더 출력에 합성곱 층과 시그모이드 활성화 함수를 적용하여 예측 마스크를 생성합니다.
- 예측 마스크를 0.5 임계값을 사용하여 최종 분할 결과를 얻는데, 예측 확률 0.5≥ 픽셀은 폴립으로, 나머지 픽셀은 배경으로 분류됩니다.
3. 핀휠 컨볼루션 모듈 (그림 3)
- 핀휠 컨볼루션 모듈(PCM)은 표준 병목 컨볼루션 대신 폴립의 다방향 기하학적 특징을 포착합니다. 이 모듈을 다음과 같이 구현하세요:
- 입력 채널에 C를, 출력 채널에 C를 두고 크기 3 x 3의 기본 컨볼루션 커널 W를 정의합니다.
- 회전 각도 집합 Θ = {0°, 45°, 90°, ..., 315°}를 정의합니다. 각 각도 θ ∈ Θ에 대해, W에 쌍선형 보간 기반 회전을 적용하여 회전된 핵W θ 를 생성한다. 8개의 회전된 핵 모두 동일한 기본 매개변수를 공유하며; 가중치의 공간적 배열만 다릅니다.
- 각 각도 θ에 대해 방향별 특징 지도를 계산한다:

여기서 X는 입력 특징 맵입니다. - 8개의 방향성 특징 맵을 채널 축을 따라 채널 단위로 연계하여 (8 x Cout) x H x W 차원의 텐서를 만듭니다. 그 후 1 x 1 합성곱을 적용하여 채널 차원을 C아웃으로 줄이고, 배치 정규화와 ReLU 활성화31을 수행합니다:

참고: 회전과 보간은 입력 특징 맵이 아닌 커널 가중치에 대해 수행됩니다. 이 설계는 입력 해상도를 높이지 않고도 매개변수 효율적인 다방향 특징 추출을 가능하게 합니다. 현재 구현에서는 병목 단계에서 Cin = 1024, Cout = 1024로 설정되어 ResNet-50 layer4의 출력 채널 치수와 일치합니다. 전체 구현은 보조 코드 패키지를 참고하세요.
4. 이중 주의 메커니즘 (그림 4)
참고: 이중 주의 메커니즘(DAM)은 각 스킵 연결에 내장되어 배경 소음을 억제하고 채널 및 공간 차원 모두에서 폴립 영역 특징을 강화합니다.
- 채널 주의
채널 주의 분기는 가장 유익한 특징 채널을 식별합니다. 입력 특징 F ∈ RC×H×W 주어짐:- 글로벌 평균 풀링(Global Average Pooling)을 통해 공간 차원을 압축하여 RC×1×1 채널 디스크립터 z∈ 얻습니다.
- z를 2층 MLP(완전 연결 층)를 통과시키고, 축소비 r = 16을 가집니다. 첫 번째 계층은 ReLU 활성화를 통해 차원을 C에서 C/16으로 줄입니다; 두 번째 층은 시그모이드 활성화를 통해 C/16에서 C로 복원하여 채널 가중 벡터 Ac를 생성합니다:
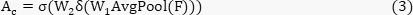
여기서 δ는 ReLU, σ는 Sigmoid를 나타냅니다.
- 공간적 주의
공간 주의 분기는 목표 영역이 어디에 있는지 위치를 나타냅니다:- 채널 차원을 따라 최대 풀링과 평균 풀링을 모두 적용하여 크기 1 x H x W 크기의 두 개의 2D 특징 지도를 생성합니다.
- 두 맵을 채널 축을 따라 연결하여 2 x H x W 텐서를 만듭니다. 7 x 7 합성곱층을 적용한 후 시그모이드 활성화를 통해 공간 가중치 맵 As ∈ R1×H×W를 생성합니다:
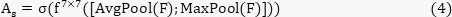
- 기능 융합
- 채널과 공간적 주의 출력을 입력 특징과 요소별 곱셈을 통해 융합합니다:

여기서 α와 β는 학습 가능한 균형 계수로, 둘 다 0.5로 초기화되어 학습 중 그라디언트 기반 최적화를 통해 네트워크 파라미터와 함께 업데이트됩니다.
참고: 전체 구현은 보충 코드 패키지(dam_module.py)를 참조하십시오.
- 채널과 공간적 주의 출력을 입력 특징과 요소별 곱셈을 통해 융합합니다:
5. 다중 규모 특징 융합
- 디코더에서 다중 스케일 특징 융합(MSF) 전략을 적용하여 심부 지형의 공간적 세밀 손실을 해결합니다. 각 디코더 단계마다 다음과 같은 동작을 수행하세요:
- 쌍선형 보간을 사용하여 이전 디코더 단계에서 특징 맵을 2배 업샘플링합니다.
- 업샘플링된 특징을 채널 축을 따라 DAM으로 향상된 공간 해상도의 인코더 기능과 연결합니다.
- 연속된 3 x 3 합성 합성곱 레이어 두 개(각 레이어 뒤에 배치 정규화와 ReLU 활성화32)를 적용하여 연결된 특징을 융합합니다.
참고: 이 교차 융합은 폴립(얕은 인코더 특징으로 제공됨)과 의미 위치(깊은 특징에 의해 제공됨)의 경계 세부사항을 동시에 보존하여 세밀한 분할 결과를 생성합니다.
6. 손실 함수 및 훈련 구성
- 손실 함수
- 네트워크를 공동 최적화하기 위해 하이브리드 손실 함수 L_total이 채택되어 폴립 분할에서 널리 보이는 전경-배경 클래스 불균형을 해결합니다.
이진 교차 엔트로피 손실(LBCE)은 픽셀 단위 분류 정확도를 측정합니다:
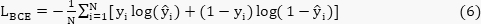
여기서 N은 총 픽셀 수이고, yi ∈ {0,1}는 근거 진실 라벨이며, ŷi ∈ [0,1]는 예측 확률이다. - 주사위 손실(LDice)은 예측된 영역과 실제 영역 간의 집합 유사성을 정량화합니다:


여기서 ε는 0으로 나누는 것을 피하기 위한 평활화 인수(1 x 10⁻5로 설정)입니다.
두 손실 항의 기여도를 균형 맞추기 위해 λ = 0.5를 설정하세요.
- 네트워크를 공동 최적화하기 위해 하이브리드 손실 함수 L_total이 채택되어 폴립 분할에서 널리 보이는 전경-배경 클래스 불균형을 해결합니다.
- 훈련 구성
- ImageNet 사전 학습된 ResNet-50 가중치로 인코더를 초기화하세요. 모든 디코더 계층, PCM, DAM 파라미터를 Kaiming 균일 초기화로 초기화합니다.
- 옵티마이저와 훈련 일정을 다음과 같이 설정하세요. β₁ = 0.9, β₂ = 0.999인 Adam 옵티마이저를 사용하세요. 초기 학습 속도를 1 x 10⁻⁴로 설정하세요. Tmax = 50, ηmin = 1 x 10⁻⁶ 코사인 어닐링 학습률 스케줄을 적용합니다. 배치 크기를 16으로 사용하고 모델을 50 에포크에 대해 학습시킵니다.
- 학습 세트에서 50에포크(800장의 이미지)를 학습시킵니다. 각 에포크가 끝날 때, 주사위 계수를 주요 모니터링 지표로 사용하여 검증 세트(100장의 이미지)에서 모델을 평가합니다.
- 검증 세트에서 가장 높은 주사위 계수를 달성한 모델 체크포인트를 저장하세요. 이 체크포인트를 테스트 세트에 대한 모든 후속 평가의 최종 모델로 사용하세요.
참고: 조기 정지가 명시적으로 적용되지는 않습니다. 최적 검증-주사위 체크포인트 선택 전략이 모델 선택 기준으로 사용됩니다. 모든 실험은 재료표에 명시된 하드웨어 및 소프트웨어 환경을 사용하여 수행됩니다. 800장의 이미지에서 50에포흐 훈련은 약 2시간이 소요됩니다. 보고된 모든 결과는 지정된 무작위 시드(시드 = 42)를 사용한 단일 훈련 실행에서 얻어졌습니다. 전체 교육 스크립트는 보조 코드 패키지를 참고하세요.
7. 의사 코드
- 알고리즘 1을 PWD Net의 전체 워크플로우 맵으로 사용하세요. 알고리즘 내 PCM, DAM, 주요 아키텍처, 학습 파이프라인 블록을 보조 코드 패키지의 해당 파일과 일치시킵니다.
- 4행부터 12행에 표시된 PCM 블록을 구현하세요. 3 x 3 합성곱 커널을 정의하고, 0°, 45°, 90°, 135°, 180°, 225°, 270°, 315°에서 8개의 회전된 커널을 쌍선형 보간법을 사용해 생성한다.
- 모든 회전된 PCM 커널에 대해 동일한 학습 가능한 기본 매개변수를 유지하세요. 각 회전 각도마다 한 방향의 특정 특징 지도를 계산합니다.
- 8개의 PCM 특징 맵을 채널 차원을 따라 연결합니다. 1 x 1 합성곱, 배치 정규화, ReLU 활성화를 적용하여 원래 채널 차원을 복원합니다.
- 14행부터 19행에 표시된 DAM 블록을 구현하세요. 글로벌 평균 풀링을 적용하여 채널 디스크립터를 생성한 후, 이를 16의 감축 비율을 가진 2계층 MLP를 통과시켜 채널 가중치를 얻습니다.
- 입력 특징에 채널별 평균 풀링과 최대 풀링을 적용하여 공간 주의 맵을 생성합니다. 두 맵을 연결하고 7 x 7 합성곱 처리한 후 시그모이드 활성화를 진행합니다.
- DAM 채널과 공간 주의 출력을 입력 기능과 요소별 곱셈을 결합합니다. 학습 가능한 계수가 α과 β인 두 주의력 맵을 가중치로 가중치하며, 둘 다 0.5로 초기화합니다.
- 21행부터 32행에 표시된 주요 PWD Net 아키텍처를 구축하세요. 입력 이미지를 사전 학습된 ResNet 50 인코더의 5단계를 거쳐 e1부터 e5까지 얻으며, 공간 해상도는 H x W에서 H/32 x W/32로 감소합니다.
- 병목 지점의 e5에 PCM을 적용하세요. 이 기능들을 디코더에 스킵 연결을 통해 전송하기 전에 DAM을 e1부터 e4에 적용하세요.
- 특징 맵을 깊은 층에서 얕은 층으로 디코딩합니다. 각 디코더 레벨에서 이전 특징을 업샘플링하고, 해당 DAM 강화 인코더 기능과 연결한 뒤, 특징 융합을 위해 DoubleConv를 적용합니다.
- 1 x 1 합성곱 변환과 시그모이드 활성화로 분할 출력을 생성합니다. 픽셀별 확률 맵을 예측 마스크로 사용하세요.
- 34행부터 39행에 표시된 훈련 루프를 구현하세요. 각 에포크마다 PWD Net을 통해 순방향 전파를 실행하고 예측된 마스크를 계산합니다.
- 훈련 손실을 0.5 x BCE 손실에 0.5 x 주사위 손실을 더한 것으로 계산합니다. 역전파를 통해 Adam 최적화기로 학습 가능한 모든 매개변수를 업데이트하세요.
알고리즘 1: PWD-넷 폴립 분할
1: 입력: 대장내시경 영상 I ∈ RH×W×3
2: 출력: 세그멘테이션 마스크 M ∈ {0,1}(H×W)
3:
4: 기능 PCM(X) ▷ 핀휠 컨볼루션 모듈
5: 기본 핵 W(3 x 3)를 정의하라. 각도 Θ = {0°, 45°, ..., 315°}
6: 각 θ에 대해 θ∈ do(행)
7: Wθ ← BilinearRotate(W, θ) ▷ 핵 회전
8: Yθ ← Conv2d(X, Wθ) ▷ 방향별 특징
9: 끝
10: Yout ← ReLU(BN(Conv1 x 1(Concat({Yθ})))) ▷ 집계
11: Y반환 아웃
12: 끝 함수
13:
14: 기능 DAM(F) ▷ 이중 주의 메커니즘
15: Ac ← Sigmoid(MLP(AvgPool(F))) ▷ 채널 주의 (r=16)
16: As ← 시그모이드(Conv7 x 7([AvgPool(F); MaxPool(F)])) ▷ 공간적 주의
17: F' ← F ⊗ (α · Ac + β · As) ▷ 학습 가능한 α과 퓨즈, β (init=0.5)
18: 귀환 F'
19: 기능 종료
20:
21: 기능 PWD-Net(I)
22: 인코더: e1,e 2, e3, e4, e5 ← ResNet50_Stages(I) ▷ 5단계 사전 학습 인코더
23: 병목 현상: b ← PCM(e5) ▷ 병목 현상 PCM 적용
24: 연결 건너뛰기: si ← DAM(ei) = 1, 2, 3, 4 ▷ 필터 인코더 기능
25: 디코더:
26: d4 ← 더블 컨브(Concat(Up(b), s4))
27: d3 ← 더블 컨브(Concat(업(d4), s3))
28: d2 ← 더블 컨브(Concat(위(d3), s2))
29: d1 ← 더블 컨브(Concat(업(d2), s1))
30: M ← 시그모이드(Conv1 x 1(d1))
31: 귀환 M
32: 기능 종료
33:
34: 훈련:
35: 각 에포크 도에 대해
36: M̂ ← PWD-Net(I)
37: L ← 0.5 · BCE(M̂, Mgt) + 0.5 · DiceLoss(M̂, Mgt) ▷ λ = 0.5
38: 역전파를 통한 매개변수 업데이트 (Adam optimizer)
39: 끝
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
결과
실험 장치
데이터셋
Kvasir SEG 데이터셋은 이질적인 폴립 외관을 가진 대장내시경 이미지에서 PWD Net의 분할 행동을 평가하는 데 사용되었습니다. 이 데이터셋은 1,000개의 주석이 달린 폴립 이미지를 포함하고 있으며, 폴립 크기, 형태, 질감, 조명, 배경 복잡성의 변동성을 포함하여 작은 표적 탐지, 경계 위치 파악, 시각적 간섭에 대한 견고성 평가에 적합합니다. 데이터셋은 훈련, 검증, 테스트 하위 집합으로 나뉘었으며, 최종 테스트 세트는 성능 평가에만 사용되었습니다. 이미지 분포는 표 1에 요약되어 있습니다.
구현 세부사항
재현성을 위해 필요한 구현 설정은 표 2 에 요약되어 있으며, 전체 절차적 세부사항은 데이...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
토론
PWD-Net 프로토콜의 여러 설계 선택은 신뢰할 수 있는 세분화 결과를 달성하기 위해 매우 중요하며, 구현 시 세심한 주의가 필요합니다. 첫째, 인코더 백본의 선택과 초기화는 수렴 동작과 최종 성능에 직접적인 영향을 미칩니다. 이 프로토콜은 ImageNet에서 사전 학습된 ResNet-50 인코더를 사용하여 강력한 저수준 및 중간 수준 기능 초기화를 제공합니다. 이는 특히 훈련 데이터가 제한된 의료 이미지 분할 작업(본 연구에서 800장의 이미지)에서 중요합니다. 모든 인코더 계층을 정지 대신 미세 조정하면, 네트워크는 점막 질감과 스펙큘러 반사와 같은 대장내시경 이미지의 특정 특성에 미리 학습된 특징을 적응시킬 수 있습니다. 둘째, 각 핵심 모듈의 아키텍처 내 배치는 의도적입니다. 핀휠 컨볼루션 모듈(PCM)은 공간 해상도가 가장 낮지만 의미 정보가 가장 풍부한 병목 지점에 위치해 있어 과도한 계산 비용 없이 전 세계 기하학적 패턴을 효율적으로 캡처할 수 있습니다....
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
공개 사항
저자들은 공개할 것이 없습니다.
감사의 글
이 연구는 중국 국가 중점 연구개발 프로그램(프로그램 번호 2022YFC3500200 및 2022YFC3500204)의 지원을 받았습니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| Adam Optimizer | — | — | PyTorch에 포함됨 |
| Albumentations | Albumentations Team | v1.0+ | 데이터 증강 라이브러리 |
| CUDA Toolkit | NVIDIA | v11.3+ | GPU 가속 |
| Kvasir-SEG 데이터셋 | SimulaMet | — | https://datasets.simula.no/kvasir-seg/ |
| Matplotlib | Matplotlib Community | v3.4+ | 학습 곡선 시각화 |
| NumPy | NumPy Community | v1.21+ | 수치 계산 |
| NVIDIA Tesla P100 | NVIDIA | P100-PCIE-16GB | 학습 및 추론용 GPU |
| OpenCV | OpenCV Community | v4.5+ | 이미지 전처리 |
| Python | Python Software Foundation | v3.8+ | 프로그래밍 언어 |
| PyTorch | Meta Platforms | v1.12+ | 딥러닝 프레임워크 |
| ResNet-50 사전 학습된 가중치 | PyTorch Model Zoo | — | ImageNet-1K 사전 학습 |
| Ubuntu | Canonical | 18.04+ | 운영 체제 |