본 논문에서는 급성 췌장염에서 다장기 기능 부전 증후군의 조기 위험 계층화를 위한 코호트 구성, 실험실 표준화, 페널티 모델 개발, 검증 및 병상 점수 구축 프로토콜을 제시합니다.
이 논문에서
요약
초록
급성 췌장염에서 다기관 기능 부전 증후군을 조기에 인식하는 것은 여전히 어려운데, 이는 전통적인 중증도 평가가 완료되기 전에 장기 기능 저하가 발생할 수 있기 때문입니다. 본 논문은 입원 후 24시간 이내에 수행된 일상적인 실험실 검사 결과를 기반으로 입원 시 생화학-응고 복합 점수를 개발, 검증 및 적용하기 위한 재현 가능한 프로토콜을 설명합니다. 다기관 기능 부전 증후군은 하나 이상의 장기 시스템 전체에 걸쳐 임상적으로 중대한 기능 부전을 반영하며, 조기 모니터링 강도, 단계적 치료 계획 및 중환자 진료 자원 배분에 직접적인 정보를 제공하므로 일차 평가 지표로 선정되었습니다. 본 프로토콜은 다기관 코호트 구성, 적격성 스크리닝, 평가 지표 판정, 실험실 단위 표준화, 결측치 처리, 예측 변수 스케일링, 패널티 회귀 모델 개발, 홀드아웃 검증, 점수 구축, 기존 중증도 점수와의 벤치마킹 및 민감도 분석을 다룹니다. 정보 손실을 줄이기 위해 모델 개발 단계에서는 연속형 실험실 변수를 유지하며, 최종 모델을 실용적인 침상 옆 점수로 변환할 때에만 임상적으로 해석 가능한 범주를 사용합니다. 절차적 체크포인트에는 코호트 구성 확인, 결측치 임계값, 고정된 전처리 규칙, 모델 선택 결과, 검증 결과 및 최종 점수 해석이 포함됩니다. 이 워크플로우를 사용하면 일상적으로 측정되는 생화학 및 응고 마커를 급성 췌장염 관련 다기관 기능 부전 증후군을 위한 구조화된 입원 위험 층화 도구로 통합할 수 있습니다. 이 점수는 보다 면밀한 관찰, 반복적인 실험실 평가 및 장기 지원 경로 준비를 지원하기 위한 것이며, 임상적 판단이나 기성 중증도 프레임워크를 대체하기보다는 이를 보완해야 합니다.
서론
급성 췌장염은 흔한 소화기 응급 질환으로, 경미하고 자가 제한적인 염증부터 장기 기능 부전이 동반되어 빠르게 진행되는 질환에 이르기까지 임상 경과가 다양합니다. 현재의 중증도 평가는 일반적으로 개정된 애틀랜타 분류(revised Atlanta classification)를 따르며, 이는 국소 합병증, 전신 합병증, 그리고 장기 부전의 발생 여부와 지속 기간에 따라 질병의 중증도를 정의합니다1. 입원 초기에는 위험 평가 및 치료 단계 상향 결정을 지원하기 위해 병상 옆 점수 체계(bedside scoring systems)가 사용되기도 합니다. 급성 췌장염 병상 옆 중증도 지수(Bedside Index for Severity in Acute Pancreatitis)는 초기 24시간 이내에 확인 가능한 5가지 변수를 사용하여 원내 사망 위험을 추정하기 위해 개발되었습니다2. 최근의 임상 지침은 중증 질환의 조기 발견, 반복적인 재평가, 적절한 수액 소생술, 장기 지원 계획 및 적시의 치료 단계 상향을 지속적으로 강조하고 있습니다3.
일상적인 진료에서 초기 위험 평가는 여전히 어렵습니다. 급성 췌장염의 염증 반응은 빠르게 변화하며, 일부 전통적인 점수 체계는 반복적인 측정, 입원 후 변화하는 생리학적 변수 또는 첫 임상 진료 시점에 확보되지 않을 수 있는 영상 의학적 소견을 필요로 합니다4. 그 결과, 위험 분류는 샘플링 시간, 지역적 워크플로우 및 치료 경로에 따라 달라질 수 있습니다. 이러한 불확실성은 저위험군 환자에게 불필요한 집중 모니터링이나 중재로 이어질 수 있는 반면, 상태가 빠르게 악화되는 환자는 치료 단계의 격상이 지연되는 경험을 할 수 있습니다. 급성 췌장염의 중증도 예측에 관한 최근 검토에 따르면, 임상 점수 및 개별 바이오마커의 성능은 환자군, 질환 중증도 분포 및 평가 기간에 따라 다양하게 나타난다고 언급되었습니다5.
최근의 대부분의 예측 연구들은 입원 후 24시간 이내에 수집된 변수들을 사용하려 했으며, 주로 지속성 장기 부전이나 중증 급성 췌장염을 표적 결과로 설정하였습니다. 이러한 접근 방식은 임상적으로 유용하지만, 발표된 많은 모델들은 단일 센터 설계, 불완전한 검증, 전처리 및 결측치 처리 방법의 불충분한 보고라는 한계가 있습니다6. 예측 모델에서는 선정 기준, 예측 변수 정의, 표본 크기, 결측치 처리, 모델 구축 결정 및 검증 절차가 재현성과 임상적 해석에 직접적인 영향을 미치기 때문에 투명한 보고가 특히 중요합니다7. 입원 기반 방법이 여러 기관에서 사용 가능하려면, 일상적으로 수행되는 검사에 의존하고, 단위 변환 절차를 정의하며, 실험실 측정값이 어떻게 조화되었는지 설명하고, 모델 적합 전 불완전한 예측 변수 값이 어떻게 처리되는지 명시해야 합니다.
생화학적 이상과 응고 이상은 모두 급성 췌장염의 초기 악화와 관련이 있습니다. 염증 활성화, 내피 세포 손상, 혈액 농축, 신장 저관류 및 미세순환 장애가 초기에 발생하여 장기 기능 부전의 원인이 될 수 있습니다. 응고 활성화는 염증과 밀접하게 연관되어 있으며, 급성 췌장염 관련 응고병증은 지속적인 장기 부전 및 불량한 예후로 진행되는 과정의 일부로 설명되어 왔습니다8. D-dimer 또한 급성 췌장염에서 장기 부전, 국소 합병증, 중환자실 입원 및 사망률과 연관된 입원 시 지표로 보고되었습니다9. 하지만 응고 지표들은 체계적인 입원 워크플로우 내에서 루틴한 생화학적 변수들과 결합되어 해석되기보다 개별적으로 해석되는 경우가 많습니다.
다장기 기능부전 증후군은 하나 이상의 장기 시스템 전반에 걸쳐 임상적으로 중대한 기능부전을 나타내므로 본 프로토콜의 1차 종점으로 선정되었습니다. 지속성 장기 부전은 급성 췌장염의 중증도 분류에서 여전히 핵심적인 요소이지만, 다장기 기능부전 증후군은 환자가 더 밀접한 감시, 반복적인 실험실 재평가, 장기 보조 준비 또는 중환자실 자원을 필요로 할 가능성이 있는지라는 실제적인 입원 결정 질문에 더 가깝습니다. 또한 이 종점을 통해 생화학 및 응고 신호를 단일 장기 기반의 결과가 아닌 더 광범위한 전신 악화 패턴과 연계하여 평가할 수 있습니다.
본 방법론 논문은 급성 췌장염 환자의 다기관 기능 부전 증후군에 대한 조기 위험 계층화를 위한 재현 가능한 입원 시 생화학-응고 점수 산출 프로토콜을 설명합니다. 이 프로토콜은 입원 후 24시간 이내에 얻은 일상적인 실험실 변수를 사용하며, 단위 조화 및 결측치 처리 과정을 표준화하고, 벌점화 모델 개발(penalized model development)을 적용하여 최종 모델을 임상적으로 해석 가능한 복합 점수로 변환합니다. 본 프로토콜의 목적은 임상적 판단이나 기설정된 중증도 체계를 대체하는 것이 아니라, 의료 기관이 입원 시 실험실 데이터를 실행 가능한 위험 정보로 체계화하는 데 도움이 되는 투명하고 재현 가능한 워크플로우를 제공하는 것입니다.
프로토콜
연구 프로토콜은 가싱대학교 부속 지아산 병원 지아산 제1인민병원의 인간 대상 생물의학 연구 윤리 위원회로부터 승인을 받았습니다(승인 번호 2026 Research Approval No. 005, 접수 번호 LW2026004, 승인 날짜 2026년 1월 13일). 본 후향적 연구는 비식별화된 임상 데이터를 사용하였으므로 개별 고지된 동의 요건은 면제되었습니다. 분석 전, 성명, 병원 등록 번호, 전화번호, 주소 및 주민등록번호를 포함한 직접 식별자는 모두 제거되었습니다. 데이터 처리는 기관의 데이터 보호 요구 사항 및 헬싱키 선언을 준수하였습니다.10.
연구 설계 및 다기관 코호트 구성
본 후향적 다기관 코호트 연구에서는 입원 시 생화학 및 응고 데이터를 사용하여 급성 췌장염(AP) 환자의 다기관 기능 부전 증후군(MODS) 조기 위험 계층화를 위한 재현 가능한 점수화 워크플로우를 구축하였습니다. AP는 전형적인 복통, 정상 상한치의 3배 이상인 혈청 아밀라아제 또는 리파아제, 또는 AP와 일치하는 영상학적 소견 중 최소 두 가지 기준을 충족하는 것으로 정의하였습니다. 기초 분석 기간은 병원 입원 후 첫 24시간으로 정의하였습니다. 각 실험실 예측 변수에 대해, 해당 기간 내의 가장 이른 유효 값을 사용하였습니다. MODS의 첫 기록된 발생 이후에 얻은 값은 예측 변수 구축에 사용하지 않았습니다.
2023년 1월 1일부터 2025년 12월 20일까지 참여 센터에서 발생한 연속적인 급성 췌장염(AP) 입원 사례를 통합 스크리닝 로그, 적격성 체크리스트, 데이터 딕셔너리 및 종점 판정 양식을 사용하여 스크리닝하였다. 스크리닝 로그에는 전체 스크리닝 입원 건수, 중복 입원 건수, AP 미확정, 18세 미만, 만성 췌장염, 췌장암 관련 췌장염, 신뢰할 수 없는 입원 시간, 24시간 실험실 데이터 부재, 불완전한 종점 기록으로 인한 제외 건수 및 최종 분석 코호트가 기록되었다. 잠금 처리된 스크리닝 로그는 다음을 생성하는 데 사용되었다. 그림 1환자 수는 그림 1 분석 전, 최종 분석 데이터 세트와 대조하여 확인되었습니다.
분석 코호트가 확정된 후, 환자들을 개발 코호트와 홀드아웃 검증 코호트에 7:3 비율로 배정하였다. 데이터 분할은 R 버전 4.3.2의 caret 패키지 버전 6.0-94를 사용하여 수행되었으며, 랜덤 시드는 20260420으로 고정하였다. MODS 상태와 센터에 따라 층화 추출을 수행하였다. 코호트 간 센터 분포 차이가 5%포인트를 초과하는 경우, 센터-MODS 결합 층을 사용하였다. 코호트 배정은 모델 피팅 전에 저장되었으며, 이후 수정되지 않았다. 전처리 규칙, 결측치 대체 설정, 모델 튜닝, 계수 추정, 점수 산출 및 컷오프 선택은 오직 개발 코호트만을 통해 도출되었다. 홀드아웃 검증 코호트는 확정된 모델의 평가 용도로만 사용되었다.
적격성 기준 및 등록 절차
적격 환자는 AP가 확진되었고, 추적 가능한 병원 입원 시간이 있으며, 입원 후 24시간 이내에 최소 한 번의 생화학적 또는 응고 실험실 패널 검사를 받았으며, 종점 판정을 위한 완전한 병원 내 기록을 보유한 18세 이상의 성인으로 하였다. AP를 확진할 수 없거나, 만성 췌장염 또는 췌장암 관련 췌장염이 있는 경우, 또는 첫 병원 입원 시간을 신뢰성 있게 재구성할 수 없는 경우 환자를 제외하였다. 전원 사례의 경우, 기관 간에 첫 입원 시간, 첫 실험실 샘플링 시간 또는 초기 장기 기능 부전 상태를 추적할 수 없을 때 제외하였다. 연구 기간 중 동일 환자가 반복적으로 입원한 경우, 첫 번째 적격 입원 사례만 유지하였다. 제외된 각 사례에 대해 하나의 주요 제외 사유를 기록하였다.
결과 및 종점 판정
1차 결과 지표는 원내 MODS로, 이는 입원 중 2개 이상의 장기 체계에서 기능 부전이 발생한 것으로 정의되었다. 장기 기능 부전은 전자 의무 기록의 호흡기, 심혈관, 신장, 간, 응고 및 신경계 기록을 통해 평가되었다. 모델 개발 전 모든 센터에 동일하게 사전 지정된 장기 체계 기준이 적용되었으며, 종점 판정에 사용된 운영 기준은 부록 표 1에 요약되어 있다.
훈련된 두 명의 검토자가 입원 기록, 경과 기록, 중환자실 기록, 시술 기록, 실험실 보고서, 활성 징후 기록 및 퇴원 요약지를 사용하여 익명화된 각 기록을 독립적으로 평가하였습니다. 판정 양식에는 환자 연구 코드, 관련 장기 시스템, 소스 기록, 발생 날짜 및 시간, 근거가 되는 실험실 또는 생리학적 수치, 검토자 결정 및 최종 판정 상태가 기록되었습니다. 검토자 간의 일치 의견은 최종 결정으로 수용되었으며, 불일치 사항은 제3의 상급 검토자가 해결하였습니다. 이차 결과 지표에는 중환자실 입원, 침습적 또는 비침습적 기계적 환기, 신대체 요법, 원내 사망률, 감염성 괴사 또는 배농 시술, 그리고 입원 기간이 포함되었습니다. 입원 기간은 퇴원 날짜에서 입원 날짜를 뺀 후 1일을 더하여 계산하였습니다.
입원 시 후보 예측 인자
후보 예측 인자는 입원 후 24시간 이내에 확인 가능한 루틴 변수로 제한하였다. 24시간 창 내에서 반복 검사가 수행된 경우, 가장 먼저 측정된 적격 값을 유지하였다. 생화학적 변수에는 백혈구 수, C-reactive protein, 프로칼시토닌(사용 가능한 경우), 젖산, 포도당, 총 칼슘, 혈액 요소 질소, 크레아티닌, 알라닌 아미노전이효소, 총 빌리루빈, 알부민 및 젖산 탈수소효소가 포함되었다. 응고 변수에는 혈소판 수, 프로트롬빈 시간, 프로트롬빈 시간-국제 표준화 비율, 활성화 부분 트롬보플라스틴 시간, 피브리노겐 및 D-dimer가 포함되었다.
환자군 특성 설명 및 벤치마크 점수 계산을 위해 기저 임상 변수를 수집하였습니다. 해당 변수에는 연령, 성별, 체질량 지수, 증상 발현부터 입원까지의 시간, AP 원인, 흡연 여부, 췌장염 기왕력, 동반 질환, 입원 시 심박수, 평균 동맥압, 전신성 염증 반응 증후군 상태, Bedside Index for Severity in Acute Pancreatitis 점수, Acute Physiology and Chronic Health Evaluation II 점수 및 Sequential Organ Failure Assessment 점수가 포함되었습니다. 프로트롬빈 시간과 프로트롬빈 시간-국제 표준화 비율을 모두 사용할 수 있는 경우, 모델링에는 프로트롬빈 시간-국제 표준화 비율을 사용하였으며, 기술적 보고를 위해 프로트롬빈 시간을 유지하였습니다. 추출 파일은 입원당 한 행으로 구성되었으며 센터 코드, 환자 연구 코드, 입원 시간, 샘플링 시간, 원시 값, 원시 단위, 표준화 값, 표준화 단위, 소스 테이블 및 결측치 플래그를 포함하였습니다.
센터 간 실험실 측정값 표준화
분석 전 모든 실험실 변수를 미리 지정된 대상 단위로 변환하였다: 백혈구 수 및 혈소판 수, 109/L; C-반응성 단백질, mg/L; 프로칼시토닌, ng/mL; 젖산, 포도당, 총 칼슘 및 혈액 요소 질소, mmol/L; 크레아티닌 및 총 빌리루빈, µmol/L; 알라닌 아미노전이효소 및 젖산 탈수소효소, U/L; 알부민 및 피브리노겐, g/L; 프로토롬빈 시간 및 활성화 부분 트롬보플라스틴 시간, seconds; 프로토롬빈 시간-국제 표준 비율, 단위 없는 비율; 그리고 D-dimer, mg/L fibrinogen-equivalent units. µg/mL fibrinogen-equivalent units로 보고된 D-dimer 값은 1:1 수치 변환을 통해 mg/L fibrinogen-equivalent units로 변환하였다. D-dimer units로 보고된 D-dimer 값은 해당 지역 실험실에서 검증된 변환 계수를 제공한 경우에만 변환하였다. 검증된 변환 계수가 없는 값은 모델링 시 결측치로 처리하였다.
각 센터의 보고 단위, 참고 범위, 분석 기록 및 분석기 노트는 데이터를 통합하기 전에 검토되었습니다. 조화 파일(harmonization file)에는 원래 단위, 대상 단위, 변환 규칙 및 변환 확인을 담당한 검토자가 유지되었습니다. 기본 분석에서 실험실 수치는 센터별 참고 범위로 정규화되지 않았는데, 이는 점수가 절대적인 임상 수치를 사용하도록 설계되었기 때문입니다. 결측치 대체 및 민감도 분석 과정에서 센터 코드는 그대로 유지되었습니다. 비음성 테스트의 음수 값, 호환되지 않는 단위, 24 h 범위를 벗어난 타임스탬프 및 소스 기록으로 뒷받침되지 않는 값들은 플래그 처리되었습니다. 소스 기록을 통해 전사 오류 또는 단위 변환 오류가 확인된 경우에만 값을 수정하였으며, 그렇지 않은 경우에는 결측치로 처리했습니다.
데이터 전처리 및 결측 데이터 처리
모델 적합 전, 변수, 센터 및 MODS 상태별로 결측치를 요약하였습니다. 전체 결측률이 30%를 초과하거나 단일 센터에서 결측률이 50%를 초과하는 경우, 해당 후보 예측 변수는 모델 개발에서 제외하였습니다. 후보 예측 변수의 40% 이상이 결측되었거나 일차 결과(primary outcome)를 판정할 수 없는 환자는 모델링 데이터 세트에서 제외하였습니다.
연속형 예측 변수들은 개발 코호트에서 추정된 1번째 및 99번째 백분위수에서 윈저화(winsorized)되었습니다. 동일한 임계값이 홀드아웃 검증 코호트에도 적용되었습니다. 검증 데이터에서 임계값은 재추정되지 않았습니다. 윈저화 후 왜도가 2보다 큰 변수들은 자연로그를 사용하여 변환되었습니다. 0을 포함할 수 있는 변수의 경우 log(x + 0.01)이 사용되었습니다. 연속형 예측 변수들은 개발 코호트의 평균과 표준편차를 사용하여 표준화되었으며, 동일한 매개변수가 검증 데이터에 적용되었습니다.
다중 대체(Multiple imputation)는 R의 mice 패키지 버전 3.16.0의 연쇄 방정식(chained equations)을 사용하여 수행되었습니다. 데이터셋당 20회의 반복을 통해 20개의 대체 데이터셋을 생성했습니다. 연속형 변수에는 예측 평균 일치법(predictive mean matching)을, 이분형 변수에는 로지스틱 회귀 분석을, 명목 범주형 변수에는 다항 로지스틱 회귀 분석을 사용했습니다. 대체 모델에는 모델 개발을 위한 후보 예측 인자, 센터 코드, 코호트 지표 및 MODS 상태가 포함되었습니다. 검증 결과는 전처리 규칙, 변수 적격성 또는 임계값을 수정하는 데 사용되지 않았습니다. 회귀 추정치는 보고 시 Rubin의 규칙(Rubin’s rules)을 사용하여 통합되었습니다. 예측 지표는 각 대체 데이터셋 내에서 계산되었으며, 통합 추정치 또는 범위가 포함된 중앙값 추정치로 요약되었습니다. 두 가지 민감도 분석이 사전에 지정되었습니다. 하나는 최종 모델 예측 인자에 결측치가 없는 환자만을 이용한 완전 사례 분석(complete-case analysis)이며, 다른 하나는 가장 이른 값 대신 24시간 이내의 적격 실험실 수치 중 최악의 값을 사용하는 기저치 분석(baseline-value analysis)입니다.
통계 분석 및 모델 개발
기초 특성은 개발 코호트와 홀드아웃 검증 코호트에서 각각 요약되었습니다. 연속형 변수는 평균 ± 표준편차 또는 중앙값 및 사분위 범위로 표기하였으며, 범주형 변수는 n (%)로 표기하였습니다. 입원 시 생화학 및 응고 변수를 MODS 환자와 비환자 간에 비교하였습니다. 연속형 변수에는 Student’s t-test 또는 Wilcoxon rank-sum test를 사용하였고, 범주형 변수에는 카이제곱 검정 또는 Fisher’s exact test를 사용하였습니다. 이러한 P 값은 기술 통계용이며 예측 변수 선택을 위해 단독으로 사용되지 않았습니다.
모델 개발은 개발 코호트로 제한되었다. 이벤트 수가 제한적이고 상관관계가 있는 실험실 예측 변수가 존재하는 상황에서 과적합을 줄이기 위해 패널티 로지스틱 회귀분석을 기본 모델로 사용하였다. 모델은 R version 4.3.2에서 glmnet package version 4.1-8을 사용하여 이항 분포(binomial family), 표준화된 예측 변수, 그리고 alpha = 1로 지정된 최소 절대 수축 및 선택 연산자(LASSO) 패널티를 적용하여 적합되었다. 패널티 튜닝을 위해 무작위 시드(random seed)를 20260420으로 고정한 상태에서 10회 반복된 10겹 교차 검증을 수행하였다. 패널티 매개변수는 1-표준 오차 규칙(one-standard-error rule)을 사용하여 선택하였다. 계수 경로, 교차 검증 오차 값, 선택된 패널티 매개변수 및 유지된 예측 변수를 저장하였다. 분석 워크플로우는 그림 2에 표시되어 있다. 프로토콜에 사용된 소프트웨어, 통계 패키지, 데이터베이스 시스템 및 실험실 플랫폼은 재료 표에 나열되어 있다.
패널티가 적용된 선택 이후, 패널티가 없는 로지스틱 회귀 분석은 주요 추론 모델로 사용되지 않았습니다. 임상적 해석을 위해 오즈비(odds ratio)가 보고된 경우, 이는 선택 후의 기술적 추정치로 표기되었습니다. 판별력은 수신자 작동 특성 곡선 아래 면적(AUC-ROC)을 사용하여 추정하였으며, 95% 신뢰구간은 pROC 패키지 버전 1.18.5의 DeLong 방법을 사용하여 계산하였습니다. 보정(calibration)은 보정 절편, 보정 기울기, Brier 점수 및 보정 곡선을 통해 평가하였습니다. 개발 코호트에서는 1,000회 반복의 부트스트랩 재표본 추출을 사용하여 낙관주의-교정 성능을 추정하였습니다. 결정 곡선 분석(Decision-curve analysis)은 수정된 분석 세트에서 제외되었으므로, 원고에서 임상적 순이익에 관한 주장은 삭제되었습니다.
점수 도출 및 해석
점수 기반의 입원 생화학-응고 복합 점수는 고정된 페널티 모델 계수로부터 도출되었습니다. 모델 피팅 과정에서는 연속 변수가 사용되었습니다. 침상 옆 계산을 지원하기 위해 모델 최종 확정 후에만 범주화된 임계값이 도입되었습니다. 임계값은 기설정된 임상 참조 범위, 일반적으로 사용되는 실험실 이상치 임계값 또는 검증 전 개발 코호트에서 정의된 계수 기반 컷포인트에 따라 선택되었습니다. 검증 코호트에서 임계값 최적화는 수행되지 않았습니다.
고정 계수의 방향과 상대적 크기에 따라 정수 점수를 할당하였습니다. 점수가 높을수록 더 불량한 실험실 프로파일을 나타냈습니다. 총점은 유지된 성분들의 점수를 합산하여 계산하였습니다. 사전에 지정된 위험 범주는 오직 위험 층화(stratification)를 위해서만 사용되었으며, MODS를 정의하는 데 사용되지 않았습니다. 이 점수는 더 면밀한 관찰, 반복적인 실험실 평가 또는 장기 지원 경로 준비가 필요할 수 있는 환자를 식별하기 위한 목적으로 고안되었습니다. 이는 단독 진단 규칙, 항응고 요법의 트리거 또는 임상의의 재평가를 대체하는 수단으로 사용되지 않았습니다.
홀드아웃 검증 및 벤치마킹
고정된 전처리 규칙, 결측치 대체 구조, 윈저라이징 임계값, 표준화 파라미터, 모델 계수, 점수 산정 규칙 및 사전 지정된 컷오프 값을 홀드아웃 검증 코호트에 적용하였습니다. 추가적인 예측 변수 선별, 모델 재적합, 계수 재보정 또는 임계값 최적화는 수행하지 않았습니다. 검증 성능은 판별력, 보정력, Brier score, 민감도, 특이도, 양성 예측도 및 음성 예측도를 사용하여 요약하였습니다.
데이터를 사용할 수 있는 동일한 입원 기간을 기준으로 기설정된 중증도 도구들을 계산하였으며, 여기에는 Bedside Index for Severity in Acute Pancreatitis, Acute Physiology and Chronic Health Evaluation II 점수, Sequential Organ Failure Assessment 점수, Ranson 점수, Harmless Acute Pancreatitis Score 및 전신성 염증 반응 증후군 기준이 포함되었습니다. 비교에는 동일한 종점, 분석 대상군 및 검증 프레임워크가 사용되었습니다. 곡선 하 면적의 짝지은 비교는 DeLong 검정을 사용하여 수행되었습니다.
모든 검증 플롯 및 점수 층화 플롯은 고정된 분석 데이터 세트를 통해 생성되었습니다. 각 그림 패널의 표본 크기는 그림 작성 전 최종 분석 코호트, 개발 코호트, 보류 검증 코호트 또는 사전 지정된 점수 층과 대조하여 확인되었습니다. 고차원 오믹스, 생태학적 카운트 데이터 또는 차등 풍부도 분석을 위해 설계된 시각적 방법은 일반적인 임상 실험실 데이터에는 사용되지 않았습니다.
결과
코호트 특성 및 기저치 비교 가능성
최종 분석 코호트에는 급성 췌장염 환자 총 300명이 포함되었습니다. 미리 지정된 7:3 층화 무작위 분할(stratified hold-out split)에 따라 210명의 환자는 개발 코호트로, 90명의 환자는 홀드아웃 검증 코호트로 할당되었습니다. 포함된 모든 환자는 입원 후 24시간 이내에 적절한 생화학 및 응고 측정치 결과가 확인되었습니다.
기초 특성은 Table 1에 제시되어 있다. 개발 코호트와 홀드아웃 검증 코호트는 연령(54.0 years ± 16.4 years vs 55.3 years ± 15.2 years, P = 0.486), 성별 분포(남성: 61.9% vs 61.1%, P = 0.898), 체질량 지수(25.0 [22.6–27.9] kg/m2 vs 24.7 [22.2–27.5] kg/m2, P = 0.293), 증상 발현부터 입원까지의 시간(13.2 [7.1–22.6] h vs 12.8 [6.8–21.7] h, P = 0.612), 및 급성 췌장염 원인(P = 0.931) 측면에서 유사했다. 동반 질환, 입원 시 활력 징후, 전신성 염증 반응 증후군 상태, 급성 췌장염 중증도 침상 지수(BISA) 점수, 순차적 장기 부전 평가(SOFA) 점수, 그리고 나열된 입원 시 생화학 및 응고 변수 또한 두 코호트 간에 균형이 잡혀 있었다. 이러한 비교를 통해 홀드아웃 분할이 임상적으로 유의미한 기초 불균형을 초래하지 않았음을 확인하였다.
MODS 상태에 따른 입원 시 생화학 및 응고 프로필
300명의 환자 중 50명은 입원 중 다장기부전증후군(MODS)이 발생하였고, 250명은 발생하지 않았습니다. MODS 상태에 따른 입원 시 생화학 및 응고 프로필은 표 2에 요약되어 있습니다. MODS가 발생하지 않은 환자와 비교하여, MODS가 발생한 환자는 백혈구 수(14.4 × 10⁹/L ± 5.2 × 10⁹/L vs 12.3 × 10⁹/L ± 4.6 ×10⁹/L, P = 0.008), 중성구-림프구 비율(13.4 [9.1–21.3] vs 9.0 [5.9–14.2], P < 0.001), C-반응성 단백질(138.6 [86.9–226.7] mg/L vs 61.4 [29.2–123.8] mg/L, P < 0.001), 프로칼시토닌(1.25 [0.56–3.28] ng/mL vs 0.43 [0.18–1.02] ng/mL, P < 0.001), 젖산(2.7 [2.0–4.0] mmol/L vs 1.7 [1.2–2.4] mmol/L, P = 0.004) 및 포도당(11.2 [8.9–15.1] mmol/L vs 8.9 [7.3–11.4] mmol/L, P = 0.010) 수치가 더 높았습니다.
MODS 군은 칼슘(1.96 mmol/L ± 0.21 mmol/L vs 2.06 mmol/L ± 0.17 mmol/L, P = 0.013)과 알부민(32.5 g/L ± 5.6 g/L vs 35.9 g/L ± 4.8 g/L, P < 0.001) 수치가 더 낮게 나타났으며, 혈중 요소 질소(9.4 [7.4–13.2] mmol/L vs 6.6 [5.1–8.9] mmol/L, P < 0.001), 크레아티닌(108.9 [84.7–163.4] µmol/L vs 77.1 [62.4–97.6] µmol/L, P < 0.001), 총 빌리루빈(22.1 [14.2–38.9] µmol/L vs 18.6 [12.3–31.7] µmol/L, P = 0.038), 그리고 젖산 탈수소효소(372.4 [289.8–512.3] U/L vs 254.6 [203.2–329.1] U/L, P < 0.001) 수치는 더 높게 나타났다. 프로트롬빈 시간, 프로트롬빈 시간-국제 표준화 비율, 활성화 부분 트롬보플라스틴 시간 및 D-dimer 또한 MODS 군에서 더 높았다. 혈소판 수(P = 0.096)와 피브리노겐(P = 0.268)은 군 간에 유의미한 차이가 없었다. 이러한 비교는 기술적 분석이며 예측 인자 선정에 단독으로 사용되지 않았다.
초기 결과 패턴 및 점수 관련 경향
다기관 기능부전 증후군 상태에 따른 가공되지 않은 임상 결과가 그림 3에 제시되어 있습니다. 다기관 기능부전 증후군이 발생한 환자는 다기관 기능부전 증후군이 발생하지 않은 환자보다 입원 기간이 더 길었습니다(그림 3A). 또한 이들은 중환자실 입원(그림 3B), 기계적 환기(그림 3C), 신대체 요법(그림 3D), 감염성 괴사 또는 배액술 시행(그림 3E), 그리고 원내 사망률(그림 3F) 비율이 더 높았습니다. 모든 패널은 확정된 300명의 환자 분석 코호트를 바탕으로 작성되었습니다.
사전에 지정된 점수 기반 복합 점수 층별로 관찰된 임상 결과는 그림 4에 제시되어 있습니다. 다기관 기능 부전 증후군의 발생률은 저위험, 중위험, 고위험 및 초고위험군에 걸쳐 점진적으로 증가했습니다(그림 4A). 중환자실 입원(그림 4B), 원내 사망률(그림 4C), 그리고 감염성 괴사 또는 배액 술식(그림 4D)에서도 이와 유사한 순차적 증가가 관찰되었습니다. 입원 기간 또한 4가지 점수 층에 따라 증가했습니다(그림 4E). 이러한 경향은 다기관 기능 부전 증후군 발생률과 중환자실 입원에서 가장 뚜렷하게 나타났습니다. 모든 패널은 사전에 지정된 점수 범주를 사용하여 고정된 분석 데이터 세트로부터 생성되었습니다.
수정된 Atlanta 중증도 범주에 따른 점수 기반 복합 점수의 분포가 그림 5에 나타나 있습니다. 복합 점수의 중앙값은 경증, 중등도 중증 및 중증 급성 췌장염에 따라 점진적으로 증가했으며, 이는 입원 시 생화학-응고 점수와 확립된 임상 중증도 범주 사이에 일치성이 있음을 나타냅니다. 그림 5는 동일하게 고정된 300명의 환자 분석 코호트를 통해 생성되었습니다. 서열화, 차이 풍부도, 화산 플롯, q-값, Bray–Curtis 거리 또는 주좌표 분석 시각화는 사용되지 않았습니다.
벌점 모델 개발 및 유지된 예측 인자
벌점 모델 개발은 개발 코호트에서만 수행되었습니다. 후보 입원 예측 인자의 계수 궤적은 그림 6A에 나타나 있으며, 벌점 매개변수 선택에 사용된 반복 10겹 교차 검증 곡선은 그림 6B에 나타나 있습니다. 1-표준 오차 규칙을 사용하여 선택된 벌점 매개변수에서, 라소(least absolute shrinkage and selection operator) 벌점 방식은 albumin, blood urea nitrogen, creatinine, calcium, lactate dehydrogenase, prothrombin time–international normalized ratio, D-dimer, platelet count, glucose의 9가지 입원 예측 인자를 유지했습니다.
유지된 예측 변수와 선택 후 기술적 추정치는 표 3에 제시되어 있습니다. 이러한 추정치는 임상적 해석을 돕기 위해 보고되었으며, 패널티 선택 후의 확정적 추론으로 처리되지 않았습니다. 연관성의 방향은 임상적으로 일관되었습니다. 즉, 낮은 알부민, 높은 혈중 요소 질소, 높은 크레아티닌, 낮은 칼슘, 높은 젖산 탈수소효소, 높은 프로트롬빈 시간-국제 표준화 비율, 높은 D-dimer, 낮은 혈소판 수 및 높은 포도당이 MODS 위험 증가와 연관되어 있었습니다. 선택 후 기술적 추정치는 다음과 같았습니다. 알부민 5 g/L 감소당 오즈비 1.29 (95% 신뢰구간 1.13–1.47); 혈중 요소 질소 1 mmol/L 증가당 오즈비 1.12 (1.06–1.18); 크레아티닌 10 µmol/L 증가당 오즈비 1.05 (1.02–1.09); 칼슘 0.1 mmol/L 감소당 오즈비 1.18 (1.07–1.30); 젖산 탈수소효소 100 U/L 증가당 오즈비 1.21 (1.07–1.37); 프로트롬빈 시간-국제 표준화 비율 0.1 증가당 오즈비 1.14 (1.05–1.25); D-dimer 1.0 mg/L fibrinogen-equivalent units 증가당 오즈비 1.09 (1.02–1.17); 혈소판 수 50 × 109/L 감소당 오즈비 1.16 (1.01–1.34); 그리고 포도당 1 mmol/L 증가당 오즈비 1.05 (1.00–1.10)였습니다.
점수 기반 복합 점수의 구성
점수 기반 입원 생화학-응고 복합 점수를 구성하는 데 사용된 규칙은 표 4에 제시되어 있습니다. 이 점수는 고정된 페널티 모델의 계수로부터 도출되었으며, 병상 옆에서 계산할 수 있도록 임상적으로 해석 가능한 범주로 변환되었습니다. 알부민, 혈중 요소 질소, 크레아티닌, 칼슘, 젖산 탈수소효소, 프로트롬빈 시간, 국제 표준화 비율, D-dimer 및 혈소판 수의 8가지 변수가 핵심 점수 구성 요소로 포함되었습니다. 포도당의 경우, 다기관 기능부전 증후군과의 연관성 방향은 고정된 모델과 일치했으나, 핵심 생화학 및 응고 변수에 비해 기여도가 낮았기 때문에 선택적 수정 인자로 유지되었습니다.
잠금 처리된 패널티 모델(locked penalized model)에 의해 유지된 9가지 예측 인자를 모두 통합한 노모그램이 그림 7에 제시되어 있습니다. 이 노모그램은 입원 시 albumin, blood urea nitrogen, creatinine, calcium, lactate dehydrogenase, prothrombin time-international normalized ratio, D-dimer, platelet count 및 glucose 수치를 기반으로 다기관 기능 부전 증후군의 확률에 대한 개별화된 추정치를 제공합니다. 노모그램은 해석 보조 도구로 포함되었으며, 점수 기반의 복합 점수는 일상적으로 이용 가능한 입원 시 실험실 측정값으로부터 직접 계산할 수 있기 때문에 주요한 실무적 병상 도구로 유지되었습니다.
모델 성능 및 내부 검증
개발 및 홀드아웃 검증 코호트에서의 모델 성능은 표 5에 제시되어 있습니다. 페널티 항이 포함된 페널티 로지스틱 모델은 개발 코호트에서 0.873 (95% 신뢰 구간 0.820–0.926), 홀드아웃 검증 코호트에서 0.836 (0.751–0.921)의 ROC 곡선 하 면적(AUC)을 달성했습니다. Brier 점수는 개발 코호트에서 0.117, 홀드아웃 검증 코호트에서 0.139였습니다. 보정 절편과 기울기는 개발 코호트에서 각각 0.04 (−0.08–0.16) 및 0.97 (0.79–1.18)였으며, 홀드아웃 검증 코호트에서는 0.08 (−0.14–0.30) 및 0.91 (0.68–1.15)였습니다.
사전에 지정된 예측 위험 컷오프 값 0.18에서, 해당 모델은 개발 코호트에서 0.82의 민감도와 0.77의 특이도를 보였으며, 홀드아웃 검증 코호트에서는 0.75와 0.74를 나타냈습니다. 양성 및 음성 예측도는 개발 코호트에서 0.39 및 0.96, 홀드아웃 검증 코호트에서 0.39 및 0.93이었습니다. 점수 기반 복합 점수는 고정된 패널티 모델보다 판별력은 낮았으나, 수신자 조작 특성 곡선 아래 면적(AUC) 값이 개발 코호트에서 0.823, 홀드아웃 검증 코호트에서 0.783으로 유용한 스크리닝 성능을 유지했습니다. 사전에 지정된 컷오프 값인 ≥8점에서, 해당 점수는 개발 코호트와 홀드아웃 검증 코호트에서 각각 0.93과 0.91의 음성 예측도를 보였습니다.
기존 중증도 점수와의 벤치마킹
기존 중증도 평가 도구와의 벤치마킹 비교 결과는 Table 6에 나타나 있다. 고정된 입원 시 생화학-응고 모델은 두 코호트 모두에서 Ranson score, Harmless Acute Pancreatitis Score, 그리고 전신성 염증 반응 증후군(systemic inflammatory response syndrome) 기준보다 더 높은 판별력을 보였다. 개발 코호트에서, 해당 모델은 DeLong 테스트 결과 Sequential Organ Failure Assessment score와 유의미한 차이가 없었으나 (P = 0.12), Acute Physiology and Chronic Health Evaluation II score (P = 0.03), Bedside Index for Severity in Acute Pancreatitis score (P = 0.01), Ranson score (P < 0.001), Harmless Acute Pancreatitis Score (P < 0.001), 그리고 전신성 염증 반응 증후군 기준 (P < 0.001)보다는 더 높은 판별력을 보였다. 홀드아웃 검증 코호트에서는 Sequential Organ Failure Assessment score (P = 0.34), Acute Physiology and Chronic Health Evaluation II score (P = 0.08), 또는 Bedside Index for Severity in Acute Pancreatitis score (P = 0.05)와 비교했을 때 유의미한 차이가 없었으나, Ranson score (P = 0.02), Harmless Acute Pancreatitis Score (P = 0.01), 그리고 전신성 염증 반응 증후군 기준 (P = 0.02)에 대해서는 유의미한 차이가 유지되었다.
점수 기반의 위험 층화
위험 층화 결과는 Table 7에 제시되어 있다. 환자들은 저위험(0–4점), 중등도 위험(5–8점), 고위험(9–12점) 및 초고위험(≥13점) 점수 군으로 분류되었다. MODS 발생률은 저위험군의 3.5% (4/115)에서 중등도 위험군 8.9% (9/101), 고위험군 33.3% (20/60), 초고위험군 70.8% (17/24)로 증가하였다. 중환자실 입원율은 4개 군에 걸쳐 8.7%에서 23.8%, 60.0%, 83.3%로 증가하였다. 원내 사망률은 0.9%에서 2.0%, 10.0%, 25.0%로 증가하였으며, 감염성 괴사 또는 배액술 시행률은 2.6%에서 8.9%, 23.3%, 33.3%로 증가하였다. 입원 기간 중앙값은 저위험군의 7.6 (5.2–10.4)일에서 위험도가 높은 군들로 갈수록 11.4 (8.0–16.5), 18.6 (13.0–26.8), 24.9 (17.5–37.2)일로 증가하였다.
민감도 분석
민감도 분석 결과는 부록 표 2에 요약되어 있습니다. 이 분석들은 주요 결과가 결측 데이터 처리 방식이나 기저치 할당 방식에 따라 달라지는지 평가하였습니다. 완전 사례 분석(complete-case analysis)에서 유지된 예측 인자와 연관성 방향은 1차 대체 분석(imputed analysis)과 일치했습니다. 판별력은 약간만 변화하였으며, 수신자 조작 특성 곡선 아래 면적(AUC)은 개발 코호트에서 0.861, 홀드아웃 검증 코호트에서 0.821이었습니다. 초기값 대신 첫 24시간 이내의 가장 좋지 않은 적격 실험실 수치를 사용한 기저치 민감도 분석에서, 모델은 수신자 조작 특성 곡선 아래 면적 값이 개발 코호트에서 0.879, 홀드아웃 검증 코호트에서 0.829로 나타났습니다. 점수 층화 MODS 발생률은 두 민감도 분석 모두에서 저위험, 중등도 위험, 고위험 및 초고위험군에 걸쳐 순서대로 유지되었습니다. 이러한 결과는 입원 시 생화학-응고 워크플로우가 미리 지정된 전처리 대안들에 의해 실질적으로 변경되지 않았음을 나타냅니다.
데이터 가용성:
주요 분석을 재현하는 데 사용된 비식별 데이터 세트는 데이터 사전, 단위 변환 표 및 분석 스크립트와 함께 고유 데이터 식별자 https://doi.org/10.6084/m9.figshare.32565768.v1가 지정된 Figshare에 저장되었습니다. 데이터 저장 전 직접적인 환자 식별 정보는 제거되었으며, 센터 식별 정보는 기관의 데이터 보호 요구 사항에 따라 코딩되었습니다. 해당 저장소에는 본 원고에 보고된 코호트 설명, 예측 변수 전처리, 모델 개발, 점수 구축, 홀드아웃 검증, 벤치마킹 분석, 민감도 분석 및 수치 결과물을 재현하는 데 필요한 파일들이 포함되어 있습니다.
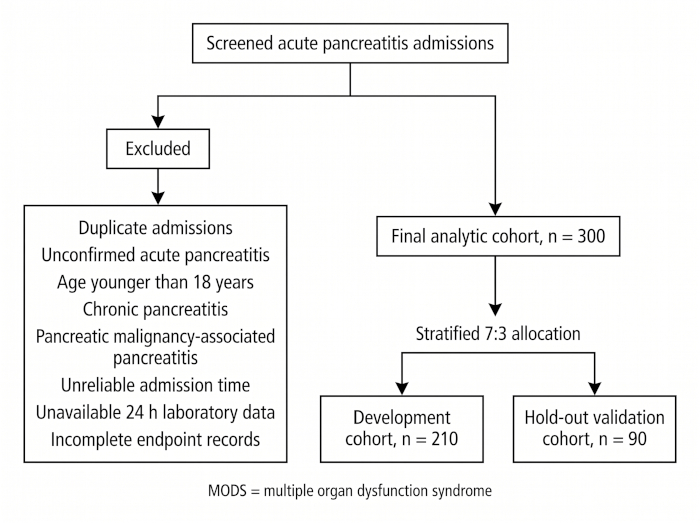
그림 1: 환자 스크리닝 및 코호트 할당. 이 흐름도는 참여 센터 전체에서 스크리닝된 연속적인 급성 췌장염 입원 환자, 제외 사유, 최종 분석 코호트, 그리고 개발 코호트와 홀드아웃 검증 코호트로 7:3 비율로 층화 할당된 과정을 보여준다. 개발 코호트는 210명의 환자로 구성되었으며, 홀드아웃 검증 코호트는 90명의 환자로 구성되었다. MODS는 다장기 기능 부전 증후군을 의미한다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
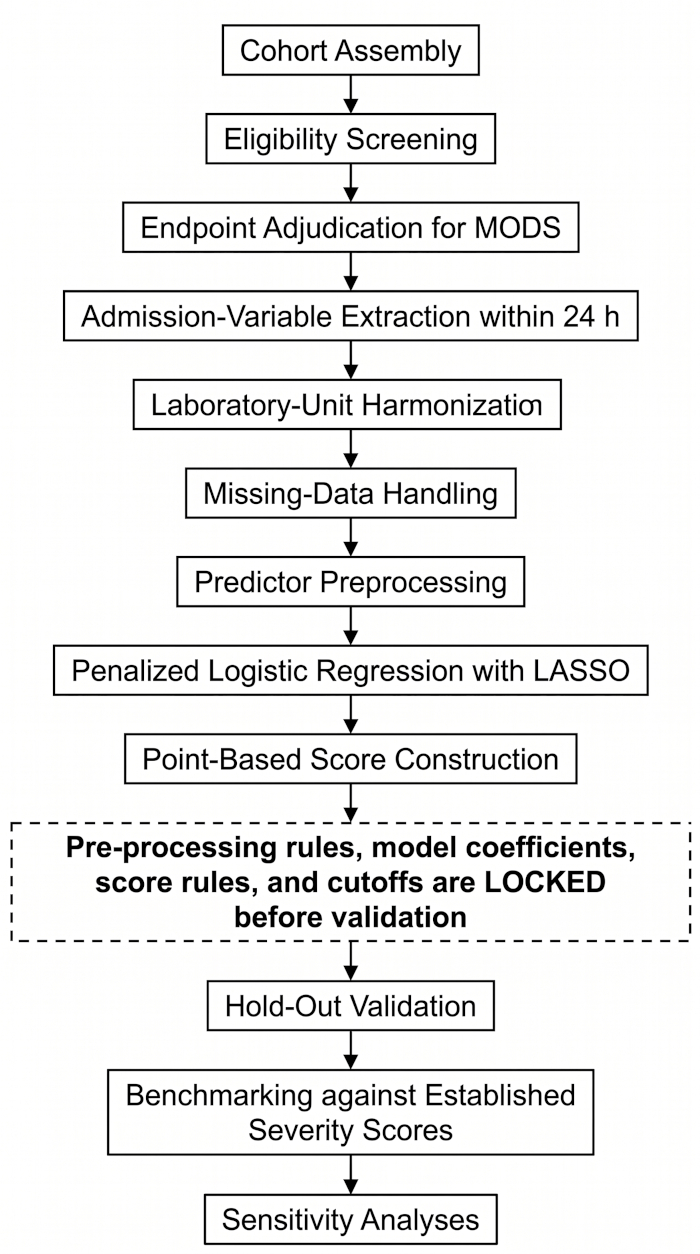
그림 2: 입원 시 생화학-응고 점수 개발을 위한 재현 가능한 분석 워크플로우. 이 모식도는 코호트 구성, 적격성 스크리닝, 종점 판정, 입원 변수 추출, 실험실 단위 표준화, 결측치 처리, 예측 변수 전처리, 페널티 모델 개발, 포인트 기반 점수 구성 및 고정된 홀드아웃 검증 과정을 요약하고 있습니다. 모든 전처리 규칙, 모델 계수, 점수 구성 절차 및 컷오프 정의는 홀드아웃 검증 코호트에서 평가하기 전 개발 코호트에서 수립되었습니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
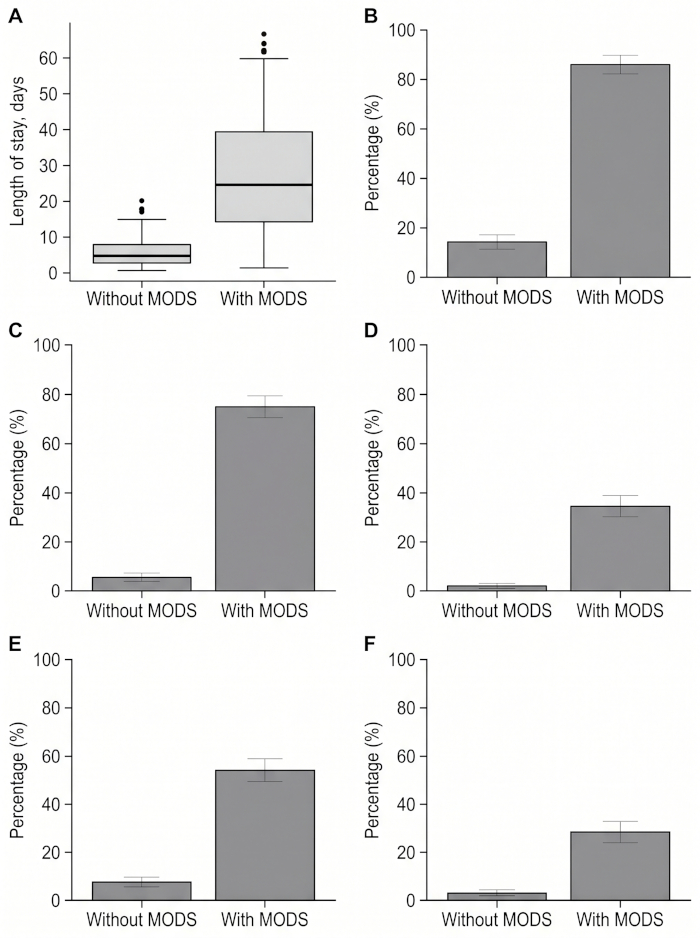
그림 3: 다기관 기능부전 증후군 상태에 따른 조 임상 결과. (A) 다기관 기능부전 증후군이 없는 환자와 있는 환자의 입원 기간. (B) 다기관 기능부전 증후군 상태에 따른 중환자실 입원율. (C) 다기관 기능부전 증후군 상태에 따른 기계적 환기율. (D) 다기관 기능부전 증후군 상태에 따른 신대체 요법 시행률. (E) 다기관 기능부전 증후군 상태에 따른 감염성 괴사 또는 배농 술식 시행률. (F) 다기관 기능부전 증후군 상태에 따른 원내 사망률. 모든 패널은 확정된 300명의 분석 코호트를 통해 생성되었습니다. MODS는 다기관 기능부전 증후군을, ICU는 중환자실을 나타냅니다. 여기에서 이 그림의 확대 버전을 확인하십시오.
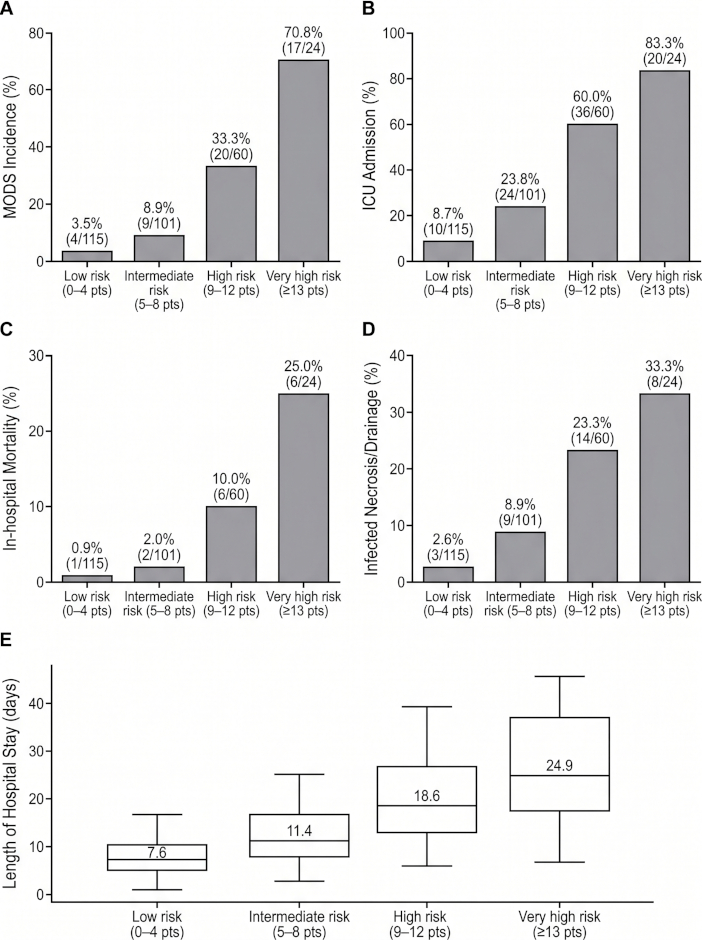
그림 4: 포인트 기반 복합 점수 층에 따른 관찰된 결과 발생률. (A) 저위험, 중등도 위험, 고위험 및 초고위험 군에서의 다장기 부전 증후군 발생률. (B) 4개 점수 층에 따른 중환자실 입원율. (C) 4개 점수 층에 따른 원내 사망률. (D) 4개 점수 층에 따른 감염성 괴사 또는 배액술 시행률. (E) 4개 점수 층에 따른 입원 기간. 모든 패널은 저위험(0–4점), 중등도 위험(5–8점), 고위험(9–12점), 초고위험(≥13점)으로 사전 정의된 점수 범주를 사용하여 확정된 분석 데이터셋으로부터 생성되었습니다. MODS는 다장기 부전 증후군을, ICU는 중환자실을 나타냅니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
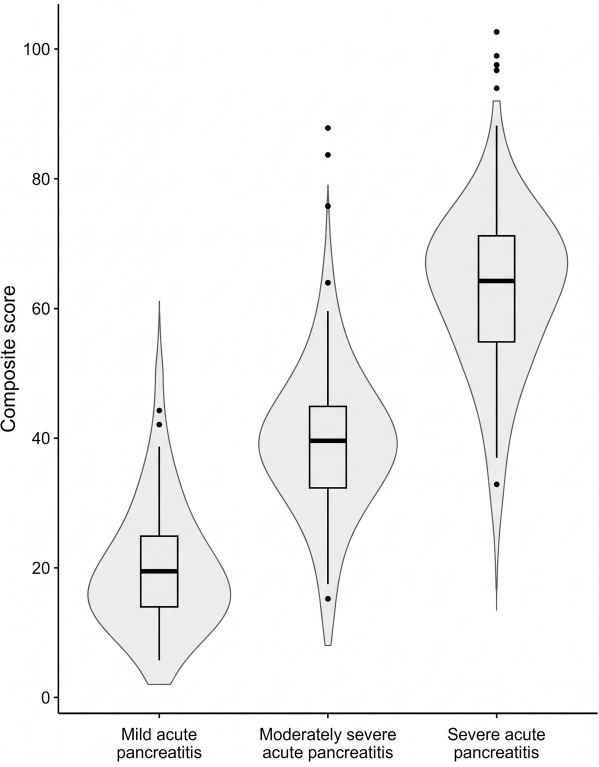
그림 5: 개정된 Atlanta 중증도 범주에 따른 점수 기반 복합 점수의 분포. 경증, 중등도 중증 및 중증 급성 췌장염 환자의 복합 점수 분포를 나타낸 것이다. 복합 점수는 세 가지 중증도 범주에 따라 점진적으로 상승했으며, 이는 입원 시 생화학-응고 점수와 개정된 Atlanta 중증도 분류 사이에 일치성이 있음을 나타낸다. 본 도표는 확정된 300명의 환자 분석 코호트를 통해 생성되었다. AP는 급성 췌장염을 의미한다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
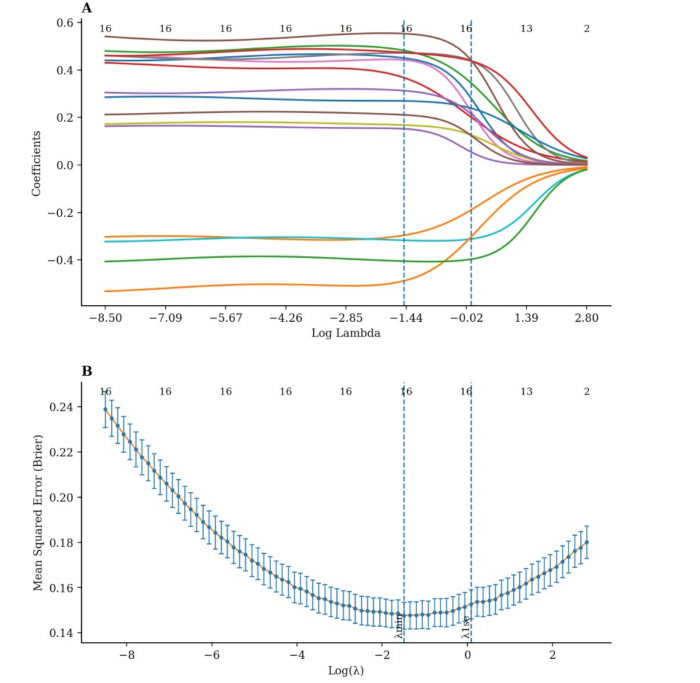
그림 6: 개발 코호트에서의 패널티 모델 개발. (A) 후보 입원 생화학 및 응고 예측 인자에 대한 최소 절대 수축 및 선택 연산자(LASSO) 계수 궤적. (B) 패널티 매개변수를 선택하기 위해 반복 10-겹 교차 검증 결과를 사용하였다. 점수 생성 및 홀드아웃 검증을 위한 간결한 고정 모델을 얻기 위해 1-표준 오차 규칙을 적용하였다. LASSO는 least absolute shrinkage and selection operator를, PT-INR은 프로트롬빈 시간-국제 표준 비율을 나타낸다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
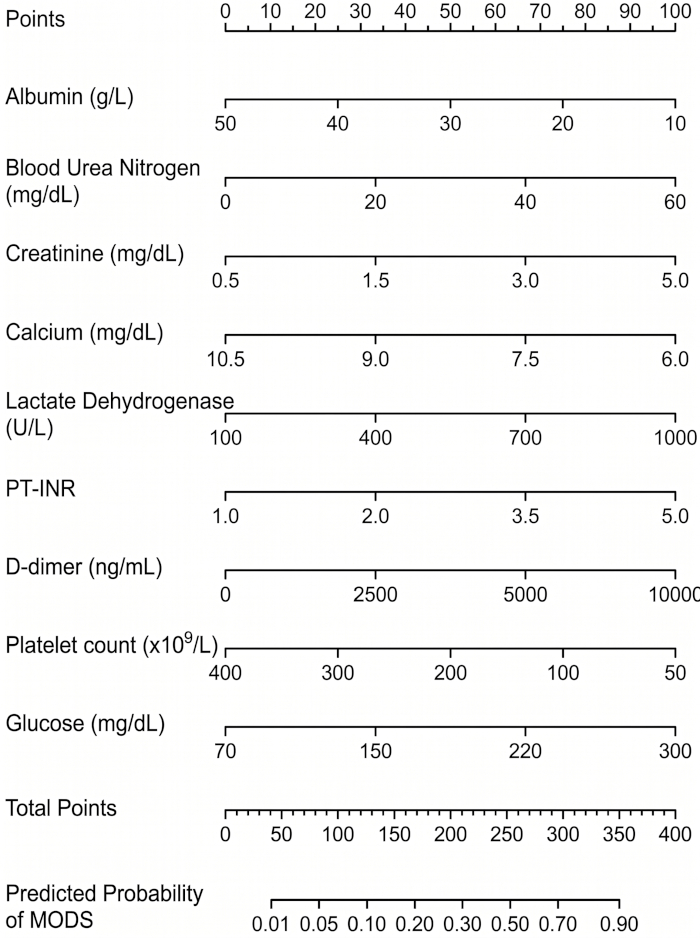
그림 7: 개별 위험도 추정을 위해 고정된 예측 모델을 기반으로 작성한 노모그램. 이 노모그램에는 고정된 페널티 모델에 의해 유지된 9가지 입원 예측 변수인 albumin, blood urea nitrogen, creatinine, calcium, lactate dehydrogenase, prothrombin time–international normalized ratio, D-dimer, platelet count 및 glucose가 포함되어 있습니다. 각 예측 변수는 총점에 점수를 부여하며, 이 총점은 다발성 장기 기능 부전 증후군의 추정 확률과 일치합니다. 노모그램은 해석 보조 도구로 포함되었으며, 점수 기반의 복합 점수가 주요한 실제 병상 도구로 사용되었습니다. MODS는 multiple organ dysfunction syndrome, PT-INR은 prothrombin time-international normalized ratio, FEU는 fibrinogen-equivalent units를 나타냅니다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
| 변수 | 개발 코호트 n=210 | 홀드아웃 검증 코호트 n=90 | p-값 |
| 연령, 세 | 54.0 ± 16.4 | 55.3 ± 15.2 | 0.486 |
| 남성, n (%) | 130 (61.9) | 55 (61.1) | 0.898 |
| 체질량 지수, kg/m² | 25.0 (22.6–27.9) | 24.7 (22.2–27.5) | 0.293 |
| 증상 발현부터 입원까지의 시간, h | 13.2 (7.1–22.6) | 12.8 (6.8–21.7) | 0.612 |
| 원인, n (%) | 0.931 | ||
| 담즙의 | 89 (42.4) | 38 (42.2) | |
| 고중성지방혈증 | 65 (31.0) | 29 (32.2) | |
| 알코올 관련 | 19 (9.0) | 8 (8.9) | |
| 특발성 | 25 (11.9) | 11 (12.2) | |
| 기타 | 12 (5.7) | 4 (4.4) | |
| 췌장염 기왕력, n (%) | 31 (14.8) | 12 (13.3) | 0.742 |
| 흡연력, n (%) | 58 (27.6) | 24 (26.7) | 0.868 |
| 당뇨병, n (%) | 37 (17.6) | 17 (18.9) | 0.795 |
| 고혈압, n (%) | 62 (29.5) | 28 (31.1) | 0.784 |
| 만성 신장질환, n (%) | 8 (3.8) | 4 (4.4) | 0.797 |
| 입원 시 심박수, beats/min | 92.4 ± 15.8 | 93.1 ± 16.2 | 0.726 |
| 평균 동맥압, mmHg | 88.6 ± 12.4 | 87.9 ± 11.8 | 0.65 |
| 전신성 염증 반응 증후군, n (%) | 72 (34.3) | 30 (33.3) | 0.871 |
| 급성 췌장염 중증도 평가를 위한 Bedside Index for Severity in Acute Pancreatitis 점수 | 1.0 (0.0–2.0) | 1.0 (0.0–2.0) | 0.842 |
| 순차적 장기 부전 평가 점수 | 1.0 (0.0–2.0) | 1.0 (0.0–2.0) | 0.796 |
| 급성 생리학 및 만성 건강 평가 II 점수 | 7.0 (5.0–10.0) | 7.0 (5.0–10.0) | 0.884 |
| 다장기 부전 증후군, n (%) | 35 (16.7) | 15 (16.7) | 1 |
| 백혈구 수, ×10⁹/L | 12.8 ± 4.7 | 12.9 ± 4.9 | 0.865 |
| C-반응성 단백질, mg/L | 70.6 (32.8–141.5) | 72.4 (35.1–145.9) | 0.778 |
| 포도당, mmol/L | 9.1 (7.4–11.8) | 9.0 (7.2–11.6) | 0.691 |
| 총 칼슘, mmol/L | 2.05 ± 0.18 | 2.04 ± 0.19 | 0.672 |
| 혈중 요소 질소, mmol/L | 6.9 (5.2–9.4) | 7.1 (5.3–9.6) | 0.584 |
| 크레아티닌, μmol/L | 80.2 (64.5–104.8) | 81.1 (65.1–106.2) | 0.731 |
| 알부민, g/L | 35.2 ± 5.1 | 35.0 ± 5.0 | 0.754 |
| 젖산탈수소효소, U/L | 270.8 (212.5–356.7) | 275.6 (216.2–361.4) | 0.637 |
| 프로트롬빈 시간-국제 표준화 비율 | 1.09 (1.02–1.18) | 1.10 (1.03–1.19) | 0.694 |
| D-dimer, mg/L 피브리노겐 등가 단위 | 1.84 (0.92–3.82) | 1.91 (0.95–3.96) | 0.744 |
| 혈소판 수, ×10⁹/L | 203.6 ± 68.4 | 201.8 ± 66.9 | 0.836 |
표 1: 개발 및 홀드아웃 검증 코호트 환자의 기본 특성. 개발 코호트와 홀드아웃 검증 코호트 간의 기본 인구통계학적, 임상적, 중증도 점수, 생화학 및 응고 변수를 비교하였다. 연속형 변수는 평균 ± 표준 편차 또는 중앙값(사분위수 범위)으로 표시하였으며, 범주형 변수는 n (%)로 표시하였다. P 값은 코호트 간의 기술적 비교를 위해 사용되었다.
| 변수 | 비-MODS군 n = 250 | MODS 군 n = 50 | P 값 |
| 백혈구 수, ×10⁹/L | 12.3 ± 4.6 | 14.4 ± 5.2 | 0.008 |
| 호중구-림프구 비율 | 9.0 (5.9–14.2) | 13.4 (9.1–21.3) | <0.001 |
| C-반응성 단백질, mg/L | 61.4 (29.2–123.8) | 138.6 (86.9–226.7) | <0.001 |
| 프로칼시토닌, ng/mL | 0.43 (0.18–1.02) | 1.25 (0.56–3.28) | <0.001 |
| 젖산, mmol/L | 1.7 (1.2–2.4) | 2.7 (2.0–4.0) | 0.004 |
| 포도당, mmol/L | 8.9 (7.3–11.4) | 11.2 (8.9–15.1) | 0.01 |
| 총 칼슘, mmol/L | 2.06 ± 0.17 | 1.96 ± 0.21 | 0.013 |
| 혈중 요소 질소, mmol/L | 6.6 (5.1–8.9) | 9.4 (7.4–13.2) | <0.001 |
| 크레아티닌, μmol/L | 77.1 (62.4–97.6) | 108.9 (84.7–163.4) | <0.001 |
| 알라닌 아미노전이효소, U/L | 46.2 (25.6–93.8) | 58.7 (31.5–119.4) | 0.084 |
| 총 빌리루빈, μmol/L | 18.6 (12.3–31.7) | 22.1 (14.2–38.9) | 0.038 |
| 알부민, g/L | 35.9 ± 4.8 | 32.5 ± 5.6 | <0.001 |
| 젖산탈수소효소, U/L | 254.6 (203.2–329.1) | 372.4 (289.8–512.3) | <0.001 |
| 혈소판 수, ×10⁹/L | 207.4 ± 67.2 | 190.3 ± 72.5 | 0.096 |
| 프로트롬빈 시간, s | 12.7 (11.8–13.9) | 14.1 (12.9–15.7) | 0.002 |
| 프로트롬빈 시간-국제 표준화 비율 | 1.08 (1.02–1.16) | 1.22 (1.10–1.38) | 0.002 |
| 활성화 부분 트롬보플라스틴 시간, 초 | 31.8 (28.4–36.5) | 36.9 (31.7–42.8) | 0.006 |
| 피브리노겐, g/L | 4.12 ± 1.18 | 4.31 ± 1.29 | 0.268 |
| D-dimer, mg/L 피브리노겐 등가 단위 | 1.48 (0.78–3.16) | 4.62 (2.10–8.95) | <0.001 |
표 2: 다장기 기능 부전 증후군 상태에 따른 입원 시 생화학 및 응고 프로파일. 실험실 지표는 병원 입원 후 24시간 이내에 측정된 최초의 적격 측정값을 나타냅니다. 연속 변수는 평균 ± 표준 편차 또는 중앙값(사분위 범위)으로 표시됩니다. P 값은 다장기 기능 부전 증후군이 발생한 환자와 그렇지 않은 환자 간의 서술적 비교 결과입니다. 이러한 비교는 입원 시의 차이점을 특성화하기 위해 사용되었으며, 예측 인자 선택을 위한 단독 근거로 사용되지 않았습니다.
| 고정 모델에 유지된 예측 변수 | MODS 위험 증가와 관련된 방향 | 해석을 위한 척도 단위 | 기술적 오즈비 | 95% 신뢰 구간 | 모델링 역할 |
| 알부민 | 낮은 값 | 5 g/L 감소당 | 1.29 | 1.13–1.47 | 핵심 점수 구성 요소 |
| 혈액 요소 질소 | 높은 값 | 1 mmol/L 증가당 | 1.12 | 1.06–1.18 | 핵심 점수 구성 요소 |
| 크레아티닌 | 높은 값 | 10 μmol/L 증가당 | 1.05 | 1.02–1.09 | 핵심 점수 구성 요소 |
| 총 칼슘 | 낮은 값 | 0.1 mmol/L 감소당 | 1.18 | 1.07–1.30 | 핵심 점수 구성 요소 |
| 젖산 탈수소효소 | 높은 값 | 100 U/L 증가당 | 1.21 | 1.07–1.37 | 핵심 점수 구성 요소 |
| 프로트롬빈 시간-국제 표준화 비율 | 높은 값 | 0.1 증가당 | 1.14 | 1.05–1.25 | 핵심 점수 구성 요소 |
| D-dimer | 높은 값 | 1.0 mg/L fibrinogen-equivalent units 증가당 | 1.09 | 1.02–1.17 | 핵심 점수 구성 요소 |
| 혈소판 수 | 낮은 값 | 50 × 10⁹/L 감소당 | 1.16 | 1.01–1.34 | 핵심 점수 구성 요소 |
| 포도당 | 높은 값 | 1 mmol/L 증가당 | 1.05 | 1.00–1.10 | 선택적 수정 변수 |
표 3: 고정된 페널티 모델에서 유지된 예측 변수 및 기술적 선택 후 추정치.이 표는 고정된 최소 절대 수축 및 선택 연산자(lasso) 페널티 로지스틱 모델에 의해 유지된 예측 변수와 임상적 해석을 위한 기술적 선택 후 추정치를 보여줍니다. 오즈비(Odds ratios)는 표시된 스케일 단위로 제시되었습니다. 이러한 추정치는 페널티 선택 후의 확증적 추론으로 처리되지 않습니다.
| 점수 구성 요소 | 카테고리 | 할당된 점수 |
| 알부민, g/L | ≥38 | 0 |
| 34–37.9 | 1 | |
| 30–33.9 | 2 | |
| <30 | 3 | |
| 혈중 요소를 함유한 질소, mmol/L | <6.5 | 0 |
| 6.5–8.9 | 1 | |
| 9.0–12.9 | 2 | |
| ≥13.0 | 3 | |
| 크레아티닌, μmol/L | <80 | 0 |
| 80–109 | 1 | |
| 110–169 | 2 | |
| ≥170 | 3 | |
| 총 칼슘, mmol/L | ≥2.10 | 0 |
| 2.00–2.09 | 1 | |
| 1.90–1.99 | 2 | |
| <1.90 | 3 | |
| 젖산탈수소효소, U/L | <250 | 0 |
| 250–349 | 1 | |
| 350–499 | 2 | |
| ≥500 | 3 | |
| 프로트롬빈 시간-국제 표준화 비율 | <1.10 | 0 |
| 1.10–1.19 | 1 | |
| 1.20–1.39 | 2 | |
| ≥1.40 | 3 | |
| D-dimer, mg/L 피브리노겐 등가 단위 | <1.0 | 0 |
| 1.0–2.9 | 1 | |
| 3.0–5.9 | 2 | |
| ≥6.0 | 3 | |
| 혈소판 수, ×10⁹/L | ≥200 | 0 |
| 150–199 | 1 | |
| 100–149 | 2 | |
| <100 | 3 | |
| 포도당, mmol/L | <10.0 | 0 |
| ≥10.0 | 1 |
표 4: 입원 시 생화학-응고 복합 점수의 구성.
점수 기반의 복합 점수는 고정된 패널티 모델로부터 도출되었으며, 임상적으로 해석 가능한 병상 분류 단계로 변환되었습니다. 점수는 유지된 예측 변수의 방향성과 상대적 기여도에 따라 할당되었습니다. 총점은 유지된 모든 점수 구성 요소를 합산하여 계산합니다. 포도당은 핵심 생화학-응고 구성 요소보다 연관성이 약했으나, 위험 증가와 방향성이 일치했으므로 선택적 보정 변수로 유지되었습니다.
| 도구 | 코호트 | 곡선 아래 면적 | 브라이어 점수(Brier score) | 검정 절편 | 검정 곡선 기울기 | 컷오프 | 민감도 | 특이도 | 양성 예측도 | 음성 예측도(NPV) |
| (95% 신뢰구간) | (95% 신뢰구간) | (95% 신뢰구간) | ||||||||
| 고정 페널티 모델 | 개발 코호트 | 0.873 (0.820–0.926) | 0.117 | 0.04 (−0.08 ~ 0.16) | 0.97 (0.79–1.18) | 예측 위험도 ≥0.18 | 0.82 | 0.77 | 0.39 | 0.96 |
| 고정 패널티 모델 | 홀드아웃 검증 코호트 | 0.836 (0.751–0.921) | 0.139 | 0.08 (−0.14 ~ 0.30) | 0.91 (0.68–1.15) | 예측 위험도 ≥0.18 | 0.75 | 0.74 | 0.39 | 0.93 |
| 점수 기반 종합 점수 | 개발 코호트 | 0.823 (0.758–0.888) | 0.132 | 해당 사항 없음 | 해당 사항 없음 | 8점 이상 | 0.76 | 0.72 | 0.35 | 0.93 |
| 점수 기반 복합 점수 | 홀드아웃 검증 코호트 | 0.783 (0.684–0.882) | 0.151 | 해당 사항 없음 | 해당 사항 없음 | 8점 이상 | 0.7 | 0.69 | 0.31 | 0.91 |
표 5: 고정된 패널티 모델 및 점수 기반 복합 점수의 성능. 개발 코호트와 홀드아웃 검증 코호트에 대한 판별력, 보정 및 임계값 기반 성능이 제시되어 있다. 판별력은 95% 신뢰 구간을 포함한 ROC 곡선 아래 면적(AUC)으로 보고되었다. 보정은 Brier 점수, 보정 절편 및 보정 기울기로 요약되었다. 임계값 지표는 사전 지정된 컷오프 값에서 보고되었다: 고정된 패널티 모델의 경우 예측 위험도 ≥0.18, 점수 기반 복합 점수의 경우 점수 ≥8점이다.
| 예측 도구 | 개발 AUC | 고정 모델 대비 DeLong P 값 | 홀드아웃 검증 AUC | 고정 모델 대비 DeLong P 값 |
| (95% CI) | (개발) | (95% CI) | (검증) | |
| 고정 생화학-응고 모델 | 0.873 (0.820–0.926) | 기준 | 0.836 (0.751–0.921) | 기준 |
| Sequential Organ Failure Assessment 점수 | 0.842 (0.780–0.904) | 0.12 | 0.810 (0.712–0.908) | 0.34 |
| Acute Physiology and Chronic Health Evaluation II 점수 | 0.812 (0.744–0.880) | 0.03 | 0.790 (0.682–0.898) | 0.08 |
| Bedside Index for Severity in Acute Pancreatitis 점수 | 0.795 (0.724–0.866) | 0.01 | 0.765 (0.648–0.882) | 0.05 |
| Ranson 점수 | 0.742 (0.661–0.823) | <0.001 | 0.701 (0.577–0.825) | 0.02 |
| Harmless Acute Pancreatitis Score | 0.701 (0.618–0.784) | <0.001 | 0.688 (0.560–0.816) | 0.01 |
| 전신성 염증 반응 증후군 기준 | 0.684 (0.598–0.770) | <0.001 | 0.672 (0.541–0.803) | 0.02 |
표 6: 기존 중증도 평가 도구와의 벤치마크 비교. 데이터를 사용할 수 있는 경우, 입원 초기 동일 기간 내에 계산된 기존의 급성 췌장염 중증도 또는 장기 기능 부전 평가 도구와 고정 입원 생화학-응고 모델을 비교하였다. 개발 코호트와 홀드아웃 검증 코호트에 대한 95% 신뢰 구간을 포함한 수신자 작동 특성 곡선 아래 면적(AUC) 값이 표시되어 있다. 각 코호트 내에서 각 벤치마크 도구와 고정 생화학-응고 모델을 비교하기 위해 짝지은 DeLong 검정을 수행하였다.
| 위험 범주 | 점수 범위 | 환자 수, n | MODS 발생률, n (%) | 중환자실 입원, n | 기계 환기, n (%) | 신대체요법, n (%) | 원내 사망률, n (%) | 감염성 괴사 또는 배농, n (%) | 입원 기간, 일수 |
| (%) | |||||||||
| 저위험 | 0–4 | 115 | 4 (3.5) | 10 (8.7) | 3 (2.6) | 1 (0.9) | 1 (0.9) | 3 (2.6) | 7.6 (5.2–10.4) |
| 중간 위험도 | 5–8 | 101 | 9 (8.9) | 24 (23.8) | 9 (8.9) | 4 (4.0) | 2 (2.0) | 9 (8.9) | 11.4 (8.0–16.5) |
| 고위험 | 9–12 | 60 | 20 (33.3) | 36 (60.0) | 18 (30.0) | 10 (16.7) | 6 (10.0) | 14 (23.3) | 18.6 (13.0–26.8) |
| 매우 높은 위험 | ≥13 | 24 | 17 (70.8) | 20 (83.3) | 13 (54.2) | 7 (29.2) | 6 (25.0) | 8 (33.3) | 24.9 (17.5–37.2) |
표 7: 점수 기반 복합 점수에 따른 위험 층화. 환자들은 총점 점수를 바탕으로 저위험, 중등도 위험, 고위험 및 초고위험군으로 분류됩니다. 관찰된 다기관 기능 부전 증후군 발생률과 주요 임상 결과가 점수 층별로 보고됩니다. 범주형 결과는 n (%)으로 표시하며, 입원 기간은 중앙값(사분위 범위)으로 표시합니다.
보충 표 1: 다기관 기능 부전 증후군의 종점 판정을 위한 운영 기준.이 표는 호흡기, 심혈관, 신장, 간, 응고 및 신경계 기능 부전을 판정하는 데 사용된 사전 지정된 기관-계통 기준을 정의합니다. 입원 중 두 개 이상의 기관 계통에서 기능 부전이 발생했을 때 최종 종점으로 할당되었습니다. 숙련된 두 명의 검토자가 각 사례를 독립적으로 평가했으며, 의견 불일치는 세 번째 상급 검토자가 해결했습니다.이 파일을 다운로드하려면 여기를 클릭하십시오.
보충 표 2: 결측치 처리 및 기저치 할당에 대한 민감도 분석.이 표는 완전 사례 분석, 첫 24시간 이내 최악 값 기저치 할당, 센터 조정 성능 확인을 포함하여, 일차 대치 분석 및 사전 지정된 민감도 분석 결과를 요약합니다. 본 분석은 모델 판별력, Brier 점수, 유지된 예측 변수 패턴 및 점수 층화 위험 구배가 전처리 대안에 의해 실질적으로 변경되었는지 평가합니다.이 파일을 다운로드하려면 여기를 클릭하십시오.
토론
급성 췌장염과 관련된 다장기 기능 부전 증후군(MODS)은 특히 조기 전신 염증, 혈관 내피 손상, 조직 관류 장애 및 대사적 불안정성을 보이는 환자에게서 입원 후 짧은 기간 내에 발생할 수 있습니다. 본 프로토콜은 입원 후 첫 24시간이 환자가 일반 병동 관찰 상태로 남을지, 아니면 더 면밀한 재평가, 모니터링 강화 또는 장기 지원 경로 준비가 필요할지를 결정하는 경우가 많다는 점에 착안하여 해당 입원 기간을 중심으로 설계되었습니다. 연구 결과, 일상적으로 측정 가능한 생화학 및 응고 변수들을 고정되고 재현 가능한 모델링 워크플로우로 처리했을 때, 급성 췌장염의 조기 MODS 위험 층화를 위한 해석 가능한 점수로 구성할 수 있음이 나타났습니다11. 이러한 접근 방식은 단일 바이오마커나 지연된 중증도 분류만으로는 고위험군 급성 췌장염에서 나타나는 조기 전신 악화 양상을 완전히 파악하지 못할 수 있다는 임상적 현실과 일치합니다12.
생화학적 변수와 응고 변수를 결합하는 생물학적 근거는 임상적으로 타당합니다. 중증 급성 췌장염은 단일한 고립된 경로에 의해 발생하는 것이 아니며, 초기 악화 과정에서 전신 염증, 내피 세포 활성화, 모세혈관 누출, 신장 저관류, 응고 활성화 및 미세순환 장애가 서로를 강화할 수 있습니다. 유지된 생화학적 예측 인자들은 이러한 다축적 과정을 반영합니다. 낮은 알부민 수치는 염증 관련 혈관 누출 및 생리적 예비능 감소를 나타낼 수 있으며, 높은 혈액 요소 질소와 크레아티닌 수치는 저혈량증, 신장 저관류 또는 초기 신손상과 일치합니다. 낮은 칼슘, 높은 젖산 탈수소효소 및 높은 포도당 수치는 대사 스트레스, 조직 손상 및 더 심각한 전신 염증 장애를 반영할 수 있습니다13. 응고 예측 인자들은 보완적인 신호를 추가합니다. 연장된 프로트롬빈 시간-국제 표준화 비율, 상승된 D-dimer 및 낮은 혈소판 수치는 명백한 장기 기능 부전이 완전히 확립되기 전의 응고 활성화, 피브린 전환, 혈소판 소모 및 미세순환 장애를 나타낼 수 있습니다14. 따라서 점수 층계에 따라 MODS 발생률과 2차 결과가 단계적으로 증가하는 것은, 이 점수가 단순한 개별 검사실 이상 수치가 아니라 초기 전신 악화라는 임상적으로 일관된 패턴을 포착했음을 시사합니다.
이 연구의 핵심적인 방법론적 기여는 재현성에 대한 강조에 있습니다. 수정된 프로토콜에서는 입원 창(admission window)을 고정하고, 24 h 이내의 가장 이른 적격 실험실 수치를 사용하였으며, 명시적인 단위 표준화 규칙을 적용하고, 결측치 임계값을 정의하고, 전처리를 표준화하였으며, 모델 튜닝을 개발 코호트로 제한하였습니다. 이러한 단계들은 해당 점수가 기관 간에 재현될 수 있는지 여부에 직접적인 영향을 미칩니다. 예를 들어, D-dimer 보고 방식은 실험실마다 다르며, 검증된 변환 계수 없이 국소 보고서에서 D-dimer 단위를 사용하는 경우 피브리노겐 등가 단위를 가정할 수 없습니다. 마찬가지로, 실험실 수치의 결측은 데이터의 무작위적 부재보다는 국소적인 검사 경로를 반영할 수 있습니다15. 따라서 다음과 같은 여러 프로토콜 단계가 매우 중요합니다. 24 h 기선(baseline) 규칙이 일관되게 적용되어야 하며, MODS 발생 이후의 실험실 수치는 예측 변수 구축에 사용해서는 안 됩니다. 평가지표 판정은 미리 지정된 장기-계통 기준을 따라야 하며, 실험실 수치는 풀링(pooling) 전에 공통 대상 단위로 변환되어야 합니다. 또한, 홀드아웃 검증 코호트는 특징 선택, 계수 재교정 또는 컷오프 튜닝에 사용해서는 안 됩니다16.
워크플로우는 서로 다른 기관 설정에 맞게 수정될 수 있으나, 이러한 수정 사항은 사전에 지정되어야 합니다. 입원 시 일상적으로 측정되지 않아 후보 변수의 결측치가 과도한 경우, 방어 가능한 임계값을 넘어 대체(imputation)하기보다 모델 개발에서 제외해야 합니다. D-dimer 단위를 피브리노겐 등가 단위로 통일할 수 없는 경우, 근거 없는 가정을 통해 변환하기보다 조화 불가능한 값으로 처리해야 합니다. 지역 실험실에서 서로 다른 분석 플랫폼을 사용하는 경우, 주 분석에서는 절대적인 임상 수치를 유지하되 민감도 분석에서 센터 코드나 분석 플랫폼을 보정 요인으로 포함할 수 있습니다. MODS 발생 횟수가 예상보다 적은 경우, 모델링 전략은 불안정한 신호에 맞추기 위해 모델을 확장하기보다 더 강력한 수축(shrinkage), 더 적은 수의 예측 변수 유지, 또는 더 단순한 점수 구조를 택하는 것이 바람직합니다17. 실질적인 문제 해결 과정에는 응고 검사가 입원 시 일상적으로 처방되는지, 예측 변수의 분포가 센터별로 예상치 못하게 다른지, 검증 임계값이 실수로 재조정되었는지, 그리고 모든 그림 패널이 고정된 분석 데이터 세트와 일치하는지 확인하는 작업이 포함되어야 합니다18.
본 연구 결과는 몇 가지 제한점을 고려하여 해석해야 합니다. 홀드아웃 검증 코호트(hold-out validation cohort)가 동일한 회고적 다기관 데이터셋에서 도출되었으므로, 이는 독립적인 외부 검증이라기보다 내부 홀드아웃 검증에 해당합니다. 이벤트 수가 제한적이었으며, 이로 인해 페널티 모델링을 적용하더라도 예측 변수 유지의 불안정성 위험이 증가했습니다. 선택 후 기술적 오즈비(odds ratios)는 임상적 해석을 지원하기 위해서만 포함되었으며, 확증적 추론으로 취급되어서는 안 됩니다. 일부 엔드포인트 구성 요소는 전자 의무 기록의 문서화 품질에 의존했으며, 측정되지 않은 센터 수준의 임상 관행 차이가 장기 보조 결정에 영향을 미쳤을 수 있습니다. 수정된 분석 세트에서 결정 곡선 분석(decision-curve analysis)은 제외되었으므로, 본 원고는 임계 확률 전반에 걸친 임상적 순이익을 주장하지 않습니다19. 또한, 본 점수가 기존의 중증도 평가, 반복적인 임상 검사, 필요한 경우의 영상 진단 또는 임상의의 판단을 대체해서는 안 됩니다. 낮은 점수는 일상적인 관찰과 표준 재평가를 뒷받침할 수 있으나 이후의 상태 악화 가능성을 배제하지 않으며, 높은 점수는 고정된 치료 지침이라기보다 보다 세밀한 모니터링, 반복적인 실험실 평가 및 장기 보조 경로에 대한 조기 준비를 위한 촉구로 해석해야 합니다20.
종합적으로, 본 연구는 급성 췌장염에서 MODS의 조기 위험 계층화를 위한 재현 가능한 입원 시 생화학-응고 점수 산출 워크플로우를 제시합니다. 고정된 패널티 모델(locked penalized model)과 점수 기반 체계는 개발 코호트와 홀드아웃 검증 코호트에서 일관된 판별력과 정렬된 위험 구배를 보여주었으며, 민감도 분석 결과 주요 결과들이 사전에 지정된 결측 데이터 또는 기저치 대안에 의해 실질적으로 변경되지 않았음을 시사했습니다. 이 접근법의 주요 가치는 일상적으로 사용 가능한 입원 시 실험실 데이터를 해석 가능한 조기 위험 신호로 구성하여, 트리아제(triage)를 지원하고, 모니터링 강도를 조정하며, 장기 지원 경로를 준비할 수 있게 하는 데 있습니다21. 향후 연구에서는 서로 다른 실험실 플랫폼을 사용하는 병원들 간의 전향적 외부 검증, 실시간 보정(calibration) 평가, 동일한 고정 모델에서 도출된 전자 위험 계산기와의 비교, 그리고 점수 기반 모니터링 경로가 불필요한 중환자실 이용을 늘리지 않으면서 단계적 치료의 지연을 줄이는지 여부에 대한 평가를 우선적으로 수행해야 합니다22.
공개 사항
저자들은 본 연구와 관련하여 이해상충이 없음을 밝힙니다.
감사의 글
저자들은 급성 췌장염 환자의 진단, 치료 및 데이터 수집에 참여한 모든 임상의와 실험실 직원들에게 감사를 표합니다. 또한, 본 연구를 가능하게 해준 임상 데이터를 제공해주신 환자분들께도 깊은 감사를 드립니다. 이분들의 기여에 진심으로 감사드립니다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| 이름 | 회사명 | 카탈로그 번호 / URL | 비고 |
| R statistical software | R Foundation for Statistical Computing | Version 4.3.2 https://www.r-project.org/ | 데이터 전처리, 모델 개발, 검증 및 그림 생성에 사용된 통계 계산 환경. |
| caret R package | CRAN / Max Kuhn | Version 6.0-94 https://cran.r-project.org/package=caret | createDataPartition을 이용한 7:3 비율의 층화 개발 및 홀드아웃 검증 분할에 사용됨. |
| glmnet R package | CRAN / glmnet authors | Version 4.1-8 https://cran.r-project.org/package=glmnet | binomial family 및 alpha = 1을 적용한 LASSO 페널티 로지스틱 회귀에 사용됨. |
| mice R package | CRAN / amices project | Version 3.16.0 https://cran.r-project.org/package=mice | 20개의 대체 데이터셋과 20회의 반복 횟수를 적용한 연쇄 방정식 의한 다중 대체에 사용됨. |
| pROC R package | CRAN / pROC authors | Version 1.18.5 https://cran.r-project.org/package=pROC | ROC 분석, AUC 추정, 신뢰 구간 및 DeLong 비교에 사용됨. |
| cobas 8000 modular analyzer series | Roche Diagnostics | 05641446001 / SYS_128 https://diagnostics.roche.com/global/en/products/systems/cobas-8000-analyzer-series-sys-128.html | 생화학 및 면역화학 분석. 제출 전 참여 실험실 기록과 분석기 모델 및 카탈로그 정보를 확인하십시오. |
| XN-1000 Automated Hematology Analyzer | Sysmex Corporation | Model XN-1000 https://www.sysmex.com/en-us/lab-solutions/hematology/xn-series/xn-1000 | 백혈구 및 혈소판 수치를 포함한 전혈구 계산 변수. 제출 전 참여 실험실 기록과 확인하십시오. |
| CS-5100 Automated Blood Coagulation Analyzer | Sysmex Corporation | Model CS-5100 https://www.sysmex.com/en-us/lab-solutions/hemostasis/sysmex-cs-5100 | PT, APTT, 피브리노겐 및 D-dimer를 포함한 응고 변수. 제출 전 참여 실험실 기록과 확인하십시오. |
| ABL90 FLEX PLUS blood gas analyzer | Radiometer Medical ApS | Model ABL90 FLEX PLUS https://www.radiometer.com/en/products/blood-gas-testing/abl90-flex-plus-blood-gas-analyzer | 해당 플랫폼을 사용한 경우, 젖산 측정. 제출 전 참여 실험실 기록과 확인하십시오. |
| 전자 의무 기록 시스템 | 참여 병원 | 기관별 상이; 해당 없음 | 입원 기록, 경과 기록, ICU 기록, 처치, 활력 징후 및 퇴원 기록을 추출하는 데 사용됨. 가능한 경우 실제 벤더 및 시스템 이름으로 대체하십시오. |
| 실험실 정보 시스템 | 참여 병원 | 기관별 상이; 해당 없음 | 실험실 타임스탬프, 원시 값, 단위 및 조화된 데이터를 추출하는 데 사용됨. 가능한 경우 실제 벤더 및 시스템 이름으로 대체하십시오. |
| 종점 판정 서식 | 연구팀 | 맞춤형 연구 문서; 해당 없음 | 두 명의 검토자와 한 명의 상급 검토자가 MODS 상태 및 발생 시점을 판정하는 데 사용하는 표준 서식. |
| 데이터 사전 및 단위 변환 표 | 연구팀 | 맞춤형 연구 문서; 해당 없음 | 변수명, 대상 단위, 변환 규칙, 결측치 플래그, 센터 코드 및 분석 준비 형식을 정의함. |
참고문헌
- Banks PA, et al. Classification of acute pancreatitis-2012: revision of the Atlanta classification and definitions by international consensus. Gut. 2013;62(1):102-111.
- Wu BU, et al. The early prediction of mortality in acute pancreatitis: a large population-based study. Gut. 2008;57(12):1698-1703.
- Tenner S, et al. American College of Gastroenterology Guidelines: Management of Acute Pancreatitis. Am J Gastroenterol. 2024;119(3):419-437.
- Lee DW, Cho CM. Predicting severity of acute pancreatitis. Medicina (Kaunas). 2022;58(6):787.
- Metri A, Bush N, Singh VK. Predicting the severity of acute pancreatitis: current approaches and future directions. Surg Open Sci. 2024;19:109-117.
- Efthimiou O, et al. Developing clinical prediction models: a step-by-step guide. BMJ. 2024;386.
- Collins GS, Reitsma JB, Altman DG, Moons KGM. Transparent reporting of a multivariable prediction model for individual prognosis or diagnosis: the TRIPOD statement. Ann Intern Med. 2015;162(1):55-63.
- Li L, et al. Coagulopathy and acute pancreatitis: pathophysiology and clinical treatment. Front Immunol. 2024;15:1477160.
- Wan J, et al. Serum D-dimer levels at admission for prediction of outcomes in acute pancreatitis. BMC Gastroenterol. 2019;19:67.
- World Medical Association. World Medical Association Declaration of Helsinki: ethical principles for medical research involving human subjects. JAMA. 2013;310(20):2191-2194.
- Garg PK, Singh VP. Organ failure due to systemic injury in acute pancreatitis. Gastroenterology. 2019;156(7):2008-2023.
- Wu BU. Prognosis in acute pancreatitis. CMAJ. 2011;183(6):673-677.
- Wang H, et al. Early predictive value of different indicators for persistent organ failure in acute pancreatitis: a systematic review and network meta-analysis. J Clin Gastroenterol. 2024;58(3):307-314.
- Dumnicka P, et al. The interplay between inflammation, coagulation and endothelial injury in the early phase of acute pancreatitis: clinical implications. Int J Mol Sci. 2017;18(2):354.
- Favaloro EJ, Dean E. Variability in D-dimer reporting revisited. Pathology. 2021;53(4):538-540.
- Wolff RF, et al. PROBAST: A tool to assess the risk of bias and applicability of prediction model studies. Ann Intern Med. 2019;170(1):51-58.
- Riley RD, et al. Calculating the sample size required for developing a clinical prediction model. BMJ. 2020;368.
- Collins GS, et al. Evaluation of clinical prediction models (part 1): from development to external validation. BMJ. 2024;384.
- Vickers AJ, Elkin EB. Decision curve analysis: a novel method for evaluating prediction models. Med Decis Making. 2006;26(6):565-574.
- Riley RD, van der Windt D, Croft P, Moons KGM, editors. Prognosis Research in Healthcare: Concepts, Methods, and Impact. Oxford University Press; Oxford; 2019.
- Wu H, Li J, Zhao J, Li S. A new scoring system can be applied to predict the organ failure related events in acute pancreatitis accurately and rapidly. Pancreatology. 2020;20(4):622-628.
- Riley RD, et al. Evaluation of clinical prediction models (part 2): how to undertake an external validation study. BMJ. 2024;384.