본 프로토콜은 디지털 보존 및 창의적 유산 활용을 지원하기 위해, 트랜스포머 기반 특징 추출, 적대적 재구성 및 공간 적응형 이미지 생성을 이용하여 무형문화유산 문양의 시맨틱 세그멘테이션, 재구성 및 예술적 스타일 합성을 수행하는 딥러닝 워크플로우를 설명합니다.
이 콘텐츠를 보려면 JoVE 구독이 필요합니다. 로그인하거나 오늘 무료 평가판을 시작하세요.
이 논문에서
요약
초록
딥러닝 기반 이미지 합성 기술의 발전과 함께 무형문화유산(ICH) 문양의 디지털 보존 및 복원에 대한 관심이 높아지고 있습니다. 기존의 SegCycle-SPADE 기반 접근 방식은 전통 공예 문양의 구조적 세그멘테이션과 예술적 복원 가능성을 입증하였으나, 데이터셋 다양성 부족, 문화적 의미론적 요소의 반영 미흡, 복원 과정에서의 구조적 문양 특징 보존 부족 등의 한계가 남아 있습니다. 이러한 과제를 해결하기 위해 본 연구에서는 ICH 문양 유형의 의미론적 세그멘테이션 및 예술적 복원을 위한 개선된 SegCycle-SPADE 프레임워크를 제안합니다. 모티프 경계와 문양 영역을 정확하게 식별하기 위해 Transformer 기반 세그멘테이션 모델인 SegFormer를 채택하였습니다. 또한, 문화적으로 중요한 모티프를 강화하고 특징 표현력을 높이기 위해 교차 주의 집중 문화 특징 융합 모듈(Cross-Attention Cultural Feature Fusion Module)을 도입하였습니다. 문양 변환 및 복원은 CycleGAN을 사용하여 수행하며, 세그멘테이션 맵과 생성된 이미지 간의 의미론적 일관성을 유지하기 위해 공간 적응형 비정규화(Spatially-Adaptive Denormalization, SPADE)를 통한 예술적 스타일 합성을 적용하였습니다. 모델의 일반화 성능과 예술적 다양성을 향상시키기 위해 묘족 바틱(Miao Batik) 문화 모티프 데이터셋과 WikiArt 데이터셋을 모두 사용하여 프레임워크를 학습시켰습니다. 실험 결과, 제안된 주의 집중 기반 SegCycle-SPADE 프레임워크는 기존의 생성적 적대 신경망(GAN) 기반 복원 방법과 비교하여 세그멘테이션 정확도와 문화유산 문양 복원 성능을 향상시키는 것으로 나타났습니다. 본 프레임워크는 인공지능 보조 문화유산 기록, 복원 및 전통 문양 디자인의 예술적 재생을 위한 확장 가능한 솔루션을 제공합니다.
서론
관습, 언어, 신념과 같은 무형의 요소와 예술 작품, 건축물, 기록물과 같은 유형의 요소를 모두 포함하는 문화유산은 인류의 역사, 창의성 및 정체성의 근본적인 발현입니다1. 유산 보존은 지역사회가 그들의 기원과 다시 연결될 수 있도록 하며, 미래 세대가 집단적 문화 기억의 혜택을 누릴 수 있게 합니다. 또한 이는 상호 문화적 이해, 다양한 전통과 관습에 대한 감상, 그리고 서로 다른 역사적 서사에 대한 인식을 증진합니다. 이러한 문화적 자산은 우리가 이전 세대의 가치, 관점 및 경험을 이해하도록 도우며, 현대의 사회적 정체성 형성과 문화적 연속성에 기여합니다. 문화유산 보존의 기본 원칙은 그림 1에 예시되어 있습니다.
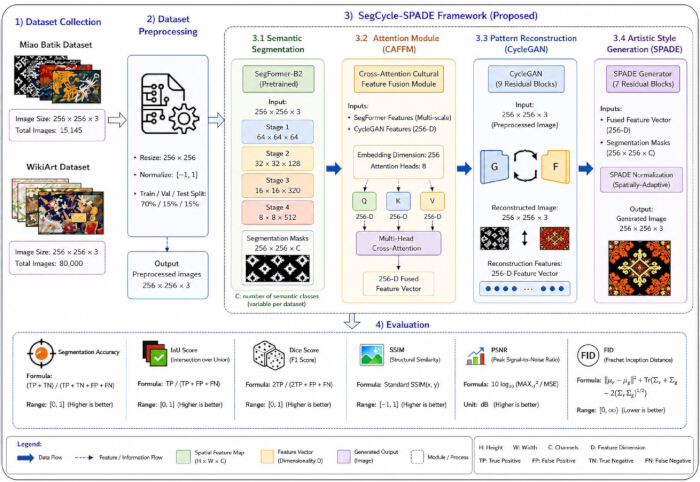
그림 1SegCycle-SPADE 프레임워크를 이용한 문화유산 패턴 복원의 개념적 개요. 무형문화유산 패턴의 복원 및 강화를 위해 제안된 접근 방식의 모식도. 워크플로우는 Miao Batik 및 WikiArt 데이터셋의 데이터셋 수집, 이미지 전처리, SegFormer-B2를 이용한 시맨틱 세그멘테이션, 교차 주의집중 문화 특징 융합 모듈(CAFFM)을 이용한 특징 융합, CycleGAN을 이용한 패턴 복원, SPADE를 이용한 예술적 스타일 합성, 그리고 세그멘테이션 및 복원 지표를 이용한 최종 평가를 포함한다. 화살표는 프레임워크 전반의 데이터 및 특징 표현의 흐름을 나타낸다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
인류 사회의 집단적 기억과 문화적 유산은 무형문화유산(ICH)에 구현되어 있으며, 이는 예술적 표현과 문화적 정체성을 나타내는 중요한 매개체 역할을 합니다. 그러나 무형문화유산은 세계화와 디지털화의 영향으로 인해 상당한 도전에 직면해 있습니다2,3,4. 숙련된 장인의 수 감소와 현대 시장에 대한 적응력 부족으로 인해, 멸실 위기에 처한 많은 무형문화유산 관행들은 보존과 발전을 위한 새로운 접근 방식이 필요합니다5,6. 무형문화유산 연구의 중요한 분야인 지속 가능한 디자인은 문화, 사회 및 환경의 통합적 발전을 강조하며, 무형문화유산의 지속적인 보존을 위한 실질적인 경로를 제공합니다. 지속 가능한 디자인 접근 방식을 통해, 무형문화유산은 현대 사회의 요구에 적응하면서 동시에 활성화될 수 있습니다7,8.
본 연구에서 “무형문화유산 패턴”이라는 용어는 기저에 깔린 무형의 문화적 가치를 전달하고 보존하는 시각적 모티프 표현을 의미합니다. 따라서 제안된 프레임워크는 이러한 모티프의 시각적 형태를 재구성하는 동시에, 이와 관련된 문화적 정보를 보존하고 기록하는 것을 목표로 합니다.
묘족 자수와 바틱(batik)은 중국 무형문화유산(ICH)의 중요한 형태로, 새, 나비, 조상 토템과 같은 상징적 문양을 통해 묘족 공동체의 역사, 신념 및 전통을 반영합니다9. 이러한 문양은 제례 의복과 축제 관습에 깊이 내재되어 있으며, 지역의 문화적 및 경제적 발전에 기여하고 있습니다10,1. 특히 인공지능(AI)과 딥러닝(DL)을 비롯한 디지털 기술의 발전은 문화유산의 보존, 분석, 복원 및 기록을 위한 새로운 기회를 창출했습니다. 중국에서 가장 잘 보존된 바틱 전통 중 하나인 귀저우 묘족 바틱은 묘족의 문화적 지식, 신념, 풍습 및 의례를 전달하는 중요한 매체 역할을 합니다12,13,14,15,16.
최근 연구들은 문화유산 보존 및 패턴 복원을 위한 딥러닝(DL)의 가능성을 입증하였으며, U-Net 및 DeepLabV3+와 비교하여 향상된 세그멘테이션 정확도(픽셀 정확도 = 8.6%, 평균 교집합 대비 합집합 [IoU]= 78.1%)와 복원 성능을 달성했습니다. 하지만 몇 가지 과제가 남아 있습니다. 기존의 생성적 적대 신경망(GAN) 기반 방식들은 복잡한 패턴의 미세한 구조적 세부 사항을 보존하는 데 어려움을 겪는 경우가 많으며17, 제한된 데이터셋의 다양성은 문화 영역 전반에 걸친 모델의 일반화 성능을 제한합니다18. 또한, CycleGAN과 같은 이미지-대-이미지 변환 모델은 세그멘테이션 맵과 생성된 이미지 사이의 의미론적 일관성을 유지하지 못할 수 있으며19, 어텐션 메커니즘의 부재는 복원 과정에서 문화적으로 중요한 모티프의 세부 사항 손실로 이어질 수 있습니다20. 따라서 효과적인 무형문화유산(ICH) 패턴 복원을 위해서는 트랜스포머 기반 세그멘테이션, 어텐션 가이드 특징 학습 및 다중 데이터셋 학습이 통합된 강화된 프레임워크가 필요합니다.
묘족 자수의 디지털화와 생성형 AI의 급격한 발전으로 문화유산 보존을 위한 새로운 기회가 나타났습니다. 최근 부상하고 있는 딥 생성 모델의 일종인 확산 모델(Diffusion models)은 강력한 콘텐츠 생성 능력 덕분에 컴퓨터 비전 작업에서 뛰어난 성능을 입증했습니다21,2,23,24,25. 역확산 과정 동안 모델은 노이즈가 섞인 표현으로부터 원래의 입력 데이터를 점진적으로 재구성하는 법을 학습합니다26,27,28. 이전 연구들은 또한 문화유산의 보존과 전파를 위해 3차원 재구성 및 컴퓨터 지원 설계(CAD) 기술의 적용을 탐구해 왔습니다.
합성곱 신경망(CNN)과 GAN은 이미지 생성 및 특징 보존 성능이 뛰어나지만, 여전히 제한된 수용 영역, 모드 붕괴 및 훈련 불안정성과 관련된 문제에 직면해 있습니다29. SegFormer 및 Segmenter와 같은 트랜스포머 기반 아키텍처는 전역 문맥과 시맨틱 관계를 포착하는 데 탁월하지만, 계산 비용이 많이 들고 세밀한 디테일을 처리하는 데 어려움을 겪을 수 있습니다. Stable Diffusion과 같은 확산 모델은 강력한 이미지 생성 능력을 보여주지만, 생성된 디자인의 구조적 및 예술적 특성에 대한 정밀한 제어 능력이 부족한 경우가 많습니다. 또한, 대부분의 기존 접근 방식은 독립적인 훈련 전략을 채택하여 세그멘테이션과 생성 구성 요소 간의 효과적인 정보 공유 및 협동 최적화를 제한하며, 이로 인해 구조적 정확성과 예술적 진정성 사이에 트레이드오프가 발생합니다30.
latent diffusion 및 Stable Diffusion과 같은 최근의 확산 기반 모델들은 고품질의 이미지 합성을 구현하지만, 반복적인 디노이징 과정이 필요하여 계산 비용과 추론 시간이 증가한다는 단점이 있습니다. 또한, 특화된 컨디셔닝 메커니즘 없이는 세밀한 문화적 모티프와 구조적 일관성을 유지하는 것이 여전히 어렵습니다. Transformer 기반 생성 모델은 전역적인 문맥 관계를 효과적으로 포착하지만, 종종 대규모 데이터셋과 상당한 계산 자원을 필요로 합니다. 이와 대조적으로, 본 연구에서 제안하는 SegCycle-Spatially Adaptive Denormalization (SegCycle-SPADE) 프레임워크는 SegFormer 기반 세그멘테이션, 교차 주의집중(cross-attention) 특징 융합, CycleGAN 재구성 및 SPADE 가이드 합성을 결합하여 명시적인 구조적 가이드를 제공함으로써 모티프 보존, 의미론적 일관성 및 문화유산 패턴의 제어 가능한 재구성을 개선합니다.
최신 시맨틱 세그멘테이션 기술의 대부분은 U자형 구조의 완전 합성곱 신경망(FCNN)에 의존합니다31. 인코딩 단계에서는 일련의 합성곱 및 다운샘플링 연산을 통해 수용 영역이 넓은 심층 특징을 추출합니다. 디코딩 단계에서는 업샘플링을 통해 공간 해상도를 점진적으로 복원하여 최종적으로 픽셀 단위의 시맨틱 예측을 가능하게 합니다. 스킵 연결은 다운샘플링 과정에서 발생하는 공간 정보 손실을 보완하고 다양한 응용 분야에서 세그멘테이션 성능을 향상시키며, 서로 다른 인코더 레벨의 고해상도 정보가 디코더로 직접 통합될 수 있게 합니다32.
최근 GAN 기반, CNN 기반 및 확산 기반 방법들이 이미지 생성과 문화유산 복원에서 유망한 결과를 보여주었으나, 이러한 방법들은 대개 세맨틱 일관성을 유지하고 미세한 구조적 모티프를 보존하며 다양한 문화적 패턴 전반에서 재현 가능한 복원을 보장하는 데 어려움을 겪습니다. 기존의 대부분의 접근 방식은 세그멘테이션, 복원 및 스타일 합성을 별개의 프로세스로 처리하며, 이는 문화적으로 중요한 요소의 손실과 일관성 없는 결과물로 이어질 수 있습니다. 이러한 방법론적 공백을 해결하기 위해, 본 연구에서는 SegFormer 기반의 세맨틱 세그멘테이션, 새로운 교차 주의 집중 문화 특징 융합 모듈(Cross-Attention Cultural Feature Fusion Module, CAFFM), CycleGAN 기반 복원 및 SPADE 유도 스타일 합성을 통합한 단일 SegCycle-SPADE 프레임워크를 제안합니다. 구조적 세그멘테이션 정보와 생성적 특징 학습을 명시적으로 통합함으로써, 제안된 프레임워크는 문화적 진정성과 예술적 품질을 모두 유지하면서 무형문화유산(ICH) 모티프의 더 신뢰할 수 있고 세맨틱적으로 일관되며 재현 가능한 복원을 가능하게 합니다.
본 연구에서는 현재의 문화유산 복원 방식에서 세 가지 주요 한계점을 확인하였다: (i) GAN 기반 복원 방법에서 미세 구조 모티프의 보존이 불충분함; (ii) 소규모 또는 특정 도메인 데이터셋으로 학습함에 따른 일반화 능력의 한계; (iii) 이미지-투-이미지 변환 프레임워크 내 세그멘테이션 출력값과 생성된 이미지 간의 불충분한 의미론적 일관성. 또한, 세그멘테이션, 복원 및 스타일 합성이 일반적으로 별개의 과정으로 처리되어 복원 과정 중 문화적으로 중요한 요소들이 손실되는 문제가 발생한다. 트랜스포머 기반 세그멘테이션, 교차 주의집중(cross-attention) 특징 융합, CycleGAN 복원 및 SPADE 유도 예술적 합성을 통합 아키텍처 내에서 결합함으로써, 제안된 SegCycle-SPADE 프레임워크는 이러한 한계점을 해결하고 무형문화유산(ICH) 패턴 복원 시 모티프 보존, 의미론적 일관성 및 예술적 정통성을 향상시킨다.
본 연구의 주요 목적은 무형문화유산(ICH) 패턴의 시맨틱 세그멘테이션 기반 예술적 복원을 위한 개선된 SegCycle-SPADE 프레임워크를 개발하는 것입니다. 이 프레임워크는 정확한 문화적 모티브 세그멘테이션을 위한 SegFormer, 패턴 복원을 위한 CycleGAN, 그리고 스타일 일관성을 갖춘 예술적 합성을 위한 SPADE를 통합합니다. 특성 표현을 개선하고 미세한 구조적 세부 사항을 보존하기 위해, 세그멘테이션 특성과 생성 특성 간의 효과적인 상호작용을 촉진하는 CAFFM을 도입하였습니다. Miao Batik 및 WikiArt 데이터셋으로 학습된 제안된 프레임워크는 복원의 진위성, 스타일 일관성 및 문화적으로 중요한 모티브의 보존 능력을 향상시킵니다.
본 연구는 시맨틱 세그멘테이션, 어텐션 가이드 특징 융합, 패턴 재구성 및 스타일 합성을 단일 아키텍처 내에서 결합하여 무형문화유산(ICH) 패턴의 예술적 재구성을 위한 새로운 SegCycle-SPADE 프레임워크를 제시합니다. 본 연구의 주요 기여도는 다음과 같습니다. 첫째, SegFormer를 통합하여 새로운 시맨틱 세그멘테이션 가이드 재구성 프레임워크를 개발함으로써 복잡한 문화적 모티브와 구조적 요소의 정확한 추출 및 보존이 가능해졌습니다. 둘째, 세그멘테이션 특징과 생성적 표현을 효과적으로 융합하는 새로운 CAFFM을 도입하여 모델이 문화적 모티브와 예술적 스타일 패턴 사이의 장거리 관계를 포착할 수 있도록 하였습니다. 셋째, 제안된 CAFFM은 문화적으로 중요한 요소의 보존 능력을 강화하는 동시에 재구성된 유산 패턴의 시각적 사실성과 구조적 일관성을 개선합니다. 넷째, 문화 패턴 재구성을 위한 CycleGAN과 세그멘테이션 가이드 예술적 합성을 위한 SPADE를 통합함으로써, 생성된 출력물의 시맨틱 정확성과 스타일의 진본성을 모두 보장하는 프레임워크를 구축하였습니다. 다섯째, 일반화 성능과 예술적 다양성을 향상시키기 위해 문화 패턴 학습을 위한 Miao Batik 문화 모티브 데이터셋과 예술적 스타일 표현을 위한 WikiArt 데이터셋을 사용하여 모델을 학습시켰습니다. WikiArt는 묘족 문화유산 제품에 직접 적용하기 위한 대상 스타일이 아니라, 다양한 시각적 맥락에서 프레임워크의 일반화 능력, 특징 학습의 강건성 및 스타일 제어 효과를 평가하기 위한 보조 데이터셋으로 활용되었습니다. 마지막으로, 기존의 GAN 기반 문화유산 재구성 방법과 비교하여, 실험 결과 제안된 SegCycle-SPADE 프레임워크가 세그멘테이션 정확도, 재구성 품질 및 스타일 일관성 면에서 향상된 성능을 달성함을 입증하였습니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
프로토콜
제안된 SegCycle-SPADE 프레임워크는 시맨틱 세그멘테이션, 어텐션을 이용한 특징 강화, 생성적 재구성 및 예술적 스타일 합성을 통해 전통 문화유산 패턴을 복원하고 개선하도록 설계되었습니다. 본 연구에서는 Miao Batik 데이터셋과 WikiArt 데이터셋을 포함하여 공개적으로 이용 가능한 문화유산 및 예술 이미지 데이터셋을 활용하였습니다. 본 연구에는 인간 참여자, 환자 데이터, 개인 정보, 동물 피험자 또는 임상 기록이 포함되지 않았으므로, 기관 윤리 위원회의 승인 및 고지된 동의가 필요하지 않았습니다. 우선, 평가를 위해 Miao Batik 문화 모티프 데이터셋과 WikiArt 데이터셋이 활용됩니다. Miao Batik 데이터셋은 Quan 등(2024)32에서 기술되었으며, 전통 Miao batik 모티프에 대한 15,148개의 주석 처리된 이미지를 포함하고 있습니다. 데이터셋 제작자가 제공한 기존 주석을 직접 사용하였으며, 본 연구에서 추가적인 수동 주석을 생성하지는 않았습니다. 그 다음, 리사이징, 정규화, 노이즈 제거 및 세그멘테이션 마스크 생성을 통해 이미지 전처리를 수행합니다. 정확한 전처리 파라미터는 데이터 전처리 소섹션에 기술되어 있습니다. 제안된 프레임워크는 데이터의 시맨틱 세그멘테이션을 위해 SegFormer-B2라는 트랜스포머 기반 모델을 활용합니다. 이 방법은 문화 모티프의 주요 영역을 탐지하고 그 구조를 학습하도록 설계되었습니다. 세그멘테이션된 특징은 어텐션 메커니즘을 통해 강화되며, 여기서 문화 모티프와 관련된 중요한 정보는 강조되고 무관한 정보는 제거됩니다. 어텐션 메커니즘 구성은 CAFFM 소섹션에 기술되어 있습니다. 강화된 특징은 CycleGAN으로 전달되어 순환 학습을 통해 손상된 구조가 복원됩니다. 학습 과정에서는 원본 Miao Batik 이미지에 무작위 마스킹 및 부분 가림 작업을 적용하여 불완전한 모티프 샘플을 인위적으로 생성하였습니다. 이러한 퇴화 절차는 퇴락한 문화유산 유물에서 흔히 관찰되는 모티프 영역의 누락과 구조적 손상을 모사하였습니다. 결과로 생성된 불완전한 이미지는 CycleGAN 복원 모듈의 입력값으로 사용되었으며, 이에 대응하는 원본 이미지는 복원 목표로 사용되었습니다. 복원된 문화유산 패턴은 이후 SPADE를 통해 강화되며, 여기서 생성된 세그멘테이션 맵을 기반으로 예술적 강화가 수행됩니다. 제안된 프레임워크의 성능은 정량적인 세그멘테이션 및 이미지 품질 지표를 사용하여 평가하며, 복원된 문화 모티프의 시각적 진정성은 정성적으로 평가합니다. 시각적 진정성은 생성된 문화 패턴의 육안 검사를 통해 평가되었으며, 독립적인 정량적 지표로 사용되지 않았습니다. 평가는 대응하는 참조 문화 모티프와 비교하여 모티프 보존, 시맨틱 일관성, 문화적 특성, 구조적 일관성 및 예술적 외형에 중점을 두었습니다. 모델 성능의 정량적 평가는 Segmentation Accuracy, IoU, Dice Coefficient, Structural Similarity Index Measure (SSIM), Peak Signal-to-Noise Ratio (PSNR) 및 Fréchet Inception Distance (FID)를 사용하여 수행되었습니다. 그림 2는 제안된 SegCycle-SPADE 프레임워크의 전체 워크플로우를 보여주며 본 연구에서 사용된 평가 지표를 요약하여 나타냅니다.
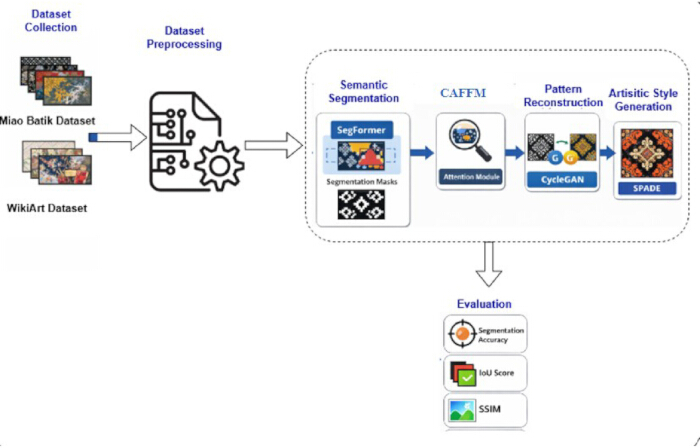
그림 2제안된 SegCycle-SPADE 프레임워크의 전체 아키텍처 워크플로. 전체 SegCycle-SPADE 워크플로우의 개요. Miao Batik 및 WikiArt 데이터셋의 이미지는 전처리를 거친 후, SegFormer-B2를 이용한 시맨틱 세그멘테이션, CAFFM을 이용한 특징 강화, CycleGAN을 이용한 패턴 재구성, 그리고 SPADE를 이용한 예술적 스타일 생성 과정을 거친다. 모델 성능은 세그멘테이션 정확도, IoU(Intersection over Union), 다이스 계수(Dice Coefficient), 구조적 유사도 지수(SSIM), PSNR, FID(Fréchet Inception Distance)를 통해 평가하며, 시각적 정통성은 정성적으로 평가한다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
그림 2에 나타낸 바와 같이, 문화유산 패턴 재구성을 위한 SegCycle-SPADE 프레임워크는 정확한 모티프 세그멘테이션, 재구성 및 예술적 향상을 위해 다수의 DL 구성 요소를 통합하도록 설계되었습니다. 다양한 문화적 패턴과 예술적 스타일을 제공하기 위해 Miao Batik 문화 모티프 데이터셋과 WikiArt 데이터셋의 이미지가 사용되었습니다. 우선, SegFormer 기반의 시맨틱 세그멘테이션 모듈을 사용하여 이미지를 처리함으로써 배경에서 문화 모티프를 식별하고 경계를 구분합니다. 전체 아키텍처는 네 가지 주요 단계로 구성됩니다. 첫째, SegFormer 모델이 문화 패턴 이미지에서 시맨틱 세그멘테이션 맵을 추출합니다. 둘째, CAFFM이 세그멘테이션 특징을 생성적 표현과 통합하여 특징 학습을 강화합니다. 셋째, CycleGAN 모듈이 융합된 특징 표현을 사용하여 문화 패턴을 재구성합니다. 마지막으로, SPADE 모듈이 세그멘테이션 유도 합성을 통해 구조적 일관성을 유지하면서 스타일적으로 향상된 출력을 생성합니다. 정제된 특징 맵은 이후 CycleGAN 재구성 모듈에 의해 처리되며, 이 모듈은 훼손된 패턴을 그에 대응하는 완전한 형태로 매핑함으로써 불완전한 문화 모티프를 복원하는 법을 학습합니다. 불완전한 모티프 샘플은 원본 Miao Batik 이미지에 무작위 마스킹 및 부분 가림 연산을 적용하여 생성되었으며, 이를 통해 손상된 문화 유물에서 흔히 관찰되는 패턴 영역의 결손과 구조적 퇴화를 시뮬레이션했습니다. 각 훼손된 이미지는 학습 과정 중 재구성 목표로 사용되는 대응하는 원본 이미지와 쌍을 이루었습니다. 이러한 전략을 통해 CycleGAN 모듈은 시맨틱 일관성과 문화적으로 중요한 특성을 유지하면서 결손된 모티프 구조의 복원을 학습할 수 있었습니다. 마지막으로, SPADE 생성기는 생성된 세그멘테이션 맵을 조건으로 이미지 합성을 수행함으로써 시각적으로 향상된 예술적 출력을 생성하며, 이를 통해 예술적 향상 과정 전반에 걸쳐 문화 모티프의 구조적 무결성을 유지합니다.
제안된 SegCycle-SPADE 프레임워크에는 다음과 같은 단계들이 포함됩니다.
1단계: 데이터셋 수집
문화적 패턴 학습 및 예술적 스타일 생성을 목표로 하기 위해 두 가지 데이터셋을 사용하였다. 전통 문화 패턴 정보를 제공하기 위해 묘족 바틱 문화 모티프 데이터셋(Miao Batik Cultural Motif Dataset)을 사용하였다. 해당 데이터셋은 Zenodo(https://doi.org/10.5281/zenodo.20807658)를 통해 공개적으로 이용 가능하며, 15,148장의 주석 처리된 전통 묘족 바틱 모티프 이미지를 포함하고 있다. 데이터셋 제작자가 제공한 기존 주석을 직접 사용하였으며, 본 연구에서 추가적인 수동 주석을 생성하지는 않았다. 예술적 스타일 생성을 위한 다양한 예술적 스타일 정보를 제공하기 위해 WikiArt 데이터셋을 사용하였으며, 이는 공개된 WikiArt 저장소(https://www.wikiart.org/)에서 확보하였다.
단계 2: 데이터 전처리
모든 이미지는 크기 조정, 정규화 및 노이즈 제거를 통해 전처리되었습니다. 시맨틱 세그멘테이션 단계를 지원하기 위해 원래 데이터셋 소스에서 얻은 기존의 문화적 모티프 어노테이션이 사용되었습니다. 본 연구의 일환으로 추가적인 어노테이션이나 재라벨링 절차는 수행되지 않았습니다.
단계 3: SegFormer를 이용한 의미론적 패턴 분할
문화적 모티프 분할을 위해 SegFormer 모델이 사용되었습니다. 구체적인 SegFormer 백본 및 초기화 전략은 SegFormer를 이용한 의미론적 패턴 분할 소섹션에 기술되어 있습니다. 특히, 의미론적 모티프 분할을 위해 ImageNet으로 사전 학습된 MIT-B2 백본을 갖춘 SegFormer-B2 아키텍처가 채택되었습니다. 이 모델은 전통 문화 패턴의 복잡한 구조적 세부 사항을 보존하면서 전역적인 문맥 정보를 효과적으로 포착합니다.
단계 4: CAFFM
CAFFM은 시맨틱 세그멘테이션 특징과 생성적 표현을 결합하여, 프레임워크가 구조적 모티프 특성과 예술적 스타일 정보를 모두 학습할 수 있도록 합니다. CAFFM의 통합 세부 사항은 CAFFM 하위 섹션에 제공됩니다. 이 모듈은 SegFormer 기반의 시맨틱 세그멘테이션 단계와 생성적 재구성 단계 사이에 위치하며, 멀티 헤드 교차 주의 집중(multi-head cross-attention)을 통해 세그멘테이션에서 도출된 구조적 특징과 재구성 특징을 융합합니다. 이 과정은 문화적 모티프의 보존 성능을 향상시키고 재구성된 출력물의 사실감을 높입니다.
단계 5: 패턴 재구성 (CycleGAN)
융합된 특징들은 이후 CycleGAN 모듈에 의해 처리되어 문화적 패턴 구조를 재구성합니다. CycleGAN의 아키텍처 및 학습 설정은 CycleGAN을 이용한 패턴 재구성 하위 섹션에 기술되어 있습니다. 재구성 모듈은 두 개의 생성기와 두 개의 판별자로 구성되며, 9개의 잔차 블록(residual block)을 가진 잔차 네트워크 생성기 아키텍처를 활용하고 PatchGAN 판별기를 사용하며, 적대적 손실(adversarial loss)과 사이클 일관성 손실(cycle-consistency loss)을 사용하여 학습됩니다. 이러한 설정은 양방향 도메인 매핑을 가능하게 하여 불완전한 문화적 패턴 구조의 재구성을 용이하게 합니다.
단계 6: 예술적 스타일 생성 (SPADE)
재구성된 패턴은 이후 SPADE 모듈을 통해 처리되어 세그멘테이션 가이드 기반의 예술적 스타일 합성을 수행합니다. SPADE 생성기 설정은 SPADE를 이용한 예술적 스타일 생성 소섹션에 설명되어 있습니다. 이 모듈은 SPADE 잔차 블록, 공간 적응형 정규화 층, 그리고 SegFormer 세그멘테이션 맵과 CAFFM 특징 표현에서 도출된 시맨틱 조건화를 사용합니다. 이미지 생성을 세그멘테이션 맵에 조건화함으로써, 합성된 결과물은 예술적 스타일 특성을 통합하는 동시에 기존의 문화적 모티프와 구조적 정렬을 유지합니다.
단계 7: 성능 추정
제안된 프레임워크는 분할 정확도(Segmentation Accuracy), IoU, Dice 유사 계수(Dice), SSIM, PSNR 및 FID를 포함한 여러 분할 및 이미지 품질 평가 지표를 사용하여 평가되었습니다. 실험의 일관성을 평가하기 위해 모든 실험은 서로 다른 무작위 시드를 사용하여 5회 반복되었으며, 결과는 평균 ± 표준 편차로 보고되었습니다. 통계적 유의성은 쌍체 t-검정(paired t-tests)을 통해 평가되었으며, 유의 수준은 p < 0.05로 설정되었습니다.
데이터셋 수집
제안된 SegCycle-SPADE 프레임워크에서는 문화적 패턴 이해와 스타일 학습을 위해 두 가지 데이터셋이 사용됩니다. 제안된 프레임워크에 사용된 첫 번째 데이터셋은 묘족 바틱(Miao Batik) 문화 모티프 데이터셋입니다. 이 데이터셋은 묘족 예술에 사용되는 동물, 식물, 기하학적 모양과 같은 모티프가 포함된 전통 묘족 바틱 이미지들로 구성된 문화 모티프 데이터셋입니다. 이 데이터셋은 문화유산 보존에 일반적으로 중요한 풍부한 질감 정보가 포함된 이미지들을 포함하고 있습니다. SegCycle-SPADE 제안 프레임워크에 사용된 두 번째 데이터셋은 WikiArt 데이터셋입니다. 이 데이터셋은 일반적으로 서로 다른 스타일을 가진 방대한 양의 예술 작품들을 포함하고 있습니다. 이 데이터셋은 예술 작품의 질을 높이는 데 일반적으로 유용한 복잡한 스타일 학습을 위해 사용됩니다. 이 데이터셋은 27가지의 서로 다른 디자인을 가진 80,0점의 HD 예술 작품으로 구성되어 있어, 딥러닝(DL) 기반의 스타일 생성 또는 변환 작업에 더욱 유용합니다.
묘족 바틱 데이터셋(Miao Batik Dataset):
묘족 바틱 데이터셋(https://doi.org/10.5281/zenodo.20807658)은 문화적으로 중요한 모티프를 묘사한 15,148장의 바틱 패턴 이미지로 구성되어 있습니다. 이 이미지들에는 동물 모티프(예: 나비 및 물고기), 식물 기반 패턴, 그리고 문화적 상징성을 지닌 기하학적 모티프와 같은 다양한 전통 디자인이 포함되어 있습니다. 이 데이터셋은 패턴 재구성 과정에서 세그멘테이션 모듈이 모티프 경계를 정확하게 식별하고 보존할 수 있도록 실제 문화적 구조를 제공하므로, 제안된 프레임워크의 중요한 구성 요소가 됩니다(표 1). 본 연구에서 문화적으로 중요한 모티프란 조류, 나비, 꽃 패턴, 조상 토템 등 묘족 문화유산 문헌에 일반적으로 기록되어 있고 데이터셋 주석에 표현된 상징적 시각 요소를 의미합니다. 이러한 모티프들은 단순히 발생 빈도나 공간적 구성이 아니라, 기록된 문화적 중요성과 전통 묘족 바틱 및 자수 디자인에서 반복적으로 나타나는 특성을 바탕으로 선정되었습니다. 전문가가 안내한 모티프 주석 및 세그멘테이션 레이블은 기존 묘족 바틱 데이터셋 소스에서 가져와 본 연구에 직접 사용되었습니다. 저자들에 의한 추가적인 수동 주석 처리, 레이블 재지정 또는 전문가 안내 주석 절차는 수행되지 않았습니다. 데이터셋 제작자가 제공한 기존 주석이 시맨틱 세그멘테이션 학습 및 평가에 활용되었습니다.
| 매개변수 | 설명 |
| 데이터 세트 이름 | 먀오족 바틱 문화 패턴 데이터셋 |
| 데이터 세트 출처 | Zenodo 저장소 (DOI: 10.5281/zenodo.20807658) |
| 도메인 | 무형문화유산(ICH) / 직물 문양 분석 |
| 전체 이미지 | 15,148장의 이미지 |
| 이미지 유형 | 전통 묘족(Miao) 바틱 직물 패턴의 디지털 이미지 |
| 패턴 범주 | 동물 문양, 식물 문양 및 기하학적 문양 |
| 문화적 기원 | 중국 구이저우성 묘족 문화 |
| 원본 이미지 해상도 | 전처리 전 raw 스캔 또는 사진으로 캡처한 고해상도 이미지(통상적으로 짧은 쪽의 길이가 1,0픽셀 이상) |
| 교육 해상도 | 전처리 과정 중 이미지를 256 × 256 픽셀로 크기 조정함 |
| 주석 제공 여부 | 데이터셋 제작자가 제공한 기존의 세그멘테이션 어노테이션을 수정 없이 학습 및 평가에 사용하였습니다. 본 연구에서는 추가적인 수동 어노테이션, 재레이블링 또는 전문가 확인 절차를 수행하지 않았습니다. |
| 본 연구에서의 적용 | 문화적 모티프 분할, 특징 추출, 모티프 보존 및 패턴 재구성 |
표 1: 묘족 바틱 문화 패턴 데이터셋의 특성. 시맨틱 세그멘테이션, 문화 패턴 분석 및 모티프 재구성에 사용된 묘족 바틱 문화 모티프 데이터셋의 요약이다. 이 표는 데이터셋 출처, 이미지 특성, 모티프 범주, 문화적 기원, 이미지 해상도 및 제안된 SegCycle-SPADE 프레임워크 내에서의 역할을 설명한다.
WikiArt 데이터셋:
WikiArt 데이터셋[https://www.wikiart.org/]은 27가지의 서로 다른 예술적 스타일을 가진 80,0장 이상의 이미지로 구성된 인기 있는 대규모 디지털 예술 저장소입니다. 표 2스타일에는 르네상스 예술, 인상주의, 입체주의 및 초현실주의가 포함됩니다. 이 데이터셋은 세그멘테이션 과정에서 얻은 구조적 정보를 유지하면서 SPADE 모듈이 문화적으로 풍부한 패턴을 생성할 수 있도록 지식을 제공하므로 제안된 프레임워크에서 매우 중요합니다. 데이터셋은 학습용 이미지 56,0장과 검증 및 테스트용 이미지 12,0장으로 구성됩니다. 데이터셋의 이미지들은 DL 모델을 효과적으로 학습시키는 데 도움을 줍니다.
| 매개변수 | 설명 |
| 데이터셋 이름 | WikiArt 데이터셋 |
| 데이터세트 출처 | WikiArt 리포지토리 (https://www.wikiart.org/) |
| 도메인 | 디지털 아트 및 회화 |
| 전체 이미지 | 약 80,0점의 예술 작품 |
| 훈련 이미지 | 56,000 |
| 검증 이미지 | 12,000 |
| 테스트 이미지 | 12,000 |
| 예술 양식 | 르네상스, 인상주의, 입체주의, 초현실주의, 표현주의, 사실주의, 추상 예술을 포함한 27가지 예술 양식 |
| 원본 이미지 해상도 | 원본 이미지 해상도는 작품과 출처에 따라 다양합니다. 전처리 과정에서 이미지를 256 × 256 픽셀의 균일한 해상도로 크기를 조정하였습니다. |
| 교육 해상도 | 예술적 스타일 학습 및 세그멘테이션 가이드 이미지 합성에 앞선 전처리 과정에서 이미지를 256 × 256 픽셀로 크기 조정하였습니다. |
| 데이터셋 분할 | 고정된 랜덤 시드 42를 사용하여 층화 무작위 분할(훈련 세트 70%, 검증 세트 15%, 테스트 세트 15%) 수행 |
| 스타일 샘플링 전략 | 훈련, 검증 및 테스트 서브셋 전반에 걸쳐 27가지 예술 스타일의 분포를 유지하기 위해 층화 비례 추출법을 사용하였습니다. |
| 본 연구에서의 적용 | 예술적 스타일 학습, 스타일 표현 및 세그멘테이션 유도 예술적 합성 |
표 2: WikiArt 데이터셋의 특성. 예술적 스타일 학습 및 스타일 기반 이미지 합성에 사용된 WikiArt 데이터셋의 요약이다. 본 표는 데이터셋 출처, 이미지 분포, 예술적 스타일 범위, 데이터셋 분할, 이미지 해상도 및 제안된 SegCycle-SPADE 프레임워크 내에서의 적용 내용을 설명한다.
Miao Batik 데이터셋은 전통 묘족 문화 모티프를 나타내는 15,148장의 이미지로 구성되어 있습니다.32 이 데이터셋은 Zenodo (https://doi.org/10.5281/zenodo.20807658)를 통해 공개적으로 이용 가능합니다. 모델 학습에 앞서 모든 이미지를 시각적으로 검토하고 256 × 256 픽셀로 크기를 조정한 후 정규화하였으며, 손상되거나 중복된 샘플이 있는지 확인하였습니다. 품질 관리 스크리닝 결과 제외된 이미지는 없었으며, 따라서 15,148장의 모든 이미지가 이후 분석에 사용되었습니다. 데이터셋 분할의 재현성을 보장하기 위해 고정 무작위 시드 42를 사용하여 데이터셋을 학습(70%), 검증(15%), 테스트(15%) 서브셋으로 무작위 분할하였습니다. WikiArt 데이터셋은 공식 WikiArt 저장소 (https://www.wikiart.org/)를 통해 접근하였으며, 27가지 예술 스타일을 아우르는 80,00점 이상의 예술 작품을 포함하고 있습니다. 스타일 학습 실험을 위해 56,00장의 이미지를 학습에, 12,00장을 검증에, 12,0장을 테스트에 사용하였습니다.
데이터 전처리
제안된 SegCycle-SPADE 프레임워크를 학습시키기 전, 이미지 품질의 일관성을 보장하고 정확한 특징 표현을 위해 묘족 바틱(Miao Batik) 문화 문양 데이터셋과 WikiArt 데이터셋에 대해 여러 전처리 단계를 수행하였습니다. 가우시안 노이즈 제거, 정규화, 일관된 입력 해상도로의 크기 조정 및 이미지 품질 검증을 포함하는 동일한 기본 전처리 파이프라인이 두 데이터셋 모두에 적용되었습니다. 다만, 각 데이터셋은 프레임워크 내에서 서로 다른 역할을 수행하였습니다. WikiArt 데이터셋은 예술적 스타일 학습 및 합성에 사용되었으며, 묘족 바틱 데이터셋은 주로 문화 문양의 세그멘테이션 및 재구성에 사용되었습니다. 이러한 작업별 역할 외에 데이터셋별로 별도의 전처리 변경 사항은 없었습니다. 딥러닝(DL) 모델의 일관된 처리를 위해, 이미지들은 먼저 고정된 해상도로 크기가 조정되었습니다. 이는 두 데이터셋의 이미지들이 출처에 따라 해상도가 다양했기 때문에 필수적인 단계였습니다. 크기 조정을 통해 계산 효율성을 높이고 차원 불일치가 학습에 영향을 주는 것을 방지하였습니다. 두 번째 전처리 단계는 정규화로, 학습 중 그래디언트 업데이트를 안정화하기 위해 픽셀 값을 표준 범위로 스케일링하였습니다. 이후 가우시안 필터링을 사용하여 문화 문양 구조를 방해할 수 있는 노이즈를 제거하였습니다. 묘족 바틱 데이터셋의 경우, 원본 데이터셋 출처에서 직접 얻은 기존 문화 문양 세그멘테이션 마스크를 수정 없이 시맨틱 세그멘테이션 학습 및 평가에 사용하였습니다. 본 연구를 위해 별도의 세그멘테이션 마스크를 새로 생성하지는 않았습니다.
별도의 언급이 없는 한, 기존 방법론을 설명하는 방정식은 이전 연구에서 인용 및 수정되었으며 이에 따라 출처가 표기되었습니다. 제안된 CAFFM 및 복합 SegCycle-SPADE 최적화 프레임워크를 설명하는 방정식은 본 연구를 위해 저자들이 개발하였습니다.
데이터셋의 입력 이미지를 다음과 같이 나타내어 봅니다. 식 1:
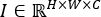 (1)
여기서 H, W, 그리고 C는 각각 이미지의 높이, 너비 및 컬러 채널 수를 나타냅니다. 모든 이미지는 수식 2에 표시된 것과 같이 고정된 크기인 H′ × W′로 크기가 조정됩니다.
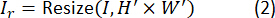
여기서 Ir은 크기가 조정된 이미지입니다. 정규화된 픽셀 값은 식 3에 따라 계산됩니다:
 (3)
이는 학습 과정을 안정화하는 데 도움이 됩니다. 노이즈 필터링은 다음에서 보는 바와 같이 가우시안 필터를 사용하여 수행됩니다. 식 4:
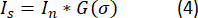
여기서 G(σ)는 가우시안 필터이며 *는 컨볼루션을 나타냅니다. 표준 편차가 σ = 1.0인 5 × 5 커널 가우시안 필터가 사용되었습니다. 가장자리 아티팩트를 줄이기 위해 경계 픽셀에 반사 패딩(reflective padding)을 적용하였습니다. 스케일링 및 정규화에 앞서, 이미지 로딩 직후에 노이즈 제거 프로세스를 수행하였습니다. 연구 전반에 걸쳐 균일한 전처리를 보장하기 위해, Miao Batik 및 WikiArt 데이터셋의 모든 이미지에 동일한 필터 설정을 적용하였습니다. Miao Batik 데이터셋의 경우, 세그멘테이션 마스크는 식 5에 따라 생성됩니다:

여기서 M은 SegFormer 모델을 안내하는 데 사용되는 세그멘테이션 마스크입니다.
그림 3에 나타낸 바와 같이, 전처리 파이프라인은 Miao Batik 데이터셋과 WikiArt 데이터셋의 이미지 획득부터 시작됩니다. 훈련 과정에서 데이터 증강 기술은 사용되지 않았습니다. 크기 조정, 정규화, 가우시안 노이즈 제거 및 세그멘테이션 마스크 준비를 포함하는 전처리를 거친 후, 이미지들은 제안된 SegCycle-SPADE 프레임워크의 훈련, 검증 및 테스트에 직접 사용되었습니다. 전처리 파이프라인의 첫 번째 단계는 딥러닝(DL) 모델이 이미지를 더 효율적으로 처리할 수 있도록 이미지 크기를 고정된 크기로 조정하는 것입니다. 두 번째 단계는 정규화로, 픽셀 값을 표준화된 수치 범위로 변환하여 모델의 수렴을 돕습니다. 세 번째 단계는 노이즈 제거로, 패턴 인식 능력을 향상시키기 위해 이미지에서 불필요한 노이즈를 제거합니다. 또한, Miao Batik 데이터셋의 경우 문화적 모티프 영역을 어노테이션하여 마스크를 생성하며, 이는 제안된 모델의 세그멘테이션 모듈에서 사용되어 생성 과정 동안 문화적 모티프가 보존되도록 합니다. 이 단계의 최종 결과물은 제안된 모델의 세그멘테이션 및 생성 모듈을 훈련시키기에 적합한 정제된 데이터셋입니다.
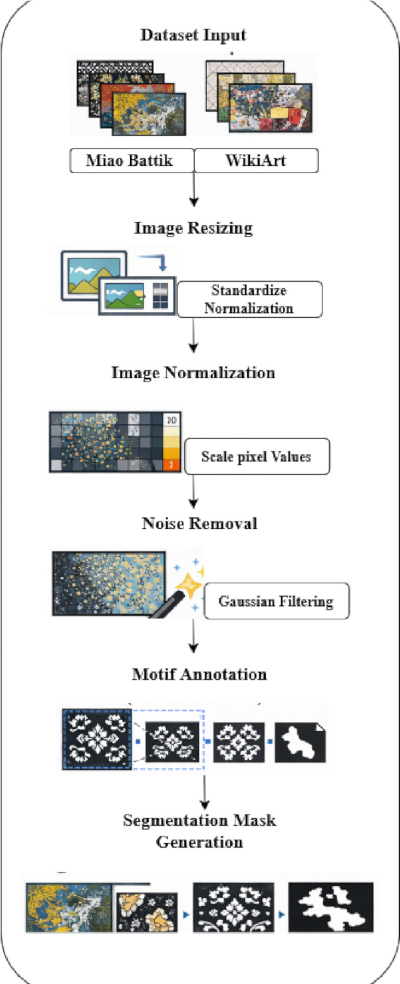
그림 3문화유산 이미지의 데이터 전처리 파이프라인. 모델 학습 전 적용된 이미지 전처리 절차를 나타내는 워크플로. 파이프라인에는 데이터셋 획득, 이미지 크기 조정, 정규화, 가우시안 노이즈 제거, 기존 문화적 모티프 주석 달기 및 세그멘테이션 마스크 준비가 포함된다. 처리된 결과 이미지와 마스크는 시맨틱 세그멘테이션 및 패턴 재구성의 입력값으로 사용된다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
모델 학습 전 모든 이미지에 대해 품질 관리 프로세스를 수행하였습니다. Miao Batik 데이터셋은 15,148장의 이미지로 구성되었습니다. 손상되었거나 중복된 샘플 및 저품질 샘플은 이미 원본 데이터셋 제작자에 의해 처리되었으므로, 본 연구의 품질 관리 스크리닝 과정에서 추가로 제외된 이미지는 없었습니다. 결과적으로 15,148장의 모든 이미지가 분석에 사용되었습니다. 전처리 과정에서 이미지는 RGB 형식으로 로드되었으며, bilinear interpolation을 사용하여 256 × 256 픽셀로 크기를 조정하였습니다. 픽셀 값은 25로 나누어 [0, 25] 범위에서 [0, 1] 범위로 스케일링되었습니다. 이후 빨강, 초록, 파랑 채널에 대해 각각 [0.485, 0.456, 0.406]의 평균값과 [0.29, 0.224, 0.25]의 표준편차 값을 사용하여 채널별 정규화를 적용하였습니다. 전처리 파이프라인에는 이미지 로딩, RGB 변환, 크기 조정, 픽셀 값 스케일링, 정규화 및 텐서 변환이 포함되었습니다. 필요한 경우, DL 모델과의 호환성을 유지하기 위해 그레이스케일 이미지를 3채널 RGB 형식으로 변환하였습니다. 전처리를 마친 후, 이미지는 학습, 검증 및 테스트 서브셋으로 분할되었습니다. 시맨틱 세그멘테이션, 특징 융합, 모티프 재구성 및 SPADE 기반 예술적 합성을 포함한 SegCycle-SPADE 프레임워크의 모든 단계에서는 256 × 256 픽셀의 일관된 입력 해상도를 사용하였습니다.
SegFormer를 이용한 시맨틱 패턴 세그멘테이션
이전처리 단계 이후, 정제 및 정규화된 묘족 바틱(Miao Batik) 문화 모티프 데이터셋과 WikiArt 데이터셋의 이미지들이 제안된 SegFormer-B2 프레임워크 기반의 시맨틱 세그멘테이션 모듈로 입력됩니다. 이 단계의 목적은 전통 문양에 존재하는 문화적 모티프를 정확하게 식별하고 분리하는 것입니다. 제안된 SegFormer 프레임워크는 계층적 트랜스포머(Transformer) 인코더와 경량 MLP 디코더를 통합한 트랜스포머 아키텍처를 기반으로 하여, 복잡한 전통 문양으로부터 전역적인 문맥 정보와 세부적인 구조 정보를 정확하게 포착합니다. 모델은 먼저 입력 이미지에서 다중 스케일의 특징 표현을 추출한 다음, 디코더를 통해 이러한 표현들을 융합하여 정밀하게 세그멘테이션된 패턴을 생성합니다. 이를 통해 전통 이미지 내의 패턴이 기하학적 문양, 꽃 문양, 상징적 문양과 같은 모티프로 정확하게 분할되어, 구조적 무결성을 유지하면서 배경으로부터 분리됩니다. 이러한 구조 정보는 이후 SegCycle-SPADE 프레임워크 내의 패턴 생성 후기 단계에서 활용됩니다.
전처리된 입력 이미지를 식 6과 같이 나타낼 수 있습니다:
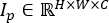 (6)
SegFormer 인코더는 이미지를 패치로 분할하고 식 71에 나타낸 바와 같이 트랜스포머 층을 사용하여 계층적 특징을 추출합니다.
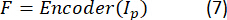
여기서 F는 트랜스포머 인코더에서 얻은 멀티스케일 특징 맵을 나타냅니다. 이러한 특징들은 모티프 영역 간의 국소적 질감 패턴과 전역적 문맥 관계를 모두 인코딩합니다. SegFormer 모델은 식 8에 정의된 바와 같이 서로 다른 스케일의 특징 맵을 추출합니다:
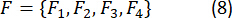
다중 스케일 표현의 사용은 문화적 모티프 내에서 다양한 크기의 패턴을 검출하는 것을 용이하게 합니다. 마지막으로, 특징들은 다음의 MLP 디코더를 사용하여 결합됩니다. 식 91:
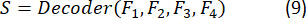
여기서 S는 최종 예측 분할 맵을 나타냅니다.
SegFormer-B2 백본은 ImageNet으로 사전 학습된 가중치를 사용하여 초기화되었으며, 이후 문화적 모티프 분할을 위해 Miao Batik 데이터셋에서 미세 조정되었습니다. 사전 학습된 체크포인트는 공식 SegFormer 구현체에서 확보하였습니다. 구체적으로, 미세 조정 전 SegFormer-B2 백본을 초기화하기 위해 공식 SegFormer 저장소에서 제공하는 ImageNet-1K 사전 학습 MIT-B2 체크포인트(mit_b2.pth)를 사용하였습니다. 사전 학습된 가중치는 SegFormer 저자들이 공개한 MIT-B2 백본에 해당하며, 시맨틱 분할 학습을 위한 초기화 모델로 활용되었습니다. 나머지 작업 특화 레이어들은 학습 전 PyTorch의 기본 가중치 초기화 절차를 사용하여 초기화되었습니다.
중첩 패치 임베딩을 갖춘 4단계 계층적 Transformer 인코더가 아키텍처에 사용되었습니다. 초기 단계에서 패치 크기는 7 × 7로, 스트라이드는 4로 설정되었습니다. 4개의 인코더 단계 각각에 대한 임베딩 차원은 64, 128, 320, 512였습니다. 4단계에 걸쳐 멀티헤드 셀프 어텐션 헤드는 각각 1, 2, 5, 8개였으며, 해당하는 인코더 깊이는 3, 4, 6, 3 레이어였습니다. 인코더에서 추출된 다중 스케일 특징은 경량 all-MLP 디코더를 사용하여 집계되었습니다. 최종 세그멘테이션 맵을 생성하기 전에, 디코더는 모든 인코더 단계의 특징을 단일 임베딩 공간으로 투영했습니다. 모든 Transformer 블록에는 GELU(Gaussian Error Linear Unit) 활성화 함수가 사용되었습니다. 일반화 성능을 향상시키고 과적합을 줄이기 위해 훈련 과정에서 0.1의 드롭아웃 비율이 적용되었습니다.
훈련 단계에서 SegFormer 프레임워크는 두 데이터셋으로부터 전처리된 이미지를 입력받습니다. Miao Batik 데이터셋의 이미지에는 세그멘테이션 모델의 지도 학습을 위한 레이블 역할을 하는 문양 영역이 포함되어 있습니다. Transformer 인코더는 이미지 전체를 처리하여 이미지 구성 요소 간의 장거리 관계를 포착하며, 이는 공간적으로 분포된 문양을 포함하는 전통 바틱 패턴에서 특히 중요합니다. 계층적 특징 추출 메커니즘은 반복되는 기하학적 텍스처와 같은 국소 구조를 동시에 포착합니다. MLP 디코더는 이렇게 추출된 특징을 처리하여 문양 영역이 강조된 세그멘테이션 마스크를 생성합니다. 이 단계에서 생성된 세그멘테이션 맵은 이후 어텐션 모듈과 패턴 재구성 단계의 구조적 입력으로 사용되어, 생성된 패턴의 정통성을 유지하는 데 기여합니다.
문화적 모티프는 시각적 및 문화적 특성에 따라 시맨틱 세그멘테이션을 위해 서로 다른 클래스로 분류되었습니다. 세그멘테이션 분류 체계는 동물 모티프(예: 나비, 물고기, 새 및 기타 상징적 동물), 식물 모티프(예: 꽃, 잎, 덩굴 및 식물학적 패턴), 기하학적 모티프(예: 반복되는 모양, 테두리 및 추상적 기하학적 구조), 그리고 모티프가 없는 영역을 나타내는 배경 영역으로 구성되었습니다. 픽셀 수준의 세그멘테이션 마스크를 사용하여 각 픽셀을 사전 정의된 클래스 중 하나에 할당하였습니다. 정수 레이블은 다음과 같이 인코딩되었습니다: 레이블 0 = 배경, 레이블 1 = 동물 모티프, 레이블 2 = 식물 모티프, 레이블 3 = 기하학적 모티프. 세그멘테이션 주석과 모티프 레이블은 원래의 Miao Batik 데이터셋 소스에서 직접 가져왔습니다. 본 연구에서는 추가적인 수동 주석 작성, 레이블 재지정, 경계 검증 또는 전문가 확인 절차를 수행하지 않았습니다. 데이터셋 제작자가 제공한 기존 주석을 수정 없이 학습 및 평가에 사용하였습니다.
문화적 모티프 세분화를 위한 SegFormer 모델은 그림 4에 표시된 바와 같이, 트랜스포머 기반 메커니즘을 사용하여 Miao Batik 데이터셋과 WikiArt 데이터셋의 전처리된 이미지를 처리함으로써 문화적 패턴 영역을 정확하게 검출합니다. 먼저, 전통 문화 모티프가 포함된 입력 이미지가 SegFormer 모델에 제공됩니다. 트랜스포머 인코더는 이미지 패치로부터 전역적 문맥 정보와 지역적 구조 특징을 모두 추출합니다. 생성된 다중 스케일 특징은 세분화 디코더로 전달되며, 디코더는 Mix Feed-Forward Network를 활용하여 특징 표현을 정밀화하고 모티프 검출 성능을 향상시킵니다. SegFormer 모델의 출력은 관련 없는 배경 정보는 억제하고 문화적 패턴에 해당하는 픽셀을 강조하는 세분화 마스크입니다. 이렇게 분리된 문화적 패턴은 이후 SegCycle-SPADE 프레임워크의 다음 단계에서 구조적 가이드 역할을 합니다.
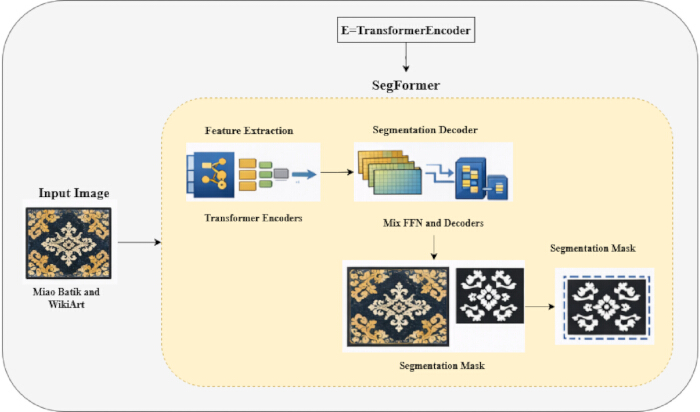
그림 4SegFormer-B2 기반의 문화적 모티프 시맨틱 세그멘테이션. 문화적 모티프 추출을 위해 사용되었으며 Miao Batik 데이터셋으로만 학습된 SegFormer-B2 시맨틱 세그멘테이션 모듈의 구조. 이 프레임워크는 다중 스케일 특징 추출을 위한 Transformer 기반 인코더와 모티프 마스크 생성을 위한 경량 세그멘테이션 디코더로 구성된다. 모델은 동물, 식물, 기하학적 문양, 배경의 네 가지 시맨틱 클래스를 예측하며, 결과물인 세그멘테이션 마스크는 무관한 배경 정보를 억제하는 동시에 문화적으로 중요한 모티프 영역을 식별한다. 이러한 세그멘테이션 출력은 제안된 SegCycle-SPADE 프레임워크의 후속 단계인 특징 융합, 재구성 및 예술적 합성 단계에 구조적 가이드를 제공한다. 이 그림의 확대 버전을 보시려면 여기를 클릭하십시오.
제안된 프레임워크에서는 새로운 세그멘테이션 어노테이션을 생성할 필요가 없습니다. Miao Batik 데이터셋은 이미 존재하는 공개 소스에서 수집되었으며, 모델은 데이터셋 제작자가 제공한 관련 모티프 정보를 사용하여 학습되었습니다. 학습 과정에서 SegFormer 모델이 시맨틱 세그멘테이션 맵을 생성하였습니다. 결과적으로, 본 연구에서는 추가적인 수동 어노테이션 소프트웨어, 어노테이션 가이드라인 또는 어노테이션 품질 관리 절차가 필요하지 않았습니다.
CAFFM
시맨틱 세그멘테이션의 특징과 생성적 재구성의 표현 사이의 상호작용을 개선하기 위해, 본 연구에서는 CAFFM을 제안하였습니다. SegFormer-B2 인코더는 CAFFM 모듈에 시맨틱 특징 맵을 제공하며, CycleGAN 재구성 단계는 생성적 특징 맵을 제공합니다. 먼저, 선형 투영 층을 사용하여 두 특징 스트림을 공통 임베딩 공간으로 투영합니다. 교차 주의(cross-attention) 계산을 위해, 생성된 특징 텐서를 사용하여 쿼리(Q), 키(K), 값(V) 표현을 생성합니다. 이후 멀티헤드 교차 주의를 사용하여 구조적 모티프 정보와 예술적 스타일 요소 간의 관계를 모델링합니다. 그 다음, 융합된 특징 표현에 레이어 정규화, 잔차 연결 및 GELU 활성화 함수가 적용된 피드포워드 층을 적용합니다. SPADE 기반 합성 단계는 CAFFM 모듈의 출력을 전달받아, 예술적 일관성을 해치지 않으면서 문화적으로 의미 있는 테마를 보존할 수 있게 합니다.
특징 간의 호환성을 보장하기 위해, 입력 특징들은 먼저 선형 투영 층을 통해 임베딩 차원이 256인 공유 임베딩 공간으로 투영됩니다. 그 후, 시맨틱 구조 정보와 생성적 스타일 표현 사이의 상호 연결은 8개의 어텐션 헤드를 가진 MultiHead Cross-Attention 메커니즘을 사용하여 모델링됩니다. 교차 어텐션(Cross-attention) 계산에는 특정 선형 변환 층에 의해 생성된 Query (Q), Key (K), Value (V) 벡터가 사용됩니다. 학습 안정성을 높이고 특징의 무결성을 유지하기 위해, 잔차 연결(residual connections)과 Layer Normalization을 적용하여 융합된 특징 표현을 더욱 강화합니다. 이후 Gaussian Error Linear Unit (GELU) 활성화 함수가 적용된 피드포워드 네트워크를 통해 비선형 특징 학습을 개선합니다. 이 모듈을 통해 차원이 256인 출력 특징 표현이 생성되며, 이는 창의적 합성을 위해 다른 단계로 전달됩니다. CAFFM은 교차 어텐션 기반의 융합 기법을 사용하여 예술적 스타일 데이터와 문화적 모티프 구조를 성공적으로 결합하며, 이를 통해 재구성된 문화 유산 패턴에서 모티프 보존과 시각적 일관성을 향상시킵니다.
제안된 시스템에서 구조적 특징은 Miao Batik 데이터셋에서 도출되며, 스타일 특징은 WikiArt 데이터셋에서 학습됩니다. Miao Batik 데이터셋의 이미지를 사용한 SegFormer 세그멘테이션 네트워크에서 도출된 특징 맵을 Fs로, WikiArt 이미지를 사용한 스타일 특징 추출 분기에서 도출된 특징 맵을 Fa로 정의합니다. 제안된 CAFFM은 교차 주의(cross-attention) 메커니즘을 사용하여 두 특징 도메인을 결합함으로써 문화적 패턴의 구조적 및 스타일적 의존성을 모두 학습합니다. 표 3에는 임베딩 차원, 정규화 층, 활성화 함수 및 어텐션 헤드 구성을 포함한 모든 아키텍처 특성이 기록되어 있습니다. 256 × 256 픽셀의 입력 이미지 크기에 대해, SegFormer-B2 인코더는 64 × 64 × 128 크기의 시맨틱 특징 맵을 생성했고, 스타일 특징 추출 분기는 64 × 64 × 128 크기의 특징 맵을 생성했습니다. 두 특징 맵은 교차 주의 융합 전, 학습 가능한 선형 층을 통해 256 차원의 공유 임베딩 공간으로 투영되었습니다.
| 매개변수 | 설정 |
| 제안된 프레임워크 | SegCycle-SPADE |
| 시맨틱 세그멘테이션 모델 | SegFormer-B2 |
| SegFormer 인코더 단계 | 4 |
| 가중치 초기화 | ImageNet-1K 사전 학습된 SegFormer-B2 (MIT-B2 백본) |
| 체크포인트 출처 | 공식 NVIDIA SegFormer 리포지토리 (https://github.com/NVlabs/SegFormer); 체크포인트: segformer.b2.512x512.ade.160k |
| 미세 조정 전략 | Miao Batik 데이터셋에 대한 엔드투엔드 미세 조정 |
| 패치 임베딩 크기 | 7 × 7 |
| 패치 스트라이드 | 4 |
| 임베딩 차원 | 64, 128, 320, 512 |
| 인코더 깊이 | 3, 4, 6, 3 |
| 어텐션 헤드 | 1, 2, 5, 8 |
| 디코더 유형 | All-MLP 디코더 |
| 활성화 함수 | GELU |
| 드롭아웃 비율 | 0.1 |
| 특징 강화 모듈 | 교차 어텐션 문화적 특징 융합 모듈 (CAFFM) |
| CAFFM 임베딩 차원 | 256 |
| CAFFM 어텐션 헤드 | 8 |
| CAFFM 융합 스케일 | 4 |
| 재구성 모델 | CycleGAN |
| 스타일 생성 모델 | SPADE |
| 문화 데이터셋 | Miao Batik 데이터셋 |
| 스타일 데이터셋 | WikiArt 데이터셋 |
| Miao Batik 이미지 수 | 15,148 |
| WikiArt 이미지 수 | 약 80,0 |
| 입력 이미지 해상도 | 256 × 256 pixels |
| 색상 형식 | RGB |
| 보간법 | 쌍선형 보간법 |
| 노이즈 제거 방법 | 가우시안 필터링 |
| 가우시안 커널 크기 | 5 × 5 |
| 가우시안 시그마 (σ) | 1 |
| 정규화 범위 | [0, 1] |
| 배치 크기 | 16 |
| 에포크 수 | 100 |
| 옵티마이저 | Adam |
| 학습률 | 0.02 |
| Adam 매개변수 | β₁ = 0.5, β₂ = 0.9, ε = 1 × 10⁻⁸, 가중치 감쇠 = 0 |
| 손실 함수 | 세그멘테이션 손실, 적대적 손실, 사이클 일관성 손실, 재구성 손실, 모티프 보존 손실 및 스타일 일관성 손실 |
| 데이터셋 분할 전략 | 훈련 / 검증 / 테스트 |
| 훈련 세트 | 70% |
| 검증 세트 | 15% |
| 테스트 세트 | 15% |
| 랜덤 시드 | 42 |
| 평가 지표 | 세그멘테이션 정확도, IoU, Dice 계수, SSIM, PSNR 및 FID |
| 프로그래밍 언어 | Python 3.8.10 |
| 딥러닝 프레임워크 | PyTorch 1.10.0 |
| 하드웨어 플랫폼 | NVIDIA RTX 3090 GPU (24 GB VRAM), Intel Core i7 (1세대), 32 GB RAM |
| 운영 환경 | Ubuntu 20.04 LTS |
표 3: 실험 설정 및 모델 구성. 제안된 SegCycle-SPADE 프레임워크의 구현 및 평가에 사용된 아키텍처 구성 요소, 학습 설정, 전처리 설정, 데이터셋, 최적화 파라미터, 평가 지표 및 컴퓨팅 환경의 요약.
어텐션 모듈은 먼저 식 10을 사용하여 특징 맵을 쿼리, 키, 밸류 표현으로 매핑합니다:
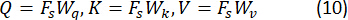
여기서는, Wq, Wk및 Wv 학습 가능한 가중치 행렬입니다. 어텐션 가중치는 쿼리 벡터와 키 벡터 사이의 유사도를 기반으로 다음을 사용하여 계산됩니다. 식 117:
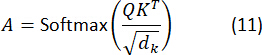
여기에서, dk 키 벡터의 차원입니다. 향상된 특징 표현은 다음을 사용하여 어텐션 가중치와 밸류 행렬을 곱함으로써 계산됩니다. 식 12:
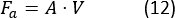
여기에, Fa 특성 맵의 강화된 특성 표현입니다. 강화된 특성 표현은 기존의 세분화 특성과 어텐션 메커니즘을 통해 얻은 강화된 특성을 결합하여 계산하며, 여기에는 다음이 사용됩니다. 식 13:
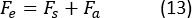
여기에, Fe 강화된 특징 맵(feature map)은 패턴 재구성에 사용됩니다. CAFFM은 다양한 규모의 문화적 모티프에 대한 특징을 추출하기 위해 다중 스케일 교차 주의 집중(multiscale cross-attention) 메커니즘으로 확장됩니다. 다음과 같이 정의합니다. Fsi 스케일에 따른 세그멘테이션 특징을 나타내십시오. i, 한편 Faj 동일한 스케일의 예술적 스타일 특징을 나타냅니다. 최종 특징 표현은 다음과 같이 정의됩니다. 식 14:
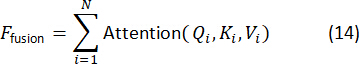
여기서 Qi, Ki, Vi는 각각 스케일 i에서의 쿼리, 키, 값 행렬을 나타내며, N은 특징 스케일의 수를 의미합니다. 본 연구에서는 N = 4이며, 이는 입력 이미지 크기의 1/4, 1/8, 1/16, 1/32 공간 해상도에서 추출된 특징 맵에 해당합니다. 이러한 다중 스케일 특징 표현은 재구성 및 예술적 합성에 앞서 학습 가능한 어텐션 가중치를 사용하여 융합되었습니다. 위와 같은 확장을 통해 본 방법은 문화적 패턴을 재구성하기 위한 전역적 문화 모티프와 텍스처를 추출할 수 있습니다. CAFFM은 제안된 SegCycle-SPADE 시스템에서 SegFormer 기반의 세그멘테이션 단계와 SPADE 기반의 창의적 합성 단계 사이에 위치합니다. 먼저, CycleGAN이 스타일 및 패턴 관련 정보가 포함된 재구성 특징을 동시에 생성하는 동안, SegFormer-B2는 문화적 모티프의 구조적 특성을 묘사하는 시맨틱 특징 맵을 복원합니다. CAFFM 모듈은 이 두 특징 스트림을 입력받아 교차 어텐션 기반 융합을 통해 구조적 표현과 예술적 표현 사이의 관계를 식별합니다. 이후 시맨틱 일관성과 구조적 특징을 유지하면서 문화적으로 정통한 패턴을 생성하기 위해, 융합된 특징 맵은 세그멘테이션 가이드 창의적 합성을 위해 SPADE 모듈로 전송됩니다.
CycleGAN을 이용한 패턴 재구성
어텐션 기반의 특징 강화 단계가 완료되면, 특징 맵에는 강화된 문화적 모티프 구조가 포함됩니다. 하지만 특징 맵에는 여전히 불완전하거나 손상된 패턴 영역이 포함되어 있을 수 있습니다. 따라서 패턴 재구성 문제를 해결하기 위해, 제안된 프레임워크에서는 CycleGAN 모델을 사용합니다. 제안된 프레임워크에서 두 개의 도메인은 원래의 문화적 모티프 패턴과 재구성된 문화적 모티프 패턴이 됩니다. 이전 단계에서 얻은 강화된 특징을 사용하여, CycleGAN 모델은 구조적 일관성을 유지하면서 문화적 패턴을 재구성합니다. 이를 통해 기하학적 패턴, 꽃무늬 패턴 및 상징적 패턴과 같은 문화적 패턴이 공간적 배치를 유지하도록 보장합니다. 원래의 묘족 바틱(Miao Batik) 이미지는 불완전하거나 손상된 문화적 모티프를 생성하기 위해 무작위 마스킹 및 부분 가림 처리를 거쳤습니다. 이러한 퇴화 절차는 훼손된 문화 유산 유물에서 흔히 관찰되는 패턴 영역의 결손과 구조적 손상을 모의하였습니다. 퇴화된 이미지는 재구성 모듈의 입력값으로 사용되었으며, 이에 대응하는 원본 이미지는 성능 평가 및 재구성 품질 평가를 위한 참조 이미지로 활용되었습니다. 이러한 전략을 통해 모델은 세그먼트의 의미적 일관성과 문화적 특성을 보존하면서 누락된 모티프 구조의 복원을 학습할 수 있었습니다.
X를 불완전한 문화적 패턴의 도메인이라 하고, Y를 재구성된 문화적 패턴의 도메인이라고 하자. 두 생성기는 식 15를 사용하여 양방향 매핑을 수행하도록 학습한다:
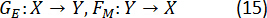
여기서 GE는 모티프 구조를 재구성하는 데 사용되며, FM은 패턴을 원래의 도메인으로 다시 매핑하는 데 사용됩니다. 적대적 손실은 재구성된 패턴이 사실적임을 보장하기 위해 사용됩니다 (식 16)30
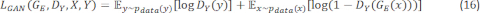
여기에, DY 판별자(discriminator)는 실제 패턴과 재구성된 패턴을 구분하는 데 사용되며, GE(x) 생성된 재구성 패턴을 나타냅니다. 또한 CycleGAN은 문화적 모티프의 구조적 배치를 보존하기 위해 사이클 일관성(cycle consistency)을 강제합니다.수식 17)30.
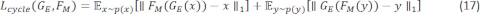
최종 손실 함수는 식 1830을 사용하여 정의됩니다.
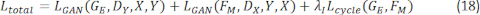
여기서 λi는 사이클 일관성 손실(cycle-consistency loss)에 대한 가중치 계수를 나타내며, 원래의 CycleGAN 정식화와 일관되게 학습 과정 동안 10으로 설정되었습니다. 이 값은 적대적 학습과 소스 및 타겟 도메인 간의 재구성 일관성 사이의 균형을 맞추기 위해 선택되었습니다.
CycleGAN 재구성 모듈은 양방향 이미지 변환을 위해 두 개의 생성자와 두 개의 판별자로 구성됩니다. 각 생성자는 초기 7 × 7 컨볼루션 층, 이어서 두 개의 다운샘플링 컨볼루션 층, 9개의 잔차 블록(residual blocks), 그리고 두 개의 업샘플링 층으로 이루어진 잔차 네트워크 아키텍처를 따릅니다. 입력 층은 향상된 특징 추출을 위해 7 × 7 커널을 사용하며, 이를 제외한 모든 컨볼루션 연산에는 3 × 3 커널 크기를 적용합니다. 학습 안정성을 높이기 위해 각 컨볼루션 층 이후에 인스턴스 정규화(Instance Normalization)를 적용하였으며, 생성자 네트워크 전반에 걸쳐 ReLU 활성화 함수를 사용하였습니다. 출력 층에는 정규화된 이미지 출력을 생성하기 위해 Tanh 활성화 함수를 사용합니다. 판별자는 4 × 4 커널 크기의 컨볼루션 층이 연속되고 특징 채널이 점진적으로 증가하는 70 × 70 PatchGAN 아키텍처를 따릅니다. 판별자에서는 특징 판별 및 적대적 학습을 개선하기 위해 인스턴스 정규화와 LeakyReLU 활성화 함수(negative slope = 0.2)를 사용하였습니다. CycleGAN 모듈은 전처리된 문화적 모티브 이미지를 입력으로 받아 재구성된 패턴 표현을 생성하며, 이는 이후 세그멘테이션 특징과 통합하기 위해 CAFFM으로 전달됩니다. CycleGAN 학습은 Adam 옵티마이저(β₁ = 0.5, β₂ = 0.9)를 사용하였으며, 초기 학습률은 0.002로 설정하였습니다. 학습률은 처음 10 에포크 동안 유지되었으며, 이후 나머지 학습 기간 동안 선형적으로 0까지 감소하였습니다. 판별자 학습을 안정화하기 위해 이전에 생성된 이미지 50장을 포함하는 리플레이 버퍼(replay buffer)를 사용하였습니다. 생성자와 판별자는 1:1 업데이트 비율을 사용하여 업데이트되었으며, 각 학습 반복마다 한 번의 생성자 업데이트 후 한 번의 판별자 업데이트가 수행되었습니다.
CycleGAN의 재구성 프로세스는 그림 5의 CAFFM 메커니즘을 통해 얻은 강화된 특징 맵(feature maps)을 기반으로 합니다. 이 특징 맵에는 이전의 세그멘테이션 및 CAFFM 단계에서 얻은 강화된 문화적 모티프가 포함되어 있습니다. 이 특징 맵은 첫 번째 생성기 GE의 입력값으로 사용됩니다. 첫 번째 생성기 GE는 문화적 패턴을 재구성하는 데 필요한 매핑을 학습합니다. 이후 출력값은 판별기 DY로 전달되어 실제 문화적 패턴과 재구성된 패턴을 구별하게 됩니다. 판별기 DY는 생성기 GE가 사실적인 출력을 생성하도록 돕습니다. 재구성 과정에서 문화적 패턴이 왜곡되지 않도록 하기 위해, 두 번째 생성기 FM이 사이클 일관성(cycle-consistency) 매핑을 수행합니다. 두 번째 생성기 FM은 출력값을 다시 원래 도메인으로 매핑합니다. 이후 출력값은 판별기에 의해 평가되어 사실성을 보장받습니다. 최종 출력값은 제안된 SegCycle-SPADE 프레임워크의 다음 단계인 예술적 스타일 생성을 위해 SPADE 모듈로 전달됩니다.
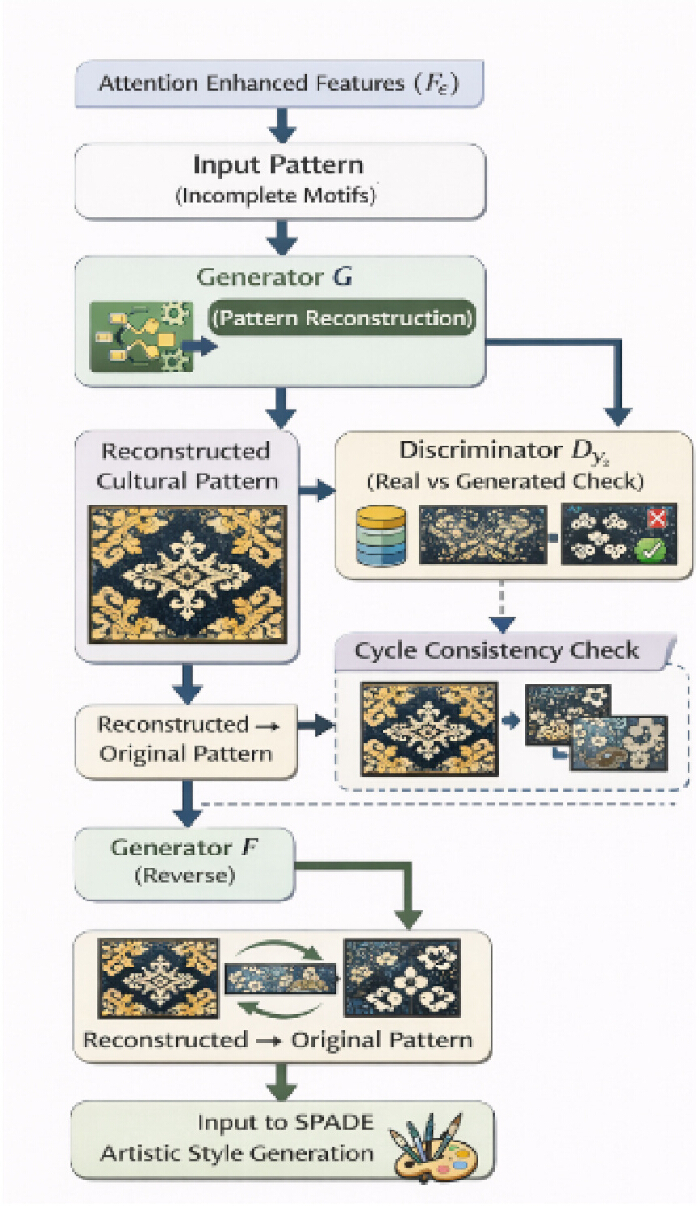
그림 5CycleGAN 기반 패턴 재구성 워크플로우. CycleGAN 재구성 모듈의 워크플로우. 불완전한 문화적 모티프를 재구성하기 위해 어텐션 강화 특성 표현(attention-enhanced feature representations)이 생성자 네트워크의 입력값으로 제공된다. 판별자는 재구성된 결과물을 참조 패턴과 비교하여 평가하며, 사이클 일관성 매핑(cycle-consistency mapping)은 양방향 이미지 변환 과정에서 구조적 무결성을 유지한다. 재구성된 모티프는 이후 예술적 스타일 합성을 위해 SPADE 모듈로 전달된다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
SPADE를 이용한 예술적 스타일 생성
그 후, 재구성된 문화적 모티프는 예술적 스타일 생성을 위해 SPADE 모듈에 적용됩니다. SPADE 모듈의 주요 목표는 모티프의 구조적 배치를 손상시키지 않으면서 재구성된 문화적 모티프에 시각적으로 더욱 풍부한 예술적 스타일의 텍스처를 추가하는 것입니다. SPADE 모듈은 이미지 생성을 위해 이미지 분할(image segmentation) 개념을 활용하는 조건부 이미지 생성 기술입니다. 미리 정의된 모티프 클래스에 해당하는 다채널 세만틱 맵(semantic maps)이 SegFormer-B2에서 생성된 세만틱 분할 마스크로부터 인코딩되었습니다. SPADE 생성기는 이러한 인코딩된 맵을 조건부 입력으로 받았습니다. 공간 적응형 스케일(γ) 및 바이어스(β) 파라미터는 각 SPADE 층 내의 컨볼루션 층을 통해 세만틱 맵을 처리함으로써 생성되었습니다. 생성기는 정규화된 특징 활성화에 이러한 파라미터를 적용함으로써 예술적 합성 과정 동안 모티프 경계, 구조적 배치 및 세만틱 정보를 유지할 수 있었습니다. 조건화 과정이 SPADE 생성기의 여러 층에서 수행되었기 때문에, 세만틱 가이딩은 고수준의 구조적 재구성과 저수준의 텍스처 합성에 모두 영향을 줄 수 있었습니다. 결과적으로, 생성된 예술적 패턴은 분할 단계에서 발견된 문화적 모티프 구조를 유지하면서 WikiArt 데이터셋에서 얻은 스타일적 특성을 통합하였습니다.
르네상스, 인상주의, 입체주의, 표현주의, 초현실주의, 사실주의 및 추상 미술 등 27가지의 다양한 예술 범주를 포함하는 WikiArt 데이터셋이 예술적 스타일을 이해하기 위한 주요 리소스로 사용되었습니다. 모델이 다양한 창의적 특성에 노출되게 하여 스타일 일반화 능력을 향상시키기 위해, 학습 과정 중 여러 범주에서 스타일 이미지를 무작위로 선택하였습니다. 스타일 편향을 줄이기 위해 데이터셋은 예술 범주가 균형 있게 표현되도록 학습, 검증 및 테스트 하위 집합으로 나누었습니다. 27개 모든 예술 범주의 균형 잡힌 표현을 보장하기 위해 층화 추출법(stratified sampling)이 사용되었습니다. 각 범주의 샘플은 원래의 클래스 분포를 유지하면서 학습, 검증 및 테스트 하위 집합에 비례적으로 할당되었습니다. WikiArt 이미지에서 도출된 스타일 요소와 CycleGAN에 의해 생성된 재구성 특징을 결합하기 위해 CAFFM 모듈이 사용되었습니다. 합성 네트워크가 세그멘테이션 맵에서 도출된 시맨틱 구조와 문화적 모티프 경계를 유지하면서 예술적 특성을 전이할 수 있도록, 결과적으로 융합된 표현형을 SPADE 생성기에 조건부 정보로 제공하였습니다. 이러한 스타일 조건화 기법 덕분에 제안된 프레임워크는 일관된 구조적 및 스타일적 표현을 가진 문화적으로 정통한 예술적 패턴을 생성할 수 있었습니다.
SPADE는 또한 세그멘테이션 맵에 따라 달라지는 공간 적응형 파라미터를 도입합니다. 이 파라미터들은 다음과 같이 정의될 수 있습니다. 식 191:
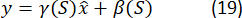
여기서 γ(S)는 공간적으로 변하는 스케일 매개변수이며 β(S)는 공간적으로 변하는 바이어스 매개변수입니다. 이 매개변수들은 생성자가 이미지의 시맨틱 영역에 따라 서로 다른 질감과 스타일을 생성하도록 돕습니다. 최종 문화 예술 작품은 수식 20에 표시된 것과 같이 정의될 수 있습니다.
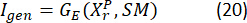
여기서 GE는 SPADE 생성기이고, XrP는 재구성된 패턴이며, SM은 세그멘테이션 맵입니다. 최종 결과물은 문화적 모티프의 구조적 무결성을 유지하면서 예술적 외관을 향상시킵니다. 제안된 SegCycle-SPADE 아키텍처를 최적화하기 위해 시맨틱 세그멘테이션 정확도, 문화적 모티프 보존, 패턴 재구성 품질 및 예술적 스타일 일관성의 균형을 맞추는 복합 손실 함수가 사용되었습니다. 전체 학습 목표를 설정하기 위해 세그멘테이션 손실(Lseg), 적대적 손실(Ladv), 사이클 일관성 손실(Lcycle), 재구성 손실(Lrecon), 모티프 보존 손실(Lmotif) 및 스타일 일관성 손실(Lstyle)의 가중치 혼합이 사용되었습니다. 총 손실 함수는 식 21에 정의되어 있습니다.
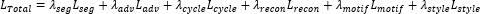 (21)
입력 이미지와 재구성된 문화적 모티프 사이의 구조적 일관성을 보장하기 위해, 사이클 일관성 손실 계수는 10으로 설정되었습니다. 세밀한 모티프 특징을 유지하고 시각적 정확도를 높이기 위해, 재구성 손실 계수는 5로 설정되었습니다. 예술적 합성 과정에서 문화적으로 중요한 구조적 패턴의 보존을 강조하기 위해, 모티프 보존 손실 계수는 2로 설정되었습니다. 세만틱 모티프 구조를 과도하게 왜곡하지 않으면서 예술적 스타일 전이를 촉진하기 위해, 스타일 일관성 손실 계수는 1로 조정되었습니다. 실사 이미지 생성과 정밀한 모티프 세그멘테이션 사이의 균형 잡힌 기여도를 유지하기 위해, 세그멘테이션 손실과 적대적 손실에 동일한 가중치를 부여하였습니다. 스타일 일관성 손실을 계산하기 위해 WikiArt 데이터셋의 특징 기반 스타일 표현이 사용되었습니다. 특히, 심층 특징 맵(deep feature maps)에서 추출한 Gram 행렬 상관관계를 통해 예술적 스타일 특성을 포착하였습니다. Equation 2에 나타난 바와 같이, 타겟 스타일 이미지와 생성된 이미지의 Gram 행렬 간 프로베니우스 노름(Frobenius norm) 차이를 이용하여 스타일 손실을 계산하였습니다.
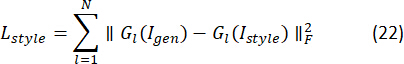
여기, G입력된 텍스트가 없습니다. 번역할 내용을 제공해 주십시오. Gram 행렬은 다음으로부터 계산됩니까? 제공된 텍스트가 없습니다. 번역할 내용을 입력해 주세요.th 피처 레이어, I제공된 텍스트가 없습니다. 번역할 내용을 입력해 주세요. 생성된 예술적 이미지를 나타내며, I스타일 는 WikiArt 데이터셋의 타겟 스타일 이미지를 나타내며, F 는 프로베니우스 노름(Frobenius norm)을 나타냅니다. 이러한 정식화를 통해 제안된 프레임워크는 문화적 모티프의 구조적 및 세만틱 무결성을 유지하면서 예술적 특성을 보존할 수 있습니다.
CAFFM 모듈에 의해 생성된 융합 특징 표현은 제안된 프레임워크의 예술적 합성 구성 요소인 SPADE 모듈의 조건부 입력으로 사용됩니다. SPADE 생성기는 256채널의 잠재 특징 차원을 가진 7개의 SPADE 잔차 블록으로 구성되며, 256 × 256 픽셀 해상도의 출력 이미지를 생성합니다. SegFormer–CAFFM 모듈에서 얻은 시맨틱 세그멘테이션 맵은 SPADE 잔차 레이어 전반에 걸쳐 조건부 입력으로 사용됩니다. SPADE 레이어는 각 잔차 블록 내의 활성화 함수 이전에 적용되어 세그멘테이션 기반의 시맨틱 조건화를 가능하게 합니다. 연속적인 업샘플링 및 컨볼루션 연산을 통해 잠재 특징 표현이 점진적으로 정제되어, 시맨틱 일관성과 모티프 구조를 유지하면서 고해상도 예술 패턴을 생성합니다. 생성기 전반에는 LeakyReLU 활성화 함수가 사용되며, 출력 레이어에는 정규화된 이미지를 생성하기 위해 Tanh 활성화 함수가 적용됩니다.
알고리즘 및 워크플로우
SegCycle-SPADE 프레임워크는 통합된 학습 파이프라인 내에서 시맨틱 세그멘테이션, 특징 융합, 패턴 재구성 및 예술적 스타일 합성을 통합합니다. 워크플로우는 이미지 크기 조정, 정규화, 노이즈 제거 및 세그멘테이션 마스크 준비를 포함한 데이터셋 획득 및 전처리와 함께 시작됩니다. 전처리된 이미지는 이후 SegFormer-B2 세그멘테이션 네트워크를 사용하여 처리되어 시맨틱 모티프 표현을 추출합니다. 결과로 얻은 세그멘테이션 특징은 CAFFM을 통해 재구성 특징과 융합되어, 구조적 모티프 정보와 예술적 특징 표현 간의 상호작용을 가능하게 합니다. 융합된 특징 맵은 이후 CycleGAN 재구성 모듈로 전달되어, 시맨틱 일관성을 유지하면서 불완전한 문화적 모티프 구조를 복원합니다. 재구성된 패턴은 이후 세그멘테이션 가이드 기반의 예술적 합성을 위해 SPADE 생성기로 제공되어, 모티프 경계와 구조적 진위성을 유지하면서 스타일적 향상을 가능하게 합니다. 학습 과정에서 모델 파라미터는 수식 21 및 2에 설명된 복합 손실 함수를 사용하여 최적화되며, 이는 세그멘테이션 정확도, 모티프 보존, 재구성 품질 및 예술적 스타일 일관성의 균형을 맞춥니다. 데이터셋 로딩, 전처리, 모델 초기화, 학습 반복, 검증 절차, 체크포인트 선택 및 최종 평가를 포함한 상세한 단계별 구현 워크플로우는 보충 파일 1 (알고리즘 1)에 제공됩니다. 전체 알고리즘 워크플로우는 배치 크기 16, 학습률 0.02, 10 epoch의 학습 횟수로 구현되었습니다. 데이터셋 분할, 모델 초기화 및 모든 학습 실험에는 42의 고정된 랜덤 시드가 사용되었습니다. 재현성을 보장하기 위해 Python, NumPy 및 PyTorch 난수 생성기에 걸쳐 시드가 일관되게 적용되었습니다. Adam 최적화는 β₁ = 0.5, β₂ = 0.9, 가중치 감쇠 없음(weight decay = 0)으로 설정되었습니다. 모델 체크포인트는 검증 데이터셋에서 달성한 가장 높은 검증 IoU 점수를 기준으로 선택되었습니다.
손실 함수 최적화
재구성 및 예술적 합성과정에서 문화적 모티프 구조를 보존하기 위해, 제안된 프레임워크는 세그멘테이션, 적대적, 사이클 일관성, 재구성, 모티프 보존 및 스타일 일관성 손실을 결합한 복합 최적화 목적 함수를 사용합니다. 전체 수학적 공식, 가중치 계수 및 스타일 손실 정의는 SPADE를 이용한 예술적 스타일 생성 하위 섹션의 수식 21 및 2에 제공되어 있습니다. 모티프 보존 구성 요소는 예측된 모티프 영역과 해당 그라운드 트루스(ground-truth) 세그멘테이션 마스크 사이의 구조적 편차에 페널티를 부여함으로써, 재구성 프로세스 전반에 걸쳐 문화적으로 중요한 패턴 구조가 보존되도록 유도합니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
결과
제안된 SegCycle-SPADE 프레임워크는 묘족 바틱(Miao Batik) 문화 모티프 데이터셋과 WikiArt 데이터셋의 두 가지 데이터셋을 사용하여 평가되었습니다. 묘족 바틱 데이터셋은 전통 문화유산 이미지를 포함하며 주로 시맨틱 세그멘테이션 및 구조적 재구성 작업에 사용된 반면, WikiArt 데이터셋은 다양한 예술적 스타일을 포함하며 예술적 스타일 학습 및 생성에 사용되었습니다. 두 데이터셋의 이미지들은 시맨틱 세그멘테이션, CAFFM, 패턴 재구성 및 SPADE 기반의 예술적 스타일 생성을 포함하는 전체 SegCycle-SPADE 파이프라인을 통해 처리되었습니다. 문화적 모티프 정보와 예술적 스타일 표현의 통합을 통해 프레임워크는 문화적으로 의미 있고 시각적으로 일관된 결과물을 생성할 수 있었습니다.
모든 실험은 Intel Core i7 프로세서와 NVIDIA GPU가 장착된 GPU 활성화 워크스테이션에서 수행되었습니다. 구체적으로, Intel Core i7(1세대)...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
토론
전통 공예의 점진적인 소실로 인해 최근 무형문화유산(ICH) 패턴의 보존 및 디지털 복원이 점점 더 많은 관심을 받고 있습니다. 이전 연구들은 딥러닝(DL) 기반의 이미지 처리 기술을 통해 문화유산의 손실 문제를 해결하려 시도해 왔습니다. 예를 들어, Quan 등32은 구이저우 묘족 바틱 문화를 위해 지식 그래프와 DL 기반의 문화유산 보존 프레임워크를 제안했습니다. 해당 연구는 문화 패턴의 디지털 복원에 중점을 두었으나, 그 방법론은 주로 지식 그래프 표현에 의존했습니다. 마찬가지로 Fu와 Razmjooy16는 문화유산 이미지의 강화 및 복원을 위해 피라미드 특징 네트워크(FPN) 기반의 프레임워크를 제안했습니다. 이 방법은 이미지 강화를 위한 효과적인 특징 추출을 제공했지만, 불완전한 문화 패턴에 대한 이미지 세그멘테이션 가이드나 생성적 복원 메커니즘을 포함하지 않았습니다. 이와 대조적으로, 제안된 SegCycle-SPADE 프레임워크는 이...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
공개 사항
이해상충:
저자들은 경쟁 관계에 있는 이해관계가 없음을 밝힙니다.
감사의 글
저자들은 본 연구를 수행하는 동안 광동공정폴리테크닉(Guangdong Engineering Polytechnic)과 화남사범대학교(South China Normal University)에서 제공한 학술적 및 제도적 지원에 감사를 표합니다. 본 연구는 “디지털 재생 박물관: 중국 고전 서화 문화유산의 활성화 및 소통에 관한 연구”라는 제목의 2023년 국가사회과학기금 일반 프로젝트(No. 23BH161)의 지원을 받았습니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| Adam Optimizer | PyTorch Optimizer 라이브러리 | Adam | 모델 학습 중에 사용되는 최적화 알고리즘. |
| CUDA Toolkit | NVIDIA Corporation | CUDA 11.3 | 딥러닝 연산을 위한 GPU 가속. |
| cuDNN | NVIDIA Corporation | cuDNN 8.2 | 학습 및 추론 속도를 높이는 데 사용되는 딥 뉴럴 네트워크 가속 라이브러리. |
| CycleGAN | University of California, Berkeley / 오픈 소스 | 공식 PyTorch 구현체 (https://github.com/junyanz/pytorch-CycleGAN-and-pix2pix) | 문화적 모티프 복원에 사용되는 생성적 적대 신경망. |
| ImageNet 사전 학습 가중치 | ImageNet / 오픈 소스 | mit_b2.pth (ImageNet-1K 사전 학습 체크포인트) | Miao Batik 데이터셋으로 미세 조정하기 전 SegFormer-B2 백본을 초기화하는 데 사용됨. |
| Intel 프로세서 | Intel Corporation | Intel Core i7 (11세대) | 이미지 전처리, 모델 학습 지원 및 추론에 사용되는 CPU. |
| Matplotlib | Matplotlib 개발 팀 | Matplotlib 3.5.1 | 학습 곡선 및 평가 결과의 시각화. |
| Miao Batik 데이터셋 | Zenodo 리포지토리 | DOI: 10.5281/zenodo.20807658 | 시맨틱 세그멘테이션 및 패턴 복원에 사용되는 15,148장의 이미지가 포함된 문화적 모티프 데이터셋. |
| NumPy | NumPy 개발자 | NumPy 1.21.5 | 수치 연산 및 데이터셋 처리. |
| NVIDIA GPU | NVIDIA Corporation | NVIDIA RTX 3090 (24 GB VRAM) | 모델 학습 및 추론에 사용되는 하드웨어 플랫폼. |
| OpenCV | OpenCV Foundation | OpenCV 4.5.5 | 이미지 전처리, 크기 조정, 보간 및 가우시안 노이즈 제거. |
| 운영 체제 | Canonical Ltd. | Ubuntu 20.04 LTS | 실험 실행 환경. |
| Pillow (PIL) | Python Imaging Library | Pillow 8.4.0 | 이미지 로딩 및 조작. |
| Python | Python Software Foundation | Python 3.8.10 | 구현 및 실험에 사용된 프로그래밍 언어. |
| PyTorch | Meta AI | PyTorch 1.10.0 | 모델 학습 및 추론에 사용되는 딥러닝 프레임워크. |
| 랜덤 시드 | 실험 설정 | 42 | 데이터셋 분할, 모델 초기화 및 실험 재현성을 위해 사용된 고정 시드. |
| Scikit-learn | Scikit-learn 개발자 | Scikit-learn 1.0.2 | 데이터셋 분할, 통계 분석 및 평가 지표. |
| Seaborn | 오픈 소스 커뮤니티 | Seaborn 0.11.2 | 통계 데이터 시각화. |
| SegFormer-B2 | NVIDIA Research / 오픈 소스 | SegFormer-B2 (MIT-B2 백본) | 문화적 모티프 세그멘테이션에 사용되는 Transformer 기반 시맨틱 세그멘테이션 모델. |
| 세그멘테이션 마스크 / 어노테이션 | Miao Batik 데이터셋 | 데이터셋에 포함됨 | 모티프 분류 및 학습에 사용되는 픽셀 수준의 시맨틱 세그멘테이션 레이블. |
| SPADE | NVIDIA Research / 오픈 소스 | 공식 PyTorch 구현체 (https://github.com/NVlabs/SPADE) | 예술적 패턴 생성에 사용되는 세그멘테이션 가이드 이미지 합성 모델. |
| TorchVision | Meta AI | TorchVision 0.11.1 | PyTorch와 함께 사용되는 이미지 처리 유틸리티 및 데이터셋 변환. |
| WikiArt 데이터셋 | WikiArt | https://www.wikiart.org/ | 스타일 학습 및 합성에 사용되는, 27가지 예술 스타일에 걸쳐 80,000점 이상의 예술 작품이 포함된 예술 스타일 데이터셋. |
참고문헌
- Huang B, Mo L. SegCycle-SPADE: An end-to-end framework for semantic segmentation-based automated extraction and artistic reconstruction of traditional craft patterns using conditional GAN. PLoS ONE. 2025;20:e0329100.
- Yan Z, et al. Digital sustainability of heritage: Exploring indicators affecting the effectiveness of digital dissemination of intangible cultural heritage through qualitative interviews. Sustainability. 2025;17:1593.
- Yan Z, et al. Construction of digital dissemination effects evaluation indicator system of traditional techniques of intangible cultural heritage. npj Heritage Science. 2025;13:224.
- Imon SS. Intangible cultural heritage as a tourism product in the historic city of Macao. In: Sustainable Management of Historic Settlements in Asia: Role of Intangible Cultural Heritage. Springer Nature Singapore; Singapore. 2025. p.233-240.
- Buragohain D, et al. Digitalizing cultural heritage through metaverse applications: Challenges, opportunities, and strategies. Heritage Science. 2024;12:295.
- Ma Y. The ghostly ethics of mediatized shaping: Cultural memory creative transformation of Anhui’s ICH in reviving the craftsmanship. Journal of Current Social Issues Studies. 2025;2:240-249.
- Wanju T, Wang Z, Tu Y. ICH and e-commerce: Bridging tradition and modernity in cultural creative products. Journal of Economics, Management and Trade. 2025;31:1-8.
- Sun L, et al. Research on the redesign of China’s intangible cultural heritage based on sustainable livelihood—The case of Luanzhou shadow play empowering rural development. Sustainability. 2024;16:4555.
- Pan S, et al. Constructing a sustainable evaluation framework for AIGC technology in Yixing Zisha pottery: Balancing heritage preservation and innovation. Sustainability. 2025;17:910.
- Na Z, Sharul Azim SR. Research on innovative development of Miao embroidery intangible cultural heritage in Guizhou, China based on digital design. Journal of Business and Economic Review. 2024;9:85-94.
- Guo S, Canessa A. Ethnic elder poverty: Miao household livelihoods and elderly self-sufficiency practices in Midwest China. Culture, Agriculture, Food and Environment. 2023;45:55-68.
- Han D, Cong L. Miao traditional patterns: The origins and design transformation. Visual Studies. 2023;38:425-432.
- Dong B, et al. Spatial distribution and tourism competition of intangible cultural heritage: Take Guizhou, China as an example. Heritage Science. 2023;11:64-80.
- Chen Z, Ren X, Zhang Z. Cultural heritage as rural economic development: Batik production amongst China’s Miao population. Journal of Rural Studies. 2021;81:182-193.
- Zhennan LY, Yahaya SR. An aesthetic study on traditional batik design of Miao ethnicity in China. Kupas Seni. 2021;9:12-25.
- Fu X, Razmjooy N. Preserving and enhancing cultural heritage through art design using feature pyramid network optimized by modified builder optimization algorithm. Scientific Reports. 2025;15:42603.
- Liu X, Wan J, Wang N. Ancient painting inpainting with regional attention-style transfer and global context perception. Applied Sciences. 2024;14:8777.
- Xu Q, Iwasaki M. Image restoration model of wood-structured raw lacquer cultural relics based on diffusion generation network. Journal of Asian Architecture and Building Engineering. 2025:1-19.
- Cherian A, Sullivan A. Sem-GAN: Semantically-consistent image-to-image translation [conference presentation]. Presented at: IEEE Winter Conference on Applications of Computer Vision (WACV); 2019. doi: 10.1109/WACV.2019.00196.
- Rombach R, et al. High-resolution image synthesis with latent diffusion models [conference presentation]. Presented at: IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR); 2022. p.10684-10695. Available from: http://openaccess.thecvf.com/content/CVPR2022/papers/Rombach_High-Resolution_Image_Synthesis_With_Latent_Diffusion_Models_CVPR_2022_paper.pdf.
- Gendy GGH, Nabil S. Diffusion models for image super-resolution: State-of-the-art and future directions. Neurocomputing. 2025;617:128911.
- Kazerouni A, et al. Diffusion models in medical imaging: A comprehensive survey. Medical Image Analysis. 2023;88:102846.
- Yang L, et al. Diffusion models: A comprehensive survey of methods and applications. ACM Computing Surveys. 2023;56:1-39.
- Croitoru FA, Hondru V, Ionescu RT, Shah M. Diffusion models in vision: A survey. IEEE Transactions on Pattern Analysis and Machine Intelligence. 2023;45:10850-10869.
- Cao H, et al. A survey on generative diffusion models. IEEE Transactions on Knowledge and Data Engineering. 2024;36:2814-2830.
- Po R, et al. State of the art on diffusion models for visual computing. Computer Graphics Forum. 2024;43:e15063.
- Thampanichwat C, et al. Mindful architecture from text-to-image AI perspectives: A case study of DALL-E, Midjourney, and Stable Diffusion. Buildings. 2025;15:972.
- Li W. Enhanced automated art curation using supervised modified CNN for art style classification. Scientific Reports. 2025;15:7319.
- Chen C. Algorithm and tool development for creative generation of graphic design of folk houses and ancient buildings integrating cultural and creative elements. Scalable Computing: Practice and Experience. 2024;25:4729-4736.
- Liu B, Ji J, Gu L, Jiang Z. An integrated CycleGAN-diffusion approach for realistic image generation [conference presentation]. Presented at: International Conference on Signal Processing and Machine Learning; 2024. p.92-101. doi: 10.1117/12.3027121.
- Bao Q, Zhao J, Liu Z, Liang N. AI-assisted inheritance of Qinghua porcelain cultural genes and sustainable design using low-rank adaptation and stable diffusion. Electronics. 2025;14:725.
- Quan H, et al. Protection of Guizhou Miao batik culture based on knowledge graph and deep learning. Heritage Science. 2024;12:1-22.
- Sun H, et al. HRPGAN: A GAN-based model to generate high-resolution remote sensing images. IOP Conference Series: Earth and Environmental Science. 2020;428:012060.
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. Available from: https://proceedings.neurips.cc/paper/2020/file/4c5bcfec8584af0d967f1ab10179ca4b-Paper.pdf.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.