본 연구는 중국 관련 서사를 번역하는 영어 전공자들의 의사결정 및 수정 행동을 조사하며, 키스트로크 로깅 기록과 탄막(danmu) 코퍼스를 통합하여 텍스트의 두드러짐(salience)이 처리 노력과 번역 품질에 어떠한 영향을 미치는지 밝힙니다.
이 논문에서
요약
초록
중국 중심의 서사가 국제적으로 널리 유통됨에 따라, 중-영 번역은 단순한 언어적 전이가 아닌 의미 협상의 장이 되었습니다. 학생 번역가들에게 닥치는 주요 과제는 단순히 어휘를 선택하는 것을 넘어, 문화적 함의가 짙은 참조, 평가적 태도, 그리고 서사적 배치를 원문 맥락 외부의 독자들에게 어떻게 전달할지 결정하는 것입니다. 본 연구는 중국 중심의 서사를 번역하는 영어 전공자 72명의 실시간 의사결정 및 수정 행태를 조사합니다. 프로세스-결과물 설계(process-product design)를 사용하여, Translog-II로 수집한 키스트로크 로깅 데이터, 번역 결과물 평가, 그리고 세그먼트 수준의 언어적 난이도를 직접 측정하는 것이 아니라 청중의 주목도를 나타내는 층으로 처리한 보조 단무(danmu, 시간 동기화 주석) 코퍼스를 통합하여 분석하였습니다. 번역 프로세스는 일시 중지 시간, 수정 빈도, 수정 위치 및 단계별 분포를 통해 분석되었으며, 결과물의 품질은 전문가 평가와 문화 관련 세그먼트의 표적 코딩을 통해 평가되었습니다. Bilibili 영상 24개에서 추출한 18,642개의 단무 댓글 코퍼스를 활용하여 대중적으로 주목받는 서사적 테마와 문화적 민감 표현을 식별하였습니다. 연구 결과, 문화적 함의가 크고 평가적 밀도가 높은 세그먼트에서 더 긴 일시 중지와 증가된 재귀적 수정, 그리고 프로세스 중간 단계에서의 더 밀집된 재구성 행태가 나타났습니다. 고품질의 번역은 전체 수정 횟수의 많고 적음보다는 담화 및 문화적 적응 수준에서의 선택적이고 전략적인 시점의 수정과 관련이 있는 것으로 나타났습니다. 단무에서 주목받은 서사적 트리거와 높은 노력이 투입된 번역 세그먼트 사이의 중첩은 인과관계의 증거가 아니라, 청중의 주목도와 번역가의 처리 압박이 수렴한다는 증거로 해석됩니다. 본 연구는 수정 행태를 문화적 내재 서사 번역과 연결함으로써 번역 프로세스 연구를 발전시키며, 교차 문화 소통을 위한 번역가 교육에 시사점을 제공합니다.
서론
최근 몇 년 동안 중국 관련 담론의 번역은 상대적으로 전문적인 관심사에서 국제 커뮤니케이션의 핵심 쟁점으로 이동하였습니다1. 이러한 번역에서 관건이 되는 것은 단순히 명제적 내용의 전달이 아니라, 정치적 입장, 문화적 프레임, 그리고 청중 설계를 담고 있는 공적 내러티브의 재구성입니다. 중국 정치 담론 번역에 관한 연구들은 이 점을 점점 더 명확히 해왔습니다. 즉, 중국 외부의 독자를 위해 텍스트를 번역할 때 단어 선택, 양태, 텍스트 강조점에 관한 선택은 곧 중국이 해외에서 어떻게 서술되고 해석되는지에 대한 선택이 된다는 것입니다2. 문제가 이러한 방식으로 규정되면, 결과물 중심의 접근법만으로는 불충분해집니다. 완성된 번역본은 무엇이 선택되었는지는 보여줄 수 있지만, 언제 불확실성이 나타났는지, 어디서 재구성이 시작되었는지, 혹은 서로 경쟁하는 해결책들이 어떻게 테스트되고 폐기되었는지는 보여줄 수 없기 때문입니다3.
이러한 한계점들은 왜 경험적 번역 과정 연구가 번역학 내에서 중요한 흐름이 되었는지를 설명하는 데 도움이 됩니다. 이 연구들은 최종 텍스트로부터 간접적으로 추론하기보다, 프로세스 추적 도구를 사용하여 일시 정지, 삭제, 삽입 및 의사결정의 시간적 형태를 포착합니다4. 이는 결과물 중심, 사회학적, 문화적 또는 코퍼스 기반 접근 방식을 대체하는 것이 아니라, 번역 결정이 매 순간 어떻게 형성되는지에 대한 증거를 추가하는 것입니다. 최근의 연구들은 개별적인 일시 정지를 기술하는 수준에서 벗어나, 번역을 시간적으로 구조화된 활동으로 모델링하는 방향으로 나아가고 있습니다. 예를 들어, 망설임-지향-흐름(hesitation-orientation-flow) 분류법은 번역 행동을 불확실성, 탐색, 유창한 생산 사이의 패턴화된 교차로 취급하며, 왜 과업의 특정 구간이 불안정해지고 재구성을 유발하는지를 설명합니다5. 이러한 전환은 언어 능숙도, 주제 지식 및 전략적 통제력이 여전히 동시에 발달하고 있는 학생 번역에서 특히 중요합니다6.
시선 추적과 키스트로크 로깅을 결합한 증거에 따르면, 초보 번역가들은 주의력을 균등하게 배분하지 않으며, 중-영 번역 과정에서 도착어 텍스트 생성 단계가 인지 부하의 주요 지점이 되는 경우가 많음이 나타났습니다7. 결과적으로, 최종 결과물에서 국소적인 표현 문제로 보이는 것이 실제로는 실시간 처리 과정 중 주의력과 노력의 광범위한 재편성을 반영하는 것일 수 있습니다8. 최근의 증거는 학생 번역가들이 표면적인 적절성 면에서는 유사한 텍스트를 생성하더라도, 이에 필요한 노력, 불확실성 및 자기 모니터링의 양에서는 상당한 차이를 보일 수 있음을 시사합니다. 만족스러운 최종 번역 결과물이 도출되었더라도, 이는 프로세스 민감 측정법을 통해서만 포착될 수 있는 취약하거나 비효율적인 의사결정 경로에 기반했을 가능성이 있습니다9. 또한, 비교 연구에 따르면 번역 전문성은 일시 정지, 검색, 초안 작성 계속 진행 또는 수정을 위한 회귀 시점에 대한 안정적인 메타인지적 제어를 포함하는 것으로 나타났습니다10.
수정 작업은 이러한 숨겨진 인지 과정이 가장 명확하게 드러나는 지점입니다. 번역가는 수정 단계에서 이전의 표현으로 돌아가 대안을 테스트하며, 문제가 어휘적인지, 구문적인지, 담화적인지, 혹은 문화적인 것인지를 판단합니다. 따라서 수정은 단순히 후반부의 다듬기 단계로 취급되어서는 안 되며, 번역가 역량 발전의 핵심 지표로 보아야 합니다. 더 나은 결과물은 제작 과정 중 대안들이 어떻게 통합되는지와 연관되어 있으며, 이는 효과적인 수정이 단순히 편집 횟수를 늘리는 것이 아니라 선택적이고 전략적인 시점에 이루어지며 더 큰 텍스트적 요구에 대응하는 과정임을 보여줍니다11,12,13.
원문이 중립적인 정보 전달 지문이 아니라 중국 중심의 서사일 때, 의사결정과 수정 과정의 복잡성은 더욱 두드러집니다. 이러한 텍스트는 명시적인 설명보다는 공유된 배경지식에 의존하는 문화적 함의가 담긴 가정, 역사적 맥락이 반영된 표현, 그리고 평가적 단서에 빈번하게 의존합니다14,15,16. 텍스트의 난이도는 처리의 세밀함 자체를 변화시킵니다. 문화적 또는 평가적 밀도가 높은 서사 텍스트는 번역자로 하여금 더 작은 단위로 작업하게 하고, 비선형적인 작업을 수행하게 하며, 반복적인 국소적 재구성을 하도록 강제합니다8. 학생 번역자들에게 있어 핵심 과제는 문화적 특수성을 훼손하지 않으면서, 원래의 담화 공동체 외부의 독자들을 위해 그러한 암묵적 배경을 어느 정도까지 풀어내거나 재구성할지 결정하는 것입니다.
본 연구는 세 가지의 구체적인 공백에서 동기를 얻었습니다. 첫째, 일시 정지 지속 시간, 장기 일시 정지 빈도, 커서 중단, 사전 참조와 같은 번역 과정 지표들은 종종 수정 유형과 분리되어 분석되므로, 의사결정 압박이 이후의 재구성 과정에서 어떻게 가시화되는지 파악하기 어렵습니다. 둘째, 중국 중심의 내러티브는 번역가가 문화적 부하, 평가적 밀도, 압축된 배경 함의를 동시에 처리해야 하는 경우가 많음에도 불구하고14,15,16, 문화 특수적 내러티브 범주는 일반적인 학술 또는 설명 텍스트보다 과정 기반의 주목을 덜 받았습니다. 본 연구에서 문화적 부하란 문화 의존적 참조와 공유된 전제의 밀도를 의미하며, 평가적 밀도는 명시적 또는 암시적인 입장 표명, 정서적 강도, 가치 함축적 프레이밍을 의미합니다. 또한, 내러티브 압축은 배경 정보, 인과 관계 또는 사회적 위치 설정이 짧은 텍스트 구간 내에 응축된 정도를 의미합니다. 셋째, 번역 과제는 일반적으로 텍스트 내부 분석만을 기반으로 설계되며, 어렵다고 식별된 구간이 디지털 유통 과정에서 대중의 관심을 끄는 지점과 일치하는지는 거의 고려되지 않습니다. 단무(시간 동기화 비디오 댓글)는 파라텍스트 및 참여적 담론으로서 작동하며 관객이 주목하고, 논쟁하며, 재해석하는 부분을 부각할 수 있습니다17,18. 다만, 단무의 현저성은 구간 단위의 언어적 난이도를 직접적으로 대체하는 것이 아니라, 관객 참여의 의미론적 수준의 지표로 다루어져야 합니다.
이러한 공백을 메우기 위해, 본 연구는 영어 전공자들이 중국 중심의 서사를 중국어에서 영어로 번역할 때 어떻게 의사결정을 내리고 수정하는지를 조사합니다. 번역 과정 데이터와 디지털 청중의 담론을 동일한 분석 틀로 가져옴으로써, 본 연구는 학생 번역가들이 어느 지점에서 어려움을 겪는지뿐만 아니라 왜 그러한 어려움이 특정 유형의 서사적 의미를 중심으로 집중되는지를 설명하는 것을 목표로 합니다.
구체적으로, 본 연구는 다음 네 가지 연구 질문을 다룹니다: (1) 영어 전공자들의 중국 중심 서사에 대한 중-영 번역에서 어떠한 의사결정 패턴이 나타나는가? (2) 문화적 부하와 서사 밀도의 수준이 서로 다른 세그먼트 간에 수정 행동은 어떻게 다르게 나타나는가? (3) 수정 행동의 어떤 차원이 더 높은 번역 품질과 관련이 있는가? (4) 단무(danmu) 담론에서 식별된 문화적 두드러짐 포인트가 번역 과정 중 가장 많은 처리 노력을 유발하는 세그먼트와 겹치는가?
이에 따라, 본 연구는 단일 분석 시퀀스 내에서 네 가지 연계 가설을 검증합니다: H1은 문화적 부하가 높은 세그먼트가 문화적 부하가 낮은 세그먼트보다 더 긴 일시 정지, 더 큰 결정 불확실성 및 더 빈번한 수정을 유발할 것이라고 제안합니다. H2는 두 가지 경로를 구분하여, 평가적 밀도가 지연된 수정을 증가시키는 반면 서사적 압축은 담화 수준의 재구성을 증가시킬 것이라고 예측합니다. H3는 번역 품질이 단순히 전체 수정 횟수보다는 수정의 선택성과 타이밍에 의해 더 강력하게 설명될 것이라고 예측합니다. 마지막으로 H4는 시청자 돌출성과 번역자의 처리 압력 사이의 연관적 수렴으로서, danmu 돌출 세그먼트가 고부하 번역 세그먼트와 겹칠 것이라고 예측합니다.
프로토콜
인간 피험자를 대상으로 하는 모든 방법은 기관 가이드라인을 준수하여 수행되었으며, 한산사범대학교의 기관생명윤리위원회(IRB) 또는 인간연구윤리위원회의 승인을 받았습니다. 실험 전 모든 참여자로부터 고지된 동의를 얻었습니다.
개념적 틀 및 연구 설계
본 연구는 보조 담화 층을 포함한 과정-결과 연구 설계를 채택하여 시청자가 생성한 단무(danmu) 댓글이 자막 번역에 어떤 영향을 미치는지 조사하였다. 분석 프레임워크에는 텍스트 특성, 번역 과정의 지표 및 번역 품질 결과가 통합되었다. 구체적으로, 단무 밀도로 반영되는 시청자의 주의 집중이 번역가의 인지 자원을 특정 텍스트 특징으로 유도하는지, 그리고 이러한 주의 할당이 결과적으로 번역 품질에 영향을 미치는지를 분석하였다.
이 프레임워크를 실행하기 위해, 본 연구는 먼저 문화적 부하, 평가적 밀도, 서사적 압축, 그리고 단무(danmu) 두드러짐이라는 네 가지 차원을 기반으로 세그먼트 수준의 텍스트 특징을 설정하였습니다. 문화적 부하는 각색이나 설명이 필요한 문화 특수적 참조의 존재 여부를 의미했습니다. 평가적 밀도는 세그먼트 내에서 감정적 또는 태도적 색채가 강한 언어의 집중도를 측정했습니다. 서사적 압축은 자막의 제약 하에 의미적 내용이 응축된 정도를 포착했습니다. 단무 두드러짐은 동기화된 단무 댓글의 양으로 정량화하여, 각 자막 세그먼트에 집중된 시청자 주의도의 정도를 나타냈습니다. 일반적인 번역 난이도 측정 방식과 달리, 단무 두드러짐은 내재적인 텍스트 복잡성이 아니라 사회적으로 분산된 주의도를 반영했습니다. 시청자의 많은 참여를 끌어낸 세그먼트가 반드시 번역하기 더 어렵다는 것을 의미하는 것은 아니며, 대신 시청 경험 내에서 커뮤니케이션적 중요성이 높아진 지점을 나타냈습니다.
분석 프레임워크는 서로 연결된 세 가지 데이터셋으로 구성되었습니다. 참여자 수준 데이터셋에는 개별 인구통계학적 특성과 번역 전문성이 포함되었습니다. 프로세스-결과물 데이터셋은 각 자막 세그먼트를 키스트로크 로깅에서 추출한 행동 지표 및 전문가의 번역 품질 평가 점수와 연결하였습니다. 탄막 데이터셋에는 자막 타이밍에 맞춰 동기화된 관객 댓글이 포함되었으며, 이를 통해 탄막 현저도 수치를 산출하였습니다. 이러한 데이터셋들은 참여자 및 세그먼트 식별자를 통해 연결되어, 번역된 각 자막 세그먼트를 번역자 특성, 인지 처리 행동, 관객 주의도 및 번역 결과와 관련하여 동시에 분석할 수 있도록 하였습니다. 최종 통합 데이터베이스는 216회의 완전한 번역 세션과 3,168개의 참여자-텍스트-세그먼트 관찰 데이터로 구성되었으며, 이는 후속 프로세스-결과물 분석을 위한 실증적 토대를 제공하였습니다.
참가자 스크리닝 및 배경 프로파일링
표본은 중국 남부의 한 공립대학교에서 모집한 영어 전공자 72명으로 구성되었으며, 학부 2, 3, 4학년에 걸쳐 균등하게 배분되었습니다(학년별 24명). 모든 참여자는 영어 작문 및 번역에 관한 정규 교육을 받는 중국어 원어민이었습니다. 예비 번역가 집단 내의 비교 가능성을 확보하기 위해, 영어권 국가에서 6개월 이상 거주했거나 전문 번역 자격증을 보유한 개인은 제외되었습니다. 참여자들은 번역 경험, 문화적 친숙도 또는 제2외국어 능숙도에 따라 별도의 실험군으로 층화되지 않았습니다. 대신, 학년, 최근 영어 능숙도 시험 점수, 이전 번역 교과 과정 이수 여부, 중국 관련 문화 주제에 대한 자기 평가 친숙도, 그리고 주당 평균 이중 언어 연습 참여 시간이 기록되었으며, 이는 통계 모델의 참여자 수준 공변량으로 포함되었습니다. 이러한 설명은 동료 심사 과정에서 제기된 참여자 수의 불일치 문제 또한 해결합니다. 원고와 재현 데이터셋 모두 72명의 참여자, 216회의 과업 세션, 그리고 3,168개의 세그먼트 수준 관찰치를 포함하고 있습니다.
소스 텍스트 선택 및 작업 구성
번역 자료는 저작권이 있는 자료의 재현을 피하고 실제 공적 담론을 반영하기 위해 본 연구를 위해 특별히 개발된 세 가지의 현대 중국 중심 서사 텍스트로 구성되었습니다. 각 텍스트는 205~225자의 한자를 포함하고 있으나 내부 특성 면에서 체계적인 차이가 있습니다. 텍스트 A는 적절한 수준의 문화적 부하와 상대적으로 단순한 구문을 가진 춘절 귀향 서사를 제시합니다. 텍스트 B는 단오절의 기억을 기술하며, 문화 특수적 표현과 암시적 배경 지식의 밀도가 더 높습니다. 텍스트 C는 농촌 라이브 스트리밍 및 전자 상거래 서사를 묘사하며, 밀집된 평가적 언어와 압축된 서사적 위치 설정이 특징입니다.
텍스트는 절 경계를 기준으로 체계적으로 분할된 후 의미 단위 경계로 세분화되었으며, 그 결과 3가지 번역 과제 전반에 걸쳐 44개의 분석 가능 단위가 도출되었습니다(표 1). 정식 코딩에 앞서, 코딩 매뉴얼을 통해 문화적 부하, 평가적 밀도 및 서사적 압축을 1~5점 서열 척도로 정의하였습니다. 본 실험에 참여하지 않은 학생 12명을 대상으로 한 예비 연구를 통해 의도한 난이도 조정, 과제 지침의 명확성, 그리고 키스트로크 정렬을 위한 세그먼트 경계의 안정성을 확인하였습니다.
보조 코퍼스 구축 및 현저성 매핑
대중적으로 두드러진 서사적 단서를 식별하기 위해, 2023년 1월부터 2025년 12월 사이에 업로드된 24개의 Bilibili 비디오로부터 보조 단무(danmu) 코퍼스를 구축하였다. 비디오는 소스 텍스트에 나타난 세 가지 의미 영역 중 하나와 일치하고, 조회수가 50,000회 이상이며, 단무 상호작용이 활발하고, 시간 동기화된 댓글의 내보내기 및 주제 매핑이 가능한 경우에만 포함되었다. 중복 제거와 이모지, 의성어 충전어 및 무관한 파편들의 필터링을 거친 후, 최종 코퍼스는 18,642개의 댓글로 구성되었다.
내용어는 원문 관련 키워드 앵커를 사용하여 표준화 및 클러스터링되었습니다. 이후 각 원문 세그먼트에는 정규화된 키워드 클러스터 빈도, 해당 주제 클러스터 내의 댓글 집중도, 그리고 평균 평가 강도의 가중치 합산물을 기반으로 연속적인 danmu 현저도 점수가 부여되었습니다. 이러한 절차를 통해 직접적인 어휘 매칭이 아닌 의미론적 클러스터 수준에서 번역자의 처리 노력과 시청자 현저도를 비교할 수 있습니다. danmu는 실험적 번역 작업 자체가 아니라 온라인 영상에 대한 시청자의 반응을 반영하므로, danmu 현저도는 원문 세그먼트의 언어적 난이도에 대한 직접적인 증거라기보다 시청자 참여도의 외부 지표로 해석됩니다.
실험 절차 및 데이터 캡처
번역 세션은 표준화된 하드웨어, 소프트웨어 및 인터넷 접속 조건 하에 통제된 컴퓨터 실험실에서 개별적으로 진행되었습니다(그림 2). 국제적인 독자가 읽기 쉬운 영어를 작성하도록 강조하는 5분간의 오리엔테이션 후, 참가자들은 키보드 적응 효과를 최소화하기 위해 3분 동안 영어 타이핑 워밍업을 완료했습니다. 세 가지 번역 과제는 Translog-II를 사용하여 순차적으로 부여되었으며, 피로도 및 순서 효과를 참가자 전원에게 균등하게 분산시키기 위해 라틴 방격법(Latin-square design)으로 과제 순서를 상쇄 설계하였습니다. 참가자들에게는 텍스트당 최대 20분이 할당되었으며, 각 과제 사이에는 5분의 휴식 시간이 주어졌습니다.
내장된 이중 언어 사전의 사용은 허용되었으나, 기계 번역 시스템 및 외부 검색 엔진의 사용은 금지되었습니다. 모든 키 입력, 일시 중지 및 커서 이동은 자동으로 기록되었으며, 비선형 수정 과정을 검증하기 위해 동기화된 화면 녹화가 보완적으로 사용되었습니다. 각 과제를 마친 후, 참가자들은 경계선에 있는 코딩 사례의 해석을 돕기 위한 목적으로만 사용되는 자기 보고식 난이도 평가를 작성하였습니다.
공정 측정 및 변수 코딩
키스트로크 기록을 미리 정의된 세그먼트 구조에 맞추어 정렬하였습니다. 정렬 에피소드는 해당 세그먼트에 대응하는 첫 번째 대상 언어 키스트로크와 함께 시작되었으며, 참여자가 다음 세그먼트로 확실히 넘어갔을 때 종료되었습니다. 중첩된 수정 사항은 타임스탬프가 기록된 커서 추적 기록을 사용하여 다시 할당되었습니다.
의사 결정 행동은 다섯 가지 지표를 사용하여 정량화하였다: 첫 번째 세그먼트 번역 전의 첫 일시 정지 지속 시간, 세그먼트 내 평균 일시 정지 지속 시간, 2초를 초과하는 일시 정지 빈도, 사전 참조 횟수, 그리고 선형 초안 작성에서 벗어난 것을 나타내는 커서 기반 중단 횟수(Table 2). 수정 행동은 시점과 기능의 두 가지 차원으로 분류하였다. 시점은 즉각적인 국소 수정과 현재 세그먼트를 넘어 초안 작성이 진행된 후 수행된 지연 수정을 구분하였다. 기능적 코딩은 수정을 표면적 수정(의미 변화 없는 형태 수준의 교정), 의미적 수정(어휘 또는 구문 수정), 담화 수준 수정(절 관계 또는 일관성 조정), 그리고 문화적 적응 수정(타겟 청중 지향적 재구성)으로 분류하였다. 교육을 받은 두 명의 코더가 판정 전 각 수정 에피소드를 독립적으로 분석하고 각 이벤트에 단일 기본 기능 범주를 할당하였다. 모든 코딩 측정치에서 평가자 간 신뢰도는 견고하였다. Cohen’s ĸ는 수정 기능의 범주형 코딩에 대해 상당한 일치도를 나타냈다(ĸ = 0.84, p < 0.001). 서열 텍스트 수준 변수의 경우, 급내 상관계수(ICC, 이원 혼합 효과 모델, 절대 일치도)는 문화적 부하(ICC = 0.86), 평가 밀도(ICC = 0.78), 그리고 서사 압축(ICC = 0.82)에 대해 높은 신뢰도를 보였다. 초기 코딩 불일치는 이후 공동 판정을 통해 해결하였다.
번역 품질 평가
번역 품질은 박사 학위 수준의 교육을 받고 번역 지도 분야에서 풍부한 경험을 쌓은 두 명의 평가자가 프로세스 데이터와 독립적으로 평가하였습니다. 평가자들은 참가자의 신원과 프로세스 측정값을 모르는 블라인드 상태에서, 의미적 정확성, 언어적 유창성, 서사적 일관성, 문화적 표현, 그리고 레지스터의 적절성이라는 다섯 가지 차원에 고르게 배분된 100점 만점의 루브릭을 적용하였습니다(표 3). 8점을 초과하는 점수 차이가 발생한 경우에는 공동 검토 및 합의를 통한 재채점을 실시하였으며, 이렇게 조정된 평균값을 최종 번역 품질 점수로 사용하였습니다. 재현 자료에서 평가자 간 신뢰도를 투명하게 보고하기 위해 조정 전의 평가 기록을 유지하였습니다.
통계적 모델링
분석은 세 단계의 순차적인 과정으로 진행되었습니다. 첫째, 학년 그룹 및 텍스트 유형에 따른 모든 변수를 요약하기 위해 기술 통계량을 산출하였습니다. 둘째, 텍스트 내 세그먼트의 중첩 구조와 개별 참여자의 반복 측정치를 고려하여 혼합 효과 회귀 모델을 사용하여 세그먼트 수준의 처리 노력을 분석하였습니다. 첫 휴지 지속 시간과 수정 빈도를 포함한 종속 변수는 참여자의 숙달도를 통제한 상태에서 문화적 부하, 평가적 밀도, 서사적 압축 및 단무(danmu) 돌출성의 함수로 모델링되었습니다. 통계적 투명성을 높이기 위해 예측 변수 간 상관관계, 분산 팽창 진단, 95% 신뢰 구간, 효과 크기 추정치 및 모델 적합도 지수를 포함하였습니다.
마지막으로, 전체 수정 빈도 대비 수정 시점과 수정 기능의 예측 기여도를 평가하기 위해 번역 품질을 모델링하였습니다. danmu-두드러진 세그먼트와 고노력 번역 세그먼트 간의 중첩은 각 분포의 상위 20%(upper quintile), 표준화된 복합 노력 지수, 그리고 우연 중첩 분석(chance-overlap analysis)을 사용하여 평가하였습니다. 탐색적 요인 분석이나 구조 방정식 모델링은 수행되지 않았습니다. 따라서 첨부된 그림들은 개념적, 기술적 또는 회귀 기반의 요약으로만 제시되었습니다.
결과
번역 세션의 전체 프로필
총 72명의 참가자가 표준화된 실험 조건 하에 세 가지 번역 과제를 완료하여, 총 216회의 번역 세션이 도출되었습니다. 세그먼트 정렬 후, 최종 분석 데이터 세트는 3,168개의 참가자-텍스트-세그먼트 관찰치로 구성되었습니다. 표본 전체의 평균 과제 완료 시간은 텍스트당 998.4 s였으며, 학년 그룹 및 원문 텍스트에 따라 뚜렷한 차이가 나타났습니다(표 4; 그림 3). 이에 따라 원고와 첨부 데이터 모두 n = 72명의 참가자 표본 크기를 일관되게 뒷받침하며, 하위 집단을 요약하는 모든 도표에는 해당 하위 집단을 명확히 식별하여 표시해야 합니다.
4학년 학생들은 2학년 학생들보다 번역 과제를 더 빠르게 완료했으며 중단 횟수도 더 적었습니다. 이러한 차이는 단순한 처리 속도를 넘어섰습니다. 4학년 집단은 평균 첫 휴지(first-pause) 시간이 더 짧았고, 긴 휴지 횟수가 적었으며, 전체 수정 횟수 또한 더 적었음에도 불구하고 가장 높은 번역 품질 점수를 기록했습니다. 반면, 2학년 학생들은 가장 많은 수정을 수행했으며, 이들 대부분은 표면적인 수정이나 즉각적인 국소적 교정이었습니다. 상급 학생들은 지연 수정(delayed revisions)과 문화적 적응 수정의 비율이 더 높게 나타났으며, 이는 우수한 번역 성과가 수정 횟수의 증가보다는 선택적인 수정 전략과 관련이 있음을 시사합니다.
세 가지 소스 텍스트 간의 차이 또한 이와 유사하게 뚜렷하게 나타났다. 텍스트 A는 가장 짧은 완독 시간, 가장 적은 횟수의 긴 휴지(pause), 그리고 가장 낮은 수정 밀도를 보였다. 텍스트 B와 C는 모두 더 높은 처리 요구도를 유발했으나, 그 메커니즘은 서로 달랐다. 텍스트 B는 문화 관련 수정 이벤트의 횟수가 가장 많았던 반면, 텍스트 C는 담화 수준의 수정 빈도가 가장 높았으며 세그먼트 내 평균 휴지 시간이 가장 길었다. 따라서 처리 과정의 어려움이 발생하는 원인은 텍스트마다 서로 달랐다. 텍스트 B의 경우 어려움은 문화적 참조 및 암묵적인 배경 가정에 집중되었으며, 텍스트 C의 경우 주로 서사적 압축 및 평가적 포지셔닝과 관련이 있었다.
일원 분산 분석 결과, 학년 그룹 간 전체 번역 품질에서 유의미한 차이가 확인되었으며, F (2, 69) = 31.84, p < 0.001로 큰 효과 크기(참가자 수준 평균 점수 기준 η2 ≈ 0.48)를 보였습니다. 사후 비교 분석 결과, 4학년 학생들의 점수가 3학년 학생들보다 유의미하게 높았으며, 3학년 학생들은 다시 2학년 학생들보다 높은 성적을 거둔 것으로 나타났습니다. 동일한 양상이 첫 휴지(first-pause) 지속 시간, 장기 휴지 빈도 및 지연 수정 비율에서도 관찰되었습니다. 종합적으로, 이러한 기초 분석 결과는 후속 분석을 위한 두 가지 중요한 점을 시사합니다. 첫째, 세 가지 원문 텍스트는 단순히 주제적 내용이 아니라 처리 난이도에서 차이가 있었습니다. 둘째, 높은 번역 품질은 단순히 처리 노력의 감소가 아니라 번역 과정의 재구성과 관련이 있었습니다.
텍스트 현저성이 의사결정 및 수정 행동에 미치는 영향
세그먼트 수준의 텍스트 속성이 처리 노력을 예측하는지 확인하기 위해, 첫 휴지 지속시간, 긴 휴지 빈도, 총 수정 밀도 및 지연 수정 밀도에 대한 혼합 효과 모델을 추정하였습니다. 문화적 부하, 평가적 밀도, 서사적 압축 및 단무 돌출성을 고정 효과로 설정하였으며, 참여자와 세그먼트를 무작위 절편으로 포함하였습니다.표 5; 그림 4). 예측 변수 스크리닝 결과, 모든 분산팽창지수(VIF) 값이 보수적 기준치인 2.5보다 훨씬 낮아(최대 VIF = 1.45), 문제가 되는 다중공선성이 없음이 확인되었습니다. 모델 적합도와 설명된 분산의 비율을 평가하기 위해, 한계 R²와 조건부 R²를 모두...2 모든 혼합 효과 모델에 대해 값(marginal R)이 계산되었습니다.2 0.08에서 0.19 범위이며; 조건부 R2 (0.46에서 0.64 사이). 랜덤 효과(참가자 및 세그먼트 절편)에 대한 전체 분산 성분과 그에 해당하는 모델 적합도 지수는 다음에서 자세히 설명한다. 표 5계수 추정치는 95% 신뢰구간과 함께 해석하며, 단독으로 해석하지 않습니다. p-값만으로.
문화적 부하(cultural load)가 모든 모델에서 가장 강력하고 일관된 효과를 보였다. 첫 휴지(first-pause) 모델에서 문화적 부하 점수가 1단위 증가할 때마다 첫 휴지 지속 시간이 0.91 s 증가하는 연관성이 나타났다(b = 0.91, SE = 0.12, 95% CI [0.67, 1.15], p < 0.001). 또한 문화적 부하는 긴 휴지(long-pause) 빈도(b = 0.19, SE = 0.04, 95% CI [0.11, 0.27], p < .001)와 전체 수정 밀도(total revision density)(b = 0.27, SE = 0.06, 95% CI [0.15, 0.39], p < .001)를 유의미하게 증가시켰다. 따라서 문화적 부하가 높은 세그먼트는 초기 처리를 지연시킬 뿐만 아니라 이후의 재구조화 가능성을 높이는 것으로 나타났다.
서사적 압축(Narrative compression) 또한 동등하게 강력하면서도 뚜렷한 영향 패턴을 보였습니다. 이는 담화 수준의 수정(b = 0.31, SE = 0.07, 95% CI [0.17, 0.45], p < .001)의 강력한 예측 변수였으며, 세그먼트 내 평균 일시 정지 지속 시간을 유의미하게 증가시켰습니다(b = 0.58, SE = 0.14, 95% CI [0.31, 0.85], p < .001). 실제적으로, 방대한 배경 정보를 짧은 텍스트 범위로 응축한 세그먼트는 즉각적인 어휘 교체로 이어질 가능성은 낮았으며, 더 광범위한 구조적 재검토를 필요로 할 가능성이 더 높았습니다.
평가적 밀도(evaluative density) 또한 유의미한 기여를 했으나, 그 주요 영향은 초기 결정 잠복기보다는 지연된 수정에 작용했다. 지연 수정 모델에서 평가적 밀도는 양의 계수를 나타냈다(b = 0.23, SE = 0.05, 95% CI [0.13, 0.33], p < .001). 첫 일시 정지 지속 시간에 미치는 영향은 상대적으로 미미했다(b = 0.34, SE = 0.13, 95% CI [0.09, 0.59], p = 0.010). 이러한 결과는 평가적 단서가 초기 번역 과정에서 항상 처리 병목 현상으로 인식된 것은 아님을 시사한다. 대신, 이러한 단서들은 초안이 작성된 후에야 문제가 되는 경우가 많았으며, 이로 인해 번역자가 입장, 어조 또는 서술의 적절성 문제를 다시 검토하게 되었다.
텍스트 내부 변수들을 통제한 후에도 단무(danmu)의 현저성(salience)은 유의미한 예측 변수로 남았습니다. 이는 첫 휴지 기간(b = 0.36, SE = 0.14, 95% CI [0.09, 0.63], p = 0.011)과 총 수정 밀도(b = 0.17, SE = 0.06, 95% CI [0.05, 0.29], p = 0.006) 모두를 유의미하게 예측했습니다. 비록 그 효과 크기는 문화적 부하(cultural load)나 서사적 압축(narrative compression)보다 작았지만, 일관된 기여도는 단무 코퍼스에서 더 많은 대중의 관심을 끄는 세그먼트가 번역 과정에서 더 많은 처리 노력을 요구하는 경향이 있음을 시사합니다. 이러한 결과는 단무 빈도가 번역 난이도를 직접적으로 유발한다는 증거라기보다, 의미적 현저성을 보여주는 수렴적 증거로 해석됩니다.
수정 행동 및 번역 품질
후속 분석에서는 번역 품질이 수정의 전체 양에 의해 더 잘 설명되는지, 아니면 수정의 시간적 및 기능적 특성에 의해 더 잘 설명되는지 조사하였습니다. 품질 모델(Table 5)은 명확한 결과 패턴을 보여주었습니다. 총 수정 횟수는 번역 품질을 유의미하게 예측하지 않았으나(b = 0.04, 95% CI [-0.06, 0.14], p = 0.412), 수정 시점과 수정 기능은 모두 유의미한 예측 변수였습니다. 구체적으로, 지연 수정 비율(b = 1.12, 95% CI [0.39, 1.85], p = 0.003), 담화 수준 수정(b = 1.76, 95% CI [0.96, 2.56], p < 0.001), 그리고 문화적 적응 수정(b = 2.04, 95% CI [1.14, 2.94], p < 0.001)은 모두 번역 품질과 정적 상관관계를 보였습니다. 반면, 표면적 수정은 작지만 통계적으로 유의미한 부적 상관관계를 나타냈습니다(b = -0.63, 95% CI [-1.18, -0.08], p = 0.028).
이러한 결과는 수정 횟수만으로는 생산적인 재구성과 불안정한 초안 작성을 구분할 수 없음을 나타냅니다(그림 5). 번역 스크립트에 대한 정성적 검토는 이러한 해석을 뒷받침했습니다. 점수가 낮은 번역의 경우, 수정 사항이 중국어 서술 단서와 영어 수사적 프레임 간의 더 깊은 불일치를 해결하지 못한 채 국소적인 어휘 교체 및 문법 교정에 집중되는 경향이 있었습니다. 반면 점수가 높은 번역에서는 지연된 수정이 정보 구조의 재구성, 선택적 명시화 도입 또는 국제 독자의 이해도를 높이기 위한 평가적 언어 조정과 관련이 있는 경우가 많았습니다. “이 표현은 매우 중국적이다”, “배경 설명이 필요하다”, “외국인 청중은 이 참조 내용을 이해하지 못할 수도 있다”를 포함한 대표적인 번역 단무(danmu) 댓글들은 해당 세그먼트 클러스터와 관련된 문화적으로 두드러진 청중의 고민 유형을 보여줍니다. 이러한 예시들은 오직 해석을 돕기 위해 제시된 것이며, 참여자의 의도를 증명하는 근거로 해석되어서는 안 됩니다.
danmu 현저성과 번역 병목 현상 간의 중첩
최종 분석에서는 danmu 코퍼스에서 대중적으로 두드러진 세그먼트가 번역 과정 중 가장 많은 처리 노력이 투입된 세그먼트와 일치하는지 조사하였다. 첫 휴지(first-pause) 지속 시간, 긴 휴지(long-pause) 빈도 및 수정 밀도를 표준화하여 합산함으로써 각 세그먼트에 대한 종합 노력 지수를 산출하였다. 이후 이 종합 노력 지수를 기준으로 상위 20%에 해당하는 세그먼트를 danmu 두드러짐 순위 상위 20%의 세그먼트와 비교하였다.
중첩 정도는 상당했습니다. 가장 많은 노력이 투입된 9개 세그먼트 중 6개가 가장 단무(danmu) 돌출도가 높은 9개 세그먼트에도 포함되었으며, 이는 66.7%의 중첩률에 해당합니다. 상위 20% 비교에는 단 9개의 세그먼트만 포함되었기 때문에 Wilson 신뢰 구간이 상대적으로 넓었습니다(95% CI 약 35.4%–87.9%). 그럼에도 불구하고, 정확한 확률적 중첩 분석 결과, 무작위 배분 하에서 6개 이상의 세그먼트가 중첩될 가능성은 낮은 것으로 나타났습니다(p ≈ .001). 세그먼트 수준에서 단무 돌출도는 종합 노력 지수와 양의 상관관계를 보였습니다(Spearman's ρ = 0.41, p = 0.006). 중첩된 세그먼트의 대부분은 텍스트 B와 C에서 발생했으며, 문화적 내포 참조, 디지털 기업가 정신 및 평가적 포지셔닝을 중심으로 나타났습니다. 이러한 결과는 공적 담론이 서사적 의미가 특히 두드러지는 지점을 보여주는 외부 지표 역할을 한다는 점을 시사하지만, 이 관계는 인과적이라기보다 상관관계에 머물러 있습니다.
종합하면, 이러한 결과는 중국 중심의 서사를 번역할 때의 처리 노력(processing effort)이 세그먼트별로 차이가 있으며, 주로 문화적 부하, 서사적 압축 및 평가적 밀도에 의해 형성된다는 것을 보여줍니다. 번역 품질은 전체적인 수정 양이 아니라, 지연되고 담화에 민감하며 문화 지향적인 수정 전략에 달려 있습니다. 마지막으로, 높은 노력이 투입된 번역 세그먼트와 danmu(단무) 상에서 두드러진 서사 지점 사이에서 관찰된 일치는, danmu의 두드러짐 자체가 번역 난이도를 유발한다고 암시하지는 않으면서도 시청자의 주목도와 번역가의 처리 노력 사이에 연관 관계가 있음을 뒷받침합니다.
데이터 가용성:
모든 원시 데이터, 키스트로크 로깅 파일, 처리된 세그먼트 수준 관찰 데이터, 세션 수준 관찰 데이터, danmu-비디오 메타데이터 및 처음 표시된 5,000개의 danmu 댓글은 복제 데이터셋 워크북에 제공됩니다. 18,642개의 댓글이 포함된 전체 danmu-댓글 파일은 데이터셋 패키지와 함께 저장되었습니다. 해당 데이터셋은 Zenodo 저장소(https://doi.org/10.5281/zenodo.19289665)를 통해 액세스할 수 있습니다.
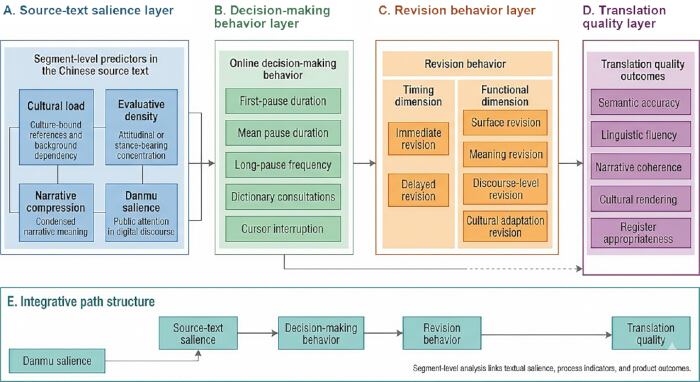
그림 1: 연구의 개념적 틀. (A) 문화적 부하, 평가적 밀도, 서사적 압축 및 danmu 현저성을 포함한 세그먼트 수준의 텍스트 예측 변수. (B) 첫 일시 중지 지속 시간, 평균 일시 중지 지속 시간, 장기 일시 중지 빈도, 사전 참조 및 커서 중단을 포함하여 온라인 의사결정 행동을 구체화하는 데 사용된 프로세스 지표. (C) 수정 시점 및 수정 기능에 따른 수정 행동의 2차원 분류. (D) 번역 품질 평가에 사용된 5가지 차원: 의미적 정확성, 언어적 유창성, 서사적 일관성, 문화적 표현 및 레지스터 적절성. (E) 원문 현저성, 의사결정 행동, 수정 행동 및 번역 품질 간의 관계를 보여주는 전체 분석 프레임워크이며, danmu 현저성은 의미적 청중 두드러짐의 외부 지표 역할을 함. 본 연구에서는 탐색적 요인 분석(EFA) 또는 구조 방정식 모델링(SEM)을 수행하지 않았으며 제시하지 않음. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
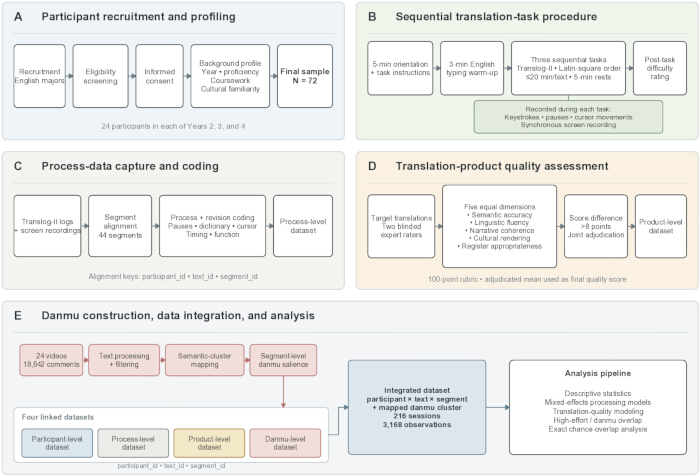
그림 2: 데이터 수집 및 데이터 정렬 워크플로. (A) 참가자 모집, 적격성 스크리닝, 고지된 동의 및 배경 정보 수집. (B) 표준화된 실험 조건 하의 Translog-II에서의 세 가지 번역 과제 수행. (C) 키스트로크, 일시 정지, 커서 이동, 수정 에피소드 및 동기화된 화면 녹화를 포함한 프로세스 데이터 수집. (D) 번역 결과물에 대한 전문가의 블라인드 평가 및 이후 점수 불일치에 대한 조정. (E) 보조 단무(danmu) 코퍼스 구축 및 이를 참가자, 텍스트, 세그먼트, 프로세스 및 결과물 수준의 데이터 세트와 정렬하여 추론 분석에 사용될 최종 통합 데이터 세트 생성. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
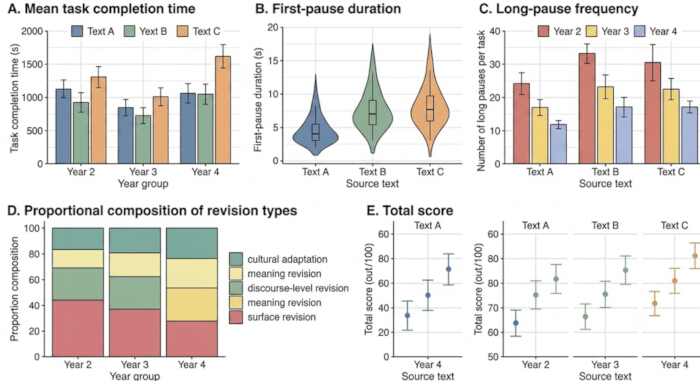
그림 3: 학년 및 소스 텍스트별 프로세스 및 결과 측정값의 분포. (A) 소스 텍스트 및 학년별 평균 과제 완료 시간. (B) 세 가지 소스 텍스트에 따른 첫 번째 일시 정지 지속 시간의 분포. (C) 소스 텍스트 및 학년별 장기 일시 정지 빈도. (D) 표면적 수정, 의미 수정, 담화 수준 수정 및 문화적 적응 수정을 포함한 학년별 수정 범주의 비율 분포. (E) 각 소스 텍스트에 대한 학년별 총 번역 품질 점수. 종합적으로, 이 패널들은 학년이 높을수록 처리 중단이 적고, 더 선택적인 수정 전략을 사용하며, 번역 품질이 높다는 것을 보여주는 반면, 텍스트 B와 C는 텍스트 A보다 더 큰 처리 요구도를 부과함을 보여준다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
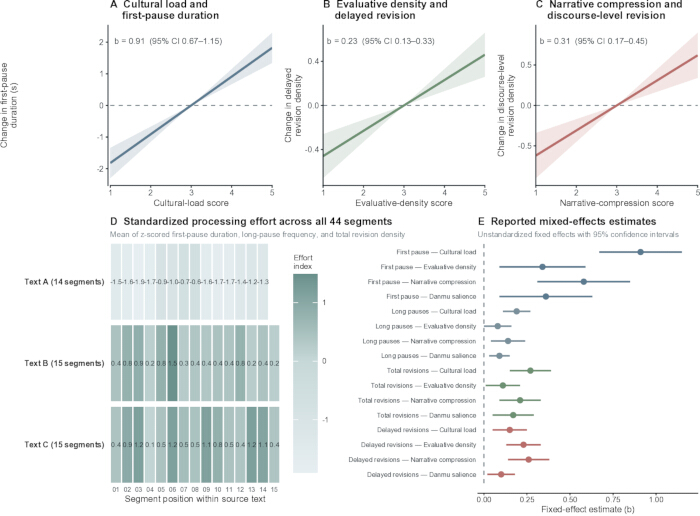
그림 4: 세그먼트 수준의 텍스트 두드러짐이 번역 프로세스 행동에 미치는 영향. (A) 첫 번째 일시정지 지속시간에 대한 문화적 부하의 적합된 한계 효과. (B) 지연된 수정 밀도에 대한 평가 밀도의 적합된 한계 효과. (C) 담화 수준 수정 밀도에 대한 서사 압축의 적합된 한계 효과. (D) 원문별로 그룹화된 모든 원문 세그먼트에 걸친 표준화된 처리 노력 지수의 히트맵. (E) 혼합 효과 회귀 모델에서 추정된 표준화된 고정 효과 계수. 이 그림은 서로 다른 텍스트 특성이 각기 다른 처리 경로를 활성화하며, 문화적 부하, 평가 밀도 및 서사 압축이 부분적으로 서로 다른 메커니즘을 통해 망설임과 수정에 기여함을 보여준다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
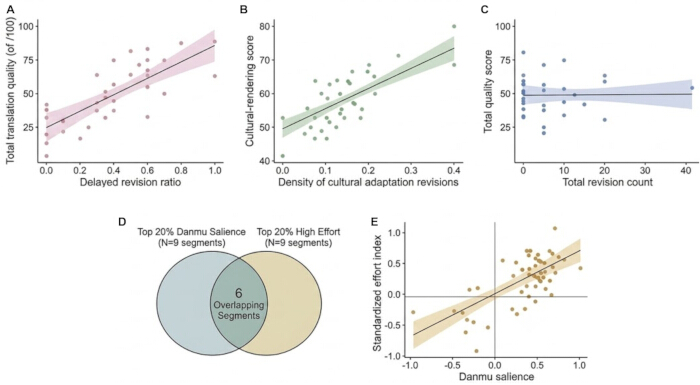
그림 5: 번역 과정, 번역 품질 및 danmu 두드러짐(salience) 간의 관계. (A) 지연 수정 비율과 총 번역 품질 점수 간의 연관성. (B) 문화적 적응을 위한 수정과 문화적 표현 점수 간의 관계. (C) 총 수정 횟수와 전반적인 번역 품질 간의 연관성으로, 수정 횟수만으로는 예측 가치가 제한적임을 보여줌. (D) danmu-두드러짐 상위 20% 세그먼트와 고노력 번역 상위 20% 세그먼트 간의 중첩. (E) danmu 두드러짐과 표준화된 처리 노력 지수 간의 세그먼트 수준 연관성. 종합적으로, 이 패널들은 성공적인 번역 성과가 단순히 수정 양보다는 전략적으로 타이밍을 맞추고 기능적으로 목표를 설정한 수정과 관련이 있으며, 대중적으로 두드러진 서사 세그먼트가 번역 병목 현상과 일치하는 경향이 있음을 보여준다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
| 텍스트 ID | 서술형 주제 | 한자 | 세그먼트 수 | 문화적 부하 점수 (1–5) | 평가 밀도 점수 (1–5) | 서사 압축 점수 (1–5) | 예상 난이도 | 검증 노트 |
| 텍스트 A | 춘절 귀향 서사 | 212 | 14 | 3 | 2 | 3 | 중등도 | 참여하지 않은 학생 12명을 대상으로 사전 테스트를 실시함 |
| 텍스트 B | 단오절 기억 서사 | 219 | 15 | 5 | 3 | 4 | 높음 | 참여하지 않은 학생 12명을 대상으로 예비 테스트를 수행함 |
| 텍스트 C | 농촌 라이브 스트리밍과 고향 발전 서사 | 223 | 15 | 4 | 5 | 4 | 높음 | 참여하지 않은 학생 12명을 대상으로 예비 테스트를 실시함 |
표 1: 소스 텍스트 프로필 및 세그먼트 구조.
| 변수 | 단계 | 조작적 정의 | 측정 단위 |
| 첫 휴지 지속 시간 | 분절 | 세그먼트 시작부터 첫 번째 관련 대상 언어 키 입력까지의 시간 | 초 |
| 세그먼트 내 평균 일시정지 지속 시간 | 세그먼트 | 세그먼트 내 모든 휴지기의 평균 지속 시간 | 초 |
| 장기 휴지 빈도 | 분절(Segment) | 2초보다 긴 휴지 횟수 | 계수 |
| 사전 조회 | 세그먼트 | 세그먼트 처리 중의 딕셔너리-윈도우 활성화 횟수 | 계수 |
| 커서 중단 | 분절 | 안정적인 완료 전 커서 기반의 선형 드래프팅 이탈 횟수 | 계수 |
| 즉시 수정 | 분절 | 초안 작성 전 수행된 수정 사항이 현재의 로컬 텍스트 영역을 벗어납니다. | 수 / 밀도 |
| 지연 재수술 | 분절 | 초안 작성 과정이 후속 텍스트 영역으로 진행된 후 이루어진 수정물 | 계수 / 밀도 |
| 표면 수정 | 수정 기능 | 의미 변화 없는 문장 수준의 수정 | 수 / 밀도 |
| 의미 수정 | 검토 기능 | 의미 표현에 영향을 미치는 어휘적 또는 구문적 변형 | 수 / 밀도 |
| 담화 수준의 수정 | 검토 기능 | 절 관계, 일관성 또는 정보 순서의 조정 | 수 / 밀도 |
| 문화적 적응 수정 | 수정 기능 | 타겟 청중을 고려한 재구성 또는 문화적 맥락에 따른 의미 명시화 | 수/밀도 |
| 복합 노력 지수 | 분절 | 첫 휴지 지속 시간, 긴 휴지 빈도 및 수정 밀도의 표준화된 복합 지표 | z-점수 |
| 단무 현저성 | 세그먼트 / 의미론적 클러스터 | 정규화된 키워드-클러스터 빈도, 댓글 집중도 및 평가 강도에 기반한 가중치 부여 시맨틱-클러스터 프록시 | 연속형 점수 |
표 2: 공정 변수의 조작적 정의.
| 차원 | 점수 범위 | 채점 초점 |
| 의미론적 정확성 | 1-20 | 원문의 의미에 대한 충실성, 전달 내용의 정밀성 및 중대한 왜곡의 부재 |
| 언어적 유창성 | 1-20 | 문법성, 자연스러움, 관용적 표현 및 문장 수준의 가독성 |
| 서사적 일관성 | 1-20 | 정보 흐름, 절 연결, 전개 및 텍스트 안정성 |
| 문화적 렌더링 | 1-20 | 문화 고유 참조물의 처리, 명시화, 프레이밍 및 해석적 접근성 |
| 등록 적절성 | 1-20 | 의도된 독자층에 맞춘 최적화, 스타일의 적절성 및 어조 조절 |
표 3: 번역 품질 평가 루브릭.
| 섹션 | 변수 | 2년 차 (n = 24), 평균 ± 표준편차 | 3년 차 (n = 24), 평균 ± 표준편차 | 4년 차 (n = 24), 평균 ± 표준편차 |
| 참가자 수준의 세션 프로필 | 작업 완료 시간 (초) | 1070.84 ± 18.22 | 996.59 ± 20.08 | 927.76 ± 19.91 |
| 참가자 수준의 세션 프로필 | 평균 첫 정지 지속 시간(초) | 7.09 ± 0.50 | 6.65 ± 0.40 | 6.38 ± 0.41 |
| 참가자 수준의 세션 프로필 | 작업당 장기 휴지 빈도 | 21.04 ± 0.32 | 18.47 ± 0.30 | 16.31 ± 0.19 |
| 참가자 수준의 세션 프로필 | 작업당 총 수정 횟수 | 28.65 ± 2.87 | 26.24 ± 2.63 | 24.59 ± 2.42 |
| 개정 구성 | 지연 수정 비율 | 0.45 ± 0.01 | 0.54 ± 0.01 | 0.63 ± 0.01 |
| 개정 구성 | 담화 수준 수정 비율 | 0.37 ± 0.01 | 0.40 ± 0.01 | 0.45 ± 0.01 |
| 개정 구성 | 문화적 적응 수정 비율 | 0.38 ± 0.01 | 0.42 ± 0.00 | 0.48 ± 0.01 |
| 수정 구성 | 표면 수정률 | 0.04 ± 0.00 | 0.02 ± 0.00 | 0.00 ± 0.00 |
| 제품 품질 | 총 품질 점수 | 77.82 ± 4.65 | 84.03 ± 4.44 | 88.27 ± 4.56 |
| 제품 품질 | 문화적 렌더링 점수 | 77.73 ± 4.49 | 83.95 ± 4.85 | 88.18 ± 4.86 |
표 4: 공정 및 제품 변수에 대한 기술 통계.
| 결과 변수 | 예측 인자 | b | 표준 오차 | 95% 신뢰구간 | t/z | p |
| 첫 휴지 지속 시간 | 문화적 부하 | 0.91 | 0.12 | [0.67, 1.15] | 7.58 | < 0.001 |
| 첫 휴지 시간 | 평가 밀도 | 0.34 | 0.13 | [0.09, 0.59] | 2.62 | 0.01 |
| 첫 휴지 기간 | 서사 압축 | 0.58 | 0.14 | [0.31, 0.85] | 4.14 | < 0.001 |
| 첫 휴지 시간 | 단무 돌출도 | 0.36 | 0.14 | [0.09, 0.63] | 2.55 | 0.011 |
| 장휴지 빈도 | 문화적 부하 | 0.19 | 0.04 | [0.11, 0.27] | 4.75 | < 0.001 |
| 장기 휴지 빈도 | 평가 밀도 | 0.08 | 0.04 | [0.00, 0.16] | 2 | 0.046 |
| 장기 휴지 빈도 | 내러티브 압축 | 0.14 | 0.05 | [0.04, 0.24] | 2.8 | 0.005 |
| 장휴지 빈도 | 단무 돌출도 | 0.09 | 0.03 | [0.03, 0.15] | 3 | 0.003 |
| 총 수정 밀도 | 문화적 부하 | 0.27 | 0.06 | [0.15, 0.39] | 4.5 | < 0.001 |
| 총 리비전 밀도 | 평가 밀도 | 0.11 | 0.05 | [0.01, 0.21] | 2.2 | 0.028 |
| 총 수정 밀도 | 서사 압축 | 0.21 | 0.06 | [0.09, 0.33] | 3.5 | < 0.001 |
| 총 수정 밀도 | 단무 돌출도 | 0.17 | 0.06 | [0.05, 0.29] | 2.75 | 0.006 |
| 지연 수정 밀도 | 문화적 부하 | 0.15 | 0.05 | [0.05, 0.25] | 3 | 0.003 |
| 지연 개정 밀도 | 평가 밀도 | 0.23 | 0.05 | [0.13, 0.33] | 4.6 | < 0.001 |
| 지연 수정 밀도 | 서사 압축 | 0.26 | 0.06 | [0.14, 0.38] | 4.33 | < 0.001 |
| 지연 수정 밀도 | 단무 돌출도 | 0.1 | 0.04 | [0.02, 0.18] | 2.5 | 0.013 |
| 총 품질 점수 | 전체 수정본 | 0.04 | 0.05 | [-0.06, 0.14] | 0.82 | 0.412 |
| 총 품질 점수 | 지연 수정 비율 | 1.12 | 0.37 | [0.39, 1.85] | 3.03 | 0.003 |
| 총 품질 점수 | 담화 수준의 수정 | 1.76 | 0.41 | [0.96, 2.56] | 4.29 | < 0.001 |
| 총 품질 점수 | 문화적 적응 수정 사항 | 2.04 | 0.46 | [1.14, 2.94] | 4.43 | < 0.001 |
| 총 품질 점수 | 표면 수정 | -0.63 | 0.28 | [-1.18, -0.08] | -2.25 | 0.028 |
| 총 품질 점수 | 학년도 | 3.48 | 0.69 | [2.13, 4.83] | 5.04 | < 0.001 |
표 5: 세그먼트 수준의 프로세스 동작 및 번역 품질을 예측하는 혼합 효과 모델.
토론
본 연구 결과는 중국 중심 서사의 중-영 번역 시 발생하는 난이도가 텍스트 전체에 균등하게 분포되지 않음을 보여줍니다. 대신, 문화적 참조, 평가적 태도, 압축된 서사적 의미가 수렴되는 구간에 집중되어 나타납니다. 이는 번역 난이도를 어휘력 부족의 관점이 아닌, 프로세스 기반의 관점에서 바라보는 견해를 뒷받침합니다. 실증적인 번역 프로세스 연구에서는 번역이 망설임, 방향 설정, 생산 단계가 불균등하게 분포되는 시간적으로 조직된 활동임을 강조합니다19. 본 연구에서 관찰된 노력의 집중도는 특정 구간이 더 큰 해석적 압박을 가함으로써, 다른 구간보다 선형적인 초안 작성을 더 심하게 저해한다는 점을 반영합니다. 가설 검증 결과는 다음과 같이 요약할 수 있습니다. H1은 문화적 부하가 초기 망설임과 수정 밀도를 증가시켰으므로 지지되었습니다. H2는 평가적 밀도와 서사적 압축이 서로 다른 수정 경로를 통해 작용했으므로 수정되었습니다. H3는 수정 시점과 기능이 전체 수정 횟수보다 품질을 더 강력하게 예측했으므로 지지되었습니다. H4는 단무(danmu)의 두드러짐과 고노력 구간 사이의 연상적 중첩으로 나타났으며, 인과 관계가 아니었으므로 지지되었습니다.
수정 행동과 관련하여, 데이터는 총 수정 횟수가 번역 품질을 예측하지 않는다는 점을 보여준다. 오히려 지연된 수정, 담화 수준의 수정, 그리고 문화적 적응 수정이 성능 향상의 주요 동인이다. 이러한 차이는 수정이 단순한 반복적 국소 수정을 넘어 구조화된 재평가로 실행될 때만 생산적이라는 것을 시사한다. 과업이 어려워질 때 초보 번역가들이 노력을 다르게 배분한다는 시선 추적 및 키스트로크 로깅 연구와 일치하게, 본 연구의 우수한 학생들은 단순히 더 활동적이었던 것이 아니다7. 이들은 임시 해결책을 선택적으로 중단하고, 후속 단계에서 이를 재평가하며, 서사적 또는 문화적 적합성을 향해 수정을 진행했다. 결과적으로, 유사한 최종 점수가 매우 다른 과정 궤적에서 도출되는 경우가 많기 때문에, 결과물 점수만으로는 번역가의 성능을 설명하기에 불충분하다9.
이 현상은 노력의 전환(effort conversion)이라는 관점에서 가장 잘 이해될 수 있습니다. 점수가 낮은 번역물의 경우, 인지적 노력이 국소적 수준에 머물러 있었습니다. 즉, 학생들은 잠시 멈추거나 어휘 항목을 교체하고 관사를 조정했지만, 원문이 내포하는 의미와 도착어 텍스트 구성 방식 사이의 더 깊은 불일치를 해결하는 데는 실패했습니다. 반대로, 점수가 높은 답안에서는 그러한 노력이 도착어 독자에게 최적화된 텍스트를 만드는 구조적 결정으로 전환된 모습을 보였습니다. 학생들의 포스트 에디팅 성능에 관한 연구와 마찬가지로, 이러한 결과는 프로세스상의 노력이 자동으로 유익한 것은 아니며, 그 가치는 해석 가능한 텍스트의 개선으로 전환되는지 여부에 달려 있음을 확인시켜 줍니다20.
또한, 서로 다른 텍스트 특성은 각기 다른 처리 메커니즘을 활성화합니다. 문화적 부하는 초기 망설임과 수정 밀도를 안정적으로 증가시킨 반면, 서사적 압축은 담화 수준의 수정을 강력하게 예측했습니다. 이러한 구분은 번역 과정에서 난해한 세그먼트가 서로 다르게 나타나는 이유를 명확히 해줍니다. 일부는 초기 정식화 단계에서 인지적 접근을 방해하는 반면, 다른 일부는 더 넓은 담화 범위에 걸쳐 일관성을 유지하는 과정에서만 문제가 됩니다. 난해한 텍스트가 더 작은 처리 단위와 더 빈번한 중단을 유발한다는 연구 결과와 일치하게, 이러한 발견은 압축된 문화적 및 평가적 의미가 번역자로 하여금 국소적 표현과 전체적인 서사 프레임 사이를 오가게 만든다는 점을 강조합니다8.
본 연구의 중요한 방법론적 기여는 단무(danmu) 현저성을 시청자-담론 층위로 통합한 점에 있습니다. 높은 노력이 투입된 번역 세그먼트와 단무 현저 세그먼트 사이에 상당한 중첩이 나타난다는 것은, 학생들이 겪는 병목 구간이 디지털 유통 과정에서 시청자의 높은 주의를 끄는 지점과 자주 일치함을 시사합니다. 이는 번역의 난이도를 참여적 담론과 연결하면서도, 두 개념을 하나로 뭉뚱그리지 않고 구분하여 분석한 것입니다. 단무 댓글은 비디오 매개 유통 과정에서 시청자가 무엇에 주목하거나 이견을 제기하는지를 보여주는 반면, 키스트로크 및 수정 기록은 학생 번역자가 소스 텍스트의 의미론적 관련 세그먼트를 어떻게 처리하는지를 보여줍니다. 따라서 가장 타당한 해석은 공통 단서(common-cue) 설명입니다. 즉, 문화적 함의가 담긴 참조, 압축된 배경 가정, 평가적 포지셔닝은 시청자의 주의를 끄는 동시에 번역자의 처리 압박을 증가시킬 수 있습니다21.
교육학적 관점에서 이러한 중첩은 중국 중심의 내러티브가 즉각성, 이해 가능성, 청중과의 조화와 같은 상충하는 우선순위에 의해 지배되며, 의미가 공개적이고 빠르게 협상되는 맥락에서 유통됨을 시사한다22. 결과적으로, 번역가 교육은 수정 작업을 일반적인 교정 단계로 보는 관점에서 벗어나 기능적이고 시간적으로 전략적인 개입을 강조하는 방향으로 전환되어야 한다. 관찰된 병목 현상은 단순히 용어 자체로 인해 발생하는 경우는 드물었으며, 내러티브의 의미가 문화적 기반의 전제, 관계적 프레이밍, 그리고 청중의 선택적 접근성에 의존하는 지점에서 나타났다. 중국 소수민족 내러티브 문학의 보급과 마찬가지로, 이러한 내러티브를 전달하려면 어휘적 충실함을 넘어 더 광범위한 글로벌 유통을 위해 지역적 문화 의미를 어떻게 재구성해야 하는지를 결정해야 한다23. 이 방법은 키스트로크 로그, 화면 녹화, 청중 담론 사례 등을 활용하여 학생들이 단순한 어휘 교체가 아니라 명시화, 순서 재배치, 문화적 프레이밍 또는 레지스터 조정이 필요한 구간을 식별할 수 있도록 돕는 번역가 교육에 적용될 수 있다.
이러한 결과의 해석에는 몇 가지 제한점이 있습니다. 첫째, danmu salience는 청중 참여도를 나타내는 의미론적 클러스터 대리 지표이며 언어적 난이도를 직접 측정하는 척도가 아니며, 본 상관관계 연구 설계로는 대중적 인지도와 번역 노력 사이의 인과관계를 입증할 수 없습니다. 향후 연구에서는 문화적 부하, 평가적 밀도, 서사적 압축을 실험적으로 조작하여 인과 경로를 테스트할 수 있을 것입니다. 둘째, 표본이 한 대학의 번역가 교육생으로 제한되었으며, 참가자의 경력, 문화적 친숙도, 제2외국어 숙련도는 완전한 층화 표집이 아닌 통계적 제어를 통해 처리되었습니다. 전문 번역가, 여러 기관의 학생, 그리고 더 넓은 숙련도 범위를 포함한 재현 연구를 통해 일반화 가능성을 강화할 수 있을 것입니다. 셋째, 소스 텍스트는 과업 보정을 위해 연구자가 구성하고 파일럿 테스트를 거쳤으나, 향후 연구에서는 실제 공개 텍스트와 독립적인 자료 개발 패널을 활용한 추가 검증이 포함되어야 합니다. 넷째, 문화적 부하, 평가적 밀도, 서사적 압축 및 수정 기능의 코딩은 투명한 조작적 정의, 독립적인 코더 기록, 그리고 조정된 코딩 파일과 함께 검증 가능한 평가자 간 신뢰도에 의존합니다. 또한 향후 연구에서는 키스트로크 로깅을 안구 추적, 회고적 인터뷰, 생각 소리 내어 말하기 프로토콜 또는 사후 편집 과업과 결합하여 수정 결정의 근거가 되는 인지 기제를 삼각 측량할 수 있을 것입니다.
궁극적으로, 본 연구는 중국 관련 서사의 중-영 번역에서 학생들의 수행 능력이 나타나는 프로세스 기반을 명확히 밝힙니다. 키스트로크 로깅 데이터, 결과물 평가, 그리고 디지털 청중 담론을 연결함으로써, 번역의 병목 현상이 공공연하게 민감한 서사적 의미가 담긴 지점에서 발생한다는 점을 결과로 입증하였습니다. 교차 문화 번역의 결정적인 요인은 단순한 수정 횟수가 아니라, 해석적 재구성이 필요한 구간을 인식하고 안정적이며 청중에게 적합한 해결책이 도출될 때까지 전략적으로 완결을 늦출 수 있는 번역자의 능력입니다.
공개 사항
저자들은 공개할 이해관계가 없음을 밝힙니다.
저자 기여도
Weijia Chen: 개념화, 방법론, 정식 분석, 조사, 초안 작성.
Chunming Wu: 연구 설계, 정식 분석 및 데이터 처리 절차 지도, 그리고 리뷰어 의견에 따른 수정 사항 검토 및 피드백.
감사의 글
본 연구는 Hanshan Normal University의 두 가지 연구비 지원을 통해 수행되었습니다. 구체적으로, 본 연구는 "Theory and Practice of Chinese–English Translation II"에 대한 2023년 일류 학부 과정(오프라인 일류 과정) 프로그램(승인 번호 YHS [2023] 172)의 단계적 연구 성과에 해당합니다. 또한, 본 연구는 "Chinese–English Translation"의 커리큘럼 기반 이데올로기 및 정치 교육 모델 코스로 지정된 2025년 교육 품질 및 교육 개혁 프로젝트(승인 번호 YHSJ〔2025〕126)의 지원을 받았습니다. 저자들은 본 연구의 완수를 위해 제공된 기관의 지원에 깊은 감사를 표합니다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| Bilibili 단무 코퍼스 | Bilibili | 24 videos; 18,642 comments;https://www.bilibili.com | 보조 단무 코퍼스 구축 및 세그먼트 수준의 단무 돌출도 계산 |
| Microsoft Excel | Microsoft Corporation | Excel 2021;https://www.microsoft.com/microsoft-365/excel | 데이터 정제, 코딩 정리 및 기초 데이터 관리 |
| R | R Foundation for Statistical Computing | R 4.3.1;https://www.r-project.org | 혼합 효과 모델링, 상관관계 분석 및 도표 생성 |
| 화면 녹화 소프트웨어 | Laboratory workstation | Local workstation utility; no catalog number | 비선형 수정 에피소드 검증 및 프로세스 데이터 백업 |
| SPSS | IBM Corporation | SPSS Statistics 27.0;https://www.ibm.com/products/spss-statistics | 기술 통계, ANOVA 및 기초 통계 분석 |
| Translog-II | Copenhagen Business School / CRITT | Translog-II;https://sites.google.com/site/centretranslationinnovation/translog-ii | 번역 작업 중 키스트로크 로깅 및 일시 정지, 커서 이동, 수정 에피소드 기록 |
참고문헌
- Valdeón RA, Li S. Political discourse translation in contemporary Chinese and Western contexts. Translator. 2024;30(4):1-14.
- Du L, Afzaal M. Analyzing modality-mediated ideology in translated Chinese political discourses: An ideological square model approach. Humanit Soc Sci Commun. 2024;11:956.
- Carl M. Empirical translation process research: Past and possible future perspectives. Transl Cogn Behav. 2024;6(2):252-274.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589-1604.
- Carl M, et al. Hesitation, orientation, and flow: A taxonomy for deep temporal translation architectures. Ampersand. 2024;12:100164.
- Swar O, Mohsen M. Students' cognitive processes in L1 and L2 translation: Evidence from a keystroke logging program. Interact Learn Environ. 2023;31(10):6247-6263.
- Wang Y, Li S, Rasmussen YZ. Translators' allocation of cognitive resources in two translation directions: A study using eye-tracking and keystroke logging. Appl Sci. 2025;15(8):4401.
- Wang F, Xu Q. Processing of translation units by student and semi-professional translators in translating texts with different levels of translation difficulty. PLoS One. 2025;20(4):e0320809.
- Chen X, Yan JX. Examining student translators' writing and translation products: Quality, errors, and self-perceived mental workload. Interpret Transl Train. 2024;18(3):465-485.
- Dong D, Chen ML. Metacognitive strategies in translation: A comparative study of student and professional translators. Humanit Soc Sci Commun. 2025;12:890.
- Chen X, Yan JX. Investigating the processing effort in translation students' L2 writing and L2 translating: Evidence from keylogging. Humanit Soc Sci Commun. 2025;12:1810.
- Cao L, Doherty S, Lee JF. The process and product of translation revision: Empirical data from student translators using eye tracking and screen recording. Interpret Transl Train. 2023;17(4):548-565.
- Van Egdom GW, Schrijver I, Verplaetse H, Segers W. The impact of collaborative processes on target text quality in translator training. Interpret Transl Train. 2024;18(3):486-506.
- Riondel A. How to teach revision: Tips from an interview study. Interpret Transl Train. 2024;18(3):507-522.
- Lu S, Chen X. An experimental study on viewing perception and gratification of danmu subtitled online video streaming. J Spec Transl. 2024;42:217-238.
- Lei Y, Peng M, Han Y. Mistaken presuppositions and the translation of cultural texts: A study of two English translations of The Classic of Tea. Perspectives. 2025. doi:10.1080/0907676X.2025.2599854.
- Kim HR. Danmu as paratext: An exploratory study of paratextual functions in Chinese fan-subtitled videos. J Transl Stud. 2025;26(3):197-231.
- Wu X, Fitzgerald R. The danmu discourse of user engagement with cross-posted broadcast interviews in Chinese social media. Journalism. 2025;26(3):733-751.
- Yamada M, Carl M, Schaeffer MJ. Introduction to the special Ampersand issue on empirical translation process research. Ampersand. 2024;12:100179.
- Peng X, Wang X, Li X. When student translators meet with machine translation: The impacts of machine translation quality and perceived self-efficacy on post-editing performance. SAGE Open. 2024;14(4):21582440241291624.
- Yang Y. Making sense of the raw meat: A social semiotic interpretation of user translation on the danmu interface. Discourse Context Media. 2021;44:100550.
- Zeng D. Danmu subtitling as a self-regulative practice: A descriptive discourse analysis of Bilibili danmu subtitles from ethical perspectives. Front Psychol. 2025;16:1577260.
- Li Y, Cai X. The translation of ethnic literature: An analysis of the Chinese and English translations of the Yi folk narrative poem Ashima and their dissemination. Perspectives. 2025. doi:10.1080/0907676X.2025.2502935.