본 연구는 교차 문화적 맥락에서 영어 작문 전이 역량을 강화하기 위해 DeepSeek 기반의 계층적 프롬프트 최적화 프레임워크를 개발합니다. 3단계 프롬프트 체인과 60명의 영어 전공자를 대상으로 한 유사 실험을 통해, 실험군이 대조군에 비해 유의미한 향상을 보였음을 확인하였습니다.
이 논문에서
요약
초록
전통적인 영어 작문 교육이 언어 전이(language transfer)의 체계적인 함양을 간과하고 기존의 프롬프트 프레임워크가 교실 수업에 적합하지 않다는 한계를 해결하기 위해, 본 연구는 DeepSeek 모델을 기반으로 문장, 단락, 담화, 문화라는 4단계의 점진적 과제 계층을 포함하는 계층적 전이 훈련 시스템을 구축하였으며, 모든 과제는 트리플(triple) 형태로 정의되었습니다. 구문, 구조, 문화, 레지스터, 논리를 아우르는 5차원 과제 라이브러리를 구축하고, 학생들의 실제 작문 초안으로부터 타겟 프롬프트를 자동으로 생성하였습니다. 모델의 전문가 혼합(Mixture of Experts, MoE) 아키텍처와 결합하여, 복잡한 과제를 의미적 재구성, 언어적 수정, 문화적 적응이라는 세 가지 순차적 단계로 분리하는 중첩 프롬프트 체인을 개발하였습니다. 준실험 설계를 채택하여, 한 대학교의 영어 전공 2학년 학생 60명을 모집해 각각 30명씩 실험군과 대조군으로 배정하고 3회차의 훈련 라운드에 걸쳐 3주간 단계적 중재를 실시하였습니다. 실험 후 결과에 따르면, 실험군의 문화적 전이 점수는 2.8에서 4.5로 상승한 반면, 대조군은 단 0.3점 증가하는 데 그쳤습니다. 또한 실험군의 교사 평가 평균 점수는 59.1에서 74.4로 향상되었으나, 대조군은 60.1에서 64.9로 증가하는 데 그쳤습니다. AI 채점과 교사 평가 간의 상관계수 대부분이 0.8을 초과하였으며, 참여자의 90% 이상이 AI 재작성 및 구조 최적화 기능에 만족하였습니다. 본 시범 연구의 표본 크기가 작음에도 불구하고, 이러한 최적화 접근 방식은 대학 영어 작문 수업에 적용 가능한 것으로 나타났습니다.
서론
교차 문화적 맥락의 영어 작문 교육에서 비원어민 영어 학습자들은 언어 지식을 실제 적용으로 전환하는 과정에서 전이 능력이 부족하여 어려움을 겪는 경우가 많습니다1,2. 학생들은 어느 정도의 문법 및 어휘 기초를 갖추고 있음에도 불구하고, 문장 패턴, 구조 및 문화적 표현을 실제 작문으로 효과적으로 변환하는 데 어려움을 겪으며, 이는 정형화된 언어 출력과 제한적인 사고로 이어져 결과적으로 전반적인 작문 품질에 영향을 미칩니다3. 또한, 언어 구조, 논리적 구성 및 화용론적 규범의 교차 문화적 차이는 작문 전이의 복잡성을 더욱 가중시킵니다4. 최근 몇 년 동안 대규모 언어 모델(LLM)은 작문 교육에 새로운 기술적 지원을 제공해 왔습니다5. DeepSeek와 같은 지능형 작문 도구는 언어 생성 및 재구성 분야에서 강력한 능력을 입증했습니다. 그러나 교육 현장에서 이러한 도구들은 대부분 표면적인 언어 교정에 국한되어 있으며, 전이 능력 배양을 중심으로 하는 교육 과정에 아직 깊이 통합되지 못했습니다. 또한 교육 목표 지향성과 생성 동작에 대한 제어 가능성이 부족합니다6,7. 현재 널리 사용되는 AI 보조 작문 애플리케이션들은 대부분 그 기능을 표면적인 문법 오류 교정에 한정하고 있으며, 체계적인 전이 역량 배양을 목표로 하지 않아 모델 출력물에 대한 교육적 제어력이 떨어지는 결과를 초래하고 있습니다.
ESL 작문 보조에 관한 기존 연구는 크게 세 가지 범주로 나뉩니다: 전통적인 프롬프트 기반 작문 피드백, 범용 AI 교정 개입, 그리고 수동 중심의 전이 학습입니다. 첫째, 일반적인 프롬프트 엔지니어링 연구는 계층적 전이 교육 목표와의 정렬 없이 질의응답 및 텍스트 재작성의 기술적 최적화에 우선순위를 둡니다8,9. 둘째, 전형적인 ChatGPT 기반 ESL 튜터링은 계층적인 구문적, 구조적 및 교차 문화적 전이 함양보다는 전반적인 작문 정확도 향상에 집중합니다10. 셋째, 모방 및 대조 작문에 의존하는 전통적인 전이 교수법은 지능형 도구로 지원되는 폐쇄 루프 피드백이 부족합니다11. 이전 연구들과 달리, 본 연구에서는 다단계 교육 목표에 맞춘 전이 지향적 계층형 프롬프트를 맞춤 설정하고 샘플 기반 프롬프트 자동 생성 워크플로우를 구축하여 모델 생성, 교사 피드백 및 학생 수정이 결합된 독특한 폐쇄 루프 훈련 메커니즘을 형성합니다.
기존 문헌에서는 언어적 문화적 차이, 모델 고유의 구조적 제약, 그리고 분절된 강의실 실습 사이의 잠재적 연결 고리가 있을 것으로 가설을 세웠으나, 이러한 인과 관계는 기존 실증 연구에서 충분히 검증되지 않았으며, 이에 따라 본 논문에서 검증하고자 하는 핵심 연구 가설이 되었다12,13. 본 논문에서 언급된 DeepSeek의 고유 특성과 관련하여, 개방형 지시 인터페이스와 MoE 기반 전문가 라우팅 설계는 기존 모델 기술 보고서 및 응용 언어 연구에 기록되어 있다. 이러한 기록된 모델 특성을 바탕으로, 본 연구에서는 복잡한 교차 문화 전이 과제를 분해하기 위해 중첩된 프롬프트 체인을 맞춤 설계하고, 차별화된 전이 과제 부여를 위한 동적 하위 모델 스케줄링 규칙을 개발한다. 구조화된 전이 능력 개발에 초점을 맞춰, 본 연구는 표적 DeepSeek 프롬프트 최적화를 탐구하며, 이를 통해 대규모 언어 모델을 범용 텍스트 편집 도구에서 대학 영어 글쓰기 지도를 위한 전문 전이 학습 시스템으로 전환하는 것을 목표로 한다.
제2언어 작문 연구 분야에서 전이 현상은 오랫동안 핵심 주제였습니다14,15. 전통적인 언어 전이 이론은 주로 모국어가 목표 언어 습득 과정에 미치는 긍정적 및 부정적 전이 효과에 초점을 맞추며, 특히 음성학, 어휘 및 구문에 중점을 둡니다16. Mirzayev E는 제2언어로서의 영어(ESL) 작문 지도에서 제1언어로부터의 부정적 전이가 학생들의 작문 능력 발달을 제한하는 주요 요인으로 남아 있다고 지적했습니다17. 연구 범위가 확장됨에 따라 학계는 점차 작문 구조 전이로 관심을 넓혀왔습니다18. 중간언어 작문은 여러 요인으로 인해 언어적 오류와 화석화 현상이 자주 나타납니다19. 동시에 인지 전이 이론 또한 점점 더 많은 주목을 받고 있습니다20. 이 이론은 작문 과정에서의 인지적 조직 및 표현 방식의 차이를 강조합니다. 예를 들어, 서구의 작문은 선형적 추론과 명시적 논리를 강조하는 반면, 중국의 전통은 나선형 방식과 의미적 모호성을 선호합니다. 이 두 방식 사이에는 상당한 긴장 관계가 존재합니다. 따라서 언어 전이는 단순히 언어 단위의 변환뿐만 아니라, 더 깊은 수준에서의 사고 구조와 문화적 표현 규범의 적응 및 변형을 포함하며, 이는 현재 영어 작문 지도에서의 중요한 과제입니다21.
전이 능력을 배양하는 실제 과정에서, 기존 연구들은 학습자가 대상 언어의 전이 메커니즘을 이해하고 적용하는 능력을 향상시키기 위해 모방 쓰기22, 대조 쓰기23, 번역 훈련24과 같은 전략을 자주 활용한다. 모방 쓰기는 기본적인 담화 능력을 구축하는 데 도움이 되지만, 구조적 경직성으로 이어지기 쉽다. 대조 쓰기는 언어 스타일과 문화적 인식을 개선할 수 있으나, 체계적인 과업 계층화와 개인별 맞춤형 피드백이 부족하다. 번역 훈련은 문화적 은유 인식을 촉진할 수 있지만, 적절한 안내가 없으면 의미적 편차나 화용론적 부적절함으로 이어지기 쉽다. 위의 전략들은 주로 수동적인 시연과 경험적 지도25에 의존하며, 전이 전략의 명시적인 구축과 체계적인 피드백 메커니즘이 부족하여 언어 능숙도와 인지 양식의 개인차에 대응하기 어렵다. 일부 연구에서 다양화된 쓰기 과업을 통해 전이 훈련을 확장하려 시도했으나26,27, 교수 과정에서 "전이 목표-언어 생성-전략 피드백"의 폐쇄 루프가 아직 형성되지 않았다. 이로 인해 전이 전략의 내면화 효과가 제한적이며, 실제 쓰기 과업에서 학생들의 전이 능력 발달은 여전히 미흡한 상태이다28.
대규모 언어 모델 기술의 발전과 함께, 언어 교육에서의 보조적 잠재력이 점점 더 많은 관심을 받고 있습니다29. ChatGPT(Chat Generative Pre-trained Transformer)30 및 DeepSeek31으로 대표되는 생성형 AI 도구들은 텍스트 교정, 언어 재작성 및 언어 조정과 같은 시나리오에서 널리 사용되어 왔습니다. Diasamidze 등은 ChatGPT를 사용하는 ESL 학생들이 문법적 정확성, 어휘의 풍부함 및 텍스트 구성 능력 측면에서 전통적인 교육 그룹보다 우수한 성과를 보였다는 것을 발견했습니다32. 하지만 기존의 응용 프로그램들은 대부분 표면적인 언어 처리 수준에 머물러 있으며, 전이 목표에 대한 체계적인 가이드가 부족한 실정입니다. Ranade는 현재의 교육 시나리오에서 프롬프트 기반 프로젝트가 대부분 일반적인 템플릿에 의존하고 있으며, 생성된 콘텐츠에 맥락적 적응성과 과제 특이성이 부족하다고 지적했습니다33. 또한, 주류 모델 훈련은 공개 말뭉치에 의존하고 있어 중어와 영어의 문화적 표현 차이에 대한 심층적인 모델링이 부족합니다. 이로 인해 생성된 텍스트에서 문화적 부적절함과 부자연스러운 화용론적 특성이 나타나기 쉬우며34,35, 이는 교차 문화 작문 전이 교육의 심층적인 적용을 제한하고 있습니다.
프로토콜
윤리적 승인
실험에 앞서 저자들은 대학으로부터 승인(승인 번호: NBCC-ETH-2026-037)을 받았으며, 모든 학생 참여자에게 고지된 동의서를 배부하였다. 모든 학생에게 연구 목적, 실험 절차 및 데이터 사용 규정에 대해 명확히 안내하였다. 참여는 자발적으로 이루어졌으며, 참여자는 언제든지 연구에서 탈퇴할 수 있었다. 개인정보 보호를 위해 모든 개인 데이터와 작성물은 익명화되었으며, 학술적 분석 목적으로만 사용되었다. 참여자 60명 전원은 연구에 참여하기 전 동의서에 서명하였다. 참여자는 동일한 고등 직업 대학의 두 개의 병행 2학년 영어 작문 수업에서 편의 표집법을 통해 선정되었다. 선정 기준은 CET-6 합격 점수 포함이었다. > 425명, 이번 학기 결석 없음, 그리고 최근 두 차례의 단원별 쓰기 시험에서 평균 점수를 기록한 인원을 대상으로 하였다. 제외 기준은 수업 시간 외 상용 영어 AI 쓰기 소프트웨어의 장기 사용 및 심각한 난독증이었다.
모든 연속형 결과 변수의 변동성은 평균 ± 표준편차(SD)로 보고되었습니다. 모든 분석은 그룹당(실험군 vs. 대조군) n = 30명의 참가자, 총 N = 60명의 표본 크기로 수행되었습니다. 종단적 반복 측정 데이터의 경우, 그룹과 시간의 주효과 및 그룹-시간 상호작용을 검토하기 위해 반복 측정 분산 분석(RM-ANOVA)이 사용되었습니다. 개별 시점에서의 사후 쌍별 비교를 위해 독립 표본 t-검정이 사용되었습니다. 대조군은 전통적인 작문 지도와 더불어 일반적인 무료 비맞춤형 AI 작문 도구(단계별 프롬프트 및 전이 지향 템플릿 없음)를 제공받았습니다. 지도 시간, 작문 과제, 피드백 빈도 및 훈련 텍스트는 본 연구에서 사용된 맞춤형 중첩 프롬프트 체인 및 5단계 과제 라이브러리 중재가 없었다는 점을 제외하고 실험군과 동일했습니다. 실험군은 중첩 프롬프트 체인 가이드, 교차 문화 적응 출력 및 "생성-성찰-재생성" 메커니즘을 포함하여 작문 지도를 최적화하기 위해 DeepSeek 모델 기반의 지침을 사용했습니다. 반면 대조군은 전통적인 교수법 또는 최적화되지 않은 AI 보조 도구를 사용했습니다. 두 그룹의 교육 효과를 비교함으로써, 거대 언어 모델 기반의 전이 훈련 방법이 학생들의 작문 전이 능력을 향상시키는 데 미치는 효과를 검증하였습니다.
전체 연구 개념
본 연구는 DeepSeek의 교육적 활용에 특히 초점을 맞추어, 학생들의 영어 작문 전이 능력을 향상시키고 효과적인 교수 설계 방법을 개발하는 것을 목표로 하였다. 우선, 모델 프롬프트를 재설계하기 위한 지시어 최적화 전략을 제안하였다. 이를 통해 구문 구조, 단락 논리, 문화적 표현을 포함한 작문 교육의 다양한 전이 목표와 생성된 결과물 간의 정렬도를 높였다. 둘째, 교사의 작문 과업을 구조화되고 목표 지향적인 프롬프트 템플릿으로 변환하였다. 이후 교수 과업과 모델 동작 간의 매핑 관계를 설정함으로써 모델의 제어 가능성을 높이고 생성된 콘텐츠가 교육적으로 유효하도록 보장하였다. 마지막으로, 본 연구는 “생성–성찰–재작성–재생성”으로 이어지는 폐쇄 루프 전이 훈련 프로세스를 개발하였다. 이 프로세스는 학생들이 모델의 지원을 받아 전이 전략을 식별하고 언어 표현을 능동적으로 정교화하도록 유도하였다. 반복적인 이터레이션을 통해 학생들의 교차 언어 및 교차 문화 작문 전이 능력이 지속적으로 강화되었다. 문장 구조 변환 단계는 그림 1A–D에 제시되어 있다.
AI 보조 작문 훈련 시스템의 전체 작동 로직을 명확히 하고 재현성을 높이기 위해, 원본 입력, 교사 개입, 프롬프트 적용, 학생 활동, 최종 결과물 및 해당 평가 기준을 포함하는 핵심 단계를 표 1에 전체 구현 워크플로로 요약하였다.
전이 지향적 작업 구성 전략
본 연구는 영어 쓰기에서의 전이 능력 배양에 초점을 맞추었습니다. 이를 위해 얕은 단계에서 깊은 단계로 진행되는 전이 과제 경로를 구축하여, 학생들이 다층적인 언어 전이 전략을 체계적으로 습득하고 연습할 수 있도록 안내하였습니다. 전체적인 경로 구조를 설명하기 위해, 이를 4단계 과제 세트로 정의하였습니다.
T = {T1,T2,T3,T4} (1)
T1 은 문장 수준의 전이 과업을 나타내며, 학생들이 다양한 문장 구조 방법을 익힐 수 있도록 짧은 문장 확장, 태 변화, 절 교체와 같은 기본적인 문법 구조 조작에 집중합니다. T2 는 단락 수준의 전이 과업으로, 학생들이 단락 내 정보의 구성과 연결에 주의를 기울이도록 안내하며, 핵심 문장 추출 및 문장 간 논리 조정을 통해 단락의 구조적 명확성과 표현의 일관성을 향상시키도록 훈련합니다. T3은 담화 수준의 과업을 나타내며, 이는 장(chapter)의 전반적인 논리적 배치와 논증 리듬으로 더욱 확장되어, 학생들이 단락 순서를 조정하고 구조적 병치 관계를 최적화함으로써 완전한 논증 체계를 갖춘 영어 기사를 작성하도록 안내합니다. T4 는 문화 수준의 전이 과업으로, 학생들이 모국어 작문에서 나타나는 함축적 표현 방식(함축적 어휘 및 의미적 힌트 등)의 특성을 식별하고, 이를 대상 언어 문화에 부합하는 직접적인 표현이나 논리적으로 명시적인 형태로 변환하도록 요구합니다. 그 진화 과정은 그림 2에 제시되어 있습니다. 과업 설계의 운용성과 평가 가능성을 높이기 위해, 본 연구에서는 각 수준의 과업을 다음과 같이 트리플(triple) 형태로 정의하였습니다.
Ti = (Si,Gi,Ei) (2)
Sj 는 과제 입력 샘플을, Gi 는 대상 전이 연산을, Ei 는 지원 평가 기준을 나타냅니다. 이러한 구조적 표현을 통해 각 단계의 과제가 이전 단계의 전략 숙달을 바탕으로 구축되도록 하였으며, 상응하는 샘플, 대상 설명 및 성과 기준을 갖추게 하여 전이 경로의 안정적인 발전을 위한 메커니즘을 제공하였습니다. 전이 학습 시스템을 구축하는 과정에서 과제 유형의 체계적인 범위 설정과 교수 호출의 효율적인 관리를 달성하기 위해, 본 연구에서는 작문 전이의 공통 언어 전환 차원을 기반으로 다섯 가지 전이 목표 유형을 포함하는 구조화된 과제 라이브러리를 구축하였습니다. 과제 라이브러리는 다음과 같이 공식적으로 표현되었습니다:
M = {(Dj,TDj)∣j = 1,2,3,4,5} (3)
Dj 은 구문적 전이, 구조적 전이, 문화적 전이, 레지스터 전이, 그리고 논리적 전이의 다섯 가지 전이 차원에 해당하며, 각 차원과 연관된 과업 집합 TDj 는 해당 차원의 조작 하위 집합을 나타냅니다. 과업 라이브러리를 개발하는 과정에서 저자들은 먼저 수많은 실제 학생 작문 샘플을 바탕으로 일반적인 전이 어려움과 언어 오류 유형을 요약 및 분류하였으며, 실제 교수 요구 사항 및 평가 표준과 결합하여 서로 다른 전이 유형을 기능 영역으로 나누고 각 과업의 핵심 훈련 목표와 조작 모드를 설정하였습니다. 각 과업은 다음과 같은 트리플 구조로 추상화되어 표현되었습니다:
Ti,j = (Si,j,Gi,j,Ci,j) (4)
Si,j는 과제 입력 샘플을, Gi,j는 과제의 전이 목표 기술을, Ci,j는 과제의 평가 및 제어 차원을 나타냅니다. 구문 전이 과제에서 본 연구는 문장 연결, 절의 내포, 수동태 전환 및 관련 개념을 포함하여 쉬운 단계에서 어려운 단계로 진행되는 문장 재구성 시퀀스를 설계함으로써, 학생들의 문장 확장 및 문법 변형 능력을 향상시키는 것을 목표로 하였습니다. 구조 전이 과제는 주제문 다시 쓰기, 뒷받침 문장 정렬, 인과 관계 및 예시 관계 재구성을 통해 단락 논리를 최적화하고, 정보 조직력을 강화하며, 논리적 구성 능력을 높이는 데 중점을 두었습니다. 문화 전이 과제는 교차 문화 말뭉치를 기반으로 하며, 함축적 표현이나 완곡어법과 같은 화용론적 편차를 대상으로 합니다. 이는 문화적 적응력 발달을 촉진하기 위해 실제 맥락에 가까운 표현 전환을 설계하였습니다. 레지스터 전이 과제는 학생들이 구어체 표현을 학술적 언어로 변환하고 레지스터 전환 전략을 습득하도록 안내하였습니다. 논리 전이 과제는 접속사 사용, 논리적 관계의 명시화, 단락 전환에 관한 훈련을 수행하는 동시에 추론 사슬을 구축하고 표현의 명확성을 확보하는 데 집중하였습니다.
학생들의 실제 작문 샘플을 바탕으로, 본 연구는 교수 학습 과제와 밀접하게 연계된 프롬프트 생성 프로세스를 개발하여 지시문의 관련성과 생성된 콘텐츠의 실용성을 높이고자 했습니다. 이 프로세스는 교사가 주도하였으며, 교사는 교수 과정 중 중복된 문장, 무분별한 구조, 부적절한 문화적 표현과 같은 전형적인 전이(transfer) 문제가 나타나는 대표적인 학생 텍스트 단편을 선정했습니다. 이후 교사는 시스템 인터페이스를 통해 샘플에 전이 유형을 주석으로 달아 학습 목표를 명확히 했습니다. 주석 정보를 수신한 시스템은 자동으로 전이 과제 식별 모듈을 활성화했습니다. 그다음 입력값과 사전 정의된 과제 라이브러리 및 프롬프트 템플릿 라이브러리를 매칭했습니다. 매칭 과정에서는 전이 유형, 언어적 특징, 텍스트 구조 등의 요소를 고려했습니다. 이러한 요소를 바탕으로 시스템은 가장 적합한 템플릿을 선택하여 초기 프롬프트를 생성했습니다. 또한 시스템은 구조화된 강화 처리 과정을 지원했습니다. 교사의 주석은 모델이 쉽게 해석할 수 있는 표준화된 형식으로 변환되었습니다. 관련 교수 지침 힌트가 프롬프트에 삽입되어 모델이 교사의 의도와 학생의 질문을 모두 정확하게 이해할 수 있도록 도왔습니다. 지시문의 유연성과 제어 가능성을 향상시키기 위해 시스템에는 교사 보조 모듈이 포함되었습니다. 이 모듈을 통해 교사는 교수 지침을 수정하고, 문맥 설정을 조정하며, 톤과 스타일을 맞춤 설정함으로써 프롬프트를 정교하게 다듬을 수 있었습니다. 결과적으로 교사는 생성 프로세스에 대해 더 큰 제어 권한을 갖게 되었으며, 이를 다양한 교육 시나리오에 더 잘 적용할 수 있었습니다.
Deepseek 명령 최적화 메커니즘
영어 작문 전이 훈련의 실질적인 요구 사항을 바탕으로, 본 연구에서는 다섯 가지 유형의 전이 지향적 프롬프트 템플릿을 개발하였다. 이 템플릿들은 대규모 언어 모델의 생성 동작을 안내하고 조절하도록 설계되었다. 구조적 전이 템플릿은 단락 구성과 담화 구조에 중점을 두었다. 이는 학생들이 서론-본론-결론과 같은 구조를 채택하고 아이디어의 논리적 흐름을 개선함으로써 텍스트를 재구성하도록 도왔다. 구문론적 전이 템플릿은 문장 수준의 복잡성을 강조하였다. 이는 수동태, 병렬 구조, 복합 절을 포함한 다양한 문법 구조의 사용을 장려하여 작문 표현의 정교함을 높였다. 문화적 전이 템플릿은 작문 시의 문화적 적절성을 다루었다. 이는 학생들이 모국어와 문화의 영향을 받은 표현을 영어권 환경에서 더 자연스럽고 수용 가능한 형태로 조정하도록 안내하였다. 레지스터 전이 템플릿은 스타일 적응과 레지스터 조절에 집중하였다. 이는 학생들이 서로 다른 작문 목적, 독자 및 장르에 따라 언어 사용을 조정하도록 도왔다. 논리적 전이 템플릿은 논리적 조직력을 강화하는 것을 목표로 하였다. 이는 인과 관계, 비교 및 대조, 병렬 전개와 같은 관계를 효과적으로 사용하도록 촉진하여 응집성과 논증의 엄밀함을 향상시켰다. 이 다섯 가지 템플릿은 종합적으로 작문 전이의 주요 차원들을 포괄하였다. 이들은 교수 학습 과제 설계와 모델 기반 텍스트 생성 모두에 구조화된 교육적 지원을 제공하였다.
각 템플릿 유형은 다양한 교육 상황에서 보편성과 적응성을 보장하기 위해 통일된 형식을 따랐습니다. 템플릿은 네 가지 핵심 요소로 구성되었습니다. 첫 번째는 요구되는 전이 과업을 명확하게 나타내는 지시 대상이었으며, 두 번째는 교육의 효과를 위해 코퍼스 기반의 실제 언어 단편을 학생들에게 제공하는 샘플 입력이었습니다. 세 번째는 학생들이 비교하고 모델 튜닝에 활용할 수 있도록 전이 후의 이상적인 언어 출력 표준 스타일을 보여주는 목표 출력이었습니다. 네 번째는 해당 템플릿에 적용 가능한 언어 수준, 텍스트 유형 및 사용 전략을 설명하고, 생성 제어 및 교육 지도 효과를 높이기 위한 조정 가능한 파라미터 프롬프트를 제공하는 사용 제안이었습니다.
프롬프트 템플릿의 설계 논리와 실제 적용 사례를 더욱 자세히 설명하기 위해, 전이 중심 프롬프트의 대표적인 다섯 가지 예시를 아래에 제시합니다. 모든 템플릿은 지시 대상, 입력 샘플, 대상 출력 및 사용 제안으로 구성된 통합 프레임워크를 준수하였습니다. 학생들은 단순한 문장을 확장하고, 문장의 태를 전환하며, 절을 삽입하여 구문적 다양성을 풍부하게 하도록 안내받았습니다. 예를 들어, 학생의 초안인 "I study English writing. It is very important for cross-cultural communication"이 주어진 경우, 최적화된 출력값은 "Learning English writing plays a vital role in improving learners’ ability of cross-cultural communication"입니다. 이 프롬프트는 기초적인 구문 재구성 및 태 전환에 집중하며, 중간 정도의 난이도를 가진 영어영문학 전공 2학년 학생들의 문장 수준 훈련에 적합하였습니다. 또 다른 유형의 프롬프트는 문화적 전이를 목표로 하여, 모국어의 문화적 사고 방식에 영향을 받은 콩글리시 표현을 식별하고 이를 서구 문화 규범에 부합하는 자연스러운 영어 화용론적 표현으로 재작성하는 것을 목적으로 하였습니다. 학생의 문장 "Many people think you must work hard if you want to succeed"를 예로 들면, 수정된 버전은 "People generally believe that diligence is the key to success"였습니다. 이 프롬프트는 내재된 중국어식 사고 패턴을 제거하고 영어 맥락에서의 명시적 표현 능력을 배양하는 데 집중하는 문화 수준의 전이 훈련에 적용되었습니다.
본 연구는 또한 학생들의 단락 초안을 통합 입력값으로 받아 순차적 단계로 실행되는 3단계 중첩 프롬프트 체인을 개발하였습니다. 첫 번째 단계는 의미적 재구성으로, 참가자가 주어진 단락의 문장을 재배치하고, 아이디어의 논리적 순서를 최적화하며, 명확한 주제문이 포함된 완전한 단락을 구성하도록 요구하는 프롬프트로 구성되었습니다. 두 번째 단계는 언어적 수정 단계로, 수정된 단락을 정중한 학술적 영어로 다시 쓰고, 구어체 단어를 교체하며, 복문과 수동태 구조를 적절하게 사용하도록 요청하였습니다. 세 번째 단계는 문화적 적응 단계로, 텍스트 내의 문화적-화용적 표현을 확인하고, 모국어의 문화적 간섭을 제거하며, 영어의 교차 문화적 작문 관습에 맞게 내용을 다듬도록 안내하는 프롬프트를 사용하였습니다. 위의 예시들은 단일 프롬프트 템플릿과 중첩 프롬프트 체인의 작동 방식을 충분히 보여주었습니다. 이를 바탕으로 본 연구는 DeepSeek의 MoE 아키텍처와 결합된 완전한 단계별 프롬프트 체인을 설계하였습니다.
생성 제어 및 작업 응답 깊이 측면에서 단일 라운드 프롬프트의 한계를 극복하기 위해, 본 연구에서는 단계적이고 연속적인 특성을 가진 중첩 프롬프트 체인 구조를 설계하여 계층적 가이드와 복잡한 번역 작업의 점진적 생성을 가능하게 했다. 이 메커니즘은 하나의 완전한 번역 작업을 여러 개의 하위 목표로 세분화하고 각 하위 목표에 상응하는 프롬프트 템플릿을 설계했으며, 이를 의미 재구성, 언어 스타일 조정, 문화적 화용론적 적응이라는 논리적 순서로 직렬 연결하여 문맥 의존성을 가진 생성 체인을 형성했다. 본 연구는 표준 오픈 API를 통해 DeepSeek에 대한 중첩 프롬프트 체인 최적화를 구현했다. DeepSeek 모델은 외부 프롬프트와 독립적으로 작동하는 고유의 내부 추론 모듈인 자동 백엔드 전문가 라우팅 시스템을 갖춘 Mixture of Experts (MoE) 아키텍처를 기본적으로 채택하고 있다. 맞춤형 다단계 프롬프트는 모델 입력의 내용적 특성만을 조정했다. 최적화된 입력에 포함된 의미적, 스타일적, 문화적 요구 사항에 따라, 모델의 고유 MoE 라우팅 메커니즘은 텍스트 생성 과정에서 가장 적합한 전문가 모듈을 자율적으로 활성화했다. 의미 재구성, 스타일 조정, 문화적 적응에 초점을 맞춘 3단계 프롬프트 설계는 단순히 입력 텍스트를 정교하게 다듬었을 뿐, 모델 내부의 전문가 선택 및 할당 로직을 방해하지 않았다.
운영 프로세스 측면에서, 시스템은 교사가 업로드한 학생의 텍스트를 수신하고 대상 주석을 전달하며, 중첩 체인 구조의 활성화 여부를 자동으로 결정했습니다. 활성화된 경우, 시스템은 세 단계를 순차적으로 실행했습니다. 첫 번째 단계는 의미적 재구성이었으며, 구조 전달 템플릿을 호출하여 단락 구성과 논리적 단서를 최적화했습니다. 두 번째 단계는 언어 스타일 조정으로, 언어 템플릿을 사용하여 구어체 표현을 학술적 문어체 언어로 변환했습니다. 세 번째 단계는 문화적 적응으로, 문화 전달 템플릿을 호출하여 대상 언어 문화에 부합하지 않는 표현을 식별 및 교체함으로써 더욱 자연스러운 텍스트를 생성했습니다.
각 생성 단계에서는 이전 단계의 출력을 입력값으로 사용하였으며, 의미적 일관성을 보장하기 위해 컨텍스트 벡터 캐시를 유지하였습니다. 교사는 템플릿 선택, 지침 수정, 순서 조정을 포함하여 시스템 인터페이스 내의 프롬프트 체인 구조를 맞춤 설정하였습니다. 또한, 시스템은 교사가 작업을 재사용하거나 일괄 할당하는 데 유용한 "템플릿 조합 패키지" 기능을 지원하였습니다. 아울러, 시스템에는 생성 단계마다 중간 결과를 제공하는 내장형 동적 중단 및 피드백 메커니즘이 포함되었습니다. 교사는 후속 지침을 실시간으로 주석 처리하거나 조정함으로써 "생성-조정-재생성"으로 이어지는 교수 학습 폐쇄 루프를 형성하였습니다.
모델 생성 및 평가
DeepSeek 모델 기반의 텍스트 생성 및 평가 과정에서, 본 연구는 생성된 텍스트를 구문 복잡성, 구조적 표준화, 담화 일관성이라는 세 가지 측면에서 체계적으로 분석하고 정량적으로 평가하기 위해 다차원 자동 채점 메커니즘을 구축하였습니다. 텍스트 특징 추출 및 자동 평가를 위해 spaCy 의존성 파서와 Coreferee 상호참조 해결 확장 모듈을 사용하였습니다. spaCy 의존성 파서는 영어 텍스트의 구문 구조를 분석하여 평균 문장 길이 및 중첩 절의 수와 같은 핵심 지표를 추출함으로써 구문 복잡성의 정량적 분석을 가능하게 하였습니다. spaCy 프레임워크 내에서 실행되는 Coreferee 상호참조 해결 확장 모듈은 주로 텍스트 내의 내부 참조 관계를 식별하고 담화 참조 일관성을 평가하여 자동 작성 품질 채점을 위한 기술적 지원을 제공하였습니다. 네트워크 제한으로 인해 앞서 언급한 해외 오픈 소스 웹사이트에 접근할 수 없었습니다.
먼저, 시스템은 구문론적 복잡성을 평가했습니다. 평균 문장 길이, 절 내포 깊이 및 문장 다양성과 같은 특징을 추출했습니다. 이러한 특징들은 의존 구문 분석과 심층 구문 트리 모델링을 통해 얻었습니다. 분석 결과에 기초하여, 시스템은 학생들이 단순한 문장 패턴에서 더 복잡한 구조로 성공적으로 발전했는지를 평가했습니다. 둘째, 시스템은 단락 구성을 평가했습니다. BERT 기반의 텍스트 표현을 분류 모델과 결합하여 주제문, 뒷받침문, 결론문을 포함한 핵심 단락 요소들을 식별했습니다. 이후 단락 구조 맵을 구축하여 구성이 영어 학술 글쓰기의 관습을 따랐는지 판단했습니다. 셋째, 시스템은 텍스트 일관성을 평가했습니다. 논리적 연결어의 사용, 문장 간의 의미론적 일치성 및 텍스트 전반의 참조 링크 품질을 조사했습니다. 이러한 지표들은 논리적 전개의 명확성과 아이디어의 매끄러운 흐름을 평가하는 데 사용되었습니다. 주제 일관성을 측정하기 위해 시스템은 벡터 기반 표현을 사용하여 의미론적 유사도를 계산했습니다. 참조 일관성은 상호 참조 해결 기술을 통해 평가되었으며, 이는 의미적 공백과 모호한 참조를 줄이는 데 도움이 되었습니다. 마지막으로, 모든 차원의 점수를 통합하여 하나의 통합 점수 벡터로 만들었습니다. 그 결과는 표준화되어 종합 평가 시스템을 형성하였으며, 이를 통해 서로 다른 작문 샘플 간의 신뢰할 수 있는 비교가 가능해졌습니다.
수동 평가 단계에서, 본 연구는 교사 평가의 관련성과 교수 피드백의 효과를 높이기 위해 전이 행동의 명확성, 표현의 자연스러움, 문화적 적응성을 포함하는 작문 전이 훈련을 위한 3차원 채점 시스템을 개발하였습니다. 이 시스템은 보조 기능을 결합하여 정량적 채점과 정성적 논평의 유기적인 결합을 구현하였습니다. 전이 행동 차원에서 교사들은 미리 설정된 과제 목표에 따라 학생들이 텍스트를 재작성할 때 전이 전략을 어떻게 사용했는지 판단하였습니다. 시스템은 원문과 생성된 버전을 나란히 비교하는 뷰를 제공하여, 문장 조정 및 구조적 재구성 등의 조작이 요구되는 전이 유형을 효과적으로 반영했는지 교사가 식별할 수 있도록 지원하였습니다.
자연스러운 표현력 평가에서는 언어 출력의 유창성과 진정성에 중점을 두었습니다. 교사들은 시스템에서 생성한 언어 지표를 활용하여 문장이 영어 원어민의 표현 습관과 일치하는지 확인하고, 문법 구조, 단어의 조합 및 문장의 리듬이 자연스럽고 적절한지 판단하였습니다. 또한, 주석을 통해 문제점을 지적하고 대안 표현을 제안하였습니다. 문화적 적응력 차원에서는 교차 문화 화용론의 적절성에 중점을 두었습니다. 교사들은 텍스트에 의미적 모호성, 수사적 충돌 또는 모호한 가치 판단과 같이 출발어 문화의 간섭으로 인해 발생하는 부적절한 표현이 포함되어 있는지 식별해야 했습니다. 시스템은 일반적인 문화적 편향 단어 예시를 제공하였으며, 교사가 코멘트란에 수정 근거와 문화적 맥락 요구 사항을 설명할 수 있도록 지원하여 학생들이 문화적 전이 인식과 표현의 정확도를 높일 수 있도록 안내하였습니다. 각 차원은 5점 척도로 점수를 매겼으며, 자유 주석 및 제안 입력 모듈이 포함되었습니다. 최종 평가 결과는 방사형 차트로 제시되었습니다.
평가 효율성을 높이고 실제 교실 수업에서의 활용을 지원하기 위해, 본 연구에서는 AI 기반 채점과 교사 평가를 결합한 협력적 평가 메커니즘을 개발하였습니다. 이 시스템은 먼저 DeepSeek가 생성한 텍스트에 대해 다차원적인 평가를 수행합니다. 자동 채점 모듈을 통해 구문 복잡도, 단락 구성, 텍스트 일관성과 같은 핵심 요소들을 평가하였습니다. 채점 결과는 교사 인터페이스에 실시간으로 표시되었습니다. 교사들은 각 차원의 세부 점수를 검토하고, 전문적인 판단과 학생들의 전이 수행 능력에 대한 이해를 바탕으로 필요 시 점수를 조정하였습니다. 또한, 자동 채점으로 포착되지 않을 수 있는 피드백과 교수법적 제안을 제공하기 위해 텍스트에 직접 맞춤형 의견을 추가하였습니다. 각 평가 차원에는 5점 척도가 적용되었습니다. 인터페이스에는 개인별 맞춤 피드백을 용이하게 하기 위해 자유 형식의 텍스트 주석 및 추천 모듈이 포함되었습니다. 평가 결과는 방사형 차트로 시각화되어, 교사가 다양한 전이 차원에 따른 학생들의 강점과 약점을 빠르게 파악할 수 있도록 하였습니다.
또한, 이 시스템을 통해 교사는 교육 목표에 맞추어 특정 차원의 가중치나 종합 점수를 조정할 수 있었습니다. 이러한 기능은 최종 평가가 학생들의 실제 성취도와 학습 요구를 더욱 정확하게 반영할 수 있도록 보장했습니다. 수동 검토가 완료된 후, 시스템은 기계 생성 평가 데이터와 교사 생성 평가 데이터를 자동으로 통합했습니다. 그 다음, 시각적 피드백 보고서가 생성되었습니다. 이 보고서에는 전이 수행 능력 레이더 차트와 버전 추적 차트가 포함되었습니다. 이러한 시각화 자료는 여러 차례의 텍스트 생성 및 수정 과정에서 나타나는 학생들의 전이 능력 변화를 명확하게 보여주어, 학습 진전 상황을 지속적으로 모니터링할 수 있게 했습니다.
전이 학습 과정
본 연구는 완전한 전이 훈련 과정을 설계하였다. 먼저, 교사는 교수 목표와 학생들의 실제 수준에 근거하여 구체적인 영어 쓰기 과제를 부여하고, 훈련의 전이 유형과 중점 사항을 명확히 하였다. 그 다음, 시스템은 교사가 설정한 과제를 바탕으로 그에 상응하는 프롬프트 지시어를 자동으로 생성하고, DeepSeek 모델을 호출하여 쓰기 초안을 생성함으로써 학생들이 재작성과 전이 훈련을 수행하는 데 필요한 기초 자료를 제공하였다. 초안을 받은 후, 학생들은 텍스트에 반영된 전이 특성을 능동적으로 식별하고, 학습한 전이 전략을 사용하여 구문 구조, 단락 구성 및 문화적 표현의 적절성을 개선하는 방식으로 내용을 표적 재작성해야 했다. 재작성이 완료되면, 교사는 제출된 텍스트에 대해 상세한 검토를 제공하여 전이 전략의 효과성을 강조하고 개선을 위한 구체적인 제안과 쓰기 지도를 제공하였다. 교사의 피드백을 바탕으로 DeepSeek 모델을 다시 호출하여 최적화된 버전을 생성함으로써, 학생들이 텍스트를 더욱 정교화하고 전이 전략 실습을 심화할 수 있도록 추가적으로 지원하였다. 마지막으로, 학생은 최종안 제출을 완료하고 전이 인지 표를 작성하며 자기 평가를 수행하였으며, 전이 방법과 그 효과를 요약함으로써 메타인지 능력의 향상과 쓰기 전이 기술의 내면화를 도모하였다. 본 연구를 위해 설계된 전이 인지 표는 다음과 같다. 표 2.
모든 항목은 1(숙달되지 않음)부터 5(완전 숙달)까지의 1~5점 척도를 적용하였습니다. 자가 평가 데이터는 세 차례의 순차적 교육 후에 수집되었으며, 점수 기준점은 5차원 작업 라이브러리에 정의된 전이 작업 표준을 참조하였습니다.
결과
실험 설계 교육
본 연구에서는 DeepSeek의 기본 오픈 소스 버전을 사용하였으며, 프로그램 호출을 위해 플랫폼의 오픈 API 인터페이스에 의존하였습니다. 5가지 프롬프트 템플릿 텍스트 전체 세트, 4단계의 과제 예시 항목, 전이 주석 카테고리 태그 및 작문 오류-템플릿 매칭 매핑 규칙은 보충 부록에 정리되었습니다. 시스템은 온도 계수 0.7의 고정 호출 매개변수를 가졌으며, 생성 길이는 작문 문제 유형에 따라 동적으로 제한되었습니다. 시스템은 의미적 재구성 > 스타일 조정 > 문화적 적응의 고정된 순서를 엄격히 따르며 중첩된 프롬프트 체인 호출을 실행하였습니다. 모델 출력물은 교실 수업에서 효과적인 텍스트를 사용하기 위해 지도교수가 수동으로 선택하였습니다.
본 연구에서는 5년 이상의 경력을 가진 전임 대학 영어 작문 강사 3명을 수동 채점에 참여하도록 요청하였습니다. 모든 채점자는 공식 채점 전 표준화된 교육을 통해 평가 차원, 5점 척도 채점 체계, 문화적 전이, 구문, 담화 및 기타 채점 세부 사항을 익히고 사전 채점 보정 작업을 완료하였습니다. 모든 학생 에세이는 두 명의 강사가 블라인드 및 이중 맹검 채점 방식으로 독립적으로 채점하였습니다. 두 채점자의 점수 차이가 1점(5점 만점 기준)을 초과하는 경우, 제3의 선임 강사가 채점을 중재하였으며, 두 개의 유효한 점수의 평균을 해당 샘플의 최종 수동 채점 점수로 처리하였습니다. 연구 목적에 따라 평가 단계에 두 그룹의 평가자가 참여하였습니다. 정식 실험에서는 5년 이상의 교육 경력을 가진 전임 대학 영어 작문 강사 3명이 모든 학생 작문 샘플에 대해 블라인드 이중 채점을 수행하였으며, 5점 척도에서 채점 차이가 1점을 초과할 때 제3의 선임 강사가 중재자 역할을 수행하였습니다. 반면, 평가자 간 평가 기준의 일관성을 검증하기 위해 별도로 실시된 급내상관계수(ICC) 기반의 평가자 간 신뢰도 검사에는 5명의 평가자가 참여하였습니다. 평가자 수의 차이는 서로 다른 기능적 요구 사항에서 비롯된 것입니다. 즉, 3명의 핵심 강사는 실험 데이터의 실제 채점을 보장하였고, 확대된 5인의 평가자 패널은 전체 평가 시스템의 신뢰도에 대해 더 강력한 근거를 제공하였습니다.
구문 복잡도, BERT 텍스트 구조 점수 및 의미적 유사도는 모두 0~5점 범위 내에서 측정되었습니다. 각 차원의 가중치는 외국어 작문 교수법 및 연구 표준에 따라 구문 0.35, 텍스트 구조 0.35, 논리 및 문화 0.3으로 설정되었습니다. 가중치 값은 동일 분야의 성숙한 작문 정량 평가 시스템을 기반으로 하였습니다. AI 자동 채점 모듈은 사전 분류된 15편의 모델 에세이를 기반으로 한 임계값을 사용하여 보정되었습니다. 인간 채점은 통일된 5점 척도 등급 체계를 따랐습니다. 정식 평가 전, 기계 채점과 인간 보정을 결합하여 사전 실험 검증을 수행하였습니다.
교육 과제는 "구문-구조-문화"라는 3단계 전이 목표를 중심으로 수행되었으며, 각 1주일씩 총 3차례의 교육이 진행되었습니다. 1차 교육에서는 구문적 다양성과 표현의 정확도를 높이기 위해 문장 수준의 다시 쓰기를 진행하였고, 2차 교육에서는 단락의 구성과 논리적 일관성을 강화하기 위해 단락 수준의 구조적 재구성을 수행하였으며, 3차 교육에서는 교차 문화적 화용 인식과 표현 적응력을 강화하기 위해 문화 수준의 전이를 진행하였습니다. 사전 테스트, 3단계의 순차적 교육 과정, 그리고 사후 테스트를 통해 동일한 참가자로부터 수집된 반복 측정 데이터를 바탕으로, 집단(실험군 vs. 대조군)의 주효과, 측정 시점의 주효과, 그리고 교육 기간 동안의 점수 변화가 두 집단 간에 차이가 있는지를 반영하는 집단 × 시점 상호작용 효과를 검토하기 위해 반복 측정 분산 분석(RM-ANOVA)을 주요 통계 방법으로 채택하였습니다. 구형성 가정은 Mauchly의 검정을 통해 검증하였으며, 구형성 가정이 충족되지 않은 경우에는 Greenhouse–Geisser 교정을 적용하였습니다. 독립 표본 t-검정은 개별 시점에서의 집단 간 사후 쌍별 비교에만 제한적으로 사용하였으며, 채점 일관성과 효과 크기 정량화를 위해서는 각각 Pearson 상관분석과 Cohen’s d를 사용하였습니다.
모든 통계 분석은 데이터 수집 전에 미리 지정되었습니다. 두 집단 간의 사전-사후 쓰기 지표를 비교하기 위해 독립표본 t-검정을 채택하였으며, 기본 귀무가설은 쓰기 전이 성능에 있어 집단 간 차이가 없다고 가정하였습니다. AI 자동 채점과 교사의 수동 평가 간의 선형 연관성을 정량화하기 위해 피어슨 상관 분석을 사용하였으며, 집단 간 비교를 위한 표준화된 효과 크기로 Cohen’s d를 계산하였습니다. 모든 가설 검정의 유의 수준은 α = 0.05로 설정하였으며, 모든 검정 통계량과 함께 95% 신뢰 구간을 산출하였습니다. 모든 통계 계산에는 SPSS 26.0이 활용되었습니다. 모든 참여자가 3라운드의 전체 훈련과 관련 평가를 완료하였으므로, 학생의 시험 점수 및 설문지 데이터셋에서 누락된 데이터는 발생하지 않았으며, 따라서 결측값에 대한 대체나 사례 삭제는 필요하지 않았습니다.
평가 지표 체계 구축
학생들의 영어 작문 전이 훈련 성과를 종합적으로 평가하기 위해, 본 연구는 "구문-구조-문화"라는 3단계 전이 목표를 포함하고 언어 능력, 모델 응답, 교수 피드백 및 자기 인식을 통합한 다차원 평가 체계를 구축하여 6가지 핵심 지표를 설정하였다. 첫째, "작문 전이 지수"는 구문적 다양성, 구조적 명확성 및 문화적 적응성을 포괄하는 종합 평가 지표로, 시스템의 자동 채점과 교사의 수동 채점을 결합하여 정량 분석을 수행하였다. "구문 복잡도 점수"는 자연어 처리 기술을 활용하여 평균 문장 길이, 절 중첩 수준의 수, 동사구 사용 빈도와 같은 특징을 추출함으로써 학생들의 문장 풍부함과 복잡성을 평가하였다. "학술적 스타일 일치도" 분석은 NLP (Natural Language Processing) 모델을 기반으로 수동태 사용 비율과 격식 있는 어휘의 비율을 검토하여, 텍스트가 영어 학술 작문의 스타일 규범을 준수하는지 판단하였다. 또한, 본 연구는 주관적 평가 차원을 도입하여 교사 설문지를 통해 모델이 생성한 제안의 수용도와 실용성에 대한 피드백을 수집함으로써 AI 보조 교육의 실제 영향력을 평가하였다. "교사 검토 점수의 변화"는 실험 전후 학생들의 에세이에 대한 교사의 점수를 비교함으로써 AI 보조 교육이 작문 품질 향상에 미친 영향을 반영하였다. 마지막으로, "학생의 전이 능력 자기 평가"는 전이 인지 표를 활용하여 학생들이 구조, 구문, 문화 및 기타 차원에 대한 자신의 숙달 정도를 스스로 평가하도록 유도함으로써 메타인지적 인식과 성찰 능력을 향상시켰다. 각 지표에 대한 구체적인 설명과 데이터 소스는 Table 3에 제시되어 있다.
구문 및 스타일 지표는 의존 구문 분석과 BERT 기반 분류를 통해 자동으로 계산되었으며, 정규화된 점수는 0에서 5까지의 범위를 갖습니다. 수동 평가는 5점 척도를 사용합니다. 구문 복잡도 계산 공식은 전체 단어 수/절 수를 핵심 분모로 사용했습니다. 원시 데이터 소스: 등록된 학생 60명 전원의 사전 및 사후 쓰기 작문물.
실험 결과 및 분석
구문 전이, 구조적 전이, 문화적 전이라는 세 가지 차원에서 학생들의 종합적인 수행 능력 차이를 직관적으로 제시하기 위해, 그림 3에서는 실험 전후 실험군과 대조군 학생들의 평균 쓰기 전이 지수를 비교하였다. 그림 3 은 구문 전이, 구조적 전이, 문화적 전이의 세 가지 차원에서 실험군과 대조군의 평균 점수 차이를 보여준다. 실험군은 실험 후 각 차원에서 전이 능력이 유의미하게 향상되었으며, 레이더 차트의 외곽 원이 내부 원보다 현저히 더 크게 나타나 DeepSeek 모델 기반의 지시문 최적화 방법이 학생들의 영어 쓰기 전이 능력 발달을 촉진하는 데 긍정적인 영향을 미쳤음을 시사한다. 반면, 대조군의 다양한 전이 능력 지표는 실험 전후로 비교적 큰 변화가 없었다. 전반적인 향상이 제한적이었으며, 이는 기존의 교수법이나 시스템 지시문이 최적화되지 않은 AI 보조 도구가 전이 훈련에서 수행하는 역할이 제한적임을 나타낸다. 이는 다차원적 언어 전이에서 학생들의 학습 잠재력을 효과적으로 자극하는 것이 어려웠음을 보여준다.
실험 전 실험군의 구문 전이, 구조 전이 및 문화 전이 차원에서의 평균 작문 전이 지수는 각각 3.0, 2.9, 2.8이었으며, 실험 후에는 4.3, 4.1, 4.5로 각각 1.3, 1.2, 1.7 증가하였다. 이는 해당 교수법이 서로 다른 전이 수준에서 우수한 중재 효과를 나타냈음을 의미한다. 대조군의 실험 전 점수는 3.0, 3.0, 2.9였으며, 실험 후에는 각각 3.4, 3.3, 3.2로 증가하였으나, 이는 실험군의 수치보다 현저히 낮았다. 특히 문화 전이 차원에서 실험군은 2.8에서 4.5로 1.7점 증가하여 가장 뚜렷한 개선을 보였으며, 이는 대조군의 0.3점 증가보다 유의미하게 높았다. 이러한 결과는 제안된 교수법이 학생들이 영어 문화 표현 규범을 식별하고 이에 적응하는 데 중요한 역할을 한다는 것을 시사한다. 이는 언어 형태의 조정뿐만 아니라, 학생들의 교차 문화적 화용 인식의 향상과 목표 언어의 문화적 표현 습관에 대한 이해의 깊이 증가로도 나타났다. 언어 전이는 주로 구문 복잡성, 언어 스타일 적응 및 기타 측면에서 반영되었다. 본 연구에서는 자동화된 NLP 기술을 활용하여 학생들의 작문 텍스트를 심층 분석하고 주요 언어 특징을 추출하였으며, 이를 교사 점수와 결합하여 세 차례의 과제 수행 과정에 따른 학생들의 언어 전이 능력 변화를 체계적으로 평가하였다.
구문 복잡성 및 언어적 스타일
구문 복잡성 측면에서, 본 연구는 각 단계의 과제에서 지정된 쓰기 과제를 완료한 후 학생들이 생성한 텍스트의 평균 문장 길이와 절 중첩 수준의 수를 기록하였습니다. 이 두 가지 지표는 언어 표현의 복잡성을 측정하는 데 널리 사용됩니다. 그림 4에 나타난 바와 같이, 이는 문장의 다양성과 구조적 조직 능력에 있어 학생들의 발달 수준을 효과적으로 반영하였습니다.
구문 복잡성의 종단적 진화 과정에서, 실험군은 세 차례의 과제 수행 동안 뚜렷한 상승 추세를 보였으며, 이는 전이 훈련이 학생들의 언어 구조 표현 능력을 효과적으로 증진시켰음을 반영한다. 평균 문장 길이 관점에서 보면, 실험군은 과제 1의 12.5단어에서 과제 3의 16.1단어로 3.6단어 증가하였으며, 이는 동일 기간 대조군이 0.9단어(12.4에서 13.3으로) 증가한 것에 비해 유의미하게 높은 수치였다. 마찬가지로 절 중첩 층수(number of clause nesting layers)로 측정된 구조적 복잡성 차원에서 실험군은 1.8층에서 2.7층으로 증가한 반면, 대조군은 1.7층에서 1.9층으로 상대적으로 완만한 증가를 보였다. 두 학생 그룹 간의 구문 복잡성 차이가 통계적으로 유의미한지 추가로 검증하기 위해, 본 연구에서는 독립 표본 t-검정을 사용하여 세 단계의 과제별 평균 문장 길이와 절 중첩 층수를 분석하였다. 분석 결과, 평균 문장 길이에서 실험군과 대조군 사이에 유의미한 차이가 있었으며, t(58) = 4.23, p < 0.001, Cohen’s d = 0.98로 나타났다. 또한 절 중첩 층수에서도 유의미한 차이가 관찰되었다, t(58) = 3.15, p = 0.002, Cohen’s d = 0.78. 이러한 비교는 체계적인 전이 훈련이 학생들의 복잡한 문장 구성 능력을 향상시켰을 뿐만 아니라 문법적 조직 전략에 대한 숙달도를 강화했음을 보여주었다. 특히 과제의 세 번째 단계에서 실험군 학생들은 다층 절과 복잡한 문장 구조를 사용하는 데 있어 더 큰 유연성을 보였다. 이는 언어 전이가 '기능적' 수준에서 보다 '전략적' 수준으로 뚜렷하게 전환되었음을 반영한다. 전이 지향적 훈련 경로는 학생들의 구문 전이 기술을 지속적으로 강화하여, 전통적인 교수법에서 흔히 나타나는 단문 쓰기의 한계와 고정된 표현 패턴을 효과적으로 극복하게 하였다. 언어 스타일 적응 측면에서는 실험 전후의 학생 작문 텍스트를 추출하였다. NLP 모델을 사용하여 공식적 어휘의 비율과 수동태 사용 빈도를 학술적 언어 스타일 일치도를 평가하는 핵심 지표로 설정하였다. 이러한 지표들은 학생들이 영어 작문 시 목표 스타일에 적응할 수 있는 언어 인식과 표현 능력을 갖추었는지를 반영한다. 관련 결과는 그림 5에 제시되어 있다.
그림 5는 과제 수행 전후 실험군과 대조군의 학술적 스타일 일치도 변화를 보여주며, 주로 격식체 어휘 비율과 수동태 사용 빈도라는 두 가지 핵심 지표에 초점을 맞추고 있습니다. 전반적으로 DeepSeek 모델 기반의 전이 학습을 완료한 후, 실험군의 학술적 스타일 적응 능력이 유의미하게 향상되었으며, 이는 학생들이 언어 규범에 대한 인식을 기르고 학술적 스타일에 적응하는 능력을 배양하는 데 있어 본 교수법이 효과적임을 입증합니다. 격식체 어휘 비율의 경우, 실험군은 과제 수행 전 0.42에서 수행 후 0.56으로 비교적 큰 폭으로 증가했습니다. 반면, 대조군은 0.43에서 0.48로 소폭 증가하는 데 그쳐 개선 정도가 제한적임을 시사했습니다. 이러한 결과는 체계적인 프롬프트 지도와 모델 피드백을 받은 실험군 학생들이 글쓰기 과정에서 학술적 스타일 요구 사항에 부합하는 격식체 어휘를 사용하는 경향이 더 강해졌으며, 이들의 언어 스타일이 영어 학술 글쓰기 기준에 점차 가까워졌음을 보여줍니다. 수동태 사용 빈도 측면에서는 실험군이 과제 수행 전 0.18에서 수행 후 0.27로 0.09 증가하며 유의미한 상승을 보인 반면, 대조군은 0.02 증가하는 데 그쳤습니다.
위의 변화가 통계적으로 유의미한지 추가로 검증하기 위해, 과제 수행 전후의 데이터에 대해 독립 표본 t-검정을 실시하였다. 결과적으로 실험군에서 격식체 어휘의 비율이 유의미하게 개선되었으며, t(58) = 3.89, p < 0.001, Cohen's d = 0.92로 나타났다. 수동태 사용 빈도의 증가 또한 유의미하였다, t(58) = 4.56, p < 0.001, Cohen’s d = 1.05. 이는 실험군 학생들이 언어 스타일 적응에 있어 상당한 진전을 이루었음을 보여주며, 이러한 진전은 우연이 아니라 체계적인 프롬프트 안내와 모델 피드백의 결합된 효과로 인한 결과임을 시사한다.
통계적 검증
또한, 교육 실습에서 AI 생성 콘텐츠의 신뢰성을 추가로 검증하기 위해, 본 연구는 서로 다른 프롬프트 유형에 따른 AI 생성 콘텐츠와 교사 생성 콘텐츠의 평균 점수를 비교하였습니다. 두 결과 사이의 일관성은 피어슨 상관계수를 계산하여 평가하였습니다. 관련 비교 결과는 표 4에 제시되어 있습니다. 표 4는 다섯 가지 유형의 전이 지향적 프롬프트에서 AI 생성 콘텐츠와 교사 점수의 일관성을 보여줍니다. 평균 점수 관점에서 보면, 전반적으로 AI 점수가 교사 점수보다 약간 낮았습니다. 그럼에도 불구하고 대부분의 과제 유형에서 그 차이는 합리적인 범위 내에 있었으며, 이는 DeepSeek 모델이 쓰기 전이 과제를 평가하는 데 있어 높은 안정성과 참고 가치를 지니고 있음을 나타냅니다. 구문 전이 프롬프트의 경우, 교사 평균 점수는 4.1점, AI 점수는 4.0점으로 두 점수 간의 차이는 0.1점에 불과했습니다. 구조 및 논리 전이 프롬프트에서는 AI 점수가 교사 점수보다 단 0.1점 낮았는데, 이는 언어 구조의 비중이 높고 규칙이 명확한 이러한 과제에서 모델이 교사의 평가 기준을 더 잘 모방할 수 있음을 시사합니다. 반면, 문화 전이 및 레지스터 전이 프롬프트에서의 점수 편차는 비교적 뚜렷하게 나타났으며, AI 점수는 각각 3.6점과 3.7점으로 교사 점수보다 0.2점 낮았습니다. 이는 의미적 함축이나 문화적 화용론과 같이 주관성이 높은 과제를 처리할 때 AI가 여전히 어느 정도 한계가 있음을 반영합니다. 평가자 간 신뢰도는 ICC(n = 평가자 5명)를 통해 평가하였습니다. 수동 채점의 전체 ICC는 0.86이었으며, 각 차원별 ICC는 0.82에서 0.89 사이로 나타나 평가자 간 합의도가 만족스러운 수준임을 확인하였습니다.
피어슨 상관계수를 추가로 분석한 결과, 다양한 프롬프트 하에서 점수의 일관성이 높은 수준으로 나타났으며, 이는 AI 점수가 값의 측면에서 교사의 판단과 유사할 뿐만 아니라 채점 경향에서도 우수한 선형 관계를 보임을 나타냅니다. 그중 구문 전이(syntactic transfer) 프롬프트의 일관성 계수가 0.87로 가장 높았으며, 구조 전이(structural transfer)와 논리 전이(logical transfer) 프롬프트 또한 각각 0.83과 0.85로 나타나, 구문 복잡성, 단락 구성 및 논리적 일관성 측면에서의 AI 평가 결과가 교사의 판단과 매우 일치함을 보여주었습니다. 이는 해당 과업들이 명확한 목표와 정량화 가능한 언어적 특징을 가지고 있어 모델의 인식과 안정적인 판단이 용이했기 때문일 수 있습니다. 영역 전이(domain transfer) 프롬프트의 상관계수는 0.81로, 약간 감소하기는 했으나 여전히 강력한 평가 능력을 입증했으며, 이는 AI가 문체 적응 수준에서 일정 수준의 판단 능력을 갖추고 있음을 나타냅니다. 다만, 문화 전이(cultural transfer) 프롬프트의 일관성 계수는 0.79로 다른 유형보다 낮았으나, 여전히 수용 가능한 범위 내에 있었습니다.
교수 실습에서 다양한 유형의 프롬프트 적용 가능성과 교사들의 수용도를 조사하기 위해 프롬프트 응답 만족도 설문지를 설계하였다. 5명의 영어 교사(T1~T5로 표기)를 대상으로 그림 6에 표시된 5단계 척도(매우 불만족에서 매우 만족까지)를 사용하여 다섯 가지 유형의 프롬프트 생성 제안에 대해 평가하도록 요청하였다. 다섯 명의 교사가 평가한 다섯 가지 프롬프트 유형의 점수는 어느 정도 차이가 있었으나, 전반적인 인식도는 높았다. 그 중 "구문 전이(syntactic transfer)"와 "문화 전이(cultural transfer)" 프롬프트가 평균 4.0으로 가장 높은 점수를 기록하여, 교수법에서의 강력한 실용성과 적응성을 보여주었다. 반면, "레지스터 전이(register transfer)" 프롬프트는 평균 2.4로 상대적으로 낮은 점수를 기록했으며, T4 및 T5와 같은 일부 교사들은 최하점을 부여하여 교육 적용 시의 안내 및 적응성이 여전히 개선될 필요가 있음을 나타냈다.
개인적 차원에서 교사들의 채점 경향에는 분명한 차이가 있었다. T1의 종합 점수는 긍정적이었으며, 이는 AI 보조 글쓰기에 대한 수용도가 높음을 나타내는 반면, T5의 점수는 여러 프롬프트 차원, 특히 "레지스터 전이(register transfer)"와 "논리 전이(logic transfer)"에서 낮게 나타났다. 이러한 차이는 교사의 교육 경력, 선호 언어 또는 AI 도구에 대한 친숙도와 관련이 있을 수 있으며, 이는 향후 프롬프트 설계 시 다양한 교사 집단의 수용도를 높이기 위해 개인 맞춤형 적응 메커니즘을 고려해야 함을 시사한다. AI 보조 교육이 학생들의 글쓰기 품질 향상에 미치는 실제 효과를 추가로 검증하기 위해, 본 연구에서는 교사가 평가한 실험군과 대조군의 실험 전후 종합 점수 변화를 비교하였다. 비교 결과는 그림 7에 제시되어 있다.
그림 7에서 보듯이, 실험 전후에 교사가 평가한 실험군과 대조군의 총점은 유의미한 차이를 보였습니다. 전반적으로 DeepSeek 모델 기반의 수업 최적화 교수법 중재 이후, 실험군의 총점은 유의미한 상승 추세를 나타냈습니다. 반면, 대조군의 점수 변화는 상대적으로 완만했습니다. 실험 전 실험군의 평균 교사 평가 점수는 59.1점이었으며, 실험 후 평균 점수는 74.4점으로 크게 증가하여 15.3점이 상승했습니다. 이는 AI 보조 학습이 학생들의 작문 품질에 긍정적인 영향을 미쳤음을 나타냅니다. 박스 플롯(box plot)을 통해 실험군의 점수 분포 범위 또한 확장되었음을 관찰할 수 있었습니다. 특히, 실험 후의 점수 박스가 실험 전보다 현저히 높고, 상위 최댓값과 하위 최솟값이 모두 증가하여 학생들의 전반적인 수준이 크게 향상되었음을 보여줍니다. 이와 대조적으로, 대조군의 점수 변화는 상대적으로 제한적이었습니다. 실험 전 대조군의 평균 점수는 60.1점이었으며, 실험 후에는 64.9점으로 4.8점 상승했습니다. 이러한 증가 폭은 실험군보다 훨씬 낮았으며, 대조군의 점수 박스는 실험 전후로 큰 변화가 없었는데, 이는 전통적인 교수법이나 최적화되지 않은 AI 보조 도구가 작문 품질 향상에 미치는 효과가 제한적임을 시사합니다.
또한, 본 연구에서는 전이 인지 표를 활용하여 학생들이 구조 조정, 문장 변형, 문화적 표현 등 여러 영역에서의 능력 발달에 대해 세 차례의 자기 평가를 수행하도록 유도함으로써, 학생들의 메타인지적 인식 변화 추이와 전이 전략 습득 정도를 반영하였습니다. 결과는 그림 8에 나타나 있습니다. 그림 8에 제시된 학생들의 전이 능력 자기 평가 레이더 차트 데이터에 따르면, 세 차례의 과업 수행 과정에서 구조적 전이, 통사적 전이, 문화적 전이, 레지스터 전이 및 논리적 전이의 다섯 가지 차원에 대한 학생들의 자기 평가 점수가 지속적인 상승 추세를 보였으며, 이는 DeepSeek 모델 기반의 교수법 최적화 교육 처치 하에 학생들의 전이 전략 사용 능력이 유의미하게 향상되었음을 나타냅니다. 첫 번째 라운드 과업에서 학생들의 자기 평가 점수는 전반적으로 낮았습니다. 다섯 가지 차원 중 "구조적 전이"와 "논리적 전이"는 각각 3.2점과 3.0점을 기록한 반면, "문화적 전이"와 "레지스터 전이"는 2.5점과 2.7점을 기록하여, 학생들이 전이 전략을 식별하고 사용하는 데 여전히 미숙함을 보였습니다. 두 번째 라운드 과업에 이르러 각 항목의 점수가 향상되었으며, "구조적 전이"는 3.8점, "통사적 전이"는 3.5점, "논리적 전이"는 3.7점으로 상승하였습니다. 이는 교사의 지도와 모델 피드백의 지원을 통해 학생들이 기본적인 전이 조작의 핵심 사항을 점진적으로 습득하고 이를 실제 작문에 처음으로 적용하기 시작했음을 보여줍니다. 세 번째 라운드 과업에서는 학생들의 자기 평가 점수가 크게 증가하여 "구조적 전이"와 "논리적 전이"가 각각 4.5점과 4.3점에 도달하였고, 다른 차원들 또한 4.0점 이상으로 안정화되었습니다. 이는 다회차 전이 훈련이 학생들의 언어 형태 제어 및 텍스트 구성 능력을 향상시키는 데 지속적인 효과가 있음을 보여줍니다. 이 단계에서 학생들은 전이 전략의 이해, 실행 및 성찰 사이에 기본적인 인지적 폐쇄 루프를 형성하였습니다. 교사 피드백 외에도, 본 연구는 실험군 전체 학생을 대상으로 AI 보조 작문 기능에 대한 만족도 설문 조사를 실시하였으며, 총 30부의 유효한 설문지를 수집하였습니다. 설문지는 재작성 제안, 구조 최적화, 문화적 힌트라는 세 가지 기능 모듈에 대한 AI의 성능을 평가하였으며, 학생들은 5단계 기준에 따라 옵션을 선택하도록 하였습니다. 결과는 표 5에 제시되어 있습니다.
표 5에 제시된 AI 보조 글쓰기 기능에 대한 학생 만족도 조사 결과에 따르면, 실험군 학생들은 대체로 재작성 제안, 구조 최적화, 문화적 프롬프트라는 세 가지 기능 모듈의 AI 성능에 대해 긍정적인 의견을 보였으며, 이는 글쓰기 훈련 효율성과 교수 지원 품질을 향상시키는 데 있어 AI 보조 글쓰기 시스템의 좋은 활용 전망을 보여줍니다. 전반적으로 "재작성 제안"과 "구조 최적화"의 두 기능 항목에서 90% 이상의 학생들이 "매우 만족" 또는 "만족"한다고 응답했으며, 그중 "재작성 제안"의 만족도가 91%로 가장 높게 나타나 학생들이 AI의 구문 재구성 및 언어 다듬기 능력에 대해 높은 인지도를 가지고 있음을 나타냈습니다. 이에 비해 "문화적 프롬프트" 기능에 대한 만족도는 상대적으로 낮았으나, 여전히 83%에 달해 AI가 교차 문화적 표현을 안내하는 데 있어 어느 정도의 복잡성과 주관성이 있음에도 불구하고, 학생들이 모국어의 문화적 간섭을 식별하고 조정하도록 돕는 역할은 대부분의 학생들에게 인정받았음을 시사합니다. 불만족 측면에서는 세 가지 기능 모두에서 "불만족" 또는 "매우 불만족"을 선택한 학생의 비율이 5% 미만이었으며, 이는 AI 보조 기능이 대부분의 응용 시나리오에서 우수한 사용성과 수용성을 가지고 있음을 나타냅니다. 주목할 점은 "문화적 프롬프트" 항목에서 "보통"으로 평가한 학생의 비율이 상대적으로 높았다는 것이며, 이는 현재의 AI가 문화적 적응 문제를 다룰 때 학생들의 기대치를 완전히 충족시키지 못할 수 있으며 여전히 개선의 여지가 있음을 시사합니다. 종합적인 분석 결과, DeepSeek 기반의 지시어 최적화 방법은 특히 언어 형식 지원 측면에서 학생들에게 널리 인정받은 것으로 나타났습니다.
반복측정 분산분석(RM-ANOVA)
집단(집단 간 요인: 실험군 vs. 대조군)과 시간(집단 내 요인: 사전 검사, 과제 1, 과제 2, 과제 3, 사후 검사), 그리고 이들의 상호작용이 학생들의 영어 작문 전이 수행 능력에 미치는 영향을 분석하기 위해 이원 반복측정 분산분석(RM-ANOVA)을 실시하였습니다. Mauchly의 구형성 검사 결과 구형성 가정이 위배된 것으로 나타나(p < 0.05), 집단 내 효과의 자유도를 조정하기 위해 Greenhouse–Geisser 교정을 적용하였습니다. 모든 분석은 집단당 n = 30명의 참가자를 대상으로 수행되었습니다. 결과는 표 6에 제시되어 있습니다:
Greenhouse–Geisser 보정을 적용한 반복측정 분산분석(repeated-measures ANOVA) 결과, 모든 측정 차원에서 집단(Group), 시간(Time) 및 집단 × 시간 상호작용의 유의미한 주효과가 나타났다(p < 0.001). 전체 전이 지수(Overall Transfer Index)의 경우, 유의미한 집단 효과(F(1,58) = 76.32)와 더불어 유의미한 시간 효과(F(2.14,124.12) = 92.75) 및 유의미한 집단 × 시간 상호작용(F(2.14,124.12) = 68.49)이 관찰되었으며, 이는 시간에 따른 전체 전이 수행능력의 변화가 집단 간에 유의미하게 달랐음을 시사한다.
마찬가지로, 통사적 전이(syntactic transfer)에서도 집단(Group) (F(1,58) = 52.18), 시간(Time) (F(2.11,122.38) = 71.26), 그리고 집단 × 시간 상호작용(Group × Time interaction) (F(2.11,122.38) = 45.73)의 유의미한 효과가 나타났으며, 이는 집단과 측정 시점에 따라 통사적 전이 능력의 발달 패턴이 다름을 나타냅니다. 구조적 전이(Structural Transfer)의 경우에도 유의미한 집단 효과(F(1,58)=48.65), 시간 효과(F(2.09,121.22) = 67.81) 및 상호작용 효과(F(2.09,121.22) = 41.36)가 확인되었으며, 이는 집단에 따른 궤적을 보이며 일관된 향상이 있었음을 반영합니다. 특히, 문화적 전이(Cultural Transfer)에서 가장 강력한 효과가 나타났는데, 유의미한 집단 효과(F(1,58) = 81.44), 뚜렷한 시간 효과(F(2.07,119.96) = 98.52), 그리고 강한 집단 × 시간 상호작용(F(2.07,119.96) = 79.27)이 관찰되어 이 영역에서 가장 실질적이고 차별화된 성장 패턴이 나타났음을 시사합니다. 종합적으로, 모든 지표에서 통계적으로 유의미한 효과가 입증되었으며, 이는 중재가 시간이 경과함에 따라 전이 발달에 안정적이고 차별적인 영향을 미쳤음을 확인해 줍니다.
데이터 가용성:
본 연구 과정에서 생성되거나 분석된 모든 데이터는 이 논문에 포함되어 있습니다. 원시 평가 데이터는 부록 표 1에 제공됩니다.
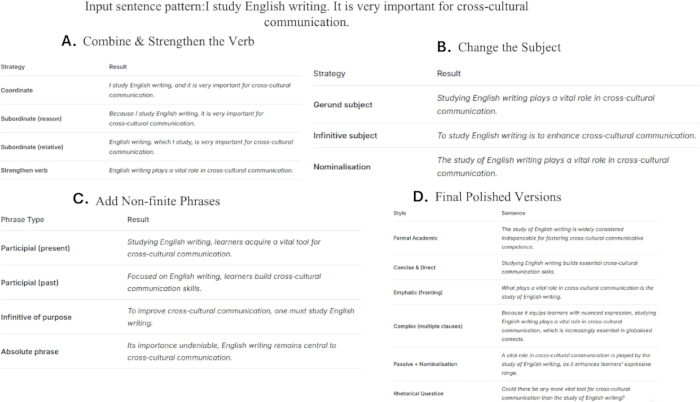
그림 1: 문장 구조 변형 단계. (A) 문장 구조 개선을 위한 동사의 결합 및 강화 전략. (B) 동명사, 부정사 및 명사화된 주어를 포함한 대안적 주어 변형. (C) 문장의 다양성과 간결성을 높이기 위한 비정형 구의 사용. (D) 향상된 학술적 스타일과 교차 문화적 영어 표현을 보여주는 최종 수정본의 예시. 여기를 클릭하여 이 그림의 더 큰 버전을 확인하십시오.
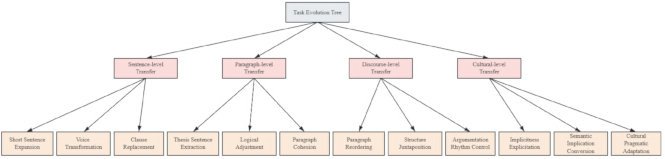
그림 2: 과업 진화 트리 도표. 문장, 단락, 담화에서 문화적 수준에 이르는 4단계 전이 과업의 점진적 구조를 보여준다. 여기를 클릭하여 이 그림의 확대 버전을 확인하십시오.
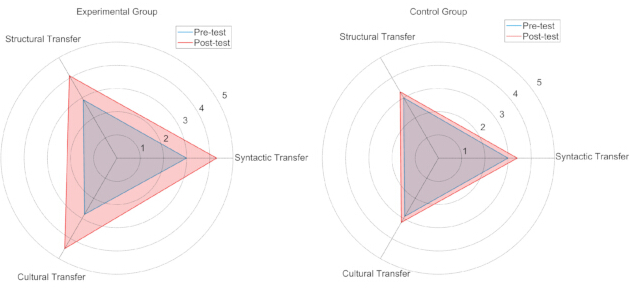
그림 3: 실험 전후의 작문 전이 능력 비교. 레이더 차트는 구문적, 구조적 및 문화적 전이 차원에서 실험군과 대조군의 사전 테스트 및 사후 테스트 점수를 보여줍니다. 여기를 클릭하여 이 그림의 더 큰 버전을 확인하십시오.
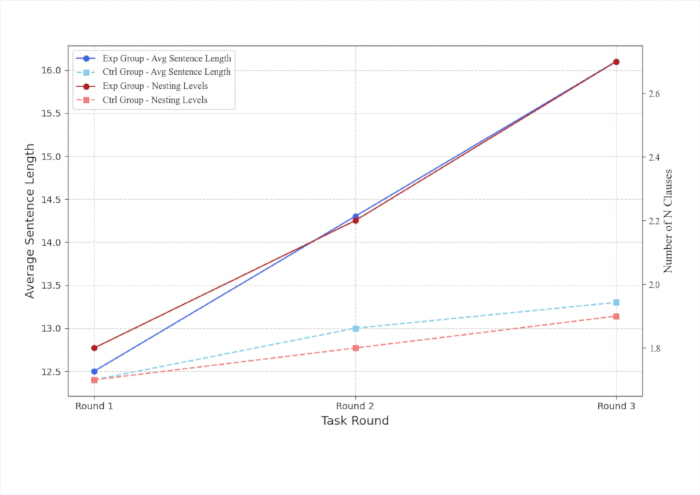
그림 4: 구문 복잡도 추세선 차트. 3가지 훈련 과제에 따른 평균 문장 길이와 절 내포 단계의 변화를 나타낸다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
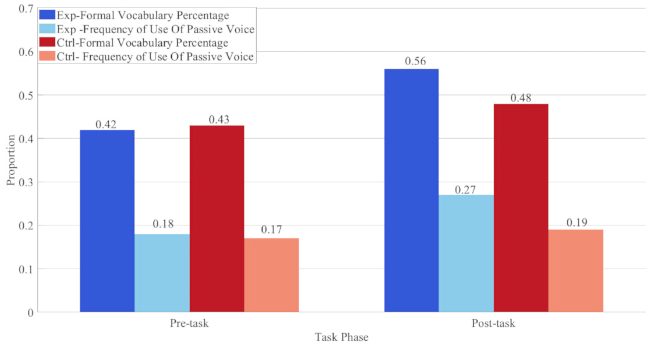
그림 5: 학술 용어 일치. 이 그림은 중재 전후의 격식 어휘 비율과 수동태 빈도의 변화를 보여줍니다. 여기에서 이 그림의 확대 버전을 확인하십시오.
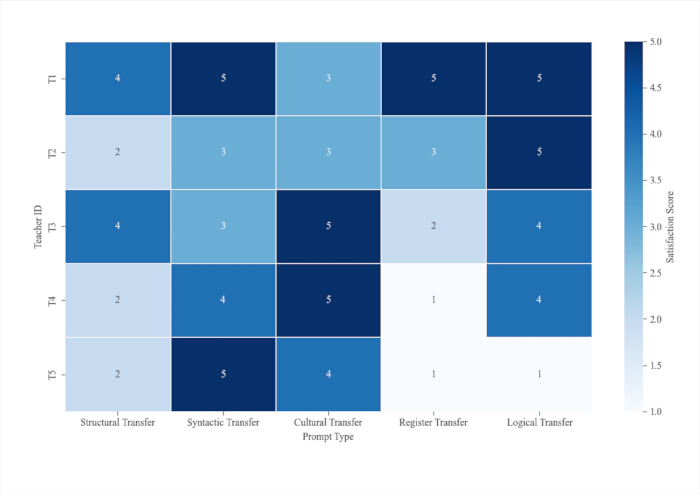
그림 6: 프롬프트 응답 만족도 히트맵. 참여 교사들이 평가한 다섯 가지 유형의 프롬프트 템플릿 점수를 여기에 요약하였다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
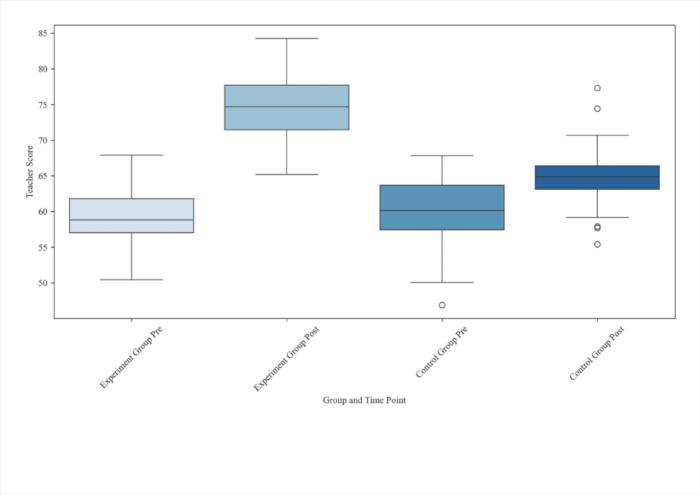
그림 7: 교사 평가 변화의 박스 플롯. 이 박스 플롯은 실험 전후 두 그룹의 교사 평가 쓰기 점수의 분포와 전반적인 변화를 보여줍니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
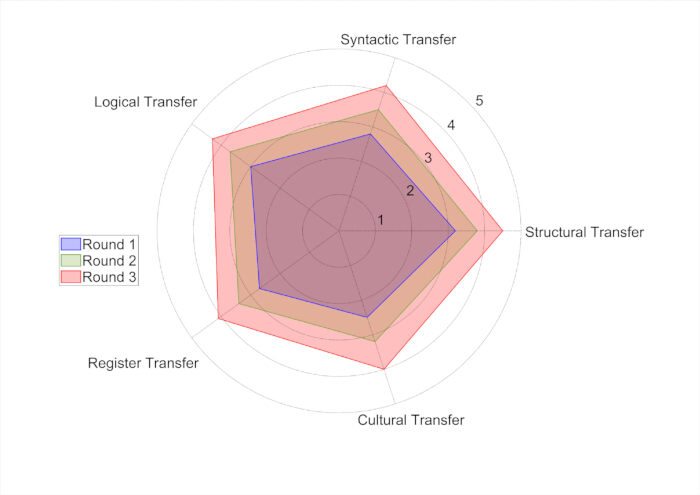
그림 8: 학생들의 자기 평가 전이 능력 레이더 차트. 세 차례의 교육 회차에 걸쳐 다섯 가지 전이 차원에 대한 학생들의 자기 평가 점수를 보여줍니다. 여기에서 이 그림의 더 큰 버전을 확인하십시오.
| 입력 | 교사 조작법 | 프롬프트 유형 | 학생 조작 | 출력 | 평가 기준 |
| 학생들의 최초 작성 초안 (문장/단락/에세이) | 1. 라벨 전송 유형 및 작업 수준 2. 필요한 경우 프롬프트 파라미터 조정 | 단일 전송 프롬프트 / 3단계 중첩 프롬프트 체인 | 1. 전이 전략 학습 2. AI 피드백을 바탕으로 초안 수정 3. 자기 평가 완료 | AI 수정 텍스트 + 학생 수정 최종 초안 | 구문 복잡성, 구조적 합리성, 문화적 적절성, 논리적 일관성, 레지스터 표준화 (0~5 척도) |
표 1: 워크플로우 요약 표. 이 표는 입력 자료, 교사 및 학생의 조작, 프롬프트 유형, 최종 결과물 및 그에 따른 평가 기준을 포함하여 AI 보조 영어 쓰기 전이 학습의 전체 운영 워크플로우를 요약합니다.
| 프로젝트 범주 | 목차 |
| 임무 목표에 대한 이해 | 이번 작성 작업의 마이그레이션 목표인 구조적 조정, 문화적 적응 및 언어 전환에 대해 간략히 설명해 주십시오. |
| 사용된 이동 전략 | 채택하신 마이그레이션 전략을 모두 선택해 주십시오(중복 선택 가능): |
| 구조 조정 | |
| 문장 변형 | |
| 언어 전환 | |
| 문화적 발현 | |
| 논리적 연결 강화 | |
| 기타:_______ | |
| 예시 및 지침 재작성 | 재작성된 문장을 1~2개 선택하여 수정 전과 후의 버전을 보여주고, 변경 이유와 의도한 전달 목표를 설명하십시오. |
| 발생한 어려움 및 의문점 | 마이그레이션 중에 겪은 어려움이나 특정 표현에 대해 가졌던 의문 사항을 기술하십시오. |
| 자기 평가 점수 (5점 만점 중) | 다음 세 가지 측면을 바탕으로 귀하의 텍스트 재작성 결과물을 평가해 주십시오: |
| • 전략 적용 정확도 (/5) | |
| • 표현의 자연스러운 유창성 (/5) | |
| • 문화적 적합성 (/5) | |
| 향후 작문 개선 목표 | 다음 훈련 단계에서 강화하거나 최적화하고자 하는 전이 가능성(transferability)에 대해 간략히 기술하십시오. |
표 2: 전이 인지 표. 학생들의 쓰기 전이 전략에 대한 자기 평가를 위해 1~5점 척도(1 = 숙달되지 않음, 5 = 완전히 숙달됨)가 채택되었습니다.
| 지표 이름 | 상세 설명 | 데이터 소스 |
| 작성 전이 지수 (0–5) | 구문, 구조, 문화의 세 가지 수준을 포괄하여 언어 전이 능력을 종합적으로 측정하는 정량적 지표. | 시스템에 의한 자동 채점 + 교사에 의한 수동 채점 |
| 구문 복잡도 점수 | 평균 문장 길이, 절 내장 횟수, 동사구 풍부성 등을 포함함. | NLP 자동 분석 |
| 학술적 스타일 일치 | 영어 학술 글쓰기 기준에 부합합니까? | 자연어 처리 모델 판정 |
| 프롬프트 응답 만족도 | 모델 생성 제안에 대한 교사의 수용도 및 실무적 평가 | 교사 설문지 |
| 교사 검토 성적 수정 | 작문 품질의 향상을 반영하기 위한 실험 전후 교사 점수 비교 | 교사 평가 기록 |
| 학생들의 자기 평가 전이 능력 | 학생들은 다양한 전이 차원에 대한 자신의 숙달도를 자기 평가합니다. | 이주 인식 양식을 작성하십시오. |
표 3: 평가 지표, 설명 및 데이터 소스 요약. 이 표는 본 연구의 각 핵심 평가 지표에 대한 정의, 측정 방법 및 원본 데이터 소스를 명시합니다.
| 프롬프트 유형 | 교사 평균 평점 | AI 평균 점수 | 피어슨 상관계수 |
| 구조적 전이 | 4 | 3.9 | 0.83 |
| 통사적 전이 | 4.1 | 4 | 0.87 |
| 문화적 전이 | 3.8 | 3.6 | 0.79 |
| 레지스터 전이 | 3.9 | 3.7 | 0.81 |
| 논리적 전이 | 4.2 | 4.1 | 0.85 |
표 4: AI 생성 콘텐츠와 교사 평가 간의 일관성 비교. 결과는 다양한 프롬프트 유형에 걸쳐 AI 생성 콘텐츠와 교사 평가 간의 일관성을 보여줍니다.
| 기능 항목 | 매우 만족 | 만족 | 보통 | 불만족 | 매우 불만족 |
| 재작성 제안 | 66% | 25% | 7% | 1.50% | 0.50% |
| 구조 최적화 | 60% | 30% | 7% | 2% | 1% |
| 문화적 팁 | 55% | 28% | 12% | 3.50% | 1.50% |
표 5: AI 보조 기능에 대한 학생 만족도 설문 통계.이 통계는 AI 재작성, 구조 최적화 및 문화적 프롬프트 기능에 대한 학생 만족도의 분포를 보여줍니다.
| 측정 | 그룹 F(df) | 시간 F(df)GG | 집단 × 시간 F(df)GG | p |
| 전체 전이 지수 | 76.32 (1, 58) | 92.75 (2.14, 124.12) | 68.49 (2.14, 124.12) | <0.001 |
| 통사적 전이 | 52.18 (1, 58) | 71.26 (2.11, 122.38) | 45.73 (2.11, 122.38) | <0.001 |
| 구조적 전이 | 48.65 (1, 58) | 67.81 (2.09, 121.22) | 41.36 (2.09, 121.22) | <0.001 |
| 문화적 전이 | 81.44 (1, 58) | 98.52 (2.07, 119.96) | 79.27 (2.07, 119.96) | <0.001 |
표 6: 반복 측정 분산 분석(ANOVA) 결과 요약.본 표는 전반적인 쓰기 전이 수행 능력과 3가지 하위 차원에 대한 이원 반복 측정 분산 분석 결과를 보여주며, 집단, 시간의 주효과 및 집단-시간 상호작용 효과를 포함한다. 약어: GG = Greenhouse–Geisser 교정.
보충 표 1: 원시 데이터 평가. 본 연구의 모든 분석에 사용된 원시 데이터를 포함합니다.여기를 클릭하여 파일을 다운로드하십시오.
토론
본 연구는 교차 문화적 영어 작문 전이 교육을 위해 DeepSeek의 MoE 아키텍처에 기반한 다층적 지시어 최적화 프레임워크를 구축합니다. 문장에서 문화적 차원에 이르는 4단계 점진적 과업과 5가지 범주의 표준화된 과업 라이브러리를 중심으로, 실제 학생의 작문 샘플을 기반으로 한 자동 프롬프트 생성을 구현하고 복잡한 교차 문화 적응 과업을 분해하기 위한 3단계 중첩 프롬프트 체인을 수립합니다. 텍스트 교정에 국한된 기존의 일반적인 프롬프트 설계와 달리, 제안된 솔루션은 프롬프트 구성을 언어 전이 교육 목표와 밀접하게 결합하며 모델 생성, 교사 주석 및 학생의 반복적 수정으로 이어지는 폐쇄 루프 교육 흐름을 구축합니다. 학문적 진전 관점에서 본 연구는 제2언어 습득에서 프롬프트 엔지니어링의 실질적 경계를 확장하며, 대규모 언어 모델의 파라미터 특성을 EFL 교실의 타겟 훈련과 결합하기 위한 정량화 가능한 템플릿 구축 경로를 제공합니다. 또한, 구문적 부정 전이 오류에만 집중했던 기존의 연구 결과36,37를 보완하여 AI 보조 환경에서의 교차 문화적 화용 전이 연구에 대한 경험적 근거를 풍부하게 합니다.
경험적 유사 실험 데이터는 실험군이 구문적, 구조적, 문화적 전이 지표 전반에서 뚜렷한 향상을 보였음을 확인해주나, 몇 가지 내재적 제약으로 인해 연구 결과의 일반화에는 한계가 있다. 연구 조건의 제약으로 인해 평가자 맹검 처리 없이 비무작위 학급 배정을 채택하였으며, 모든 표본이 단일 대학의 영어 전공자들로 선정되었다. 이로 인해 점수 변동 과정에서 학습자의 자기주도적 학습 동기와 교사의 장기적인 교수 습관으로 인한 간섭을 배제하기 어렵다. 또한, 본 중재는 3주 동안만 진행된 단기 훈련 프로그램이었다. 모든 참여자가 하나의 전문대학에서 모집된 단일 센터 표집 설계와 결합되어, 관찰된 긍정적 효과가 장기적인 교수 실제에서도 완전히 안정적으로 유지되지 않을 수 있다. 따라서 연구 결과는 주의 깊게 해석해야 하며, 본 결론을 서로 다른 유형의 대학, 더 긴 교수 주기 또는 언어 능력이 다양한 학생 집단에 직접적으로 일반화하는 것은 부적절하다.
실제 교육 현장에 적용했을 때, 현재의 프롬프트 최적화 시스템과 DeepSeek 모델의 결합은 뚜렷한 한계와 전형적인 실패 사례를 보여줍니다. 문화 및 레지스터(register) 전이 작업의 경우, 모델이 미묘한 문화적 함의와 문맥 의존적인 스타일 요구사항이 포함된 텍스트를 처리할 때 때때로 화용론적으로 부적절한 표현이나 경직된 스타일 변환 결과를 생성합니다38,39. 또한 길고 복잡한 단락 내에 내재된 원어민의 문화적 사고방식을 정확하게 식별하지 못해, 콩글리시(Chinglish) 표현의 수정이 불완전하게 이루어지는 경우가 발생합니다. 자동 채점에서는 매우 주관적인 문화적 화용 항목에 대해 AI 평가의 일관성이 현저히 떨어지며, 수사적 표현의 미세한 차이와 교차 문화적 함의를 효과적으로 구분하지 못합니다. 아울러, 3단계 중첩 프롬프트 체인은 다회차 반복 생성 과정에서 의미론적 편차가 발생하기 쉬우며, 첫 번째 단계인 의미 재구성에서 발생한 오류가 이후의 언어적 수정 및 문화적 적응 단계로 계승되어 증폭되는 경향이 있습니다40,41.
후속 개발 동향의 관점에서, 세 가지 실질적인 차원을 통해 추가적인 개선을 추진할 수 있다. 첫째, 비영어 전공자와 다양한 언어 능력을 갖춘 학생들로부터 작문 코퍼스를 수집하여 태스크 라이브러리의 규모를 확장함으로써, 다양해진 학습자 그룹에 대한 템플릿 호환성을 강화한다. 둘째, 경량화된 DeepSeek 서브모듈의 지속적인 미세 조정을 결합하여 AI 문화 전이 점수 산정 시 발생하는 편차를 줄인다. 이는 현재의 통계에서 교사 평가와 비교했을 때 일관성이 낮은 것으로 나타난 부분이다. 셋째, 전체 프롬프트 최적화 시스템을 기존의 온라인 외국어 학습 플랫폼에 내장하여, 프롬프트 규칙의 지속적인 반복 최적화를 위한 장기 데이터를 자동으로 축적한다. 교차 언어 문화 코퍼스 자원이 지속적으로 풍부해짐에 따라, 제안된 기술 프레임워크는 향후 연구에서 이중 언어 번역 교육 및 상호문화 의사소통 과정으로 그 응용 범위를 확장할 수 있을 것으로 기대된다.
공개 사항
저자들은 금융적 이해상충이 없음을 선언합니다.
감사의 글
본 연구는 Zhejiang Provincial Education Planning Project 2026: Research on Reconstruction of Teaching Competency Framework and Promotion Strategies of Higher Vocational Teachers Under Digital and Intelligent Empowerment(과제 번호: ZWT26024; 승인 번호: 2026SCG360)의 지원을 받아 수행되었습니다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| BERT 사전 학습 언어 모델 | https://github.com/google-research/bert | 텍스트 표현, 단락 구조 인식, 의미적 유사도 계산 및 텍스트 분류를 통해 작문 내용의 자동 채점을 지원함. | |
| Coreferee | Explosion AI | https://github.com/explosion/coreferee | 텍스트의 지칭 관계를 식별하고 담화 지칭 일관성을 평가하여 작문 품질의 자동 채점을 보조함. |
| DeepSeek 대규모 언어 모델 | DeepSeek AI | https://chat.deepseek.com/ | MoE 모델 아키텍처를 기반으로 지시어 최적화 및 프롬프트 체인 설계를 수행함. 모델은 온도 계수 0.7의 고정 매개변수를 사용하며, 생성 길이는 질문 유형에 따라 동적으로 제한됨. |
| spaCy | Explosion AI | https://github.com/explosion/spaCy | 영어 텍스트의 의존 구문 구조를 분석하고, 평균 문장 길이 및 중첩 절의 수와 같은 지표를 추출하여 구문 복잡도를 정량화함. |
| SPSS 26.0 | IBM | https://www.ibm.com/products/spss-statistics | 반복 측정 분산 분석 (RM-ANOVA), 독립 표본 t-검정, Pearson 상관 분석, 효과 크기 (Cohen’s d) 계산 및 신뢰도 (ICC) 검정과 같은 통계 분석을 수행함. |
참고문헌
- Maqsood M, Zahid A, Asghar T, et al. Issues in teaching English in a cultural context. Migr Lett. 2024; 21(4): 1020–1027.
- Tran NT, Nguyen TT, Pham HH. Exploring the challenges of L1 negative transfer among Vietnamese English language learners: a qualitative study. rEFLections. 2024; 31(2): 837–857.
- Zhu P. Cultural dimensions as guidelines in handling language problems for effective written communication across cultures. Int J Linguist Lit Transl. 2023; 6(12): 85–95.
- Zeng Z, Nair SM, Wider W. A comparative study of Chinese EFL undergraduates' pragmatic competence in English letter writing between urban and suburban universities. World J Engl Lang. 2022; 12(6): 377–388.
- Litvinova TA, Mikros GK, Dekhnich OV. Writing in the era of large language models: a bibliometric analysis of the research field. Nauchnyi Rezultat Voprosy Teoreticheskoi i Prikladnoi Lingvistiki. 2024; 10(4): 5–16.
- Long M. Cultivating interdisciplinary foreign language talents through interdisciplinary synergy of on-campus teaching and off-campus practices under the new liberal arts. Educ Rev USA. 2025; 9(5): 520–526.
- Voss E, Cushing ST, Ockey GJ, et al. The use of assistive technologies including generative AI by test takers in language assessment: a debate of theory and practice. Lang Assess Q. 2023; 20(4-5): 520-532.
- Manyasa J. When language transfer is negative: analysis of morpho-syntactic interference errors by learners of French in Tanzanian higher learning institutions. J Foreign Lang. 2021; 13(1): 165-190.
- Fikri N. The study of language transfer in EFL students' translation work. J Pendidik Nonformal. 2023; 1(1): 9.
- Ahmat A, Yang Y, Ma B, et al. Cross-lingual prompting method with semantic-based answer space clustering. Appl Intell. 2025; 55(2): 1-17.
- Maity S, Deroy A, Sarkar S. Investigating large language models for prompt-based open-ended question generation in the technical domain. SN Comput Sci. 2024; 5(8): 1-32.
- Wu W, Cao Y, Yi N, et al. Detecting and reducing the factual hallucinations of large language models with metamorphic testing. Proc ACM Softw Eng. 2025; 2(FSE): 1432-1453.
- Kaganovich P, Münz-Manor O, Ezra-Tsur E. Style transfer of modern Hebrew literature using text simplification and generative language modeling. CEUR Workshop Proc. 2023; 1613: 73-95.
- Yuan Y. Influence of native language transfer on senior high school English writing. Theory Pract Lang Stud. 2021; 11(2): 170-176.
- Jiamin M. The influence of cultural factors on language transfer in second language acquisition. Res J Engl Lang Lit. 2024; 12(1): 186-195.
- Zhang L. Native language transfer in vocabulary acquisition: an empirical study from connectionist perspective. J Lang Teach Res. 2023; 14(2): 446-458.
- Mirzayev E. The influence of first language interference on ESL writing skills. EuroGlob J Linguist Lang Educ. 2024; 1(1): 33-39.
- Fujiwara Y, Iwao T, Ito H, et al. Exploring the transfer of topic-comment structures called unagi-sentences in Asian L2 Englishes: cross-proficiency-level and cross-varietal studies. Asian Englishes. 2025; 27(1): 25-40.
- Guo Q. Interlanguage and its implications to second language teaching and learning. Pac Int J. 2022; 5(4): 8-14.
- Vereeck A, Janse M, De Herdt K, et al. Why Plato needs psychology: proposal for a theoretical framework underpinning research on the cognitive transfer effects of studying classical languages. Psiholoska Obzorja. 2023; 32: 121-130.
- Zhang W. Study on the negative transfer of mother tongue on college students. Int J Front Sociol. 2023; 5(16): 164-171.
- Li C. A review of theories, pedagogies and vocabulary learning tasks of English vocabulary learning apps for Chinese EFL learners. J China Comput Assist Lang Learn. 2024; 4(2): 346-375.
- Nsengimana I, Niyibizi E, Ngabonziza JDA. The impact of language transfers on learners' writing skills in English learning among students in Mahama Refugee Camp, Rwanda. Afr J Empir Res. 2024; 5(3): 605-613.
- Jovein S K, Sharifabad E D, Yazdani M. On the relationship between university translator training programs and the translation market requirements: The case of English translation graduates and postgraduates of Imam Reza International University. Journal of Critical Studies in Language and Literature. 2024; 5(6): 1-13.
- Qin X. Collaborative inquiry in action: a case study of lesson study for intercultural education. Asian Pac J Second Foreign Lang Educ. 2024; 9(1): 66-91.
- Sun L, Asmawi A. The effect of WeChat-based instruction on Chinese EFL undergraduates’ business English writing performance. International Journal of Instruction. 2023; 16(1): 43-60.
- Moro G, Piscaglia N, Ragazzi L, et al. Multi-language transfer learning for low-resource legal case summarization. Artificial Intelligence and Law. 2024; 32(4): 1111-1139.
- Sun Y. A study of college English writing teaching based on dynamic assessment. Pac Int J. 2023; 6(1): 83-88.
- Jeon J, Lee S. Large language models in education: a focus on the complementary relationship between human teachers and ChatGPT. Educ Inf Technol. 2023; 28(12): 15873-15892.
- Kostka I, Toncelli R. Exploring applications of ChatGPT to English language teaching: opportunities, challenges, and recommendations. TESL-EJ. 2023; 27(3): n3-n22.
- Antara IMAR, Anggreni NPY. Analyzing grammatical errors in EFL students' opinion essays using DeepSeek AI: patterns and pedagogical implications. Stilistika. 2025; 13(2): 210-218.
- Diasamidze L, Tedoradze T. Enhancing ESL students' writing skills through natural language processing model ChatGPT. Eurasia Proc Educ Soc Sci. 2024; 35: 230-238.
- Ranade N, Saravia M, Johri A. Using rhetorical strategies to design prompts: a human-in-the-loop approach to make AI useful. AI Soc. 2025; 40(2): 711-732.
- Zhou W, Gao B. Construction and application of English-Chinese multimodal emotional corpus based on artificial intelligence. Int J Hum Comput Interact. 2025; 41(3): 1782-1793.
- Chen B, Bao L, Zhang R, et al. A multi-strategy computer-assisted EFL writing learning system with deep learning incorporated and its effects on learning: a writing feedback perspective. J Educ Comput Res. 2024; 61(8): 60-102.
- Jeon H. Designing teaching for transfer in English for academic purposes. RELC Journal. 2024; 55(2): 567-577.
- Pei Y J. Construction of a" Feedback-Revision" Teaching Model for Senior High School English Continuation Writing Based on Generative AI. International Journal of Educational Development. 2026; 3(1): 16-25.
- Holubnycha L, Kuznetsova O, Shchokina T, et al. AI-Powered Teaching: Literature Review of ChatGPT's Impact on University Educators. International Journal of Interactive Mobile Technologies. 2025; 19(15): 41.
- Almuhanna M A. Teachers' perspectives of integrating AI-powered technologies in K-12 education for creating customized learning materials and resources. Education and Information Technologies. 2025; 30(8): 10343-10371.
- Hastomo T, Mandasari B, Widiati U. Scrutinizing Indonesian pre-service teachers’ technological knowledge in utilizing AI-powered tools. Journal of education and learning (EduLearn). 2024; 18(4): 1572-1581.
- Cai H, Lu L, Han B, et al. Exploring pre-service teachers’ reflection mediated by an AI-powered teacher dashboard in video-based professional learning: a pilot study. Educational technology research and development. 2025; 73(2): 1129-1154.