본 연구에서는 네트워크 약리학, 분자 도킹, 분자 동역학 및 MM-PBSA를 통합하여 NSCLC에서 글루타치온 반응성 아염기 부위 트래핑 프로드러그의 잠재적 단백질 상호작용 우선순위를 정하였습니다. 화합물 5가 MMP9 및 SRC 후속 연구 대상으로 선정되었으나, 이는 여전히 계산적 후보 단계에 머물러 있습니다. 본 연구 결과는 가설 생성 단계이며, 향후 생화학적 및 세포 기반 검증이 필요합니다.
연구 논문
비소세포폐암에서의 글루타치온 반응성 아베이스 사이트 트래핑 프로드러그를 위한 잠재적 단백질 상호작용의 인 실리코 우선순위 결정
이 논문에서
요약
초록
비소세포폐암(NSCLC)은 여전히 암 관련 사망의 주요 원인이며, 치료 효능은 획득 내성과 전신 독성으로 인해 제한되는 경우가 많습니다. 글루타치온 반응성 무염기 부위 트랩핑 프로드러그는 이전의 실험적 연구에서 선택적인 항암 활성을 보여주었으나, 방출된 대사산물이 암 관련 단백질과 유의미한 상호작용을 하는지 여부는 아직 확립되지 않았습니다. 본 연구에서는 네트워크 약리학, 분자 도킹, 분자 동역학(MD) 및 분자 역학 포아송-볼츠만 표면적(MM-PBSA) 분석을 결합한 통합 in silico 워크플로우를 사용하여 두 가지 글루타치온 반응성 프로드러그(Compound 1 및 Compound 2), 이들의 아미노옥시 함유 생성물(Compound 4 및 Compound 5), 그리고 이에 대응하는 비트랩핑 대조군 쌍(Compound 3 및 Compound 6)에 대해 테스트 가능한 단백질 상호작용 가설의 우선순위를 정했습니다. 화합물 및 질병 관련 표적이 교차하는 21개의 타겟이 식별되었으며, 단백질-단백질 상호작용 토폴로지에 따라 AKT serine/threonine kinase 1 (AKT1), epidermal growth factor receptor (EGFR), tumor necrosis factor (TNF), matrix metalloproteinase 9 (MMP9) 및 SRC proto-oncogene non-receptor tyrosine kinase (SRC)가 우선순위로 선정되었습니다. Compound 5는 MMP9(-8.418 kcal·mol⁻1)과 가장 유리한 단일 AutoDock Vina 점수를 생성했으며, MMP9 및 SRC MD 궤적 전반에 걸쳐 상대적으로 지속적인 도킹 유도 포즈를 보여주었습니다. 그러나 가장 높은 순위의 MMP9 포즈는 촉매 Zn2⁺ 이온의 직접적인 배위나 His401, Glu402, His405 또는 His411의 직접적인 관여를 보여주지 않았으므로, 이를 전형적인 MMP9 억제 결합 모드로 지정할 수 없습니다. MD 및 MM-PBSA 분석은 궤적 행동과 이러한 복합체의 상대적 에너지 순위만을 특성화하며, 세포 내 타겟 결합, 효소 억제 또는 경로 조절을 입증하지는 않습니다. 따라서 기설정된 무염기 부위 트랩핑 활성과 새롭게 예측된 단백질 상호작용은 입증된 기전적 사슬이라기보다 별개의 잠재적 병렬 가설로 취급됩니다. 종합적으로, 본 결과는 향후 테스트를 위한 특정 화합물-타겟 쌍의 우선순위를 정하지만, 다중 타겟 항-NSCLC 기전을 확립하는 것은 아닙니다.
서론
비소세포폐암(NSCLC)은 폐암의 가장 흔한 조직학적 하위 유형이며 전 세계적으로 암 관련 사망의 주요 원인으로 남아 있습니다1. 표적 치료 및 정밀 종양학 분야에서 상당한 진전이 이루어졌음에도 불구하고, 획득 내성, 제한적인 반응 지속성, 치료 관련 독성으로 인해 장기적인 치료 효능이 저해되는 경우가 여전히 빈번합니다2. 상피세포 성장인자 수용체(EGFR) 표적 약제는 분자적으로 선택된 환자들의 예후를 개선했으나, 치료 중 내성이 거의 필연적으로 발생하므로 대안적 또는 보완적 메커니즘을 통해 작용하는 치료 전략이 절실히 필요한 실정입니다3,4. 전통적인 백금 기반 화학요법은 여전히 치료의 중요한 구성 요소이지만, 장기 사용 시 누적 독성과 내성으로 인해 임상적 이점이 제한적입니다5,6. 종합적으로, 이러한 한계점들은 메커니즘적으로 구별되면서 종양 환경에서 선택적으로 활성화되는 항종양제의 발굴 필요성을 강조합니다.
내인성 DNA 손상 중에서 abasic 또는 apyrimidinic 부위는 매우 흔하며 생물학적으로 중요한 영향을 미치며, 매일 각 세포에서 수천 개의 손상이 발생합니다7. 이러한 손상이 효율적으로 복구되지 않으면 가닥 절단(strand breaks)으로 전환될 수 있으며, 이는 게놈 불안정성과 세포 사멸을 촉진할 수 있습니다8,9. Apurinic/apyrimidinic endonuclease 1은 abasic 부위를 절단하고 이후의 복구 과정을 가능하게 하기 때문에 염기 절제 복구 경로의 핵심 효소입니다10,11. 이러한 복구 의존성으로 인해 abasic 부위 관련 손상은 항암제 개발의 매력적인 표적이 되었습니다12. 이러한 이론적 근거를 바탕으로, 종양 세포의 높은 글루타치온 환경을 이용하기 위해 글루타치온 반응성 abasic 부위 포획 전구약물이 이전에 개발되었습니다. 글루타치온에 의해 트리거된 이들의 생성물은 알데히드성 abasic 부위를 포획할 수 있는 aminooxy 작용기를 포함하고 있으며, 이전의 실험 연구에서는 H1299 세포에서 선택적 세포 독성, 세포 주기 정지 및 세포 사멸이 나타남을 보여주었습니다13. 이러한 데이터는 화합물 설계의 DNA 손상 포획 구성 요소를 뒷받침합니다. 하지만, 이 데이터들이 MMP9, SRC, EGFR, AKT1 또는 TNF가 abasic 부위 포획의 하위 단계에서 조절된다는 것을 보여주는 것은 아닙니다. 따라서 본 계산 분석에서 확인된 모든 단백질 표적 상호작용은 두 과정이 동일한 생물학적 시스템에서 입증되지 않는 한 별개의 가설로 간주되어야 합니다.
본 연구는 이러한 구분을 중심으로 설계되었습니다. 생물학적 근거의 첫 번째 단계는 이전에 확립된 글루타치온 반응성 방출 및 무염기 부위 트래핑 화학입니다14. 여기서 검토하는 두 번째 단계는 탐색적 질문으로, 모프로드러그(parent prodrugs) 또는 그 방출 산물이 선택된 암 관련 단백질과 계산적으로 호환되는지 여부입니다. 네트워크 약리학을 사용하여 후보 단백질의 우선순위를 정한 다음, 도킹, MD 및 MM-PBSA 분석을 통해 선택된 단백질-리간드 복합체를 조사하였습니다15,16. 이러한 계산은 예측된 단백질이 알려진 DNA 손상 표현형을 매개한다는 것을 증명하거나, 무염기 부위 트래핑과 발암 신호 전달 사이의 인과 관계를 확립하기 위한 것이 아니었습니다. 대신, 이 워크플로우는 향후 직접 결합, 효소 활성, 경로, DNA 손상 및 표현형 분석을 통해 평가할 수 있는 실험적으로 검증 가능한 가설들의 순위화된 세트를 생성하는 데 사용되었습니다.
프로토콜
Institutional review board approval was not required because this study was entirely computational and involved no human participants, vertebrate animals, patient-derived biospecimens, or identifiable personal data. Informed consent was therefore not applicable. All databases, software packages, force fields, and computational resources used in this protocol are listed in the Table of Materials.
Study compounds and analytical workflow
Previously reported glutathione-responsive abasic site-trapping compounds were used as study molecules17. Compound 1 and Compound 2 were selected as the parent prodrugs because glutathione-triggered cleavage generates the aminooxy-containing products Compound 4 and Compound 5, respectively. Compound 4 and Compound 5 were selected for structural analysis because they represent the released species that retain the abasic-site-reactive aminooxy group. Compound 3 was included as a matched glutathione-responsive structural control; its cleavage product, Compound 6, lacks the aminooxy functionality required for covalent trapping of abasic-site aldehydes. Accordingly, Compounds 1–3 were included in reverse target prediction to compare the parent scaffolds, Compound 4 and Compound 5 were evaluated against the prioritized proteins, and Compound 6 was used as the negative-control ligand in the SRC MD comparison. The SRC–Compound 6 trajectory was included to provide a matched structural comparator for the aminooxy-containing Compound 5 system, not as evidence that the aminooxy group itself determines SRC binding. The chemical structures and activation relationships of Compounds 1–6 are shown in Figure 1. This design intentionally keeps the established DNA lesion-trapping chemistry separate from the present hypothesis-generating analysis of possible protein interactions.
Prediction of compound-associated targets
The two-dimensional structures of Compound 1, Compound 2, and Compound 3 were saved in MDL MOL format and converted to canonical simplified molecular-input line-entry system (SMILES) strings using Open Babel version 3.1.1 with the canonical SMILES output format18. Each exported string was re-imported, and the regenerated structure was visually cross-checked against the corresponding two-dimensional structure before submission to SwissTargetPrediction, with the species restricted to Homo sapiens19. Predicted targets with nonzero probability values were retained. The target lists obtained for the three compounds were merged, duplicate entries were removed, and the remaining targets were standardized to official human gene symbols before further analysis. The standardized compound-target pairs were imported into network visualization and analysis software as a network table, with compounds and predicted targets represented as nodes and compound-target relationships represented as edges, to visualize the predicted target relationships20.
Retrieval of disease-related targets and identification of intersecting targets
Disease-associated targets were retrieved from the GeneCards database using the search term “lung cancer H1299”21. A relevance score threshold greater than 0.27 was applied to retain genes with stronger relevance to this query. Gene symbols were standardized, and duplicate entries were removed manually. The overlap between compound-predicted targets and disease-associated targets was identified using online Venn-diagram/intersection analysis tool22. Only the intersecting targets were retained for subsequent protein-protein interaction (PPI), enrichment, and target prioritization analyses.
Protein-protein interaction analysis and screening of core targets
The intersecting targets were submitted to the Search Tool for the Retrieval of Interacting Genes/Proteins (STRING) version 11.5, with the species restricted to Homo sapiens and the minimum required interaction score set to 0.40023. The resulting PPI data were imported into Cytoscape version 3.10.0 for visualization and topology analysis. Within a network-topology analysis plugin, degree, betweenness centrality, and closeness centrality were calculated for each node in the original 21-node PPI network; the resulting values were then used for the sequential median-based filtering described below24. Centrality metrics were calculated on the original 21-node PPI network and then used for sequential filtering. The median degree of the original network was 12, and nodes with degree ≥ 12 were retained, yielding 13 candidates. Within these 13 candidates, the median betweenness centrality was 0.031293, and the median closeness centrality was 0.769231. The second filter retained nodes with betweenness centrality ≥ 0.031293 and closeness centrality > 0.769231, yielding five hub candidates: AKT1, EGFR, TNF, MMP9, and SRC. The reported centrality values were carried forward from the original 21-node network rather than recalculated after subsetting. The final five hub candidates were used for subsequent structural analysis. The original topology metrics correspond to an undirected PPI network containing 21 nodes and 116 edges.
Gene Ontology and Kyoto Encyclopedia of Genes and Genomes enrichment analysis
The intersecting targets were subjected to Gene Ontology (GO) and Kyoto Encyclopedia of Genes and Genomes (KEGG) enrichment analysis using the Database for Annotation, Visualization and Integrated Discovery (DAVID), with the species restricted to Homo sapiens25. GO enrichment was evaluated for biological process (BP), cellular component (CC), and molecular function (MF), as well as KEGG signaling pathways. For this exploratory analysis, nominal p < 0.10 was the inclusion threshold used to retain enrichment entries; Benjamini-adjusted p-values, Bonferroni values, false discovery rates, and Fisher's exact test values were reported in the supplementary tables but were not used to define the retained set. Retained entries were ranked by nominal p-value. For downstream visualization and interpretation, the top 20 KEGG pathways and the top 10 terms from each GO category were retained. Bar charts and bubble plots were generated using an online bioinformatics visualization tool.
Preparation of receptors and ligands for molecular docking
The crystal structures of the prioritized proteins were retrieved from the RCSB Protein Data Bank (PDB): AKT1, PDB ID 3O96; EGFR, PDB ID 5UWD; TNF, PDB ID 2AZ5; MMP9, PDB ID 1GKC; and SRC, PDB ID 2H8H. Protein structures used for docking were prepared in molecular visualization software by removing co-crystallized ligands and water molecules, followed by processing in docking-preparation software. For MMP9, an unmodified copy of PDB 1GKC was retained separately as the crystallographic reference for the catalytic Zn2⁺ environment and the N2-[(2R)-2-{[formyl(hydroxy)amino]methyl}-4-methylpentanoyl]-N,3-dimethyl-L-valinamide (NFH) binding mode. In chain A of 1GKC, the catalytic Zn2⁺ is coordinated by His401, His405, and His411 at 2.21, 2.23, and 2.22 Å, respectively, whereas the two NFH oxygen atoms coordinate Zn2⁺ at 2.07 and 2.38 Å; Glu402 is the catalytic acid/base residue. These crystallographic contacts were used as a positive structural reference for evaluating the Compound 5 docking interaction map. For SRC, PDB 2H8H was used for the SRC MD calculations. These structural comparisons were used for interpretation only and were not treated as evidence of enzyme inhibition or intracellular target engagement.
The three-dimensional structures of Compound 4 and Compound 5 were obtained from PubChem and optimized by energy minimization in molecular modeling software26. Ligands were protonated under physiological conditions and minimized using the Merck molecular force field 94 (MMFF94) until the energy gradient was below 0.01 kcal·mol⁻1·Å⁻1. Hydrogen atoms were added, Gasteiger charges were assigned, and rotatable bonds were defined in docking-preparation software. Compound 6, the glutathione-cleavage product of the non-trapping Compound 3 control, was prepared using the same workflow and docked to SRC only to generate the starting pose for the matched control MD trajectory. Thus, Compound 6 was neither introduced as an additional predicted therapeutic ligand nor used to support a multi-target mechanism.
Molecular docking procedure
Molecular docking was performed using molecular docking software under a semiflexible docking protocol, with receptors kept rigid and ligands allowed to remain flexible27,28. For each receptor, the docking box was centered on the position of the co-crystallized ligand so that the search region corresponded to the experimentally defined binding pocket. The docking box dimensions were set to 24 Å × 24 Å × 24 Å for AKT1, EGFR, and SRC, 26 Å × 26 Å × 26 Å for MMP9, and 28 Å × 28 Å × 28 Å for TNF. Exhaustiveness was set to 32, the number of output poses was set to 20, and the energy range was set to 4 kcal·mol⁻1. The top-ranked conformation from each docking run was retained for interaction analysis.
To assess the internal reliability of the docking setup, each co-crystallized ligand was redocked into its corresponding receptor pocket using the same parameters, with a heavy-atom root mean square deviation (RMSD) below 2.0 Å used as the acceptance criterion. Final poses were inspected in molecular visualization software. For the MMP9–Compound 5 complex, the retained interaction map was examined specifically for annotated direct ligand coordination to the catalytic Zn2⁺ ion and for contacts with His401, Glu402, His405, and His411, and the ligand position was compared with the crystallographic NFH pose in PDB 1GKC. A quantitative metal-coordination distance was reported only when direct ligand-Zn2⁺ coordination was evident in the retained pose; otherwise, it was designated not applicable rather than inferred. So, an MMP9 docking pose lacking these canonical catalytic-site features was categorized as noncanonical and was not interpreted as evidence of MMP9 enzymatic inhibition. More generally, AutoDock Vina scores and docking poses were used for relative prioritization and hypothesis generation, not as proof of binding affinity or intracellular target engagement.
Molecular dynamics protocol
Protein-ligand complexes selected for MD analysis were constructed from the docking-derived binding poses. MD calculations were performed with GROMACS29. Proteins were parameterized using the CHARMM36 force field, while ligand atom types and parameters were assigned with the second-generation General Amber Force Field (GAFF2)30,31. Austin Model 1-bond charge correction (AM1-BCC) partial charges were generated through small-molecule parameterization and ligand-topology generation tools; ligand topology generation software then generated the GROMACS-compatible ligand topology files32,33,34. Each complex was placed in a TIP3P water box under periodic boundary conditions with a minimum solute-to-box distance of 1.0 nm. Sodium and chloride ions were added to neutralize the net charge in each system, and additional NaCl was added to achieve a final ionic strength of 0.15 M.
Energy minimization was performed using the steepest-descent algorithm until the maximum force fell below 1000 kJ·mol⁻1·nm⁻1. The minimized systems were then equilibrated under constant particle number, pressure, and temperature (NPT) conditions at 310 K and 1 bar with positional restraints applied to the protein backbone. Temperature was controlled with the V-rescale thermostat, and pressure with the Parrinello-Rahman barostat. Long-range electrostatic interactions were calculated using the particle mesh Ewald method. The short-range electrostatic cutoff and van der Waals cutoff were both set to 1.0 nm, and all bonds involving hydrogen atoms were constrained using the linear constraint solver (LINCS) algorithm. Production trajectories were generated for 150 ns with a 2-fs integration time step, and coordinates were saved every 10 ps for subsequent analysis.
Trajectory analysis
Trajectory analyses were performed on the equilibrated portions of the production trajectories. Protein backbone RMSD and ligand RMSD were calculated after least-squares fitting to the initial reference conformation. Root mean square fluctuation (RMSF) values were calculated on a per-residue basis using Cα atoms. Hydrogen-bond analysis between each ligand and its receptor was performed using a donor-acceptor distance cutoff of 3.5 Å and a donor-hydrogen-acceptor angle cutoff of 30°. Hydrogen-bond occupancy was defined as the proportion of analyzed frames in which a given hydrogen bond was present. These metrics were used to characterize structural stability, residue-level flexibility, and persistence of intermolecular contacts across the three MD trajectories.
Molecular mechanics Poisson-Boltzmann surface area (MM-PBSA) binding free-energy calculation
Binding free energy was calculated using the MM-PBSA method implemented with MM-PBSA analysis software on the equilibrated segments of the MD trajectories35. For each protein-ligand complex, the final 50 ns of the 150 ns production trajectory was used for free-energy analysis. A total of 500 evenly spaced frames were sampled at 100 ps intervals from 100.0 ns through 149.9 ns; the 150.0 ns endpoint was excluded from the sampled set. The total binding free energy was calculated as the sum of the van der Waals energy, electrostatic energy, polar solvation energy, and nonpolar solvation energy terms:
ΔG_bind = ΔE_vdW + ΔE_ele + ΔG_polar + ΔG_nonpolar (1)
No entropy correction was applied. Mean binding free energies and standard deviations were calculated across all sampled frames.
Reproducibility and computational validation controls
All gene names used in the target-prediction, disease-target retrieval, and intersection-analysis steps were standardized to official human gene symbols before downstream analysis. Identical docking parameters were maintained across all receptor-ligand pairs. The docking setup was technically checked by redocking the corresponding co-crystallized ligand into each receptor pocket using the same search settings and the prespecified heavy-atom RMSD acceptance threshold of <2.0 Å. The crystallographic MMP9–NFH complex was retained as the positive structural reference for the catalytic Zn2⁺ environment, while SRC–Compound 6 served as the matched non-trapping comparator for the SRC trajectory analysis. MD trajectories were inspected for temperature and pressure stability and for the absence of abnormal box-volume drift before inclusion in subsequent analyses. All input files, receptor structures, ligand topology files, docking configuration files, MD parameter files, and MM-PBSA frame-selection records were archived to support computational reproducibility.
결과
화합물 관련 표적 예측 및 교차 표적 식별
화합물 1–3의 역 타겟 예측을 통해 212개의 잠재적 인간 타겟을 도출하였습니다. 이와 병행하여, GeneCards에서 "lung cancer H1299"라는 키워드와 0.27 초과의 관련성 점수 임계값을 사용하여 질병-타겟 검색을 수행한 결과, 188개의 NSCLC 관련 타겟이 식별되었습니다. 화합물 예측 타겟과 질병 관련 타겟 풀 사이의 교집합 분석을 통해 21개의 중첩 타겟이 도출되었으며, 이를 이후의 모든 분석에 사용하였습니다. 두 타겟 세트 간의 중첩 결과는 그림 2에 나타나 있습니다. 이러한 결과는 연구 대상 화합물들이 광범위하고 비특이적인 타겟 공간이 아닌, 질병 관련 타겟의 제한된 하위 집합으로 수렴되었음을 나타냅니다.
단백질-단백질 상호작용 분석 및 핵심 표적 스크리닝
교차하는 21개의 표적을 STRING으로 가져와 PPI 네트워크를 구축하였다. 그 결과 21개의 노드와 116개의 엣지로 구성된 네트워크가 생성되었다. 다음의 노드 차수(node-degree) 값은 부록 표 1 합계는 232이며, 이는 116개의 무방향 엣지(undirected edges)와 일치합니다. 이 원래 네트워크에 대해 중심성(centrality) 값을 계산하였습니다. 차수(degree)의 중앙값은 12였으며, 차수 ≥ 12 조건을 적용하여 13개의 후보군을 유지하였습니다. 이 13개의 후보군 중 매개 중심성(betweenness centrality)의 중앙값은 0.031293이었고, 근접 중심성(closeness centrality)의 중앙값은 0.769231이었습니다. 매개 중심성 ≥ 0.031293 조건과 근접 중심성 조건을 함께 적용한 결과 > 0.769231의 값으로 AKT1, EGFR, TNF, MMP9, SRC 등 5개의 허브 후보군이 우선순위로 선정되었습니다. 유지된 하위 집합에 표시된 값은 필터링 과정에서 그대로 유지된 기존 21개 노드 네트워크의 중심성 지표이며, 13개 노드 또는 5개 노드 서브 네트워크에 대해 재계산된 것이 아닙니다. 이들의 네트워크 중심성은 이후의 구조 기반 평가를 위한 후보군 순위를 매기는 데에만 사용되었으며, 이들이 해당 화합물의 생물학적 표적이라는 증거로 해석되어서는 안 됩니다. 부록 표 1, 부록 표 2, 그리고 보충 표 3 최초의 21개 노드 네트워크, 1차 스크리닝 단계 후 유지된 13개의 후보군, 그리고 최종 5개의 허브 후보군에 대한 지표를 각각 보고하십시오. 순차적 PPI 네트워크 스크리닝 과정과 최종 5개의 허브 후보군은 다음의 [그림/표]에 나타나 있습니다. 그림 3A, 그림 3B, 그림 3C, 그리고 그림 3D.
유전자 온톨로지 및 교토 유전자 및 게놈 백과사전 농축 분석
식별된 21개의 교차 타겟에 대한 기능적 풍부도 분석 결과, 공칭 p < 0.10 포함 기준을 충족하는 121개의 KEGG 경로가 확인되었습니다. 상위 20개 경로는 그림 4A에 나타내었습니다. 이 중 내분비 저항성, 암 경로, 암의 프로테오글리칸, EGFR 티로신 키나아제 억제제 저항성 및 ErbB 신호 전달 경로가 특히 두드러졌습니다. 이러한 경로들은 비소세포폐암(NSCLC)의 종양 증식, 생존, 침습 및 치료 저항성과 밀접하게 관련되어 있습니다. 공칭 p < 0.10을 충족하여 유지된 모든 121개 KEGG 경로에 대한 전체 풍부도 통계는 보충 표 4에 제공되어 있습니다.
GO 농축 분석을 통해 동일한 명목상 기준을 충족하는 177개의 생물학적 과정(BP) 용어, 29개의 세포 성분(CC) 용어 및 61개의 분자 기능(MF) 용어를 추가로 식별하였습니다. p < 0.10 포함 기준. 각 범주에서 가장 순위가 높은 10개 용어가 다음의 표에 제시되어 있습니다. 그림 4B, 그림 4C, 및 그림 4D주요 생물학적 프로세스에는 혈관 관련 평활근 세포 증식의 양성 조절, 유사분열 세포 주기의 G2/M 전이, 인슐린 유사 성장 인자 수용체 신호 전달, 단백질 인산화, 세포 사멸의 음성 조절 및 신호 전달이 포함되었다. 주요 세포 구성 요소 용어는 핵, 막 지질 뗏목(membrane raft), 초점 부착, 세포막 및 염색체의 텔로미어 영역이었다. 대조적으로, 다음에서 나타난 상위 분자 기능 용어는 그림 4D 단백질 인산화효소 활성, 단백질 세린 인산화효소 활성, ATP 결합, 단백질 세린/트레오닌 인산화효소 활성, 단백질 티로신 인산화효소 활성, RNA 중합효소 II CTD 헵타펩타이드 반복 서열 인산화효소 활성, 인산화효소 활성, 히스톤 H2AXY142 인산화효소 활성, 히스톤 H3Y41 인산화효소 활성, 그리고 동일 단백질 결합이 포함되었다. BP, CC 및 MF에 대한 전체 농축 통계는 다음에서 제공된다. 부록 표 5, 보충 표 6, 및 보충 표 7종합적으로, 이러한 농축 결과는 교집합 타겟 세트가 비소세포폐암(NSCLC) 진행과 관련된 신호 전달, 생존 조절 및 종양 유발 반응 과정에 집중되어 있음을 나타냅니다.
분자 도킹 기반의 대사체-표적 복합체 우선순위 선정
화합물 4 및 화합물 5와 네트워크 토폴로지에 의해 우선순위가 지정된 5종의 단백질 사이에 분자 도킹을 수행하였다. 표 1에 보고된 값은 AutoDock Vina 도킹 점수이며, 실험적으로 측정된 결합 자유 에너지가 아니다. 화합물 5가 MMP9과 결합했을 때 가장 유리한 단일 점수(-8.418 kcal·mol⁻1)를 나타냈으며, 화합물 4와 MMP9의 결합(-7.840 kcal·mol⁻1)이 그 뒤를 이었다. 또한 화합물 5는 AKT1 및 EGFR에 대해서도 화합물 4보다 더 유리한 점수를 기록한 반면, SRC(-6.549 대 -6.204 kcal·mol⁻1)와 TNF(-5.436 대 -5.299 kcal·mol⁻1)에 대해서는 화합물 4가 약간 더 유리한 점수를 보였다. 따라서 화합물 5가 5종의 단백질 전체에 걸쳐 일관된 점수 우위를 보인 것은 아니었다. 도킹 결과는 추가적인 구조 분석을 위한 대표 복합체의 우선순위를 정하는 데에만 사용되었다.
대표적인 도킹 컨포메이션은 그림 5에 나타나 있다. 가장 높은 순위의 MMP9–Compound 5 상호작용 맵에서, 표시된 접촉점은 Ala417 및 Pro421 근처에 위치하며 거리는 각각 약 3.0 Å 및 2.4 Å였다. 유지된 최상위 포즈 상호작용 맵에서는 Compound 5-ZN2⁺의 직접적인 배위 결합이 표시되지 않았으며, His401, Glu402, His405 또는 His411과의 직접적인 접촉도 나타나지 않았다. 이는 His401, His405 및 His411이 촉매 ZN2⁺를 2.21, 2.23 및 2.22 Å에서 배위하고, 역-하이드록삼산 억제제인 NFH가 두 개의 산소 원자를 통해 동일한 ZN2⁺를 2.07 및 2.38 Å에서 배위하는 1GKC 결정 구조 참조 데이터와 대조적이다. 유지된 상호작용 맵에서 Compound 5-ZN2⁺의 직접적인 배위 결합이 표시되지 않았기 때문에, Compound 5-ZN2⁺ 배위 거리는 할당되지 않았다. 이는 측정된 금속 분리 값이 아니라, 유지된 맵에서 증명된 직접적인 배위 결합이 없음을 의미하는 것으로 해석된다. MMP9–NFH 결정 구조 참조 데이터와의 3차원 비교는 부록 그림 1에 나타나 있다. 따라서 기하학적 구조가 전형적인 아연 의존적 억제 결합 모드와 다르며, 이번 도킹 결과는 Compound 5를 MMP9 억제제로 분류하는 것을 뒷받침하지 않는다. MMP9를 MD 분석 대상으로 유지한 것은 오직 이러한 특정한 비전형적 도킹 기하 구조가 궤적 동안 지속되는지 확인하기 위함이었다. 다른 복합체의 경우, Compound 5는 AKT1 및 SRC와 예측된 접촉을 보였으며, Compound 4 또한 MMP9 및 SRC와 정의된 도킹 상호작용을 형성했다. 그림 5F와 일치하게, 이러한 관찰 결과는 실험적으로 검증된 친화도가 아니라 예측된 상호작용 및 상대적 도킹 점수를 설명한 것이다.
확인보다는 비교 목적으로 세 가지 복합체를 MD 분석 대상으로 선정하였습니다. MMP9–Compound 5는 단일 도킹 점수가 가장 우수했으나, 신중한 구조적 후속 확인이 필요한 비정형 MMP9 포즈를 보였기에 선정되었습니다. SRC–Compound 5를 두 번째 후보 복합체로 선정하였으며, SRC–Compound 6를 매칭된 비트래핑 대조군 궤적으로 포함하였습니다. 이에 해당하는 초기 컨포메이션은 그림 6A, 그림 6B, 및 그림 6C에 나타나 있습니다. 이러한 설계는 MD 안정성을 표적 결합이나 기능 조절의 증거로 처리하지 않으면서, 선택된 도킹 기하 구조의 지속성을 비교할 수 있게 하였습니다.
분자 동역학 분석
동적 수성 조건에서 선택된 도킹 유래 기하 구조의 지속성을 비교하기 위해, MMP9–Compound 5 및 SRC (PDB 2H8H)–Compound 5 복합체에 대해 150 ns MD 궤적을 생성하였으며, SRC (PDB 2H8H)–Compound 6를 대응하는 음성 대조군 궤적으로 포함시켰습니다. 초기 컨포메이션은 그림 6A, 그림 6B, 및 그림 6C에 나타나 있습니다. 이러한 궤적 전반에서 Compound 5는 SRC 내의 Compound 6보다 MMP9 및 SRC 시스템에서 더 낮은 리간드 RMSD(그림 6D)를 보였습니다. MMP9–Compound 5 궤적은 상대적으로 변동이 적은 영역에 도달했고, SRC–Compound 5 궤적은 초기 조정 기간 이후 안정화되었으며, SRC–Compound 6 궤적은 더 큰 변동을 보였습니다. 이러한 차이는 MD 과정 동안 선택된 Compound 5의 도킹 포즈가 더 높은 지속성을 가짐을 나타냅니다. 이는 Compound 5가 세포 내에서 MMP9 또는 SRC에 결합한다는 것을 입증하는 것은 아니며, MMP9 궤적 또한 시작 포즈에서 정준 촉매-ZN2⁺ 상호작용이 결여된 점을 극복하지 못했습니다.
단백질 백본의 RMSD 또한 유사한 비교 패턴을 보였습니다. MMP9–Compound 5 궤적은 약 30 ns 이후 상대적으로 안정적인 백본 영역에 진입한 반면, SRC–Compound 5 궤적은 더 늦게 정체기에 도달했으며, SRC–Compound 6 궤적은 더 큰 변동을 나타냈습니다. 이러한 관찰 결과는 궤적의 거동만을 설명한 것입니다. 안정적인 단백질 백본 또는 리간드 궤적만으로는 세포 내 표적 점유, 효소 억제 또는 신호 전달 조절을 입증할 수 없습니다. 세 시스템 모두에 대한 단백질 백본 RMSD 프로파일은 Supplementary Figure 2에 제공되어 있습니다.
궤적 분석
MD 궤적 내에서의 접촉 지속성을 설명하기 위해 수소 결합 점유율 및 잔기 변동 분석이 사용되었습니다(그림 7A). 화합물 5는 MMP9 궤적에서 Arg95와 높은 점유율의 수소 결합(>85%)을 보였으며, SRC 궤적에서는 Leu325와 반복적인 상호작용(>70%)을 보인 반면, SRC-화합물 6 대조군에서의 대표적인 접촉들은 더 낮은 점유율을 나타냈습니다. 이러한 잔기들이 기능적 표적 조절의 증거로 제시된 것은 아니며, 점유율 값은 분석된 궤적 동안 특정 접촉이 얼마나 빈번하게 발생했는지만을 나타냅니다.
결합 포켓 잔기에 대한 RMSF 분석 결과, 국소적 유연성에서 시스템별 차이가 나타났다(그림 7B). SRC–Compound 6 궤적은 SRC–Compound 5 궤적보다 몇몇 국소적 변동이 더 크게 나타난 반면, MMP9–Compound 5 궤적은 자체 결합 포켓 잔기 세트 내에서 상대적으로 억제된 변동 프로파일을 보였다. MMP9와 SRC는 서로 다른 단백질이므로, 잔기 수준의 RMSF 값은 잔기 대 잔기의 직접적인 비교로 해석하지 않았다. 수소 결합 점유율과 함께 이러한 결과는 접촉 지속성과 국소적 유연성을 특성화하여 실험적 검증을 위한 복합체의 우선순위를 정하는 데 도움을 준다. 이러한 결과가 MMP9 또는 SRC를 세포 내 표적으로 확립하거나, 두 단백질 중 어느 하나가 화합물의 항암 표현형을 매개한다는 것을 입증하는 것은 아니다.
분자 역학 Poisson-Boltzmann 표면적 결합 자유 에너지 계산
평형 상태의 궤적 세그먼트로부터 계산된 MM-PBSA 추정치가 그림 8에 제시되어 있습니다. MMP9–Compound 5 복합체는 -19.65 ± 6.43 kcal·mol⁻1의 ΔG_bind 추정치를 나타냈고, SRC–Compound 5 복합체는 -17.72 ± 6.84 kcal·mol⁻1, SRC–Compound 6 대조군은 -10.37 ± 5.61 kcal·mol⁻1를 나타냈습니다. 따라서 본 계산 프로토콜 내에서의 상대적인 에너지 순위는 MMP9–Compound 5, SRC–Compound 5, SRC–Compound 6 순이었습니다. 이러한 값들은 유한한 궤적 세그먼트에서 도출된 방법론 의존적 추정치이며, 엔트로피 보정이 적용되지 않았습니다. 그러므로 이 값들은 연구 내 비교 목적으로만 사용되었으며, 실험적으로 측정된 결합 친화도나 기능적 단백질 조절의 근거로 해석되어서는 안 됩니다.
도킹, MD, 접촉-점유율, 잔기-변동 및 MM-PBSA 분석 전반에 걸쳐, 화합물 5는 MMP9 및 SRC 복합체에서의 후속 연구를 위해 계산적으로 우선순위가 지정되었습니다. 이러한 계산 결과들 사이의 수렴은 후속 실험을 위해 이 쌍들을 선택한 논거를 강화하지만, 이것이 MMP9 또는 SRC를 직접적인 세포 내 표적으로 검증하는 것은 아닙니다. 특히, 비정형적인 MMP9 포즈와 촉매 ZN2⁺ 배위의 입증 부재로 인해, 현재의 구조 데이터로부터 정형적인 MMP9 억제 메커니즘을 추론하는 것은 불가능합니다.
결과로부터 도출된 결론
계산 워크플로우를 통해 21개의 중복되는 질병 관련 표적을 우선순위화하였으며, AKT1, EGFR, TNF, MMP9, SRC를 위상적 허브 후보로 식별하였습니다. 구조 기반 분석을 통해 MMP9 및 SRC 복합체에 대한 실험적 후속 연구 대상으로 화합물 5를 추가로 우선순위화하였습니다. 이러한 결과는 직접적인 표적 결합, MMP9 또는 SRC 억제, 경로 조절, 또는 단백질 상호작용과 이전에 확립된 무염기 부위 트래핑(abasic-site-trapping) 효과 사이의 인과적 기전 연결성을 입증하는 것은 아닙니다. 따라서 본 연구는 실험적으로 확립된 다중 표적 항-NSCLC 기전보다는 검증 가능한 일련의 계산적 가설을 뒷받침합니다.
데이터 가용성:
본 연구의 결과를 뒷받침하는 데이터셋은 Wang X, Peng Z, Xing Y, Xue L. In silico prioritization of potential protein interactions for glutathione-responsive abasic site-trapping prodrugs in non-small cell lung cancer [dataset]. Figshare; 2026. doi:10.6084/m9.figshare.33313620.v1.에서 공개적으로 이용 가능합니다.
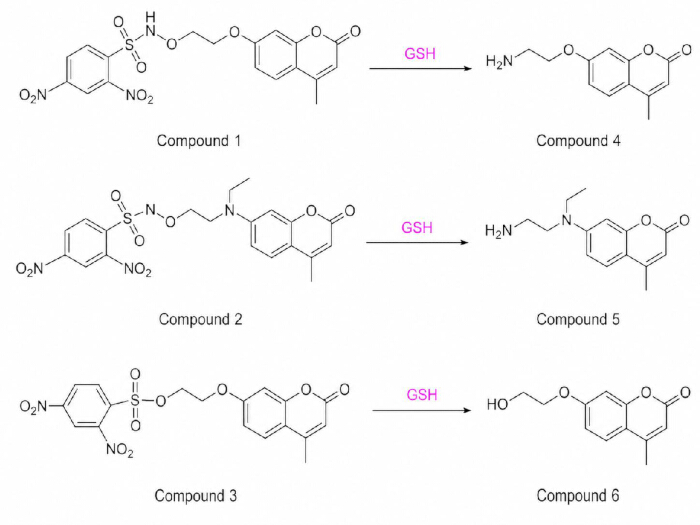
그림 1: 연구 화합물의 화학 구조 및 글루타치온 유도 전환 관계. 화합물 1과 화합물 2는 각각 아미노옥시를 포함하는 대사체인 화합물 4와 화합물 5를 방출하는 글루타치온 반응성 전구약물이다. 화합물 3은 화합물 6을 생성하는 글루타치온 반응성 구조 대조군으로, 화합물 6은 아미노옥시 기반의 abasic-site-trapping 기능이 없다. 화합물 1–3은 역타겟 예측에, 화합물 4와 화합물 5는 허브 타겟 도킹에 사용되었으며, 화합물 6은 SRC 분자 동역학 비교에서 음성 대조군 리간드로 사용되었다. 약어: SRC, SRC 원암유전자, 비수용체 티로신 키나아제. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
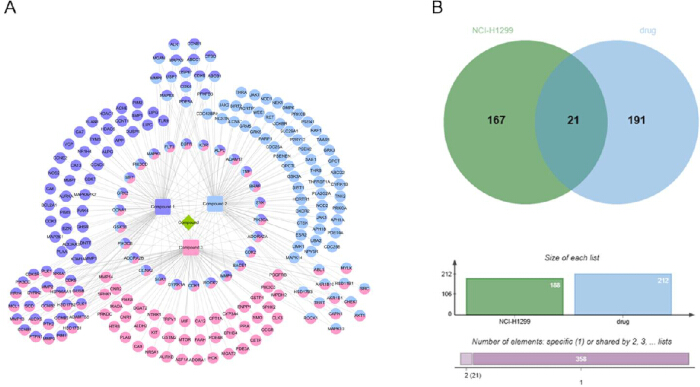
그림 2: 화합물 예측 표적과 비소세포폐암 관련 표적 간의 교집합. (A) 화합물 1–3의 역표적 예측 결과로부터 생성된 화합물-표적 네트워크. (B) H1299 폐암 쿼리를 사용하여 검색한 화합물 예측 표적과 질환 관련 표적 간의 중첩을 보여주는 벤 다이어그램. 교차하는 21개의 표적을 단백질-단백질 상호작용 분석, 농축 분석 및 후속 구조 기반 우선순위 결정 분석을 위해 유지하였다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
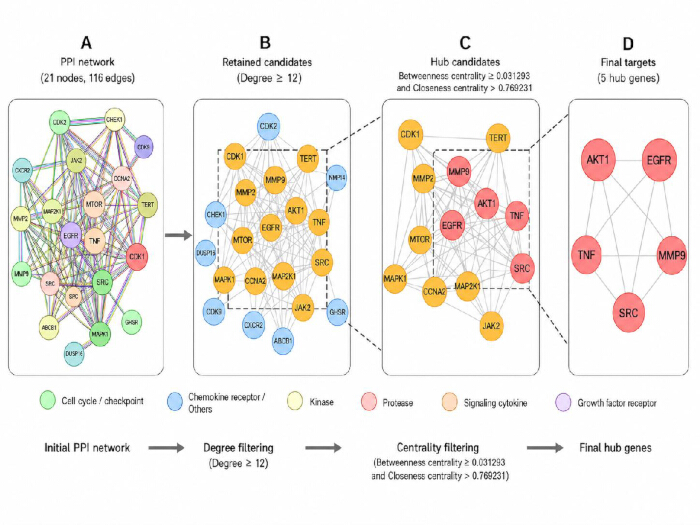
그림 3: 단백질-단백질 상호작용 네트워크 및 핵심 타겟 스크리닝. (A) 21개 교차 타겟의 단백질-단백질 상호작용 네트워크 (116개 엣지). (B) Degree ≥ 12를 이용한 1차 스크리닝 단계로, 13개의 후보군이 유지됨. (C) betweenness centrality ≥ 0.031293 및 Closeness centrality > 0.769231을 이용한 13개 유지 후보군의 2차 스크리닝을 통해 5개의 허브 후보군이 도출됨. (D) 최종 5개 허브 후보군: AKT1, EGFR, TNF, MMP9 및 SRC. 순차적 필터링에 사용된 중심성 값은 원래의 21개 노드, 116개 엣지 네트워크에서 계산되었으며, 각 서브셋이 형성된 후 재계산하지 않고 그대로 적용됨. 약어: AKT1, AKT serine/threonine kinase 1; EGFR, epidermal growth factor receptor; TNF, tumor necrosis factor; MMP9, matrix metalloproteinase 9; SRC, SRC proto-oncogene, non-receptor tyrosine kinase. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
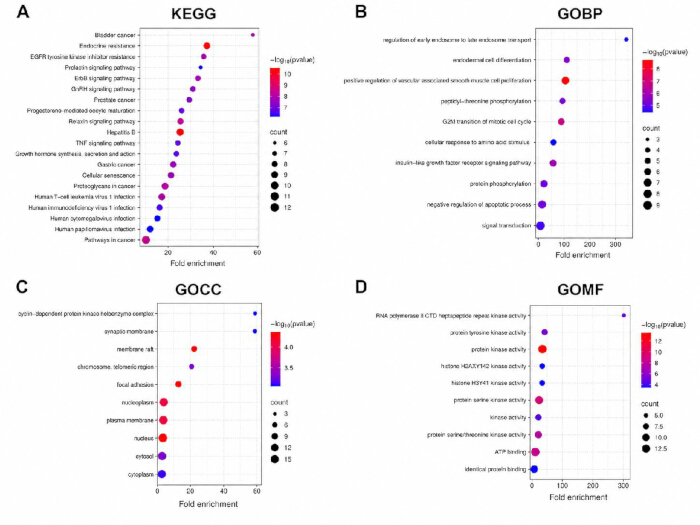
그림 4: 교차 타겟의 기능적 농축 분석. (A) 상위 20개 농축 Kyoto Encyclopedia of Genes and Genomes 경로의 버블 도표. (B) 상위 10개 농축 Gene Ontology 생물학적 과정 항의 막대 도표. (C) 상위 10개 농축 Gene Ontology 세포 성분 항의 막대 도표. (D) 상위 10개 농축 Gene Ontology 분자 기능 항의 막대 도표. 최종 시각화의 x축에는 농축 배수(Fold enrichment)가 표시되어 있으며, 패널 A의 버블 크기는 유전자 수를 반영한다. 보충 표 4–7에 포함된 모든 기본 KEGG 및 GO 항목은 명목상 p < 0.10 포함 기준을 충족하였으며, 도표에 표시된 경로/항은 명목상 p-값이 가장 높은 항목들이다. 다중 검정 보정 값은 보충 표에 보고되었으나 포함 기준으로 사용되지는 않았다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
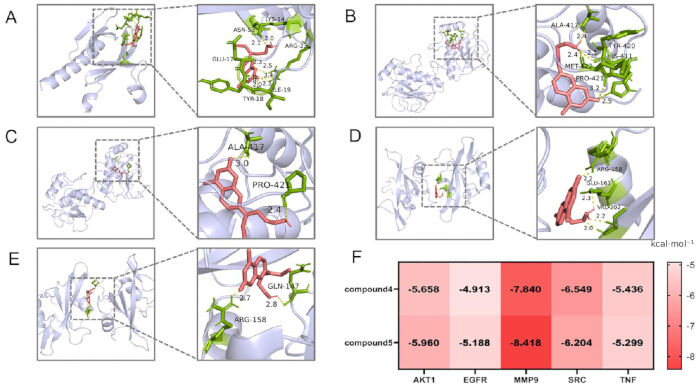
그림 5: 우선순위 단백질과 화합물 4 및 화합물 5의 분자 도킹 포즈 및 AutoDock Vina 점수. (A) AKT1과 화합물 5의 예측 도킹 포즈. (B) MMP9과 화합물 4의 예측 도킹 포즈. (C) MMP9과 화합물 5의 최상위 예측 포즈; 표시된 접촉점은 Ala417 및 Pro421 근처이며, 촉매 ZN2⁺ 배위나 His401, Glu402, His405 또는 His411과의 직접적인 접촉은 주석으로 표시되지 않았음. 따라서 이 포즈는 전형적인 MMP9 억제 결합 모드로 제시되지 않음. 결정학적 ZN2⁺ 배위 거리를 포함하여 NFH가 결합된 MMP9 결정 구조(PDB 1GKC)와의 참조 상호작용 맵 비교가 보충 그림 3에 제공됨. (D) SRC와 화합물 4의 예측 도킹 포즈. (E) SRC와 화합물 5의 예측 도킹 포즈. (F) 우선순위 단백질 5종에 대한 화합물 4 및 화합물 5의 AutoDock Vina 도킹 점수(kcal·mol⁻1) 히트맵. 값이 더 음수일수록 본 도킹 프로토콜 내에서 더 유리한 Vina 점수를 나타내며, 이는 실험적으로 측정된 결합 친화도가 아님. 약어: AKT1, AKT serine/threonine kinase 1; MMP9, matrix metalloproteinase 9; NFH, N2-[(2R)-2-{[formyl(hydroxy)amino]methyl}-4-methylpentanoyl]-N,3-dimethyl-L-valinamide; SRC, SRC proto-oncogene, non-receptor tyrosine kinase; PDB, Protein Data Bank; Ala, alanine; Pro, proline; His, histidine; Glu, glutamate. 여기를 클릭하여 이 그림의 더 큰 버전을 확인하십시오.
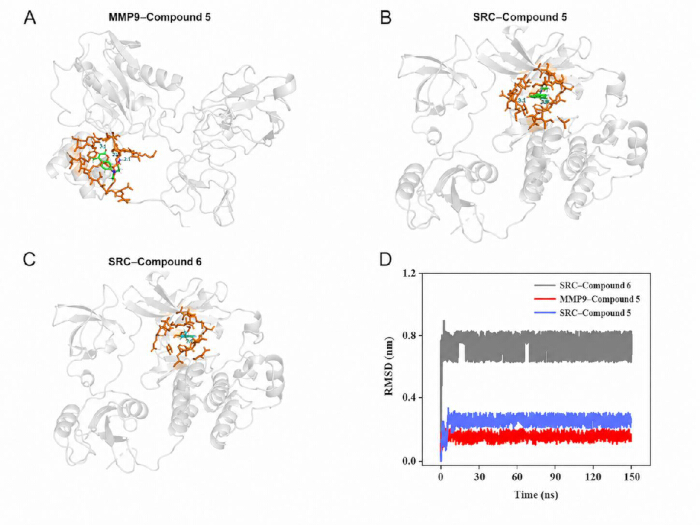
그림 6: MD 복합체의 구조적 개요 및 리간드 안정성 분석. (A) MD의 시작 구조로 사용된 MMP9와 화합물 5의 초기 도킹 형태. (B) SRC (PDB 2H8H)와 화합물 5의 초기 도킹 형태. (C) SRC (PDB 2H8H)와 화합물 6의 초기 도킹 형태; 화합물 6은 대조군인 화합물 3의 글루타치온 절단 생성물이며 aminooxy abasic-site-trapping 기능이 결여되어 있음. (D) MMP9–화합물 5, SRC–화합물 5, SRC–화합물 6의 150 ns 궤적 동안 초기 도킹 포즈 대비 리간드 평균 제곱근 편차. 해당 패널은 MD 중 포즈 지속성을 비교하는 것이며 세포 내 표적 결합을 입증하는 것은 아님. 약어: MD, 분자 역학; MMP9, matrix metalloproteinase 9; SRC, SRC proto-oncogene, non-receptor tyrosine kinase; PDB, Protein Data Bank; RMSD, 평균 제곱근 편차. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
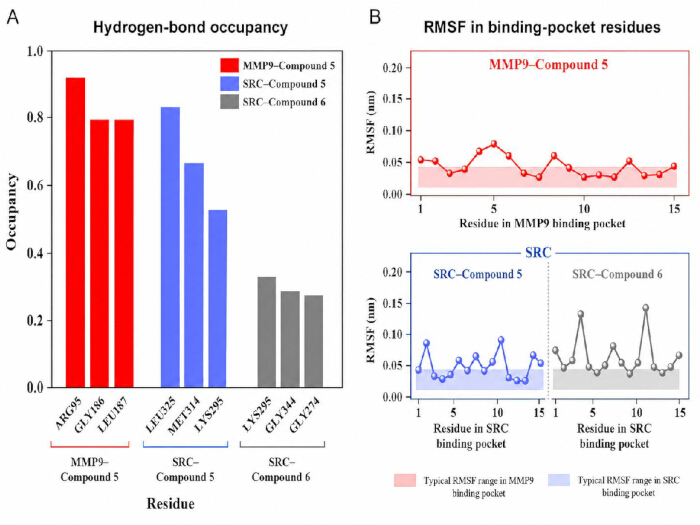
그림 7: 분자 동역학 분석 중의 동적 상호작용 특성. (A) MMP9–Compound 5, SRC–Compound 5 및 SRC–Compound 6의 150 ns 궤적 동안 대표적인 리간드-단백질 수소 결합의 점유율. (B) 결합 포켓 잔기의 평균 제곱 변동. MMP9 프로파일은 MMP9 시스템 내에서 해석되며, SRC–Compound 5 및 SRC–Compound 6 프로파일은 SRC 내에서 직접적인 매칭 비교를 제공한다. 이러한 분석은 MD 동안의 접촉 지속성과 국소적 유연성을 설명하며, 세포 내 표적 결합이나 MMP9 또는 SRC의 기능적 조절을 입증하는 것은 아니다. 약어: MD, 분자 동역학; MMP9, matrix metalloproteinase 9; SRC, SRC proto-oncogene, non-receptor tyrosine kinase; RMSF, 평균 제곱 변동. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
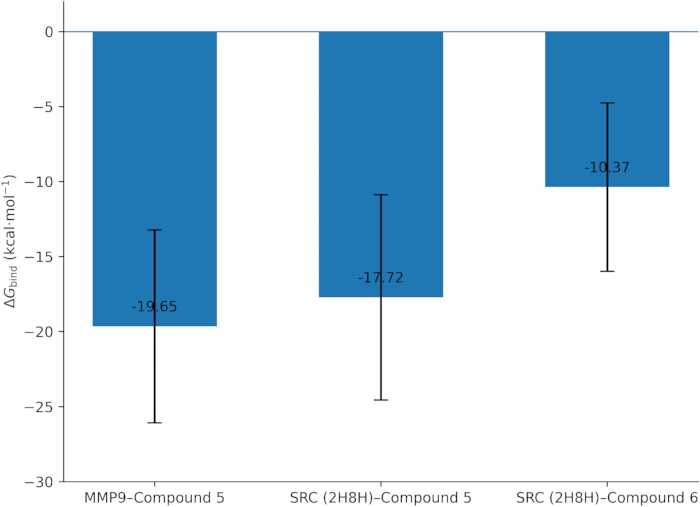
그림 8: 분석된 복합체들에 대한 분자 역학 Poisson-Boltzmann 표면적(MM-PBSA) 에너지 추정치. MMP9–Compound 5, SRC (PDB 2H8H)–Compound 5, 그리고 SRC (PDB 2H8H)–Compound 6 복합체의 평형 상태 궤적 세그먼트로부터 분자 역학 Poisson-Boltzmann 표면적 방법을 통해 얻은 ΔG_bind 추정값이다. 값은 평균 ± 표준 편차로 표시되었으며, 실험적으로 측정된 결합 친화도가 아니라 연구 내 상대적 비교를 위해 사용되었다. 그림 8의 y축 레이블은 방법 및 결과 섹션에서 사용된 식 및 용어와 일치하도록 ΔG_bind (kcal·mol⁻1)로 표기하였다. 약어: MMP9, matrix metalloproteinase 9; SRC, SRC proto-oncogene, non-receptor tyrosine kinase; PDB, Protein Data Bank; ΔG_bind, 결합 자유 에너지; MM-PBSA, molecular mechanics Poisson–Boltzmann surface area. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
| 화합물 | AKT1 (kcal·mol⁻¹) | EGFR (kcal·mol⁻¹) | MMP9 (kcal·mol⁻¹) | SRC (kcal·mol⁻¹) | TNF (kcal·mol⁻¹) |
| 화합물 4 | -5.658 | -4.913 | -7.840 | -6.549 | -5.436 |
| 화합물 5 | -5.960 | -5.188 | -8.418 | -6.204 | -5.299 |
표 1: 우선순위가 지정된 5종의 단백질에 대한 화합물 4와 화합물 5의 AutoDock Vina 도킹 점수. AKT1, EGFR, MMP9, SRC 및 TNF에 대한 화합물 4와 화합물 5의 AutoDock Vina 도킹 점수 (kcal·mol⁻1). 지정된 도킹 프로토콜 내에서 값이 더 음수일수록 더 유리한 점수임을 나타냅니다. 이 값들은 계산된 점수이며, 실험적으로 측정된 결합 자유 에너지 또는 친화도로 기술해서는 안 됩니다. 약어: AKT1, AKT serine/threonine kinase 1; EGFR, epidermal growth factor receptor; MMP9, matrix metalloproteinase 9; SRC, SRC proto-oncogene, non-receptor tyrosine kinase; TNF, tumor necrosis factor.
보충 그림 1: MMP9–NFH 결정학적 참조 구조와 최상위 순위 MMP9–화합물 5 도킹 포즈의 구조적 비교.(A) MMP9–NFH 참조 복합체(PDB 1GKC)의 촉매 ZN2⁺ 환경으로, His401, His405, His411, Glu402 및 표시된 NFH 배위 거리를 보여줌. (B) 표시된 Ala417 및 Pro421 접촉을 보여주는 최상위 순위 화합물 5 도킹 포즈. (C) 동일한 화합물 5 도킹 포즈의 대체 3차원 뷰. 이 비교는 구조적 참조로 제공된 것이며 MMP9 억제를 입증하는 것은 아님. 약어: MMP9, matrix metalloproteinase 9; NFH, N2-[(2R)-2-{[formyl(hydroxy)amino]methyl}-4-methylpentanoyl]-N,3-dimethyl-L-valinamide; PDB, Protein Data Bank; Ala, alanine; Pro, proline; His, histidine; Glu, glutamate.이 파일을 다운로드하려면 여기를 클릭하십시오.
보충 그림 2: 분자 역학 분석 동안의 단백질 백본 제곱평균제곱근 편차. 전체 분자 역학 궤적에 걸친 MMP9–Compound 5, SRC (PDB 2H8H)–Compound 5 및 SRC (PDB 2H8H)–Compound 6 시스템의 단백질 백본 제곱평균제곱근 편차 프로파일. 마지막 그래프에는 표준화된 레이블인 MMP9–Compound 5, SRC–Compound 5 및 SRC–Compound 6이 사용되었으며, 축은 RMSD (nm) 및 Time (ns)로 표시되었다. 이 프로파일은 MD 동안의 시간 의존적 구조 행동을 설명하며, 세포 결합이나 단백질 조절의 증거로 해석되어서는 안 된다. 약어: MMP9, matrix metalloproteinase 9; SRC, SRC proto-oncogene, non-receptor tyrosine kinase; PDB, Protein Data Bank; RMSD, root mean square deviation; MD, molecular dynamics.이 파일을 다운로드하려면 여기를 클릭하십시오.
부록 그림 3: 1GKC-NFH 참조 복합체와 최상위 순위 화합물 5(Compound 5) 도킹 포즈의 MMP9 촉매 ZN2⁺ 환경 비교. 결정학적 MMP9–NFH 참조 복합체(PDB 1GKC)에서 His401, His405, His411은 각각 2.21, 2.23, 2.22 Å의 거리에서 촉매 ZN2⁺와 배위 결합하며, 두 개의 NFH 산소 원자가 2.07 및 2.38 Å에서 ZN2⁺와 배위 결합한다; Glu402는 촉매 산/염기 잔기이다. 이와 대조적으로, 유지된 최상위 순위 화합물 5의 상호작용 맵은 Ala417 (3.0 Å) 및 Pro421 (2.4 Å)과의 접촉을 보여주지만, 주석 처리된 직접적인 ZN2⁺ 배위나 His401, Glu402, His405 또는 His411과의 직접적인 접촉은 나타나지 않는다. 이에 따라 화합물 5-ZN2⁺ 배위 거리는 할당되지 않았다. 이러한 비교는 화합물 5의 포즈가 전형적인 아연 의존적 억제 결합 모드가 아니라 비전형적인 예측 결합으로 분류됨을 뒷받침한다. 약어: MMP9, matrix metalloproteinase 9; PDB, Protein Data Bank; Ala, alanine; Pro, proline; His, histidine; Glu, glutamate.이 파일을 다운로드하려면 여기를 클릭하십시오.
보충 표 1: 초기 21개 노드, 116개 엣지로 구성된 단백질-단백질 상호작용 네트워크의 위상학적 지표. 중심성 기반 스크리닝 전의 21개 교차 타겟 노드 전체에 대한 위상학적 파라미터로, 평균 최단 경로 길이, 매개 중심성, 근접 중심성, 클러스터링 계수, 차수, 이심률, 이웃 연결성, 방사성, 스트레스 및 위상 계수가 포함됨. 노드 차수의 합은 232이며, 이는 116개의 무방향 엣지에 해당함.여기에서 파일을 다운로드하십시오.
보충 표 2: 차수 기반 스크리닝 후 유지된 13개 후보의 원본 네트워크 위상 지표. 초기 21개 노드, 116개 엣지 네트워크에 차수 기준을 적용하여 유지된 13개 노드의 위상 매개변수입니다. 이 값들은 이후의 매개 중심성 및 근접 중심성 필터링 단계를 위해 그대로 가져온 원본 21개 노드, 116개 엣지 네트워크 지표이며, 13개 노드 서브네트워크에서 재계산된 것이 아닙니다.이 파일을 다운로드하려면 여기를 클릭하십시오.
보충 표 3: 순차적 필터링 후 유지된 최종 5개 허브 후보의 원래 네트워크 위상 지표. 순차적 필터링 후 유지된 최종 5개 허브 후보인 AKT1, EGFR, TNF, MMP9 및 SRC에 대한 원래의 21개 노드, 116개 엣지 네트워크 위상 매개변수. 이 이월된 값들은 네트워크 기반의 우선순위 지정만을 뒷받침하며, 5개 노드 하위 네트워크에서 재계산된 지표를 나타내거나 해당 단백질들이 실험적으로 검증된 약물 표적임을 입증하는 것은 아닙니다. 약어: AKT1, AKT serine/threonine kinase 1; EGFR, epidermal growth factor receptor; TNF, tumor necrosis factor; MMP9, matrix metalloproteinase 9; SRC, SRC proto-oncogene, non-receptor tyrosine kinase.이 파일을 다운로드하려면 여기를 클릭하십시오.
보충 표 4: 공칭 p < 0.10 포함 기준을 충족하는 121개 경로에 대한 전체 Kyoto Encyclopedia of Genes and Genomes 농축 결과. 21개의 교차 타겟 중 유지된 모든 121개 경로(공칭 p < 0.10)에 대한 전체 Kyoto Encyclopedia of Genes and Genomes 농축 통계로, 유전자 비율, 유전자 수, 리스트 총계, 모집단 히트 수, 모집단 총계, p-값, Benjamini 값, 농축 배수(fold enrichment), Bonferroni 값, 허위 발견율(false discovery rates) 및 Fisher's exact test 값이 포함됨. 상위 20개 경로의 시각화 자료는 그림 4A에 제시됨. 공칭 p-값 기준이 포함 여부를 정의하였으며, Benjamini, Bonferroni 및 허위 발견율 값은 투명성을 위해 보고되었을 뿐 유지 세트를 정의하는 데 사용되지 않음.이 파일을 다운로드하려면 여기를 클릭하십시오.
부록 표 5: 전체 유전자 온톨로지 생물학적 과정 농축 결과(공칭 p < 0.10을 충족하는 177개 용어). 유전자 비율, 유전자 수, 목록 총합, 모집단 히트 수, 모집단 총합, p-값, Benjamini 값, 농축 배수, Bonferroni 값, 허위 발견율 및 Fisher의 정확 검정 값을 포함하여, 유지된 모든 177개 유전자 온톨로지 생물학적 과정 용어(공칭 p < 0.10)에 대한 전체 농축 통계입니다. 상위 10개 용어는 그림 4B에 시각화되어 있습니다. 포함 여부는 공칭 p-값 기준으로 정의되었으며, 조정된 값은 투명성을 위해 보고되었을 뿐 유지 세트를 정의하는 데 사용되지 않았습니다.이 파일을 다운로드하려면 여기를 클릭하십시오.
보충 표 6: 전체 Gene Ontology 세포 성분 농축 결과 (공칭 p < 0.10을 충족하는 29개 항목). 유전자 비율, 유전자 수, 리스트 합계, 모집단 히트 수, 모집단 합계, p-값, Benjamini 값, 농축 배수, Bonferroni 값, 위양성률(false discovery rate) 및 Fisher의 정확 검정 값을 포함하여, 유지된 29개 Gene Ontology 세포 성분 항목(공칭 p < 0.10)에 대한 전체 농축 통계입니다. 상위 10개 항목은 그림 4C에 시각화되어 있습니다. 포함 기준은 공칭 p-값으로 정의되었으며, 조정된 값은 투명성을 위해 보고되었을 뿐 유지 세트를 정의하는 데 사용되지 않았습니다.이 파일을 다운로드하려면 여기를 클릭하십시오.
보충 표 7: 전체 유전자 온톨로지(Gene Ontology) 분자 기능 농축 결과(공칭 p < 0.10을 충족하는 61개 용어). 유전자 비율, 유전자 수, 리스트 총합, 모집단 히트 수, 모집단 총합, p-값, Benjamini 값, 농축 배수, Bonferroni 값, 허위 발견율 및 Fisher의 정확 검정 값을 포함하여, 유지된 61개 유전자 온톨로지 분자 기능 용어(공칭 p < 0.10)에 대한 전체 농축 통계입니다. 상위 10개 용어는 그림 4D에 시각화되어 있습니다. 포함 기준은 공칭 p-값으로 정의되었으며, 조정된 값은 투명성을 위해 보고되었을 뿐 유지 세트를 정의하는 데 사용되지 않았습니다.이 파일을 다운로드하려면 여기를 클릭하십시오.
토론
본 연구는 두 단계의 기전적 프레임워크 내에서 해석되어야 합니다. 첫 번째 단계는 이전의 실험적 연구에 의해 뒷받침됩니다. 글루타치온 반응성 활성화는 알데히드성 abasic site를 포획할 수 있는 아미노옥시 함유 종을 방출하며, 해당 화합물 군은 H1299 세포에서 선택적 세포독성, 세포 주기 영향 및 세포사멸을 나타냈습니다. 두 번째 단계는 탐색적 단계이며 본 연구의 핵심 초점입니다. 계산 기반의 타겟 예측 및 구조 기반 분석은 동일한 화학적 계열이 특정 암 관련 단백질과도 결합 가능함을 시사합니다. 본 연구의 어떤 실험도 예측된 단백질 상호작용이 세포 내에서 발생하거나, 이것이 abasic-site 포획의 하위 결과임을 입증하지는 않았습니다. 따라서 이 두 단계는 증명된 다중 타겟 기전으로 통합하기보다 의도적으로 분리하여 유지하였습니다.
네트워크 수준에서 21개의 교차 타겟은 암 및 내성 관련 경로에 농축되었으며, AKT1, EGFR, TNF, MMP9 및 SRC가 PPI 네트워크에서 중심적인 위치를 차지했습니다. 이러한 결과는 후보군 우선순위 선정에 유용하지만, 네트워크 중심성과 농축도만으로는 화합물이 단백질과 물리적으로 결합하거나 경로를 변화시킨다는 것을 입증할 수 없습니다. 따라서 허브 단백질을 표적 검증을 위한 후보로 고려해야 합니다. 기능적 역할을 규명하기 위해서는 세포 표현형을 측정하는 데 사용된 것과 동일한 NSCLC 세포주에서 직접적인 섭동 또는 타겟 결합 실험이 필요할 것입니다.
MMP9은 왜 이러한 구분이 중요한지를 잘 보여줍니다. 화합물 5는 MMP9와 가장 유리한 단일 도킹 점수를 기록했지만, 유지된 최상위 포즈(top-pose) 상호작용 맵에서는 촉매 Zn2+ 이온의 직접적인 배위나 His401, Glu402, His405 또는 His411의 직접적인 결합이 표시되지 않았습니다. 1GKC 결정 구조 참조 데이터에서는 His401, His405, His411이 각각 2.21, 2.23, 2.22 Å 거리에서 Zn2+에 배위하며, 두 개의 NFH 산소 원자가 2.07 및 2.38 Å 거리에서 Zn2+에 배위하고 Glu402는 촉매 산/염기 잔기로 작용합니다. 반면 화합물 5의 맵은 Ala417 및 Pro421 근처의 접촉을 보여주었습니다. 부록 그림 3은 참조 상호작용 맵 비교 결과를 나타냅니다. 화합물 5-Zn2+ 간의 직접적인 배위가 표시되지 않았기 때문에, 화합물 5-Zn2+ 배위 거리는 할당되지 않았습니다. 따라서 현재의 구조적 결과는 촉매 부위 억제의 증거가 아니라, MMP9와의 비정형적인 예측 결합으로 설명하는 것이 가장 적절합니다. 이후의 MD 궤적은 해당 특정 도킹 포즈가 시간이 지나도 지속되는지 여부만을 테스트하는 것이며, 비정형적인 도킹 기하 구조를 효소 억제의 증거로 변환시킬 수는 없습니다36,37. 그러므로 MMP9은 주요 타겟이나 검증된 타겟이라기보다 생화학적 테스트를 위한 후보군으로 남겨두어야 합니다. MMP9은 암 침습, 종양 미세환경 재구성 및 MMP9 표적 치료 전략과 관련하여 널리 논의되어 왔습니다38,39.
동일한 증거적 경계가 SRC에도 적용됩니다. SRC–Compound 5 궤적은 SRC–Compound 6 대조군보다 더 지속적인 접촉을 보였으나, MD 안정성이 세포 내 표적 점유율과 동일한 것은 아닙니다40,41. Compound 6의 사용은 비포획 절단 생성물에 대한 맞춤형 비교를 제공하고 내부 구조 비교를 강화하지만, 이것이 아미노옥시 작용기가 SRC 결합의 원인이 된다거나 세포 내에서 SRC 신호 전달이 변경되었다는 것을 증명하지는 않습니다. 이러한 주장을 뒷받침하기 위해서는 전체 SRC, p-SRC/SRC, 하위 신호 전달 마커 및 직교 표적 결합 측정에 대한 직접적인 평가가 필요할 것입니다.
마찬가지로 MM-PBSA는 실험적인 결합 친화도 측정이 아니라 샘플링된 궤적에 대한 상대적인 에너지 추정치를 제공합니다. MMP9–Compound 5 및 SRC–Compound 5에 대한 추정치가 SRC–Compound 6보다 더 유리하게 나타난 것은 비교 궤적 관찰 결과와 일치하지만, 이러한 계산은 샘플링된 컨포메이션과 방법론적 근사치에 민감하며, 본 분석에는 엔트로피 보정이 포함되지 않았습니다. 따라서 도킹, MD 및 MM-PBSA 간의 일치는 내부적인 계산 일관성을 높여줄 뿐, MMP9 또는 SRC의 기능적 조절을 입증하는 것은 아닙니다.
무염기 부위 포획(abasic-site trapping)과 예측된 단백질 상호작용 사이의 관계는 아직 규명되지 않았습니다. 한 가지 가능성은 글루타치온에 의해 방출된 아미노옥시 스캐폴드가 기존의 DNA 손상 포획 활성을 유지하는 동시에, 특정 단백질들과 독립적이고 병렬적인 상호작용을 한다는 것입니다. 또 다른 가능성은 예측된 일부 단백질 상호작용이 생물학적으로 유의미한 농도에서 일어나지 않거나 표현형에 기여하지 않는다는 것입니다. 현재의 데이터로는 이러한 가능성들을 구분할 수 없습니다. 기전적 연결 고리를 입증하려면 화합물 처리 후 DNA 손상 반응과 단백질 경로 변화를 동시에 측정해야 하며, 이어서 후보 표적을 변화시켰을 때 항암 표현형이 변화함을 보여주는 섭동 실험(perturbation experiments)이 필요할 것입니다.
향후 실험적 검증은 이 화학 계열의 이전 실험적 특성 분석에 사용되었던 것과 동일한 세포 모델인 H1299 세포에서 수행되어야 한다. 단계적 전략으로서, 먼저 농도-반응 생존율, 세포 사멸, 세포 주기, 이동/침윤 및 γH2AX 분석을 통해 화합물 5를 대조군(vehicle) 및 그에 대응하는 비트랩핑 화합물 6과 비교하여 표현형 및 DNA 손상 맥락을 확립해야 한다42. 그 다음으로 gelatin zymography와 단백질 발현 분석을 통해 MMP9를 조사해야 하며, SRC 신호 전달은 전체 SRC와 Tyr416-인산화된 SRC를 통해 평가하고, p-SRC/SRC 비율을 주요 신호 판독값으로 사용해야 한다. 화합물-단백질 간의 직접적인 결합은 표면 플라스몬 공명(surface plasmon resonance)과 같은 직교 타겟 결합 방법을 사용하여 독립적으로 평가해야 한다43. 상호작용 후보는 직접 결합 증거가 그에 상응하는 세포 기능 판독값과 일치할 때만 실험적으로 뒷받침되는 것으로 간주해야 한다. MMP9 또는 SRC에 대한 유전적 또는 약리학적 섭동은 두 후보 중 어느 것이 H1299 표현형에 인과적으로 기여하는지에 대한 추가적인 테스트를 제공할 것이다. 이러한 단계적 프레임워크는 이전에 확립된 abasic-site-trapping 활성과 계산적으로 우선순위가 지정된 MMP9/SRC 상호작용 가설 사이의 구분을 유지하는 동시에, 후속 실험 테스트를 위한 직접적인 경로를 정의한다.
공개 사항
저자들은 본 연구와 관련된 경쟁 관계의 재정적 이익이나 기타 이해 상충 관계가 없음을 선언합니다. 연구비 지원 기관은 연구 설계, 데이터 수집, 분석 또는 해석, 원고 작성 또는 결과 발표 결정에 관여하지 않았습니다.
감사의 글
본 연구는 랴오닝성 교육부 청년 프로젝트(JYTQN2023441), 랴오닝성 과학기술부 공동 기금 박사 연구 개시 프로젝트(2023-BSBA-151), 그리고 진주 의과대학 청년 과학 기술 인재 지원 프로젝트(JYQT202305)의 지원을 받아 수행되었습니다. 원고 수정 과정에서 언어 편집, 구성 및 수정 지원을 위해 ChatGPT(OpenAI)가 사용되었습니다. 저자들은 과학적 내용, 데이터 해석 및 최종 문구를 검토하고 확인하였으며, 본 원고에 대해 모든 책임을 집니다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| ACPYPE | ACPYPE 개발자 / Bio2Byte | 버전 2023.11.14 | 소분자 리간드 토폴로지 파일의 생성 및 GROMACS 호환 형식으로의 변환. |
| AmberTools (Antechamber) | AMBER 개발팀 | AmberTools 23.3 | AM1-BCC 부분 전하 할당 및 GAFF2 리간드 파라미터 생성. |
| AutoDock Vina | Forli Lab, Scripps Research | 버전 1.2.5 | 분자 도킹 및 순위가 매겨진 단백질-리간드 포즈 생성. |
| AutoDockTools (MGLTools) | Scripps Research, 계산 구조 생물학 센터 | 버전 1.5.7 | 수용체 및 리간드 준비, Gasteiger 전하 할당, 회전 가능 결합 정의 및 PDBQT 변환. |
| BIOVIA Discovery Studio Visualizer | Dassault SystèmesèBIOVIA mes | 2025년 버전 | 도킹 포즈 시각화 및 단백질-리간드 상호작용 검토. |
| CHARMM36 포스 필드 | MacKerell 연구실 / CHARMM 포스 필드 개발자들 | CHARMM36 | 분자 동역학 계산을 위한 단백질 파라미터화; 본 연구 전반에 걸쳐 CHARMM36(CHARMM36m 아님)을 일관되게 사용하였다. |
| Chem3D Ultra (ChemOffice Professional) | Revvity Signals 소프트웨어 | 버전 22.2 | MMFF94 포스 필드를 이용한 리간드 에너지 최소화. |
| 화합물 1–6 | Li et al., ACS Chemical Biology (2022)에 기술된 바와 같이 이전에 합성됨 | 해당 사항 없음 | 계산 워크플로에 사용된 글루타치온 반응성 모전구약물, 방출 생성물 및 이에 대응하는 비포획 대조군 쌍. |
| cytoHubba | cytoHubba 개발자 / Cytoscape 앱 스토어 | 버전 0.1 | 허브-타겟 우선순위 선정을 위한 차수, 매개 중심성 및 근접 중심성 분석. |
| Cytoscape | Cytoscape 컨소시엄 | 버전 3.10.0 | 화합물-표적 및 PPI 네트워크 시각화와 토폴로지 분석. |
| DAVID 생물정보학 리소스 | Frederick 국립 암 연구소, 인간 레트로바이러스학 및 면역정보학 연구실 | 웹 리소스 | 유전자 온톨로지 및 KEGG 농축 분석; 명목 p값 &< 0.10을 탐색적 포함 기준으로 사용하였으며, 보정된 값을 보고하였으나 이를 최종 선정 세트를 정의하는 데 사용하지는 않았습니다. |
| GAFF2 | AMBER 개발팀 | GAFF2 | 리간드 포스 필드 매개변수화. |
| GeneCards 인간 유전자 데이터베이스 | GeneCards Suite / LifeMap Sciences, Inc. / 와이즈만 과학 연구소 | 웹 리소스 | 쿼리 'lung cancer H1299'를 이용한 질환 관련 타겟 검색. |
| gmx_MMPBSA | gmx_MMPBSA 개발팀 | 버전 1.6.3 | GROMACS 분자 역학 궤적을 이용한 MM-PBSA 결합 자유 에너지 계산; 100.0에서 500개의 프레임을 샘플링함–150.0-ns 종점(endpoint)을 제외하고 100-ps 간격으로 149.9 ns까지 측정하였으며, 엔트로피 보정은 적용하지 않았습니다. |
| GROMACS | GROMACS 개발팀 | 버전 2024.4 | 분자 동역학 궤적 생성 및 궤적 분석. |
| Microbioinfo 온라인 시각화 플랫폼 | Shanghai Newcore Biotechnology Co., Ltd. / Microbioinfo | 웹 리소스 | 농축 막대 그래프 및 버블 플롯 생성. |
| Open Babel | Open Babel 개발팀 | 버전 3.1.1 | SwissTargetPrediction 입력을 위한 구조 파일의 표준 SMILES 변환. |
| PubChem | 미국 국립보건원(NIH) 국립의학도서관 국립생물공학정보센터 | 웹 리소스 | 3차원 리간드 구조의 검색. |
| PyMOL 분자 그래픽 시스템 | Schrödinger, LLC | 버전 2.5.4 | 단백질 준비, 구조 시각화 및 도킹 포즈 검토. |
| RCSB 단백질 데이터 은행 | 구조 생물정보학 연구 협력체 (RCSB) | PDB ID: 3O96; 5UWD; 2AZ5; 1GKC; 2H8H | AKT1, EGFR, TNF, MMP9 및 SRC의 단백질 구조 검색. |
| 제공된 텍스트가 없습니다. 번역할 내용을 입력해 주십시오. | STRING 컨소시엄 | 버전 11.5 | 단백질-단백질 상호작용 네트워크 구축; Homo sapiens; 최소 요구 상호작용 점수 0.400; 원래의 토폴로지 메트릭은 21개 노드와 116개 엣지로 구성된 무방향 PPI 네트워크에 해당함. |
| SwissTargetPrediction | 로잔 대학교 분자 모델링 그룹 / SIB 스위스 생물정보학 연구소 | 웹 리소스 | 화합물 1에 대한 역타겟 예측–3; Homo sapiens에 국한된 종. |
| TIP3P 물 모델 | GROMACS에서 구현됨 | TIP3P | 단백질-리간드 복합체의 용매화를 위해 사용된 3-사이트 명시적 용매 물 모델. |
| Venny | BioinfoGP, 국립 생명공학 센터(Centro Nacional de Biotecnología)ía (CNB-CSIC) | 버전 2.1 | 화합물 예측 타겟 목록과 질환 관련 타겟 목록의 교집합. |
참고문헌
- Sung H, et al. Global cancer statistics 2020: GLOBOCAN estimates of incidence and mortality worldwide for 36 cancers in 185 countries. CA Cancer J Clin. 2021;71:209-49.
- Herbst RS, Morgensztern D, Boshoff C. The biology and management of non-small cell lung cancer. Nature. 2018;553:446-54.
- Kim J, et al. Updates on the treatment of epidermal growth factor receptor-mutant non-small cell lung cancer. Cancer. 2025;131:e35778.
- Lin Y, Wang X, Jin H. EGFR-TKI resistance in NSCLC patients: mechanisms and strategies. Am J Cancer Res. 2014;4:411-35.
- Dasari S, et al. Pharmacological effects of cisplatin combination with natural products in cancer chemotherapy. Int J Mol Sci. 2022;23:1532.
- Ellie S, et al. Chemotherapy drugs cyclophosphamide, cisplatin and doxorubicin induce germ cell loss in an in vitro model of the prepubertal testis. Sci Rep. 2018;8:1773.
- De Bont R, van Larebeke N. Endogenous DNA damage in humans: a review of quantitative data. Mutagenesis. 2004;19:169-85.
- Ciccia A, Elledge SJ. The DNA damage response: making it safe to play with knives. Mol Cell. 2010;40:179-204.
- David SS, Williams SD. Chemistry of glycosylases and endonucleases involved in base-excision repair. Chem Rev. 1998;98:1221-62.
- Robson CN, Hickson ID. Isolation of cDNA clones encoding a human apurinic/apyrimidinic endonuclease that corrects DNA repair and mutagenesis defects in E. coli xth (exonuclease III) mutants. Nucleic Acids Res. 1991;19:5519-23.
- Sczepanski JT, et al. Rapid DNA-protein cross-linking and strand scission by an abasic site in a nucleosome core particle. Proc Natl Acad Sci U S A. 2010;107:22475-80.
- Krokan HE, Bjørås M. Base excision repair. Cold Spring Harb Perspect Biol. 2013;5:a012583.
- Li X, et al. Selective antitumor activity and photocytotoxicity of glutathione-activated abasic site trapping agents. ACS Chem Biol. 2022;17:797-803.
- Hopkins AL. Network pharmacology: the next paradigm in drug discovery. Nat Chem Biol. 2008;4:682-90.
- Meng XY, et al. Molecular docking: a powerful approach for structure-based drug discovery. Curr Comput Aided Drug Des. 2011;7:146-57.
- Hollingsworth SA, Dror RO. Molecular dynamics simulation for all. Neuron. 2018;99:1129-43.
- Genheden S, Ryde U. The MM/PBSA and MM/GBSA methods to estimate ligand-binding affinities. Expert Opin Drug Discov. 2015;10:449-61.
- O'Boyle NM, et al. Open Babel: an open chemical toolbox. J Cheminform. 2011;3:33.
- Daina A, Michielin O, Zoete V. SwissTargetPrediction: updated data and new features for efficient prediction of protein targets of small molecules. Nucleic Acids Res. 2019;47:W357-64.
- Shannon P, et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13:2498-504.
- Stelzer G, et al. The GeneCards Suite: from gene data mining to disease genome sequence analyses. Curr Protoc Bioinformatics. 2016;54:1.30.1-1.30.33.
- Oliveros JC. Venny: an interactive tool for comparing lists with Venn's diagrams [Internet]. BioinfoGP, CNB-CSIC; 2007-2015.
- Szklarczyk D, et al. The STRING database in 2021: customizable protein-protein networks and functional characterization of user-uploaded gene/measurement sets. Nucleic Acids Res. 2021;49:D605-12.
- Chin CH, et al. cytoHubba: identifying hub objects and subnetworks from complex interactome. BMC Syst Biol. 2014;8:S11.
- Sherman BT, et al. DAVID: a web server for functional enrichment analysis and functional annotation of gene lists (2021 update). Nucleic Acids Res. 2022;50:W216-21.
- Kim S, et al. PubChem 2023 update. Nucleic Acids Res. 2023;51:D1373-80.
- Eberhardt J, et al. AutoDock Vina 1.2.0: new docking methods, expanded force field, and Python bindings. J Chem Inf Model. 2021;61:3891-8.
- Gerek ZN, Ozkan SB. A flexible docking scheme to explore the binding selectivity of PDZ domains. Protein Sci. 2010;19:914-28.
- Abraham MJ, et al. GROMACS: high-performance molecular simulations through multi-level parallelism from laptops to supercomputers. SoftwareX. 2015;1-2:19-25.
- Best RB, et al. Optimization of the additive CHARMM all-atom protein force field targeting improved sampling of backbone and side-chain dihedral angles. J Chem Theory Comput. 2012;8:3257-73.
- Vassetti D, Pagliai M, Procacci P. Assessment of GAFF2 and OPLS-AA general force fields in combination with the water models TIP3P, SPCE, and OPC3 for the solvation free energy of druglike organic molecules. J Chem Theory Comput. 2019;15:1983-95.
- Jakalian A, Jack DB, Bayly CI. Fast, efficient generation of high-quality atomic charges. AM1-BCC model: II. Parameterization and validation. J Comput Chem. 2002;23:1623-41.
- Sousa da Silva AW, Vranken WF. ACPYPE—AnteChamber PYthon Parser interfacE. BMC Res Notes. 2012;5:367.
- Case DA, et al. AmberTools. J Chem Inf Model. 2023;63:6183-91.
- Valdés-Tresanco MS, et al. gmx_MMPBSA: a new tool to perform end-state free-energy calculations with GROMACS. J Chem Theory Comput. 2021;17:6281-91.
- Islam MT, Jang NH, Lee HJ. Natural products as regulators against matrix metalloproteinases for the treatment of cancer. Biomedicines. 2024;12:794.
- Mondal S, et al. Matrix metalloproteinase-9 (MMP-9) and its inhibitors in cancer: a minireview. Eur J Med Chem. 2020;194:112260.
- Rashid ZA, Bardaweel SK. Novel matrix metalloproteinase-9 (MMP-9) inhibitors in cancer treatment. Int J Mol Sci. 2023;24:12133.
- Kessenbrock K, Plaks V, Werb Z. Matrix metalloproteinases: regulators of the tumor microenvironment. Cell. 2010;141:52-67.
- Vandooren J, Van den Steen PE, Opdenakker G. Biochemistry and molecular biology of gelatinase B or matrix metalloproteinase-9 (MMP-9): the next decade. Crit Rev Biochem Mol Biol. 2013;48:222-72.
- Merchant N, et al. Matrix metalloproteinases: their functional role in lung cancer. Carcinogenesis. 2017;38:766-80.
- Chabanon RM, et al. Targeting the DNA damage response in immuno-oncology: developments and opportunities. Nat Rev Cancer. 2021;21:701-17.
- Das S, et al. Surface plasmon resonance as a fascinating approach in target-based drug discovery and development. TrAC Trends Anal Chem. 2024;171:117501.