이 프로토콜은 공개된 전사체 데이터셋과 대장 상피세포 검증을 통합하여 염증성 장 질환, 대장암, 췌장 선암과 관련된 공동 바이오마커로 S100P를 확인합니다.
이 콘텐츠를 보려면 JoVE 구독이 필요합니다. 로그인하거나 오늘 무료 평가판을 시작하세요.
연구 논문
염증성 장질환, 대장암, 췌장 선암에서 공유 바이오마커로서의 S100P: 통합 전사체 분석
* These authors contributed equally
이 논문에서
요약
초록
염증성 장 질환(IBD)은 대장암(CRC)과 췌장 선암(PAAD) 위험 증가와 관련이 있으나, 이들 질환에 공통된 분자적 특징은 아직 완전히 이해되지 않았습니다. 본 연구는 통합 전사체 분석과 실험적 검증을 통해 IBD, CRC, PAAD와 관련된 공통 유전자와 생물학적 경로를 규명하는 것을 목표로 했습니다. IBD, CRC, PAAD의 유전자 발현 데이터셋은 암 게놈 아틀라스와 유전자 발현 옴니버스 데이터베이스에서 수집되었습니다. 가중 유전자 공동 발현 네트워크 분석과 차별 발현 분석을 통해 질병 관련 및 공유 유전자를 식별하였습니다. 유전자 온톨로지와 교토 유전자 및 게놈 백과사전(분석은 풍부한 생물학적 기능과 경로를 탐색하는 데 사용됨). 면역 세포 침투는 RNA 전사체의 상대 하위 집합을 추정하여 세포형 식별을 통해 평가하였습니다. 일반 유전자의 진단 성능을 평가하기 위해 수신자 작동 특성 분석이 수행되었습니다. S100P의 세포 분포를 조사하기 위해 단일 세포 RNA 시퀀싱 분석이 수행되었습니다. 또한, S100P 하향 조절의 효과를 지다당류(LPS) 자극 대장 상피 세포에서 평가하였습니다. 총 162개의 질병 관련 유전자와 4개의 흔한 유전자가 확인되었습니다. 기능 풍부화 분석 결과, 인터루킨-17 신호 전달 경로를 포함한 면역 및 염증 관련 경로가 유의미하게 풍부해졌음을 나타냈습니다. 면역 침윤 분석 결과, IBD, CRC, PAAD 전반에 걸친 여러 면역세포 집단에서 유사한 경향이 나타났습니다. 단세포 분석 결과, 세 가지 질환 모두에서 상피세포에서 S100P 발현이 상승하는 것이 확인되었습니다. S100P 하향 조절은 LPS 자극 대장상피 세포의 증식 능력을 회복시키고 염증성 사이토카인 발현을 감소시켰다. 통합 전사체 분석을 통해 S100P가 IBD, CRC, PAAD와 관련된 바이오마커임을 확인하고, 이들 질환 전반에 걸쳐 면역 관련 공통 특징이 있음을 강조하였습니다.
서론
염증성 장질환(IBD)은 궤양성 대장염과 크론병을 포함한 위장관에 영향을 미치는 면역 관련 질환의 스펙트럼을 대표합니다. IBD의 병인은 점막 면역 이상, 군중 불균형, 유전적 감수성 등을 포함하는 매우 복잡합니다. IBD는 발생률이 증가하고 경제적 부담이 커지는 전 세계적인 보건 문제이며, 그 확산률이 높아지면서상당한 주목을 받고 있습니다. 중요한 점은, IBD 환자가 대장암(CRC)3 과 췌장선암(PAAD)4 발병 위험이 유의하게 증가한다는 것입니다. 이 연관성은 잘 문서화되었지만, IBD, CRC, PAAD 간의 유전적 교차 현상은 아직 완전히 이해되지 않았습니다.
이전 연구들은 IBD, CRC, PAAD가 공통된 병원성 과정을 공유한다는 점을 강하게 시사합니다; 그러나 특이적이고 민감한 진단 바이오마커는 여전히 부족하며, 공유된 병원 기전도 완전히 밝혀지지 않았습니다. 다행히도, 고속 처리량 시퀀싱 기술의 빠른 발전과 광범위한 보급으로 IBD, CRC, PAAD 환자들의 수많은 전사체 데이터셋이 공개되어 이들 질환 간의 분자 상호연관성을 체계적으로 조사할 수 있게 되었습니다 2,5,6.
본 연구는 IBD, CRC, PAAD 환자들의 고처리량 시퀀싱 데이터를 활용하여 가중 유전자 공동 발현 네트워크 분석(WGCNA)과 차등 발현 분석을 통해 질병 관련 및 공유 유전자를 식별하였습니다. 이 유전자들은 IBD, CRC, PAAD 간 잠재적 공유 신호 경로를 규명하기 위해 추가로 조사되었습니다. 또한 이러한 흔한 유전자들의 진단적 가치를 평가했습니다. 단일 세포 RNA 시퀀싱(scRNA-seq) 분석 결과, 핵심 유전자 S100P가 주로 상피세포에서 발현됨이 입증되었습니다. 마지막으로, IBD에서 S100P의 생물학적 역할을 조사했습니다.
결론적으로, 본 연구는 IBD, CRC, PAAD와 관련된 공통 진단 바이오마커 및 생물학적 경로를 규명하여 이들 질병의 공동 예방 및 치료에 대한 귀중한 임상적 통찰을 제공하는 것을 목표로 했습니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
프로토콜
이 연구는 암 게놈 아틀라스(TCGA)와 유전자 발현 옴니버스(GEO)의 공개된 식별 해제 데이터셋과 확립된 상업용 세포주를 사용했습니다. 새로 모집된 인간 참가자, 식별 가능한 환자 정보, 환자 유래 샘플은 포함되지 않았습니다. 모든 분석은 관련 기관 지침과 공개 데이터베이스의 이용 약관에 따라 수행되었습니다. 따라서 이 연구에는 추가적인 기관 윤리적 승인과 사전 동의가 필요하지 않았습니다.
데이터 출처
IBD 코호트(GSE179285; 플랫폼: GPL6480 및 GSE24287; 플랫폼: GPL6480), CRC 코호트(TCGA-CRC; 플랫폼: Illumina HiSeq 2000 및 GSE87211; 플랫폼: GPL13497), PAAD 코호트(GSE128735; 플랫폼: GPL20301 및 GSE62452; 플랫폼: GPL6244)의 RNA-seq 데이터는 TCGA와 GEO에서 다운로드되었습니다. 모든 데이터셋은 2025년 12월 5일에 접근되었습니다.
각 데이터셋에 대해 샘플은 엄격히 두 개의 하위 그룹으로 나뉘었으며, 질병 병변/종양 조직이 증례군으로, 해당 비병변 정상 조직이 대조군으로 지정되었습니다. 구체적으로, IBD 코호트에는 IBD 환자 297점의 장 점막 샘플과 건강한 개인의 정상 점막 샘플 56점이 포함되었습니다; CRC 코호트에는 841개의 원발성 대장항암 조직과 211개의 인접 정상 대장항장 상피 조직이 일치했으며; PAAD 코호트는 114개의 PAAD 종양 조직과 106개의 정상 췌장 실질 조직으로 구성되었습니다.
동일한 질병 범주 내의 모든 데이터셋이 균일하게 통합되었습니다. limma 패키지의 정규화 BetweenArrays 함수는 교차 샘플 분위수 정규화를 수행하여 플랫폼 간 배치 효과를 효과적으로 제거하고 이후 차별 발현 분석을 위해 서로 다른 데이터셋 간 유전자 발현 값을 표준화하는 데 사용되었습니다.
IBD, CRC, PAAD 관련 유전자와 흔한 유전자의 선별검사
먼저, LIMMA 패키지를 사용하여 IBD, CRC, PAAD 코호트에서 차별발현 유전자(DEG)를 선별하고, 원래 P 값은 Benjamini-Hochberg 거짓 발견률(FDR) 방법으로 보정하였습니다. IBD, CRC, PAAD 코호트에서는 선별 기준이 |logFC| > 0.4, P < 0.05. 또한 WGCNA는 모든 유전자에 대해 수행되었으며, 최소 모듈 유전자 임계값은 100(소프트 임계값 파워 = 0.90; 네트워크 유형 = 서명됨)으로 설정되었습니다. 그 결과, 세 코호트 모두에서 공통 DEG와 모듈 유전자가 확인되었습니다. 두 방법 모두에서 일관되게 확인된 유전자는 공통 유전자로 정의되었고, 나머지 유전자들은 관련 유전자로 분류되었습니다.
PPI와 기능 풍부 분석
이 분석들은 질병 관련 유전자에 대해 수행되었습니다. 단백질-단백질 상호작용(PPI) 분석은 STRING 데이터베이스를 사용하여 수행되었으며(상호작용 점수 > 0.40). 기능적 풍부 분석에는 clusterProfiler, enrichplot, org를 사용하여 수행된 유전자 온톨로지(GO)와 교토 유전자 및 게놈 백과사전(KEGG) 분석이 포함되었습니다. Hs.eg.db 패키지(P < 0.05, FDR 조정 q 값 [벤자미니–호흐버그 방법] < 0.05).
면역 미세환경 프로파일링
CIBERSORT는 기본 LM22 서명 행렬7을 사용하여 유전자 발현 데이터로부터 면역 세포 침윤 수준을 추정하는 신뢰할 수 있는 알고리즘입니다. 본 연구에서는 CIBERSORT 알고리즘을 사용하여 IBD, CRC, PAAD 코호트의 샘플에서 면역 세포 침윤 정도를 추정하여 세 질병 간 면역 미세환경의 공통 특성을 탐구하였습니다. 분석은 각 샘플의 P 값을 계산하기 위해 1,000가지 순열로 수행되었으며, 혼합 표현 파일에 분위수 정규화(QN = TRUE)를 적용하였습니다. 이후 분석을 위해 CIBERSORT P 값이 0.05< 샘플만 보관하여 디컨볼루션 결과의 신뢰성을 보장했습니다.
일반 유전자의 진단적 가치 평가
IBD, CRC, PAAD 코호트에서 흔한 유전자의 진단 가치는 r의 pROC 패키지를 사용한 수신자 작동 특성(ROC) 분석을 통해 평가하였다. 민감도와 특이성 간의 최적 상충관계는 ROC 곡선을 사용하여 시각화되었습니다.
qRT-PCR, 세포 형질전환, 콜로니 형성 분석법
qRT-PCR과 세포 형질전환은이전 연구들에 따라 수행되었습니다. 일시적 트랜스펙션은 제조사 지침에 따라 jetPRIME 트랜스펙션 시약(폴리플러스, 중국)을 사용하여 수행되었습니다. 세포는 형질전환 혼합물과 6시간 인큐베이션된 후 배지를 완전한 DMEM으로 교체하였다. 이후 실험들은 형질전환 후 48시간 후에 수행되었다.
간단히 말해, TRIzol 시약을 사용해 전체 세포 RNA를 추출했습니다. RNA는 PrimeScript RT 마스터 믹스를 사용해 cDNA로 역전사되었습니다. 정량 PCR은 TB Green qPCR을 사용하여 수행되었습니다. β-액틴은 발현 정규화의 내부 참조 유전자로 사용되었습니다. 생물학적 실험은 세 번에 걸쳐 수행되었다. 프라이머 서열과 siS100P 서열은 이전 연구에서 찾을 수 있습니다 11.
NCM460, FHC, HCT116, SW116, PANC1, BXPC2 세포는 재료표에 나열된 대로 얻었습니다. 모든 세포주가 세포 식별과 마이코플라즈마 검사를 받았습니다.
실험 동안 모든 세포는 3–5세대 동안 전달되었습니다. 모든 세포는 태아 소 혈청 10%와 페니실린-스트렙토마이신 1%를 포함한 완전한 DMEM에서 배양하였습니다.
군집 형성 분석은이전 연구에서 설명한 대로 수행되었습니다. 간단히 말해, 6웰 플레이트의 각 웰에 1,000 개의 세포를 시딩하고 10일간 배양한 후 실험이 종료되었습니다. 세포는 4% 파라포름알데히드로 고정하고, 0.1% 결정 바이올렛으로 염색했으며, ImageJ를 사용해 콜로니를 세었습니다.
scRNA-seq 데이터를 기반으로 한 일반 유전자 분석
IBD 데이터셋(GSE214695), CRC 데이터셋(GSE166555), PAAD 데이터셋(GSE154778)의 scRNA-seq 데이터는 이전 연구에서 설명한 대로 사전 처리되었습니다 8,13. 원시 계수 행렬은 limma::avereps를 사용하여 중복 유전자 심볼에 대한 평균 발현으로 접혔습니다. 초기 필터링은 최소 3개의 세포와 최소 50개의 고유 전사체를 포함하는 세포에서 검출된 유전자를 유지했습니다. 미토콘드리아 전사체 분율이 50개 미만> 또는 50개 미만으로 검출된 세포를 제거했습니다. 로그 정규화는 10,000 척도 인수로 수행된 후 분산 안정화 변환을 통해 주성분 분석(PCA) 전에 Z 점수 표준화된 상위 1,500개의 고변동성 유전자를 식별하였습니다. 군집 정의 마커 유전자는 log2(fold change) > 0.5, 표적 군집에서 검출 비율≥0.25, 그리고 조정된 P 값 <0.05를 사용하여 필터링하였습니다.
간단히 말해, 데이터 전처리는 Seurat 패키지를 사용했고, 셀 유형 주석은 SingleR 패키지(버전 2.6.0)를 사용해 수행되었습니다. 셀 클러스터링은 수라에서 k-최근접 그래프 구성과 PCA 차원 1–20을 기반으로 한 t-SNE 임베딩을 사용하여 수행되었습니다. 이후 다양한 세포 유형에 걸쳐 공통 유전자의 분포와 발현 수준을 조사하였습니다.
IBD 모델의 구축
이전 연구들에 따르면, 지다당(LPS)은 정상 인간 대장 상피세포(FHC 및 NCM460)에서 염증을 유도하는 데 사용되어 염증을 모방하는 IBD 모델을 생성했습니다. 생물학적 실험은 세 번에 걸쳐 수행되었다. 세포는 37°C의 가습 인큐베이터에서 5%CO2로 배양되었습니다. 세포 합류율이 약 50%–70%에 도달하면 배양 배지를 신선한 완전 배지로 교체하고, 세포를 12시간 동안 10 ng/mL LPS로 처리했습니다. 차량 통제 장치로 동일한 양의 멸균 인산염 완충 식염수(PBS)가 사용되었습니다. 배양 부피는 6웰 플레이트에서 웰당 2mL였습니다. 처리 후 배지를 제거하고, 세포를 미리 냉각된 멸균 PBS로 두 번 세척한 후 세포를 수집하여 후속 분석을 수행했습니다.
통계 분석
모든 생물정보학 분석은 R 소프트웨어(버전 4.1.2)를 사용하여 수행되었습니다. 두 그룹 간 비교는 학생 t-검정을 사용했으며, 다그룹 간 비교는 일방향 분산분석(ANOVA)을 사용했습니다. 상관관계 분석은 스피어먼 방법을 사용하여 수행되었습니다. 모든 세포 실험은 최소 세 번 이상 반복되었으며, 데이터는 평균 ± 표준편차(SD)로 제시되었습니다. P 값 또는 FDR < 0.05는 통계적으로 유의미한 것으로 간주되었습니다. 신경 쓰이기, 중요하지 않고; P < 0.05 (*), P < 0.01 (**), P < 0.001 (***).
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
결과
IBD, CRC, PAAD의 DEG
첫째, IBD 코호트(GSE179285 및 GSE24287), CRC 코호트(TCGA-CRC 및 GSE87211), PAAD 코호트(GSE128735 및 GSE62452)를 통합하고, PCA 및 유전자 발현 밀도 플롯을 사용하여 통합을 평가하였습니다. 결과는 서로 다른 데이터셋 간 배치 효과가 통합 후 효과적으로 제거되었음을 보여주었다(그림 1A–F).
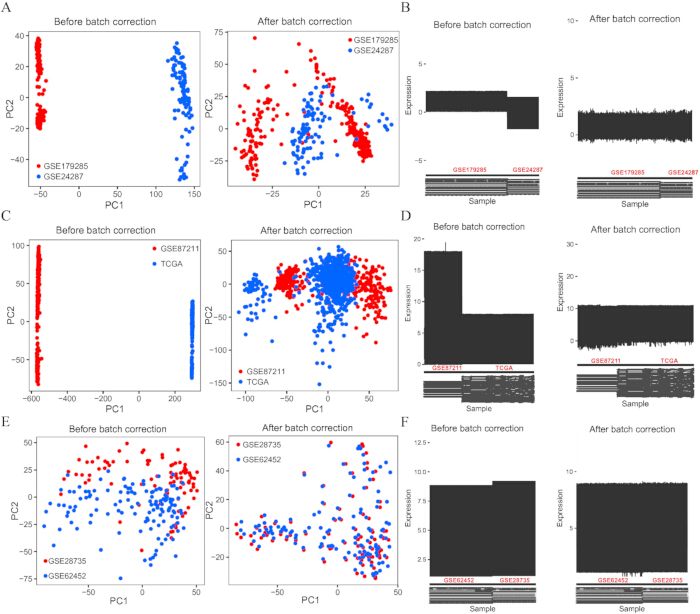
그림 1. 염증성 장질환(IBD), ...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
토론
이전 연구들은 면역 관련 위장 질환인 IBD가 신경퇴행성 질환17, 다발성 경화증18, 근위축성 측삭경화증19, 자궁내막증20, 류마티스 관절염2, 호지킨 림프종21, CRC22, PAAD23 등 여러 질환과 연관성을 강조했습니다. IBD는 일반적으로 CRC24 와 PAAD23 발병 위험을 증가시키는 것으로 간주됩니다. 이들 질병 간의 역학적 연관성은 보고되었으나, 이들의 공통된 분자 특성은 아직 완전히 이해되지 않았습니다. 본 연구에서는 IBD,...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
공개 사항
이해 상충:
저자들은 상충하는 이해관계가 없다고 선언한다.
감사의 글
저자들은 중국 국가 핵심 연구개발 계획(보조금 번호 2023YFB3210400)의 재정 지원을 인정합니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| BXPC2 cell line | Cell Bank of the Chinese Academy of Sciences | N/A | Human pancreatic adenocarcinoma cell line |
| CIBERSORT | N/A | N/A | Immune cell infiltration analysis |
| clusterProfiler package | Bioconductor | v4.8.0 | Gene Ontology (GO) and Kyoto Encyclopedia of Genes and Genomes (KEGG) enrichment analyses |
| Dulbecco's Modified Eagle Medium (DMEM) | Thermo Fisher Scientific | 11965092 | Cell culture medium |
| Fetal bovine serum (FBS) | Thermo Fisher Scientific | A5256701 | Cell culture supplement |
| FHC cell line | Cell Bank of the Chinese Academy of Sciences | N/A | Human normal colonic epithelial cell line |
| GEO dataset (GSE128735) | Gene Expression Omnibus (GEO) | N/A | Public gene expression dataset for pancreatic adenocarcinoma |
| GEO dataset (GSE154778) | Gene Expression Omnibus (GEO) | N/A | Public single-cell RNA sequencing dataset for pancreatic adenocarcinoma |
| GEO dataset (GSE166555) | Gene Expression Omnibus (GEO) | N/A | Public single-cell RNA sequencing dataset for colorectal cancer |
| GEO dataset (GSE179285) | Gene Expression Omnibus (GEO) | N/A | Public gene expression dataset for inflammatory bowel disease |
| GEO dataset (GSE214695) | Gene Expression Omnibus (GEO) | N/A | Public single-cell RNA sequencing dataset for inflammatory bowel disease |
| GEO dataset (GSE24287) | Gene Expression Omnibus (GEO) | N/A | Public gene expression dataset for inflammatory bowel disease |
| GEO dataset (GSE62452) | Gene Expression Omnibus (GEO) | N/A | Public gene expression dataset for pancreatic adenocarcinoma |
| GEO dataset (GSE87211) | Gene Expression Omnibus (GEO) | N/A | Public gene expression dataset for colorectal cancer |
| ggplot2 package | CRAN | v3.4.2 | Data visualization |
| HCT116 cell line | Cell Bank of the Chinese Academy of Sciences | N/A | Human colorectal cancer cell line |
| ImageJ | National Institutes of Health (NIH) | v1.8.0 | Colony counting |
| jetPRIME Transfection Reagent | Polyplus | 101000046 | Cell transfection |
| Lipopolysaccharide (LPS) | Beyotime Co., Ltd | S1735 | Induction of an inflammation-mimicking IBD cell model |
| limma package | Bioconductor | v3.54.0 | Differential expression analysis |
| NCM460 cell line | Cell Bank of the Chinese Academy of Sciences | N/A | Human normal colonic epithelial cell line |
| org.Hs.eg.db package | Bioconductor | v3.23.1 | Gene annotation for enrichment analysis |
| PANC1 cell line | Cell Bank of the Chinese Academy of Sciences | N/A | Human pancreatic adenocarcinoma cell line |
| Penicillin–streptomycin | Thermo Fisher Scientific | 15140-122 | Antibiotic supplement for cell culture |
| pheatmap package | CRAN | v1.0.12 | Heatmap visualization |
| pROC package | CRAN | v1.19.0.1 | Receiver operating characteristic (ROC) analysis |
| PrimeScript RT Master Mix | Takara Bio | RR036A | Reverse transcription of RNA into cDNA |
| Primer sets for qRT-PCR | Tsingke Biotech Co., Ltd | N/A | Primer sequences reported in Reference 11 |
| R software | R Foundation for Statistical Computing | v4.1.2 | Statistical and bioinformatics analyses |
| Seurat package | CRAN | v4.0 | Single-cell RNA sequencing data preprocessing and analysis |
| siS100P | Tsingke Biotech Co., Ltd | N/A | Small interfering RNA targeting S100P |
| SingleR package | Bioconductor | v2.6.0 | Cell type annotation for single-cell RNA sequencing |
| STRING database | STRING Consortium | N/A | Protein-protein interaction analysis |
| SW1116 cell line | Cell Bank of the Chinese Academy of Sciences | N/A | Human colorectal cancer cell line |
| TB Green qPCR Mix | Takara Bio | RR430B | Quantitative real-time PCR |
| TCGA-CRC dataset | The Cancer Genome Atlas (TCGA) | N/A | Public colorectal cancer transcriptomic dataset |
| TRIzol reagent | Invitrogen | 15596-026 | Total RNA extraction |
| WGCNA package | CRAN | v1.73 | Weighted gene co-expression network analysis |
참고문헌
- Xu R, Du W, Yang Q, Du A. ITGB2 related to immune cell infiltration as a potential therapeutic target of inflammatory bowel disease using bioinformatics and functional research. Journal of cellular and molecular medicine. 2024;28(15):e18501.
- Sun HW, Zhang X, Shen CC. The shared circulating diagnostic biomarkers and molecular mechanisms of systemic lupus erythematosus and inflammatory bowel disease. Frontiers in immunology. 2024;15:1354348.
- Faye AS, Holmer AK, Axelrad JE. Cancer in inflammatory bowel disease. Gastroenterology clinics of North America. 2022;51(3):649-66.
- Yu J, et al. Risk of hepato-pancreato-biliary cancer is increased by primary sclerosing cholangitis in patients with inflammatory bowel disease: A population-based cohort study. United European gastroenterology journal. 2022;10(2):212-24.
- Xia B, et al. Identification of potential shared gene signatures between gastric cancer and type 2 diabetes: A data-driven analysis. Frontiers in medicine. 2024;11:1382004.
- Luo Y, et al. Exploring the molecular mechanism of comorbidity of type 2 diabetes mellitus and colorectal cancer: Insights from bulk omics and single-cell sequencing validation. Biomolecules. 2024;14(6).
- Newman AM, et al. Robust enumeration of cell subsets from tissue expression profiles. Nature methods. 2015;12(5):453-7.
- Sun W, et al. Construction and validation of a novel senescence-related risk score can help predict the prognosis and tumor microenvironment of gastric cancer patients and determine that STK40 can affect the ROS accumulation and proliferation ability of gastric cancer cells. Frontiers in immunology. 2023;14:1259231.
- Hong J, et al. A zinc metabolism-related gene signature for predicting prognosis and characteristics of breast cancer. Front Immunol. 2023;14:1276280.
- Man KF, et al. CREB1-BCL2 drives mitochondrial resilience in RAS GAP-dependent breast cancer chemoresistance. Oncogene. 2025;44(16):1093-105.
- Zhou H, et al. S100P promotes trophoblast syncytialization during early placenta development by regulating YAP1. Frontiers in endocrinology. 2022;13:860261.
- Zhou C, et al. Novel exosome-associated LncRNA model predicts colorectal cancer prognosis and drug response. Hereditas. 2025;162(1):79.
- Hong J, et al. Integrative PANoptosis-focused omics analysis uncovers GSDMC as a candidate biomarker in breast cancer. Frontiers in Cell and Developmental Biology. 2026;Volume 14 - 2026.
- Qiu C, et al. Hsa_circ_0004662 accelerates the progression of ulcerative colitis via the microRNA-532/HMGB3 signalling axis. Journal of cellular and molecular medicine. 2025;29(6):e70430.
- Schmid F, et al. Calcium-binding protein S100P is a new target gene of MACC1, drives colorectal cancer metastasis and serves as a prognostic biomarker. British journal of cancer. 2022;127(4):675-85.
- Arumugam T, Simeone DM, Van Golen K, Logsdon CD. S100P promotes pancreatic cancer growth, survival, and invasion. Clinical cancer research: an official journal of the American Association for Cancer Research. 2005;11(15):5356-64.
- Zong J, et al. The two-directional prospective association between inflammatory bowel disease and neurodegenerative disorders: A systematic review and meta-analysis based on longitudinal studies. Frontiers in immunology. 2024;15:1325908.
- Yaqubi K, et al. Inflammatory bowel disease is associated with an increase in the incidence of multiple sclerosis: A retrospective cohort study of 24,934 patients. European journal of medical research. 2024;29(1):186.
- Li CY, et al. Genome-wide genetic links between amyotrophic lateral sclerosis and autoimmune diseases. BMC medicine. 2021;19(1):27.
- Shigesi N, et al. The association between endometriosis and autoimmune diseases: A systematic review and meta-analysis. Human reproduction update. 2019;25(4):486-503.
- Sonnenberg A, Duong HT, McCarty DJ, El-Serag HB. Concurrence of inflammatory bowel disease with multiple sclerosis or Hodgkin lymphoma. European journal of gastroenterology & hepatology. 2023;35(12):1349-53.
- Chacon-Millan P, et al. A combination of microarray-based profiling and biocomputational analysis identified miR331-3p and hsa-let-7d-5p as potential biomarkers of ulcerative colitis progression to colorectal cancer. International journal of molecular sciences. 2024;25(11).
- Everhov Å H, et al. Inflammatory bowel disease and pancreatic cancer: A Scandinavian register-based cohort study 1969-2017. Alimentary pharmacology & therapeutics. 2020;52(1):143-54.
- Contran N, et al. Colorectal cancer and inflammatory bowel diseases share common salivary proteomic pathways. Scientific reports. 2024;14(1):17711.
- Sun W, et al. Osthole pretreatment alleviates TNBS-induced colitis in mice via both cAMP/PKA-dependent and independent pathways. Acta pharmacologica Sinica. 2017;38(8):1120-8.
- Li SY, et al. Diosgenin exerts anti-tumor effects through inactivation of cAMP/PKA/CREB signaling pathway in colorectal cancer. European journal of pharmacology. 2021;908:174370.
- Castro-Pando S, et al. Pancreatic epithelial IL17/IL17RA signaling drives B7-H4 expression to promote tumorigenesis. Cancer immunology research. 2024;12(9):1170-83.
- Kayed H, et al. FXYD3 is overexpressed in pancreatic ductal adenocarcinoma and influences pancreatic cancer cell growth. International journal of cancer. 2006;118(1):43-54.
- Wang H, et al. Mesenchymal stem cells ameliorate DSS-induced experimental colitis by modulating the gut microbiota and MUC-1 pathway. Journal of inflammation research. 2023;16:2023-39.
- Li W, et al. MUC1-C drives stemness in progression of colitis to colorectal cancer. JCI insight. 2020;5(12).
- Murthy D, et al. The MUC1-HIF-1α signaling axis regulates pancreatic cancer pathogenesis through polyamine metabolism remodeling. Proceedings of the National Academy of Sciences of the United States of America. 2024;121(14):e2315509121.
- Sun W, et al. TRIM47 regulates energy metabolism via glycolytic reprogramming to drive hepatocellular carcinoma progression and represents an efficient therapeutic target. Adv Sci (Weinh). 2026;13(17):e16996.
- Sun W, et al. METTL4 enhances GLI1 translation through m(6)Am modification to promote tumor progression as a therapeutic target for hepatocellular carcinoma. J Adv Res. 2026.
- Yuan Y, et al. RNA nanotherapeutics for hepatocellular carcinoma treatment. Theranostics. 2025;15(3):965-92.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.