여기서는 의료 분석을 위한 설명 가능한 인공지능 모델을 개발하고 평가하기 위한 재현 가능한 프로토콜을 제시합니다. 이 워크플로우는 데이터 전처리, 예측 모델링, SHAP, LIME, Grad-CAM 기반 설명 가능성, 정량적 평가, 인간 중심 검증을 통합하여 투명하고 신뢰할 수 있는 임상 의사결정을 지원합니다.
이 콘텐츠를 보려면 JoVE 구독이 필요합니다. 로그인하거나 오늘 무료 평가판을 시작하세요.
이 논문에서
요약
초록
설명 가능한 인공지능(XAI)은 투명성과 의사결정 설명 능력이 임상 의사결정의 필수 요소인 신뢰할 수 있는 AI 시스템 구축에 필수적인 도구로 점점 더 인정받고 있습니다. 이 출판물은 의료 분석을 위한 설명 가능한 AI 시스템 개발 및 평가를 위한 재현 가능한 실험적 접근법을 제시합니다. 개발된 파이프라인은 데이터 전처리, 예측 모델링, 해석 생성, 평가 단계를 하나의 원활한 워크플로우로 통합하여 구조화된 임상 데이터와 의료 영상 데이터셋 모두에 적용할 수 있습니다. 앙상블 머신러닝 모델은 구조화된 표 형식 데이터셋에서 강력한 예측 성능을 보여주었으며, 딥러닝 모델은 의료 영상 데이터의 복잡한 패턴을 학습하는 데 효과적입니다. SHAP, LIME, Grad-CAM과 같은 기법들은 모델 해석을 용이하게 하는 전역 및 국소적 설명입니다. 정말 도움이 많이 됐어요. 프레임워크의 정량적 평가는 정확성, 정밀도, 회상률, F1 점수, ROC-AUC, 설명 지표, 충실도, 안정성 등 다양한 지표를 아우릅니다. 결과는 실험 조건이 통제되었을 때, 프레임워크가 평가된 실험 조건 하에서 예측 성능과 설명 품질이 향상되었음을 보여줍니다. 프로토콜에 의해 이끄는 문서로서, 이 작업은 재현성과 확장성, 그리고 다른 생명체에 의한 지속적인 구현을 뒷받침합니다. 이 투명하고 이해하기 쉬운 AI 모델은 임상 의사결정 지원과 의료 분석 시스템이 대규모로 신뢰와 활용을 얻는 기반이 됩니다.
서론
인공지능(AI)은 질병 진단, 예후, 위험 계층화, 의료 영상 분석 및 임상 의사결정을 지원함으로써 현대 의료의 중요한 구성 요소가 되었습니다. 머신러닝과 딥러닝의 발전으로 의료 시스템은 대량의 구조화 및 비구조화 데이터를 처리할 수 있게 되었으며, 종종 기존 통계 접근법과 동등하거나 그 이상으로 예측 성능을 달성할 수 있게 되었습니다2. 이러한 발전에도 불구하고, 많은 AI 모델은 복잡한 블랙박스 시스템처럼 작동하여 임상의와 의료 이해관계자가 예측이 어떻게 생성되는지 이해하기 어렵습니다. 이러한 투명성 부족은 고위험 의료 환경에서 신뢰, 채택, 책임성을 제한할 수 있습니다 4,5.
설명 가능한 인공지능(XAI)은 머신러닝 모델의 투명성과 해석 가능성을 향상시키는 유망한 접근법으로 떠올랐습니다6. SHAP(Shapley 가산 설명), LIME(국소 해석 가능한 모델 무관적 설명), 그리고 구배 가중 클래스 활성화 매핑(Grad-CAM) 등 널리 사용되는 설명 기법들은 특징 귀속과 시각적 설명 메커니즘 7,8,9를 통해 모델 행동에 대한 통찰을 제공합니다. 이러한 방법들은 임상 해석, 모델 감사, 의사결정 지원을 지원하는 의료 응용 분야에 점점 더 많이 적용되고 있습니다10,11. 하지만 설명 가능성만으로는 신뢰성, 재현성, 임상적 유용성을 보장하지 않습니다. 최근 연구들은 설명 불안정성, 교란에 대한 민감성, 임상의의 검증 부족, 설명 출력과 진정한 모델 추론 간의 불일치 등과 관련된 도전 과제를 강조했습니다 12,13,14,15.
설명 가능성 문제 외에도, 재현성은 의료 머신러닝 연구에서 여전히 중요한 관심사로 남아 있습니다16, 17, 18. 많은 연구들은 전처리 절차, 소프트웨어 환경, 하이퍼파라미터 구성, 검증 전략, 구현 워크플로우에 관한 제한된 정보를 제공하여 독립 복제가 어렵습니다19, 20, 21. 더불어, 의료 AI 연구는 예측 성과에 초점을 맞추는 경우가 많지만, 설명 품질 평가, 임상가 중심 평가, 실질적 실행 고려사항에 관한 제한적인 지침을 제공합니다22. 이러한 한계는 설명 가능한 AI 시스템을 연구 환경에서 실제 의료 환경으로 전환하는 데 장애물이 될 수 있습니다 23,24,25,26,27.
현재 의료 XAI 워크플로우는 개별 설명 기법이나 예측 모델을 개별적으로 평가하며, 데이터 준비, 예측 모델링, 설명 가능성 평가, 인간 중심 평가, 재현성 자원을 통합한 표준화된 프로토콜을 거의 제공하지 않습니다. 28,29,30,31. 따라서 연구자와 실무자는 워크플로우를 재현하거나, 설명 방법 비교하거나, 다양한 의료 데이터셋과 응용 분야에서 설명 가능한 AI 시스템의 실용성을 평가하는 데 어려움을 겪을 수 있습니다. 따라서 의료 설명 가능한 AI 워크플로우의 일관된 구현, 평가 및 보고를 촉진하기 위해 포괄적이고 재현 가능한 프로토콜이 필요합니다 32,33,34,35.
여기서는 의료 분석 분야에서 설명 가능한 인공지능 시스템을 개발, 평가 및 해석하기 위한 재현 가능한 프로토콜을 제시합니다. 프로토콜은 데이터 전처리, 예측 모델링, SHAP, LIME, Grad-CAM을 이용한 설명 가능성 평가, 임상 중심 평가, 검증 절차, 재현성 자원을 통합된 워크플로우 내에 통합합니다. 목표는 투명한 모델 개발, 설명 품질 평가, 그리고 다양한 의료 데이터셋 36,37,38,39에서 재현 가능한 구현을 지원하는 표준화된 프레임워크를 제공하는 것입니다. 이 연구의 방법론적 기여는 예측 분석, 설명 가능성 평가, 임상의사 검증, 재현성 관행을 의료 AI 연구, 교육 및 배포 지향 연구에 적합한 단일 프로토콜로 통합한 데 있습니다 40,41,42,43.
이 연구의 주요 기여는 새로운 설명 가능성 알고리즘의 개발이 아닙니다.
오히려 예측 모델링, 설명 가능성 평가, 시각화, 평가, 인간 중심 해석을 통합하여 의료 분석 및 JoVE 기반 프로토콜 배포에 적합한 통합 워크플로우로 통합한 표준화되고 재현 가능하며 실험적으로 검증된 프로토콜을 제공합니다. 이 연구의 주요 목적은 새로운 예측 알고리즘을 도입하는 것이 아니라, 의료 분석에서 설명 가능한 인공지능 워크플로우를 구현하기 위한 표준화되고 재현 가능하며 실험적으로 검증된 프로토콜을 제공하는 것입니다. 프로토콜은 데이터 전처리, 예측 모델링, 설명 가능성 평가, 임상가 중심 평가, 재현성 자원을 통합하여 채택, 재현, 교육 배포에 적합한 통합 프레임워크를 만듭니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
프로토콜
본 연구에 사용된 모든 데이터셋은 UCI 머신러닝 저장소, PhysioNet MIMIC-III 데이터베이스, NIH 흉부 X선 데이터셋 등 공개 및 완전 익명화된 저장소에서 수집되었습니다. 식별 가능한 환자 정보는 접근되지 않았습니다. 이 연구는 공개된 익명성 해제 데이터의 2차 분석에 대한 기관 연구 윤리 지침을 준수하였습니다. 인간 참여자가 직접 모집되지 않았고 보호 건강 정보가 사용되지 않았기 때문에 공식 기관심의위원회(JB) 승인이 필요하지 않았습니다.
1. 실험 프레임워크 개요
- 투명한 의료 분석을 위한 재현 가능하고 설명 가능한 인공지능(XAI) 파이프라인을 개발하세요. 워크플로우를 데이터 계층, 전처리 계층, 모델링 계층, 설명 가능성 계층, 평가 계층, 시각화 계층으로 조직하세요.
- 이러한 모듈을 통합하여 구조화된 임상 데이터, 전자 건강 기록, 의료 영상 데이터셋을 처리할 수 있는 통합 워크플로우로 만듭니다.
- 각 모듈이 재현성, 해석 가능성, 확장성, 표준화된 실험 실행에 기여하도록 보장합니다.
- 연속적인 데이터 스트리밍을 지원하도록 모듈러 아키텍처를 설계하고, 파이프라인의 각 단계가 실험 워크플로우 전반에 걸쳐 재현성, 해석 가능성, 확장성에 기여하도록 보장합니다.
2. 계산 환경 및 시스템 구성
- 워크플로우를 실행하기 전에 명령줄 터미널을 열고 다음 명령을 실행하여 필요한 소프트웨어 의존성을 설치하세요:
PIP install numpy pandas scikit-learn tensorflow shap lime opencv-python matplotlib seaborn - 데이터 전처리 및 모델 개발을 진행하기 전에 모든 소프트웨어 패키지의 성공적인 설치를 확인하고 재료표에 나열 된 소프트웨어 버전과의 호환성을 확인하세요.
- Python 3.11을 주요 프로그래밍 환경으로 사용하세요. 데이터 조작 및 기능 엔지니어링 작업을 위해 NumPy 1.26과 Pandas 2.1을 설치 및 구성하세요. 머신러닝 모델 개발 및 평가를 위해 Scikit-learn 1.5를 설치하세요.
- 딥러닝 모델 훈련 및 추론을 위해 TensorFlow 2.15를 설치하세요. 설명 가능성 분석을 위해 SHAP 0.46과 LIME 0.2.0을 설치하세요. 이미지 처리 작업을 위해 OpenCV 4.10을 설치하세요. 데이터 시각화 및 결과 보고를 위해 Matplotlib 3.9와 Seaborn 0.13을 설치하세요. 재현성을 위해 필요한 완전한 소프트웨어 사양과 구현 세부사항은 재료 표를 참조하십시오.
- 멀티코어 프로세서, 그래픽 처리 장치(GPU) 가속, 그리고 대규모 의료 데이터셋과 딥러닝 작업을 수용할 수 있는 충분한 메모리 자원을 갖춘 워크스테이션을 사용하여 컴퓨팅 환경을 구성하세요.
- 데이터 분할, 모델 초기화, 훈련 절차에 고정된 무작위 시드를 설정하여 실험 실행에서 재현성을 보장합니다. 워크플로우 전반에 걸쳐 데이터 전처리 작업, 모델 구성, 하이퍼파라미터 설정, 훈련 절차, 평가 결과를 기록할 수 있는 로깅 메커니즘을 활성화합니다.
- 표 1에 요약된 명세에 따라 모델 아키텍처, 최적화 매개변수, 학습률, 배치 크기, 훈련 설정, 하이퍼파라미터 값을 구성하세요. 재현 실험 중에는 보고된 결과와 일관성을 유지하기 위해 이러한 설정을 준수하세요.
- 기대 출력 - 모든 필요한 소프트웨어 패키지, 하드웨어 자원, 로깅 메커니즘, 모델 구성 설정을 포함하여 이후 데이터 전처리, 모델 개발, 설명 가능성 분석 및 평가 절차를 위한 완전 구성 및 재현 가능한 컴퓨팅 환경.
| 구성 요소 | 매개변수 | 가치 | 설명 |
| 랜덤 포레스트 | n_estimators | 100 | 나무 수 |
| 랜덤 포레스트 | max_depth | 전혀 없습니다 | 나무 깊이 |
| XGBoost | learning_rate | 0.01 | 학습 속도 |
| XGBoost | n_estimators | 100 | 부스터 탄환 |
| CNN | 시대 | 25 | 훈련 시기 |
| CNN | batch_size | 32 | 배치 크기 |
| CNN | 옵티마이저 | 아담 | 최적화 알고리즘 |
| MLP | hidden_layers | 2 | 숨겨진 층의 수 |
| MLP | 활성화 | ReLU | 활성화 함수 |
| 일반 | train_split | 70% | 학습 데이터 비율 |
| 일반 | validation_split | 15% | 검증 비율 |
| 일반 | test_split | 15% | 검사 비율 |
표 1: 구현 세부사항 및 하이퍼파라미터 구성.
이 표는 제안된 설명 가능한 AI 프레임워크의 실험 평가 전반에 걸쳐 사용되는 계산 환경, 소프트웨어 라이브러리, 머신러닝 및 딥러닝 모델 구성, 최적화 설정, 학습률, 배치 크기, 학습 매개변수, 하이퍼파라미터 값을 요약합니다.
3. 데이터셋 준비 및 전처리
- 실험 워크플로우의 투명성과 재현성을 보장하기 위해 공개된 의료 데이터셋을 선택하세요.
- 제안된 프레임워크를 검증하기 위해 네 가지 대표적인 의료 시나리오를 사용한다: (i) 위스콘신 유방암 데이터셋을 이용한 유방암 진단, (ii) 피마 인디언 당뇨병 데이터셋을 이용한 당뇨병 위험 예측, (iii) MIMIC-III 전자 건강 기록을 이용한 임상 결과 예측, (iv) NIH 흉부 X선 데이터셋을 이용한 흉부 질환 분류. 이 데이터셋을 선택하여 구조화된 임상 기록, 종단 전자 건강 기록, 의료 의사결정 지원 시스템에서 흔히 사용되는 의료 영상 기법 전반에 걸쳐 프레임워크를 평가할 수 있습니다.
- 각 데이터셋을 Python 환경에 가져오고, 레코드를 입력 특징과 대상 변수로 분리하세요. 질병 예측 과제를 위한 구조화된 임상 데이터, 종단 결과 분석을 위한 전자 건강 기록, 진단 분류 작업을 위한 의료 영상 데이터셋을 조직합니다. 각 데이터셋의 무결성을 확인한 후 전처리 작업을 진행하세요.
- 적절한 보철 기법을 사용하여 누락된 값을 식별하고 해결하세요. 변수 간 비교 가능성을 보장하기 위해 특징 스케일링 및 정규화 절차를 통해 수치 특징을 표준화합니다.
- 데이터셋 특성에 기반한 적절한 인코딩 방법으로 범주 변수를 인코딩합니다. 상관관계 분석과 모델 기반 특징 중요성 측정을 사용하여 특징 선택을 수행하여 가장 관련 있는 변수를 식별하고 데이터 차원을 줄입니다.
- 모델 학습 전에 모든 의료 이미지를 224,224 픽셀로 크기 조정하세요. 선택한 딥러닝 아키텍처의 요구사항에 따라 픽셀 강도 값을 정규화합니다. 이미지 회전과 수평 뒤집기 등 데이터 보강 기법을 적용하여 모델 일반화를 개선하고 과적합을 줄이세요. 이미지 품질을 검증하고 데이터셋 전반에 걸쳐 이미지 치수의 일관성을 보장합니다.
- 데이터셋의 완전성, 일관성, 특징-라벨 정렬을 평가하여 데이터 무결성을 평가합니다. 모든 레코드가 해당 대상 클래스에 올바르게 할당되었는지 확인하세요. 표 2에 요약된 표 크기, 특징 수, 데이터 양측성 등 데이터셋의 특성을 검토 합니다.
- 방법론적 엄격성과 재현성을 보장하기 위해 데이터셋별 검증 절차를 구현하세요. 각 데이터셋에 대해 표본 크기, 클래스 분포, 트레인-검증-테스트 분할 전략, 누수 방지 조치, 하이퍼파라미터 최적화 절차, 교차 검증 설계, 외부 테스트 프로토콜을 기록하세요. 표 3에 이러한 검증 절차를 요약해 보세요 .
- 결손값 처리, 이상치 제거, 특징 확장, 범주 인코딩, 클래스 분포 보존, 데이터셋 분할 절차를 평가하여 전처리 품질 관리 검사를 수행합니다. 모든 데이터셋에서 전처리 작업이 일관되게 적용되는지 확인하세요.
- 데이터셋 분할 과정에서 상당한 데이터 유출이 없음을 확인하세요. 그림 1 에 제시된 전처리 검증 결과를 검토하여 이후 머신러닝 및 설명 가능성 분석을 위한 표준화된 데이터셋이 생성되었는지 확인하십시오.
- 기대 출력 - 누락값이 적절히 해결된 깨끗하고 표준화된 데이터셋을 생성하고, 범주별 변수를 인코딩하며, 수치 특징을 정규화하고, 기록을 훈련, 검증, 테스트 하위 집합으로 나누어야 합니다. 데이터셋의 특성, 클래스 분포, 검증 절차가 표 2와 표 3에 보고된 것과 일치하는지 확인하고, 그림 1에 나타난 전처리 검증이 성공적으로 이루어졌는지 확인하세요.
| 데이터셋 | 유형 | 샘플 | 특징 | 목표 |
| 유방암 | 표 형식 | 569 | 30 | 양성/악성 |
| 당뇨병 | 표 형식 | 768 | 8 | 당뇨병 결과 |
| 미믹-III | 전자건강기록(EHR) | ~60,000 | 임상 변수 | 사망자 |
| 흉부 엑스레이 | 영상 | ~112,000 | 이미지 | 질병 라벨 |
표 2: 데이터셋 특성 및 의료 사용 사례.
이 표는 연구에 사용된 의료 데이터셋의 요약을 제공하며, 데이터셋 유형, 샘플 수, 특징 수, 대상 변수, 의료 응용 도메인 및 관련 임상 사용 사례를 포함합니다. 데이터셋은 구조화된 임상 기록, 전자 건강 기록, 의료 영상 데이터를 포함하여, 다양한 의료 분석 시나리오에서 프레임워크의 적용 가능성을 보여줍니다.
| 데이터셋 | 표본 크기 | 클래스 분포 | 분할 전략 | 누수 방지 | 하이퍼파라미터 탐색 | 교차 검증 | 외부 시험 |
| 유방암 (UCI 위스콘신) | 569 | 357 양성 / 212 악성 | 70/15/15 | 열차 전용 전처리 | 그리드 탐색 | 5겹 층화 CV | 독립 홀드아웃 집합 |
| 피마 인디언 당뇨병 | 768 | 비당뇨병 500명 / 당뇨병 268명 | 70/15/15 | 열차 전용 전처리 | 그리드 탐색 | 5겹 층화 CV | 독립 홀드아웃 집합 |
| 미믹-III EHR | 5274 | 결과 계층화 코호트 | 70/15/15 환자 수준 | 환자 수준 분리 | 랜덤 서치 | 5단계 환자 수준 CV | 독립 홀드아웃 집합 |
| NIH 흉부 엑스레이 | 112120 | 폐렴/정상 층화 | 70/15/15 | 이미지 수준 분리 | 랜덤 서치 | 5겹 층화 CV | 독립 홀드아웃 집합 |
표 3: 데이터셋 수준 검증 및 실험 설계.
이 표는 각 데이터셋에 사용되는 검증 방법론을 요약하는데, 여기에는 표본 크기, 클래스 분포, 훈련-검증-테스트 분할 전략, 누수 방지 절차, 하이퍼파라미터 최적화 방법, 교차 검증 설계, 외부 테스트 프로토콜 등이 포함됩니다. 이러한 조치들은 방법론적 엄격성, 재현성, 편향 없는 모델 평가를 보장하기 위해 시행되었습니다.
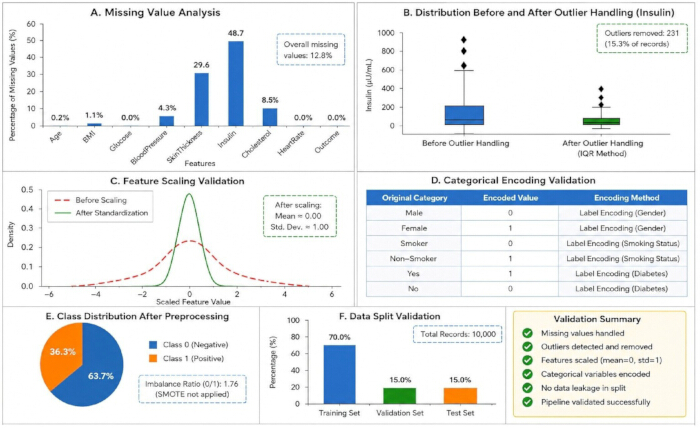
그림 1: 데이터 전처리 파이프라인 검증.
모델 개발 전에 수행된 주요 전처리 작업의 검증 결과. (A) 대표적인 의료 특징에 걸친 결핍 가치 분석. (B) 이상치 처리 전후의 수치 변수 분포. (C) 표준화를 이용한 기능 확장성 검증. (D) 범주 인코딩 검증. (E) 전처리 후 클래스 분포. (F) 트레인-검증-테스트 데이터 분할의 검증. 이 결과는 예측 모델링 및 설명 가능성 분석을 위한 데이터셋의 성공적인 전처리 및 준비를 확인시켜 줍니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭해 주세요.
4. 설명 가능한 AI 프레임워크의 시스템 아키텍처
- 모듈화된 처리를 용이하게 하고, 워크플로우의 투명성을 높이며, 재현 가능한 구현을 지원하기 위해 계층화된 아키텍처를 사용해 프레임워크를 조직하세요. 원시 의료 데이터셋을 수신하고 관리할 수 있도록 데이터 레이어를 설정하세요. 모든 들어오는 데이터셋을 데이터 레이어를 통해 라우팅한 후 전처리 작업을 시작하세요.
- 전처리 계층 내에서 데이터 정제, 변환, 정규화, 특징 엔지니어링, 인코딩 절차를 수행합니다. 모델 개발 전에 모든 전처리 작업이 완료되었는지 확인하세요.
- 머신러닝과 딥러닝 알고리즘을 활용해 모델링 계층 내에서 예측 모델을 개발합니다. 사전 처리 데이터셋과 최적화된 하이퍼파라미터 구성을 사용하여 그라디언트 부스트닝, 랜덤 포레스트, 다층 퍼셉트론(MLP), 합성곱 신경망(CNN) 모델을 훈련합니다.
- 설명 가능성 계층 내에서 설명 가능성 기법을 적용하여 모델 예측을 해석합니다. 구조화된 데이터셋에 대해 SHAP과 LIME을 사용하여 특징 귀속 설명을 생성합니다. 이미지 기반 모델에 대해 Grad-CAM 히트맵을 생성하여 모델 예측에 기여하는 영역을 시각화합니다.
- 평가 계층 내에서 예측 및 설명 가능성 성과를 평가합니다. 정확성, 정확성, 회상율, F1 점수, ROC-AUC, 충실도, 안정성, 임상가 중심 평가 지표를 계산합니다. 모든 평가 결과물을 기록하여 후속 분석 및 보고를 수행하세요.
- 시각화 계층 내에서 임상적으로 해석 가능한 시각적 출력을 생성합니다. 성과 비교 플롯, 특징 중요도 시각화, SHAP 요약 플롯, LIME 설명, Grad-CAM 히트맵, 임상가 대상 보고 대시보드를 생성합니다. 최종 실험 보고서에 포함할 수 있도록 모든 시각적 결과물을 저장하세요.
- 워크플로우 실행을 진행하기 전에 그림 2 에 나타난 전체 프레임워크 아키텍처를 검토하세요.
- 기대 출력 - 그라디언트 부스팅, 랜덤 포레스트, CNN, MLP 아키텍처를 포함한 완전히 훈련된 머신러닝 및 딥러닝 모델을 생성합니다. 모델 구성, 최적화된 하이퍼파라미터, 훈련 로그, 체크포인트 파일, 설명 가능성 출력, 시각화 산물을 저장하여 이후 평가 및 해석 가능성 분석을 지원합니다.
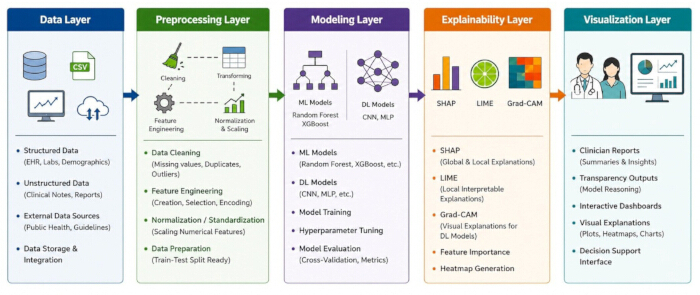
그림 2: 의료 분석을 위한 설명 가능한 AI 프레임워크의 시스템 아키텍처. 이 그림의 더 큰 버전을 보려면 여기를 클릭해 주세요.
5. 워크플로우 실행
- 공개된 저장소에서 의료 데이터셋을 획득하여 머신러닝 및 딥러닝 분석에 적합한 구조화된 형식으로 저장합니다. 실험 절차를 시작하기 전에 그림 3 에 나타난 전체 워크플로우를 검토하세요.
- 3절에 설명된 절차에 따라 데이터 정제 및 전처리를 수행하십시오. 적절한 스케일링 방법으로 수치 변수를 정규화하세요. 적절한 인코딩 기법을 사용하여 범주 변수를 인코딩합니다. 데이터셋별 보철 전략을 사용하여 누락값을 식별하고 보석합니다. 모델 개발을 진행하기 전에 데이터 품질, 특징 라벨 정렬, 데이터셋 완전성을 확인하세요.
- 각 데이터셋을 학습, 검증, 테스트 하위 집합으로 나누어 편향 없는 모델 평가를 지원하세요. 데이터셋 분할 시 클래스 분포를 보존하고, 해당되는 경우 누설 방지 조치를 구현합니다. 테스트 하위 집합은 최종 모델 평가용으로만 예약하세요.
- Gradient Boosting과 Random Forest를 포함한 앙상블 기반 알고리즘을 사용하여 구조화된 데이터셋에서 머신러닝 모델을 학습합니다. 공간 이미지 특징을 학습할 수 있는 합성곱 신경망(CNN) 아키텍처를 사용하여 이미지 데이터셋에서 딥러닝 모델을 학습합니다. 학습 중에 모델 매개변수를 반복적으로 업데이트하고, 각 훈련 에포크가 끝난 후 검증 성능을 모니터링합니다. 검증 성능이 저하되거나 미리 정의된 정지 기준에 따라 개선되지 않을 때 조기 중단을 적용하세요.
- 그리드 검색과 무작위 탐색을 포함한 체계적 탐색 전략을 사용하여 모델 하이퍼파라미터를 최적화합니다. 학습 속도, 추정자 수, 트리 깊이, 배치 크기, 에포크 수 및 기타 모델별 매개변수를 검증 성능에 따라 조정합니다. 검증 데이터셋 전반에 걸친 예측 성능과 일반화 능력을 바탕으로 최종 모델을 선택하세요.
- 모델 훈련을 완료한 후 설명 가능성 방법을 적용하세요. 특징 귀인 기법을 사용하여 모델 예측에 가장 크게 기여하는 변수를 식별하기 위해 전역 설명을 생성합니다. 개별 예측 사례를 분석하고 샘플 수준에서 모델 행동을 평가하기 위한 국소적 설명을 생성합니다. 이미지 분류 모델용 Grad-CAM 히트맵을 생성하여 예측 결과에 기여하는 이미지 영역을 강조합니다. 모든 설명 출력물을 저장하여 후속 분석 및 보고에 활용하세요.
- 정확도, 정밀도, 회상율, F1 점수, 곡선 하 수신자 작업 특성 면적(ROC-AUC)을 사용하여 예측 성능을 평가합니다. 설명의 신뢰도와 일관성을 평가하기 위해 충실도와 안정성 지표를 활용하세요. 데이터셋과 설명 방법 전반에 걸쳐 모델 성능을 비교하여 프레임워크의 견고성과 일반화 가능성을 평가합니다.
- 결과를 임상적으로 해석할 수 있도록 시각화 결과와 분석 보고서를 생성하세요. 성능 비교 차트, 특징 중요도 그래프, SHAP 요약 시각화, LIME 설명 출력, Grad-CAM 히트맵 및 기타 임상적으로 관련된 시각화를 만듭니다. 보고 전에 모든 시각적 결과물을 검토하여 명확성과 일관성을 확인하세요.
- 모든 전처리 작업, 모델 구성, 하이퍼파라미터 설정, 설명 가능성 절차, 검증 전략, 평가 결과를 문서화하세요. 워크플로우의 재현성과 독립적인 복제를 용이하게 하기 위해 상세한 실험 기록을 유지하세요. 반복 실험 실행에 따른 결과의 일관성을 검증하고, 모든 워크플로우 산출물을 향후 참고를 위해 아카이브하세요.
- 기대 출력 - 최적화된 하이퍼파라미터, 저장된 모델 가중치, 학습 로그, 성능 지표, 설명 가능성 출력(SHAP 설명, LIME 설명, Grad-CAM 히트맵 포함)을 포함한 완전 학습된 예측 모델을 생성합니다. 모든 모델 산출물, 평가 보고서, 시각화 결과를 저장하여 후속 분석 및 재현성 평가를 지원합니다.
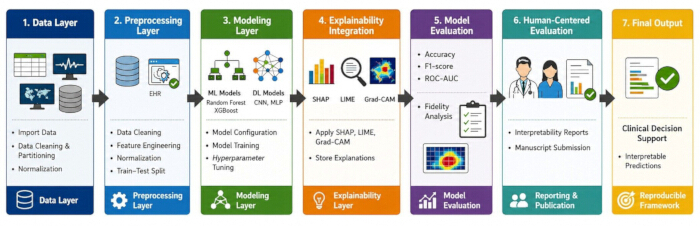
그림 3: 설명 가능한 AI 파이프라인의 종단 간 워크플로우. 이 그림의 더 큰 버전을 보려면 여기를 클릭하세요.
6. 모델 평가 및 설명 가능성 평가
- 정확도, 정밀도, 회상률, F1 점수, 곡선 하 수신자 작동 특성 면적(ROC-AUC) 등 표준 분류 지표를 사용하여 예측 모델 성능을 평가합니다. 전체 분류 정확성을 측정하기 위해 정확도를 계산합니다.
- 정확히 확인된 긍정적 예측의 비율을 평가하기 위해 정밀도를 계산합니다. 리콜 수를 계산하여 모델이 양성 사례를 식별하는 능력을 평가합니다. 정확도와 기억력을 균형 있게 계산하기 위해 F1 점수를 계산하세요. ROC-AUC를 계산하여 다양한 분류 임계값 간 판별적 성과를 평가합니다.
- 이러한 평가 지표를 모든 데이터셋과 모델 아키텍처에 일관되게 적용하여 객관적인 성과 비교를 용이하게 하세요. 모든 지표 값을 기록하고 평가 결과를 저장하여 이후 통계 분석 및 보고를 위해 사용하세요.
- 충실도와 안정성 지표를 사용하여 설명 가능성 성능을 평가하세요. 생성된 설명이 모델 예측과 의사결정 행동을 얼마나 정확하게 반영하는지 결정하기 위해 충실도를 계산합니다.
- 유사한 입력 샘플에서 생성된 설명을 비교하고 설명 출력의 일관성을 정량화하여 안정성을 계산합니다. 모델 설명을 해석하기 전에 충실도와 안정성 값이 미리 정해진 품질 기준을 충족하는지 확인하세요.
- SHAP, LIME, Grad-CAM 출력 간의 설명 가능성 성능을 비교하세요.
- 기대 출력 - 정확성, 정밀도, 회상율, F1 점수, ROC-AUC, 충실도, 안정성 지표 등 정량적 평가 결과를 생성합니다. 과학적 보고, 재현성 평가, 임상 해석에 적합한 설명 가능성 산출물과 시각화를 작성합니다.
7. 인간 중심 평가
- 6명의 의사, 3명의 방사선과 의사, 3명의 임상 데이터 분석가로 구성된 12명의 의료 전문가를 채용합니다. 임상 의사결정, 의료 영상 해석, 의료 분석 또는 전자 건강 기록 검토 경험이 있는 참가자를 선발합니다. 평가 절차를 시작하기 전에 모든 참가자로부터 사전 동의를 받으세요.
- 모델 훈련과 설명 가능성 분석을 완료한 후 테스트 데이터셋에서 무작위로 100개의 사례를 선택합니다. 각 경우에 대해 두 가지 평가 조건을 생성합니다:
- 예측 전용 출력과
- 예측과 설명 가능성 정보가 함께 제공됩니다. 사례 및 평가 조건의 발표 순서를 무작위화하여 발표 편향과 학습 효과를 최소화합니다.
- 예측 결과, 설명 결과, 평가 설문지를 포함한 표준화된 평가 양식을 준비하세요. 컴퓨터 기반 평가 인터페이스를 사용하여 참가자들에게 개별 사례를 제시합니다.
- 참가자들이 다른 평가자와 답변을 논의하지 않고 독립적으로 각 사례를 검토하도록 지시하세요. 참가자들이 동일한 실험 조건에서 모든 평가를 완료할 수 있도록 허용합니다.
- 발표된 설명 가능한 인공지능 평가 연구를 바탕으로 한 5점 리커트 척도 설문지를 실시합니다. 참가자들에게 검토된 각 사례에 대해 신뢰도, 해석 가능성, 사용 가능성을 평가하도록 지시합니다. 설문지 응답을 전자적으로 기록하고 모든 설문 항목의 완료 여부를 확인한 후 통계 분석으로 진행하세요.
- 평가 과정에서 임상적 유용성의 객관적 지표를 측정하세요. 참가자의 결정과 해당 참조 라벨 또는 근거 진실을 비교하여 의사결정 일치를 기록합니다. 의사결정 합의를 참가자 결정 중 참조 결과와 일치하는 비율로 계산합니다.
- 각 사건의 검토 시간을 기록하여 사건 발표와 최종 응답 제출 사이의 간격을 측정하세요. 예측 전용 조건과 설명 포함 예측 조건에 대해 평균 검토 시간을 별도로 계산하세요.
- 모든 참가자와 평가 사례에서 평균 신뢰도, 해석 가능성, 사용성 점수를 계산합니다. 예측 단지 예측 조건과 설명이 포함된 예측 조건에서 얻은 점수를 비교합니다.
- 모든 참가자 평가 완료 후 쌍 t-검정을 수행하여 신뢰도, 해석 가능성, 사용성, 의사결정 합의, 검토 시간의 차이가 통계적으로 유의미한지 확인하세요. 모든 통계적 비교에 대해 유의율 임계값을 p 0.05로 사용하세요.
- 모든 참가자의 응답을 수집한 후 Fleiss Kappa를 계산하여 평가자 간 동의도를 평가합니다. 집계된 참가자 평점을 사용하여 평가자 간 평가의 일관성을 판단합니다. 확립된 합의 지침에 따라 Fleiss Kappa 가치를 해석하고 그 결과 합의 통계를 기록하세요.
- 표 4에 참가자 인구통계, 평가 방법론, 설문지 설계, 통계 분석 절차, 객관적 성과 지표, 평가자 간 합의 결과를 요약하라.
- 두 평가 조건 모두에서 모델 출력을 검토하고 참가자들의 반응을 조건 간에 비교합니다. 설명이 의사결정 품질에 부정적인 영향을 주지 않으면서도 신뢰도, 해석 가능성, 사용성을 향상시키는지 검증하세요.
- 계산된 Fleiss Kappa 통계를 사용하여 참가자 평가의 일관성을 확인하라. 모든 평가 결과를 기록하여 후속 보고 및 재현성 평가를 수행하세요.
- 기대 결과 - 임상의의 신뢰 점수, 해석 가능성 평가, 사용성 평가, 의사결정 합의 척도, 검토 시 통계, 쌍 t-검정 결과, 평가자 간 합의 통계를 생성합니다. 설명 가능한 인공지능 프레임워크의 임상적 유용성, 해석 가능성, 신뢰성을 설명하는 정량적 증거를 생산합니다.
| 매개변수 | 가치 |
| 전문가들 | 12 |
| 의사들 | 6 |
| 방사선과 전문의 | 3 |
| 임상 데이터 분석가 | 3 |
| 검토된 사건들 | 100 |
| 평가 설계 | 무작위 (예측 전용 vs 예측+설명) |
| 측량 기기 | 5점 리커트 척도 |
| 신탁 평가 | 해석 가능성, 신뢰도, 사용성 |
| 통계 검정 | 쌍 t-검정 (p 0.05) |
| 평가자 간 신뢰성 | 플라이스 카파 |
| 객관적 측정 | 결정 합의, 검토 시간 |
표 4: 인간 중심 평가 프로토콜 및 임상가 평가 설계.
이 표는 설명 가능한 AI 시스템의 해석 가능성, 신뢰성, 사용성을 평가하는 임상의 평가 프레임워크를 제시합니다. 참여자 인구통계, 사례 검토 방법론, 설문 설계, 통계 분석 절차, 평가자 간 신뢰도 평가 및 객관적 평가 지표에 관한 정보가 요약되어 있습니다.
8. 검증 및 재현성 평가
- 제안된 프레임워크의 견고성과 신뢰성을 평가하기 위해 검증 및 절제 연구를 수행하십시오. 선택한 설명 가능성 방법을 사용하여 중요도 점수가 높은 특징을 식별합니다. 중요한 특징을 점진적으로 제거하고, 각 특징 제거 단계 후에 예측 모델을 재학습합니다.
- 각 절제 실험 후 정확도, 정밀도, 회상력, F1 점수, ROC-AUC 지표를 사용하여 모델 성능을 평가합니다. 결과 성능 값과 기저선 모델 성능을 비교하여 개별 특징이 예측 결과에 얼마나 기여하는지 판단합니다.
- SHAP, LIME, Grad-CAM을 사용하여 유사한 입력 샘플에 대한 설명을 생성하여 설명 안정성을 평가합니다. 반복 평가 간 설명 출력을 비교하고, 미리 정의된 안정성 지표를 사용하여 일관성을 정량화합니다. 설명이 미세한 입력 변동과 반복 실험 실행에서도 안정적으로 유지되는지 검증하세요.
- 작업 흐름 전반에 걸쳐 모든 실험 절차를 기록하세요. 문서 데이터 전처리 작업, 데이터셋 분할 절차, 모델 아키텍처, 하이퍼파라미터 설정, 훈련 구성, 설명 가능성 방법, 검증 전략, 평가 지표 등이 포함됩니다. 재현성과 독립적인 검증을 용이하게 하기 위해 모든 구성 매개변수와 실험 출력을 구조화된 형식으로 저장합니다.
- 모든 실험 기록을 검토하여 완전성과 일관성을 확인하세요. 문서화된 절차, 구성 파일, 소프트웨어 사양을 사용하여 워크플로우를 재현할 수 있는지 확인하세요. 프로토콜의 향후 연구를 위한 적응을 용이하게 하고, JoVE 방법론적 요구사항에 부합하는 비디오 기반 실험 프로토콜로의 전환을 지원하기 위해 모듈식 워크플로우 구조를 유지합니다.
9. 재현성 자원
- 모든 실험은 고정된 무작위 시드를 사용하여 반복 실행에서 재현 가능한 결과를 보장합니다. 소스 코드, 전처리 스크립트, 구성 파일, 환경 사양, 모델 매개변수, 시각화 스크립트를 공개 접근 가능한 저장소 내에서 유지하세요.
- 데이터셋 획득, 전처리, 실험 실행, 모델 학습, 설명 가능성 생성, 검증 절차, 보고된 모든 표와 그림의 재생성에 대한 상세한 지침을 제공합니다. 독립 복제에 필요한 모든 워크플로우 구성 요소(소프트웨어 사양, 전처리 워크플로우, 구성 파일, 데이터셋 접근 지침, 모델 체크포인트, 시각화 자산 포함)를 아카이브합니다.
- 표 5에서 프레임워크 전반에 걸쳐 사용되는 소프트웨어 자원, 전처리 워크플로우, 구성 파일, 데이터셋 접근 지침, 재현성 자산을 요약하세요.
- 기대 출력 - 전처리 스크립트, 구성 파일, 학습된 모델, 모델 체크포인트, 설명 가능성 출력, 검증 보고서, 시각화 산출물, 소프트웨어 명세, 그리고 제안된 프레임워크의 독립적 복제 및 검증에 필요한 문서들을 포함하는 완전한 재현 가능한 실험 패키지를 생성합니다.
| 자료 | 설명 |
| 소스 코드 | 데이터 전처리, 모델 학습, 설명 가능성 및 평가를 위한 Python 구현 스크립트 |
| 환경 파일 | requirements.txt 패키지 의존성 및 버전을 포함함 |
| 구성 파일 | 모델 아키텍처 설정, 하이퍼파라미터 및 실험 구성 |
| 고정된 무작위 시드 | 재현 가능한 실험에 사용되는 씨앗 = 42 |
| 데이터셋 접근 지침 | 공공 의료 데이터셋 획득을 위한 링크 및 절차 |
| 전처리 스크립트 | 데이터 정제, 정규화, 인코딩 및 기능 선택을 위한 스크립트 |
| 피규어 생성 스크립트 | 모든 원고 도형을 재생하는 스크립트 |
| 테이블 생성 스크립트 | 보고된 표와 지표를 재현하는 스크립트 |
| 입력 예시 | 샘플 데이터셋 및 입력 파일 |
| 예제 출력 | 예측 결과, 설명 및 평가 보고서 |
표 5: 재현성 자원 및 실험 자산.
이 표는 실험적 재현성을 지원하기 위해 제공된 자원을 요약하는데, 여기에는 소스 코드, 전처리 스크립트, 구성 파일, 환경 사양, 데이터셋 접근 지침, 고정된 무작위 시드 설정, 그림 생성 스크립트, 보고된 결과를 재현하는 데 필요한 예시 입출력 파일 등이 포함됩니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
결과
우리는 전체 파이프라인의 설명 AI 요소를 철저히 평가하여, 구조화된 임상 데이터와 의료 이미지 등 다양한 유형의 의료 데이터 전반에서 얼마나 잘 예측하는지 평가했습니다. 결과는 평가된 데이터셋 전반에 걸쳐 일관된 예측 성능을 나타냈습니다. 테스트 모델 중 구배 부스트 모델이 97.4%로 가장 높은 정확도를 기록했으며, 그 다음으로 무작위 숲 모델이 94.2%로 뒤를 이었습니다. 이미지 세트에 적용된 딥러닝 기법은 91.3%의 정확도를 달성한 반면, 다층 지각론 모델은 약간 낮은 90.8%의 결과를 냈습니다. 이는 앙상블 기반 머신러닝 모델이 구조화된 의료 데이터에서 가장 우수한 성능을 보이는 반면, 딥러닝 아키텍처는 영상 작업에 뛰어나다는 것을 시사합니다. 표 6은 정확도, 정밀도, 회상율, F1 점수 등 예측 함수의 다양한 성능 지표와 충실도와 안정성과 같은 설명 가능성 지표를 자세히 설명합니다. 우리는 5배 교차 검증을 적용하고 결과...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
토론
이 연구는 예측 모델링, 설명 가능성 평가, 임상가 중심 평가, 재현 자원을 단일 프로토콜 내에 통합한 의료 분석을 위한 재현 가능한 설명 가능한 인공지능(XAI) 워크플로우를 개발하고 평가했습니다. 결과는 앙상블 기반 머신러닝 모델, 특히 그라디언트 부스팅과 랜덤 포레스트가 평가된 구조화된 의료 데이터셋에서 가장 높은 예측 성능을 보였으며, 딥러닝 모델이 이미지 기반 분석에 더 적합함을 보여주었습니다. 이러한 발견은 더 복잡한 모델이 항상 우수한 성능을 낼 것이라고 가정하기보다는 데이터 특성에 따라 모델 아키텍처를 선택하는 것의 중요성을 강조합니다. 이 연구의 핵심 기여는 예측 모델링, 설명 가능성 평가, 인간 중심 평가, 재현성 관행을 표준화된 워크플로우 내에 통합한 것입니다. 설명 가능성 기법을 고립적으로 평가하는 연구와 달리, 제안된 프레임워크는 다양한 의료 데이터셋에서 투명하고 재현 가능한 실험을 지원하는 프로토콜 기반 방법론을 제공합니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
공개 사항
저자들은 이 작업과 관련된 상충하는 재정적 이해관계나 이해 충돌이 없음을 선언합니다. 이 연구는 잠재적 이해 충돌로 해석될 수 있는 상업적 또는 금융적 관계 없이 독립적으로 수행되었습니다.
인공지능 사용 공개
인공지능 도구는 언어 개선, 문법 검사, 원고 준비 중 편집 지원에 사용되었습니다. 모든 과학적 내용, 실험 설계, 데이터 분석, 해석, 최종 원고 검증은 저자들이 수행하였습니다. 저자들은 모든 AI 지원 산출물을 검토하고 검증하여 정확성, 무결성, 저널 가이드라인 준수를 보장했습니다.
감사의 글
저자들은 이 연구를 수행하는 데 필요한 인프라와 연구 지원을 제공해 준 각 기관에 감사의 뜻을 전합니다. 저자들은 또한 제안된 설명 가능한 AI 프레임워크의 개발과 평가를 용이하게 한 공개 데이터셋과 오픈소스 도구의 사용을 인정합니다. 인간 중심 평가 단계에서 귀중한 통찰을 제공해 준 도메인 전문가분들께 특별한 감사를 전합니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
재료
```html
```
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| GPU 워크스테이션 | 제조업체 종속 | NA | 딥러닝 모델 훈련 |
| Jupyter Notebook | Project Jupyter | 최신 안정 릴리즈 | 대화형 실험 실행 |
| LIME | LIME | 버전 0.2.0 | 로컬 해석 가능한 설명 |
| Matplotlib | Matplotlib 프로젝트 | 버전 3.9 | 데이터 시각화 |
| MIMIC-III 데이터베이스 | PhysioNet | 버전 1.4 | 전자 건강 기록 분석 |
| NIH 가슴 X-ray 데이터셋 | NIH Clinical Center | 공개 데이터셋 | 흉부 질환 분류 |
| NumPy | NumPy 개발자 | 버전 1.26 | 수치 계산 및 배열 작업 |
| OpenCV | OpenCV 재단 | 버전 4.10 | 이미지 사전 처리 |
| Pandas | Pandas 개발팀 | 버전 2.1 | 데이터 조작 및 사전 처리 |
| Pima Indians 당뇨병 데이터셋 | UCI 머신 러닝 저장소 | 공개 데이터셋 | 당뇨병 위험 예측 |
| Python 3.11 | Python 소프트웨어 재단 | 버전 3.11 | 기본 프로그래밍 환경 |
| Scikit-learn | scikit-learn | 버전 1.5 | 머신러닝 알고리즘 및 평가 |
| Seaborn | Seaborn | 버전 0.13 | 통계 시각화 |
| SHAP | SHAP | 버전 0.46 | 특징 기여 및 설명 가능성 |
| TensorFlow | TensorFlow | 버전 2.15 | 딥러닝 모델 개발 |
| Windows / Ubuntu Linux | Microsoft / Canonical | NA | 운영 체제 |
| Wisconsin 유방암 데이터셋 | UCI 머신 러닝 저장소 | 공개 데이터셋 | 유방암 진단 |
참고문헌
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Ribeiro MT, Singh S, Guestrin C. Why should I trust you. Explaining the predictions of any classifier. Presented at: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; 2016. p. 1135-44. doi:10.1145/2939672.2939778.
- Selvaraju RR, et al. Grad-CAM: Visual explanations from deep networks via gradient-based localization. Int J Comput Vis. 2020;128(2):336-59.
- Tjoa E, Guan C. A survey on explainable artificial intelligence: Toward medical XAI. IEEE Trans Neural Netw Learn Syst. 2021;32(11):4793-813.
- Samek W, et al. Explainable AI: Interpreting, Explaining and Visualizing Deep Learning. Springer; Cham; 2019.
- Arrieta AB, et al. Explainable artificial intelligence: Concepts, taxonomies, opportunities and challenges toward responsible AI. Inf Fusion. 2020;58:82-115.
- Holzinger A, et al. Causability and explainability of artificial intelligence in medicine. Wiley Interdiscip Rev Data Min Knowl Discov. 2020;10(5):e1312.
- Topol E. Deep medicine: How artificial intelligence can make healthcare human again. Nat Med. 2020;25:44-56.
- Esteva A, et al. A guide to deep learning in healthcare. Nat Med. 2019;25(1):24-9.
- Rajpurkar P, Chen E, Banerjee O, Topol EJ. AI in health and medicine. Nat Med. 2022;28:31-38.
- Doshi-Velez F, Kim B. Towards a rigorous science of interpretable machine learning. arXiv. 2021. doi:10.48550/arXiv.1702.08608.
- Molnar C. Interpretable Machine Learning. Lulu Press; 2022.
- Rudin C. Stop explaining black box machine learning models for high-stakes decisions and use interpretable models instead. Nat Mach Intell. 2019;1(5):206-15.
- Zhang Q, Zhu S. Visual interpretability for deep learning: A survey. Front Inf Technol Electron Eng. 2020;21:27-39.
- Holzinger A, Biemann C, Pattichis CS, Kell DB. What do we need to build explainable AI systems for the medical domain. arXiv. 2020. Available at: https://arxiv.org/abs/1712.09923.
- McDermott MB, et al. Reproducibility in machine learning for health. Nat Med. 2021;27:1016-23.
- Kelly CJ, et al. Key challenges for delivering clinical impact with AI. BMC Med. 2019;17:195.
- Ahmad MA, Teredesai A, Eckert C. Interpretable machine learning in healthcare. Proc ACM Conf Health Inference Learn. 2021;4:1-7.
- Ghassemi M, Oakden-Rayner L, Beam AL. The false hope of current approaches to explainable AI in healthcare. Lancet Digit Health. 2021;3(11):e745-50.
- Carvalho DV, Pereira EM, Cardoso JS. Machine learning interpretability: A survey on methods and metrics. Inf Fusion. 2020;58:82-115.
- Chen RJ, et al. Synthetic data in healthcare: A narrative review. Nat Biomed Eng. 2021;5:493-97.
- Zhou B, et al. Learning deep features for discriminative localization. Presented at: Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition; 2016. p. 2921-29.
- Vellido A. The importance of interpretability and visualization in machine learning for applications in medicine and health care. Expert Syst Appl. 2020;146:113222.
- Lipton ZC. The mythos of model interpretability. Commun ACM. 2018;61(10):36-43.
- Guidotti R, et al. A survey of methods for explaining black box models. ACM Comput Surv. 2018;51(5):93.
- Suresh H, Guttag J. A framework for understanding unintended consequences of machine learning. Commun ACM. 2021;64(12):42-50.
- Wiens J, et al. Do no harm: A roadmap for responsible machine learning for health care. Nat Med. 2019;25(9):1337-40.
- Rajkomar A, Dean J, Kohane I. Machine learning in medicine. N Engl J Med. 2019;380(14):1347-58.
- Lundberg SM, Lee SI. A unified approach to interpreting model predictions. Presented at: Advances in Neural Information Processing Systems. 2017;30:4765-74.
- Agarwal R, et al. Neural additive models: Interpretable machine learning with neural nets. Presented at: Advances in Neural Information Processing Systems. 2021;34:4699-711.
- Singh C, Murdoch WJ, Yu B. Hierarchical interpretations for neural network predictions. Proc Natl Acad Sci U S A. 2020;117(32):19950-57.
- Tonekaboni S, Joshi S, McCradden MD, Goldenberg A. What clinicians want: Contextualizing explainable machine learning for clinical end use. Nat Mach Intell. 2019;1(5):176-85.
- Wang F, Preininger A. AI in health care: Applications, challenges, and future directions. Annu Rev Biomed Data Sci. 2019;2:221-52.
- Azizi S, et al. Big self-supervised models advance medical AI. Nat Med. 2021;27(8):1431-42.
- Zhang Y, et al. Explainable deep learning for healthcare: Methods, applications and challenges. IEEE Access. 2020;8:120455-475.
- Holzinger A, et al. Explainable AI methods: A brief overview. Mach Learn Knowl Extr. 2021;3(2):606-27.
- Rudin C, Radin J. Why are we using black box models in AI when we do not need to A lesson from an explainable AI competition. Nat Mach Intell. 2019;1(5):206-15.
- Doshi-Velez F, et al. Accountability of AI Under the Law: The Role of Explanation. Harvard University; Cambridge; 2020.
- Kaur H, et al. Interpreting interpretability: Understanding data scientists' use of interpretability tools for machine learning. Presented at: Proceedings of the CHI Conference on Human Factors in Computing Systems; 2020. p. 1-14.
- Caruana R, et al. Intelligible models for healthcare: Predicting pneumonia risk and hospital 30-day readmission. Presented at: Proceedings of the ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; 2015. p. 1721-30.
- Mangalote IAC, et al. Development and validation of a class imbalance-resilient cardiac arrest prediction framework incorporating multiscale aggregation, ICA and explainability. IEEE Trans Biomed Eng. 2025;72(5):1674-84.
- Ansari MY, Mangalote IAC, Masri D, Dakua SP. Neural network-based fast liver ultrasound image segmentation. Presented at: 2023 International Joint Conference on Neural Networks; 2023. p. 1-8.
- Dakua SP, et al. Artificial intelligence enabled biomineralization for eco-friendly nanomaterial synthesis: Charting future trends. Nano Select. 2025;6(5):e202400118.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.