제안된 MSCNN-LSTM 프레임워크는 스포츠 비디오 행동 인식을 위해 다중 스케일 공간 특징 추출과 시계열 시퀀스 모델링을 통합하여, 벤치마크 스포츠 행동 데이터셋에서 경쟁력 있는 분류 성능을 달성하는 동시에 세밀한 공간적 특징과 시간적 움직임 패턴을 포착합니다.
연구 논문
장단기 메모리(LSTM) 기반 시계열 모델링과 다중 스케일 컨볼루션 네트워크를 이용한 스포츠 비디오의 동작 인식
이 논문에서
요약
초록
스포츠 비디오의 동작 인식은 복잡한 운동 역학, 가려짐(occlusion) 및 높은 클래스 내 변동성으로 인해 여전히 어려운 과제로 남아 있습니다. CNN-BiLSTM 및 전이 학습 기반 모델을 포함한 기존의 딥러닝 접근 방식이 인간 활동 인식에서 효과적임을 입증했지만, 빠르고 다양한 움직임이 나타나는 스포츠 시나리오에서는 성능이 제한적일 수 있습니다. 많은 기존 방법들이 단일 스케일 합성곱 필터에 의존하고 있으며, 이는 세밀한 동작 특성과 거친 동작 특성을 동시에 효과적으로 캡처하지 못할 수 있습니다. 이러한 한계를 해결하기 위해, 본 연구에서는 스포츠 비디오 동작 인식을 위해 Long Short-Term Memory (LSTM) 네트워크와 통합된 다중 스케일 합성곱 신경망(Multi-Scale Convolutional Neural Network, MSCNN)을 제안합니다. MSCNN은 병렬 합성곱 커널을 통해 여러 수용 영역(receptive fields)에서 공간적 표현을 추출함으로써 상세한 동작 특징과 문맥적 동작 특징을 모두 학습할 수 있게 합니다. 이후 이러한 특징들은 LSTM에 의해 처리되어 연속된 프레임 간의 시간적 의존성과 동작의 연속성을 캡처합니다. 실험적 평가는 UCF11, UCF Sports 및 JHMDB 벤치마크 데이터셋을 대상으로 수행되었습니다. 제안된 MSCNN-LSTM 모델은 각각 98.3%, 95.4%, 81.7%의 분류 정확도를 달성하여, 본 연구에서 평가한 비교 접근 방식들보다 우수한 성능을 보였습니다. 절제 연구(ablation study)를 통해 다중 스케일 특징 추출과 시간적 모델링이 전체 성능에 기여함을 추가로 입증하였습니다. 이러한 결과는 스포츠 비디오 동작 인식을 위해 공간 및 시간 정보를 결합하는 제안된 프레임워크의 잠재력을 보여줍니다.
서론
인간 행동 인식은 지능형 감시, 이상 징후 탐지, 행동 기반 시청각 검색 및 의료 환자 모니터링을 포함하여 다양한 실제 영역에서 광범위하게 응용됩니다1,2. 특히 감시 시스템과 소셜 미디어 플랫폼의 비디오 스트림에서의 행동 인식은 이상 징후 탐지 및 이벤트 이해에 있어 상당한 잠재력을 가지고 있습니다3. 비디오 분석에서 인간의 행동은 손과 다리와 같은 서로 다른 신체 부위의 관찰을 통해 식별됩니다. 정지 영상과 달리, 단일 프레임만으로는 행동을 표현하기에 불충분한 경우가 많습니다4. 예를 들어, 축구와 줄넘기 활동의 초기 자세는 단일 프레임에서 유사하게 보일 수 있습니다. 이러한 행동 간의 차이는 신체 움직임 패턴과 주변 환경과의 상호작용을 포착하는 일련의 프레임을 통해 관찰할 때 분명해집니다5,6,7. 가독성을 높이고 용어의 일관성을 유지하기 위해 본 원고 전반에서 사용된 약어들을 표 1에 정리하였습니다.
| 약어 | 전체 형식 |
| 인공지능 | 인공지능 |
| 곡선 아래 면적 (AUC) | 곡선 아래 면적 |
| 양방향 LSTM (BiLSTM) | 양방향 장단기 메모리 |
| 합성곱 신경망 | 합성곱 신경망 |
| CUDA | 컴퓨팅 통합 장치 아키텍처 |
| F1-스코어 | 정밀도와 재현율의 조화 평균 |
| 그래픽 처리 장치(GPU) | 그래픽 처리 장치 |
| HAR | 인간 행동 인식 |
| JHMDB | 통합 인간 동작 데이터베이스 |
| 장단기 메모리 (LSTM) | 장단기 메모리 |
| mAP-T | 시간적 평균 정밀도 평균 (Temporal Mean Average Precision) |
| MCC | 매튜스 상관계수 |
| 다중 규모 합성곱 신경망(MSCNN) | 다중 규모 합성곱 신경망 |
| ROC (수신자 조작 특성 곡선) | 수신자 조작 특성 (Receiver Operating Characteristic) |
| TSI | 시간적 안정성 지수 |
| UCF | 센트럴 플로리다 대학교 |
| 비디오 램 (VRAM) | 비디오 랜덤 액세스 메모리 |
표 1: 원고에 사용된 약어 목록. 연구 전반에 걸쳐 사용된 일반적인 약어 및 acronym과 그에 해당하는 전체 명칭.
빠르고 정확한 스포츠 비디오 분류는 스포츠 분석, 이벤트 탐지, 콘텐츠 기반 검색 및 추천 시스템11,12,13을 포함한 광범위한 응용 분야에서 중요합니다8,9,10. 스포츠 관련 비디오 콘텐츠가 급격히 증가함에 따라 초기 분석 프레임워크의 한계가 점점 더 분명해졌습니다14. 이에 따라 스포츠 활동의 복잡성과 동적인 특성을 처리할 수 있는 견고한 접근 방식에 대한 수요가 증가하고 있습니다. 기존의 스포츠 비디오 분류 방법은 주로 광학 흐름(optical flow) 및 HOG(Histogram of Oriented Gradients)와 같은 수작업 기술자(handcrafted descriptors)에 의존하여 스포츠 비디오의 동작 패턴과 활동을 특징짓는 방식을 사용해 왔습니다15.
정지 이미지 분류에서 괄목할 만한 성공을 거둔 ConvNet은 비디오 분석에도 적용되어 왔습니다. 하지만 비디오는 동적인 시공간 정보를 포함하고 있기 때문에 행동 인식은 여전히 더 어려운 과제로 남아 있습니다. 현재의 딥러닝 기반 접근 방식은 일반적으로 투-스트림 네트워크16, 3D 컨볼루션 네트워크, 그리고 계산 효율적 아키텍처의 세 가지 그룹으로 분류할 수 있습니다. 광학 흐름(optical flow)으로부터 시간 정보를 학습하기 위해 투-스트림 네트워크는 추가적인 ConvNet17,18을 사용하지만, 이 방식은 계산 비용이 많이 듭니다. C3D, I3D, R3D와 같은 3D 컨볼루션 아키텍처는 시간 정보를 직접 모델링할 수 있지만, 파라미터 수를 상당히 증가시켜 최적화를 더 어렵게 만듭니다. 계산 효율적 방법들은 분해된 3D 연산을 탐색함으로써 모델 복잡도를 줄이려고 시도합니다.
또한, CNN은 국소적인 공간 특징을 추출할 수 있고 LSTM은 시간적 문맥 정보를 포착할 수 있기 때문에, 하이브리드 모델은 센서 입력으로부터 시공간적 움직임 패턴을 효과적으로 학습할 수 있습니다. CNN과 순환 신경망 구조를 결합한 최근의 연구들은 고무적인 결과를 도출했습니다18,19,20. 하지만 LSTM은 시퀀스 처리 과정에서 정보를 압축하므로, 특징 추출 중에 유입된 노이즈가 인식 성능에 영향을 미칠 수 있습니다. 이 문제를 해결하기 위해 여러 연구에서 어텐션 메커니즘을 도입했습니다21,22. 어텐션 메커니즘은 모델이 인식 작업과 가장 관련성이 높은 특징에 집중할 수 있게 하여 분류 성능을 향상시킵니다.
CNN 기반의 특징 추출과 결합된 심층 양방향 LSTM 모델이 인간 활동 인식에서 유망한 결과를 얻었지만, 이러한 프레임워크를 스포츠 비디오 동작 인식으로 확장할 때는 몇 가지 과제가 남아 있습니다. 첫째, 기존의 CNN-LSTM 아키텍처는 종종 단일 규모의 합성곱 특징 추출을 사용하며, 이는 스포츠 장면에서 선수와 물체가 동시에 움직이는 것과 같이 다양한 공간적 및 시간적 해상도에서 발생하는 동작을 포착하는 능력을 제한할 수 있습니다. 3D CNN23 및 Two-stream CNN을 포함한 다중 규모 합성곱 네트워크는 서로 다른 규모에서 공간 및 동작 단서를 포착하는 것의 중요성을 입증했으나, 이러한 개념은 LSTM 기반 하이브리드 시스템에서 상대적으로 덜 탐구되었습니다. 둘째, 대부분의 이전 CNN-BiLSTM 모델24은 주로 단기 시간적 의존성에 집중하는 반면, 팀 스포츠에서 흔히 나타나는 장거리 동작 연속성과 객체 간 상호작용은 적절히 표현되지 않을 수 있습니다. MobileNetV2 및 ResNet과 같은 많은 전이 학습 기반 접근 방식은 정적 프레임 특징에 의존하며, 시간적 어텐션 메커니즘이나 적응형 다중 규모 특징 융합을 충분히 활용하지 않습니다25. 또한, 대부분의 기존 모델은 주로 UCF11 및 JHMDB와 같은 벤치마크 데이터셋을 통해 평가되었습니다. SoccerNet 및 FineGym과 같이 복잡한 카메라 움직임과 활동 패턴을 포착하는 최신 스포츠 전용 데이터셋은 여전히 충분히 연구되지 않은 상태입니다. 이러한 한계는 스포츠 비디오 동작 인식에서 세밀한 공간 표현과 장거리 시간적 의존성을 모두 더 잘 포착하기 위해, LSTM 또는 BiLSTM 네트워크와 같은 시간적 메모리 모듈과 통합된 다중 규모 합성곱 특징 추출 프레임워크의 필요성을 강조합니다.
또한, CNN은 국소적인 공간적 특징을 추출할 수 있으며, LSTM은 시간적 맥락을 모델링할 수 있습니다. 따라서 하이브리드 CNN-RNN 아키텍처는 인간 활동 인식 분야에서 유망한 성능을 보여주었습니다26,27. 최근 연구들은 인간 활동 인식 성능을 향상시키기 위해 상호 보완적인 학습 전략을 통합함으로써 기존의 CNN-LSTM 프레임워크를 확장해 왔습니다. 예를 들어, 작업 관련 특징을 강조하고 정보량이 적은 표현을 억제하여 인식 성능을 높이기 위해 어텐션 메커니즘이 도입되었습니다28. 다른 접근 방식으로는 동작 인식과 시간적 세그멘테이션 작업을 공동으로 최적화하여 학습 효율성과 특징 표현을 향상시키는 멀티태스크 학습이 채택되었습니다29. 이러한 발전에도 불구하고, 세밀한 공간적 및 시간적 특징이 항상 효과적으로 포착되지 않기 때문에 기존 방법들은 시각적으로 유사한 동작을 구분하는 능력이 여전히 제한적일 수 있습니다. 표 2는 기존 접근 방식들의 강점과 한계점을 요약하여 보여줍니다30.
| 참고 문헌 / 연도 | 사용된 방법 | 데이터셋 | 성능 지표 | 주요 강점 | 한계점 |
| Hassan et al. (2024)1 | KFDI (Key Frame Dynamic Image) | UCF11 | 정확도: 85.3% | 효율적인 키프레임 선택 및 개선된 동적 이미지 표현. | 프레임 선택 오류에 민감함; 제한적인 시간적 모델링. |
| Zhou et al. (2023)24 | Dilated CNN + BiLSTM + Residual Block | UCF11, UCF Sports | 정확도: UCF11: 89 및 UCF Sports: 92.2% | 공간적 및 시간적 학습의 통합; 다중 스케일 정보 캡처. | 계산 집약적임; 소규모 데이터셋에서 과적합 위험이 있음. |
| Ullah et al. (2025)34 | Local–Global Feature + QSVM | UCF11 | 정확도: 82.6% | 강건한 인식을 위해 수작업 특징과 딥러닝 특징을 결합함. | 수동 튜닝 필요; 확장성이 제한적임. |
| Shin et al. (2025)25 | ViT-ReT (Vision Transformer + Recurrent Transformer) | UCF11, UCF50, UCF101, and JHMDB | 정확도: UCF11: 97.73%; UCF50: 98.81%; UCF101: 98.46%; JHMDB: 83.38% | 장거리 공간 및 시간적 의존성을 캡처함. | 높은 계산 비용 및 데이터 요구 사항. |
| Su et al. (2024)23 | 3D-CNN | UCF11 | 정확도: 85.1% | 엔드-투-엔드 시공간 특징 학습. | 높은 메모리 및 GPU 요구 사항. |
| Karuppannan et al. (2024)35 | Deep Autoencoder + CNN | UCF11 | 정확도: 96.2% | 압축된 특징 표현을 학습함. | 제한적인 장기 시간적 모델링. |
| Sahoo et al. (2020)36 | HAR-Depth | KTH, UCF sports, JHMDB, UCF101, and HMDB51 | 정확도: KTH: 97.67%; UCF Sports: 95.00%; JHMDB: 73.13%; UCF101: 92.97%; HMDB51: 69.74% | 효과적인 깊이 기반 시간적 학습. | 정확한 깊이 추정과 광범위한 전처리가 필요함. |
표 2: 스포츠 비디오 동작 인식을 위한 기존 딥러닝 방법의 비교. 데이터셋, 방법론적 특성, 장점 및 한계점을 포함한 대표적인 딥러닝 접근 방식의 요약으로, 제안된 MSCNN-LSTM 프레임워크가 해결하고자 하는 연구 공백을 강조함.
오디오 동기화에 의해 구동되는 얼굴 애니메이션 프레임워크가 제안되었으며, 이는 감정적으로 표현력이 풍부한 얼굴 애니메이션을 생성하기 위해 Facial Denoiser Model (FDM)과 Local-to-global Latent Diffusion Model (LG-LDM)을 결합한 것입니다. 세밀한 3차원 얼굴 기하학적 구조와 미세한 표정 변화를 재구성하기 위해 Emotion-centric Vector Quantized Variational Autoencoder (EVQ-VAE)가 사용되었습니다31. 또한, 가려짐이 있는 조건에서 대상 분할, 위치 추적, 가려짐 추론 및 다중 대상 파지 포즈 추정을 수행하기 위해 양안 스테레오 비전을 사용하는 가려짐 인식 로봇 파지 프레임워크가 개발되었습니다32. 아울러, 격자 투영과 적응형 빈 분할을 이용한 포인트 클라우드 기반의 2단계 지면 추출 프레임워크가 소개되었으며, 여기서는 격자 기반 특징 분석을 통한 1차 추출 이후 지면-장애물 경계를 정밀하게 다듬기 위해 고도 및 곡률 확률이 사용되었습니다33.
딥러닝 기반 행동 인식의 상당한 발전에도 불구하고, 기존 방법들은 빠른 움직임, 카메라 이동, 여러 선수 간의 상호작용을 포함하여 스포츠 비디오의 높은 가변성과 복잡성을 처리하는 데 여전히 어려움을 겪고 있습니다. 많은 기존의 CNN 또는 LSTM 기반 모델은 단일 공간 스케일에서 작동하므로, 국소적 및 전역적 움직임 패턴을 모두 효과적으로 포착하는 데 한계가 있을 수 있습니다. 또한, 장시간 시퀀스에서 시간적 일관성을 유지하거나 중첩되는 행동을 처리하는 것은 여전히 어려운 과제로 남아 있습니다. 전이 학습 방법이 특징 추출 성능을 향상시켰으나, 이를 스포츠 특화 데이터셋에 적용하는 연구는 상대적으로 미흡한 실정입니다.
본 연구는 다중 규모 공간 특징 추출과 LSTM 기반의 시계열 모델링을 통합하여 미세한 공간적 특징과 장기적인 시간적 의존성을 모두 포착함으로써, 스포츠 비디오 동작 인식을 위한 다중 규모 합성곱 신경망-장단기 메모리(MSCNN-LSTM) 프레임워크를 개발하고 평가하는 것을 목표로 합니다. 제안된 프레임워크는 보완적인 합성곱 커널과 다단계 특징 융합을 활용하여 까다로운 조건 하에서의 복잡한 스포츠 동작 표현력을 향상시킵니다. 본 프레임워크의 성능은 UCF11, UCF Sports 및 JHMDB 벤치마크 데이터셋을 사용하여 정확도, 정밀도, 재현율, F1-스코어, 시간 평균 정밀도(mAP-T), 시간 안정성 지수(TSI), 코헨의 카파 계수(κ), 매슈스 상관 계수(MCC) 및 ROC 곡선 아래 면적(AUC)을 통해 평가되었습니다. 실험 결과, 본 연구에서 평가된 다른 방법들과 비교하여 경쟁력 있는 성능을 보여주었으며, 이는 스포츠 분석, 선수 성능 모니터링, 자동 이벤트 탐지 및 스포츠 비디오 이해 분야에서 본 프레임워크의 잠재력을 강조합니다.
프로토콜
본 연구에서는 다중 규모 합성곱 신경망(Multi-Scale Convolutional Neural Network, MSCNN)과 장단기 메모리(Long Short-Term Memory, LSTM) 네트워크를 결합한 스포츠 비디오 동작 인식을 위한 2단계 딥러닝 프레임워크를 사용하였습니다. 모델 개발 및 평가를 위해 공개 벤치마크 데이터셋인 UCF11, UCF Sports, JHMDB가 활용되었습니다. 인간 참여자로부터 새로운 데이터를 수집하지 않았으며, 개인 식별 정보에 접근하거나 이를 처리하지 않았습니다. 본 연구는 공개된 익명 데이터셋의 이차 분석을 수행하였으며 직접적인 인간 참여가 포함되지 않았으므로, 기관 윤리 위원회의 승인 및 고지된 동의가 필요하지 않았습니다.
워크플로우는 프레임 샘플링과 시간적 정규화로 시작하여, MSCNN 모듈을 이용한 특징 추출 단계로 이어졌습니다. 추출된 특징들은 이후 시간적 모델링을 위해 LSTM 네트워크를 통해 처리되었으며, 다중 클래스 분류 층으로 전달되었습니다. 마지막으로, 선택된 벤치마크 데이터셋을 사용하여 모델을 학습시키고 평가하였습니다. 그림 1 은 제안된 프레임워크의 전체 아키텍처를 보여줍니다.
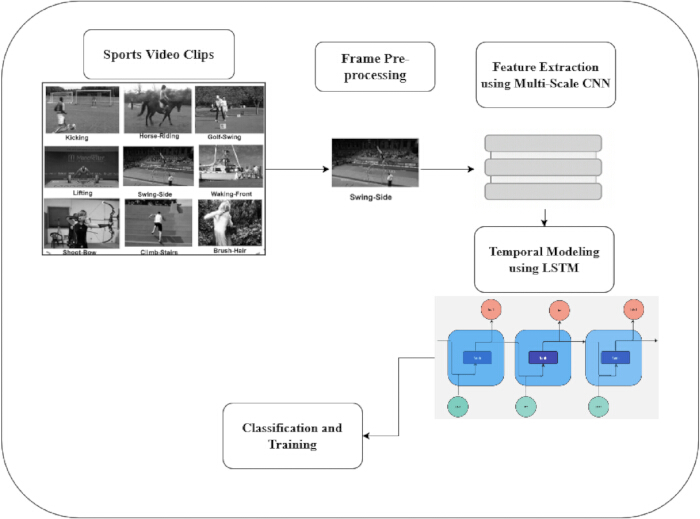
그림 1: 스포츠 비디오 동작 인식을 위해 제안된 MSCNN-LSTM 프레임워크. 비디오 전처리, 다중 규모 공간 특징 추출, 시계열 시퀀스 학습 및 동작 분류를 나타내는 전체 워크플로우. 여기에서 이 그림의 더 큰 버전을 확인하십시오.
그림 1은 하이브리드 MSCNN-LSTM 아키텍처 기반의 제안된 스포츠 비디오 행동 인식 프레임워크의 워크플로우를 보여줍니다. 이 프로세스는 킥, 승마, 골프 스윙을 포함한 다양한 운동 동작이 포함된 스포츠 비디오 클립에서 시작됩니다. 전처리 단계에서 원본 비디오는 개별 프레임으로 분해되었으며, 여기서 프레임은 크롭, 표준화 및 모델 입력을 위해 준비됩니다. 전처리된 프레임은 이후 특징 추출을 위해 MSCNN 모듈로 입력됩니다. 멀티스케일 컨볼루션 아키텍처는 서로 다른 수용 영역에서 공간적 특징을 캡처하여 스포츠 비디오 프레임으로부터 국소적 정보와 문맥적 정보를 모두 추출할 수 있게 합니다. 추출된 특징 벡터는 이후 LSTM 네트워크에 의해 처리되어 시간적 의존성과 연속적인 프레임 간의 동작 진화를 모델링합니다. 마지막으로, 분류 및 학습 모듈은 학습된 시공간 표현을 사용하여 각 비디오 클립의 행동 카테고리를 예측합니다. 제안된 프레임워크는 UCF11 (YouTube Actions), UCF Sports, JHMDB 벤치마크 데이터셋을 이용한 데이터 수집 및 전처리를 시작으로 네 가지 순차적 단계로 구성되었습니다. 각 스포츠 비디오는 일련의 프레임으로 변환되었으며, 환경 변화에 대한 강건성을 높이기 위해 크기 조정, 정규화, 회전, 반전 및 크롭을 통한 증강 과정을 거쳤습니다. 전처리된 프레임은 이후 제안된 멀티스케일 컨볼루션 신경망(MSCNN)에 의해 처리되었으며, 여기서 3 × 3, 5 × 5, 7 × 7 커널을 가진 병렬 컨볼루션 분기들이 상호 보완적인 국소 및 문맥 공간 특징을 추출했습니다. 이러한 멀티스케일 특징들은 배치 정규화와 맥스 풀링을 통해 결합 및 정제되어 압축된 특징 표현을 생성했습니다. 결과로 얻은 프레임 수준 특징들은 이후 연속 프레임 간의 시간적 의존성을 모델링하기 위해 LSTM(Long Short-Term Memory) 네트워크로 제공되었습니다. 최종 LSTM 출력은 플래튼(flatten)되어 ReLU 활성화 함수가 적용된 완전 연결 계층을 통과한 후, 행동 카테고리를 예측하기 위한 Softmax 분류기로 전달되었습니다. 네트워크는 과적합을 줄이기 위해 교차 엔트로피 손실 함수와 드롭아웃 정규화를 적용한 Adam 옵티마이저를 사용하여 학습되었습니다. 모델 성능은 최종적으로 UCF11, UCF Sports, JHMDB 벤치마크 데이터셋에서 정확도, 정밀도, 재현율 및 F1-score를 사용하여 평가되었습니다.
1. 데이터 수집 및 전처리
본 연구에서는 스포츠 및 인간 행동에 대해 공개적으로 사용 가능한 세 가지 벤치마크 데이터셋을 사용하였습니다. 이 데이터셋들은 카메라 움직임, 관점 및 배경 복잡성이 다양한 실제 스포츠 영상들을 포함하고 있습니다. 구체적으로, 본 연구에서는 약 25명의 개인으로부터 기록된 1,168개의 YouTube 비디오에서 수집된 11가지 행동 카테고리를 포함하며 행동당 여러 샘플이 있는 UCF11 (YouTube Actions) (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php)을 활용하였습니다. Joint-Annotated Human Motion Database (JHMDB)34,35 에는 21개의 행동 클래스와 928개의 어노테이션된 비디오가 포함되어 있습니다. UCF Sports 데이터셋은 방송 소스에서 캡처된 720 × 480 픽셀 해상도의 10가지 행동 클래스와 150개의 비디오 시퀀스로 구성됩니다 (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php).
종합적으로, 이 데이터셋들은 개인 및 팀 스포츠를 모두 포함하며, 제안된 MSCNN-LSTM 동작 인식 프레임워크를 평가하기 위해 시간적 지속 시간과 시각적 규모의 다양성을 제공합니다. 데이터 품질 스크리닝 과정의 일환으로, UCF11, UCF Sports 및 JHMDB 데이터셋에서 손상된 비디오, 중복 파일 및 주석이 불완전한 클립이 있는지 검토하였습니다. 이러한 제외 기준에 해당하는 샘플은 발견되지 않았으며, 따라서 사용 가능한 모든 비디오를 후속 분석을 위해 유지하였습니다. 그 후, 일관된 무작위 분할 전략을 사용하여 데이터셋을 학습(70%), 검증(15%) 및 테스트(15%) 서브셋으로 나누었습니다. 그림 2는 학습 및 평가에 사용된 대표 이미지들을 보여줍니다.
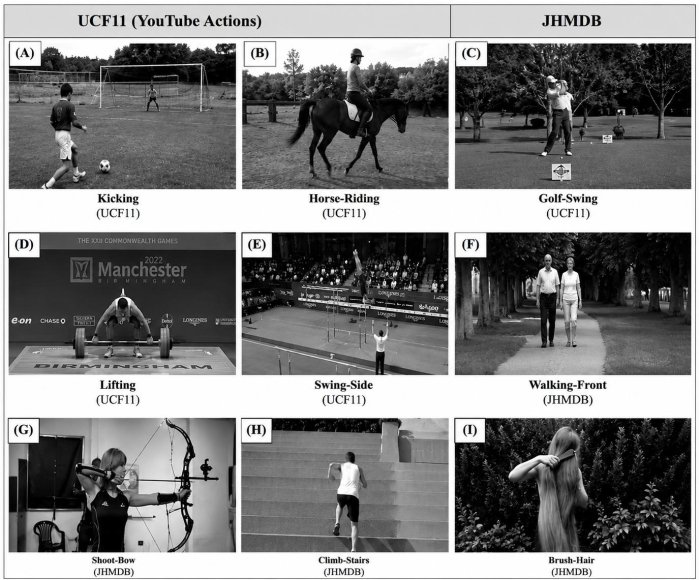
그림 2: 벤치마크 스포츠 동작 인식 데이터셋의 대표 프레임.패널 (A–D)는 UCF11 (YouTube Actions) 데이터셋의 예시를, 패널 (E–H)는 UCF Sports 데이터셋의 예시를, 그리고 패널 (I–L)은 JHMDB 데이터셋의 예시를 보여준다. 각 프레임은 동작 클래스, 시점, 배경, 조명 조건 및 동작 복잡도의 다양성을 나타낸다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
제안된 행동 인식 모델은 UCF11, UCF Sports 및 JHMDB 벤치마크 데이터셋을 통해 평가되었으며, 그 결과는 다음의 요약과 같습니다. 표 3이 데이터셋들은 다양한 동작 패턴과 까다로운 환경 조건을 나타냅니다. UCF11(YouTube Actions) 데이터셋은 다양한 조명, 시점 및 배경 조건에서 수집된 11개 클래스의 스포츠 동작을 포함하고 있습니다. UCF Sports 데이터셋은 전문 방송에서 추출한 150개의 필드 스포츠 비디오로 구성되며, 실제적인 동작 시퀀스를 특징으로 합니다. JHMDB 데이터셋은 21개의 세부 동작 카테고리에 대한 상세한 인체 동작 어노테이션을 제공하며, 시공간 동작 인식의 벤치마크 데이터셋으로 활용됩니다. 이 데이터셋들은 함께 사용되어 스포츠 및 인체 동작 시나리오 전반에 걸친 모델 성능을 평가하는 데 사용되었습니다. 네트워크는 Adam 옵티마이저를 사용하여 100 에포크 동안 학습되었으며, 배치 크기는 32, 초기 학습률은 0.001, 손실 함수로는 교차 엔트로피 손실 함수가 사용되었습니다. 검증 손실이 가장 낮은 모델이 최종 평가를 위해 선택되었습니다. 모든 실험에는 42의 고정 랜덤 시드가 사용되었습니다. 수렴도를 높이기 위해 조기 종료 및 학습률 감소(ReduceLROnPlateau) 기법이 적용되었으며, LSTM 학습 중 기울기 폭주를 방지하기 위해 임계값 5.0의 그래디언트 클리핑이 사용되었습니다. 제안된 MSCNN-LSTM 모델은 약 1,500만 개의 학습 가능한 파라미터를 포함하고 있습니다. 구현에 사용된 하드웨어 및 소프트웨어 구성은 다음 요약에 나와 있습니다. 표 4클래스 분포가 충분히 균형 잡혀 있었으므로, 추가적인 클래스 가중치 부여나 재표집 절차는 적용하지 않았습니다. 비교 모델들은 원래 연구에서 보고된 하이퍼파라미터를 사용하여 구현되었으며, 가능한 경우 훈련 설정을 일치시켰습니다. 성능 값은 평균으로 보고되었습니다. ± 서로 다른 무작위 초기화로 수행한 5회의 독립적인 실행에 대한 표준 편차. 제안된 모델과 비교 모델 간의 차이는 대응표본을 사용하여 평가되었다. t-유의 수준 임계값에서 검정함 p < 0.05.
| 데이터 세트 | 클래스 수 | 동영상 수 | 해상도 (px) | 제공된 소스 텍스트가 없습니다. 번역할 내용을 입력해 주세요. | 설명 |
| UCF11 (YouTube 액션) | 11 | 1168 | 변수 (≈ 320×240) | 센트럴 플로리다 대학교 | 스포츠(예: 농구 슛, 다이빙, 골프 스윙, 축구 저글링)에서 추출한 11가지 인간 행동을 포함합니다. 영상은 YouTube에서 수집되었으며 조명, 시점 및 배경의 변동성이 큽니다. |
| UCF 스포츠 | 10 | 150 | 720×480 | UCF 스포츠 액션 데이터셋 | 실제 방송 TV 영상(BBC, ESPN)에서 기록된 다이빙, 승마, 골프 스윙, 달리기, 역도와 같은 스포츠 활동을 포함합니다. |
| JHMDB | 21 | 928 | 320×240 | 막스 플랑크 지능 시스템 연구소 | 동작 및 포즈 분석을 위한 관절 어노테이션이 포함된 잡기, 점프, 머리 빗질, 슈팅, 달리기와 같은 일상 및 스포츠 활동을 포함합니다. |
표 3: 훈련 및 평가에 사용된 벤치마크 데이터셋의 특성. 액션 클래스 수, 비디오 샘플 수, 데이터셋 특성 및 모델 훈련, 검증, 테스트에서의 역할을 포함한 UCF11, UCF Sports 및 JHMDB 데이터셋의 개요.
| 사용된 파라미터 | 설명 |
| 프로그래밍 언어 | Python 3.8.18 [4] |
| 딥러닝 프레임워크 | TensorFlow 2.15.0 [1] |
| GPU 가속기 | NVIDIA GeForce RTX 3090 (24 GB VRAM) [1] |
| 중앙처리장치 | Intel Core i9 @ 3.5 GHz × 16코어 |
| 운영 체제 | Windows 11 |
| 메모리 (RAM) | 64 GB DDR4 |
| 최적화 도구 | Adam (학습률 = 0.001) |
| 배치 크기 | 32 |
| 에포크 수 | 100 |
| 활성화 함수 | ReLU (CNN 레이어), Softmax (출력 레이어) |
| 중도 탈락률 | 0.5 |
표 4: 제안된 MSCNN-LSTM 모델의 시뮬레이션 환경 및 하이퍼파라미터 구성.모델 학습 및 평가 중에 사용된 하드웨어 사양, 소프트웨어 환경, 옵티마이저 설정, 학습률, 배치 크기, 에포크 수, 입력 차원 및 기타 하이퍼파라미터.
2. 전처리
학습 전, 각 원본 비디오는 시간 순서에 따른 프레임 시퀀스로 변환된 후 정규화, 시간적 샘플링 및 증강 과정을 거쳤습니다. 각 입력 비디오 V는 먼저 프레임 시퀀스로 변환되어 4D 텐서 V ∈ RT×H×W×C로 표현되었으며, 여기서 T는 프레임 수, H × W i는 프레임 인덱스, C는 색상 채널 수(RGB의 경우 3)를 나타냅니다. 전처리 파이프라인은 특징 추출 전, 프레임 추출, 공간적 크기 조정 후 고정 해상도(H′, W′)로의 중앙 또는 무작위 크롭, 픽셀당 강도 정규화, 그리고 무작위 뒤집기, 스케일링 및 컬러 지터링을 포함한 선택적 데이터 증강으로 구성되었습니다. 구체적으로, 강도 정규화는 식 (1)과 같은 표준 점수 정규화 방식으로 구현되었습니다.
 (1)
여기서 μ, σ는 훈련 세트를 통해 계산된 채널 평균 및 표준 편차이며, 또는 식 (2)와 같이 최소-최대 스케일링(min–max scaling)으로 나타낼 수 있습니다.
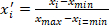 (2)
정규화 후, 각 프레임은 F̃t ∈ RH′×W′×C′로 표현되었으며, 결과 비디오 텐서는 V′ ∈ RT×H′×W′×C로 표현되었습니다. 다중 스케일 컨볼루션 프런트엔드에서는 서로 다른 커널 크기를 가진 여러 2-D(또는 초기 시공간 컨볼루션의 경우 3-D) 컨볼루션을 적용하여 다중 수용역 공간 특징 맵을 얻습니다. 그런 다음 각 프레임 또는 짧은 비디오 클립에 대해 시간적 특징 표현을 생성하여 LSTM 모듈로 전달했습니다. 원본 논문에서는 MobileNetV2를 적용한 후 시간적 모델링을 위해 Deep BiLSTM을 사용했습니다. 위에서 설명한 것과 동일한 전처리 파이프라인은 다중 스케일 컨볼루션 + LSTM 대체 방식과 완전히 호환됩니다.
3. 샘플링 및 시간적 정규화
데이터셋 간 및 내부적으로 비디오 길이 T가 다양하므로, 멀티스케일 컨볼루션 + LSTM에 프레임 또는 짧은 스니펫 단위의 고정된 입력 길이 N을 제공하기 위해 프레임을 균일하게 샘플링하거나 시간적으로 재샘플링합니다. 균일한 프레임 인덱스는 식 (3)과 같이 계산할 수 있습니다.
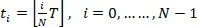 (3)
따라서, 샘플링된 프레임 시퀀스는 Vs = {F̃t0, …, F̃tN−1}입니다. 더 세밀한 시간적 충실도가 필요한 경우, 선형 시간 보간을 수행합니다. 즉, 식 (4)와 같이 계산된 임의의 재샘플링된 분수 시간 τ ∈ [0, T−1]에 대하여 보간을 실시합니다.
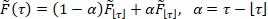 (4)
재샘플링된 시퀀스 Vs가 정확히 N개의 프레임을 가지며 부드러운 움직임을 유지하도록 합니다. 대안적으로, 짧은 연속 클립(스트라이드 s를 가진 시간적 윈도우 길이 w)으로 샘플링하면 클립 텐서 집합이 생성되며, 여기서 각 클립 Cj ∈ RT×H′×W′×C이고 j = 0, …, ⌊(T − w)/s⌋입니다. 네트워크 내부의 시간적 정규화를 위해, 여러 스케일에서의 단순한 시간적 풀링이 효과적입니다. 다중 스케일 컨볼루션을 통해 생성된 시간적 특징 시퀀스 X = {x1, …, xN}가 주어지면, 식 (5)와 같이 풀링된 특징을 적용합니다.
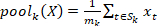 (5)
여기서 Sk는 스케일 k에 대한 시간적 지지 영역(예: Sk는 겹치지 않는 블록 또는 확장된 인덱스일 수 있음)이며, mk = |Sk|입니다.
특징 추출에 앞서, 모든 비디오는 224 × 224 픽셀로 크기를 조정하고 초당 25프레임으로 샘플링하였습니다. 모든 실험에는 32프레임의 일정한 시퀀스 길이를 적용하였습니다. 데이터 증강 기법으로는 무작위 크롭핑(scale = 0.8–1.0), 무작위 회전(±15°), 무작위 수평 뒤집기(확률 = 0.5) 및 밝기 조정(±20%) 등이 사용되었습니다. 픽셀 값의 표준화를 위해 ImageNet 평균값 [0.485, 0.456, 0.406]과 표준 편차 [0.229, 0.224, 0.225]를 사용하였습니다. 모든 비디오 시퀀스에 대해 시간적 샘플링을 위해 균일 프레임 선택 방식을 사용하였습니다. 32프레임보다 짧은 비디오는 제로 패딩을 처리하였으며, 더 긴 비디오는 일관된 시퀀스 길이를 유지하기 위해 균일하게 트리밍하거나 샘플링하였습니다. 이러한 설정은 학습 및 평가 전 과정에서 지속적으로 적용되었습니다.
4. MSCNN을 이용한 특징 추출
스포츠 비디오 내 동작의 공간적 표현력을 높이기 위해 다중 스케일 컨볼루션 신경망(MSCNN)이 활용되었습니다. 단일 커널 크기에 의존하는 기존의 컨볼루션 신경망은 다양한 공간적 스케일의 특징을 포착하는 능력이 제한적일 수 있습니다. 일부 스포츠 동작은 시각적 특성이 유사하기 때문에, 단일 스케일의 컨볼루션 구조로는 국소적 특징과 전역적 특징을 동시에 포착하기 어려울 수 있습니다. 이러한 한계를 해결하기 위해, 제안된 프레임워크는 서로 다른 크기의 컨볼루션 커널을 사용하여 다중 스케일 특징 추출 및 특징 융합을 수행합니다.
제안된 네트워크 아키텍처에서는 채널 간 정보를 정리하고 입력 피처 맵의 차원을 줄이기 위해 1 × 1 컨볼루션 커널이 사용되었습니다. 또한, 이러한 레이어는 추가적인 피처 변환과 비선형 표현을 도입함으로써 네트워크의 표현 능력을 향상시킵니다. 다양한 크기의 컨볼루션 커널은 여러 스케일에서 공간 정보를 추출할 수 있게 합니다. 학습 안정성을 높이기 위해 가중치 기반의 멀티 스케일 피처 퓨전 이후 순차적 정규화가 수행됩니다. 딥 네트워크 학습 중 발생하는 기울기 소실 및 기울기 폭주 문제를 완화하기 위해, 제안된 아키텍처는 잔차 연결(residual connections)과 LSTM 기반의 시계열 모델링을 사용합니다.
다중 스케일 설계는 서로 다른 공간 해상도에서 특징을 캡처하는 네트워크의 능력을 향상시키고 특징 표현 능력을 개선합니다. 또한, 기존의 N × N 컨볼루션 커널은 N × 1 및 1 × N 컨볼루션 연산으로 분해됩니다. MSCNN 모듈에 사용된 N × 1 및 1 × N 컨볼루션은 개별 비디오 프레임에서 상보적인 방향성 및 다중 스케일 공간 특징을 캡처하도록 설계되었습니다. 이러한 컨볼루션 연산은 서로 다른 수용장(receptive-field) 스케일에서 패턴을 추출함으로써 공간 특징 표현을 강화합니다. 이후 연속된 프레임 간의 시간적 관계는 LSTM 모듈에 의해 모델링되며, 이 모듈은 MSCNN에서 추출된 특징 시퀀스를 처리하여 행동 인식을 위한 장기 시간적 의존성을 학습합니다.
각 스포츠 비디오 V = {F1, F2, …, FT}는 T개의 프레임으로 분해됩니다. 예를 들어 선수 포즈, 모션 블러, 공의 궤적과 같은 공간적 변화를 인코딩하기 위해, 3 × 3, 5 × 5 및 7 × 7 커널 크기에 해당하는 세 가지 서로 다른 스케일 s ∈ {1, 2, 3}에서 합성곱 분기(convolutional branches)가 작동합니다. 각 분기는 식 (6)과 같이 특징 맵을 추출합니다:
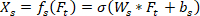 (6)
Ws와 bs는 스케일 s에서의 합성곱 가중치와 편향이며, σ는 ReLU 활성화 함수입니다. 다중 스케일 융합 층은 식 (7)과 같이 특징을 집계합니다:
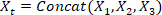 (7)
이 융합된 특징 텐서는 미세한 동작 단서와 그룹 활동과 같은 넓은 영역의 문맥 정보를 모두 내포합니다. 그림 3은 MSCNN 특징 추출 모듈만을 보여줍니다. 시계열 모델링 및 분류에 사용된 LSTM 층(256개 은닉 유닛), 밀집 층(128개 뉴런) 및 드롭아웃 층(0.5)은 그림 4에 별도로 제시되어 있습니다.
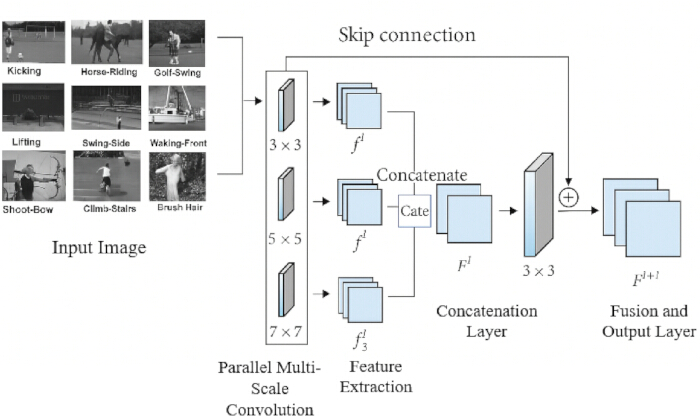
그림 3: 제안된 다중 스케일 합성곱 신경망(MSCNN) 특징 추출 모듈. 3 × 3, 5 × 5, 7 × 7 커널 크기를 가진 세 개의 병렬 합성곱 분기가 상호 보완적인 다중 스케일 공간 특징을 추출하며, 이는 LSTM 네트워크에 의한 시계열 모델링 전에 융합됩니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
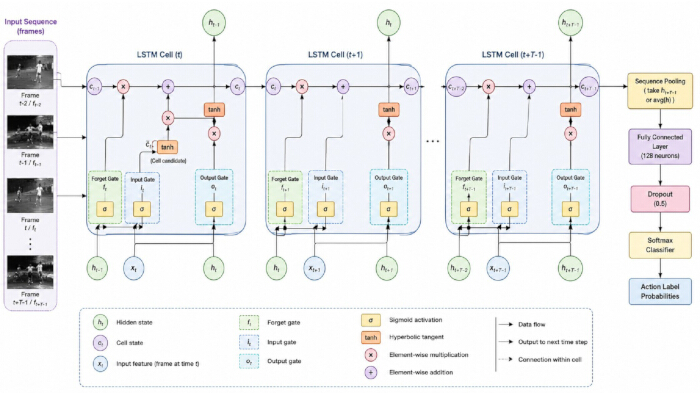
그림 4: 스포츠 비디오 동작 인식을 위해 제안된 LSTM 아키텍처. LSTM 모듈은 연속적인 비디오 프레임 전체에서 입력, 망각 및 출력 게이트 연산을 통해 시간적 의존성을 모델링한다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
그림 3 스포츠 비디오 동작 인식을 위해 제안된 다중 규모 합성곱 신경망(Multi-Scale Convolutional Neural Network, MSCNN) 특징 추출 모듈을 보여줍니다. 입력 비디오 프레임은 커널 크기가 3인 세 개의 합성곱 브랜치를 통해 병렬로 처리되었습니다. × 3, 5 × 5 및 7 × 7개로 구성되었으며, 각각은 상보적인 세밀함 및 거친 입도의 공간적 특징을 포착하기 위해 64개의 필터를 포함합니다. 출력값은 배치 정규화(Batch Normalization), ReLU 활성화 함수 및 2를 사용하여 정제되었습니다. × 2개의 맥스 풀링(max pooling) 후, 1개의 층으로 결합 및 융합됨 × 128개의 필터를 가진 1회 컨볼루션(convolution)을 수행하였다. 잔차 스킵 연결(residual skip connection)을 통해 저수준 공간 정보를 보존하고 경사 흐름(gradient flow)을 개선하였다. 융합된 특징 맵(feature maps)은 평탄화(flatten)되어 256개의 은닉 유닛을 가진 LSTM 층으로 전달되어 시계열 모델링이 이루어졌으며, 이후 128개의 뉴런과 ReLU 활성화 함수, 0.5의 드롭아웃 비율(dropout rate)을 갖는 완전 연결 층(fully connected layer)을 거쳐 Softmax 층을 통해 최종 분류가 수행되었다. 다중 스케일 특징 맵(f1제시된 텍스트가 없습니다. 번역할 내용을 입력해 주세요., f2입력된 텍스트가 없습니다. 번역할 내용을 제공해 주시기 바랍니다., 그리고 f3제공된 텍스트가 없습니다. 번역할 내용을 입력해 주세요.)를 연결하여 융합 표현(을/를) 형성하였다(F제공된 텍스트가 없습니다. 번역할 내용을 입력해 주세요.), 이는 3에 의해 추가로 정제되었습니다 × 다음 층의 출력 특징 맵을 생성하기 위해 3개의 컨볼루션을 사용합니다. 이러한 계층적 구조는 여러 수용장(receptive field)에서 상호 보완적인 공간적 특징을 학습할 수 있게 하여, 스포츠 동작 인식 성능을 향상시켰습니다.
5. LSTM을 이용한 시계열 모델링
비디오 엣지 전반의 시간 기반 진화를 모델링하기 위해, 동적 의존성과 동작의 연속성을 포착하도록 집계된 특징 시퀀스를 LSTM 시스템에 제공하였습니다. 각 입력 비디오에 대해 먼저 프레임당 다중 스케일 CNN 특징을 추출하였습니다. 비디오 프레임을 I1, …, IT라고 합니다. 각 프레임 t와 각 스케일 s에 대해 다중 스케일 컨볼루션 인코더는 특징 벡터 ft(s) ∈ Rd를 생성합니다. 그다음 식 (8)과 같이 투영 및 연결(projection + concat) 또는 가중치 합산 방식을 통해 각 스케일을 단일 프레임 기술자로 융합합니다:
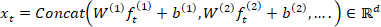 (8)
그런 다음 시퀀스 {xt}tT=1를 LSTM에 입력하여 시간적 역학을 모델링합니다. 표준 LSTM 표기법에 따라, 시간 t에서의 게이트와 상태는 식 (9)에서 (13)과 같습니다:
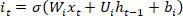 (9)
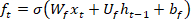 (10)
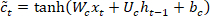 (11)
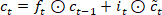 (12)
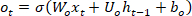 (13)
여기서 σ는 시그모이드 활성화 함수이며, ⊙는 요소별 곱셈을 나타냅니다.) 양방향 LSTM 구조를 사용하여 과거와 미래의 시간적 문맥을 모두 포착할 수 있지만, 제안된 프레임워크는 순차적인 비디오 프레임 전반의 시간적 의존성을 모델링하기 위해 표준 LSTM을 사용합니다. 이러한 설계 선택은 본 연구에서 제시한 MSCNN-LSTM 구조와 일치합니다. 클립을 처리한 후, 클립 표현(예: 마지막 은닉 상태 또는 시간적 풀링)을 얻었습니다: z = Poolt(vt).
그림 4 스포츠 동작 인식을 위해 제안된 LSTM 아키텍처의 워크플로우를 보여줍니다. 네트워크는 비디오 프레임 시퀀스 또는 CNN으로 추출된 특징을 입력받아 연속적인 시간 단계에 걸쳐 처리합니다(t−2, t-1, 그리고 t각 LSTM 셀은 네트워크를 통한 정보 흐름을 조절하는 입력 게이트, 망각 게이트 및 출력 게이트로 구성되었습니다. 입력 게이트는 새로운 정보를 셀 상태에 통합하고, 망각 게이트는 무관한 시간적 정보를 폐기하며, 출력 게이트는 다음 시간 단계로 전파되는 은닉 상태를 생성했습니다. 셀 상태는 장기적인 시간적 의존성을 유지하는 반면, 은닉 상태는 단기적인 시간적 정보를 캡처했습니다. 순차적 처리 후, LSTM 출력은 풀링되어 시간적 특징 표현을 생성했으며, 이는 전결합층과 Softmax 분류기로 전달되어 해당 스포츠 동작을 예측했습니다. 네트워크는 Adam 옵티마이저를 사용하여 100 에포크 동안 배치 크기 32, 초기 학습률 0.001 및 교차 엔트로피 손실 함수로 학습되었습니다. 검증 손실이 가장 낮은 모델이 최종 평가를 위해 선택되었습니다. 재현성을 보장하기 위해 모든 실험은 42의 고정된 랜덤 시드를 사용하여 수행되었습니다. 수렴도를 높이기 위해 조기 종료 및 정체기 학습률 감소 기법이 적용되었으며, LSTM 학습 중에는 기울기 폭주를 방지하기 위해 5.0의 임계값으로 기울기 클리핑을 적용했습니다. 제안된 MSCNN-LSTM 모델은 약 1,500만 개의 학습 가능한 파라미터를 포함했습니다.
최종 클래스 점수와 확률은 식 (14)와 같이 선형 레이어 + 소프트맥스(softmax)를 사용하여 산출합니다:
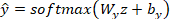 (14)
식 (15)과 같이 레이블이 지정된 클립에 대해 교차 엔트로피 손실을 최소화하여 학습시킵니다:
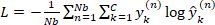 (15)
여기서 Nb는 배치의 크기, C는 클래스의 수, y(n)은 원-핫(one-hot) 정답 값입니다. 정규화(xt/LSTM 출력에 대한 드롭아웃, 가중치 감쇠)를 수행하며, 긴 스포츠 시퀀스에 대한 안정성을 높이기 위해 그래디언트 클리핑(gradient clipping)을 적용합니다.
결과
제안된 MSCNN-LSTM 모델은 다양한 스포츠 동작, 관점 및 모션 패턴이 포함된 UCF11 (YouTube Actions), UCF Sports 및 JHMDB 데이터셋을 통해 학습 및 평가되었습니다. 클래스 분포가 충분히 균형 잡혀 있었으므로, 추가적인 클래스 가중치 부여나 재샘플링 절차는 적용하지 않았습니다. 비교 모델들은 원래 연구에서 보고된 하이퍼파라미터를 사용하여 구현되었으며, 가능한 경우 학습 설정을 일치시켰습니다. 결과는 서로 다른 무작위 초기화를 통한 5회의 독립적인 실행에서 얻은 평균 ± 표준편차로 보고되었습니다. 제안된 모델과 비교 모델 간의 차이는 유의 수준 p < 0.05의 대응표본 t-검정을 사용하여 평가되었습니다.
그림 5는 세 가지 데이터셋에 대한 분류 정확도를 비교한 것입니다. MSCNN-LSTM 모델은 UCF11에서 98.3%, UCF Sports에서 95.4%, JHMDB에서 81.7%의 가장 높은 정확도를 달성했습니다. 이 수치들은 Dilated CNN–BiLSTM, Two-Stream LSTM 및 ViT-ReT 모델을 통해 얻은 결과보다 높았습니다. JHMDB에서 정확도가 낮게 나타난 것은 저해상도 비디오에서 세밀한 동작을 인식하는 것이 더 어렵다는 점을 반영합니다.
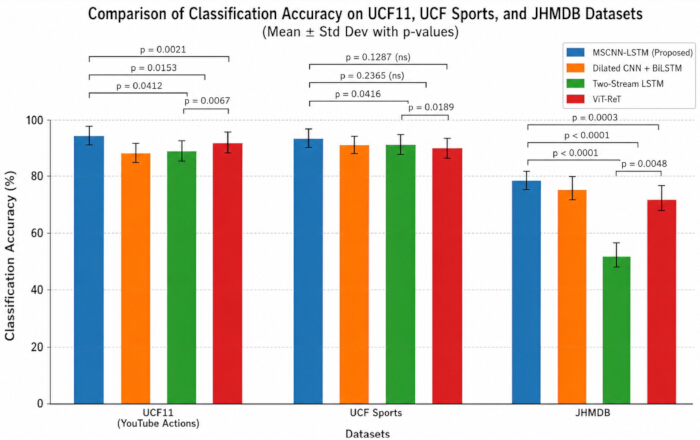
그림 5: 스포츠 비디오 데이터셋에 대한 다양한 딥러닝 모델의 분류 정확도(%) 비교. UCF11, UCF Sports 및 JHMDB 데이터셋에서 MSCNN-LSTM, ViT-ReT, Two-Stream LSTM, 그리고 Dilated CNN + BiLSTM의 분류 정확도. 결과는 5회 독립 실행(n = 5)의 평균 ± 표준편차(SD)로 나타냈다. 오차 막대는 1 표준편차를 나타낸다. 통계적 유의성은 양측 paired t-검정(p < 0.05)을 사용하여 평가하였다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
제안된 모델은 모든 데이터셋에서 가장 높은 정밀도를 달성하였으며, UCF11에서 약 96%, UCF Sports에서 93%, JHMDB에서 78%의 값을 기록하였다(그림 6). 재현율 값은 각각 약 95%, 94%, 77%였으며(그림 7), 이에 상응하는 F1-스코어는 약 95.5%, 93.5%, 77.5%였다(그림 8). 이러한 결과는 해당 모델이 행동 클래스를 정확하게 식별하는 것과 위양성 예측을 제한하는 것 사이에서 적절한 균형을 유지했음을 나타낸다.
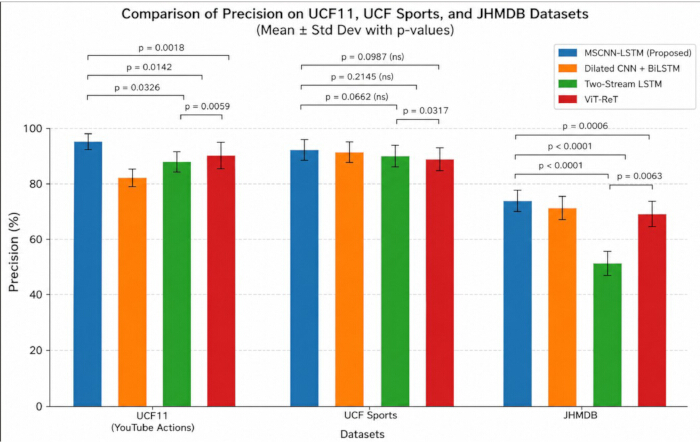
그림 6: 스포츠 비디오 데이터셋에 대한 다양한 딥러닝 모델의 정밀도(%) 비교. 정밀도 값은 5회의 독립적인 실행(n = 5)에 대한 평균 ± 표준편차(SD)로 보고되었습니다. 오차 막대는 1 표준편차를 나타냅니다. 통계적 유의성은 양측 짝지은 t-검정(p < 0.05)을 사용하여 평가되었습니다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
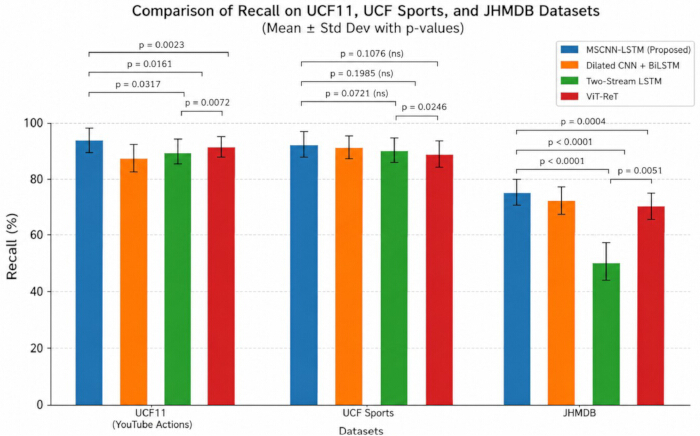
그림 7: 스포츠 비디오 데이터셋에서 서로 다른 딥러닝 모델의 재현율(%) 비교. 재현율 값은 5회의 독립적인 실행(n = 5)에서 얻은 평균 ± 표준편차(SD)로 표시되었습니다. 오차 막대는 1 표준편차를 나타냅니다. 통계적 유의성은 양측 꼬리 대응 표본 t-검정(p < 0.05)을 사용하여 평가되었습니다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
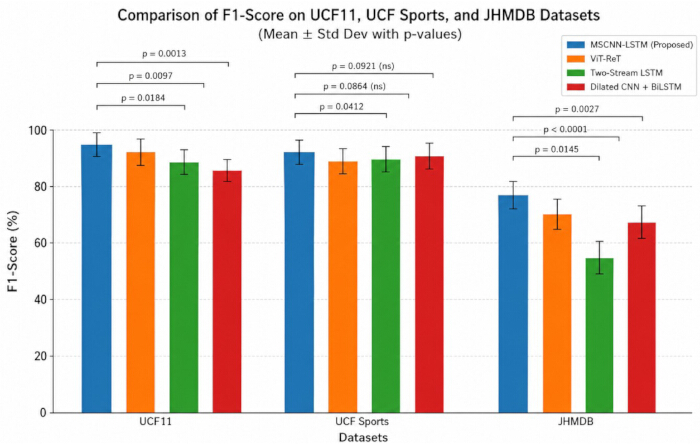
그림 8: 스포츠 비디오 데이터셋에 대한 서로 다른 딥러닝 모델의 F1-score (%) 비교. F1-score는 5회의 독립적인 실행(n = 5)에서 얻은 평균 ± 표준편차(SD)로 나타내었다. 오차 막대는 1 표준편차를 나타낸다. 통계적 유의성은 양측 대응 t-검정(p < 0.05)을 사용하여 평가하였다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
표 5는 Cohen의 kappa 및 Matthews 상관 계수 결과를 보여줍니다. UCF11 데이터셋에서 제안된 모델은 κ = 0.96 및 MCC = 0.96을 달성했으며, 이는 ViT-ReT의 0.92/0.92, Two-Stream LSTM의 0.90/0.90, Dilated CNN–BiLSTM의 0.87/0.87 값과 비교됩니다. UCF Sports 데이터셋에서 MSCNN-LSTM은 κ = 0.95 및 MCC = 0.94를 달성하여 ViT-ReT (0.90/0.90), Two-Stream LSTM (0.88/0.89), Dilated CNN–BiLSTM (0.84/0.85)에서 얻은 해당 값들을 상회했습니다. JHMDB 데이터셋에서 제안된 모델은 κ = 0.83 및 MCC = 0.84를 달성했으며, 이는 ViT-ReT의 0.74/0.75, Two-Stream LSTM의 0.70/0.71, Dilated CNN–BiLSTM의 0.71/0.72와 비교됩니다. 이러한 결과는 제안된 모델의 예측 라벨과 정답 라벨(ground-truth label) 간의 일치도가 더 높음을 보여주었습니다.
| 모델 | 데이터셋 | Cohen’s Kappa (κ) | 매슈 상관계수 (MCC) |
| Dilated CNN + BiLSTM [4] | UCF11 (YouTube Actions) | 0.87 ± 0.01 | 0.88 ± 0.01 |
| UCF Sports | 0.84 ± 0.02 | 0.85 ± 0.02 | |
| JHMDB | 0.71 ± 0.03 | 0.72 ± 0.03 | |
| Two-Stream LSTM [38] | UCF11 (YouTube Actions) | 0.90 ± 0.01 | 0.91 ± 0.01 |
| UCF Sports | 0.88 ± 0.02 | 0.89 ± 0.02 | |
| JHMDB | 0.70 ± 0.03 | 0.71 ± 0.03 | |
| ViT-ReT (Vision Transformer + Recurrent Transformer) [6] | UCF11 (YouTube Actions) | 0.92 ± 0.01 | 0.92 ± 0.01 |
| UCF Sports | 0.90 ± 0.01 | 0.90 ± 0.01 | |
| JHMDB | 0.74 ± 0.02 | 0.75 ± 0.02 | |
| 제안된 MSCNN–LSTM | UCF11 (YouTube Actions) | 0.96 ± 0.01 | 0.96 ± 0.01 |
| UCF Sports | 0.95 ± 0.01 | 0.94 ± 0.01 | |
| JHMDB | 0.83 ± 0.02 | 0.84 ± 0.02 |
표 5: 서로 다른 딥러닝 모델 간의 Cohen's kappa (κ) 및 Matthews 상관 계수 (MCC) 비교. UCF11, UCF Sports 및 JHMDB 데이터셋에 대한 MSCNN-LSTM, ViT-ReT, Two-Stream LSTM, Dilated CNN + BiLSTM의 성능 비교. 값이 높을수록 예측 레이블과 실제 레이블 간의 일치도가 높고 분류 신뢰도가 높음을 나타낸다. 값은 5회의 독립적인 실행(n = 5)을 통한 평균 ± SD로 표기되었다.
그림 9는 수신자 조작 특성 곡선을 보여줍니다. 제안된 MSCNN-LSTM은 UCF11에서 0.975, UCF Sports에서 0.961, JHMDB에서 0.937의 AUC 값을 달성했습니다. 일관되게 높게 나타난 AUC 값은 복잡도가 서로 다른 데이터셋 전반에서 행동 클래스 간의 강력한 판별 능력을 나타냅니다.
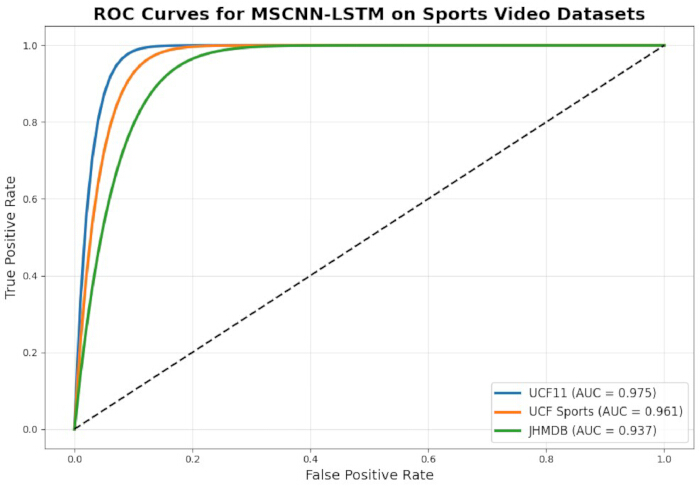
그림 9: 제안된 MSCNN-LSTM 모델의 수신자 조작 특성(ROC) 곡선. 진양성률과 위양성률 사이의 트레이드-오프를 보여주는 UCF11, UCF Sports 및 JHMDB 데이터셋의 ROC 곡선이다. 곡선 아래 면적(AUC)은 분류 임계값에 따른 모델의 판별 성능을 요약하여 나타낸다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
시간적 성능 결과는 표 6에 요약되어 있습니다. UCF11에서 제안된 모델은 98.3%의 mAP-T, 96.5%의 프레임 수준 정확도 및 0.95의 TSI를 달성했습니다. UCF Sports에서의 해당 값은 각각 95.4%, 94.0%, 0.93이었습니다. JHMDB에서 모델은 81.7%의 mAP-T, 78.9%의 프레임 수준 정확도 및 0.88의 TSI를 달성했습니다(표 7). 이러한 값들은 비교 모델들에서 얻은 값보다 높았으며, 단기 및 장기 동작 시퀀스 모두에서 시간적 일관성과 예측 안정성이 향상되었음을 나타냅니다.
| 방법 | 데이터셋 | mAP-T (%) | 프레임 수준 정확도 (%) | 시간적 안정성 지수 (Temporal Stability Index, TSI) |
| 확장 CNN + BiLSTM4 | UCF11 (YouTube 작업) | 93.6 ± 0.8 | 91.8 ± 0.9 | 0.87 ± 0.01 |
| UCF 스포츠 | 90.2 ± 1.0 | 89.1 ± 1.1 | 0.83 ± 0.02 | |
| JHMDB | 72.4 ± 1.5 | 70.3 ± 1.7 | 0.78 ± 0.03 | |
| 이중 스트림 LSTM38 | UCF11 (YouTube 액션) | 94.8 ± 0.7 | 92.6 ± 0.8 | 0.89 ± 0.01 |
| UCF 스포츠 | 91.3 ± 0.9 | 90.0 ± 1.0 | 0.85 ± 0.02 | |
| JHMDB | 73.8 ± 1.4 | 71.5 ± 1.6 | 0.79 ± 0.03 | |
| ViT-ReT (비전 트랜스포머 + 순환 트랜스포머)6 | UCF11 (YouTube 작업) | 95.5 ± 0.6 | 93.4 ± 0.7 | 0.90 ± 0.01 |
| UCF 스포츠 | 92.4 ± 0.8 | 91.2 ± 0.9 | 0.87 ± 0.01 | |
| JHMDB | 74.6 ± 1.3 | 72.8 ± 1.4 | 0.81 ± 0.02 | |
| . | UCF11 (YouTube 작업) | 98.3 ± 0.5 | 96.5 ± 0.6 | 0.95 ± 0.01 |
| UCF 스포츠 | 95.4 ± 0.7 | 94.0 ± 0.8 | 0.93 ± 0.01 | |
| JHMDB | 81.7 ± 1.1 | 78.9 ± 1.3 | 0.88 ± 0.02 |
표 6: 스포츠 비디오 동작 인식의 시간적 성능 지표 비교. 벤치마크 데이터셋 전반에 걸쳐 서로 다른 딥러닝 모델의 시간적 세그먼트 평균 정밀도(mAP-T), 프레임 수준 정확도 및 시간적 안정성 지표(TSI)에 대한 실험 결과. 수치는 5회의 독립적인 실행(n = 5)에 대한 평균 ± 표준편차(SD)로 표기됨.
| 구성 | Multi-Scale CNN (MSCNN) | LSTM | 정확도 (%) | F1-Score (%) | mAP-T (%) |
| CNN 전용 베이스라인 | ✗ | ✗ | 90.4 ± 1.2 | 89.8 ± 1.3 | 88.9 ± 1.4 |
| CNN + LSTM | ✗ | ✓ | 93.1 ± 0.9 | 92.4 ± 1.0 | 91.7 ± 1.1 |
| MSCNN 전용 | ✓ | ✗ | 94.2 ± 0.8 | 93.6 ± 0.9 | 92.8 ± 1.0 |
| 제안된 MSCNN-LSTM | ✓ | ✓ | 98.3 ± 0.5 | 97.8 ± 0.6 | 97.1 ± 0.6 |
표 7: 제안된 MSCNN-LSTM 프레임워크의 어블레이션 연구(Ablation study).동일한 훈련 및 평가 설정 하에서 MSCNN 및 LSTM 구성 요소의 성능 기여도. 값은 5회의 독립적인 실행(n = 5)에 대한 평균 ± 표준편차(SD)로 표기됨.
그림 10, 그림 11, 그림 12는 각각 UCF11, UCF Sports 및 JHMDB에 대한 행 정규화 혼동 행렬을 나타냅니다. 세 행렬 모두 뚜렷한 대각 우세를 보여 대부분의 행동 클래스가 정확하게 식별되었음을 나타냈습니다. 제한적인 비대각 오류는 주로 시각적 또는 운동 특성이 유사한 행동들 사이에서 발생했습니다. JHMDB 행렬은 상대적으로 더 큰 클래스 혼동을 보였으며, 이는 더 까다로운 데이터셋인 이 데이터셋에서 관찰된 더 낮은 정량적 성능과 일치합니다.
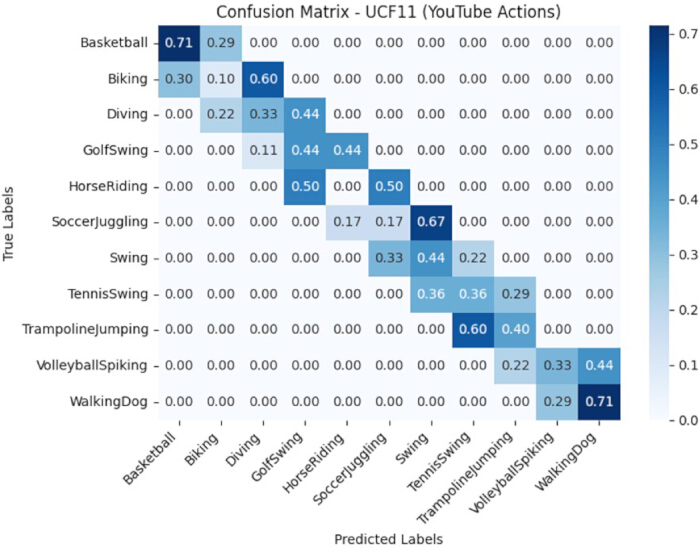
그림 10: UCF11 데이터셋에 대해 제안된 MSCNN-LSTM 모델의 행 정규화 혼동 행렬.각 행은 1로 정규화되었으며, 대각선 항목은 별도로 보고된 전체 분류 정확도가 아닌 클래스별 재현율(recall)을 나타냅니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
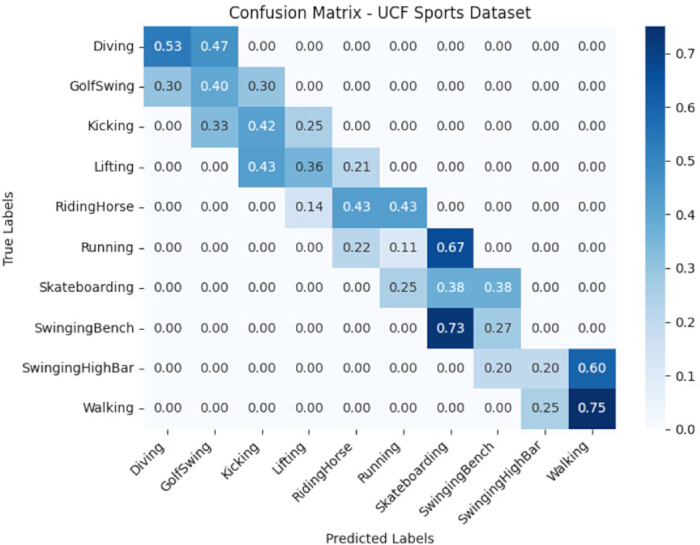
그림 11: UCF Sports 데이터셋에 대한 제안된 MSCNN-LSTM 모델의 행 정규화 혼동 행렬.각 행은 1로 정규화되었으며, 대각선 항목은 별도로 보고되는 전체 분류 정확도가 아닌 클래스별 재현율을 나타냅니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
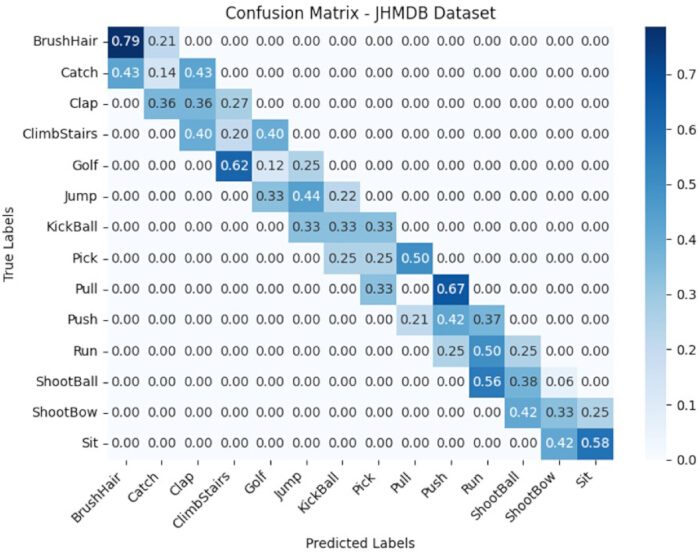
그림 12: JHMDB 데이터셋에 대한 제안된 MSCNN-LSTM 모델의 행 정규화 혼동 행렬. 각 행은 1로 정규화되었으며, 대각 성분은 별도로 보고되는 전체 분류 정확도가 아니라 클래스별 재현율(recall)을 나타냅니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
전반적으로, 제안된 MSCNN-LSTM 프레임워크는 분류, 일치도, 판별력 및 시간적 안정성 척도 전반에서 평가된 비교 모델보다 일관되게 우수한 성능을 보였습니다. 이러한 결과는 다중 스케일 공간 특징 추출과 LSTM 기반의 시간적 모델링을 결합함으로써 동작 복잡성, 이미지 품질 및 시점 조건이 다양한 데이터셋 전반에서 스포츠 동작 인식 성능이 향상된다는 가설을 뒷받침하였습니다.
데이터 가용성:
본 연구에서 분석된 데이터세트는 다음 소스에서 공개적으로 이용 가능합니다: UCF11 (YouTube Actions) 데이터세트 (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php) 및 UCF Sports 데이터세트 (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php). 본 연구의 재현성을 지원하기 위해 실험에 사용된 전처리 파이프라인, 데이터세트 분할(훈련/검증/테스트 분할 생성), 구현 파일, 설정 파일 및 지원 문서가 Zenodo 저장소에 저장되었으며, https://doi.org/10.5281/zenodo.21020947에서 공개적으로 이용할 수 있습니다.
토론
제안된 MSCNN-LSTM 프레임워크는 UCF11, UCF Sports 및 JHMDB 벤치마크 데이터셋 전체에서 평가된 방식들보다 일관되게 우수한 성능을 보였습니다. Dilated CNN–BiLSTM, Vision Transformer 아키텍처 및 3D CNN 기반의 기존 방법들은 효과적인 시공간 특징 학습을 입증했으나, 높은 계산 복잡성, 상당한 학습 요구 사항 또는 세밀한 동작 패턴의 표현 부족으로 인해 제한적일 수 있습니다23,24,25. 이와 대조적으로, 제안된 프레임워크는 다중 스케일 공간 특징 추출을 LSTM 기반의 시간적 모델링과 통합하여, 국소적 동작 세부 사항과 장기적 시간 의존성을 모두 캡처할 수 있게 했습니다. 이러한 통합은 복잡한 스포츠 동작의 인식력을 향상시키고, 클래스 간 혼동을 줄였으며, 특히 더 까다로운 JHMDB 데이터셋에서 시간적 일관성을 강화했습니다. 이러한 결과는 제안된 프레임워크가 평가된 CNN, 순환 신경망 및 트랜스포머 기반 방식들과 비교하여 공간 및 시간 정보의 균형 잡힌 표현을 제공했음을 나타냅니다.
이론적 관점에서 MSCNN-LSTM 프레임워크는 다중 스케일 특징 융합과 순차적 시간 학습을 위한 통합된 접근 방식을 제공하였습니다36,37. 계층적 수용 영역의 사용을 통해 서로 다른 스케일에서 공간 정보를 추출할 수 있었으며, LSTM은 연속적인 비디오 프레임 간의 의존성을 모델링하였습니다. 이러한 설계는 시간적 모델링 이전에 국소적 및 문맥적 공간 정보를 보존함으로써 기존의 CNN-LSTM 파이프라인을 확장하였습니다. 다양한 동작 클래스, 움직임 패턴 및 카메라 시점이 포함된 데이터셋 전반에서 일관된 성능을 보였다는 점은 제안된 아키텍처의 견고성을 더욱 뒷받침하였습니다.
실용적인 관점에서 본 프레임워크는 자동화된 스포츠 분석, 운동선수 성능 평가, 이벤트 탐지 및 스포츠 비디오 이해에 대한 잠재력을 보여주었습니다. 다만, 실제 운영 환경에서의 추가적인 검증이 배포 전에 필요합니다. 본 아키텍처는 강력한 인식 성능을 달성하였으나, 리소스 제한 장치나 클라우드 기반 분석 플랫폼에 대한 적합성은 계산 비용, 추론 시간, 메모리 요구 사항 및 에너지 소비에 대한 추가 평가를 통해 확인되어야 합니다.
절제 연구(ablation study)를 통해 MSCNN과 LSTM 구성 요소의 상호 보완적인 기여도가 입증되었습니다. MSCNN은 다양한 수용장(receptive-field) 스케일에서 표현을 학습함으로써 공간적 특징 추출을 개선한 반면, LSTM은 연속적인 프레임 간의 모션 의존성을 포착하여 시간적 모델링을 강화했습니다. 전체 MSCNN-LSTM 구성이 가장 우수한 성능을 보였으며, 이는 다중 스케일 공간 특징 추출과 시간적 시퀀스 모델링이 행동 인식의 성능 향상에 공동으로 기여했음을 나타냅니다.
종합적으로, 제안된 MSCNN-LSTM 프레임워크는 스포츠 비디오 동작 인식을 위한 공간 및 시간 표현 학습을 효과적으로 결합하였습니다. UCF11, UCF Sports 및 JHMDB 데이터셋에 대한 평가 결과, 비교 대상이 된 딥러닝 접근 방식들에 비해 향상된 성능을 보였습니다. 이러한 결과는 다중 스케일 컨볼루션 특징을 LSTM 기반의 시간적 모델링과 통합하는 것이 복잡한 스포츠 동작의 인식률을 높인다는 가설을 뒷받침합니다. 그럼에도 불구하고, 일반화 가능성과 실제 적용 가능성을 확립하기 위해서는 더 크고 다양하며 교차 도메인인 데이터셋을 통한 검증이 필요합니다.
몇 가지 제한 사항을 고려해야 합니다. 첫째, 평가는 공개적으로 사용 가능한 벤치마크 데이터셋으로 제한되었으며, 이는 실제 스포츠 환경의 다양성과 복잡성을 완전히 반영하지 못했을 수 있습니다. 둘째, 고정된 훈련, 검증 및 테스트 분할을 사용하였으나, 데이터셋 편향과 의도치 않은 데이터 누출을 완전히 배제할 수는 없었습니다. 셋째, 보고된 성능은 데이터셋 구성, 모델 초기화, 전처리 절차 및 훈련 설정에 따라 달라질 수 있습니다. 또한, 다중 스케일 합성곱 및 시간적 모델링 구성 요소로 인해 계산 요구량이 증가하였으며, 이는 리소스가 제한된 장치에서의 배포에 영향을 줄 수 있습니다. 본 프레임워크는 외부 데이터셋이나 실시간 프로덕션 시나리오를 통해 평가되지 않았습니다.
트랜스포머 기반 비디오 모델은 대규모 행동 인식 데이터셋에서 강력한 성능을 보여주었으나, 종종 상당한 계산 자원과 방대한 훈련 데이터가 필요합니다. 제안된 MSCNN-LSTM 프레임워크는 다중 규모 공간 특징 추출과 재귀적 시간 모델링을 결합함으로써 대안적인 접근 방식을 제공합니다. 향후 연구에서는 교차 데이터셋 검증, 실시간 추론, 계산 최적화, 불확실성 추정, 그리고 제안된 다중 규모 CNN-LSTM 프레임워크에 트랜스포머 기반 어텐션 메커니즘을 통합한 하이브리드 아키텍처를 조사해야 합니다38.
공개 사항
저자들은 이해관계의 충돌이 없음을 밝힙니다.
감사의 글
본 연구는 Universiti Kebangsaan Malaysia 정보과학기술학부 인공지능기술센터(CAIT)에서 수행되었습니다. 저자들은 제공된 기관의 지원과 연구 시설에 깊은 감사를 표합니다. 본 연구는 공공, 상업 또는 비영리 자금 지원 기관으로부터 어떠한 특정 연구비를 지원받지 않았습니다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| GeForce RTX 3090 GPU | NVIDIA Corporation | RTX 3090, 24 GB VRAM | 딥러닝 모델 학습 및 추론에 사용됨 |
| Intel Core i9 프로세서 | Intel Corporation | 16코어, 3.5 GHz | 데이터 전처리 및 계산에 사용됨 |
| 시스템 메모리 | 일반적인 | 64 GB DDR4 RAM | 대규모 비디오 처리 지원 |
| Python 프로그래밍 언어 | Python Software Foundation | 버전 3.8.18 | 구현을 위한 주요 프로그래밍 언어 |
| TensorFlow | 버전 2.15 | 모델 개발에 사용된 딥러닝 프레임워크 | |
| 운영체제 | Microsoft Corporation | Windows 11 | 모델 개발 및 실험 |
| CUDA 툴킷 | NVIDIA Corporation | CUDA 11.8 | 모델 학습을 위한 GPU 가속 |
| cuDNN | NVIDIA Corporation | cuDNN 8.9.7 | 심층 신경망 가속 라이브러리 |
| OpenCV | 오픈 소스 | 버전 4.8.1 | 비디오 프레임 추출 및 전처리 |
| NumPy | 오픈 소스 | 버전 1.24.4 | 수치 계산 및 배열 처리 |
| Scikit-learn | 오픈 소스 | 버전 1.3.2 | 성능 평가 및 통계 분석 |
| Matplotlib | 오픈 소스 | 버전 3.7.5 | 실험 결과의 시각화 |
| UCF11 데이터셋 | 센트럴 플로리다 대학교 | 공공 데이터셋 | 스포츠 동작 인식 벤치마크 데이터셋 |
| UCF 스포츠 데이터셋 | 센트럴 플로리다 대학교 | 공공 데이터세트 | 스포츠 동작 인식 벤치마크 데이터셋 |
| JHMDB 데이터셋 | 막스 플랑크 정보학 연구소 | 공공 데이터 세트 | 인체 동작 및 행동 인식 벤치마크 데이터셋 |
참고문헌
- Hassan N, Miah ASM, Shin J. A deep bidirectional LSTM model enhanced by transfer-learning-based feature extraction for dynamic human activity recognition. Appl Sci. 2024;14:603. https://doi.org/10.3390/app14020603
- Egawa R, et al. Dynamic fall detection using graph-based spatial temporal convolution and attention network. Electronics. 2023;12:3234. https://doi.org/10.3390/electronics12153234
- Riahi M, Eslami M, Safavi SH, Torkamani Azar F. Human activity recognition using improved dynamic image. IET Image Process. 2020;14:3223–3231. https://doi.org/10.1049/iet-ipr.2020.0372
- Muhammad K, et al. Human action recognition using attention-based LSTM network with dilated CNN features. Future Gener Comput Syst. 2021;125:820–830. https://doi.org/10.1016/j.future.2021.06.017
- Al-Obaidi S, Al-Khafaji H, Abhayaratne C. Making sense of neuromorphic event data for human action recognition. IEEE Access. 2021;9:82686–82700. https://doi.org/10.1109/ACCESS.2021.3085769
- Wensel J, Ullah H, Munir A. ViT-ReT: Vision and recurrent transformer neural networks for human activity recognition in videos. IEEE Access. 2023;11:72227–72249. https://doi.org/10.1109/ACCESS.2023.3293445
- Vrskova R, Hudec R, Kamencay P, Sykora P. Human activity classification using the 3DCNN architecture. Appl Sci. 2022;12:931. https://doi.org/10.3390/app12020931
- Ullah A, et al. Action recognition using optimized deep autoencoder and CNN for surveillance data streams of non-stationary environments. Future Gener Comput Syst. 2019;96:386–397. https://doi.org/10.1016/j.future.2019.01.041
- Jaouedi N, Boujnah N, Bouhlel MS. A new hybrid deep learning model for human action recognition. J King Saud Univ Comput Inf Sci. 2020;32:447–453. https://doi.org/10.1016/j.jksuci.2018.08.001
- Zebhi S, Al-Modarresi SMT, Abootalebi V. Converting video classification problem to image classification with global descriptors and pre-trained network. IET Comput Vis. 2020;14:614–624. https://doi.org/10.1049/iet-cvi.2020.0023
- Cust E, Sweeting AJ, Ball K, Robertson S. Machine and deep learning for sport-specific movement recognition: A systematic review. J Sports Sci. 2019;37:568–600. https://doi.org/10.1080/02640414.2018.1504613
- Cao S, Wang B, Zhang W, Ma L. Visual consensus modeling for video-text retrieval. In Proc AAAI Conf Artif Intell. 2022:167–175. https://doi.org/10.1609/aaai.v36i1.19890
- Yu H, et al. Fine-grained video captioning for sports narrative. In Proc IEEE Conf Comput Vis Pattern Recognit (CVPR). 2018:6006–6015. https://doi.org/10.1109/CVPR.2018.00628
- Browne P, Sweeting AJ, Woods CT, Robertson S. Methodological considerations for furthering the understanding of constraints in applied sports. Sports Med Open. 2021;7:22. https://doi.org/10.1186/s40798-021-00307-9
- Gao T, et al. Sports video classification method based on improved deep learning. Appl Sci. 2024;14:948. https://doi.org/10.3390/app14020948
- Dong Z, Xie M, Li X. Multi-scale receptive fields convolutional network for action recognition. Appl Sci. 2023;13:3403. https://doi.org/10.3390/app13063403
- Liu S, et al. Human memory update strategy: A multi-layer template update mechanism for remote visual monitoring. IEEE Trans Multimed. 2021;23:2188–2198. https://doi.org/10.1109/TMM.2020.3009234
- Liu S, Liu D, Muhammad K, Ding W. Effective template update mechanism in visual tracking with background clutter. Neurocomputing. 2021;458:615–625. https://doi.org/10.1016/j.neucom.2021.05.032
- Haque MN, et al. GRU-based attention mechanism for human activity recognition. In Proc ICASERT. 2019:1–6. https://doi.org/10.1109/ICASERT.2019.8934521
- Al-qaness MA, Dahou A, AbdElaziz M, Helmi A. Multi-ResAtt: Multilevel residual network with attention for human activity recognition using wearable sensors. IEEE Trans Ind Inform. 2022;19:144–152. https://doi.org/10.1109/TII.2022.3147850
- Duan F, et al. A multi-task deep learning approach for sensor-based human activity recognition and segmentation. IEEE Trans Instrum Meas. 2023;72:2514012. https://doi.org/10.1109/TIM.2023.3264512
- Gomes E, et al. Machine learning algorithms for activity-intensity recognition using accelerometer data. Sensors. 2021;21:1214. https://doi.org/10.3390/s21041214
- Su C, et al. A novel model for fall detection and action recognition combining lightweight 3D-CNN and ConvLSTM networks. Pattern Anal Appl. 2024;27:3. https://doi.org/10.1007/s10044-023-01234-5
- Zhou T, et al. Behavior recognition based on improved density clustering and context-guided Bi-LSTM model. Multimed Tools Appl. 2023;82:45471–45488. https://doi.org/10.1007/s11042-023-14678-9
- Shin J, et al. Video-based human activity recognition using hybrid deep learning model. Comput Model Eng Sci. 2025;143:3615. https://doi.org/10.32604/cmes.2025.058341
- Vrskova R, Hudec R, Kamencay P, Sykora P. A new approach for abnormal human activities recognition based on ConvLSTM architecture. Sensors. 2022;22:2946. https://doi.org/10.3390/s22082946
- Vijeikis R, Raudonis V, Dervinis G. Efficient violence detection in surveillance. Sensors. 2022;22:2216. https://doi.org/10.3390/s22062216
- Rendón-Segador F, et al. ViolenceNet: Dense multi-head self-attention with bidirectional ConvLSTM for detecting violence. Electronics. 2021;10:1601. https://doi.org/10.3390/electronics10131601
- Kalfaoglu E, Kalkan S, Alatan A. Late temporal modeling in 3D CNN architectures with BERT for action recognition. In Proc ECCV Workshops. 2020. https://doi.org/10.1007/978-3-030-66823-5_43
- Moaaz M, Mohamed E. Violence detection in surveillance videos using deep learning. Inf Bull Fac Comput Artif Intell. 2020;2:6.
- Song W, et al. Expressive 3D facial animation generation based on local-to-global latent diffusion. IEEE Trans Vis Comput Graph. 2024;30:7397–7407. https://doi.org/10.1109/TVCG.2024.3456213
- Li L, Cherouat A, Snoussi H, Wang T. Grasping with occlusion-aware ally method in complex scenes. IEEE Trans Autom Sci Eng. 2025;22:5944–5954. https://doi.org/10.1109/TASE.2024.3434610
- Li R, et al. UE-Extractor: A grid-to-point ground extraction framework for unstructured environments. IEEE Robot Autom Lett. 2025;10:5991–5998. https://doi.org/10.1109/LRA.2025.3563127
- Jhuang, H., Gall, J., Zuffi, S., Schmid, C., Black, M. J. Towards understanding action recognition. Proceedings of the IEEE International Conference on Computer Vision. 3192–3199, doi:10.1109/ICCV.2013.396 (2013).
- OpenMMLab. MMAction2: JHMDB dataset preparation. GitHub. https://github.com/open-mmlab/mmaction2/tree/main/tools/data/jhmdb (2026).
- Ullah W, Khalid YN, Khan SH. A novel deep hybrid framework with ensemble-based feature optimization for HAR. arXiv preprint arXiv:2508.18695. 2025. https://arxiv.org/abs/2508.18695
- Karuppannan K, Darmanayagam SE, Cyril SR. Human action recognition using fusion-based discriminative features and LSTM classification. Concurr Comput Pract Exp. 2022;34:e7250. https://doi.org/10.1002/cpe.7250
- Sahoo SP, et al. HAR-depth: A novel framework for human action recognition using sequential learning and depth estimated history images. IEEE Trans Emerg Top Comput Intell. 2020;5:813–825. https://doi.org/10.1109/TETCI.2020.3006543