본 프로토콜은 임상 의사결정 지원을 위해 FHIR 기반의 임상 데이터와 검색 증강 생성(Retrieval-Augmented Generation) 및 멀티 에이전트 거대 언어 모델을 통합하는 상호 운용 가능한 웹 플랫폼의 구현 방법을 설명합니다. 이 워크플로우를 통해 재현 가능한 배포, 표준화된 데이터 통합, 그리고 인공지능(AI) 보조 의료 데이터 분석에 대한 평가가 가능합니다.
이 콘텐츠를 보려면 JoVE 구독이 필요합니다. 로그인하거나 오늘 무료 평가판을 시작하세요.
연구 논문
의료 데이터 분석을 위한 거대 언어 모델 기반 상호 운용 가능 웹 플랫폼: 임상 의사 결정 지원 프로토콜
이 논문에서
요약
초록
임상 의사결정은 파편화된 전자 건강 기록과 서로 다른 의료 정보 시스템 간의 제한적인 상호 운용성으로 인해 자주 제약을 받습니다. 본 논문은 Fast Healthcare Interoperability Resources (FHIR) 표준을 통해 임상 데이터를 통합하고, 검색 증강 생성 (RAG), 대규모 언어 모델 (LLMs) 및 다중 에이전트 임상 추론 프레임워크를 결합하여 의료 데이터 분석과 임상 의사결정을 지원하는 상호 운용 가능한 웹 플랫폼을 구현하기 위한 단계별 프로토콜을 제시합니다. 본 프로토콜은 계산 환경 구성, 임상 데이터 세트 전처리, FHIR 기반 데이터 통합, 벡터 데이터베이스 구축, 검색 설정, 프롬프트 엔지니어링, 다중 에이전트 오케스트레이션 및 시스템 평가를 포함한 전체 워크플로우를 설명합니다. 대표적인 결과는 이 플랫폼이 서로 다른 데이터 소스 간의 의미론적 상호 운용성을 개선하는 동시에, 임상적으로 관련성이 있고 문맥적으로 일관된 응답을 생성할 수 있는 능력이 있음을 입증합니다. 시스템 성능은 BLEU, ROUGE, BERTScore 및 코사인 유사도를 포함한 상호 보완적인 정량적 및 의미론적 지표를 사용하여 평가되었습니다. 제안된 방법론적 워크플로우의 재현성을 평가하기 위해 공개적으로 이용 가능한 완전 익명화된 벤치마크 의료 데이터 세트를 사용하여 정성적 평가를 수행했습니다. 제안된 아키텍처는 표준화된 의료 상호 운용성과 검색 강화 언어 모델을 결합하여 문맥적 추론을 개선하고, 환각 현상을 줄이며, 재현 가능한 AI 지원 임상 워크플로우를 지원합니다. 본 프로토콜은 임상 의사결정 지원, 의료 데이터 분석 및 향후 중개 연구를 위해 상호 운용 가능하고 개인정보 보호를 고려한 지능형 의료 시스템을 구현하려는 연구자와 개발자에게 확장 가능하고 재현 가능한 프레임워크를 제공합니다.
서론
건강 정보는 병원, 진단 센터, 실험실 및 외래 진료소를 통해 일상적으로 생성되지만, 종종 서로 다른 이기종 정보 시스템에 분산되어 남아 있습니다. 이러한 단편화는 상호 운용성을 제한하고 종합적인 환자 기록에 대한 적시 접근을 방해하여, 임상 진료, 데이터 통합 및 의료 관리에 지속적인 어려움을 초래합니다1,2,3,4.
이러한 파편화의 결과는 환자 정보에 대한 적시 접근이 필수적인 임상 워크플로우에서 특히 분명하게 나타납니다. 의료 전문가가 완전하고 통합된 의료 기록을 검색할 수 없으면 임상 평가가 더 어려워지며, 이는 불완전한 의사결정의 위험을 높이고 의료 제공의 효율성을 저하시키며, 특히 응급 상황에서 더욱 그러합니다5,6.
인공지능(AI), 특히 대규모 언어 모델(LLM)의 최근 발전은 헬스케어 응용 분야에서 활용 가능한 계산적 접근 방식의 범위를 확장했습니다. 이러한 모델들은 진단 보조, 임상 트리아제(triage) 및 의사결정 지원과 같은 작업에서 연구되어 왔습니다. 예를 들어, Jahan 등5은 생의학 작업에서 LLM의 활용을 평가했으며, Taylor 등7은 디지털 정신 건강 스크리닝을 위해 미세 조정된 모델을 조사하여 특수 임상 환경에서 고무적인 결과를 보고했습니다.
LLM의 적용 범위는 더욱 전문적인 임상 영역으로 확대되었습니다. Song 등49은 진폐증 진단에서의 활용 가능성을 탐구하였으며, Chien 등8은 비공식 간병인의 업무 부하 패턴을 분석하는 데 이러한 모델들을 적용하였습니다. 안과 분야에서는 Xue 등9이 녹내장 진단을 위한 질의응답 시스템을 제안하였고, Tan 등3 과 Wu 등10은 하이브리드 진단 시스템 및 중의학 상담에서의 LLM 활용 사례를 보고하였습니다.
LLM의 활용은 직접적인 임상 적용에만 국한되지 않습니다. Zhang 등11은 정신 건강 시나리오에서의 감정 인식에 대한 LLM의 적용을 조사하였으며, Sarzaeim 등12은 공공 보건 관련 분석에도 기여할 수 있는 지능형 치안 시스템을 탐구하였습니다. 이러한 연구들은 다양한 헬스케어 관련 분야에서 LLM 기반 접근법의 광범위한 적용 가능성을 보여줍니다.
LLM이 헬스케어 애플리케이션의 가능성을 확장시켰지만, 이를 임상 환경에 통합하는 과정에는 여전히 중요한 기술적, 조직적 및 규제적 과제가 수반됩니다. 실제 배포를 위해서는 적절한 컴퓨팅 인프라, 효과적인 데이터 거버넌스, 그리고 일반 데이터 보호 규정(GDPR) 및 브라질 일반 데이터 보호법(LGPD)과 같은 규제 프레임워크의 준수가 필요합니다. 이러한 프레임워크는 AI 보조 헬스케어 시스템의 개인정보 보호, 신뢰성 및 알고리즘 편향과 관련된 문제를 해결하는 동시에 민감한 건강 정보의 안전하고 윤리적인 처리를 위한 요구 사항을 규정합니다13,14.
전자 건강 기록(EHR), 의료 영상 시스템 및 사물 인터넷(IoT) 기기를 포함한 이기종 헬스케어 데이터 소스 간의 상호 운용성은 AI 보조 헬스케어 솔루션 배포에 있어 여전히 주요한 기술적 과제로 남아 있습니다. 이러한 맥락에서 HL7 FHIR와 같은 표준 상호 운용성 프레임워크는 의미적 일관성을 유지하고 확장 가능한 통합을 지원하는 동시에, 서로 다른 시스템 간에 임상 정보를 교환할 수 있는 구조화된 메커니즘을 제공합니다.
본 연구는 이기종 임상 환경에서의 의료 데이터 분석을 지원하기 위해 대규모 언어 모델(Large Language Models)과 의료 상호운용성 표준을 통합한 상호운용 가능한 웹 플랫폼을 제시합니다. 제안된 아키텍처는 HL7 FHIR 기반의 데이터 통합을 검색 증강 생성(Retrieval-Augmented Generation, RAG) 및 멀티 에이전트 처리 프레임워크와 결합하여, 브라질 일반 데이터 보호법(LGPD)을 포함한 관련 데이터 보호 요구 사항을 준수하는 동시에 문맥 인식 AI 지원 분석을 제공합니다.
본 프로토콜은 확립된 헬스케어 상호운용성 표준을 사용하여 이기종 임상 데이터를 통합하기 위한 상호운용 가능한 아키텍처를 설명합니다. 또한, 대규모 및 소규모 언어 모델(LLM 및 SLM) 기반의 멀티 에이전트 처리 파이프라인 구현 방법과, 제안된 플랫폼의 동작을 평가하기 위해 정량적 지표와 정성적 분석을 결합한 평가 프레임워크에 대해 상세히 다룹니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
프로토콜
본 연구는 인간 참여자 모집, 식별 가능한 환자 기록 접근 또는 동물 실험을 포함하지 않았습니다. 프로토콜은 방법론적 검증을 위해 공개적으로 이용 가능한 완전 익명화된 데이터셋만을 사용하여 개발 및 평가되었습니다. 개인 건강 정보는 접근하거나 처리하지 않았습니다. 따라서 기관생명윤리위원회(IRB) 또는 연구윤리위원회의 승인이 필요하지 않았습니다. 본 프로토콜은 향후 임상 데이터와 관련된 응용 연구를 지원하기 위해 브라질 일반데이터보호법(LGPD)을 포함한 관련 데이터 보호 원칙에 따라 개발되었습니다.
데이터셋 선택 및 전처리
제안된 프로토콜은 방법론적 검증을 위해 구조화된 전자 건강 기록(EHR), 임상 질의응답 데이터 및 의료 영상 데이터셋으로 구성된 공개 및 완전 익명화된 임상 데이터셋을 사용하여 평가되었습니다. 플랫폼에 통합되기 전, 데이터셋은 데이터 정규화, 일관성이 없거나 불완전한 기록 제거, HL7 FHIR 리소스 매핑, 텍스트 정제, 검색 청크로의 세그멘테이션, 벡터 인덱싱을 위한 임베딩 생성 등 표준화된 전처리 과정을 거쳤습니다. 이러한 전처리 단계는 서로 다른 데이터 소스 간의 의미론적 일관성을 보장하여 상호운용성을 촉진하고, 적용 가능한 데이터 개인정보 보호 원칙을 준수하는 동시에 제안된 워크플로의 재현성을 가능하게 했습니다.
데이터셋은 인공지능 및 디지털 헬스 연구에서 일반적으로 사용되는 공개 벤치마크 저장소에서 확보되었습니다. 구조화된 전자 건강 기록(EHR), 비구조화된 임상 서사, 임상 질의응답 작업 및 의료 영상 메타데이터를 포함하여 이질적인 임상 정보를 대표하도록 데이터셋을 선정하였습니다. 본 프로토콜은 특정 임상 코호트를 평가하기보다, 다양한 헬스케어 데이터셋에 적용 가능한 재현 가능한 구현 워크플로우를 입증하는 데 중점을 둡니다. 이러한 벤치마크 데이터셋의 다양성을 통해 여러 임상 데이터 모달리티에 걸친 상호운용성 파이프라인, 검색 증강 생성(RAG) 및 멀티 에이전트 추론 프레임워크의 검증이 가능합니다.
실험 환경 구성
실험 환경은 제어 가능하고 재현 가능한 조건 하에서 상호 운용 가능한 플랫폼을 평가하도록 구성되었습니다. 아키텍처는 의료 데이터 분석을 위한 단일 처리 파이프라인으로 구성된 데이터 수집 모듈, 상호 운용성 계층, 대규모 언어 모델(LLMs) 및 평가 구성 요소로 이루어져 있습니다. 그림 1은 임상 데이터 수집부터 진단 결과 생성까지의 전체 워크플로를 보여줍니다.
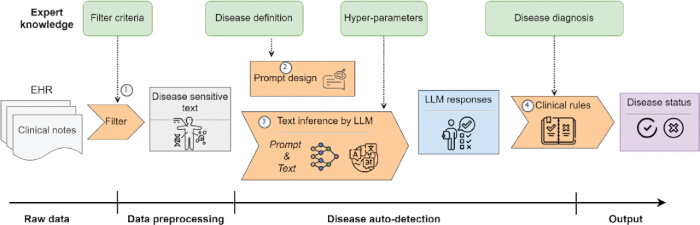
그림 1원시 임상 데이터부터 질환 상태 출력까지의 처리 파이프라인을 보여주는 전체 시스템 워크플로. 이 과정은 전자 건강 기록(EHR) 수집으로 시작하여, 질환 관련 정보를 추출하기 위한 데이터 필터링 및 전처리가 이어집니다. 구조화된 프롬프트 설계 단계에서는 전문가 지식, 질환 정의 및 하이퍼파라미터를 통합하여 거대 언어 모델(LLM)과의 효과적인 상호작용을 가능하게 합니다. LLM은 텍스트 추론을 수행하여 문맥 기반 응답을 생성하며, 이는 이후 임상 규칙을 통해 평가되어 최종 질환 상태를 결정합니다. 이 워크플로우는 임상 의사결정을 지원하기 위한 데이터 전처리, 지식 기반 프롬프팅 및 AI 기반 추론의 통합을 강조합니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
헬스케어 상호운용성 아키텍처
백엔드 인프라는 플랫폼 구성 요소 간의 통신을 지원하기 위해 RESTful API 기반의 모듈형 아키텍처를 채택하였습니다(그림 2). 이 아키텍처는 구조화된 전자 건강 기록(EHR), 의사 소견서, 의료 영상 시스템에서 도출된 메타데이터를 포함하는 이기종 임상 정보를 수용합니다. 이러한 데이터는 다양한 소스와 형식에서 발생하므로, 표준화된 데이터 모델, 특히 Fast Healthcare Interoperability Resources (FHIR) 프레임워크15,16,17..를 통해 상호 운용성을 달성하였습니다. FHIR의 도입은 분산된 헬스케어 환경에서 확장성과 유연성을 유지하면서 구조화된 정보 교환을 지원합니다. 또한, 의료 기관에서 여전히 널리 사용되고 있는 기존 임상 시스템과의 통합을 용이하게 하기 위해 HL7 기반의 통신 메커니즘이 통합되었습니다16,17.
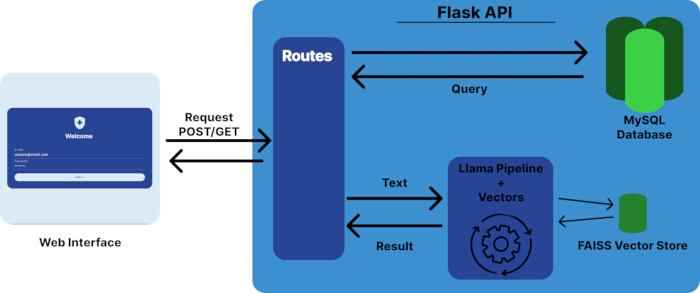
그림 2: 제안된 상호 운용 가능한 플랫폼의 시스템 아키텍처. 웹 인터페이스는 HTTP POST/GET 요청을 사용하는 Flask API를 통해 백엔드와 통신합니다. API는 라우팅, 쿼리 처리, 그리고 정형 및 비정형 데이터 소스와의 상호작용을 관리합니다. MySQL 데이터베이스는 정형 임상 데이터를 저장하며, FAISS 기반 벡터 저장소는 검색 작업을 위한 유사도 검색을 지원합니다. LLaMA 기반 파이프라인은 텍스트 입력을 처리하고 벡터 표현을 사용하여 응답을 생성함으로써 검색 증강 생성(RAG)을 가능하게 합니다. 이 아키텍처는 웹 서비스, 데이터베이스 관리, 벡터 검색 및 대규모 언어 모델 추론이 단일 시스템으로 통합된 구조를 보여줍니다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
다중 에이전트 워크플로우 설정
멀티 에이전트 아키텍처는 워크플로의 각기 다른 단계를 담당하는 전문화된 기능적 에이전트들로 구성됩니다. 전처리 에이전트가 데이터 정규화 및 FHIR 매핑을 수행하며, 이어서 검색 에이전트가 벡터 데이터베이스 내에서 시맨틱 검색을 담당합니다. 추론 에이전트는 검색된 컨텍스트를 LLM과 통합하여 응답을 생성하며, 검증 에이전트는 최종 응답이 반환되기 전 출력의 일관성과 서식을 확인합니다. 에이전트 간의 조정은 각 에이전트의 출력이 다음 단계의 입력으로 사용되는 순차적 오케스트레이션 전략을 따르며, 이를 통해 재현 가능하고 모듈화된 구현을 보장합니다.
임상 데이터 통합
데이터 통합 계층은 여러 임상 소스로부터 정보를 수집하여 후속 처리를 위해 준비합니다. 전처리는 서로 다른 데이터 세트 간의 의미론적 일관성을 향상시키기 위해 데이터 정규화, 토큰화 및 개체 정렬을 포함합니다. 임상 정보는 구조와 품질이 다양하므로, 이러한 작업은 노이즈를 줄이고 AI 모델과의 상호작용을 용이하게 하는 데 도움이 됩니다. 그림 315,16,17에 나타낸 바와 같이, 서로 다른 데이터 형식을 조화시키고 처리 파이프라인과의 호환성을 유지하기 위해 구조화된 매핑 전략이 적용되었습니다.
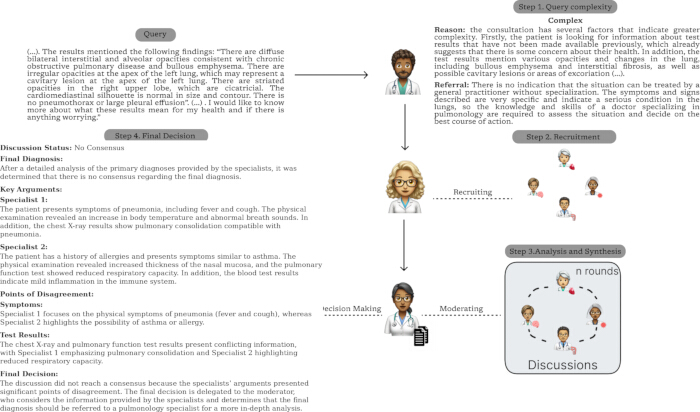
그림 3: 멀티 에이전트 임상 추론 과정의 세부 예시. 이 그림은 임상 질의가 복잡성 평가, 전문가 모집, 협동 논의 및 최종 의사결정을 포함한 여러 단계를 통해 어떻게 분석되는지 보여줍니다. 이 과정은 질의 복잡성에 따라 추론 전략을 동적으로 조정하는 시스템의 능력을 입증하며, 이는 임상 의사결정 지원 시나리오에서 효율성과 진단 정확도를 모두 향상시킵니다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
검색 증강 생성(Retrieval-Augmented Generation) 파이프라인 구성하기
검색 증강 생성(Retrieval-Augmented Generation, RAG)은 정보 검색과 대규모 언어 모델의 생성 능력을 결합하여 문맥 인식 분석을 제공하기 위해 통합되었습니다. 사용자 쿼리는 임베딩 모델을 통해 벡터 표현으로 변환되며, 시맨틱 유사도 검색을 사용하여 벡터 데이터베이스와 매칭함으로써 가장 관련성이 높은 문맥적 구절을 검색합니다. 검색된 문서들은 LLM의 추론 전 단계에서 원래의 쿼리와 결합됩니다. 이러한 전략은 응답 생성 중에 문맥 정보를 제공하는 데 도움을 주며, 의료 분야를 포함한 지식 집약적 애플리케이션에서 사실적 일관성 향상 및 환각 현상 감소와 연관되어 왔습니다18,19. 그림 1 및 그림 3은 전체 검색 워크플로우와 그에 따른 추론 과정을 보여줍니다.
각 사용자 요청에 대해, 원래의 쿼리를 벡터 데이터베이스에서 검색된 가장 관련성 높은 문맥 단락들과 결합하여 최종 프롬프트를 동적으로 구성합니다. 검색된 정보는 추론 전에 문맥적 근거로 통합되며, 이를 통해 언어 모델은 의미론적 일관성을 유지하고 근거 없는 생성을 줄이면서 검색된 헬스케어 지식에 기반한 응답을 생성할 수 있습니다.
프롬프트 엔지니어링 및 멀티 에이전트 추론
본 프로토콜은 응답 생성 시 문맥적 해석을 개선하기 위해 구조화된 프롬프팅 전략을 통합하였습니다. 이러한 프롬프팅 기법은 고급 추론 메커니즘과 결합하여 복잡한 임상 시나리오에서의 추론 과정을 안내하며, 이는 최근 문헌에 보고된 발전 내용과 일치합니다20.
이 아키텍처는 데이터 검증, 컨텍스트 필터링, 임상 추론 지원 및 출력 검증을 포함하여 처리 파이프라인 내에서 서로 다른 기능을 수행하는 전문 모듈로 구성된 멀티 에이전트 프레임워크를 포함합니다. 이러한 모듈형 조직을 통해 작업은 순차적으로 또는 병렬로 실행될 수 있으며, 다양한 처리 요구 사항에 대한 유연성을 제공합니다(그림 4). 이러한 활동을 여러 에이전트에 분산함으로써 단일 언어 모델에 대한 의존도를 낮추고 더욱 견고한 처리 워크플로우를 지원합니다. 이러한 아키텍처 전략은 분산 인공지능 및 지능형 시스템 설계의 최신 발전 방향과 일치합니다21,22.
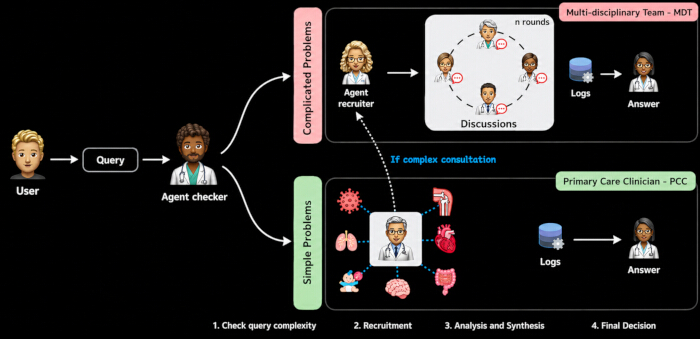
그림 4: 임상 추론을 위한 다중 에이전트 결정 프레임워크. 프로세스는 사용자 질의로 시작되며, 이는 질의 복잡성을 평가하는 책임 에이전트 체커에 의해 평가됩니다. 복잡한 사례의 경우, 시스템은 전문 에이전트로 구성된 다학제 팀(MDT)을 동적으로 모집하며, 이들은 최종 결정을 내리기 전 문제를 분석하고 지식을 종합하기 위해 반복적인 토론 라운드를 진행합니다. 더 단순한 사례의 경우, 질의는 일차 진료 임상의(PCC) 에이전트에 의해 처리되어 더 빠른 응답 생성이 가능해집니다. 이러한 적응형 아키텍처는 효율성과 분석적 깊이 사이의 균형을 맞추어, 헬스케어 애플리케이션에서의 결정 품질과 시스템 확장성을 향상시킵니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
성능 평가
생성된 결과물의 언어적 품질과 의미적 일관성을 모두 파악할 수 있는 상호 보완적인 지표를 사용하여 시스템 성능을 평가하였다. n-gram 중첩을 기반으로 구문적 유사성을 측정하기 위해 BLEU를 적용하였으며23, ROUGE를 통해 특히 요약 및 정보 추출 작업에서의 재현율과 콘텐츠 커버리지를 평가하였다24. 의미적 유사성은 트랜스포머 기반 모델에서 도출된 문맥 임베딩을 사용하여 생성 텍스트와 참조 텍스트를 비교하는 BERTScore로 평가하였다25. 추가 분석으로는 모델의 신뢰도와 의미적 일관성을 각각 조사하기 위해 퍼플렉시티(perplexity)와 코사인 유사도 분석을 수행하였다26,27.
선택된 평가 지표는 어휘 및 의미론적 분석을 결합하여 시스템 성능에 대한 상호 보완적인 관점을 제공합니다. 이러한 결합은 문맥적 해석이 어휘적 유사성만큼이나 중요한 헬스케어 응용 분야에서 특히 유용합니다. 해당 플랫폼은 클라우드 기반 및 로컬 배포를 모두 지원하는 제어된 컴퓨팅 환경에서 평가되었습니다. 민감한 임상 정보를 처리할 때 데이터 개인정보 보호 요구 사항을 충족하고 외부 서비스에 대한 의존도를 낮추기 위해 LLM의 로컬 실행이 옵션으로 포함되었습니다. 이러한 배포 전략은 데이터 보호 프레임워크와 호환되며 다양한 운영 환경에 맞게 조정될 수 있습니다4.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
결과
생성된 출력물의 언어적 정확성과 의미론적 일관성을 모두 검토하기 위해 정성적 분석과 더불어 상보적인 정량적 지표를 사용하여 시스템 성능을 평가했습니다. 이러한 평가 전략은 어휘적 및 의미론적 측정 방식을 결합하여, 헬스케어 관련 언어 생성 작업에서 모델 동작에 대한 보다 광범위한 특성 분석을 제공합니다.
표 1은 BLEU, ROUGE 및 BERTScore를 통해 얻은 정량적 결과들을 보여줍니다. 이러한 지표들은 어휘적 유사성, 정보 커버리지 및 의미적 정렬을 포함하여 생성된 텍스트의 상호 보완적인 측면들을 평가하며, 자연어 처리 연구에서 널리 사용되기 때문에 선택되었습니다.
<...| 판단 모델 | 프롬프트 |
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
토론
본 연구에서 제시된 평가는 공개적으로 이용 가능하며 완전히 익명화된 벤치마크 헬스케어 데이터셋을 사용하여 수행된 방법론적 검증을 나타냅니다. 본 연구의 목적은 임상적 유효성보다는 재현 가능한 구현 프로토콜을 입증하는 것이므로, 의료 전문가나 환자 모집이 포함된 전향적 임상 검증은 수행되지 않았습니다.
본 연구의 결과는 의료 상호운용성 표준과 대규모 언어 모델을 결합하는 것이 이기종 임상 정보를 통합하기 위한 실용적인 프레임워크를 제공한다는 점을 시사합니다. 제안된 아키텍처는 FHIR 및 HL7을 포함한 구조화된 데이터 교환 메커니즘을 AI 기반 언어 처리와 통합하여, 최신 디지털 헬스 시스템의 발전 방향과 일치하는 단일 워크플로우로 구현하였습니다15,16,17.
제...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
공개 사항
저자들은 본 원고에 보고된 연구에 영향을 미칠 수 있는 경쟁적인 재정적 이해관계나 개인적 관계가 없음을 밝힙니다. 생성형 인공지능(AI) 도구는 언어 편집, 문법 교정 및 원고의 가독성 개선을 돕기 위한 용도로만 사용되었습니다. 모든 과학적 내용, 연구 설계, 방법론, 데이터 분석, 결과 해석 및 편집 결정은 저자들에 의해 개발, 검증 및 승인되었으며, 저자들은 본 원고의 내용에 대해 모든 책임을 집니다.
감사의 글
저자들은 본 연구의 개발을 지원한 연구 환경과 기술적 논의를 제공해 준 Ceará 연방 대학교(UFC)의 임베디드 및 분산 시스템 연구소(LESC)에 감사를 표합니다. 또한 저자들은 본 연구 전반에 걸쳐 사용된 오픈 소스 소프트웨어, 상호 운용성 표준 및 공개 데이터 세트의 개발자와 유지 관리자에게 감사를 표합니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| FAISS | Meta Platforms Inc. | 버전 1.8.0 | 검색 증강 생성(RAG) 파이프라인의 유사도 검색에 사용되는 벡터 데이터베이스. |
| FHIR 표준 | HL7 International | 릴리스 4 (R4) | 구조화된 임상 데이터 교환을 위해 채택된 헬스케어 상호운용성 표준. |
| 플라스크 | 팔레트 프로젝트 | 버전 3.0.3 | RESTful 백엔드 API를 구현하는 데 사용된 Python 웹 프레임워크. |
| HL7 표준 | HL7 International | 버전 2.x | 병원 정보 시스템과의 상호 운용성을 위해 사용되는 레거시 메시징 프로토콜. |
| HTTP REST API | 사용자 정의 구현 | 입력된 텍스트가 없습니다. 번역할 내용을 제공해 주십시오. | 프런트엔드, 백엔드, 데이터베이스 및 AI 서비스 간의 RESTful 통신 계층. |
| LangChain | LangChain Inc. | 버전 0.3.x | LLM, 프롬프트 엔지니어링 및 검색 증강 생성(Retrieval-Augmented Generation) 워크플로를 통합하는 데 사용되는 프레임워크. |
| LangGraph | LangChain Inc. | 버전 0.2.x | 다중 에이전트 임상 추론 워크플로를 조정하는 데 사용된 프레임워크. |
| LLaMA 3.1 8B Instruct | Meta Platforms Inc. | 버전 3.1 | 임상적 추론 및 자연어 생성을 위해 활용되는 거대 언어 모델. |
| MySQL 커뮤니티 서버 | Oracle Corporation | 버전 8.0 | 구조화된 임상 데이터를 저장하는 데 사용되는 관계형 데이터베이스. |
| Ollama | Ollama Inc. | 버전 0.9.x | 환자 개인정보를 보호하면서 거대 언어 모델을 실행하는 데 사용되는 로컬 추론 엔진. |
| 파이썬 | Python Software Foundation | 버전 3.11 | 전체 플랫폼 구현에 사용된 프로그래밍 언어. |
| PyTorch | Linux Foundation | 버전 2.4 | 대규모 언어 모델 추론에 사용되는 딥러닝 프레임워크. |
| 검색 증강 생성(RAG) 파이프라인 | 맞춤형 구현 | 제공된 소스 텍스트가 없습니다. 번역할 내용을 입력해 주세요. | 문맥 인식 응답 생성을 위해 시맨틱 검색과 LLM 추론을 결합한 AI 프레임워크. |
| 문장 트랜스포머(Sentence Transformers) | Hugging Face Inc. | all-MiniLM-L6-v2 | 의미론적 문서 검색을 위한 밀집 벡터 표현을 생성하는 데 사용되는 임베딩 모델. |
| Ubuntu Linux | Canonical Ltd. | 버전 24.04 LTS | 개발 및 실험적 평가에 사용된 운영체제. |
| Visual Studio Code | Microsoft Corporation | 버전 1.100 | 소프트웨어 구현 및 디버깅에 사용되는 통합 개발 환경. |
참고문헌
- Chukwu E, Garg L. A systematic review of blockchain in healthcare: frameworks, prototypes, and implementations. IEEE Access. 2020;8:21196-21214. doi:10.1109/ACCESS.2020.2969881.
- Al-Nbhany WANA, Zahary AT, Al-Shargabi AA. Blockchain-IoT healthcare applications and trends: a review. IEEE Access. 2024;12:4178-4212. doi:10.1109/ACCESS.2023.3349187.
- Tan Y, et al. MedChatZH: a Chinese medical large language model. Comput Biol Med. 2024;172:108290.
- OLLAMA TEAM. Ollama: Run Large Language Models locally. Version 0.x. San Francisco: Ollama, 2024.
- Jahan I, Laskar MTR, Peng C, Huang JX. A comprehensive evaluation of large language models on benchmark biomedical text processing tasks. Comput Biol Med. 2024;171:108189. doi:10.1016/j.compbiomed.2024.108189.
- Liu X, Zhou Y, Wang Z, et al. Disease topic modeling of users' inquiry texts: a text mining-based PQDR-LDA model for analyzing the online medical records. IEEE Trans Eng Manag. 2023.
- Taylor N, Kormilitzin A, Lorge I, Nevado-Holgado A, Cipriani A, Joyce DW. Model development for bespoke large language models for digital triage assistance in mental health care. Artif Intell Med. 2024;157:102988.
- Song M, et al. PneumoLLM: a large language vision model for pneumonia diagnosis. Med Image Anal. 2024;97:103248.
- Chien SC, Yen CM, Chang YH, Chen YE, Liu CC, Hsiao YP, et al. Using large language model (LLM) to identify high-burden informal caregivers in long-term care. Comput Methods Programs Biomed. 2024;255:108329. doi:10.1016/j.cmpb.2024.108329.
- Xue X, Zhang D, Sun C, et al. Xiaoqing: a Q&A model for glaucoma based on LLMs. Comput Biol Med. 2024;174:108399.
- Wu D, Nie L, Mumtaz RA, Agarwal K. A LLM-based hybrid-transformer diagnosis system in healthcare. IEEE J Biomed Health Inform. 2024.
- Zhang Y, et al. LLM-enhanced multi-teacher knowledge distillation for modality-incomplete emotion recognition in daily healthcare. IEEE J Biomed Health Inform. 2024.
- Sarzaeim P, Mahmoud QH, Azim A. A framework for LLM-assisted smart policing system. IEEE Access. 2024;12:74915-74929. doi:10.1109/ACCESS.2024.3404862.
- Leme RS, Blank M. Lei Geral de Proteção de Dados e segurança da informação na área da saúde. Cad Ibero-Am Direito Sanit. 2020;9(3):210-224. doi:10.17566/ciads.v9i3.690.
- Zaganelli MV, Binda Filho DL. O sigilo médico e os dados sensíveis na telemedicina à luz da Lei Geral de Proteção de Dados. RECIIS. 2023;17(3):729-740. doi:10.29397/reciis.v17i3.3689.
- Tabari P, Costagliola G, De Rosa M, Boeker M. State-of-the-art Fast Healthcare Interoperability Resources (FHIR)-based data model and structure implementations: systematic scoping review. JMIR Med Inform. 2024.
- Martinez T, et al. HL7 systems and interoperability ecosystems in modern healthcare. IEEE Rev Biomed Eng. 2024.
- Chen L, et al. HL7 integration and semantic interoperability in distributed healthcare networks. IEEE J Biomed Health Inform. 2024.
- Liu W, Li W, Huang W, Gao Y. Security framework for medical data sharing. Telemed E-Health. 2024.
- Basile LJ, Carbonara N, Panniello U, Pellegrino R. How can technological resources improve the quality of healthcare service? IEEE Trans Eng Manag. 2024;71:5771-5781. doi:10.1109/TEM.2022.3192405.
- Singh A, et al. Prompt engineering in large language models: a survey using SWOT analysis [preprint]. arXiv. 2024
- Chen L, Chen Y, Liang W, Li X, Li KC, Wang J, Xiong N. MASS: a multiattribute sketch secure data sharing scheme for IoT wearable medical devices based on blockchain. IEEE Internet Things J. 2025;12(2):1990-2001. doi:10.1109/JIOT.2024.3468733.
- Autoridade Nacional de Proteção de Dados (BR). Diretrizes para agentes de tratamento de pequeno porte. Brasília (DF): ANPD; 2021.
- Patel R, Kim H. Interoperability in EHR. IEEE Transactions on Biomedical Engineering, v. 70, n. 8, p. 2341-2354, ago. 2023. DOI: 10.1109/TBME.2023.3241567.
- Zhang T, Kishore V, Wu F, Weinberger KQ, Artzi Y. BERTScore: evaluating text generation with BERT. In: International Conference on Learning Representations (ICLR); 2020.
- Chen X, Lu X, Li Q, Li D, Zhu F. Integration of LLM and Human-AI Coordination for Power Dispatching With Connected Electric Vehicles Under SAGVNs. IEEE Trans Veh Technol. 2025;74(2):1992-2002. doi:10.1109/TVT.2024.3434969
- Zhou S, Chen C, Gu HH. Testing and evaluating SNOMED CT web browsers' textual search feature. In: Proceedings of the IEEE International Conference on Bioinformatics and Biomedicine (BIBM); 2019.
- McPeak G, Sautmann A, George O, Hallal A, Simal EA, Schwartz AL, Abaluck J, Ravi N, Pless R. An LLM's medical testing recommendations in a Nigerian clinic: potential and limits of prompt engineering for clinical decision support. In: Proceedings of the 2024 IEEE 12th International Conference on Healthcare Informatics (ICHI); 2024.
- LLAMA TEAM, AI @ META. The Llama 3 Herd of Models. arXiv preprint arXiv:2407.21783, 2024. Disponível em: https://arxiv.org/abs/2407.21783.
- Conselho Nacional de Saúde (BR). Resolução nº 466, de 12 de dezembro de 2012. Aprova as diretrizes e normas regulamentadoras de pesquisas envolvendo seres humanos. Brasília (DF): Ministério da Saúde; 2012.
- Singhal K, Azizi S, Tu T, et al. Large language models encode clinical knowledge. Nature. 2023;620:172-180. doi:10.1038/s41586-023-06291-2.
- Sahoo P, et al. A systematic survey of prompt engineering in large language models [preprint]. arXiv. 2024. Available from: https://arxiv.org/abs/2402.07927
- Yan Y, Hou Y, Xiao Y, Zhang R, Wang Q. KNOWNET: guided health information seeking from LLMs via knowledge graph integration. IEEE Trans Vis Comput Graph. 2024.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.