본 연구는 MetaFormer 특징 추출과 융합 전 교차 모달 정렬을 위한 양방향 흐름 매칭을 이용한 하이퍼스펙트럴 및 LiDAR 지표면 피복 분류를 위한 2단계 프레임워크를 제시합니다. 세 가지 공개 벤치마크 데이터셋에 대한 평가 결과, 고정된 벤치마크 프로토콜 하에서 경쟁력 있는 분류 성능을 입증하였습니다.
이 콘텐츠를 보려면 JoVE 구독이 필요합니다. 로그인하거나 오늘 무료 평가판을 시작하세요.
이 논문에서
요약
초록
다중 모달 원격 탐사 분류는 도시 지도 작성 및 환경 모니터링과 같은 응용 분야에서 중요한 역할을 합니다. 그러나 센싱 모달리티 간의 이질적인 특성 분포는 특성 미정렬 및 세만틱 불일치를 초래하여 다중 모달 융합의 효과를 제한할 수 있습니다. 합성곱, 그래프 기반, 어텐션 기반, 대조 학습, 전송 지향 및 시퀀스 기반 방법을 포함한 기존의 다중 모달 융합 방식은 상보적 정보를 활용할 수 있지만, 모달리티별 특성 분포를 적절하게 정렬하지 못할 수 있습니다. 본 연구에서는 다중 모달 플로우 매칭을 통해 이러한 문제를 해결하는 2단계 다중 모달 분류 프레임워크인 FlowErs를 제안합니다. 작동 가설은 특성 융합 전에 쌍을 이룬 특성 분포 간의 불일치를 줄이면 고정된 벤치마크 프로토콜 하에서 지표면 피복 분류 성능이 향상된다는 것입니다. 첫 번째 단계에서는 모달리티별 MetaFormer 인코더가 초분광 이미지(HSI) 및 LiDAR 데이터로부터 계층적 표현을 추출합니다. 이후 다중 모달 플로우 매칭 모듈이 양방향 평균 제곱 오차 목적 함수를 사용하여 쌍을 이룬 특성 분포를 공유 잠재 표현으로 이동시키기 위한 시간 조건부 속도장을 학습합니다. 두 번째 단계에서는 사전 학습된 정렬 모듈을 재사용하여 다중 모달 표현을 정렬한 후, 경량 융합 헤드가 픽셀 단위 분류를 수행합니다. 3개의 공개 벤치마크 데이터셋에 대한 평가 결과, 고정 벤치마크 분할 하에서 최대 97.56%의 전체 정확도(OA)를 나타냈습니다. 성능은 개별 지표면 피복 클래스마다 다르게 나타났으며, 본 연구에서는 클래스별 제한 사항과 클래스 불균형이 종합 지표에 미치는 영향에 대해 논의합니다. 현재 평가는 반복 실행 통계 분석이나 계산 프로파일링이 없는 고정 분할 실험으로 제한되어 있습니다. 향후 연구에서는 통계적 강건성, 계산 효율성 및 지역 간 일반화 가능성을 조사할 예정입니다.
서론
원격 탐사 영상을 이용한 정밀한 토지 이용 및 토지 피복(LULC) 분류는 도시 개발, 환경 모니터링, 재난 관리 및 지속 가능한 개발을 포함한 광범위한 실제 응용 분야에서 필수적입니다1. 최근 몇 년 동안 초분광 영상(HSI), LiDAR(light detection and ranging) 및 합성 개구 레이더(SAR)를 포함한 다중 모달 원격 탐사 데이터의 가용성이 점점 높아지고 있습니다. 이러한 가용성의 증가는 세밀한 토지 피복 분류를 위한 원격 탐사의 역량을 실질적으로 확장시켰습니다2. 이러한 탐사 모달리티들은 지구 표면의 서로 다르면서도 상호 보완적인 특성을 포착합니다. HSI는 물질 구성을 특성화하기 위한 풍부한 분광 정보를 제공하는 반면, LiDAR는 정확한 구조 및 고도 정보를 제공합니다3. 이러한 이종 데이터 소스를 통합하면 단일 모달리티를 사용할 때보다 더 변별력 있고 노이즈에 강하며 의미론적으로 포괄적인 특징 표현을 생성할 수 있습니다4.
그럼에도 불구하고, 멀티모달 데이터를 효율적으로 활용하는 것은 여전히 오래된 과제로 남아 있습니다5. 주요한 어려움은 센싱 모달리티 자체의 이질성에서 비롯되는데, 이는 공간 해상도, 노이즈 특성, 통계적 분포 및 특징 세맨틱스에서 차이가 납니다6. 예를 들어, 동일한 지표 피복 객체가 HSI에서는 고차원 스펙트럼 시그니처로, LiDAR에서는 희소한 기하학적 구조로 표현될 수 있습니다7. 결과적으로 모달리티별 특징들은 서로 다른 특징 매니폴드에 존재하는 경우가 많으며, 이로 인해 직접적인 특징 융합은 비효율적이거나 잠재적으로 오해의 소지가 있을 수 있습니다. 또한, 컨볼루션, 어텐션 및 Transformer 기반 방법을 포함한 많은 기존의 멀티모달 융합 접근 방식은 서로 다른 센서에서 추출된 특징들이 이미 공간적 및 세맨틱적으로 정렬되어 있다고 암묵적으로 가정합니다8. 그러나 이러한 가정은 실제 응용 분야에서 유효하지 않은 경우가 많습니다. 단순한 특징 연결이나 픽셀 단위 융합으로는 모달리티 간의 불일치를 충분히 포착할 수 없으며, 이는 잠재적으로 불안정한 최적화와 일반화 성능 저하로 이어질 수 있습니다. 나아가, 어텐션 기반 융합 방법은 특징 간 상호작용을 개선하지만, 대규모 또는 고해상도 지표 피복 분류에 필요한 장거리 교차 모달 의존성에 대한 모델링 능력이 제한적일 수 있습니다9. 결과적으로, 호환되지 않는 임베딩은 상호 보완적인 정보의 통합을 제한할 수 있기 때문에 이질적인 특징 표현의 효율적인 정렬은 멀티모달 원격 탐사 분야에서 여전히 주요한 과제로 남아 있습니다.
이러한 과제를 해결하기 위해, 교차 모달 정렬은 조건부 특징 전송 문제로 정식화됩니다. 플로우 매칭(Flow matching)은 서로 다른 이종 특징 분포 사이의 연속적이고 가역적인 매핑을 학습하기 위한 수학적 근거를 갖춘 프레임워크를 제공합니다10. 이는 상미분 방정식(ODE)으로 매개변수화된 시간 의존적 속도장을 통해 하나의 분포를 다른 분포로 전송함으로써, 특징 매니폴드 간의 연속적인 변환을 촉진합니다11. 확률적 노이즈 섭동이나 적대적 학습을 통한 암시적 분포 매칭에 의존하는 확산 기반 모델과 달리, 플로우 매칭은 구조화된 특징 공간 사이의 결정론적이고 전단사적인 변환을 학습합니다12. 이러한 특성 덕분에 플로우 매칭은 HSI, LiDAR, SAR가 각각 지구 표면의 상호 보완적인 특성을 캡처하는 고차원 특징 매니폴드를 나타내는 다중 모달 원격 탐사에 매우 적합합니다13. 따라서 플로우 매칭은 특징 정렬 중 기하학적 일관성을 촉진하는 동시에, 연속적인 특징 전송을 통해 교차 모달 대응 관계를 설정하는 원리적인 접근 방식을 제공합니다. 적절한 정칙성 가정이 충족되면 ODE 플로우는 가역 매핑을 제공할 수 있으나, 본 연구에서는 정확한 가역성과 물리적 해석 가능성을 경험적으로 평가하지 않았습니다. 본 연구의 작동 가설은 특징 융합 전에 쌍을 이룬 특징 분포 간의 불일치를 줄임으로써, 고정된 벤치마크 분할 조건 하에서 종합적인 지표 피복 분류 성능을 향상시킬 수 있다는 것입니다.
이러한 고려 사항을 바탕으로, 제안된 프레임워크인 FlowErs는 2단계 아키텍처 내에 흐름 기반 정렬 단계를 포함합니다. 첫 번째 단계에서는 각 모달리티의 특성 매니폴드를 정렬하기 위해 양방향 흐름 네트워크를 학습시킵니다. 구체적으로, 모달리티별 MetaFormer 백본이 계층적 특성 임베딩을 추출하며, 모달리티별 특성 분포 간에 샘플을 운송하기 위해 flow-matching 목적 함수를 최적화합니다. 이 과정은 특성 공간 사이의 매끄럽고 가역적인 변환을 제공하여, 동일한 의미론적 클래스에 속하는 표현들이 공유 잠재 도메인 내에서 더 밀접하게 정렬되도록 유도합니다. 두 번째 단계에서는 사전 학습된 흐름 정렬기를 동결하고, 새로운 다중 모달 입력 데이터를 변환한 후 경량 분류기를 통해 융합합니다. 이러한 분리된 학습 전략은 기하학적 정렬과 의미론적 분류를 구분하여, 두 단계가 상호 보완적인 목적 함수를 최적화할 수 있게 합니다. 정렬 모듈은 특성 융합 전의 특성 분포 불일치를 줄이기 위한 것이며, 부피 보존 보장(volume-preservation guarantee)이 입증되었다고 주장하지는 않습니다. 또한, FlowErs는 다중 모달 융합을 위한 명시적인 특성 운송 정식화를 제공하지만, 등록 오차(registration errors)에 대한 강건성은 본 연구에서 별도로 평가되지 않았습니다.
본 연구의 주요 기여도는 다음과 같이 요약된다. 다중 모달 지표면 피복 분류를 위한 2단계 프레임워크인 FlowErs를 제안한다. 제안된 프레임워크에서는 먼저 MetaFormer 인코더를 사용하여 모달리티별 특징을 추출한 후, 경량 특징 융합 전에 흐름 기반 모듈을 통해 이를 정렬한다. 이러한 디커플링 설계는 서로 다른 센싱 모달리티 전반에 걸쳐 유연성을 유지하면서 효율적인 최적화를 지원한다. 또한, 본 연구는 다중 모달 원격 탐사에서 쌍을 이룬 교차 모달 특징 정렬을 위한 특징 전송 메커니즘으로 조건부 흐름 매칭(conditional flow matching)을 조사한다. 양방향 흐름 모듈은 특징 융합 전에 쌍을 이룬 특징 표현에 대해 서로 반대되는 속도 타겟을 예측함으로써, 다중 모달 통합 이전에 명시적인 정렬 전략을 제공한다. 나아가 제안된 프레임워크를 3개의 공개 벤치마크 데이터셋에서 평가하여, 제공된 고정 벤치마크 분할 조건 하에 최대 97.56%의 전체 정확도(OA)를 달성하였다. 클래스 수준의 한계점과 현재 평가의 범위 또한 명확히 기록하였다.
플로우 매칭(flow matching)의 최근 발전은 이를 확산(diffusion), 에너지(energy) 및 전송(transport) 기반 모델을 통합하는 강력한 생성 모델링 프레임워크로 정립시켰습니다. 확산 모델처럼 확률적 궤적을 시뮬레이션하는 대신, 플로우 매칭은 학습 가능한 속도장(velocity field)을 통해 가우시안 노이즈와 같은 단순한 사전 분포를 대상 데이터 분포로 운송하는 결정론적 ODE를 학습합니다15. 이러한 공식화는 스코어 추정(score estimation)을 밀도 진화(density evolution)와 직접적으로 연결하여, 더 매끄러운 확률 궤적과 더 안정적인 학습 역학을 가능하게 합니다. 플로우 매칭의 핵심 장점은 결정론적이며 계산 효율적인 공식화에 있습니다. 정류 흐름(Rectified flow) 모델16은 전송 궤적을 거의 직선 경로로 더욱 단순화하여 수치적 안정성을 향상시키고, 상대적으로 적은 적분 단계만으로도 고품질의 샘플 생성을 가능하게 합니다. 일관성 모델(consistency models)17을 포함한 후속 연구들은 효율적인 추론을 통해 대등하거나 향상된 샘플 품질을 달성하기 위해 확산 기반의 목적 함수를 콤팩트한 플로우 기반 프레임워크에 통합했습니다. 또한, 플로우 기반 학습은 사전 학습된 확산 백본을 활용할 수 있어, 샘플링 비용을 줄이면서 대규모 생성 사전 지식을 사용할 수 있게 합니다. 최근 연구들은 플로우 매칭을 광범위한 응용 분야로 확장했습니다. 예를 들어, Hu 등18은 플로우 매칭을 이용한 제어 가능하고 합성 가능한 이미지 편집을 위해 트랜스포머 백본과 잠재 공간 조작을 조사했습니다. 다른 응용 분야로는 이미지 합성19, 베어링 결함 진단20, 다중 타겟 및 다중 심 로봇 용접21 등이 있습니다. 종합적으로, 이러한 연구들은 플로우 매칭이 고해상도 및 조건부 이미지 합성을 넘어 적용 가능하며, 도메인 일반화 가능성을 지닌 잘 확립된 이론적 토대를 제공함을 보여줍니다. 연속적이고 결정론적인 전송 맵을 학습함으로써, 플로우 매칭은 효율성, 제어 가능성 및 생성 충실도 사이의 균형을 제공합니다. ODE 기반의 공식화는 현대 생성 모델링에 대한 통합된 관점을 제시하며, 다중 모드 데이터 표현 및 특징 정렬을 포함하는 응용 분야를 위한 이론적 기초를 제공합니다.
다중모달 원격 탐사 분류는 HSI, 다중분광 이미지, LiDAR 및 SAR의 상호 보완적인 정보를 통합함으로써 개별 센싱 모달리티의 한계를 극복하는 것을 목표로 합니다. 초기 융합 방식은 수작업으로 설계된 특징이나 서포트 벡터 머신(SVM)과 같은 커널 기반 알고리즘에 의존했으나, 고차원성 및 불충분한 교차 모달 상호작용으로 인해 한계가 있었습니다22. 딥러닝의 발전으로 초기, 중간 및 후기 융합을 포함한 구조적 융합 전략이 가능해졌으며, 그중 특징 수준 융합은 정보 통합과 계산 복잡성 사이에서 실질적인 균형을 제공합니다23. 합성곱 신경망(CNN)은 국소적인 공간-분광 정보를 효과적으로 캡처하는 반면, Transformer 기반 아키텍처는 더 높은 계산 비용으로 장거리 의존성을 모델링합니다24. 결과적으로, 두 방식의 상호 보완적인 강점을 결합한 하이브리드 CNN-Transformer 아키텍처가 점점 더 인기를 얻고 있습니다. 대표적인 예로, 교차 스케일 상호작용을 통해 문맥 정보를 강화하는 인접 스케일 융합 방법25과 적응형 어텐션 메커니즘을 사용하여 얕은 CNN 특징과 깊은 Transformer 표현을 결합하는 다단계 프레임워크26 등이 있습니다. 종합적으로, 이러한 연구들은 특징 중복을 줄이고 의미론적 표현을 개선하기 위한 효과적인 교차 스케일 및 교차 모달 상호작용의 중요성을 강조합니다.
최근의 연구들은 다중 모달 학습을 위한 상호 보완적인 전략들도 탐구해 왔습니다. 예를 들어, Ebbinghaus 곡선 가이드 프레임워크와 같은 저차원 표현 방법은 중복 정보를 억제하는 동시에 매니폴드 구조를 보존함으로써 과적합을 줄입니다27. 이와 병행하여, 실제 응용 분야에서의 개인정보 보호 및 통신 제약 문제를 해결하기 위해 분산 다중 모달 학습이 연구되었습니다. 일례로, FedFusion은 얕은 특징들을 저차원 부분 공간으로 투영하여 연합 다중 모달 학습을 가능하게 합니다28. 종합적으로, 이러한 연구들은 세 가지 상호 보완적인 연구 방향을 보여줍니다. 즉, 지역적 및 전역적 특징 모델링의 균형을 맞추기 위한 하이브리드 CNN-Transformer 아키텍처, 중복성과 노이즈를 줄이기 위한 저차원 학습, 그리고 확장 가능하고 개인정보를 보호하는 배포를 위한 분산 학습입니다. 그럼에도 불구하고, 모달리티 불균형, 라벨링된 데이터의 제한적인 가용성, 그리고 모델 압축과 분류 정확도 사이의 트레이드오프를 포함한 중요한 과제들이 남아 있습니다. 이러한 과제들은 경량화되고 일반화 가능한 다중 모달 퓨전 프레임워크에 대한 지속적인 연구를 촉진했습니다. 최근의 다중 모달 정렬 접근 방식들은 교차 모달 어텐션, 대조 학습, 그래프 기반 퓨전, 도메인 적응 및 분포 매칭 전략을 통합해 왔습니다. 이와 대조적으로, FlowErs는 다중 모달 정렬을 쌍을 이룬 시간 조건부 특징 전송으로 정식화하며, 기존 방식의 보편적인 대체제가 아닌 상호 보완적인 정렬 전략으로 제시됩니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
프로토콜
본 연구는 원격 탐사 지표면 피복 분류를 위해 공개적으로 이용 가능한 벤치마크 데이터셋(Houston2013, Augsburg, MUUFL)만을 사용하였습니다. 인간 대상자, 동물 실험 또는 새로 수집된 생물학적 샘플은 포함되지 않았습니다. 따라서 기관의 윤리 승인은 필요하지 않았습니다.
연구 개요
제안된 FlowErs 프레임워크는 2단계 학습 전략을 통해 다중 모달 지표 피복 분류를 수행합니다. 전체 워크플로우는 그림 1A–C에 예시되어 있습니다. 이 프레임워크는 세 가지 주요 구성 요소로 이루어져 있습니다: (i) 이기종 센싱 모달리티로부터 계층적 특징 표현을 추출하는 MetaFormer 기반 인코더, (ii) 교차 모달 특징 분포를 명시적으로 정렬하는 다중 모달 흐름 매칭(MFM) 모듈, (iii) 융합된 특징 표현으로부터 지표 피복 범주를 예측하는 경량 분류 헤드입니다. 전체 워크플로우는 먼저 모달리티별 특징을 추출한 후, 조건부 흐름 매칭을 통해 공유 잠재 공간 내에서 이러한 특징들을 정렬하며, 마지막으로 정렬된 다중 모달 표현을 사용하여 픽셀 단위의 지표 피복 분류를 수행합니다.
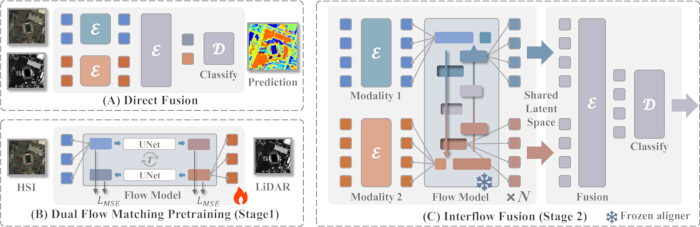
그림 1: 다중 모달 지표면 피복 분류를 위해 제안된 FlowErs 프레임워크의 개요. (A) 기존의 직접 특징 융합 방식으로, 하이퍼스펙트럼 이미지(HSI)와 LiDAR 데이터에서 추출된 모달리티별 특징들이 분류 전 직접 연결됨. (B) 1단계: 양방향 다중 모달 플로우 매칭 사전 훈련. 시간 조건부 U-Net이 평균 제곱 오차 손실을 사용하여 이질적인 특징 분포를 정렬함으로써, 모달리티별 특징 표현 사이의 연속적인 양방향 특징 전송을 학습함. (C) 2단계: 인터플로우 융합. 사전 훈련된 플로우 매칭 모듈을 고정하고 재사용하여 모달리티별 특징 표현을 정렬한 후, 경량 특징 융합 및 픽셀 단위 지표면 피복 분류를 수행함. E, 인코더; D, 디코더; T, 시간 임베딩; , 평균 제곱 오차 손실; S, 공유 잠재 표현. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
제안된 프레임워크는 2단계 학습 전략을 통해 특징 정렬과 시맨틱 분류를 분리합니다. 첫 번째 단계에서는 MFM 모듈을 학습시켜 모달리티별 특징 매니폴드 간의 양방향 특징 전송을 학습합니다. 두 번째 단계에서는 사전 학습된 흐름 정렬 모듈을 동결하고 이를 재사용하여, 경량 특징 융합 및 분류 전에 멀티모달 특징 표현을 정렬합니다. 이러한 디커플링 설계는 정렬 모듈과 분류 네트워크가 상호 보완적인 목적 함수를 최적화할 수 있게 하며, 멀티모달 융합 전 특징 분포의 불일치를 줄여줍니다.
이론적 개요
플로우 매칭(Flow matching)은 두 확률 분포 사이의 연속적이고 결정론적인 변환을 학습하는 최근 제안된 생성 모델링 패러다임입니다. 노이즈 섭동을 통해 확률성을 도입하는 확산 기반 모델과 달리, 플로우 매칭은 한 확률 분포를 다른 분포로 연속적으로 운송하는 학습 가능한 속도장(velocity field)을 직접 매개변수화합니다. 이러한 연속 운송 공식은 ODE를 통한 특징 정렬(feature alignment)을 가능하게 하여, 서로 다른 센싱 모달리티에서 얻은 쌍을 이룬 특징 표현들이 특징 융합 전 공유 궤적을 따라 진화할 수 있도록 합니다. 본 연구에서는 MetaFormer 인코더에 의해 추출된 모달리티별 임베딩 간의 양방향 특징 운송을 학습하기 위해 조건부 플로우 매칭(conditional flow matching)을 채택하였습니다. 모델은 보간된 특징 표현들에 대해 예측된 속도장과 타겟 속도장 사이의 불일치를 최소화하는 조건부 플로우 매칭 목적 함수를 사용하여 학습됩니다. 전체 수학적 공식, 이론적 도출, 지배 방정식 및 학습 목적 함수는 보충 파일 1(Supplementary File 1)에 제공되어 있습니다.
문제 정의
다중 모드 원격 탐사 데이터로부터의 지표 피복 분류는 HSI 및 LiDAR와 같은 이종 감지 모달리티로부터 시맨틱 표현을 학습하는 과정을 포함합니다. 이러한 모달리티들은 서로 다른 감지 특성을 나타냅니다. HSI는 수백 개의 채널을 통해 풍부한 분광 정보를 획득하는 반면( ), LiDAR는 상대적으로 적은 채널로 세밀한 구조적 정보를 제공합니다(
 ). 분광 정보의 풍부함과 구조적 정보의 희소성 사이의 이러한 불균형은 특성 분포에서 상당한 도메인 격차를 유발하며, 이로 인해 직접적인 특성 융합은 최적의 결과를 내지 못하거나 잠재적으로 불안정해질 수 있습니다.
형식적으로, 한 쌍의 멀티모달 입력이 주어졌을 때, 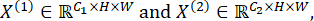 목표는 수식 1에 따라 픽셀 단위의 시맨틱 맵을 예측하는 것입니다:
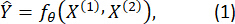
여기에서 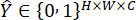 은 원-핫 인코딩된 레이블 텐서이고, C 은 지표 피복 범주의 총 수를 나타내며, θ는 학습 가능한 모든 모델 파라미터를 나타냅니다. Houston2013 데이터셋은 144개의 초분광(HSI) 밴드와 1개의 LiDAR 밴드를 포함하며 이미지 크기는 349 × 1905 픽셀입니다. Augsburg 데이터셋은 224개의 HSI 밴드와 1개의 LiDAR 밴드를 포함하며 이미지 크기는 1152 × 480 픽셀입니다. MUUFL 데이터셋은 64개의 HSI 밴드와 2개의 LiDAR 밴드를 포함하며 이미지 크기는 325 × 220 픽셀입니다. 모든 데이터셋에 대해, 입력 이미지 패치는 학습 전 32 × 32 픽셀로 크기가 조정되었습니다.
기존의 다중 모달 접근 방식은 연결(concatenation) 또는 어텐션 메커니즘을 통해 모달리티별 특징을 융합하며, 이는 서로 다른 모달리티가 호환 가능한 특징 공간에 존재한다는 것을 암묵적으로 가정합니다. 그러나 모달리티별 통계적 분포와 공간-분광 특성이 상당히 다르기 때문에, 원격 탐사 데이터의 경우 이러한 가정은 거의 성립하지 않습니다.
이러한 불일치를 명시적으로 해결하기 위해 flow matching 모듈인  을 도입합니다. 이 모듈은
 로 매개변수화되며, 모달리티별 특징 매니폴드 사이의 연속적인 양방향 변환을 학습합니다. 구체적으로 (수식 2),
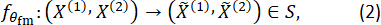
여기서 S는 모달리티별 특성 표현들이 기하학적으로 정렬되는 공유 잠재 공간을 나타냅니다. 이어서, 정렬된 특성 표현들은 수식 3에 따라 다음과 같이 융합 및 분류됩니다:
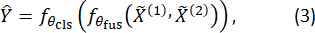
여기에서  와
 는 각각 특징 융합 및 분류 모듈을 나타냅니다. 이 공식은 전체 FlowErs 프레임워크를 정의합니다. 제안된 프레임워크는 암시적인 통계적 특징 융합에만 의존하는 대신, 다중 모달 특징 융합 및 의미론적 예측 전에 모달리티별 특징 표현을 공유 잠재 공간으로 지속적으로 전달하는 명시적인 흐름 기반 정렬 메커니즘을 도입합니다.
MetaFormer 인코더
FlowErs는 각 센싱 모달리티로부터 정보력이 있고 기하학적으로 일관된 특징 표현을 학습하는 경량의 모달리티 특화 인코더를 사용하여 교차 모달리티 특징 정렬을 수행합니다. 그림 2에 나타낸 바와 같이, 각 모달리티는 MetaFormer 아키텍처 기반의 독립적인 인코더에 의해 처리됩니다. MetaFormer는 셀프 어텐션을 명시적으로 계산하지 않고 토큰 믹싱과 채널 변환을 분리함으로써 기본적인 Transformer 설계를 일반화합니다. 이러한 설계는 고차원 HSI의 효율적인 처리를 가능하게 하는 동시에 LiDAR와 같은 저채널 모달리티에도 유연하게 적응할 수 있도록 합니다.
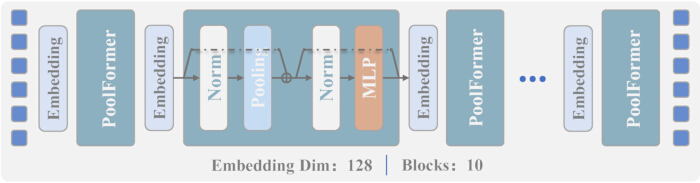
그림 2: 제안된 FlowErs 프레임워크에 사용된 모달리티 특이적 MetaFormer 인코더의 구조. 인코더는 반복적인 임베딩 및 PoolFormer 블록을 통해 모달리티 특이적 입력을 계층적 특징 표현으로 변환합니다. 각 PoolFormer 블록은 정규화, 풀링 기반 토큰 믹싱, 잔차 더하기, 정규화 및 다층 퍼셉트론(MLP)으로 구성됩니다. 결과로 생성된 계층적 특징 표현은 교차 모달 특징 정렬을 위해 다중 모달 흐름 매칭 모듈로 전달됩니다. Norm, 정규화; MLP, 다층 퍼셉트론. 여기를 클릭하여 이 그림의 더 큰 버전을 확인하십시오.
각 양상별로  , MetaFormer 인코더
 , 입력을 변환합니다
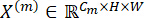 잠재 특징 표현의 계층 구조로 (식 4):
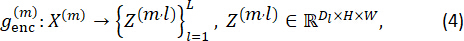
여기서 L은 인코더 단계의 총 수를 나타내며, Dl은 l단계의 임베딩 차원을 나타냅니다. MetaFormer 인코더는 각각 64, 128, 256의 임베딩 차원을 갖는 3개의 단계(N = 3)로 구성됩니다. 원고에 설명된 점진적 계층 구조에 따라 각 단계의 PoolFormer 블록 수는 각각 2, 6, 2개입니다.
각 인코더는 1로 시작합니다. × 입력 채널을 공통 임베딩 공간으로 투영하는 1개의 컨볼루션 (식 5):
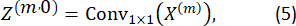
이 투영 층 다음에는 L개의 MetaFormer 블록이 쌓여 있습니다. 각 블록은 두 가지 잔차 연산으로 구성됩니다: (i) 문맥 정보를 집계하기 위한 공간 풀링을 통한 토큰 믹싱 및 (ii) 분광-공간 특징 표현을 정밀화하기 위한 다층 퍼셉트론(MLP)을 통한 채널 변환입니다. 이러한 연산은 식 6 및 7을 사용하여 다음과 같이 표현됩니다:
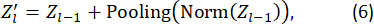

여기서 Pooling(·)은 평균 풀링 기반의 공간적 문맥 집계(spatial context aggregation)를 나타내며, MLP(·)는 GELU 활성화 함수와 드롭아웃 정규화가 포함된 2층 컨볼루션 피드포워드 네트워크를 나타냅니다.
인코더는 연속적인 단계에 따라 임베딩 차원이 점진적으로 증가하는 계층적 구조를 따릅니다(예: 64  128 256). 이러한 점진적 설계는 더 깊은 층이 더욱 풍부한 공간-분광 정보를 인코딩할 수 있게 하며, 학습된 특징의 표현 능력을 향상시킵니다. 구현에는 3 × 3 풀링 커널, 128의 MLP 은닉 차원, 0.1의 드롭아웃 비율이 사용되었습니다. MetaFormer 인코더 내의 모든 컨볼루션 층은 스트라이드 1, 패딩 없음의 1 × 1 커널을 사용합니다. 풀링 연산자에는 스트라이드 1, 패딩 1의 3 × 3 평균 풀링이 사용됩니다. 인코더 전반에 걸쳐 배치 정규화(BatchNorm2d)가 사용되었습니다. MLP는 128의 은닉 차원을 가지며, GELU 활성화 함수를 채택하고 0.1의 드롭아웃 비율을 사용합니다. 세 개의 인코더 단계는 각각 2개, 6개, 2개의 PoolFormer 블록을 포함하며, 이러한 구조적 설정은 모든 단계에 일관되게 적용됩니다.
Transformer 기반 인코더와 비교하여, MetaFormer 인코더는 셀프 어텐션(self-attention)과 관련된 이차적 계산 비용을 제거하는 동시에 특성 추출 과정에서의 모달리티 특이적 편향을 줄여줍니다. 이 인코더의 풀링 기반 토큰 믹서는 국소적 공간 문맥을 효율적으로 집계하며, 이후 플로우 매칭(flow matching) 모듈에 의해 교차 모달리티 정렬이 수행됩니다. 결과적으로, 인코더에 의해 생성된 최상위 특성 표현은 다중 모달 특성 정렬을 위한 의미론적으로 유익하고 기하학적으로 일관된 입력을 제공합니다.
멀티모달 플로우 매칭
특징 추출 이후의 주요 과제는 서로 다른 특징 매니폴드(feature manifold)에 존재하는 서로 다른 센싱 모달리티에서 기인한 이종 특징 표현들을 정렬하는 것입니다.  와
 를 직접 연결하는 방식은 일관되지 않은 특징 분포와 모달리티 특유의 편향으로 인해 성능이 낮게 나타나는 경우가 많습니다. FlowErs는 그림 1B에서 개념적으로 보여준 바와 같이, 두 특징 공간 사이의 연속적인 양방향 변환을 학습하는 MFM 모듈을 도입하여 이러한 과제를 명시적으로 해결합니다.
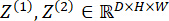 을 MetaFormer 인코더에 의해 추출된 특징 표현이라고 하자. 보간 시간
 으로 매개변수화된 연속 흐름장은 식 8을 사용하여 다음과 같이 정의된다:
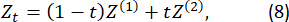
여기서 t = 0은 소스 모달리티(source modality)에 해당하며, t = 1은 타겟 모달리티(target modality)에 해당합니다.
플로우 매칭 모델은, 시간 조건부 U-Net으로 구현되며, 이 보간 궤적을 따라 변환을 제어하는 순시 속도장을 예측합니다. 각 흐름 예측기는 3개의 다운샘플링 블록(64 128 256 512) 및 세 개의 상응하는 업샘플링 블록(512 256 128 64) 3을 사용하여 × 3개의 컨볼루션, 배치 정규화 및 정류 선형 유닛(ReLU) 활성화 함수가 사용되었습니다. 중간 시간 임베딩의 차원은 각각 128, 256, 512, 256, 128입니다. 시간 임베딩에는 고정된 사인 함수 형태의 위치 인코딩(sinusoidal positional encoding)이 사용됩니다. ODE 적분은 고정된 단계 크기를 갖는 전방 오일러 방법을 사용하여 수행됩니다. 훈련 중 적분 단계 수는 6으로 설정되었으며, 추론 중에는 기본적으로 5단계의 적분이 사용되었습니다. 실제 적분 루프 반복 횟수는 다음과 같이 계산됩니다. 
예측된 속도장은 식 9에 의해 다음과 같이 주어집니다:
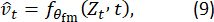
여기서  은(는) 예측된 순간 속도를 나타냅니다. 모델은 변위
 을(를) 근사하도록 학습하며, 이를 통해 모달리티별 특징 공간 간의 연속적인 변환을 촉진합니다. 학습 목표는 다음과 같이 시간 조건부 양방향 평균 제곱 오차(MSE) 손실로 공식화됩니다 (식 10):
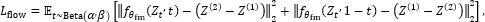 (10)
지정된 베타 분포(Beta distribution)로부터 t 를 샘플링하면 모델이 중간 보간 상태에 노출되지만, 정확한 사이클 일관성(cycle consistency)이 확립되지는 않습니다. 확산 기반 정렬 방법과 달리, 제안된 플로우 매칭(flow matching) 공식은 결정론적이며, 추론 과정에서 확률적 샘플링이 필요하지 않고, 라벨이 있는 데이터와 없는 데이터 모두를 사용하여 학습할 수 있습니다.
훈련된 flow 모델은 이후 모달리티별 특징 표현을 공유 잠재 공간 S로 투영하는 결정론적 정렬 연산자 역할을 합니다. 정렬된 표현은 다음과 같이 얻어집니다 (식 11):
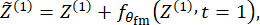
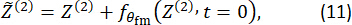
여기에서  및
 은 정렬된 특징 표현을 나타냅니다. 플로우 기반 정렬은 임베딩 차원이 각각 64와 128인 처음 두 인코더 단계(Stage 1 및 Stage 2)의 중간 특징 표현에 적용됩니다. 가장 높은 레벨의 인코더 특징(Stage 3, 임베딩 차원 256)은 플로우 매칭 모듈에 의해 처리되지 않습니다. 대신, 이러한 특징들은 직접 연결되어 멀티모달 예측을 위해 분류기로 전달됩니다.
이 양방향 정렬 메커니즘은 연속적인 흐름장(flow field)을 통해 모달리티별 특징 표현을 공유 잠재 공간으로 점진적으로 전달합니다. 결과적으로, 다중 모달 특징 융합 이전에 이들이 더 밀접하게 정렬되어, 후속 분류를 위해 의미론적으로 일관되고 기하학적으로 호환 가능한 특징 표현을 제공하게 됩니다.
훈련 파이프라인
그림 1(B,C)에 나타낸 바와 같이, FlowErs는 2단계 훈련 전략을 통해 안정적인 교차 모달 정렬을 유지하면서 라벨이 지정된 데이터와 라벨이 지정되지 않은 데이터를 모두 활용합니다. 첫 번째 단계에서는 비지도 흐름 매칭(unsupervised flow matching)을 통해 모달리티 불변 정렬 모듈을 학습합니다. 두 번째 단계에서는 사전 학습된 흐름 정렬 모듈을 재사용하는 동시에, 정렬된 잠재 표현을 사용하여 지도 분류를 수행합니다.
단계 1: 비지도 흐름 사전 학습
멀티모달 이미지 쌍이 주어졌을 때,  모달리티 특이적 특징 표현,
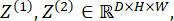 MetaFormer 인코더를 사용하여 추출합니다. 중간 특징 표현은 다음에서 정의된 보간법을 사용하여 생성됩니다. 식 8, 여기서
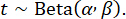 플로우 매칭 모듈은,
 , 는 다음에서 정의된 양방향 시간 조건부 목적 함수를 최소화함으로써 최적화됩니다. 식 10 클래스 레이블을 사용하지 않고 수행합니다. 이 단계에서는 유동 매칭(flow-matching) 파라미터만
 업데이트되어, 모델이 지도 분류 이전에 라벨이 지정된 샘플과 라벨이 지정되지 않은 샘플 모두로부터 기하학적 인지 대응 관계를 학습할 수 있게 합니다. 1단계(흐름 매칭 사전 학습)는 1의 학습률을 가진 AdamW 옵티마이저를 사용하여 수행되었습니다. × 10⁻4, 가중치 감쇠 1 × 10⁻2그리고 코사인 어닐링 학습률 스케줄을 적용하였습니다. Houston2013 및 Trento 데이터셋에는 16의 배치 크기를 사용하였으며, Augsburg 및 MUUFL 데이터셋에는 32의 배치 크기를 사용하였습니다. 플로우 매칭 모듈은 라벨이 있는 샘플과 없는 샘플을 모두 사용하여 2,000 에포크 동안 사전 학습되었습니다. 랜덤 시드는 3407로 고정되었습니다. 모든 실험은 단일 NVIDIA A100 GPU(80 GB 메모리)에서 PyTorch를 사용하여 수행되었습니다.
2단계: 공유 정렬기를 이용한 지도 분류
사전 학습된 플로우 매칭 모듈은 지도 학습 중에 재사용되며, 모든 특징 레벨이 아닌 처음 두 개의 인코더 단계에 적용됩니다. 정렬된 특징 표현은 이후 분류 헤드를 통해 융합되어 픽셀 단위 예측을 생성합니다. 지도 최적화는 마스킹된 교차 엔트로피 손실(식 12):
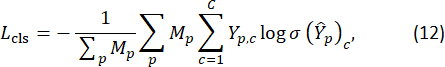
여기서 M은 레이블 마스크를, Y는 원-핫 인코딩된 정답 레이블을 나타내며, σ(·)는 소프트맥스 함수를 나타냅니다. 2단계(지도 학습) 동안, 사전 학습된 플로우 매칭 모듈은 완전히 고정된 상태로 유지되어 고정된 교차 모달 정렬 연산자로 기능했습니다. 사전 학습된 가중치는 2단계 시작 시 로드되었으며, 지도 학습 과정 중에는 업데이트되지 않았습니다. MetaFormer 인코더와 분류기 파라미터만 최적화되었습니다. 지도 학습은 AdamW 옵티마이저를 사용하여 수행되었으며, 데이터셋별 학습률은 1 × 10⁻4 (Houston2013), 1 × 10⁻3 (Augsburg), 1 × 10⁻2 (MUUFL), 1 × 10⁻5 (Trento)로 설정되었습니다. 가중치 감쇠(Weight decay)는 MUUFL의 경우 5 × 10⁻2를 사용하였고, 그 외 모든 데이터셋에 대해서는 1 × 10⁻2로 설정되었습니다. 배치 크기는 데이터셋에 따라 16 또는 32를 적용했습니다. 모델은 코사인 어닐링 학습률 스케줄을 사용하여 100 에포크 (Houston2013 및 MUUFL), 200 에포크 (Augsburg), 20 에포크 (Trento) 동안 학습되었습니다. 손실 함수로는 평균 감소(mean reduction) 방식의 CrossEntropyLoss를 사용했습니다. 조기 종료(early stopping)는 적용하지 않았으며, 대신 테스트 세트에서 가장 높은 전체 정확도(OA)를 달성한 모델 체크포인트를 최종 모델로 선택했습니다. 2단계 학습 절차의 전체 구현 워크플로우는 보충 파일 S1 (알고리즘 S1)에 요약되어 있습니다.
이 디커플링된 학습 전략은 기하학적 정렬과 세맨틱 판별을 분리합니다. 1단계에서는 모델이 flow-matching 목적 함수를 사용하여 연속적인 양방향 특징 매핑을 학습합니다. 2단계에서는 사전 학습된 정렬 모듈이 멀티모달 특징 융합 전 공통 특징 전송 연산을 제공하며, 분류 네트워크는 정렬된 잠재 공간으로부터 클래스 판별적 표현을 학습합니다. 사전 학습된 정렬기를 재사용하면 융합 전 일관된 특징 정렬이 촉진되지만, 이것이 일반화 성능 향상을 독립적으로 보장하는 것으로 제시되지는 않습니다.
실험 데이터 세트
제안된 프레임워크는 세 가지 대표적인 멀티모달 원격 탐사 벤치마크 데이터셋인 Houston201329, Augsburg30 및 MUUFL31을 사용하여 평가되었습니다.
Houston2013 데이터셋은 IEEE GRSS 데이터 퓨전 콘테스트의 일환으로 공개되었습니다. 이 데이터셋은 미국 휴스턴의 다양한 도시 경관을 나타내며, 주거 지역, 도로, 식생, 수역을 포함한 15개의 지표 피복 클래스로 구성되어 있습니다. 해당 데이터셋은 가시광선에서 근적외선 영역에 걸친 144개의 분광 밴드를 가진 HSI와 2.5 m의 공간 해상도를 가진 단일 밴드 LiDAR 유도 디지털 표면 모델(DSM)을 포함하고 있습니다. 복잡한 도시 질감과 상당한 클래스 내 분광 가변성으로 인해, 이 데이터셋은 정확한 지표 피복 분류에 있어 도전적인 과제를 제공합니다.
Augsburg 데이터셋은 독일의 밀집된 도시 지역에서 수집되었습니다. 이 데이터셋은 400–1000 nm 파장 범위를 커버하는 224개의 분광 밴드를 가진 초분광 이미지와 정합된 LiDAR 고도 데이터로 구성됩니다. 해당 데이터셋은 2 m의 공간 해상도로 건축 구조물, 나지, 아스팔트, 식생 및 그림자를 포함한 17개의 주석 처리된 지표 피복 클래스를 포함하고 있습니다. Houston2013과 비교하여 Augsburg은 더 강한 분광 상관관계와 더 높은 클래스 다양성을 나타내며, 이는 교차 모달 특징 정렬 및 일반화를 평가하기 위한 도전적인 벤치마크를 제공합니다.
MUUFL Gulfport 데이터셋은 대학 캠퍼스에서 수집되었으며, 풍부한 식생과 소규모 인공 구조물이 포함된 준도시 환경을 나타냅니다. 이 데이터셋에는 노이즈가 제거된 64밴드 초분광 이미지와 고도 및 강도 정보로 구성된 듀얼밴드 LiDAR 측정값이 포함되어 있습니다. 또한 11개의 지표 피복 클래스를 포함하며, 세밀한 공간적 디테일, 혼합 픽셀 및 다양한 조명 조건을 보여주므로 소형 객체 분류를 위한 다중 모달 특징 융합을 평가하는 데 매우 적합합니다.
종합적으로, 이 세 가지 벤치마크 데이터셋은 공간 해상도(1–2.5 m), 분광 차원(64–224 bands), 장면 복잡성 및 지표 피복 구성에서 상당한 변이를 포함하고 있습니다. 결과적으로, 이는 다중모달 지표 피복 분류 방법의 효과와 일반화 능력을 평가하기 위한 다양한 벤치마크를 제공합니다. 데이터셋의 주요 특성은 표 1에 요약되어 있습니다. 세 데이터셋 모두의 훈련/테스트 분할은 원본 데이터 제공자가 제공한 공식 벤치마크 분할과 일치합니다. 구체적으로, Houston2013 데이터셋은 2,832개의 훈련 샘플과 12,197개의 테스트 샘플로 구성된 2013 IEEE GRSS Data Fusion Contest의 공식 분할을 사용합니다. Augsburg 데이터셋은 공식적으로 제공된 mask_train 및 mask_test 어노테이션을 사용하여 4,538개의 훈련 샘플과 47,896개의 테스트 샘플을 도출했습니다. MUUFL 데이터셋은 28,645개의 훈련 샘플과 24,283개의 테스트 샘플을 포함하는 공식 train_test_gt.mat 분할을 사용합니다. 각 데이터셋에 대해, 레이블이 지정된 각 픽셀을 중심으로 하는 32 × 32-pixel 이미지 패치를 개별 훈련 또는 테스트 샘플로 추출했습니다. 추가적인 데이터 분할이나 재샘플링은 수행되지 않았습니다.
| 특성 | 휴스턴2013 | 아우크스부르크 | MUUFL |
| HSI 이미지 크기(픽셀) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| LiDAR 이미지 크기 (픽셀) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| HSI 분광 밴드 | 144 | 224 | 64 |
| LiDAR 밴드 | 1 | 1 | 2 |
| HSI 파장 범위 | 0.38–1.05 µm | 0.40–1.00 µm | 375–1050 nm |
| LiDAR 파장 범위 | 해당 사항 없음 | 해당 없음 | 해당 사항 없음 |
| 공간 해상도 (HSI) | 2.5 m | 2.0 m | 0.54 m × 1.00 m |
| 공간 해상도 (LiDAR) | 2.5 m | 2.0 m | 0.60 m × 0.78 m |
| 토지 피복 클래스 수 | 15 | 17 | 11 |
표 1: 평가에 사용된 세 가지 다중모달 원격 탐사 벤치마크 데이터셋의 특성. 이 표는 제안된 FlowErs 프레임워크를 평가하는 데 사용된 Houston2013, Augsburg 및 MUUFL 벤치마크 데이터셋의 이미지 크기, 분광 특성, 공간 해상도 및 지표 피복 클래스 수를 요약하여 보여줍니다.
구현 세부 사항
FlowErs 프레임워크는 PyTorch로 구현되었으며, 80 GB 메모리를 갖춘 그래픽 처리 장치(GPU)를 사용하여 훈련 및 평가되었습니다. 훈련은 배치 크기 16으로 100 epoch 동안 수행되었습니다. 초기 학습률 1 × 10⁻⁴ 및 가중치 감쇠 1 × 10⁻²를 적용한 AdamW 옵티마이저가 사용되었습니다. 훈련 과정 전반에 걸쳐 학습률을 업데이트하기 위해 코사인 어닐링 학습률 스케줄러가 사용되었습니다. 모델 일반화 능력을 향상시키고 과적합을 줄이기 위해 0.1의 드롭아웃 비율을 적용하였습니다. 지도 최적화를 위해 교차 엔트로피 손실 함수가 사용되었습니다. 재현성을 위해 모든 실험은 3407의 고정된 랜덤 시드를 사용하여 초기화되었습니다. 추가적인 검증 세트를 생성하지 않고 제공된 훈련/테스트 분할을 그대로 사용하였습니다. 각 입력 패치는 훈련 전 32 × 32 픽셀로 크기가 조정되었습니다. 데이터 증강, 명시적인 이미지 등록 보정 또는 추가적인 데이터 로더 정규화는 적용되지 않았습니다. 음성 라벨과 관련된 픽셀은 지도 손실 계산에서 제외되었습니다. 누락되거나 노이즈가 있는 픽셀 처리는 별도로 평가되지 않았습니다.
평가 지표
분류 성능을 평가하기 위해 널리 채택되는 세 가지 평가 지표인 OA, 평균 정확도(AA) 및 Kappa 계수(k)가 사용되었습니다. OA는 전체 샘플 중 정확하게 분류된 샘플의 비율을 측정하고, AA는 모든 지표면 피복 클래스 전체의 평균 분류 정확도를 나타내며, Kappa 계수는 우연히 일치할 가능성을 고려한 후 예측 분류와 참조 분류 간의 일치도를 정량화합니다. 세 가지 지표 모두 값이 높을수록 분류 성능이 더 좋음을 나타냅니다. 표 2–6에 보고된 모든 값은 랜덤 시드 3407을 사용하여 얻은 고정 분할 점 추정치입니다. 신뢰 구간, 통계적 유의성 검정 또는 p-값은 보고되지 않았습니다.
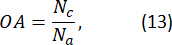
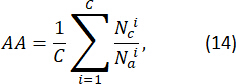
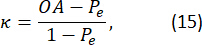
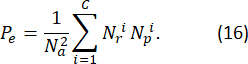
여기서 Nc 와 Na는 각각 정확하게 분류된 샘플의 총 수와 평가된 샘플의 총 수를 나타냅니다.  및
 는 각각 i번째 클래스에 대해 정확하게 분류된 샘플 수와 전체 샘플 수를 나타냅니다. Kappa 계수 계산에서 Pe 는 우연히 일치할 확률을 나타내며,
 와
 는 각각 i번째 클래스에 대한 참조 샘플 수와 예측 샘플 수를 나타냅니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
결과
제안된 FlowErs 프레임워크의 전체 평가 워크플로우는 2단계 멀티모달 분류 전략을 요약한 그림 1에 도식화되어 있습니다. MetaFormer 인코더 기반의 모달리티별 특징 추출 과정은 그림 2에 나타나 있으며, 평가에 사용된 3가지 벤치마크 데이터셋의 주요 특성은 표 1에 요약되어 있습니다. 이후 프로토콜 섹션에 정의된 OA, AA 및 Kappa 계수(κ)를 사용하여 MUUFL, Houston2013 및 Augsburg 벤치마크 데이터셋에 대해 분류 성능을 평가하였습니다.
타 방법과의 비교
제안된 프레임워크의 종합적인 비교를 위해 여러 벤치마크 멀티모달 분류 네트워크가 포함되었습니다. DFINet32은 depth-wis...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
토론
본 연구에서는 2단계 학습 전략을 통해 교차 모달 특징 정렬과 세만틱 분류를 분리하는 다중 모달 원격 탐사 프레임워크인 FlowErs를 소개합니다. 제안된 프레임워크는 서로 다른 모달리티별 특징을 직접 융합하는 대신, 다중 모달 융합 및 분류 이전에 조건부 흐름 매칭(conditional flow matching)을 사용하여 특징 표현을 먼저 정렬합니다. 이러한 설계는 HSI와 LiDAR 간의 이질적인 특징 분포라는 오랜 과제를 해결하며, 이는 센싱 메커니즘의 차이로 인해 기존의 연결(concatenation) 또는 어텐션 기반 융합 전략의 효과가 제한되는 경우가 많기 때문입니다23,26,35,36,37,
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
공개 사항
이해상충:
저자들은 이해상충이 없음을 선언합니다.
감사의 글
이 연구는 산시성 A&F 대학교 과학연구기금과제(ZK25-38번) 및 산시성 교육청 과제(24JK0734번)의 재정적 지원을 받아 수행되었습니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
재료
참고문헌
- Geng X, et al. Fast and effective: Progressive hierarchical fusion classification for remote sensing images. IEEE Trans Multimed. 2024;26:9776–89.
- Tian F, et al. HireNet: Hierarchical-relation network for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–10.
- Ye Z, et al. A multiscale incremental learning network for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Li Q, Chen Y, He X, Huang L. Co-training transformer for remote sensing image classification, segmentation, and detection. IEEE Trans Geosci Remote Sens. 2024;62:1–18.
- Qin A, et al. Deep updated subspace networks for few-shot remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Wang S, et al. Personalized multiparty few-shot learning for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Yang JY, et al. Multifrequency graph convolutional network with cross-modality mutual enhancement for multisource remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Zhou G, Qian L, Gamba P. A novel iterative self-organizing pixel matrix entanglement classifier for remote sensing imagery. IEEE Trans Geosci Remote Sens. 2024;62:1–21.
- Zhu J, et al. MVP: Meta visual prompt tuning for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–13.
- Gat I, et al. Discrete flow matching. Adv Neural Inf Process Syst. 2024;37:133345–85.
- Miller BK, Chen RT, Sriram A, Wood BM. FlowMM: Generating materials with Riemannian flow matching [Internet]. 2024 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2406.04713
- Xin Y, et al. Confidence-weighted dual-teacher networks with biased contrastive learning for semi-supervised semantic segmentation in remote sensing images. IEEE Trans Geosci Remote Sens. 2024;62:1–16.
- He Y, et al. IGroupSS-Mamba: Interval group spatial-spectral Mamba for hyperspectral image classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Liao D, Wang Q, Lai T, Huang H. Joint classification of hyperspectral and LiDAR data based on Mamba. IEEE Trans Geosci Remote Sens. 2026;19:11445–61.
- Lipman Y, et al. Flow matching for generative modeling [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=PqvMRDCJT9t
- Liu X, et al. Flow straight and fast: Learning to generate and transfer data with rectified flow [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=XVjTT1nw5z
- Geng Z, et al. Consistency models made easy [conference paper]. Presented at: 13th International Conference on Learning Representations (ICLR); 2025. Available from: https://openreview.net/forum id=1x7sJYh37d
- Hu VT, et al. Latent space editing in transformer-based flow matching [conference paper]. Presented at: AAAI Conference on Artificial Intelligence; 2024;38:2247–55. Available from: https://doi.org/10.1609/aaai.v38i3.28014
- Jeong J, Kim K, Kim W, Kim NJ. Real-time person image synthesis using a flow matching model [Internet]. 2025 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2505.03562
- Kakesh MH, et al. An efficient data generation method based on flow matching for bearing fault diagnosis under imbalanced data conditions. IEEE Trans Energy Convers. 2026;1–11.
- Chu Z, et al. End-to-end seam tracking with flow matching-based diffusion policy [conference paper]. Presented at: International Conference on Machine Intelligence and Nature-Inspired Computing (MIND); Xiamen, China; 2025. p. 304–9. Available from: https://doi.org/10.1109/MIND67540.2025.11351867
- Melgani F, Bruzzone L. Classification of hyperspectral remote sensing images with support vector machines. IEEE Trans Geosci Remote Sens. 2004;42:1778–90.
- Li J, et al. Deep learning in multimodal remote sensing data fusion: A comprehensive review. Int J Appl Earth Obs Geoinf. 2022;112:102926.
- Vaswani A, et al. Attention is all you need [Internet]. 2017 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/1706.03762
- Zhuang Y, Chen M, Zhu D. UWASR-GAN: An attention-guided multi-scale residual framework for underwater image enhancement in underwater Internet of Things applications. IEEE Internet Things J. 2026;12:29452–71.
- Ma X, Zhang X, Pun MO, Liu M. A multilevel multimodal fusion transformer for remote sensing semantic segmentation. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Xie W, Lu Y, Li D, Li Y. Ebbinghaus-curve guided low-rank component-induced attention for multisource remote sensing classification. IEEE Trans Geosci Remote Sens. 2024;62:1–12.
- Li D, Xie W, Li Y, Fang L. FedFusion: Manifold-driven federated learning for multi-satellite and multi-modality fusion. IEEE Trans Geosci Remote Sens. 2023;62:1–13.
- Debes C, et al. Hyperspectral and LiDAR data fusion: Outcome of the 2013 GRSS data fusion contest. IEEE J Sel Top Appl Earth Obs Remote Sens. 2014;7:2405–18.
- Hu J, et al. MDAS: A new multimodal benchmark dataset for remote sensing. Earth Syst Sci Data Discuss. 2022:1–26.
- Gader P, et al. MUUFL Gulfport hyperspectral and LiDAR airborne data set. University of Florida; Gainesville (FL); Technical Report REP-2013-570; 2013.
- Gao Y, et al. Hyperspectral and multispectral classification for coastal wetland using depthwise feature interaction network. IEEE Trans Geosci Remote Sens. 2021;60:1–15.
- Feng Y, Song L, Wang L, Wang X. DSHFNet: Dynamic scale hierarchical fusion network based on multiattention for hyperspectral image and LiDAR data classification. IEEE Trans Geosci Remote Sens. 2023;61:1–14.
- Hong D, et al. More diverse means better: Multimodal deep learning meets remote-sensing imagery classification. IEEE Trans Geosci Remote Sens. 2020;59:4340–54.
- Feng Z, et al. Cross-modal contrastive learning for remote sensing image classification. IEEE Trans Geosci Remote Sens. 2023;61:1–13.
- Xu X, et al. Multisource remote sensing data classification based on convolutional neural network. IEEE Trans Geosci Remote Sens. 2017;56:937–49.
- Yao J, et al. Extended vision transformer (ExViT) for land use and land cover classification: A multimodal deep learning framework. IEEE Trans Geosci Remote Sens. 2023;61:1–15.
- Chang H, et al. Deep symmetric fusion transformer for multimodal remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;63:1–15.
- Wang A, et al. CTPMSN: Enhancing multimodal remote sensing classification with composite text prompts. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:27960–27978.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.