본 행동 과학 및 심리 평가 프로토콜은 대학생의 인터넷 중독과 정서 조절 어려움을 평가하기 위해 온라인 설문 조사 실시, 채점, 데이터 품질 스크리닝 및 재현 가능한 분석 과정을 표준화합니다.
이 논문에서
요약
초록
인터넷 사용은 대학 생활의 깊숙한 부분에 자리 잡고 있지만, 문제성 인터넷 사용을 단순히 노출 시간만으로 적절하게 평가할 수는 없습니다. 여러 증거에 따르면 부적응적이거나 강박적인 인터넷 사용 패턴은 정서 조절의 어려움과 관련이 있는 것으로 나타났으나, 설문지 순서, 자격 기준, 스크리닝 임계값, 채점 절차 및 분석 보고의 불일치로 인해 연구 간의 비교 가능성이 계속해서 제한되고 있습니다. 본 방법론 논문은 대학생의 인터넷 중독과 정서 조절 어려움을 조사하는 행동 과학 및 심리 평가 연구를 위한 표준화된 설문 조사 프로토콜을 제시합니다. 워크플로우에는 고정된 설문 순서, 사전 정의된 자격 기준, 필수 응답 설정, 파일럿 테스트 기반의 완료 시간 임계값, 순차적 데이터 품질 스크리닝, Internet addiction test 및 16-item difficulties in emotion regulation scale의 표준화된 채점, 그리고 재현 가능한 기술적, 상관적 및 다변량 회귀 분석이 포함됩니다. 또한 이 프로토콜은 원시 응답, 스크리닝 로그, README/코드북 파일 및 최종 분석용 데이터 세트의 아카이빙을 명시합니다. 도구의 타당성을 검증하거나 유병률을 설정하기보다는 프로토콜의 실행을 보여주기 위해 대표적인 구현 사례를 보고합니다. 해당 구현에서 520명의 학생이 초대되었으며, 480부의 설문지가 회수되었습니다. 중복 제출, 성급한 응답, 주의력 확인 실패, 패턴 응답, 논리적 불일치 및 핵심 데이터 누락을 순차적으로 제외한 후, 452부의 유효한 설문지가 유지되었습니다. 사전 정의된 분석 시연에서는 Internet addiction test 총점과 difficulties in emotion regulation scale 총점 사이의 연관성을 조사하였습니다. 유지된 표본의 Internet addiction test 총점 평균은 51.94였으며, Difficulties in emotion regulation scale 총점 평균은 35.95였습니다. 정서 조절의 어려움은 인터넷 중독 심각도 그룹에 따라 증가했으며, 인구통계학적 및 행동 공변량을 보정한 후에도 그 연관성은 분명하게 유지되었습니다. 이 프로토콜은 대학생 집단을 대상으로 한 향후의 단면 연구, 반복 측정 연구 또는 종단 연구에서 반복, 감사 및 적용이 가능한 투명한 워크플로우를 제공합니다.
서론
인터넷 사용은 학업, 사회적 소통, 오락, 정보 탐색 및 정서적 대처를 포함하여 대학 생활의 일상적인 부분이 되었습니다. 이러한 이유로 학생들의 인터넷 행동을 단순히 화면 노출 시간이나 온라인 접속 시간으로만 해석해서는 안 됩니다. 이전의 연구 결과에 따르면, 현재의 모바일 플랫폼 환경이 고도로 포화되기 전부터 청소년 및 대학생 집단에서 문제가 되는 인터넷 사용 양상이 이미 나타났음을 알 수 있습니다1. 보다 최근의 대학 기반 연구들은 문제가 되는 인터넷 사용이 매우 흔하며, 따라서 비공식적인 묘사보다는 체계적인 평가가 필요함을 시사합니다2.
대학생은 학업적 압박, 사회적 전환, 독립적인 생활, 그리고 자율성 증가가 동일한 발달 단계에서 빈번하게 발생하기 때문에 표준화된 평가에 있어 특히 유의미한 대상 집단입니다. 이러한 요구 사항들은 종종 조절하기 어려워질 수 있는 동일한 디지털 기기와 플랫폼을 통해 관리됩니다. 한 메타 분석 검토 결과에 따르면, 학생들의 문제적 인터넷 사용은 여러 정신 건강 결과와 연관되어 있으며, 이는 이를 단순한 기술 사용 문제가 아닌 더 광범위한 행동적 및 심리적 문제로 해석해야 함을 뒷받침합니다3. 또한, 대학생의 지각된 스트레스는 인터넷 중독 패턴과 연관이 있는 것으로 나타났으며, 이는 해당 분야의 설문지 기반 연구를 설계할 때 정서적 및 상황적 압박을 고려해야 함을 시사합니다4.
본 프로토콜에서는 인터넷 중독 검사(Internet addiction test)로 측정되는 구성 개념 및 확립된 점수 범주를 구체적으로 지칭할 때 “인터넷 중독”이라는 용어를 사용합니다. 부적응적, 과도하거나 기능적 손상을 초래하는 인터넷 관련 행동에 관한 더 넓은 문헌을 논할 때는 “문제적 인터넷 사용”이라는 광범위한 용어를 사용합니다. “강박적 인터넷 사용”은 인용된 문헌에서 조절 능력 상실, 충동 또는 부정적인 결과에도 불구하고 반복적으로 사용하는 점을 강조할 때만 사용됩니다. 따라서 이러한 용어들은 서로 관련이 있지만 완전히 상호 대체 가능한 것으로 취급되지 않습니다. 본 프로토콜을 인터넷 중독 검사와 함께 시행할 때는 도구 특이적 용어로서 “인터넷 중독”을 유지하며, 대체 또는 수정된 도구를 사용할 때는 선택한 측정 도구의 구성 개념 라벨 및 진단 가정에 맞춰 용어를 조정해야 합니다.
정서 조절은 일부 학생들이 빈번한 인터넷 사용에서 부적응적 인터넷 사용으로 이행하게 되는 이유를 이해하기 위한 타당한 심리학적 진입점을 제공합니다. 1년간의 전향적 연구에 따르면, 정서 조절의 어려움은 대학생의 인터넷 중독의 추후 발생과 관해 모두에 관련이 있는 것으로 나타났습니다5. 이러한 발견은 정서 조절이 단순한 추가적 상관관계가 아니라, 학생들이 고통을 회피, 감소 또는 관리하기 위해 인터넷을 사용하는 방식에 영향을 미칠 수 있다는 점에서 프로토콜 설계에 있어 중요합니다. 동시에 사회적 기능 또한 여전히 중요합니다. 대학생의 문제적 인터넷 사용은 사회적 기술과 연관되어 있으며, 이는 대인 관계 및 정서적 요인이 디지털 사용 변수와 함께 평가되어야 함을 시사합니다6. COVID-19 기간 동안 중국 대학생들의 문제적 인터넷 사용은 더 광범위한 심리적 어려움과 공존하였으며, 이는 대학 환경에서 구조화된 평가의 필요성을 더욱 뒷받침합니다7.
또 다른 과제는 디지털 행동이 이질적이라는 점입니다. 학생들은 학습, 사회적 접촉, 오락, 건강 정보 습득 또는 일시적인 정서적 완화를 위해 디지털 플랫폼을 사용할 수 있으며, 모든 고빈도 사용이 해로운 것은 아닙니다. 대학생의 정신 건강 관련 디지털 이용에 대한 체계적 문헌 고찰에 따르면, 디지털 참여는 여러 심리적 목적을 수행할 수 있는 것으로 나타났습니다8. 따라서 이 분야에서는 일반적인 고빈도 사용과 문제적이거나 조절되지 않는 사용을 구분하는 절차가 필요합니다. 대학생의 문제적 스마트폰 사용에 관한 최근 증거 또한 위험성이 단순히 지속 시간보다는 행동 패턴, 기능 및 맥락에 따라 달라짐을 시사합니다9. 이러한 이유로, 본 프로토콜은 단일 노출 지표에 의존하는 대신 인터넷 사용 시간, 심야 사용, 주요 온라인 활동 및 표준화된 증상 점수를 결합하여 분석합니다.
측정 또한 불일치의 주요 원인입니다. 인터넷 중독 검사(Internet addiction test)는 인터넷 중독 증상을 평가하는 데 가장 널리 사용되는 도구 중 하나로 남아 있으나, 그 차원성과 해석은 환경에 따라 다양하게 나타났습니다. 체계적인 심리 측정학적 근거에 따르면, 이 도구가 광범위하게 사용되어 왔음에도 불구하고 요인 구조와 점수 해석에 대한 의문이 계속 제기되고 있음을 알 수 있습니다10. 대학생 표본에서도 유사한 우려가 보고되었으며, 해당 척도의 광범위한 사용이 측정 대상이 되는 구성 개념에 대한 불확실성을 완전히 해결하지는 못했습니다11. 스페인과 페루의 대학생 집단을 대상으로 한 타당도 연구에서도 이 도구가 적절하게 작동할 수 있음을 보여주지만, 심리 측정학적 특성은 적용 대상 집단 내에서 고려되어야 함을 보여줍니다12,13.
따라서 본 프로토콜은 작업 흐름은 안정적으로 유지하되, 사용 기구의 선택은 유연하게 조정할 수 있도록 설계되었습니다. 여기서는 역사적인 사용 사례, 가용한 임계값, 그리고 이전의 대학생 대상 연구와의 비교 가능성 때문에 인터넷 중독 검사를 사용하였습니다. 하지만 본 프로토콜이 인터넷 중독 검사를 무조건적으로 최선으로 유지하도록 요구하지는 않습니다. 진단 체계가 발전하거나 특정 집단에 더 적합한 새로운 도구가 등장할 경우, 척도별 모듈, 점수 범위, 중증도 임계값, 코드북 항목 및 README 문서를 교체함으로써 동일한 작업 흐름을 유지할 수 있습니다. 이러한 교체는 공식적인 데이터 수집이 시작되기 전에 이루어져야 하며, 임의의 분석적 변경이 아닌 프로토콜 수정 사항으로 보고되어야 합니다.
이 논문에서 다루는 방법론적 문제는 단순히 인터넷 중독과 정서 조절에 관한 연구들이 서로 다른 결론에 도달한다는 점만이 아닙니다. 오히려 많은 연구가 설문지 순서, 적격성 기준, 설문 플랫폼 설정, 중복 응답 처리, 주의력 확인 절차, 완료 시간 임계값, 누락 데이터 규칙, 점수 산정 검증 및 분석 가능 파일의 보고 방식에서 차이를 보입니다. 이러한 차이로 인해 결과의 비교와 재현이 어렵고, 추후 증거 합성 연구에 포함시키기도 어렵습니다. 본 프로토콜은 관리 순서, 스크리닝 로직, 점수 산정 구조 및 분석 경로를 투명하게 반복, 감사 및 수정할 수 있는 방식으로 고정함으로써 이러한 공백을 해결합니다. 따라서 본 연구의 기여도는 프로토콜 중심적이며, 새로운 심리학적 개념을 제안하거나 유병률 연구를 주요 결과로 제시하기보다는 대학생 집단을 대상으로 한 관찰 행동 과학 및 심리 평가 연구를 위한 재현 가능한 워크플로를 제공하는 데 있습니다.
프로토콜
The study, entitled “A Standardized Questionnaire Protocol for Internet Addiction and Emotion Regulation Assessment in University Students,” was reviewed and approved by the Ethics and Academic Committee of Zhengzhou University of Economics and Business under Approval Number 20260113004 before participant recruitment began14. The study used a cross-sectional, anonymous online questionnaire design involving full-time university students aged 18–24 years and was conducted in accordance with institutional ethical requirements and the Declaration of Helsinki. Electronic informed consent was obtained before questionnaire access. Participants received an electronic information sheet describing the study purpose, procedures, voluntary nature of participation, and data-protection measures, and they were free to withdraw at any time without penalty. No directly identifiable personal information, including name, student identification number, exact address, telephone number, personal email address, or social-media account, was collected in the main survey file. Platform-generated identifiers were used only for duplicate-response screening and were removed before dataset analysis. All data were stored securely and analyzed in de-identified form. This questionnaire workflow was not prospectively registered before participant recruitment. However, all core protocol components, including the locked questionnaire version, README/codebook, screening log, scoring rules, analysis syntax, and analysis-ready workflow files, were archived and are provided as supplementary workflow materials to support reproducibility and auditability.
Platform-generated response identifiers and device- or account-limited technical identifiers were used only for duplicate-response screening and were removed from the final anonymized analytical dataset. The core variables and scoring rules are summarized in Table 1, and the complete variable dictionary is provided in Supplementary Table 1. The questionnaire files, codebook, screening log, output plan, and analysis-ready workflow materials are provided in Supplementary File 1.
| Domain | Variable | Coding/Scoring | Role in protocol |
| Eligibility | Age | Years; eligible range 18–24 | Eligibility variable and covariate |
| Demographics | Sex | 1 = male; 2 = female; 3 = prefer not to say | Descriptive variable and regression covariate |
| Demographics | Academic year | 1 = first year; 2 = second year; 3 = third year; 4 = fourth year or above; 5 = postgraduate | Descriptive variable |
| Demographics | Discipline category | 1 = humanities and social sciences; 2 = science and engineering; 3 = business and management; 4 = arts and design; 5 = other | Descriptive variable |
| Demographics | Residence type | 1 = on-campus dormitory; 2 = off-campus rental; 3 = family home; 4 = other | Descriptive variable |
| Demographics | Monthly living expenses | 1 = <1,000 CNY; 2 = 1,000–1,999 CNY; 3 = 2,000–2,999 CNY; 4 = ≥3,000 CNY | Descriptive variable |
| Internet-use behavior | Weekday internet use | 1 = <2 h; 2 = 2–3.9 h; 3 = 4–5.9 h; 4 = ≥6 h | Behavioral covariate |
| Internet-use behavior | Weekend internet use | 1 = <2 h; 2 = 2–3.9 h; 3 = 4–5.9 h; 4 = ≥6 h | Behavioral covariate |
| Internet-use behavior | Primary online activity | 1 = study; 2 = social media; 3 = gaming; 4 = entertainment/video; 5 = shopping; 6 = mixed use; 7 = other | Descriptive variable |
| Internet-use behavior | Primary access device | 1 = smartphone; 2 = tablet; 3 = laptop/desktop; 4 = mixed devices | Descriptive variable |
| Internet-use behavior | Late-night use after 23:00 | 1 = never; 2 = less than once per week; 3 = 1–2 nights/week; 4 = 3–5 nights/week; 5 = almost every night | Behavioral covariate and logical-consistency screening variable |
| Core scale | IAT total score | Sum of 20 items; each item scored 1–5; total range 20–100 | Primary independent variable |
| Core scale | IAT severity group | 20–39 = normal use; 40–69 = problematic use; 70–100 = severe problematic use | Grouping variable |
| Core scale | DERS-16 total score | Sum of 16 items after required reverse coding; total range 16–80 | Primary dependent variable |
| Core scale | DERS-16 subscales | Computed according to the locked DERS-16 scoring key | Descriptive emotion-regulation outcomes |
| Covariate | Sleep duration | 1 = <6 h; 2 = 6–6.9 h; 3 = 7–7.9 h; 4 = ≥8 h | Adjustment variable |
| Covariate | Weekly physical activity | 0 = none; 1 = 1–2 sessions; 2 = 3–4 sessions; 3 = ≥5 sessions | Adjustment variable |
| Covariate | Academic stress | 1 = low; 2 = moderate; 3 = high | Adjustment variable |
| Quality control | Attention check | 1 = pass; 0 = fail | Exclusion criterion |
| Quality control | Completion time | Completion duration in seconds | Timing-based screening variable |
| Quality control | Long-string response count | Maximum run length of identical responses across the 36 scored scale items | Patterned-response screening variable |
| Quality control | Within-person SD | Within-person standard deviation across the 36 scored scale items | Invariant-response screening variable |
| Quality control | Logical-consistency flag | 0 = no inconsistency; 1 = inconsistency detected | Logical-consistency screening variable |
Table 1: Core variables, coding structure, and scoring rules used in the standardized questionnaire protocol. This table summarizes the core eligibility, demographic, internet-use, scale, covariate, and quality-control variables used in the main workflow. It includes the coding values, score ranges, scoring rules, and roles of the main variables used for questionnaire administration, screening, scoring, and analysis. Abbreviations: IAT = internet addiction test; DERS-16 = 16-item difficulties in emotion regulation scale. Please click here to download this Table.
1. Set up the study population, questionnaire structure, and survey flow
- Define the target population and valid sample
- Recruit full-time undergraduate and postgraduate students aged 18–24 years who can complete the questionnaire independently on a mobile phone or computer. Record the questionnaire language version and use scale versions that have been validated or appropriately adapted for the target student population.
- Document any accessibility or language modification before data collection when international students, students with disabilities, or multilingual student groups are included.
- Restrict participation to one completed response per participant. Use the survey platform’s device restriction, account restriction, cookie restriction, or authenticated-link function when available.
NOTE: When the same participant account generates responses from multiple devices, identify and reconcile those records during duplicate screening using the account-limited identifier, timestamp, questionnaire status, and response-pattern similarity. - Set the minimum final valid sample at 450 questionnaires and continue recruitment until the cleaned dataset remains above this threshold after screening.
NOTE: When severe problematic internet use or another small subgroup is a primary analysis target, set a larger recruitment target before data collection begins. - Record the number invited, the number returned, the number excluded at each prespecified screening step, and the final number retained so that the participant flow can later be summarized in Figure 1.
- Construct the questionnaire in a fixed order
- Arrange the questionnaire in the following sequence: informed consent, demographic information, internet-use behavior, Internet Addiction Test, Difficulties in emotion regulation scale short form, sleep duration, weekly physical activity, and perceived academic stress. Keep this order unchanged for all participants. Do not randomize the order of the core scales.
- Record age, sex, academic year, discipline category, residence type, and monthly living expenses using closed-ended response categories. Mark all demographic items as mandatory.
NOTE: For sex, include male, female, and prefer not to say. Retain “prefer not to say” in descriptive analyses. In regression analyses, code sex using indicator variables with male as the reference category, including separate indicators for female and prefer not to say. Do not delete participants solely because they select “prefer not to say.” - Record weekday internet-use duration, weekend internet-use duration, primary online activity, primary access device, and late-night internet use after 23:00. Code late-night use as 1 = never, 2 = less than once per week, 3 = 1–2 nights per week, 4 = 3–5 nights per week, and 5 = almost every night.
- Record the academic period during which the questionnaire is administered. In the representative implementation, the survey was administered during a regular teaching semester, outside final examination weeks, specifically during semester weeks 6–7.
- Administer and score the core instruments
- Administer the 20-item Internet addiction test as a mandatory scale and score each item from 1 to 5. Sum all 20 items to obtain a total score ranging from 20 to 100, then classify 20–39 as normal use, 40–69 as problematic use, and 70–100 as severe problematic use15.
- Use “internet addiction” when reporting IAT-based scores and severity groups. Use “problematic internet use” only when referring to the broader literature or non-IAT constructs.
- Administer the 16-item Difficulties in emotion regulation scale short form immediately after the internet addiction test and score each item from 1 to 5. Reverse-code Items 1, 6, and 8 before summation, then calculate a total score ranging from 16 to 80, with higher scores indicating greater difficulty in emotion regulation16.
- Generate five subscale scores for nonacceptance, goals, impulse, strategies, and clarity after reverse coding has been verified.
- Recheck the coding direction of all reversed items before calculating the total and subscale scores. Use the same DERS-16 scoring key for every participant and document the scoring key in the README/codebook.
- When a revised or alternative internet-addiction instrument is used, replace the scale-specific module before data collection begins and update the item names, score range, severity thresholds, scoring syntax, README/codebook, questionnaire screenshots, and Table of Materials.
- Add covariates and one attention-check item
- Record sleep duration as <6 h, 6–6.9 h, 7–7.9 h, and ≥8 h. Record weekly physical activity frequency as 0, 1–2, 3–4, and ≥5 sessions. Record perceived academic stress as low, moderate, or high. Define one physical-activity session as ≥20 min of moderate or vigorous activity.
- Insert one directed-response attention-check item in the behavioral section and require the participant to select one specified response option. The attention-check item used in the representative implementation was: “To confirm that you are reading carefully, please select ‘3 = sometimes’ for this item”. Mark any questionnaire that fails this item for exclusion during cleaning17.
CRITICAL STEP: Do not change item wording, response anchors, scale order, exclusion thresholds, survey-platform settings, coding rules, or statistical-analysis rules after formal data collection begins.
NOTE: Summarize the core variables, coding values, score ranges, and scoring rules in Table 1. Provide the complete variable dictionary, file-status fields, screening flags, technical identifier fields, dataset-tracking variables, file names, and software versions in Supplementary Table 1 and the README/codebook.
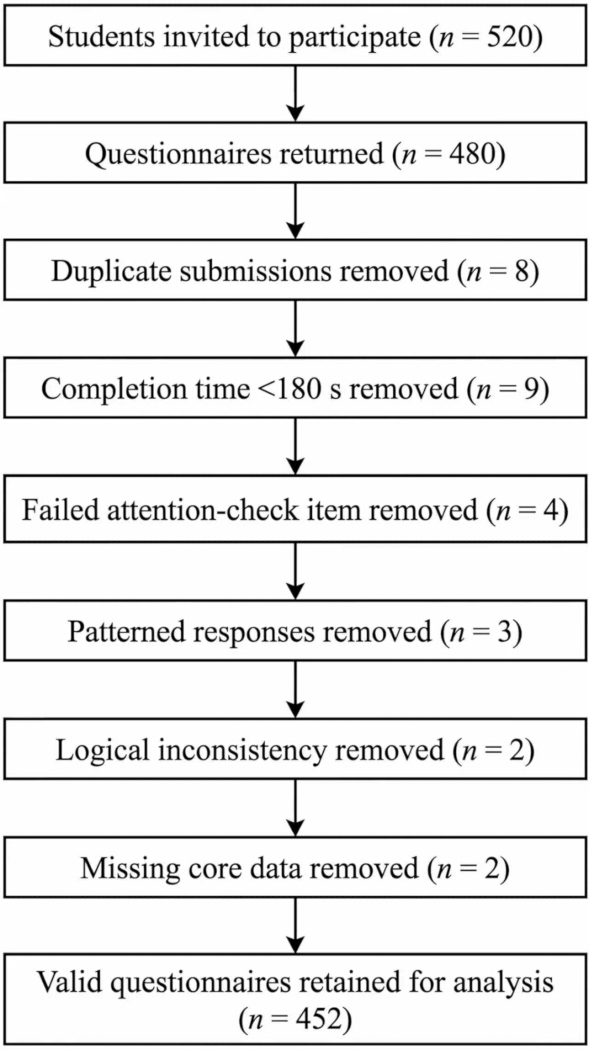
Figure 1: Questionnaire flow for recruitment, screening, exclusion, and final analytic retention. This flow diagram shows the progression from invited students to returned questionnaires, through sequential data-quality screening and exclusion by prespecified criteria, to final retention of valid questionnaires for analysis. The figure presents the number of invited students, returned questionnaires, excluded records at each screening step, and the final analytic sample. Please click here to view a larger version of this figure.
2. Pilot-test the questionnaire and lock the final field version
- Pilot-test the full questionnaire
- Administer the full questionnaire to 20–30 students who satisfy the formal inclusion criteria but are not retained in the final dataset.
- Record completion time and written feedback on clarity, response burden, technical access, item order, attention-check comprehension, and any ambiguity in demographic or behavioral response options.
- Record the pilot sample size, median completion time, interquartile range, minimum and maximum completion time, and all wording changes made after pilot testing.
- In the representative implementation, the pilot included 25 students, the median completion time was 540 s, and the expected completion time was set at 6–8 min.
- Revise ambiguous wording, duplicated meaning, unclear response options, or software-display problems identified during pilot testing, then freeze the final questionnaire version before formal release.
NOTE: If the study includes multilingual students, older adults, adolescents, or students with disabilities, conduct additional cognitive testing or subgroup pilot testing before formal release.
- Fix the operational settings and export rules
- Create a new survey project in the selected online survey platform. Enter the consent page as the first page and set the consent item as a required branching item.
- Configure the survey so that participants who do not provide consent exit the survey automatically without seeing the questionnaire body.
- Enter all demographic, internet-use, IAT, DERS-16, covariate, and attention-check items using the locked wording and response anchors. Set all core items as mandatory.
- Activate automatic recording of start time, end time, completion duration, response status, and platform-generated response identifier.
- Enable one-response-per-participant controls when available, including authenticated survey links, device restriction, cookie-based repeat prevention, account-based repeat prevention, or duplicate-response review settings. Record the enabled controls in the README/codebook.
- Disable collection of unnecessary direct identifiers. If the platform records IP address by default, disable IP storage or replace it with a non-identifying duplicate-screening field when permitted by institutional policy.
NOTE: When IP addresses or device metadata are temporarily retained for duplicate screening, store them only in the encrypted raw file, restrict access to the study analyst, and remove them before producing the final analytical dataset. - Specify whether pause-and-resume is permitted. In this protocol, a formal save-and-return function across different sessions is not enabled. Participants may pause only within the same open browser session, and the recorded completion time includes the full elapsed time.
- Export the raw return file in both spreadsheet and comma-separated-value formats at survey closure18. Also export a survey-to-document file or PDF/A copy containing the final questionnaire wording, item order, branching settings, mandatory-item settings, and coding structure. Save these files with version-controlled names.
- Calculate the pilot median completion time and set the minimum valid completion threshold at approximately one-third of that value. Fix the final lower threshold at 180 s and apply it uniformly during formal screening.
- Because this cutoff is derived from the pilot sample, re-establish the threshold when the protocol is implemented in a substantially different population, platform, language version, or institutional setting.
NOTE: Archive the final questionnaire screenshots, final questionnaire export, README/codebook, pilot log, attention-check wording, screening-log template, export settings, and statistical syntax as supplementary or audit files.
3. Release the questionnaire and preserve the raw dataset
- Recruit participants through fixed channels
- Distribute one standardized invitation through student communication groups, class channels, or institutional mailing lists during a fixed 14-day collection window.
- State the study purpose, expected completion time of 6–8 min, anonymous handling of data, voluntary participation, and the absence of academic penalty or reward for nonparticipation in both the invitation and the consent page.
- Display the consent page before any questionnaire item appears and require active agreement before entry. Do not permit access to the questionnaire body without an affirmative consent response.
- State on the consent page that participants may stop before final submission and that incomplete responses will not be used in the final analysis.
- Use the same locked questionnaire version across all recruitment channels. If several recruitment channels are used, record the channel only when it is prespecified as a study variable.
- Preserve the raw return file
- Retain all returned records, including incomplete and later-excluded submissions, in the raw export file. Export the full dataset immediately after survey closure and store it as raw_returns_YYYYMMDD.csv and raw_returns_YYYYMMDD.xlsx.
- Preserve the original submission time, completion duration, response status, platform-generated response identifier, and device-limited or account-limited technical identifier in the raw file. Do not overwrite these fields during later cleaning.
- Save one read-only raw-data copy before screening begins. Store the raw file, screening log, and final analytic dataset in separate folders. Restrict access to the raw file containing technical identifiers to authorized study personnel only.
CAUTION: Do not collect directly identifying information, such as full name, student identification number, exact dormitory address, personal telephone number, personal email address, or social media account, in the main survey file.
NOTE: Pause the workflow after raw export, save one read-only copy of the raw dataset, and restart cleaning only from that preserved copy.
4. Screen returned questionnaires and generate the final analytic dataset
- Apply the screening sequence in a fixed order
- Sort all returned records by device-limited identifier, account-limited identifier when available, timestamp, questionnaire status, and response similarity. Identify duplicate submissions first. Retain the earliest complete record when two or more submissions originate from the same participant within the same collection cycle.
- If multiple submissions are detected from the same authenticated account but different devices, treat them as duplicate submissions from the same participant. Retain the earliest complete record and exclude later complete records. If the earliest record is incomplete and a later record is complete, retain the earliest complete record.
- Remove records with completion time <180 s, review records completed in 180–240 s, and remove records that fail the directed-response attention-check item fourth. Document the number removed at each step in screening_log_v1.xlsx19.
- For records completed in 180–240 s, conduct manual review using the attention-check result, long-string responding flag, within-person standard deviation, and logical-consistency flag.
- Retain a borderline-speed record only when no additional data-quality flag is present. Record every borderline-speed decision in the screening log.
- Remove patterned, inconsistent, or incomplete records
- Remove all questionnaires showing long-string responding, defined as 18 or more consecutive identical responses across the 36 scored scale items, or a within-person standard deviation ≤0.25 across those items.
- Remove any questionnaire showing impossible behavioral combinations. Define “the highest response category on nearly all Internet addiction test items” as a score of 5 on at least 18 of the 20 IAT items.
NOTE: The logical-inconsistency rule is triggered when a respondent reports both weekday and weekend internet use in the lowest duration category (<2 h per day), late-night internet use coded as “almost every night,” and a score of 5 on at least 18 of the 20 IAT items. Apply this rule only after duplicate, completion-time, attention-check, and patterned-response screening have been completed. - Remove all questionnaires with missing values in any IAT item, any DERS-16 item, or any prespecified covariate.
NOTE: This complete-case rule is used because the online survey uses mandatory core items and because the representative regression model requires a fixed covariate set. When missing covariate data exceed 5%, use a prespecified alternative missing-data method, such as multiple imputation. - Assign one anonymous study ID to each retained record and save the remaining file as analytic_dataset_v1.csv and analytic_dataset_v1.xlsx.
- Remove platform-generated response identifiers, device-limited identifiers, account-limited identifiers, IP addresses if retained during screening, timestamps, and free-text review notes from the final analytic dataset. Keep only the anonymous study ID and analysis variables.
CRITICAL STEP: Apply the screening sequence in the same order to every record and do not re-enter previously excluded cases at later stages. Assign the first triggered exclusion criterion as the primary exclusion reason and record secondary flags only as screening-log notes.
NOTE: Summarize the final exclusion counts by reason in Table 2, and keep those counts identical to the participant flow reported later in Figure 1.
| Screening order | Screening item | Operational rule | Screening action | Documentation rule |
| Step 1 | Raw export preservation | Export all returned records immediately after survey closure and save them as raw_returns_YYYYMMDD.csv and raw_returns_YYYYMMDD.xlsx | Preserve one read-only copy before any cleaning begins | Archive in raw-data folder |
| Step 2 | Consent and access check | Identify records without active electronic informed consent before questionnaire access | Exclude records without consent from the analytic workflow | Log excluded or inaccessible records in screening_log_v1.xlsx when retained in the platform export |
| Step 3 | Duplicate screening | Identify records sharing the same device-limited identifier or account-limited identifier within the same collection cycle and matching on sex, age, academic year, and at least 80% identical questionnaire responses | Retain the earliest complete record and exclude all later duplicates | Log excluded count and affected raw_record_id values in screening_log_v1.xlsx; assign primary exclusion_reason = 1 |
| Step 4 | Multiple-device duplicate reconciliation | Identify multiple complete submissions from the same authenticated participant account across different devices | Treat these records as duplicate submissions; retain the earliest complete record | Log the account-limited identifier and retained raw_record_id in screening_log_v1.xlsx; assign later records primary exclusion_reason = 1 |
| Step 5 | Completion-time screening | Identify all questionnaires with completion time <180 s | Exclude all such records automatically | Log excluded count in screening_log_v1.xlsx; assign primary exclusion_reason = 2 |
| Step 6 | Borderline-speed review | Identify all questionnaires with completion time 180–240 s | Review each record manually using attention-check, long-string, within-person SD, and logic flags; retain only if no additional flag is present | Record each case as retained_after_manual_review = 1 or excluded_after_manual_review = 1 in screening_log_v1.xlsx |
| Step 7 | Attention-check screening | Identify all records failing the directed-response attention-check item | Exclude all failed records not already excluded at an earlier step | Log excluded count in screening_log_v1.xlsx; assign primary exclusion_reason = 3 |
| Step 8 | Patterned-response screening | Identify records with 18 or more consecutive identical responses across the 36 scored scale items, or within-person SD ≤0.25 across those items | Exclude all such records not already excluded at an earlier step | Log excluded count in screening_log_v1.xlsx; assign primary exclusion_reason = 4 |
| Step 9 | Logical-consistency screening | Identify records showing the prespecified impossible behavioral combination: weekday_internet_use and weekend_internet_use both coded as <2 h, late_night_use coded as almost every night, and a score of 5 on at least 18 of the 20 IAT items | Exclude all such records not already excluded at an earlier step | Log excluded count and review note in screening_log_v1.xlsx; assign primary exclusion_reason = 5 |
| Step 10 | Core-missingness screening | Identify records with any missing value in IAT_1–IAT_20, DERS_1–DERS_16, age, sex, weekday_internet_use, weekend_internet_use, sleep_duration, physical_activity, or academic_stress; “prefer not to say” for sex is treated as a valid response, not as missing | Exclude all such records not already excluded at an earlier step | Log excluded count in screening_log_v1.xlsx; assign primary exclusion_reason = 6 |
| Step 11 | Primary exclusion assignment | Identify records meeting more than one exclusion criterion | Assign the first triggered criterion in the prespecified screening sequence as the primary exclusion reason | Record secondary flags in review notes only; do not assign multiple primary reasons |
| Step 12 | Technical identifier removal | Identify platform-generated response identifiers, device-limited identifiers, account-limited identifiers, timestamps, and any temporarily retained technical metadata in the cleaned file | Remove these fields from the final analytic dataset after screening is complete | Document removal in screening_log_v1.xlsx |
| Step 13 | Final retention | Retain all records that pass all prior screening steps | Assign one anonymous study ID to each retained record | Save as analytic_dataset_v1.csv and analytic_dataset_v1.xlsx |
| Step 14 | Screening summary | Count the number removed at each step and the final number retained | Summarize the final counts for manuscript reporting | Keep the counts in Table 2 identical to Figure 1 |
| Step 15 | Audit trail preservation | Preserve the raw file, screening log, and final analytic dataset as separate files | Do not overwrite, merge, or manually edit archived source files | Store in raw-data, screening, and analytic folders separately |
Table 2: Prespecified screening sequence, exclusion thresholds, screening actions, and documentation rules for questionnaire cleaning. This table summarizes the fixed screening order used to clean returned questionnaires, including consent and access checks, duplicate screening, multiple-device reconciliation, completion-time screening, borderline-speed review, attention-check failure, patterned responding, logical inconsistency, core missingness, technical identifier removal, final retention, and audit-trail preservation. Abbreviations: IAT = internet addiction test; DERS-16 = 16-item difficulties in emotion regulation scale. Please click here to download this Table.
5. Score variables, verify reliability, and prepare the analysis-ready file
- Generate total scores, subscale scores, and derived categorical variables
- Sum the 20 IAT item scores to generate the total internet addiction score, then store both the continuous score and the three-level severity class in the analysis-ready file.
- Reverse-code DERS-16 Items 1, 6, and 8, calculate the total score and five subscale scores, and append all derived variables to the same participant-level dataset.
- Run a range check before score calculation. Confirm that all IAT and DERS-16 item values fall within 1–5, all reverse-coded values fall within 1–5, IAT total scores fall within 20–100, and DERS-16 total scores fall within 16–80. Record the range-check output in the scoring log.
- Recode covariates into fixed analytic categories
- Recode weekday and weekend internet-use duration as <2 h, 2–3.9 h, 4–5.9 h, and ≥6 h. Recode late-night internet use as never, <1 night/week, 1–2 nights/week, 3–5 nights/week, and almost every night.
- Recode sleep duration, physical activity frequency, and perceived academic stress using the prespecified category rules defined in Section 1.4 and store the recoded values under fixed variable names in the same dataset.
- Recode sex for regression using two indicator variables: female versus male and prefer not to say versus male. Report the coding in the table footnote and README/codebook.
- Verify scoring integrity and internal consistency
- Calculate Cronbach’s alpha for the IAT total score and the DERS-16 total score before inferential analysis. Recheck item coding, reverse coding, and impossible item ranges if either alpha is <0.7020. Report the Cronbach’s alpha values in the Representative Results section.
- Calculate item-total correlations or alpha-if-item-deleted values if either scale shows unexpectedly low internal consistency. Do not remove scale items from the primary analysis unless item removal was prespecified or the study is explicitly designed as a psychometric validation study.
- Save the final analysis-ready dataset together with a README file listing variable names, coding rules, exclusion thresholds, file names, software versions, questionnaire version, scoring syntax, regression model specification, and procedures required to regenerate the same dataset.
6. Analyze the data and preserve reproducible outputs
- Generate descriptive statistics and group comparisons
- Report continuous variables as mean ± standard deviation and categorical variables as frequency and percentage. Summarize demographic characteristics, internet-use behavior, and scale scores using the predefined output structure.
- Report the sample size used for every analysis. Use the retained analytic sample as the denominator unless a table clearly states otherwise.
- Compare DERS-16 total and subscale scores across the three IAT severity groups and use two-sided testing with α = 0.05 for the primary analyses. Report standardized effect sizes where appropriate.
NOTE: For group comparisons, report η2 or partial η2 for analysis of variance, or an equivalent nonparametric effect size if a nonparametric test is used. Interpret severe problematic-use subgroup comparisons cautiously when the subgroup is small. - Calculate the Pearson correlation between IAT total score and DERS-16 total score when both variables show acceptable distributional behavior; otherwise, use Spearman correlation as a sensitivity analysis. Report n, r or ρ, 95% confidence interval if generated by the statistical software, p value, and interpretation of magnitude.
- Fit the adjusted regression model and archive outputs
- Use the DERS-16 total score as the dependent variable and the IAT total score as the primary independent variable. Enter age, sex, weekday internet use, weekend internet use, sleep duration, physical activity, and perceived academic stress as covariates. This model is the predefined analytic demonstration of the standardized workflow.
- Before interpreting the adjusted regression model, evaluate regression assumptions and model stability. Inspect residual-versus-fitted plots for linearity and homoscedasticity, inspect a Q-Q plot or normality test for residual distribution, and calculate variance inflation factors to assess multicollinearity.
- Report these diagnostics in the Representative Results section or supplementary analysis output.
- If residual heteroscedasticity is detected, report heteroscedasticity-robust standard errors as a sensitivity analysis.
- If influential observations are present, report whether the primary coefficient for the IAT total score remains materially unchanged after influence diagnostics. Do not remove influential observations unless a prespecified data-quality rule is met.
- Report unstandardized coefficients, standard errors, standardized coefficients, p values, model R2, adjusted R2, model F statistic, and VIF range for the adjusted model. Include the sample size in the table title or table footnote.
- If interactions, subgroup effects, or mediation pathways are tested, specify those analyses before data collection or label them as exploratory. The core protocol does not require interaction testing unless subgroup differences are a predefined study aim.
- Save all statistical syntax, output tables, residual plots, VIF output, reliability output, and generated figures under version-controlled file names. Regenerate all reportable outputs directly from analytic_dataset_v1 rather than from manually edited files.
NOTE: Keep the protocol text focused on workflow replication. Present the detailed representative statistics, subgroup figures, regression diagnostics, multicollinearity assessment, and model outputs in the Representative Results section.
결과
연구 흐름 및 최종 분석 유지
결과는 인터넷 중독 검사나 DERS-16의 독립적인 검증보다는 표준화된 설문지 워크플로의 실행을 보여줍니다. 14일간의 설문 조사 기간 동안 520명의 대학생이 참여 요청을 받았으며, 480부의 설문지가 회수되었습니다. 스크리닝은 미리 지정된 순서대로 진행되었습니다. 먼저 중복 제출된 8건이 제거되었으며, 이어서 완료 시간이 180 s 미만인 설문지 9건, 지시 응답 주의력 확인 항목을 통과하지 못한 설문지 4건, 패턴 응답을 보인 설문지 3건, 논리적 불일치가 있는 설문지 2건, 핵심 데이터가 누락된 설문지 2건이 제거되었습니다. 전체 스크리닝 시퀀스를 완료한 후, 최종 분석 데이터셋에는 452부의 유효한 설문지가 유지되었습니다. 최종 유지율은 회수된 설문지 중 94.2%, 참여 요청을 받은 학생 중 86.9%였습니다. 요청부터 최종 분석 유지까지의 설문 흐름은 그림 1에 제시되어 있습니다.
참가자 특성
최종 분석 표본은 학생 452명으로 구성되었으며, 평균 연령은 20.41 ± 1.58세였습니다. 여성 응답자가 표본의 더 큰 비중을 차지했으며, 여성 학생 279명, 남성 학생 167명, 그리고 “응답 거부”를 선택한 학생 6명이 포함되었습니다. 참가자들은 모든 학년과 다양한 전공에서 모집되었으며, 2학년과 3학년 학생이 가장 큰 비율을 차지했습니다. 대부분의 응답자는 교내 기숙사에 거주하고 있었으며, 월평균 생활비는 1,000–1,999 및 2,000–2,999 범주에 집중되었습니다. 유지된 표본은 또한 상당한 수준의 일상적인 인터넷 노출을 보였습니다. 평일에는 주로 2–3.9 h 및 4–5.9 h 범주에 분포가 집중되었으나, 주말 사용량은 증가하여 452명 중 322명의 학생이 하루 최소 4 h 이상 사용한다고 보고했습니다. 스마트폰 접속이 지배적인 접속 방식이었습니다. 가장 빈번하게 보고된 주요 온라인 활동은 소셜 미디어, 엔터테인먼트/비디오 및 학습 관련 이용이었습니다. 23:00 이후의 심야 이용이 흔했으며, 452명 중 228명의 학생이 일주일 중 최소 3일 이상 심야 이용을 한다고 보고했습니다. 수면 시간은 6에서 7.9 h 사이에 집중되었고, 신체 활동은 주로 일주일에 1–2회 세션 범주에 해당했으며, 보통 수준의 학업 스트레스가 최빈 응답이었습니다. 유지된 표본의 인구통계학적 및 행동 프로필은 표 3에 제시되어 있습니다.
| 특성 | 범주 | n | % |
| 성별 | 남성 | 167 | 36.9 |
| 여성 | 279 | 61.7 | |
| 응답 거부 | 6 | 1.3 | |
| 학년 | 1학년 | 88 | 19.5 |
| 2학년 | 124 | 27.4 | |
| 3학년 | 131 | 29 | |
| 4학년 이상 | 79 | 17.5 | |
| 대학원생 | 30 | 6.6 | |
| 전공 범주 | 인문 및 사회과학 | 118 | 26.1 |
| 이공계 | 96 | 21.2 | |
| 경영 및 관리 | 104 | 23 | |
| 예술 및 디자인 | 82 | 18.1 | |
| 기타 | 52 | 11.5 | |
| 거주 형태 | 교내 기숙사 | 301 | 66.6 |
| 교외 자취 | 79 | 17.5 | |
| 본가 | 58 | 12.8 | |
| 기타 | 14 | 3.1 | |
| 월평균 생활비, CNY | <1,000 | 61 | 13.5 |
| 1,000–1,999 | 176 | 38.9 | |
| 2,000–2,999 | 149 | 33 | |
| ≥3,000 | 66 | 14.6 | |
| 평일 인터넷 사용 시간 | <2 h | 52 | 11.5 |
| 2–3.9 h | 157 | 34.7 | |
| 4–5.9 h | 166 | 36.7 | |
| ≥6 h | 77 | 17 | |
| <2 h | 29 | 6.4 | |
| 2–3.9 h | 101 | 22.3 | |
| 4–5.9 h | 178 | 39.4 | |
| ≥6 h | 144 | 31.9 | |
| 주요 온라인 활동 | 학습 | 74 | 16.4 |
| 소셜 미디어 | 126 | 27.9 | |
| 게임 | 61 | 13.5 | |
| 엔터테인먼트/동영상 | 102 | 22.6 | |
| 쇼핑 | 28 | 6.2 | |
| 복합 사용 | 47 | 10.4 | |
| 기타 | 14 | 3.1 | |
| 주요 접속 기기 | 스마트폰 | 323 | 71.5 |
| 태블릿 | 18 | 4 | |
| 노트북/데스크톱 | 67 | 14.8 | |
| 여러 기기 혼용 | 44 | 9.7 | |
| 23:00 이후 심야 사용 | 전혀 없음 | 48 | 10.6 |
| 주 1회 미만 | 57 | 12.6 | |
| 주 1–2회 | 119 | 26.3 | |
| 주 3–5회 | 141 | 31.2 | |
| 거의 매일 밤 | 87 | 19.2 | |
| 수면 시간 | <6 h | 83 | 18.4 |
| 6–6.9 h | 146 | 32.3 | |
| 7–7.9 h | 157 | 34.7 | |
| ≥8 h | 66 | 14.6 | |
| 주간 신체 활동 | 없음 | 91 | 20.1 |
| 1–2회 | 176 | 38.9 | |
| 3–4회 | 128 | 28.3 | |
| ≥5회 | 57 | 12.6 | |
| 학업 스트레스 | 낮음 | 73 | 16.2 |
| 보통 | 241 | 53.3 | |
| 높음 | 138 | 30.5 | |
| 연령, years | 평균 ± 표준편차 | 20.41 ± 1.58 | — |
표 3: 유지된 표본의 기초 인구통계학적 및 행동적 특성. 이 표는 사전 정의된 스크리닝 후 최종적으로 유지된 표본의 인구통계학적 프로필과 인터넷 사용 특성을 보여줍니다. 변수에는 성별, 학년, 전공 분야, 거주 형태, 월평균 생활비, 평일 및 주말 인터넷 사용량, 주요 온라인 활동, 주요 접속 기기, 23:00 이후 심야 사용 여부, 수면 시간, 주간 신체 활동, 학업 스트레스 및 연령이 포함됩니다. 약어: CNY = 중국 위안; SD = 표준 편차. 여기에서 이 표를 다운로드하십시오.
인터넷 중독 심각도, 정서 조절 결과 및 신뢰도
최종 분석 대상 표본(n = 452)에서 인터넷 중독 검사 총점의 평균은 51.94 ± 16.58이었다. 미리 설정된 심각도 기준에 따라, 응답자 중 200명은 일반 사용자, 239명은 문제적 사용자, 13명은 심각한 문제적 사용자로 분류되었으며, 문제적 사용자 그룹이 가장 큰 하위 그룹을 형성했다. 분석 대상 표본의 DERS-16 총점 평균은 35.95 ± 8.89였다. 인터넷 중독 검사의 Cronbach's alpha 값은 0.91로 수용 가능한 수준의 내적 일관성을 보였으며, DERS-16 또한 Cronbach's alpha 값이 0.88로 수용 가능한 내적 일관성을 나타냈다. 세 가지 IAT 심각도 그룹별로 DERS-16 총점을 살펴본 결과, 일반 사용자 그룹의 평균이 가장 낮았고, 문제적 사용자 그룹의 평균이 더 높았으며, 심각한 문제적 사용자 그룹의 평균이 가장 높았다. 분석 대상 표본(n = 452; F = 72.80, p < 0.001; η2 = 0.245)에서 DERS-16 총점에 대한 그룹 간 비교는 통계적으로 유의미했다. DERS-16 하위 척도 요약에서도 동일한 방향성의 패턴이 관찰되었다. 심각한 문제적 사용자 하위 그룹의 규모가 작으므로(n = 13), 해당 하위 그룹의 값은 세밀한 하위 그룹 추론의 근거보다는 전반적인 분포 패턴의 일부로 제시되었다. 인터넷 중독 심각도와 정서 조절 결과는 표 4에 요약되어 있다.
| 측정 | 일반 사용 | 문제적 사용 | 심각한 문제적 사용 | 합계 |
| n = 200 | n = 239 | n = 13 | n = 452 | |
| IAT 총점 | 34.20 ± 3.90 | 65.33 ± 6.90 | 78.70 ± 6.20 | 51.94 ± 16.58 |
| DERS-16 총점 | 31.20 ± 7.10 | 39.24 ± 8.30 | 48.50 ± 9.60 | 35.95 ± 8.89 |
| DERS-16 비수용 | 5.90 ± 1.90 | 7.29 ± 2.10 | 8.90 ± 2.40 | 6.72 ± 2.16 |
| DERS-16 목표 | 6.20 ± 1.80 | 7.82 ± 2.00 | 9.10 ± 2.30 | 7.14 ± 2.09 |
| DERS-16 충동성 | 5.80 ± 1.70 | 7.72 ± 2.10 | 9.40 ± 2.50 | 6.92 ± 2.19 |
| DERS-16 전략 | 9.60 ± 2.90 | 12.29 ± 3.30 | 15.10 ± 3.80 | 11.18 ± 3.44 |
| DERS-16 명확성 | 3.70 ± 1.30 | 4.18 ± 1.40 | 5.00 ± 1.60 | 3.99 ± 1.41 |
| IAT 크론바흐 알파(Cronbach’s alpha) | — | — | — | 0.91 |
| DERS-16 크론바흐 알파(Cronbach’s alpha) | — | — | — | 0.88 |
| DERS-16 전체 집단 비교 | — | — | — | F = 72.80; p < 0.001; η² = 0.245 |
| IAT 총점과 DERS-16 총점 간의 피어슨 상관관계 | — | — | — | n = 452; r = 0.524; 95% CI: 0.45–0.59; p < 0.001 |
표 4: 최종 분석 표본의 인터넷 중독 심각도 그룹, 정서 조절 결과, 신뢰도 및 상관관계.이 표는 일반 사용자, 문제적 사용자 및 심각한 문제적 사용자 그룹의 IAT 총점, DERS-16 총점 및 DERS-16 하위 척도 값을 나타냅니다. 또한 전체 표본 평균, IAT 및 DERS-16의 Cronbach’s alpha 값, DERS-16 총점 그룹 간 비교, 그리고 IAT 총점과 DERS-16 총점 간의 Pearson 상관관계를 나타냅니다. 약어: IAT = 인터넷 중독 검사; DERS-16 = 16문항 정서 조절 곤란 척도; CI = 신뢰 구간; SD = 표준 편차. 이 표를 다운로드하시려면 여기를 클릭하십시오.
인터넷 중독과 정서 조절 간의 연관성
최종 분석 표본(n = 452)을 대상으로 IAT 총점과 DERS-16 총점 사이의 사전 정의된 연속 점수 연관성을 평가하였다. IAT 총점과 DERS-16 총점 사이의 Pearson 상관관계는 양의 상관관계를 보였으며 그 크기는 중간 정도였다(r = 0.524, 95% CI: 0.45–0.59, p < 0.001). 따라서 IAT 총점이 높은 학생일수록 전반적인 정서 조절에 더 큰 어려움을 겪는 경향이 있었다. 이 결과는 Table 4에 나타난 바와 같이 중증도 그룹 분포와 일치하였으며, 단순히 범주형 IAT 분류에만 의존하지 않았다.
다변량 회귀 분석
보정된 회귀 모델에는 최종 분석 표본(n = 452)이 포함되었습니다. DERS-16 총점을 종속 변수로, IAT 총점을 주요 독립 변수로 입력하였습니다. 연령, 성별, 평일 인터넷 사용량, 주말 인터넷 사용량, 수면 시간, 주간 신체 활동 및 학업 스트레스를 동일한 모델의 공변량으로 포함하였습니다. 성별은 남성을 참조 범주로 하고 여성과 응답 거부자에게 별도의 지표를 부여하는 사전 지정된 지표 변수 코딩을 사용하여 입력하였습니다. 보정 후에도 IAT 총점은 DERS-16 총점과 정적인 상관관계를 유지하였습니다 (B = 0.21, SE = 0.02, β = 0.39, p < 0.001). 공변량 중에서는 학업 스트레스가 DERS-16 총점과 정적인 상관관계를 보였으며 (B = 2.36, β = 0.23, p < 0.001), 수면 시간 (B = -1.12, β = -0.13, p < 0.001)과 주간 신체 활동 (B = -0.84, β = -0.10, p = 0.003)은 DERS-16 총점과 부적인 상관관계를 보였습니다. 평일 인터넷 사용량은 보정 후에도 상대적으로 작은 정적 계수를 유지하였으나 (B = 0.71, β = 0.09, p = 0.015), 주말 인터넷 사용량은 보정 모델에서 통계적 유의성을 유지하지 못하였습니다 (B = 0.49, β = 0.07, p = 0.071). 동일한 조건에서 연령과 두 성별 지표 모두 유의미한 독립 예측 변수가 아니었습니다. 해당 모델은 DERS-16 총점 분산의 39.8%를 설명하였으며, 수정된 R2 값은 0.386이었고, 전체 모델은 통계적으로 유의미하였습니다, F(9, 442) = 32.47, p < 0.001. 분산팽창요인(VIF) 범위가 1.03에서 1.42로 나타나 다중공선성은 두드러지지 않았습니다. 잔차 대 적합값 검토 결과, 선형성이나 등분산성을 크게 위배하는 점은 발견되지 않았습니다. 잔차 Q-Q 플롯은 정규분포 근사치에서 크게 벗어나지 않았습니다. Breusch-Pagan 검정은 통계적으로 유의하지 않았습니다, p = 0.214. 최대 Cook의 거리 값은 0.18이었으며, Cook의 거리가 0.50을 초과하는 관측치는 없었습니다. 보정된 회귀 모델은 표 5에 보고되어 있습니다.
| 예측 인자 | B | 표준 오차 | β | t | p | 분산팽창요인 |
| 상수 | 18.42 | 2.11 | — | 8.73 | <0.001 | — |
| IAT 총점 | 0.21 | 0.02 | 0.39 | 9.84 | <0.001 | 1.42 |
| 연령 | 0.18 | 0.11 | 0.03 | 1.64 | 0.102 | 1.08 |
| 성별, 암컷 대 수컷 | 0.62 | 0.54 | 0.04 | 1.15 | 0.252 | 1.05 |
| 성별, 응답 거부 vs. 남성 | 0.28 | 1.89 | 0.01 | 0.15 | 0.882 | 1.03 |
| 평일 인터넷 사용 | 0.71 | 0.29 | 0.09 | 2.45 | 0.015 | 1.36 |
| 주말 인터넷 이용 | 0.49 | 0.27 | 0.07 | 1.81 | 0.071 | 1.31 |
| 수면 시간 | -1.12 | 0.31 | -0.13 | -3.61 | <0.001 | 1.18 |
| 주간 신체 활동 | -0.84 | 0.28 | -0.1 | -3 | 0.003 | 1.12 |
| 학업 스트레스 | 2.36 | 0.39 | 0.23 | 6.05 | <0.001 | 1.27 |
표 5: 최종 분석 표본에서 IAT 총점 및 공변량에 따른 DERS-16 총점의 다변량 선형 회귀 분석.이 표는 DERS-16 총점을 종속 변수로, IAT 총점을 주요 독립 변수로 설정한 보정 회귀 모델을 보여줍니다. 연령, 성별, 평일 인터넷 사용량, 주말 인터넷 사용량, 수면 시간, 주간 신체 활동 및 학업 스트레스가 공변량으로 포함되었습니다. 또한 이 표는 표준화 계수, 분산 팽창 요인 및 모델 진단 결과를 보고합니다. 약어: IAT = internet addiction test; DERS-16 = 16-item difficulties in emotion regulation scale; VIF = variance inflation factor. 이 표를 다운로드하려면 여기를 클릭하십시오.
보충 표 1: 표준화된 설문지 워크플로우에 사용된 전체 변수 사전, 파일 존재 여부, 코딩 구조 및 데이터 관리 필드. 이 보충 표는 윤리 및 동의 변수, 설문 설정 변수, 인구통계학적 변수, 인터넷 사용 변수, 품질 관리 플래그, 척도 항목, 유도 점수, 공변량, 기술 식별자 필드, 데이터 세트 추적 변수, 파일 상태 정보 및 코딩 규칙을 포함하여 본 프로토콜에 사용된 전체 변수 사전을 제공합니다. 약어: IAT = 인터넷 중독 검사; DERS-16 = 16문항 정서 조절 곤란 척도.여기에서 파일을 다운로드하십시오.
보충 파일 1: 보충 설문지 워크플로우 자료. 이 보충 파일에는 표준화된 설문지 작성, 스크리닝, 점수 산정 및 분석 워크플로우를 재현하는 데 사용된 설문지 파일, 코드북, 스크리닝 로그, 출력 계획 및 분석 준비 워크플로우 자료가 포함되어 있습니다.이 파일을 다운로드하려면 여기를 클릭하십시오.
토론
이 논문의 주요 기여는 인터넷 중독과 정서 조절 어려움 사이에서 관찰된 대표적인 연관성보다는 표준화된 설문조사 워크플로우에 있습니다. 구현 결과, 전자 동의, 인구통계학적 항목, 인터넷 이용 행태, IAT 점수 산출, DERS-16 점수 산출, 공변량 수집, 순차적 데이터 품질 스크리닝, 그리고 재현 가능한 회귀 분석으로 이어지는 고정된 시퀀스가 대학생 표본에서 실행될 수 있음을 보여주었습니다. 이러한 절차적 강조는 중요합니다. 왜냐하면 문헌상에서 문제성 인터넷 사용은 종종 정서 조절 장애와 연결되지만, 일관되지 않은 실시 및 정제 절차로 인해 연구 간 결과 비교가 어려울 수 있기 때문입니다21. 따라서 본 워크플로우는 해석을 시작하기 전 측정 순서, 제외 규칙, 점수 산출 단계 및 분석 결과물을 명시함으로써 비교 가능성을 지원합니다.
재현성을 위해 특히 중요한 몇 가지 절차적 단계가 있습니다. 첫째, 설문지 접속 전에 전자 동의를 완료해야 하며, 중복 확인에 사용된 기술적 식별자는 최종 익명화된 분석 데이터 세트에서 분리해야 합니다. 둘째, 중복 확인은 완료 시간 확인, 주의 집중 확인 검토, 정형적 응답 확인, 논리적 일관성 검토 및 결측치 확인보다 먼저 수행되어야 합니다. 이는 순서를 변경할 경우 최종 유지 표본이 달라질 수 있기 때문입니다. 셋째, 역코딩 및 심각도 분류를 포함한 IAT 및 DERS-16 채점 절차는 데이터 수집 전에 확정되어야 합니다. 이러한 단계들은 온라인 설문 연구에서 피할 수 있는 변동성을 줄여주며, 인터넷 중독 결과가 측정 절차의 차이뿐만 아니라 스트레스, 자기 통제력 및 불안의 영향을 받을 수 있다는 보다 광범위한 우려와 일치합니다22.
본 프로토콜은 실행 과정에서 여러 가지 트러블슈팅 점검을 필요로 합니다. 설문 플랫폼에서 중복 제출을 제한할 수 없는 경우, 중복 스크리닝은 계정 제한 식별자, 기기 제한 식별자, 타임스탬프, 설문지 상태 및 응답 패턴 유사성의 조합에 의존하여 수행해야 합니다. 많은 레코드가 경계선 속도 범위 내에 해당하는 경우, 완료 시간만을 사용하는 대신 주의 집중 점검 결과, 긴 문자열 응답 수, 개인 내 표준 편차 및 논리적 일관성 플래그를 함께 검토해야 합니다. Cronbach’s alpha 값이 예상보다 낮을 경우, 항목 수준의 결정을 내리기 전에 항목 코딩, 역코딩 및 점수 범위를 확인해야 합니다. 온라인 및 스마트폰 관련 행동은 수면 및 정서 조절 과정과 연관되어 있으므로, 부주의한 스크리닝이나 잘못된 코딩은 왜곡된 추론의 잠재적 원인이 될 수 있어 이러한 절차들이 특히 중요합니다23.
대표적인 구현 단계에서 사용된 제외 임계값은 이 워크플로우 내에서는 표준화된 것으로 간주해야 하지만, 향후 모든 대상 집단에 대해 보편적으로 고정된 값으로 취급해서는 안 됩니다. 180s의 최저 완료 시간 임계값은 파일럿 테스트를 통해 도출되었으며, 이 프로토콜을 고령자, 청소년, 다국어 응답자, 접근성 조정 설문지 또는 디스플레이 형식이 다른 플랫폼에 적용할 때는 다시 조정해야 합니다. 논리적 불일치 규칙과 패턴 응답 기준 또한 척도 길이, 항목 순서 또는 응답 앵커가 다를 경우 조정이 필요할 수 있습니다. 마찬가지로, 대표 구현 단계에서 나타난 소수의 심각한 문제적 사용 하위 그룹은 하위 그룹 비교를 위해 설계된 연구의 경우 데이터 수집 전 모집 목표를 높이거나 층화 추출법을 사용해야 함을 시사합니다. 신체 활동을 포함한 행동 및 라이프스타일 변수가 주의력, 반추 및 자기 조절과 상호작용하는 방식이 학생 그룹마다 다를 수 있으므로 이러한 유연성이 중요합니다24.
이 프로토콜을 적용할 때 몇 가지 제한 사항을 고려해야 합니다. 워크플로우에 자기 보고식 도구가 사용되므로, 회상 오류, 사회적 바람직성 편향 및 공통 방법 분산이 노출 및 결과 측정치 모두에 영향을 미칠 수 있습니다. 이러한 위험은 중립적인 문구 사용, 고정된 설문지 순서, 주의력 확인, 사전 지정된 공변량, 그리고 누락 및 제외 사항에 대한 투명한 보고를 통해 줄일 수 있으나 완전히 제거할 수는 없습니다. 향후 연구에서는 구성 타당도를 강화하기 위해 스마트폰 화면 시간 로그, 앱 사용 기록 또는 플랫폼 기반 사용 요약과 같은 객관적인 디지털 행동 측정치를 통합할 수 있습니다. 하지만 이러한 추가 사항에는 별도의 동의 문구, 개인정보 보호 장치, 데이터 최소화 절차 및 연결 규칙이 필요합니다. 따라서 이는 설문지 워크플로우에 비공식적으로 추가하기보다 계획된 프로토콜 확장 형태로 추가해야 합니다25.
본 프로토콜은 조정이 가능하지만, 모든 환경에 기계적으로 적용해서는 안 됩니다. 비대학생 인구를 대상으로 할 경우, 선정 기준, 모집 경로, 학업 스트레스 항목 및 인터넷 사용 범주를 수정해야 할 수 있습니다. 국제 다기관 연구에서는 데이터를 통합하기 전 번역, 문화적 적응, 플랫폼 동등성, 시간대 처리, 데이터 보호 규정 및 사이트 수준의 모니터링 내용을 문서화해야 합니다. 만약 IAT가 더 최신 측정 도구나 특정 인구 집단용 측정 도구로 대체되더라도 워크플로우는 그대로 유지할 수 있으나, 점수 범위, 심각도 임계값, 코드북, 구문은 재료 목록또한, 데이터 수집 전에 보조 변수 사전이 업데이트되어야 합니다. 인터넷 사용 시간과 조절 장애 사용 간의 이러한 구분은 중요한데, 온라인 접속 시간만으로는 문제적 또는 강박적 사용과 동일한 개념을 포착하지 못할 수 있기 때문입니다.26.
마지막으로, 본 대표 사례의 구현 방식은 횡단적 연구였으므로 이를 시간적 방향성의 증거로 해석해서는 안 됩니다. IAT 총점과 DERS-16 총점 사이에서 관찰된 연관성은 분석 경로가 어떻게 작동하는지를 보여주는 것이지, 정서 조절의 어려움이 문제적 인터넷 사용을 유발하는지 또는 문제적 인터넷 사용이 시간이 지남에 따라 정서 조절을 악화시키는지에 대한 인과관계를 나타내는 것이 아닙니다. 다른 대학 환경에서도 유사한 횡단적 패턴이 보고된 바 있으나, 방향성과 변화를 조사하기 위해서는 종단적 연구 또는 반복 측정 적용이 필요합니다27. 본 프로토콜의 가치는 이러한 향후 연구를 위한 안정적인 기준 워크플로우를 제공한다는 점에 있습니다. 동의서 작성, 설문지 관리, 스크리닝, 채점, 신뢰도 검사, 모델 진단, 파일 아카이빙 및 보조 문서화를 표준화함으로써, 본 프로토콜은 재현 가능성이 더 높은 횡단적 연구를 지원할 수 있으며, 시간적 문제가 주요 목표가 될 때 종단적 연구 또는 중재 설계로 확장될 수 있습니다28. 코드북, 스크리닝 로그, 출력 계획 및 분석 준비 완료 워크플로우 자료를 포함한 것은 FAIR 지향적 연구 소프트웨어 및 워크플로우 문서화 원칙29과 투명하고 재현 가능한 보고를 위한 더 광범위한 오픈 사이언스 권고 사항30과도 일치합니다.
공개 사항
저자는 공개할 사항이 없습니다.
감사의 글
본 연구는 2025년 허난성 연성과학 프로젝트인 “학령인구 변화가 허난성 민립 고등교육의 고품질 발전에 미치는 영향 및 최적화 경로 연구”(과제 번호 252400410490)와 정저우 경제경영대학교의 2025년 박사 연구 기금 프로젝트인 “대학생의 네트워크 집단 행동 형성 기제 및 여론 지도 기제 연구”의 지원을 받아 수행되었습니다. 저자는 기관의 지원을 제공한 정저우 경제경영대학교에 감사를 표합니다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| 분석 가능 데이터셋 | 연구 특정 내부 문서 | analytic_dataset_v1.csv 및 analytic_dataset_v1.xlsx | 모든 보고 가능한 기술, 신뢰도, 상관 및 회귀 분석에 사용된 최종 익명화 데이터 세트 |
| 분석 구문 | 연구별 내부 문서 | analysis_syntax_v1.R 또는 이에 상응하는 스크립트 파일 | 점수 산출 검증, 신뢰도 점검, 기술 통계, 상관 분석, 회귀 모델링, VIF 산출 및 진단 결과의 재현에 사용됨 |
| 주의 확인 항목 문구 | 연구별 내부 문서 | 이 텍스트 파일은 번역할 대상 콘텐츠가 포함되지 않은 주의 확인용 파일인 것으로 보입니다. 번역할 실제 과학적 또는 교육적 텍스트를 제공해 주시기 바랍니다. | 설문 조사 실시 중 사용된 지시 응답 주의 확인 항목의 고정 문구 |
| DERS-16 설문지 | 원본 척도 소스 또는 공인/수정된 설문지 버전 | 16문항 정서 조절 곤란 척도 단축형 | 정서 조절 어려움을 평가하는 데 사용되며, 채점은 코드북에 기록된 고정된 DERS-16 채점 기준표를 따릅니다. |
| 전자 정보 시트 및 동의서 페이지 | 연구 특정 내부 문서 | consent_form_v1.pdf 또는 플랫폼 동의 페이지 | 설문지 접속 전 연구 정보를 제공하고 전자 고지된 동의를 얻기 위해 사용됨 |
| 파일 명명 규칙 시트 | 연구 특정 내부 문서 | 파일_명명_규칙_v1.xlsx | 원시 데이터, 정제 데이터, 분석 데이터, 스크리닝 로그, 코드북 및 출력 파일의 명칭을 표준화하는 데 사용됨 |
| 최종 설문지 스크린샷 | 연구 특정 내부 문서 | 설문지_스크린샷_v1.pdf | 잠긴 설문 조사 화면, 항목 순서, 응답 앵커 및 필수 항목 설정을 기록하는 데 사용됨 |
| 통합 개발 환경 | 가정하다 | RStudio Desktop | 스크립트, 로그 및 재현 가능한 분석 워크플로 관리에 사용됨 |
| 인터넷 중독 검사 설문지 | 원척도 소스 또는 공인/번안된 설문지 버전 | 20문항 인터넷 중독 검사(Internet Addiction Test) | 인터넷 중독 증상을 평가하고 정상적 이용, 문제적 이용 및 심각한 문제적 이용으로 분류하는 데 사용됨 |
| 온라인 설문조사 플랫폼 | Qualtrics | XM 플랫폼; 기관 또는 라이선스 계정 | 설문지 작성, 필수 항목 지정, 동의 기반 접근 권한 관리, (활성화 시) 중복 제출 제한 및 응답 데이터 내보내기에 사용됨 |
| 선택 사항인 메뉴 기반 통계 패키지 | IBM | SPSS Statistics | 기술 통계, 신뢰도 검정 또는 회귀 분석을 위해 GUI 기반의 분석 워크플로우가 필요할 때 사용함 |
| README/코드북 파일 | 연구별 내부 문서 | README_v1.txt 또는 codebook_v1.xlsx | 변수 이름, 코딩 규칙, 점수 범위, 역코딩 규칙, 제외 임계값, 파일 이름 및 소프트웨어 버전을 기록하는 데 사용됨 |
| 읽기 전용 보관용 사본 | 휴대용 문서 형식 | PDF/A 또는 기관 승인 보관용 PDF | 잠금 처리된 설문 조사 도구, 동의서 페이지 및 프로토콜 지원 문서의 보존에 사용됨 |
| 스크리닝 기록 워크북 | 연구 전용 내부 문서 | 스크리닝_로그_v1.xlsx | 중복 스크리닝, 완료 시간 스크리닝, 주의력 확인 실패, 패턴 응답, 논리적 불일치, 결측치, 수동 검토 결정 및 최종 유지 건수를 기록하는 데 사용됨 |
| 스프레드시트 소프트웨어 | Microsoft | Microsoft Excel 통합 문서 형식(.xlsx) | 스크리닝 로그, 변수 사전, 수동 검토 기록 및 보조 워크북 작성에 사용됨 |
| 통계 컴퓨팅 환경 | R 재단 / CRAN | R 4.5.3 | 점수 검증, 기술 통계, 신뢰도 검사, 상관 분석, 회귀 분석, VIF 계산 및 진단 결과 출력에 사용됨 |
| 보충 파일 1 | 연구별 보충 파일 | 보충 파일 1.xlsx | 설문조사 워크플로우 자료, 코드북, 스크리닝 로그, 출력 계획 및 분석 준비 완료된 워크플로우 자료 포함 |
| 보충 표 S1 | 연구별 보충 표 | 보충 표 S1 | 전체 변수 사전, 파일 존재 여부, 코딩 구조, 기술 식별자 필드, 스크리닝 변수 및 데이터셋 추적 필드를 제공합니다. |
| 설문 조사 내보내기 문서 | Qualtrics | 설문-Word 내보내기 또는 PDF 내보내기 | 최종 설문지 문구, 항목 순서, 분기 설정, 필수 항목 설정 및 응답 코딩을 기록 보관하는 데 사용됨 |
| 설문 조사 내보내기 형식 | Qualtrics | CSV 내보내기 | 원시 데이터 보존 및 분석 가능 데이터 내보내기에 사용됨 |
참고문헌
- Moreno MA, et al. Problematic internet use among US youth: a systematic review. Arch Pediatr Adolesc Med. 2011;165:797-805.
- Ramón-Arbués E, et al. Prevalence and factors associated with problematic internet use in a population of Spanish university students. Int J Environ Res Public Health. 2021;18:7620.
- Cai Z, et al. Associations between problematic internet use and mental health outcomes of students: a meta-analytic review. Adolesc Res Rev. 2023;8:45-62.
- Gong Z, Wang L, Wang H. Perceived stress and internet addiction among Chinese college students: mediating effect of procrastination and moderating effect of flow. Front Psychol. 2021;12:632461.
- Tsai JK, et al. Relationship between difficulty in emotion regulation and internet addiction in college students: a one-year prospective study. Int J Environ Res Public Health. 2020;17:4766.
- Romero-López M, Pichardo C, De Hoces I, García-Berbén T. Problematic internet use among university students and its relationship with social skills. Brain Sci. 2021;11:1301.
- Xie X, et al. Problematic internet use was associated with psychological problems among university students during COVID-19 outbreak in China. Front Public Health. 2021;9:675380.
- Montagni I, et al. Mental health-related digital use by university students: a systematic review. Telemed J E Health. 2020;26:131-146.
- Candussi CJ, Kabir R, Sivasubramanian M. Problematic smartphone usage, prevalence and patterns among university students: a systematic review. J Affect Disord Rep. 2023;14:100643.
- Moon SJ, Hwang JS, Kim JY, Shin AL, Bae SM, Kim JW. Psychometric properties of the Internet Addiction Test: a systematic review and meta-analysis. Cyberpsychol Behav Soc Netw. 2018;21:473-484.
- Jelenchick LA, Becker T, Moreno MA. Assessing the psychometric properties of the Internet addiction test in US college students. Psychiatry Res. 2012;196:296-301.
- Tafur-Mendoza AA, Acosta-Prado JC, Zárate-Torres RA, Ramírez-Ospina DE. Assessing the psychometric properties of the Internet addiction test in Peruvian university students. Int J Environ Res Public Health. 2020;17:5782.
- Fernández-Villa T, Molina AJ, García-Martín M, Llorca J, Delgado-Rodríguez M, Martín V. Validation and psychometric analysis of the Internet addiction test in Spanish among college students. BMC Public Health. 2015;15:953.
- World Medical Association. World Medical Association Declaration of Helsinki: ethical principles for medical research involving human subjects. JAMA. 2013;310:2191-2194.
- Wei Z, Hassan NC, Hassan SA, Ismail N, Gu X, Dong J. Psychometric validation of Young’s Internet addiction test among Chinese undergraduate students. PLoS One. 2025;20:e0320641.
- Bjureberg J, et al. Development and validation of a brief version of the Difficulties in emotion regulation scale : the DERS-16. J Psychopathol Behav Assess. 2016;38:284-296.
- Muszyński M. Attention checks and how to use them: review and practical recommendations. ASK: Research and Methods. 2023;32:3-38.
- Broman KW, Woo KH. Data organization in spreadsheets. Am Stat. 2018;72:2-10.
- Leiner DJ. Too fast, too straight, too weird: non-reactive indicators for meaningless data in internet surveys. Surv Res Methods. 2019;13:229-248.
- Taber KS. The use of Cronbach’s alpha when developing and reporting research instruments in science education. Res Sci Educ. 2018;48:1273-1296.
- Gioia F, Rega V, Boursier V. Problematic Internet use and emotional dysregulation among young people: a literature review. Clin Neuropsychiatry. 2021;18:41-54.
- Chen M, Zhang X. Factors influencing internet addiction among university students: the mediating roles of self-control and anxiety. Acta Psychol (Amst). 2024;250:104535.
- Akbari M, Seydavi M, Sheikhi S, Spada MM. Problematic smartphone use and sleep disturbance: the roles of metacognitions, desire thinking, and emotion regulation. Front Psychiatry. 2023;14:1137533.
- Wang S, Cheng Y, Yang Y, Lu B. The impact of physical activity on internet addiction among college students: the chain mediation role of rumination and mindfulness. BMC Public Health. 2025;25:3643.
- Struminskaya B, Sakshaug JW. Ethical considerations for augmenting surveys with auxiliary data sources. Public Opin Q. 2023;87:619-633.
- Yin J, et al. Associations between both smartphone addiction and objectively measured smartphone use and sleep quality and duration among university students: a cross-sectional study. JMIR Ment Health. 2025;12:e77796.
- Hainagiu SM, Neagu SN. Caught in the Web—emotional regulation difficulties and internet addiction among Romanian medical and technical university students: a pilot cross-sectional study. Healthcare (Basel). 2025;13:2528.
- Guo C, Chen M, Ji X, Li J, Ma Y, Zang S. Association between internet addiction and sleep quality in medical students: a longitudinal study. Front Psychol. 2025;16:1517590.
- Barker M, Chue Hong NP, Katz DS, Lamprecht AL, Martinez-Ortiz C, Psomopoulos F, et al. Introducing the FAIR Principles for research software. Sci Data. 2022;9:622.
- Nosek BA, Alter G, Banks GC, Borsboom D, Bowman SD, Breckler SJ, et al. Promoting an open research culture. Science. 2015;348:1422-1425.