이 단일 센터 회고적 연구에서는 뇌동맥류성 지주막하 출혈 후 지연성 뇌허혈을 예측하기 위한 로지스틱 회귀 모델을 개발하고 내부적으로 검증하였습니다. 680명의 환자를 대상으로 한 분석에서 6가지 초기 임상, 실험실 및 영상 변수가 예비 예측 가치를 나타냈습니다. 임상 적용 전 추가적인 외부 검증이 필요합니다.
이 논문에서
요약
초록
지연성 뇌허혈(DCI)은 뇌동맥류성 지주막하 출혈(aSAH) 이후 발생하는 2차 신경학적 손상의 중요한 원인입니다. 본 후향적 단일 센터 연구에서는 2022년 7월부터 2024년 12월 사이에 치료받은 aSAH 성인 환자 680명의 데이터를 사용하여 DCI 예측 모델을 개발하고 평가했습니다. 환자들은 결과 기반 층화 추출을 통해 8:2 비율로 나누어, 544명의 환자로 구성된 훈련 코호트와 136명의 환자로 구성된 내부 검증용 홀드아웃 코호트로 구분하였습니다. DCI는 훈련 코호트에서 175명, 내부 검증 코호트에서 42명의 환자에게서 발생했습니다. 예측 변수 선택은 10-겹 교차 검증을 포함한 라쏘(least absolute shrinkage and selection operator) 회귀 분석을 사용하여 훈련 코호트에서 수행되었습니다. 최종적으로 연령, 뇌부종, 저알부민혈증, 수정 Fisher 등급, Hunt-Hess 등급, 세계신경외과학회(WFNS) 등급의 6가지 변수가 선정되었습니다. 로지스틱 회귀, extreme gradient boosting, light gradient boosting machine, 서포트 벡터 머신, k-최근접 이웃 모델을 비교 분석하였습니다. 로지스틱 회귀 모델은 내부 검증 코호트에서 ROC 곡선 아래 면적(AUC) 0.832(95% 신뢰 구간, 0.758–0.906)를 나타냈습니다. 보정 기울기, 보정 절편 및 Brier 점수는 각각 0.98, 0.02, 0.168이었으나, 이러한 보정 추정치에 대한 신뢰 구간은 확보되지 않았습니다. 본 연구 결과는 단일 홀드아웃 내부 검증 코호트에서의 예비 성능을 나타냅니다. 현재로서는 불완전한 재현성 기록, 모델 절편의 부재, 재표본 추출 기반의 낙관주의 보정 부족 및 외부 검증의 부재로 인해 환자 수준의 확률 계산 및 임상 적용이 어렵습니다.
서론
aSAH 이후의 DCI에 대한 여러 예측 모델이 제안되었으나, 많은 모델이 작은 표본 크기, 불완전한 보정 평가, 모델 개발 절차의 불충분한 보고 및 외부 검증의 부족으로 인해 한계를 보였습니다. 많은 연구가 주로 판별력에 집중한 반면, 보정, 재현성 및 임상적 영향 평가는 덜 일관되게 보고되었습니다. 따라서 모델 성능은 투명한 방법을 통해 평가되어야 하며, 검증이 단일 센터로 제한된 경우에는 신중하게 해석해야 합니다.
본 연구의 목적은 일상적으로 이용 가능한 초기 임상, 실험실 및 영상 변수를 사용하여 DCI 예측 모델을 개발하고 내부적으로 평가하는 것이었습니다. 동일한 선택된 예측 인자 세트를 사용하여 다섯 가지 모델링 접근 방식을 비교하였습니다. 의도한 예측 시점은 최초 입원, 실험실 및 영상 평가 이후이면서 주요 DCI 위험 기간 이전이었습니다. 해당 모델들은 연구 기반의 위험 추정을 위해 개발되었으며, DCI를 진단하거나 임상적 판단을 대체하거나 독자적으로 치료법을 결정하기 위한 목적이 아니었습니다. 임상에 적용하기 전에는 외부 검증, 재보정 및 임상적 영향 테스트가 필요합니다.
지연성 뇌허혈(Delayed cerebral ischemia, DCI)은 지주막하 출혈(aSAH) 이후 임상적으로 가장 중요하며 잠재적으로 예방 가능한 2차 손상 중 하나입니다. DCI는 보통 발병 후 수일 뒤, 일반적으로 3~14일 이내에 발생하는 합병증으로, 새로운 국소 신경학적 결손, 의식 수준의 악화 및/또는 후속 신경영상 검사상 뇌경색의 발생과 관련이 있습니다. 기관마다 진단 관행에 일부 차이가 있으나, DCI는 항상 중환자실의 장기 체류, 높은 의료 자원 소모 및 불량한 신경학적 예후와 연관됩니다. 보고된 DCI의 발생률은 통상적으로 30~40%이며, 이는 해당 질환의 유병률과 중요한 예후적 함의를 강조합니다.1,2,3,4,5,6특히, 지연성 뇌허혈(DCI)은 단일 경로로 발생하는 과정이 아닙니다. 그동안 대혈관 뇌혈관 연축에 초점이 맞춰져 왔으나, 축적된 증거들에 따르면 초기 뇌손상, 피질 확산성 저분극, 신경 염증, 미세 혈전증, 내피 세포 기능 장애, 자가 조절 능력 손상 및 미세 순환 부전이 모두 허혈성 위험의 요인임을 보여줍니다. 이러한 다요인적 병태생리는 다음을 설명하는 데 도움이 됩니다. 혈관경련 표적 치료가 지연성 뇌허혈(DCI) 관련 경색을 완전히 예방하지 못할 수 있는 이유와 일반적인 임상 환경에서 고위험군 환자를 식별하기 어려운 이유에 대하여.
aSAH 이후 DCI의 위험 층화는 매우 중요하며, 고위험 환자를 신속하게 식별함으로써 더 세밀하게 모니터링하고 예방적 또는 구제 조치를 즉각적으로 강화할 수 있기 때문입니다7. 임상 현장에서의 모니터링 계획에는 더 빈번한 신경학적 검사, 경두개 도플러 초음파, 컴퓨터 단층 촬영 관류술과 같은 정밀 영상 기법의 사용, 혈역학 및 혈관 내 용적 최적화, 니모디핀 요법의 엄격한 준수, 그리고 뇌수종, 재출혈, 발작, 감염 또는 대사 불균형과 같은 신경학적 악화의 조기 식별이 포함될 수 있습니다. 그럼에도 불구하고, 개인별 데이터 기반의 DCI 확률 추정치보다는 전반적인 중증도 척도와 임상의의 경험이 임상적 결정에 더 큰 영향을 미치는 경향이 있습니다8,9,10. 그 이유 중 하나는 문헌에 따르면 위험 요인이 다양하며, 환자 요인, 출혈량, 생리적 이상 및 신경학적 등급 척도 간의 상호작용이 비선형적이고 복잡할 수 있기 때문입니다. 이전 연구자들은 연령, 고혈압, 기저 신경학적 상태, 뇌동맥류 특성, 실험실 지표(혈청 나트륨 및 알부민 등), 출혈량을 나타내는 영상 특징, 수술 전후 또는 치료 관련 요인을 포함하여 DCI의 잠재적 예측 인자들을 조사해 왔습니다. 전통적인 회귀 분석 기법이 도움이 되었으나, 예측 인자 간에 상관관계가 있거나, 예측 인자와 위험 사이의 관계가 비선형적이거나, 변수 간의 상호작용이 있는 경우에는 제한적일 수 있습니다11. 동시에, DCI 위험을 평가하기 위해 여러 도구(가장 일반적으로는 노모그램)가 제안되었습니다. 노모그램은 실행 가능하고 시각적으로 명확하지만, 대부분 적은 표본을 기반으로 하고 포함된 변수가 적으며, 과적합되었거나 검증이 부족할 수 있습니다. 또한, 특정 센터에서 개발 및 테스트된 모델은 환자 구성, 영상 해석, 치료 및 DCI 진단 임계값의 차이로 인해 다른 의료 기관에 즉각적으로 적용하기 어려울 수 있습니다.
머신러닝 방법은 엄격한 선형 가정을 세울 필요 없이 임상 데이터의 더 많은 차원을 탐색하고 더 복잡한 경향을 관찰할 수 있게 해주므로, 전통적인 임상 예측 모델을 보완할 수 있습니다. 머신러닝 기반의 예측 모델은 최근 몇 년 동안 결과 및 합병증 예측뿐만 아니라 의사 결정 지원을 포함하여 뇌혈관 질환 분야에서 점점 더 많은 응용 사례가 발견되고 있습니다.12,13,14일반적으로 적용되는 머신러닝 알고리즘에는 Extreme Gradient Boosting(XGBoost) 및 Light Gradient Boosting Machine(LightGBM)과 같은 앙상블 트리 방법, 서포트 벡터 머신(SVM)과 같은 커널 기반 분류기, 그리고 k-최근접 이웃(KNN)과 같은 거리 기반 분류기가 포함됩니다. 이러한 모델들은 원칙적으로 비선형성을 모델링할 수 있습니다. 그리고 전통적인 방식보다 더 많은 상호작용을 하며15하지만 ML 모델에는 과적합 위험, 해석력 저하, 그리고 전처리, 튜닝, 보정, 평가 및 검증 처리 필요성과 같은 실질적인 문제들이 수반됩니다. 광범위한 임상 시나리오에서, 특히 예측 변수의 수가 적고 신호 대 잡음비가 적당한 경우, 잘 지정된 로지스틱 회귀 분석이 더 복잡한 알고리즘만큼 또는 그보다 더 효과적으로 수행될 수 있다는 점에 주목할 필요가 있습니다. 따라서 성능 및 임상 적용 가능성과 상관관계가 있는 모델을 식별하기 위해, 유사한 예측 변수와 평가 지표를 사용한 다양한 알고리즘의 비교 분석이 필요합니다.16,17,18.
지연성 뇌허혈에 대한 여러 예측 모델이 이전에 제안되었으나, 많은 모델이 소규모 표본 크기, 제한적인 보정 평가, 알고리즘 간의 직접 비교 부족 및 불충분한 검증과 같은 중요한 한계점을 가지고 있습니다. 또한, 이전 연구들은 변별력(discrimination)을 주로 강조하는 반면, 실제 임상 적용에 필수적인 보정(calibration) 및 임상적 유용성 지표에 대한 보고는 부족한 경우가 많았습니다. 본 연구는 비교적 대규모 코호트에서 예측 모델을 개발하고, LASSO(least absolute shrinkage and selection operator) 회귀 분석을 사용하여 체계적인 예측 변수 선택을 구현하며, 통합 모델링 프레임워크 내에서 여러 머신러닝 알고리즘을 비교하고, 변별력, 보정 및 결정 분석 성능을 종합적으로 평가함으로써 이러한 공백을 해결하고자 합니다.
aSAH 이후 DCI를 예측하기 위한 여러 예측 모델이 제안되었으나, 소규모 코호트, 제한적인 보정 평가, 모델 개발 과정의 불완전한 보고, 외부 또는 시간적 검증의 부족 등 많은 한계가 있었습니다. 또한, 많은 연구가 판별력(discrimination)만을 보고하며, 보정(calibration) 및 결정 곡선 분석(decision-curve analysis)은 일관성 있게 제시되지 않는 경우가 많습니다. 본 연구는 외부 검증 문제를 해결하는 대신, 일상적으로 사용 가능한 임상, 실험실 및 영상 변수를 이용한 단일 센터 개발 및 내부 검증 연구를 제공합니다. 의도된 사용 사례는 입원 및 초기 동맥류 치료 후, 주요 DCI 위험 기간이 도래하기 전의 조기 위험 층화입니다. 이 모델은 임상의가 더 정밀한 신경학적 모니터링, 혈관 영상 감시, 생리학적 이상 교정 및 신경중환자 치료팀의 조기 검토가 필요한 환자를 식별하는 데 도움을 줄 수 있습니다. 본 모델은 임상적 판단을 대체하거나 DCI를 진단하거나, 외부 검증 및 임상적 영향 테스트 없이 치료를 안내하기 위한 용도가 아닙니다. 이전 연구들에서 aSAH 이후 DCI 예측을 위한 여러 모델이 제안되었으나, 많은 연구가 작은 표본 크기, 보정 보고의 불완전함, 모델링 방법 간의 제한적인 비교 또는 외부 검증의 부족으로 인해 한계가 있었습니다. 본 연구는 임상적으로 검증된 결정 도구를 제공한다고 주장하지 않습니다. 대신, 단일 센터 코호트로부터 일상적으로 사용 가능한 조기 임상, 실험실 및 영상 변수를 사용하여 예측 모델을 개발하고 내부적으로 검증하는 것을 목표로 합니다. 의도된 사용 사례는 입원 및 초기 동맥류 치료 후, 주요 DCI 위험 기간 전의 조기 위험 층화입니다. 이러한 상황에서 예측 위험도가 높게 나타나면 더 면밀한 신경학적 평가, 혈관 모니터링, 생리학적 이상 교정 및 신경중환자 치료팀의 조기 검토를 지원할 수 있습니다. 본 모델은 DCI를 진단하거나 임상의의 판단을 대체하기 위한 것이 아닙니다.
프로토콜
The study was approved by the Institutional Ethics Committee of Yulin First Hospital, Shaanxi Province, China. Because this was a retrospective analysis of routinely collected hospital data, and because all data were anonymized before analysis, the requirement for written informed consent was waived. The study was conducted in accordance with institutional data-protection requirements and the principles of the Declaration of Helsinki.
Data and Methods
Study Population and Design
This was a retrospective single-center cohort study conducted at Yulin First Hospital, Shaanxi Province, China. The hospital records of patients admitted with aSAH between July 2022 and December 2024 were screened. Eligible patients were adults aged 18 years or older with a diagnosis of aSAH confirmed by cranial and intracranial vascular imaging. Patients were required to have been admitted within 72 h after symptom onset and to have undergone aneurysm treatment during the index hospitalization.
Patients were excluded if they had traumatic subarachnoid hemorrhage, non-aneurysmal subarachnoid hemorrhage, severe pre-existing hematological disease, other major intracranial disease affecting outcome assessment, insufficient records for DCI evaluation, or in-hospital death before an adequate DCI assessment period. Excluding early in-hospital deaths may introduce survivorship bias because the most severe cases may be removed from analysis. Therefore, the findings should be interpreted as applying mainly to patients who survived long enough for DCI evaluation.
Data Collection
Clinical, laboratory, imaging, and treatment-related variables were extracted from the electronic medical record using a predefined data-extraction form. The extracted variables included demographic factors, medical history, aneurysm features, early neurological grade, early imaging findings, laboratory results, treatment approach, and hospital complications. The intended prediction time point was after completion of the initial admission and perioperative assessment, but before the main DCI risk window.
Age, sex, body mass index, smoking status, alcohol use, hypertension, diabetes, aneurysm size, aneurysm location, modified Fisher grade, Hunt-Hess grade, World Federation of Neurological Surgeons grade, intraventricular hemorrhage, and rebleeding were taken from admission records and initial imaging. Laboratory variables, including hemoglobin, serum albumin, and serum sodium, were obtained from the earliest available blood test prior to the prediction time point. Cerebral edema was assessed using baseline or immediate post-treatment imaging available before DCI diagnosis. Variables recorded only after DCI onset were not used for model development to reduce information leakage.
Anemia was defined as hemoglobin <110 g/L in female patients and <120 g/L in male patients. Hypoalbuminemia was defined as serum albumin <35 g/L. Hyponatremia was defined as serum sodium <130 mmol/L.
Patients were managed according to the institutional aSAH care pathway. Standard management included early aneurysm securing, neurological observation, blood pressure control, fluid and electrolyte management, and surveillance for complications including hydrocephalus, rebleeding, seizure, infection, vasospasm, and DCI. Nimodipine was used unless contraindicated. Vasospasm monitoring was performed using neurological examination, vascular imaging, and transcranial Doppler ultrasonography when clinically indicated. Hydrocephalus was managed with cerebrospinal fluid diversion when required. Hemodynamic optimization and rescue therapy were applied according to the treating team’s assessment. Because treatment intensity and rescue-therapy details were not completely captured in the retrospective dataset, these factors could not be fully adjusted in the model and were considered a limitation.
Diagnosis of DCI
DCI was defined as a new focal neurological impairment, a decrease in level of consciousness, or a new cerebral infarction on follow-up computed tomography or magnetic resonance imaging occurring during the expected DCI risk window and not explained by another cause. The DCI risk window was defined as days 3–14 after the hemorrhage ictus. Alternative explanations, including rebleeding, hydrocephalus, seizure, infection, metabolic disturbance, sedative effect, and procedure-related infarction, were reviewed before classifying an event as DCI.
Outcome adjudication was performed by two clinicians with experience in the management of aSAH, including one neurosurgeon and one neurologist/neurocritical care physician. The adjudicators reviewed clinical notes, neurological examinations, imaging reports, and follow-up imaging. They were blinded to the final model output during outcome assessment. Disagreements were resolved through consensus discussion with review of the relevant imaging and clinical timeline. Formal inter-rater agreement was not measured, and this limitation was added because DCI classification may involve clinical judgment.
Sample Size Calculation
The sample size was estimated using the 10-events-per-variable (EPV) rule of thumb11. With 20 candidate predictor variables and an expected DCI incidence of approximately 35%, a minimum sample size of 20 × 10 / 0.35 ≈ 572 patients was required. Our final cohort of 680 patients exceeded this requirement. Although the events-per-variable (EPV) rule was applied as a general guideline, modern predictive modeling, particularly machine learning algorithms, may require more flexible sample-size considerations. The final cohort size was considered adequate to ensure model stability, minimize the risk of overfitting, and enable reliable estimation of model performance metrics.
Model development and validation
Patients were allocated to a training cohort of 544 patients and a hold-out internal validation cohort of 136 patients using an outcome-stratified 8:2 split. Outcome stratification was used to maintain a similar proportion of DCI events in the two cohorts. DCI occurred in 175 of 544 patients in the training cohort and 42 of 136 patients in the internal-validation cohort. The 8:2 hold-out design was retained because it was the prespecified model-development strategy and provided a separate cohort for preliminary internal performance assessment.
Predictor selection was performed only in the training cohort using least absolute shrinkage and selection operator regression with 10-fold cross-validation. The selected penalty parameter was λ = 0.031. Six predictors were retained: age, cerebral edema, hypoalbuminemia, modified Fisher grade, Hunt-Hess grade, and World Federation of Neurological Surgeons grade.
Logistic regression, extreme gradient boosting, light gradient boosting machine, support vector machine, and k-nearest neighbor models were developed using the same set of selected predictors. All preprocessing, predictor selection, and model-development procedures were restricted to the training cohort. The internal-validation cohort was not used during predictor selection or model tuning and was evaluated only after model development.
The numerical random seed used for the original cohort allocation was not retained in the archived analysis records and could not be retrospectively verified. Bootstrap optimism correction and repeated k-fold internal validation were also not available. Therefore, the present analysis is described as a single hold-out internal validation rather than an optimism-corrected or repeated cross-validated performance assessment.
Machine-learning reproducibility
LASSO predictor selection used 10-fold cross-validation within the training cohort. Continuous predictors were standardized when required by the modeling algorithm, and categorical predictors were represented using predefined binary clinical categories. The validation cohort was not used for tuning or model selection.
The archived analysis materials did not retain the final tuning grids, selected hyperparameters, complete package versions, original random seed, or a confirmed class-imbalance procedure for XGBoost, LightGBM, SVM, and KNN. These settings were therefore not reconstructed or estimated. The machine-learning comparisons should consequently be interpreted as exploratory comparisons of algorithms rather than fully reproducible model-development experiments. Reproducibility information, both available and unavailable, should be summarized in Supplementary Table 1.
Bias Control & Sensitivity Analysis
Consecutive eligible patients were included to reduce selection bias. Standardized variable definitions and a structured data-extraction form were used to reduce information bias. Predictors were restricted to information available before the intended DCI prediction time point to reduce information leakage. Predictor selection, preprocessing, and model development were performed only in the training cohort.
Modified Fisher grade, Hunt-Hess grade, and WFNS grade represent related aspects of hemorrhage burden and neurological severity. Although all three variables were retained after LASSO selection, the numerical variance inflation factor values and the results from a sensitivity model excluding overlapping severity scales were not included in the archived analysis output. These analyses could not be reconstructed from the aggregate tables because patient-level correlations and fitted model outputs are required. Therefore, the individual coefficients of these severity measures were not interpreted as independent or causal effects. They were retained only as components of the prediction model selected in the training cohort.
Model Interpretability
Clinical applicability was believed to require model interpretability as a crucial element. In the most effective model, the effects of predictors were considered to assess the clinical plausibility and conformity with existing pathophysiological knowledge of delayed cerebral ischemia. This method enabled a clear assessment of model behavior and improved the potential for clinical translation.
Missing Data
Variable-level missingness was assessed during data preparation. However, the original pre-imputation missing counts and percentages for each candidate variable were not retained in the archived analysis records and could not be accurately reconstructed from the aggregate tables. Consequently, no assumption of complete data was made, and no unverified missingness percentages were reported.
A verified supplementary missing-data table should be generated directly from the original deidentified patient-level dataset. Supplementary Table 2 should report, for every candidate variable, the number and percentage of missing observations before data handling, the method used to address missingness, and the number of observations included in the final analysis. The inability to recover the original variable-specific missingness pattern was considered a limitation of the present report.
Statistical Analysis
Predictor selection was performed in the training cohort using LASSO regression with 10-fold cross-validation. Discrimination was assessed using the area under the receiver operating characteristic curve with 95% confidence intervals. Calibration was described using calibration plots and point estimates of the calibration slope, calibration intercept, and Brier score. Bootstrap confidence intervals for calibration measures were not available.
Threshold-dependent classification measures were calculated from the available internal-validation confusion matrices. The exact numerical probability threshold used to generate the archived confusion matrices was not retained and could not be verified. Therefore, these measures were interpreted descriptively and were not used as the primary basis for model selection. Decision-curve analysis was also considered exploratory because the exact prespecified threshold range and patient-level net-benefit output were not retained. A two-sided P value below 0.05 was considered statistically significant.
결과
훈련 코호트와 내부 검증 코호트 간의 기선 특성 비교
총 680명의 aSAH 환자가 포함되었습니다. 훈련 코호트는 544명의 환자로 구성되었으며, 그 중 175명에서 DCI가 발생했습니다. 내부 검증 코호트는 136명의 환자로 구성되었으며, 그 중 42명에서 DCI가 발생했습니다. DCI 발생률은 훈련 코호트에서 32.2%, 내부 검증 코호트에서 30.9%였습니다. 기초 특성은 표 1에 제시되어 있습니다. 일부 보관된 표 항목에 분모 불일치가 포함되어 있으므로, 최종 제출 전에 해당 표를 원본 환자 수준 데이터 세트와 대조하여 확인해야 합니다.
| 변수 | 훈련 코호트 (n = 544) | 내부 검증 코호트 (n = 136) | t/χ²/Z | P 값 | SMD | 수정 사항 |
| 연령, years | 62.88 ± 9.41 | 63.25 ± 9.52 | 0.409 | 0.693 | 0.039 | |
| 성별 | 0.429 | 0.512 | 0.063 | |||
| 남성 | 180 (33.09) | 41 (30.15) | ||||
| 여성 | 364 (66.91) | 95 (69.85) | ||||
| BMI, kg/m² | 23.46 ± 3.56 | 23.61 ± 3.65 | 0.437 | 0.662 | 0.042 | |
| 흡연력 | 0.118 | 0.731 | 0.033 | |||
| 있음 | 101 (18.57) | 27 (19.85) | ||||
| 없음 | 443 (81.43) | 109 (80.15) | ||||
| 음주 여부 | 0.417 | 0.518 | 0.062 | |||
| 있음 | 118 (21.69) | 33 (24.26) | ||||
| 없음 | 426 (78.31) | 103 (75.74) | ||||
| 고혈압 병력 | 0.348 | 0.555 | 0.057 | |||
| 있음 | 329 (60.48) | 86 (63.24) | ||||
| 없음 | 215 (39.52) | 50 (36.76) | ||||
| 당뇨병 병력 | 0.116 | 0.733 | 0.033 | 검증군 '없음' 수가 합계 136이 되도록 수정됨. | ||
| 있음 | 70 (12.87) | 19 (13.97) | ||||
| 없음 | 474 (87.13) | 117 (86.03) | ||||
| 동맥류 직경, mm | 0.213 | 0.645 | 0.044 | |||
| >10 | 288 (52.94) | 75 (55.15) | ||||
| ≤10 | 256 (47.06) | 61 (44.85) | ||||
| 동맥류 위치 | 0.980 | 0.322 | 0.095 | |||
| 전방 순환계 | 448 (82.35) | 107 (78.68) | ||||
| 후방 순환계 | 96 (17.65) | 29 (21.32) | ||||
| 뇌부종 | 0.612 | 0.434 | 0.075 | |||
| 있음 | 125 (22.98) | 27 (19.85) | ||||
| 없음 | 419 (77.02) | 109 (80.15) | ||||
| 저헤모글로빈혈증 | 0.684 | 0.408 | 0.079 | 검증군 '없음' 수가 합계 136이 되도록 수정됨. 훈련군 수는 표 2와 상충되므로 최종 데이터셋에서 확인 필요. | ||
| 있음 | 147 (27.02) | 32 (23.53) | ||||
| 없음 | 397 (72.98) | 104 (76.47) | ||||
| 저알부민혈증 | 0.367 | 0.545 | 0.058 | |||
| 있음 | 115 (21.14) | 32 (23.53) | ||||
| 없음 | 429 (78.86) | 104 (76.47) | ||||
| 저나트륨혈증 | 0.186 | 0.666 | 0.041 | |||
| 있음 | 331 (60.85) | 80 (58.82) | ||||
| 없음 | 213 (39.15) | 56 (41.18) | ||||
| 수정 Fisher 등급 | 0.249 | 0.618 | 0.048 | |||
| ≥III | 259 (47.61) | 68 (50.00) | ||||
| I–II | 285 (52.39) | 68 (50.00) | ||||
| Hunt-Hess 등급 | 0.178 | 0.673 | 0.040 | 검증군 ≥III 수가 합계 136이 되도록 53에서 63으로 수정됨; 최종 데이터셋과 대조 확인 필요. | ||
| ≥III | 263 (48.35) | 63 (46.32) | ||||
| I–II | 281 (51.65) | 73 (53.68) | ||||
| WFNS 등급 | 0.249 | 0.618 | 0.048 | |||
| ≥III | 277 (50.92) | 66 (48.53) | ||||
| I–II | 267 (49.08) | 70 (51.47) | ||||
| 수술 접근법 | 0.717 | 0.397 | 0.081 | |||
| 혈관 내 치료 | 449 (82.54) | 108 (79.41) | ||||
| 클리핑술 | 95 (17.46) | 28 (20.59) | ||||
| 수술 시간, h | 2.78 ± 0.81 | 2.81 ± 0.79 | 0.388 | 0.698 | 0.037 | |
| 뇌실내 출혈 | 0.383 | 0.536 | 0.059 | |||
| 있음 | 134 (24.63) | 37 (27.21) | ||||
| 없음 | 410 (75.37) | 99 (72.79) | ||||
| 재출혈 | 0.784 | 0.376 | 0.085 | |||
| 있음 | 98 (18.01) | 29 (21.32) | ||||
| 없음 | 446 (81.99) | 107 (78.68) |
표 1: 훈련 및 내부 검증 코호트의 기선 특성.연속 변수는 평균 ± 표준 편차로, 범주형 변수는 n (%)으로 표시됨. P 값과 표준화된 평균 차이는 두 코호트를 비교한 결과임. 약어: BMI, 체질량 지수; SMD, 표준화된 평균 차이. 이 표를 다운로드하려면 여기를 클릭하십시오.
훈련 세트 내 non-DCI 그룹과 DCI 그룹 간의 기저 특성 비교
훈련 데이터셋 내에서 지연성 뇌허혈(DCI)은 175명의 환자(32.17%)에서 발생하였으며, 369명의 환자(67.83%)에서는 DCI가 발생하지 않았다. 내부 검증 코호트에서의 DCI 발생률 또한 유사하게 나타나, 결과의 유병률이 안정적임을 보여주었다. 비-DCI 그룹과 DCI 그룹 간의 비교 분석 결과, 몇 가지 통계적으로 유의미한 차이가 발견되었다(Table 2). DCI가 발생한 환자들은 연령이 유의하게 더 높았으며(P = 0.026), 이는 이차적 허혈성 손상에 대한 연령 관련 감수성을 시사한다. 특히 뇌부종과 같은 초기 뇌 손상의 방사선학적 증거는 DCI 환자군에서 현저하게 더 많이 나타났다(P = 0.001). 저알부민혈증(P = 0.007), 저나트륨혈증(P = 0.048) 및 낮은 헤모글로빈 수치(P < 0.001)를 포함한 실험실적 이상 소견은 DCI 발생과 유의미한 연관성이 있었다. 신경학적 중증도 지표는 가장 강력한 연관성을 보였다. 수정된 Fisher 등급(modified Fisher grade)의 상승(≥III)은 DCI 환자군에서 유의하게 더 빈번하게 나타났으며(P < 0.001), 이는 출혈 부담과 지연성 허혈 합병증 사이에 강력한 관계가 있음을 나타낸다. 마찬가지로, 더 높은 Hunt–Hess 등급과 세계신경외과연맹(WFNS) 등급 또한 DCI 발생과 강한 연관성을 보였다(두 항목 모두 P < 0.001). 반면, 인구통계학적 변수, 생활 습관 요인, 뇌동맥류 형태, 수술 접근법 및 수술 시간은 통계적으로 유의미한 차이를 보이지 않았다.
| 변수 | 비-DCI군 (n = 369) | DCI 군 (n = 175) | t/χ²/Z | P 값 | 정정 공고 |
| 연령, 세 | 62.25 ± 9.54 | 64.22 ± 9.75 | 2.234 | 0.026 | |
| 성별 | 0.638 | 0.424 | |||
| 수컷 | 118 (31.98) | 62 (35.43) | |||
| 암컷 | 251 (68.02) | 113 (64.57) | |||
| 체질량지수, kg/m²² | 23.43 ± 3.56 | 23.52 ± 3.72 | 0.271 | 0.786 | |
| 흡연력 | 0.351 | 0.554 | |||
| 예 | 66 (17.89) | 35 (20.00) | |||
| 아니요 | 303 (82.11) | 140 (80.00) | |||
| 알코올 사용 | 0.046 | 0.837 | |||
| 네 | 81 (21.95) | 37 (21.14) | |||
| 아니요 | 288 (78.05) | 138 (78.86) | |||
| 고혈압의 역사 | 2.960 | 0.085 | |||
| 네 | 214 (57.99) | 115 (65.71) | |||
| 아니요 | 155 (42.01) | 60 (34.29) | |||
| 당뇨병의 역사 | 0.463 | 0.496 | |||
| 네 | 45 (12.20) | 25 (14.29) | |||
| 아니요 | 324 (87.80) | 150 (85.71) | |||
| 동맥류 직경, mm | 0.380 | 0.538 | |||
| >10 | 192 (52.03) | 96 (54.86) | |||
| ≤10 | 177 (47.97) | 79 (45.14) | |||
| 동맥류 위치 | 3.602 | 0.058 | |||
| 전방 순환계 | 296 (80.22) | 152 (86.86) | |||
| 후방 순환계 | 73 (19.78) | 23 (13.14) | |||
| 뇌부종 | 10.410 | 0.001 | |||
| 네 | 70 (18.97) | 55 (31.43) | |||
| 아니요 | 299 (81.03) | 120 (68.57) | |||
| 낮은 헤모글로빈 수치 | 23.965 | <0.001 | 합계가 표 1과 다릅니다. 최종 데이터셋과 대조하여 확인하십시오. | ||
| 네 | 122 (33.06) | 82 (46.86) | |||
| 아니요 | 247 (66.94) | 93 (53.14) | |||
| 저알부민혈증 | 7.283 | 0.007 | |||
| 네 | 66 (17.89) | 49 (28.00) | |||
| 아니요 | 303 (82.11) | 126 (72.00) | |||
| 저나트륨혈증 | 3.914 | 0.048 | |||
| 네 | 214 (57.99) | 117 (66.86) | |||
| 아니요 | 155 (42.01) | 58 (33.14) | |||
| 수정된 피셔 등급(Modified Fisher grade) | 58.679 | <0.001 | |||
| ≥III | 134 (36.31) | 125 (71.43) | |||
| I–II | 235 (63.69) | 50 (28.57) | |||
| Hunt-Hess 등급 | 39.909 | <0.001 | |||
| ≥III | 144 (39.02) | 119 (68.00) | |||
| I–II | 225 (60.98) | 56 (32.00) | |||
| WFNS 등급 | 28.137 | <0.001 | |||
| ≥III | 159 (43.09) | 118 (67.43) | |||
| I–II | 210 (56.91) | 57 (32.57) | |||
| 수술적 접근법 | 0.691 | 0.406 | |||
| 혈관 내 치료 | 308 (83.47) | 141 (80.57) | |||
| 클리핑 | 61 (16.53) | 34 (19.43) | |||
| 수술 시간, h | 2.74 ± 0.82 | 2.85 ± 0.76 | 1.496 | 0.135 | |
| 뇌실내 출혈 | 0.163 | 0.687 | |||
| 네 | 89 (24.12) | 45 (25.71) | |||
| 아니요 | 280 (75.88) | 130 (74.29) | |||
| 재출혈 | 1.168 | 0.280 | |||
| 네 | 71 (19.24) | 27 (15.43) | |||
| 아니요 | 298 (80.76) | 148 (84.57) |
표 2: 훈련 코호트 내 지연성 뇌허혈 발생 환자와 비발생 환자의 기저 특성. 연속형 변수는 평균 ± 표준편차로, 범주형 변수는 n (%)으로 표시함. P 값은 DCI 발생 환자와 비발생 환자를 비교한 결과임. 약어: DCI, 지연성 뇌허혈; WFNS, 세계신경외과학회. 이 표를 다운로드하려면 여기를 클릭하십시오.
내부 검증 코호트의 결과 분포
내부 검증 코호트(n = 136)에서 지연성 뇌허혈(DCI)은 42명의 환자(30.9%)에서 발생했으며, 94명의 환자(69.1%)에서는 DCI가 발생하지 않았습니다. 결과 유병률은 훈련 데이터셋에서 관찰된 것과 유사했으며, 이는 데이터셋 전반에 걸쳐 이벤트 분포가 안정적임을 뒷받침합니다.
특성 선택
예측 변수 선택은 10겹 교차 검증(10-fold cross-validation)을 이용한 LASSO 회귀 분석을 통해 훈련 코호트에서 수행되었습니다. 선택된 페널티 파라미터는 λ = 0.031이었습니다. 연령, 뇌부종, 저알부민혈증, 수정된 Fisher 등급, Hunt-Hess 등급, 그리고 WFNS 등급의 6가지 예측 변수가 0이 아닌 계수로 유지되었습니다. 선택된 모든 예측 변수는 의도된 예측 시점 이전에 확인 가능했습니다. 그림 1A,B는 예측 변수 선택에 사용된 계수 궤적과 교차 검증 곡선을 보여줍니다.
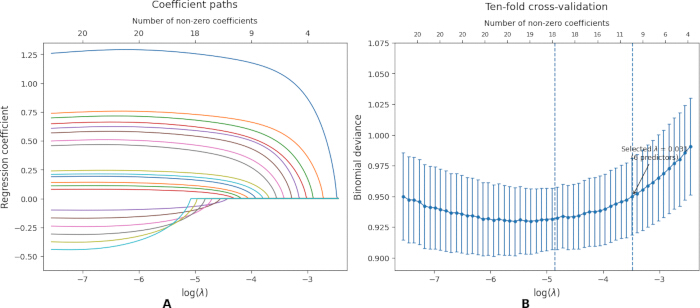
그림 1: 뇌동맥류성 지주막하 출혈 후 지연성 뇌허혈에 대한 LASSO 기반 예측 변수 선택. (A) log(λ) 값에 따른 후보 예측 변수의 계수 궤적. 각 곡선은 하나의 후보 예측 변수를 나타내며, 상단 축의 숫자는 각 페널티 값에서 유지된 0이 아닌 계수의 수를 나타낸다. (B) 이항 편차(binomial deviance)에 대한 10겹 교차 검증 곡선. 점은 평균 교차 검증 편차를, 오차 막대는 표준 오차를 나타내며, 수직 점선은 최소 오차 및 1 표준 오차 페널티 값을 나타낸다. 최종 선택된 페널티 매개변수는 λ = 0.031이었다. LASSO, 최소 절대 수축 및 선택 연산자; DCI, 지연성 뇌허혈. 여기를 클릭하여 이 그림의 더 큰 버전을 확인하십시오.
모델 개발 및 평가
다섯 가지 모든 모델은 동일하게 선택된 6개의 예측 변수를 사용하여 개발되었습니다. 내부 검증 코호트에서 로지스틱 회귀 분석은 0.832(95% CI, 0.758–0.906)의 AUC를 보였으며, SVM은 0.811(95% CI, 0.729–0.893), XGBoost는 0.777(95% CI, 0.690–0.864), LightGBM은 0.755(95% CI, 0.672–0.838), 그리고 KNN은 0.708(95% CI, 0.613–0.803)의 AUC를 나타냈습니다(표 3).
| 데이터 세트 | 모델 | 곡선 아래 면적(AUC) | 95% 신뢰구간 | 정확도 | 민감도 | 특이성 | F1 스코어 | 정정 고지 |
| 훈련 | XGBoost | 0.916 | 0.888–0.944 | 0.848 | 0.853 | 0.847 | 0.682 | |
| 교육 | 로지스틱 회귀 분석 | 0.833 | 0.794–0.872 | 0.816 | 0.71 | 0.81 | 0.594 | |
| 훈련 | LightGBM | 0.751 | 0.707–0.794 | 0.69 | 0.781 | 0.669 | 0.489 | |
| 훈련 | 서포트 벡터 머신(SVM) | 0.807 | 0.762–0.852 | 0.809 | 0.704 | 0.833 | 0.583 | |
| 교육 | K-최근접 이웃 (K-Nearest Neighbors) | 0.915 | 0.896–0.935 | 0.754 | 0.878 | 0.696 | 0.607 | 그림 2 범례의 KNN AUC 값이 표의 값과 일치하도록 수정되었습니다. |
| 검증 | XGBoost | 0.777 | 0.690–0.864 | 0.755 | 0.608 | 0.794 | 0.507 | |
| 검증 | 로지스틱 회귀분석 | 0.832 | 0.758–0.906 | 0.809 | 0.714 | 0.851 | 0.698 | 표 6의 혼동 행렬(confusion matrix)로부터 재계산된 분류 지표. |
| 검증 | LightGBM | 0.755 | 0.672–0.838 | 0.696 | 0.799 | 0.669 | 0.522 | |
| 검증 | 서포트 벡터 머신(SVM) | 0.811 | 0.729–0.893 | 0.779 | 0.69 | 0.819 | 0.659 | 표 6의 혼동 행렬을 바탕으로 재계산한 분류 지표. |
| 검증 | K-최근접 이웃 (K-Nearest Neighbors) | 0.708 | 0.613–0.803 | 0.647 | 0.715 | 0.629 | 0.456 |
표 3: 훈련 및 내부 검증 코호트에서 예측 모델의 판별 및 분류 성능.AUC 값은 95% 신뢰 구간과 함께 보고되었습니다. 정확도, 민감도, 특이도 및 F1 점수는 사전 지정된 분류 임계값에서 계산되었습니다. 약어: AUC, 수신자 조작 특성 곡선 아래 면적; CI, 신뢰 구간; KNN, k-최근접 이웃; LightGBM, light gradient boosting machine; SVM, 서포트 벡터 머신; XGBoost, extreme gradient boosting. 보관된 분석에 사용된 정확한 확률 임계값을 확인할 수 없었기 때문에, 임계값 의존적 분류 측정값은 모델 비교의 주요 근거로 사용되지 않았습니다. 여기에서 이 표를 다운로드하십시오.
신뢰 구간이 겹쳤으며, 로지스틱 회귀 분석이 다른 모델보다 통계적으로 우월한 것으로 해석되지 않았습니다. 하지만 로지스틱 회귀 분석은 안정적인 내부 판별력을 제공하고 모델 구조를 직접적으로 해석할 수 있다는 점에서 주 모델로 유지되었습니다. 결과는 단일 홀드아웃 내부 검증 코호트에서의 성능을 나타내며, 낙관주의 교정, 시계열 또는 외부 검증을 구성하지는 않습니다(그림 2A–D).
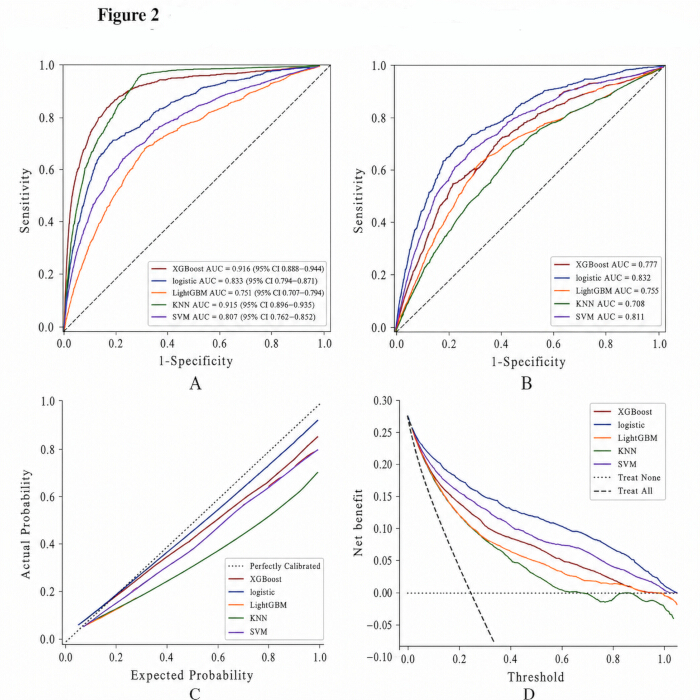
그림 2: 예측 모델의 판별력, 보정 및 결정 곡선 성능.
(A) 훈련 코호트의 수신자 조작 특성 곡선. (B) 내부 검증 코호트의 수신자 조작 특성 곡선. 곡선 레이블은 95% 신뢰 구간과 함께 수신자 조작 특성 곡선 아래 면적(AUC)을 나타낸다. (C) 예측된 DCI 확률과 관찰된 확률을 비교한 보정 곡선; 대각선 점선은 완벽한 보정을 나타낸다. (D) 임계 확률에 따른 순 이득을 보여주는 결정 곡선 분석. 수평 점선은 치료하지 않음 전략을, 파선은 모두 치료함 전략을 나타낸다. AUC, 수신자 조작 특성 곡선 아래 면적; DCI, 지연성 뇌허혈; KNN, k-최근접 이웃; LightGBM, light gradient boosting machine; SVM, 서포트 벡터 머신; XGBoost, extreme gradient boosting. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
탐색적 결정 곡선 분석
순이익(net benefit)에 대한 탐색적 평가로서 결정 곡선 분석(Decision-curve analysis)을 수행하였습니다. 하지만, 미리 지정된 정확한 임계 확률 범위와 환자 수준의 순이익 결과값이 보관된 분석 기록에 유지되지 않았습니다. 따라서 결정 곡선 분석 결과만으로는 임상적 유용성을 확립하거나 임상적으로 적절한 중재 임계값을 정의할 수 없습니다.
모든 환자 치료 또는 치료하지 않음 전략에 비해 나타나는 겉보기 순이익 이점은 현재의 내부 데이터셋 내에서의 예비적 패턴으로만 해석되어야 합니다. 해당 모델이 환자 관리 결정에 유용하다고 간주되기 위해서는 외부 검증, 전향적 임계값 선택, 임상적 결과 평가 및 공식적인 임상 영향 연구가 필요합니다(그림 3).
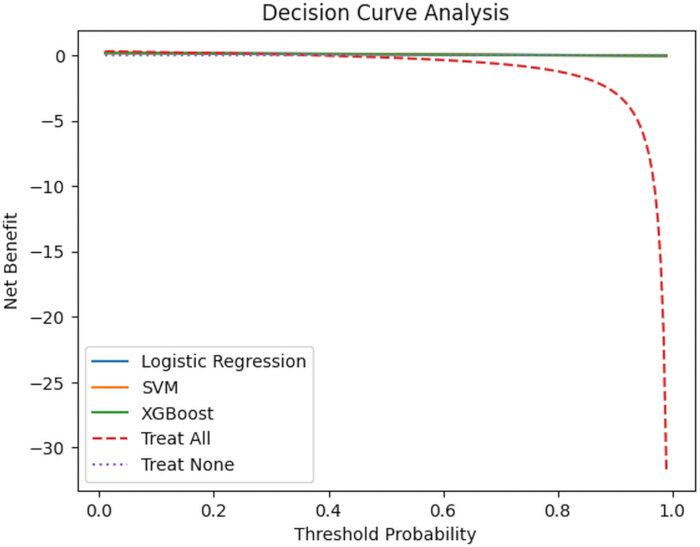
그림 3: 내부 검증 코호트에서 선택된 예측 모델의 결정 곡선 분석(Decision-curve analysis). 로지스틱 회귀, SVM 및 XGBoost 모델에 대해 임계 확률에 따른 순이익(Net benefit)을 도식화하였다. 점선으로 표시된 treat-all 선은 모든 환자를 모니터링하는 전략을 나타내며, 점으로 표시된 treat-none 선은 어떤 환자도 모니터링하지 않는 전략을 나타낸다. 모델의 순이익 곡선이 두 기준 전략보다 위에 있는 임계 확률에서 해당 모델은 임상적으로 유용한 것으로 간주된다. SVM: support vector machine; XGBoost: extreme gradient boosting. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
다변량 로지스틱 회귀 모델
최종 로지스틱 회귀 모델에는 연령, 뇌부종, 저알부민혈증, 수정 Fisher 등급, Hunt-Hess 등급 및 WFNS 등급이 포함되었습니다. 회귀 계수, 오즈비, 95% 신뢰 구간 및 P 값은 표 4에 제시되어 있습니다. 연령의 계수는 0.038이었으며, 뇌부종, 저알부민혈증, 수정 Fisher 등급 ≥ III, Hunt-Hess 등급 ≥ III 및 WFNS 등급 ≥ III의 계수는 각각 0.842, 0.615, 1.274, 0.933 및 0.781이었습니다.
| 예측 인자 | β 계수 | 오즈비 (OR) | 95% 신뢰구간(CI) | P 값 | 해석 참고 사항 |
| 절편 | 번역할 소스 텍스트가 제공되지 않았습니다. 번역이 필요한 영어 텍스트를 입력해 주시기 바랍니다. | — | — | — | 환자 수준의 위험도 계산을 위해 필요함. |
| 연령 | 0.038 | 1.039 | 1.012–1.067 | 0.004 | 예측적 연관성일 뿐이며, 인과 관계는 아님. |
| 뇌부종 | 0.842 | 2.321 | 1.541–3.496 | <0.001 | DCI 진단 전에 측정됨. |
| 저알부민혈증 | 0.615 | 1.85 | 1.206–2.837 | 0.005 | 예측 시점 이전의 가장 빠른 가용 알부민 수치. |
| 수정된 Fisher 등급 ≥III | 1.274 | 3.575 | 2.401–5.324 | <0.001 | 중증도 표지자; 다중공선성에 유의하여 해석하십시오. |
| Hunt-Hess 등급 ≥III | 0.933 | 2.542 | 1.674–3.861 | <0.001 | 중증도 마커; 공선성에 주의하여 해석하십시오. |
| WFNS 등급 ≥III | 0.781 | 2.184 | 1.447–3.298 | <0.001 | 중증도 지표; 공선성 주의하여 해석할 것. |
표 4: 지연성 뇌허혈 예측을 위한 최종 다변량 로지스틱 회귀 모델. LASSO 선택 후 유지된 예측 변수에 대해 회귀 계수, 오즈비, 95% 신뢰 구간 및 P 값이 표시되어 있습니다. 모든 예측 변수는 예정된 예측 시점 이전에 평가되었습니다. 약어: CI, 신뢰 구간; DCI, 지연성 뇌허혈; OR, 오즈비; WFNS, 세계신경외과학회. 보관된 모델 출력물에서 수치 로지스틱 회귀 절편을 사용할 수 없었습니다. 따라서 보고된 계수는 개별 예측 확률을 계산하는 데 사용할 수 없습니다. 계수는 예측적 연관성을 나타내며 독립적인 인과 효과로 해석해서는 안 됩니다. 이 표를 다운로드하려면 여기를 클릭하십시오.
이 계수들은 개발 코호트 내의 예측적 연관성을 설명합니다. 수정 Fisher 등급, Hunt-Hess 등급 및 WFNS 등급은 질환 중증도의 중첩되는 차원을 나타내며 수치적 다중공선성 진단을 사용할 수 없었으므로, 이를 독립적인 인과 관계로 해석해서는 안 됩니다. 해당 변수들은 확인된 독립적 위험 인자가 아니라 예측 모델의 구성 요소로서 유지되었습니다.
교정 성능
교정(Calibration)은 내부 검증 코호트에서 교정 기울기, 교정 절편 및 Brier score의 점 추정치를 사용하여 요약되었습니다. 로지스틱 회귀 분석의 교정 기울기는 0.98, 교정 절편은 0.02, Brier score는 0.168이었습니다. 이에 상응하는 값은 SVM의 경우 0.94, 0.05 및 0.182였으며, XGBoost는 0.88, 0.09 및 0.201, LightGBM은 0.91, 0.07 및 0.194, KNN은 0.92, 0.06 및 0.190이었습니다(표 5).
재표집에 필요한 개별 예측 확률이 분석 출력물 보관본에 저장되지 않아, 이러한 보정 측정값에 대한 부트스트랩 신뢰구간을 구할 수 없었습니다. 따라서 보정 결과는 내부 검증 코호트 내의 예비 점추정치로 제시되었으며, 이를 다른 의료 기관이나 환자군에서의 보정 근거로 해석해서는 안 됩니다(그림 4).
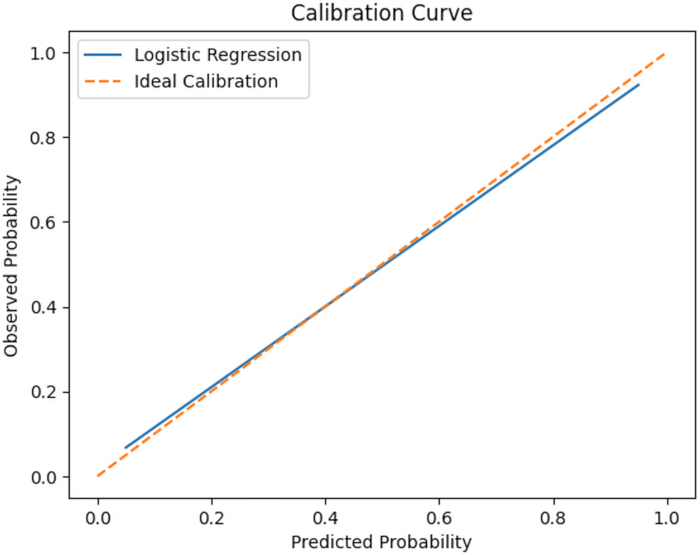
그림 4: 내부 검증 코호트에서 로지스틱 회귀 모델의 보정.실선은 지연성 뇌허혈의 예측 확률과 관찰 확률 사이의 관계를 나타낸다. 대각선 점선은 완벽한 보정을 의미하며, 두 선이 서로 가까울수록 보정 성능이 더 좋음을 나타낸다. DCI, 지연성 뇌허혈. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
| 모델 | 검량선 기울기 | 교정 기울기 95% 신뢰구간 | 검량선 절편 | 교정 절편 95% CI | 브라이어 점수 | Brier 점수 95% 신뢰구간 | 정정 공고 |
| 로지스틱 회귀 분석 | 0.98 | [부트스트랩 95% 신뢰구간 삽입] | 0.02 | [부트스트랩 95% 신뢰구간 삽입] | 0.168 | [부트스트랩 95% 신뢰구간 삽입] | 최종 분석 결과에서 부트스트랩 신뢰구간(CIs)을 사용할 수 있는 경우 추가하십시오. |
| 서포트 벡터 머신 (SVM) | 0.94 | [부트스트랩 95% 신뢰구간 삽입] | 0.05 | [부트스트랩 95% 신뢰구간 삽입] | 0.182 | [부트스트랩 95% 신뢰구간 삽입] | |
| XGBoost | 0.88 | [부트스트랩 95% 신뢰구간 삽입] | 0.09 | [부트스트랩 95% 신뢰구간 삽입] | 0.201 | [부트스트랩 95% 신뢰구간 삽입] | |
| LightGBM | 0.91 | [부트스트랩 95% 신뢰구간 삽입] | 0.07 | [부트스트랩 95% 신뢰구간 삽입] | 0.194 | [부트스트랩 95% 신뢰구간 삽입] | |
| K-최근접 이웃 (KNN) | 0.92 | [부트스트랩 95% 신뢰구간 삽입] | 0.06 | [부트스트랩 95% 신뢰구간 삽입] | 0.19 | [부트스트랩 95% 신뢰구간 삽입] |
표 5: 내부 검증 코호트에서 예측 모델의 보정 성능. 보정 기울기(calibration slope) 1.0과 보정 절편(calibration intercept) 0은 이상적인 보정을 나타냅니다. Brier score가 낮을수록 전반적인 예측 정확도가 높음을 의미합니다. 약어: KNN, k-nearest neighbor; LightGBM, light gradient boosting machine; SVM, support vector machine; XGBoost, extreme gradient boosting. 보정 기울기, 보정 절편 및 Brier score는 점 추정치로 보고되었습니다. 붓스트랩 신뢰 구간은 제공되지 않았습니다. 이 결과는 홀드아웃 내부 검증 코호트 내에서의 예비 보정만을 설명합니다. 이 표를 다운로드하려면 여기를 클릭하십시오.
혼동 행렬 유도 지표.
로지스틱 회귀 분석의 내부 검증 혼동 행렬 결과, 진양성 30건, 진음성 80건, 위양성 14건, 위음성 12건으로 나타났다. 재계산된 정확도는 0.809, 민감도는 0.714, 특이도는 0.851, 양성 예측도는 0.682, 음성 예측도는 0.870, F1 스코어는 0.698이었다.
SVM의 경우, 혼동 행렬은 29개의 진양성, 77개의 진음성, 17개의 위양성 및 13개의 위음성을 포함했습니다. 재계산된 정확도는 0.779, 민감도는 0.690, 특이도는 0.819, 양성 예측도는 0.630, 음성 예측도는 0.856, F1 점수는 0.659였습니다(표 6).
| 측정 지표 | 로지스틱 회귀분석 | 서포트 벡터 머신(SVM) | 계산 노트 |
| 진양성 | 30 | 29 | 검증 코호트 |
| 진음성 | 80 | 77 | 검증 코호트 |
| 위양성 | 14 | 17 | 검증 코호트 |
| 위음성 | 12 | 13 | 검증 코호트 |
| 정확도 | 0.809 | 0.779 | (TP + TN) / 전체 |
| 민감도 | 0.714 | 0.69 | TP / (TP + FN) |
| 특이성 | 0.851 | 0.819 | TN / (TN + FP) |
| 양성 예측도 | 0.682 | 0.63 | TP / (TP + FP) |
| 음성 예측도 | 0.87 | 0.856 | TN / (TN + FN) |
| F1 스코어 | 0.698 | 0.659 | 2TP / (2TP + FP + FN) |
표 6: 내부 검증 코호트에서 로지스틱 회귀 및 SVM의 혼동 행렬 기반 성능 측정치. 측정치는 보관된 혼동 행렬로부터 계산되었으나, 정확한 임계값은 유지되지 않았습니다. 표 하단 각주에 정확한 임계값을 명시하십시오. 약어: NPV, 음성 예측도; PPV, 양성 예측도; SVM, 서포트 벡터 머신. 혼동 행렬은 내부 검증 코호트에서 얻었습니다. 재계산된 로지스틱 회귀의 정확도, 민감도, 특이도, 양성 예측도, 음성 예측도 및 F1 점수는 각각 0.809, 0.714, 0.851, 0.682, 0.870, 0.698이었습니다. 이에 해당하는 SVM 값은 0.779, 0.690, 0.819, 0.630, 0.856, 0.659였습니다. 원래 분석에 사용된 정확한 분류 임계값은 유지되지 않았으므로 최종 제출 전에 확인해야 합니다. 이 표를 다운로드하려면 여기를 클릭하십시오.
수치적 일관성을 보장하기 위해 동일한 혼동 행렬(confusion matrices)로부터 이 값들을 직접 재계산하였습니다. 하지만 원래의 분류 분석에서 사용된 정확한 확률 임계값은 유지되지 않았습니다. 따라서 임계값 의존적 측정치들은 기술적으로 보고되었으며, 원래의 분석 코드로부터 임계값이 확인될 때까지는 모델 비교의 기본 근거로 사용해서는 안 됩니다(표 7).
| 하위 그룹 | AUC (로지스틱 회귀) |
| 연령 ≥65세 | 0.821 |
| 연령 <65세 | 0.836 |
| 수정된 Fisher 분류 ≥III | 0.844 |
| 수정된 Fisher I–II | 0.801 |
| 클리핑 | 0.825 |
| 혈관 내 치료 | 0.835 |
표 7: 로지스틱 회귀 모델의 탐색적 하위 그룹 판별 분석.AUC 값은 연령, 수정된 Fisher 등급 및 치료 하위 그룹별로 보고되었습니다. 이러한 분석은 탐색적이며 모델의 일반화 가능성에 대한 증거로 해석되어서는 안 됩니다. 모든 하위 그룹에 대해 하위 그룹 표본 크기, DCI 발생 횟수 및 95% 신뢰 구간을 추가하십시오.
약어: AUC, 수신자 조작 특성 곡선 아래 면적; DCI, 지연성 뇌허혈. 이 표를 다운로드하려면 여기를 클릭하십시오.
탐색적 하위 그룹 평가
보관된 하위 그룹 결과물에는 연령, 수정된 Fisher 등급 및 치료 접근 방식에 따른 AUC 점 추정치가 포함되어 있었습니다. 그러나 하위 그룹의 표본 크기, 하위 그룹의 DCI-이벤트 수, 95% 신뢰 구간, 상호작용 또는 이질성에 대한 정식 검정 결과는 제공되지 않았습니다. 따라서 하위 그룹 분석 결과는 불완전하며 탐색적인 것으로 간주되었습니다. 이는 모델 성능이 환자 하위 그룹 전반에 걸쳐 견고하거나 일관적이며 일반화 가능하다는 주장을 뒷받침하는 용도로 사용되지 않았습니다.
위험 층화 성능
기록된 위험 성층화 결과에서는 제안된 저위험, 중위험 및 고위험군에 대해 관찰된 DCI 백분율이 각각 10.2%, 33.6%, 69.1%로 보고되었습니다. 그러나 이에 해당하는 그룹 분모, DCI 이벤트 수, 신뢰 구간 및 확률 컷오프에 대한 사전 지정된 임상적 또는 통계적 근거는 제공되지 않았습니다. 따라서 해당 분석은 탐색적인 것으로 간주되었으며, 검증된 위험 분리 또는 임상적 적용 가능성에 대한 주장을 뒷받침하는 데 사용되지 않았습니다(표 8).
| 위험 범주 | 확률 범위 | 관찰된 DCI 발생률 |
| 저위험 | <0.20 | 10.2% |
| 중등도 위험 | 0.20–0.50 | 33.6% |
| 고위험 | >0.50 | 69.1% |
표 8: 내부 검증 코호트의 모델 기반 위험 범주별 지연성 뇌허혈 발생률. 위험 범주는 최종 로지스틱 회귀 모델의 예측 확률을 사용하여 정의되었습니다. 이 표를 다운로드하려면 여기를 클릭하십시오.
최종 로지스틱 회귀 모델
보관된 회귀 분석 결과에는 선택된 6개 예측 변수에 대한 계수는 포함되어 있었으나, 수치적 모델 절편은 포함되어 있지 않았습니다. 개별 예측 확률을 계산하려면 절편이 필요하므로, 완전한 환자 수준의 예측 방정식을 보고할 수 없었습니다. 따라서 불완전한 방정식을 가정된 값이나 재구성된 값으로 완성하는 대신 삭제하였습니다.
표 4에 제시된 계수들은 적합된 모델 내에서 예측 변수 연관성의 방향과 상대적 크기를 설명하는 데 사용될 수 있으나, 환자 수준의 DCI 확률을 계산하는 데 사용해서는 안 됩니다. 완전한 예측 방정식은 원래의 적합된 모델에서 절편을 복원하거나 실제 환자 수준의 데이터 세트를 재분석하여 다시 생성한 후에만 제공될 수 있습니다.
Logit(DCI) = [절편] + 0.038 × 연령 + 0.842 × 뇌부종 + 0.615 × 저알부민혈증 + 1.274 × 수정 Fisher 등급 ≥III + 0.933 × Hunt-Hess 등급 ≥III + 0.781 × 세계 신경외과 연맹 등급 ≥III.
DCI의 예측 확률은 다음과 같이 계산되었습니다:
P(DCI) = 1 / [1 + exp(−Logit)].
이진 예측 변수는 해당 조건이 있는 경우 1로, 없는 경우 0으로 코딩하였습니다. 수정된 Fisher grade ≥III, Hunt-Hess grade ≥III 및 세계신경외과학회(World Federation of Neurological Surgeons) grade ≥III는 환자가 해당 임계치에 도달한 경우 1로, 그렇지 않은 경우 0으로 코딩하였습니다. 절편은 환자 수준의 확률 계산에 필요하므로 보고하지 않았습니다. 이 방정식은 외부 검증 및 재보정이 완료될 때까지 연구 해석용으로만 사용해야 합니다.
수정된 Fisher 등급, Hunt-Hess 등급 및 세계 신경외과학회(World Federation of Neurological Surgeons) 등급은 모두 질병의 중증도를 반영하며, 임상적 의미에서 부분적으로 중복될 수 있습니다. 수치적 공선성 진단과 중복되는 중증도 척도를 제외한 완전한 민감도 모델을 사용할 수 없었기 때문에, 본 원고에서는 이러한 변수들을 독립적인 인과 예측 인자로 해석하지 않습니다. 이들은 훈련 코호트에서 선택된 예측 모델의 구성 요소로서만 유지되었습니다. 이러한 제한점은 각 중증도 척도의 독립적인 기여도에 대한 신뢰도를 낮추며, 향후 외부 검증 연구에서 다루어져야 합니다.
데이터 가용성:
전체 환자 수준의 병원 데이터셋은 민감한 임상 정보가 포함되어 있으며 기관의 윤리 및 데이터 보호 요구 사항의 적용을 받으므로 공개적으로 제공되지 않습니다. 방법론적으로 정당한 연구 제안서, 윤리 승인 증빙 및 적절한 데이터 사용 협약서를 제출한 후, Yulin First Hospital의 기관 윤리 위원회의 심의를 통해 비식별화된 분석 데이터셋에 대한 접근 권한을 고려할 수 있습니다. 공유되는 데이터셋에서는 성명, 병원 식별 번호, 정확한 날짜, 연락처 정보 및 기타 직접적 또는 간접적 식별자가 제외됩니다. 기관 정책이 허용하는 범위 내에서, 검증된 변수 사전, 분석 스크립트, 모델 개발 및 재현성 정보가 설명된 Supplementary Table 1, 변수별 결측치가 보고된 Supplementary Table 2가 제공됩니다. 시연용 또는 합성 데이터셋은 원본 임상 연구 데이터로 표시되지 않습니다.
보충 표 1: 모델 개발을 위한 재현성 세부 사항 및 최종 하이퍼파라미터. 이 표는 XGBoost, LightGBM, SVM 및 KNN에 대한 랜덤 시드, 소프트웨어 및 패키지 버전, 전처리 단계, 결측치 대체 절차, 교차 검증 방법, 튜닝 그리드 및 최종 하이퍼파라미터를 보고합니다.이 파일을 다운로드하려면 여기를 클릭하십시오.
보충 표 2: 후보 예측 변수에 대한 결측치 요약 및 처리 전략.각 후보 예측 변수별로 결측 관측치의 수와 비율, 대체 방법, 그리고 해당 변수가 분석을 위해 유지되었는지 여부를 보고합니다.이 파일을 다운로드하려면 여기를 클릭하십시오.
토론
본 연구에서는 초기 임상, 실험실 및 영상 변수를 이용하여 aSAH 후 DCI에 대한 예측 모델을 개발하고 내부적으로 검증하였습니다. 예측 변수 선택 후 연령, 뇌부종, 저알부민혈증, 수정 Fisher 등급, Hunt-Hess 등급 및 세계신경외과학회(WFNS) 등급의 6가지 변수가 유지되었습니다. 평가된 모델들 중 로지스틱 회귀 분석이 안정적인 내부 판별력과 수용 가능한 보정도를 보였습니다. 검증 코호트가 훈련 코호트와 동일한 센터 및 기간에서 추출되었으므로, 본 결과는 예비적인 내부 검증으로만 해석되어야 합니다.
선택된 예측 인자들은 aSAH 맥락에서 임상적으로 타당합니다. 수정된 Fisher 등급이 높을수록 출혈 부담이 더 큼을 반영하며, Hunt-Hess 및 WFNS 등급은 내원 당시의 신경학적 중증도를 나타냅니다14,15. 뇌부종은 초기 뇌 손상을 나타낼 수 있으며, 고령은 생리적 예비능의 감소를 의미할 수 있습니다. 저알부민혈증은 전신 질환, 염증, 영양 상태 또는 내피 세포의 취약성을 반영할 수 있습니다19,20. 그러나 이러한 연관성은 예측을 위해 식별된 것이며 인과 관계로 해석해서는 안 됩니다. 또한, 수정된 Fisher, Hunt-Hess 및 WFNS 등급은 질병 중증도의 서로 연관된 측면들을 측정합니다. VIF 값과 수치적 민감도 분석을 사용할 수 없었기 때문에, 각 등급 척도의 독립적인 기여도는 확립할 수 없었습니다.
홀드아웃 내부 검증 코호트에서 더 복잡한 머신러닝 방법들은 로지스틱 회귀 분석에 비해 뚜렷한 이점을 보이지 않았습니다. 로지스틱 회귀 분석이 가장 높은 검증 AUC를 나타냈으나, 신뢰 구간은 다른 모델들의 신뢰 구간과 겹쳤습니다. 복잡한 알고리즘은 비선형 패턴을 포착할 수 있지만, 예측 변수 세트가 작고 데이터가 단일 센터에서 유래한 경우에는 과적합될 가능성이 있습니다. 따라서 해석 가능성과 안정적인 내부 판별력 덕분에 로지스틱 회귀 분석을 주 모델로 유지하였습니다. 그럼에도 불구하고, 하이퍼파라미터와 소프트웨어 버전에 대한 기록이 불완전하여 머신러닝 비교 연구의 재현성이 제한됩니다.
현재의 모델은 확립된 임상적 역할이 없습니다. 이론적으로는 추정 위험도가 높을 경우 더욱 면밀한 신경학적 관찰이나 조기 전문의 검토를 뒷받침할 수 있으나, 모델 절편(intercept)을 사용할 수 없기 때문에 현재로서는 환자 수준의 확률을 계산할 수 없습니다. 또한, 결정 곡선 임계값 범위, 하위 그룹 성능 및 위험 범주 결과가 불충분하게 기록되었습니다. 따라서 본 모델을 단독 진단 도구, 모니터링 규칙 또는 치료 결정의 근거로 사용해서는 안 됩니다. 실제 적용을 고려하기 전에는 완전한 모델 재구성, 외부 검증, 재보정 및 전향적 임상 영향 평가가 필요합니다.
본 연구에는 몇 가지 제한점이 있습니다. 첫째, 단일 센터에서 수행된 후향적 연구이므로 일반화하는 데 한계가 있습니다. 둘째, 모델 성능 평가가 단일 결과 층화 8:2 홀드아웃 분할(hold-out split) 방식을 통해 이루어졌습니다. 부트스트랩 낙관주의 교정(Bootstrap optimism correction), 반복 k-겹 교차 검증(repeated k-fold validation), 시간적 검증 및 외부 검증은 수행되지 않았습니다. 셋째, 원래의 랜덤 시드, 최종 머신러닝 하이퍼파라미터, 튜닝 그리드, 클래스 불균형 처리 절차 및 전체 소프트웨어 패키지 버전이 보존되지 않아 계산 재현성에 한계가 있습니다. 넷째, 수치적 로지스틱 회귀 절편을 사용할 수 없어 개별 예측 확률을 계산할 수 없었습니다. 다섯째, 수정된 Fisher 등급, Hunt-Hess 등급 및 WFNS 등급은 서로 연관된 중증도 지표이며, 중복 척도를 제외한 VIF 진단 및 수치적 민감도 분석은 수행되지 않았습니다. 여섯째, 보정 기울기(calibration slope), 보정 절편(calibration intercept) 및 Brier 점수의 신뢰 구간이 계산되지 않았습니다. 일곱째, 정확한 분류 임계값과 DCA 임계값 범위를 확인할 수 없었습니다. 여덟째, 하위 그룹 및 위험 층화 분석에서 전체 분모, 이벤트 수, 신뢰 구간 및 정식 상호작용 검증이 부족했습니다. 아홉째, 원래의 변수별 결측치 패턴이 보존되지 않았습니다. 마지막으로, 입원 초기 사망자가 제외되어 생존 편향(survivorship bias)이 발생했을 가능성이 있습니다. 이러한 제한점으로 인해 본 모델은 예비적인 것으로 간주되어야 하며, 완전한 재분석과 독립적인 외부 검증을 거치기 전까지 임상적 의사 결정에 사용해서는 안 됩니다.
본 연구에서는 초기 임상, 실험실 및 영상 변수를 사용하여 aSAH 이후 DCI에 대한 예측 모델을 개발하고 평가하였습니다21. LASSO 선택 후 연령, 뇌부종, 저알부민혈증, 수정 Fisher 등급, Hunt-Hess 등급 및 WFNS 등급의 6가지 예측 인자가 유지되었습니다22,23,24,25,26,27,28,29. 로지스틱 회귀 분석은 홀드아웃 내부 검증 코호트에서 0.832 (95% CI)의 AUC를 달성했으며 해석 가능한 모델 구조를 도출하였습니다29,30. 그러나 분석이 단일 내부 분할에 의존했으며, 완전한 재표본 추출 기반 검증, 외부 검증 및 계산 재현성에 대한 정보가 제공되지 않았습니다. 따라서 본 결과는 임상적으로 검증된 예측 도구의 근거라기보다 예비 모델 개발 결과로 해석되어야 합니다.
이 단일 센터 후향적 연구에서는 6가지의 조기 임상, 실험실 및 영상 변수를 사용하여 aSAH 이후의 DCI 예측 모델을 개발하고 평가했습니다. 로지스틱 회귀 분석 결과, 단일 홀드아웃 내부 검증 코호트에서 예비 판별력이 나타났으며 해석 가능한 모델 구조가 도출되었습니다31,32,33,34. 그러나 불완전한 재현성 기록, 수치적 절편의 부재, 재표집 기반 검증의 불가능, 불완전한 불확실성 평가 및 외부 검증의 부족으로 인해 환자 수준의 확률 계산과 임상적 활용이 불가능합니다. 따라서 실제 환자 수준 데이터셋을 이용한 재분석, 모델 개발 설정의 완전한 보고 및 독립적인 다기관 검증이 필요합니다.
감사의 글
저자들은 익명화된 임상 데이터를 수집하는 데 도움을 준 유린 제1병원의 의료 기록 직원들의 지원에 감사드립니다. 해당 직원들은 연구 설계, 결과 판정, 통계 모델링, 결과 해석, 원고 작성 또는 최종 원고 승인에 참여하지 않았으며, 따라서 저자 자격 기준을 충족하지 않았습니다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| 전자 의료 기록 시스템 | Yulin First Hospital | 해당 없음 | 회고적 임상 데이터의 출처; 정확한 상용 플랫폼은 보관된 기록에 남아 있지 않음. |
| IBM SPSS Statistics | IBM Corporation | Version 25.0 | 기술 및 추론 통계 분석. |
| K-최근접 이웃 구현 | 패키지/소스 보관되지 않음 | 사용 불가 | 탐색적 머신러닝 모델; 정확한 패키지 및 버전은 원래 코드 환경에서 복구해야 함. |
| LightGBM | Microsoft / open-source project | 버전 사용 불가 | 탐색적 그래디언트 부스팅 모델; 정확한 패키지 버전 및 하이퍼파라미터가 보관되지 않음. |
| R 통계 소프트웨어 | R Foundation for Statistical Computing | Version 4.3.2 | 통계 모델링 및 내부 성능 평가. |
| 서포트 벡터 머신 구현 | 패키지/소스 보관되지 않음 | 사용 불가 | 탐색적 머신러닝 모델; 정확한 패키지, 커널 설정 및 버전이 보관되지 않음. |
| XGBoost | Open-source project | 버전 사용 불가 | 탐색적 그래디언트 부스팅 모델; 정확한 패키지 버전 및 하이퍼파라미터가 보관되지 않음. |
참고문헌
- Caylor MM, MacDonald RL. Pharmacological prevention of delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage. Neurocrit Care. 2024;40(1):159–169.
- Shah VA, Gonzalez LF, Suarez JI. Therapies for delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage. Neurocrit Care. 2023;39(1):36–50.
- Clarke JV, et al. Microvascular platelet aggregation and thrombosis after subarachnoid hemorrhage: a review and synthesis. J Cereb Blood Flow Metab. 2020;40(8):1565–1575.
- Dodd WS, et al. Pathophysiology of delayed cerebral ischemia after subarachnoid hemorrhage: a review. J Am Heart Assoc. 2021;10(15). doi:10.1161/JAHA.121.021845.
- Stragier H, et al. Pathophysiological mechanisms underlying early brain injury and delayed cerebral ischemia in the aftermath of aneurysmal subarachnoid hemorrhage: a comprehensive analysis. Front Neurol. 2025;16:1587091. doi:10.3389/fneur.2025.1587091.
- Xiao ZK, et al. Risk factors for the development of delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage: a systematic review and meta-analysis. World Neurosurg. 2025;193:427–446.
- Sirsat MS, Fermé E, Câmara J. Machine learning for brain stroke: a review. J Stroke Cerebrovasc Dis. 2020;29(10):105162. doi:10.1016/j.jstrokecerebrovasdis.2020.105162.
- Mao M, et al. Construction of a nomogram model for predicting delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage patients. Sci Rep. 2025;15(1):17739. doi:10.1038/s41598-025-01693-w.
- Connolly ES Jr, et al. Guidelines for the management of aneurysmal subarachnoid hemorrhage: a guideline for healthcare professionals from the American Heart Association/American Stroke Association. Stroke. 2012;43(6):1711–1737.
- Vergouwen MD, et al. Definition of delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage as an outcome event in clinical trials and observational studies: proposal of a multidisciplinary research group. Stroke. 2010;41(10):2391–2395.
- Riley RD, et al. Calculating the sample size required for developing a clinical prediction model. BMJ. 2020;368. doi:10.1136/bmj.m441.
- Veldeman M, et al. Delayed cerebral ischaemia prevention and treatment after aneurysmal subarachnoid haemorrhage: a systematic review. Br J Anaesth. 2016;117(1):17–40.
- Azzam AY, et al. Prediction of delayed cerebral ischemia followed aneurysmal subarachnoid hemorrhage: a machine-learning based study. J Stroke Cerebrovasc Dis. 2024;33(4):107553. doi:10.1016/j.jstrokecerebrovasdis.2023.107553.
- Jeong TS, et al. Factors related to the development of shunt-dependent hydrocephalus following subarachnoid hemorrhage in the elderly. Turk Neurosurg. 2018;28(2):226–233.
- Becerril-Gaitan A, et al. The effect of age on cerebral vasospasm and delayed cerebral ischemia in patients with aneurysmal subarachnoid hemorrhage. World Neurosurg. 2024;187–e1024.
- Hayman EG, et al. Mechanisms of global cerebral edema formation in aneurysmal subarachnoid hemorrhage. Neurocrit Care. 2017;26(2):301–310.
- Fistouris P, et al. The impact of intracranial blood clearance on brain edema as a predictor of delayed cerebral infarction following subarachnoid hemorrhage. Cerebrovasc Dis. Published online June 28, 2025:1–8.
- Liu JP, et al. Analysis of risk factors for delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage [in Chinese]. Chin J Cerebrovasc Dis. 2017;14(1):10–14.
- Guo X, et al. Admission albumin-globulin ratio associated with delayed cerebral ischemia following aneurysmal subarachnoid hemorrhage. Front Neurol. 2024;15:1438728. doi:10.3389/fneur.2024.1438728.
- Sanicola HW, et al. Pathophysiology, management, and therapeutics in subarachnoid hemorrhage and delayed cerebral ischemia: an overview. Pathophysiology. 2023;30(3):420–442.
- Wang L, et al. Risk factors and predictive models of poor prognosis and delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage complicated with hydrocephalus. Front Neurol. 2022;13:1014501. doi:10.3389/fneur.2022.1014501.
- Raatikainen E, et al. Prognostic value of the 2010 consensus definition of delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage. J Neurol Sci. 2021;420:117261. doi:10.1016/j.jns.2020.117261.
- Shah AH, Snow R, Wendell LC, et al. Association of hemoglobin trend and outcomes in aneurysmal subarachnoid hemorrhage: a single center cohort study. J Clin Neurosci. 2023;107:77–83.
- Jiang C, et al. Risk and prognostic factors for rupture of intracranial aneurysms during endovascular embolization. World Neurosurg. 2019;129–e649.
- Naraoka M, et al. Role of microcirculatory impairment in delayed cerebral ischemia and outcome after aneurysmal subarachnoid hemorrhage. J Cereb Blood Flow Metab. 2022;42(1):186–196.
- Hu P, et al. Effect of surgical clipping versus endovascular coiling on the incidence of delayed cerebral ischemia in patients with aneurysmal subarachnoid hemorrhage: a multicenter observational cohort study with propensity score matching. World Neurosurg. 2023;172–e388.
- Ching T, et al. Opportunities and obstacles for deep learning in biology and medicine. J R Soc Interface. 2018;15(141):20170387. doi:10.1098/rsif.2017.0387.
- Jiang F, et al. Artificial intelligence in healthcare: past, present and future. Stroke Vasc Neurol. 2017;2(4):230–243.
- Coulibaly AP, Provencio JJ. Aneurysmal subarachnoid hemorrhage: an overview of inflammation-induced cellular changes. Neurotherapeutics. 2020;17(2):436–445.
- Gris T, et al. Innate immunity activation in the early brain injury period following subarachnoid hemorrhage. J Neuroinflammation. 2019;16(1):253. doi:10.1186/s12974-019-1629-7.
- Wu Z, et al. Study on the predictive value of laboratory inflammatory markers and blood count-derived inflammatory markers for disease severity and prognosis in COVID-19 patients: a study conducted at a university-affiliated infectious disease hospital. Ann Med. 2024;56(1):2415401. doi:10.1080/07853890.2024.2415401.
- Okugawa Y, et al. Lymphocyte–C-reactive protein ratio as a promising new marker for predicting surgical and oncological outcomes in colorectal cancer. Ann Surg. 2020;272(2):342–351.
- Xie L, et al. The systemic inflammation response index as a significant predictor of short-term adverse outcomes in acute decompensated heart failure patients: a cohort study from southern China. Front Endocrinol (Lausanne). 2024;15:1444663. doi:10.3389/fendo.2024.1444663.
- Yan F, et al. Association between the stress hyperglycemia ratio and 28-day all-cause mortality in critically ill patients with sepsis: a retrospective cohort study and predictive model establishment based on machine learning. Cardiovasc Diabetol. 2024;23(1):163. doi:10.1186/s12933-024-02265-4.