본 프로토콜은 다차원 전사체 데이터를 머신러닝과 통합하여 확장성 심근병증에서 노화 및 미토콘드리아 관련 유전자를 식별함으로써 바이오마커 발굴 및 분자 하위 유형 분류를 수행합니다.
이 논문에서
요약
초록
확장성 심근병증(DCM)은 좌심실 확장 및 수축기 기능 장애를 특징으로 하며, 미토콘드리아 기능 장애 및 면역-염증성 활성화와 관련이 있습니다. 그러나 DCM에서 노화 관련 분자적 특성과 미토콘드리아 조절 경로는 아직 완전히 밝혀지지 않았습니다. 본 연구에서는 Gene Expression Omnibus 데이터베이스에서 6개의 벌크 전사체 데이터셋과 1개의 단일 세포 RNA 시퀀싱 데이터셋을 분석하였습니다. 데이터 정규화, 배치 보정 및 세포 유형 주석 처리 후, 차등 발현 분석, 가중 유전자 공동 발현 네트워크 분석 및 단백질-단백질 상호작용 네트워크 구축을 통해 노화 및 미토콘드리아 관련 후보 유전자를 식별하였습니다. 핵심 유전자는 최소 절대 수축 및 선택 연산자(LASSO) 회귀, 랜덤 포레스트 및 서포트 벡터 머신-재귀적 특징 제거(SVM-RFE)를 사용하여 추가로 선별되었습니다. DCM의 심장 면역 미세환경을 특성화하기 위해 면역 세포 침윤, 세포 간 통신 및 분자 서브타이핑 분석을 수행하였습니다. 총 66개의 노화 관련 유전자와 16개의 미토콘드리아 관련 유전자가 DCM과 연관되어 있었으며, 주로 저산소 유도 인자-1(HIF-1) 신호 전달, 산화적 인산화 및 산화질소 합성효소 관련 경로에 농축되어 있었습니다. 머신 러닝 및 단일 세포 RNA 시퀀싱 분석을 통해 SERPINE1, TGFB2, CYBB 및 TLR2를 핵심 유전자로 식별하였습니다. CYBB와 TLR2는 단핵구와 대식세포에서 높게 발현된 반면, SERPINE1과 TGFB2는 주로 기질 세포에서 발현되었습니다. 면역 랜드스케이프 분석 결과, DCM 샘플에서 염증성 대식세포 활성화가 증가하고 세포 간 통신이 변화했음을 확인하였습니다. 핵심 유전자 발현을 기반으로 DCM 샘플을 혈관 내피 성장 인자 신호 전달 및 일차 담즙산 생합성과 각각 연관된 두 가지 분자 서브타입으로 나누었습니다. 본 프로토콜은 DCM의 후보 바이오마커와 분자 서브타입을 식별하기 위한 통합적인 프레임워크를 제공합니다.
서론
확장성 심근병증(DCM)은 좌심실 확장과 수축 기능 저하를 특징으로 하는 심근 질환입니다. 이는 심부전의 세 번째로 흔한 원인이며, 전 세계적으로 심장 이식을 시행하는 가장 주요한 적응증입니다1. 인구 기반 연구에 따르면 성인 250명당 약 1명 꼴로 유병률이 나타나며, 남성에서 더 높은 유병률을 보이고 단일 유전자 변이에 의한 사례가 상당한 비율을 차지하는 것으로 추정됩니다2. 이러한 결과는 유전적 소인과 환경적 요인 모두가 DCM의 발생과 진행에 기여함을 시사합니다.
DCM의 병태생리는 염증성 활성화, 산화적 스트레스, 심근세포 아포토시스 및 조절되지 않는 섬유화 촉진 신호 전달을 포함하여 서로 연결된 프로세스들과 관련이 있습니다. tumor necrosis factor-α 프로모터 변이체를 포함한 염증 유전적 다형성은 바이러스성 DCM에 대한 감수성과 관련이 있는 것으로 알려져 있습니다3. 또한, 증가된 산화적 스트레스는 인간 DCM 하위 유형에서 심근세포 사멸 및 좌심실 기능 부전과 관련이 있습니다4. 이에 더해, Wnt/β-catenin 및 calcineurin/nuclear factor of activated T cells 신호 전달의 비정상적인 활성화는 심근 비대와 간질성 섬유화를 촉진하여 질병의 진행에 기여합니다5,6. 심근세포는 에너지 요구량이 높기 때문에 미토콘드리아 기능 장애 또한 DCM의 또 다른 중요한 구성 요소입니다. 미토콘드리아 생합성, 칼슘 항상성, 미토파지 및 미토콘드리아 DNA 무결성의 파괴는 산화적 인산화를 손상시키고 점진적인 심장 기능 부전에 기여할 수 있습니다7,8,9,10.
이러한 기전적 발견에도 불구하고 여전히 중요한 지식 공백이 존재합니다. 특히, DCM의 시작 및 진행 과정에서 미토콘드리아 구조 재형성과 생체 에너지 기능 장애 사이의 시간적 및 인과적 관계가 아직 완전히 정의되지 않았습니다11. 이에 따라 여러 치료 전략이 연구되어 왔습니다. 줄기세포 치료는 파라크라인, 세포 보호 및 면역 조절 효과를 통해 재생 가능성을 보여주었으나, 세포원, 전달 경로 및 이식 후 생존율의 최적화가 여전히 필요합니다12. 아데노 부속 바이러스 기반 전달 및 CRISPR 기반 게놈 편집을 포함한 유전자 치료 접근법 또한 정밀 치료 전략으로서 잠재력을 제공합니다. 하지만 심장 친화성, 벡터 면역원성 및 장기적 안전성과 관련된 한계점들은 아직 해결되지 않은 상태입니다13.
Gene Expression Omnibus (GEO)와 같은 리포지토리의 공개 전사체 데이터셋은 DCM의 바이오마커 발굴에 널리 활용됩니다. 이러한 리소스는 다기관 임상 코호트에 대한 접근을 가능하게 하고, 비용 효율적이며 재현 가능한 연구를 지원하며, 데이터셋 간 통합을 통해 통계적 검정력을 향상시킬 수 있습니다14. 또한 전사체 프로파일링을 통해 전장 유전체 수준의 후보 유전자 스크리닝, 분자 아형 분류 및 경로 수준의 분석이 가능합니다15. 하지만 공개 데이터셋은 기술적 배치 효과, 임상적 및 병인론적 이질성, 인과 관계 추론 능력의 한계, 그리고 불완전한 종단적 또는 예후 정보와 같은 내재적인 한계가 있습니다16. 따라서 공개 전사체 데이터셋에서 도출된 결과는 가설 생성 및 후보 바이오마커 우선순위 선정에 가장 적합하며, 독립적인 코호트와 실험 모델을 통한 검증이 필요합니다.
DCM에 관한 많은 생정보학 연구들은 주로 차별 발현 분석에 의존하고 있으나, 이는 위양성 결과를 생성할 수 있으며 심장 조직 내의 유전자 공동 발현 네트워크나 세포 이질성을 완전히 특성화하지 못합니다. 이러한 한계를 해결하기 위해 본 연구에서는 상호 보완적인 방법들을 결합한 통합 분석 전략을 채택하였습니다. 벌크 전사체 분석은 대조군 비교에 적합한 조직 수준의 발현 프로파일을 제공합니다. 가중 유전자 공동 발현 네트워크 분석(WGCNA)은 표현형 특성과 관련된 유전자 모듈을 식별하며, 개별 차별 발현 유전자가 아닌 기능적으로 연관된 유전자 세트의 우선순위를 정할 수 있게 합니다. 단백질-단백질 상호작용(PPI) 네트워크 분석은 네트워크 토폴로지를 기반으로 연결성이 높은 유전자를 식별합니다. 통합 데이터셋 전반에서 후보 바이오마커를 식별하기 위해 LASSO 회귀, 랜덤 포레스트, 서포트 벡터 머신-재귀적 특성 제거라는 세 가지 머신러닝 알고리즘이 사용되었습니다¹⁷. 이후 단일 세포 RNA 시퀀싱(scRNA-seq)을 통해 세포 유형별 발현 패턴과 세포 간 통신 네트워크를 조사하였습니다18.
DCM에서 미토콘드리아 기능 장애와 노화 관련 분자 변화가 각각 연구되어 왔으나, 질병 관련 전사 변화와 이들의 통합적인 연관성에 대해서는 아직 충분히 연구되지 않았습니다. 본 연구에서는 다수의 bulk 전사체 및 scRNA-seq 데이터셋을 통합하여 DCM의 노화 및 미토콘드리아 관련 허브 유전자를 식별하고, 심장 면역 미세환경의 특성을 분석하며, 식별된 유전자를 기반으로 분자 아형을 조사하였습니다. 이러한 통합적 접근 방식은 후보 바이오마커의 우선순위를 정하고, 후속 기전 연구 및 검증 연구를 위한 기초를 제공하는 데 사용되었습니다.
프로토콜
모든 동물 실험 절차는 중국 중의약대학교 제2부속병원의 실험동물 윤리위원회의 검토 및 승인을 받았습니다(승인 번호 HNSZYYYJS2023011150). 모든 절차는 실험동물 복지 윤리 심사 지침(GB/T 35892-2018) 및 대체(Replacement), 감소(Reduction), 개선(Refinement)의 3R 원칙에 따라 수행되었습니다. 본 연구에 사용된 시약, 데이터베이스, 소프트웨어 및 장비는 재료 표에 나열되어 있습니다.
1. 데이터 리소스 및 실험 재료
자발적 확장성 심근병증(DCM) 표현형을 가진 체중 25 ± 2 g의 SPF 등급 수컷 CTNTR141W 형질전환 마우스를 모델군으로 사용하였다. 체중 25 ± 2 g의 연령이 일치하는 SPF 등급 수컷 C57BL/6J 마우스를 대조군으로 사용하였다. 각 군에는 12마리의 마우스가 포함되었다. 모든 동물은 유효한 실험동물 생산 허가를 보유한 기관에서 구입하였으며, 22 ± 2 °C 온도와 40%–60% 상대 습도, 12시간 명/암 주기의 SPF 등급 차단 환경에서 사육하였으며, 멸균된 사료와 물을 자유롭게 섭취하도록 하였다. 1주일의 적응 기간 후, 모든 마우스를 동일한 조건에서 4주 더 유지한 뒤 심기능 평가 및 시료 수집을 수행하였다. 실험 시작 시 모든 마우스의 연령은 6–8주였다. 마우스는 깊게 마취시킨 후 경추 탈구법으로 안락사시켰다.
DCM 환자의 좌심실 심근 조직에 대한 7개의 공개 전사체 데이터셋을 Gene Expression Omnibus (GEO)19 데이터베이스에서 검색하였습니다. 이 데이터셋에는 6개의 bulk 전사체 데이터셋과 1개의 단일 세포 RNA 시퀀싱(scRNA-seq) 데이터셋인 GSE145154가 포함되었습니다. CD45 양성 및 CD45 음성 분획이 모두 분석에 포함되었습니다. CD45 양성 및 CD45 음성 세포 분획은 클러스터링 전에 결합되었습니다. 샘플 식별 정보는 Harmony 통합을 위한 주요 배치 변수로 사용되었습니다. GSE145154의 정상 좌심실 및 DCM 좌심실 샘플, 구체적으로 GSM4307515, GSM4307516, GSM4307520 및 GSM4307521이 포함되었습니다. 본 연구에 사용된 데이터셋은 GSE145154, GSE5406, GSE42955, GSE57338, GSE79962, GSE116250 및 GSE141910입니다. DCM 이외의 모든 샘플은 제외되었으며, 대조군 샘플(Control group)과 DCM 샘플(DCM group)만 유지되었습니다. 품질 관리 후 제거된 샘플은 없었습니다. 포함된 GEO 데이터셋의 샘플 정보는 다음과 같이 요약됩니다: GSE5406은 102개 샘플(대조군 16개, DCM 샘플 86개), GSE42955는 17개 샘플(대조군 5개, DCM 샘플 12개), GSE57338은 231개 샘플(대조군 136개, DCM 샘플 95개), GSE79962는 20개 샘플(대조군 11개, DCM 샘플 9개), GSE116250은 51개 샘플(대조군 14개, DCM 샘플 37개), 그리고 GSE141910은 322개 샘플(대조군 161개, DCM 샘플 161개)을 포함하였습니다.
2. 벌크 전사체 데이터 전처리
6개의 벌크 데이터 세트에 대한 원시 발현 행렬과 임상 주석 파일은 GEOquery 패키지20를 사용하여 다운로드하였습니다. Affymetrix 마이크로어레이 데이터 세트의 경우 원시 CEL 파일을 추출하였으며, RNA-seq 데이터 세트의 경우 원시 카운트 행렬을 추출하였습니다. 마이크로어레이 데이터의 배경 보정, 분위수 정규화 및 발현량 계산은 affy 패키지21에 구현된 RMA(robust multi-array average) 알고리즘을 사용하여 수행하였습니다.
RNA-seq 카운트 데이터는 edgeR 패키지22의 TMM(trimmed mean of M-values) 방법을 사용하여 정규화되었으며, log₂ 변환된 CPM(counts per million) 값으로 변환되었습니다. 프로브 식별자는 플랫폼 특이적 주석 파일을 사용하여 공식 유전자 기호로 변환되었습니다. 여러 개의 프로브가 동일한 유전자에 매핑된 경우, 평균 발현값을 계산하였습니다.
sva 패키지의 ComBat 알고리즘을 사용하여 데이터셋 간의 기술적 배치 효과를 제거했습니다23. 데이터셋 출처와 검출 플랫폼을 배치 요인으로 지정하였습니다. 배치 효과 제거의 효율성을 평가하기 위해 배치 교정 전후로 주성분 분석을 수행하였습니다.
3. 단일 세포 전사체 데이터 전처리 및 세포 주석 지정
GSE145154의 유전자 발현 행렬을 Seurat 버전 524로 가져와 Seurat 객체를 구축하였습니다. 세포당 검출된 유전자 수 200–6,000개, 총 고유 분자 식별자(unique molecular identifier) 수 500개 초과, 미토콘드리아 유전자 비율 25% 미만이라는 다음 임계값을 사용하여 저품질 세포를 제외하였습니다. 이러한 품질 관리 임계값을 벗어나는 세포는 저품질 또는 파열된 세포로 간주하여 제외하였습니다. 상술한 품질 관리 임계값만을 사용하여 저품질 세포를 제외하였습니다.
NormalizeData 함수를 사용하여 스케일 인자 10,000으로 로그 정규화를 수행하였습니다. vst 방법을 적용한 FindVariableFeatures 함수를 사용하여 상위 3,000개의 고변동성 유전자를 선정하였습니다. ScaleData를 사용하여 데이터를 스케일링한 후, 선형 차원 축소를 위해 주성분 분석을 수행하였습니다.
배치 효과(Batch effects)는 샘플 식별자를 그룹화 변수로 지정하여 RunHarmony 함수를 통한 Harmony 알고리즘25으로 보정하였다. FindNeighbors 및 FindClusters 함수를 사용하여 처음 15개의 주성분(principal components)으로 세포를 클러스터링하였다. 클러스터링은 0.15의 해상도에서 Leiden 알고리즘을 사용하여 수행되었다. 비선형 차원 축소 및 시각화는 UMAP(uniform manifold approximation and projection)을 통해 수행되었다.
세포 유형은 SingleR 패키지26를 이용한 자동 주석 처리와 함께 표준 마커 유전자를 사용하여 주석을 달았습니다. 마커 유전자는 다음과 같습니다: B 세포, IGKC, MS4A1, CD79A; 심근세포, TNNI3, MYL2, ACTC1; 내피세포, VWF, PECAM1, EGFL7; 대식세포, C1QC, C1QB, C1QA; 단핵구, S100A8, S100A9, G0S2; 자연살해세포, NKG7, GNLY, CCL5; 평활근세포, MYL9, TAGLN, ACTA2; 기질세포, FBLN1, LUM, DCN; 그리고 T 세포, CD3E, CD3G, CD3D.
4. 차등 발현 분석 및 유전자 세트 풍부도 점수 산출
DCM 그룹과 건강한 대조군 간의 유전자 발현을 비교하기 위해 limma 패키지27를 사용하여 선형 모델을 구축하였습니다. P value < 0.05이며 절대 폴드 변화(absolute fold change)가 1.5보다 큰 유전자(절대 log₂ 폴드 변화 0.58보다 큰 경우에 해당)를 유의미하게 차등 발현된 것으로 정의하였습니다.
각 샘플의 노화 관련 및 미토콘드리아 관련 유전자 세트에 대한 풍부도 점수를 계산하기 위해 단일 샘플 유전자 세트 풍부도 분석을 수행하였습니다28. DCM 그룹과 건강한 대조군 그룹 간의 풍부도 점수 차이는 Wilcoxon 순위 합 검정을 사용하여 평가하였으며, P value < 0.05를 통계적으로 유의한 것으로 간주하였습니다.
단일 세포 수준에서, Seurat의 AddModuleScore 함수를 사용하여 노화 관련 및 미토콘드리아 모듈 점수를 계산하였습니다. 그룹 간의 모듈 점수 차이는 Wilcoxon 순위합 검정을 통해 평가하였습니다.
노화 관련 유전자 시그니처는 CellAge 데이터베이스(https://genomics.senescence.info/cells/)에서 검색하였으며, 미토콘드리아 관련 유전자 세트는 GeneCards(https://www.genecards.org/)에서 확보하였습니다. 점수 계산에 사용된 전체 유전자 목록은 보충 파일 1(Supplementary File 1)에 제공되어 있습니다.
5. 가중 유전자 공동 발현 네트워크 구축
벌크 전사체 데이터에서 발현 분산이 가장 높은 상위 5000개의 단백질 코딩 유전자를 네트워크 구축을 위해 유지하였습니다. pickSoftThreshold 함수를 적용하여 여러 소프트 임계값 거듭제곱 조건에서의 척도 없는 토폴로지 적합 지수를 계산하였습니다. 최적 임계값은 R2 값이 0.9 이상인 척도 없는 네트워크를 생성하는 최소 거듭제곱 값으로 결정하였습니다. 이에 따라, 이후의 네트워크 분석을 위해 β = 5의 소프트 임계값 거듭제곱을 채택하였습니다.
최소 모듈 크기를 30으로 설정하여 blockwiseModules 함수를 이용해 부호 있는 가중치 공발현 네트워크(signed weighted co-expression network)를 구축했습니다. 각 모듈 고유유전자(eigengene)와 노화 관련 또는 미토콘드리아 농축 점수 간의 피어슨 상관 계수를 계산했습니다. 상관 계수의 절대값이 0.4보다 크고 P < 0.001인 모듈을 유의미하게 연관된 모듈로 간주했습니다.
유의미하게 연관된 모듈 내의 유전자들을 차별 발현 유전자들과 교차 분석하여 DCM 관련 노화 후보 유전자 및 DCM 관련 미토콘드리아 후보 유전자를 식별하였습니다.
6. 기능적 풍부도 분석
clusterProfiler 패키지29를 사용하여 후보 유전자에 대해 Gene Ontology (GO) 및 Kyoto Encyclopedia of Genes and Genomes (KEGG) 경로 분석을 포함한 기능적 풍부도 분석을 수행하였다. GO 풍부도 분석은 생물학적 과정, 세포 구성 성분, 분자 기능의 세 가지 표준 범주를 대상으로 하였다.
모든 분석은 인간 종 주석(human species annotation)을 사용하여 수행되었으며, P-값 보정을 위해 허위 발견율(FDR)을 적용하고 q-값 임계값은 0.05로 설정하였습니다. 유전자 세트는 10~500개의 유전자 범위로 제한하였으며, FDR이 < 0.05을 통계적으로 유의미한 것으로 정의하였다. 마지막으로, GO 농축 분석 결과를 시각화하였다. ~을 통해 / ~을 경유하여 그룹 막대 그래프로 나타내었으며, KEGG 농축 결과는 버블 플롯을 사용하여 표시하였다.
7. PPI 네트워크 구축 및 허브 유전자 스크리닝
후보 유전자들을 STRING 버전 11.5 데이터베이스30에 입력하였으며, 생물종은 Homo sapiens로, 상호작용 신뢰도 임계값은 결합 점수 0.7 초과로 설정하였다. 연결되지 않은 노드는 숨겼으며, 상호작용 데이터는 탭 구분 값(TSV) 형식으로 내보냈다.
상호작용 데이터는 시각화를 위해 Cytoscape 버전 3.9.1로 가져왔습니다31. 노드 위상 점수는 Degree, maximum neighborhood component, maximal clique centrality의 세 가지 알고리즘을 사용하는 CytoHubba 플러그인32을 통해 계산되었습니다.
네트워크 내의 핵심 기능 모듈은 다음과 같은 기본 매개변수(degree cutoff 2; k-core 2; node score cutoff 0.2; maximum depth 100)를 설정한 MCODE 플러그인33을 사용하여 식별하였습니다. 세 가지 위상 알고리즘 모두에서 상위 10위 내에 랭크된 유전자들을 MCODE 핵심 서브네트워크의 유전자들과 교차 분석하여 최종 단백질-단백질 상호작용 허브 유전자를 식별하였습니다.
8. 머신러닝 기반의 핵심 유전자 선택 및 진단 모델 구축
재현성과 균형 잡힌 표현을 보장하기 위해, 통합 벌크 전사체 데이터셋을 고정된 랜덤 시드(seed = 123456)를 사용하여 7:3의 비율로 훈련 세트와 검증 세트로 무작위 분할하였습니다. 이러한 분할은 두 세트 간의 일관된 클래스 비율을 유지하기 위해 질환군(DCM 대 대조군)에 따라 층화 추출 방식으로 수행되었습니다. 분할 전, 서로 다른 데이터셋 소스에서 발생하는 배치 효과는 sva 패키지를 사용하여 보정하였으며, 통합된 샘플들은 무작위 할당 과정에서 하나의 통합된 코호트로 처리되었습니다.
후보 유전자를 선별하기 위해 세 가지 머신러닝 알고리즘이 적용되었습니다. 먼저, LASSO 로지스틱 회귀 분석을 수행하였습니다. ~을 통해 glmnet 패키지의 cv.glmnet 함수34AUC를 평가 지표로 채택하여 5-겹 교차 검증 이진 분류 모델을 구축하였다. lambda.min에서 계수가 0이 아닌 유전자를 후보 유전자로 선정하였다.
둘째, randomForest 패키지35를 사용하여 500개의 결정 나무를 포함하는 랜덤 포레스트 분류 모델을 구축하였습니다. 각 분할 시 샘플링되는 변수의 수는 전체 특성 수의 제곱근으로 설정하였습니다. 지니 계수를 기반으로 유전자 중요도를 정량화하였으며, 중요도 점수가 가장 높은 상위 10개 유전자를 선정하였습니다.
셋째, caret 패키지36의 rfe 함수를 사용하여 SVM-RFE 분석을 수행하였습니다. 특성 수는 1–10 범위로 설정하였으며, 모델 학습을 위해 5-겹 교차 검증을 채택하였습니다. 최종적으로 교차 검증 정확도가 가장 최적화된 유전자 하위 집합을 선택하였습니다.
세 가지 알고리즘 모두에 의해 식별된 유전자를 DCM의 최종 핵심 노화 및 미토콘드리아 관련 유전자로 정의하였습니다. 이후 의사결정 나무, 그래디언트 부스팅 머신, 부스티드 일반화 선형 모델, k-최근접 이웃, 로지스틱 회귀, 신경망, 부분 최소 제곱, 랜덤 포레스트, 서포트 벡터 머신, extreme gradient boosting의 10가지 분류 알고리즘을 사용하여 진단 모델을 구축하였습니다.
pROC 패키지37를 사용하여 수신자 조작 특성 곡선을 생성하였습니다. 훈련 세트와 검증 세트에서의 진단 성능을 평가하기 위해 곡선 아래 면적, 정확도, 민감도 및 특이도를 계산하였습니다.
모델 예측에 대한 각 핵심 유전자의 기여도를 계산하기 위해 SHapley Additive exPlanations 분석을 수행하였다38. 요약 플롯(Summary plots)과 샘플별 워터폴 플롯(waterfall plots)을 생성하였다. 검증 세트에서 곡선 아래 면적(area under the curve)이 0.8보다 큰 최종 진단 모델을 진단 성능이 우수한 것으로 간주하였다.
9. 세포 간 통신 추론
심장 미세환경 내의 세포 간 통신 네트워크는 CellChat 패키지39를 사용하여 추론하였습니다. CellChatDB.human 데이터베이스를 이용해 CellChat 객체를 구축하였습니다. identifyOverExpressedGenes를 사용하여 차별적으로 발현된 리간드와 수용체를 식별하였으며, identifyOverExpressedInteractions를 사용하여 유의미한 상호작용 쌍을 필터링하였습니다.
세포 유형 간의 통신 확률은 computeCommunProb를 사용하여 계산하였습니다. 전역 세포 유형 수준의 통신 네트워크는 aggregateNet를 사용하여 집계하였습니다. 각 세포 유형 쌍 간의 상호작용 수와 통신 강도를 정량화하였으며, 이를 히트맵과 막대 그래프로 시각화하였습니다.
10. 면역 세포 침윤 정량화
단일 샘플 유전자 세트 풍부성 분석28 및 면역 세포 시그니처 유전자 세트40를 사용하여 각 벌크 샘플에 대해 28가지 면역 세포 유형의 풍부성 점수를 산출하였다. DCM 그룹과 건강한 대조군 간의 면역 세포 풍부성 점수를 비교하기 위해 Wilcoxon 순위합 검정을 사용하였다. P < 0.05일 때 통계적으로 유의미한 것으로 간주하였다.
핵심 유전자 발현 수준과 면역 세포 풍부도 점수 간의 연관성을 평가하기 위해 피어슨 상관 분석(Pearson correlation analysis)을 수행하였습니다. P < 0.05인 모든 상관관계는 통계적으로 유의미한 것으로 간주하였습니다.
11. 분자 아형 분류를 위한 합의 군집화
핵심 유전자 발현 프로파일을 사용하여 DCM 샘플의 비지도 합의 클러스터링을 수행하였다. ~을 통해 ConsensusClusterPlus 패키지41클러스터링 매개변수는 최대 클러스터 수 6, 재표본 추출 횟수 1,000회, 재표본 추출 비율 0.8로 설정하였다. 클러스터링에는 유클리드 거리를 이용한 Medoids 주변 분할법(Partitioning around medoids)을 채택하였으며, 재현성을 보장하기 위해 고정된 랜덤 시드(random seed)를 사용하였다.
델타 영역 도표(delta area plot)와 합의 클러스터 안정성 점수(consensus cluster stability scores)에 따라 최적의 서브타입 수를 결정하였으며, 최종적으로 K = 2로 확인되었습니다. 두 분자 서브타입의 뚜렷한 분리를 검증하기 위해 주성분 분석(Principal component analysis)을 추가로 수행하였습니다.
샘플별 KEGG 경로 농축 점수를 계산하기 위해 유전자 세트 변이 분석(Gene set variation analysis)42을 적용하였다. 서브타입 간의 차별적 경로 활성화를 검출하기 위해 limma 패키지27를 활용하였으며, P 값이 0.05 미만인 경우를 통계적으로 유의미한 것으로 정의하였다.
12. 심장 기능을 위한 심초음파 평가
마우스를 마취하였다. ~을 통해 1% 펜토바르비탈나트륨(30 mg/kg)을 복강 내 투여하고 항온 수술대 위에 앙와위로 고정하였다. 흉부의 털을 제거한 후, 심전 영역에 초음파 커플링 젤을 고르게 도포하였다.
소동물 초음파 시스템을 사용하여 좌심실 유두근 수준에서 2차원 유도 M-모드 심초음파 검사를 수행하였습니다. 좌심실 이완기말 직경, 수축기말 직경, 박출률 및 분획 단축률을 측정하기 위해 3회의 연속적이고 안정적인 심장 주기를 캡처하였습니다. 모든 심초음파 평가는 전문 초음파 검사자가 눈가림법으로 진행하였습니다.
심초음파 검사를 위해 각 그룹에서 생쥐 3마리를 무작위로 선정하였으며, 이들 총 6마리의 동물을 이후 희생시켜 심근 조직 수집 및 ELISA 측정을 수행하였습니다. 나머지 실험 동물들은 추가적인 병행 실험 분석을 거쳤으며, 해당 데이터는 본 연구에 포함되지 않았습니다.
13. 심근 조직 수집, 단백질 추출 및 효소 결합 면역 흡착 분석법
심초음파 평가 후, 마우스는 깊은 마취 상태에서 안락사되었습니다. 심장 조직을 신속하게 적출하였습니다. ~을 통해 정중 흉강 절개술을 시행하고, 좌심실 심근을 얼음 위에서 적출하였다. 분리된 조직은 심장 내 잔류 혈액을 제거하기 위해 ice-cold 인산염 완충 식염수(PBS)로 충분히 세척하였다. 멸균 여과지로 과잉 액체를 닦아낸 후, 시료를 즉시 액체 질소로 급속 냉동하여 −80 °C 이후 단백질 추출을 위해 보관하며, 반복적인 동결-해동 주기는 엄격히 피해야 한다.
동결된 심근 조직의 무게를 측정한 후, 얼음 위에서 약 1 mm3 크기의 조각으로 절단하였다. 조직은 protease 및 phosphatase 억제제가 포함된 차가운 RIPA lysis buffer에 조직 10 mg당 buffer 100 µL의 표준 비율로 넣어 용해시켰다. 샘플을 얼음 위에서 기계적으로 완전히 균질화한 후, 완전한 세포 용해를 위해 30분 동안 배양하였다.
용해물을 4 °C에서 12,000 × g로 15분 동안 원심분리했습니다. 생성된 상층액을 효소가 없는 튜브에 수집하였으며, 제조사의 프로토콜에 따라 bicinchoninic acid 단백질 분석 키트를 사용하여 총 단백질 농도를 정량하였습니다. 모든 샘플은 용해 버퍼를 사용하여 동일한 단백질 농도로 표준화했습니다.
심근 용해물 내 4가지 허브 유전자의 단백질 발현 수준을 해당 효소 결합 면역 흡착 분석(ELISA) 키트를 사용하여 측정하였다. 단계별로 희석한 표준 시료와 정규화된 조직 용해물을 미리 코팅된 마이크로플레이트에 중복으로(웰당 100 µL) 첨가하였다. 플레이트를 실온에서 2 h 동안 배양한 후, 키트에 제공된 세척 완충액으로 충분히 세척하였다.
각 웰에 효소-접합 항체를 첨가하고 실온에서 1시간 동안 배양한 후, 충분히 세척하였다. 그 다음 기질 발색 용액을 첨가하고 암실 상태의 실온에서 20분 동안 배양하였다. 정지 용액을 사용하여 발색 반응을 종료시켰으며, 전파장 마이크로플레이트 리더기를 사용하여 450 nm(기준 파장: 570 nm)에서 흡광도를 측정하였다.
14. 통계 분석
모든 통계 분석 및 데이터 시각화는 R version 4.2.3을 사용하여 수행되었다. 각 표적 유전자(TGFB2, SERPINE1, CYBB, TLR2)의 ELISA 농도 측정값에 대해, 먼저 Control 군과 DCM 군의 데이터 정규성을 각각 평가하기 위해 Shapiro-Wilk 검정을 적용하였다. 이어서 두 군 간의 분산 균질성을 평가하기 위해 F-test를 사용하였다. 군 간 비교 방법은 분산 균질성 검정 결과에 따라 결정되었다. 분산이 균질한 경우(P ≥ 0.05)에는 군 간 평균값 비교를 위해 unpaired Student’s t-test를 채택하였으며, 분산이 불균질한 경우(P < 0.05)에는 보정된 Welch’s t-test를 사용하여 분석하였다. 모든 검정은 양측 검정으로 수행되었으며, 통계적 유의성 임계값은 P < 0.05로 설정하였다. 데이터는 개별 데이터 포인트가 jitter 형태로 표시된 박스 플롯(boxplot)으로 시각화하였다. 모든 검정의 P 값과 적용된 t-test의 유형은 각 그래프에 상세히 표기하였다.
결과
데이터 전처리 및 차등 발현 분석
6개의 모든 벌크 전사체 데이터셋은 다운스트림 분석 전 표준화된 전처리와 배치 효과 보정을 거쳤습니다. 마이크로어레이 데이터는 robust multi-array average 알고리즘을 사용하여 정규화하였으며, RNA-seq 카운트 데이터는 trimmed mean of M-values 방법을 사용하여 정규화하였습니다. 데이터셋 출처 및 검출 플랫폼과 관련된 기술적 배치 효과를 제거하기 위해 ComBat 알고리즘을 적용하였습니다. 주성분 분석 결과, 보정 전에는 샘플들이 데이터셋 출처별로 군집을 이루었으나, 보정 후에는 배치에 의한 가시적인 분리 없이 더 균일하게 분포되었습니다.
limma 패키지를 사용하여 확장성 심근병증(DCM) 그룹과 건강한 대조군(HC) 그룹 간의 차등 발현 분석을 수행하였습니다. 가장 유의미하게 차등 발현된 20개 유전자의 히트맵은 두 그룹 간의 발현 프로필이 분리됨을 보여주었습니다(그림 1A). P value < 0.05 및 |log₂ fold change| > 0.58의 임계값을 사용하여 총 1,473개의 차등 발현 유전자가 식별되었습니다. 이 중 DCM 심근 샘플에서 819개 유전자는 발현이 증가되었고, 654개 유전자는 발현이 감소되었습니다(그림 1B).
그 후, 각 샘플에서 노화 관련 및 미토콘드리아 관련 유전자 세트의 농축 점수를 계산하기 위해 단일 샘플 유전자 세트 농축 분석을 사용하였습니다. 두 점수 모두 DCM 그룹과 HC 그룹 간에 유의미한 차이를 보였습니다(그림 1C).
가중 유전자 공발현 네트워크 분석
노화 관련 및 미토콘드리아 농축 점수와 연관된 유전자 모듈을 식별하기 위해 가중 유전자 공발현 네트워크 분석을 수행하였다. 벌크 데이터셋에서 발현 분산이 가장 높은 5,000개의 단백질 코딩 유전자를 사용하여 네트워크를 구축하였다. 소프트 임계값 전력 β = 5에서 척도 없는 토폴로지 적합 지수가 R2 = 0.9를 초과하여, 척도 없는 네트워크 기준을 충족하였다(그림 1D).
계층적 군집 분석(Hierarchical clustering)과 모듈 병합을 통해 세 개의 유전자 모듈을 확인하였습니다. 세 모듈 모두 노화 관련 점수와 유의미한 상관관계를 보였습니다. 그 중 turquoise 모듈이 노화 관련 점수와 가장 강한 상관관계를 나타냈습니다(r = 0.69, P < 0.001). 미토콘드리아 점수의 경우, blue 모듈과 grey 모듈이 유의미한 상관관계를 보였으며, 특히 blue 모듈이 가장 강한 연관성을 나타냈습니다(r = 0.56, P < 0.001; 그림 1E). 따라서 노화 관련 유전자 스크리닝에는 turquoise 모듈을, 미토콘드리아 관련 유전자 스크리닝에는 blue 모듈을 선택하였습니다.
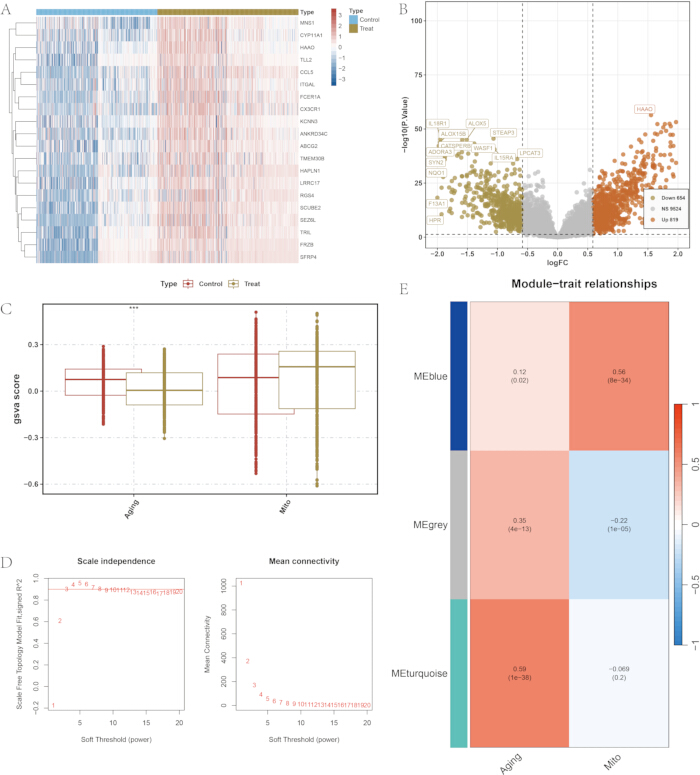
그림 1: 차별 발현 분석 및 가중 유전자 공발현 네트워크 구축. (A) 확장성 심근병증(DCM) 그룹과 건강한 대조군(HC) 그룹 간에 가장 유의하게 차별 발현된 상위 20개 유전자의 히트맵. (B) 모든 차별 발현 유전자의 볼케이노 플롯. 빨간색은 상향 조절된 유전자를, 녹색은 하향 조절된 유전자를, 회색은 유의하지 않은 유전자를 나타낸다. 임계값은 P value < 0.05 및 |log₂ fold change| > 0.58로 설정하였다. (C) 노화 관련 및 미토콘드리아 관련 유전자 세트에 대한 단일 샘플 유전자 세트 풍부성 분석 점수의 박스 플롯. (D) 가중 유전자 공발현 네트워크 분석을 위한 소프트 임계값 선택으로, 다양한 소프트 임계값 전력에 따른 무척도 토폴로지 적합 지수와 평균 연결성을 보여준다. (E) 모듈 고유유전자(eigengene)와 노화 관련 및 미토콘드리아 점수 간의 상관관계를 나타낸 히트맵. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
노화 및 미토콘드리아 관련 후보 유전자 식별
차별 발현 유전자, 선택된 가중 유전자 공동 발현 네트워크 분석(WGCNA) 모듈 내 유전자, 그리고 해당 참조 유전자 세트의 교집합을 통해 후보 유전자를 식별하였다. 이 분석을 통해 66개의 DCM 관련 노화 후보 유전자(그림 2A)와 16개의 DCM 관련 미토콘드리아 후보 유전자(그림 2B)를 확인하였다.
Gene Ontology 농축 분석 결과, 노화 관련 후보 유전자들은 산화질소 합성효소 생합성 및 콜라겐 함유 세포외 기질 조직화를 포함한 생물학적 과정에서 농축된 것으로 나타났습니다(그림 2C). 미토콘드리아 관련 후보 유전자들은 미토콘드리아 내막 및 호흡 연쇄 복합체를 포함하여 미토콘드리아 에너지 대사와 관련된 항목들에서 농축되었습니다(그림 2D).
Kyoto Encyclopedia of Genes and Genomes 분석 결과, 노화 관련 후보 유전자들이 hypoxia-inducible factor-1, phosphoinositide 3-kinase-protein kinase B 및 advanced glycation end product-receptor for advanced glycation end product 신호 전달 경로에 풍부하게 분포되어 있음을 확인하였습니다(그림 2E). 미토콘드리아 관련 후보 유전자들은 oxidative phosphorylation을 포함한 경로들에 풍부하게 분포되어 있었습니다(그림 2F).
DCM 그룹과 HC 그룹 간의 노화 관련 후보 유전자 66개의 차별적 발현 패턴을 발현 히트맵을 사용하여 시각화하였습니다(그림 2G). 미토콘드리아 관련 후보 유전자 16개의 발현 패턴은 박스 플롯을 사용하여 시각화하였습니다(그림 2H).
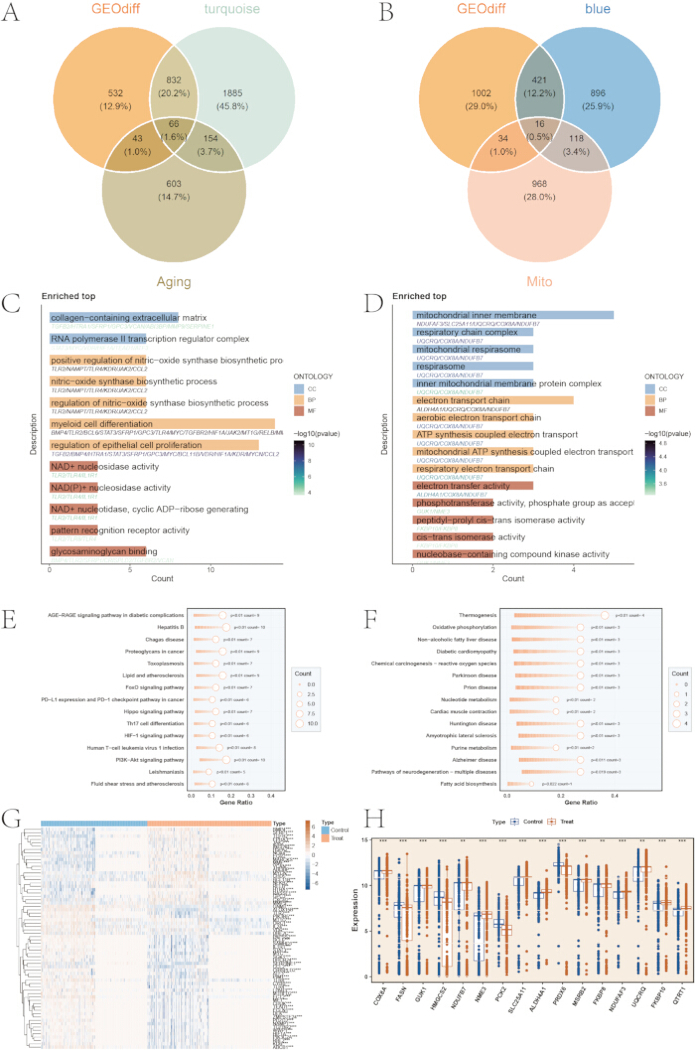
그림 2: 후보 유전자의 스크리닝 및 기능적 풍부도 분석. (A) 차등 발현 유전자, 가중 유전자 공발현 네트워크 분석 모듈 유전자 및 노화 관련 참조 유전자 세트의 교집합을 나타내는 벤 다이어그램. (B) 차등 발현 유전자, 가중 유전자 공발현 네트워크 분석 모듈 유전자 및 미토콘드리아 관련 참조 유전자 세트의 교집합을 나타내는 벤 다이어그램. (C) 노화 관련 후보 유전자의 Gene Ontology 풍부도 분석. (D) 미토콘드리아 관련 후보 유전자의 Gene Ontology 풍부도 분석. (E) 노화 관련 후보 유전자의 Kyoto Encyclopedia of Genes and Genomes 경로 풍부도 분석. (F) 미토콘드리아 관련 후보 유전자의 Kyoto Encyclopedia of Genes and Genomes 경로 풍부도 분석. (G) DCM 및 HC 그룹에서 66개 노화 관련 후보 유전자의 발현 히트맵. (H) DCM 및 HC 그룹에서 16개 미토콘드리아 관련 후보 유전자의 발현 박스 플롯. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
단일 세포 RNA 시퀀싱 데이터셋의 세포 유형 주석 처리
단일 세포 해상도 검증을 위해 GSE145154 단일 세포 RNA 시퀀싱 데이터셋을 사용하였다. 품질 관리 필터링, 로그 정규화 및 Harmony 배치 보정을 거친 후, 서로 다른 샘플의 세포들은 샘플별 뚜렷한 분리 없이 균일 매니폴드 근사 및 투영(UMAP) 공간에 분포되었다. 상위 15개 주성분과 0.15의 클러스터링 해상도를 사용하여 세포들을 9개의 클러스터로 나누었다(그림 3A).
정준 마커 유전자(Canonical marker genes)와 SingleR을 이용한 자동 주석 달기를 통해 대식세포, 자연 살해 세포, T 세포, B 세포, 혈관 내피 세포, 평활근 세포, 단핵구, 기질 세포 및 심근세포의 9가지 주요 세포 유형을 식별하였습니다(그림 3B). 세포 유형 특이적 마커 유전자의 발현 패턴은 이러한 주석 결과를 뒷받침하였습니다(그림 3C).
AddModuleScore 함수를 사용하여 각 세포의 미토콘드리아 모듈 점수를 계산하였으며, 확장성 심근병증 그룹과 건강한 대조군 그룹 간에 유의미한 차이가 나타났습니다 (P < 2.22 × 10⁻16; 그림 3D). 노화 관련 모듈 점수 또한 두 그룹 간에 유의미한 차이를 보였습니다 (P < 2.22 × 10⁻16; 그림 3E). 미토콘드리아 점수를 UMAP(uniform manifold approximation and projection) 공간에 투영한 결과, 높은 점수가 주로 심근세포에서 관찰되었습니다 (그림 3F). 반대로, 높은 노화 관련 점수는 주로 대식세포에서 관찰되었습니다 (그림 3G).
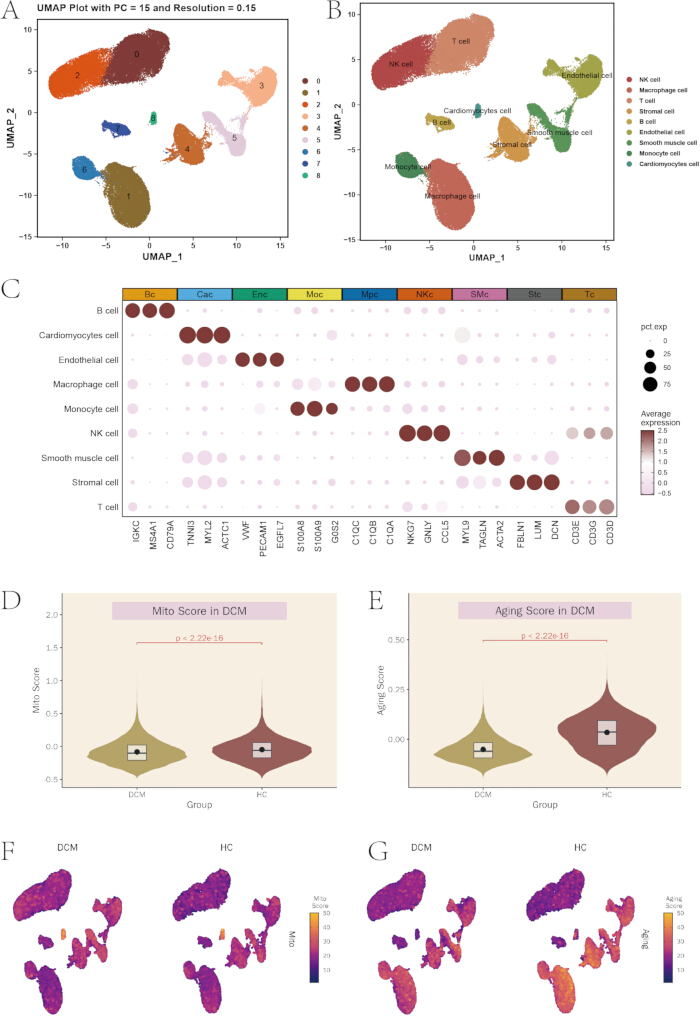
그림 3: 단일 세포 전사체 주석 및 모듈 점수 분석. (A) 상위 15개 주성분과 0.15의 클러스터링 해상도를 사용하여 생성된 세포 클러스터의 균일 매니폴드 근사 및 투영(UMAP) 플롯. (B) 주석이 지정된 세포 유형의 균일 매니폴드 근사 및 투영(UMAP) 플롯. (C) 세포 유형별 표준 마커 유전자의 발현을 보여주는 버블 플롯. (D) DCM 및 HC 그룹의 미토콘드리아 모듈 점수를 나타낸 바이올린 플롯. (E) DCM 및 HC 그룹의 노화 관련 모듈 점수를 나타낸 바이올린 플롯. (F) 세포 전체의 미토콘드리아 모듈 점수 분포를 보여주는 균일 매니폴드 근사 및 투영(UMAP) 플롯. (G) 세포 전체의 노화 관련 모듈 점수 분포를 보여주는 균일 매니폴드 근사 및 투영(UMAP) 플롯. 여기를 클릭하여 이 그림의 확대 버전을 확인하십시오.
단백질-단백질 상호작용 네트워크 구축
노화 관련 후보 유전자 66개와 미토콘드리아 관련 후보 유전자 16개로 구성된 통합 세트를 STRING 버전 11.5 데이터베이스에 입력하여, 결합 점수(combined score) > 0.7의 고신뢰도 임계값을 적용해 단백질-단백질 상호작용 네트워크를 구축하였다. 해당 네트워크는 시각화 및 위상 분석을 위해 Cytoscape로 가져왔다(그림 4A).
고도로 연결된 노드와 핵심 서브네트워크를 식별하기 위해 Degree, maximal clique centrality, maximum neighborhood component 및 MCODE 분석을 사용했습니다. 이러한 방법으로 식별된 서브네트워크는 그림 4B–E에 나타나 있습니다.
Degree, 최대 클리크 중심성(maximal clique centrality) 및 최대 이웃 구성 요소(maximum neighborhood component) 순으로 상위 10위까지의 유전자를 MCODE 핵심 서브네트워크의 유전자와 교차 분석하였습니다. 이 분석을 통해 TGFB2, TLR2, SERPINE1, CYBB, KDR, TLR4, HIF1A, CCL2, MMP9, CXCR2 등 10개의 후보 유전자를 식별하였습니다.
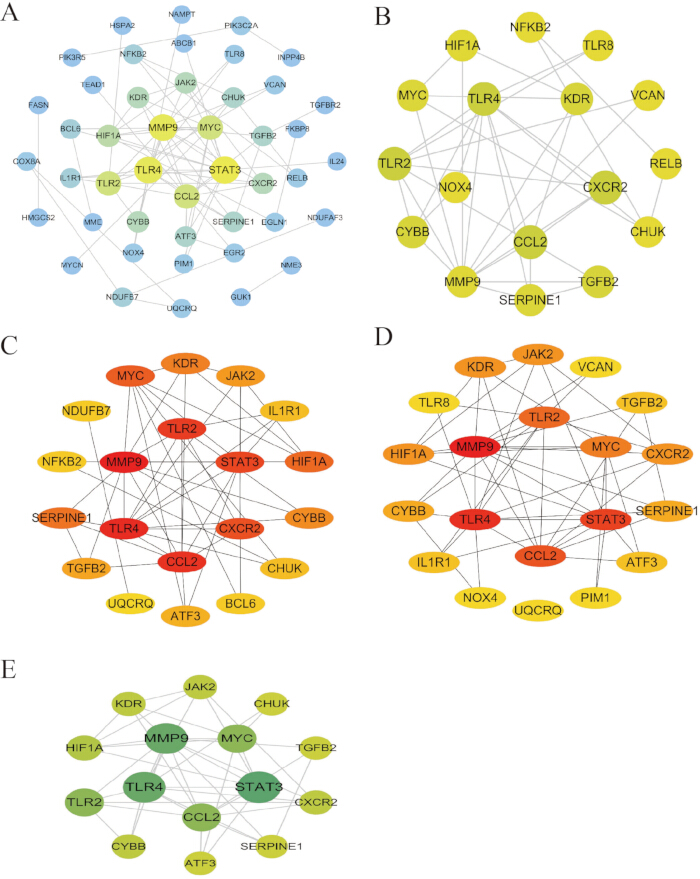
그림 4: 단백질-단백질 상호작용 네트워크 구축 및 허브 유전자 스크리닝.
(A) 후보 유전자들의 전체 단백질-단백질 상호작용 네트워크. (B) MCODE를 사용하여 식별한 핵심 서브네트워크. (C) 최대 클리크 중심성(maximal clique centrality)을 사용하여 식별한 핵심 서브네트워크. (D) 최대 이웃 구성 요소(maximum neighborhood component)를 사용하여 식별한 핵심 서브네트워크. (E) 연결도(Degree)를 사용하여 식별한 핵심 서브네트워크. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
머신러닝 기반의 허브 유전자 스크리닝
10개의 단백질-단백질 상호작용 후보군에서 허브 유전자를 스크리닝하기 위해 LASSO(least absolute shrinkage and selection operator) 로지스틱 회귀, 랜덤 포레스트(random forest), 그리고 SVM-RFE(support vector machine-recursive feature elimination)의 세 가지 머신러닝 알고리즘을 적용하였습니다. 모든 분석은 고정된 랜덤 시드(set.seed(12345))와 5-겹 교차 검증(5-fold cross-validation)을 사용하여 수행되었습니다. LASSO 모델에서는 최적 람다(lambda.min)에서 0이 아닌 계수를 가진 유전자들을 후보군으로 유지하였습니다 (그림 5A).
서포트 벡터 머신-재귀적 특성 제거 모델에서 10개의 특성을 포함했을 때 0.859의 가장 높은 교차 검증 정확도를 달성했으며(그림 5B), 이에 따른 최소 오차율은 0.141이었다(그림 5C). 500개의 결정 트리를 사용한 랜덤 포레스트 모델은 out-of-bag 오차율의 안정적인 수렴을 보여주었다(그림 5D). Gini 계수 기반의 유전자 중요도 순위에서 TGFB2, TLR2, SERPINE1, CYBB가 최상위 순위 유전자로 선정되었다(그림 5E). 세 가지 알고리즘 모두에 의해 선택된 유전자들의 교집합을 통해 최종적으로 CYBB, SERPINE1, TGFB2, TLR2의 4가지 허브 유전자가 도출되었다(그림 5F).
모델 예측에 대한 각 허브 유전자의 기여도를 평가하기 위해 SHapley Additive exPlanations 분석을 수행하였습니다. TGFB2의 평균 절대 SHapley Additive exPlanations 값이 0.249로 가장 높았으며, SERPINE1이 0.103, CYBB가 0.083, TLR2가 0.078로 그 뒤를 이었습니다(그림 6A). 요약 도표(summary plot)는 샘플 전반에 걸친 유전자 기여도의 분포와 방향을 보여주었습니다(그림 6B). 의존성 도표(dependence plots)는 개별 유전자 값과 모델 기여도 사이의 관계를 나타냈으며(그림 6C), 샘플별 워터폴 도표(waterfall plots)는 개별 예측에 대한 각 유전자의 기여도를 보여주었습니다(그림 6D).
네 가지 허브 유전자를 기반으로 한 진단 분류 모델이 이후 10가지 분류 알고리즘을 사용하여 구축되었습니다. 훈련 세트에서 대부분의 알고리즘은 0.85 이상의 곡선 아래 면적(AUC) 값을 달성했습니다.그림 6E). 내부 검증 세트에서 대부분의 알고리즘은 0.78 이상의 곡선 아래 면적 값을 달성했다(그림 6F).
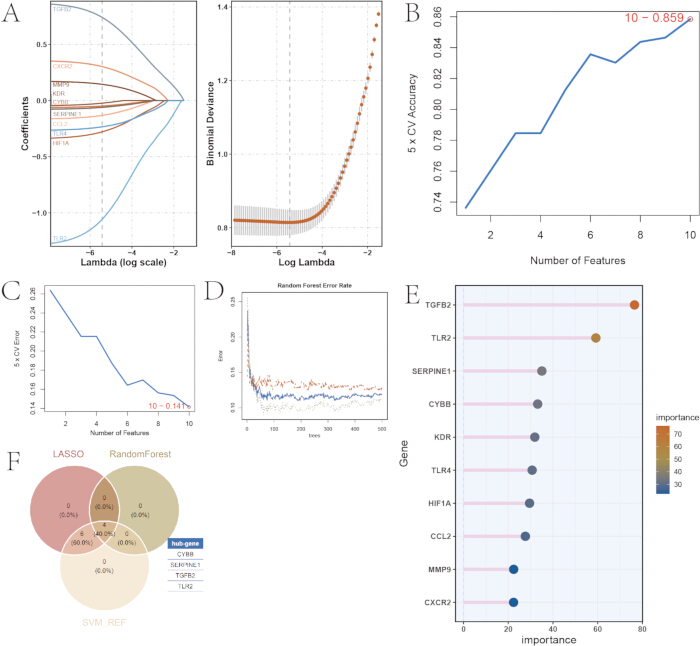
그림 5: 머신러닝 기반의 허브 유전자 스크리닝. (A) 최소 절대 수축 및 선택 연산자(Least absolute shrinkage and selection operator) 회귀 계수 궤적 및 최적 람다 선택. (B) 서포트 벡터 머신-재귀적 특성 제거(support vector machine-recursive feature elimination) 모델의 교차 검증 정확도 곡선. (C) 서포트 벡터 머신-재귀적 특성 제거 모델의 교차 검증 오류 곡선. (D) 랜덤 포레스트 모델의 OOB(Out-of-bag) 오류율 곡선. (E) 랜덤 포레스트 모델에서 지니 계수(Gini coefficient)에 기반한 유전자 중요도 순위. (F) 세 가지 머신러닝 알고리즘으로 식별된 허브 유전자를 보여주는 벤 다이어그램. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
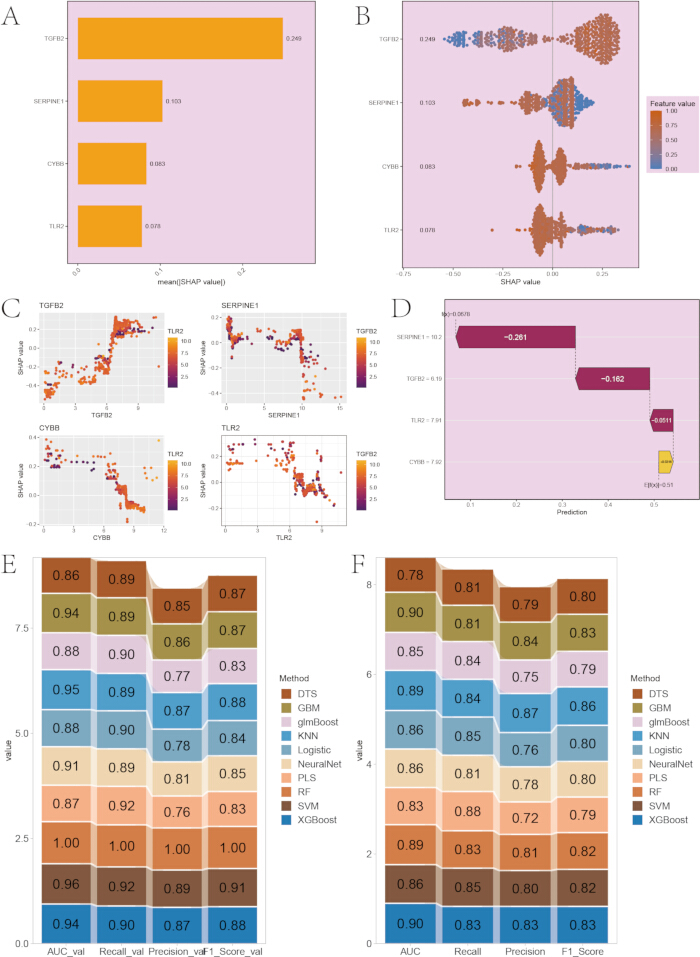
그림 6: 진단 모델 평가 및 SHapley Additive exPlanations 분석. (A) 4가지 허브 유전자에 대한 평균 절대 SHapley Additive exPlanations 값. (B) 유전자 기여도의 분포와 방향을 보여주는 SHapley Additive exPlanations 요약 플롯. (C) 각 허브 유전자에 대한 SHapley Additive exPlanations 의존성 플롯. (D) 대표 샘플에 대한 SHapley Additive exPlanations 워터폴 플롯. (E) 훈련 세트에서 10가지 분류 알고리즘의 진단 성능 히트맵. (F) 검증 세트에서 10가지 분류 알고리즘의 진단 성능 히트맵. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
단일 세포 검증 및 세포 간 통신 분석
4가지 허브 유전자의 발현 패턴을 단일 세포 수준에서 평가하였다. 세포 유형 분포 분석 결과, CYBB와 TLR2는 단핵구와 대식세포에서 높게 발현된 반면, SERPINE1과 TGFB2는 주로 기질 세포에서 발현되었다(그림 7A).
바이올린 도표(Violin plot)를 통해 확장성 심근병증 집단과 건강한 대조군 집단 사이에 CYBB 발현이 유의하게 차이가 남을 확인하였다(그림 7B). SERPINE1 (그림 7C), TGFB2 (그림 7D) 및 TLR2 (그림 7E) 또한 집단 간에 유의한 차이를 보였다. 네 가지 유전자 모두 건강한 대조군에 비해 확장성 심근병증 집단에서 유의하게 상향 조절되었으며, 각 비교 분석에서 P < 0.0001이었다.
CellChat과 리간드-수용체 데이터베이스를 사용하여 심장 미세환경 내의 세포 간 통신 네트워크를 추론하였습니다. 세포 간 상호작용의 수와 전체적인 강도는 확장성 심근병증 그룹과 대조군 그룹 간에 차이가 있었습니다(그림 7F). 세포 유형 간의 차별적인 통신 강도 또한 관찰되었습니다(그림 7G). 단핵구, 대식세포, 심근세포 및 기질 세포가 통신 네트워크의 주요 참여 세포였습니다.
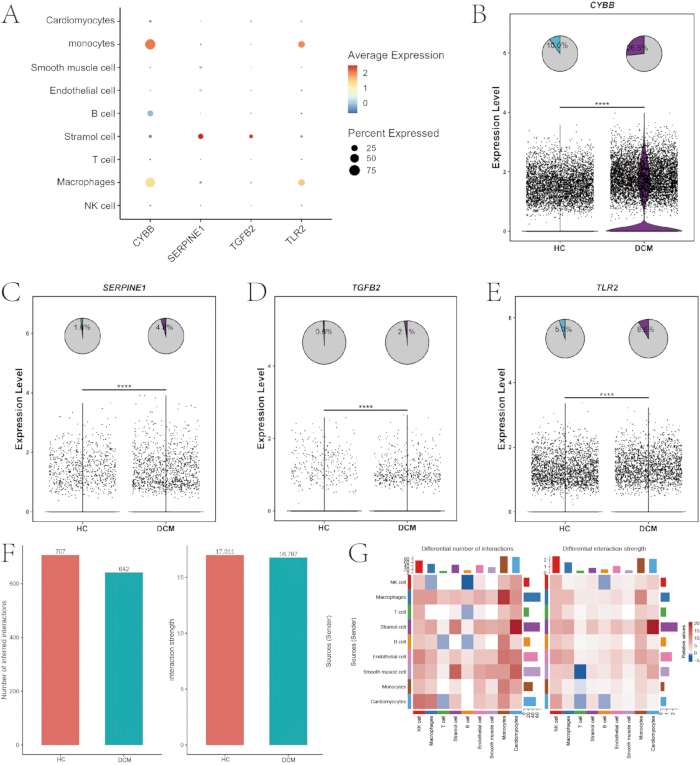
Figure 7: 허브 유전자의 단일 세포 검증 및 세포 간 통신 분석. (A) 세포 유형별 4가지 허브 유전자의 발현을 보여주는 버블 플롯. (B) DCM 및 HC 그룹의 CYBB 발현을 나타내는 바이올린 플롯. (C) DCM 및 HC 그룹의 SERPINE1 발현을 나타내는 바이올린 플롯. (D) DCM 및 HC 그룹의 TGFB2 발현을 나타내는 바이올린 플롯. (E) DCM 및 HC 그룹의 TLR2 발현을 나타내는 바이올린 플롯. (F) 세포 간 상호작용의 수와 전반적인 강도를 보여주는 막대 그래프. (G) 그룹 간 세포 간 통신의 차별적 강도를 보여주는 히트맵. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
면역 세포 침윤 분석
단일 샘플 유전자 세트 풍부도 분석(single-sample gene set enrichment analysis)을 사용하여 각 벌크 샘플에 대해 28가지 면역 세포 하위 집합의 풍부도 점수를 산출하였습니다. 대부분의 면역 세포 유형의 풍부도는 확장성 심근병증 군과 건강한 대조군 사이에 유의미한 차이를 보였습니다(그림 8A).
그 후, 허브 유전자 발현과 면역 세포 농축 점수 사이의 관계를 평가하기 위해 피어슨 상관 분석을 수행하였다. CYBB 발현은 여러 면역 세포 유형의 풍부도와 유의미한 상관관계를 보였다(그림 8B). SERPINE1(그림 8C), TGFB2(그림 8D) 및 TLR2(그림 8E)에서도 유사한 상관관계가 관찰되었다. CYBB, SERPINE1 및 TLR2는 단핵구와 대식세포를 포함한 여러 선천 면역 세포 집단과 양의 상관관계를 나타냈다.
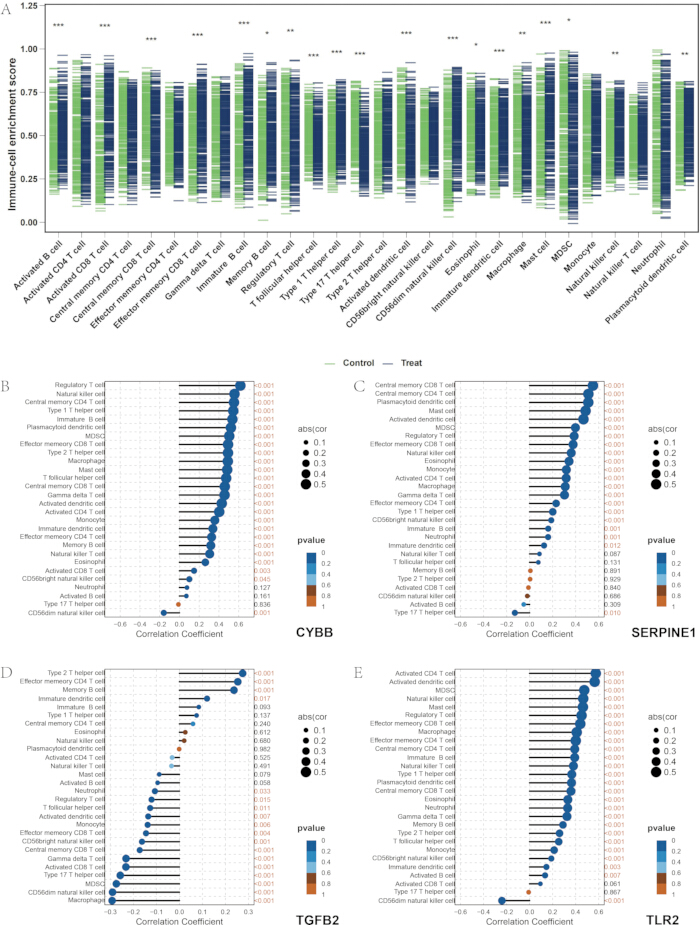
그림 8: 면역 세포 침윤 및 상관관계 분석. (A) DCM 및 HC 그룹의 28가지 면역 세포 유형에 대한 농축 점수 박스 플롯. (B) CYBB 발현과 면역 세포 풍부도 간의 상관관계를 보여주는 롤리팝 플롯. (C) SERPINE1 발현과 면역 세포 풍부도 간의 상관관계를 보여주는 롤리팝 플롯. (D) TGFB2 발현과 면역 세포 풍부도 간의 상관관계를 보여주는 롤리팝 플롯. (E) TLR2 발현과 면역 세포 풍부도 간의 상관관계를 보여주는 롤리팝 플롯. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
확장성 심근병증의 분자적 아형 분석
네 가지 허브 유전자의 발현 프로파일을 기반으로 확장성 심근병증 샘플에 대해 비지도 합의 클러스터링(unsupervised consensus clustering)을 수행하였다. 합의 클러스터링 행렬은 K = 2에서의 분리를 뒷받침하였다(그림 9A). 델타 영역 도표(delta area plot)는 K = 2가 최적의 클러스터 수임을 추가로 입증하였으며, 이에 따라 샘플을 두 가지 분자적 아형인 C1과 C2로 나누었다(그림 9B).
CYBB, SERPINE1 및 TLR2의 발현 수준은 두 서브타입 간에 유의미한 차이를 보였다(그림 9C). 여러 면역 세포 하위 집단의 풍부도 또한 서브타입 간에 차이가 있었다(그림 9D). 유전자 세트 변이 분석(GSVA) 결과, C1 서브타입에서는 혈관 내피 성장 인자 신호 전달 경로가 상대적으로 활성화된 반면, C2 서브타입에서는 일차 담즙산 생합성 및 글리코스핑고지질 생합성이 농축되어 있었다(그림 9E). 주성분 분석(PCA) 결과, 두 서브타입으로 분류된 샘플 간의 분리가 확인되었다(그림 9F).
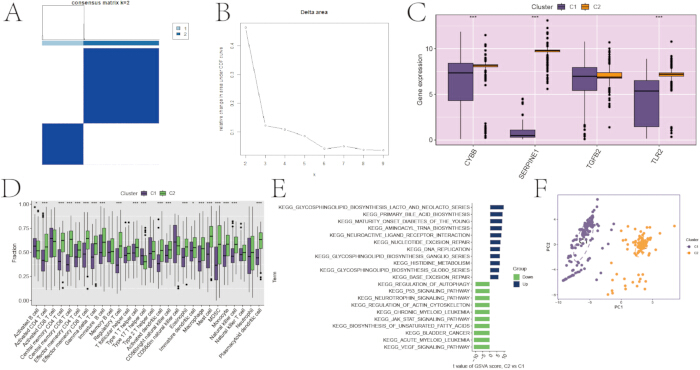
그림 9: 확장성 심근병증의 분자 아형 분류를 위한 컨센서스 클러스터링. (A) K = 2일 때의 컨센서스 클러스터링 행렬. (B) 최적의 클러스터 수를 결정하는 데 사용된 델타 영역 플롯. (C) 두 분자 아형에서의 허브 유전자 발현 박스 플롯. (D) 두 분자 아형에서의 면역 세포 풍부도 박스 플롯. (E) 두 분자 아형 간에 차별적으로 농축된 Kyoto Encyclopedia of Genes and Genomes 경로의 히트맵. (F) 두 분자 아형 간의 분리를 보여주는 주성분 분석 플롯. 이 그림의 확대 버전을 보려면 여기를 클릭하십시오.
In vivo 확장성 심근병증 마우스 모델에서의 검증
자발적 확장성 심근병증 표현형을 가진 CTNTR141W 형질전환 마우스를 in vivo 검증에 사용하였습니다. 연령이 일치하는 야생형 C57BL/6J 대조군 마우스와 비교했을 때, 형질전환 마우스는 좌심실 이완기말 직경이 유의하게 증가하고 좌심실 박출률이 감소하여 심실 확장 및 수축 기능 장애와 일치하는 양상을 보였습니다 (그림 10A).
좌심실 심근 조직에서 총 단백질을 추출하였으며, bicinchoninic acid 기반의 총 단백질 정규화 후 효소결합 면역흡착 분석법(ELISA)을 통해 4가지 허브 유전자 인코딩 단백질의 농도를 측정하였다. 모든 분석은 이중으로 수행되었다. 표준 곡선의 상관계수(R2)는 0.99 이상이었으며, 이중 웰 간의 변동 계수는 10% 미만이었다. 대조군과 DCM 군 사이의 통계적 유의성은 F-test로 평가한 분산의 동일성 여부에 따라 Student's t-test 또는 Welch's t-test를 사용하여 평가하였다(정규성은 Shapiro-Wilk test로 확인하였다). 4가지 허브 유전자 모두에 해당하는 심근 단백질 수치는 대조군에 비해 확장성 심근병증(DCM) 마우스에서 유의하게 증가하였다(그림 10B). ELISA 검증을 위해 각 군에 3개의 생물학적 반복 시료(개별 마우스)가 포함되었다. ELISA 검증을 위해 군당 3개의 독립적인 생물학적 반복 시료가 포함되었다. 이러한 결과는 예비적인 것으로 간주되어야 하며 더 큰 코호트에서의 확인이 필요하다.
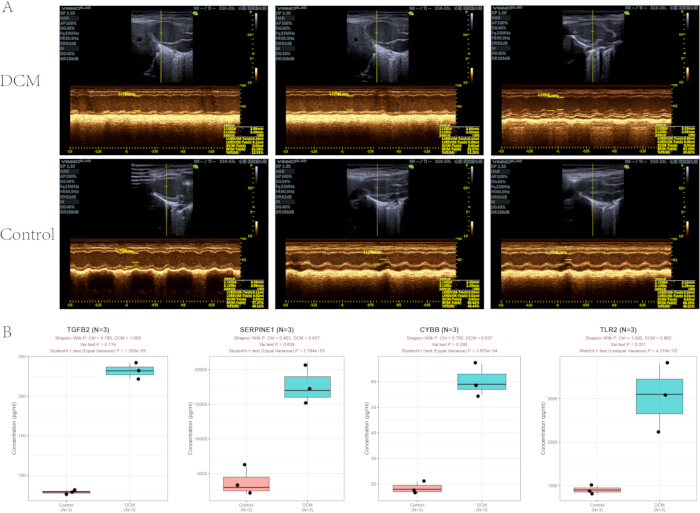
그림 10: CTNTR141W 형질전환 확장성 심근병증 마우스 모델에서의 In vivo 검증. (A) CTNTR141W 형질전환 DCM 마우스와 야생형 대조군 마우스의 대표적인 M-모드 심초음파 영상. (B) 마우스 좌심실 심근 조직 내 4가지 허브 유전자 유래 단백질의 ELISA 정량 결과. 박스-위스커 플롯은 대조군과 DCM 그룹의 단백질 농도를 나타냄 (그룹당 n = 3 생물학적 반복 실험). 각 박스 플롯에서: 박스 내부의 실선 수평선은 중앙값을 나타내며, 박스의 상단 및 하단 경계는 75백분위수와 25백분위수(사분위수 범위, IQR)를 나타냄; 상단 및 하단 위스커는 1.5 × IQR 범위 내의 최대 및 최소 비이상치 데이터 포인트까지 연장됨; 개별 검은색 실점은 단일 동물로부터 얻은 독립적인 생물학적 반복 실험 결과에 해당함. y축은 절대 단백질 농도를 나타내며, TGFB2와 CYBB는 pg/mL, TLR2와 SERPINE1은 ng/mL 단위임. 두 그룹 간의 통계적 비교는 Student’s t-test(등분산) 또는 Welch’s t-test(이분산)를 사용하여 수행되었으며, 정규성은 Shapiro-Wilk test로, 분산의 균질성은 F-test로 검증함. 제한 사항: n = 3 반복 실험에서 얻은 ELISA 결과는 예비 탐색적 결과이며, 향후 표본 크기를 확대한 추가 검증이 필요함. 이 그림의 확대 버전을 보려면 여기를 클릭하십시오.
데이터 가용성:
본 연구에서 분석된 6개의 벌크 전사체 데이터셋과 1개의 단일 세포 RNA 시퀀싱 데이터셋은 Gene Expression Omnibus 데이터베이스에서 등록 번호 GSE5406, GSE42955, GSE57338, GSE79962, GSE116250, GSE141910 및 GSE145154로 공개적으로 이용 가능합니다. 단일 세포 분석에는 GSE145154의 샘플 GSM4307515, GSM4307516, GSM4307520 및 GSM4307521이 포함되었습니다. 본 연구 중에 생성되거나 분석된 모든 기타 데이터는 계산 코드와 함께 본 게시 논문 및 보충 정보 파일에 포함되어 있습니다. 구체적으로, 보충 파일 1에는 전체 노화 및 미토콘드리아 관련 유전자 목록, 28-세포 면역 시그니처, 맞춤형 분석 스크립트, 정규화된 전사체 데이터 행렬, ELISA 분석을 위한 소스 데이터 및 모든 원고 그림의 근거가 되는 원시 소스 데이터가 포함되어 있습니다.
보충 파일 1: 노화 및 미토콘드리아 관련 유전자 세트, 면역 시그니처, 분석 스크립트, 정규화된 전사체 데이터 및 그림 소스 데이터. 이 파일을 다운로드하려면 여기를 클릭하십시오.
토론
통합 다층 워크플로우는 벌크 전사체 메타 분석, 가중 유전자 공발현 네트워크 구축, 앙상블 머신 러닝, 단일 세포 전사체 검증 및 in vivo 동물 모델 검증을 결합하였습니다. 노화 및 미토콘드리아 관련 허브 유전자인 CYBB, SERPINE1, TGFB2 및 TLR2의 4가지가 확장성 심근병증(DCM)의 진단 바이오마커 후보로 식별되었습니다. 마이크로어레이 및 RNA 시퀀싱 플랫폼을 포함하여 Gene Expression Omnibus 저장소에서 확보한 6개의 독립적인 좌심실 전사체 데이터 세트를 통합함으로써, 단일 데이터 세트의 편향을 줄이고 분석의 통계적 근거를 강화하였습니다43,44,45. 사전 정의된 노화 관련 및 미토콘드리아 유전자 세트와 결합된 가중 유전자 공발현 네트워크 분석을 통해, 단순한 차등 발현 분석에만 의존하지 않고 형질 관련 기능 모듈을 식별할 수 있었습니다46. 앙상블 머신 러닝은 개별 특성 선택 방법과 관련된 알고리즘별 편향을 줄였으며47,48, SHapley Additive exPlanations 분석을 통해 각 허브 유전자가 모델 예측에 기여하는 정도를 정량화하였습니다49. 벌크 심근 전사체, 단일 세포 전사체 및 형질전환 마우스 모델을 통한 검증을 통해 선택된 유전자의 세포 분포와 심근 단백질 수준을 추가로 규명하였습니다50.
잔여 데이터셋 특이적 변이가 차별 발현 분석 및 모듈-형질 연관성에 영향을 줄 수 있으므로, 통합 분석에서 배치 교정(batch correction)은 매우 중요한 단계였습니다. 따라서 데이터셋 출처와 검출 플랫폼을 ComBat 모델의 배치 요인으로 포함하였습니다. 주성분 분석(PCA) 도표에서 데이터셋에 따른 잔여 클러스터링이 나타난다면, 이는 교정이 불충분하며 잠재적인 계통적 편향이 있음을 나타냅니다44. 또한 가중 유전자 공발현 네트워크 구축을 위해 소프트 임계값 전력(soft-thresholding power) 설정이 중요했습니다. 척도-무지향성 토폴로지 적합 지수(scale-free topology fit index) R2 > 0.9를 생성하는 최소값을 선택하여 β = 5로 설정하였습니다. 이보다 낮은 값은 모듈을 파편화하거나 기능적으로 무의미하게 만들 수 있으며, 높은 값은 유전자 연결성을 약화시켜 모듈-형질 상관관계 분석의 통계적 검정력을 감소시킬 수 있습니다46. 심근세포는 대사 활동이 활발하기 때문에 단일 세포 품질 관리 임계값을 심장 조직에 맞게 조정하였습니다. 파손되거나 품질이 낮은 세포를 제거하면서 심근세포는 유지하기 위해, 미토콘드리아 유전자 비율 컷오프 25% 미만 및 검출 유전자 범위 200–6,000의 엄격한 필터링 전략을 시행하였습니다50. 반복적인 머신러닝 분석 간의 변동을 줄이기 위해 데이터셋 분할, 모델 학습 및 교차 검증에 set.seed(12345)로 설정된 고정 난수 시드를 사용하였습니다47.
동물 실험에서 표현형의 안정성을 유지하기 위해서는 유전자형 확인, 표준화된 사육 및 일관된 심초음파 측정이 중요했습니다. CTNTR141W 형질전환 마우스는 지정된 적응 및 급여 기간 후에 좌심실 확장과 수축 기능 장애가 나타납니다51. 그룹화 전 유전자형 검증은 비형질전환 동물을 제외하고 표현형의 오분류를 방지하기 위해 필수적입니다. 심초음파 측정은 좌심실 유두근 수준에서 일관되게 수행해야 하며, 3회의 연속적인 안정된 심장 주기 전체의 평균값을 측정해야 합니다. 영상 촬영 위치나 마취 깊이의 차이는 좌심실 구출률 측정의 변동성을 증가시킬 수 있습니다51. 효소결합 면역흡착 분석의 품질은 표준 곡선 상관계수 R2 ≥ 0.99 및 중복 웰 간의 변동 계수 < 10%를 사용하여 평가되었습니다. 표준 곡선의 선형성이 낮거나 중복 측정값이 일관되지 않으면 단백질 농도 추정치에 계통 오차가 발생할 수 있습니다.
워크플로를 구현하는 동안 여러 분석 문제가 발생할 수 있습니다. ComBat 보정 후에도 배치 분리가 지속되는 경우, 배치 변수와 임상 요인 간의 공선성, 저발현 유전자의 필터링 부족 또는 모델링되지 않은 기술적 변동이 원인일 수 있습니다. 사용 가능한 경우 연령 및 성별과 같은 임상 공변량을 보호 변수로 포함할 수 있으며, 노이즈를 줄이기 위해 샘플의 70% 이상에서 발현량이 0인 유전자를 제거할 수 있습니다44. 잔여 분리가 남아 있는 경우 removeBatchEffect를 통한 추가 보정을 고려할 수 있습니다. 차별적으로 발현된 유전자의 수가 예상보다 너무 많거나 적은 경우에는 샘플의 이질성, 정규화, 이상치 및 임계값 선택에 대한 평가가 필요할 수 있습니다27. 낮은 모듈-특성 상관관계는 분산 임계값, 소프트 임계값 거듭제곱 및 극단적인 특성 값을 재평가하여 해결할 수 있습니다. 가장 변동성이 큰 유전자를 5,000개에서 7,500개로 확장하거나, 단일 샘플 유전자 세트 풍부성 분석을 유전자 세트 변이 분석으로 대체하면 모듈 검출 능력이 향상될 수 있습니다46. 단백질-단백질 상호작용 네트워크에 고립된 노드가 과도하게 많은 경우, STRING 신뢰도 임계값을 조정하거나 후보 유전자 세트를 확장해야 할 수 있습니다30. 머신러닝 성능이 저조한 것은 훈련 세트와 검증 세트 간의 분포 차이, 특성 중복 또는 그룹 불균형을 반영하는 것일 수 있습니다. 층화 추출, 중복 특성 제거 또는 소수 클래스의 오버샘플링을 통해 이러한 효과를 줄일 수 있습니다47. 모호한 단일 세포 클러스터링의 경우 Harmony 보정, 주성분 선택 및 마커 유전자 주석을 재평가해야 할 수 있습니다50.
몇 가지 제한 사항을 고려해야 합니다. 전사체 데이터셋은 공공 저장소에서 회고적으로 수집되었으며, 원래의 연구 설계 및 임상적 혼란 변수를 제어할 수 없었습니다. 데이터셋 전반에 걸쳐 임상 주석이 불완전했으며, 대부분의 데이터셋에 병인, 약물 복용 이력, 환자 연령 및 장기 결과에 대한 세부 정보가 부족했습니다. 이러한 제한으로 인해 선택된 유전자와 예후, 치료 반응 또는 시간적 노화 사이의 연관성을 평가하는 것이 불가능했습니다52. 배치 교정(batch correction)을 거쳤음에도 불구하고 잔류 기술적 변동이 남아 있을 수 있습니다. 분석은 주로 messenger RNA 발현을 기반으로 하였으며, 통합된 후성유전체, 단백질체 또는 대사체 데이터는 포함되지 않았습니다. 결과적으로 단백질 활성, 번역 후 조절 및 상위 기전은 결정할 수 없었습니다. 단 하나의 단일 세포 데이터셋만이 포함되어 DCM 병인에 따른 세포 이질성 평가가 제한되었습니다50. CTNTR141W 형질전환 모델은 주로 심장 troponin T 변이와 관련된 유전성 DCM을 나타내며, 특발성, 바이러스성 또는 허혈성 형태의 질환을 재현하지 못했을 수 있습니다51. 마우스와 인간 사이의 종 간 차이 또한 직접적인 임상 적용을 제한합니다. 단백질 수준의 검증은 마우스의 심근 조직으로 제한되었으며, 대규모 임상 코호트 분석 및 기존 바이오마커와의 비교는 수행되지 않았습니다. 4개의 허브 유전자는 DCM에 특이적이지 않으며, 다른 심혈관 질환이나 염증성 질환에서도 변할 수 있습니다. 또한, 후보 유전자 선택은 사전 정의된 노화 관련 및 미토콘드리아 유전자 세트를 기반으로 하였습니다. 이러한 가설 기반 전략은 선택된 참조 세트 외부의 유전자를 제외할 수 있으며, 세 가지 머신러닝 알고리즘 간의 교집합 분석은 단 하나의 방법으로만 식별된 유전자를 누락시킬 수 있습니다48.
이 분석 프레임워크는 향후 DCM의 분자 아형 분류, 바이오마커 검증 및 멀티오믹스 연구를 지원할 수 있습니다. 4개 유전자 패널은 진단 또는 아형 분류 도구로 평가하기 전, 독립적인 말초혈액 또는 심근 코호트에서 평가될 수 있습니다. C1 및 C2 아형은 서로 다른 면역 및 대사 경로 프로파일을 보였으며, 이는 아형 특이적 생물학적 특징의 후속 검증을 위한 기초를 제공합니다15. 선택된 유전자들은 분자 도킹, 세포 및 기능 연구에서도 조사될 수 있습니다. TLR2와 CYBB는 염증 신호 전달 및 활성 산소종 생성과 관련이 있는 반면, TGFB2와 SERPINE1은 섬유화 및 심장 리모델링과 관련이 있습니다53. 프로테오믹스, 메타볼로믹스, 에피게노믹스, 전전장 유전체 연관 분석 및 멘델 무작위 분석 데이터와의 통합은 조절 관계 및 잠재적 인과 관계를 평가하는 데 도움이 될 수 있습니다54. 또한, 질환 특이적 데이터셋과 참조 유전자 세트를 교체함으로써 이 워크플로우를 비대성 심근병증, 허혈성 심근병증 및 심부전의 전사체 연구에 적용할 수 있습니다45. 향후 트랜스포사제 접근 가능 염색질 시퀀싱 및 공간 전사체 분석을 위한 단일 세포 분석을 통합하면 세포 조절 및 공간적 발현에 대한 추가 정보를 제공할 수 있을 것입니다. 대식세포에서 관찰된 노화 관련 시그니처의 농축과 심근세포에서의 미토콘드리아 시그니처 농축은 심장 질환의 염증 및 미토콘드리아 과정에 관한 이전 보고들과 일치합니다55,56,57.
본 연구에는 인정해야 할 몇 가지 한계점이 있습니다. 특히, 단백질 정량에 사용된 상용 ELISA 키트는 공식적으로 혈청 샘플 내 표적 단백질 검출에 대해 검증된 것입니다. 본 연구에서는 혈청 대신 심근 조직 용해물을 검출 매질로 채택하였습니다. 실험 데이터의 신뢰성과 비교 가능성을 확보하기 위해 분석 전 과정에서 일관된 샘플 전처리 및 실험 조작 절차를 엄격히 수행하였으나, 심근 조직 용해물 샘플에 대한 해당 ELISA 키트의 공식적인 제조사 검증 부재로 인해 단백질 정량 결과에 미세한 편차가 발생했을 가능성이 있습니다. 따라서 혈청 특이적 ELISA 키트를 심근 조직 용해물에 적용한 점은 본 연구의 방법론적 한계로 작용합니다.
공개 사항
저자는 이해관계의 충돌이 없음을 선언합니다.
감사의 글
Gene Expression Omnibus 데이터베이스를 통해 제공된 공개 데이터에 감사드립니다. 또한, 원고에 대해 건설적인 의견을 주신 심사위원과 편집자분들께 감사드립니다. 본 연구는 성-정 도급 과학 연구 프로젝트(지원 번호 2021JDZX2026), “Yiqi Huoxue 처방의 죽상경화성 혈관 리모델링 완화 기전”의 지원을 받아 수행되었습니다. ~을 통해 KLF2-Nrf2 매개 염증 조절.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| Aquasonic Clear 초음파 겔 | Parker Laboratories, Inc. | Mar-34 | 소동물 심초음파 영상 촬영에 사용됨. |
| BCA 단백질 정량 분석 키트 | Thermo Fisher Scientific | 23227 | 562 nm에서 검출; 범위, 20–2,000 µg/mL; 생쥐 심장 용해물의 총 단백질 정량에 사용되었습니다. |
| CellAge 데이터베이스 | 인체 노화 유전체 자원 | https://genomics.senescence.info/cells/ | 노화 관련 유전자 시그니처의 소스. |
| CytoHubba, Cytoscape 플러그인 | Cytoscape 앱 스토어 | 버전 0.1 | 단백질-단백질 상호작용 네트워크의 노드 토폴로지 점수 산출에 사용됨. |
| Cytoscape | Cytoscape 컨소시엄 | 버전 3.9.1 | 단백질-단백질 상호작용 네트워크 시각화에 사용됨. |
| 전파장 마이크로플레이트 리더 | Thermo Fisher Scientific | Multiskan FC | ELISA 분석에서 흡광도를 측정하는 데 사용됩니다. |
| 유전자 발현 옴니버스 | 국립생물공학정보센터 | https://www.ncbi.nlm.nih.gov/geo/ | 전사체 데이터 세트를 획득하는 데 사용된 공공 저장소. |
| GeneCards | 와이즈만 과학 연구소 | https://www.genecards.org/ | 미토콘드리아 관련 유전자 세트의 출처. |
| Halt Protease and Phosphatase Inhibitor Cocktail, 100×, EDTA 무첨가 | Thermo Fisher Scientific | 78441 | 보관 조건 4 °C; 다음의 농도로 RIPA 완충액에 추가함 10 µL/mL 사용 직전에. |
| 액체 질소 | 지역 실험실 가스 공급업체 | 해당 사항 없음 | 심근 조직의 급속 냉동에 사용됩니다. |
| 수컷 SPF 등급 C57BL/6J 마우스, 6마리–8주령, 25 ± 2 g | Beijing Vital River Laboratory Animal Technology Co., Ltd. | 해당 없음 | 동물생산허가번호 SCXK (Jing) 2021-0006; 정상 대조군으로 사용됨. |
| 수컷 SPF 등급 CTNTR141W 형질전환 DCM 마우스, 6마리–8주령, 25 ± 2 g | 중국 의학科学院 실험동물과학연구소 | 해당 사항 없음 | 동물 생산 허가 번호 SCXK (Jing) 2021-0065; 자발성 DCM 모델로 사용됨. |
| MCODE, Cytoscape 플러그인 | Cytoscape 앱 스토어 | 버전 2.0.2 | 단백질-단백질 상호작용 네트워크 내에서 핵심 기능적 하위 네트워크를 식별하는 데 사용됩니다. |
| 마우스 CYBB ELISA 키트 | Biogradetech | A-QEK09250-96웰 | 마우스 심근 조직 용해물에서 CYBB를 측정하기 위해 본 연구에서 사용되었다. |
| 마우스 PAI-1 ELISA 키트 | EK-BIO | ML30970 | 본 연구에서는 마우스 심근 조직 용해물 내의 SERPINE1 인코딩 단백질인 PAI-1을 측정하기 위해 사용되었습니다. |
| 마우스 TGF-β2 ELISA 키트 | ElaBoX | SEKM-0036 | 본 연구에서는 TGF-를 측정하기 위해 사용되었습니다.β마우스 심근 조직 용해물 내의 2. |
| 마우스 TLR-2 ELISA 키트 | Solarbio | SEKM-0163 | 마우스 심근 조직 용해물에서 TLR-2를 측정하기 위해 본 연구에서 사용되었다. |
| 인산완충생리식염수, pH 7.4, 칼슘 및 마그네슘 제거 | 생명공학 산업 | 02-024-1ACS | 멸균 1× 용액; 보관 온도 4 °C; 조직 세척 및 희석에 사용됨. |
| R 패키지: caret | CRAN | 버전 6.0-94 | 서포트 벡터 머신-재귀적 특성 제거(support vector machine-recursive feature elimination)에 사용됨. |
| R 패키지: CellChat | CellChat 개발자 | 버전 1.6.1 | 단일 세포 RNA 시퀀싱 데이터로부터 세포 간 통신 추론에 사용됨. |
| R 패키지: clusterProfiler | Bioconductor | 버전 4.8.3 | 기능적 풍부도 분석에 사용됨. |
| R 패키지: ConsensusClusterPlus | Bioconductor | 버전 1.64.0 | 비지도 합의 군집화에 사용됨. |
| R 패키지: edgeR | Bioconductor | 버전 3.42.4 | 절단 평균 M-값(trimmed mean of M-values) 방법을 이용한 RNA 시퀀싱 데이터 정규화에 사용됩니다. |
| R 패키지: GEOquery | Bioconductor | 버전 2.68.0 | Gene Expression Omnibus에서 데이터를 다운로드하는 데 사용됩니다. |
| R 패키지: glmnet | CRAN | 버전 4.1-8 | 최소 절대 수축 및 선택 연산자(least absolute shrinkage and selection operator) 로지스틱 회귀 분석에 사용됨. |
| R 패키지: limma | Bioconductor | 버전 3.56.2 | 차등 발현 분석 및 통계 모델링에 사용됩니다. |
| R 패키지: pROC | CRAN | 버전 1.18.5 | 수신기 작동 특성 곡선 분석에 사용됨. |
| R 패키지: randomForest | CRAN | 버전 4.7-1.2 | 랜덤 포레스트 머신러닝에 사용됨. |
| R 패키지: Seurat | CRAN | 버전 5.0.1 | 단일 세포 RNA 시퀀싱 데이터 분석에 사용됨. |
| R 패키지: SingleR | Bioconductor | 버전 2.2.0 | 자동화된 세포 유형 주석 지정에 사용됩니다. |
| R 패키지: sva | Bioconductor | 버전 3.48.0 | ComBat 배치 효과 보정에 사용됨. |
| 냉장 원심분리기 | Sigma-Aldrich | SIGMA 3-K | 심근 조직 용해물 원심분리에 사용됨. |
| RIPA 용해 및 추출 완충액 | Thermo Fisher Scientific | 89900 | 즉시 사용 가능 1× 용액; 보관 조건 4 °C사용 전 프로테아제 및 포스파타아제 억제제를 첨가하였습니다. |
| 소형 동물 초음파 영상 시스템 | VINNO Technology Co., Ltd. | VINN06LAB | 심기능의 심초음파 평가에 사용됨. |
| 펜토바르비탈 나트륨 | Sinopharm Chemical Reagent Co. | 20040428 | 멸균 생리식염수에 1% 용액(10 mg/mL)으로 조제하여, 30 mg/kg의 용량으로 복강 내 마취에 사용하였다. |
| STRING 데이터베이스 | STRING 컨소시엄 | 버전 11.5 | 단백질-단백질 상호작용 네트워크 구축에 사용됨. |
| TGrinder H24 조직 균질기 | TIANGEN | OSE-TH-01 | RIPA 완충액에서 마우스 심근 조직을 6.0 m/s의 속도로 30초 동안 균질화하는 데 사용됨–2분 동안 60초씩–3회 반복. |
| 소동물을 위한 항온 동물 플랫폼/가열 수술대 | Shanghai Yuyan Scientific Instrument Co., Ltd. | T-30350 | 마우스를 ~에서 유지하는 데 사용됨 37 °C 심초음파 검사 중; 작동 범위, 상온에서 50 °C. |
참고문헌
- Pinto YM et al. Proposal for a revised definition of dilated cardiomyopathy, hypokinetic non-dilated cardiomyopathy, and its implications for clinical practice: a position statement of the ESC working group on myocardial and pericardial diseases. Eur Heart J. 2016;37(23):1850-1858. https://doi.org/10.1093/eurheartj/ehv727
- Newman NA, Burke MA. Dilated Cardiomyopathy: A Genetic Journey from Past to Future. Int J Mol Sci. 2024;25(21):11460. https://doi.org/10.3390/ijms252111460
- Mishra B et al. Tumour necrosis factor-alpha promoter polymorphism and its association with viral dilated cardiomyopathy in Indian population: a pilot study. Indian J Med Microbiol. 2015;33(1):16–20. https://doi.org/10.4103/0255-0857.148368
- Frustaci A et al. Oxidative myocardial damage in human cocaine-related cardiomyopathy. Eur J Heart Fail. 2015;17(3):283-290. https://doi.org/10.1002/ejhf.219
- Ni B et al. The role of β-catenin in cardiac diseases. Front Pharmacol. 2023;14:1157043. https://doi.org/10.3389/fphar.2023.1157043
- Kuwahara K et al. TRPC6 fulfills a calcineurin signaling circuit during pathologic cardiac remodeling. J Clin Invest. 2006;116(12):3114-3126. https://doi.org/10.1172/JCI27702
- He SL et al. Mitochondrial-related gene expression profiles suggest an important role of PGC-1alpha in the compensatory mechanism of endemic dilated cardiomyopathy. Exp Cell Res. 2013;319(17):2604–2616. https://doi.org/10.1016/j.yexcr.2013.07.017
- Luczak ED et al. Mitochondrial CaMKII causes adverse metabolic reprogramming and dilated cardiomyopathy. Nat Commun. 2020;11(1):4416. https://doi.org/10.1038/s41467-020-18165-6
- Li E et al. BMAL1 regulates mitochondrial fission and mitophagy through mitochondrial protein BNIP3 and is critical in the development of dilated cardiomyopathy. Protein Cell. 2020;11(9):661–679. https://doi.org/10.1007/s13238-020-00713-1
- Alila-Fersi O et al. First description of a novel mitochondrial mutation in the MT-TI gene associated with multiple mitochondrial DNA deletion and depletion in family with severe dilated mitochondrial cardiomyopathy. Biochem Biophys Res Commun. 2018;497(4):1049-1054. https://doi.org/10.1016/j.bbrc.2018.02.162
- Ramaccini D et al. Mitochondrial Function and Dysfunction in Dilated Cardiomyopathy. Front Cell Dev Biol. 2020;8:624216. https://doi.org/10.3389/fcell.2020.624216
- Yang J et al. Stem cells in the treatment of myocardial injury-induced cardiomyopathy: mechanisms and efficient utilization strategies. Front Pharmacol. 2025;16:1600604. https://doi.org/10.3389/fphar.2025.1600604
- Van Linthout S et al. State of the art and perspectives of gene therapy in heart failure. A scientific statement of the Heart Failure Association of the ESC, the ESC Council on Cardiovascular Genomics and the ESC Working Group on Myocardial & Pericardial Diseases. Eur J Heart Fail. 2025;27(1):5–25. https://doi.org/10.1002/ejhf.3516
- Alimadadi A, Munroe PB, Joe B, Cheng X. Meta-Analysis of Dilated Cardiomyopathy Using Cardiac RNA-Seq Transcriptomic Datasets. Genes (Basel). 2020;11(1):60. https://doi.org/10.3390/genes11010060
- Verdonschot J et al. Clustering of Cardiac Transcriptome Profiles Reveals Unique Subgroups of Dilated Cardiomyopathy Patients. JACC Basic Transl Sci. 2023;8(4):406–418. https://doi.org/10.1016/j.jacbts.2022.10.007
- Zhu T et al. Identification and Verification of Feature Biomarkers Associated With Immune Cells in Dilated Cardiomyopathy by Bioinformatics Analysis. Front Genet. 2022;13:874544. https://doi.org/10.3389/fgene.2022.874544
- Li H et al. Identification of Centrosome Duplication-Related Biomarkers in Hypertrophic Cardiomyopathy Through Integrative Multi-Omics, Single-Cell Transcriptomics, and Experimental Validation. J Am Heart Assoc. 2026;15(12):e047416. https://doi.org/10.1161/JAHA.125.047416
- Ni L et al. Dissecting and validation the biomarker of heart failure progression in patients with atherosclerosis by single-cell sequencing, bioinformatics, and machine learning. Front Genet. 2025;16:1587274. https://doi.org/10.3389/fgene.2025.1587274
- Barrett T et al. NCBI GEO: archive for functional genomics data sets--update. Nucleic Acids Res. 2013;41(Database issue):D991–D995. https://doi.org/10.1093/nar/gks1193
- Davis S, Meltzer PS. GEOquery: a bridge between the Gene Expression Omnibus (GEO) and BioConductor. Bioinformatics. 2007;23(14):1846-1847. https://doi.org/10.1093/bioinformatics/btm254
- Irizarry RA et al. Exploration, normalization, and summaries of high density oligonucleotide array probe level data. Biostatistics. 2003;4(2):249-264. https://doi.org/10.1093/biostatistics/4.2.249
- Robinson MD, McCarthy DJ, Smyth GK. edgeR: a Bioconductor package for differential expression analysis of digital gene expression data. Bioinformatics. 2010;26(1):139–140. https://doi.org/10.1093/bioinformatics/btp616
- Leek JT et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882–883. https://doi.org/10.1093/bioinformatics/bts034
- Butler A et al. Integrating single-cell transcriptomic data across different conditions, technologies, and species. Nat Biotechnol. 2018;36(5):411-420. https://doi.org/10.1038/nbt.4096
- Korsunsky I et al. Fast, sensitive and accurate integration of single-cell data with Harmony. Nat Methods. 2019;16(12):1289-1296. https://doi.org/10.1038/s51592-019-0619-0
- Aran D et al. Reference-based analysis of lung single-cell sequencing reveals a transitional profibrotic macrophage. Nat Immunol. 2019;20(2):163-172. https://doi.org/10.1038/s41590-018-0276-y
- Ritchie ME et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. https://doi.org/10.1093/nar/gkv007
- Barbie DA et al. Systematic RNA interference reveals that oncogenic KRAS-driven cancers require TBK1. Nature. 2009;462(7269):108-112. https://doi.org/10.1038/nature08460
- Yu G et al. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284-287. https://doi.org/10.1089/omi.2011.0118
- Szklarczyk D et al. STRING v11: protein-protein association networks with increased coverage, supporting functional discovery in genome-wide experimental datasets. Nucleic Acids Res. 2019;47(D1):D607–D613. https://doi.org/10.1093/nar/gky1131
- Shannon P et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-2504. https://doi.org/10.1101/gr.1239303
- Chin CH et al. cytoHubba: identifying hub objects and sub-networks from complex interactome. BMC Syst Biol. 2014;8(Suppl 4):S11. https://doi.org/10.1186/1752-0509-8-S4-S11
- Bader GD, Hogue CW. An automated method for finding molecular complexes in large protein interaction networks. BMC Bioinformatics. 2003;4:2. https://doi.org/10.1186/1471-2105-4-2
- Friedman J, Hastie T, Tibshirani R. Regularization Paths for Generalized Linear Models via Coordinate Descent. J Stat Softw. 2010;33(1):1-22. https://doi.org/10.18637/jss.v033.i01
- Touw WG et al. Data mining in the Life Sciences with Random Forest: a walk in the park or lost in the jungle. Brief Bioinform. 2013;14(3):315-326. https://doi.org/10.1093/bib/bbs034
- Chicco D. Ten quick tips for machine learning in computational biology. BioData Min. 2017;10:35. https://doi.org/10.1186/s13040-017-0155-3
- Robin X et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77. https://doi.org/10.1186/1471-2105-12-77
- Lundberg SM et al. From Local Explanations to Global Understanding with Explainable AI for Trees. Nat Mach Intell. 2020;2(1):56-67. https://doi.org/10.1038/s42256-019-0138-9
- Jin S et al. Inference and analysis of cell-cell communication using CellChat. Nat Commun. 2021;12(1):1088. https://doi.org/10.1038/s41467-021-21246-9
- Charoentong P et al. Pan-cancer Immunogenomic Analyses Reveal Genotype-Immunophenotype Relationships and Predictors of Response to Checkpoint Blockade. Cell Rep. 2017;18(1):248–262. https://doi.org/10.1016/j.celrep.2016.12.019
- Wilkerson MD, Hayes DN. ConsensusClusterPlus: a class discovery tool with confidence assessments and item tracking. Bioinformatics. 2010;26(12):1572–1573. https://doi.org/10.1093/bioinformatics/btq170
- Hänzelmann S, Castelo R, Guinney J. GSVA: gene set variation analysis for microarray and RNA-seq data. BMC Bioinformatics. 2013;14:7. https://doi.org/10.1186/1471-2105-14-7
- Zheng Y et al. Exploring Key Genes to Construct a Diagnosis Model of Dilated Cardiomyopathy. Front Cardiovasc Med. 2022;9:865096. https://doi.org/10.3389/fcvm.2022.865096
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics. 2007;8(1):118-127. https://doi.org/10.1093/biostatistics/kxj037
- Koslow M, Mondaca-Ruff D, Xu X. Transcriptome studies of inherited dilated cardiomyopathies. Mamm Genome. 2023;34(2):312-322. https://doi.org/10.1007/s00335-023-09978-z
- Zhang B, Horvath S. A general framework for weighted gene co-expression network analysis. Stat Appl Genet Mol Biol. 2005;4:Article17. https://doi.org/10.2202/1544-6115.1128
- Lin M et al. Machine learning and multi-omics integration: advancing cardiovascular translational research and clinical practice. J Transl Med. 2025;23(1):388. https://doi.org/10.1186/s12967-025-06425-2
- Climente-González H et al. Interpretable machine learning leverages proteomics to improve cardiovascular disease risk prediction and biomarker identification. Commun Med (Lond). 2025;5(1):170. https://doi.org/10.1038/s43856-025-00872-0
- Shah P et al. Predicting cardiovascular risk with hybrid ensemble learning and explainable AI. Sci Rep. 2025;15(1):17927. https://doi.org/10.1038/s41598-025-01650-7
- Chaffin M et al. Single-nucleus profiling of human dilated and hypertrophic cardiomyopathy. Nature. 2022;608(7921):174-180. https://doi.org/10.1038/s41586-022-04817-8
- Juan F et al. The changes of the cardiac structure and function in cTnTR141W transgenic mice. Int J Cardiol. 2008;128(1):83-90. https://doi.org/10.1016/j.ijcard.2008.03.006
- Russell-Hallinan A et al. Single-Cell RNA Sequencing Reveals Cardiac Fibroblast-Specific Transcriptomic Changes in Dilated Cardiomyopathy. Cells. 2024;13(9):752. https://doi.org/10.3390/cells13090752
- Knowlton KU. Dilated Cardiomyopathy. Circulation. 2019;139(20):2339-2341. https://doi.org/10.1161/CIRCULATIONAHA.119.040037
- Smith GD, Ebrahim S. Mendelian randomization: prospects, potentials, and limitations. Int J Epidemiol. 2004;33(1):30-42. https://doi.org/10.1093/ije/dyh132
- Chen R et al. Macrophages in cardiovascular diseases: molecular mechanisms and therapeutic targets. Signal Transduct Target Ther. 2024;9(1):130. https://doi.org/10.1038/s41392-024-01840-1
- Liu R et al. Tead1 is essential for mitochondrial function in cardiomyocytes. Am J Physiol Heart Circ Physiol. 2020;319(1):H89-H99. https://doi.org/10.1152/ajpheart.00732.2019
- Sharma S et al. SOD2 deficiency in cardiomyocytes defines defective mitochondrial bioenergetics as a cause of lethal dilated cardiomyopathy. Redox Biol. 2020;37:101740. https://doi.org/10.1016/j.redox.2020.101740