본 연구는 코드북 활성화 희소성(Codebook Activation Rarity, CAR)을 분석하여 대장암 조직 병리 이미지의 이상 징후를 탐지하는 비지도 딥러닝 프레임워크인 RareCode를 제시하며, 이는 라벨링된 훈련 데이터 없이도 사전 스크리닝을 지원할 수 있는 잠재력을 가지고 있습니다.
이 논문에서
요약
초록
조직병리 이미지의 비지도 이상 탐지는 재구성 오차를 측정하는 재구성 기반 접근법을 통해 널리 연구되어 왔으나, 이러한 방법들은 조직 질감의 내재적 이질성으로 인해 미세한 의미론적 수준의 병리적 변이를 포착하지 못하는 경우가 많습니다. 이러한 한계를 해결하기 위해, 본 연구에서는 픽셀 수준의 재구성을 넘어 의미론적 수준의 코드북 활성화 분석을 통합한 벡터 양자화 기반 프레임워크인 RareCode를 제시합니다. 핵심 혁신 기술은 코드북 활성화 희귀도(Codebook Activation Rarity, CAR) 스코어링으로, 이는 정상 샘플만으로 학습하는 동안 각 코드북 항목의 활성화 빈도를 프로파일링하고, 추론 시에 드물게 발생하는 활성화를 이상 징후로 표시함으로써 재구성 오차를 의미론적 수준의 판별력으로 보완합니다. 이러한 단일 규모 CAR 메커니즘을 바탕으로, 학습 가능한 융합 가중치를 가진 다양한 크기의 코드북을 사용하는 다중 규모 계층적 코드북(Multi-scale Hierarchical Codebook, MHC) 모듈을 추가로 도입하여, 거친 조직 수준의 구조부터 미세한 세포 수준의 세부 사항까지 아우르는 병리적 패턴을 포착하도록 했습니다. 이러한 다중 규모 설계를 활용하여 각 코드북 입도별로 계층적 이상 히트맵을 생성함으로써, 병리 의사가 이상 징후가 발생하는 위치와 구조적 수준을 모두 알 수 있는 해석 가능하고 다차원적인 시각적 국소화 단서를 제공합니다. Shenzhen People's Hospital에서 얻은 임상 주석이 포함된 대장암 조직병리 이미지 데이터셋에 대해 5겹 교차 검증을 수행한 결과, RareCode는 곡선 아래 면적(AUC) 96.82%를 달성하여 베이스라인 방법들보다 우수한 성능을 보였습니다. 클래스별 분석 결과, 염증 탐지(AUC = 94.30%, 특이도 = 60.4%)보다 암 탐지(AUC = 9.4%, 특이도 = 94.21%)에서 더 강력한 성능을 나타냈습니다. 이러한 결과는 CAR 분석이 조직병리 이상 탐지를 위한 유망한 비지도 접근법이 될 수 있으며, 잠재적으로 대장암 진단의 임상 사전 스크리닝에 도움이 될 수 있음을 시사합니다.
서론
대장암에 대한 신뢰할 수 있는 조직병리학적 스크리닝은 전문가의 주석 달기와 수동 검토의 제약을 받고 있으며, 특히 염증성 병변과 악성 종양의 형태가 중첩될 때 더욱 그러합니다1,2. 이러한 제약으로 인해, 광범위한 비정상 주석 없이도 정상 조직으로부터 학습하는 비지도 계산 방식의 접근법이 요구되고 있습니다3,4.
자동화된 조직병리 스크리닝의 임상적 시급성은 진단 수요와 가용 병리 전문 지식 사이의 심화되는 불균형으로 인해 더욱 강조되고 있으며, 병리 전문의 인력이 계속 감소하는 가운데 미국 병리 전문의 1인당 진단 업무량은 단 10년 만에 40% 이상 증가했습니다5. 대장암(CRC)의 경우, 조직적인 스크리닝 프로그램이 사망률을 29-68% 감소시키는 것과 연관이 있었으나6, 수동 병리 검토 역량은 여전히 인력 가용성에 의해 제한적인 상황입니다. 우선 검토가 필요한 의심 사례를 신뢰성 있게 식별하는 자동 사전 스크리닝 시스템은 이러한 부담을 완화하고 진단 소요 시간을 단축하는 데 도움이 될 수 있습니다. 그러나 이러한 시스템을 구축하려면 위양성을 피하기 위한 높은 민감도와 과도한 오경보를 방지하기 위한 적절한 특이도가 모두 필요합니다7.
비지도 이상 탐지(UAD)는 비정상 훈련 레이블을 필요로 하지 않고 정상 조직 분포를 모델링할 수 있기 때문에 의료 영상 분석에서 점점 더 중요해지고 있습니다83,9,10. 오토인코더, 변분 오토인코더, 생성적 적대 신경망 및 메모리 증강 변형을 포함하는 재구성 기반 모델은 재구성 오차를 통해 이상 징후를 식별하지만, 고용량 디코더는 여전히 비정상 영역을 높은 충실도로 재구성할 수 있습니다1,12,13,14,15,16,17. PatchCore 및 PaDiM과 같은 특징 기반 방법은 사전 훈련된 표현을 사용하지만, 자연 영상에서 학습된 특징은 조직병리학의 미세한 비정형성을 완전히 포착하지 못할 수 있습니다18,19,20,21. 병리학 특화 파운데이션 모델과 확산 기반 이상 탐지기는 강력한 대안을 제공하지만, 데이터 요구 사항이나 계산 비용으로 인해 고처리량 스크리닝에 직접 사용하기에는 제한이 있을 수 있습니다2,23. EvoAAE24 및 MoARNN-AM25과 같은 최근의 자동화 및 진화적 방법은 이상 탐지를 위한 적응형 모델 최적화의 가치를 더욱 잘 보여주지만, 이들의 적용 맥락은 조직병리학적 영상 분석과는 다릅니다. 이와 대조적으로, 벡터 양자화(VQ) 기반 방법은 항등 매핑을 줄일 수 있는 이산 코드북 제약을 부과합니다. 하지만 기존의 VQ 기반 접근 방식은 여전히 주로 공간적 재구성 오차에 의존하며, 코드북 활성화 패턴에 포함된 의미론적 정보를 충분히 활용하지 못하고 있습니다26,27.
앞서 언급한 방법들이 일반적인 도메인에서 유망한 성능을 보여주었으나, 복잡한 조직병리학적 시나리오에 적용하는 데에는 특정한 어려움이 따릅니다. 조직병리학적 이미지는 여러 구조적 수준에 걸쳐 복잡한 조직 이질성을 보이는 것이 특징입니다28. 실제로 이미지 분석은 일반적으로 조직 절편에서 추출한 국소 이미지 패치를 대상으로 수행되며, 병리학적 진단은 본질적으로 교차 척도적입니다. 즉, 병리 의사는 저배율에서 선조직 및 조직 형태를 평가하는 동시에 고배율에서 핵 다형성과 유사분열상을 검토합니다29. 본 연구에서는 현재 접근 방식의 세 가지 주요 한계점을 확인하였습니다. 첫째, 병리학적 이상 부위와 정상 조직은 염색 스타일 및 국소 질감과 같은 저수준 시각적 특징에서 높은 유사성을 보입니다. 이로 인해 정상 샘플과 이상 샘플 모두 시맨틱 수준에서 유사한 재구성 품질을 생성할 수 있어, 재구성 기반 방법으로는 미세한 이상 부위를 검출하는 데 실패하게 됩니다. 둘째, 기존 방법의 대부분은 단일 척도 특징 추출을 사용하므로, 조직 수준과 세포 수준 모두에서 이상 특징을 동시에 포착하는 것이 어렵습니다30,31. 셋째, 주류 방법들은 픽셀 수준의 히트맵을 생성할 수 있지만, 이상 부위의 계층적 속성을 직관적으로 포착하지 못하는 경우가 많아 임상 진단 보조 도구로서의 유용성이 제한됩니다.
위의 과제들을 해결하기 위해, 본 연구에서는 여러 추상화 수준에서 코드북 활성화 패턴과 계층적 특징 표현을 탐색하는 UAD 프레임워크인 RareCode를 제안합니다. 이 프레임워크는 세 가지 주요 구성 요소로 이루어져 있습니다. (1) 코드북 활성화 희소성(Codebook Activation Rarity, CAR) 점수 산출 메커니즘은 정상 샘플만으로 학습된 항목 활성화 빈도를 기반으로 희소성 점수를 계산하여, 시맨틱 수준에서 정상 샘플과 이상 샘플을 구별하며 기존의 공간적 재구성 오차를 보완하는 판별 신호를 제공합니다. (2) 다중 스케일 계층적 코드북(Multi-scale Hierarchical Codebook, MHC) 융합 아키텍처는 다양한 용량의 코드북을 사용하여 거친 구조적 패턴부터 미세한 세포 세부 사항까지 여러 입도 수준에서 병리적 특징을 포착하며, 학습 가능한 가중치를 통해 적응형 융합을 구현합니다. (3) 계층적 해석 가능 로컬라이제이션 모듈은 이러한 다중 스케일 아키텍처를 활용하여 서로 다른 입도에서 이상 부위 히트맵을 생성함으로써, 병리학자에게 다중 스케일의 시맨틱 해석이 가능한 진단 참조 자료를 제공합니다.
본 연구의 주요 가설은 정상 대장 조직 병리 이미지로만 학습된 코드북에서 도출된 코드북 활성화 빈도 프로파일이 픽셀 수준의 재구성 오차를 넘어 이상 징후와 관련된 의미론적 정보를 인코딩하며, 이러한 상호 보완적 신호들의 다중 스케일 통합이 대표적인 UAD 방법론들에 비해 암성 또는 염증성 조직이 포함된 이미지를 정상 이미지로부터 구별하는 성능을 향상시킬 것이며, 이는 주로 AUC를 통해 평가될 것이라는 점이었습니다. 이 가설을 검증하기 위해, 임상적으로 주석이 달린 CRC 데이터셋에 대해 5-겹 교차 검증을 사용하여 RareCode를 평가하였으며, 핵심 구성 요소들의 기여도와 해석 가능성을 조사하기 위해 어블레이션(ablation) 및 국소화 분석을 수행하였습니다.
프로토콜
이 연구는 선전시 인민병원 임상연구윤리위원회의 승인을 받았으며, 선전시 인민병원에서 모든 실험이 수행되었습니다.'s 병원 (승인 번호: LL-KY-2025300-01). 본 연구는 기존의 조직병리학적 이미지와 임상 자료를 활용한 후향적 연구로서 환자와의 직접적인 접촉이나 중재가 없었기 때문에, 윤리위원회에서 서면 동의 요건을 면제하였다. 모든 임상 자료 및 조직병리학적 이미지는 분석 전에 익명화되었으며, 본 연구에서는 개인을 식별할 수 있는 정보가 사용되지 않았다. 본 연구에서 사용된 모든 자료는 기관 및 국가 연구 위원회의 윤리 기준에 따라 취급되었다.
프레임워크 개요
제안된 UAD 프레임워크인 RareCode의 전체 아키텍처는 다음에 도시되어 있다. 그림 1. 이 프레임워크는 병렬 이중 브랜치 구조를 채택한다. 각 512 × 512 입력 이미지에 대해, 미세 스케일 입력과 거시 스케일 입력으로 각각 겹치지 않는 32 × 32 및 64 × 64 패치를 추출한다. 64 × 64 패치는 네트워크로 전달되기 전에 32 × 32 크기로 재조정되며, 이를 통해 두 브랜치가 동일한 인코더-디코더 입력 크기를 공유하면서도 서로 다른 수용 영역을 유지할 수 있다. 각 브랜치의 인코더는 추출된 특징들을 잠재 공간으로 매핑하며, 여기서 MHC 모듈이 이산화 제약 조건을 부여한다. 이후 디코더는 양자화된 특징들로부터 이미지를 재구성하여 공간 도메인 상의 재구성 오차를 계산한다. CAR 메커니즘은 코드북 활성화 빈도를 분석함으로써 의미 수준의 이상 정도를 측정한다. 마지막으로, 모델은 재구성 점수와 CAR 점수를 가중 결합하여 이미지 수준의 이상 점수를 산출한다. RareCode 프레임워크는 정상 샘플만을 사용하여 엔드투엔드 방식으로 학습되며, 이상에 대한 주석이 필요하지 않다. 이중 브랜치 설계는 국소 세포 특징과 더 넓은 선종 구조를 모두 포착하기 위해 사용되었으며, MHC 모듈은 서로 다른 용량의 코드북을 통해 이러한 특징들을 모델링하기 위해 사용되었다.
인코더-디코더 아키텍처
RareCode는 미세 스케일 및 거친 스케일 브랜치 각각에 대해 구조적으로 독립적인 인코더와 디코더를 구성한다. 각 브랜치는 동일한 인코더-디코더 설계를 사용하지만, 파라미터는 공유하지 않는다. 인코더는 3×3 합성곱, 배치 정규화, ReLU 활성화 함수, 드롭아웃으로 구성된 총 네 개의 합성곱 블록으로 이루어진다. 채널 폭은 64에서 128로, 이후 256으로 증가하며, 최종 특징 맵은 평탄화된 후 64차원의 잠재 임베딩 공간으로 투영된다. 디코더는 완전 연결 투영 층에 이어 네 개의 전치 합성곱 층을 배치하여 인코더를 대칭적으로 구성하며, 각 패치를 네트워크의 원래 입력 크기로 재구성한다. 재구성 오차는 입력 패치와 재구성된 패치 간의 평균 제곱 오차로 계산된다. RareCode는 이러한 인코더-디코더 구조에 이산 코드북 제약 조건을 결합함으로써 정상 조직의 압축된 표현을 학습하고, 추론 과정에서 이로부터의 편차를 측정한다.
다중 규모 계층적 코드북
여러 수준의 추상화에서 병리학적 특징을 포착하기 위해—광범위한 조직 패턴에서 국소적인 세포 수준의 변이까지—MHC 모듈은 K개의 이산적 코드북을 사용한다  다양한 용량으로 n1, n2, ..., nK최종 FourScales 구성에서 각 브랜치는 각각 64, 128, 256, 512개의 엔트리를 가진 네 개의 코드북(codebook)을 포함하며, 각 코드북 엔트리는 64차원 임베딩을 갖는다. 각 인코딩된 패치 특성(patch feature)에 대해 유클리드 거리에 따라 가장 가까운 코드북 엔트리가 선택된다. 이후 서로 다른 코드북에서 얻어진 양자화된 출력은 코드북 간 정규화된 학습 가능한 가중치를 사용하여 융합된다. 더 강한 압축 제약 조건을 가지는 작은 크기의 코드북은 국소적 변동을 추상화한 거친 수준의 전형적 패턴을 인코딩하는 반면, 더 큰 크기의 코드북은 보다 구체적인 구조적 특성을 포착하는 섬세한 수준의 특징을 보존할 것으로 기대된다. 각 코드북마다
 , 여기서 ek(i)
 Rd 는 k번째 코드북의 i번째 임베딩 벡터를 나타내며, 연속형 특징들은 최근접 이웃 탐색을 통해 이산적인 코드북 공간에 매핑된다(수식 1 및 2).
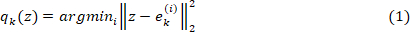

다중 스케일 특징의 적응적 융합을 달성하기 위해 학습 가능한 가중치를 도입한다. 소프트맥스 정규화 후, 각 코드북의 양자화된 출력에 대해 가중 합산이 수행된다(식 3).
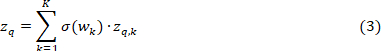
여기서 σ(·)은 소프트맥스 함수를 나타내며, 가중치가 다음 조건을 만족하도록 보장함 Σk σ(wk) = 1. 이 설계는 모델이 입력 특징의 의미적 내용에 따라 다양한 세분성 수준의 코드북 기여 비율을 자동으로 조정할 수 있도록 한다.
코드북 학습을 최적화하기 위해, 우리는 표준 VQ 손실 함수(Eq. 4)를 채택한다:
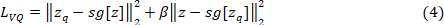
sg[·]는 정지 구배(stopping-gradient) 연산을 나타내며, β = 0.25는 커밋먼트 손실 가중 계수이다. 첫 번째 항은 코드북 벡터가 인코더 출력 방향으로 이동하도록 유도하며, 두 번째 항은 인코더 출력이 해당 코드북 벡터와 일관성을 유지하도록 유도한다. 다중 스케일 VQ의 전체 동작 방식은 다음에 도시되어 있다. 그림 2.
코드북 활성화 희귀도 점수 산정
CAR은 정상 훈련 샘플에서 추정한 코드북 활성화 통계를 기반으로 의미 수준의 이상을 측정한다. 모델 훈련 후, 모든 정상 훈련 이미지를 데이터 증강 없이 인코더와 MHC 모듈을 통해 전달하였다. 각 브랜치 및 각 코드북에 대해 모든 패치 특징의 할당 인덱스를 기록하고, 각 코드북 엔트리에 할당된 횟수를 집계하였다. 이후 이 집계값을 정규화하여 해당 코드북의 활성화 빈도 분포를 얻었다(수식 5).

추론 과정에서 각 테스트 이미지는 동일한 패치 추출, 인코딩 및 최근접 이웃 코드북 할당 절차를 거쳤다. 할당된 각 코드북 항목에 대해 희귀성 점수는 정상 훈련 집합에서의 활성화 빈도의 음의 로그로 계산된다(식 6).

여기서 ε 수치적 안정성을 위해 사용되는 작은 상수이다. 따라서 저주파 코드북 항목은 더 높은 희귀성 점수를 받으며, 이는 해당 패치 특징이 학습된 정상 조직 분포와 일치하지 않을 가능성이 더 높음을 나타낸다. 패치 수준의 희귀성 점수는 각 이미지 내에서 평균화되었으며, 미세 및 거친 스케일 브랜치들 간에도 평균화되어 이미지 수준의 희귀성 반응을 산출하였다.
활성화 빈도의 드물ness를 보완하기 위해 백분위수 기반 양자화 거리 점수(식 7)도 계산한다:
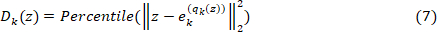
이 점수는 각 인코딩된 특징 벡터와 그에 가장 가까운 코드북 항목 사이의 유클리드 거리로부터 산출된다. 거리 분포는 정상 훈련 샘플로부터 추정되며, 테스트 샘플의 거리는 백분위수 점수로 변환된다. 백분위수 점수가 클수록 인코딩된 특징이 학습된 정상 코드북 프로토타입을 사용하여 표현하기 더 어렵다는 것을 나타낸다.
최종 CAR 점수는 학습 가능한 코드북 가중치를 사용하여 모든 코드북에 걸친 활성화 희소성과 양자화 거리의 조합이다(식 8).
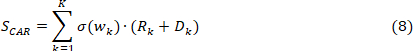
표준화된 코드북 가중치는 다중 스케일 특징 융합에 사용된 것과 동일하게 점수 수준 융합에도 적용되어 표현 학습과 이상 점수 산정 간의 일관성을 유지한다. 결과적으로 계산된 CAR 점수는 이미지 수준에서 산출되며, 이후 재구성 점수와 결합되어 최종 이상 점수가 도출된다. 전체적인 CAR 점수 산정 방식은 다음에 도시되어 있다. 그림 3.
최종 이상 점수 계산
공간 영역 재구성 오차와 의미 수준의 CAR 점수를 융합한다. 융합 전에 두 점수는 각각 백분위수 기반의 최소-최대 정규화(min-max normalization)를 사용하여 정규화하여 극단적인 이상치의 영향을 줄인다. 최종 이미지 수준의 이상 점수는 다음과 같이 정의된다(식 9):
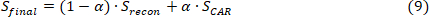
여기서 S재구성 정규화된 평균 제곱 재구성 오차를 나타내며, 픽셀 공간에서의 샘플 재구성 품질을 반영함; SCAR 위에서 설명한 CAR 점수는 의미 수준의 이상 정도를 반영한다. 하이퍼파라미터 α [0,1]은 두 구성 요소 간의 상대적 가중치를 조절하며, 최적의 값은 검증 세트에서 결정된다.
훈련 목적
RareCode 프레임워크는 정상 샘플만을 사용하여 엔드투엔드 방식으로 훈련된다. 전체 훈련 손실은 다음의 구성 요소들로 이루어진다(식 10):

각 용어의 정의는 다음과 같다. 재구성 손실: 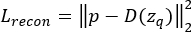 , 입력 패치 간의 평균 제곱 오차 측정 p 재구성된 패치들 D(zq) 양자화 후이다. 이 손실은 32에 대해 개별적으로 적용된다. × 32패치 브랜치 (
 ) 및 64 × 64패치 브랜치 (
 공간적 척도의 양쪽에서 효과적인 특징 학습을 보장하기 위해.
데이터셋 설명
희귀코드(RareCode)를 평가하기 위해, 헤마톡실린-에오신(H&E)으로 염색된 대장절제조직 절편의 임상 주석이 달린 대장암(CRC) 조직병리 이미지 데이터셋을 이용한 실험을 수행하였다.&E), 선전 인민병원에서 제공받음's 병원. 이 데이터셋의 모든 이미지는 실제 임상 사례에서 촬영된 것이다. 이미지들은 40배의 배율로 디지털화되었으며, 원본 해상도는 1024 × 1024픽셀. 주석의 신뢰성과 품질을 보장하기 위해 모든 샘플 범주 라벨은 더블 블라인드 프로토콜에 따라 두 명 이상의 고위 전문 병리의사가 공동으로 검토하고 확인하였다.
조직병리학적 특성에 기반하여, 데이터셋은 정상 조직(1,226장), 암(1,215장), 염증(1,214장)의 세 가지 클래스로 분류되었다. 이진 이상 탐지(UAD) 설정에서는 암 및 염증 샘플을 이상 샘플로 간주하고, 정상 샘플을 기준 분포로 사용하였다. 이러한 설정은 추가 병리학적 검토가 필요한 사례와 형태학적으로 정상인 사례를 구분하는 목적의 분류 과제를 반영한다.
모든 H&E-염색 이미지를 512로 크기 조정함 × 512픽셀로 조정한 후 네트워크 입력으로 사용하였다. 평가에는 계층화된 5-폴드 교차 검증을 사용하였다. 각 폴드에서 정상 샘플을 먼저 훈련용, 검증용 및 별도의 테스트용 서브셋으로 분할하였다. RareCode는 훈련용 정상 샘플에 대해서만 훈련시켰으며, 검증 서브셋(이 역시 정상 샘플만 포함)은 모델 선택, 하이퍼파라미터 조정 및 융합 가중치 선정에 사용하였다. α보이지 않는 정상 샘플과 암 및 염증을 포함한 이상 샘플로 구성된 홀드아웃 테스트 세트는 최종 성능 평가 용도로만 사용되었으며, 모델 훈련, 하이퍼파라미터 선택 또는 α 선택. 대표적인 범주, 데이터셋 구조 및 검증 프로토콜은 다음에 나와 있다. 그림 4.
구현 세부 사항
제안된 RareCode 프레임워크 및 비교 기준 기법들은 PyTorch를 사용하여 구현되었다. 모든 실험은 단일 NVIDIA GeForce RTX 4060 Ti GPU(16GB)가 장착된 워크스테이션에서 수행되었다. 네트워크 아키텍처 구성에서 다양한 공간 범위의 특징을 추출하기 위해, 듀얼 브랜치 아키텍처는 32과 두 가지 스케일에서 겹치지 않는 패치를 처리한다. × 32픽셀(더 작은 수용야, 국부적인 질감 패턴을 포착함) 및 64 × 64픽셀(더 큰 수용야를 가져 넓은 공간적 맥락을 포착함)이다. 두 브랜치 인코더가 생성하는 연속형 특징 임베딩 차원은 모두 균일하게 64로 설정한다. MHC 모듈에서는 각 브랜치에 대해 서로 다른 용량을 가진 네 개의 코드북을 구성하며, 이산형 프로토타입의 수는 각각 64, 128, 256, 512이다.
최적화 과정에서 네트워크는 배치 크기 8로 50에포크 동안 엔드투엔드로 훈련시켰다. 가중치 갱신에는 AdamW 옵티마이저를 사용하였으며, 초기 학습률은 5였다. × 과적합을 방지하기 위해 weight decay를 적용하였다. 또한, 원활한 학습 수렴을 보장하기 위해 코사인 어닐링 학습률 스케줄을 사용하여 후반 학습 단계에서 보다 정교한 최적화가 가능하도록 하였다. 패치 크기와 코드북 크기는 다중 스케일 표현과 계산 비용 간의 균형을 고려하여 선정하였다. 최종 FourScales 구성은 제거 분석(ablation analysis)을 통해 뒷받침되었으며, α 검증 세트에서 테스트 세트 평가 이전에 선택되었다.
디코더 복잡도 제거 실험을 위해 FourScales 구성에 기반한 복잡한 디코더 변형을 구현하였다. 이 변형은 동일한 데이터 분할, 코드북 크기, 훈련 에포크, 옵티마이저, 학습률, 검증 기반 α 선택 및 평가 지표를 FourScales 모델로 삼았다. 기본 디코더는 다중 스케일 딥와이즈 합성곱 블록과 합성곱 블록 어텐션 모듈(CBAM)로 구성된 EMCAD 스타일의 디코더로 교체하였다. 처음 세 단계의 전치 합성곱 업샘플링 각각 이후에, 병렬 3 × 3, 5 × 5, 및 7 × 7단계의 깊이 방향 합성곱을 적용한 후, 1 × 1 대 1 융합, 배치 정규화, ReLU 활성화, 잔차 연결, 및 CBAM 어텐션. CBAM은 평균 풀링 및 최대 풀링 기술자를 기반으로 하는 채널 어텐션과 7×7 커널을 사용하는 공간 어텐션을 포함함 × 7개의 합성곱. 최종 단계에서는 전치 합성곱과 시그모이드 활성화를 사용하여 32를 재구성함 × 32개 패치
결과
기준 방법과의 비교
희귀코드(RareCode) 프레임워크를 평가하기 위해, 재구성 기반 방법(CAE)을 포함한 여러 대표적인 UAD 방법들을 기준선으로 선정하였다.32, VAE12, SAE33, MAE34, 패치SAE35), 메모리 증강 재구성(MemAE)36), 지식 증류(STFPM37), 합성 이상 생성(DRAEM)38), 및 사전 훈련된 특징 추출 (PatchCore18). 기준 모델 선정 시, 비교 가능한 수준의 계산 자원과 데이터 가정 조건(정상 샘플에 대한 비라벨링된 훈련 데이터만 접근 가능) 하에서 훈련하거나 적용할 수 있는 방법들에 초점을 맞추어, 성능 차이가 사전 훈련 데이터 규모의 차이가 아닌 방법론적 기여도에 기인함을 보장하였다. 공정한 비교를 위해 모든 방법은 동일한 5-폴드 데이터 분할 방식, 전처리 파이프라인, 평가 지표 및 계산 환경에서 평가되었다. 모든 모델은 정상 훈련 샘플만을 사용하는 동일한 비정상 탐지(UAD) 프로토콜 하에서 훈련되었으며, 하이퍼파라미터와 임계값은 검증 세트에서 선정하고, 최종 성능은 별도의 테스트 세트에서만 평가하였다. 표 1 5겹 교차 검증 결과를 요약합니다. 그림 5 다중 지표 레이더 차트 비교를 제공한다.
다음과 같이 보여진 바와 같이 표 1 그리고 그림 5, RareCode는 CRC 데이터셋에서 우수한 검출 성능과 통계적 안정성을 달성한다. AUC 측면에서 RareCode(96.82 ± 0.23%)은 MemAE(94.97%)을 포함한 여러 재구성 기반 기준 모델보다 우수한 성능을 보인다. ± 0.81%). 통계 분석은 RareCode가 모든 재구성 기반 베이스라인보다 우수하다는 것을 확인시켜 준다(쌍체 t-검정, p < 0.05), MemAE 대비 개선이 통계적으로 유의미함 (p < 0.01). RareCode는 성능 변동이 적은데(표준편차 0.23%), 이는 교차 검증 폴드 간의 일관된 안정성을 나타낸다. 합성 이상 데이터를 기반으로 하는 DRAEM의 제한된 성능은 단순한 텍스처 오버레이 전략이 복잡한 병리학적 이형성을 충분히 모사하지 못하기 때문일 가능성이 있다.
특이성 측면에서 RareCode는 58.24를 달성한다 ± 5.99%로, 모든 비교 방법보다 위양성 감소 측면에서 우수한 성능을 보였다. 이는 재구성만을 기반으로 한 기준선(NoCAR, 33.76%) 대비 약 25%p 향상된 결과로서, CAR 메커니즘의 효과를 입증한다.'STFPM과 자연 이미지 사전 훈련 특징에 의존하는 PatchCore의 낮은 특이도는 자연 이미지와 조직병리 이미지 간의 도메인 갭에서 부분적으로 기인할 수 있다. 주목할 만하게도, STFPM과 DRAEM은 높은 특이도 변동성을 나타낸다.±33.53% 및 ±7.09%)이며, 각 폴드의 특이성은 거의 0에서부터 중간 수준까지 다양하여, 이들의 적용 신뢰성에 대한 우려를 제기한다.
클래스별 검출 성능
각 클래스별 분석은 암 및 염증 샘플을 정상 샘플과 각각 별도로 비교하여 수행하였다(표 2). RareCode는 암 검출에서 더 높은 성능을 달성하였다(AUC = 99.44 ± 0.12%, 재현율 = 98.13 ± 0.29%, 특이도 = 94.21 ± 2.22%)보다 염증 검출의 경우에서 더 높았다(AUC = 94.30) ± 0.44%, 재현율 = 96.55 ± 0.78%, 특이도 = 60.44 ± 4.34%)이다. 이러한 결과는 RareCode가 염증성 변화보다 악성 이상에 대해 더 강한 판별력을 보일 수 있음을 시사하며, 염증-정상 경계가 전반적인 특이도 감소에 상당히 기여하는 것으로 보인다.
제거 연구
희귀코드(RareCode) 프레임워크 내 주요 구성 요소들의 기여도를 조사하기 위해, CAR 메커니즘과 MHC 모듈이 탐지 성능에 미치는 영향을 평가하기 위한 제거 실험(ablation experiments)을 수행하였다. 결과는 다음에 자세히 설명되어 있다. 표 3. 아래에서 보여주는 바와 같이 그림 6A, 재구성 전용 기준선에 CAR을 추가하면 AUC가 92.81%에서 95.92%로 향상되었으며, 다중 스케일 코드북 퓨전을 적용하면 AUC가 추가로 96.82%까지 증가하였다. 그림 6B CAR이 특이성(specificity)도 개선했음을 보여주며, NoCAR 기준 모델의 33.76%에서부터 전체 FourScales 모델에서 58.24%로 증가시켰다. 이러한 결과는 코드북 활성화 희소성(codebook activation rarity)과 다중 스케일 융합(multi-scale fusion)의 상보적 가치를 뒷받침한다.
또한 FourScales 구성으로 디코더 복잡도 제거 실험을 수행하였다. 아래에서 보는 바와 같이 표 3, 다중 스케일 딥와이즈 합성곱 블록과 합성곱 블록 어텐션 모듈(CBAM)을 갖춘 복합 디코더 변형 모델은 기본 FourScales 모델보다 AUC가 낮았다(95.17 ± 0.44% 대비 96.82 ± 0.23%). 이 결과는 현재의 VQ-AE 기반 RareCode 설정 내에서 디코더 용량을 증가시켜도 이상 탐지 성능이 향상되지 않았으며, 코드북 제약 조건이 있는 표현의 효율성을 오히려 저하시킬 수 있음을 시사한다.
계층적 공간 반응 분석
정상 샘플과 이상 샘플 간에 패치 수준의 재구성 오차 및 코드북 희귀도 맵을 이미지 수준에서 통합하여 RareCode가 생성한 공간 반응을 평가하였다. 에너지 비율, 코헨's d 및 AUC를 사용하여 이미지 수준의 반응 분리를 정량화하였다. 자세한 결과는 다음에 제시되어 있다. 표 4 그리고 그림 7 그리고 그림 8.
결과는 모든 스케일에서 코드북 희소도 점수가 비정상 샘플에서 반응 증가를 나타냄을 보여준다(에너지 비율 > 1). 용량이 더 작은 코드북(코드북 64)은 더 강한 위치 수준의 판별 성능을 달성하며(78.79% AUC), 이는 더 높은 압축률이 정상 조직 아키타입에서의 편차에 더 민감한, 보다 추상적이고 전형적인 패턴 학습을 유도한다는 기대와 일치한다. 재구성 오차만으로도 상당한 이상 탐지 능력을 제공하며(93.31% AUC), CAR 점수는 의미적 빈도 차원에서 보완적인 신호를 제공한다.
정성적 검사 그림 7 암 샘플에서 증가된 반응은 불규칙하고 응집된 선관, 핵 비대, 과염색성, 가성층화, 그리고 상피 극성의 상실과 겹쳐졌다. 염증 샘플에서는 왜곡된 은행 주위와 밀도 높은 염증세포 침윤 부위에서 더 강한 반응이 관찰되었다. 용량이 낮은 코드북은 보다 광범위한 조직 구조적 변이를 포착하는 경향이 있었으나, 용량이 높은 코드북은 더 국소적인 세포 수준의 반응을 생성하였다. 이러한 결과는 정성적인 형태학적 해석을 제공하지만 픽셀 수준의 검증은 제공하지 않는다.
융합 파라미터 분석
융합 가중치 α 공간적 재구성 오차와 CAR 점수의 기여도를 최종 이상 점수에 균형 있게 반영한다. 최적 α 각 폴드에 대한 값은 검증 세트에서 그리드 서치(스텝 크기 0.05)를 통해 결정되었으며, 결과는 다음에 제시되어 있다. 표 5 그리고 그림 9. 최적 α 값은 주로 0.85–0.95 범위에 집중되어 있으며, 평균은 0.90이다. ± 0.05. 최적의 설정에서 모델은 평균 AUC 96.82를 달성한다. ± 테스트 세트에서 0.23%의 수치를 나타냈다. 더 높은 최적 가중치(약 0.90)는 재구성 오차보다 CAR 점수가 최종 탐지에 더 크게 기여함을 시사하며, 재구성 오차는 보조적인 국소 제약을 제공한다. 비교하면 α 감도 분석에서 = 0 설정 대비(AUC = 93.29%), 검증 선택된 퓨전 설정은 AUC를 약 3.53%p 향상시켰다.
본 연구에서는 전통적인 생성 모델에서 발생하는 정체성 매핑(identity-mapping) 문제를 완화하기 위해 조직병리학적 이미지에서 비지도 이상 탐지에 사용할 수 있는 RareCode 프레임워크를 제시한다. CAR 메커니즘은 픽셀 수준의 재구성 오차에 대한 과도한 의존도를 줄여주며, MHC 모듈은 다중 세분화 수준에서 계층적 특징 표현을 제공하여 다양한 추상화 수준에서 상호 보완적인 이상 판별이 가능하게 한다. CRC 데이터셋에서의 실험 결과, RareCode는 96.82%의 AUC를 달성하였으며, 클래스별 분석을 통해 암 검출의 효과성(AUC = 99.44%)과 염증 대비 암에 대한 더 강한 판별력을 입증하였다. 이는 염증과 정상 조직 간의 중첩이 여전히 주요한 과제임을 시사한다. 제거 실험(ablation study)을 통해 VQ로부터 얻은 이산적 의미 특징과 다중 스케일 조직 형태학적 표현을 통합하는 것이 이상 탐지 성능을 향상시킨다는 것을 확인하였다. RareCode'높은 재현율(98.40%)과 중간 정도의 특이도(58.24%)는 이를 의심스러운 조직병리학적 이미지를 우선 선별하는 사전 스크리닝 도구로 활용할 수 있는 가능성을 시사하지만, 병리학자의 업무 부담에 실제로 미치는 영향은 향후 프로스펙티브한 워크플로우 평가를 통해 확인해야 한다.
데이터 이용 가능성:
이 연구에서 사용한 대장암 조직병리학 이미지 데이터셋은 선전시 인민병원에서 획득하였으며, 선전시 인민병원 임상시험 및 임상연구 윤리심의위원회의 승인을 받았다.'s 병원의 기관 윤리 승인 하에 진행되었다(승인 번호 LL-KY-2025300-01). 환자 개인정보 보호 및 기관의 데이터 공유 정책으로 인해 데이터셋은 공개되지 않는다. 해당 데이터는 책임저자에게 타당한 요청을 통해 기관 승인 및 데이터 사용 계약을 전제로 접근이 허용될 수 있다. RareCode 프레임워크의 소스 코드는 https://github.com/XL-alg/RareCode에서 공개적으로 이용 가능하다.
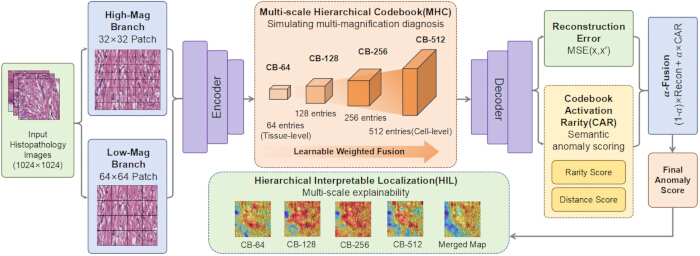
그림 1희귀코드 프레임워크의 전체 아키텍처 및 데이터 흐름. 512 × 512 H&E 염색된 조직병리학 이미지는 겹치지 않는 32개로 분할된다 × 32 및 64 × 64개의 패치를 미세 및 거친 스케일의 입력으로 사용한다. 두 개의 분기는 각각 패치들을 잠재 임베딩으로 인코딩한 후, 다중 스케일 계층적 코드북(MHC) 이산화를 적용하고, 패치를 재구성하여 재구성 오차 점수를 계산한다. 동시에, 코드북 활성화 희귀도(CAR) 메커니즘은 정상 훈련 샘플로부터 학습된 코드북 활성화 빈도 프로파일을 기반으로 의미적 희귀도를 추정한다. 정규화된 재구성 점수와 CAR 점수는 최종 이미지 수준의 이상 점수를 생성하기 위해 융합되며, 패치 수준의 응답은 계층적 위치 탐지를 위해 다시 이미지 평면으로 투영된다. 이 그림의 확대 버전을 보려면 여기를 클릭하십시오.
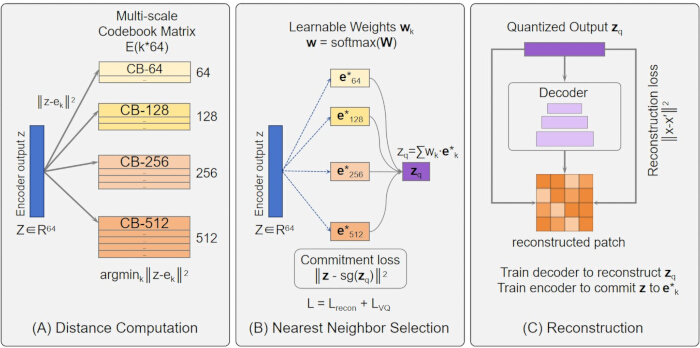
그림 2: 다중 스케일 벡터 양자화 메커니즘. (A) 인코더 출력 특징과 코드북 임베딩 벡터 간의 거리 계산. (B) 코드북 용량이 64, 128, 256 및 512인 경우에 대한 최근접 이웃 선택 및 가중 융합. (C) 전치 합성곱 디코더를 통한 양자화된 특징들로부터의 재구성. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
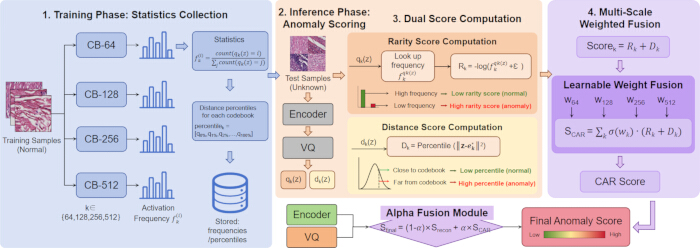
그림 3: CAR 점수 산정 메커니즘. 이 그림은 네 단계를 보여준다. 1단계: 정상 훈련 샘플만을 사용하여 활성화 빈도 통계를 계산한다. 2단계: 테스트 샘플이 인코더와 벡터 양자화를 통해 활성화 지수와 거리 값을 얻는다. 3단계: 훈련 세트의 빈도 프로파일을 기반으로 희소성 점수와 거리 점수를 계산한다. 4단계: 각 코드북 스케일의 점수를 가중치를 학습 가능한 방식으로 융합하여 최종 CAR 점수를 생성한다. 이 그림의 확대 버전을 보려면 여기를 클릭하십시오.
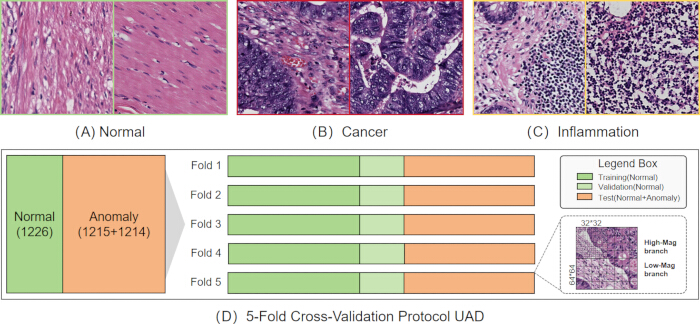
그림 4: 대장암 데이터셋 구성 및 실험 절차 (A–C) 대표적인 H&정상 대장 조직, 대장암 및 대장 염증의 H&E 염색 조직병리 이미지.D) UAD를 위한 5-겹 교차 검증 프로토콜로, 정상 샘플은 훈련 및 검증에 사용되었고, 보류된 정상 샘플과 이상 샘플은 테스트에 사용되었다. 이미지는 40배 확대에서 디지털화되어 32×32 및 64×64 패치로 처리되었다. 녹색, 연한 녹색, 주황색은 각각 훈련 세트, 검증 세트, 테스트 세트를 나타낸다. 이 그림의 확대 버전을 보려면 여기를 클릭하십시오.
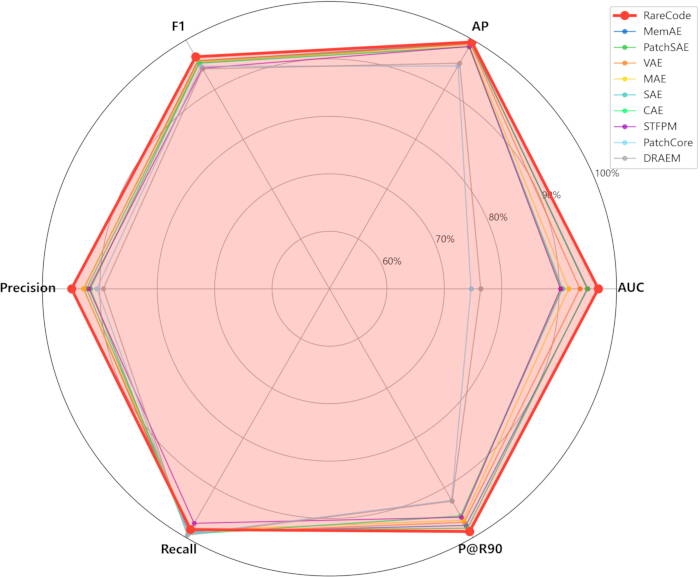
그림 5: 이상 탐지 방법의 다중 지표 비교 레이더 차트. AUC, 평균 정밀도(AP), F1 점수, 정밀도, 재현율, 90% 재현율에서의 정밀도(P@R90)를 기준으로 RareCode와 기준 방법들 간의 성능을 비교한 레이더 차트. 모든 값은 5-겹 교차 검증을 통해 산출된 평균 성능을 나타냄. 이 그림의 확대 버전을 보려면 여기를 클릭하십시오.
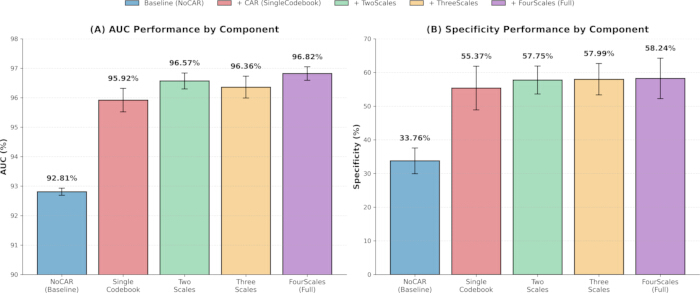
그림 6: 제거 연구 구성 요소의 점진적 기여도 분석 (A) 재구성만을 기반으로 한 기준 모델(NoCAR)에서 단일 코드북을 거쳐 다중 스케일 구성에 이르기까지 점진적인 개선을 보여주는 AUC 성능 비교.B) CAR 메커니즘을 입증하는 특이성 성능 비교'위양성 감소에 대한 효과. 모든 오차 막대는 5겹 교차 검증을 통해 산출된 표준편차(SD)를 나타낸다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
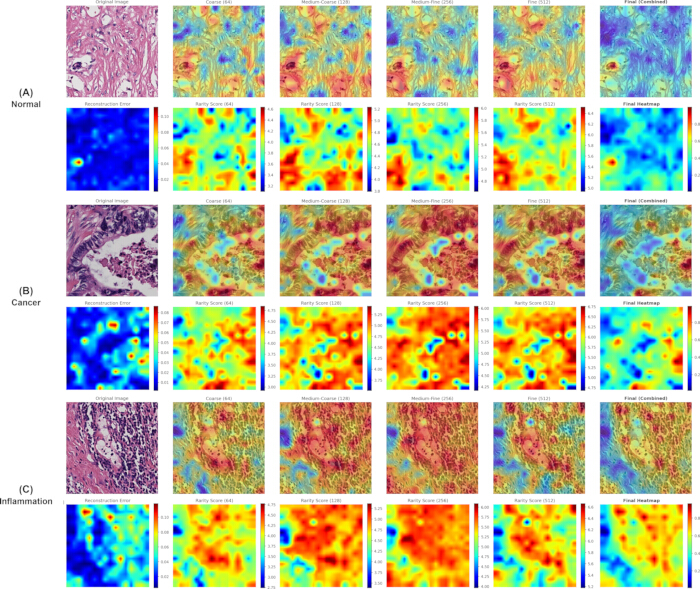
그림 7다중 스케일 코드북 계층적 위치 추정 히트맵 대표적인 예시가 아래에 나와 있다. (A) 정상, (B) 암, 및 (C) 염증 샘플. 각 행에는 원본 이미지, 오버레이, 재구성 오차 맵, 다양한 용량(64, 128, 256, 512)의 코드북에서 생성된 희귀성 점수 맵, 그리고 최종 융합된 위치 지정 맵이 포함되어 있다. 용량이 작은 코드북은 더 강한 압축 추상화를 통해 거친 수준의 패턴을 강조하는 반면, 용량이 큰 코드북은 더 섬세한 구조적 세부 정보를 보존한다. 반응이 높은 영역은 질병 또는 염증 관련 병리조직학적 특징과 질적으로 대응하지만, 픽셀 수준의 전문가 주석을 통한 검증은 수행되지 않았다. 이 그림의 확대 버전을 보려면 여기를 클릭하십시오.
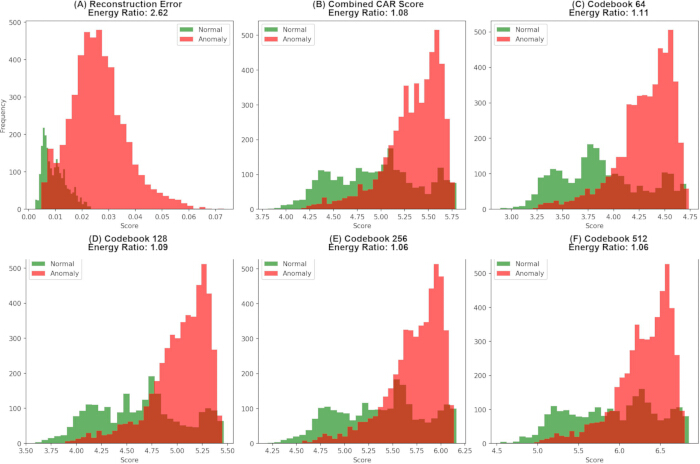
그림 8: 다양한 점수 유형의 분포 히스토그램 히스토그램은 정상 샘플과 비정상 샘플 간의 점수 분포를 비교합니다. (A) 재구성 오차, (B) 결합된 CAR 점수, (C) 코드북 64, (D) 코드북 128, (E) 코드북 256, 및 (F) 코드북 512. 녹색 및 빨간색 히스토그램은 각각 정상 샘플과 비정상 샘플을 나타낸다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
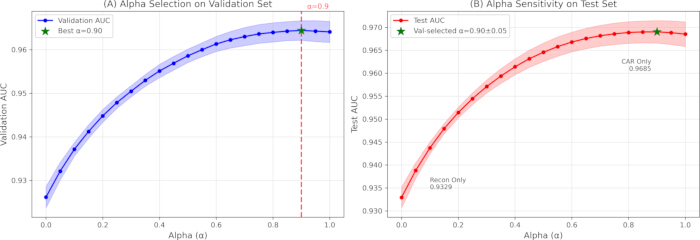
그림 9: 알파 파라미터 민감도 분석 (A) 검증 세트 AUC 사용 목적 α 선택 (B) 다양한 조건에서의 테스트 세트 AUC α 값. 검증 선택된 α 값은 0.85에서 0.95까지의 범위를 나타냈으며, 평균은 0.90이었다. ± 0.05로, 표 5와 일치함. AUC 변동은 0.5% 미만으로 유지됨. α [0.70, 1.00] 범위 내에서 다양하게 나타나 넓은 파라미터 범위에 걸쳐 안정적인 성능을 보였다. 이 그림의 확대 버전을 보려면 여기를 클릭하십시오.
| 방법 | AUC (%) | AP (%) | F1 (%) | 정밀도(%) | 재현율 (%) | 특이도 (%) | P@R90(%) |
| CAE | 90.37 ± 0.94 | 98.62 ± 0.18 | 95.34 ± 0.15 | 91.64 ± 0.40 | 99.35 ± 0.22 | 28.14 ± 3.88 | 95.66 ± 0.32 |
| SAE | 90.58 ± 0.94 | 98.66 ± 0.18 | 95.34 ± 0.15 | 91.67 ± 0.40 | 99.32 ± 0.24 | 28.46 ± 3.97 | 95.71 ± 0.30 |
| VAE | 93.60 ± 0.82 | 99.13 ± 0.12 | 95.86 ± 0.19 | 92.81 ± 0.49 | 99.12 ± 0.29 | 39.07 ± 4.70 | 96.94 ± 0.43 |
| MAE | 91.65 ± 2.75 | 98.76 ± 0.50 | 95.61 ± 0.60 | 92.87 ± 1.56 | 98.55 ± 0.55 | 39.74 ± 14.32 | 96.55 ± 0.97 |
| MemAE | 94.97 ± 0.81 | 99.35 ± 0.11 | 95.78 ± 0.33 | 92.82 ± 1.07 | 98.95 ± 0.60 | 39.15 ± 9.99 | 97.57 ± 0.33 |
| 패치SAE | 94.86 ± 0.36 | 99.34 ± 0.05 | 95.39 ± 0.13 | 92.32 ± 0.27 | 98.67 ± 0.12 | 34.91 ± 2.57 | 98.13 ± 0.24 |
| STFPM | 90.23 ± 3.05 | 98.70 ± 0.44 | 94.32 ± 0.21 | 91.90 ± 3.51 | 97.14 ± 3.38 | 29.82 ± 33.53 | 95.93 ± 1.96 |
| DRAEM | 76.34 ± 2.82 | 95.34 ± 0.90 | 94.19 ± 0.07 | 89.39 ± 0.65 | 99.56 ± 0.65 | 6.19 ± 7.09 | 92.69 ± 0.57 |
| 패치코어 | 74.64 ± 1.82 | 94.76 ± 0.55 | 94.73 ± 0.05 | 90.52 ± 0.15 | 99.36 ± 0.12 | 17.49 ± 1.54 | 92.54 ± 0.15 |
| 레어코드 | 96.82 ± 0.23 | 99.59 ± 0.03 | 96.63 ± 0.15 | 94.93 ± 0.67 | 98.40 ± 0.48 | 58.24 ± 5.99 | 98.80 ± 0.10 |
표 1: 기준 방법과의 비교 결과 (5-겹 교차 검증). RareCode 및 9개의 기준 UAD 방법들이 CRC 데이터셋에서의 검출 성능. 평가 지표는 AUC, 평균 정밀도(AP), 재현율, 특이도, F1-점수, 90% 재현율에서의 정밀도(P@R90), 정밀도를 포함함. 모든 값은 평균을 나타냄 ± 5겹 교차 검증에서의 표준편차(SD). 굵게 표시된 값은 각 지표에서 가장 뛰어난 성능을 나타낸다.
| 카테고리 | AUC (%) | AP (%) | F1 (%) | 회수율 (%) | 특이도 (%) |
| 암 | 99.44 ± 0.12 | 99.86 ± 0.03 | 98.34 ± 0.17 | 98.13 ± 0.29 | 94.21 ± 2.22 |
| 염증 | 94.30 ± 0.44 | 98.48 ± 0.12 | 93.44 ± 0.29 | 96.55 ± 0.78 | 60.44 ± 4.34 |
표 2: 이상 징후 하위 유형별 클래스당 검출 성능. 희귀코드의 독립적 평가'정상 샘플 대비 암 및 염증 샘플에 대한 s의 검출 성능. AUC, AP, F1-점수, 재현율 및 특이도를 포함한 클래스별 지표는 클래스별 최적 임계값을 사용하여 계산하였다.
| 변이형 | 코드북 구성 | CAR | AUC (%) | AP (%) | F1(%) | 특이도 (%) | P@R90(%) |
| NoCAR |  | | 92.81 ± 0.12 | 99.05 ± 0.02 | 95.30 ± 0.08 | 33.76 ± 3.82 | 96.72 ± 0.12 |
| 싱글코드북 | [256] |  | 95.92 ± 0.40 | 99.47 ± 0.05 | 96.25 ± 0.14 | 55.37 ± 6.51 | 98.31 ± 0.43 |
| 투스케일스 | [128, 512] | | 96.57 ± 0.27 | 99.56 ± 0.04 | 96.45 ± 0.12 | 57.75 ± 4.14 | 98.75 ± 0.12 |
| 쓰리스케일스 | [128, 256, 512] | | 96.36 ± 0.37 | 99.53 ± 0.05 | 96.52 ± 0.17 | 57.99 ± 4.65 | 98.60 ± 0.23 |
| 포스케일스 | [64, 128, 256, 512] | | 96.82 ± 0.23 | 99.59 ± 0.03 | 96.63 ± 0.15 | 58.24 ± 5.99 | 98.80 ± 0.10 |
| FourScales + 복합 디코더 | [64, 128, 256, 512] | | 95.17 ± 0.44 | 99.39 ± 0.06 | 95.32 ± 0.20 | 53.83 ± 21.45 | 98.40 ± 0.37 |
표 3: 소거 연구 결과. 성분을 점진적으로 추가한 RareCode 구성의 성능 비교: 재구성 전용 기준선(NoCAR), 단일 코드북 CAR(SingleCodebook), 다중 스케일 구성(TwoScales, ThreeScales, FourScales). FourScales 구성에서 추가로 디코더 복잡도에 대한 소거 분석도 포함되었다. 평가 지표는 AUC, 평균 정밀도(AP), F1-점수, 특이도 및 90% 재현율에서의 정밀도(P@R90)를 포함한다.
| 점수 유형 | 에너지 비율 | 코헨's d | AUC (%) |
| 재구성 오차 | 2.623 | 2.006 | 93.31 |
| 결합된 CAR | 1.078 | 1.002 | 74.85 |
| 코드북 64 | 1.109 | 1.207 | 78.79 |
| 코드북 128 | 1.085 | 1.067 | 76.19 |
| 코드북 256 | 1.065 | 0.916 | 72.80 |
| 코드북 512 | 1.064 | 0.833 | 70.38 |
표 4: 위치 정보 기반 반응의 이미지 수준 분석. 정상 샘플과 비정상 샘플 간의 이미지 평균 재구성 오차 및 코드북 희소도 반응을 에너지 비율, 코헨's d 및 AUC.
| 접기 | 최적 α | Val AUC(%) | 검사 AUC (%) |
| 1 | 0.95 | 96.22 | 96.91 |
| 2 | 0.9 | 96.38 | 96.39 |
| 3 | 0.85 | 96.71 | 96.82 |
| 4 | 0.85 | 96.22 | 96.93 |
| 5 | 0.95 | 96.72 | 97.05 |
| 평균 | 0.90 ± 0.05 | 96.45 ± 0.23 | 96.82 ± 0.23 |
표 5: 폴드 간 최적 알파 값 각 교차 검증 폴드의 검증 세트에서 그리드 서치(스텝 크기 0.05)를 통해 결정된 최적의 융합 가중치 알파의 평균 및 표준편차 통계값.
토론
결과는 코드북 활성화 패턴이 공간 재구성 오차에 대한 보완적인 정보를 제공할 수 있음을 시사합니다. NoCAR에서 전체 FourScales 모델로의 성능 향상은 CAR 스코어링의 잠재적 기여를 뒷받침하며, 선택된 퓨전 가중치는 의미론적 희소성이 최종 이상치 점수에서 중요한 역할을 할 수 있음을 나타냅니다. 한 가지 가능한 설명은 CRC 관련 이상 징후가 핵 비정형성부터 선 구조의 파괴에 이르기까지 서로 다른 형태학적 척도를 가질 수 있으며, 따라서 여러 입도(granularity)의 특징 표현을 통해 이점을 얻을 수 있다는 것입니다14. 현재 모델은 동일한 배율 수준에서 32 × 32 및 64 × 64 패치를 사용하여 서로 다른 공간적 범위를 캡처하며, 향후 전체 슬라이드 이미지(WSI) 처리 프레임워크와의 통합을 통해 계층적 슬라이드 수준 분석을 더욱 지원할 수 있을 것입니다39.
임상적으로 RareCode는 자율 진단 시스템이라기보다 사전 스크리닝 선별 도구로 간주하는 것이 가장 적절할 수 있습니다. 높은 재현율(98.40%)은 이상 사례를 놓칠 위험이 상대적으로 낮음을 시사하며40, 중간 정도의 특이도(58.24%)는 비지도 학습 환경에서 염증성 변화와 정상 조직을 구별하는 것의 어려움을 반영하는 것으로 보입니다. 암 특이적 특이도가 더 높게 나타난 점(94.21%)은 임상적으로 가장 중요한 하위 유형에 대한 오경보 빈도가 더 낮을 수 있음을 시사합니다. 이러한 성능 특성은 전문가의 평가가 필요한 사례의 우선순위를 정하고 병리 검토 과정을 효율화하기 위한 사전 스크리닝 도구로서 RareCode의 잠재적 활용 가능성을 뒷받침합니다5,6.
클래스별 결과는 트리아지(triage)에서 RareCode의 잠재적 역할을 더욱 뒷받침할 수 있습니다. 염증보다 암에서 상대적으로 더 강력한 성능을 보인 것은 극성 소실, 핵 다형성 및 기질 형성성 섬유화와 같이 악성 조직에서 흔히 관찰되는 더 뚜렷한 구조적 및 세포학적 편차를 반영하는 것일 수 있습니다14,39. 반면, 염증성 변화는 양성 조직의 변이와 더 밀접하게 겹칠 수 있으며, 이는 염증 특이적 특이도가 더 낮게 나타난 이유를 부분적으로 설명할 수 있습니다. 따라서 전체적인 특이도는 주의해서 해석해야 하며, 암 검출은 결정적인 자율 진단보다는 임상적으로 중요한 활용 사례로 보아야 합니다.
RareCode의 잠재적인 실패 모드는 단일 클래스 학습 목표라는 맥락에서 해석되어야 합니다. 이 모델은 질병 특이적 범주가 아닌 정상 조직의 패턴을 학습하기 때문에, 재생 상피, 섬유화, 괴사 또는 뚜렷한 염증과 같은 비종양성 변화 또한 높은 이상치 점수를 받을 수 있습니다. 반대로, 미세한 이형성증이나 정상에 가까운 선 구조를 가진 고분화 암종은 더 약한 반응을 보일 수 있습니다. 염색 변이, 조직 접힘, 절편 제작 아티팩트, 디포커스 및 이미지 압축을 포함한 기술적 요인 또한 재구성 오차와 코드북 활성화 빈도에 영향을 미칠 수 있습니다. 이러한 고려 사항들은 임상 적용을 위해 이미지 품질 관리, 염색 조화, 스캐너 맞춤형 보정 및 다기관 검증이 필요함을 시사합니다39,41.
기준 비교 범위. 본 연구의 실험적 평가는 비교 가능한 데이터 및 계산 가정이 적용되는 방법, 구체적으로 외부 사전 학습 코퍼스 없이 소규모의 레이블되지 않은 정상 샘플만을 사용하여 엔드-투-엔드로 학습할 수 있는 방법들에 집중합니다. 이 범위에는 비지도 이상 탐지의 주요 패러다임인 재구성 기반(CAE, VAE, SAE, MAE, PatchSAE), 메모리 증강(MemAE), 지식 증류(STFPM), 합성 증강(DRAEM) 및 사전 학습된 특징 매칭(PatchCore)이 포함됩니다. 두 가지 범주의 방법이 직접적인 기준 모델로 포함되지 않았음을 밝힙니다. 첫째, 병리학 특화 파운데이션 모델(UNI, CONCH, CTransPath)은 수백만 장의 큐레이션된 병리 이미지로 사전 학습을 수행하며, 이들의 성능 우위는 이상 탐지 메커니즘보다는 주로 사전 학습 데이터의 규모와 다양성에 기인합니다. 따라서 직접적인 비교는 사전 학습 데이터의 기여도와 탐지 방법론의 기여도를 혼동하게 만들 수 있습니다. ImageNet으로 사전 학습된 백본을 사용하는 STFPM과 PatchCore의 낮은 성능은 범용 사전 학습 특징을 조직병리학적 시나리오에 적용했을 때 발생하는 도메인 갭의 영향을 실증적으로 보여주며, 병리학 특화 사전 학습이 이러한 간극을 메울 수 있음을 시사합니다. 둘째, 확산 기반 이상 탐지 방법은 유망하지만, 추론 중에 상당히 높은 계산 오버헤드(통상적으로 수백 단계의 반복적 디노이징 단계 필요)가 발생하여 처리 효율성이 실질적 요구 사항인 고처리량 임상 스크리닝 워크플로우에서의 적용성이 제한됩니다. 향후 연구에서는 현재의 엔드-투-엔드 학습 인코더를 병리학 특화 사전 학습 인코더로 대체하여 RareCode 아키텍처에 통합함으로써, CAR 메커니즘의 해석 가능성상 이점을 유지하면서 탐지 성능을 더욱 향상시킬 수 있는지 조사할 예정입니다.
몇 가지 한계점을 인정해야 한다. 첫째, 검증이 단일 센터의 CRC 데이터셋으로 제한되었으며, 여러 기관, 스캐너 및 염색 프로토콜에 걸친 추가적인 다기관 평가가 필요하다. 둘째, 암 특이적 특이도는 고무적이었으나, 전체적인 특이도는 여전히 염증-정상 경계의 영향을 받았다. 셋째, 픽셀 수준의 전문가 어노테이션을 사용할 수 없었기에 Dice 및 IoU를 계산할 수 없었으며, 국소화 평가는 정성적 시각화와 집계된 공간 응답의 이미지 수준 분석으로 제한되었다. 넷째, 계층적 히트맵이 진단 정확도나 판독 효율성을 향상시킬 수 있는지 결정하기 위해 공식적인 판독자 연구가 여전히 필요하다. 마지막으로, RareCode는 현재 패치 및 이미지 수준 분석을 수행하며, WSI 수준의 배포를 위해서는 추가적인 처리 프레임워크와의 통합이 필요할 것이다39,41,42.
향후 연구에서는 WSI 처리 프레임워크와 통합한 후 공공 벤치마크 및 다기관 코호트에서 RareCode를 평가해야 합니다. 전향적 독자 연구를 통해 진단 정확도, 검토 시간 및 관찰자 간 일치도에 미치는 잠재적 영향을 평가하는 것이 도움이 될 수 있습니다42. 추가적인 연구 방향으로는 계산 효율성 향상, 다중 클래스 이상 징후 하위 유형 분류로의 모델 확장, 슬라이드 수준 진단을 위한 다중 인스턴스 학습의 통합 등이 있습니다28,39.
공개 사항
저자들은 본 논문에 보고된 연구에 영향을 미칠 수 있는 알려진 재정적 이해관계나 개인적 관계가 없음을 선언합니다. 본 연구를 준비하는 동안, 저희는 원고의 언어 및 가독성을 개선하고 데이터 시각화 코드 생성을 지원받기 위해 ChatGPT를 사용하였습니다. 해당 도구를 사용한 후, 저희는 필요에 따라 내용을 검토 및 수정하였으며 출판된 논문에 대해 모든 책임을 집니다.
감사의 글
본 연구는 Yong Dai 학술원 워크스테이션 (자가면역질환 진단 기술) (Wan Ke Science and Technology [2023] No. 317), 허페이 국립 보건 과학 기술 연구 센터 직업 의학 및 건강 공동 연구 센터 대학원 혁신 기금 프로젝트 오픈 펀드 (No.OMH-2023-04), 안후이성 임상 및 중개 연구 프로젝트 (No.20242761020132)의 지원을 받아 수행되었습니다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| GeForce RTX 4060 Ti GPU | NVIDIA | 입력된 텍스트가 없습니다. 번역할 내용을 제공해 주시기 바랍니다. | 16 GB VRAM; 모든 실험에 단일 GPU 사용 (RRID:SCR_02858) |
| Matplotlib | Matplotlib 개발 팀 | 버전 3.8.4 | 데이터 시각화 및 도표 생성 (RRID:SCR_08624) |
| NumPy | NumPy 개발자 | 버전 1.26.4 | 수치 계산 및 배열 연산 (RRID:SCR_00863) |
| 판다스 | pandas 개발팀 | 버전 2.2.3 | 데이터 정리 및 표 형식의 결과 처리 (RRID:SCR_018214) |
| 필로우 | Python Imaging Library / Pillow 기여자 | 버전 10.3.0 | 이미지 로딩 및 전처리 |
| 파이썬 | Python Software Foundation | 버전 3.12.3 | 모델 개발 및 데이터 분석에 사용된 프로그래밍 언어 (RRID:SCR_08394) |
| PyTorch | Meta Platforms, Inc. | 버전 2.7.0+cu18 | 모델 구현 및 학습에 사용된 딥러닝 프레임워크 (RRID:SCR_018536) |
| scikit-learn | scikit-learn 개발자 | 버전 1.4.2 | 교차 검증, 훈련-테스트 분할 및 평가 지표 (RRID:SCR_0257) |
| SciPy | SciPy 개발자 | 버전 1.13.1 | 통계 분석 (RRID:SCR_08058) |
| torchvision | PyTorch 프로젝트 | 버전 0.2.0+cu18 | 영상 전처리 및 데이터 변환 |
| tqdm | tqdm 개발자 | 버전 4.6.4 | 훈련 및 평가 진행 상황 모니터링 |
참고문헌
- Fan J, Sun Q, Di Y, et al. DIPathMamba: A domain-incremental weakly supervised state space model for pathology image segmentation. Med Image Anal. 2025;103:103563.
- Nan T, Zheng S, Qiao S, et al. Deep learning quantifies pathologists' visual patterns for whole slide image diagnosis. Nat Commun. 2025;16(1):5493.
- Lagogiannis I, Meissen F, Kaissis G, et al. Unsupervised pathology detection: a deep dive into the state of the art. IEEE Trans Med Imaging. 2024;43(1):241-252.
- Tian Y, Liu F, Pang G, et al. Self-supervised pseudo multiclass pre-training for unsupervised anomaly detection and segmentation in medical images. Med Image Anal. 2023;90:102930.
- Metter DM, Colgan TJ, Leung ST, et al. Trends in the US and Canadian pathologist workforces from 2007 to 2017. JAMA Netw Open. 2019;2(5):e194337.
- Shaukat A, Levin TR. Current and future colorectal cancer screening strategies. Nat Rev Gastroenterol Hepatol. 2022;19(8):521-531.
- Ancker JS, Edwards A, Nosal S, et al. Effects of workload, work complexity, and repeated alerts on alert fatigue in a clinical decision support system. BMC Med Inform Decis Mak. 2017;17(1):36.
- Litjens G, Kooi T, Ehteshami Bejnordi B, et al. A survey on deep learning in medical image analysis. Med Image Anal. 2017;42:60-88.
- Stepec D, Skocaj D. Unsupervised detection of cancerous regions in histology imagery using image-to-image translation. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition Workshops. 2021:3785-3792.
- Li Y, Lao Q, Kang Q, et al. Self-supervised anomaly detection, staging and segmentation for retinal images. Med Image Anal. 2023;87:102805.
- Hinton GE, Salakhutdinov RR. Reducing the dimensionality of data with neural networks. Science. 2006;313(5786):504-507.
- Kingma DP, Welling M. Auto-encoding variational Bayes. In: Proceedings of the 2nd International Conference on Learning Representations (ICLR). 2014.
- Goodfellow IJ, Pouget-Abadie J, Mirza M, et al. Generative adversarial nets. In: Advances in Neural Information Processing Systems. 2014;27:2672-2680.
- Lu S, Zhang W, Zhao H, et al. Anomaly detection for medical images using heterogeneous auto-encoder. IEEE Trans Image Process. 2024;33:2770-2782.
- Yang Z, Zhang T, Soltani Bozchalooi I, et al. Memory-augmented generative adversarial networks for anomaly detection. IEEE Trans Neural Netw Learn Syst. 2022;33(6):2324-2334.
- Huyan N, Quan D, Zhang X, et al. Unsupervised outlier detection using memory and contrastive learning. IEEE Trans Image Process. 2022;31:6440-6454.
- Jézéquel L, Beaudet J, Histace A, et al. Unified anomaly detection via multi-scale contrasted memory. IEEE Trans Image Process. 2026;35:2802-2815.
- Roth K, Pemula L, Zepeda J, et al. Towards total recall in industrial anomaly detection. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022:14298-14308.
- Defard T, Setkov A, Loesch A, et al. PaDiM: a patch distribution modeling framework for anomaly detection and localization. In: International Conference on Pattern Recognition. Cham: Springer; 2021:475-489.
- Zingman I, Stierstorfer B, Lempp C, et al. Learning image representations for anomaly detection: application to discovery of histological alterations in drug development. Med Image Anal. 2024;92:103067.
- Jiang Y, Cao Y, Shen W. Prototypical learning guided context-aware segmentation network for few-shot anomaly detection. IEEE Trans Neural Netw Learn Syst. 2025;36(7):12016-12026.
- Wang X, Zhao J, Marostica E, et al. A pathology foundation model for cancer diagnosis and prognosis prediction. Nature. 2024;634(8035):970-978.
- Frotscher A, Kapoor J, Wolfers T, et al. Unsupervised anomaly detection in medical imaging using aggregated normative diffusion. Med Image Anal. 2026;109:103895.
- Zeng GQ, Yang YW, Lu KD, et al. Evolutionary adversarial autoencoder for unsupervised anomaly detection of industrial Internet of Things. IEEE Trans Reliab. 2025;74(3):3454-3468.
- Lu KD, Zhang BX, Xu Y, et al. MoARNN-AM: multi-objective automated recurrent neural network with attention mechanism for cyber-attack detection of UAV. IEEE Trans Consum Electron. 2026;72(1):1738-1749.
- van den Oord A, Vinyals O, Kavukcuoglu K. Neural discrete representation learning. In: Advances in Neural Information Processing Systems. 2017;30:6306-6315.
- Ghafourian A, Shui H, Upadhyay D, et al. Targeted collapse regularized autoencoder for anomaly detection: black hole at the center. IEEE Trans Neural Netw Learn Syst. 2025;36(6):10348-10358.
- Gao Z, Mao A, Dong Y, et al. SMMILe enables accurate spatial quantification in digital pathology using multiple-instance learning. Nat Cancer. 2025;6(12):2025-2041.
- Wang X, Liu H, Zhang Y, et al. Joint modeling histology and molecular markers for cancer classification. Med Image Anal. 2025;102:103505.
- Jin H, Shen J, Cui L, et al. Dynamic graph based weakly supervised deep hashing for whole slide image classification and retrieval. Med Image Anal. 2025;101:103468.
- Schmitz R, Madesta F, Nielsen M, et al. Multi-scale fully convolutional neural networks for histopathology image segmentation: from nuclear aberrations to the global tissue architecture. Med Image Anal. 2021;70:101996.
- Masci J, Meier U, Ciresan D, et al. Stacked convolutional auto-encoders for hierarchical feature extraction. In: International Conference on Artificial Neural Networks. Berlin: Springer; 2011:52-59.
- Ng A. Sparse autoencoder. CS294A Lecture Notes. 2011;72:1-19.
- He K, Chen X, Xie S, et al. Masked autoencoders are scalable vision learners. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022:16000-16009.
- Lim H, Choi J, Choo J, et al. Sparse autoencoders reveal selective remapping of visual concepts during adaptation. In: Proceedings of the 13th International Conference on Learning Representations (ICLR). 2025.
- Gong D, Liu L, Le V, et al. Memorizing normality to detect anomaly: memory-augmented deep autoencoder for unsupervised anomaly detection. In: Proceedings of the IEEE/CVF International Conference on Computer Vision. 2019:1705-1714.
- Wang G, Han S, Ding E, et al. Student-teacher feature pyramid matching for anomaly detection. In: Proceedings of the 32nd British Machine Vision Conference (BMVC). 2021.
- Zavrtanik V, Kristan M, Skocaj D. DRAEM: a discriminatively trained reconstruction embedding for surface anomaly detection. In: Proceedings of the IEEE/CVF International Conference on Computer Vision. 2021:8330-8339.
- Niazi MKK, Parwani AV, Gurcan MN. Digital pathology and artificial intelligence. Lancet Oncol. 2019;20(5):e253-e261.
- Raab SS, Grzybicki DM, Janosky JE, et al. Clinical impact and frequency of anatomic pathology errors in cancer diagnoses. Cancer. 2005;104(10):2205-2213.
- Schömig-Markiefka B, Pryalukhin A, Hulla W, et al. Quality control stress test for deep learning-based diagnostic model in digital pathology. Mod Pathol. 2021;34(12):2098-2108.
- Steiner DF, MacDonald R, Liu Y, et al. Impact of deep learning assistance on the histopathologic review of lymph nodes for metastatic breast cancer. Am J Surg Pathol. 2018;42(12):1636-1646.