본 프로토콜은 원시 데이터 내보내기 및 응답 스크리닝부터 척도 점수 산출, 신뢰도 검토, 회귀 분석 진단, 그림-출처 검증, 그리고 시각화 가능 분석 결과 도출에 이르기까지, 익명화된 학부생 웰빙 설문지 데이터를 처리하기 위한 체계적이고 감사 가능한 워크플로우를 제시합니다.
이 논문에서
요약
초록
설문지 기반 연구는 학생의 웰빙을 조사하는 데 널리 사용되지만, 원시 응답부터 분석 가능한 변수, 통계 표, 시각적 결과물에 이르는 절차적 경로는 종종 충분히 기록되지 않습니다. 본 프로토콜은 여러 개의 Likert 유형 척도 섹션으로 수집된 익명화된 학부생 웰빙 설문 데이터의 처리를 위한 구조화되고 감사 가능한 워크플로우를 제시합니다. 워크플로우는 윤리 승인, 동의서 문서화, 설문지 구성 및 원시 데이터 내보내기로 시작하여, 응답 스크리닝, 중복 응답 검토, 결측치 처리, 항목 코딩, 역코딩, 신뢰도 평가, 기술 분석, 상관 분석, 대조군 비교, 회귀 모델링, 진단 확인 및 시각화 소스 준비로 이어집니다. 예시 설문지는 Depression Anxiety Stress Scales-21, Tuckman Procrastination Scale, Psychological Sense of School Membership Scale, 고차 사고 측정 문헌 및 주관적 웰빙 척도 문헌을 기반으로 하며, 출처가 기록되고 연구에 맞게 수정된 척도 섹션을 사용합니다. 항목 수준의 응답이 추적 가능한 분석 결과물로 어떻게 변환될 수 있는지 보여주기 위해 부정적 정서, 학업 지연, 학교 소속감, 고차 사고 및 주관적 웰빙을 예시 척도 수준 변수로 사용합니다. 대표적인 결과물로는 스크리닝 흐름 표, 인구통계학적 요약, 기술 및 범위 확인 통계, 내부 일관성 추정치, 상관 행렬, 대조 비교 결과, 회귀 계수, 잔차 및 영향력 진단, 그리고 그림 소스 파일이 포함됩니다. 본 프로토콜은 미리 지정된 결정 규칙, 연결된 척도 맵, 분석 전 스크리닝 로그, 역코딩 검증 및 그림의 수치 소스 검증을 강조합니다. 새로운 심리 측정 척도를 제안하거나 측정 모델을 검증하거나 인과 관계를 설정하는 대신, 이 방법은 학부생 웰빙 설문 데이터를 스크리닝, 점수화, 분석 및 시각화해야 하는 연구자들에게 실용적이고 감사 가능한 절차를 제공합니다. 척도 맵, 윤리 승인, 점수 산정 규칙, 응답 스크리닝 임계값 및 시각화 소스 파일이 분석 전에 정의된다면, 이 워크플로우를 관련 설문지 기반 연구에 적용할 수 있습니다.
서론
주관적 안녕감은 학생들이 학습 환경 내에서 자신의 삶, 정서적 경험, 사회적 관계 및 일상적 기능을 어떻게 평가하는지를 반영하므로 학생 연구에서 중요한 결과 변수입니다. 고등 교육에서 학생의 안녕감은 단순히 삶의 만족도나 심리적 고통에 국한되지 않는 다차원적인 특성을 갖습니다1. 따라서 연구자가 동일한 분석 틀 내에서 정서적, 행동적, 사회적, 인지적 경험 및 안녕감 관련 경험을 조사해야 할 때 설문지 데이터는 계속해서 유용하게 활용됩니다.
설문조사 데이터의 가치는 선택된 구성 개념뿐만 아니라 원시 응답이 분석 변수로 변환되는 방식에 따라 달라집니다. 많은 연구가 원시 기록을 최종 표 및 그림으로 연결하는 중간 결정 과정을 보여주지 않은 채 척도 점수, 상관행렬, 집단 간 비교 또는 회귀 모델만을 보고합니다. 결측 응답이 일관성 없게 처리되거나, 역코딩 항목이 잘못 코딩되거나, 중복 제출된 데이터가 데이터셋에 남아 있을 수 있으며, 성의 없는 응답이 유효한 관찰치로 처리될 수도 있습니다. 따라서 결측 데이터 처리 결정은 보이지 않는 사후 단계로 취급하기보다 계획되고 문서화되어 보고되어야 합니다2. 온라인 설문조사 데이터의 경우, 빠른 응답, 일직선 응답, 일관성 없는 답변 및 기타 낮은 노력의 응답 패턴이 기술 통계, 신뢰도 추정치 및 관찰된 연관성을 왜곡할 수 있으므로 명시적인 응답 품질 규칙이 필요합니다3.
이 프로토콜의 독창성은 원시 설문지 내보내기부터 최종 통계 및 시각적 출력물까지 연결된 감사 추적(audit trail)에 있습니다. 구체적으로, 이 워크플로우에는 완성된 척도 맵, 분석 전 스크리닝 로그, 역채점 체크포인트, 채점 검증 로그, 그림을 위한 수치 소스 검증, 그리고 각 표나 그림을 해당 소스 파일과 연결하는 감사 추적이 추가되었습니다. 이는 일반적인 설문 데이터 정제, 척도 채점, 신뢰도 테스트 또는 시각화 관행과 이 방법을 차별화합니다. 단순히 설문 데이터가 정제되고 분석되었다고 기술하는 대신, 이 프로토콜은 어떤 파일이 잠금 처리되고, 어떤 파일이 스크리닝되며, 어떤 규칙이 적용되고, 어떤 척도 점수가 생성되며, 각 시각적 출력물을 생성하는 데 어떤 검증된 수치 표가 사용되는지를 명시합니다.
본 워크플로우는 부정적 정서, 학업 지연 행동, 학교 소속감, 고차원적 사고, 주관적 안녕감의 5가지 척도 수준 변수를 포함하는 익명화된 대학생 설문 데이터로 시연됩니다. 이러한 구성 개념들은 하나의 구조화되고 감사 가능한 워크플로우 내에서 정서적, 행동적, 학교 환경적, 인지적 및 결과 지향적인 예시를 제공하기 위해 선택되었습니다. 학업 지연 행동은 우울, 불안 및 스트레스 관련 결과를 포함하여 대학생들의 추후 정신 건강 문제와 연관이 있는 것으로 알려져 있습니다4. 학교 소속감과 주관적 안녕감 또한 학생 집단 사이에서 밀접하게 연결되어 있으며, 이는 동일한 설문 처리 프레임워크 내에 소속감 및 안녕감 관련 측정 항목을 포함하는 근거가 됩니다5. 다만, 본 프로토콜에서 이러한 구성 개념들은 인과적 심리 모델을 설정하기보다는 워크플로우를 시연하기 위한 목적으로 사용되었습니다.
본 프로토콜의 핵심 특징은 데이터 처리 결정과 실질적 해석을 분리하는 것입니다. 척도 맵은 분석 전에 준비하고, 응답 품질 기준은 척도 점수 산정 전에 고정하며, 역코딩 검증은 통계적 검정 전에 완료하고, 수치 소스 표를 확인한 후에만 도표를 생성합니다. 이러한 순서가 중요한 이유는 리커트(Likert) 유형의 응답 척도는 문항 문구, 응답 앵커, 점수 산정 방향 및 통계적 처리 간의 세심한 정렬이 필요하기 때문입니다6. 또한, 본 프로토콜은 투명한 전처리 및 점수 검증을 모델 복잡성보다 우선시합니다. 예측 또는 다변량 모델은 학생 연구에서 유용할 수 있으며7, 검증된 수치 행렬과 연계된 그래픽 요약은 해석력을 높일 수 있지만8, 이 두 가지 모두 입력 변수의 투명한 준비에 달려 있습니다. 이러한 이유로, 본 워크플로우에서는 상관 분석, 대조 집단 비교, 회귀 모델링, 진단 확인 및 시각화를 필수적인 실질적 주장이라기보다 예시 모듈로 사용합니다.
본 프로토콜은 익명화된 학생 웰빙 데이터에 대한 실용적인 설문지 처리 워크플로가 필요한 연구자를 위해 제작되었습니다. 온라인 플랫폼에서 항목 수준의 설문 응답을 내보내고, 리커트 척도 항목으로부터 척도 수준의 변수를 계산해야 하며, 투명한 기술 통계, 상관 분석, 집단 비교, 회귀 분석, 진단 및 시각화 가능한 결과물을 생성하는 것이 목적일 때 적합합니다. 인과 관계 설정, 새로운 척도의 타당도 검증, 확인적 요인 분석 대체, 측정 동일성 검사 대체, 또는 문항 반응 이론이나 잠재 변수 모델링을 대체하기 위해 설계된 것이 아닙니다. 본 프로토콜의 기여도는 절차적인 측면에 있으며, 설문 기록부터 보고용 표와 그림에 이르는 과정을 가시화하고 재현 및 감사가 가능하도록 만드는 것입니다. 이러한 초점은 온라인 설문 데이터 품질9, 회귀 분석 및 영향력 확인10, 그리고 감사가 가능한 설문 기반 분석 워크플로11에 관한 최근의 관심사와 일치합니다.
프로토콜
인간 대상자를 포함하는 본 연구는 구이저우 개방대학교 항공대학 윤리위원회(승인 번호 GZOU-EDU-2024-015)의 심의 및 승인을 받았습니다. 위원회는 본 연구가 익명의 자발적 설문 조사 절차를 사용하며 참여자에게 미치는 위험이 최소 수준 이하라고 판단하여 윤리적 면제 대상으로 결정하였습니다. 모든 참여자는 설문지를 작성하기 전 전자 고지된 동의서에 서명하였으며, 어떠한 불이익 없이 언제든지 응답을 중단할 수 있었습니다. 일부 항목이 부정적인 감정, 스트레스, 외로움, 무력감, 불만족 또는 관련 웰빙 경험을 다루고 있었으므로, 불편함을 느끼는 참여자를 위해 동의 페이지와 최종 설문 페이지에 연구자와 기관의 연락처를 제공하였습니다. 본 프로토콜에 사용된 데이터 세트는 스크리닝, 점수 산출, 분석 및 시각화 이전에 익명화되었습니다. 전체 설문지는 부록 파일 1로 제공됩니다.
1. 설문지, 윤리 관련 자료 및 워크플로 결과물 준비
- 설문지를 프로그래밍하기 전에 대상 인구, 연구 설정, 설문지 구성 요소 및 계획된 분석 결과물을 정의하십시오.
- 대상 인구 집단, 모집 경로, 설문지 내용, 예상 소요 시간, 익명성 보호, 데이터 저장, 철회 절차, 참여자 지원 정보 및 계획된 분석 내용을 포함하는 윤리 심의 신청서를 작성하십시오.
- 데이터 수집을 시작하기 전에 윤리 승인 또는 면제 문서, 동의서 문구, 모집 안내문, 설문지 버전, 참여자 지원 정보 및 계획된 워크플로우를 프로젝트 폴더에 저장하십시오.
- 대상 모집단을 18세 이상이며, 현재 고등 교육 기관에 재학 중인 전일제 학부생으로서, 설문지를 이해할 수 있고 고지된 동의서를 제공할 수 있는 자로 정의한다.
- 모집 전 제외 기준을 정의하십시오. 동의를 거부하거나, 대상 집단 정의에 부합하지 않거나, 중복 응답을 제출하거나, 결측치 임계값을 초과하거나, 단계 1.4에 설명된 결합 무효 응답 기준에 해당하는 응답자를 제외하십시오.
- 설문지의 시작 부분에 고지된 동의서를 배치하십시오. 연구 목적, 참여의 자발성, 약 12분의 예상 소요 시간, 익명성 보호, 철회 권리, 데이터 활용 계획, 연구자 연락처 및 지원 센터 연락처를 명시하십시오.
- 학생 식별 번호, 국가 식별 번호, 휴대전화 번호, 개인 이메일 주소, 기숙사 주소 또는 기타 개인 식별자를 포함하여 직접적으로 식별 가능한 정보를 수집하지 마십시오.
- 설문지를 다음과 같은 순서로 구성하십시오: 고지된 동의서, 인구통계학적 정보, 부정적 정서 문항, 학업 지연 문항, 학교 소속감 문항, 고차원적 사고 문항, 그리고 주관적 안녕감 문항.
- 설문지를 프로그래밍하기 전에 소스 도구를 선택하십시오. 본 프로토콜에서는 부정적 정서는 21개 문항의 Depression Anxiety Stress Scales-21을 사용하여 평가하였으며, 학업 지연 행동은 16개 문항의 Tuckman Procrastination Scale을, 학교 소속감은 18개 문항의 Psychological Sense of School Membership Scale을 사용하였습니다. 또한 고등 사고력은 기출판된 고등 사고력 측정 문헌을 응용한 20개 문항의 고등 사고력 문항 세트를 통해 평가하였으며, 주관적 웰빙은 대학생 연구용 20개 문항의 주관적 웰빙 척도를 사용하여 평가하였습니다.12,13,14,15,16.
- 설문지를 프로그래밍하기 전에 고정 척도 맵(locked scale map)을 준비하십시오. 여기에는 구성 개념 이름, 원래 척도 이름, 원문 인용, 언어 버전, 허가 또는 승인 상태, 번역 또는 수정 절차, 문항 코드, 문항 문구, 응답 범위, 응답 닻(response anchors), 점수 방향, 역채점 문항 여부, 최종 척도 수준 변수 및 채점 규칙이 포함되어야 합니다.
- 원천 도구, 인용 문헌, 타당도 입증 근거, 그리고 수정 또는 번역 상태가 문서화된 경우에만 항목 세트를 타당도가 검증된 척도로 기술하십시오. 저자가 직접 개발하였거나 특정 연구를 위해 제작된 항목 세트는 다음과 같이 식별하십시오. 표 1 및 보충 파일 1.
- 데이터 수집 전 측정 체계를 확정하십시오. 번역 또는 수정된 도구를 사용하는 경우, 대상자 모집 시작 전에 번역, 검토, 조정 및 파일럿 점검을 완료하십시오.
- 잠금 처리된 설문지 파일, 척도 맵, 원시 데이터 내보내기 체크리스트, 스크리닝 로그, 점수 검증 로그, 분석 로그, 그림-출처 표 템플릿, 그리고 분석 구문 또는 스크립트 파일이 포함된 워크플로 감사 패키지를 준비하십시오.
- 모든 워크플로 아티팩트에 버전이 지정된 파일 이름을 사용하십시오.
- 각 감사 파일에 필요한 열을 정의하십시오.
- 스크리닝 로그에는 레코드 ID, 스크리닝 기준, 플래그 상태, 제외 상태, 제외 사유, 결정 날짜 및 검토자 이니셜이 포함됩니다.
- 척도 맵에는 구성 개념 이름, 척도 출처, 항목 코드, 항목 문구, 응답 범위, 응답 닻(response anchors), 역코딩 여부, 최종 변수명, 채점 규칙, 그리고 허가 또는 수정 상태가 포함됩니다.
- 점수 검증 로그에는 항목 코드, 원래 값 범위, 재코딩된 값 범위, 역채점 공식, 범위 확인 결과, 불일치 상태, 수정 사항 및 수정 날짜가 포함됩니다.
- 그림 소스 표에는 그림 번호, 패널 번호, 소스 표, 도식화된 변수, 표시된 통계치, 표본 크기 및 검증 상태가 포함됩니다.
- 설문지 프로그래밍 전에 다음과 같은 분석 워크플로를 정의하십시오: 설문 실시, 원시 데이터 내보내기, 응답 스크리닝, 척도 점수 산정, 신뢰도 평가, 기술 분석, 상관 분석, 고-저 집단 비교, 회귀 모델링, 진단 점검 및 시각화 준비17.
- 소프트웨어 메뉴 경로보다는 결정 사항, 조작 단계 및 검증 결과물을 중심으로 프로토콜을 구성하십시오.
- 기관 및 학술지 정책이 허용하는 경우, 설문지 파일, 척도 맵, 스크리닝 로그 템플릿, 점수 기록 로그 템플릿, 분석 구문 또는 스크립트 파일, 그림 소스 표를 포함한 워크플로 리소스를 제공하십시오.
참고: 그림 1 설문지 작성부터 로우 데이터 내보내기, 응답 스크리닝, 척도 점수 산출, 통계 분석, 진단 검토 및 시각화 출력까지의 경로를 보여줍니다. 표 1 각 구성 개념에 대해 출처 도구, 항목 수, 응답 범위, 채점 체계, 역채점 규칙, 허가 또는 수정 여부, 그리고 최종 척도 수준 변수를 보고합니다.
2. 설문지 구성 및 배포
- 설문조사 플랫폼이 동의 게이팅, 필수 항목, 중복 제출 검토, 타임스탬프 캡처 및 응답 소요 시간 기록을 지원하는지 확인합니다.
- 재료 표에 나열된 온라인 설문조사 플랫폼을 사용하여 설문지를 작성합니다. 확정된 척도 맵에 따라 설문지를 프로그래밍합니다.
- 설문 링크를 배포하기 전, 프로그래밍된 설문지를 확정된 척도 맵과 항목별로 대조합니다. 수정 사항은 모두 연구 로그에 기록합니다.
- 고지된 동의 항목을 첫 번째 필수 항목으로 설정합니다. 참여자가 “참여에 동의하지 않습니다”를 선택하면 설문조사가 자동으로 종료되도록 설정합니다.
- 단계 1.8에서 정해진 순서에 따라 인구통계학적 및 심리 척도 섹션을 프로그래밍합니다. 척도 맵과 일치하는 항목 코드를 사용합니다.
- 윤리 승인 또는 면제 사항에서 허용되고 참여자가 불이익 없이 철회할 수 있는 경우에만 심리 척도 항목을 필수 항목으로 설정합니다. 강제 응답이 허용되지 않는 경우, 데이터 수집 전 결측치 처리 규칙을 기록합니다.
- 각 척도 섹션 앞에 응답 앵커를 표시하고, 각 척도 내에서 앵커를 일관되게 유지합니다18.
- 설문 플랫폼에서 해당 기능을 제공하는 경우 중복 제출을 비활성화합니다. 중복 응답 검토에 필요한 익명 기기, 브라우저, 플랫폼 또는 제출 식별자를 유지합니다.
- 제출 시간 및 완료 소요 시간이 자동으로 기록되도록 설정합니다.
- 설문조사 개시 기간을 달력 기준 7일로 설정하거나, 윤리 위원회에서 승인한 수집 기간을 사용합니다.
- 승인된 기관 모집 채널을 통해 설문 링크를 전송합니다. 모든 참여자에게 동일한 서면 지침을 제공합니다.
- 사전에 지정된 수집 기간이 종료되면 설문조사를 마감합니다.
참고: 모집 문구, 설문 링크, 개시 및 마감일, 플랫폼 설정, 동의 문구, 최종 설문지 버전 및 플랫폼 내보내기 설정을 연구 로그에 보관합니다.
3. 원시 데이터 내보내기 및 보안 저장
- 설문 조사 수집 기간이 종료된 직후, 완료된 설문 응답을 스프레드시트 파일로 내보내십시오.
- 처음 내보낸 파일을 잠금 처리된 원시 데이터셋으로 저장하십시오. 이 파일은 수정하지 마십시오.
- 스크리닝, 점수 산정 및 분석을 위한 작업용 사본을 하나 생성하십시오. 파일 이름에는 날짜, 버전 번호 및 프로젝트 식별자를 기입하십시오.
- 내보낸 파일에 응답자당 하나의 행이 있고, 인구통계학적 변수, 설문 항목, 타임스탬프 변수, 플랫폼 변수 또는 파생 플랫폼 필드당 하나의 열이 있는지 확인하십시오.
- 잠금 처리된 원시 데이터셋, 작업용 사본, 척도 맵, 설문지 파일, 연구 로그, 스크리닝 로그, 점수 검증 로그, 분석 로그, 도표 소스 표, 그리고 구문 또는 스크립트 파일을 암호 보호된 프로젝트 폴더에 저장하십시오.
- 데이터셋에 직접적으로 식별 가능한 정보가 포함되어 있지 않은지 확인하십시오. 분석 전 작업용 사본에서 예상치 못한 식별 필드를 제거하고, 필드 이름, 제거 사유, 제거 날짜 및 담당 검토자를 연구 로그에 기록하십시오.
- 참가자 수준의 데이터를 공유하거나 게시하기 전에 간접 식별 가능성을 확인하십시오. 성별, 연령, 학년, 기관 범주 및 전공 범주의 조합으로 생성된 소규모 인구통계학적 셀을 검토하십시오. 셀에 포함된 응답자가 5명 미만인 경우, 범주를 통합하거나 셀을 억제하거나 집계된 데이터만 제공하십시오.
- 참가자 수준의 데이터의 가용 여부, 윤리 또는 개인정보 보호 요구 사항으로 인한 제한 여부, 또는 집계된 워크플로우 데이터셋으로 대체되었는지 여부를 포함하여 데이터 가용성 상태를 연구 로그에 기록하십시오.
- 데이터 정제 전에 스크리닝 로그를 작성하십시오. 원시 표본 크기, 스크리닝 기준, 플래그 표시된 레코드 수, 제거된 레코드 수, 유지된 레코드 수, 제외 사유, 결정 날짜 및 검토자 이니셜을 기록하십시오.
- 통계 분석 전에 분석 추적 파일을 생성하십시오. 소프트웨어 이름, 소프트웨어 버전, 운영 체제, 파일 이름, 데이터 버전, 스크립트 또는 구문 버전, 그리고 각 분석 실행 날짜를 기록하십시오.
참고: 잠금 처리된 원시 데이터셋은 검증용으로만 사용하십시오. 모든 스크리닝, 점수 산정 및 분석은 작업용 사본을 사용하여 수행하십시오.
4. 응답 스크리닝 및 분석 데이터 세트 구축
- 척도 수준의 점수를 계산하기 전에 미리 지정된 제외 및 품질 관리 규칙을 적용합니다.
- 작업 복사본에 다음 순서대로 스크리닝 규칙을 적용합니다: 동의 상태, 적격성, 중복 제출, 누락된 데이터, 응답 소요 시간, 일직선 응답, 범위를 벗어난 값, 그리고 결합된 응답 품질 지표.
- 각 스크리닝 작업 후, 플래그가 지정된 기록, 제거된 기록 및 유지된 기록의 수를 스크리닝 로그에 기록합니다. 작업 파일의 이전 버전을 덮어쓰지 마십시오.
- 고지된 동의 항목이 “아니오”로 표시되었거나 응답하지 않은 모든 기록을 제거합니다.
- 단계 1.4에서 정의된 포함 기준을 충족하지 않는 모든 기록을 제거합니다.
- 익명 응답 식별자, 제출 시간, 플랫폼 중복 제출 플래그 및 반복되는 응답 패턴을 사용하여 중복 제출을 스크리닝합니다.
- 중복 항목이 감지되면, 후속 완전 응답을 유지해야 할 문서화된 이유가 없는 한 첫 번째 완전 제출본을 유지합니다.
- 척도 점수를 계산하기 전에 모든 응답 품질 규칙을 수정합니다. Table 2는 워크플로에 사용된 제외 임계값, 플래그 지정 임계값, 근거, 문헌 근거 및 민감도 분석 계획을 요약하여 보여줍니다.
- 누락된 데이터를 스크리닝합니다. 모든 척도 항목의 20% 이상이 누락된 응답자는 제거합니다. 해당 척도의 최소 80%가 완료된 경우에만, 고립된 누락 항목을 해당 응답자의 동일 척도 평균 점수로 대체합니다. 변수가 분석에 사용되지 않는 경우가 아니면 인구통계학적 변수를 대체하지 마십시오.
- 20% 초과 척도 항목 누락으로 제외된 응답자 수와 척도 내 평균 대체법을 적용받은 응답자 수를 기록합니다. 현재 데이터셋에서는 20% 초과 척도 항목 누락으로 4명의 응답자가 제외되었으며, 21명의 응답자가 37개의 고립된 누락 항목에 대해 척도 내 평균 대체를 적용받았습니다.
- 응답 소요 시간을 스크리닝합니다. 180 s 미만으로 완료된 응답에 플래그를 지정합니다. 이 값은 자동 제외 규칙이 아닌 스피딩(speeding) 플래그로 처리합니다.
- 일직선 응답을 스크리닝합니다. 모든 리커트 척도 항목의 90% 이상에서 동일한 옵션이 선택된 응답에 플래그를 지정합니다. 이 값은 자동 제외 규칙이 아닌 응답 패턴 플래그로 처리합니다.
- 중복 제출의 증거, 불가능한 타임스탬프, 서로 다른 제출물 간의 반복된 응답 문자열, 또는 플랫폼 메타데이터와 설문지 내용 간의 충돌을 포함한 추가적인 낮은 노력 지표를 스크리닝합니다.
- 극도로 짧은 완료 시간과 일직선 응답의 결합, 중복 제출 증거, 또는 불가능한 플랫폼 메타데이터19와 같이 최소 두 개의 품질 관리 지표가 부적절한 응답임을 시사하는 경우에만 플래그가 지정된 응답을 제거합니다.
- 유지되는 경우라도 플래그가 지정된 모든 기록을 기록합니다. 현재 데이터셋에서는 완료 소요 시간 < 180 s로 19개의 응답에 플래그가 지정되었고, >90% 일직선 응답으로 8개의 응답에 플래그가 지정되었으며, 두 개 이상의 응답 품질 지표를 충족하여 13개의 기록이 제외되었습니다.
- 범위를 벗어난 값을 스크리닝합니다. 부정적 정서 항목이 1–4 범위에, 학업 지연, 학교 소속감 및 고차원적 사고 항목이 1–5 범위에, 그리고 주관적 안녕감 항목이 1–6 범위에 있는지 확인합니다.
- 원본 내보내기 파일에서 서식 오류가 명확하게 나타나는 경우에만 값을 수정합니다. 심리적 점수가 비정상적으로 높거나 낮게 나타난다는 이유만으로 유효한 점수를 변경하지 마십시오.
- 제출된 설문지, 동의 및 적격성 제외, 중복 제외, 누락 데이터 제외, 응답 품질 플래그, 결합된 품질 관리 제외, 고립 항목 대체, 유지된 분석 케이스 및 최종 분석 표본 크기를 보고하는 스크리닝 흐름표를 생성합니다.
- 잠금 처리된 스크리닝 로그를 사용하여 스크리닝 흐름표를 작성하고 스크리닝 결정에 대한 내보내기된 감사 기록을 보관합니다. 현재 데이터셋의 스크리닝 흐름은 다음과 같습니다: 제출된 설문지, n = 448; 동의 또는 적격성 제외, n = 6; 중복 제출 제거, n = 5; >20% 척도 항목 누락으로 제외된 기록, n = 4; 두 개 이상의 응답 품질 지표로 제외된 기록, n = 13; 최종 분석 데이터셋, n = 420.
- 유지된 기록을 분석 데이터셋으로 저장합니다. 새로운 버전의 파일 이름을 사용하고 분석 데이터셋과 함께 스크리닝 로그를 보관하십시오.
참고: 문서화된 응답 품질 문제가 없는 한 유효한 극단값을 유지하십시오.
5. 심리 척도 점수 산출
- 응답 스크리닝이 완료되고 분석 데이터 세트가 저장된 후에만 항목 수준의 응답을 척도 수준의 변수로 변환하십시오.
- 잠긴 설문지의 응답 앵커와 척도 맵의 채점 규칙에 따라 모든 리커트 유형 항목을 코딩하십시오.
- 원래의 항목 변수는 변경 없이 유지하십시오. 재코딩되거나 역채점된 항목에 대해서는 별도의 파생 변수를 생성하십시오.
- 잠긴 척도 맵과 해당 원본 도구 또는 채점 매뉴얼에 따라 각 척도를 채점하십시오.
- 주관적 안녕감 점수를 계산하기 전에 지정된 주관적 안녕감 항목을 역채점하십시오. 1–6 응답 척도의 경우, 각 역채점 항목을 7에서 원래 점수를 뺀 값으로 계산하고 파생 변수 이름 뒤에 _R을 추가하십시오.
- 주관적 안녕감을 계산할 때는 원래 변수가 아닌 역채점된 변수를 사용하십시오.
- 부정적 정서, 학업 지연 행동, 학교 소속감, 고차원적 사고, 주관적 안녕감의 각 척도 수준 점수를 유지된 항목들의 평균으로 계산하십시오.
- 최종 척도 수준 변수의 이름을 Negative emotion, Academic procrastination, School belongingness, Higher-order thinking, Subjective well-being으로 지정하십시오.
- 각 척도 수준 변수의 최소값과 최대값이 이론적 응답 범위와 일치하는지 확인하십시오. 점수가 예상 범위를 벗어난 경우 코딩, 역채점 및 결측값 처리를 재확인하십시오.
- 추론 분석 전에 척도 맵을 대조하여 각 척도의 방향성을 확인하십시오. 높은 점수가 해당 구성 개념의 의도된 방향을 반영해야 합니다.
- 분석 전 역채점 감사를 수행하십시오. 기록의 무작위 하위 집합에 대해 또는 가능한 경우 모든 역채점 항목에 대해 역채점 항목을 재계산하고, 감사 결과를 채점 확인 로그에 기록하십시오.
- 채점 오류가 발견되면 파생 변수를 수정하고, 영향을 받은 척도 점수를 다시 생성하며, 채점 확인 로그를 업데이트한 후, 수정된 분석 데이터 세트를 기반으로 모든 후속 분석과 그림 소스 표를 다시 실행하십시오.
참고: 역채점 및 범위 확인을 상관 분석, 집단 비교, 회귀 모델링 또는 시각화 전의 필수 체크포인트로 처리하십시오.
6. 내부 일관성 및 기술적 특성 평가
- 잠긴 척도 맵에 정의된 항목 변수를 사용하여 각 척도에 대한 내부 일관성, 수정된 항목-전체 상관관계 및 기술 통계량을 계산합니다.
- 각 척도에 대해 Cronbach’s alpha, 항목 수, 유효 표본 크기, 수정된 항목-전체 상관관계 및 항목 제거 시 alpha 값을 기록합니다.
- 본 워크플로에서는 Cronbach’s alpha 0.70을 최소 허용 신뢰도 임계값으로 사용합니다. 항목을 제거하기 전에 항목 문구, 점수 방향, 역채점, 구성 개념 일치 여부 및 원본 도구 문서20를 확인하십시오.
- 분석 환경에서 지원하는 경우 보조 신뢰도 추정치로 McDonald’s omega를 계산합니다. 두 추정치에 따른 신뢰도 해석이 서로 다를 경우 omega를 Cronbach’s alpha와 함께 보고합니다.
- 제거를 고려하기 전에 수정된 항목-전체 상관관계가 음수이거나 매우 낮은 항목을 검토하십시오. 이를 우선적으로 코딩, 역채점 또는 구성 개념 일치 문제의 가능성으로 처리하십시오.
- 단순히 Cronbach’s alpha를 높이기 위해 항목을 제거하지 마십시오. 항목 제거는 채점 매뉴얼, 항목 문구, 수정된 항목-전체 상관관계, 개념적 적합성 및 문서화된 채점 검증에 의해 정당화되어야 합니다.
- 평균, 표준편차, 최솟값, 최댓값, 왜도 및 첨도를 포함하여 5가지 척도 수준 변수 모두에 대한 기술 통계량을 계산합니다.
- 각 척도에서 가능한 최솟값과 최댓값을 기록하여 바닥 효과 또는 천장 효과 집중도를 확인합니다.
- 신뢰도 추정치, 항목-전체 진단 결과, 기술 통계량 및 모든 채점 결정 사항을 분석 로그에 기록합니다.
참고: Cronbach’s alpha는 신뢰도 확인 지점으로 사용되며, 완전한 심리 측정적 타당화 절차로 사용되는 것이 아닙니다. 공식적인 측정 평가가 필요한 경우, 본 워크플로에 McDonald’s omega, 확인적 요인 분석, 측정 동일성 검정, 문항 반응 모델링 또는 기타 잠재 변수 방법을 추가로 적용하십시오.
7. 상관관계 분석 수행
- 검증된 5가지 척도 수준 변수인 부정적 정서, 학업 지연 행동, 학교 소속감, 고차원적 사고 및 주관적 안녕감을 사용하십시오.
- 피어슨 상관계수를 산출하기 전, 척도 수준 변수의 각 쌍에 대해 분포와 이변량 산점도를 검토하십시오.
- 변수들이 대략적으로 연속적인 점수 변동을 보이는지, 심한 왜도가 있는지, 비선형 관계가 있는지 또는 영향력 있는 이상치 패턴이 있는지 평가하십시오.
- 기술적 연관성 분석을 위한 가정이 충족되는 경우, 모든 척도 수준 변수 쌍에 대해 피어슨 상관계수와 양측 p-값을 계산하십시오.
- 상관계수를 기록하십시오. p각 변수 쌍에 대한 p-값, 표본 크기 및 연관성 방향.
- 상관계수는 소수점 셋째 자리까지 표기하십시오.
- 각 계수의 방향을 척도 지도(scale map)와 비교하십시오. 계수가 의도한 구성 개념의 방향과 상충하는 경우, 항목 채점 방식을 재확인하십시오.
- 검증된 상관관계 행렬을 대표 결과(Representative Results) 섹션에 삽입할 상관관계 히트맵의 수치 소스 테이블로 저장하십시오.
- 분포가 현저하게 왜곡되었거나, 서열 척도의 민감도가 필요하거나, 산점도가 단조로우나 비선형적인 연관성을 시사하는 경우, 스피어만 상관분석을 사용하여 분석을 반복하고 연관성의 방향과 상대적 크기를 비교하십시오.
- Pearson 및 Spearman 결과가 동일한 실질적 해석으로 이어졌는지 기록하십시오.
참고: 상관관계 분석을 기술적 연관성 확인과 점수 방향성 검토의 목적으로 모두 활용하십시오.
8. 주관적 웰빙 고집단 및 저집단 구성
- 정제 및 점수화가 완료된 분석 데이터 세트를 사용하십시오. 그룹 구성 시 원본 내보내기 데이터로 돌아가지 마십시오.
- 회귀 모델링의 기본 결과 변수로 연속형 주관적 안녕감 점수를 사용하십시오. 고-저 그룹화는 대조적 프로파일 비교용으로만 사용하십시오.
- 응답자를 주관적 안녕감 점수가 높은 순에서 낮은 순으로 정렬하십시오.
- 사전에 지정된 27% 극단 그룹 규칙을 적용하여 주관적 안녕감 고집단과 저집단을 정의하십시오. 이 임계값에 대한 근거를 표 2와 분석 로그에 기록하십시오.
- 상위 27%의 응답자를 주관적 안녕감 고집단으로, 하위 27%의 응답자를 주관적 안녕감 저집단으로 배정하십시오.
- 중간 46%의 응답자는 기술 통계, 상관 분석, 성별 비교 및 회귀 모델링을 위해 전체 분석 데이터 세트에 유지하되, 고-저 대조 분석에서는 제외하십시오.
- 주관적 안녕감 그룹이라는 이름의 그룹 변수를 생성하십시오. 상위 그룹은 High, 하위 그룹은 Low, 나머지 응답자는 Middle로 코딩하십시오.
- 고집단과 저집단에 의도한 수의 사례가 포함되었는지 확인하십시오. 27% 경계에서 동점자가 발생하는 경우, 사전에 지정된 동점 처리 규칙을 적용하고 그 결정을 분석 로그에 기록하십시오.
- 동점자나 작은 표본 크기로 인해 27% 경계에서 그룹 구성이 불안정한 경우 민감도 검사를 수행하십시오. 삼분위 그룹화와 같은 대안적인 사전 지정 규칙을 사용하고, 해석 결과가 동일한지 보고하십시오.
참고: 고-저 그룹화는 기술적 대조 절차입니다. 이는 기본 회귀 모델에서 연속형 주관적 안녕감 점수를 대체해서는 안 됩니다.
9. 주관적 웰빙 고집단과 저집단 비교
- 분석 데이터셋을 필터링하여 주관적 웰빙 그룹화 변수에서 '높음(High)' 또는 '낮음(Low)'으로 코딩된 응답자만 남깁니다.
- 부정적 정서, 학업 지연 행동, 학교 소속감, 고차원적 사고에 대해 고집단과 저집단을 비교하십시오.
- 그룹 간 비교를 수행하기 전, 각 변수에 대해 그룹별 분포, 표본 크기 및 분산의 동일성을 확인하십시오.
- 독립 표본을 사용하십시오. t분포 및 분산 가정이 적절한 경우 t-검정을 수행하십시오. 그렇지 않은 경우 Welch의 t-검정을 사용하십시오. t-등분산 가정(equality-of-variance assumption)이 충족되지 않을 때 사용하는 검정.
- 그룹 평균, 표준 편차, 평균 차이를 기록하십시오. tp-값, 자유도, pp-값 및 95% 신뢰구간.
- 각 그룹 간 차이에 대한 Cohen's d를 산출하고, p-값과 함께 효과 크기를 해석하십시오.
- 각 집단 간 차이의 방향이 구성 개념 정의 및 상관행렬과 일치하는지 검토하십시오.
- 검증된 그룹 비교 표를 모든 그룹 비교 시각화의 수치 데이터 소스로 저장하십시오.
- 본 분석 결과를 극단적인 주관적 안녕감 프로파일 간의 대비로 보고하십시오.
참고: 고-저 비교를 인과적 증거로 해석하지 마십시오.
10. 성별 차이 조사
- 고-저 집단 필터를 제거하고 전체 분석 데이터셋으로 돌아갑니다.
- 성별을 인과적 노출 변수가 아닌 기술적 그룹화 변수로 사용합니다.
- 부정적 정서, 학업 지연 행동, 학교 소속감, 고차원적 사고 및 주관적 웰빙에 대해 여성 응답자와 남성 응답자를 비교합니다.
- 비교 전, 집단별 표본 크기, 결측치, 분포 및 분산의 동일성을 점검합니다.
- 가정이 충족되는 경우 독립 표본 t-검정을 사용합니다. 분산 동일성 가정이 충족되지 않는 경우 Welch의 t-검정을 사용합니다.
- 집단 평균, 표준 편차, 평균 차이, t-값, 자유도, p-값, 95% 신뢰 구간 및 Cohen’s d 값을 기록합니다.
- 성별 차이를 기술적으로 해석하고 p-값과 함께 효과 크기를 보고합니다.
- 성별 비교 결과를 사후 제외, 척도 수정 또는 인과적 해석의 근거로 사용하지 마십시오.
참고: 성별 비교는 본 단면 설문조사 워크플로우 내에서 기술적 하위 그룹 점검 항목으로 포함되었습니다.
11. 회귀 모델 추정
- 주관적 안녕감을 종속 변수로 사용하십시오.
- 부정적 정서, 학업 지연 행동, 학교 소속감, 고등 사고 능력을 동시에 투입하는 척도 수준 예측 변수로 사용하십시오21.
- 척도 채점 과정에서 생성된 연속형 척도 수준 변수를 사용하십시오. 연속형 주관적 안녕감 점수를 고-저 집단 분류 변수로 대체하지 마십시오.
- 동시 투입 다중 선형 회귀 분석을 사용하여 기본 모델을 적합시키십시오.
- 비표준화 계수, 표준화 계수, 표준 오차, t값, p값, 95% 신뢰 구간, R2, 수정된 R2, 공선성 진단 지수(tolerance) 및 분산 팽창 요인(VIF)을 기록하십시오.
- 심각한 다중공선성이 없음을 판단하는 임계값으로 분산 팽창 요인 값이 5.00 미만인 경우를 사용하십시오.
- 이변량 산점도, 부분 회귀 플롯 또는 성분-잔차 플롯을 검토하여 예측 변수와 주관적 안녕감 사이의 연관성이 대략적으로 선형인지 평가하십시오.
- Durbin-Watson 통계량을 사용하여 잔차의 독립성을 평가하십시오.
- 잔차 Q-Q 플롯을 사용하고, 표본 크기에 적절한 경우 공식적인 정규성 검정을 수행하여 잔차의 정규성을 평가하십시오.
- 표준화된 예측값 대비 표준화된 잔차 플롯을 사용하여 등분산성을 평가하십시오.
- 진단 확인을 위해 표준화된 잔차, 표준화된 예측값, 레버리지 값 및 Cook의 거리(Cook’s distance)를 저장하십시오.
- 네 가지 심리적 예측 변수와 성별, 연령, 학년, 기관 범주, 전공 범주를 포함하여 표본 설명에 보고된 인구통계학적 변수들이 가용하고 적절히 분포되어 있는 경우, 이를 포함한 보조 조정 모델을 추정하십시오.
- 기본 모델과 보조 조정 모델을 비교하십시오. 인구통계학적 조정 후에도 네 가지 심리적 예측 변수의 방향, 크기 및 통계적 해석이 안정적으로 유지되는지 기록하십시오.
- 기본 모델에서 검증된 표준화 계수와 95% 신뢰 구간을 '대표 결과' 섹션의 계수 플롯을 위한 수치 소스 표로 저장하십시오22.
참고: 회귀 계수는 인과 관계가 아닌 조건부 연관성으로 해석하십시오. 인구통계학적 조정 모델은 가용한 배경 변수를 고려한 후에도 워크플로우 결론이 안정적으로 유지되는지 평가하기 위한 민감도 분석에 사용됩니다.
12. 회귀 모델 진단
- 적합된 회귀 모델의 표준화 잔차를 검토하십시오. 절대 표준화 잔차가 3.00보다 큰 사례를 표시하십시오.
- 영향력 있는 관측치를 확인하기 위해 레버리지 값과 Cook's distance를 검토하십시오.
- Cook's distance가 4/n보다 큰 관측치를 잠재적 영향력이 있는 것으로 표시하십시오(여기서 n은 분석 표본 크기임). Cook's distance가 1.00보다 큰 경우는 유일한 스크리닝 경계가 아닌 심각한 영향력의 기준 임계값으로 처리하십시오.
- 잔차-예측값 도표를 통해 비선형성, 불균일 분산 및 비정상적인 클러스터링 여부를 검토하십시오.
- 잔차 Q-Q 도표와 잔차 정규성 검정 결과를 검토하십시오. 정규성 평가 결과가 기술적 연관성 분석을 위한 선형 모델 사용을 뒷받침하는지 기록하십시오.
- Durbin-Watson 통계량을 기록하고 잔차의 독립성이 허용 가능한 수준인지 판단하십시오.
- 표시된 모든 사례를 스크리닝 로그, 점수 검증 로그 및 적격성 기준과 대조하여 검토하십시오.
- 표시된 사례가 유효한 관측치이며 데이터 입력 오류, 점수 산정 오류, 중복 제출, 적격성 위반 또는 기록된 응답 품질 문제가 반영된 것이 아닐 경우 해당 사례를 유지하십시오.
- 감사 추적(audit trail)을 통해 기록된 절차적, 적격성, 코딩, 점수 산정 또는 데이터 입력 오류가 확인된 경우에만 표시된 사례를 수정하거나 제거하십시오.
- 기록된 수정 사항이 있을 경우 회귀 모델을 다시 실행하고 계수, 신뢰 구간, R2, 조정된 R2 및 진단 출력값을 원래 모델과 비교하십시오.
- Cook's distance가 4/n보다 큰 사례를 제외한 후 모델을 다시 적합시켜 영향도 민감도 체크를 수행하십시오. 실질적인 해석에 변화가 있는지 보고하십시오.
- 분석 로그에 최종 진단 결정을 기록하십시오. 여기에는 표준화 잔차에 의해 표시된 사례 수, Cook's distance가 4/n보다 커서 표시된 사례 수, 최대 Cook's distance, Durbin-Watson 통계량, 잔차 정규성 및 선형성 체크 결과에 따른 결론이 포함되어야 합니다.
참고: 단순히 모델 적합도를 높이기 위해 영향력 있는 사례를 제거하지 마십시오. 제거 또는 수정은 기록된 감사 추적 근거에 기반해야 합니다.
결과
응답 스크리닝 후 생성된 분석 데이터 세트
응답 스크리닝 워크플로를 통해 제출된 448건의 설문지 중 420건의 익명화된 학생 기록으로 구성된 분석 데이터셋이 생성되었습니다. 스크리닝 로그에는 각 결정 지점이 기록되었습니다. 동의 또는 적격성 요건을 충족하지 못한 기록 6건, 중복 제출 건 5건, 전체 척도 항목의 20% 이상이 누락된 기록 4건, 그리고 두 가지 이상의 응답 품질 지표에 해당한 기록 13건이 제외되었습니다. 응답 완료 소요 시간과 관련하여 19건의 응답이 플래그 처리되었습니다. <180초 동안 8개의 응답이 ~로 표시되었습니다. >90%의 직선 응답(straight-line responding)이 나타났으며, 21명의 응답자는 37개의 개별 누락 항목에 대해 척도 내 평균 대체법(within-scale mean imputation)을 적용받았습니다. 최종 분석 데이터셋에는 직접적으로 식별 가능한 참여자 정보가 포함되지 않았으며, 유지된 사례 중 누락 데이터 제외 임계값을 초과한 경우는 없었고, 유지된 모든 항목 응답은 사전에 정의된 응답 범위 내에 있었습니다. 스크리닝 흐름은 다음과 같이 요약됩니다. 표 3.
최종 분석 대상 표본은 여성 응답자 275명과 남성 응답자 145명으로 구성되었으며, 이는 전체 분석 데이터셋의 각각 65.5%와 34.5%에 해당합니다. 평균 연령은 20.1 ± 1.2세였습니다. 응답자는 4개의 학부 학년 수준으로 분포되어 있으며, 1학년부터 4학년까지의 비율은 표본의 각각 27.1%, 27.4%, 25.5%, 20.0%였습니다. 데이터셋에는 또한 3개의 기관 범주와 5개의 전공 범주가 포함되었습니다. 범주 검토 후, 공개된 인구통계학적 셀 중 응답자 수가 5명 미만인 경우는 없었습니다. 분석 데이터셋의 인구통계학적 특성은 표 4에 요약되어 있습니다.
척도 구성, 범위 검증 및 최적화되지 않은 워크플로우 예시
항목 코딩 및 역채점 후, 부정적 정서, 학업 지연 행동, 학교 소속감, 고차원적 사고, 주관적 웰빙이라는 다섯 가지 척도 수준 변수를 산출하였습니다. 각 점수는 이론적 응답 범위 내에 유지되었습니다. 부정적 정서 점수는 1-4 척도에서 1.048에서 3.143 사이로 나타났습니다. 학업 지연 행동, 학교 소속감, 고차원적 사고는 각각의 1–5 척도에서 1.312에서 4.250, 2.333에서 4.444, 2.350에서 4.850 사이의 범위를 보였습니다. 주관적 웰빙은 1–6 척도에서 2.000에서 5.300 사이였습니다. 역채점 검증 결과, 도출된 역채점 변수와 최종 분석 데이터셋의 고정된 채점 규칙 사이에 불일치가 없음이 확인되었습니다. 이러한 점검을 통해 항목 코딩, 역채점, 누락 항목 처리 및 점수 합산이 감지 가능한 범위 오류 없이 완료되었음을 확인하였습니다.
이 워크플로우는 최종 분석 전 오류나 의심스러운 출력물을 어떻게 감지하는지 보여주는 차선책의 감사 사례들도 생성했습니다. 감사 실행 중, 스코어링 검증 로그가 원본 값, 기대 공식인 “역채점 점수 = 7-원본 점수”, 도출된 값, 그리고 최종 척도 범위를 비교함으로써 잘못 도출된 주관적 웰빙 역채점 값이 감지되었습니다. 이에 따라 도출된 변수가 수정되었고, 주관적 웰빙 점수가 재생성되었으며, 이후의 모든 기술 통계, 상관관계, 비교, 회귀 분석, 진단 및 그림-출처 출력물이 다시 실행되었습니다. 또 다른 중간 작업 파일에서는 범위 검증 중에 범위를 벗어난 항목 값이 확인되었으며, 이는 잠금 처리된 원본 내보내기 파일이 아니라 스프레드시트 처리 과정에서 발생한 것으로 추적되었습니다. 유효한 극단적 응답은 변경하지 않은 채 작업 복사본을 수정하고 문서화하였습니다. 또한, 동일 척도의 다른 항목들에 비해 한 항목의 수정 항목-전체 상관관계가 낮게 나타나 신뢰도 경고가 검토되었습니다. 해당 항목의 문구, 점수 방향 및 구성 개념 일치성이 정확했으므로 해당 항목은 유지되었습니다. 그림이 검증된 수치 소스 표와 일치하지 않는 초안 시각화 불일치가 확인되었으며, 검증된 표를 바탕으로 그림을 재생성하고 그림-출처 기록을 업데이트하였습니다. 이러한 사례들은 이 워크플로우가 성공적인 결과물을 생성할 뿐만 아니라, 감사 추적을 통해 코딩 오류, 범위 문제, 신뢰도 경고, 그림-출처 불일치 및 응답 품질 문제를 감지한다는 것을 입증합니다.
기술적 특성 및 내부 일관성
5가지 척도 수준 변수에서 사용 가능한 변동성이 나타났다. 부정적 정서의 평균 점수는 2.099 ± 0.391였으며, 학업 지연 행동의 평균 점수는 2.639 ± 0.484였다. 학교 소속감과 고등 사고력은 각각 3.343 ± 0.390 및 3.627 ± 0.418로 중간 정도로 높은 평균값을 보였다. 주관적 안녕감의 평균 점수는 3.784 ± 0.543였다. 어떤 척도에서도 뚜렷한 바닥 효과나 천장 효과 패턴은 나타나지 않았으며, 이론적 최솟값 또는 최댓값에 해당하는 응답자의 비율은 각 척도당 2.0% 미만이었다.
다섯 가지 척도 모두에서 내적 일치도가 수용 가능한 수준으로 나타났다. Cronbach’s alpha 값은 0.834에서 0.899 범위로, 사전 설정된 임계치인 0.70을 초과하였다. 부정적 정서가 Cronbach’s alpha 0.899로 가장 높은 내적 일치도를 보였으며, 주관적 안녕감이 0.895로 그 뒤를 이었다. McDonald’s omega 값은 0.842에서 0.906 범위였으며, omega 추정치는 신뢰도 해석에 영향을 미치지 않았다. 수정된 문항-총점 상관관계 검토 결과, 제거가 필요한 문항은 발견되지 않았다. 기술 통계 및 신뢰도 추정치는 표 5에 보고되었다.
척도 수준 변수 간의 상관 구조
상관 행렬을 연관성의 기술적 척도 및 채점 방향 확인용으로 사용하였다. Pearson 상관 계수를 계산하기 전에 척도 분포와 이변량 산점도를 검토하였다. 어떤 변수에서도 심각한 왜도나 첨도가 나타나지 않았으며, 기술적 Pearson 상관 분석을 무효화할 만한 강한 비선형 패턴을 보이는 이변량 도표도 없었다. 주관적 안녕감은 부정적 정서(r = -0.496) 및 학업 지연 행동(r = -0.294)과 부적 상관관계를 보였으며, 학교 소속감(r = 0.481) 및 고차원적 사고(r = 0.386)과는 정적 상관관계를 보였다. 나머지 연관성 또한 동일한 채점 논리를 따랐다. 부정적 정서는 학업 지연 행동(r = 0.270)과 정적 연관성이 있었고, 학교 소속감(r = -0.346) 및 고차원적 사고(r =-0.205)와는 부적 연관성이 있었다. 학업 지연 행동은 학교 소속감(r = -0.222) 및 고차원적 사고(r = -0.134)와 부적 연관성이 있었으며, 학교 소속감은 고차원적 사고(r = 0.310)와 정적 연관성이 있었다. 전체 Pearson 상관 행렬은 표 6에 제시되어 있다.
Spearman 민감도 분석 결과, 모든 변수 쌍에서 동일한 방향의 해석이 도출되었습니다. 주관적 안녕감과 4가지 예측 변수 간의 Spearman 상관계수는 부정적 정서의 경우 ρ = -0.502, 학업 지연행동의 경우 ρ = -0.301, 학교 소속감의 경우 ρ = 0.477, 고차원적 사고의 경우 ρ = 0.392였습니다. 검증된 Pearson 행렬이 시각화를 위한 수치 소스 테이블로 사용되었습니다. 그림 2A는 5가지 척도 수준 변수 전체에 대한 상관관계 히트맵을 나타냅니다. 그림 2B는 주관적 안녕감과의 4가지 상관관계를 보여줍니다.
높은 주관적 안녕감 그룹과 낮은 주관적 안녕감 그룹을 이용한 대조 시연
27% 그룹화 규칙은 실제 안녕감 프로필의 실질적인 분류가 아닌, 대조 워크플로우 시연을 위해 사용되었습니다. 이 규칙을 통해 고주관적 안녕감 그룹 113명과 저주관적 안녕감 그룹 113명으로 크기가 동일한 두 그룹이 생성되었습니다. 중간 범위의 응답자 194명은 전체 분석 데이터셋에는 유지되었으나, 이번 대조 비교에서는 제외되었습니다. 경계값 동점자로 인해 그룹 배정이 변경된 경우는 없었습니다.
본 모듈은 워크플로를 통해 미리 지정된 그룹화 변수를 생성하고, 분석 데이터세트를 필터링하며, 그룹별 기술 통계량을 계산하고, 가정에 적합한 그룹 비교를 수행하며, 시각화를 위한 검증된 소스 테이블을 내보낼 수 있음을 보여주었습니다. 주관적 안녕감이 높은 그룹은 낮은 그룹보다 부정적 정서가 낮았으며(1.864 ± 0.358 vs. 2.335 ± 0.343; 평균 차이 = -0.472), 학업 지연 행동 또한 더 낮게 나타났습니다(2.455 ± 0.476 vs. 2.801 ± 0.483; 평균 차이 = -0.346). 학교 소속감과 고차원적 사고는 주관적 안녕감이 높은 그룹에서 더 높게 나타났으며, 평균 차이는 각각 0.454와 0.351이었습니다. 네 가지 비교 모두 통계적으로 유의했으며(p < 0.001), Cohen’s d 값은 부정적 정서 -1.346, 학업 지연 행동 -0.722, 학교 소속감 1.279, 고차원적 사고 0.860으로 나타났습니다. 등분산 가정 조건이 충족되지 않은 경우에는 Welch’s t-test를 사용하였고, 그 외에는 표준 독립 표본 t-test를 적용하였습니다. 그룹을 결과 변수를 기반으로 생성한 후 상관관계가 있는 변수들로 비교했기 때문에, 이러한 출력 결과가 선택된 예측 변수들이 실제 학생의 안녕감 프로파일을 정의한다는 증거로 해석되어서는 안 됩니다. 고-저 그룹 비교 결과는 Table 7에 요약되어 있습니다.
성별에 따른 기술적 비교
성별을 기술적 그룹화 변수로 조사하였다. 여성 응답자가 남성 응답자보다 부정적 정서 점수의 평균이 약간 더 높게 나타났다 (2.129 ± 0.380 vs. 2.042 ± 0.407). 이러한 차이는 통계적으로 유의미했으나 그 크기는 작았다 (p = 0.033; Cohen’s d = 0.224). 학업 지연 행동, 학교 소속감, 고차원적 사고 및 주관적 안녕감에서는 유의미한 성별 차이가 나타나지 않았다. 주관적 안녕감 평균은 여성 응답자와 남성 응답자 간에 거의 동일했다 (3.781 ± 0.521 vs. 3.789 ± 0.583; p = 0.887; Cohen’s d = -0.015). Welch’s t-검정 민감도 분석 결과에서도 성별 비교 결과에 대한 해석은 변하지 않았다. 성별 차이 결과는 표 8에 제시되어 있다.
모델 생성 및 진단 확인의 예시로서의 회귀 모델
점수화된 설문지 데이터로부터 모델을 생성, 진단 및 검증하는 예시로 다중 선형 회귀 모델이 사용되었습니다. 주관적 안녕감을 종속 변수로 입력하였으며, 부정적 정서, 학업 지연 행동, 학교 소속감 및 고차원적 사고를 척도 수준의 예측 변수로 동시에 입력하였습니다. 이 모듈의 목적은 계수 추출, 다중공선성 확인, 잔차 진단, 영향력 평가, 인구통계학적 조정 민감도 분석, 그리고 도표 및 출처 준비 방법을 시연하는 것입니다.
해당 모델은 주관적 안녕감 분산의 중간 정도의 비율을 설명하였으며, R2 = 0.411, 수정된 R2 = 0.406로 나타났다. 부정적 정서가 가장 큰 음의 표준화 계수를 보였다(B = -0.450, 표준화 β = -0.324). 학업 지연 행동 또한 음의 계수를 나타냈다(B = -0.130, 표준화 β = -0.116). 학교 소속감과 고차원적 사고는 각각 β = 0.275 및 β = 0.218의 양의 표준화 계수를 보였다. 적합 모델에서 네 가지 예측 변수 모두 통계적으로 유의미하였으며, 부정적 정서, 학교 소속감, 고차원적 사고는 p < 0.001에서, 학업 지연 행동은 p = 0.004에서 유의미했다. 모든 분산팽창요인(VIF) 값이 1.24 미만으로 나타나 다중공선성은 없는 것으로 확인되었다. 이러한 회귀 분석 결과는 대표적인 모델 검증 출력값이며, 학생 안녕감에 대한 확정적인 심리학적 설명은 아니다. 표 9에 전체 회귀 분석 결과가 제시되어 있다.
성별, 연령, 학년, 기관 범주 및 전공 범주를 4가지 심리적 예측 변수에 추가하여 보충적인 인구통계학적 조정 모델을 추정하였습니다. 조정된 모델은 R2 = 0.427 및 조정된 R2 = 0.414로 유사한 분산 비율을 설명했습니다. 4가지 심리적 예측 변수의 방향성과 통계적 해석은 인구통계학적 조정 후에도 변하지 않았습니다. 인구통계학적 조정 민감도 모델은 표 10에 요약되어 있습니다. 그림 3A는 4가지 예측 변수에 대한 표준화 계수와 95% 신뢰 구간을 보여줍니다. 그림 3B는 표준화된 예측값, 표준화된 잔차 및 Cook의 거리를 기반으로 한 진단 표시를 나타냅니다.
회귀 진단 및 모델 유지
회귀 진단 결과, 적합된 모델이 단일 영향력 있는 기록에 의해 결정되지 않았음을 나타냈습니다. 이변량 및 부분 회귀 도표에서는 강한 비선형성이 관찰되지 않았습니다. 잔차 대 예측값 도표에서는 심각한 이분산성이나 비정상적인 클러스터링이 나타나지 않았습니다. Durbin-Watson 통계량은 1.93으로, 잔차의 독립성이 허용 가능한 수준임을 뒷받침했습니다. 잔차 Q-Q 도표에서는 정규성으로부터의 심각한 일탈이 보이지 않았습니다. 공식적인 잔차 정규성 검사 결과는 통계적으로 유의미했으나(W = 0.992, p = 0.031), Q-Q 도표와 표본 크기를 근거로 기술적 연관성 분석을 위해 선형 모델을 유지하기로 하였습니다.
2개의 레코드가 3.00보다 큰 절대 표준화 잔차를 보였습니다. Cook의 거리(Cook’s distance)가 1.00보다 큰 레코드는 없었습니다. 더 민감한 임계값인 Cook의 거리 >4/n (n = 420, 4/n = 0.0095)을 사용했을 때, 17개의 레코드가 잠재적 영향력이 있는 것으로 표시되었습니다. 최대 Cook의 거리는 0.037이었습니다. 표시된 잔차 및 영향 사례들을 스크리닝 로그, 점수 검증 로그 및 적격성 기준과 대조하여 검토하였습니다. 데이터 입력 오류, 잘못된 점수 측정, 중복 응답, 적격성 미달 또는 기록된 응답 품질 문제의 증거가 나타나지 않았으므로, 이 사례들은 최종 모델에 유지되었습니다. Cook의 거리 >4/n인 사례를 제외한 영향 민감도 분석 결과, 기본 모델과 동일한 워크플로 해석이 도출되었습니다. 표준화 계수의 최대 절대 변화량은 0.026이었으며, 수정된 R2 값은 0.406에서 0.405로 변경되었습니다. 진단 및 민감도 분석 결과는 Table 11에 요약되어 있습니다.
분석 파이프라인 내부 검증
동일한 점수 산정 규칙, 결정 임계값 및 분석 추적 파일을 사용하여 정제 및 점수화된 분석 데이터셋으로부터 워크플로를 반복 수행하였다. 내부 일관성 분석, 기술 통계, 상관 분석, 고-저 집단 비교, 성별 비교, 회귀 모델링, 진단 확인 및 시각화 소스 준비 과정을 반복하였다. 반복 수행된 결과물은 기존의 기술 통계, 상관 행렬, 집단 비교 값, 회귀 계수, 진단 출력물 및 시각화 소스 파일과 일치하였다. 이를 통해 동일한 고정 분석 데이터셋에 적용했을 때 분석 파이프라인의 계산 안정성이 확인되었다. 이 확인 과정은 독립적인 분석가가 고정된 원시 내보내기 데이터부터 전체 워크플로를 적용하여 문서화된 것과 동일한 결과물에 도달해야 하는 독립적 절차 재현성을 구성하는 것은 아니다.
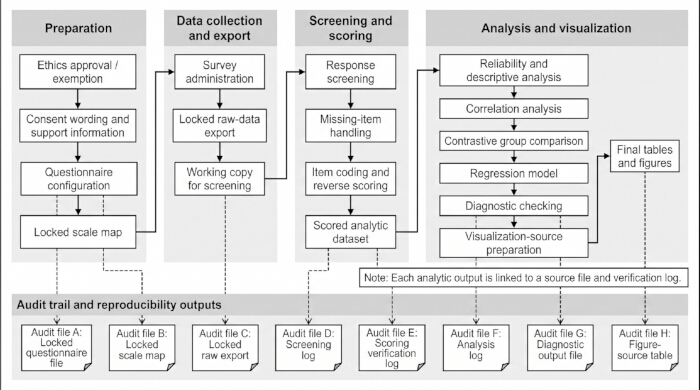
그림 1: 설문지 기반 주관적 웰빙 데이터 처리 워크플로. 이 도식은 윤리 준비, 설문지 구성, 설문 실시, 원시 데이터 내보내기, 척도 맵, 스크리닝 로그, 점수가 산정된 분석 데이터 세트, 검증된 분석 표, 회귀 진단, 그림 소스 파일 및 시각화 결과물을 포함한 프로토콜 순서와 주요 감사 결과물을 보여줍니다. 이 그림의 확대 버전을 보려면 여기를 클릭하십시오.
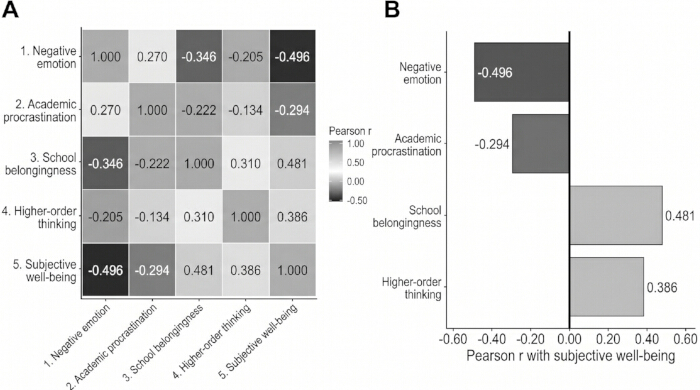
그림 2척도 수준 변수 간의 상관 구조. (A) [해당] 검증된 상관 행렬로부터 생성된 피어슨 상관 계수 히트맵 표 6. (B) 동일한 검증된 소스 테이블로부터 생성된 주관적 안녕감 중심의 상관관계 프로필. 부정적 정서, 학업 지연 행동, 학교 소속감, 고차원적 사고, 주관적 안녕감의 5가지 척도 수준 변수가 모두 표시되어 있다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
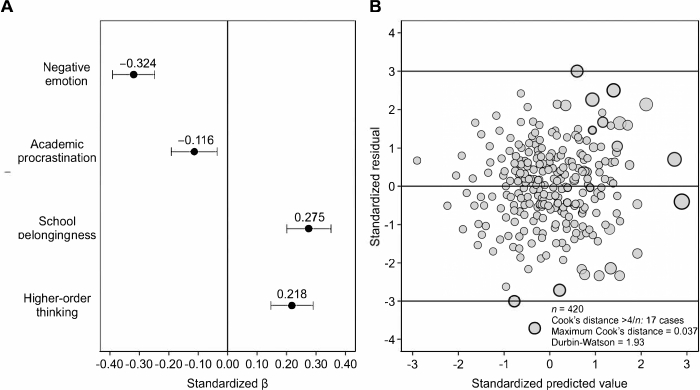
그림 3: 회귀 계수 및 진단 시각화. (A) 표 9의 기본 회귀 결과로부터 생성된 표준화 회귀 계수 및 95% 신뢰 구간. (B) 표 11에 요약된 표준화 예측값, 표준화 잔차 및 Cook's distance 값으로부터 생성된 회귀 진단 디스플레이. Cook's distance 값이 클수록 적합 모델에 더 큰 잠재적 영향력을 가진 관측치를 나타낸다. 여기에서 이 그림의 더 큰 버전을 확인하십시오.
표 1: 설문지 구조 및 척도 점수 산정 체계.이 표는 구성 개념 이름, 출처 도구, 출처 인용, 수정 또는 문서화 상태, 항목 번호, 응답 범위, 점수 방향, 역채점 필요 여부, 점수 산정 방법, 최종 척도 수준 변수 및 프로토콜 역할을 포함한 측정 체계를 요약한 것입니다. 이 표를 다운로드하시려면 여기를 클릭하십시오.
표 2: 응답 스크리닝 및 분석 결정 기준. 이 표는 동의 스크리닝, 적격성 스크리닝, 중복 응답 검토, 누락 데이터 처리, 응답 소요 시간 플래깅, 일직선 응답 탐지, 유효 응답 범위, 신뢰도 평가, 고-저 집단 분류, 회귀 진단 및 민감도 분석을 위해 사전에 지정된 기준을 나열합니다. 이 표를 다운로드하려면 여기를 클릭하십시오.
표 3: 제출된 설문지부터 최종 분석 데이터 세트까지의 스크리닝 흐름. 이 표는 각 스크리닝 단계에서 제출된 설문지 수, 플래그 지정된 레코드, 제거된 레코드, 유지된 레코드 및 확인 소스를 보고합니다. 완료 소요 시간과 직선형 응답은 자동 제외 기준이 아닌 응답 품질 플래그로 처리되었습니다. 여기에서 이 표를 다운로드하십시오.
표 4: 분석 데이터 세트의 인구통계학적 특성. 이 표는 성별, 연령, 학부 학년, 기관 범주 및 전공 범주를 포함하여, 응답 스크리닝 후 유지된 익명화된 학생 기록을 요약한 것입니다. 보고 전 인구통계학적 셀에 대해 간접 식별 위험 여부를 검토하였습니다. 이 표를 다운로드하려면 여기를 클릭하십시오.
표 5: 5개 척도 수준 변수의 기술 통계, 범위 검증 및 내부 일치도.이 표는 부정적 정서, 학업 지연 행동, 학교 소속감, 고차원적 사고 및 주관적 안녕감에 대한 문항 수, 이론적 범위, 관찰된 범위, 평균, 표준 편차, Cronbach’s alpha, McDonald’s omega 및 바닥/천장 효과 농도를 나타냅니다. 이 표를 다운로드하려면 여기를 클릭하십시오.
표 6: 척도 수준 변수들의 피어슨 상관관계 행렬. 이 표는 부정적 정서, 학업 지연 행동, 학교 소속감, 고차원적 사고 및 주관적 안녕감 간의 피어슨 상관계수를 나타냅니다. 이 행렬은 기술적 연관성 결과물 및 점수 방향 검증 단계로 사용되었습니다. 이 표를 다운로드하려면 여기를 클릭하십시오.
표 7: 주관적 안녕감이 높은 집단과 낮은 집단 간의 대비 비교. 이 표는 주관적 안녕감 점수가 상위 27%인 응답자와 하위 27%인 응답자 간의 부정적 정서, 학업 지연 행동, 학교 소속감 및 고차원적 사고를 비교합니다. 이 비교는 안녕감 프로필의 실질적인 분류보다는 그룹화 및 비교 워크플로우를 보여주기 위한 것입니다. 여기를 클릭하여 이 표를 다운로드하십시오.
표 8: 성별에 따른 기술적 비교. 이 표는 성별에 따른 부정적 정서, 학업 지연 행동, 학교 소속감, 고차원적 사고 및 주관적 안녕감의 기술적 비교를 나타냅니다. 성별은 기술적 그룹화 변수로 처리되었습니다. 이 표를 다운로드하려면 여기를 클릭하십시오.
표 9: 주관적 안녕감을 예측하는 일차 다중 선형 회귀 모델. 이 표는 주관적 안녕감을 종속 변수로 하고, 부정적 정서, 학업 지연 행동, 학교 소속감 및 고차원적 사고를 척도 수준의 예측 변수로 동시에 투입한 일차 회귀 모델을 보여줍니다. 표준 오차, 신뢰 구간 및 분산 팽창 요인 값이 포함되어 있습니다. 이 표를 다운로드하려면 여기를 클릭하십시오.
표 10: 주관적 안녕감을 예측하는 인구통계학적 보정 회귀 민감도 모델. 이 표는 성별, 연령, 학부 학년, 기관 범주 및 전공 범주를 보정한 후의 4가지 심리적 예측 변수를 나타냅니다. 범주형 인구통계학적 변수는 더미 코딩을 사용하여 입력되었습니다. 표준 오차, 신뢰 구간 및 분산 팽창 요인 값이 포함되어 있습니다. 이 표를 다운로드하려면 여기를 클릭하십시오.
표 11: 회귀 진단 및 영향도 민감도 검사. 이 표는 표준화 잔차, Cook의 거리 > 1.00, Cook의 거리 > 4/n, 최대 Cook의 거리, Durbin-Watson 통계량, 잔차 Q-Q 플롯, 잔차 정규성 검정, 잔차 대 예측값 플롯, 선형성 검사 및 영향도 민감도 분석을 포함한 잔차, 영향도 및 모델 진단 출력 결과를 요약한 것입니다. 여기에서 이 표를 다운로드하십시오.
보충 파일 1: 설문지 구조, 척도 출처 및 채점 문서.이 보충 파일은 설문 조사 실시 순서, 고지된 동의 문구, 인구통계학적 변수, 원본 도구 문서, 항목 코드, 응답 기준, 수정 및 문서화 상태 정보, 채점 방향, 역채점 규칙, 최종 척도 수준 변수 구성, 누락 항목 처리 규칙, 응답 품질 연결 필드, 범위 검증 규칙 및 5가지 설문 구성 개념에 대한 참조 연결 정보를 제공합니다. 이는 워크플로 내에서 척도 프로그래밍, 채점 및 검증을 문서화하기 위한 설문지/코드북 보충 자료의 역할을 합니다.이 파일을 다운로드하려면 여기를 클릭하십시오.
토론
본 프로토콜은 설문지 기반의 웰빙 연구에서 흔히 수행되지만 자주 누락되는 과정인 원시 응답 기록에서 스크리닝된 데이터, 점수화된 척도 변수, 통계 출력물 및 시각화 준비 파일로 이어지는 과정을 표준화합니다. 본 연구의 기여점은 새로운 주관적 웰빙 이론의 개발이나 인과 모델의 제안이 아닙니다. 대신, 이 워크플로우는 설문지 구성, 응답 스크리닝, 척도 점수화, 신뢰도 검사, 기술 분석, 연관 분석, 회귀 진단 및 도표 소스 검증을 위한 감사 가능한 경로를 제공합니다. 이러한 구분이 중요한 이유는 설문지 기반 연구의 감사 가능성이 통계적 해석이 시작되기 전에 이루어지는 절차적 결정, 즉 어떤 기록을 유지할 것인지, 결측 항목을 어떻게 처리할 것인지, 역채점 항목을 어떻게 처리할 것인지, 그리고 숫자 소스 테이블을 시각적 출력물과 어떻게 연결할 것인지에 달려 있기 때문입니다. 이러한 결정들을 명시적으로 밝힘으로써 척도 기반 연구에서의 의심스러운 측정 관행을 줄이고23 더욱 투명한 연구 문화를 지원할 수 있습니다24.
본 프로토콜의 핵심 특징은 단순한 구두 설명 대신 구체적인 감사 결과물(audit artifacts)을 사용하는 것입니다. 수정된 워크플로우는 각 구성 개념을 해당 소스 도구, 항목 범위, 응답 앵커, 점수 방향, 역채점 규칙, 최종 척도 수준 변수, 그리고 적응 또는 문서화 상태 정보와 연결합니다. 감사 추적에는 잠금 처리된 설문지 파일, 잠금 처리된 척도 맵, 잠금 처리된 원시 데이터 내보내기 파일, 스크리닝 로그, 채점 검증 로그, 분석 로그, 진단 출력 파일 및 도표 소스 표가 포함됩니다. 이러한 파일들은 어떤 버전의 설문지가 사용되었는지, 어떤 기록이 제외되거나 유지되었는지, 점수가 어떻게 생성되었는지, 그리고 각 도표를 작성하는 데 어떤 검증된 표가 사용되었는지를 명확히 해줍니다. 참가자 수준의 데이터를 공개적으로 공유할 수 없는 경우, 동일한 변수 구조와 완료된 스크리닝/채점 로그를 갖춘 합성 데이터셋을 제공함으로써 독자가 식별 가능하거나 간접적으로 식별 가능한 기록에 접근하지 않고도 계산 워크플로우를 테스트할 수 있도록 할 수 있습니다. 이러한 결과물 기반 구조는 재사용 가능한 연구 결과물에 명확한 출처, 구조 및 접근 조건이 필요하다는 FAIR 원칙과 일치합니다25.
대표 결과는 학생 웰빙의 심리적 결정 요인에 대한 실질적인 증거라기보다 워크플로 출력값으로 해석해야 합니다. 주관적 웰빙의 고-저 비교는 미리 지정된 그룹화 규칙을 어떻게 구현, 확인 및 보고할 수 있는지 보여주기 위해 포함된 것이며, 이를 실제 웰빙 프로필의 분류로 해석해서는 안 됩니다. 마찬가지로, 회귀 모델은 점수화된 설문지 데이터를 어떻게 모델링하고, 다중공선성을 확인하며, 잔차 및 영향력 진단으로 평가하고, 검증된 그림-출처 표와 연결하는지를 보여줍니다. 이는 부정적 정서, 학업 지연, 학교 소속감 또는 고차원적 사고가 주관적 웰빙을 인과적으로 결정한다는 것을 입증하는 것이 아닙니다. 모든 주요 변수가 동일한 자기보고식 설문지를 통해 한 시점에서 수집되었으므로, 공통 방법 편향, 응답 스타일 효과 및 공유된 측정 맥락의 가능성을 배제할 수 없습니다26.
또한 이 워크플로우가 전체적인 심리측정적 타당도 검증을 대체하는 것은 아닙니다. Cronbach’s alpha, McDonald’s omega, 관찰 범위 확인, 문항-총점 검토 및 역코딩 확인은 감사 가능한 채점 워크플로우를 위한 유용한 품질 관리 단계이지만, 요인 타당도, 측정 동일성, 문항 반응 특성 또는 집단 간 비교 가능성을 확립해주지는 않습니다. 설문지를 실질적인 이론 검증에 사용하는 연구에서는 확인적 요인 분석, 관련 인구통계학적 또는 기관별 집단 간 측정 동일성 검사, 그리고 적절한 경우 추가적인 타당도 검증을 수행해야 합니다27. 따라서 본 프로토콜은 감사 가능한 데이터 처리 및 보고 프레임워크로 이해되어야 하며, 포함된 구성 개념에 대한 완전한 타당도 연구로 간주되어서는 안 됩니다.
이 워크플로우는 외부 검증 없이 단일 시점에서 수집된 자기 보고식 설문지 데이터를 사용하여 학부생 1명의 샘플로 시연되었습니다. 이를 다른 인구 집단, 학문 분야, 기관, 언어 및 문화적 환경에 그대로 적용할 수 있다고 가정해서는 안 됩니다. 이 워크플로우를 다른 맥락에서 재사용하는 경우, 척도 맵을 기계적으로 복사하기보다 새로 구축해야 합니다. 연구자는 항목의 출처, 번역 또는 수정 상태, 웰빙 항목의 문화적 및 맥락적 의존성, 응답 앵커, 역코딩 규칙, 점수 해석 및 지역적 윤리 요구 사항을 검토해야 합니다. 번역 및 수정 절차는 비공식적인 문구 변경이 아니라 명시적인 문서화가 필요하며28, 교육 및 심리 검사 점수의 해석은 의도된 용도와 대상 집단에 대한 근거에 기반해야 합니다29.
실제적으로, 본 프로토콜은 설문지 기반의 웰빙 연구에서 데이터 처리 및 보고를 위한 감사 가능한 프레임워크로서 매우 유용합니다. 이는 연구자가 해석을 시작하기 전에 데이터 정제, 점수 산출, 진단 및 시각화에 관한 결정 과정을 투명하게 공개하도록 돕습니다. 향후 응용 단계에서는 독립적인 표본, 서로 다른 기관 환경, 종단적 설계 및 독립적으로 재현된 분석팀을 통해 이 워크플로우를 검증해야 합니다. 외부 타당도 검증, 사전 등록된 결정 규칙, 공유 합성 데이터셋, 작성이 완료된 예시 스크리닝/점수 산출 로그, 그리고 독립적인 분석가에 의한 재현이 이루어진다면 본 워크플로우의 이식성과 신뢰성을 더욱 강화할 수 있을 것입니다.
공개 사항
저자들은 선언할 이해관계 충돌이 없습니다.
감사의 글
저자들은 데이터 수집 과정에서 설문조사에 참여하여 도움을 준 대학생들에게 감사를 표합니다. 또한 설문지 배포, 데이터 정리, 결과 검증, 표 및 그림 작성에 도움을 준 관련 강사진과 연구 보조원들에게도 감사를 표합니다. 본 연구는 특정 연구비를 지원받지 않았습니다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| broom R 패키지 | CRAN | R 패키지 | 회귀 분석 출력값을 구조화된 계수 및 모델 요약 표로 변환하는 데 사용됩니다. |
| car R 패키지 | CRAN | R 패키지 | 분산 팽창 요인 검증 및 회귀 진단 지원에 사용됨. |
| 우울 불안 스트레스 척도-21(Depression Anxiety Stress Scales-21) 원본 문서 | 호주 심리학 재단 | Lovibond 및 Lovibond, 1995 | 부정적 정서 섹션의 소스 문서입니다. 워크플로우에는 최근의 부정적 정서 상태 평가와 일치하도록 연구에 맞게 조정된 문구가 사용되었습니다. |
| dplyr R 패키지 | CRAN | R 패키지 | 데이터 필터링, 리코딩, 그룹화, 스크리닝 흐름 요약 및 분석 표 작성에 사용됩니다. |
| ggplot2 R 패키지 | CRAN | R 패키지 | 상관관계 히트맵, 주관적 안녕감 상관관계 도표, 회귀 계수 도표 및 진단 디스플레이를 생성하는 데 사용되었습니다. |
| 고차원적 사고 측정 소스 문서 | Springer Nature | DOI: 10.1038/s41598-024-70908-3 | 고차원적 사고 섹션을 위한 소스 문서입니다. 해당 워크플로우는 분석적, 평가적, 성찰적, 통합적 및 증거 기반 사고에 맞춘 연구 적응형 문항 세트를 사용했습니다. |
| IBM SPSS Statistics | IBM Corp. | 버전 29.0.2.0 | 기술 통계에 사용됨, Cronbach’Cronbach's alpha, 피어슨 상관계수, 독립 표본 및 Welch 검정’t-검정, 다중 선형 회귀, Durbin-Watson 통계량, 표준화 잔차, 레버리지 값, Cook의 거리’s 거리 및 분산 팽창 요인. |
| psych R 패키지 | CRAN | R 패키지 | 심리측정 요약에 사용됨, Cronbach’s 알파 검증 및 McDonald’s 오메가 |
| 학교 소속감 심리 척도 출처 문서 | Wiley | Psychol Sch. 1993;30(1):79-90 | 학교 소속감 섹션의 출처 문서입니다. 워크플로우에는 학교 환경에서의 인지된 수용, 연결, 지지 및 소속감과 일치하도록 연구에 맞게 조정된 문구가 사용되었습니다. |
| R 통계 환경 | R Foundation for Statistical Computing | 버전 4.4.2 | 2차 분석 검증에 사용됨, McDonald’$\omega$ (오메가), Spearman 민감도 분석, 회귀 분석 결과 준비, 진단 결과 준비 및 시각화 소스 준비. |
| readxl R 패키지 | CRAN | R 패키지 | 스프레드시트 설문지 내보내기 파일을 R 검증 워크플로우로 가져오는 데 사용됩니다. |
| 중국 시민 대상 주관적 웰빙 척도 소스 문서 | 과학적 & 학술 출판 | DOI: 10.5923/j.ijap.20190905.01 | 주관적 안녕감 섹션에 대한 근거 문서입니다. 워크플로우에는 삶의 만족도, 의미, 지지, 진전, 불만족, 무력감 및 스트레스 관련 안녕감 경험과 일치하도록 연구에 맞게 수정된 문구와 역채점 항목이 사용되었습니다. |
| 보충 파일 1: 설문지 구조 및 척도 문서 | 저자 | 보충 파일 1 | 투여된 설문지 구조, 구성 개념 순서, 척도 출처, 항목 코드, 응답 앵커, 채점 방향, 역채점 규칙, 척도 수준의 점수 구성 및 문서화 상태 정보를 제공합니다. |
| Tuckman 지연 행동 척도 소스 문서 | SAGE Publications | Educ Psychol Meas. 1991;51(2):473-480 | 학업 지연 행동 섹션을 위한 소스 문서입니다. 해당 워크플로우는 학업적 지체 및 과제 미루기 행동에 맞춘 연구 적응형 용어를 사용했습니다. |
| Wenjuanxing 온라인 설문조사 플랫폼 | Changsha Ranxing Information Technology Co., Ltd. | 웹 기반 플랫폼 | 전자 동의, 설문지 프로그래밍, 문항 응답 수집, 타임스탬프 캡처, 완료 소요 시간 기록, 중복 제출 검토 및 원시 응답 내보내기에 사용됨. |
참고문헌
- 1. Khatri P et al. Student well-being in higher education: scale development and validation with implications for management education. Int J Manag Educ. 2024;22(1):100933.
- Mirzaei A, Carter SR, Patanwala AE, Schneider CR. Missing data in surveys: key concepts, approaches, and applications. Res Social Adm Pharm. 2022;18(2):2308-16.
- Gummer T, Roßmann J, Silber H. Using instructed response items as attention checks in web surveys: properties and implementation. Sociol Methods Res. 2021;50(1):238-64.
- Johansson F et al. Associations between procrastination and subsequent health outcomes among university students in Sweden. JAMA Netw Open. 2023;6(1):e2249346.
- Li X, Kuo YL, Huggins TJ. Perceived feedback and school belonging: the mediating role of subjective well-being. Front Psychol. 2024;15:1450788.
- Sönning L. Ordinal response scales: psychometric grounding for design and analysis. Res Methods Appl Linguist. 2024;3(3):100156.
- Song P et al. Predictive analysis of college students’ academic procrastination behavior based on a decision tree model. Humanit Soc Sci Commun. 2024;11:869.
- Dudáš A. Graphical representation of data prediction potential: correlation graphs and correlation chains. Vis Comput. 2024;40(10):6969-82.
- Niessen ASM, Meijer RR, Tendeiro JN. Detecting careless respondents in web-based questionnaires: which method to use? J Res Pers. 2016;63:1-11.
- Parsons J, Bao L. A unified approach for outliers and influential data detection: the value of information in retrospect. Stat. 2022;11(1):e442.
- Donche V et al. Careless responding in online student learning surveys: profiles and impact on data quality. Frontline Learn Res. 2026;13(3):1-14.
- Lovibond SH, Lovibond PF. Manual for the Depression Anxiety Stress Scales. 2nd ed. Psychology Foundation; Sydney; 1995.
- Tuckman BW. The development and concurrent validity of the Procrastination Scale. Educ Psychol Meas. 1991;51(2):473-80.
- Goodenow C. The psychological sense of school membership among adolescents: scale development and educational correlates. Psychol Sch. 1993;30(1):79-90.
- Li D, Fan X, Meng L. Development and validation of a higher-order thinking skills (HOTS) scale for major students in the interior design discipline for blended learning. Sci Rep. 2024;14:20287.
- Huang L, Xing Z. A nationwide study on Subjective Well-being Scale for Chinese Citizens (SWBS-cc). Int J Appl Psychol. 2019;9(5):117-27.
- DeSimone JA, Harms PD, DeSimone AJ. Best practice recommendations for data screening. J Organ Behav. 2015;36(2):171-81.
- Revilla MA, Saris WE, Krosnick JA. Choosing the number of categories in agree-disagree scales. Sociol Methods Res. 2014;43(1):73-97.
- Muszyński M. Attention checks and how to use them: review and practical recommendations. ASK Res Methods. 2023;32(1):3-38.
- McNeish D. Thanks coefficient alpha, we’ll take it from here. Psychol Methods. 2018;23(3):412-33.
- Romeo I, Stanislaw H, McCreary J, Hawley M. The importance of belonging for well-being in college students. PLOS Ment Health. 2024;1(1):e0000057.
- Kastellec JP, Leoni EL. Using graphs instead of tables in political science. Perspect Polit. 2007;5(4):755-71.
- Flake JK, Fried EI. Measurement schmeasurement: questionable measurement practices and how to avoid them. Adv Methods Pract Psychol Sci. 2020;3(4):456-65.
- Nosek BA et al. Promoting an open research culture. Science. 2015;348(6242):1422-5.
- Wilkinson MD et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.
- Podsakoff PM, MacKenzie SB, Lee JY, Podsakoff NP. Common method biases in behavioral research: a critical review of the literature and recommended remedies. J Appl Psychol. 2003;88(5):879-903.
- Vandenberg RJ, Lance CE. A review and synthesis of the measurement invariance literature: suggestions, practices, and recommendations for organizational research. Organ Res Methods. 2000;3(1):4-70.
- van de Vijver FJR, Hambleton RK. Translating tests: some practical guidelines. Eur Psychol. 1996;1(2):89-99.
- American Educational Research Association, American Psychological Association, National Council on Measurement in Education. Standards for educational and psychological testing. American Educational Research Association; Washington, DC; 2014.