본 프로토콜은 회피 반응을 동반한 파블로프-도구적 공포 조건화, 사회적 자극을 통한 공포 습득-소거-재습득, 그리고 확률적 보상 학습으로 구성된 60분 통합 배터리를 설명하며, 성인 참가자 개개인의 위협 및 보상 학습 지표를 도출하기 위해 피부 전도도, 행동 및 단계별 평정치를 동시에 기록합니다.
이 콘텐츠를 보려면 JoVE 구독이 필요합니다. 로그인하거나 오늘 무료 평가판을 시작하세요.
이 논문에서
요약
초록
아동기 부정적 경험(ACEs)은 성인기 불안 및 우울증의 확립된 범진단적 위험 요인이지만, 초기 역경을 증상과 연결 짓는 신경인지적 메커니즘은 통합적인 틀 내에서 여전히 불분명합니다. 본 프로토콜은 단일 실험실 세션 내에서 위협 식별, 안전 학습 및 보상 민감도를 측정하는 통합 다중 시스템 실험 배터리를 제시합니다. 38명의 건강한 성인이 세 가지 행동 패러다임 — 회피를 동반한 파블로프-조작적 공포 조건화(실험 1), 사회적 자극을 이용한 공포 습득-소멸-재습득(실험 2), 확률적 보상 학습(실험 3) — 과 함께 아동기 역경(CTQ-SF), 아동기 긍정적 경험(BCE), 우울증(PHQ-9) 및 불안(GAD-7, STAI)에 대한 검증된 자기 보고서를 작성하였습니다. 자율 신경 각성도의 생리적 지표인 피부 전도 반응(SCR), 행동 지표로서의 버튼 누르기 회피 및 확률적 선택, 그리고 기대감, 위협 및 안도감에 대한 단계별 주관적 평가가 다채널로 동시에 수집되었습니다. 각 패러다임은 전형적인 효과를 나타냈습니다: SCR에서의 파블로프 식별(p = 0.009, ηp2 = 0.12), 기대감(p < 0.001, ηp2 = 0.58), 위협 평가(p < 0.001, ηp2 = 0.35); 회피 가능 위협과 회피 불가능 위협을 식별하는 조작적 안도감(p < 0.001, d = 0.86); 실험 2에서 습득 단계에서는 나타났으나 소멸 단계에서는 나타나지 않은 차별적 자율 신경 반응(습득 p = 0.008; 소멸 p = 0.168)과 동시에 지속된 수반성에 대한 선언적 지식(p < 0.001, d = 3.08); 그리고 실험 3에서 우연 수준을 상회하는 확률적 보상 학습(M = 73%, p < 0.001, d = 1.97)이 확인되었습니다. 이러한 다중 시스템 설계는 단일 채널로는 놓쳤을 해리 현상을 밝혔으며, 특히 지속적인 주관적 위협과 함께 감쇠된 자율 신경 반응이 가장 두드러졌습니다. 본 프로토콜에서 도출된 참가자별 지표는 아동기 경험의 개인차에 민감하게 반응하였으며, 이에 대한 예시적 조절 분석 결과는 보충 자료에 보고되었습니다. 본 프로토콜은 초기 역경이 성인기의 위협 및 보상 처리를 어떻게 재조정하는지 지표화할 수 있는 휴대 가능하고 확장 가능한 프레임워크를 제공합니다.
서론
학대, 방임 및 가정 기능 장애를 포함하는 아동기 부정적 경험(ACEs)은 전 세계적으로 매우 빈번하게 나타나며, 많은 인구 집단에서 그 비율이 60%를 초과합니다1. 연구 종합 결과에 따르면 대부분의 아동이 발달 과정 중에 적어도 하나의 부정적인 사건에 노출되는 것으로 나타났습니다2. ACEs는 성인 정신병리의 잘 알려진 범진단적 위험 요인이며3, 불안 장애의 약 30%와 우울증 사례의 40%에 기여하는 것으로 추정됩니다1. 이러한 강력한 연관성에도 불구하고, 일반적으로 사용되는 임상 평가 방식은 범주적 진단과 회고적 자기 보고에 의존하고 있으며, 이는 회상 편향에 취약하고 실시간 신경인지 과정을 포착하지 못한다는 한계가 있습니다4.
이러한 한계를 극복하기 위해, 기저 메커니즘, 특히 연합 학습을 표적으로 하는 진단 간 접근법(transdiagnostic approaches)에 대한 강조가 증가하고 있습니다. 파블로프식 조건 형성(Pavlovian conditioning)과 조작적 조건 형성(operant conditioning)을 모두 포함하는 연합 학습은 개인이 의사결정을 안내하기 위해 환경적 신호, 행동 및 결과 사이의 관계를 어떻게 부호화하는지 이해하기 위한 틀을 제공합니다4,5. 이러한 틀 내에서 잠재적 취약성 이론(latent vulnerability theory)은 초기 역경이 예측 불가능한 환경에서는 처음에는 적응적이지만, 이후의 더 안전한 상황에서는 부적응적이 될 수 있는 고도의 경계심과 같은 신경생물학적 적응을 유도한다고 가정합니다6,7.
증거에 따르면 ACEs는 위협 및 보상 관련 학습 과정 모두에 영향을 미치는 것으로 나타났습니다. 역경의 경험이 있는 개인은 조건화된 위험(CS+)과 안전(CS−) 신호 사이의 변별력이 감소하는 경향을 보이며, 이는 위협 학습의 변화를 나타냅니다8. 이와 병행하여, 초기 역경은 보상 민감도의 저하와 관련이 있으며, 이는 보상 조건부 학습의 정확도 감소와 습득 속도 저하로 반영됩니다8. 불확실한 조건 하에서 이러한 개인들은 선택의 가변성이 증가하고 보상이 무작위로 제공된다고 가정하는 편향을 보일 수 있으며, 이는 변동성이 큰 환경에 초기에 노출된 것과 일치합니다5,9.
이러한 학습 패턴은 보호 요인 및 상태 의존적 요인에 의해 더욱 구체화됩니다. 긍정적 아동기 경험(Benevolent Childhood Experiences, BCEs)은 학습 체계에 미치는 역경의 영향을 완화할 수 있으며10, 불안과 같은 현재의 정서 상태는 조건 형성 과정을 조절할 수 있습니다11. 피부 전도도 반응(Skin Conductance Response, SCR)을 포함한 자율신경계 각성도의 생리학적 측정치는 이러한 과정에 대한 객관적 지표를 제공하며, 조건 형성 패러다임에서 널리 사용됩니다12.
현재 문헌의 주요 한계점은 위협 학습 또는 보상 학습을 독립적으로 평가하는 분리된 과제들을 사용함으로써, 통합적인 신경인지 기능을 파악하는 능력이 제한된다는 점입니다1. 본 프로토콜은 여러 학습 영역에 걸쳐 행동 및 생리학적 측정법을 결합한 표준화된 프레임워크를 제공함으로써 이러한 공백을 해결합니다. 구체적으로, 본 프로토콜은 세 가지 실험 구성 요소를 포함합니다: (1) 파블로프 조건형성에서 조작적 조건형성으로의 전이를 평가하는 패러다임, (2) 사회적 공포 소멸 과제, 그리고 (3) 확률적 보상 학습 과제입니다8.
이러한 특정 패러다임 조합을 선택한 근거는, 세 가지 과제 중 어느 하나가 단독으로 다른 많은 기성 학습 패러다임보다 조기 역경에 더 민감하기 때문이 아니라 측정 관점의 근거에 따른 것입니다. Ruge 등1은 81건의 연구(위협 38건, 보상 43건)에 대한 체계적 문헌 고찰을 통해, ACE와 연합 학습을 연결하는 문헌들이 여전히 이질적이며 핵심적인 면에서 결정적이지 않다는 점을 보여주었습니다. 이는 정확히 연구들이 일반적으로 단일 과제를 사용하고, 단일 반응 채널만을 기록하며, 역경을 표준화되지 않은 방식으로 조작화하기 때문입니다. 예시적으로, 행동 보상 학습 연구의 절반은 학습 둔화를 보고한 반면 나머지 절반은 유의미한 결과가 없음을 보고했습니다. 소수의 소거 관련 문헌은 결과가 없다는 발견과 이전의 획득 단계가 생략된 보고들이 주를 이루고 있습니다. 또한 보편적으로 더 신뢰할 수 있는 결과 측정법이 나타나지 않았으므로, 서로 다른 반응 채널을 상호 대체 가능한 대리 지표로 사용할 수 없습니다. 그들의 명시적인 권고 사항은 개인 수준의 지표를 산출할 수 있는 피험자 내, 다중 도메인 및 다중 채널 프로토콜로 이동하는 것입니다. 본 연구의 세 가지 과제 조합은 해당 권고를 따랐는데, 이는 세 가지 과제가 단일 패러다임으로는 커버할 수 없는, 계산적으로 분리 가능한 세 가지 요구 사항을 포괄하며, 잠재적 취약성 이론7에서 역경이 서로 다른 방식으로 형성할 것이라고 예측하는 영역들이기 때문입니다: (i) 도구적 제어 가능성과 결합된 위협-안전 변별로, 안도감이 회피의 추정 강화제로 작용하며13; (ii) 대인 관계 학대와 생태학적으로 관련이 있는 자극 영역인 사회적 얼굴 자극11으로 탐색하는 억제(안전) 학습 및 공포의 회복; (iii) 확률적 불확실성 하에서의 강화 학습으로, 참가자별 계산 파라미터(학습률 alpha, 역온도 beta)8를 산출합니다. 이 세 가지를 모두 동일한 참가자에게 실시함으로써, 본 설계는 ACE 관련 변화가 도메인 일반적인지(Hanson 등8이 제안하고 신경 계산적 잠재 취약성 설명이 예측하는 바와 같은 연합 학습의 전반적 재조정6), 아니면 위협에 국한된 가치 특이적인지를 묻도록 구성되었습니다. 단일 과제 연구로는 구조적으로 이러한 상충하는 가설들을 판정할 수 없습니다.
본 배터리는 일련의 명시적이고 방향성 있는 가설들을 검증하도록 설계되었으며, 현재의 표본으로는 이를 판정할 통계적 검정력이 부족하므로 여기서는 충분한 검정력을 갖춘 연구들의 목표로 제시한다. Ruge 등에 의해 기술된 둔화된 학습 패턴1과 일관되게, 더 높은 ACE 부하(load)는 다음 사항들과 연관될 것으로 예측된다: (i) 실험 1에서 CS+/CS− 변별 능력의 감소로, 이는 CS+에 대한 반응 약화에 의해 유도되며, 선언적 기대치(declarative expectancy)는 유지될 수 있는 반면 자율신경 경로(SCR)에서 더 뚜렷하게 나타날 것으로 예상된다; (ii) 회피 강화 학습13과 일관되게, 회피 가능한 CS+에 대해 더 강한 회피 반응과 더 높은 주관적 안도감을 보임; (iii) 실험 2에서 더 느린 소거 및 재습득 시 더 빠르고 더 큰 공포의 회복으로, 이는 대인 관계의 역경과 생태학적 관련성이 있는 사회적(얼굴) 자극에 의해 증폭될 것으로 예측된다11; (iv) 실험 3에서 더 낮은 선택 정확도, 더 낮은 학습률(alpha) 및 더 큰 선택 변동성(더 낮은 beta)8. 결정적으로, 세 가지 과제는 다섯 번째 변별 예측에 대해 종합적인 정보를 제공한다: 만약 ACE 관련 변화가 도메인 일반적(domain-general)이라면 모든 세 과제에서 약화가 나타날 것이며, 만약 그것이 가가성(valence) 특이적이라면 두 가지 위협 패러다임에 국한되고 확률적 보상 학습에서는 나타나지 않을 것이다. 반응 경로가 동시에 기록되므로 추가적인 예측 또한 테스트 가능하다. 즉, ACE 효과는 균일하기보다 경로 의존적일 것이며, 따라서 단일 경로에서 도출된 결론이 다른 경로로 일반화되지 않을 것이다.
실험 1은 San Martín 등13이 개발한 회피 및 시행별 안도감 평가가 포함된 파블로프식-조작적 공포 조건 형성 패러다임을 응용한 것입니다. 이 패러다임에서는 두 개의 CS+ 단서(회피 가능 단서 하나, 회피 불가능 단서 하나)와 하나의 CS− 단서를 사용하여, 파블로프식 변별과 혐오 결과에 대한 도구적 제어를 분리합니다. 기존 패러다임에서는 파블로프 학습 단계 동안의 US 기대치 평가가 시행별로 이루어지지 않고, 해당 단계가 끝난 후 실험자에 의해 회고적으로 평가되었습니다. 본 응용 방식에서는 시각 아날로그 척도를 사용하여 과제 수행 전반에 걸쳐 기대치, 위협 및 안도감에 대한 주관적 평가를 단계별로 동시에 수집함으로써, 단계별 학습 역동성을 지속적으로 추적할 수 있도록 하였습니다.
실험 2에서는 Dibbets와 Evers9의 사회적(얼굴) 자극을 이용한 공포 습득-소멸 프로토콜을 응용하였으며, 조건화된 반응의 신속한 재출현(절약 효과)을 평가하기 위해 짧은 재습득 테스트를 추가하여 확장하였습니다.
실험 3은 초기 역경 관련 학습 차이를 연구하기 위해 Hanson 등이 도입한8 확률적 보상 학습 과제를 응용하였으며, 참가자별 강화 학습 파라미터(Q-learning Alpha 및 Beta)를 추정할 수 있도록 두 가지 보상 조건(80/20 및 70/30)을 설정하였습니다. 본 프로토콜은 이 세 가지 패러다임을 단일 실험 세션 내에 통합함으로써, 일반적으로 개별적으로 연구되는 위협 학습과 보상 학습 과정을 참가자 내에서 직접적으로 비교할 수 있게 합니다. 분석 파이프라인은 시행당 정확도와 Q-learning 파라미터 외에도, 더 큰 표본에 적용 가능한 선형 혼합 모델 적합을 통한 개별 학습 궤적 기울기를 산출합니다.
여기서는 두 가지 뚜렷한 목표가 서로 동등하지 않으므로 이를 구분해야 합니다. 첫 번째 목표는 이러한 일련의 검사 배터리를 60분 동안의 단일 통합 세션으로 운영할 수 있으며, 각 구성 요소가 설계된 대로의 전형적인 효과를 유도한다는 것을 입증하는 것입니다. 전형적인 효과를 재현하는 것은 이 첫 번째 목표에 충분한 증거가 됩니다. 두 번째 목표는 결과로 도출된 지표들이 아동기 역경의 결과에 대해 민감하고 특이적이라는 점을 입증하는 것입니다. 전형적인 효과의 재현만으로는 이에 대한 충분한 증거가 되지 않으며, 본 샘플은 이를 입증할 만큼의 통계적 검정력을 갖추고 있지 않습니다. 따라서 본 보고서의 주된 목적은 통합 배터리의 기술적 및 방법론적 타당성을 확인하는 것입니다. 즉, 단일 세션 내에서 위협 습득, 안도감이 동반된 도구적 회피, 사회적 자극에 의한 공포의 소거 및 회복, 그리고 확률적 보상 학습이 자율신경계, 행동 및 자기보고 채널 전반에 걸쳐 동시에 습득될 수 있는지, 그리고 이 파이프라인이 안정적이고 재사용 가능한 참여자별 지표(차등 SCR 대비, 조작적 안도 대비, Q-learning 알파 및 베타 파라미터, 개별 학습 궤적 기울기)를 산출하는지 확인하는 것입니다. 학습에서 ACE 관련 변화를 평가하는 것은 부차적이고 탐색적이며 예시적인 목표에 해당합니다. 여기서 보고된 개별 차이 분석은 프로토콜의 측정 능력을 입증하고 향후 연구에서 사용할 수 있도록 후보 지표들을 제공하기 위한 것이지, 트라우마-학습 경로를 구체적으로 테스트하기 위한 것이 아닙니다. 따라서 본 프로토콜은 후보 지표들을 제공하며, 이 지표들이 아동기 역경의 신경인지적 결과를 특징짓는 데 필요한 민감도와 특이도를 갖추고 있는지는 향후 더 큰 규모의, 이상적으로는 극단 집단이 보강되고 사전 등록된 샘플1,14을 통해 입증되어야 합니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
프로토콜
본 프로토콜은 윤리 위원회의 요구 사항에 따라 18세 이상의 건강한 피험자를 대상으로 피부 전도 반응(Skin Conductance Response, SCR)을 측정하는 데 사용되는 절차와 기기를 설명합니다. 연구에 참여하기 전, 모든 피험자는 6개월 후 추적 평가를 위해 다시 연락받을 가능성이 포함된 고지된 동의서에 서명하였습니다. 이 문서에 기술된 모든 절차는 Universidad de los Andes의 과학 윤리 위원회(ID: CEC2025023)의 승인을 받았습니다.
참고: 본 프로토콜은 참가자 일정 예약, 실험실 준비, 생체 신호 수집, 데이터 정리 및 실험 후 데이터 처리를 포함한 전체 실험 워크플로우(그림 1)에 대한 상세한 설명을 제공합니다. 또한, 모든 실험 세션에서 SCR 기록이 일관되고 표준화되며 신뢰할 수 있게 수집되도록 시행된 스태프 교육 절차를 설명합니다.
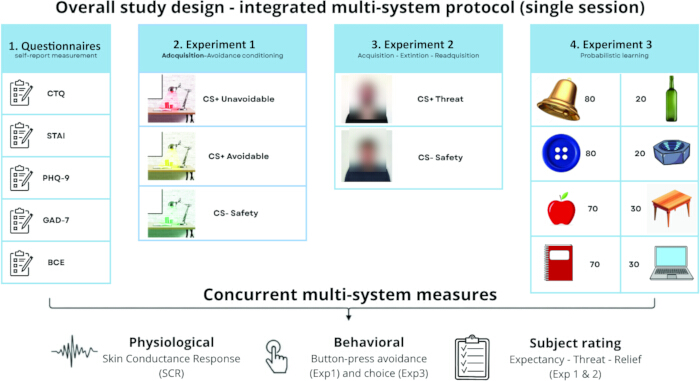
그림 1: 연구 설계의 전체 개요도. 각 참가자는 회피가 포함된 파블로프-조작적 공포 조건화(실험 1), 사회적 자극을 이용한 공포 획득-소거-재획득(실험 2), 그리고 확률적 보상 학습(실험 3)의 세 가지 연속적인 행동 패러다임을 포함하는 단일 실험실 세션을 완료하였다. 아동기 역경(CTQ-SF), 긍정적 아동기 경험(BCE) 및 현재 증상(PHQ-9, GAD-7, STAI)에 대한 자기 보고 데이터도 수집되었다. 피부 전도 반응, 행동(회피, 확률적 선택) 및 주관적 평가(기대, 위협, 안도감)와 같은 다채널 데이터가 동시에 기록되었다. 참가자별 지표는 개인차 분석에 입력되었다(보충 파일 2 참조). 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
1. 직원 교육
- 데이터 측정의 표준화와 정확성을 보장하기 위해 모든 팀원을 세 단계의 점진적인 과정으로 교육합니다.
- 각 연구원이 샘플을 채취하고 세 가지 실험 모두를 각각의 프로토콜에 따라 수행하는 내부 시험을 실시하여, 교육생이 장비 및 피험자 응대 방식에 익숙해지도록 합니다.
- 다음으로, 교육생이 최소 한 명의 책임 연구자 감독 하에 실제 피험자로부터 샘플을 채취하게 하여 프로토콜 수행 능력을 검증하고 오류를 수정합니다.
- 감독 하에 전체 프로토콜이 정확하게 적용된 것이 확인된 후에만 보조 연구원이 자율적으로 샘플을 채취하고 새로운 피험자 일정을 잡을 수 있도록 승인합니다.
2. 일정 계획
- 소셜 미디어를 통해 연구의 일반적인 목적과 참여 기준을 안내하여 참가자를 모집하고 일정을 계획하십시오.
- 디지털 포스터를 제작하고 이를 모집 채널을 통해 배포하여 가능한 한 많은 잠재적 참여자에게 도달하십시오.
- 관심 있는 지원자는 이메일로 연구팀에 연락하여 참가자가 편리한 날짜에 세션 일정을 예약하도록 안내하십시오.
- 참가자에게 "보이지 않는 흔적: 아동기 부정적 경험과 성인기 정신 건강 관계에서 연합 학습의 역할"이라는 제목의 온라인 설문지 링크를 전송하십시오.
- 설문지를 고지된 동의서로 시작하고, 이후 항목이 제시되기 전에 참여자가 이를 읽고 동의하도록 요청하십시오.
- 설문지에 사회인구학적 섹션과 다음과 같이 검증된 심리측정 척도를 포함하십시오: Patient Health Questionnaire-9 (PHQ-9)15, 범불안장애 척도 (GAD-7)16, 상태-특성 불안 척도 (STAI)17, 아동기 외상 질문지—단축형 (CTQ-SF)18, 그리고 긍정적 아동기 경험 (BCEs)10.
3. 준비 과정
- 참가자가 도착하기 전, 최소 한 명의 직원이 실험실에 상주하도록 합니다. 세션을 시작하기 전, 실험 환경을 준비하고 장비의 정상 작동 여부를 확인하며 모든 프로토콜 요구 사항이 충족되었는지 확인하십시오:
- 실험실 컴퓨터를 켜고 운영 체제, 실험 소프트웨어 및 모든 주변 기기가 올바르게 작동하는지 확인합니다.
- 실험 파일과 데이터 수집 시스템이 사용할 준비가 되었는지 확인합니다.
- 참가자가 실험실에 들어오기 전, 일일 실행 파일(daily running file)을 열어 검토합니다.
- 방문하는 참가자에게 할당된 해당 식별 코드(ID)를 확인합니다.
- 사전에 정의된 카운터밸런싱(counterbalancing)에 따라 실험 조건의 실행 순서를 확인합니다.
- 데이터 수집을 시작하기 전, 참가자가 올바른 실험 순서에 할당되었는지 확인합니다.
참고: 일일 실행 파일에는 모든 실험 조건에 걸쳐 필요한 카운터밸런싱을 유지하면서 참가자의 ID를 할당하고 실험 실행 순서를 결정하는 데 필요한 모든 정보가 포함되어 있습니다. 예를 들어, 참가자에게 ID "015"가 할당될 수 있습니다. - 자동 처리 파이프라인에서 요구하는 표준 디렉토리 구조에 따라 실험실 컴퓨터의 데이터 저장 공간을 정리합니다: 실험당 하나의 최상위 폴더, 카운터밸런싱 조건당 하나의 하위 폴더, 참가자 ID당 하나의 폴더를 생성하고, 처리된 데이터와 통합 데이터베이스를 저장하는 두 개의 전역 폴더를 생성합니다(Supplementary File 1 참조).
- 데이터 수집을 시작하기 전 일일 실행 파일에 기재된 ID 및 카운터밸런싱 조건에 해당하는 참가자 폴더를 생성하고, 세션 전반에 걸쳐 Supplementary File 1에 명시된 디렉토리 및 파일 명명 규칙을 따릅니다. 이는 전처리 및 데이터베이스 스크립트가 경로와 이름으로 파일을 찾기 때문입니다.
참고: 디렉토리 트리, 카운터밸런싱 하위 폴더 레이블, 파일 명명 규칙 및 실제 적용 예시는 Supplementary File 1에 제시되어 있습니다. 이러한 규칙을 따르지 않으면 자동 파이프라인이 참가자의 파일을 찾을 수 없습니다. - 실험 책상에 외부 물체나 주의를 분산시키는 물건이 전혀 없는지 확인합니다. 데이터 수집 시스템과 실험에 필요한 컴퓨터 주변 기기만 책상 위에 둡니다.
- 차분하고 전문적인 태도로 참가자를 실내로 안내합니다.
- 참가자에게 모든 개인 소지품을 지정된 장소에 따로 두도록 요청합니다.
- 실험 세션 중 중단이나 주의 분산을 방지하기 위해 참가자에게 모바일 기기를 무음 모드로 설정하도록 안내합니다.
- 측정에 방해가 될 수 있으므로, 참가자에게 비우세손의 모든 액세서리, 특히 반지, 팔찌 또는 가운데 손가락과 약지에 착용한 모든 물건을 제거하도록 요청합니다.
- 참가자가 실험실 컴퓨터 앞에 놓인 의자에 편안하게 앉도록 안내합니다.
- 참가자에게 고지된 동의서(informed consent document)의 인쇄본을 제공합니다.
- 참가자가 문서를 읽고 필요한 경우 질문할 수 있도록 충분한 시간을 줍니다.
- 어떤 실험 절차라도 시작하기 전, 고지된 동의서에 올바르게 서명되었는지 확인합니다.
참고: 고지된 동의 절차는 윤리 위원회에서 정한 요구 사항을 따르고 참가자의 동의 문서에 대한 물리적 백업을 유지하기 위해 물리적 서면 형식으로 반복 수행됩니다.
4. 실험 설정
참고: 모든 생리학적 측정값이 참가자 전반에 걸쳐 동일하게 제어된 조건 하에서 획득될 수 있도록, 실험 설정은 엄격하고 표준화된 프로토콜을 따라야 합니다.
- 데이터 수집 시스템을 켜고 장치가 실험실 컴퓨터에 올바르게 연결되었으며 수집 시스템 소프트웨어에서 인식되는지 확인하십시오 (그림 2A–E 참조).
- 피험자 준비를 진행하기 전에 필요한 모든 모듈과 주변 기기가 제대로 작동하는지 다시 한번 확인하십시오.
- 두 개의 전기피부활동(EDA) 전극을 준비하십시오 (그림 2F 참조).
- 각 전극의 접촉면에 소량의 전도성 겔을 도포하십시오 (그림 2G,H 참조).
- 피험자의 피부와의 전기적 접촉을 개선하고 신호 품질을 최적화하기 위해 전도성 겔이 전극 표면에 고르게 도포되었는지 확인하십시오.
참고: 전극에 전도성 겔을 도포하지 않으면 기록된 신호에 과도한 노이즈가 포함될 수 있으며, 피부전도도반응(SCR) 측정 품질이 심각하게 저하될 수 있습니다. - 피험자의 비우세손에 전극을 배치하십시오.
- 하나의 전극은 가운데 손가락(세 번째 손가락)의 첫 번째 마디에, 다른 전극은 약지(네 번째 손가락)의 첫 번째 마디에 부착하십시오 (그림 2I 참조).
- 두 전극이 단단히 부착되었는지, 그리고 피험자에게 불편함을 주지 않으면서 피부와 안정적인 접촉을 유지하고 있는지 확인하십시오.
- 피험자의 손목에 손목 스트랩을 착용시키십시오.
- 교정 단계 동안에는 EDA 전극을 손목 스트랩에서 분리된 상태로 두십시오 (그림 2J 참조).
- 생체 신호 수집 시스템과 무선 통신을 설정하기 위해 손목 스트랩의 전원을 켜십시오.
- 장치가 성공적으로 감지되었는지 확인하십시오.
참고: 전체 실험 세션 동안 손목 스트랩에 특별한 주의를 기울여야 합니다. 통신 중단은 생체 신호 기록에 영향을 줄 수 있으므로, 연구원은 실험을 시작하기 전 장치의 전원이 켜져 있고 연결된 상태인지 지속적으로 확인해야 합니다. - 수집 소프트웨어에서 데이터 수집 프로세스를 시작하십시오.
- 수집이 시작되면 화면에 자동으로 나타나는 교정 창이 뜰 때까지 기다리십시오.
- 전극이 손목 스트랩에서 분리된 상태에서 교정 절차를 수행하십시오.
- 절차가 완료될 때까지 소프트웨어에서 제공하는 교정 지침을 따르십시오.
- 교정이 성공적으로 완료되면 EDA 전극을 손목 스트랩에 연결하십시오 (그림 2K 참조).
- 소프트웨어에서 피부전도도반응(SCR) 신호가 올바르게 수집되고 있는지 확인하십시오.
- 피험자에게 실험 전체 과정 동안 비우세손을 완전히 움직이지 말고 유지하도록 안내하십시오.
- 불필요한 움직임, 손가락 수축 또는 자세 변화가 SCR 신호에 노이즈를 유발할 수 있음을 설명하십시오.
- 세션 동안 피험자가 편안하고 이완된 자세를 유지하도록 요청하십시오.
- 실험 과제를 시작하기 전 피험자에게 헤드폰을 제공하십시오.
- 헤드폰이 제대로 작동하는지, 그리고 피험자가 실험 중에 제시되는 청각 자극을 명확하게 인지할 수 있는지 확인하십시오.
- PsychoPy19에서 실험 과제를 실행하십시오.
- PsychoPy 인터페이스가 열리면, 요청 창에 피험자 이름을 입력하십시오.
- 실험을 시작하기 전, 일일 실행 파일에 명시된 대로 피험자에게 할당된 ID를 정확하게 입력하십시오.
참고: 이전 예시를 따르면, PsychoPy에 입력할 피험자 ID는 "015"여야 합니다.
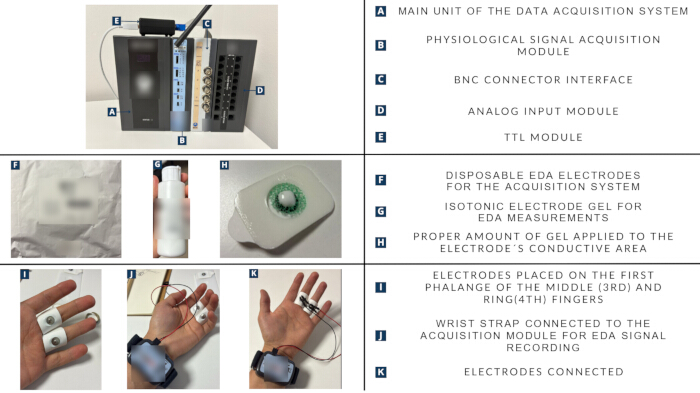
그림 2: 피부 전도도 기록을 위한 수집 시스템, 재료 및 전극 배치. (A) Biopac MP200 메인 유닛. (B) 생리적 신호 수집 모듈 (PPG/EDA). (C) 센서 커넥터 모듈. (D) 아날로그 입력 모듈. (E) PsychoPy와 AcqKnowledge 간 통신을 위한 TTL 모듈. (F) 일회용 전극 (EL507A). (G) 피부 접촉 개선을 위한 등장성 젤 (GEL101A). (H) 전극에 젤을 도포하는 모습. (I) 비우세손의 세 번째 및 네 번째 손가락 첫마디에 배치된 전극. (J) SCR 측정을 위해 비우세손에 손목 스트랩을 배치한 모습. (K) 보정 과정 후 연결된 전극. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
5. 실험 시작
- 실험 과제를 시작하기 전, 실험 중에 제시되는 질문에 어떻게 응답해야 하는지 피험자에게 자세히 설명하십시오.
- 피험자가 다음 사항을 명확히 이해했는지 확인하십시오: (i) 과제 수행 중 사용할 응답 방법, (ii) 화면에 표시되는 지침의 의미, (iii) 실험 전반에 걸쳐 주의를 유지하고 불필요한 움직임을 최소화하는 것의 중요성.
- 녹화 세션을 시작하기 전, 피험자의 남은 질문에 모두 답변하십시오.
- 생체 신호 수집 시스템 통신, 손목 스트랩 연결, SCR 신호 품질, PsychoPy 실행, 헤드폰을 통한 오디오 출력, 그리고 정확한 피험자 ID 등록을 포함하여, 모든 시스템이 설정된 프로토콜에 따라 정상적으로 작동하는지 전체 실험 설정을 최종 확인하십시오.
- 모든 시스템이 확인되고 피험자가 시작 준비가 되었음을 확인하면 실험 과제를 시작하십시오.
- 데이터 수집 중 외부 영향과 방해 요인을 최소화하기 위해, 과제가 시작되면 실험실 밖으로 나가십시오.
- 기술적 지원이나 피험자 보조가 필요한 경우에 대비하여 근처에서 대기하며, 피험자가 세션을 마칠 때까지 기다리십시오.
6. 실험 간 단계
- 참가자가 과제를 마치면 실험실로 다시 들어가 획득 소프트웨어의 생체 신호 기록을 중단하십시오.
- 생리적 기록 데이터를 참여자의 폴더에 획득 파일(acquisition file)로 저장한 다음, 해당 기록을 이벤트가 포함된 MATLAB 형식으로 내보내어 내보낸 파일에 TTL 모듈을 통해 PsychoPy에서 생성된 자극 마커가 포함되도록 하십시오. 내보내기 과정에서 별도의 마커 파일이 추가로 생성됩니다.
참고: 이벤트 및 마커 정보는 전처리 파이프라인(섹션 8)에서 신호를 시행(trial) 및 자극 유형별로 분할하는 데 필요합니다. - 작업 종료 시 생성되는 PsychoPy 출력 스프레드시트를 동일한 피험자 폴더에 저장하십시오. 다음에서 상세히 설명하는 표준 파일 명명 규칙을 사용하십시오. 보충 파일 1 4개 파일 모두에 대해.
참고: 각 실험이 종료되면 참여자 폴더에 획득 파일, 내보낸 MATLAB 파일, 마커 파일 및 PsychoPy 스프레드시트가 포함되어 있어야 합니다. 정확한 파일 이름, 경로 및 작성 예시는 다음에서 제공됩니다. 보충 파일 1. - 피실험자로부터 EDA 전극을 조심스럽게 분리하며, 제거 과정에서 과도한 움직임이나 불편함이 발생하지 않도록 주의하십시오.
- 다음 PsychoPy 실험 과제를 열고, 이어지는 실험을 준비하기 위해 데이터 수집 소프트웨어를 재시작하십시오.
- 단계 4.1부터 시작하여 전체 준비 및 획득 절차를 반복하십시오.
참고: 전체 실험 세션은 세 개의 독립적인 실험으로 구성됩니다. 따라서 두 번째 실험이 종료되면, 세 번째 실험을 위해 위에 설명된 것과 동일한 절차를 반복해야 합니다. - 전체 실험 세션이 종료되면, 참가자가 각 실험 과제별로 3개의 하위 폴더를 가지고 있으며, 각 폴더에 앞서 언급된 모든 파일이 포함되어 있는지 확인하십시오.
참고: 각 실험 과제의 대략적인 소요 시간은 세션 동안 스태프가 참가자를 모니터링하고 데이터 획득 시스템의 정상 작동 여부를 확인하기 위해 사전에 추정되었습니다. 각 실험의 추정 소요 시간은 다음과 같습니다.
실험 1: 약 24분.
실험 2: 약 17분.
실험 3: 약 8분.
준비, 교정, 실험 간 전환 시간 및 마무리 절차를 고려할 때, 전체 실험 세션의 소요 시간은 약 60분입니다.
7. 실험 종료
- 세 가지 실험 과제가 모두 완료되면 생리적 측정 세션을 종료합니다.
- 데이터 수집 소프트웨어에서 수집 프로세스가 아직 중단되지 않았다면 이를 중단합니다.
- 손목 스트랩에서 EDA 전극을 분리하고 참가자의 손목에서 손목 스트랩을 제거합니다.
- 불편함을 최소화하고 피부에서 안전하게 제거할 수 있도록 참가자가 직접 EDA 전극을 제거하게 합니다.
- 세션을 마치기 전에 모든 실험 파일과 생리적 측정 데이터가 올바르게 저장되었는지 확인합니다.
- 실험 절차가 완료되면 참가자의 협조에 감사를 표하고, 감사의 표시로 가벼운 간식을 제공합니다.
참고: 손목 스트랩과 생리적 수집 시스템 모듈 간의 통신 단절, 손목 스트랩의 갑작스러운 전원 종료, 전극의 헐거워짐 또는 부분적 탈착, 연결 문제로 인한 일시적인 신호 중단 또는 과도한 노이즈를 포함하되 이에 국한되지 않는 기술적 문제로 인해 생리적 측정 중 문제가 발생하더라도, 실험은 계획대로 계속 진행해야 하며 참가자가 실험 세션을 반복해서는 안 됩니다.
8. 데이터 전처리
참고: 실험 세션이 완료되고 모든 생리학적 기록이 적절하게 저장되면, 분석 전 SCR 데이터에 대해 표준화된 전처리 과정을 수행해야 합니다.
- 실행하십시오 Ledalab_서식 데이터 수집 소프트웨어에서 내보낸 생리적 기록의 데이터 구조를 재구성하여, EDA 신호 분석을 위해 설계된 MATLAB 기반 툴박스인 Ledalab과 호환되도록 하는 MATLAB 스크립트입니다.
참고: 다음의 Ledalab_Format.mat 코드, 다음의 경로를 정의하십시오. {Identification_Code}.mat 입력 변수로 파일을 설정합니다. 이를 통해 내보낸 생리학적 기록 파일을 Ledalab에서 정확하게 읽고 처리할 수 있는 형식으로 변환할 수 있습니다. 변환 과정이 완료되면, 다음의 명명 규칙을 사용하여 해당 피험자 폴더 내에 새로운 MATLAB 파일을 생성하고 저장해야 합니다. Ledalab_{식별_코드}.mat이전 예시와 마찬가지로, 실험 1(Experiment_1)의 데이터가 피험자 "015"에 대해 변환되는 경우, 생성된 파일의 이름은 Ledalab_015.mat로 지정해야 합니다. - Ledalab을 실행하고, 왼쪽 상단에 위치한 메뉴 바에서 다음을 선택하십시오. 파일 > 데이터 가져오기 > Matlab 파일 (*.mat)그런 다음, 해당 피험자의 실험 조건에 대응하여 새로 생성된 데이터 파일을 로드하십시오.
- 파일이 로드되면 Ledalab에 표시되는 설정 창에 샘플링 파라미터를 입력하십시오.
- SCR 신호의 원래 수집 주파수는 2000 Hz입니다. 계산 부하를 줄이기 위해 다음과 같은 매개변수를 사용하여 신호를 10 Hz로 다운샘플링하십시오. 대상 샘플링 주파수: 10 Hz, 다운샘플링 계수: 200, 리샘플링 방법: Steps.
- 다운샘플링 절차를 완료한 후, 연속 분해 분석(CDA)을 수행하십시오.20 Ledalab 내에서 EDA 신호를 긴장성(tonic) 성분과 위상성(phasic) 성분으로 분해합니다.
- 메뉴 바에서 다음을 선택하십시오. 분석 > 연속 분해 분석 (연속적인 위상성/긴장성 활동의 추출).
- 화면에 설정 창이 나타날 때까지 기다리십시오.
- 이 창에서 다음을 선택하십시오. 최적화 분석 파라미터를 자동으로 조정하는 옵션.
- 최적화 과정이 완료되면, 클릭하십시오. 적용하십시오 CDA 분석을 시작하기 위해.
- CDA 분석이 완료되면, 다음을 선택하십시오. 결과 > 사건 관련 분석, 화면에 설정 창이 나타납니다.
- 최소 진폭 임계값을 Ledalab 기본값인 다음으로 설정하십시오. 0.01 µS 그리고 z-scale 옵션은 선택하지 않은 상태로 둡니다. 획득 소프트웨어에서 내보낸 이벤트 마커는 조건 자극의 시작과 무조건 자극의 시작을 각각 별도로 표시하므로, 이벤트 관련 분석을 통해 각각의 반응을 얻을 수 있습니다. 반응 창(response window)을 다음과 같이 설정하십시오.
- 실험 1의 경우, 이벤트 마커 이후 0초에서 9초까지의 구간을 사용하십시오.
- 실험 2의 경우, 이벤트 마커 이후 0초에서 6초까지의 구간을 사용하십시오.
- 결과를 스프레드시트 파일로 내보내십시오. Ledalab은 SCR 신호에서 추출한 관련 생리학적 정보 및 이벤트 관련 정보가 포함된 스프레드시트를 생성합니다.
참고: 응답 창은 각 과제에서 조건 자극이 제시되는 전체 지속 시간과 일치합니다 (부록 표 1실험 1에서는 9초, 실험 2에서는 6초)로 설정하여, 조건자극(CS) 유발 반응이 전체 CS-US 간격을 포괄하게 하고, 별도의 이벤트 마커로 개별 측정되는 무조건 반응에 의해 오염되지 않도록 하였습니다. 다음 기준치 미만인 반응은 0.01 µS 임계값은 Ledalab에 의해 0으로 기록되며 분석에서도 0으로 유지됩니다. 이를 삭제하지 마십시오. 삭제할 경우 반응 정도가 낮은 참가자들의 평균 반응 값이 부풀려질 수 있기 때문입니다. - 실험 2에 대해 전체 전처리, 다운샘플링 및 CDA 절차를 반복하십시오(다른 절차를 따르며 CDA 결과물이 필요하지 않은 실험 3에 대해서는 아래의 참고 사항을 확인하십시오).
참고: 전처리 단계가 끝나면 각 실험 폴더에는 Ledalab에서 생성한 CDA 분석 결과에 해당하는 스프레드시트 파일이 추가로 포함되어야 합니다. 이 파일은 이후 저장, 정리 및 추가 분석을 위해 .xlsx 형식으로 변환해야 합니다. 실험 3은 다른 전처리 절차를 따릅니다. 이 실험의 경우 MATLAB 스크립트만 사용해야 하며, CDA 출력값은 필요하지 않고 알파 및 베타 값만 필요합니다. "Experiment_3"에 대해 스크립트를 실행하면 알파 및 베타 값이 자동으로 추출되어 행동 정보와 병합되며, 그 결과 스프레드시트가 다음 경로에 저장됩니다. 글로벌_데이터/실험_3. - 신호 품질 관리, 무응답자 및 아티팩트 처리를 수행하십시오.
- 통계 분석을 수행하기 전, Ledalab에서 각 참가자의 다운샘플링된 전체 피부 전도도 트레이스를 표시하고 첫 번째 이벤트 마커부터 마지막 마커까지 시각적으로 검사하십시오. 신호 품질은 채널 및 작업별로 다르므로, 모든 참가자와 모든 작업에 대해 각각 개별적으로 이 검사를 수행하십시오.
- 다음 중 어느 하나라도 관찰되는 경우, 해당 트레이스 전체를 기각하고 해당 참가자의 해당 과제에 대한 SCR 채널을 결측치로 처리하십시오: (i) 과제 수행 동안 신호가 평탄하거나 나타나지 않아 손목 스트랩과의 무선 통신 단절, 손목 스트랩 전원 꺼짐 또는 전극 탈락이 나타나는 경우; (ii) 강성 피부 전도 수준이 다음보다 낮은 경우 0.05 µS 작업 전반에 걸쳐 지속되는 현상으로, 이는 낮은 각성 상태보다는 전극과 피부 간의 접촉 불량을 나타냅니다; (iii) 해석 불가능한 드리프트 또는 특정 이벤트와 시간적으로 일치하지 않는 갑작스럽고 지속적인 진폭의 증가; 또는 (iv) 증폭기 범위의 포화 상태.
주의: 세션을 반복하지 마십시오. 또한, 다른 과제나 행동 및 자기 보고 채널에서 참가자를 제외하지 마십시오. - 특정 과제에 대해 위상성 반응(phasic response)이 다음 기준에 도달하거나 이를 초과하지 않는 경우, 해당 참가자를 무반응자로 정의하십시오. 0.01 µS 강화 시행의 무조건 자극 이벤트를 포함하여 해당 과제의 모든 이벤트에 대한 임계값, 즉 참가자가 혐오적인 결과 자체에 대해서조차 측정 가능한 전기피부반응을 생성하지 않는 경우를 의미합니다.
- 무조건 자극에 대해서조차 피부전도 반응이 전혀 나타나지 않는다는 것은 해당 세션에서 피부전도 체계를 측정할 수 없었음을 의미하며, 이는 참가자가 수반성에 전혀 관여하지 않았을 가능성을 시사하므로, 무반응자를 해당 과제의 모든 채널(피부전도, 행동, 주관적 평정 모두 포함)에서 제외하십시오.
- 해당 참가자를 나머지 두 가지 과제에 계속 포함시키십시오. 이 경우를 기술적인 신호 손실(전극 탈락 또는 무선 통신이 끊긴 손목 스트랩 등)과 구분하십시오. 기술적 신호 손실의 경우 참가자는 반응했으나 신호가 기록되지 않은 것이므로, 해당 과제의 SCR 채널은 결측치로 처리하되 피부전도 신호 품질의 영향을 받지 않는 해당 과제의 행동 및 주관적 데이터는 그대로 유지하십시오.
- 모든 과제에 대해 무응답률과 기술적 손실률을 각각 별도로 보고하십시오.
- 트레이스 상의 움직임 아티팩트를 (i) 어떤 이벤트 마커와도 시간적으로 일치하지 않는 급격한 상승 과도 응답, 또는 (ii) 손가락 수축, 자세 변화, 혹은 전극이 의자나 책상에 쓸리면서 발생하는 토닉 레벨의 계단식 오프셋으로 식별하십시오.
- 해당 아티팩트가 포함된 모든 시행의 스코어링 윈도우를 표시하고 해당 시행을 제외하되, 참가자는 제외하지 마십시오.
- 특정 과제의 시행 횟수 중 25% 이상이 아티팩트로 오염된 것으로 표시된 경우, 해당 참가자를 SCR 분석뿐만 아니라 해당 과제의 모든 채널에서 제외하십시오. 이 경우 남은 시행들만으로는 참가자별 안정적인 추정치를 산출할 수 없으며, 해당 세션의 기록 조건이 어떤 채널에서도 적절하지 않은 것으로 간주합니다. 다만, 나머지 두 가지 과제에서는 해당 참가자를 유지하십시오.
- 전기피부 진폭(electrodermal amplitudes)의 양의 왜곡 분포를 정규화하기 위해, 평균을 내기 전 시행 수준의 진폭을 log(SCR + 1)로 변환하십시오. 이때 기선 표류(baseline drift)로 인해 드물게 발생하는 음수 CDA 값은 변환 전에 0으로 고정하십시오.
- 변환된 시행들을 합산하여 참가자별, 단계별, 자극별로 하나의 값을 산출하십시오.
- 채널별 손실로 인해 n 값이 서로 달라지므로, 각 채널(SCR, 행동, 평가) 및 각 과제에 대해 분석 대상 n 수를 각각 별도로 보고하십시오.
- 단계 8.14.1~8.14.9에서 결정한 모든 사항을 다음 내용을 포함하는 참여자별 품질 로그에 기록하십시오: 참여자 ID, 과제, 역균형 조건, 트레이스 수용 또는 거부 여부(사유 포함), 토닉 레벨 범위, 아티팩트로 인해 거부된 시행 횟수 및 식별 번호, 아티팩트로 인해 거부된 시행의 백분율, 무반응자 상태, 그리고 각 채널별 최종 분석 n 기여도.
- 채널별 데이터 손실에 대한 감사 및 재현이 가능하도록 품질 로그를 통합 데이터베이스와 함께 저장하십시오.
참고: 본 표본에서는 8.14.3단계의 무반응 기준에 해당하는 참가자가 없었으며, 8.14.6단계의 25% 아티팩트 임계값을 초과한 참가자도 없었습니다. 결과적으로, 어떤 참가자도 특정 과제의 모든 채널에서 제외되지 않았습니다. 분석 대상 수(n)의 차이는 두 가지 독립적인 원인에 의한 것입니다. 하나는 전기피부 활동 채널의 기술적 손실로, 이 경우 해당 과제의 행동 및 주관적 기록은 그대로 유지됩니다. 다른 하나는 불완전한 행동 또는 자기 보고 기록(과제 미완료 또는 시각 아날로그 응답 누락)으로, 이는 전기피부 신호의 품질과는 무관합니다. 모든 채널과 과제에 대한 정확한 분석 대상 수(n)는 '대표 결과(Representative Results)'의 분석 표본 단락에 보고되어 있습니다. 실험 3에는 SCR 채널이 포함되지 않으므로, 해당 실험의 n 이는 전기피부 데이터의 손실보다는 행동 데이터의 손실을 반영합니다. 이러한 기준을 명시적으로 보고하는 것은 Ruge 등이 강조한 전기피부 결과의 조작화 및 보고에 있어 조화가 부족한 문제를 직접적으로 해결합니다.1.
9. 데이터베이스
- Python 스크립트 Data_Bases.py를 실행하여 각 참여자에 대해 SCR 기록에서 얻은 생리학적 측정값과 실험 과제 중에 수집된 응답을 병합합니다.
참고: 이 스크립트는 Ledalab을 통해 처리된 생리학적 기록 정보, CDA 분석 결과, 그리고 실험 중에 생성된 PsychoPy 응답 스프레드시트를 통합합니다. - 스크립트가 성공적으로 실행되면, 단일 참여자의 생리학적 정보와 행동 정보가 모두 포함된 통합 스프레드시트가 생성되어 Global_Data 폴더에 저장되었는지 확인합니다.
참고: 이전 예시와 같이 분석 대상으로 Experiment_1이 선택된 경우, Python 스크립트가 해당 실험과 관련된 모든 참여자의 폴더를 자동으로 탐색하여, 각 참여자의 CDA 결과와 해당 행동 데이터를 병합하고 Global_Data/Exp_1 폴더 내에 참여자별 개별 스프레드시트 파일을 생성합니다. - 개별 참여자 데이터베이스가 생성되면, Python 스크립트 Completed_Bases_Per_Experiment.py를 사용하여 각 실험 과제에 대한 모든 참여자의 데이터를 병합합니다.
참고: 이 스크립트는 모든 참여자 폴더의 정보를 실험별로 단일 데이터베이스로 결합하여, 이후의 통계 분석과 데이터 처리를 용이하게 합니다. 절차가 성공적으로 완료되면 세 가지 실험 각각에 해당하는 세 개의 최종 스프레드시트가 생성됩니다:
Experiment_1용 스프레드시트 1개
Experiment_2용 스프레드시트 1개
Experiment_3용 스프레드시트 1개 - 결과로 생성된 전체 데이터베이스를 Complete_Data_Bases 폴더에 저장합니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
결과
분석 시료
총 38명의 건강한 성인이 전체 실험 세션과 자기 보고식 설문지(CTQ-SF, BCE, PHQ-9, GAD-7, STAI) 작성을 완료했습니다. 분석별 표본 크기는 참가자의 중도 탈락이 아닌 채널별 데이터 손실로 인해 약간의 차이가 있었습니다. 분석별 표본 크기는 다음과 같습니다: 실험 1 — SCR 및 평가 ANOVA(파블로프 및 조작적 단계), n = 37; 조작적 버튼 누르기 ANOVA, n = 38. 실험 2 — 평가 분석(습득, 소거, 재습득) 및 습득 SCR, n = 36; 소거 SCR 및 SCR 단계 × 자극 ART-ANOVA, n = 35. 실험 3 — 모든 분석, n = 37. 자기 보고식 측정치(CTQ, BCE, 증상)만 포함된 상관 분석에는 전체 표본(N = 38)이 사용되었습니다.
실험 1: 회피를 동반한 파블로프식 및 조작적 조건 형성<...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
토론
본 결과는 도구적 제어를 통한 위협 습득, 안전 학습, 공포의 회귀 및 확률적 보상 학습을 포괄하는 통합된 단일 세션 배터리의 기술적 및 방법론적 타당성을 입증합니다. 35~38명의 건강한 성인 표본에서(참가자 중도 탈락이 아닌 채널별 신호 손실로 인해 실험 간 분석 표본 크기에 약간의 차이가 있음), 모든 패러다임이 그 전형적인 효과를 재현하였습니다. 즉, 파블로프 단계에서의 차등적인 주관적 및 (상대적으로 약한) 자율신경계 조건형성, 조작적 단계에서의 제어 가능성에 따른 회피 및 안도감, 실험 2에서의 자율신경계 반응의 비선택적 감소와 함께 나타난 선언적 위협의 선택적 소거, 그리고 실험 3에서의 확률적 학습의 신뢰할 수 있는 우연 수준 이상의 결과가 확인되었습니다. 이것이 무엇을 증명하고 무엇을 증명하지 않는지 정확히 명시하는 것이 중요합니다. 증명된 점은 세 가지 패러다임을 상호 간섭 없이 하나의 60분 세션 내에서 동시에 실행할 수 있으며, 이러한 세션이 강제하는 시행 횟수 압축 속에서도 세 가지 전형적 효과가 모두 유...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
공개 사항
저자들은 경쟁 관계에 있는 재정적 또는 비재정적 이해관계가 없음을 밝힙니다.
감사의 글
저자들은 시간과 정성을 들여 참여해 주신 모든 참가자분들과 Universidad de los Andes의 연구 보조원 및 실험실 팀에 감사드립니다. 본 연구는 Fondecyt Iniciacion grant #11250037(책임 연구자: Maria Consuelo San Martin)을 통해 칠레 국가 연구 및 개발청(Agencia Nacional de Investigacion y Desarrollo de Chile, ANID)의 지원을 받았습니다. R.C.V는 Basal ANID의 National Center for Artificial Intelligence CENIA FB210017의 지원을 받았습니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| AcqKnowledge 소프트웨어 | BIOPAC Systems Inc. | ACK100W (Windows) / ACK100M (Mac) | 생리학적 신호 데이터 수집 및 분석 소프트웨어. RRID:SCR_014279 (현재 SciCrunch 항목 확인 필요). |
| afex (R 패키지) | Singmann, Bolker, Westfall, Aust & Ben-Shachar | 버전 1.5-1 | 요인 실험용 R 패키지. aov_ez()를 통해 모든 반복 측정 ANOVA(실험 1-3)에 사용됨. RRID:SCR_022761 (현재 SciCrunch 항목 확인 필요). |
| ARTool (R 패키지) | Wobbrock, Findlater, Gergle & Higgins | 버전 0.11.2 | 비모수 요인 ANOVA를 위한 정렬 순위 변환(Aligned Rank Transform) 도구. 분포가 비가우시안(non-Gaussian)인 실험 2의 피부 전도도에 대한 Phase x Stimulus ANOVA에 사용됨. |
| 긍정적 아동기 경험(BCE) 척도 | Narayan, Rivera, Bernstein, Harris & Lieberman (2018) | 공용 도구 (10개 항목) | 스페인어 적응판 사용. 이 도구에 할당된 RRID 없음; 원본 타당도 검증 논문을 인용할 것. |
| BioNomadix 손목 스트랩 (송신기) | BIOPAC Systems Inc. | BN-PPGED-T | EDA 및 PPG 신호용 웨어러블 송신기. BioNomadix 수신기 모듈과 쌍으로 사용됨. |
| 아동기 트라우마 질문지 - 단축형 (CTQ-SF) | Bernstein et al. (2003) | 타당도가 검증된 28개 항목의 회고적 자기 보고서 | 5개 하위 척도(EA, PA, SA, EN, PN). RRID 없음; 원본 타당도 검증 논문을 인용할 것. 스페인어 적응판 사용. |
| EDA 전극용 전도성 젤 | BIOPAC Systems Inc. | GEL101A | 피부 전도도 측정을 위한 등장성 젤. |
| 일회용 Ag/AgCl EDA 전극 | BIOPAC Systems Inc. | EL507A | 피부 전도도 기록용 일회용 전극. |
| 범불안장애 척도 (GAD-7) | Spitzer, Kroenke, Williams & Löwe (2006) | 7개 항목의 자기 보고서 | 타당도가 검증된 스페인어 버전 사용. 도구 RRID 없음; 원본을 인용할 것. |
| ggplot2 (R 패키지) | Wickham | 버전 4.0.3 | 그래픽 문법 기반의 플로팅 시스템. RRID:SCR_014601 (현재 SciCrunch 항목 확인 필요). |
| 헤드폰 (오버이어) | HyperX (HP Inc.) | Cloud III | 유선 밀폐형 게이밍 헤드셋; 공포 조건 형성 중 청각적 무조건 자극을 전달하는 데 사용됨. |
| Ledalab | Benedek & Kaernbach (2010) | 오픈 소스 MATLAB 툴박스 v3.2.5 | 피부 전도도 신호의 연속 분해 분석(CDA). RRID가 할당되지 않음 (대신 원본 논문을 인용할 것). |
| lme4 (R 패키지) | Bates, Maechler, Bolker & Walker | 버전 1.1-37 | 선형 혼합 효과 모델. 실험 3에서 참가자별 학습 궤적의 기울기를 추정하는 데 사용됨. RRID:SCR_015654 (현재 SciCrunch 항목 확인 필요). |
| MATLAB | MathWorks | R2025a | Ledalab 및 SCR 전처리 파이프라인 실행에 사용됨. RRID:SCR_001622. |
| 우울 증상 질문지-9 (PHQ-9) | Kroenke, Spitzer & Williams (2001) | 9개 항목의 자기 보고서 | 타당도가 검증된 스페인어 버전 사용. 도구 RRID 없음; 원본을 인용할 것. |
| 생리학적 데이터 수집 장치 (PsychoPy) | BIOPAC Systems Inc. | MP200 | 주 생리학적 신호 수집 장치. BioNomadix 무선 EDA 모듈과 결합하여 사용됨. |
| Python | Python Software Foundation | 버전 3.12 | Ledalab 출력값과 PsychoPy 행동 기록을 병합하는 전처리 파이프라인(Data_Bases.py, Completed_Bases_Per_Experiment.py)에 사용됨. RRID:SCR_008394 (현재 SciCrunch 항목 확인 필요). |
| R (통계 컴퓨팅 환경) | R Foundation for Statistical Computing | 버전 4.5.0 | 모든 통계 분석이 수행된 환경. 조절 모델은 기본 stats 패키지의 lm() 함수를 이용한 최소제곱 회귀분석으로 추정하였으며, 예측 변수는 z-표준화하고 상호작용 항은 이들의 곱으로 계산함; 별도의 조절 분석 패키지는 사용하지 않음. RRID:SCR_001905 (현재 SciCrunch 항목 확인 필요). |
| 상태-특성 불안 척도 (STAI) | Spielberger et al. (1983) | STAI Form Y (40개 항목, SAI + TAI) | 타당도가 검증된 스페인어 버전 사용. 도구 RRID 없음; 원본을 인용할 것. |
| 자극 제시 모니터 | Samsung | LS22D300GALXZS (S22D300, 22인치 LED) | 시각적 CS+ / CS- 자극 및 평가 척도 표시용 디스플레이. |
참고문헌
- Ruge J, et al. How adverse childhood experiences get under the skin: a systematic review, integration and methodological discussion on threat and reward learning mechanisms. eLife. 2024;13:e92700.
- Madigan S, et al. Adverse childhood experiences: a meta-analysis of prevalence and moderators among half a million adults in 206 studies. World Psychiatry. 2023;22(3):463-71.
- Teicher MH, Gordon JB, Nemeroff CB. Recognizing the importance of childhood maltreatment as a critical factor in psychiatric diagnoses, treatment, research, prevention, and education. Mol Psychiatry. 2022;27(3):1331-8.
- Smith KE, Pollak SD. Children's value-based decision making. Sci Rep. 2022;12:5953.
- Montague PR, Hyman SE, Cohen JD. Computational roles for dopamine in behavioural control. Nature. 2004;431(7010):760-7.
- Gerin MI, et al. A neurocomputational investigation of reinforcement-based decision making as a candidate latent vulnerability mechanism in maltreated children. Dev Psychopathol. 2017;29(5):1689-705.
- McCrory EJ, Viding E. The theory of latent vulnerability: reconceptualizing the link between childhood maltreatment and psychiatric disorder. Dev Psychopathol. 2015;27(2):493-505.
- Hanson JL, et al. Early adversity and learning: implications for typical and atypical behavioral development. J Child Psychol Psychiatry. 2017;58(7):770-8.
- van den Bos W, Güroğlu B, van den Bulk BG, Rombouts SARB, Crone EA. Better than expected or as bad as you thought? The neurocognitive development of probabilistic feedback processing. Front Hum Neurosci. 2009;3:52.
- Narayan AJ, Rivera LM, Bernstein RE, Harris WW, Lieberman AF. Positive childhood experiences predict less psychopathology and stress in pregnant women with childhood adversity. Child Abuse Negl. 2018;78:19-30.
- Dibbets P, Evers EAT. The influence of state anxiety on fear discrimination and extinction in females. Front Psychol. 2017;8:347.
- Sperl MFJ, Panitz C, Hermann C, Mueller EM. A pragmatic comparison of noise burst and electric shock unconditioned stimuli for fear conditioning research with many trials. Psychophysiology. 2016;53(7):1017-34.
- San Martín C, Jacobs B, Vervliet B. Further characterization of relief dynamics in the conditioning and generalization of avoidance: effects of distress tolerance and intolerance of uncertainty. Behav Res Ther. 2020;124:103526.
- McLaughlin KA, DeCross SN, Jovanovic T, Tottenham N. Mechanisms linking childhood adversity with psychopathology: learning as an intervention target. Behav Res Ther. 2019;118:101-9.
- Kroenke K, Spitzer RL, Williams JBW. The PHQ-9: validity of a brief depression severity measure. J Gen Intern Med. 2001;16(9):606-13.
- Spitzer RL, Kroenke K, Williams JBW, Löwe B. A brief measure for assessing generalized anxiety disorder: the GAD-7. Arch Intern Med. 2006;166(10):1092-7.
- Spielberger CD. Manual for the State-Trait Anxiety Inventory (Form Y). Consulting Psychologists Press; Palo Alto (CA); 1983.
- Bernstein DP, et al. Development and validation of a brief screening version of the Childhood Trauma Questionnaire. Child Abuse Negl. 2003;27(2):169-90.
- Peirce J, et al. PsychoPy2: experiments in behavior made easy. Behav Res Methods. 2019;51(1):195-203.
- Benedek M, Kaernbach C. A continuous measure of phasic electrodermal activity. J Neurosci Methods. 2010;190(1):80-91.
- Lonsdorf TB, et al. Don't fear "fear conditioning": methodological considerations for the design and analysis of studies on human fear acquisition, extinction, and return of fear. Neurosci Biobehav Rev. 2017;77:247-85.
- LeDoux JE, Moscarello J, Sears R, Campese V. The birth, death and resurrection of avoidance: a reconceptualization of a troubled paradigm. Mol Psychiatry. 2017;22(1):24-36.
- Wobbrock JO, Findlater L, Gergle D, Higgins JJ. The aligned rank transform for nonparametric factorial analyses using only ANOVA procedures. Presented at: Proceedings of the SIGCHI Conference on Human Factors in Computing Systems (CHI '11); New York (NY); 2011.
- Fritz MS, MacKinnon DP. Required sample size to detect the mediated effect. Psychol Sci. 2007;18(3):233-9.
- Bouton ME. Learning and behavior: a contemporary synthesis. Sinauer Associates; Sunderland (MA); 2007.
- Rescorla RA, Wagner AR. A theory of Pavlovian conditioning: variations in the effectiveness of reinforcement and nonreinforcement. In: Black AH, Prokasy WF, editors. Classical Conditioning II: Current Research and Theory. Appleton-Century-Crofts; New York (NY); 1972.
- McClelland GH, Judd CM. Statistical difficulties of detecting interactions and moderator effects. Psychol Bull. 1993;114(2):376-90.
- Maier SF, Seligman MEP. Learned helplessness at fifty: insights from neuroscience. Psychol Rev. 2016;123(4):349-67.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
재인쇄 및 허가
이 논문이 게재되었습니다
동영상 곧 제공