본 연구는 물리적 비용 쿼터와 동적인 거시경제적/기술적 조정 및 XGBoost 기반의 잔차 보정을 결합한 전력망 하이브리드 비용 예측 모델을 제안합니다. 2.34%의 MAPE를 달성한 이 모델은 정확성과 해석 가능성의 균형을 맞추어, 요금 책정 시 규제 투명성 요구 사항을 충족합니다.
이 콘텐츠를 보려면 JoVE 구독이 필요합니다. 로그인하거나 오늘 무료 평가판을 시작하세요.
이 논문에서
요약
초록
전 세계적인 에너지 전환과 지속적인 전력 시장 개혁으로 인해 전력망 기업들은 안정적인 전력 공급과 점점 더 엄격해지는 송배전 요금 규제 사이에서 균형을 맞추어야 하는 상황에 놓여 있습니다. 과거 데이터의 외삽에 기반한 전통적인 예산 책정 방식은 자산 운영의 물리적 근거를 반영하지 못하는 경우가 많으며, 데이터 기반의 머신러닝 모델은 높은 예측 정확도를 달성하지만 규제 비용 검증에 필요한 투명성이 부족합니다. 예측 정확도와 해석 가능성 사이의 절충안을 마련하기 위해, 본 연구에서는 비용 쿼터(cost quotas)에 기반한 하이브리드 비용 예측 모델을 제안합니다. 이 프레임워크는 표준화된 운영 쿼터를 물리적 예산 책정의 기준선으로 사용하며, 거시 경제 조건과 기술 진보에 따라 구동되는 쿼터 진화의 동적 메커니즘을 통합합니다. 쿼터 기반 추정치를 벗어나는 비선형 잔차를 포착하기 위해 Extreme Gradient Boosting (XGBoost)를 채택하였으며, 주요 비용 동인의 기여도를 해석하기 위해 SHAP (Shapley Additive exPlanations)를 사용하였습니다. 이 모델은 중국의 한 성급 전력망에서 수집한 16년 치의 익명화된 운영 데이터를 사용하여 평가되었습니다. 그 결과 2.34%의 평균 절대 백분율 오차 (MAPE)를 달성하였으며, 이는 SARIMAX, 단독 XGBoost 및 Attention-LSTM 모델과 비교하여 예측 오차를 각각 61.8%, 46.6%, 34.1% 감소시킨 수치입니다. 제안된 프레임워크는 공학적 비용 쿼터 원칙과 설명 가능한 인공지능을 통합함으로써, 정확한 장기 비용 예측과 규제 허용 비용 검증을 위한 투명한 의사 결정 지원 도구를 동시에 제공합니다.
서론
분산형 재생 에너지 발전의 통합, 극한 기상 현상의 증가, 그리고 IoT 기술의 광범위한 도입으로 인해 글로벌 에너지 전환이 전력망 자산 관리 및 운영 관행을 재편하고 있으며, 이 모든 요소는 시스템 신뢰성 확보를 위해 더 높은 운영 유연성과 유지보수 자원을 요구하고 있습니다1,2. 동시에, 전력 규제 기관들은 영국의 RIIO 및 미국 연방 에너지 규제 위원회(Federal Energy Regulatory Commission)의 수익률 검토와 같은 프레임워크를 통해 송배전 요금 감독을 강화하며 비용 정당화의 투명성을 강조해 왔습니다3. 중국 또한 이와 유사하게 "허용 비용에 합리적 수익을 더한" 규제 메커니즘을 채택하여, 유틸리티 기업이 엔지니어링 활동과 재무 지출 간의 명확한 연관성을 입증하도록 요구하고 있습니다4. 그러나 유틸리티 기업들은 물리적 자산 운영을 비용 예측과 연결하는 투명한 정량적 도구가 부족한 경우가 많으며, 이는 규제적 비용 검증의 실효성을 제한하고 있습니다5.
이러한 환경에서 기존의 예측 방식은 중요한 한계점을 가지고 있습니다6. 증분 예산 편성 및 ARIMA 기반 모델을 포함한 전통적인 방법들은 역사적 패턴이 비교적 안정적이라고 가정하며, 경제 변동이나 극한 기상 현상으로 인한 구조적 변화가 발생할 경우 예측 성능이 떨어지는 경우가 많습니다7. 반대로 LSTM 및 Transformer 아키텍처와 같은 현대적인 머신러닝 모델은 단기 예측에서 높은 정확도를 제공하지만, 규제 의사결정에 필요한 공학적 해석력이 부족합니다8,9. 최근의 하이브리드 예측 방식들이 통계적 기법과 머신러닝 기법을 결합하고 있음에도 불구하고, 일반적으로 전력망 회계 시스템의 기초가 되는 표준화된 공학적 비용 할당량(quota)을 간과하고 있습니다10. 이러한 한계를 해결하기 위해, 본 연구에서는 동적 할당량 진화와 머신러닝 기반의 잔차 보정을 결합하여 공학적 해석력을 유지하면서도 예측 정확도를 향상시키는 할당량 기반 하이브리드 예측 프레임워크를 제안합니다.
주요한 연구 방향 중 하나는 영국의 RPI-X 메커니즘과 중국의 허용 비용 검증 체계를 포함하여, 자연 독점 산업의 인센티브 규제에서 비롯되었습니다11. 이러한 연구들은 주로 자료포락분석(DEA) 및 확률적 프런티어 분석(SFA)을 사용하여 운영 효율성을 평가합니다12. 이전 연구에서는 요금 규제를 지원하기 위해 자본 지출(CAPEX), 운영 지출(OPEX) 및 비용 효율성 간의 장기적 관계를 조사하였습니다13,14. 이러한 접근 방식은 가치 있는 거시경제적 통찰력을 제공하지만, 그 결과물은 일반적으로 연간 예산 책정에 적합한 금전적 예측보다는 상대적 효율성 점수로 표현됩니다15,16. 또한, 프런티어 모델은 일반적으로 물리적 자산 구조와 운영 조건이 비교적 안정적이라고 가정하므로, 자산 노후화, 인프라 교체 또는 급격한 수요 증가로 인한 갑작스러운 비용 변화를 포착하는 능력에 한계가 있습니다17,18.
두 번째 연구 방향은 통계 및 인공지능 기반의 예측 모델에 초점을 맞춥니다. 초기 연구에서는 비용 예측을 위해 다중 선형 회귀 및 외생 변수를 포함한 자기회귀 누적 이동 평균 모델(ARIMAX)을 사용했습니다19. 최근에는 서포트 벡터 회귀, 랜덤 포레스트, XGBoost, LSTM 및 Transformer 모델이 비선형 관계와 고차원 특징 공간을 활용함으로써 예측 성능을 크게 향상시켰습니다20,21,22. 이러한 접근 방식에는 전력 수요, 생산자 물가지수(PPI) 및 기후 변수와 같은 거시경제 지표가 자주 포함됩니다23. 그러나 전력망 운영 비용은 거시경제 변수뿐만 아니라 엔지니어링 활동, 자산 노후화, 유지보수 일정 및 관리 결정으로 인해 발생합니다24. 결과적으로, 순수하게 데이터 기반인 모델은 흔히 "블랙박스"처럼 작동하여, 규제 검토나 허용 비용 검증 과정에서 예측된 비용을 설명하기 어렵게 만듭니다25,26.
엔지니어링 비용 쿼터 관리는 이러한 과제에 대한 잠재적인 해결책을 제공합니다27. 활동기준원가계산(ABC)은 일상적인 그리드 운영을 위한 노동력, 자재, 장비 및 유지보수 요구 사항을 추정하기 위해 오랫동안 표준화된 운영 쿼터에 의존해 왔습니다28. 중국의 주요 유틸리티 기업들은 점검, 유지보수, 테스트, 수리 및 장비 교체 활동을 포괄하는 종합적인 쿼터 데이터베이스를 구축했습니다. 그럼에도 불구하고, 이러한 엔지니어링 표준은 동적인 장기 예측보다는 주로 프로젝트 정산 및 감사 용도로 사용됩니다29,30. 더욱이, 쿼터 표준은 일반적으로 수년마다 한 번씩만 개정되므로 원자재 가격의 변동, 기술적 진보 및 운영 관행의 변화에 충분히 대응하지 못하는 실정입니다31. 수백만 개의 분산 자산에 쿼터 시스템을 적용하는 것 또한 대규모 예측을 위한 상당한 계산적 과제를 야기합니다32.
통계적 예측, 머신러닝 및 엔지니어링 비용 관리 분야의 상당한 발전에도 불구하고, 표준화된 엔지니어링 비용 쿼타(quota), 동적 거시경제 조정 및 설명 가능한 머신러닝을 규제 비용 검증을 위한 하나의 통합 예측 모델로 효과적으로 결합한 프레임워크는 아직 존재하지 않습니다. 본 연구에서는 동적으로 진화하는 비용 쿼타를 XGBoost 기반의 잔차 학습(residual learning)과 결합하면, 규제 의사결정에 필요한 엔지니어링 투명성을 유지하면서 장기 예측 정확도를 향상시킬 수 있다는 가설을 세웠습니다. 이 가설을 검증하기 위해 물리적 비용 모델링, 거시경제 및 기술적 조정 메커니즘, XGBoost 잔차 보정 및 SHAP 기반 모델 해석을 통합한 하이브리드 쿼타 기반 예측 프레임워크를 개발하였습니다. 제안된 접근 방식은 현대 전력 시장 규제 하에서 허용 비용 검증을 지원하기 위한 정확한 장기 비용 예측과 투명한 근거를 모두 제공하는 것을 목표로 합니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
프로토콜
본 연구에서는 중국 동부 지역의 성급 전력망에서 수집된 익명화된 운영 및 재무 데이터를 사용하였습니다. 모든 데이터는 분석 전 집계 및 비식별화 과정을 거쳤으며, 개인 식별 가능 정보나 민감한 개인 수준의 정보는 포함되지 않았습니다. 따라서 윤리적 승인은 필요하지 않았습니다. 데이터 접근 및 분석은 전력 부문 정보에 관한 관련 데이터 보호 규정 및 기관 협약을 준수하였습니다.
예측 프레임워크 개요
물리 기반 및 데이터 기반 예측 접근 방식을 통합하기 위해, 엔지니어링 비용 할당량과 머신러닝을 결합한 하이브리드 예측 프레임워크가 개발되었습니다. 이 프레임워크는 단순히 여러 알고리즘을 결합하는 대신, 물리 모델이 기본 예측치를 설정하고 머신러닝이 잔차 오차를 보정한다는 원칙을 따릅니다. 이러한 설계는 예측 프로세스가 단순히 과거 비용의 외삽에 의존하는 것이 아니라, 전력망 생산 및 운영 활동의 기초가 되는 물리적 메커니즘에 근거하도록 보장합니다.
이 프레임워크는 먼저 전력망 자산, 표준 운영 활동 및 재무 비용 계정 간의 계층적 매핑을 설정합니다. 생산 및 운영 비용은 변전소, 송전선, 배전 피더, 계량 장치 및 디지털 점검 장비를 포함한 물리적 자산이 점검, 유지보수, 시험, 수리 및 교체와 같은 일상적인 활동 중에 소비하는 자원의 금전적 표현으로 처리됩니다. 비용 할당량은 측정 가능한 엔지니어링 작업 부하와 그에 상응하는 재무 지출을 연결하는 고리 역할을 합니다.
그림 1에서 보여주는 바와 같이, 비용 할당량은 추상적인 재무 배분 규칙이 아니라 자산 운영 및 유지보수 프로세스 전반에 내재된 표준화된 회계 단위로 기능합니다. 최하위 수준의 자산 작업 부하는 표준 운영 할당량으로 변환되며, 이후 인건비, 재료비, 건설 장비, 외주 서비스 및 비상 용품을 포함한 비용 범주로 매핑됩니다. 이러한 계층적 매핑은 예측 프로세스 전반에서 공학적 해석 가능성과 규제 추적성을 유지하며, 정적 기준 할당량 모델을 구축하기 위한 물리적 기반을 제공합니다.
방법론적 워크플로우 개요
제안된 예측 프레임워크는 세 가지 순차적 단계로 구성됩니다: (1) 자산 수준의 작업 부하 할당량을 이용한 물리적 기준선 구축, (2) 거시 경제 및 기술적 조정을 통한 비용 할당량의 동적 진화, (3) 체계적인 비선형 효과를 포착하기 위한 머신러닝 기반의 잔차 보정입니다. 그림 1에 나타난 바와 같이, 이 프레임워크는 하위 수준의 자산 및 표준화된 운영 활동부터 생산 및 운영 비용 예측까지의 계층적 매핑을 수립합니다. 각 단계의 구현 세부 사항은 다음 하위 섹션에서 설명합니다.
자산 수준 작업 부하 기반의 물리적 기준 비용 모델
전력망의 생산 및 운영 비용인 Ctotal은 변전소 운영, 송전선 유지보수, 배전망 관리, 고객 서비스 및 지원 시스템을 포함한 여러 사업 활동과 관련된 지출로 구성됩니다. 본 연구에서는 기준 운영 비용이 각 표준화된 운영 활동에 의해 생성된 작업량과 그에 따른 비용 할당량에 의해 결정된다고 가정합니다.
정적 베이스라인 비용은 다음과 같이 계산됩니다:
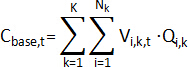 (1)
여기서 Vi,k,t는 기간 t 동안 비즈니스 범주 k 내의 i번째 자산 또는 운영 작업과 관련된 작업량을 나타내며, Qi,k는 엔지니어링 비용 할당 시스템에 의해 정의된 해당 표준 단위 비용을 나타냅니다. 비즈니스 범주에는 변전소 유지보수, 송전선 점검, 배전망 운영 및 고객 서비스와 같은 주요 운영 기능이 포함됩니다. 이 이중 합계는 모든 표준화된 운영 활동의 비용을 합산하여 정상적인 그리드 운영을 유지하는 데 필요한 이론적 기준 지출액을 추정합니다.
식 (1)은 표준화된 운영 활동을 비용 계정에 직접 매핑함으로써 공학적 작업 부하와 재정적 지출 사이의 물리적 관계를 설정합니다. 순수하게 통계적인 예측 모델과 달리, 이 정식화는 이후의 동적 할당량 조정 및 머신러닝 기반 잔차 보정의 기초가 되는 해석 가능한 공학적 기준선을 제공합니다. 이 식은 중국 성급 전력망 기업에서 사용하는 운영 관행과 비용 할당 시스템을 바탕으로 개발되었습니다. 표 1은 작업 부하(Vi,k,t), 표준 단위 비용(Qi,k), 운영 작업 수(Nk), 비즈니스 카테고리 인덱스(k)를 포함하여 식 (1)에 사용된 표기법을 요약하여 보여줍니다.
외부 환경 교란 하에서의 쿼터 동적 진화 메커니즘
표준화된 비용 할당량(Qi,k)은 물리적으로 해석 가능한 기준선을 제공하지만, 거시 경제 조건의 변화나 기술적 진보를 반영하지는 않습니다. 장기적인 적용 가능성을 높이기 위해, 물가 상승과 기술 기반의 효율성 향상 모두에 대응하여 기준 할당량을 조정하는 동적 진화 메커니즘이 도입되었습니다.
첫 번째 조정은 거시 경제 인플레이션으로 인한 조달 비용의 변화를 반영합니다. 전력망 운영 및 유지보수는 구리, 알루미늄, 규소강을 포함한 벌크 자재에 크게 의존하며, 이러한 자재의 가격은 생산자물가지수(PPI)의 변동과 밀접한 관련이 있습니다.  은 기준값이 100인 지수이므로, 먼저 표준화된 인플레이션율로 변환됩니다:
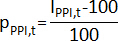 (2)
이를 바탕으로, 가격 조정 함수  은 다음과 같이 정의됩니다:
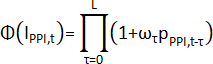 (3)
여기서  는 다음을 만족하는 길이 L의 지연-가중치 벡터입니다.
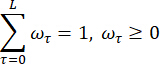
시차 구조는 거시 경제 인플레이션이 전력망 공급망 내 조달 비용으로 전이되는 지연 현상을 나타냅니다. PPI 지수를 표준화된 인플레이션율로 변환하면, 지수 값을 직접 사용할 때 발생하는 척도 편향을 방지하면서 가격 변동의 누적 효과를 유지할 수 있습니다. 식 (2)와 (3)은 기성 거시 경제 인플레이션 조정 모델을 기반으로 하며, 시차 구조는 전력 부문 조달 주기에 맞게 보정되었습니다33,34.
무인 항공기 점검, 지능형 로보틱스 및 디지털 유지보수 기술과 같은 진보로 인한 운영 효율성 향상을 반영하는 비용 절감 계수를 통해 기술적 진보를 통합하였습니다. 기술 조정 계수는 다음과 같이 정의됩니다:
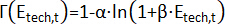 (4)
이 부분에서 α와 β는 비선형 최소제곱법을 사용하여 과거 패널 데이터로부터 추정된 경험적 탄성 계수입니다. 기술 진보 요인이 항상 단위 할당량 비용의 합리적인 감소를 나타내도록 하기 위해, 매개변수 추정 과정에서 0 < Γ(Etech,t) ≤ 1로 제약합니다. 이 요인은 주로 성숙한 기술의 대체로 인한 장기적인 효율성 향상을 반영한다는 점에 유의해야 합니다. 식 (4)는 에너지 기술 비용 문헌35,36의 학습 곡선 개념을 그리드 유지보수 운영에 맞게 조정하여 본 연구에서 독자적으로 고안한 것입니다. 구 시스템과 신 시스템의 병행 운용, 플랫폼 통합, 통신 테스트 및 추가 유지보수와 같이 디지털 장비 도입 초기 단계에서 발생할 수 있는 추가 비용은 기준 할당량에서 강제로 차감되지 않으며, 대신 후속 머신러닝 잔차 보상 모듈에 의해 식별됩니다.
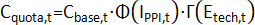 (5)
여기서 Cbase,t 는 최하위 자산 워크로드와 표준 운영 비용 할당량을 통해 계산된 정적 기준 비용을 나타내며; 은 거시적 가격 변동이 자재, 장비 및 외부 서비스 가격에 미치는 전이 효과를 포착하며; Γ(Etech,t)는 기술 성숙 이후 효율성에 기반한 단위 운영 및 유지보수 비용의 감소를 반영합니다. 이상의 동적 진화 메커니즘을 통해, 할당량 기준은 더 이상 정적인 회계 기준에 머물지 않고 경제 환경 및 기술 조건의 변화에 따라 적응적으로 조정될 수 있습니다. 식 (5)는 본 연구의 독창적인 결과물이며, 가격 및 기술 보정치를 할당량 기준 체계에 통합한 새로운 접근 방식을 나타냅니다.
할당량 제약 하의 체계적 비선형 잔차 캡처
복잡한 진화적 보정에도 불구하고, 쿼터 모델은 예측 불가능한 재난 관련 기상 교란이나 임시 관세 인하 기간 중 고객 서비스 불만 처리 비용의 증가와 같은 갑작스러운 정책 지침에 직면했을 때 필연적으로 계통적 편차를 생성합니다. 이러한 편차는 방정식 양변의 잔차항을 형성합니다.
Rt=Cactual,t-Cquota,t (6)
전통적인 물리적 법칙으로는 이러한 측면을 설명할 수 없으므로, 머신러닝을 통해 이러한 한계를 해결할 수 있습니다. 고차원 특성으로 인해 발생하는 차원의 저주를 피하기 위해, 본 연구에서는 결정 트리 앙상블 기반의 XGBoost 알고리즘을 사용하여 비선형 관계 Rt37,38를 모델링합니다. 연간 극한 결빙 일수 Dice 와 같은 기상 특성 및 거시 정책 강도를 포함하는 강한 교란 특성 행렬 Xt를 정의합니다.
회귀 트리로 구성된 비선형 보상기의 경우, 예측 잔차  의 생성 로직은 다음과 같이 표현될 수 있습니다39:
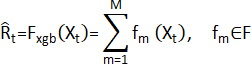 (7)
여기서 F는 가능한 모든 분류 및 회귀 트리 구조의 공간을 나타냅니다. 적합 정확도와 과적합 방지 사이의 균형을 맞추기 위해, 구조적 복잡도 패널티 항을 포함하는 정규화된 목적 함수를 구성하고 m번째 반복 단계에서 이를 최소화합니다:
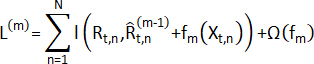 (8)
여기서  은 실제 잔차와 예측 잔차 사이의 차이를 측정하는 볼록 손실 함수입니다. 본 논문에서는 비정상적인 피크 지출에 대한 모델의 강건성을 높이기 위해 Huber Loss를 채택하였습니다. 정규화 항
 은 트리 구조의 복잡성을 제한하는 데 사용되며 다음과 같이 정의됩니다:
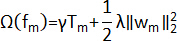 (9)
여기서 Tm은 m번째 트리의 리프 노드 수를 나타내고, wm은 그에 해당하는 리프 가중치 벡터를 나타내며, γ와 λ는 각각 리프 노드 수 페널티 계수와 가중치 정규화 계수를 의미합니다.
최종 예측 방정식은 다음과 같습니다:
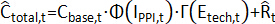 (10)
다음과 같이 추가로 확장됨:
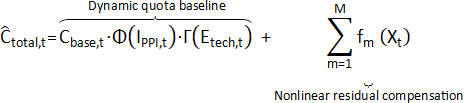 (11)
위의 공식은 제안된 예측 모델의 폐루프 구조를 수학적으로 나타낸 것입니다. 최종 생산 및 운영 비용 수요는 머신러닝 모델에 의해 직접 생성되지 않으며, 대신 머신러닝 모듈을 통해 식별된 비선형 잔차 보상을 동적 할당량 기준선에 중첩하여 얻습니다. 이러한 구성 요소 중 가격 및 기술 요인은 주로 할당량 기준선의 동적 진화를 반영하며, 기후 충격, 정책적 교란, 수리 이벤트의 급증과 같이 규칙을 통해 명확하게 특성화하기 어려운 요인들은 머신러닝 잔차 보상 모듈에 의해 포착됩니다. 식 (10)과 (11)은 본 연구의 독창적인 결과물이며, 물리적 기준선과 ML 기반의 잔차 포착을 하나의 통합된 예측 프레임워크로 합성합니다.
그림 2는 제안된 모델의 예측 결과가 명확한 계층적 생성 로직을 나타냄을 보여줍니다. 한편으로, 기본 할당량은 비용 수요에 대해 안정적이고 투명하며 감사 가능한 물리적 기초를 제공하며, 다른 한편으로 가격 조정, 기술 효과 및 외부 충격 잔차를 통해 모델이 복잡한 환경에서의 동적인 변화에 적응할 수 있도록 합니다. 예측값을 직접 출력하는 블랙박스 모델과 비교했을 때, 이러한 분해 구조는 "비용이 상승하거나 하락하는 이유"를 명확하게 드러낼 수 있으며, 이를 통해 예산 심사 및 송배전 요금 규제에서 모델 결과의 해석력을 높일 수 있습니다.
데이터 소스 및 수집 절차
이론적 모델은 실질적인 유용성을 입증하기 위해 경험적 데이터를 통해 엄격하게 검증되어야 합니다. 전력 부문의 핵심 재무 데이터는 국가 인프라 운영과 관련된 민감한 정보를 포함하고 있으므로, 본 연구에서는 편의상 E-Grid로 지칭하는 중국 동부의 전형적인 성급 전력망에서 2010년부터 2025년까지 16년 연속의 고정밀 익명화 월별 회계 데이터를 추출하였습니다. 이 지역은 전통적인 중공업 주도 성장에서 첨단 제조업으로 전환되는 전형적인 경제 주기 과정을 거쳤으며, 전력망 자산 규모의 연평균 성장률(CAGR)은 7.4%에 달했습니다. 따라서 이 지역의 복잡한 비용 구조 진화 과정은 빠르게 발전하는 다른 전력망 시스템에도 잠재적인 관련성을 가집니다. 데이터는 세 가지 주요 출처에서 기인합니다: (1) 자산 수준의 작업량, 점검 빈도 및 수리 이벤트를 기록한 내부 운영 및 유지보수 로그, (2) 인건비, 재료비, 장비비 및 외주 서비스에 걸친 월별 비용 명세서를 제공하는 재무 회계 시스템, (3) 중국 기상청의 기상 기록과 국가통계국의 거시 경제 지표를 포함한 외부 환경 데이터베이스입니다.
품질 관리 및 결측치 처리
다양한 소스 시스템에서 통합된 130개 이상의 초기 지표에 대해 엄격한 품질 관리 절차를 수행하였습니다. 전체 관측치의 3% 미만을 차지하는 결측값의 경우, 시간적 추세가 있는 연속형 변수는 선형 보간법을 사용하였으며, 범주형 지표는 최빈값 대체법을 사용하여 처리하였습니다. 이상치는 사분위수 범위(IQR) 방법을 통해 식별하였으며, 데이터의 무결성을 유지하고 극단값으로 인한 왜곡을 완화하기 위해 제3사분위수보다 3.0배 이상의 IQR을 초과하는 값은 99백분위수로 윈저라이징(winsorized) 처리하였습니다.
표본 크기 고려 사항
데이터셋은 192개의 월별 관측치(2010년 1월~2025년 12월)로 구성되었으며, 이 중 156개 관측치(2010~2022년)는 학습 및 검증용으로 할당되었고 36개 관측치(2023~2025년)는 표본 외 테스트용으로 예약되었습니다. 이러한 표본 크기는 딥러닝 응용 분야에서는 상대적으로 작지만, 정규화 및 트리 가지치기 메커니즘을 통해 소규모 및 중규모 정형 데이터셋에서 우수한 성능을 내도록 특별히 설계된 XGBoost 알고리즘에는 적합합니다. 잠재적인 과적합 위험을 완화하기 위해 (1) 엄격한 정규화 패널티(γ = 0.1, λ = 1.0)를 적용하였고, (2) 50라운드의 patience를 갖는 조기 종료(early stopping)를 설정했으며, (3) 보수적인 트리 깊이 제한(max depth = 5)을 두었습니다. 이러한 조치들은 제한된 표본 크기에도 불구하고 모델의 안정성과 일반화 성능을 종합적으로 보장합니다.
데이터 세분화 및 다중 소스 이기종 통합
엄격한 테스트를 위해, 2010년 1월부터 2022년 12월까지의 데이터를 156개의 관측치가 포함된 훈련-검증 구간으로 할당하였으며, 이는 할당량 진화 계수와 할당량 보정 잔차 네트워크를 훈련하는 데 사용되었습니다. 2023년 1월~2025년 12월은 36개의 관측치가 포함된 홀드아웃 표본 외 테스트 세트로 예약되었습니다. 왜 이 기간이 최종 테스트 영역으로 선택되었을까요? 그 이유는 이 3년의 기간이 신형 전력 시스템 구축의 가속화와 맞물렸으며, 대규모의 극심한 El Niño 관련 고온 현상 및 분산 재생 에너지 발전의 급격하고 불균등한 성장이 복합적으로 작용했기 때문입니다. 이로 인해 전력망은 자재 공급망과 수리 인력 배치 면에서 전례 없는 압박에 직면했습니다.
비용 유발 요인의 과학적 선택과 정량적 정의는 머신러닝 잔차 네트워크가 계통적 변동을 효과적으로 포착할 수 있도록 보장하는 기초가 됩니다. 전력 시스템의 표준 운영 비용 관리 로직을 바탕으로, 본 연구는 과거의 현금 흐름에만 의존하는 전통적인 재무 예측의 단일 차원을 탈피하여, 운영 로그와 외부 시스템 장부를 활용해 물리적 자산 규모, 운영 및 유지보수 조건, 거시 경제 진화, 외부 기후 환경이라는 네 가지 핵심 경계로부터 특성 공학(feature engineering)을 재구성하였습니다. 실제 모델링 과정에서 다중 소스 시스템 통합을 통해 도출된 130개 이상의 원래 지표들에 대해, 본 연구는 Pearson 상관관계 검사를 사용하여 |r| > 0.85의 임계값으로 고도로 공선성이 있는 중복 변수들을 제거하였습니다. 숙련된 전력망 전문가들의 사전 지식을 바탕으로 최종적으로 42개의 핵심 입력 특성을 선택하여 특성 행렬 Xt를 구성하였습니다. 입력 텐서의 기저 데이터 구조와 분포를 명확하게 제시하기 위해, 표 2에서는 위의 네 가지 평가 차원에서 12개의 대표적인 핵심 특성을 선택하여 관찰 기간 동안의 기술 통계량을 요약하였습니다.
다중 소스 특징 시스템의 공간-위상적 기반을 추가로 설명하기 위해, 그림 3에서는 연구 대상인 성급 전력망의 익명화된 개략적 위상도를 제시합니다. 이 그림에는 전압 레벨별 변전소, 송전 회랑, 분산형 재생 에너지 클러스터, 부하 중심지 및 대표적인 환경 교란 구역이 중첩되어 표시되어 있습니다. 이러한 위상도는 자산 규모, 네트워크 구조, 긴급 복구 강도 및 외부 기후 충격이 왜 생산 및 운영 비용에 공동으로 영향을 미치는지 설명하는 데 도움이 됩니다. 또한 이는 XGBoost 보정 모듈에서 사용되는 잔차 구동 변수에 대한 공간적 해석 근거를 제공합니다.
표 2는 서로 다른 비즈니스 차원의 설명 변수들이 뚜렷하게 다른 통계적 형태를 보임을 나타냅니다. 변전소 용량 및 선로 길이와 같이 내생적 기업 발전 동역학을 나타내는 물리적 자산 변수들은 표준편차가 비교적 안정적이며 왜도 값이 0.1에서 0.8 사이에 집중되어 있습니다. 전체적인 데이터 구조는 대략적으로 정규 분포를 따르며, 이는 인프라 구축 주기 내 전력망 발전의 안정적인 속성을 객관적으로 반영합니다. 이와 극명하게 대조되는 것이 표 하단의 기상 및 외부 환경 교란 변수들입니다. 예를 들어, 지난 90일간의 경보 수준 고온 일수 누적치와 선로 정전 영향 지수는 각각 2.15와 2.45의 왜도 값을 보이며 매우 강한 우측 편향성을 나타냅니다. 이러한 전형적인 헤비테일(heavy-tailed) 분포는 실제 전력망 운영 및 유지보수에서 무시할 수 없는 객관적인 페인 포인트(pain point)를 확인시켜 줍니다. 즉, 극한 기상 재해는 연간 일정상으로는 비교적 드물게 발생하지만, 일단 발생하면 수리 인력 투입과 예비 부품 소비를 기하급수적으로 증가시키는 경우가 많습니다. 또 다른 관점에서, 이러한 다중 소스 특징 분포의 높은 불균일성과 극값 왜도는 전력망 비용의 복잡한 추적 시 정규성과 등분산성 가정을 기반으로 하는 ARIMAX와 같은 전통적인 선형 시계열 모델의 이론적 한계를 드러냅니다. 이는 물리적 회계 기준선을 넘어 머신러닝 모듈을 도입하는 것의 합리성을 더욱 공고히 할 뿐만 아니라, 희소한 특징 분포와 비선형 매핑을 효율적으로 처리하여 비용 잔차를 근사할 수 있는 XGBoost 트리 모델을 본 논문에서 선택한 것에 대한 견고한 통계적 근거를 제공합니다.
하이퍼파라미터 최적화 및 평가 시스템 설정
특징 입력 공간을 결정한 후, 모델 하이퍼파라미터의 설정은 잔차 근사 네트워크의 피팅 성능에 직접적인 영향을 미칩니다. XGBoost 보정 네트워크는 트리 깊이(max depth), 학습률, 정규화 패널티 항을 포함한 여러 파라미터가 포함되어 있으며, 이러한 파라미터들은 비선형 상호작용을 일으키기 때문에 기존의 그리드 서치(grid search) 방식은 계산 복잡도가 높을 뿐만 아니라 고차원 공간에서 국소 최솟값(local minima)에 빠지는 경향이 있습니다. 따라서 본 연구에서는 파라미터 튜닝 과정에 베이지안 최적화 방법인 Tree-structured Parzen Estimator (TPE)를 도입하였습니다. TPE 알고리즘은 이전 평가의 손실 함수 피드백을 사용하여 이후의 샘플링 방향을 동적으로 안내할 수 있습니다. 목적 변수의 사후 커널 밀도 추정(KDE)을 구축함으로써 파라미터 탐색 공간을 적응적으로 좁혀, 높은 계산 비용을 들이지 않고도 모델이 전역 최적 하이퍼파라미터 구성을 근사할 수 있게 합니다. TPE 최적화의 목적은 100회 반복 동안 검증 RMSE를 최소화하는 것이었으며, 50라운드 동안 개선이 없을 경우 조기 종료(early stopping)하도록 설정하였습니다.
내부 검증 세트에서 파라미터 최적화를 완료한 후, 샘플 외 테스트 세트에서 각 모델의 최종 성능을 객관적으로 평가하고 비용 검증에 대한 규제 기관의 정량적 평가 요구 사항을 충족하기 위해, 본 연구에서는 평균 절대 백분율 오차(MAPE)를 사용하여 예측 시퀀스의 상대적 편차를 정량화합니다. 한편, 운영 중 발생하는 극심한 비용 예측 실패를 제어해야 하는 실무적 필요성을 해결하기 위해, 더 큰 오차에 더 강력한 패널티를 부여하는 평균 제곱근 오차(RMSE) 또한 도입합니다. 마지막으로, 결정 계수 R2를 통해 실제 타겟 분산 대비 회귀 분석의 전반적인 설명력을 정량화합니다.
지표의 수학적 정의는 다음과 같습니다:
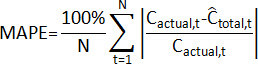 (12)
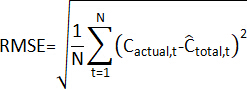 (13)
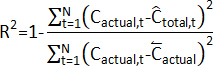 (14)
여기서  는 기간 t의 실제 생산 및 운영 비용을 나타내고,
 는 모델에서 예측된 비용을 나타내며,
 는 테스트 샘플의 평균 실제 비용을 나타내고, N은 테스트 세트의 샘플 수를 의미한다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
결과
예측 정확도의 파노라마 차원 축소 비교
팬데믹 이후의 회복 변동성과 극심한 고온 현상이 포함된 2023~2025년 표본 외(out-of-sample) 테스트 세트를 통해 모든 Tree-structured Parzen Estimator (TPE) 최적화 모델을 평가함으로써, 주류 예측 알고리즘들의 성능을 객관적으로 비교할 수 있었습니다. 엄격하고 종합적인 평가를 위해 서로 다른 방법론적 접근 방식을 대표하는 네 가지 벤치마크 모델이 포함되었습니다: 전통적인 금융 예측을 대표하는 전통적 지수 평활법(Traditional Exponential Smoothing), 선형 계절성 시계열 모델링을 대표하는 SARIMAX, 할당량 제약이 없는 순수 데이터 기반 접근 방식을 대표하는 단독 XGBoost 회귀, 그리고 긴 시퀀스 예측에 널리 사용되는 어텐션 강화 장단기 메모리 네트워크인 Attention-LSTM입니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
토론
본 연구는 산업 비용 쿼터를 머신러닝과 통합함으로써 장기 전력망 비용 예측을 위한 해석 가능하고 정확한 프레임워크를 제공함을 입증합니다. 결과에 따르면 기후 관련 변수, 특히 극한 고온 일수와 선로 탈조 영향 지수가 비용 잔차의 지배적인 동인이며, 이는 유틸리티 지출에 대한 외부 교란의 영향력이 증가하고 있음을 강조합니다. 이러한 발견은 기상 관련 비용을 더 이상 부수적인 운영 비용으로 처리해서는 안 되며, 대신 전용 예비비에 포함시키고 예측된 기후 리스크와 연계하여 예비비를 활성화해야 함을 시사합니다. 선로 탈조 영향이 주요 비용 동인으로 확인된 것은 운영 중단과 비용 변동성을 모두 줄이는 데 있어 예측 유지보수 및 상태 모니터링 전략의 가치를 더욱 뒷받침합니다.
또한 이번 분석을 통해, 디지털 전환은 초기 구현 단계에서 즉각적인 효율성 향상보다는 과도기적 이중 시스템 운영으로 인해 운영 비용을 증가시킬 수 있다는 점이 밝혀졌습니다. 이러한 결과는 전력 회사가 디지털 투자 평가...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
공개 사항
모든 저자는 이해관계의 충돌이 없음을 선언합니다.
저자 기여도:
Xiaohui Wang은 연구를 구상 및 설계하고, 방법론을 개발했으며, 공식 분석을 수행하고 초안 원고를 작성하였습니다. Tong Li는 데이터 큐레이션, 소프트웨어 구현 및 검증에 기여하였습니다. Yanchao Lu는 방법론 개발, 조사 및 데이터 해석에 기여하였습니다. Quanfeng Lv은 리소스를 제공하고, 데이터 수집을 감독하였으며, 원고를 비판적으로 검토하였습니다. Fan Liu는 프로젝트를 감독하고, 결과의 개념화 및 해석에 기여하였으며, 연구비를 확보하고 원고를 비판적으로 수정하였습니다. 모든 저자는 원고의 최종본을 검토하고 승인하였습니다.
감사의 글
본 연구는 "생산 및 운영 비용 배분 분석 및 비동기 최적화 기술 연구"(프로젝트 번호: 520600250029-183-ZN)라는 명칭의 중국 국가전력망공사(State Grid Corporation of China) 기술 프로젝트의 지원을 받아 수행되었습니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| E-Grid 익명화 월간 회계 데이터셋 | 중국 동부 성급 전력망 | N/A | 물리적 자산, 운영 및 유지보수, 거시경제 및 환경 데이터를 포함하여 192개의 관측치로 구성된 익명화된 월간 생산 및 운영 비용 데이터셋(2010–2025)입니다. 모델 개발(156개 관측치) 및 표본 외 테스트(36개 관측치)에 사용되었습니다. |
| Matplotlib 플로팅 라이브러리 | Matplotlib 개발팀 | 3.5.2 | 모델 성능 그래프, 토폴로지 시각화, 잔차 진단, 레이더 차트 및 SHAP 관련 시각적 요약을 포함한 원고 도표 및 그래픽 출력물을 생성하는 데 사용되었습니다. |
| NumPy 수치 계산 라이브러리 | NumPy 개발자 | 1.22.3 | 수치 배열 연산, 행렬 계산 및 재현성 제어에 사용되었습니다. 관련 항목에 고정 랜덤 시드 42가 적용되었습니다. |
| Pandas 데이터 조작 라이브러리 | pandas 개발팀 | 1.4.2 | 데이터 임포트, 통합, 구조 재편, 필터링 및 전처리에 사용되었으며, 여기에는 결측값 대체, 시계열 정렬 및 모델 입력 변수 준비가 포함됩니다. |
| Python 프로그래밍 환경 | Python Software Foundation | 3.9.13 | 데이터 전처리, 특성 공학, 모델 학습, 하이퍼파라미터 최적화, 예측, 통계적 검정 및 성능 평가를 포함한 전체 예측 워크플로우를 구현하는 데 사용된 프로그래밍 환경입니다. |
| Scikit-learn 머신러닝 라이브러리 | scikit-learn 기여자 | 1.0.2 | 데이터 전처리, 학습-검증 분할, 보조 모델 평가 및 Pearson 상관 분석과 선택된 성능 지표 계산을 포함한 통계적 절차에 사용되었습니다. |
| SciPy 과학 계산 라이브러리 | SciPy 기여자 | 1.9.0 | Pearson 상관 분석과 이상치 처리 및 윈저라이제이션(winsorization) 지원 절차를 포함한 통계 계산에 사용되었습니다. |
| Tree-structured Parzen Estimator 구현체 | Optuna 기여자 | 3.1.0 | 최대 트리 깊이, 학습률 및 정규화 파라미터를 포함한 XGBoost 하이퍼파라미터를 튜닝하는 데 사용된 베이지안 최적화 구현체입니다. Tree-structured Parzen Estimator는 오픈 소스 Optuna 패키지를 통해 구현되었습니다. |
| XGBoost 소프트웨어 라이브러리 | DMLC / XGBoost 기여자 | 1.7.1 | 비선형 잔차 보정을 위해 사용된 결정 트리 기반 앙상블 학습 라이브러리입니다. 해당 모델은 수식 7–9에 기술된 바와 같이 Huber loss와 트리 복잡도 페널티가 적용된 정규화된 목적 함수를 구현했습니다. |
참고문헌
- Rao H, Li J, Sun X. Demand forecasting and allocation optimization of green power grid supply chain based on machine learning algorithm: A study based on the whole-process data of power grid materials. Sustainability. 2025;17(3):1247.
- Huang C, et al. Demand response for industrial micro-grid considering photovoltaic power uncertainty and battery operational cost. IEEE Trans Smart Grid. 2021;12(4):3043-3055.
- Phuangpornpitak N, Prommee W. A study of load demand forecasting models in electric power system operation and planning. GMSARN Int J. 2016;10:19-24.
- Nasir J, et al. A hybrid LMD–ARIMA–machine learning framework for enhanced forecasting of financial time series: Evidence from the NASDAQ Composite Index. Mathematics. 2025;13(15):2389.
- Matos C, et al. Model for integrating the electricity cost consumption and power demand into aggregate production planning. Appl Sci. 2022;12(15):7577.
- Valenzuela J, Mazumdar M, Kapoor A. Influence of temperature and load forecast uncertainty on estimates of power generation production costs. IEEE Trans Power Syst. 2000;15(2):668-674.
- Khan F, et al. A hybrid vector autoregressive model for accurate macroeconomic forecasting: An application to the US economy. Mathematics. 2025;13(11):1706.
- Fatema I, Kong X, Fang G. Electricity demand and price forecasting model for sustainable smart grid using comprehensive long short-term memory. Int J Sustain Eng. 2021;14(6):1714-1732.
- Singh AK, Ibraheem SK, Muazzam M, Chaturvedi DK. An overview of electricity demand forecasting techniques. Netw Complex Syst. 2013;3(3):38-48.
- Iftikhar H, et al. A novel hybrid framework for forecasting stock indices based on nonlinear time series models. Comput Stat. 2025;40(8):4163-4186.
- Jiang P, Li R, Lu H, Zhang X. Modeling of electricity demand forecast for power system. Neural Comput Appl. 2020;32(11):6857-6875.
- Chan SC, et al. Load/price forecasting and managing demand response for smart grids: Methodologies and challenges. IEEE Signal Process Mag. 2012;29(5):68-85.
- Hernandez L, et al. A survey on electric power demand forecasting: Future trends in smart grids, microgrids and smart buildings. IEEE Commun Surv Tutor. 2014;16(3):1460-1495.
- Zareipour H, Canizares CA, Bhattacharya K. Economic impact of electricity market price forecasting errors: A demand-side analysis. IEEE Trans Power Syst. 2009;25(1):254-262.
- Botterud A. Forecasting renewable energy for grid operations. In: Renewable Energy Integration. Academic Press; 2017:133-143.
- Mirowski P, Chen S, Ho TK, Yu CN. Demand forecasting in smart grids. Bell Labs Tech J. 2014;18(4):135-158.
- Sobu A, Wu G. Optimal operation planning method for isolated micro grid considering uncertainties of renewable power generations and load demand. In: IEEE PES Innovative Smart Grid Technologies [conference proceedings]. IEEE; 2012. Available at: https://ieeexplore.ieee.org/
- Han B, et al. Optimal design of an on-grid microgrid considering long-term load demand forecasting: A case study. Distrib Gener Altern Energy J. 2020;35:345-362.
- Tripathy SC. Demand forecasting in a power system. Energy Convers Manag. 1997;38(14):1475-1481.
- Adshead NS, Price DH. Demand forecasting and cost performance in a model of a real manufacturing unit. Int J Prod Res. 1987;25(9):1251-1265.
- Gellert A, et al. A study on forecasting electricity production and consumption in smart cities and factories. Int J Inf Manage. 2019;49:546-556.
- Hernández L, et al. A multi-agent system architecture for smart grid management and forecasting of energy demand in virtual power plants. IEEE Commun Mag. 2013;51(1):106-113.
- Klingler AL, Teichtmann L. Impacts of a forecast-based operation strategy for grid-connected PV storage systems on profitability and the energy system. Sol Energy. 2017;158:861-868.
- Ghalehkhondabi I, Ardjmand E, Weckman GR, Young WA. An overview of energy demand forecasting methods published in 2005–2015. Energy Syst. 2017;8(2):411-447.
- Aderibigbe AO, et al. Enhancing energy efficiency with AI: A review of machine learning models in electricity demand forecasting. Eng Sci Technol J. 2023;4(6):341-356.
- Arumugham V, et al. An artificial-intelligence-based renewable energy prediction program for demand-side management in smart grids. Sustainability. 2023;15(6):5453.
- Dudek G, Piotrowski P, Baczyński D. Intelligent forecasting and optimization in electrical power systems: Advances in models and applications. Energies. 2023;16(7):3024.
- Liu N, et al. A hybrid forecasting model with parameter optimization for short-term load forecasting of micro-grids. Appl Energy. 2014;129:336-345.
- Mohammad AA, et al. Mathematical and statistical modelling of electricity demand forecasting using artificial neural networks and SARIMA: Implications for energy supply chain planning. Alex Eng J. 2026;139:98-108.
- Singh AR, et al. A blockchain-enabled multi-agent deep reinforcement learning framework for real-time demand response in renewable energy grids. Energy Strateg Rev. 2025;62:101905.
- Lu R, et al. Data-driven real-time price-based demand response for industrial facilities energy management. Appl Energy. 2021;283:116291.
- Kondaiah VY, Saravanan B, Sanjeevikumar P, Khan B. A review on short-term load forecasting models for micro-grid application. J Eng. 2022;2022(7):665-689.
- Lee BL, Wilson C, Simshauser P, Majiwa E. Deregulation, efficiency and policy determination: An analysis of Australia's electricity distribution sector. Energy Econ. 2021;98:105210.
- Wang Y, et al. Transmission network expansion planning considering wind power and load uncertainties based on multi-agent DDQN. Energies. 2021;14(19):6073.
- Ding Q, Zhao H. Study on e-commerce logistics cost control methods in the context of COVID-19 prevention and control. Soft Comput. 2021;25(18):11955-11963.
- Duan Y, Xu Z, Chen H, Wang Y. Novel machine learning approach for enhanced smart grid power use and price prediction using advanced Shark Smell-tuned flexible support vector machine. Sci Rep. 2025;15(1):20909.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining [conference proceedings]. San Francisco, CA, USA; 2016. Available at: https://doi.org/10.1145/2939672.2939785
- Lin KY, et al. Predictive maintenance in industrial systems: An XGBoost-based approach for failure time estimation and resource optimization. J Ind Prod Eng. 2025;42(8):876-899.
- Ajayi OO, Kurien AM, Djouani K, Dieng L. A proactive predictive model for machine failure forecasting. Machines. 2025;13(8):663.
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Chen H, Gao T, Wang L, Guo P. Explainable machine learning methods for predicting electricity consumption in a long-distance crude oil pipeline. Sci Rep. 2025;15(1):43305.
- Neubauer A, Brandt S, Kriegel M. Explainable multi-step heating load forecasting: Using SHAP values and temporal attention mechanisms for enhanced interpretability. Energy AI. 2025;20:100480.
- Ahmad T, Chen H. Potential of three variant machine-learning models for forecasting district-level medium-term and long-term energy demand in smart grid environment. Energy. 2018;160:1008-1020.
- Masa-Bote D, et al. Improving photovoltaics grid integration through short-time forecasting and self-consumption. Appl Energy. 2014;125:103-113.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.