이 프로토콜은 인간 음성 녹음에서 파킨슨병을 분류하기 위한 재현 가능한 양자-고전 하이브리드 워크플로우를 설명하며, 데이터 전처리, 양자 회로 구현, 모델 학습, 독립 복제를 위한 교차 검증을 포함합니다.
이 콘텐츠를 보려면 JoVE 구독이 필요합니다. 로그인하거나 오늘 무료 평가판을 시작하세요.
이 논문에서
요약
초록
파킨슨병은 접근성 저비용 선별 방법이 제한적인 진행성 신경퇴행성 질환입니다. 지속 모음 음성 녹음에는 전문 장비 없이도 획득할 수 있는 질병 관련 음향 바이오마커가 포함되어 있습니다. 이 프로토콜은 매개변수화된 양자 회로와 얕은 고전 분류 계층을 결합하여 차원이 축소된 음향 음성 특징을 사용하여 파킨슨병을 분류하는 4큐비트 양자-고전 하이브리드 합성곱 신경망(QI-HCNN)을 설명합니다. 프로토콜은 또한 제안된 접근법을 축소 및 전체 특징 집합 모두에서 훈련한 차원 매칭 고전 신경망과 그라디언트 부스트 트리 분류기와 비교하여 벤치마킹합니다. 공개된 식별 해제 데이터셋(31명 195건의 음성 녹음)을 사용하여, QI-HCNN은 3중 층별 교차 검증을 통해 수신자 작업 특성 곡선 아래 영역 0.78을 달성했으며, 이는 고전 신경망의 0.87과 축소 및 전체 특징 집합에서 학습된 그라디언트 부스트 기준선 0.94–0.95보다 낮았습니다. 통제된 소작 분석 결과, 회로 내 두 개의 얽힘 연산 중 하나는 설계상 측정된 출력에 영향을 미치지 못하는 반면, 나머지 얽힘 연산은 비얽힘 변형에 비해 분류 성능을 개선하기보다는 감소시켰다. 환자 그룹 교차 검증 결과, 테스트 세트에 배정된 개인에 따라 성능 추정치가 크게 다르며, 제한된 코호트 규모를 반영했습니다. 따라서 이 프로토콜은 완전히 명시되고 독립적으로 재현 가능한 양자-고전 기준선과 함께 현재 회로 설계의 강점과 한계에 대한 데이터 기반 평가를 제공하여 진단 준비성 주장을 뒷받침하기보다는 향후 연구의 방법론적 토대를 제공합니다.
서론
파킨슨병은 흑질에서 도파민성 신경세포가 점진적으로 소실되어 발생하는 만성 신경퇴행성 질환으로, 전 세계적으로 1,000만 명 이상에게 영향을 미치며 상당하고 증가하는 공중보건 부담을 나타냅니다. 이 질환은 떨림, 경직, 서맥 등 운동 증상과 수면 장애, 후각 상실과 같은 비운동 증상을 모두 유발합니다. 임상 진단은 주로 표준화된 운동 평가 척도를 이용한 신경학적 검사에 의존하며, 가능할 경우 도파민 수송체 영상이 보조됩니다; 그러나 두 접근법 모두 전문성과 인프라가 필요하며, 이는 일관되게 접근성이 없으며, 초기 임상 평가는 주관적입니다2. 현재 질병 조절 치료법이 없기 때문에, 조기 발견은 조기 증상 관리와 종단 모니터링을 가능하게 하기 때문에 매우 중요합니다. 이러한 필요성은 임상 평가를 대체하기보다는 보완할 수 있는 저비용, 확장 가능, 비침습적 선별 접근법 개발을 촉진했습니다.
음성 장애는 파킨슨병과 관련된 가장 초기 측정 가능한 변화 중 하나이며, 종종 명백한 운동 증상에 앞서 나타납니다. 유지된 모음의 지속 발음은 지터, 시머, 조화-잡음비, 재발 주기 밀도 엔트로피, 디트렌드 변동 분석 등 음향적 특징을 추출할 수 있는 제어된 신호를 제공합니다. 이러한 기능들은 진단적으로 중요한 정보를 포함하고 있음이 반복적으로 입증되었으며, 소비자용 녹음 장비 4,5를 사용해 획득할 수 있습니다. 이러한 기록에서 파생된 공개된 벤치마크 데이터셋은 이 작업의 표준 테스트베드가 되었으며, 지지 벡터 기계, 랜덤 포레스트, 그라디언트 부스트 트리 등 전체 특징 세트에 적용된 고전적 머신러닝 기법들은 수신기 작동 특성 곡선 아래 면적 값이 0.99 6,7,8에 근접하는 결과를 보고했습니다, 전체 기능 세트와 적절한 클래스 불균형 처리 전략을 사용할 때 분류 과제가 거의 해결되었음을 시사합니다. 양자 기계 학습은 생의학 분류 작업에 대한 대안적 계산 패러다임으로 등장했으며, 매개변수화된 양자 회로는 중첩과 얽힘을 이용해 비교적 적은 훈련 가능한 매개변수로 특징 상호작용을 표현하고, 회로 구배는 유한 차분 근사 대신 매개변수 이동 규칙을 사용하여 해석적으로 계산할 수 있습니다 9. 그러나 생의학 응용을 위한 "양자" 또는 "양자 영감을 받은" 신경망을 설명하는 많은 연구들은 시뮬레이터나 양자 하드웨어10에서 실제 매개변수화된 양자 회로를 실행하지 않고도 양자 영감을 받은 수학적 형식을 완전히 고전적으로 구현하고 있습니다. 파킨슨병 탐지의 최근 발전에는 하이브리드 합성곱 신경망-트랜스포머 아키텍처11, 자기공명영상(MRI)을 위한 주의 기반 딥러닝 기법12, 그리고 계산 효율적인 진단을 위해 설계된 경량 합성곱 신경망13이 포함되며, 이는 인공지능 접근법이 여러 데이터 모달리스에 걸쳐 빠르게 확장되고 있음을 보여줍니다. 더 넓게는 비침습적 컴퓨터 지원 진단이 하이브리드 머신러닝과 딥러닝 파이프라인 등 다른 생의학 응용 분야로 성공적으로 확장되었습니다14. 동일한 공개 음성 데이터셋에 대한 딥러닝 아키텍처 비교 평가는 기존의 완전 특징 고전 모델을 사용하여 달성할 수 있는 강력한 성능을 더욱 입증합니다15.
이러한 발전은 (i) 진정하고 완전히 명시된 양자 회로를 실행하는 재현 가능한 양자-고전 하이브리드 합성곱 신경망(QI-HCNN) 모델에 대한 구체적인 방법론적 필요성을 강조합니다; (ii) 동일한 입력 특징을 사용하여 아키텍처적으로 매칭된 고전 신경망과 강력한 고전 기준선을 기준으로 벤치마킹됩니다; 그리고 (iii) 분류 불균형, 인구통계학적 교란, 교차 검증 중 환자 수준의 데이터 유출 등 소규모 생의학 데이터셋에서 편향의 주요 원인을 명시적으로 조사하는 프로토콜을 사용하여 평가합니다.
이 프로토콜의 전반적인 목표는 인간 음성 녹음을 사용하여 파킨슨병 분류를 위한 완전 재현 가능한 QI-HCNN 워크플로우를 제공하는 것입니다. 이 프로토콜은 각도 인코딩을 사용하는 4개의 큐비트 매개변수화된 양자 회로, 두 개의 제어 NOT 기반 얽힘 층, 그리고 매개변수 이동 규칙을 이용해 최적화된 훈련 가능한 변분 계층을 설명하며, 얕은 고전 분류 헤드와 결합되어 공개 음성 녹음 데이터셋의 4성분 주성분 표현에 적용합니다. 워크플로우는 독립적인 복제가 가능한 수준에서 모든 전처리 절차, 완전한 회로 구성, 고전적 훈련 구성, 평가 절차를 명시하며, 차원 매칭 고전 신경망, 차원 매칭 및 전체 특징 구배 부스트 트리 기준선과의 비교, 통제된 회로 구성 요소 소작, 환자 그룹 교차 검증(보류 참가자에 대한 민감도 평가), 명시적 통계 등을 포함합니다 유의성 검사. 이 프로토콜은 단순히 긍정적인 결과만 제시하는 대신, 개별 회로 구성 요소가 측정 가능하게 성능을 향상시키지 않을 때 투명하게 보고하도록 설계되어, 향후 소규모 코호트 생의학 분류 과제를 위한 QI-HCNN 아키텍처 개발에 참고할 수 있는 재현 가능한 방법론적 틀을 제공합니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
프로토콜
이 프로토콜은 공개적으로 이용 가능한 식별 해제된 제3자 음성 녹음 데이터셋을 사용합니다. 저자들은 새로운 인간-피실험자 데이터를 수집하지 않았으며, 이 연구에 대해 추가적인 기관심사위원회(IRB) 승인도 필요하지 않았습니다. 데이터셋 획득 및 참가자 수준 데이터 처리 하위 섹션에 설명된 데이터셋은 원래 Little 등에 의해 기관 윤리적 승인을 받아 수집되었으며, 참가자를 직접 식별할 수 있는 정보는 없고(익명화된 기록 식별자만 포함), 연구용으로 공개되어 있습니다. 귀하의 기관 정책에 따라 이 공개된 데이터셋의 2차 분석이 윤리 심사가 필요한지 확인해 주세요. 저자들이 속한 기관에서는 이 완전히 식별 해제되고 공개적으로 보관된 데이터셋에 대한 사후 2차 분석이 IRB 전체 검토에서 제외된다고 결정되었습니다.
데이터셋 획득 및 참가자 수준 데이터 처리
Little 등3이 원래 기술한 파킨슨병 분류 데이터셋(UCI 머신러닝 저장소, 데이터셋 ID 174)이 다운로드되었습니다. 데이터셋에는 31명의 개인(파킨슨병 진단 23명, 건강한 대조군 8명; 연령대: 46–85세)의 지속 모음 /a/ 음성 녹음이 포함되어 있습니다. 저장소가 버전이 지정된 DOI를 제공하지 않기 때문에, 정확한 다운로드 날짜는 자료표에 기록 및 보고되었습니다. 데이터셋은 쉼표 구분값(CSV) 파일(parkinsons.csv)로 제공되었습니다. 압축 해제나 파일 변환이 필요 없었으며, 파일은 판다스 라이브러리의 read_csv 함수를 통해 직접 가져왔습니다(재료 표 참조).
다운로드된 데이터셋은 195행과 24열로 확인되었으며, 기록 식별자 열(형식: phon_R01_S  subject
 _ recording), 22개의 연속 음향 특징 열(표 1), 그리고 1개의 이진 분류 라벨 열(상태: 1 = 파킨슨병; 0 = 건강한 대조군)을 포함하고 있습니다. 표 1은 프로토콜 전반에 걸친 모든 음향 특징 및 특징 범주의 기준으로 사용되었습니다.
| 카테고리 | 대표 특징 | 임상적 의의 |
| 기본 주파수 | MDVP:Fo(Hz), MDVP:Fhi(Hz), MDVP:Flo(Hz) | 발음의 평균, 최대, 최소 기본 주파수; 성대 진동의 안정성을 반영합니다. |
| 지터(주파수 섭동) | MDVP:Jitter(%), MDVP:Jitter(Abs), MDVP:RAP, MDVP:PPQ, Jitter:DDP | 음정 주기의 주기별 변동은 후두 운동 조절 장애를 반영합니다. |
| 반짝임 (진폭 섭동) | MDVP:반광, MDVP:반짝임(dB), 반짝임:APQ3, 반박:APQ5, MDVP:APQ, 반짝임:DDA | 신호 진폭의 주기별 변동으로, 숨소리가 섞이거나 불안정한 발음을 반영합니다. |
| 소음 측정 | NHR, HNR | 음성 신호의 잡음과 고조파(음조) 성분의 비율. |
| 비선형 동역학 / 프랙탈 스케일링 | RPDE, D2, DFA, spread1, spread2, PPE | 성대 진동과 관련된 비선형 음성 역학, 주기성 및 장거리 시간적 상관관계 측정. |
표 1: 파킨슨병 분류에 사용되는 음향 특징 범주. 파킨슨병 분류 데이터셋에서 추출한 22개의 음향 음성 특징은 기본 주파수, 지터, 시머, 노이즈 측정, 비선형 동역학의 다섯 가지 특징 범주로 분류됩니다. 각 범주별로 대표적인 특징과 그에 따른 임상적 중요성이 나열되어 있습니다. MDVP, 다차원 음성 프로그램; RAP, 상대평균 섭동; PPQ, 피치 주기 섭동 지수; APQ, 진폭 섭동 몫; DDP, 시기 차이의 차이; DDA, 진폭의 평균 절대 차이; NHR, 잡음 대 고조파 비율; HNR, 고조파 대 잡음비; RPDE, 재발 주기 밀도 엔트로피; D2, 상관 차원; DFA, 디트렌드 변동 분석; 개인 보호 장비(PPE), 음정 주기 엔트로피.
각 녹음마다 참가자 식별자는 녹음 이름의 마지막 밑줄에 앞서는 부분 문자열을 파싱하여 추출했습니다. 예를 들어, phon_R01_S01_1 와 phon_R01_S01_2 는 참가자 S01에게 할당되었습니다. 이후 평가자 식별자는 기록 식별자 대신 평가 프로토콜 하위 섹션에서 설명된 모든 그룹 또는 한 명을 제외하는 검증 절차에 사용되었는데 , 이는 동일한 참가자로부터 얻은 녹음이 음향적으로 상관되어 있기 때문입니다. 추출 후, 식별자 빈도 표를 생성하고 검사하여 195개의 모든 녹화가 정확히 31명의 고유 참가자에게 할당되었는지, 할당되지 않은 녹음이 없는지, 참가자당 녹음 수가 원본 데이터셋 문서와 일치하는지 확인했습니다.
분류 분포는 기록 수준(파킨슨병 기록 147건, 75.4%; 건강 대조 기록 48건, 24.6%)과 참가자 수준(31명 중 23명, 74.2%, 파킨슨병 진단)으로 모두 집계되었습니다. 두 분포 모두 기록 수준과 참여자 수준 클래스 불균형이 동일하지 않아 후속 평가에 영향을 미치기 때문에 보고되었습니다.
원본 데이터셋에서 연령 또는 성별에 맞는 파킨슨병 및 건강한 대조군이 없다는 점은 연구의 한계로 문서화되었으며, 이 특성은 원래 데이터 수집을 반영하여 하위 전처리로 보정할 수 없기 때문에 논의로 이어졌습니다.
전처리 파이프라인
모든 전처리 절차는 평가 프로토콜 하위 섹션에 설명된 교차 검증 절차의 각 학습 접드 내에서 독립적으로 수행되었습니다. 최소-최대 정규화 단계와 주성분 분석(PCA)은 각 접힘의 훈련 분할만을 사용하여 적합되었습니다. 적합된 변환은 이후 해당 테스트 파티션에 재조정 없이 적용되어 정보 유출을 방지했습니다.
각 훈련 파티션의 22개의 원시 음향 특징은 출력 범위 [0, π]의 최소-최대 스케일러를 사용해 정규화되었습니다. 적합한 스케일러는 해당 폴드의 훈련 및 테스트 분할 모두에 적용되었다(방정식 1). 방정식 1 은 표준 최소-최대값 정규화 공식을 따르며, 본 프로토콜에 맞게 정의되었습니다. Min–Max 정규화는 scikit-learn(버전 1.8.0)의 MinMaxScaler 클래스를 사용하여 feature_range=(0, π), copy=True, clip=False 상태로 수행되었습니다.
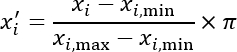 (1)
n_components = 4인 PCA 모델은 정규화된 훈련 데이터만을 사용하여 적합되었습니다. 그 후 맞춤된 PCA 변환을 훈련 및 테스트 분할 모두에 적용했습니다. 네 가지 유지된 주성분이 설명하는 총 분산의 비율이 각 접힘마다 기록되었습니다. 여기 보고된 분석 전체에서 네 가지 유지된 주성분은 전체 분산의 81.5%(각각 50.3%, 16.3%, 9.4%, 5.5%)를 설명했습니다. PCA는 n_components=4, svd_solver="full", whiten=False, random_state=42의 PCA 클래스를 사용하여 수행되었습니다.
PCA가 음수값 구성 점수를 생성할 수 있기 때문에, 출력 범위 [0, π]인 두 번째 최소-최대 스케일러가 PCA 변환 훈련 파티션을 사용해 적합되었습니다. 이 맞춤 스케일러는 이후 훈련 및 시험 구역 모두에 적용되었습니다. 구간 [0, π] 밖에 위치한 변환된 테스트 분할값은 스케일러가 훈련 파티션만을 사용해 적합했기 때문에 가장 가까운 경계로 클리핑되었다. 데이터셋에는 제로 분산 특징이 존재하지 않았습니다. 195개의 모든 녹음에서 피처링의 범위는 엄격히 긍정적이었으며; 따라서 제로로 나누는 조건은 발생하지 않았다. 이는 스케일링 출력에 NaN이나 무한대가 포함되지 않다는 확인을 통해 확인되었습니다.
네 개의 재정규화된 주성분은 양자 회로 구성(Quantum Circuit Construction ) 하위 섹션에서 설명된 각도 부호화 절차 중 큐비트 0, 1, 2, 3의 회전 각도로 순차적으로 할당되었습니다. 첫 번째 주성분은 큐비트 0, 두 번째는 큐비트 1, 세 번째는 큐비트 2, 네 번째는 큐비트 3에 할당되었습니다. 이로써 전처리 파이프라인이 완성되었고, 처리된 고전적 특징을 양자 회로로 전송했습니다. 두 번째 최소-최대 스케일링 단계 이후, 모든 출력 값이 [0, π] 구간 내에 있는 것이 확인되었습니다. 부동소수점 반올림으로 인해 이 범위 밖에 약간 벗어난 테스트 분할 값은 NumPy(버전 2.4.4)의 클립 함수를 사용해 가장 가까운 경계로 클리핑되었습니다. 이 절차는 각도 인코딩 계층의 네 가지 입력 모두가 구간 [0, π] 내에서 유효한 회전 각도임을 보장했습니다.
양자 회로 구성
4-큐비트 회로는 재료표 에 나열된 상태 벡터 시뮬레이터와 아래에 설명된 게이트 시퀀스를 사용하여 구성되었습니다. 보조 코딩 파일 1 은 게이트 구성과 파라미터 시프트 그래디언트 계산을 위한 모든 보조 함수를 포함한 완전한 실행 회로 구현으로 사용되었습니다. 그림 1 은 음성 녹음 전처리부터 네 개의 회로 계층, 고전적 후처리 헤드, 최종 분류까지의 전체 워크플로우를 보여줍니다.
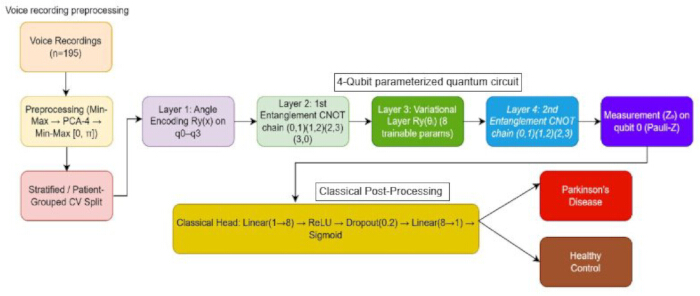
그림 1. 시스템 아키텍처와 양자 회로 워크플로우. 인간 음성 녹음을 통한 파킨슨병 분류 워크플로우. 도표는 음성 녹음 전처리, 층화 또는 환자 그룹 교차 검증, 4큐비트 매개변수화된 양자 회로 실행, 큐비트 0에 대한 단일 큐비트 파울리-Z 측정, 고전적 후처리, 그리고 최종 이진 분류를 파킨슨병 또는 건강한 대조군으로 보여줍니다. CNOT, 통제-NOT 게이트; PCA, 주성분 분석; ReLU, 정류 선형 유닛. 이 그림의 더 큰 버전을 보시려면 여기를 클릭해 주세요.
4큐비트 레지스터는 계산 기저 상태 ∣0000에서 초기화되었습니다.
각도 인코딩 계층의 경우, R y (xi) 회전 게이트가 큐비트 i에 적용되었으며, i = 0,1,2,3이며, 이는 전처리 파이프라인에서 생성된 네 개의 각도를 사용했습니다(식 2). 방정식 2는 Mitarai 등9의 매개변수화된 양자 회로 학습 프레임워크와 일치하는 매개변수화된 양자 회로에서 사용되는 표준 각도 부호화 절차를 설명하며, 본 프로토콜에 정의된 특정 4큐비트 구성에 적용되었습니다.
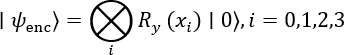 (2)
첫 번째 얽힘 층에서는 제어 NOT 게이트의 원형 체인이 다음 제어 대상 순서로 적용되었습니다: (0,1), (1,2), (2,3), (3,0).
변분 층의 경우, 8개의 훈련 가능한 매개변수 w0부터 w7까지는 평균이 0이고 표준편차가 0.3인 정규분포에서 독립적으로 샘플링하여 초기화되었습니다. 사용된 무작위 씨앗은 재료표에 기록되었습니다. 8개의 변분 양자 매개변수는 numpy.random.default_rng(42 + fold_index).normal(0, 0.3, size = 8)을 사용하여 초기화되었으며, 여기서 fold_index는 0 기반 접수 수로, 접힘 특이이지만 재현 가능한 초기화를 제공한다. 각 큐비트 i = 0, 1, 2, 3에 대해 Rz(wi) 게이트가 적용되었고, 이어서 Ry(wi+4) 게이트가 적용되었습니다(방정식 3). 방정식 3은 Mitarai 등9가 도입한 일반 매개변수화된 양자 회로 학습 프레임워크와 일치하는 변분(훈련 가능) 양자 층을 설명하며, 현재 프로토콜에 정의된 특정 게이트 시퀀스와 매개변수화를 사용하여 여기서 구현되었습니다.
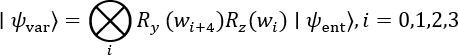 (3)
두 번째 얽힘 층에서는 다음 순서로 제어-NOT 게이트의 열린 연쇄가 적용되었습니다: (0,1), (1,2), (2,3). 이 사슬은 큐비트 0으로 닫히지 않았습니다.
큐비트 0에서만  파울리연산자의 기대값은 상태 벡터 내적을 사용하여 계산되었다. 회로 실행은 표준 수치 배열 연산(보조 코딩 파일 1; qhcnn.py)을 사용하여 구현된 맞춤형 상태 벡터 시뮬레이터를 사용했습니다. Complex128 정밀도(numpy.complex128)가 전반적으로 사용되었습니다. 기대값은 상태 벡터 내적으로부터 해석적으로 계산되었으며; 따라서 샷 기반 샘플링은 수행되지 않았습니다. 서드파티 양자 컴퓨팅 프레임워크가 필요하지 않았습니다. 만약 상태 벡터 시뮬레이터 대신 샘플링 기반 시뮬레이터나 양자 장치가 사용되었다면, 큐비트 0에 대한 반복적인 계산 기반 측정이 수행되었고, 그 결과 비트 주파수가 기대값으로 변환되었을 것입니다(식 4). 방정식 4 는 표준 양자역학적 기대값 공식으로, 본 프로토콜에서 정의된 단일 큐비트 파울리관측값에 적용되었습니다. 샷 기반 샘플링이 수행되지 않았기 때문에 측정 오차 완화가 필요하지 않았습니다. 시뮬레이터는 빅 엔디언 큐비트 인덱싱을 사용했으며, 큐비트 0은 상태 벡터 인덱스의 최상위 비트에 해당합니다. 이 관례는 파울리 관측 가능 값을 구성할 때 명시적으로 고려되어 올바른 기대값이 측정되도록 했다.
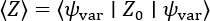 (4)
8개의 변분 매개변수 각각에 대한 기울 기는 매개변수-이동 규칙을 사용하여 계산되었다. 회로는 각 매개변수에 대해 각 그라디언트 계산 시 두 번 평가되었으며, 한 번은 θ + π/2에서, 한 번은 θ - π/2에서 평가되었습니다(식 5). 방 정식 5 는 Mitarai 등이 9번 발표한 표준 매개변수 이동 규칙으로, 수정 없이 적용되었습니다.
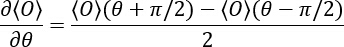 (5)
앞서 명시한 두 번째 얽힘 계층은 큐비트 0을 대상으로 한 제어-NOT 게이트를 적용하지 않았습니다. controlled-NOT 게이트는 제어 큐비트의 축소된 상태를 유지하기 때문에, 두 번째 얽힘 계층은 훈련 가능한 매개변수 값과 상관없이 를 변경할 수 없습니다. 수정된 프로토콜에서 두 번째 얽힘 계층이 측정된 출력에 영향을 미치려면, 예를 들어 추가(3,0) 제어-NOT 게이트로 체인을 닫는 방식으로 큐비트 0을 타겟으로 포함해야 하거나, 단일 큐비트 기대값 대신 다중 큐비트 관측값을 측정해야 합니다. 원래 지정된 두 번째 얽힘 층은 이 프로토콜에 유지되었으며, 그 측정된 기여도는 이번 연구 결과의 일부로 조용히 수정되지 않고 결과 섹션에서 명시적으로 보고되었습니다.
고전적 후처리 계층
고전적인 후처리 단계는 재료표에 나열된 표준 배열 기반 수치 연산을 사용하여 구현된 피드포워드 신경망으로 구성되었습니다. 단일 스칼라 회로 출력은  완전 연결 계층을 사용하여 8개의 숨겨진 장치에 매핑되었고, 이후 정류 선형 장치(ReLU) 활성화가 이어졌습니다. 훈련 중에는 유지율 0.8(중도 탈락률 = 0.2)의 중도 퇴출층이 적용되었습니다. 8개의 숨겨진 유닛은 두 번째 완전 연결 층을 사용하여 단일 출력 유닛에 매핑되었고, 시그모이드 활성화 함수를 적용하여 최종 클래스 확률 ŷ(식 6)를 생성했다. 식6 은 현재 프로토콜에서 사용되는 특정 고전적 후처리 아키텍처를 정의하며, 표준 선형, 정류 선형 유닛(ReLU), 그리고 시그모이드 연산을 포함합니다.
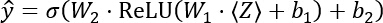 (6)
1층과 2층 가중치 행렬은 평균이 0이고 표준편차가 0.5인 정규분포에서 독립적으로 샘플링하여 초기화되었으며, 모든 편향 항은 0으로 초기화되었습니다. 양자 변분 매개변수 초기화에 사용된 동일한 난수 생성기 인스턴스와 시드는 고전 계층에도 사용되어 런 간 재현성을 보장했습니다. 구체적으로, 고전적인 가중치 행렬은 numpy.random.default_rng(42 + fold_index).normal(0, 0.5, size=...)으로 초기화되었으며, 모든 바이어스 항은 0으로 초기화되었습니다. 각 교차 검증 접힘 시작 지점에 42 + fold_index로 초기화된 단일 시드 난수 생성기 인스턴스가 생성되어, 각 프로세스별로 독립적인 시드 스트림을 사용하지 않고 양자 매개변수 초기화, 고전적 가중치 초기화, 미니 배치 셔플, 드롭아웃 마스크 생성에 순차적으로 재사용되었습니다.
훈련 중에는 각 순방향 패스에서 새롭게 샘플링된 이진 마스크를 생성하여 인버티드 드롭아웃 방식을 사용했으며, 생존 유닛은 1/0.8씩 스케일링되었습니다. 검증 및 테스트 과정에서 드롭아웃은 완전히 비활성화되었고, 전체 규모가 아닌 네트워크가 추론에 사용되었습니다.
QI-HCNN 결합 모델은 33개의 학습 가능한 매개변수를 포함했는데, 이 중 8개는 양자 회로의 양자 변분 매개변수, 25개의 고전 매개변수였습니다. 고전 성분은 첫 번째 완전 연결 층에 8개의 가중치와 8개의 편향, 그리고 두 번째 완전 연결 층에 8개의 가중치와 1개의 편향으로 구성되어 있었습니다. 가중치와 바이어스 텐서 차원은 와  였습니다
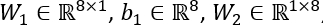 . 고전적인 후처리 계층은 추가적인 기계 학습 프레임워크 없이 표준 수치 배열 연산만으로 완전히 구현되었습니다. 모든 고전적 계산은 float64(배정밀도) 산술을 사용해 수행되었습니다.
모델 트레이닝
양자 회로 구성 하위 섹션에서 설명된 양자 회로와 고전적 후처리 계층이 단일 종단 간 학습 가능한 모델로 결합되었습니다. 33개의 훈련 가능한 매개변수 모두 Adam 최적화기로 공동 최적화되었으며, 초기 학습률은 0.01이고 가중치 감소는 고전 가중치 행렬에만 적용된 L2 페널티로 구현되었습니다. 아담 옵티마이저는 표준 수치 배열 연산을 사용하여 수동 구현되었으며, 학습률 = 0.01, β1 = 0.9, β2 = 0.999, ∈ = 1 × 10⁻⁸, 가중치 감쇠 = 1 × 10⁻⁴ 설정이 적용되었으며, 이는 고전적 가중치 행렬에만 적용되고 편향 항이나 양자 분분 매개변수에는 적용되지 않았습니다.
손실 함수로 이진 교차엔트로피가 사용되었습니다. 평가 프로토콜 하위 섹션에서 설명한 분할 후 클래스 밸런싱 절차에서, 각 학습 샘플의 손실 기여도는 현재 접힘의 훈련 분할 내에서 해당 클래스의 역주파수에 따라 가중치가 부여되었습니다. 불균형 프로토콜에는 균일한 표본 가중치가 할당되었습니다. 이진 교차엔트로피는 표준 이진 교차엔트로피 공식을 사용하여 각 미니 배치 내 모든 샘플의 평균 손실로 계산되었습니다.
이 모델은 16개의 샘플로 구성된 미니 배치를 사용하여 30개의 에포크를 훈련시켰습니다. 학습 샘플은 각 에포크 시작 시 numpy.random.default_rng(42 + fold_index).permutation(n)을 사용하여 무작위로 섞어 무작위 샘플 순서를 생성했습니다. 훈련 샘플 수가 16으로 균등하게 나누어지지 않을 때는 최종 소규모 미니 배치를 버리지 않고 실제 크기로 보존하고 처리했습니다.
교육 기간 동안 단계별 학습률 일정이 적용되었습니다. 학습률은 10개의 에포크를 완료할 때마다, 특히 에포크 11과 21의 시작 지점에서 0.7배가 배되었습니다.
8개의 양자 변분 매개변수에 대한 기울기는 양자 회로 구성 하위 섹션에서 설명된 매개변수-이동 규칙을 사용하여 계산되었습니다. 25개의 고전 매개변수에 대한 구배는 고전 층을 통한 표준 역모드 미분을 사용해 계산되었습니다. 양자 회로 출력과 그 매개변수 이동 구배는 양자 회로와 고전층 사이의 인터페이스 역할을 했다. 33개의 모든 매개변수는 동일한 Adam 옵티마이저 인스턴스를 사용하여 업데이트되었습니다.
검증 기반 조기 중단은 사용되지 않았습니다. 각 모델은 고정된 30 에포크 일정에 맞춰 훈련되었고, 최종 에포크 완료 후 유지된 테스트 분할 성능이 보고되었습니다. 모든 모델 매개변수(양자 변분 매개변수, 고전 가중치 행렬, 바이어스 항)는 각 교차 검증 접힘 시작 시 접힘 특이적 무작위 시드(42 + fold_index)를 사용해 독립적으로 재초기화되었습니다. 매개변수는 폴드나 베이스라인 실행에 걸쳐 공유되지 않았습니다.
프로세서, 메모리, 소프트웨어 버전, 그리고 접힘당 월클록 학습 시간 등 계산 환경은 재료표에 기록되었습니다.
평가 프로토콜
모델 성능은 기록 수준과 참가자 수준 교차 검증 절차를 모두 사용하여 평가되었으며, 베이스라인-모델 비교, 클래스 밸런싱 분석, 회로 소작 실험, 통계적 유의성 검정, 특징 중요도 분석도 함께 수행되었습니다.
1차 평가를 위해 195개의 음성 녹음을 고정된 무작위 시드를 사용해 세 개의 층화된 접힘으로 나누었으며, 각 접힘 내에서 녹음 수준의 파킨슨병/건강 조절 비율인 75.4%/24.6%를 유지하였습니다. 앞서 설명한 모델은 두 개의 접힘으로 훈련되었고, 나머지 보류된 접힘에서 평가되었으며, 이 과정을 각 접힘이 테스트 분할로 한 번 사용할 때까지 반복되었습니다. 각 접힘마다 정확도, 정밀도, 회상률, F1 점수, 수신자 운행특성 곡선(AUC–ROC) 아래 면적을 계산하여 세 접힘 전반± 평균 표준편차로 보고하였습니다. 주요 3중 층화 교차 검증은 n_splits=3, 셔플=참, random_state=42인 StratifiedKFold 클래스를 사용하여 구현되었습니다.
이진 클래스 예측은 고전적 후처리 계층에서 생성된 예측 클래스 확률 ŷ에 고정된 확률 임계값 0.50을 적용하여 생성되었습니다. 정확도, 정밀도, 회상율, F1 점수는 이 임계값 예측에서 계산된 반면, AUC–ROC는 임계값 없이 연속 확률값에서 직접 계산되었습니다. 정확도, 회상률, F1 점수는 zero_division=0의 측정 함수를 사용하여 계산되었으며, 정의되지 않은 측정치에 0.0을 부여했습니다. 보고된 실험 중에는 그러한 불정의 상태는 발생하지 않았습니다.
기본 모델은 동일한 폴드 파티션과 전처리 파이프라인에서 생성된 동일한 4성분 전처리 특징 표현을 사용하여 평가되었습니다. 8개의 ReLU 활성화 유닛으로 구성된 1층의 숨겨진 계층을 포함하는 고전적 다층 지각론은 하이브리드 모델의 고전 구성 요소와 구조적으로 일치하지만 양자 회로는 포함되지 않았으며, L2 패널티가 1 × 10⁻⁻으로 아담 옵티마이저를 사용해 학습되었다. 200개의 트리, 최대 트리 깊이 3, 학습률 0.1, 각 훈련 접드 내 역클래스 빈도에 해당하는 클래스 가중치를 가진 동일한 4성분 표현으로 학습된 그라디언트 부스트 트리 분류기도 사용되었습니다. 또한, 두 번째 그라디언트 부스트 트리 분류기는 PCA나 양자 특징 인코딩 없이 초기 최소-최대값 정규화 이후 생성된 전체 22개 특징 표현을 사용하여 훈련되었습니다. 이 모델은 300개의 트리, 최대 트리 깊이 4, 학습률 0.05, 역훈련 폴드 클래스 가중치 전략을 사용했습니다. 고전적인 다층 지각론 기준선은 MLPClassifier를 사용하여 구현되었으며, hidden_layer_sizes=(8),활성화="relu", solver="adam", alpha=1 × 10⁻4, batch_size="auto", learning_rate_init=0.001, max_iter=500, early_stopping=False, shuffle=True, random_state=42. 구현에서 제공한 기본 Glorot(Xavier) 균일 가중치 초기화가 사용되었습니다. 그라디언트 부스트 트리 베이스라인은 XGBoost 3.3.0을 사용하여 구현되었으며, objectities = "binary:logistic", eval_metric = "logloss", tree_method = "auto", 서브샘플 = 1.0, colsample_bytree = 1.0, reg_alpha = 0, reg_lambda = 1, random_state = 42.
분할 클래스 밸런싱 효과를 평가하기 위해, QI-HCNN 모델에 대해 표본 가중치를 활성화한 상태에서 1차 교차 검증 절차를 반복하였다. 균형 가중치는 트레인/테스트 분할 후 각 폴드의 훈련 분할에서만 계산되었으며, 해당 보류 테스트 분할에서는 계산되지 않았습니다.
회로-성분 소작 실험은 양자 회로의 두 개의 얽힘 층만 수정하면서 완전한 전처리, 훈련, 평가 워크플로우를 네 번 반복하여 수행되었습니다. 네 가지 회로 변형은 다음과 같다: (i) 두 개의 얽힘 층을 포함하는 완전한 회로; (ii) 첫 번째 얽힘층이 제거되고 두 번째 얽힘층이 유지된 회로; (iii) 첫 번째 얽힘 층을 유지하고 두 번째 얽힘층을 제거한 회로; 그리고 (iv) 두 개의 얽힘 층이 모두 제거된 회로. 네 실험 모두에서 동일한 폴드 파티션, 무작위 시드, 훈련 구성이 유지되어, 관찰된 성능 차이는 오로지 얽힘층 구성에만 기인할 수 있었습니다.
견고성 평가로서, 참가자 그룹 교차 검증은 195명의 기록이 아닌 31명의 참가자를 6명에서 7명씩 포함하는 5개 그룹으로 나누어 수행했습니다. 각 반복 동안 모델은 네 개 그룹 참가자들의 녹음을 사용해 학습되었고, 나머지 그룹 참가자들의 녹음을 사용해 평가하여 동일한 폴드의 훈련 및 테스트 분할에 모두 녹음을 기여하지 않도록 했습니다. 정확성, 정밀도, 기억력, F1 점수, AUC–ROC는 QI-HCNN 모델, 고전적 다층 퍼셉트론, 그리고 4가지 특징 그라디언트 강화 기준선의 다섯 개 참가자 그룹 접힘 간 평균 ± 표준편차로 보고되었습니다. 참여자 그룹 교차 검증은 n_splits=5의 GroupKFold 클래스를 사용하여 구현되었으며, 여기서 참가자 식별자가 그룹 변수로 사용되었습니다. GroupKFold는 그룹을 섞지 않기 때문에, 참가자들은 구현의 기본 결정론적 순서에 따라 배정되었고, 그 결과 6명 또는 7명의 참가자가 포함된 폴드가 형성되었습니다.
통계적 유의성은 1차 평가 모델과 기초선 모델에서 얻은 AUC–ROC 값에 대해 Wilcoxon 부호 순위 검정을 쌍으로 적용하여 평가하였습니다. 정확한 p-값과 그에 따른 쌍 관찰 수가 보고되었는데, 이는 이 검정의 통계적 검정력이 제한된 경우에 해당합니다. 네 가지 쌍별 AUC–ROC 비교가 사전에 정의되었습니다: (1) QI-HCNN 대 고전 다층 인식기; (2) QI-HCNN 대 PCA 매칭 경배 부스트 트리 기준선; (3) 고전적 다층 인식론과 PCA 매칭 구배 강화 트리 기준선; 그리고 (4) 비균형 QI-HCNN 모델과 분할 후 균형 잡힌 QI-HCNN 모델의 비교. 분석이 탐색적이었고 접힘 수가 제한되어 통계적 검정력이 크게 떨어졌기 때문에 다중 비교 보정은 적용되지 않았습니다.
특징 중요도 분석은 전체 22개 특징 표현에서 훈련된 그라디언트 강화 트리 분류기를 사용하여 수행되었습니다. 모든 원래 음향 특징에 대해 이득 기반 특징 중요도 점수를 추출하여 순위를 매겼습니다. 별도로, PCA는 보고 목적으로만 전체 데이터셋에 적합되었으며 모델 평가 시에는 사용되지 않았습니다. 각 원래 음향 특징에 대해 네 가지 보존된 주성분에 대한 절대 부하를 합산하고, 이 값에 따라 특징을 순위 매겼습니다. 두 순위 방법 모두와 그 중복 부분이 보고되었습니다. 게인 기반 특징 중요도 분석에서는 그라디언트 부스트 트리 구현이 고유한 부동소수점 이득 값을 생성했으며, 동점은 발생하지 않았습니다. 주성분-부하 순위의 경우, 절대 부하 값의 합산 동점이 데이터셋 내 원래 특징-열 순서에 따라 해결되었습니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
결과
본문에 보고된 모든 수치는 그림 2–8 및 표 2–4에 제시된 값과 일치하여 동일합니다. 모든 도표는 수작업으로 작성되지 않고 보조 코딩 파일 1 에 제공된 코드에서 직접 생성되어, 보고된 수치값과 그래프 데이터 간의 일관성을 보장했습니다.
주요 교차 검증 성능
불균형 훈련 프로토콜 하에서 QI-HCNN 모델은 정확도 0.759 ± 0.007, 정밀도 0.774 ± 0.029, 리콜 0.966 ± 0.048, F1 점수 0.858 ± 0.003, 수신자 작전 특성 곡선(AUC–ROC) 아래 면적은 세 개의 층화된 교차 검증 접힘 전반에서 0.782± 0.022를 달성했습니다(표 2). 그림 2 는 해당 퍼폴드 결...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
토론
이 프로토콜은 음성 녹음에서 파킨슨병 분류를 위한 완전 재현 가능한 QI-HCNN 아키텍처를 명시하며, 모든 게이트, 매개변수 초기화 선택, 전처리 단계, 평가 절차가 독립적으로 구현할 수 있는 수준으로 설명됩니다. 제안된 회로는 동일한 입력 특징과 동일한 교차 검증 폴드 파티션을 사용하여 아키텍처적으로 매칭된 고전적 다계층 지각론과 그라디언트 부스트 트리 기준선을 기준으로 벤치마킹됩니다. 이 벤치마킹 설계는 통제된 회로-구성 요소 소작술, 환자 그룹별 견고성 평가, 명시적 통계적 유의성 검정을 포함하여, 양자 라벨 구조가 항상 자원이 동등한 고전적 대안과 비교해 평가되거나 소규모 생의학 코호트의 특정 실패 모드를 검증하지 않는 이 하위 분야에서 방법론적 실무를 발전시키기 위한 목적입니다10. 프로토콜의 핵심 단계로는 정보 누출을 방지하기 위한 폴드별 전처리, 동일 개인의 반복 기록으로 인한 편향을 최소화하기 위한 참가자 수준...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
공개 사항
이해 상충:
저자들은 이 연구와 관련된 경쟁적인 재정적 또는 비재정적 이해관계가 없다고 선언합니다.
감사의 글
이 작업은 기술적이거나 재정적으로 어떤 기관이나 조직의 자금 지원을 받지 않았습니다. 저자들은 이 연구에 사용된 음성 녹음 데이터셋에 대한 공개 접근 권한을 제공해 준 UCI 머신러닝 저장소의 관리자들에게 감사를 표합니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| Adam 최적화 | 표준 수치 최적화 구현 | 사용자 정의 구현; NumPy 2.4.4 | 양자 및 고전적 파라미터의 공동 최적화; 모델 훈련 |
| 이진 크로스-엔트로피 손실 구현 | NumPy를 사용한 사용자 정의 구현 | NumPy 2.4.4; 각 미니-배치에 대한 평균 손실(평균 감소) | 훈련 손실 함수; 모델 훈련 |
| 그래디언트-부스트 트리 분류기 | XGBoost 오픈소스 그래디언트 부스팅 라이브러리 | XGBoost 3.3.0; objective="binary:logistic"; eval_metric="logloss"; tree_method="auto"; random_state=42 | PCA-매칭 및 전체 기능 고전적 기준선; 평가 프로토콜 |
| 기계 학습 라이브러리 | scikit-learn 오픈소스 기계 학습 라이브러리 | scikit-learn 1.8.0 | 최소-최대 스케일링, 주성분 분석, 계층적 교차 검증, 참가자 그룹 교차 검증, 다층 퍼셉트론 기준선 및 평가 지표 |
| 수치 계산 라이브러리 | NumPy 오픈소스 수치 계산 라이브러리 | NumPy 2.4.4 | 코어 배열 연산, 상태벡터 시뮬레이션, 파라미터 초기화 및 수동 그라디언트 계산 |
| 파킨슨 질환 분류 데이터셋 | Little, McSharry, Roberts, Costello 및 Moroz; UCI 기계 학습 저장소를 통해 배포 | UCI 데이터셋 ID 174; 31명의 참가자로부터 195개의 녹음; 2025년 6월 19일 접근 | 지속 모음 음성 녹음 데이터셋 소스; https://archive.ics.uci.edu/dataset/174 |
| 과학 계산 라이브러리 | SciPy 오픈소스 과학 계산 라이브러리 | SciPy 1.17.1 | 윌콕슨 부호 순위 통계적 유의성 검정; 평가 프로토콜 |
| 상태벡터 시뮬레이터 | 사용자 정의 상태벡터 시뮬레이터(보충 코딩 파일 1; qhcnn.py) | 순수 NumPy 구현; complex128(더블) 정밀도; 외부 백엔드 필요 없음 | 4-쿼벳 양자 회로의 실행; 양자 회로 구성 |
| 테이블 형식 데이터 라이브러리 | Pandas 오픈소스 데이터 분석 라이브러리 | Pandas 3.0.2 | 데이터셋 로딩, 검사 및 테이블 형식 조작 |
| 워크스테이션 계산 환경 | 로컬 CPU 워크스테이션(클라우드 호스팅 리눅스 컨테이너) | x86_64 CPU; 우분투 리눅스; 파이썬 3; GPU 또는 양자 하드웨어 사용 안 함; 대략적인 벽걸시 훈련 시간은 폴드당 30-60초 | 모든 훈련 및 평가에 사용된 계산 환경; CPU 기반 상태벡터 시뮬레이션; GPU 또는 양자 하드웨어 필요 없음 |
참고문헌
- Rabie H, Akhloufi MA. A review of machine learning and deep learning for Parkinson's disease detection. Discov Artif Intell. 2025;5:24.
- Devi SVA, et al. Hybrid deep learning methods for enhancing Parkinson's disease early detection [conference presentation]. Presented at: 4th International Conference on Smart Applications, Data and Living (ICSADL); 2025; Bhimdatta, Nepal. IEEE. p. 1462-1469. Available from: https://doi.org/10.1109/ICSADL65848.2025.10933259.
- Little MA, et al. Exploiting nonlinear recurrence and fractal scaling properties for voice disorder detection. Biomed Eng Online. 2007;6:23.
- Costantini G, et al. Artificial intelligence-based voice assessment of patients with Parkinson's disease off and on treatment. Sensors (Basel). 2023;23(4):2293.
- Gunduz H. Deep learning-based Parkinson's disease classification using vocal feature sets. IEEE Access. 2019;7:115540-115551.
- Naeem I, et al. Voice biomarkers as prognostic indicators for Parkinson's disease using machine learning techniques. Sci Rep. 2025;15:12129.
- Ebrahimzadeh E, et al. Explainable machine learning for early detection of Parkinson's disease in aging populations using vocal biomarkers. Front Aging Neurosci. 2025;17:1672971.
- Alishah S. An explainable ensemble and deep learning framework for accurate and interpretable Parkinson's disease detection from voice biomarkers. Diagnostics (Basel). 2025;15(22):2892.
- Mitarai K, Negoro M, Kitagawa M, Fujii K. Quantum circuit learning. Phys Rev A. 2018;98(3):032309.
- Alissa M, et al. Parkinson's disease diagnosis using convolutional neural networks and figure-copying tasks. Neural Comput Appl. 2022;34(2):1433-1453.
- Kumari GRP, Ravi Kanth M, Kamal MV. Parkinson's disease early detection using hybrid attentive CNN-transformer model. Neural Comput Appl. 2025;37(32):26523-26543.
- Palakayala R, Kuppusamy P. AttentionLUNet: a hybrid model for Parkinson's disease detection using MRI brain. IEEE Access. 2024;12:91752-91769.
- Wang X, et al. A light-weight CNN model for efficient Parkinson's disease diagnostics [conference presentation]. Presented at: IEEE International Symposium on Computer-Based Medical Systems (CBMS); 2023; L'Aquila, Italy. IEEE. p. 616-621. Available from: https://doi.org/10.1109/CBMS58004.2023.00289.
- Haq I, et al. Lung nodules localization and report analysis from computerized tomography (CT) scan using a novel machine learning approach. Appl Sci. 2022;12(24):12614.
- Alzaidi A, et al. Comparative study of deep learning models for Parkinson's disease detection using the UCI vocal dataset. TBench. 2025;5(2):10021
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.