본 논문은 Transformer와 PPO 강화 학습을 통합한 동적 스케줄링 최적화 알고리즘을 연구하며, 특히 노동조합 활동 스케줄링 시 빈번하게 발생하는 자원 충돌과 응답 지연 문제에 초점을 맞춥니다.
이 논문에서
요약
초록
노동조합 활동 관리 시 빈번한 자원 할당 충돌과 지연된 일정 응답으로 인해 발생하는 조직 효율성 저하 문제를 해결하기 위해, 본 논문은 Transformer와 PPO(Proximal Policy Optimization)를 통합한 동적 스케줄링 알고리즘을 제안한다. 구체적인 구현 과정에서는 먼저 활동, 인력 및 자원 상태를 텐서 입력으로 변환하기 위한 통합 스케줄링 시나리오 모델링 구조를 설계하여 다차원 제약 조건의 통합을 달성한다. 다음으로, Transformer 멀티 헤드 어텐션 메커니즘을 사용하여 과거 활동 요청 및 자원 상태의 시계열을 인코딩함으로써 다차원 시공간 특징을 추출하고 충돌 위험에 대한 인지 능력을 향상시킨다. 이어서, 인코딩 결과와 PPO 전략 네트워크를 기반으로 현재 상태에서 스케줄링 액션을 생성하여 복잡한 환경에 대한 전략의 적응성을 높인다. 마지막으로, 가지치기 업데이트와 어드밴티지 함수 보정 메커니즘을 통해 반복 과정 중의 전략 안정성과 개선된 스케줄링 성능을 보장한다. 실험 결과, 작업 밀도가 1000일 때 스케줄링 알고리즘의 평균 결정 시간은 0.72s, 평균 응답 지연 시간은 1.59s로 나타나 높은 응답 속도와 의사결정 효율성을 보였다. 7가지 활동 유형과 복잡도 수준에 걸쳐 자원 충돌률은 0.05–0.12, 평균 자원 이용률은 0.75–0.86, 스케줄링 안정성 지수는 0.8–0.91로 나타나, 빈번한 자원 할당 충돌을 효과적으로 줄이고 높은 스케줄링 안정성을 달성하였다. 고동시성 조건에서 자원 균형 지수와 전략 전이 강건성 지수는 각각 0.88과 0.85로 나타나, 작업 동시성 부하에 대한 우수한 적응성을 입증하였다.
서론
조합 활동은 여러 작업과 자원의 복잡한 일정 계획을 수반하므로, 시스템에 효율적인 동적 대응 능력이 필요합니다1,2. 활동 요구사항은 빈번하게 변경되며, 인력 및 장소 자원의 배분이 복잡하여 일정 충돌 및 자원 낭비가 발생하기 쉽습니다3,4. 활동 이력과 실시간 자원 상태를 정확하게 파악하고, 잠재적 충돌을 식별하고 대응하는 능력을 향상시키는 것이 조직의 운영 효율성을 높이는 핵심입니다5,6. 고급 시계열 모델링 기술과 강화 학습 알고리즘을 통합하면 복잡한 일정 계획 환경에서 심층적인 이해와 지능적인 최적화를 달성할 수 있으며, 이는 자원 활용도를 극대화하고 일정 대응 속도를 높이며 조합 활동 관리의 지능적 업그레이드를 촉진하는 데 도움이 됩니다.
그러나 실제의 기존 스케줄링 방식은 대부분 규칙 기반 및 정적 방식으로, 빈번한 작업 변경과 리소스 변동에 적응하지 못하며, 이는 종종 응답 시간 연장과 심각한 리소스 충돌로 이어집니다. 노동조합 활동 스케줄링에서 작업 유형은 매우 다양하며, 리소스 사용은 제약이 많고 빈번하게 변경됩니다. 또한 활동 간의 의존성과 리소스 간의 경쟁 관계는 복잡한 스케줄링 맵을 형성합니다7,8. 실제로 활동 일정은 인력 및 장소와 같은 리소스의 가용 시간 창과 효율적으로 맞출 수 없으며9,10, 충돌이 빈번하게 발생하여 조직 운영의 전반적인 일관성을 약화시킵니다11,12. 스케줄링 시스템은 단일 최적화 목표가 아니라 리소스 충돌 최소화, 응답 속도 최대화, 스케줄링 전략의 안정성, 작업 완료율과 같은 다차원 지표 간의 균형을 맞춰야 하며13,14, 이는 전형적인 다목적 최적화 특성을 나타냅니다. 또한, 노동조합 활동은 뚜렷한 단계와 주기를 보이므로, 스케줄링 전략은 서로 다른 작업 단계에 따른 리소스 수요 구조의 변화에 동적으로 적응해야 합니다. 한 번 생성된 정적 계획으로는 빈번한 변경이 발생하는 실행 환경을 지원할 수 없습니다15,16. 기존의 스케줄링 로직은 과거 작업 동작과 리소스 상태 변경 패턴에 대한 심층적인 탐색이 부족하여, 미래에 대한 정확한 예측과 전략적 추론을 제공할 수 없습니다17,18. 시스템의 스케줄링 전략은 갑작스러운 작업과 일시적인 리소스 변경에 느리게 반응하여 운영의 전반적인 지속 가능성에 영향을 미칩니다19,20. 예측 가능성, 유연성 및 안정성을 갖춘 스케줄링 시스템을 구축하는 것이 실제 응용 분야의 핵심 기술 요구 사항이 되었습니다. 이를 위해서는 모델이 고차원 정보 인지, 시퀀스 기억 및 전략 전이 능력을 갖추어야 하며, 다중 작업 환경에서 강건한 의사결정과 리소스 균형을 유지함으로써 노동조합 활동 스케줄링의 지능적이고 최적화된 조율을 가능하게 해야 합니다.
수많은 연구에서 동적 스케줄링 문제에 대한 다양한 해결책을 제안해 왔습니다. 그중에서도 딥러닝과 강화학습의 결합은 강력한 적응성과 최적화 능력을 보여주었습니다. 일부 연구자들은 LSTM(Long Short-Term Memory)21,22을 사용하여 시계열 데이터를 모델링하고, 강화학습 전략을 결합하여 스케줄링 동작을 최적화함으로써 일정 수준의 성과를 거두었습니다. 또 다른 유형의 연구에서는 그리디 알고리즘(greedy algorithm) 기반의 휴리스틱 방법을 사용하여 스케줄링 결정의 단순성과 효율성을 강조하였으며, 이는 규칙이 명확한 시나리오에 적합합니다23,24. 그 외의 연구들에서는 딥 Q-네트워크(DQN)를 스케줄링에 적용하여 가치 함수 근사를 통해 개선된 전략을 구현하였습니다25,26. 그러나 이러한 방법들은 복잡하고 가변적인 연합 활동 시나리오에 직면했을 때 장기 의존성 포착 부족, 불안정한 전략 업데이트, 큰 응답 지연 등의 문제를 가지고 있어, 고밀도의 다양한 작업에 대한 스케줄링 요구사항을 충족하기 어렵습니다. 따라서 효율적인 특징 추출과 안정적인 전략 업데이트 능력을 갖춘 스케줄링 알고리즘을 어떻게 구축할 것인가가 현재 연구에서 해결해야 할 병목 지점이 되었습니다.
다중 도메인 스케줄링 연구에서 Transformer 아키텍처는 장기적인 시간적 의존성을 효과적으로 포착하는 멀티 헤드 셀프 어텐션(multi-head self-attention) 메커니즘 덕분에 다양한 시계열 예측 및 스케줄링 최적화 작업에 적용되어 왔습니다27,28. 강화 학습의 PPO 알고리즘과 결합하면 목적 함수를 트리밍하여 전략을 안정적이고 효율적으로 업데이트할 수 있으며, 이러한 접근 방식은 로봇 제어 및 지능형 제조와 같은 분야에서 우수한 성능을 보여주었습니다29,30,31. 일부 연구에서는 복잡한 자원 스케줄링을 위해 Transformer를 강화 학습과 통합하려는 시도가 있었습니다32. 그러나 노동조합 활동의 동적 스케줄링에 있어 다양한 활동 유형과 복잡한 자원 제약의 결합을 다룬 연구는 거의 없습니다. 일부 연구에서는 그래프 신경망을 활용하여 자원과 작업 간의 관계를 모델링함으로써 충돌 식별의 정확도를 향상시켰습니다33,34. 일부 학자들은 모델의 효율성과 성능을 높이기 위해 엣지 컴퓨팅 기반의 자원 스케줄링을 최적화했습니다35,36. 하지만 이러한 방법들은 여전히 시간적 문맥에 대한 모델링 능력이 제한적입니다. 이를 바탕으로 본 논문에서는 Transformer를 사용하여 과거 활동 및 자원 상태 시퀀스를 인코딩하고, 이를 PPO 정책 네트워크와 결합함으로써 충돌 위험에 대한 높은 인지 능력을 확보하고 스케줄링 전략을 안정적으로 업데이트하여 노동조합 활동의 변화무쌍하고 복잡한 스케줄링 요구 사항에 대응하는 방법을 제안합니다.
보다 최근의 연구들은 클라우드 컴퓨팅의 에너지 효율을 위한 VM 통합37, 셀룰러 네트워크의 인증 알고리즘38, 지속 가능한 클라우드 컴퓨팅을 위한 라이브 마이그레이션 기반의 개선된 VM 통합39, 대기 예측 및 진화 알고리즘을 이용한 트래픽 최적화40, 그리고 최적화 및 무결성 보존이 강화된 블록체인 기반 클라우드 스토리지41와 같이 다양한 관점에서 자원 스케줄링 최적화를 탐구해 왔습니다. 이러한 연구들은 자원 할당 및 최적화 알고리즘에 대한 가치 있는 통찰력을 제공하지만, 주로 클라우드 인프라, 통신 또는 스토리지 시스템을 대상으로 하며, 노조 활동 관리의 고유한 특성인 다중 유형 활동 제약, 역동적인 인력-장소 자원 충돌 및 실시간 스케줄링 요구사항을 구체적으로 다루지 않습니다. 이러한 차이점은 노조 활동의 조직적 맥락에 맞게 설계된 전용 스케줄링 프레임워크의 필요성을 더욱 강조합니다.
기존의 학생회 활동 스케줄링 방법은 장기적인 시공간적 의존성을 포착하지 못하고 동적인 변화 속에서 정책 안정성을 유지하는 데 어려움이 있어, 느린 응답 시간과 높은 리소스 충돌을 초래하는 경우가 많습니다. 이러한 연구 공백을 해결하기 위해, 본 연구는 Transformer 멀티헤드 어텐션(multi-head attention)이 충돌 예측을 위해 이력 시퀀스를 효과적으로 인코딩할 수 있다는 원리와, 클립된 목적 함수를 가진 근사 정책 최적화(Proximal Policy Optimization, PPO)가 안정적이고 적응적인 정책 업데이트를 보장한다는 원리에 기반한 스케줄링 최적화 모델을 제안합니다. 구체적으로, Transformer를 적용하여 활동 및 리소스 상태 시퀀스를 인코딩함으로써 충돌 예견 능력을 향상시키기 위한 핵심 시공간 특징을 추출하고, PPO를 결합하여 효율적인 스케줄링 행동 생성과 안정적인 업데이트를 수행합니다. 또한 활동, 인원, 장소를 매핑하는 통합 제약 행렬을 설계하여 복잡한 의존성 인식 능력을 개선했습니다. 본 연구의 핵심 혁신 사항은 다음과 같습니다: (1) 학생회 활동 스케줄링에 특화된 시간 인코딩과 강화 학습의 통합, (2) 위험 인식을 우선시하는 충돌 인식 어텐션 메커니즘, (3) 높은 동시성 환경에서 전략의 강건성을 보장하기 위한 어드밴티지 함수 보정 기반의 가지치기 업데이트입니다. 다양한 작업 밀도와 복잡성 조건에서 수행한 광범위한 실험을 통해, 본 모델이 응답 속도, 리소스 활용도 및 안정성 측면에서 기존 방법보다 우수함을 검증하였으며, 학생회 활동 관리를 위한 실용적이고 확장 가능한 지능형 스케줄링 솔루션을 제공합니다.
프로토콜
그림 1은 시계열 모델링과 강화 학습을 통합한 연합 활동 스케줄링 시스템의 구조를 보여줍니다. 입력 레이어는 활동 일정, 리소스 가용성 및 인력 시간 창 정보를 통합하며, 제약 그래프 모듈을 통해 다차원 작업 및 리소스 충돌 관계 행렬을 구축합니다. 트랜스포머는 활동 및 리소스 상태의 과거 시퀀스에 대해 멀티 헤드 어텐션 인코딩을 수행하여 시간적 의존성을 가진 은닉 상태를 생성합니다. 정책 모듈은 인코딩 결과를 사용하여 행동 분포와 상태 추정치를 생성하고, 행동을 샘플링한 후 스케줄링 결정을 실행합니다. 실행 결과는 환경으로 피드백되어 리소스 상태를 업데이트하고 즉각적인 보상을 생성합니다. 이를 바탕으로 최적화 모듈은 클리핑 목적 함수를 구축하고 이득 함수를 평가하며, 가치 네트워크의 추정치를 수정하여 정책 드리프트를 제한하고 스케줄링 행동의 안정적인 업데이트를 보장합니다. 모듈 간에 폐쇄형 데이터 루프가 형성되어 동적 환경에서 리소스 충돌에 대한 고감도 인지와 적응형 전략 업데이트를 달성함으로써, 다중 작업 및 고제약 시나리오에서 연합 활동 스케줄링 시스템의 지능적 응답 능력과 리소스 할당 효율성을 향상시킵니다.
노조 활동 일정 계획의 시나리오 모델링
스케줄링 시스템의 모든 활동 요청은 시간 단계(time step)를 기반으로 개별적인 스케줄링 시퀀스로 구성됩니다. 각 활동은 명확한 시작 및 종료 시간, 리소스 범주, 단계 및 우선순위 수준으로 정의됩니다. 사이트 이용 상태는 2차원 타임슬롯 행렬로 모델링되며, 여기서 가로축은 표준화된 시간 단위를 나타내고 세로축은 공간 리소스 번호를 나타냅니다. 리소스 상태는 가용(available) 및 점유(occupied)로 표시되어 정적 구조의 초기 리소스 분포 맵을 형성합니다. 인력 스케줄링 정보는 시간-식별자 차원으로 확장되어 연속적인 시간 윈도우 벡터를 구성하며, 각 벡터는 인력의 작업-유휴 상태 및 부서 번호를 기록합니다. 모든 입력 정보는 3차원 텐서 구조로 통합되며, 여기서 $\text{T}$는 이산 시간 단계를, $\text{R}$은 리소스 엔티티의 수를, $\text{A}$는 해당 리소스 이용 속성 코드(점유 여부, 활동 번호, 이용 우선순위 등)를 나타냅니다. 이러한 구조를 통해 스케줄링 시스템은 어느 시점에서든 리소스 구성을 읽을 수 있으며, 서로 다른 리소스 상태 유형의 통합된 표현을 보장합니다.
작업 정보가 모델에 연결되면, 활동 우선순위와 리소스 사용 기간을 바탕으로 작업 강도 벡터가 설정됩니다. 충돌을 일으킬 수 있는 작업 조합은 시간 윈도우 중첩 탐지 방법을 통해 표시됩니다. 충돌 조합은 노드 집합으로 변환되며, 암시적 의존성을 명시적으로 나타내기 위해 공유 리소스 유형과 기간을 기반으로 엣지 집합이 구축됩니다. 최종적으로 구축된 작업 그래프에는 시간 순서, 리소스 중첩 또는 제약 충돌에 대한 경계 정보가 포함되어, 후속 충돌 탐지 및 스케줄링 전략 생성을 위한 구조적 기반을 제공합니다. 이 구조는 작업 스케줄링의 동적인 특성과 리소스 상태의 지속적인 변화를 유지하며, 스케줄링 제약 조건의 변경 사항을 실시간으로 인식할 수 있도록 지원합니다.
충돌 검출은 텐서 구조 내 시간 및 리소스 차원의 희소한 중첩 영역을 판단의 초기 조건으로 사용합니다. 이는 스케줄링 대상이 중첩되는 태스크 쌍에 대해 정적 관계 인코딩 처리를 수행합니다. 또한 그래프 구조 G=(V,E,C)를 구축하며, 여기서 V는 활성 노드 집합을, E는 리소스 충돌을 기반으로 생성된 엣지를, C는 엣지에 대한 충돌 가중치 인코딩 행렬을 나타냅니다. 충돌 가중치 함수는 다음과 같은 형태로 정의됩니다:
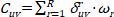 (1)
여기서 Cuv는 활동 u와 v 사이의 충돌 가중치이며, u와 v는 활동 인덱스입니다. R은 총 자원 유형의 수이고, δuvr ∈ {0,1}은 자원 r에서 활동 u와 v의 시간 창(time window)이 겹치는지 여부를 나타내며, ωr는 자원 r의 충돌 민감도 가중치입니다. 이 함수는 충돌 강도의 분포에 대한 정량적 표현을 유지하면서, 스케줄링 결과에 따른 자원 충돌의 중요도 차이를 고려하여 충돌 강도의 가중 합을 수행합니다.
위의 충돌 그래프 구조는 희소 행렬 표현을 통해 제약 경계 행렬로 변환됩니다. 행렬의 각 항목은 리소스 충돌 정도를 포함합니다. 이 행렬은 태스크를 병렬로 스케줄링할 수 있는지 결정하기 위해 스케줄링 결정 프로세스에 내장되며, 액션 쉴딩 로직은 정책 네트워크에 위치합니다. 주기적인 활동 집계와 고밀도 태스크 버스트에 대응하기 위해, 태스크 상태의 변화를 모니터링하고 리소스가 해제되거나 추가됨에 따라 행렬 내용을 실시간으로 수정하는 동적 업데이트 메커니즘이 구현되어, 태스크 진화 과정 전반에서 스케줄링 경계의 연속성과 일관성을 보장합니다.
이러한 충돌 그래프 구조를 적용하면 스케줄링 시스템이 잠재적인 리소스 병목 현상과 작업 중첩 패턴을 시각적으로 모델링할 수 있으며, 이를 통해 복잡한 제약 시나리오에 대한 결정 네트워크의 디커플링 분석 효율성을 향상시킬 수 있습니다. 스케줄링 동작은 더 이상 규칙 기반의 논리적 매칭에 의존하지 않습니다. 대신, 제약 공간 내에서 최적의 경로를 탐색함으로써 로컬 리소스 충돌과 글로벌 작업 맵 간의 동적 균형을 맞추는 능력을 강화합니다. 시스템은 리소스가 변동하고 작업이 빈번하게 추가 또는 제거되는 환경에서도 스케줄링 안정성과 작업 일관성을 유지할 수 있습니다.
그림 2는 작업 충돌 가중치 관계를 기반으로 한 네트워크 구조도를 보여줍니다. 그림의 각 노드는 스케줄링 대상 작업을 나타내며, 노드 사이의 선은 리소스 사용 충돌을 나타냅니다. 에지의 두께는 충돌의 가중치를 반영합니다. 충돌이 심각할수록 선이 더 두껍게 표시됩니다. 가중치 계산은 리소스 중첩을 통합하고 다양한 리소스의 충돌 민감도를 결합하여 작업 간의 복합 충돌 강도를 형성합니다. 그래프 구조를 통해 일부 작업이 조밀하게 연결된 영역을 형성함을 알 수 있으며, 이는 리소스 활용에 대한 상당한 경쟁이 있음을 나타냅니다. 이러한 유형의 국소적 충돌 응집 현상은 스케줄링 과정에서 리소스 병목 현상과 작업 지연의 주요 원인이 되며, 스케줄링 알고리즘은 이에 따라 우선순위 조정 목표를 설정할 수 있습니다. 노드 배치는 힘 지향 레이아웃(force-directed layout) 전략을 사용하여 충돌이 심한 작업을 자동으로 응집시키며, 이를 통해 스케줄링 시스템이 주요 작업 그룹을 식별하고 전략 분배를 최적화함으로써 전반적인 스케줄링 일관성과 리소스 조율을 향상시킬 수 있습니다.
과거 상태 시퀀스 인코딩
구축된 충돌 그래프와 제약 행렬을 바탕으로 다음 단계는 활동 및 자원 상태의 과거 시퀀스를 인코딩하는 것이며, 이를 통해 이후의 의사결정을 위해 이러한 제약 조건의 기초가 되는 시간적 패턴을 추출할 수 있습니다. 스케줄링 시나리오의 핵심 정보는 활동 요청, 자원 상태 변경 및 작업 피드백 기록으로 구성됩니다. 이 정보는 이벤트 시점, 자원 사용 식별자, 활동 실행 상태와 같은 속성에 해당하는 다수의 이종 시계열을 구성합니다. 처리 구조를 통일하기 위해 각 입력 유형은 동일한 길이의 벡터 시퀀스로 인코딩되며, 시간 동기화 하에 상태 정렬을 보장하기 위해 통일된 시간 인덱스가 설정됩니다. 각 시점의 입력 단위는 세 가지 특징 벡터 집합의 연결(concatenation)로 표현됩니다. 활동 특징 벡터는 작업 유형, 우선순위 및 단계 번호를 나타내며, 자원 특징 벡터는 현재 자원 점유 상태, 잔여 용량 및 가용 윈도우 위치를 기록하고, 피드백 특징 벡터는 이전 시점에 작업이 원활하게 실행되었는지 여부와 자원 충돌 또는 지연 이벤트 발생 여부를 설명합니다.
모든 특성은 선형 변환되어 동일한 차원 공간으로 매핑됨으로써 표준화된 임베딩 행렬 X ∈ ℝT×d를 얻으며, 여기서 T는 타임 스텝의 수를, d는 통합 임베딩 차원을 나타냅니다. 시간적 구조를 보존하기 위해, 입력 행렬은 위치 인코딩 행렬 P에 요소별로 더해져 위치 인식 입력(position-aware input)을 형성합니다.
Z = X + P (2)
Z는 최종 입력 시퀀스로, 이후의 어텐션 메커니즘의 입력으로 사용됩니다. 위치 인코딩 설계는 고정된 사인 및 코사인 함수 템플릿을 사용하여 미래 정보의 누출을 방지하고, 인코딩 중에 인과적 제약 조건이 엄격하게 충족되도록 합니다. 위의 구조를 통해 모델은 작업 특성, 리소스 상태 및 시간적 위치를 동시에 인식할 수 있습니다. 이는 완전한 상태 메모리 기반을 갖추고 있어, 이후의 어텐션 메커니즘을 위한 고해상도의 통합된 구조를 제공합니다.
어텐션 모듈은 입력 시퀀스를 처리하여 여러 타임 스텝 간의 잠재적 관계를 포착합니다. 시퀀스를 개별적으로 처리하기 위해 여러 그룹의 어텐션 헤드가 사용되며, 이를 통해 다양한 유형의 상태 진화 경로에 대한 모델의 민감도를 높입니다. 각 어텐션 헤드는 입력 시퀀스로부터 쿼리 행렬 Q, 키 행렬 K, 밸류 행렬 V를 생성하고, 가중치 분포 행렬을 계산하여 가중 표현을 생성합니다. 단일 헤드 어텐션의 출력은 다음과 같습니다:
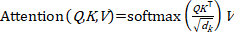 (3)
제공해주신 텍스트가 없습니다. 번역할 내용을 입력해 주세요.k 는 헤드당 특성 차원의 수입니다. 이 공식에서, QK⊤ 모멘트 간의 유사도를 나타내며, √dk 수치적 안정성을 위해 사용되며, softmax 함수는 가중치 정규화를 보장합니다. 서로 다른 어텐션 헤드는 타임 스텝의 서로 다른 조합에 집중하며, 이를 통해 포착하는 동적 의존성 또한 다양하여 작업 충돌의 전조, 자원 소비 패턴 및 비정상적인 피드백 추세와 같은 암시적 규칙을 드러내는 데 도움을 줍니다.
모든 어텐션 헤드 출력은 연결되어 선형 변환 층을 통과함으로써 통합 코딩 시퀀스를 생성하며, 이는 스케줄링 전략 생성 네트워크의 상태 입력으로 사용됩니다. 이 시퀀스는 현재 스케줄링 윈도우 내의 태스크 동작 궤적, 리소스 변경 특성 및 이전 실행 편차의 영향을 임베딩하여, 스케줄링 동작의 높은 이력 의존성 문제와 희소한 특징 표현 문제를 효과적으로 해결합니다. 딥 네트워크의 학습 안정성과 표현 유지 능력을 향상시키기 위해 인코딩 출력 층에 잔차 연결 및 층 정규화 모듈이 포함되었습니다.
출력 은닉 상태 시퀀스는 시간 진화 정보를 유지할 뿐만 아니라, 갑작스러운 작업이나 일시적인 리소스 불일치로 인해 발생하는 변화에 대응하여 강력한 적응력을 보여줍니다. 이러한 구조적 설계는 명시적인 규칙 정의를 피하고, 동적 스케줄링 환경의 구조적 모델링을 가능하게 하며, 다중 목적 조건 하에서 전역적 일관성과 지역적 적응성을 갖춘 스케줄링 솔루션을 생성하도록 후속 정책 모듈을 지원합니다.
동적 스케줄링 전략 생성
시간적 의존성과 리소스 충돌 정보를 모두 내포하고 있는 인코딩된 은닉 상태 시퀀스는 이후 정책 네트워크로 전달되어 현재 환경에 적응하는 스케줄링 동작을 생성합니다. 인코딩 모듈에서 출력된 은닉 상태 시퀀스는 스케줄링 전략 네트워크의 입력으로 사용됩니다. 각 시점의 상태 벡터 세트는 태스크 특성의 진화, 리소스 사용 추세 및 과거 피드백 궤적을 포괄하며, 이는 현재 환경 관찰 표현을 구성합니다. 상태 표현 차원과 시간 창 길이는 고정되며, 상태 변화의 연속성은 슬라이딩 업데이트 메커니즘을 통해 캡처됩니다. 상태 벡터가 정책 네트워크로 전송되기 전에 정규화 및 특징 재구성이 수행되어, 입력값이 고차원 공간에서 안정적인 수치 분포를 유지함으로써 그래디언트 폭주와 수렴 변동을 줄이도록 합니다.
정책 네트워크 구조는 듀얼 브랜치 출력 모듈을 사용하며, 여기서 한 브런치는 행동 분포를 생성하고 다른 브런치는 상태 가치 함수 추정치를 출력합니다. 행동 공간은 모든 스케줄링 가능 작업과 할당 가능 리소스로 구성됩니다. 후보 스크리닝 메커니즘은 불법적이거나 중복된 작업 조합을 필터링하여 제한된 합법적 행동 세트를 형성합니다. 정책 브런치는 확률 분포 π(at|st)를 출력하며, 여기서 at는 해당 타임 스텝에서의 스케줄링 행동을, st는 현재 상태 입력을 나타냅니다. 실제 스케줄링을 위해 분포에서 행동을 선택하는 과정에는 표준화된 가우시안 샘플링 또는 소프트맥스 샘플링 전략이 사용됩니다. 다른 출력은 상태 가치 함수 추정치로, 이는 주어진 상태에서의 장기적 보상 기댓값을 나타내며 정책 평가 및 업데이트에 사용됩니다.
정책 네트워크의 은닉층에서는 비선형 표현력을 향상시키고 네트워크 수렴을 가속화하기 위해 활성화 함수와 배치 정규화를 적용합니다. 의사 결정 과정에서는 서로 다른 태스크의 실행 우선순위, 리소스 스케줄링 비용, 과거 성능을 어텐션 요소로 고려하며, 이를 특정 가중치 행렬을 통해 행동 선택 메커니즘에 적용하여 적응적으로 조정 가능한 정책 출력 프레임워크를 구성합니다. 이러한 설계는 고정된 규칙에 의존하는 것을 방지함으로써, 갑작스러운 충돌 및 구조적 병목 현상을 처리하는 전략의 유연성을 강화합니다.
스케줄링 전략은 무작위 샘플링 메커니즘을 사용하여 실제 액션 시퀀스를 생성합니다. 각 스케줄링 주기마다 현재 액션 분포에서 실행 가능한 액션을 샘플링하며, 리소스 상태와 태스크 노드 마크가 업데이트됩니다. 액션이 실행된 후, 시스템은 리소스 변경 사항과 태스크 진행 결과에 기반하여 즉각적인 피드백 보상을 계산함으로써 이번 라운드의 스케줄링이 전체 목표에 미친 영향을 측정합니다. 보상 설계는 태스크 완료율, 리소스 활용 효율성, 충돌 억제 정도를 포함한 다차원적인 측면을 고려합니다. 이는 종합적인 지표를 통해 전략 업데이트 모듈에 피드백을 제공합니다.
전체 스케줄링 프로세스는 마르코프 결정 체인을 구축하고 경험적 궤적 샘플링 방법을 사용하여 (st, at, rt, st+1)로 표시되는 상태-행동-보상 시퀀스를 기록합니다. 전략 최적화는 어드밴티지 함수(advantage function)의 구축에 의존하며, 여기서 어드밴티지 추정치는 다음과 같은 형태로 정의됩니다:
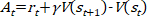 (4)
At는 이점(advantage) 값을 나타내며, rt는 현재 시점의 보상, γ는 보상 할인 계수, 그리고 V(st)와 V(st+1)는 각각 현재 상태와 다음 상태에서의 상태 가치 함수 출력값입니다. 이점 함수는 전략의 평균 성능 대비 현재 행동의 우월성을 반영합니다. 이는 후속 전략 개선을 안내하는 데 사용됩니다. 만약 At > 0이라면, 이는 현재의 행동이 평균적인 기대치보다 더 낫다는 것을 의미하며 해당 행동의 확률을 높여야 합니다. 반대의 경우에는 선택 경향을 낮추어야 합니다.
전략 업데이트 과정에서 과도한 업데이트 진폭으로 인한 전략 진동을 방지하기 위해, 타겟 분포 절단 메커니즘을 적용하여 신규 전략과 기존 전략 간의 변화 범위를 제한함으로써 네트워크 출력의 연속성과 안정성을 유지합니다. 행동 분포와 피드백 보상 사이에 긴밀한 결합을 구축하여, 전략이 복잡한 제약 조건의 변화에 즉각적으로 대응할 수 있도록 합니다. 이 메커니즘은 작업이 빈번하게 변경되거나 자원이 갑자기 불일치하는 상황에서도 의사결정의 안정성과 합리적인 자원 스케줄링을 유지하며, 중복 할당, 자원 혼잡 또는 작업 큐 적체와 같은 문제를 효과적으로 방지합니다. 스케줄링 시스템은 다양한 작업 밀도와 자원 부족 상황에서도 더 나은 작동 상태를 유지할 수 있으며, 강력한 적응 능력을 보여줍니다.
전략 반복 및 안정적 업데이트 메커니즘
생성된 스케줄링 전략이 안정적으로 유지되고 반복적인 학습 라운드 동안 성능이 저하되지 않도록 하기 위해, 본 하위 섹션에서는 클리핑(clipping) 및 어드밴티지 보정(advantage correction)이 포함된 반복적 업데이트 메커니즘을 도입합니다. 이전 전략과 새 전략 사이의 절단 업데이트 간격을 설정하고, 클리핑 목적 함수를 사용하여 전략 드리프트를 제한함으로써 전략 업데이트 과정 중의 스케줄링 충격을 방지합니다. 가치 네트워크는 어드밴티지 함수와 결합하여 보정되며, 이를 통해 장기 스케줄링의 정확도를 향상시킵니다.
정책 네트워크의 행동 출력 확률 분포는 연속적인 스케줄링 반복 과정에서 급격한 변동이 발생하기 쉬우며, 이는 불안정한 동작이나 무질서한 자원 할당으로 이어질 수 있습니다. 정책 드리프트로 인한 스케줄링 충격을 완화하기 위해, 새로운 정책과 기존 정책 간의 변화 범위를 제어하도록 절단 업데이트 간격을 설계하고, 목적 함수를 정밀하게 조정하기 위한 제한 항을 구축합니다. 샘플링 라운드에서 과거 정책 확률을 기록하고, 현재 정책 확률을 이용해 비율 항을 구성합니다. 정책 업데이트 목표는 다음과 같이 설정합니다:
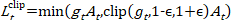 (5)
여기서 gt = πθ(at|st)/πθold(at|st)는 새로운 정책과 이전 정책 간의 확률 비율을 나타내며, ε는 정책 업데이트 범위를 제한하는 클리핑 임계값입니다. 비율이 경계를 초과하면 클리핑 값이 대신 사용되어, 전략이 극단적인 샘플로부터 과도한 그래디언트를 생성하는 것을 방지하고 네트워크 매개변수 조정이 미리 설정된 범위 내에서 유지되도록 합니다. 이러한 구조는 각 스케줄링 라운드에서 출력 전략의 변경 범위를 동적으로 제한하여, 조밀한 작업 분포 하에서 전략 출력의 매끄러움과 일관성을 유지하고 스케줄링 동작의 지터율(jitter rate)을 크게 감소시킵니다.
정책 목적 함수는 업데이트 과정에서 행동 분포의 다양성을 높이고 조기 수렴을 억제하기 위해 정규화 및 엔트로피 보상 항으로 보강됩니다. 매 정책 업데이트 회차마다 여러 배치의 경험 궤적 샘플을 사용하여 롤링 학습을 수행함으로써 상태 공간의 커버리지 범위를 넓게 유지합니다. 업데이트 전후의 출력 행동 시퀀스 확률 분포를 비교하여 분포의 편차율을 계산하며, 하드 임계값을 통해 정책의 허용 가능한 교란 범위를 선별합니다. 이러한 메커니즘은 사이클 간 스케줄링 정책 마이그레이션을 위한 경계 제어를 제공하여, 리소스 상태의 급격한 변화로 인한 과적합을 억제합니다.
전략 업데이트는 가치 함수에 의해 제공되는 상태 평가에 의존합니다. 상태 가치 추정의 편차는 어드밴티지 함수의 정확성에 직접적인 영향을 미쳐 전략 반복의 방향을 바꿀 수 있습니다. 가치 평가의 정확도를 높이기 위해 다중 시계열 백트래킹 메커니즘을 구축하고, 미래 보상의 할인 누적 가치를 사용하여 현재 상태 가치를 보정합니다. 백트래킹 보상은 다음과 같이 정의되는 일반화된 어드밴티지 추정(GAE) 구조를 채택합니다:
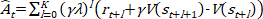 (6)
Ât는 보정된 이점 값이며, λ는 백트래킹 균형 계수이다. rt+l는 (t+l)번째 단계의 즉각적 보상을 나타내고, V(st+l)는 가치 평가 네트워크에서 출력된 상태 값이다. 이러한 구조는 단기적인 즉각적 피드백과 장기적인 상태 기대치를 통합하여, 향후 리소스 충돌, 피크 부하 및 작업 누적에 대한 전략의 응답 예측 편차를 보정한다. λ는 백트래킹 깊이를 조절하며, 급격한 리소스 동적 변동 기간 동안 자동으로 조정되어 갑작스러운 이벤트에 대한 가치 평가 네트워크의 응답 강건성을 향상시킨다.
이점 함수(advantage function)에 내장된 다중 규모 시계열 구조를 통해 가치 네트워크가 장기적인 자원 추세를 모델링할 수 있습니다. 정책 출력 편차를 감지할 때는 정책 행동 일관성 지표를 사용하여 네트워크가 가치 오차에 대해 과도하게 반응하는지 평가합니다. 피드백 차이 잔차 항은 정책 업데이트 동작을 모니터링하며, 훈련 목표와 가치 함수의 가중치 업데이트 진폭을 동적으로 보정합니다. 가치 네트워크와 정책 네트워크를 공동으로 최적화하여, 고주파 스케줄링으로 인해 자원 충돌 상태를 오판하는 것을 방지하는 동시에 가치 추정치가 작업 완료 목표에서 벗어나지 않도록 보장합니다.
이러한 안정적인 정책 업데이트 메커니즘은 고차원 동적 작업 환경에서 정책 동작 업데이트의 제어 가능성과 일관성을 효과적으로 유지하여, 작업 커버리지 효율성과 리소스 활용 유연성을 향상시키고 지속적으로 반복되는 지능형 스케줄링 구조를 형성할 수 있습니다. 스케줄링 동작은 장기적인 진화 과정에서 지역 최적점(local optimality)에 빠지는 것을 방지하며, 작업 패턴의 변화와 리소스 사이클의 변동에 대한 전반적인 적응력을 강화합니다.
그림 3A는 서로 다른 절단 임계값 조건에서 훈련 반복 횟수에 따른 목적 함수 값의 추세를 보여줍니다. 가로축은 훈련 반복 횟수이며, 세로축은 클리핑된 목적 함수의 수치입니다. ε은 0.1, 0.2, 0.3으로 설정되어 서로 다른 수준의 정책 드리프트 제어 강도를 나타냅니다. ε 값이 작을수록 곡선의 변동이 적으며, 목적 함수가 안정적으로 유지됩니다. ε = 0.1일 때, 전체적인 목적 함수 값은 0.8에서 1 사이로 나타나며, 이는 전략 업데이트의 점진성과 안정성을 보여줍니다. 반면, ε 값이 클수록 변동이 뚜렷해집니다. ε = 0.3일 때, 전체적인 목적 함수 값은 0.65에서 0.95 사이이며, 목적 함수 곡선은 더 큰 진폭의 진동을 보여 전략 업데이트 과정에서 심각한 편차가 발생할 위험이 있음을 반영합니다. 임계값이 작을수록 전략이 더 안정적이며, 이는 제약 조건이 많은 스케줄링 환경에 적합합니다. 그림 3B는 서로 다른 백트래킹 균형 계수 하에서의 일반화된 어드밴티지 추정치(GAE) 변화를 보여줍니다. 미래 보상의 백트래킹 깊이를 제어하기 위해 λ을 각각 0.8, 0.9, 1.0으로 설정하였습니다. 곡선을 통해 λ가 높을수록 GAE 변동이 적고 장기적인 추세가 더 매끄러우며, 여러 단계 이후의 스케줄링 동작이 미치는 잠재적 영향을 더 정확하게 포착함을 알 수 있습니다. λ가 0.8인 곡선은 뚜렷한 주기적 변동을 보이며, 이는 즉각적인 보상에 더 민감하여 단기적이고 갑작스러운 작업에 더 적합함을 나타냅니다. 반대로, λ가 1.0인 경우 장기적인 추세 모델링에 더 집중하며 주기적인 작업 시나리오에 적합합니다.
계산 복잡도 및 확장성 분석
제안된 Transformer-PPO 프레임워크의 계산 복잡도는 Transformer 인코더와 PPO 정책 최적화라는 두 가지 주요 구성 요소에 의해 결정됩니다.
다음과 같은 Transformer 인코더에 대하여 L 층, H 어텐션 헤드, 임베딩 차원 d, 및 입력 시퀀스 길이 T (과거 시간 창), 순전파 1회당 시간 복잡도는 O(L·T2·d + L·T·d2), 여기서 T2 이 용어는 셀프 어텐션(self-attention) 메커니즘에서 비롯됩니다. 구현 시, L = 3, H = 4, 입력된 텍스트가 없습니다. 번역할 내용을 제공해 주시기 바랍니다. = 128이며, T 100개 시간 단계로 고정되어 계산 오버헤드를 관리 가능한 수준으로 유지합니다. 더 긴 과거 윈도우의 경우, 이차항은 T2 지배적인 요인이 됩니다. 하지만 실제로 노동조합 활동 일정 계획은 일반적으로 유한한 과거 기간(예: 1분기 또는 1년의 롤링 윈도우)을 포함하며, 정확성과 효율성의 균형을 맞추기 위해 시간 단계 해상도를 조정할 수 있습니다.
PPO 구성 요소의 경우, 정책 네트워크(policy network)와 가치 네트워크(value network)는 경량 MLP(은닉층당 256 및 128개 뉴런)이며, 추론 복잡도는 O(d·m)입니다. 여기서 m은 은닉 유닛의 수로, 이는 Transformer 인코더에 비해 무시할 수 있는 수준입니다. 학습 중 정책 업데이트는 여러 에포크의 미니 배치 경사 업데이트를 포함하며, 복잡도는 O(B·E·d2)입니다. 여기서 B는 배치 크기이고, E는 업데이트 에포크 횟수입니다.
확장성 측면에서, 본 프레임워크는 세 가지 유리한 특성을 보입니다. 첫째, 어텐션 메커니즘은 타임 스텝 전반에 걸쳐 병렬화가 가능하여 효율적인 GPU 가속을 지원합니다. 둘째, 제약 행렬이 고정된 파라미터로 내장되는 것이 아니라 스케줄링 단계별로 동적으로 구성되므로, 모델 크기가 활동이나 리소스의 수와 무관합니다. 이를 통해 동일하게 학습된 모델을 재학습 없이 서로 다른 규모의 연합(unions)에 배치할 수 있습니다. 셋째, 극도로 대규모인 시나리오의 경우, 트레이드오프를 통해 과거 윈도우 길이 T와 임베딩 차원 d를 줄이거나, 희소 어텐션(sparse attention) 변형 모델을 채택하여 O(T2) 복잡도를 O(T log T) 또는 O(T)로 낮출 수 있습니다.
결과
실험 데이터
본 논문에서 제시한 Transformer-PPO 동적 스케줄링 알고리즘의 성능을 종합적으로 평가하기 위해, 본 실험에서는 최근 3년간의 대규모 기업 노조 활동 관리 데이터를 벤치마크 데이터셋으로 사용하였다. 이 데이터셋은 회의, 교육, 오락 등 다양한 유형의 활동 기록 5,000건 이상을 포함하고 있으며, 장소, 장비, 인력과 같은 다중 리소스에 대한 스케줄링 정보를 담고 있다. 각 기록에는 활동의 시작 및 종료 시간, 리소스 요구 사항, 우선순위, 실제 실행 상태(충돌 이벤트 및 리소스 활용도 포함)가 상세히 기록되어 있다. 실제 시나리오의 동적 변화를 모사하기 위해, 데이터에 10%의 무작위 버스트 태스크와 리소스 변경 이벤트(임시 장소 점유 및 인력 시간 윈도우 조정 등)를 추가로 증강하여 매우 불확실한 환경에서 알고리즘의 강건성을 검증하였다. 연속적인 상태 시퀀스는 Transformer 타이밍 모델링과 PPO 정책 학습을 위한 구조화된 입력을 제공한다. 실험에서는 평가 범위가 실제 응용 분야의 전형적인 시나리오를 포괄하도록 서로 다른 태스크 밀도와 복잡도 하에서 스케줄링 성능을 비교하였으며, 현재 널리 쓰이는 LSTM-PPO 모델, 그리디 탐색 스케줄링 모델, 그리고 DQN 정책 스케줄링 모델과 성능을 비교하였다.
Transformer 인코더는 3개의 층으로 구성되며, 각 층은 4개의 어텐션 헤드, 128의 임베딩 차원, 그리고 256의 피드포워드 은닉층 크기를 갖습니다. 정책 네트워크와 가치 네트워크는 동일한 Transformer 출력을 입력으로 공유한 후, 두 개의 별도 다층 퍼셉트론(MLP)으로 분기됩니다. 각 MLP는 ReLU 활성화 함수를 사용하며, 각각 256개와 128개의 뉴런을 가진 두 개의 은닉층으로 구성됩니다. 모든 선형 층은 Xavier 균등 초기화 방식을 사용하여 초기화되었습니다.
옵티마이저는 Adam을 사용하며 학습률은 3 × 10⁻⁴, 배치 크기는 64, 엔트로피 계수는 0.01로 설정합니다. PPO 클리핑 파라미터 ε은 0.2, 할인 계수 γ = 0.99, GAE λ = 0.95로 설정합니다. 모델은 5,000 에피소드 동안 학습하며, 각 에피소드는 최대 100회의 스케줄링 단계로 구성됩니다. 그래디언트 폭주를 방지하기 위해 최대 노름 0.5의 그래디언트 클리핑을 적용합니다. 이러한 파라미터들은 사전 그리드 탐색을 통해 선택되었으며, 강화 학습 기반 스케줄링 작업의 일반적인 관행과 일치합니다. 모든 실험은 Python 3.9와 딥러닝 프레임워크를 사용하여 단일 GPU 가속기(40 GB 메모리)에서 수행되었습니다(재료 표 참조).
멀티헤드 어텐션 출력의 시간적 추세, 인코딩 특징의 시간적 변화에 따른 잔차 강화 및 작업 우선순위 계층화
실제 스케줄링 이력을 입력값으로 사용하여 연속적인 시간 단계에서 작업 요청, 리소스 사용 상태 및 피드백 실행 상태를 추출하며, 선형 매핑과 위치 인코딩을 통해 다중 유형의 정보를 통합된 특징 공간에 임베딩합니다. 멀티헤드 어텐션 메커니즘은 서로 다른 특징 시퀀스 간의 시간적 상관관계를 병렬로 계산하여 작업, 리소스, 피드백의 세 가지 유형의 어텐션 가중치 시퀀스를 생성합니다. 각 가중치 유형은 각 시간 단계에서 해당 상태에 대한 모델의 어텐션 강도를 나타냅니다. 정규화 후 추세 곡선을 그려 스케줄링 이력 내 서로 다른 정보 차원에 대한 인코딩 층의 인지 초점과 동적 변화 구조를 반영합니다. 이 프로세스는 스케줄링 시나리오의 실제 액티비티 실행 궤적과 리소스 사용 로그를 기반으로 완료됩니다.
그림 4는 연합 활동 스케줄링에서 다양한 상태 정보에 대한 멀티헤드 어텐션 메커니즘의 동적 어텐션 추세를 보여줍니다. 가로축은 시간 단계로 스케줄링 시퀀스의 지속적인 진행을 나타내며, 세로축은 [0,1] 범위로 제한된 정규화된 어텐션 가중치로, 작업 특성, 리소스 상태 및 피드백 상태에 대한 모델의 상대적 중요도를 나타냅니다. 작업 특성에 대한 어텐션은 15단계 부근에서 뚜렷한 정점을 보입니다. 스케줄링 초기 단계에서 모델은 잠재적 충돌과 리소스 병목 현상을 예측하기 위해 핵심 작업의 타이밍 특성을 캡처하는 것을 우선시하며, 이는 활동 스케줄링의 이 단계에서 위험에 대한 민감도를 반영합니다. 리소스 상태에 대한 어텐션 곡선은 주기적인 변동을 보이며, 전체 어텐션 가중치는 0.2에서 0.8 사이로 나타납니다. 이는 스케줄링 시스템이 리소스 점유 변경 사항을 지속적으로 추적하여 리소스 공유 및 할당의 복잡한 처리를 지원하고, 여러 동시 작업 간의 동적인 리소스 경쟁에 효과적으로 대응하고 있음을 반영합니다. 피드백 상태에 대한 어텐션은 점진적으로 증가하며 가중치 정점은 35단계 부근에서 나타나는데, 이는 스케줄링 중후반 단계에서 실행 결과 및 이상 상태에 대한 피드백에 모델이 주목하고 있음을 강조하며, 이는 스케줄링 편차를 처리하기 위한 전략을 조정하고 전체 스케줄링의 강건성을 향상시키는 데 도움이 됩니다. 이러한 추세는 멀티헤드 어텐션 메커니즘을 통합한 인코딩 구조가 시간적 특징의 미세한 변화를 포착하고, 다양한 리소스와 복잡한 작업 의존성에 대한 스케줄링 전략의 적응성을 높여 결과적으로 연합 활동의 동적 스케줄링에 대한 전반적인 효율성과 안정성을 향상시킬 수 있음을 보여줍니다.
은닉 상태 인코딩 시퀀스와 태스크 특성 응답 구조가 처리됩니다. 상태 비교 부분은 동일한 입력 조건 하에서 잔차 연결 전후의 특성 전파 경로를 구축하고, 연속적인 시간 단계에 걸친 은닉 상태의 시간적 진화를 관찰하며, 국소적 안정성과 전역적 연속성 특성을 추출하여 정보 전달 중 상태 표현의 매끄러운 진화를 분석합니다. 태스크 우선순위 응답 경향은 서로 다른 스케줄링 가중치 전략에 따른 특성 활성화 경로로부터 추출됩니다. 시간에 따른 서로 다른 태스크 범주의 활성화 수준을 추적함으로써, 태스크 차별화 능력에 대한 모델의 동적 조정 효과를 포착합니다.
그림 5A는 잔차 연결 메커니즘 적용 전후의 모델 은닉 상태 추세를 보여줍니다. 가로축은 시간 단계이며, 세로축은 은닉 상태 값입니다. 잔차 연결이 없는 기존 출력은 크게 변동하며, 뚜렷한 국소적 불안정성과 추세 단절을 보입니다. 파란색 실선은 잔차 구조를 적용한 후의 상태 값을 나타냅니다. 전반적인 추세가 안정적으로 유지되고 변동이 현저히 감소하였으며, 이는 모델이 상태 전파 과정에서 그래디언트 버퍼링과 특징 강화를 달성했음을 나타냅니다. 이러한 현상은 장기 의존 구조의 안정성을 향상시키고, 심층 레이어에 의한 정보 감쇠를 효과적으로 억제하며, 과거 상태 시퀀스의 연속적인 표현 능력을 강화하는 잔차 메커니즘의 역할을 검증합니다. 그림 5B는 시계열 내 세 가지 유형 작업의 특징 활성화 역학을 묘사합니다. 가로축은 시간 단계이며, 세로축은 특징 활성화 값으로, 서로 다른 우선순위 수준에 따른 작업의 시간 민감도와 전략적 주의 집중도를 반영합니다. 낮은 우선순위 작업은 감쇠 추세를 보이며 후반부에는 특징 활성화 값이 0.5 미만으로 떨어지는데, 이는 모델이 스케줄링 초기 단계에서는 적절한 주의를 기울이다가 시간이 지남에 따라 자원 응답을 점진적으로 약화시킴을 나타냅니다. 중간 우선순위 작업의 특성은 시간이 지남에 따라 서서히 증가하며 주기적인 진동이 나타나는데, 이는 모델이 해당 수요 변동을 유연하게 인지하고 추적하고 있음을 반영합니다. 높은 우선순위 작업은 시간이 지나도 지속적인 상승 추세를 유지하며, 특징 활성화 값이 항상 2 이상으로 높고 안정적인 활성화 수준을 보이는데, 이는 모델이 이러한 작업에 대해 항상 높은 수준의 응답성을 유지하고 있음을 나타냅니다. 이러한 차별적 응답은 상태 인코딩 모듈이 작업 속성을 정확하게 식별하는 능력을 갖추었음을 입증하며, 스케줄링 전략 생성 시 의사결정을 위한 계층적 근거를 제공합니다.
Transformer-PPO 동적 스케줄링 알고리즘의 다차원 성능 진화 분석
과거 스케줄링 시퀀스와 리소스 상태의 Transformer 인코딩을 기반으로 시공간적 특징을 추출하여 PPO의 상태 입력으로 사용합니다. 이후 정책 네트워크가 스케줄링 동작을 출력하면, 환경이 즉각적인 보상을 피드백하고 상태를 업데이트합니다. 학습 과정 동안 각 라운드의 원래 지표를 기록한 뒤, 슬라이딩 평균 필터링을 통해 노이즈를 제거하여 알고리즘의 수렴 경향을 분석합니다. 최종 시각화에서 원본 데이터는 순간적인 동역학을 보여주며, 매끄러운 곡선은 장기적인 성능 향상을 반영함으로써, 본 모델이 시계열 모델링과 정책 최적화를 통해 안정적인 스케줄링을 달성함을 입증합니다.
그림 6A,B는 Transformer-PPO 동적 스케줄링 알고리즘의 다차원 성능 진화 분석을 보여줍니다. 원본 데이터의 변동은 스케줄링 과정에서의 순간적인 노이즈를 반영하는 반면, 평활화된 데이터는 슬라이딩 평균을 통해 장기적인 추세를 추출하여 알고리즘 성능 평가에 대한 단기적 교란의 간섭을 제거하고 성능 진화를 더 쉽게 관찰할 수 있게 합니다. 평활화된 데이터를 분석하면, 보상과 정책 엔트로피 사이의 동적 관계에서 보상 곡선이 로그 성장을 보이며 정책이 탐색을 통해 효과적으로 액션을 스케줄링하는 방법을 빠르게 학습함을 알 수 있습니다. 성장세는 후반부에 평탄해지는 경향이 있으며, 보상의 포화 값은 약 12에서 안정화되어 정책이 지역 최적값에 근접했음을 나타냅니다. 정책 엔트로피는 초기의 약 2.2에서 약 0.6까지 점진적으로 감소합니다. PPO는 엔트로피 보상 항목을 통해 필요한 탐색 능력을 유지합니다. 초기 단계의 높은 탐색(높은 엔트로피)은 보상의 급격한 증가를 촉진하며, 이후의 전략은 가지치기와 업데이트를 통해 탐색과 활용의 균형을 맞춥니다. 충돌률과 자원 이용률의 협동 최적화를 보면, 충돌률이 10% 미만 수준으로 떨어지며, 그 하한선은 작업의 무작위성으로 인해 실제 시스템에서 제거할 수 없는 충돌을 반영합니다. 이러한 하향 추세는 과거 활동 시퀀스를 인코딩하는 Transformer의 능력 덕분이며, 이를 통해 모델이 자원 경합을 선제적으로 예측할 수 있게 됩니다. 자원 이용률은 한계 효용 체감의 법칙에 따라 거의 75%까지 증가했습니다. 과도한 이용률은 큐잉 지연을 유발할 수 있으므로 이용률이 더 높은 수준에 도달하지 않은 것은 합리적입니다. 충돌 감소로 인해 더 많은 가용 자원이 확보되었으며, 최적화된 자원 할당이 충돌을 더욱 억제했습니다.
응답 속도 및 의사결정 효율성 평가
다양한 작업 밀도(작업 수: 100, 300, 500, 700, 1000)에서의 평균 결정 시간과 평균 응답 지연 시간을 비교합니다. 본 논문의 Transformer-PPO 스케줄링 모델을 LSTM-PPO 모델, 그리디 서치(greedy search) 스케줄링 모델 및 DQN 전략 스케줄링 모델과 비교합니다.
그림 7A,B는 서로 다른 작업 밀도 조건에서 네 가지 스케줄링 전략의 평균 결정 시간과 평균 응답 지연을 보여주며, 이는 고부하 시나리오에서 알고리즘의 실시간 의사결정 능력과 시스템 응답성을 반영한다. 작업 수가 증가함에 따라 각 전략의 두 지표 모두 상승하는 추세를 보이지만, 증가 폭과 안정성에는 차이가 있다. 작업 집약적 시나리오에서 Transformer-PPO 구조는 상대적으로 안정적인 평균 결정 시간 성능을 유지한다. 작업 밀도가 1000일 때 평균 결정 시간은 0.72s, 평균 응답 지연은 1.59s이며, 이는 주로 시간적 특징 인코딩의 상태 공간 압축 효과와 액션 공간 내의 무효한 동작을 효과적으로 회피했기 때문이다. 반면, DQN 전략은 작업 수가 증가함에 따라 결정 시간과 응답 지연이 더 길어지는 경향을 보이며, 이는 고차원 상태 전이 전반에 걸쳐 정책을 일반화하는 능력이 제한적임을 나타낸다. Greedy 전략은 다양한 작업 수에서 더 빠르게 결정을 내리지만, 장기 의존성 모델링의 부재로 인해 복잡한 작업 그래프에서 응답 성능이 저하된다. LSTM-PPO는 시퀀스 모델링에서 어느 정도의 시간 인지 능력을 갖추고 있으나, 제한된 구조적 깊이로 인해 장기 의존성 시나리오에서는 성능이 낮다. 이러한 결과는 스케줄링 시스템의 응답성에 있어 구조적 설계가 핵심적인 영향을 미친다는 점을 밝히며, 고동시성 조건에서 인코딩 메커니즘과 정책 샘플링 효율성의 협력적 최적화가 필수적임을 강조한다.
충돌률 및 자원 활용도 평가
다양한 활동 유형 복잡도 조건(단일 유형, 다중 유형 독립, 다중 유형 교차, 다단계 워크플로우, 부서 간 협업, 임시 삽입, 반복 주기) 하에서 자원 충돌률과 평균 자원 활용도를 통계적으로 분석합니다. 본 논문의 Transformer-PPO 스케줄링 모델을 LSTM-PPO, 탐욕적 탐색(greedy search) 및 DQN 스케줄링 모델과 비교합니다.
그림 8A,B는 7가지 활동 복잡도 수준에 따른 다양한 스케줄링 모델의 자원 충돌률과 평균 자원 이용률을 보여줍니다. 세로축은 스케줄링 모델이며, 가로축은 활동 유형입니다. 전반적인 추세는 활동 구조(다단계 프로세스, 부서 간 협업, 일시적 삽입 및 반복 주기 등)의 복잡성이 증가함에 따라 모든 모델에서 충돌률이 증가함을 보여줍니다. 그리디(greedy) 전략과 DQN 방식은 동적인 변화에 대한 적응력이 제한적이며 충돌 제어 능력이 분명히 부족합니다. Transformer-PPO 모델은 고복잡도 조건에서도 전반적인 자원 충돌률 0.05–0.12의 낮은 충돌률을 유지하며, 이는 작업 의존성 구조와 자원 변화에 대한 깊은 이해를 반영합니다. 자원 이용률 측면에서 Transformer-PPO는 모든 조건, 특히 다유형 교차 및 일시적 삽입 상황에서 높은 수준을 유지합니다. 동적 조정 전략을 통해 자원 유휴 상태를 효과적으로 줄여 0.75–0.86의 평균 자원 이용률을 기록했습니다. 이 데이터는 Transformer-PPO 모델이 스케줄링 유연성과 자원 효율성 사이에서 더 나은 균형을 달성하며, 더 높은 실용성과 확장성을 제공함을 검증합니다.
스케줄링 안정성
스케줄링 안정성 지수는 다양한 활동 유형 복잡도 조건(단일 유형, 다중 유형 독립, 다중 유형 교차, 다단계 공정, 부서 간 협업, 임시 삽입 및 반복 주기) 하에서 계산됩니다. 본 논문의 Transformer-PPO 스케줄링 모델을 LSTM-PPO, 그리디 탐색(greedy search) 및 DQN 스케줄링 모델과 비교하였습니다.
표 1은 7가지 활동 유형 복잡도 조건 하에서 서로 다른 스케줄링 모델 간의 스케줄링 안정성 지수 비교 결과를 보여줍니다. 선택된 복잡도 유형은 다양한 시나리오에서 스케줄링 시스템의 안정성 성능을 반영합니다. 지수 값의 범위는 0에서 1까지입니다. 이 값이 높을수록 스케줄링 교란에 대한 모델의 저항력이 강하며 전략 출력의 안정성이 높음을 의미합니다. 실험 결과, Transformer-PPO는 모든 작업 구조에서 높은 안정성 지수를 유지하는 것으로 나타났습니다. 특히 다유형, 부서 간 협업 및 반복 주기 시나리오에서 스케줄링 전략의 안정성이 다른 모델보다 우수하여, 강력한 구조 보존 및 적응형 스케줄링 능력을 입증했습니다. 전체적인 스케줄링 안정성 지수는 0.8에서 0.91 사이입니다. 반면, 그리디 알고리즘(greedy algorithm)과 DQN의 안정성은 작업 구조가 복잡해짐에 따라 크게 감소했으며, 뚜렷한 정책 지터(jitter)와 실행 편차가 발생했습니다. LSTM-PPO는 어느 정도의 안정성을 보였으나, 전반적인 성능은 Transformer-PPO보다 낮았습니다. 이러한 비교는 멀티 헤드 어텐션 메커니즘과 정책 가지치기 업데이트 메커니즘이 스케줄링 출력의 안정성에 긍정적으로 기여함을 검증하며, 복잡한 연합 활동 시나리오에서 해당 모델이 가진 안정성 측면의 강점을 강조합니다.
작업 동시성 부하 적응 분석
동시 작업 수가 계속해서 증가함에 따라, 스케줄링 시스템은 리소스 분배 충돌과 정책 일반화 저하라는 두 가지 과제를 해결해야 합니다. 작업 부하 확장에 따른 서로 다른 모델의 스케줄링 적응성을 테스트하기 위해, 본 섹션에서는 세 가지 수준의 작업 동시성(낮음: 100개 항목, 중간: 500개 항목, 높음: 1000개 항목)을 설정하여 스케줄링 주기 동안의 시스템 리소스 분배 및 정책 응답 일관성을 모니터링합니다. 리소스 균형 지수는 스케줄링 과정 중 서로 다른 리소스 유닛의 부하 균형을 반영하는 데 사용되며, 다음과 같이 계산됩니다:
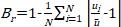 (7)
ui는 리소스 단위의 실제 이용률을 나타내며, ū는 모든 리소스의 평균 이용률을, N은 리소스의 총 개수를 나타냅니다. 값의 범위는 [0,1]이며, 1에 가까울수록 리소스 분포가 더 균형 잡혀 있음을 의미합니다.
정책 전이 강건성 지수 Rs는 서로 다른 작업 부하 조건에서 정책 출력의 일관성 정도를 측정하며, 다음과 같이 정의됩니다:
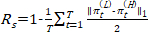 (8)
πt(L) 및 πt(H)는 각각 저부하 및 고부하 시나리오에서의 스케줄링 전략 분포이며, T는 총 타임스텝입니다. 이 값이 1에 가까울수록 전략 마이그레이션의 강건성이 더 강해지며 적응성이 더 높아집니다.
표 2는 다양한 작업 동시성 부하 조건에서 리소스 균형 및 정책 전이 강건성 측면에서 네 가지 스케줄링 모델의 성능을 체계적으로 보여줍니다. 작업 동시성 수준은 모델의 다양한 작업 규모 압박 하에서의 스케줄링 적응성을 반영하여 각각 낮음(100개 항목), 중간(500개 항목), 높음(1000개 항목)으로 설정되었습니다. 결과에 따르면, Transformer-PPO 모델은 모든 부하 수준에서 가장 높은 리소스 균형 지수를 달성하였으며, 이는 동시 다중 작업 시나리오에서 리소스를 합리적으로 할당하는 능력을 반영합니다. 동시에 정책 전이 강건성 지수 또한 비교 모델보다 훨씬 우수하여, 강력한 정책 일관성과 적응성을 보여주었습니다. 고동시성 조건에서 리소스 균형 지수와 정책 전이 강건성 지수는 각각 0.88과 0.85였습니다. 이에 비해 LSTM-PPO는 두 번째 성적을 거두었으며, Greedy 알고리즘과 DQN 모델은 고부하 상태에서 리소스 분포가 불균형하고 정책 변동이 심화되는 등 뚜렷한 성능 저하를 보였습니다. 이러한 평가는 작업 부하 확장 시 스케줄링 시스템의 리소스 관리 및 정책 강건성의 차이를 명확히 드러냈으며, 동적이고 복잡한 연합 활동 스케줄링에 대한 Transformer-PPO 융합 솔루션의 적용 가능성과 우수성을 더욱 검증하였습니다.
추가적인 최신 방법론과의 비교
제안된 방법을 최근의 최신(SOTA) 접근 방식들과 추가로 벤치마킹하기 위해, 딥러닝과 강화학습을 결합하여 스케줄링 문제에 적용한 최신 문헌의 대표적인 알고리즘 3가지를 구현하였다: (1) 최근의 가치 기반 스케줄링 연구에서 탐구된 바와 같이, 본 연구와 동일한 Transformer 인코더를 사용하되 정책 학습을 위해 PPO를 DQN으로 대체한 Transformer+DQN42; (2) 고급 RNN 기반 방법을 대표하여 시간적 의존성을 포착하기 위해 Transformer 인코더를 Gated Recurrent Unit(GRU)으로 대체한 GRU+PPO43; (3) 스케줄링을 위한 최근의 그래프 신경망 접근 방식을 반영하여 태스크-리소스 관계를 그래프로 모델링하는 GraphSAGE 인코더를 채택한 GraphSAGE+PPO44이다. 공정한 비교를 위해 모든 방법은 동일한 실험 조건(동일한 데이터셋, 1000의 태스크 밀도 및 에피소드 설정) 하에서 훈련되었으며, 하이퍼파라미터는 그리드 탐색을 통해 조정되었다. 각 방법은 10회의 독립적인 실행을 통해 평가되었으며, 주요 성능 지표(응답 지연, 리소스 충돌률, 리소스 활용도 및 스케줄링 안정성 지수)의 평균값이 기록되었다.
표 3에 나타난 바와 같이, 제안된 Transformer+PPO 방법은 평가된 모든 지표에서 세 가지 SOTA 베이스라인보다 일관되게 우수한 성능을 보였습니다. 제안된 방법의 평균 응답 지연 시간(1.59s)은 Transformer+DQN(2.13s), GRU+PPO(1.89s), GraphSAGE+PPO(1.72s)보다 현저히 낮으며, 이는 더 뛰어난 의사 결정 효율성을 나타냅니다. 제안된 방법의 자원 충돌률(0.09) 또한 가장 낮게 나타나, 더 효과적인 선제적 충돌 회피 능력을 보여주었습니다. 이러한 개선은 GRU 또는 GraphSAGE보다 장거리 의존성을 더 효과적으로 포착하는 Transformer의 멀티 헤드 어텐션(multi-head attention)과 PPO의 안정적인 정책 업데이트가 결합된 결과입니다. 자원 활용도 측면에서 제안된 방법은 0.82를 달성하여 다른 방법들보다 최소 8%포인트 더 높은 성능을 보였으며, 이는 더 효율적인 자원 할당이 이루어졌음을 입증합니다. 제안된 방법의 안정성 지수(0.88) 또한 가장 높게 나타났으며, 이는 PPO의 클리핑 목적 함수(clipping objective)와 GAE 보정이 DQN이나 다른 PPO 변형 모델보다 더 강건한 스케줄링 정책을 생성함을 확인시켜 줍니다. 종합적으로, 본 결과는 제안된 프레임워크에서 Transformer와 PPO의 특정 조합이 최근의 대안적 아키텍처보다 명확한 이점을 제공함을 검증하며, 동적 연합 활동 스케줄링에 적용하는 근거를 더욱 강화합니다.
데이터 가용성 성명서:
본 연구에 사용된 익명화된 데이터셋은 데이터 전처리 파이프라인 및 평가 스크립트와 함께 Figshare 저장소에 기탁되었으며, https://doi.org/10.6084/m9.figshare.33059243 (DOI: 10.6084/m9.figshare.33059243)에서 공개적으로 이용 가능합니다. 해당 데이터셋에는 대규모 기업 노동조합의 활동 일정, 리소스 사용 로그 및 충돌 이벤트 기록이 포함되어 있으며, 모든 개인 식별 정보 및 상업적 민감 정보는 제거되었습니다.
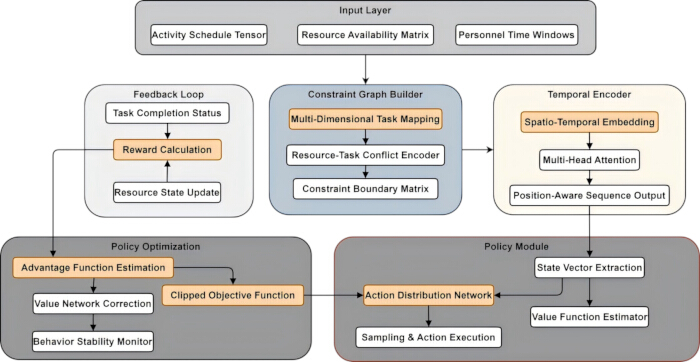
그림 1: 통합 활동 스케줄링 시스템의 구조. 활동 요청, 자원 가용성 및 인력 시간 창 정보가 통합되어 작업-자원 제약 그래프와 충돌 행렬을 구축합니다. 과거 활동 및 자원 상태 시퀀스는 멀티 헤드 어텐션(multi-head attention)이 적용된 Transformer를 사용하여 인코딩됩니다. 인코딩된 상태는 근사 정책 최적화(proximal policy optimization, PPO) 정책 및 가치 네트워크에 제공되며, 이는 스케줄링 작업 확률과 상태 가치 추정치를 생성합니다. 선택된 작업은 스케줄링 환경을 업데이트하고 보상을 생성합니다. 이후 클리핑된 PPO 목적 함수와 일반화된 어드밴티지 추정(generalized advantage estimation)을 사용하여 모델을 업데이트함으로써 적응형 스케줄링 및 자원 할당을 위한 폐쇄형 피드백 루프를 형성합니다. 여기를 클릭하여 이 그림의 더 큰 버전을 확인하십시오.
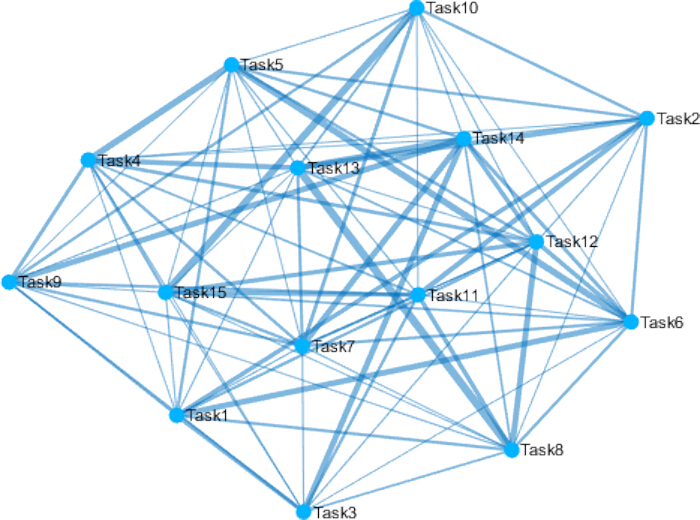
그림 2: 작업 충돌 가중치 네트워크 (에지의 두께는 충돌의 심각도를 반영함). 각 노드는 스케줄링을 기다리는 활동을 나타내며, 각 에지는 인력, 장소, 장비 또는 기타 자원의 중복 사용으로 인해 발생하는 충돌을 나타냅니다. 에지의 두께는 계산된 충돌 가중치에 비례하며, 에지가 두꺼울수록 더 심각한 충돌을 의미합니다. 밀접하게 연결된 노드 그룹은 잠재적인 자원 병목 현상 및 경쟁 작업 클러스터를 나타냅니다. 강하게 충돌하는 작업들을 서로 가깝게 배치하기 위해 힘 지향 레이아웃(force-directed layout)이 사용되었습니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
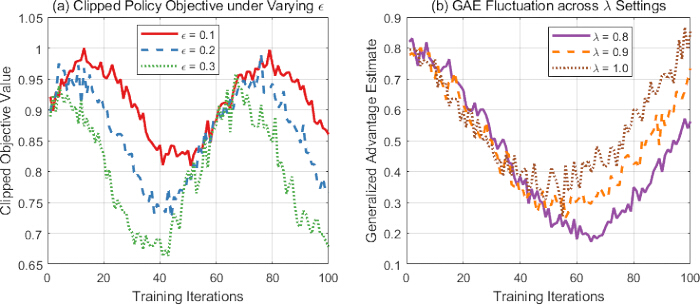
그림 3: 스케줄링 최적화 반복 중 전략 안정성 및 이점 추정의 동적 특성. (A) ε 변화에 따른 Clipped Policy Objective. (B) λ 설정에 따른 GAE 변동. 이 그림의 확대 버전을 보려면 여기를 클릭하십시오.
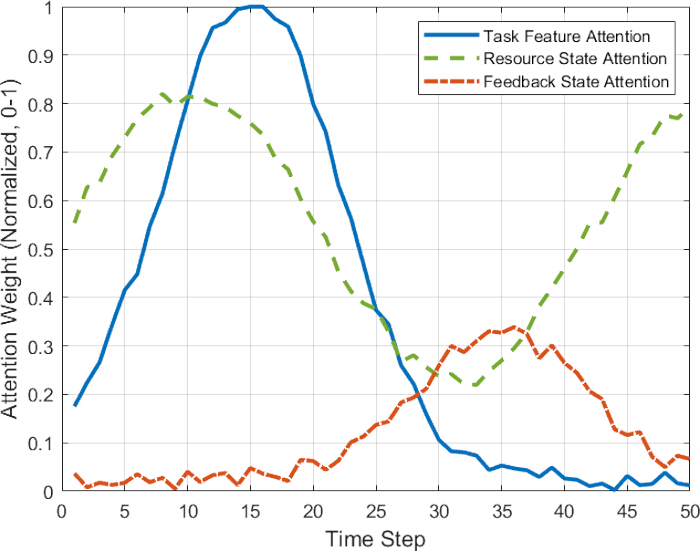
그림 4: 멀티 헤드 어텐션 출력의 시간적 추세 이 그림의 확대 버전을 보시려면 여기를 클릭하십시오.
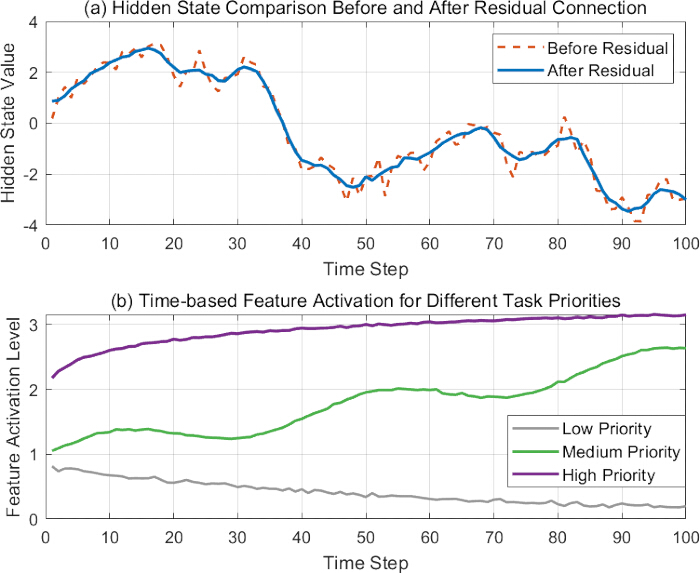
그림 5: 인코딩 특징의 시간적 변화에 따른 잔차 강화 및 작업 우선순위 계층화. (A) 잔차 연결 전후의 은닉 상태 비교. (B) 다양한 작업 우선순위에 따른 시간 기반 특징 활성화. 여기를 클릭하여 이 그림의 확대 버전을 확인하십시오.
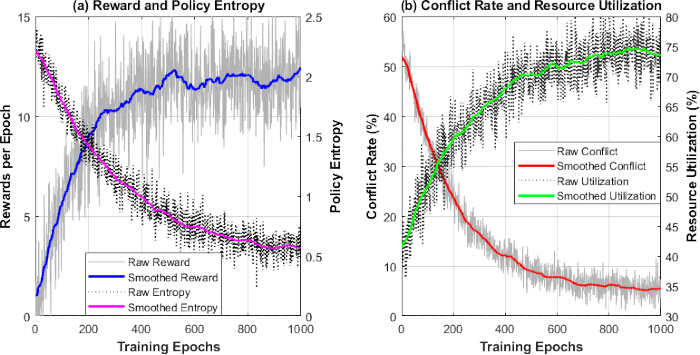
그림 6다차원 성능 진화 분석. (A) 보상 및 정책 엔트로피 (B) 충돌률 및 자원 활용도. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
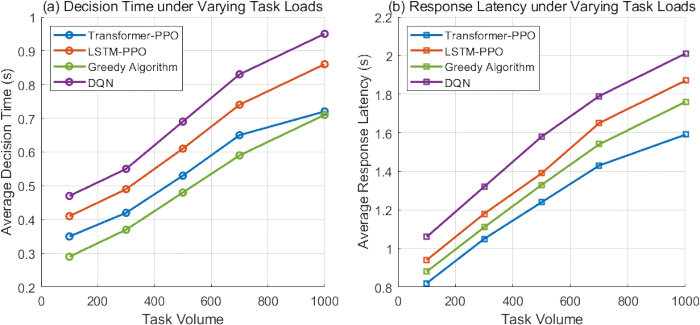
그림 7: 평균 결정 시간 및 평균 응답 지연 시간. (A): 작업 부하 변화에 따른 결정 시간. (B): 작업 부하 변화에 따른 응답 지연 시간. 여기를 클릭하여 이 그림의 확대 버전을 확인하십시오.
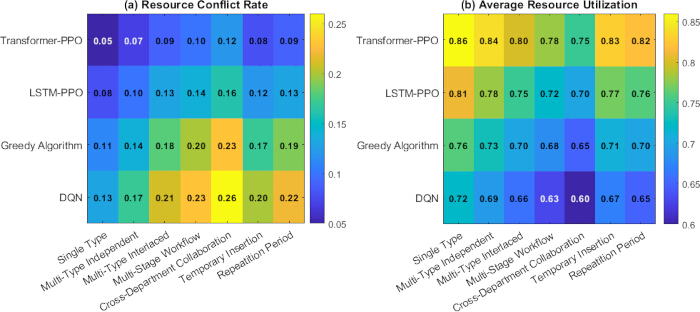
그림 8: 자원 충돌률과 평균 자원 이용률의 비교(A) 자원 충돌률. (B) 평균 자원 이용률 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
| 활동 복잡도 조건 | Transformer-PPO | LSTM-PPO | 탐욕 알고리즘 | 심층 Q-네트워크(DQN) |
| 단일 유형 | 0.91 | 0.86 | 0.74 | 0.78 |
| 다중 유형 독립형 | 0.88 | 0.81 | 0.7 | 0.73 |
| 다중 유형 인터레이스드 | 0.85 | 0.76 | 0.65 | 0.68 |
| 다단계 워크플로 | 0.83 | 0.73 | 0.61 | 0.66 |
| 부서 간 협업 | 0.8 | 0.7 | 0.59 | 0.63 |
| 일시적 삽입 | 0.86 | 0.78 | 0.68 | 0.72 |
| 반복 주기 | 0.84 | 0.75 | 0.64 | 0.69 |
표 1: 다양한 활동 복잡도에 따른 스케줄링 안정성 지수 비교. Transformer–PPO, long short-term memory–PPO (LSTM–PPO), greedy-search 및 deep Q-network (DQN) 모델의 스케줄링 안정성 지수를 단일 유형 활동, 독립적 다유형 활동, 교차 다유형 활동, 다단계 워크플로, 부서 간 협업, 임시 작업 삽입, 반복 주기 활동의 7가지 조건에서 비교하였다. 안정성 지수는 0에서 1 사이의 범위를 가지며, 값이 높을수록 스케줄링 교란에 대한 저항력이 더 크고 정책 출력이 더 일관됨을 나타낸다.
| 작업 동시성 조건 | 스케줄링 모델 | 리소스 균형 지수 | 정책 전이 강건성 지수 |
| 낮은 동시성 (100 Tasks) | Transformer-PPO | 0.94 | 0.92 |
| LSTM-PPO | 0.89 | 0.85 | |
| Greedy Algorithm | 0.83 | 0.78 | |
| DQN | 0.85 | 0.81 | |
| 중간 동시성 (500 Tasks) | Transformer-PPO | 0.91 | 0.89 |
| LSTM-PPO | 0.86 | 0.82 | |
| Greedy Algorithm | 0.78 | 0.71 | |
| DQN | 0.81 | 0.76 | |
| 높은 동시성 (1000 Tasks) | Transformer-PPO | 0.88 | 0.85 |
| LSTM-PPO | 0.82 | 0.76 | |
| Greedy Algorithm | 0.7 | 0.63 | |
| DQN | 0.75 | 0.68 |
표 2: 작업 동시성 부하 적응성 평가. 각각 100, 500, 1,000개의 동시 작업에 해당하는 저, 중, 고 동시성 조건 하에서 네 가지 스케줄링 모델의 리소스 균형 지수와 정책 전이 강건성 지수를 비교하였다. 두 지수 모두 0에서 1 사이의 값을 가지며, 값이 높을수록 리소스 할당이 더 균형 잡혀 있고 작업 부하 변화에 따른 스케줄링 정책의 일관성이 더 높음을 나타낸다.
| 방법 | 평균 응답 지연 시간 (s) | 자원 충돌률 | 자원 활용 | 안정성 지수 |
| Transformer+DQN | 2.13 ± 0.12 | 0.18 ± 0.02 | 0.68 ± 0.03 | 0.76 ± 0.04 |
| GRU+PPO | 1.89 ± 0.09 | 0.15 ± 0.01 | 0.72 ± 0.02 | 0.79 ± 0.03 |
| GraphSAGE+PPO | 1.72 ± 0.08 | 0.13 ± 0.01 | 0.74 ± 0.02 | 0.82 ± 0.03 |
| 제안된 | 1.59 ± 0.05 | 0.09 ± 0.01 | 0.82 ± 0.02 | 0.88 ± 0.02 |
| (Transformer+PPO) |
표 3: 추가적인 최신 기법들과의 성능 비교. 제안된 Transformer–PPO 방법은 작업 밀도가 1,000인 동일한 실험 조건 하에서 Transformer–DQN, gated recurrent unit–PPO (GRU–PPO) 및 GraphSAGE–PPO와 비교되었습니다. 결과는 10회의 독립적인 실행에서 얻은 평균값을 나타냅니다. 평가 항목에는 초 단위의 응답 지연, 자원 충돌률, 자원 활용률 및 스케줄링 안정성 지수가 포함됩니다. 응답 지연과 충돌률은 낮을수록, 자원 활용률과 안정성 지수는 높을수록 성능이 우수함을 나타냅니다.
토론
실험 결과, 제안된 Transformer-PPO 알고리즘이 모든 평가 지표에서 베이스라인 방법(LSTM-PPO, greedy search, DQN)보다 일관되게 우수한 성능을 보임을 입증하였습니다. 이러한 우수한 성능은 두 가지 핵심 요인에 기인합니다. 첫째, Transformer의 멀티헤드 셀프 어텐션(multi-head self-attention) 메커니즘은 활동 및 리소스 상태 시퀀스의 장기적인 시간적 의존성을 효과적으로 포착하여 잠재적 충돌을 선제적으로 식별할 수 있게 합니다. 이는 모델이 리소스 경합이 발생하기 전에 이를 예측할 수 있기 때문에, 높은 복잡도(예: 부서 간 협업 및 임시 삽입) 상황에서도 충돌률이 낮게 유지되는 이유를 설명해 줍니다. 둘째, PPO의 클리핑된 목적 함수(clipped objective function)와 GAE 기반의 어드밴티지 보정(advantage correction)은 안정적인 정책 업데이트를 보장하며, 이를 통해 스케줄링 결정의 급격한 변동을 방지하고 다양한 작업 부하 하에서도 높은 강건성을 유지합니다.
기존의 스케줄링 방식과 비교하여, 제안된 방법은 긴 시퀀스에서 기울기 소실 문제가 발생하는 LSTM 기반 모델의 한계를 해결하고, 동적인 환경에서 그리디(greedy) 및 DQN 방법의 낮은 일반화 성능을 극복합니다. LSTM-PPO는 중간 정도의 성능을 보이지만, 높은 동시성 환경에서 더 높은 충돌률과 더 낮은 리소스 균형을 보이는 것에서 알 수 있듯이 작업 간의 의존성이 긴 시간 범위에 걸쳐 있을 때 안정성을 유지하지 못합니다. 그리디 알고리즘은 계산 효율성은 높지만, 미래 예측 능력이 부족하여 최적이 아닌 리소스 할당으로 이어지며 응답 지연을 증가시킵니다. 반면, DQN은 신뢰 영역 제약(trust-region constraint)의 부재로 인해 정책 진동 현상이 나타나며, 이는 멀티태스크 시나리오에서 성능 저하를 유발합니다.
그럼에도 불구하고, 본 연구에는 몇 가지 한계점이 있습니다. 데이터셋이 단일 기업 노동조합에서 도출되었으므로, 연구 결과를 다른 조직적 상황으로 일반화하는 데 제약이 있을 수 있습니다. 또한, 본 모델은 모든 활동 및 리소스 정보가 완전히 관찰 가능하다는 것을 가정하는데, 데이터가 불완전하거나 노이즈가 존재하는 실제 환경에서는 이것이 성립하지 않을 수 있습니다. Transformer 인코더의 계산 부하는 과거 윈도우의 길이가 길어질수록 증가하며, 이는 매우 대규모 시스템에서의 실시간 적용 가능성에 영향을 미칠 수 있습니다.
향후 연구는 순환 상태 추정(recurrent state estimation)을 사용하여 부분적으로 관찰 가능한 환경을 처리하도록 모델을 확장하고, 제한된 과거 데이터로 새로운 유니온에 빠르게 적응할 수 있도록 메타 학습 기술을 통합하는 데 집중할 수 있습니다. 또한, 의사 결정 지연 시간을 줄이고 분산 스케줄링을 지원하기 위해 클라우드-에지 협업 아키텍처에 알고리즘을 배치할 계획입니다. 나아가, 설명 가능한 AI 구성 요소를 통합하면 인간 운영자에게 해석 가능한 스케줄링 근거를 제공하여 신뢰도와 실제 도입 가능성을 높일 수 있을 것입니다.
본 논문은 노동조합 활동 스케줄링에서 빈번하게 발생하는 리소스 충돌과 응답 지연 문제에 초점을 맞추어, Transformer와 PPO 강화 학습을 통합한 동적 스케줄링 최적화 알고리즘을 연구한다. 이 알고리즘은 멀티 헤드 어텐션 메커니즘을 통해 활동 이력과 리소스 상태의 시공간적 특성을 철저히 분석함으로써 잠재적인 충돌 위험을 식별하는 능력을 향상시킨다. 또한, 클리핑 목적 함수를 통한 전략의 안정적인 업데이트 메커니즘과 결합하여 동적 환경에서 효율적인 응답과 리소스 할당을 달성한다. 이 방법은 복잡하고 다양한 활동 유형과 작업 부하에 대해 뛰어난 스케줄링 안정성, 리소스 활용도 및 충돌 제어 능력을 보여준다. 실증 분석 결과, 해당 알고리즘은 높은 작업 밀도에서도 응답 지연이 적은 것으로 나타났다. 7가지 서로 다른 활동 유형과 복잡도 하에서 리소스 충돌률은 0.05–0.12, 평균 리소스 활용도는 0.75–0.86, 스케줄링 안정성 지수는 0.8–0.91을 기록했다. 이는 현재 주류인 LSTM-PPO, 그리디 탐색 및 DQN 스케줄링 모델보다 유의미하게 낮은 리소스 충돌률과 높은 리소스 균형을 유지함을 보여준다. 동시에 전략 전이의 강건성과 스케줄링 안정성이 모두 우수하여, 해당 알고리즘이 강력한 적응력과 외란 억제 능력을 갖추고 있음을 시사한다. 이러한 성능 우위는 동적으로 변화하는 리소스 스케줄링 시나리오에서 노동조합 활동 관리 시스템을 위한 견고한 기술적 지원을 제공한다.
공개 사항
저자들은 재정적 이해관계의 충돌이 없음을 선언합니다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| Python 3.9 | Python Software Foundation | https://www.python.org/downloads/release/python-390/ | 핵심 프로그래밍 언어 |
| PyTorch 1.12 | Meta AI | https://pytorch.org/get-started/previous-versions/ | 딥러닝 프레임워크 (Transformer/PPO 구현) |
| NumPy 1.23 | NumPy Developers | https://numpy.org/doc/stable/release/1.23.0-notes.html | 수치 계산 라이브러리 |
| Matplotlib 3.5 | Matplotlib Development Team | https://matplotlib.org/stable/users/installing.html | 결과 시각화 |
| Union activity scheduling dataset | 협력 기업 내부 데이터베이스 (익명화됨) | 기밀 유지 계약으로 인해 공개되지 않음; 연구자는 액세스를 위해 교신 저자에게 문의 가능 | 3년간 대기업 노동조합에서 수집한 5,000건 이상의 활동 기록 (회의, 교육, 오락) |
| NVIDIA A100 GPU | |||
| PyTorch |
참고문헌
- Bosire RK, Muya J, Matula D. Employee recognition programs and employee output as moderated by workers’ union activities: evidence from Kenyatta National Hospital (KNH), Kenya. Saudi J Bus Manag Stud. 2021;6(3):61-70.
- Carneiro B, Costa HA. Digital unionism as a renewal strategy? Social media use by trade union confederations. J Ind Relat. 2022;64(1):26-51.
- Geelan T. Introduction to the special issue: the internet, social media and trade union revitalization—still behind the digital curve or catching up? New Technol Work Employ. 2021;36(2):123-39.
- Hennebert MA, Pasquier V, Lévesque C. What do unions do…with digital technologies? An affordance approach. New Technol Work Employ. 2021;36(2):177-200.
- Panagiotopoulos P. Digital audiences of union organising: a social media analysis. New Technol Work Employ. 2021;36(2):201-18.
- Wang W, Seifert R. Trade-union-engendered employee trust in senior management: a case study of digitalisation. Ind Relat J. 2024;55(6):472-91.
- Katsabian T. Collective action in the digital reality: the case of platform-based workers. Mod Law Rev. 2021;84(5):1005-40.
- Holgate J. Trade unions in the community: building broad spaces of solidarity. Econ Ind Democr. 2021;42(2):226-47.
- Ovi RP, Rana MS, Jodder PK, Sarkar B. Performance evaluation of e-service delivery of union digital centers at the local level using composite indexing method: a study of Batiaghata upazilla in Khulna district. Inf Dev. 2024;40(4):620-34.
- Crossan J, et al. Colours of democracy: trade union banners and the contested articulations of democratic spatial practices. Trans Inst Br Geogr. 2023;48(1):23-38.
- Victor C, Kavishe AM. The challenges faced by trade unions in improving employee welfare and strategies to address them: a case of the Tanzania Union of Government and Health Employees (TUGHE) at the National Health Insurance Fund (NHIF). Afr J Empir Res. 2025;6(1):189-200.
- Rogalewski A. Trade unions challenges in organising Polish workers: a comparative case study of British and Swiss trade union strategies. Eur J Ind Relat. 2022;28(4):385-404.
- Pacetti V, Rossi P, Romens AI. Remotizzare, o non remotizzare: questo è il dilemma. Imprese e sindacati di fronte alla remotizzazione ibrida del lavoro. Stato Merc. 2023;43(3):421-49.
- Hunt T, Connolly H. COVID-19 and the work of trade unions: adaptation, transition and renewal. Ind Relat J. 2023;54(2):150-66.
- Joyce S, Stuart M, Forde C. Theorising labour unrest and trade unionism in the platform economy. New Technol Work Employ. 2023;38(1):21-40.
- Dupuis M. Algorithmic management and control at work in a manufacturing sector: workplace regime, union power and shopfloor conflict over digitalisation. New Technol Work Employ. 2025;40(1):81-101.
- Suryadevara S. Real-time task scheduling optimization in WirelessHART networks: challenges and solutions. Int J Adv Eng Technol Innov. 2022;1(3):29-55.
- Roşu D, Cojanu F, Ştefănică V, et al. Experimental management of work collectives through social and socialization activities. J Phys Educ Sport. 2022;22(7):1742-47.
- Ahmed AAA, et al. Multi-project scheduling and material planning using Lagrangian relaxation algorithm. Ind Eng Manag Syst. 2021;20(4):580-87.
- Gao H, et al. TBDB: token bucket-based dynamic batching for resource scheduling supporting neural network inference in intelligent consumer electronics. IEEE Trans Consum Electron. 2024;70(1):1134-44.
- Ouhame S, Hadi Y, Ullah A. An efficient forecasting approach for resource utilization in cloud data centers using a CNN-LSTM model. Neural Comput Appl. 2021;33(16):10043-55.
- Valarmathi K, Kanaga Suba Raja S. Resource utilization prediction technique in the cloud using a knowledge-based ensemble random forest with an LSTM model. Concurr Eng. 2021;29(4):396-404.
- Yang Y, Shen H. Deep reinforcement learning enhanced greedy optimization for online scheduling of batched tasks in cloud HPC systems. IEEE Trans Parallel Distrib Syst. 2022;33(11):3003-14.
- Tang B, Luo J, Obaidat MS, Vijayakumar P. Container-based task scheduling in a cloud-edge collaborative environment using a priority-aware greedy strategy. Cluster Comput. 2023;26(6):3689-705.
- Zhang Y, Zou YH, Zhang XD. Manufacturing resource scheduling based on a deep Q-network. Wuhan Univ J Nat Sci. 2022;27(6):531-38.
- Mangalampalli S, et al. DRLBTSA: deep reinforcement learning-based task-scheduling algorithm in cloud computing. Multimed Tools Appl. 2024;83(3):8359-87.
- Wang Y, Wang Q, Chu X. Energy-efficient online scheduling of transformer inference services on GPU servers. IEEE Trans Green Commun Netw. 2022;6(3):1649-59.
- Liu L, et al. Dynamic sparse attention for scalable transformer acceleration. IEEE Trans Comput. 2022;71(12):3165-78.
- He X, et al. Channel assignment and power allocation for throughput improvement with PPO in B5G heterogeneous edge networks. Digit Commun Netw. 2024;10(1):109-16.
- Liu H, et al. A new multi-domain cooperative resource scheduling method using proximal policy optimization. Neural Comput Appl. 2024;36(9):4931-45.
- Jin J, Xu Y. Optimal policy characterization enhanced proximal policy optimization for multitask scheduling in cloud computing. IEEE Internet Things J. 2022;9(9):6418-33.
- Chavva M, Veera S. Dynamic cost-aware language models: a real-time framework for optimizing cloud resource recommendations. Int J Mach Learn Sustain Dev. 2023;5(2):1-15.
- Zhao Z, et al. Link scheduling using graph neural networks. IEEE Trans Wirel Commun. 2023;22(6):3997-4012.
- Zhang Z, et al. A resource optimization scheduling model and algorithm for heterogeneous computing clusters based on GNN and RL. J Supercomput. 2024;80(16):24138-72.
- Chai F, et al. Joint multi-task offloading and resource allocation for mobile edge computing systems in satellite IoT. IEEE Trans Veh Technol. 2023;72(6):7783-95.
- Luo Q, et al. Resource scheduling in edge computing: a survey. IEEE Commun Surv Tutor. 2021;23(4):2131-65.
- Gupta A, Namasudra S, Kumar P. An enhanced strategy for energy-efficient cloud computing environment through VM consolidation. In: Dagur A, Singh K, Mehra PS, Shukla DK, editors. Intelligent Computing and Communication Techniques. Boca Raton (FL): CRC Press; 2025. p. 330–34. https://doi.org/10.1201/9781003530176-46
- Sombo B, Apeh ST, Edeoghon IA. Review on authentication algorithms in cellular communication networks. Cloud Comput Data Sci. 2025;6(1):54-66.
- Gupta A, Kumar P, Namasudra S. Sustainable cloud computing: an enhanced energy-efficient VM consolidation approach using live migration. Iran J Comput Sci. 2026;9:27. doi:10.1007/s42044-025-00385-y.
- García F, et al. Traffic optimization through waiting prediction and evolutive algorithms. Int J Interact Multimed Artif Intell. 2025;9(3):96-103.
- Sharma P, Namasudra S, Lorenz P. Blockchain-based cloud storage system with enhanced optimization and integrity preservation. Presented at: IEEE International Conference on Communications (ICC); Rome, Italy; 2023. p. 3744-49.
- Ding F, et al. Transformer-enhanced DQN approach for energy- and cost-efficient large-scale dynamic workflow scheduling in a heterogeneous environment. IEEE Internet Things J. 2024;11(22):37351-67.
- Yu H, Tang N, Zhu Z, Guo Z. Flexible job-shop scheduling via gated recurrent unit and deep reinforcement learning. Knowl Based Syst. 2025;330:114734. doi:10.1016/j.knosys.2025.114734.
- Do KH, et al. Graph Neural PPO for joint user association and resource allocation in Open RAN [conference paper]. Presented at: 40th International Conference on Information Networking (ICOIN); Hanoi, Vietnam; 2026. p. 37-42.