본 연구에서는 알츠하이머병, 전두측두엽 치매 및 건강한 대조군을 구분하기 위한 뇌전도(electroencephalography) 바이오마커를 조사합니다. 제곱평균제곱근(root mean square), 전력 스펙트럼 밀도(power spectral density) 및 엔트로피 특성을 이용한 랜덤 포레스트(Random Forest) 모델을 설명 가능한 인공지능과 효과 크기 분석을 통해 해석하였습니다. 영향력이 낮은 엔트로피 특성을 제거함으로써 분류 성능을 향상시켰으며, 94%의 테스트 정확도를 달성하였습니다.
이 논문에서
요약
초록
뇌전도(EEG)는 신경퇴행성 질환에서 뇌 활동의 특성을 규명하기 위한 비침습적 접근 방식으로 연구되어 왔습니다. 본 연구에서는 다중 도메인 EEG 바이오마커가 알츠하이머병(AD), 전두측두엽 치매(FTD) 및 건강 대조군(HC)을 구분할 수 있는지 평가하였습니다. 공개 데이터셋에는 AD 환자 36명, FTD 환자 23명, 건강 대조군 29명을 포함한 총 88명의 참가자로부터 측정된 휴지기 눈 감음 상태의 EEG 기록이 포함되었습니다. 머신러닝 분류를 위해 다중 도메인 EEG 바이오마커와 인구통계학적 특성을 추출하였습니다. EEG 유래 특성에는 제곱평균제곱근(RMS), 전력 스펙트럼 밀도(PSD) 및 엔트로피 측정값이 포함되었습니다. 통합 특성 세트를 사용하여 랜덤 포레스트(Random Forest) 분류기를 학습시켰으며, 설명 가능한 인공지능을 통해 이를 해석하였습니다. 특성 기여도를 평가하기 위해 특성 안정성 및 Cohen’s d 효과 크기 분석을 수행한 후, 어블레이션(ablation) 분석을 실시하였습니다. 엔트로피 기반 특성이 분류에 대한 기여도가 가장 낮게 나타났습니다. 전체 다중 도메인 모델은 96%의 학습 정확도와 92%의 테스트 정확도를 달성하였습니다. 엔트로피 특성을 제거한 후, 테스트 정확도는 94%로 증가하였습니다. 이러한 결과는 랜덤 포레스트 프레임워크 내에서 선택된 다중 도메인 EEG 및 인구통계학적 특성의 분류 성능을 보여줍니다.
서론
알츠하이머병(AD)은 인지 및 운동 기능의 저하와 관련된 진행성 신경 질환입니다. 유병률은 연령에 따라 상당히 증가하며, 치매는 노년층의 주요 이환 및 사망 원인입니다1,2,3,4,5. 진단 및 질병 분류가 여전히 까다롭기 때문에, 치매와 관련된 신경생리학적 변화를 특성화하는 수단으로 뇌 신호 분석이 연구되어 왔습니다.
뇌전도(EEG)는 뇌의 전기적 활동을 기록하는 비침습적 방법으로, 알츠하이머병 및 기타 신경계 질환 연구에 활용되어 왔습니다6,7,8,9,10,11. EEG 신호는 뉴런 활동에 의해 생성된 전기적 전위를 반영하며, 두피의 여러 위치에서 비침습적으로 기록됩니다12,13,14. 뇌 활동은 일반적으로 delta, theta, alpha, beta, gamma 주파수 대역을 사용하여 특성화합니다15. 알츠하이머병은 EEG 서파화, 신호 복잡성 감소 및 동기화 변화와 관련이 있는 것으로 알려져 있습니다16. 스펙트럼 분석 결과, 건강한 대조군에 비해 AD 환자에게서 delta 및 theta 활동은 증가하고 alpha 및 beta 활동은 감소하는 것으로 보고되었습니다17,18,19. 기존의 EEG 분류 연구들은 AD와 건강한 대조군(HC), 그리고 전두측두엽 치매(FTD)와 HC를 구분하는 데 있어 높은 성능을 보고했습니다. 반면, AD와 FTD 사이의 감별 진단은 일반적으로 더 어려운 것으로 나타났습니다10,11.
기계 학습 방법은 신경계 질환과 관련된 EEG 신호의 패턴을 식별하는 데 사용되어 왔습니다20,21. 따라서 특징 추출은 EEG 기반 분류의 중요한 구성 요소입니다. 이전 연구들에서는 기계 학습 모델과 결합하여 스펙트럼, 시간적, 복잡성 및 기능적 연결성 특징을 조사하였습니다3,15,22,23. 스펙트럼 특징은 AD에서 보고된 알파 활성 감소 및 세타 활성 증가를 포함하여, 뇌 활동의 주파수 의존적 변화를 정량화하기 때문에 특히 중요합니다23,24,25,26.
여러 EEG 기반 연구에서 다양한 특징, 분류기 및 검증 전략의 조합을 평가해 왔습니다. 연결성 기반 분석은 AD, FTD 및 HC를 구분하는 데 사용되었으며, 보고된 분류 성능은 비교 대상과 특징 선택 절차에 따라 다르게 나타났습니다27. 푸리에 기반 특징 또한 AD, 경도 인지 장애(MCI) 및 건강한 대조군을 구분하기 위해 평가되었으나, 제한적인 전처리와 검증 전략과 관련된 과적합 가능성이 한계점으로 지적되었습니다28. 비선형 EEG 복잡도 측정값은 AD 분류에 있어 판별 잠재력을 보여주었으며, 일부는 높은 정확도, 민감도 및 특이도를 달성했지만, MCI 및 질병 단계 판별에 대한 적용 가능성은 여전히 제한적입니다21.
시간-주파수 EEG 표현 기반의 딥러닝 방법 또한 AD, MCI 및 HC의 다중 클래스 분류를 위해 연구되어 왔습니다29. 높은 분류 성능이 보고되었으나, 소규모 또는 선택된 코호트, 클래스 불균형, 불균일한 질환 중증도, 외부 검증의 부족, 그리고 모델 해석력 저하 등이 한계점으로 지적됩니다29. 검증 전략 또한 중요한 방법론적 고려 사항입니다. 참가자 독립적 접근법에 따르면, 동일한 참가자의 에포크(epoch)가 훈련 세트와 테스트 세트 모두에 포함될 경우 기존의 에포크 수준 교차 검증이 성능을 과대평가할 수 있음이 입증되었습니다30. 이러한 한계는 서로 다른 검증 체계를 사용하는 연구 간의 분류 결과를 비교할 때 특히 중요합니다.
복잡도 및 연결성 측정치 또한 서포트 벡터 머신 분류기를 사용하여 평가되었으며, 위상 기반 연결성과 다중 스케일 엔트로피는 서로 다른 수준의 판별 성능을 보였습니다31,32. 푸리에 및 웨이브릿 유도 특징을 이용한 다른 연구에서는 AD, MCI 및 HC 비교 전반에 걸쳐 가변적인 성능이 보고되었으며, 일반적으로 다중 클래스 분류가 이진 분류보다 더 어려운 것으로 나타났습니다14. 엔트로피 및 동기화 기반 접근 방식 또한 AD와 대조군 사이의 판별력을 입증했으나, 대조군 집단의 특성이 관찰된 효과 크기에 영향을 미칠 수 있습니다2.
본 연구에서는 EEG 주파수 대역에서 추출한 제곱평균제곱근(RMS), 전력 스펙트럼 밀도(PSD) 및 엔트로피 측정치로 구성된 다중 도메인 특성 세트와 인구통계학적 변수인 연령을 평가합니다. RMS는 각 주파수 대역 내의 신호 진폭을 나타내며, PSD는 주파수 도메인의 전력을 나타냅니다. 엔트로피는 신호 복잡성의 척도로 포함되었습니다. 이러한 특성들은 EEG 활동에 대한 상호 보완적인 설명을 제공하며, 랜덤 포레스트(Random Forest) 분류기를 사용하여 평가됩니다. 또한, 본 연구는 추출된 특성들의 상대적 기여도를 평가하기 위해 특성 중요도, 특성 안정성, 설명 가능한 인공지능 및 효과 크기 분석을 추가로 조사합니다. 본 연구는 머신러닝을 이용하여 알츠하이머병(AD), 전두측두엽 치매(FTD) 및 건강한 대조군(HC)을 구별하는 데 있어 스펙트럼, 시간 및 복잡성 기반 측정치를 포함한 다중 도메인 EEG 특성의 유효성을 조사합니다. 또한 PSD, RMS 및 엔트로피 측정치를 사용할 때 어떤 EEG 주파수 대역 특성이 분류에 가장 강력하게 기여하는지 살펴봅니다. 아울러, PSD 및 RMS를 포함한 전력 기반 특성의 기여도를 엔트로피 기반 특성의 기여도와 비교하고, 분류 모델에 대한 연령의 기여도를 평가합니다.
프로토콜
EEG 전처리, 특징 추출 및 분류 워크플로의 개략적인 개요가 그림 1에 제시되어 있습니다. 연구에 사용된 재료 및 소프트웨어는 재료 표에 나열되어 있습니다.
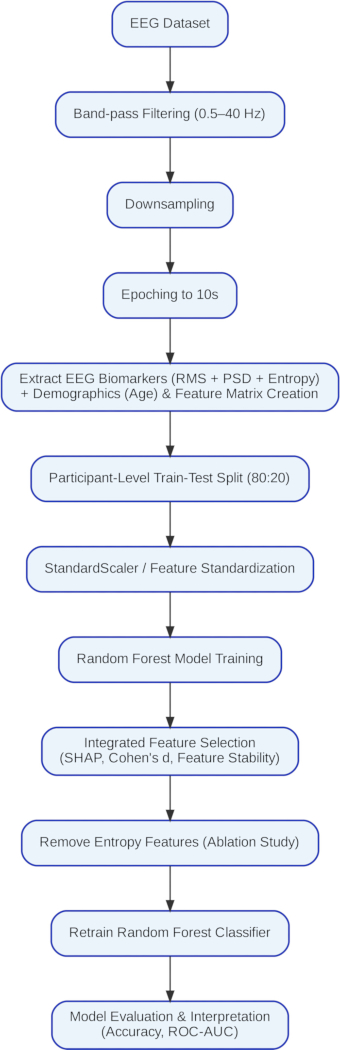
그림 1: EEG 전처리, 특징 추출 및 분류 파이프라인의 워크플로. EEG 데이터 검증, 밴드패스 필터링 및 재참조, 제곱평균제곱근(RMS), 전력 스펙트럼 밀도(PSD) 및 엔트로피 특징 추출, 연령 추가, 훈련-테스트 데이터 분할, Random Forest 모델 개발, 특징 안정성 분석, SHAP 분석, Cohen’s d 효과 크기 분석, 통합 특징 선택, 엔트로피 특징 제거(ablation), 모델 재학습 및 성능 평가를 포함한 연구 워크플로의 개략도. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
1. 데이터 획득
공개적으로 이용 가능한 휴지기 EEG 데이터셋을 OpenNeuro 저장소(데이터셋 ds004504, 버전 1.0.9)에서 획득하였다33. 참가자 라벨과 인구통계학적 정보를 확인하였다. 해당 데이터셋은 알츠하이머병(AD) 환자 36명, 전두측두엽 치매(FTD) 환자 23명, 건강한 대조군(HC) 29명을 포함하여 총 88명의 참가자로 구성되었다.
2. EEG 기록 가져오기
각 참가자에 대해 MNE-Python 라이브러리를 사용하여 EEG 기록을 로드하였습니다. 각 EEG 파일의 접근 가능 여부, 성공적인 가져오기 가능 여부 및 유효한 참가자 식별자 포함 여부를 확인하였습니다. 파일이 누락되었거나 손상된 기록은 제외하였습니다. 이 단계에서는 500 Hz의 원래 EEG 샘플링 주파수를 유지하였습니다. 본 연구에 임상적으로 유의미한 모든 EEG 정보를 보존하면서 계산 부하를 줄이기 위해 신호를 다운샘플링하였습니다.
3. 대역 통과 필터링
연속 EEG 기록은 저역 차단 주파수 0.5 Hz 및 고역 차단 주파수 40 Hz의 4차 대역 통과 필터를 사용하여 필터링되었습니다.
4. 공통 평균 참조 및 에포킹
필터링된 EEG 기록에 공통 평균 참조(CAR)를 적용했습니다. 각 시간 샘플에서 사용 가능한 모든 EEG 채널의 평균 신호를 계산하여 각 채널에서 뺐습니다. 참조된 EEG 신호를 이후 분석을 위해 유지했습니다. 각 참조된 EEG 기록은 MNE-Python의 make_fixed_length_epochs() 함수를 사용하여 고정 길이의 에포크로 분할되었습니다. 에포크 길이는 10 s, 중첩 시간은 0 s로 설정했습니다.
5. 에포크 검증
각 참가자에 대해, 10s의 완전한 에포크만 유지하였습니다. 기록 끝부분에 남은 10s 미만의 EEG 세그먼트는 모두 폐기하였습니다. 이렇게 유지된 각 에포크는 이후 특징 추출을 위한 개별 샘플로 사용되었습니다.
6. 특성 준비
소스 데이터셋에 Mini-Mental State Examination (MMSE) 데이터가 포함되어 있었으나, 본 분석에서는 제외하였습니다. 추출된 EEG 특성을 participants.csv 메타데이터 파일에서 얻은 연령 및 진단 레이블을 포함한 참가자 인구통계학적 정보와 병합하였습니다. 참가자 식별자를 공통 키로 사용하였으며, EEG 특성 기록과 그에 해당하는 인구통계학적 정보가 모두 있는 참가자만 유지하였습니다.
다중 도메인 특성 행렬에는 5가지 제곱 평균 제곱근(RMS) 특성(delta_rms, theta_rms, alpha_rms, beta_rms 및 gamma_rms), 5가지 전력 스펙트럼 밀도(PSD) 특성(delta_psd, theta_psd, alpha_psd, beta_psd 및 gamma_psd), 그리고 5가지 엔트로피 특성(delta_entropy, theta_entropy, alpha_entropy, beta_entropy 및 gamma_entropy)이 포함되었습니다. 연령은 보완적인 인구통계학적 변수로 포함되었습니다. 진단 그룹 간에 연령 분포가 다를 수 있으므로, 인구통계학적 혼란 변수의 영향을 완전히 배제할 수는 없었습니다. AD, HC 또는 FTD로 정의된 진단 그룹을 타겟 라벨로 지정하였습니다.
7. 데이터 전처리 및 훈련-테스트 데이터 분할
전처리 단계에서는 관심 있는 EEG 주파수 정보를 유지하면서 계산 요구 사항을 줄이기 위해, 기록된 데이터를 500 Hz에서 250 Hz로 다운샘플링했습니다.
데이터셋은 그룹 분할 전략을 사용하여 피험자 수준에서 훈련(80%) 및 테스트(20%) 하위 집합으로 분할되었습니다. 이후 각 참가자에게 속한 예측 에포크들에 대해 다수결 투표를 실시하여 피험자 수준의 예측값을 얻었습니다. 주요 평가는 동일한 참가자의 에포크가 두 하위 집합 모두에 나타나는 것을 방지하기 위해 피험자 수준의 그룹 훈련-테스트 분할을 사용하였습니다. 피험자 수준의 예측값은 각 참가자에게 속한 예측 에포크들에 대한 다수결 투표를 통해 얻었습니다. 데이터셋의 결측값을 점검하였으며, 결측 관측치는 해당되는 경우 제거하거나 대체하였습니다. 진단 레이블은 인코딩되었습니다. StandardScaler를 훈련 데이터에 맞춘(fitted) 후 훈련 및 테스트 데이터셋 모두에 적용하였습니다.
8. 랜덤 포레스트 모델 개발
80개의 트리, 최대 트리 깊이 10, 최대 4개의 특성, 리프당 최소 5개의 샘플, 그리고 random state 42를 사용하여 랜덤 포레스트(Random Forest) 분류기를 초기화했습니다. 이 분류기는 표준화된 훈련 데이터셋을 사용하여 학습되었습니다.
9. 모델 평가
훈련 데이터셋과 테스트 데이터셋 모두에 대해 클래스 레이블을 예측했습니다. 혼동 행렬을 생성하고, 분류 보고서와 함께 정확도, 정밀도, 재현율 및 F1-스코어를 계산했습니다. 훈련 및 테스트 정확도를 기록했습니다.
참가자별 평가를 위해, 특정 참가자의 모든 에포크(epoch)가 훈련 세트 또는 테스트 세트 중 하나에만 배타적으로 할당되었는지 확인하십시오. Random Forest 분류기는 기본 분석과 동일한 하이퍼파라미터를 사용하여 훈련되었습니다.
10. 교차 검증
추가적인 모델 평가 절차로서, shuffle = True 및 random_state = 30을 사용하여 5-겹 층화 교차 검증(five-fold stratified cross-validation)을 수행하였다. 5개 폴드 전체의 평균 정확도와 표준 편차를 계산하였다. 이 분석은 1차 피험자 수준 홀드아웃 평가와는 별개로 고려되었다.
11. 특성 안정성 분석
0부터 9까지의 무작위 시드(random seed)를 사용하여 Random Forest 학습을 10회 반복함으로써 특성 안정성을 평가하였다. 각 실행마다 테스트 정확도와 특성 중요도 점수를 기록하였다. 10회 실행에 걸쳐 각 예측 변수의 특성 중요도 점수의 평균과 표준 편차를 계산하였으며, 예측 변수들을 안정성에 따라 순위 매겼다. 이 분석은 일차적인 피험자 수준의 평가를 대체하기보다는 특성 순위의 일관성을 평가하기 위해 사용되었다.
12. 설명 가능한 인공지능 분석
훈련된 Random Forest 모델에 SHAP TreeExplainer를 적용하였습니다. 각 특성이 모델의 예측에 기여하는 정도를 추정하기 위해 SHAP 값을 계산하였습니다. 각 특성에 대해 평균 절대 SHAP 값을 산출하였으며, SHAP 기여도에 따라 특성의 순위를 매겼습니다. 일관되게 낮은 SHAP 값을 보이는 특성들을 식별하여 이를 특성 안정성 및 Cohen’s d 분석 결과와 비교하였습니다. 일관되게 낮은 기여도를 보이는 특성들을 선정하여 이후의 절제 연구(ablation) 및 모델 재훈련에 활용하였습니다.
13. 통계적 효과 크기 분석
AD에 대한 각 EEG 바이오마커의 Cohen's d를 산출하였다. 대비 건강 대조군, 알츠하이머병 대비 전두측엽 치매 및 전두측엽 치매 대조 건강 대조군(HC)과의 비교. 효과 크기의 정도는 소효과 0.20, 중효과 0.50, 대효과 0.80의 임계값을 사용하여 해석하였다.
14. 통합 특성 선택
Random Forest 특성 중요도 분석, SHAP 분석 및 Cohen’s d 분석 결과를 비교하였습니다. 특성 중요도가 지속적으로 낮고, SHAP 기여도가 낮으며, 효과 크기가 작은 예측 변수들을 제거 대상으로 선정하였습니다.
15. 특성 제거 분석
탐색적 제거 분석을 통해 엔트로피 특성을 평가하였으며, RMS, PSD 및 연령을 포함하는 축소된 특성 행렬을 구축하였습니다. 동일한 하이퍼파라미터를 사용하여 랜덤 포레스트(Random Forest) 분류기를 재학습시켰습니다. 축소된 특성 세트를 사용하여 모델 학습, 테스트, 교차 검증 및 수신자 조작 특성(ROC) 분석을 반복 수행하였습니다.
16. ROC 분석
최적화된 Random Forest 분류기로부터 클래스 확률을 얻었습니다. 다중 클래스 ROC 곡선은 one-대비-휴식 전략. 클래스별 곡선 아래 면적(AUC) 값과 평균 AUC를 산출하였다.
17. 성능 비교
전체 특징 모델의 성능을 엔트로피 특징 제거(entropy-feature ablation) 후 얻은 축소 특징 모델의 성능과 비교하였습니다.
결과
Random Forest 모델은 96%의 훈련 정확도와 92%의 테스트 정확도를 달성했습니다. 매크로 평균(macro-average) F1-score는 92%였으며, 가중 평균(weighted-average) F1-score 또한 92%로 나타나 세 가지 클래스 모두에서 유사한 성능을 보였습니다. 표 1에 제시된 바와 같이, 알츠하이머병(AD) 클래스에서 분류 성능이 가장 높았으며, 전두측엽 치매(FTD) 클래스는 상대적으로 낮은 성능을 보였습니다.
분류 임계값에 따른 클래스 분리도를 평가하기 위해 수신자 조작 특성(ROC) 분석을 사용하였습니다. 그림 2에 나타낸 바와 같이, 세 클래스 모두에서 ROC 곡선 아래 면적(AUC)이 0.98을 초과하여 AD, FTD 및 건강 대조군(HC) 그룹 간의 높은 분리도가 확인되었습니다.
Random Forest 분류 모델에 대한 특성 기여도를 평가하기 위해 TreeExplainer를 이용한 SHAP 분석을 수행하였습니다. 그림 3의 요약 막대 그래프는 전력 스펙트럼 밀도(PSD), 제곱 평균 제곱근(RMS), 엔트로피 및 인구통계학적 특성의 상대적 기여도를 보여주었습니다. 절대 SHAP 값이 높을수록 모델 예측에 더 강하게 기여했으며, 엔트로피 관련 특성들은 상대적으로 낮은 기여도를 보였습니다.
특성 안정성 분석은 지정된 무작위 시드(random seeds)에 대해 랜덤 포레스트(Random Forest) 학습을 반복하여 수행되었습니다. 각 실행마다 테스트 정확도와 특성 중요도 점수를 기록하였으며, 특성 중요도의 평균과 표준 편차를 계산하였습니다. 이 분석에서 모델은 평균 95%의 분류 정확도를 달성하였으며, 표준 편차는 0.17%였습니다. 이러한 반복 실행은 주로 특성 순위의 일관성을 평가하기 위해 사용되었으며, 기본 대상 수준의 홀드아웃(holdout) 평가와는 별개로 고려되었습니다. 표 2에 나타난 바와 같이, 특성 안정성 분석에서 연령이 높은 순위로 나타났습니다. theta_psd 및 theta_rms 특성 또한 높은 순위를 기록한 반면, alpha_psd, alpha_rms, beta_psd 및 beta_rms는 중간 정도의 특성 중요도를 보였습니다.
표 3에 제시된 바와 같이, 집단 간 차이의 크기를 평가하기 위해 Cohen’s d를 계산하였습니다. 알파 대역의 감쇠(alpha_rms, d = 0.97; alpha_psd, d = 0.87)와 세타 활동의 증가(theta_rms, d = 0.72)는 AD 환자와 건강한 대조군 사이에서 가장 큰 차이를 보였습니다. 이러한 결과는 치매 EEG 연구에서 보고된 피질 서파화(cortical slowing) 현상과 일치합니다34. 엔트로피 기반 특징들은 상대적으로 작은 효과 크기를 보였습니다. AD와 FTD 간의 비교에서는 주로 작거나 중간 정도의 효과 크기가 나타났습니다.
알파파 대역 특성은 AD-군에서 큰 효과 크기를 나타냈다.대조-HC 및 FTD-대비-HC 비교. AD 대상 대조 HC의 경우, 보고된 효과 크기는 alpha_psd에서 -0.87, alpha_rms에서 -0.97이었다. FTD의 경우 대비 HC의 경우, 알파 대역 감쇠는 -0.73이었다. theta_psd 특성은 AD에 대해 0.61의 효과 크기를 나타냈다. 대조 HC에서는 theta_rms의 효과 크기가 0.72로 나타났다. AD에서는 더 작은 차이가 관찰되었다. 대조 전두측엽 치매
Beta-band 특성은 주로 작거나 중간 정도의 집단 효과 크기를 나타냈습니다. beta_psd 효과 크기는 AD versus HC의 경우 −0.35, AD versus FTD의 경우 −0.41이었으며, beta_rms는 대부분 작은 효과를 보였습니다. Gamma-band 특성은 일부 비교에서 중간 정도의 효과를 나타냈습니다. gamma_psd 효과 크기는 FTD versus HC의 경우 0.47, AD versus HC의 경우 0.20이었으며, gamma_rms는 FTD versus HC에서 0.50의 효과 크기를 보였습니다.
Delta PSD 및 RMS는 AD 대 HC(각각 0.29 및 0.34)와 FTD 대 HC(각각 0.25 및 0.25)에서 작은 양의 효과 크기를 나타냈습니다. AD 대 FTD의 효과 크기는 0에 가까웠습니다. Delta entropy는 세 가지 비교군 모두에서 작은 효과 크기(0.08, 0.20, −0.11)를 보였습니다.
특성 안정성, SHAP 및 효과 크기 분석 결과, 엔트로피 특성의 기여도가 상대적으로 낮은 것으로 나타났다. 이에 따라 엔트로피 특성을 제외하고 RMS, PSD 및 연령만을 유지하는 절제 분석(ablation analysis)을 수행하였다. 특성 절제 후, Random Forest 모델은 96%의 훈련 정확도와 94%의 테스트 정확도를 달성하였다. 이 결과는 평가된 특성 선택 프레임워크 내에서의 탐색적 비교로 해석되었다. AD, HC 및 FTD 클래스에 대한 정밀도, 재현율, F1-스코어 및 서포트 값은 표 4에 제시되어 있다.
엔트로피 특성 제거(ablation) 전후의 성능을 표 5에서 비교하였다. 엔트로피를 제거한 후 테스트 정확도는 92%에서 94%로 증가하였다. 클래스별 변화는 표 6에 제시되어 있다. FTD의 경우 정밀도는 4% 증가하였고, F1-score는 2% 증가하였다. HC 그룹의 재현율은 4% 증가한 반면, 정밀도는 2% 감소하였다. 특성 제거 후 매크로 평균(macro-average) 및 가중 평균(weighted-average) 성능 지표는 약 1%–2% 증가하였다.
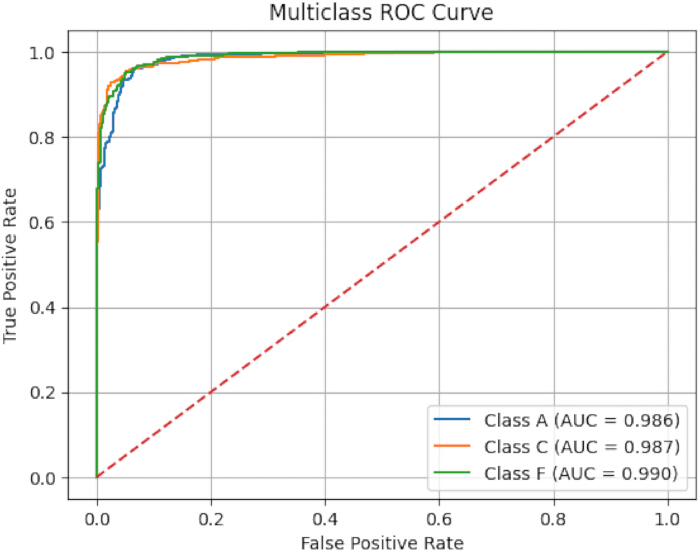
그림 2알츠하이머병, 전두측두엽 치매 및 건강 대조군의 수신자 조작 특성 곡선. 단일- 대 다수(one-vs-all) 방식을 사용하여 생성된 다중 클래스 수신기 작동 특성(ROC) 곡선대비알츠하이머병(A군), 전두측두엽 치매(F군) 및 건강한 대조군(C군)에 대한 휴식 전략. 각 군에 대해 곡선 아래 면적(AUC)을 계산하였다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
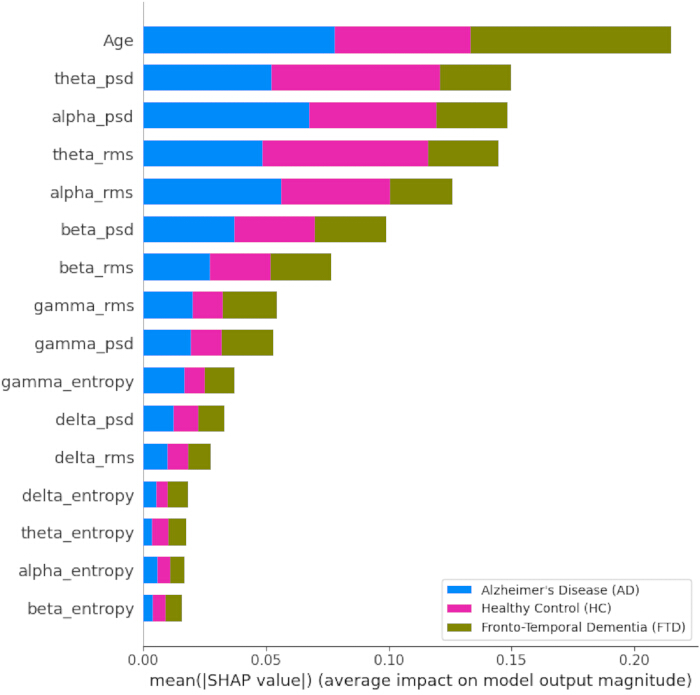
그림 3: 학습된 Random Forest 모델의 SHAP 요약 분석. EEG 유래 특성과 인구통계학적 특성이 Random Forest 분류 모델에 기여하는 상대적 정도를 나타내는 요약 막대 그래프. 평균 절대 SHAP 값을 사용하여 root mean square (RMS), power spectral density (PSD), 엔트로피 및 연령 특성의 기여도를 순위 매겼습니다. 여기에서 이 그림의 더 큰 버전을 확인하십시오.
| 정밀도 | 재현율 | F1-스코어 | 지원 | |
| 알츠하이머병 | 0.92 | 0.95 | 0.94 | 579 |
| 대조군 | 0.93 | 0.92 | 0.93 | 480 |
| 전두측두엽 치매 | 0.93 | 0.87 | 0.9 | 314 |
| 매크로 평균 | 0.93 | 0.92 | 0.92 | 1373 |
| 가중 평균 | 0.93 | 0.92 | 0.92 | 1373 |
표 1: 테스트 데이터에 대한 분류 보고서. 테스트 데이터셋 내 알츠하이머병, 건강 대조군 및 전두측엽 치매 클래스에 대한 정밀도(precision), 재현율(recall), F1-스코어(F1-score) 및 서포트(support)와 매크로 평균 및 가중 평균 성능 지표.
| 특징 | 평균 | 표준 편차 |
| Age | 0.1966 | 0.0017 |
| theta_psd | 0.0936 | 0.0027 |
| theta_rms | 0.0911 | 0.0023 |
| alpha_psd | 0.0824 | 0.0022 |
| alpha_rms | 0.0824 | 0.0024 |
| beta_psd | 0.0638 | 0.0013 |
| beta_rms | 0.0629 | 0.0012 |
| gamma_psd | 0.0534 | 0.001 |
| gamma_rms | 0.0527 | 0.0014 |
| delta_psd | 0.0403 | 0.0007 |
| delta_rms | 0.0359 | 0.001 |
| gamma_entropy | 0.0326 | 0.0008 |
| alpha_entropy | 0.0325 | 0.0006 |
| beta_entropy | 0.0283 | 0.0009 |
| theta_entropy | 0.0258 | 0.0004 |
| delta_entropy | 0.0255 | 0.0005 |
표 2: Random Forest 모델의 특성-안정성 순위. 0 – 9까지의 랜덤 시드를 사용하여 반복적인 Random Forest 학습을 통해 얻은 평균 특성 중요도 값 및 그에 따른 가변성. 특성들은 실행 간의 안정성에 따라 순위가 매겨졌다.
| 특성 | AD vs. HC | AD vs. FTD | FTD vs. HC |
| Delta PSD | 0.293 | -0.069 | 0.253 |
| Theta PSD | 0.612 | 0.23 | 0.355 |
| Alpha PSD | -0.869 | -0.219 | -0.64 |
| Beta PSD | -0.352 | -0.408 | 0.201 |
| Gamma PSD | 0.201 | -0.326 | 0.468 |
| Delta Entropy | 0.081 | 0.199 | -0.111 |
| Theta Entropy | 0.208 | 0.033 | 0.163 |
| Alpha Entropy | -0.061 | 0.071 | -0.137 |
| Beta Entropy | -0.37 | -0.042 | -0.332 |
| Gamma Entropy | -0.338 | 0.047 | -0.391 |
| Delta RMS | 0.342 | 0.041 | 0.251 |
| Theta RMS | 0.718 | 0.354 | 0.318 |
| Alpha RMS | -0.977 | -0.205 | -0.73 |
| Beta RMS | -0.494 | -0.365 | 0.015 |
| Gamma RMS | 0.187 | -0.33 | 0.5 |
표 3: 진단 그룹 간의 Cohen’s d 효과 크기 비교. 알츠하이머병 대 건강한 대조군, 알츠하이머병 대 전두측두엽 치매, 그리고 전두측두엽 치매 대 건강한 대조군 비교에 따른 EEG 바이오마커의 Cohen’s d 값.
| 정밀도(Precision) | 재현율(Recall) | F1-스코어(F1-Score) | 지원수(Support) | |
| 알츠하이머병 | 0.94 | 0.95 | 0.94 | 579 |
| 대조군 | 0.91 | 0.96 | 0.94 | 480 |
| 전두측두엽 치매 | 0.97 | 0.89 | 0.92 | 314 |
| 매크로 평균 | 0.94 | 0.93 | 0.93 | 1373 |
| 가중 평균 | 0.94 | 0.94 | 0.94 | 1373 |
표 4: 특성 제거 후 분류 보고서. 엔트로피 특성을 제거하고 Random Forest 모델을 재학습시킨 후, 알츠하이머병, 건강 대조군 및 전두측두엽 치매 클래스에 대한 정밀도(Precision), 재현율(Recall), F1-score 및 서포트(Support) 값이다.
| 측정 지표 | 절제 전 | 절제술 후 | 변경 |
| 훈련 정확도 | 0.96 | 0.96 | 0% 변화 |
| 테스트 정확도 | 0.92 | 0.94 | +2% 개선 |
| 매크로 정밀도 | 0.93 | 0.94 | +1% 개선 |
| 매크로 회상 | 0.92 | 0.93 | +1% 개선 |
| 매크로 F1-스코어 | 0.92 | 0.93 | 1% 개선 |
| 가중 정밀도 | 0.93 | 0.94 | 1% 개선 |
| 가중 재현율 | 0.92 | 0.94 | +2% 개선 |
| 가중 F1-스코어 | 0.92 | 0.94 | 2% 향상 |
표 5: 특성 제거 전후의 성능 비교. 전체 다중 도메인 특성 세트와 엔트로피 특성을 제거한 후 얻은 축소 특성 세트에 대한 모델 성능 지표 비교.
데이터 가용성:
모델 개발 및 분석에 사용된 처리된 CSV 데이터 세트는 보충 파일 1로 제공됩니다. 전처리 코드는 Python 노트북(https://colab.research.google.com/drive/1PwidMZCbbIHdthDhat5OEZa7ya6f0-aC?usp=sharing)에서 확인할 수 있으며, 모델 구축 및 분석 코드는 https://colab.research.google.com/drive/1q8wYJjQpofAqZGYxz9xHKB0emGF4YGwM?usp=sharing에서 확인할 수 있습니다. 제공된 전처리 코드를 사용하여 처리된 CSV 데이터 세트를 다시 생성할 수도 있습니다.
| 분류 | 측정 지표 | 이전 | 이후 | 변화 |
| 알츠하이머병 | 정밀도(Precision) | 0.92 | 0.94 | 0.02 |
| 재현율(Recall) | 0.95 | 0.95 | 변화 없음 | |
| F1-점수(F1-score) | 0.94 | 0.94 | 변화 없음 | |
| 대조군 | 정밀도(Precision) | 0.93 | 0.91 | −2% |
| 재현율(Recall) | 0.92 | 0.96 | 0.04 | |
| F1-점수(F1-score) | 0.93 | 0.94 | 0.01 | |
| FTD | 정밀도(Precision) | 0.93 | 0.97 | 0.04 |
| 재현율(Recall) | 0.87 | 0.89 | 0.02 | |
| F1-점수(F1-score) | 0.9 | 0.92 | 0.02 |
표 6: 특성 제거 전후의 클래스별 성능 변화. 엔트로피 특성을 제거한 후 알츠하이머병, 건강 대조군 및 전두측두엽 치매 클래스의 정밀도, 재현율 및 F1-score의 변화.
보충 파일 1: 모델 개발 및 분석에 사용된 처리된 에포크 레벨 EEG 특징 데이터셋. 이 파일을 다운로드하려면 여기를 클릭하십시오.
토론
전력 스펙트럼 밀도(PSD), 제곱 평균 제곱근(RMS) 및 엔트로피 측정값을 포함한 다중 도메인 특징을 사용하여 뇌전도(EEG) 샘플을 알츠하이머병(AD), 전두측엽 치매(FTD) 및 건강한 대조군(HC) 그룹으로 분류하기 위해 랜덤 포레스트(Random Forest) 분류기가 사용되었습니다. 연령은 보조적인 인구통계학적 변수로 포함되었습니다. 진단 그룹 간에 연령 분포가 다를 수 있기 때문에 인구통계학적 교란 요인을 완전히 배제할 수 없었으며, 따라서 보고된 성능은 인구통계학적 정보와 전기생리학적 정보의 결합된 기여도를 반영합니다. 본 분석에서는 다중 도메인 EEG 특징이 AD, FTD 및 HC 그룹을 구별하는 능력을 조사하고, 델타, 세타, 알파, 베타 및 감마 대역 특징이 분류에 기여하는 정도를 평가하였습니다35. 특징 안정성 및 효과 크기 분석 결과, PSD와 RMS를 포함한 전력 기반 특징이 엔트로피 기반 특징보다 더 강하게 기여하는 것으로 나타났습니다. 추출된 EEG 바이오마커는 또한 리듬의 서파화 및 알파 활동 감소와 관련된 패턴을 반영하였습니다.
이전 연구들은 서로 다른 머신러닝 접근 방식을 사용하여 엔트로피, PSD 및 RMS 기반의 EEG 특징들을 평가하였습니다2,14,27,28,36,37. 엔트로피는 EEG의 복잡성과 불규칙성을 특성화하는 데 사용되었으며, PSD는 스펙트럼 특성을 정량화하는 데 사용되었습니다2,14,27,28,36. RMS 또한 주파수 대역 특징으로서 평가된 바 있습니다37. 동일한 기본 데이터셋을 사용하여, 이전 연구에서는 leave-one-subject-out 검증을 통한 PSD 기반 이진 분류를 적용하였습니다33. 반면 본 분석에서는 다중 클래스 분류 프레임워크 내에서 alpha, beta, gamma, theta 및 delta 대역에 걸쳐 RMS, 엔트로피 및 PSD를 결합하였습니다. 동일한 데이터셋에서 leave-one-subject-out 이진 분류 전략을 사용한 경량 EEG 트랜스포머를 평가하였습니다. 동일한 데이터셋에서 leave-one-subject-out 이진 분류 전략을 사용하여 평가한 경량 EEG 트랜스포머는 83.28%의 정확도를 보고하였습니다. 분류 작업과 검증 절차가 서로 다르기 때문에, 본 결과와의 직접적인 수치 비교는 신중하게 해석되어야 합니다38.
알파 대역 특성은 AD와 HC, 그리고 FTD와 HC를 구분하는 데 있어 가장 큰 효과 크기를 보였으며, 세타 활동의 증가 또한 AD와 HC의 구분하는 데 기여했습니다. 베타 대역 특성은 그룹 간에 더 작은 효과를 보인 반면, 엔트로피 기반 특성은 상대적으로 제한적인 판별 유용성을 보였습니다. 감마 대역 특성은 FTD versus HC를 포함한 일부 비교에서 중간 정도의 효과를 보였습니다. 이전 연구들은 AD 및 관련 진단 비교에서 더 낮은 알파 전력과 변화된 세타 활동을 보고한 바 있습니다23,25,39. 엔트로피 또한 신경퇴행성 질환에서 잠재적으로 유용한 바이오마커로 설명되어 왔으며36, 이는 엔트로피의 기여도가 데이터셋, 특성 정의 및 분석 접근 방식에 따라 달라질 수 있음을 시사합니다.
서포트 벡터 머신은 이전의 EEG 분류 연구에서 빈번하게 사용되어 왔습니다3,21,24,37. 본 분석에 사용된 랜덤 포레스트 분류기는 특성 중요도 추정치를 제공하며, 본 연구에서 사용된 구조화된 특성 세트에 적용 가능했습니다40,41. 엔트로피 특성 제거(ablation) 후 훈련 및 테스트 정확도는 각각 96%와 94%로 나타났습니다. 엔트로피 특성의 제거는 모델 성능 향상과 관련이 있었으며, 이는 안정성, SHAP 및 효과 크기 분석에서 해당 특성들의 상대적 기여도가 낮게 관찰된 점을 뒷받침합니다. 딥러닝 및 트랜스포머 기반 접근 방식 또한 EEG 분류에 적용되어 왔으나, 이러한 방식들은 일반적으로 더 큰 데이터셋을 필요로 하며 고차원 또는 순차적 표현을 위해 설계되었습니다27,39,42,43,44,45.
EEG 신호는 노이즈가 많고 비정상성(non-stationary)을 띠며, 앙상블 트리 기반 모델은 구조화된 특징 표현을 분석할 때 강건성(robustness)을 제공할 수 있습니다. 본 연구에서는 RMS, PSD, 엔트로피 및 연령을 랜덤 포레스트(Random Forest) 모델의 상호 보완적인 입력 변수로 평가하였습니다. RMS는 주파수 대역 내의 신호 진폭을, PSD는 스펙트럼 전력을, 엔트로피는 신호의 복잡성을 나타냈습니다. 연구 결과, 평가된 프레임워크 내에서 PSD와 RMS가 엔트로피보다 분류에 더 강력하게 기여하는 것으로 나타났습니다. 연령 또한 모델에 기여하였으나, 이를 포함함으로써 인구통계학적 교란 변수가 발생할 가능성이 제기되었습니다. 향후 연구에서는 더 큰 데이터셋을 통해 추가적인 인구통계학적 변수와 대안적인 머신러닝 또는 딥러닝 접근법을 평가함으로써 일반화 가능성과 분류 성능을 더욱 상세히 검토할 수 있을 것입니다.
공개 사항
본 연구에서 보고된 작업에 영향을 미칠 수 있는 알려진 경쟁적 재정적 이해관계, 개인적 관계, 재정적 관계 또는 기타 활동은 신고되지 않았습니다.
감사의 글
본 연구에 사용된 공개 EEG 데이터셋과 연구 목적으로 해당 데이터셋을 사용할 수 있도록 기여한 연구자들의 공로에 감사를 표합니다. 공공, 상업 또는 비영리 자금 지원 기관으로부터 받은 특정 연구비는 없습니다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| Google Colab | [환경 확인]colab runtime | 분석 노트북 실행에 사용되는 클라우드 기반 컴퓨팅 환경 | |
| MNE-Python | MNE-Python project | 1.12.1 | EEG 전처리, 참조, 필터링 및 에포크 분할에 사용 |
| NumPy | NumPy project | (2.0.2) | 수치 및 배열 기반 계산에 사용 |
| OpenNeuro EEG 데이터셋 | OpenNeuro | ds004504, (1.0.9) | AD, FTD 및 HC 기록을 포함하는 공개 휴지기 EEG 데이터셋 |
| Python | Python Software Foundation | [3.12.13 (main, Mar 4 2026, 09:23:07) [GCC 11.4.0]] | 데이터 처리 및 모델 개발에 사용되는 프로그래밍 환경 |
| scikit-learn | scikit-learn project | 1.6.1 | 전처리, 그룹화된 데이터 분할, Random Forest 분류 및 성능 평가에 사용 |
| SciPy | SciPy project | (1.16.3) | 신호 처리 및 통계 계산에 사용 |
| SHAP | SHAP project | 0.52.0 | TreeExplainer를 이용한 설명 가능한 인공지능 분석에 사용 |
참고문헌
- Rodrigues PM, et al. Early prediction of Alzheimer's with the electroencephalogram. Procedia Comput Sci. 2016;100:865–71. https://doi.org/10.1016/j.procs.2016.09.236
- Houmani N, et al. Diagnosis of Alzheimer's disease with electroencephalography in a differential framework. PLoS One. 2018;13(3):e0193607. https://doi.org/10.1371/journal.pone.0193607
- Tripanpitak K, et al. Biomarkers for Alzheimer's disease and mild cognitive impairment: recent advances in task-based EEG. J Alzheimers Dis. 2025 [Epub ahead of print].
- Kung HC, Hoyert DL, Xu J, Murphy SL. Deaths: final data for 2005. Natl Vital Stat Rep. 2008;56(10):1-120.
- Falk TH, Fraga FJ, Trambaiolli L, Anghinah R. EEG amplitude modulation analysis for semi-automated diagnosis of Alzheimer's disease. EURASIP J Adv Signal Process. 2012;2012(1):192. https://doi.org/10.1186/1687-6180-2012-192
- Lehmann C, et al. Application and comparison of classification algorithms for recognition of Alzheimer's disease in electrical brain activity (EEG). J Neurosci Methods. 2007;161(2):342–50. https://doi.org/10.1016/j.jneumeth.2006.10.023
- Campanharo AS, Doescher E, Ramos FM. Automated EEG signals analysis using quantile graphs. In: Ferrández Vicente JM, Álvarez-Sánchez JR, de la Paz López F, Adeli H, editors. International Work-Conference on Artificial Neural Networks (IWANN 2017). Cham: Springer; 2017. p. 95–103. https://doi.org/10.1007/978-3-319-59147-6_9
- Adeli H, Ghosh-Dastidar S, Dadmehr N. Alzheimer's disease: models of computation and analysis of EEGs. Clin EEG Neurosci. 2005;36(3):131–40. https://doi.org/10.1177/155005940503600303
- Zheng H, Xiong X, Zhang X. Multi-threshold recurrence rate plot: a novel methodology for EEG analysis in Alzheimer's disease and frontotemporal dementia. Brain Sci. 2024;14(6):565. https://doi.org/10.3390/brainsci14060565
- Zheng X, et al. Diagnosis of Alzheimer's disease via resting-state EEG: integration of spectrum, complexity, and synchronisation signal features. Front Ageing Neurosci. 2023;15:1288295. https://doi.org/10.3389/fnagi.2023.1288295
- Abd Rahman F, Othman MF, Shaharuddin NA. Analysis methods of EEG signals: a review in EEG applications for brain disorders. J Teknol. 2015;72(2):41-6.
- Jackson AF, Bolger DJ. The neurophysiological bases of EEG and EEG measurement: a review for the rest of us. Psychophysiology. 2014;51(11):1061–71. https://doi.org/10.1111/psyp.12283
- Fouad IA, Labib FEZM. Identification of Alzheimer's disease from central lobe EEG signals utilising machine learning and a residual neural network. Biomed Signal Process Control. 2023;86:105266. https://doi.org/10.1016/j.bspc.2023.105266
- Fiscon G, et al. Combining EEG signal processing with supervised methods for Alzheimer's patients' classification. BMC Med Inform Decis Mak. 2018;18(1):35. https//doi.org/10.1186/s12911-018-0613-7
- Dauwels J, Vialatte F, Cichocki A. Diagnosis of Alzheimer's disease from EEG signals: where are we standing? Curr Alzheimer Res. 2010;7(6):487–505. https://doi.org/10.2174/156720510792231720
- Jelic V, Kowalski J. Evidence-based evaluation of diagnostic accuracy of resting EEG in dementia and mild cognitive impairment. Clin EEG Neurosci. 2009;40(2):129-42.
- Coben LA, Danziger WL, Berg L. Frequency analysis of the resting awake EEG in mild senile dementia of Alzheimer type. Electroencephalogr Clin Neurophysiol. 1983;55(4):372–80. https://doi.org/10.1016/0013-4694(83)90124-4
- Cibils D. Dementia and qEEG (Alzheimer's disease). Suppl Clin Neurophysiol. 2002;54:289-94.
- Ramírez-Arias FJ, et al. Evaluation of machine learning algorithms for the classification of EEG signals. Technologies. 2022;10(4):79. https://doi.org/10.3390/technologies10040079
- Hosseini MP, Hosseini A, Ahi K. A review on machine learning for EEG signal processing in bioengineering. IEEE Rev Biomed Eng. 2021;14:204–18. https://doi.org/10.1109/RBME.2020.2969915
- Vicchietti ML, Ramos FM, Betting LE, Campanharo AS. Computational methods of EEG signals analysis for Alzheimer's disease classification. Sci Rep. 2023;13(1):8184.
- Rahimi P, Noroozian M, Hatami J, Sadeghi M. Differential role of electroencephalography between mild cognitive impairment and Alzheimer disease during spatial working memory task. Iran J Neurodevelop Disord. 2025;4(1):101-10.
- Wang J, et al. Alzheimer's disease diagnosis using rhythmic power changes and phase differences: a low-density EEG study. Front Aging Neurosci. 2025;16:1485132. https://doi.org/10.3389/fnagi.2024.1485132
- Senkaya Y, Kurnaz C, Ozbilgin F. Enhancing Alzheimer's diagnosis with machine learning on EEG: a spectral feature-based comparative analysis. Diagnostics (Basel). 2025;15(17):2190. https://doi.org/10.3390/diagnostics15172190
- McBride JC, et al. Spectral and complexity analysis of scalp EEG characteristics for mild cognitive impairment and early Alzheimer's disease. Comput Methods Programs Biomed. 2014;114(2):153–63. https://doi.org/10.1016/j.cmpb.2014.01.019
- Al-Nuaimi AH, Jammeh E, Sun L, Ifeachor E. Changes in the EEG amplitude as a biomarker for early detection of Alzheimer's disease. In: 2016 38th Annual International Conference of the IEEE Engineering in Medicine and Biology Society (EMBC); 2016; Orlando, FL, USA. Piscataway: IEEE; 2016. p. 993–6. https://doi.org/10.1109/EMBC.2016.7590869
- Ma Y, Bland JKS, Fujinami T. Classification of Alzheimer's disease and frontotemporal dementia using electroencephalography to quantify communication between electrode pairs. Diagnostics (Basel). 2024;14(19):2189. https://doi.org/10.3390/diagnostics14192189
- Fiscon G, et al. Alzheimer's disease patients classification through EEG signals processing. In: 2014 IEEE Symposium on Computational Intelligence and Data Mining (CIDM); 2014; Orlando, FL, USA. IEEE; 2014. p. 105–12. https://doi.org/10.1109/CIDM.2014.7008655
- Fouladi S, et al. Efficient deep neural networks for classification of Alzheimer’s disease and mild cognitive impairment from scalp EEG recordings. Cogn Comput. 2022;14(4):1247–68. https://doi.org/10.1007/s12559-022-10022-y
- Miltiadous A, et al. Alzheimer’s disease and frontotemporal dementia: A robust classification method of EEG signals and a comparison of validation methods. Diagnostics. 2021;11(8):1437. https://doi.org/10.3390/diagnostics11081437
- Nobukawa S, et al. Classification methods based on complexity and synchronization of electroencephalography signals in Alzheimer’s disease. Front Psychiatry. 2020;11:255. https://doi.org/10.3389/fpsyt.2020.00255
- Huggins CJ, et al. Deep learning of resting-state electroencephalogram signals for three-class classification of Alzheimer’s disease, mild cognitive impairment and healthy ageing. J Neural Eng. 2021;18(4):046087. https://doi.org/10.1088/1741-2552/ac1a80
- Miltiadous A, et al. DICE-net: a novel convolution–transformer architecture for Alzheimer detection in EEG signals. IEEE Access. 2023;11:71840–58. https://doi.org/10.1109/ACCESS.2023a.3294618
- Miller R. Theory of the normal waking EEG: from single neurones to waveforms in the alpha, beta and gamma frequency ranges. Int J Psychophysiol. 2007;64(1):18–23. https://doi.org/10.1016/j.ijpsycho.2006.07.009
- Thomas JS, Thivakaran TK. Data mining algorithms and statistical techniques for identification of schizophrenia: A survey. In: 2020 International Conference on Smart Technologies in Computing, Electrical and Electronics (ICSTCEE); 2020; Bengaluru, India. IEEE; 2020. p. 246–51. https://doi.org/10.1109/ICSTCEE49637.2020.9276856
- Cacciotti A, et al. EEG entropy insights in the context of physiological aging and Alzheimer's and Parkinson's diseases: a comprehensive review. Geroscience. 2024;46(6):5537–57. https://doi.org/10.1007/s11357-024-01200-5
- Subhashree S, Eric PV. A unique EEG-Hyfusion fully automated stacked model for classification of Alzheimer's disease and frontotemporal dementia. J Vis Exp. 2026;(228):e69762.
- Miltiadous A, et al. A dataset of scalp EEG recordings of Alzheimer's disease, frontotemporal dementia and healthy subjects from routine EEG. Data (Basel). 2023;8(6):95. https://doi.org/10.3390/data8060095
- Malakouti SM, Menhaj MB, Suratgar AA. Enhanced epilepsy detection using discrete wavelet transform and bandpass filtering on EEG data: integration of ART-based and LVQ models. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.02.001
- Durga P, et al. An ensemble model for detection of Parkinson's disease by comparing numerous machine learning models and XGBoost based on vocal features. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.01.001
- Behnamian A, et al. A systematic approach for variable selection with random forests: achieving stable variable importance values. IEEE Geosci Remote Sens Lett. 2017;14(11):1988–92. https://doi.org/10.1109/LGRS.2017.2745049
- Macia G, Liddell A, Doyle V. Conversational AI with large language models to increase the uptake of clinical guidance. Clin eHealth. 2024;7:147–52. https://doi.org/10.1016/j.ceh.2024.07.001
- Zhao W. Research on the deep learning of small sample data based on transfer learning. AIP Conf Proc. 2017;1864(1):020018. https://doi.org/10.1063/1.4992835
- Hassan U, Singhal A. Convolutional neural network framework for EEG-based ADHD diagnosis in children. Health Inf Sci Syst. 2024;12(1):44. https://doi.org/10.1007/s13755-024-00303-x
- Jeong T, Park U, Kang SW. Novel quantitative electroencephalogram feature image adapted for deep learning: verification through classification of Alzheimer’s disease dementia. Front Neurosci. 2022;16:1033379. https://doi.org/10.3389/fnins.2022.1033379