이 프로토콜은 의료 이미지 분할을 위한 다중 뷰 Vision Mamba U-Shaped 네트워크 프레임워크를 구축, 훈련 및 평가하는 방법을 설명하며, 표준화된 데이터셋 준비, 모델 구현, 성능 평가를 통해 피부 병변과 복부 장기의 재현 가능한 분할을 가능하게 합니다.
이 콘텐츠를 보려면 JoVE 구독이 필요합니다. 로그인하거나 오늘 무료 평가판을 시작하세요.
이 논문에서
요약
초록
의료 이미지 분할은 전반적 맥락, 국소 경계, 다층 해부학적 구조를 정확히 포착하면서도 다양한 응용 분야에서 재현 가능한 계산 방법이 필요합니다. 이 글은 2차원 의료 이미지 분할을 위한 다중 뷰 비전 맘바 U-Shaped 네트워크 프레임워크를 구축, 훈련 및 평가하는 프로토콜을 제시합니다. 이 프로토콜은 공개 데이터셋 획득, 이미지 및 마스크 전처리, 네트워크 구축, 모델 학습, 체크포인트 선택, 정량적 및 정성적 성능 평가를 포함한 재현 가능한 워크플로우를 제공합니다. 이 프레임워크는 다중 뷰 특징 스캔을 통합하여 보완적인 공간, 윤곽, 축척, 경계 정보를 포착하고, U자형 인코더-디코더 아키텍처 내에서 다단계 특징 융합을 적용하여 세분화 중 특징 통합을 향상시킵니다. 이 프로토콜은 공개된 피부 병변 및 복부 장기 분할 데이터셋을 사용하여 시연됩니다. 설명된 구현 워크플로우 하에서, 프레임워크는 표준 평가 지표를 사용하여 경쟁력 있는 세분화 성능을 달성합니다. 이 프로토콜에서 제시된 절차를 따르면, 연구자들은 모델 구현을 재현하고, 정의된 실험 설정을 사용해 네트워크를 훈련하며, 분할 성능을 평가하고, 재현 가능한 딥러닝 기반 분석이 필요한 관련 의료 영상 분할 작업에 맞게 워크플로우를 조정할 수 있습니다.
서론
의료 영상 분할은 컴퓨터 비전 및 의료 영상 분석 분야에서 기본적인 작업입니다. 1,2,3. 이 과정은 이미지를 여러 영역이나 객체로 나누어 추가 분석과 처리를 수행하는 과정을 포함합니다. 이 기술은 임상의가 병리 영역을 식별하고 국소화하는 데 도움을 주어 진단 정확도와 치료 계획을 향상시키기 때문에 특히 의료 영상에서 중요합니다. 자기공명영상(MRI), 컴퓨터 단층촬영(CT), 양전자 방출 단층촬영(PET)과 같은 의료 영상 기술의 발전과 함께 정확한 의료 영상 분할 기술에 대한 수요가 계속 증가하고 있습니다. 현재 의료 영상 분할 방법은 크게 세 가지 주요 접근법으로 분류할 수 있습니다: 합성곱 신경망(CNN) 기반 방법4, 트랜스포머 기반 방법5, 상태 공간 모델(SSM) 기반 방법 6,7. CNN 기반 방법은 일반적으로 의료 영상 분할을 위해 U자형 네트워크 아키텍처를 사용합니다. 이 범주에서 가장 널리 사용되는 아키텍처는 U-Net8로, 이는 생의학 이미지 분할을 위한 U자형 인코더-디코더 아키텍처의 효율성을 입증했습니다. U-Net3+는 UNet++9의 밀집 스킵 연결과 풀스케일 스킵 연결을 결합하여 다중 스케일 특징 집계를 향상시킵니다. 그러나 CNN 기반 방법은 장거리 의존성을 포착하는 데 한계가 있어 장거리 맥락 정보를 효과적으로 모델링하지 못할 수 있습니다.
트랜스포머 기반 방법은 자기 주의 메커니즘을 통해 장거리 의존성을 효과적으로 포착하며, 병렬 계산을 가능하게 하고 관심 영역별로 다른 주의 가중치를 할당합니다. UNETR++10 은 매개변수 수와 계산 비용을 줄이기 위해 효율적인 쌍 주의(EPA) 모듈을 도입했습니다. nnFormer11 은 인터리브 합성곱 연산과 자기 주의 연산을 결합하고, 3차원(3D) 의료 이미지 분할에서 부피 표현을 학습하기 위한 국소-전역 부피 기반 자기 주의 메커니즘을 도입합니다. H2Former12 는 인코더에서 주의 메커니즘과 CNN 기반 특징 추출을 결합한 효율적인 계층적 하이브리드 비전 트랜스포머를 제안합니다. 하지만 트랜스포머 기반 방법은 시퀀스 길이가 증가할수록 계산 복잡도가 2차 증가하여 계산 비용이 크게 증가합니다. 그림 1 은 MVM-UNet의 동기를 보여주며, 제안된 다중 뷰 스캔 전략을 기존 SSM 기반 분할 프레임워크와 비교합니다.
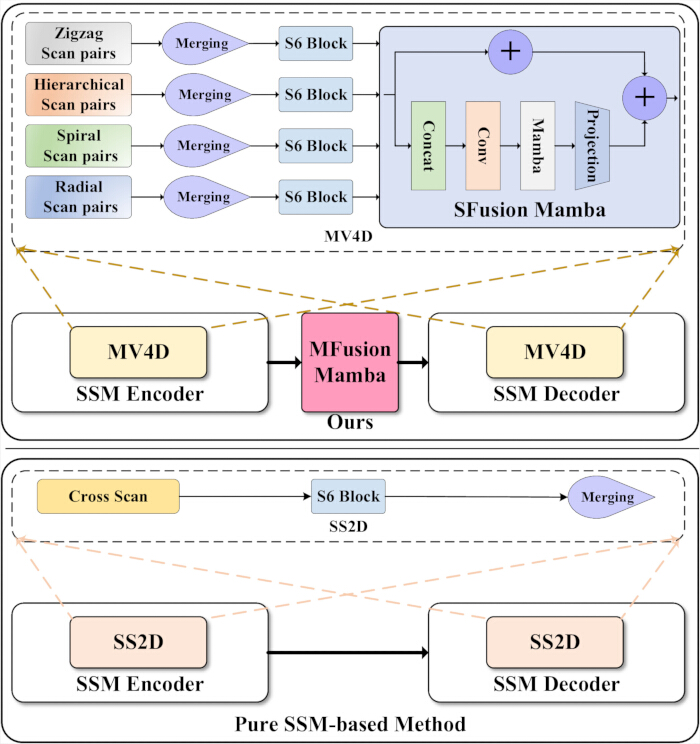
그림 1. MVM-UNet과 기존의 순수 상태-공간-모델(SSM) 기반 분할 아키텍처 비교. 기존의 순수 상태 공간 모델(SSM) 기반 세분화 프레임워크와 제안된 다중 뷰 맘바 U-Net(MVM-UNet) 아키텍처 간의 비교. 상단 패널은 MVM-UNet을 보여주는데, 이 모듈에서는 다중 뷰 4방향(MV4D) 모듈이 지그재그, 계층형, 나선형, 방사형 스캔 쌍을 이용해 공간을 융합 Mamba(SFusion Mamba)로 통합하여 상호 보완적인 특징을 추출하고, Multi-stage Fusion Mamba(MFusion Mamba)는 디코딩 전에 다중 스케일 인코더 기능을 집계합니다. 하단 패널은 교차 스캔이 가능한 선택적 스캔 2차원(SS2D) 모듈을 사용한 대표적인 순수 SSM 기반 아키텍처를 보여줍니다. 도표는 기존 SSM 기반 세분화 네트워크와 제안된 MVM-UNet 간의 아키텍처적 차이를 강조합니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭해 주세요.
SSM 기반 방법은 트랜스포머의 전역 모델링 능력과 선형 계산 복잡도를 결합합니다. 맘바 아키텍처는 선택적 상태 공간 모델(Selective-SSM)을 사용하여 입력 정보를 선택적으로 처리하여, 입력에 따라 모델이 매개변수를 동적으로 조정하면서 관련 없는 정보를 필터링하고 정보 제공 기능을 강조할 수 있습니다. Vim13 과 VMamba14 는 Mamba 아키텍처를 컴퓨터 비전 작업에 맞게 적용합니다. U-Mamba15 는 의료 영상 분할에 SSM의 적용을 탐구하기 위해 하이브리드 CNN–SSM 아키텍처를 사용하는 반면, Mamba-UNet16 은 의료 영상 분할을 위해 완전한 SSM 기반 인코더-디코더 아키텍처를 채택합니다. 이 방법들은 훨씬 적은 매개변수를 사용하면서도 경쟁력 있는 성능을 달성합니다. 그러나 현재의 SSM/맘바 기반 방법은 주로 간단한 이미지 패치와 SS2D 스캐닝 전략을 사용하여 이미지 특징을 추출하며, 이는 의료 이미지 분할에 여러 한계를 제공합니다. 첫째, SS2D 및 패치 기반 기법은 주로 일반적인 컴퓨터 비전 작업을 위해 설계되었습니다. Local Mamba17 과 Motion Mamba18 은 SS2D 스캐닝 전략이 모든 시각 작업에 충분하지 않다고 제안했는데, 이는 서로 다른 유형의 시각 정보를 포착하기 때문입니다. 둘째, SS2D 스캔 전략은 비교적 단순하여 수평 및 수직 스캔 방향에만 의존합니다. 따라서 복잡한 공간적 관계나 세밀한 구조적 세부사항을 충분히 포착하지 못할 수 있습니다. 의료 이미지 분할은 전 지구적 공간적 맥락과 정밀한 국부 해부학적 특징을 동시에 모델링해야 합니다. 더불어, 현재의 SSM/맘바 기반 방법은 인코더와 디코더 간의 제한된 기능 융합을 제공합니다. UNet++, FATNet과 같은 아키텍처는 향상된 특징 융합을 통해 분할 정확도를 높이며, 의료 이미지 분할에 효과적인 특징 통합의 중요성을 강조합니다.
이러한 한계를 해결하기 위해 본 논문은 MVM-UNet이라 불리는 새로운 맘바 기반 의료 영상 분할 프레임워크를 제안합니다. 그림 1에 나타난 것처럼, 제안된 다중 뷰 4방향(MV4D) 모듈은 MVM-UNet의 핵심 특징 추출 구성 요소로, 네 가지 서로 다른 스캐닝 전략의 정보를 통합하여 의료 이미지 분할을 위해 특별히 설계되었습니다. 각 스캐닝 전략은 상호 보완적인 이미지 특징을 추출하여 입력 이미지의 서로 다른 뷰를 나타냅니다. 지그재그 스캐닝19 는 각 행 또는 열의 끝에서 이동 방향을 번갈아 사용하여 국부와 전역 공간 정보를 균형 있게 조정합니다. 반면, 나선형 및 방사형 스캔 방식20 은 중심에서 바깥쪽이나 주변부에서 안쪽으로 확장하여 포괄적인 범위 커버리지를 제공합니다. 계층적 스캐닝18 은 여러 규모에서 국적·전역적 특징을 모두 포착합니다. 각 스캔 전략의 견고성을 높이기 위해 스캔 쌍은 S6 블록에 입력되기 전에 병합됩니다. 스캔뷰 퓨전 맘바(SFusion Mamba) 모듈은 네 가지 스캔 방식에서 추출한 특징을 통합합니다. 멀티스케일 인코더 기능을 효과적으로 활용하기 위해, 본 논문은 각 인코더 단계의 출력을 축적하고 융합한 후 퓨전 기능을 디코더에 전달하는 멀티스케일 맘바 퓨전 모듈(MFusion Mamba)을 제안합니다. MVM-UNet은 ISIC 2017, ISIC 2018, Synapse 데이터셋에서 평가되었습니다. 실험 결과는 MVM-UNet이 ISIC 2017, ISIC 2018, Synapse 데이터셋에서 경쟁력 있는 세분화 성능을 달성함을 보여줍니다.
대표적인 세분화 아키텍처는 의료 이미지 세분화를 더욱 발전시켰습니다. U-Net은 세포 계수, 검출, 형태계측21과 같은 생의학 영상 분석 과제에도 성공적으로 적용되었습니다. CA-Net22와 같은 주의 강화 CNN 아키텍처는 포괄적인 주의 메커니즘을 통해 특징 표현을 향상시킵니다. TransUNet23, Pyramid Medical Transformer24, Swin U-Net25, TransAttUNet26, TransCUNet27 등 대표적인 Transformer 기반 세분화 프레임워크들은 의료 이미지 분할을 위한 주의 기반 글로벌 특징 모델링의 효과를 더욱 입증합니다.
MVM-UNet의 설계는 기존 SSM/맘바 기반 분할 방법의 두 가지 한계에 의해 동기부여되었습니다. 첫째, 현재 많은 Vision Mamba 모델은 단순한 2차원 스캐닝 전략에 의존하는데, 이는 불규칙한 병변 경계, 작은 표적 영역, 다층 해부학적 구조를 포함하는 의료 이미지에는 부족할 수 있습니다. 둘째, 기존의 U자형 인코더-디코더 아키텍처는 주로 해당 스킵 연결을 통해 기능을 전송하여, 디코딩 시 다단계 인코더 정보를 직접 사용하는 것을 제한합니다. 따라서 MVM-UNet은 다중 뷰 공간 모델링을 향상시키기 위해 MV4D를, 다단계 인코더 기능을 명시적으로 집계하는 MFusion Mamba를 도입합니다. 이 설계는 맘바 기반 장거리 모델링을 의료 영상 분할의 특정 요구사항에 맞게 조정하기 위해 설계되었습니다.
MVM-UNet은 일반적인 인코더-디코더 패러다임과 맘바 기반 시퀀스 모델링을 기반으로 하지만, 이 구성 요소들이 의료 영상 분할에 맞게 어떻게 적응되고 통합되는지에 새로움이 있습니다. 표준 맘바 블록을 U자형 네트워크 백본에 단순히 통합하는 대신, 제안된 프레임워크는 여러 작업 지향 스캔 쌍 분기를 통해 공간 모델링 과정을 재설계하고, 스캔별 표현을 통합하는 SFusion Mamba를 도입하며, 잔차 및 투영 경로로 MVV 블록을 강화하고, 인코더와 디코더 사이에 MFusion Mamba를 삽입하여 다단계 인코더 기능을 집계한 후 디코딩합니다. 이 아키텍처 수준의 설계는 의료 이미지에서 흔히 관찰되는 불규칙한 경계, 작은 목표 영역, 다층 해부학적 구조를 해결하는 것을 목표로 합니다.
이 프로토콜은 2차원 의료 이미지에서 장거리 맥락 정보, 불규칙한 물체 경계, 다중 규모 해부학적 구조를 동시에 모델링해야 하는 분할 작업에 가장 적합합니다. CNN 기반 분할 방법과 비교할 때, 맘바 기반 인코더-디코더 설계는 의료 이미지 분할 연구자들이 익숙한 U자형 워크플로우를 유지하면서 효과적인 맥락 모델링 메커니즘을 제공합니다. 트랜스포머 기반 방법과 비교할 때, 제안된 프레임워크는 이차 자기 주의를 직접 사용하지 않으며, 비교적 효율적인 시퀀스 모델링 메커니즘을 이용한 전역 맥락 모델링을 추구하는 연구자들을 위한 것입니다. 따라서 이 프로토콜은 피부 병변 분할, 복부 장기 분할 및 전반적 구조 정보와 국소 경계 세부사항이 모두 중요한 유사한 2차원 의료 영상 분할 작업에 적합합니다.
이 프로토콜에는 사용 전에 고려해야 할 제한 사항도 있습니다. 경량 CNN이 이미 충분한 성능을 제공하는 비교적 단순한 분할 작업에는 필요하지 않을 수 있습니다. 또한, 아키텍처적 적응 없이 완전한 3차원 체적 분할을 위해 직접 설계된 것은 아닙니다. 주석이 달린 데이터가 매우 제한적이거나, 그래픽 처리 장치(GPU) 자원이 제한적이거나, 해석 가능한 고전 모델이 요구되는 연구자들도 프로토콜을 적용하기 전에 이러한 제약 조건을 고려해야 합니다. 전반적으로 이 방법은 장거리 맥락 모델링, 국소 경계 표현, 다단계 특징 융합을 균형 있게 결합한 맘바 기반 U자형 분할 프레임워크를 재현하고 평가하려는 연구자들을 위한 것입니다.
주요 기여는 다음과 같습니다:
1. 본 논문은 MVM-UNet이라 불리는 새로운 맘바 기반 의료 영상 분할 프레임워크를 제시합니다. 기존의 SS2D 기반 또는 표준 맘바 블록을 직접 통합하는 접근법과 달리, MVM-UNet은 지그재그, 계층, 나선, 방사형 스캔 등 네 가지 상호 보완적인 스캔 쌍 뷰에서 의료 영상 특징을 모델링하는 MV4D를 도입합니다.
2. 본 논문은 SFusion Mamba와 MVV 블록을 설계하여 스캔 특화 표현을 통합하고 특징 변환을 향상시키도록 합니다. SFusion Mamba는 서로 다른 스캔쌍 가지에서 추출한 특징들을 융합하는 반면, MVV 블록 내의 잔류 및 상하 투사 분기는 특징 표현을 안정화하고 풍부하게 하는 상호 보완적인 특징 경로를 제공합니다.
3. 본 논문은 인코더와 디코더 사이의 중간 다단계 융합 모듈로서 MFusion Mamba를 소개합니다. 주로 대응하는 단계 특징을 전달하는 기존의 스킵 연결과 달리, MFusion Mamba는 다단계 인코더 기능을 거친 융합에서 미세한 융합으로 명시적으로 집계하며, 디코딩을 위한 풍부한 정보를 제공합니다.
4. 광범위한 실험 결과에 따르면 제안된 MVM-UNet은 ISIC 2017 및 ISIC 2018 데이터셋에서 경쟁력 있는 세분화 성능을 보이며, Synapse 다기관 세분화 데이터셋에서는 강력한 성능을 보입니다. 더 나아가, 포괄적인 절제 연구는 MVM-UNet 내 각 구성 요소의 기여를 검증합니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
프로토콜
이 연구는 ISIC 2017, ISIC 2018, Synapse 등 공개적으로 이용 가능한 및 식별 해제된 의료 이미지 데이터셋만을 사용했습니다. 이 연구에서는 새로운 인간 참가자, 동물 대상 또는 식별 가능한 개인 의료 기록이 수집되지 않았습니다. 본 연구에 사용된 ISIC 2017 데이터셋은 공식 국제 피부 영상 협력 도전 데이터 저장소(https://challenge.isic-archive.com/data/#2017)에서 얻은 ISIC 2017 챌린지 피부 병변 분절 데이터셋입니다. 본 연구에서 사용된 데이터셋 버전은 ISIC 2017 병변 분할 과제에 해당하며, 공식 훈련, 검증 및 테스트 파티션을 포함합니다. 이 데이터셋은 2024년 3월 15일에 다운로드되었습니다. 본 연구에 사용된 ISIC 2018 데이터셋은 공식 국제 피부 영상 협력체 도전 데이터 저장소(https://challenge.isic-archive.com/data/#2018)에서 얻은 ISIC 2018 챌린지 과제 1 병변 경계 분할 데이터셋입니다. 본 연구에서 사용된 데이터셋 버전은 ISIC 2018 과제 1: 병변 경계 분할에 해당합니다. 데이터셋은 2024년 7월 8일에 다운로드되었습니다.
본 연구에서 사용된 시냅스 데이터셋은 Synapse 저장소에서 accession identifier syn3193805 (https://www.synapse.org/Synapse:syn3193805) 하에 얻은 Multi-Atlas Labeling Beyond the Cranial Vault 복부 CT 데이터셋이었습니다. 본 연구에서 사용된 데이터셋은 일반적으로 사용되는 30건의 복부 CT 다기관 분할 데이터셋에 해당합니다. 다운로드된 아카이브는 Abdomen/RawData.zip로, accession syn3193805로 이용 가능하다. 다운로드 당시 저장소에서는 별도의 버전 번호, 릴리스 라벨, 날짜가 명시된 릴리스 태그를 제공하지 않았습니다. 이전 연구에서 채택된 표준 분할에 따라 18건은 훈련에, 12건은 시험에 사용되었습니다. 데이터 분할은 TransUNet23가 사용한 사례 목록을 따랐습니다. 구체적으로, 교육 사례는 case0031, case0007, case0009, case0005, case0026, case0039, case0024, case0034, case0033, case0030, case0023, case0040, case0010, case0021, case0006, case0027, case0028, case0037이었으며, 테스트 사례는 case0008, case0022, case0038, case0036, case0032, case0002, case0029, case0003, case0001, case0004, case0025, case0035였습니다. 이 데이터셋은 2024년 7월 9일에 다운로드되었습니다. 이 연구는 공개된 식별 해제 데이터셋만을 사용했고, 새로운 인간-피험자 데이터나 식별 가능한 개인 정보 수집을 포함하지 않았기 때문에, 이 프로토콜에 설명된 계산 실험에 대해 기관심사위원회의 승인이 필요하지 않았습니다. 공식적인 기관 면제 결정은 이루어지지 않았다. 지역 기관 정책에 의해 요구되는 경우, 연구자들은 공개된 데이터셋에 대한 2차 분석을 수행하기 전에 기관 면제 결정을 받아야 합니다. 이 연구에는 기관 윤리 면제 참조 번호나 공식 면제 문서가 제공되지 않았습니다.
1. 데이터셋 준비
- ISIC 2017 피부병변 분할 데이터셋을 공식 국제 피부 영상 협력 저장소에서 다운로드하세요. 공식 교육, 검증, 테스트 파티션을 사용하세요. 데이터셋에 2,000개의 학습 이미지, 150개의 검증 이미지, 600개의 테스트 이미지가 포함되어 있는지 확인하세요.
- ISIC 2018 피부 병변 분할 데이터셋을 국제 피부 영상 협력 공식 저장소에서 다운로드하세요. 공식 교육, 검증, 테스트 파티션을 사용하세요. 세분화 데이터셋에 2,594개의 학습 이미지, 100개의 검증 이미지, 1,000개의 테스트 이미지가 포함되어 있는지 확인하세요.
- 시냅스 다기관 분할 데이터셋을 다운로드하세요. 훈련용으로 18사례(2,212 축 단면)와 12 사례(1,567 축 단면)로 구성된 표준 분할을 사용하세요. 별도의 검증 세트를 도입하지 마세요.
- 12건의 검사 사례는 최종 평가용으로 예약하세요. 테스트 케이스를 모델 학습, 하이퍼파라미터 튜닝, 모델 선택에 사용하지 마십시오. 분할 작업에는 대동맥, 담낭, 비장, 왼쪽 신장, 오른쪽 신장, 간, 췌장, 위 등 8개의 복부 장기가 포함됩니다.
- 다음 Synapse 데이터셋 분할을 사용하세요. 18개의 교육 사례는 case0031, case0007, case0009, case0005, case0026, case0039, case0024, case0034, case0033, case0030, case0023, case0040, case0010, case0021, case0006, case0027, case0028, case0037입니다. 12건의 검사 사례는 case0008, case0022, case0038, case0036, case0032, case0002, case0029, case0003, case0001, case0004, case0025, case0035였습니다.
- 각 데이터셋을 별도의 이미지 폴더와 마스크 폴더로 정리하세요. 각 이미지가 동일한 케이스 식별자를 가진 해당 세분화 마스크를 갖도록 하세요.
- 각 피부 병변 마스크를 이진 전경-배경 분할 맵으로 변환합니다. Synapse 데이터셋의 원래 다중 클래스 기관 라벨을 유지하세요.
- ISIC 2017 및 ISIC 2018 데이터셋의 경우, 이진 마스크 변환 후 배경 픽셀에는 0, 병변(전경) 픽셀에 1을 라벨 값을 할당합니다. 원본 마스크 값이 0보다 큰 픽셀은 전경으로 간주되어 1로 변환되고, 원본 마스크 값이 0인 픽셀은 배경으로 간주되어 0으로 유지됩니다. Synapse 데이터셋의 경우, 0은 배경 클래스, 1–8은 전경 8개의 전경 오르간 클래스를 나타내는 원래 정수 라벨 값을 유지합니다.
- ISIC 2017과 ISIC 2018의 이미지와 마스크를 원본 화면 비율을 유지하지 않고 256 × 256 픽셀로 크기 조정합니다. 크롭이나 패딩을 적용하지 마세요.
- 각 Synapse CT 슬라이스와 해당 라벨을 224 × 224 픽셀로 크기 조정하세요. RGB 이미지에는 쌍선형 보간을, CT 슬라이스에는 3차 스플라인 보간을, 세그멘테이션 마스크에는 최근이웃 보간을 사용하세요.
- 파이썬에서 이미지 크기 조절.
- ISIC 2017 및 ISIC 2018 데이터셋의 경우, utils.py 에서 구현된 맞춤형 myResize 변환을 사용하여 torchvision.transforms.functional.resize를 호출하여 이미지 및 마스크 텐서를 256 × 256 픽셀로 재조정합니다. 이 변환에서 명시적인 보간 모드나 안티앨리어싱 인수를 지정하지 마세요.
- Synapse 데이터셋은 datasets/dataset.py 에서 scipy.ndimage.zoom을 사용하세요. 3차 스플라인 보간(차수 = 3)을 사용해 CT 이미지 슬라이스를 224 × 224 픽셀로 크기 조정하고, 최근접 이웃 보간(차수 = 0)으로 라벨 맵을 크기 조정합니다. 크기 조절 시 별도의 안티앨리어싱 작업이나 anti_aliasing=True 설정을 적용하지 마세요.
- 텐서 변환 전에 데이터셋별 평균 및 표준편차(SD)를 사용하여 다음과 같은 식 을 사용하여 각 ISIC RGB 이미지를 정규화합니다:
 (1)
그 후 최소 최대(min–max) 정규화를 사용해 0–255 범위로 정규화된 이미지를 재조정합니다.- ISIC 2017 학습 세트에는 μ = 159.922, σ = 28.871, ISIC 2017 검증 및 테스트 세트에는 μ = 148.429, σ = 25.748을 사용하세요. ISIC 2018 훈련 세트에는 μ = 157.561, σ = 26.706을, ISIC 2018 검증 및 테스트 세트에는 μ = 149.034, σ = 32.022를 사용하세요.
- 각 정규화된 이미지를 3 × 256 × 256의 텐서로 변환합니다. 각 이진 마스크를 1 × 256 × 256의 텐서로 변환합니다.
- 데이터셋별 평균 및 표준편차 정규화 후 각 이미지에 대해 독립적으로 최소-최대 정규화를 수행합니다. 구체적으로, 각 이미지에서 데이터셋별 평균을 빼고 해당 표준편차로 나누는 것입니다.
- 정규화된 이미지에서 최소 및 최대 강도 값을 계산하고, 이 이미지별 최소값과 최대 값을 사용하여 0–255 범위로 이미지를 재조정합니다. 이 최소 최대 재조정 단계에 대해 데이터셋 전체 최소값과 최대값을 사용하지 마십시오.
- 각 Synapse CT 슬라이스를 2차원 그레이스케일 이미지로 준비하세요. 각 CT 슬라이스를 float32로 변환하고 단일 채널 차원을 더하면 1 × 224 × 224의 입력 텐서를 얻습니다.
- 각 Synapse 라벨 맵은 224 × 224 모양의 단일 채널 정수 마스크로 유지합니다. 데이터 로더에서 추가적인 데이터셋 수준의 평균 표준값 정규화를 적용하지 마십시오.
- 학습 슬라이스에는 .npz 형식으로 제공된 사전 처리된 Synapse 파일을 사용하고, 볼륨 테스트에는 .npy.h5 형식을 사용하세요. 교육 중에는 각 .npz 파일에서, 테스트 중에는 각 .npy.h5 파일에서 직접 이미지 및 라벨 배열을 불러오세요. 공개된 데이터 로더에서는 추가적인 강도 클리핑, CT 윈도잉, 데이터셋 수준 정규화, 원시 볼륨 재샘플링을 적용하지 마십시오.
- 모델 학습 중에는 로드된 각 2차원 슬라이스를 float32로 변환하고, scipy.ndimage.zoom을 사용해 이미지 슬라이스의 순서는 = 3, 라벨 맵은 순서 = 0으로 하여 목표 공간 크기로 크기를 조정한 후, 크기 변경된 배열을 싱글톤 채널 차원의 텐서로 변환합니다.
- 데이터 증강은 훈련 세트에만 적용하세요. ISIC 2017과 ISIC 2018에서는 0°에서 360°까지 샘플링한 각도로 무작위 수평 뒤집기(p = 0.5), 무작위 수직 뒤집기(p = 0.5), 무작위 회전(p = 0.5)을 적용합니다.
- 각 이미지 마스크 쌍에 동일한 기하학적 변환을 적용합니다. 검증 및 테스트 중에는 크기 조정, 정규화, 텐서 변환만 적용하세요.
- Synapse 데이터셋의 경우, 훈련 중에 무작위 회전과 무작위 뒤집기를 적용하세요. 각 이미지 라벨 쌍을 무작위로 k × 90°(여기서 k ∈ {0,1,2,3})로 회전시키거나, 한 공간 축을 따라 무작위로 뒤집거나, −20°에서 20° 사이에서 샘플링한 각도로 이미지-라벨 쌍을 무작위로 회전시키세요.
- 테스트 중에는 확률적 증강을 적용하지 마십시오.
- RandomGenerator 변환에서 구현된 상호 배타적 분기를 사용하여 Synapse 데이터셋에 데이터 증강을 적용합니다.
- 각 학습 샘플에 대해 먼저 조건 random.random() > 0.5를 평가합니다. 이 조건이 충족되면 무작위로 90° 회전(k = 0, 1, 2, 3)과 한 공간 축을 따라 무작위 뒤집는 random_rot_flip을 적용합니다.
- 첫 번째 분기가 선택되지 않으면 두 번째 조건인 random.random() > 0.5를 평가합니다. 이 조건이 충족되면 −20°에서 20° 사이의 무작위 회전각을 선택해 random_rotate 적용합니다. 두 조건 모두 충족되지 않으면 표본에 확률적 증강을 적용하지 마십시오.
- 동일한 변환을 입력 이미지와 해당 라벨 맵 모두에 적용합니다.
- 데이터셋 로딩, 전처리, 학습 전에 랜덤 시드를 설정하세요. 주요 비교 실험에는 무작위 씨앗 1, 52, 100을 사용하고, 별도 명시가 없는 한 소작 검사에는 씨앗 100을 사용하세요.
- 데이터 로더를 구축하기 전에 Python, NumPy, PyTorch CPU, PyTorch CUDA, cuDNN 무작위 생성기를 초기화하세요. 모든 시드 실행에서 데이터셋 파티션, 전처리 절차, 증강 설정, 정규화 매개변수, 크기 조절 전략, 평가 전처리는 변경하지 않도록 유지하세요.
- ISIC과 Synapse 실험 모두에 대해 num_workers = 0으로 설정하여 메인 프로세스에서 데이터 로딩을 수행합니다. 데이터셋을 구성하고 DataLoader를 만들기 전에, Python, NumPy, PyTorch CPU, PyTorch CUDA, cuDNN 난수 생성기를 시딩하는 set_seed 함수를 사용해 글로벌 랜덤 시드를 초기화합니다. 별도의 worker_init_fn 또는 DataLoader 전용 무작위 생성기를 정의하지 마세요. 이들은 출시된 구현에서 사용되지 않습니다.
2. MVM-UNet 아키텍처의 구성
- U자형 인코더-디코더 아키텍처를 사용하여 제안된 다중 뷰 비전 맘바 유닛(MVM-UNet)을 구축합니다.
- 입력 이미지 크기를 H × W × 3으로 설정하세요. 입력 이미지를 패치 임베딩 레이어를 통과시킵니다.
- 커널 크기가 4× 4, 스트라이드가 4, 입력 채널 3개, 출력 채널 96개인 2D 합성곱을 사용해 패치 임베딩 계층을 구현합니다.
- 입력 특징 맵을 H/4 × W/4의 공간 해상도로 변환하고, C = 96개의 출력 채널을 사용합니다.
- 네 개의 인코더 단계와 네 개의 디코더 단계를 구성합니다. 인코더 단계마다 공간 해상도를 절반으로 줄이고 채널 차원을 두 배로 늘리세요.
- 대칭 인코더-디코더 구성을 사용하세요. 인코더와 디코더 모두에서 MVV 블록 수를 {2, 2, 2, 2}로 설정하세요.
- 각 인코더 단계에 MVV 블록 2개, 디코더 단계마다 2개의 MVV 블록을 배치하세요.
- 모든 인코더와 디코더 단계에 MVV 블록을 삽입하세요. 각 MVV 블록 내에서 MV4D 모듈을 핵심 특징 추출 모듈로 사용하세요.
- 인코더와 디코더 사이에 MFusion Mamba 모듈을 삽입하세요. 이 모듈을 사용해 디코딩 전에 다단계 인코더 기능을 융합하세요.
- 전체 MVM-UNet 워크플로우를 구성하세요. 인코더 전체에서 특징 추출을 위해 MV4D를 사용하세요.
- 인코더 출력은 스킵 연결로 유지하세요. 인코더 출력을 해당 디코더 단계로 전달합니다.
- 디코딩 전에 인코더 기능을 MFusion Mamba에 전달하세요. 퓨전 표현을 디코더를 통해 점진적으로 업샘플링하여 분할 헤드를 사용해 최종 분할 맵을 생성합니다.
- 입력 ∈이미지를 RB×H×W×3 을 패치 임베딩 레이어를 통과시키면 여기서 C = 96을 얻
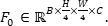 습니다.
- 인코더 특징 맵 생성: E1 ∈ RB×H/4×W/4×C, E2 ∈ RB×H/8×W/8×2C, E3 ∈ RB×H/16×W/16×4C, E4 ∈ RB×H/32×W/32×8C. 모든 인코더 단계에 MV4D가 포함된 MVV 블록을 사용하세요.
- 해당 스킵 연결에 대해 모든 인코더 기능을 보존하세요. 모든 인코더 기능을 MFusion Mamba로 전달하여 다단계 기능 융합을 진행하세요.
- MFusion Mamba 내에서 거칠고 미세 융합하기 전에 인코더 특징을 공통 특징 공간에 정렬하세요. 퓨즈 표현을 디코더에 전달합니다.
- 디코더 표현을 점진적으로 업샘플링하세요. 디코더 기능을 H/16 × W/16, E2 H/8 × W/8, E1 H/4 × W/4 퓨전합니다.
- 최종 디코더 기능을 원본 이미지 해상도로 업샘플링합니다. RB×H×W×K ∈ 예측 지도
 를 생성합니다. 여기서 이중 병변 분할은 K = 1, 시냅스 다기관 분할은 K = 8입니다.
- 전체 네트워크 아키텍처는 그림 2 를, 각 단계별 연산, 주요 매개변수, 출력 기능 치수를 포함한 전체 계층별 아키텍처 명세는 보조 표 1 을 참조하십시오
- 인코더-디코더 전이 계층
- 다운샘플 인코더는 패치 머징 전환 계층을 사용하는 기능입니다. 각 전이마다 2× 2 이웃에서 공간적으로 교차된 네 가지 특징군을 샘플링하여 채널 차원을 따라 연결하고, 레이어 정규화(Layer Norm)를 적용한 뒤, 결과 4C 차원 특징을 바이어스 없는 선형 층을 사용해 2C 채널에 투영합니다. 이 연산은 공간 해상도를 2배로 낮추면서 채널 차원을 두 배로 늘립니다.
- 패치 확장 전이 계층을 사용하는 업샘플 디코더 기능. 바이어스 없는 선형 투영법을 적용하고, 확장된 특징을 공간적으로 재배열하여 해상도를 2배 높인 뒤, 공간 확장 후에 레이어노름을 적용합니다. 이 과정을 반복하여 H/32 × W/32에서 H/16 × W/16, H/8 × W/8, H/4 × W/4로 점진적으로 특징 지도를 재구성합니다.
- MFusion Mamba 모듈 내 인코더 특징을 쌍선형 보간(align_corners = False)으로 대상 공간 해상도에 맞게 크기 조정한 후, 특징 융합 전에 학습 가능한 선형 채널 투영을 적용합니다.
- 세분화 헤드
- 최종 패치 확장 레이어를 사용해 최종 디코더 특징 맵을 H/×4에서 W/4에서 원래 이미지 해상도(H × W)로 업샘플링합니다. 선형 투영을 적용하고, 팽창 계수 4로 공간 재배열을 수행한 후 LayerNorm을 적용합니다.
- 텐서를 채널 우선 형식으로 변환한 후 1 × 1 합성곱을 사용해 재구성된 특징 맵을 K 출력 채널로 투영합니다.
- 평가 시 이진 병변 분할에는 S모이드 활성화 함수를, 시냅스 다기관 분할에는 소프트맥스 활성화 후 argmax를 적용하여 최종 예측을 생성합니다. 세그멘테이션 헤드 자체에 활성화 기능을 적용하지 마세요.
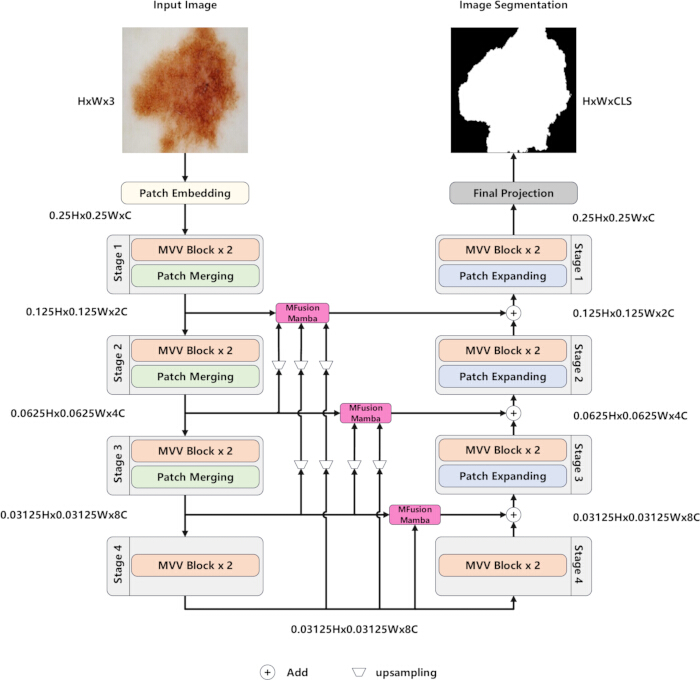
그림 2. 멀티뷰 맘바 U-Net(MVM-UNet)의 전체 아키텍처. 제안된 멀티뷰 맘바 U-Net(MVM-UNet) 아키텍처 개요. 입력 이미지는 패치 임베딩으로 변환되며, 멀티뷰 비전(MVV) 블록으로 구성된 네 개의 인코더 단계를 거치며 패치 머지 작업으로 분리됩니다. 인코더 기능은 다단계 퓨전 맘바(MFusion Mamba)에 의해 집계되어 스킵 연결을 통해 디코더로 전파됩니다. 디코더는 패치 확장 연산을 통해 공간 해상도를 점진적으로 복원하고, 투영 계층을 통해 최종 분할 지도를 생성합니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭해 주세요.
3. MV4D 모듈 제작
- MVV 블록에서 기본 특징 추출 장치로 MV4D 모듈을 사용하세요. 입력 기능 패치를 네 개의 스캔 쌍 분기로 입력합니다. 공간 평탄화, 스캔 쌍 인덱스 생성, 서열 수집, S6/맘바 처리, 역공간 재정렬, 스캔 쌍 융합, SFusion 맘바 융합, 투영, 출력 재형성의 완전한 의사 코드를 참조하라.
- 모델/mvmunet/core.py 에서 구현된 정확한 지그재그, 계층, 나선, 방사형 스캔 인덱스 생성 절차를 사용하세요. 각 스캔 전략에 대해 순방향 스캔 순서와 역방향 순서를 하나의 양방향 스캔 쌍으로 사용합니다.
- 지그재그 스캔 쌍을 구성하세요. 각 행이나 열의 끝에서 이미지를 교차 방향으로 횡단시킵니다. 이 스캔 패턴을 사용해 국소와 전 세계 공간 정보를 균형 있게 조정하세요.
- 계층적 스캔 쌍을 구성합니다. 포획 특징은 여러 공간 규모에서 이루어집니다. 이 스캔 패턴을 활용해 로컬 및 글로벌 표현 추출을 강화하세요.
- 나선형 스캔 쌍을 구성하세요. 이미지 특징을 중심에서 경계 쪽으로 또는 경계에서 중심으로 스캔하세요. 이 스캔 패턴을 사용하여 전역 윤곽 정보 추출을 강화합니다.
- 방사형 스캔 쌍을 구성하세요. 여러 방사형 방향에 따라 이미지 특징을 스캔합니다. 이 스캔 패턴을 사용하여 국소 경계 및 경계 세부 정보를 추출하는 데 도움을 줍니다.
- 각 스캔 쌍을 병합한 후 병합된 시퀀스를 S6 블록에 입력하세요. 쌍 설계를 활용해 각 스캔 전략의 견고성을 높이면서도 계산 효율성을 유지하세요.
- 각 스캔 쌍 분기의 출력 시퀀스를 S6 블록에 입력합니다. 지그재그, 계층적, 나선형, 방사형 스캐닝 뷰에 해당하는 네 가지 특징 표현을 얻습니다.
- SFusion Mamba 모듈을 사용해 추출한 네 가지 특징 표현을 융합합니다. 두 개의 평행한 융합 경로를 사용하세요. 첫 번째 경로에서는 네 가지 특징을 요소별 덧셈으로 통합합니다.
- 두 번째 SFusion Mamba 경로에서는 네 가지 특징을 연결하세요. Conv1d와 Mamba를 사용하여 연속된 표현을 처리합니다. 채널 치수를 S6 블록 출력 치수에 맞게 프로젝션 레이어를 사용해 줄이세요.
- 모델 차원으로 특징 차원 C를 사용하여 S6/Mamba 블록을 구성하세요. 투영 레이어를 사용해 융합 전에 각 병합된 스캔 쌍 특징을 채널 차원 C로 매핑하세요.
- SFusion Mamba에서는 첫 번째 경로에서 원소별 덧셈을 수행하세요. Conv1d, Mamba, 선형 투영 앞의 두 번째 경로에서 네 개의 스캔 뷰 특징을 연결한다. 4단계에서 설명한 대로 MV4D를 둘러싼 정규화, 선형 투영, 깊이별 분리 합성곱, 활성화 연산을 사용하세요.
- 두 융합 경로의 출력을 더해 MV4D 모듈의 최종 출력을 얻습니다.
- 수평 및 수직 스캔 방향만 사용하는 대신 네 개의 상호 보완적인 스캔 쌍 분기를 구성하세요. 지그재그 스캐닝을 사용해 연속적인 공간 횡단을 강조하고, 계층적 스캐닝을 통해 다중 스케일 표현을 강화하며, 나선형 스캐닝을 통해 중심에서 경계까지의 윤곽선 정보를 캡처하고, 방사형 스캐닝을 통해 경계 지향적 지역 세부 정보 추출을 강화합니다.
- 각 스캔 쌍 분기를 독립적으로 처리합니다. 결과물들을 SFusion Mamba로 융합하세요. 각 처리된 서열을 융합 전 원래 공간 순서로 다시 매핑합니다.
- 입력 특징 사상 X가 RB×H×W×C ∈주어지면, 이를 RB×L×C ∈ X연속으로 평평화하는데, 여기서 L = H × W
- 평탄화된 시퀀스를 각 스캔 쌍 분기의 스캔 인덱스에 따라 재정렬합니다. 재정렬된 각 서열을 S6 블록을 사용해 처리합니다. 처리된 시퀀스를 원래의 공간 순서로 복원합니다.
- 네 가지 스캔 뷰 기능을 가산 경로와 SFusion Mamba 경로를 융합하여 최종 MV4D 출력을 얻습니다. MV4D 아키텍처는 그림 3 과 전체 텐서 수준 구현 워크플로우는 알고리즘 1, 보충 파일 1 을 참조하십시오.
- 모델/mvmunet/core.py 에서 완전한 소프트웨어 구현을 사용하세요. 이 파일에는 스캔 인덱스 생성기인 PairwiseScanMamba, SequenceS6, SFusion Mamba, 그리고 MV4D 래퍼 모듈이 포함되어 있습니다.
- 멀티뷰 스캔 인덱스 생성
- models/mvmunet/core.py 에서 공개된 구현을 따라 스캔 인덱스를 생성하세요. 공간 크기의 입력 특징 지도를 H× W를 사용하면, 각 픽셀 위치를 1차원 인덱스로 평탄화하는데, 인덱스 = r × W + c를 사용하며, 여기서 are와 c는 각각 행과 열의 좌표를 나타냅니다.
- 이미지 대각선을 상수 r + c로 횡단하여 지그재그 스캔을 생성합니다. 각 대각선의 유효한 픽셀 인덱스를 수집하고, 짝수 번호 대각선의 순서를 반대로 하여 이동 방향을 번갈아 가며 진행합니다.
- 이미지를 재귀적으로 네 개의 사분면으로 나누어 계층적 스캔을 생성합니다. 왼쪽 위, 오른쪽 위, 왼쪽 아래, 오른쪽 아래 사분면을 차례로 방문하여 하위 영역의 높이나 너비가 2픽셀을 넘지 않을 때까지 한 후, 나머지 픽셀들은 행 순서대로 순회합니다.
- 나선형 스캔은 상단 행을 따라 왼쪽에서 오른쪽으로, 오른쪽 열을 따라 아래로, 아래쪽 행을 따라 오른쪽에서 왼쪽으로, 왼쪽 열을 따라 위쪽으로 이동하면서 화면 중앙 쪽으로 경계를 점차 줄여가면서 생성합니다.
- 각 픽셀을 이미지 중심으로부터의 제곱 거리로 정렬하고, atan2 함수를 사용해 계산한 극각에 따라 반경 스캔을 생성합니다.
- 각 스캔 전략에 대해 해당 순방향 스캔 순서를 역방향으로 하여 역스캔을 생성합니다. 순방향 및 후진 스캔 시퀀스를 결합하여 각 스캐닝 전략에 대해 하나의 스캔 쌍을 형성한 후 MV4D 모듈로 스캔 쌍을 전달합니다.
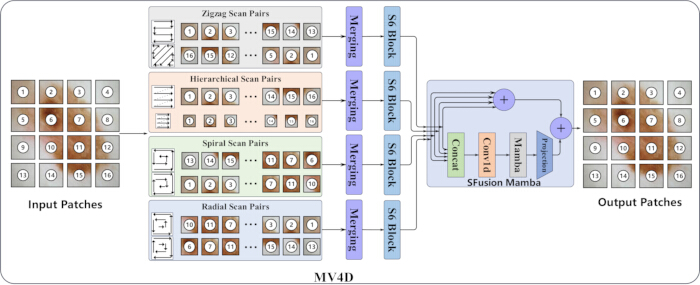
그림 3. 멀티뷰 4방향(MV4D) 모듈의 아키텍처. 다중 뷰 4방향(MV4D) 특징 추출 모듈의 구조. 입력 패치는 지그재그, 계층, 나선, 방사형 스캔 등 네 가지 상호 보완적인 스캔 쌍 분기를 통해 처리됩니다. 네 가지 분기에서 추출한 특징들은 병합되고, 상태 공간 블록을 사용해 처리되며, Spatial Fusion Mamba(SFusion Mamba)에 의해 통합되어 출력 특징 표현을 생성합니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭해 주세요.
4. MVV 블록 건설
- MVV 블록은 하나의 메인 지선과 두 개의 보조 지선을 사용해 건설합니다. 그림 4에 표시된 전체 구조를 사용하세요.
- 메인 브랜치의 입력 기능에 레이어 정규화를 적용하세요. 정규화된 특징을 선형 층에 입력하세요. 변환된 특징을 깊이별 분리 가능한 합성곱에 전달합니다.
- 변환된 특징을 깊이별 분리 합성곱을 사용해 처리합니다. GELU 활성화 기능을 적용하세요. 활성화된 기능을 MV4D 모듈에 입력하세요.
- 첫 번째 보조 분기를 항등 잔류 연결로 구성한다. 입력 기능을 최종 출력에 직접 연결하세요. 이 분기를 사용해 원래의 표현을 보존하고 훈련을 안정화하세요.
- 두 번째 보조 가지를 투영 하행 가지로 구성하세요. 입력 특징을 다운프로젝션 레이어를 사용해 압축합니다. 업프로젝션 레이어를 사용해 특징 차원을 복원합니다.
- 메인 브랜치와 두 보조 브랜치의 출력을 병합하세요. 최종 MVV 블록 출력을 얻으세요. 전체 아키텍처는 그림 4를 참조하세요.
- 메인 브랜치의 숨겨진 차원을 입력 채널 차원 Cs와 같게 설정합니다. 주요 선형 투영 전에 LayerNorm(Cs)을 적용하고, 치수 Cs→Cs의 선형 레이어를 사용하세요. 깊이별로 분리 가능한 컨볼루션을 사용하는데, 3×3 깊이 방향 합성 컨볼루션을 패딩 1, 군 = Cs, 편향 없는 1×1 점별 컨볼루션으로 구성됩니다.
- 깊이별 분리 가능한 합성곱 후에 GELU 활성화 함수를 적용합니다. 활성화된 특징을 MV4D에 입력하고, Cs→Cs의 출력 선형 투영법을 적용합니다. LayerNorm(Cs), 투영 비율 4, 하행 투영 Cs→Cs/4, GELU 활성화, 그리고 상향 투영 Cs/4→Cs를 사용하여 투영 하행 분기를 구성합니다.
- 원소별 덧셈을 사용하여 동일 분기, 투영 다운업 분기, 드롭 패스 처리된 메인 분기를 결합하여 최종 MVV 블록 출력을 얻습니다.
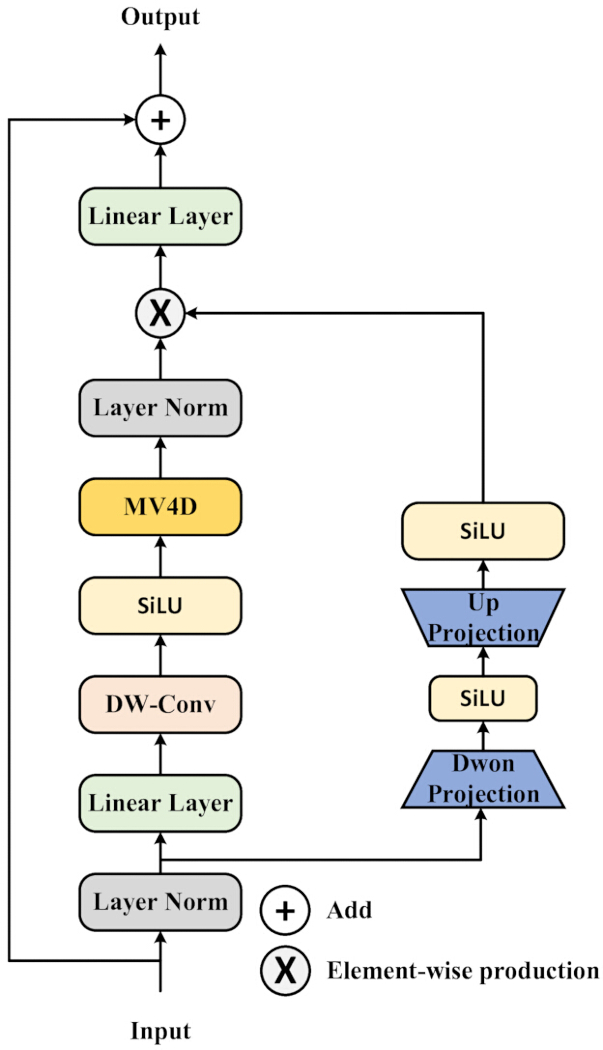
그림 4. 멀티뷰 비전(MVV) 블록의 아키텍처. 멀티뷰 비전(MVV) 블록의 구조. 이 블록은 다중 뷰 4방향(MV4D) 모듈과 깊이별 합성곱, 정규화, 선형 투영 계층을 포함하는 주요 특징 추출 분기로 구성되어 있습니다. 보조 상하 투영 분기는 요소별 곱셈을 통해 게이티드 특징 변조를 제공하며, 잔류 덧셈을 통해 출력 특징 표현을 생성합니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭해 주세요.
5. MFusion Mamba 건설
- 모든 인코더 단계의 특징 맵을 수집하세요. 필요 시 인코더 기능을 크기를 조정하거나 투영하여 통합 표현 공간에 정렬하세요. 전체 텐서 수준 구현 워크플로우는 알고리즘 2, 보조 파일 1 을 참조하십시오.
- 필요 시 인코더 특징을 목표 공간 해상도에 맞게 크기 조정합니다. 서로 다른 채널 차원의 특징을 같은 채널 차원에 투영합니다. 다단계 융합 전에 모든 인코더 기능을 정렬하세요.
- 정렬된 인코더 기능을 거친 융합 컴포넌트에 입력하세요. Hadamard 제품을 사용하여 거칠게 융합을 수행하세요. 거친 융합 표현을 생성하세요.
- 거친 융합 표현을 미세 융합 성분에 넣습니다. 두 개의 평행한 미세 융합 경로를 구축하세요. 두 경로를 독립적으로 처리하세요.
- 선형 레이어를 사용하여 첫 번째 미세 융합 경로를 처리합니다. 두 번째 미세 융합 경로를 업프로젝션, Conv1d, Mamba, 다운프로젝션을 사용해 처리합니다. 하향 투사 후 특징 차원을 복원합니다.
- 두 미세 융합 경로의 출력을 Hadamard 곱을 사용해 병합합니다. 최종 선형 레이어를 적용하세요. MFusion Mamba 출력을 얻으세요.
- MFusion Mamba 출력을 디코더에 입력하세요. 퓨즈드 다단계 표현과 인코더-디코더 스킵 기능을 함께 디코딩합니다. 최종 세분화 지도를 생성하세요.
- 서로 다른 단계의 인코더 특징들을 통합된 특징 공간으로 정렬한 후 거친 융합을 진행하세요. 조잡 및 미세 융합 단계를 사용하여 정렬된 특징 표현을 처리합니다. MFusion Mamba 아키텍처는 그림 5 를 참조하고, 전체 텐서 수준 구현 워크플로우는 보조 알고리즘 2를 참조하세요.
- MFusion Mamba 구현 매개변수를 다음과 같이 사용하세요. 각 인코더 특징 Ei 에 대해 채널 차원을 Ci 에서 Ct로 투영합니다. 필요 시 align_corners=False를 적용한 쌍선형 보간법을 사용해 투영된 특징을 목표 공간 크기로 재조정합니다.
- Hadamard 제품을 적용하여 정렬된 인코더 특징에 대해 거친 융합을 수행합니다. 첫 번째 미세 융합 경로를 C t → C t의 선형 층으로 구성합니다. 두 번째 미세 융합 경로를 2Ct→ 상향 투영 C t, Conv1d, 모델 차원 2Ct, 하나의 스캔 방향, 상태 차원 16, 그리고 하향 투영 2Ct → Ct를 사용하여 구성합니다.
- 미세 융합 경로의 출력을 Hadamard 곱을 사용해 융합합니다. 최종 선형 투영법을 C t에 대한 차원 C t로 적용합니다. 퓨즈된 다단계 표현을 디코더에 입력하세요.
- MFusion Mamba 활용 퓨즈 다단계 인코더 기능
- 네 개의 인코더 단계(E1,E 2,E 3, E4) 모두에서 인코더 기능을 수집하여 MFusion Mamba 모듈의 입력으로 사용합니다. 디코더 퓨전을 위해 해당 단계 인코더 기능만 선택하지 마십시오.
- 모든 인코더 기능을 현재 디코더 단계에 필요한 공간 해상도에 맞춰 정렬하세요. 인코더 피처를 목표 해상도에 맞게 재조정하고, 특징 융합 전에 필요한 채널 크기로 프로젝션하세요.
- 각 디코더 단계마다 특징 정렬 절차를 반복합니다. 디코더가 H/16 × W/16, H/8 × W/8, H/4 × W/4에서 동작할 때, E1,E 2,E 3, E4 를 해당 목표 특징 공간으로 크기 조정하고 투영합니다.
- MFusion Mamba 모듈의 거친 융합 및 파인 융합 연산을 사용하여 정렬된 다단계 인코더 특징을 융합하고, 해당 스케일에서 퓨즈된 표현과 디코더 기능을 결합합니다.
- 모델/mvmunet/core.py 에서 공개된 구현에 따라 특징 투영, 크기 조정, 융합 작업을 수행하세요.
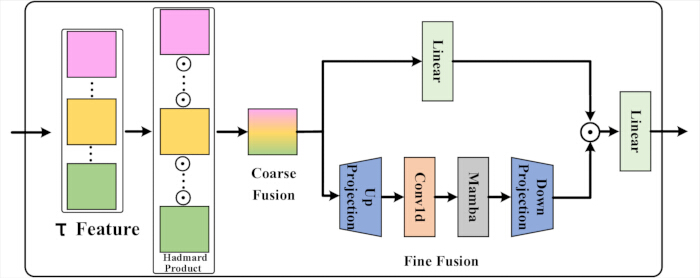
그림 5. 다단계 핵융합 맘바(MFusion Mamba) 모듈의 아키텍처. 다단계 융합 맘바(MFusion Mamba) 모듈의 구조. 다중 스케일 인코더 특징들은 먼저 거친 융합으로 결합되고, 이후 선형 투영, 1차원 컨볼루션(Conv1d), 맘바 블록, 특징 투영 층으로 구성된 파인 퓨전 모듈을 통해 정제되어 디코더가 사용하는 융합 특징 표현을 생성합니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭해 주세요.
6. 모델 훈련
- Ubuntu 22.04.1에서 리눅스 커널 버전 6.8.0을 탑재한 MVM-UNet을 학습하세요. 13세대 인텔 코어 i9-13900K CPU와 NVIDIA A800 GPU가 장착된 워크스테이션을 사용하세요. 교육과 평가 내내 동일한 하드웨어 구성을 사용하세요.
- CUDA 11.8이 적용된 PyTorch 2.0.1을 사용해 모델을 구현하고 학습하세요. 교육 전에 필요한 모든 소프트웨어 의존성을 설치하세요.
- 초기 학습률 3 × 10⁻⁻, β1 = 0.9, β2 = 0.999, ε = 1 × 10⁻⁹, 가중치 감쇠 0.01의 AdamW 옵티마이저를 사용하세요. 별도 명시가 없는 한 배치 크기를 32로 설정하세요.
- 각 모델을 300 에포크에 대해 훈련시키세요. η분 = 1 × 10⁻⁻⁻ 코사인 어닐링 학습률 일정을 사용하세요. 입력 이미지 크기를 ISIC 2017과 ISIC 2018은 256× 256, Synapse는 224× 224로 설정하세요.
- 주요 비교 실험에는 세 개의 독립적인 무작위 시드(1, 52, 100)를 사용하세요. 각 씨앗에 대해 완전한 훈련과 평가 과정을 반복하세요. 최종 정량적 결과를 세 번의 연속 평균 ± SD로 보고하세요.
- 별도 명시가 없는 한 모든 절제 검사에는 고정된 무작위 시드인 100을 사용하세요. 모든 소작 실험에서 데이터셋 파티션, 전처리 전략, 네트워크 아키텍처, 옵티마이저, 학습률, 배치 크기, 학습 에포크 수를 변경하지 않도록 하세요.
- ISIC 2017과 ISIC 2018에서 이진 병변 분할에 BCE-Dice 손실을 사용하세요. BCE와 주사위 손실 가중치를 1.0으로 설정하세요. Synapse의 CE-Dice 손실을 사용하고, 교차 엔트로피와 Dice 손실 가중치를 모두 1.0으로 설정하세요.
- 1단계에서 설명한 전처리 절차를 사용하여 ISIC 2017과 ISIC 2018 학습 이미지를 재크기, 정규화, 보강할 수 있습니다. 1단계에서 설명한 대로 Synapse 학습 이미지에 크기 조정, 무작위 회전, 무작위 뒤집기를 적용하세요. 모든 훈련 실행 시 동일한 전처리 설정을 사용하세요.
- 데이터셋별 검증 프로토콜에 따라 모델 체크포인트를 선택합니다. ISIC 2017과 ISIC 2018의 검증 성능이 가장 좋은 체크포인트를 저장하고, 30 에포크마다 검증을 수행하세요. 검증 세트 없이 300 에포크간 Synapse를 훈련시키고, 최종 훈련 체크포인트를 테스트용으로 사용하세요.
- ISIC 2017과 ISIC 2018에서는 모델 선택에만 공식 검증 세트를 사용하세요. Synapse 테스트 세트를 훈련, 하이퍼파라미터 튜닝, 체크포인트 선택에 사용하지 마세요. 모든 검사 데이터는 최종 평가용으로 독점적으로 예약하세요.
- 재현성을 위해 다음 훈련 매개변수를 사용하세요. 모든 데이터셋의 배치 크기를 32로 설정하세요. 초기 학습률이 3 × 10⁻⁻, β1 = 0.9, β2 = 0.999, ε = 1 × 10⁻⁹, 가중치 감쇠 1 × 10⁻²인 AdamW를 사용한다.
- ISIC 2017과 ISIC 2018을 위해 코사인 어닐링 학습율 스케줄러를 Tmax = 50, ηmin = 1×10⁻⁻으로 설정하세요. Synapse의 경우 스케줄러를 Tmax = 100, min = 1 η×10−5로 설정하세요. 모든 반복 실험에서 스케줄러 설정을 변경하지 마세요.
- 모든 모델을 완전 정밀도 FP32 산술로 훈련시키세요. 자동 혼합정밀 훈련을 비활성화하세요. 최적화 중에는 그라데이션 클리핑을 적용하지 마세요.
- 정밀 설정, 구배 업데이트 전략, 최적화기 구성, 학습률 일정, 무작위 시드 프로토콜은 모든 비교 실험, 소작 연구, 재현성 실행에서 변경하지 않도록 유지하세요.
- 최적의 모델 체크포인트를 선택하세요
- ISIC 2017 및 ISIC 2018 데이터셋의 각 학습 에포크가 끝난 후 검증 세트에서 모델을 평가합니다.
- 각 검증 배치에 대해 이진 교차 엔트로피(BCE)-주사위 손실을 계산하고, 전체 검증 세트에 걸친 평균 검증 손실을 계산합니다.
- 평균 검증 손실이 이전에 기록된 최소 검증 손실보다 낮을 때 현재 모델을 최적의 체크포인트로 저장합니다.
- 성능 모니터링 시 성능 모니터링을 위해 연합 간 평균 교차(mIoU), 주사위 유사 계수(DSC), 정확도(Acc), 특이도(Spe), 민감도(Sen)를 기록하세요. 이 지표들을 체크포인트 선택 기준으로 사용하지 마십시오.
7. 모델 평가
- 각 데이터셋의 공식 테스트 세트를 사용해 학습된 모델을 평가하세요. 최종 성과 평가에는 시험 세트만 사용하세요.
- ISIC 2017과 ISIC 2018의 경우, mIoU, DSC, Acc, Sen, Spe를 계산하세요. 모든 계산에 픽셀 단위의 진실양성(TP), 거짓 양성(FP), 진음성(TN), 거짓 음성(FN)을 사용하세요.
- ISIC 2017과 ISIC 2018의 모델 출력에 시그모이드 활성화 함수를 적용합니다. 확률 맵을 0.5의 임계값을 사용하여 이진 분할 마스크로 변환합니다. 평가 지표는 방 정식 2–6을 사용하여 계산합니다:
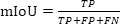 (2)
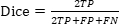 (3)
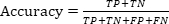 (4)
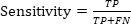 (5)
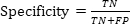 (6)
- Synapse의 경우 모델 출력에 softmax 활성화 함수를 적용하세요. argmax 연산을 사용하여 각 픽셀 또는 복셀을 가장 확률이 높은 클래스에 할당합니다. 각 전경 기관에 대해 DSC와 95백분위수 하우스도르프 거리(HD95)를 계산하고 모든 검사 사례의 평균 값을 보고합니다.
- MVM-UNet과 대표적인 CNN 기반, 트랜스포머 기반, 상태 공간 모델(SSM) 기반 분할 방법과 비교해 보십시오. 모든 방법에 동일한 데이터셋 파티션, 전처리 절차, 입력 해상도, 평가 지표를 사용하세요.
- ISIC 2017 및 ISIC 2018의 공식 교육, 검증, 테스트 파티션을 사용하세요. Synapse는 18개의 훈련 케이스와 12개의 테스트 케이스로 표준 분할을 사용하세요. ISIC 데이터셋과 Synapse에 대해 입력 해상도를 각각 다음과 같이 설정하세요.
- 공식 구현 방식을 사용할 수 있을 때 기본 방법을 재현하세요. 보고서는 반복 실행 ± 평균 SD로 결과를 재현했습니다. 문헌에서 처음 발표된 값을 유지하고 해당 표 노트에서 구분하세요.
- 별도 명시가 없는 한 고정된 무작위 시드 100을 사용하여 소작 연구를 수행하십시오. 데이터셋 파티션, 전처리 절차, 입력 해상도, 옵티마이저, 학습률 일정, 배치 크기, 에포크 수, 손실 함수, 평가 지표는 모든 소작 실험에서 변경하지 않습니다.
- MV4D, SFusion Mamba, MVV 블록 내 업-다운 투사 분기, MFusion Mamba, 입력 이미지 크기, 드롭아웃 값, 인코더-디코더 계층 구성의 기여를 평가합니다. 각 소작 실험에서는 목표 성분이나 매개변수만 수정하세요.
- ISIC 2017과 ISIC 2018의 이미지별 결과와 Synapse의 사례별 결과를 쌍으로 사용하여 Wilcoxon 서명 순위 검정을 수행합니다. 통계적 유의성을 나타내기 위해 0.05보다 작은 p-값을 고려합니다.
- 모든 방법에 대해 동일한 하드웨어 환경과 입력 해상도를 사용하여 계산 효율성을 평가합니다. 에포크별 훈련 시간, 이미지당 추론 시간, 훈련 중 GPU 메모리 최대 사용량, 모델 매개변수 수, 부동소수점 연산(FLOP)을 측정합니다. 단일 전진 패스를 사용해 FLOP을 계산하세요.
- 모델 평가를 완료한 후 테스트 세트에서 대표적인 정성적 예시만 선택하세요. 원본 이미지, 지상 진실 마스크, 예측 마스크를 동일한 테스트 케이스를 모든 방법으로 비교합니다. 작은 표적, 불규칙한 경계, 모호한 경계, 대표적인 다기관 구조 등 대표적인 예시를 선택하세요.
- 평가 지표를 계산하고 통계 분석을 수행합니다
- NumPy와 sklearn.metrics.confusion_matrix를 사용해 Python으로 ISIC 2017 및 ISIC 2018 데이터셋의 세분화 지표를 계산하세요. 예측 확률 맵을 0.5에서 임계값을 계산하고, 픽셀 단위의 TP, FP, TN, FN을 얻은 뒤, 이 값들로부터 mIoU, DSC, Acc, Sen, Spe를 계산합니다.
- medipy.metric.binary.dc 및 medpy.metric.binary.hd95를 사용하여 Synapse 데이터셋의 DSC와 HD95를 각각 계산하세요. 평가 지표를 계산하기 전에 모델 출력에 softmax 다음에 argmax를 적용하세요.
- thop.profile을 사용하여 단일 포워드 패스로 FLOP의 수와 학습 가능한 매개변수를 계산합니다.
- scipy.stats.wilcoxon을 사용하여 Python에서 Wilcoxon 부호 순위 검정을 수행하세요. ISIC 2017 및 ISIC 2018 데이터셋에는 이미지별 지표 값을 짝지어, Synapse 데이터셋에는 사례별 지표 값을 짝지어 사용하세요.
8. 손실 함수 정의
- 다중 클래스 분할에는 표준 교차 엔트로피(CE) 손실을, 이진 분할에는 표준 BCE 손실을 사용하세요. 세분화에는 표준 주사위 손실 공식을 사용하세요. 방 정식 7–11 은 이 프로토콜에서 사용되는 손실 함수를 정의합니다.
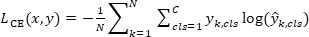 (7)
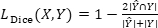 (8)
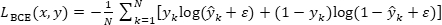 (9)
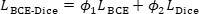 (10)
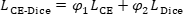 (11)
- ISIC 2017과 ISIC 2018의 BCE와 Dice 손실 가중치를 1.0으로 설정하여 1 = 1.0,
 2 = 1.0이 되도록 설정하세요. 시냅스의 CE와 주사위 손실 가중치를 1.0으로 설정하세요. 예를 들어 1 = 1.0, φ2 = 1.0 φ
- 손실 함수를 utils.py 에 구현하세요. nn을 사용하세요. BCE 학기와 nn에 대한 BCELoss CE 항에 대한 CrossEntropyLoss. 각 예측된 마스크와 근전 진실 마스크를 평탄화하고, 각 샘플의 다이스 손실을 계산하며, 배치 전체의 손실을 평균화하여 이진 다이스 손실을 계산합니다. 대상 라벨 맵을 원핫 형식으로 변환하고, 모델 출력에 softmax를 적용하며, 각 클래스별 주사위 손실을 계산하고 모든 클래스에 걸쳐 손실을 평균화하여 다중 클래스 주사위 손실을 계산합니다.
- 이진 주사위 손실은 평탄화 상수를 1, 다중류 주사위 손실은 1×10⁻⁵ 으로 설정합니다. bceDiceLoss 클래스를 사용하여 bb = 1, wd = 1로 BCE-Dice 손실을 구현합니다. CeDiceLoss 클래스를 사용하여 loss_weight = [1, 1]로 CE-Dice 손실을 구현합니다. 모든 데이터셋, 무작위 시드, 실험에 대해 평활화 상수, 감축 전략, 소프트웨어 구현은 변경하지 마세요.
- 손실 감소 설정
- nn을 인스턴스화하세요. BCELoss()와 nn. 감소 인자를 명시적으로 명시하지 않은 CrossEntropyLoss()
- 두 손실 함수 모두 기본 PyTorch 손실 감소 설정(reduction = "mean")을 사용하세요. reduction = "합" 또는 감축되지 않은 손실 출력은 사용하지 마십시오.
9. 재현성 설정 및 실행
- https://github.com/LIXUEGUANG002/MVM-UNet 에서 공개된 구현 버전을 다운로드하세요. 저장소를 재료표에 나열된 소프트웨어 패키지, 데이터셋, 하드웨어 사양 및 계산 자원과 함께 사용하세요.
- 저장소를 복제하고 프로젝트 디렉터리에 git clone https://github.com/LIXUEGUANG002/MVM-UNet.git 실행한 뒤 cd MVM-Unet을 실행하세요.
- ISIC 2017 또는 ISIC 2018 실험은 config/config_setting.py에서 데이터셋 이름, 데이터셋 경로, 입력 크기, 배치 크기, 에포크 수, 손실 함수, 옵티마이저, 학습률 스케줄러, 무작위 시드를 설정하여 구성하세요. 저장소 루트에서 파이썬 train.py 로 학습 스크립트를 실행하세요.
- Synapse 실험을 구성하려면 config/config_setting_synapse.py에서 데이터셋 이름, 학습 데이터 경로, 테스트 볼륨 경로, 리스트 디렉터리, 입력 크기, 클래스 수, 배치 크기, 에포크 수, 손실 함수, 옵티마이저, 학습률 스케줄러, 무작위 시드를 설정하세요. 저장소 루트에서 파이썬 train_synapse.py로 훈련 스크립트를 실행하세요.
- only_test_and_save_figs = True를 설정하고, 학습된 체크포인트로 best_ckpt_path하며, 해당 구성 파일의 출력 디렉터리로 img_save_path하여 추론 전용 평가를 수행합니다. ISIC 2017 또는 ISIC 2018을 위해 파이썬 train.py 을 실행하거나, Synapse에서 파이썬 train_synapse.py을 실행해 예측 결과와 정성적 수치를 생성할 수 있습니다.
- 공개된 소스 코드 버전을 사용하세요
- 공개된 GitHub 저장소를 복제하고, 데이터셋, 학습 스크립트, 평가 설정을 설정하기 전에 마스터 브랜치에서 ee891b42c2f2f083c4990eed72f1d4463adc5e103e를 확인해 보세요.
- 이 커밋을 사용해 이 연구에서 보고된 실험을 재현하세요. 원고 개정 당시 저장소에는 태그가 붙은 릴리스 버전이 없었습니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
결과
예상 결과 및 해석
이 프로토콜이 올바르게 구현되면, 훈련된 MVM-UNet 모델은 반복 실행에서 안정적인 분할 성능을 보이며, 대부분의 평가 지표에서 서로 다른 무작위 시드 간에 약간의 변동만 있을 것으로 기대됩니다. ISIC 2017과 ISIC 2018의 성공적인 결과는 높은 DSC, mIoU, Acc, Sen, Spe 값과 함께 실제 병변 경계를 밀접하게 따르는 예측 병변 마스크로 반영됩니다(그림 6 및 7). 시냅스의 경우, 성공적인 결과는 전경 기관 전반에서 높은 평균 DSC 값과 낮은 HD95 수치로 나타납니다(그림 8). 프로토콜 실행 중에는 정량적 지표와 이에 대응하는 정성적 세분화 결과가 함께 해석되어야 합니다. 높은 DSC를 달성하지만 경계 누설, 작은 구조의 누락, 또는 예측이 단편화된 모델은 부분적으로만 성공한 것으로 간주되어야 ...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
토론
이 프로토콜은 맘바 기반의 의료 영상 분할 프레임워크인 MVM-UNet을 설명합니다. 이 방법은 기존 세분화 모델의 두 가지 한계를 해결하기 위해 설계되었습니다. 첫째, 기존 CNN 기반 방법은 복잡한 의료 영상에서 장거리 의존성과 계층적 맥락 정보를 모델링하는 데 제한적인 능력을 가지고 있습니다43. 둘째, 트랜스포머 기반 방법은 전역 맥락을 모델링할 수 있지만 보통 더 높은 계산 비용이 필요합니다23,25. MVM-UNet은 Mamba아키텍처 13,14,15,16,17,18,19,20을 사용하여 효율적인 장거리 모델링을 구현하고, 멀티뷰 스캔과 다단계 기능 융합을 도입하여 세분화 정확도를 향상시켰습니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
공개 사항
저자들은 경쟁하는 재정적 이해관계가 없다고 선언합니다.
감사의 글
이 연구는 외부 자금 지원을 받지 못했습니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
재료
```html
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| Hardware - GPU workstation or GPU server | Institutional computing platform / local workstation | Custom-built local GPU workstation; Ubuntu 22.04.1 with Linux kernel 6.8.0; Intel Core i9-13900K CPU; NVIDIA A800 GPU; 128 GB RAM; 512 GB local storage. | Computational platform for training, validation, testing, ablation, and inference-only experiments. |
| Hardware - Graphics processing unit (GPU) | NVIDIA Corporation | NVIDIA A800 GPU (80 GB memory). | GPU-accelerated model training and inference. |
| Hardware - Central processing unit (CPU) | Intel Corporation / AMD | 13th Gen Intel Core i9-13900K CPU. | Host processor for data loading, preprocessing, and experiment execution. |
| Hardware - System memory (RAM) | Institutional computing platform / local workstation | 128 GB system RAM | Memory for dataset loading, preprocessing, and training. |
| Hardware - Storage | Institutional computing platform / local workstation | 2 TB NVMe solid-state drive. | Storage for datasets, checkpoints, logs, and generated prediction figures. |
| Software environment - Operating system | Canonical Ltd. | Recommended: Ubuntu 22.04.1 LTS | Operating system for the computational environment. |
| Software environment - Conda environment | Anaconda, Inc. / Miniconda | Environment name: mvmunet | Python environment used to install and isolate dependencies. |
| Software environment - Python | Python Software Foundation | Python 3.8 | Programming language used for implementation and experiment execution. |
| Software environment - CUDA toolkit | NVIDIA Corporation | CUDA Toolkit 11.8 | GPU computing backend required by PyTorch and Mamba-related packages. |
| Software environment - cuDNN | NVIDIA Corporation | cuDNN 8.7.0. | GPU-accelerated deep-learning primitives used through PyTorch. |
| Python package - PyTorch | PyTorch | torch == 2.0.1 | Deep-learning framework for model training, loss calculation, optimization, and inference. |
| Python package - Torchvision | PyTorch | torchvision == 0.14.0 | Image transform utilities used in preprocessing and augmentation. |
| Python package - Torchaudio | PyTorch | torchaudio == 0.13.0 | Installed with the recommended PyTorch environment. |
| Python package - timm | timm developers | timm == 0.4.12 | Model-component or utility dependency listed in the repository environment instructions. |
| Python package - triton | OpenAI / Triton developers | triton == 2.0.0 | Dependency used by GPU-accelerated sequence modeling components. |
| Python package - causal-conv1d | causal-conv1d developers | causal_conv1d == 1.0.0 | Efficient causal convolution dependency required by the Mamba implementation. |
| Python package - mamba-ssm | Mamba SSM developers | mamba_ssm == 1.0.1 | State-space sequence modeling package used for Mamba/S6-related components. |
| Python package - NumPy | NumPy developers | NumPy version 1.24.3. | Numerical computation and array operations. |
| Python package - SciPy | SciPy developers | SciPy version 1.10.1. | Scientific computation; scipy.ndimage.zoom is imported in utils.py. |
| Python package - SimpleITK | Insight Software Consortium | SimpleITK version 2.2.1. | Medical image input/output and preprocessing utility imported in utils.py. |
| Python package - MedPy | MedPy developers | MedPy version 0.4.0. | Medical image metric calculation package imported in utils.py. |
| Python package - scikit-image | scikit-image developers | scikit-image version 0.21.0. | Image-processing dependency listed in README. |
| Python package - scikit-learn | scikit-learn developers | scikit-learn version 1.3.2. | Machine-learning utility package listed in README. |
| Python package - matplotlib | Matplotlib developers | Matplotlib version 3.7.2. | Used for saving qualitative visualization figures. |
| Python package - h5py | h5py developers | h5py version 3.9.0. | HDF5 file support for Synapse test volumes. |
| Python package - thop | THOP developers | THOP version 0.1.1.post2209072238. | Used when calculating FLOPs and parameter-related computational cost. |
| Python package - packaging | Python Packaging Authority | packaging version 23.1. | Dependency listed in README. |
| Python package - pytest | pytest developers | pytest version 7.4.0. | Dependency listed in README. |
| Python package - chardet | chardet developers | chardet version 5.2.0. | Dependency listed in README. |
| Python package - yacs | YACS developers | yacs version 0.1.8. | Configuration utility dependency listed in README. |
| Python package - termcolor | termcolor developers | termcolor version 2.3.0. | Logging/terminal utility dependency listed in README. |
| Python package - submitit | submitit developers | submitit version 1.4.5. | Experiment/job utility dependency listed in README. |
| Python package - tensorboardX | tensorboardX developers | tensorboardX version 2.6.2.2. | Training log visualization utility listed in README. |
| Python package - ml-collections | ml_collections developers | ml-collections version 0.1.1. | Imported by configs/config_setting_synapse.py. |
| Dataset - ISIC 2017 Challenge dataset | International Skin Imaging Collaboration | ISIC 2017 skin lesion segmentation dataset | Public de-identified dermoscopic skin lesion images and masks used for binary segmentation. |
| Dataset - ISIC 2018 Challenge Task 1 dataset | International Skin Imaging Collaboration | ISIC 2018 Task 1: Lesion Boundary Segmentation | Public de-identified dermoscopic skin lesion images and masks used for binary segmentation. |
| Dataset - Synapse Multi-Atlas Labeling Beyond the Cranial Vault dataset | Synapse / Sage Bionetworks | Accession identifier: syn3193805 | Public abdominal CT multi-organ segmentation dataset. |
| Data organization - ISIC 2017 data folder | Authors / repository layout | data/isic2017/ | Expected local folder containing train and validation images/masks. |
| Data organization - ISIC 2018 data folder | Authors / repository layout | data/isic2018/ | Expected local folder containing train and validation images/masks. |
| Data organization - Synapse data folder | Authors / repository layout | data/Synapse/ | Expected local folder for Synapse lists, train_npz, and test_vol_h |
참고문헌
- Zhang F, et al. Cross co-teaching for semi-supervised medical image segmentation. Pattern Recognit. 2024;152:110485.
- Gu Y, et al. Dual-scale enhanced and cross-generative consistency learning for semi-supervised medical image segmentation. Pattern Recognit. 2025;158:111140.
- Zhu X, Wang W, Zhang C, Wang H. Polyp-Mamba: A hybrid multi-frequency perception gated selection network for polyp segmentation. Inf Fusion. 2025;115:103161.
- Iqbal S, et al. TBConvL-Net: A hybrid deep learning architecture for robust medical image segmentation. Pattern Recognit. 2025;158:111147.
- Zhao Z, et al. Balanced feature fusion collaborative training for semi-supervised medical image segmentation. Pattern Recognit. 2025;157:110986.
- Zhou T, et al. MambaYOLACT: You only look at Mamba prediction head for head-neck lymph nodes. Artif Intell Rev. 2025;58(6).
- Zhao Y, et al. MGF-GCN: Multimodal interaction Mamba-aided graph convolutional fusion network for semantic segmentation of remote sensing images. Inf Fusion. 2025;122:103268.
- Ronneberger O, Fischer P, Brox T. U-Net: Convolutional networks for biomedical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2015.
- Zhou Z, Siddiquee MMR, Tajbakhsh N, Liang J. UNet++: Redesigning skip connections to exploit multiscale features in image segmentation. IEEE Trans Med Imaging. 2019;39(6):1856-1867.
- Shaker A, et al. UNETR++: Delving into efficient and accurate 3D medical image segmentation. IEEE Trans Med Imaging. 2024;43(9):3377-3390.
- Zhou HY, et al. nnFormer: Volumetric medical image segmentation via a 3D Transformer. IEEE Trans Image Process. 2023;32:4036-4045.
- He A, et al. H2Former: An efficient hierarchical hybrid Transformer for medical image segmentation. IEEE Trans Med Imaging. 2023;42(9):2763-2775.
- Zhu L, et al. Vision Mamba: Efficient visual representation learning with bidirectional state space model. In: Proceedings of the 41st International Conference on Machine Learning (ICML). 2024.
- Liu Y, et al. VMamba: Visual state space model. Adv Neural Inf Process Syst. 2024;37:103031-103063.
- Ma J, Li F, Wang B. U-Mamba: Enhancing long-range dependency for biomedical image segmentation. arXiv. 2024;arXiv:2401.04722.
- Wang Z, et al. Mamba-UNet: UNet-like pure visual Mamba for medical image segmentation. arXiv. 2024;arXiv:2402.05079.
- Huang T, et al. LocalMamba: Visual state space model with windowed selective scan. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Zhang Z, et al. Motion Mamba: Efficient and long sequence motion generation. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Hu VT, et al. Zigma: A DiT-style zigzag Mamba diffusion model. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Rahman MM, et al. Mamba in vision: A comprehensive survey of techniques and applications. arXiv. 2024;arXiv:2410.03105.
- Falk T, et al. U-Net: Deep learning for cell counting, detection, and morphometry. Nat Methods. 2019;16(1):67-70.
- Gu R, et al. CA-Net: Comprehensive attention convolutional neural networks for explainable medical image segmentation. IEEE Trans Med Imaging. 2020;40(2):699-711.
- Chen J, et al. TransUNet: Rethinking the U-Net architecture design for medical image segmentation through the lens of Transformers. Med Image Anal. 2024;97:103280.
- Zhang Z, Zhang W. Pyramid medical Transformer for medical image segmentation. arXiv. 2021;arXiv:2104.14702.
- Cao H, et al. Swin-Unet: UNet-like pure Transformer for medical image segmentation. In: European Conference on Computer Vision (ECCV). Springer; 2022.
- Chen B, et al. TransAttUNet: Multi-level attention-guided U-Net with Transformer for medical image segmentation. IEEE Trans Emerg Top Comput Intell. 2023.
- Jiang S, Li J. TransCUNet: UNet cross-fused Transformer for medical image segmentation. Comput Biol Med. 2022;150:106207.
- Wu R, Liu Y, Liang P, Chang Q. H-vmunet: High-order Vision Mamba UNet for medical image segmentation. Neurocomputing. 2025;624:129447.
- Liu J, et al. Swin-UMamba: Adapting Mamba-based vision foundation models for medical image segmentation. IEEE Trans Med Imaging. 2024.
- Huang X, et al. MISSFormer: An effective Transformer for 2D medical image segmentation. IEEE Trans Med Imaging. 2023;42(5):1484-1494.
- Ruan J, et al. MALUNet: A multi-attention and lightweight U-Net for skin lesion segmentation. In: 2022 IEEE International Conference on Bioinformatics and Biomedicine (BIBM). IEEE; 2022.
- Ruan J, Xiang S. VM-UNet: Vision Mamba UNet for medical image segmentation. arXiv. 2024;arXiv:2402.02491.
- Valanarasu JMJ, Patel VM. UNeXt: MLP-based rapid medical image segmentation network. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2022.
- Ren S, Li X. HResFormer: Hybrid residual Transformer for volumetric medical image segmentation. IEEE Trans Neural Netw Learn Syst. 2025;36(6):10558-10566.
- Karimijafarbigloo S, Azad R, Kazerouni A, Merhof D. MedScale-Former: Self-guided multiscale Transformer for medical image segmentation. Med Image Anal. 2025;103.
- Yan S, et al. Multi-scale convolutional attention frequency-enhanced Transformer network for medical image segmentation. Inf Fusion. 2025;119.
- Gao Y, Zhou M, Metaxas DN. UTNet: A hybrid Transformer architecture for medical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2021.
- Mei J, et al. SANet: A slice-aware network for pulmonary nodule detection. IEEE Trans Pattern Anal Mach Intell. 2021;44(8):4374-4387.
- Hu XZ, Jeon WS, Rhee SY. ATT-UNet: Pixel-wise staircase attention for weed and crop detection. In: 2023 International Conference on Fuzzy Theory and Its Applications (iFUZZY). IEEE; 2023.
- Wang X, et al. Transferable normalization: Towards improving transferability of deep neural networks. Adv Neural Inf Process Syst. 2019;32.
- Azad R, et al. TransDeepLab: Convolution-free Transformer-based DeepLabV3+ for medical image segmentation. In: International Workshop on Predictive Intelligence in Medicine (PRIME). Springer; 2022.
- Ruan J, Gao J, Xie M, Xiang S. Learning multi-axis representation in frequency domain for medical image segmentation. Mach Learn. 2025;114(1):10.
- Goodfellow I, Bengio Y, Courville A. Deep Learning. MIT Press; Cambridge, MA; 2016.
- Milletari F, Navab N, Ahmadi SA. V-Net: Fully convolutional neural networks for volumetric medical image segmentation. In: 2016 Fourth International Conference on 3D Vision (3DV). IEEE; 2016.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.