본 논문은 이중 구축 세션 그래프를 기반으로 게이티드-슬롯 선형 어텐션을 채택한 세션 기반 추천을 위한 게이티드-슬롯 선형 어텐션 그래프 신경망이라는 새로운 모델을 제안합니다. 이 모델은 추천 정확도와 효율성을 높이며, 세 가지 공개 데이터셋에서 SOTA 성능을 능가합니다.
이 논문에서
요약
초록
세션 기반 추천(Session-based Recommendation, SBR) 시스템은 현재 세션 내의 행동 시퀀스를 바탕으로 사용자가 다음에 상호작용할 가능성이 높은 아이템을 예측하는 것을 목표로 합니다. Transformer attention 메커니즘(예: GC-SAN)을 활용한 최근의 접근 방식들은 전통적인 방법들보다 우수한 성능을 보여주었으나, self-attention의 이차 비용(quadratic cost)으로 인해 과도한 연산 부하와 공간 복잡도 문제점이 있습니다. 이러한 한계를 해결하기 위해, linear attention을 학습 가능한 게이팅 메커니즘 및 gated-slot attention에서 영감을 받은 슬롯 기반 메모리 업데이트 전략과 통합한 GSLA4Rec(gated‑slot linear attention graph neural networks for session‑based recommendation)라는 새로운 모델이 제안되었습니다. 구체적으로, GSLA4Rec은 먼저 두 개의 그래프를 구축하는데, 세션 내 아이템 전이를 포착하기 위한 세션 그래프와 세션 간 협업 신호를 인코딩하기 위한 이웃 글로벌 그래프를 통해 지역적 및 글로벌 컨텍스트 정보를 모두 모델링합니다. 제안된 접근 방식의 핵심인 gated-slot linear attention 메커니즘은 (1) 게이팅 유닛을 사용하여 긴 세션 내의 무관하거나 불필요한 상호작용에서 발생하는 노이즈를 억제하고, (2) 슬롯 유닛을 활용하여 컴팩트한 세션 표현을 동적으로 저장 및 업데이트함으로써 메모리 오버헤드를 줄이며, (3) self-attention을 linear attention으로 대체하여 선형 시간 복잡도를 달성합니다. 이러한 구성 요소들이 결합되어 진화하는 사용자의 관심사를 포착하는 모델의 예측 정확도와 효율성을 크게 향상시킵니다. Diginetica, Tmall, NowPlaying을 포함한 여러 공개 벤치마크 데이터셋에 대한 광범위한 실험 결과, GSLA4Rec이 추천 성능 면에서 SOTA SBR 방법들을 일관되게 능가함을 보여주었으며, 이는 GSLA 메커니즘의 효과를 입증합니다.
서론
온라인 서비스(전자상거래, 숏폼 비디오 플랫폼, 뉴스 피드 등)의 급격한 발전으로 인해 정보 과부하 문제가 점점 더 두드러지고 심각해지고 있습니다. 추천 시스템1,2은 사용자의 행동 데이터를 심층적으로 분석하여 개인화되고 정밀한 정보 푸시 서비스를 제공합니다. 하지만 익명 접속, 비로그인 사용자, 개인정보 보호 및 짧은 상호작용 시간이 특징인 많은 실제 응용 분야에서 협업 필터링3 및 행렬 분해4,5와 같은 전통적인 추천 방법은 추천 알고리즘의 적용 가능성을 크게 제한합니다. 이러한 과제를 해결하기 위해 SBR6,7,8,9이 등장했습니다. SBR는 사용자의 현재 세션 내 상호작용 시퀀스 데이터에 집중하여 다음 잠재적 관심 지점을 예측합니다. 이 패러다임은 장기적인 사용자 이력 데이터에 대한 의존도를 피할 수 있을 뿐만 아니라, 단기적인 동적 관심사 변화를 예리하게 포착하므로 전자상거래, 숏폼 비디오, 음악 추천 등의 시나리오에서 독특한 응용 가치를 보여줍니다.
초기 방법들은 주로 세션 시퀀스 내 항목 간의 전이 확률을 모델링하기 위해 마르코프 체인(Markov Chains)5,10,11,12에 의존했습니다. 이러한 방법들은 1차 시퀀스 의존성을 포착할 수 있었으나, 사용자 관심사의 복잡한 고차 의존성과 비선형 역학을 특성화하는 데는 한계가 있어 복잡한 시나리오에서 모델의 효과가 제한되었습니다. 딥러닝(Deep-Learning) 기술의 발전13,14과 함께 신경망 기반 방법들이 SBR에 널리 적용되었습니다. GRU4REC15는 순환 신경망(recurrent neural networks)14 (RNNs) 을 세션 기반 추천에 최초로 적용하여 시퀀스의 시간적 의존성을 효과적으로 포착했습니다. NARM16은 RNN에 어텐션 메커니즘(attention mechanisms)을 통합하여 핵심 사용자의 관심사를 발굴하는 능력을 더욱 강화했습니다. STAMP17는 다층 퍼셉트론(multi-layer perceptrons, MLPs)과 어텐션 메커니즘을 결합하여 사용자의 단기 관심사 포착에 집중했습니다. 이러한 방법들은 시퀀스 모델링에서 어느 정도 진전을 이루었으나, 장기 의존성 처리의 어려움과 노이즈에 대한 민감성 같은 과제에 여전히 직면해 있었습니다.
최근 몇 년 동안 그래프 신경망(Graph Neural Networks, GNNs)18,19,20,21은 SBR 작업에 새로운 관점을 제시했습니다. SR-GNN22과 같은 모델은 세션 그래프(session graph, SG)를 구축하여 복잡한 전이 관계를 명시적으로 모델링함으로써 추천 정확도를 상당히 향상시켰습니다. 하지만 기존의 대부분의 GNN 기반 방법들은 개별 세션 내에서 그래프 구축과 메시지 전달을 수행하므로, 전역적인 아이템 상관관계 정보를 효과적으로 활용하지 못한다는 한계가 있습니다. 이 문제를 해결하기 위해 GCE-GNN23은 이웃 전역 그래프(neighbor global graph, NGG)를 구축하고 셀프 어텐션 메커니즘을 통해 전역 시맨틱과 세션 그래프를 통합함으로써 아이템 중요도를 적응적으로 가중치화하여 상당한 성능 향상을 이루었습니다. 그럼에도 불구하고 기존의 GNN 기반 방법들은 여전히 두 가지 주요 병목 현상에 직면해 있습니다. 첫째, 셀프 어텐션 메커니즘의 복잡도가 세션 길이에 따라 제곱으로 증가하여 긴 세션을 처리할 때 상당한 계산 오버헤드가 발생합니다. 둘째, 전통적인 GNN은 정보 집계 과정에서 아이템 중요도를 동적으로 조절하는 능력이 부족하여 노이즈와 핵심 행동을 구분하기 어려우며, 이는 표현(representation)의 품질에 영향을 미칩니다.
이러한 과제를 해결하기 위해, 본 논문은 세션 기반 추천을 위한 게이트 슬롯 선형 어텐션 그래프 신경망(GSLA4Rec)을 제안합니다: (1) 게이팅을 통해 노이즈를 필터링하고 세션 슬롯에 핵심 세만틱 정보를 저장함으로써 모델의 강건성을 높이고 저장 오버헤드를 줄이는 게이트 슬롯 메커니즘을 설계했습니다. (2) 세션 길이를 N이라 할 때, 계산 복잡도를 O(N2)에서 O(N)으로 낮추면서도 장거리 의존성을 모델링하는 능력을 유지하는 선형 어텐션 메커니즘을 도입했습니다. (3) 세 가지 공개 벤치마크 데이터셋(Diginetica, Tmall, NowPlaying)에 대해 광범위한 실험을 수행하여 GSLA4Rec이 기존의 SOTA 방법들을 유의미하게 능가하며, 특히 긴 세션 및 희소 시나리오에서 뚜렷한 강점이 있음을 입증했습니다.
프로토콜
세션 기반 추천 경험하기
세션 기반 추천은 SBR, 전역 문맥 학습 및 GSLA의 세 가지 관점에서 검토할 수 있습니다(재료 표 참조). 본 연구에는 인간 피험자나 동물이 참여하지 않았습니다. 본 연구에 사용된 모든 실험 데이터셋은 공개적으로 이용 가능하며 보충 파일: GSLA4Rec. zip으로 제출되었습니다.
세션 기반 추천
세션 기반 추천(SBR)은 다회차 자연어 대화를 통해 사용자와 상호작용함으로써 사용자의 선호도를 동적으로 파악하고 개인화된 추천을 제공하는 인공지능 시스템이었습니다. SBR은 전통적인 방식에서 딥러닝 기반 및 하이브리드 접근 방식으로 발전했으며, 이후 대규모 언어 모델(LLM) 기반 솔루션으로 더욱 진화했습니다.
전통적인 세션 기반 추천
전통적인 SBR은 일반적으로 마르코프 체인(Markov Chain) 기반 방법과 협업 필터링(Collaborative Filtering)으로 표현되었습니다. 전자는 사용자별 확률 전이 행렬을 분해하여 추천을 생성했습니다. 예를 들어, Guy Shani24는 해당 행렬을 분해하여 추천을 생성하는 마르코프 결정 과정(Markov Decision Process) 기반 추천 방법을 제안했으며, Wanrong Gu25는 마르코프 체인에 구매 시간 간격을 통합하여 추천 성능을 향상시켰습니다. 후자는 행렬 분해를 통해 인접한 상호작용 항목 간의 숨겨진 순차적 관계를 추출하여 추천을 생성했습니다. 예를 들어, Sarwar B1는 사용자의 과거 선호도와 일치하는 항목을 추천하기 위해 사용자의 과거 행동(점수 및 클릭 등)을 기반으로 항목 간 유사도를 계산했습니다. 만약 사용자 A가 항목 a를 좋아했고 항목 c가 a와 매우 유사하다면, 시스템은 A에게 c를 추천합니다. Rendle S5는 인접한 상호작용 항목 간의 숨겨진 순차적 관계를 포착하기 위해 행렬 분해와 마르코프 체인을 결합한 순차 추천 모델인 FPMC를 제안했습니다. 그러나 이러한 전통적인 SBR은 인접한 항목 간의 순차적 관계에 집중했기 때문에 복잡한 의존 관계를 모델링하는 데 어려움이 있었습니다.
딥러닝 기반 세션 추천
딥러닝 기반 세션 기반 추천(SBR)은 합성곱 신경망(CNN)26,27,28,29, RNN 및 GNN을 포함하는 단계들을 거쳐 발전해 왔습니다. CNN 기반 SBR은 합성곱 및 풀링과 같은 연산을 활용하여 각 세션 컨텍스트의 표현을 학습하고, 이를 후속 추천에 사용했습니다. Caser30는 임베딩 층을 통해 사용자가 상호작용한 가장 최근의 L개 항목을 d차원 벡터로 변환하여 시간 및 잠재 공간에 매핑된 "이미지"로 처리되는 임베딩 행렬을 형성했습니다. 그 후 포인트 레벨, 스킵 없는 유니온 레벨, 1회 스킵 유니온 레벨의 세 가지 시퀀스 패턴 합성곱 필터를 사용하여 순차적 패턴을 학습함으로써 SBR 성능을 향상시켰습니다. Tuan 등31은 3D 합성곱 커널을 통해 세션 클릭 스트림과 콘텐츠 특징을 균일하게 모델링하여 시공간-콘텐츠 통합 표현을 형성했습니다.
RNN은 순차적 데이터를 처리하기 위해 특별히 설계된 신경망 아키텍처의 한 종류였습니다. 핵심 아이디어는 장단기 메모리 네트워크(LSTM)와 같은 재귀 구조를 통해 시간적 의존성을 포착하는 것이었습니다.13 및 게이트 순환 유닛(GRUs)32또한, 이는 자연어 처리(NLP)와 같은 분야에서 널리 사용되었습니다.33, 음성 인식34텍스트 번역35, 이동36,37, 범죄38, 및 향후 동향 예측39 (예: 트래픽)40, 주식 시장41,42및 기상학43Hidasi 등이 제안한 GRU4Rec은 SBR 연구의 이정표가 되었으며, SBR에 RNN을 최초로 도입하고 GRU를 통해 사용자의 순차적 행동 패턴을 포착함으로써 개인화된 추천을 구현하였습니다.
GNNs44는 그래프 구조 데이터 내의 복잡한 관계를 모델링하는 데 강력한 표현력을 입증했으며, 일부 연구자들은 세션 내부 또는 세션 간의 복잡한 전이를 모델링하기 위해 GNNs를 도입했습니다. 서로 다른 GNNs 모델 아키텍처에 따라, SBR을 위한 GNNs 기반 방법은 일반적으로 gated graph neural networks (GGNNs)45, graph convolutional networks (GCNs)46, 그리고 graph attention networks (GATs)47로 분류됩니다. SR-GNN은 세션 시퀀스를 유향 그래프로 표현하고 GGNNs를 사용하여 세션 내의 복잡한 아이템 전이 관계를 포착하며, 이를 어텐션 메커니즘과 결합하여 최종 세션 임베딩을 얻음으로써 추천 성능을 향상시킨 최초의 GNNs 기반 SBR 적용 사례였습니다. Chen L48은 구조화된 속성과 비구조화된 키워드를 결합하여 다차원적인 제품 연관성을 모델링함으로써 SBR의 정확도를 높이는 multi view GNNs 프레임워크를 제안했습니다. Driss E49는 복잡한 아이템 특징을 포착하고 SBR의 예측 정확도를 높이기 위해 capsule graph neural networks를 채택한 혁신적인 세션 추천 시스템을 설계했습니다.
앞서 언급한 딥러닝 기법들은 SBR의 연구 범위를 확장하고 성능을 효과적으로 향상시켰으나, 여전히 다음과 같은 몇 가지 한계점이 존재했습니다. 1) 새로 등장한 아이템이나 매우 희소한 세션의 경우, 전역적 문맥 정보의 부족으로 인해 모델이 정확한 예측을 수행하기 어려웠습니다. 2) 모든 과거 세션에 포함된 전역적 패턴을 활용할 수 없었습니다.
하이브리드 세션 기반 추천
하이브리드 세션 기반 추천은 협업 필터링, 딥러닝, 어텐션 메커니즘과 같은 다양한 기술의 장점을 통합하여 SBR 성능을 향상시켰습니다. GC-SAN50은 SR-GNN 기반의 셀프 어텐션 메커니즘을 도입하여 세션 내 중요 아이템의 상호작용 정보를 더 잘 포착했습니다. FGNN51은 멀티 헤드 어텐션 메커니즘을 통해 주변 아이템의 정보를 추가로 집계함으로써 대상 아이템의 다중 관계를 학습했습니다. SR-HetGNN52은 이종 그래프를 이용한 SBR에 해당하며, 다중 유형 아이템(사용자, 아이템, 세션)과 다중 관계 엣지(클릭, 구매, 공통 출현, 속성 연관성)를 도입하여 글로벌 지식 네트워크를 구축함으로써 단일 아이템 시퀀스의 한계를 극복하였고, 최근 몇 년간 익명 사용자의 행동과 세션 간 관심 연관성을 모델링하는 중요한 방법이 되었습니다. KGSR-SAP53은 아이템들을 다중 관계 엣지로 연결하여 지식 그래프를 구축함으로써 다양한 사용자-아이템 상호작용을 묘사했고, 글로벌 그래프가 단일 유형(사용자-아이템 상호작용)의 엣지만 포함하여 발생하는 정보 손실 문제를 해결했습니다. Wang ZH54는 확산 기반 세션 추천 모델인 DiffSBR을 제안했습니다. 이 모델은 노이즈 제거 과정을 시뮬레이션하여 신뢰할 수 있는 다음 아이템 선호도를 생성함으로써 동적인 사용자 클릭 시퀀스의 모델링을 개선합니다. Qiao ST55는 다중 뷰 의도 학습과 LLM 정렬을 결합한 SBR 프레임워크를 구축했습니다. 이는 다양한 관점에서 사용자의 암시적 의도를 마이닝하고 언어 모델을 활용하여 시맨틱 특징을 정렬함으로써 추천 성능을 더욱 향상시켰습니다.
글로벌 컨텍스트
"세션을 개별적으로 보는" 단점을 극복하기 위해, 연구자들은 전역 정보(global information)를 사용하여 현재 세션의 표현 능력을 향상시킴으로써 전통적인 SBR에서 발생하는 데이터 희소성, 콜드 스타트 및 시맨틱 갭과 같은 문제를 해결할 수 있다는 점을 깨달았습니다. 한편, 전역 컨텍스트를 구성할 때 노이즈 간섭을 최소화하면서 전역 정보를 단일 세션에 통합하는 것이 필요했습니다. CSRM56은 현재 세션과 주변 세션 간의 협업 정보를 통합하여 세션 수준의 표현을 최적화하였으며, 외부 메모리 인코더(OME)를 사용하여 협업 정보로부터 협업 의도를 추출했습니다. CA-TCN57은 교차 세션 인지 시간적 합성곱 네트워크 모델을 제안하여 전역 그래프와 세션 컨텍스트 그래프를 구축함으로써 교차 세션이 아이템과 세션에 미치는 영향을 시뮬레이션하였으며, 시간적 합성곱 네트워크(TCN)는 확장 합성곱(dilated convolutions)을 통해 수용 영역을 확장하고 레이어 수가 지수적 길이의 시퀀스를 커버하도록 하여(receptive field = ) RNN의 기울기 소실 문제를 해결했습니다. Chen58은 하이퍼그래프 신경망(SR-HGNNs) 기반의 SBR 방법을 제안하였는데, 이는 혼합 차수(저차수 및 고차수) 전파와 어텐션 메커니즘을 통합하여 짧은 세션에서 전통적인 GNN의 과도하게 매끄러워지는(over-smoothing) 문제를 해결하고 서로 다른 전파 차수의 중요도를 구별함으로써, 종속성을 더 정확하게 포착하고 노이즈 간섭을 피할 수 있었습니다. GCE-GNN은 다차수 공기 아이템 쌍을 사용하여 무방향 가중치 그래프를 구축하고 아이템 공기 빈도를 계산하여 세션 내 아이템의 중요도를 반영했습니다. AGNN-GC59는 교차 세션 아이템 전이 관계를 사용하여 전역 협업 그래프를 구축하고 전역 그래프에서의 아이템 전이 확률을 계산하여 세션 내 관심도 변화를 반영했습니다. DA-GCN60은 최단 경로를 사용하여 인접 행렬을 업데이트함으로써 동적 가중치 그래프를 구축하고, 전역 그래프 공기 빈도와 아이템 간 경로 거리를 계산했습니다. 상기 문헌들에 영감을 받아, 본 논문에서는 이웃 기반 방식, 즉 Jaccard 유사도 계수를 사용하여 유사한 세션을 계산함으로써 전역 그래프를 구축하는 방법을 제안했습니다. 이는 전역 정보를 활용할 뿐만 아니라 노이즈(무관한 아이템)를 필터링하여 전역 컨텍스트를 정확하게 구축하는 목적을 달성하고, 이후의 SBR 알고리즘을 위한 견고한 토대를 마련했습니다.
게이티드 슬롯 선형 어텐션(Gated-slot linear attention)
전통적인 트랜스포머61는 다음과 같이 전체 시퀀스에 걸쳐 완전 연결 어텐션 연산이 필요하기 때문에 높은 시공간적 복잡성이 발생했습니다:
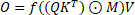 (1)
여기서 Q, K, V ∈ RN×d는 입력 항목의 선형 변환이며, M = {Mij = 1 if i ≥ j, o.w. −∞ }는 미래 정보의 유출을 방지하기 위한 인과 마스크(causal mask)이고, ⊙는 요소별 곱셈을, f는 활성화 함수인 softmax를 나타냅니다.
선형 어텐션(linear attention)62을 구현하기 위한 가장 직접적인 아이디어는 활성화 함수인 softmax를 제거하는 것이었습니다. 하지만 활성화 함수 softmax를 직접 제거한다면, 선형 어텐션은 신경망의 강력한 표현력을 상실하여 복잡한 실제 세계의 문제를 해결할 수 없게 된다는 잠재적인 문제로 이어질 것이 분명합니다.
유계 메모리 제어를 이용한 슬롯 선형 어텐션
활성화 함수인 softmax를 유지해야 한다고 가정할 때, K와 V는 각각 K̃, Ṽ ∈ Rm×d로 압축되었습니다. 메모리 네트워크 관점에서 K̃와 Ṽ는 시퀀스에 따라 길이가 증가하는 메모리 슬롯을 가졌으며, 즉 슬롯의 수 m = N이었습니다. 만약 m이 고정되었다면 선형화가 분명히 가능했을 것입니다. Bounded-memory Control63에서 영감을 받아, 길이가 N인 입력 항목의 각 토큰이 m개의 슬롯에 경쟁적으로 기록되도록 하였습니다.
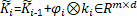 ,
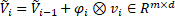 ,
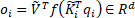 (2)
여기서 f는 활성화 함수 softmax이며, φi는 다음과 같이 키 값 ki를 제어하기 위한 유효 입력을 조절하는 벡터이다.
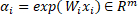 ,
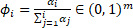 (3)
여기서 (φi)j는 i번째 토큰의 j번째 슬롯에 대한 쓰기 강도를 나타내며, 누적 소프트맥스 함수를 사용하여 얻었습니다.
효율적인 선형 계산을 달성하기 위해 식 (2)를 식 (4)로 다시 작성하였으며, 이는 {οi|i=1T, qi, ki, vi)|i=1T}를 통해 qi, ki, vi로부터 οi를 계산(식 4)하고 2패스 순차 계산 방식을 채택하였다:
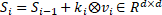 ,
 (4)
따라서 다음과 같은 SLA 연산을 도출할 수 있습니다:
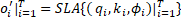 ,
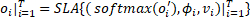 (5)
oi′ ∈ ℝm, οi ∈ ℝd라고 할 때, SLA는 하드웨어 효율적인 선형 시간 청크 단위 학습(chunk-wise training)64을 획득할 수 있습니다.
게이티드 슬롯 선형 어텐션
제한된 메모리 제어를 갖춘 슬롯 선형 어텐션은 계산 및 공간 복잡도를 줄일 수 있습니다. 하지만 정보의 축적은 세션 상호작용에 노이즈 정보를 유입시킬 수 있으므로, 정보를 선택적으로 유지하고 잊기 위해 데이터 종속적 감쇠가 매우 중요하며, 이러한 선택적 메커니즘은 최근의 선택적 상태 공간 모델에서 다시 다루어졌습니다65. 데이터 종속성을 갖춘 GSLA는 다음과 같이 표현될 수 있습니다:
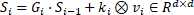 ,
 (6)
여기서 붕괴 게이트(decay gates)는 외적 형태인 Gi = αi ⊗ βi, αi, βi ∈ [0,1]d로 매개변수화되었습니다. 이어지는 내용에서 GSLA는 일반적으로 βt = 1로 설정하고 64와 같이 행렬 곱셈을 사용하여 다음과 같은 동등한 형태로 작성될 수 있습니다:
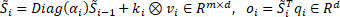 (7)
αi와 ki가 각각 망각 게이트(forget gate)와 입력 게이트(input gate)를 나타낼 때, 게이트형 RNN 관련 문헌에서 영감을 얻어 두 게이트를 ki = 1 − αi와 같이 결합할 수 있었습니다. 식 (8)에서와 같이 GSLA는 2패스 순차 계산으로 정식화될 수 있음이 분명했습니다. 2차 구조는 훈련 효율을 높이기 위해 블록 병렬 훈련을 지원했으며, 2차 구조 중간에 softmax 연산을 삽입하여 유한 슬롯 메모리의 모델링 능력을 향상시켰습니다.
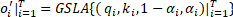 ,
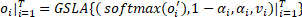 (8)
세션 데이터 변환
문제 정의
주어진 세션 시퀀스를 S = {v1s, v2s, ⋯, vns}라고 하며, 여기서 vis는 i번째로 클릭한 아이템을 나타냅니다. 이 시퀀스 내에서 사용자의 클릭 행동을 분석함으로써, 시스템은 사용자가 관심을 가질 가능성이 있는 다음 아이템 vn+1s를 예측했습니다.
그래프 구축
세션 그래프 구축
세션 S = {v1s, v2s, ⋯, vns}에 대하여, 유향 그래프 Gs = (Vs, εs)를 구성하였다. 여기서 Vs는 주어진 세션 S의 아이템 집합이며, εs = {eijlocal|vi, vj, vi, vj ∈ Vs}는 주어진 세션 S의 간선 집합이다. ε(vi-1s, vis)는 해당 세션에서 연속적으로 클릭된 아이템을 나타낸다. 간선 eijlocal는 ein, eout, ein-out, eself의 네 가지 유형으로 나눌 수 있다. 시퀀스 내에 동일한 아이템이 반복적으로 나타날 수 있으므로, 각 간선에 대한 가중치 값이 계산되었다.
현재 세션 s = [v1, v2, v4, v2, v3]는 다음에서 보여주는 바와 같이 SG로 전환되었습니다. 그림 1A.
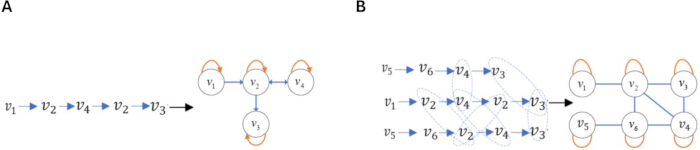
그림 1: 상호작용 항목을 그래프 구조로 변환. (A) 세션을 그래프로 변환하여 세션 그래프(SG)를 구축하는 과정의 모식도. (B) 여러 세션을 하나의 그래프로 결합하여 이웃 글로벌 그래프(NGG)를 구축하는 과정의 모식도. 이 그림은 Visio를 통해 모든 요소를 완전히 맞춤 설정하여 직접 작성하였습니다. 저작권이 있는 외부 그래픽 리소스를 사용하지 않았으므로 추가적인 제3자 저작권 라이선스는 필요하지 않았습니다. 그림의 저작권은 저자들에게 있으며, 논문 게재 승인 시 학술지의 저작권 규정을 준수할 것입니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
이웃 글로벌 그래프 구축
현재 세션 S를 기반으로, 크로스 세션 방식으로 현재 세션의 표현 학습을 강화하기 위해 그에 대응하는 NGG Gg = (Vg, εg)를 구축하였다. Vg는 Gg에 포함된 모든 아이템의 아이템 집합이며, εg = {eijglobal|vi, vj, vi, vj ∈ Vg}는 Gg의 엣지 집합이다. ε(vi-1g, vig)는 NGG Gg에서 직접적으로 상호작용하는 아이템 vi-1g와 vig를 나타낸다. 이 과정은 이웃 세션 획득과 NGG 구축의 두 단계로 구성된다.
이웃 세션 획득
전체 데이터셋에서 현재 세션과 공통으로 나타나는 아이템 수가 최대인 세션들을 검색하였습니다. 공통 출현 횟수가 가장 높은 상위 N개 세션을 선택하여 후보 이웃 세션 집합 S를 구성하였습니다. 이후 식 (9)에 나타난 바와 같이, 자카드 유사도 계수(Jaccard similarity coefficient)를 사용하여 현재 세션 cu와 후보 집합 S에 속한 세션 Sr ∈ S 사이의 유사도를 계산하였습니다.
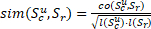 (9)
여기에서 co(Scu, Sr)는 Scu와 Sr 모두에 공통으로 나타나는 항목의 수를 나타내며, l(Scu)와 l(Sr)는 각각 Scu와 Sr의 길이를 나타내고, Scu와 Sr는 현재 세션과 이웃 세션을 나타낸다. 특정 임계값(하이퍼파라미터로 설정 가능) 미만의 유사도를 가진 세션들은 필터링되어 제거되었으며, 남은 세션들이 현재 세션에 대한 이웃 세션 집합 Ns를 구성하였다.
이웃 전역 그래프 구축
이웃 세션 세트 Ns를 기반으로 그림 1B에 나타낸 바와 같이 NGG를 구축하였다. 인접 행렬을 구성하는 동안, 두 항목(vi, vj) 사이에 상호작용이 있는 경우 해당 항목 Aij를 1로 설정하고, 그렇지 않은 경우 0으로 설정하였다. 또한 항목 간의 상호작용은 무방향으로 처리하고 셀프 루프를 추가한 후, 표 1에 표시된 것과 같이 정규화를 수행하였다.
| 1 | 2 | 3 | 4 | 5 | 6 | |
| 1 | 1/2 | 1/2 | 0 | 0 | 0 | 0 |
| 2 | 0 | 1/4 | 1/4 | 1/2 | 0 | 0 |
| 3 | 0 | 0 | 1 | 0 | 0 | 0 |
| 4 | 0 | 1/4 | 1/2 | 1/4 | 0 | 0 |
| 5 | 0 | 0 | 0 | 0 | 1/3 | 2/3 |
| 6 | 0 | 1/3 | 0 | 1/3 | 0 | 1/3 |
표 1: 이웃 전역 그래프의 정규화된 인접 행렬. 이 표는 구축된 이웃 전역 그래프 내 노드 간의 가중치 연결을 나타내는 정규화된 인접 행렬을 보여줍니다.
세션 기반 추천 알고리즘 설계
이 섹션에서는 SG와 NGG의 공동 특징 표현에 GSLA 메커니즘을 도입하여 SBR 성능을 향상시킨 제안된 혁신 모델인 GSLA4Rec에 대해 상세히 설명합니다.
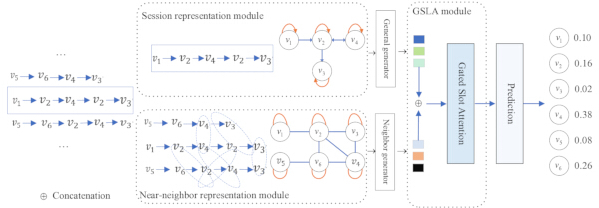
그림 2: GSLA4Rec 프레임워크. 이 프레임워크는 세션 그래프와 이웃 전역 그래프 구조 학습을 통합하고, 게이팅 메커니즘으로 상호작용 노이즈를 필터링하며, 메모리 슬롯 메커니즘으로 저장 공간과 효율성의 균형을 맞추고, 선형 어텐션 메커니즘으로 아이템 관련성을 포착하여 사용자의 다음 클릭 선호도를 예측합니다. 이 그림은 Visio를 사용하여 모든 요소를 완전히 맞춤 설정하여 직접 그렸습니다. 저작권이 있는 외부 그래픽 리소스는 사용되지 않았으며, 따라서 추가적인 제3자 저작권 라이선스는 필요하지 않았습니다. 그림의 저작권은 저자들에게 있으며, 논문 수락 시 학술지의 저작권 규정을 준수할 것입니다. GSLA4Rec은 SBR을 위한 gated-slot linear attention 그래프 신경망을 나타냅니다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
그림 2는 GSLA4Rec의 프레임워크를 나타내며, 이는 네 가지 주요 구성 요소로 이루어져 있습니다: 1) 세션 수준 항목 표현. SG에 GNNs 모델을 적용하여 현재 세션 내의 세션 수준 항목 임베딩을 학습합니다; 2) 이웃 글로벌 수준 항목 표현. NGG를 기반으로 각 항목의 이웃 임베딩을 재귀적으로 통합하기 위해 GRU를 사용하여 모든 세션에 걸친 글로벌 수준 항목 임베딩을 학습합니다; 3) GSLA. 세션 수준과 글로벌 수준 모두에서 학습된 항목 표현을 집계하여 현재 세션의 사용자 선호도를 모델링합니다; 4) 예측 레이어. 후보 항목들에 대한 예측 확률을 출력합니다. 이 네 가지 구성 요소에 대한 상세 내용은 다음과 같습니다.
세션 표현
SBR에서 사용자의 상호작용 행동을 이해하는 것은 매우 중요했습니다. 이를 위해 세션 표현 학습을 위한 SG와 NGG를 구축하여 사용자의 상호작용 행동을 종합적으로 이해하고, 이를 통해 사용자의 더 진정한 의도를 포착하고자 했습니다.
세션 수준의 항목 표현
그림 1A의 SG를 기반으로 하여, SG의 특징을 추출하기 위해 가중치 기반 양방향 그래프 어텐션(Weighted Bidirectional Graph Attention, WBGAT) 방법이 사용되었습니다. 이 방법은 표준 GAT 메커니즘을 바탕으로 엣지 가중치와 항목 방향성(In-neighbor 및 Out-neighbor)을 도입하여, 중요한 엣지를 강화하고 양방향 의존성을 캡처하는 효과를 거두었으며, 이를 통해 비대칭적 항목 관계 및 상호작용 강도와 관련된 기존 GAT의 단점을 해결하였습니다. 계산 과정은 다음과 같습니다:
먼저, 항목 내입 차수 정규화 가중치를 계산합니다.
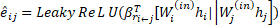 (10)
여기서 eij는 항목 j의 특성이 항목 i에 미치는 1차 인접 가중치를 나타내며,  는 항목 i와 항목 j 사이의 관계를, β* ∈ ℝd는 가중치 벡터를, hi와 hj는 각각 항목 i와 j의 표현을, Wi(in) ∈ ℝd*d 및 Wj(in) ∈ ℝd*d는 학습 가능한 파라미터를, ||는 연결(concatenation) 연산을 나타낸다. 서로 다른 진입 차수(in-degree) 관계를 구분하기 위해 rin 및 rin-self라는 두 개의 가중치 벡터를 학습시켰다. 활성화 함수로는 LeakyReLU를 채택하였다.
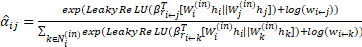 (11)
서로 다른 항목 간에 계수를 비교 가능하게 만들기 위해, 어텐션 가중치를 softmax 함수를 통해 정규화하였습니다. Ni(in)이 항목 i의 1차 인-이웃(in-neighbor) 집합일 때,  은 SG에서 유향 엣지 (i←j)의 인-이웃 가중치를 나타내며, 이 방법은 엣지 가중치의 로그값을 취해 기존 어텐션 점수 eij에 더함으로써 그래프 구조의 고유한 연결 강도 정보를 유지하는 동시에 모델이 항목 특성 간의 상관관계를 학습할 수 있도록 하였습니다.
둘째, 항목 외차수 정규화 가중치를 계산합니다.
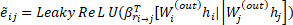 (12)
여기서 ẽij는 항목 j의 특징에서 항목 i로 향하는 1차 아웃-네이버(out-neighbor) 가중치를 나타내며,  는 항목 i와 j 사이의 관계였으며, 두 개의 가중치 벡터인 rout와 rout-self가 학습되었습니다.
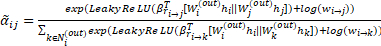 (13)
여기서 Ni(out)는 항목 i의 1차 나가는 이웃(out-neighbor) 집합이며,  는 SG에서 유향 엣지 (i→j)의 나가는 이웃 가중치이다.
셋째, 정보 집계입니다. 항목 i의 1차 진입 차수(in-degree) 및 진출 차수(out-degree) 임베딩에 가중치를 부여하고 합산하여 해당 항목의 업데이트된 임베딩을 얻을 수 있습니다.
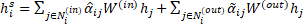 (14)
여기서  와 α̃ij는 각각 항목 i의 진입 차수(in-degree) 및 진출 차수(out-degree) 가중치를 나타내며,
 는 항목 i의 업데이트된 표현을 나타냅니다.
이웃 글로벌 수준 아이템 표현
최근의 연구들은 전역 그래프(global graph)를 구축하는 것이 데이터 표현력을 높여 SBR 성능을 향상시킬 수 있다는 점에 일관되게 동의했으며, 이는 의심의 여지가 없었습니다. 하지만 데이터를 전역적으로 강화하면 노이즈와 같은 무관한 정보가 도입될 수도 있습니다. 제안된 모델에서는 노이즈를 최대한 최소화하면서 전역 데이터 증강을 달성하기 위해 근접 이웃 전역 그래프(near-neighbor global graph)를 구축하였습니다.
그림 1B의 NGG와 표 1의 정규화된 인접 행렬을 기반으로, 현재 세션과 인접 세션들을 NGG로 변환하였으며, NGG의 특징을 추출하기 위해 GGNNs45 방법을 적용하였습니다. NGG 내 아이템 벡터의 학습 과정은 식 (15)에 나타내었습니다.
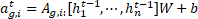
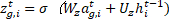
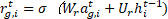
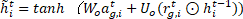
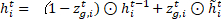 (15)
W ∈ ℝd×2d는 제어 가중치를 나타내며, zg,i와 rg,i는 각각 업데이트 게이트와 리셋 게이트를 나타냅니다. [h1t-1, ⋯, hnt-1]은 세션 s에 포함된 모든 아이템 벡터의 리스트를 나타냅니다. σ(x) = 1/(1 + e-x)는 로지스틱 시그모이드 함수이며, ⊙는 요소별 곱셈을, hi ∈ ℝd는 게이트 업데이트 후의 벡터를 나타냅니다. 인접 행렬 As ∈ ℝn×n은 인접 세션 내 아이템 간의 연결성을 나타내며, As,i: ∈ ℝ1×n은 인접 행렬에서 아이템 vs,i에 해당하는 열 블록 As를 나타냅니다. 현재 세션 s = [v1, v2, v4, v2, v3]에 대한 NGG 및 정규화된 인접 행렬은 각각 그림 1B와 표 1에 제시되어 있습니다.
항목 표현
항목 표현은 식 (16)에 표시된 바와 같이 세션 수준 항목 벡터와 이웃 글로벌 수준 항목 벡터를 합산하여 얻었습니다:
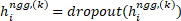
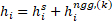 (16)
과적합을 완화하기 위해 전역 수준의 이웃 항목 표현에 드롭아웃을 적용하였습니다.
게이트 슬롯 선형 어텐션
본 논문의 게이티드-슬롯 선형 어텐션(gated-slot linear attention, GSLA)은 선형 어텐션을 유한 메모리 제어 및 데이터 의존적 게이팅 메커니즘과 통합하였습니다. 우선, 이는 어텐션 기반 컨트롤러(attention-based controller, ABC) 모델의 유한 메모리 슬롯 메커니즘을 계승하여, 본래 시퀀스 길이에 따라 증가하는 키-값 쌍을 고정된 수의 슬롯으로 압축하고 각 슬롯을 경쟁적 쓰기(competitive writing)를 통해 업데이트함으로써 트랜스포머 전역 어텐션의 계산 복잡도 문제를 해결하였습니다. 또한, GLA와 유사한 세밀한 게이팅 메커니즘을 도입하여, 입력 데이터가 망각 게이트 αi를 통해 과거 정보의 유지 비율을 동적으로 조정하게 함으로써 ABC의 망각 메커니즘 부재로 인해 발생하는 노이즈 문제를 해결하였습니다.
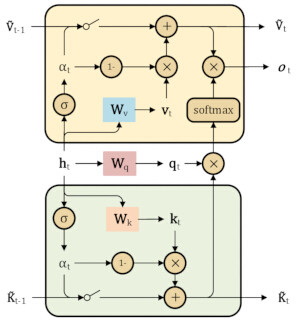
그림 3: GSLA의 모식도. 입력 벡터는 각각 쿼리 벡터, 키워드 벡터, 값 벡터로 매핑된 후, 유계 메모리 제어 및 데이터 의존적 게이팅 메커니즘이 적용된 선형 어텐션을 통해 처리되어 업데이트된 쿼리 벡터, 키워드 벡터, 값 벡터 및 출력 벡터를 얻습니다. 이 그림은 Visio를 사용하여 모든 요소를 완전히 맞춤 설정하여 직접 그렸습니다. 저작권이 있는 외부 그래픽 리소스는 사용되지 않았으므로 추가적인 제3자 저작권 라이선스는 필요하지 않았습니다. 그림의 저작권은 저자들에게 있으며, 게재 승인 시 학술지의 저작권 규정을 준수하게 됩니다. GSLA는 gated-slot linear attention을 나타냅니다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
그림 3에서 구체적으로 구현된 바와 같이, 입력 벡터는 쿼리(query) 벡터, 키(key) 벡터 및 밸류(value) 벡터로 각각 매핑되었습니다64:
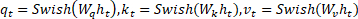 (17)
여기서 Wq, Wk, Wv ∈ ℝd×d는 각각 쿼리(query), 키(key), 값(value)에 해당하는 변환 가중치 행렬을 나타내며, ht는 세션 입력 시퀀스의 t번째 타임 스텝에서의 임베딩 벡터를 의미한다. Swish 함수는 Swish(x) = x · σ(x)로 정의되는 셀프 게이팅 활성화 함수로, 여기서 σ는 시그모이드(Sigmoid) 함수이며, 이는 여러 딥러닝 작업에서 기존의 ReLU 활성화 함수보다 우수한 성능을 보였다.
GSLA는 입력 데이터에 따라 망각 게이트 αi와 입력 게이트 1 − αi를 사용하여 i번째 메모리 슬롯의 정보를 동적으로 업데이트했습니다. 그 과정은 다음과 같습니다64:
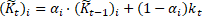 (18)
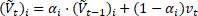 (19)
여기서 K̃t 및 Ṽt는 시간 단계 t에서의 키 벡터 슬롯과 값 벡터 슬롯을 나타내며, K̃t-1 및 Ṽt-1는 시간 단계 t−1에서의 키 벡터 슬롯과 값 벡터 슬롯을 나타낸다. 망각 게이트 αi = σ(Wαht)1/τ에서, Wα ∈ ℝd는 변환 가중치 행렬이고, σ는 시그모이드(Sigmoid) 함수이며, τ는 망각 게이트의 부드러움(softness)을 조절하는 데 사용되는 감쇠 계수(통상적으로 8로 설정)이다. 이를 통해 GSLA는 과거 정보의 망각률을 부드럽게 조정할 수 있다. 즉, αi가 클수록 GSLA는 과거 정보에 더 많이 의존하고, αi가 작을수록 GSLA는 현재 입력에 더 집중하게 된다.
t번째 단계의 슬롯에 해당하는 키 벡터 슬롯 K̃t와 값 벡터 슬롯 Ṽt는 식 (20) 및 (21)에서 보여준 바와 같이65 행렬 형태로 작성되었습니다:
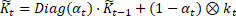 (20)
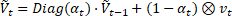 (21)
그 다음, 2차 특성을 갖는 GSLA(식 (8) 참조)를 활용하여 각 타임 스텝 i ∈ [1, …, T]에 대한 출력 oi |i=1T를 계산하였습니다. 각 타임 스텝의 출력에 선형 변환을 적용하여 결과 h̃t를 얻었습니다. 마지막으로, 세션 시퀀스 내 모든 항목 표현의 평균값을 계산하여 동적 메모리 업데이트가 적용된 세션 임베딩 S̃e를 생성하였습니다:
 (22)
 (23)
여기서 ot는 시간 단계 t에서의 Gated-Slot 출력을 나타내며, h̃t는 ot에 선형 변환을 적용한 결과를 의미합니다. S̃e는 모든 시간 단계에서 h̃t의 평균값을 나타냅니다.
예측 레이어
획득한 세션 표현 S̃e와 아이템 i의 초기 임베딩을 기반으로, 각 후보 아이템 hi에 대한 점수를 계산하기 위해 내적 연산을 수행하였습니다. 이후, 소프트맥스 함수를 사용하여 후보 아이템 i의 추천 확률을 구하였습니다:
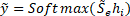 (24)
여기서 ỹ는 후보 항목의 추천 확률을 나타내고, hi는 후보 항목의 벡터를 의미하며, 모델 학습을 위해 교차 엔트로피 손실 함수가 사용되었다.
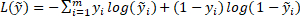 (25)
여기서 y는 정답(ground truth)의 원-핫 인코딩(one-hot encoded) 표현입니다.
결과
데이터셋 및 전처리
본 실험에서는 모델의 성능을 평가하기 위해 실제 응용 시나리오의 실제 거래 데이터에서 파생된 세 가지 공개 SBR 데이터셋을 선정하였습니다. CIKM Cup 2016 경진대회에서 추출되어 사용자의 거래 및 클릭 기록을 포함하는 Diginetica, Tmall 플랫폼의 사용자 로그로 사용자의 탐색 및 구매 행동을 기록한 Tmall, 그리고 음악 플랫폼에서의 사용자 재생 기록을 포함하는 Nowplaying이 그것입니다. 이러한 데이터셋은 SBR 연구에서 널리 사용되었으며, 모델의 효과성과 적용 가능성을 종합적으로 평가할 수 있습니다.
데이터 전처리 단계에서는 데이터 품질의 일관성을 보장하기 위해 데이터셋을 표준화하였습니다. 구체적으로, 길이가 2 미만인 모든 세션은 필터링하여 제외하였으며, 5회 미만으로 나타나는 항목들은 제거하였습니다. 또한, 각 세션 S = {v1, v2, ..., vn}에 대해 모델 학습 및 테스트를 위한 여러 하위 시퀀스를 생성하였습니다. 이 하위 시퀀스들은 ([v1]|v2), ([v1, v2]|v3), ..., ([v1, v2, ..., vn-1]|vn)의 형태를 가집니다. 앞서 언급한 전처리를 완료한 후 데이터셋에 대한 통계 분석을 수행하였으며, 상세 정보는 Table 2에 제시하였습니다.
| 데이터세트 | 디지네티카(Diginetica) | 티몰(Tmall) | 현재 재생 중 |
| 클릭 | 982961 | 818479 | 1367963 |
| 훈련 | 719470 | 351268 | 825304 |
| 테스트 | 60858 | 25898 | 60417 |
| 항목 | 43097 | 40728 | 60417 |
| 평균 길이 | 5.12 | 6.69 | 7.42 |
표 2: 데이터셋 설명. 이 표는 클릭 수, 훈련 및 테스트 샘플 수, 아이템 수, 평균 세션 길이를 포함하여 Diginetica, Tmall, Nowplaying 데이터셋의 통계치를 요약하여 보여줍니다.
실험 설정
매개변수 설정
실험의 공정성을 보장하기 위해 GSLA4Rec 모델의 파라미터를 사전 설정하는 동시에 세 가지 데이터셋을 처리하기 위한 전처리 방법을 채택하였습니다. Diginetica 및 Nowlaying 데이터셋의 배치 크기는 150으로 설정하였고, Tmall 데이터셋은 300으로 설정하였습니다. 본 모델의 파라미터는 평균 0, 표준편차 0.1인 가우시안 분포를 사용하여 초기화하였으며, 차원은 100으로 설정하였습니다. 최적화 도구로는 Adam을 사용하였으며 초기 학습률은 0.001로 설정하고, 매 3 epoch마다 학습률에 0.1을 곱하였습니다. 훈련은 최적의 값을 얻기 위해 NVIDIA TITAN V GPU와 PyTorch 1.11.0 (cu113 버전, 재료 표 참조) 환경에서 총 30 epoch 동안 수행되었습니다. 이웃 세션 필터링을 위한 임계값은 0.5로 설정하였으며, 실험에 L2 정규화를 적용하였습니다. 각 데이터셋에 대해 거래 시간순으로 정렬된 데이터의 마지막 10%를 테스트 세트로 선택하였고, 나머지 10%와 80%를 각각 검증 세트와 훈련 세트로 무작위 선택하였습니다. GSLA의 메모리 슬롯 수는 {0, 1, 2, 3, 4, 5} 중 하나의 값으로 설정하였습니다.
평가 지표
본 논문에서는 P@N (Precision@N, N = 10/20)과 MRR@N (Mean Reciprocal Rank@N, N = 10/20)을 채택하였습니다. P@N은 처음 N개의 추천 결과 중 정확한 추천의 비율을 측정하는 데 사용되었으며, MRR@N은 정확한 프로젝트의 평균 역순위(average reciprocal ranking)를 계산하는 데 사용되었습니다. MRR 값이 높을수록 정렬 성능이 더 우수함을 의미합니다.
성능 분석
GSLA4Rec 모델의 효과는 기술 발전의 서로 다른 단계를 대표하는 베이스라인 모델들과 비교하여 평가되었습니다. 초기에는 SBR을 위해 머신러닝 방법이 사용되었으며, 예를 들어 FPMC5는 마르코프 체인을 기반으로 순차적 효과를 예측하는 데 사용되었습니다. 이후 인공지능의 발전과 함께 딥러닝이 SBR에 널리 적용되었습니다. 예를 들어, GRU4Rec10은 여러 층의 GRU를 쌓아 SBR을 모델링하는 RNN을 기반으로 하며, SBR을 최적화하기 위해 특화된 손실 함수를 설계했습니다. NARM16은 사용자의 주요 관심사를 포착하기 위해 AM을 도입하여 다음에 추천 가능한 항목의 최종 임베딩 표현을 생성했으며, STAMP17는 사용자의 일반적인 관심사와 즉각적인 관심사를 동시에 포착하기 위해 AM이 강화된 다층 퍼셉트론을 채택했습니다. 최근 몇 년 동안은 강력한 비유클리드 데이터 학습 능력 덕분에 그래프 신경망 또한 SBR에 널리 사용되고 있습니다. 예를 들어, SR-GNN22은 SBR에 GNN을 처음으로 적용하여 GGNN을 통해 복잡한 항목 전이 관계를 도출하고 AM과 결합하여 사용자의 즉각적인 관심사에 집중했습니다. GCE-GNN23은 GAT를 활용하여 지역 및 전역 문맥에서의 항목 전이 관계를 도출하고 RPE와 soft-AM을 통해 세션 표현을 생성했습니다. S2-DHCN66은 세션 데이터를 하이퍼그래프와 라인 그래프로 변환하고 자기지도 학습을 활용하여 SBR을 강화했습니다.
최근 SBR의 성능을 향상시키기 위해 종합적인 접근 방식이 채택되었습니다. 예를 들어, GC-SAN50은 GNN과 다층 self-attention 네트워크를 결합하여 단기 및 장기 의존성을 모델링함으로써 추천 성능을 높였으며, TASRec67은 서로 다른 타임스탬프에서 동적 그래프 스냅샷 시퀀스를 구축하여 시간 정보를 통합하였습니다. CT-GNN68은 시간 정보가 결합된 GNN을 채택하여 아이템 간의 추가적인 시간적 연관 정보를 학습하였고, CORE69는 아이템의 동시 발생 정보와 시간 정보를 융합하여 최종 세션 표현을 획득하였습니다. RESTC70는 대조 학습의 균일성 및 정렬 특성에서 영감을 얻은 시공간 상호작용 패턴을 제안하였으며, COTRec66,71은 두 개의 세션 그래프 뷰에 대한 자기지도 학습과 공동 학습을 채택하여 SBR의 데이터 희소성 문제를 해결하였습니다. RAIN71은 엣지 마스킹과 구조적 재구성을 활용하고, 엣지 표시기를 공동 학습시켜 노이즈 엣지를 명시적으로 식별하고 제거함으로써 SBR의 정확도와 강건성을 크게 향상시켰습니다.
| 데이터 세트 | Diginetica | 티몰(Tmall) | 현재 재생 중 | ||||||||||
| 방법론 분류- 확인 | 평가 지표 | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 |
| 머신러닝 | FPMC | 15.42 | 22.10 | 6.20 | 6.66 | 13.12 | 16.05 | 7.10 | 7.30 | 5.28 | 7.35 | 2.66 | 2.82 |
| 딥러닝 | GRU4REC | 17.92 | 30.80 | 7.73 | 8.20 | 9.47 | 10.93 | 5.78 | 5.89 | 6.74 | 7.92 | 4.40 | 4.48 |
| 딥러닝 | 비알코올성 지방간염 (NASH) 또는 비알코올성 지방간질환 (NAFLD) 관련 모델 (NARM) | 35.44 | 48.32 | 15.12 | 16.00 | 19.16 | 23.30 | 10.40 | 10.70 | 13.60 | 18.59 | 6.62 | 6.92 |
| 딥러닝 | STAMP | 33.97 | 46.62 | 14.26 | 15.13 | 22.63 | 26.47 | 13.10 | 13.35 | 13.20 | 17.65 | 6.57 | 6.88 |
| 그래프 신경망(GNN) | SR-GNN | 38.42 | 51.26 | 16.89 | 17.76 | 23.41 | 27.57 | 13.46 | 13.72 | 14.17 | 18.86 | 7.15 | 7.47 |
| 그래프 신경망(GNNs) | S2 -DHCN | 40.21 | 53.66 | 17.59 | 18.51 | 26.22 | 31.42 | 14.60 | 15.05 | 17.35 | 23.50 | 7.87 | 8.18 |
| 그래프 신경망(GNN) | GCE-GNN | 41.16 | 54.22 | 18.15 | 19.04 | 28.01 | 33.42 | 15.08 | 15.42 | 16.94 | 22.37 | 8.03 | 8.40 |
| GNNs+Att | TASRec | 39.85 | 52.53 | 17.19 | 18.22 | 25.72 | 29.58 | 14.22 | 14.51 | 16.35 | 20.52 | 7.30 | 7.78 |
| GNNs+Att | 가스크로마토그래피-단일조절 네트워크 분석 | 38.40 | 51.30 | 16.80 | 17.80 | 23.50 | 27.60 | 13.50 | 13.80 | 14.20 | 18.90 | 7.20 | 7.50 |
| GNNs+Tem | CT-GNN | 39.40 | 52.71 | 17.50 | 18.56 | 25.95 | 31.42 | 14.52 | 15.00 | 16.55 | 22.28 | 7.75 | 8.06 |
| GNNs+Tem | 핵심 | 41.03 | 52.84 | 17.95 | 18.47 | 32.97 | 39.16 | 18.72 | 19.16 | 17.65 | 21.81 | 7.92 | 7.35 |
| GNNs+Tem | RESTC | 42.35 | 55.93 | 18.75 | 19.65 | 35.57 | 42.47 | 18.05 | 18.52 | 18.39 | 24.79 | 8.31 | 8.72 |
| GNN 및 COT (그래프 신경망 및 생각의 사슬) | COTRec | 39.87 | 54.18 | 17.53 | 19.07 | 30.62 | 36.35 | 17.65 | 18.04 | - | - | - | - |
| GNNs+ReStr | 비 | - | 55.50 | - | 19.20 | - | 38.73 | - | 19.12 | - | 24.17 | - | 8.47 |
| GNNs+Gated-Slot | GSLA4Rec | 43.35 | 56.47 | 19.38 | 19.98 | 36.56 | 43.60 | 19.46 | 19.96 | 19.80 | 27.10 | 8.86 | 9.32 |
| 표준편차 | ±0.0009 | ±0.0011 | ±0.0008 | ±0.0009 | ±0.0018 | ±0.0021 | ±0.0016 | ±0.0018 | ±0.0028 | ±0.0031 | ±0.0024 | ±0.0026 | |
| p-값 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.01 | |
| T추론 | 0.294 | 0.296 | 0.295 | 0.297 | 0.168 | 0.169 | 0.169 | 0.171 | 0.472 | 0.478 | 0.475 | 0.479 | |
표 3: 세 가지 데이터셋에 대한 성능 비교. 이 표는 Diginetica, Tmall, Nowplaying 데이터셋에서 P@10, P@20, MRR@10, MRR@20을 사용하여 GSLA4Rec을 머신러닝, 딥러닝, GNN 기반, 어텐션 기반, 시계열 및 기타 추천 방법과 비교한 결과입니다. GSLA4Rec에 대한 SD와 p-값도 함께 보고되었습니다.
GSLA4Rec 모델의 성능을 검증하고 무작위 요인으로 인한 성능 향상의 우연성을 배제하기 위해, 테스트 세트에 대해 여러 차례의 그룹화 실험과 통계 분석을 수행하였습니다. 구체적으로, 테스트 세트를 배치당 150개의 세션으로 나누어 랜덤 시드 방법을 사용하여 30회 반복하였습니다. 모든 그룹화 실험의 평균 결과와 시간 소모량을 각각 GSLA4Rec 모델의 성능과 추론 시간으로 계산하였습니다. 또한, GSLA4Rec 모델의 성능 향상에 대한 안정성과 확실성을 추가로 검증하기 위해 표준 편차(SD)와 통계적 유의성 t-검정을 계산하였습니다. 표 3은 세 가지 데이터셋에서 제안된 추천 모델인 GSLA4Rec의 성능, SD, p-값 및 Tinference를 베이스라인 모델들과 비교하여 나타낸 것입니다. 밑줄 친 숫자는 가장 우수한 베이스라인 방법을 나타내며, 각 평가 지표에 대해 가장 뛰어난 성능을 보인 모델은 굵은 검은색으로 표시하였습니다.
머신러닝 추천 방법: SBR 작업에서 전통적인 FPMC 방법은 가장 낮은 성능을 보였으며, 이는 주로 마르코프 체인 모델이 아이템 간의 복잡한 전이 패턴을 포착하지 못했기 때문입니다. 2) 딥러닝 추천 방법: GRU4REC, NARM, STAMP와 같은 모델은 시퀀스 모델링 접근 방식을 채택하여 어느 정도의 성능 향상을 달성했습니다. 그중 NARM과 STAMP는 GRU4REC보다 더 나은 추천 결과를 보여주었는데, 이는 주로 NARM이 사용자의 주요 관심사를 포착하기 위해 어텐션 메커니즘을 도입했기 때문입니다. 3) GNN 추천 방법: SBR에 GNN을 도입함으로써 뚜렷한 성능 향상이 이루어졌습니다. 예를 들어, 세션 시퀀스를 그래프 구조로 변환하여 아이템의 공간적 구조 정보를 포착하는 방식을 개척한 SR-GNN은 STAMP로 대표되는 딥러닝 방법보다 0.36–4.64% 향상된 성능을 보여, 순차 데이터 처리에서 그래프 구조의 공간적 이점을 입증했습니다. S2-DHCN은 이중 채널 하이퍼그래프 컨볼루션을 채택하여 아이템 간의 고차 의존성을 포착하고, 표현력을 높이기 위해 자기 지도 대조 학습을 결합함으로써, 쌍별 관계만 모델링하고 정보가 부족했던 기존 GNN의 한계를 해결하여 STAMP로 대표되는 딥러닝 방법보다 1.30–7.04% 높은 성능을 기록했습니다. GCE-GNN은 단일 세션 정보와 글로벌 세션 정보를 효과적으로 통합함으로써 STAMP로 대표되는 딥러닝 방법보다 1.46–7.60%, SR-GNN보다 0.88–5.85% 더 우수한 성능을 보였으며, 이는 글로벌 문맥 정보를 통합한 그래프 구조 방법이 SBR 성능을 크게 향상시킬 수 있음을 나타냅니다. 4) GNN + 어텐션 메커니즘 추천 방법: TASRec은 시간 인식 메커니즘을 도입하여 사용자 행동 시퀀스의 단기 및 장기 선호도를 더 정확하게 포착하는 것을 목표로 했으며, 그 성능은 딥러닝 방법보다 0.73–5.91%, SR-GNN 모델보다 0.30–2.31% 높았으나, GCE-GNN 모델보다는 0.59–3.84% 낮았습니다. GC-SAN은 세션 시퀀스에서 변환된 그래프 구조와 멀티 헤드 셀프 어텐션 메커니즘을 결합하여 세션 내의 국소 및 장기 의존성을 성공적으로 포착했으며, 성능은 SR-GNN 모델과 비슷하거나 약간 더 강했지만 TASRec 및 GCE-GNN 모델보다는 낮았습니다. 이는 어텐션 메커니즘의 도입이 SBR 성능을 효과적으로 개선할 수 있지만, 글로벌 정보에 의한 개선보다는 덜 유의미함을 시사하며, 글로벌 문맥 정보의 중요성을 재확인시켜 주었습니다. 5) GNN + 시간 인코딩 추천 방법: CT-GNN은 그래프 구조와 시간 인코딩을 결합하여 "공간적 구조"와 "시간적 역동성"을 동시에 포착한 최초의 모델로, GC-SAN 모델보다 0.55–3.82% 우수한 성능을 보였습니다. CORE는 글로벌 세션의 아이템 공동 발생 빈도를 통계적으로 분석하고 현재 세션에 대한 시간적 위치 가중치를 각각 설계함으로써 장기 선호도와 단기 의도를 포착했으며, 이 공동 발생 정보와 시간 정보를 융합하여 최종 세션 표현을 얻었습니다. 이 모델의 성능은 TASRec 모델보다 0.25–9.58%, GC-SAN 모델보다 0.67–11.56% 높았으며, Tmall 데이터셋에서는 GCE-GNN 모델보다 3.64–5.74%의 유의미한 성능 향상을 보였습니다. RESTC는 공간-시간 GNN 기반의 대조 학습 모델을 도입하여, 공간 그래프 구조에만 집중하고 시간 정보를 무시하며 공간-시간 융합이 부족했던 기존 GNN의 문제를 해결했으며, 그 성능은 CORE 모델보다 0.39–3.31%, GCE-GNN 모델보다 0.28–7.56% 높게 나타나 시간 인코딩과 대조 학습 모두 SBR 성능을 효과적으로 향상시킴을 보여주었습니다. RAIN은 에지 마스킹 및 구조적 재구성 기술을 활용하여 노이즈 에지를 명시적으로 식별하고 제거하기 위한 에지 지표를 공동 훈련함으로써 RESTC 모델에 근접한 성능을 달성했습니다.
제안된 모델인 GSLA4Rec은 전역 문맥 정보와 게이트 슬롯 선형 어텐션(gated-slot linear attention) 메커니즘을 통합하여, 노이즈를 필터링하고 계산 복잡도를 줄이는 동시에 사용자의 문맥 정보를 효과적으로 캡처하였습니다. 이 모델은 모든 데이터셋에서 성능 향상을 보였으며, 가장 우수한 성능의 베이스라인인 RESTC 모델보다 0.54–2.31%, GCE-GNN 모델보다 0.83–10.18% 더 높은 성능을 기록하였습니다. 이러한 결과는 특히 SBR의 롱 세션 시나리오에서 순차적 의존성을 처리할 때 두드러졌습니다(구체적으로 Tmall 및 Nowplaying 데이터셋에서 GCE-GNN 대비 각각 10.18% 및 4.73%, RESTC 대비 각각 1.44% 및 2.31% 향상됨). 요약하자면, 제안된 GSLA4Rec 모델은 사용자 문맥을 캡처하고 노이즈를 필터링하기 위해 효율적인 그래프 구축 방식을 도입하였으며, 모든 데이터셋에서 일관되게 SOTA를 능가하는 성능을 나타냈습니다.
효율성 분석
~에서 보여지는 바와 같이 그림 4Diginetica 데이터셋에 대한 실험 결과, 제안된 GSLA4Rec은 에포크당 훈련 시간 측면에서 베이스라인 모델들보다 더 빠른 훈련 속도를 달성했으며, 모든 실험은 NVIDIA TITAN V GPU에서 실행되었고 약 9300MB의 메모리를 소모했다. STAMP, NARM, GRU4Rec을 포함한 딥러닝 기반 모델들은 효율적으로 실행되었으나 가장 낮은 성능을 보였으며, GNN 및 셀프 어텐션 메커니즘 기반의 TASRec과 GC-SAN 모델은 성능을 향상시켰으나 상당한 시간이 소요되는 문제점이 있었다. 비록 S2GNN 기반의 DHCN 및 CORE는 계산 시간을 약간 증가시켰으나, 전반적인 성능은 현저히 향상되었으며, 특히 제안된 GSLA4Rec 모델은 성능 면에서 상당한 개선을 보였다. 주요 원인은 GSLA4Rec 모델이 베이스라인 모델들에 비해 그래프 구축에 소요되는 시간이 더 적었으며, 고정 메모리 슬롯을 갖춘 2패스 게이티드 선형 어텐션(two-pass gated linear attention) 메커니즘을 채택했기 때문이다. m, 그 결과 선형 시간 복잡도를 갖게 됩니다 O(Ldm). 이 설계는 표준 셀프 어텐션(self-attention)보다 훨씬 더 효율적이었습니다. O(L2입력된 텍스트가 없습니다. 번역할 내용을 제공해 주시기 바랍니다.)는 소프트맥스(softmax)로 강화된 슬롯 읽기를 통해 강력한 메모리 용량을 유지하는 동시에, 마지막 행에 표시된 바와 같이 통계적 추론 시간을 동기화하기 위해 테스트 세트에서 성능 테스트 실험을 수행합니다. 표 3, GSLA4Rec 모델의 효율성 측면의 이점을 입증하였으며, 이를 통해 ~을 방지했습니다. "거짓 높은 정확도이나 이용 불가능함" 그리고 효과성과 효율성 사이의 진정한 절충안을 달성하는 것입니다.
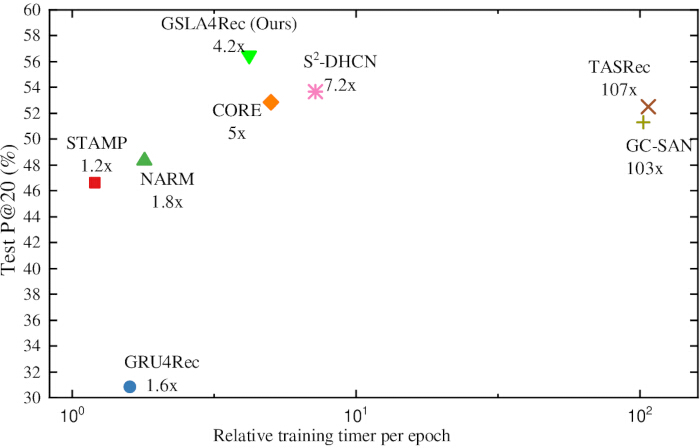
그림 4: Diginetica 데이터셋에서 GSLA4Rec의 실행 시간에 따른 성능. 이 그림은 제안된 GSLA4Rec 및 베이스라인 모델들을 NVIDIA TITAN V GPU에서 Diginetica 데이터셋을 사용하여 실행했을 때의 에포크당 상대적 학습 시간을 보여주며, GSLA4Rec이 베이스라인 모델들보다 더 빠른 학습 속도를 달성했음을 나타냅니다. 이 그림은 OriginPro를 통해 모든 요소를 완전히 맞춤 설정하여 직접 작성되었습니다. 저작권이 있는 외부 그래픽 리소스는 사용되지 않았으므로, 추가적인 제3자 저작권 라이선스는 필요하지 않았습니다. 그림의 저작권은 저자들에게 있으며, 논문 수락 시 저널의 저작권 규정을 준수할 것입니다. GSLA4Rec은 SBR을 위한 gated-slot linear attention 그래프 신경망을 의미합니다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
요약하자면, 선형 복잡도 게이티드 슬롯 어텐션(gated-slot attention)을 적용한 제안된 GSLA4Rec 모델의 효율성은 모든 데이터셋에서 SOTA를 일관되게 능가했습니다. 특히, GSLA4Rec는 Tmall 및 Nowplaying 데이터셋의 긴 세션 추천 시나리오에서 상당한 성능 향상을 달성했으며, 우수한 순차적 의존성 모델링 능력을 보여주었습니다.
절제 실험 분석
SG, NGG 및 GSLA의 영향
SG, NGG, 게이팅 메커니즘, 메모리 슬롯 및 선형 어텐션이 현재 SBR에 미치는 영향을 평가하기 위해, Diginetica, Tmall 및 Nowplaying 데이터셋을 대상으로 어블레이션 연구를 수행하였습니다. GSLA4Rec‑NotSG는 NGG 인코딩은 유지하면서 SG 특징 인코딩을 제외하였고, GSLA4Rec‑NotNGG는 NGG 인코딩을 버리고 오직 SG만을 기반으로 특징 추출을 수행하였으며, GSLA4Rec‑NotGM은 GSLA 내의 게이팅 메커니즘만을 제거하였습니다. GSLA4Rec‑NotMS는 GSLA의 메모리 슬롯만을 없앴으며, GSLA4Rec‑NotLA는 GSLA에서 선형 어텐션 모듈만을 생략하였습니다.
| 데이터셋 | Diginetica | Tmall | Nowplaying | |||
| 측정 지표 | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Recs-NotSG | 54.28 | 18.87 | 31.40 | 15.11 | 22.48 | 7.45 |
| GSLA4Recs-NotNGG | 52.65 | 17.67 | 28.90 | 14.61 | 20.17 | 7.74 |
| GSLA4Rec-NotGM | 53.82 | 18.21 | 39.26 | 16.52 | 23.14 | 7.62 |
| GSLA4Rec-NotMS | 53.40 | 17.60 | 38.05 | 15.65 | 22.55 | 7.40 |
| GSLA4Rec-NotLA | 51.86 | 16.92 | 29.12 | 13.96 | 20.82 | 7.28 |
표 4: GSLA4Rec 어블레이션 실험 성능. 이 표는 Diginetica, Tmall, Nowplaying 데이터셋에서 개별 모델 구성 요소를 제거한 후 GSLA4Rec의 어블레이션 성능을 P@20 및 MRR@20으로 평가하여 나타낸 결과이다.
표 4는 서로 다른 데이터셋에 대한 어블레이션 연구 결과를 보여주며, 모든 성능 지표가 전체 모델에 비해 감소했습니다. 근접 이웃 전역 세션 그래프 인코딩을 제거했을 때(GSLA4Rec-NotNGG)의 성능 감소가 세션 그래프 특징 인코딩을 제거했을 때(GSLA4Rec-NotSG)보다 더 두드러졌습니다. GSLA의 하위 모듈을 삭제하면 성능 저하가 발생하며, 성능 저하의 정도는 선형 어텐션, 메모리 슬롯, 게이팅 메커니즘 순으로 높게 나타났습니다. 그 이유는 SBR에서 각 아이템의 중요도가 분명히 다르며, 아이템 간의 연상 메모리가 필요하기 때문입니다. 이를 통해 GSLA가 본 논문 모델의 핵심 부분임을 알 수 있습니다.
다양한 응집 방법의 영향
서로 다른 정보 집계 방법이 GSLA4Rec 모델의 성능에 미치는 영향을 평가하기 위해, 다음과 같은 세 가지 고전적인 정보 집계 방법을 조사하였다: 1) Average Pooling: SG와 NGG에 의해 생성된 벡터들에 대해 평균 풀링 연산을 수행함; 2) Vector Concatenation: SG와 NGG에 의해 생성된 벡터들을 연결함; 3) Vector Summation: SG와 NGG에 의해 생성된 벡터들을 합산함. 결과는 Table 5에 나타났다. Vec-Sum을 적용한 GSLA4Rec이 Diginetica, Tmall, Nowplaying에서 가장 우수한 성능을 달성하였다. 반면, Mean-pooling은 모든 데이터셋에서 저조한 결과를 보였다. 평균 집계 및 연결 집계의 낮은 성능은 과도한 파라미터로 인한 과적합에서 기인하여 전반적인 모델 성능을 저하시켰을 가능성이 있다.
| 데이터셋 | Diginetica | 티몰(Tmall) | 현재 재생 중 | |||
| 측정 항목 | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| 평균 풀링(Mean-Pooling) | 45.26 | 15.63 | 38.84 | 16.3 | 23.56 | 7.55 |
| 벡터 연결(Vec-Concating) | 51.77 | 17.24 | 39.83 | 18.24 | 24.06 | 8.88 |
| 벡터 합 | 56.47 | 19.98 | 43.6 | 19.96 | 27.1 | 9.32 |
표 5: 서로 다른 집계 방법의 효과. 이 표는 Diginetica, Tmall 및 Nowplaying 데이터셋에 대해 P@20 및 MRR@20을 사용하여 평균 풀링(mean pooling), 벡터 연결(vector concatenation) 및 벡터 합산(vector summation)이 GSLA4Rec 성능에 미치는 영향을 비교합니다.
하이퍼파라미터 설정 분석
서로 다른 메모리 슬롯 크기의 영향
메모리 슬롯은 이전 타임 스텝의 정보를 저장하며, 이는 특히 시간적 의존성이 있는 작업에서 매우 중요합니다. 본 섹션에서는 메모리 슬롯 크기 m = [0, 1, 2, 3, 4, 5]가 SBR 성능에 미치는 영향을 조사하였습니다. 표 6에 제시된 실험 결과에 따르면, 메모리 슬롯 크기 m을 3으로 설정했을 때 세 가지 데이터셋 모두에서 P@20 및 MRR@20 지표가 최적의 성능을 보였습니다. 이는 적절한 크기의 메모리 슬롯이 모델의 추천 정확도와 랭킹 품질을 효과적으로 향상시킴을 시사합니다. 메모리 슬롯 크기가 너무 작으면 충분한 이력 정보를 기억하는 데 어려움이 있어 사용자의 단기적 관심사에 더 집중하게 되는 반면, 메모리 슬롯 크기가 4 이상으로 증가하면 모델이 과도한 이력 정보를 저장하게 되어 더 중요한 현재 입력 정보를 간과하고 과거의 관심사에 과하게 의존하게 됨으로써 추천 성능이 저하되는 것으로 나타났습니다.
| 데이터세트 | 디지네티카(Diginetica) | 티몰(Tmall) | 현재 재생 중 | |||
| 측정 항목 | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Rec-m0 | 53.40 | 17.60 | 38.05 | 15.65 | 22.55 | 7.40 |
| GSLA4Rec-m1 | 55.43 | 18.92 | 41.55 | 17.12 | 25.60 | 8.43 |
| GSLA4Rec-m2 | 56.02 | 19.35 | 42.90 | 18.25 | 26.62 | 8.95 |
| GSLA4Rec-m3 | 56.47 | 19.98 | 43.60 | 19.96 | 27.10 | 9.32 |
| GSLA4Rec-m4 | 53.96 | 19.25 | 43.06 | 19.09 | 26.34 | 8.35 |
| GSLA4Rec-m5 | 52.18 | 18.03 | 42.12 | 17.56 | 24.86 | 8.85 |
표 6: 서로 다른 메모리 슬롯 크기의 효과. 이 표는 Diginetica, Tmall, Nowplaying 데이터셋에 대해 P@20 및 MRR@20을 사용하여 서로 다른 메모리 슬롯 구성(m0–m5)에 따른 GSLA4Rec의 성능을 나타냅니다.
다양한 드롭아웃 비율의 효과
과적합을 방지하기 위해 드롭아웃 정규화(dropout regularization)를 도입하였다. 세션 수준 아이템 벡터와 이웃 글로벌 수준 아이템 벡터를 합산하기 전, GSLA4Rec 모델의 강건성과 일반화 능력을 향상시키기 위해 이웃 글로벌 수준 아이템 벡터 hingg,(k)의 뉴런 출력을 무작위로 드롭아웃시켰다.
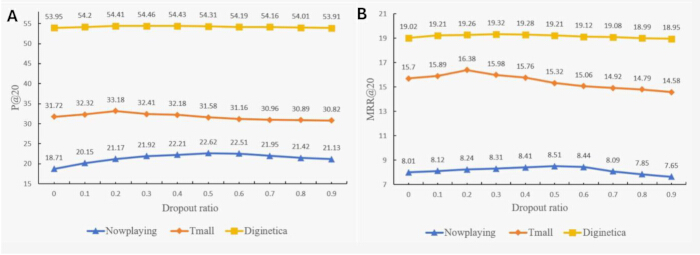
그림 5: 다양한 드롭아웃 비율에 따른 GSLA4Rec의 성능. (A) Nowplaying, Tmall 및 Diginetica 데이터셋에서 다양한 드롭아웃 비율에 따른 GSLA4Rec의 P@20 및 (B) MRR@20. 드롭아웃 비율이 증가함에 따라 성능이 처음에는 증가했다가 이후 감소하여 모델의 강건성과 일반화 능력을 입증하였다. GSLA4Rec, 세션 기반 추천(SBR)을 위한 게이트-슬롯 선형 어텐션 그래프 신경망. 이 그림은 OriginPro를 사용하여 모든 요소를 완전히 맞춤 설정하여 직접 작성하였다. 저작권이 있는 외부 그래픽 리소스는 사용되지 않았으므로 추가적인 제3자 저작권 라이선스는 필요하지 않았다. 그림의 저작권은 저자에게 있으며, 게재 승인 시 저널의 저작권 규정을 준수할 것이다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
그림 5A–B는 식 (16)의 서로 다른 드롭아웃 비율이 모델 성능에 미치는 영향을 보여줍니다. 실험 결과, 드롭아웃 비율이 낮을 때는 모델의 성능이 저조했으나, 드롭아웃 비율이 증가함에 따라 모델 성능이 점차 향상되어 최적 수준에 도달하는 것으로 나타났습니다. 구체적으로, 최적의 드롭아웃 비율은 Diginetica 데이터셋의 경우 0.3, Tmall 데이터셋의 경우 0.2, Nowplaying 데이터셋의 경우 0.5였습니다. 드롭아웃 비율이 이러한 최적값을 초과하면 모델 성능이 감소하기 시작했는데, 이는 주로 과도한 뉴런 드롭아웃으로 인해 모델이 세션 데이터로부터 중요한 특징을 효과적으로 학습하지 못했기 때문입니다.
다양한 임베딩 크기의 영향
최적의 모델 성능을 유지하면서 계산 오버헤드를 최대한 최소화하기 위해, 서로 다른 임베딩 차원 d가 GSLA4Rec 모델의 성능에 미치는 영향을 조사하였습니다. 그림 6A–B에 나타난 바와 같이, 세 가지 공개 데이터셋인 Diginetica, Tmall, Nowplaying에서 임베딩 차원 d가 10–40일 때 GSLA4Rec 모델의 성능은 낮게 나타났으나, d 값이 증가함에 따라 모델 성능이 빠르게 상승하였습니다. 성능 지표는 d 값이 80에서 120 범위 내에 있을 때 안정화되는 경향을 보였으며, 이후 d가 계속 증가함에 따라 큰 임베딩 차원으로 인한 과적합으로 인해 성능이 실제로 감소하였습니다. 따라서 아이템 임베딩 벡터의 차원은 최종적으로 100으로 설정되었습니다.
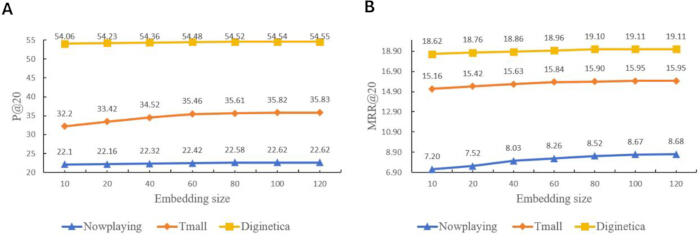
그림 6: 다양한 임베딩 크기에 따른 GSLA4Rec의 성능. Nowplaying, Tmall 및 Diginetica 데이터셋에서 다양한 임베딩 크기에 따른 GSLA4Rec의 (A) P@20 및 (B) MRR@20. 임베딩 크기가 증가함에 따라 모델 성능이 점진적으로 향상되었으며 결국 정체기에 도달하였다. GSLA4Rec는 세션 기반 추천(SBR)을 위한 gated-slot linear attention graph neural networks를 의미한다. 이 그림은 모든 요소를 완전히 맞춤 설정하여 OriginPro를 사용하여 직접 작성하였다. 저작권이 있는 외부 그래픽 리소스는 사용되지 않았으므로 추가적인 제3자 저작권 라이선스는 필요하지 않았다. 그림의 저작권은 저자들에게 있으며, 게재 승인 시 저널의 저작권 규정을 준수할 것이다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
세션 길이에 따른 영향
세 가지 실제 SBR 데이터셋(Diginetica, Tmall, Nowplaying)에 따라 각 세션의 길이가 다양하다는 점은 잘 알려져 있습니다. 다양한 세션 길이에서 베이스라인 모델 대비 GSLA4Rec 모델의 강건성을 검증하기 위해, Diginetica와 Tmall의 모든 세션을 각각 1~6개(단축 그룹, S), 7~12개(중간 그룹, M), 12개 초과(장축 그룹, L)의 세 그룹으로 나누었습니다. MRR이 정답 결과의 순위 품질을 더 잘 반영할 수 있기 때문에, 방법론의 성능 검증을 위해 P@20 대신 MRR@20을 채택하였습니다. 그림 7A–B는 GSLA4Rec 모델이 서로 다른 세션 길이에서 시퀀스 기반 베이스라인인 NARM, GNN 기반 베이스라인인 SR-GNN, 대조 학습이 강화된 GNN 베이스라인인 S2-DHCN, 그리고 시공간 베이스라인인 RESTC보다 우수한 성능을 보였음을 나타냅니다. 한편, 장거리 아이템 전이는 사용자의 선호도를 포착하기 어렵게 만들기 때문에 모든 방법의 성능이 시퀀스 길이가 증가함에 따라 감소하는 것이 관찰되었습니다. 그러나 제안된 GSLA4Rec 모델은 Gated-slot 메커니즘이 무관한 아이템을 필터링할 수 있어 베이스라인들에 비해 성능 감소 속도가 가장 느렸으며, Diginetica와 Tmall의 장축 그룹에서 GSLA4Rec의 성능은 NARM 모델보다 각각 6.3 및 8.85 더 높게 나타났습니다.
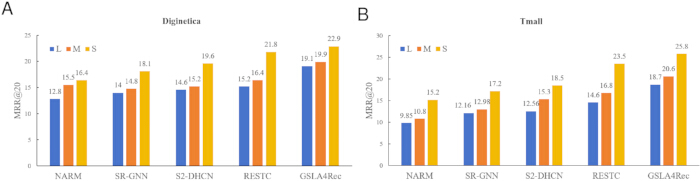
그림 7: 다양한 세션 길이에 따른 GSLA4Rec의 성능. MRR@20을 사용하여 평가한 (A) Diginetica 및 (B) Tmall 데이터셋의 다양한 세션 길이 그룹에 따른 GSLA4Rec 및 베이스라인 모델의 성능. 세션 길이 그룹은 L, M, S로 표시됨. GSLA4Rec는 세션 기반 추천(SBR)을 위한 게이티드 슬롯 선형 어텐션 그래프 신경망임. 이 그림은 완전히 맞춤 설정된 요소를 사용하여 OriginPro로 직접 작성되었음. 저작권이 있는 외부 그래픽 리소스는 사용되지 않았으며, 따라서 추가적인 제3자 저작권 라이선스는 필요하지 않음. 그림의 저작권은 저자에게 있으며, 게재 승인 시 학술지의 저작권 규정을 준수할 것임. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
결론
본 논문은 SBR을 위한 글로벌 컨텍스트 게이트 슬롯 선형 어텐션 네트워크를 제안합니다. SG와 NGG를 결합하고 게이트 슬롯 선형 어텐션 메커니즘을 도입함으로써, 이 방법은 세션 시퀀스의 핵심 항목에 집중하고 장단기 의존성을 포착하며, 노이즈를 효과적으로 줄이는 동시에 계산 복잡도를 낮출 수 있습니다. 실험 결과, 이 방법은 3개의 공개 데이터셋에서 우수한 추천 정확도와 효율성을 보였으며, 특히 장기 의존성 모델링 작업에서 탁월한 성능을 나타냈음을 확인하였습니다.
데이터 가용성:
본 연구의 결과를 뒷받침하는 세 가지 일반적인 공개 데이터셋(Diginetica, Tmall, Nowplaying, URL은 재료 표에서 확인 가능)을 인터넷에서 공개적으로 이용할 수 있습니다. 이와 동시에, 널리 사용되는 세 가지 공개 데이터셋과 본 연구의 소스 코드가 보충 폴더: GSLA4Rec.zip으로 제출되었습니다. 이 파일을 다운로드하려면 여기를 클릭하십시오.
토론
기준점과 비교할 때, GSLA4Rec 모델은 세 가지 핵심 이유로 인해 성능과 효율성이라는 두 가지 측면에서 모두 향상된 결과를 달성한다. 첫째, NGG에 게이팅 메커니즘을 적용함으로써 데이터 희소성을 완화하고 효과적으로 노이즈를 필터링할 수 있다. 둘째, 메모리 슬롯 메커니즘은 하이퍼파라미터를 통해 저장 용량과 효율성 사이의 균형을 조절한다. m 조정. 세 번째로, 선형 어텐션 메커니즘은 항목 간 상관관계를 계산한다. O(N) 복잡성, 훨씬 낮음 O(N2)61GSLA4Rec 모델은 사용자에 과도하게 의존한다.' 상호작용 서열을 포함하며 항목들의 다중모달 특성은 무시함48한편, NGG 구조는 동적 조정 기능 없이 고정된 자카드 임계값을 사용하며, 메모리 슬롯 m 적응형 조절성을 달성할 수 없다65.
GSLA4Rec 모델은 SG를 구축하는&NGG는 게이트 방식 슬롯 선형 어텐션을 채택하여 익명 세션 기반 추천에 특히 적합함39 전자상거래 및 온라인 스트리밍 플랫폼 전반에 걸쳐 활용된다. 전자상거래 플랫폼에서는 이 모델이 사용자의 특성 속성에 의존하지 않고, 사용자의 브라우징, 클릭, 장바구니 담기 등의 행동을 파악하여 사용자에게 맞는 상품을 추천한다. 본 논문에서 사용된 Diginetica 및 Tmall 데이터셋은 전자상거래 추천 데이터셋이다. 짧은 동영상 및 음악 스트리밍 플랫폼의 경우, 이 방법은 사용자 분석을 수행한다.' 재생 순서를 분석하여 사용자의 묵시적 선호를 추론하고, 콘텐츠 요약을 업데이트하여 사용자를 유지하며 시청 시간을 연장한다. 본 논문에서 사용된 데이터셋인 Nowplaying은 음악 추천 데이터셋이다.
게이티드 슬롯 선형 어텐션 아키텍처를 대체할 수 있는 대안적 솔루션이 존재한다. 등장하고 있는 맘바(Mamba)65 기반 상태 공간 모델은 대안으로서 선택적 상태 저장 공간과 선형 계산 복잡도라는 특성을 가지며, 선형 복잡도와 장기간 시퀀스 적합 능력 사이의 균형을 이루고, LLM과 결합된다.55 향상 프레임워크는 사용자 정보를 추출한다' 원래의 상호작용 기록에서 암묵적인 사용자 의도를 추출함으로써 우수한 추천 성능과 효율성을 달성한다. 향후 연구에서는 GSLA4Rec을 다양한 측면에서 최적화할 수 있다: 고정된 자카드 필터링을 대체할 동적 NGG 구축, 다양한 길이의 세션에 자동으로 적합하게 조정되는 가변 메모리 슬롯 구현, 그리고 추천 정확도 향상을 위한 사용자 다중 모달 정보 통합 등이 가능하다. 또한, LLM 기반 강화 모델의 도움을 통해55, 사용자' 암묵적인 의도는 상호작용 순서에서 추출할 수 있으며, 노이즈가 포함된 대화 데이터도 더욱 정확하게 필터링할 수 있다72.
공개 사항
저자들은 본 논문에 보고된 연구에 영향을 미칠 수 있는 알려진 경쟁적 재정적 이해관계나 개인적 관계가 없음을 선언합니다.
감사의 글
저자는 심사 과정 동안 세심한 피드백과 제안을 해주신 심사위원분들과 세심하게 지도해주신 박사 과정 지도교수 Jiang Nan 교수님께 감사드립니다. 본 연구는 중국 국가자연과학기금(National Science Foundation of China)의 Grant No.6217072713 및 Grant No.62061019의 지원을 일부 받았으며, 2025년 Jiangxi Province unmanned sensing system and artificial intelligence technology Engineering Research의 공개 연구 주제 및 Jiangxi Provincial Key Laboratory of Advanced Electronic Materials and Devices(No.2024SSY03012)의 지원을 일부 받았습니다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| CUDA 11.3 | NVIDIA | 없음 | CUDA 11.3은 2021년 NVIDIA에서 출시한 병렬 컴퓨팅 플랫폼 및 프로그래밍 모델 버전으로, GPU 가속 애플리케이션의 성능과 개발 유연성 향상을 목적으로 합니다. |
| Diginetica | Diginetica | 없음 | Diginetica는 2016년 CIKM(국제 정보 검색 컨퍼런스) 컵의 공식 경진대회 데이터셋으로, 검색 문맥을 활용한 이커머스의 개인화된 상품 검색 문제를 해결하기 위한 CIKM 알고리즘 경진대회에 사용되었습니다. 현재 이 데이터셋은 세션 기반 추천(SBR) 분야에서 가장 주류인 표준 이커머스 벤치마크 데이터셋이 되었습니다. |
| Nowplaying | Zenodo | 없음 | 이 데이터셋은 "# nowplaying" 태그 트윗 마이닝을 기반으로 구축된 대규모 음악 청취 행동 데이터셋으로, 주로 음악 대화 추천, 문맥 인식 추천 및 감성 상관 분석 연구에 사용됩니다. |
| OriginPro 2024 (64-bit) SR1 | OriginLab Corporation | 없음 | OriginPro는 OriginLab Corporation에서 개발한 상용 전문 과학 작도 및 데이터 분석 소프트웨어로, 논문 수준의 차트 작성, 데이터 통계, 곡선 피팅, 신호 처리 등에 일반적으로 사용됩니다. 본 논문에서는 OriginPro를 사용하여 실험 비교 차트, 꺾은선형 차트 및 막대형 차트를 작성하였습니다. |
| PyTorch 1.11.0 | PyTorch Foundation | 없음 | PyTorch는 2016년 Facebook에서 출시한 머신러닝 및 딥러닝을 위한 오픈 소스 딥러닝 프레임워크입니다. 주로 자동 미분을 구현하며 동적 계산 그래프를 도입하여 모델 구축의 유연성을 높였습니다. |
| TITAN V GPU | NVIDIA | 없음 | NVIDIA TITAN V는 2017년 말 NVIDIA에서 출시한 플래그십 그래픽 카드로, 주로 고성능 컴퓨팅 및 인공지능 분야를 겨냥한 제품입니다. |
| Tmall | Tmall | 없음 | IJCAI 2015 Alibaba Tmall 추천 경진대회로부터 Alibaba Tianchi가 비식별화된 실제 Tmall 온라인 로그를 공개적으로 배포하였습니다. 이는 SBR 분야의 3대 표준 데이터셋(Diginetica, Yoocoose, Tmall) 중 하나이며, 중국 이커머스 시나리오에서 선호되는 평가 데이터셋입니다. |
| visio 2021 | Microsoft | 없음 | Visio는 Microsoft에서 개발한 벡터 드로잉 소프트웨어로, 과학 연구 논문에서 모델 구조도, 순서도, 프레임워크 다이어그램, 네트워크 토폴로지 다이어그램을 작성하고 논문 삽화를 위한 벡터 도면을 출력하는 데 사용됩니다. |
참고문헌
- Sarwar B, Karypis G, Konstan J, Riedl J. Item-based collaborative filtering recommendation algorithms. In: Proceedings of the 10th International Conference on World Wide Web; 2001 May 1–5; Hong Kong, China. ACM; 2001.p.285-295.
- Zhao ZD, Shang MS. User-based collaborative-filtering recommendation algorithms on hadoop. In: 2010 Third International Conference on Knowledge Discovery and Data Mining; 2010 Jan 9–10; Washington, DC, USA. IEEE; 2010.p.478-481.
- Koren Y, Rendle S, Bell R. Recommender Systems Handbook. Berlin: Springer; 2022.
- Koren Y, Bell R, Volinsky C. Matrix factorization techniques for recommender systems. Computer. 2009;42(8):30-37.
- Rendle S, Freudenthaler C, Schmidt-Thieme L. Factorizing personalized markov chains for next-basket recommendation. In: Proceedings of the 19th International Conference on World Wide Web; 2010 Apr 26–30; Raleigh, North Carolina, USA. ACM; 2010.p.811-820.
- Wang S et al. A survey on session-based recommender systems. ACM Comput Surv. 2021; 54(7): 1-38.
- Ninichuk M, Namiot D. Survey On Methods For Building Session-Based Recommender Systems. Int J Open Inf Technol. 2023;11(5):22-32.
- Saxena A. A Survey of Session-Based Recommender Systems. In: 2023 5th International Conference on Advances in Computing, Communication Control and Networking. IEEE, 2023.
- Ravanmehr R, Mohamadrezaei R. Session-Based Recommender Systems Using Deep Learning. Berlin: Springer; 2023.
- He R, McAuley J. Fusing similarity models with markov chains for sparse sequential recommendation. In: 2016 IEEE 16th International Conference on Data Mining; 2016 Dec 12–15; Barcelona, Spain. IEEE; 2016.p.191-200.
- Chen R, Fan J, Wu M. MC-RGN: Residual graph neural networks based on Markov chain for sequential recommendation. Inf Process Manag. 2023;60(6):103519.
- Ni S, Hu S, Li L. An intention-aware markov chain based method for top-k recommendation. IEEE Trans Autom Sci Eng. 2022;21(1):581-592.
- Yu Y, Si X, Hu C, Zhang J. A review of recurrent neural networks: LSTM cells and network architectures. Neural Comput. 2019;31(7):1235-1270.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517.
- Hidasi B, Karatzoglou A, Baltrunas L, Tikk D. Session-based recommendations with recurrent neural networks. In: Bengio Y, LeCun Y, editors. Proceedings of International Conference on Learning Representations; 2016 May 2–4; San Juan, Puerto Rico.
- Li J et al. Neural attentive session-based recommendation. In: Proceedings of the 2017 ACM Conference on Information and Knowledge Management; 2017 Nov 6–10; Singapore. ACM; 2017. p.1419-1428.
- Liu Q, Zeng Y, Mokhosi R, Zhang H. STAMP: short-term attention/memory priority model for session-based recommendation. In: Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining; 2018 Aug 19–23; London, United Kingdom. ACM; 2018.p.1831-1839.
- Zhou J et al. Graph neural networks: A review of methods and applications. AI open. 2020;1:57-81.
- Scarselli F, Gori M, Tsoi AC, Hagenbuchner M, Monfardini G. The graph neural network model. IEEE Trans Neural Netw. 2009;20(1):61‑80.
- Corso G, Stark H, Jegelka S, Jaakkola T, Barzilay R. Graph neural networks. Nat Rev Methods Primers. 2024;4(1):17.
- Zheng Y, Yi L, Wei Z. A survey of dynamic graph neural networks. Front Comput Sci. 2025;19(6):196323.
- Wu S et al. Session-based recommendation with graph neural networks. In: Proceedings of the AAAI Conference on Artificial Intelligence; 2019 Jan 27‑Feb 1; Honolulu, USA. AAAI Press; 2019.p.346-353.
- Wang Z et al. Global context enhanced graph neural networks for session‑based recommendation. In: Proceedings of the 43rd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2020 Jul 25‑30; Virtual conference. ACM; 2020.p.169‑178.
- Shani G, Heckerman D, Brafman RI. An MDP‑based recommender system. J Mach Learn Res. 2005;6:1265‑1295.
- Gu W, Dong S, Zeng Z. Increasing recommended effectiveness with Markov chains and purchase intervals. Neural Comput Appl. 2014;25(5):1153‑1162.
- O'shea K, Nash R. An introduction to convolutional neural networks. arXiv preprint arXiv:1511.08458, 2015.
- Wu J. Introduction to convolutional neural networks. Nanjing: National Key Lab for Novel Software Technology, Nanjing University; 2017.
- Li Z, Yang W, Peng S, Liu F. A survey of convolutional neural networks: analysis, applications, and prospects. IEEE Trans Neural Netw Learn Syst. 2021;33(12):6999‑7019.
- Krichen M. Convolutional neural networks: A survey. Computers. 2023;12(8):151.
- Tang J, Wang K. Personalized top-n sequential recommendation via convolutional sequence embedding. In: Proceedings of the 11th ACM International Conference on Web Search and Data Mining; 2018 Feb 5–9; Marina Del Rey, California, USA. ACM; 2018.p.565-573.
- Tuan T, Phuong T. 3D convolutional networks for session-based recommendation with content features. In: Proceedings of the 11th ACM Conference on Recommender Systems; 2017 Aug 27–31; Como, Italy. ACM; 2017.p.138-146.
- Graves A. Generating sequences with recurrent neural networks. arxiv preprint arxiv: 1308.0850, 2013.
- Tang D, Qin B, Liu T. Document modeling with gated recurrent neural network for sentiment classification. In: Proceedings of the 2015 Conference on Empirical Methods in Natural Language Processing; 2015 Sep 17‑21; Lisbon, Portugal. Association for Computational Linguistics; 2015.p.1422‑1432.
- Chan W, Jaitly N, Le Q, Vinyals O. Listen, attend and spell: a neural network for large vocabulary conversational speech recognition. In: 2016 IEEE International Conference on Acoustics, Speech and Signal Processing; 2016 Mar 20‑25; Shanghai, China. IEEE; 2016.p. 4960‑4964.
- Sutskever I, Vinyals O, Le QV. Sequence to sequence learning with neural networks. In: Advances in Neural Information Processing Systems 27; 2014 Dec 8‑13; Montreal, Canada.
- Xiao C, Li Z, Tang J, Lee J. United prediction of travel modes and purposes in travel chains based on multitask learning deep neural networks. Mathematics. 2025;13(9):1528.
- Chmielewski J, Wójcik M. The use of deep neural networks (DNN) in travel demand modelling. Appl Sci. 2025;15(20):11290.
- Shahmoradi N, Alesheikh AA, Jafari A, Lotfata A. Hybrid ST-ResNet and LSTM approach for precise crime hotspot prediction. Sci Rep. 2025;15:18672.
- Park J, Yi D, Ji SM. Analysis of recurrent neural network and predictions. Symmetry.2020;12(4): 615.
- Ramakrishnan N, Soni T. Network traffic prediction using recurrent neural networks. In: 2018 17th IEEE International Conference on Machine Learning and Applications; 2018 Dec 17‑20; Orlando, Florida, USA. IEEE; 2018.p.187‑193.
- Yu P, Yan X. Stock price prediction based on deep neural networks. Neural Comput Appl. 2020;32(6):1609‑1628.
- Zhao J, Zeng D, Liang S, Kang H, Liu Q. Prediction model for stock price trend based on recurrent neural network. J Ambient Intell Humaniz Comput. 2021;12:745‑753.
- Zaytar MA, Chaker EA. Sequence to sequence weather forecasting with long short-term memory recurrent neural networks. Int J Comput Appl. 2016;143(11):7-11.
- Xu L, Peng J, Jiang X, Chen E, Luo B. Graph neural network based on graph kernel: a survey. Pattern Recognit. 2025;161:111307.
- Li Y, Tarlow D, Brockschmidt M, Zemel R. Gated graph sequence neural networks. arxiv preprint arxiv: 1511.05493, 2015.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. arXiv preprint arXiv:1609.02907;2016.
- Veličković P et al. Graph attention networks. arXiv preprint arXiv:1710.10903;2017.
- Chen L, Zhu X, Zhu G. Exploiting attributes and keywords for session-based recommendation with multi-view graph neural network. Expert Syst Appl. 2025;128990.
- Driss El Alaoui et al. A novel session-based recommendation system using capsule graph neural network. Neural Netw. 2025;185:107176.
- Xu C et al. Graph contextualized self‑attention network for session‑based recommendation. In: Proceedings of the 28th International Joint Conference on Artificial Intelligence; 2019 Aug 10‑16; Macao, China. 2019.p.3940‑3946.
- Qiu R, Huang Z, Li J, Chen H. Rethinking the item order in session‑based recommendation with graph neural networks. In: Proceedings of the 28th ACM International Conference on Information and Knowledge Management; 2019 Nov 3‑7; Beijing, China. ACM; 2019.p.579‑588.
- Chen J, Ji J, Li H, Zhang X. SR‑HetGNN: session‑based recommendation with heterogeneous graph neural network. Knowl Inf Syst. 2024;66(2):1111‑1134.
- Wang Y et al. Knowledge graph‑based session recommendation with session‑adaptive propagation. In: Companion Proceedings of the ACM Web Conference 2024; 2024 May 13‑17; Singapore. ACM; 2024.p.264‑273.
- Wang Z, Jin B. DiffSBR: a diffusion model for session-based recommendation. Inf. Process. Manag. 2026;63(1):104284.
- Qiao S et al. Multi-view intent learning and alignment with large language models for session-based recommendation. ACM Trans. Inf. Syst. 2025;43(4):91.
- Wang M et al. A collaborative session‑based recommendation approach with parallel memory modules. In: Proceedings of the 42nd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2019 Jul 21‑25; Paris, France. ACM; 2019. p.345‑354.
- Ye R, Zhang Q, Luo H. Cross-session aware temporal convolutional network for session-based recommendation. In: 2020 International Conference on Data Mining Workshops; 2020 Nov 16–19; Sorrento, Italy. IEEE Computer Society; 2020.p.220-226.
- Chen Y, Huang L, Wang C, Lai J. Hybrid-order gated graph neural network for session-based recommendation. IEEE Trans Ind Inform. 2021;18(3):1458‑1467.
- Chen Y, Tang Y, Yuan Y. Attention-enhanced graph neural networks with global context for session-based recommendation. IEEE Access. 2023;11:26237-26246.
- Tang L, Wang X, Wang H, Shi C, Song L. DA‑GCN: a domain‑aware attentive graph convolution network for shared‑account cross‑domain sequential recommendation. In: Proceedings of the 30th International Joint Conference on Artificial Intelligence; 2021 Aug 19‑27; Montreal, Canada.
- Vaswani A et al. Attention is all you need. In: Advances in Neural Information Processing Systems 30; 2017 Dec 4‑9; Long Beach, USA.
- Lu Y, Letey M, Zavatone‑Veth JA, Maiti A, Pehlevan C. Asymptotic theory of in‑context learning by linear attention. Proc. Natl. Acad. Sci. U.S.A. 2025;122(28):e2502599122.
- Peng H, Pappas N, Yogatama D, Kong L. ABC: attention with bounded‑memory control. In: Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics; 2022 May 22‑27; Dublin, Ireland. Association for Computational Linguistics; 2022.p.7469‑7483.
- Yang S et al. Gated linear attention transformers with hardware‑efficient training. In: Proceedings of the 41st International Conference on Machine Learning; 2024 Jul 21‑27; Vienna, Austria. PMLR; 2024.
- Yuan H et al. DG‑mamba: robust and efficient dynamic graph structure learning with selective state space models. In: Proceedings of the 39th AAAI Conference on Artificial Intelligence; 2025 Feb 25‑Mar 4; Philadelphia, Pennsylvania, USA. AAAI Press; 2025.p.22272‑22280.
- Xia X et al. Self‑supervised graph co‑training for session‑based recommendation. In: Proceedings of the 30th ACM International Conference on Information and Knowledge Management; 2021 Oct 25‑29; Virtual Event. ACM; 2021.p.2180‑2190.
- Zhou H, Zhang D, Song M, Han W. Temporal augmented graph neural networks for session‑based recommendations. In: Proceedings of the 44th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2021 Jul 11‑15; Montreal, Canada. ACM; 2021. p. 1798‑1802.
- Chen Q, Jiang F, Wang Y, Li Y, Zhang Y. Combine temporal information in session‑based recommendation with graph neural networks. Expert Syst Appl. 2024;238:121969.
- Hou Y, Hu B, Zhang Z, Zhao W. Core: simple and effective session‑based recommendation within consistent representation space. In: Proceedings of the 45th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2022 Jul 11‑15; Madrid, Spain. ACM; 2022.p.1796‑1801.
- Wan Z et al. Spatio‑temporal contrastive learning‑enhanced GNNs for session‑based recommendation. ACM Trans. Inf. Syst. 2023;42(2):1‑26.
- Zeng X et al. RAIN: reconstructed‑aware in‑context enhancement with graph denoising for session‑based recommendation. Neural Netw. 2025;184:107056.
- Zhan H et al. Capturing dynamic interests with deformable attention mechanism for session-based recommendation. Int J Mach Learn Cybern. 2026;17:375.