본 프로토콜은 기상 기반 데이터셋의 생성과 더불어, 모래폭풍, 안개, 비, 눈을 포함한 이라크의 다양한 환경 조건에서 자유 공간 광통신(free-space optical communications)의 대기 감쇠를 예측하기 위한 머신 러닝, 딥 러닝 및 하이브리드 모델의 체계적인 평가 방법을 설명합니다.
이 논문에서
요약
초록
자유 공간 광통신 시스템은 높은 대역폭, 향상된 보안성 및 무면허 운용의 장점이 있지만, 산란과 흡수로 인한 대기 감쇠로 인해 성능 저하의 영향을 크게 받습니다. 환경이 무작위로 덥고 먼지가 많으며 안개와 비가 내리는 이라크에서는 감쇠 예측의 정확성이 더욱 중요합니다. 본 연구의 목적은 다양한 이라크 기상 조건에서 자유 공간 광통신 시스템의 대기 감쇠를 예측하기 위한 머신러닝, 딥러닝 및 하이브리드 모델링 기법의 성능을 평가하는 것입니다. 맑은 하늘, 안개, 비, 먼지 폭풍 및 눈의 다섯 가지 기상 체계에 대해 잘 확립된 물리적 전파 모델을 사용하여 1,500개 샘플의 합성 데이터 세트를 생성했습니다. 6가지 머신러닝 기법(Random Forest [RF], Extreme Gradient Boosting, Light Gradient Boosting Machine, Support Vector Regression, Linear Regression, K-Nearest Neighbors), 6가지 딥러닝 아키텍처(Multilayer Perceptron, Deep Neural Network, Long Short-Term Memory [LSTM], One-Dimensional Convolutional Neural Network [CNN], CNN–LSTM, Attention-based Network) 및 3가지 하이브리드 접근 방식을 포함한 총 15가지 예측 모델을 체계적으로 평가했습니다. 결과에 따르면 RF가 딥러닝 접근 방식(최고 R2 = 0.7766) 및 하이브리드 방법(최고 R2 = 0.9571)에 비해 가장 우수한 성능(R2 = 0.9654, root mean square error = 1.324 dB/km)을 보였습니다. Shapley Additive exPlanations를 통해 특성 중요도를 분석한 결과, 먼지 농도(67.3%)와 가시거리(21.2%)가 가장 영향력 있는 요인인 것으로 나타났습니다. RF는 훈련 및 추론 속도가 상당히 빨랐으나, 통계적 검정 결과 RF와 가장 성능이 좋은 하이브리드 접근 방식 사이에 유의미한 차이는 없었습니다(p = 0.083). 기존 머신러닝 기법의 성능은 잘 알려진 물리적 전파 이론과 일치하게, 열악한 환경 조건의 FSO 통신 시스템에서 대기 감쇠를 추정하는 데 매우 효율적인 것으로 입증되었습니다. 다만, 이러한 결론은 합성 데이터를 기반으로 한 것이며, 실제 FSO 시스템에 적용하기 전에는 실제 대기 측정값을 통해 검증되어야 함을 강조합니다.
서론
자유 공간 광통신(FSO) 네트워크는 일반적으로 더 높은 용량과 우수한 보안성을 제공하지만, 산란 및 흡수로 인한 대기 감쇠는 통신 거리의 주요 제한 요인이 됩니다1. 본 연구에서는 고온, 모래폭풍 및 불규칙한 강우가 발생하는 이라크의 까다로운 환경에서 FSO 신호 감쇠를 평가하기 위한 머신러닝, 딥러닝 및 하이브리드 접근 방식2에 대한 상세한 분석을 제공합니다.
FSO 통신 시스템은 수백 미터에서 수 킬로미터 거리에서 100 Gbps를 초과하는 데이터 전송 속도를 제공하여 고대역폭 무선 연결을 위한 유망한 솔루션 중 하나로 부상했습니다34. FSO 링크는 기존의 무선 주파수 시스템과 달리 가시광선 및 적외선 스펙트럼에서 작동하며, 면허 없는 운영, 전자기 간섭에 대한 내성, 좁은 빔 발산각을 통한 보안 강화 및 넓은 대역폭 용량과 같은 이점을 제공합니다5. 이러한 특징 덕분에 FSO는 백홀 응용 분야, 건물 간 링크, 재난 복구 네트워크, 그리고 광섬유 구축 비용이 지나치게 비싼 라스트 마일 연결에 매력적인 기술이 됩니다6. 그러나 산란, 빔 굴절 및 흡수를 통한 통신은7,8 가용성 및 성능 측면에서 환경 조건에 크게 의존합니다. 이러한 과제는 자유 공간 광통신 시스템의 주요 제약 요인 중 하나입니다. 기상 조건은 감쇠 수준(dB/km)에 광범위한 변동을 일으킵니다. 맑은 하늘 조건에서는 감쇠가 0.5 dB/km 미만일 수 있는 반면, 심한 안개는 1550 nm에서 감쇠가 ≥50 dB/km에 도달하게 할 수 있으며(1550 nm에서 가시거리가 50 m 미만일 때 감쇠 값이 최대 50 dB/km에 이른다고 예측하는 Kim 안개 모델 사용)9,10, 폭우는 강우량에 따라 감쇠가 최대 20–30 dB/km에 도달할 수 있습니다(Carbonneau 모델 예측)11. 따라서 신뢰할 수 있는 링크 설계, 네트워크 계획 및 적응형 전송 전략을 위해서는 감쇠에 대한 정확한 예측이 필요합니다. 전통적인 방법은 안개에 대한 Kim 모델12, 강우에 대한 Carbonneau 모델13, 그리고 에어로졸 입자에 대한 Mie 산란 이론14과 같은 물리적 전파 모델을 기반으로 합니다. 그러나 이러한 모델들은 훌륭한 이론적 토대를 제공하지만, 실제로는 항상 사용할 수 없는 정확한 대기 매개변수에 의존하는 경우가 많으며, 동시에 발생하는 여러 기상 현상 사이의 복잡한 상호작용을 고려하지 않는 경우가 빈번합니다15.
이라크의 극심한 환경 변동성은 자유 공간 광통신(FSO) 시스템의 구축에 상당한 어려움을 초래합니다. 전송 환경은 적은 강수량과 간헐적인 안개 발생으로 인해 더욱 복잡하며, 겨울철 기온은 영하로 떨어지고 여름철 기온은 50 °C16 이상으로 상승할 수 있습니다. 일반적인 파장인 1550 nm와 같이 자주 사용되는 스펙트럼에서, 현지에서 "al-haboob"라고 불리는 모래폭풍은 가시거리를 100m 미만으로 제한하여 20dB/km17를 초과하는 감쇠 값을 유발할 수 있습니다. 이라크 및 기타 중동 국가에서 FSO 시스템을 성공적으로 구축하기 위해서는 이러한 다양한 환경 조건 하에서 시스템 성능을 정확하게 예측할 수 있는 신뢰할 수 있는 예측 모델을 개발하는 것이 필수적입니다18.
머신러닝의 새로운 발전은 기존의 물리 기반 모델링 기법을 대체할 수 있는 실행 가능한 대안을 제시합니다. 감쇠와 대기 요인 사이의 복잡한 비선형 상관관계를 직접 학습하는 머신러닝 기법의 능력은 기존의 분석 모델이 간과할 수 있는 미세한 상호작용의 탐지를 가능하게 합니다19. 다양한 기후 예측 작업에서 랜덤 포레스트(RF) 및 그래디언트 부스팅 전략은 강력한 성능을 입증해 왔습니다20. 마찬가지로, 딥러닝 기법은 자연어 처리, 컴퓨터 비전 및 시계열 예측 분야에서 괄목할 만한 성공을 거두었습니다21. 그러나 이러한 접근 방식은 FSO 감쇠 예측, 특히 제한된 데이터셋과 가변성이 큰 기상 조건 하에서는 충분히 연구되지 않았습니다22. 이러한 공백을 메우기 위해, 본 연구에서는 이라크의 대기 조건에서 FSO 신호 감쇠를 예측하기 위한 머신러닝, 딥러닝 및 하이브리드 접근 방식에 대한 철저한 조사를 제시합니다. 이는 잘 알려진 물리적 전파 모델을 기반으로 설계된 합성 데이터셋을 구축함으로써 달성됩니다23. 본 연구에서는 지배적인 예측 변수가 적은 중간 규모의 정형 환경 데이터셋의 경우, 트리 기반 앙상블 방법의 예측 성능이 복잡한 딥러닝 아키텍처보다 뛰어날 것이라는 가설을 세웠습니다. 주요 목적은 (1) 통제된 시뮬레이션 환경에서 예측 방법론 비교를 위한 기준 방법론을 수립하고, (2) 대기 감쇠 예측을 위한 최적의 알고리즘 전략을 식별하며, (3) 특성 중요도와 모델 해석력을 평가하여 감쇠에 가장 큰 영향을 미치는 환경 요인에 대한 통찰을 얻는 것입니다. 본 연구에서는 합성 데이터를 사용하였으나, 이는 향후 연구로 예정된 실제 실험 측정치를 통한 검증을 위한 토대를 마련한 것입니다. 또한, 감쇠에 영향을 미치는 가장 중요한 환경 요인을 결정하기 위해 특성 중요도 및 해석력 분석이 포함되었습니다.
프로토콜
본 연구는 인간 참여자나 척추동물, 또는 조직 샘플링을 포함하지 않았습니다. 이 연구에 사용된 모든 데이터는 물리적 전파 모델과 공개된 기상 매개변수를 사용하여 합성적으로 생성되었습니다. 따라서 기관생명윤리위원회(IRB) 또는 기관동물실험윤리위원회(IACUC)의 윤리 승인이 필요하지 않았습니다.
물리적 전파 이론에 기반한 데이터셋 생성. 데이터셋은 이라크의 대기 조건에서 1년(2024년) 동안의 자유 공간 광통신 시스템을 위한 시간당 대기 조건을 모방하도록 구축되었습니다. 시간당 1,500개의 샘플을 포함하는 합성 데이터베이스를 생성하였습니다.
먼저, 지역적 경향에 따라 기상 조건을 무작위로 할당하였다: 맑음(54.3%), 먼지(24.9%), 안개(10.5%), 비(7.4%), 눈(2.8%). 둘째, 기상 조건에 따라 각 샘플에 해당하는 물리적 감쇠 모델을 적용하였다. 즉, 맑은 하늘에는 Beer-Lambert 법칙을, 안개에는 Kim 모델을, 비에는 Carbonneau 이론을, 그리고 먼지 폭풍에는 Mie 산란 이론을 적용하였다. 셋째, FSO 시스템의 파라미터를 다음과 같이 설정하였다: 송신 전력 20 dBm, 파장 1550 nm, 전송 거리 3 km, 송신 구경 2.5 cm, 수신 구경 20 cm. 넷째, 각 샘플에 대해 감쇠량을 dB/km 단위로 계산하였다. 마지막으로, 전체 데이터셋을 1,200개의 학습 샘플(80%)과 300개의 테스트 샘플(20%)로 무작위로 나누었다. 시뮬레이션 조건에는 모래폭풍과 관련된 높은 먼지 농도, 폭우, 그리고 −4.89°C에서 47.99°C 사이의 온도 변화가 포함된다. 기상 조건 및 파라미터 분포는 2020~2024년 기간의 이라크 기후 기록을 기반으로 선택하였다. 다섯 가지 기상 체계(맑음, 안개, 비, 먼지 폭풍, 눈)는 이라크의 FSO 감쇠에 영향을 미치는 모든 대기 조건 범위를 포괄하며, 특히 중동 지역에서 빈번한 먼지 폭풍을 고려하여 선정하였다. 이라크 전 지역에서 수집된 기상 역사 데이터를 사용하여 각 기상 조건에 대한 확률 분포를 생성하였다. 그 결과 도출된 분포는 다음과 같다: 맑음(주요 상태) 54.3%, 먼지(이라크의 모래폭풍 문제 반영) 24.9%, 안개(이라크 북부 겨울철 빈번) 10.5%, 비(이라크의 전형적인 낮은 강수량) 7.4%, 눈(북부 산악 지역에서 간헐적 발생) 2.8%. 관련 기상 파라미터는 각 기상 조건에 대해 다음과 같은 확률 분포를 사용하여 모델링하였다: 온도는 이라크의 계절별 극값을 기반으로 −4.89°C에서 47.99°C 사이의 정규 분포(평균 28.55±11.18°C)를 사용하였고, 습도는 0%에서 100%까지의 균등 분포(평균 42.01±25.56%)를 사용하였다. 가시거리는 먼지 폭풍 중 빈번한 저가시성 이벤트를 반영하기 위해 0.05 km에서 29.99 km 사이의 로그 정규 분포(평균 13.10±10.91 km)를 사용하였으며, 먼지 농도는 저농도에서 확률이 높고 극심한 먼지 이벤트에 대해 긴 꼬리를 갖는 0에서 4.96 mg/m3 사이의 지수 분포(평균 0.74±1.30 mg/m3)를 사용하여 모델링하였다.
통신 시스템은 전송 전력 20 dBm, 파장 1550 nm, 최대 전송 거리 3 km, 전송 구경 2.5 cm, 그리고 발산 손실을 보정하기 위한 수신 구경 20 cm로 설계되었습니다. FSO 시스템의 매개변수는 모든 샘플에 대해 변경되지 않는 고정 매개변수와 데이터 세트 생성 과정에서 변경되는 가변 매개변수의 두 그룹으로 나누었습니다. 모든 1,500개 샘플에 대해 전송 전력 (20 dBm), 동작 파장 (1550 nm), 전송 구경 (직경 2.5 cm, 효율 0.7) 및 수신 구경 (직경 20 cm, 효율 0.7)의 매개변수를 고정하였습니다. 이러한 매개변수들은 FSO 시스템 하드웨어의 물리적 사양이며 기상 조건에 따라 변하지 않으므로 고정하였습니다. 데이터 세트는 온도 (−4.89°C ~ 47.99°C), 습도 (0% ~ 100%), 가시거리 (0.05 km ~ 29.99 km), 먼지 농도 (0 ~ 4.96 mg/m3) 및 기상 조건 (맑음, 안개, 비, 먼지, 눈)의 매개변수를 달리하여 1,500개의 샘플로 생성되었습니다. 이러한 매개변수들은 2020~2024년 사이의 이라크 기후 기록에서 도출된 확률 분포에 따라 수정되었습니다. 각 샘플에 대해 기상 조건과 가변 매개변수의 특정 조합에 따라 해당 물리적 감쇠 모델을 사용하여 감쇠 값 (dB/km)을 계산하였습니다.
물리적 감쇠는 강우의 경우 Carbonneau 모델, 맑은 날씨의 경우 Beer-Lambert 법칙, 먼지의 경우 Mie 산란 이론, 그리고 안개의 경우 Kim 모델을 사용하여 모델링하였다24. Beer-Lambert 법칙은 분자 산란과 흡수가 감쇠의 주된 요인이 되어 거리에 따라 지수 함수적으로 감소하는 맑은 하늘 조건에 적용된다25. 1550 nm에서의 소멸 계수 α는 공기 분자에 의한 Rayleigh 산란과 대기 가스에 의한 흡수로 인해 발생한다26. Kim 모델은 안개 입자 크기 분포에서 유도된 경험적 계수를 통해 감쇠와 가시성의 관계를 나타내는 안개 특화 모델이다. 파장 종속 지수 q는 Mie 산란을 반영한다27. Carbonneau 모델의 주요 파라미터는 강우 강도 R인데, 이는 강우 감쇠가 빗방울의 크기와 밀도에 따라 달라지며, 계수들은 1550 nm에서 경험적으로 도출되어 광학 파장에 맞게 특별히 보정되었기 때문이다28. Mie 산란 이론은 먼지 입자 크기(반지름 0.1–100 μm)가 파장(1550 nm)과 비슷하고, 중동 지역 먼지의 복소 굴절률 m = 1.55–0.005i가 산란과 흡수를 모두 포함하므로 먼지 조건에 적용 가능하다29. 다음과 같은 물리적 감쇠 모델들이 각각의 방정식과 파라미터 설정과 함께 구현되었다.
맑은 하늘 조건의 경우, Beer-Lambert 법칙이 사용되었습니다:
Aclear = 10×log₁₀(e(α×d)) (1)
여기서 α는 소멸 계수(맑은 조건의 1550 nm에서 0.02 dB/km를 중심으로 ±0.005 dB/km의 변동을 갖는 정규 분포를 사용하여 가변됨)이며, d는 전송 거리(3 km로 고정)입니다. 안개 조건의 경우, 다음 식을 사용하여 Kim 모델을 구현하였습니다:
Afog = 10×ln(10)/V×(λ/550)−q (2)
여기서 V는 km 단위의 가시거리(0.05km에서 10km까지 변화), λ는 nm 단위의 파장(1550nm로 고정), 그리고 q는 다음과 같이 계산된 입자 크기 분포 계수입니다: V>50 km인 경우 q=1.6, 6<V<50 km인 경우 q=1.3, 1 <V<6km인 경우 q=0.585×V(1/3), 0.5<V<1km인 경우 q=0, V<0.5km인 경우 q=0.5입니다. 강우 조건의 경우, Carbonneau 모델이 사용되었습니다:
Arain=0.023×R0.93 (3)
여기서 R은 강우 강도(이라크 강우 기록에 따라 0.25에서 50mm/h 사이로 변경됨)를 mm/h 단위로 나타냅니다. 소산 효율 관계는 Mie 산란을 이용하여 모래 폭풍 상황에 적용되었습니다:
Adust=10×log₁₀(e(τ×L)) (4)
여기서 τ=∫₀^∞ πr2Qext(r,λ,m)N(r)dr이며, r은 입자 반지름(이라크 먼지 성분에 따라 0.1–100μm), Qext는 Mie 이론을 사용하여 계산된 소멸 효율, λ=1550nm, m=1.55–0.005i는 중동 지역 먼지의 복소 굴절률, N(r)은 기하 평균 반지름 2.5 μm 및 표준 편차 2.0의 로그-정규 분포를 사용하여 모델링한 입자 크기 분포입니다. 감쇠 모델은 적설 조건에 대해 다음과 같이 구현되었습니다:
Asnow = 0.1×S0.75 (5)
여기서 S는 강설률(mm/h, 0.5–15 mm/h)이며, 이 경험식은 문헌의 연구 결과를 바탕으로 선택되었습니다.30눈송이 크기 분포에 Mie 산란 이론을 적용하여 눈을 통한 광학 전파 감쇄 모델을 개발하였습니다. 이 방정식은 0.5에서 15mm/h 사이의 강설률에 대해 유효하며, 전형적인 눈송이 직경이 1-10mm인 건설 조건임을 가정합니다. 계수 0.1과 지수 0.75는 1550nm 파장에서의 눈에 대한 Mie 산란 계산 결과에 곡선 적합(curve-fitting)을 수행하여 얻었습니다. 이 모델은 건설에 대해서는 타당한 추정치를 제공하지만, 감쇄 특성이 가변적일 수 있는 습설이나 혼합 강수 상황은 반영하지 않습니다. 본 연구에서는 이 접근 방식이 계산 효율적이고 FSO 관련 문헌에서 자주 인용되며, 이라크 북부(1월과 2월의 쿠르디스탄 지역)의 예상 강설 상황에 적합하기 때문에 이를 선택하였습니다. 모든 모델은 Numpy를 이용한 수치 계산을 통해 Python 3.9에서 구현되었습니다. 무작위로 선택된 기상 조건 및 샘플링된 주변 환경 데이터에 대응하는 모델을 사용하여 각 샘플에 대한 감쇄 값을 계산하였습니다. 수집된 기상 분포는 맑은 날 814건(54.27%), 먼지 발생 375건(25.00%), 안개 발생 157건(10.47%), 강우 발생 111건(7.40%) 및 강설 발생 43건(2.87%)을 포함하였습니다.
2020년부터 2024년 사이 이라크의 여러 지역(바그다드, 바스라, 모술 및 라마디)에 위치한 기상 관측소에서 수집된 과거 기상 정보를 조사하여 기상 상황의 비율을 설정하였다. 기초 데이터는 이라크 교통부와 이라크 기상지질청(IMOS)에서 제공하였다. 해당 데이터에는 매일의 현재 대기 상태를 기록한 일일 기상 기록이 포함되었다. 이러한 기록에서 추출한 구체적인 특성으로는 온도(일일 최저, 최고 및 평균), 상대 습도, 가시거리, 강수량 및 황사 발생 등이 있다. 이라크 정부의 공공 데이터 포털(https://www.motrans.gov.iq/)을 통해 IMOS 데이터의 일부에 접근할 수 있으나, 본 연구에 사용된 특정 기록들은 중앙 저장소에 공개적으로 저장되어 있지 않다. 기상 조건의 백분율과 매개변수 값을 계산하는 데 사용된 기후 정보는 표 1에 요약되어 있다. 맑은 날은 강수가 없고 가시거리가 10km보다 크며 황사 활동이 없는 날로 정의되었으며, 이는 기록된 1,825일 중 54.27%를 차지하였다. 황사 발생일(전면적인 황사(가시거리 < (1km) 및 부유 먼지(가시거리 1~5km)가 전체 일수의 25.00%를 차지했으며, 이는 이라크의 건조 및 반건조 기후에서 모래폭풍 사건이 빈번하게 발생함을 나타낸다. 먼지로 인한 가시거리 감소를 제외하고, 물방울의 부유로 인해 가시거리가 1km 미만이 된 날은 안개 발생일로 분류하였다. 안개 발생일의 비율은 10.47%였으며, 주로 겨울철 이라크 북부 지역에서 나타났다. 강수일은 측정 가능한 강수량이 기록된 날로... >0.1mm인 경우는 7.40%였으며, 이는 이라크의 연평균 강수량이 150~200mm로 낮다는 점과 일치합니다. 강설일(결빙 강수량이 누적된 날)은 전체의 2.87%를 차지했으며, 1월과 2월의 북부 산악 지역(쿠르디스탄 지역)에 국한되었습니다. 이러한 비율은 이후 데이터셋 생성 시 무작위 표집을 위한 확률 가중치로 사용되었습니다. 따라서 이 합성 데이터셋은 이라크 환경에서 각 기상 조건이 나타나는 실제 빈도를 반영합니다.
합성 데이터 생성 시의 편향 고려 사항
가능한 편향을 줄이기 위해 다음과 같은 여러 단계의 조치를 취했습니다:
(1) 분포 선택: 소스 기후 데이터의 통계적 특성을 사용하여 확률 분포를 선택하였습니다. 온도는 IMOS에 기록된 평균과 표준편차를 가진 정규 분포를 따랐습니다. 습도는 관측된 전체 범위(0-100%)에 대해 균등 분포를 가졌습니다. 가시성은 먼지 폭풍 동안 저시정 현상이 빈번하게 발생하는 것을 고려하여 로그 정규 분포를 따르는 것으로 가정하였습니다. 먼지 농도는 낮은 농도에서 확률이 더 높고 극심한 먼지 발생 시 긴 꼬리를 가지는 지수 분포를 따랐습니다31. 이는 이라크에서 관측된 먼지 발생 빈도와 일치하였습니다32.
(2) 기상 조건 비율: 4개 지역 전체에서 1,825건의 일일 관측치로 구성된 2020~2024년 IMOS 기록을 분석한 결과, 그 비율은 맑음 54.3%, 황사 24.9%, 안개 10.5%, 비 7.4%, 눈 2.8%로 나타났다. 강수 없는 날, 가시거리 >시정 10km 이상이며 먼지 활동이 없는 날을 맑은 날로 정의하였다. 먼지 폭풍이 발생한 날에는 전체 먼지 폭풍(시정 <1 km) 및 부유 먼지(가시거리 1~5 km). 안개 발생일은 가시거리가 1 km 미만이며 그 원인이 물방울의 부유(먼지가 아님)인 날로 정의하였다. 강우일은 측정 가능한 강수량이 있었던 날로 정의하였다. >0.1mm. 강설일은 누적 동결 강수량이 있는 날로 정의되었다.33.
(3) 매개변수 범위: 매개변수의 범위는 IMOS 기록에서 관찰된 극값들을 기준으로 설정하였다. 온도는 −4.89 °C(모술, 겨울)에서 47.99 °C(바스라, 여름)까지, 가시거리는 0.05 km(심한 먼지 폭풍)에서 29.99 km(맑은 조건)까지, 먼지 농도는 0에서 4.96 mg/m3까지(심각한 하부브 현상 동안 관찰된 최대 먼지 농도 기준)였다34.
(4) 독립성 가정: 우리는 환경 매개변수가 독립적으로 샘플링되었다고 가정하였으며, 이는 대기 변수들이 서로 상관관계가 있는(예: 높은 먼지 농도는 종종 낮은 가시성과 상관관계가 있음) 실제 환경 조건을 단순화한 것입니다. 체계적인 모델 비교를 위한 제어된 시뮬레이션 환경을 제공하기 위해 이러한 독립성 가정을 채택하였습니다 35. 이러한 가정으로 인한 영향은 고찰(Discussion) 섹션에서 다룹니다.
(5) 층화 추출 분할: 훈련-테스트 분할은 기상 조건 카테고리(맑음, 안개, 비, 먼지, 눈)를 기준으로 층화 추출(stratified splitting)하여, 훈련 세트와 테스트 세트 내 각 기상 조건의 비율이 원래 데이터셋의 분포와 일치하도록 하였습니다. 이를 통해 희귀한 기상 조건(특히 2.87%인 눈)에 대해 테스트 세트가 불균형해지지 않도록 하였습니다36.
결정론적 표적 생성 확인
여기서 관찰된 우수한 예측 성능은 모델이 합성 표적 값을 생성하는 데 사용된 결정론적 물리 방정식들을 학습하거나 근사했기 때문일 수 있다는 점을 지적하는 것이 중요합니다37. 측정 노이즈, 기기 오차 및 모델링되지 않은 물리적 현상이 포함된 실제 실험 측정값과 달리, 합성 데이터셋은 입력 특성과 감쇠 표적 사이의 깨끗하고 노이즈가 없는 관계를 제공합니다. 이는 감쇠 값이 입력 파라미터를 기반으로 물리적 전파 모델(Beer-Lambert 법칙, Kim 모델, Carbonneau 모델 및 Mie 산란 이론)로부터 직접 계산되었기 때문입니다. 따라서 정량적 성능 지표(R2, RMSE, MAE)는 방정식에서 도출된 합성 데이터에 대한 성능을 나타내며, 노이즈가 있는 관측 데이터나 실험 데이터에서의 예상 성능으로 해석해서는 안 됩니다. 결과는 일차적으로 제어된 시뮬레이션 환경에서의 모델링 방법론에 대한 비교 평가로 간주되어야 합니다38.
모델 학습을 위한 전체 특성 집합
훈련 데이터셋에는 모델 훈련을 위한 10가지 입력 특성이 포함되었습니다:
1. 온도 (°C)
2. 습도 (%)
3. 가시거리 (km)
4. 먼지 농도 (mg/m3)
5. 강우 강도 (mm/h)
6. 강설량 (mm/h)
7. 풍속 (m/s)
8. 대기압 (hPa)
9. 월 (숫자, 1–12)
10. 계절 (원-핫 인코딩: 봄, 여름, 가을, 겨울)
중요 설명: 기상 조건(맑음, 안개, 비, 먼지, 눈)은 데이터셋 분할 시 층화 추출을 위한 범주형 변수로 사용되었으며, 어떤 모델의 입력 특성으로도 포함되지 않았습니다. SHAP 분석에는 위에 나열된 10가지 특성만 포함되었습니다. 계절 변수는 원-핫 인코딩(4개 범주: 봄, 여름, 가을, 겨울)되었으며, SHAP 분석을 위해 원-핫 인코딩된 계절 변수들의 기여도를 계절별로 합산하여 단일 계절 기여도 값을 생성하였습니다. 이 결합된 값은 감쇠 예측에 대한 모든 계절 관련 변수의 총 기여도를 나타냅니다. 요약 도표를 생성하기 전, 4개의 원-핫 인코딩된 계절 열을 식별하고 각 샘플에 대해 해당 SHAP 값들을 더했습니다. 이 방법은 모델이 계절을 복합 범주형 변수로 사용하는 방식이 SHAP 분석과 일치함을 보장합니다.
물리적 메커니즘을 통해 광 감쇠에 직접적으로 영향을 미치는 주요 환경 요인은 특성 1~6이었습니다. 보조 기상 요인으로 특성 7 및 8(풍속 및 기압)을 추가한 것은 공기 안정성과 에어로졸 분산에 영향을 주어 감쇠에 간접적인 영향을 미칠 수 있습니다. 대기 조건의 계절적 변동을 고려하기 위해 특성 9~10(월 및 계절)을 시간적 기술자로 포함했습니다. 모든 모델의 타겟 변수로는 감쇠 값(dB/km)이 사용되었습니다. 주요 데이터셋 통계로는 온도(28.55°C ± 11.18°C), 습도(42.01% ± 25.56%), 가시거리(13.10 ± 10.91 km; 범위: 0.05–29.99 km), 먼지 농도(0.74 ± 1.30 mg/m3; 최대값: 4.96 mg/m3), 감쇠(4.80 ± 7.20 dB/km; 범위: 0.09–50.93 dB/km), 작동 거리(5.74 ± 1.97 km), 및 신호 대 잡음비(64.88 ± 15.07 dB)가 포함되었습니다. 작동 거리와 SNR은 표준 FSO 링크 버젯 방정식을 사용하여 감쇠 값으로부터 계산되었습니다.
작동 범위 계산
운용 범위(km 단위)는 링크 버짓 방정식을 사용하여 계산되었습니다:
Prx=Ptx×Gt×Gr×(λ/(4πR))2×10(−A×R/10) (6)
여기서: Prx = 수신 전력(최소 감도인 −30 dBm으로 설정); Ptx = 송신 전력(20 dBm으로 고정); Gt = 송신기 이득(개구부 크기로부터 계산); Gr = 수신기 이득(개구부 크기로부터 계산); λ = 파장(1550 nm); R = km 단위의 거리; A = dB/km 단위의 대기 감쇠(물리 모델로부터 계산).
송신 및 수신 이득: 송신 이득(Gt)은 다음과 같이 계산되었다: Gt = 10×log₁₀[0.7×(π×0.025/1.55×10⁻6)2] ≈ 44.2 dBi. 수신 이득(Gr)은 다음과 같이 계산되었다: Gr = 10×log₁₀[0.7×(π×0.20/1.55×10⁻6)2] ≈ 62.3 dBi. 송신 개구면의 직경은 2.5 cm였으며 효율은 0.7였다. 수신 개구면의 직경은 20 cm였으며 효율은 0.7였다. 각 감쇠 값에 대해 달성 가능한 최대 링크 거리를 결정하기 위해 R에 대해 방정식을 반복적으로 풀었다.
신호 대 잡음비 계산
dB 단위의 SNR(신호 대 잡음비)은 다음 식을 사용하여 계산하였습니다:
SNR=Prx−10×log₁₀(kTB)−NF (7)
여기서: Prx = dBm 단위의 수신 전력 (링크 버젯으로부터 계산됨); k = 1.38×10⁻23 J/K (볼츠만 상수); T = 290 K (수신기 온도); B = 109 Hz (수신기 대역폭, 1 GHz); NF = 3 dB (수신기 잡음 지수). 잡음 바닥(noise floor)은 다음과 같이 계산되었습니다:
10 × log10(kTB) ≈ −84 dBm (8)
각 샘플에 대해 적절한 물리적 모델을 사용하여 감쇠 A를 계산한 후, 링크 버젯을 통해 R을 구하여 작동 범위를 도출하였으며, 해당 범위에서의 수신 전력 Prx를 바탕으로 SNR을 계산하였습니다.
기상 조건별 작동 범위 값: 작동 범위는 기상 조건에 따라 다르게 나타났습니다: 맑은 하늘 (7.12 ± 1.85 km), 안개 (5.81 ± 1.92 km), 눈 (5.42 ± 1.56 km), 비 (3.81 ± 0.98 km), 그리고 먼지 (3.72 ± 1.08 km). 현재 계산에는 3 dB 마진을 적용하지 않았으며, 작동 범위는 시스템 마진이 없는 이론적 최대 범위를 나타냅니다. 보고된 작동 범위 (5.74 ± 1.97 km)는 모든 기상 조건에 대한 전체 평균값입니다39.
고정 전송 거리: 물리적 감쇠 모델의 전송 거리는 3 km로 설정되었습니다. 이는 감쇠 계산이 수행된 링크 거리입니다. 보고된 작동 범위는 링크 버짓 방정식(link budget equation)을 사용하여 계산된 이론적 최대 거리이며, 이는 고정된 3 km 전송 거리와 다를 수 있습니다. 기상 조건별 감쇠 값은 맑은 날(0.27±0.06 dB/km), 안개(1.88±1.92 dB/km), 눈(6.45±2.54 dB/km), 비(13.58±6.32 dB/km), 먼지(13.10±7.32 dB/km)에 대해 기록되었습니다. 별도로 명시되지 않는 한, 본 원고에 보고된 모든 정량적 값은 평균 ± 표준 편차(SD)로 표시됩니다40.
교차 검증 R2 Random Forest의 결과는 0.960으로 보고되었습니다.±0.007. 온도(-4.89에서 47.99°C), 가시거리 (0.05 ~ 29.99km), 먼지 농도 (0 ~ 4.96 mg/m3), 그리고 감쇠(0.09~50.93dB/km)의 경우 범위(최저값에서 최고값)를 구두로 기술하였다. 데이터셋은 테스트용(300개 샘플; 20%)과 훈련용(1,200개 샘플; 80%) 하위 그룹으로 분할되었다. 훈련-테스트 분할을 수행하기 위해 층화 무작위 추출법을 사용하였다. 훈련 세트(80%)와 테스트 세트(20%) 내 각 기상 조건의 비율이 원래 데이터셋의 분포와 일치하도록 기상 조건 범주(맑음, 안개, 비, 먼지 및 눈)를 기준으로 층화를 적용하였다. 구체적으로, 1,500개 샘플 중 1,200개(80%)를 학습 세트에, 300개(20%)를 테스트 세트에 할당하였다. 원래의 비율을 유지하면서 각 기상 조건 범주별로 샘플을 무작위로 선택하였다. 맑음 샘플 814개(54.27%) 중 651개는 훈련용으로, 163개는 테스트용으로 할당하였으며, 먼지 샘플 375개(25.00%) 중 300개는 훈련용으로, 75개는 테스트용으로, 안개 샘플 157개(10.47%) 중 126개는 훈련용으로, 31개는 테스트용으로, 비 샘플 111개(7.40%) 중 89개는 훈련용으로, 22개는 테스트용으로, 눈 샘플 43개(2.87%) 중 34개는 훈련용으로, 9개는 테스트용으로 할당하였다. 재현성을 보장하기 위해 각 층 내에서의 무작위 추출은 랜덤 시드 42를 사용하여 수행되었다. 이러한 층화 접근 방식은 테스트 세트에서 희귀 기상 조건(특히 2.87%인 눈)의 표현이 불균형해지는 것을 방지하기 위해 선택되었으며, 그렇지 않을 경우 해당 조건들에 대한 성능 평가의 신뢰도가 떨어질 수 있기 때문이다.
머신러닝 모델 평가
방사 기저 함수 커널(C = 100)을 사용하는 서포트 벡터 회귀(SVR), K-최근접 이웃(KNN; k = 10, 거리 가중치 적용), RF(트리 200개, 최대 깊이 = 20), Extreme Gradient Boosting(XGBoost; 추정기 200개, 최대 깊이 = 10, 학습률 = 0.1), Light Gradient Boosting Machine(LightGBM; 추정기 200개, 최대 깊이 = 10, 학습률 = 0.1), 그리고 기준이 되는 선형 회귀를 포함하여 총 6가지의 머신러닝 방법을 평가하였다. 모든 머신러닝 및 딥러닝 모델에 대해 가장 중요한 파라미터들에 대해 하이퍼파라미터 튜닝을 수행하였으며, 명시되지 않은 파라미터들은 기본값을 유지하였다. 머신러닝 모델의 경우, 훈련 세트에 대해 5-겹 교차 검증을 이용한 그리드 탐색을 통해 다음 파라미터들을 명시적으로 튜닝하였다: 1) Random Forest: 트리 수(테스트 범위: 50, 100, 150, 200, 250)와 최대 깊이(테스트 범위: 10, 15, 20, 25, 제한 없음)를 튜닝하여 최적값으로 트리 수 200개와 깊이 20을 선택하였다. 2) XGBoost: 추정기 수(테스트 범위: 100, 150, 200, 250), 최대 깊이(테스트 범위: 6, 8, 10, 12), 학습률(테스트 범위: 0.05, 0.1, 0.2)을 튜닝하여 최적값으로 추정기 200개, 깊이 10, 학습률 0.1을 선택하였다. 3) LightGBM: 동일한 튜닝 범위를 사용하여 추정기 200개, 깊이 10, 학습률 0.1의 결과를 얻었다. 4) SVR: 규제 파라미터 C(테스트 범위: 1, 10, 50, 100)와 커널 계수 gamma(테스트 범위: ‘scale’, ‘auto’, 0.1, 0.01)를 튜닝하여 최적값 C = 100과 RBF 커널을 선택하였다. 5) KNN: 이웃 수 k(테스트 범위: 3, 5, 7, 10, 15)를 튜닝하여 최적값 k = 10과 거리 가중 투표 활성화를 선택하였다.
이 모델들의 다른 모든 파라미터는 scikit-learn에 정의된 기본값으로 유지되었습니다(참조 재료 목록 버전별 설정은 다음과 같습니다. 예: Random Forest: bootstrap=True, min_samples_split=2, min_samples_leaf=1; XGBoost: subsample=1.0, colsample_bytree=1.0, gamma=0. 딥러닝 모델의 경우, 아키텍처(레이어 수 및 레이어당 유닛 수)와 드롭아웃 비율(20%)은 검증 세트를 통한 반복적인 실험을 통해 수동으로 튜닝하였으며, 옵티마이저(Adam), 초기 학습률(0.001), 조기 종료 patience(20 epoch), 학습률 감소 파라미터(factor 0.5, patience 10)는 문헌의 표준 관행에 따라 설정하고 모든 딥러닝 실험에서 고정하였습니다.
기후 데이터 소스
2020년부터 2024년 사이 이라크 내 여러 지역(바그다드, 바스라, 모술, 라마디)의 기상 관측소에서 수집된 과거 기상 정보를 사용하여 기상 상태 비율과 변수 분포를 계산하였습니다. 기초 데이터는 이라크 교통부와 이라크 기상지질청(IMOS)에서 제공받았습니다. 데이터에는 매일의 지배적인 대기 상태를 상세히 기록한 일일 기상 기록이 포함되었습니다. 이 기록을 통해 얻은 구체적인 변수로는 온도(일일 최저, 최고 및 평균), 상대 습도, 가시거리, 강수량 및 먼지 폭풍 발생 횟수가 포함되었습니다. IMOS 데이터의 일부는 이라크 정부의 오픈 데이터 포털(https://www.motrans.gov.iq/)을 통해 이용 가능하지만, 본 연구에 사용된 구체적인 기록은 중앙 저장소에 공개적으로 보관되어 있지 않습니다. 기상 조건 비율과 매개변수 범위를 결정하는 데 사용된 기후 데이터의 요약은 Table 1에 제공되어 있습니다.
모든 머신러닝 모델의 하이퍼파라미터 튜닝 및 성능 추정을 위해 훈련 세트(1,200개 샘플)에 5겹 교차 검증(Fivefold cross-validation)을 사용하였습니다. 모든 입력 변수(온도, 습도, 가시거리, 먼지 농도, 강우량, 강설량, 풍속, 기압)는 표준화(Z-score normalization)를 통해 특성 스케일링을 수행하였습니다: x_scaled = (x − μ)/σ (여기서 μ와 σ는 훈련 세트의 평균과 표준편차임). 데이터 누수를 방지하기 위해 각 교차 검증 폴드 내에서 훈련 폴드의 통계량만을 사용하여 표준화를 진행하였습니다. 트리 기반 모델(Random Forest, XGBoost, LightGBM)은 스케일 불변 특성을 가지나, 모든 머신러닝 모델 간의 일관성을 위해 동일한 표준화를 적용하였습니다. 딥러닝 모델에는 최소-최대 정규화(Min-max normalization)를 사용하였습니다: x_scaled = (x−x_min)/(x_max−x_min), 이는 훈련 세트의 최소/최대값을 기준으로 특성을 [0, 1] 범위로 스케일링합니다. 제한된 범위의 입력값은 신경망의 수렴 속도를 높이므로 이를 선택하였습니다. 테스트 세트는 훈련 세트에서 얻은 파라미터를 사용하여 스케일링하였으며, 모델 선택이나 하이퍼파라미터 튜닝에는 사용되지 않았습니다.
테스트 결정계수(R2), 평균 제곱근 오차(RMSE), 평균 절대 오차(MAE), 교차 검증 R2 및 훈련 시간을 포함한 전체 성능 지표를 기록하였다. 모든 머신러닝 및 딥러닝 모델의 훈련 시간은 속도가 빠른 모델(Linear Regression, KNN, SVR, Random Forest, XGBoost, LightGBM)의 경우 초(s) 단위로, 속도가 느린 모델(딥러닝 아키텍처)의 경우 분(min) 단위로 보고하였다. 공정한 비교를 위해 모든 모델은 동일한 컴퓨팅 환경에서 훈련되었다41.
훈련 시간은 Python time 모듈을 사용하여 측정하였습니다. 즉, 데이터 로딩 및 전처리에 소요되는 시간을 제외하고, 모델 피팅 함수의 시작부터 종료까지 경과된 실제 시간(wall-clock time)을 측정하였습니다. 딥러닝 모델의 훈련 시간은 조기 종료(early stopping)가 발생할 때까지 모든 에포크를 완료하는 데 걸린 시간입니다. 여기에는 순전파, 역전파 및 검증 확인 단계가 포함됩니다. 일관된 시간 측정값을 얻기 위해 모든 실험은 시스템에서 다른 계산 집약적인 프로세스가 실행되지 않는 상태에서 수행되었습니다. 제시된 시간은 5회 독립 시행의 평균값(표준 편차)입니다42.
딥러닝 모델 평가
GPU 가속을 이용하여 다층 퍼셉트론(MLP; 64-32-16), 배치 정규화가 포함된 심층 신경망(DNN; 128-64-32-16), 장단기 메모리 네트워크(LSTM; 64-32 유닛, 시퀀스 길이 = 10), 1차원 합성곱 신경망(1D-CNN), CNN-LSTM 하이브리드 모델, 그리고 어텐션 기반 네트워크를 포함한 6가지 딥러닝 아키텍처를 평가하였다. 모든 딥러닝 모델은 Keras API와 TensorFlow를 사용하여 구현되었으며 GPU 가속으로 실행되었다(하드웨어/소프트웨어 버전은 재료 표 참조). 1D-CNN 아키텍처는 3개의 합성곱 층(필터 64, 128, 256개, 커널 크기 3, ReLU 활성화 함수, padding=’same’), 2개의 MaxPooling1D 층(풀 크기 2), GlobalAveragePooling1D 층, 128개 유닛과 ReLU 활성화 함수를 갖는 Dense 층, Dropout 층(0.2), 그리고 Dense 출력 층(1개 유닛, 선형 활성화 함수)으로 구성되었으며, 총 학습 가능 파라미터 수는 약 245,000개였다. CNN-LSTM 하이브리드 아키텍처는 5개의 특성을 가진 10개의 타임 스텝 입력 시퀀스를 받아들였으며, 2개의 Conv1D 층(필터 64, 128개, 커널 크기 3, ReLU, padding=’same’), MaxPooling1D 층(풀 크기 2), 2개의 LSTM 층(64, 32 유닛, return_sequences=False), Dropout 층(0.2), Dense 층(32 유닛, ReLU), 그리고 Dense 출력 층(1개 유닛, 선형 활성화 함수)을 사용하였고, 총 학습 가능 파라미터 수는 약 198,000개였다. 어텐션 기반 네트워크는 4개의 헤드(키 및 값 차원 64)를 갖는 멀티헤드 어텐션 메커니즘을 사용하였으며, 입력을 64차원으로 투영한 후 스케일드 닷-프로덕트 어텐션(수식: Attention(Q, K, V) = softmax(QKT/√d_k)V), 잔차 연결(residual connections), 층 정규화(layer normalization), 피드포워드 네트워크(128→64 유닛), 글로벌 평균 풀링, Dropout(0.2), Dense 층(32 유닛, ReLU), 그리고 Dense 출력 층(1개 유닛, 선형 활성화 함수)이 이어졌으며, 총 학습 가능 파라미터 수는 약 167,000개였다43.
모든 모델은 조기 종료(patience = 20), 학습률 감소(factor = 0.5, patience = 10), 드롭아웃(20%), 그리고 Adam 옵티마이저(learning rate = 0.001)를 사용하였습니다. 모든 딥러닝 모델의 경우, 배치 크기는 32개 샘플로 설정하였고, 최대 학습 에포크 수는 조기 종료(patience = 20, 최적 가중치 복원)를 포함하여 200회로 설정하였으며, 손실 함수로는 평균 제곱 오차(MSE)를 사용하였습니다. 훈련-검증 데이터 분할은 다음과 같았습니다: 80/20 훈련-테스트 분할 후 남은 기존 1,200개의 훈련 샘플 중 80%(960개 샘플)는 훈련에, 20%(240개 샘플)는 검증에 사용하였습니다. 분포를 유지하기 위해 기상 조건별로 훈련-검증 분할을 층화 추출하였습니다. 검증 세트는 조기 종료, 학습률 감소 및 과적합 모니터링 용도로만 사용되었으며, 이러한 자동화된 절차 외에 모델 선택이나 하이퍼파라미터 튜닝에는 전혀 사용되지 않았습니다. 머신러닝 모델의 경우 별도의 검증 세트를 분리하지 않고, 대신 1,200개의 훈련 샘플에 대해 5-겹 교차 검증을 수행하여 하이퍼파라미터를 튜닝하고 성능을 추정하였습니다44.
LSTM 및 CNN–LSTM 아키텍처 평가에 대한 근거
주요 데이터셋은 독립적으로 생성된 기상 샘플로 구성되어 있으나, 다음과 같은 이유로 LSTM 및 CNN-LSTM 아키텍처 또한 테스트하였습니다: (1) 실제 대기 상태는 시간적으로 자기 상관되어 있으며, 시퀀스 기반 모델을 테스트함으로써 이러한 의존성을 포착하는 것이 예측 정확도를 향상시킬 수 있는지 판단할 수 있기 때문입니다; (2) 최근의 대기 예측 연구에서 기상 매개변수의 시간적 진화를 모델링하는 데 있어 순차적 아키텍처의 잠재적 가치가 입증되었기 때문입니다34; (3) 다양한 범위의 아키텍처를 테스트함으로써 방법론적 접근 방식에 대한 종합적인 비교를 보장할 수 있으며, 이는 본 연구의 핵심적인 기여 사항입니다; (4) CNN-LSTM 하이브리드 아키텍처는 공간적 특징 추출과 시간적 모델링을 결합하여, 여러 대기 변수 간의 복잡한 상호작용을 포착하는 데 유익할 수 있기 때문입니다45.
순차적 모델 입력을 위한 데이터 포맷팅
순차적 아키텍처(LSTM 및 CNN-LSTM)의 경우, 입력 데이터는 슬라이딩 윈도우 방식을 사용하여 독립적인 샘플에서 의사 시퀀스(pseudo-sequences) 형태로 재구성되었습니다. 구체적으로, 1,200개의 훈련 샘플은 물리적 일관성을 유지하기 위해 먼저 기상 조건 카테고리로 분류되었습니다. 각 기상 카테고리 내에서 샘플들은 생성된 타임스탬프(2024년 달력 연도에 대한 시간별 시뮬레이션 관측치) 순으로 정렬되었습니다. 그 다음, 길이가 10인 슬라이딩 윈도우를 적용하여 10개의 연속적인 시간 단계(각 단계는 온도, 습도, 가시거리, 먼지 농도, 강우 강도의 5가지 특성을 가짐)로 구성된 입력 시퀀스를 생성함으로써 11번째의 감쇠도를 예측하였습니다.th 시간 단계. 이 방법은 시뮬레이션된 관찰치의 시간적 순서를 유지하는 동시에 순차 모델이 시간적 의존성을 학습할 수 있도록 한다. 테스트 세트의 구조는 윈도우 크기와 특성 집합이 동일하다는 점을 제외하고는 동일했다. 이러한 의사 순차적(pseudo-sequential) 구조화는 방법론적 단순화이며 실제 세계의 시간적 역동성을 반영하지 않는다는 점을 인지하고 있다. 우리는 고찰 섹션에서 이를 한계점으로 명시하였다.
하이브리드 접근법 평가
세 가지 하이브리드 접근 방식이 검토되었습니다. 첫 번째 방식은 Random Forest, XGBoost 및 Deep Neural Network 모델의 예측값을 동일한 가중치(각 모델에 1/3의 가중치 할당)로 평균한 Voting Ensemble이며, 최종 예측값은 다음과 같이 계산되었습니다:
ŷensemble=(1/3)ŷRF+(1/3)ŷXGB+(1/3)ŷDNN (9)
추가적인 하이퍼파라미터 도입을 방지하고 개별 모델에 편향되지 않은 기본 앙상블 성능을 평가하기 위해 동일 가중치 방식을 선택하였습니다. 두 번째 접근 방식으로는 Ridge 메타 학습기 스태킹(stacking)을 적용하였습니다. 기본 학습기로는 Random Forest, XGBoost 및 딥 뉴럴 네트워크(Attention 기반)를 사용하였습니다. 스태킹 절차는 두 단계로 진행되었습니다. 첫째, 5-겹 교차 검증(5-fold cross-validation)을 사용하여 1,200개 샘플의 전체 훈련 세트로 각 기본 학습기를 훈련시켜 out-of-fold 예측값을 생성함으로써 1,200×3 크기의 새로운 메타 특성 행렬(샘플당 기본 모델별 하나의 예측값)을 구축하였습니다. 둘째, 기본 학습기들의 최적 조합 가중치를 학습시키기 위해, 원래의 감쇠값을 타겟으로 하여 이러한 메타 특성을 기반으로 Ridge 회귀 메타 학습기(L2 정규화 파라미터 alpha=1.0)를 훈련시켰습니다. 최종 스태킹 예측식은 다음과 같습니다.
ŷstacking=wRF×ŷRF+wXGB×ŷXGB+wDNN×ŷDNN (10)
여기서 가중치 w는 Ridge 메타 학습기에 의해 학습되었습니다. 세 번째 접근 방식은 안개 조건 샘플에 대해 신경망 예측치의 70%와 Kim 모델의 예측치 30%를 결합한 물리 정보 신경망(Physics-Informed Neural Network)이었습니다. 결합은 다음 공식을 이용한 고정 가중 평균으로 수행되었습니다:
ŷhybrid=0.7×ŷneural+0.3×ŷKim (11)
여기서 ŷneural은 Attention 기반 신경망의 출력이며, ŷKim은 가시성 입력을 기반으로 Kim 안개 모델에서 계산된 감쇄 값입니다. 안개가 없는 샘플의 경우, 물리적 부분은 0으로 설정되었으며 모델은 순수 신경망으로 작동하였습니다. 가중치(신경망 70%, 물리 모델 30%)는 검증 세트(테스트 세트가 아님)에서 90:10, 80:20, 70:30, 60:40, 50:50의 가중치 조합을 테스트한 예비 실험을 바탕으로 고정되었습니다. 70/30 분할은 가장 좋은 검증 R2 값을 제공하는 동시에, Kim 모델이 확립된 이론적 감쇄 경계를 제공하는 안개 상황에서 예측을 정규화하고 물리적으로 불가능한 출력을 방지할 수 있는 충분한 물리적 제약을 유지했기에 선택되었습니다.
특성 중요도 및 해석 가능성 분석
불순도 기반 특성 중요도(분산 감소)를 적용한 Random Forest 모델을 사용하여 10가지 입력 특성의 중요도 순위를 추출하였습니다. 분석 결과, 먼지 농도(67.3%)와 가시거리(21.2%)가 가장 중요한 예측 변수로 나타났으며, 이 두 변수가 전체 예측 중요도의 88.5%를 설명하는 것으로 확인되었습니다. 세 번째로 중요한 특성은 강수 강도(6.0%)였으며, 이어서 풍속(2.1%), 온도(1.5%), 습도(0.9%), 월(0.5%), 계절(0.3%), 강설 강도(0.1%), 기압(0.1%) 순이었습니다. 시간적 특성(월 및 계절)의 중요도 점수가 낮게 나타난 것은 대기 감쇠의 계절적 변동이 시간적 패턴 그 자체보다는 주로 기저 환경 매개변수에 의해 반영됨을 시사합니다.
환경 요인과 감쇠 사이의 관계를 평가하기 위해 SHAP (Shapley Additive exPlanations) 분석을 수행하였습니다. SHAP 구현에는 Random Forest, XGBoost, LightGBM을 포함한 트리 기반 모델에 최적화된 SHAP 라이브러리의 TreeExplainer 모듈을 사용하였습니다 (버전은 재료 표 참조). SHAP 분석 설정은 다음과 같습니다: 학습된 Random Forest 모델을 TreeExplainer에 전달하였으며, TreeExplainer는 모델 출력의 조건부 기댓값에 기반한 개입적(marginal) 특성 기여도 접근 방식을 사용하여 SHAP 값을 계산하였습니다. 300개의 테스트 세트 샘플 전체에 대해 SHAP 값을 계산하여 300 × 10 크기의 행렬(샘플당 특성별 SHAP 값 1개)을 생성하였습니다. 각 특성에 대해 SHAP 값은 기준점(모델 예측 평균값) 대비 예측에 기여한 정도를 나타냅니다. 음수의 SHAP 값은 하향 이동을 나타내며, 양수의 SHAP 값은 해당 특성이 감쇠 예측치를 높였음을 나타냅니다. 기여도의 강도는 SHAP 값의 크기로 표시되었습니다. 각 특성에 대한 SHAP 값의 분포(beeswarm plot 사용), 영향의 방향(특성 값과 SHAP 값 사이의 상관관계) 및 특성 중요도 순위는 모두 요약 플롯(summary plot)을 통해 시각화하였습니다. 모든 SHAP 시각화에는 SHAP 라이브러리의 내장 플로팅 함수인 beeswarm plot용 shap.summary_plot()과 전역 특성 중요도용 shap.bar_plot()이 사용되었습니다.
원-핫 인코딩된 변수의 처리: 먼저 계절 변수를 인코딩하기 위해 4개의 이진 열(봄, 여름, 가을, 겨울)을 사용하였습니다. SHAP 분석을 위해 샘플당 단일 "계절" 기여도 값을 생성하고자, 각 계절 범주에 대한 SHAP 값을 합산하여 이 4가지 원-핫 인코딩된 변수의 기여도를 결합하였습니다. 이 그룹화 작업을 수행하기 위해, 원-핫 인코딩된 계절 그룹에 해당하는 모든 열을 찾아 각 샘플에 대한 SHAP 값을 추출한 후 요소별로 합산하였습니다. 이렇게 결합된 SHAP 값은 감쇄 예측에 대한 계절의 전반적인 기여도를 나타냅니다. 이 방법은 SHAP 요약 플롯에서 단일 "계절" 행을 생성할 수 있게 하며, 복합 범주형 변수로서 계절을 사용하는 모델의 방식과 일관성을 보장합니다. 결합된 수치가 계절의 총 기여도에 대해 더 이해하기 쉬운 묘사를 제공하므로, 계절 SHAP 값을 각 계절 범주별로 개별 표시하지 않았습니다.
결과
합성 데이터셋의 특성은 그림 1A–F에 요약되어 있습니다. 이 데이터셋에는 맑은 하늘, 먼지, 안개, 비, 눈 조건이 포함되었으며 (그림 1A), 샘플은 고온 건조 및 저온 다습 계절(그림 1B)과 낮 및 밤 시간대(그림 1C)에 걸쳐 분포되어 있습니다. 다양한 기상 조건에 따른 온도, 습도 및 가시성의 분포는 그림 1D–F에 나타나 있습니다.
머신 러닝 모델들은 대기 감쇄를 추정하는 데 있어 강력한 예측 성능을 보여주었습니다(그림 2A–D; 표 3). 평가된 모델 중 RF가 테스트 R2 0.9654와 RMSE 1.324 dB/km로 가장 강력한 전반적 성능을 달성했습니다(그림 2A; 표 3). RF는 1.5 dB/km 미만의 예측 오차를 유지하면서 관찰된 변동성의 96.54%를 설명했습니다. XGBoost 또한 좋은 성능을 보였으며(그림 2C), LightGBM이 그 뒤를 이었습니다(그림 2B). 모델의 강건성은 5-겹 교차 검증을 통해 입증되었으며, RF는 0.960 ± 0.007의 교차 검증 R2를 달성했습니다(그림 2D). 반면, K-최근접 이웃(K-Nearest Neighbors)은 훈련 R2 1.000과 테스트 R2 0.7341로 과적합 징후를 보였으며, 선형 회귀(Linear Regression)는 중간 정도의 예측 성능을 나타냈습니다(그림 2A; 표 3).
위에 언급된 10가지 입력 특성에 대한 특성 중요도 분석 결과가 그림 3A에 나타나 있습니다. 상대적 중요도 점수의 순위는 다음과 같습니다: 먼지 농도 (67.3%), 가시거리 (21.2%), 강우 강도 (6.0%), 풍속 (2.1%), 온도 (1.5%), 습도 (0.9%), 월 (0.5%), 계절 (0.3%), 강설 강도 (0.1%), 그리고 기압 (0.1%) 순입니다. ‘기상 조건’ 변수는 데이터셋 층화에 사용되었으나 특성 중요도 분석에는 포함되지 않았는데, 이는 여러 기저 물리 파라미터를 나타내는 범주형 합성 변수이며 그 영향이 개별 환경 특성들에 의해 반영되기 때문입니다. 특성 중요도 및 해석 가능성 분석을 통해 감쇠와 가장 강하게 연관된 환경 변수들을 식별하였습니다(그림 3A,B). 먼지 농도 (67.3%), 가시거리 (21.2%), 강우 강도 (6.0%)가 전체 예측 중요도의 94.4%를 공동으로 차지하였습니다(그림 3A). SHAP 분석 결과, 먼지 농도의 증가와 가시거리의 감소가 감쇠 예측치의 증가와 연관되어 있음이 추가적으로 입증되었습니다(그림 3B).
딥러닝 모델은 머신러닝 방식보다 낮은 예측 성능을 보였습니다(그림 4A–D). 가장 성능이 좋은 딥러닝 모델인 어텐션 기반 네트워크(Attention-based network)는 R2 0.7766 및 RMSE 3.362 dB/km를 달성했습니다(그림 4A). 순환 신경망 구조는 특히 저조한 성능을 보였으며, LSTM과 CNN–LSTM 모델 모두 R2 값이 0에 가깝고 RMSE 값은 7.19 dB/km를 초과했습니다(그림 4B). LSTM 및 CNN-LSTM 구조의 상대적으로 낮은 성능(R2 = 각각 0.0110 및 0.0109, RMSE = 각각 7.193 dB/km 및 7.196 dB/km)는 입력 데이터의 의사 순차적(pseudo-sequential) 특성으로 어느 정도 설명될 수 있으며, 이는 대기 상태의 실제 시간적 역학을 완전히 포착하지 못합니다.
순차적 의존성이 강하고 명확하게 정의된 실시간 시계열 애플리케이션과 달리, 본 연구의 데이터셋은 주로 인위적인 시간 순서가 부여된 독립적인 샘플들로 구성되었습니다. 이러한 구조들의 예측 성능이 저조했다는 점은 슬라이딩 윈도우(sliding-window) 방식으로 추출된 시간 정보가 불충분했거나 실제 대기 진화 과정을 대표하지 못했음을 시사합니다(그림 4C). 이는 이러한 특성의 데이터셋의 경우, 복잡한 시퀀스 기반 딥러닝 모델보다 단순한 머신러닝 접근 방식이 더 적합하다는 본 연구의 결론을 뒷받침합니다. 모든 딥러닝 구조에 대한 검증 성능은 그림 4D에 요약되어 있습니다.
머신러닝, 딥러닝 및 하이브리드 접근 방식의 성능은 그림 5A,B 및 표 3에 요약되어 있습니다. 하이브리드 방법 중 Voting Ensemble은 R2 0.9340과 RMSE 1.827 dB/km를 달성했습니다(그림 5A,B; 표 3). Ridge meta-learner stacking은 R2 0.9571과 RMSE 1.473 dB/km를 달성하여(그림 5A,B; 표 3), RF의 성능에 근접했으나 학습 시간이 상당히 더 오래 걸렸습니다. Physics-Informed Neural Network는 R2 = 0.8269 및 RMSE = 2.960 dB/km를 기록했으며(그림 5A,B; 표 3), 딥러닝 모델보다는 성능이 좋았으나 최상의 머신러닝 접근 방식만큼 우수하지는 않았습니다. RF와 Stacking Ensemble 모델 간의 통계적 비교 결과, 예측 성능에서 유의미한 차이가 나타나지 않았습니다(표 3; paired t-test: t = −1.74, p = 0.083). 따라서 RF가 수치상으로 가장 높은 R2를 달성했음에도 불구하고, 최상의 하이브리드 접근 방식과의 차이는 통계적으로 유의미하지 않았습니다.
전반적으로, 본 결과는 머신러닝 접근 방식이 이라크의 기상 조건 하에서 대기 감쇠를 정확하게 예측할 수 있다는 가설을 뒷받침합니다. RF가 일관되게 가장 높은 예측 성능을 보였으며(그림 2A,B; 표 3), 특성 중요도 및 SHAP 분석을 통해 먼지 농도와 가시성이 감쇠에 영향을 미치는 주요 환경 요인임을 확인하였습니다(그림 3A,B).
검증 데이터 성명서: 모든 모델 평가는 방법 섹션에 상세히 기술된 합성 데이터셋을 대상으로 수행되었습니다. 모델 검증 과정에서 대기 감쇠에 관한 실험적 또는 관찰적 데이터는 사용되지 않았습니다. 합성 데이터셋은 이라크 기후 기록에 기반한 확률 분포에서 선택된 기상 매개변수와 잘 알려진 물리적 전파 모델(Beer-Lambert 법칙, Kim 모델, Carbonneau 모델 및 Mie 산란 이론)을 사용하여 생성되었습니다. 방법 섹션에서 언급했듯이, 강력한 예측 성능은 모델의 학습 능력이나 타겟 값 생성에 사용된 결정론적 물리 방정식의 근사치가 일부 반영된 결과일 수 있습니다. 따라서 정량적 성능 지표(R2, RMSE, MAE)는 방정식 기반 합성 데이터에 대한 성능을 나타내며, 이는 실제 운용 중인 FSO 시스템에 대한 절대적인 성능 보장이 아니라 통제된 시뮬레이션 환경 내에서의 모델링 방법론 간 상대적 비교로 해석되어야 합니다. 이러한 접근 방식은 예측 모델링 방법론(표 2에 나열됨)의 비교 평가를 위한 통제된 환경을 제공하지만, 실제 이라크 기상 조건 하에서의 실제 FSO 감쇠 측정값을 통한 검증을 대체하지는 않습니다.
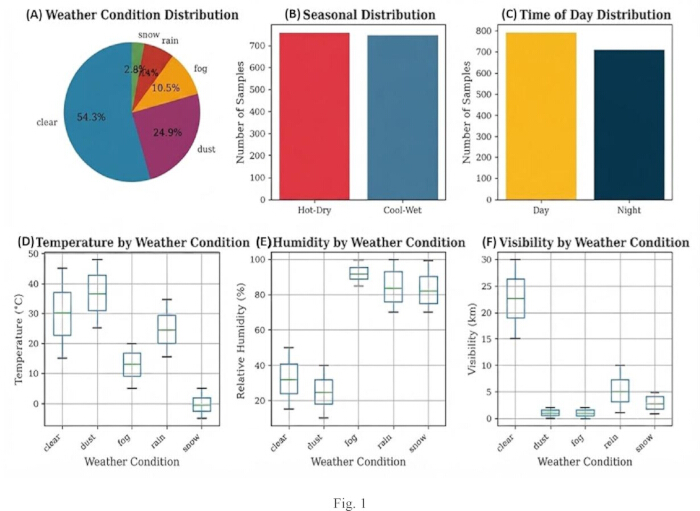
그림 1: 대기 감쇠 모델링에 사용된 합성 데이터셋의 특성과 환경 변수. (A) 맑은 하늘, 먼지, 안개, 비, 눈 상황을 포함하여 데이터셋에 표현된 기상 조건의 분포. (B) 고온 건조 및 저온 다습 기간에 따른 샘플의 계절적 분포. (C) 주간 및 야간 조건 동안 수집된 샘플의 분포. (D) 각 날씨 조건별 온도 분포. (E) 각 날씨 조건별 습도 분포. (F) 각 날씨 조건별 가시거리 분포. 박스 플롯은 중앙값(중앙선), 사분위수 범위(상자), 그리고 최소값 및 최대값(수염)을 나타낸다. 온도는 °C, 습도는 %, 가시거리는 km로 표시되었다. 이 그림의 확대 버전을 보려면 여기를 클릭하십시오.
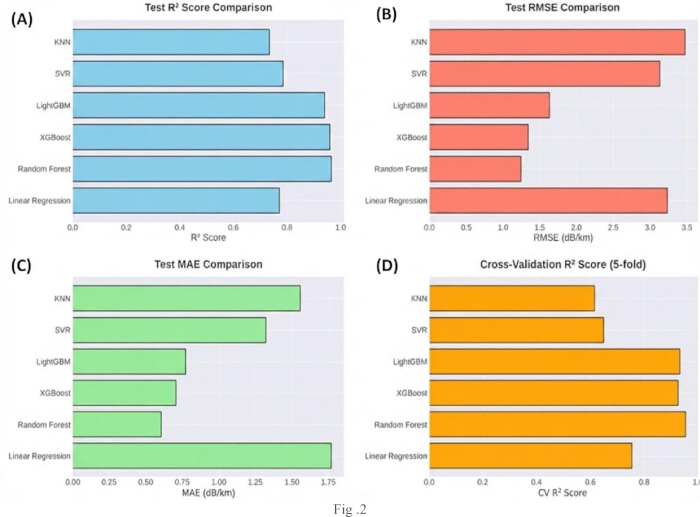
그림 2: 대기 감쇠 예측을 위한 머신러닝 모델의 성능 비교. (A) 선형 회귀(Linear Regression), 랜덤 포레스트(Random Forest), XGBoost(Extreme Gradient Boosting), LightGBM(Light Gradient Boosting Machine), 서포트 벡터 회귀(SVR) 및 K-최근접 이웃(KNN)을 포함하여 평가된 머신러닝 모델의 테스트 결정 계수(R2) 점수. (B) 각 머신러닝 모델의 테스트 평균 제곱근 오차(RMSE) 값. (C) 각 머신러닝 모델의 테스트 평균 절대 오차(MAE) 값. (D) 5-겹 교차 검증을 사용하여 얻은 교차 검증 결정 계수(R2) 점수. R2 값이 높을수록, 그리고 RMSE 및 MAE 값이 낮을수록 예측 성능이 향상되었음을 나타냄. RMSE와 MAE는 dB/km 단위로 표기됨. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
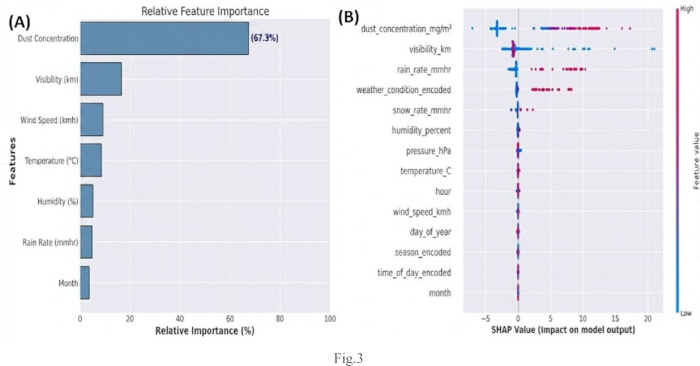
그림 3: 대기 감쇠 예측을 위한 특성 중요도 및 모델 해석 가능성 분석. (A) Random Forest 모델의 상대적 불순도 기반 특성 중요도 순위로, 감쇠 예측에 대한 10가지 모든 환경 및 시간 변수의 기여도를 보여준다. 가장 영향력 있는 특성은 먼지 농도(67.3%)였으며, 가시거리(21.2%), 강우 강도(6.0%), 풍속(2.1%), 온도(1.5%), 습도(0.9%), 월(0.5%), 계절(0.3%), 강설 강도(0.1%), 기압(0.1%) 순으로 나타났다. 상대적 중요도는 전체 모델 중요도에 대한 백분율이다. (B) 개별 특성이 모델 예측에 미치는 영향을 나타내는 SHapley Additive exPlanations (SHAP) 요약 플롯. SHAP 행렬은 300개의 테스트 세트 샘플(300 × 10개 특성)에 대해 계산되었다. 원-핫 인코딩된 계절 변수(원래 봄, 여름, 가을, 겨울의 4개 이진 열)의 경우, 샘플당 단일 '계절' 기여도 값을 생성하기 위해 4개 범주를 합산하여 SHAP 값을 결합하였다. 각 점은 샘플을 나타내며, 색상 척도는 낮음(파란색)부터 높음(빨간색)까지의 특성 값을 나타낸다. 양의 SHAP 값은 예측된 감쇠의 증가를 나타내고, 음의 SHAP 값은 예측된 감쇠의 감소를 나타낸다. 여기를 클릭하여 이 그림의 더 큰 버전을 확인하십시오.
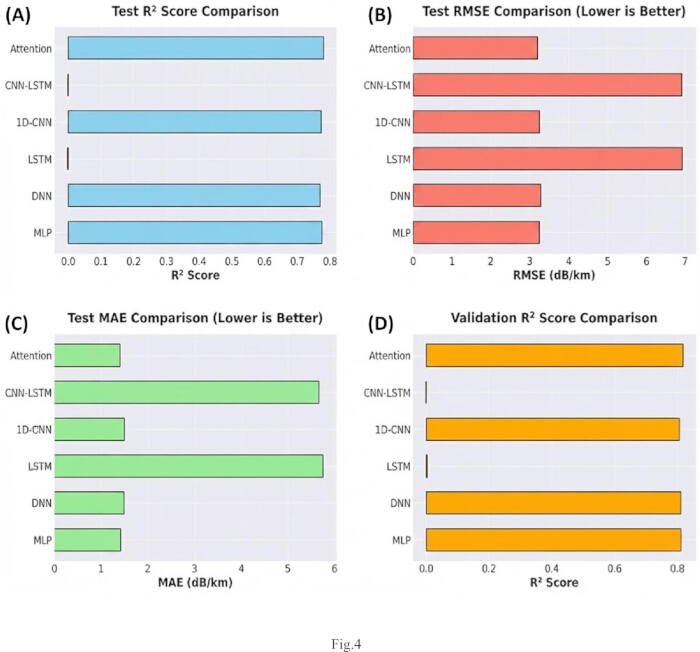
그림 4: 대기 감쇠 예측을 위한 딥러닝 모델의 성능 비교. (A) Multilayer Perceptron (MLP), Deep Neural Network (DNN), Long Short-Term Memory (LSTM), 1차원 합성곱 신경망 (1D-CNN), Convolutional Neural Network–Long Short-Term Memory (CNN–LSTM) 및 Attention 기반 모델을 포함하여 평가된 딥러닝 아키텍처의 테스트 결정계수 (R2) 점수. (B) 각 딥러닝 모델의 테스트 평균 제곱근 오차 (RMSE) 값. (C) 각 딥러닝 모델의 테스트 평균 절대 오차 (MAE) 값. (D) 평가된 딥러닝 모델의 검증 결정계수 (R2) 점수. R2 값이 높고 RMSE 및 MAE 값이 낮을수록 예측 성능이 향상되었음을 나타냅니다. RMSE와 MAE는 dB/km 단위로 표시되었습니다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
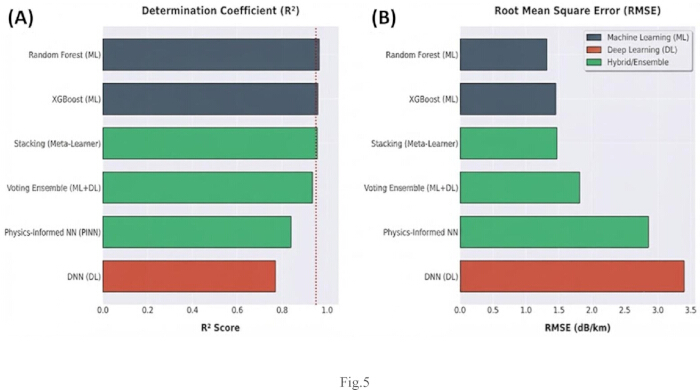
그림 5대기 감쇄 예측을 위한 머신러닝, 딥러닝 및 하이브리드 모델의 성능 비교 분석. (A결정계수 (R²2Random Forest, Extreme Gradient Boosting (XGBoost), 심층 신경망 (Deep Neural Network, DNN), Voting Ensemble, Stacking, 그리고 물리 정보 신경망 (Physics-Informed Neural Network) 모델을 포함한 대표적인 머신 러닝, 딥 러닝 및 하이브리드 접근 방식에 대한 값.B) 동일한 모델들에 대한 평균 제곱근 오차(RMSE) 값. 모델들은 머신러닝(ML), 딥러닝(DL), 하이브리드/앙상블 기법의 세 가지 범주로 색상 구분되어 있다. R² 값이 높을수록 예측 성능이 향상되었음을 나타낸다.2 그리고 더 낮은 RMSE 값을 나타냅니다. RMSE는 dB/km로 표기합니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
| 기상 조건 | 비율 | 온도 범위 | 습도 범위 | 가시 범위 | 주요 파라미터 범위 |
| 맑은 하늘 | 54.27% (814개 샘플) | −4.89에서 47.99°C | 0–100% | >10 km | — |
| 먼지 | 25.00% (375개 샘플) | 10–45°C | 10–60% | 0.05–5 km | 먼지: 0–4.96 mg/m³3 |
| 안개 | 10.47% (157개 샘플) | −5에서 20°C | 70–100% | 0.05–1 km | — |
| 비 | 7.40% (111개 샘플) | 5–30°C | 60–100% | 1–10 km | 강우량: 0.25–50 mm/h |
| 눈 | 2.87% (43개 샘플) | −10에서 5°C | 50–100% | 0.5–5 km | 눈: 0.5–15 mm/h |
표 1: 대기 감쇠 예측을 위한 머신러닝 모델의 성능 측정 지표.
| 모델 | 테스트 R2 | RMSE (dB/km) | MAE (dB/km) | CV R2 | 훈련 시간 (s) |
| 랜덤 포레스트 | 0.9654 | 1.324 | 0.815 | 0.960 ± 0.007 | 1.6 |
| XGBoost | 0.9582 | 1.455 | 0.892 | 0.953 ± 0.009 | 2.1 |
| LightGBM | 0.9507 | 1.581 | 0.971 | 0.946 ± 0.011 | 1.8 |
| 서포트 벡터 회귀 (Support Vector Regression, SVR) | 0.8874 | 2.389 | 1.445 | 0.879 ± 0.015 | 3.2 |
| 선형 회귀 | 0.8358 | 2.889 | 1.791 | 0.831 ± 0.018 | 0.2 |
| K-최근접 이웃 (KNN) | 0.7341 | 3.671 | 2.296 | 0.721 ± 0.022 | 0.8 |
표 2: 특정 딥러닝, 하이브리드 및 머신러닝 모델의 비교 평가.
| 모델 | 카테고리 | 테스트 R2 | RMSE (dB/km) | 순위 |
| Random Forest | ML | 0.9654 | 1.324 | 1 |
| XGBoost | ML | 0.9582 | 1.455 | 2 |
| Stacking Ensemble | Hybrid | 0.9571 | 1.473 | 3 |
| LightGBM | ML | 0.9507 | 1.581 | 4 |
| Voting Ensemble | Hybrid | 0.934 | 1.827 | 5 |
| Physics-Informed Neural Network | Hybrid | 0.8269 | 2.96 | 6 |
| Attention | DL | 0.7766 | 3.362 | 7 |
| LSTM / CNN–LSTM | DL | −0.0006 | 7.195 | — |
표 3: 평가된 각 모델의 계산 효율성(학습 및 추론) 비교.
데이터 가용성:
모든 입력 특성(온도, 습도, 가시거리, 먼지 농도, 강우율, 강설율, 풍속, 기압, 월, 계절 및 기상 조건)과 타겟 변수(dB/km 단위의 감쇠)가 포함된 1,500개 샘플의 전체 합성 데이터셋은 https://doi.org/10.5281/zenodo.21792999 의 본 원고 보충 파일로 제공됩니다. 해당 데이터셋은 모든 계산 변수(작동 범위 및 SNR)를 포함하여 각 샘플이 한 행을 차지하도록 구성되었습니다.
데이터 생성 스크립트(물리 모델 구현), 전처리 및 특성 스케일링을 위한 함수, 모든 머신러닝 모델 구현체, 모든 딥러닝 모델 구현체, 평가 및 시각화 스크립트, 그리고 하이퍼파라미터 튜닝 및 교차 검증 절차를 포함한 전체 구현 코드는 보충 파일로 제공될 예정입니다.
기상 기초 데이터: 합성 데이터 분포를 정의하는 데 사용된 기상 데이터는 2020~2024년 기간을 대상으로 이라크 기상 및 지진 기구(IMOS)와 이라크 교통부로부터 수집되었습니다. 기상 조건의 비율과 파라미터 범위를 결정하는 데 사용된 기상 데이터의 요약 내용은 부록 표 1에 제공되어 있습니다. 본 연구에 사용된 특정 IMOS 기록은 중앙 저장소에 공개적으로 보관되어 있지 않으나, IMOS에 직접 요청하여 얻을 수 있습니다. 재현성을 위해 요약 통계 및 도출된 확률 분포를 부록 자료로 제공합니다.
저장소 정보: 소스 코드와 데이터셋은 공개 저장소(Zenodo)에 https://doi.org/10.5281/zenodo.21792999로 보관되어 있습니다.
토론
이라크 기상 조건 하에서 작동하는 FSO 통신 시스템의 공기 감쇠를 예측하기 위해, 본 연구에서는 머신러닝, 딥러닝 및 하이브리드 기법을 평가하였다. 대기 영향이 링크 성능과 가용성에 영향을 미치는 주요 문제 중 하나로 계속 남아 있기 때문에, 최근의 평가들은 FSO 시스템을 위한 예측 모델링의 중요성이 증대되고 있음을 강조해 왔다21. 결과에 따르면, 고전적인 머신러닝 접근 방식, 특히 RF와 XGBoost가 높은 예측 정확도를 보였으며 일부 경우에는 수치적으로 딥러닝 및 하이브리드 방법을 능가했다. 하지만 통계적 검증 결과 RF와 최적의 하이브리드 앙상블(Stacking) 사이에 유의미한 차이(p=0.083)가 나타나지 않았으며, 이는 두 접근 방식 모두 해당 데이터셋에서 유사한 결과에 도달할 수 있음을 의미한다. 본 연구 결과는 중간 정도의 샘플 크기와 소수의 지배적인 예측 변수를 가진 정형 환경 데이터에 대해 트리 기반 앙상블 방법이 여전히 매우 높은 성능을 발휘함을 시사한다. 특성 중요도 분석 결과, 먼지 농도와 가시성이 감쇠의 주요 요인인 것으로 나타났으며, 이들이 예측력의 대부분을 함께 설명하였다. 이러한 결과는 안개, 먼지, 에어로졸 및 대기 오염이 광신호 전파에 중요한 영향을 미친다는 이전 연구들과 일치한다22,23,24,25. 머신러닝 모델이 소수의 매우 유용한 변수를 포함하는 데이터셋으로부터 이점을 얻는 경우가 많은 환경 모니터링 응용 분야에서도 유사한 결과가 보고된 바 있다26,27,28,29,30,31,32. SHAP 분석은 개별 환경 파라미터가 감쇠 예측에 미치는 영향을 정량화함으로써 모델의 해석 가능성을 더욱 향상시켰다.
딥러닝 모델의 낮은 성능은 여러 요인에 기인한 것일 수 있습니다. 데이터셋의 크기가 복잡한 신경망 구조를 학습시키기에 상대적으로 작았으며(https://doi.org/10.5281/zenodo.21792999 참조), 환경 변수들의 특성 중요도가 매우 집중된 양상을 보였습니다. 기존 연구들에 따르면, 딥러닝 방법은 일반적으로 대규모 데이터셋, 계층적 특성 구조 및 복잡한 비선형 표현이 있을 때 효과적입니다33,34,35,36,37. 반면, 본 연구에 사용된 감쇠 데이터셋은 지배적인 예측 변수의 수가 제한적이었으며, 순환 구조에 필요한 시계열적 의존성이 부족했습니다. LSTM 및 CNN–LSTM 모델의 저조한 성능은 이 응용 분야에서 순차 학습 메커니즘이 실질적인 이점을 제공하지 못할 수 있음을 시사합니다.
대기 감쇠의 예측 변수로서 먼지 농도(67.3%)와 가시거리(21.2%)가 지배적인 이유는 여러 요인에 기인할 수 있다. 첫째, 1550 nm에서의 분자 산란 및 흡수는 먼지 입자에 의한 Mie 산란에 의해 가려진다. Mie 이론에서 소산 효율 Q_ext는 입자 농도에 매우 민감하며, 중등도에서 고농도 영역에서 감쇠는 먼지 농도와 거의 선형적으로 비례한다. 둘째, 이라크는 빈번한 먼지 폭풍(기후 기록상 일수의 25.00%)의 영향을 받으며, 이는 4–30 dB/km의 감쇠 값을 초래한다. 이는 안개(10.47%, 0.5–10 dB/km) 및 강우(7.40%, 2–25 dB/km)와 대조적이다. 먼지 감쇠의 더 큰 변동성은 모델이 학습할 수 있는 더 강한 신호를 제공한다. 셋째, 먼지 농도의 지수 분포(0.4–4.96 mg/m3)는 광범위한 감쇠 값을 생성한다. 극한의 먼지 현상에 대한 긴 꼬리 분포는 정확한 예측에 중요한 높은 감쇠 값을 생성한다. 넷째, Mie 산란 모델은 먼지 농도에 대해 더 단순한(대략 선형적인) 의존성을 가지며, 이는 Kim 모델의 가시거리와 안개 감쇠 사이의 더 복잡한 관계에 비해 트리 기반 모델이 근사하기 더 쉽다. 다섯째, 먼지 폭풍은 중동 지역 FSO에 있어 가장 까다로운 환경 조건 중 하나이므로 이 발견은 실질적인 중요성을 갖는다. 먼지 현상 발생 시의 정확한 예측은 시스템의 신뢰할 수 있는 운용을 위해 필수적이다.
본 연구 결과는 대기 감쇠 예측을 위한 알고리즘 선택에 관한 실질적인 지침을 제공함으로써 FSO 통신 연구를 발전시킵니다. 정확한 감쇠 예측은 중동과 같이 까다로운 환경에서 네트워크 계획, 적응형 링크 관리 및 광통신 시스템의 신뢰성 있는 구축을 위해 필수적입니다23,28,30,36. 또한, 본 방법론은 공기 전파, 대기 모니터링 및 광 네트워크 성능 평가와 관련된 다른 환경 예측 문제에도 적용 가능할 것입니다38,39,40. 더 큰 규모의 실제 데이터셋, 정교한 앙상블 학습 기법, 전이 학습 프레임워크 또는 더 복잡한 물리 정보 기반 아키텍처 등이 이 개념을 검토하기 위한 또 다른 방법들이 될 수 있습니다41,42,43,44,45.
결론의 범위 및 일반화 가능성 문제
본 연구의 결론은 주로 잘 확립된 물리적 전파 모델(Beer-Lambert 법칙, Kim 모델, Carbonneau 모델 및 Mie 산란 이론)로부터 생성된 합성 데이터셋을 기반으로 합니다. 이러한 방법론적 접근 방식은 연구 결과의 범위와 일반화 가능성에 다음과 같은 시사점을 가집니다.
시뮬레이션 데이터의 결론: (1) 대기 감쇠 예측을 위한 머신러닝, 딥러닝 및 하이브리드 접근 방식의 비교 성능 순위. (2) 모델링된 조건 하에서 광학 감쇠의 지배적인 환경 예측 인자로 먼지 농도와 가시성 확인. (3) 딥러닝 아키텍처 대비 트리 기반 앙상블 방법의 계산 효율성 이점. (4) 모델 예측을 설명하기 위한 특성 중요도 및 SHAP 분석의 해석 가능성.
실제 환경에서의 검증이 필요한 결론: (1) 평가된 모델을 통해 얻은 R2 및 RMSE의 절대값은 합성 데이터셋의 특정 특성에 따라 달라지며, 이는 타겟 생성에 사용된 결정론적 물리 방정식에 대한 모델의 학습 결과가 반영된 것일 수 있다. (2) 최적 모델인 Random Forest가 미지의 실제 대기 조건에 적용 가능한지는 아직 증명되지 않았다. (3) 본 연구 결과가 이라크에 설치된 운영 FSO 장치에 적용되기 위해서는 현장 검증이 필수적이다. (4) 확인된 특성 중요도 순위가 현장 측정 조건에서도 견고하게 유지되는지 확인하는 과정이 필요하다.
수식으로 도출된 합성 데이터에서의 성능과 노이즈가 포함된 관측 또는 실험 데이터에서의 성능을 구분하는 것이 중요합니다. 합성 데이터셋은 입력 특성과 감쇠 대상 사이의 노이즈 없는 깨끗한 관계를 제공하며, 이는 측정 노이즈, 기기 오류 및 모델링되지 않은 물리적 현상이 존재하는 실제 데이터로 얻을 수 있는 것보다 더 높은 예측 성능 지표를 생성할 수 있습니다. 본 연구에서 제시한 결과를 검증하고 제안된 방법론의 실제 일반화 능력을 평가하기 위해, 향후 연구는 이라크 기상 조건하에서의 실제 FSO 감쇠 측정값을 확보하는 방향으로 진행될 것을 권장합니다.
모델 일반화 가능성에 대한 합성 데이터의 영향
본 연구에서 합성 데이터를 사용한 것이 모델의 일반화 가능성에 미치는 영향은 신중하게 고려되어야 합니다:
합성 접근법의 장점: 이 데이터셋은 확립된 물리적 전파 모델의 사용을 통해 물리적으로 일관되며, 기존의 이론적 프레임워크를 기반으로 합니다. 데이터셋이 이라크의 실제 기상 조건의 통계적 특성을 반영하도록 이라크의 기상 기록에서 기상 매개변수를 추출하였습니다. 이는 현장 측정의 혼란 변수(측정 오차, 장비 보정 또는 불충분한 데이터 기록 등)를 방지할 뿐만 아니라, 통제된 환경을 통해 모델링 방법론에 대한 체계적인 검토를 가능하게 합니다.
일반화의 한계: 합성 데이터셋은 다음과 같은 실제 대기 감쇠의 복잡성을 완전히 포착하는 데 한계가 있습니다: (1) 동시에 발생하는 여러 대기 현상의 상호작용; (2) 대기 매개변수의 비선형 및 비정상성 거동; (3) 샘플링 분포에 반영되지 않은 장기적인 기후 변동성; (4) FSO 전파에 상당한 영향을 미칠 수 있는 국지적 미세기후 효과; (5) 실제 데이터 수집 시 내재되는 노이즈 및 불확실성.
합성 데이터 생성 시의 편향 고려 사항: 환경 매개변수의 독립적 샘플링 가정(방법 섹션 참조)은 대기 변수들이 서로 상관관계가 있는 경향이 있는(예: 높은 먼지 농도는 낮은 가시성과 상관관계가 있는 경향이 있음) 실제 환경 조건을 지나치게 단순화한 것입니다. 체계적인 모델 비교를 위한 제어된 시뮬레이션 환경을 구축하기 위해 독립성 가정을 적용하였습니다. 그러나 이 방법은 대기 매개변수 간 상호작용의 전체적인 복잡성을 충분히 포착하지 못할 수 있습니다. 당사는 테스트 세트에서 희귀 조건(특히 2.87%의 강설)이 불균형하게 표현될 가능성을 최소화하기 위해 층화 분할법(훈련 세트와 테스트 세트에서 기상 조건의 비율을 유지하는 방법)을 사용하였습니다.
결정론적 타겟 생성: 본 연구에서 관찰된 높은 예측 성능은 모델이 타겟 값을 생성하는 데 사용된 결정론적 물리 방정식들을 학습했기 때문일 수 있습니다. 반면, 실제 실험 데이터에는 측정 노이즈, 기기 오차 및 모델링되지 않은 물리적 현상이 포함되어 있어 예측이 더 어렵습니다. 따라서 정량적 성능 지표(R2, RMSE, MAE)는 실제 운영되는 FSO 시스템에 대한 절대적인 성능 보장으로 보기보다는, 통제된 시뮬레이션 환경 내에서의 방법론 간 상대적 비교로 해석해야 합니다.
따라서 합성 데이터의 물리적 일관성 덕분에 모델 성능 순위에 대한 비교 결과는 견고할 가능성이 높지만, 절대적인 성능 지표(R2, RMSE, MAE)를 실제 운용 중인 FSO 시스템에서 기대되는 성능의 지표로 간주해서는 안 됩니다. 이라크의 다양한 기상 조건 하에서 얻은 실험적 대기 감쇠 측정값을 사용하여 실제 환경에 대한 모델의 일반화 능력을 테스트하는 것이 필요합니다.
주의해야 할 몇 가지 제한 사항이 있습니다. 첫째, 본 연구는 현장 관찰 대신 잘 알려진 물리적 전파 모델을 사용하여 생성된 합성 데이터셋에 의존했습니다. 앞서 언급했듯이, 운영 중인 FSO 시스템에 대한 절대적인 성능 보장을 제공하기보다는 정량적 성능 지표(R2, RMSE, MAE)를 제어된 시뮬레이션 환경 내에서의 접근 방식에 대한 상대적 비교로 간주해야 합니다. 둘째, 데이터셋의 규모로 인해 표준 모델과 딥러닝 모델이 견고한 특징 표현을 학습하지 못했을 수 있습니다. 셋째, 감쇠 예측에 집중하기 위해 연결 가용성, 포인팅 오류, 난류 유발 페이딩과 같은 다른 FSO 성능 지표는 고려하지 않았습니다. 넷째, 기상 조건의 비율을 계산하기 위해 2020년부터 2024년까지의 과거 기록을 사용했으며, 이는 이라크 기후 패턴의 연도별 변화를 정확하게 반영하지 못할 수 있습니다. 다섯째, CNN–LSTM 및 LSTM 모델의 유사 순차적 입력 데이터 구조는 방법론적 단순화이며, 이는 실제 응용 분야의 시간적 역동성을 충분히 포착하지 못할 수 있습니다. 결과를 평가할 때 이러한 제한 사항들이 결과의 일반화 가능성에 영향을 미칠 수 있음을 고려해야 합니다.
권장 우선순위: 실제 환경에서의 검증. 이라크 기상 조건 하에서 실제 FSO 감쇠 측정값을 수집하고 분석하는 것이 가장 중요한 향후 연구 방향입니다. 여기에는 다음 사항이 포함되어야 합니다: (1) 지역별 기후 변화를 기록하기 위해 이라크의 다양한 지역(예: 바그다드, 바스라, 모술, 라마디)에 FSO 테스트베드 구축; (2) FSO 설치 지점에서 교정된 기기를 사용하여 대기 파라미터(온도, 습도, 가시거리, 먼지 농도)를 동시에 측정; (4) 극한 기상 현상(먼지 폭풍, 짙은 안개, 폭우) 동안의 감쇠 기록; (5) 재현성과 비교 연구가 가능하도록 수집된 데이터를 공개; (3) 계절적 변동을 포착하기 위해 최소 1년의 전체 주기 동안 모니터링 지속. 이러한 실제적인 검증은 모델의 일반화 가능성을 평가하고 본 연구에서 개발된 예측 기법을 개선할 기회를 제공할 것입니다.
생성된 모델을 검증하고 개선하기 위해, 향후 연구는 이라크의 기상 조건에서 얻은 실제 FSO 측정값을 통합하는 데 집중해야 합니다. 또한 관련 대기 데이터 세트를 활용하는 전이 학습 전략, 변화하는 환경 조건에 적응하는 온라인 학습 프로그램, 그리고 측정된 데이터와 물리적 모델을 결합한 하이브리드 실험-시뮬레이션 전략에 대한 추가 연구가 수행될 수 있습니다. 설명 가능한 AI 및 정교한 물리 기반 학습 접근 방식에 대한 추가 연구는 공기 감쇠의 근본적인 메커니즘을 더욱 명확히 밝히고 차세대 예측 시스템의 회복력을 강화할 수 있을 것입니다.
공개 사항
이해관계 충돌: 저자들은 이해관계 충돌이 없음을 선언합니다.
감사의 글
저자들은 본 연구를 위해 외부 연구비를 지원받지 않았음을 밝힙니다. 이라크 바그다드 쿼터의 국제 응용 및 이론 연구 센터(IATRC)에 감사를 표합니다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| CUDA Toolkit | NVIDIA Corporation | 11.8 | 딥러닝 학습용 GPU 가속 라이브러리 |
| cuDNN | NVIDIA Corporation | 8.6.0 | GPU 가속 딥 뉴럴 네트워크 라이브러리 |
| GPU (그래픽 처리 장치) | NVIDIA Corporation | GeForce RTX 4090, 24 GB VRAM | GPU 가속 딥러닝 학습에 사용 |
| CPU (중앙 처리 장치) | Intel Corporation | Core i9-13900K, 24 cores/32 threads | 모든 모델 학습 및 평가를 위한 워크스테이션 프로세서 |
| 시스템 메모리 (RAM) | n/a | 64 GB DDR5, 5200 MHz | 워크스테이션 메모리 |
| Keras API | Open source (TensorFlow의 일부) | TensorFlow 2.11.0에 포함 | 모든 DL 아키텍처에 사용된 고수준 딥러닝 API |
| LightGBM | Open source (Microsoft) | 3.3.5 | 그레이디언트 부스팅 프레임워크 |
| NumPy | Open source (NumFOCUS) | 1.23.5 | 수치 계산 라이브러리 |
| 운영 체제 | Canonical Ltd. | Ubuntu 22.04 LTS | 워크스테이션 운영 체제 |
| Python | Python Software Foundation | 3.9 | 모든 데이터 생성 및 모델링에 사용된 프로그래밍 언어 |
| scikit-learn | Open source | 1.2.2 | 머신러닝 라이브러리 (RF, SVR, KNN, 선형 회귀, 교차 검증, 스케일링) |
| SHAP (SHapley Additive exPlanations) | Open source | 0.41.0 | 모델 해석력 라이브러리, TreeExplainer 모듈 |
| TensorFlow | Open source (Google) | 2.11.0 | 6가지 모든 DL 아키텍처에 사용된 딥러닝 프레임워크 |
| XGBoost | Open source | 1.7.5 | Extreme Gradient Boosting 라이브러리 |
참고문헌
- Kadhim MS, Hussein H, Elwi TA. Hybrid ANN-Z method for modeling carbon nanotube-based reconfigurable intelligent surfaces for terahertz beam steering. J Vis Exp. 2026;in press.
- Raham JK, Alshaibi M, Elwi TA. SMS optical fiber laser sensor for transformer oil temperature monitoring-based IoT of AI control. Prog Electromagn Res B. 2026;118:72–86.
- Abdulkareem ZJ, Hamad TK, Elwi TA. Reconfigurable metasurface based on graphene optical antennas for dynamic beam steering. Sustain Eng Innov. 2025;7:127–136.
- Abdulsattar RK, et al. Optical-microwave sensor for real-time measurement of water contamination in oil derivatives. AEU Int J Electron Commun. 2023;170:154798. doi:10.1016/j.aeue.2023.154798.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote control of miniaturized 3D reconfigurable CRLH printed self-powered MIMO antenna array for 5G applications. Micromachines. 2022;13(12):2061. doi:10.3390/mi13122061.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote-controlled miniaturized 3D reconfigurable CRLH-printed MIMO antenna array for 5G applications. Microw Opt Technol Lett. 2023;65(2):603–610.
- Jassim DA, Elwi TA. Optical nano monopoles for interconnection of electronic chip applications. Optik. 2022;249:168142. doi:10.1016/j.ijleo.2021.168142.
- Elwi TA. A novel approach for modeling the geometry and constitutive parameters of an armchair single-wall carbon nanotube antenna operating in the NIR regime. Al-Ma’mon Coll J. 2014;(24):261–285.
- Mohammed, AB.F.A., Al-hadeethi, S.T., Al-khaylani, H.H. et al. An investigation of success probability and fidelity of quantum repeater in asymmetry in midpoint placement in fiber-based quantum networks. J Opt (2025). https://doi.org/10.1007/s12596-025-02866-6.
- Kim II, McArthur B, Korevaar EJ. Comparison of laser beam propagation at 785 nm and 1550 nm in fog and haze for optical wireless communications [conference paper]. Presented at: Optical Wireless Communications III; Boston, MA, USA; 2000. Proc SPIE. 2001;4214:26–37. https://doi.org/10.1117/12.417512.
- Okbi ZA, Alak IK, Abdulla EN, Al-Khaylani HH. Design and security analysis of an image encryption based on a gigabit passive optical network employing fiber-FSO protection at the last mile. J Opt Commun. 2025. doi:10.1515/joc-2025-0466.
- Ojo JS, Olaitan JA, Ojo OL. Characterization of fog-induced attenuation for optimizing optical propagation links in Nigeria. Results Opt. 2022;9:100279. doi:10.1016/j.rio.2022.100279.
- Khidher SA. Dust storms in Iraq: Past and present. Theor Appl Climatol. 2024;155:4721–4735.
- Ali, Alaa Hussein, Abdulla, Essam N. and Al-Azawi, Razi J.. "Security and network performance analysis of coexistence TWDM – NG-PON2, GPON and 10G-EPON systems based on Hill Cipher" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0435.
- Lionis A, et al. Using machine learning algorithms for accurate received optical power prediction of an FSO link over a maritime environment. Photonics. 2021;8(6):212. doi:10.3390/photonics8060212.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA, USA; 2016. p. 785–794. https://doi.org/10.1145/2939672.2939785.
- Bai Y, et al. Air pollutants concentrations forecasting using back propagation neural network based on wavelet decomposition with meteorological conditions. Atmos Pollut Res. 2016;7(3):557–566.
- LeCun Y, Bengio Y, Hinton G. Deep learning. Nature. 2015;521:436–444.
- Mousa, Ekhlass, Abdulla, Essam N. and Adnan, Salah A.. "Enhancing network security based on 10G-EPON with the use of the Hill cipher algorithm" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0201.
- Lu G, et al. A survey of deep learning for time series forecasting: Theories, datasets, and state-of-the-art techniques. Comput Mater Contin. 2025;85(2):2403–2441.
- Liu J, Yang X, Wei Y, Zhao F. Integrated THz/FSO communications: A review of practical constraints, applications and challenges. Micromachines. 2025;16(11):1297. doi:10.3390/mi16111297.
- Bott A, Sievers U, Zdunkowski W. A radiation fog model with a detailed treatment of the interaction between radiative transfer and fog microphysics. J Atmos Sci. 1990;47:2153–2166.
- Fadhil HA, et al. Optimization of free space optics parameters: An optimum solution for bad weather conditions. Optik. 2013;124(19):3969–3973.
- Osipov S, et al. Severe atmospheric pollution in the Middle East is attributable to anthropogenic sources. Commun Earth Environ. 2022;3:203. doi:10.1038/s43247-022-00514-6.
- Castellanos P, et al. Mineral dust optical properties for remote sensing and global modeling: A review. Remote Sens Environ. 2024;303:113982. doi:10.1016/j.rse.2023.113982.
- Lolli S. Urban PM2.5 concentration monitoring: A review of recent advances in ground-based, satellite, model, and machine learning integration. Urban Clim. 2025;63:102566. doi:10.1016/j.uclim.2025.102566.
- Ridha, Fay F., Abdulla, Essam N. and Abdulhadi, Ali H.. "Machine learning based on raw ensemble predictions scheme for TWDM-PON" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0373.
- Khalid H, Sajid SM, Cheema MI, Leitgeb E. Optical signal attenuation through smog in controlled laboratory conditions. Photonics. 2024;11(2):172. doi:10.3390/photonics11020172.
- Ejike O, Ndị D, Shakir MZ. Comparative study of machine learning-based rainfall prediction in tropical and temperate climates. Climate. 2025;13(8):167. doi:10.3390/cli13080167.
- Esmail MA, Fathallah H, Alouini MS. An experimental study of FSO link performance in desert environment. IEEE Commun Lett. 2016;20(9):1888–1891.
- Kshirsagar MP, Khare KC. Support vector regression models of stormwater quality for a mixed urban land use. Hydrology. 2023;10(3):66. doi:10.3390/hydrology10030066.
- Mosso S, Lapo K, Stiperski I. Revealing the drivers of turbulence anisotropy over flat and complex terrain: An interpretable machine learning approach. Boundary Layer Meteorol. 2025;191:51. doi:10.1007/s10546-025-00946-5.
- Mohsen S, Ali AM, Emam A. Automatic modulation recognition using CNN deep learning models. Multimed Tools Appl. 2024;83:7035–7056.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517. doi:10.3390/info15090517.
- Castelli M, et al. Generative adversarial networks for generating synthetic features for Wi-Fi signal quality. PLoS One. 2021;16(11). doi:10.1371/journal.pone.0260308.
- Al-Imran, Chowdhury MZ, Mofidul RB, Jang YM. Machine learning and deep learning in FSO communication: A comprehensive survey. ICT Express. 2025;11(6):1026–1046.
- Grose MG, Watson EA. Forecasting atmospheric turbulence conditions from prior environmental parameters using artificial neural networks. Appl Opt. 2023;62:3370–3379.
- Radhi SS, et al. Design a secure TWDM-PON via the Hill cipher algorithm. Opt Contin. 2025;4:1051–1064.
- Mushatet, Adil Fadhil, Fadil, Elaf A. and Abdulla, Essam N.. "High bit rate secure FSO system utilizing Hill coding" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0147.
- Musadaq R, Abdulwahid SN, Abd Alwahed NN, Abdulla EN. Security analysis of an image encryption algorithm based on Blowfish in GPON. J Opt Commun. 2025. doi:10.1515/joc-2025-0109.
- Raissi M, Yazdani A, Karniadakis GE. Hidden fluid mechanics: Learning velocity and pressure fields from flow visualizations. Science. 2020;367(6481):1026–1030.
- Vasiliauskaite V, Antulov-Fantulin N. Generalization of neural network models for complex network dynamics. Commun Phys. 2024;7:348. doi:10.1038/s42005-024-01837-w.
- Oh S, Hong SK. Physics-informed neural modeling of 2D transient electromagnetic fields. Appl Sci. 2025;15(23):12612. doi:10.3390/app152312612.
- Pradhan S, Bhattarai JS, Murugavel M, Sharma OP. Machine learning approaches to surpass the limitations of the Beer–Lambert law. ACS Omega. 2025;10(16):16597–16601.
- Pavlyshenko B. Using stacking approaches for machine learning models [conference paper]. Presented at: 2018 IEEE Second International Conference on Data Stream Mining and Processing (DSMP); Lviv, Ukraine; 2018. p. 255–258. https://doi.org/10.1109/DSMP.2018.8478522.