본 프로토콜은 연합 학습, 멀티모달 트랜스포머, 확산 기반 증강, 그래프 기반 개인 맞춤형 약물 추천 및 설명 가능한 인공지능을 통해 프라이버시를 보호하는 멀티모달 당뇨병 지능형 프레임워크인 FedMediFormer-XAI를 제안하며, 이를 통해 정확한 예측, 투명한 의사결정 및 개인 맞춤형 당뇨병 관리를 구현하고자 합니다.
방법 논문
FedMediFormer-XAI: 당뇨병을 위한 확산 증강 및 그래프 기반 약물 추천 기반의 연합 멀티모달 트랜스포머
이 논문에서
요약
초록
당뇨병 관리는 파편화된 의료 데이터, 개인정보 보호 문제, 낮은 설명 가능성, 그리고 개인 맞춤형 치료 지침의 부족과 같은 여러 장애물에 직면해 있습니다. 본 연구에서는 연합 학습(federated learning), 멀티모달 트랜스포머(multimodal transformers), 확산 기반 데이터 증강(diffusion-based data augmentation), 약물 추천을 위한 그래프 신경망(GNNs), 그리고 당뇨병 인텔리전스를 위한 설명 가능한 인공지능(XAI)을 통합한 적절한 단일 프레임워크인 FedMediFormer-XAI를 소개합니다. 이 시스템은 임상 기록, 인구 건강 지표, 연속 혈당 측정 데이터, 망막저두부 영상, 웨어러블 센서 측정값, 약리학적 정보 등 다양한 유형의 의료 데이터를 활용합니다. 합성 샘플을 생성하고 클래스 불균형 문제를 해결하기 위해 확산 모델이 사용되며, 매우 서로 다른 데이터 소스 간의 관계를 학습하기 위해 멀티모달 트랜스포머 아키텍처가 채택되었습니다. 연합 학습을 통해 가공되지 않은 환자 데이터를 공유하지 않고도 개인정보를 보호하는 방식으로 모델의 협동 학습이 가능합니다. GNN 구성 요소는 개인 맞춤형 약물 추천을 위해 환자-약물 및 약물-약물 상호작용을 포착합니다. SHapley Additive exPlanations (SHAP), 어텐션 시각화(attention visualization), 통합 기울기(Integrated Gradients) 및 반사실적 추론(counterfactual reasoning)과 같은 설명 가능성 방법은 예측 및 추천 결과에 대한 투명한 해석을 제공합니다. 대표적인 구현 결과, 제안된 프레임워크는 정확도 94.2%, 정밀도 93.1%, 재현율 92.8%, F1-score 92.9%, 매슈 상관 계수(MCC) 0.88, 그리고 수신자 조작 특성 곡선 아래 면적(AUC-ROC) 0.96을 달성했습니다. 그래프 기반 추천 모듈은 정밀도 = 0.89, 재현율 = 0.84, 정규화된 할인 누적 이득(NDCG) = 0.91을 기록했습니다. 본 프로토콜은 멀티모달 트랜스포머, 연합 학습, 확산 기반 증강, 그래프 기반 추천 및 설명 가능한 인공지능을 사용하여 이기종 의료 데이터를 통합하는 구조적 접근 방식을 제공합니다. 보고된 계산 결과는 당뇨병 예측 및 개인 맞춤형 약물 추천에 대한 본 프레임워크의 잠재력을 입증하며, 연합 설계는 분산형 데이터 처리를 지원합니다. 임상적 유용성, 일반화 가능성 및 실제 적용 가능성을 확립하기 위해서는 전향적 다기관 임상 평가가 필요합니다.
서론
당뇨병은 인류에게 영향을 미치는 주요 만성 대사 질환 중 하나이며, 장기적인 영향과 막대한 환자 치료 비용으로 인해 지속적으로 증가함에 따라 중대한 공중 보건 문제가 되고 있습니다1,2. 한 보고서에 따르면, 현재 전 세계적으로 5억 3,700만 명 이상의 성인이 당뇨병을 앓고 있으며, 이 수치는 향후 수십 년 동안 상당히 증가할 것으로 예상됩니다3. 고혈당 수치가 조절되지 않으면 관상동맥성 심장 질환4, 신장 손상5, 신경 손상6, 시력 상실7, 뇌졸중8과 같은 심각한 합병증이 발생할 수 있습니다. 따라서 질병을 조기에 발견하고 환자의 상태를 정기적으로 모니터링하며, 첨단 의료 접근법을 통해 교육을 제공하는 것은 환자가 더 건강한 삶을 살 수 있도록 돕고, 결과적으로 국가 의료 시스템의 비용을 절감하는 데 필요한 단계입니다9,10.
최근 전자 건강 기록(EHR), 웨어러블 기기, 연속 혈당 측정(CGM) 시스템, 망막 영상 기술 및 모바일 헬스 애플리케이션의 사용이 빠르게 확산되면서, 분석 가능한 방대한 양의 이질적인 헬스케어 데이터가 생성되고 있습니다11. 이러한 다양한 데이터 수집 도구들은 인체, 질병의 각 단계별 기능 수행 능력, 다양한 치료법에 대한 환자의 반응, 그리고 환자의 실제 생활 패턴에 관한 다각적인 정보를 제공할 수 있습니다12. 인공지능(AI)은 매우 복잡한 데이터를 처리하고, 당뇨병을 예측하며, 질병을 모니터링하고, 의사의 임상적 의사결정을 지원하는 데 최적의 솔루션임이 입증되었습니다13. 또한, 랜덤 포레스트(random forests), 서포트 벡터 머신(support vector machines), 그래디언트 부스팅(gradient boosting) 방법을 포함한 머신러닝 알고리즘은 당뇨병 위험 평가에서 뛰어난 결과를 보여주었습니다14. 보다 최근에는 딥러닝 아키텍처를 통해 자동 특징 추출이 가능해졌으며, 다양한 헬스케어 애플리케이션 전반에서 예측 성능이 향상되었습니다15.
다양한 양식의 학습 방법을 사용하여 구조화된 임상 기록, 생리학적 측정치, 망막 이미지 및 행동 지표를 단일 예측 프레임워크로 통합함으로써 당뇨병 인텔리전스가 크게 향상되었습니다16. 다중 소스의 정보를 활용하는 멀티모달 모델은 각 양식을 개별적으로 조사했을 때는 보이지 않는 패턴을 식별할 수 있습니다17. 최근 트랜스포머 기반 모델은 다양한 유형의 헬스케어 데이터로부터 장거리 의존성과 문맥적 관계를 매우 효과적으로 학습해 왔습니다18. 하지만 불균형한 클래스, 데이터 누락, 데이터의 이질성 및 제한된 일반화 가능성과 같은 문제들이 여전히 임상 현장에서 멀티모달 AI 시스템의 광범위한 사용을 저해하고 있습니다19.
이러한 발전에도 불구하고, 많은 기존 당뇨병 지능형 시스템은 여전히 서로 다른 기관의 환자 데이터를 단일 저장소로 통합해야 하는 중앙 집중식 학습 프레임워크에 의존하고 있습니다20. 이러한 방식은 이미 환자 개인정보 보호, 데이터 관리 권한, 사이버 보안 및 규제 준수와 관련한 분쟁을 야기하고 있습니다21. 실제로 법적 및 윤리적 고려 사항으로 인해 의료 제공자는 민감한 환자 데이터를 공유하는 능력에 제약을 받는 경우가 많습니다22. 이러한 맥락에서 연합 학습(federated learning)은 실제 환자 데이터를 공유하지 않고도 협업 모델을 학습시킬 수 있어 실행 가능한 해결책이 되고 있습니다23. 분산 최적화와 보안 파라미터 집계를 통해, 연합 학습은 지리적으로 분산된 데이터셋의 지식을 활용함으로써 개인정보가 보호되는 건강 분석을 가능하게 합니다24. 그럼에도 불구하고, 통신 오버헤드, 클라이언트 이질성 및 수렴 안정성은 연합 헬스케어 시나리오에서 여전히 주요한 문제로 남아 있습니다25.
현재 사용 중인 당뇨병 지능형 시스템의 또 다른 단점은 투명성이 부족하고 개인 맞춤형 치료에 대한 지원이 미흡하다는 점입니다. 많은 딥러닝 모델이 블랙박스처럼 작동하는데, 이는 예측과 권고의 근거를 이해하고자 하는 임상의들에게 문제가 됩니다26. SHAP, Integrated Gradients, 어텐션 시각화, 반사실적 추론과 같은 설명 가능한 인공지능(XAI) 방법들은 모델의 투명성과 임상의의 신뢰를 높이는 데 큰 잠재력이 있음이 입증되고 있습니다27. 이에 더해, 그래프 신경망(GNN)은 환자-약물 및 약물-약물 상호작용을 포착하는 가장 진보된 도구가 되었으며, 이를 통해 개인 맞춤형 약물 권고와 투약 안전성 평가가 가능해졌습니다28. 새로운 확산 모델 또한 실제와 유사한 합성 헬스케어 데이터를 생성하고 클래스 불균형 문제를 해결하기 위한 솔루션을 제시했습니다29.
트랜스포머(Transformers), 연합 학습(federated learning), 확산 기반 합성 데이터 생성(diffusion-based synthetic data generation), 그래프 신경망(graph neural networks) 및 설명 가능한 인공지능(explainable artificial intelligence)은 각각 헬스케어 응용 분야에서 유망한 결과를 보여주었으나, 이를 단일한 재현 가능한 당뇨병 인텔리전스 프레임워크 내에 통합하려는 시도는 여전히 제한적입니다. 기존의 접근 방식들은 일반적으로 이러한 구성 요소들을 독립적으로 다루어, 개인화된 치료 추천 없는 개인정보 보호 학습, 분산 학습 없는 다중 모달 예측, 또는 그래프 기반 임상 의사 결정 지원 없는 설명 가능성에만 집중해 왔습니다. 확산 모델은 클래스 불균형 해소를 지원할 수 있고 트랜스포머 아키텍처는 이질적인 헬스케어 모달리티 간의 관계를 학습할 수 있음에도 불구하고, 이러한 상호 보완적 기술들을 통합하기 위한 표준화된 프로토콜은 여전히 부족한 실정입니다. 따라서 본 연구에서는 다중 모달 예측, 확산 기반 증강, 연합 최적화, 그래프 기반 개인 맞춤형 약물 추천 및 설명 가능한 인공지능을 재현 가능한 워크플로우 내에 결합한 통합 방법론적 프로토콜을 제시하며, 향후 임상 검증 및 적용을 위한 토대를 제공하고자 합니다.
환자 수준의 다중 모달 데이터셋이 가용하다고 가정하는 연구들과 달리, 본 프로토콜은 직접적인 환자 매칭을 수행하지 않고 이질적인 공공 데이터셋을 통합합니다. 각 데이터 소스에 대해 독립적인 모달리티별 모델을 학습시키며, 잠재 특징 임베딩은 교차 모달 어텐션 메커니즘을 통해 결합됩니다. 이러한 설계는 방법론적 엄격함을 유지하는 동시에 다양한 의료 저장소 전반에 걸쳐 다중 모달 지식 통합을 가능하게 합니다.
제시된 프로토콜은 주로 방법론적 개발 및 서로 다른 저장소나 기관에 이질적인 데이터 소스가 분산되어 있어 직접적인 데이터 중앙 집중화가 제한되는 분산 헬스케어 AI 환경을 위해 고안되었습니다. 현재의 구현 방식에서 모달리티별 데이터셋은 독립적이며 환자 간 매칭이 되어 있지 않습니다. 따라서 멀티모달 통합은 직접적인 환자 수준의 대응이 아닌 학습된 표현 수준에서 수행됩니다. 실제 적용을 위해서는 적절하게 연결된 멀티모달 환자 데이터, 참여 기관 간의 일관된 전처리 및 결과 정의, 적절한 컴퓨팅 인프라, 그리고 관련 윤리, 개인정보 보호 및 규제 요구 사항의 준수가 필요합니다.
본 논문은 예측, 추천 및 설명 가능성 기능을 하나의 체계 내에서 제공하여 개인정보를 보호하는 당뇨병 인텔리전스를 가능하게 하는 연합 멀티모달 트랜스포머 프레임워크인 FedMediFormer-XAI를 소개합니다. 이 프레임워크는 클래스 불균형 문제를 해결하기 위한 확산 기반 데이터 증강, 당뇨병 예측을 위한 멀티모달 트랜스포머 학습, 협력적 모델 개발을 위한 연합 학습, 그래프 신경망 기반의 개인 맞춤형 약물 추천, 그리고 투명한 방식으로 임상 결정을 지원하는 설명 가능한 인공지능 방법론을 통합합니다. 제안된 FedMediFormer-XAI 프레임워크의 전체 아키텍처와 워크플로우는 그림 1에 도식화되어 있습니다.
제안된 FedMediFormer-XAI 프레임워크의 주요 기여도는 다음과 같이 요약됩니다: (1) 당뇨병 인텔리전스를 위해 연합 학습, 멀티모달 트랜스포머, 확산 기반 데이터 증강, 그래프 신경망 기반 개인 맞춤형 약물 추천 및 설명 가능한 인공지능을 단일 재현 가능 워크플로우 내에 통합한 통합 프로토콜을 제시하였습니다. (2) 원본 환자 데이터를 공유하지 않고 시뮬레이션된 분산 의료 클라이언트 간의 협력적 모델 학습을 가능하게 하는 개인정보 보호 연합 학습 전략을 개발하였습니다. (3) 구조화된 임상 기록, 연속 혈당 측정 데이터, 망막 저저 사진 및 인구 보건 지표로부터 상호 보완적인 표현을 공동으로 학습하는 멀티모달 트랜스포머 아키텍처를 도입하였습니다. (4) 원본 학습 데이터의 통계적 특성을 유지하면서 클래스 불균형을 줄이고 모델 견고성을 향상시키기 위해 확산 기반 합성 데이터 생성을 통합하였습니다. (5) 개인 맞춤형 약물 추천 및 상호작용 인식 치료 순위 결정을 위해 환자-약물 및 약물-약물 관계를 모델링하는 GraphSAGE 기반 이종 그래프 학습 모듈을 채택하였습니다. (6) 모델 투명성을 높이고 해석 가능한 예측 및 추천 결과를 제공하기 위해 SHapley Additive exPlanations (SHAP), Integrated Gradients, 어텐션 시각화 및 반사실적 설명을 포함한 다수의 설명 가능한 인공지능 기술을 통합하였습니다. (7) 예측 평가, 연합 학습 평가, 추천 평가, 설명 가능성 분석, 임상의 중심 평가, 외부 검증 및 재현성 평가를 포함하는 종합적인 검증 프로토콜을 제공하였습니다.
프로토콜
본 연구에 사용된 모든 데이터셋은 공개 저장소에서 확보하였으며, 비식별 처리된 환자 정보를 포함하고 있습니다. 여기에는 Pima Indians Diabetes Dataset, CDC Diabetes Health Indicators Dataset, OhioT1DM Dataset, APTOS 2019 Blindness Detection Dataset, Drug Review Dataset 및 Drug-Drug Interaction Dataset이 포함됩니다. 직접적인 환자 모집, 중재, 검체 수집 또는 식별 가능한 개인 건강 정보에 대한 접근은 수행되지 않았습니다. 본 연구는 방법론 개발 및 검증을 위해 공개된 익명화 데이터셋의 2차 분석으로 제한되었으며, 해당 데이터 사용에 관한 기관 요구 사항에 따라 수행되었습니다. 본 프로토콜에 기술된 인간 중심 평가는 향후 구현을 위한 것이며, 본 연구에서는 수행되지 않았습니다. 이 평가를 수행하는 연구자는 기관 윤리 위원회(Institutional Ethics Committee)로부터 적절한 승인을 받고, 모든 참여자로부터 서면 동의서를 얻어야 하며, 관련 기관 요구 사항, 데이터 사용 계약 및 국가 규정을 준수해야 합니다.
1. 계산 환경 설정
- 기본 프로그래밍 환경으로 Python 3.11을 설치합니다. 딥러닝 모델 개발 및 학습을 위해 PyTorch 2.3과 TensorFlow 2.15를 설치합니다. 트랜스포머 기반 아키텍처를 구현하기 위해 Transformers 라이브러리(v4.45)를 설치합니다.
- 그래프 신경망 구축 및 학습을 지원하기 위해 PyTorch Geometric(v2.5)을 설치합니다. 설명 가능성 및 특성 기여도 분석을 수행하기 위해 SHAP(v0.47)과 Captum(v0.8)을 설치합니다.
- 수치 계산, 데이터 전처리 및 머신러닝 유틸리티를 위해 NumPy, Pandas 및 Scikit-learn을 설치합니다. 이미지 처리 및 시각화 작업을 위해 OpenCV와 Matplotlib을 설치합니다. 약물 상호작용 그래프를 구축하고 분석하기 위해 NetworkX를 설치합니다.
- 하드웨어 가속 계산을 가능하게 하기 위해 CUDA Toolkit과 호환되는 NVIDIA GPU 드라이버를 설치합니다. 최소 32 GB의 시스템 메모리를 갖춘 NVIDIA RTX 4090 GPU를 설정합니다. 결과의 재현성을 보장하기 위해 학습, 검증 및 테스트의 랜덤 시드를 42로 설정합니다. 사용 중인 소프트웨어 라이브러리의 설치 상태와 호환성을 확인합니다. 분석에 사용된 소프트웨어 버전, 하드웨어 사양 및 모델 설정 파라미터를 기록합니다.
2. 데이터셋 준비 및 전처리
- 필요한 임상, 생리학, 영상 및 약리학 데이터셋을 다운로드하여 모달리티별 저장소에 정리하고 무결성을 검증하십시오. 표 1 및 2에 명시된 대로 데이터셋 특성, 예측 대상 및 통합 수준을 확인하십시오. 워크플로우는 그림 2에 도식화되어 있습니다.
- 중복, 유효하지 않거나 일관성이 없는 기록 및 필수 변수가 누락된 기록을 제거하십시오. 적용 가능한 각 데이터셋을 환자 독립적인 훈련(70%), 검증(15%) 및 테스트(15%) 서브셋으로 나누십시오. 중앙값 대체(median imputation), Min-Max 스케일링 및 범주형 인코딩은 훈련 서브셋만을 사용하여 적합시키고, 적합된 변환을 검증 및 테스트 서브셋에 변경 없이 적용하십시오. 합성 데이터 생성은 훈련 서브셋에 대해서만 수행하십시오. 보충 표 1에 따라 파티셔닝 및 데이터 누수 방지 여부를 검증하십시오.
- 포도당, 음식 섭취, 인슐린 투여량, 신체 활동 및 수면 데이터를 가져오십시오. 타임스탬프를 표준화하고, 이벤트를 규칙적인 간격으로 정렬하며, 기록되지 않은 포도당 값은 선형으로 보간하고, 연속 기록을 고정 길이 윈도우로 나누며, z-score 정규화를 적용하여 temporal transformer 입력을 생성하십시오.
- 망막 저저 이미지들을 로드하고 손상되었거나 읽을 수 없는 파일, 중복 이미지, 라벨이 누락된 이미지, 심한 아티팩트가 있거나 망막 영역 가시성이 불충분한 이미지를 제거하십시오.
- 유지된 이미지의 크기를 224 × 224 픽셀로 조정하고, 픽셀 강도를 [0, 1]로 정규화하며, 대비 제한 적응형 히스토그램 평활화(CLAHE)를 적용하십시오.
- ±15° 이내의 무작위 회전, 0.5의 확률로 수평 뒤집기, 0.9–1.1× 이내의 무작위 줌 및 ±20% 이내의 밝기 조정을 사용하여 훈련 이미지를 증강하십시오. 검증 또는 테스트 이미지에는 확률적 증강을 적용하지 마십시오. 처리된 이미지들을 Vision Transformer 훈련을 위해 저장하십시오.
- 표 2에 요약된 데이터셋 통합 전략에 따라 모달리티별 표현을 통합하십시오. 공통 환자 식별자를 사용할 수 없는 경우 독립적인 저장소 간에 직접적인 환자 수준 매칭을 수행하지 마십시오.
- 저장소 간에 환자 식별자가 공유되지 않으므로 각 공공 데이터셋을 독립적인 모달리티별 데이터셋으로 저장하십시오.
- 해당 데이터셋을 사용하여 모달리티별 특징 추출기를 독립적으로 훈련시키십시오: (a) 임상 기록 → TabTransformer 인코더; (b) 인구 건강 지표 → TabTransformer 인코더; (c) 연속 포도당 모니터링 → Temporal Transformer; (d) 망막 저저 이미지 → Vision Transformer; (e) 약리학 데이터 → GraphSAGE 모듈
- 각 모달리티에서 잠재 특징 임베딩을 독립적으로 추출하십시오. 가공되지 않은 환자 기록을 병합하는 대신, 제안된 교차 모달 어텐션 융합 모듈을 통해 학습된 잠재 임베딩만을 융합하십시오.
- 독립적인 공공 데이터셋 간에 인위적인 환자 매칭이 수행되지 않도록 하십시오. 전처리, 증강 및 모델 개발 전 과정에서 각 데이터셋에 대해 독립적인 훈련, 검증 및 테스트 파티션을 유지하십시오.
- 하위 예측, 연합 학습, 설명 가능성 및 개인 맞춤형 약물 추천을 위해 융합된 다중 모달 특징 표현을 저장하십시오(그림 2).
3. 확산 기반 데이터 증강 수행
- TabDDPM을 사용하여 구조화된 표 형식의 임상 및 인구 건강 데이터 세트에 확산 기반 증강(diffusion-based augmentation)을 적용하십시오. 정보 누출을 방지하기 위해 전처리된 훈련 파티션에서만 합성 샘플을 생성하십시오. 모델을 다음과 같이 설정하십시오. 부록 표 2.
- Adam 옵티마이저(학습률 = 1)를 사용하여 TabDDPM을 최대 500 에포크(epoch) 동안 학습시킵니다. × 10⁻4(배치 크기 = 256). 검증 손실이 20 epoch 동안 연속으로 최소 0.001만큼 개선되지 않을 경우 조기 종료를 적용하십시오. 과소 대표된 클래스에 대해 합성 샘플을 생성하십시오.
- Kolmogorov-Smirnov(KS) 통계량, Jensen-Shannon 발산, Wasserstein 거리, 특성별 상관관계 분석 및 다운스트림 분류 성능을 통해 합성 데이터의 품질을 평가하십시오. 히스토그램 중첩, 커널 밀도 추정 및 쌍별 상관계수를 사용하여 원본 특성과 합성 특성의 분포를 비교하십시오.
- 클래스별 특성 분포가 원래의 훈련 데이터와 일관되게 유지되는 경우에만 합성 샘플을 수용하십시오 (KS 검정, p > 0.05; 젠슨-샤논 발산 < 0.10)이며, 비현실적인 임상 수치를 포함하지 않아야 합니다. 승인된 샘플을 기존 학습 데이터셋과 결합하여 클래스 균형이 잡힌 데이터셋을 생성합니다. 증강 워크플로우는 다음에서 보여줍니다. 그림 3.
- 원본 훈련 데이터셋과 증강된 훈련 데이터셋을 사용하여 당뇨병 예측 모델을 재학습시켜 합성 데이터의 유효성을 검증하십시오. 정확도(Accuracy), F1-스코어, MCC 및 AUC-ROC를 비교하여 모델의 일반화 성능 변화와 분포 편향을 평가하십시오.
4. 다중모달 트랜스포머 모델 개발
구조화된 임상 데이터, CGM 시퀀스 및 망막 저저 사진을 위한 모달리티별 인코더를 갖춘 멀티모달 트랜스포머를 그림과 같이 구성하십시오. 그림 4. 당뇨병 예측 및 그래프 기반 개인 맞춤형 약물 추천을 위해 교차 모달 어텐션(cross-modal attention)을 사용하여 생성된 표현들을 통합하십시오.
- 임상 인코더 개발
- TabTransformer 인코더 아키텍처를 초기화한다. 정규화된 임상 변수와 인구 건강 지표를 입력한다. 트랜스포머 어텐션 메커니즘을 사용하여 문맥적 특징 표현을 생성한다.
- TabTransformer 인코더를 32개의 구조화된 임상 입력 변수, 128의 임베딩 차원, 4개의 트랜스포머 층, 8개의 어텐션 헤드, 512의 피드포워드 차원, 0.20의 드롭아웃 비율 및 Gaussian Error Linear Unit (GELU) 활성화 함수로 구성한다.
- 환자 속성 간의 관계를 포착하는 잠재 임상 임베딩을 학습한다. 결과로 얻은 임상 임베딩을 멀티모달 통합을 위해 저장한다.
- 연속 혈당 측정 인코더 개발
- 시계열 트랜스포머 인코더를 초기화한다. 연속 혈당 측정 시퀀스와 생리학적 측정값을 입력한다. 셀프 어텐션 메커니즘을 사용하여 시간적 의존성을 인코딩한다.
- 시계열 트랜스포머를 96 타임 스텝의 시퀀스 길이, 15 min의 샘플링 간격, 128의 임베딩 차원, 4개의 트랜스포머 층, 8개의 어텐션 헤드, 사인파 형태의 위치 인코딩 및 0.20의 드롭아웃 비율로 구성한다.
- 환자의 혈당 역동성을 반영하는 순차적 임베딩을 생성한다. 시간적 임베딩을 다음 퓨전 프로세스를 위해 준비해 둔다.
- 비전 트랜스포머 인코더 개발
- Vision Transformer 아키텍처를 초기화한다. 전처리된 망막 저저 이미지들을 입력한다. 이미지를 고정된 크기의 패치로 나눈다.
- Vision Transformer를 224 × 224 pixels의 입력 이미지 해상도, 16 × 16 pixels의 패치 크기, 768의 임베딩 차원, 12개의 트랜스포머 블록, 12개의 어텐션 헤드 및 0.10의 드롭아웃 비율로 구성한다.
- 패치 수준의 특징 표현을 생성한다. 망막 병증 및 질병 관련 바이오마커를 나타내는 시각적 특징을 획득한다. 멀티모달 퓨전을 위해 이미지 임베딩을 저장한다.
- 교차 모달 퓨전 수행
- 임상, CGM 및 Vision Transformer 인코더에서 잠재 표현을 추출하고, 독립적인 선형 투영 후 Layer Normalization을 사용하여 각각을 공통의 256차원 잠재 공간으로 투영한다.
- 투영된 모달리티 토큰들을 연결하고, 학습 가능한 모달리티 유형 임베딩을 추가하며, 멀티헤드 교차 모달 어텐션을 적용하여 임상, CGM 및 망막 표현 간의 정보 교환이 가능하게 한다. 어텐션 블록을 8개의 헤드, 256차원의 모델 공간, 1,024차원의 피드포워드 층, GELU 활성화 함수, 0.10 드롭아웃, 잔차 연결 및 Layer Normalization으로 구성한다.
- 각 모달리티별 토큰 그룹을 평균 풀링하고 결과 표현들을 연결한다. 연결된 768차원 벡터를 512차원의 통합 멀티모달 표현으로 투영하며, 이후의 설명 가능성 및 어블레이션 분석을 위해 어텐션 가중치와 퓨전된 표현을 유지한다.
- 통합 표현을 당뇨병 예측 및 GraphSAGE 기반 약물 추천 모듈로 전달한다. 독립적인 데이터셋 간의 인위적인 환자 수준 매칭 없이 퓨전 전 과정 동안 원래의 모달리티별 훈련, 검증 및 테스트 파티션을 유지한다.
- Supplementary Table 3에 요약된 모델 파라미터에 따라 멀티모달 트랜스포머를 구성한다.
5. 연합 학습 구성
- 환자 수준의 데이터를 교환하지 않고 지리적으로 분산된 의료 기관 간의 협력적 모델 학습이 가능하도록 연합 학습 프레임워크를 구성하십시오. 각 참여 기관에서 로컬로 사용 가능한 데이터를 사용하여 로컬 모델 최적화를 수행하십시오. 보호된 모델 파라미터만을 중앙 집계 서버와 공유하십시오. 환자 개인정보를 보호하는 동시에 멀티모달 모델의 협력적 개발을 가능하게 하십시오.
- 멀티모달 데이터셋을 분리하여 여러 연합 클라이언트에 분배함으로써, 서로 다른 의료 기관들이 데이터를 공유하지 않고 협업하는 시나리오를 모방합니다.
- 연합 학습 네트워크를 10개의 참여 병원 클라이언트, 1개의 중앙 집계 서버, 통신 라운드당 5회의 로컬 에포크, 100회의 통신 라운드, 80%의 클라이언트 참여 비율, 각 통신 라운드 시의 무작위 클라이언트 선택, 그리고 라운드당 최소 8개의 참여 클라이언트로 설정하십시오.
- 각 클라이언트에게 특정 기관에 속한 데이터셋을 부여하여 데이터가 로컬에 유지되고 기밀이 보장되도록 합니다. Dirichlet 기반의 비독립 동일 분포(non-IID) 전략을 사용하여 멀티모달 학습 데이터를 10개의 시뮬레이션 병원 클라이언트에 분할합니다. 이질적인 클래스 분포, 인구통계학적 구성 및 클라이언트 데이터셋 크기를 생성하기 위해.
- 재현성을 보장하기 위해 고정된 랜덤 시드(random seed)를 사용하십시오. 결과로 도출된 클라이언트 수준의 분포를 확인하고, 연합 학습 전 과정 동안 이 파티션을 유지하십시오. 검증 및 테스트 데이터셋은 클라이언트 파티션과 독립적으로 유지하십시오.
- 중앙 집계 서버로부터 수신한 전역 모델 파라미터로 각 로컬 클라이언트를 초기화합니다. 클라이언트의 로컬 훈련 데이터를 사용하여 로컬 멀티모달 트랜스포머를 5 에포크 동안 훈련합니다. 학습률 1의 AdamW 옵티마이저를 사용하여 로컬 모델을 최적화합니다. × 10⁻4.
- 로컬 학습 완료 후 로컬 모델 파라미터 업데이트 값을 계산하십시오. 중앙 집계 서버로 전송하기 전 로컬 모델 파라미터를 보호 처리하십시오. 보호된 로컬 모델 파라미터를 글로벌 집계를 위해 중앙 집계 서버로 전송하십시오.
- 모든 참여 병원 클라이언트로부터 보호된 모델 파라미터를 수신합니다. 집계 전, 수신된 모델 업데이트의 무결성을 검증합니다. 연합 평균화(Federated Averaging, FedAvg) 알고리즘을 사용하여 로컬 모델 가중치를 집계합니다. 집계된 모델 파라미터를 사용하여 글로벌 멀티모달 트랜스포머를 업데이트합니다.
- 업데이트된 글로벌 모델 파라미터를 참여 병원 클라이언트에 재배포합니다. 100회의 통신 라운드가 완료되거나 미리 정의된 수렴 기준이 충족될 때까지 로컬 학습 및 글로벌 집계 과정을 반복합니다.
- 지정된 보안 집계 메커니즘과 AES-256 암호화를 사용하여 전송되는 모델 파라미터를 보호하십시오. 디지털 인증서를 사용하여 참여 클라이언트를 인증하십시오.
- 전송 계층 보안(Transport Layer Security, TLS) 1.3을 사용하여 암호화된 통신 채널을 구축하십시오. 매 통신 라운드가 완료된 후에는 집계된 전역 모델 파라미터만 유지하십시오.
- 원시 데이터 노출, 무단 공유, 멤버십 추론 및 모델 인버전 평가를 통해 개인정보 보호 및 보안성을 평가하십시오. 멤버십 추론의 경우, 공격 AUC-ROC를 무작위 기준선(0.50)과 비교하십시오. 인버전 평가는 망막 이미지의 경우 구조적 유사도 지수(SSIM) 및 최대 신호 대 잡음비(PSNR)를 사용하고, 수치형 특성의 경우 정규화된 재구성 오차를 사용하여 평가하십시오.
- 서버가 집계되지 않은 개별 클라이언트 업데이트에 접근할 수 없음을 확인하여 보안 집계(secure aggregation)를 검증하십시오. AES-256/TLS 1.3 보호 상태를 검증하고 암호화되지 않은 모델 업데이트 전송이 발생하지 않음을 확인하십시오.
- 해당하는 경우 연합 및 중앙 집중식 구성 간의 개인정보 보호 지표를 비교하고, 다음에서 지정한 지표를 보고하십시오. 부록 표 4.
- 로컬 트랜스포머 학습의 계산 복잡도를 $O(N^2)$로 추정하십시오. × L × d2여기서 N은 샘플 수를, L은 트랜스포머 층 수를, d는 임베딩 차원을 나타냅니다.
- 연합 집계의 계산 복잡도를 O(K로 추정하십시오. × P) 통신 라운드당, 여기서 K는 참여 클라이언트 수를 나타내고 P는 학습 가능한 모델 파라미터 수를 나타냅니다.
- 각 통신 라운드 동안 참여 클라이언트와 중앙 집계 서버 간에 보호된 모델 파라미터만 교환하십시오. 모델 크기, 참여 클라이언트 수 및 통신 라운드 수를 기준으로 통신 오버헤드를 계산하십시오.
- 파라미터 교환 오버헤드를 해당 멀티모달 헬스케어 데이터 세트 전송의 추정 비용과 비교하십시오. 다음의 요약된 파라미터에 따라 연합 학습 프레임워크를 구성하십시오. 보충 표 4. 연합 학습 워크플로우와 파라미터 집계 과정은 다음에서 설명되어 있습니다. 그림 5.
6. 맞춤형 약물 추천 모듈 구축
- 약리학, 약물, 환자 치료 및 약물 상호작용 데이터를 계산 환경으로 가져옵니다. 환자, 약물, 질환, 실험실 검사 및 임상 위험 요인 노드를 포함하는 이종 헬스케어 그래프를 구축합니다.
- 환자-질환, 환자-약물, 질환-약물, 약물-약물 상호작용 및 환자-실험실 관계를 그래프 에지로 정의합니다. 모델 학습 전 그래프 구조를 검증하고 중복되거나 유효하지 않은 관계, 또는 연결되지 않은 관계를 제거합니다.
- 환자 노드는 연령, 성별, 체질량 지수(BMI), HbA1c, 혈당, 혈압 및 당뇨병 유병 기간을 사용하여 나타냅니다. 약물 노드는 약물 클래스, 작용 기전, 용량, 투여 빈도 및 알려진 부작용을 사용하여 나타냅니다.
- 질환 노드는 질환 중증도, 질환 단계 및 관련 합병증을 사용하여 나타냅니다. GraphSAGE 학습 전 범주형 속성을 인코딩하고 연속적인 노드 특성을 정규화합니다.
- 전처리된 노드 특성을 사용하여 노드 임베딩을 초기화합니다. 이웃 집계 과정 중 각 타겟 노드에 대해 최대 25개의 이웃 노드를 샘플링합니다. 평균 집계를 사용하여 이웃 노드 표현을 집계합니다. 집계된 이웃 표현을 사용하여 타겟 노드 임베딩을 업데이트합니다.
- 각 GraphSAGE 층 이후에 ReLU(rectified linear unit) 활성화 함수를 적용합니다. 생성된 노드 임베딩을 정규화합니다. 세 개의 GraphSAGE 층에 걸쳐 이웃 집계 절차를 반복합니다.
- GraphSAGE 모델을 은닉 차원 256, 임베딩 차원 128, GraphSAGE 층 3개, 이웃 샘플링 크기 25, 드롭아웃 비율 0.30, 학습률 1 × 10⁻4, 배치 크기 512, 최대 학습 에포크 100으로 설정합니다. Adam 옵티마이저를 사용하여 모델을 최적화합니다.
- 학습된 GraphSAGE 모델로부터 환자별 임베딩을 계산합니다. 후보 약물에 대한 임베딩을 계산합니다. 환자 표현과 후보 약물 표현 간의 적합성 점수를 계산합니다. 예측된 적합성 점수에 따라 후보 약물의 순위를 매깁니다.
- 사용 가능한 약물-약물 상호작용 정보를 사용하여 금기 사항이거나 잠재적으로 안전하지 않은 약물을 식별하여 제거합니다. 적격성이 확인된 약물 중 순위가 가장 높은 5가지 약물을 개인 맞춤형 Top-5 추천 약물로 반환합니다.
- BPR(Bayesian Personalized Ranking) 손실을 사용하여 추천 모델을 학습시킵니다. 덜 적합한 후보 약물보다 임상적으로 적절한 약물에 더 높은 점수를 부여하도록 랭킹 목표를 최적화합니다.
- 각 약물 추천에 기여하는 영향력 있는 이웃 노드와 임상적으로 관련 있는 그래프 관계를 식별합니다. 추천에 기여하는 환자, 질환, 실험실 및 약물 관련 특성에 대한 특성 기여도 점수를 계산합니다.
- 각 개인 맞춤형 약물 추천에 기여하는 관계를 보여주는 시각적 그래프 기반 설명을 생성합니다. Supplementary Table 5에 요약된 파라미터에 따라 GraphSAGE 추천 모델을 설정합니다. 그래프 기반 개인 맞춤형 약물 추천 워크플로우는 Figure 6에 도식화되어 있습니다.
7. 설명 가능성 평가 수행
- SHAP 분석 수행
- 훈련된 멀티모달 트랜스포머와 분리된 테스트 데이터셋을 계산 환경에 로드한다.
- 훈련된 예측 모델과 당뇨병 결과 클래스에 따른 층화 무작위 추출법을 사용하여 훈련 데이터셋에서만 단독으로 선택한 100개의 훈련 샘플 배경 샘플을 사용하여 SHAP 설명 도구(explainer)를 초기화한다. 배경 샘플에서 전체 훈련 파티션의 대략적인 클래스 분포를 유지하며, 샘플 선택의 재현성을 보장하기 위해 고정된 랜덤 시드 42를 사용한다. 선택한 테스트 샘플에 대해 SHAP 값을 계산한다.
- 절대 SHAP 값으로부터 전역 특성 중요도(global feature importance)를 계산하고, 전역 및 지역 SHAP 시각화를 생성하며, 이후의 정량적 및 통계적 분석을 위해 계산된 값을 보관한다.
- 통합 그래디언트(Integrated Gradients) 분석 수행
- 분리된 테스트 데이터셋에서 대표적인 정답 분류 샘플과 오분류 샘플을 선택한다. 통합 그래디언트를 계산하기 전에 모달리티별 기준(baseline) 입력을 정의한다. 정규화된 임상 및 CGM 수치 특성에는 정규화된 특성 기여도가 0임을 나타내는 제로 기준(zero baseline)을 사용하고, 정규화된 망막 이미지 입력에는 값이 0인 기준 이미지를 사용한다.
- 기준과 원래 입력 사이의 100단계 보간법을 사용하여 통합 그래디언트 기여도 점수를 계산한다. 특성과 모달리티 간의 비교가 가능하도록 결과 기여도 점수를 정규화한다. 기여도 시각화를 생성하여 개별 모델 예측에 기여하는 영향력 있는 임상, 시간 및 영상 특성을 식별한다.
- 어텐션(Attention) 시각화 수행
- 대표 테스트 샘플에 대해 훈련된 트랜스포머 층에서 어텐션 행렬을 추출한다. 해당 어텐션 헤드 전체에 대한 평균 어텐션 가중치를 계산한다. 임상, 시간 및 망막 영상 표현 간의 교차 모달 상호작용을 시각화하기 위해 어텐션 히트맵을 생성한다. 예측 중에 높은 어텐션 가중치를 받는 지배적인 임상, 시간 및 망막 특성을 식별한다.
- 무작위로 선택된 분리 테스트 샘플에 대해 훈련된 멀티모달 트랜스포머에서 어텐션 가중치를 추출하고, 이에 해당하는 임상 특성, CGM 시간, 망막 공간 및 교차 모달 어텐션 분포를 시각화한다.
- 반사실적 설명(Counterfactual Explanations) 생성
- 분리된 테스트 데이터셋에서 대표 환자 기록을 선택한다. 반사실적 샘플을 생성하기 전에 수정 가능한 환자 특성에 대해 임상적으로 허용 가능한 범위와 제약 조건을 정의한다. 연속형 특성은 관찰된 훈련 데이터 범위로 제한하고, 범주형 특성은 훈련 데이터에서 관찰된 유효한 범주로 제한한다. 연령 및 성별을 포함한 불변의 인구통계학적 특성은 수정하지 않는다.
- 사전에 정의된 임상 및 특성 도메인 제약 조건을 유지하면서 허용된 수정 가능 특성만을 최소한으로 수정하여 반사실적 샘플을 생성한다. 관찰된 훈련 데이터 범위를 벗어난 값, 유효하지 않은 범주 상태 또는 불변 특성에 대한 수정이 포함된 반사실적 샘플은 제외한다. 예측된 결과를 변경하는 데 필요한 임상적으로 타당한 최소한의 특성 수정을 식별한다.
- 수정된 특성, 원래 값, 반사실적 값 및 그에 따른 모델 예측의 변화를 보고한다. 설명 가능성 평가 워크플로우는 그림 7에 예시되어 있으며, 대표적인 어텐션 시각화 및 반사실적 설명 출력 결과는 부록 그림 1에 제시되어 있다.
- 설명 품질 평가
- 생성된 설명과 예측 모델의 동작 사이의 일치도를 정량화하기 위해 충실도(fidelity)를 계산한다. 작은 입력 섭동 하에서 반복적으로 설명을 생성하고 결과 기여도 패턴을 비교하여 안정성(stability)을 계산한다. 임상적으로 유사한 테스트 샘플에 대해 생성된 설명을 비교하여 일관성(consistency)을 평가한다.
- 각 설명에 실질적으로 기여하는 특성의 수 또는 비율을 결정하여 희소성(sparsity)을 계산한다. 기여 특성이 해당 모델 출력을 충분히 설명하는지 확인하기 위해 완전성(completeness)을 평가한다. 입력 특성의 제어된 섭동에 따른 기여도 점수의 변화를 측정하여 민감도(sensitivity)를 평가한다.
- 특성 기여도와 관찰된 모델 예측 변화 사이의 불일치를 정량화하기 위해 불충실도(infidelity)를 계산한다. 이후의 통계 분석을 위해 모든 정량적 설명 가능성 지표를 기록한다.
- 전향적 임상 전문가 검증 수행
- 향후 전향적 임상 검증을 위해, 임상 전문가를 모집하기 전 해당 기관 윤리 위원회의 승인을 받는다. 윤리적 승인을 얻은 후 내분비학 전문의 6명, 당뇨병 전문가 3명, 임상 약리학자 3명으로 구성된 12명의 임상 의사를 모집하고, 평가를 시작하기 전 모든 참여자로부터 고지된 동의서를 받는다.
- 임상 의사 평가를 위해 대표적인 모델 예측과 그에 해당하는 설명을 무작위로 선택한다. 선택된 설명을 표준화된 평가 형식을 사용하여 각 참여 임상 의사에게 독립적으로 제시한다.
- 각 임상 의사에게 5점 리커트 척도(Likert scale)를 사용하여 설명의 유용성, 임상적 관련성, 해석 가능성 및 신뢰성을 평가하도록 요청한다. 익명화된 임상 의사 평가 점수를 기록하고, 단계 7.7에 명시된 대로 평가자 간 일치도 및 해당 통계 지표를 계산한다.
- 통계 분석 수행
- 통계적 비교 검정 방법을 선택하기 전에 정량적 평가 점수의 분포를 평가한다. 적절하게, 정규 분포를 따르는 쌍체 측정치에는 대응 표본 t-검정(paired t-test)을 적용하고, 정규 분포를 따르지 않는 쌍체 측정치에는 윌콕슨 부호 순위 검정(Wilcoxon signed-rank test)을 적용한다.
- 참여 임상 의사 간의 평가자 간 일치도를 정량화하기 위해 Fleiss' kappa를 계산한다. 주요 설명 가능성 및 임상 의사 평가 지표에 대한 95% 신뢰 구간을 계산한다. 통계적 유의성 임계값은 p < 0.05로 설정한다.
- 계산된 검정 통계량, 신뢰 구간 및 p-값을 해당 평가 결과와 함께 보고한다. 부록 표 6에 요약된 기준에 따라 설명 가능성 지표를 평가하고 보고한다.
8. 모델 성능 평가
- FedMediFormer-XAI를 Logistic Regression, Random Forest, XGBoost, TabTransformer, Vision Transformer, Temporal Transformer 및 중앙 집중식 멀티모달 트랜스포머와 비교하고, accuracy, precision, recall, F1-score, MCC, AUC-ROC를 사용하여 평가한다.
- 제안된 프레임워크와 일관된 비교를 보장하기 위해, 동일하게 사전 정의된 훈련, 검증 및 테스트 전략을 사용하여 각 베이스라인 평가를 수행한다.
- 독립적인 실험 실행을 통해 모델 평가를 반복하고, 각 실행에서 얻은 성능 지표를 기록한다. Accuracy, Precision, Recall, F1-score, MCC, AUC-ROC에 대한 평균, 표준 편차(SD) 및 95% 신뢰 구간(CI)을 계산한다. 성능 결과는 평균 ± SD와 그에 해당하는 95% CI로 보고한다.
- FedMediFormer-XAI와 각 베이스라인 모델 간의 쌍을 이룬 성능 차이의 정규성을 평가한다. 정규 분포를 따르는 쌍 측정치에는 paired t-test를 적용하고, 비정규 분포를 따르는 쌍 측정치에는 Wilcoxon signed-rank test를 적용한다. 통계적 유의성 임계값은 p < 0.05로 설정한다.
- 관찰된 성능 차이의 통계적 유의성과 불확실성을 정량화하기 위해 해당 검정 통계량, p-value 및 95% 신뢰 구간을 보고한다.
- 모델이 최종적으로 수렴할 때까지의 모든 통신 라운드 횟수를 산출한다. 연합 학습 중에 글로벌 모델의 성능이 어떻게 나타나는지 모니터링한다. 통신 라운드에 따라 수렴 양상이 시간에 따라 어떻게 변화하는지 연구한다.
- 파라미터 집계가 얼마나 잘 작동하는지 확인한다. 분산 학습이 예측 성능에 미치는 영향을 조사한다. 연합 학습과 중앙 집중식 학습의 결과를 비교한다.
- 통신 라운드에 따른 연합 수렴도를 평가하고, 연합 예측 성능과 중앙 집중식 예측 성능을 비교한다. Precision@5, Recall@5, NDCG@5를 사용하여 약물 추천 성능을 평가한다.
- 해당 환자에 대해 양성 환자-약물 상호작용으로 관찰되지 않은 약물을 적격 후보 약물 풀에서 선택하여 음성 샘플-약물 샘플을 생성한다. 음성 샘플링 풀에서 모든 알려진 양성 상호작용과 모든 금기 약물을 제외한다. 추천 훈련을 위해 음성 대 양성 샘플링 비율을 1:1로 고정하여 유지하며, 재현 가능한 음성 샘플 선택을 위해 42의 고정 랜덤 시드를 사용한다.
- 홀드아웃 평가 데이터만을 사용하여 각 환자에 대한 관련 항목 집합을 구축한다. 환자 u에 대한 관련 항목 집합 Ru를 홀드아웃 정답 기록에서 양성 환자-약물 기준을 충족하는 약물 집합으로 정의한다. Ru를 구축하는 데 모델 예측을 사용하지 않는다. 순위를 매기기 전에 후보 추천 집합에서 금기 약물을 제거한다.
- 각 평가 환자에 대해 순위가 가장 높은 적격 약물 5개를 생성한다. Precision@5를 추천된 5개의 약물 중 환자의 관련 항목 집합 Ru에 속하는 약물의 비율로 계산한다. Recall@5를 5개의 추천 약물 중 검색된 환자의 관련 약물 비율로 계산한다. 추천된 약물의 등급화된 관련성을 사용하여 NDCG@5를 계산하며, 임상적으로 적절한 약물에는 높은 관련성을, 관련 없는 약물에는 0의 관련성을 부여한다. 모든 평가 환자에 대해 지표를 집계하고 평균 Precision@5, Recall@5, NDCG@5를 보고한다.
- 모델 평가 전에 추천 정답(ground truth)을 구축하고, 홀드아웃 환자-약물 상호작용을 추천 훈련 데이터와 분리하여 유지한다. GraphSAGE 훈련, 음성 샘플링 또는 후보 순위 지정 중에 테스트 세트의 약물 상호작용, 테스트 세트 레이블 또는 향후 치료 정보를 사용하지 않는다.
- 설명이 모델의 동작과 얼마나 잘 일치하는지 확인하기 위해 Fidelity를 측정한다. 여러 차례의 검토를 통해 설명의 안정성을 평가한다. 의사 중심의 기준을 바탕으로 Comprehensibility를 판단한다.
- 다양한 유형의 데이터에 대해 설명이 얼마나 일관된지 조사한다. 생성된 설명의 임상적 가치를 확인한다. 연구 전반에 사용된 평가 지표는 Supplementary Table 7에 요약되어 있다.
9. 전향적 임상의 검증 수행
- 적절한 윤리 승인 및 고지된 동의를 얻은 후, 단계 7.6–7.8에 설명된 모집, 평가, 데이터 수집 및 통계 분석 절차에 따라 전향적 임상의 검증을 수행합니다. 참여자 구성, 평가 기준, 비교 조건 및 계획된 통계 분석을 포함한 전향적 임상의 검증 설계는 보충 표 8에 요약되어 있습니다.
10. 검증 및 재현성 평가 수행
- 동일한 데이터셋 분할, 전처리 절차, 훈련 설정 및 평가 기준을 유지하면서 전체 FedMediFormer-XAI 프레임워크에서 개별 구성 요소를 체계적으로 제거하여 어블레이션 연구(ablation studies)를 수행하십시오. 전체 모델과 더불어 확산 증강(diffusion augmentation), 연합 학습(federated learning), GraphSAGE 기반 약물 추천, 그리고 멀티모달 퓨전(multimodal fusion)이 제외된 구성 설정들에 대해 평가하십시오.
- 정확도(Accuracy), 정밀도(Precision), 재현율(Recall), F1-스코어(F1-score), MCC 및 AUC-ROC를 사용하여 절제 구성(ablated configurations)을 전체 FedMediFormer-XAI 프레임워크와 비교하십시오. 각 성능 지표의 변화량을 정량화하여 프레임워크 각 구성 요소의 기여도를 결정하십시오. 일반화 가능성을 평가하기 위해 검증 결과와 내부 테스트 결과를 비교하십시오. 관찰된 성능 차이의 신뢰성을 결정하기 위해 통계적 유의성 검정을 수행하십시오.
- 호환 가능한 입력 변수 및 결과 정의를 가진 독립적인 외부 데이터셋을 사용할 수 있는 경우, 이를 통해 프레임워크의 일반화 가능성을 평가하십시오. 내부 테스트 데이터셋에 사용된 것과 동일한 전처리 및 평가 절차를 적용하고, 그 결과로 도출된 성능 지표를 내부 테스트 결과와 비교하십시오.
- 반복 실험 실행 간의 통계적 유의성 분석을 수행하십시오. 통계 검정 전, 쌍을 이룬 성능 차이의 정규성을 평가하십시오. 정규 분포를 따르는 쌍 측정치에는 대응표본 t-검정을 적용하고, 정규 분포를 따르지 않는 쌍 측정치에는 윌콕슨 부호 순위 검정을 적용하십시오. 통계적 유의성 임계값은 p < 0.05로 설정하십시오. < 0.05.
- 정확도(Accuracy), 정밀도(Precision), 재현율(Recall), F1-점수(F1-score), MCC 및 AUC-ROC에 대한 평균과 95% 신뢰구간을 계산하십시오. 주요 모델 비교에 대한 해당 검정 통계량, p-값 및 신뢰구간을 보고하십시오. 보고된 실험을 재현하는 데 필요한 모든 모델 매개변수, 전처리 과정, 훈련 설정 및 평가 프로토콜을 기록하십시오.
- 보고된 실험에 사용된 소스 코드, 설정 파일, 평가 스크립트 및 학습된 모델 사양을 보존하십시오. 모델 학습, 실험 설정, 랜덤 시드 및 평가 결과에 대한 상세한 기록을 유지하십시오.
- 가용한 재현성 자료의 완전성과 일관성을 검증하십시오. 문서화된 방법과 재료가 실험 워크플로우를 독립적으로 재현하는 데 필요한 충분한 정보를 제공하는지 확인하십시오.
- 본 연구에 사용된 재현성 리소스 및 검증 절차를 요약하십시오. 보충 표 9주요 프레임워크 구성 요소의 기여도를 평가하기 위한 어블레이션 연구(ablation study) 절차와 평가 기준을 기록하십시오.
결과
예측 성능 분석
FedMediFormer-XAI는 평가된 단일 모달 및 기존 베이스라인 모델과 비교하여 향상된 예측 성능을 보여주었습니다. 확산 기반 증강(Diffusion-based augmentation)을 통해 소수 클래스의 표현력이 개선되었으며, 그 결과로 나타난 예측 성능은 Table 3에 요약되어 있습니다. 반복 실행 평가 결과, 평가된 모든 모델에서 안정적인 예측 성능이 확인되었습니다. FedMediFormer-XAI는 정확도 94.20 ± 0.34% (95% CI: 93.78–94.62), 정밀도 93.10 ± 0.30% (95% CI: 92.73–93.47), 재현율 92.80 ± 0.28% (95% CI: 92.45–93.15), F1-score 92.90 ± 0.28% (95% CI: 92.5–93.25)로 가장 높은 종합 성능을 달성했습니다. 또한, 이 모델은 MCC 0.8 ± 0.02 (95% CI: 0.86–0.90)와 AUC-ROC 0.96 ± 0.01 (95% CI: 0.95–0.97)를 기록했습니다. 중앙 집중형 멀티모달 트랜스포머가 그다음으로 좋은 종합 성능을 보인 반면, 단일 모달 및 기존 머신러닝 모델들은 상대적으로 낮은 예측 성능을 나타냈습니다. 이러한 결과는 연합 최적화(federated optimization)와 결합된 멀티모달 표현 학습이 더 향상되고 안정적인 당뇨병 분류 성능을 제공함을 시사합니다.
어블레이션 연구
확산 증강(diffusion augmentation), 연합 학습(federated learning), GraphSAGE 기반 약물 추천 및 멀티모달 융합의 기여도를 평가하기 위해 구성 요소별 어블레이션 분석을 수행하였다. 전체 FedMediFormer-XAI 프레임워크는 5회의 독립적인 실행 결과 정확도 94.20 ± 0.34%, 정밀도 93.10 ± 0.30%, 재현율 92.80 ± 0.28%, F1-score 92.90 ± 0.28%, MCC 0.8 ± 0.02, AUC-ROC 0.96 ± 0.01을 달성하였다. 확산 증강을 제거했을 때 정확도는 91.80 ± 0.42%로 낮아져 2.40%포인트 감소하였으며, F1-score와 AUC-ROC는 각각 90.30 ± 0.38%와 0.94 ± 0.01로 감소하였다. 이러한 감소는 소수 클래스 표현력과 예측 강건성에 대한 확산 기반 증강의 기여를 나타낸다.
연합 학습(federated learning)을 제거했을 때 정확도는 93.10 ± 0.37%로 나타났으며, 이는 전체 프레임워크 대비 1.10% 포인트 감소한 수치입니다. 정밀도(Precision), 재현율(recall), F1-score, MCC 및 AUC-ROC 또한 각각 92.20 ± 0.34%, 91.80 ± 0.32%, 92.0 ± 0.3%, 0.86 ± 0.02, 0.95 ± 0.01로 감소했습니다. 이러한 비교는 예측 성능에 있어 연합 구성의 기여도를 입증합니다.
GraphSAGE 기반의 개인 맞춤형 약물 추천 구성 요소를 제거했을 때 당뇨병 예측 성능은 비교적 적게 변화하였으며, 정확도는 93.80 ± 0.35%, F1-score는 92.60 ± 0.30%로 감소하였습니다. 이에 해당하는 MCC 및 AUC-ROC는 각각 0.87 ± 0.02와 0.96 ± 0.01이었습니다. 이러한 결과는 GraphSAGE가 당뇨병 분류 성능을 직접적으로 결정하기보다는 주로 개인 맞춤형 약물 추천에 기여한다는 것을 나타냅니다.
멀티모달 퓨전(multimodal fusion)을 제거했을 때 가장 큰 감소가 관찰되었습니다. 정확도는 87.60 ± 0.5%로 감소하여 6.60 퍼센트 포인트의 하락을 보였으며, 정밀도(precision), 재현율(recall), F1-score, MCC 및 AUC-ROC는 각각 86.80 ± 0.51%, 85.90 ± 0.54%, 86.30 ± 0.52%, 0.76 ± 0.03, 0.91 ± 0.01로 감소했습니다. 이러한 결과는 임상, CGM 및 망막 모달리티의 상호 보완적인 정보를 공동으로 모델링하는 것이 중요하다는 점을 입증합니다.
연합 학습 분석
연합 학습 프레임워크를 통해 원본 환자 데이터의 분산 처리를 유지하면서 분산된 클라이언트 간의 협업 모델 학습이 가능했다. 학습 과정에서 각 클라이언트의 로컬 모델은 개별적으로 미세 조정되었으며, Federated Averaging 방법을 통해 결합되었다. 10회의 통신 라운드 후 글로벌 모델이 수렴하였으며, 예측 성능은 중앙 집중식 학습과 일관되게 유지되었다. 연합 학습 프레임워크는 클라이언트 데이터 분포가 이질적임에도 불구하고 통신 라운드 전반에 걸쳐 안정적인 수렴을 보여주었다. 보호된 파라미터 교환을 통해 데이터 분산 처리가 유지되었으며, 글로벌 모델은 중앙 집중식 베이스라인 대비 경쟁력 있는 예측 성능을 유지했다. 표 4는 중앙 집중식 구현과 연합 학습 구현을 비교한 것이다. 연합 학습은 통신 오버헤드로 인해 추가적인 학습 시간이 필요했으나, 중앙 집중식 학습과 대등한 예측 성능을 유지했다.
데이터셋 수준의 성능 분석
다양한 의료 모달리티 전반의 일반화 가능성을 평가하기 위해, 각 데이터셋에 대한 성능을 개별적으로 분석하였다. 멀티모달 FedMediFormer-XAI 모델은 평가된 데이터셋 전반에서 강력하고 대체로 경쟁력 있는 성능을 입증하였다. 이 모델은 Pima Indians Diabetes, CDC Diabetes Health Indicators, OhioT1DM, APTOS 2019 데이터셋에서 각각 91.8%, 93.1%, 92.4%, 94.2%의 정확도를 달성하였다. APTOS 2019 데이터셋의 경우 단일 모달리티일 때 멀티모달 모델보다 약간 더 높은 정확도(94.7%)와 정밀도(93.9%)를 기록하였으나, 제안된 멀티모달 접근 방식은 모든 데이터셋에서 경쟁력 있는 성능을 유지하였으며, 가장 높은 데이터셋 수준의 AUC-ROC와 유사한 0.96의 AUC-ROC를 달성하였다. 데이터셋 수준의 전반적인 결과는 표 5에 제시되어 있다. 단일 데이터셋의 경우 망막 이미지 분석을 단독으로 사용했을 때 가장 좋은 성능을 보인 반면, 멀티모달 융합은 가장 안정적이고 균형 잡힌 예측 결과를 생성하였다.
개인 맞춤형 약물 추천 분석
그래프 신경망 기반의 추천 구성 요소는 약물 효능 정보와 약물 상호작용 데이터를 사용하여 평가되었으며, 학습된 환자-약물 적합성 점수에 따라 후보 약물의 순위를 매기고 추천 생성 과정에서 금기 조합을 제외하였습니다. 이종 그래프 형식을 사용하고 환자-약물 및 약물-약물 상호작용을 모델링함으로써 개인 맞춤형 약물 선택과 안전성 평가를 철저하게 지원할 수 있었습니다. GraphSAGE 추천 모델은 환자, 질병, 검사 결과 및 약물 간의 복잡한 관계를 효과적으로 포착하였습니다. 개인 맞춤형 추천은 그래프 이웃 분석과 특성 기여도를 통해 임상적으로 유의미한 설명을 유지하는 동시에 높은 순위 지정 성능을 입증하였습니다.
표 6에 따르면, 개인 맞춤형 약물 추천 모듈은 Precision@5, Recall@5 및 NDCG@5를 사용하여 평가되었습니다. 이러한 지표는 GraphSAGE 기반 추천 모듈에서 생성된 상위 5개 개인 맞춤형 약물 추천의 관련성과 순위 품질을 정량화합니다. 해당 추천 시스템은 precision = 0.89, recall = 0.84, NDCG = 0.91로 우수한 순위 성능을 달성했습니다.
설명 가능성 분석
본 프레임워크는 다중 모달 예측의 해석을 지원하기 위해 SHAP, Integrated Gradients, 어텐션 시각화 및 반사실적 설명을 통합하였습니다. SHAP는 특성 수준의 기여도를 정량화하는 데 사용되었고, Integrated Gradients는 예측 결과를 입력 특성에 할당하는 데 사용되었으며, 어텐션 시각화는 모달리티 전반에 걸친 모델의 집중도를 조사하는 데, 그리고 반사실적 설명은 대안적 예측과 관련된 특성 변화를 식별하는 데 사용되었습니다. 그림 8은 학습된 FedMediFormer-XAI 모델에서 생성된 대표적인 모델 유도 SHAP 요약 도표를 나타내며, 그림 9는 학습된 트랜스포머에서 추출한 대표적인 어텐션 시각화 결과를 보여줍니다. 이 그림들은 제안된 아키텍처의 도식적 그림이 아니라 모델 평가를 통해 얻은 출력 결과입니다.
그림 8에는 특성 중요도의 집계 수준 순위가 제시되어 있습니다. 절대 SHAP 값이 더 높은 특성일수록 모델 예측에 더 큰 영향을 미쳤으며, 이는 기존의 임상 지식과도 잘 일치했습니다.
그림 9는 무작위로 선택된 홀드아웃 테스트 샘플에 대해 학습된 FedMediFormer-XAI 모델에서 직접 추출한 대표적인 어텐션 시각화 결과를 보여줍니다. 시각화에는 임상 특징 어텐션, CGM 시간적 어텐션, 망막 공간적 어텐션, 그리고 세 가지 모달리티 간의 교차 모달리티 어텐션이 포함됩니다. 어텐션 시각화는 여러 모달리티에 걸쳐 모델이 학습한 어텐션 할당 방식을 추가로 입증했습니다. 선택된 샘플은 임상 특징 중 HbA1c, 당뇨병 유병 기간, 연령에 상대적으로 더 높은 어텐션을 보였으며, CGM 어텐션 맵은 포도당 변동성이 두드러진 여러 기간을 강조했습니다. 망막 어텐션 맵은 모델 표현에 기여하는 특정 이미지 영역을 식별하였고, 교차 모달리티 어텐션 행렬은 모달리티 내 및 모달리티 간 어텐션 패턴을 모두 보여주었습니다. 그림 9에 나타난 바와 같이, 모델에서 도출된 대표적인 어텐션 맵은 홀드아웃 테스트 샘플에서 선택된 시간적 포도당 패턴, 영향력 있는 임상 변수 및 진단적으로 관련 있는 망막 이미지 영역을 강조합니다.
인간 중심 평가 결과
예측 전용 조건과 예측 및 설명 제공 조건 하에서 임상의의 신뢰도, 해석 가능성, 사용성, 임상적 유용성 및 설명의 관련성을 평가하기 위해 전향적 인간 중심 평가 프로토콜이 설계되었습니다. 제안된 평가는 기관윤리위원회의 적절한 승인과 고지된 동의를 거쳐 내분비학자, 당뇨병 전문가 및 임상 약리학자가 참여하게 됩니다. 본 평가는 향후 전향적 시행을 목적으로 하므로, 본 프로토콜에서는 임상의 수준의 결과 점수를 보고하지 않습니다.
표 7은 제안된 전향적 임상의 평가 설계와 설명이 임상의의 신뢰도, 해석 가능성 및 인지된 유용성에 미치는 영향을 평가하기 위한 사전 정의된 기준을 요약한 것입니다. 이 전향적 평가는 사전 정의된 리커트 척도 기준을 사용하여, 설명이 수반된 모델 예측과 수반되지 않은 모델 예측에 대한 임상의의 평가를 비교할 것입니다. 제안된 전향적 인간 중심 설명 가능성 평가 프레임워크는 그림 10에 제시되어 있습니다.
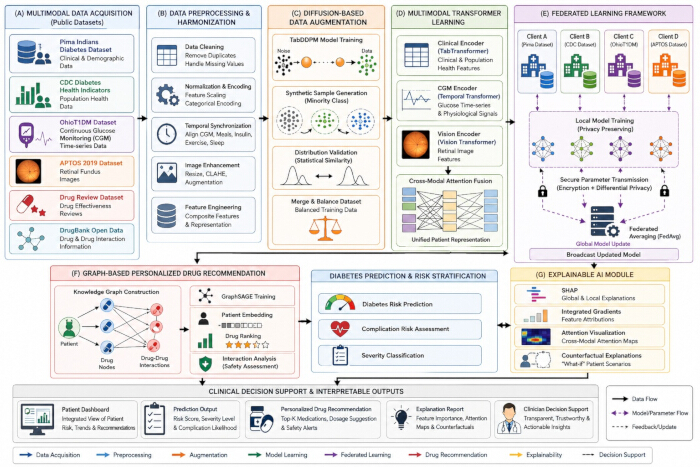
그림 1전체 FedMediFormer-XAI 프레임워크 아키텍처. FedMediFormer-XAI 프레임워크의 도식적 개요로, 다중 모달 데이터 수집 및 전처리, 확산 기반 증강, 모달리티별 트랜스포머 학습, 연합 모델 훈련, GraphSAGE 기반 개인 맞춤형 약물 추천 및 설명 가능성 분석을 보여준다. 이 프레임워크는 당뇨병 예측, 개인 맞춤형 약물 추천 및 해석 가능한 모델 출력을 생성한다. 이 그림의 확대 버전을 보시려면 여기를 클릭하십시오.
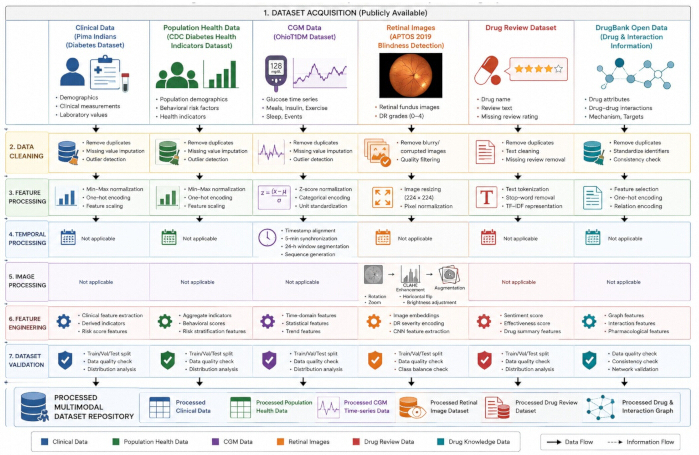
그림 2다중 모달 데이터셋 획득 및 전처리 파이프라인. FedMediFormer-XAI에 사용된 다중 모달 데이터셋의 획득 및 전처리 단계에 대한 모식도. 임상 및 인구 보건 데이터, CGM 기록, 망막 영상 및 약물 정보는 모달리티별 품질 관리, 전처리, 정규화, 인코딩 및 증강 과정을 거쳐 하위 분석을 위한 모델 준비 표현형으로 변환된다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
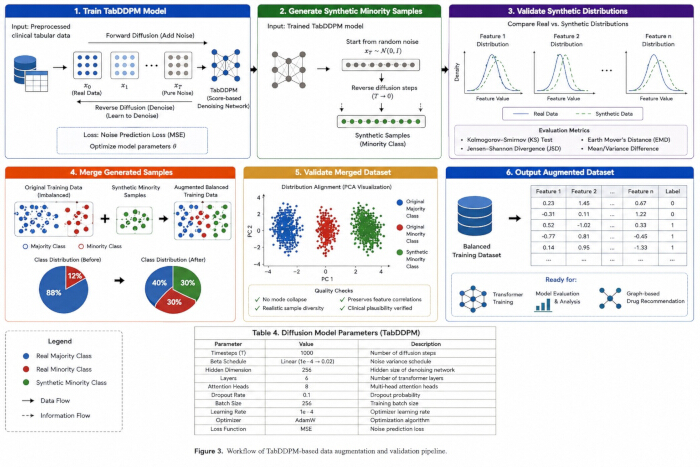
그림 3: 확산 기반 데이터 증강 워크플로. TabDDPM을 이용한 구조화된 표 형식 훈련 데이터의 확산 기반 증강에 대한 도식적 워크플로. 생성된 샘플은 품질 및 분포 유사성 평가를 거친 후, 클래스 불균형을 개선하기 위해 기존 훈련 데이터와 통합된다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
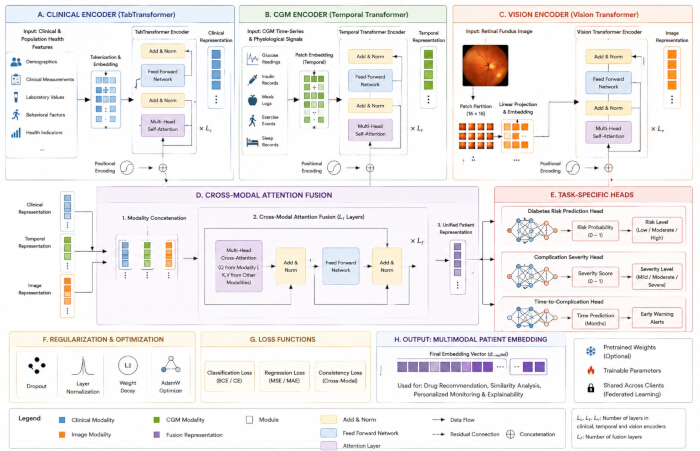
그림 4제안된 멀티모달 트랜스포머 프레임워크의 구조. 다음으로 구성된 도식적 구조: (A) 임상 데이터를 위한 TabTransformer 인코더, (B) CGM 데이터를 위한 시간적 트랜스포머 인코더 및 (C) 망막 영상을 위한 비전 트랜스포머(Vision Transformer) 인코더. (D) 양식별 표현은 교차 양식 주의 집중(cross-modal attention)을 통해 통합되어 단일한 다중 양식 표현을 생성합니다. (E) 작업 특화 예측 헤드가 모델 출력을 생성합니다. (F) 정규화 및 최적화 구성 요소는 모델 학습을 지원하며, (G분류, 회귀 및 교차 모달 일관성 손실이 최적화 과정을 유도합니다. 이를 통해 생성된 다중 모달 표현은 하위의 예측, 추천 및 설명 가능성 태스크를 지원합니다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
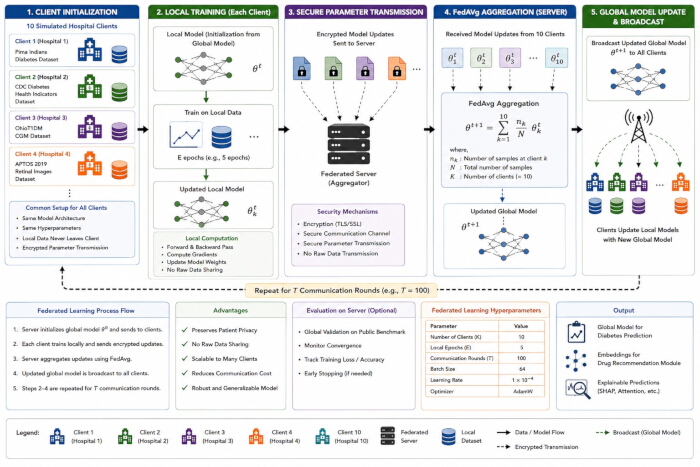
그림 5연합 학습 통신 프레임워크. 분산된 병원 클라이언트 간의 연합 학습을 위한 도식적 워크플로. 각 클라이언트의 특정 데이터를 사용하여 로컬 멀티모달 모델을 학습시키고, 보호된 모델 업데이트 사항을 중앙 서버로 전송하여 연합 평균화(Federated Averaging)를 수행한다. 집계된 글로벌 모델은 이후의 통신 라운드를 위해 클라이언트로 다시 배포된다. 또한, 이 프레임워크는 보안 파라미터 교환과 개인정보 보호, 통신 및 계산 요구 사항에 대한 평가 과정을 보여준다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
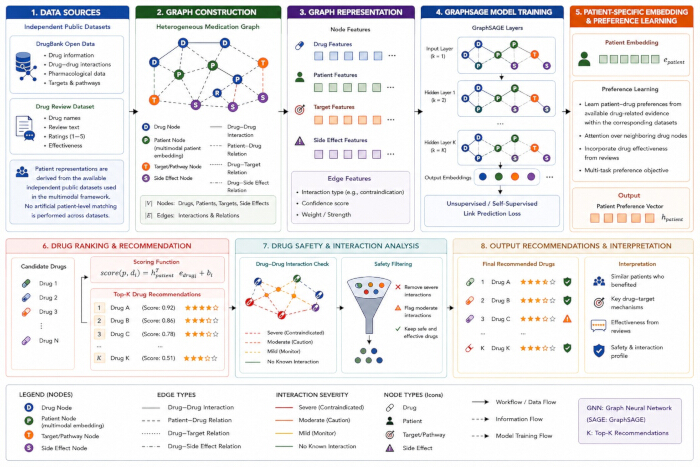
그림 6그래프 기반 개인 맞춤형 약물 추천 워크플로우. GraphSAGE 기반 개인 맞춤형 약물 추천의 도식적 워크플로. 약리학 및 환자 표현 데이터는 관련 의료 엔티와 관계를 포함하는 이종 그래프로 구성된다. GraphSAGE는 환자 및 약물 표현을 학습하며, 이는 환자-약물 적합성 점수를 계산하고 후보 약물의 순위를 매기는 데 사용된다. 최종 Top-K 추천 목록을 생성하기 전 금기 약물 또는 안전하지 않은 약물 조합이 필터링되며, 그래프 기반 정보가 추천 결과의 해석을 뒷받침한다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
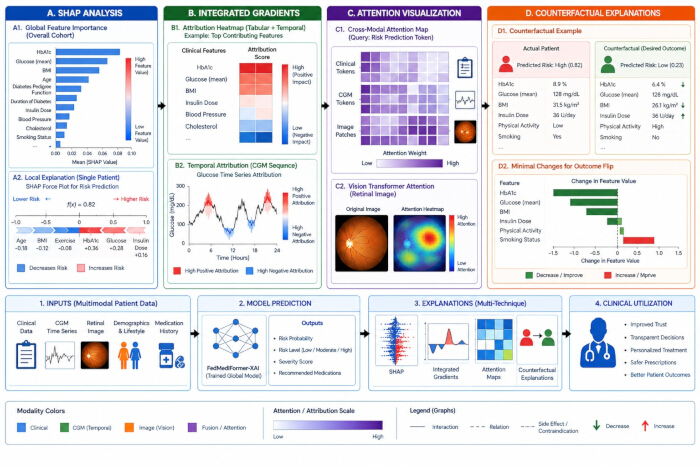
그림 7설명 가능성 평가 프레임워크. 설명 가능성 워크플로의 도식적 개요. (A) SHAP 분석은 전역 및 지역 특성 기여도를 평가합니다; (B) Integrated Gradients는 속성 기반 설명을 제공합니다; (C) 어텐션 시각화를 통해 영향력 있는 특성과 모달리티 간 상호작용을 식별하며; (D) 반사실적 분석은 변경된 예측과 연관된 특성 변화를 식별합니다. 그 결과로 도출된 설명 출력물은 모델 예측의 해석과 개인 맞춤형 추천을 지원합니다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
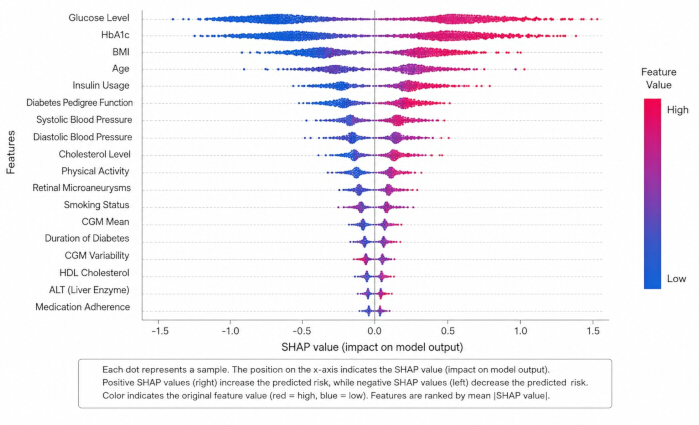
그림 8훈련된 FedMediFormer-XAI 모델에 의해 생성된 대표적인 모델 유래 SHAP 특성 중요도 분석SHAP 요약 도표는 평가된 샘플 전반에 걸친 SHAP 값의 분포를 보여주며, 특성들은 평균 절대 SHAP 기여도에 따라 순위가 매겨집니다. 양수의 SHAP 값은 예측된 당뇨병 위험도를 높이는 방향으로의 기여를 나타내며, 음수 값은 예측 위험도를 낮추는 방향으로의 기여를 나타냅니다. 색상은 해당 특성 값을 나타내며, 높은 특성 값은 빨간색으로, 낮은 값은 파란색으로 표시됩니다. 이 도표는 도식적인 삽화가 아니라 실제 모델에서 도출된 설명 가능성 출력물을 나타냅니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
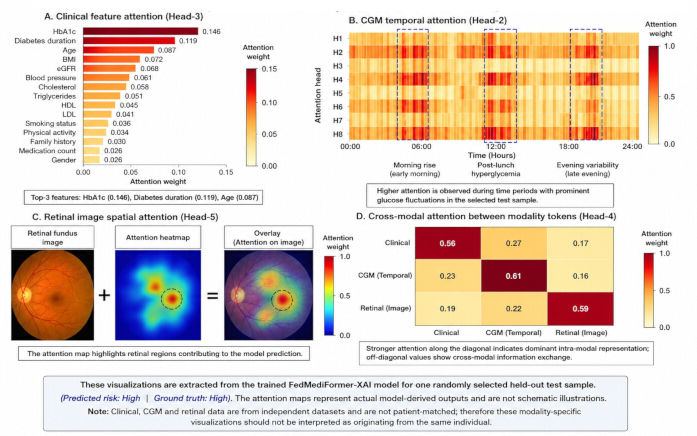
그림 9무작위로 선택된 하나의 홀드아웃 테스트 샘플에 대해 훈련된 FedMediFormer-XAI 모델이 생성한 대표 어텐션 출력값. (A) 멀티모달 트랜스포머의 어텐션 헤드에서 얻은 임상적 특징 어텐션으로, 임상적 특징에 할당된 상대적 어텐션 가중치를 보여줌. (B) CGM 시퀀스 전반의 시간적 어텐션(temporal attention)으로, 모델의 어텐션이 더 높게 나타나는 시간대를 보여줌. (C) 원본 이미지, 어텐션 히트맵 및 어텐션 오버레이를 포함한 망막저 이미지의 공간 어텐션. (D) 임상, CGM 및 망막 모달리티 토큰 간의 교차 모달리티 어텐션(cross-modal attention)으로, 모달리티 내 정보 및 모달리티 간 정보의 가중치를 보여준다. 표시된 시각화 자료는 학습된 모델에 의해 생성된 모델 도출 출력물이다. 어텐션 가중치는 선택된 테스트 샘플에 대해 표시되었으며, 이는 임상적 인과 관계의 독립적인 측정치가 아니라 모델의 어텐션 패턴으로 해석해야 한다. 이 그림의 확대 버전을 보시려면 여기를 클릭하십시오.
| 데이터셋 | 데이터 유형 | 샘플/레코드 | 특징/내용 | 목적 | 공개 가능 여부 |
| Pima Indians Diabetes Dataset | 임상 표 데이터 | 768 patients | 8개 임상 변수 | 당뇨병 위험 예측 | 공개 |
| CDC Diabetes Health Indicators | 인구 건강 데이터 | 253,680 records | 인구통계, 라이프스타일, 건강 지표 | 인구 위험 분석 | 공개 |
| OhioT1DM Dataset | CGM 시계열 데이터 | 12 subjects | 포도당, 인슐린, 식사, 운동, 수면 | 시계열 당뇨병 모델링 | 공개 |
| APTOS 2019 Blindness Detection | 망막 이미지 | 3,62 images | 중증도 라벨이 포함된 안저 사진 | 당뇨망막병증 분석 | 공개 |
| Drug Review Dataset | 약리학 데이터 | 215,063 reviews | 약물 효과, 평점, 리뷰 | 약물 추천 | 공개 |
| DrugBank Open Data | 약물 지식 그래프 | 수천 개의 약물 | 약물-약물 상호작용, 표적, 경로 | 그래프 구축 | 공개/학술적 접근 |
표 1: 데이터셋 특성. 데이터셋 유형, 샘플 크기, 데이터 모달리티, 특징 콘텐츠, 목적 및 가용성을 포함하여 본 연구에 사용된 공개 데이터셋의 요약.
| 데이터셋 | 양상 | 예측 대상 | 융합 수준 |
| 피마 인디언 당뇨병 | 임상 | 당뇨병 분류 | 특징 임베딩 |
| CDC 당뇨병 건강 지표 | 인구 건강 | 당뇨병 위험 예측 | 특징 임베딩 |
| OhioT1DM | 연속 혈당 측정 | 포도당 추세 예측 | 특징 임베딩 |
| APTOS 2019 | 망막 저저 영상 | 당뇨망막병증 분석 | 특징 임베딩 |
| 약물 리뷰 + DrugBank | 약리학적 | 약물 추천 | 그래프 임베딩 |
표 2: 다중모드 데이터셋 통합 전략. 데이터 모달리티, 예측 대상 및 모달리티별 표현이 통합되는 수준을 포함하여 다중모드 당뇨병 인텔리전스에 사용된 데이터셋의 요약이다. 임상, 인구 건강, 연속 혈당 측정 및 망막 이미지 데이터는 특성 임베딩으로 표현되는 반면, 약물 정보는 개인 맞춤형 약물 추천을 위해 그래프 임베딩을 통해 통합된다.
| 모델 | 정확도, 평균 ± 표준편차 (95% 신뢰구간) | 정밀도, 평균 ± 표준편차 (95% 신뢰구간) | 재현율, 평균 ± 표준편차 (95% 신뢰구간) | F1-스코어, 평균 ± 표준편차 (95% 신뢰구간) | MCC, 평균 ± 표준편차 (95% 신뢰구간) | AUC-ROC, 평균 ± 표준편차 (95% 신뢰구간) |
| 랜덤 포레스트 | 83.60 ± 0.74 (82.68–84.52) | 82.70 ± 0.60 (81.96–83.44) | 81.90 ± 0.56 (81.21–82.59) | 82.30 ± 0.56 (81.61–82.99) | 0.67 ± 0.03 (0.63–0.71) | 0.88 ± 0.01 (0.87–0.89) |
| XGBoost | 85.30 ± 0.71 (84.42–86.18) | 84.70 ± 0.60 (83.96–85.44) | 83.80 ± 0.56 (83.11–84.49) | 84.20 ± 0.56 (83.51–84.89) | 0.70 ± 0.03 (0.66–0.74) | 0.90 ± 0.01 (0.89–0.91) |
| TabTransformer | 87.50 ± 0.52 (86.85–88.15) | 87.00 ± 0.60 (86.26–87.74) | 86.20 ± 0.56 (85.51–86.89) | 86.60 ± 0.56 (85.91–87.29) | 0.75 ± 0.03 (0.71–0.79) | 0.92 ± 0.01 (0.91–0.93) |
| 비전 트랜스포머 | 88.80 ± 0.50 (88.18–89.42) | 88.20 ± 0.60 (87.46–88.94) | 87.60 ± 0.56 (86.91–88.29) | 87.90 ± 0.56 (87.21–88.59) | 0.78 ± 0.03 (0.74–0.82) | 0.93 ± 0.01 (0.92–0.94) |
| 시계열 트랜스포머 | 87.20 ± 0.51 (86.57–87.83) | 86.60 ± 0.60 (85.86–87.34) | 85.90 ± 0.56 (85.21–86.59) | 86.20 ± 0.56 (85.51–86.89) | 0.74 ± 0.03 (0.70–0.78) | 0.91 ± 0.01 (0.90–0.92) |
| CNN-LSTM | 86.90 ± 0.58 (86.18–87.62) | 86.30 ± 0.60 (85.56–87.04) | 85.60 ± 0.55 (84.92–86.28) | 85.90 ± 0.56 (85.21–86.59) | 0.73 ± 0.03 (0.69–0.77) | 0.91 ± 0.01 (0.90–0.92) |
| 중앙 집중식 멀티모달 트랜스포머 | 91.30 ± 0.12 (91.15–91.45) | 90.70 ± 0.60 (89.96–91.44) | 90.10 ± 0.56 (89.41–90.79) | 90.40 ± 0.56 (89.71–91.09) | 0.83 ± 0.03 (0.79–0.87) | 0.95 ± 0.01 (0.94–0.96) |
| FedMediFormer-XAI | 94.20 ± 0.34 (93.78–94.62) | 93.10 ± 0.30 (92.73–93.47) | 92.80 ± 0.28 (92.45–93.15) | 92.90 ± 0.28 (92.55–93.25) | 0.88 ± 0.02 (0.86–0.90) | 0.96 ± 0.01 (0.95–0.97) |
표 3: 당뇨병 예측 성능. accuracy, precision, recall, F1-score, MCC 및 AUC-ROC 지표를 사용하여 FedMediFormer-XAI와 기본 머신러닝 및 딥러닝 모델의 예측 성능을 비교한 결과입니다.
| 측정 지표 | 중앙 집중식 학습 | 연합 학습 |
| 정확도 (%) | 94.7 | 94.2 |
| AUC-ROC | 0.97 | 0.96 |
| 개인정보 보호 | 아니요 | 네 |
| 원시 데이터 공유 필수 | 네 | 아니요 |
| 통신 라운드 | 제공된 소스 텍스트가 없습니다. 번역할 내용을 입력해 주세요. | 100 |
| 훈련 시간(시간) | 4.8 | 5.6 |
| 규제 준수 | 중등도 | 높음 |
표 4: 연합 학습 대 중앙 집중식 학습 성능. 예측 성능, 원시 데이터 공유 요구 사항, 통신 라운드 및 학습 시간 측면에서 중앙 집중식 학습과 연합 학습 구현의 비교.
| 데이터셋 | 정확도 (%) | 정밀도 (%) | 재현율 (%) | AUC-ROC (수신기 작동 특성 곡선 아래 면적) |
| 피마 인디언 당뇨병 데이터셋 | 91.8 | 90.5 | 89.8 | 0.93 |
| CDC 당뇨병 건강 지표 | 93.1 | 92.2 | 91.6 | 0.95 |
| OhioT1DM 데이터세트 | 92.4 | 91.8 | 91.1 | 0.94 |
| APTOS 2019 실명 탐지 | 94.7 | 93.9 | 93.5 | 0.96 |
| 다중 모드 융합 (FedMediFormer-XAI) | 94.2 | 93.1 | 92.8 | 0.96 |
표 5: 데이터셋 수준의 결과. 개별 데이터셋 및 다중 모달 융합 설정에 따른 성능 분석. 결과는 전체 예측 성능에 대한 서로 다른 데이터 모달리티의 기여도를 보여준다.
| 측정 지표 | 값 |
| Precision@5 | 0.89 |
| Recall@5 | 0.84 |
| NDCG@5 | 0.91 |
| 약물 상호작용 검출 정확도 | 0.95 |
| 추천 커버리지 | 0.88 |
| 평균 상호 순위 (Mean Reciprocal Rank, MRR) | 0.86 |
| 안전 준수 점수 | 0.94 |
표 6: 개인 맞춤형 약물 추천 성능. 랭킹 지표, 상호작용 검출 정확도, 추천 커버리지 및 약물 안전성 평가를 이용한 그래프 기반 개인 맞춤형 약물 추천 평가.
| 평가 기준 | 제안된 평가 설계 |
| 임상의의 신뢰 | 5점 리커트 척도 평가 |
| 해석 가능성 | 5점 리커트 척도 평가 |
| 임상적 관련성 | 5점 리커트 척도 평가 |
| 설명 유용성 | 5점 리커트 척도 평가 |
| 인지된 유용성 | 5점 리커트 척도 평가 |
| 평가자 간 일치도 | 전향적 평가 후 산출될 Fleiss' kappa |
| 통계적 비교 | 데이터 수집 후 적절한 대응 표본 통계 검정 수행 |
| 참가자 | 윤리 승인 및 고지된 동의를 거친 임상의 12명 |
| 평가 상태 | 전향적/미래 평가 |
표 7: 제안된 인간 중심 평가 기준. FedMediFormer-XAI 설명의 유용성, 임상적 관련성, 해석 가능성, 신뢰성 및 사용성을 평가하기 위해 제안된 잠재적 임상의 중심 평가 프레임워크입니다. 평가는 표준화된 5점 리커트 척도 평가, Fleiss' kappa를 이용한 평가자 간 일치도 분석, 예측 전용 조건과 예측 및 설명 제공 조건의 통계적 비교, 그리고 95% 신뢰 구간을 포함합니다. 임상의의 평가는 반드시 적절한 기관생명윤리위원회(Institutional Ethics Committee)의 승인을 받고 고지된 동의를 얻은 후에 수행되어야 합니다.
보충 표 1: 데이터 세트 검증 전략재현성과 신뢰할 수 있는 모델 평가를 보장하기 위해 데이터셋 분할, 검증 절차, 클래스 불균형 해소 전략 및 품질 관리 조치를 시행하였습니다. 이 파일을 다운로드하려면 여기를 클릭하십시오.
부록 표 2: 확산 모델 매개변수훈련 파라미터, 최적화 설정, 잠재 차원, 노이즈 스케줄링 전략 및 합성 샘플 생성 사양을 포함한 TabDDPM 확산 모델의 구성 설정. 이 파일을 다운로드하려면 여기를 클릭하십시오.
부록 표 3: 멀티모달 트랜스포머 구성임상, 시간 및 이미지 인코더, 임베딩 및 융합 차원, 어텐션 헤드, 옵티마이저, 학습률, 배치 크기, 훈련 에포크, 조기 종료 기준 및 결합 훈련 손실을 포함한 멀티모달 트랜스포머 아키텍처의 구성. 이 파일을 다운로드하시려면 여기를 클릭하십시오.
부록 표 4: 연합 학습 설정. 참여 병원 수, 통신 라운드 수, 로컬 학습 에포크, 클라이언트 참여율, 집계 알고리즘, 옵티마이저, 학습률, 암호화 방법, 통신 프로토콜 및 원시 데이터 공유 정책을 포함하여 개인정보 보호 연합 학습에 사용된 파라미터. 이 파일을 다운로드하려면 여기를 클릭하십시오.
보충 표 5: GraphSAGE 설정. 그래프 유형, 은닉 및 임베딩 차원, 그래프 층 수, 이웃 샘플링 크기, 최적화 도구, 학습률, 배치 크기, 훈련 에포크, 베이지안 개인화 순위(Bayesian Personalized Ranking) 손실 및 상위 추천 약물 수 등 이종 GraphSAGE 기반 개인 맞춤형 약물 추천 모듈의 구성. 이 파일을 다운로드하려면 여기를 클릭하십시오.
보충 표 6: 설명 가능성 평가 지표. FedMediFormer-XAI 프레임워크의 설명 가능성을 평가하기 위해 사용된 정량적 및 인간 중심 지표. 해당 지표들은 설명 충실도, 안정성, 일관성, 희소성, 완결성, 민감도, 불충실도, 평가자 간 일치도 및 임상의가 인지한 설명 품질을 평가한다. 이 파일을 다운로드하려면 여기를 클릭하십시오.
부록 표 7: 평가 지표프레임워크의 성능, 강건성, 순위 지정 품질 및 해석 가능성을 평가하기 위해 예측, 연합 학습, 추천 및 설명 가능성 지표가 사용됩니다. 이 파일을 다운로드하시려면 여기를 클릭하십시오.
부록 표 8: 인간 중심 평가 설계참가자 그룹, 평가 조건, 평가 기준 및 통계 분석 절차를 포함한 임상의 중심 평가 연구 설계. 이 파일을 다운로드하려면 여기를 클릭하십시오.
부록 표 9: 재현성 자산제안된 FedMediFormer-XAI 프레임워크의 재현성을 지원하는 데 필요한 데이터셋 요약, 구현 사양, 설정 파일, 평가 절차, 문서 및 실험 기록. 이 파일을 다운로드하시려면 여기를 클릭하십시오.
토론
주요 결과의 해석
대표적인 결과는 멀티모달 트랜스포머 학습, 연합 학습, 확산 기반 증강, 그래프 신경망 기반 약물 추천 및 설명 가능한 인공지능을 하나의 통합된 당뇨병 지능 프레임워크로 결합하는 것이 가능하다는 것을 보여줍니다. 임상 기록, 인구 건강 지표, 연속 혈당 측정 데이터, 망막저저 이미지 및 약리학적 정보를 통합함으로써, 제안된 FedMediFormer-XAI 프레임워크는 해석 가능하고 분산된 모델 개발을 지원하는 동시에 강력한 예측 성능을 입증했습니다. 멀티모달 학습 방법은 서로 다른 헬스케어 모달리티에서 유용한 특징을 추출하여, 더욱 정확한 당뇨병 예측과 개인 맞춤형 치료 추천으로 이어졌습니다.
연합 학습의 이점
제안된 프레임워크의 주요 기여 중 하나는 분산형 협동 모델 구축을 가능하게 하는 연합 학습의 통합입니다. 연합 학습은 원시 환자 데이터를 직접 공유하지 않고도 여러 기관이 모델 훈련에 참여할 수 있도록 한다는 점에서 기존의 중앙 집중식 학습 방법과 다릅니다. 주요 연구 결과에 따르면, 연합 학습은 분산형 데이터 처리를 지원하면서도 중앙 집중식 학습과 유사한 예측 정확도를 유지하는 것으로 나타났습니다. 이러한 특징은 기관 정책 및 개인정보 보호 요구 사항으로 인해 데이터 공유가 제한되는 의료 시나리오에서 특히 유용합니다.
설명 가능성 분석
설명 가능성 평가 결과, SHAP 분석, Integrated Gradients, attention 시각화 및 counterfactual 설명 모두 모델의 동작에 대해 임상적으로 의미 있는 통찰을 제공할 수 있는 것으로 나타났습니다. 전역 및 지역 설명은 임상적 관점에서의 주요 예측 변수(즉, 포도당 측정치, 체질량 지수, 연령, 인슐린 투여 패턴 및 망막 이상)에 대해 대체로 일치했습니다. Attention 시각화 또한 트랜스포머 아키텍처가 임상적으로 관련 있는 시간적 및 영상적 특징에 집중했음을 보여주었습니다. 이러한 접근 방식은 모델 예측과 특징 기여도에 대한 상호 보완적인 해석을 제공함으로써 투명성을 향상시킵니다.
개인 맞춤형 약물 추천 분석
본 연구에서는 환자-약물 및 약물-약물 관계의 모델링과 더불어 개인 맞춤형 약물 추천을 제공하는 GNN 기반 추천 모델을 제안합니다. 실제로 이질적 그래프 토폴로지(heterogeneous graph topology)를 통해 치료 효능 패턴의 파악과 약물 투여 안전성 고려가 모두 가능했습니다. 본 연구에서 얻은 우수한 약물 추천 결과는 그래프 기반 학습 방법이 질병 예측을 넘어 개인 맞춤형 치료 지원 체계로서 당뇨병 지능형 시스템을 개발하는 데 기여할 수 있음을 보여줍니다.
인간 중심 평가
본 프레임워크는 설명 가능성이 임상의의 신뢰도, 해석 가능성, 사용성 및 인지된 임상적 유용성에 미치는 영향을 평가하기 위해 전향적 인간 중심 평가 프로토콜을 포함합니다. 제안된 평가는 표준화된 평가 기준을 사용하여 예측 전용 조건과 예측 및 설명 병행 조건을 비교할 것입니다. 기관윤리위원회(Institutional Ethics Committee)의 적절한 승인과 고지된 동의를 거쳐 향후 이 평가를 시행함으로써, 임상의의 수용도와 생성된 설명의 실질적인 유용성에 대한 경험적 근거를 제공할 것입니다.
성공적이고 재현 가능한 구현을 위한 핵심 단계
제시된 프로토콜의 여러 단계에서는 재현성을 보장하기 위해 특별한 주의가 필요합니다. 데이터셋 전처리와 분할 시에는 환자 수준의 분리를 유지하여 데이터 누출을 방지해야 하며, 연합 학습 과정에서 지정된 non-IID 클라이언트 분포가 유지되어야 합니다. 교차 모달 융합(Cross-modal fusion) 시에는 정의된 잠재 차원, 어텐션 설정, 모달리티 유형 임베딩, 정규화 및 최종 투영을 유지해야 합니다. 확산 기반 증강(Diffusion-based augmentation)에는 일관된 전처리 및 학습 매개변수를 사용해야 하며, GraphSAGE 기반 추천에서는 일관된 환자-약물 표현, 상호작용 스크리닝, 관련 항목 정의 및 Top-K 랭킹 기준을 유지해야 합니다. 설명 가능성 분석에는 고정된 SHAP 배경 샘플, Integrated Gradients 베이스라인, 어텐션 추출 절차 및 임상적으로 허용 가능한 반사실적 제약 조건(counterfactual constraints)을 사용해야 합니다. 구현 방식에 따른 편차를 최소화하기 위해 소프트웨어 버전, 랜덤 시드, 모델 설정, 데이터셋 분할 및 평가 매개변수를 문서화해야 합니다.
한계점
본 연구의 결과를 해석할 때 몇 가지 한계점을 고려해야 합니다. 첫째, 본 프레임워크는 공개 데이터셋을 사용하여 개발 및 평가되었으며, 이는 실제 의료 대상군과 임상 환경의 다양성을 충분히 반영하지 못했을 수 있습니다. 둘째, 연합 학습은 시뮬레이션된 병원 클라이언트를 통해 평가되었으나, 독립적인 의료 기관들이 참여하는 대규모 검증은 수행되지 않았습니다. 셋째, 연합 학습은 추가적인 통신 및 계산 오버헤드를 발생시켜 자원이 제한된 환경에서 확장성에 영향을 줄 수 있습니다. 마지막으로, 본 연구에 사용된 설명 가능성 기술은 주로 사후 해석 방법(post hoc interpretation methods)이며, 복잡한 모델의 동작을 완전히 포착하지 못할 수 있습니다.
제안된 인간 중심 검증 프로토콜은 내분비 전문의, 당뇨병 전문가 및 임상 약리학자로 구성된 12명의 임상 전문가 초기 패널을 고려합니다. 이 표본 크기는 결정적인 임상 검증보다는 사용성과 해석 가능성에 대한 예비 평가를 목적으로 합니다. 상대적으로 적은 수의 전문가 패널은 통계적 검정력과 일반화 가능성을 제한할 수 있습니다. 따라서 향후 전향적 연구에서는 다양한 임상 환경과 전문 분야를 대표하는 더 규모가 큰 다기관 임상의 코호트를 포함해야 합니다.
제시된 프레임워크의 주요 한계점은 임상 데이터, CGM, 망막 영상 및 약물 관련 모달리티가 환자 매칭된 다중 모달 기록이 아닌 독립적인 공개 데이터셋에서 도출되었다는 점입니다. 결과적으로, 교차 모달 융합 구성 요소는 동일한 환자에 대한 동시 다중 모달 측정에서 도출된 증거라기보다 상보적인 모달리티 표현을 통합하기 위한 방법론적 프레임워크로 해석되어야 합니다. 소스 데이터셋 간의 인구통계학적 특성, 획득 프로토콜, 특징 분포 및 질환 정의의 차이는 분포상의 불일치를 유발할 수 있으며, 학습된 교차 모달 관계가 실제 환자 수준의 연관성을 대표하는 정도를 제한할 수 있습니다. 본 프로토콜은 독립적인 데이터셋 간의 인위적인 환자 수준 매칭을 명시적으로 피하고 있으나, 이러한 설계는 환자 특이적 다중 모달 상호작용의 직접적인 평가를 제한하며 임상적 일반화 가능성에 영향을 미칠 수 있습니다. 따라서 보고된 다중 모달 성능을 전향적으로 수집된 환자 매칭 다중 모달 코호트에 대한 검증과 동일하게 해석해서는 안 됩니다. 향후 연구에서는 동일한 환자로부터 동기화된 임상, CGM, 망막 및 치료 정보가 포함된 더 크고 독립적으로 수집된 데이터셋을 사용하여 이 프레임워크를 검증해야 합니다.
문제 해결 및 프로토콜 수정
제안된 프로토콜을 구현할 때 몇 가지 실질적인 고려 사항이 영향을 미칠 수 있습니다. 소수 클래스의 비중이 낮을 때 클래스 불균형이 예측 성능을 저하시킬 수 있으며, 이러한 문제는 확산 기반 증강 및 재샘플링 전략을 통해 완화할 수 있습니다. 결측값 및 일관되지 않은 데이터 형식은 모델 안정성에 영향을 줄 수 있으므로 엄격한 전처리 과정을 통해 해결해야 합니다. 클라이언트 데이터셋의 이질성이 심할 경우 연합 학습의 수렴이 불안정해질 수 있으며, 로컬 학습 에포크, 학습률 및 집계 빈도를 조정함으로써 안정성을 향상시킬 수 있습니다. 특히 대규모 멀티모달 데이터셋과 트랜스포머 아키텍처를 처리할 때 하드웨어 제약이 학습 효율성에 영향을 줄 수 있습니다. 이러한 경우, 배치 크기나 모델 복잡도를 줄이면 재현성을 유지하면서 계산 가능성을 높일 수 있습니다.
향후 방향
향후 연구는 개인별 질환 시뮬레이션 및 치료 계획 수립을 위한 디지털 트윈 기술의 통합에 집중할 수 있습니다. 대규모 멀티모달 헬스케어 데이터셋으로 학습된 파운데이션 모델은 표현 학습과 모델 일반화 능력을 더욱 향상시킬 수 있습니다. 인과적 설명 가능성 기술은 상관관계 기반의 설명을 넘어 질환 메커니즘과 치료 효과에 대한 더 깊은 통찰력을 제공할 수 있습니다. 또한, 강화 학습 접근법은 적응형 치료 최적화 및 동적 약물 추천 전략을 지원할 수 있습니다. 이러한 발전은 당뇨병 지능형 시스템의 임상적 유용성과 개인화 역량을 더욱 강화할 것입니다. 나아가, AI가 생성한 예측 및 약물 추천은 전문적인 임상적 판단을 대체하는 것이 아니라 의사 결정 지원 도구로 간주되어야 합니다. 헬스케어 인공지능 시스템의 책임감 있고 윤리적인 배포를 위해서는 적절한 인간의 감독이 여전히 필수적입니다.
결론
FedMediFormer-XAI는 당뇨병 인텔리전스를 위해 멀티모달 학습, 연합 학습, 개인 맞춤형 약물 추천 및 설명 가능성을 통합한 재현 가능한 프레임워크를 제공합니다. 대표적인 결과들은 제안된 워크플로우의 타당성을 뒷받침하며, 실제 임상 적용 전에는 환자 매칭 멀티모달 데이터셋, 더 넓은 임상 환경 및 전향적 임상의 평가를 통한 추가 검증이 필요합니다.
공개 사항
저자들은 본 연구에서 보고된 작업에 영향을 미칠 수 있는 경쟁적 재정적 이해관계, 이해상충 또는 개인적 관계가 없음을 선언합니다. 인공지능 도구는 본 논문의 작성 과정에서 언어 정교화, 원고 구성, 서식 지정 및 편집을 돕는 용도로만 사용되었습니다. 모든 과학적 내용, 연구 설계, 방법론, 데이터 분석, 결과 해석 및 결론은 저자들에 의해 개발, 검증 및 승인되었습니다. 저자들은 본 원고에 제시된 작업의 정확성, 무결성 및 독창성에 대해 모든 책임을 집니다.
감사의 글
저자들은 본 연구에 사용된 공개 데이터셋과 오픈 소스 소프트웨어 리소스의 개발자 및 유지 관리자들에게 감사를 표합니다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| AES 암호화 | NIST | AES-256 | 연합 학습에서의 저장 데이터 및 보호된 모델 파라미터 암호화 |
| APTOS 2019 Blindness Detection Dataset | Kaggle/APTOS | 2019 Release | 망막 저저 이미지 데이터셋; 공개 및 비식별 처리됨; https://www.kaggle.com/competitions/aptos2019-blindness-detection/data |
| Captum | Meta AI | Version 0.8 | 모델 해석 가능성 및 기여도 분석 |
| CUDA Toolkit | NVIDIA | Version 12.2 | GPU 가속 연산 |
| Diabetes Health Indicators Dataset (CDC BRFSS 2015) | CDC/BRFSS; Kaggle | 2015 Release | 인구 건강 지표; 공개 및 비식별 처리됨; https://www.kaggle.com/datasets/alexteboul/diabetes-health-indicators-dataset |
| Diabetic Retinopathy Detection Dataset | Kaggle | Public Release | 망막 이미지 데이터셋; 공개 및 비식별 처리됨; https://www.kaggle.com/c/diabetic-retinopathy-detection/data |
| 디지털 인증서 | - | - | 연합 학습에서의 클라이언트 인증 |
| Drug Interaction Dataset | Kaggle | Public Release | 약물-약물 상호작용 그래프 데이터; 공개 및 비식별 처리됨; https://www.kaggle.com/datasets/rohanharode07/drug-drug-interaction |
| Drug Review Dataset | UCI Machine Learning Repository | Dataset 462 | 약물 효능 및 리뷰 데이터셋; 공개 및 비식별 처리됨; https://archive.ics.uci.edu/dataset/462/drug+review+dataset+drugs+com |
| Matplotlib | Matplotlib Developers | Version 3.9 | 시각화 |
| MTS Diabetes Dataset | Kaggle | Public Release | 웨어러블 센서 / 당뇨병 예측 데이터셋; 공개 및 비식별 처리됨; https://www.kaggle.com/datasets/marshalpatel3558/diabetespredictiondataset |
| NetworkX | NetworkX Developers | Version 3.3 | 약물 상호작용 그래프 구축 및 분석 |
| NumPy | NumPy Developers | Version 1.26 | 수치 연산 |
| NVIDIA RTX 4090 GPU | NVIDIA | RTX 4090 | 모델 학습 및 추론; 최소 32 GB 시스템 메모리 |
| OhioT1DM Dataset | Ohio University | Public Release | 연속 혈당 측정 데이터셋; 공개 및 비식별 처리됨; https://webpages.charlotte.edu/rbunescu/data/ohiot1dm/OhioT1DM-dataset.html |
| OpenCV | OpenCV Foundation | Version 4.10 | 이미지 처리 |
| Pandas | PyData | Version 2.2 | 데이터 처리 및 전처리 |
| Pima Indians Diabetes Dataset | UCI Machine Learning Repository | Dataset 34 | 임상 당뇨병 예측 데이터셋; 공개 및 비식별 처리됨; https://archive.ics.uci.edu/dataset/34/diabetes |
| Python | Python Software Foundation | Version 3.11 | 주 프로그래밍 환경 |
| PyTorch | Meta AI | Version 2.3 | 딥러닝 모델 개발 및 학습 |
| PyTorch Geometric | PyG Team | Version 2.5 | 그래프 신경망 구축 및 학습 |
| Scikit-learn | Scikit-learn Developers | Version 1.5 | 머신러닝 유틸리티 및 평가 |
| 보안 집계 메커니즘 | - | - | 연합 학습에서의 로컬 모델 파라미터 보호 집계 |
| SHAP | SHAP Developers | Version 0.47 | 설명 가능한 AI 및 특성 기여도 분석 |
| TensorFlow | Version 2.15 | 딥러닝 모델 개발 및 학습 | |
| Transformers | Hugging Face | Version 4.45 | 트랜스포머 기반 아키텍처 구현 |
| 전송 계층 보안 | IETF | TLS 1.3 | 연합 파라미터 교환을 위한 암호화 통신 채널 |
| 워크스테이션 | Generic | - | 연산 환경; 최소 32 GB 시스템 메모리 |
참고문헌
- Al-Hejri AM, et al. A hybrid explainable federated-based vision transformer framework for breast cancer prediction via risk factors. Sci Rep. 2025;15:18453.
- Dosovitskiy A, et al. An image is worth 16×16 words: transformers for image recognition at scale [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2010.11929]
- Touvron H, et al. Training data-efficient image transformers & distillation through attention [conference presentation]. Presented at: 38th International Conference on Machine Learning; 2021. [https://arxiv.org/abs/2012.12877]
- Kotelnikov A, Baranchuk D, Rubachev I, Babenko A. TabDDPM: modelling tabular data with diffusion models [conference presentation]. Presented at: 40th International Conference on Machine Learning (ICML); 2023. [https://arxiv.org/abs/2209.15421]
- Pinaya WHL, et al. Brain imaging generation with latent diffusion models [conference presentation]. Presented at: International Conference on Medical Image Computing and Computer-Assisted Intervention (MICCAI); 2022. [https://arxiv.org/abs/2209.07162]
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. [https://arxiv.org/abs/2006.11239]
- Song Y, et al. Score-based generative modeling through stochastic differential equations [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2011.13456]
- Li T, Sahu AK, Talwalkar A, Smith V. Federated learning: challenges, methods, and future directions. IEEE Signal Process Mag. 2020;37(3):50-60.
- Kairouz P, et al. Advances and open problems in federated learning. Found Trends Mach Learn. 2021;14(1-2):1-210.
- Rieke N, et al. The future of digital health with federated learning. NPJ Digit Med. 2020;3:119.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-11.
- Sheller MJ, et al. Federated learning in medicine: facilitating multi-institutional collaborations without sharing patient data. Sci Rep. 2020;10:12598.
- McMahan HB, et al. Communication-efficient learning of deep networks from decentralized data [conference presentation]. Presented at: International Conference on Artificial Intelligence and Statistics (AISTATS); 2017. [https://arxiv.org/abs/1602.05629]
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Ribeiro MT, Singh S, Guestrin C. Why should I trust you? Explaining the predictions of any classifier [conference presentation]. Presented at: ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD); 2016. [https://arxiv.org/abs/1602.04938]
- Wachter S, Mittelstadt B, Russell C. Counterfactual explanations and algorithmic recourse in healthcare AI. AI Ethics. 2021;1(2):123-37.
- Chen J, Liao W, Yu W. Explainable AI for precision medicine: a systematic review. Brief Bioinform. 2024;25(2):bbae045.
- Zitnik M, Agrawal M, Leskovec J. Modeling polypharmacy side effects with graph neural networks. Bioinformatics. 2020;36(2):i457-i466.
- Wu Z, et al. A comprehensive survey on graph neural networks. IEEE Trans Neural Netw Learn Syst. 2021;32(1):4-24.
- Hamilton WL. Graph representation learning. Morgan & Claypool Publishers; San Rafael (CA); 2020.
- Shang J, Ma T, Xiao C, Sun J. Pre-training of graph augmented transformers for medication recommendation [conference presentation]. Presented at: International Joint Conference on Artificial Intelligence (IJCAI); 2021. [https://arxiv.org/abs/1906.00346]
- Wang X, et al. Neural graph collaborative filtering. IEEE Trans Knowl Data Eng. 2021;33(5):2136-49.
- Yu KH, Beam AL, Kohane IS. Artificial intelligence in healthcare. Nat Biomed Eng. 2021;5(8):719-31.
- Muhammad G, Hossain MS, Kumar N. EEG-based pathology detection for home health monitoring. IEEE J Sel Areas Commun. 2021;39(2):603-10.
- Alshehri F, Muhammad G. Internet of Things and edge computing in healthcare: a survey. IEEE Access. 2021;9:3660-78.
- Vaid A, et al. Federated learning of electronic health records to improve mortality prediction. JMIR Med Inform. 2021;9(1):e24207.
- Lim WYB, et al. Dynamic contract design for federated learning in smart healthcare applications. IEEE Internet Things J. 2021;8(23):16853-62.
- Chikumo OT, et al. Transformer-based models for disease prediction using electronic health records: a systematic review. J Appl Artif Intell Comput. 2026;10(1):1-18.
- Lai T. Interpretable medical imagery diagnosis with self-attentive transformers: a review of explainable AI for healthcare. Diagnostics (Basel). 2023;13(18):3021.