본 연구는 시나리오 실험과 뇌파 측정을 통합하여, 전문가 및 동료 역할 프레이밍이 다양한 의료 작업 상황에서 신뢰와 어떻게 연관되는지 조사합니다.
이 논문에서
요약
초록
온라인 의료 AI가 백엔드 분석 도구에서 환자 대면 서비스 인터페이스로 진화함에 따라, 적절하게 조정된 신뢰(calibrated trust)가 설계 및 거버넌스의 점점 더 중요한 문제로 부상하고 있습니다. 본 연구는 역할 일치 이론(role congruity theory)을 바탕으로 전문가 및 동반자 역할 프레이밍이 다양한 의료 작업 맥락에서 신뢰와 어떻게 연관되는지 조사하였습니다. 연구 1에서는 2(역할: 전문가 vs 동반자) × 2(작업: 질병 상담 vs 건강 상담) 시나리오 실험(N = 300)을 수행하였습니다. 전문가 프레이밍은 인지된 전문성을 높였고, 동반자 프레이밍은 사회적 실재감을 높였으며, 두 인식 모두 동시에 투입되었을 때 전반적인 신뢰와 독립적으로 연관되었습니다. 전문성을 통한 간접적 연관성은 작업 맥락에 의해 조건화되었으나, 직접 부트스트랩 비교 결과 전반적인 신뢰에 대한 두 조절된 매개 지수 간에 유의미한 차이는 나타나지 않았습니다. 측정 진단 결과, 인지된 전문성과 인지적 신뢰 사이, 그리고 사회적 실재감과 정서적 신뢰 사이에 상당한 중첩이 관찰되어 해석에 주의가 필요함을 시사하였습니다. 연구 2에서는 39회의 쌍 관찰을 통해 EEG를 사용하여 전문가 및 동반자 프레이밍 진술을 비교하였습니다. 전문가 프레이밍에서는 더 높은 전두-중앙선 세타 ERS와 덜 부정적인 기선 보정 FCz-F6 세타 ΔPLV가 동반된 반면, 조건 수준의 행동 결과에서는 신뢰율, 응답 시간 또는 무응답률에서 신뢰할 만한 차이가 나타나지 않았습니다. 이러한 EEG 결과는 조건부 간접 모델의 신경학적 검증이라기보다 탐색적인 프로세스 수준의 상관관계로 보아야 합니다. 종합적으로, 역할 단서는 상호 배타적이지 않은 역량 지향적 평가와 관계 지향적 평가를 형성하는 것으로 보입니다. 따라서 역할 설계는 단순히 신뢰를 극대화하기보다 역량의 경계 설정, 불확실성의 전달, 위험 기반 경고 및 적절한 단계적 에스컬레이션을 통해 적절하게 조정된 의존성을 지원해야 합니다.
서론
현재 의료 AI는 이미지 인식, 병리 분석, 신약 개발과 같은 백엔드 애플리케이션부터 환자 대면 서비스 인터페이스에 이르기까지 광범위하게 적용되고 있습니다. 산업 분석에 따르면 헬스케어 AI 시장은 2033년까지 지속적으로 성장할 것으로 전망됩니다1. 대규모 언어 모델(LLM)을 통해 의료 AI 시스템은 건강 관련 질문에 답변하고, 검사 결과를 해석하며, 정보를 요약하고, 자연어로 권고 사항을 제공할 수 있게 되었습니다2. 이러한 변화는 사용자와 기술 간의 관계를 바꿉니다. 백엔드 분석 도구는 임상의와 기관에 의해 평가되지만, 환자 대면 인터페이스는 자신의 역할, 근거, 불확실성 및 한계를 사용자에게 전달해야 합니다. 의료 AI는 진단 보조 도구, 가정의 인터페이스 또는 건강 관리 동반자의 형태로 나타날 수 있으며, 각각은 사용자가 시스템의 서비스 정체성을 이해하는 방식에 영향을 미칩니다. 이러한 시스템이 질환 상담 및 일상적인 건강 관리에 점점 더 많이 참여함에 따라, 신뢰는 단순한 기술적 태도를 넘어 더 중요한 의미를 갖게 됩니다. 신뢰는 사용자가 정보를 공개할지 여부, 권고 사항을 신뢰할 수 있다고 생각하는지, 시스템과 상호작용하는 방식, 그리고 건강 지침에 따라 행동하는지에 영향을 미칩니다. 따라서 신뢰는 디지털 헬스 플랫폼의 설계 및 거버넌스에서 핵심적인 고려 사항입니다.
기술적 역량만으로는 사용자가 의료 AI를 신뢰할 수 있고 수용 가능한 것으로 간주하는지 여부를 결정하지 않습니다. 헬스케어 대화형 에이전트에 대한 검토 결과에 따르면, 구현 가능성은 상호작용의 품질, 임상적 관련성, 투명성 및 배포 조건에 따라 달라집니다3. 의료 AI의 신뢰할 수 있는 근거에 관한 최근 연구에서도, 주장이 의도된 용도에 적합한 근거에 의해 뒷받침되지 않는 한 모델의 성능만으로는 불충분하다고 주장합니다4. 투명성은 필수적인데, 이는 환자가 단순히 유창한 언어만으로 신뢰성을 추론하는 것이 아니라, 역량의 한계와 불확실성, 그리고 권고의 근거를 식별할 수 있어야 하기 때문입니다5. 정보 시스템 연구에서도 이와 유사하게 AI 보조 진단의 도입을 해석 가능성, 개인정보 보호 및 인터페이스 단서가 공동으로 수용도를 형성하는 신뢰 구성 문제로 정의합니다6. 이러한 고려 사항은 언어 모델 인터페이스에서 중요합니다. 유창함은 답변을 이해하기 쉽게 만들 수 있지만, 시스템이 임상적 지식을 갖추고 있는지, 그 권고가 사용자의 상황에 적용되는지, 그리고 언제 자격을 갖춘 임상의에게 진료를 넘겨야 하는지는 해결되지 않은 채로 남을 수 있습니다. 관련 핵심 질문은 의료 AI가 답변을 생성할 수 있는지뿐만 아니라, 사용자가 적절한 수준의 의존도를 가지고 그 답변을 평가할 수 있는지 여부입니다.
의료 AI에 대한 신뢰는 작업 맥락에 따라 민감하게 반응합니다. 의료 AI에 대한 거부감 연구에 따르면, 사용자들은 알고리즘이 자신의 고유성을 고려할 수 없다고 믿기 때문에 위험 부담이 큰 결정에서는 알고리즘의 권고를 거부할 수 있습니다7. 이러한 거부감이 보편적인 것은 아닙니다. 알고리즘 선호 연구에 따르면, 작업이 객관적이고 규칙이 명확할 때 사람들은 알고리즘의 판단을 더 선호할 수 있습니다8. 온라인 건강 상담에서는 AI가 생성한 조언의 개인화 정도와 세심함이 신뢰와 채택에 영향을 미칩니다9. 기존 방식, 디지털 방식 및 AI 기반 상담을 비교한 이산 선택 연구에서도 형식에 따라 선호도와 신뢰 기대치가 다름을 발견했습니다10. 또한 인간-AI 팀워크는 인간의 전문성에서 AI 지원 서비스 체계로 신뢰가 전이됨으로써 거부감을 줄일 수 있습니다11. 따라서 의료 AI에 대한 신뢰는 인지된 위험, 작업 요구 사항, 소통 방식 및 시스템 평가의 상호작용을 통해 형성됩니다. 질병 상담은 불확실성, 잠재적 손실, 진단 결과 및 오류 비용을 두드러지게 합니다. 반면 건강 상담은 주로 식단, 운동, 수면, 복약 준수 및 예방 관리에 관한 것이며, 여기서는 지속적인 상호작용과 관계적 접근성이 더 큰 비중을 차지할 수 있습니다. 결과적으로 사용자가 장기적인 건강 관리보다 잠재적 질병에 대한 도움을 구하는 경우, 동일한 인터페이스 단서라도 다르게 해석될 수 있습니다.
역할 프레임워크는 이러한 기대치를 전달할 수 있는 인터페이스 기능 중 하나입니다. 의료 AI는 전문적 권위, 구조적 추론, 임상적 경계 및 역량 근거를 강조하는 전문가로 프레임화되거나, 공감, 안심, 사회적 지지 및 지속성을 강조하는 동반자로 프레임화될 수 있습니다. 이러한 구분은 사회적 지각의 두 가지 차원인 유능함과 따뜻함과 관련이 있지만, 단순히 유능한 시스템과 따뜻한 시스템 사이의 선택 문제는 아닙니다12. 의사소통 스타일과 에이전시 프레임워크는 대화형 에이전트에 대한 평가에 영향을 미칩니다13. 모바일 의료 애플리케이션에서 사회적 신호와 개인정보 보호 우려는 신뢰도와 행동 의도에 공동으로 영향을 미칩니다14. 헬스케어 대화형 에이전트의 의인화된 신호는 사회적 실재감, 신뢰 및 수용도를 높일 수 있지만, 시스템 역량을 초과하는 기대치를 형성할 수도 있습니다15. 인간-AI 팀에 관한 연구에 따르면 따뜻함과 유능함은 서로 다른 형태의 수용성을 예측합니다16. 고위험 작업에서 신뢰도는 팀 역할, 작업 맥락 및 성능 위반 사이의 적합성에 달려 있습니다17. 챗봇의 사회적 역할과 성능 사이의 일관성 또한 신뢰 구축 및 회복에 영향을 미칩니다18. 따라서 전문가 및 동반자 신호는 단순히 대화 톤을 바꾸는 것이 아니라 서로 다른 평가 기준을 두드러지게 만듭니다.
두 가지 공백이 남아 있습니다. 첫째, 역량 및 관계 지향적 단서의 관련성이 의료 과업 요구 사항에 따라 어떻게 변화하는지에 대한 연구가 이루어지지 않았습니다. AI에 대한 인간의 신뢰를 다룬 리뷰들은 맥락 의존성을 강조하지만, 질병 상담과 건강 상담 전반에서 전문가 및 동반자 단서가 어떻게 작동하는지는 명확히 하지 않았습니다19. 둘째, 의료 AI 신뢰에 관한 연구들은 자기 보고에 의존하고 있어, 역할 프레임 평가와 관련된 처리 과정에 대한 증거가 제한적입니다. 개인정보 보호, 투명성, 책임성 및 편향성 또한 프론트엔드 역할 단서의 해석을 제한합니다20,21. 이러한 공백을 메우기 위해, 본 연구는 역할 단서와 맥락적으로 두드러진 요구 사항 간의 일치성을 통해 평가를 설명하는 역할 일치 이론(role congruity theory)을 적용합니다22. 연구 1에서는 무작위 2 (역할: 전문가 vs. 동반자) x 2 (과업: 질병 상담 vs. 건강 상담) 시나리오 실험(N = 300)을 통해 역할 프레이밍, 과업 맥락, 그리고 인지된 전문성과 사회적 실재감을 통한 병렬적 간접 연관성을 조사합니다. 연구 2에서는 별도의 피험자 내 EEG 실험(N = 39)을 사용하여 전문가 및 동반자 프레임 문구에 대한 세타 대역(theta-band) 활동을 비교합니다. 연구 1은 행동적 연관성과 맥락적 조절 효과를 평가하며, 연구 2는 조건부 간접 모델의 신경학적 검증보다는 탐색적인 프로세스 수준의 비교를 제공합니다.
이론적 틀 및 가설 설정
의료 AI의 역할 프레이밍
의료 AI는 질병 위험, 치료 권고, 법적 책임 및 윤리적 경계가 얽힌 고위험 환경에서 작동합니다23. 따라서 프런트엔드 언어가 역량, 근거 및 책임의 경계를 사용자에게 더 분명하게 혹은 덜 분명하게 인식시킬 수 있기 때문에 역할 프레이밍이 중요합니다. 투명성 연구 또한 의료 AI 시스템이 역량의 한계와 근거 기반을 전달해야 함을 강조합니다5. 전문가 스타일의 응답은 공식적인 용어, 구조화된 추론, 경계 설정 문구 및 실행 권고를 통해 전문성을 전달하는 반면, 동반자 스타일의 응답은 공감, 안심 및 협력적인 어조를 통해 관계적 지지를 전달합니다. 이러한 신호들은 단순한 인터페이스 장식이 아니며, 사용자가 시스템을 평가할 때 적용하는 기준을 형성합니다24,25. 의인화는 사회적 반응을 이끌어낼 수 있지만, 비현실적인 기대감을 조성하고 책임 경계를 모호하게 만들 수 있습니다26,27. 인간-AI 팀 및 챗봇에 관한 연구에 따르면 따뜻함, 전문성, 역할-맥락 적합성, 그리고 사회적 역할과 성능 간의 일관성이 수용도와 신뢰에 영향을 미칩니다16,17,18. 본 연구에서 역할 일치성은 AI 응답에 의해 전달되는 신호와 상담 과제에서 두드러지는 평가적 요구 사이의 정렬을 의미합니다22.
이중 경로 신뢰: 인지된 전문성과 사회적 실재감
역할 일치성은 별도의 주관적 구성 개념으로 측정되는 것이 아니라, 관찰된 역할과 과업 간의 상호작용으로부터 추론됩니다. 따라서 이러한 해석은 실험적 상호작용에 국한되며, 참가자들이 역할 적합성에 대한 느낌을 의식적으로 보고했음을 의미하지는 않습니다. 신뢰는 역량 및 신뢰성에 관한 인지적 판단과 관계적 안정성 및 편안함에 관한 정서적 판단을 포함합니다28,29,30. 의료 AI 이용 시 사용자는 시스템이 건강 관련 결정을 지원할 수 있는지와 시스템과의 상호작용이 충분히 안전하고 접근 가능하다고 느껴지는지를 모두 평가합니다. 전문가 프레이밍은 역량 중심의 평가를 더 두드러지게 만들어야 합니다. 임상 의사결정 지원 연구의 증거에 따르면, 시스템 추론에 관한 설명과 정보가 신뢰와 의존도에 영향을 미칩니다31. 온라인 건강 상담의 경우, 개인화와 배려 또한 신뢰 및 수용도와 관련이 있습니다9. 인지된 전문성은 신뢰와 관련된 역량 중심의 평가를 포착합니다25. 온라인 건강 상담에 관한 연구에서도 마찬가지로 정보원 신뢰성이 사용자의 건강 제안 수용과 관련이 있음을 확인했습니다32. 따라서 본 연구에서는 전문가 프레이밍이 더 높은 인지된 전문성과 관련이 있는지 테스트합니다.
H1: 동반자 역할은 전문가 스타일의 의료 AI에 비해 인지된 전문성이 낮게 나타난다.
동료 프레이밍은 관계적 평가를 더 두드러지게 만들어야 합니다. 사회적 실재감이란 시스템이 인간이라는 믿음보다는 매개된 상호작용에서 느껴지는 대인 관계적 질을 의미합니다33. 이는 온라인 서비스 및 건강 상담 에이전트에서의 상호작용 품질, 신뢰 및 수용도와 관련이 있습니다15,34.
사회적 실재감은 자기 공개의 심리적 비용을 줄이고 온라인 상담 중 정보 교환을 지원할 수 있습니다32. 따라서 본 연구에서는 동반자 프레이밍이 더 높은 사회적 실재감과 관련이 있는지 테스트합니다.
H2: 전문가 역할은 동반자 스타일의 의료 AI에 비해 낮은 사회적 실재감을 생성한다.
인지된 전문성과 사회적 실재감은 신뢰와 병렬적이며 상호 배타적이지 않은 연관 관계로 취급됩니다. 고위험 자동화 시스템에 대한 적절한 의존도는 단순히 신뢰를 극대화하는 것이 아니라 시스템의 성능, 한계 및 과업 요구 사항에 따라 결정됩니다35.
H3: 지각된 전문성과 사회적 실재감은 동시에 모델링되었을 때 각각 신뢰를 정(+)의 방향으로 예측한다.
과업 맥락의 조절 효과
동일한 역할 단서라도 의료 작업의 종류에 따라 서로 다른 심리적 가중치를 가질 수 있습니다. 작업-기술 적합성(Task-technology fit)은 역할 단서가 작업 요구 사항과 일치하는지 검토하기 위한 맥락적 근거를 제공합니다36. 질병 상담은 더 높은 불확실성, 손실 위험 및 오류 비용을 수반하므로 전문성, 정확성 및 명확한 경계가 특히 중요하게 작용합니다7,37. 따라서 전문가 단서는 동료 단서보다 이러한 요구 사항에 더 밀접하게 부합해야 합니다. 건강 상담은 장기적인 건강 관리, 행동 지속성 및 상호작용의 연속성에 중점을 둡니다. AI 기반 임상 의사 결정 지원 및 건강 대화형 에이전트에 대한 검토 결과는 맥락 정보, 실행 가능성, 상호작용 및 구현 조건의 중요성을 강조하고 있습니다3,38,39.
본 연구는 인지된 전문성에서 전문가와 동료 간의 차이가 건강 상담보다 질병 상담에서 더 크게 나타날 것으로 예측합니다. 사회적 실재감에 대한 유의미하지 않은 상호작용을 불변성의 증거로 간주하지 않습니다. 가설은 다음과 같이 제안됩니다:
H4: 과업 맥락은 전문가 역할이 인지된 전문성에 미치는 영향력을 유의미하게 조절한다. 이러한 영향은 건강 상담보다 질병 상담에서 더 강하게 나타난다.
프로토콜
연구 개요
본 연구는 헬싱키 선언에 따라 수행되었으며, 온라인 시나리오 실험과 EEG 실험 모두를 포함하여 화교대학교 윤리위원회(M2025021)의 승인을 받았습니다. 모든 참여자는 고지된 동의서를 제출하였으며, 실험 완료 후 보상을 받았습니다.
본 논문은 두 가지 상호 보완적인 연구를 포함하고 있습니다 (그림 1 참조). 연구 1은 역할 프레이밍과 과업 문맥 효과를 추정하고, 측정 구조를 평가하며, 인지된 전문성과 사회적 실재감을 통한 병렬 조건부 간접 연관성을 테스트하는 무작위 2 × 2 시나리오 실험입니다. 연구 2는 전문가 프레이밍 진술과 동료 프레이밍 진술 하에서의 세타 대역 활동을 비교하는 피험자 내 EEG 실험이며, 이는 탐색적인 프로세스 수준의 비교로 해석됩니다. 이 연구들은 서로 다른 수준에서 행동 및 신경학적 근거를 제공하며, 단일한 점진적 메커니즘으로 취급되지 않습니다.
연구 1: 시나리오 실험
참가자 및 설계
연구 1에서는 역할 프레이밍(전문가 vs. 동료)과 과업 상황(질병 상담 vs. 건강 상담)을 변수로 하는 균형 잡힌 2 × 2 집단 간 설계를 사용하였다. 기존의 G*Power 계산에서는 중간 정도의 옴니버스 ANOVA 효과(f = 0.25), α = .05, 검정력 = .80을 가정하여 최소 128명의 참가자가 필요한 것으로 나타났다40. 해당 계산은 조건부 간접 효과에 맞게 조정된 것이 아니므로, 조절된 매개 효과에 대한 검정력 근거가 아닌 초기 모집 기준으로서 보고되었다. N = 300명 및 4개의 균형 잡힌 셀을 기준으로 수행한 민감도 분석 결과, α = .05에서 f = 0.162(부분 η2 = .026)의 상호작용을 탐지할 수 있는 검정력은 80%로 나타났다.
우리는 또한 300명의 사례가 포함된 SPSS 설문지 데이터셋을 사용하여 조절된 매개 지수에 대한 사후 시뮬레이션 기반 검정력 분석을 수행하였습니다. 시뮬레이션은 경험적 잔차를 재표본 추출하여 적합된 병렬 매개 모델로부터 1,000개의 균형 잡힌 2 × 2 표본을 생성하였으며, 각 시뮬레이션 데이터셋에는 500회의 사례 재표본 추출 백분위수 부트스트랩 신뢰 구간이 사용되었습니다. 신뢰 구간에서 0이 제외될 추정 확률은 전문성 지수의 경우 .698, 사회적 실재감 지수의 경우 .157, 그리고 두 지수 간의 직접적 차이의 경우 .279였습니다. 이 분석은 관찰된 계수, 잔차 분포 및 모델 사양을 전제로 하며, 사전 표본 크기 정당화 분석이 아닙니다. 전체 사후 시뮬레이션 기반 검정력 분석 결과는 부록 표 S1에 제시되어 있습니다.
Credamo를 통해 300명의 참가자를 모집하여 4가지 조건에 무작위로 배정하였습니다(집단당 n = 75). 표본은 남성 109명(36.3%)과 여성 191명(63.7%)으로 구성되었으며, 연령대는 21-30세가 43.7%, 31-40세가 41.3%였고, 69.7%가 학사 학위를 보유하고 있었습니다. 모든 필수 설문 항목이 완료되었습니다. 별도의 주의 확인 항목이나 사전 등록된 완료 시간 기반 제외 기준은 사용되지 않았으며, 제외된 참가자는 없었습니다. 완료 시간의 중앙값은 268 s(범위 = 67-1,894 s)였습니다. 이례적으로 빠른 응답에 대한 민감도를 평가하기 위해 완료 시간의 하위 5% 미만(<125 s; 유지된 n = 285) 응답을 제외한 사후 강건성 분석을 수행하였습니다. 상세한 조작 확인 통계 및 완료 시간 민감도 분석 결과는 부록 표 S2(Supplementary Table S2)에 보고되어 있습니다.
실험 자극 및 절차
자극물은 과제 시나리오 소개와 AI 의사의 대화 응답으로 구성되어 총 4개의 완전한 실험 세트를 형성하였습니다. 질환 상담 시나리오에서는 참가자가 반복적인 야간 흉부 압박감과 심계항진을 느끼며, 즉각적인 병원 진료가 필요한지에 대해 걱정하는 상황을 가정하도록 했습니다. 건강 상담 시나리오에서는 참가자가 전반적으로 건강한 상태에서 개인 맞춤형 식단 및 운동 계획을 찾는 상황을 가정하도록 했습니다. 각 과제 범주는 하나의 시나리오로 대표되었으므로, 결론은 모든 질환 및 건강 상담으로 일반화하기보다는 이 두 가지 시나리오로 제한됩니다.
사용된 네 가지 설문지 스크린샷은 모두 동일한 아이콘을 사용하고 시스템 이름인 Medical AI (DiagnosPro)를 표시하여, 조건 전반에 걸쳐 표시된 정체성을 일정하게 유지하였습니다. 전문가 프레임 응답은 구조적 분석, 위험 또는 근거 진술, 지시적 언어 및 명시적인 행동 권고를 사용하였습니다. 동반자 프레임 응답은 공감, 안심, 협력적 문구 및 유연한 제안을 사용하였습니다. 따라서 이러한 조작은 역할에 부합하는 의사소통과 정보 단서의 패키지를 나타낸 것이며, 역할 프레임을 구체성, 실행 가능성, 확실성, 의학적 세부 사항 또는 정서적 지원으로부터 분리하여 고립시킨 것은 아니었습니다. 공유된 이름인 DiagnosPro 또한 모든 조건에서 전문가 단서를 전달했을 수 있습니다. 자극제의 전체 세트는 Supplementary File 1에 제공됩니다.
참가자들은 먼저 고지된 동의서를 읽은 후 네 가지 실험 조건 중 하나에 무작위로 배정되었습니다. 시나리오와 대화 자극물을 읽은 후, 참가자들은 자신의 응답을 바탕으로 설문지를 작성하였습니다. 설문지는 조작 점검(manipulation checks)으로 시작하여 인지된 전문성, 사회적 실재감, 신뢰도 측정 및 인구통계학적 특성 조사 순으로 진행되었습니다. 전체 절차는 약 15분 정도 소요되었습니다.
모든 척도는 7점 리커트(Likert) 점수법을 사용하였으며, 1점은 매우 그렇지 않다, 7점은 매우 그렇다를 나타냈다. 인지된 전문성은 ‘이 의료 AI는 의학적 조언을 제공할 능력이 있다’, ‘이 의료 AI는 매우 전문적으로 보인다’, ‘이 의료 AI는 의료 분야의 전문가이다’의 세 가지 항목으로 측정되었다(α = .883)41. 사회적 실재감은 ‘이 의료 AI와의 상호작용에서 인간적인 접촉을 느꼈다’, ‘이 의료 AI와의 상호작용은 친밀감을 느끼게 했다’, ‘이 의료 AI는 상호작용 동안 사교적으로 보였다’의 세 가지 항목으로 측정되었다(α = .932)42. 인지적 신뢰는 ‘이 의료 AI는 조언을 제공하는 데 필요한 기술을 가지고 있으므로 믿을 수 있다’, ‘나는 이 의료 AI가 제공하는 조언의 정확성을 확신한다’, ‘이 의료 AI는 나의 건강 문제를 처리할 충분한 능력을 갖추고 있다’의 세 가지 항목으로 구성되었다(α = .837). 정서적 신뢰는 ‘이 의료 AI는 따뜻함과 배려심을 느끼게 한다’, ‘이 의료 AI가 나의 건강을 신경 쓰는 것처럼 보이므로 이 AI에 의존하는 것은 안전하다고 느낀다’, ‘나는 이 의료 AI가 의도적으로 나에게 해로운 일을 하지 않을 것이라고 믿는다’의 세 가지 항목으로 구성되었다(α = .700). 전반적 신뢰는 6개 신뢰 항목 전체의 평균값으로 산출되었다(α = .784). 이러한 측정치들은 상호 배타적인 구성 개념이 아니라 역량 지향적, 대인 관계적, 인지적 신뢰, 정서적 신뢰 및 전반적 신뢰 결과로 분석되었다.
분석은 네 단계로 진행되었습니다. 첫째, 확인적 요인 분석을 통해 제안된 4요인 모델을 2요인 및 1요인 대안 모델과 비교하였으며, 합성 신뢰도, 평균 분산 추출값, 잠재 상관관계 및 HTMT(heterotrait-monotrait) 비율을 검토하였습니다. 둘째, 전체 2 x 2 요인 모델을 통해 인지된 전문성, 사회적 실재감, 인지적 신뢰, 정서적 신뢰 및 전반적 신뢰에 대한 주효과와 상호작용 효과를 추정하였으며, 셀 평균, 신뢰 구간 및 부분 η2를 산출하였습니다. 추정된 주변 평균과 95% 신뢰 구간은 그림 2에 표시되어 있습니다. 셋째, PROCESS 4.2 beta 모델 7을 사용하여 인지된 전문성과 사회적 실재감을 병렬 매개변수로 동시에 투입하였으며, 5,000개의 퍼센타일 부트스트랩 표본을 생성하였습니다43. 역할 프레이밍은 1 = 전문가, 2 = 동반자로 코딩하였고, 과업 맥락은 1 = 질병 상담, 2 = 건강 상담으로 코딩하였습니다. 공통 재표집 부트스트랩을 통해 조절된 매개의 두 지표를 직접 대조하였습니다. 넷째, 인지적 신뢰와 정서적 신뢰를 탐색적 결과 변수로 각각 나누어 분석하였습니다. 매개변수와 결과 변수가 동시에 측정되었으므로, 추정치는 인과적인 심리적 기제라기보다 매개 작용과 일치하는 간접적 연관성으로 해석됩니다.
연구 2: EEG 실험
참가자
연구 2에는 40명의 참가자가 모집되었습니다. 적어도 하나의 실험 조건에서 아티팩트로 오염된 시행이 30%를 초과한 참가자 1명이 제외되어, 최종 EEG 분석에는 39명의 참가자가 포함되었습니다. 이 기준을 통해 유지된 모든 참가자가 각 조건에서 최소 70%의 시행을 기여하도록 보장하였습니다. 모든 참가자는 서면 동의서를 제출하였으며 실험 종료 후 보상을 받았습니다. 인구통계학적 정보가 유지된 모든 EEG 기록과 연결되지 않았으므로, 최종 EEG 표본에 대한 요약은 제공되지 않았습니다.
실험 자극 및 절차
본 실험은 표준 EEG 실험실에서 피험자 내 설계(within-subjects design)를 사용하여 수행되었으며, 자극제는 E-Prime 2.1을 통해 제시되었습니다. 참가자들은 의료 AI 시스템과 상호작용하는 상황을 상상하고, 각 의료 상담 시나리오에 대해 시스템에 대한 신뢰도를 평가하도록 안내받았습니다. 본 실험에서는 전문가형과 동료형 변이형을 포함하여 의료 AI 시스템의 인지된 역할을 조작하였습니다.
총 40개의 중국어 문장 자극물이 구성되었습니다. 전문가 유형 조건에는 '의료 AI 전문가'로 시작하는 자극물 20개가 포함되었으며, 동반자 유형 조건에는 '의료 AI 동반자'로 시작하는 20개의 병렬 자극물이 포함되었습니다. 의료 시나리오는 병력 청취, 검사 보고서 분석, 심박수 데이터 평가, 유전자 검사 해석, 질병 위험 판단 및 치료 계획 추천과 같은 전문적 진단 기능과 신체 상태에 대한 관심 표명, 수면 질 문의, 불안 완화, 건강 데이터 기록, 치료 순응도 독려 및 일상 건강 팁 제공과 같은 지원적 건강 관리 기능을 모두 포괄하였습니다. 따라서 각 조건은 의미론적 내용과 복잡성에서도 차이가 있었으며, 독립적인 자극물 매칭이나 사전 테스트는 수행되지 않았습니다.
본 실험에 앞서 참가자들은 짧은 연습 블록을 수행하였습니다. 각 시행은 500 ms 동안의 고정 십자선으로 시작되었으며, 이어서 300–500 ms의 무작위 빈 화면 간격과 1,600 ms 동안 제시되는 의료 AI 진술문이 나타났습니다. 그 후 참가자들은 F 키를 눌러 신뢰함 또는 J 키를 눌러 신뢰하지 않음을 표시함으로써 자신의 속도에 맞게 이진 신뢰 판단을 내렸습니다(그림 3 참조). 전문가 프레임과 동반자 프레임의 진술문은 무작위 순서로 제시되었습니다. E-Prime 작업 로그에 따르면 작업 기록당 80회의 본 실험 시행이 이루어졌습니다. 즉, 전문가 진술 40회와 동반자 진술 40회가 수행되었으며, 각 역할당 20개의 고유 진술문이 각각 두 번씩 제시되었습니다.
행동 과제 데이터
최종 EEG 표본 39명 중 38명의 행동 과제 데이터를 사용할 수 있었으며, 참가자 1명의 E-Prime 과제 기록은 사용할 수 없었습니다. 따라서 행동 분석에는 N = 38이 사용되었습니다. 상세한 행동 결과 및 표본 산정 내역은 부록 표 S3에 제공되어 있습니다. 신뢰는 F-키 응답으로, 비신뢰는 J-키 응답으로 코딩되었습니다. 무응답 또는 기록된 응답 시간이 0 ms인 경우는 결측치로 코딩되었습니다. 신뢰율은 응답이 완료된 시행을 대상으로 계산되었으며, 응답 시간은 응답이 완료된 시행에 대해 요약되었습니다. 분석 가능한 신경 데이터에는 조건별로 집계된 측정값은 포함되어 있었으나, 시행 수준의 EEG 지표나 각 행동 기록을 해당 EEG 기록과 연결하는 검증된 식별자가 없었습니다. 따라서 EEG와 신뢰 판단에 대한 시행 수준의 혼합 모델은 추정되지 않았습니다.
EEG 기록 및 분석
전극-피부 임피던스를 5 kOhm 미만으로 유지하기 위해 Quik-Gel 전도성 전해질 겔을 사용하였다. FCz를 장치의 기본 온라인 참조전극으로 설정하였으며, 샘플링 속도는 1,000 Hz였다. 양측 유양돌기 평균을 이용한 오프라인 참조화는 CURRY의 내장 재참조 기능을 통해 수행되었다. 이때 FCz는 유지되었으며 새로운 참조전극에 대해 자동으로 재구성되었고, 별도의 사용자 정의 재구성 명령어나 스크립트는 사용되지 않았다. 이후의 오프라인 처리는 MATLAB R2020b의 EEGLAB44 및 ICLabel45를 사용하여 수행하였다. 데이터는 500 Hz로 다운샘플링되었으며, 0.1에서 40 Hz까지 밴드패스 필터링을 거쳤다. 불량 채널과 심하게 오염된 데이터 세그먼트는 시각적 검사를 통해 식별하여 제거하였으며, 자동 보간법이나 자동 세그먼트 제거 임계값은 적용하지 않았다. 그 후 기본 EEGLAB runica 구현 방식(Infomax ICA)을 사용하였으며, ICLabel이 특정 아티팩트 클래스(예: 안구, 근육, 심장, 라인 노이즈 또는 채널 노이즈 활동)에 대해 최소 .70의 확률을 할당한 성분들을 제거하였다. 두 조건 중 어느 하나에서 아티팩트로 오염된 시행이 30%를 초과하는 참가자는 제외하여, 각 조건에서 최소 70%의 시행 유지율을 확보하였다. 에포크(Epoch) 범위는 −1,000에서 1,996 ms였다. 기능적 연결성 분석을 위해 전처리된 데이터를 250 Hz로 추가 다운샘플링하였으며, 위상 동기화 추정 전에 P7, P8, F7, F8을 포함한 주변부 전극들을 제외하였다.
전두엽-정중선 두피 부위에서 기록된 세타 활동은 인지 제어 요구에 의해 관여되는 계산 과정과 연관되어 왔습니다46. 내측 및 외측 전두엽 전극 부위 간의 세타 대역 위상 동기화 또한 제어 관련 처리 과정 중의 협응과 연관되어 왔습니다47. 특히, 갈등 또는 오류 탐지 후에 FCz 및 F6와 같은 부위 간의 세타 대역 위상 동기화가 강화되는 것이 관찰되었습니다48. 이러한 두피 측정치들은 인지 제어에만 고유하게 특이적인 것은 아니기 때문에, 여기서는 단일 인지 기제의 직접적인 판독값이 아니라 수렴적 프로세스 지표로 취급됩니다.
첫째, 자극 후 800–1,000 ms 창 내의 4–8 Hz 대역에서 전두엽 정중선 세타 이벤트 관련 동기화(ERS)를 정량화하였습니다. ERS는 시간-주파수 분석을 사용하여 계산되었으며, 상대적 전력 변화는 -500에서 -200 ms의 자극 전 기저선과 비교하여 산출되었습니다. 양수 값은 전력 강화(동기화)를 나타내고, 음수 값은 전력 억제(비동기화)를 나타냅니다. 둘째, 전처리된 데이터를 250 Hz로 추가 다운샘플링하고 P7, P8, F7, F8을 포함한 말초 전극을 제외한 후 기능적 연결성을 추정하였습니다. FCz와 F6 사이의 세타 대역 위상 잠금 값(PLV)을 계산하기 전에 단시간 푸리에 변환(STFT)을 적용하였습니다. 기저선 보정 PLV 변화량(ΔPLV)은 -600에서 -200 ms의 자극 전 기저선과 비교하여 계산되었습니다. 원시 PLV는 0과 1 사이의 값을 가지므로, 음수 ΔPLV 값은 음의 위상 잠금이 아니라 기저선 대비 감소를 의미합니다. 이러한 두피 측정치는 제어 관련 처리 및 전전두엽 협응과 관련된 탐색적 패턴으로 해석되며, 특정 인지 과정이나 신경원을 직접적으로 식별하는 것은 아닙니다.
결과
연구 1: 시나리오 실험 결과
측정 모델. 4요인 모델이 2요인 및 1요인 대안 모델보다 더 적합한 것으로 나타났으나, 절대적 적합도는 엇갈린 결과가 나왔다: χ2(48) = 223.93, p < .001; CFI = .935; TLI = .911; RMSEA = .111; SRMR = .140. 표준화 적재량은 .382에서 .937 범위였다. 합성 신뢰도는 인지된 전문성 .886, 사회적 실재감 .932, 인지적 신뢰 .840, 정서적 신뢰 .709였으며, 이에 해당하는 AVE 값은 각각 .722, .821, .636, .474였다. 판별 타당도는 제한적이었다: HTMT 값은 인지된 전문성과 인지적 신뢰 사이에서 .935, 사회적 실재감과 정서적 신뢰 사이에서 .926으로 나타났다. 따라서 조건부 프로세스 결과는 신중하게 해석하며, 차원별 신뢰 분석은 탐색적으로 수행되었다(표 1).
조작 점검. 전문가 프레이밍 참여자(n = 150, M = 5.57, SD = 1.18)는 동반자 프레이밍 참여자(n = 150, M = 3.21, SD = 1.76)보다 의료 AI를 더 전문가답다고 평가했다. 분산이 달랐기 때문에(F = 47.42, p < .001), Welch's 검정을 사용하였으며, t(259.90) = 13.63, p < .001, 평균 차이 = 2.36, 95% CI [2.02, 2.70]였다. 질병 조건 참여자(n = 150, M = 2.51, SD = 1.53)는 건강 조건 참여자(n = 150, M = 5.98, SD = 1.22)보다 예방 건강 지향성 점수를 더 낮게 부여했다(F = 10.96, p = .001); Welch’s t(284.11) = −21.70, p < .001, 평균 차이 = −3.47, 95% CI [−3.79, −3.16]. 분산이 균등하지 않을 때 Welch 자유도는 N − 2와 일치하지 않으며, 모든 분석에는 N = 300이 사용되었다.
실험 조건별 기술 통계입니다. 전문가 프레이밍의 경우, 질병 및 건강 상담에서 인지된 전문성 평균은 각각 5.69 (SD = 0.83) 및 5.85 (SD = 0.63), 사회적 실재감 평균은 4.28 (SD = 1.54) 및 4.25 (SD = 1.64), 그리고 전반적 신뢰도 평균은 5.45 (SD = 0.86) 및 5.28 (SD = 0.87)로 나타났습니다. 동료 프레이밍의 경우, 그에 대응하는 질병 및 건강 상담의 평균은 인지된 전문성에서 4.52 (SD = 1.47) 및 5.25 (SD = 0.94), 사회적 실재감에서 5.68 (SD = 1.07) 및 5.93 (SD = 0.74), 그리고 전반적 신뢰도에서 5.30 (SD = 1.02) 및 5.61 (SD = 0.64)였습니다. 표 2에 모든 조건별 신뢰 구간과 전체 요인 테스트 결과가 보고되어 있습니다.
전체 요인 분석 결과입니다. 인지된 전문성은 역할 프레이밍의 주효과, F(1, 296) = 56.92, p < .001, partial η2 = .161, 과업 맥락의 주효과, F(1, 296) = 14.37, p < .001, partial η2 = .046, 그리고 역할 × 과업 상호작용 효과, F(1, 296) = 5.89, p = .016, partial η2 = .020가 나타났습니다. 사회적 실재감은 역할 프레이밍의 주효과, F(1, 296) = 105.57, p < .001, partial η2 = .263를 보였으나, 과업 주효과, F(1, 296) = 0.59, p = .442와 상호작용 효과, F(1, 296) = 0.84, p = .359는 모두 유의하지 않았습니다. 후자의 결과는 조절 효과가 검출되지 않았음을 나타내며, 이것이 과업 간의 동등성을 입증하는 것은 아닙니다. 인지적 신뢰의 경우, 역할 × 과업 상호작용이 유의하였으며, F(1, 296) = 5.60, p = .019, partial η2 = .019였고, 정서적 신뢰의 경우 해당 상호작용은 유의하지 않았습니다, F(1, 296) = 3.48, p = .063, partial η2 = .012. 전체 신뢰는 역할 프레이밍 주효과, F(1, 296) = 0.81, p = .369 또는 과업 주효과, F(1, 296) = 0.55, p = .459를 보이지 않았으나, 역할 × 과업 상호작용은 유의하였습니다, F(1, 296) = 5.78, p = .017, partial η2 = .019. 질병 상담에서 전체 신뢰는 동반자 프레이밍과 전문가 프레이밍 사이에 차이가 없었습니다, mean difference = −0.15, SE = 0.14, t(296) = −1.06, p = .288, 95% CI [−0.42, 0.13]. 건강 상담에서 전체 신뢰는 동반자 프레이밍 하에서 더 높게 나타났습니다, mean difference = 0.33, SE = 0.14, t(296) = 2.34, p = .020, 95% CI [0.05, 0.60].
평행 조건부 간접 연관성. 인지된 전문성과 사회적 실재감을 동시에 투입했을 때, 두 요인 모두 전반적인 신뢰와 정적 연관성을 보였다: 각각 b = 0.4872, SE = 0.0258, p < .001, 95% CI [0.4294, 0.5460] 및 b = 0.3293, SE = 0.0208, p < .001, 95% CI [0.2762, 0.3829]. 직접적인 역할 프레이밍 연관성은 유의하지 않았다, b = 0.0119, SE = 0.0680, p = .861, 95% CI [−0.1071, 0.1361]. 전문성의 간접 연관성은 질병 상담에서 −0.5695, 95% bootstrap CI [−0.7687, −0.3851]였으며, 건강 상담에서는 −0.2923, 95% bootstrap CI [−0.4288, −0.1634]였다. 사회적 실재감의 간접 연관성은 질병 상담에서 0.4625, 95% bootstrap CI [0.3165, 0.6091]였으며, 건강 상담에서는 0.5532, 95% bootstrap CI [0.3855, 0.7383]였다(Table 3). 인지된 전문성을 통한 조절된 매개 지수는 0.2772, 95% bootstrap CI [0.0594, 0.5035]였으며, 사회적 실재감을 통한 지수는 0.0907, 95% bootstrap CI [−0.0984, 0.3008]였다. 두 지수 간의 직접 bootstrap 대비는 유의하지 않았다, difference = 0.1864, 95% bootstrap CI [−0.0856, 0.4447]. 따라서 이 결과는 전문성과 관련된 간접 연관성의 맥락적 조절을 지지하지만, 두 연관성 간의 통계적으로 유의미한 맥락적 조절의 차이는 입증하지 않았다.
탐색적 신뢰 차원 분석. 인지적 신뢰의 경우, 전문성과 사회적 실재감의 조절된 매개 지수 간의 대조 결과는 양수였으며, 차이 = 0.3707, 95% bootstrap CI [0.0493, 0.6996]였습니다. 정서적 신뢰의 경우, 해당 대조 결과는 지지되지 않았으며, 차이 = 0.0022, 95% bootstrap CI [−0.3421, 0.3127]였습니다. 두 매개 변수 모두 두 신뢰 차원과 양의 상관관계를 유지했으며, 이는 배타적 효과보다는 교차 경로 효과임을 나타냅니다. 높은 HTMT 수치를 고려할 때, 이러한 결과가 인지적 기제와 정서적 기제의 확정적인 분리를 의미하는 것으로 해석해서는 안 됩니다.
사후 조절된 매개 분석 통계적 검정력. 적합 모델 및 잔차 재표집 가정 하에서, 백분위수 부트스트랩 신뢰구간이 0을 제외할 추정 확률은 전문성 지수의 경우 .698, 사회적 실재감 지수의 경우 .157, 그리고 두 지수의 직접적 차이의 경우 .279였습니다(1,000회 시뮬레이션; 시뮬레이션당 500회 부트스트랩 재표집). 이러한 관찰 설계 추정치는 지지된 전문성 지수와 유의하지 않은 직접 대비 결과가 서로 다른 맥락적 조절에 대한 결정적인 증거로 해석되어서는 안 되는 이유를 설명해 줍니다.
완료 시간 강건성. 125 s 미만의 응답 15건을 제외하고 285건의 사례가 남았습니다. 전체 신뢰 상호작용은 p = .029로 유의미하게 유지되었으며, 전문성 지수는 95% bootstrap CI [0.0242, 0.4827]로 계속 지지되었습니다. 또한 조절된 매개 지수 간의 대비는 95% bootstrap CI [−0.1027, 0.4506]로 계속해서 유의미하지 않았습니다. 주요 결론은 가장 빠른 상위 5%의 응답에 의존하지 않았습니다.
연구 2: EEG 결과
전두-정중선 theta ERS. 최종 분석 샘플(N = 39)에서 4–8 Hz, 800–1,000 ms 윈도우의 theta ERS는 전문가 프레이밍(M = 0.2948, SD = 0.8218)이 동료 프레이밍(M = −0.0422, SD = 1.2155)보다 더 높게 나타났으며, 평균 차이는 0.3369, 95% CI [0.0125, 0.6614], t(38) = 2.10, p = .042, Cohen’s dz = 0.337, partial η2 = .104였습니다. 보고된 두 가지 쌍체 EEG 결과에 대해 Holm-보정된 p-값은 .042였습니다. 이러한 차이는 해당 과제 윈도우에서 theta 대역 처리 과정이 상이함을 나타내며, theta ERS 단독으로는 특정 심리적 과정을 식별하지 않습니다.
FCz-F6 기저선 보정 세타 PLV 변화(ΔPLV). 최종 분석 표본(N = 39)에서, 세타 ΔPLV는 동료 프레이밍(M = −0.0350, SD = 0.0473)보다 전문가 프레이밍(M = −0.0111, SD = 0.0546)에서 덜 음수 값으로 나타났으며, 평균 차이 = 0.0239, 95% CI [0.0058, 0.0420], t(38) = 2.68, p = .011, Cohen’s dz = 0.429, partial η2 = .159였다. 보고된 두 가지 짝지은 EEG 결과에 대해 Holm 보정된 p 값은 .022였다. 이러한 패턴은 전문가 프레이밍 시 기저선 대비 세타 위상 일관성의 감소 폭이 더 작음을 나타내며, 이것만으로 더 강력한 전전두엽 제어 또는 특정 인지 메커니즘이 입증되는 것은 아니다(그림 4 및 표 4 참조).
행동 과제 결과. 분석된 38개의 과제 기록에서, 신뢰-반응률은 전문가 프레이밍 조건에서 83.1% (SD = 15.8%), 동료 프레이밍 조건에서 82.4% (SD = 17.5%)였으며, 평균 차이는 0.7% 포인트, 95% CI [−0.9, 2.4], t(37) = 0.91, p = .371, dz = 0.147였다. 평균 반응 시간은 각각 828.7 ms (SD = 204.6) 및 826.1 ms (SD = 208.9)였으며, 평균 차이는 2.5 ms, 95% CI [−14.0, 19.1], t(37) = 0.31, p = .758, dz = 0.050였다. 무응답률은 각각 6.3% (SD = 7.4%) 및 5.2% (SD = 6.3%)였으며, 평균 차이는 1.1% 포인트, 95% CI [−1.0, 3.1], t(37) = 1.05, p = .302, dz = 0.170였다.
데이터 가용성 성명서:
비식별화된 연구 1 설문지 데이터, 전처리된 EEG 파일 및 연구 2를 뒷받침하는 통합 EEG 결과 파일은 Open Science Framework (OSF) (https://doi.org/10.17605/OSF.IO/JKSP7)에서 공개적으로 이용 가능합니다. 보충 자료에는 전체 실험 자극(보충 자료 1), 조작 확인, 추가 행동 분석, 사후 검정력 분석 및 보충 방법론 정보.
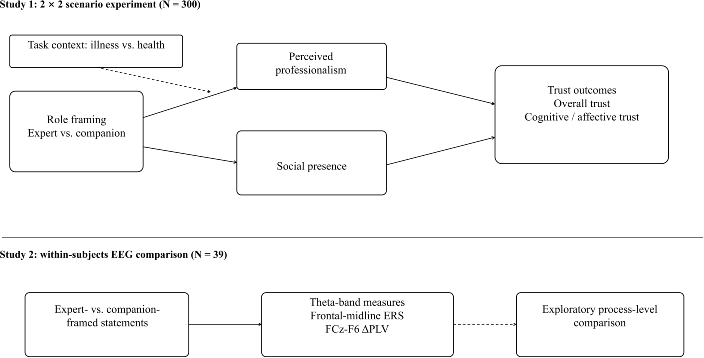
그림 1. 연구 프레임워크. 연구 1은 인지된 전문성과 사회적 실재감을 통한 역할 프레이밍, 과업 맥락 및 병렬 간접 연관성을 조사하는 2 × 2 시나리오 실험(N = 300)입니다. 연구 2는 전문가 프레이밍 및 동료 프레이밍 진술에 대한 탐색적 뇌전도(EEG) 비교 분석(N = 39)을 제공하며, 조건부 간접 모델을 직접적으로 테스트하지는 않습니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
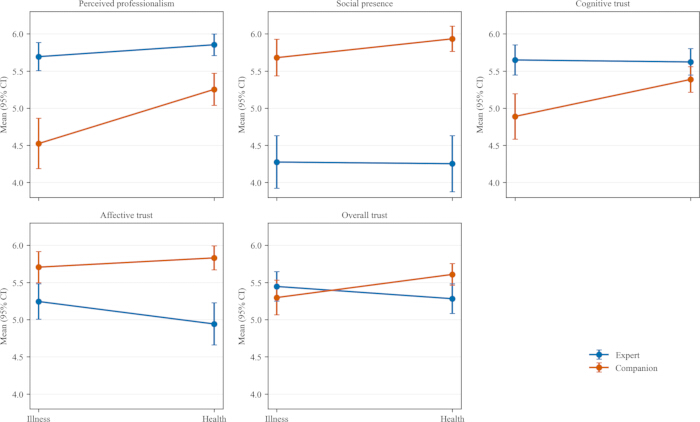
그림 2. 인지된 전문성, 사회적 실재감, 인지적 신뢰, 정서적 신뢰 및 전반적 신뢰에 대한 역할 프레이밍 × 과업 맥락 도표. 점은 셀 평균을 나타내며, 오차 막대는 95% 신뢰 구간을 나타냄(셀당 n = 75). 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
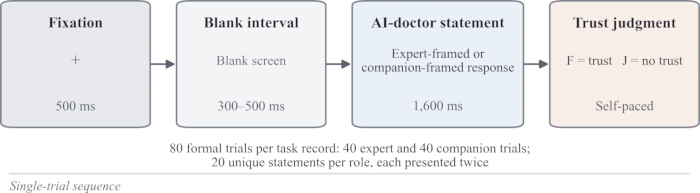
그림 3. 연구 2의 단일 시행 시퀀스. 각 시행은 500 ms의 주시점, 300–500 ms의 무작위 공백 구간, 1,600 ms의 전문가 또는 동료 프레임 기반 AI 의사 진술, 그리고 피험자 속도로 진행되는 이분법적 신뢰 판단으로 구성되었다. E-Prime 작업 로그에 따르면 과제 기록당 80회의 공식 시행이 있었으며, 역할 프레이밍 조건당 40회씩, 조건별로 20개의 고유 진술문이 각각 2회씩 제시되었다. 여기를 클릭하여 이 그림의 확대 버전을 확인하십시오.
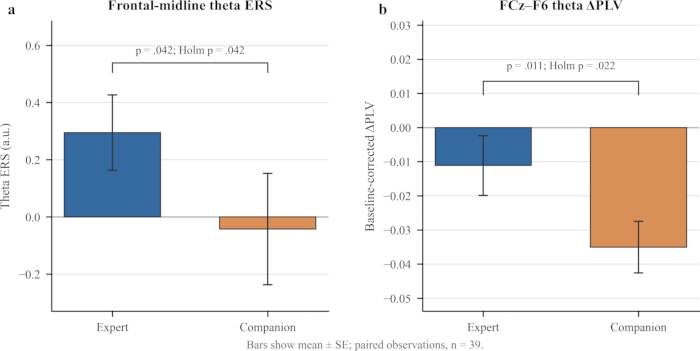
그림 4. 의료 AI 역할 프레이밍이 전두-정중선 theta ERS 및 FCz-F6 theta delta PLV에 미치는 영향. (A>) 전두-정중선 theta 사건 관련 동기화. (B>) 기선 보정된 FCz-F6 theta 위상 잠금 값 변화(ΔPLV); 음수 값은 자극 전 기선으로부터의 감소를 나타냄. 막대는 n = 39에 대한 평균 ± SE를 나타냄. 대응표본 t 검정 결과 theta ERS의 경우 p = .042, ΔPLV의 경우 p = .011임; 보고된 두 결과에 대해 Holm 보정된 p 값은 각각 .042와 .022였음. 약어: 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
표 1: 연구 1에 대한 측정 모델 진단.이 표는 인지된 전문성, 사회적 실재감, 인지적 신뢰 및 정서적 신뢰에 대한 표준화된 적재값, Cronbach’s α, 합성 신뢰도, 평균 분산 추출값, 잠재 상관관계 및 HTMT 값을 나타냅니다. N = 300. 4요인 모델이 대안 모델들보다 더 적합했으나, RMSEA와 SRMR은 낮은 절대 적합도를 나타냈으며 두 개의 HTMT 값이 .90을 초과했습니다. 약어: CR = 합성 신뢰도; AVE = 평균 분산 추출값; HTMT = 이질특성-단일특성 비율. 이 표를 다운로드하려면 여기를 클릭하십시오.
표 2: 연구 1에 대한 4가지 조건의 기술 통계 및 완전 2 × 2 요인 분석 결과. 셀 항목은 n, 평균, 표준 편차 및 95% 신뢰 구간을 나타내며, 요인 분석은 F, p 및 partial η2를 나타냅니다. N = 300; 셀당 n = 75. 역할 프레이밍은 1 = 전문가, 2 = 동료로 코딩되었으며, 과업 맥락은 1 = 질병, 2 = 건강 상담으로 코딩되었습니다. 계수와 신뢰 구간은 비표준화된 값입니다. 이 표를 다운로드하려면 여기를 클릭하십시오.
표 3: 연구 1의 병렬 조건부 간접 연관성. N = 300. 역할 프레이밍은 1 = 전문가, 2 = 동료로 코딩되었으며, 과업 맥락은 1 = 질병 상담, 2 = 건강 상담으로 코딩되었습니다. 인지된 전문성과 사회적 실재감은 동시에 투입되었습니다. 추정치는 비표준화되었으며, 백분위 부트스트랩 신뢰 구간은 5,000회 재표본 추출을 사용했습니다. 이 표에는 조건부 간접 연관성, 조절된 매개 효과의 두 지표, 그리고 이들의 직접적인 부트스트랩 대비가 포함되어 있습니다. 전체 신뢰도에 대한 두 조절된 매개 지표 간의 직접 대비는 0.1864, 95% CI [-0.0856, 0.4447]였습니다. 이 표를 다운로드하려면 여기를 클릭하십시오.
표 4: 연구 2의 쌍체 EEG 결과. 최종 분석 표본의 N = 39 쌍체 관찰치. 이 표는 전두-중앙선 theta ERS 및 기선 보정 FCz-F6 theta ΔPLV에 대한 조건별 평균, 쌍체 평균 차이, 95% 신뢰 구간, 쌍체 t 검정, Cohen’s dz, partial η2, 그리고 Holm 보정 p 값을 나타냅니다. Holm 보정은 보고된 두 가지 쌍체 EEG 결과에만 적용되었으며, 전극, 대역 또는 시간 창에 대해 문서화되지 않은 광범위한 탐색을 재구성하지 않았습니다. 이 표를 다운로드하려면 여기를 클릭하십시오.
보충 파일 1: 연구 1에서 사용된 실험 자극물. 이 파일에는 질병 상담 및 건강 상담 시나리오에서 사용된 전문가 프레임 및 동료 프레임의 의료 AI 응답 전문이 포함되어 있습니다. 중국어 원문과 영어 번역본이 모두 제공됩니다.이 파일을 다운로드하려면 여기를 클릭하십시오.
보충 표 S1. 조절된 매개 모델에 대한 사후 시뮬레이션 기반 검정력 분석. 이 파일을 다운로드하려면 여기를 클릭하십시오.
보충 표 S2. 연구 1에 대한 조작 확인 통계 및 완료 시간 민감도 분석. 이 파일을 다운로드하려면 여기를 클릭하십시오.
보충 표 S3. 연구 2의 행동 과제 결과, 표본 산출 및 기술 통계. 이 파일을 다운로드하려면 여기를 클릭하십시오.
토론
이론적 시사점
두 연구는 서로 다른 수준에서 증거를 제공합니다. 연구 1은 무작위 시나리오 실험을 통해 역할-과업 연관성 및 병렬적 간접 연관성을 확인한 반면, 연구 2는 탐색적인 프로세스 수준의 EEG 비교를 제공합니다. 따라서 본 연구들은 단일한 점진적 메커니즘보다는 역할 프레임 평가의 제한적 설명(bounded account)을 뒷받침합니다. 이러한 결과는 일치성을 역할 단서와 과업 중심의 평가적 요구 사이의 정렬로 처리함으로써 역할 일치 이론(role congruity theory)을 의료 AI 분야로 확장합니다22. 이러한 해석은 역량-온정(competence-warmth) 콘텐츠 및 과업-기술 적합성(task-technology fit)과는 구별됩니다. 알고리즘 혐오 및 알고리즘 선호 결과는 역할과 능력 단서가 과업에 적합한지에 대한 맥락 민감적 평가로 이해될 수 있습니다49,50.
결과는 또한 역할 프레이밍, 인지된 전문성, 사회적 실재감 및 신뢰 사이의 병렬적이고 비배타적인 연관성을 뒷받침합니다. 전문성은 인지적 신뢰와 겹치고, 사회적 실재감은 정서적 신뢰와 겹치기 때문에, 이러한 증거는 차별화된 평가 내용은 지지하지만 두 가지로 명확히 분리된 메커니즘은 지지하지 않습니다. 인지된 전문성에 대한 역할과 과업의 상호작용은 제안된 역할 일치 설명과 일치합니다. 이러한 증거는 전문성과의 연관성에 대한 맥락적 조절을 뒷받침하지만, 통계적으로 비대칭적인 맥락적 메커니즘이나 사회적 실재감 경로의 불변성을 입증하지는 않습니다.
EEG 결과는 탐색적인 프로세스 수준의 관점을 제공합니다. 전문가 프레임 진술에서는 뚜렷한 theta-band 패턴이 나타났으나, 각 조건은 의미적 내용과 복잡성에서도 차이가 있었으며, 조건 수준의 행동에서는 신뢰도에 있어 신뢰할 만한 차이가 나타나지 않았습니다. 따라서 EEG 측정값은 별도의 인지 제어 또는 신뢰 메커니즘을 입증하지 않습니다. 신경과학적 결과는 가설 생성 단계로 간주되어야 합니다. 연구 2에서는 과제 맥락을 조작하거나, 인지된 전문성 또는 사회적 실재감을 측정하지 않았으며, 시행 수준의 EEG 지표를 신뢰 판단과 연결하지 않았습니다. 그러므로 EEG 결과는 조건부 간접 모델을 검증하기보다는 보완하는 역할을 합니다.
이러한 결과는 최대치가 아닌 적절한 수준의 의존성과 일치합니다. 자동화 시스템에 대한 의존도는 시스템의 기능, 한계 및 작업 요구 사항에 맞춰 조정되어야 합니다35. 관련 연구에서는 조정된 신뢰와 의존성을 지원할 수 있는 적응적 인지 메커니즘에 대해 설명합니다51. NeuroIS 관점은 시간적 분해능을 가진 프로세스를 조사할 때 행동 증거를 보완하는 수단으로 신경 측정법을 사용하는 것을 지지합니다52. 기존의 fMRI 연구 또한 온라인 신뢰 판단 중의 신경 활동이 대상과 상황에 따라 다양하게 나타남을 보여줍니다53.
관리적 시사점
온라인 의료 플랫폼의 경우, 실질적인 시사점은 단순한 신뢰의 극대화가 아니라 조정된 의존성(calibrated reliance)을 구축하는 것입니다. 역할 단서는 과업 요구 사항에 맞게 설정되어야 하며, 불확실성에 대한 소통, 명시적인 능력의 한계, 위험 기반 경고 및 자격을 갖춘 임상의로의 단계적 이관과 결합되어야 합니다.
진단, 비정상적 결과의 해석, 의료적 조언 또는 트리아지(triage)를 포함하는 고위험 모듈에서는 역량 중심의 단서가 사용자에게 과도한 권위를 부여하지 않으면서도 근거와 조치의 경계를 인식하는 데 도움을 줄 수 있습니다. 식단, 운동, 수면, 복약 준수 및 정서적 지원과 같이 긴급도가 낮은 모듈에서는 관계 중심의 단서가 거짓 안심이나 부적절한 의인화를 유발하지 않으면서 참여도를 높이는 데 기여할 수 있습니다.
역할 설계는 고정된 페르소나 설정보다는 모듈식 및 시나리오 기반으로 이루어져야 합니다. 역할 구성은 설명, 개인정보 보호 프롬프트, 위험 레이블 및 에스컬레이션 메커니즘과 통합되어야 합니다. 거버넌스 연구에서는 신뢰할 수 있는 프런트엔드 역할 단서가 백엔드의 위험을 은폐하지 않도록 투명성, 책임성, 편향 관리 및 개인정보 보호가 함께 설계되어야 함을 강조합니다6,20,21.
연구의 한계 및 향후 방향
연구 1은 실제 상담이 아닌 시나리오 실험입니다. 각 조건은 길이, 단어 빈도, 가독성, 정확성, 실행 가능성, 정서적 가가치, 각성도, 위험성, 친숙도 또는 복잡성에 대해 독립적으로 사전 테스트되지 않았습니다. 향후 연구에서는 여러 시나리오, 중립적인 시스템 이름, 내용이 일치하는 자극, 독립적인 조작 또는 시간적으로 분리된 측정, 그리고 참가자 및 자극 수준의 랜덤 효과를 사용해야 합니다.
연구 2는 프로세스 수준의 EEG 증거를 제공하였으나, 최종 39명에 대한 인구통계학적 연결이 불완전했으며, EEG 문장들이 문장 길이, 단어 빈도, 가독성, 정서적 가가, 각성도, 인지된 위험, 친숙도 및 복잡성에 대해 독립적으로 매칭되거나 사전 테스트되지 않았고, 명시적인 역할 레이블이 요구 특성을 유발했을 가능성이 있습니다. 본 연구에서는 기능적 연결성의 사전 정의된 측정치로 기선 보정 위상 잠금 값(ΔPLV)을 사용하였습니다. 가중 위상 지연 지수(wPLI)는 볼륨 전도에 덜 민감하지만, 원래의 분석 파이프라인에는 포함되지 않았습니다. 향후 연구에서는 wPLI 또는 기타 보완적인 연결성 측정치를 사용하여 본 연구의 결과가 재현되는지 확인해야 합니다. 가용한 신경 출력값은 조건별로 합산되어 있어 시행 수준의 신뢰 판단과 연결할 수 없으므로, 시행 수준의 EEG-행동 혼합 모델은 추정되지 않았습니다. 두피 PLV 또한 공통 참조 및 볼륨 전도 효과에 민감합니다. 이러한 제한점들로 인해 신경학적 결과는 탐색적인 수준으로 유지되어야 하며, 고유한 인지 제어 또는 신뢰 메커니즘에 대한 증거로 해석되어서는 안 됩니다.
공개 사항
저자들은 선언할 이해상충이 없습니다.
본 연구의 준비 과정에서 저자들은 언어 개선을 위해 ChatGPT를 사용하였습니다. 해당 도구/서비스를 이용한 후, 저자들은 필요한 경우 내용을 검토 및 수정하였으며, 출판물 내용에 대해 모든 책임을 집니다.
감사의 글
본 연구 프로젝트는 중국 국가사회과학기금 일반 프로젝트(지원 번호 22BGL006)의 지원을 받아 수행되었습니다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| Credamo 온라인 설문 플랫폼 | Credamo (Jianshu), China | 해당 없음 | 연구 1에서 사용된 온라인 설문지, 무작위 배정 및 참가자 모집 플랫폼. |
| CURRY 재참조(rereferencing) 기능 | Compumedics Neuroscan, USA | 버전 미지정 | FCz 온라인 참조에서 양측 유양돌기 평균으로의 내장 오프라인 재참조; FCz는 새로운 참조를 기준으로 자동 재구성됨. |
| EEG 전극 캡, 64채널 | Compumedics Neuroscan (Compumedics Limited), Australia | 모델/카탈로그 번호 미지정 | 지속적인 EEG 기록에 사용된 64채널 Ag/AgCl 전극 캡. |
| EEGLAB | Swartz Center for Computational Neuroscience, University of California San Diego, USA | Version 2023.0 | EEG 전처리 및 독립 성분 분석에 사용된 MATLAB 툴박스. |
| E-Prime | Psychology Software Tools, Inc., USA | Version 2.1 | 연구 2의 자극 제시 및 반응 수집. |
| G*Power | Heinrich Heine University Dusseldorf, Germany | Version 3.1.9.7 | 연구 1을 위한 사전 표본 크기 계산, 상호작용 민감도 분석 및 사후 모델 기반 검정력 분석. |
| IBM SPSS Statistics | IBM Corp., USA | Version 27 | PROCESS 매크로 실행에 사용된 통계 환경. |
| ICLabel | Swartz Center for Computational Neuroscience, University of California San Diego, USA | Version 1.7 | 아티팩트 독립 성분을 분류하는 데 사용된 EEGLAB 플러그인. |
| MATLAB | The MathWorks, Inc., USA | Release R2020b | EEG 처리 및 분석에 사용된 컴퓨팅 환경. |
| SPSS용 PROCESS 매크로 | Andrew F. Hayes, Canada | Version 4.2 beta | 연구 1에서 인지된 전문성과 사회적 실재감을 병렬 매개변수로 동시에 입력한 모델 7이며, 5,000개의 백분위 부트스트랩 샘플을 사용함. |
| Quik-Gel 전도성 전해질 겔 | Compumedics Neuroscan (Compumedics Limited), Australia | 카탈로그 번호 미지정; 32 oz | EEG 기록 중 전극-피부 임피던스를 줄이는 데 사용된 전도성 겔. |
| SynAmps2 EEG 증폭기 | Compumedics Neuroscan (Compumedics Limited), Australia | SynAmps2; 카탈로그 번호 미지정 | 64채널 기록용으로 구성된 64-256채널 EEG 증폭기. |
참고문헌
- Grand View Research. Artificial intelligence in healthcare market size & share, industry report, 2033 [Internet]. Grand View Research; [cited 2026 Jul 11]. Available from: https://www.grandviewresearch.com/industry-analysis/artificial-intelligence-ai-healthcare-market
- Singhal K, et al. Large language models encode clinical knowledge. Nature. 2023;620(7972):172-80.
- Laranjo L, et al. Conversational agents in healthcare: a systematic review. J Am Med Inform Assoc. 2018;25(9):1248-58.
- Kouzy R, Hong JC, Bitterman DS. One shot at trust: building credible evidence for medical artificial intelligence. Lancet Digit Health. 2025;7(7):100883.
- Kim C, Gadgil SU, Lee SI. Transparency of medical artificial intelligence systems. Nat Rev Bioeng. 2026;4(1):11-29.
- Bian X, Chen Y, Yang A. Configuring trust in AI-augmented healthcare: the role of AI interpretability and data privacy in patient adoption of AI-assisted diagnosis. Int J Inf Manage. 2026;88:103039.
- Longoni C, Bonezzi A, Morewedge CK. Resistance to medical artificial intelligence. J Consum Res. 2019;46(4):629-50.
- Logg JM, Minson JA, Moore DA. Algorithm appreciation: people prefer algorithmic to human judgment. Organ Behav Hum Decis Process. 2019;151:90-103.
- Qin H, et al. Examining the impact of personalization and carefulness in AI-generated health advice: trust, adoption, and insights in online healthcare consultations experiments. Technol Soc. 2024;79:102726.
- Mayer CJ, et al. User preferences and trust in hypothetical analog, digitalized and AI-based medical consultation scenarios: an online discrete choice survey. Comput Human Behav. 2024;161:108419.
- Du G, Zhou C, Cheng X. Reducing consumers’ resistance to AI agents in online healthcare consultations: the role of human-AI teaming from a trust transfer perspective. J Bus Res. 2026;206:115959.
- Fiske ST, Cuddy AJC, Glick P, Xu J. A model of often mixed stereotype content: competence and warmth respectively follow from perceived status and competition. J Pers Soc Psychol. 2002;82(6):878-902.
- Araujo T. Living up to the chatbot hype: the influence of anthropomorphic design cues and communicative agency framing on conversational agent and company perceptions. Comput Human Behav. 2018;85:183-9.
- Zhang J, Luximon Y, Li Q. Seeking medical advice in mobile applications: how social cue design and privacy concerns influence trust and behavioral intention in impersonal patient-physician interactions. Comput Human Behav. 2022;130:107178.
- Li Q, Luximon Y, Zhang J. The influence of anthropomorphic cues on patients’ perceived anthropomorphism, social presence, trust building, and acceptance of health care conversational agents: within-subject web-based experiment. J Med Internet Res. 2023;25:e44479.
- Harris-Watson AM, et al. Social perception in human-AI teams: warmth and competence predict receptivity to AI teammates. Comput Human Behav. 2023;145:107765.
- Schelble BG, et al. Addressing the role of context on trust in human-AI teams: the influence of team role and violation type in high-risk tasks. Ergonomics. 2025. doi:10.1080/00140139.2025.2570300.
- Mou Y, Ye X, Ma W. Building and repairing trust in chatbots: the interplay between social role and performance during interactions. Behav Sci (Basel). 2026;16(1):118.
- Glikson E, Woolley AW. Human trust in artificial intelligence: review of empirical research. Acad Manage Ann. 2020;14(2):627-60.
- Luo Y, Li S, Ye Q, Zheng J. How privacy calculus builds user engagement through trust in AI medical consultation. Electron Mark. 2025;35(1):50.
- Nouis SCE, Uren V, Jariwala S. Evaluating accountability, transparency, and bias in AI-assisted healthcare decision-making: a qualitative study of healthcare professionals’ perspectives in the UK. BMC Med Ethics. 2025;26(1):89.
- Eagly AH, Karau SJ. Role congruity theory of prejudice toward female leaders. Psychol Rev. 2002;109(3):573-98.
- Laï MC, Brian M, Mamzer MF. Perceptions of artificial intelligence in healthcare: findings from a qualitative survey study among actors in France. J Transl Med. 2020;18(1):14.
- Feine J, Gnewuch U, Morana S, Maedche A. A taxonomy of social cues for conversational agents. Int J Hum Comput Stud. 2019;132:138-61.
- Mayer RC, Davis JH, Schoorman FD. An integrative model of organizational trust. Acad Manage Rev. 1995;20(3):709-34.
- Nass C, Moon Y. Machines and mindlessness: social responses to computers. J Soc Issues. 2000;56(1):81-103.
- Epley N, Waytz A, Cacioppo JT. On seeing human: a three-factor theory of anthropomorphism. Psychol Rev. 2007;114(4):864-86.
- McAllister DJ. Affect- and cognition-based trust as foundations for interpersonal cooperation in organizations. Acad Manage J. 1995;38(1):24-59.
- McKnight DH, Choudhury V, Kacmar C. Developing and validating trust measures for e-commerce: an integrative typology. Inf Syst Res. 2002;13(3):334-59.
- Johnson D, Grayson K. Cognitive and affective trust in service relationships. J Bus Res. 2005;58(4):500-7.
- Bussone A, Stumpf S, O’Sullivan D. The role of explanations on trust and reliance in clinical decision support systems [conference paper]. Presented at: 2015 International Conference on Healthcare Informatics; 2015. p. 160-9. doi:10.1109/ICHI.2015.26.
- Li Y, Chen L, Fu L. Vicarious interaction in online health consultation service: the effects of generative AI’s anthropomorphism and social support on intended responses through social presence and source credibility. Int J Hum Comput Interact. 2025;41(17):11209-26.
- Short J, Williams E, Christie B. The social psychology of telecommunications. John Wiley & Sons; London; 1976.
- Gefen D, Straub DW. Consumer trust in B2C e-commerce and the importance of social presence: experiments in e-products and e-services. Omega. 2004;32(6):407-24.
- Lee JD, See KA. Trust in automation: designing for appropriate reliance. Hum Factors. 2004;46(1):50-80.
- Goodhue DL, Thompson RL. Task-technology fit and individual performance. MIS Q. 1995;19(2):213-36.
- Castelo N, Bos MW, Lehmann DR. Task-dependent algorithm aversion. J Mark Res. 2019;56(5):809-25.
- Parsons CS, et al. Task-technology fit of artificial intelligence-based clinical decision support systems: a review of qualitative studies. BMC Med Inform Decis Mak. 2025;25(1):397.
- Wutz M, Hermes M, Winter V, Köberlein-Neu J. Factors influencing the acceptability, acceptance, and adoption of conversational agents in health care: integrative review. J Med Internet Res. 2023;25:e46548.
- Faul F, Erdfelder E, Lang AG, Buchner A. G*Power 3: a flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behav Res Methods. 2007;39(2):175-91.
- Tadros FJ, et al. Perceived professionalism of a dietitian is not influenced by attire or white coat: a prospective, randomized online study. Top Clin Nutr. 2021;36(3):231-41.
- Shams G, Kim KK, Kim K. Enhancing service recovery satisfaction with chatbots: the role of humor and informal language. Int J Hosp Manag. 2024;120:103782.
- Hayes AF. Introduction to mediation, moderation, and conditional process analysis: a regression-based approach. 3rd ed. Guilford Press; New York; 2022.
- Delorme A, Makeig S. EEGLAB: an open source toolbox for analysis of single-trial EEG dynamics including independent component analysis. J Neurosci Methods. 2004;134(1):9-21.
- Pion-Tonachini L, Kreutz-Delgado K, Makeig S. ICLabel: an automated electroencephalographic independent component classifier, dataset, and website. Neuroimage. 2019;198:181-97.
- Cavanagh JF, Frank MJ. Frontal theta as a mechanism for cognitive control. Trends Cogn Sci. 2014;18(8):414-21.
- Buzzell GA, et al. Adolescent cognitive control, theta oscillations, and social observation. Neuroimage. 2019;198:13-30.
- Cavanagh JF, Cohen MX, Allen JJB. Prelude to and resolution of an error: EEG phase synchrony reveals cognitive control dynamics during action monitoring. J Neurosci. 2009;29(1):98-105.
- Dietvorst BJ, Simmons JP, Massey C. Algorithm aversion: people erroneously avoid algorithms after seeing them err. J Exp Psychol Gen. 2015;144(1):114-26.
- Jussupow E, Benbasat I, Heinzl A. An integrative perspective on algorithm aversion and appreciation in decision-making. MIS Q. 2024;48(4):1575-90.
- Lebiere C, Blaha L, Fallon C, Jefferson BA. Adaptive cognitive mechanisms to maintain calibrated trust and reliance in automation. Front Robot AI. 2021;8:652776.
- Dimoka A, et al. On the use of neurophysiological tools in IS research: developing a research agenda for NeuroIS. MIS Q. 2012;36(3):679-702.
- Riedl R, Hubert M, Kenning P. Are there neural gender differences in online trust? An fMRI study on the perceived trustworthiness of eBay offers. MIS Q. 2010;34(2):397-428.