본 계산 연구는 공공 호흡기 바이러스 전사체 분석의 벤치마킹을 위한 구획 인식 워크플로우를 제시하며, 비강 및 혈액 내 숙주 반응이 유전자 수준에서는 제한적인 일치성을 보이지만, 독립적인 데이터셋, 임상 비교, 종단적 회복 및 강건성 분석 전반에 걸쳐 재현 가능하고 생물학적으로 해석 가능한 구획 특이적 모듈을 생성함을 입증합니다.
연구 논문
비강 및 혈액 호스트 반응 모듈을 위한 호흡기 바이러스 전사체 벤치마킹의 구획 인식 분석: 계산 과학적 연구
이 논문에서
요약
초록
공개된 호흡기 바이러스 전사체 데이터는 숙주 반응 연구에 매우 가치 있지만, 조직 출처, 대조군 정의 및 연구 설계의 차이가 통합 분석에 혼란을 줄 수 있습니다. 본 연구에서는 비강 및 혈액의 생물학적 맥락을 유지하면서 재현 가능한 숙주 반응 활성을 식별할 수 있는지 결정하기 위해 구획 인식(compartment-aware) 계산 워크플로우를 개발했습니다. 쌍을 이룬 GSE17827 소아 코호트를 앵커 데이터셋으로 활용하였으며, 여기에는 증상이 있는 picornavirus 감염, 증상이 있는 respiratory syncytial virus 감염, 증상이 없는 picornavirus 검출 및 바이러스 음성 대조군의 비강 면봉 및 전혈 전사체가 포함되었습니다. HUGO Gene Nomenclature Committee (HGNC) 필터링 후 27,685개의 유전자를 분석했습니다. 상위 양성 반응으로부터 각각 50개의 유전자로 구성된 단백질 코딩 비강 및 혈액 모듈을 정의하고 외부 평가 전에 이를 고정했습니다. 유전자 수준의 비강 및 혈액 효과는 거의 독립적이었으며(Pearson r = 0.015), 두 모듈은 6개의 탐색적 순위 중첩 유전자(Jaccard index = 0.064)를 공유했습니다. 그럼에도 불구하고, 비강 모듈은 독립적인 상기도 코호트에서 감염군과 대조군을 구분하였으며, 수신자 조작 특성 곡선 아래 면적(AUROCs)은 각각 0.749, 0.693, 0.609였습니다. 반면, 혈액 모듈은 외부 혈액 코호트에서 0.832, 0.924, 0.870의 AUROCs를 달성했습니다. 종단적 자연 감염 데이터에서 매칭된 점수는 급성 질환 시기부터 퇴원 시까지 감소했으며, 쌍을 이룬 델타 값은 비강 샘플의 경우 0.436, 혈액의 경우 0.330이었습니다. 6개의 외부 샘플로 구성된 3개의 추가 벤치마크 데이터셋과 함께 무작위 유전자 널(null) 분석, 모듈 크기 스윕, 부트스트랩 안정성, 마커-프로그램 상관관계 및 분산 분할을 통해 워크플로우의 견고성과 한계를 정의했습니다. Pandya 3-messenger ribonucleic acid (mRNA) 세트는 바이러스 대 세균 구분에 더 강력하게 유지된 반면, 혈액 모듈은 세균성 폐렴에서도 증가했습니다. 이러한 결과는 구획 특이적 모듈이 보편적인 범조직 바이오마커나 독립적인 병원체 분류기라기보다, 코호트 비교 및 회복 추적을 위한 재사용 가능한 숙주 반응 활성 점수로 유용함을 뒷받침합니다.
서론
숙주 전사체 시그니처는 감염성 증후군을 분류하고 병원체 간의 면역 반응을 비교하는 데 널리 사용됩니다1,2,3,4,5. 호흡기 바이러스는 종종 중첩되는 인터페론 자극 유전자(ISGs), 염증 매개체 및 항원 제시 경로를 활성화합니다6,7,8,9,10. 최근의 쌍체 및 종단적 연구들은 국소 기도 반응과 전신 반응이 타이밍, 세포 구성 및 강도 면에서 다를 수 있음을 보여줍니다1. 이러한 문제는 인플루엔자, 호흡기 세포 융합 바이러스(RSV), 라이노바이러스 및 SARS-CoV-2를 넘어섭니다. 휴먼 메타뉴모바이러스는 호흡기 질환의 중요한 원인으로 남아 있으나, 이에 대한 숙주 반응 및 중재 문헌은 여전히 발전 단계에 있습니다12,13. 호흡기 바이러스 감염 전반에 걸친 이러한 관찰 결과는 국소 기도 반응과 전신 숙주 반응 사이의 차이를 더욱 부각시킵니다14. 따라서 계산적 숙주-바이러스 연구에서 실질적인 질문은 단순히 반응의 존재 여부만이 아닙니다. 조직의 맥락을 보존하고 재현 가능한 숙주 반응 점수를 산출하는 투명한 워크플로우를 통해 공개 데이터를 재사용할 수 있는지 여부입니다.
대부분의 공개 호흡기 바이러스 전사체 데이터세트는 바이러스 간 또는 조직 간의 명확한 추론을 위해 설계되지 않았습니다. 조직의 기원, 시점, 중증도, 연령, 대조군 정의 및 플랫폼이 서로 함께 변화하는 경우가 많습니다. 또한 고처리량 발현 데이터세트는 원치 않는 기술적 및 연구 수준의 변동에 취약합니다15,16. 따라서 통합 분석을 수행하면 강력한 인터페론 또는 염증 시그니처를 찾아낼 수는 있으나, 그 기원을 모호하게 만들 수 있습니다. 비강 샘플은 상피 및 점막 면역 생물학을 포착하는 반면, 전혈은 전신 백구 반응을 반영합니다. 이러한 구획들을 상호 교환 가능한 것으로 취급하면 점수 계산은 쉬워지지만 해석은 어려워집니다.
우리는 사용 가능한 가장 큰 발견 컬렉션17 대신, 동일 연구의 쌍을 이룬 비강-혈액 코호트인 GSE17827을 중심으로 분석을 구축했습니다. 이 코호트는 규모가 작지만, 비강과 혈액의 효과 크기를 비교할 때 연구 간 교란 요인을 줄여줍니다. 여기에는 증상이 있는 picornavirus 감염, 증상이 있는 RSV 감염, 무증상 picornavirus 검출 및 바이러스 음성 대조군이 포함됩니다. 따라서 우리는 이를 별도의 구획 특이적 모듈을 위한 앵커로만 사용했습니다. 모듈 멤버십은 외부 테스트 전에 고정되었습니다. 소규모 코호트 선택의 안정성은 층화 부트스트랩 재표집, 무작위 유전자 널 모델 및 모듈 크기 민감도 분석을 통해 검토되었습니다.
우리는 박테리아 및 비감염성 비교군을 포함한 벤치마킹 레이어를 추가했습니다. GSE6390은 바이러스성, 박테리아성 또는 비감염성으로 분류된 전혈 급성 호흡기 질환 샘플을 포함하고 있습니다18. GSE4012는 중증 지역사회 획득성 폐렴, 전신성 염증 반응 증후군(SIRS) 및 건강한 대조군을 포함합니다19. 이러한 코호트는 특정 모듈이 일반적인 숙주 반응 활성을 반영하는지 아니면 병원체 클래스 특이성을 반영하는지를 테스트합니다. GSE53543은 ex vivo 말초혈액 단핵구(PBMC) 라이노바이러스 섭동 벤치마크로서 별도로 분석되었습니다. 이는 제어된 자극 하에서 백혈구의 반응성을 측정하지만, 자연 감염과 동일하지는 않습니다.
우리의 전제는 의도적으로 보수적입니다. 우리는 이질적인 공공 데이터로부터 보편적인 항바이러스 시그니처를 증명하려 하지 않습니다. 대신, 구획 인식(compartment-aware) 워크플로우가 외부 검증 후에도 유용한 모듈 점수를 생성할 수 있는지 확인하고자 합니다. 본 방법의 의도된 용도는 Pandya 3-mRNA와 같은 진단 분류기의 보완적 수단입니다. 이 모듈들은 코와 혈액에서의 숙주 반응 활성도를 코호트, 회복 정도 및 증상 구배에 따라 점수화합니다. 이는 병원체 분류를 할당하기 위해 설계된 것이 아닙니다.
프로토콜
본 연구는 비식별화된 공개 데이터를 재분석하였으며, 새로운 피험자 모집, 중재 또는 검체 수집을 포함하지 않았습니다. 따라서 본 2차 분석을 위한 기관 윤리 승인 및 새로운 고지된 동의는 필요하지 않았습니다. 원본 연구에 대한 윤리 승인 및 고지된 동의는 각각의 데이터 생성자에 의해 보고되었습니다.
연구 설계 및 워크플로 논리
본 연구는 Gene Expression Omnibus20,21에 등록된 데이터셋을 이용한 회고적 공공 데이터 생물정보학 연구로 수행되었습니다. 새로운 환자 샘플, 세포 배양 실험, 동물 모델 또는 습식 실험실 검증은 생성되지 않았습니다. 워크플로는 앵커 우선(anchor-first) 설계를 사용하였습니다. GSE17827은 효과 크기 추정, 모듈 구축, 구획 간 일치성 및 증상 구배 분석에 사용되었습니다. 독립적인 데이터셋은 모듈 멤버십이 확정된 이후에만 도입되었습니다. 워크플로는 쌍을 이룬 구획 앵커링, HGNC 매핑 및 단백질 코딩 필터링, 개별 비강 및 혈액 모듈 구축, 조직 일치 및 종단적 검증, 임상 벤치마킹, 그리고 강건성 분석으로 구성되었습니다. 확증 분석에는 고정된 조직 일치 및 종단적 테스트가 포함되었습니다. 중첩 유전자, 증상 구배, 마커 프로그램 및 분산 분석은 탐색적 또는 기술적 분석으로 수행되었습니다.
앵커 코호트 및 기본 대조군
GSE17827에는 26명의 아동으로부터 얻은 비강 스왑 및 전혈 발현 프로파일이 포함되어 있으며, 여기에는 유증상 picornavirus 사례 9명, 무증상 picornavirus 검출 5명, 유증상 RSV 사례 6명, 그리고 무증상 바이러스 음성 대조군 6명이 포함됩니다17. RSV 사례 중 2명은 혈액 검체가 없었습니다. 따라서 전체 앵커 설계에는 50개의 샘플이 포함되었으며, 모듈 구축 시 무증상 picornavirus 검출 샘플을 제외한 후 기본 감염군 대조군 대조에는 40개의 샘플이 포함되었습니다. 기본 대조를 위해 유증상 picornavirus 및 유증상 RSV 샘플은 감염군으로, 무증상 바이러스 음성 샘플은 대조군으로 분류되었습니다. 무증상 picornavirus 검출 사례는 증상 없는 바이러스 검출이 바이러스 음성 건강 상태와 생물학적으로 구별되기 때문에 대조군으로 처리하지 않았습니다. 이 샘플들은 모듈 구축에서 제외되었으며 이후 증상 구배 분석에 사용되었습니다.
프로브 매핑 및 전처리
GSE117827은 GPL23126에서 프로파일링되었습니다. 전사체 클러스터 식별자는 GEO 플랫폼 GPL24539를 통해 배포된 Clariom D Human na36, hg38 주석 파일을 사용하여 유전자 기호로 매핑되었습니다. HGNC 승인 기호만 유지되었습니다2. 컨트롤 프로브, ERCC 프로브, 매핑되지 않은 전사체 클러스터 및 미승인 기호는 제거되었습니다. 동일한 승인 기호로 매핑되는 여러 전사체 클러스터는 발현값의 중앙값을 사용하여 통합되었습니다. 필터링 및 통합 후, 앵커 분석에 사용할 수 있는 유전자는 27,685개였습니다. 발현 행렬의 95번째 백분위수가 50을 초과하여 로그 변환되지 않은 강도 척도임이 확인된 경우에만 log₂(x + 1) 변환을 적용하였습니다. 결측값이 20% 이상인 유전자는 제거되었으며, 나머지 결측값은 해당 유전자 내의 중앙값으로 대체되었습니다. 이후 각 유전자는 해당 데이터 세트의 모든 샘플에 대해 z = (x − 평균)/샘플 표준 편차 (ddof = 1)로 표준화되었습니다. 분산이 0인 유전자는 표준화 값 0으로 할당되었습니다. 모듈 구축은 HGNC 전체 세트에서 단백질 코딩 유전자로 분류된 항목으로 제한되었습니다.
효과 크기 분석 및 모듈 구축
비강 및 혈액 구획을 각각 별도로 분석하였다. 증상이 있는 바이러스 샘플과 바이러스 음성 대조군을 Hedges g 표준화 평균 차이 및 양측 Welch 검정을 사용하여 비교하였다23. Hedges g는 감염군과 대조군의 평균 차이를 통합 표준 편차로 나눈 후, 소표본 보정 값인 1 − 3/(4df − 1)을 곱하여 계산하였으며, 여기서 df = ninfected + ncontrol − 2이다. Welch 검정은 등분산을 가정하지 않고 수행되었다. 각 구획 내에서 테스트된 모든 유전자에 대해 Benjamini–Hochberg 허위 발견율(FDR)을 계산하였다24. 소규모 앵커 코호트에서 FDR < 0.05 및 Hedges g > 0.8이라는 사전 지정된 엄격한 조합 조건을 충족하는 단백질 코딩 유전자가 없었기 때문에, 양성 효과 유전자를 먼저 양측 Welch P 값의 오름차순으로, 그다음 Hedges g의 내림차순으로 순위를 매겼으며, 최종 동점자 처리 기준으로는 유전자 기호를 사용하였다. 상위 50개 유전자가 각각의 기본 모듈을 형성하였다. 50개 유전자는 플랫폼 간 유전자 누락 손실을 제한하면서 생물학적 폭을 유지할 수 있는 적절한 모듈 크기로 사전 선정되었다. 이 모듈 크기는 외부 AUROC에 맞추어 조정되지 않았다. 10, 25, 50, 10, 20개 유전자를 사용한 민감도 분석 결과, 동일한 질적 앵커 분리 결과가 도출되었다. 분석의 목적은 단일 유전자 발견이 아니라 모듈 수준의 재현성이었다.
구획 간 일치성
비강 및 혈액의 Hedges g 추정치를 유전자별로 정렬하고 Pearson 및 Spearman 상관분석을 사용하여 비교하였다. 비강 상위 50개 모듈과 혈액 상위 50개 모듈 간의 중복 정도는 중복 수와 Jaccard 지수로 요약하였다. 중복 유전자는 검증된 보존 바이오마커라기보다 탐색적인 구획 간 순위 중복 후보로 해석하였다.
외부 조직 일치 검증
모듈 점수 검증에는 해석 가능한 소스 그룹이 포함된 독립적인 공공 데이터셋이 사용되었습니다. 상기도 검증에는 GSE41374 RSV 비강 세척 샘플과 SARS-CoV-2 데이터셋인 GSE152075 및 GSE156063이 포함되었습니다. 혈액 검증에는 GSE1710과 별도로 정규화된 두 개의 GSE3890 단위인 GPL1058 (샘플 36개; RSV 28개 및 대조군 8개) 및 GPL6884 (샘플 138개; RSV 107개 및 대조군 31개)가 포함되었습니다. 모든 외부 데이터셋에 대해 프로브를 HGNC 기호로 매핑하였으며, 중복 기호는 발현값의 중앙값으로 통합하였습니다. 앵커 데이터셋에 사용된 것과 동일한 변환, 결측값 필터링, 중앙값 대체 및 유전자별 z-표준화 규칙이 각 데이터셋 내에 적용되었습니다. 모듈 점수는 해당 모듈 유전자들의 표준화된 발현값의 비가중 평균으로 계산되었습니다. AUROC, 평균 정밀도 및 Welch-test FDR은 임상적 진단 성능의 추정치가 아니라 이식성 지표로 보고되었습니다.
대규모 임상 벤치마크 및 ex vivo 섭동 데이터 세트
두 개의 전혈 데이터 세트가 발견 코호트가 아닌 임상 벤치마크로 사용되었습니다. GSE6390의 경우, 기탁된 감염 상태 메타데이터에 따라 샘플을 바이러스성 호흡기 감염(n = 17), 세균성 호흡기 감염(n = 73) 또는 비감염성 질환(n = 90)으로 분류하였으며, 이러한 명확한 라벨이 없는 샘플은 제외되었습니다18. GSE4012에서는 기탁된 진단 필드를 인플루엔자 A 폐렴(n = 39), 인플루엔자를 동반하지 않은 세균성 폐렴(n = 61), 폐렴이 없는 SIRS(n = 40), 건강한 대조군(n = 36) 또는 세균/인플루엔자 혼합 폐렴(n = 14)으로 매핑하였습니다19. 세균/인플루엔자 혼합 샘플은 기술되었으나 이진 벤치마크 대조군에서는 제외되었습니다.
GSE53543에는 98명의 개인으로부터 얻은 196개의 ex vivo PBMC 프로파일이 포함되어 있습니다. 각 개인은 배지만 사용한 샘플 하나와 rhinovirus 16에 24 h 동안 노출시킨 샘플 하나를 제공했으며, 피험자 식별자를 통해 98쌍의 완전한 쌍이 확인되었습니다. AUROC는 순위 분리 지표이므로, 주요 벤치마크에서는 98개의 자극 샘플과 98개의 비자극 샘플 전체에 대한 AUROC를 보고했습니다. 피험자 쌍 정보는 메타데이터에 유지되었으며, 점수 차이에 대한 쌍체 민감도 분석에 사용되었습니다. 이 실험은 자연 임상 감염과는 별도로 분석되었으며, 임상 진단 주장을 뒷받침하는 데 사용되지 않았습니다.
GSE6390, GSE4012 및 GSE53543에 대한 Raw GEO 시리즈 행렬을 다운로드하였다. GSE63990에는 GPL571, GSE4012에는 GPL6947, GSE53543에는 GPL1058이 사용되었다. 프로브는 HGNC 승인 심볼로 매핑되었으며, 중복 매핑된 항목은 중앙값 발현량으로 통합하였다. 기탁된 정규화 행렬을 사용하였다. 일반적인 95 백분위수 규칙에 따라 로그 변환이 되지 않은 척도의 행렬에 대해서만 log₂(x + 1) 변환을 수행하였다. GSE53543은 이미 원 저자에 의해 log₂ 변환, 순위 불변 정규화 및 처리 일자 보정이 완료되었으므로 추가적인 로그 변환을 적용하지 않았다. 결측값이 20%를 초과하는 유전자를 제거하고 남은 결측값을 중앙값으로 대체한 후, 각 유전자를 해당 데이터 세트 내의 모든 샘플에 대해 z-표준화하였다. 벤치마크 레이어에는 470개의 임상 전혈 샘플과 196개의 ex vivo PBMC 샘플이 포함되었다.
참조 시그니처 벤치마킹
앵커 비강 및 혈액 모듈을 가중치를 적용하지 않은 세 가지 참조 세트와 비교하여 벤치마킹하였다. 공식 Pandya 3-mRNA 세트는 원본 분류기 보고서의 Supplementary Table 15에서 전사하였다. Andres-Terre 비교군은 보고된 다중 바이러스 시그니처3에서 큐레이션한 3개의 인터페론 지향 유전자로 구성되었다. Hallmark 비교군은 MSigDB HALLMARK_INTERFERON_ALPHA_RESPONSE 세트25,26와 연결된 33개 유전자의 인터페론-알파 핵심 하위 집합으로 구성되었다. 세 가지 참조 세트의 전체 유전자 목록은 Supplementary Data 1에 제공된다. 이러한 참조 점수는 원래의 가중 분류기를 재현한 것이 아니다. 각 데이터셋에 대해 점수는 사용 가능한 유전자별 z 점수의 비가중 평균으로 계산되었으며, 최소 3개의 대표 유전자가 필요했으며 대표 유전자의 수를 보고하였다. 벤치마크 대조군은 필요한 그룹이 있는 경우 바이러스 대 박테리아, 바이러스 대 비감염성, 바이러스 대 박테리아 또는 비감염성, 바이러스 대 건강/대조군, 그리고 박테리아 대 건강/대조군으로 설정하였다. AUROC 및 평균 정밀도를 벤치마킹 지표로 해석하였다. Welch-test P 값은 벤치마크 표의 모든 유효한 데이터셋-대조군-모듈 조합에 대해 Benjamini–Hochberg 절차를 사용하여 조정되었다.
독립적 종단적 검증
쌍을 이룬 급성기 대 퇴원 시 데이터 세트인 GSE9741 및 GSE9742는 종단적 검증용으로만 사용되었다27. 제출된 메타데이터에서 RSV 단독 감염(RSVsi) 또는 라이노바이러스(hRV)로 표시된 샘플이 기본 분석 대상이 되었으며, RSV 공동 감염(RSVco)은 보충 결과에만 유지되었다. 급성기 및 퇴원 라벨은 샘플 제목에서 파싱되었다. 샘플은 데이터 세트, 구획, 바이러스 그룹 및 피험자 식별자를 기준으로 매칭되었으며, 두 시점의 데이터가 모두 있는 피험자만 유지되었다. 기본 결합 그룹은 38쌍의 RSVsi와 30쌍의 hRV로 구성되었다(구획당 68쌍).
GSE9741 또는 GSE9742 데이터셋은 유전자 선택, 모듈 정제 또는 임계값 조정에 사용되지 않았으며, 이 데이터셋들은 외부 검증용으로 예약되었습니다. 프로브 식별자는 승인된 HGNC 심볼로 매핑되었으며, 중복된 심볼은 중앙값 발현량으로 통합되었습니다. 고정된 GSE17827 모듈 점수를 계산하기 전에 동일한 95백분위수 로그 변환 규칙, 결측값 필터링, 중앙값 대체 및 데이터셋 내 유전자별 z-표준화 절차가 적용되었습니다.
각 조직 및 모듈에 대해, 급성기 및 회복기 점수를 피험자와 바이러스 그룹별로 짝지었습니다. 각 쌍에 대해 급성기 점수에서 회복기 점수를 뺀 차이값을 계산했습니다. Cohen dz는 짝지은 차이의 평균을 해당 표본 표준 편차로 나누어 계산했습니다. 양측 짝지은 t 검정과 양측 Wilcoxon 부호 순위 검정 결과가 보고되었으며, 급성기 대 회복기 점수 구분능력을 나타내는 AUROC가 함께 제시되었습니다. 전체 종단적 결과(두 개의 데이터 세트, 두 개의 모듈 소스 및 다섯 개의 사전 지정된 바이러스 그룹 요약)에서 수행된 20개의 유효한 짝지은 t 검정 전체에 대해 Benjamini–Hochberg FDR 값을 계산했습니다.
증상 구배 및 사후 분석
모듈 멤버십이 확정된 후, GSE17827의 홀드아웃 무증상 피코르나바이러스 검출 사례는 증상 구배 분석에만 사용되었습니다. 서열 임상 점수는 바이러스 음성 대조군의 경우 0점, 무증상 피코르나바이러스 검출의 경우 1점, 유증상 감염의 경우 2점으로 설정하였습니다. Spearman 상관 분석을 통해 서열 추세를 평가하였으며, Kruskal–Wallis 검정으로 세 그룹 간의 전반적인 차이를 평가하였습니다. 양측 Mann–Whitney U 사후 검정을 사용하여 세 그룹의 쌍별 비교를 수행하였습니다. Benjamini–Hochberg 보정은 각 구획 내의 세 가지 쌍별 비교군에 대해 개별적으로 적용되었습니다.
기능적 풍부도 분석
비강 및 혈액 모듈 유전자는 gseapy를 통해 MSigDB Hallmark 2020, Reactome 202 및 GO Biological Process 2023 라이브러리를 사용하여 Enrichr로 분석되었습니다.25,26,28,29,30,31Enrichr는 피셔 정확 검정(Fisher's exact test)에 기반한 표준 과잉 표현(over-representation) 프레임워크를 사용하였습니다. 라이브러리에서 보고된 벤자민-호치버그(Benjamini–Hochberg) 보정값은 P 값 < 0.05를 유의미한 것으로 간주하였다. 조회를 수행한 3개 라이브러리 전반에 걸쳐 모듈당 가장 유의미한 8개 용어를 보정된 값으로 순위를 매겼다. P 값. 농축 결과는 해석 용도로만 사용되었다.
강건성, 마커 프로그램 및 분산 분석
강건성 분석을 통해 결과가 모듈 크기나 무작위 선택에 의존하는지 테스트했습니다. 10, 25, 50, 10, 200개 유전자로 구성된 모듈 크기를 평가했습니다. 무작위 유전자 널 분석(null analysis)을 위해, 처리된 GSE17827 매트릭스에 포함된 HGNC 단백질 코딩 유전자 전체를 대상군으로 설정했습니다. NumPy 무작위 시드 2026062를 사용하여 중복 없이 50개의 유전자로 구성된 세트를 50회 샘플링했습니다. 부트스트랩 재선택은 각 구획의 원래 앵커 분석에서 가장 높게 순위가 매겨진 상위 1,0개의 양성 효과 단백질 코딩 유전자로 제한했습니다. 각 재샘플링에서 양성 단백질 코딩 유전자는 양측 Welch P 값의 오름차순으로, 그 다음 평균 차이의 내림차순으로 순위를 매겼습니다. 상위 50개 유전자가 선택되었습니다. 유전자 안정성은 선택 횟수를 10으로 나누어 계산했습니다. 각 구획에서 선택 빈도가 가장 높은 20개 유전자를 표시했습니다.
마커 프로그램 점수는 세포 분획 추정치가 아니라 기술적 보조 지표로 사용되었습니다. 상피 세포(EPCAM, KRT8, KRT18, KRT19, MUC1, KRT5, KRT14, SCGB1A1, FOXJ1), 단핵구/대식세포(LYZ, LST1, S10A8, S10A9, FCGR3A, FCGR1A, CD14, MS4A7, CTSS), 호중구(S10A8, S10A9, MPO, ELANE, CEACAM8, FCGR3B, OLFM4, MMP8), T/NK 세포(CD3D, CD3E, TRAC, NKG7, GNLY, PRF1, GZMB, KLRD1, IL7R), B/형질 세포(MS4A1, CD79A, CD79B, MZB1, JCHAIN, IGHG1, SDC1), 그리고 골수성 인터페론(SIGLEC1, IFI27, IFI4L, ISG15, MX1, OAS1, RSAD2, IFIT3)의 6가지 큐레이션된 프로그램을 평가하였습니다. 각 프로그램 점수는 가용한 유전자별 z 점수의 평균으로 계산되었으며, 최소 3개의 대표 유전자가 포함되어야 했습니다. Spearman P 값은 전체 데이터셋-모듈-프로그램 상관관계 패밀리에 대해 Benjamini–Hochberg 절차를 사용하여 보정되었습니다. 일원 분산 분석의 eta-squared는 각 모듈-요인 쌍에 대해 집단 간 제곱합을 총 제곱합으로 나누어 계산하였습니다. 관련 요인이 누락된 행은 해당 계산에서 제외되었습니다. 본 분석은 기술적인 분석이며 상호 상관관계가 있는 요인들에 대해 보정하지 않았습니다.
재현성
모든 분석은 Python 3.12.13의 스크립트 워크플로우를 사용하여 수행되었으며, 사용된 소프트웨어 패키지 및 버전은 재료 표에 기재되어 있습니다. 무작위 절차에는 2026062의 고정 시드(seed)가 사용되었습니다. 공개 GEO 발현 행렬은 원본 입력 데이터, 처리된 데이터, 통계 출력값, 표 및 그림을 분리한 일관된 프로젝트 구조를 사용하여 처리되었습니다. 독립적인 검증을 지원하기 위해 모듈 정의, 샘플 큐레이션 기록, 효과 크기 추정치, 검증 통계, 농축 분석 결과, 강건성 분석 및 그림 소스 데이터가 보존되었습니다. 분석 코드, 종속성 사양 및 지원 파생 데이터는 데이터 가용성 성명서에 기술된 대로 이용 가능합니다.
결과
앵커 단계 벤치마킹을 통해 조직 특이적 유전자 효과와 범조직적 유전자 효과를 분리함
큐레이션된 GSE117827 앵커 매트릭스에는 27,685개의 HGNC 승인 유전자가 포함되었습니다. 주요 비강 대조군에는 증상이 있는 감염 샘플 15개와 바이러스 음성 대조군 샘플 6개가 포함되었으며, 혈액 대조군에는 증상이 있는 감염 샘플 13개와 대조군 6개가 포함되었습니다(표 1). 이 소규모 코호트는 안정적인 단일 유전자 발굴을 지원할 수 없으므로, 쌍을 이룬 구획 앵커로 사용되었습니다. 안정성은 부트스트랩 리샘플링, 무작위 유전자 널 테스트, 외부 검증 및 모듈 크기 민감도 분석을 통해 모듈 수준에서 평가되었습니다.
| 제공해주신 소스 텍스트가 없습니다. 번역할 텍스트를 입력해 주세요. | 그룹 | 조건 | 일차 대조군 | n |
| 혈액 | 호흡기 세포융합 바이러스 | 감염된 | 네 | 4 |
| 혈액 | 무증상 피코나바이러스 | 이차적인 | 아니요 | 5 |
| 혈액 | 증상성 피코나바이러스(Symptomatic picornavirus) | 감염된 | 네 | 9 |
| 혈액 | 바이러스 음성 대조군 | 대조군 | 네 | 6 |
| 비강의 | 호흡기 세포융합 바이러스 (RSV) | 감염된 | 네 | 6 |
| 비강의 | 무증상 피코르나바이러스 | 이차적 | 아니요 | 5 |
| 비강의 | 증상성 피코르나바이러스 | 감염된 | 네 | 9 |
| 비강의 | 바이러스 음성 대조군 | 대조군 | 네 | 6 |
표 1: 1차 대조군 큐레이션 후의 GSE117827 앵커 설계. 1차 대조군 큐레이션 후 쌍을 이룬 앵커 데이터셋 내 혈액 및 비강 구획의 샘플 분포. 증상이 있는 호흡기 세포 융합 바이러스(RSV) 및 증상이 있는 피코나바이러스 샘플은 감염군으로 분류되어 1차 대조군에 포함되었으며, 바이러스 음성 대조군은 대조군으로 분류되어 1차 대조군에 포함되었다. 증상이 없는 피코나바이러스 샘플은 2차군으로 지정되어 모듈 구축에서 제외되었으며, 탐색적 증상-기울기 분석에만 사용되었다. RSV 사례 중 2건은 혈액 검체가 부족하여, 결과적으로 혈액 RSV 샘플 4개와 비강 RSV 샘플 6개가 확보되었다.
공유된 27,685개 유전자에 대해 코와 혈액의 Hedges g 추정치는 거의 상관관계가 없었습니다 (Pearson r = 0.015; 그림 1). 이 결과는 단일 연구 내에서 도출되었으며, 여러 코호트를 통합하여 비교한 경우보다 연구 간 차이의 영향을 덜 받습니다. 밀집된 중앙의 구름 모양은 대부분의 유전자가 두 구획에서 유사하게 움직이지 않았음을 보여줍니다. 강조 표시된 중첩 유전자들은 두 순위 목록의 상단에 위치한 예외 사례들이었습니다. 이러한 패턴은 코와 혈액 모듈을 각각 별도로 구축하는 방식을 뒷받침합니다.
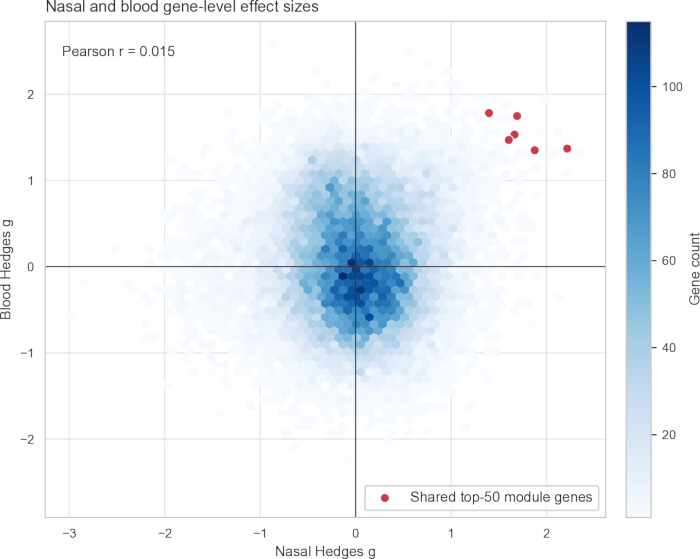
그림 1쌍을 이룬 GSE117827 앵커 코호트 내 비강 및 혈액의 유전자 수준 효과 크기. 헤지(Hedges) 제시된 텍스트가 없습니다. 번역할 내용을 입력해 주세요. 값들은 27,685개 유전자에 대해 증상이 있는 감염군과 바이러스 음성 대조군을 비교한 것입니다. x축에는 비강 추정치(감염군 15명, 대조군 6명)가 표시되어 있으며, y축에는 혈액 추정치(감염군 13명, 대조군 6명)가 표시되어 있습니다. 육각형 빈(bin) 음영은 빈당 유전자 수를 나타냅니다. 빨간색 점은 비강 및 혈액 상위 50개 모듈에서 공통으로 나타나는 6개 유전자를 나타냅니다. 피어슨(Pearson) r = 0.015. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
모듈 구축 결과 인터페론 중심의 작은 중첩 영역이 생성됨
상위 50개 비강 및 혈액 모듈에서 6개의 유전자가 공유되었음: ISG15, ACRBP, IFIT1, RSAD2, CCRL2, XAF1 (Jaccard index = 0.064; 표 2; 그림 2). ISG15, IFIT1, RSAD2 및 XAF1은 인터페론 관련 항바이러스 생물학적 기전과 부합함32,33,34. CCRL2는 염증성 백혈구 이동의 관점에서 해석하는 것이 더 적절함35. ACRBP는 확립된 항바이러스 역할이 없음. 투명성을 위해 6개 유전자를 모두 보고하였으나, 이 중 어떤 것도 검증된 교차 조직 바이오마커로 주장되지 않음. 소규모 앵커 코호트에서 이들 단일 유전자의 FDR 값은 유의미하지 않았음. 따라서 주요 추론은 중첩 목록이 아닌, 고정된 모듈 수준의 검증에 근거함.
| 유전자 | 비강 Hedges g | 비강 FDR | 혈액 Hedges g | 혈액 FDR | 해석 |
| ISG15 | 2.215 | 0.213 | 1.369 | 0.442 | 인터페론 자극 항바이러스 유전자; 탐색적 중첩 |
| ACRBP | 1.69 | 0.205 | 1.748 | 0.429 | 확립된 항바이러스 역할 없음; 투명성을 위해 유지 |
| IFIT1 | 1.875 | 0.213 | 1.35 | 0.442 | 인터페론 자극 항바이러스 유전자; 탐색적 중첩 |
| RSAD2 | 1.663 | 0.213 | 1.532 | 0.442 | 인터페론 자극 항바이러스 유전자; 탐색적 중첩 |
| CCRL2 | 1.396 | 0.217 | 1.782 | 0.442 | 염증성 백혈구 이동 맥락; 바이러스 특이적이지 않음 |
| XAF1 | 1.603 | 0.226 | 1.47 | 0.442 | 인터페론 관련 세포사멸 인자; 탐색적 중첩 |
표 2: 최상위 순위의 비강 및 혈액 모듈 간의 완전한 탐색적 중첩. 공유된 6개 유전자의 비강 및 혈액 Hedges g 값과 유전자별 FDR 값이 보고되었다. 소규모 앵커 코호트에서 유전자별 FDR 값이 유의미하지 않았으므로 6개 유전자 모두 탐색적 순위-중첩 후보로 처리되었다. ACRBP는 확립된 항바이러스 역할이 없음에도 불구하고 투명성을 위해 유지되었다. 6개 유전자 중 어느 것도 검증된 보편적 바이오마커로 제시되지 않았으며, 주요 근거는 모듈 수준의 외부 검증에 기반한다.
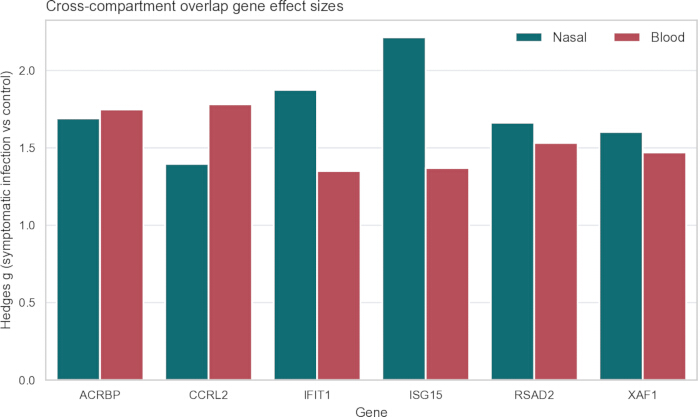
그림 2. 6가지 탐색적 비강-혈액 중첩 유전자의 효과 크기. GSE117827에서 ACRBP, CCRL2, IFIT1, ISG15, RSAD2 및 XAF1의 비강 및 혈액 Hedges g 추정치가 표시되어 있다. 양수 값은 바이러스 음성 대조군보다 증상이 있는 감염군에서 발현량이 더 높음을 나타낸다. 투명성을 위해 전체 중첩 결과가 제시되었으나, 단일 유전자 FDR 값은 유의하지 않았으며, 이 유전자들은 검증된 보편적 바이오마커로 제시된 것이 아니다. 이 그림의 확대 버전을 보려면 여기를 클릭하십시오.
기능적 풍부도 분석을 통해 모듈 콘텐츠에 대한 생물학적 검증을 수행하였다.
두 모듈 모두 인터페론 및 항바이러스 경로가 풍부하게 나타났으나, 유전자 구성과 농축 강도는 서로 달랐다 (그림 3). 모듈당 가장 유의미한 8개 용어가 표시됩니다. 비강 모듈의 경우, Hallmark 인터페론-감마 반응(보정된 P = 2.23 × 10⁻24), 특징적인 인터페론-알파 반응 (보정됨 P = 1.40 × 10⁻22), Reactome 인터페론-알파/베타 신호 전달 (보정됨 P = 3.64 × 10⁻19), 그리고 바이러스에 대한 GO 방어 반응 (보정됨 P = 5.47 × 10⁻15) 상위 용어에 포함되었습니다. 혈액 모듈은 더 낮은 농축 강도에서 동일한 광범위한 생물학적 특성을 보였습니다: 인터페론-알파 반응 (보정된 P = 3.87 × 10⁻6), Reactome 인터페론-알파/베타 신호 전달(보정됨 P = 5.70 × 10⁻6), 인터페론-감마 반응 (보정됨 P = 8.89 × 10⁻6), 그리고 바이러스에 대한 방어 반응(조정됨 P = 1.07 × 10⁻4). 이러한 결과는 구획별 유전자 순위가 동일함을 의미하지 않으면서도 생물학적 일관성을 뒷받침합니다.
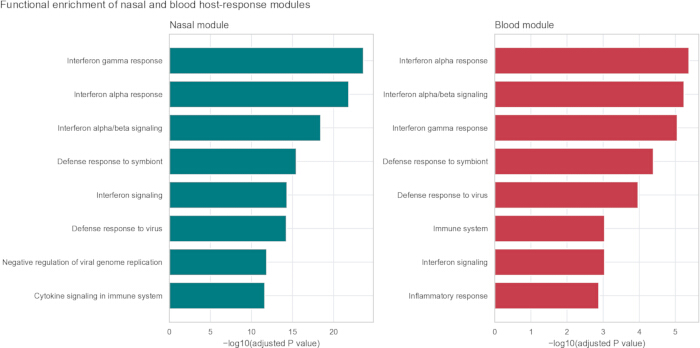
그림 3비강 및 혈액 모듈에 대해 선택된 농축 용어들. Hallmark 2020, Reactome 2022 및 GO Biological Process 2023을 사용하여 Enrichr로 과잉 표현 분석(over-representation analysis)을 수행하였다. Benjamini-Hochberg 보정값이 가장 작은 8개 항목은 P 각 모듈에 대한 값이 표시되어 있습니다. 막대의 길이는 −log 값을 나타냅니다.10(조정됨) P 값). 왼쪽과 오른쪽 패널은 각각 비강 및 혈액 모듈을 보여준다. 용어는 문장 표기법(sentence case)으로 표시되었다. 농축 분석(Enrichment analysis)은 모듈 소속을 변경시키지 않았다. 이 그림의 확대 버전을 보시려면 여기를 클릭하십시오.
고정된 모듈은 조직 일치 외부 검증을 통해 테스트되었습니다
고정된 비강 모듈은 GSE41374에서 0.749, GSE152075에서 0.693, GSE156063에서 0.609의 AUROC에 도달했습니다(표 3; 그림 4). 고정된 혈액 모듈은 GSE171110에서 0.832, GSE38900 GPL10558 단위에서 0.924, GPL6884 단위에서 0.870의 AUROC에 도달했습니다. 내부 앵커 성능은 구성상 낙관적으로 편향되어 있으므로 생략되었습니다. 외부 AUROC는 이식성 요약으로 간주됩니다. 이는 임상적 민감도, 특이도 또는 진단 준비도를 입증하는 것이 아닙니다.
| 코호트 | 시료/바이러스 | 모듈 | 양성 수(n) | 음성 수(n) | 표현된 유전자 수 | AUROC | 평균 정밀도 | Welch-test FDR |
| GSE152075 | SARS-CoV-2 상기도 | 비강 | 430 | 54 | 50 | 0.693 | 0.935 | 2.20 × 10⁻⁴ |
| GSE156063 | SARS-CoV-2 상기도 | 비강 | 93 | 100 | 49 | 0.609 | 0.551 | 1.38 × 10⁻² |
| GSE171110 | SARS-CoV-2 전혈 | 혈액 | 44 | 10 | 50 | 0.832 | 0.959 | 7.94 × 10⁻⁴ |
| GSE38900-GPL10558 | RSV 전혈 | 혈액 | 28 | 8 | 50 | 0.924 | 0.979 | 7.94 × 10⁻⁴ |
| GSE38900-GPL6884 | RSV 전혈 | 혈액 | 107 | 31 | 49 | 0.87 | 0.962 | 3.47 × 10⁻¹⁵ |
| GSE41374 | RSV 비강 세척액 | 비강 | 76 | 10 | 50 | 0.749 | 0.951 | 2.63 × 10⁻² |
표 3: 외부 조직 일치 모듈 점수 검증. 고정된 비강 모듈은 GSE41374, GSE152075 및 GSE156063에서 테스트되었으며, 고정된 혈액 모듈은 GSE171110 및 GSE38900 플랫폼 단위인 GPL10558 및 GPL6884에서 테스트되었습니다. 이 표는 양성 및 음성 샘플 수, 대표 모듈 유전자, AUROC, 평균 정밀도 및 Welch-test FDR을 보고합니다. 내부 앵커 성능은 생략되었습니다. AUROC와 평균 정밀도는 이식성 요약으로 보고된 것이며 임상 진단 성능의 추정치가 아닙니다.
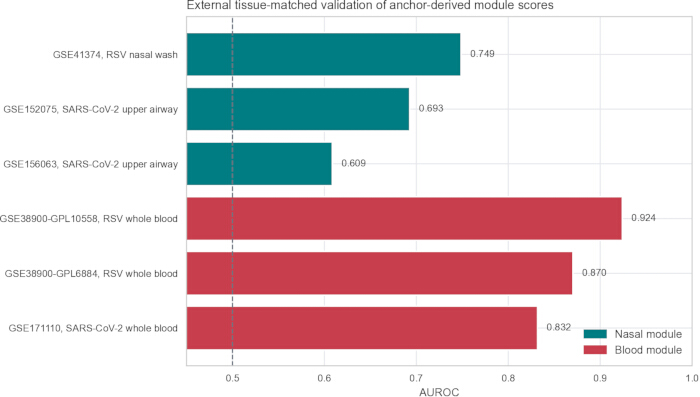
그림 4외부 조직 일치 모듈 점수의 이식성. GSE41374 (RSV 76례, 대조군 10례), GSE152075 (SARS-CoV-2 430례, 대조군 54례), GSE156063 (SARS-CoV-2 93례, 대조군 100례)의 비강 모듈과 GSE171110 (SARS-CoV-2 44례, 대조군 10례), GSE38900-GPL10558 (RSV 28례, 대조군 8례), GSE38900-GPL6884 (RSV 107례, 대조군 31례)의 혈액 모듈에 대한 AUROC가 표시되어 있습니다. 점수는 각 유전자의 z-값에 대한 가중치 없는 평균값입니다. 점선은 AUROC = 0.5를 나타냅니다. 해당 수치는 이식성 요약 결과이며, 임상 진단 추정치가 아닙니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
종단적 검증을 통해 회복 과정에서 점수가 감소하는지 테스트함
GSE97741/GSE97742 동반 데이터셋은 입원 아동의 급성기 및 퇴원 시 샘플을 통해 독립적인 자연 감염 검증 환경을 제공했습니다27. 이 샘플들은 건강 대조군 탐색 데이터로 사용되지 않았습니다. 대신 급성 질환 단계에서 퇴원 시까지 앵커 기반 모듈 점수가 감소하는지 평가하는 데 사용되었습니다.
사전 정의된 RSV 단독 감염 및 라이노바이러스 복합 그룹의 경우, 각 조직당 68쌍의 피험자를 분석하였습니다(표 4; 그림 5). 혈액 모듈은 급성 질환 시기부터 퇴원 시까지 혈액에서 감소하였습니다(mean delta = 0.330; Cohen dz = 0.740; paired-test FDR = 1.98 × 10⁻7; AUROC = 0.765). 비강 모듈 또한 비인두 샘플에서 감소하였습니다(mean delta = 0.436; Cohen dz = 0.477; paired-test FDR = 3.06 × 10⁻4; AUROC = 0.679). 쌍을 이룬 궤적과 표준 오차를 통해 그룹 수준의 감소가 소수의 비정상적인 극단값에 의해 유도되지 않았음을 확인하였습니다.
| 데이터 세트 | 샘플 출처 | 모듈 | 조직 일치 여부 | 쌍 수(n) | 평균 급성-퇴원 델타 | Cohen dz | AUROC | 대응 표본 검정 FDR |
| GSE97741 | 혈액 | 혈액 | 예 | 68 | 0.330 | 0.740 | 0.765 | 1.98 × 10⁻⁷ |
| GSE97741 | 혈액 | 비강 | 아니요 | 68 | 0.479 | 0.721 | 0.755 | 3.19 × 10⁻⁷ |
| GSE97742 | 비인두 | 혈액 | 아니요 | 68 | 0.361 | 0.914 | 0.845 | 9.42 × 10⁻¹⁰ |
| GSE97742 | 비인두 | 비강 | 예 | 68 | 0.436 | 0.477 | 0.679 | 3.06 × 10⁻⁴ |
표 4: 독립적 종단적 급성기 대 퇴원기 검증. 이 표는 GSE97741 및 GSE97742의 고정 모듈에 대한 완전한 쌍의 수, 급성기-퇴원기 평균 점수 차이, Cohen dz, AUROC 및 쌍체 검정 FDR을 보고합니다. 양수의 델타 값은 급성 질환 기간 동안 모듈 점수가 더 높음을 나타냅니다. 쌍체 검정 FDR 값은 전체 종단적 결과의 유효한 20개 쌍체 t-검정에 대해 계산된 Benjamini–Hochberg 보정 양측 쌍체 t-검정 P 값입니다.
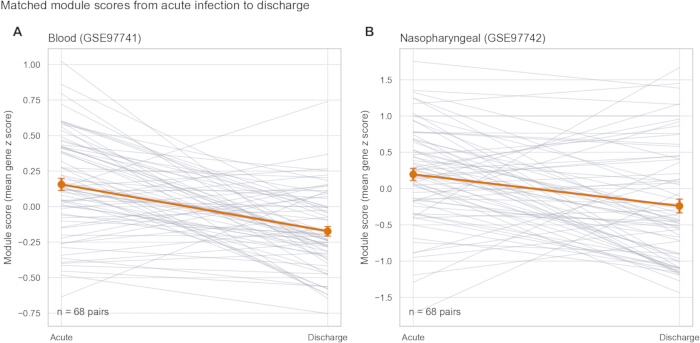
그림 5급성 질환 시점부터 퇴원 시점까지의 쌍을 이룬 모듈 점수 변화. (A) 전혈의 혈액 모듈 점수 (GSE97741). (B) 비인두 샘플의 비강 모듈 점수(GSE97742). 각 패널은 68쌍의 완전한 피험자 데이터를 포함함: RSV 단독 감염 38례 및 리노바이러스 감염 30례. 가는 선은 피험자 매칭 측정값을 연결함. 주황색 점은 그룹 평균을 나타내며, 주황색 오차 막대는 평균 표준 오차를 나타냄. 양측 대응 t 검정 및 Wilcoxon 부호 순위 검정을 수행하였으며, 20개의 유효한 종단적 쌍체 비교에 대해 Benjamini–Hochberg FDR 보정을 적용하였습니다. 제공된 텍스트가 없습니다. 번역할 내용을 입력해 주십시오. 검사. 이 그림의 확대 버전을 보시려면 여기를 클릭하십시오.
교차 구획 테스트를 통해 유용한 미묘한 차이가 드러났습니다. 앵커(anchor)에서 개별 비강 및 혈액의 효과 크기가 약하게 일치했음에도 불구하고, 비인두 샘플에 적용된 혈액 모듈은 0.845의 AUROC를 나타냈습니다. 쌍을 이룬 궤적을 검토한 결과, 라벨 분포가 반전되기보다는 점수가 일관되게 감소하는 양상을 보였습니다. 따라서 이 결과는 동일한 개별 유전자가 두 조직 모두에서 지배적이라는 증거가 아닙니다. 이는 조율된 인터페론/염증 프로그램이 서로 다르지만 부분적으로 중복되는 유전자 세트에 의해 요약될 수 있음을 나타냅니다. 구획 특이성은 유전자 순위 수준에서 가장 강하며, 경로 또는 점수 수준에서는 절대적이지 않습니다.
증상 구배 동작을 테스트한 제외된 무증상 검출군
GSE117827의 무증상 picornavirus 검출군은 기본 대조군에 포함되는 것을 방지하기 위해 모듈 구축에서 제외되었습니다. 이후 이 제외된 그룹은 생물학적 검증 수단으로 활용되었습니다. 두 구획 모두에서 모듈 점수는 바이러스 음성 대조군, 무증상 picornavirus 검출군, 유증상 감염군의 순서대로 증가하였습니다(그림 6A,B).
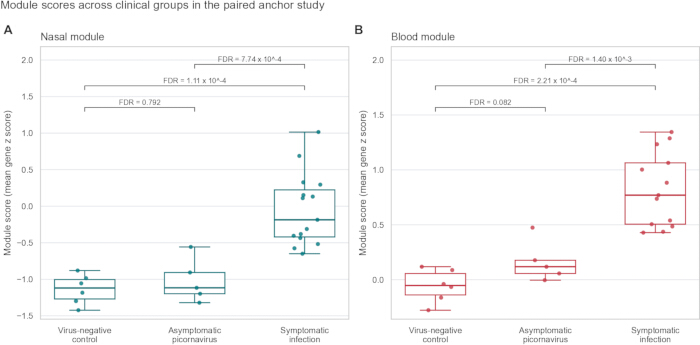
Figure 6. 제외된 증상 구배에 따른 모듈 점수. (A) 비강 모듈: 바이러스 음성 대조군 6명, 무증상 picornavirus 검출군 5명, 유증상 감염군 15명. (B) 혈액 모듈: 바이러스 음성 대조군 6명, 무증상 picornavirus 검출군 5명, 유증상 감염군 13명. 점은 개별 샘플을 나타낸다. 중앙선은 중앙값을, 박스는 25~75 백분위수를 나타내며, 오차 막대는 사분위 범위의 1.5배 이내에서 가장 극단적인 값까지 연장된다. 레이블은 구획당 3가지 비교에 대해 Benjamini–Hochberg 교정을 적용한 양측 Mann–Whitney U 사후 비교 결과를 나타낸다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
비강 모듈은 서열 증상 점수와 상관관계를 보였습니다(Spearman rho = 0.818, P = 3.28 × 10⁻7; Kruskal-Wallis P = 1.57 × 10⁻4). 혈액 모듈 또한 유사한 경향성을 나타냈습니다(rho = 0.861, P = 6.89 × 10⁻8; Kruskal-Wallis P = 1.92 × 10⁻4). 각 3중 비교 집단 내에서 보정을 거친 후, 증상성 감염군은 두 구획 모두에서 대조군 및 무증상 검출군과 차이를 보였습니다. 무증상 검출군은 바이러스 음성 대조군과 차이가 없었습니다(nasal FDR = 0.792; blood FDR = 0.082). 따라서 이 모듈들은 바이러스 검출 단독보다 증상성 숙주 반응 활성도를 더 명확하게 추적하였습니다.
임상 벤치마크를 통해 숙주 반응과 병원체 특이성 간의 경계를 정의함
임상 벤치마크를 통해 숙주 반응 활성과 병원체 분류 간의 구분을 정의하였다(표 5; 그림 7). GSE63990에서 비강 모듈은 바이러스성 질환 대 세균성 질환의 경우 0.782, 바이러스성 질환 대 비감염성 질환의 경우 0.791의 AUROC 값을 나타냈다. 혈액 모듈은 각각 0.678과 0.753의 AUROC 값을 나타냈다. Pandya 33-mRNA 비교군은 각각 0.867과 0.852의 AUROC 값을 보여 더 우수한 성능을 나타냈다. 이러한 결과는 바이러스성/비바이러스성 구분을 위해 설계된 세트에서 예상되는 결과이며, 앵커 모듈이 대체 진단 분류기로 제시되어서는 안 된다는 것을 보여준다.
| 데이터 세트 | 대조군 | 비강 앵커 | 혈액 앵커 | Pandya 33 mRNA | Andres-Terre ISG | Hallmark 인터페론-알파 |
| GSE63990 | 바이러스성 vs 세균성 | 0.782 | 0.678 | 0.867 | 0.833 | 0.831 |
| GSE63990 | 바이러스성 vs 비감염성 | 0.791 | 0.753 | 0.852 | 0.851 | 0.848 |
| GSE40012 | 바이러스성 vs 세균성 폐렴 | 0.755 | 0.789 | 0.893 | 0.867 | 0.872 |
| GSE40012 | 바이러스성 폐렴 vs SIRS | 0.897 | 0.907 | 0.985 | 0.965 | 0.956 |
| GSE40012 | 바이러스성 폐렴 vs 건강 대조군 | 0.804 | 0.986 | 0.923 | 0.906 | 0.891 |
| GSE40012 | 세균성 폐렴 vs 건강 대조군 | 0.476 | 0.917 | 0.465 | 0.391 | 0.378 |
| GSE53543 | Ex vivo 리노바이러스 자극 vs 비자극 PBMC | 1 | 0.957 | 1 | 1 | 1 |
표 5: 앵커 모듈 및 참조 호스트 반응 세트에 대한 AUROC 벤치마크. GSE63990 및 GSE40012는 임상 전혈 코호트입니다. GSE53543은 98명의 쌍을 이룬 피험자가 포함된 ex vivo PBMC 섭동 실험이며, 자연 임상 코호트와는 별도로 보고되었습니다. 참조 세트는 원래의 가중 분류기가 아닌 가중치가 부여되지 않은 유전자 평균으로 점수를 산출하였습니다. AUROC 값은 벤치마킹 지표로 보고되었으며, 임상 진단 성능의 추정치로 보고된 것이 아닙니다.
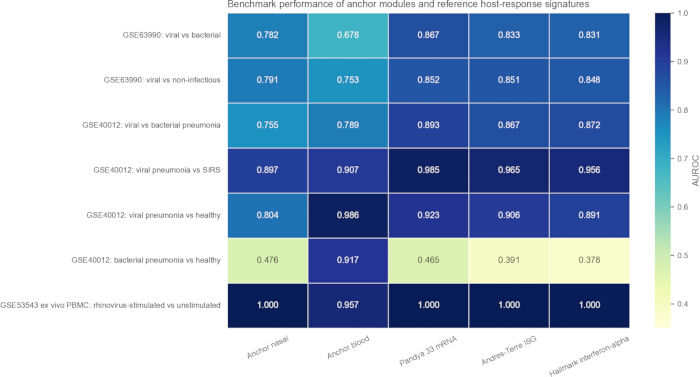
그림 7앵커 모듈 및 참조 호스트 반응 세트의 AUROC 벤치마킹. 행은 GSE63990, GSE40012 및 GSE53543에서 사전 지정된 대비(contrast)를 나타내며, 열은 두 개의 앵커 모듈과 세 개의 가중치 없는 참조 세트를 나타냅니다. GSE53543은 ex vivo 라이노바이러스 자극 PBMC 대 비자극 PBMC로 표시되며, 자연 발생 임상 코호트와 별도로 제시됩니다. Hallmark 비교군은 Hallmark 인터페론-알파로 표시됩니다. 셀 값은 방법론 벤치마킹에 사용된 AUROC를 나타내며, 임상 진단 성능의 추정치로 해석해서는 안 됩니다. 이 그림의 확대 버전을 보시려면 여기를 클릭하십시오.
GSE40012는 이 경계를 더욱 명확히 했습니다. Pandya 비교군은 바이러스성 폐렴 대 세균성 폐렴의 경우 0.893, 바이러스성 폐렴 대 SIRS의 경우 0.985의 AUROC 값에 도달했습니다. 혈액 모듈은 인플루엔자 A 폐렴을 건강한 대조군(AUROC = 0.986) 및 SIRS(AUROC = 0.907)와 구분하였으나, 세균성 폐렴 또한 건강한 대조군(AUROC = 0.917)과 구분하였습니다. 따라서 혈액 모듈은 광범위한 전신 염증 및 인터페론 관련 활성을 측정합니다. 이는 바이러스 특이적이지 않으며, 높은 점수만으로는 병원체 분류를 지정할 수 없습니다.
별도의 GSE53543 ex vivo PBMC 벤치마크에서, 비강 모듈과 인터페론 비교군은 라이노바이러스로 자극한 PBMC와 배지만 사용한 PBMC에 대해 1.000의 AUROC에 도달했으며, 혈액 모듈은 0.957의 AUROC에 도달했습니다. 총 98명의 피험자가 쌍을 이룬 조건에 참여했습니다. 이 대조 결과는 점수가 매겨진 프로그램이 라이노바이러스 자극에 반응한다는 것을 뒷받침합니다. 이는 임상적 진단 성능을 추정한 것이 아닙니다.
강건성 확인을 통해 모듈 크기, 무작위 대안 및 선택 안정성을 테스트함
상위 랭킹 유전자 수를 10, 25, 50, 100, 200개로 변경해도 앵커 분리는 변하지 않았습니다 (그림 8A). 이러한 내부 AUROC는 외부 검증은 아니지만, 정성적인 결과가 정확히 50개의 유전자를 선택한 것에 의존하지 않았음을 보여줍니다. 500개의 무작위 50-유전자 세트에서 널 AUROC 중앙값은 비강에서 0.489, 혈액에서 0.705였으며, 이에 해당하는 99백분위수는 각각 0.722와 0.872였습니다 (그림 8B). 관찰된 모듈은 이러한 널 분포를 상회했습니다. 부트스트랩 선택 빈도는 단일한 불변 리스트에 집중되지 않고 분산되어 나타났습니다 (그림 8C). 이 결과는 작은 앵커 샘플 크기를 직접적으로 반영합니다. 이는 집합적인 신호가 안정적임을 뒷받침하는 동시에, 선택된 모든 유전자를 고정된 것으로 취급하는 것에 주의가 필요함을 시사합니다.
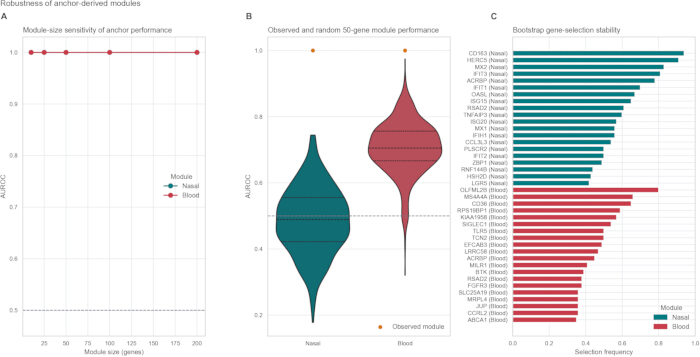
그림 8모듈 크기, 무작위 유전자 및 부트스트랩 강건성 분석. (A) 10, 25, 50, 100, 200개 유전자의 모듈 크기별 앵커 AUROC; 이 값들은 내부 민감도 확인 결과를 나타냅니다. (B) GSE117827에 나타난 유전자들로부터 비복원 추출로 샘플링한 500개의 무작위 단백질 코딩 50-유전자 세트의 AUROC 분포 (seed = 20260622). 주황색 점은 관찰된 모듈 AUROC를 나타낸다. 각 바이올린 도표 내의 수평선은 25분위수, 중앙값 및 75분위수를 나타낸다. (C) 부트스트랩 재선택은 각 구획의 최초 앵커 분석에서 가장 높게 순위가 매겨진 양성 효과 단백질 코딩 유전자 1,000개로 제한되었다. 막대는 구획당 선택 빈도가 가장 높은 20개 유전자를 나타내며, 선택 빈도는 선택 횟수를 100으로 나누어 계산하였다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
마커 프로그램 및 분산 분석을 통해 점수가 측정하는 바를 명확히 함
GSE40012, GSE53543 및 GSE63990 전체에서, 두 모듈 모두 myeloid interferon 프로그램과 가장 일관되게 상관관계를 보였다(그림 9A). 비강 모듈(Nasal-module)의 상관관계는 0.812, 0.878, 0.882였으며, 혈액 모듈(blood-module)의 상관관계는 0.517, 0.843, 0.774였다. 분산 분할 결과는 기술적이었다(표 6; 그림 9B). 혈액 모듈의 경우, 상태(condition)와 세부 그룹(detailed group)이 데이터 세트(0.066), 시료 유형(0.026) 또는 소스 그룹(0.025)보다 더 많은 분산을 설명했다(eta-squared 기준 각각 0.282 및 0.250). 비강 모듈의 경우에도 세부 그룹과 상태가 데이터 세트, 시료 유형 또는 소스 그룹보다 더 많은 분산을 설명했다. 따라서 생물학적 상태와 세부 그룹이 데이터 세트나 시료 유형보다 모듈 점수 분산의 더 큰 비율을 차지했으나, 0이 아닌 데이터 세트 및 구성 효과가 남아 있다는 점은 벌크 공공 데이터 재사용의 한계점으로 남는다.
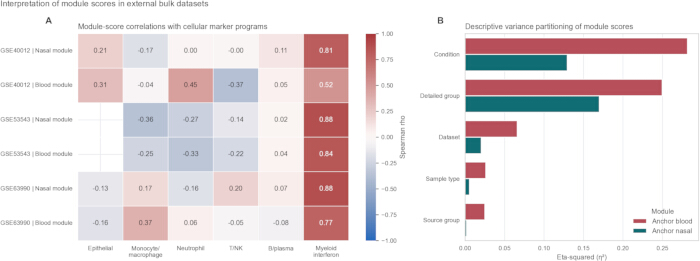
그림 9. 마커 프로그램 상관관계 및 기술적 분산 분할. (A) GSE40012, GSE53543 및 GSE63990에서 모듈 점수와 6가지 마커 프로그램 점수 간의 Spearman 상관관계. 프로그램은 최소 3개의 대표 유전자가 필요함. P 값은 모든 데이터셋-모듈-프로그램 상관관계 전체에 대해 보정됨. 빈 셀은 유전자 및 샘플 요구 사항 충족 후 이용 불가능하거나 추정할 수 없는 조합을 나타냄. (B) 조건, 세부 그룹, 데이터셋, 샘플 유형 및 소스 그룹에 대한 일원 분산 분석의 eta-squared (η2; 그룹 간 제곱합/전체 제곱합). 분석에는 934개의 혈액 모듈 및 1,469개의 비강 모듈 점수가 포함되었으며, 이는 인과 관계가 아닌 기술적 분석임. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
| 모듈 | 요인 | 에타 제곱 | n개의 시료 |
| 혈액 고정 | 조건 | 0.282 | 934 |
| 혈액 고정 | 상세 그룹 | 0.25 | 934 |
| 혈액 고정 | 데이터셋 | 0.066 | 934 |
| 혈액 고정 | 시료 유형 | 0.026 | 934 |
| 혈액 고정 | 소스 그룹 | 0.025 | 934 |
| 비강 고정 | 상세 그룹 | 0.17 | 1469 |
| 비강 고정 장치 | 조건 | 0.13 | 1469 |
| 비강 앵커 | 데이터 세트 | 0.021 | 1469 |
| 비강 앵커 | 시료 유형 | 0.006 | 1469 |
| 비강 고정 | 소스 그룹 | 0.002 | 1469 |
표 6: 모듈 점수의 기술적 분산 분할. 각 모듈-요인 쌍에 대해 하나의 행이 제공되며, 해당 eta-제곱 값과 표본 크기가 표시되어 있습니다. eta-제곱은 관련 모듈 점수나 요인이 누락된 행을 제외한 후, 집단 간 제곱합을 전체 제곱합으로 나누어 계산하였습니다. 요인들은 개별적으로 평가되었으므로, 본 분석은 기술적 분석이며 상호 상관 관계가 있는 요인들에 대해 보정하지 않았으며, 인과 관계가 있는 것으로 해석해서는 안 됩니다.
데이터 가용성:
본 연구에서 분석된 모든 전사체 데이터셋은 Gene Expression Omnibus의 accession number GSE117827, GSE41374, GSE152075, GSE156063, GSE171110, GSE38900, GSE97741, GSE97742, GSE63990, GSE40012 및 GSE53543을 통해 공개적으로 제공됩니다. 주요 그림과 표의 기초가 되는 분석 유도 데이터 및 분석 코드는 합리적인 요청 시 교신 저자로부터 제공받을 수 있습니다. 본 연구에서는 제한된 데이터나 새로 생성된 참여자 수준의 데이터를 사용하지 않았습니다.
토론
주요 교훈은 운영상의 관점에 있습니다. 즉, 가장 큰 풀링된 매트릭스가 아니라 샘플링된 구획부터 시작하는 것입니다. GSE17827은 규모가 작지만, 쌍을 이룬 설계 덕분에 한 연구 내에서 비강과 혈액을 직접 비교할 수 있었습니다. 유전자 수준의 효과 상관관계가 거의 0에 가깝다는 점은, 조직 전체를 풀링한 순위 목록이 상당한 구획 구조를 가릴 수 있음을 보여줍니다. 따라서 개별 모듈을 사용하는 것이 더 타당한 설계였습니다. 이러한 모듈의 외부 및 종단적 성능은 보편적인 유전자 목록이 아니라, 모듈 수준에서 재현 가능한 호스트 반응 활성이 존재함을 뒷받침합니다.
유전자 수준의 이식성과 모듈 수준의 이식성은 서로 다릅니다. 개별 비강 및 혈액 효과 크기 사이의 일치도가 낮았음에도 불구하고, 혈액 모듈은 비인두 종단적 샘플에서 우수한 성능(AUROC 0.845)을 보였습니다. 쌍을 이룬 궤적에서 라벨 반전은 나타나지 않았습니다. 더 가능성 있는 설명은 경로 중복성입니다. 즉, 조정된 인터페론 및 염증 활동은 서로 다른 구획의 서로 다른 유전자 하위 집합으로 요약될 수 있습니다6,7,8,9,10,1,32,3,34. 이것이 우리가 모듈을 구획 배타적이라기보다 구획 인지적이라고 설명하는 이유입니다. 정확한 순위는 다르지만, 공유된 경로 수준의 구성 요소는 여전히 검출 가능합니다. 벌크 프로파일 또한 발현 변화와 세포 구성의 변화가 혼재되어 나타납니다. 마커 프로그램 상관관계로 이러한 문제를 식별할 수 있지만, 세포 단위로 분해된 메커니즘을 제공할 수는 없습니다36,37.
임상적 벤치마크는 두 번째 경계를 정의합니다. Pandya 3-mRNA 및 인터페론 비교군은 바이러스성 대 세균성 감염의 구별에서 더 강력했습니다. 앵커 모듈은 다른 질문에 답합니다. 즉, 샘플이 급성 호스트 반응 프로그램을 얼마나 강력하게 발현하는가 하는 점입니다. 혈액 모듈 또한 세균성 폐렴에서 증가했습니다. 따라서 이는 바이러스 특이적 분류기가 아니라 광범위한 전신 염증/인터페론 활성 점수로 해석되어야 합니다. 높은 점수는 코호트 비교, 반응 추적 또는 염증 상태 설명에 도움이 될 수 있지만, 병원체를 식별할 수는 없습니다. human metapneumovirus와 같은 바이러스의 임상적 중요성이 커지고 있다는 점은 좁은 바이러스 세트로부터의 외삽보다는 병원체적으로 다양하고 조직에 맞춘 검증이 필요함을 더욱 뒷받침합니다12,13.
6개의 중첩 유전자는 탐색적입니다. ISG15, IFIT1, RSAD2 및 XAF1은 타당한 인터페론 관련 역할을 가지고 있으며32,3,34, CCRL2는 염증성 백혈구 이동과 관련이 있고35, ACRBP는 확립된 항바이러스적 해석이 없습니다. 소규모 코호트와 유전자별로 유의하지 않은 FDR 값으로 인해 더 강한 주장을 제기하는 것은 어렵습니다. 방법론적 혁신은 다른 부분에 있습니다. 즉, 동일 연구 내 쌍을 이룬 앵커, 고정된 구획 특이적 모듈, 조직 일치 외부 테스트, 쌍을 이룬 회복 분석, 임상 비교군 벤치마킹, 그리고 명시적인 무작위, 크기, 부트스트랩, 마커 및 분산 검증이 그것입니다. 이러한 증거 계층 구조는 결과 해석을 위한 보수적인 프레임워크를 제공합니다.
몇 가지 한계점이 남아 있습니다. 앵커 코호트는 감염된 비강 샘플 15개와 대조군 비강 샘플 6개, 그리고 감염된 혈액 샘플 13개와 대조군 혈액 샘플 6개만을 포함하고 있습니다. 부트스트랩 결과는 개별 유전자 멤버십이 완전히 안정적이지 않음을 확인해 줍니다. 증상이 있는 RSV와 피코르나바이러스가 결합되었으므로, 앵커 효과가 바이러스 특이적이지는 않습니다. 외부 코호트는 연령, 플랫폼, 중증도, 시점 및 대조군 정의에서 차이가 있습니다. GSE53543은 ex vivo 쌍체 섭동 연구입니다. GSE6390 및 GSE40012는 유용한 임상 비교군을 제공하지만, 쌍으로 이루어진 비강-혈액 샘플링은 제공하지 않습니다. 바이러스 부하, 증상 지속 기간, 산소 필요량 및 중증도 데이터가 일관되게 확보되지 않았습니다. 더 강력한 전향적 설계라면 동일한 참가자로부터 일치하는 시점에 비강 면봉 샘플과 혈액을 수집하고, 바이러스 부하 및 증상 측정, 박테리아 및 증상성 바이러스 음성 비교군, 그리고 세포 해상도 검증을 포함해야 할 것입니다1,14,36,37.
결론적으로, 현재의 공공 전사체 데이터는 조직 문맥이 유지될 때 재현 가능한 비강 및 혈액 숙주 반응 활성 모듈을 뒷받침합니다. 이러한 데이터는 조직 간에 상호 교환 가능한 범조직 유전자 시그니처는 지원하지 않습니다. 페어 앵커(paired anchor)는 유전자 수준에서 일치도가 낮게 나타난 반면, 고정 모듈 점수는 일치하는 조직 내에서 전이되었으며 회복기에 접어들며 감소했습니다. 세균성 폐렴에서 혈액 모듈의 반응과 기존 분류기의 우수한 바이러스 대 세균 분류 성능은 본 연구의 의도된 용도를 정의합니다. 즉, 이 모듈들은 숙주 반응 활성을 설명하고 투명한 코호트 벤치마킹을 지원하는 것이지, 단독적인 병원체 분류기가 아닙니다. 분석 코드와 도출된 데이터는 워크플로우의 독립적인 검증과 재사용을 지원하기 위해 데이터 가용성(Data Availability) 성명서에 설명된 대로 제공됩니다.
공개 사항
저자들은 본 연구와 관련하여 재정적 또는 비재정적 이해관계의 충돌이 없음을 밝힙니다.
감사의 글
저자들은 본 연구에서 재분석된 공개 GEO 연구의 조사자들과 참여자들에게 감사를 표합니다. 저자 자격 기준을 충족하는 추가 인원은 없었습니다. 본 연구는 공공, 상업 또는 비영리 부문의 어떠한 지원 기관으로부터도 특정 보조금을 지원받지 않았습니다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| Andres-Terre 다중 바이러스 인터페론 자극 유전자 세트 | Andres-Terre et al. | 3-유전자 비교군; Supplementary Data 1 | 보고된 다중 바이러스 시그니처로부터 큐레이션된 가중치 없는 인터페론 중심 비교군이며, 전체 유전자 목록은 Supplementary Data 1에 제공됨. |
| Enrichr | Ma'ayan Laboratory | 2026년 8월 18일 접속; RRID:SCR_01575 | gseapy를 통해 접속한 유전자 세트 과잉 표현 리소스. |
| Gene Expression Omnibus | National Center for Biotechnology Information | GEO; RRID:SCR_05012 | 분석 데이터 세트에 접속하는 데 사용된 공공 전사체 저장소. |
| Gene Ontology | Gene Ontology Consortium | GO Biological Process 2023; RRID:SCR_0281 | Enrichr를 통해 사용된 기능적 주석 라이브러리. |
| GPL1058 | NCBI GEO | GPL1058 | GSE53543 및 36개 샘플 GSE3890 검증 유닛을 위한 플랫폼. |
| GPL23126 | NCBI GEO | GPL23126 | GSE17827을 위한 발현 플랫폼. |
| GPL24539 | NCBI GEO | Clariom_D_Human.na36.hg38. probeset.csv | GSE117827 전사체 클러스터 매핑에 사용된 Clariom D Human na36, hg38 주석. |
| GPL571 | NCBI GEO | GPL571 | GSE63990에 적용된 플랫폼 주석. |
| GPL6884 | NCBI GEO | GPL684 | 138개 샘플 GSE3890 RSV 전혈 검증 유닛을 위한 플랫폼. |
| GPL6947 | NCBI GEO | GPL6947 | GSE4012에 적용된 플랫폼 주석. |
| GSE17827 | NCBI GEO | GSE17827 | 기본 쌍을 이룬 비강 스왑 및 전혈 앵커 데이터 세트. |
| GSE152075 | NCBI GEO | GSE152075 | 외부 SARS-CoV-2 상기도 검증 데이터 세트. |
| GSE156063 | NCBI GEO | GSE156063 | 외부 SARS-CoV-2 상기도 검증 데이터 세트. |
| GSE1710 | NCBI GEO | GSE17110 | 외부 SARS-CoV-2 전혈 검증 데이터 세트. |
| GSE3890 | NCBI GEO | GSE3890; GPL1058 및 GPL684 | 별도로 정규화된 36개 및 138개 샘플 플랫폼 유닛으로 분석된 외부 RSV 전혈 검증 데이터. |
| GSE4012 | NCBI GEO | GSE4012 | 임상 인플루엔자 A 폐렴, 세균성 폐렴, SIRS 및 건강 대조군 벤치마크. |
| GSE41374 | NCBI GEO | GSE41374 | 외부 RSV 비강 세척 검증 데이터 세트. |
| GSE53543 | NCBI GEO | GSE53543 | 98명의 대상자와 196개 샘플이 포함된 쌍을 이룬 ex vivo PBMC 라이노바이러스 섭동 벤치마크. |
| GSE6390 | NCBI GEO | GSE6390 | 임상 바이러스성, 세균성 및 비감염성 전혈 벤치마크. |
| GSE9741 | NCBI GEO | GSE9741 | 종단적 전혈 급성기 대 퇴원 검증 데이터 세트. |
| GSE9742 | NCBI GEO | GSE9742 | 종단적 비인두 급성기 대 퇴원 검증 데이터 세트. |
| gseapy | gseapy 개발자 | Version 1.3.1 | Enrichr 쿼리에 사용된 Python 인터페이스. |
| HGNC 유전자 기호 리소스 | HUGO Gene Nomenclature Committee | 2026년 8월 18일 접속; RRID:SCR_02827 | 승인된 유전자 기호 정규화 및 단백질 코딩 분류 리소스. |
| Matplotlib | Matplotlib 개발 팀 | Version 3.11.1 | 그림 생성. |
| MSigDB Hallmark 유전자 세트 | Broad Institute | Hallmark 2020; RRID:SCR_016863 | Enrichr를 통해 접속한 Hallmark 농축 라이브러리. |
| MSigDB Hallmark 인터페론-알파 반응 유전자 세트 | Broad Institute | HALLMARK_INTERFERON_ALPHA_ RESPONSE; Supplementary Data 1의 3-유전자 핵심 서브셋 | 가중치 없는 인터페론-알파 비교군이며, 정확한 서브셋은 Supplementary Data 1에 제공됨. |
| NumPy | NumPy 개발자 | Version 2.5.2 | 수치 계산 및 시드 기반 무작위 샘플링. |
| pandas | pandas 개발 팀 | Version 3.0.5 | 표 형식 데이터 처리. |
| Pandya 3-mRNA 호스트 반응 유전자 세트 | Pandya et al. | Supplementary Table 1; Supplementary Data 1 | 가중치 없는 비교군으로 점수가 매겨진 공식 3-유전자 세트. |
| Python | Python Software Foundation | Version 3.12.13 | 컴퓨팅 분석 환경. |
| Reactome | Reactome | Reactome 202; RRID:SCR_03485 | Enrichr를 통해 접속한 경로 농축 라이브러리. |
| scikit-learn | scikit-learn 개발자 | Version 1.9.0 | AUROC 및 평균 정밀도 계산. |
| SciPy | SciPy 개발자 | Version 1.18.0 | Welch, paired t, Wilcoxon, Mann–Whitney 및 상관관계 테스트. |
| Seaborn | Seaborn 개발 팀 | Version 0.13.2 | 통계 그래픽. |
| statsmodels | statsmodels 개발자 | Version 0.14.6 | 통계 유틸리티. |
참고문헌
- Zaas AK, et al. Gene expression signatures diagnose influenza and other symptomatic respiratory viral infections in humans. Cell Host Microbe. 2009;6(3):207-17.
- Woods CW, et al. A host transcriptional signature for presymptomatic detection of infection in humans exposed to influenza H1N1 or H3N2. PLoS One. 2013;8(1):e52198.
- Andres-Terre M, et al. Integrated, multi-cohort analysis identifies conserved transcriptional signatures across multiple respiratory viruses. Immunity. 2015;43(6):1199-211.
- Herberg JA, et al. Diagnostic test accuracy of a 2-transcript host RNA signature for discriminating bacterial vs viral infection in febrile children. JAMA. 2016;316(8):835-45.
- Pandya R, et al. A machine learning classifier using 33 host immune response mRNAs accurately distinguishes viral and non-viral acute respiratory illnesses in nasal swab samples. Genome Med. 2023;15(1):64.
- Ioannidis I, et al. Plasticity and virus specificity of the airway epithelial cell immune response during respiratory virus infection. J Virol. 2012;86(10):5422-36.
- Mejias A, et al. Whole blood gene expression profiles to assess pathogenesis and disease severity in infants with respiratory syncytial virus infection. PLoS Med. 2013;10(11):e1001549.
- Blanco-Melo D, et al. Imbalanced host response to SARS-CoV-2 drives development of COVID-19. Cell. 2020;181(5):1036-45.e9.
- Hadjadj J, et al. Impaired type I interferon activity and inflammatory responses in severe COVID-19 patients. Science. 2020;369(6504):718-24.
- Mick E, et al. Upper airway gene expression reveals suppressed immune responses to SARS-CoV-2 compared with other respiratory viruses. Nat Commun. 2020;11(1):5854.
- Yoshida M, et al. Local and systemic responses to SARS-CoV-2 infection in children and adults. Nature. 2022;602(7896):321-7.
- Jamali MC, et al. Respiratory infections by human metapneumovirus: epidemiological evidence and treatment prospects. Res J Pharm Technol. 2026;19(8):3905-12. doi:10.52711/0974-360X.2026.00549.
- Gao G, Lin R, Ma D. Human metapneumovirus: pathogenesis, epidemiology, diagnostic technologies, and potential intervention strategies. Virol J. 2025;22(1):376.
- Lim FY, et al. homeRNA self-blood collection enables high-frequency temporal profiling of presymptomatic host immune kinetics to respiratory viral infection: a prospective cohort study. EBioMedicine. 2025;112:105531.
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics. 2007;8(1):118-27.
- Leek JT, et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882-3.
- Yu J, et al. Host gene expression in nose and blood for the diagnosis of viral respiratory infection. J Infect Dis. 2019;219(7):1151-61.
- Tsalik EL, et al. Host gene expression classifiers diagnose acute respiratory illness etiology. Sci Transl Med. 2016;8(322):322ra11.
- Parnell GP, et al. A distinct influenza infection signature in the blood transcriptome of patients with severe community-acquired pneumonia. Crit Care. 2012;16(4):R157.
- Edgar R, Domrachev M, Lash AE. Gene Expression Omnibus: NCBI gene expression and hybridization array data repository. Nucleic Acids Res. 2002;30(1):207-10.
- Barrett T, et al. NCBI GEO: archive for functional genomics data sets-update. Nucleic Acids Res. 2013;41(D1):D991-5.
- Tweedie S, et al. Genenames.org: the HGNC and VGNC resources in 2021. Nucleic Acids Res. 2021;49(D1):D939-46.
- Welch BL. The generalization of Student's problem when several different population variances are involved. Biometrika. 1947;34(1-2):28-35.
- Benjamini Y, Hochberg Y. Controlling the false discovery rate: a practical and powerful approach to multiple testing. J R Stat Soc Series B Stat Methodol. 1995;57(1):289-300.
- Subramanian A, et al. Gene set enrichment analysis: a knowledge-based approach for interpreting genome-wide expression profiles. Proc Natl Acad Sci U S A. 2005;102(43):15545-50.
- Liberzon A, et al. The Molecular Signatures Database Hallmark Gene Set Collection. Cell Syst. 2015;1(6):417-25.
- Do LAH, et al. Host transcription profile in nasal epithelium and whole blood of hospitalized children under 2 years of age with respiratory syncytial virus infection. J Infect Dis. 2018;217(1):134-46.
- Ashburner M, et al. Gene Ontology: tool for the unification of biology. Nat Genet. 2000;25(1):25-9.
- The Gene Ontology Consortium. The Gene Ontology resource: enriching a GOld mine. Nucleic Acids Res. 2021;49(D1):D325-34.
- Gillespie M, et al. The Reactome pathway knowledgebase 2022. Nucleic Acids Res. 2022;50(D1):D687-92.
- Kuleshov MV, et al. Enrichr: a comprehensive gene set enrichment analysis web server 2016 update. Nucleic Acids Res. 2016;44(W1):W90-7.
- Schoggins JW, et al. A diverse range of gene products are effectors of the type I interferon antiviral response. Nature. 2011;472(7344):481-5.
- Schneider WM, Chevillotte MD, Rice CM. Interferon-stimulated genes: a complex web of host defenses. Annu Rev Immunol. 2014;32:513-45.
- Perng YC, Lenschow DJ. ISG15 in antiviral immunity and beyond. Nat Rev Microbiol. 2018;16(7):423-39.
- Schioppa T, et al. Molecular basis for CCRL2 regulation of leukocyte migration. Front Cell Dev Biol. 2020;8:615031.
- Avila Cobos F, et al. Benchmarking of cell type deconvolution pipelines for transcriptomics data. Nat Commun. 2020;11(1):5650.
- Maden SK, et al. Challenges and opportunities to computationally deconvolve heterogeneous tissue with varying cell sizes using single-cell RNA-sequencing datasets. Genome Biol. 2023;24(1):288.