본 연구에서는 데이터 증강, 전처리 및 하이브리드 모델 커스텀 설정(중간 융합)을 통해 DenseNet121과 EfficientNetB7의 특징 융합 능력을 강화한 FusionNetX 접근법을 제시하여, 공개된 5가지 데이터셋에서 뇌종양 분류를 수행하였으며, 98.77%에서 99.89% 범위의 결과를 달성하여 여러 평가 파라미터 전반에서 우수한 성능을 나타냈습니다.
이 콘텐츠를 보려면 JoVE 구독이 필요합니다. 로그인하거나 오늘 무료 평가판을 시작하세요.
이 논문에서
요약
초록
뇌종양은 세계에서 가장 치명적인 질병 중 하나로 간주되며, 이를 잘못 진단하는 것은 환자의 생명을 위험에 빠뜨리고 생존율을 낮춥니다. 특히 합성곱 신경망(convolutional neural networks)과 같은 딥러닝 기반 기술을 결합한 자기공명영상(MRI)은 뇌 내부 구조의 더 세밀한 검사를 가능하게 하고 뛰어난 학습 및 예측 능력을 제공하므로 이러한 장애물을 극복하는 데 매우 중요합니다. 뇌종양의 정확한 진단에 대한 필요성은 여전히 큽니다. 따라서 학습 가능 및 학습 불가능 계층을 포함한 맞춤형 미세 조정 하이퍼파라미터를 사용하여 두 가지 사전 학습 모델인 DenseNet121과 EfficientNetB7의 장점을 활용하는 강화된 특징 융합 기반 DL 모델(FusionNetX)이 제안되었습니다. 제안된 FusionNetX 모델은 Br35H, Figshare, Sartaj, Masoud 및 Balanced Brain Tumor의 5가지 공개 뇌종양 데이터셋에 적용되었습니다. 이미지 품질을 개선하고 리사이징 및 데이터 증강을 통해 과적합 문제를 해결하기 위해 일부 전처리 단계가 적용되었습니다. 정확도, 손실, 양성 예측도, 음성 예측도, 진양성률, 진음성률, F1-score, 위음성률 및 위양성률과 같은 다양한 성능 평가 지표를 사용하여 분석한 결과, 제안된 FusionNetX 모델은 Br35H에서 99.33%, Figshare에서 99.13%, Masoud에서 99.89%, BBT-Dataset에서 99.19%, 그리고 Sartaj에서 98.77%의 정확도를 보였습니다. 또한, 제안된 FusionNetX 모델의 중요성을 입증하기 위해 5가지 뇌종양 데이터셋을 후기 융합(late fusion) 및 어텐션 기반 융합(attention-based fusion)을 사용하여 평가하였으며, 그 결과 모든 데이터셋에서 0.3%에서 1.9%의 향상을 보이며 실질적으로 더 나은 성능을 나타냈습니다. 나아가 수신자 조작 특성 곡선(receiver operating characteristic curve)을 산출하였으며, 다양한 성능 평가 지표의 결과는 제안된 FusionNetX 모델이 뇌종양을 정확하게 검출 및 예측하여 의료 종사자가 적시에 결정을 내리는 데 도움을 줄 수 있음을 시사합니다.
서론
암은 그 심각성과 증가하는 발병률로 인해 오늘날 인체에서 가장 치명적인 질병이며, 뇌종양, 유방암, 폐결절, 신장암 등 다양한 암성 질환이 인체에서 발견되어 사망률을 높이고 있습니다. 암은 체내의 세포나 조직이 비정상적으로 증식할 때 발생합니다. 암이 전이되면 다른 인체 장기를 손상시켜 더욱 위험해질 수 있습니다1. 뇌는 모든 신체 기능을 조절하므로, 뇌에 발생하는 모든 손상은 전신에 광범위한 영향을 미칠 수 있습니다. 이것이 바로 뇌종양이나 뇌암이 인간에게 매우 치명적인 이유입니다2. 또한, 뇌종양은 크게 양성과 악성 두 가지 범주로 나뉩니다. "양성"은 기본적으로 암이 아니라는 뜻이며, 단순히 주변 환경을 변화시켜 해결할 수 있는 뇌의 문제입니다. 반면, 악성의 경우 전이성 특성 때문에 위험한 것으로 간주되는데, 이는 비정상적인 세포나 조직이 신체의 다른 부위로 이동하거나 그곳에서 나와 다른 장기까지 방해함으로써 체내에서 암이 발생할 가능성을 높이기 때문입니다3.
또한, 미국 뇌종양 협회와 세계보건기구(WHO)에 따르면 뇌암의 세 가지 주요 범주는 뇌하수체 종양, 수막종 및 신경교종입니다4. 신경교종은 뇌의 뉴런에 영양을 공급하는 신경교세포에서 기원합니다. 뇌하수체 종양은 뇌 기저부에 위치하며 다양한 신체 기능을 담당하는 뇌하수체에서 시작됩니다. 반면, 수막종은 뇌와 척수를 둘러싸고 보호하는 막인 수막에서 시작됩니다. 또한, 진단 목적으로 신체 내부를 검사하기 위해 X-선, 컴퓨터 단층촬영(CT) 스캔, 자기공명영상(MRI)을 포함한 여러 의료 영상 기법이 일반적으로 사용됩니다5,6. 각 영상 기법은 저마다의 장단점이 있습니다. MRI는 신체, 특히 뇌의 연조직과 세포에 대한 상세한 영상을 제공하는 영상 기법입니다. 암은 신체 내의 비정상적인 조직이나 세포를 포함하며, MRI는 이러한 이상 부위에 대한 상세한 영상을 제공하므로 뇌종양이나 암을 진단하는 데 더 유용한 영상 기법이 됩니다. 또한, MRI는 신체 내부 구조를 검사하는 동안 해로운 방사선을 생성하지 않으므로 다른 영상 기법보다 더 안전합니다.
또한, 기계 학습(ML), 영상 처리(IP), 딥 러닝(DL)을 포함한 많은 계산 방법론이 뇌종양과 관련된 진단 과제를 해결하기 위해 고용되며, 각 접근 방식은 암을 진단하기 위해 영상 진단 기기로 촬영한 이미지에 적용됩니다7. 이러한 접근 방식은 이미지 내의 서로 다른 객체들의 숨겨진 패턴과 구조를 학습하여, 병변 부위의 패턴을 식별함으로써 암을 진단합니다. 각 계산적 접근 방식은 진단 과정에서 각각의 장단점을 가집니다. ML 및 IP 기반 접근 방식은 수작업으로 설계된 특징(handcrafted features)을 추출하는데, 이는 특히 대규모 데이터셋에서 대개 부정확한 예측과 오진으로 이어집니다8. 수작업 특징 추출의 문제를 극복하기 위해, 사람들은 이미지에서 최적의 특징을 자동으로 학습하고 추출하여 종양을 정확하게 진단하는 딥 러닝 기반 모델, 즉 일반적으로 합성곱 신경망(CNN) 기반 모델이라 불리는 모델로 이동하고 있습니다. DL 기반 접근 방식은 대규모 데이터에서 복잡한 패턴을 학습하고 추출하여 더 정확한 결과를 생성하는 능력 덕분에, 인체 내 질병 진단, 특히 뇌종양, 유방암, 폐암 및 기타 질병의 조기 및 정확한 검출을 위한 의료 영상 분야에서 현재 흔히 사용되고 있습니다9. DL 모델에서 직면하는 주요 문제는 더 많은 자원 소모와 데이터 샘플링이며, 이는 전이 학습(TL)10이라고 불리는 또 다른 딥 러닝 기반 접근 방식을 통해 극복됩니다. 전이 학습에서는 사전 학습된 모델을 사용하여 질병을 진단함으로써 시간과 자원을 절약합니다. 대규모 데이터셋으로부터 질감, 색상, 가장자리 등과 관련된 기본 특징을 이미 학습한 사전 학습된 모델을 통해 건강 문제의 조기 및 정확한 진단이 가능해집니다. 이러한 모델은 모델을 활용하고 하이퍼파라미터와 학습 가능 및 학습 불가능 레이어를 추가함으로써, 이전에 본 적 없는 새로운 데이터셋으로 전이될 수 있습니다11. 뇌종양 분류에 대해 상당한 양의 연구가 수행되었으며, Table 112,13,14,15,16,17,18,19,20,21,22,23에 접근 방식, 데이터셋 및 결과를 포함한 이 연구들의 세부 사항이 제시되어 있습니다. 그럼에도 불구하고, 견고한 특징 추출을 위해 두 가지 전이 학습 모델을 결합하고 원활한 학습 및 테스트를 보장하기 위해 정규화 기법을 조정한 방법론을 채택한 연구는 아직 없습니다. 제안된 방법론에 대한 심층적인 평가는 다양한 뇌종양 특징에 따른 모델 성능에 대한 통찰을 제공합니다.
| 참고 문헌 | 접근법 | 데이터 샘플 | 결과 | 한계점 |
| 12 | 사용자 정의 CNN | Br35H | 정확도 = 97.45%, | 결과를 개선할 필요가 여전히 있으며, 자체 제작한 CNN을 사용하는 대신 기존의 CNN 모델을 수정하여 사용하는 것이 더 바람직합니다. |
| 손실 = 0.1141%, | ||||
| 재현율 = 98.09%, | ||||
| F1-Score = 97.69%, | ||||
| 정밀도 = 97.29%, | ||||
| 증강된 Br35H | 정확도 = 98.99%, | |||
| 정밀도 = 98.90%, | ||||
| 손실 = 0.0570%, | ||||
| 재현율 = 98.91%, | ||||
| F1-스코어 = 99.04% | ||||
| 13 | 특징 융합 DNN 모델 | Br35H | 정확도 = 98.22%, | 결과에 대한 개선이 여전히 필요하며, 맞춤형 모델을 사용하는 대신 특성 융합(feature fusion)을 위해 기존 모델을 사용할 필요가 있습니다. |
| FNR = 1.77%, | ||||
| 민감도 = 98.2%, | ||||
| F1-스코어 = 98%, | ||||
| 특이도 = 98%, | ||||
| Figshare | 정확도 = 98.01%, | |||
| 민감도 = 96.03%, | ||||
| F1-Score = 96%, | ||||
| 특이도 = 98.67%, | ||||
| FNR = 3.96% | ||||
| 14 | SGD를 이용한 AlexNet | Br35H | 정확도 = 98.79%, | 그럼에도 불구하고 결과의 일부 개선이 필요하며, 다양한 데이터 샘플에 대해 몇 가지 고급 CNN 기반 모델을 확인해야 합니다. |
| MCR = 1.20%, | ||||
| 민감도 = 98.98%, | ||||
| 특이도 = 98.58%, | ||||
| F1-스코어 = 98.82% | ||||
| 15 | InceptionV3 | Figshare | 정확도 = 98.89%, | 저자들은 세 가지 종양 클래스가 포함된 Figshare 데이터셋을 사용하였습니다. 저자들은 종양을 분류하는 대신 종양의 존재 여부를 분류하였으며, 결과의 개선뿐만 아니라 종양 클래스를 범주화하는 작업이 여전히 필요한 상황입니다. |
| 민감도B = 95.28%, | ||||
| 민감도M = 94.47% | ||||
| 16 | 최적화된 ResNet50 | Figshare | 정확도 = 99.03%, | 결과를 더욱 개선하기 위해 다른 성능 평가 파라미터들을 추가로 계산할 필요가 있었다. |
| 재현율 = 99%, | ||||
| F1-Score = 99% | ||||
| 17 | Res-BRNet | Br35H | 정확도 = 98.22%, | 결과에 있어 여전히 개선이 필요합니다. |
| 민감도 = 98.11%, | ||||
| 정밀도 = 98.22%, | ||||
| Figshare | F1-Score = 98.41% | |||
| 18 | ResNet101 + DenseNet121 | Figshare | 정확도 = 99.18%, | 결과가 약간 개선되었으며, 뇌종양 관련 데이터 세트를 더 많이 확인할 필요가 있습니다. |
| 재현율 = 99.11%, | ||||
| F1-Score = 99.08, | ||||
| 정밀도 = 99.07%, | ||||
| 사르타즈 | 정확도 = 97.24%, | |||
| 재현율(Recall) = 97.58%, | ||||
| F1-Score = 97.28%, | ||||
| 정밀도 = 97.06%, | ||||
| 19 | CNN-SVM | 교모세포종 | 정확도 = 98.02%, | SVM을 적용한 기존 모델들을 활용할 필요가 있으며, 결과 측면에서는 여전히 개선이 필요합니다. |
| F1-Score = 98.31%, | ||||
| 정밀도 = 98.09%, | ||||
| 민감도 = 98.53%, | ||||
| 특이도 = 97.30%, | ||||
| Sartaj | 정확도 = 96.83%, | |||
| 정밀도 = 95.36%, | ||||
| 민감도 = 94.73%, | ||||
| 특이도 = 97.56%, | ||||
| F1-스코어 = 95% | ||||
| 20 | 미세 조정된 EfficientNetB3 | Figshare | 정확도 = 98.70% | 결과를 개선하기 위해 앞서 언급한 EfficientNetB3의 변형 모델들이 필요합니다. |
| Sartaj | 정확도 = 97.50% | |||
| 21 | InceptionV4 | 마수드 | 정확도 = 98.7%, | 더 많은 데이터 세트를 사용하여 결과의 일부 개선이 필요합니다. |
| 정밀도 = 99%, | ||||
| 민감도 = 98%, | ||||
| 특이도 = 99%, | ||||
| F1-Score = 99.1% | ||||
| 22 | VGG16 | 마수드 | 정확도 = 98% | 더 많은 심층 신경망 모델을 검토함으로써 결과의 개선이 필요합니다. |
| 23 | MFR-CNN | 마수드 | 정확도 = 94%, | 본 제안 솔루션에는 복잡한 아키텍처가 사용되었습니다. |
| 재현율 = 96%, | ||||
| F1-스코어 = 96%, | ||||
| 정밀도 = 96%, |
표 1: 최신 연구 작업의 비교 검토.이 표는 기존 연구와 그에 따른 접근 방식, 데이터 샘플, 결과 및 한계점을 요약하여 보여줍니다. 이 표를 다운로드하려면 여기를 클릭하십시오.
표 1에서는 기존의 접근 방식들을 검토하며, 결과 개선에 있어 이러한 방식들이 가진 한계점과 다양한 뇌종양 데이터셋에서 더 나은 성능을 발휘하는 효율적인 프레임워크 내에서 다양한 통계적 파라미터를 통해 성능을 평가하는 동시에 기존의 DL 모델을 사용할 필요성을 강조합니다.
연구 목적 및 문제 정의
수동 판독은 시간이 많이 소요되며 관찰자 간 변동성이 발생하므로, MRI를 통한 뇌종양 유형의 신속하고 정확한 분류는 임상적 의사결정에 매우 중요합니다. 현재 자동 뇌종양 분류를 위한 대부분의 딥러닝(DL) 접근 방식은 단일 백본 네트워크나 단순한 결정 수준 융합(decision-level fusion)에 기반하고 있어, 여러 사전 학습된 아키텍처에서 얻은 상호 보완적인 특징 표현을 충분히 활용하지 못하며, 종종 단일 데이터셋에서만 검증되어 일반화 가능성에 대한 신뢰도가 제한적입니다.
본 연구 프로젝트의 목적은 상보적 특징 표현을 활용하여 MRI로부터 견고한 뇌종양 분류를 가능하게 하는 듀얼 백본 딥러닝(DL) 프레임워크(EfficientNetB7 및 DenseNet121)를 사용하여 인체 뇌의 뇌암을 진단하기 위한 완전하고 정확한 방법을 개발하고 제공하는 것입니다. 또한, 여러 독립적인 공개 데이터셋을 통해 해당 프레임워크의 견고성을 평가합니다. 이러한 접근 방식은 방사선 전문의와 구급대원이 뇌종양을 빠르고 효과적으로 진단하도록 도와, 종양의 인식 및 분류를 가능하게 함으로써 환자의 생명을 구하는 데 기여할 수 있습니다.
특정한 연구 문제를 해결하고 본 연구 프로젝트의 목적이나 목표를 달성하기 위해, 다음과 같은 연구 질문과 해당 질문을 해결하기 위한 기여 사항을 설정하였습니다. 1) 뇌종양 분류에 있어 두 개의 사전 학습된 백본 네트워크를 특징 수준(중간)에서 융합하는 것이 결정 수준(후기) 및 어텐션 기반 융합 기법보다 더 효과적인가? 2) 제안된 시스템이 독립적으로 획득된 여러 뇌종양 MRI 데이터셋에서 일관된 분류 성능을 제공하는가?
본 연구의 범위는 5가지의 공개 뇌종양 MRI 데이터셋(Br35H, Figshare, Sartaj, Masoud, BBT-Dataset)을 이용한 이미지 수준(2D MRI 슬라이스) 분류로 제한되며, 데이터셋 간의 교차 검증이 아닌 개별적인 평가를 수행하였으며, 방법론 섹션에 기술된 특정 아키텍처, 전처리 파이프라인 및 실험 설정을 사용하였습니다. 본 연구에는 환자 수준의 검증이나 임상 적용 환경에서의 테스트는 포함되지 않았습니다.
본 연구의 주요 기여도는 다음과 같습니다: 1) 최적화된 하이퍼파라미터를 적용한 DenseNet121 및 EfficientNetb7을 포함하여, 더 나은 특징 추출을 위해 듀얼 사전 학습 모델을 활용한 것이 본 연구의 일차적인 기여입니다. 2) 견고한 성능을 위해 듀얼 사전 학습 모델의 연결된 특징과 고급 정규화 기법이 통합된 혁신적인 모델 아키텍처를 제안하였습니다. 3) 과적합 문제를 극복하고 더 일반적이고 구체적인 특징을 학습시키기 위해 훈련 샘플의 다양성을 높이는 효과적인 데이터 증강 전략을 적용하였습니다. 4) 제안된 모델의 성능을 5가지의 서로 다른 공개 뇌종양 데이터셋을 통해 평가하였으며, 정확도, 오분류율, 정밀도, 음성 예측도, 민감도, 특이도, F1-Score, 위음성률 및 위양성률을 포함한 다양한 통계적 평가 파라미터에 집중하였습니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
프로토콜
세계에서 가장 위협적인 질병 중 하나는 뇌종양입니다. 정확한 진단은 환자의 생존율을 높이는 데 유익할 수 있습니다. 하지만 여전히 뇌종양을 조기에 발견할 수 있는 정확한 진단 시스템이 필요합니다. 이 문제를 해결하기 위해, DenseNet121 및 EfficientNetB7 모델을 기반으로 최적화된 하이퍼파라미터와 미세 조정된 레이어를 적용한 하이브리드 듀얼 딥러닝 메커니즘을 사용하여, 뇌종양을 조기에 정확하게 검출할 수 있는 더욱 신뢰할 수 있는 기술이 제안되었습니다. 제안된 접근 방식은 2D MRI 영상을 입력으로 받아, 이진 분류 데이터셋인 Br35H에 대해서는 종양 존재 여부를 예측하고, 다른 4가지 다중 클래스 분류 데이터셋에 대해서는 종양 범주화를 출력합니다. 따라서 본 섹션에서는 그림 1에 나타낸 바와 같이 데이터 수집부터 최종 출력까지의 주요 단계인 데이터 획득, 데이터 전처리, 데이터 분할, 모델 선택, 특징 추출, 종양 예측 및 제안된 모델의 평가 과정을 설명합니다.
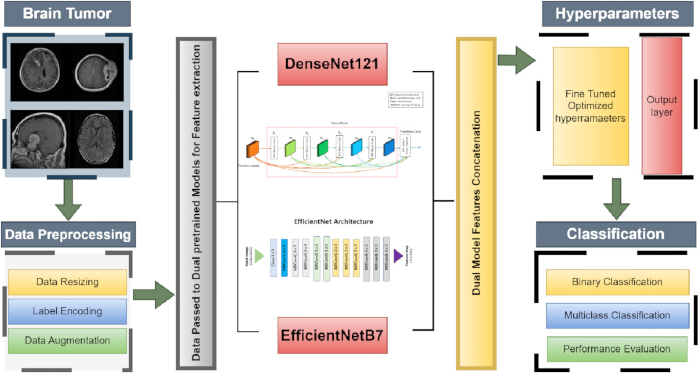
그림 1: 제안된 방법론의 워크플로우. 이 다이어그램은 데이터 획득 및 전처리, 특징 추출을 위한 두 가지 사전 학습 모델, 추출된 특징의 결합, 그리고 종양 분류 및 유형 판별을 위한 하이퍼파라미터 미세 조정(fine-tuning)을 포함하여 제안된 모델의 전체 아키텍처를 보여줍니다. 여기를 클릭하여 이 그림의 더 큰 버전을 확인하십시오.
데이터 획득
모든 실험 연구에서 첫 번째 단계는 데이터 수집입니다. 이를 위해 Br35H24, Figshare25, Sartaj26, Masoud27, 그리고 오픈 소스 라이브러리인 Kaggle28의 뇌종양 MRI 영상 기반 데이터셋을 포함하여, 이미 많은 연구 학자들이 뇌종양 진단 및 검출에 사용한 다섯 가지의 서로 다른 공개 데이터셋을 선정하였습니다. Br35H 데이터셋은 건강한 뇌 영상과 비정상(종양) 뇌 영상의 두 가지 클래스로 구성된 3,000장의 이미지를 포함하며, 각 클래스당 1,500장씩 배분되어 있습니다. Figshare 데이터셋은 종양 유형에 따라 세 그룹으로 나뉜 3,064장의 이미지로 구성되어 있으며, glioma 이미지 1,426장, meningioma 이미지 708장, pituitary tumor 이미지 930장으로 이루어져 있습니다. Sartaj 데이터셋은 glioma(926장), meningioma(937장), pituitary tumor(901장), 그리고 건강 또는 종양 없음(500장)의 네 가지 종양 클래스로 분류된 3,264장의 이미지를 포함합니다. 또한, Masoud 데이터셋 역시 네 가지의 서로 다른 종양 클래스로 구성되어 있으며, 앞서 언급한 세 가지 데이터셋에서 추출한 총 7,023장의 이미지로 이루어져 있습니다. 이는 다시 glioma(1,621장), meningioma(1,645장), pituitary(1,757장), 그리고 건강 또는 종양 없음(2,000장)으로 분류됩니다. 마지막으로 선정된 데이터셋은 MRI 영상 기반 데이터셋으로, 총 5,248장의 이미지가 네 가지 클래스로 구성되어 있습니다. 이는 glioma 이미지 1,312장, meningioma 이미지 1,312장, pituitary 이미지 1,312장, 그리고 건강 또는 종양 없음 이미지 1,312장으로 종양 유형별로 균등하게 나누어져 있어 균형 잡힌 데이터셋으로 간주됩니다.
데이터 전처리
데이터 수집 후 다음 단계는 전처리이며, 이는 더 나은 결과를 얻고 데이터에서 최적의 특징을 추출 및 학습하는 계산적 접근 방식에 필수적이어서 더욱 정확한 결과를 산출합니다. 첫 번째로 적용된 단계는 이미지 크기 조정입니다. 서로 다른 클래스와 이미지 크기를 가진 5개의 공개 데이터셋을 선택하였으며, 동일한 데이터셋 내에서도 종양 클래스에 따라 크기가 달랐으므로 모델의 해석과 학습 효율을 높이기 위해 모든 이미지를 224 x 224 크기로 균일하게 조정했습니다. 또한, 모든 데이터셋에 대해 다양한 각도에서 추가 샘플을 생성하는 데이터 증강을 적용하여 딥러닝(DL) 모델의 특징 추출 및 학습 능력을 향상시켰습니다. 이를 위해 모든 이미지에 7%의 회전 범위를 적용하여 최대 7도까지 회전시켰습니다. 이어서 모든 이미지에 수평 및 수직 방향으로 5%의 랜덤 시프트를 적용하였으며, 이는 원본 이미지의 높이와 너비 대비 5%의 이동 거리였습니다. 그 후 이미지를 원본 대비 10% 확대하였고, 마지막으로 모든 이미지를 수평 및 수직으로 반전시켰습니다. 데이터 증강29을 수행하는 주된 이유는 원본 데이터 샘플의 다양한 변형 버전을 학습시킴으로써 과적합을 극복하고 모델의 일반화 성능을 향상시키는 것입니다. 데이터셋을 훈련 세트와 검증 세트로 분할하기 전에 레이블 인코딩을 적용하였으며, 이는 훈련 및 검증 과정에서 손실 값을 계산하는 데 유용할 뿐만 아니라 모델이 레이블을 정확하게 처리하는 데 필수적입니다. 추가적으로, 데이터셋을 훈련 세트와 검증 세트로 80% 대 20% 비율30로 분할하였으며, Table 2는 데이터 샘플의 전체 분포와 훈련 및 검증 비율을 보여줍니다.
| 데이터셋 | 종양 클래스 | 총 이미지 수 | 훈련 이미지 수 | 검증 이미지 수 |
| Br35H | 정상 | 1500 | 1200 | 300 |
| 종양 | 1500 | 1200 | 300 | |
| 총 이미지 수 | 3000 | 2400 | 600 | |
| Figshare | 교모세포종 | 1426 | 1141 | 285 |
| 수막종 | 708 | 566 | 142 | |
| 뇌하수체종 | 930 | 744 | 186 | |
| 총 이미지 수 | 3064 | 2451 | 613 | |
| Sartaj | 교모세포종 | 926 | 741 | 185 |
| 수막종 | 937 | 749 | 188 | |
| 종양 없음 | 500 | 400 | 100 | |
| 뇌하수체종 | 901 | 721 | 180 | |
| 총 이미지 수 | 3264 | 2611 | 653 | |
| Masoud | 교모세포종 | 1621 | 1297 | 324 |
| 수막종 | 1645 | 1316 | 329 | |
| 종양 없음 | 2000 | 1600 | 400 | |
| 뇌하수체종 | 1757 | 1405 | 352 | |
| 총 이미지 수 | 7023 | 5618 | 1405 | |
| Balanced brain tumor dataset (BBT-Dataset) | 교모세포종 | 1312 | 1050 | 262 |
| 수막종 | 1312 | 1050 | 262 | |
| 종양 없음 | 1312 | 1050 | 262 | |
| 뇌하수체종 | 1312 | 1050 | 262 | |
| 총 이미지 수 | 5248 | 4200 | 1048 |
표 2: 데이터 세트 분포. 이 표는 뇌종양 데이터 세트의 클래스별 전체, 훈련 및 검증 이미지 수에 대한 통계를 보여줍니다.
Br35H 데이터셋은 3000장의 이미지로 구성되어 있으며, 그 중 2400장은 훈련용으로, 600장은 검증용으로 선택되었습니다. Figshare 데이터셋은 3064장의 이미지로 구성되어 있습니다. 전체 이미지 중 2451장은 훈련용으로, 나머지 613장은 검증용으로 선택되었습니다. Sartaj 데이터셋은 총 3264장의 이미지로 구성되며, 2611장은 훈련용으로, 나머지 653장은 검증용으로 사용되었습니다. Masoud 데이터셋은 총 7023장의 이미지로 구성되며, 이 중 5618장은 훈련용으로, 나머지 1405장은 검증용으로 사용되었습니다. BBT 데이터셋은 총 5248장의 이미지로 구성됩니다. 전체 이미지 중 4200장은 훈련 목적으로, 나머지 1048장은 검증 목적으로 고려되었습니다. 또한, 아래의 그림 2는 다양한 뇌종양 이미지를 보여줍니다.
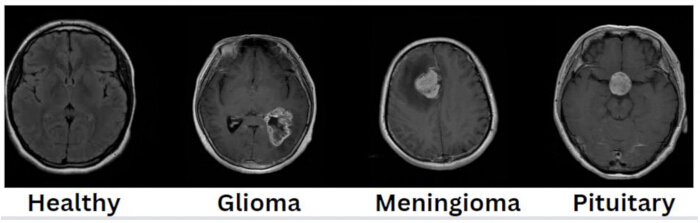
그림 2: 종양 유형을 포함한 뇌종양 영상. 데이터셋에는 건강한 뇌 조직 영상 4장과 신경교종, 수막종, 뇌하수체종의 종양 영상 3장이 포함되어 있습니다. 여기를 클릭하여 이 그림의 확대 버전을 확인하십시오.
제안된 모델
전처리 단계 이후의 다음 단계는 뇌종양 분류에만 효과적인 훈련 모델을 제안하는 것입니다. 이를 위해 뇌종양 분류에 특화된 효율적인 훈련 모델이 제안되었습니다. 특히, 이미지에서 특징을 추출하는 데 사용된 DenseNet12131,32 및 EfficientNetB733을 포함하는 새롭고 효율적인 하이브리드 특징 융합 기반의 사전 훈련된 모델이 제안되었습니다. 나아가, 추출된 특징들을 결합하여 훈련 가능 및 훈련 불가능 층을 포함한 서로 다른 미세 조정된 하이퍼파라미터에 전달함으로써 뇌종양을 정확하게 진단하도록 하였으며, 이는 앞선 관련 섹션에서 논의된 5가지의 서로 다른 공개 데이터셋에 구현되었습니다. 또한, DenseNet121 모델은 2017년 Gao Huang과 동료들에 의해 개발되었으며 121개의 층으로 구성되어 있습니다. 이 모델의 주요 목적은 특징 재사용을 극대화하고 기울기 소실 문제(vanishing gradient problem)34를 방지하는 데 집중하는 것이었습니다. 이 모델의 층들은 밀집 블록(dense blocks)으로 구성되며, 각 블록은 특징을 추출하고 학습하는 여러 개의 컨볼루션 층을 포함합니다. 각 층은 이전의 모든 층에서 생성된 특징 맵을 입력으로 받으며, 그 출력은 해당 층들의 출력과 연결되어 동일한 블록 내의 후속 층들에 순방향 방식으로 입력으로 전달됩니다. 또한, 밀집 블록 사이에는 전이 층(transition layers)이 추가되며, 각 전이 층은 1 × 1 컨볼루션 층, BatchNormalization 층, 그리고 2 × 2 평균 풀링 층으로 구성되어 모델의 복잡도를 제어하기 위해 특징 맵을 축소합니다. 더불어, 분류를 위해 전역 평균 풀링 층 이전에 SoftMax 활성화 함수(AF)가 포함된 최종 층이 추가됩니다. DenseNet121 모델의 기본 설계는 아래 그림 334에 나와 있습니다.
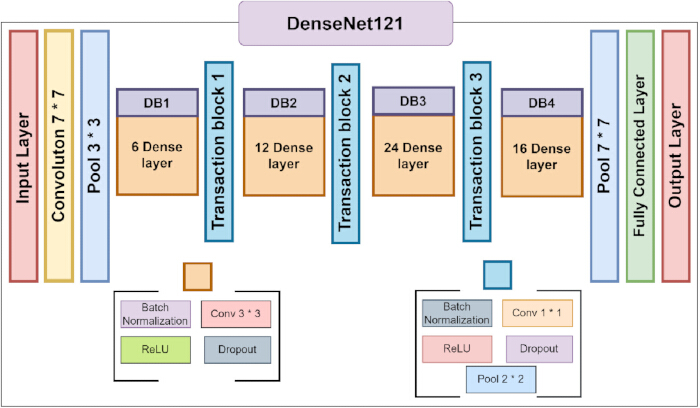
그림 3: DenseNet121 구조 상세도34. 이 그림은 모든 밀집 블록과 전이 블록을 포함한 DenseNet121 모델의 구조적 상세 내용을 보여줍니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
또한, EfficientNetB7 모델은 2019년 Tan과 Lee에 의해 개발되었습니다. 이 모델은 B0부터 B7까지의 변형 모델을 가진 EfficientNet 제품군에 속하며, 주요 목표는 더 적은 파라미터와 연산 능력을 사용하면서도 타 모델보다 우수한 성능을 내는 것입니다. 모델의 너비(레이어당 채널 수), 깊이(레이어 수) 및 해상도는 모델의 핵심 기능인 compound scaling을 통해 미세 조정될 수 있습니다. 또한, 이 모델은 MBConv(mobile inverted bottleneck convolutional) 블록으로 구성되어 있으며, 여기에는 채널을 확장하는 역할을 하는 1 × 1 합성곱 확장 레이어, 각 채널에 개별적으로 합성곱을 적용하는 depthwise separable convolution, 그리고 채널 수를 원래대로 줄이는 1 × 1 합성곱 투영 레이어가 포함됩니다. 아울러, 각 MBConv 블록은 채널별 특징을 재보정하여 네트워크가 가장 중요한 특징에 집중할 수 있도록 돕는 Squeeze and Excitation (SE) 블록35으로 구성됩니다. 또한, sigmoid나 다른 AF 대신 Swish 함수가 사용되는데, 이는 음수 값을 허용함으로써 ReLU보다 우수한 성능을 보이며 그래디언트 흐름에 도움을 줍니다. 더불어, 분류 목적으로 global average pooling 레이어 앞에 SoftMax AF가 포함된 최종 출력 레이어가 추가됩니다. 그림 435는 EfficientNetB7 모델의 기본 설계를 보여주며, 그림 5는 권장되는 모델 아키텍처를 보여줍니다.
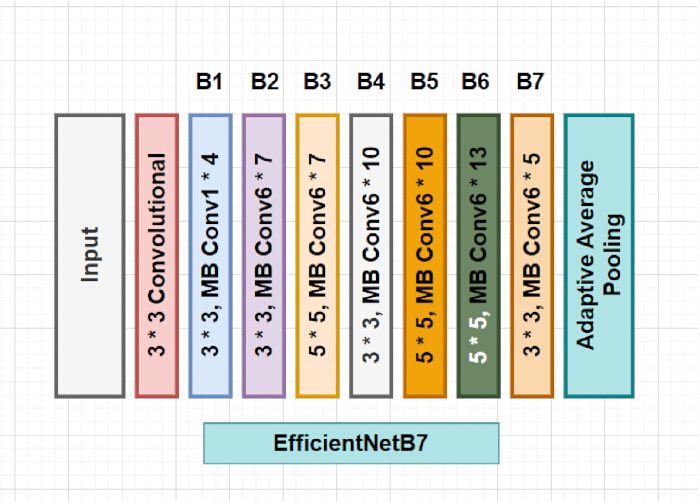
그림 4: EfficientNetB7 아키텍처 상세 구조35. 이 그림은 모든 모바일 역병목 합성곱 블록(mobile inverted bottleneck convolutional blocks)을 포함한 EfficientNetB7 모델의 아키텍처 상세 구조를 보여줍니다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
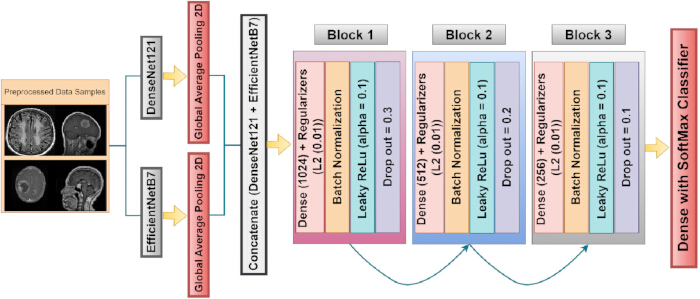
그림 5: 제안된 하이브리드 융합 모델 구조. 제안된 구조는 전처리된 영상이 어떻게 특성 추출기로 전달되는지를 보여주며, 이 추출기는 서로 다른 하이퍼파라미터를 가진 세 개의 맞춤형 블록과 그 뒤를 잇는 출력층으로 구성됩니다. 여기를 클릭하여 이 그림의 확대 버전을 확인하십시오.
추가적으로, 사전 학습된 DenseNet121 및 EfficientNetB7 모델로부터 초기 특징들을 추출하였습니다. 사전 학습된 모델의 업데이트된 가중치를 학습된 모델에 로드하였으며, 모델이 다시 학습되는 것을 방지하기 위해 학습 불가능한 베이스 레이어들을 동결시켰습니다. 이는 모델이 과거의 최적 지식을 유지하고, 새로운 데이터 샘플에 맞춰 이를 조정함으로써 수렴도를 높이며, 추가 레이어의 학습과 고급 특징 추출에 집중하는 데 도움이 됩니다. 아래의 식 1과 2는 DenseNet121 및 EfficientNetB7 모델의 작동 원리를 보여줍니다.
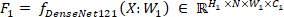 (1)
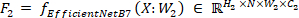 (2)
위의 식 1과 2는 특징 추출과 관련된 사전 학습된 모델의 작동 방식을 보여줍니다. F1은 입력 이미지 X를 처리하여 사전 학습된 DenseNet121 모델에서 생성된 출력 특징 맵을 나타내며, F2는 사전 학습된 EfficientNetB7 모델에서 생성된 출력 특징 맵을 나타냅니다. 또한, W1과 W2는 각각 DenseNet121 및 EfficientNetB7 모델의 첫 번째 블록과 레이어에 관련된 학습 가능한 파라미터 또는 가중치입니다. 더불어, ∈ RN ×H1×W1×C1 및 ∈ RN ×H2×W2×C2는 각각 DenseNet121 및 EfficientNetB7 모델 출력 특징 맵의 차원을 나타내며, 그 크기는 H1 ×N×W1×C1 및 H2 ×N×W2×C2입니다. 여기서 N는 이미지의 배치 크기를 나타내며 16으로 설정되었습니다. 또한, H1×W1은 DenseNet121 모델에 대한 이미지의 높이와 너비를 나타내고, H2×W2는 EfficientNetB7 모델에 대한 이미지의 높이와 너비를 나타내며 224 × 224 크기로 선택되었습니다. C1 및 C2는 각각 DenseNet121 및 EfficientNetB7 모델의 컬러 채널을 나타냅니다. EfficientNetB7에서는 2560 채널, DenseNet121에서는 1024 채널의 출력 특징 맵을 얻은 후, 모든 공간 차원의 평균을 내어 단일 벡터로 변환함으로써 공간 차원을 줄이는 global average pooling 2D36 레이어를 출력 특징 맵에 적용합니다. 이는 해석 가능한 특징 관점에서 더 나은 특징 추출과 패턴 인식을 위해 다음 레이어로 전달하기에 더 용이합니다.
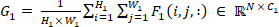 (3)
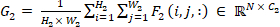 (4)
위의 식 3과 4는 각각 DenseNet121 및 EfficientNetB7 모델에 적용된 global average pooling 2D 층의 작동 방식을 보여주며, 여기서  및
 은 풀링된 출력이 단순한 합계가 아닌 평균이 되도록 두 모델 모두에서 총 공간 위치 수로 합계를 나누어 정규화하는 과정을 나타냅니다.
 및
 은 특성 맵의 공간 차원에 걸친 합산을 나타내며, i와 j는 각각 두 모델의 특성 맵을 합산하기 위해 높이와 너비를 반복하는 인덱스입니다. 또한, F1(i, j, :) 및 F2(i, j, :)는 각각 DenseNet121 및 EfficientNetB7 모델의 모든 채널에 걸쳐 특정 공간 위치(i, j)에서의 특성 맵 값을 나타냅니다. 이 풀링 작업은 모든 이미지에서 가장 중요한 특성을 보존하면서 공간 정보를 더 간결하고 정확한 표현으로 집계합니다. 나아가, global average pooling 층의 출력은 연결(concatenate)되어 각 샘플에 대한 단일 특성 벡터를 생성하며, 이는 종종 두 모델의 강점을 모두 활용하여 성능을 향상시키기 위해 서로 다른 모델의 특성을 융합하는 데 사용됩니다. 식 5는 이 작동 방식을 보여줍니다.
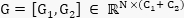 (5)
위의 식 5는 두 가지 서로 다른 모델 특징 벡터 [G1, G2]의 연결 과정을 보여주며, 여기서 G1은 DenseNet121 모델의 특징 벡터를, G2는 EfficientNetB7 모델의 특징 벡터를 나타낸다. 연결된 특징 벡터의 형태는 RN ×(C1+ C2)로 표시되며, 여기서 N은 병렬로 처리되는 샘플 수를 나타내는 배치 크기이고, (C1+ C2)는 모델 1과 2에서 각각 얻은 총 특징 수로 약 3584개이며 병렬로 처리된다. 이렇게 연결된 출력 특징 벡터는 G로 표시된다. 또한, 더 정확하고 효율적인 결과를 얻기 위해 더 복잡한 특징을 추출하고, 일반화 성능을 향상시키며, 과적합을 방지하도록 융합된 모델을 수정하기 위해 세 개의 서로 다른 블록이 추가되었다. 각 블록은 서로 다른 수의 뉴런을 가진 밀집층(dense layer)으로 구성되며, 첫 번째 블록의 밀집층은 1024개의 뉴런을 가져 데이터의 광범위한 특징과 보다 일반적인 패턴을 포착하는 데 집중한다. 두 번째 블록의 밀집층은 512개의 뉴런을 가지며, 차원을 축소하고 더 구체적인 패턴에 집중함으로써 특징을 정교하게 다듬는다. 세 번째 블록의 밀집층은 256개의 뉴런을 포함하며, 가장 관련성이 높은 특징과 패턴만이 출력층으로 전달되어 더 적절한 작업을 수행할 수 있도록 특징을 구체적으로 증류한다. 또한, 가중치가 커지는 것에 페널티를 부여하여 과적합을 방지하기 위해 각 블록의 모든 밀집층에 L2 정규화37 기법이 추가되었으며, 이는 모델을 더 정교하게 만든다. 각 블록 뒤에는 드롭아웃 층38이 도입되어 블록 1, 2, 3에 대해 각각 뉴런의 30%, 20%, 10%를 무작위로 무시함으로써, 네트워크가 단일 뉴런에 의존하지 않는 더 견고한 특징을 개발하도록 강제한다. 나아가 훈련 과정을 안정화하기 위해 각 밀집층 뒤에 배치 정규화(BatchNormalization)39 층을 적용하여 활성화 값이 안정적인 범위 내에 유지되도록 하며, 이는 훈련 단계에서 기울기 소실 및 기울기 폭주와 같은 문제를 피하는 데 도움을 준다. 또한, 이 배치 정규화 층은 손실 지형(loss landscape)을 매끄럽게 하여 최적화 알고리즘이 전역 최솟값(global minima)을 더 쉽게 찾을 수 있게 함으로써 훈련 속도를 가속화하고 모델이 더 빠르게 수렴하도록 하였다. 더불어, 각 블록에서는 비선형성을 생성하기 위해 leaky ReLU 활성화 함수40가 사용되어 모델이 복잡한 패턴을 학습할 수 있게 하며, leaky ReLU는 음수 입력에 대해 작고 0이 아닌 기울기를 허용함으로써 뉴런이 비활성화되지 않도록 보장한다는 점에서 다른 활성화 함수보다 장점이 있다. 마지막으로, 아래의 식 6은 하이브리드 융합 모델에 통합된 각 블록의 작동 방식을 보여준다.
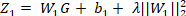 (6)
연결된 벡터를 얻은 후, G는 1024개의 뉴런을 가진 블록 1 밀집 층(전결합 층)을 통과합니다. 여기서 가중치 행렬 W1은 입력 벡터 G를 1024차원 출력 벡터로 변환하며, 출력 벡터의 각 요소는 입력 특성의 선형 결합으로 구성됩니다. 그 다음, b1 편향 벡터가 출력의 1024개 요소 각각에 더해져, 모델이 입력 특성의 출력을 독립적으로 이동시킬 수 있게 합니다. 또한, L2 정규화 항인 λ||W1||22는 큰 가중치에 페널티를 부여하여 모델이 단일 뉴런에 과도하게 의존하는 것을 방지함으로써 과적합을 피하도록 돕습니다. 여기서 신경망의 특정 층의 가중치 행렬은 W1이며, ||W1||22는 가중치 행렬 W1의 L2 노름의 제곱을 나타내고, λ는 적용되는 정규화 정도를 제어하는 정규화 매개변수로, 모든 블록에서 0.1로 설정되었습니다. 연결된 벡터 G로부터 전달된 입력에 대해 밀집 층과 L2 정규화를 적용한 후의 새로운 특성 표현은 Z1이 되며, 이는 식 6에 나타나 있습니다.
블록 1의 밀집층(dense layer)으로부터 출력값 Z1을 얻은 후, 학습 과정을 가속화하기 위해 배치 정규화(BatchNormalization) 층을 적용하였으며, 그 작동 방식은 아래의 식 7과 같습니다.
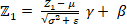 (7)
σ2는 배치 전체에 걸친 마지막 레이어 Z1 출력의 분산을 나타내며, μ는 각 뉴런별로 개별적으로 계산된 출력 Z1의 평균을 나타냅니다(첫 번째 dense layer의 경우 1024개). 한편, ε은 수치적 안정성을 확보하고 0으로 나누는 것을 방지하기 위해 포함된 작은 상수입니다. 정규화된 출력은 학습 가능한 스케일 매개변수인 γ를 통해 조정될 수 있으며, 학습 가능한 시프트 매개변수인 β를 통해 이동될 수 있습니다. 최종적으로 dense layer의 출력에 BatchNormalization 레이어를 적용하면, 정규화된 출력 Z1을 통해 서로 다른 레이어 간에 활성화 값들이 일관된 분포를 갖게 되어 훈련의 안정화와 가속화에 도움이 됩니다. BatchNormalization 이후 정규화된 출력 Z1은 leaky ReLu 활성화 함수를 통과하며, 이는 네트워크에 비선형성을 부여하여 데이터의 복잡한 패턴을 학습하는 데 도움을 줍니다. ReLU나 다른 활성화 함수 대신 leaky ReLU를 선택하였는데, 이는 ReLU 활성화 함수처럼 음수 값을 0으로 만드는 대신 작은 음수 값들도 고려하는 ReLU 함수의 수정 버전으로, dying ReLU 문제를 극복하기 위함입니다. 아래의 식 8은 이 작동 방식을 보여줍니다.
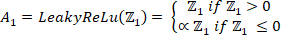 (8)
여기서 Z1은 BatchNormalization 층의 출력값으로, 비선형성을 수행하기 위해 Leaky ReLU의 입력으로 전달되며, ∝는 함수의 음수 부분 기울기를 결정하는 데 사용되는 작은 상수입니다. 또한, A1은 비선형성을 적용한 후 얻은 출력값을 나타냅니다. 마지막으로, 식 9에 표시된 것과 같이 Leaky ReLu 활성화 함수로부터 입력으로 받은 출력값 A1에 드롭아웃 층을 적용합니다.
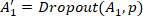 (9)
여기서 A1은 마지막 ReLu 활성화 함수로부터 전달된 원래의 활성화 함수 출력이며, p는 0과 1 사이에서 변하는 드롭아웃 비율로, 뉴런의 일부를 드롭하기 위해 세 개의 블록 층에 대해 각각 0.3, 0.2, 0.1로 선택되었습니다. 또한, A1′은 드롭아웃 층을 적용하여 일부 뉴런이 0으로 설정된 후의 수정된 출력을 나타냅니다. 이를 사용하는 주요 장점은 공동 적응(co-adaptation)을 줄이는 것뿐만 아니라 과적합 문제를 방지하는 것입니다. 나아가, 블록 1의 출력인 A1′은 더 추상적인 특징을 다시 추출하기 위해 다음 블록으로 다시 전달되며, 밀집 층(dense layer)에서 1024개 대신 512개의 뉴런을 사용하고 드롭아웃 비율을 0.3 대신 0.2로 구분한 점을 제외하고는 블록 1과 동일한 파라미터 및 나머지 연산 순서가 적용되며, 이는 아래의 식 10에서 13에 기술되어 있습니다.
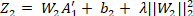 (10)
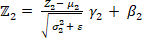 (11)
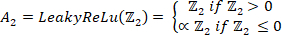 (12)
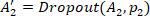 (13)
블록 1로부터 얻은 출력값 A1′은 512개의 뉴런을 가진 블록 2 밀집층(dense layer, 완전 연결층)을 통과합니다. 여기서 가중치 행렬 W2는 입력 벡터 A1′를 512차원의 출력 벡터로 변환하며, 출력 벡터의 각 요소는 입력 특성들의 선형 결합으로 나타납니다. 그 다음, b2 편향(bias) 벡터가 출력의 512개 요소 각각에 더해져, 모델이 입력 특성의 출력을 독립적으로 이동시킬 수 있게 합니다. 또한, L2 정규화가 적용되어 λ||W2||22를 통해 큰 가중치에 패널티를 부여하며, 이는 모델이 이 특정 블록의 특정 뉴런에 과도하게 의존하는 것을 방지하여 과적합을 완화하는 역할을 합니다. 여기서 W2는 신경망 내 특정 층의 가중치 행렬이며, λ는 정규화 정도를 조절하는 정규화 매개변수로 0.1로 적용되었습니다. 블록 1에서 전달된 입력에 밀집층과 L2 정규화를 적용한 후의 새로운 특성 표현은 Z2가 되며, 이는 식 10에 나타나 있습니다.
또한, 학습 과정을 가속화하기 위해 새로운 특징 Z2에 BatchNormalization 층을 적용하였습니다. 여기서 σ22는 배치 전체의 분산을 나타내며, μ2는 출력 Z2의 평균입니다. ε은 수치적 안정성을 보장하기 위해 포함된 작은 상수이며, γ는 모델이 정규화된 출력을 수정할 수 있게 하는 학습 가능한 스케일 파라미터이고, β는 모델이 정규화된 출력을 이동시킬 수 있게 하는 학습 가능한 시프트 파라미터입니다. 마지막으로, 식 11에 표시된 BatchNormalization 층을 적용한 후, 정규화된 출력 Z2는 네트워크에 비선형성을 부여하는 leaky ReLU AF를 통과하며, 이는 식 12에 표시되어 있습니다. 여기서 Z2는 BatchNormalization 층의 출력에 해당하며, 비선형성 수행을 위해 Leaky ReLU의 입력으로 전달됩니다. 한편, A2는 비선형성을 적용한 후 얻어지는 출력을 나타냅니다.
마지막으로, 식 13에 표시된 바와 같이 Leaky ReLU 활성화 함수로부터 입력으로 받은 출력 A2에 드롭아웃 층을 적용합니다. 여기서 A2는 마지막 ReLU 활성화 함수에서 얻은 출력이며, p2는 뉴런의 일부를 누락시키기 위해 이 블록에서 0.2로 선택된 드롭아웃 비율입니다. 또한, A2′는 드롭아웃 층을 적용하여 일부 뉴런이 0으로 설정된 수정된 출력을 나타냅니다. 나아가, 블록 2의 출력인 A2′는 더 추상적인 특징을 다시 추출하기 위해 세 번째 블록으로 전달되며, 블록 2와 동일한 파라미터가 적용됩니다. 다만, 밀집 층(dense layer)의 뉴런 수가 512개 대신 256개로, 드롭아웃 비율이 0.2 대신 0.1로 구분되며, 그 외의 연산 순서는 동일하며 이는 아래의 식 14에서 17에 설명되어 있습니다.
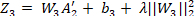 (14)
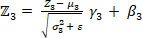 (15)
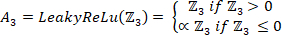 (16)
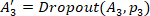 (17)
블록 2로부터 출력된 A2′는 256개의 뉴런을 가진 블록 3의 밀집층(전결합층)을 통과합니다. 여기서 가중치 행렬 W3은 입력 벡터 A2′를 256차원 출력 벡터로 변환하며, 출력 벡터의 각 요소는 입력 특성들의 선형 결합으로 나타납니다. 이후 b3 편향 벡터가 출력의 256개 각 요소에 더해져, 모델이 입력 특성의 출력을 독립적으로 이동시킬 수 있게 합니다. 또한, λ||W3||22로 표현되는 L2 정규화가 적용되어 큰 가중치에 페널티를 부여함으로써 모델이 단일 뉴런에 과도하게 의존하는 것을 방지하고 과적합을 피하도록 돕습니다. 여기서 W3은 신경망 내 특정 층의 가중치 행렬이며, 적용된 정규화의 정도는 0.01로 설정된 정규화 매개변수 λ에 의해 제어됩니다. 블록 3에서 전달된 입력에 대해 밀집층과 L2 정규화를 적용한 후의 새로운 특성 표현은 Z3이 되며, 이는 식 14에 나타나 있습니다.
또한, 학습 프로세스의 속도를 높이기 위해 새로운 특성 Z3에 BatchNormalization 층을 적용하였으며, σ32는 배치 전체의 분산을, μ3는 출력 Z3의 평균을 나타냅니다. 한편, ε는 수치적 안정성을 위해 추가되는 작은 상수입니다. 정규화된 출력은 모델의 학습 가능한 스케일 파라미터 γ3를 통해 조정될 수 있으며, 학습 가능한 시프트 파라미터 β3를 통해 이동될 수 있습니다. 마지막으로, 식 15에 표시된 BatchNormalization 층을 적용한 후, 정규화된 출력 Z3는 네트워크에 비선형성을 부여하는 leaky ReLU 활성화 함수를 통과하며, 이는 식 16에 표시되어 있습니다. 여기서 Z3는 BatchNormalization 층의 출력에 해당하며, 비선형성을 수행하기 위해 Leaky ReLU의 입력으로 전달됩니다. 한편, A3는 비선형성을 적용한 후 얻어진 출력을 나타냅니다.
마지막으로, 식 17에 표시된 바와 같이 Leaky ReLU 활성화 함수로부터 입력으로 받은 출력 A3에 드롭아웃 층을 적용합니다. 여기서 A3는 마지막 ReLU 활성화 함수로부터 받은 출력이며, p3는 뉴런의 일부를 제거하기 위해 이 블록에서 0.1로 선택된 드롭아웃 비율입니다. 나아가, A3′는 드롭아웃 층을 적용하여 일부 뉴런이 0으로 설정된 후의 수정된 출력을 나타냅니다.
또한, 블록 3 A3′의 출력은 분류를 위해 데이터셋의 실제 클래스 수를 나타내는 K개의 뉴런이 있는 마지막 밀집층(dense layer)을 통과하며, 이는 아래의 식 18에 기술되어 있습니다.
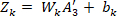 (18)
두꺼운 층(thick layer)과 연결된 가중치 행렬은 Wk이며, 이는 256차원 벡터 A3′를 k차원 벡터로 변환하는 역할을 합니다. 이 벡터는 이전 블록에서 학습된 특징을 나타내며 출력값으로 제공됩니다. 또한, bk는 입력값이 0일 때 활성화 함수가 0이 아닌 출력을 갖도록 예측값을 조정하는 편향 벡터를 나타내며, Zk는 활성화 함수를 적용하기 전 최종 층의 출력으로 각 클래스에 대한 로짓(logits)을 생성합니다. 마지막으로 SoftMax41 분류기가 적용되어 로짓 Zk를 각 클래스의 확률로 변환하며, 이는 식 19와 20에 표시되어 있습니다.
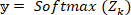 (19)
 (20)
i번째 클래스의 예측 확률이 yi로 표현될 때, K는 클래스의 수이며, Zk, i는 i번째 클래스의 로짓(logit)이고, eZk, i는 i번째 클래스 로짓의 지수 값입니다. y는 가능한 모든 클래스의 확률 분포를 나타내며 확률의 합이 1이 되도록 보장합니다. 아래의 표 3은 재현성과 성능 향상을 위해 채택된 구조적 세부 사항을 포함하여, 제안된 하이브리드 모델 학습에 사용된 하이퍼파라미터 세부 정보를 제공합니다.
| 하이퍼파라미터 | 제안된 모델 (FusionNetX) |
| 이미지 크기 | 224 × 224 |
| 백본 아키텍처 | 사전 학습된 EfficientNetB7 및 DenseNet121을 BBA1 및 BBA2로 사용 |
| 데이터 증강 | 회전 범위 = 7, |
| 너비/높이 이동 범위 최대 0.05, | |
| 확대/축소 범위 최대 0.01, | |
| 수평/수직 뒤집기 | |
| 데이터 분할 비율 | 고정된 randome_state = 42의 층화 추출법을 통해 학습용 80%, 검증용 20%로 분할 |
| 특징 추출 및 융합 | 각 백본의 출력에 전역 평균 풀링을 적용: BBA1은 2560, BBA2는 1024이며, 이를 융합하여 3584의 공동 특징 벡터를 생성 |
| 완전 연결 블록 구성 | 1개의 출력 레이어를 포함한 3개의 완전 연결 블록. 각 블록은 L2 정규화 (λ=0.01), BatchNormalization, LeakyReLU (α=0.01), 드롭아웃 (각각 0.3, 0.2, 0.1) 및 은닉 차원 (각각 1024, 512, 256)으로 구성됨. 융합 헤드에 추가적인 스킵 연결은 도입되지 않음 |
| 활성화 함수 | Leaky ReLU & SoftMax |
| 옵티마이저 및 학습률 | 학습률 스케줄러 없이 0.00001로 고정된 Adam |
| 손실 함수 | sparse_categorical_crossentropy |
| 배치 크기 | 16 |
| 에포크 | 각 데이터셋에 대해 100 에포크로 고정 |
| 사용 플랫폼 | TensorFlow 및 Keras 플랫폼 기반의 P100 GPU 및 16GB VRAM을 갖춘 Kaggle Notebook |
표 3: 제안된 모델 학습에 사용된 하이퍼파라미터 및 제안된 아키텍처 세부 사항. 이 표는 미세 조정된 파라미터 및 구현 환경과 함께 제안된 모델의 구조적 및 아키텍처적 세부 사항을 제공합니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
결과
이 섹션에서는 Br35H, Figshare, Sartaj, Masoud 및 Balanced Brain tumor 데이터셋을 포함한 뇌암 관련 5가지 오픈 소스 데이터셋에 대해 제안된 이중 특징 융합 모델을 테스트한 결과를 상세히 설명하며, 정확도42,43,44, 오분류율(MCR)45, PPV라고도 하는 정밀도46, NPV, 민감도47 또는 재현율로 알려진 TPR, 특이도로 알려진 TNR, F1-스코어48, 위음성률(FNR) 및 위양성률(FPR)을 포함한 다양한 통계적 성능 평가 파라미터를 통해 성능을 평가합니다. 아래의 방정식들은 위 성능 평가 파라미터들의 수학적 표현을 보여줍니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
토론
결론적으로, 제안된 모델은 다음과 같이 작동하였습니다. 먼저, 모든 중요한 정보를 유지하면서 데이터 샘플로부터 적절한 특징을 추출하고 학습시키기에 적당한 크기인 224 × 224로 이미지 크기를 설정하였습니다. 이어서 데이터 샘플을 보다 다양한 방향으로 생성하여 모델이 서로 다른 평면이나 각도에서 특징을 추출하는 데 중요한 역할을 하는 데이터 증강을 수행하였으며, 회전 범위는 7%, 너비 및 높이 이동 범위는 0.05, 줌 범위는 0.01로 설정하였습니다. 또한 수평 및 수직 뒤집기를 적용하여 데이터를 다양한 각도로 이동 및 확대/축소하였습니다. 추가적으로, 균형 잡힌 접근 방식을 보장하기 위해 데이터셋을 훈련용 80%, 검증용 20%로 분할하였으며, 셔플링을 위해 고정된 랜덤 시드(random_state = 42)를 사용하였습니다. 다음으로, 제안된 모델에 계수 (λ) 0.01의 L2 정규화기를 적용하였습니다. 이는 훈련 중 큰 가중치에 페널티를 부여함으로써 가중치 크기를 줄이고 손실 함수를 매끄럽게 하여, 모델의 과적합을 방...
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
공개 사항
저자들은 공개할 사항이 없으며 이해관계의 충돌이 없습니다. 또한, 원고 및 도표 작성을 위해 AI 도구를 사용하지 않았습니다.
감사의 글
저자들은 사우디아라비아 리야드의 Princess Nourah bint Abdulrahman University 연구자 지원 프로젝트(PNURSP2026R192)와 Princess Nourah bint Abdulrahman University의 지원에 감사드립니다. 또한 본 연구에 기여한 연구 참여자들과 기관들에 감사의 마음을 전합니다.
연구비 지원:
본 연구는 대한민국 정부(과학기술정보통신부)의 재원으로 한국연구재단(NRF)의 지원(No. RS-2023-00218176) 및 순천향대학교 연구비 지원을 통해 수행되었습니다. 또한 사우디아라비아 리야드 소재 Princess Nourah bint Abdulrahman University의 연구자 지원 프로젝트(번호 PNURSP2026R192)의 지원을 받았습니다.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| Br35H 뇌종양 데이터셋 | Kaggle (데이터셋 기여정 | https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection | 공개 데이터셋; 이진 분류 (종양 있음 / 종양 없음) 300 MRI 이미지 |
| Figshare 뇌종양 데이터셋 | Kaggle / Figshare | https://doi.org/10.6084/m9.figshare.1512427 | 공개 데이터셋; 다중 클래스 (교종, 수막종, 뇌하수체 종양) 3064 MRI 이미지 |
| Sartaj 뇌종양 분류 MRI 데이터셋 | Kaggle (Sartaj Bhuvaji 제공 데이터셋) | https://doi.org/10.34740/kaggle/dsv/12745533 | 공개 데이터셋; 다중 클래스 (교종, 수막종, 종양 없음, 뇌하수체 종양) 3264 MRI 이미지 |
| Masoud 뇌종양 MRI 데이터셋 | Kaggle (Masoud Nickparvar 제공 데이터셋) | https://doi.org/10.34740/kaggle/dsv/14832123 | 공개 데이터셋; 다중 클래스 (교종, 수막종, 종양 없음, 뇌하수체 종양) 7023 MRI 이미지 |
| BBT-Dataset (뇌종양 데이터셋) | Kaggle (데이터셋 기여정 | https://doi.org/10.34740/kaggle/dsv/6758053 | 공개 데이터셋; 균형 잡힌 다중 클래스 뇌종양 5248 MRI 이미지 |
| Python | Python Software Foundation | https://www.python.org | 프로그래밍 언어, 버전 3.10.13 |
| TensorFlow / Keras | Google / TensorFlow 개발자 | https://www.tensorflow.org | 딥러닝 프레임워크; 모델 구축, 학습 및 평가, 버전 2.15.0 |
| EfficientNetB7 (사전 학습됨) | Google / Keras Applications | https://keras.io/api/applications/efficientnet/ | ImageNet 사전 학습 백본; 특징 추출 |
| DenseNet121 (사전 학습됨) | Keras Applications | https://keras.io/api/applications/densenet/ | ImageNet 사전 학습 백본; 특징 추출 |
| scikit-learn | scikit-learn 개발자 (NumFOCUS) | https://scikit-learn.org | 레이블 인코딩, 훈련-테스트 분할, 평가 지표 (분류 보고서, 혼동 행렬, ROC/AUC) |
| OpenCV (cv2) | OpenCV 팀 | https://opencv.org | 이미지 로드 및 크기 조정 |
| NumPy | NumPy 개발자 (NumFOCUS) | https://numpy.org | 수치 계산 및 배열 연산 |
| pandas | pandas 개발 팀 (NumFOCUS) | https://pandas.pydata.org | 데이터 구성 및 지표 표 작성 |
참고문헌
- He Z, et al. A review on methods for diagnosis of breast cancer cells and tissues. Cell Prolif. 2020;53(7):e12822. doi:10.1111/cpr.12822.
- Siegel RL, Giaquinto AN, Jemal A. Cancer statistics, 2024. CA Cancer J Clin. 2024;74(1):12–49.
- Varuna Shree N, Kumar TNR. Identification and classification of brain tumor MRI images with feature extraction using DWT and probabilistic neural network. Brain Inform. 2018;5(1):23–30.
- Ghoreishi Mokri SM, Valadbeygi N, Grigoryeva V. Diagnosis of glioma, menigioma and pituitary brain tumor using MRI images recognition by deep learning in Python. EAI Endorsed Trans Intell Syst Mach Learn Appl. 2024;1:1–9.
- Sadeghi MH, et al. Deep learning in ovarian cancer diagnosis: a comprehensive review of various imaging modalities. Pol J Radiol. 2024;89:e30–e48.
- Anari S, Safarpour H, Cunneen M, Bendechache M. AR-EpiAid: an augmented reality decision support system for real-time interpretation of multimodal epilepsy data [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468245.
- Iyortsuun NK, et al. A review of machine learning and deep learning approaches on mental health diagnosis. Healthcare (Basel). 2023;11(3):285. doi:10.3390/healthcare11030285.
- An Q, Rahman S, Zhou J, Kang JJ. A comprehensive review on machine learning in the healthcare industry: classification, restrictions, opportunities, and challenges. Sensors (Basel). 2023;23(9):4178. doi:10.3390/s23094178.
- Iqbal S, Qureshi AN, Li J, Mahmood T. On the analyses of medical images using traditional machine learning techniques and convolutional neural networks. Arch Comput Methods Eng. 2023;30:3173–3233.
- Chhimpa GR, et al. A transfer learning-driven fine-tuning of YOLOv10 for improved brain tumor detection in MRI images. Sci Rep. 2026;16:98. doi:10.1038/s41598-025-28813-w.
- Akbarian S, Seyyed-Kalantari L, Khalvati F, Dolatabadi E. Evaluating knowledge transfer in the neural network for medical images. IEEE Access. 2023;11. doi:10.1109/ACCESS.2023.3283216.
- Meena G, Mohbey KK, Acharya M, Lokesh K. An improved convolutional neural network-based model for detecting brain tumors from augmented MRI images. J Auton Intell. 2023;6:1–19.
- Ata MM, Yousef RN, Karim FK, Khafaga DS. An improved deep structure for accurately recognizing brain tumors. Comput Syst Sci Eng. 2023;46(2):1597–1616.
- Khushi HMT, et al. Performance analysis of state-of-the-art CNN architectures for brain tumour detection. Int J Imaging Syst Technol. 2024;34:e22949. doi:10.1002/ima.22949.
- Agarwal M, et al. Deep learning for enhanced brain tumor detection and classification. Results Eng. 2024;22:102117. doi:10.1016/j.rineng.2024.102117.
- Peddinti AS, Maloji S. Optimised ResNet50 for multiclass classification of brain tumors. Scalable Comput Pract Exp. 2024;25(3):1667–1680.
- Zahoor MM, et al. Brain tumor MRI classification using a novel deep residual and regional CNN. Biomedicines. 2024;12(7):1395. doi:10.3390/biomedicines12071395.
- Chen W, et al. A robust approach for multitype classification of brain tumors using deep feature fusion. Front Neurosci. 2024;18:1288274. doi:10.3389/fnins.2024.1288274.
- Suryawanshi S, Patil SB. Efficient brain tumor classification with a hybrid CNN-SVM approach in MRI. J Adv Inf Technol. 2024;15:340–354.
- Reyes D, Sánchez J. Performance of convolutional neural networks for the classification of brain tumors using magnetic resonance imaging. Heliyon. 2024;10:e25468. doi:10.1016/j.heliyon.2024.e25468.
- Bibi N, et al. A transfer learning-based approach for brain tumor classification. IEEE Access. 2024;12:111218–111238.
- Albalawi E, et al. Integrated approach of federated learning with transfer learning for classification and diagnosis of brain tumor. BMC Med Imaging. 2024;24:110. doi:10.1186/s12880-024-01261-0.
- Alkhatib AJ, et al. Diagnosing brain tumors from MRI images through a multi-fused CNN with auxiliary layers. Sustain Mach Intell J. 2024;6(1):4–13.
- Hamada A. Br35H: Brain Tumor Detection 2020 [dataset]. Kaggle; 2020. Available from: https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection.
- Cheng J. Brain tumor dataset [dataset]. Figshare; 2024. Available from: https://doi.org/10.6084/m9.figshare.1512427.
- Bhuvaji S. Brain Tumor Classification (MRI) [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/12745533.
- Nickparvar M. Brain Tumor MRI Dataset [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/14832123.
- Jayanti V. Brain Tumor MRIs [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/6758053.
- Tuteja P, et al. Augmented multimodal fusion for optimized brain tumor detection: evaluation and comparative analysis. J Vis Exp. 2025;(220):e67822. doi:10.3791/67822.
- Rasool N, et al. CNN-TumorNet: leveraging explainability in deep learning for precise brain tumor diagnosis on MRI images. Front Oncol. 2025;15:1554559. doi:10.3389/fonc.2025.1554559.
- Huang G, Liu Z, van der Maaten L, Weinberger KQ. Densely connected convolutional networks [conference paper]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition; Honolulu, HI, USA; 2017. p. 4700–4708. Available from: https://openaccess.thecvf.com/content_cvpr_2017/html/Huang_Densely_Connected_Convolutional_CVPR_2017_paper.html.
- Tuteja P, Wani MA, Wani NA, Bedi J. EASE-Net: an explainable AI-based segmentation and ensemble network for interpretable brain tumor diagnosis and classification in MRI images. Arab J Sci Eng. 2026;in press. doi:10.1007/s13369-026-11350-7.
- Tan M, Le QV. EfficientNet: rethinking model scaling for convolutional neural networks [conference paper]. Presented at: 36th International Conference on Machine Learning; Long Beach, CA, USA; 2019. p. 6105–6114. Available from: https://proceedings.mlr.press/v97/tan19a.html.
- Vellaichamy AS, Swaminathan A, Varun C, Kalaivani S. Multiple plant leaf disease classification using DenseNet-121 architecture. Int J Electr Eng Technol. 2021;12(5):38–57.
- Naidji MR, Elberrichi Z. Automatic detection of COVID-19 from chest X-ray images using the EfficientNet-B7 CNN model with channel-wise attention. Int J Comput Digit Syst. 2024;15:1443–1456.
- Malla PP, Sahu S, Alutaibi AI. Classification of tumors in brain MR images using a deep convolutional neural network and global average pooling. Processes. 2023;11(3):679. doi:10.3390/pr11030679.
- Shi G, Zhang J, Li H, Wang C. Enhance the performance of deep neural networks via L2 regularization on the input of activations. Neural Process Lett. 2019;50:57–75.
- Srivastava N, et al. Dropout: a simple way to prevent neural networks from overfitting. J Mach Learn Res. 2014;15:1929–1958.
- Ioffe S, Szegedy C. Batch normalization: accelerating deep network training by reducing internal covariate shift [conference paper]. Presented at: 32nd International Conference on Machine Learning; Lille, France; 2015. p. 448–456. Available from: https://proceedings.mlr.press/v37/ioffe15.html.
- Varshney M, Singh P. Optimizing nonlinear activation functions for convolutional neural networks. Signal Image Video Process. 2021;15:1323–1330.
- Bera S, Shrivastava VK. Analysis of various optimizers on a deep convolutional neural network model in the application of hyperspectral remote-sensing image classification. Int J Remote Sens. 2020;41:2664–2683.
- Safarpour H, et al. A dual-phase segmentation framework utilizing Gumbel-Softmax and a cascaded Swin Transformer for multiclass brain tumor segmentation. Research Square. 2025:doi:10.21203/rs.3.rs-7093467/v1.
- Seyrek EC, Uysal M. A comparative analysis of various activation functions and optimizers in a convolutional neural network for hyperspectral image classification. Multimed Tools Appl. 2024;83:53785–53816.
- Maxwell AE, Warner TA, Guillén LA. Accuracy assessment in convolutional neural network-based deep-learning remote-sensing studies—part 1: literature review. Remote Sens (Basel). 2021;13(13):2450. doi:10.3390/rs13132450.
- Villon S, et al. A new method to control error rates in automated species identification with deep-learning algorithms. Sci Rep. 2020;10:10972. doi:10.1038/s41598-020-67573-7.
- Rasool N, et al. TransResUNet: revolutionizing glioma brain tumor segmentation through transformer-enhanced residual UNet. IEEE Access. 2024;12:72105–72116.
- Chen Y, et al. Evaluation efficiency of hybrid deep-learning algorithms with neural-network decision-tree and boosting methods for predicting groundwater potential. Geocarto Int. 2022;37:5564–5584.
- Alakus TB, Turkoglu I. Comparison of deep-learning approaches to predict COVID-19 infection. Chaos Solitons Fractals. 2020;140:110120. doi:10.1016/j.chaos.2020.110120.
- Ranjbarzadeh R, et al. Explainable attention-guided Swin Transformer networks for brain tumor segmentation from 3D MRI. Lect Notes Netw Syst. 2026;1730:110–128. Available from: https://lero.ie/bibliography/explainable-attention-guided-swin-transformer-networks-for-brain-tumor-segmentation-from-3d-mri/.
- Ranjbarzadeh R, et al. A global-local 3D brain tumor segmentation model using vision transformers and axial state-space modeling [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468214.
- Hussain SS, et al. Next-generation automation in neuro-oncology: advanced neural networks for MRI-based brain tumor segmentation and classification. IEEE Access. 2025;13:41141–41158.
액세스가 제한되었습니다. 이 콘텐츠를 보려면 로그인하거나 체험판을 시작하세요.