본 논문은 43점의 청대 중국 수출화에 나타난 여성의 반복적 재현을 조사하기 위한 인간 감독형 계산 워크플로우를 제시합니다. 7가지의 인간 참조 범주와 반복되는 시각적 단서가 코퍼스 내의 패턴을 특징짓고 있으며, 연구 결과는 샘플링된 이미지에 국한되므로 청대의 사회적 현실이나 역사적 수용도를 측정하는 것은 아닙니다.
이 논문에서
요약
초록
본 연구는 1757년부터 191년 사이에 제작된 43점의 청대 중국 수출화 코퍼스에서 여성 정체성의 반복적인 표현과 계급으로 부호화된 시각적 단서를 조사하였습니다. 워크플로우는 예비 라벨링을 위한 CLIP ViT-B/32, Segment Anything Model (SAM) 기반의 위치 식별, 차원 축소 및 클러스터링, 그리고 두 명의 독립적인 코더에 의한 수동 도상학적 코딩을 결합하여 진행되었습니다. CLIP 라벨은 예비 정리에 사용되었고, SAM은 위치 식별 보조 도구로 활용되었으며, 조정 과정을 거친 인간 코딩이 참조 카테고리를 제공하였습니다. 종합 결과, 엘리트/미인 (n = 12), 노동 (n = 72), 가사 (n = 64), 하인 (n = 58), 의례/결혼 (n = 45), 시장 (n = 43), 공연 (n = 39)의 7가지 인간 참조 카테고리가 식별되었습니다. 예비 계산 라벨은 43점의 그림 중 356점(82.2%)에서 인간 참조 라벨과 일치했으며, 카테고리 수준의 재현율은 73.3%에서 8.4% 사이로 나타났습니다. 의복, 공간적 배경, 사물, 자세 및 묘사된 사회적 관계의 반복적인 조합을 통해 이러한 카테고리들의 시각적 프로필을 특징지었습니다. 43개의 사례 수준 AI-인간 라벨 쌍을 평가하여 종합적인 카테고리 수준의 정밀도, 재현율 및 F1 점수를 산출하였으며, 분류 패턴을 상세히 나타내는 혼동 행렬을 함께 제시하였습니다. 클러스터 검증을 통해 선택된 클러스터링 솔루션의 타당성을 입증하였으며, 도출된 클러스터와 인간이 정의한 참조 카테고리 간의 일치성을 확인하였습니다. 전반적으로 의복, 공간적 배경, 사물, 자세 및 사회적 관계의 반복적인 조합은 표본 코퍼스 내에 정형화된 회화적 유형론이 존재함을 나타냅니다. 이러한 결과는 청대 중국 수출화의 시각적 표현을 특징짓지만, 이를 법적 지위, 실제 경험, 시장 수요 또는 역사적인 외국의 수용도에 대한 직접적인 측정치로 해석해서는 안 됩니다.
서론
청대 중국 수출화는 18세기 후반부터 광둥과 다른 수집 중심지를 유럽 및 미국의 구매자들과 연결하는 상업적, 문화적 네트워크의 일부를 형성했습니다1,2,3,4,5. 상인, 여행자, 외교관, 선교사 및 수집가들은 이러한 그림들을 휴대 가능한 상품, 기념품, 시각적 정보원, 그리고 장소, 직업, 생산, 풍습 및 사회적 유형의 재현물로서 획득했습니다. 따라서 이러한 작품들의 유통은 중국 공방의 관행과 외부 시장의 기대치를 모두 반영하고 있었습니다.
해외 수요는 인지 가능한 주제, 연작 형식, 반복되는 모티프, 그리고 수집 및 비교가 가능한 장면들을 선호했습니다. 공방에서는 판매를 위해 매체, 규모, 구도 및 주제를 조정했으며, 구매자들은 주로 직업, 의례, 실내, 정원, 거리, 그리고 그림 같은 사회적 유형들의 명확한 묘사를 선호했습니다. 광둥 공방 장면들의 반복된 버전들은 예술가와 조수들이 해외 후원자들을 위해 도상학적 요소와 서양의 회화적 기법을 어떻게 응용했는지를 더욱 잘 보여줍니다1,2,3,4,5. 시장 수요가 제작 및 보존 대상에 영향을 주었을 수 있으나, 현재의 말뭉치(corpus)가 개별 구매자의 선호도나 반응을 직접적으로 측정하는 것은 아닙니다.
따라서 이러한 회화들은 일상생활에 대한 포괄적인 기록이라기보다는 선택적이고 매개된 자료로 간주되어야 합니다. 작품 속 장면들은 작업장의 관례, 시장의 선택, 박물관의 수집, 목록화 및 디지털화 과정을 통해 사회적 관습을 이상화, 단순화, 표준화하거나 변형했을 가능성이 있습니다1,2,3,4,5. 역사적 해석을 할 때는 회화에서 직접 관찰 가능한 특징과, 묘사된 인물, 제작 조건, 그리고 후대 관람자가 작품에 부여한 의미에 대한 추론을 반드시 구분해야 합니다.
여성 형상은 이러한 구분을 조사하는 집중적인 수단을 제공합니다. 의복, 헤어스타일, 자세, 공간적 배경, 사물, 활동, 그리고 다른 형상들과의 관계는 여성을 엘리트/미용, 가사, 하인, 노동, 시장, 공연, 그리고 의례/결혼 범주를 포함하여 시각적으로 반복되는 역할로 조직할 수 있습니다. 이러한 범주들은 회화적 패턴에 대한 분석적 설명이며, 그 자체로 법적 지위, 부, 직업, 민족성, Banner 또는 Han 소속, 도덕적 성품, 또는 실제 삶의 정체성을 입증하는 것은 아닙니다.
디지털 미술사와 컴퓨터 비전은 디지털화된 시각 컬렉션의 대규모 비교를 촉진하는 동시에, 계산 모델에 내재된 가설에 대한 비판적 검토를 가능하게 합니다6,7. 시각-언어 모델은 반복되는 시각적 모티프를 식별하고 정리하는 데 도움을 줄 수 있으나, 현대의 모델 어휘를 역사적인 비서구권 이미지에 적용할 때는 문화적 편향이 중요한 한계로 남습니다8. 중국 전통 회화에 관한 관련 계산 연구 역시 정량적 패턴 탐지와 역사적 정보에 기반한 해석을 결합하는 것의 가치를 유사하게 보여줍니다9.
본 연구는 세 가지 질문을 다룹니다: (1) 코퍼스에 어떤 판정된 인간 코딩 여성 정체성 범주가 나타나는가? (2) 의복, 공간적 배경, 사물, 자세 및 사회적 관계의 어떤 조합이 이러한 범주들의 특징을 나타내는가? (3) 전체 정확 일치 정확도(exact-match accuracy)와 범주별 재현율(recall)이 7개 범주에 걸쳐 어떻게 달라지는가? 연구 워크플로우는 전통 중국 회화에 대한 계산적 접근 방식9을 활용하며, 역사적 주장을 샘플링된 이미지와 기록된 분석 내용으로 제한합니다.
본 연구의 목적은 역사학적 관점과 기술적 관점 모두에 기여하는 것입니다. 코퍼스 규모의 비교 분석을 통해 반복되는 도상적 공식을 식별할 수 있으며, 이후 정밀한 역사적 분석을 통해 이를 맥락화할 수 있습니다. 이러한 접근 방식은 이미지의 빈도를 사회적 보편성의 증거로 취급하거나 시각적 유사성을 역사적 동일성의 증거로 간주하지 않으면서도 젠더, 계급 구조, 일상생활의 표현, 그리고 문화 간 교류에 관한 연구에 유용한 정보를 제공할 수 있습니다.
프로토콜
연구 설계 및 분석 단위
각 회화 작품 또는 카탈로그 기록을 하나의 분석 단위로 취급하였다. 메타데이터 검토, 예비 계산적 분류, 독립적인 수동 코딩 및 미술사적 해석을 결합한 코퍼스 기반 관찰 설계를 사용하였다. 연구 기간은 1757~1911년으로 정의하였으며, 이 기간 내에 선정 및 제외 기준을 적용하였다. 역사적 예술 작품과 이와 관련된 카탈로그 메타데이터를 분석하였다. 기간이 서로 다른 날짜 간격 간의 분포를 비교할 때는 간격 기간에 따라 빈도를 정규화하였으며, 해석 과정에서 잠재적인 생존 및 수집 편향을 고려하였다.
코퍼스 구축 및 선택
후보 기록은 인용된 박물관 카탈로그, 디지털 아카이브 및 출판된 카탈로그에서 추출되었습니다. 각 후보 기록에 대해 기관, 제목, 날짜 또는 날짜 범위, 매체, 등록 또는 카탈로그 번호, 고유 소스 URL, 검색 날짜 및 권리 성명서를 유지하였습니다. 해당 이미지 파일을 법적으로 재배포할 수 없는 경우에도 소스 링크는 보존하였습니다. 보고된 스크리닝 절차는 612개의 후보 이미지로 시작되었습니다. 이 중 85개는 1757~191년 기간을 벗어나거나 수출 회화 전통에 해당하지 않아 제외되었고, 58개는 현대 복제품, 흐릿한 기록 또는 잘못된 피사체를 묘사하여 제외되었으며, 29개는 식별 가능한 여성 인물이 없거나 이미지 해상도가 부족하여 제외되었고, 7개는 메타데이터가 불충분하여 제외되었습니다. 최종 분석 코퍼스는 43개의 기록으로 구성되었습니다.
메타데이터 표준화 및 이미지 전처리
최종 분석 코퍼스의 각 회화 작품에는 QEP_01부터 QEP_43까지의 고유한 QEP 식별자가 부여되었습니다. 소속 기관, 등록 번호, 제목, 제작 연도, 매체 또는 재료, 원산지, 소스 링크 및 이용 가능한 카탈로그 설명 등 관련 박물관 메타데이터를 유지하였습니다. 시각적 분석을 위해 예비 AI 레이블, 판정된 인간 분류, 여성 인물 수, 연령층, 자세, 의복, 공간적 배경, 관련 사물 및 사회적 관계를 기록하였습니다. 각 회화는 엘리트/미인, 가정, 하인, 노동, 시장, 공연 또는 의례/결혼의 7가지 기본 범주 중 하나로 분류되었습니다. 여러 여성 인물이 포함된 장면의 경우, 시각적 두드러짐과 서사적 중심성에 따라 중심 인물을 식별하였습니다. 지배적인 단일 여성 인물이 없는 경우에는 묘사된 주요 활동과 전체적인 장면 맥락에 따라 기본 범주를 할당하였습니다. 중복되는 범주는 의복이나 외양만으로 판단하기보다 묘사된 활동과 장면 맥락에 우선순위를 두어 해결하였습니다. 모호한 사례는 두 명의 코더가 독립적으로 검토한 후 합의를 통해 해결하였습니다. 원본 이미지는 JPEG 또는 PNG 형식으로 저장하였습니다. 웹페이지 테두리, 카탈로그 프레임 또는 이미지 외곽의 여백만 잘라냈습니다. 채색된 내용은 재구성, 재색칠, 강화 또는 복원하지 않았습니다.
CLIP 기반 예비 레이블링
예비 이미지-텍스트 유사성 분석을 위해 CLIP ViT-B/32 이미지 인코더가 사용되었습니다9. 정체성 후보 용어에는 elite woman, domestic woman, female servant, working woman, market woman, female performer, bride, ritual woman이 포함되었습니다. 장면 용어에는 Chinese interior, garden, street market, workshop, tea production, textile work, ceremonial scene이 포함되었습니다. 각 이미지에 대해 전체 프롬프트 템플릿 세트, 순서, 프롬프트 앙상블 여부, 텍스트 정규화 절차, 결정 규칙, 신뢰도 점수 및 동점 처리 결과가 유지되었습니다.
전체 프롬프트 목록은 Python 3.10, PyTorch 2.0.1 및 OpenAI CLIP 패키지로 구현된 OpenAI CLIP ViT-B/32 모델을 사용하여 모든 이미지에 일관되게 적용되었습니다. 추론은 CUDA 지원 GPU에서 배치 크기 32, FP32 정밀도로 수행되었습니다. 각 이미지는 224 × 24 픽셀로 크기를 조정하고 중앙을 크롭하였으며, RGB 채널은 ViT-B/32 모델과 관련된 전처리 변환을 사용하여 정규화되었습니다. 텍스트 프롬프트는 위에서 정의한 식별자 및 장면 기술자를 사용하여 구성되었으며, CLIP 텍스트 인코더로 인코딩되었습니다. 정규화된 이미지 및 텍스트 임베딩 간의 코사인 유사도를 계산하였고, 유사도 점수가 가장 높은 프롬프트를 예비 AI 레이블로 할당하였습니다. 이후의 인간 검토를 위해 모든 후보 레이블에 대한 유사도 점수를 보존하였습니다. 고정 랜덤 시드 42를 사용하였으며, 동일한 전처리 절차, 프롬프트 템플릿 및 결정 규칙을 43점의 모든 회화에 적용하였습니다.
SAM 보조 위치 지정
Segment Anything Model(SAM)은 인간의 시각적 검토를 위해 인물, 의복, 가구, 도구, 제례 대상 및 건축 영역의 위치를 지정하는 데에만 엄격히 사용되었습니다. SAM은 분류 파이프라인에 참여하지 않았음을 강조합니다. SAM의 마스크, 크롭 및 파생 특징은 CLIP 레이블링 및 클러스터링 과정으로부터 격리되었으며, 이를 통해 SAM의 적용이 분류 성능에 영향을 주거나 이를 부풀리지 않고 위치 지정 보조 수단만을 제공하도록 하였습니다.
시각적 요소의 국소화(localization)를 정밀하게 조정하기 위해 필요한 경우 수동 포인트 프롬프트 또는 바운딩 박스를 적용하였습니다. 여성 형상, 의복, 가구, 도구, 제례 대상 및 건축 요소에 대해 SAM 마스크를 생성하였으며, 각 세그멘테이션 결과가 적절한 영역을 커버하는지 시각적으로 검사하였습니다. 생성된 마스크는 관련 도상학적 특징의 식별 및 검토를 지원하였으나, CLIP 레이블링이나 카테고리 할당에는 사용되지 않았습니다.
차원 축소 및 클러스터링
CLIP 이미지 임베딩을 계산하였으며, 2차원 시각화를 위해 코사인 거리를 이용한 UMAP을 사용하였다10. 전처리 절차, 차원 및 거리 정의와 함께 클러스터링에 사용된 표현 방식을 기록하였다.
말뭉치 내에서 반복되는 시각적 그룹화를 식별하기 위해 이미지 특성 표현에 K-평균 및 계층적 군집화를 적용하였다11. k = 5–9에 대한 K-평균 후보 솔루션은 실루엣 계수와 Davies–Bouldin 지수를 사용하여 평가하였다. K-means++ 초기화를 사용하였으며, 설정값은 n_init = 10, max_iter = 30, tol = 1 × 10⁻4, random_state = 42였다. 계층적 군집화는 평균 연결법(average linkage)과 코사인 거리를 이용한 응집형 군집화(agglomerative clustering)로 수행하였다. 후보 솔루션들은 정량적 검증 지수, 군집 안정성 및 미술사적 해석 가능성을 통해 비교되었으며, 반복되는 시각적 패턴을 가장 일관되게 표현하는 최종 군집 솔루션을 선택하였다. 43점의 각 회화에 대해 도출된 군집 할당 결과는 이후 인간이 코딩한 범주와 비교하기 위해 보존되었다.
수동 코딩, 교육 및 판정
두 명의 코더가 기본 범주, 그림 수, 연령대, 자세, 의복, 공간적 배경, 사물 및 사회적 관계를 포함하는 버전 관리된 코드북을 사용하여 43장의 모든 이미지를 독립적으로 검토하였습니다. 판정 전 코더별 기록을 보관하였습니다. 코더들은 미술사와 시각 분석 분야의 관련 배경 지식을 갖추었으며, 표준화된 코딩 매뉴얼과 회화 코퍼스의 대표 사례를 통해 교육을 받았습니다. 정식 코딩에 앞서, 7가지 정체성 범주와 5가지 시각적 단서 차원에 대한 일관된 해석을 도모하기 위해 30점의 회화를 대상으로 캘리브레이션 작업을 수행하였습니다.
정식 코딩 과정에서, 두 명의 코더는 서로의 코딩 결정, 예비 AI 레이블 및 클러스터 할당 내용을 알지 못하는 맹검 상태에서 적격한 모든 회화를 독립적으로 평가했습니다. 코더 간 신뢰도는 Cohen’s kappa를 사용하여 평가되었습니다. 주요 정체성 범주에 대해 관찰된 kappa 값은 0.8이었으며, 범주형 시각적 단서 변수는 0.79에서 0.92 범위로 나타나 코더 간의 강력한 일치도를 보였습니다. 의견 불일치는 논의와 합의를 통해 해결되었으며, 판정된 범주 및 시각적 단서 코드는 이후 분석을 위해 기록되었습니다12. 판정 전 레이블은 그대로 보존되었습니다.
AI-인간 일치도 및 성능 추정
판정된 인간 분류를 참조 기준으로 사용하여 회화당 하나의 예비 AI 라벨과 기술적 비교를 수행하였다. 전체 정확 일치 정확도는 356/43 (82.2%)로 계산되었다. 범주 재현율은 각 범주에 대해 AI와 인간의 정확 일치 수를 인간 참조 지지 수로 나누어 계산하였다. 범주 지지 수, 정확 일치 수, 불일치 수 및 해당 분모를 명시적으로 보고하였다.
43건의 사례 수준으로 쌍을 이룬 AI 및 인간 라벨을 기반으로, 타겟 클래스의 위양성(false positives), 카테고리별 정밀도(precision), 재현율(recall) 및 F1 점수를 계산했습니다. 오진단 분류 패턴을 분석하기 위해 전체 혼동 행렬(confusion matrix)을 구성하였으며, 이는 이후 불일치 검토, 오류 분류 체계 문서화 및 판정 규칙 수립의 기초가 되었습니다.
재현성 패키지 및 자료
계산 워크플로와 지원 연구 자료는 버전 관리 저장소에 정리되었습니다. 재현성 패키지는 전처리, CLIP 분석, SAM 국소화, UMAP, 클러스터링, 일치도 분석 및 그림 생성을 위한 스크립트와 더불어 수동 코딩 코드북, 설정 파일, 의존성 정보, 사례 수준의 유도 출력물, 그리고 이미지 출처 및 권리 정보가 포함된 기계 판독 가능 인벤토리를 포함하도록 설계되었습니다. 재현성과 재사용을 용이하게 하기 위해 아카이브된 연구 자료에 지속적 식별자가 할당되었습니다.
메타데이터를 정리하고 관리하기 위해 Microsoft Excel 2021을 사용하였다. 계산 분석에는 예비 시각-언어 레이블링을 위한 CLIP ViT-B/32, 시각적 요소의 위치 확인을 위한 SAM, 차원 축소를 위한 코사인 거리 기반의 UMAP, 그리고 탐색적 패턴 분석을 위한 K-평균 및 계층적 군집 분석을 사용하였다. 군집 분석 결과는 실루엣 계수와 Davies–Bouldin 지수를 사용하여 평가하였으며, 코더 간 일치도는 Cohen’s kappa를 사용하여 평가하였다. 재현성을 보장하기 위해 워크플로우 전반에 걸쳐 사용된 소프트웨어 환경, 모델 구성, 계산 설정 및 랜덤 시드를 기록하였다.
결과
말뭉치 구축 및 기술적 구성
그림 1은 말뭉치의 4개 패널 개요를 보여줍니다. 그림 1A는 612개의 후보 기록에서 433개의 유지 기록으로 이어지는 보고된 스크리닝 과정을 보여줍니다. 그림 1B는 매체 및 형식의 대표적인 예시를 표시합니다. 그림 1C는 4개 날짜 구간별 수치를 제시하며, 그림 1D는 말뭉치의 출처 및 매체 구성을 요약합니다. 날짜 구간이 서로 다른 기간을 포괄하므로, 이 수치들은 샘플링된 말뭉치의 구성을 설명하는 것이며 역사적 생산율로 해석해서는 안 됩니다.
표 1은 코퍼스의 종합적인 특성을 요약한 것입니다. 박물관 소장품이 302건, 디지털 아카이브가 81건, 출판된 카탈로그가 50건을 차지했습니다. 매체는 수출용 수채화(n = 176), 피스페이퍼 회화(n = 112), 수출용 앨범 리프(n = 83), 인물화(n = 41) 및 기타 형식(n = 21)으로 분류되었습니다. 메타데이터는 완전함(n = 288), 부분적임(n = 118) 또는 최소한(n = 27)으로 분류되었습니다. 여성 인물은 중심적(n = 214), 부차적(n = 102) 또는 다수(n = 117)로 분류되었습니다. 각 분류 블록은 총 433건의 레코드로 구성되었습니다.
예비 AI 라벨 및 인간 참조 범주
표 2는 433점의 회화 작품 전체에 걸쳐 예비 AI 생성 라벨과 인간 참조 범주 간의 종합 일치도를 요약하며, 부록 표 1은 그에 해당하는 사례별 예비 AI 라벨, 코더 분류, 조정된 인간 참조 범주, 일치 여부 및 클러스터 할당 정보를 제공합니다. 전반적으로 AI 라벨과 인간 참조 라벨은 356점의 회화에서 일치하였으며, 이는 82.2%의 정확한 일치 정확도에 해당합니다. 범주별 재현율은 각 범주의 인간 참조 지지 수 대비 AI-인간 간의 정확한 일치 비율로 계산되었습니다.
카테고리 수준의 재현율(recall)은 의례/결혼 장면의 73.3%(33/45)에서 엘리트/미용의 88.4%(99/112)까지 범위로 나타났다. 재현율은 노동의 경우 84.7%(61/72), 공연의 경우 82.1%(32/39), 가사 노동의 경우 79.7%(51/64), 하인의 경우 79.3%(46/58), 그리고 시장의 경우 79.1%(34/43)였다. 전반적인 정확한 일치도는 356/433(82.2%)이었다. 사례 수준 쌍에 대한 평가를 통해 7개 카테고리 전체에 대한 정밀도(precision)와 F1 점수를 산출하였으며, 정밀도는 74.5%에서 89.2% 사이, F1 점수는 0.75에서 0.88 사이의 범위로 나타났다. 타겟 클래스의 위양성과 비대각 패턴을 상세히 보여주는 종합 혼동 행렬(confusion matrix)은 Supplementary Figure 1에 제공되어 있다.
보고된 계산 패턴 요약
그림 2는 보고된 네 가지 계산 분석 디스플레이를 보여줍니다. 그림 2A는 시각적 국소화 및 검토에 사용된 색상 세그멘테이션 오버레이가 포함된 9점의 회화 갤러리를 보여줍니다. 그림 2B는 C1–C7로 표시된 밀도 등고선이 포함된 보고된 CLIP 이미지 임베딩의 UMAP 산점도를 보여줍니다. 그림 2C는 보고된 회화의 수(채워진 점)와 카테고리 수준의 재현율(빈 원)을 비교하며, 그림 2D는 동일한 레이블에 따라 그룹화된 대표 회화들의 갤러리를 보여줍니다. 클러스터 검증 결과, 실루엣 점수 0.54와 Davies–Bouldin 지수 0.92를 나타낸 선택된 클러스터링 솔루션이 타당한 것으로 확인되었습니다. 클러스터와 인간 정의 카테고리 간의 매핑은 강력한 일치성을 보였으며, 유도된 각 클러스터는 주로 서로 다른 인간 참조 카테고리에 대응되었습니다.
표 3은 7가지 인간 참조 카테고리 지지 사례 수에 해당하는 표본 크기를 가진 7개의 보고된 계산 프로파일을 보여줍니다. 카테고리별 클러스터 분할표는 부록 표 2에 제공되며, 판정된 7가지 인간 참조 카테고리가 클러스터 C1–C7에 어떻게 분포되어 있는지 보여줍니다. 이러한 사례 수준의 클러스터 할당 분석 결과, 계산적 클러스터링이 7가지 인간 참조 카테고리와 밀접하게 일치하는 시각적 구조를 복원했음을 입증했습니다.
시각적 단서 연관성 및 해석적 종합
표 4는 사람이 코딩한 7가지 범주를 특성화하는 데 사용된 질적 시각적 단서 프로파일을 요약한 것입니다. 이 프로파일은 의복, 공간적 배경, 자세, 사물 및 사회적 관계 사이의 반복적인 연관성을 설명합니다. 이는 정량적 교차 분석을 통해 도출된 것이 아니므로 법적 지위, 민족성, 사회적 인과관계 또는 관객의 수용도를 입증하지는 않았습니다.
그림 3 코딩된 시각적 특징의 기술적 정량 요약과 해석적 개념 모델을 통합합니다. 그림 3A 판정된 7가지 인간 참조 카테고리와 각 카테고리의 표본 크기를 나타냅니다. 그림 3B 이 그림은 의복, 공간적 배경, 사물, 자세, 사회적 관계라는 다섯 가지 차원에 걸쳐 이러한 범주와 코딩된 시각적 표식 사이의 상대적 연관성을 보여줍니다. 표시된 연관 강도는 각 인간 참조 범주 내의 사례 수준 주석으로부터 계산되었습니다. 그림 3C 코딩된 관찰 결과로부터 도출된 가중 흐름을 사용하여 인간 참조 범주, 시각적 표식 차원 및 클래스 함의 원형 간의 관계를 요약합니다. 이러한 정량적 관계는 표본 추출된 회화 작품 내에서 반복되는 재현 패턴을 특징짓는 것이며, 역사적 인구 통계학적 또는 사회적 분포에 대한 추정치로 해석해서는 안 됩니다. 그림 3D 개념적인 교차 문화적 해석 모델을 제시하며, 이는 경험적으로 검증된 인과 경로라기보다 역사적 정보에 기반한 해석적 틀로 이해되어야 합니다.
시각적 패턴의 통합적 해석
전체 말뭉치에서 7가지 여성 정체성 범주는 의복, 공간적 배경, 사물, 자세 및 사회적 관계의 반복적인 조합으로 특징지어졌다. 이러한 조합은 샘플링된 회화 내의 정형화된 시각적 관례에 대한 기술적 증거를 제공했다. 젠더, 위계 및 교차 문화적 매개에 관한 역사적 해석은 추론적인 영역으로 남았다.
종합하면, 집계된 결과는 7개의 인간 참조 여성 정체성 범주와 이를 특징짓는 데 사용된 5가지 반복적 차원(의복, 공간적 배경, 사물, 자세, 사회적 관계)을 식별했습니다. 예비 AI 레이블은 433점의 회화 중 356점(82.2%)에서 판정된 인간 범주와 일치했으며, 범주 수준에서 가장 낮은 재현율은 의식/결혼 장면(73.3%)에서 관찰되었습니다. 이러한 발견은 코퍼스의 기술적 조직 및 비교를 뒷받침했습니다. 사례 수준의 AI-인간 레이블을 통해 범주 수준의 정밀도와 F1 추정치가 가능했습니다. 별도로, 군집 분석을 통해 7개의 인간 참조 범주에 해당하는 구조가 식별되었습니다. 그럼에도 불구하고, 이러한 계산적 결과는 시각적 표현 관습을 특징짓는 것이며, 역사적 사회 현실이나 관객의 수용에 대한 인과적 주장을 입증하는 것은 아닙니다.
데이터 가용성:
메타데이터, 소스 정보 및 스크리닝 기록을 포함하여 본 연구를 뒷받침하는 데이터는 Zenodo(https://doi.org/10.5281/zenodo.21130291)를 통해 이용할 수 있습니다.
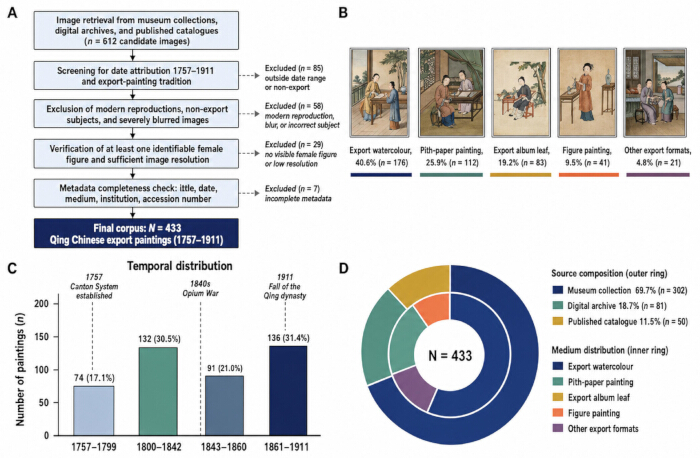
그림 1: 433점의 회화 표본에 대한 코퍼스 구축 및 기술적 구성. (A) 612점의 후보 이미지를 순차적으로 스크리닝하여 433점의 적격 회화를 선정함. 제외 항목은 연구 기간 또는 수출화 전통을 벗어난 회화 (n = 85), 현대 복제품, 흐릿한 이미지 또는 잘못된 대상 (n = 58), 식별 가능한 여성 형상이 없거나 해상도가 불충분한 이미지 (n = 29), 메타데이터가 부족한 기록 (n = 7)으로 구성됨. (B) 다섯 가지 매체 및 형식의 대표 사례: 수출 수채화 (40.6%, n = 176), 피지화 (25.9%, n = 112), 수출 앨범 리프 (19.2%, n = 83), 인물화 (9.5%, n = 41), 기타 수출 형식 (4.8%, n = 21). (C) 4개의 연대기적 구간에 따른 표본 회화의 분포. (D) 소장처(외곽 링) 및 매체/형식(내부 링)의 분포. 백분율은 전체 표본 (N = 433)을 기준으로 하며 소수점 첫째 자리까지 반올림함. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
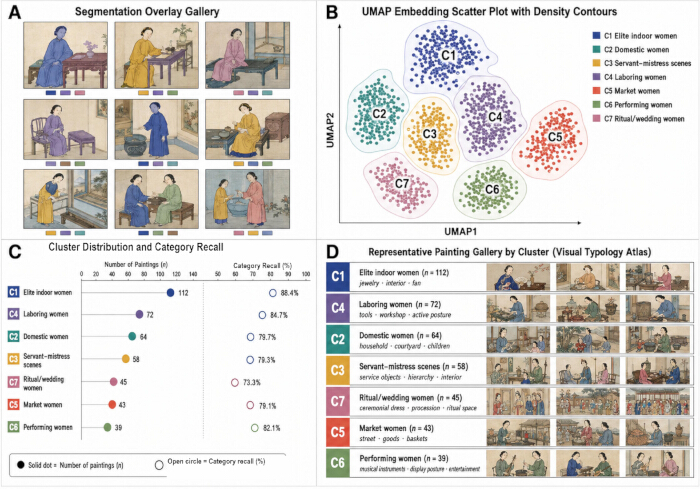
그림 2: 보고된 세그멘테이션, 임베딩 시각화, 클러스터 분포, 카테고리 재현율 및 대표 회화. (A) 검토를 위해 인물이나 시각적 요소를 국소화하는 데 사용된 컬러 세그멘테이션 오버레이가 적용된 9점의 회화 갤러리. (B) 밀도 등고선과 C1–C7 레이블이 표시된 보고된 CLIP 이미지 임베딩의 UMAP 산점도. (C) 보고된 회화 수(채워진 점, 상단 축)와 카테고리 재현율(빈 원, 하단 축); 카테고리 재현율은 정확한 일치 수를 인간 참조 지지 수로 나눈 값임. 신뢰 구간이나 오차 막대는 표시되지 않음. (D) 각 클러스터 중심과의 근접성을 기준으로 선택된 이미지를 포함하며, C1–C7 레이블별로 그룹화된 대표 회화 갤러리. 약어: AI = artificial intelligence; CLIP = Contrastive Language–Image Pre-training; SAM = Segment Anything Model; UMAP = Uniform Manifold Approximation and Projection; C1–C7 = 보고된 레이블 1–7. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
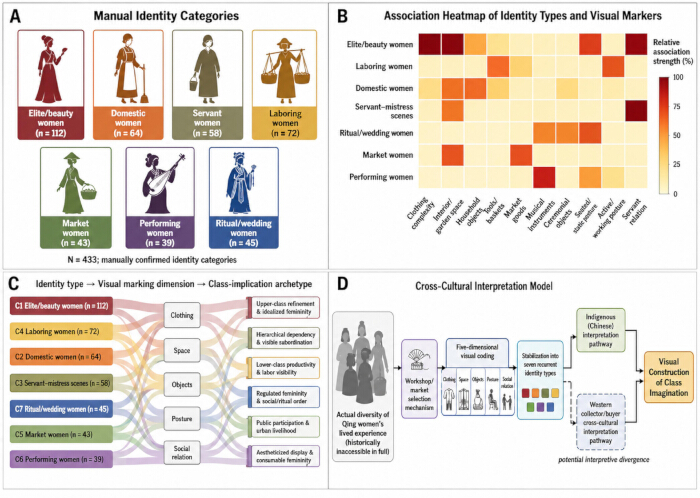
그림 3: 시각적 단서 연관성 및 교차 문화적 해석 체계. (A) 433점의 회화 코퍼스 내에서 판정된 7가지 인간 참조 여성 정체성 범주와 해당 표본 크기. (B) 의복, 공간적 배경, 사물, 자세 및 사회적 관계 전반에 걸쳐 코딩된 시각적 마커와 7가지 인간 참조 범주 간의 관계적 강도를 나타내는 연관성 히트맵. 연관성 강도는 각 범주 내의 사례 수준 주석에서 도출되었다. (C) 코딩된 관찰 결과를 바탕으로 인간 참조 범주, 시각적 마킹 차원 및 클래스 함의 원형 간의 가중치 관계를 요약한 엘루비얼(Alluvial) 표현. (D) 묘사된 활동, 작업장 및 시장 선택, 5차원 시각적 코딩, 반복되는 정체성 유형 및 잠재적 해석 경로를 연결하는 개념적 교차 문화적 해석 모델. 여기를 클릭하여 이 그림의 더 큰 버전을 확인하십시오.
표 1: 말뭉치 특성 및 메타데이터 완결성 (N = 433). 빈도수와 백분율은 날짜 구간, 출처, 매체 또는 형식, 메타데이터 완결성, 여성 인물 묘사, 장면 유형의 6개 개별 블록으로 요약되어 있습니다. 각 블록은 N = 433을 분모로 하며 합계는 433입니다. 백분율은 블록 내 말뭉치 비율이며 소수점 첫째 자리에서 반올림되었습니다. 이 파일을 다운로드하려면 여기를 클릭하십시오.
표 2: 예비 AI 라벨 및 인간 참조 범주 (N = 433). Support는 각 인간 참조 범주에 할당된 회화의 수를 나타냅니다. Exact matches는 예비 AI 생성 라벨이 인간 참조 범주와 일치하는 회화를 나타냅니다. 범주 수준 재현율(Category-level recall)은 정확한 일치 수(exact matches)를 인간 참조 support 수로 나누어 계산합니다. 이 파일을 다운로드하려면 여기를 클릭하십시오.
표 3: 보고된 계산 프로파일 요약. C1–C7은 검증된 프로파일 크기와 주요 레이블을 재현한다. 케이스 수준의 클러스터 할당과 카테고리별 클러스터 분할표의 통합 결과는 비지도 클러스터링이 7개의 인간 참조 카테고리에 해당하는 시각적 구조를 효과적으로 포착했음을 확인시켜 준다. 이 파일을 다운로드하려면 여기를 클릭하십시오.
표 4: 여성 정체성 범주 및 계급 관련 시각적 단서의 정성적 프로필. 수치와 백분율은 인간 참조 범주를 요약하며, 의복, 공간, 사물, 자세 및 사회적 관계는 각 범주와 관련된 반복적인 시각적 프로필의 특성을 나타냅니다. 계급 관련 해석은 역사적 사회적 지위의 직접적인 측정치가 아니라 회화적 패턴에 대한 도상학적 해석을 나타냅니다. 이 파일을 다운로드하려면 여기를 클릭하십시오.
보충 그림 1: 433점의 회화 코퍼스에 대해 예비 AI 레이블과 판정된 인간 참조 범주를 비교한 혼동 행렬(Confusion matrix).행은 판정된 인간 참조 범주(실제 레이블)를 나타내며, 열은 예비 CLIP 생성 범주(예측 레이블)를 나타냅니다. 셀 값은 각 AI-인간 레이블 조합에 해당하는 회화의 수를 나타냅니다. 대각선 셀은 정확한 AI-인간 일치를 나타내며, 해당 범주 수준의 재현율(recall)이 백분율로 표시됩니다. 비대각선 셀은 예비 AI 분류와 판정된 인간 참조 범주 간의 불일치를 나타냅니다. 전체 정확한 일치 정확도는 82.2%(356/433)였습니다. 이 파일을 다운로드하려면 여기를 클릭하십시오.
보조 표 1: 예비 AI 라벨, 판정된 인간 참조 범주 및 UMAP 클러스터 할당의 사례별 비교. 각 행은 분석 코퍼스에 포함된 433점의 청대 중국 수출 회화 중 하나를 나타냅니다. 이 표는 고정된 QEP 이미지 식별자, 예비 CLIP ViT-B/32 라벨, 인간 코더 1과 인간 코더 2의 독립적 분류, 판정된 인간 참조 범주, AI-인간 일치 여부 및 UMAP 클러스터 할당을 보고합니다. “Exact Match”는 예비 AI 라벨과 판정된 인간 참조 범주가 일치함을 나타내며, “Mismatch”는 불일치를 나타냅니다. 판정된 인간 범주는 AI-인간 일치 분석을 위한 참조 분류로 사용되었습니다. 이 파일을 다운로드하려면 여기를 클릭하십시오.
보충 표 2: 인간 기준 분류와 계산 클러스터 할당의 분할표.행은 판정된 7가지 인간 기준 분류를 나타내며, 열은 계산 클러스터링 분석을 통해 얻은 클러스터 C1–C7을 나타냅니다. 셀 값은 각 분류-클러스터 조합에 할당된 회화의 수를 나타냅니다. 전체 지지도는 각 인간 기준 분류에 속한 회화의 수를 나타냅니다. 분류-클러스터 조합 전반에 걸친 관찰치의 집중도는 독립적으로 도출된 계산 클러스터와 판정된 인간 기준 분류 간의 대응 관계에 대한 기술적 평가를 제공합니다. 이 파일을 다운로드하려면 여기를 클릭하십시오.
토론
제공된 종합 요약본 내에서 43개의 기록이 7개의 인간 참조 범주로 정리되었으며, 5개의 시각적 단서 군으로 설명되었습니다. 엘리트/미용(Elite/beauty)이 가장 큰 범주(12/433)였으며, 356개의 예비 라벨이 보고된 인간 참조와 일치했습니다(82.2%). 이는 코퍼스 관찰 결과입니다. 이러한 결과는 반복되는 회화적 공식에 대한 연구를 뒷받침하지만, 해당 공식이 청나라 사회를 충실히 재현했다거나 외국 관객들 사이에서 특정한 반응을 일으켰다는 더 강력한 주장을 뒷받침하지는 않습니다13.
규범적인 젠더 담론, 가계 내 지위, 노동, 그리고 청나라의 법은 여성의 삶을 형성하였으나 이를 일률적으로 결정짓지는 않았습니다. 전성기 청대 여성에 관한 학술 연구들은 규범적인 가족 및 정절 체제와 더불어 노동, 저술, 의례, 종교 및 오락에 참여한 여성들의 사례를 기록하고 있습니다. 팔기(Eight Banners)는 법과 행정 관행에 의해 정의된 세습적이고 다민족적인 신분 집단을 형성하였으므로, 팔기 구성원임을 곧바로 만주족 정체성과 동일시해서는 안 됩니다14,15,16,17. 본 연구에서 의복, 자세, 사물 및 배경은 법적 품계, 팔기/한족 소속, 민족성, 도덕적 순응 또는 실제 정체성의 증거라기보다는 회화적 단서로 간주됩니다. 그러한 주장을 위해서는 기록물 및 법적 근거가 필요할 것입니다.
계산적 결과에는 문화적 및 기술적 절제가 필요합니다. 범용 시각-언어 모델이 문화적으로 중립적이라고 가정해서는 안 됩니다. 발표된 CulturalVQA 결과는 지역 및 문화적 측면에 따라 성능이 불균등함을 보여주었으나, 해당 벤치마크는 CLIP ViT-B/32를 평가하지 않았으며 동아시아 역사 미술을 사용하지도 않았습니다8,18,19. 따라서 이는 이 코퍼스에 기반한 사례 매칭 벤치마크를 대체하는 것이 아니라 오히려 필요성을 부여합니다. 그러한 실험 결과가 나오기 전까지 CLIP은 청나라의 정체성이나 위계에 관한 권위가 아니라 예비적인 조직화 도구로 활용됩니다. 계산 파이프라인을 통해 SAM이 엄격하게 보조적인 국소화 증거로만 기능했음을 확인했습니다. 마스크나 마스크 기반 특징은 라벨링 또는 클러스터링의 입력값으로 사용되지 않았으며, 이를 통해 시각적 분류가 세그먼트화되지 않은 이미지의 전역 시맨틱 임베딩에만 전적으로 의존하도록 보장했습니다. 디지털 유산 학술 연구 또한 문화적 감수성, 학제 간 감독, 접근성, 데이터 보호 및 투명한 워크플로우를 강조합니다20.
역사적으로 이러한 패턴의 중요성은 수출용 회화 무역에 있습니다. 중국의 공방들과 해외 수요는 휴대 가능하고, 이해하기 쉬우며, 수집 가치가 있는 주제들을 선택하고 표준화했습니다. 또한 공방에서 반복적으로 나타나는 이미지들은 단순한 기계적 복제가 아니라 변주를 통한 모방이 이루어졌음을 보여줍니다1,2,3,4,5. 따라서 이 말뭉치는 대규모로 반복되는 정형화된 표현들을 제시함으로써 젠더, 계층, 일상생활의 이미지, 그리고 교차 문화적 조우의 역사에 기여할 수 있습니다. 다만, 이것이 해당 이미지들이 포괄적인 민족지학적 기록임을 입증하는 것은 아닙니다. 컴퓨터를 이용한 비교 분석은 정밀 독해와 교차 문화적 맥락화를 안내할 수 있으며21, 시장의 의도나 관객이 느낀 의미에 관한 주장은 생산 기록, 구매 이력 및 수용 증거를 통해 뒷받침되어야 합니다.
정서적 및 인지적 반응은 본 연구의 결과라기보다 향후 연구 방향으로 남아 있습니다. Shi와 동료들은 선호도 평가, 잠재 차원 분석 및 시선 추적을 결합하여 Xiashi Pinprick Lantern Pictures에 대한 반응에서 정서적, 형식-미학적 및 인지적 경로를 구분하였습니다22. 이와 유사한 설계를 통해 관람자가 수출화의 의복, 사물, 자세 또는 위계에 서로 다르게 주목하는지 테스트할 수 있을 것입니다. 본 연구에서는 평가, 시선 추적 또는 기타 관람객 데이터를 수집하지 않았으므로, 이미지 콘텐츠만으로는 정서적 각성, 시각적 돌출성 또는 수용도를 추론할 수 없습니다.
본 연구의 한계점은 이론적, 방법론적, 그리고 실무적 측면으로 나뉩니다. 이론적으로는 물질적 단서 범주가 성별, 가구 관계, 법적 위계, 민족성 및 실제 삶의 경험을 단순화했다는 점이 있습니다. 방법론적으로는 추론 과정이 유물 생존율, 수집, 디지털화, 메타데이터, 제로샷(zero-shot) 모델, 코딩 및 불균등한 시기적 편향의 제약을 받습니다. 분석 파이프라인이 견고한 패턴 탐색 능력을 보여주었지만, 이러한 구조적 편향은 컴퓨터 분석 결과를 청나라의 사회적 실상을 투명하게 보여주는 창으로 보기보다 회화적 관습에 대한 분석으로 다루어야 할 필요성을 강조합니다. 실무적으로는 이미지 저작권으로 인해 재배포가 제한되며, 연구 결과가 다른 기관, 시대, 매체 또는 컴퓨팅 환경으로 일반화되지 않을 수 있습니다. 이러한 제한 사항 내에서, 본 연구는 반복적인 시각적 관찰을 자동화된 결론이 아닌 검증 가능한 역사적 질문으로 전환하기 위한 인간 감독 기반의 프레임워크를 제공합니다. 본 연구는 개입 연구가 아닌 해석적 연구이므로, 지속가능발전목표(SDG)나 지표에 대한 진척도를 평가하지 않았습니다. 그럼에도 불구하고 연구 주제는 목표 5와 관련이 있으며, 권리를 고려한 문서화 및 교차 문화적 교육 프레임워크는 타겟 11.4 및 4.7과 개념적으로 일치합니다. 다만, 측정된 SDG 성과는 없습니다. 제공된 재현성 패키지는 투명한 디지털 유산 워크플로우에 대한 최근의 요구 및 지속적 식별자, 풍부한 메타데이터, 라이선스, 출처, 그리고 재사용 가능한 데이터, 알고리즘, 도구 및 워크플로우에 관한 FAIR 요건을 준수합니다20,23.
공개 사항
저자들은 공개할 이해관계가 없습니다.
감사의 글
저자들은 말콤과 앨버트 박물관, 대영 박물관, 메트로폴리탄 미술관, 스미소니안 국립 아시아 미술관, 피바디 에섹스 박물관, 홍콩 미술관, 대영 도서관, 게티 연구소 및 온라인 기록을 통해 말뭉치 발견을 지원한 기타 소장 기관과 카탈로그 팀에 감사드립니다. 온라인 기록에 액세스할 수 있다고 해서 해당 이미지의 재배포 권한이 부여됨을 의미하는 것은 아니며, 이에 따라 패널 수준의 권한과 소스 링크는 별도로 기록되었습니다. 또한 저자들은 CLIP 및 SAM을 지원하는 개방형 연구 커뮤니티와 마카오 시립대학교 및 광둥 폴리테크닉 사범대학교의 행정적 지원에 감사를 표합니다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| CLIP ViT-B/32 | OpenAI | OpenAI CLIP, ViT-B/32 | 예비 이미지–텍스트 유사성 분석 및 예비 AI 라벨 할당에 사용된 시각-언어 모델. |
| 컴퓨팅 워크스테이션 | 저자’ 컴퓨팅 워크스테이션 | CUDA 지원 GPU; 정확한 하드웨어 구성 보고 필요 | CLIP 및 SAM 추론과 계산 분석에 사용된 워크스테이션; 원래 실행 환경의 GPU, CPU, RAM, 운영 체제 및 CUDA 사양을 보고해야 함. |
| Matplotlib | Matplotlib 개발 팀 | Python 패키지; 정확한 버전 보고 필요 | 계산 시각화와 분석 그림 및 플롯 생성에 사용됨. |
| Microsoft Excel 2021 | Microsoft Corporation | Microsoft Excel 2021 | 메타데이터 정리, 스크리닝 기록 및 표 형식의 연구 데이터 관리에 사용됨. |
| NumPy | NumPy 개발자 | Python 패키지; 정확한 버전 보고 필요 | 수치 계산 및 이미지 특징과 분석 배열의 조작에 사용됨. |
| pandas | pandas 개발 팀 | Python 패키지; 정확한 버전 보고 필요 | 구조화된 데이터 처리, 메타데이터 프로세싱 및 사례 수준 분석 결과 정리에 사용됨. |
| Python 3.10 | Python Software Foundation | Python 3.10 | 계산 이미지 분석 워크플로우를 구현하는 데 사용된 프로그래밍 환경. |
| PyTorch 2.0.1 | PyTorch Foundation | PyTorch 2.0.1 | CLIP 기반 이미지 및 텍스트 인코딩과 GPU 추론을 실행하는 데 사용된 딥러닝 프레임워크. |
| scikit-learn | scikit-learn 개발자 | Python 패키지; 정확한 버전 보고 필요 | K-means 클러스터링, 응집형 클러스터링, 실루엣 계수, Davies–Bouldin 지수 및 Cohen’s kappa 계산에 사용됨. |
| Segment Anything Model (SAM) | Meta AI Research | SAM | 시각적 검사를 위해 여성 인물, 의복, 가구, 도구, 제례 도구 및 건축 영역을 국소화하는 데 사용된 세그멘테이션 모델. |
| umap-learn | McInnes et al. | UMAP Python 구현체 | 코사인 거리를 이용한 CLIP 이미지 임베딩의 차원 축소 및 2차원 시각화에 사용됨. |
참고문헌
- Gao J, Zhang Y, Liu J, Sousa JP. A digital humanities approach to Chinese export watercolours: a case study on the Victoria and Albert Museum collection. Digit Scholarsh Humanit. 2026;41(2):692-714.
- Liu H, Fu C, Li W. Silk road heritage: the artistic representation of port trading culture in the images of characters in Qing Dynasty Guangzhou export paintings. PLoS One. 2024;19(10):e0308309.
- Ao J, Ye Z, Li W, Ji S. Impressions of Guangzhou city in Qing Dynasty export paintings in the context of trade economy: a color analysis of paintings based on k-means clustering algorithm. Herit Sci. 2024;12:77.
- Mok MKW. Chinese export paintings: a marketing success story. Cambridge Scholars Publishing; Newcastle upon Tyne; 2025.
- Yaron E. The many versions of the painting of Tingqua's studio: painting copying and originality in nineteenth-century Canton. Humanit Soc Sci Commun. 2020;7:132.
- Impett L, Offert F. There is a digital art history. Vis Resour. 2022;38(2):186-209.
- Münster S. Artificial intelligence for digital heritage innovation: setting up a R&D agenda for Europe. Heritage. 2024;7(2):794-816.
- Foka A, Griffin G. AI, cultural heritage, and bias: some key queries that arise from the use of GenAI. Heritage. 2024;7(11):6125-6136.
- Zhang W. Computational approaches for traditional Chinese painting: from the Six Principles of Painting perspective. J Comput Sci Technol. 2024;39(2):269-285.
- McInnes L, Healy J, Saul N, Großberger L. UMAP: Uniform Manifold Approximation and Projection. J Open Source Softw. 2018;3(29):861.
- Rousseeuw PJ. Silhouettes: a graphical aid to the interpretation and validation of cluster analysis. J Comput Appl Math. 1987;20:53-65.
- Cohen J. A coefficient of agreement for nominal scales. Educ Psychol Meas. 1960;20(1):37-46.
- Stejskal J. Art-historical empiricism and digital visualization of cultural heritage. Synthese. 2025;205:132.
- Mann S. Precious records: women in China's long eighteenth century. Stanford University Press; Stanford; 1997.
- Porter DC. Slaves of the emperor: service, privilege, and status in the Qing Eight Banners. Columbia University Press; New York; 2023.
- Sommer MH. Sex, law, and society in late imperial China. Stanford University Press; Stanford; 2000.
- Theiss JM. Disgraceful matters: the politics of chastity in eighteenth-century China. University of California Press; Berkeley; 2005.
- Nayak S, et al. Benchmarking vision language models for cultural understanding [conference paper]. Presented at: 2024 Conference on Empirical Methods in Natural Language Processing; Miami, Florida, USA; 2024. https://aclanthology.org/2024.emnlp-main.329/
- Vitaloni C, Shullani D, Baracchi D. A comparative study of vision language models for Italian cultural heritage. Heritage. 2025;8(3):95.
- Li W. Systematic review: a scientometric analysis of the status, trends and challenges in the application of digital technology to cultural heritage conservation (2019-2024). npj Herit Sci. 2025;13:90.
- Zhang W, et al. CultiVerse: towards cross-cultural understanding for paintings with large language model [conference paper]. Presented at: 33rd ACM International Conference on Multimedia; Dublin, Ireland; 2025. https://doi.org/10.1145/3746027.3755698
- Shi W. A dual-path approach to emotional arousal and visual cognition in intangible cultural heritage: the case of Xiashi Pinprick Lantern Pictures. Digit Scholarsh Humanit. 2026;41(1):376-395.
- Wilkinson MD, et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.