본 프로토콜은 영-중 서면 번역 및 시역에서 인지적 노력의 관찰 가능한 상관관계와 수정의 기능적 효과를 평가하기 위해 다중 모드 행동 기록을 통합합니다. 여기에는 키스트로크 로깅, 화면 캡처, 오디오 분석, 전사 기반 코딩 및 표준화된 품질 평가가 결합되어 있습니다.
이 논문에서
요약
초록
본 논문은 영-중 서면 번역 및 시역 과정에서 인지적 노력과 전략적 수정의 관찰 가능한 상관관계를 조사하기 위한 다중 모드 행동 프로토콜을 제시합니다. 서면 번역의 경우 키스트로크 로그와 화면 녹화 영상을 동기화하며, 시역의 경우 오디오 녹음과 축자 전사본을 사용합니다. 수정 및 자기 수정 에피소드는 전체적인 출력 품질 평가와는 별개로, 유형 및 기능적 결과(효과적, 중립적 또는 해로움)에 따라 코딩됩니다. 초보자 그룹과 숙련자 그룹으로 배정된 62명의 참가자를 대상으로 한 시연에서, 두 그룹 모두 상쇄 순서로 두 가지 과제 조건을 수행했습니다. 숙련자 참가자들은 서면 번역(20.1 ± 2.1 vs. 16.8 ± 2.3)과 시역(18.9 ± 2.4 vs. 15.4 ± 2.6) 모두에서 더 높은 평균 출력 품질 점수를 보였으며, 효과적인 수정 또는 자기 수정의 비율이 더 높았습니다. 일시 정지, 삭제, 시작 지연 및 수정 밀도는 간접적이며 과제에 따라 민감하게 반응하므로, 이를 단일 구성 개념의 직접적인 측정치가 아니라 삼각 측량이 필요한 행동적 상관관계로 해석합니다. 본 프로토콜은 통제된 설명문 텍스트를 대상으로 하며, 입력 방식 처리, 일시 정지 임계값, 텍스트 비교 가능성 및 채점 절차를 재조정하여 다른 언어 쌍에도 적용할 수 있습니다.
서론
영어-중국어 필기 번역과 시역은 원문 이해, 언어 간 전이, 그리고 도착어 표현 능력을 필요로 하지만, 서로 다른 과제 조건을 부과합니다. 필기 번역은 반복적인 읽기와 지연된 편집이 가능한 반면, 시역은 더 엄격한 시간적 제약 하에서 구어적 산출을 요구합니다. 인지 부하(Cognitive load), 처리 난이도(processing difficulty), 그리고 인지적 노력(cognitive effort)은 서로 관련이 있지만 상호 대체될 수 없는 개념들입니다. 부하는 과제의 요구 사항에 관한 것이며, 노력은 그러한 요구 사항 하에서 참가자가 투입하는 자원에 관한 것입니다. 인지적 노력은 잠재적이고 다차원적이므로, 본 연구에서는 잠복기, 휴지, 삭제 및 수정 밀도를 계획, 모니터링, 운동 프로세스 또는 난이도를 반영할 수 있는 행동적 상관물로 취급하며, 이를 노력의 직접적인 측정치라기보다 종합적으로 해석해야 합니다1,2,3,4,5,6,7,8.
과정 중심 연구는 제품 점수와 시간별로 정렬된 행동 기록을 결합하여 번역 결정이 언제, 어떻게 일어나는지 확인합니다. 키스트로크 로깅은 생성 및 수정 순서를 파악하는 데 유용하지만, 중국어 입력 방식의 조합 과정에서 실제 키 이벤트와 최종 입력된 문자가 분리될 수 있습니다. 따라서 가시적인 텍스트 상태를 재구성하기 위해 동기화된 화면 녹화가 필요합니다9,10,11. 일시 정지 임계값은 보편적인 인지적 경계라기보다 분석적 선택 사항이며, 임계값을 짧게 설정하면 일시 정지 기반의 결론이 실질적으로 달라질 수 있습니다8,12. 따라서 본 프로토콜에서는 명시적인 동기화 확인, 임계값 민감도 분석, 그리고 과제 특이적 측정 항목과 공유 측정 항목의 분리가 요구됩니다.
수정 빈도만으로는 모니터링이 결과물을 개선하는지 여부를 판단할 수 없습니다. 서면 수정과 구어적 자가 수정은 어휘 선택, 구문, 의미 또는 스타일을 대상으로 할 수 있지만, 그 기능적 결과는 원문 의미 및 직전에 생성된 타겟 세그먼트와 비교하여 판단해야 합니다. 영어-중국어 및 중국어-영어 처리에 관한 시역 연구에 따르면 훈련, 방향성, 눈-음성 협응, 그리고 언어별 문제 유발 요인이 수행 패턴을 변화시킬 수 있음이 나타났습니다13,14,15,16. 이러한 이유로 에피소드 유형, 에피소드 결과, 최종 결과물 품질 및 전달 관련 행동을 별개의 변수로 코딩합니다.
본 프로토콜은 통제된 컴퓨터 기반 세션에서 짧은 비전문가용 설명문을 다루는 성인 학습자 또는 숙련된 번역가/통역사를 대상으로 설계되었습니다. 작문 생산을 위해 키스트로크(keystroke) 및 화면 기록을 캡처할 수 있고, 구어 생산을 위해 고품질 오디오를 녹음할 수 있는 환경에 가장 적합합니다. 본 프레임워크는 다른 언어 쌍에도 적용할 수 있으나, 텍스트 매칭, 정보 단위로의 분절, 키보드 또는 입력 방식의 동작, 일시 정지 임계값 및 등급 척도 기준점은 각 언어 쌍과 문자 체계에 맞게 다시 검증되어야 합니다17. 본 시연에서는 텍스트 길이, 시간 제한, 출력 모드 및 수정 기회가 서로 다르기 때문에 모든 차이점을 단순히 양식(modality)의 차이로만 돌리지 않고 과제 조건 간의 비교를 수행합니다.
프로토콜
인체 대상자를 포함하는 모든 방법은 기관 지침을 준수하여 수행되었으며, Guilin Institute of Information Technology의 인체 연구 윤리 위원회로부터 명시적인 승인을 받았습니다(승인 번호 UYHAJ2025899). 모든 참여자로부터 참여 전 서면 동의서를 받았습니다. 본 연구에 사용된 장비 및 소프트웨어의 전체 목록은 재료 표를 참조하시기 바랍니다.
1. 참여자 모집 및 그룹 배정
- 영어 또는 번역 전공자 및 전문 통역사 교육생을 포함하여 62명의 참가자를 모집하십시오. 모든 참가자가 모국어가 중국어이며, 시력과 청력이 정상 또는 교정 후 정상인지 확인하십시오.
- 체계적인 번역 교육 기간이 12개월 미만인 참가자는 초보자 그룹에, 12개월 이상인 참가자는 숙련자 그룹에 배정하십시오. 모든 참가자에 대해 이전의 서면 번역 및 시역 연습 경험을 별도로 기록하십시오.
- 과제 배정 전 참가자 스크리닝을 통해 원문 텍스트에 미리 노출되었거나, 교정되지 않은 감각 장애가 있거나, 표준 중국어 입력 방식을 사용할 수 없는 사람을 제외하십시오.
- 금지된 외부 도구 사용, 불완전한 수행, 파일 손상 또는 오디오 사용 불가와 같이 미리 지정된 사유가 있는 경우에만 녹화 후 과제를 제외하십시오.
- 개인 식별 정보가 포함되지 않은 과제 제외 로그를 유지하십시오. 최종 분석 샘플을 본문과 그림 1A–D에 일관되게 보고하십시오.
2. 재료 선택 및 예비 평가
- 일반 학술, 교육, 사회 또는 공공 소통 영역에서 짧은 영어 설명문을 선택한다. 지필 번역 텍스트는 약 180–220단어, 시역 텍스트는 약 120–160단어 분량으로 구성한다.
- 과제 조건 전반에 걸쳐 텍스트 길이, 어휘 난이도, 구문 복잡성, 정보 밀도 및 주제 친숙도를 일치시키거나 통계적으로 조정한다.
- 3명의 이중언어 전문가에게 어휘 난이도, 구문 복잡성, 정보 밀도, 주제 친숙도 및 전이 적합성을 1~5점 척도(1 = 매우 낮음, 5 = 매우 높음)로 독립적으로 평가하도록 요청한다.
- 평균 평가 점수에 대해 95% 신뢰구간을 포함한 이원 무작위 효과 내내 상관계수(ICC)를 산출한다. 일치도가 낮은 항목(ICC < 0.75)은 수정한다.
- 표준화된 매칭 변수가 ±10% 허용 오차 범위 내에 있는 텍스트 쌍만 유지한다.
- 정보 단위를 독립적으로 점수화할 수 있는 하나의 아이디어, 관계 또는 사건을 표현하는 가장 작은 원문 명제로 정의한다. 과제 시행 전 경계 설정에 대한 이견을 해결한다.
- 본 분석에 포함되지 않는 참가자들을 대상으로 지침, 입력 방법, 동기화, 음질 및 시간 제한에 대해 사전 테스트를 실시한다. 완료 시간 분포와 각 시간 제한에 도달한 비율을 기록한다.
- 사전 테스트 참가자들이 천장 효과/바닥 효과, 지속적인 모호함 또는 기록 불안정성을 보일 경우 텍스트나 시간 제한을 수정한다. 본 연구를 시작하기 전 모든 변경 사항을 문서화한다.
3. 과제 수행 관리 및 기록 설정
- 표준화된 하드웨어 및 소프트웨어 구성을 사용하여 조용하고 방음 처리된 공간에서 참가자를 개별적으로 테스트한다.
- 표준화된 지침 스크립트를 읽어주고, 실험 외의 연습 항목을 한 번 허용한다. 사전, 검색 엔진, 생성형 인공지능, 기계 번역 및 외부 코퍼스의 사용을 금지한다.
- 각 훈련 그룹 내에서 두 가지 과제 순서(필기 번역 우선 vs. 시역 우선)를 균형 배치하고, 5분의 휴식 시간을 유지한다.
- 모집 완료 전에 할당 목록을 작성하고, 적격성이 확인될 때까지 배정을 숨긴다. 여러 개의 소스 텍스트를 사용하는 경우, 과제 순서와는 독립적으로 텍스트 식별자를 균형 배치하고 분석을 위해 텍스트 ID 변수를 유지한다.
- 영어 소스 텍스트를 지속적으로 제시하고, 지정된 입력 필드에 정확하고 자연스러운 중국어 번역문을 작성하도록 참가자에게 지시한다. 수정은 제한 없이 허용하되, 외부 텍스트를 붙여넣는 것은 엄격히 금지한다.
- 카운트다운 시계를 표시하지 않은 상태에서 파일럿 테스트를 통해 설정된 20분의 제한 시간을 적용하고, 제한 시간에 도달했는지 여부를 기록한다.
- 화면 녹화와 동기화된 키스트로크 로깅 소프트웨어를 사용하여 필기 번역 과정 전체를 연속적으로 캡처한다. 이후 행동 데이터 추출을 위해 타임스탬프가 찍힌 로그 파일과 함께 최종 번역 결과물을 보관한다.
- 시역 소스 텍스트를 화면에 제시하고, 서면 메모 없이 중국어 구두 통역을 시작하도록 참가자에게 지시한다.
- 6분의 제한 시간을 일관되게 적용하고, 이 제한 시간에 도달했는지 여부를 기록한다. 시간 제한으로 인한 관찰과 정상적으로 완료된 관찰을 구분한다.
- 디지털 오디오 캡처 소프트웨어를 사용하여 구두 출력물을 기록한다. 이후 코딩을 용이하게 하기 위해 해당 녹음 파일로부터 엄격한 축자 전사본을 생성한다.
4. 행동 과정 지표의 추출
- 로그 파일에서 쓰기 과제 행동 상관물을 추출하고, 초기 잠복기를 자극 제시부터 첫 번째 중국어 글자 입력까지의 간격으로 정의한다.
- 총 과제 수행 시간, 일시 정지 횟수 및 지속 시간, 삭제율, 수정 밀도 및 생산율을 추출한다. 원시 타임스탬프와 각 정규화된 측정치에 사용된 정확한 분모를 유지한다.
- 운용적 쓰기 일시 정지 임계값으로 2 s를 사용한다. 커서 이동, 텍스트 선택 또는 입력법 후보 선택 중의 일시 정지가 포함되었는지 여부를 보고한다.
- 파형과 검증된 전사본에서 말하기 과제 행동 상관물을 추출하고, 시작 잠복기를 자극 제시부터 첫 번째 의미 있는 목표 언어 발화까지의 간격으로 정의한다.
- 흡기, 헛기침 및 중단된 비어휘적 소리를 시작 잠복기에서 제외한다. 총 통역 시간, 무음 일시 정지, 충전 일시 정지, 반복, 잘못된 시작, 자기 수정 및 말하기 속도를 추출한다.
- 말하기 무음 일시 정지를 발화 내에서 최소 1.0 s 이상의 침묵으로 정의한다. 파형 및 검증된 전사본과 대조하여 일시 정지 경계를 검토하고, 발화 내 일시 정지 횟수에서 앞뒤의 침묵은 제외한다.
- 수행된 모든 과제에 대해 품질 관리 기록을 작성한다. 해당 프로세스 파일을 읽을 수 있고 완전한지, 전사본이 검증되었는지, 코딩이 완료되었거나 판정되었는지 여부를 기록한다. 원본 기록을 보존하고 모든 수정 사항을 감사 추적에 기록한다.
5. 전략적 수정 및 구어적 자기 수정의 코딩
- 키스트로크 로그, 화면 영상 및 최종 텍스트를 정렬하여 작성된 각 수정 사항을 재구성합니다.
- 동일한 대상 세그먼트를 향한 편집 동작의 연속된 시퀀스를 하나의 에피소드로 간주하며, 다른 곳에서 제작이 최소 2 s 동안 재개되거나 다른 세그먼트가 편집될 때 해당 에피소드를 종료합니다.
참고: 중국어 입력의 경우, 확정 전의 조합 변경과 확정 후의 대상 텍스트 삭제를 구분하고 후자만을 텍스트 수정으로 코딩합니다. - 의미적, 구문적, 어휘적 또는 스타일적 변화를 바탕으로 하나의 주요 수정 유형을 할당합니다. 중첩되는 경우 보조 태그를 허용하되, 상호 배타적인 집계에는 주요 태그를 사용합니다. Supplementary File 1에 제공된 예시를 적용합니다.
- 구어적 자가 수정을 코딩하기 전에 타임스탬프가 포함된 축자 전사본을 생성합니다. 첫 번째 전사자에게 어휘 내용, 충전 휴지, 반복, 거짓 시작, 중단 및 이해 불가능한 구간을 표시하도록 지시합니다.
- 훈련된 두 번째 검토자가 오디오와 대조하여 전사본을 확인하고, 원래의 오디오 타임스탬프를 유지하면서 불일치 사항을 해결합니다.
- 구어적 자가 수정을 바로 앞의 대상 언어 세그먼트를 대체, 완성 또는 수정하는 명시적인 재구성으로 정의합니다. 침묵만으로 잠재적 모니터링을 추론하지 않습니다. 구어적 자가 수정에도 동일한 어휘적, 구문적, 의미적 및 스타일적 결정 규칙을 적용합니다.
- 수정 사항이 없는 정확한 반복은 비유창성으로, 새로운 구성에 이어지는 포기된 시작은 거짓 시작 및 수정으로, 명시적인 재구성 없는 누락이나 오역은 출력 오류로 코딩합니다.
- 오디오가 불분명하거나 두 범주가 동일하게 가능성 있을 경우, 해당 에피소드를 모호함으로 표시합니다. 모호한 에피소드에 대해서는 임시 태그를 유지하고 신뢰도 분석 전에 판정을 내립니다.
- 에피소드 전후의 대상 세그먼트를 소스 정보 단위 및 지역 대상 문맥과 비교하여 기능적 결과를 판단합니다. 최종 종합 점수를 공개하기 전에 이 판단을 내립니다. 종합 점수의 변화를 효과성의 정의로 사용하지 않습니다.
- 두 그룹과 작업 순서 전반에 걸쳐 선택된 출력물의 최소 20%를 이중 코딩하고, 판정 전 독립적인 코드에 대해 신뢰도를 계산합니다.
- 평가자 간 일치도가 Cohen’s kappa 0.80 미만으로 떨어지면 재훈련 및 재코딩을 실시합니다. 이 정확한 임계값과 취해진 모든 시정 조치를 기록합니다.
6. 품질 평가 및 통계 모델링
- 보충 파일 1에 명시된 25점 만점의 분석 루브릭을 사용하여 각 최종 서술 번역 및 시역 결과물을 채점하십시오.
- 제시된 기준점을 사용하여 정확성, 완결성, 어휘의 적절성, 일관성 및 도착어의 자연스러움을 0점에서 5점까지 평가하십시오. 집단 소속을 확인한 후 채점 기준을 임의로 수정하지 마십시오.
- 시역 평가 항목에 대해서는 평가자가 오디오와 검증된 전사본을 모두 사용하도록 안내하십시오. 일시 정지 및 비유창성 측정치는 루브릭 점수와 별도로 분석하십시오.
- 코드북과 최소 10개의 연습 출력물을 사용하여 두 명의 독립적인 평가자를 교육하되, 평가자에게 참가자 집단과 과제 순서를 알리지 마십시오.
- 독립적인 채점과 에피소드 코딩이 완료된 후, 토론 전 신뢰도를 계산하십시오. 의견 불일치는 합의를 통해 해결하며, 합의에 도달할 수 없는 경우에만 제3의 평가자에게 자문을 구하십시오.
- 평균 연속 품질 점수에 대해 이원 무작위 효과, 절대 일치 내부 상관 계수를 보고하십시오. 주요 범주형 수정 코드에 대해서는 Cohen's kappa를 보고하고, 효과적/중립적/해로운 결과 코드에 대해서는 별도의 kappa를 보고하십시오. 이중 코딩된 에피소드의 정확한 수와 백분율을 명시하십시오.
- 분석 전 각 프로세스 파일이 읽기 가능하고 완전한지 확인하고, 서술 과제 로그를 해당 화면 녹화와 일치시키며, 전사본을 오디오와 대조하여 검증하십시오.
- 정렬 실패, 이해 가능성 문제 및 시정 조치를 품질 관리 로그에 기록하십시오. 빈도 측정치의 경우, 일시 정지 빈도는 소스 텍스트 정보 단위 100개당, 서술 수정 밀도는 생성된 중국어 문자 100자당으로 정규화하십시오.
- 기능적 결과는 최종 종합 품질 점수와 독립적으로 코딩하십시오. 수정 후 세그먼트가 새로운 문제를 일으키지 않고 텍스트를 개선한 경우 '효과적', 실질적인 변화가 없는 경우 '중립적', 오류를 유발한 경우 '해로운' 것으로 에피소드를 코딩하십시오.
- 효과율은 분류 가능한 모든 에피소드 중 효과적인 에피소드의 비율로 계산하며, 분모에서 모호한 에피소드는 제외하십시오.
- 본 시연을 탐색적 반복 측정 데이터셋으로 분석하십시오. 과제 조건, 교육 집단, 일시 정지 지표, 수정 밀도, 효과율, 비유창성 부담 및 발화 속도를 사용하여 총 품질 점수를 예측하는 고정 효과 모델을 지정하십시오.
- 참가자 무작위 절편을 포함하고, 설계에 독립적으로 샘플링된 텍스트가 충분히 포함된 경우에만 소스 텍스트 무작위 효과를 포함하십시오.
- 연속 예측 변수를 중심화하고, 잔차를 점검하며, 공선성을 확인하십시오. 추정 방법, 소프트웨어 버전, β, SE, 95% CI, 정확한 p 값, 분산 성분, AIC, BIC 및 주변/조건부 R2를 보고하십시오. 해당 분석을 탐색적인 것으로 기술하고 확정적인 인과 관계 주장은 피하십시오.
- 비식별 데이터, 사전, 코드북, 루브릭, 소프트웨어 세부 정보, 스크립트 및 출력물이 포함된 재현 가능한 분석 패키지를 내보내십시오. 공개 전 모든 그림과 표의 값이 지정된 변수 및 분석 단계로 추적 가능한지 확인하십시오.
결과
참가자 기초 특성 및 데이터 가용성
설문조사에는 총 62명의 참가자(초심자 31명, 숙련자 31명)가 포함되었으며, 작업 시트에는 124개의 기록이 포함되어 참가자당 두 개의 작업 기록을 완료했음을 나타냅니다(표 1). 초심자 그룹은 12개월 미만의 체계적인 번역 훈련을 받았으며(관찰된 최대치 8.6개월), 숙련자 그룹은 최소 12개월 이상의 훈련을 받았습니다(관찰된 최소치 13.3개월). 연령, 성별, 영어 학습 기간, 능숙도 및 작업 순서 분포는 두 그룹 간에 유사했습니다. 그림 1은 최종 분석 샘플을 보고하며, 작업별 데이터를 정확하게 구분하고 있습니다. 즉, 키스트로크 로그와 화면 녹화는 서면 번역에 적용되고, 오디오 및 축어록은 시각 통역에 적용되며, 품질 등급은 두 작업 모두에 적용됩니다.
과제 조건별 행동 프로필
두 가지 과제 조건 및 훈련 그룹 간에 행동 프로필의 차이가 나타났다(표 2; 그림 2A–E). 필기 번역은 완료 시간이 더 길고 평균 휴지 시간이 더 길었던 반면, 시역은 보고된 임계값 미만의 정보 단위 100개당 휴지 횟수가 더 많았다. 각 과제 조건 내에서, 훈련 그룹은 과제를 더 빠르게 완료했으며 평균 출력 점수가 더 높았다. 이러한 대조 결과는 텍스트 길이, 시간 제한, 출력 방식 및 수정 기회 또한 서로 달랐기 때문에 순수한 양식 효과로 해석해서는 안 된다. 휴지가 항상 방해 요소가 되는 것은 아니다. 휴지는 해결되지 않은 어려움, 성공적인 계획, 모니터링 또는 입력 방식의 활동을 반영할 수 있으므로, 휴지 측정치는 수정, 전달 및 품질 측정치와 함께 종합적으로 해석된다.
전략적 수정, 자기 수선 및 예측 모델링
코딩 프레임워크는 에피소드 유형을 기능적 결과와 분리하였습니다(표 3; 그림 3A–D). 훈련된 참가자들은 초보자보다 더 많은 서면 수정 에피소드를 생성하였으며(과제당 12.4 ± 3.7 vs. 8.9 ± 3.0), 반면 총 구어 자기 수정은 그룹 간에 유의미한 차이가 없었습니다(과제당 4.9 ± 1.6 vs. 4.4 ± 1.5). 그럼에도 불구하고 훈련된 그룹은 두 과제 모두에서 효과적인 에피소드의 비율이 더 높았습니다. 표 4에 보고된 혼합 효과 요약은 인과 경로가 아닌 연관성을 나타내며, 따라서 그림 3E는 인과 관계 다이어그램 대신 보고된 고정 효과 추정치와 신뢰 구간을 표시합니다.
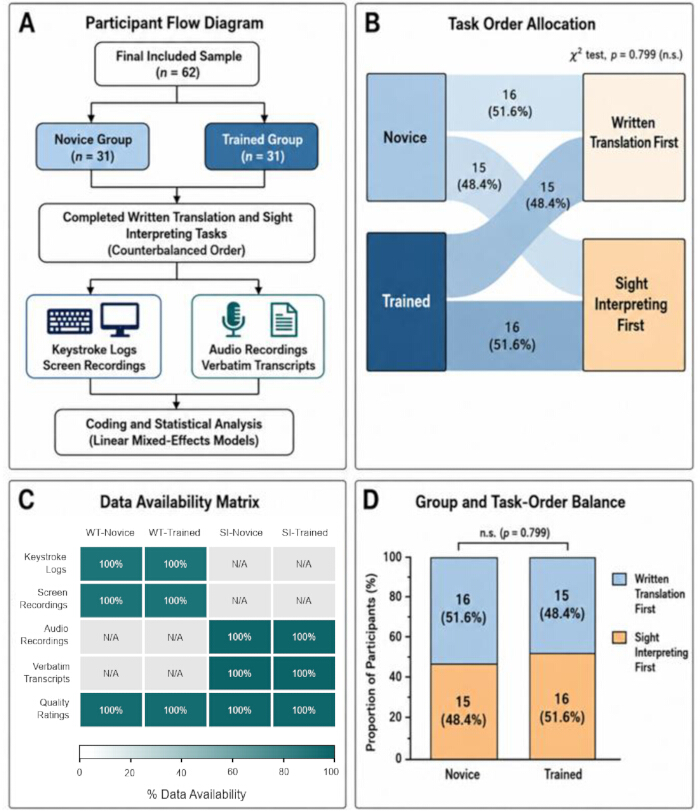
그림 1: 참가자 흐름, 과업 순서 할당 및 과업별 데이터 가용성. (A) 최종 분석된 62명의 참가자와 124개의 과업 기록 샘플. (B) 초보자 및 숙련자 그룹 내의 균형 설계된 과업 순서 할당. (C) 가용성 매트릭스로, 키스트로크 로그와 화면 녹화는 필기 번역에만, 오디오 녹음과 축어 전사본은 시역에만, 품질 등급은 두 과업 모두에 적용됨. (D) 그룹별-순서별 균형 (카이제곱 검정, p = 0.799). n = 62명의 참가자 (그룹당 31명). 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
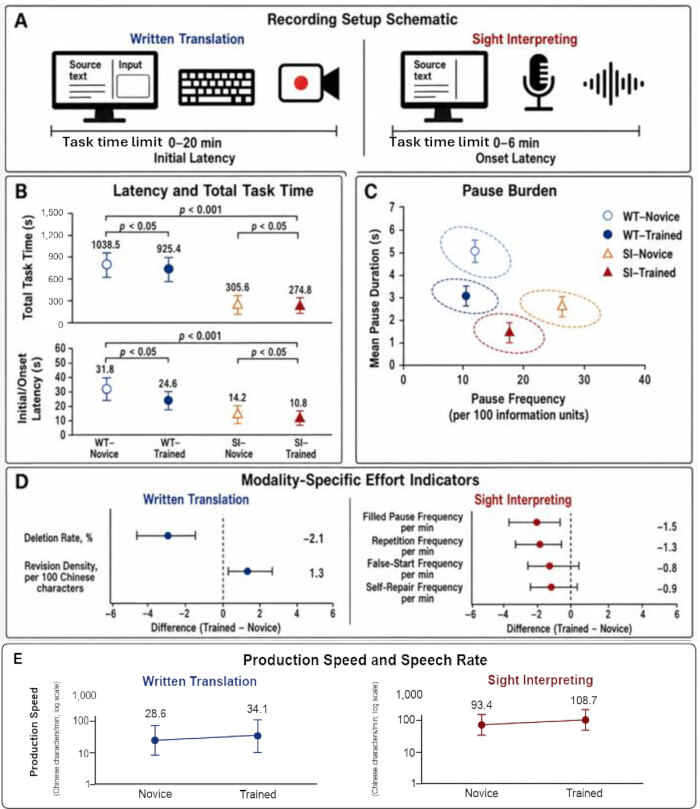
그림 2: 필기 번역 및 시역 과제 조건에 따른 행동 프로필. (A) 과제별 녹음 설정. (B) 초기/시작 잠복기 및 총 과제 시간. (C) 일시 정지 빈도와 평균 일시 정지 지속 시간의 결합 분포. (D) 과제별 삭제, 수정 및 구어 유창성 저하 지표. (E) 필기 생산 속도 및 구어 발화 속도. 패널 B, C, E에서 점과 오차 막대는 그룹 평균 ± SD를 나타내며, 패널 D에서 점은 숙련자-초보자 간의 평균 차이를, 오차 막대는 95% 신뢰 구간을 나타냄. 그룹당 n = 31명의 참가자. 패널 E의 y축은 로그 스케일로 표시됨. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
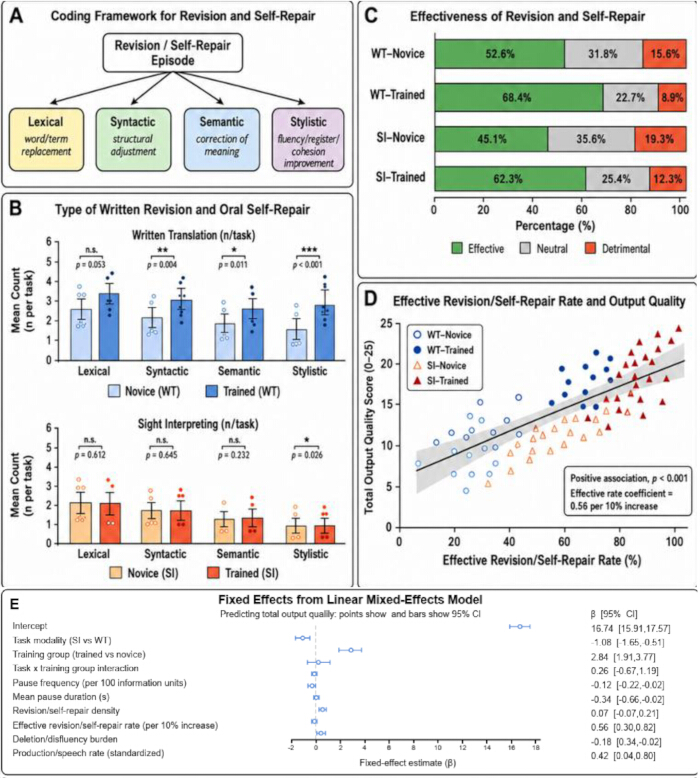
그림 3: 수정/자가 수정 코딩, 기능적 결과 및 출력 품질 간의 연관성. (A) 에피소드 유형과 기능적 결과를 독립적으로 할당하기 위한 결정 프레임워크. (B) 각 과제 조건에서 나타난 어휘적, 구문적, 의미적 및 양식적 에피소드의 평균 횟수. (C) 효과적, 중립적 및 해로운 에피소드의 평균 비율. (D) 효과적 에피소드 비율과 총 출력 품질 점수 간의 기술적 연관성. (E) 95% 신뢰 구간을 포함한 선형 혼합 효과 모델의 고정 효과를 보여주는 포레스트 플롯(표 4에 상세히 설명됨); 이 플롯은 연관성을 나타내며 인과 경로 모델을 나타내지는 않음. 여기를 클릭하여 이 그림의 더 큰 버전을 확인하십시오.
| 변수 | 초보자 그룹 (n = 31) | 숙련자 그룹 (n = 31) | p 값 |
| 연령, years | 21.9 ± 1.7 | 22.4 ± 1.9 | 0.279 |
| 여성, n (%) | 22 (71.0) | 21 (67.7) | 0.779 |
| 영어 학습 기간, years | 12.4 ± 2.1 | 12.9 ± 2.2 | 0.36 |
| 영어 능통도 점수 | 548.6 ± 41.3 | 562.4 ± 45.8 | 0.216 |
| 번역 훈련 기간, months | 5.6 ± 3.0 | 18.7 ± 5.4 | <0.001 |
| 통역 훈련 기간, months | 2.3 ± 2.1 | 13.9 ± 5.7 | <0.001 |
| 이전 서면 번역 실습 ≥5회, n (%) | 9 (29.0) | 24 (77.4) | <0.001 |
| 이전 시역 실습 ≥5회, n (%) | 5 (16.1) | 20 (64.5) | <0.001 |
| 서면 번역 우선, n (%) | 16 (51.6) | 15 (48.4) | 0.799 |
| 시역 우선, n (%) | 15 (48.4) | 16 (51.6) | 0.799 |
표 1: 그룹별 참가자 특성 및 기초 언어 훈련 프로필. 변수는 연속형 데이터의 경우 평균 ± 표준편차로, 범주형 데이터의 경우 빈도(백분율)로 표시되었습니다. 보고된 p-값은 기초 인구통계학적 균형을 확인하고 의도된 훈련 기간의 차이를 검증하기 위한 그룹 간 비교 결과를 나타냅니다.
| 변수 | 필기 번역 초보자 (n = 31) | 필기 번역 숙련자 (n = 31) | 시역 초보자 (n = 31) | 시역 숙련자 (n = 31) | 과업 효과 p | 집단 효과 p |
| 초기/시작 지연 시간, s | 31.8 ± 12.4 | 24.6 ± 9.7 | 14.2 ± 5.6 | 10.8 ± 4.2 | <0.001 | 0.003 |
| 총 과업 시간, s | 1038.5 ± 168.2 | 925.4 ± 151.6 | 305.6 ± 59.3 | 274.8 ± 50.7 | <0.001 | 0.004 |
| 일시 정지 빈도, 정보 단위 100개당 | 18.6 ± 6.1 | 14.2 ± 5.0 | 24.8 ± 7.4 | 19.6 ± 6.3 | <0.001 | 0.001 |
| 평균 일시 정지 지속 시간, s | 4.1 ± 1.2 | 3.3 ± 1.0 | 2.7 ± 0.8 | 2.3 ± 0.7 | 0.012 | 0.002 |
| 생산/발화 속도, 중국어 글자 수/min | 28.6 ± 6.7 | 34.1 ± 7.5 | 93.4 ± 18.9 | 108.7 ± 20.4 | 0.001 | |
| 삭제율, % | 8.9 ± 3.4 | 6.8 ± 2.7 | 0.009 | |||
| 수정 밀도, 중국어 글자 100개당 | 7.6 ± 2.8 | 8.9 ± 3.1 | 0.087 | |||
| 채워진 일시 정지 빈도, 분당 | 5.7 ± 1.9 | 4.2 ± 1.6 | 0.002 | |||
| 반복 빈도, 분당 | 4.9 ± 1.8 | 3.6 ± 1.4 | 0.004 | |||
| 거짓 시작 빈도, 분당 | 2.8 ± 1.1 | 2.0 ± 0.9 | 0.006 | |||
| 자기 수정 빈도, 분당 | 4.8 ± 1.7 | 3.9 ± 1.4 | 0.031 | |||
| 총 품질 점수, 0–25 | 16.8 ± 2.3 | 20.1 ± 2.1 | 15.4 ± 2.6 | 18.9 ± 2.4 | 0.002 | <0.001 |
| 정확도, 0–5 | 3.4 ± 0.7 | 4.1 ± 0.6 | 3.1 ± 0.8 | 3.8 ± 0.7 | 0.004 | <0.001 |
| 완전성, 0–5 | 3.3 ± 0.8 | 4.0 ± 0.6 | 3.0 ± 0.8 | 3.7 ± 0.7 | 0.006 | <0.001 |
| 어휘 적절성, 0–5 | 3.2 ± 0.7 | 4.0 ± 0.6 | 3.1 ± 0.7 | 3.8 ± 0.6 | 0.041 | <0.001 |
| 일관성, 0–5 | 3.5 ± 0.6 | 4.0 ± 0.6 | 3.1 ± 0.7 | 3.8 ± 0.6 | 0.003 | <0.001 |
| 대상 언어 자연스러움, 0–5 | 3.4 ± 0.7 | 4.0 ± 0.6 | 3.1 ± 0.7 | 3.8 ± 0.7 | 0.007 | <0.001 |
표 2: 과제 조건 및 집단별 행동 프로세스 지표와 산출물 품질.값은 평균 ± 표준편차로 표시되었다. 보고된 p-값은 각 프로세스 및 품질 변수에 대한 과제 양식(번역 vs. 시역)과 훈련 배경(초보자 vs. 훈련자)의 주효과를 나타낸다.
| 변수 | 번역 작성 초보자 | 번역 작성 숙련자 | p 값 | 시역 초보자 | 시역 숙련자 | p 값 |
| 어휘적 수정/자기 교정, n/task | 3.4 ± 1.5 | 4.2 ± 1.7 | 0.053 | 1.8 ± 0.8 | 1.7 ± 0.7 | 0.612 |
| 통사적 수정/자기 교정, n/task | 2.1 ± 1.1 | 3.0 ± 1.2 | 0.004 | 1.1 ± 0.7 | 1.2 ± 0.8 | 0.645 |
| 의미적 수정/자기 교정, n/task | 1.8 ± 1.0 | 2.5 ± 1.1 | 0.011 | 0.9 ± 0.6 | 1.1 ± 0.7 | 0.232 |
| 문체적 수정/자기 교정, n/task | 1.6 ± 0.9 | 2.7 ± 1.2 | <0.001 | 0.6 ± 0.4 | 0.9 ± 0.6 | 0.026 |
| 총 수정/자기 교정 횟수, n/task | 8.9 ± 3.0 | 12.4 ± 3.7 | <0.001 | 4.4 ± 1.5 | 4.9 ± 1.6 | 0.209 |
| 효과적인 에피소드, % | 52.6 ± 13.5 | 68.4 ± 12.1 | <0.001 | 45.1 ± 14.2 | 62.3 ± 13.0 | <0.001 |
| 중립적 에피소드, % | 31.8 ± 10.4 | 22.7 ± 8.8 | 0.001 | 35.6 ± 11.7 | 25.4 ± 9.6 | 0.001 |
| 부정적 에피소드, % | 15.6 ± 7.1 | 8.9 ± 5.6 | <0.001 | 19.3 ± 8.6 | 12.3 ± 6.8 | 0.001 |
표 3: 과제 조건에 따른 서면 수정 및 구두 자기 수정의 유형 및 효과. 에피소드 유형은 과제당 평균 횟수(± 표준 편차)로 표시하였으며, 기능적 결과는 평균 백분율(± 표준 편차)로 표시하였다. p-값은 각 과제 양식 내에서 그룹 간 차이의 유의성을 나타낸다.
| 고정 효과 | β | SE | 95% 신뢰구간 | p 값 |
| 절편 | 16.74 | 0.42 | 15.91 ~ 17.57 | <0.001 |
| 작업 모달리티: 시각 해석 대 서면 번역 | -1.08 | 0.29 | -1.65에서 -0.51까지 | <0.001 |
| 훈련 그룹: 숙련자 vs 초보자 | 2.84 | 0.47 | 1.91에서 3.77까지 | <0.001 |
| 과제 양상 × 훈련 그룹 | 0.26 | 0.47 | -0.67에서 1.19까지 | 0.581 |
| 정보 단위 100개당 일시 정지 빈도 | -0.12 | 0.05 | -0.22에서 -0.02까지 | 0.018 |
| 평균 일시 중지 지속 시간, s | -0.34 | 0.16 | -0.66 ~ -0.02 | 0.041 |
| 수정/자가-수복 밀도 | 0.07 | 0.07 | -0.07 ~ 0.21 | 0.334 |
| 10% 증가당 유효 교정/자가 수선율 | 0.56 | 0.13 | 0.30 ~ 0.82 | <0.001 |
| 삭제/비유창성 부담 | -0.18 | 0.08 | -0.34에서 -0.02까지 | 0.027 |
| 표준화된 생성/발화 속도 | 0.42 | 0.19 | 0.04에서 0.80까지 | 0.032 |
표 4: 총 출력 품질을 예측하는 선형 혼합 효과 모델의 보고된 고정 효과.요약 내용은 지정된 모든 과제 및 행동 예측 변수에 대한 비표준화 계수(β), 표준 오차(SE), 95% 신뢰 구간(CI) 및 정확한 p-값을 상세히 나타냅니다.
토론
본 연구는 영어-중국어 서면 번역 및 시역(sight interpreting) 과정에서 관찰 가능한 프로세스 지표를 측정하고 전략적 수정 사항을 코딩하기 위한 다중 모드 프로토콜을 제시합니다. 이 프로토콜은 단일한 인지적 노력 변수를 직접 측정하지 않습니다. 대신, 잠복기(latency), 휴지(pause), 삭제 및 수정 패턴을 작업 민감형 행동 상관물로 해석하며, 그 의미는 동기화된 기록 및 산출물 품질 증거와의 삼각측량에 의해 결정됩니다1,2,3,4,5,6,7,8. 또한 두 작업은 자료, 타이밍, 산출 방식 및 수정 기회 면에서 차이가 있으며, 따라서 대표적인 대조 결과는 개별적인 모달리티 효과라기보다 작업 조건의 차이를 설명합니다. 주요 분석적 기여는 수정 빈도와 기능적 결과를 분리한 것입니다. 보고된 요약 내용에 따르면, 훈련된 참가자들은 서면 수정을 더 많이 수행했으며, 구어 자가 수정(self-repair)의 총 횟수는 집단 간에 유의미한 차이가 없었습니다. 이들의 유효 에피소드 비율이 더 높다는 점은 모니터링 품질이 단순 빈도보다 더 유용한 정보를 제공할 수 있음을 시사하지만, 이러한 해석은 투명한 결정 규칙, 독립적인 결과 코딩 및 보고된 신뢰도에 근거합니다. Supplementary File 1의 코드북과 실습 예제는 이러한 구분을 홍보하기 위함이 아니라 재현 가능하게 만들기 위한 것입니다.
핵심 단계는 기록 간 정렬, 오디오 품질, 전사본 검증 및 코딩 일관성 확보입니다. 로그와 녹음 파일을 정렬할 때는 사용 가능한 타임스탬프와 작업 경계 단서를 확인해야 합니다. 전사 작업 전 오디오의 클리핑 발생 여부와 명료도를 점검해야 하며, 제안된 일시 정지 경계는 파형 및 전사본과 대조하여 검증해야 합니다. 중국어 입력의 경우, 글자 조합을 위한 키 입력(composition keystrokes)을 확정된 문자의 수정으로 간주해서는 안 됩니다. 이러한 점검 및 수정 조치는 품질 관리 로그에 기록하여 보관해야 합니다.
해석에는 몇 가지 제한 사항이 있습니다. 본 시연은 학생 및 교육생 코호트, 짧은 일반 설명문, 서로 다른 과제 길이 및 시간 제한, 그리고 가용성 기반 표본을 사용하였습니다. 또한 과제 조건이 출력 방식과 수정 기회 면에서 차이가 있으며, 데이터셋에 텍스트 수준의 변동성을 추정하기 위한 독립적으로 샘플링된 소스 텍스트 식별자가 포함되어 있지 않습니다. 아울러, 일시 정지 임계값은 운영상의 선택 사항이며, 더 긴 일시 정지는 생산적인 계획과 해결되지 않은 어려움 모두를 반영할 수 있습니다. 전문가, 전문 분야, 다른 언어 쌍 또는 다른 문자 체계로 일반화하려면 자료, 입력 방법 처리, 임계값 및 채점 기준점에 대한 재검증이 필요합니다.
향후 연구에서는 행동 기록을 시선 추적, 동공 측정법 또는 주관적 작업 부하 측정과 결합하여, 어떤 일시 정지와 수정이 주의 집중, 체감 노력 또는 성공적인 계획 수립과 일치하는지 테스트할 수 있습니다5,6,13,14,15,16. Shreve 등은 시역 번역(sight translation)에 시선 추적을 사용하였으므로 동공 측정 연구로 인용해서는 안 되며18, 동공 측정법은 Seeber에 의해 직접적으로 논의되었습니다5. 이러한 다중 모드 확장 연구에서도 과제 요구도, 투입된 노력, 관찰된 행동 및 수행 능력 간의 구분은 유지되어야 합니다. 따라서 본 프로토콜은 지표들이 잠재적 인지 노력에 대한 주장을 뒷받침하지만, 그 자체만으로 이를 입증하지는 않는 투명한 프로세스 평가 프레임워크로 사용하는 것이 가장 적절합니다.
공개 사항
저자들은 상업적 또는 재정적 이해관계의 충돌이 없음을 보고합니다. 인공지능 사용과 관련하여, 저자들은 언어 편집, 일관성 확인, 변경 내용 추적 준비 및 저자가 제공한 데이터를 기반으로 한 그림 레이아웃 재생성을 돕기 위해 수정 과정에서 OpenAI Codex가 엄격하게 활용되었음을 밝힙니다. 저자들은 AI 지원 결과물을 세심하게 검토하였으며, 최종 원고의 정확성, 무결성 및 독창성에 대해 모든 책임을 집니다. 보고된 요약의 기초가 된 구조화된 워크북은 Zenodo(https://doi.org/10.5281/zenodo.21189434)에서 공개적으로 이용 가능합니다. 보충 파일 1에는 코딩 매뉴얼과 고정된 품질 루브릭이 포함되어 있습니다.
감사의 글
저자는 실험실 지원을 제공한 구이린 정보 기술 연구소(Guilin Institute of Information Technology)와 원문을 평가한 이중 언어 전문가들, 독립 평가자들, 그리고 참여자들에게 감사를 표합니다. 본 연구는 공공, 상업 또는 비영리 부문의 어떤 지원 기관으로부터도 특정 보조금을 지원받지 않았습니다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| 음향 분석 소프트웨어 (Praat) | Paul Boersma and David Weenink | https://www.fon.hum.uva.nl/praat/ | |
| 데스크톱 컴퓨터 | Dell | OptiPlex | |
| 디지털 오디오 녹음 소프트웨어 (Audacity) | Audacity Team | https://www.audacityteam.org/ | |
| 키스트로크 로깅 소프트웨어 (Inputlog) | University of Antwerp | https://www.inputlog.net/ | |
| 화면 녹화 소프트웨어 (OBS Studio) | OBS Project | https://democreator.wondershare.com/ | |
| 통계 분석 소프트웨어 (SPSS) | IBM | Version 27 |
참고문헌
- Gieshoff AC, Heeb AH. Cognitive load and cognitive effort: probing the psychological reality of a conceptual difference. Transl Cogn Behav. 2023;6(1):3–28.
- Sweller J, van Merriënboer JJG, Paas F. Cognitive architecture and instructional design. Educ Psychol Rev. 1998;10(3):251–96.
- Paas F, Tuovinen JE, Tabbers H, Van Gerven PWM. Cognitive load measurement as a means to advance cognitive load theory. Educ Psychol. 2003;38(1):63–71.
- Gile D. Basic Concepts and Models for Interpreter and Translator Training. Amsterdam: John Benjamins; 2009.
- Seeber KG. Cognitive load in simultaneous interpreting: measures and methods. Target. 2013;25(1):18–32.
- Ferreira A, Schwieter JW, Gottardo A, Jones JA. Cognitive effort in direct and inverse translation performance: insight from eye-tracking technology. Cad Trad. 2016;36(3):60–80.
- Zou D, Zhang J. Measuring the invisible: clarifying the concept of cognitive effort in translation and interpreting processes. Curr Trends Transl Teach Learn E. 2023;10:217–58.
- Lacruz I, Shreve GM, Angelone E. Average pause ratio as an indicator of cognitive effort in post-editing: a case study. Workshop on Post-Editing Technology and Practice. San Diego: Association for Machine Translation in the Americas; 2012. p. 21–30.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589–604.
- Ma X, Li D. Effect of word order asymmetry on the cognitive load of English–Chinese sight translation: Evidence from eye movement data. Transl Interpret Stud. 2024;19(1):105–31.
- Leijten M, Van Waes L. Keystroke logging in writing research: using Inputlog to analyze and visualize writing processes. Written Commun. 2013;30(3):358–92.
- Heilmann A, Neumann S, editors. Dynamic pause assessment of keystroke logged data for the detection of complexity in translation and monolingual text production. Proceedings of the Workshop on Computational Linguistics for Linguistic Complexity; 2016; Osaka: COLING.
- Su W, Li D. Identifying translation problems in English-Chinese sight translation: an eye-tracking experiment. Transl Interpret Stud. 2019;14(1):110–34.
- Su W, Li D. Exploring processing patterns of Chinese-English sight translation: an eye-tracking study. Babel. 2020;66(6):999–1024.
- Su W, Li D. Exploring the effect of interpreting training: eye-tracking English-Chinese sight interpreting. Lingua. 2021;256:103094.
- Su W. Eye-voice span in sight interpreting: an eye-tracking investigation. Perspectives. 2023;31(5):969–85.
- Rojo López AM, Muñoz Martín R. Research Methods in Cognitive Translation and Interpreting Studies. Amsterdam: John Benjamins; 2025.
- Shreve GM, Lacruz I, Angelone E. Cognitive effort, syntactic disruption, and visual interference in a sight translation task. Transl Interpret Stud. 2010;5(1):63–84.
재인쇄 및 허가
태그
이 논문이 게재되었습니다
동영상 곧 제공