본 프로토콜은 실제 중의학 외래 진료 기록으로부터 감사 가능한 집계 결과물을 생성하기 위해 비식별화, 용어 표준화, 출처 검증 및 재현 가능한 시각화를 통합합니다.
방법 논문
허간건비탕을 이용한 실제 전통 중의학 사례 기록의 소스 감사 마이닝 및 시각화
* These authors contributed equally
이 논문에서
요약
초록
실제 임상 현장의 전통 중의학(TCM) 외래 기록에는 진단, 증후 요소, 증상 서술 및 개별 맞춤 처방에 관한 종단적 정보가 포함되어 있으나, 반구조화된 형식으로 인해 재현 가능한 분석이 어렵습니다. 본 논문은 비식별화된 사례 기록을 추적 가능한 집계 표와 출판 가능한 시각화 자료로 변환하기 위한 소스 감사 프로토콜을 제시합니다. 이 워크플로우는 적격성 기준과 분석 단위를 정의하고, 원본 용어와 표준화된 용어 간의 매핑을 유지하며, 보고된 모든 분자와 분모를 검증하고, 버전 관리된 소스 표로부터 도표를 재생성합니다. 2015년 1월부터 2024년 6월까지의 기록에 이 프로토콜을 적용한 결과, 396명의 환자로부터 555건의 적격 처방 방문 사례를 식별했습니다. 최종 데이터셋에는 324개의 표준화된 약재 라벨과 9,339건의 약재 사용 사례가 포함되었습니다. 이 워크플로우를 통해 서양 의학과 TCM 질환 스펙트럼의 병렬 생성, 명시적인 증후 요소 스펙트럼 및 공생 행렬, 약재 빈도 및 본초학 프로필, 병력 기반의 37개 용어 증상 스펙트럼, 15개의 유향 연관 규칙, 계층적 군집 분석, 그리고 진단별로 층화된 약재 사용 히트맵을 생성했습니다. 474건의 방문(85.41%)에서 하나 이상의 사전 지정된 병력 키워드가 검출되었습니다. 기관 정책에 따라 허용되는 경우, 인간이 감독하는 인공지능(AI) 옵션을 통해 용어 점검, 파일 간 일관성 검토 및 캡션-도표 정렬을 지원받을 수 있습니다. AI의 모든 사용 내역은 별도의 감사 기록에 문서화되어야 하며 소스 데이터 검토를 대체해서는 안 됩니다. 거버넌스, 표준화, 계산, 임상적 해석 및 시각적 출력을 하나의 재현 가능한 워크플로우로 통합함으로써, 본 방법은 분산된 임상 문서를 검토 가능한 연구 자원으로 변환합니다. 이 프로토콜은 다른 전문가 진료 데이터셋, 다기관 용어 프로젝트 및 전향적 임상 데이터 플랫폼에도 적용될 수 있습니다.
서론
실제 전통 중의학(TCM) 외래 진료 기록은 서술형 증상, 병렬적 진단 체계, 증후군 설명 및 개별 맞춤 처방을 통해 종단적 임상 추론 과정을 보존하고 있습니다. 초기 지식 발견 연구에서는 사례 기록을 복잡한 경험적 데이터로 인식하였으며, 그 패턴을 신뢰성 있게 연구하기 위해서는 전용 정보학적 방법이 필요함을 확인하였습니다1. 이후의 연구들에 따르면, 동의어 증상 표현, 세분화된 개체 및 지역적으로 문서화된 진단 용어들은 원래의 문구를 삭제하지 않고 표준화되어야 합니다2,3,4,5,6. 전자 건강 기록(EHR) 데이터는 임상적 맥락과 데이터 계보가 가시적으로 유지될 때, 전산적 처방 연구 및 재사용 가능한 분석 도구의 활용을 지원할 수 있습니다7,8. 따라서 약재명, 포제법, 성질, 맛 및 귀경을 표준화하기 위해 권위 있는 본초학 참조 문헌이 필요합니다9,10. 보고 수준에서 RECORD 및 STROBE 성명서는 데이터 소스, 적격성 규칙, 변수 및 분석 결정에 대한 투명한 설명을 요구하며, FAIR 원칙은 추적 가능하고 재사용 가능한 연구 객체를 강조합니다11,12,13. 이러한 고려 사항은 기록에 반복 방문, 누락된 필드, 중복되는 용어 및 자유 텍스트가 포함되어 있을 때 특히 중요합니다. 사용 적합성 평가는 완전성, 준수성, 타당성 및 소스 일치 여부를 다루어야 합니다14,15. 자유 텍스트의 비식별화 또한 명시적인 절차와 인간의 검토가 필요한데, 이는 자동화된 방법이 유용한 임상 내용은 보존하면서도 잔여 프라이버시 위험을 남길 수 있기 때문입니다16,17,18.
거버넌스와 용어가 설정되면, 빈도 프로파일링, 연관 규칙 마이닝 및 계층적 군집 분석을 통해 처방 구조에 대한 상호 보완적인 관점을 제공할 수 있습니다19,20,21. 네트워크 및 사이언스 맵핑 방법은 단일 순위 목록으로는 포착할 수 없는 관계를 조정된 시각적 표현이 어떻게 드러낼 수 있는지를 추가적으로 보여줍니다22,23,24,25. 우울증을 동반한 류마티스 관절염, 궤양성 대장염에서의 Janus kinase 억제제, 섬유근육통을 동반한 류마티스 관절염에 관한 최근 연구들은 버전 고정 검색 기준, 공생 네트워크, 군집 분석, 시간적 해석 및 분석적 한계에 대한 명시적 진술의 가치를 잘 보여줍니다26,27,28. 본 연구는 이러한 전이 가능한 설계 원칙을 문헌 계량학이 아닌 임상 기록 마이닝에 적용합니다. 소스 기록에서 Hegan Jianpi Formula는 Yao Nai-li 교수의 진료와 관련된 경험 기반 처방을 의미합니다29,30. 관련 출판물에서는 그의 더 광범위한 간-비 조화 및 비-위 임상 접근법을 설명하고 있습니다29,30. 본 방법론 논문에서 처방 명칭은 소스 기록의 맥락만을 식별하며, 고정된 구성, 용량, 치료 적응증 또는 효능 주장을 설정하지 않습니다. 계산 워크플로우에는 결정론적 규칙과 범용 통계 방법이 사용됩니다. 재현 가능한 계산 관행을 위해서는 입력 데이터의 보존, 매개변수의 문서화, 스크립트 기반 변환 및 검토 가능한 출력물이 추가로 필요합니다31,32. 인간 감독 하의 인공지능(AI) 옵션은 사용 내용이 문서화된 경우 용어 점검, 파일 간 일관성 검토 및 시각적 품질 관리를 도울 수 있습니다. 임상적 전문성, 개인정보 보호 조치 및 책임 있는 인간의 의사결정이 항상 우선되어야 합니다 (Supplementary Table 1)33,34. 이 방법의 전반적인 목표는 비식별화된 TCM 사례 기록을 질환, 증후군, 증상, 약재 사용, 연관성, 군집 및 진단별로 층화된, 소스 감사가 완료된 출력 체인으로 변환하는 것입니다. 실습 예제에서는 396명의 환자로부터 얻은 555건의 적격 처방 방문 기록을 사용하여, 환자 수준의 기록, 정확한 처방 세부 사항, 용량 비율 또는 처방 지침을 공개하지 않고 거버넌스, 정규화, 계산, 임상적 해석 및 시각적 공개를 어떻게 통합할 수 있는지 보여줍니다.
프로토콜
비식별화된 임상 기록에 대한 본 회고적 분석은 중국중의과학원 광안문 병원 의학윤리위원회의 심의 및 승인을 받았습니다(승인 번호 2026-108-KY; 2026년 7월 13일). 고지된 동의에 대한 요구 사항은 위원회에 의해 면제되었습니다.
1. 윤리, 거버넌스 및 데이터 보안 수립
- 데이터 관리자, 소스 데이터 분석가, 임상 용어 검토자, 정량적 검토자 및 집계 데이터 공개 승인 권한이 있는 연구자를 지정하십시오. 각 역할을 프로젝트 로그에 기록하십시오.
- 허용된 소스 시스템, 연구 기간, 필드, 저장 위치, 액세스 권한, 백업 절차, 보존 기간 및 연결 키 제한 사항을 명시한 데이터 관리 계획을 수립하십시오.
- 사전에 정의된 분석에 필요한 최소한의 변수만 내보내십시오. 로컬 환자 식별자, 방문 날짜, 허용된 경우 연령 또는 생년월일, 성별, 서양 의학 진단명, TCM 질환명, 비식별화된 병력 텍스트, 설진 텍스트, 맥진 텍스트, 변증 텍스트 및 처방 약재 필드를 포함하십시오.
- 통제된 기관 환경 내에서 이름, 주민등록번호, 전화번호, 상세 주소, 보험 식별자, 연락처 정보 및 기타 직접 식별자를 제거하십시오. 각 의무 기록 번호를 프로젝트 전용 환자 식별자로 대체하십시오.
- 자유 텍스트 필드에서 잔류 식별자를 스캔하고 감지된 모든 항목을 마스킹하십시오. 모든 연결 키는 분석 데이터셋과 분리하여 저장하고, 작업, 협업 및 제출 폴더에서 제외하십시오.
- 초기 비식별화 내보내기 파일을 읽기 전용 소스 스냅샷으로 보존하십시오. 파일 이름, 생성 날짜, 행 수, 열 수, 파일 크기 및 체크섬을 소스 매니페스트에 기록하십시오.
- 소스 파일, 작업 파일, 사전, 집계 표, 그림, 스크립트 및 감사 기록을 위한 별도의 디렉토리를 생성하십시오.
- 공개 또는 공유 자료를 집계 표, 승인된 비식별화 사전, 스크립트 및 출판용 그림으로 제한하십시오. 식별 가능하거나 재식별 가능성이 있는 기록을 공개 생성형 AI 시스템, 승인되지 않은 클라우드 서비스 또는 공개 저장소에 업로드하지 마십시오.
참고: 기관 정책상 사람이 감독하는 AI 지원이 허용되는 경우, 비식별화된 텍스트 발췌본 또는 집계 표만 제공하십시오. 목적, 검토된 결과물, 수용된 수정 사항, 검토자 및 날짜를 감사 로그에 기록하십시오.
2. 기록 식별 규칙 및 분석 단위 정의
- 스크리닝 전, 기관, 외래 진료 환경, 담당 임상 팀, 전자의무기록 시스템 및 소스 기간을 정의하십시오. 예시 사례의 경우, 2015년 1월부터 2024년 6월까지의 기록을 사용하십시오.
- 분석 결과를 검토하기 전, 코호트 식별 규칙을 접근이 제한되고 버전 관리가 되는 파일에 저장하십시오. 원고에 기밀 제형 세부 사항을 공개하지 않고, 허용된 용어 변형과 모든 포함 및 제외 조건을 기록하십시오.
- 약재명 정규화 후, 처방 방문 수준에서 버전이 고정된 기록 식별 규칙을 적용하십시오. 소스 파일, 사전, 코호트 규칙 및 분석 매개변수를 하나의 릴리스 세트로 확정하십시오.
- 버전이 고정된 구성 요소가 변경될 때마다 새 버전을 생성하고 모든 종속 출력물을 다시 생성하십시오. 질병 분포, 약재 빈도, 연관 규칙 또는 클러스터를 검토한 후에는 코호트 식별 규칙을 수정하지 마십시오.
- 외래 방문이 버전 고정된 연구 기간 내에 있고, 유효한 프로젝트 환자 식별자와 매핑되며, 해석 가능한 처방 기록을 포함하고, 제한된 기록 식별 규칙을 충족하는 경우 해당 방문을 포함하십시오.
- 정확히 중복된 내보내기 데이터, 연구 기간 외의 기록, 해석 가능한 처방이 없는 기록, 버전 고정된 식별 규칙을 통과하지 못한 행은 제외하십시오. 제외된 각 행에 하나의 주요 제외 사유를 할당하십시오.
- 반복된 내보내기 데이터와 실제 추적 관찰 방문을 구분하십시오. 시스템 또는 내보내기 상의 정확한 중복 데이터만 제거하고 실제 반복 방문은 유지하십시오.
- 안정적인 환자 및 처방 방문 식별자를 할당하십시오. 소스 버전, 규칙 버전, 스크리닝 상태, 포함 또는 제외 사유, 환자 식별자, 방문 식별자 및 검토자 상태를 포함하는 코호트 명세서를 작성하십시오.
- 연령 및 성별을 포함한 고정 인구통계학적 요약에는 고유 환자당 하나의 기록을 사용하십시오. 질병, 증후군, 병력 키워드, 설진, 맥진, 약재, 연관 규칙 및 클러스터링 분석에는 처방 방문을 분석 단위로 사용하십시오.
- 코호트 적격성과 변수 가용성을 분리하십시오. 변수별 필드가 누락되었더라도 그 외의 조건에서 적격한 방문은 유지하고, 각 분석에 대해 평가 가능한 분모를 보고하십시오.
- 기술 분석 전에 코호트 명세서를 동결하십시오. 적격한 처방 방문 수와 고유 환자 수를 기록하고, 적격성 결정이 변경되면 모든 종속 출력물을 다시 생성하십시오.
3. 용어 표준화 및 감사 추적 보존
- 약초, 서양의학 진단명, 중의학 질환명, 증후군 요소, 병력 키워드, 설진 용어, 맥진 용어 및 약재 속성에 대해 각각 버전 관리가 가능한 개별 사전을 생성하십시오.
- 각 사전마다 원어, 정규화된 용어, 용어 범주, 소스 필드, 규칙, 참조 소스, 사전 버전, 검토자, 검토 날짜 및 비고를 포함하십시오. 정규화 후에도 모든 원어를 유지하십시오.
- 권위 있는 명명법 참조 문헌을 사용하여 중약재(CMM) 명칭 정규화하기9,10임상적으로 의미 있는 처리 형태는 유지하면서 오타 변형 및 시스템 약어를 수정하십시오.
- 볶음, 초초, 밀초, 강초, 주초, 초탄, 생을 포함한 가공 한정어를 별도의 라벨로 유지하십시오.
- 철자나 임상적으로 구별되는 약재는 분리하여 유지하십시오. 백작약(Bai Shao)을 백출(Bai Zhu)과 통합하지 마십시오. 또한 원문을 검토하지 않은 상태에서 모호한 약어로부터 약재를 추론하지 마십시오.
- 가능한 경우 원래의 용량과 단위를 별도의 필드에 보존하십시오. 방문 수준의 약초 존재 변수를 구성할 때만 용량 텍스트를 제거하십시오.
- 발생 빈도를 누적 용량 또는 치료 강도로 해석하지 마십시오.
- 서양의학 및 중의학 질환명을 독립적으로 정규화하십시오. 진단 체계와 주진단 상태를 보존하고, 서양의학 진단과 중의학 질환명이 모두 명시적으로 기록되지 않은 한 중의학 질환명을 서양의학 진단명으로 번역하지 마십시오.
- 독자의 이해를 돕기 위해 필요한 경우, 처음 등장할 때 한의학 질환 명칭의 음역어를 정의하십시오. 원래의 소스 레이블은 그대로 유지하십시오.
- 버전 고정 구분 기호를 사용하여 다중 값 명시적 증후군 텍스트를 분리하고, 소스 표현식을 정규화된 증후군 요소로 매핑하십시오. 방문별로 각 정규화된 요소를 중복 제거하십시오.
- 명시적인 증후군 텍스트를 유전 또는 점수 유도 지표 열과 분리하여 유지하십시오.
- 원본의 설진, 맥진, 구조화된 증상 및 비식별화된 병력 필드를 각각 별개의 데이터 제품으로 유지하십시오. 병력 키워드 일치를 임상의가 입력한 구조화된 증상과 동일하게 취급하지 마십시오.
- 한 명의 검토자에게 모호하거나 다대일 매핑에 해당하는 각 항목에 대해 제안하도록 요청하고, 두 번째 임상 검토자가 이를 검증하도록 하십시오. 소스 검토를 통해 해결될 때까지 불확실한 매핑은 공개 분석에서 제외하십시오.
- 공백의 정규화된 레이블, 일대다 매핑, 다대일 매핑, 중복된 사전 항목, 검토되지 않은 용어 및 처리 레이블의 우발적 손실 여부를 확인하십시오. 집계 표를 생성하기 전에 사전 버전을 고정하십시오.
4. 소스 필드를 확인하고 보고 가능한 출력을 고정합니다
- 각 원고의 주장, 표, 그림 패널별로 한 행씩 할당하여 증거 원장을 작성하십시오. 분석 단위, 소스 필드, 소스 버전, 사전 버전, 스크립트 버전, 분자, 분모, 출력 파일, 검토자 및 승인된 문구를 기록하십시오.
- 버전이 고정된 파일에서 대상 방문 횟수 및 고유 환자 수, 인구통계학적 요약, 질병 수, 명시적 증후군 수, 병력 키워드 수, 병합된 약초 빈도 및 약초 사용 총계를 직접 재계산하십시오.
- 재계산된 각 값을 해당 원고, 스프레드시트 또는 그림 값과 비교하십시오. 불일치가 확인될 때마다 원고를 수정하고 종속된 출력물을 다시 생성하십시오.
- 각 불일치를 소스 필드 수준에서 해결하십시오. 영향을 받은 결과물을 공개하기 전, 증거 원장에 사유, 수정 사항, 검토자 및 날짜를 기록하십시오.
- 각 집계 표에 해당 진술을 재현하는 데 필요한 정규화된 레이블, 분자, 분모, 백분율 정의, 분석 단위 및 소스 식별자가 포함되어 있는지 확인하십시오.
- 각 백분율에 사용된 분모를 확인하십시오. 고정된 인구통계학적 특성에는 고유 환자를 사용하고, 동적인 임상 및 처방 변수에는 처방 방문 횟수를 사용하십시오.
- 그림 레이블, 값, 순서 및 패널 정의를 버전이 고정된 집계 표와 비교하십시오. 표 수정 후에는 플롯 값을 수동으로 편집하지 말고 각 그림을 다시 생성하십시오.
- 임상 검토자에게 용어 매핑 확인을 요청하십시오. 정량 검토자에게 수치, 비율, 규칙 지표 및 히트맵 분모 확인을 요청하십시오.
- 원고를 작성하기 전, 증거 원장, 집계 표 및 그림 소스를 하나의 버전 식별자 아래로 고정하십시오.
5. 기술적 스펙트럼 및 공존 출력 생성
- 고유 환자당 한 행의 데이터를 사용하여 환자 수준의 연령 및 성별 요약을 생성합니다. 알 수 없음(unknown) 범주는 유지하고 명시적으로 보고합니다.
- 처방-방문 수준에서 서양의학 및 중의학(TCM) 질병 스펙트럼을 각각 생성합니다. 원래의 진단 체계를 유지하고, 공통 방문 분모를 사용하여 주요 정규화 레이블을 계산합니다.
- 명시적인 정규화 증후군 텍스트 필드로부터 증후군-요소 스펙트럼을 생성합니다. 버전 고정 구분 기호를 사용하여 용어를 분리하고, 방문 내의 각 용어를 중복 제거한 뒤 방문 수준 빈도를 계산합니다.
- 동일한 방문 내 토큰 집합을 사용하여 증후군 동시 발생 행렬을 구축합니다. 노드 크기는 방문 빈도로, 엣지 너비 또는 히트맵 강도는 쌍별 동시 발생 횟수로 인코딩합니다.
- 증상 정보가 주로 서술형인 경우 정확한 병력-키워드 사전을 미리 지정합니다. 비식별화된 병력 필드만 스캔하며, 방문 내에서 각 개념은 최대 한 번만 카운트합니다.
- 적어도 하나의 병력 키워드를 포함하는 적격 방문의 비율을 계산하고 모든 키워드 횟수의 순위를 매깁니다. 전체 표와 플롯으로 시각화된 하위 집합을 내보냅니다.
- 정규화된 처방 데이터로부터 병합 약재 빈도를 생성합니다. 정규화된 각 약재 레이블은 방문당 최대 한 번만 카운트하며, 임상적으로 의미 있는 포제 형태는 별도의 레이블로 유지합니다.
- 버전 고정된 본초학 사전으로부터 사기(Four-Qi), 오미(five-flavor) 및 귀경(meridian-tropism) 프로필을 생성합니다. 사기는 속성 코딩된 각 약재 발생에 대해 단일 값 범주로 취급합니다.
- 오미와 귀경은 다중 레이블 속성으로 취급합니다. 속성 코딩된 분모를 명시하고 별도의 분석 단위를 유지합니다.
- 최종 도표를 생성하기 전, 각 기술 도메인에 대해 기계 판독이 가능한 집계 표를 하나씩 내보냅니다.
6. 연관 규칙 및 계층적 군집 분석 수행
- 버전 고정된 정규화 처방 표로부터 이진 처방-방문-약재 매트릭스를 구성합니다. 적격 방문당 한 행을 사용하고, 정규화된 약재 레이블당 한 열을 사용합니다.
- 방향성이 있는 단일 약재 연관 규칙의 지지도(support), 신뢰도(confidence) 및 향상도(lift)를 계산합니다19. 신뢰도는 전건(antecedent)에 따라 달라지므로 각 규칙의 방향성을 유지합니다.
- 사전에 지정된 임계값인 지지도 ≥ 0.30, 신뢰도 ≥ 0.70, 향상도 > 1.0을 적용합니다. 유지된 각 규칙을 공동 출현 횟수 및 세 가지 지표와 함께 내보냅니다.
- 유지된 전체 규칙 세트를 방향성 이분 규칙 네트워크와 정렬된 규칙 강도 프로파일로 그립니다. 네트워크 엣지 너비는 지지도로, 엣지 색상은 향상도로 인코딩합니다.
- 점 크기는 지지도로 인코딩하고, 정렬된 프로파일에 신뢰도를 표기합니다.
- 두 규칙 표시 방식 모두 동일한 유지 규칙 세트를 포함하고 규칙 방향이 보존되었는지 확인합니다. 배포 전 내보낸 규칙 표와 대조하여 모든 불일치 사항을 조정합니다.
- 계층적 군집화를 위해 빈도가 가장 높은 20개의 약재 존재 변수를 선택합니다. 쌍별 Jaccard 거리를 계산하고 평균 연결법(average linkage)을 적용합니다.
- 덴드로그램에 정규화된 약재 이름을 표시합니다. 가지의 근접성은 방문 수준의 출현 패턴에서의 유사성으로만 해석합니다.
- 그림 생성 전에 이진 매트릭스 사양, 규칙 표, 네트워크 엣지 리스트, 군집화 입력 순서, 거리 매트릭스 및 연결 매트릭스를 내보냅니다.
- 정량적 검토자에게 요청하여 규칙 지표 하나를 수동으로 재현합니다. 모든 네트워크 엣지를 규칙 표와 비교합니다.
- 코호트, 용어 사전 또는 약재 존재 매트릭스가 변경될 때마다 전체 규칙 및 군집화 워크플로우를 다시 실행합니다.
- 실습 예제의 경우, 각 환자에 대해 소스 순서상 가장 빠른 기록만 유지하여 결정론적인 환자당 1회 방문 민감도 분석을 수행합니다. 결과로 도출된 12개 규칙을 방문 수준 분석에서 얻은 15개 규칙과 비교합니다.
- 이러한 변화를 환자 수준의 검증이 아닌 기술적 강건성 결과로 보고합니다. Supplementary File 1에 제공된 결정론적 재계산 방법을 사용합니다.
7. 진단별 층화 패턴 및 임상 해석 프레임워크 생성
- 진단별 약재 분포를 확인하기 전에 임상적으로 유의미한 주요 서양의학 진단 층을 선택합니다.
- 각 진단 층 내에서 방문당 정규화된 약재 레이블을 최대 한 번만 계산합니다. 유병률은 해당 레이블이 포함된 방문 횟수를 해당 층의 전체 대상 방문 횟수로 나누어 계산합니다.
- 진단 층 전반에 걸쳐 동일한 표시 약재 세트와 고정된 0%–100% 색상 척도를 사용합니다. 정확한 해석을 유지하기 위해 셀 값을 표시합니다.
- 표시된 각 셀의 분자와 분모를 별도의 집계 표에 보고합니다.
- 기술적 히트맵을 완성한 후 별도의 임상 해석 패널을 구축합니다. 계산된 결과와 전문가 해석을 시각적으로 명확히 구분합니다.
- 버전이 고정된 이력 키워드 표 또는 명시적인 정규화된 증후군 텍스트로 추적 가능한 용어만 큐 레이어에 채웁니다.
- 두 명의 임상 검토자가 선택된 큐의 간결한 맥락적 해석에 합의하도록 요청합니다. 검토자와 최종 문구를 근거 장부에 기록합니다.
- 각 맥락적 해석을 변수 선택, 전향적 검증 또는 가설 생성과 같은 연구 용도와 연결합니다.
- 해석 레이어에는 방향성이 없는 점선 연결선을 사용합니다. 용량, 고정 조성 및 치료 권고 내용은 제외합니다.
- 히트맵과 해석 패널을 함께 검토합니다. 계산된 유병률, 전문가 맥락 및 향후 연구 용도가 명확하게 구분되어 있는지 확인합니다.
8. 재현성 패키지 조립 및 검증
- 소스 매니페스트, 코호트 매니페스트, 사전 버전, 증거 원장, 분석 스크립트, 집계 표, 그림 소스 및 최종 그림을 각각 별도의 디렉터리에 내보냅니다.
- 각 파일의 이름은 고정된 그림 또는 표 번호와 버전 날짜를 사용하여 지정합니다. 권위 있는 최신 버전 하나를 유지하고, 대체된 출력물은 별도로 보관합니다.
- 각 그림을 하나의 다중 패널 이미지 파일로 생성합니다. 검토를 위해 고해상도 PDF와 300 dpi PNG 파일을 내보냅니다.
- 그림 범례는 원고에 배치하고 이미지 파일 외부로 유지합니다. 각 패널, 분석 단위, 분모 및 시각적 인코딩을 설명합니다.
- 각 표에 대해 독립적인 XLSX 파일을 하나씩 준비합니다.
- 독립적인 검토자에게 원고의 수치와 집계 표를 비교하고, 백분율과 그 분자 및 분모를 비교하도록 요청합니다.
- 규칙 엣지를 규칙 표와 비교하고, 히트맵 셀을 소스 매트릭스와 비교합니다.
- 파일명 일관성, 필수 섹션, 그림 크기, 표 개수, 참고 문헌 개수, 템플릿 잔재 및 제한된 용어 사용 여부에 대해 자동 점검을 수행합니다.
- 임상 저자 팀에 용어, 해석, 지식 재산권 경계, 저자 세부 정보, 연구비 지원 순서, 윤리 관련 문구 및 최종 그림 세트의 검토를 요청합니다.
- 제출 패키지에서 환자 수준 파일, 연결 키, 제한 없는 자유 텍스트, 내부 서신 및 임시 검토 결과물을 제거합니다.
- 릴리스 패키지를 동결하고 버전, 날짜, 체크섬, 원고 버전 및 저자 승인 상태를 기록합니다. 이후의 각 수정 사항에 대해 새로운 버전과 변경 로그를 생성합니다.
결과
본 프로토콜을 성공적으로 적용하여 비식별화된 소스 스냅샷, 코호트 매니페스트, 용어 사전, 집계 테이블, 스크립트 및 최종 도표를 연결하는 추적 가능한 체인을 구축하였습니다. 버전이 고정된 스크리닝 절차를 통해 396명의 고유 환자로부터 555건의 적격 처방 방문 사례를 확인하였습니다. 그림 1은 거버넌스, 용어 표준화, 그리고 임상 검토를 포함한 분석이라는 세 가지 조정 단계로 구성된 본 방법론을 요약하여 보여줍니다. AI 보조 검토를 위한 집계 전용 경계 설정을 포함한 관련 투명성 및 감사 문서는 보충 표 1에 제공되어 있습니다.
최종 코호트는 396명의 고유 환자가 제공한 555건의 적격 처방 방문으로 구성되었습니다(그림 2 및 표 1). 동적인 임상 및 처방 변수의 경우 실제 반복 방문 데이터를 유지하였으며, 연령과 성별은 환자 수준의 중복 제거 후 요약하였습니다. 환자의 연령은 13세에서 94세 사이였으며, 평균은 47.11세, 표준 편차는 14.88세였습니다. 코호트에는 여성 환자 228명(57.58%), 남성 환자 167명(42.17%), 성별 미상 환자 1명(0.25%)이 포함되었습니다. 이러한 분석 단위의 분리를 통해 인구통계학적 분모를 부풀리지 않고 종단적 진료 기록을 보존하였습니다.
서양의학 및 중의학(TCM)의 질병 스펙트럼은 그림 3에 요약되어 있습니다. 서양의학적 진단은 위장관, 간담도 및 췌장 질환에 집중되었습니다. 계층적 그룹화 결과, 271건의 방문이 위장관 질환으로, 222건이 간담도 또는 췌장 질환으로, 62건이 기타 계통으로 분류되었습니다(그림 3A). 주요 개별 진단명으로는 만성 위염 133건(23.96%), 지방간 77건(13.87%), 간경변증 46건(8.29%) 순이었으며, 그 뒤를 이어 만성 위축성 위염, 복통, 만성 B형 간염, 소화불량, 역류성 식도염, 만성 표재성 위염 및 만성 췌장염이 차지하였습니다(그림 3C 및 표 2).
상응하는 TCM 질환명 스펙트럼은 동일한 방문 기록을 병렬 진단 시스템에 따라 정리하였습니다. 비위 또는 장 질환명이 280건, 간담 질환명이 223건, 기혈진액 장애가 26건, 심흉두 장애가 12건, 경락 또는 사지 장애가 5건, 부인과 질환이 4건, 그리고 기타 범주가 5건의 방문 기록을 차지하였습니다(그림 3B). 상복부 팽만감 또는 불편함에 대해 유지된 TCM 질환 레이블인 Wei pi는 163건(29.37%)의 방문 기록에서 기록되었습니다. Ji 질환(축적 유형의 원천 TCM 레이블), Gan zhuo(직역하면 간 고착; 유지된 고전 TCM 질환 레이블), Bi 질환(비증) 및 Xiao ke(소갈)는 원천 TCM 레이블로 유지되었으며 현대 생의학적 진단명으로 변환되지 않았습니다. 지방간 질환에 대한 현대 중국 합의에서 사용되는 TCM 질환 레이블인 Gan pi는 77건(13.87%)의 방문 기록에서 기록되었습니다35. 서양의학과 TCM 원천 필드는 독립적으로 유지되었으며 서로 대체되지 않았습니다(그림 3D 및 표 3). Xie xie(묽은 변 또는 수양변)와 Fu xie(설사)는 각각 6회와 2회 기록된 별개의 원래 TCM 질환 레이블이었으며, 어느 것도 현대 생의학적 진단과 동일시되지 않았습니다. 두 스펙트럼을 나란히 표시함으로써 각 진단 시스템의 논리를 보존하는 동시에 원천 기록의 임상적 광범위함을 입증하였습니다.
명시적인 정규화된 증후군 텍스트 필드에는 555개의 적격 방문 행이 포함되어 있었습니다. 방문 내 중복 제거 후, 주요 요소는 362건의 방문(65.23%)에서 비장, 304건(54.77%)에서 간, 295건(53.15%)에서 기허, 171건(30.81%)에서 위장, 151건(27.21%)에서 습, 109건(19.64%)에서 기체 순으로 나타났습니다(그림 4A 및 표 4). 열, 수독, 혈, 어혈, 경락, 신장, 심장 및 음허가 표시된 스펙트럼의 나머지를 구성했습니다. 단일 방문 중에 여러 증후군 요소가 나타날 수 있으므로 백분율은 상호 배타적이지 않았습니다.
네트워크 및 카운트 행렬은 동일한 방문 수준 토큰 세트로부터 생성되었습니다(그림 4B,C). 비장, 간, 기허를 중심으로 빈번한 공동 기록이 나타났으며, 위장, 습기, 기체, 열, 수독과의 추가적인 연결이 확인되었습니다. 빈도 도표, 네트워크 및 히트맵에 대해 버전이 고정된 하나의 행렬을 사용함으로써 세 가지 패널 모두 서로 다른 상세 수준에서 동일한 근거 자료를 나타내도록 보장했습니다. 복구된 감사는 555개 행 중에서 정확하게 일치하는 증후군 텍스트/지표 매칭이 0건이었으며, 텍스트-지표 자카드 유사도 평균은 0.1806으로 나타났습니다. 따라서 지표 열은 실질적인 보고에서 제외되었습니다. 보존된 자료에는 전처리 전의 분포 벡터를 재구성할 수 있는 데이터가 포함되어 있지 않았으며, 결과적으로 버전 간 분포 안정성은 추정되지 않았습니다. 대신 환자당 1회 방문 민감도 분석을 통해 반복 방문의 영향을 다루었습니다. 소스 감사 및 데이터 품질 결과는 보충 표 2에 요약되어 있습니다.
용어 표준화 및 임상적으로 의미 있는 포제 형태를 유지한 결과, 555건의 방문 사례에서 324종의 고유 통합 약재 라벨과 9,339건의 약재 사용 사례가 확인되었다. 백작약이 531건(95.68%)으로 가장 많이 기록되었으며, 복령 520건(93.69%), 당귀 510건(91.89%), 적작약 467건(84.14%), 초백출 361건(65.05%)이 그 뒤를 이었다. 그림 5A 및 표 5). 상위 36개 레이블의 순위-빈도 곡선은 가파른 고빈도 구간 이후 점진적으로 넓어지는 꼬리 부분을 보였으며(그림 5B), 이는 공통 배경 및 개별 처방 구성 요소에 대한 압축된 표현을 제공합니다. 약초 명명법의 기초가 되는 소스-정규화 매핑, 처리 한정어, 표준 CMM 명칭, 소스 종 및 근거 경계는 다음의 내용에 기록되어 있습니다. 보충 표 3.
보조 본초 사전에는 속성이 코딩된 약초 사용 사례 9,115건이 포함되었습니다. 주요 사기(Four-Qi) 범주는 온(warm, 2,588건, 28.39%), 미한(slightly cold, 2,339건, 25.66%), 평(neutral, 2,330건, 25.56%), 한(cold, 1,221건, 13.40%) 순이었습니다(그림 5C). 화합물 소스 풍미 용어를 정규화한 후, 주요 오미(five-flavor) 범주는 고(bitter, 4,488건, 49.24%), 감(sweet, 4,377건, 48.02%), 신(pungent, 2,893건, 31.74%) 순이었습니다(그림 5D). 귀경(Meridian-tropism) 코딩은 비경(spleen, 5,541건, 60.79%), 간경(liver, 4,801건, 52.67%), 폐경(lung, 3,358건, 36.84%), 위경(stomach, 2,988건, 32.78%), 심경(heart, 2,702건, 29.64%) 순으로 나타났습니다(그림 5E). 그림 5F에는 개별 방문 수준 분석 단위와 속성 코딩 분석 단위, 그리고 이들 간의 재현성 연결 관계가 기록되어 있습니다. 종합적으로, 이러한 패널들은 처방 빈도와 표준화된 본초 기술어들을 처리 특유의 용어를 손실시키지 않고 어떻게 요약할 수 있는지를 보여줍니다.
사전에 지정된 이력 사전에는 37개의 정확한 증상 개념이 포함되어 있었습니다. 적격 방문 555건 중 474건(85.41%)에서 적어도 하나의 개념이 검출되었습니다. 주요 용어는 178건(32.07%)의 건조한 목, 151건(27.21%)의 피로, 139건(25.05%)의 수면 부족, 115건(20.72%)의 복부 팽만, 100건(18.02%)의 위산 역류, 99건(17.84%)의 쓴맛, 90건(16.22%)의 속쓰림, 87건(15.68%)의 딸꾹질, 87건(15.68%)의 트림, 그리고 77건(13.87%)의 묽은 변이었습니다(그림 6A,B 및 표 6).
전체 순위-빈도 곡선은 37개 용어의 전체 분포를 보여주며, 누적 선은 순위에 따른 모든 키워드 검출의 집중도를 요약하여 나타냅니다(그림 6C). 그림 6D에는 스펙트럼을 생성하는 데 사용된 재현 가능한 시퀀스가 기록되어 있습니다: 사전 고정, 비식별화된 기록 텍스트 스캔, 각 방문 내 개념 중복 제거, 그리고 집계된 횟수 및 비율 내보내기 순으로 진행됩니다.
연관 규칙 마이닝에는 버전 고정된 555행의 처방-방문별 약재 존재 행렬이 사용되었습니다. 15개의 단일 약재 지향성 규칙이 지지도 ≥ 0.30, 신뢰도 ≥ 0.70, 향상도 > 1.0 조건을 충족했습니다(그림 7A,B 및 표 7). 유지된 지지도 값은 0.3009에서 0.7892, 신뢰도 값은 0.7302에서 0.9748, 향상도 값은 1.0010에서 1.1226 범위였습니다.
가장 빈번하게 함께 기록된 유향 쌍은 Chi Shao > Fu Ling이었으며, 438건의 방문을 기준으로 지지도(support) 0.7892, 신뢰도(confidence) 0.9379, 리프트(lift) 1.0010을 나타냈다. 역방향 규칙은 동일한 지지도와 0.8423의 신뢰도를 보였으며, 이는 규칙의 방향성을 유지해야 하는 이유를 입증한다. 임계값 민감도 분석 결과, 지지도 ≥ 0.25 또는 ≥ 0.35, 신뢰도 ≥ 0.65 또는 ≥ 0.75, 또는 리프트 > 1.02 또는 > 1.05 조건에서 각각 18, 11, 21, 14, 7, 4개의 규칙이 유지되었다. 환자당 1회 방문 분석에서는 동일한 쌍이 316건의 방문에서 발생했으며, 지지도 0.7980, 신뢰도 0.9489, 리프트 0.9994를 기록하여 리프트 > 1.0 기준에서는 유지되지 않았다. 임계값 섭동 및 반복 방문 민감도 결과는 Supplementary Table 4에 제공되며, 결정론적 재계산 내용은 Supplementary File 1에 제공된다. 따라서 높은 방문 수준의 지지도를 환자 수준의 검증으로 해석해서는 안 된다.
가장 높은 리프트 값은 Gan Cao > stir-fried Bai Zhu (1.1226)와 Gan Cao > Chi Shao (1.1200)에서 관찰되었습니다. 그림 7A는 유지된 15가지 규칙 모두를 유향 이분 네트워크(directed bipartite network)로 통합한 것이며, 에지의 너비는 지지도(support)를, 에지의 색상은 리프트(lift)를 나타냅니다. 그림 7B는 동일한 규칙들을 리프트 순으로 정렬하고, 각 점의 크기를 지지도로 조절하며, 신뢰도(confidence)를 표기한 것입니다. 따라서 이 두 패널은 동일한 시각적 표현을 중복해서 보여주는 것이 아니라, 네트워크 토폴로지와 규칙의 정량적 강도를 구분하여 나타냅니다.
가장 빈도가 높은 20가지 약초 변수에 대한 계층적 군집 분석에는 Jaccard 거리와 평균 연결법이 사용되었습니다(그림 7C). 덴드로그램은 방문 수준의 출현 패턴에 대한 유사성의 전역적 표현을 제공하며, 이는 연관 규칙이 제공하는 국소적 방향성 정보를 보완합니다. 종합적으로, 이 패널들은 상호 보완적인 분석 관점들이 어떻게 단일 버전 고정 이진 행렬에 정렬될 수 있는지를 보여줍니다.
지방간(77회 방문), 간경변증(46회 방문) 및 만성 위염(133회 방문; 그림 8A 및 표 8)에 대해 진단별 유병률을 계산하였습니다. 백작약(Bai Shao), 복령(Fu Ling) 및 당귀(Dang Gui)는 세 가지 층 모두에서 높은 유병률을 보였습니다. 간경변증 방문에서는 단삼(Dan Shen)(95.65%), 초오두구(vinegar-processed E Zhu)(86.96%), 초별갑(vinegar-processed Bie Jia)(84.78%) 및 생황기(Sheng Huang Qi)(60.87%)의 기록이 두드러졌습니다. 지방간 방문에서는 다른 층보다 인진(Yin Chen)(41.56%)과 택사(Ze Xie)(31.17%)의 유병률이 더 높게 나타난 반면, 만성 위염 방문에서는 황련(Huang Lian)(44.36%), 목향(Mu Xiang)(34.59%) 및 시호(Chai Hu)(36.09%)가 반복적으로 나타났습니다. 따라서 히트맵은 주요 임상 상황에 따른 종합적인 처방 패턴의 간결한 기술적 비교를 제공합니다.
그림 8B는 계산과 해석을 구분합니다. 검증된 이력 단서는 간결한 전문가 컨텍스트와 연결되고, 이어 증후군 요소의 맥락화, 진단별 층화 패턴 비교, 전향적 검증을 위한 변수 선택, 그리고 후속 질문 생성과 같은 연구 활용 단계로 연결됩니다. 이 마지막 패널은 분석 결과와 계산된 유병률을 명확히 구분하면서도, 임상적 전문 지식이 어떻게 분석 결과물을 풍부하게 만들 수 있는지를 보여줍니다.
그림 8C는 소스 검증 또는 재분석된 성분과 주의 또는 추가 확인이 필요한 요소를 구분하여 재현성과 릴리스 경계를 요약합니다. 이 최종 감사 단계는 해결되지 않았거나 재구성 불가능한 분석 결과물이 검증된 출력물로 제시되는 것을 방지합니다.
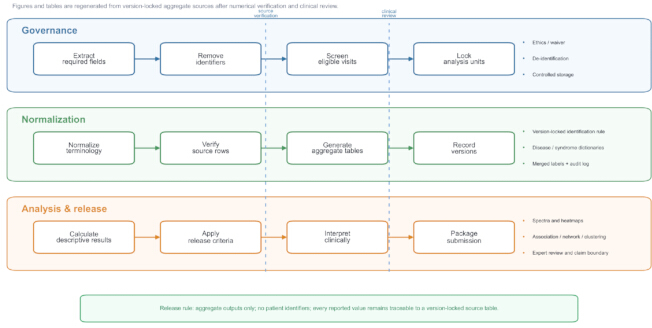
그림 1: 소스 감사 기반의 케이스 기록 마이닝 워크플로우. 거버넌스, 용어 표준화, 집계 분석, 임상 검토 및 릴리스 패키징이 워크플로우의 순차적 단계로 표시되어 있다. 파란색, 녹색, 주황색 띠는 워크플로우 도메인을 구분하며, 수직 점선은 감사 게이트를 나타낸다. 화살표는 워크플로우 순서를 나타내며 생물학적 인과 관계를 의미하지 않는다. 릴리스 규칙은 집계된 결과물만 릴리스하고, 환자 식별자는 제외하며, 보고된 모든 값은 버전이 고정된 소스 테이블로 추적 가능해야 함을 명시한다. 적용 가능한 오차 막대는 없다. 여기를 클릭하여 이 그림의 확대 버전을 확인하십시오.
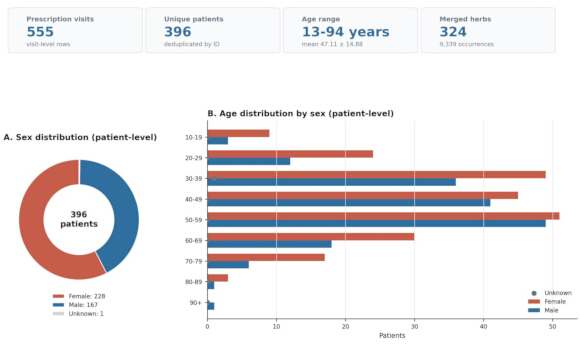
그림 2: 데이터셋 프로필 및 환자 수준의 인구통계학적 특성. 요약 상자에는 555건의 처방 방문, 396명의 고유 환자, 13–94세(평균 연령 47.11 ± 14.88세)의 환자 수준 연령 범위, 그리고 9,339건의 약초 사용 사례를 나타내는 324개의 통합 약초 라벨이 기록되어 있다. (A) 여성, 남성 및 알 수 없음 범주를 포함한 396명의 고유 환자 중 환자 수준의 성별 분포. (B) 동일한 396명의 환자 중 성별에 따른 환자 수준의 연령 분포. 요약 상자에는 해당하는 경우 표시된 방문 수준 또는 환자 수준의 분모가 사용되었다. 색상은 성별 범주와 요약 요소를 구분하며 추론적인 의미는 없다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
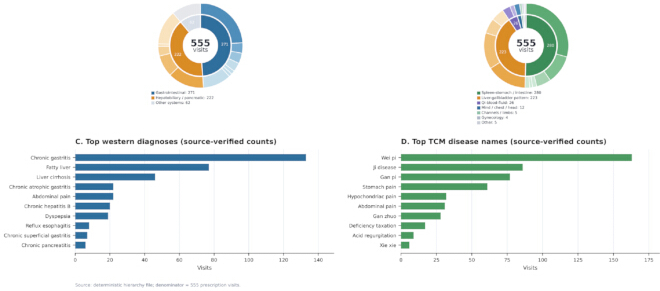
그림 3: 처방 방문을 통해 수집된 질병 스펙트럼. (A) 555건의 적격 처방 방문으로부터 도출된 계층적 서양의학 질병군 및 (B) 계층적 TCM(전통 중의학) 질병군. (C) 동일한 방문 수준 분모에서의 주요 정규화 서양의학 진단명 및 (D) 주요 정규화 TCM 질병명. 링 세그먼트와 막대는 방문 횟수를 나타내며, 색상은 진단 체계 또는 범주를 구분하며 치료 효과를 나타내지 않습니다. 유지된 TCM 원문 레이블은 표 3에 정의되어 있습니다: Wei pi(상복부 팽만감 또는 불편감), Ji disease(적취형 원문 TCM 레이블), Gan pi(지방간 질환에 사용되는 TCM 질병 레이블), Gan zhuo(직역하면 간 고착; 유지된 고전 TCM 질병 레이블), Bi disease(비증), Xiao ke(소갈), Xie xie(묽은 변 또는 수양변), 그리고 Fu xie(설사). 이러한 설명은 원문 레이블을 현대 생의학적 진단명으로 변환한 것이 아닙니다. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
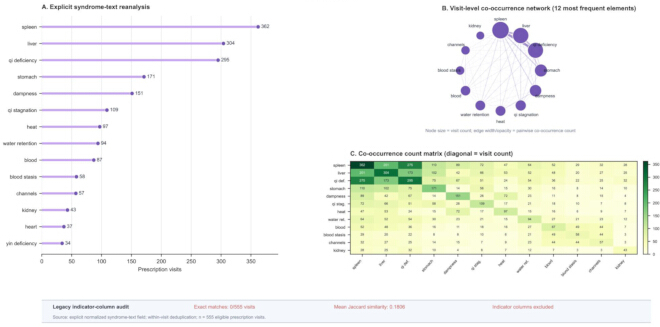
그림 4: 명시적 증후군-텍스트 스펙트럼 및 공생 구조. (A) 방문 내 중복 제거 후 14가지 정규화된 증후군 요소의 방문 수준 빈도로, 적격 처방 방문 555건을 분모로 사용함. (B) 가장 빈번한 12가지 증후군 요소의 공생 네트워크; 노드 크기는 방문 빈도를 나타내며, 엣지의 너비와 불투명도는 쌍별 공생 횟수를 나타냄. (C) 이에 대응하는 대칭 공생 횟수 행렬; 대각선 셀은 개별 방문 빈도를 나타내고, 비대각선 셀은 쌍별 공생 횟수를 나타냄. 감사 스트립 결과 555개 행 전체에서 정확한 증후군-텍스트/지표 일치 항목이 0건이었으며, 텍스트-지표 자카드 유사도 평균은 0.1806으로 나타남; 따라서 기존 지표 열은 실질적인 보고에서 제외됨. 행렬에서 Qi def.는 기허(qi deficiency), Qi stag.는 기체(qi stagnation), Water ret.는 수독(water retention)을 의미함. 색상 팔레트는 기술적인 용도로 사용됨. 오차 막대는 해당 없음. 그림의 확대 버전을 보시려면 여기를 클릭하십시오.
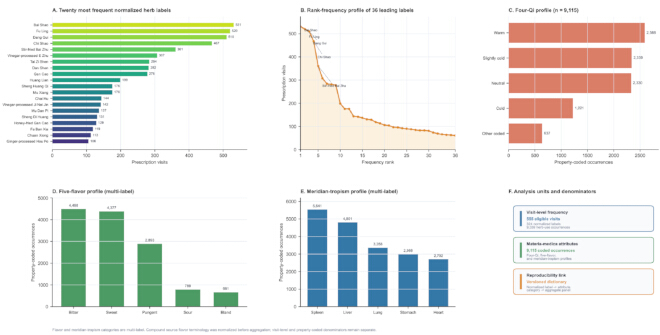
그림 5: 고빈도 약재 및 정규화된 본초학 속성 프로파일. (A) 적격 처방 방문 555건 중 가장 빈도가 높은 20가지 정규화 약재 레이블. (B) 주요 정규화 약재 레이블 36가지의 순위-빈도 프로파일. (C) 9,115건의 속성 코딩된 약재 사용 사례를 기반으로 한 사기(Four-Qi) 분포; 사기는 각 코딩된 사례에 대해 단일 값으로 할당됨. (D) 오미(Five-flavor) 및 (E) 귀경(meridian-tropism) 분포; 동일한 속성 코딩 분모를 기반으로 하며, 두 속성 모두 다중 레이블 속성이므로 카테고리 합계가 배타적이지 않음. (F) 방문 수준 및 속성 코딩 분석 단위와 이들의 재현성 연결 관계. 막대 길이는 빈도를 나타내며, 색상은 패널을 구분함. 오차 막대는 적용되지 않음. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
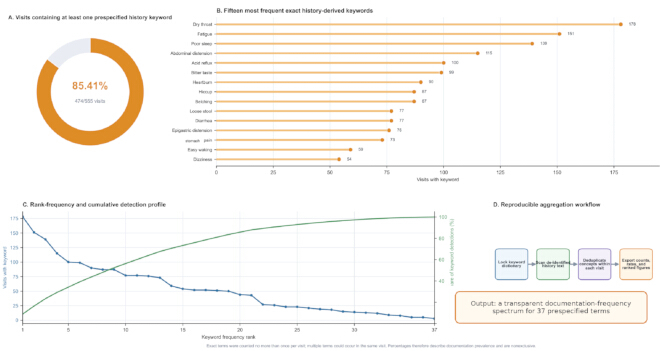
그림 6: 병력 기반 증상 키워드 스펙트럼 및 재현 가능한 집계 워크플로우. (A) 최소 하나 이상의 사전 정의된 병력 키워드가 포함된 적격 처방 방문 555건의 비율; 474건의 방문(85.41%)에 최소 하나 이상의 키워드가 포함됨. (B) 가장 빈번하게 나타난 15가지의 정확한 병력 기반 증상 개념. (C) 37개 용어 전체의 순위-빈도 분포 및 키워드 검출의 누적 점유율. (D) 사전 정의된 사전에서 집계 출력까지의 버전 고정 워크플로우. 각 개념은 한 번의 방문 내에서 최대 한 번만 계수되었으며, 동일한 방문에서 여러 개념이 나타날 수 있음. 주황색 막대는 키워드 수를 나타내며, 워크플로우 색상은 처리 단계를 구분함. 오차 막대는 해당 없음. 여기에서 이 그림의 더 큰 버전을 확인하십시오.
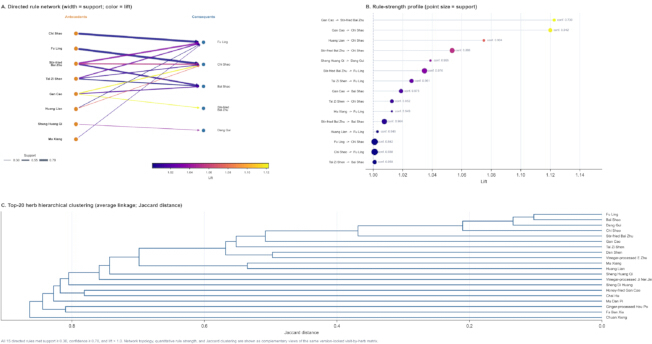
그림 7: 지향성 약재 연관 규칙 및 계층적 군집 분석. (A) 지지도(support) ≥ 0.30, 신뢰도(confidence) ≥ 0.70, 향상도(lift) > 1.0의 사전 설정 임계값을 충족하는 총 15가지 단일 약재 연관 규칙의 지향성 이분 네트워크. 선의 너비는 지지도를, 선의 색상은 향상도를 나타낸다. (B) 향상도 순으로 정렬한 동일한 15가지 규칙의 규칙 강도 프로필; 점의 크기는 지지도를 나타내며, 인접한 레이블은 신뢰도(conf.)를 나타낸다. (C) Jaccard 거리를 이용한 빈도수 상위 20가지 약재 존재 변수의 평균 연결 계층적 군집 분석. 모든 패널은 처방 방문을 분석 단위로 사용하며, 효능, 시너지 또는 권장 고정 조합이 아닌 공동 기록 패턴을 설명한다. 오차 막대는 해당 사항이 없다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
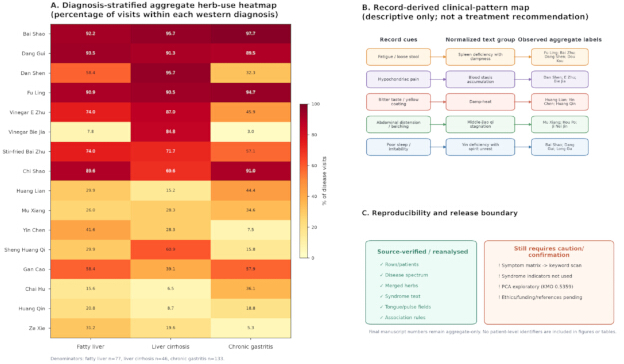
그림 8: 진단별 층화된 종합 약재 패턴, 임상 패턴 맵 및 공개 경계. (A) 지방간 (n = 77), 간경변증 (n = 46) 및 만성 위염 (n = 133)에서 16가지 정규화된 약재 레이블의 방문 수준 유병률을 보여주는 진단별 층화 히트맵. 각 셀은 0%–100%의 고정된 색상 척도를 사용하여 해당 서양 의학적 진단 층 내 적격 방문의 백분율을 나타낸다. (B) 검증된 기록 단서를 정규화된 텍스트 그룹 및 관찰된 종합 약재 레이블과 연결하는 기록 기반 임상 패턴 맵. 점선으로 된 비방향성 연결선은 이 기술적 해석 층을 계산된 유병률과 구분하며, 본 패널은 치료 권장 사항을 구성하지 않는다. (C) 소스 검증 또는 재분석된 구성 요소와 주의 또는 확인이 필요한 항목을 구분하는 재현성 및 공개 경계. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
| 측정 지표 | 값 | 단위/분모 | 상태 |
| 처방 방문 | 555 | 555건의 처방 방문 | 복구된 XLSX 파일에서 확인됨 |
| 고유 환자 수 | 396 | 396명의 고유 환자 | 복구된 XLSX 파일에서 확인됨 |
| 환자별 연령 범위 | 13-94 | 년 | 검증됨 |
| 환자별 연령 평균 +/- 표준편차 | 47.11 +/- 14.88 | 년 | 검증됨 |
| 방문별 연령 평균 +/- 표준편차 | 48.22 +/- 15.82 | 년 | 검증됨 |
| 환자 수준의 성별 | 여성 228명; 남성 167명; 미상 1명 | 396명의 환자 | 검증됨 |
| 방문 수준 성별 | 여성 327명; 남성 227명; 알 수 없음 1명 | 555회 방문 | 검증됨 |
| 혼합 약초 | 324 | 중복 제거된 병합 이름 | 검증됨 |
| 통합된 약초 사용 사례 | 9339 | 555건의 처방 진료 | 검증됨 |
표 1: 데이터셋 프로필. 환자 수준의 인구통계학적 특성과 처방 방문 수준의 변수들이 각각의 분모를 사용하여 보고되었습니다. 정규화된 약초 총량 또한 제공됩니다.
| 질환명 | 계수 | 방문 비율 |
| 만성 위염 | 133 | 24 |
| 지방간 | 77 | 13.9 |
| 간경변증 | 46 | 8.3 |
| 만성 위축성 위염 | 22 | 4 |
| 복통 | 22 | 4 |
| 만성 B형 간염 | 20 | 3.6 |
| 소화불량 | 19 | 3.4 |
| 역류성 식도염 | 8 | 1.4 |
| 만성 표층성 위염 | 7 | 1.3 |
| 만성 췌장염 | 6 | 1.1 |
| 궤양성 대장염 | 6 | 1.1 |
| 담낭 용종 | 6 | 1.1 |
| 담낭절제술 후 증후군 | 6 | 1.1 |
| 장 기능 장애 | 6 | 1.1 |
| 담석 | 6 | 1.1 |
| 만성 간염 | 5 | 0.9 |
| 피로 | 5 | 0.9 |
| 위장관 기능 장애 (원래 라벨 불확실) | 5 | 0.9 |
| 만성 위염 (원래 라벨 불분명) | 5 | 0.9 |
| 자가면역성 간경변증 | 4 | 0.7 |
표 2: 주요 표준화 서구 진단명. 555건의 적격 처방 방문 기록에서 나타난 주요 표준화 서구 진단명의 빈도 및 백분율. 백분율은 적격 처방 방문 수를 분모로 사용함.
| TCM 질환명 | 수 | 방문 비율(%) |
| 위비(Wei pi, 상복부 팽만감 또는 불쾌감) | 163 | 29.4 |
| 적취병(Ji disease, 축적 유형의 TCM 레이블) | 86 | 15.5 |
| 간비(Gan pi, 지방간 질환에 사용되는 TCM 질환 레이블) | 77 | 13.9 |
| 위통 | 61 | 11 |
| 늑간통 | 32 | 5.8 |
| 복통 | 31 | 5.6 |
| 간착(Gan zhuo, 말 그대로 간의 고정; 유지된 고전 TCM 질환 레이블) | 28 | 5 |
| 허손 | 17 | 3.1 |
| 산 역류 | 9 | 1.6 |
| 설사(Xie xie, 묽은 변 또는 수양변) | 6 | 1.1 |
| 불면증 | 4 | 0.7 |
| 이질 | 4 | 0.7 |
| 두통 | 4 | 0.7 |
| 비증(Bi disease, 저해 질환) | 4 | 0.7 |
| 월경 장애 | 3 | 0.5 |
| 흉비 | 3 | 0.5 |
| 한증(발한 장애) | 3 | 0.5 |
| 변비 | 3 | 0.5 |
| 부설(Fu xie, 설사) | 2 | 0.4 |
| 소갈(Xiao ke, 소모성 갈증) | 2 | 0.4 |
표 3: 주요 정규화 TCM 질환명. 555건의 적격 처방 방문 기록에서 나타난 주요 정규화 TCM 질환명의 빈도 및 백분율. 백분율은 적격 처방 방문 수를 분모로 사용함. 유지된 소스 라벨 및 설명적 글로스(gloss)가 현대 생의학적 진단과 동일함을 의미하지는 않음.
| 순위 | 증후군 요소 | 처방 방문 | 적격 방문 | 방문 백분율 |
| 1 | 비장 | 362 | 555 | 65.23% |
| 2 | 간 | 304 | 555 | 54.77% |
| 3 | 기허 | 295 | 555 | 53.15% |
| 4 | 위 | 171 | 555 | 30.81% |
| 5 | 습기 | 151 | 555 | 27.21% |
| 6 | 기체(氣滯) | 109 | 555 | 19.64% |
| 7 | 열 | 97 | 555 | 17.48% |
| 8 | 수분 저류 | 94 | 555 | 16.94% |
| 9 | 혈액 | 87 | 555 | 15.68% |
| 10 | 어혈 | 58 | 555 | 10.45% |
| 11 | 채널 | 57 | 555 | 10.27% |
| 12 | 신장 | 43 | 555 | 7.75% |
| 13 | 심장 | 37 | 555 | 6.67% |
| 14 | 음허 | 34 | 555 | 6.13% |
표 4: 주요 정규화된 증후군 요소. 증후군 요소는 명시적인 정규화된 증후군 텍스트에서 추출되었으며, 각 처방 방문별로 중복 제거되었습니다. 건수는 적격한 처방 방문 555건을 분모로 사용하였으며, 한 번의 방문 내에서 여러 증후군 요소가 나타날 수 있으므로 백분율의 합은 100%를 초과할 수 있습니다.
| 통합 약재명 | 횟수 | 방문 비율(%) |
| 백작약 | 531 | 95.7 |
| 복령 | 520 | 93.7 |
| 당귀 | 510 | 91.9 |
| 적작약 | 467 | 84.1 |
| 초백출 | 361 | 65 |
| 초어쭉 | 307 | 55.3 |
| 태자삼 | 284 | 51.2 |
| 단삼 | 282 | 50.8 |
| 감초 | 278 | 50.1 |
| 황련 | 199 | 35.9 |
| 생황기 | 176 | 31.7 |
| 목향 | 176 | 31.7 |
| 시호 | 144 | 25.9 |
| 초계내금 | 142 | 25.6 |
| 목단피 | 137 | 24.7 |
| 생지황 | 131 | 23.6 |
| 자감초 | 129 | 23.2 |
| 법반하 | 119 | 21.4 |
| 천궁 | 113 | 20.4 |
| 강포후박 | 106 | 19.1 |
| 인진 | 104 | 18.7 |
| 생백출 | 97 | 17.5 |
| 두구 | 96 | 17.3 |
| 생용골 | 92 | 16.6 |
| 절배모 | 90 | 16.2 |
| 황금 | 88 | 15.9 |
| 당삼 | 85 | 15.3 |
| 초별갑 | 83 | 15 |
| 계지 | 83 | 15 |
| 생무이 | 81 | 14.6 |
| 교지자 | 74 | 13.3 |
| 합환피 | 69 | 12.4 |
| 주제황정 | 66 | 11.9 |
| 진피 | 64 | 11.5 |
| 택사 | 63 | 11.4 |
| 금전초 | 61 | 11 |
표 5: 처방 방문 빈도별 주요 정규화 약재 라벨. 각 정규화 약재 라벨은 처방 방문당 최대 한 번만 집계되었습니다. 빈도와 백분율은 적격 처방 방문 555건을 분모로 사용하였으며, 임상적으로 의미 있는 가공 형태는 별도의 라벨로 유지하였습니다.
| 순위 | 이력 기반 키워드 | 처방 방문 | 적격 방문 | 방문 비율 |
| 1 | 인후 건조증 | 178 | 555 | 32.07% |
| 2 | 피로 | 151 | 555 | 27.21% |
| 3 | 수면 부족 | 139 | 555 | 25.05% |
| 4 | 복부 팽만 | 115 | 555 | 20.72% |
| 5 | 위산 역류 | 100 | 555 | 18.02% |
| 6 | 쓴맛 | 99 | 555 | 17.84% |
| 7 | 가슴쓰림 | 90 | 555 | 16.22% |
| 8 | 딸꾹질 | 87 | 555 | 15.68% |
| 9 | 트림 | 87 | 555 | 15.68% |
| 10 | 묽은 변 | 77 | 555 | 13.87% |
| 11 | 설사 | 77 | 555 | 13.87% |
| 12 | 상복부 팽만 | 76 | 555 | 13.69% |
| 13 | 복통 | 73 | 555 | 13.15% |
| 14 | 손쉬운 깨우기 | 59 | 555 | 10.63% |
| 15 | 어지럼증 | 54 | 555 | 9.73% |
| 16 | 구토 | 52 | 555 | 9.37% |
| 17 | 메스꺼움 | 52 | 555 | 9.37% |
| 18 | 둔통 | 51 | 555 | 9.19% |
| 19 | 팽창통 | 50 | 555 | 9.01% |
| 20 | 식욕 부진 | 44 | 555 | 7.93% |
| 21 | 복통 | 43 | 555 | 7.75% |
| 22 | 흉부 압박감 | 27 | 555 | 4.86% |
| 23 | 과민성 | 26 | 555 | 4.68% |
| 24 | 두통 | 23 | 555 | 4.14% |
| 25 | 장명 | 23 | 555 | 4.14% |
| 26 | 상복부 불쾌감 | 21 | 555 | 3.78% |
| 27 | 심계항진 | 19 | 555 | 3.42% |
| 28 | 황색 소변 | 18 | 555 | 3.24% |
| 29 | 이물감 | 15 | 555 | 2.70% |
| 30 | 찌르는 듯한 통증 | 14 | 555 | 2.52% |
| 31 | 변비 | 13 | 555 | 2.34% |
| 32 | 졸음 | 12 | 555 | 2.16% |
| 33 | 인후 이물감 | 9 | 555 | 1.62% |
| 34 | 과다 발한 | 8 | 555 | 1.44% |
| 35 | 건강염려증성 통증 | 5 | 555 | 0.90% |
| 36 | 이급후증 | 5 | 555 | 0.90% |
| 37 | 건조 변 | 3 | 555 | 0.54% |
표 6: 병력 기반 주요 증상 키워드. 비식별화된 병력 텍스트에서 검출된 정확한 증상 개념. 각 개념은 처방 방문 1회당 최대 한 번만 계산되었으며, 동일한 방문 내에서 여러 개념이 나타날 수 있음. 횟수와 백분율은 적격한 처방 방문 555건을 분모로 사용함.
| 선행 요인 | 결과적인 | 동시 발생 방문 | 지원 | 신뢰도 | 리프트 |
| 치 샤오 | 복령 | 438 | 0.7892 | 0.9379 | 1.0010 |
| 복령 | 치 샤오 | 438 | 0.7892 | 0.8423 | 1.0010 |
| 백출 볶음 | 복령 | 350 | 0.6306 | 0.9695 | 1.0348 |
| 백출 볶음 | 백작약 | 348 | 0.6270 | 0.9640 | 1.0076 |
| 백출 볶음 | 치 샤오 | 320 | 0.5766 | 0.8864 | 1.0535 |
| 태자삼 | 복령 | 273 | 0.4919 | 0.9613 | 1.0260 |
| 태자삼 | 백작약 | 272 | 0.4901 | 0.9577 | 1.0010 |
| 감초 | 백작약 | 271 | 0.4883 | 0.9748 | 1.0189 |
| 감초 | 치 샤오 | 262 | 0.4721 | 0.9424 | 1.1200 |
| 태자삼 | 치 샤오 | 242 | 0.4360 | 0.8521 | 1.0127 |
| 감초 | 백출 볶음 | 203 | 0.3658 | 0.7302 | 1.1226 |
| 황련 | 복령 | 187 | 0.3369 | 0.9397 | 1.0029 |
| 황련 | 치 샤오 | 180 | 0.3243 | 0.9045 | 1.0750 |
| 생황기 | 당귀 | 168 | 0.3027 | 0.9545 | 1.0388 |
| 목향 | 복령 | 167 | 0.3009 | 0.9489 | 1.0127 |
표 7: 사전 지정된 임계값을 충족하는 지향성 약초 연관 규칙. 지지도(support) ≥ 0.30, 신뢰도(confidence) ≥ 0.70, 리프트(lift) > 1.0를 사용하여 555개의 이진 처방 방문 행으로부터 규칙을 생성하였습니다. 지지도는 555건의 처방 방문을 분모로 사용하며, 신뢰도는 방향성을 가지므로 규칙의 방향을 유지하였습니다.
| 약재 명칭 | 지방간 (n) | 지방간 (N) | 지방간 (%) | 간경변증 (n) | 간경변증 (N) | 간경변증 (%) | 만성 위염 (n) | 만성 위염 (N) | 만성 위염 (%) |
| 백작약 | 71 | 77 | 92.21% | 44 | 46 | 95.65% | 130 | 133 | 97.74% |
| 당귀 | 72 | 77 | 93.51% | 42 | 46 | 91.30% | 119 | 133 | 89.47% |
| 단삼 | 45 | 77 | 58.44% | 44 | 46 | 95.65% | 43 | 133 | 32.33% |
| 복령 | 70 | 77 | 90.91% | 43 | 46 | 93.48% | 126 | 133 | 94.74% |
| 초어주 | 57 | 77 | 74.03% | 40 | 46 | 86.96% | 61 | 133 | 45.86% |
| 초별갑 | 6 | 77 | 7.79% | 39 | 46 | 84.78% | 4 | 133 | 3.01% |
| 초백출 | 57 | 77 | 74.03% | 33 | 46 | 71.74% | 76 | 133 | 57.14% |
| 적작약 | 69 | 77 | 89.61% | 32 | 46 | 69.57% | 121 | 133 | 90.98% |
| 황련 | 23 | 77 | 29.87% | 7 | 46 | 15.22% | 59 | 133 | 44.36% |
| 목향 | 20 | 77 | 25.97% | 13 | 46 | 28.26% | 46 | 133 | 34.59% |
| 인진 | 32 | 77 | 41.56% | 13 | 46 | 28.26% | 10 | 133 | 7.52% |
| 생황기 | 23 | 77 | 29.87% | 28 | 46 | 60.87% | 21 | 133 | 15.79% |
| 감초 | 45 | 77 | 58.44% | 18 | 46 | 39.13% | 77 | 133 | 57.89% |
| 시호 | 12 | 77 | 15.58% | 3 | 46 | 6.52% | 48 | 133 | 36.09% |
| 황금 | 16 | 77 | 20.78% | 4 | 46 | 8.70% | 25 | 133 | 18.80% |
| 택사 | 24 | 77 | 31.17% | 9 | 46 | 19.57% | 7 | 133 | 5.26% |
표 8: 진단별 한약 사용 유병률. 지방간(n = 77), 간경변증(n = 46), 만성 위염(n = 133)에서 16가지 표준화된 한약 라벨의 분자, 분모 및 방문 수준 유병률. 각 한약 라벨은 적격한 처방 방문당 최대 한 번만 집계되었습니다.
보충 표 1: AI 지원 투명성 및 감사 기록. 2026년 8월 21일에 수행된 수정 단계의 일관성 검토와 원래의 분석 기록을 구분하는 문서입니다. 이 표에는 도구/모델/버전, 입력 범위, 목적, 식별된 사기(Four-Qi) 카디널리티 불일치, 인간에 의한 수정, 사용 제한, 검토자 정보, 처리 결과 및 프롬프트 템플릿이 기록되어 있습니다. AI 시스템에 가공되지 않은 환자 수준의 행 데이터는 제공되지 않았습니다. 이 파일을 다운로드하려면 여기를 클릭하십시오.
보충 표 2: 소스 감사 데이터 품질 결과. 소스 임상 필드 및 레거시 분석 구조에 대한 복구 필드 완전성, 감사 결과, 분석 조치 및 릴리스 상태가 보고되었습니다. 이 표는 조정되지 않은 레거시 증후군 지표의 제외, 이전 식물 총수의 수정, 버전 간 안정성 추정을 위한 세척 전 재구성 가능한 분포 벡터의 부재, 그리고 재구성할 수 없었던 수량을 기록하고 있습니다. 이 파일을 다운로드하려면 여기를 클릭하십시오.
보충 표 3: 약초 명명법 매핑. 제어된 약초 표시 레이블이 가공 한정어, 표준 중약재(CMM) 명칭, 출처 용어, 식물학적, 동물학적 또는 광물적 기원, 참조 버전, 근거 위치 및 근거 범위와 연결되어 있습니다. 임상적으로 의미가 있는 경우 가공 관련 레이블을 유지하였습니다. 이 파일을 다운로드하려면 여기를 클릭하십시오.
보충 표 4: 임계값 및 반복 방문 민감도 분석. 연관 규칙 임계값 섭동, 환자당 1회 방문 규칙 집합 비교, Chi Shao > Fu Ling 민감도 지표 및 190개 쌍의 클러스터링 입력 거리 비교가 보고되었습니다. 이 파일을 다운로드하려면 여기를 클릭하십시오.
보충 파일 1: 결정론적 임계값 및 재방문 민감도 스크립트. 버전 고정 소스 데이터셋으로부터 집계 임계값 및 재방문 민감도 지표를 재현하는 데 사용된 결정론적 스크립트입니다. 이 파일에는 환자 수준의 데이터가 포함되어 있지 않습니다. 이 파일을 다운로드하려면 여기를 클릭하십시오.
토론
본 프로토콜의 핵심 기여는 비식별화된 TCM 사례 기록부터 종합적인 연구 수치에 이르기까지 완전하고 검토 가능한 경로를 제공하는 것입니다. 가장 중요한 단계는 분석 결과를 확인하기 전에 코호트 식별 규칙을 확정하고, 고유 환자와 처방 방문을 구분하며, 모든 원본-정규화 용어 매핑을 보존하고, 시각화 전에 각 분자와 분모를 검증하는 것입니다. 이러한 제어 절차는 데이터 정제 과정을 보이지 않는 예비 활동에서 방법론의 문서화된 구성 요소로 변모시킵니다. 또한, 이러한 워크플로우는 RECORD, STROBE, FAIR 및 확립된 EHR 데이터 품질 프레임워크11,12,13,14,15와 일치합니다. 결과값의 소스 필드, 분석 단위, 사전 버전, 계산 규칙, 분모, 표, 그림 및 검토자 결정 사항이 증거 원장에 추적 가능할 때에만 해당 결과가 발표 가능한 상태인 것으로 간주됩니다.
이 방법은 거버넌스, 용어 공학, 계산, 시각화 및 임상 검토를 별개의 작업으로 취급하지 않고 통합했다는 점에서 혁신적입니다. 단일한 명시적 증후군 매트릭스를 통해 빈도 스펙트럼, 공생 네트워크 및 히트맵을 생성합니다. 단일 처방-방문-약재 매트릭스는 빈도 요약, 유향 연관 규칙 및 계층적 군집화를 지원합니다19,20,21. 단일 진단 층화 표는 정확한 백분율과 최종 히트맵을 모두 지원합니다. 분석 워크플로우는 스크립트화된 재현 가능한 오픈 소스 도구를 사용하므로36,37,38,39,40, 상위 딕셔너리나 코호트 결정의 수정 사항을 모든 종속 출력물에 전파할 수 있습니다. 이전의 임상 데이터 웨어하우스 연구 또한 소스 연결 전처리 및 구조화된 데이터 재사용의 중요성을 입증합니다41,42. 이러한 아키텍처는 수동 전사를 줄이고, 그래픽 인코딩과 소스 표 간의 일관성을 유지하며, 감사, 교육 및 다른 연구 팀으로의 이전을 용이하게 합니다.
최근 수행된 세 건의 데이터베이스 마이닝 연구는 분석 단위가 임상 방문이 아닌 출판물이기는 하지만 유용한 설계 원칙을 제공합니다. 류마티스 관절염 및 우울증 연구에서는 사전 정의된 검색 전략을 국가, 기관, 저자, 학술지, 키워드 및 타임라인 분석과 결합하였습니다26. 궤양성 대장염 및 Janus kinase 억제제 연구에서는 조정된 협업, 공동 인용, 클러스터링 및 버스트 분석을 사용하여 지속적인 주제와 새롭게 부상하는 연구 전선을 구분하였습니다27. 류마티스 관절염 및 섬유근육통 연구에서는 두 가지 증거 계층 간의 구분을 유지하면서 생물정보학을 통해 서지학적 매핑을 확장하였습니다28. 본 프로토콜은 조정되었으나 상호 대체 불가능한 분석 관점이라는 동일한 원칙을 적용합니다. 이를 산부인과, 호흡기 내과, 류마티스 내과 또는 다른 전문 분야로 전이하려면 규칙 세트를 재사용하기 전에 해당 전문 분야의 특수 필드, 용어 사전, 선정 및 제외 규칙, 결과 지표, 임상 검토 절차를 재구축해야 합니다. 질환 스펙트럼, 증후군 네트워크, 증상 키워드, 연관 규칙, 클러스터링 및 진단 층화 패턴은 모두 버전이 고정된 소스에서 생성되지만, 각각은 서로 다른 질문을 다루며 고유한 분모와 해석 경계를 유지합니다.
인간이 감독하는 AI는 승인된 비식별 발췌본이나 집계 자료로 제한될 때 추가적인 품질 관리 계층을 제공할 수 있습니다. 이 워크플로 내에서 AI는 파일 간의 용어를 비교하고, 캡션과 표 사이의 불일치를 표시하며, 그림 경계를 벗어나는 레이블을 식별하고, 표시된 각 네트워크 노드에 유효한 엣지가 있는지 확인하며, 더 명확한 표현을 제안할 수 있습니다. AI는 코호트 적격성을 결정하거나, 용어 매핑을 임의로 생성하거나, 치료 효과를 추론하거나, 소스 데이터 검토를 대체하지 않습니다. 이러한 책임 분담은 의료 AI가 책임 소재를 불분명하게 하기보다는 인간의 판단을 보완해야 한다는 더 넓은 관점과 일치합니다33. 또한 이는 투명한 인적 요인, 오류 처리 및 책임 있는 평가를 강조하는 DECIDE-AI의 관점을 반영합니다34. 따라서 AI 지원을 사용하는 경우에는 각 프롬프트의 목적, 검토된 출력물, 수락된 수정 사항, 검토자 및 날짜를 감사 로그에 기록해야 합니다.
결과값이 임상적으로 타당해 보이지만 소스 데이터와의 대조(source reconciliation)에 실패했을 때 트러블슈팅은 특히 중요합니다. 이러한 경우, 불일치의 원인이 적격성 판정, 중복 제거, 용어 매핑, 필드 선택, 분모 선택 또는 수치 집계 중 어디에 있는지 추적될 때까지 후속 해석을 중단해야 합니다. 수정 후에는 모든 종속 결과물을 다시 생성해야 합니다. 실습 예제는 반복 방문이 서로 독립적이지 않은 단일 센터, 후향적, 전문가-외래환자 데이터셋을 유지합니다. 환자당 1회 방문 기준의 민감도 분석 결과, 상위 20개 약재의 구성원은 모두 유지되면서 보존된 규칙 세트는 15개에서 12개로 감소했습니다. 이 20개 공유 변수 사이의 모든 190개 무순서 쌍(unordered pairs)에 대하여 피어슨 상관계수는 0.9944, 스피어만 rho는 0.9836, 자카드 거리의 평균 절대 변화량은 0.0146, 최대 변화량은 0.0528이었습니다.보충 표 4). 따라서 높은 방문 수준의 지지도는 환자 수준의 검증으로 해석되어서는 안 됩니다. 이력-키워드 스펙트럼은 검증된 증상 척도가 아니라 문자 그대로의 기록 내용을 반영합니다. 약물학적 요약(Materia-medica summaries)은 용량 가중치가 아닌 발생 빈도 가중치를 적용합니다. 연관 규칙은 인과관계가 아닌 공동 기록 상태를 기술합니다. 진단별 층화 히트맵은 기술적 자료이며, 비교 효능, 질병 특이성 또는 치료 필요성을 입증하지 않습니다.
이 프로토콜은 전문가의 임상 경험 전수, 전문 외래 코호트의 기술, 다기관 용어 표준화, 문서 품질 검토, 전향적 레지스트리를 위한 변수 선정, 그리고 개인정보 보호를 고려한 통합 협력 데이터셋 준비 연구에 적용될 수 있습니다. 향후 연구에서는 전향적 구조화 증상 수집, 환자 군집 모델, 명시적 용량 변수, 사전 지정된 비교 가설, 외부 검증, 버전 관리 용어 서비스, 프라이버시 보존 컴퓨팅 및 인터랙티브 근거 원장의 도입을 고려할 수 있습니다. 버전 잠금 규칙과 인간의 검증 하에 제어된다면, 자연어 처리 및 AI 지원 검토를 통해 반복적인 큐레이션 작업을 더욱 줄일 수 있을 것입니다. 더 넓은 의미에서, 이 프로토콜은 분산된 임상 경험을 검토, 재현, 반박 및 확장이 가능한 투명한 연구 객체로 변환할 수 있게 합니다. 이 방법은 빈도를 효능으로 변환하는 것이 아니라, 문서화되지 않은 분석적 결정을 가시적인 근거로 변환함으로써 더욱 엄격한 임상 질문과 더 지속 가능한 실세계 TCM 연구를 위한 토대를 제공합니다.
공개 사항
저자들은 이해관계의 충돌이 없음을 밝힙니다.
감사의 글
원고 수정 과정에서 집계 수준의 파일 간 일관성 확인 및 문구 제안을 위해 OpenAI Codex (gpt-5.6-luna 및 gpt-5.6-sol)가 독점적으로 사용되었습니다. 환자 수준의 기록은 AI 시스템에 제공되지 않았습니다. AI 지원을 통해 생성된 모든 출력물은 2026년 8월 21일에 Tian Xia가 원본 자료와 대조하여 독립적으로 검증하였습니다. 저자들은 최종 내용을 검토하고 승인하였으며 원고에 대해 모든 책임을 집니다. 본 프로젝트는 중국 국가 중점 연구 개발 프로그램의 중의학 현대화 핵심 특별 프로젝트 (No. 2025YFC3512800), 중국 국가 과학 기술 주요 프로젝트 (프로젝트 No. 2026ZD0554100; 하위 프로젝트 No. 2026ZD0554101), 중앙 고수준 중의학 병원 임상 연구 및 성과 전환 역량 강화 프로젝트의 저명한 고위 중의학 전문가 학술 경험 계승 특별 프로젝트 (No. HLCMHPP2023016) 및 신장 위구르 자치구 자연 과학 재단 (No. 2025D01C213)의 지원을 받았습니다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| 집계 재분석 스프레드시트 | 저자 생성 로컬 파일 | 해당 없음 | 집계 수치, 표 및 그림 생성에 사용됨. |
| 비식별화된 외래 환자 사례 기록 내보내기 | 기관 전자 의료 기록 시스템 | 해당 없음 | 통제된 기관 환경 내에서만 사용됨; 환자 수준의 기록은 제출 자료가 아님. |
| lxml | lxml project | 6.1.1 | 수정 단계의 재생성 과정 중 네임스페이스를 보존하는 직렬화에 사용된 소프트웨어 버전; 과거의 원본 분석 버전이 아님. |
| Matplotlib | Matplotlib project (matplotlib.org) | 3.11.1 | 수정 단계의 재생성 환경 및 Figure 3 SVG 메타데이터에서 확인된 버전; 과거의 원본 분석 버전이 아님. |
| NetworkX | NetworkX project | PyPI package: networkx | 패키지 식별자가 기록됨; 상속된 환경에서 정확한 수정 단계 버전은 확인되지 않음. |
| NumPy | NumPy project | 2.3.5 | 수정된 집계 출력물을 재생성하는 데 사용된 소프트웨어 버전; 과거의 원본 분석 버전이 아님. |
| openpyxl | openpyxl project | 3.1.5 | 수정된 집계 XLSX 출력물을 작성하는 데 사용된 소프트웨어 버전; 과거의 원본 분석 버전이 아님. |
| pandas | pandas project | 3.0.1 | 수정된 집계 출력물을 재생성하는 데 사용된 소프트웨어 버전; 과거의 원본 분석 버전이 아님. |
| PyMuPDF | PyMuPDF project | 1.28.2 | 수정된 그림 출력물의 수정 단계 재생성에 사용된 소프트웨어 버전; 과거의 원본 분석 버전이 아님. |
| Python | Python Software Foundation | 3.13.15 | 수정된 집계 출력물을 재생성하는 데 사용된 소프트웨어 버전; 과거의 원본 분석 버전이 아님. |
| SciPy | SciPy project | PyPI package: scipy | 패키지 식별자가 기록됨; 상속된 환경에서 정확한 수정 단계 버전은 확인되지 않음. |
참고문헌
- Wang YH, et al. Study on knowledge discovery in traditional Chinese medical case records [in Chinese]. Zhong Xi Yi Jie He Xue Bao. 2007;5(4):368-372.
- Wang Y, et al. Automatic symptom name normalization in clinical records of traditional Chinese medicine. BMC Bioinformatics. 2010;11:40.
- Zhou L, et al. Natural language processing algorithms for normalizing expressions of synonymous symptoms in traditional Chinese medicine. Evid Based Complement Alternat Med. 2021;2021:6676607.
- Chu X, et al. Quantitative knowledge presentation models of traditional Chinese medicine (TCM): a review. Artif Intell Med. 2020;103:101810.
- Zhang T, et al. Constructing fine-grained entity recognition corpora based on clinical records of traditional Chinese medicine. BMC Med Inform Decis Mak. 2020;20:64.
- Wang Q, et al. A study of entity-linking methods for normalizing Chinese diagnosis and procedure terms to ICD codes. J Biomed Inform. 2020;105:103418.
- Zhang H, et al. Transformer- and generative adversarial network-based inpatient traditional Chinese medicine prescription recommendation: development study. JMIR Med Inform. 2022;10(5):e35239.
- Dan W, et al. SinoMedminer: an R package and Shiny application for mining and visualizing traditional Chinese medicine herbal formulas. Chin Med. 2025;20:80.
- Chinese Pharmacopoeia Commission. Pharmacopoeia of the People's Republic of China. 2025 ed. China Medical Science and Technology Press; Beijing; 2025.
- Editorial Committee of Zhonghua Bencao, State Administration of Traditional Chinese Medicine. Zhonghua Bencao. 10 vols. Shanghai Scientific and Technical Publishers; Shanghai; 1999. ISBN: 7532351068. Available from: National Diet Library record
- Benchimol EI, et al. The REporting of studies Conducted using Observational Routinely-collected health Data (RECORD) statement. PLoS Med. 2015;12(10):e1001885.
- von Elm E, et al. The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: guidelines for reporting observational studies. Lancet. 2007;370(9596):1453-1457.
- Wilkinson MD, et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.
- Weiskopf NG, Weng C. Methods and dimensions of electronic health record data quality assessment: enabling reuse for clinical research. J Am Med Inform Assoc. 2013;20(1):144-151.
- Kahn MG, et al. A harmonized data quality assessment terminology and framework for the secondary use of electronic health record data. EGEMS (Wash DC). 2016;4(1):18.
- Kovačević A, Bašaragin B, Milošević N, Nenadić G. De-identification of clinical free text using natural language processing: a systematic review of current approaches. Artif Intell Med. 2024;151:102845.
- Meystre SM, et al. Text de-identification for privacy protection: a study of its impact on clinical text information content. J Biomed Inform. 2014;50:142-150.
- Neamatullah I, et al. Automated de-identification of free-text medical records. BMC Med Inform Decis Mak. 2008;8:32.
- Agrawal R, Srikant R. Fast algorithms for mining association rules in large databases. Presented at: 20th International Conference on Very Large Data Bases; Santiago, Chile; 1994. p. 487-499.
- Hahsler M, Grün B, Hornik K. arules: a computational environment for mining association rules and frequent item sets. J Stat Softw. 2005;14(15):1-25.
- Murtagh F, Contreras P. Algorithms for hierarchical clustering: an overview. WIREs Data Min Knowl Discov. 2012;2(1):86-97.
- van Eck NJ, Waltman L. Software survey: VOSviewer, a computer program for bibliometric mapping. Scientometrics. 2010;84(2):523-538.
- Chen C. CiteSpace II: detecting and visualizing emerging trends and transient patterns in scientific literature. J Am Soc Inf Sci Technol. 2006;57(3):359-377.
- Aria M, Cuccurullo C. bibliometrix: an R-tool for comprehensive science mapping analysis. J Informetr. 2017;11(4):959-975.
- Donthu N, et al. How to conduct a bibliometric analysis: an overview and guidelines. J Bus Res. 2021;133:285-296.
- Zhao Y, Chen GY, Fang M. Research trends of rheumatoid arthritis and depression from 2019 to 2023: a bibliometric analysis. J Multidiscip Healthc. 2024;17:4465-4474.
- Wang Y, et al. Research trends and hotspots in JAK inhibitors for ulcerative colitis: a bibliometric analysis from 2015 to 2024. J Multidiscip Healthc. 2025;18:6755-6771.
- Chen G, Yan Z, Wang Y, Tao Q. Rheumatoid arthritis and fibromyalgia syndrome: a bibliometric and bioinformatics perspective on comorbidity research. J Multidiscip Healthc. 2025;18:6811-6827.
- Wang SL, et al. Yao Naili's experience in applying the harmonizing liver and spleen method. Journal of Traditional Chinese Medicine. 2008;49(7):596-597.
- Wang L, et al. Analysis of Professor Naili Yao's experience in treating spleen-stomach diseases [in Chinese]. Lishizhen Med Mater Med Res. 2022;33(6):1436-1438.
- Sandve GK, Nekrutenko A, Taylor J, Hovig E. Ten simple rules for reproducible computational research. PLoS Comput Biol. 2013;9(10):e1003285.
- Munafò MR, et al. A manifesto for reproducible science. Nat Hum Behav. 2017;1:0021.
- Topol EJ. High-performance medicine: the convergence of human and artificial intelligence. Nat Med. 2019;25(1):44-56.
- Vasey B, et al. Reporting guideline for the early-stage clinical evaluation of decision support systems driven by artificial intelligence: DECIDE-AI. Nat Med. 2022;28(5):924-933.
- Branch of Gastrointestinal Diseases, China Association of Chinese Medicine. Expert consensus on traditional Chinese medicine diagnosis and treatment of Gan pi (2023). Chinese Journal of Integrative Digestive Diseases. 2024;32(9):741-747.
- McKinney W. Data structures for statistical computing in Python [conference paper]. Presented at: 9th Python in Science Conference; Austin, TX; 2010. p. 56-61. doi:10.25080/Majora-92bf1922-00a.
- Harris CR, et al. Array programming with NumPy. Nature. 2020;585(7825):357-362.
- Virtanen P, et al. SciPy 1.0: fundamental algorithms for scientific computing in Python. Nat Methods. 2020;17(3):261-272.
- Hunter JD. Matplotlib: a 2D graphics environment. Comput Sci Eng. 2007;9(3):90-95.
- Hagberg AA, Schult DA, Swart PJ. Exploring network structure, dynamics, and function using NetworkX. Presented at: 7th Python in Science Conference; Pasadena, CA; 2008. p. 11-15. doi:10.25080/TCWV9851.
- Zhou X, et al. Development of traditional Chinese medicine clinical data warehouse for medical knowledge discovery and decision support. Artif Intell Med. 2010;48(2-3):139-152.
- Liu B, et al. Data processing and analysis in real-world traditional Chinese medicine clinical data: challenges and approaches. Stat Med. 2012;31(7):653-660.