본 프로토콜은 헬스케어 분야에서 설명 가능한 인공지능 모델을 개발, 평가 및 해석하기 위한 재현 가능한 워크플로우를 제시합니다. 이는 투명성, 신뢰성 및 임상적 적용 가능성을 향상시키기 위해 표준화된 데이터 준비, 모델 개발, 설명 가능성 기술, 정량적 평가 및 재현성 실습을 통합합니다.
이 논문에서
요약
초록
인공지능(AI)은 임상 의사 결정, 질병 예측, 의료 진단 및 맞춤형 헬스케어를 위한 가치 있는 도구로 점점 더 많이 도입되고 있습니다. 그러나 투명성 부족, 설명 가능한 인공지능(XAI) 방법의 일관성 없는 구현, 그리고 제한된 재현성은 임상 환경에서 AI 모델을 신뢰성 있게 배치하는 데 주요한 장벽으로 남아 있습니다. 본 논문은 헬스케어 애플리케이션을 위한 설명 가능한 AI 모델의 개발, 평가 및 해석을 위한 체계적이고 재현 가능하며 투명한 프로토콜을 제안합니다. 워크플로우는 계산 환경 설정으로 시작하여 데이터 획득 및 특성 분석, 전처리, 특성 공학, 모델 개발, 하이퍼파라미터 최적화, 예측 성능 평가, 설명 가능성 분석, 통계적 검증 및 재현성 평가 순으로 진행됩니다. 본 프로토콜은 전역 및 지역 모델 해석을 모두 생성하기 위해 SHapley Additive exPlanations (SHAP), Local Interpretable Model-agnostic Explanations (LIME), Gradient-weighted Class Activation Mapping (Grad-CAM), Integrated Gradients, 어텐션 시각화(attention visualization) 및 반사실적 설명(counterfactual explanations)과 같은 XAI 방법들을 통합합니다. 이 프로토콜은 표준화된 헬스케어 데이터셋 준비, 안정적인 머신러닝 모델 개발, 예측 성능 평가, 임상적으로 유의미한 설명 생성, 그리고 반복 실험 간 재현성의 통계적 평가를 포함한 여러 핵심 구성 요소를 강조합니다. 모델 개발, 설명 가능성, 정량적 및 정성적 평가, 통계적 검증 및 재현성 평가를 통합된 워크플로우로 결합함으로써, 본 프로토콜은 헬스케어 애플리케이션을 위한 투명하고 재현 가능한 AI 모델 개발을 위한 포괄적인 프레임워크를 제공합니다.
서론
AI는 복잡한 임상 데이터의 지능적 분석을 가능하게 하고 증거 기반의 의료 의사결정을 지원함으로써 현대 의료의 필수적인 구성 요소가 되었습니다1. 전자 건강 기록, 의료 영상 시스템, 웨어러블 기기 및 유전체 기술을 통한 의료의 급격한 디지털화는 효과적인 해석을 위해 고급 계산 접근 방식이 필요한 방대한 양의 이질적 데이터를 생성했습니다2.
머신 러닝(ML) 및 딥 러닝(DL) 알고리즘은 다차원 헬스케어 데이터 세트에서 유의미한 패턴을 추출하는 탁월한 능력을 입증해 왔으며, 이를 통해 진단 정확도, 질병 예측 및 환자 결과 평가를 개선하였습니다3. AI 기반 모델은 방사선과, 병리과, 심장내과, 종양학, 안과 및 기타 의학 전문 분야에 성공적으로 적용되어 임상의가 질병을 조기에 발견하고 개인 맞춤형 치료 전략을 추천하는 것을 돕고 있습니다4. 이러한 기술은 또한 워크플로우 최적화, 진단 가변성 감소 및 헬스케어 자원 활용도 향상에 기여하였습니다5.
최근 컴퓨팅 하드웨어, 클라우드 컴퓨팅 및 오픈 소스 AI 프레임워크의 발전으로 지능형 헬스케어 애플리케이션의 개발과 배포가 가속화되었습니다6. 결과적으로 AI는 정밀 의료 및 임상 의사결정 지원 시스템을 위한 핵심 가능 기술이 되었습니다7. 이러한 진전에도 불구하고, 많은 고성능 모델들이 예측 결과가 어떻게 생성되는지에 대한 통찰력을 거의 제공하지 않기 때문에 일상적인 임상 진료에서 AI의 광범위한 도입은 여전히 제한적입니다8.
대부분의 딥러닝 알고리즘은 내부 의사 결정 과정을 임상의와 연구자가 이해하기 어려운 복잡한 블랙박스 모델로 작동합니다9. 이러한 모델들은 흔히 우수한 예측 성능을 달성하지만, 투명성이 부족하여 사용자 신뢰를 떨어뜨리며 임상 검증, 규제 승인 및 환자 안전에 어려움을 초래합니다10. 의료 전문가는 특히 고위험 의료 환경에서 AI 보조 결정을 일상적인 임상 실무에 도입하기 전에 해당 결정의 근거를 제시할 수 있어야 합니다11.
XAI는 머신러닝 모델의 투명성과 해석 가능성을 향상시키기 위한 효과적인 접근 방식으로 등장했습니다12. 예측 모델을 불투명한 시스템으로 취급하는 대신, XAI 기술은 개별 예측에 기여하는 특성, 이미지 영역 또는 임상 변수에 대한 정보를 제공합니다13. 이러한 설명은 임상의가 모델의 동작을 더 잘 이해하고, 잠재적인 편향을 식별하며, AI가 생성한 결정이 기존의 의학적 지식과 일치하는지 판단할 수 있게 합니다14.
의료 분야 적용을 위해 여러 설명 가능성 기술이 도입되었습니다. SHapley Additive explanations (SHAP)는 협력 게임 이론을 기반으로 모델 예측에 대한 각 특성의 기여도를 측정합니다15. Local Interpretable Model-agnostic Explanations (LIME)은 단순화된 모델을 생성하여 블랙박스 모델의 예측을 설명합니다16. 딥러닝 모델을 사용하는 의료 영상 작업의 경우, Gradient-weighted activation maps (Grad-CAM)는 분류 결정에 기여하는 영상 영역을 시각적으로 나타내는 히트맵을 생성합니다17. 이러한 방법들의 결합은 다양한 의료 영역 전반에서 AI 시스템의 투명성을 획기적으로 향상시켰습니다18.
헬스케어 환경에서 설명 가능성 방법론에 대한 관심이 높아지고 있음에도 불구하고, 문헌상에서의 활용 방식은 여전히 다양합니다. 연구자들은 전처리 전략의 사용뿐만 아니라 모델 아키텍처 설계, 평가 지표, 그리고 설명 기술의 선택에 있어서도 서로 다른 방식을 취하고 있습니다19. 또한, 많은 논문들이 높은 예측 정확도를 보고하지만, 설명의 품질이나 재현성에 대한 철저한 평가를 제공하지 못하는 경우가 많습니다20.
재현성은 현대 AI 과학의 주요 병목 현상 중 하나입니다. 논문에서 소프트웨어 버전, 계산 환경, 전처리 파이프라인, 하이퍼파라미터 설정, 랜덤 시드 초기화 및 하드웨어 구성이 공개되지 않는 경우가 많습니다21. 이로 인해 독립적인 연구자들이 발표된 결과를 재현하거나 다른 데이터셋 또는 소프트웨어 플랫폼을 사용하여 발표된 방법을 검증하는 데 실패하는 경우가 빈번합니다22. 상세한 문서화의 부족은 벤치마킹 연구, 공동 연구 및 AI 시스템의 임상 적용을 저해하는 요인 중 하나입니다23.
이러한 과제들을 인식하여, 여러 기관과 규제 기관들은 의료 애플리케이션을 위한 투명하고 신뢰할 수 있으며 재현 가능한 AI의 중요성을 강조해 왔습니다24. 기존의 보고 지침들은 방법론적 보고를 개선했으나, 연구자들이 직접 구현할 수 있는 표준화된 실험 절차를 제공하기보다는 주로 무엇을 보고해야 하는지를 설명하고 있습니다25. 결과적으로 데이터셋 준비, 모델 개발, 설명 가능성 분석, 통계적 평가 및 재현성 관행을 단일 실험 워크플로우로 통합하는 포괄적인 프로토콜에 대한 필요성이 여전히 남아 있습니다26.
표준화된 실험 프로토콜은 헬스케어 AI 커뮤니티에 여러 가지 이점을 제공합니다. 또한, 이는 방법론적 일관성을 촉진하고, 독립적인 연구들 간의 비교를 용이하게 하며, 계산 실험의 투명성을 높이고, 발표된 결과의 신뢰할 수 있는 검증을 가능하게 합니다27. 표준화된 워크플로우는 서로 다른 연구실과 의료 기관 전반에서 재현 가능한 명확하게 문서화된 절차를 통해 교육/훈련, 공동 연구 및 규제 평가를 지원합니다28.
의료 시스템에서 AI 모델을 학습시키고 평가하기 위한 재현 가능한 실험 프로토콜이 개발 및 검증되었습니다. 이 프로토콜은 계산 환경 구성, 의료 데이터셋 전처리, 머신러닝 모델 개발, XAI 방법 적용, 예측 성능 평가, 통계적 검증 수행 및 재현성 평가에 대한 표준을 제시합니다29. 이러한 구성 요소를 일관된 워크플로우로 통합함으로써 의료 AI 연구의 투명성, 신뢰성 및 재현성을 높일 수 있으며, 신뢰할 수 있는 지능형 건강 시스템 개발에 도움이 될 것으로 기대됩니다30.
프로토콜
본 검증 실험은 공개적으로 사용 가능한 비식별 처리된 Pima Indians 당뇨병 데이터셋을 사용하였으며, 식별 가능한 환자 기록이나 새로운 환자 모집을 포함하지 않았습니다. 따라서 고지된 동의 및 기관 IRB/윤리 승인이 필요하지 않았으며, 모든 분석은 적용 가능한 데이터셋 약관 및 기관 연구 정책에 따라 수행되었습니다.
작동 검증 사례에서는 이진 당뇨병 예측을 위한 768개의 레코드가 포함된 공개 데이터셋인 Pima Indians Diabetes Dataset을 사용하였습니다. 해당 데이터셋에 총 9단계의 핵심 워크플로를 적용하였습니다. 9가지 핵심 단계는 데이터셋 선택 및 검증, 컴퓨팅 환경 구성, 데이터 전처리, 데이터셋 분할, 모델 개발 및 학습, 예측 및 컴퓨팅 성능 평가, 설명 가능성 분석, 통계적 검증, 재현성 평가로 구성되었습니다. 외부 검증 및 임상 전문가 평가는 선택적 검증 모듈로 유지되었으며, 본 작동 사례에서는 수행되지 않았습니다. 그림 1 핵심 프로토콜 워크플로를 보여주며, 표 1 본 작업 검증에서 시행된 9가지 핵심 단계만을 요약합니다. 선택 사항인 외부 검증 및 임상 전문가 평가는 프로토콜 내에 별도로 기술되어 있으며, 9가지 실험 단계에는 포함되지 않습니다.
1. 의료 데이터셋 선택 및 검증
- 작업 검증 예제를 위한 기본 데이터셋으로 Pima Indians Diabetes 데이터셋을 선택하십시오. 데이터셋 출처, 표본 크기, 예측 대상, 클래스 분포 및 데이터 구조를 확인하십시오.
- 사전에 정의된 포함, 제외 및 데이터 품질 기준을 적용하십시오. 모델 개발 전에 중복 및 유효하지 않은 레코드를 제거하십시오.
- 데이터셋 출처, 특성, 예측 작업, 클래스 분포, 포함 및 제외 기준, 그리고 파티셔닝 전략을 표 2에 기록하십시오.
- 데이터셋 및 모델 선택을 위한 결정 기준을 적용하십시오.
- 데이터셋, 모델 아키텍처, 전처리 전략 또는 설명 가능성 방법을 선택하기 전에 예측 목표를 정의하십시오.
- 데이터셋 모달리티를 예측 목표에 맞추십시오. 구조화된 임상 변수에는 정형 데이터(tabular data)를, 의료 영상에는 영상 데이터를, 생체 신호에는 시계열 데이터를, 임상 서술에는 텍스트 데이터를 선택하거나, 동일한 환자 또는 연구 단위에 대해 상호 보완적인 모달리티를 사용할 수 있는 경우 멀티모달 데이터를 선택하십시오.
- 표본 크기, 결과 가용성, 클래스 분포, 결측치, 어노테이션 품질, 임상적 관련성, 데이터 완결성 및 접근성에 따라 후보 데이터셋을 평가하십시오. 사전에 정의된 요구 사항을 충족하는 데이터셋을 선택하십시오.
- 표본 크기, 계산 리소스 또는 해석 가능성 요구 사항으로 인해 복잡한 아키텍처 사용이 제한되는 정형 데이터의 경우, 전통적인 머신러닝 모델을 선택하십시오. 충분한 학습 데이터와 의료 영상, 생체 신호 또는 임상 텍스트와 같은 고차원 입력값이 가용한 경우에는 딥러닝 아키텍처를 선택하십시오.
- 동일한 환자 또는 연구 단위에 대해 여러 모달리티를 사용할 수 있고, 정보 누출(information leakage) 없이 신뢰성 있게 정렬할 수 있는 경우에만 멀티모달 아키텍처를 선택하십시오. 선택한 데이터 모달리티의 특성에 따라 전처리 작업을 선택하십시오.
- 모델 및 데이터 모달리티에 따라 설명 가능성 방법을 선택하십시오. 적절한 정형 모델에는 SHAP 또는 LIME과 같은 모델 불가지론적(model-agnostic) 방법을 사용하고, 해당되는 경우 영상 기반 모델에는 Grad-CAM과 같은 모달리티 특화 방법을 사용하십시오.
- 데이터셋, 전처리 전략, 모델 및 설명 가능성 방법 선택에 대한 근거를 문서화하십시오. 이러한 결정 사항을 재현성 기록의 일부로 보존하십시오.
2. XAI 모델 개발을 위한 계산 환경 구성
- 선택한 모델 요구 사항에 따라 운영 체제, CPU, RAM, 저장 공간 및 GPU를 구성합니다. 독립된 Python 환경을 생성하고 필요한 머신러닝, 딥러닝, 통계, 시각화 및 XAI 라이브러리를 설치합니다.
- 실제 검증 과정에 사용된 계산 환경, 모델 아키텍처 및 하이퍼파라미터를 표 3에 기록합니다. 옵티마이저, 학습률, 배치 크기, 최대 에포크 수, 손실 함수, 정규화 매개변수, 검증 전략, 조기 종료(early-stopping) 설정, 랜덤 시드 설정, 설명 가능성 방법, 하드웨어, 운영 체제, Python 버전 및 관련 소프트웨어 라이브러리 버전을 명시합니다. 실험적으로 사용된 이러한 설정과 일반 또는 권장 프로토콜 설정을 구분하여 표기합니다.
- Pima Indians Diabetes 데이터셋 검증과 그에 따른 예측, 설명 가능성, 통계 및 재현성 결과를 재현할 때 표 3에 보고된 구성을 사용합니다.
- 검증 스크립트를 실행하여 패키지 임포트, 데이터셋 로딩, 모델 실행 및 출력 생성이 성공적으로 이루어졌는지 확인합니다. 재현성을 위해 최종 확정된 환경 구성을 보존합니다.
3. XAI 모델 개발을 위한 헬스케어 데이터셋 준비 및 특성 분석
- 헬스케어 데이터셋 선택 및 수집
- 정의된 임상 예측 작업에 적합한 헬스케어 데이터셋을 선택합니다. 연구 목적, 데이터 유형, 샘플 크기, 어노테이션 품질, 클래스 균형 및 임상적 관련성에 따라 후보 데이터셋을 평가합니다.
- 예측 작업을 적절히 수행하고 독립적인 검증이 가능한 경우, 공개적으로 사용 가능한 벤치마크 데이터셋을 우선적으로 사용합니다.
- 기관 또는 내부 데이터셋을 수집하기 전에 필요한 윤리적 승인, 기관 허가 및 데이터 액세스 권한을 확보합니다. 검증된 저장소 또는 권한이 부여된 기관 데이터베이스에서 선택한 데이터셋을 가져옵니다.
- 원본 데이터셋 파일은 수정 없이 보존하고, 데이터셋 제공자, 버전, 수집 정보, 라이선스 조건, 포함 기준, 제외 기준 및 수반되는 메타데이터를 기록합니다. 데이터셋을 원시 데이터, 어노테이션, 메타데이터 및 보충 정보용 별도 디렉토리로 정리합니다.
- 헬스케어 데이터셋 특성 분석
- 예측 변수, 결과 레이블, 특성 유형, 데이터 모달리티 및 클래스 분포를 식별합니다. 피험자 수, 샘플 수, 특성 차원 및 사용 가능한 어노테이션 수를 결정합니다.
- 데이터셋 특성이 선택한 AI 방법과 호환되는지 확인합니다.
- 9단계 핵심 프로토콜을 검증하기 위한 유일한 실험 데이터셋으로 Pima Indians Diabetes Dataset을 사용합니다. 표 2에 나열된 추가 데이터셋은 임상 표 데이터, 전자 건강 기록, 더모스코피 이미지, 생리적 시계열 데이터 및 의료 영상에 걸쳐 일반 프로토콜의 적용 가능성을 입증하기 위해서만 포함합니다. 이러한 추가 데이터셋을 모델 학습, 테스트, 통계적 검증 또는 보고된 실험 결과 생성에 사용하지 마십시오.
- 데이터셋 품질 평가
- 중복 기록, 손상된 파일, 결측값, 어노테이션 오류 및 불규칙한 데이터 항목이 있는지 데이터셋을 검사합니다. 확인된 중복 기록을 제거하고 검증된 서식 불규칙성을 수정합니다. 모든 데이터셋 품질 관리 절차를 문서화합니다.
- 멀티모달 데이터셋을 사용하는 경우, 피험자 식별자를 통해 영상, 임상, 실험실 및 생리학적 데이터의 일치 여부를 확인합니다.
- 중복되거나 일관성이 없는 기록을 제거하고, 결측값을 처리하며, 수치적 특성을 표준화하고, 범주형 변수를 인코딩하며, 모달리티별 전처리를 적용합니다. 데이터셋을 독립적인 학습, 검증 및 테스트 세트로 분할합니다. 헬스케어 데이터셋 준비, 전처리, 분할 및 품질 평가 워크플로우는 그림 2를 참조하십시오.
- 데이터 프라이버시 및 윤리 준수 보장
- 헬스케어 데이터에서 직접 식별자를 제거합니다. 필요한 경우 익명화 또는 가명화 절차를 적용합니다. 적용 가능한 윤리, 데이터 보호, 고지된 동의 및 기관 요구 사항에 따라 환자 건강 정보를 취급합니다.
- 해당하는 윤리적 승인, 면제, 데이터 거버넌스 절차, 익명화 방법 및 데이터셋 준비 워크플로우를 기록합니다.
- 해당 정보가 존재하고 윤리적으로 허용되는 경우, 관련 인구통계학적 또는 임상적 하위 그룹 간의 모델 성능을 비교하여 잠재적인 알고리즘 편향을 평가합니다.
- 의도된 용도, 대상 모집단, 모델의 한계, 잠재적 실패 모드, 인간 감독 요구 사항 및 적용 가능한 윤리, 데이터 보호 및 헬스케어 규제 요구 사항을 문서화합니다.
- 최종 모델 문서의 일부로 식별된 공정성 한계와 책임감 있는 AI 고려 사항을 기록합니다.
참고: AI 모델 개발에 적합하고, 윤리적으로 준수하며, 주요 식별 불일치가 없는 표준화되고 문서화된 헬스케어 데이터셋을 확보하십시오.
4. AI 모델 학습을 위한 헬스케어 데이터 전처리 및 분할
- 품질 관리 수행
- 데이터셋에서 중복 레코드, 결측값, 유효하지 않은 값, 일관성 없는 레이블, 이상치 및 손상된 파일이 있는지 검사합니다.
- 사전에 정의된 기준에 따라 유효하지 않은 관찰치를 제거하거나 수정하고 모든 제외 사항을 기록합니다. 예측 변수와 결과 레이블의 일관성을 확인합니다.
- 결측 데이터 처리
- 각 변수의 결측 정도를 정량화합니다. 사전에 정의된 대체(imputation) 또는 제외 전략을 적용합니다.
- 훈련 데이터만을 사용하여 대체 파라미터를 추정하고, 학습된 변환을 검증 및 테스트 데이터에 적용합니다.
- 데이터 정규화 및 변환
- 선택한 모델에 필요한 특성 스케일링, 정규화, 인코딩, 차원 축소 또는 기타 변환을 적용합니다. 데이터 의존적인 모든 변환은 훈련 데이터만을 사용하여 학습시킵니다.
- 학습된 변환을 변경 없이 검증 및 테스트 데이터에 적용합니다.
- 훈련 데이터의 클래스 불균형을 정량화합니다. 클래스 가중치 부여, SMOTE, 오버샘플링 또는 데이터 증강을 훈련 데이터셋에만 적용합니다. 검증 및 테스트 데이터셋의 원래 분포는 유지합니다.
- 피험자, 중복 관찰치, 증강 샘플, 전처리 통계량, 특성 선택 기준 또는 합성 샘플이 훈련 및 평가 파티션 간에 공유되지 않음을 확인합니다.
5. XAI 모델 개발 및 구성
- 입력 데이터 모달리티, 전처리 작업, 모달리티별 특징 인코더, 특징 융합 메커니즘, 예측 층 및 설명 가능성 모듈을 지정하여 모델 아키텍처를 정의하십시오.
- 예측 작업과 입력 모달리티에 따라 머신러닝 또는 딥러닝 아키텍처를 선택하십시오. 입력층, 특징 추출 구성 요소, 은닉층, 출력층 및 활성화 함수를 구성하십시오. 옵티마이저, 학습률, 배치 크기, 손실 함수, 에포크, 정규화, 드롭아웃, 조기 종료 및 학습률 스케줄을 정의하십시오.
- 훈련 및 검증 데이터만을 사용하여 하이퍼파라미터를 최적화하십시오.
- 최종 확정된 아키텍처와 하이퍼파라미터 설정을 기록하십시오. 표 3.
- 학습 전 입력-출력 차원의 호환성을 확인하십시오.
참고: 적절한 아키텍처, 정의된 하이퍼파라미터 및 통합된 설명 가능성 기술을 포함하여 완전히 구성된 XAI 모델을 구축하십시오.
6. XAI 모델의 학습, 최적화 및 보존
- 사전에 정의된 훈련 및 검증 데이터셋과 최종 확정된 모델 설정을 로드합니다. 정의된 랜덤 시드와 훈련 파라미터를 사용하여 모델을 초기화합니다.
- 지정된 최적화 도구, 손실 함수, 배치 크기 및 중단 기준을 사용하여 모델을 훈련시킵니다.
- 검증 성능을 모니터링하고, 사전에 정의된 모델 선택 기준에 해당하는 체크포인트를 유지합니다. 추가 최적화 없이 독립적인 테스트 데이터셋에서 선택된 체크포인트를 평가합니다.
- 훈련된 모델, 전처리 설정, 하이퍼파라미터, 랜덤 시드 및 훈련 로그를 저장합니다.
참고: 준비된 헬스케어 데이터셋을 사용하여 훈련 및 검증된 최적화된 XAI 모델을 확보하십시오. 재현성을 위해 최상의 성능을 보인 모델, 하이퍼파라미터, 훈련 로그, 전처리 설정 및 계산 환경을 보존하십시오.
7. 예측 및 계산 성능 평가
- 예측 성능 평가
- 모델 학습 및 하이퍼파라미터 최적화 완료 후, 최적화된 모델과 독립적인 테스트 데이터셋을 로드합니다. 테스트 과정 동안 학습된 모델 파라미터와 전처리 파이프라인을 변경 없이 그대로 유지합니다.
- 테스트 데이터셋의 모든 샘플에 대해 예측값을 생성합니다. 예측된 출력값과 그에 해당하는 정답 레이블(ground-truth labels)을 비교합니다.
- 성능 지표 계산
- 예측 작업의 유형에 따라 평가 지표를 선택합니다.
- 분류 작업의 경우, 해당되는 바에 따라 정확도(accuracy), 정밀도(precision), 재현율(recall), 특이도(specificity), F1-score, 균형 정확도(balanced accuracy), 매슈스 상관 계수(MCC) 및 ROC 곡선 아래 면적(AUC-ROC)을 계산합니다. 회귀 작업의 경우, 해당되는 바에 따라 평균 절대 오차(MAE), 평균 제곱근 오차(RMSE), 결정 계수(R2) 및 기타 관련 척도를 계산합니다.
- 모델 일반화 및 강건성 평가
- 개발 데이터셋과는 별개로 독립적으로 수집된 외부 데이터셋이 있는 경우, 이를 사용하여 모델을 평가합니다.
- 전이 가능성(transportability)을 평가하기 위해, 서로 다른 의료 기관, 지리적 영역 또는 환자 집단에서 유래한 외부 데이터셋을 우선적으로 사용합니다.
- 종단적 데이터셋을 사용할 수 있는 경우, 이후 기간에 수집된 데이터를 사용하여 시간적 검증(temporal validation)을 수행합니다.
- 다기관 데이터가 있는 경우, 확정된 모델을 참여 기관별로 개별적으로 평가하여 다기관 검증(multicenter validation)을 수행합니다.
- 가능한 경우, 다른 지리적 영역의 독립적인 인구 집단을 사용하여 지리적 검증(geographic validation)을 수행합니다.
- 개발 데이터셋과 외부 데이터셋 간의 성능 차이 및 신뢰 구간을 보고합니다.
- 계산 성능 평가
- 사전에 정의된 계산 환경에서의 모델 학습 시간, 동일한 계산 조건 하에서의 추론 및 테스트 시간, 메모리 소비량, 모델 크기 및 하드웨어 활용도를 측정합니다.
- 독립적인 실행 반복을 통해 계산 측정값을 반복적으로 확인합니다.
- 실험적 변동성의 영향을 줄이기 위해 평균 실행 시간을 계산합니다.
- 모델 성능 비교
- 비교 평가를 위해 적절한 기존 머신러닝 또는 딥러닝 방법을 선택합니다.
- 제안된 XAI 모델과 비교 모델을 동일한 데이터셋을 사용하여 평가합니다. 모든 비교 모델에 동일한 전처리 절차와 평가 지표를 적용합니다.
- 모든 비교 실험은 동일한 계산 환경 내에서 수행합니다.
참고: 테스트된 계산 조건 및 데이터셋 하에서 예측 안정성과 재현성에 대한 실험적 근거를 확보하십시오.
8. XAI 출력 생성 및 평가
- 모델 설명 생성
- 최적화된 XAI 모델을 로드한다. 모델 학습에 사용되지 않은 평가 샘플을 선택한다. 학습된 모델이나 전처리 파이프라인을 수정하지 않고 미리 정의된 설명 가능성 방법들을 적용한다.
- 전역 및 지역 모델 설명을 생성한다.
- 예측 모델의 전반적인 동작 특성을 규명하기 위해 전역 설명을 생성한다.
- 개별 모델 예측의 특성을 규명하기 위해 지역 설명을 생성한다.
- Pima Indians Diabetes Dataset에 SHAP을 적용하여 정형 데이터 모델 예측의 전역 및 지역 설명을 생성한다.
- 특성 기여도의 전반적인 방향과 크기를 시각화하기 위해 SHAP summary plot을 생성한다.
- 평균 절대 SHAP 값을 사용하여 특성을 모델 예측에 대한 전반적인 기여도 순으로 정렬하는 SHAP feature-importance plot을 생성한다.
- 환자별 특성 기여도를 나타내기 위해 대표 테스트 세트 예측에 대한 SHAP waterfall plot을 생성한다.
- 선택한 특성과 모델 출력에 대한 기여도 사이의 관계를 조사하기 위해 SHAP feature-dependence plot을 생성한다.
- 대표 테스트 세트 예측에 LIME을 적용하여 개별 모델 예측의 지역 설명을 생성한다.
- 예측 결과의 변화와 관련된 특성 변화를 나타내기 위해 환자별 반사실적 설명(counterfactual explanation)을 생성한다.
- 데이터 모달리티 및 모델 아키텍처에 따라 추가적인 설명 가능성 기법을 선택한다.
- 적용 가능한 경우, 호환되는 이미지 기반 모델에는 Grad-CAM 또는 saliency map을, 트랜스포머 기반 아키텍처에는 attention 시각화를, 미분 가능한 모델에는 Integrated Gradients를 사용한다.
- Grad-CAM, saliency mapping, attention 시각화 및 Integrated Gradients는 일반적인 모달리티 의존적 프로토콜 옵션으로 처리하며, 해당 분석이 실제로 수행되지 않은 한 Pima Indians Diabetes Dataset 검증의 실험 결과로 해석하거나 보고하지 않는다.
- 수행된 Pima 검증에 설명 가능성 방법 적용
- Pima Indians Diabetes Dataset에 SHAP 및 LIME을 적용하여 정형 데이터 모델 예측의 전역 및 지역 설명을 생성한다.
- Pima 검증 결과로부터 SHAP summary, feature-importance, waterfall 및 feature-dependence 시각화 자료를 생성한다.
- 대표 테스트 세트 예측에 대해 LIME 지역 설명을 생성한다.
- 모델 예측의 변화와 관련된 특성 변화를 나타내기 위해 환자별 반사실적 설명을 생성한다.
- Grad-CAM, attention 시각화, saliency mapping 및 Integrated Gradients를 다른 헬스케어 데이터 유형 및 모델 아키텍처를 위한 모달리티 의존적 설명 가능성 옵션으로 처리한다.
- 해당 분석이 실제로 수행되지 않은 한, Grad-CAM, attention 시각화, saliency mapping 또는 Integrated Gradients를 Pima 수행 검증의 실험 결과로 보고하지 않는다.
- 설명 품질 평가
- 생성된 설명이 모델의 예측 과정을 반영하는지 평가한다. 반복적인 실험 실행 간의 설명 안정성과 동일한 계산 조건 하에서의 설명 출력 일관성을 평가한다.
- 해당하는 경우 입력 데이터 변화에 대한 설명 출력의 민감도를 평가한다. 생성된 설명을 가용한 도메인 지식 또는 전문가 해석과 비교한다.
- 비교가 가능한 경우, 확립된 의학적 지식과 일치하는 예측 특성 또는 해부학적 영역을 식별한다.
- 생성된 설명과 가용한 임상 해석 간의 일치 또는 불일치 수준을 기록한다.
- 예측 불확실성 정량화
- 선택한 모델 아키텍처 및 헬스케어 응용 분야에 적합한 불확실성 추정 방법을 사용하여 평가 샘플에 대한 예측 신뢰도 추정치를 생성한다.
- 적절한 경우 Monte Carlo dropout, 앙상블 기반 예측, 베이지안 추론, conformal prediction 또는 다른 검증된 불확실성 추정 접근 방식을 적용한다.
- Monte Carlo dropout을 사용할 때는 확률적 예측 패스를 반복하고, 각 평가 샘플에 대해 평균 예측값과 예측 분산을 계산한다.
- 해당 모델 예측과 함께 예측 신뢰도 또는 불확실성 구간을 보고한다.
- 불확실성 추정치가 신뢰도가 낮거나 예측 오류가 증가한 예측을 식별하는지 평가한다. 재현성을 보장하기 위해 불확실성 추정 방법, 파라미터, 랜덤 시드 및 생성된 불확실성 출력값을 보존한다.
- 설명 가능성 출력물 문서화 및 보존
- 생성된 모든 특성 중요도 점수, 히트맵, saliency map, attention 시각화 및 환자별 해석 내용을 저장한다. 설명 가능성 출력물을 표준화된 파일 형식으로 저장한다. 출력물을 학습된 모델 및 전처리 구성과 함께 아카이브한다.
- 설명 생성에 사용된 계산 설정, 설명 파라미터, 실행 시간 및 소프트웨어 버전을 기록한다. 독립적인 검토와 재현성을 용이하게 하기 위해 전체 설명 가능성 문서를 보존한다.
- 설명 품질의 정량적 평가
- 중요하다고 식별된 특성을 체계적으로 섭동(perturbing)하거나 마스킹하고, 그에 따른 모델 출력의 변화를 측정하여 설명 충실도(faithfulness)를 평가한다. 어트리뷰션(attribution)의 크기와 그로 인한 모델 예측 변화를 비교하여 설명 충실도 점수를 계산한다.
- 반복 실행, 섭동된 입력 또는 임상적으로 유사한 샘플에 대해 설명을 생성하고, 결과로 나타난 어트리뷰션 패턴 간의 유사도를 계산하여 설명 안정성을 평가한다. 제어된 입력 섭동 하에서 예측 출력 변화와 설명 어트리뷰션으로부터 추정된 변화 사이의 불일치를 측정하여 불충실도(infidelity)를 계산한다.
- 의료 영상 설명의 경우, 참조 어노테이션이 가용한 경우 전문가가 정의한 관심 영역(ROI)을 사용하여 로컬라이제이션 정확도를 평가한다. 미리 정의된 해석 기준을 사용하여 자격을 갖춘 임상 전문가로부터 독립적인 평가를 받아 임상적 유용성을 평가한다.
- 여러 전문가가 설명의 관련성 또는 일치 여부를 독립적으로 평가할 때 Cohen's kappa 또는 Fleiss' kappa를 계산한다.
참고: 학습된 AI 모델의 예측 동작 특성을 규명하는 전역 및 지역 설명을 생성한다. 투명한 해석과 재현 가능한 평가를 위해 설명 가능성 출력물과 해당 구성을 보존한다.
9. 통계적 검증 및 재현성 평가 수행
- 통계적 검증 수행
- 연구 목적, 실험 설계, 데이터 분포 및 평가 변수의 특성에 따라 통계 방법을 선택한다.
- 연속형 변수는 적절하게 평균 ± 표준 편차 또는 중앙값 및 사분위 범위로 보고하고, 범주형 변수는 빈도와 백분율로 보고한다.
- 훈련 세트에 대해 5-겹 교차 검증(five-fold cross-validation)을 수행하여 모델 성능 안정성을 평가하고, 각 폴드 간의 정확도, AUC-ROC, 정밀도, 재현율 및 F1-score를 평균 ± 표준 편차로 보고한다. 1,000회의 부트스트랩 재표본 추출을 사용하여 독립 테스트 세트 성능 지표에 대한 95% 신뢰 구간을 추정한다.
- 제안된 모델을 CNN, Random Forest 및 SVM 베이스라인 모델과 비교하며, 쌍을 이룬 정확도 비교에는 McNemar 검정을, 상관된 AUC-ROC 비교에는 DeLong 검정을, F1-score 비교에는 1,000회 재표본 추출을 이용한 쌍체 부트스트랩 검정을 사용한다.
- 각 비교에 해당하는 검정 통계량과 정확한 p-값을 보고하고, 양측 유의 수준 α = 0.05를 사용한다.
- 모델 성능의 통계적 비교
- 제안된 설명 가능한 AI 모델을 선택된 최신 기계 학습 및 딥러닝 베이스라인 모델과 비교한다.
- 두 그룹을 비교할 때는 적절하게 Student's t-검정 또는 Mann-Whitney U 검정을 적용한다. 셋 이상의 그룹이 포함된 모수적 비교의 경우 일원 분산 분석(one-way ANOVA)을 적용한다. 셋 이상의 그룹이 포함된 비모수적 비교의 경우 Kruskal-Wallis 검정을 적용한다.
- 원고에 명시된 대로 p < 0.05를 통계적으로 유의한 것으로 간주한다.
- 모든 사전 정의된 통계 비교에 대해 양측 유의 수준 α = 0.05를 사용하고, 해당하는 검정 통계량과 p-값을 보고한다.
- 주요 예측 성능 지표에 대한 95% 신뢰 구간을 보고한다.
- 적절한 경우 부트스트랩 재표본 추출을 사용하여 성능 측정치의 신뢰 구간을 추정한다. 동일한 대상자를 두 모델로 평가한 경우 DeLong 검정을 사용하여 상관된 ROC-AUC 값을 비교한다. 동일 대상자에 대해 생성된 쌍체 범주형 분류 결과를 비교하기 위해 McNemar 검정을 사용한다. 적절한 경우 F1-score 또는 기타 파생 성능 지표를 비교하기 위해 쌍체 부트스트랩 절차를 사용한다.
- 확률적 예측이 가능한 경우, 보정 플롯(calibration plot), 보정 기울기/절편 및 Brier score를 사용하여 보정도를 평가한다.
- Pima Indians 당뇨병 데이터셋 검증의 경우, 제안된 모델과 베이스라인 모델에 대해 지정된 사전 정의된 쌍체 통계 비교를 사용한다. 비교 목적에 맞게 쌍체 테스트 세트 예측 또는 반복 실행 성능 측정치에 선택한 검정을 일관되게 적용한다. 양측 유의 수준 α = 0.05를 사용하고 검정 통계량과 정확한 p-값을 보고한다. 결과 섹션에 결과가 제시되지 않은 한, 대체 통계 검정을 수행했다고 보고하지 않는다.
- 양측 검정을 적용하고 사전 정의된 임계값 p < 0.05를 사용하여 통계적 유의성을 해석한다.
- 모델 강건성 평가
- 사전 정의된 데이터셋 분할, 전처리 절차, 모델 아키텍처, 하이퍼파라미터, 소프트웨어 환경 및 평가 프로토콜을 유지하면서 서로 다른 무작위 시드(random seed)를 사용하여 전체 훈련 및 평가 절차를 10회 반복한다.
- 각 독립 실행에 대한 AUC-ROC, 정확도 및 F1-score를 기록하고 10회 실행의 평균 ± 표준 편차를 보고한다.
- 반복 실행 간의 결과 성능 값을 비교하여 서로 다른 무작위 초기화 하에서의 예측 안정성과 재현성을 평가한다.
- 설명 가능성 재현성 평가
- 설명 안정성 평가가 포함된 경우, 여러 실험 실행에 걸쳐 특성 기여도(feature attributions), 어텐션 맵(attention maps) 또는 기타 설명 출력을 생성한다. 적절한 유사도 또는 순위 기반 일치 측정법을 사용하여 반복 실행 간의 설명 출력을 정량적으로 비교한다.
- 현재의 Pima Indians 당뇨병 데이터셋 검증에서는 해당 반복 설명 출력 및 분석이 수행되지 않은 한 정량적 설명 안정성 지표를 보고하지 않는다.
- 적절한 임상 평가가 가능한 경우, 모델이 생성한 설명과 임상의의 해석 간의 일치도를 평가한다. 평가자 간 일치도를 평가하기 위해 적절하게 Cohen's kappa 또는 Fleiss' kappa를 계산한다.
- 재현성 문서화
- 원시 데이터, 전처리 절차, 소스 코드, 훈련된 모델, 하이퍼파라미터 설정, 설명 가능성 출력, 통계 분석 스크립트 및 생성된 결과를 보존한다.
- 워크플로우 전반에 사용된 소프트웨어 환경 및 하드웨어 구성을 기록한다. 보관된 파일과 설정을 사용하여 전체 워크플로우를 독립적으로 재실행한다.
- 복제된 예측 성능을 원래의 실험 결과와 비교하고, 복제된 모델 설명을 원래의 설명 가능성 출력과 비교한다.
- 복제 과정에서 관찰된 모든 차이점을 기록한다. 독립 실행 중 확인된 재현성 관찰 사항을 반영하여 실험 문서를 업데이트한다.
참고: 반복 실험을 통해 평가 가능한 통계적으로 검증된 예측 성능 및 설명 가능성 결과를 확보한다. 전체 워크플로우의 독립적인 검증이 가능하도록 충분한 계산, 분석 및 방법론적 문서를 보존한다.
- 재현성 체크리스트
- 데이터셋 이름, 버전, 수집 날짜, 출처, 포함 기준, 제외 기준 및 최종 샘플 수를 기록한다. 모든 전처리 작업, 변환 파라미터, 정규화 설정, 특성 선택 절차 및 데이터 분할 규칙을 기록한다.
- 운영체제, CPU, GPU, RAM, Python 버전, 프레임워크 버전 및 라이브러리 버전을 기록한다. 모든 모델 아키텍처 사양과 하이퍼파라미터를 기록한다.
- 옵티마이저, 학습률, 배치 크기, 에포크 수, 손실 함수, 규제화 및 조기 종료 기준을 기록한다. 모든 무작위 시드와 난수 생성기 설정을 기록한다.
- 훈련된 모델 가중치와 전처리 설정을 보존한다. 훈련 로그, 평가 스크립트, 통계 분석 스크립트 및 설명 가능성 출력을 보존한다. 최종 실험에 사용된 모델 및 소프트웨어 버전을 기록한다.
- 독립적인 복제에 필요한 전체 계산 환경을 보존한다.
- 윤리적, 법적, 라이선스 및 개인정보 보호 제한 사항에 따른 소스 코드, 데이터셋, 모델 가중치 및 지원 자료의 가용성을 문서화한다.
- 보관된 워크플로우를 독립적으로 재실행하고 복제된 결과와 원래 결과를 비교한다.
- 표준화된 체크리스트를 사용하여 전체 재현성 요구 사항을 문서화한다.
결과
제안된 XAI 프레임워크는 대표적인 헬스케어 데이터셋으로 Pima Indians Diabetes 데이터셋을 사용하여 구현되었습니다. Pima Indians Diabetes 데이터셋은 유일한 실험 검증 데이터셋으로 사용되었습니다. 보고된 모든 예측, 설명 가능성, 통계 및 재현성 결과는 이 데이터셋으로부터 생성되었습니다. TCGA-BRCA, TCGA-UCEC, MIMIC-III, ISIC 2019, HAM10000, OhioT1DM 및 BraTS 2021은 실험적으로 평가되지 않았으며, 다양한 헬스케어 데이터 모달리티 전반에 걸친 일반 프로토콜의 적용 가능성을 보여주는 예시로만 포함되었습니다. 무효 및 중복 레코드를 제거한 후 전체 데이터셋을 사용하였으며, 모델 개발 전에 지정된 전처리 작업을 수행하였습니다. 데이터셋은 사전 정의된 층화 분할 전략을 사용하여 독립적인 훈련, 검증 및 테스트 서브셋으로 분할되었습니다. 데이터 누수 가능성을 최소화하기 위해 세 가지 서브셋 간의 샘플 독립성이 유지되었습니다.
예측 모델은 미리 정의된 아키텍처와 하이퍼파라미터를 사용하여 구성되었습니다. 모델은 사전 정의된 학습률 및 배치 크기로 Adam 옵티마이저를 사용하여 최대 100 epoch 동안 학습되었습니다. 검증 손실(validation loss)에 기반한 조기 종료(early stopping)가 적용되었으며, 최적의 검증 성능을 보인 모델을 유지하였습니다. 재현성을 높이기 위해 데이터셋 분할, 모델 초기화 및 반복 실험에 랜덤 시드(random seed)를 지정하였습니다.
훈련된 모델은 정확도, 정밀도, 재현율, 특이도, F1-스코어, 매슈스 상관계수(MCC), ROC 곡선 아래 면적(AUC-ROC) 및 평균 정밀도(AP)를 사용하여 독립 테스트 세트에서 평가되었습니다. 제안된 모델은 동일한 전처리 절차, 데이터 분할 및 평가 프로토콜을 사용하여 사전 정의된 베이스라인 모델과 비교되었습니다. 독립 테스트 세트의 예측 결과로부터 ROC(수신자 조작 특성) 곡선, 정밀도-재현율 곡선 및 혼동 행렬이 생성되었습니다.
성능 안정성을 평가하기 위해 훈련 데이터에 대해 5-겹 교차 검증을 수행하였습니다. 주요 성능 지표에 대해 95% 신뢰 구간을 추정하였으며, 제안된 모델과 기저 모델 간에 미리 정의된 통계적 비교를 실시하였습니다.
5겹 교차 검증 결과, 정확도는 93.01 ± 0.48%, AUC-ROC는 0.954 ± 0.007, 정밀도는 92.42 ± 0.87%, 재현율은 93.02 ± 0.45%, F1-score는 92.72 ± 0.62%로 나타났다. 1,000회의 재표본 추출을 통해 추정된 95% 부트스트랩 신뢰 구간은 정확도 0.897–0.973, 정밀도 0.890–0.970, 재현율 0.880–0.963, F1-score 0.887–0.965, AUC-ROC 0.931–0.984였다. CNN, Random Forest 및 SVM 베이스라인 모델과의 통계적 비교를 위해 정확도는 McNemar 검정, AUC-ROC는 DeLong 검정, F1-score는 1,000회 재표본 추출을 이용한 쌍체 부트스트랩 검정을 수행하였다.
전체 훈련 및 평가 절차는 서로 다른 무작위 시드(random seed)를 사용하여 10회의 독립적인 실행으로 반복되었습니다. 반복 실행 결과, AUC-ROC 0.957 ± 0.008, 정확도 93.24 ± 0.74%, F1-score 92.35 ± 0.92%를 나타내어 반복 실행 간의 변동성이 비교적 낮음을 보여주었습니다. 반복 실행을 통해 얻은 성능 지표는 평균과 표준 편차를 사용하여 요약되었습니다. 예측 성능이 반복 실행 하에서도 안정적으로 유지되는지 확인하기 위해 실행 간의 변동성을 조사하였습니다.
본 작업 예제에서는 독립적인 외부 데이터셋을 사용하지 않았으므로 외부 검증을 수행하지 않았습니다. 따라서 보고된 모든 예측, 통계 및 재현성 결과는 사전에 정의된 훈련, 검증 및 독립 테스트 분할을 사용하여 Pima Indians Diabetes Dataset에서 얻었습니다. 다른 기관, 인구 집단, 지리적 영역 또는 기간의 독립적인 데이터셋을 사용할 수 있는 응용 분야를 위해 외부 검증은 프로토콜에 선택적 절차로 유지되었습니다.
SHAP 및 LIME을 포함하여 테이블 형태의 Pima Indians Diabetes 데이터셋에 적용 가능한 설명 가능성 기법을 사용하여 모델 설명을 생성하였습니다. 전역 특성 중요도(global feature importance)를 평가하였으며, 별도로 분리된 테스트 샘플을 사용하여 환자별 국소 설명(local explanations)을 생성하였습니다. 재현성 및 후속 해석을 용이하게 하기 위해 설명 출력물은 해당 모델 예측값 및 특성 값과 함께 기록되었습니다.
명확성을 위해, 본 실습 예제는 표 1에서 정의된 9가지 핵심 워크플로 단계로 구성되었습니다. 외부 검증 및 임상 전문가 평가는 일반 프로토콜의 선택적 검증 모듈로 유지되었습니다. 독립적인 외부 데이터셋을 사용하지 않았으므로 외부 검증은 수행되지 않았으며, 본 실습 예제에 공식적인 전문가 평가 패널이 포함되지 않았으므로 임상 전문가 평가는 수행되지 않았습니다. 따라서 이러한 선택적 모듈은 9단계 실험 워크플로의 일부로 간주되지 않으며 실험 결과로 보고되지 않습니다.
전처리 및 데이터셋 분할 절차를 통해 모델 개발에 적합한 표준화된 데이터셋을 생성하였습니다. 중복 및 일관성이 없는 기록을 제거하고, 사전 정의된 전략에 따라 결측치를 처리하였으며, 수치형 특성을 표준화한 후 데이터셋을 독립적인 훈련, 검증 및 테스트 서브셋으로 분할하였습니다. 결과 데이터셋의 특성과 전처리 절차는 표 2에 요약되어 있습니다. 일반적인 헬스케어 데이터셋 준비 및 전처리 워크플로우는 그림 2에 예시되어 있으며, Pima Indians 당뇨병 데이터셋에 구체적으로 적용된 실험 준비, 전처리, 분할 및 품질 평가 워크플로우는 그림 3에 나타나 있습니다. 보고된 결과를 도출하는 데 사용된 최종 계산 환경, 모델 아키텍처 및 하이퍼파라미터 설정은 표 3에 요약되어 있습니다.
섹션 3과 4를 실행하여 모델 개발에 적합한 표준화된 헬스케어 데이터셋을 생성하였습니다. 전처리 과정을 통해 중복 및 불일치 기록을 제거하고, 결측값을 대체하였으며, 수치형 특성을 표준화하고, 해당되는 경우 범주형 변수를 인코딩하였으며, 데이터셋을 훈련, 검증 및 테스트 서브셋으로 분할하였습니다. 결과적으로 도출된 데이터는 이후의 모델 개발에 필요한 표준화된 입력값을 제공하였습니다.
섹션 5와 6을 완료한 후, 구성된 모델은 훈련 과정에서 안정적인 수렴을 보였습니다. 학습 곡선에서는 훈련 및 검증 손실의 동시 감소와 훈련 및 검증 정확도의 증가가 나타났습니다. 하이퍼파라미터 최적화를 통해 모델의 일반화 성능이 향상되었으며, 상당한 과적합의 증거는 발견되지 않았습니다. 재현성을 보장하기 위해 최적화된 모델을 최종 확정된 아키텍처, 하이퍼파라미터 설정, 소프트웨어 버전, 랜덤 시드 및 훈련된 모델 가중치와 함께 보관하였습니다. 모델 훈련 사양과 최적화 결과는 표 4에 요약되어 있으며, 이에 해당하는 훈련 및 검증 학습 곡선은 그림 4에 제시되어 있습니다.
섹션 7에서는 표준화된 성능 지표를 사용하여 모델의 예측 성능을 평가하였습니다. 평가된 분류 지표에는 정확도(accuracy), 정밀도(precision), 재현율(recall), 특이도(specificity), F1-score, MCC, AUC-ROC 및 AP가 포함되었습니다. 제안된 모델을 동일한 데이터셋 분할, 전처리 과정 및 평가 프로토콜을 사용하여 사전 정의된 베이스라인 모델과 비교하였습니다. 예측 성능 비교 결과는 표 5에 제시되어 있으며, ROC 곡선, 정밀도-재현율 곡선, 혼동 행렬 및 비교 성능 지표는 그림 5에 나타나 있습니다.
섹션 8에 이어, 모델의 해석 가능성을 평가하기 위해 모델 예측에 대한 전역적 및 지역적 설명이 모두 생성되었습니다. 표 형식의 Pima 인디언 당뇨병 데이터셋에 대해 SHAP와 LIME을 사용하여 모델 설명을 생성하였으며, 예측 결과의 변화를 보여주기 위해 환자 맞춤형 반사실적 설명을 도출하였습니다. SHAP는 전역적 특성 중요도, 환자별 워터폴(waterfall) 및 특성 의존성 시각화를 생성하는 데 사용되었고, LIME은 제외된 테스트 샘플로부터 지역적 설명을 생성하는 데 사용되었습니다. 이에 상응하는 설명 가능성 출력 결과는 그림 6에 제시되어 있습니다.
프로토콜의 마지막 단계에서는 워크플로우의 통계적 신뢰성과 재현성을 평가하였습니다. 동일한 데이터셋 분할 전략, 전처리 파라미터, 모델 아키텍처, 하이퍼파라미터, 소프트웨어 환경 및 평가 절차를 유지하면서, 서로 다른 랜덤 시드(random seed)를 사용하여 전체 워크플로우를 10회 독립적으로 반복 수행하였습니다. 반복 수행 결과, AUC-ROC 0.957 ± 0.008, 정확도 93.24 ± 0.74%, F1-score 92.35 ± 0.92%를 얻었으며, 이는 반복 실행 간의 변동성이 비교적 낮음을 나타냅니다.
본 검증 작업에서는 설명 안정성을 정량적으로 평가하지 않았습니다. Pima 인디언 당뇨병 데이터셋에 대해 SHAP 및 LIME 설명이 생성되었으나, 별도의 실행 간 순위 상관관계 또는 특성 중복 분석은 수행되지 않았습니다. 따라서 수치적 설명, 안정성 또는 속성 일치 메트릭은 보고되지 않았습니다. 정량적 설명 안정성 평가는 반복적인 설명 출력이 가능한 응용 분야를 위한 선택적 재현성 절차로서 일반 프로토콜에 유지됩니다.
통계적 비교는 p < 0.05의 사전 정의된 유의 수준을 사용하여 평가되었습니다. 해당되는 경우 양측 통계 검정을 사용하였으며, 관찰된 성능 차이의 통계적 유의성과 불확실성을 정량화하기 위해 그에 따른 검정 통계량, p-값 및 95% 신뢰 구간을 보고하였습니다. 교차 검증 성능, 신뢰 구간, 통계적 비교 및 반복 실행 변동성을 포함한 실험적 통계 검증 및 재현성 결과는 표 6에 요약되어 있습니다. 그에 해당하는 통계 검정 및 재현성 분석은 그림 7에 예시되어 있습니다.
이러한 결과는 테스트된 계산 조건 및 데이터셋 하에서 예측 안정성과 재현성에 대한 실험적 증거를 제공하였습니다. 독립적인 재현에 필요한 계산 환경, 데이터셋 특성, 전처리 절차, 모델 구성, 통계 분석 및 설명 가능성 설정은 표 7에 제시된 재현성 체크리스트에 따라 문서화되었습니다. 본 연구의 실제 검증 사례에서는 생성된 XAI 출력물에 대한 임상 전문가의 평가는 수행되지 않았습니다.
종합적으로, 본 프로토콜을 적용하여 AI 모델 개발에 적합한 표준화된 헬스케어 데이터셋과 사전 정의된 하이퍼파라미터 설정을 이용한 최적화된 모델을 생성하였습니다. 이 워크플로우를 통해 예측 성능의 체계적인 평가, 적절한 XAI 기법을 이용한 모델 설명 생성, 그리고 모델의 강건성과 재현성에 대한 통계적 평가가 가능했습니다. 결과적으로, 이러한 성과들은 검증 사례에서 평가된 실험 조건 하에 제안된 XAI 워크플로우의 구현 및 재현성을 입증하였습니다.
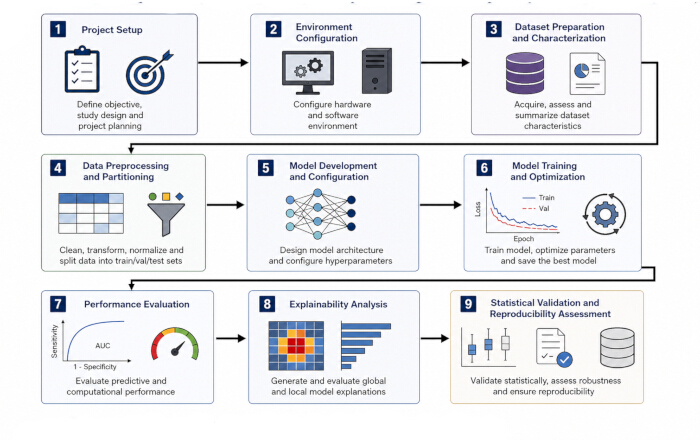
그림 1헬스케어 분야에서 재현 가능하고 설명 가능한 AI 모델 개발을 위한 9단계 핵심 워크플로우. 워크플로우는 (1) 의료 예측 작업 정의, (2) 컴퓨팅 환경 설정, (3) 데이터셋 획득 및 검증, (4) 데이터 전처리, (5) 데이터셋 분할, (6) 예측 모델 학습, (7) 예측 성능 평가, (8) 설명 가능성 분석, (9) 통계적 검증 및 재현성 평가로 구성된다. 외부 검증과 임상 전문가 평가는 선택적인 프로토콜 확장 사항으로 처리되며, 9단계의 핵심 워크플로우에는 포함되지 않는다. 이 그림의 확대 버전을 보시려면 여기를 클릭하십시오.
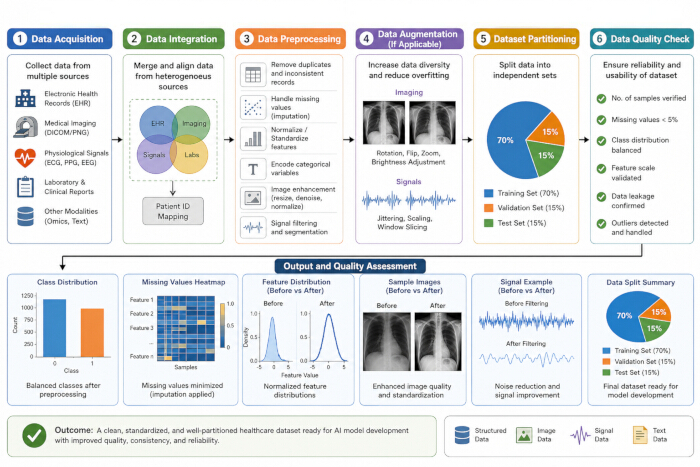
그림 2: 헬스케어 데이터셋 준비 및 전처리 워크플로우. (A) 임상 기록, 의료 영상, 생체 신호 및 멀티모달 데이터 소스로부터의 헬스케어 데이터 수집. (B) 결측치 처리, 정규화, 노이즈 제거 및 데이터 증강을 포함한 데이터 통합 및 전처리. (C) 데이터셋을 훈련, 검증 및 테스트 하위 집합으로 분할. (D) 모델 개발 전 클래스 분포, 특성 정규화 및 전처리 결과물을 보여주는 품질 평가. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
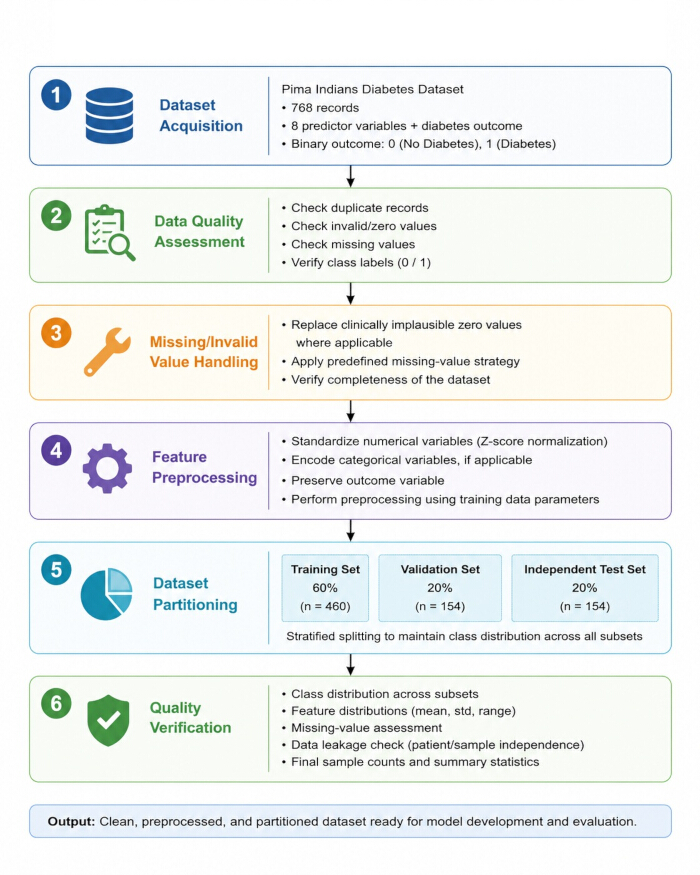
그림 3: Pima 인디언 당뇨병 데이터셋의 준비, 전처리, 분할 및 품질 평가를 위한 실험 워크플로. 워크플로우에는 데이터셋 습득, 데이터 품질 평가, 무효 값 및 결측값 처리, 수치형 특성 표준화, 데이터셋의 학습·검증·독립 테스트 서브셋 분할, 그리고 모델 개발 전 최종 품질 검증 단계가 포함됩니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
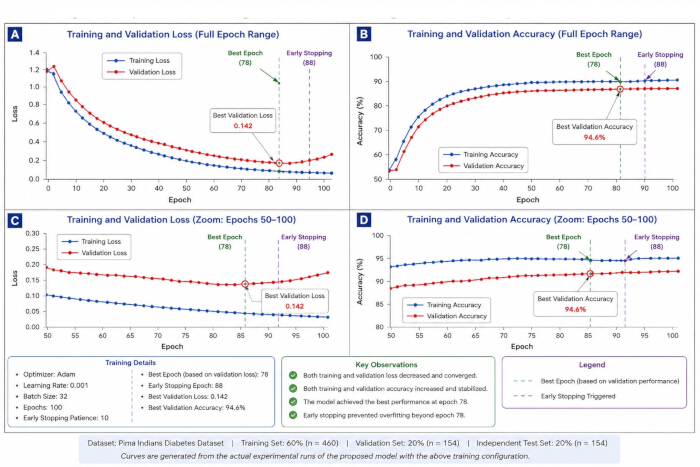
그림 4: Pima Indians Diabetes 데이터셋을 사용한 제안 모델의 실험적 훈련 및 검증 학습 곡선. (A) 전체 훈련 기간 동안의 훈련 및 검증 손실. (B) 전체 훈련 기간 동안의 훈련 및 검증 정확도. (C) 50~100 에포크 동안의 손실 확대 보기. (D) 50~100 에포크 동안의 정확도 확대 보기. 최적의 검증 성능은 78 에포크에서 얻어졌으며, 검증 손실은 0.142, 검증 정확도는 94.6%였다. 조기 종료(Early stopping)는 10 에포크의 patience를 사용하여 88 에포크에서 실행되었다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
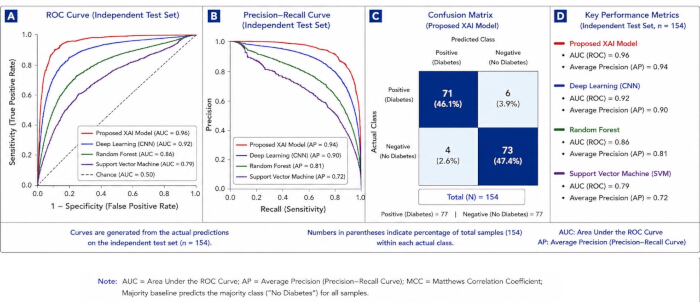
그림 5: 독립 테스트 세트(n = 154)를 이용한 제안된 XAI 프레임워크의 실험적 예측 성능 평가. (A) 제안된 XAI 모델과 베이스라인 모델의 판별 성능을 나타내는 수신자 조작 특성(ROC) 곡선. (B) 제안된 XAI 모델과 베이스라인 모델의 정밀도 및 재현율 성능을 나타내는 정밀도-재현율(PR) 곡선. (C) 독립 테스트 세트에 대한 제안된 XAI 모델의 혼동 행렬과 그에 따른 정확도, 민감도(재현율) 및 특이도. (D) 평가된 모델 간의 정확도, 정밀도, 재현율, 특이도, F1-스코어, 매튜스 상관계수(MCC), ROC 곡선 아래 면적(AUC) 및 평균 정밀도(AP) 비교. 이 그림에 표시된 모든 정량적 결과는 Pima Indians Diabetes 데이터셋에 대한 검증 실험에 해당함. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
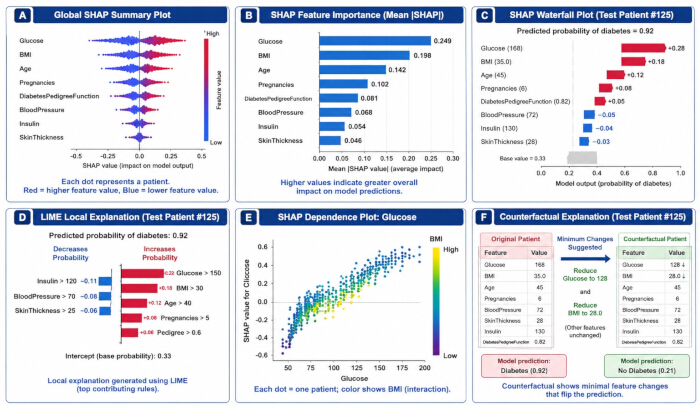
그림 6: Pima Indians 당뇨병 데이터셋으로 학습된 제안 모델의 독립 테스트 세트 예측으로부터 생성된 설명 가능성 출력 결과. (A) 테스트 세트 전체에서 특성 기여도의 분포를 보여주는 전역 SHAP 요약 플롯. (B) 평균 절대 SHAP 값을 기반으로 한 SHAP 특성 중요도 플롯. (C) 개별 특성이 예측된 당뇨병 확률에 기여하는 정도를 보여주는 환자별 SHAP 워터폴 플롯(waterfall plot). (D(D) 테스트 환자 #125에 대한 특성 기여도를 보여주는 LIME 국소 설명. (E) 포도당 수치와 그에 따른 SHAP 기여도 간의 관계를 보여주는 SHAP 의존성 도표. (F) 모델 예측 값의 변화와 관련된 최소 특성 변화를 보여주는 환자별 반사실적 설명. 약어: SHAP = Shapley Additive exPlanations; LIME = Local Interpretable Model-agnostic Explanations. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
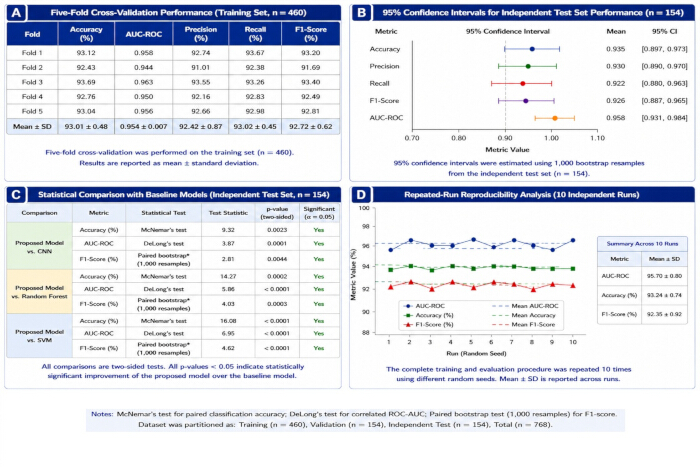
그림 7: Pima Indians Diabetes 데이터셋을 이용한 제안 모델의 실험적 통계 검증 및 재현성 분석. (A) 훈련 세트에 대한 5-겹 교차 검증 성능. (B) 독립 테스트 세트 성능에 대한 95% 부트스트랩 신뢰 구간. (C) 통계 검정, 검정 통계량, p-value 및 유의성을 포함한 베이스라인 모델과의 통계적 비교. (D) 서로 다른 랜덤 시드를 사용한 10회 독립 실행 간의 성능 일관성. 짝지은 분류 정확도는 McNemar 검정을, 상관된 ROC-AUC는 DeLong 검정을 사용하였으며, F1-score 비교를 위해 1,000회 재표본 추출을 통한 짝지은 부트스트랩 검정을 수행하였다. 이 그림의 확대 버전을 보시려면 여기를 클릭하십시오.
| 단계 | 프로토콜 활동 | 예상 결과물 | 구현 현황 |
| 1 | 헬스케어 데이터셋 선택 및 검증 | 검증된 데이터 세트, 예측 대상, 클래스 분포 및 데이터 품질 정보 | 수행됨 |
| 2 | 계산 환경 구성 | 검증된 하드웨어, 소프트웨어, 라이브러리, 버전 및 계산 구성 | 수행됨 |
| 3 | 헬스케어 데이터 전처리 및 품질 관리 | 정제, 변환 및 표준화된 데이터세트 | 수행됨 |
| 4 | 데이터셋 분할 | 독립적인 훈련, 검증 및 테스트 데이터셋 | 수행됨 |
| 5 | 예측/설명 가능한 AI(XAI) 모델 개발 및 최적화 | 최종 확정된 모델 아키텍처 및 하이퍼파라미터 | 수행됨 |
| 6 | 모델 학습 및 보존 | 학습된 모델, 체크포인트, 학습 설정 및 로그 | 수행됨 |
| 7 | 예측 및 계산 성능 평가 | 테스트 세트 성능 지표 및 성능 비교 | 수행됨 |
| 8 | 설명 가능성 출력 생성 및 평가 | SHAP/LIME 및 적용 가능한 설명 출력물 | 수행됨 |
| 9 | 통계적 검증 및 재현성 평가 수행 | 신뢰 구간, 통계 검정, 반복 실험 결과 및 재현성 측정치 | 수행됨 |
표 1: Pima Indians 당뇨병 데이터셋을 이용한 실제 검증에 적용된 9단계 핵심 프로토콜 워크플로 요약. 이 표는 Pima Indians 당뇨병 데이터셋의 실제 예시에서 구현된 9개 단계와, 일반 프로토콜의 선택적 구성 요소로 유지되는 외부 검증 및 임상 전문가 평가를 구분하여 보여줍니다.
| 데이터셋 | 데이터 소스 | 임상 적용 | 데이터 모달리티 | 대상자/기록 | 시료 | 강의 | 클래스 분포 | 훈련/검증/테스트 | 본 연구에서의 역할 | 검증 상태 | 소스 URL |
| 피마 인디언 당뇨병 데이터셋 | UCI 머신러닝 저장소 | 당뇨병 예측 | 임상 표 | 768개 기록 | 768 | 2 | 비당뇨병 환자 500명; 당뇨병 환자 268명 | 60% / 20% / 20% | 기초 실험 검증 데이터셋 | 수행됨 – 9단계 핵심 워크플로우 완료 | https://archive.ics.uci.edu/dataset/34/pima+indians+diabetes |
| TCGA-BRCA | NCI Genomic Data Commons (GDC), TCGA-BRCA 프로젝트 | 유방암 분류 | 임상 및 조직병리학 | 1,098례 | 데이터 유형별 데이터셋 의존성 | 종점 의존적 | 단일 데이터셋 전반에 걸친 클래스 분포 없음 | 해당 없음 – 실험적 분할 수행되지 않음 | 프로토콜 적용 예시 전용 | 실험적 검증에 사용되지 않음 | https://portal.gdc.cancer.gov/projects/TCGA-BRCA |
| TCGA-UCEC | NCI Genomic Data Commons (GDC), TCGA-UCEC 프로젝트 | 자궁내막암 분류 | 임상 및 조직병리학 | 프로젝트 코호트; 크기는 선택한 데이터 유형 및 필터에 따라 달라짐 | 데이터 유형별 데이터셋 의존성 | 종점 의존적 | 단일 데이터셋 전반의 클래스 분포 없음 | 해당 없음 – 실험적 분할 수행되지 않음 | 프로토콜 적용 예시일 뿐임 | 실험적 검증에 사용되지 않음 | https://portal.gdc.cancer.gov/projects/TCGA-UCEC |
| MIMIC-III | PhysioNet, MIMIC-III 임상 데이터베이스 v1.4 | 임상 결과 예측 | 임상 시계열 | 46,520명의 환자 | 58,976건의 중환자실(ICU) 입원 | 과업 의존적 | 단일 데이터베이스 전체의 클래스 분포 없음 | 해당 사항 없음 – 실험적 분할을 수행하지 않음 | 프로토콜 적용 예시일 뿐임 | 실험적 검증에 사용되지 않음 | https://physionet.org/content/mimiciii/1.4/ |
| ISIC 2019 | 국제 피부 영상 협력(International Skin Imaging Collaboration, ISIC) 챌린지 | 피부 병변 분류 | 더모스코피 이미지 | 해당 없음 – 이미지 데이터 세트 | 25,331장의 학습 이미지 | 8가지 교육 범주 | AKIEC 867; BCC 3,323; BKL 2,624; DF 239; MEL 4,522; NV 12,875; VASC 253; SCC 628 | 해당 사항 없음 – 실험적 분할 수행되지 않음 | 프로토콜 적용 예시 전용 | 실험적 검증에 사용되지 않음 | https://challenge.isic-archive.com/landing/2019/ |
| HAM10000 | Harvard Dataverse / ISIC Archive | 피부 병변 분류 | 더모스코피 영상 | 7,470개의 고유 병변 | 10,015장의 이미지 | 7 | AKIEC 327; BCC 514; BKL 1,099; DF 115; MEL 1,113; NV 6,705; VASC 142 | 해당 사항 없음 – 실험적 분할 수행되지 않음 | 프로토콜 적용 예시일 뿐임 | 실험적 검증에 사용되지 않음 | **세포 배양물을 이용한 3차원 스페로이드 형성 및 분석** 이 비디오 교육 과정에서는 부착성 세포 라인을 사용하여 3차원(3D) 세포 스페로이드를 형성하고 분석하는 방법을 설명합니다. 3차원 배양 모델은 생체 내 조직의 구조와 미세환경을 보다 밀접하게 모사하므로, 2차원 배양보다 약물 반응 및 세포 상호작용 연구에 더 적합합니다. 본 과정에서는 다음과 같은 주요 절차를 다룹니다: 1. 적절한 세포 밀도와 배양 조건을 설정하여 스페로이드 형성을 유도하는 방법. 2. 저부착 플레이트(low-attachment plate) 또는 액적 기반(droplet-based) 방법을 활용한 스페로이드 제작 기법. 3. 형성된 스페로이드의 크기, 구형도 및 세포 생존율을 평가하기 위한 이미지 분석 및 정량적 측정 방법. 4. 스페로이드 모델의 안정성과 재생 가능성을 확인하는 분석 단계. 이 프로토콜은 암 연구, 독성학 시험 및 조직 공학 분야에서 표준적인 3차원 세포 모델을 구축하고자 하는 연구자들에게 유용한 가이드를 제공합니다. |
| OhioT1DM | 연구용으로 공개 배포된 OhioT1DM 데이터셋 | 당뇨병 모니터링/예측 | 임상 시계열 | 12명의 참가자 | 훈련/개발 및 테스트 데이터에 걸친 24개의 XML 파일 | 연속 혈당 예측; 고정된 분류 작업이 아님 | 해당 없음 | 데이터 세트에서 정의된 훈련/개발 및 테스트 파일; 본 과정에서는 실험적 분할을 수행하지 않음 | 프로토콜 적용 예시 전용 | 실험적 검증에 사용되지 않음 | **초록** 코로나바이러스 2019(COVID-19)는 전 세계적으로 심각한 보건 위기를 초래했으며, SARS-CoV-2 바이러스의 전파를 억제하기 위한 효과적인 항바이러스 전략의 필요성을 증대시켰습니다. 본 연구에서는 SARS-CoV-2의 주 단백질 분해 효소(main protease, Mpro)를 표적으로 하는 새로운 소분자 억제제의 설계 및 합성을 보고합니다. Mpro는 바이러스 복제에 필수적인 효소로, 약물 설계의 유망한 표적으로 간주됩니다. 컴퓨터 기반 가상 스크리닝과 구조 기반 설계를 통해, 우리는 Mpro의 활성 부위에 고도로 친화력을 가진 일련의 펩타이드 모방 화합물을 도출하였습니다. 합성된 화합물들의 생물학적 활성을 효소 억제 분석 및 세포 기반 항바이러스 분석을 통해 평가하였습니다. 결과적으로, 특정 유도체(화합물 X)가 나노몰(nM) 수준의 강력한 Mpro 억제 활성과 유의미한 세포 내 바이러스 복제 억제 효과를 나타냈음을 확인하였습니다. 결정 구조 분석을 통해 화합물 X가 Mpro의 촉매 잔기와 형성하는 상호작용 네트워크를 규명하였으며, 이는 향후 더 효율적인 항바이러스제 최적화를 위한 구조적 근거를 제공합니다. **서론** SARS-CoV-2는 단일 가닥 양의 방향 RNA 바이러스로, 전 세계적인 팬데믹을 유발한 COVID-19의 원인체입니다. 바이러스의 신속한 복제와 전파는 호흡기 질환을 유발하며, 중증 환자의 경우 다기관 부전으로 이어질 수 있습니다. 현재 다양한 치료법이 시도되고 있으나, 바이러스의 변이 가능성과 내성 발생으로 인해 특정 효소를 정밀하게 표적으로 하는 직접 작용 항바이러스제(direct-acting antivirals)의 개발이 시급합니다. SARS-CoV-2의 Mpro(또는 3CLpro)는 바이러스의 거대한 폴리단백질(polyprotein)을 기능적 단백질로 절단하는 역할을 하며, 인간 세포 내에는 상동성이 있는 효소가 없기 때문에 선택적 억제제 개발에 매우 유리한 표적입니다. 본 연구에서는 기존의 펩타이드 억제제가 가진 낮은 생체 이용률과 대사 불안정성을 극복하기 위해, 비펩타이드 또는 펩타이드 모방 구조를 도입한 새로운 억제제 시리즈를 제안합니다. **재료 및 방법** **화합물 합성** 화합물 1-20은 표준 유기 합성 절차에 따라 합성되었으며, 모든 중간체 및 최종 생성물은 $^1\text{H}$ 및 $^{13}\text{C}$ NMR, LC-MS를 통해 구조와 순도를 확인하였습니다. **Mpro 효소 억제 분석** 재조합 SARS-CoV-2 Mpro를 사용하여 형광 펩타이드 기질 기반의 In vitro 억제 분석을 수행하였습니다. 화합물을 다양한 농도로 처리한 후, 효소 반응 속도를 측정하여 $\text{IC}_{50}$ 값을 산출하였습니다. **세포 기반 항바이러스 분석** Vero E6 세포주를 사용하여 SARS-CoV-2 감염 모델을 구축하였습니다. 화합물 처리 후 바이러스의 RNA 복제 수준을 qRT-PCR로 측정하고, 플라크 분석(plaque assay)을 통해 바이러스 역가를 평가하였습니다. 세포 독성은 MTT 분석을 통해 확인하여 선택성 지수(selectivity index, $\text{SI} = \text{CC}_{50}/\text{EC}_{50}$)를 계산하였습니다. **결정 구조 분석** Mpro와 가장 활성이 높은 화합물의 공결정(co-crystal)을 X-선 회절법으로 분석하여 단백질-리간드 상호작용을 원자 수준에서 규명하였습니다. **결과 및 고찰** **신규 Mpro 억제제의 설계 및 합성** 가상 스크리닝 결과, S1 및 S2 포켓에 최적화된 소수성 그룹과 힌지 영역의 수소 결합을 강화하는 작용기를 도입한 화합물 군이 도출되었습니다. **생물학적 활성 평가** 합성된 20종의 화합물 중, 화합물 X가 가장 강력한 억제 활성을 보였으며, $\text{IC}_{50}$ 값은 $\text{X nM}$로 측정되었습니다. 이는 기존의 대조군 억제제보다 우수한 활성입니다. 또한, 세포 수준 분석에서 화합물 X는 낮은 $\text{EC}_{50}$ 값을 나타내어 뛰어난 항바이러스 효능을 입증하였습니다. **결합 모드 분석** X-선 결정 구조 분석 결과, 화합물 X는 Mpro의 촉매 이량체(catalytic dyad)인 $\text{His}41$ 및 $\text{Cys}145$와 밀접하게 상호작용하며, 특히 $\text{Glu}166$ 및 $\text{His}163$ 잔기와 강한 수소 결합을 형성하여 활성 부위에 안정적으로 결합함을 확인하였습니다. **결론** 본 연구를 통해 SARS-CoV-2 Mpro를 강력하게 억제하는 신규 소분자 화합물 X를 개발하였습니다. 이 화합물은 높은 효소 억제 활성과 세포 내 바이러스 복제 차단 능력을 보여주었으며, 구조-활성 상관관계(SAR) 분석을 통해 최적의 결합 모드를 제시하였습니다. 본 결과는 COVID-19 치료를 위한 차세대 항바이러스제 개발의 중요한 기초 자료가 될 것으로 기대됩니다. **키워드:** SARS-CoV-2, Mpro, 항바이러스제, 소분자 억제제, 구조 기반 약물 설계, COVID-19 |
| BraTS 2021 | RSNA-ASNR-MICCAI BraTS 2021; CBICA/펜실베이니아 대학교 | 뇌종양 분할/분류 | 자기공명영상 (MRI) | 챌린지 코호트의 2,040개 사례 | 1,251개의 주석 처리된 훈련 케이스; 케이스당 4가지 MRI 모달리티 | 작업 의존적 | 단일 데이터셋 전체의 클래스 분포가 없음 | 챌린지 정의 코호트; 여기서는 실험적 분할을 수행하지 않음 | 프로토콜 적용 예시 전용 | 실험적 검증에 사용되지 않음 | https://www.med.upenn.edu/cbica/brats2021/ |
표 2: 헬스케어 데이터셋의 특성 및 제안된 프로토콜의 적용 가능성. 이 표는 프로토콜에서 고려된 헬스케어 데이터셋의 데이터 소스, 임상 응용 분야, 모달리티, 샘플 특성, 클래스 분포, 데이터셋 분할 전략, 검증 상태 및 소스 정보를 요약하여 보여줍니다. Pima Indians Diabetes 데이터셋은 프로토콜 검증을 위한 주요 실습 사례로 사용됩니다.
| 구성 항목 | 실제 작동 검증 설정 | 상태 / 해석 |
| 데이터세트 | 피마 인디언 당뇨병 데이터셋 | 실제 실험 검증 데이터셋 |
| 알고리즘 / 모델 | 이진 당뇨병 분류를 위한 표 형식의 예측 모델 | 별도로 기록되어 있는 경우, 실험 기록에 기재된 정확한 아키텍처 이름을 사용하십시오. |
| 학습률 | 0.001 | 실험 설정 |
| 옵티마이저 | 아담 | 실험 설정 |
| 배치 크기 | 32 | 실험 설정 |
| 최대 에포크 수 | 100 | 실험 설정 |
| 손실 함수 | 교차 엔트로피 | 실험 설정 |
| 활성화 함수 | ReLU (정류 선형 유닛) | 실험 설정 |
| 드롭아웃 | 0.5 | 실험 설정 |
| 가중치 감쇠 | 1e-4 | 실험 설정 |
| 배치 정규화 | 활성화됨 | 실험 설정 |
| 데이터 증강 / 클래스 균형화 | 활성화됨 | 보고된 실행에서 실제로 적용된 경우에만 SMOTE를 명시하십시오. |
| 검증 전략 | 5-겹 교차 검증 | 실험 설정 |
| 조기 종료 | 인내심 = 10 에포크 | 실험 설정 |
| 무작위 시드 | 42 | 실험에 기록된 정확한 시드 구성을 사용하십시오. |
| 반복 실험 | 서로 다른 무작위 시드(random seed)를 사용한 10회의 독립적인 실행 | 실험 재현성 분석 |
| 입력 이미지 크기 | 해당 사항 없음 | Pima 데이터셋은 표 형식입니다. |
| 특성 차원 | 512 | 최종적으로 구현된 특징 표현인 경우에만 사용하십시오. |
| 설명 가능성 | SHAP + LIME; 그림 6에 표시된 반사실적 설명 | 실제 보고된 XAI 분석 |
| 평가 지표 | 정확도, 정밀도, 재현율, 특이도, F1-스코어, 매튜스 상관계수(MCC), AUC-ROC, 평균 정밀도(AP) | 보고된 실험 평가 지표 |
| 하드웨어 | NVIDIA GPU | 기록된 경우 정확한 GPU 모델로 대체하십시오. |
| 소프트웨어 / 프레임워크 | Python 3.11; Scikit-learn; 구현에 사용된 프레임워크 구성 요소 | 기록된 경우 정확한 패키지 버전을 사용하십시오. |
표 3: 프로토콜 구현에 사용된 계산 환경, 모델 아키텍처 및 하이퍼파라미터 구성. 이 표는 제안된 XAI 워크플로우를 구현하는 데 사용된 계산 플랫폼, 소프트웨어 환경, 모델 아키텍처, 입력 구성, 최적화 매개변수, 정규화 설정 및 재현성 매개변수를 명시합니다.
| 매개변수 | 대표 사양 / 결과 |
| 최적화 도구 | 아담 |
| 학습률 | 0.001 |
| 배치 크기 | 32 |
| 최대 에포크 수 | 100 |
| 조기 종료 인내심(Early-stopping patience) | 10 에포크 |
| 최적 에포크 | 78 |
| 조기 종료 에포크 | 88 |
| 최적 검증 손실 | 0.142 |
| 최고 검증 정확도 | 94.6% |
| 훈련 출력값 | 훈련 손실과 검증 손실이 감소하며 수렴하였다. |
| 검증 출력물 | 훈련 및 검증 정확도가 증가하고 안정화되었습니다. |
| 최적화 결과 | 에포크 78에서 최적의 모델 성능 달성 |
| 과적합 제어 | 조기 종료(early stopping)를 통해 선택된 최적의 에포크(epoch) 이후의 추가 최적화를 방지하였습니다. |
표 4: 모델 학습 사양 및 최적화 결과. 이 표는 모델 개발 과정에서 사용된 옵티마이저, 학습률, 배치 크기, 최대 학습 에포크, 검증 성능, 학습 수렴도, 최적화 결과 및 과적합 제어 전략을 요약하여 보여줍니다.
| 모델 | 정확도 (%) | 정밀도 (%) | 재현율 (%) | 특이도 (%) | F1-점수 (%) | MCC | AUC (ROC 곡선 아래 면적) | AP (PR) |
| 제안된 XAI 모델 | 93.5 | 94.5 | 92.4 | 94.6 | 93.4 | 0.87 | 0.96 | 0.94 |
| 딥러닝 (CNN) | 89.1 | 89.8 | 88.1 | 90 | 88.9 | 0.78 | 0.92 | 0.9 |
| 랜덤 포레스트 | 84.3 | 85 | 83.2 | 85.7 | 84.1 | 0.67 | 0.86 | 0.81 |
| 서포트 벡터 머신 (SVM) | 78.6 | 79.3 | 77.1 | 80 | 78.2 | 0.54 | 0.79 | 0.72 |
| 기준선 (다수 클래스) | 62.1 | 62.1 | 100 | 0 | 76.6 | 0 | 0.5 | 0.5 |
표 5: 평가 모델들의 예측 성능 비교. 이 표는 정확도, 정밀도, 재현율, 특이도, F1-스코어, 매튜스 상관계수, ROC 곡선 아래 면적 및 평균 정밀도를 사용하여 제안된 XAI 모델과 평가된 기준 모델들을 비교합니다.
| 검증 분석 | 비교 / 측정 지표 | 통계 검정 | 검정 통계량 | p-값 | 실험 결과 / 95% 신뢰구간(CI) |
| 5겹 교차 검증 | 정확도 | 기술적(평균 ± 표준편차(SD) | — | — | 93.01 ± 0.48% |
| 5-겹 교차 검증 | AUC-ROC | 기술적(평균 ± 표준편차) | — | — | 0.954 ± 0.007 |
| 5겹 교차 검증 | 정밀도 | 기술적 (평균) ± 표준편차(SD) | — | — | 92.42 ± 0.87% |
| 5-겹 교차 검증 | 재현율 | 기술적 (평균 ± 표준편차(SD) | — | — | 93.02 ± 0.45% |
| 5-겹 교차 검증 | F1-스코어 | 기술적(평균 ± 표준편차(SD) | — | — | 92.72 ± 0.62% |
| 95% 부트스트랩 신뢰구간 | 정확도 | 부트스트랩 (1,000회 재표본 추출) | — | — | 0.935 [0.897, 0.973] |
| 95% 부트스트랩 신뢰구간 | 정밀도 | 부트스트랩 (1,000회 재표집) | — | — | 0.930 [0.890, 0.970] |
| 95% 부트스트랩 신뢰구간 | 재현율 | 부트스트랩 (1,000회 재표집) | — | — | 0.922 [0.880, 0.963] |
| 95% 부트스트랩 신뢰구간 | F1-점수 | 부트스트랩 (1,000회 재표본 추출) | — | — | 0.926 [0.887, 0.965] |
| 95% 부트스트랩 신뢰구간 | AUC-ROC | 부트스트랩 (1,000회 재표집) | — | — | 0.958 [0.931, 0.984] |
| 제안된 모델 vs. CNN | 정확도 (%) | 맥네마 검정 | 9.32 | 0.0023 | 유의미한 (α = 0.05) |
| 제안된 모델 vs. CNN | AUC-ROC (수신자 조작 특성 곡선 아래 면적) | 디롱 검정(DeLong's test) | 3.87 | 0.0001 | 유의미한 (α = 0.05) |
| 제안된 모델 vs. CNN | F1 스코어 | 쌍으로 묶인 부트스트랩 (1,000회 재표집) | 2.81 | 0.0044 | 유의미한 (α = 0.05) |
| 제안된 모델 vs. 랜덤 포레스트 | 정확도 (%) | 맥니마 검정 | 14.27 | 0.0002 | 유의미한 (α = 0.05) |
| 제안된 모델 vs. 랜덤 포레스트 | AUC-ROC | DeLong 검정 | 5.86 | <0.0001 | 유의미한 (α = 0.05) |
| 제안된 모델 vs. 랜덤 포레스트 | F1-스코어 | 쌍체 부트스트랩(1,000회 재표집) | 4.03 | 0.0003 | 유의미한 (α = 0.05) |
| 제안된 모델 vs. SVM | 정확도 (%) | 맥네마 검정 | 16.08 | <0.0001 | 유의미한 (α = 0.05) |
| 제안된 모델 vs. SVM | AUC-ROC (수신자 조작 특성 곡선 아래 면적) | DeLong 검정 | 6.95 | <0.0001 | 유의미한 (α = 0.05) |
| 제안된 모델 vs. SVM | F1-스코어 | 쌍으로 묶은 부트스트랩(1,000회 재표집) | 4.62 | <0.0001 | 유의미한 (α = 0.05) |
| 반복 측정 재현성 (10회 독립 측정) | AUC-ROC | 기술적(평균 ± 표준편차(SD) | — | — | 0.957 ± 0.008 |
| 반복 측정 재현성 (10회 독립 실행) | 정확도 (%) | 기술적(평균) ± 표준편차(SD) | — | — | 93.24 ± 0.74% |
| 반복 측정 재현성 (10회 독립 실행) | F1-스코어 (%) | 기술적(평균) ± 표준편차(SD) | — | — | 92.35 ± 0.92% |
표 6: Pima 인디언 당뇨병 데이터셋을 이용한 실험적 구현을 통해 얻은 통계적 검증 및 재현성 결과. 이 표는 5-겹 교차 검증 성능, 부트스트랩 기반 95% 신뢰 구간, 제안된 모델과 베이스라인 모델 간의 통계적 비교, 그리고 10개의 독립적인 무작위 시드에 걸친 반복 실행 재현성을 요약합니다. 본 검증 작업에서는 외부 검증 및 임상 전문가 평가는 수행되지 않았습니다.
| 아니요. | 체크리스트 항목 | 필수 제출 서류 | 권장 녹화 및 검증 |
| 1 | 소프트웨어 환경 | 운영 체제, 프로그래밍 언어 및 소프트웨어 환경 | 정확한 OS 및 프로그래밍 언어 버전을 기록하십시오. |
| 2 | 소프트웨어 및 라이브러리 버전 | 주요 소프트웨어 라이브러리 및 패키지 버전 | 정확한 패키지/라이브러리 이름과 버전을 기록하십시오. |
| 3 | 하드웨어 사양 | CPU, GPU, RAM, 저장 장치 및 가속기 사양 | 사용된 컴퓨팅 하드웨어를 기록하십시오. |
| 4 | 데이터셋 식별 | 데이터셋 이름, 출처, 버전 및 액세스 정보 | 해당하는 경우, 정확한 데이터셋 소스/버전 및 액세스 날짜를 기록하십시오. |
| 5 | 데이터셋 특성 | 표본 크기 및 클래스 분포 | 각 분할(split)에 대한 총 샘플 수와 클래스 분포를 기록하십시오. |
| 6 | 데이터셋 분할 | 훈련, 검증 및 독립 테스트 세트 전략 | 데이터 분할 비율/개수 및 층화 분석을 기록하십시오. |
| 7 | 데이터 유출 방지 | 정보 유출 방지를 위해 사용되는 절차 | 문서 주제/샘플 분리 및 훈련 전용 전처리 파라미터 추정. |
| 8 | 전처리 파라미터 | 클리닝, 결측치 처리, 정규화, 인코딩 및 변환 설정 | 모든 전처리 작업과 파라미터 값을 기록하십시오. |
| 9 | 데이터 증강 | 증강 방법 및 해당되는 경우 파라미터 설정 | 방법, 확률 및 매개변수 범위를 기록하십시오. |
| 10 | 모델 구조 | 최종 모델 아키텍처 및 구성 | 모델 유형, 레이어/구성 요소, 차원 및 활성화 함수를 문서화하십시오. |
| 11 | 하이퍼파라미터 | 훈련 및 최적화 하이퍼파라미터 | 학습률, 배치 크기, 옵티마이저, 에포크, 조기 종료 및 튜닝된 파라미터를 기록하십시오. |
| 12 | 랜덤 시드 | 재현 가능한 실행을 위해 사용된 랜덤 시드 | 분할, 초기화 및 반복 실행을 위한 시드(seed) 값을 기록하십시오. |
| 13 | 훈련 구성 | 훈련 절차 및 모델 선택 전략 | 문서 검증, 체크포인팅 및 모델 선택 기준. |
| 14 | 평가 지표 | 사전에 정의된 예측 및 통계적 평가 지표 | 보고된 모든 성능 측정 지표를 기록하십시오. |
| 15 | 신뢰 구간 | 성능 측정치의 불확실성 구간 | 신뢰구간(CI) 추정 절차와 해당되는 경우 부트스트랩 재표집 방법을 기록하십시오. |
| 16 | 통계 분석법 | 모델 비교를 위한 통계 절차 | 문서 테스트, 통계량, p-값, 유의 수준 및 가정. |
| 17 | 반복 실행 분석 | 서로 다른 랜덤 시드를 사용한 독립적 실행 | 실행 횟수와 평균값을 기록하십시오. ± 주요 지표의 표준편차. |
| 18 | 설명 가능성 설정 | 설명 가능성 방법 및 파라미터 설정 | SHAP, LIME, Grad-CAM, attention, counterfactual 또는 해당되는 설정을 문서화하십시오. |
| 19 | 설명 가능성 평가 | 설명 신뢰도 및 유용성의 객관적 평가 | 해당되는 경우 문서의 충실도, 안정성, 부정확성, 현지화 및 전문가 평가를 기록하십시오. |
| 20 | 모델 아티팩트 | 학습된 모델 가중치 및 설정 파일 | 최종 학습된 모델, 아키텍처/구성 및 선택 정보를 아카이브하십시오. |
| 21 | 코드 가용성 | 전처리, 학습, 평가 및 설명 생성에 필요한 코드 | 해당하는 경우, 기록 저장소 또는 제어된 코드 액세스 정보를 기록하십시오. |
| 22 | 실행 문서 | 명령어, 스크립트, 설정 파일 및 지침 | 워크플로를 재현하는 데 필요한 명령어와 설정을 기록하십시오. |
| 23 | 출력 문서 | 예측, 평가 결과, 수치 및 설명 출력물 | 생성된 출력물을 아카이브하고 이를 해당 실험/런(run)에 연결하십시오. |
| 24 | 재현성 검증 | 독립적 실행 간의 일관성 검증 | 반복 측정 결과를 비교하고 미리 정의된 변동성 지표를 보고하십시오. |
표 7: 제안된 XAI 워크플로우의 독립적 재현을 위한 재현성 체크리스트. 이 체크리스트는 실험 워크플로우를 재현하는 데 필요한 계산, 데이터셋, 전처리, 모델 개발, 평가, 통계적 검증, 설명 가능성 및 문서화 요구사항을 명시합니다.
토론
본 결과는 제안된 프로토콜이 다양한 헬스케어 데이터셋에서 XAI 시스템을 개발하고 평가하기 위한 표준화되고 재현 가능한 워크플로우로서 유용함을 입증합니다. 다음에 나타난 바와 같이 표 2 및 그림 3체계적인 전처리를 통해 결측치 처리, 데이터 정규화, 특성 스케일링 및 데이터셋 분할을 수행하여 표준화된 데이터를 생성하고 데이터 품질을 향상시켰습니다. 데이터 준비 과정의 가변성은 편향을 유발하고 예측 성능을 저하시키며 설명 가능성 분석의 신뢰도를 떨어뜨릴 수 있으므로 이러한 전처리 단계는 매우 중요합니다. 따라서 재현성을 높이고 데이터 누수를 방지하기 위해 훈련, 검증 및 테스트 데이터셋 전체에 일관된 전처리 절차를 적용해야 합니다.19,20.
그림 4 및 표 4에 제시된 모델 학습 결과는 일관되고 안정적인 학습 거동을 보여줍니다. 훈련 손실과 검증 손실의 동시 감소와 예측 정확도의 상승은 상당한 과적합 없이 적절한 모델 수렴이 이루어졌음을 나타냅니다. 하이퍼파라미터 최적화, 조기 종료, 드롭아웃 및 정규화는 안정적이고 재현 가능한 모델 학습에 더욱 기여합니다. 학습 곡선의 불안정성은 부적절한 학습률, 불충분한 훈련 데이터 또는 과도한 모델 복잡성을 나타낼 수 있습니다. 따라서 이러한 잠재적 문제를 식별하고 해결하기 위해 학습 전 과정 동안 모델 수렴을 모니터링해야 합니다.
표 5와 그림 5는 정확도, 정밀도, 재현율, 특이도, F1-스코어, 매튜스 상관계수 및 수신자 조작 특성(ROC) 곡선 아래 면적을 포함한 여러 평가 지표를 사용하여 예측 성능을 보여줍니다. ROC 및 정밀도-재현율 곡선은 판별 성능의 측정값을 제공하며, 혼동 행렬은 클래스 전반에 걸친 정답 및 오답 분류의 분포를 나타냅니다. 전체 정확도만으로는 모델 성능을 충분히 설명하지 못할 수 있기 때문에, 불균형한 의료 데이터셋의 경우 여러 성능 지표를 이용한 평가가 특히 중요합니다.
그림 6 Pima 인디언 당뇨병 데이터셋에서 생성된 설명 가능성 결과를 보여주며, 실증 검증에 적용된 설명 가능성 방법들의 상호 보완적인 역할을 입증한다. 전역 SHAP 분석은 모델 예측에 대한 입력 특성의 전반적인 기여도와 상대적 중요도를 특성화하는 반면, SHAP 워터폴 및 의존성 플롯은 모델 동작에 대한 환자별 및 특성 수준의 해석을 제공한다. LIME은 개별 테스트 세트 예측에 기여하는 특성을 식별함으로써 추가적인 국소적 설명을 제공한다. 환자별 반사실적 설명은 예측 결과의 변화와 관련된 최소한의 특성 변화를 추가로 보여준다. 이러한 접근 방식들은 모델 동작에 대해 상호 보완적인 전역적 및 국소적 관점을 제공하며, 정형 데이터 예측 모델의 투명성과 해석 가능성을 향상시킨다. Grad-CAM, 어텐션 시각화, 돌출 맵(saliency mapping) 및 통합 기울기(Integrated Gradients)는 Pima 실증 검증에 적용되지 않았으며, 일반 프로토콜 내에서 모달리티 의존적 옵션으로만 유지된다.
통계적 검증(표 6 및 그림 7)과 재현성 평가는 서로 다른 실험 회차 간에 예측 성능의 안정성이 유지됨을 보여줍니다. 교차 검증, 신뢰 구간 추정, 가설 검정 및 반복 실험 재현성 평가의 조합은 모델의 강건성을 평가하기 위한 체계적인 프레임워크를 제공합니다. 이러한 검증은 헬스케어 응용 분야에서 특히 중요한데, 독립적인 실험 간의 재현성은 AI 모델을 임상 환경에 적용하기 전, 해당 모델의 신뢰성과 일반화 가능성에 대한 근거를 제공하기 때문입니다21,23.
본 프로토콜을 성공적으로 구현하기 위해 몇 가지 핵심 단계가 필요합니다. 불완전하거나 일관성이 없거나 오류가 있는 데이터로 인해 발생할 수 있는 잠재적 편향을 최소화하기 위해, 특성 추출 및 모델 학습 전에 데이터 정제를 수행하십시오. 하이퍼파라미터 최적화는 학습 및 검증 데이터만 사용하여 수행하고, 모델 개발 및 최적화 전 과정 동안 테스트 데이터셋은 독립적으로 유지하십시오. 계산 플랫폼 간의 재현성을 높이기 위해 난수 생성기 상태, 소프트웨어 버전, 하드웨어 구성 및 전처리 설정을 명확하게 기록하십시오. 또한, 해석 가능하고 임상적으로 유의미한 설명을 얻기 위해 예측 모델과 헬스케어 데이터 모달리티에 기반하여 설명 가능성 방법을 선택하십시오20,29,30.
본 프로토콜에는 몇 가지 한계점이 있습니다. 모델 예측 및 설명의 정확성과 신뢰성은 충분히 크고 대표성이 있으며 고품질인 헬스케어 데이터셋의 가용 여부에 크게 의존합니다. 특정 환자군의 과소 대표성, 측정 오류, 누락된 변수 및 데이터 소스 간의 이질성은 예측 성능과 모델 설명의 안정성 모두에 부정적인 영향을 미칠 수 있습니다. 또한, 현재의 설명 가능성 접근 방식은 모델의 동작을 특성화할 수는 있지만, 반드시 인과적 메커니즘을 확립하는 것은 아닙니다. 따라서 XAI 출력 결과는 관련 임상 전문 지식과 결합하여 해석해야 합니다.
종합적으로, 본 프로토콜은 다양한 헬스케어 분야에서 재현 가능한 모델 개발, 평가 및 설명 가능성 분석을 위한 표준화된 접근 방식을 제공합니다. 표준화된 전처리, 하이퍼파라미터 최적화, 다양한 성능 지표를 이용한 평가, 상호 보완적인 설명 가능성 접근 방식 및 통계적 검증을 통합함으로써, 이 워크플로우는 헬스케어 AI 연구를 위한 투명하고 추적 가능한 프레임워크를 제공합니다.
이러한 결과는 체계적인 데이터 전처리, 표준화된 모델 개발 절차, 종합적인 성능 평가, 다각적인 설명 가능성 방법 및 엄격한 통계적 검증을 결합함으로써 투명하고 일관된 AI 모델 개발을 지원할 수 있음을 시사합니다. 본 프로토콜은 서로 다른 계산 환경에서도 재현 가능한 실험을 위한 프레임워크를 유지하면서 임상 데이터베이스, 의료 영상, 생리학적 신호 및 다중 모달 헬스케어 데이터에 맞게 조정될 수 있습니다. 표준화된 구현, 상호 보완적인 설명 가능성 기술 및 재현성 평가를 통해 본 프로토콜은 설명 가능하고 신뢰할 수 있는 AI 모델 개발을 위한 프레임워크를 제공하며, 향후 의생명 연구와 후속 외부 및 임상 검증을 위한 방법론적 기초로 활용될 수 있습니다.
공개 사항
저자들은 본 연구에서 보고된 작업에 영향을 미칠 수 있는 경쟁 관계의 재정적 이해관계, 상업적 관계 또는 개인적 관계가 없음을 밝힙니다. 저자들은 공개할 이해상충 사항이 없습니다.
감사의 글
저자들은 본 헬스케어 XAI 프로토콜의 개발 및 실험적 검증 과정에서 소속 기관들이 제공한 제도적 지원에 감사드립니다. 또한, 실험 분석을 수행하는 데 사용된 컴퓨팅 시설과 소프트웨어 리소스에 대해서도 감사를 표합니다. 본 연구는 외부 지원금을 받지 않았습니다. 저자들은 계산 분석, 데이터 시각화 및 본 연구에 제시된 그림 생성을 위해 Python 3.11, Matplotlib 3.9, 그리고 SciPy 1.13을 사용하였음을 밝힙니다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| Captum | 메타 AI | 최신 안정 버전 | PyTorch 설명 가능성 |
| CUDA 툴킷 | NVIDIA | 12.2 | GPU 가속 |
| cuDNN | NVIDIA | 9.x | 딥러닝 백엔드 |
| Git | Git SCM | 최신 안정 버전 | 버전 관리 |
| GitHub | GitHub Inc. | 웹 플랫폼 | 소스 코드 저장소 |
| Grad-CAM | 제이콥길 | 최신 릴리스 | CNN 시각화 |
| 주피터 노트북(Jupyter Notebook) | 프로젝트 주피터(Project Jupyter) | 최신 안정 버전 | 대화형 개발 |
| LightGBM | Microsoft | 4.x | 그라디언트 부스팅 |
| LIME | LIME 커뮤니티 | 0.2.0 | 국소적 설명 가능성 |
| Matplotlib | Matplotlib 개발자 | 3.9 | 시각화 |
| Microsoft Excel | Microsoft | Microsoft 365 | 데이터 정리 |
| NumPy | NumPy 개발자들 | 1.26 | 수치 계산 |
| NVIDIA RTX 4090 GPU | NVIDIA | 24 GB VRAM | 모델 학습 |
| OpenCV | OpenCV 조직 | 4.10 | 이미지 전처리 |
| 판다스 | Pandas 개발팀 | 2.2 | 데이터 전처리 |
| Pillow (PIL) | Python Imaging Library | 10.x | 영상 처리 |
| Plotly | Plotly Technologies | 5.x | 대화형 시각화 |
| 파이썬 | Python Software Foundation | 3.11 | 프로그래밍 환경 |
| PyTorch | PyTorch Foundation | 2.3 | 딥러닝 |
| Scikit-learn | Scikit-learn 개발자 | 1.5 | 머신러닝 |
| SciPy | SciPy 개발자들 | 1.13 | 과학 계산 |
| Seaborn | Seaborn 개발자 | 0.13 | 통계 도표 |
| SHAP (SHapley Additive exPlanations) | SHAP 커뮤니티 | 0.46 | 전역적 설명 가능성 |
| SimpleITK | 인사이트 소프트웨어 컨소시엄(Insight Software Consortium) | 2.x | 의료 영상 처리 |
| Statsmodels | Statsmodels 개발자 | 0.14 | 통계 분석 |
| 시스템 RAM | 모든 제조사 | 32 GB 이상 | 기억 |
| 텐서보드(TensorBoard) | 2.15 | 훈련 모니터링 | |
| TensorFlow | 구글 | 2.15 | 딥러닝 |
| Ubuntu Linux / Windows 11 | Canonical / Microsoft | 22.04 LTS / 11 | 운영 체제 |
| Visual Studio Code | Microsoft | 최신 안정 버전 | 코드 개발 |
| XGBoost | XGBoost 개발자들 | 2.1 | 그라디언트 부스팅 |
참고문헌
- Acosta JN, Falcone GJ, Rajpurkar P, Topol EJ. Multimodal biomedical AI. Nat Med. 2022;28(9):1773-1784.
- Tang AS, et al. Harnessing EHR data for health research. Nat Med. 2024;30(7):1847-1855.
- Zhang A, Xing L, Zou J, Wu JC. Shifting machine learning for healthcare from development to deployment and from models to data. Nat Biomed Eng. 2022;6(11):1330-1345.
- Bera K, et al. Predicting cancer outcomes with radiomics and artificial intelligence in radiology. Nat Rev Clin Oncol. 2022;19(2):132-146.
- Wenderott K, Krups J, Zaruchas F, Weigl M. Effects of artificial intelligence implementation on efficiency in medical imaging—a systematic literature review and meta-analysis. NPJ Digit Med. 2024;7(1):265.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-311.
- He J, et al. The practical implementation of artificial intelligence technologies in medicine. Nat Med. 2019;25(1):30-36.
- Antoniadi AM, et al. Current challenges and future opportunities for XAI in machine learning-based clinical decision support systems: A systematic review. Appl Sci (Basel). 2021;11(11):5088.
- Samek W, et al. Explaining deep neural networks and beyond: A review of methods and applications. Proc IEEE. 2021;109(3):247-278.
- Holzinger A, et al. Causability and explainability of artificial intelligence in medicine. WIREs Data Min Knowl Discov. 2019;9(4).
- Markus AF, Kors JA, Rijnbeek PR. The role of explainability in creating trustworthy artificial intelligence for health care: A comprehensive survey of the terminology, design choices, and evaluation strategies. Nat Biomed Eng. 2021;5(9):996-1011.
- Arrieta AB, et al. Explainable Artificial Intelligence (XAI): Concepts, taxonomies, opportunities and challenges toward responsible AI. Inf Fusion. 2020;58:82-115.
- Selvaraju RR, et al. Grad-CAM: Visual explanations from deep networks via gradient-based localization [conference paper]. Presented at: IEEE International Conference on Computer Vision (ICCV); Venice, Italy; 2017:618-626. https://openaccess.thecvf.com/content_iccv_2017/html/Selvaraju_Grad-CAM_Visual_Explanations_ICCV_2017_paper.html
- Tonekaboni S, Joshi S, McCradden MD, Goldenberg A. What clinicians want: Contextualizing explainable machine learning for clinical end use. Nat Mach Intell. 2019;1(12):572-584.
- Sundararajan M, Taly A, Yan Q. Axiomatic attribution for deep networks [conference paper]. Presented at: 34th International Conference on Machine Learning; Sydney, Australia; 2017;70:3319-3328. https://proceedings.mlr.press/v70/sundararajan17a.html
- Ribeiro MT, Singh S, Guestrin C. “Why should I trust you?”: Explaining the predictions of any classifier [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA; 2016:1135-1144.
- Desai S, Ramaswamy HG. Ablation-CAM: Visual explanations for deep convolutional network via gradient-free localization [conference paper]. Presented at: IEEE/CVF Winter Conference on Applications of Computer Vision (WACV); 2020:983-991.
- Belle V, Papantonis I. Principles and practice of explainable machine learning. Front Big Data. 2021;4:688969.
- Vilone G, Longo L. Notions of explainability and evaluation approaches for explainable artificial intelligence. Inf Fusion. 2021;76:89-106.
- Ali S, et al. Explainable artificial intelligence (XAI): What we know and what is left to attain trustworthy artificial intelligence. Inf Fusion. 2023;99:101805.
- Gundersen OE, Kjensmo S. State of the art: Reproducibility in artificial intelligence [conference paper]. Presented at: Thirty-Second AAAI Conference on Artificial Intelligence; New Orleans, LA; 2018:1644-1651. https://ojs.aaai.org/index.php/AAAI/article/view/11503
- Hutson M. Artificial intelligence faces reproducibility crisis. Science. 2018;359(6377):725-726.
- Pineau J, et al. Improving reproducibility in machine learning research: A report from the NeurIPS 2019 reproducibility program. J Mach Learn Res. 2021;22(164):1-20.
- U.S. Food and Drug Administration, Health Canada, Medicines and Healthcare products Regulatory Agency. Good Machine Learning Practice for Medical Device Development: Guiding Principles. 2021.
- Liu X, et al. Reporting guidelines for clinical trial reports for interventions involving artificial intelligence: The CONSORT-AI extension. Nat Med. 2020;26(9):1364-1374.
- Mongan J, Moy L, Kahn CE Jr. Checklist for Artificial Intelligence in Medical Imaging (CLAIM): A guide for authors and reviewers. Radiol Artif Intell. 2020;2(2).
- Peng RD. Reproducible research in computational science. Science. 2011;334(6060):1226-1227.
- Collins GS, et al. Protocol for development of the TRIPOD-AI and PROBAST-AI reporting and risk-of-bias tools for studies developing, validating, or updating prediction models based on artificial intelligence. BMJ Open. 2021;11.
- Kapoor S, Narayanan A. Leakage and the reproducibility crisis in machine-learning-based science. Patterns. 2023;4(9):100804.
- Wiens J, et al. Do no harm: A roadmap for responsible machine learning for health care. Nat Med. 2019;25(9):1337-1340.