본 워크플로우는 벌크 및 단일 세포 전사체 분석을 예비 환자 조직 분석과 통합하여 당뇨병성 족부 궤양에서 MMP1의 우선순위를 결정했습니다. MMP1은 섬유아세포 중심의 발현 패턴과 더 높은 조직 풍부도를 보였으며, 이는 기질 리모델링과의 연관성을 뒷받침하나 인과 관계 및 임상적 유용성은 아직 해결되지 않은 상태로 남았습니다.
연구 논문
조직 검증을 통한 벌크 및 단일 세포 전사체 통합 분석으로 당뇨병성 족부 궤양에서 MMP1의 우선순위 확인
* These authors contributed equally
이 논문에서
요약
초록
당뇨병성 족부 궤양(DFU)에서 재현 가능한 전사체 변화의 세포 기원은 아직 완전히 규명되지 않았습니다. 본 연구에서는 차등 발현 분석, 가중 유전자 공발현 네트워크 분석(WGCNA), 당뇨병성 말초 신경병증(DPN) 유전자 스크리닝, 탐색적 머신러닝 특성 선택, 2개의 외부 벌크 전사체 데이터셋, 단일 세포 분석, 전통 중의학(TCM) 네트워크 분석, 그리고 환자 조직의 정량적 중합효소 연쇄 반응(qPCR) 및 웨스턴 블로팅을 통합적으로 수행하였습니다. GSE199939(DFU 10개 및 대조군 11개 샘플)에서 3,691개의 차등 발현 유전자가 식별되었으며, WGCNA 블루 모듈은 DFU와 강한 연관성을 보였습니다(r = 0.97, p = 5 × 10-13). 차등 발현 유전자, 블루 모듈 허브 유전자, 그리고 1,062개의 DPN 관련 유전자의 교집합을 통해 77개의 후보 유전자를 도출하였습니다. CCL7, CHEK1, MKI67, MMP1, MMP13, 및 TRPV2는 최소 두 가지 이상의 특성 선택 방법으로 뒷받침되었으며, 서포트 벡터 머신 재귀적 특성 제거에서의 완전한 분리는 발견 코호트의 과적합에 대한 우려를 제기하였습니다. MMP1은 발견 코호트에서 가장 큰 발현 변화를 보였습니다(log2 fold change = 9.854; adjusted p = 1.24 × 10⁻²⁹). 통합된 GSE68183/GSE80178 매트릭스에서 MMP1의 보정 p 값은 0.0159였으며, 수신자 조작 특성 곡선 아래 면적(AUC)은 0.981이었습니다. GSE134431에서 MMP1 발현은 비궤양성 당뇨병성 족부 피부보다 DFU에서 명목상 더 높게 나타났습니다(p = 0.0225; adjusted p = 0.135; AUC = 0.808). 24개 샘플에서 유래한 69,944개 세포를 분석한 결과, 섬유아세포에서 MMP1의 평균 발현이 가장 높았으며, DFU 섬유아세포, 각질 형성 세포 및 혈관 내피 세포에서 샘플 수준의 발현이 더 높게 나타났습니다. 환자 조직 분석 결과, 4쌍의 매칭된 쌍에서 MMP1 mRNA 풍부도가 더 높았으며(ΔCq에 대한 대응 표본 검정, p = 3.04 × 10⁻⁵), 3쌍의 매칭된 쌍에서 단백질 풍부도가 더 높았습니다(paired p = 0.0107). 통계적 재현은 불충분했습니다. 이러한 결과는 섬유아세포 중심의 매트릭스 리모델링 연관성을 시사하지만, 카운트 기반 발견 분석의 TPM(transcripts per million) 입력값, 불완전한 단일 세포 전처리 기록, 그리고 소규모 조직 분석 코호트로 인한 제한점이 있습니다. 인과 관계 및 임상적 유용성은 아직 확립되지 않았습니다.
서론
당뇨병성 족부궤양은 신경병증, 반복적인 기계적 하중, 말초 동맥 질환, 감염 취약성 및 조직 복구 장애가 복합적으로 작용하여 발생하는 당뇨병의 심각하고 재발성인 합병증입니다. 최근 추정치에 따르면 매년 전 세계적으로 수백만 명의 사람들이 영향을 받으며, 치유 기간이 연장되는 경우가 많고 재발, 입원, 하지 절단 및 사망의 상당한 위험이 따릅니다1. 따라서 예방과 관리는 국소적인 상처 치료뿐만 아니라 보호 감각 소실의 확인, 족저압 감소, 감염 및 허혈 치료, 그리고 전신적 위험 요인의 해결에 달려 있습니다1,2. 특히 당뇨병성 말초 신경병증은 진행성 감각 기능 장애가 압력, 외상 및 조직 손상에 대한 인지 능력을 저하시킬 수 있으며, 운동 및 자율 신경 이상이 족부 생체 역학과 피부 무결성을 더욱 변화시킬 수 있기 때문에 매우 중요합니다2,3. 조직 수준에서 신경병성 손상은 신경 염증, 미세혈관 기능 장애, 대사 스트레스 및 불완전한 복구와 공존할 수 있으며, 이는 표준 치료에도 불구하고 손상이 지속되는 상처 환경을 조성합니다1,3.
성공적인 피부 치유를 위해서는 염증 반응, 재상피화, 혈관 형성, 섬유아세포 활성화, 세포외 기질(ECM) 침착 및 이후의 기질 리모델링이 조화롭게 이루어져야 합니다. 당뇨병의 경우, 이러한 과정들이 시간적으로 무질서해질 수 있습니다. 즉, 염증 신호가 계속 활성화된 상태로 유지되거나, 각질 형성 세포의 이동이 저해될 수 있으며, 내피 세포의 반응이 불충분하거나, 섬유아세포가 비정상적인 기질을 생성 또는 구성할 수 있습니다. 섬유아세포는 기질 단백질을 합성하고, 콜라겐 구조를 조절하며, 면역 및 상피 세포와 소통하고, 상처 수축에 기여하므로 복구의 기질 단계에서 핵심적인 역할을 합니다. 환자 유래 DFU 섬유아세포를 이용한 연구들은 ECM 관련 전사와 기질 조립에서 지속적인 이상이 나타남을 보여주었으며, 이는 섬유아세포의 상태가 만성 상처 생물학의 중요한 구성 요소라는 관점을 뒷받침합니다4. 매트릭스 메탈로프로테이나제(MMPs)는 ECM 기질을 분해하여 세포 이동, 조직 전환 및 리모델링을 가능하게 함으로써 이 과정에 참여하지만, 그 효과는 위치, 시기, 기질 가용성 및 조직 매트릭스 메탈로프로테이나제 억제제(TIMPs)에 의한 조절에 따라 달라집니다5. 따라서 단백질 분해와 기질 교체 사이의 불균형은 손상된 복구 과정과 연관될 수 있으나, 개별 MMP의 발현 증가가 그 자체로 유해하거나 유익한 역할을 확립하는 것은 아닙니다. 섬유성 콜라겐 전환에 참여할 수 있는 간질 콜라게나제인 Matrix metalloproteinase 1 (MMP1)은 DFU 조직에서 변화된 것으로 보고되었으며, 이전의 임상 연구들은 MMP/TIMP 프로파일을 상처 상태 또는 치유 궤적과 연관시켰습니다6,7. 이러한 관찰 결과는 DFU에서 MMP1에 대한 추가적인 연구의 필요성을 뒷받침합니다.
전사체 프로파일링은 DFU와 관련된 분자 프로그램을 식별하기 위한 체계적인 접근 방식을 제공하지만, 몇 가지 방법론적 한계로 인해 해석이 복잡해질 수 있습니다. 벌크 조직 데이터셋은 각질 형성 세포, 섬유아세포, 혈관 내피 세포, 면역 세포 및 기타 구획 전체의 신호를 평균화하므로, 특정 후보 인자가 특정 세포 유형 내의 발현 변화를 반영하는지, 세포 구성의 변화를 반영하는지, 아니면 두 가지 모두를 반영하는지 판단하기 어렵습니다. 또한 플랫폼, 정규화 전략, 조직 샘플링 위치, 궤양의 심각도, 감염 상태, 질환 단계 및 대조 조직의 차이로 인해 데이터셋 간의 비교 가능성이 낮아질 수 있습니다. 중요한 점은, 궤양이 없는 당뇨성 발 피부가 임상적으로 유의미한 당뇨 조직 대조군이 되지만, 이를 건강한 피부와 동일하게 볼 수는 없다는 것입니다. 단일 세포 RNA 시퀀싱은 이질적인 세포 집단과 그 전사 상태를 분해함으로써 세포 기원 문제를 부분적으로 해결할 수 있습니다. 이전의 DFU 단일 세포 및 공간 전사체 연구에서는 뚜렷한 섬유아세포 집단을 식별했으며, 섬유아세포 프로그램이 상처의 상황과 치유 상태에 따라 다르다는 것을 입증하였습니다8. 이러한 결과는 벌크 전사체 데이터를 보완하기 위해 세포 분해 분석을 사용하는 것을 뒷받침합니다.
특성 선택 방법은 고차원 발현 데이터에서 후보군들의 우선순위를 정하는 데 도움이 될 수 있지만, 소규모 표본의 생의학 연구는 낙관적 추정치와 불안정한 유전자 선택에 특히 취약합니다. 측정된 변수의 수가 생물학적 표본의 수를 크게 초과하는 경우, 일반화 가능한 예측 정보가 제한적일 때조차 겉보기에 완벽한 분리가 일어날 수 있습니다. 특성 선택, 튜닝 및 성능 평가에 동일한 관측치를 재사용하면 AUC가 더욱 팽창하므로, 예측 성능을 평가하기 위해서는 중첩 교차 검증, 잠금 모델 및 진정으로 독립적인 테스트 코호트가 필수적입니다9,10. 공개적으로 이용 가능한 코호트가 종종 소규모이며 이질적이기 때문에 이러한 우려 사항은 DFU 연구와 관련이 있습니다. 또한, 전통 중의학 성분-표적-약재 데이터베이스는 가설 생성 용도로만 사용되었습니다.
본 연구는 벌크 전사체 분석, WGCNA, DPN 관련 유전자 스크리닝, 머신러닝 특성 선택, 외부 데이터셋 평가, 단일 세포 분석, TCM 네트워크 분석 및 환자 조직 검증을 통합하여 수행되었습니다. 발견 코호트에서 확인된 후보 유전자들을 추가적인 전사체 데이터셋을 통해 평가하였으며, 주요 후보 유전자의 경우 단일 세포 데이터를 이용하여 특정 세포 유형에서의 위치를 확인하였습니다. 이후 qPCR 및 웨스턴 블로팅을 통해 환자 조직 내 MMP1의 mRNA 및 단백질 수준을 조사하였습니다. 본 프레임워크는 재현 가능한 DFU 관련 후보 유전자를 식별하고 그 세포적 및 생물학적 맥락을 규명하기 위해 설계되었습니다.
프로토콜
Study design and data sources
The study, including the collection and use of patient tissue specimens for qPCR and western blot validation, was reviewed and approved by the Ethics Committee of Wuhan Fourth Hospital (approval No. KY2024-161-01). All procedures involving human tissue were conducted in accordance with the approved protocol and applicable ethical principles. The transcriptomic component of the study used publicly available, de-identified datasets. Written informed consent was obtained from all participants whose tissue specimens were used for the experimental validation. The publicly available transcriptomic datasets were analyzed in de-identified form, and consent procedures for the original data-generating studies were handled by the respective institutions.
This study integrated bulk transcriptomics, network analysis, feature selection, single-cell analysis, TCM network prediction, and patient-tissue validation. The discovery cohort was Gene Expression Omnibus (GEO) dataset GSE199939 (10 DFU and 11 control samples). External bulk-transcriptomic assessment included a merged GSE68183/GSE80178 matrix (9 DFU and 6 control samples) and GSE134431 (13 DFU and 8 non-ulcerated diabetic foot skin [DFS] samples). Single-cell analysis used a preprocessed, SingleR-annotated Seurat object derived from GSE165816, comprising 69,944 cells from 24 samples (14 DFU and 10 controls). Tissue assessment included four matched DFU–periwound patient pairs for qPCR and three matched pairs for western blotting, based on recovered assay records and author-confirmed pairing. All materials and equipment used in this study are listed in the Table of Materials.
Construction of the DPN-related gene set
DPN-related genes were retrieved from the National Center for Biotechnology Information (NCBI) Gene database using rentrez. Search terms included “diabetic peripheral neuropathy”, “diabetic neuropathy”, “diabetic polyneuropathy”, “painful diabetic neuropathy”, and “diabetic sensorimotor polyneuropathy”, restricted to Homo sapiens. Returned identifiers were mapped to official gene symbols, converted to uppercase, cleaned, and deduplicated. The database-derived genes were combined with a literature-curated DPN gene list and deduplicated, yielding 1,062 DPN-related genes. The complete search strings and identifier-cleaning code are included in the accompanying scripts; they also include diabetic neuropathies, diabetes combined with distal symmetric/symmetrical polyneuropathy or peripheral neuropathy, and the Diabetic Neuropathies MeSH term. The literature-derived component still requires citation-level provenance.
Discovery-cohort preprocessing and differential-expression analysis
The GSE199939 expression matrix was aligned to the phenotype table by sample identifier. Duplicate gene identifiers were made unique. The archived discovery analysis rounded the expression values and fitted a negative-binomial model using DESeq2 (version 1.48.2), with group as the design factor and DFU versus control as the contrast. Genes with missing adjusted p values were excluded. Multiple testing was controlled using the Benjamini–Hochberg (BH) procedure. The archived differentially expressed gene (DEG) list used an absolute log2 fold change greater than 1 and BH-adjusted p < 0.05. Comparison with the public GEO source confirmed that the input was TPM, rather than raw read counts. Rounding TPM does not meet the raw-count requirement of DESeq2. The original estimates are retained, but the validity of the discovery statistics and dependent WGCNA and feature-selection results remains unresolved pending appropriate reanalysis. The source comparison is documented in the supplementary archive.
For visualization, the DESeq2 variance-stabilizing transformation (VST) was applied with blind = FALSE. Principal component analysis (PCA) was performed on the VST expression matrix. The heatmap used row-wise z scores for the 50 genes with the smallest adjusted p values. The PCA implementation centered and scaled gene-wise transformed values using prcomp with scale. = TRUE.
Weighted gene co-expression network analysis
For WGCNA, genes with counts greater than 5 in at least three GSE199939 samples were retained. Size factors were estimated with DESeq2, VST was applied with blind = TRUE, and the 5,000 genes with the largest across-sample variance were selected. Sample and gene quality was assessed using goodSamplesGenes, and average-linkage hierarchical clustering was used for sample-level quality assessment.
A signed network was constructed with WGCNA (version 1.74). Candidate powers of 1–10 and 12–30 in increments of 2 were evaluated using pickSoftThreshold; a scale-free topology fit target of 0.85 was used, and the selected soft-thresholding power was 18. Modules were identified with blockwiseModules using a signed adjacency and signed topological overlap matrix, Pearson correlation, minimum module size of 30, merge cut height of 0.25, reassignment threshold of 1 × 10⁻⁶, pamRespectsDendro = FALSE, and maximum block size of 10,000.
Module eigengenes were correlated with a binary DFU trait. Non-gray modules with |r| > 0.5 and p < 0.05 were considered DFU-associated. For each associated module, gene significance (GS) was defined as the Pearson correlation between gene expression and DFU status, and module membership (MM) as the Pearson correlation between gene expression and the corresponding module eigengene. Hub genes were defined by |MM| > 0.8 and |GS| > 0.5. The blue module, which showed the strongest positive association with DFU, was carried forward. Its hub genes were intersected with the DEGs and the DPN-related gene set. The reported hub threshold therefore uses the absolute values of both MM and GS, regardless of correlation sign.
Machine-learning-based feature prioritization
The 77 genes shared by the DEG, blue-module hub-gene, and DPN-related gene sets were evaluated in GSE199939. Duplicate gene symbols were collapsed by their mean expression. The candidate-gene matrix was log2-transformed as when the maximum value exceeded 50, zero-variance features were removed, and retained features were standardized. A random seed of 123 was used. The implemented sequence was cohort-wide candidate screening, duplicate-symbol collapsing, conditional log transformation, zero-variance filtering, full-cohort centering and scaling, and algorithm-specific feature selection. DEG and WGCNA screening used the full discovery cohort before algorithm-level cross-validation. The reported workflow therefore does not establish leakage-free nested validation, and its internal AUCs cannot be used as unbiased estimates of predictive performance.
Three feature-selection procedures were applied. First, least absolute shrinkage and selection operator (LASSO) logistic regression was fitted with glmnet (version 5.0), binomial family, alpha = 1, classification error as the cross-validation measure, no additional standardization, and five-fold cross-validation constrained by the smaller class size. Features at lambda.1se were selected; lambda.min was used only if lambda.1se selected no gene. Second, a random forest with 1,000 trees was fitted using randomForest (version 4.7-1.2); genes with a mean decrease in Gini at least as large as the mean importance across candidate genes were retained. Third, linear support vector machine recursive feature elimination (SVM-RFE) was implemented with e1071 (version 1.7-17), ranking features by the squared linear weight on the full cohort before evaluating progressively smaller feature subsets by leave-one-out cross-validation (LOOCV) AUC. The ranking was not recomputed within each training fold. Linear SVM fitting used scale = FALSE and probability = TRUE without an explicit cost-tuning grid. LASSO penalty selection used its internal cross-validation without a separate outer evaluation loop, and random-forest importance was calculated from the full cohort.
No gene was selected by all three methods; therefore, genes supported by at least two methods were retained. SVM-RFE produced an AUC of 1.00 across all evaluated subset sizes, and the smallest tied subset was selected. Because this complete separation raised concerns about overfitting and optimistic assessment in the small discovery cohort, the SVM-RFE AUC was not interpreted as an estimate of clinical performance. No locked multigene model was tested in an external cohort; external receiver operating characteristic (ROC) analyses assessed individual candidate-gene expression. Inspection of the analysis script confirmed that preprocessing and SVM feature ranking were not confined to training folds. The same LOOCV results were used to choose the subset size, without an outer evaluation loop. Consequently, this workflow contains information leakage and supports exploratory feature prioritization only.
Functional enrichment analysis
Gene Ontology (GO) and Kyoto Encyclopedia of Genes and Genomes (KEGG) over-representation analyses were performed on the six-gene panel. Gene symbols were mapped to Entrez identifiers with org.Hs.eg.db (version 3.21.0). GO analysis was performed with clusterProfiler (version 4.16.0) across biological process, cellular component, and molecular function ontologies. KEGG enrichment used the human organism code (hsa). Significant terms were defined as nominal p < 0.05 and BH-adjusted p < 0.05. Because only six genes were included, enrichment analysis was used primarily for functional annotation. The KEGG script used local KEGG.db annotations with enrichKEGG(use_internal_data = TRUE); the annotation release must be documented. The GO and KEGG scripts did not supply a custom universe, so the annotation databases defined the default backgrounds.
External bulk-transcriptomic assessment
For the merged GSE68183/GSE80178 matrix, gene symbols were standardized and duplicate symbols were collapsed by mean expression across matching rows. The six candidate genes were aligned to the phenotype file. Because the available files did not fully document the upstream merging and batch-correction procedure, this dataset was analyzed as provided and interpreted cautiously. Consequently, neither the removal of batch effects nor the independence of the group signal from study effects can be established from the supplied processing record. This matrix provides exploratory cross-dataset support rather than definitive replication.
For GSE134431, the six candidate genes were extracted from the reads per kilobase per million mapped reads (RPKM) matrix and transformed as log2(RPKM + 1). DFS was used as the reference group and DFU as the comparison group. DFS represents non-ulcerated diabetic foot skin. The originally submitted Figure 4C plotted raw RPKM; the revised panel uses the stated log2(RPKM + 1) scale. Two-sided Wilcoxon tests with the normal approximation and continuity correction and automatically oriented ROC analyses were verified on both scales and gave identical p values and AUCs because the transformation is strictly monotonic.
Within each bulk validation dataset, between-group expression differences were tested using two-sided Wilcoxon rank-sum tests, and BH correction was applied across the six genes. ROC curves were calculated with pROC (version 1.19.0.1), using direction selected automatically by the package. AUCs and corresponding 95% confidence intervals (CIs) were calculated to compare discriminatory patterns across datasets. Automatically selecting ROC direction from each assessment dataset may give optimistic discrimination; these single-gene AUCs are descriptive and do not validate a prespecified clinical prediction model.
Single-cell localization and sample-level analysis
Single-cell analysis used the saved Seurat object biofsci_SingleR_annotated_MMP1_analyzed.rds from GSE165816, containing 22,889 genes and 69,944 cells in the RNA assay. The RNA assay retained a non-negative integer counts layer and a data layer generated by LogNormalize with a scale factor of 10,000 followed by log1p transformation; the latter was not TPM. The object contained 2,000 variable genes selected using the vst method (loess.span = 0.3; 20 equal-width bins), scaled expression for all retained genes (centering and scaling enabled; scale.max = 10), and 50 principal components calculated from the variable features with seed 42. The saved command history used Harmony dimensions 1–20 for nearest-neighbor construction and uniform manifold approximation and projection (UMAP). Neighbor settings included k = 20, Annoy with 50 trees and Euclidean distance, and a shared nearest-neighbor (SNN) pruning threshold of 1/15. Clustering used resolution 0.8, algorithm 1, n.start = 10, n.iter = 10, and random.seed = 0. UMAP used the uwot implementation, 30 neighbors, two output dimensions, a cosine distance metric, min.dist = 0.3, spread = 1, learning.rate = 1, and seed 42. The object retained a Harmony reduction, but the original quality-control cutoffs, complete RunHarmony call including the batch covariates, and SingleR reference and annotation settings for this analyzed object could not be recovered. Cell-type labels, group labels, and sample identifiers were stored in SingleR_label, Group, and orig.ident, respectively. Ten annotated cell types were retained: B cells, CD8+ T cells, endothelial cells, epithelial cells, fibroblasts, hematopoietic stem cells, keratinocytes, macrophages, monocytes, and neurons.
MMP1 expression was summarized by cell type. Cells with normalized MMP1 expression greater than zero were classified as MMP1-positive. For sample-level analysis, mean normalized expression was calculated for each sample-cell-type combination. DFU and control samples were compared within each cell type using two-sided Wilcoxon rank-sum tests followed by BH correction across all tested cell types. The GEO sample accession, rather than the individual cell, was the unit used in these reported comparisons. The 24 accessions were not treated as proof of 24 independent donors. The saved object did not contain a verified donor identifier, and repeated tissue sampling within donors was not modeled; the sample-level tests are consequently interpreted as exploratory. These summaries average normalized expression within sample and cell type; they are not count-summed pseudobulk differential-expression models.
Ten functional gene sets were scored with Seurat AddModuleScore. Spearman correlations between per-cell MMP1 expression and module scores were calculated and BH-corrected. For exploratory MMP1-high analysis, the three cell types with the highest mean MMP1 expression among cell types containing at least 50 cells were selected. A global cutoff was defined as the median expression among MMP1-positive cells when more than 10 positive cells were available; the script otherwise used the overall 75th percentile. Cells above this cutoff were assigned to the MMP1-high group and the remaining cells to the MMP1-low group. FindMarkers used a Wilcoxon test, logfc.threshold = 0.25, and min.pct = 0.1. Upregulated genes with adjusted p < 0.05 were subjected to GO biological-process enrichment. Because the groups were defined by MMP1 expression, this analysis was used to describe pathways associated with the MMP1-high state. Per-cell correlations, their adjusted p values, and MMP1-high versus MMP1-low enrichment are descriptive because within-sample dependence was not modeled. Individual cells were not interpreted as independent biological replicates.
TCM ingredient-target-herb prediction
The six prioritized genes were matched to column 4 of the local Comparative Toxicogenomics Database (CTD) chemical-gene interaction table. Records were restricted to Homo sapiens in column 7. Ingredient names were trimmed and normalized to lowercase for matching, and duplicate ingredient-target and herb-ingredient mappings were removed. Ingredients were linked to herbs using the herb-ingredient reference table. Database enrichment used nominal p < 0.05 and adjusted p < 0.05. Duplicate herb-ingredient-target records were removed before coverage-based summarization. Herb enrichment used clusterProfiler::enricher with the herb-ingredient mapping as TERM2GENE, minGSSize = 1, maxGSSize = 500, pvalueCutoff = 1, and qvalueCutoff = 1 before applying the nominal and BH-adjusted significance thresholds. These database links may describe changes in expression or activity and do not establish direct binding or a uniform direction of effect.
Herbs were ranked using the following coverage score:
S = 3R + 5L +2T + 3C + 2I + N (1)
Here, R is the MMP1 record count, L is the number of MMP1-linked ingredients, T is the number of covered targets, C is the core-ingredient count, I is the matrix-axis indicator, and N is the total number of ingredients.
Core ingredients were quercetin, luteolin, and berberine. The matrix-axis indicator was set to 1 when an herb covered both MMP1 and MMP13 and to 0 otherwise. Candidate herbs were required to contain at least one MMP1-linked record and either at least two MMP1-linked ingredients or at least four targets plus one core ingredient. The score was used to summarize database coverage and was not treated as a pharmacologic efficacy measure. The coefficients define a custom, heuristic coverage rule that emphasizes MMP1-linked records and ingredients, broader target coverage, the three designated ingredients, and joint MMP1/MMP13 coverage. They were not fitted to clinical outcomes or experimentally validated, and alternative weights could change herb rankings.
Patient tissue collection and preliminary qPCR and western blot assessment
Patients with clinically diagnosed diabetic foot ulcers who underwent clinically indicated debridement or surgery at Wuhan Fourth Hospital were eligible when foot tissue was available and written informed consent had been obtained. Exclusion criteria were malignancy at the sampling site, a non-diabetic cause of the ulcer, or insufficient tissue quantity or quality for the planned assays. DFU tissue and non-ulcerated tissue surrounding the wound were obtained from the same patient under the approved study protocol. The latter served as a matched periwound comparator; it was not healthy non-diabetic skin. The qPCR assessment comprised four matched pairs (four DFU specimens and four corresponding periwound specimens), and western blotting comprised three matched pairs. Matching was confirmed by the authors for each assay; cross-assay identity was not used in the statistical comparisons. Each patient was the biological unit, and technical PCR wells were repeated measurements within a specimen. These preliminary assays were intended to assess tissue-level expression of MMP1 and were not designed to establish diagnostic performance, causality, or generalizability across DFU phenotypes.
For qPCR validation, total RNA was extracted from patient-derived tissue specimens using a total RNA extraction reagent according to the manufacturer's instructions. RNA concentration and purity were assessed spectrophotometrically, and samples with an A260/A280 ratio of 1.8–2.1 were used for subsequent analyses. Total RNA (1 µg) was reverse transcribed using a Moloney murine leukemia virus (M-MLV) reverse-transcription kit in a final reaction volume of 20 µL. The available instrument project identifies a real-time PCR system. Quantitative PCR was reported using 2x SYBR Green PCR master mix in a 20 µL reaction containing 10 µL of 2x SYBR Green master mix, 0.4 µL each of the forward and reverse primers, 2 µL of complementary DNA (cDNA), and 7.2 µL of nuclease-free water. The amplification program consisted of an initial denaturation at 95 °C for 30 s, followed by 40 cycles of 95 °C for 5 s and 60 °C for 30 s. A melting-curve analysis was performed to verify amplification specificity. MMP1 transcript abundance was measured with β-actin (ACTB) as the reference gene. Primer sequences are listed in Table 1. For the revised paired analysis, the five technical wells per target within each specimen were averaged before ΔCq calculation, and relative MMP1 expression was calculated using the 2-ΔΔCq method, with the non-ulcerated periwound tissue group used as the calibrator. The recovered sample pairs were NC–DFU, NC1–DFU1, NC2–DFU2, and NC3–DFU3, confirmed by the authors as four patient-matched pairs. The previous qPCR plot used five technical-well values from only NC and DFU; the revised plot shows one specimen-level value after averaging technical wells for each of the four pairs. Paired inference used ΔCq = mean Cq(MMP1) − mean Cq(ACTB), rather than well-level fold-change values. The archived instrument project also differs from the reported reaction volume and cycling program, and its correspondence to the plotted experiment remains unresolved.
For western blot (WB) validation, tissue specimens were homogenized in ice-cold radioimmunoprecipitation assay buffer supplemented with protease inhibitors. Lysates were incubated on ice for 30 min and centrifuged at 12,000 x g for 15 min at 4 °C. The supernatants were collected, and protein concentrations were determined using a bicinchoninic acid assay. Equal amounts of protein (20 µg per lane) were separated on 4%–20% gradient sodium dodecyl sulfate-polyacrylamide gels and transferred onto 0.22 µm polyvinylidene difluoride membranes. Membranes were blocked with 5% nonfat milk in Tris-buffered saline containing 0.1% Tween-20 for 1 h at room temperature and incubated overnight at 4 °C with an MMP1 polyclonal antibody (1:1,000) and a cofilin polyclonal antibody (1:6,000). After three washes with Tris-buffered saline containing 0.1% Tween-20, membranes were incubated with horseradish peroxidase-conjugated goat anti-rabbit immunoglobulin G (IgG) (1:5,000) for 1 h at room temperature. Protein bands were visualized using an enhanced chemiluminescent substrate and imaged with a chemiluminescence imaging system using the associated operating software (version 1.2.0), as recorded in the image metadata. Bands were quantified using ImageJ software. Cofilin was used as the loading control, and MMP1 protein abundance was normalized to cofilin for between-group comparison.
Statistical analysis and software
All tests were two-sided unless otherwise stated. BH-adjusted p < 0.05 was used as the primary multiple-testing threshold. Exact sample sizes varied by dataset and, for the single-cell sample-level analysis, by the presence of a given cell type in each sample. Continuous expression summaries are shown as individual observations with boxplots displaying the median and interquartile range; whiskers extend to 1.5 times the interquartile range. For western blotting, the six recovered MMP1-to-cofilin ratios were analyzed using a two-sided paired t-test on three author-confirmed patient pairs (df = 2; p = 0.0107). For qPCR, five ACTB and five MMP1 Cq values were averaged separately within each specimen before ΔCq calculation. A two-sided paired t-test compared DFU and matched periwound ΔCq values across four author-confirmed patient pairs (df = 3; p = 3.04 × 10⁻⁵). The mean periwound ΔCq was used as the common calibrator for the relative-expression display. The geometric mean within-patient fold change and its 95% CI were obtained by back-transforming the mean paired ΔCq difference and its t-based CI. Individual biological observations are shown with lines joining matched tissues; technical wells do not increase the biological sample size. Tissue-assay p values are nominal and exploratory. With three or four patients, normality of paired differences cannot be assessed reliably, and the assays remain preliminary. Bioinformatic analyses and figure generation were performed in R 4.5.2 on Windows 11. Core package versions included DESeq2 1.48.2, WGCNA 1.74, glmnet 5.0, randomForest 4.7-1.2, e1071 1.7-17, pROC 1.19.0.1, clusterProfiler 4.16.0, Seurat 5.5.0, SingleR 2.10.0, rentrez 1.2.4, and ggplot2 4.0.3. A consolidated software, database, and parameter inventory is provided in Supplementary Table 1.
결과
발견 전사체 분석을 통해 광범위한 DFU 관련 발현 프로그램 확인
GSE199939가 발견 코호트로 사용되었으며, 여기에는 10개의 DFU 샘플과 11개의 대조군 샘플이 포함되었습니다(그림 1A). VST 정규화된 발현 값의 주성분 분석 결과 그룹 간의 명확한 분리가 나타났으며, 주성분 1과 2는 각각 전체 분산의 34.8%와 15.1%를 설명했습니다(그림 1B).
|log2 fold change| > 1 및 BH 보정 p < 0.05를 기준으로 차별 발현 분석을 수행한 결과, DFU에서 상향 조절된 1,247개의 유전자와 하향 조절된 2,444개의 유전자를 포함하여 총 3,691개의 DEG가 확인되었습니다(그림 1C). 상위 50개 DEG는 강한 그룹 구조의 발현 패턴을 형성하였습니다(그림 1D). 이후 선정된 6개의 유전자 중, MMP1이 발견 코호트에서 가장 큰 변화를 보였습니다(log2 fold change = 9.854; 보정 p = 1.24 × 10⁻²⁹).
DFU 관련 공동 발현 모듈이 DEG 및 DPN 관련 유전자와 수렴함
가장 변동성이 큰 상위 5,000개의 VST 변환 유전자를 대상으로 WGCNA를 수행하였다. 척도 없는 토폴로지 적합도와 연결성의 균형을 맞추어, 부호 네트워크(signed network)를 위한 소프트 임계값 지수(soft-thresholding power)로 18을 선택하였다.그림 2A). 계층적 군집 분석 및 동적 모듈 검출을 통해 다수의 공발현 모듈을 확인하였다(그림 2B). 파란색 모듈이 DFU와 가장 강한 양의 상관관계를 보였다 (Pearson 제시된 텍스트가 없습니다. 번역할 내용을 입력해 주세요. = 0.97, p = 5 × 10-13; 그림 2C). 그에 해당하는 샘플 클러스터링 및 모듈 크기 품질 관리 요약본이 제공됩니다. 보충 그림 1A,B.
블루 모듈 내에서 689개의 유전자가 허브 기준인 |MM| > 0.8 및 |GS| > 0.5를 충족했습니다(그림 2D). 3,691개의 DEG, 689개의 블루 모듈 허브 유전자, 그리고 1,062개의 DPN 관련 유전자의 교집합을 분석한 결과 77개의 공통 후보 유전자가 도출되었습니다(그림 2E). 블루 모듈 허브 네트워크의 희소화된 뷰와 가장 높은 순위의 허브 통계 수치는 부록 그림 2A,B에 제시되어 있습니다.
다중 방법 특성 선택을 통해 6개의 유전자가 우선순위로 선정되었으나, 발견 코호트 과적합이 나타남
교차 분석된 77개의 유전자를 LASSO, 랜덤 포레스트 및 SVM-RFE를 이용하여 분석하였다. LASSO 분석 결과, 선택된 페널티에서 7개의 유전자가 유지되었다. MMP1, MMP13, TRPV2, CCL7, AURKA, MKI67, 그리고 CHEK1 (그림 3A). 랜덤 포레스트 필터링을 통해 중요도가 평균 이상인 41개 유전자를 유지했으며, 여기에는 가장 높은 순위의 특징들 중 최종 패널의 구성원 5개가 포함되었다.그림 3B). SVM-RFE는 평가된 모든 중첩 하위 집합에 대해 1.00의 AUC를 생성했습니다. 최소 크기 동률 규칙(minimum-size tie rule)에 따라, CHEK1 단일 유전자 서브셋으로 선택되었습니다.그림 3C), 이는 발견 코호트(discovery cohort)에서의 과적합(overfitting) 및 낙관적 평가에 대한 우려를 불러일으켰습니다. 이에 해당하는 발견 코호트의 발현량, 히트맵 및 ROC 도표는 다음에서 확인할 수 있습니다. 보충 그림 3A–C.
세 가지 방법 모두에 의해 선택된 유전자는 없었습니다. 최소 두 가지 방법에서 지지된 유전자를 유지한 결과, CCL7, CHEK1, MKI67, MMP1, MMP13 및 TRPV2가 도출되었습니다 (그림 3D). 이 6개 유전자에 대한 GO 주석 분석 결과, 세포외 기질 분해, 콜라겐 이화 및 대사 과정, 응축된 염색체, 그리고 메탈로엔도펩티다아제 관련 기능이 강조되었습니다 (모든 BH 보정 p < 0.05; 그림 3E). KEGG 분석에서는 인터루킨-17 (IL-17) 신호 전달 (CCL7/MMP1/MMP13; 보정 p = 1.81 × 10⁻⁴) 및 릴랙신 신호 전달 (MMP1/MMP13; 보정 p = 0.0175; 그림 3F)이 확인되었습니다. 이러한 농축 분석 결과는 6개 유전자 패널이 나타내는 생물학적 기능을 특성화하는 데 사용되었습니다.
데이터셋 간 평가 결과, MMP1에 대해 불균일한 지지 결과가 나타났다
병합된 GSE68183/GSE80178 매트릭스(DFU 9명 및 대조군 6명)에서, 6개 유전자에 대해 BH 보정을 실시한 결과 CCL7, MMP1, MMP13이 그룹 간에 차이를 보였습니다(보정된 p = 각각 0.0168, 0.0159, 0.0431; 그림 4A). CHEK1, MKI67, TRPV2는 보정된 유의성 임계값에 도달하지 않았습니다(보정된 p = 0.259, 0.680, 0.259). 단일 유전자 ROC 분석 결과, AUC는 CCL7의 경우 0.944(95% CI, 0.825–1.000), CHEK1 0.704(0.403–1.000), MKI67 0.574(0.243–0.905), MMP1 0.981(0.930–1.000), MMP13 0.870(0.686–1.000), TRPV2 0.722(0.447–0.997)로 나타났습니다(그림 4B). 상위 병합 및 배치 보정 절차가 완전히 문서화되지 않았으므로, 이러한 ROC 값은 탐색적인 것으로 간주되었습니다.
GSE134431(DFU 샘플 13개 및 궤양이 없는 DFS 샘플 8개)에서, 명목 유의 수준에서의 Wilcoxon 검정 결과 MMP1 발현은 DFS보다 DFU에서 더 높게 나타났으나(p = 0.0225), 이러한 연관성은 BH 보정 후에는 유의미하지 않았다(보정된 p = 0.135; Figure 4C). 나머지 5개 유전자에서는 그룹 간 유의미한 차이가 나타나지 않았다. 또한 MMP1은 AUC 0.808(95% CI, 0.589–1.000)로 가장 높은 기술적 AUC를 보인 반면, 다른 후보 유전자들의 AUC는 0.529에서 0.635 사이였다(Figure 4D). 종합적으로 MMP1은 6가지 후보 중 가장 일관된 기술적 패턴을 보였으나, 통계적 재현은 불완전했다.
단일 세포 분석 결과 MMP1은 주로 섬유아세포에 국한되어 나타남
단일 세포 데이터셋은 24개 샘플(DFU 14개 및 대조군 10개)로부터 얻은 69,944개의 세포를 포함하며, 10개의 주석 처리된 세포 유형으로 구성되었다(그림 5A). UMAP 특성 시각화 결과, MMP1 발현은 전체 맵에 걸쳐 균일하게 나타나기보다 특정 세포 영역에 국한되어 나타났다(그림 5B). 전체적으로 3,799개의 세포(5.43%)에서 0보다 큰 정규화된 MMP1 발현이 관찰되었다. 섬유아세포가 가장 높은 평균 정규화 발현량(0.181)과 가장 큰 전체 MMP1 양성 분율(7.88%; 그림 5C)을 보였다.
시료 수준에서, 각질 형성 세포, 섬유아세포 및 내피 세포의 평균 MMP1 발현은 대조군 시료보다 DFU 시료에서 더 높았습니다. 테스트한 모든 세포 유형에 대해 BH 보정을 거친 후, 이러한 각 비교의 보정 p 값은 0.0214였습니다 (각질 형성 세포: 대조군 9개 및 DFU 시료 14개; 섬유아세포: 10개 및 14개; 내피 세포: 10개 및 14개; 그림 5D). MMP1 양성 분율은 섬유아세포에서 5.86%에서 9.29%로, 각질 형성 세포에서 0.026%에서 6.68%로, 내피 세포에서 0.29%에서 2.67%로 증가했습니다 (그림 5E).
세포당 모듈 점수 상관관계는 보통 수준이었습니다. 가장 큰 양의 상관관계는 노화/노화 관련 분비 표현형(SASP) 모듈 점수(Spearman rho = 0.274)에서 관찰되었으며, 이어서 세포외 기질 리모델링(rho = 0.240), 페로토시스(rho = 0.197), 섬유아세포 활성화(rho = 0.170; 그림 5F) 순으로 나타났습니다. MMP1-고발현 및 MMP1-저발현 섬유아세포를 비교한 결과, 세포외 기질 조직화, 세포외 구조 조직화, 콜라겐 섬유 조직화, 당단백질 처리 및 단백질 접힘 관련 용어들이 농축되어 있음을 확인하였습니다(그림 5G). 이러한 기술적 분석 결과는 MMP1-고발현 섬유아세포 상태가 기질 리모델링 관련 프로세스와 연관되어 있음을 보여주었습니다. 추가적인 그룹 수준 UMAP, 모든 세포 유형 샘플 요약 및 기능 점수 맥락은 부록 그림 4A–C에 제공됩니다. 개별 세포 연관성은 기증자 독립적 증거로 처리되지 않았습니다.
네트워크 커버리지는 MMP1 관련 성분 및 후보 약초를 우선시합니다
필터링된 약초-성분-타겟 관계 표에는 99종의 약초, 14종의 성분, 그리고 6개의 후보 타겟 중 5개를 연결하는 561개의 고유 기록이 포함되었습니다. 가장 빈번하게 나타난 타겟은 MMP1으로 156건의 기록이 있었으며, CHEK1 (120건), MMP13 (102건), MKI67 (100건), TRPV2 (83건)가 그 뒤를 이었습니다(그림 6A). 성분 중에서는 quercetin과 luteolin이 가장 넓은 약초 범위를 보였으며, 각각 83종과 62종의 약초와 연결되었습니다. Berberine은 10종의 약초와 연결되었습니다. 이 세 가지 성분은 우선순위 결정 규칙의 핵심 성분으로 사용되었습니다(그림 6B).
커버리지 점수 결과, 관황백(Guanhuangbo), 마황(Mahuang), 우슬(Niuxi)이 공동 최상위로 평가되었다(점수 각 38점; 그림 6C). 각각은 이용 가능한 5가지 타겟 모두를 포함했으며, 두 가지의 MMP1 연관 성분을 함유하고 있었다. 성분-타겟 행렬을 통해 퀘르세틴(quercetin)이 타겟 패널 전반에 걸쳐 가장 광범위한 커버리지를 제공하는 반면, 루테올린(luteolin)과 베르베린(berberine)은 MMP1 중심의 추가적인 연결성을 제공함을 확인하였다.그림 6D). 집중 네트워크를 통해 주요 약재와 대표 성분, 그리고 가능한 5가지 표적을 연결하였다 (그림 6E). 이러한 결과는 추가 평가를 위해 데이터베이스 커버리지가 높은 약초-성분-타겟 조합을 식별하였습니다. 이를 뒷받침하는 약초-타겟 및 핵심 성분 커버리지 행렬은 다음에서 확인할 수 있습니다. 보충 그림 5A,B.
예비 짝지은 조직 분석 결과, MMP1 mRNA 및 단백질 발현량이 더 높게 나타났다
Western blot 분석 결과, DFU 검체에서 MMP1의 발현량이 대응하는 비궤양성 주변부 검체보다 더 높게 나타났다 (그림 7A,B). 세 쌍의 매칭된 표본에서 당뇨성 족부 궤양(DFU) 부위와 상처 주변 부위 간의 MMP1/cofilin 비율의 평균 차이는 0.3553(95% CI, 0.1959–0.5147; 양측 대응)이었습니다. t-검사, t(2) = 9.592, p = 0.0107). 각 환자의 쌍으로 측정된 값은 다음에서 표시됩니다. 그림 7B각 표본의 유전자당 5개의 기술적 반복 웰(technical well) 평균을 낸 결과, qPCR에서 더 높은 정규화된 MMP1 네 가지 DFU 검체 각각에서의 mRNA 풍부도가 그에 대응하는 상처 주변부 검체보다 (그림 7C). 환자 내 평균 DFU-periwound 차이 ΔCq 차이는 −2.6035(95% 신뢰구간, −2.8024 ~ −2.4046; 양측 대응)였다. t-검사, t(3) = −41.663, p = 3.04 × 10⁻⁵), 이는 기하 평균 6.08배 증가(95% CI, 5.30-6.98)에 해당한다. 이러한 소표본 관찰 결과는 예비적인 것이며 기능적 효과를 입증하는 것은 아니다.
발견 데이터셋과 외부 대량 데이터셋 전체에서, 통계적 재현은 불완전했으나 MMP1은 우선순위가 지정된 6개 유전자 중 가장 일관된 기술적 패턴을 보였습니다. 단일 세포 요약 결과 섬유아세포에서 평균 발현량이 가장 높게 나타났으며, 3명의 환자로부터 얻은 쌍체 WB 측정값과 4명의 환자로부터 얻은 쌍체 qPCR 측정값 모두 MMP1의 풍부도가 더 높음을 보여주었습니다. 이러한 관찰 결과는 MMP1이 추가 연구를 위한 DFU 관련 후보 물질임을 뒷받침합니다. 전반적인 계산-조직 평가 워크플로우는 부록 그림 6에 요약되어 있습니다.
데이터 가용성:
공공 전사체 데이터셋은 NCBI Gene Expression Omnibus에서 등록 번호 GSE199939, GSE68183, GSE80178, GSE134431 및 GSE165816으로 이용 가능합니다. 사용 가능한 분석 및 그림 생성 스크립트, 가공된 발현 및 결과 표, 정량적 그림 소스 표, 통계 출력 표, 원본 qPCR 워크북 및 기기 프로젝트, 그리고 제공된 미절단 웨스턴 블롯 이미지는 다음 항목에 포함되어 있습니다. 보충 파일 1해당 아카이브에는 복구된 단일 세포 객체(single-cell object)에서 추출한 세포 메타데이터와 명령어 기록, 매트릭스 유형 검증 보고서 및 파일 매니페스트가 포함되어 있습니다. 보충 파일 1 과거의 소스 파일들을 유지하며, 수정된 쌍-분석(paired-assay) 소스 테이블, 통계 출력값, 도표 생성 코드 및 수정된 파라미터 목록이 포함된 R2_Updates 폴더를 포함하고 있습니다. 분석이 완료된 전체 Seurat RDS는 아카이브 문서에 명시되어 있으나, 본 보충 ZIP 파일에는 포함되어 있지 않습니다. 전체 벌크 병합 이력, 원래의 단일 세포 필터링 및 주석 설정, 그리고 원래의 블롯 배경 제거 및 레인-정량화 세부 사항은 완전히 제공되지 않으며, 이러한 제한 사항은 프로토콜과 고찰 섹션에 기술되어 있습니다. 로컬에서 복구된 RDS는 공개 저장소에 기탁되지 않았습니다.
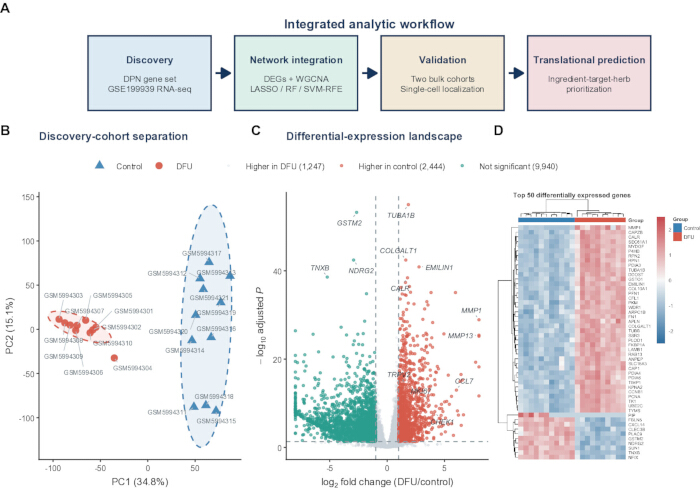
그림 1: 탐색 전사체 분석을 통해 DFU 관련 발현 프로그램을 식별함. (A) DPN 유전자 세트 구축 및 GSE199939 탐색 분석, 네트워크 및 머신러닝 통합, 벌크 및 단일 세포 평가, 그리고 TCM 성분-타겟-약초 예측으로 구성된 계산 워크플로우 개요. (B) 10개의 DFU 샘플과 11개의 대조군 샘플로부터 얻은 분산 안정화 GSE199939 발현 프로필의 주성분 분석. 타원은 90% 그룹 영역을 나타내며, 백분율은 각 성분에 의해 설명되는 분산을 나타냄. (C) DFU 대 대조군의 DESeq2 차등 발현 결과에 대한 볼케이노 플롯. |log2 fold change| > 1 및 BH 보정 p < 0.05를 사용하여 DFU와 대조군에서 각각 상향 조절된 유전자를 빨간색과 청록색 점으로 표시하였으며, 회색 점은 두 임계값을 모두 충족하지 않은 유전자를 나타냄. (D) 보정된 p 값이 가장 작은 50개 유전자의 행별 z-score 히트맵. 열은 생물학적 샘플이며 주석 바는 그룹을 나타냄. DEGs, 차등 발현 유전자; DFU, 당뇨병성 족부 궤양; DPN, 당뇨병성 말초 신경병증; VST, 분산 안정화 변환. 최종 실험 평가는 프로토콜과 그림 7에 설명되어 있음. qPCR, 정량적 중합효소 연쇄 반응; TCM, 전통 중의학; RF, 랜덤 포레스트; LASSO, 최소 절대 수축 및 선택 연산자; SVM-RFE, 서포트 벡터 머신 재귀적 특성 제거. 이 그림의 더 큰 버전을 보려면 여기를 클릭하십시오.
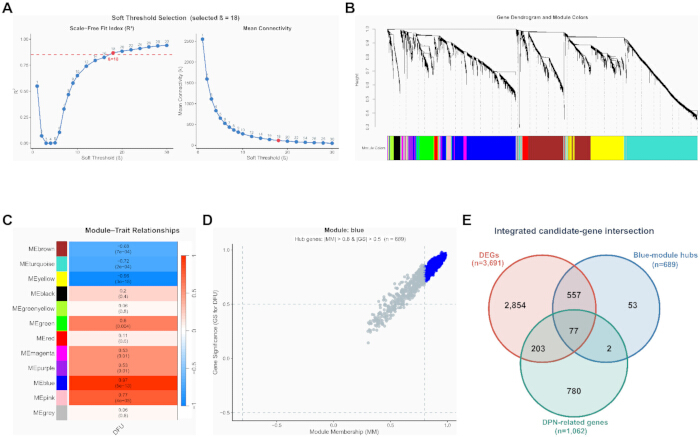
그림 2: WGCNA와 기존 DPN 지식이 77개의 후보 유전자로 수렴됨. (A) 가장 변동성이 큰 5,000개의 VST 변환 유전자에 대한 서명 네트워크 소프트 임계값 평가. 선택된 파워는 beta = 18이며, 점선은 목표 척도-무작위 네트워크 토폴로지 적합도 0.85를 나타냄. (B) 동적 모듈 색상 할당이 포함된 평균 연결 유전자 덴드로그램. (C) 모듈 고유유전자(eigengene)와 이진 DFU 형질 간의 피어슨 상관관계. 각 셀은 상관계수와 해당하는 양측 p 값을 보여주며, 색상은 방향과 크기를 나타냄. (D) 블루 모듈 내 DFU에 대한 유전자 유의성과 모듈 멤버십. 파란색 점은 |모듈 멤버십| > 0.8 및 |유전자 유의성| > 0.5를 충족하며, n = 689개의 허브 유전자를 나타냄. (E) 3,691개의 DEG, 689개의 블루 모듈 허브 유전자, 1,062개의 DPN 관련 유전자의 3개 집합 교집합을 통해 77개의 공유 후보 유전자가 도출됨. DFU, 당뇨병성 족부 궤양; DPN, 당뇨병성 말초 신경병증; GS, 유전자 유의성; MM, 모듈 멤버십; WGCNA, 가중 유전자 공발현 네트워크 분석. 발견 코호트는 21개의 샘플(DFU 10개 및 대조군 11개)을 포함함. 그림 2D 주석은 원래 선택 코드에서 검증된 절대값 기준과 일치하는 |MM| > 0.8 및 |GS| > 0.5를 사용함. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
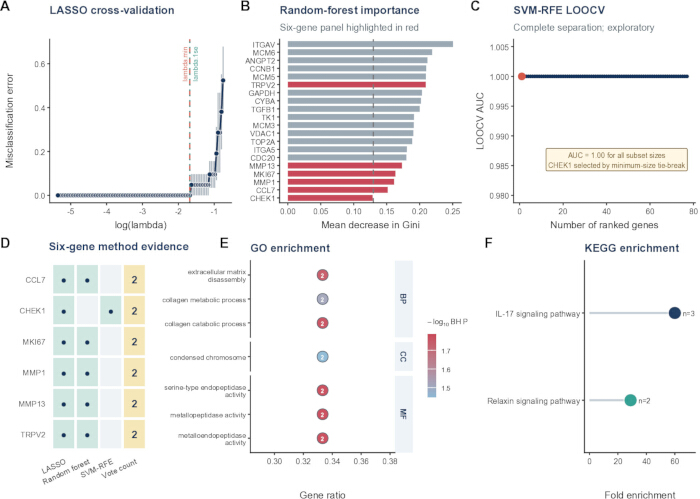
그림 3: 다중 방법 특성 우선순위 지정을 통해 도출된 6개 유전자 패널. (A) 이항 LASSO 회귀에 대한 5-겹 교차 검증 곡선. 수직 점선은 lambda.min과 lambda.1se를 나타내며, 해당 페널티로 특성이 선택되지 않은 경우를 제외하고 선택된 0이 아닌 특성은 lambda.1se에서 결정되었다. (B) 1,000개 트리 모델에서 상위 20개 유전자의 랜덤 포레스트 Gini 평균 감소량. 빨간색 막대는 최종 6개 유전자 패널의 구성원을 나타내며, 점선은 전체 후보군에서 유지 임계값으로 사용된 평균 중요도를 표시한다. (C) 중첩 특성 하위 집합에 따른 선형 SVM-RFE LOOCV AUC. 모든 하위 집합 크기에서 AUC = 1.00이 산출되었으며, 최소 크기 동점 규칙에 의해 CHEK1이 선택되어 발견 코호트에서의 과적합을 나타냈다. (D) CCL7, CHEK1, MKI67, MMP1, MMP13, TRPV2에 대한 방법 지원 행렬. 점은 LASSO, 랜덤 포레스트 또는 SVM-RFE에 의한 선택을 나타내며, 마지막 열은 지원 방법의 수를 나타낸다. (E) 6개 유전자에서 농축된 선택적 유전자 온톨로지(Gene Ontology) 용어. 점의 위치는 유전자 비율을, 점 레이블은 매핑된 유전자 수를, 색상은 -log10 BH 보정 p 값을 나타내며, 측면 스트립은 온톨로지를 나타낸다. (F) 매핑된 유전자에서 농축된 KEGG 경로. 점의 위치는 농축 배수를, 점 크기 레이블은 매핑된 유전자 수를 나타내며, 색상으로 경로를 구분한다. 농축은 공칭 p < 0.05 및 BH 보정 p < 0.05를 기준으로 하였다. AUC, 수신자 조작 특성 곡선 아래 면적; BH, Benjamini-Hochberg; BP, 생물학적 과정; CC, 세포 구성 성분; KEGG, Kyoto Encyclopedia of Genes and Genomes; LOOCV, 하나 빼기 교차 검증; MF, 분자 기능; SVM-RFE, 서포트 벡터 머신 재귀적 특성 제거. LASSO, 최소 절대 수축 및 선택 연산자. 패널 A–D는 21개의 발견 샘플(DFU 10개 및 대조군 11개)을 사용하였다. 패널 A에서 오차 막대는 교차 검증 오차의 표준 오차를 나타낸다. 여기를 클릭하여 이 그림의 더 큰 버전을 확인하십시오.
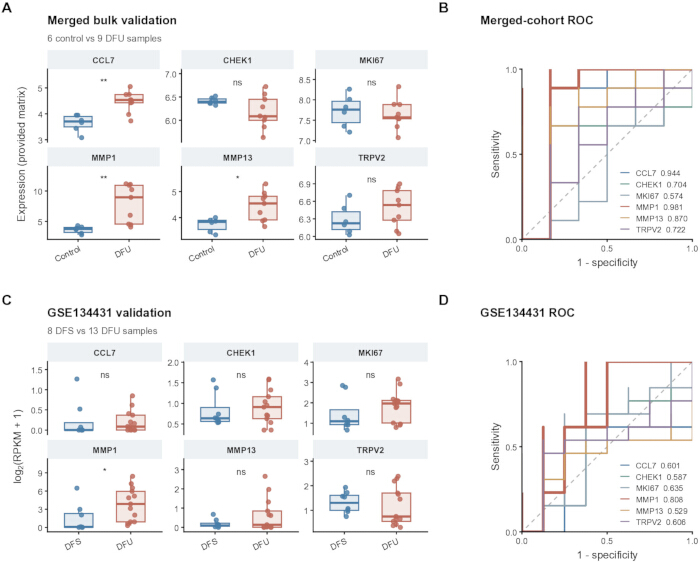
그림 4: 6-유전자 패널의 데이터셋 간 벌크 전사체 평가. (A) 통합된 GSE68183/GSE80178 매트릭스(대조군 6개 및 DFU 샘플 9개)에서의 6개 유전자 발현. (B) 이에 대응하는 단일 유전자 ROC 곡선 및 AUC 값; 95% 신뢰 구간은 소스 데이터 표에 제공됨. 상위 통합 및 배치 교정이 완전히 문서화되지 않았으므로, 이 결과는 탐색적으로 해석됨. (C) GSE134431(궤양이 없는 DFS 8개 및 DFU 샘플 13개)에서의 log2(RPKM + 1) 발현. (D) 이에 대응하는 단일 유전자 ROC 곡선 및 AUC 값. (A)와 (C)에서 상자는 중앙값과 사분위 범위를 나타내며, 오차 막대는 사분위 범위의 1.5배까지 연장되고, 점은 생물학적 샘플을 나타냄. 별표는 양측 윌콕슨 순위합 검정의 명목 유의성을 나타냄 (*p < 0.05, **p < 0.01); 6개 유전자에 대한 BH 보정 p 값은 본문 및 소스 데이터 표에 보고됨. ROC 방향은 pROC에 의해 자동으로 선택됨. AUC, 수신자 조작 특성 곡선 아래 면적; DFS, 궤양이 없는 당뇨성 족부 피부; DFU, 당뇨성 족부 궤양; RPKM, 100만 개의 매핑된 리드당 킬로베이스당 리드 수; ROC, 수신자 조작 특성. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
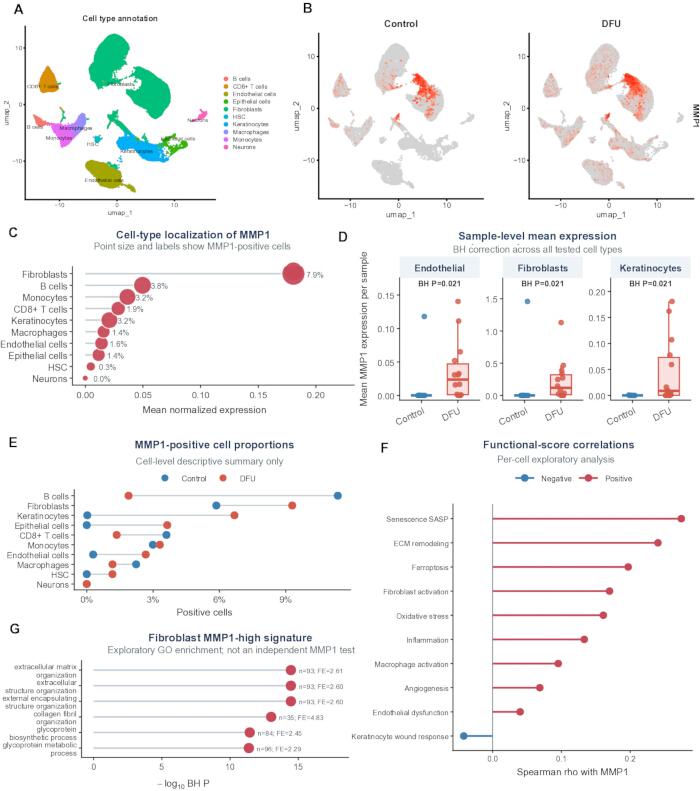
그림 5단일 세포 국소화 연결 MMP1 섬유아세포 및 기질 재구성 신호에 대해. (A(24개 샘플(대조군 10개 및 DFU 샘플 14개)에서 유래한 69,944개 세포의 UMAP으로, SingleR로 도출된 10가지 세포 유형 주석에 따라 색상으로 구분됨. (B정규화된 데이터를 보여주는 UMAP 특성 플롯(feature plots) MMP1 대조군 및 당뇨성 족부궤양(DFU) 세포에서의 발현. (C) 평균 정규화된 세포 유형별 요약 MMP1 발현; 점 크기와 레이블은 전체적인 수치를 나타냅니다 MMP1-정규화된 발현량으로 정의되는 양성 분율 > 0. (D) 샘플 수준 평균 MMP1 내피세포, 섬유아세포 및 각질형성세포에서의 발현. 상자는 중앙값과 사분위 범위를 나타내며, 점은 생물학적 샘플을 나타낸다. 모든 테스트된 세포 유형에 대해 양측 윌콕슨 순위합 검정(Wilcoxon rank-sum test)을 수행한 후 BH 보정을 실시하였다. 가용한 샘플 수는 내피세포와 섬유아세포의 경우 대조군 10개 및 DFU 14개였으며, 각질형성세포의 경우 대조군 9개 및 DFU 14개였다. (E) MMP1그룹 및 세포 유형별 -양성 세포 분율. (F) 세포당 Spearman 상관계수 분석: MMP1 발현 및 기능적 모듈 점수. (G) 중 up-regulated된 유전자들 간의 GO 생물학적 과정 풍부도 분석 MMP1-높음 대 MMP1-저섬유아세포. BH, Benjamini-Hochberg; DFU, 당뇨병성 족부 궤양; ECM, 세포외 기질; GO, 유전자 온톨로지; HSC, 조혈모세포; UMAP, 균일 매니폴드 근사 및 투영. 패널 F와 G의 세포당 상관관계 및 발현 조건부 농축은 공여자를 고려한 확인 추론이 없는 탐색적 설명임. 샘플 수준의 독립성을 위해서는 공여자 식별자의 검증이 필요함. 이 그림의 확대 버전을 보시려면 여기를 클릭하십시오.
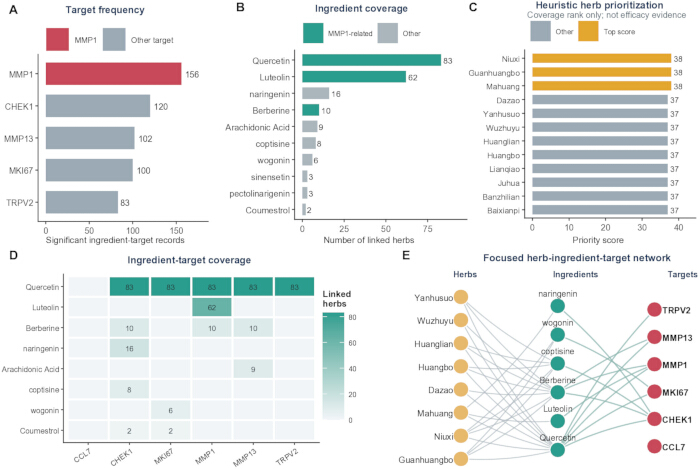
그림 6: MMP1을 중심으로 한 커버리지 기반 TCM 성분-타겟-약초 예측. (A) 가용 후보 타겟별로 필터링된 데이터베이스 약초-성분-타겟 레코드 수. (B) 가장 빈번한 성분들에 대해 연결된 약초의 수; 청록색은 MMP1과 연결된 성분을 나타냄. (C) 커버리지 점수에 따라 순위가 매겨진 주요 약초; 금색 막대는 공동 최고 점수인 3개 항목을 표시함. (D) 대표적인 고커버리지 성분들의 성분-타겟 매트릭스. 셀 값은 연결된 약초의 수를 나타내며, 빈 셀은 필터링된 관계 테이블에 레코드가 없음을 나타냄. (E) 대표적인 고순위 약초, 성분 및 후보 타겟을 연결하는 집중 네트워크. 노드 색상은 엔티티 유형을 나타내며, 회색 약초-성분 엣지는 포함 관계를, 청록색 성분-타겟 엣지는 데이터베이스 링크를 나타냄. 필터링된 관계 테이블에는 561개의 고유 레코드, 99종의 약초, 14종의 성분 및 자격 요건을 갖춘 링크가 있는 5개의 타겟이 포함되었으며, CCL7은 고립된 여섯 번째 후보 노드로 표시됨. TCM, 전통 중의학. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
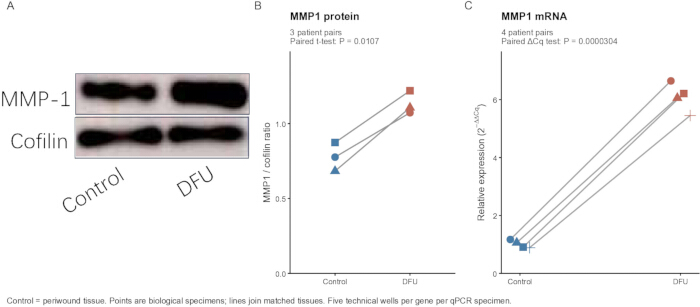
그림 7당뇨병성 족부 궤양(DFU) 내 MMP1 발현에 대한 환자 조직의 예비 qPCR 및 웨스턴 블롯 평가. (A) 이전에 제공된 대표적인 웨스턴 블롯은 비궤양성 상처 주변 조직과 당뇨병성 족부궤양(DFU) 조직의 MMP1 단백질 발현량을 보여주며, 로딩 컨트롤로 cofilin을 사용하였다. (B원래의 플로팅 프로젝트에서 복구한 MMP1 대 cofilin 비율. 기호는 세 쌍의 환자로부터 얻은 개별 생물학적 측정값을 나타내며, 선은 매칭된 상처 주변부 및 당뇨병성 족부궤양(DFU) 표본을 연결합니다. 양측 대응 t-검사 결과 제공 t(2) = 9.592 및 p = 0.0107. (C) 상대적 MMP1 저자가 확인한 4쌍의 일치 환자 샘플(NC–DFU, NC1–DFU1, NC2–DFU2, NC3–DFU3)에서의 mRNA 풍부도. 5회의 기술적 ACTB 웰 및 5개의 기술적 MMP1 각 시료 내의 웰 값들을 각각 평균한 후 ΔCq 계산. 상대적 발현량은 2^-ΔΔCq 방법으로 계산되었습니다.−ΔΔCq 평균 상처 주변부 사용법 Δ공통 보정자로 사용된 Cq. 각 기호는 하나의 생물학적 시료를 나타내며, 선은 짝지어진 조직을 연결합니다. 양측 짝지은 t-검사에 사용된 검체 수준 ΔCq 값 (t(3) = −41.663; p = 3.04 × 10⁻⁵), 기술적-웰의 배수 변화가 아님. 유의성 별표는 사용되지 않음. 기술적 웰은 생물학적 반복 시료가 아님. 대조군은 궤양이 없는 상처 주변 조직을 나타냄. Cq, 정량 사이클. 조직-분석 p 값들은 명목적이며 탐색적입니다. 이 그림의 더 큰 버전을 보시려면 여기를 클릭하십시오.
| 유전자 | RefSeq 등록번호 | 정방향 프라이머 5'에서 3' 방향 | 역방향 프라이머 5'에서 3' 방향 |
| MMP1 | NM_002421 | ATGAAGCAGCCCAGATGTGGAG | TGGTCCACATCTGCTCTTGGCA |
| ACTB | NM_001101.5 | CACCATTGGCAATGAGCGGTTC | AGGTCTTTGCGGATGTCCACGT |
표 1: MMP1의 정량적 PCR 검증을 위한 프라이머 서열. 인간 MMP1 (NM_002421) 및 ACTB (NM_001101.5)에 대한 정방향 및 역방향 올리고뉴클레오타이드 서열 (5′–3′)과 NCBI RefSeq 전사체 등록 번호가 제공됩니다. ACTB (β-actin)는 상대적 MMP1 발현의 참조 유전자로 사용되었습니다.
보충 그림 1: WGCNA 품질 관리 요약. (A) 가장 변동성이 큰 5,000개의 분산 안정화 유전자를 기반으로 한 GSE199939 샘플의 평균 연결 계층적 군집 분석. 샘플 레이블은 그룹별로 색상화되었으며, 점선 가로선은 시각적 이상치 평가에 사용된 95백분위수 덴드로그램 높이 가이드라인임. (B) 각 WGCNA 모듈에 할당된 유전자 수. 청록색 막대는 DFU 연관 기준을 충족하는 8개의 비회색 모듈을 나타내며, 회색 막대는 기타 모듈을 나타냄. DFU, 당뇨병성 족부궤양; VST, 분산 안정화 변환; WGCNA, 가중 유전자 공동 발현 네트워크 분석. 이 파일을 다운로드하려면 여기를 클릭하십시오.
보충 그림 2: 블루 모듈(Blue-module) 공발현 지원. (A) 상위 25위 블루 모듈 허브 유전자의 간소화된 공발현 네트워크. |r| > 0.70인 쌍별 상관관계 중, 표시된 네트워크는 각 유전자의 가장 강력한 두 연결의 합집합을 포함한다. 노드 크기는 표시된 희소화 네트워크 내에서의 연결 정도(degree)를 나타내며, 노드 채우기는 DFU에 대한 유전자 유의성을 나타낸다. (B) 상위 15위 허브의 유전자 유의성 및 블루 모듈 멤버십. 엣지 서브셋은 가독성을 위해 선택되었으며 모든 적격 상관관계를 나타내지는 않는다. DFU, 당뇨병성 족부궤양; GS, 유전자 유의성; MM, 모듈 멤버십. 이 파일을 다운로드하려면 여기를 클릭하십시오.
부록 그림 3내부 발견 코호트 머신러닝 디스플레이. (A) 의 정규화된 발현량 CCL7, CHEK1, MKI67, MMP1, MMP13및 TRPV2 GSE199939 발견 코호트에서. 상자는 중앙값과 사분위 범위를 나타내며, 점은 생물학적 시료를 나타낸다. (B) 샘플 수준 행-z동일한 6개 유전자의 -score 히트맵. 짧은 샘플 레이블은 소스 데이터 키의 GEO 식별자와 매핑되어 있습니다. (C) 적합된 다중 유전자 발견 코호트 모델의 ROC 곡선. 동일한 21개 샘플에 대해 모델을 적합시키고 평가함으로써 1.00의 AUC를 얻었으며, 이는 발견 코호트 내의 과적합을 나타낸다. AUC, 수신자 조작 특성 곡선 아래 면적; ROC, 수신자 조작 특성. 발견 코호트는 21개 샘플(DFU 10개 및 대조군 11개)을 포함하였다. 이 파일을 다운로드하시려면 여기를 클릭하십시오.
보충 그림 4: 단일 세포 발현 컨텍스트. (A) 대조군 및 DFU 그룹으로 색상 구분된 69,944개 세포의 UMAP. (B) 10가지 모든 세포 유형 주석에 걸친 생물학적 샘플 수준의 평균 MMP1 발현; 점은 샘플을 나타내며, x축은 표시를 위해 제곱근 변환을 사용함. (C) 각 주석된 세포 유형 내의 세포들에 대해 요약되고 각 모듈 내에서 표준화된 기능적 모듈 점수의 히트맵. DFU, 당뇨병성 족부 궤양; UMAP, 균일 매니폴드 근사 및 투영. 이 파일을 다운로드하려면 여기를 클릭하십시오.
보충 그림 5: TCM 커버리지 행렬 지원 데이터. (A) MMP1과 연관된 커버리지가 가장 높은 상위 18개 약재의 데이터베이스 내 약재-타겟 기록 수와 필터링된 관계 표에 표시된 5가지 후보 타겟. (B) 동일한 약재와 핵심 성분인 quercetin, luteolin, berberine을 연결하는 데이터베이스 기록 수. 셀 값은 중복 제거 후의 고유한 데이터베이스 기록 수를 나타냄. TCM, 전통 중국 의학. 이 파일을 다운로드하려면 여기를 클릭하십시오.
보충 그림 6: 계산 및 조직 평가 워크플로우. 이 도식은 발굴 입력, DEG/WGCNA 교집합, 탐색적 특징 선택, 외부 벌크 평가, 단일 세포 컨텍스트, TCM 확장 및 일치하는 조직-발현 평가를 요약합니다. qPCR에는 4쌍의 일치하는 환자 샘플이 사용되었으며, 웨스턴 블로팅에는 3쌍의 일치하는 환자 샘플이 사용되었습니다. 후보 수 및 보고된 계산 결과는 원래 분석의 데이터를 유지하였습니다. 카운트 기반 발굴 워크플로우의 TPM 입력, 불완전한 기존 단일 세포 전처리 기록 및 소규모 조직 분석 코호트는 여전히 한계점으로 남아 있습니다. 이 도식은 발굴 분석이 재검증되었음을 의미하지 않습니다. 이 파일을 다운로드하려면 여기를 클릭하십시오.
부록 표 1: 분석 소프트웨어, 데이터베이스, 파라미터 및 제한 사항 목록. 이 워크북은 분석 단계, 도구 또는 데이터베이스, 보고된 버전, 입력값, 주요 파라미터, 출력값, 그리고 누락된 정보 또는 제한 사항을 포함하여 총 26가지 분석 단계를 기록하고 있습니다. 여기에는 전사체 탐색, WGCNA, 유전자 스크리닝 및 특성 선택, 농축 분석, 외부 벌크 및 단일 세포 분석, TCM 네트워크 분석, 조직 분석 보고가 포함됩니다. 이 표는 이용 가능한 방법론적 정보를 기록한 것이며, 그 자체로 독립적인 재현성을 입증하는 것은 아닙니다. 이 파일을 다운로드하려면 여기를 클릭하십시오.
보충 파일 1: 데이터, 분석 코드, 그림 소스 및 분석 소스 아카이브. 이 아카이브에는 사용 가능한 분석 및 그림 생성 스크립트, 처리된 발현 및 결과 테이블, 정량적 그림 및 통계 소스 데이터, 원본 qPCR 워크북 및 장비 프로젝트, 제공된 미절단 웨스턴 블롯 이미지, 추출된 단일 세포 메타데이터 및 명령 기록, 매트릭스 유형 검증 보고서 및 파일 목록이 포함되어 있습니다. 과거 파일들이 보존되어 있으며, R2_Updates 폴더에서는 수정된 쌍 분석(paired-assay analysis), 업데이트된 그림 소스 및 개정된 파라미터 인벤토리를 제공합니다. 이 파일을 다운로드하려면 여기를 클릭하십시오.
토론
이 통합 워크플로우는 다음을 우선순위에 두었습니다. MMP1 벌크 전사체 분석, WGCNA, DPN 관련 유전자 스크리닝 및 탐색적 특성 선택을 통해 후보를 도출한 후, 세포 내 맥락과 조직 발현을 조사하였다. 최소 두 가지 이상의 선택 방법에 의해 지지된 6개의 유전자가 확인되었으며, MMP1 발견 코호트에서 가장 큰 발현 변화를 보였습니다. 외부 증거는 이질적이었습니다. MMP1 병합된 GSE68183/GSE80178 매트릭스에서는 여전히 유의미하게 유지된 반면, GSE134431에서의 연관성은 명목상이었다(p = 0.0225)이며 BH 보정(보정된 p = 0.135). GSE134431에서 나타난 0.808의 AUC는 기술적인 수치이며, 특히 ROC 방향이 평가 데이터 세트 내에서 선택되었다는 점에 기인합니다. 따라서 "가장 일관된"이라는 표현은 6개의 후보군 사이에서 관찰된 패턴을 설명하는 것이며, 완전한 통계적 재현이나 검증된 진단 바이오마커를 의미하지는 않습니다.
후보 패널은 콜라겐 전환, ECM 분해, metalloendopeptidase 활성, 그리고 IL-17 및 relaxin 신호 전달과 연관되어 주석이 달렸습니다. 이러한 주석들은 만성 상처 생물학과 일치하지만, 소수의 유전자만이 포함되어 있습니다. 이전의 인체 연구에서는 당뇨병성 상처에서 MMP 및 억제제 프로파일의 변화가 보고되었으며6, 전향적 DFU 연구에서는 더 높은 MMP1 대 tissue inhibitor of metalloproteinases 1 (TIMP1) 비율이 치유와 관련이 있음이 밝혀졌습니다7. 따라서 MMP1 발현의 증가가 반드시 일률적으로 해로운 영향을 나타내는 것은 아니며, 그 관련성은 회복 단계, 기질 가용성 및 억제제 균형에 따라 달라질 수 있습니다. MMP13, CCL7 및 IL-17에 관한 실험적 관찰 결과가 추가적인 맥락을 제공하지만11,12,13,14, 인간의 DFU에서도 이들의 기능이 동일할 것이라고 가정할 수는 없습니다.
단일 세포 요약 결과, MMP1의 평균 발현량이 섬유아세포에서 가장 높게 나타났으며, 샘플 수준에서는 DFU 섬유아세포, 각질 형성 세포 및 내피 세포에서 더 높은 발현을 보였습니다. 이러한 패턴은 DFU 유래 섬유아세포의 ECM 구성 변화4, 단일 세포 및 공간 분석 연구에서의 이질적인 섬유아세포 상태8, 그리고 대식세포 관련 치유 섬유아세포 프로그램15에 관한 보고들과 일치합니다. 다만, 샘플 식별자는 기증자 수준의 검증이 필요하며, 세포 수준의 모듈 점수 상관관계 및 발현 조건부 농축 분석은 기증자 내 의존성을 모델링하지 않았으므로 기술적인 수준에 머물러 있습니다. 상피 및 내피 세포군의 기여도는 이 메커니즘이 오직 섬유아세포 자율적으로만 일어난다는 주장에 반하는 근거가 됩니다. 공간 전사체 분석, RNA in situ hybridization 또는 면역 염색을 통해 상호 보완적인 국소화 정보를 얻을 수 있을 것입니다16.
방법론적 가치는 차등 발현, 공동 발현, 기존의 유전자 지식, 세포 분해능 요약 및 독립적인 분석 양식을 결합하여 후보군을 우선순위화한 점에 있습니다. 이는 발견 코호트의 예측 정확도에 있는 것이 아닙니다. 코호트 전체 스크리닝이 알고리즘 수준의 교차 검증보다 먼저 수행되었으며, 일관되게 1.00으로 나타난 SVM-RFE AUC 값은 데이터 누출, 과적합 및 낙관적 평가에 대한 우려를 불러일으킵니다. 따라서 해당 패널은 특성 우선순위 지정 결과로 유지되어야 합니다. 예측 평가를 위해서는 완전히 중첩된 전처리, 선택 및 튜닝을 거친 후 고정된 독립 테스트가 필요할 것입니다9,10. 발견 단계의 입력 데이터는 카운트 기반 모델에 사용되었음에도 불구하고 TPM으로 확인되었으며, 이에 따라 결과로 도출된 발견 통계 및 하위 선택 과정은 적절한 재분석 전까지 검증되지 않은 상태로 남아 있습니다. 병합된 벌크 매트릭스는 전체 전처리 이력이 누락되어 있습니다. 복구된 Seurat 객체는 정규화, 가변 특성 선택, PCA, 이웃, 클러스터링 및 UMAP 설정을 제공하지만, 원래의 필터링, 전체 Harmony 호출 및 주석 참조는 여전히 불완전하게 문서화되어 있습니다. 소스 데이터로부터의 조화로운 재처리, 문서화된 배치 효과 평가, 그리고 기증자 인지 가상 벌크(pseudobulk) 또는 혼합 모델 분석이 추가 평가를 위한 대안적 접근법입니다.
환자 조직 분석을 통해 MMP1 풍부도가 더 높다는 예비적인 직교 증거를 확보하였습니다. 대조군은 동일 환자의 궤양되지 않은 상처 주변 조직을 사용하였으므로, 이 대비는 건강한 피부와의 비교가 아니라 당뇨 조직 내에서 궤양과 관련된 국소적 차이를 반영합니다. 세 쌍의 일치하는 환자 쌍에서 얻은 WB 측정값과 저자가 확인한 네 쌍의 일치하는 쌍에서 얻은 qPCR 측정값을 대응 표본 검정을 통해 분석하였으며, 개별 생물학적 관찰 결과를 표시하였습니다. qPCR의 경우, 각 표본 내의 기술적 반복(technical wells) 값을 평균화하고 ΔCq를 이용하여 추론하였으며, 기술적 반복이 생물학적 표본 크기를 확대시키지는 않았습니다. 대응 표본 관찰 결과가 일관된 방향성을 보임으로써 예비적인 발현 비교를 뒷받침하지만, 소규모 코호트로 인해 일반화 가능성을 확립하거나 분포 가정을 신뢰성 있게 평가할 수는 없습니다. 벌크 조직의 풍부도는 세포 내 단백질 국소화, 효소 활성 또는 치유에 미치는 인과적 효과를 입증하지 않습니다. 임상적으로 특성이 정의된 더 큰 규모의 코호트가 필요합니다. 기타 제한 사항으로는 불완전한 임상 공변량, 서로 다른 대조 조직, 문헌에서 유래하여 불완전하게 문서화된 DPN 유전자 세트, 그리고 불완전한 원본 블롯 배경 제거 기록 등이 있습니다. 건강한 조직, 연구 정의 대조 조직, 궤양되지 않은 당뇨병성 족부 피부를 상호 대체 가능한 것으로 취급해서는 안 됩니다.
TCM 네트워크는 가설 생성 단계의 확장 모델입니다. 해당 모델의 맞춤형 가중치는 표적 결합력이나 효능보다는 데이터베이스의 커버리지를 요약한 것이며, 순위는 데이터베이스 콘텐츠 및 가중치 선택에 따라 변경될 수 있습니다. Quercetin과 berberine 또한 전신 노출도가 가변적이거나 제한적입니다17,18. 따라서 후보 성분 및 약초에 대해서는 직접적인 표적, 용량-반응, 약동학, 독성 및 기능 테스트가 필요합니다. 향후 연구에서는 잘 문서화된 독립적 코호트를 공간적 국소화 및 primary fibroblast 또는 다세포 상처 모델에서의 MMP1 섭동과 결합하여 분석해야 합니다. 본 연구 결과는 인과 관계나 임상적 유용성을 입증하지는 않으나, 섬유아세포 중심의 매트릭스 리모델링 맥락에서 MMP1이 DFU 관련 후보임을 뒷받침합니다.
공개 사항
저자들은 이해관계의 충돌이 없음을 선언합니다.
감사의 글
본 연구는 우한시 보건위원회가 관리하는 우한시 의료 과학 연구 프로젝트(지도 프로젝트, Grant No. WX23Z77)의 지원을 받아 수행되었습니다.
저자들은 본 연구를 위해 조직 표본을 제공해주신 참여자분들과 NCBI Gene Expression Omnibus에 공개 데이터셋을 생성 및 등록해주신 연구자분들께 감사드립니다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| 0.2-mL 박벽 투명 PCR 8-튜브 스트립 | Axygen / Corning | PCR-0208-C | URL: https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Tubes/p/PCR-0208-C |
| 1,000-μL 멸균 필터 피펫 팁 | Axygen / Corning | TF-1000-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/SEA/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-1000-R-S |
| 1.5-mL 멸균 마이크로 원심분리 튜브, DNase/RNase-free | Solarbio Life Sciences | YA0430 | **제품명: BCA 단백질 분석 키트 (BCA Protein Assay Kit)** **개요** BCA 단백질 분석 키트는 정량적으로 분석하고자 하는 시료 내의 총 단백질 농도를 결정하는 데 사용되는 고감도 분석법입니다. 본 분석법은 BCA(bicinchoninic acid) 시약의 두 단계 반응을 기반으로 합니다. 첫 번째 단계에서는 알칼리성 조건 하에서 단백질의 펩타이드 결합 및 특정 아미노산 잔기가 큐프러스 이온($Cu^{2+}$)을 큐프러스 이온($Cu^+$)으로 환원시키는 Biuret 반응이 일어납니다. 두 번째 단계에서는 두 분자의 BCA가 하나의 $Cu^+$ 이온과 결합하여 강한 보라색 복합체를 형성하며, 이는 562 nm에서 최대 흡광도를 나타냅니다. 생성된 보라색 복합체의 강도는 시료 내의 단백질 농도에 비례하므로, 표준 단백질(예: BSA)을 사용하여 작성한 표준 곡선을 통해 미지 시료의 단백질 농도를 산출할 수 있습니다. **제품 특징** * **높은 감도:** 매우 낮은 단백질 농도까지 정밀하게 측정 가능합니다. * **우수한 재현성:** 일관된 결과와 높은 정확도를 제공합니다. * **넓은 선형 범위:** 다양한 농도의 시료를 효율적으로 분석할 수 있습니다. * **계면활성제 내성:** 많은 종류의 계면활성제가 포함된 시료에서도 안정적인 분석이 가능하여 시료 준비 과정이 간소화됩니다. **구성품** * BCA 시약 A (BCA Reagent A) * BCA 시약 B (BCA Reagent B) * BSA 표준 단백질 (BSA Standard) **보관 방법** * 냉장 보관 ($2\text{--}8^\circ\text{C}$) **분석 원리** 단백질 $\xrightarrow{Cu^{2+}, \text{alkaline}}$ $Cu^+$ $\xrightarrow{\text{BCA}}$ 보라색 복합체 ($\lambda_{max} = 562\text{ nm}$) |
| 10-μL 멸균 필터 피펫 팁 | Axygen / Corning | TF-300-L-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Aerosol-Barrier-Tips/p/TF-300-L-R-S |
| 2× SYBR Green PCR 마스터믹스 | Solarbio Life Sciences | SR1110 | 제품명: DNA 정량 분석 키트 (DNA Quantification Kit) 제품 설명: 본 제품은 나노드롭(NanoDrop)과 같은 분광광도계 없이도 소량의 DNA 샘플을 정확하고 정밀하게 정량화할 수 있도록 설계되었습니다. 본 키트는 형광 염료를 사용하여 이중 가닥 DNA(dsDNA)에 선택적으로 결합하며, 이를 통해 매우 낮은 농도의 DNA도 높은 민감도로 측정할 수 있습니다. 특징: - 높은 민감도와 정확도: 극소량의 DNA 샘플에서도 신뢰할 수 있는 정량 결과 제공 - 빠른 분석 시간: 간단한 파이펫팅 과정으로 신속한 측정 가능 - 넓은 동적 범위: 다양한 농도 범위의 DNA 샘플 분석 가능 - 높은 선택성: RNA 및 단백질 오염물질의 영향을 최소화하여 dsDNA만 선택적으로 측정 구성품: - dsDNA 결합 염료 (dsDNA Binding Dye) - 표준 DNA 샘플 (Standard DNA Samples) - 반응 버퍼 (Reaction Buffer) - 사용 설명서 (Manual) 사용 방법: 1. 표준 DNA 샘플을 이용하여 농도별 표준 곡선(Standard Curve)을 작성합니다. 2. 분석하고자 하는 DNA 샘플과 형광 염료를 정해진 비율로 혼합합니다. 3. 형광 플레이트 리더기(Fluorescence Plate Reader)를 사용하여 특정 파장에서 형광 강도를 측정합니다. 4. 측정된 형광 값을 표준 곡선에 대입하여 샘플의 정확한 DNA 농도를 산출합니다. 보관 조건: -20°C에서 보관하십시오. 응용 분야: - NGS(차세대 염기서열 분석) 라이브러리 정량화 - PCR 및 qPCR 분석 전 템플릿 DNA 농도 측정 - 플라스미드 및 게놈 DNA 추출 효율 확인 - DNA 샘플의 품질 관리(QC) 및 정규화(Normalization) |
| 20× Tris 완충 염수 | Solarbio Life Sciences | T1080 | 제품명: DNA Recovery Kit 제품 개요: 본 DNA Recovery Kit는 DNA 정제, PCR, 제한효소 처리 또는 다른 효소 반응 후 DNA를 회수하기 위해 설계되었습니다. 이 키트는 실리카 멤브레인 기술을 기반으로 하며, DNA 손실을 최소화하면서 효율적으로 DNA를 회수할 수 있도록 최적화되었습니다. 또한, 유기 용매를 사용하지 않아 안전하며 빠르고 간편하게 고순도의 DNA를 얻을 수 있습니다. 특징: - 높은 회수율: 최적화된 버퍼 시스템을 통해 DNA 회수율을 극대화하였습니다. - 높은 순도: 후속 분석 및 반응에 영향을 주지 않는 고순도의 DNA를 제공합니다. - 신속한 처리: 간소화된 프로토콜로 실험 시간을 단축하였습니다. - 안전성: 독성 유기 용매를 포함하지 않아 사용자에게 안전합니다. 제품 구성: - Binding Buffer - Wash Buffer - Elution Buffer - Spin Columns - Collection Tubes 응용 분야: - PCR 정제 후 DNA 회수 - 제한효소 처리 후 DNA 회수 - DNA 합성 및 증폭 후 회수 - 기타 DNA 기반 실험의 정제 단계 보관 조건: 실온(15-25°C) 또는 냉장(2-8°C) 보관 (상세 보관 조건은 제품 매뉴얼 참조) |
| 200-μL 멸균 필터 피펫 팁 | Axygen / Corning | TF-200-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-200-R-S |
| ACTB qPCR 프라이머 쌍 | Solarbio Life Sciences (맞춤형 올리고뉴클레오타이드 합성) | 맞춤형 | RefSeq NM_001101.5; 정방향(F): CACCATTGGCAATGAGCGGTTC; 역방향(R): AGGTCTTTGCGGATGTCCACGT; URL: https://www.solarbio.com/ |
| Amersham Imager 600 | GE Healthcare Bio-Sciences AB, Uppsala, Sweden | Amersham Imager 600 | 제공된 22개 TIFF 파일 전체에 기록된 모델; 작동 소프트웨어 Ver.1.2.0; URL: https://cdn.cytivalifesciences.com/api/public/content/digi-17089-original |
| Bicinchoninic acid 단백질 정량 분석 키트 | Solarbio Life Sciences | PC0020 | 제품명: Protease Inhibitor Cocktail (Protease 억제제 칵테일) 제품 상세 정보: 이 Protease Inhibitor Cocktail은 단백질 추출 과정 중 단백질 분해 효소에 의한 단백질의 분해를 방지하기 위해 설계된 최적의 혼합물입니다. 이 제품은 다양한 생물학적 샘플에서 단백질의 안정성을 유지하며, 특히 고가의 단백질이나 분해되기 쉬운 단백질을 연구할 때 필수적입니다. 특징: - 광범위한 단백질 분해 효소 억제: 세린-프로테아제(serine-proteases), 시스테인-프로테아제(cysteine-proteases), 아스파틱-프로테아제(aspartic-proteases) 및 메탈로-프로테아제(metallo-proteases)를 효과적으로 억제합니다. - 고순도 및 고효율: 엄격한 품질 관리를 통해 제조되어 일관된 실험 결과를 보장합니다. - 사용 편의성: 즉시 사용할 수 있는 형태로 제공되어 실험 준비 시간을 단축합니다. 구성 성분: 본 제품은 다음과 같은 주요 억제제들의 최적 조합으로 구성되어 있습니다: - AEBSF (4-(2-Aminoethyl)benzenesulfonyl fluoride) - Leupeptin - Aprotinin - E-64 - Pepstatin A - EDTA 사용 방법: 1. 냉동 보관된 제품을 해동한 후, 사용 직전에 필요한 양을 분주합니다. 2. 단백질 추출 버퍼(lysis buffer)에 최종 농도가 적절하도록 희석하여 첨가합니다. (상세 희석 배수는 제품 매뉴얼의 권장 사항을 참조하십시오.) 3. 억제제가 포함된 버퍼를 사용하여 샘플을 균질화하고, 4°C 이하의 저온 상태를 유지하며 단백질을 추출합니다. 보관 조건: - -20°C에서 보관하십시오. - 빛과 온도 변화에 민감하므로 주의하여 취급하십시오. 응용 분야: - 세포 및 조직의 단백질 추출 - 면역 침전(Immunoprecipitation) - 웨스턴 블롯팅(Western Blotting) 샘플 준비 - 단백질 정제 및 분리 분석 |
| clusterProfiler | Bioconductor | https://bioconductor.org/packages/clusterProfiler/ | 버전 4.16.0 |
| Cofilin 다클론 항체 (rabbit anti-Cofilin) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., 중국 우한) | 10960-1-AP | 본 연구에 사용된 WB 희석 배수: 1:6,000; URL: https://www.ptgcn.com/; RRID:AB_2291830 |
| 비교 독성유전체학 데이터베이스 | 공통기술문서 | https://ctdbase.org/ | 성분-표적 리소스 |
| DESeq2 | Bioconductor | https://bioconductor.org/packages/DESeq2/ | 버전 1.48.2 |
| DNase/RNase-free water | Solarbio Life Sciences | R1600 | 제품명: Total Protein Assay Kit (BCA method) 제품 설명: Total Protein Assay Kit (BCA method)는 시료 내의 총 단백질 농도를 정량화하기 위한 신속하고 정밀한 방법입니다. 본 키트는 BCA(Bicinchoninic Acid) 시약을 사용하여 단백질 정량을 수행하며, 단백질이 알칼리성 조건에서 $\text{Cu}^{2+}$ 이온을 $\text{Cu}^1+$ 이온으로 환원시키고, 환원된 $\text{Cu}^1+$ 이온이 BCA 시약과 결합하여 보라색 복합체를 형성함으로써 흡광도가 증가하는 원리를 이용합니다. 본 방법은 단백질의 펩타이드 결합에 반응하므로 아미노산 조성에 따른 영향이 적어 매우 안정적인 결과를 제공합니다. 제품 특징: - 높은 감도와 정확성: 매우 낮은 농도의 단백질까지 정밀하게 측정 가능합니다. - 넓은 측정 범위: 다양한 농도 범위의 시료를 분석할 수 있습니다. - 뛰어난 안정성: 단백질의 아미노산 구성과 관계없이 일관된 결과가 도출됩니다. - 간편한 조작: 최적화된 시약 구성을 통해 실험 시간을 단축하고 재현성을 높였습니다. 구성 성분: - BCA Working Reagent - BSA Standard (Bovine Serum Albumin) 보관 방법: - $\text{2-8}^\circ\text{C}$ 냉장 보관 응용 분야: - 단백질 정량 분석 - 효소 활성 측정 전 단백질 농도 보정 - 세포 추출물 및 조직 분쇄액의 단백질 함량 측정 - 정제 단백질의 수율 확인 |
| e1071 | CRAN / e1071 저자진 | https://cran.r-project.org/package=e1071 | 버전 1.7-17 |
| ECL Plus 화학발광 기질 | Solarbio Life Sciences | PE0010 | **제품 설명서** **제품명:** 인간 고밀도 지질단백질 (human HDL)** **카탈로그 번호:** PE0010 **제품 개요** 고밀도 지질단백질(HDL)은 혈청 내에서 가장 작은 지질단백질 입자로, 콜레스테롤과 인지질을 말초 조직에서 간으로 운반하는 역할을 함으로써 항동맥경화 작용을 수행합니다. HDL은 주로 ApoA-I 단백질로 구성되어 있으며, 이는 지질단백질의 구조적 안정성을 유지하고 다양한 효소의 활성화를 돕는 필수적인 성분입니다. 본 제품은 고순도로 정제된 인간 유래 HDL로, 심혈관 질환 연구, 지질 대사 분석 및 세포 수준의 지질 수송 연구에 적합하도록 설계되었습니다. **제품 특징** * **고순도 정제:** 엄격한 정제 공정을 통해 불순물을 최소화하여 높은 생물학적 활성을 유지합니다. * **표준화된 농도:** 정밀한 정량 분석을 통해 일관된 농도를 제공하므로 실험의 재현성을 보장합니다. * **광범위한 응용:** In vitro 및 In vivo 실험에서 지질 대사 모델링 및 HDL의 기능적 연구에 널리 사용됩니다. **보관 및 안정성** * **보관 조건:** -20°C 또는 그 이하에서 보관하십시오. * **안정성:** 적절한 보관 조건 하에서 안정하며, 반복적인 동결-해동 사이클은 제품의 활성을 저하시킬 수 있으므로 사용 시 적절한 분주(aliquoting)를 권장합니다. **사용 방법** 1. **준비:** 제품을 사용하기 전, 상온에서 서서히 해동하거나 얼음 위에서 해동하십시오. 2. **희석:** 실험 목적에 맞는 적절한 완충액(예: PBS)을 사용하여 필요한 농도로 희석하십시오. 3. **적용:** 희석된 HDL 용액을 세포 배양액이나 분석 시스템에 투여하십시오. 구체적인 농도와 처리 시간은 실험 목적에 따라 최적화하시기 바랍니다. **주의 사항** * 본 제품은 연구용으로만 사용되어야 하며, 진단 또는 치료 목적으로 사용해서는 안 됩니다. * 제품을 다룰 때는 표준 실험실 안전 수칙을 준수하십시오. |
| 유전자 발현 옴니버스: GSE134431 | 미국 국립생물공학정보센터 | GSE134431 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE134431 |
| Gene Expression Omnibus: GSE165816 | 국립생물공학정보센터 | GSE165816 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE165816 |
| Gene Expression Omnibus: GSE199939 | 국립생물공학정보센터 | GSE199939 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE199939 |
| 유전자 발현 옴니버스(Gene Expression Omnibus): GSE68183 | 국립생물공학정보센터 | GSE68183 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE68183 |
| Gene Expression Omnibus: GSE80178 | 국립생물정보센터 | GSE80178 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE80178 |
| 유전자 존재론 | 유전자 온톨로지 컨소시엄 | https://geneontology.org/ | 진행하십시오. |
| ggplot2 | ggplot2 개발자 | https://ggplot2.tidyverse.org/ | 버전 4.0.3 |
| glmnet | CRAN / glmnet 저자 | https://cran.r-project.org/package=glmnet | 버전 5.0 |
| 약초 성분 참조표 | 원고에 출처가 보고되지 않음 | 보고되지 않음 | 기록되지 않음: 정확한 데이터베이스/파일명, 버전/날짜 및 공개 접속 URL |
| HRP-접합 goat anti-rabbit IgG (H+L) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., 중국 우한) | SA00001-2 | 본 연구에 사용된 WB 희석 배수: 1:5,000; URL: https://www.ptgcn.com/products/HRP-conjugated-Goat-Anti-Rabbit-IgG-H-L-SA00001-2.htm; RRID:AB_2722564 |
| 인간 당뇨병성 족부 궤양 조직 표본 | 중국 우한, 우한 제4병원 | 제공된 소스 텍스트가 없습니다. 번역할 내용을 입력해 주세요. | 환자 매칭 당뇨병성 족부궤양(DFU) 검체; qPCR n=4 검체; WB n=3 검체; 승인된 프로토콜 KY2024-161-01 |
| 인체 비궤양성 상처 주변 조직 표본 | 우한 제4병원, 중국 우한 | 해당 없음 | 환자 일치 상처 주변 대조군; qPCR n=4 시료; WB n=3 시료; 승인된 프로토콜 KY2024-161-01 |
| ImageJ | 미국 국립보건원 | https://imagej.net/ij/ | 버전 미기재 |
| 교토 유전자 및 게놈 백과사전 | KEGG | https://www.genome.jp/kegg/ | 인체 생물종 코드 hsa |
| 문헌 큐레이션 기반 DPN 유전자 목록 | 문헌 유래 성분; 유전자 수준의 소스 테이블이 완전히 문서화되지 않음 | 보고되지 않음 | 유전자 수준의 기원이 완전히 문서화되지 않음 |
| 마이크로볼륨 UV-Vis 분광광도계 | 원고에 제조사/모델명이 보고되지 않음 | 보고되지 않음 | 기재되지 않음: 정확한 제조사, 모델 및 제품 URL; 보고된 용도: RNA 농도 및 A260/A280 평가 |
| MMP1 다클론 항체 (rabbit anti-MMP1) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, China) | 10371-2-AP | 본 연구에 사용된 WB 희석 배수: 1:1,000; URL: https://www.ptgcn.com/Products/MMP1-Antibody-10371-2-AP.htm; RRID:AB_2297741 |
| MMP1 qPCR 프라이머 쌍 | Solarbio Life Sciences (맞춤형 올리고뉴클레오타이드 합성) | 사용자 정의 | RefSeq NM_002421; 정방향: ATGAAGCAGCCCAGATGTGGAG; 역방향: TGGTCCACATCTGCTCTTGGCA; URL: https://www.solarbio.com/ |
| NCBI Gene | 국립생물정보센터 | https://www.ncbi.nlm.nih.gov/gene/ | 인간 유전자 데이터베이스 |
| 탈지분유, 블로킹 시약 | Solarbio Life Sciences | D8340 | URL: https://www.solarbio.com/goodsInfo?id=1488 |
| org.Hs.eg.db | Bioconductor | https://bioconductor.org/packages/org.Hs.eg.db/ | 버전 3.21.0 |
| 프리캐스트 SDS-PAGE 겔, 4%–20% 기울기 | Solarbio Life Sciences | PG42010-S | 제품명: Bovine Serum Albumin (BSA), Fraction V 카탈로그 번호: BSA-10 설명: Bovine Serum Albumin (BSA)은 소의 혈청에서 정제된 주요 단백질로, 생화학 및 분자 생물학 연구에서 광범위하게 사용됩니다. 본 제품은 분획 V(Fraction V) 정제 공정을 통해 제조되어 고순도의 단백질을 제공하며, 다양한 실험실 응용 분야에서 표준 단백질이나 안정화제로 활용됩니다. 특징 및 용도: - 단백질 정량 분석의 표준 물질: BCA 분석 및 Bradford 분석 등에서 표준 곡선 작성 시 사용됩니다. - 차단제(Blocking agent): ELISA, 웨스턴 블롯(Western Blot) 및 면역조직화학(IHC) 실험에서 비특이적 결합을 방지하기 위한 차단제로 사용됩니다. - 안정화제: 효소, 항체 및 기타 민감한 단백질의 활성을 유지하고 응집을 방지하는 안정화제로 작용합니다. - 세포 배양 보충제: 세포 배양 배지에서 영양분을 제공하고 삼투압을 조절하는 역할을 합니다. 제품 사양: - 순도: ≥ 98% (SDS-PAGE 분석 기준) - 형태: 동결 건조 분말 (Lyophilized powder) - 저장 조건: -20°C 보관 (개봉 후 냉장 보관 가능하나, 장기 보관 시 냉동 권장) - 유래: 소 (Bovine) |
| pROC | CRAN / pROC 저자 | https://cran.r-project.org/package=pROC | 버전 1.19.0.1 |
| 프로테아제 억제제 혼합물, 100× | Solarbio Life Sciences | P6730 | 제품명: T-cell Activation Kit (T-세포 활성화 키트) 본 제품은 T-세포 활성화를 위해 설계된 고효율 키트로, CD3 및 CD28 항체를 통해 T-세포 수용체(TCR)와 공자극 분자(costimulatory molecule)를 동시에 자극함으로써 강력한 T-세포 활성화와 증식을 유도합니다. 본 키트는 일차 T-세포(primary T cells) 및 T-세포주(T-cell lines) 모두에서 사용 가능하며, 사이토카인 생성 분석, 세포 독성 시험 및 T-세포 분화 연구에 최적화되어 있습니다. 구성 성분: - 항-CD3 항체 (Anti-CD3 Antibody) - 항-CD28 항체 (Anti-CD28 Antibody) 특징: - 강력한 활성화: CD3와 CD28의 이중 자극을 통해 T-세포의 완전한 활성화를 유도합니다. - 높은 재현성: 표준화된 항체 농도와 품질을 통해 실험 간 일관된 결과를 제공합니다. - 광범위한 적용: 다양한 마우스 및 인간 T-세포 모델에 적용 가능합니다. 권장 용도: - T-세포 활성화 및 증식 유도 - 사이토카인(IL-2, IFN-γ 등) 분비 측정 - T-세포 분화 및 표현형 분석 - 면역 반응 및 신호 전달 경로 연구 보관 조건: 4°C 보관 (장기 보관 시 -20°C) |
| 단백질 전이 시스템 | 원고에 제조사/모델이 기재되지 않음 | 보고되지 않음 | 문서화되지 않음: 정확한 제조사, 모델 및 제품 URL; 보고된 용도: 0.22-로 전이μm PVDF 막 |
| PVDF 막, 0.22 μm | Solarbio Life Sciences | YA1690 | 제품명: Total RNA Extraction Kit (총 RNA 추출 키트) 제품 개요: 본 키트는 다양한 조직 및 세포로부터 고순도의 총 RNA(total RNA)를 효율적으로 추출하기 위해 설계되었습니다. 본 제품은 원심분리-컬럼 기반의 정제 방식을 사용하여, 유해한 화학 물질의 사용을 최소화하면서도 신속하고 재현성 있는 결과를 제공합니다. 추출된 RNA는 RT-PCR, Northern blotting, RNA sequencing 및 기타 하위 분석에 즉시 사용할 수 있습니다. 특징: - 높은 순도와 수율의 총 RNA 추출 - 다양한 샘플 유형에 적용 가능 (세포, 조직 등) - 유해 물질 제거 및 빠른 실험 절차 - DNA 제거 단계 포함 (옵션) 구성품: - Lysis Buffer (용해 버퍼) - Neutralization Buffer (중화 버퍼) - Binding Buffer (결합 버퍼) - Washing Buffer 1 (세척 버퍼 1) - Washing Buffer 2 (세척 버퍼 2) - Elution Buffer (용출 버퍼) - Spin Column (스핀 컬럼) - Collection Tube (수집 튜브) 보관 조건: - 키트 전체: 4°C 보관 - 일부 구성품은 상온 보관 가능 (제품 매뉴얼 참조) 응용 분야: - 유전자 발현 분석 - 전사체 연구 (Transcriptomics) - 바이러스 및 박테리아 RNA 분석 - 질병 마커 연구 |
| R | R Foundation for Statistical Computing | https://www.r-project.org/ | 버전 4.5.2 |
| 랜덤 포레스트 | CRAN / randomForest 저자들 | https://cran.r-project.org/package=randomForest | 버전 4.7-1.2 |
| 실시간 PCR 기기 | Roche Diagnostics | LightCycler 96 | 소프트웨어 버전 미확인. 프로젝트 볼륨/사이클링이 보고된 프로토콜과 상이함; 정확한 실험 연결성 확인 필요. |
| 냉장 마이크로원심분리기 | 원고에 제조사/모델이 보고되지 않음 | 보고되지 않음 | 기재되지 않음: 정확한 제조사, 모델 및 제품 URL; 보고된 사용 횟수: 12,000회 × 에서 15분 동안 원심분리하십시오. 4 °C |
| 입력하세요 | CRAN / rentrez 저자 | https://cran.r-project.org/package=rentrez | 버전 1.2.4 |
| 고농도 RIPA 용해 완충액 | Solarbio Life Sciences | R0010 | 제품명: BCA Protein Assay Kit BCA Protein Assay Kit는 단백질 농도를 정량하기 위한 신속하고 민감하며 효율적인 방법입니다. 본 키트는 Bicinchoninic acid(BCA) 법을 기반으로 하며, 선형적인 정량 범위를 제공하여 다양한 샘플 내의 단백질 농도를 정확하게 측정할 수 있습니다. 특징: - 높은 민감도와 넓은 정량 범위 - 높은 재현성과 정확성 - 다양한 완충액 및 계면활성제 존재 하에서도 안정적인 결과 제공 - 간편한 프로토콜로 빠른 결과 도출 가능 구성품: - BCA Working Reagent - BSA Standard (Bovine Serum Albumin) - Assay Buffer 응용 분야: - 세포 및 조직 추출물의 단백질 정량 - 정제된 단백질의 농도 측정 - 단백질 분석 전 샘플의 정규화(Normalization) 저장 조건: - 2-8°C에서 보관하십시오. |
| SDS-PAGE 전기영동 시스템 | 원고에 제조사/모델명이 보고되지 않음 | 보고되지 않음 | 기록되지 않음: 정확한 제조사, 모델 및 제품 URL; 보고된 용도: 4% 농도에서의 단백질 분리–20% 기울기 겔 |
| Seurat | Satija Lab / Seurat 개발자 | https://satijalab.org/seurat/ | 버전 5.5.0 |
| SingleR | Bioconductor | https://bioconductor.org/packages/SingleR/ | 버전 2.10.0 |
| 조직 균질기 | 원고에 제조사/모델명이 기재되지 않음 | 보고되지 않음 | 기록되지 않음: 정확한 제조사, 모델 및 제품 URL; 보고된 용도: 얼음처럼 차가운 용해 버퍼 내 조직 균질화 |
| TriQuick Reagent 총 RNA 추출 시약 | Solarbio Life Sciences | R1100 | **제품명:** BCA 단백질 정량 분석 키트 (BCA Protein Assay Kit) **제품 번호:** B-1083 **제품 설명:** BCA 단백질 정량 분석 키트는 용액 내 단백질 농도를 빠르고 정확하게 측정하기 위한 정밀한 분석법입니다. 이 분석법은 두 단계의 화학 반응을 기반으로 합니다. 첫 번째 단계에서는 알칼리성 조건 하에서 단백질의 펩타이드 결합과 특정 아미노산 잔기가 젖산-구리(Cu+), 즉 큐프러스 이온을 생성하는 Biuret 반응이 일어납니다. 두 번째 단계에서는 두 분자의 BCA(Bicinchoninic acid)가 하나의 큐프러스 이온과 복합체를 형성하여 562nm에서 강한 보라색을 띱니다. 이 색상의 강도는 샘플 내의 단백질 농도에 비례하며, 이를 통해 단백질의 양을 정밀하게 정량할 수 있습니다. BCA 분석법은 SDS, Triton X-100 및 다양한 완충제(buffer) 성분에 대해 높은 내성을 가지고 있어, 다양한 시료 준비 조건에서도 안정적인 결과를 제공합니다. **제품 구성:** * **BCA 시약 A:** BCA 분말, 탄산나트륨, 탄산수소나트륨 및 수산화나트륨을 포함하는 완충액 * **BCA 시약 B:** 40mM 황산구리(CuSO4·5H2O) 수용액 * **BSA 표준품:** 2 mg/mL의 Bovine Serum Albumin (BSA) 표준 용액 **특징:** * 높은 민감도와 정확도 * 다양한 계면활성제 및 완충제 성분에 대한 내성 * 간편하고 빠른 분석 절차 * 넓은 측정 범위 **보관 방법:** * 시약 A 및 B: 2~8°C 냉장 보관 * BSA 표준품: -20°C 냉동 보관 **응용 분야:** * 단백질 추출물 및 정제 단백질의 농도 측정 * 효소 활성 분석을 위한 단백질 정규화 * 단백질 발현 분석 및 정량 연구 |
| Tween-20 | Solarbio Life Sciences | T8220 | 상품명: BCA Protein Assay Kit BCA 단백질 정량 분석 키트는 정량 분석 시 매우 민감하고 정확하며, 단백질 시료의 농도를 결정하는 데 사용됩니다. BCA(bicinchoninic acid) 분석법은 두 단계의 반응을 통해 이루어집니다. 첫 번째 단계에서는 단백질이 알칼리성 조건에서 $Cu^{2+}$ 이온을 $Cu^{1+}$ 이온으로 환원시키며, 이는 펩타이드 결합에 의한 비특이적 킬레이트화에 의해 발생합니다. 두 번째 단계에서는 두 분자의 BCA가 하나의 $Cu^{1+}$ 이온과 복합체를 형성하여 562nm에서 강한 흡광도를 나타내는 보라색 복합체를 생성합니다. BCA 분석법은 단백질 농도에 비례하여 흡광도가 증가하며, 따라서 표준 단백질(Bovine Serum Albumin, BSA)을 사용하여 미지 시료의 단백질 농도를 정확하게 정량할 수 있습니다. 특징: - 높은 감도와 정확도 - 계면활성제(detergents)에 대한 내성이 강함 - 넓은 측정 범위 - 간편하고 빠른 분석 과정 구성품: - BCA Reagent A - BCA Reagent B - BSA Standard (2 mg/mL) 보관 방법: - 2-8℃에서 보관하십시오. 사용 예시: - 단백질 정량 분석 - 단백질 추출물 농도 측정 - 정제된 단백질의 수율 확인 |
| 0.2-mL PCR 튜브 스트립용 초투명 플랫 캡 | Axygen / Corning | PCR-2CP-RT-C | URL: https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Caps/p/PCR-2CP-RT-C |
| 범용 RT-PCR 키트 (M-MLV) | Solarbio Life Sciences | RP1100 | 제품명: BCA Protein Assay Kit (BCA 단백질 정량 분석 키트) 제품 개요: BCA Protein Assay Kit는 시료 내의 총 단백질 농도를 정밀하게 정량하기 위해 설계된 고감도 분석 키트입니다. 이 분석법은 BCA(Bicinchoninic acid)법을 기반으로 하며, 두 단계의 반응 과정을 통해 단백질 양을 측정합니다. 첫 번째 단계에서 단백질의 펩타이드 결합이나 특정 아미노산 잔기가 알칼리성 조건에서 컵륨 이온($Cu^{2+}$)을 $Cu^+$로 환원시키며, 두 번째 단계에서 $Cu^+$ 이온이 BCA 시약과 반응하여 보라색의 복합체를 형성합니다. 이 복합체의 흡광도는 562nm에서 측정되며, 이는 단백질 농도에 비례합니다. 특징: - 높은 감도와 정확성: 극소량의 단백질 시료까지 정밀하게 정량 가능합니다. - 광범위한 호환성: 다양한 완충액(buffer) 및 계면활성제(detergent) 존재 하에서도 안정적인 결과를 제공합니다. - 신속한 분석: 간단한 조작으로 짧은 시간 내에 결과를 얻을 수 있습니다. - 표준화된 프로토콜: 재현성 있는 실험 결과를 위해 최적화된 단계별 절차를 제공합니다. 구성품: - BCA Reagent A (BCA 시약 A) - BCA Reagent B (BCA 시약 B) - BSA Standard (BSA 표준 물질) - 사용 설명서 (Manual) 저장 조건: - 2-8°C 냉장 보관 응용 분야: - 세포 용해물(cell lysate)의 단백질 정량 - 정제된 단백질의 농도 측정 - Western blotting 전 단계의 단백질 로딩량 결정 - 단백질 정제 공정의 수율 분석 |
| 가중 유전자 공동 발현 네트워크 분석(WGCNA) | CRAN / WGCNA 저자 | https://cran.r-project.org/package=WGCNA | 버전 1.74 |
| 윈도우 | Microsoft | 제공된 링크는 Windows 11 제품 페이지로, 번역 대상인 JoVE 과학 및 교육 콘텐츠(연구 프로토콜, 학술 텍스트 등)가 아닙니다. 번역이 필요한 학술 텍스트를 제공해 주시기 바랍니다. | Windows 11 |
참고문헌
- Armstrong DG, Tan TW, Boulton AJM, Bus SA. Diabetic foot ulcers: a review. JAMA. 2023;330(1):62–75.
- Bus SA et al. Guidelines on the prevention of foot ulcers in persons with diabetes (IWGDF 2023 update). Diabetes Metab Res Rev. 2024;40(3):e3651.
- Sloan G, Selvarajah D, Tesfaye S. Pathogenesis, diagnosis and clinical management of diabetic sensorimotor peripheral neuropathy. Nat Rev Endocrinol. 2021;17(7):400–20.
- Maione AG et al. Altered ECM deposition by diabetic foot ulcer-derived fibroblasts implicates fibronectin in chronic wound repair. Wound Repair Regen. 2016;24(4):630–43.
- Caley MP, Martins VLC, O'Toole EA. Metalloproteinases and wound healing. Adv Wound Care (New Rochelle). 2015;4(4):225–34.
- Lobmann R et al. Expression of matrix-metalloproteinases and their inhibitors in the wounds of diabetic and non-diabetic patients. Diabetologia. 2002;45(7):1011–6.
- Muller M et al. Matrix metalloproteinases and diabetic foot ulcers: the ratio of MMP-1 to TIMP-1 is a predictor of wound healing. Diabet Med. 2008;25(4):419–26.
- Theocharidis G et al. Single cell transcriptomic landscape of diabetic foot ulcers. Nat Commun. 2022;13(1):181.
- Vabalas A, Gowen E, Poliakoff E, Casson AJ. Machine learning algorithm validation with a limited sample size. PLoS One. 2019;14(11):e0224365.
- Lewis MJ et al. nestedcv: an R package for fast implementation of nested cross-validation with embedded feature selection designed for transcriptomics and high-dimensional data. Bioinform Adv. 2023;3(1):vbad048.
- Hattori N et al. MMP-13 plays a role in keratinocyte migration, angiogenesis, and contraction in mouse skin wound healing. Am J Pathol. 2009;175(2):533–46.
- Pang J, Maienschein-Cline M, Koh TJ. Monocyte/macrophage heterogeneity during skin wound healing in mice. J Immunol. 2022;209(10):1999–2011.
- Finley PJ et al. Diabetic wounds exhibit decreased Ym1 and arginase expression with increased expression of IL-17 and IL-20. Adv Wound Care (New Rochelle). 2016;5(11):486–94.
- Moon JY et al. IL-17A is increased in diabetic wounds and impairs keratinocyte function via histone demethylase JMJD3. Nat Commun. 2026;17(1):780.
- Xiao Y et al. Macrophages regulate healing-associated fibroblasts in diabetic wound. Mol Biol Rep. 2024;51(1):203.
- Theocharidis G et al. Integrated skin transcriptomics and serum multiplex assays reveal novel mechanisms of wound healing in diabetic foot ulcers. Diabetes. 2020;69(10):2157–69.
- Almeida AF et al. Bioavailability of quercetin in humans with a focus on interindividual variation. Compr Rev Food Sci Food Saf. 2018;17(3):714–31.
- Khoshandam A, Imenshahidi M, Hosseinzadeh H. Pharmacokinetic of berberine, the main constituent of Berberis vulgaris L.: a comprehensive review. Phytother Res. 2022;36(11):4063–79.