Nanogaatje sequencing is een nieuwe technologie die het mogelijk maakt kosteneffectieve sequencing in afgelegen locaties en resource-arme instellingen. Hier, presenteren wij een protocol voor het rangschikken van mRNAs van geheel bloed dat met dergelijke voorwaarden compatibel is.
Methodenartikel
Het rangschikken van mRNA van geheel bloed gebruikend Nanogaatje het rangschikken
In dit artikel
Samenvatting
Samenvatting
Sequencing in afgelegen locaties en resource-slechte instellingen presenteert unieke uitdagingen. Nanogaatje sequencing kan met succes worden gebruikt in dergelijke omstandigheden, en werd ingezet om West-Afrika tijdens de recente Ebola-virus epidemie, met de nadruk op deze mogelijkheid. Naast de praktische voordelen (lage kosten, het gemak van het vervoer en het gebruik van apparatuur), deze technologie biedt ook fundamentele voordelen ten opzichte van tweede generatie sequencing benaderingen, met name de zeer lange Lees lengte, het vermogen om direct sequentie RNA, en real-time beschikbaarheid van gegevens. De ruwe gelezen nauwkeurigheid is lager dan met andere het rangschikken platforms, die de belangrijkste beperking van deze technologie vertegenwoordigt; Dit kan echter gedeeltelijk worden verzacht door de hoge lees diepte gegenereerd. Hier presenteren we een veld-compatibel protocol voor de sequencing van de mRNAs codering voor Niemann-Pick C1, dat is de cellulaire receptor voor ebolaviruses. Dit protocol omvat extractie van RNA van dierlijke bloedsteekproeven, die door RT-PCR voor doel verrijking worden gevolgd, barcoding, bibliotheek voorbereiding, en sequencing looppas zelf, en kan gemakkelijk voor gebruik met andere DNA of de doelstellingen van RNA worden aangepast.
Inleiding
Sequencing is een krachtig en belangrijk instrument in biologisch en biomedisch onderzoek. Het staat analyse van genomen, genetische variaties, en de uitdrukkings profielen van RNA toe, en speelt zo een belangrijke rol in het onderzoek van menselijke en dierlijke ziekten gelijk1,2. Sanger sequencing, een van de oudste methoden beschikbaar voor DNA sequencing, is nog steeds routinematig gebruikt om deze dag en is een hoek-steen van de moleculaire biologie. In de afgelopen 50 jaar, deze technologie is verbeterd om te bereiken lees-lengtes van meer dan 1.000 NT en een nauwkeurigheid zo hoog als 99,999%1. Echter, Sanger sequencing heeft ook beperkingen. Het rangschikken van een grotere reeks steekproeven of de analyse van gehele genoom met deze methode is tijdrovend en duur1,3. Tweede generatie (volgende-generatie) DNA sequencing methoden zoals 454 pyrosequencing en lichtsterkte technologie hebben ons toegestaan om de kosten en werklast die nodig zijn voor de sequencing in de laatste tien jaar aanzienlijk te verminderen, en hebben geleid tot een enorme toename van de hoeveelheid biologische sequentiegegevens beschikbaar4. Toch, individuele sequencing loopt met behulp van deze tweede generatie technologieën zijn duur, en sequencing onder veldomstandigheden is een uitdaging, omdat de benodigde apparatuur is omvangrijk en kwetsbaar (vergelijkbaar met Sanger sequencing apparaten), en vaak moet worden gekalibreerd en onderhouden door speciaal opgeleid personeel. Ook, voor veel van de technologieën van de tweede generatie zijn de gelezen-lengten eerder beperkt, die vaak stroomafwaartse bioinformatica analyse van deze gegevens uitdagend maakt.
Het rangschikken van de derde generatie gebruikend Pocket-sized nanogaatje rangschikkend apparaten (Zie lijst van materialen) kan als alternatief aan deze gevestigde het rangschikken platforms dienen. In deze apparaten gaat een enig-gestrande DNA of RNA molecule door een nanogaatje gelijktijdig met een Ionische stroom over die dan door een sensor wordt gemeten (Figuur 1). Aangezien de bundel de nanogaatje doorkruist, wordt de modulatie van de stroom door de nucleotiden huidig in de porie op om het even welke bepaalde tijd ontdekt, en met behulp van computer achter-vertaald in de nucleotideopeenvolging5. Door dit operationele principe, nanogaatje sequencing maakt zowel de generatie van zeer lange leest (bijna 1 x 10⁶ nucleotiden6) en de analyse van de sequencing data in real time. Barcoding is mogelijk door het aanbrengen van gedefinieerde nucleotide sequenties aan de nucleïnezuren in een monster, die het mogelijk maakt de analyse van meerdere monsters in een sequencing lopen, waardoor de steekproef doorvoer en het verlagen per sample kosten. Door hun hoge draagbaarheid en gebruiksgemak, nanogaatje sequencing apparaten zijn met succes gebruikt in het veld tijdens de recente Ebola-virusziekte epidemie in West-Afrika, met de nadruk op hun geschiktheid voor een snelle inzet in afgelegen regio's7 , 8.
Hier, beschrijven wij een gedetailleerd gebied-compatibel protocol voor het rangschikken van mRNA het coderen voor de Niemann-oogst C1 (NPC1) proteïne, die de verplichte ingangs receptor voor filoviruses zoals ebolaviruses is, en is getoond om soorten gevoeligheid te beperken om deze virussen9,10. Het protocol omvat extractie van geheel RNA van bloedsteekproeven, specifieke versterking van NPC1 mRNA door RT-PCR, barcoding van steekproeven, bibliotheek voorbereiding en het rangschikken met een nanogaatje sequencing apparaat. De analyse van gegevens kan niet worden besproken wegens ruimtebeperkingen, hoewel sommige basis richtingen in de representatieve resultaten worden verstrekt; echter, de geïnteresseerde lezer wordt verwezen naar een eerdere publicatie11 voor een meer gedetailleerde beschrijving van de workflow die we gebruikten, alsmede aan publicaties vananderen 12,13,14 voor gedetailleerde informatie met betrekking tot de analysehulpmiddelen die in deze workflow worden gebruikt.
Protocol
Monsters werden verzameld naar aanleiding van de Njala University Institutional Review Board (NUIRB) Protocol nr. IRB00008861/FWA00018924.
1. de extractie van RNA van bloedsteekproeven
- Verzamel 3 mL van het hele bloed van de soort te analyseren in een bloedafname buis gevuld met 6 mL DNA/RNA stabilisatie reagens (Zie tabel van materialen) en meng door het inverteren van 5 keer. Bewaar het bloedmonster voor maximaal een maand bij 4 °C.
- Breng de inhoud van de bloedafname buis in een 50 mL collectie buis, voeg 120 µ L van proteïnase K, en meng door vortexen voor 5 s. Incubeer het monster voor 30 minuten bij kamertemperatuur.
- Voeg 9 mL isopropanol toe aan het mengsel en draai de Vortex voor 5 s.
- Plaats een reservoir op een de rotatie kolom van de reiniging van RNA (Zie lijst van materialen) en plaats de assemblage op een vacuüm spruitstuk (Zie lijst van materialen). Voeg het monster mengsel in het reservoir. Breng een vacuüm totdat alle vloeistof is door de kolom.
- Als alternatief, als er geen vacuüm variëteit beschikbaar is, kan het bloed worden doorgegeven door de kolom in 700 µ L gedeelten door herhaalde centrifugeren voor 30 s bij 12.000 x g met de doorstroming weggegooid tussen de centrifuge stappen. Dit vergt echter ongeveer 26 centrifugale stappen.
- Plaats de de kolom van de de reiniging rotatie van RNA in een inzamelings buis en Voeg 400 µ L DNA/RNA prep buffer toe (Zie lijst van materialen). Centrifugeer bij 12.000 x g voor 30 s en gooi de doorstroming.
- Voeg 400 µ L van DNA/RNA was buffer (Zie de lijst van materialen) aan de kolom, centrifugeren bij 12.000 x g voor 30 s en gooi de doorstroming.
- Meng 5 µ L van DNase I (1 U/µ L) (Zie de lijst van materialen) met 75 µ l van de de spijsverterings buffer van DNA (Zie lijst van materialen) en voeg het mengsel op de kolom toe. Incubeer gedurende 15 minuten bij kamertemperatuur.
- Voeg 400 µ L van DNA/RNA prep buffer aan de kolom toe en centrifugeer bij 12.000 x g voor 30 s. Gooi de flow-through.
- Was de kolom met 700 µ L van DNA/RNA was buffer en centrifugeer bij 12.000 x g voor 30 s. Gooi de flow-through.
- Herhaal stap 1,9 met 400 µ L van DNA/RNA was buffer en centrifugeer bij 12.000 x g voor 2 min om alle resterende was buffer te verwijderen en de kolom te drogen. Bij het verwijderen van de kolom uit de collectie buis, zorg ervoor dat niet aan de onderzijde van de kolom natte met de buffer in de collectie buis.
-
Plaats de kolom in een nieuwe 1,5 mL micro centrifugebuis en voeg 70 µ L van Nuclease water toe. Incubeer gedurende 1 minuut bij kamertemperatuur en centrifugeer voor 30 s bij 12.000 x g. Bewaar RNA bij-80 °C tot verder gebruik (of onmiddellijk gebruik).
- Optioneel: Om het RNA te kwantificeren, neem een hoeveelheid en bepaal de concentratie gebruikend een UV spectrofotometer (Zie lijst van materialen).
2. omgekeerde transcriptie van NPC1 mRNA in cDNA
- In een 0,2 mL reactiebuis, voeg 8 µ L van de sjabloon RNA (1 pg tot 2,5 µ g van RNA) en 1 µ L elk van 10x DNase buffer en DNase enzym (Zie tabel van materialen). Incubeer bij 37 °C voor 2 min. Later, centrifugeer de reactie kort en plaats het op ijs.
- Voeg 4 µ L van reverse transcriptase Master Mix (Zie de lijst van materialen) en 6 µ l van Nuclease water aan de reactiebuis en meng zachtjes. Incubeer de reactie in een Thermocycler voor 10 min bij 25 °C (voor primer gloeien), gevolgd door 10 min bij 50 °C (voor omgekeerde transcriptie van RNA). Om het enzym te desactiveren, incubeer 5 min bij 85 °C.
- Breng cDNA over naar een nieuwe 1,5 mL micro centrifugebuis en bewaar bij-80 °C tot verder gebruik (of onmiddellijk gebruik).
3. versterking van het NPC1 open Lees frame
-
Eerste versterking stap
- Opstelling een touchdown PCR15,16 om NPC1 cDNA met inleidingsreeks 1 (Zie lijst 1) te versterken, gebruikend een hete polymerase van het begin de hoge trouw DNA (Zie lijst van materialen) met de aangewezen reactiebuffer in een 50 µ l-reactie volume met 1 µ L-sjabloon. Indien mogelijk, het opzetten van de reactie op ijs of in een 4 ° c koelblok.
- Incubeer de reactie in een Thermocycler met een eerste denaturatie stap van 30 s bij 98 °C, gevolgd door 10 cycli met denaturatie bij 98 °C voor 10 s, primer gloeien voor 20 s bij 65 ° c, het verlagen van de temperatuur met 0,5 °C per cyclus, en rek voor 1 min bij 72 ° c. Daarna, looppas een extra 20 cycli met 10 s bij 98 °C, 20 s bij 60 °C, en 1 min bij 72 °C, gevolgd door een definitieve verlengings stap van 5 min bij 72 °C.
-
PCR zuivering gebruikend magnetische parels
- Overdracht 50 µ L van PCR product in een 1,5 mL DNA-lage bindende reactiebuis (Zie lijst van materialen). Opnieuw op te schorten magnetische kralen (Zie tabel van materialen) grondig door vortexen en voeg 50 µ l kralen aan de PCR-reactie. Meng goed. Incubeer het monster op een roterende mixer (Zie de lijst van materialen) voor 5 min bij kamertemperatuur (bij 15 rpm).
- Kort spin vaststelling van de steekproef en plaats de 1,5 mL micro centrifugebuis op een magnetisch rek (Zie tabel van materialen) om pellet de magnetische kralen. Wacht tot de bovendrijvende volledig is verduidelijkt voordat u doorgaat met de volgende stap.
- Aspireren de bovendrijvende zonder verstoring van de kraal pellet en gooi.
- Pipetteer 200 µ L van 70% ethanol in de reactiebuis en incubeer voor 30 s. aspireren de ethanol zonder de pellet te storen en te ontdoen. Herhaal dit voor een totaal van twee wasbeurten. Zorg ervoor dat er geen ethanol overblijft. Het kan nodig zijn om eerst aspireren met een grotere Pipet (bijv. 1000 µ L), en vervolgens de resterende ethanol druppeltjes te verwijderen met een kleinere Pipet (bijv. 10 µ L).
- Lucht-droog de pellet voor 1 minuut bij kamertemperatuur.
- Verwijder de reactiebuis van de magneet Rack, hersuspendeer de pellet in 30 µ L van Nuclease water en incubeer gedurende 2 minuten bij kamertemperatuur.
- Plaats de reactiebuis terug op de magnetische rek en wacht tot de kralen volledig zijn pelleted.
- Verwijder de bovendrijvende zonder de pellet te verstoren en breng deze over naar een nieuwe 1,5 mL reactiebuis.
-
Toevoeging van barcode adapters door geneste PCR
- Opzetten van een 50 µ L touchdown PCR met Hot start High-Fidelity DNA-polymerase met 5x reactiebuffer en primer set 2 (Zie tabel 1). De inleidingen in deze reeks bestaan uit een doel opeenvolging-specifiek gebied om band van PCR producten toe te staan die in stap 3,2 (binnenkant van de inleidingsreeks 1 opeenvolgingen) worden geproduceerd, evenals een adapter opeenvolging die als doel in de verdere barcoding PCR reactie (cf. sectie 4) wordt gebruikt. Indien mogelijk, het opzetten van de reactie op ijs of in een 4 ° c koelblok. Gebruik 1 µ L van het gezuiverde PCR-product, opgesteld in punt 3,2 als sjabloon.
- Incubeer de reactie mix in een Thermocycler met behulp van een eerste denaturatie stap van 30 s bij 98 ° c, gevolgd door 10 cycli met denaturatie bij 98 °C voor 10 s, primer gloeien voor 20 s bij 65 °C, het verlagen van de temperatuur met 0,5 °C per cyclus , en rek voor 1 min bij 72 °C. Vervolgens Incubeer de reactie voor een verdere 30 cycli voor 10 s bij 98 °C, 20 s bij 71 °C, en 1 min bij 72 °C, gevolgd door een laatste verlengings stap van 5 min bij 72 °C.
- Reinig het PCR-product met behulp van magnetische kralen zoals beschreven in punt 3,2.
4. barcoding van NPC1 amplicons
- Voor elk in punt 3 gegenereerd PCR-product het opzetten van een barcoding PCR reactie in een 0,2 mL reactiebuis met behulp van 50 µ L van Taq DNA polymerase 2x Master Mix (Zie tabel van materialen), 2 µ l van een van de barcode primers uit een PCR barcoding Kit (Zie tabel van materialen en lijst 2), en 1 µ l van gezuiverd PCR product van stap 3.3.2 als malplaatje. Voeg 47 µ L van Nuclease vrij water toe om een definitief volume van 100 µ L te verkrijgen.
- Incubeer de reactie in een Thermocycler bij 95 °C voor 3 min als eerste denaturatie. Daarna, looppas 15 cycli voor 15 s bij 95 °C, 15 s bij 62 °C, en 1,5 min bij 65 °C. Als laatste rek, Incubeer de reactie op 65 ° c voor 5 min.
- Zuiver het PCR product zoals beschreven onder 3,2, maar gebruik 100 µ L van magnetische parels en elueer in 30 µ L van Nuclease-vrij water.
- Kwantificeer het monster indien mogelijk met behulp van een UV-spectrofotometer.
5. bibliotheek voorbereiding
- Combineer een gelijke hoeveelheid van barcodes DNA van elk monster voor een totaal van 1 µ g van DNA in een volume van 45 µ L (indien nodig, voeg Nuclease-vrij water) in een 0,2 mL reactiebuis. Als er geen UV-spectrofotometer beschikbaar is, gebruikt u gelijke volumes van elk monster. Voor dA-tailing, voeg 7 µ L van eind-prep reactiebuffer (Zie tabel van materialen), 3 µ l van end-prep enzym mix (Zie tabel van materialen), en 5 µ l van Nuclease-vrij water. Meng zachtjes door flicking de buis.
- Incubeer de reactie voor 5 min bij 20 °C, gevolgd door 5 min bij 65 °C in een Thermocycler.
- Zuiver het reactieproduct zoals beschreven in punt 3,2, maar gebruik 60 µ L magnetische kralen en elueer in 25 µ L van Nuclease water.
- Optioneel: Neem 1 µ l om de concentratie van het monster te kwantificeren met behulp van een UV-spectrofotometer. Het totale bedrag moet meer dan 700 ng.
- Combineer 22,5 µ L van gezuiverd DNA van stap 5,3 met 2,5 µ L van 1D2 adapter (Zie lijst van materialen) en 25 µ l van botte/ta ligase meester mengeling (Zie lijst van materialen) in een nieuwe 1,5 ml DNA-lage bindende reactiebuis, meng zachtjes door flicking, en kort spin neer. Incubeer gedurende 10 minuten bij kamertemperatuur.
- Zuiveren van de reactieproduct zoals beschreven in punt 3,2, maar gebruik 20 µ L van magnetische kralen, verhoging van de incubatietijd voor DNA-binding tot 10 min, Voer twee wassen stappen met 1 mL ethanol per stuk, en elueer in 46 µ L van Nuclease-vrij water.
- Combineer 45 µ L van het reactieproduct van stap 5,6 met 5 µ L van de mengeling van de adapter van de streepjescode (Zie lijst van materialen) en 50 µ l van botte/ta ligase meester mengeling in een DNA-lage bindende reactiebuis. Meng zachtjes door flicking en incubeer gedurende 10 minuten bij kamertemperatuur.
- Zuiver het reactieproduct zoals beschreven in punt 3,2, maar gebruik 40 µ L van magnetische kralen, doe twee wassen stappen met 140 µ L van ABB buffer (Zie tabel van materialen) in plaats van ethanol, de kralen opnieuw op te schorten door flicking en pellet op een magnetisch rek. Elueer in 15 µ L van elutie buffer (Zie de lijst van materialen). Verhoog de incubatietijden voor de initiële binding van DNA naar de kralen en voor de elutie stap tot 10 min. Bewaar het resulterende product op ijs of bij 4 °C tot het gebruik.
6. de controle van de kwaliteit van stroom cel
- Voer voor gebruik een kwaliteitscontrole uit op de stroom cel. Hiertoe sluit u het sequencing-apparaat aan op de hostcomputer en opent u de software.
- Voeg een stroom cel (Zie de materiaallijst) in het sequencer-apparaat in en kies het type flow Cell in het vak selector en Bevestig door te klikken op beschikbaar.
- Klik op stroom cel controleren in de onderkant van het scherm en kies het juiste type stroom cellen.
- Klik op Start test om de kwaliteitscontrole te starten. Een minimum van 800 actieve nanoporiën in totaal is vereist voor de stroom cel om bruikbaar te zijn.
7. het laden van de stroom cel en het starten van de sequencing draaien
- Open de klep van de priming-poort door deze met de klok mee te schuiven. Stel een P1000 pipet naar 200 µ L en steek de tip in de priming poort. Pas de pipet aan op 230 µ L terwijl u de tip in de priming-poort houdt, om 20-30 µ L-buffer op te stellen en eventuele luchtbellen te verwijderen.
- In een nieuwe 1,5 mL DNA-laag bindende reactiebuis bereiden de priming mix door het combineren van 576 µ L van RBF buffer (Zie tabel van materialen) met 624 µ l van Nuclease-vrij water.
- Pipetteer 800 µ L van de voor bereide priming-mix in de priming-poort en wacht 5 min. Til de bemonsterings poort af, en Pipetteer een extra 200 µ L van de voor bereide priming-mix in de priming-poort.
- Pipetteer 35 µ L van RBF buffer in een nieuwe, schone 1,5 mL DNA-laag bindende reactiebuis. Meng LLB kralen (Zie de materiaallijst) grondig door het pipetteren en voeg 25,5 µ l van de kralen toe aan de Rbf buffer. Voeg 2,5 µ L Nuclease-vrij water en 12 µ L van de bibliotheek van DNA van stap 5,8 toe en meng door te pipetteren.
- Voeg 75 µ L van het monster mengsel in een langzame dropwise manier aan de stroom cel via de steekproef haven toe.
- Vervang de voorbeeld-poort klep, sluit de priming-poort en sluit het deksel van het sequencing-apparaat.
- Controleer in de software of de stroom cel nog beschikbaar is, open een nieuw experiment en stel de parameters voor uitvoeren in door de gebruikte Kit te selecteren. Selecteer Live base-Calling. Start de sequencing uitgevoerd door te klikken op experiment beginnen. Voortzetting van de sequencing lopen totdat er voldoende experimentele gegevens worden verzameld.
Resultaten
In een representatief experiment om het gepresenteerde protocol te testen haalden we het RNA uit 10 verschillende bloedmonsters van vijf diersoorten (dat wil zeggen, 2 personen per soort (geit, schaap, varken, hond, vee)) (tabel 3). De opbrengsten van RNA en de kwaliteit na extractie kunnen sterk variëren, in het bijzonder wegens verschillen in steekproef behandeling en opslag. In ons representatieve experiment, zagen wij de concentraties van RNA tussen 43 ng en 543 ng per µ L (lijst 3). Ook, na versterking door RT-PCR, toonde de gel-analyse van de NPC-1 PCR-producten diverse resultaten (Figuur 2), met duidelijk zwakkere banden voor steekproeven BC01 en BC02 (beide geit). Deze verschillen werden waarschijnlijk veroorzaakt door verschillen in steekproef kwaliteit, hoewel de verschillen in PCR doeltreffendheid toe te schrijven aan verschillen in inleidings band aan het NPC1 gen van verschillende soorten niet kunnen worden uitgesloten. Echter, deze verschillen in rendement en/of versterking efficiëntie niet duidelijk invloed op de algemene sequencing uitkomst. Verder, kwam een extra niet-specifiek PCR product in steekproef BC10 (vee) voor. In tegenstelling tot Sanger sequencing, hebben dergelijke niet-specifieke producten geen negatieve invloed op de resultaten van nanogaatje sequencing, aangezien deze worden genegeerd tijdens het in kaart brengen van de verkregen leesbewerkingen naar een referentie sequentie als onderdeel van de gegevensanalyse.
Voorafgaand aan elke sequencing lopen, een kwaliteitscontrole van de te gebruiken stroom cellen wordt sterk aanbevolen, met een minimum vereiste van 800 totale poriën. In onze representatieve experiment, deze kwaliteit te controleren geretourneerd 1.102 poriën beschikbaar voor sequencing. Aangezien de gegevens in real time worden verstrekt en onmiddellijk kunnen worden geanalyseerd, kan de lengte van een het rangschikken looppas voor de individuele toepassing worden aangepast (d.w.z., tot de voldoende het rangschikken gegevens voor de gewenste analyse worden geproduceerd). In onze experimenten, sequencing runs worden meestal uitgevoerd 's nachts, en in het geval van onze representatief experiment hebben we ongeveer 1.400.000 keer gelezen tijdens zo'n 14 uur lopen.
Afhankelijk van het type gegevensanalyse dat moet worden uitgevoerd, kan het raadzaam zijn om slechts een subset van de verkregen leesbewerkingen te verwerken. In het geval van ons representatief experiment, werd een ondergroep van 10.000 gelezen geselecteerd voor verdere analyse. Te dit einde, de fastq bestanden gegenereerd tijdens de sequencing lopen werden verder verwerkt in een Ubuntu 18,04 LTS omgeving, en demultiplexed met behulp van Flexbar v 3.0.3 met parameters geoptimaliseerd voor het demultiplexen van nanogaatje sequencing data (barcode-staart-lengte 300 , barcode-fout-tarief 0,2, barcode-gap-penalty-1)12. Na demultiplexing, lees mapping en consensus generatie kan dan worden gedaan met behulp van een aantal verschillende instrumenten, maar een gedetailleerde bespreking van de bio-informatica aspect van nanogaatje sequencing gaat verder dan de reikwijdte van dit manuscript. Echter, in het geval van onze representatieve resultaten, lees mapping naar een referentie sequentie werd uitgevoerd met behulp van Geneious 10.2.3. Van 10.000 leest geanalyseerd, 5.457 toonde een lengte tussen 1.750 en 2.000 nucleotiden, die de verwachte grootte voor de PCR fragmenten aanpast die als deel van onze werkstroom worden versterkt (1.769 NT, Figuur 3). Een extra piek in de lengte distributie van leest werd waargenomen tussen 250 tot 500 nucleotiden, die aan onspecifieke PCR producten kunnen worden toegeschreven. Het demultiplexing van leest liet de taak van 87,6% van de gelezen aan één van de 10 barcodes/de geanalyseerde steekproeven toe (Figuur 4). Het aandeel van de gemultiplexte leest voor elke barcode varieerde van 3,4% voor barcode 1 tot 16,9% voor barcode 10; echter, als gevolg van het algemene grote aantal leest dit nog steeds toegestaan zinvolle consensus te bellen met een hoge lees diepte, zelfs voor deze lagere overvloed barcode datasets. Inderdaad, in kaart brengen van de gesorteerde leest naar een referentie sequentie van NPC1 resulteerde in tussen 31,7% (barcode 2) en 100% (barcode 7 en 8) van leest in kaart brengen van de verwijzing, het geven van een lees diepte van meer dan 90 leest op elke positie voor elk monster. Dit is dan meer dan voldoende om vertrouwen consensus base-bellen met een verwaarloosbaar foutenpercentage toe te staan.

Figuur 1: schematische weergave van DNA sequencing met behulp van nanogaatje technologie. Een single-gestrande DNA-molecuul gaat door een nanogaatje ingebed in een elektrisch resistent membraan, met een Helicase reguleren van de overgangssnelheid. Een Ionische stroom loopt gelijktijdig door de porie en wordt continu gemeten. De modulaties van de stroom die door de nucleotiden huidig in de porie wordt veroorzaakt worden ontdekt en met behulp van computer achter-vertaald in de nucleotideopeenvolging van de bundel van DNA. Klik hier om een grotere versie van dit cijfer te bekijken.
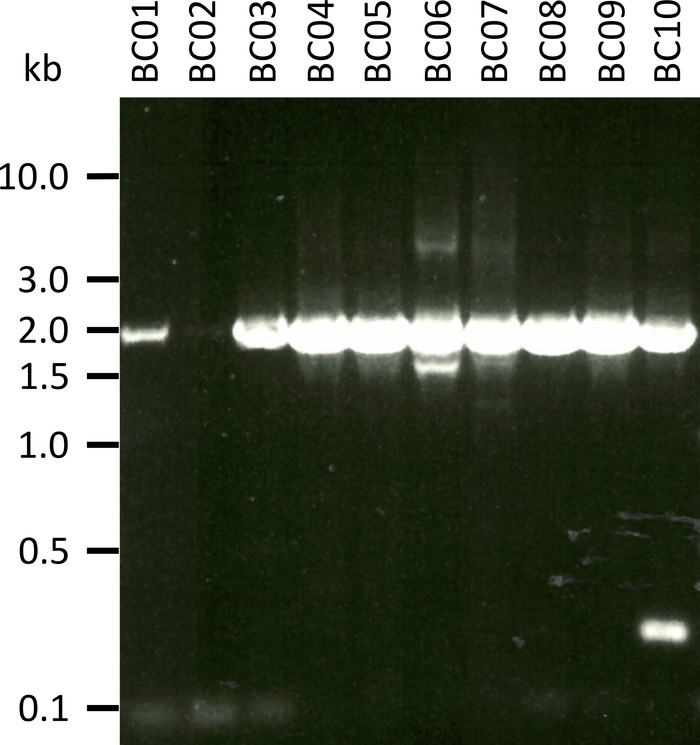
Figuur 2: versterking van PCR producten van Niemann-Kies C1 van mRNA. mRNA werd geïsoleerd van geit (BC01 en 02), schapen (BC03 en 04), varkens (BC05 en 06), hond (BC07 en 08), en vee (BC09 en 10). De genestelde PCR producten werden gescheiden in een 0,8% agarose gel in 1x TAE buffer (die van de buffer van 50x TAE wordt voorbereid: 242,28 g van tris Base, 57,1 mL glaciale azijnzuur, 100 mL van 0,5 M EDTA, dH2O tot 1 L, pH aangepast aan 8,0) voor 45 min bij 100 V en gekleurd met Sybr veilig. Klik hier om een grotere versie van dit cijfer te bekijken.
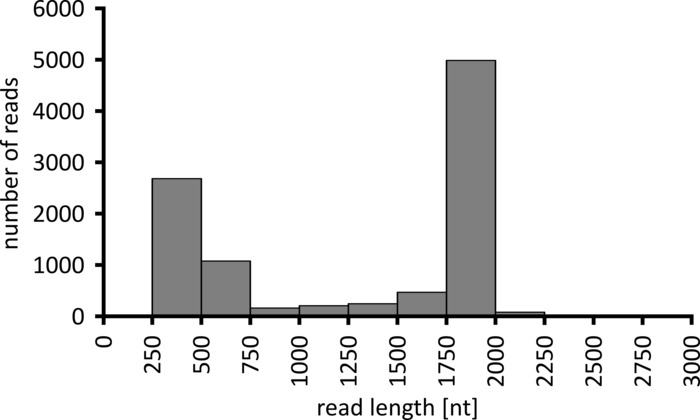
Figuur 3: Lees-lengte verdeling van 10.000 leest van het representatieve experiment. Het aantal gelezen gelezen met een bepaalde Lees lengte interval is aangegeven. Klik hier om een grotere versie van dit cijfer te bekijken.
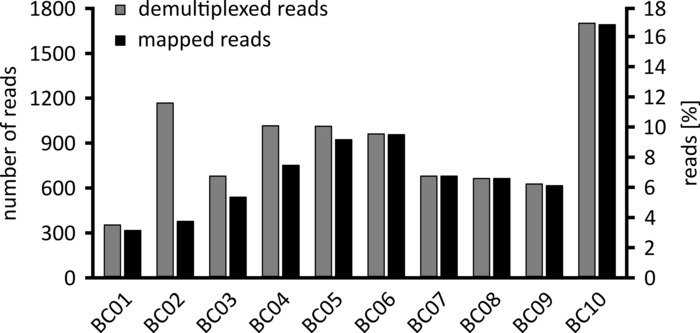
Figuur 4: verdeling van de leest na het demultiplexen. Het aantal en het percentage van de gemultiplexte (grijs) en in kaart gebrachte leest (zwart) voor elke barcode worden weergegeven. Klik hier om een grotere versie van dit cijfer te bekijken.
Tabel 1: overzicht van de gebruikte primer sets. Initiële versterking van de doel sequenties werd uitgevoerd met primer set 1. Primer set 2 werd vervolgens gebruikt voor geneste versterking en adapter toevoeging. Adapters zijn rood aangegeven. Klik hier om dit bestand te downloaden.
Tabel 2: overzicht van barcode sequenties. Individuele barcodes werden gebruikt om elk sequentieel monster te identificeren. Klik hier om dit bestand te downloaden.
Tabel 3: RNA-concentraties verkregen na extractie van bloedmonsters gerangschikt in het representatieve experiment. De concentraties van RNA van twee individuen van elk van vijf soorten worden getoond, en de verhoudingen van de optische dichtheid bij 260/280 nm en 260/230 Nm zijn vermeld. Klik hier om dit bestand te downloaden.
Discussie
In de afgelopen twee decennia is het rangschikken van biologische monsters een steeds belangrijker aspect geworden van studies in een breed scala van vakgebieden. De ontwikkeling van de tweede generatie sequencing systemen gebaseerd op de sequencing van een dichte array van DNA-functies met behulp van iteratieve cycli van enzymatische manipulatie en image-based data acquisitie1 is drastisch toegenomen doorvoer in vergelijking met de traditionele Sanger sequencing techniek, en maakt analyse van meerdere monsters, alsmede verschillende nucleïnezuur soorten in een bepaald monster in parallel4. Echter, voor de meeste van de meest gebruikte tweede generatie systemen, slechts korte leest worden geproduceerd, en alle platforms vertrouwen op gevoelige, omvangrijke en dure apparatuur3,4.
In tegenstelling tot de tweede generatie sequencing platforms, de sequencing apparaat dat wordt gebruikt in dit protocol is gebaseerd op nanogaatje technologie. Hier gaat een enig-gestrande Nucleic zure molecule door een nanogaatje, resulterend in modulatie van een Ionische stroom die ook door de zelfde nanogaatje stroomt, en die kan worden gemeten en achter-vertaald om de opeenvolging van de Nucleic zure molecule af te leiden. Deze derde generatie sequencing aanpak maakt een aantal voordelen ten opzichte van andere benaderingen. De belangrijkste voordelen die direct verband houden met de unieke werkingsprincipe van deze technologie zijn de extreem lange Lees lengte geproduceerd (Lees lengtes van maximaal 8,8 x 10⁵ nucleotiden zijn gemeld6), de mogelijkheid om sequentie niet alleen DNA, maar ook RNA direct, die onlangs werd aangetoond voor een compleet influenza-virusgenoom17, en de mogelijkheid om gegevens te analyseren in real-time als ze worden gegenereerd, die het mogelijk maakt snelle meta Genomics detectie van pathogenen binnen enkele minuten18. Extra praktische voordelen zijn de extreem geringe omvang van de nanogaatje sequencing apparaat, waardoor het gebruik ervan in elk laboratorium of op veld missies naar afgelegen locaties19,20, en de lage prijs in vergelijking met andere sequencing platforms. In termen van lopende kosten, momenteel een nieuwe stroom cel is vereist voor elke sequencing lopen, wat resulteert in kosten van ongeveer $1.100 per run voor de stroom cel en bibliotheek voorbereiding reagentia. Deze kosten kunnen worden verlaagd in sommige gevallen door het wassen en hergebruiken van de stroom cel, of door barcoding en sequencing meerdere monsters in een enkele run. Ook een nieuwe vorm van stroom cellen wordt momenteel beta-getest door een klein aantal laboratoria, die vereist het gebruik van een stroom-cel adapter (een zogenaamde "flongle"), en moet aanzienlijk verminderen stroom cellen prijs en dus de exploitatiekosten.
De belangrijkste tekortkoming van nanogaatje sequencing blijft de nauwkeurigheid, met enkele Lees nauwkeurigheid in het bereik van 83 tot 86% wordt gemeld6,21,22, en de meeste van de onnauwkeurigheden wordt veroorzaakt door invoeging/schrappingen ( indels)5,21. Echter, hoge lees diepte kan compenseren voor deze onnauwkeurigheden, en een recente studie voorgesteld op basis van theoretische overwegingen dat een lees diepte van > 10 kan de algehele nauwkeurigheid te verhogen tot > 99.8%21. Toch zullen verdere verbeteringen in de nauwkeurigheid nodig zijn, vooral als de analyse moet worden uitgevoerd op een enkel molecuul niveau in plaats van op een consensussequentie niveau. Het gebruik van 1D2 -technologie zoals beschreven in dit protocol, dat is gebaseerd op de toevoeging van de 1d2 -en barcode adapters (cf. sectie 5,5) die resulteren in beide onderdelen van een enkel DNA-molecuul dat wordt gesequenced door dezelfde nanogaatje, verhoogt Lees nauwkeurigheid aangezien de informatie van beide bundels van DNA voor opeenvolgings bepaling kan worden gebruikt. Verder, een workaround strategie die kan worden nagestreefd met het oog op de voordelen van nanogaatje sequencing (met name lange Lees lengte) combineren met de hogere nauwkeurigheid van andere sequencing technologieën is het gebruik van nanogaatje sequencing informatie als een steiger, die vervolgens gepolijst met behulp van sequencing gegevens van andere platforms6.
De meest kritieke factor voor het succes van het protocol hier gepresenteerd is sample kwaliteit, en in het bijzonder de hoeveelheid en de kwaliteit van de geëxtraheerde RNA. Juiste opslag en snelle extractie van de hulp van RNA in het bereiken van een adequate opbrengst van RNA. Het gebruik van passende bloedafname buizen kan de opslag van bloedmonsters voor maximaal een maand, maar de bloedstolling kunnen een probleem zijn, met name wanneer monsters worden opgeslagen bij verhoogde temperaturen, die het geval kan zijn onder veldomstandigheden. De tweede kritieke stap is de versterking van doel opeenvolgingen, en bijzonder onder gebiedsvoorwaarden PCR de reacties presteren vaak minder goed dan onder standaard laboratoriumvoorwaarden7. Te dit einde, zorgvuldige primer ontwerp en optimalisatie is van cruciaal belang om robuuste versterking te bereiken. Bovendien, genestelde PCR benaderingen en touchdown PCR, zoals die in dit protocol wordt gebruikt, kan zowel specificiteit als gevoeligheid van de versterking van het doel gen verhogen4,7. Inderdaad, in onze ervaring in Liberia en Guinee met deze technologie geneste protocollen werden vereist onder veldomstandigheden met veldmonsters, zelfs voor primer sets die versterking van de doelstellingen van laboratoriummonsters en onder laboratoriumomstandigheden toegestaan met een enkele ronde van PCR (7 en ongepubliceerde resultaten).
In tegenstelling tot deze meer kritieke stappen, de voorbereiding van de bibliotheek en het rangschikken looppas zelf zijn eerder robuuste procedures. Echter, onder veldomstandigheden praktische kwesties, zoals de beschikbaarheid van bepaalde onderdelen van de apparatuur kan problematisch zijn. Er is bijvoorbeeld een UV-spectrofotometer nodig om de concentraties van DNA te bepalen voordat de voorbereiding van barcode monsters in de bibliotheek wordt gemaakt. Mocht een dergelijk apparaat echter niet onder veldomstandigheden beschikbaar zijn, dan kan een gelijk volume van elk monster eenvoudig gecombineerd worden om de 45 µ L te maken die nodig is voor de voorbereiding van de bibliotheek, met verschillen in Sample input materiaal dan meestal wordt verzacht door de grote aantal keer gelezen. Evenzo, de noodzaak van Internet-connectiviteit voor de sequencing lopen kan een probleem zijn, hoewel de base-Calling niet langer moet worden uitgevoerd online, maar kan lokaal worden gedaan; echter, deze noodzaak kan worden verwijderd onder bepaalde omstandigheden door de fabrikant, indien nodig.
Samengevat, het gepresenteerde protocol maakt relatief lage kosten sequencing op locaties zonder toegang tot de traditionele sequencing-apparatuur, ook in afgelegen locaties. Het kan gemakkelijk aan om het even welk doel RNA of DNA worden aangepast, zo toestaand onderzoekers om talrijke biologische vragen te beantwoorden.
Openbaarmakingen
TH deelgenomen aan de Oxford Nanogaatje Technologies (ONT) MinION vroege toegang programma van 2014 tot 2015, en ontvangen MinION apparaten en stroom cellen voor een eerdere studie 7 uitgevoerd door de nationale instituten van de gezondheid, de VS, gratis of tegen lagere kosten . Hij werd uitgenodigd door ONT om een deel van dat werk te presenteren op de Londense Calling 2015 vergadering in Londen, het Verenigd Koninkrijk, en ONT betaald voor vervoer en accommodatie. Voor het werk dat in dit manuscript wordt voorgesteld, zijn geen voordelen (bijv. hardware of reagentia tegen gereduceerde kosten, reisvergoedingen etc.) verkregen van ONT. AM, KF en RS hebben niets te onthullen.
Dankbetuigingen
De auteurs bedanken Allison Groseth voor kritische lezing van het manuscript. Dit werk werd financieel gesteund door het Duitse federale ministerie van voedsel en landbouw (BMEL) gebaseerd op een besluit van het Parlement van de Bondsrepubliek Duitsland door het Federale Bureau voor landbouw en voedsel (BLE).
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| 1D2 adapter, barcode adapter mix, ABB buffer, elution buffer, RBF buffer, LBB beads | Oxford Nanopore Technologies | SQK-LSK308 | 1D² Sequencing Kit |
| Bloedverzamelbuis met DNA/RNA stabiliserend reagens | Zymo Research | R1150 | DNA/RNA Shield - Bloedverzamelbuis |
| Blunt/TA ligase master mix | New England Biolabs | M0367S | Blunt/TA Ligase Master Mix |
| DNA-low binding reactiebuis | Eppendorf | 30108051 | DNA LoBind Tube |
| DNase buffer en DNase | ThermoFisher Scientific | 11766050 | SuperScript™ IV VILO™ Master Mix with ezDNase™ Enzyme |
| Flow cell | Oxford Nanopore Technologies | FLO-MIN105.24 | flow cell R9.4 |
| Hot start high fidelity DNA polymerase | New England Biolabs | M0493L | Q5 Hot Start High-Fidelity DNA Polymerase (500 U) |
| Magnetische kralen | Beckman Coulter | A63881 | Agencourt AMPure XP beads |
| Magnetische rek | ThermoFisher Scientific | 12321D | DynaMag-2 Magnet |
| Nanopore sequencing apparaat | Oxford Nanopore Technologies | - | MinION Mk 1B |
| PCR barcode kit | Oxford Nanopore Technologies | EXP-PBC001 | PCR Barcoding Kit I (R9) |
| Reverse transcriptase master mix | ThermoFisher Scientific | 11766050 | SuperScript™ IV VILO™ Master Mix with ezDNase™ Enzyme |
| RNA zuivering spinkolom, DNA/RNA prep buffer, DNA/RNA wasbuffer, DNase I, DNA digestie buffer | Zymo Research | R1151 | Quick-DNA/RNA Blood Tube Kit |
| Roterende mixer | ThermoFisher Scientific | 15920D | HulaMixer Sample Mixer |
| Taq DNA polymerase | New England Biolabs | M0287S | LongAmp Taq 2x Master Mix |
| Ultra II End-prep kit | New England Biolabs | E7546S | NEBNext Ultra II End-Repair/dA-tailing Modul |
| UV spectrofotometer | Implen | - | NanoPhotometer |
| Vacuum manifold | Zymo Research | S7000 | EZ-Vac Vacuum Manifold |
Referenties
- Shendure, J., Ji, H. Next-generation DNA sequencing. Nature Biotechnology. 26 (10), 1135-1145 (2008).
- Shendure, J., Lieberman Aiden, E. The expanding scope of DNA sequencing. Nature Biotechnology. 30 (11), 1084-1094 (2012).
- Liu, L., et al. Comparison of next-generation sequencing systems. Journal of Biomedicine and Biotechnology. 2012, 251364(2012).
- Levy, S. E., Myers, R. M. Advancements in Next-Generation Sequencing. Annual Review of Genomics and Human Genetics. 17, 95-115 (2016).
- Lu, H., Giordano, F., Ning, Z. Oxford Nanopore MinION Sequencing and Genome Assembly. Genomics, Proteomics & Bioinformatics. 14 (5), 265-279 (2016).
- Jain, M., et al. Nanopore sequencing and assembly of a human genome with ultra-long reads. Nature Biotechnology. 36 (4), 338-345 (2018).
- Hoenen, T., et al. Nanopore Sequencing as a Rapidly Deployable Ebola Outbreak Tool. Emerging Infectious Diseases. 22 (2), 331-334 (2016).
- Quick, J., et al. Real-time, portable genome sequencing for Ebola surveillance. Nature. 530 (7589), 228-232 (2016).
- Carette, J. E., et al. Ebola virus entry requires the cholesterol transporter Niemann-Pick C1. Nature. 477 (7364), 340-343 (2011).
- Ndungo, E., et al. A Single Residue in Ebola Virus Receptor NPC1 Influences Cellular Host Range in Reptiles. mSphere. 1 (2), (2016).
- Martin, S., et al. A genome-wide siRNA screen identifies a druggable host pathway essential for the Ebola virus life cycle. Genome Medicine. 10 (1), 58(2018).
- Roehr, J. T., Dieterich, C., Reinert, K. Flexbar 3.0 - SIMD and multicore parallelization. Bioinformatics. 33 (18), 2941-2942 (2017).
- Li, H., et al. The Sequence Alignment/Map format and SAMtools. Bioinformatics. 25 (16), 2078-2079 (2009).
- Kielbasa, S. M., Wan, R., Sato, K., Horton, P., Frith, M. C. Adaptive seeds tame genomic sequence comparison. Genome Research. 21 (3), 487-493 (2011).
- Don, R. H., Cox, P. T., Wainwright, B. J., Baker, K., Mattick, J. S. Touchdown' PCR to circumvent spurious priming during gene amplification. Nucleic Acids Research. 19 (14), 4008(1991).
- Korbie, D. J., Mattick, J. S. Touchdown PCR for increased specificity and sensitivity in PCR amplification. Nature Protocols. 3 (9), 1452-1456 (2008).
- Keller, M. W., et al. Direct RNA Sequencing of the Coding Complete Influenza A Virus Genome. Scientific Reports. 8 (1), 14408(2018).
- Greninger, A. L., et al. Rapid metagenomic identification of viral pathogens in clinical samples by real-time nanopore sequencing analysis. Genome Medicine. 7, 99(2015).
- Castro-Wallace, S. L., et al. Nanopore DNA Sequencing and Genome Assembly on the International Space Station. Scientific Reports. 7 (1), 18022(2017).
- Goordial, J., et al. In Situ Field Sequencing and Life Detection in Remote (79 degrees 26'N) Canadian High Arctic Permafrost Ice Wedge Microbial Communities. Frontiers in Microbiology. 8, 2594(2017).
- Runtuwene, L. R., et al. Nanopore sequencing of drug-resistance-associated genes in malaria parasites, Plasmodium falciparum. Scientific Reports. 8 (1), 8286(2018).
- Rang, F. J., Kloosterman, W. P., de Ridder, J. From squiggle to basepair: computational approaches for improving nanopore sequencing read accuracy. Genome Biology. 19 (1), 90(2018).
Herprints en machtigingen
