Een massaspectrometrie-geleide genoom mijnbouw protocol is hier vastgesteld en beschreven. Het is gebaseerd op genoomsequentie-informatie en LC-MS/MS-analyse en heeft tot doel de identificatie van moleculen uit complexe microbiële en plantenextracten te vergemakkelijken.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Methodenartikel
Mass Spectrometry-Guided Genome Mining als een instrument om nieuwe natuurlijke producten te ontdekken
In dit artikel
Samenvatting
Samenvatting
De chemische ruimte bedekt met natuurlijke producten is immens en op grote schaal niet herkend. Daarom zijn handige methoden om hun functies in de natuur en potentiële menselijke voordelen (bijvoorbeeld voor toepassingen voor medicijnontdekking) te evalueren gewenst. Dit protocol beschrijft de combinatie van genoommijnbouw (GM) en moleculaire netwerken (MN), twee hedendaagse benaderingen die gencluster-gecodeerde annotaties in hele genoomsequencing matchen met chemische structuurhandtekeningen van ruwe metabole extracten. Dit is de eerste stap in de richting van de ontdekking van nieuwe natuurlijke entiteiten. Deze concepten, wanneer ze samen worden toegepast, worden hier gedefinieerd als MS-geleide genoommijnbouw. In deze methode worden de belangrijkste componenten eerder aangewezen (met behulp van MN), en structureel gerelateerde nieuwe kandidaten worden geassocieerd met genoomsequentieannotaties (met behulp van GM). Het combineren van GM en MN is een winstgevende strategie om nieuwe molecuulbackbones aan te pakken of metabole profielen te oogsten om analogen van reeds bekende verbindingen te identificeren.
Inleiding
Onderzoeken van secundair metabolisme bestaan vaak uit het screenen van ruwe extracten voor specifieke biologische activiteiten, gevolgd door zuivering, identificatie en karakterisering van de bestanddelen die behoren tot actieve fracties. Dit proces is efficiënt gebleken en heeft de isolatie van verschillende chemische entiteiten bevorderd. Tegenwoordig wordt dit echter als onhaalbaar gezien, vooral vanwege de hoge herontdekkingspercentages. Aangezien de farmaceutische industrie zonder kennis van de rollen en de functies van gespecialiseerde metabolieten een revolutie teweegbracht, werd hun identificatie uitgevoerd onder laboratoriumomstandigheden die niet nauwkeurig aardvertegenwoordigen 1. Vandaag de dag is er een beter begrip van natuurlijke signalering seinen invloeden, afscheiding, en de aanwezigheid van de meeste doelen bij niet op te sporen lage concentraties. Bovendien zal de regulering van het proces de academische gemeenschap en de farmaceutische industrie helpen om van deze kennis gebruik te maken. Het zal ook ten goede komen aan onderzoek naar directe isolatie van metabolieten in verband met stille biosynthetische genclusters (BGC's)2.
In deze context hebben de vooruitgang in genomische sequencing hernieuwde interesse in het screenen van micro-organismen metabolieten. Dit komt omdat het analyseren van de genomische informatie van onbedekte biosynthetische clusters kan onthullen genen coderen nieuwe verbindingen niet waargenomen of geproduceerd onder laboratoriumomstandigheden. Veel microbiële hele genoom projecten of ontwerpen zijn beschikbaar vandaag, en het aantal groeit elk jaar, het verstrekken van enorme vooruitzichten voor het blootleggen van nieuwe bioactieve moleculen door middel van genoom mijnbouw3,4.
De Atlas van Biosynthetische Gen Clusters is de huidige grootste verzameling van automatisch gedolzegenclusters als onderdeel van het Integrated Microbial Genomes Platform van het Joint Genome Institute (JGI IMG-ABC)2. Meest recent heeft het Minimum Information for Biosynthetic Gene Clusters (MIBiG) Standardization Initiative de handmatige reannotatie van BGC's bevorderd, met een sterk samengestelde referentiedataset5. Tegenwoordig zijn er tal van instrumenten beschikbaar om computationele mijnbouw van genetische gegevens en hun verbinding met bekende secundaire metabolieten mogelijk te maken. Er zijn ook verschillende strategieën ontwikkeld om toegang te krijgen tot nieuwe bioactieve natuurlijke producten (d.w.z. heterologe expressie, doelgenverwijdering, in vitro reconstructie, genomische sequentie, isotopengeleide screening [genomisotopische benadering], manipulatie van lokale en mondiale regelgevers, op resistentie gebaseerde mijnbouw, cultuuronafhankelijke mijnbouw en, meer recentelijk, MS-geleide/codebenaderingen2,6,7,8,9, 10,11,12,13,14,15).
Genoommining als enkelvoudstrategie vereist inspanningen om een enkele of kleine groep moleculen te annoteren; er blijven dus hiaten in het proces bestaan waarin nieuwe verbindingen prioriteit krijgen voor isolatie en structuuropheldering. In principe zijn deze benaderingen slechts gericht op één biosynthetisch traject per experiment, wat resulteert in een langzame ontdekkingssnelheid. In die zin is het gebruik van GM samen met een moleculaire netwerkbenadering een belangrijke vooruitgang voor het onderzoek naar natuurlijke producten14,15.
De veelzijdigheid, nauwkeurigheid en hoge gevoeligheid van vloeibare chromatografie-massaspectrometrie (LC-MS) maken het een goede methode voor samengestelde identificatie. Momenteel hebben verschillende platforms geïnvesteerd algoritmen en software suites voor ongerichte metabolomics16,17,18,19,20. De kern van deze programma's omvat functiedetectie (peak picking)21 en piekuitlijning, waardoor identieke functies in een batch van monsters kunnen worden gematcht en naar patronen wordt gezocht. MS-patroongebaseerde algoritmen22,23 vergelijken karakteristieke fragmentatiepatronen en matchen MS2-overeenkomsten die moleculaire families genereren die structurele kenmerken delen. Deze kenmerken kunnen vervolgens worden gemarkeerd en geclusterd, waardoor de mogelijkheid om snel te ontdekken bekende en onbekende moleculen uit een complex biologisch extract door tandem MS2,24,25. Daarom is tandem MS een veelzijdige methode om structurele informatie te verkrijgen over verschillende chemotypes in een grote hoeveelheid gegevens tegelijk.
Het Global Natural Products Social Molecular Networking (GNPS)26 algoritme gebruikt de genormaliseerde fragmentionenintensiteit om multidimensionale vectoren te construeren, waarbij gelijkenissen worden vergeleken met behulp van een cosinefunctie. De relatie tussen verschillende bovenliggende ionen wordt uitgezet in een diagramweergave, waarbij elke fragmentatie wordt gevisualiseerd als een knooppunt (cirkels) en de verwantheid van elk knooppunt wordt gedefinieerd door een rand (lijnen). De globale visualisatie van moleculen uit één bron wordt gedefinieerd als een moleculair netwerk. Structureel uiteenlopende moleculen die uniek fragmenteren, vormen hun eigen specifieke cluster of constellatie, terwijl verwante moleculen samenclusteren. Clustering chemotypes maakt het mogelijk de hypothetische verbinding van soortgelijke structurele kenmerken aan hun biosynthetische oorsprong.
Het combineren van zowel chemotype-to-genotype en genotype-to-chemotype benaderingen is krachtig bij het creëren van bio-informatica verbindingen tussen BGCs en hun kleine molecuul producten27. Daarom is MS-geleide genoommijnbouw een snelle methode en een lage materiaalverbruikende strategie, en het helpt bij het overbruggen van ouderionen en biosynthetische trajecten die door WGS van een of meer stammen onder diverse metabolische en milieuomstandigheden worden onthuld.
De workflow van dit protocol (figuur 1) bestaat uit het voeden van WGS-gegevens in een biosynthetisch genclusterannotatieplatform zoals antiSMASH28,29,30. Het helpt bij het schatten van de verscheidenheid van verbindingen en de klasse van verbindingen gecodeerd door het genoom. Er moet een strategie worden aangenomen om zich te richten op een biosynthetisch gencluster dat een chemische entiteit van belang codeert, en kweekextracten van een wilde soortstam en/of heterologe stam die de BGC bevat, kunnen worden geanalyseerd om geclusterde ionen te genereren op basis van gelijkenissen met GNPS26,31. Bijgevolg is het mogelijk om nieuwe moleculen te identificeren die zich associëren met de beoogde BGC en niet beschikbaar zijn in de database (voornamelijk onbekende analogen, soms geproduceerd in lage titers). Het is relevant om te bedenken dat gebruikers kunnen bijdragen aan deze platforms en dat de beschikbaarheid van bioinformatica en MS/MS-gegevens snel toeneemt, wat leidt tot een constante ontwikkeling en upgrade van effectieve computationele tools en algoritmen om efficiënte verbindingen van complexe extracten met moleculen te begeleiden.
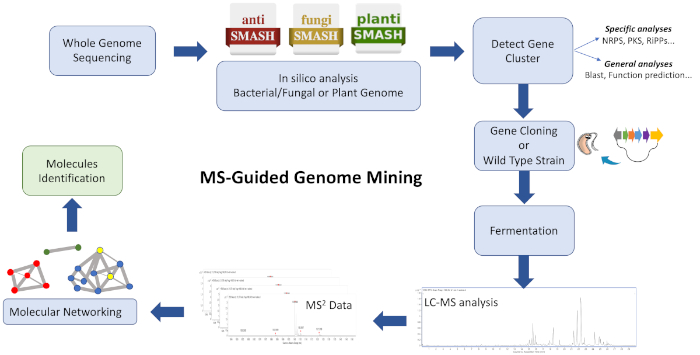
Figuur 1: Overzicht van de gehele werkstroom. Getoond is een illustratie van de bio-informatica, klonen, en moleculaire netwerkstappen die betrokken zijn bij de beschreven MS-geleide genoom mijnbouw aanpak om nieuwe metabolieten te identificeren. Klik hier om een grotere versie van dit cijfer te bekijken.
Dit protocol beschrijft een snelle en efficiënte workflow om genoommining en moleculaire netwerken te combineren als uitgangspunt voor de pijplijn voor de ontdekking van natuurlijke producten. Hoewel veel toepassingen in staat zijn om de samenstelling en verwantschap van MS-detecteerbare moleculen in één netwerk te visualiseren, worden er hier verschillende aangenomen om structureel vergelijkbare geclusterde moleculen te visualiseren. Met behulp van deze strategie, nieuwe cyclodepsipeptide producten waargenomen in metabole extracten van Streptomyces sp. CBMAI 2042 zijn met succes geïdentificeerd. Geleid door genoommijnbouw wordt de hele biosynthetische genclustercodering voor valinomycines erkend en gekloond in de producentenstam Streptomyces coelicolor M1146. Ten slotte, na een MS-patroon gebaseerde moleculaire netwerken, de moleculen gedetecteerd door MS zijn gecorreleerd met BGCs die verantwoordelijk zijn voor hun biogenese32.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
1. Genoommining voor biosynthetische genclusters
- Voer hele genoomsequencing (WGS) uit als eerste stap naar de verkiezing van een biosynthetisch gencluster (BCG) voor MS-geleide genoommining. Het hele genoom ontwerp van de stam van belang (bacteriën) kan worden verkregen door Illumina MiSeq technologie met behulp van de volgende met hoge kwaliteit genomic DNA: shotgun TruSeq PCR-Free bibliotheek prep en Nextera Mate Pair Library Preparation Kit33.
LET OP: Na het rangschikken kunnen de Illumina shotgun library en Illumina mate pair library worden samengesteld met behulp van de Newbler v3.0 (Roche, 454) assembler programma (gevonden op ) en geannoteerd met behulp van een pijplijn op basis van FgeneSB (gevonden op ), zoals eerder beschreven33. Microbiologie Resource Announcements (MRA) is een volledig open access tijdschrift met artikelen publiceren van de beschikbaarheid van een microbiologische bron gedeponeerd in een beschikbare repository (gevonden op ). De kandidaat-eiwitcoderingsgenen worden geïdentificeerd aan de hand van de RAST-serverannotatie34, en het Whole Genome Shotgun (WGS) project wordt gedeponeerd in de DDBJ/ENA/GenBank (te vinden op ) en Gold (gevonden op ) sequentiedatabases. - Om in silico-informatie over secundaire metabolism genclusters annotaties uit een volledig gesequenced genoom te verkrijgen, dient u het sequentiebestand (GenBank/EMBL of FASTA-formaat) in bij een antiSMASH-platform (gevonden op ).
- Selecteer het gencluster van belang uit uitvoergegevens(figuur 2)op basis van het meest vergelijkbare bekende cluster.
OPMERKING: Ten eerste is het routine om gen-voor-gen te verkennen en individuele zoekopdrachten (blastp) uit te voeren om te evalueren welke functies worden geassocieerd met de gewenste biosynthetische gengroepen. Deze procedure kan ook helpen om te bepalen welke BGC waarschijnlijk wordt geassocieerd met de productie van een gewenste verbinding, zelfs als het een laag percentage is. Een antiSMASH voorspelling beschouwt alle genen binnen een cluster om percentage dekking te maken, die een globaal laag percentage van gelijkenis voor de beoogde BGC kan vertegenwoordigen. Echter, bij het analyseren van gen-voor-gen, is het mogelijk om meer accurate informatie te verkrijgen met behulp van de meest vergelijkbare bekende cluster. Ten tweede heeft antiSMASH twee opties om een zoekopdracht te verfijnen: 1) detectiestriktheid: de mate van strengheid waaraan de biosynthetische gencluster moet worden beschouwd als een hit. Voor deze optie moet de gebruiker de volgende parameters gebruiken: a) strikt: detecteert uitsluitend goed gedefinieerde clusters die alle vereiste regio's bevatten, ongevoelig voor fouten over genetische informatie; b) ontspannen: detecteert gedeeltelijke clusters die een of meer functionele regio missen, die ook werkt voor het opsporen van de strikte functie; of c) los: detecteert slecht gedefinieerde clusters en clusters die waarschijnlijk overeenkomen met primaire metabolieten, wat kan leiden tot het verschijnen van valse positieven of slecht gedefinieerde BgC's. De andere optie is 2) extra functies: het type informatie dat het platform moet zoeken en weergeven in de uitvoer. In het algemeen kunnen deze twee opties tijd besparen na de voorspelling. De antiSMASH-taak vereist echter een langere periode.
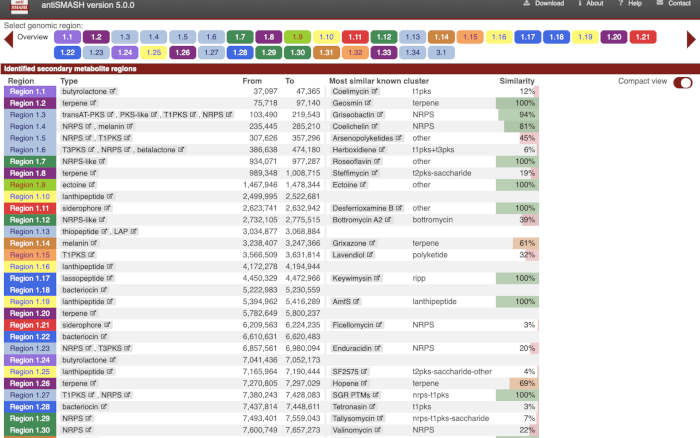
Figuur 2: Output van antiSMASH-platform. Secundair metabolisme in silico analyse van hele genoom sequentie annotatie. Klik hier om een grotere versie van dit cijfer te bekijken.
- Op basis van DNA sequentie-informatie van de BGC, ontwerp primers (20-25 nt) flankeren het gencluster voor ESAC (E. coli/Streptomyces Artificial Chromosome) bibliotheek screening.
OPMERKING: Verschillende methoden35,36 kunnen worden gebruikt om de hele biosynthetische gencluster uit DNA te vangen. Hier, de gebruikte methode is de bouw van een representatieve ESAC bibliotheek37,38 van Streptomyces sp. CBMAI 2042 met klonen met gemiddelde grootte fragmenten van ~ 95 kb.
2. Heterologe expressie van hele biosynthetische gencluster uit de ESAC-bibliotheek
- Verplaats de ESAC-vector van E. coli DH10B naar E. coli ET12567 door triparentale vervoeging32.
- Inoculaat E. coli ET12567 (CamR), TOPO10/pR9604 (CarbR), DH10B/ESAC4H (AprR) in 5 mL luria-Bertani (LB) medium met chlooramphenicol (25 μg/mL), carbenicillin (100 μg/mL) en apramycine (50 μg/mL).
- Incubeer de cultuur 's nachts bij 37 °C en 250 tpm.
- Inenting 500 μL van de nachtcultuur in 10 mL LB medium met een halve concentratie antibiotica.
- Incubeer de cultuur bij 37 °C en 250 tpm tot het bereiken van een A600 van 0,4-0,6.
- Oogst de cellen door centrifugeren op 2.200 x g voor 5 min.
- Was de cellen twee keer met 20 mL LB medium.
- Breter de cellen opnieuw in 500 μL LB-medium.
- Meng 20 μL van elke stam in een microcentrifugebuis en druppel in een agarplaat met LB-medium zonder antibiotica.
- Incubeer de platen 's nachts bij 37 °C.
- Snijd de gekweekte cellen op een verse LB agar plaat met antibiotica en incubeer 's nachts bij 37 °C.
3. Streptomyces/E. coli vervoeging
- Om het recombinante heterologe organisme te verkrijgen, voert u vervoeging32 uit tussen E. coli ET12567 met de ESAC-vector, helperplasmid pR9604 en Streptomyces coelicolor M1146 of een andere geselecteerde gastheerstam39.
- Dag 1: Inoculaat geïsoleerde kolonies S. coelicolor M1146 in 25 mL TSBY medium in een 250 mL Erlenmeyer kolf uitgerust met een inox-veer bij 30 °C en 200 tpm voor 48 h.
- Dag 2/3: Inoculaat ET12567/ESAC/pR9604 in 5 mL LB medium met chlooramphenicol (25 μg/mL), carbenicillin (100 μg/mL) en apramycine (50 μg/mL) 's nachts bij 37 °C en 250 rpm.
- Dag 3/4: Inenting 500 μL van de nachtcultuur in 10 mL van 2TY (in een conische buis van 50 mL) die halfwerkende concentraties antibiotica bevat. Incubeer bij 37 °C en 250 tpm tot het bereiken van een A600 van 0,4-0,6.
- Centrifugeer de culturen (ET12567/ESAC/pR9604 en M1146) bij 2200 x g voor 10 min.
- Was de pellets 2x in 20 mL van 2TY medium en breg in 500 μL van 2TY.
- Aliquot 200 μL van de S. coelicolor M1146 vering en verdun in 500 μL van 2TY (ophanging A).
- Aliquot 200 μL van suspensie A en verdun in 500 μL van 2TY (suspensie B).
- Aliquot 200 μL suspensie B en verdun in 500 μL van 2TY (suspensie C).
- Aliquot 200 μL van de ET12567/ESAC/pR9604 vering en meng met 200 μL ophanging C.
- Plaat 150 μL van het vervoegingsmengsel op een SFM agarplaat die antibiotica mist.
- Incubeer bij 30 °C gedurende 16 uur.
- Dek platen af met 1 mL antibioticaoplossing (volgens plasmidresistentie). Na het drogen, uitbroed op 30 °C gedurende 4-7 dagen.
OPMERKING: Hier werd een oplossing bereid met 1,0 mg/mL thiostrepton en 0,5 mg/mL nalidixic zuur. - Streep putatieve exconjugants op SFM agar platen met thiostrepton (50 mg/mL) en nalidixic zuur (25 mg/mL). Incubeer bij 30 °C.
- Streep exconjugants op een SFM agar met alleen nalidixic zuur.
- Voer PCR-analyse uit met geïsoleerde kolonies om te bevestigen dat het hele gencluster is overgebracht naar de S. coelicolor M1146-host.
4. Stamteelt
- Om het metabolische profiel te verkrijgen, inenen 1/100 van de voorkweek van de stam in de juiste fermentatiemedia en onder de juiste kweekomstandigheden.
- Centrifugeculturen op 2200 x g voor 10 min.
- Voer de extractie uit volgens de klasse van de verbinding van belang40.
5. Verwerving van massaspectra en voorbereiding op GNPS-analyse
- Om MS/MS-gegevens te verkrijgen, programmeert u geschikte HPLC- en massaspectrometriemethoden met behulp van de besturingssoftware. Zowel gegevensafhankelijke massaspectrometrieanalyse (DDA) met hoge als lage resolutie kan worden geanalyseerd.
OPMERKING: Over het algemeen is een 1 mg/mL oplossing van complexe ruwe extract monsters ideaal. Verdunningen zijn nodig voor minder complexe extracten. Opgemerkt moet worden dat MS/MS-netwerken het detecteerbare moleculaire netwerk is onder de gegeven massaspectrometrische omstandigheden. - Massaspectra converteren naar .mzXML-indeling met MSConvert van Proteowizard (gevonden op ). De invoerparameters voor de conversie worden geïllustreerd in figuur 3. Gegevens uit software van bijna alle bedrijven zijn compatibel.
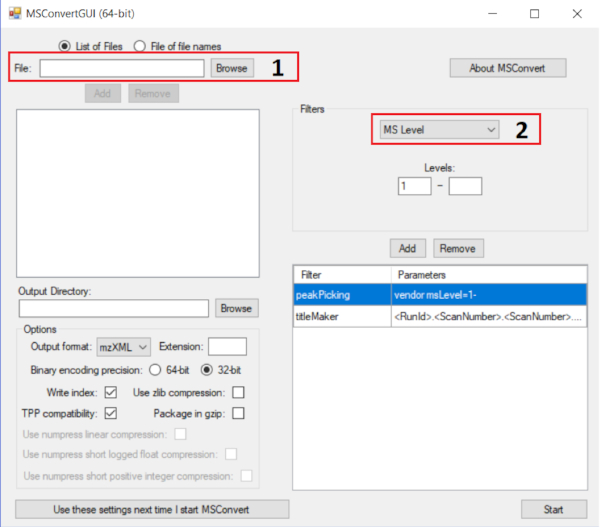
Figuur 3: MsConvert gebruiken om MS-bestanden om te zetten naar mzXML-extensie. De juiste parameter voor GNPS-analyse wordt weergegeven. De instructies zijn als volgt: voeg alle MS-bestanden toe in vak 1 en voeg het filter Peak Picking toe in vak 2; gebruik voor dit filter de algoritmeleverancier; druk op start en de conversieprocessen zullen volgen. Klik hier om een grotere versie van dit cijfer te bekijken.
- Upload de geconverteerde LC-MS/MS-bestanden naar de GNPS-database. Er zijn twee opties beschikbaar: het gebruik van een file transfer protocol (FTP) of rechtstreeks in een browser via het online platform.
OPMERKING: Gedetailleerde informatie over het installeren en overdragen van gegevens naar GNPS is beschikbaar op .
6. BNP-analyse
- Log na het aanmaken van een account in GNPS (gevonden op ), log in op het aangemaakte account selecteer Moleculair netwerk maken. Een functietitel toevoegen.
- Basisopties: selecteer de mzXML-bestanden om het moleculaire netwerk uit te voeren. Ze kunnen worden georganiseerd in maximaal zes groepen. Selecteer de bibliotheken voor de replicatieroutine (figuur 4).
OPMERKING: Deze groepen interfereren niet met de moleculaire netwerkconstructie. Deze informatie wordt alleen gebruikt voor de grafische weergave.
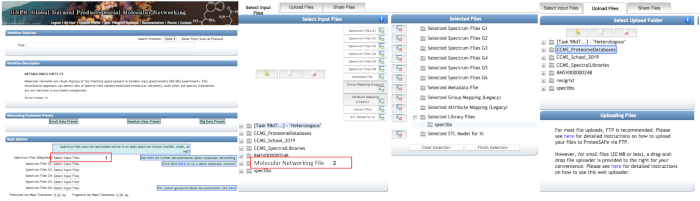
Figuur 4: Het gebruik van online GNPS-platform om moleculaire netwerkanalyse uit te voeren. De selectie van mzXML-bestanden gebeurt door in vak 1 te klikken. In het dialoogvenster Openen kunnen de bestanden worden geselecteerd uit persoonlijke map (vak 2) of worden geüpload in het tweede tabblad met behulp van de drag-and-drop bestandsuploader (minder dan 20 MB). De bestanden kunnen worden gegroepeerd in maximaal zes groepen. Klik hier om een grotere versie van dit cijfer te bekijken.
- Selecteer de voorloper ionenmassatolerantie en fragmentionenmassatolerantie van respectievelijk 0,02 Da en 0,05 Da.
OPMERKING: GNPS heeft verschillende soorten strengheid beschikbaar op basis van 1) hoe nauwkeurig de MS/MS-gegevens zijn en 2) hoe nauwkeurig de koppeling moet zijn. Basisopties: in deze map is het mogelijk om Precursor Ion Mass Tolerance en Fragment Ion Mass Tolerancein te stellen. Deze parameters worden gebruikt als een gids om te bepalen hoe nauwkeurig de voorloper ionen en fragment ionen moeten zijn. De geselecteerde massatoleranties zijn afhankelijk van de resolutie en nauwkeurigheid van de gebruikte massaspectrometer. - Geavanceerde netwerkopties: selecteer de parameters op basis van figuur 5. Deze parameters beïnvloeden direct de grootte en vorm van het netwerkcluster. Een andere parameter in de resterende tabbladen sectie zijn voor gevorderde gebruikers; laat dus de standaardwaarden achter.
OPMERKING: Geavanceerde parameters kunnen worden gelezen in GNPS-documentatie (gevonden op ).
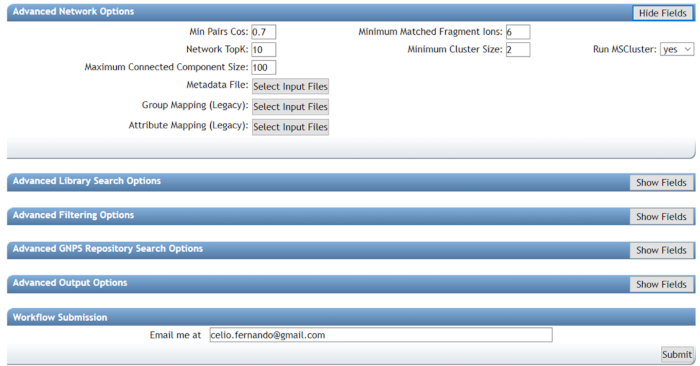
Figuur 5: GNPS gebruiken om moleculaire netwerkanalyse uit te voeren (geavanceerde opties). Min Pair Cos zal direct invloed hebben op de grootte van clusters, omdat hoge waarden zullen resulteren in het combineren van nauw verwante verbindingen en lage waarden in het combineren van verre verbindingen. Het gebruik van waarden die te laag zijn, moet worden vermeden. Minimaal overeenkomende fragmentionen vertegenwoordigen het aantal gedeelde fragmenten tussen twee fragmentatiespectra die in het netwerk moeten worden gekoppeld. Samen leiden beide parameters de netwerkindeling; lagere waarden zullen verder op afstand gerelateerde verbindingen clusteren en vice versa. Met behulp van de juiste waarden zal sterk helpen de samengestelde opheldering. Klik hier om een grotere versie van dit cijfer te bekijken.
- Kies een e-mailadres om een waarschuwing te ontvangen wanneer het werk is gedaan en dien de taak in.
7. Analyse van de BNP-resultaten
- Log in bij GNPS. Selecteer Vacatures > Gepubliceerde taak > Klaar om de taak te openen. Er wordt een webpagina geopend zoals geïllustreerd in figuur 6. Alle resultaten verkregen uit moleculaire netwerken zullen worden weergegeven.
- Selecteer Spectrale families weergeven (in browsernetwerkvisualizer) om alle netwerkclusters te bekijken (rode vak, figuur 6).
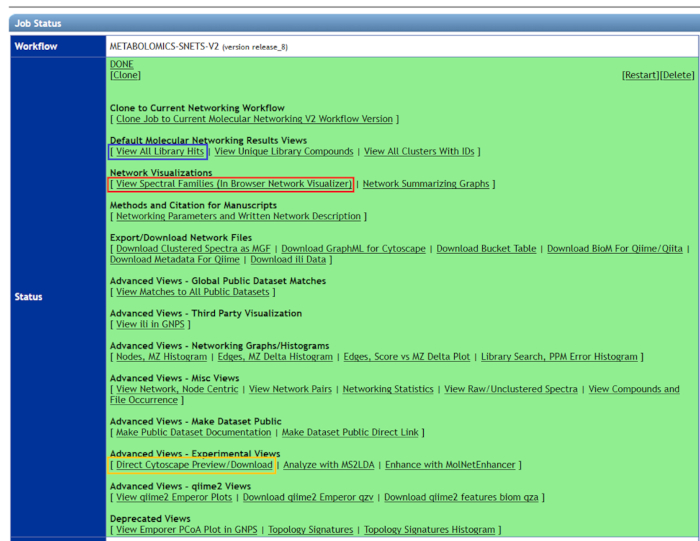
Figuur 6: GNPS gebruiken om moleculaire netwerkresultaten te visualiseren. Alle gerelateerde samengestelde clusters zijn te zien in zicht spectrale families (rode doos). Als u alleen bibliotheekhits wilt visualiseren, moet 'Alle bibliotheekhits weergeven' (blauwe doos) worden geselecteerd. Voor een betere grafische weergave van moleculaire netwerkresultaten moet "Direct Cytoscape Preview" (gele doos) worden gedownload en moet de nieuwste versie van Cytoscape worden gebruikt. Klik hier om een grotere versie van dit cijfer te bekijken.
- Er wordt een lijst weergegeven met alle gegenereerde moleculaire netwerkclusters. Als een bibliotheekzoekopdracht is geselecteerd om de bevindingen te genereren, worden voorlopige moleculen geïdentificeerd in AllID's. Selecteer Weergeven om ze te visualiseren.
OPMERKING: De gegevensanalyses kunnen worden aangestuurd voor andere resultaten (d.w.z. genoommining, biologische testen, dereplicatiemoleculen van de bibliotheek, enz.). - Als u het moleculaire netwerkcluster wilt analyseren, selecteert u Netwerk visualiseren.
OPMERKING: Elk cluster bestaat uit knooppunten (cirkels) en randen, die respectievelijk moleculen en moleculaire gelijkenis vertegenwoordigt. Degerepliceerde moleculen worden gemarkeerd als een blauw knooppunt in de online browser netwerk visualizer. - Selecteer in het vak knooppuntlabels de bovenliggende massa (rood vak, figuur 7).
- Selecteer cosine of DeltaMZ in het vak randlabels om respectievelijk knooppuntgelijkenis of massaverschil tussen knooppunten waar te nemen (geel vak, figuur 7).
- Klik in het geval van analyses met meerdere groepen op Taarten tekenen in het kleurvak van het knooppunt om de frequentie te observeren waarop elk knooppunt in elke groep wordt weergegeven (blauwe doos, figuur 7).
OPMERKING: Andere keuzes zijn mogelijk, maar de hierboven voorgestelde keuzes zijn optimaal voor het annoteren van clusterknooppunten en het ontrafelen van hun structuren.
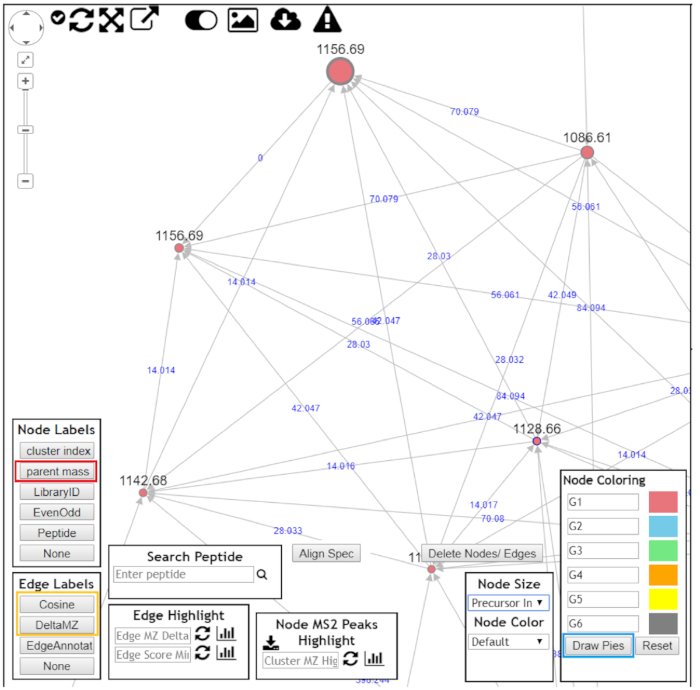
Figuur 7: GNPS gebruiken om moleculaire clusterresultaten te visualiseren. Na het openen van de moleculaire clusters voor een betere datavisualisatie, moet het volgende worden gekozen: "Oudermassa" als knooppuntlabels (rode doos); "DeltaMZ" als randlabels (gele doos); en "Draw pies" als knooppunt kleuring (blauwe doos). Navigeer door het moleculaire cluster en probeer alle knooppunten te annoteren. Klik hier om een grotere versie van dit cijfer te bekijken.
- Als u alle bibliotheekhits wilt bekijken, selecteert u Alle bibliotheekhits weergeven (blauw vak, figuur 7).
OPMERKING: Ook kan de MNW worden gedownload in "Direct Cytoscape Preview/Download" (geel vak, figuur 7), en het bestand kan worden geopend in het Cytoscape-platform (te vinden op ) voor meer opties in grafische structuur. - Handmatige bevestiging van ontrepliceerde verbindingen en structuur opheldering van verwante verbindingen nodig zijn. Open de fragmentatiespectra rechtstreeks in het GNPS-platform of in originele raw-bestanden.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Het protocol werd met succes geïllustreerd met behulp van een combinatie van genoommijnbouw, heterologe expressie, en MS-geleide / code benaderingen om toegang te krijgen tot nieuwe gespecialiseerde valinomycine analogen moleculen. De genoom-naar-molecuul workflow voor het doel, valinomycine (VLM), is vertegenwoordigd in figuur 8. Streptomyces sp. CBMAI 2042 ontwerpgenoom werd geanalyseerd in silico, en het VLM-gencluster werd vervolgens geïdentificeerd en overgebracht naar een hete...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
Het sterkste voordeel van dit protocol is het vermogen om metabole profielen snel te derepliceren en genomische informatie te overbruggen met MS-gegevens om de structuren van nieuwe moleculen, met name structureleanalogen,op te helderen 2 . Op basis van genomische informatie kunnen verschillende natuurlijke producten worden onderzocht, zoals polyketides (PK), nonribosomal peptiden (NRP) en glycosylated natural products (BNP), evenals cryptische BGCs. Metabolomic screening levert bewijs van geactiv...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteurs hebben niets te onthullen.
Dankbetuigingen
De financiële steun voor deze studie werd verstrekt door São Paulo Research Foundation - FAPESP (2019/10564-5, 2014/12727-5 en 2014/50249-8 tot L.G.O; 2013/12598-8 en 2015/01013-4 naar R.S.; en 2019/08853-9 naar C.F.F.A). B.S.P, C.F.F.A. en L.G.O. ontvingen beurzen van de Nationale Raad voor Wetenschappelijke en Technologische Ontwikkeling - CNPq (205729/2018-5, 162191/2015-4 en 313492/2017-4). L.G.O. is ook dankbaar voor de subsidiesteun van het programma For Women in Science (2008, Brazilian Edition). Alle auteurs erkennen CAPES (Coördinatie voor de verbetering van het hoger onderwijs Personeel) voor de ondersteuning van de post-afstuderen programma's in Brazilië.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Acetonitrile | Tedia | AA1120-048 | HPLC grade |
| Agar | Oxoid | LP0011 | NA |
| Apramycin | Sigma Aldrich | A2024 | NA |
| Carbenicillin | Sigma Aldrich | C9231 | NA |
| Centrifuge | Eppendorf | NA | 5804 |
| Chloramfenicol | Sigma Aldrich | C3175 | NA |
| Column C18 | Agilent Technologies | NA | ZORBAX RRHD Extend-C18, 80Å, 2.1 x 50 mm, 1.8 µm, 1200 bar drukgrens P/N 757700-902 |
| Kanamycin | Sigma Aldrich | K1377 | NA |
| Manitol P.A.- A.C.S. | Synth | NA | NA |
| Microcentrifuge | Eppendorf | NA | 5418 |
| Nalidixinezuur | Sigma Aldrich | N4382 | NA |
| Phusion Flash High-Fidelity PCR Master Mix | ThermoFisher Scientific | F548S | NA |
| Q-TOF-massaspectrometer | Agilent Technologies | NA | 6550 iFunnel Q-TOF LC/MS |
| Sacharose P.A.- A.C.S. | Synth | NA | NA |
| Schudler/Incubator | Marconi | MA420 | NA |
| Natriumchloride | Synth | NA | P. A. - ACS |
| Soy extract | NA | NA | NA |
| Sucrose | Synth | NA | P. A. - ACS |
| Thermische cycli | Eppendorf | NA | Mastercycler Nexus Gradient |
| Thiostroepton | Sigma Aldrich | T8902 | NA |
| Tryptone | Oxoid | LP0042 | NA |
| Tryptone Soja Bouillon | Oxoid | CM0129 | NA |
| UPLC | Agilent Technologies | NA | 1290 Infinity LC System |
| Gist extract | Oxoid | LP0021 | NA |
Referenties
- Davies, J. Specialized microbial metabolites: functions and origins. The Journal of Antibiotics. 66 (7), Tokyo. 361-364 (2013).
- Ziemert, N., Alanjary, M., Weber, T. The evolution of genome mining in microbes - a review. Natural Product Reports. 33 (8), 988-1005 (2016).
- Zerikly, M., Challis, G. L. Strategies for the Discovery of New Natural Products by Genome Mining. ChemBioChem. 10 (4), 625-633 (2009).
- Gomez-Escribano, J. P., Bibb, M. J. Heterologous expression of natural product biosynthetic gene clusters in Streptomyces coelicolor: from genome mining to manipulation of biosynthetic pathways. Journal of Industrial Microbiology & Biotechnology. 41 (2), 425-431 (2014).
- Medema, M. H., et al. Minimum Information about a Biosynthetic Gene cluster. Nature Chemical Biology. 11 (9), 625-631 (2015).
- Lautru, S., Deeth, R. J., Bailey, L. M., Challis, G. L. Discovery of a new peptide natural product by Streptomyces coelicolor genome mining. Nature Chemical Biology. 1 (5), 265-269 (2005).
- Chiang, Y. -M., et al. Molecular Genetic Mining of the Aspergillus Secondary Metabolome: Discovery of the Emericellamide Biosynthetic Pathway. Chemistry & Biology. 15 (6), 527-532 (2008).
- Huang, T., et al. Identification and Characterization of the Pyridomycin Biosynthetic Gene Cluster of Streptomyces pyridomyceticus NRRL B-2517. Journal of Biological Chemistry. 286 (23), 20648-20657 (2011).
- Udwary, D. W., et al. Genome sequencing reveals complex secondary metabolome in the marine actinomycete Salinispora tropica. Proceedings of the National Academy of Sciences. 104 (25), 10376-10381 (2007).
- Gross, H., et al. The Genomisotopic Approach: A Systematic Method to Isolate Products of Orphan Biosynthetic Gene Clusters. Chemistry & Biology. 14 (1), 53-63 (2007).
- Spohn, M., Wohlleben, W., Stegmann, E. Elucidation of the zinc-dependent regulation in Amycolatopsis japonicum enabled the identification of the ethylenediamine-disuccinate ([S,S ]-EDDS) genes. Environmental Microbiology. 18 (4), 1249-1263 (2016).
- Thaker, M. N., Waglechner, N., Wright, G. D. Antibiotic resistance-mediated isolation of scaffold-specific natural product producers. Nature Protocols. 9 (6), 1469-1479 (2014).
- Katz, M., Hover, B. M., Brady, S. F. Culture-independent discovery of natural products from soil metagenomes. Journal of Industrial Microbiology & Biotechnology. 43, 129-141 (2016).
- Quinn, R. A., et al. Molecular Networking as a Drug Discovery, Drug Metabolism, and Precision Medicine Strategy. Trends in Pharmacological Sciences. 38 (2), 143-154 (2017).
- Yang, J. Y., et al. Molecular Networking as a Dereplication Strategy. Journal of Natural Products. 76 (9), 1686-1699 (2013).
- Lommen, A. MetAlign: Interface-Driven, Versatile Metabolomics Tool for Hyphenated Full-Scan Mass Spectrometry Data Preprocessing. Analytical Chemistry. 81 (8), 3079-3086 (2009).
- Katajamaa, M., Miettinen, J., Oresic, M. MZmine: toolbox for processing and visualization of mass spectrometry based molecular profile data. Bioinformatics. 22 (5), 634-636 (2006).
- Pluskal, T., Castillo, S., Villar-Briones, A., Orešič, M. MZmine 2: Modular framework for processing, visualizing, and analyzing mass spectrometry-based molecular profile data. BMC Bioinformatics. 11 (1), 395(2010).
- Tautenhahn, R., Patti, G. J., Rinehart, D., Siuzdak, G. XCMS Online: A Web-Based Platform to Process Untargeted Metabolomic Data. Analytical Chemistry. 84 (11), 5035-5039 (2012).
- Kuhl, C., Tautenhahn, R., Böttcher, C., Larson, T. R., Neumann, S. CAMERA: An Integrated Strategy for Compound Spectra Extraction and Annotation of Liquid Chromatography/Mass Spectrometry Data Sets. Analytical Chemistry. 84 (1), 283-289 (2012).
- Katajamaa, M., Orešič, M. Data processing for mass spectrometry-based metabolomics. Journal of Chromatography A. 1158, 318-328 (2007).
- Liu, W. -T., et al. Interpretation of Tandem Mass Spectra Obtained from Cyclic Nonribosomal Peptides. Analytical Chemistry. 81 (11), 4200-4209 (2009).
- Ng, J., et al. Dereplication and de novo sequencing of nonribosomal peptides. Nature Methods. 6 (8), 596-599 (2009).
- Liaw, C., et al. Vitroprocines, new antibiotics against Acinetobacter baumannii, discovered from marine Vibrio sp. QWI-06 using mass-spectrometry-based metabolomics approach. Scientific Reports. 5 (1), 1-11 (2015).
- Kang, K. B., et al. Targeted Isolation of Neuroprotective Dicoumaroyl Neolignans and Lignans from Sageretia theezans Using in Silico Molecular Network Annotation Propagation-Based Dereplication. Journal of Natural Products. 81 (8), 1819-1828 (2018).
- Wang, M., et al. Sharing and community curation of mass spectrometry data with Global Natural Products Social Molecular Networking. Nature Biotechnology. 34 (8), 828-837 (2016).
- Doroghazi, J. R., et al. A roadmap for natural product discovery based on large-scale genomics and metabolomics. Nature Chemical Biology. 10 (11), 963-968 (2014).
- Medema, M. H., et al. antiSMASH: rapid identification, annotation and analysis of secondary metabolite biosynthesis gene clusters in bacterial and fungal genome sequences. Nucleic Acids Research. 39, 339-346 (2011).
- Weber, T., et al. antiSMASH 3.0-a comprehensive resource for the genome mining of biosynthetic gene clusters. Nucleic Acids Research. 43, 237-243 (2015).
- Blin, K., et al. antiSMASH 5.0: updates to the secondary metabolite genome mining pipeline. Nucleic Acids Research. 47, 81-87 (2019).
- Watrous, J., et al. Mass spectral molecular networking of living microbial colonies. Proceedings of the National Academy of Sciences. 109 (26), 1743-1752 (2012).
- Paulo, B. S., Sigrist, R., Angolini, C. F. F., De Oliveira, L. G. New Cyclodepsipeptide Derivatives Revealed by Genome Mining and Molecular Networking. ChemistrySelect. 4 (27), 7785-7790 (2019).
- Gonzaga de Oliveira, L., Sigrist, R., Sachetto Paulo, B., Samborskyy, M. Whole-Genome Sequence of the Endophytic Streptomyces sp. Strain CBMAI 2042, Isolated from Citrus sinensis. Microbiology Resource Announcements. 8 (2), 1-2 (2019).
- Aziz, R. K., et al. The RAST Server: Rapid Annotations using Subsystems Technology. BMC Genomics. 9 (1), 75(2008).
- Nah, H. -J., Pyeon, H. -R., Kang, S. -H., Choi, S. -S., Kim, E. -S. Cloning and Heterologous Expression of a Large-sized Natural Product Biosynthetic Gene Cluster in Streptomyces Species. Frontiers in Microbiology. 8, 1-10 (2017).
- Zhang, J. J., Tang, X., Moore, B. S. Genetic platforms for heterologous expression of microbial natural products. Natural Product Reports. 36 (9), 1313-1332 (2019).
- Alduina, R., et al. Artificial chromosome libraries of Streptomyces coelicolor A3(2) and Planobispora rosea. FEMS Microbiology Letters. 218 (1), 181-186 (2003).
- Jones, A. C., et al. Phage P1-Derived Artificial Chromosomes Facilitate Heterologous Expression of the FK506 Gene Cluster. PLoS One. 8 (7), 69319(2013).
- Gomez-Escribano, J. P., Bibb, M. J. Engineering Streptomyces coelicolor for heterologous expression of secondary metabolite gene clusters. Microbial Biotechnology. 4 (2), 207-215 (2011).
- Cannell, R. J. P. Natural Products Isolation. , Humana Press. Totowa, NJ. (1998).
- Kersten, R. D., et al. A mass spectrometry-guided genome mining approach for natural product peptidogenomics. Nature Chemical Biology. 7 (11), 794-802 (2011).
- Kersten, R. D., et al. Glycogenomics as a mass spectrometry-guided genome-mining method for microbial glycosylated molecules. Proceedings of the National Academy of Sciences. 110 (47), 4407-4416 (2013).
- Liu, W., et al. MS/MS-based networking and peptidogenomics guided genome mining revealed the stenothricin gene cluster in Streptomyces roseosporus. The Journal of Antibiotics. 67 (1), Tokyo. 99-104 (2014).
- Duncan, K. R., et al. Molecular Networking and Pattern-Based Genome Mining Improves Discovery of Biosynthetic Gene Clusters and their Products from Salinispora Species. Chemistry & Biology. 22 (4), 460-471 (2015).
- Cao, L., et al. MetaMiner: A Scalable Peptidogenomics Approach for Discovery of Ribosomal Peptide Natural Products with Blind Modifications from Microbial Communities. Cell Systems. , (2019).
- Chen, L. -Y., Cui, H. -T., Su, C., Bai, F. -W., Zhao, X. -Q. Analysis of the complete genome sequence of a marine-derived strain Streptomyces sp. S063 CGMCC 14582 reveals its biosynthetic potential to produce novel anti-complement agents and peptides. PeerJ. 7 (1), 6122(2019).
- Kim Tiam, S., et al. Insights into the Diversity of Secondary Metabolites of Planktothrix Using a Biphasic Approach Combining Global Genomics and Metabolomics. Toxins. 11 (9), 498(2019).
- Özakin, S., Ince, E. Genome and metabolome mining of marine obligate Salinispora strains to discover new natural products. Turkish Journal of Biology. 43 (1), 28-36 (2019).
- Trivella, D. B. B., de Felicio, R. The Tripod for Bacterial Natural Product Discovery: Genome Mining, Silent Pathway Induction, and Mass Spectrometry-Based Molecular Networking. mSystems. 3 (2), 00160(2018).
- Maansson, M., et al. An Integrated Metabolomic and Genomic Mining Workflow To Uncover the Biosynthetic Potential of Bacteria. mSystems. 1 (3), 1-14 (2016).
- Blin, K., Kim, H. U., Medema, M. H., Weber, T. Recent development of antiSMASH and other computational approaches to mine secondary metabolite biosynthetic gene clusters. Briefings in Bioinformatics. 20 (4), 1103-1113 (2019).
- Fisch, K. M. Biosynthesis of natural products by microbial iterative hybrid PKS-NRPS. RSC Advances. 3 (40), 18228-18247 (2013).
- Tatsuno, S., Arakawa, K., Kinashi, H. Analysis of Modular-iterative Mixed Biosynthesis of Lankacidin by Heterologous Expression and Gene Fusion. The Journal of Antibiotics. 60 (11), Tokyo. 700-708 (2007).
- Helfrich, E. J. N., Piel, J. Biosynthesis of polyketides by trans-AT polyketide synthases. Natural Product Reports. 33 (2), 231-316 (2016).
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Herprints en machtigingen
