Het huidige protocol beschrijft een efficiënte segmentatiemethode voor meerdere organen, Swin-PSAxialNet genaamd, die een uitstekende nauwkeurigheid heeft bereikt in vergelijking met eerdere segmentatiemethoden. De belangrijkste stappen van deze procedure omvatten het verzamelen van gegevenssets, omgevingsconfiguratie, gegevensvoorverwerking, modeltraining en -vergelijking en ablatie-experimenten.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Methodenartikel
Swin-PSAxialNet: een efficiënte segmentatietechniek voor meerdere organen
In dit artikel
Samenvatting
Samenvatting
Abdominale segmentatie van meerdere organen is een van de belangrijkste onderwerpen op het gebied van medische beeldanalyse en speelt een belangrijke rol bij het ondersteunen van klinische workflows zoals ziektediagnose en behandelplanning. In deze studie wordt een efficiënte segmentatiemethode voor meerdere organen voorgesteld, Swin-PSAxialNet genaamd, gebaseerd op de nnU-Net-architectuur. Het is speciaal ontworpen voor de nauwkeurige segmentatie van 11 buikorganen in CT-beelden. Het voorgestelde netwerk heeft de volgende verbeteringen doorgevoerd ten opzichte van nnU-Net. Ten eerste werden Space-to-depth (SPD)-modules en parametergedeelde axiale aandacht (PSAA)-functie-extractieblokken geïntroduceerd, waardoor de mogelijkheid van extractie van 3D-beeldkenmerken werd verbeterd. Ten tweede werd een multi-scale beeldfusiebenadering gebruikt om gedetailleerde informatie en ruimtelijke kenmerken vast te leggen, waardoor het vermogen om subtiele kenmerken en randkenmerken te extraheren werd verbeterd. Ten slotte werd een methode voor het delen van parameters geïntroduceerd om de rekenkosten en trainingssnelheid van het model te verlagen. Het voorgestelde netwerk behaalt een gemiddelde dobbelsteencoëfficiënt van 0,93342 voor de segmentatietaak met 11 organen. Experimentele resultaten wijzen op de opmerkelijke superioriteit van Swin-PSAxialNet ten opzichte van eerdere reguliere segmentatiemethoden. De methode vertoont een uitstekende nauwkeurigheid en lage rekenkosten bij het segmenteren van belangrijke buikorganen.
Inleiding
Hedendaagse klinische interventie, waaronder de diagnose van ziekten, het opstellen van behandelplannen en het volgen van behandelingsresultaten, is gebaseerd op de nauwkeurige segmentatie van medische beelden1. De complexe structurele relaties tussen buikorganen2maken het echter een uitdagende taak om een nauwkeurige segmentatie van meerdere buikorganen te bereiken3. In de afgelopen decennia hebben de bloeiende ontwikkelingen op het gebied van medische beeldvorming en computervisie zowel nieuwe kansen als uitdagingen opgeleverd op het gebied van abdominale multi-orgaansegmentatie. Geavanceerde magnetische resonantiebeeldvorming (MRI)4 en computertomografie (CT)-technologie5 stellen ons in staat om buikbeelden met een hoge resolutie te verkrijgen. De nauwkeurige segmentatie van meerdere organen op basis van CT-beelden heeft een aanzienlijke klinische waarde voor de beoordeling en behandeling van vitale organen zoals de lever, nieren, milt, alvleesklier, enz.6,7,8,9,10 Het handmatig anatomisch anatomiseren van deze anatomische structuren, vooral die welke interventie van radiologen of radiotherapeuten vereisen, is echter zowel tijdrovend als vatbaar voor subjectieve invloeden11. Daarom is er een dringende behoefte aan de ontwikkeling van geautomatiseerde en nauwkeurige methoden voor abdominale segmentatie van meerdere organen.
Eerder onderzoek naar beeldsegmentatie was voornamelijk gebaseerd op Convolutional Neural Networks (CNN's), die de segmentatie-efficiëntie verbeteren door lagen te stapelen en ResNet12 te introduceren. In 2020 introduceerde het onderzoeksteam van Google het Vision Transformer (VIT)-model13, een baanbrekend voorbeeld van het integreren van Transformer-architectuur in het traditionele visuele domein voor een reeks visuele taken14. Terwijl convolutionele bewerkingen alleen rekening kunnen houden met lokale functie-informatie, maakt het aandachtsmechanisme in Transformers het mogelijk om uitgebreide beschouwing van globale functie-informatie te maken.
Gezien de superioriteit van op Transformer gebaseerde architecturen ten opzichte van traditionele convolutionele netwerken15, hebben talrijke onderzoeksteams uitgebreid onderzoek gedaan naar het optimaliseren van de synergie tussen de sterke punten van Transformers en convolutionele netwerken 16,17,18,19. Chen et al. introduceerden de TransUNet voor medische beeldsegmentatietaken16, die gebruikmaakt van Transformers om wereldwijde kenmerken uit afbeeldingen te extraheren. Vanwege de hoge kosten van netwerktraining en het niet gebruiken van het concept van functie-extractiehiërarchie, zijn de voordelen van Transformer niet volledig gerealiseerd.
Om deze problemen aan te pakken, zijn veel onderzoekers begonnen te experimenteren met het opnemen van Transformers als de ruggengraat voor het trainen van segmentatienetwerken. Liu et al.17 introduceerden de Swin Transformer, die een hiërarchische constructiemethode gebruikte voor gelaagde functie-extractie. Het concept van Windows Multi-Head Self-Attention (W-MSA) werd voorgesteld, waardoor de rekenkosten aanzienlijk werden verlaagd, vooral in de aanwezigheid van grotere functiekaarten op ondiep niveau. Hoewel deze aanpak de rekenvereisten verminderde, isoleerde het ook de informatieoverdracht tussen verschillende vensters. Om dit probleem aan te pakken, introduceerden de auteurs verder het concept van Shifted Windows Multi-Head Self-Attention (SW-MSA), waardoor informatie zich tussen aangrenzende vensters kan verspreiden. Voortbouwend op deze methodologie formuleerden Cao et al. de Swin-UNet18, waarbij de 2D-convoluties in U-Net werden vervangen door Swin-modules en W-MSA en SW-MSA werden opgenomen in de coderings- en decoderingsprocessen, waardoor lovenswaardige segmentatieresultaten werden bereikt.
Omgekeerd benadrukten Zhou et al. dat het voordeel van conv-werking niet kon worden genegeerd bij het verwerken van afbeeldingen met een hoge resolutie19. Hun voorgestelde nnFormer maakt gebruik van een zelfaandachtsberekeningsmethode op basis van lokale driedimensionale beeldblokken, die een Transformer-model vormen dat wordt gekenmerkt door een kruisvormige structuur. Het gebruik van aandacht op basis van lokale driedimensionale blokken verminderde de trainingsbelasting op het netwerk aanzienlijk.
Gezien de problemen met de bovenstaande studie, wordt een efficiënte hybride hiërarchische structuur voor 3D-segmentatie van medische beelden, Swin-PSAxialNet genaamd, voorgesteld. Deze methode omvat een downsampling-blok, Space-to-depth (SPD)20-blok , dat in staat is om globale informatie te extraheren21. Bovendien voegt het een parameter shared axial attention (PSAA)-module toe, die het aantal leerparameters terugbrengt van kwadratisch naar lineair en een goed effect zal hebben op de nauwkeurigheid van netwerktraining en de complexiteit van trainingsmodellen22.
Swin-PSAxialNet netwerk
De algehele architectuur van het netwerk neemt de U-vormige structuur van nnU-Net23 aan, bestaande uit encoder- en decoderstructuren. Deze structuren houden zich bezig met lokale extractie van kenmerken en de aaneenschakeling van kenmerken uit grootschalige en kleinschalige afbeeldingen, zoals geïllustreerd in figuur 1.
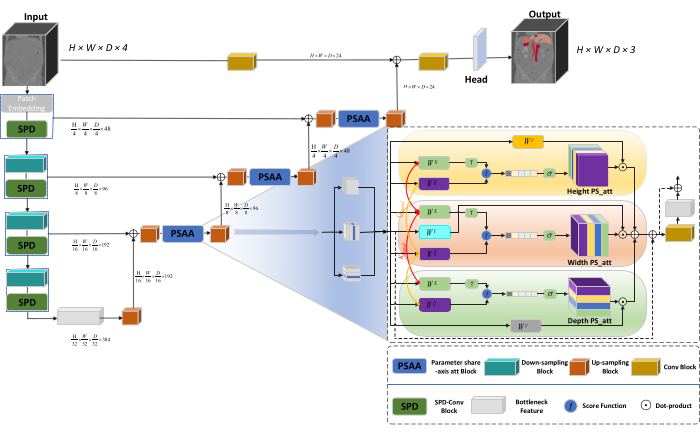
Figuur 1: Swin-PSAxialNet schematisch diagram van de netwerkarchitectuur. Klik hier om een grotere versie van deze figuur te bekijken.
In de encoderstructuur wordt het traditionele Conv-blok gecombineerd met het SPD-blok20 om een downsampling-volume te vormen. De eerste laag van de encoder bevat Patch Embedding, een module die de 3D-gegevens in 3D-patches 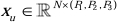 partitioneert, (P1, P2, P3) vertegenwoordigt niet-overlappende patches in deze context,
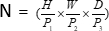 wat de sequentielengte van 3D-patches aangeeft. Na de inbeddingslaag omvat de volgende stap een niet-overlappende convolutionele downsampling-eenheid die zowel een convolutioneel blok als een SPD-blok omvat. In deze opstelling heeft het convolutionele blok een stap ingesteld op 1 en wordt het SPD-blok gebruikt voor het schalen van afbeeldingen, wat leidt tot een viervoudige vermindering van de resolutie en een verdubbeling van het aantal kanalen.
In de decoderstructuur bestaat elk upsample-blok na de Bottleneck Feature-laag uit een combinatie van een upsample-blok en een PSAA-blok. De resolutie van de functiekaart wordt verdubbeld en het aantal kanalen wordt gehalveerd tussen elk paar decoderfasen. Om ruimtelijke informatie te herstellen en de weergave van kenmerken te verbeteren, wordt functiefusie tussen grootschalige en kleinschalige afbeeldingen uitgevoerd tussen de upsampling-blokken. Uiteindelijk worden de upsampling-resultaten in de Head-laag ingevoerd om de oorspronkelijke afbeeldingsgrootte te herstellen, met een uitvoergrootte van (H × W × D × C, C = 3).
SPD-blok architectuur
Bij traditionele methoden maakt de downsampling-sectie gebruik van een enkele stap met een stapgrootte van 2. Dit omvat convolutionele pooling op lokale posities in het beeld, het beperken van het receptieve veld en het beperken van het model tot het extraheren van kenmerken uit kleine afbeeldingspatches. Deze methode maakt gebruik van het SPD-blok, dat de originele afbeelding fijn verdeelt in drie dimensies. Het originele 3D-beeld is gelijkmatig gesegmenteerd langs de x-, y- en z-assen, wat resulteert in vier subvolumelichamen. (Figuur 2) Vervolgens worden de vier volumes aaneengeschakeld door middel van een "kat"-bewerking en ondergaat het resulterende beeld een 1 × 1 × 1 convolutie om het gedownsamplede beeld20 te verkrijgen.
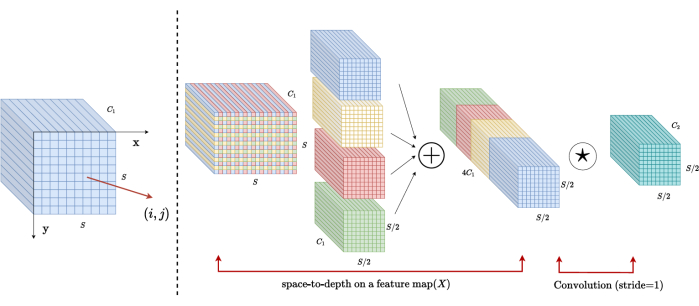
Figuur 2: SPD-blokdiagram. Klik hier om een grotere versie van deze figuur te bekijken.
PSAA-blokarchitectuur
In tegenstelling tot traditionele CNN-netwerken is het voorgestelde PSAA-blok effectiever in het uitvoeren van wereldwijde informatiefocus en efficiënter in het leren en trainen van netwerken. Dit maakt het mogelijk om rijkere beelden en ruimtelijke kenmerken vast te leggen. Het PSAA-blok bevat axiaal aandachtsleren op basis van parameters die in drie dimensies worden gedeeld: Hoogte, Breedte en Diepte. In vergelijking met het conventionele aandachtsmechanisme dat aandachtsleren uitvoert voor elke pixel in het beeld, voert deze methode zelfstandig aandachtsleren uit voor elk van de drie dimensies, waardoor de complexiteit van zelfaandacht wordt teruggebracht van kwadratisch naar lineair. Bovendien wordt een leerbaar mechanisme voor het delen van parameters met sleutels-query's gebruikt, waardoor het netwerk aandachtsmechanismebewerkingen parallel kan uitvoeren in de drie dimensies, wat resulteert in een snellere, superieure en effectievere functieweergave.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
Het huidige protocol is goedgekeurd door de ethische commissie van de Nantong University. Het omvat de intelligente beoordeling en het onderzoek van verkregen niet-invasieve of minimaal invasieve multimodale gegevens, waaronder menselijke medische beelden, bewegingen van ledematen en vasculaire beeldvorming, met behulp van kunstmatige-intelligentietechnologie. Figuur 3 geeft het algemene stroomdiagram van de segmentatie van meerdere organen weer. Alle benodigde weblinks zijn te vinden in de Materiaaltabel.

Figuur 3: Algemeen stroomschema van de segmentatie van meerdere organen. Klik hier om een grotere versie van deze figuur te bekijken.
1. Verzameling van datasets
- Download de AMOS2022 dataset24 (zie Materiaaltabel).
- Selecteer 160 afbeeldingen als trainingsgegevensset en 40 afbeeldingen als testgegevensset.
- Voer mkdir ~/PaddleSeg/contrib/MedicalSeg/data/raw_data terminaal uit.
- Open het pad van raw_data.
- Plaats de dataset in de map raw_data en zorg voor een correcte overeenkomst met de bestandsnamen in de mappen "imagesTr" en "labelsTr".
- Maak dataset.json bestand.
- Voeg gegevenssetinformatie zoals numTraining, numTest en de naam van labels toe aan het bestand 'dataset.json'.
OPMERKING: De dataset voor dit onderzoek bestaat uit 200 hoogwaardige CT-datasets die zijn geselecteerd uit de AMOS2022 officiële 500 CT-dataset voor trainings- en testdoeleinden. De dataset omvat 11 organen, waaronder de milt, rechternier, linkernier, galblaas, slokdarm, lever, maag, aorta, vena cava inferior, alvleesklier en blaas.
2. Configuratie van de omgeving
- Installeer de Paddlepaddle-omgeving (zie Materiaaltabel) en de bijbehorende CUDA-versie25.
OPMERKING: Het gebruik van Paddlepaddle versie 2.5.0 en CUDA versie 11.7 wordt aanbevolen. - Git kloon de PaddleSeg repository25.
- Voer cd ~/PaddleSeg/contrib/MedicalSeg/ terminaal uit.
- Voer pip install -r requirements.txt uit.
- Voer pip install medpy uit.
3. Voorverwerking van gegevens
- Wijzig het "yml"-bestand, inclusief parameters zoals data_root, batch_size, model, train_dataset, val_dataset, optimizer, lr_scheduler en verlies.
- Specificeer de vereiste parameters voor uitvoering, waaronder "-config, --log_iters, --precision, --nnunet, --save_dir, --save_interval, enz.
OPMERKING: De oorspronkelijke "raw_data" wordt omgezet in drie soorten gegevensbestanden: "Bijgesneden", "Decathlon" en "Voorverwerkt", die voldoen aan verschillende trainings- en evaluatievereisten om de modelprestaties en de effectiviteit van de training te verbeteren.
4. Modeltraining en vergelijking
OPMERKING: Als een veelgebruikte basislijn op het gebied van beeldsegmentatie dient nnU-Net23 als basismodel in het onderzoek. Het specifieke modelvergelijkingsproces is als volgt.
- Trein nnU-Net
- Configureer met een batchgrootte van 2 en 80.000 iteraties, registreer elke 20 iteraties en gebruik fp16-precisie.
- Stel de save_dir in als de "uitvoer"-map in de werkmap, met een opslaginterval van 1.000 iteraties.
- Voeg parameter --use_vdl toe voor visualisatie van VisualDL-parameters.
- Ren train.py.
- Maak vier yml-bestanden , specificeer vouwen 1-4 en train het model met vijfvoudige kruisvalidatie.
- Trein Swin-UNet
- Zorg voor consistentie met de eerder vastgestelde experimentele omstandigheden.
- Verwijder de parameter --nnunet en gebruik --swinunet.
- Voer het train.py bestand uit.
- Trein vouwt 1-4 afzonderlijk en wordt vervolgens onderworpen aan ensembleverwerking.
- Trein TransUNet
- Volg de procedures die worden beschreven in stap 4.1.
- Open het yml-bestand .
- Wijzig type: nnunet naar type: transunet.
- Wijzig de parameter --nnunet in --transunet.
- Voer het train.py bestand uit.
- Train vouwt 1-4 afzonderlijk en verwerkt de ensembleverwerking.
- Trein UNETR
- Behoud consistente experimentele variabelen.
- Herhaal de eerder beschreven procedures zoals Swin-UNet en TransUNet (stap 4.2 en stap 4.3).
- Ren train.py.
- Train vouwt 1-4 afzonderlijk en verwerkt de ensembleverwerking.
- Trein nnVoormalig
- Wijzig de parameters zoals Swin-UNet en TransUNet.
- Draai enkelvoudig train.py.
- Ensembleverwerking uitvoeren.
5. Ablatie experiment
- PSAA-blok voor het hele netwerk
- Houd variabelen consistent met stap 4.1.
- Stel volume_shape = (64.192.192) en Axial_attention = Waar.
- Draai enkelvoudig train.py.
- Verwerk de verwerking van het ensemble in vijf vouwen.
- SPD-blok voor het hele netwerk
- Houd variabelen consistent met stap 4.1.
- Stel SPD_enable = Waar en Axial_attention = Onwaar.
- Draai enkelvoudig train.py.
- Verwerk de verwerking van het ensemble in vijf vouwen.
- PSAA-blok voor upsampling
OPMERKING: Gebruik het SPD-blok niet voor downsampling.- Gebruik het PSAA-blok voor upsampling.
- Houd variabelen consistent met stap 4.1.
- Stel Axial_attention = Onwaar in het downsampling-gedeelte en SPD_enable = Onwaar.
- Draai enkelvoudig train.py.
- Verwerk vijf vouwen ensembleverwerking.
- PSAA-blok voor upsampling
OPMERKING: Gebruik het SPD-blok voor downsampling.- Gebruik het SPD-blok voor downsampling en het PSAA-blok voor upsampling.
- Houd variabelen consistent met stap 4.1.
- Stel Axial_attention = Onwaar in het downsampling-gedeelte en SPD_enable = Waar.
- Draai enkelvoudig train.py.
- Verwerk vijf vouwen ensembleverwerking.
- Stel het aantal iteraties in op 2.00.000 vanwege de superieure resultaten.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Dit protocol maakt gebruik van twee statistieken om het model te evalueren: Dice Similarity Score (DSC) en 95% Hausdorff Distance (HD95). DSC meet de overlap tussen voorspellingen van voxelsegmentatie en grondwaarheid, terwijl 95% HD de overlap beoordeelt tussen de voorspellingsgrenzen van voxelsegmentatie en grondwaarheid, waarbij 5% van de uitschieters wordt weggefilterd. De definitie van DSC26 is als volgt:
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
De segmentatie van buikorganen is een ingewikkeld werk. Vergeleken met andere interne structuren van het menselijk lichaam, zoals de hersenen of het hart, lijkt het segmenteren van buikorganen een grotere uitdaging vanwege het lage contrast en de grote vormveranderingen in CT-beelden27,28. Swin-PSAxialNet wordt hier voorgesteld om dit moeilijke probleem op te lossen.
In de stap voor het verzamelen van ...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteurs verklaren geen belangenconflicten.
Dankbetuigingen
Deze studie werd ondersteund door het '333' Engineering Project van de provincie Jiangsu ([2022]21-003), het Wuxi Health Commission General Program (M202205) en het Wuxi Science and Technology Development Fund (Y20212002-1), waarvan de bijdragen van onschatbare waarde zijn geweest voor het succes van dit werk." De auteurs bedanken alle onderzoeksassistenten en studiedeelnemers voor hun steun.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| AMOS2022 dataset | None | None | Datasets voor netwerktraining en -testen. De weblink is: https://pan.baidu.com/s/1x2ZW5FiZtVap0er55Wk4VQ?pwd=xhpb |
| ASUS mainframe | ASUS | https://www.asusparts.eu/en/asus-13020-01910200 | |
| CUDA versie 11.7 | NVIDIA | https://developer.nvidia.com/cuda-11-7-0-download-archive | |
| NVIDIA GeForce RTX 3090 | NVIDIA | https://www.nvidia.com/en-in/geforce/graphics-cards/30-series/rtx-3090-3090ti/ | |
| Paddlepaddle omgeving | Baidu | None | Omgevingsvoorbereiding voor netwerktraining. De weblink is: https://www.paddlepaddle.org.cn/ |
| PaddleSeg | Baidu | None | De baseline die we gebruiken: https://github.com/PaddlePaddle/PaddleSeg |
Referenties
- Liu, X., Song, L., Liu, S., Zhang, Y. A review of deep-learning-based medical image segmentation methods. Sustain. 13 (3), 1224(2021).
- Popilock, R., Sandrasagaren, K., Harris, L., Kaser, K. A. CT artifact recognition for the nuclear technologist. J Nucl Med Technol. 36 (2), 79-81 (2008).
- Rehman, A., Khan, F. G. A deep learning based review on abdominal images. Multimed Tools Appl. 80, 30321-30352 (2021).
- Schenck, J. F. The role of magnetic susceptibility in magnetic resonance imaging: Mri magnetic compatibility of the first and second kinds. Med Phys. 23 (6), 815-850 (1996).
- Palmisano, A., et al. Myocardial late contrast enhancement ct in troponin-positive acute chest pain syndrome. Radiol. 302 (3), 545-553 (2022).
- Chen, E. -L., Chung, P. -C., Chen, C. -L., Tsai, H. -M., Chang, C. -I. An automatic diagnostic system for CT liver image classification. IEEE Trans Biomed Eng. 45 (6), 783-794 (1998).
- Sagel, S. S., Stanley, R. J., Levitt, R. G., Geisse, G. J. R. Computed tomography of the kidney. Radiol. 124 (2), 359-370 (1977).
- Freeman, J. L., Jafri, S., Roberts, J. L., Mezwa, D. G., Shirkhoda, A. CT of congenital and acquired abnormalities of the spleen. Radiographics. 13 (3), 597-610 (1993).
- Almeida, R. R., et al. Advances in pancreatic CT imaging. AJR Am J Roentgenol. 211 (1), 52-66 (2018).
- Eisen, G. M., et al. Guidelines for credentialing and granting privileges for endoscopic ultrasound. Gastrointest Endosc. 54 (6), 811-814 (2001).
- Sykes, J. Reflections on the current status of commercial automated segmentation systems in clinical practice. J Med Radiat Sci. 61 (3), 131-134 (2014).
- He, K., Zhang, X., Ren, S., Sun, J. Deep residual learning for image recognition. 2016 IEEE Conference on Computer Vision and Pattern Recognition (CVPR). , Vegas, NV, USA. 770-778 (2016).
- Dosovitskiy, A., et al. An image is worth 16x16 words: Transformers for image recognition at scale. arXiv. arXiv. , 11929(2020).
- Ramachandran, P., et al. Stand-alone self-attention in vision models. Adv Neural Inf Process Syst. 32, NIPS2019 (2019).
- Vaswani, A., et al. Attention is all you need. Adv Neural Inf Process Syst. 30, NIPS2019 (2017).
- Chen, J., et al. TransUNET: Transformers make strong encoders for medical image segmentation. arXiv. , arXiv:2102 04396(2021).
- Liu, Z., et al. Swin transformer: Hierarchical vision transformer using shifted windows. Proc IEEE Int Conf Comput Vis. , 10012-10022 (2021).
- Cao, H., et al. Swin-UNET: Unet-like pure transformer for medical image segmentation. Comput Vis ECCV. , 205-218 (2022).
- Zhou, H. -Y., et al. nnformer: Interleaved transformer for volumetric segmentation. arXiv. arXiv. , arXiv:2109 03201(2021).
- Sunkara, R., Luo, T. No more strided convolutions or pooling: A new CNN building block for low-resolution images and small objects. Mach Learn Knowl Discov Databases. , 443-459 (2023).
- Çiçek, Ö, Abdulkadir, A., Lienkamp, S. S., Brox, T., Ronneberger, O. 3D U-Net: learning dense volumetric segmentation from sparse annotation. Med Comput Vis Bayesian Graph Models Biomed Imaging. 2016, 424-432 (2016).
- Kim, H., et al. Abdominal multi-organ auto-segmentation using 3D-patch-based deep convolutional neural network. Scientific reports. 10 (1), 6204(2020).
- Isensee, F., et al. nnu-net: Self-adapting framework for u-net-based medical image segmentation. arXiv. , arXiv:1809 10486(2018).
- Ji, Y., et al. A large-scale abdominal multi-organ benchmark for versatile medical image segmentation. Adv Neural Inf Process Syst. 35, 36722-36732 (2022).
- Liu, Y., et al. Paddleseg: A high-efficient development toolkit for image segmentation. arXiv. , arXiv:2101 06175(2021).
- Hatamizadeh, A., et al. UNETR: Transformers for 3D medical image segmentation. Proc IEEE Int Conf Comput Vis. , https://api.semanticscholar.org/CorpusID:232290634 574-584 (2022).
- Zhou, H., Zeng, D., Bian, Z., Ma, J. A semi-supervised network-based tissue-aware contrast enhancement method for ct images. Nan Fang Yi Ke Da Xue Xue Bao. 43 (6), 985-993 (2023).
- Ma, J., et al. Abdomenct-1k: Is abdominal organ segmentation a solved problem. IEEE Trans Pattern Anal Mach Intell. 44 (10), 6695-6714 (2021).
- Galván, E., Mooney, P. Neuroevolution in deep neural networks: Current trends and future challenges. IEEE Trans Artif Intell. 2 (6), 476-493 (2021).
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Herprints en machtigingen
