We presenteren een flexibele, uitbreidbare Jupyter-lab-gebaseerde workflow voor de niet-gesuperviseerde analyse van complexe multi-omics-datasets die verschillende voorverwerkingsstappen, schatting van het multi-omics-factoranalysemodel en verschillende stroomafwaartse analyses combineert.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Methodenartikel
Toepassing van ongecontroleerde multi-omische factoranalyse om patronen van variatie en moleculaire processen die verband houden met hart- en vaatziekten bloot te leggen
In dit artikel
Samenvatting
Samenvatting
Ziektemechanismen zijn meestal complex en worden beheerst door de interactie van verschillende afzonderlijke moleculaire processen. Complexe, multidimensionale datasets zijn een waardevolle bron om meer inzichten in die processen te genereren, maar de analyse van dergelijke datasets kan een uitdaging zijn vanwege de hoge dimensionaliteit die bijvoorbeeld het gevolg is van verschillende ziektetoestanden, tijdstippen en omics die het proces met verschillende resoluties vastleggen.
Hier laten we een aanpak zien om zo'n complexe multiomics-dataset op een ongecontroleerde manier te analyseren en te verkennen door multi-omics-factoranalyse (MOFA) toe te passen op een dataset die is gegenereerd uit bloedmonsters die de immuunrespons bij acute en chronische coronaire syndromen vastleggen. De dataset bestaat uit verschillende assays met verschillende resoluties, waaronder cytokinegegevens op monsterniveau, plasma-proteomics en neutrofiele prime-seq, en single-cell RNA-seq (scRNA-seq) gegevens. Verdere complexiteit wordt toegevoegd door verschillende tijdstippen per patiënt en verschillende patiëntsubgroepen te laten meten.
De analyseworkflow schetst hoe de gegevens in verschillende stappen kunnen worden geïntegreerd en geanalyseerd: (1) Voorverwerking en harmonisatie van gegevens, (2) Schatting van het MOFA-model, (3) Stroomafwaartse analyse. Stap 1 schetst hoe de kenmerken van de verschillende gegevenstypen kunnen worden verwerkt, kenmerken van lage kwaliteit kunnen worden uitgefilterd en genormaliseerd om hun verdelingen te harmoniseren voor verdere analyse. Stap 2 laat zien hoe het MOFA-model kan worden toegepast en hoe de belangrijkste bronnen van variantie binnen de dataset voor alle omics en functies kunnen worden verkend. Stap 3 presenteert verschillende strategieën voor de stroomafwaartse analyse van de vastgelegde patronen, waarbij ze worden gekoppeld aan de ziektetoestanden en mogelijke moleculaire processen die die aandoeningen beheersen.
Over het algemeen presenteren we een workflow voor niet-gesuperviseerde gegevensverkenning van complexe multi-omics-datasets om de identificatie van belangrijke variatieassen mogelijk te maken die zijn samengesteld uit verschillende moleculaire kenmerken die ook kunnen worden toegepast op andere contexten en multi-omics-datasets (inclusief andere assays zoals gepresenteerd in de voorbeeldige use case).
Inleiding
Ziektemechanismen zijn meestal complex en worden beheerst door de interactie van verschillende afzonderlijke moleculaire processen. Het ontcijferen van de complexe moleculaire mechanismen die tot specifieke ziekten leiden of de evolutie van een ziekte bepalen, is een taak met een hoge medische relevantie, omdat het nieuwe inzichten kan onthullen voor het begrijpen en behandelen van ziekten.
Recente technologische ontwikkelingen maken het mogelijk om die processen tegelijkertijd te meten op een hogere resolutie (bijv. op het niveau van een enkele cel) en op verschillende biologische lagen (bijv. DNA, mRNA, toegankelijkheid van chromatine, DNA-methylering, proteomics). Dit leidt tot het steeds genereren van grote multidimensionale biologische datasets, die gezamenlijk kunnen worden geanalyseerd om meer inzicht te genereren in de onderliggende processen. Tegelijkertijd blijft het combineren en analyseren van de verschillende databronnen op een biologisch zinvolle manier een uitdagende taak1.
Verschillende technologische limieten, geluiden en variabiliteitsbereiken tussen verschillende omics vormen één uitdaging. Single-cell RNA-sequencing (scRNA-seq) gegevens zijn bijvoorbeeld zeer schaars en worden vaak beïnvloed door grote technische of batcheffecten. Bovendien is de functieruimte vaak erg groot, variërend van enkele duizenden gemeten genen of eiwitten, terwijl de steekproefomvang beperkt is. Dit wordt verder gecompliceerd door complexe ontwerpen, die verschillende ziektetoestanden, verstorende factoren, tijdstippen en resoluties kunnen bevatten. In de gepresenteerde use case waren bijvoorbeeld verschillende gegevenstypen beschikbaar op het niveau van één cel of op het niveau van een monster (bulk). Daarnaast kunnen de gegevens onvolledig zijn en zijn niet alle metingen beschikbaar voor alle geanalyseerde proefpersonen.
Vanwege deze uitdagingen worden verschillende omics en opgenomen functies nog steeds vaak alleen afzonderlijk geanalyseerd2, hoewel het uitvoeren van een geïntegreerde analyse niet alleen een volledig beeld van het proces kan opleveren, maar ook biologische en technische ruis van de ene omic kan worden gecompenseerd door andere omics 3,4. Er zijn verschillende methoden voorgesteld om een geïntegreerde analyse van multi-omics-gegevens uit te voeren, waaronder Bayesiaanse methoden, netwerkgebaseerde methoden 5,6, multimodaal deep learning7 en dimensionaliteitsreductiemethoden via matrixfactorisatie 8,9. Voor dit laatste hebben de resultaten van een grote benchmarkstudie10 aangetoond dat de MOFA9-methode (multi-omic factor analysis) een van de meest geschikte instrumenten is wanneer gegevens moeten worden gekoppeld aan klinische annotaties.
Vooral in complexe omgevingen zijn matrixfactorisatiemethoden zonder toezicht een nuttige benadering om de complexiteit te verminderen en gedeelde en complementaire signalen uit verschillende gegevensbronnen en functies te extraheren. Door de complexe ruimte op te splitsen in latente representaties van lagere rang, kunnen de belangrijkste bronnen van variantie binnen de gegevens snel worden verkend en gekoppeld aan bekende covariaten. In het geval dat hetzelfde patroon van variatie wordt gedeeld over meerdere kenmerken (bijv. genen of eiwitten), kan dit worden samengevoegd tot een paar factoren, terwijl ruis wordt verminderd. Regularisatie kan worden gebruikt om de schaarste van modelcoëfficiënten te vergroten, waardoor de benadering zeer geschikt is in omgevingen waar de functieruimte groot is terwijl het aantal monsters beperkt is9.
Dit protocol biedt een flexibele analyseworkflow die het MOFA-model gebruikt om te laten zien hoe een complexe multi-omics-dataset snel kan worden verkend en de belangrijkste variatiepatronen kunnen worden gedestilleerd die deze dataset kenmerken. De workflow bestaat uit drie hoofdstappen. In de eerste stap, voorverwerking en harmonisatie van gegevens, worden verschillende strategieën voor gegevensvoorverwerking op basis van verschillende soorten invoergegevens (scRNA-seq, proteomics, cytokine, klinische gegevens) gepresenteerd. Het protocol gaat dieper in op het verwerken van de kenmerken van de verschillende invoerdatasets, het uitfilteren van kenmerken van lage kwaliteit en het normaliseren ervan om hun verdelingen te harmoniseren. We laten ook zien hoe die beslissingen voorafgaand aan de verwerking van invloed kunnen zijn op de downstream-resultaten. In de tweede stap wordt het MOFA-model toegepast op de gegevens en kan de resulterende variantie-decompositie worden gebruikt om de integratie van de verschillende datasets te evalueren. De derde stap laat zien hoe de vastgelegde factoren kunnen worden gekoppeld aan covariabelen en hoe de moleculaire programma's kunnen worden blootgelegd die die factoren definiëren. Met de gepresenteerde workflow waren we in staat om verschillende latente factoren die verband houden met klinische covariabelen te extraheren in een dataset van patiënten die lijden aan coronaire syndromen en potentiële onderliggende meercellige immuunprogramma's uit een eerder project te identificeren11. We zullen deze dataset hier gebruiken, maar het protocol kan gemakkelijk worden toegepast op andere contexten, waaronder andere omics.
De dataset bestaat uit steekproeven van patiënten met stabiele chronische coronaire syndromen (CCS), acute coronaire syndromen (ACS) en een controlegroep met gezonde kransslagaders (niet-CCS) (Figuur 1). ACS wordt veroorzaakt door plaqueruptuur in reeds bestaande CCS, wat leidt tot een acute verstoring van de bloedtoevoer naar het myocardium en een daaropvolgend ischemisch letsel van het hart. Deze verwonding veroorzaakt een ontstekingsreactie van het immuunsysteem, gevolgd door een herstelfase, die duurt tot enkele dagen na de acute gebeurtenis12. Om deze immuunrespons voor ACS-patiënten te kunnen karakteriseren, werden bloedmonsters genomen op vier verschillende tijdstippen: acuut (TP1); na rekanalisatie (14 [± 8] h) (TP2); 60 [± 12] uur later (TP3); vóór ontslag (6,5 [±1,5] dagen) (TP4) (Figuur 1A). Voor CCS en patiënten met gezonde kransslagaders was slechts één tijdstip beschikbaar (TP0). Voor alle patiënten en tijdstippen werden verschillende testen op basis van de bloedmonsters gemeten: klinische markers van ontsteking (creatinekinase (CK), CK-MB, troponine, C-reactief proteïne (CRP)), scRNA-seq van perifere mononucleaire bloedcellen (PBMC's), cytokineanalyse, plasmaproteomics en prime-seq13-gegevens van neutrofielen.

Figuur 1: Multi-omische invoerdataset voor myocardinfarct. Input dataset: De geanalyseerde gegevens omvatten bloedmonsters van patiënten (n = 62) met acuut coronair syndroom (ACS), chronisch coronair syndroom (CCS) en patiënten met gezonde kransslagaders (niet-CCS). Voor ACS-patiënten werden bloedmonsters opgenomen op vier verschillende tijdstippen (TP1-4), voor CCS- en niet-CCS-patiënten op één enkel tijdstip (TP0). Elke combinatie van patiënt en tijdstip wordt in de analyse als een afzonderlijk monster behandeld. Op de monsters werden verschillende omische testen gemeten: klinische bloedtesten (n = 125), scRNA-seq (n = 121), plasma-proteomics (n = 119), cytokinetest (n = 127) en neutrofiele prime-seq (n = 121). Vervolgens werd het beschreven protocol toegepast om de gegevens in alle omics te integreren en te verkennen met behulp van het MOFA-model en verdere stroomafwaartse analyse (factoranalyse, pathway-verrijking). Klik hier om een grotere versie van deze figuur te bekijken.
Als input voor de workflow zoals hier gepresenteerd, nemen we ruwe tellingen van scRNA-seq data na verwerking met cellranger en kwaliteitscontrole (QC) zoals bijvoorbeeld beschreven in de scanpy14 preprocessing tutorial. Voor annotatie van het celtype gebruikten we de geautomatiseerde Azimuth15-pijplijn . De tellingen worden vervolgens geaggregeerd op steekproefniveau voor elk celtype door het gemiddelde te nemen over alle cellen voor elk monster en celtype (pseudobulkaggregatie). Plasma-proteomics is opgenomen als genormaliseerde en mediaan-gecentreerde intensiteiten, en voor neutrofielen nemen we de umi unique molecular identifier (UMI) exontellingen van de prime-seq. Op cytokine- en klinische waarden is geen eerdere voorbewerking toegepast. Verdere details over het genereren van (experimentele) gegevens zijn te vinden in het bijbehorende manuscript11. Aangezien de hier gepresenteerde resultaten gebaseerd zijn op het gebruik van de geautomatiseerde azimuth-annotatie voor celtypen in de scRNA-seq-gegevens in vergelijking met de op markers gebaseerde strategie die werd gebruikt in de publicatie waarnaar wordt verwezen, zijn de hier gepresenteerde resultaten vergelijkbaar, maar niet precies hetzelfde als gepresenteerd in de publicatie. In het manuscript kon worden aangetoond dat de celtype-annotatiestrategie de belangrijkste patronen en biologische interpretaties van de analyse niet verandert, maar dat kleine veranderingen in de exacte waarden die uit het model voortvloeien kunnen variëren. Over het algemeen waren de invoergegevens een complexe multidimensionale dataset met verschillende tijdstippen en meetniveaus (single-cells vs. bulk) van meer dan 10.000 verschillende kenmerken (genen, eiwitten, klinische waarden). Een strikte strategie voor voorverwerking en harmonisatie van gegevens, gevolgd door MOFA-analyse, is een nuttig en snel hulpmiddel gebleken voor het verkennen van de gegevens en het extraheren van relevante immuunprogramma's. Elk tijdstip en elke patiëntcombinatie wordt behandeld als een onafhankelijk monster in de MOFA-analyse. Elk gegevenstype en celtype wordt beschouwd als een afzonderlijke weergave in de MOFA-analyse.
Dit protocol biedt instructies voor het voorbereiden van de invoergegevens voor de workflow, het uitvoeren van de verschillende workflowstappen, het aanpassen van configuraties, het interpreteren van de resulterende cijfers en het iteratief aanpassen van de configuraties op basis van de interpretaties. Een overzicht van de verschillende stappen van het protocol, de vereiste invoerdatasets bij elke stap en de daaruit voortvloeiende figuren en datasets wordt gegeven door het technische workflowoverzicht (Figuur 2).
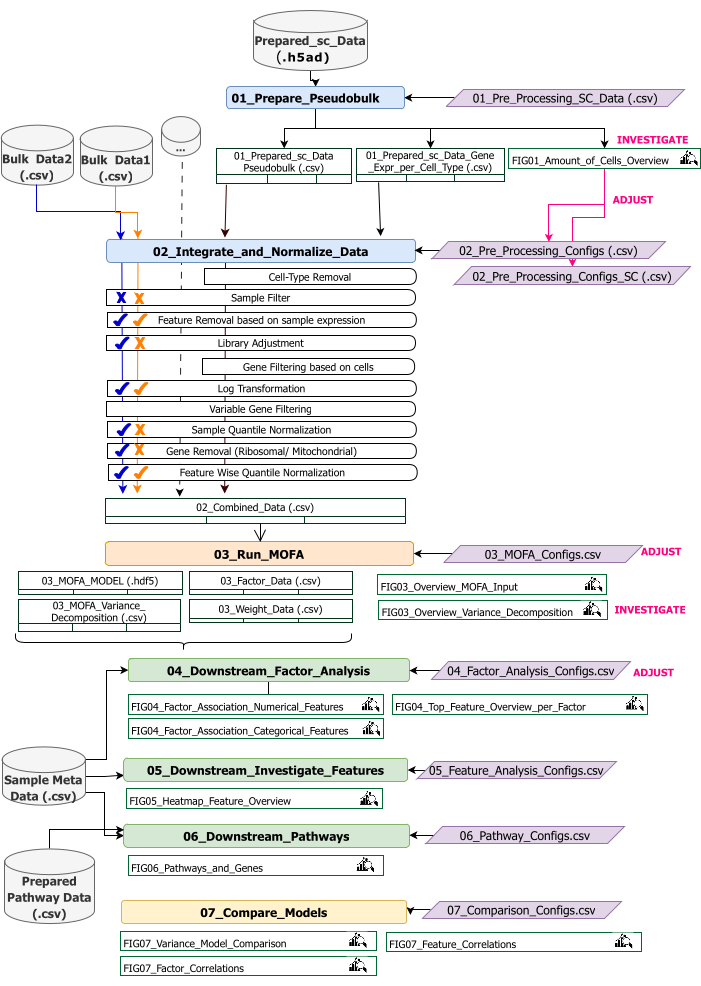
Figuur 2: Overzicht van de technische workflow. Overzicht van de workflow voor de analyse van de multi-omics dataset. De verschillende elementen worden gemarkeerd door verschillende kleuren en symbolen. Jupyter-notebooks die behoren tot de stap Gegevensvoorverwerking en -harmonisatie (1) zijn blauw gekleurd. Jupyter Notebooks die behoren tot de stap 'MOFA Model' (2) zijn oranje gekleurd. Jupyter Notebooks die behoren tot de stap 'Downstream Analysis' (3) zijn groen gekleurd. Een Jupyter Notebook die moet worden gebruikt voor het vergelijken van de resultaten is geel gekleurd. Configuratiebestanden waarin parameters voor de uitvoering van de workflow kunnen worden gewijzigd, zijn paars gemarkeerd. Invoergegevenssets die nodig zijn om de werkstroom uit te voeren, worden aangegeven met het symbool van de gegevensset en grijs gemarkeerd. Alle cijferuitvoer die tijdens de uitvoering van de werkstroom wordt gegenereerd, wordt aangegeven met het vergrootglassymbool. Gegevenssets die tijdens de uitvoering van de werkstroom worden gegenereerd, worden aangeduid als tabellen. Over het algemeen wordt de workflow sequentieel uitgevoerd: (1) Gegevensvoorverwerking en -harmonisatie bestaat uit twee stappen: eerst wordt een pseudobulktabel gegenereerd op basis van de scRNA-seq-invoergegevens (01_Prepare_Pseudobulk) en vervolgens wordt deze gegevens geïntegreerd en genormaliseerd samen met alle andere (bulk)invoer op steekproefniveau (02_Integrate_and_Normalize_Data). Binnen deze stap via de configuratiebestanden is het mogelijk om voor elke dataset afzonderlijk te configureren welke van de aangegeven voorbewerkings- en normalisatiestappen (bijv. Sample Filter) moet worden toegepast. (2) 'MOFA-model': voert het MOFA-model uit op de gegenereerde input van de eerste stap met de configuraties die zijn gespecificeerd in het configuratiebestand (03_MOFA_configs.csv) (3) 'Downstream-analyse': bestaat uit drie verschillende notebooks die onafhankelijk van elkaar kunnen worden uitgevoerd om inzichten te genereren in de gegenereerde MOFA-resultaten en deze te koppelen aan steekproefmetagegevens (covariaten) die als invoer worden verstrekt via het 'Sample Meta Data.csv'-bestand. (4) 'Modelvergelijking': is een kleine afzonderlijke stap die kan worden gebruikt om verschillende modellen te vergelijken die in stap 2 zijn gegenereerd. Klik hier om een grotere versie van deze figuur te bekijken.
De werkstroom bestaat uit verschillende Jupyter-notebooks die zijn geschreven in R en Python (kennis van de R- en Python-taal is niet vereist om de werkstroom uit te voeren, maar kan nuttig zijn voor het geval er fouten optreden). In verschillende stappen van het protocol worden parameters gewijzigd via configuratiebestanden ('.csv'-bestanden met het achtervoegsel '_Configs' in de naam). Binnen het protocol schetsen we alleen de parameters die moeten worden gewijzigd vanaf de standaardconfiguratie.
Verschillende andere parameters kunnen ook worden gewijzigd, bijvoorbeeld om de voorbewerking aan te passen. Een documentatie van deze parameters en uitleg wordt gegeven in het bestand 'Documentation_Config_Parameter', dat is opgenomen in de gedownloade repository.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
1. Voorbereidingen: Technische setup en installatie
OPMERKING: Om dit programma uit te voeren, moet wget, git en Apptainer vooraf op het apparaat zijn geïnstalleerd. Een handleiding voor het installeren van Apptainer op verschillende systemen (Linux, Windows, Mac) wordt hier gegeven: https://apptainer.org/docs/admin/main/installation.html. Installatie-informatie over git is hier te vinden: https://git-scm.com/book/en/v2/Getting-Started-Installing-Git. Afhankelijk van de grootte van de verschillende invoerdatasets wordt aanbevolen om de workflow op een geschikte machine (16 CPU, 64 GB geheugen) uit te voeren. Een rooktest met de verstrekte voorbeeldgegevens kan worden uitgevoerd op de lokale machine. Instructies en verwachte resultaten van het uitvoeren van het protocol op de voorbeeldgegevens worden gegeven in aanvullend bestand 1. Raadpleeg Aanvullend videobestand 1 voor de belangrijke stappen van het protocol die worden uitgevoerd op de hierboven beschreven dataset.
- Open de console en kies of maak een map aan waarin alle analysecode en outputs worden opgeslagen. Navigeer naar de map door de opdracht: cd path_to_folder in de terminal te typen.
- Download of kloon de coderepository van Github (https://github.com/heiniglab/mofa_workflow) of door git clone https://github.com/heiniglab/mofa_workflow.git in het terminalvenster te typen.
- Download de afbeelding met alle vereiste installaties van Zenodo door wget https://zenodo.org/records/11192947/files/mofa_image.sif in het terminalvenster te typen.
- Genereer een map waarin alle resultaatgegevens worden opgeslagen door mkdir-resultaten in het terminalvenster te typen.
- Genereer een map waarin alle invoergegevens die in de analyse moeten worden gebruikt, worden toegevoegd door mkdir input_data in het terminalvenster te typen.
- Voer de container uit die een JupyterLab-sessie start door de volgende opdracht in de terminal te typen: apptainer run mofa_image.sif. Kopieer de URL die door het commando wordt geretourneerd naar de browser, die een Jupyter-lab-sessie opent (meer informatie over Jupyter-lab is te vinden in de softwaredocumentatie16).
OPMERKING: Wanneer de workflow lokaal op een laptop wordt uitgevoerd, wordt aanbevolen om in plaats daarvan de opdracht apptainer exec mofa_image.sif jupyter-lab te gebruiken, die direct een lokaal hostadres retourneert. In het geval dat de container wordt uitgevoerd binnen een geclusterde computeromgeving, kan het nodig zijn om port forwarding in te stellen, wat via ssh kan worden gedaan.
2. Initialisatie en gegevensvoorbereiding
- Gebruik in de Jupyter-Lab-sessie het navigatiemenu aan de linkerkant. Navigeer naar de map input_data door te dubbelklikken op input_data.
- Kopieer alle datasets die als input voor de analyse worden gebruikt naar de input_data directory met behulp van Drag &Drop. Sleep het bestand uit de map waarin het zich momenteel bevindt en plaats het in de Jupyter-lab-sessie in het gebied onder de input_data map.
OPMERKING: Alle gegevenssets moeten in .csv - of .h5ad-indeling (in het geval van gegevens met één cel) zijn. Alle .csv bestanden moeten een overeenkomende sample_id kolom bevatten (identieke ID's moeten worden gebruikt in de gegevenssets). Alle andere kolommen worden gebruikt als objecten. Binnen het h5ad-bestand moet de celannotatie twee identifiers bevatten die de sample_id en cluster_id specificeren. Die zullen worden gebruikt voor aggregatie en matching. Omic-datasets in andere formaten moeten vóór gebruik worden geconverteerd naar het opgegeven .csv-formaat (Afbeelding 3). scRNA-seq-datasets die in .h5seurat-formaat worden gegeven, kunnen worden geconverteerd naar .h5ad door het Jupyter-notebook uit te voeren: 00_Data_Conversion.ipynb. - Navigeer naar de map met configuraties door op het mapsymbool te klikken en vervolgens te dubbelklikken op de mappen mofa_workflow, scripts en configuraties. Open in de map het bestand Data_configs.csv door erop te dubbelklikken.
- Voeg in de kolom Waarde de paden toe naar de mappen van de mappen input_data (data_path) en resultaten (result_path). Voeg een naam toe die als bestandsextensie wordt toegevoegd aan alle opgeslagen bestanden in de waardekolom voor de configuration_name (dit protocol wordt gebruikt MI_v1 [Myocardinfarct versie1]) (Afbeelding 4).
- Sla de wijzigingen op door in het menu bovenaan op Bestand > CSV-bestand opslaan te klikken.
- Gebruik het navigatiemenu aan de linkerkant om naar de map scripts te navigeren door op scripts te klikken. Open het initialisatienotitieboek door te dubbelklikken op 00_Configuration_Update.ipynb. Voer het script uit door op de knop Kernel opnieuw opstarten en voer alle cellen uit bovenaan te klikken en op Opnieuw opstarten te klikken in de pop-up (Figuur 5).

Figuur 3: Gegevensinvoer en -instelling. Voor de uitvoering van de workflow moeten alle gegevens worden opgeslagen in een gespecificeerde input_data map. Voor elke ingevoerde dataset moet een apart bestand worden aangeleverd. Gegevens van één cel moeten worden opgegeven als .h5ad met celannotatie op de cluster_id (bijvoorbeeld als gevolg van eerdere annotatiestappen van het celtype) en een sample_id kolom (die elk afzonderlijk monster dat moet worden geanalyseerd op unieke wijze identificeert). Alle andere invoergegevenssets moeten worden opgegeven in de vorm van een ".csv", met inbegrip van een kolom met de sample_id (overeenkomend met de overeenkomstige kolom van de eencellige gegevens) en kenmerken die in de MOFA-analyse in alle andere kolommen moeten worden gebruikt. Klik hier om een grotere versie van deze figuur te bekijken.
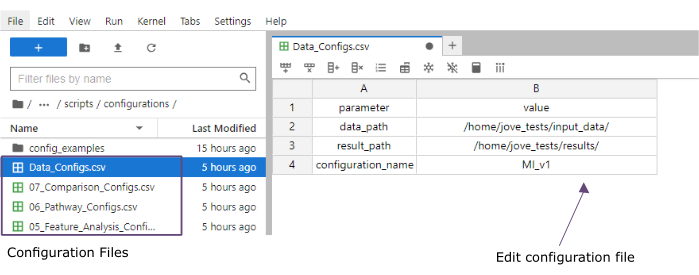
Figuur 4: Jupyter-lab configuratiebestanden. Tijdens de uitvoering van de workflow worden wijzigingen in parameters (bijv. aanpassen van filteropties enz.) gespecificeerd via '.csv'-configuratiebestanden. Binnen de gekloonde repository zijn standaard configuratiebestanden voor elke stap opgenomen. Ze kunnen rechtstreeks in de jupyter-lab-console worden bewerkt, op dezelfde manier als in een spreadsheet. Klik hier om een grotere versie van deze figuur te bekijken.
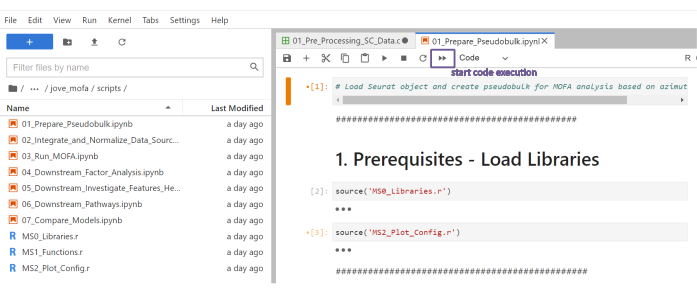
Figuur 5: Jupyter-notebooks scripts. De volledige workflow bestaat uit een reeks Jupyter-notebooks die achtereenvolgens worden uitgevoerd nadat de bijbehorende configuratiebestanden zijn gewijzigd. Door te dubbelklikken op het Jupyter notitieboek aan de linkerkant wordt het bijbehorende bestand aan de rechterkant geopend. De volledige uitvoering van het bestand kan worden gestart met de knop die bovenaan is gemarkeerd. Klik hier om een grotere versie van deze figuur te bekijken.
3. Voorverwerking en harmonisatie van de gegevens
- Voorbewerking - Converteer sc-gegevens naar pseudobulk.
OPMERKING: Deze stap hoeft alleen te worden uitgevoerd als gegevens van één cel worden gebruikt in de analyse.- Gebruik het navigatiemenu aan de linkerkant om naar de configuratiemap te navigeren door te dubbelklikken op configuratie. Open het bestand 01_Preprocessing_SC_Data.csv door te dubbelklikken. Controleer de automatisch ingevulde waarden in het bestand en pas indien nodig de waarden in de data_name kolom aan zodat ze overeenkomen met de bestandsnamen van de eencellige datasets in de input_data map die voor de analyse zal worden gebruikt.
OPMERKING: Standaard worden alle namen van .h5ad-bestanden in de map met invoergegevens toegevoegd aan het configuratiebestand in het initialisatiescript. Als sommige datasets niet voor de analyse mogen worden gebruikt, kunnen ze hier worden verwijderd. - Sla aangebrachte wijzigingen op door in het menu bovenaan op Bestand > CSV-bestand opslaan te klikken.
- Gebruik het navigatiemenu aan de linkerkant om naar de map scripts te navigeren door op scripts te klikken. Open het notitieblok 01_Prepare_Pseudobulk.ipynb door erop te dubbelklikken. Voer het script uit door op de knop Kernel opnieuw opstarten en voer alle cellen uit bovenaan te klikken en op Opnieuw opstarten te klikken in de pop-up.
- Gebruik het navigatiemenu aan de linkerkant om naar de map met figuren te navigeren door eerst op cijfers en vervolgens op 01_figures te dubbelklikken. Open de nieuw gegenereerde plot FIG01_Amount_of_Cells_overview door erop te dubbelklikken.
OPMERKING: De uitvoering van het notitieblok kan enkele minuten duren. Wanneer het notitieblok met succes is uitgevoerd, verschijnt er een pop-up en wordt het bestand FIG01_Amount_of_Cells_Overview door het notitieblok bijgewerkt of nieuw gegenereerd. De kolom Laatst gewijzigd kan aangeven wanneer het bestand is gegenereerd om te beoordelen of het een nieuw of oud bestand is. - Onderzoek de plot om clusters van celtypen te identificeren met een zeer laag aantal cellen per monster. Noteer de namen van die cluster_ids om ze in de volgende stappen uit te sluiten (Figuur 6).
- Gebruik het navigatiemenu aan de linkerkant om terug te navigeren naar de configuratiemap door te klikken op ... en vervolgens dubbelklikken op configuraties. Open het bestand 02_Preprocessing_Configs_SC.csv door erop te dubbelklikken.
- Controleer de waarden in de kolommen configuration_name en data_name en pas deze indien nodig aan.
OPMERKING: Binnen het initialisatiescript worden deze waarden vooraf ingevuld met alle namen van .h5ad-bestanden in de invoergegevensmap en de configuration_name waarde die eerder in het Data_Configs.csv-bestand is ingesteld. In het geval dat bestanden moeten worden uitgesloten van de analyse of een andere extensie voor bestandsnamen moet worden gebruikt, kan dit hier worden aangepast. - Pas de waarde in de kolom cell_type_exclusion aan en voeg alle cluster_id's toe die in de vorige stap zijn geïdentificeerd om uit te sluiten, gescheiden door ','.
- Sla de wijzigingen op door te klikken op Bestand > CSV-bestand opslaan in de navigatiebalk bovenaan.
- Gebruik het navigatiemenu aan de linkerkant om naar de configuratiemap te navigeren door te dubbelklikken op configuratie. Open het bestand 01_Preprocessing_SC_Data.csv door te dubbelklikken. Controleer de automatisch ingevulde waarden in het bestand en pas indien nodig de waarden in de data_name kolom aan zodat ze overeenkomen met de bestandsnamen van de eencellige datasets in de input_data map die voor de analyse zal worden gebruikt.
- Voorbewerking - Harmoniseer en integreer andere omics-gegevensbronnen.
- Open het bestand 02_Preprocessing_Configs.csv door erop te dubbelklikken en pas de voorverwerkingsconfiguratie aan voor elk van de datasets die worden opgenomen en opgeslagen in de map data_input (één rij per dataset).
- Controleer de waarden in de kolommen configuration_name en data_name en pas deze indien nodig aan.
- Pas de andere parameters in de kolommen dienovereenkomstig aan, afhankelijk van welke voorbewerkingsstappen moeten worden toegepast.
OPMERKING: Standaardwaarden worden toegevoegd voor elke gegevensset die zich in de map input_dataset bevindt, maar die niet specifiek zijn voor de afzonderlijke gegevenstypen van de gegevens. Daarom zullen aanpassingen nodig zijn. Een gedetailleerde documentatie van parameters wordt gegeven in het Documentation_Config_Parameter.doc bestand. - Sla de wijzigingen op door op Bestand > Opslaan CSV-bestand te klikken.
- Gebruik het navigatiemenu aan de linkerkant om naar de map scripts te navigeren door op scripts te klikken. Open het notitieblok 02_Integrate_and_Normalized_Data_Sources.ipynb door erop te dubbelklikken. Voer het script uit door op de knop Kernel opnieuw opstarten en voer alle cellen uit bovenaan te klikken en op Opnieuw opstarten te klikken in de pop-up.
- Gebruik het navigatiemenu aan de linkerkant om naar de gegenereerde map 02_results te navigeren door op het mapsymbool te klikken en vervolgens te dubbelklikken op resultaten en 02_results. Controleer of het bestand 02_Combined_data_'configuration_name'_Integrated.csv bevat dat het gecombineerde voorbewerkte gegevensinvoerbestand bevat.
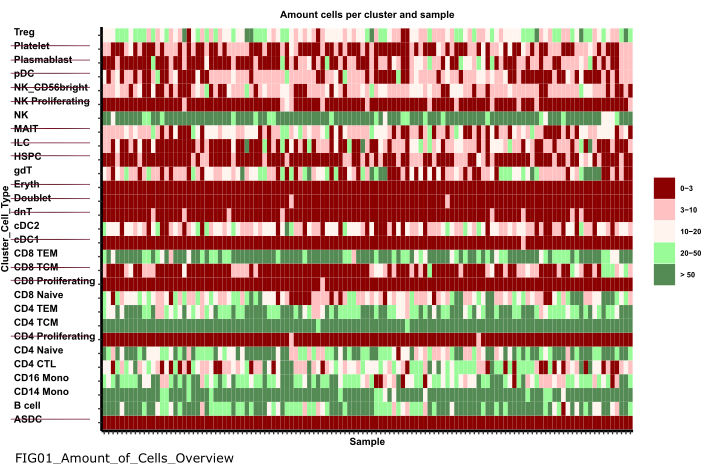
Figuur 6: Voorverwerking en harmonisatie van de gegevens. Een output van de stap '01_Prepare_Pseudobulk' is de plot 'Fig01_Amount_of_Cells_Overview'. Hier wordt voor elke cluster_id (de y-as die het celtype aangeeft uit de vorige stappen van de celtype-annotatie) het aantal cellen per monster ('sample_id') gegeven. Binnen de gepresenteerde resultaten worden celtypen met een laag aantal cellen per monster uitgesloten van de daaropvolgende analyse (aangegeven door de doorhaling). Klik hier om een grotere versie van deze figuur te bekijken.
4. MOFA uitvoeren
- Gebruik in Jupyter-Lab het navigatiemenu aan de linkerkant om naar de configuratiemap te navigeren door op het mapsymbool te klikken en vervolgens te dubbelklikken op mofa_workflow, gevolgd door dubbelklikken op scripts en configuraties. Open het bestand 03_MOFA_Configs.csv door erop te dubbelklikken.
- Controleer de vermeldingen voor de kolommen configuration_name en mofa_result_name en pas de vermeldingen aan als er alternatieve namen moeten worden gebruikt.
OPMERKING: De mofa_result_name wordt als bestandsextensie toegevoegd aan alle resultaatbestanden die op basis van de MOFA zijn gegenereerd. Dit kan afwijken van de configuration_name waarde, omdat verschillende MOFA-instellingen kunnen worden uitgevoerd met dezelfde invoergegevens (dit protocol gebruikt MI_v1_MOFA). - Voer het aantal factoren in dat moet worden geschat in het MOFA-model (amount_of_factors kolom) en definieer of weging en schaling moeten worden toegepast (weighting_of_views en scale_views kolommen) door de waarden in het bestand aan te passen.
- Sla de wijzigingen op door op Bestand > CSV-bestand opslaan te klikken.
- Gebruik het navigatiemenu aan de linkerkant om naar de map scripts te navigeren door op 'scripts' te klikken. Open het notitieblok 03_Run_MOFA.ipynb door te dubbelklikken op het bestand. Voer het script uit door op de knop Kernel opnieuw opstarten te klikken en alle cellen bovenaan uit te voeren en op Opnieuw opstarten te klikken in de pop-up.
- Navigeer naar de map 03_figures door te dubbelklikken op cijfers en vervolgens op 03_figures. Open de gegenereerde plot FIG03_Overview_Variance_Decomposition_'mofa_result_name en onderzoek het modelresultaat (Figuur 7A).
- Gebruik het navigatiemenu aan de linkerkant om naar de gegenereerde 03_results map te navigeren door op het mapsymbool te klikken en vervolgens te dubbelklikken op resultaten en 03_results. Controleer of het bestand met de steekproeffactorwaarde 03_Factor_Data_'mofa_result_name'.csv en het bestand met de functiefactorgewicht 03_Weight_Data_'mofa_result_name'.csv bevat.
5. Analyse stroomafwaarts
- Factor interpretatie.
- Gebruik het navigatiemenu aan de linkerkant om naar de map input_data te navigeren door op het mapsymbool te klikken, gevolgd door te dubbelklikken op input_data.
- Maak een .csv bestand (Prepared_Sample_Meta_Data.csv) dat alle metagegevens (covariaten) bevat van de monsters die zullen worden geanalyseerd in verband met de gegenereerde factoren. Kopieer het bestand naar de input_data map door het bestand te slepen en neer te zetten in het mappenoverzicht van de input_data map.
OPMERKING: Het moet de sample_id kolom bevatten om deze af te stemmen op de eerder gebruikte gegevens en verdere kolommen voor elk object dat moet worden geanalyseerd. - Gebruik in Jupyter-Lab het navigatiemenu aan de linkerkant om terug te navigeren naar de configuratiemap door op het mapsymbool te klikken en vervolgens te dubbelklikken op mofa_workflow, gevolgd door scripts en configuratie. Open het bestand 04_Factor_Analysis.csv door erop te dubbelklikken.
- Controleer of de vermeldingen voor de configuration_name en mofa_result_name de namen bevatten van de configuratie- en MOFA-resultaten die in het script zullen worden geanalyseerd en pas deze indien nodig aan.
- Voeg in de numeric_covariates kolom de naam toe van alle numerieke kolommen in het Prepared_Sample_Meta_Data.csv bestand die zullen worden onderzocht in relatie tot de MOFA-factoren, gescheiden door komma's (dit protocol maakt gebruik van CRP,CK).
- Voeg in de kolom 'categorical_covariates' de naam toe van alle categorische kolommen in het Prepared_Sample_Meta_Data.csv bestand die zullen worden onderzocht in relatie tot de MOFA-factoren, gescheiden door komma's (dit protocol maakt gebruik van meting).
- Sla de wijzigingen op door op Bestand te klikken > CSV-bestand opslaan.
- Gebruik het navigatiemenu aan de linkerkant om naar de map 'scripts' te navigeren door op scripts te klikken. Open het notitieblok 04_Downstream_Factor_Analysis.ipynb door erop te dubbelklikken. Voer het script uit door op de knop Kernel opnieuw opstarten te klikken en alle cellen bovenaan uit te voeren en in de pop-up op opnieuw opstarten te klikken.
- Gebruik het navigatiemenu aan de linkerkant om naar de map 04_figures te navigeren door te dubbelklikken op cijfers en vervolgens op 04_figures. Open de gegenereerde plots door erop te dubbelklikken en onderzoek de factoren voor interessante patronen en associaties: FIG04_Factor_Association_with_numeric_features_
"mofa_result_name.pdf (figuur 7B). FIG04_Factor_Association_
with_categorical_features_'mofa_result_name.pdf (Figuur 7C). FIG04_Top_Feature_Overview_per_Factor _'mofa_result_name.pdf (figuur 8A).
- Analyse van functies
- Gebruik het navigatiemenu aan de linkerkant om terug te navigeren naar de configuratiemap door te klikken op ... en vervolgens dubbelklikken op configuraties. Open het bestand 05_Feature_Analysis_Configs.csv door erop te dubbelklikken.
- Controleer of de vermeldingen voor de kolommen configuration_name en mofa_result_name overeenkomen met de namen van de configuratie en het gegenereerde MOFA-resultaat dat zal worden gebruikt voor de stroomafwaartse analyse en pas deze indien nodig aan.
- Voeg in de factorkolom de factor toe waarvoor de belangrijkste functies in het volgende script worden uitgezet.
- Voeg in de kolom faceting_variable een kolomnaam toe van een categorische kolom in de Prepared_Sample_Meta_Data.csv die zal worden gebruikt om de monsters in de plot te groeperen (dit protocol maakt gebruik van meting)
- Sla de wijzigingen op door op Bestand > CSV-bestand opslaan te klikken.
- Gebruik het navigatiemenu aan de linkerkant om naar de map scripts te navigeren door op scripts te klikken. Open het notitieblok 05_Downstream_Investigate_Features_Heatmap.ipynb door erop te dubbelklikken. Voer het script uit door op de knop Kernel opnieuw opstarten en voer alle cellen uit bovenaan te klikken en op Opnieuw opstarten te klikken in de pop-up.
- Gebruik het navigatiemenu aan de linkerkant om naar de map 05_figures te navigeren door eerst op cijfers en vervolgens op 05_figures te dubbelklikken. Open en onderzoek de gegenereerde plot FIG05_Heatmap_Feature_Overview__ 'mofa_result_name'.pdf door te dubbelklikken op het bestand (Figuur 8B).
OPMERKING: Afhankelijk van het aantal functies dat in de plot wordt getoond, kan het nodig zijn om de parameters plot_width en plot_height binnen de 05_Feature_Analysis_Configs.csv aan te passen en het script opnieuw uit te voeren om er zeker van te zijn dat alles in de plot past.
- Analyse van de weg
- Gebruik het navigatiemenu aan de linkerkant om naar de map input_data te navigeren door op het mapsymbool te klikken, gevolgd door te dubbelklikken op input_data.
- Bereid een .csv bestand (Prepared_Pathway_Data.csv) voor met een lijst met paden die zullen worden getest op verrijking. Kopieer het bestand naar de input_data map door het bestand te slepen en neer te zetten in het mappenoverzicht van de input_data map.
OPMERKING: Het moet drie kolommen bevatten: ID (een unieke identificatie van de route), gen (de genen die worden gegeven door hun gennaam (SYMBOL) die bij de route behoren, één rij per gen), pathway_name (een naam/tekstuele beschrijving van de routes). - Gebruik in de Jupyter-Lab-sessie het navigatiemenu aan de linkerkant om naar de configuratiemap te navigeren door te klikken op ... en vervolgens dubbelklikken op configuraties. Open het bestand 06_Pathway_Configs.csv door erop te dubbelklikken.
- Controleer de invoer voor de kolom mofa_result_name en zorg ervoor dat deze overeenkomt met de naam van het gegenereerde MOFA-resultaat dat zal worden gebruikt voor de berekening van de padverrijking.
- Controleer de vermelding in de kolom typen en verwijder de vermeldingen in de kolom typen die geen kenmerken bevatten die overeenkomen met de genkolom in het Prepared_Pathway_Data.csv bestand.
LET OP: Standaard worden alle verschillende weergaven die binnen het MOFA-model zijn gebruikt, tijdens de uitvoering van de workflow aan dit bestand toegevoegd. Als er weergaven zijn die geen functies bevatten die overeenkomen met ten minste één pad, moeten deze worden verwijderd; Anders mislukt de uitvoering. Een voorbeeld is dat het pathway-bestand alleen pathway-annotaties voor genen bevat, maar er is een weergave met eiwitnamen. - Sla de wijzigingen op door op Bestand > op CSV-bestand opslaan te klikken.
- Gebruik het navigatiemenu om naar de map scripts te navigeren door op scripts te klikken. Open het notitieblok 06_Downstream_Pathways.ipynb door erop te dubbelklikken. Voer het script uit door op de knop Kernel opnieuw opstarten en voer alle cellen uit in de top te klikken en op Opnieuw opstarten te klikken in de pop-up.
- Gebruik het navigatiemenu aan de linkerkant om naar de map 06_figures te navigeren door eerst te dubbelklikken op cijfers en vervolgens op 06_figures. Open de gegenereerde plot FIG06_Pathways_and_Genes_ 'mofa_result_name door erop te dubbelklikken en onderzoek de gevisualiseerde paden (Figuur 8C).
OPMERKING: Hoe de gevisualiseerde paden worden geselecteerd, kan worden geconfigureerd via het configuratiebestand. Raadpleeg de documentatie van de parameters voor meer informatie. - Gebruik het navigatiemenu aan de linkerkant om naar de gegenereerde map 06_results te navigeren door op het mapsymbool te klikken en vervolgens te dubbelklikken op resultaten en 06_results. Controleer of het bestand inclusief de verrijkte paden 06_Pathway_enrichment__'mofa_result_name' bevat.
6. Vergelijking van verschillende configuraties en uitvoeringen (aanvullende figuur 1, aanvullende figuur 2, aanvullende figuur 3, aanvullende figuur 4)
- Om het effect van het gebruik van verschillende parameters/configuraties in de workflow te vergelijken, voert u de secties 3-5 opnieuw uit, wijzigt u de parameters in de configuratiebestanden en gebruikt u verschillende configuration_name- en mofa_result_name-ID's.
OPMERKING: Nieuwe resultaten worden opgeslagen met deze namen om te worden gebruikt voor het vergelijken van verschillende runs. - Gebruik in Jupyter-Lab het navigatiemenu aan de linkerkant om naar de map met configuraties te navigeren. Open het bestand 07_Comparison_Configs.csv door erop te dubbelklikken.
- Voeg in de kolom mofa_result_name de namen toe van alle eerdere MOFA-runs die worden vergeleken (één rij per naam/configuratie, bijv. MI_v1_MOFA, MI_v2_MOFA).
- Voeg in de kolom compare_factors de factoren toe die tussen de modellen worden vergeleken. Standaard is het Factor1,Factor2,Factor3. (Aanvullende figuur 2A).
OPMERKING: In dit script worden de functie- en factorwaarden van de verschillende modellen vergeleken door ze te correleren. Dit werkt alleen voor modellen die zijn gebaseerd op dezelfde voorbeelden (aangegeven met sample_id) en dezelfde set functies. In het geval dat voorbeelden of functies niet overeenkomen tussen de vergeleken versies, worden ze uitgesloten van de vergelijking. - Sla de wijzigingen op door op Bestand > CSV-bestand opslaan te klikken.
- Gebruik het menu aan de linkerkant om naar de map scripts te navigeren door op scripts te klikken. Open het notitieblok 07_Compare_Models.ipynb door erop te dubbelklikken. Voer het script uit door op de knop Kernel opnieuw opstarten en alle cellen uit te klikken en op Opnieuw opstarten te klikken in de pop-up.
- Gebruik het menu aan de linkerkant om naar de map 06_figures te navigeren door eerst te dubbelklikken op cijfers en vervolgens op 06_figures. Open de gegenereerde plots door te dubbelklikken op de bestanden om de gelijkenis van de verschillende versies te analyseren:
FIG07_Variance_Model_Comparison.pdf (aanvullende figuur 2B)
FIG07_Factor_Correlations.pdf
(Aanvullende figuur 2C)
FIG07_Feature_Correlations.pdf
(Aanvullende figuur 3C)
7. Uitbreiding van de workflow: Andere parameters en configuraties toevoegen
OPMERKING: Naast de parameters die momenteel configureerbaar zijn in de configuratiebestanden, kunnen andere aanpassingen in de code of andere parameters worden opgenomen. Het MOFA-model zelf biedt bijvoorbeeld verschillende andere trainingsparameters17 die ofwel direct in de code kunnen worden gewijzigd of via de configuratiebestanden kunnen worden aangepast. In het volgende deel van het protocol wordt een voorbeeld gegeven van hoe u dit kunt doen voor aanvullende MOFA-modeltrainingsparameters. Voor dit deel is R-programmeerkennis vereist.
- Gebruik in Jupyter-Lab het navigatiemenu aan de linkerkant om naar de map met scripts te navigeren. Open het notitieblok 03_Run_MOFA.ipynb door erop te dubbelklikken.
- Klik op het tabblad Inhoudsopgave aan de linkerkant en navigeer vervolgens naar de subsectie 4.3 MOFA-trainingsopties instellen en voer de modeltraining uit door erop te klikken. Scroll naar beneden om de afgedrukte uitvoer van het MOFA-model met configureerbare parameters in het notitieblok te zien.
- Binnen de R van lus in de code onder de kop zijn alle MOFA-gegevens, modellen en trainingsopties ingesteld. Onder de regel model_opts$num_factors = mofa_configs$amount_of_factors[i], voeg nog een regel toe met de onderstaande code
model_opts$likes['data_type'] = 'poisson'.
OPMERKING: Hiermee wordt de verdeling gewijzigd die het model als invoer neemt voor de weergave die is opgegeven door de naam data_type voor alle MOFA-uitvoeringen. Bij het opgeven van poisson voor een gegevenstype wordt het model alleen uitgevoerd wanneer functies voor dit gegevenstype gehele getallen zijn (bijv. leestellingen van RNA-seq). Voor meer informatie over de MOFA-gegevens, training en modelopties kan men ook de MOFA-tutorials en documentatie raadplegen17. - Sla de wijzigingen op in het notitieboek door bovenaan op de knop Opslaan te klikken.
- Om nieuwe parameters via de .csv configuratiebestanden door te geven, gebruikt u de navigatie aan de linkerkant om naar de configuratiemap te navigeren door te dubbelklikken op configuraties en opent u het bestand 03_MOFA_Configs.csv door te dubbelklikken.
- Voeg een nieuwe kolom toe met de parameternaam, bijvoorbeeld number_iterations en voer een waarde in, bijvoorbeeld 1000. Sla de wijzigingen op door op Bestand > CSV-bestand opslaan te klikken.
- Gebruik het navigatiemenu om door de map scripts te navigeren door op scripts te klikken. Open het notitieblok 03_Run_Mofa.ipynb door erop te dubbelklikken. Klik op het tabblad Inhoudsopgave aan de linkerkant en navigeer vervolgens naar de subsectie 4.3 MOFA-trainingsopties instellen en voer de modeltraining uit door erop te klikken.
- Vervang de regel train_opts$maxiter = 50000 door train_opts$maxiter = mofa_configs$column_name[i] (als de naam van de toegevoegde kolom number_of_iterations is deze train_opts$maxiter = mofa_configs$number_of_iterations[i]).
OPMERKING: Het configuratiebestand dat in dit notitieblok 03_MOFA_Configs.csv, wordt aan het begin van het notitieblok (subsectie: Vereisten, configuraties en parameters) gelezen als mofa_config data.frame in de sessie en daarom wordt in deze regel code naar dit object en de bijbehorende nieuw gegenereerde kolom verwezen. Aangezien meerdere configuraties tegelijkertijd kunnen worden uitgevoerd, identificeert de i de rij van het data.frame terwijl de modelschatting wordt uitgevoerd in een for-lus over alle verschillende rijen in het .csv-bestand . Het principe van het inlezen in het configuratiebestand aan het begin van het notebook in de sectie 'Prerequisites Configurations & Parameters' is hetzelfde voor alle notebooks, en verdere wijzigingen kunnen op deze manier worden aangebracht. - Sla de wijzigingen op in het notitieboek door op de knop Opslaan te klikken.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Na de succesvolle uitvoering van de workflow worden verschillende tabellen en figuren gegenereerd, zoals aangegeven in figuur 2. Figuren worden in de map /figures geplaatst (Figuur 6, Figuur 7, Figuur 8, Aanvullende Figuur 1, Aanvullende Figuur 2, Aanvullende Figuur 3, Aanvullende Figuur 4
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
Met het geschetste protocol wordt een modulaire en uitbreidbare op Jupyter-notebooks gebaseerde workflow gepresenteerd die kan worden gebruikt om snel een complexe multi-omics-dataset te verkennen. De belangrijkste onderdelen van de workflow bestaan uit het voorverwerkings- en gegevensharmonisatiegedeelte (met verschillende standaardstappen voor het filteren en normaliseren van de gegevens), een schatting van het MOFA9-model en een aantal voorbeeldige stroomafwaar...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteurs verklaren dat er geen sprake is van belangenverstrengeling.
Dankbetuigingen
C.L. wordt ondersteund door de Helmholtz Association in het kader van de gezamenlijke onderzoeksschool "Munich School for Data Science - MUDS".
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Apptainer | NA | NA | https://apptainer.org/docs/admin/main/installation.html |
| Compute server of werkstation of cloud (Linux, Mac of Windows omgeving). Afhankelijk van de grootte van de verschillende input datasets raden we aan om de workflow op een geschikte machine uit te voeren (in onze setting gebruiken we: 16 CPU, 64GB Geheugen) | Elke fabrikant | 16 CPU, 64GB Geheugen | Groot geheugen is alleen nodig voor de verwerking van de ruwe single cell data. Na pre-processing kunnen de latere analyse stappen ook worden uitgevoerd op reguliere desktop- of laptopcomputers |
| git | NA | NA | https://git-scm.com/book/en/v2/Getting-Started-Installing-Git |
| GitHub | GitHub | NA | https://github.com/heiniglab/mofa_workflow |
Referenties
- Lähnemann, D., et al. Eleven grand challenges in single-cell data science. Genome Biol. 21 (1), 31(2020).
- Colomé-Tatché, M., Theis, F. J. Statistical single cell multi-omics integration. Curr Opin Syst Biol. 7, 54-59 (2018).
- Hawe, J., Theis, F., Heinig, M. Inferring interaction networks from multi-omics data. Front Genet. 10, 535(2019).
- Hawe, J. S., et al. Network reconstruction for trans acting genetic loci using multi-omics data and prior information. Genome Med. 14 (1), 125(2022).
- Koh, H. W. L., Fermin, D., Vogel, C., Choi, K. P., Ewing, R. M., Choi, H. iOmicsPASS: network-based integration of multiomics data for predictive subnetwork discovery. NPJ Syst Biol Appl. 5, 22(2019).
- Ogris, C., Hu, Y., Arloth, J., Müller, N. S. Versatile knowledge guided network inference method for prioritizing key regulatory factors in multi-omics data. Sci Rep. 11, 6806(2021).
- Lee, C., vander Schaar, M. A variational information bottleneck approach to multi-omics data integration. Proceedings of The 24th International Conference on Artificial Intelligence and Statistics. 130, 1513-1521 (2021).
- Singh, A., et al. DIABLO: an integrative approach for identifying key molecular drivers from multi-omics assays. Bioinformatics. 35 (17), 3055-3062 (2019).
- Argelaguet, R., et al. Multi-omics factor analysis-a framework for unsupervised integration of multi-omics data sets. Mol Syst Biol. 14 (6), e8124(2018).
- Cantini, L., et al. Benchmarking joint multi-omics dimensionality reduction approaches for the study of cancer. Nature Commun. 12 (1), 124(2021).
- Pekayvaz, K., et al. Multiomic analyses uncover immunological signatures in acute and chronic coronary syndromes. Nature Medicine. 30 (6), 1696-1710 (2024).
- Swirski, F. K., Nahrendorf, M. Cardioimmunology: the immune system in cardiac homeostasis and disease. Nat Rev Immunol. 18 (12), 733-744 (2018).
- Janjic, A., et al. Prime-seq, efficient and powerful bulk RNA sequencing. Genome Biol. 23 (1), 88(2022).
- Wolf, F. A., Angerer, P., Theis, F. J. SCANPY: large-scale single-cell gene expression data analysis. Genome Biol. 19 (1), 15(2018).
- Cao, Y., et al. Integrated analysis of multimodal single-cell data with structural similarity. Nucleic Acids Res. 50 (21), e121(2022).
- Get Started - JupyterLab 4.1.0a4 documentation. , Available from: https://jupyterlab.readthedocs.io/en/latest/getting_started/overview.html (2024).
- MOFA2: training a model in R. , Available from: https://raw.githack.com/bioFAM/MOFA2_tutorials/master/R_tutorials/getting_started_R.html (2020).
- De Silva, D., et al. Robust T cell activation requires an eIF3-driven burst in T cell receptor translation. eLife. 10, e74272(2021).
- Li, G., Liang, X., Lotze, M. HMGB1: The central cytokine for all lymphoid cells. Front Immunol. 4, 68(2013).
- Jassal, B., et al. The reactome pathway knowledgebase. Nucleic Acids Res. 48 (D1), D498-D503 (2020).
- Argelaguet, R., et al. MOFA+: a statistical framework for comprehensive integration of multimodal single-cell data. Genome Biol. 21 (1), 111(2020).
- Velten, B., et al. Identifying temporal and spatial patterns of variation from multimodal data using MEFISTO. Nat Methods. 19 (2), 179-186 (2022).
- Qoku, A., Buettner, F. Encoding domain knowledge in multi-view latent variable models: A Bayesian approach with structured sparsity. Proceedings of The 26th International Conference on Artificial Intelligence and Statistics. 206, 11545-11562 (2022).
- Multi-Omics Factor Analysis. MOFA. , Available from: https://biofam.github.io/MOFA2/ (2024).
- Mitchel, J., et al. Tensor decomposition reveals coordinated multicellular patterns of transcriptional variation that distinguish and stratify disease individuals. bioRxiv. , (2023).
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Herprints en machtigingen
