Op massaspectrometrie gebaseerde proteomische gegevens zijn beschikbaar in open databases en toegankelijk met behulp van gratis tools. Gezien de complexiteit van het doorzoeken en beschrijven van databases, missen veel biologen de kennis om deze datasets te gebruiken. Hier bieden we een gids over het gebruik van gratis tools voor het doorzoeken van basisproteomische gegevens.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Methodenartikel
Navigeren door de op massaspectrometrie gebaseerde proteomische gegevens met behulp van gratis computationele tools
In dit artikel
Samenvatting
Samenvatting
Op massaspectrometrie (MS) gebaseerde proteomics-gegevens, waaronder Data-Dependent Acquisition (DDA) en Data-Independent Acquisition (DIA), worden veel gebruikt in biologisch onderzoek. De toepassing van deze datasets in validatiestudies is echter nog steeds beperkt vanwege het ontbreken van duidelijke demonstraties over hoe proteomische gegevens effectief kunnen worden gezocht en geanalyseerd. Om deze leemte op te vullen, hebben we één DDA- en één DIA-dataset geselecteerd die is gedeponeerd in de PRoteomics IDEntifications Database (PRIDE) datarepository om de workflow voor proteomische data-analyse en de downstream nabewerking van eiwitzoekresultaten beter te illustreren. Voor demonstratiedoeleinden hebben we twee gratis computationele tools gebruikt: FragPipe (v22.0) voor DDA-datasets en DIA-NN (2.1.0) voor DIA-datasets. Nabewerkingsstappen, zoals het genereren van vulkaandiagrammen en lijsten van ontregelde eiwitten, werden gedemonstreerd met behulp van R-code. Deze studie biedt basisprotocollen voor het zoeken en analyseren van proteomische gegevens, die dienen als een essentiële beginnershandleiding om effectief met proteomische datasets om te gaan. Door dit werk willen we onderzoekers de kennis geven die nodig is om proteomische gegevens te gebruiken in hun biologisch onderzoek.
Inleiding
Het gebied van proteomics heeft een revolutie teweeggebracht door de wijdverbreide acceptatie van open access gegevensopslagplaatsen en vrije softwaretools1, die een belangrijke rol hebben gespeeld bij het bevorderen van onderzoekscapaciteiten en het bevorderen van een cultuur van gegevensuitwisseling. De oprichting van gecentraliseerde bronnen, zoals PRIDE2, en de ontwikkeling van gestandaardiseerde gegevensformaten door het Proteomics Standards Initiative (PSI)3 van de Human Proteome Organization (HUPO) hebben een ongekende kans gecreëerd voor hergebruik en inte....
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
OPMERKING: Zie Figuur 1voor een overzicht van de workflow en Materiaaltabel voor gedetailleerde beschrijvingen van de gebruikte software.
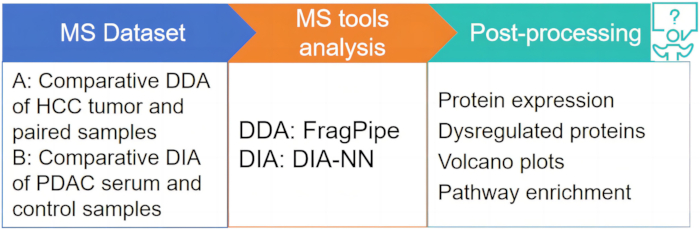
Figuur 1: Overzicht van de onderzoeksopzet. Klik hier om een grotere versie van deze figuur te bekijken.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Om de zoektocht naar proteomische datasets beter te illustreren, hebben we voor deze analyse twee soorten datasets geselecteerd. Met als doel ontregelde eiwitten in klinische contexten aan te tonen, zochten we in PRIDE op trefwoorden als kliniek. In het bijzonder hebben we een dataset geselecteerd die geschikt is voor DIA-analyse van het Clinical Proteomic Tumor Analysis Consortium (CPTAC)21, en een andere die geschikt is voor DDA-.......
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
Het gepresenteerde protocol illustreert proteomische data-analyse door de integratie van gratis tools zoals DIA-NN en FragPipe. Succes hangt af van kritieke stappen zoals nauwkeurige selectie van voorloperionen en massanauwkeurigheidsinstellingen voor het genereren van spectrale bibliotheken in DIA-NN (stap 2.3)27, die instrumentafhankelijk zijn en cruciaal zijn voor volledige peptide-identificatie. Evenzo is een nauwgezette database-instelling in FragPipe (stap 3.......
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
F.Z. is de oprichter van Molemuse Biotech Studio.
Dankbetuigingen
Dit project wordt ondersteund door Molemuse Biotech Studio.
....Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| .NET SDK v. 9.0.203 | Microsoft | https://dotnet.microsoft.com/en-us/download | |
| DIA-NN v. 2.1.0 | https://github.com/vdemichev/DiaNN/releases/tag/2.0 | ||
| FragPipe v. 22.0 | https://github.com/Nesvilab/FragPipe/releases | ||
| MSFileReader v. 3.1 | Thermo Fisher | https://github.com/thermofisherlsms/MSFileReader/blob/main/MSFileReader_x64.exe | |
| R 4.5.0 | https://cran.rstudio.com/bin/windows/base/R-4.5.0-win.exe | ||
| Rstudio v. 2024.12.1+563 | https://posit.co/download/rstudio-desktop/ |
Referenties
- Pedrioli, P. G. A., et al. A common open representation of mass spectrometry data and its application to proteomics research. Nat Biotechnol. 22 (11), 1459-1466 (2004).
- Perez-Riverol, Y., et al. The PRIDE database at 20 years: 2025 update. Nucl ....
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Herprints en machtigingen
